难视觉与易视觉:GPT-6 Astra 揭示的计算机视觉能力版图 Hard Vision, Easy Vision: What GPT-6 Astra Reveals Across Computer Vision
六个前沿通用模型在34项能力、55个基准上的全景评测,划定通用视觉的能与不能
前置知识
通用模型(Generalist)与专用模型(Specialist)
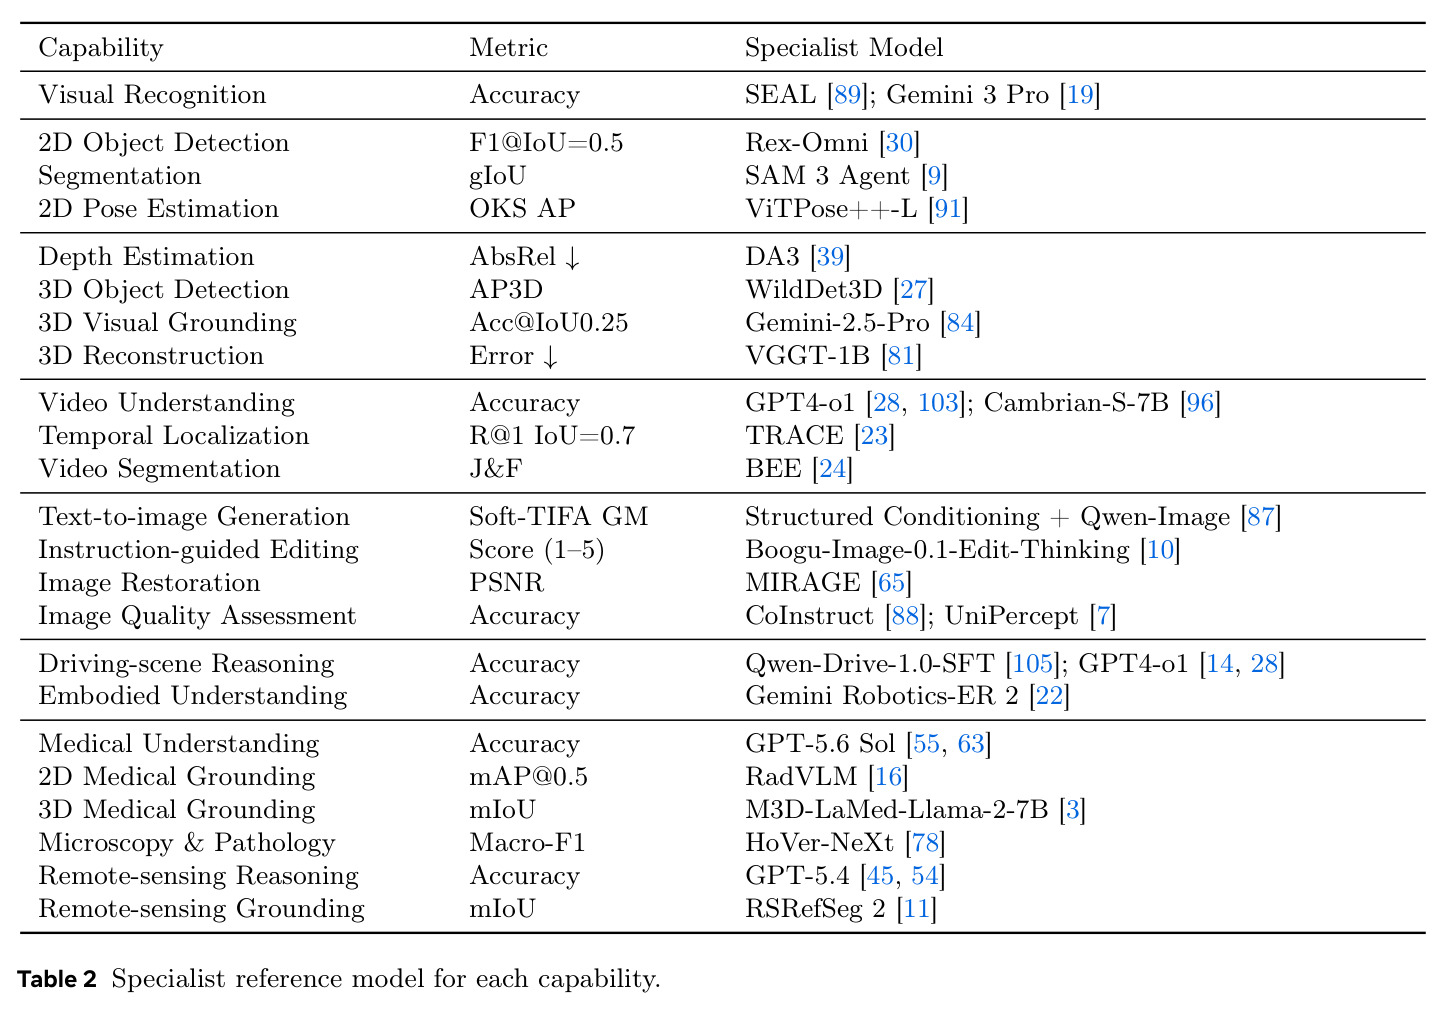
通用模型指通过自然语言接口处理多种任务的前沿多模态系统(如 GPT-6 Astra、Gemini 3.1 Pro),一个模型即可完成理解、推理、生成与具身执行;专用模型是为单一任务专门设计架构与训练流程的模型,如分割的 SAM 3 Agent、深度的 DA3、修复的 MIRAGE,它们在各自指标上通常仍是性能上限参照。
全文的核心问题就是通用者的能力边界在哪里、哪些任务仍必须依赖专用模型,理解这两类模型的分工是读懂所有结论的前提。
结构化视觉预测(Structured Prediction)
指模型输出不是文本而是带几何约束的对象:边界框、像素掩码、深度图、3D cuboid、跨帧掩码序列等。评测使用 $\text{F1@IoU}=0.5$、$gIoU$、OKS AP、$J\&F$、$\text{AbsRel}$ 等指标度量几何精度,比选择题式 VQA 更能暴露度量级误差。
论文的核心发现是通用模型语义理解强、几何精度弱,正是靠这批结构化任务与指标才被量化出来的。
J&F 分割指标
视频/图像分割常用复合指标:$J$ 为预测掩码与真值的区域交并比(IoU),$F$ 为边界级别的 F1 值,$J\&F$ 取两者平均,兼顾'找得全'与'描得准',DAVIS 是其标准评测集。
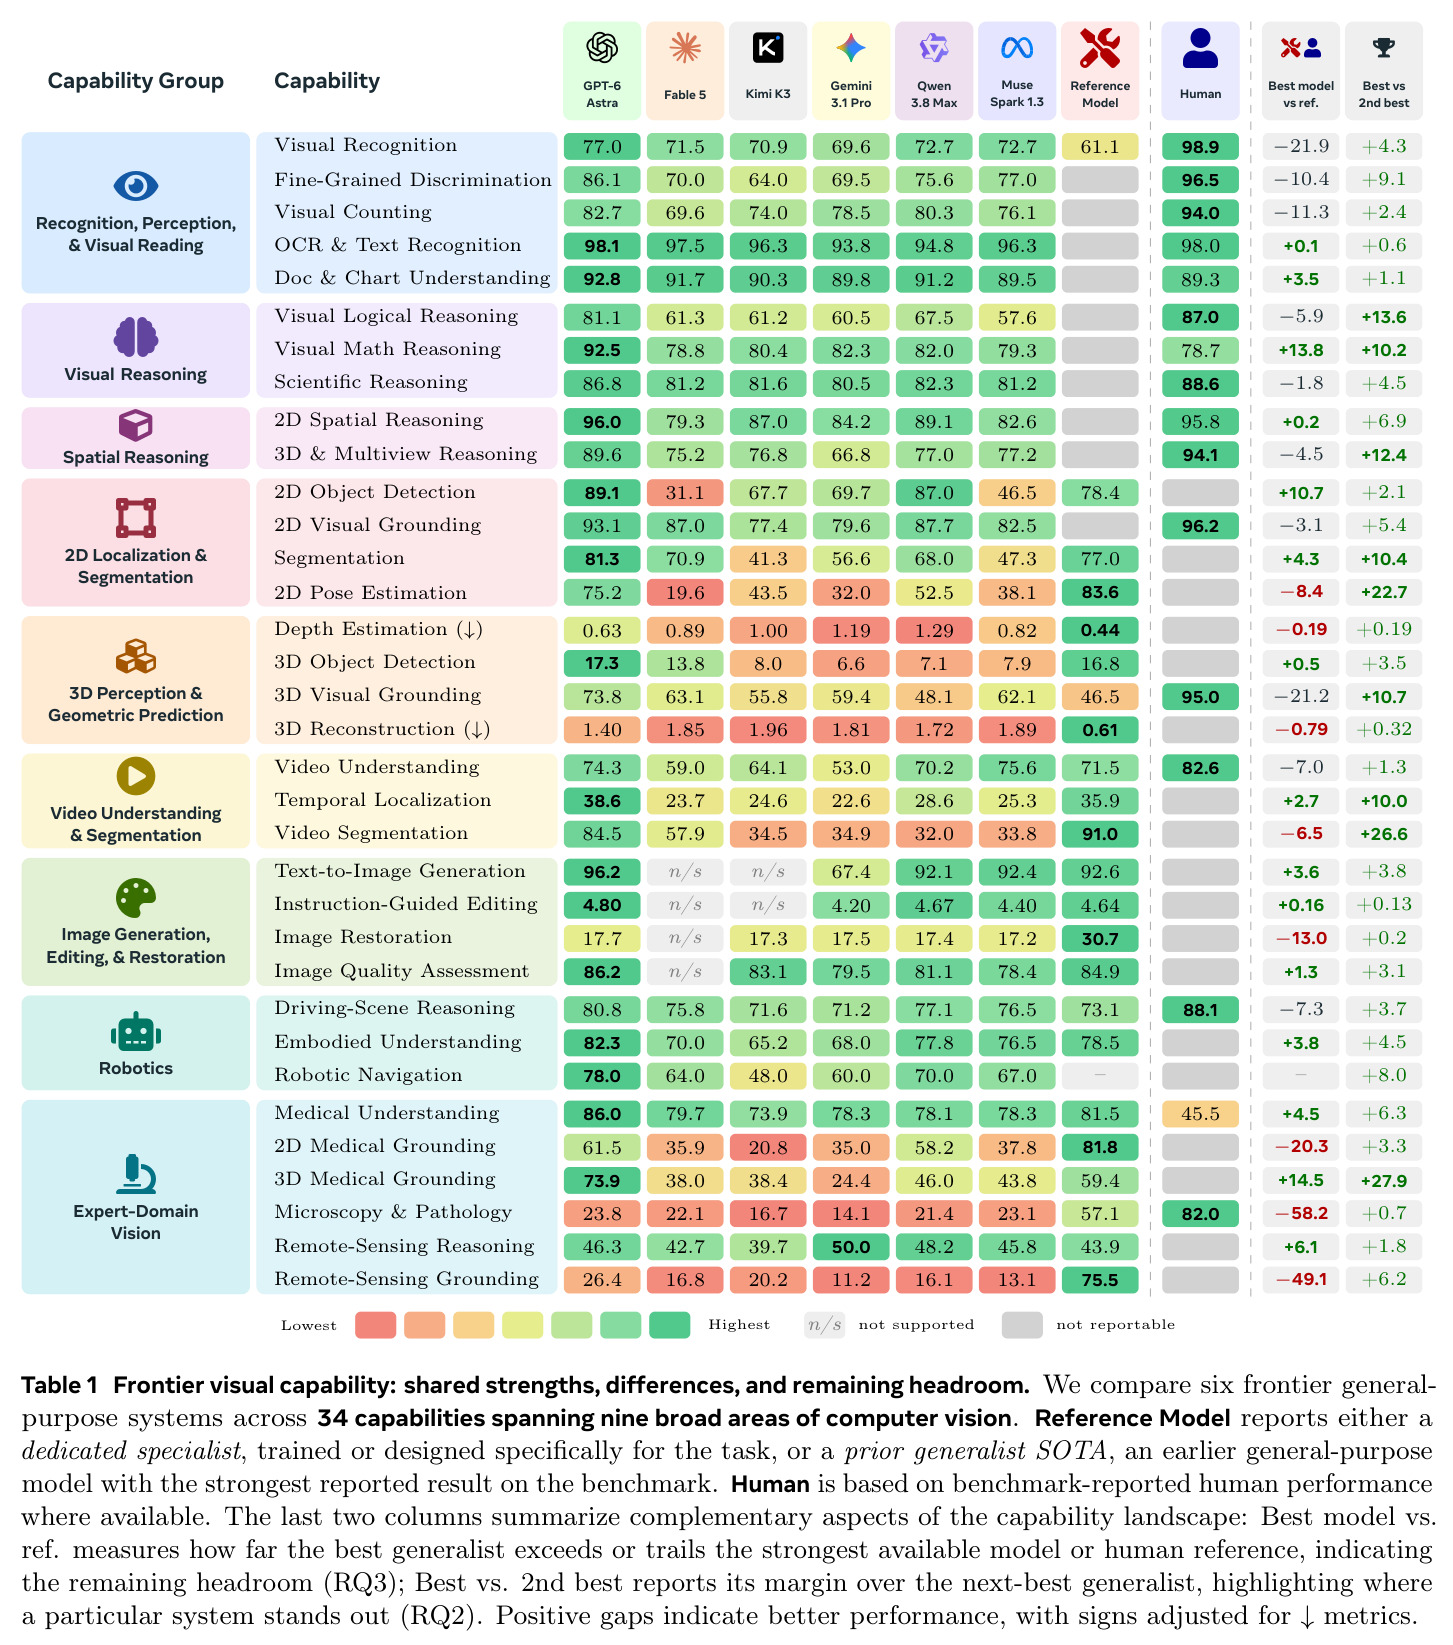
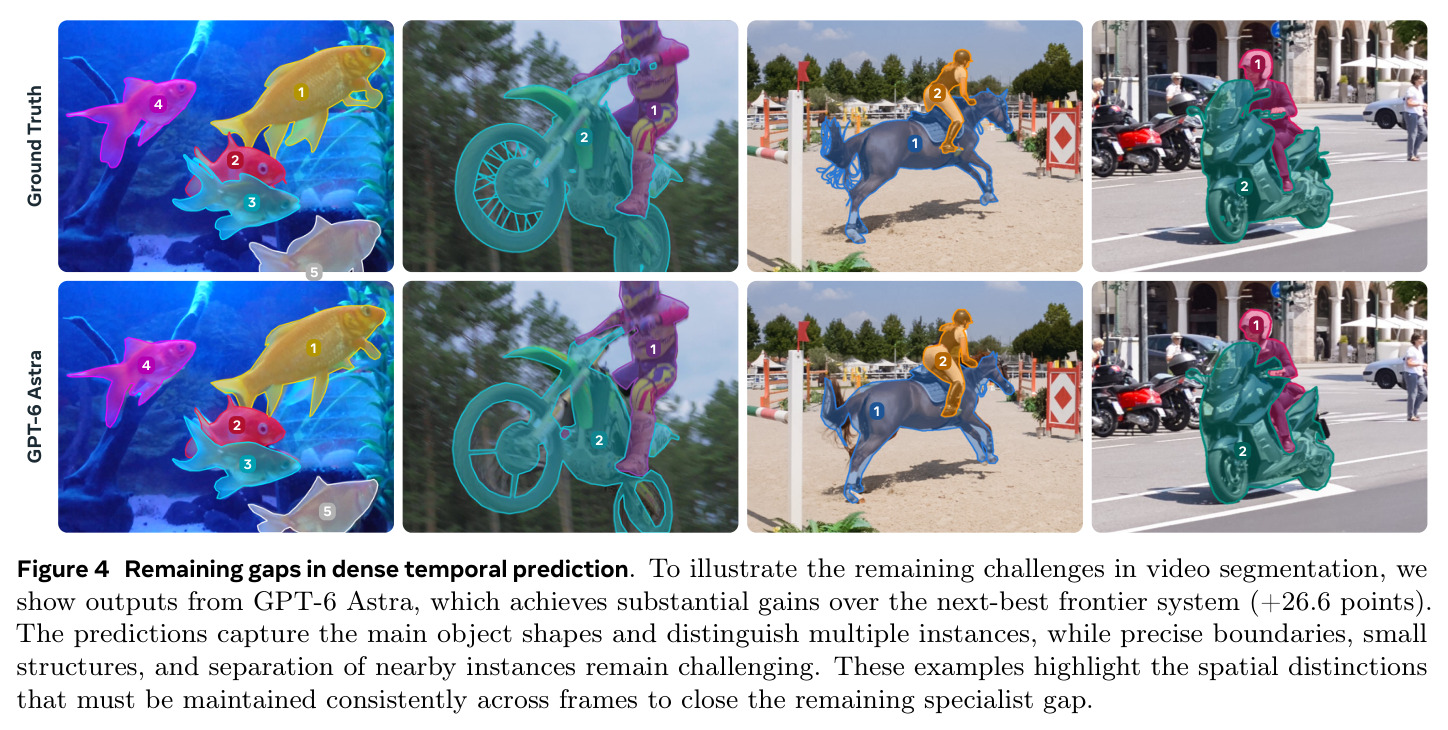
视频分割是论文'难视觉'的典型证据(Astra 84.5 vs 专用 91.0,其他通用系统仅 32.0–57.9),不懂 J&F 就无法解读这组关键数字。
AbsRel 与 PSNR
$\text{AbsRel}$(绝对相对误差)是单目深度估计的低优指标,为预测深度与真值逐像素相对误差的均值,越小越好,专用模型 DA3 达到 0.44;$\text{PSNR}$(峰值信噪比)以 dB 度量修复/重建图像与真值的像素保真度,越高越好,专用模型 MIRAGE 达 30.7 dB。
深度与修复是通用与专用差距最大的两处(0.63 vs 0.44;17.7 vs 30.7 dB),这两个指标是理解'度量精度仍是硬前沿'这一结论的直接证据。
成熟度分层(Maturity Tiers)
论文提出的汇总口径:把最佳通用者成绩换算为专用模型(S)与人类(H)参照中更强者的百分比,划分四层——超越参照($>110\%$)、达到参照($100\text{--}110\%$)、接近($85\text{--}100\%$)、差距显著($<85\%$),低优指标先取倒数再比较。
Figure 9 与全文结论都按这四层组织,掌握该口径才能快速读懂 34 项能力的完整版图。
研究动机
此前对通用视觉模型的理解高度碎片化:MMMU-Pro、BLINK、MathVista、RefCOCO 等各自榜单只回答'单个任务上谁最强',无法回答更根本的问题——通用系统到底覆盖了多少计算机视觉。证据分散导致三个具体困境:其一,一个模型可能在某榜单领先其他通用模型,却与专用模型或人类成绩相距甚远;其二,相邻任务上的强项未必迁移,例如 3D 视觉定位强不代表深度估计强;其三,学界无法据此判断分割、深度、检测等专用视觉模型还剩多少存在价值。各任务、各领域、各模型对比的证据彼此割裂,缺乏一次把语义理解到动作执行全部串联起来的全景式解读,研究资源容易被个别榜单误导。
本文的目标是本文的目标是绘制一份可比较的'通用视觉能力版图':在同一评测协议下考察 GPT-6 Astra 与 Fable 5、Kimi K3、Gemini 3.1 Pro、Qwen 3.8-Max、Muse Spark 1.3 共六个前沿通用系统,覆盖九大领域 34 项能力、55 个基准,并与合适的专用模型和人类参照对比。具体回答四个研究问题:RQ1 相对人类与专用参照,前沿系统的视觉覆盖有多广;RQ2 各系统在哪些能力上收敛、在哪些能力上仍差异巨大;RQ3 哪些任务类型已能通过通用接口达到专用级水平、什么任务属性预测剩余差距;RQ4 额外推理、显式工具或专家模型作工具的管线能否补上差距、代价多大。
与已有工作不同的是,独特切入在于'版图层分析'而非单点打榜:把输出谱系从文本答案一路扩展到边界框、掩码、深度图、3D cuboid、跨帧掩码序列、生成/编辑图像和具身动作,全部纳入同一参照框架;为每项能力选取最强专用模型或人类成绩作参照,并用两个互补摘要列——'最佳通用者 vs 参照'度量剩余空间(回答 RQ3),'最佳 vs 次佳'度量某系统的独占优势(回答 RQ2);再把性能换算成参照百分比划成超越/达到/接近/差距显著四层成熟度,最后叠加推理档位与工具使用的成本-收益消融。这种参照化、层级化、代价化的表述方式是此前单基准榜单工作所不具备的。
核心方法
整体是一个统一协议的大规模评测框架,而非新模型。首先按九大领域组织 34 项能力:识别感知与视觉阅读、视觉推理、空间推理、2D 定位检测分割、3D 感知与几何预测、视频理解与分割、图像生成编辑修复、机器人、专家域视觉;随后挑选 55 个对当前系统仍有 headroom 的挑战性基准。六个系统接受完全相同的任务指令、视觉输入与评测样本,凡支持多档推理则取最强可用档,输出用各基准官方指标打分。对比对象包括逐能力指定的专用参照模型(如检测 Rex-Omni、分割 SAM 3 Agent、深度 DA3、重建 VGGT-1B、视频分割 BEE、修复 MIRAGE,见表 2)与基准报告的人类成绩,最终以四层成熟度汇总成 Figure 9 的能力版图。
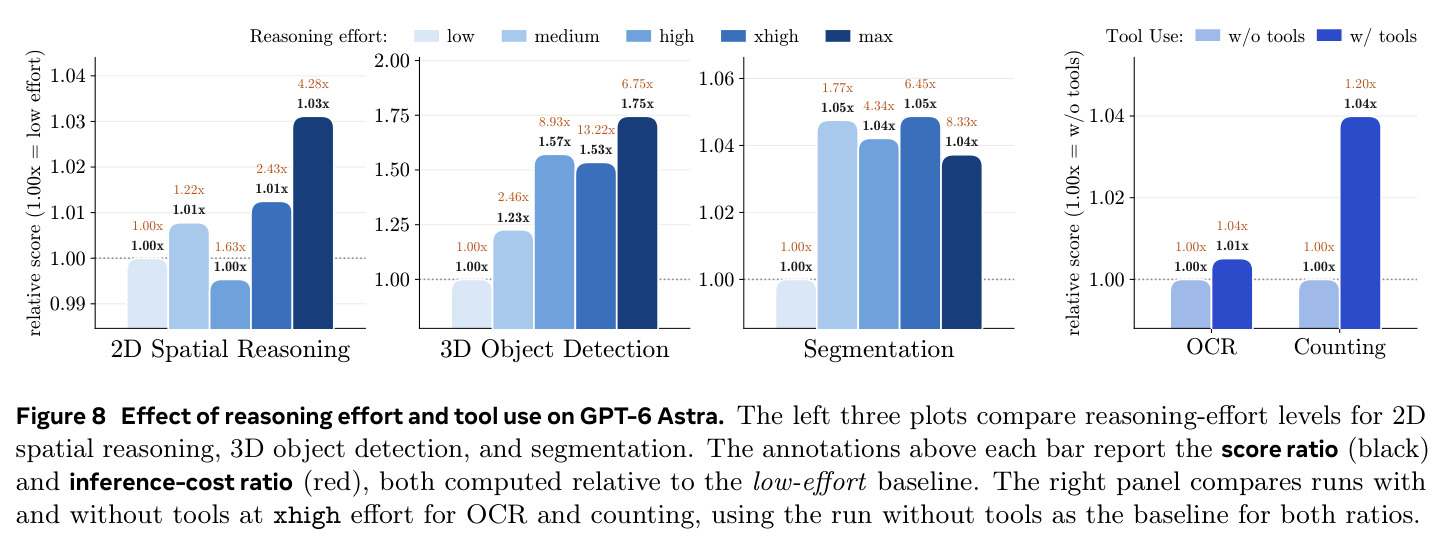
核心是'参照系百分比'这一可比化设计:对每项能力取专用模型(S)与人类(H)中更强者作为 $100\%$ 参照线,把最佳通用者得分换算成参照百分比,低优指标(如 $\text{AbsRel}$)先取倒数再比较,使准确率、$\text{F1@IoU}=0.5$、$gIoU$、$\text{PSNR}$、$\text{mAP}@0.5$ 等异构指标可在同一坐标下排序,并据此划分超越($>110\%$)、达到($100\text{--}110\%$)、接近($85\text{--}100\%$)、差距显著($<85\%$)四层。第二个关键设计是把'补差距'变成'补差距+代价':同一任务在不同推理档位(low/medium/high/xhigh/max)与有无工具下重跑,同时报告得分比与推理成本比,从而揭示哪些差距能被推理或工具闭合、以及闭合的代价。
方法步骤详情
第一步,构建九领域 34 能力的分类体系并映射到 55 个基准,包括 MMStar、BLINK、V*Bench、MathVista、RefCOCO、ReasonSeg、OCHuman、DIODE、Omni3D、DAVIS、VSI-Bench、LingoQA、LOL-v1、GenEval2、EmbodiedBench、MedXpertQA-MM、PUMA、VLRS-Bench、RefSegRS 等。第二步,六个系统在同一指令、同一视觉输入、同一样本上运行,取最强推理档。第三步,输出后处理:分割多边形栅格化为像素掩码;深度预测渲染成稠密深度图或执行模型生成代码直接产出;深度预测结合相机参数合成共享坐标系点云;预测中心、尺寸、旋转转成 cuboid 角点;病理实例图与类别图转成带标签的核多边形。第四步,用各基准官方指标打分($\text{F1@IoU}=0.5$、$gIoU$、OKS AP、$\text{AbsRel}$、AP3D、$J\&F$、PSNR 等)。第五步,对照表 2 的专用参照与人类成绩,计算 Best vs ref 与 Best vs 2nd best 并划入四层。第六步,消融分析:推理档位从 low 到 max、有无工具调用,以及专家模型作工具的管线(分割模型辅助计数、深度模型辅助距离比较、专用 grounding 模型改善遥感定位)。
技术新颖性
相对已有工作,新颖性有四点。一是覆盖广度:34 能力、55 基准、九领域,且评测的不只是'理解',还包括结构化输出的'产出'与具身'执行',此前没有工作把文本、框、掩码、深度、视频掩码序列、图像生成与机器人动作放进同一评测协议。二是参照化表述:用相对专用模型/人类的百分比与四层成熟度取代原始分数,使跨指标的能力可比。三是差异双通道:Best vs ref 回答'离参照还有多远',Best vs 2nd best 回答'谁独占优势'(如 Astra 视频分割 +26.6、姿态估计 +22.7)。四是成本显式化:把推理档位与工具使用的收益与推理成本(1.04–13.22 倍)配对报告,为'通用者内化还是外调专家'这一分工问题首次提供量化依据。
实验结果
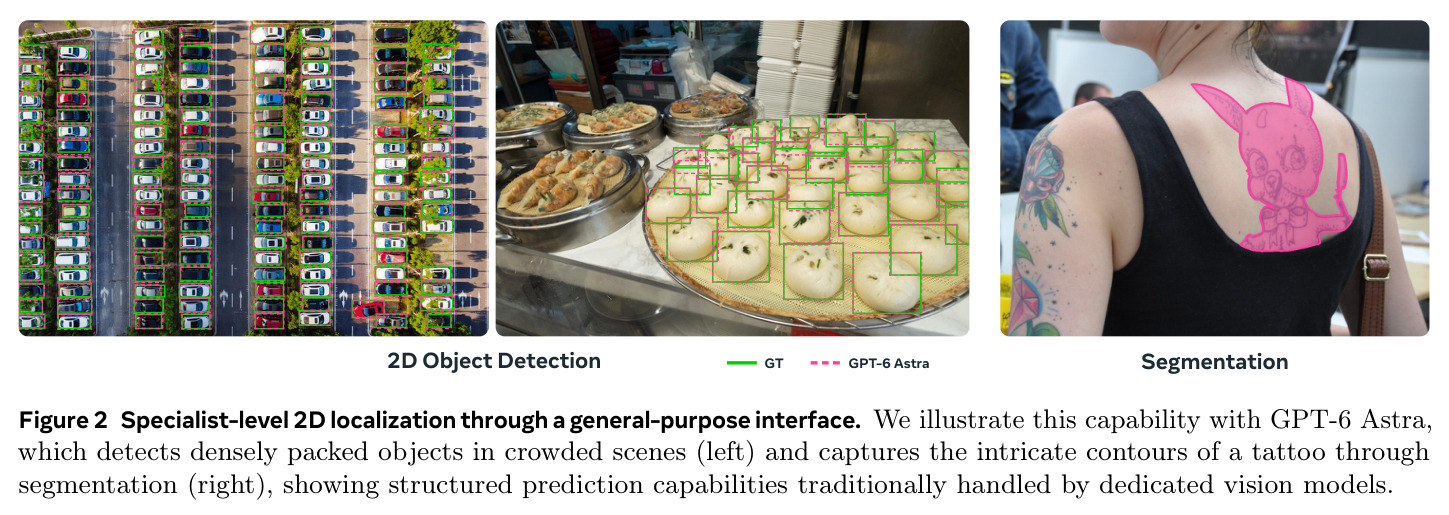
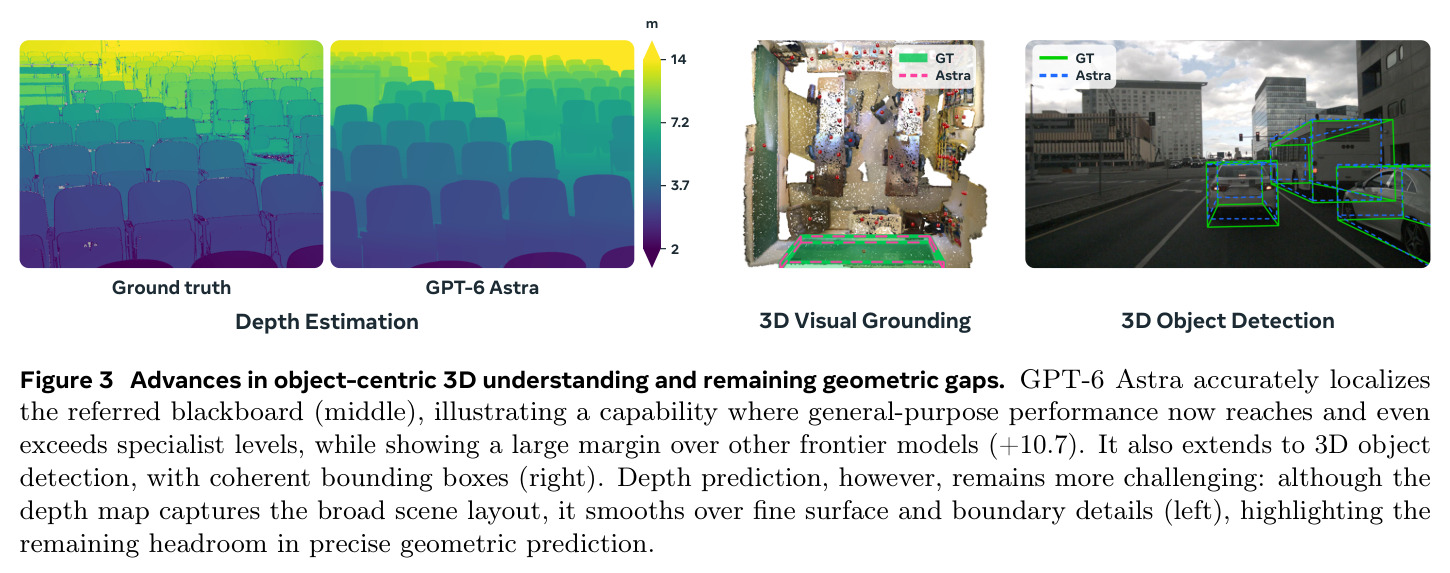
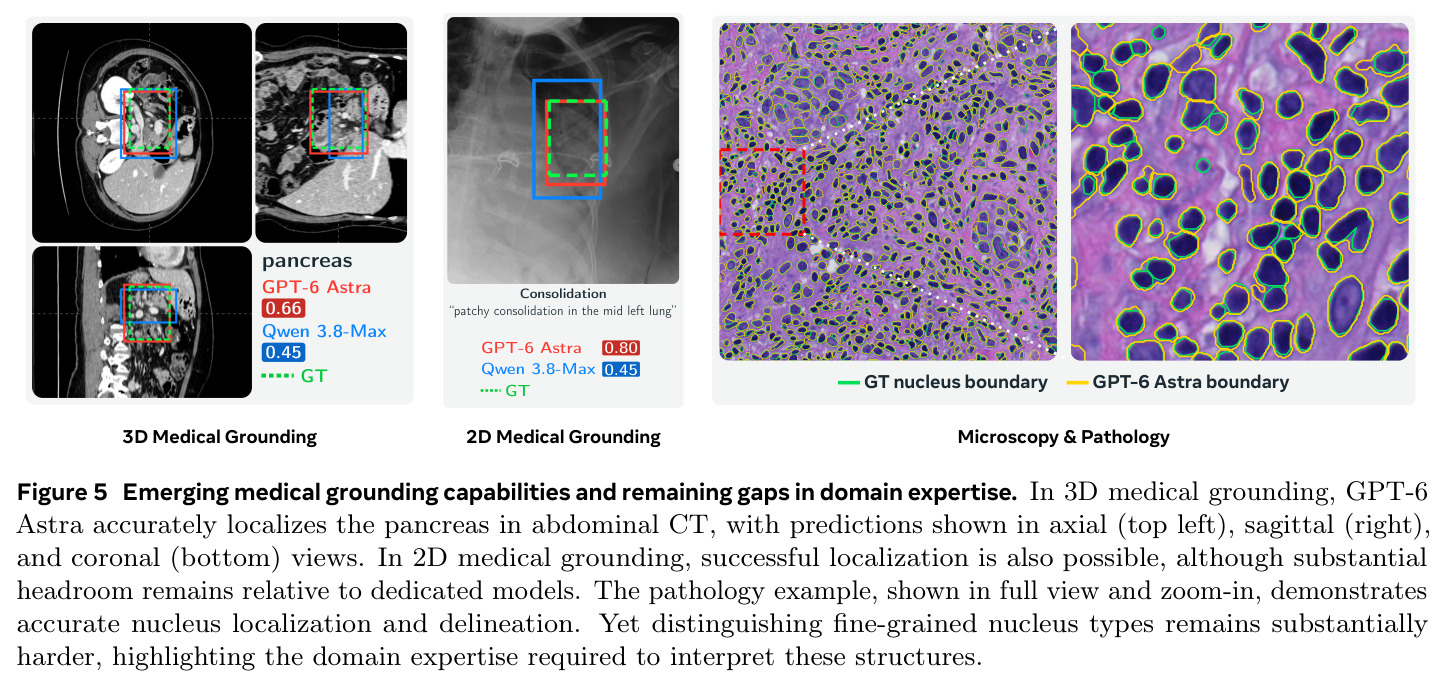
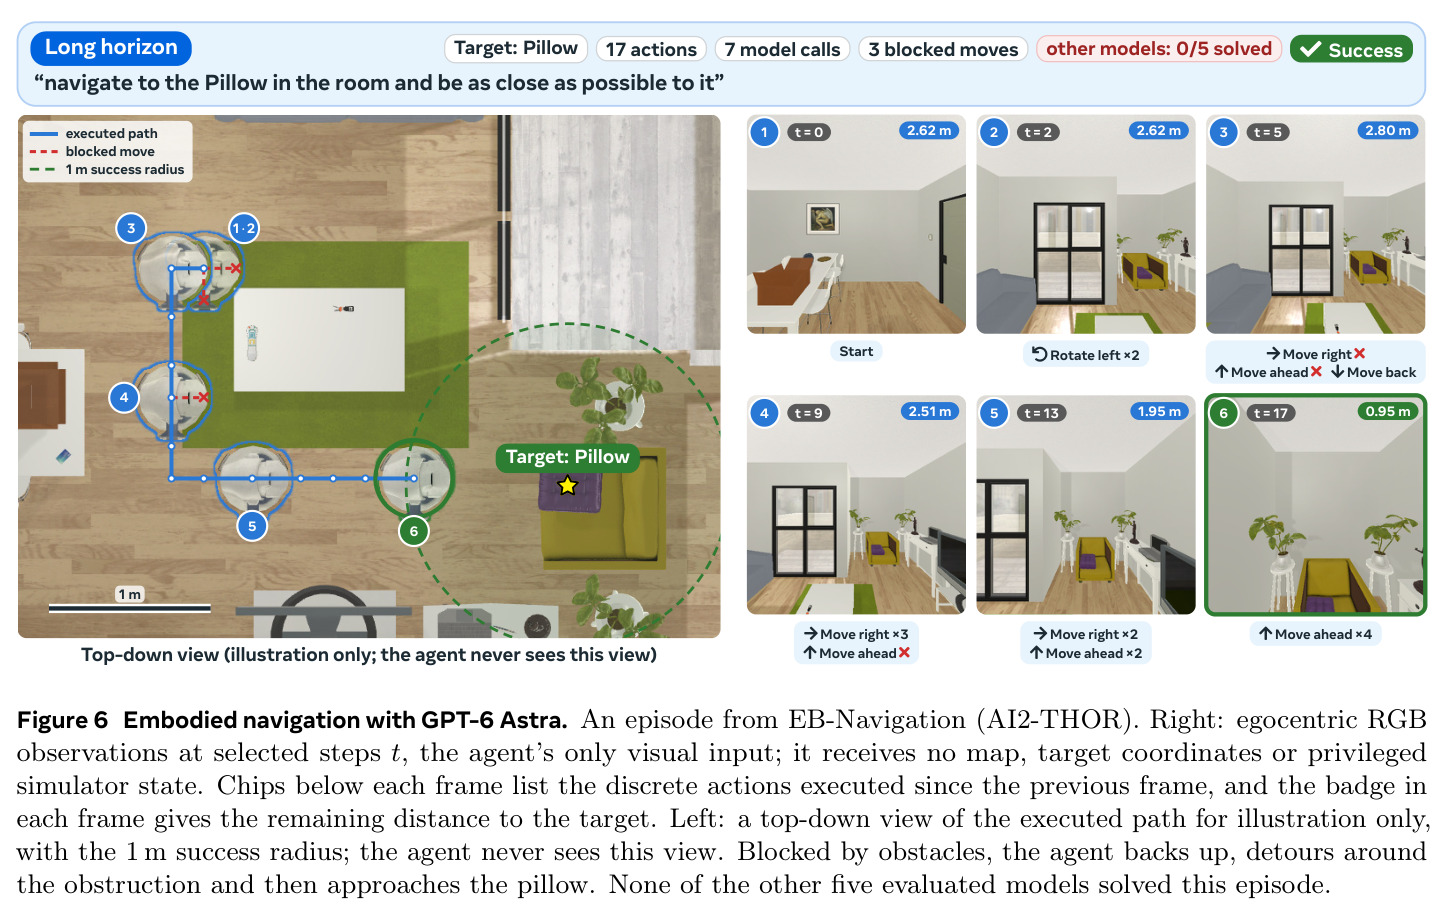
核心发现呈清晰的'易/难'分界。易的一侧:视觉阅读全面收敛,OCR 达 93.7–98.1 vs 人类 98.0,图表文档理解六系统全部超过人类(+0.2 至 +3.5);数学推理 78.8–92.5 全部越过人类 78.7;2D 空间推理 Astra 96.0 达人类 95.8。2D 定位进入专用级:Astra 检测 89.1 超专用 Rex-Omni 78.4(+10.7),分割 81.3 超 SAM 3 Agent 77.0(+4.3),Qwen 3.8-Max 检测 87.0 也超参照(+8.6);3D 物体检 Astra 17.3 逼近专用 16.8,3D 视觉定位六系统全超专用 46.5(Astra 73.8)。生成与具身:T2I 96.2(+3.6)、指令编辑 4.80(+0.16)、画质评估 86.2(+1.3)、具身理解 82.3(+3.8)、导航 78% 成功率、医学理解 86.0(+4.5)、3D 医学定位 73.9(+14.5)。难的一侧:深度 $\text{AbsRel}$ 0.63 vs DA3 0.44,重建误差 1.40 约为 VGGT-1B 0.61 的 2.3 倍;视频分割 Astra $J\&F$ 84.5 仍低于专用 BEE 91.0,其余通用者仅 32.0–57.9;图像修复 17.2–17.7 dB vs MIRAGE 30.7 dB;病理 Macro-F1 仅 14.1–23.8 vs 人类 82.0;遥感定位 26.4 vs 75.5;3D 定位虽超专用却距人类 95.0 达 −21.2。消融显示工具以 1.04–1.20 倍成本补上计数、图表、2D 医学定位等差距,高推理档可把 2D 空间推理、3D 检测、生成编辑推到专用级,但成本最高 13.22 倍。
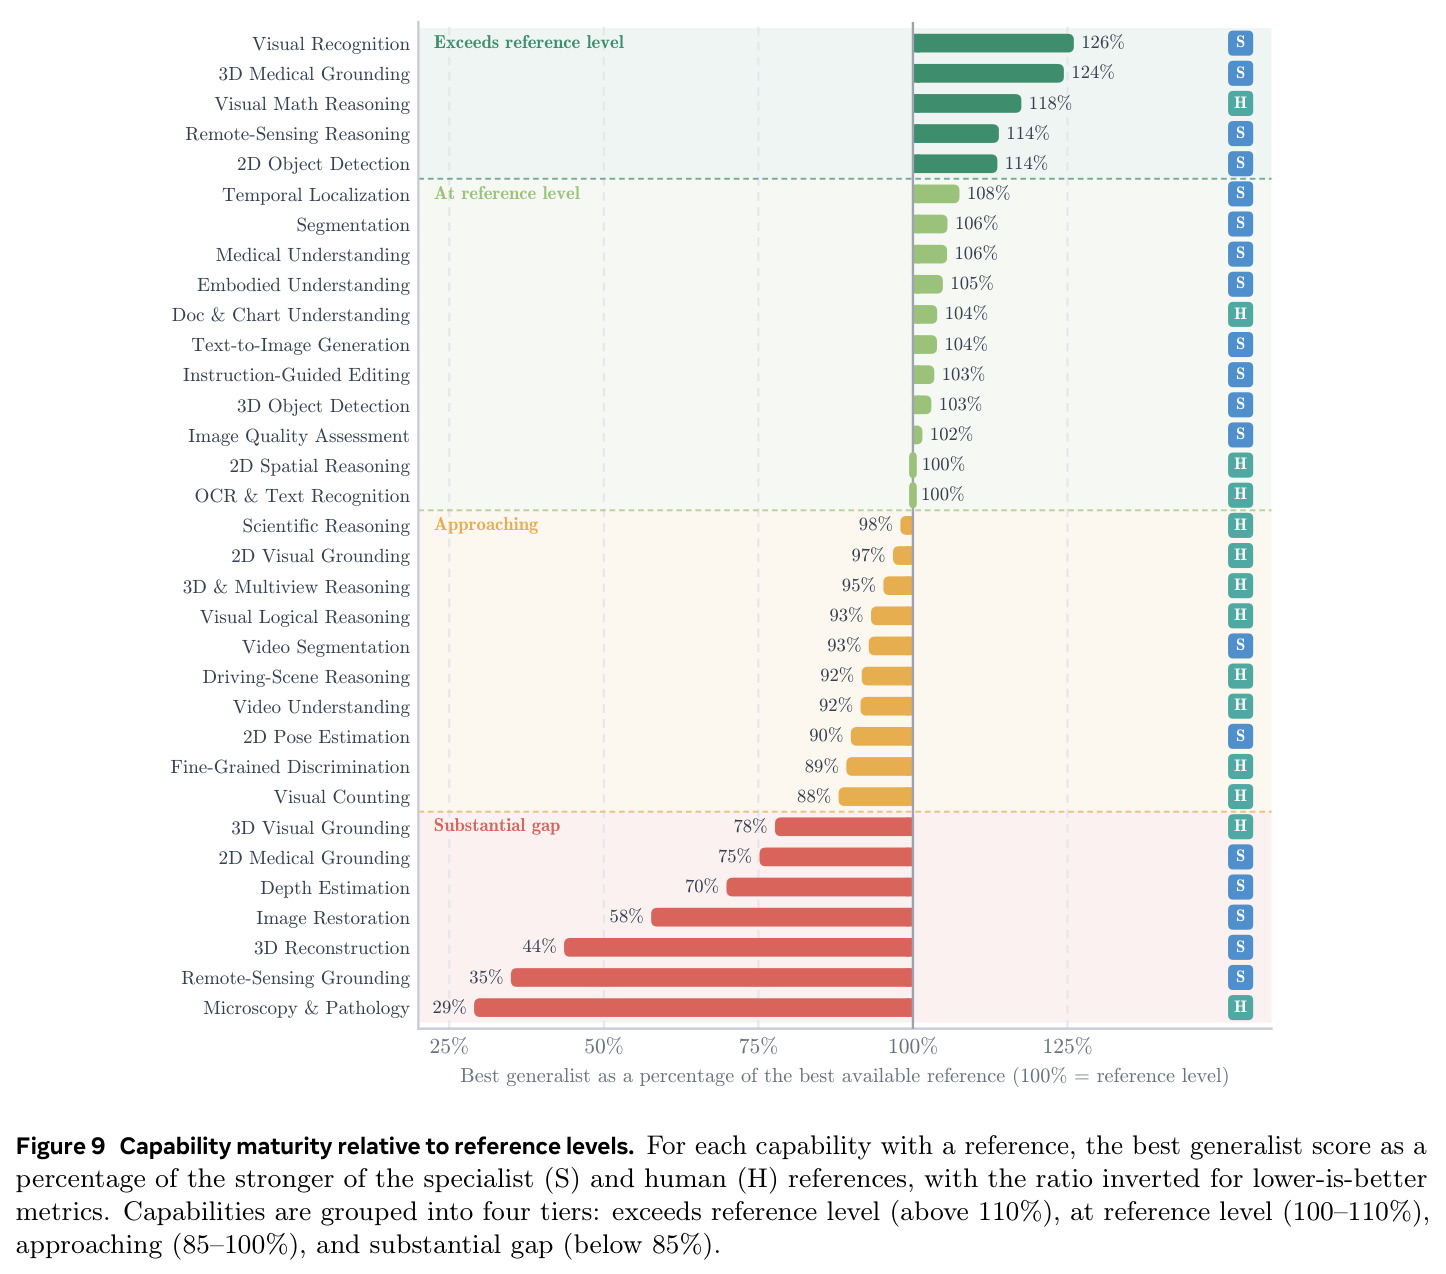
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 2D 物体检测(Dense200 等密集场景) | F1@IoU=0.5 | GPT-6 Astra 89.1(Qwen 3.8-Max 87.0) | 专用模型 Rex-Omni 78.4;其余通用系统 31.1–69.7 | +10.7 超专用参照,领先次佳通用系统 +2.1 |
| 图像分割 | gIoU | GPT-6 Astra 81.3 | 专用模型 SAM 3 Agent 77.0 | +4.3,达到参照级(106%) |
| 视频分割(DAVIS) | J&F | GPT-6 Astra 84.5 | 专用模型 BEE 91.0;其余通用系统 32.0–57.9 | 距专用 −6.5,但领先次佳通用系统 +26.6 |
| 单目深度估计(DIODE/ETH3D) | AbsRel(越低越好) | GPT-6 Astra 0.63 | 专用模型 DA3 0.44 | −0.19,仅为参照水平的 70%,差距显著 |
| 图像修复(LOL-v1 低光/去雨/去模糊等) | PSNR (dB) | GPT-6 Astra 17.7 | 专用模型 MIRAGE 30.7;其余通用系统 17.2–17.5 | −13.0 dB,全部通用系统收敛于同一低水平(58% 参照水平) |
| 显微与病理(PUMA) | Macro-F1 | 最佳通用系统 23.8 | 专用模型 HoVer-NeXt 57.1;人类 82.0 | −58.2 vs 人类参照(仅 29%),六系统全部差距显著 |
| 2D 空间推理(OmniSpatial 等) | Accuracy | GPT-6 Astra 96.0 | 人类 95.8 | +0.2,达到参照级 |
局限与改进
作者承认的局限:成熟度分层只刻画所测基准上的表现,不等于任务本身被解决;修复、病理、遥感定位、深度与重建、视频分割的差距在最强推理与工具下仍未闭合,且推理收益随能力波动很大。我自己的观察:其一,参照选取敏感——3D 视觉定位相对专用模型是超越,换成人类参照后跌至 −21.2 的'接近'档,结论对参照选择高度依赖;其二,基准刻意挑选'仍有 headroom'的困难集,可能系统性放大差距的表述;其三,六个被评系统多为闭源 API,训练数据不透明,存在基准污染风险,且全文无重复实验与显著性检验;其四,图像生成/编辑依赖外接图像模型(如 Astra 配 Sunburst、Qwen 配 Qwen Image 3 Pro),软指标评分难以区分推理模型与图像模型各自的贡献;其五,修复仅用 PSNR 类指标加定性幻觉分析,缺少感知忠实度的统一量化。
独立分析的弱点
独立分析的弱点与改进方向:1) 无不确定性量化——表中每格分数来自单次运行,采样随机性与评测噪声未报告,应每基准多次重复并给出置信区间;2) 参照异质——34 项能力各用不同专用模型与指标,'100%'的松紧不一,应报告多参照区间而非单点;3) 成本只计推理倍数(1.04–13.22 倍),未计工具管线的延迟分位与失败重试率,工程落地还需要 $p95$ 延迟与成功率数据;4) 幻觉分析停留在个例(低光增强中保龄球瓶从四变五、横幅文字被改),应引入量化幻觉指标并按风险域(医疗 vs 休闲)分级;5) 闭源系统无法审计训练分布,可加入污染探针或私有保留集;6) 具身导航仅在 AI2-THOR 仿真中测得 78% 成功率,缺少真实机器人与跨域场景验证。
未来方向
作者提出的方向:决定哪些视觉能力应由通用者内化(语义解释、语言条件推理、任务规划与协调),哪些留给专用工具(度量几何、忠实重建、稠密对应、高保真修复、稀有专家域细粒度判别),并研究通用者何时直接行动、何时调用专家、如何验证输出,在精度、成本与延迟之间权衡。基于本文成果可延伸:一是时序一致的稠密预测,把视频分割的边界精度、小结构与邻近实例分离能力做进通用模型;二是忠实可控的重建与修复,杜绝'看似合理实则幻觉'的输出;三是用本文的成熟度数据训练可学习的路由策略,让通用者自动决策'自答 vs 调用专家 vs 验证输出';四是对 13.22 倍推理成本的蒸馏与压缩,让高推理档的收益以低代价获得;五是面向病理、遥感等专家域构建细粒度判别数据集,弥补'定位得了、分类不了'的能力断层。
复现评估
复现条件中等偏上。论文给出项目页(mbzuai-oryx.github.io/frontier-vision)与 GitHub 仓库(mbzuai-oryx/frontier-vision),评测协议、能力划分与结果均可追溯;55 个基准全部公开可得,表 2 的专用参照模型多数开源(Rex-Omni、SAM 3 Agent、ViTPose++-L、DA3、WildDet3D、VGGT-1B、TRACE、BEE、MIRAGE、HoVer-NeXt、RSRefSeg 2 等)。主要障碍在六个被评系统:GPT-6 Astra、Gemini 3.1 Pro、Qwen 3.8-Max 等均为闭源 API,重跑全部实验需要可观的 API 预算——推理档位消融单任务成本最高达基线的 13.22 倍,图像生成/编辑还需外接各家图像模型;输出后处理(多边形栅格化、深度渲染、cuboid 转换、DPG-Bench 四图拼格)也存在未完全展开的工程细节。相对容易复现的部分是专用参照模型与人类参照的对比分析。
论文图表
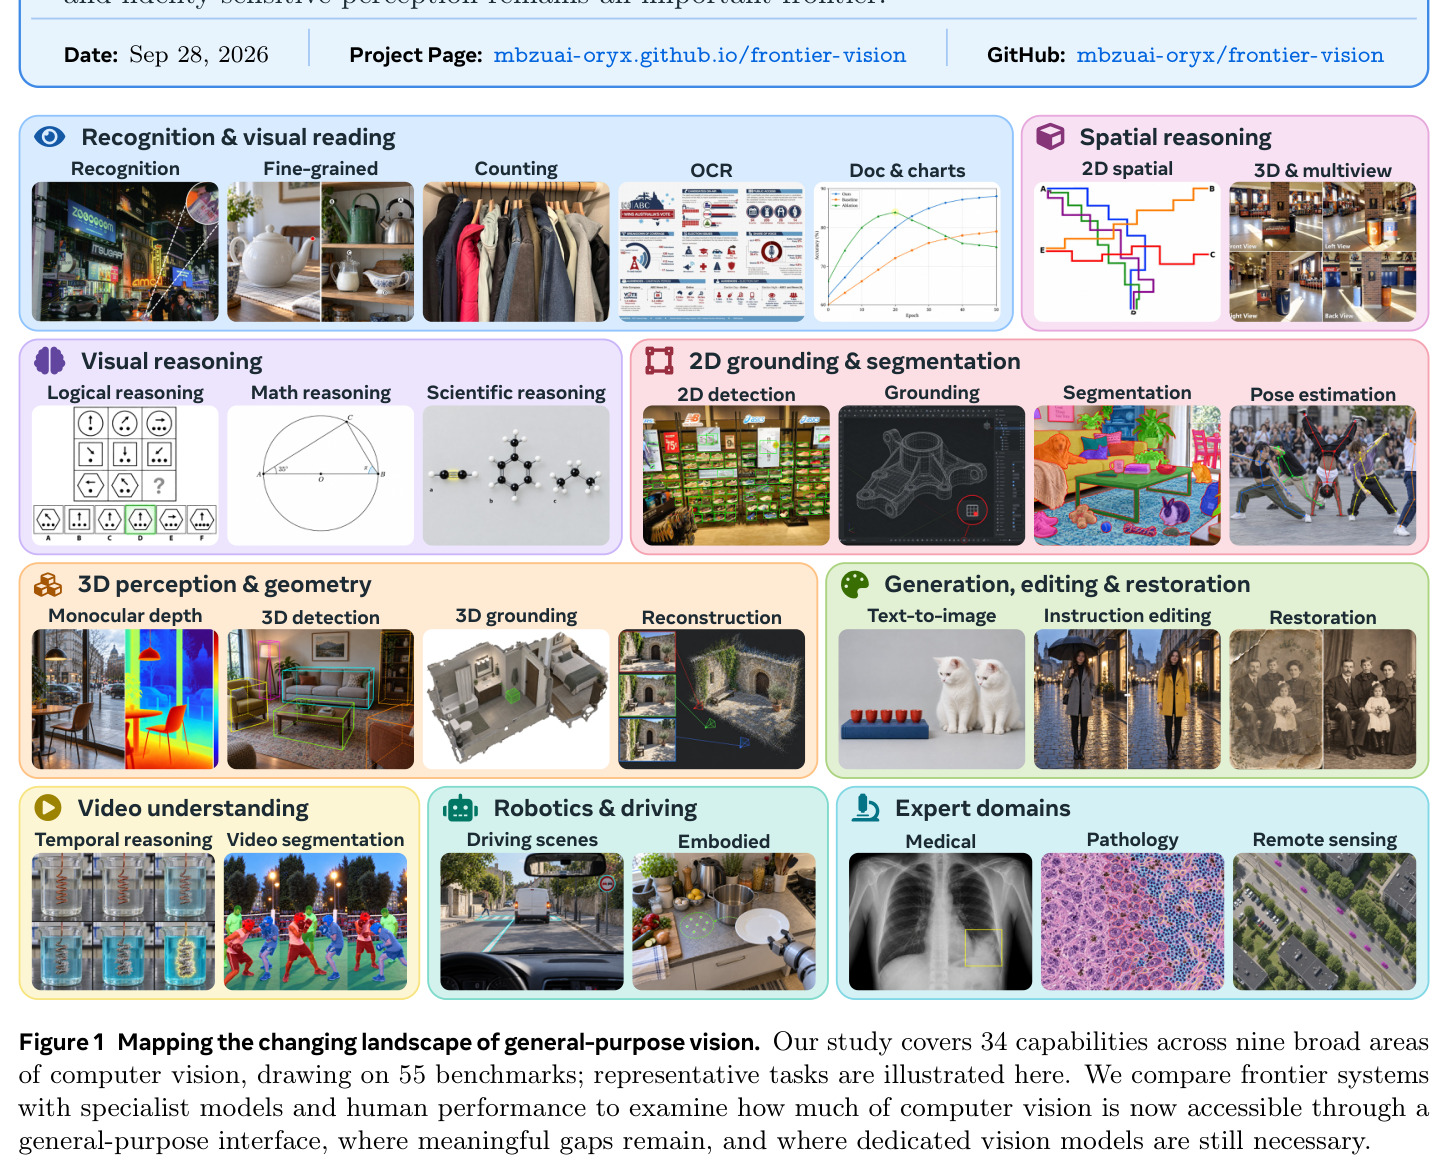
全文范围总览图:九大领域(识别与视觉阅读、视觉推理、空间推理、2D 定位与分割、3D 感知与几何、视频理解、生成编辑修复、机器人与驾驶、专家域)下的 34 项能力示意,覆盖 55 个基准,并标注与专用模型和人类参照对比的研究问题。
这是论文的'地图',30 秒内即可把握评测范围与'多少 CV 通过通用接口可及、专用模型仍必要在哪'这一核心问题,适合作为阅读全文的导航。
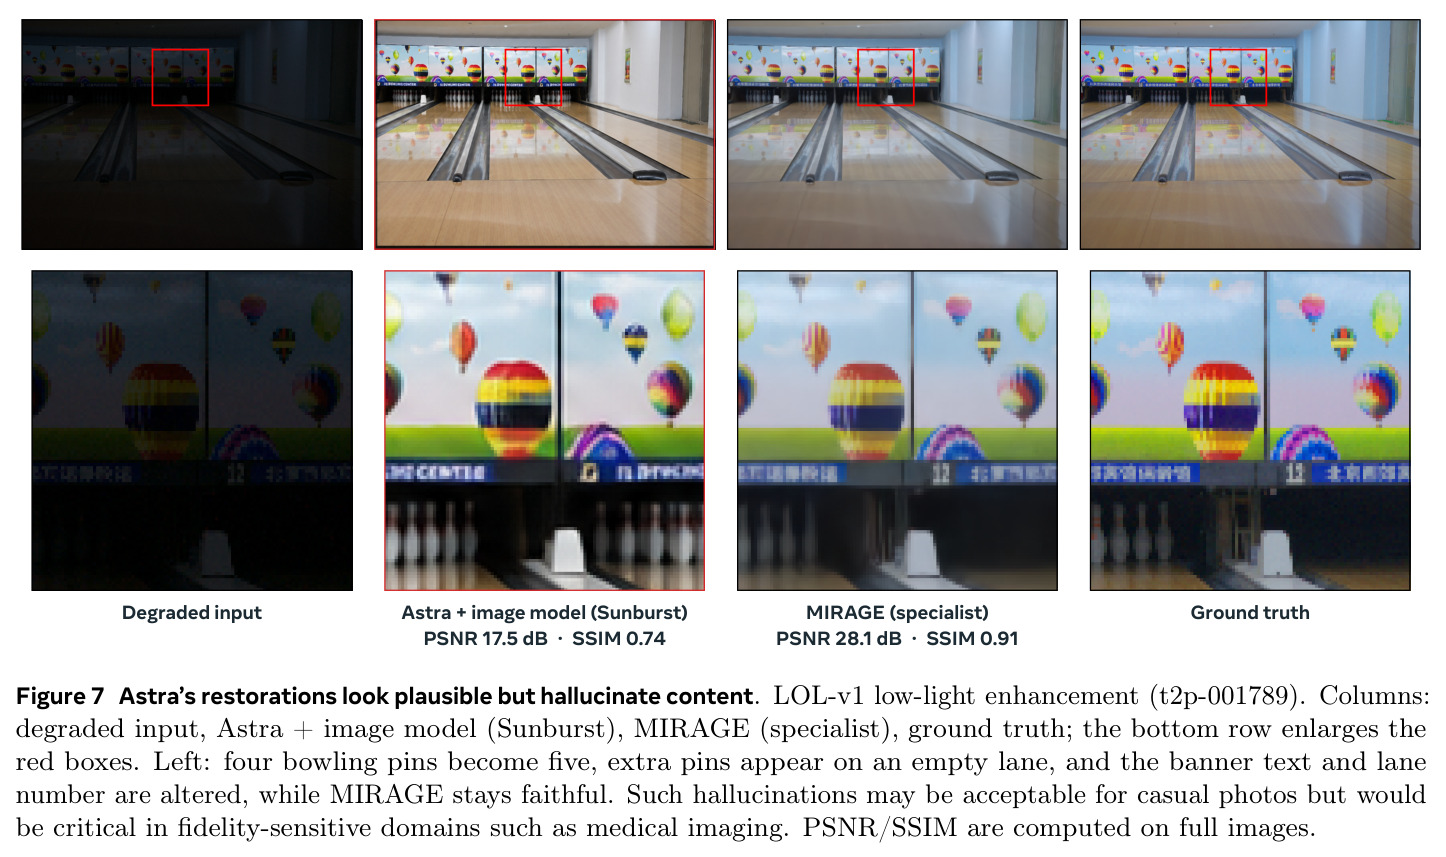
LOL-v1 低光增强对比:退化输入、Astra+图像模型 Sunburst(PSNR 17.5 dB / SSIM 0.74)、专用模型 MIRAGE(28.1 dB / 0.91)与真值四列;Astra 结果中四个保龄球瓶变五个、空球道多出球瓶、横幅文字与道号被改,而 MIRAGE 保持忠实。
揭示修复差距 −13 dB 的本质是语义幻觉:'看似合理'在医疗等保真敏感域不可接受,是全文最重要的警示图。