更少Token,更优动作:基于交互式代码执行的GPT-6 Astra精简机器人智能体 Fewer Tokens, Better Action: GPT-6 Astra Robot Agents with 14% Higher Success Rate but 65% Fewer Tokens
用Python代码单元组合机器人原语并按需返回观测,成功率+14%、Token省65%
前置知识
VLM智能体与工具调用
视觉语言模型(VLM)智能体把机器人技能封装成一个个'工具',模型每一轮根据最新观测(图像+状态)从工具列表中选择下一个工具及其参数,工具执行结果再写回对话历史,如此循环直到任务完成。由于任何依赖前序工具结果的操作都必须再等一轮模型决策,调用次数和上下文长度会随任务复杂度快速增长,中间图像与状态还会不断挤占上下文窗口。
本文的比较对象正是工具调用接口,理解其'每步一调、全量回传'的运行模式,才能体会论文要解决的token开销从何而来、节省发生在哪个环节。
VLA策略(视觉-语言-动作模型)
端到端学习的感知-动作映射模型,接收图像和语言指令后直接输出机器人动作序列,如论文用到的 π0.5、LingBot-VLA、RLDX-1。它们可被视为一种'学习到的原语',与 move_to 等经典运动/感知原语并列,供上层智能体调用。本文中两方智能体共享同一套冻结的VLA策略。
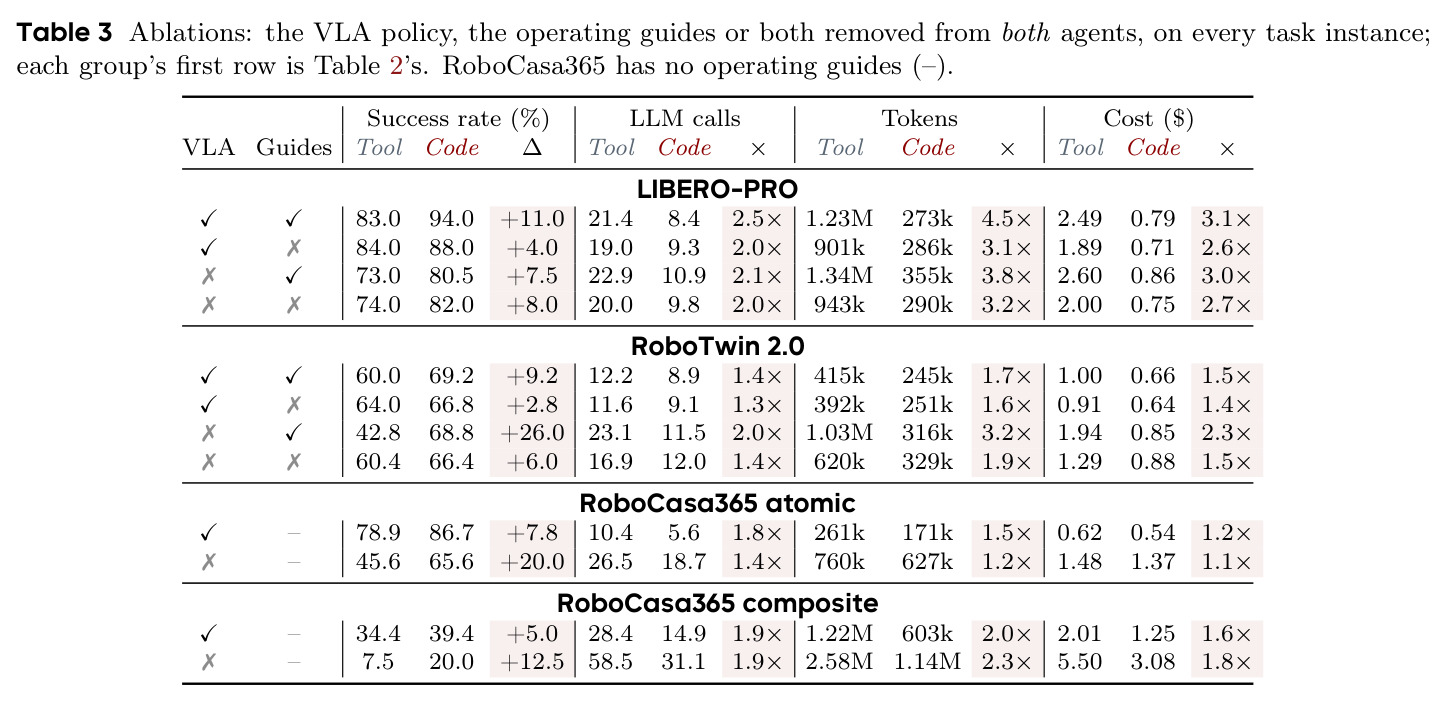
论文在同一套冻结VLA之上比较两种接口,且消融显示去掉VLA后代码接口的优势反而扩大(RoboTwin +26.0pp),理解VLA的角色是读懂实验设计与假设H3的关键。
代码执行接口(CodeAct范式)
让LLM直接生成可执行的Python代码与环境交互,而非逐个发起工具调用。代码可以在一个单元内组合多个操作、写条件分支和循环、做本地重试,中间结果保存在持久命名空间里跨单元复用,只有显式打印或请求的输出才返回给模型,从而减少模型被调用的次数与每次调用的上下文长度。
PyRUA-Lean正是把这一范式从通用agent任务迁移到机器人操控上,'机器人即Python对象 robo'是方法的全部核心,不熟悉这一范式就无法理解本文贡献。
选择性观测
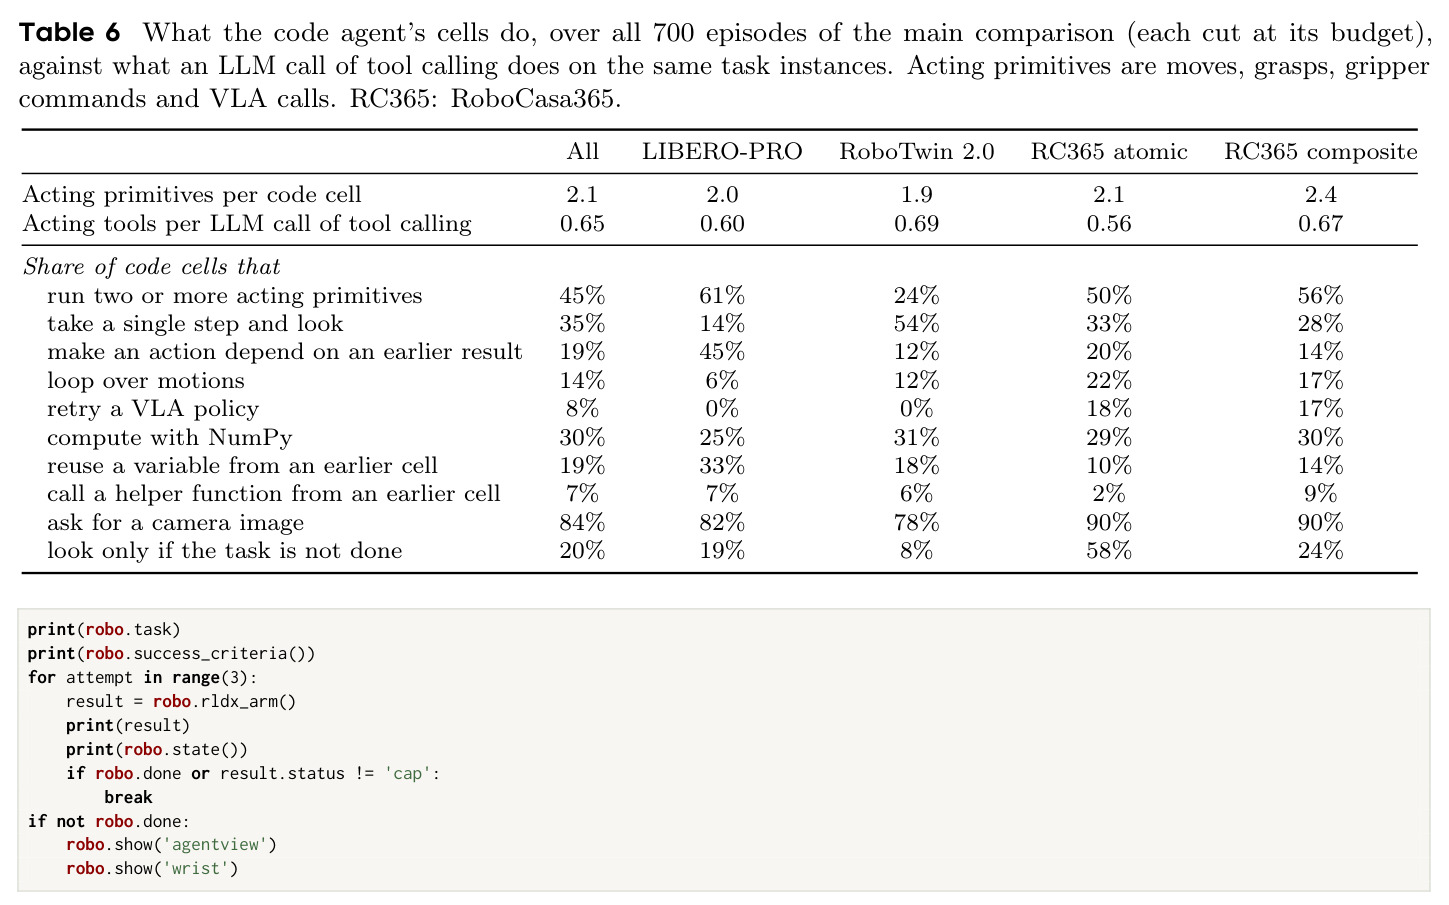
控制哪些中间信息进入模型上下文的机制:原语结果先留在代码运行时中,智能体通过 print 语句和 robo.show 显式指定要返回给VLM的文本与相机图像,其余数据(如世界坐标数组、几何计算结果)留在代码变量中供后续单元复用,避免像工具调用那样每次运动自动回传三张图像撑大prompt。
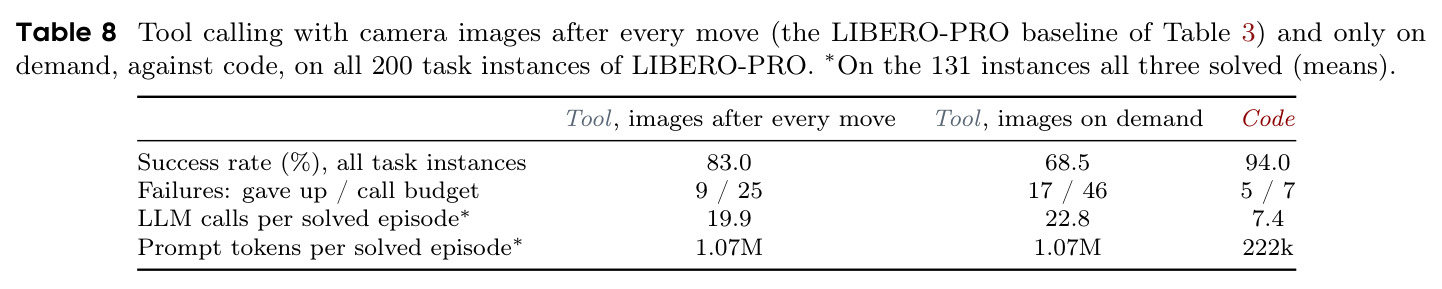
这是本文两大机制之一;消融(表8)证明只做'按需图像'而不做代码组合,成功率反而从83.0%跌到68.5%,说明必须与程序化组合协同才有效。
RPent框架与三大机器人基准
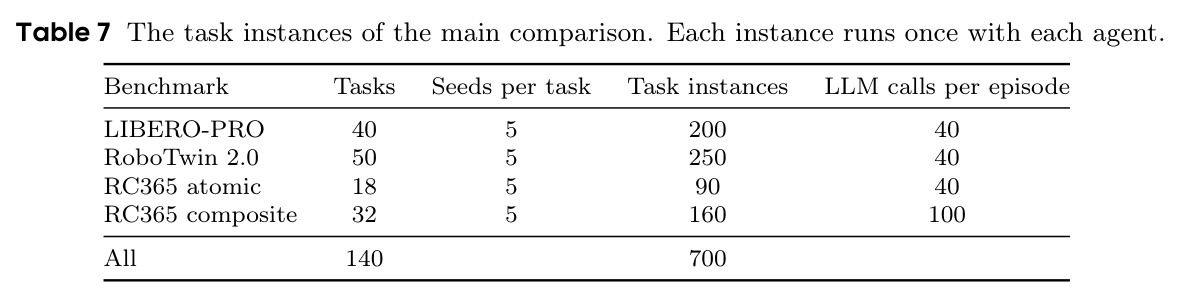
RPent是一个带记忆的机器人智能体框架,提供本文两方智能体共用的原语实现(运动、抓取、感知、VLA封装)。LIBERO-PRO、RoboTwin 2.0、RoboCasa365是三个仿真操作基准,分别考察扰动布局的桌面任务、双臂技能和长时程组合任务,每个任务在5个环境种子上评测,共700个配对任务实例、1400个episode。
它们构成实验的受控环境与数据来源,Table 1/2/3与全部效率数字都建立在这套评测协议之上,是核对论文结论时的坐标系。
研究动机
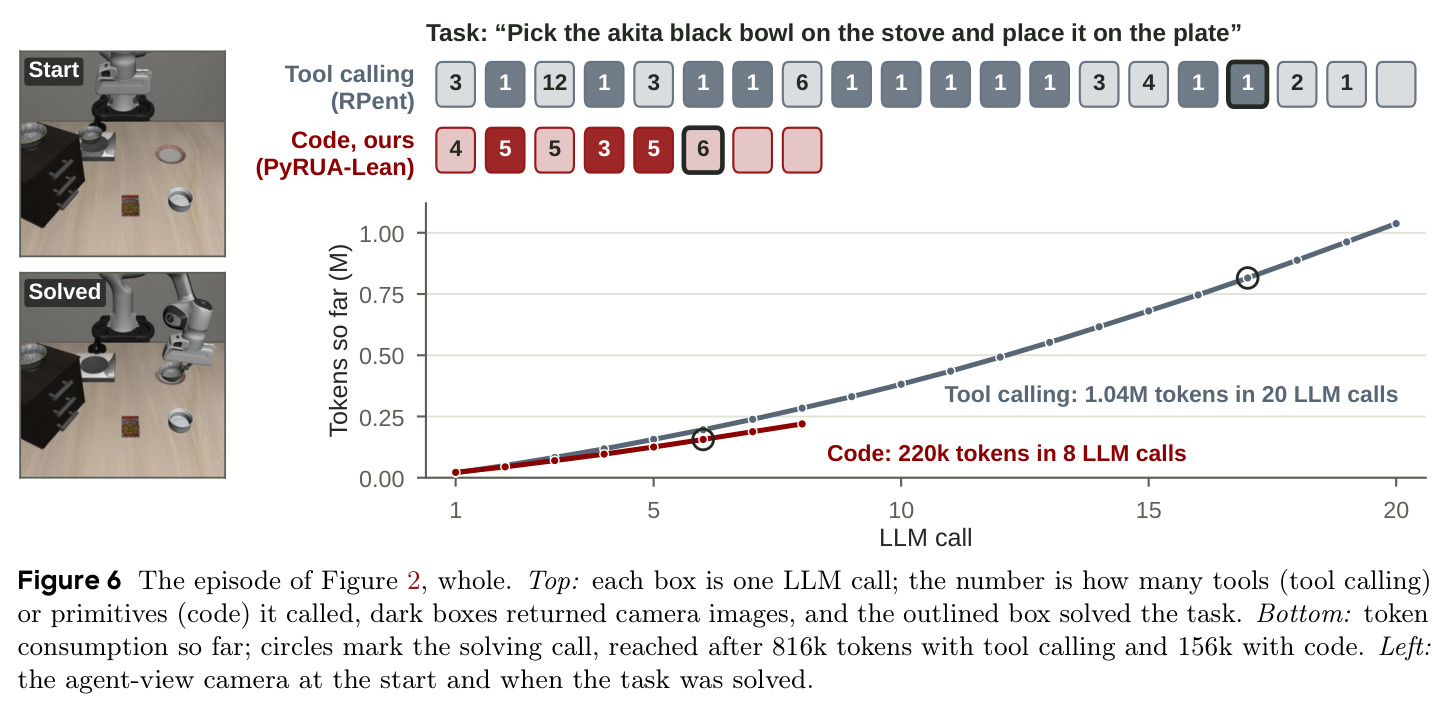
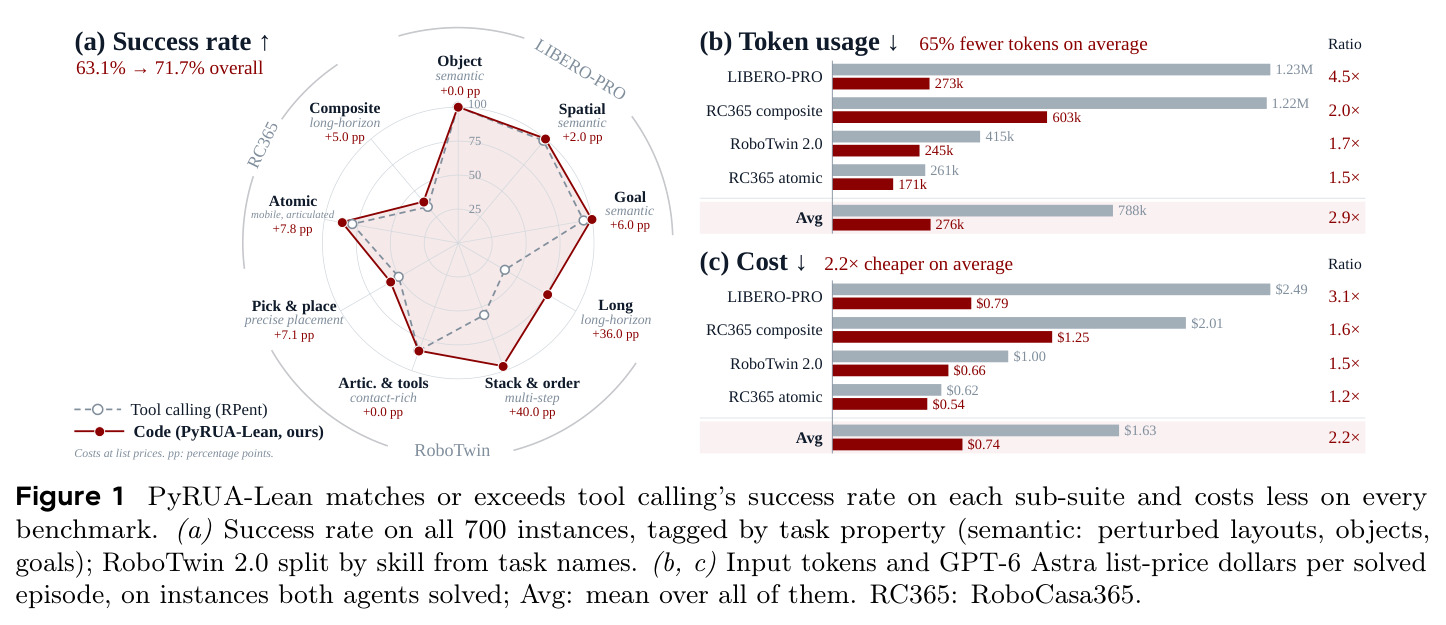
当前VLM机器人智能体普遍采用工具调用接口:每一步都由VLM基于更新后的观测选择下一个工具/技能。这带来两类严重开销。其一是调用次数膨胀——任何依赖前序工具结果的操作都需要再发起一次VLM调用,需要反复定位、运动和失败恢复的任务调用数迅速累积。其二是上下文膨胀——中间结果持续堆积在对话历史中被后续调用反复处理,且像RPent这样的系统每次运动原语会自动返回三张相机图像和状态,进一步推高输入token。实测中,在700个仿真任务实例上,工具调用基线每成功episode平均消耗17.0次LLM调用、788k输入token、约$1.63推理成本;LIBERO-PRO的长episode更是高达1.23M token、$2.49;RoboCasa365 composite上基线平均要28.4次调用、1.22M token。token开销直接转化为更少的尝试机会与更高的部署成本,也限制了在固定LLM调用预算(如每episode 40次)内能完成的任务量。
本文的目标是本文的核心问题是:在完全相同的GPT-6 Astra planner、相同的底层机器人原语(含冻结VLA策略)、相同的LLM调用预算(40次/episode,composite任务100次)和2小时时限下,仅仅改变智能体与机器人的交互接口,能否同时提升任务成功率并大幅降低推理开销。作者将其细化为三个可检验假设:H1——在等LLM调用预算下,新接口比工具调用取得更高的任务成功率;H2——解出同样任务所需的LLM调用次数与输入token更少;H3——即使去掉VLA策略或操作指南,token效率依然保持。评测覆盖LIBERO-PRO(40任务)、RoboTwin 2.0(50个双臂任务)、RoboCasa365(Target50集合)共700个配对实例,每任务5个环境种子,合计1400个episode。
与已有工作不同的是,用代码控制机器人并非新想法:Code as Policies、ProgPrompt从语言指令生成单次机器人程序,Voyager、ASPIRE、RoboRSI关注跨episode的技能积累与自改进,CodeAct已在通用agent任务上证明可执行Python优于文本/JSON动作接口。但此前工作要么聚焦一次性程序合成,要么聚焦技能库复用,要么在软件工程任务上比较接口,鲜有工作在同一个机器人栈、同一个planner和同一套冻结VLA上,把'交互式代码执行'与'工具调用'做严格配对比较。本文的独特切入是把程序化原语组合与选择性观测两个机制结合在同一个Python运行时里,且显式测量成功率、LLM调用数、输入token与美元成本四个维度,并把token节省进一步分解为'更少调用次数 × 每次调用更少token',归因到机制层面。
核心方法
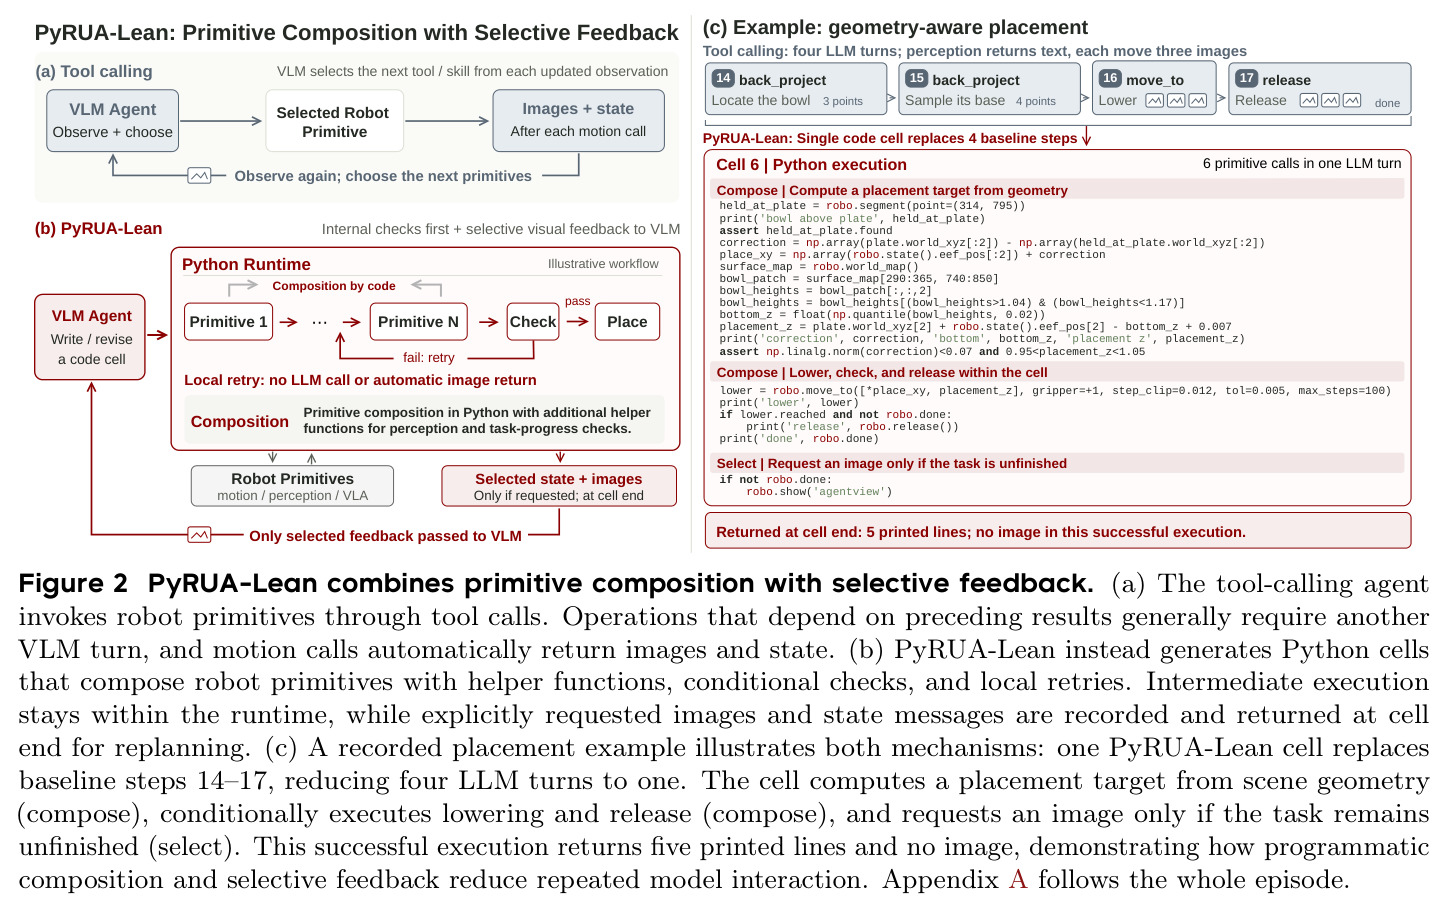
PyRUA-Lean(Python for Lean Robot-Use Agents)的直觉是:把中间协调与几何计算从LLM对话历史中移出,放进Python运行时内完成,让VLM只在大节点上做决策。技术上,机器人被封装为Python对象 robo,其方法(与RPent工具同名同参数)调用运动、抓取、感知原语和VLA策略并返回结构化结果(如物体位置、运动是否到位)。VLM通过 python(code) 工具提交代码单元,运行时在一个持久的Python命名空间中执行:变量和辅助函数跨单元保留;未捕获异常会终止当前单元但保留已赋值的变量,traceback返回给VLM供下一个单元修复;在每个作用于机器人的原语执行前检查 robo.done,任务已成功则提前终止单元;外部看门狗强制2小时episode上限。双方智能体均运行在Codex CLI中(接近272K token才压缩历史),评测中都不使用跨episode记忆,唯一的系统差异就是接口本身。
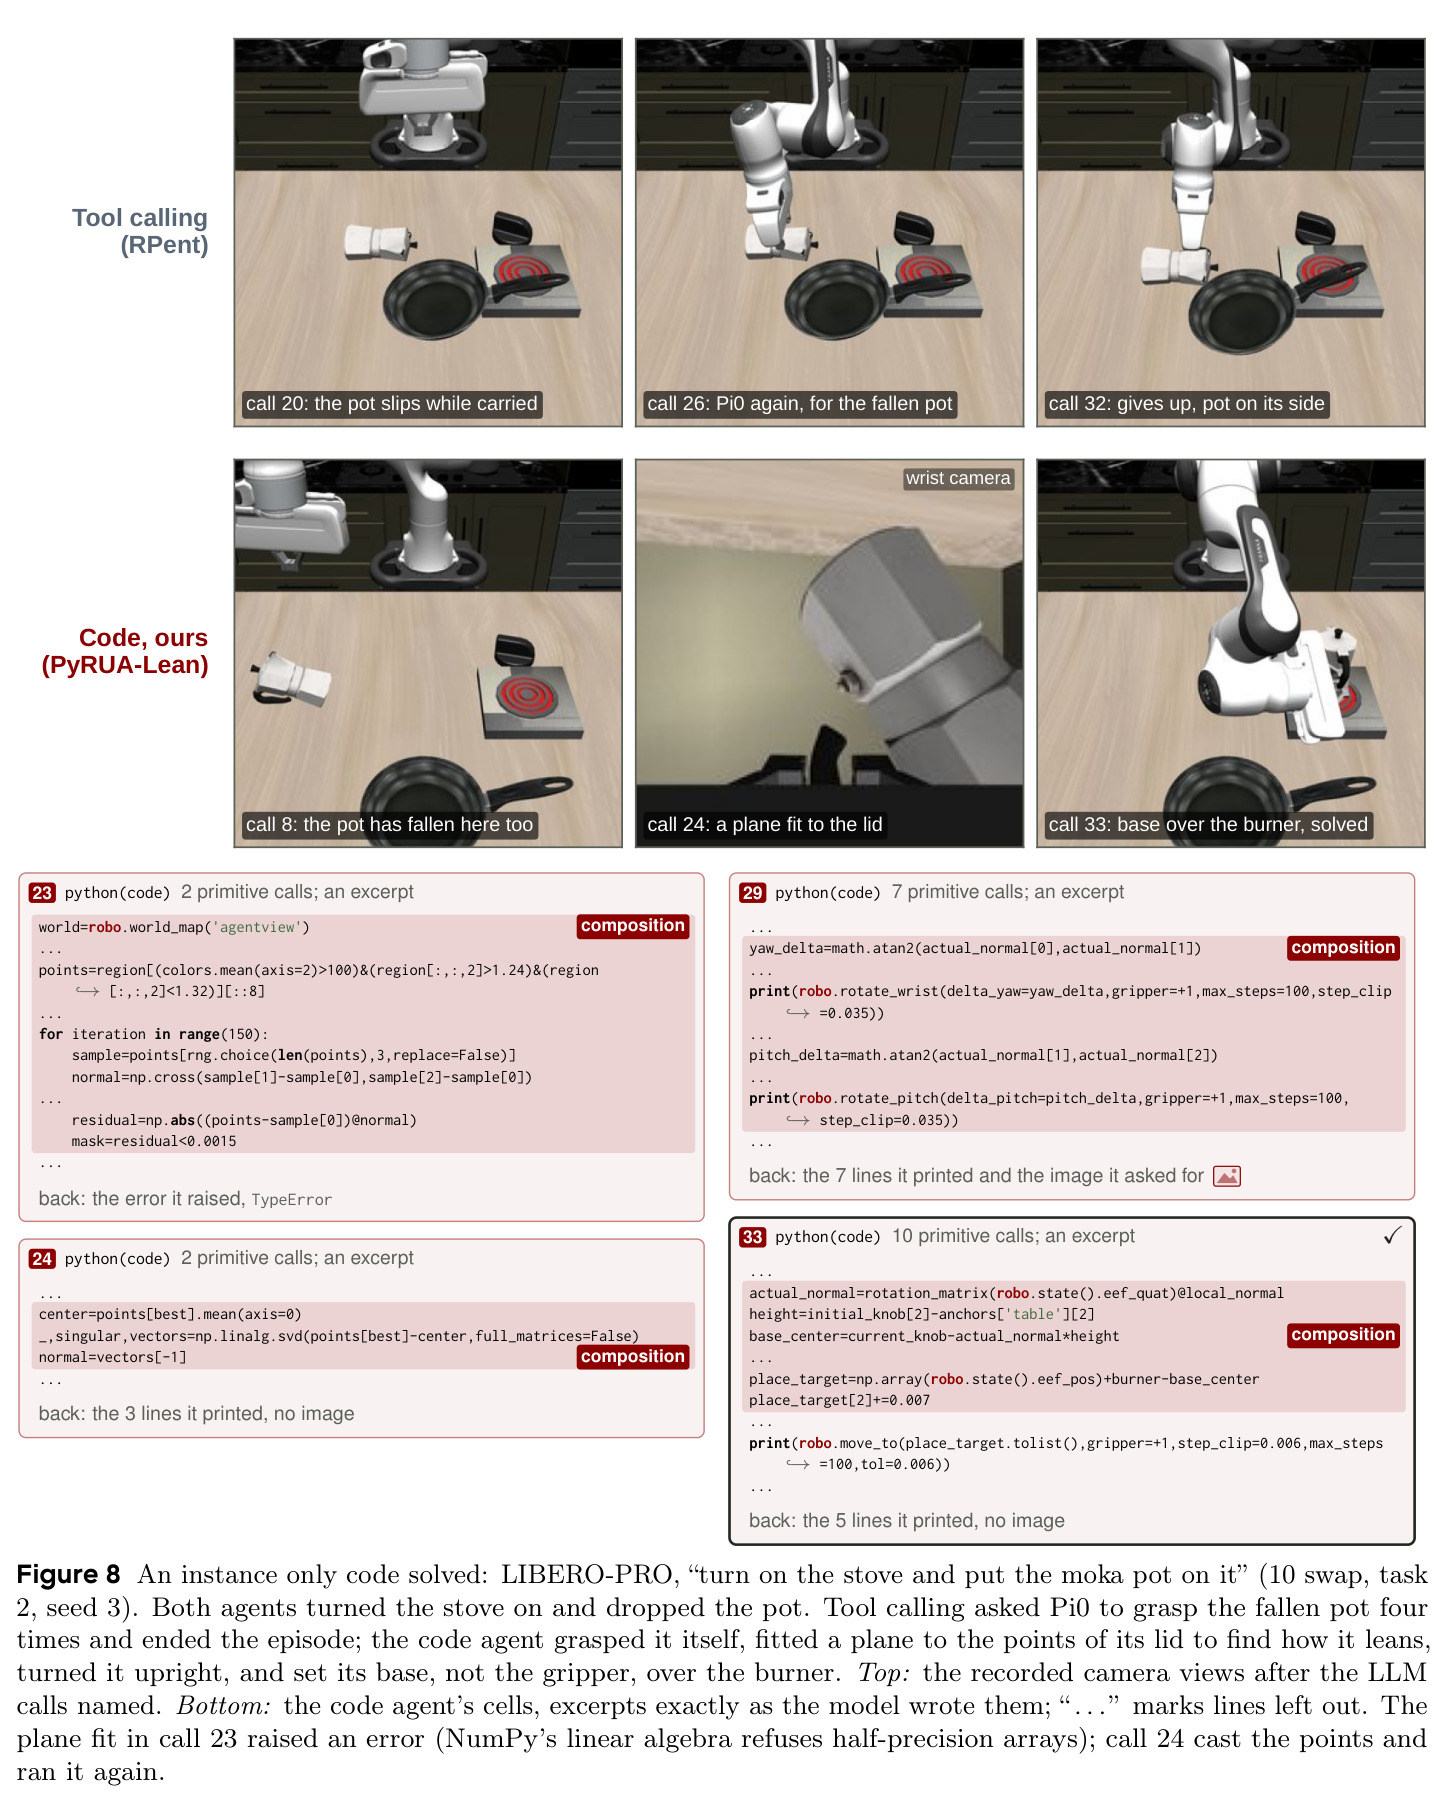
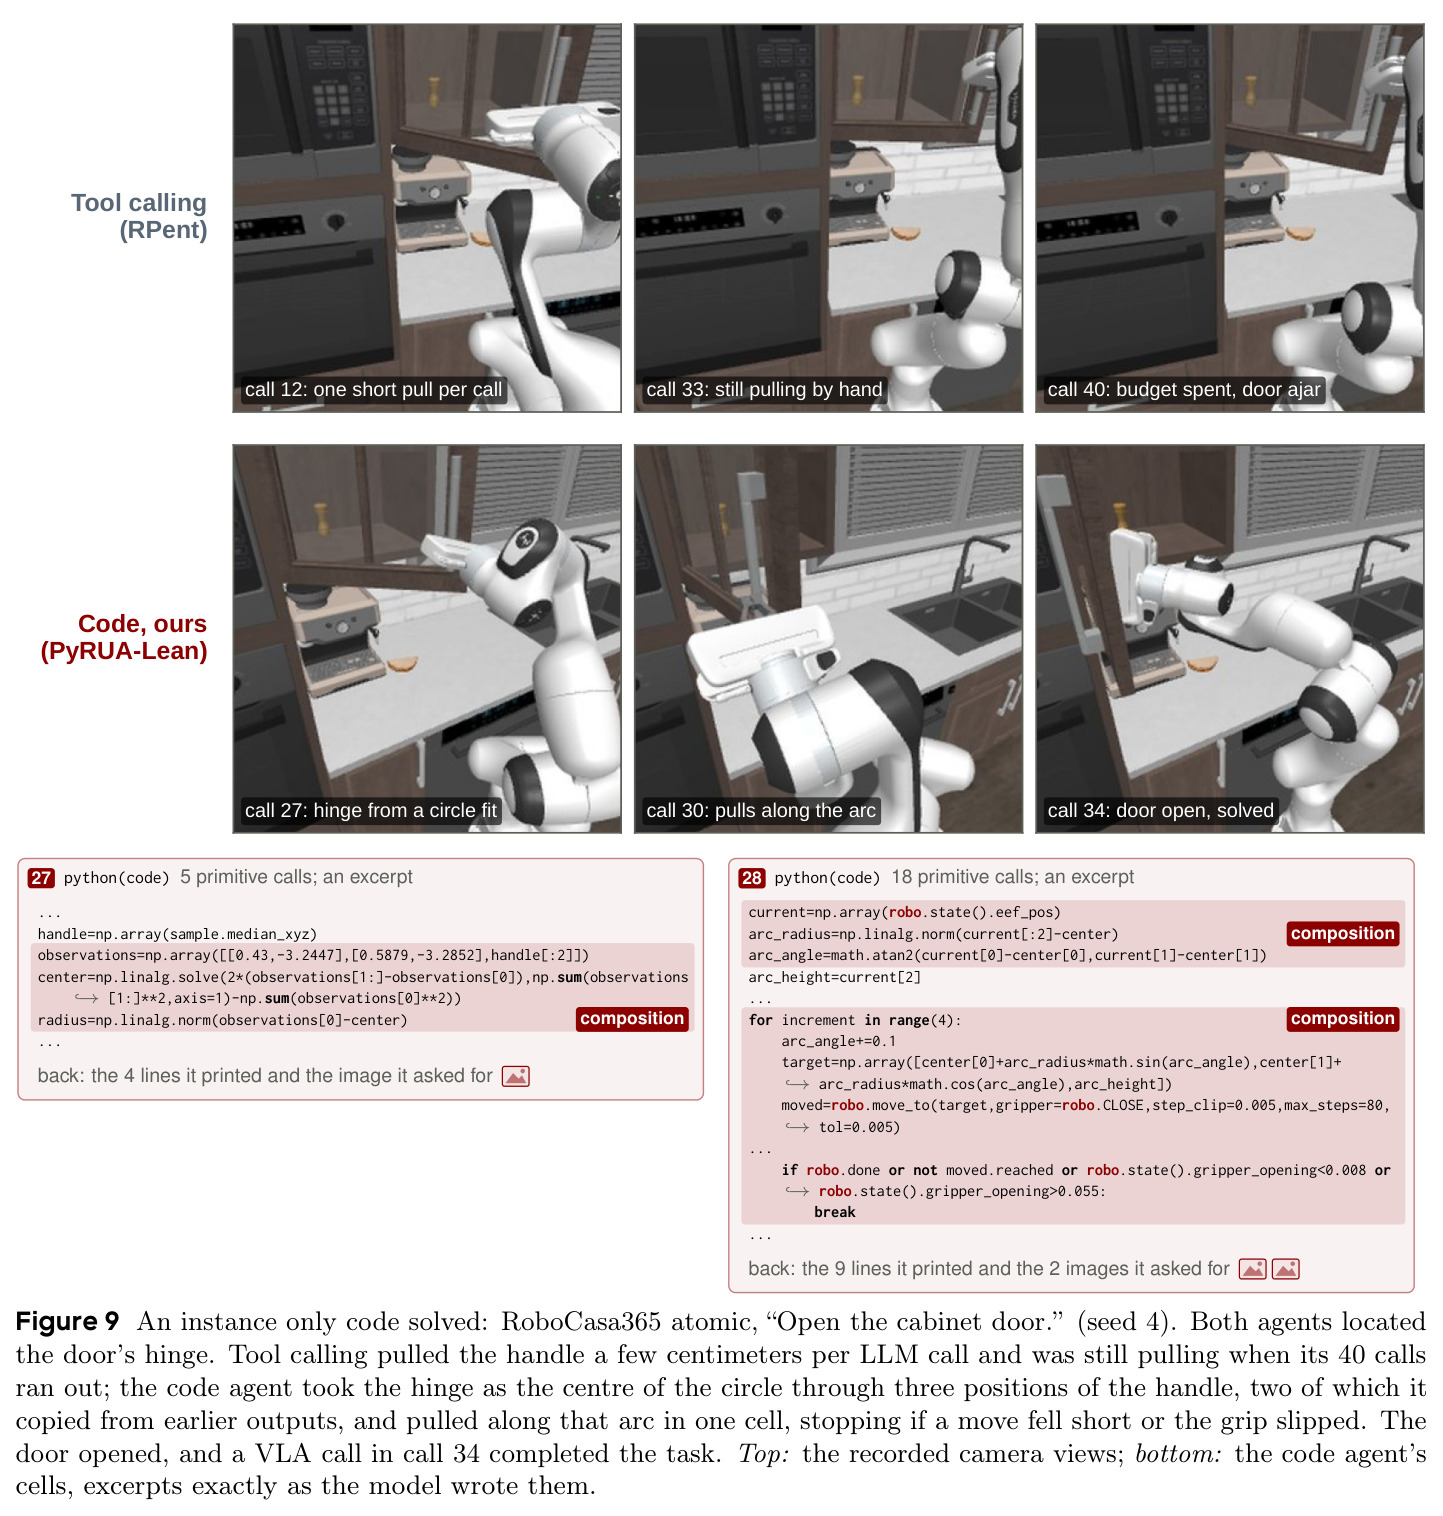
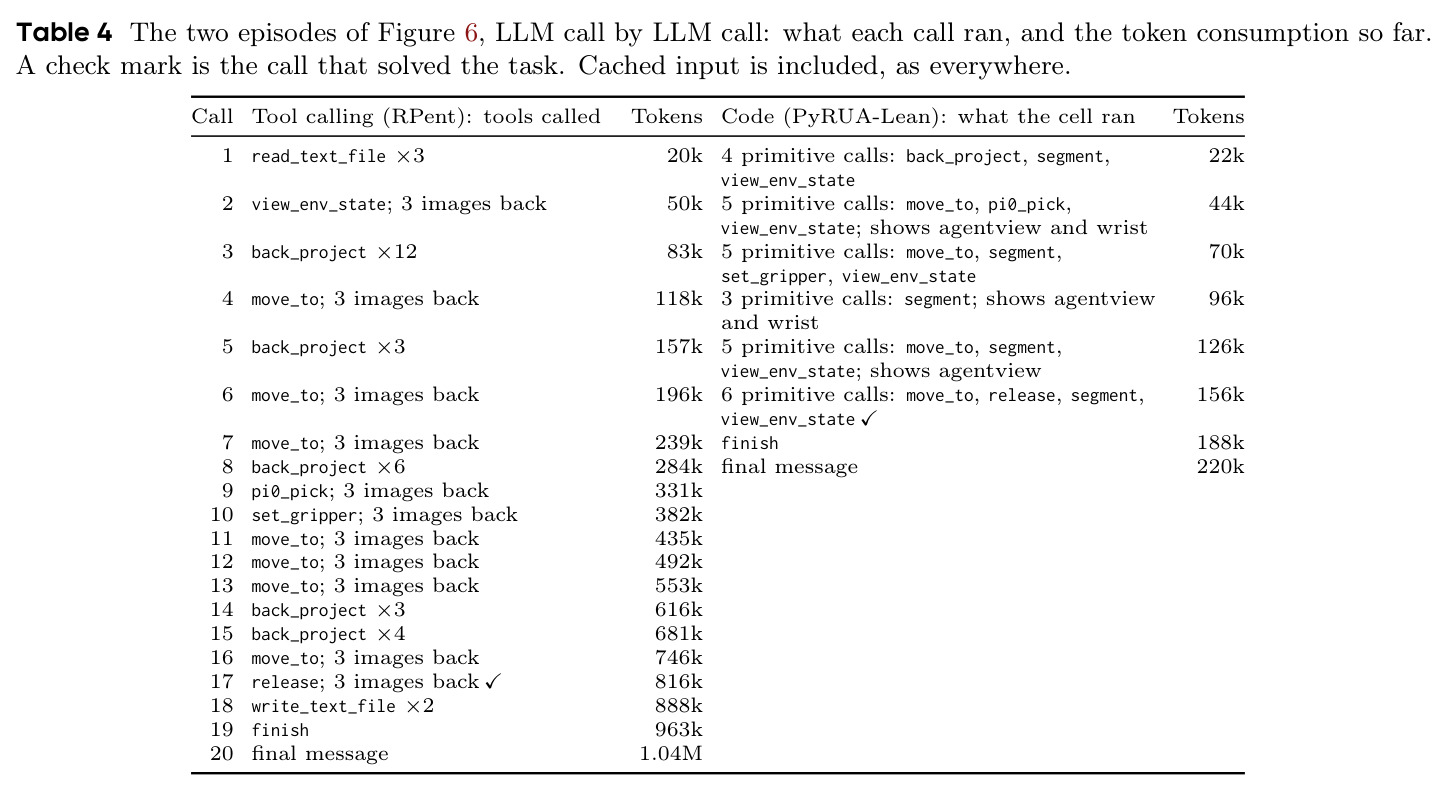
核心创新是'反馈驱动的原语组合'与'选择性观测'的结合,与工具调用有本质区别。工具调用中,依赖前序结果的操作必须再等一轮VLM决策,且运动原语自动返回三张图像塞满上下文;PyRUA-Lean则在一个代码单元内串起'接近—条件判断—抓取—本地重试'等逻辑,中间检查和分支都在运行时完成,不消耗LLM调用。观测方面,只有显式print的行和robo.show请求的图像才会在单元末尾打包返回,其余中间数据(如世界坐标地图)留在持久命名空间供后续单元复用。Figure 2(c)的放置示例中,一个单元先用robo.segment定位碗,再从robo.world_map()的表面高度图中按 $h \in (1.04, 1.17)$ 过滤并用分位数 $Q_{0.02}$ 估计碗底高度,算出放置坐标后条件执行下降与释放——成功执行仅返回5行文本、无图像,就把基线14–17步共4次LLM轮合并为1次。消融证明二者缺一不可:仅把工具调用改成按需返回图像,LIBERO-PRO成功率反而从83.0%跌到68.5%。
方法步骤详情
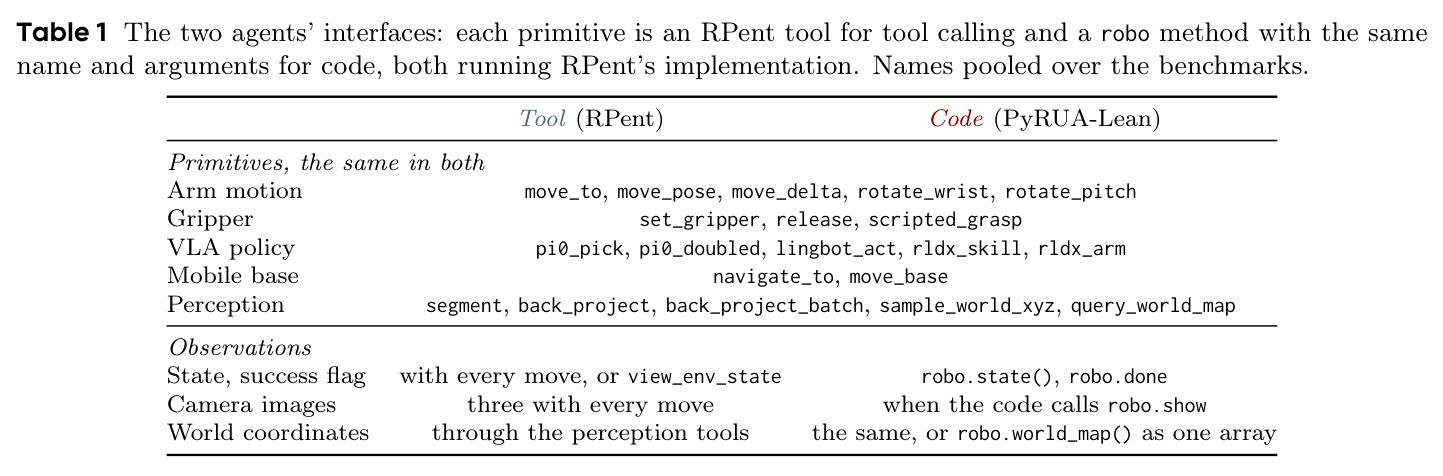
完整执行循环如下:(1)初始化——VLM收到任务指令与API参考(Table 1:move_to/rotate_wrist等臂运动,set_gripper/release/scripted_grasp抓取,pi0_pick/lingbot_act等VLA,navigate_to移动,segment/back_project/query_world_map感知),以及python(code)工具说明;(2)生成代码单元——VLM写出一段Python,可组合多个原语、定义辅助函数、做几何计算(如 $\text{SVD}$ 拟合平面求法向量);(3)运行时执行——在持久命名空间中执行,每个作用于机器人的原语前检查robo.done,异常即中断单元并返回traceback,已赋值变量保留;(4)选择性反馈——print的行与robo.show请求的图像在单元指定处记录,于单元末尾一次性返回;(5)迭代修订——VLM根据反馈写下一个单元,失败操作可基于残留变量在代码层或LLM层重试;(6)终止——任务成功,或达到40次(composite任务100次)LLM调用预算,或触发2小时看门狗。
技术新颖性
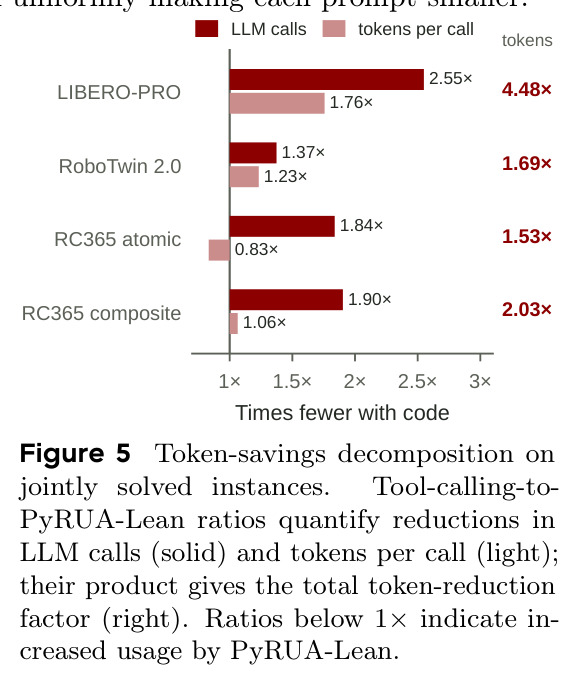
新颖性体现在四个层面。第一,对比设计干净:PyRUA-Lean与基线共享RPent的机器人栈、原语实现、GPT-6 Astra planner、冻结VLA(π0.5、LingBot-VLA、RLDX-1)与SAM 3分割,唯一变量是接口,且双方都关闭跨episode记忆——这把它与Voyager/ASPIRE等技能积累路线清晰区分开。第二,机制组合而非单一技巧:程序化组合减少调用次数,选择性观测减少每次调用的token,Figure 5的分解显示LIBERO-PRO上 $4.48\times = 2.55\times \times 1.76\times$,且两者必须协同——只做按需图像的基线反而掉11.5个点。第三,把'上下文管理'明确表述为控制新进入上下文的信息(而非压缩已有历史),双方都依赖Codex CLI的272K压缩。第四,诚实的计量口径:统计计入成功后的调用与缓存token,区分联合解出子集与全部episode的成本,并明确说明token分解是会计分析而非因果分析。
实验结果
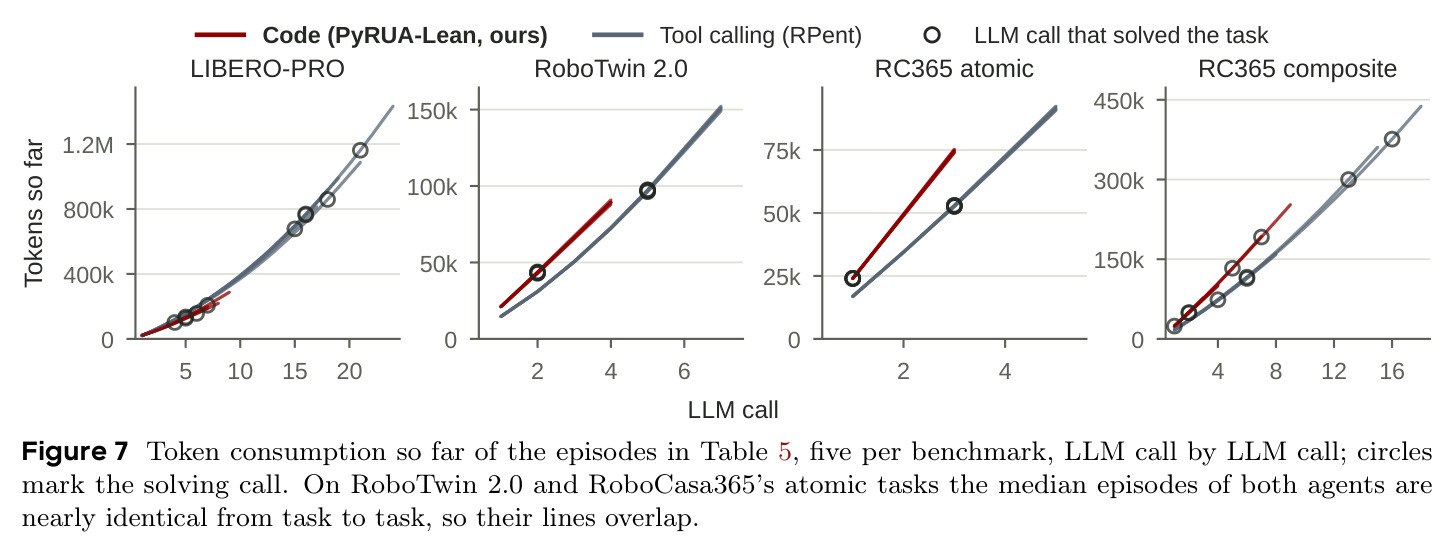
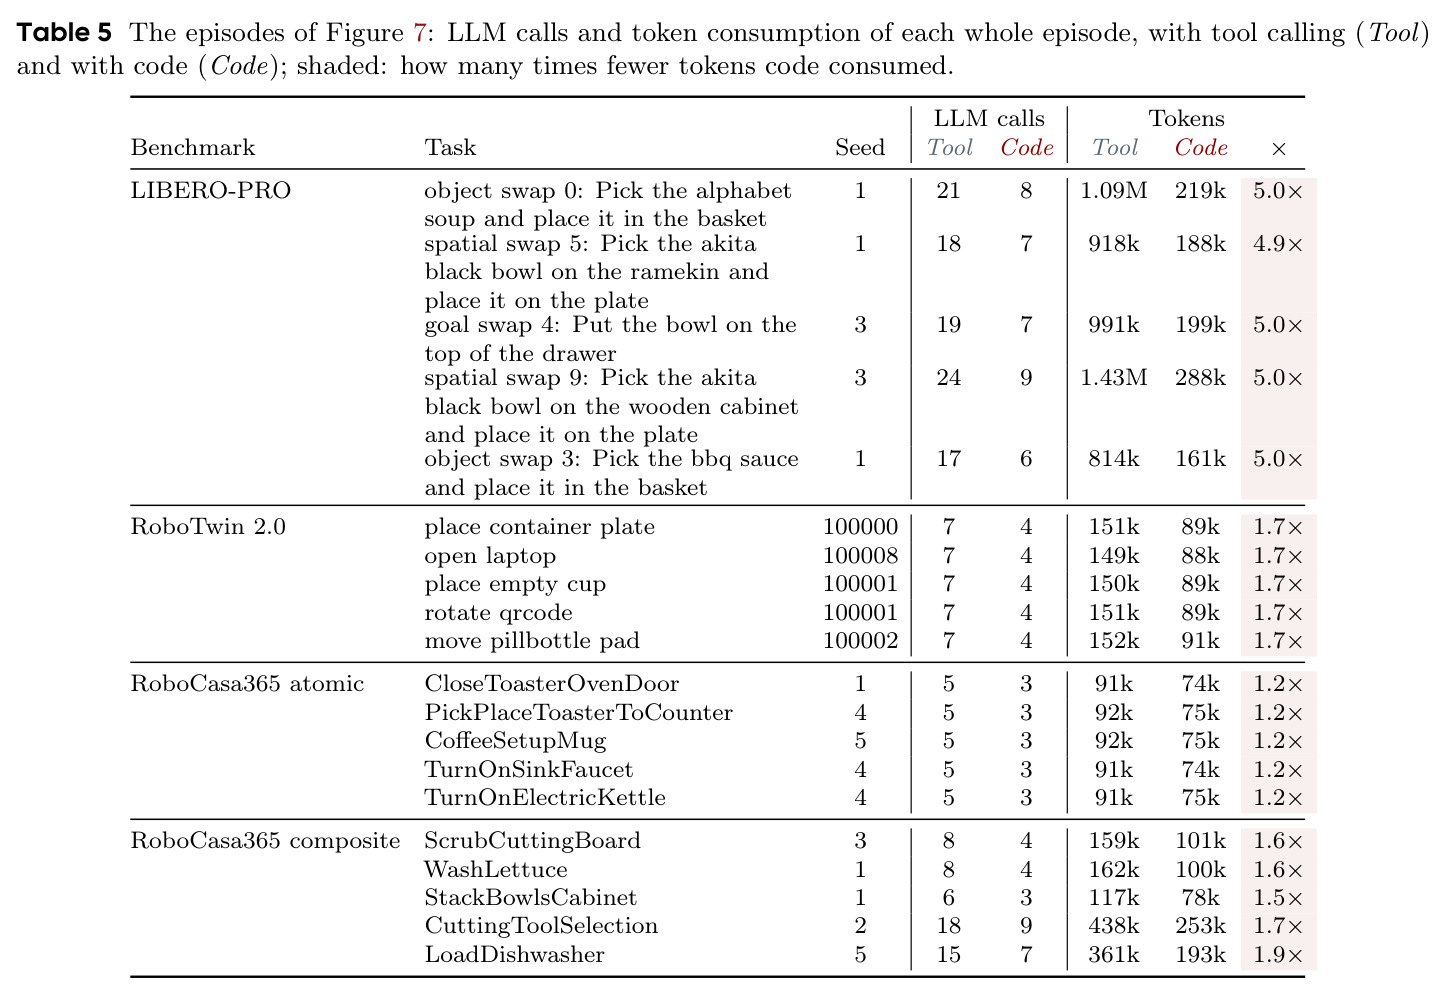
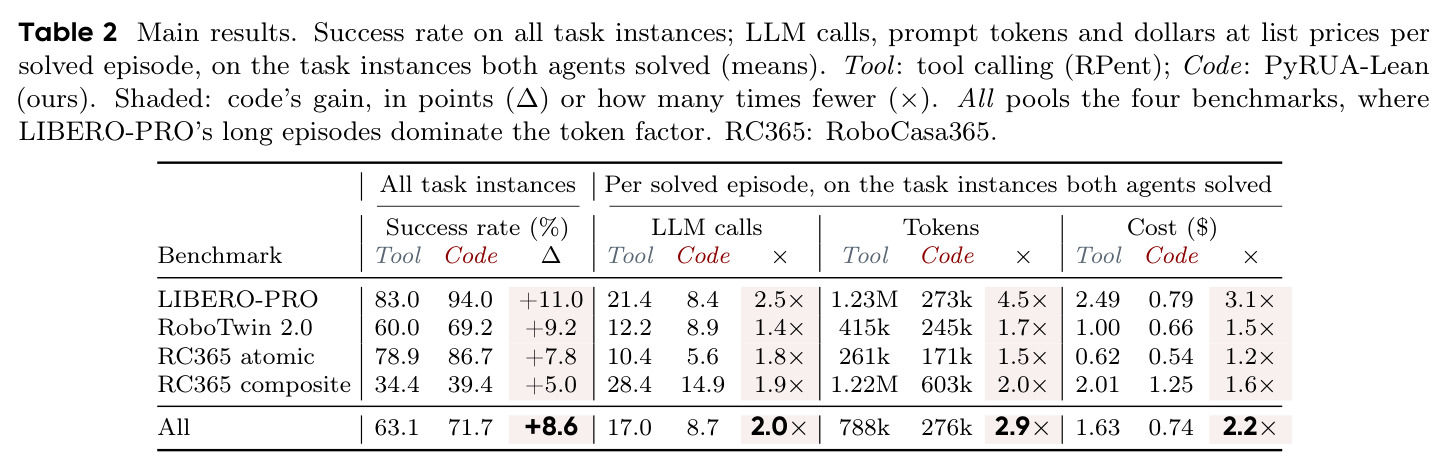
三假设均获支持。成功率(700例):总体63.1%→71.7%(+8.6pp);LIBERO-PRO 83.0%→94.0%(+11.0pp),RoboTwin 2.0 60.0%→69.2%(+9.2pp),RC365 atomic 78.9%→86.7%(+7.8pp),composite 34.4%→39.4%(+5.0pp);独解96例对36例。效率(共解实例):LLM调用17.0→8.7(↓49%),token 788k→276k(↓65%),成本$1.63→$0.74(2.2×);LIBERO-PRO token 1.23M→273k(4.5×)。分解:LIBERO-PRO $4.48\times=2.55\times\times1.76\times$;RC365 atomic调用降1.84×但每次token反增(0.83×)。RoboDojo试点26.7%(8/30)对3.4%(1/29),每成功token 11.56M→1.07M(↓90.7%)。消融:无VLA时RoboTwin 68.8%对42.8%(+26.0pp)。96个独解中52例基线耗尽预算、44例提前失败。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 总体(700实例) | 成功率 | 71.7% | 63.1% | +8.6pp(相对约14%) |
| LIBERO-PRO(40任务×5种子) | 成功率 | 94.0% | 83.0% | +11.0pp;每成功episode token 1.23M→273k(4.5×),成本$2.49→$0.79(3.1×) |
| RoboTwin 2.0(50个双臂任务) | 成功率 | 69.2% | 60.0% | +9.2pp;token 415k→245k(1.7×),成本$1.00→$0.66(1.5×) |
| RoboCasa365 atomic(50任务) | 成功率 | 86.7% | 78.9% | +7.8pp;token 261k→171k(1.5×),成本仅1.2×(收益最小的子集) |
| RoboCasa365 composite | 成功率 | 39.4% | 34.4% | +5.0pp;token 1.22M→603k(2.0×),成本$2.01→$1.25(1.6×) |
| 联合解出实例 | 每成功episode输入token | 276k | 788k | 减少65%(2.9×) |
| 联合解出实例 | 每成功episode LLM调用次数 | 8.7 | 17.0 | 减少49%(2.0×) |
| 联合解出实例 | 每成功episode推理成本(目录价) | $0.74 | $1.63 | 降低2.2×(小于token降幅,因基线历史享受缓存折扣) |
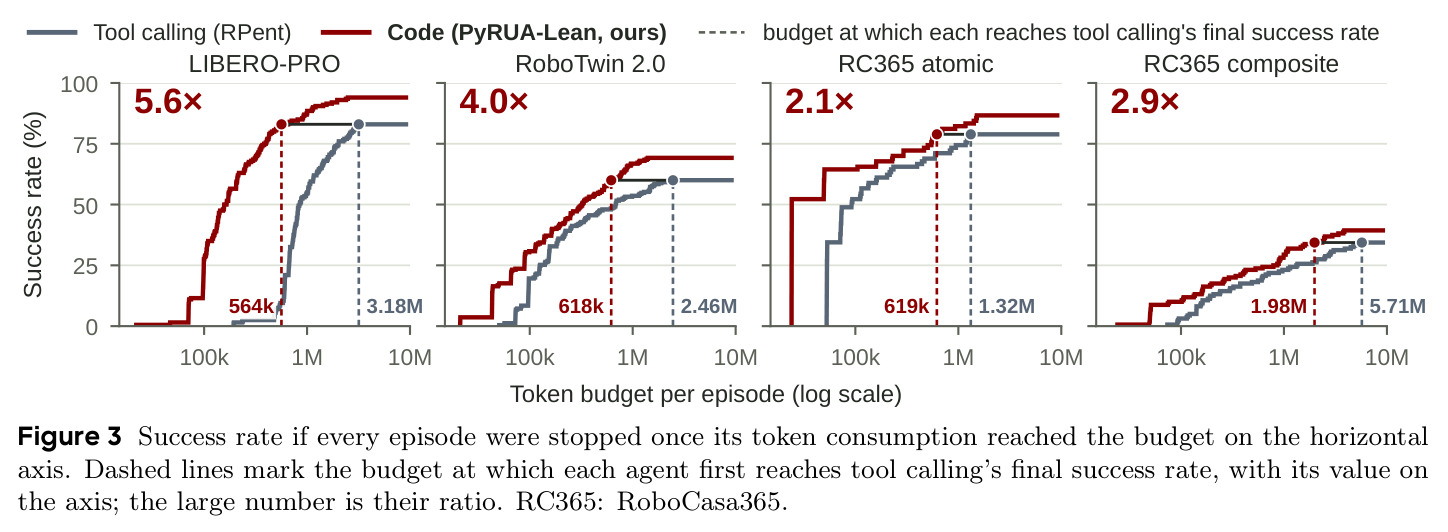
| LIBERO-PRO token预算回溯 | 达到基线最终成功率所需token/episode | 564k | 3.18M | 5.6× |
| RoboDojo试点(3任务,30/29次尝试) | 成功率 | 26.7%(8/30) | 3.4%(1/29) | +23.3pp;每成功总token 11.56M→1.07M(↓90.7%),29对匹配上总token ↓25.3% |
| RoboTwin 2.0(无VLA消融) | 成功率 | 68.8% | 42.8% | +26.0pp;token 1.03M→316k(3.2×) |
| LIBERO-PRO(按需图像的修改基线) | 成功率 | 94.0%(原基线83.0%) | 68.5%(仅按需图像的工具调用) | 证明选择性观测单独不奏效,需与代码组合协同 |
局限与改进
作者明确承认:评测仅限GPT-6 Astra一个planner、RPent一套机器人栈、纯仿真环境,每个任务实例每方只跑一次,未测其他planner、多次运行的方差以及真机表现;接口作为整体被评估,原语组合、持久状态、选择性反馈三个机制未完全隔离,token分解只是会计分析。我的补充观察:其一,效率比较基于联合解出子集,存在幸存者偏差——若计入全部episode,RC365 atomic上工具调用的估计成本仅为PyRUA-Lean的约1.1倍,优势明显缩水;其二,成本降幅(2.2×)小于token降幅(2.9×),因为基线反复处理的历史享受缓存折扣,不同计费方式下结论可能变化;其三,PyRUA-Lean的API描述更长,在VLA主导、初始prompt占大头的RC365 atomic上收益最小(token仅1.5×、成本1.2×),且成功后仍计入的调用也抬高开销;其四,任意Python执行依赖底层模型的编程与几何能力(如SVD拟合平面、numpy分位数),对较弱模型是否成立未知;其五,调试负担部分转移到VLM(读traceback修代码),复杂程序的失败模式缺乏系统分析。
独立分析的弱点
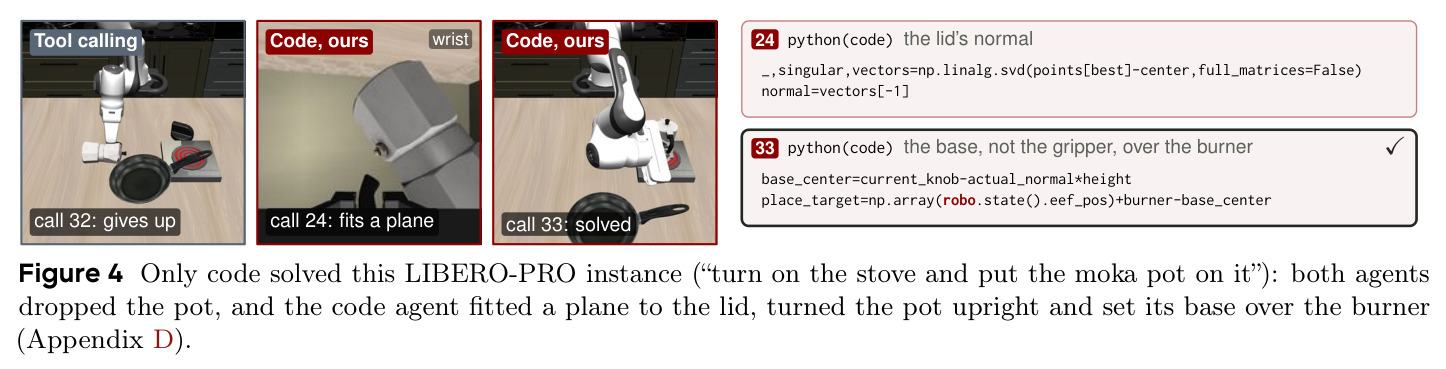
独立分析四点弱点。第一,因果归因不完整:接口级对比无法说明持久状态、原语组合、选择性观测各自的贡献,改进方向是在PyRUA-Lean内部做组件级开关消融,或构造'有代码但自动回传图像''工具调用但可定义辅助函数'等中间接口,把增益精确分配到机制上。第二,统计功效不足:每个任务-种子对每方仅1个episode,+8.6pp的总体差异没有置信区间或显著性检验,RC365 composite仅+5.0pp(约落在几次成功/失败的量级),改进方向是每对多次运行并报告bootstrap置信区间。第三,安全与鲁棒性:agent直接生成任意Python操控机器人存在执行危险动作、死循环(仅靠2小时看门狗兜底)、Codex CLI 300秒超时后单元仍在后台继续执行等风险,改进方向是引入沙箱、动作幅值/频率白名单与静态检查。第四,对底层模型能力的依赖:Figure 4式的几何推理需要模型熟练使用 numpy/SVD,如果换成较弱的planner,代码接口可能既丢成功率又添调试开销,值得做跨模型规模的接口×模型析因实验。
未来方向
作者提出的方向包括:在物理机器人上测量执行延迟与恢复行为;研究原语粒度(粗粒度技能 vs 细粒度运动)对成功率、推理成本与适应性的影响;探索已验证例程的跨episode复用。基于本文成果还可自然延伸:其一,把成功单元自动沉淀为可复用技能库,与Voyager/ASPIRE的积累路线对接,检验token优势是否随技能库增长产生复利;其二,把选择性观测形式化为主动感知问题,学习'何时值得请求一张图像'的策略,替代手工的if not robo.done规则;其三,将'更少调用'与上下文压缩、KV-cache策略联合优化,因为当前token节省发生在进入上下文之前;其四,引入成本感知规划,让agent在预算紧张时主动切换更省的执行策略;其五,评估接口收益随模型能力的变化曲线——弱模型是否更需要代码接口、还是更难驾驭代码,对接口设计的普适性结论至关重要。
复现评估
复现条件较好。代码与项目页公开(github.com/DAGroup-PKU/PyRUA-Lean),框架构建在RPent的开源机器人栈与原语实现之上;三个仿真基准LIBERO-PRO、RoboTwin 2.0、RoboCasa365均公开可用。主要门槛:(1)需要GPT-6 Astra高推理档API与SAM 3分割模型;(2)需要三个冻结VLA checkpoint(π0.5、LingBot-VLA、RLDX-1);(3)主要成本是推理预算——1400个episode、每episode约$0.5–2.5,全量复现约需数千美元API费用,另需每episode最长2小时的仿真墙钟时间;(4)论文给出272K压缩阈值、40/100次调用预算、300秒工具超时、2小时看门狗等关键实现细节,附录含成本核算口径与完整episode轨迹,便于对齐。总体难度中等:工程链路较长(三套仿真环境+VLA部署),但无需任何训练,一个科研团队数周内应能复现主表。
论文图表