迈向智能体化具身智能:A2-MEAS 多智能体框架与 A2-WLA 动作模型 Toward the Era of Agentic Embodied Intelligence
以纠正代码为接口连接推理与控制,BEHAVIOR 2026 百任务 Q 分 0.6411
前置知识
VLA(视觉-语言-动作)模型
将视觉观测与语言指令映射到机器人连续控制指令的多模态策略网络,通常由预训练视觉语言骨干(本文用 2B 参数的 Qwen3-VL)加一个动作专家(本文约 300M 参数、18 层 transformer)组成,代表工作如 π0、π0.5。策略一般按动作分块方式一次预测多步控制,再滚动执行。
A2-WLA 本身就是一个 VLA,论文的动作生成、纠正接口注入位置、所有消融实验都建立在 VLA 架构之上,不理解 VLA 无法理解纠正残差作用在哪里。
条件流匹配(Conditional Flow Matching)
一种生成式建模范式:学习时间相关速度场 $v_\theta$,把高斯噪声沿概率路径积分到数据分布。本文用线性插值 $A_\tau=(1-\tau)A+\tau\epsilon$、目标速度 $\epsilon-A$,推理从 $\tau=1$ 积分到 $\tau=0$ 共 10 步。相比扩散模型路径更直、采样步数少,适合连续动作生成。
A2-WLA 的动作专家用流匹配生成 50 步动作块,纠正 adapter 的残差在每个流积分步被重新计算,不理解流匹配就无法理解修正发生的时间粒度。
动作分块与滚动执行(Action Chunking / Receding Horizon)
策略每次调用预测一段未来控制序列(本文 $H=50$ 步、$d_a=23$ 维全身控制),但只执行前缀(至多 $H_{exec}=32$ 步,30Hz 下约 1.07 秒),随后获取新观测重新预测。这在轨迹平滑性与闭环纠错之间取得折中,未执行的后缀被丢弃。
论文的执行记录、异常检测、恢复状态全部定义在“前缀执行后重新观测”的节拍上,恢复预算(3 次重试、60 秒)也以此为计时单位。
潜世界模型(Latent World Model / WAM)
不预测原始像素而是在特征空间预测未来观测的模型。本文用冻结视觉编码器加逆动力学编码器从多视角当前/未来特征推断共享潜变量 $z^*=E_{inv}(F,F^+)$,再由各视角解码器 $\hat{F}^+_v=D_v(F,z^*)$ 重建未来特征;部署时未来帧不可得,由 backbone 的 learned queries 从当前观测与指令预测 $\hat{z}$。
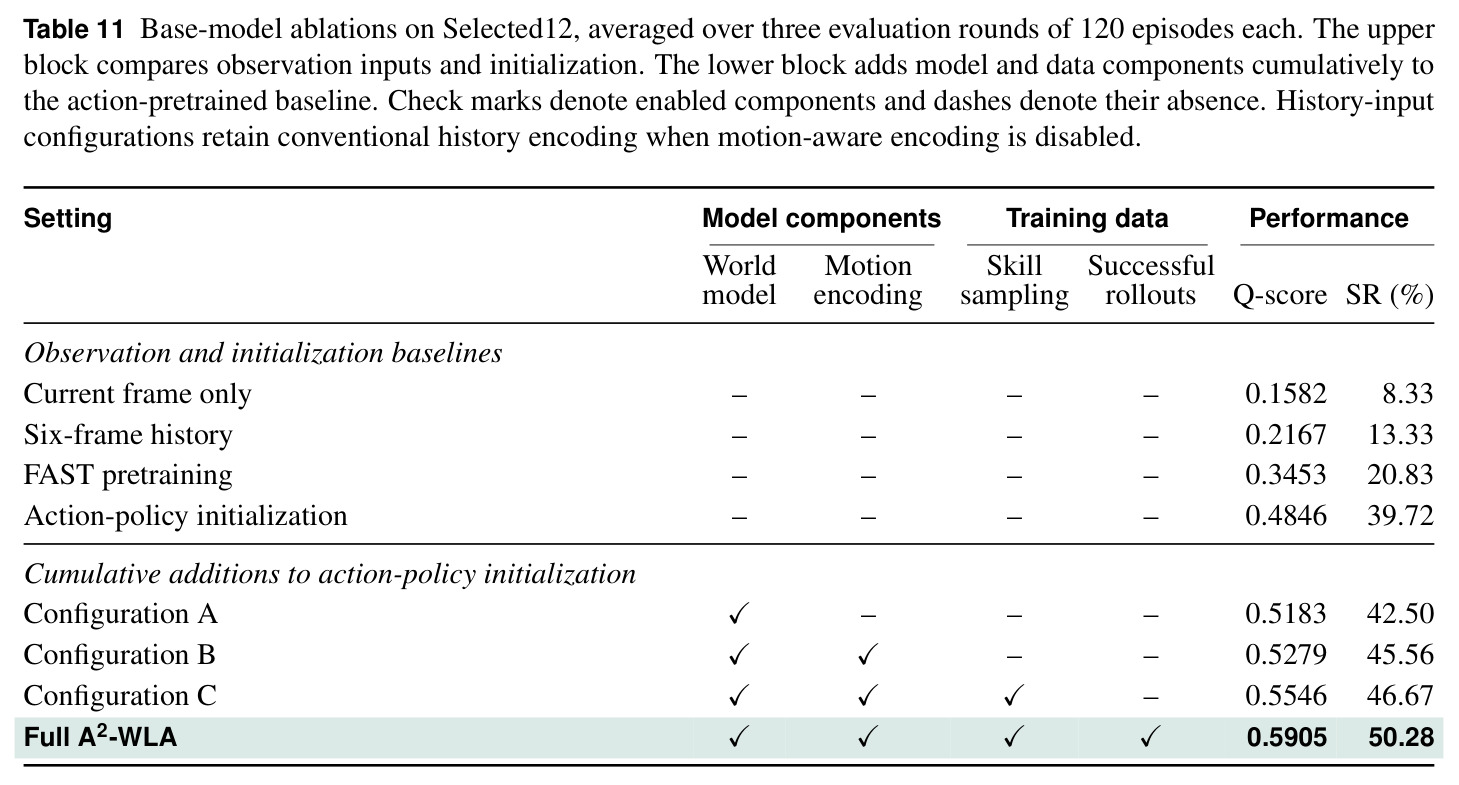
潜世界模型是 A2-WLA 三大组件之一,消融显示它带来 +0.0337 Q 分(0.4846→0.5183),是“简单架构也能强”论点的关键证据。
BEHAVIOR 2026 基准与 Q-score
基于家庭仿真的长时程全身控制基准:100 个家务任务、7 个场景、官方 20,000 条遥操作演示(约 1,950 小时,平均每条 5.86 分钟、31 种技能原语)。Q-score 衡量目标条件满足比例(部分得分),完全成功率 SR 要求整个任务完成,覆盖度统计至少一次完全成功的任务数。
论文主结果全部在该基准报告,且 Q-score 与 SR 的差距正是其“部分完成 vs 可靠完成”分析的核心,读实验必须先懂这两个指标的区别。
零初始化残差适配器(Zero-init Residual Adapter)
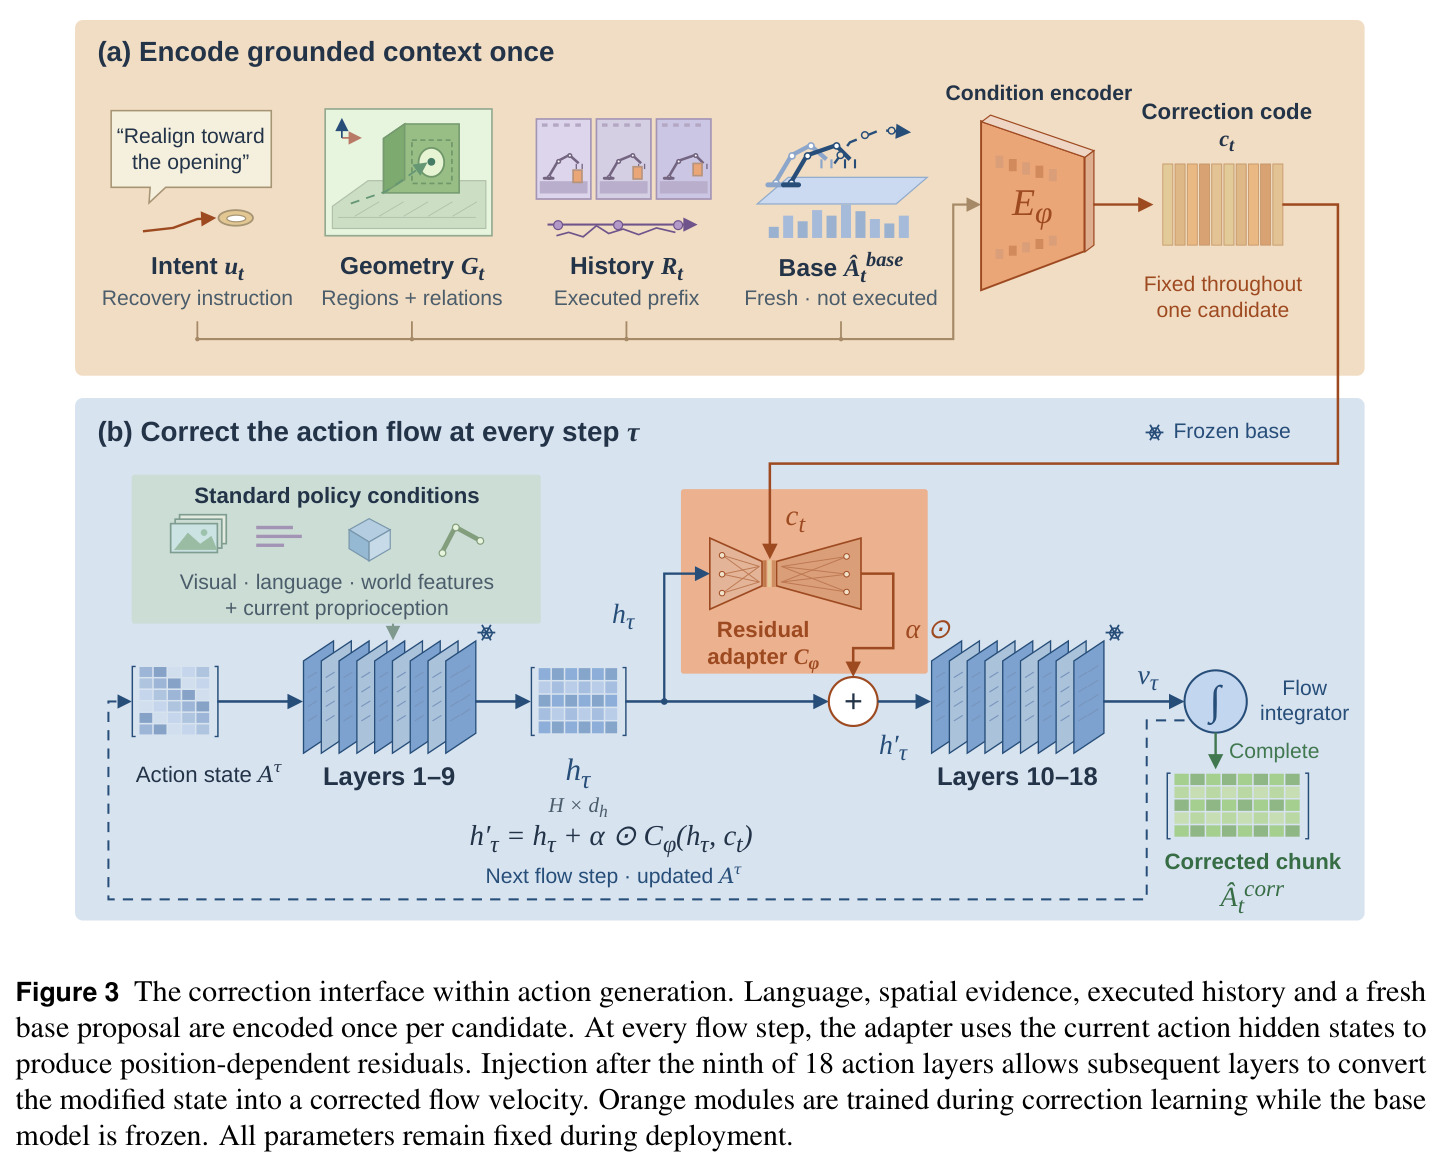
在冻结网络内部注入可训练小模块的技术:输出投影初始化为零、门控尺度 $\alpha$ 取小值(本文 0.1),使初始残差为零、不改变原网络输出;训练中学习 $\alpha\odot C_\phi(h_\tau,c_t)$ 形式的通道级残差。思想类似 LoRA/ControlNet,但作用于动作隐状态而非权重矩阵。
论文的纠正接口正是这种 adapter(瓶颈宽度 256、可训练参数不足 100M),它保证了部署时权重全冻结、纠正只通过代码注入这一核心卖点。
研究动机
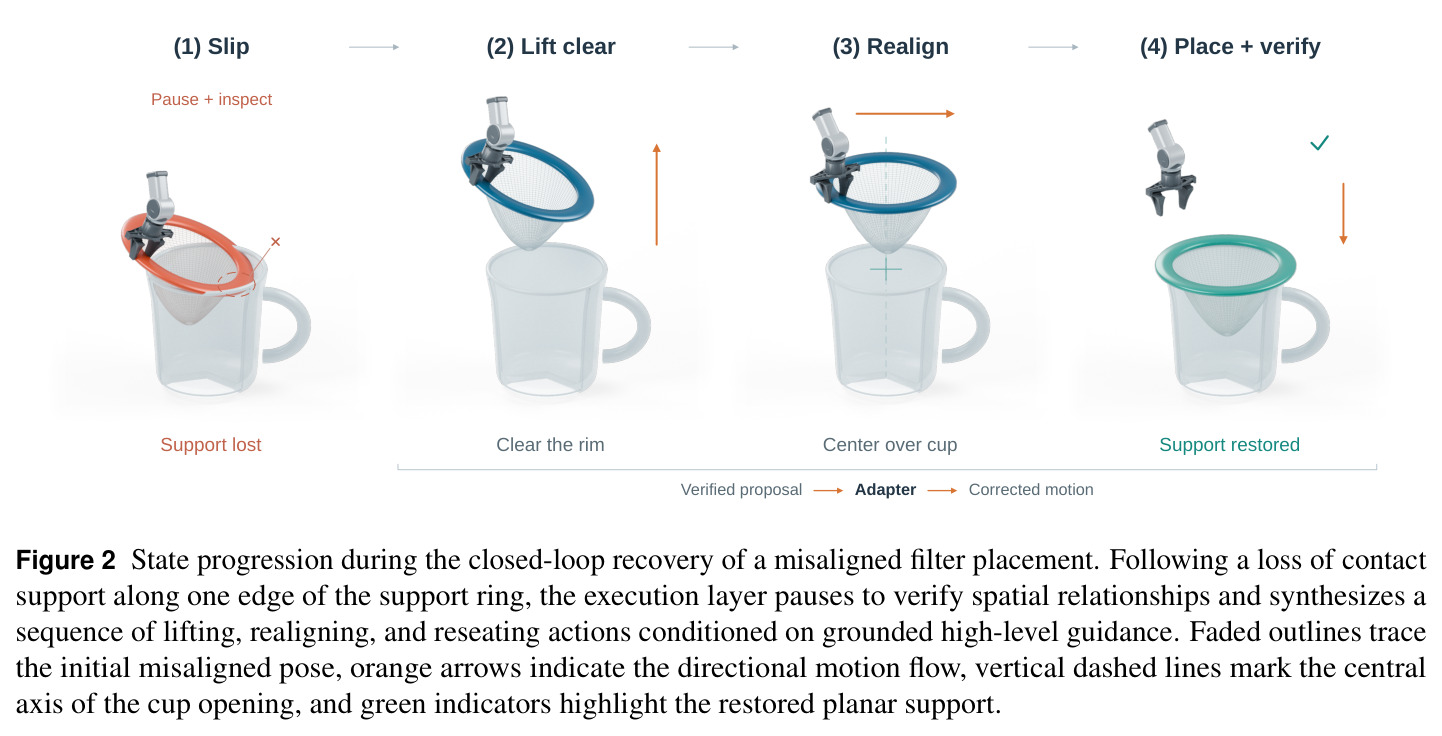
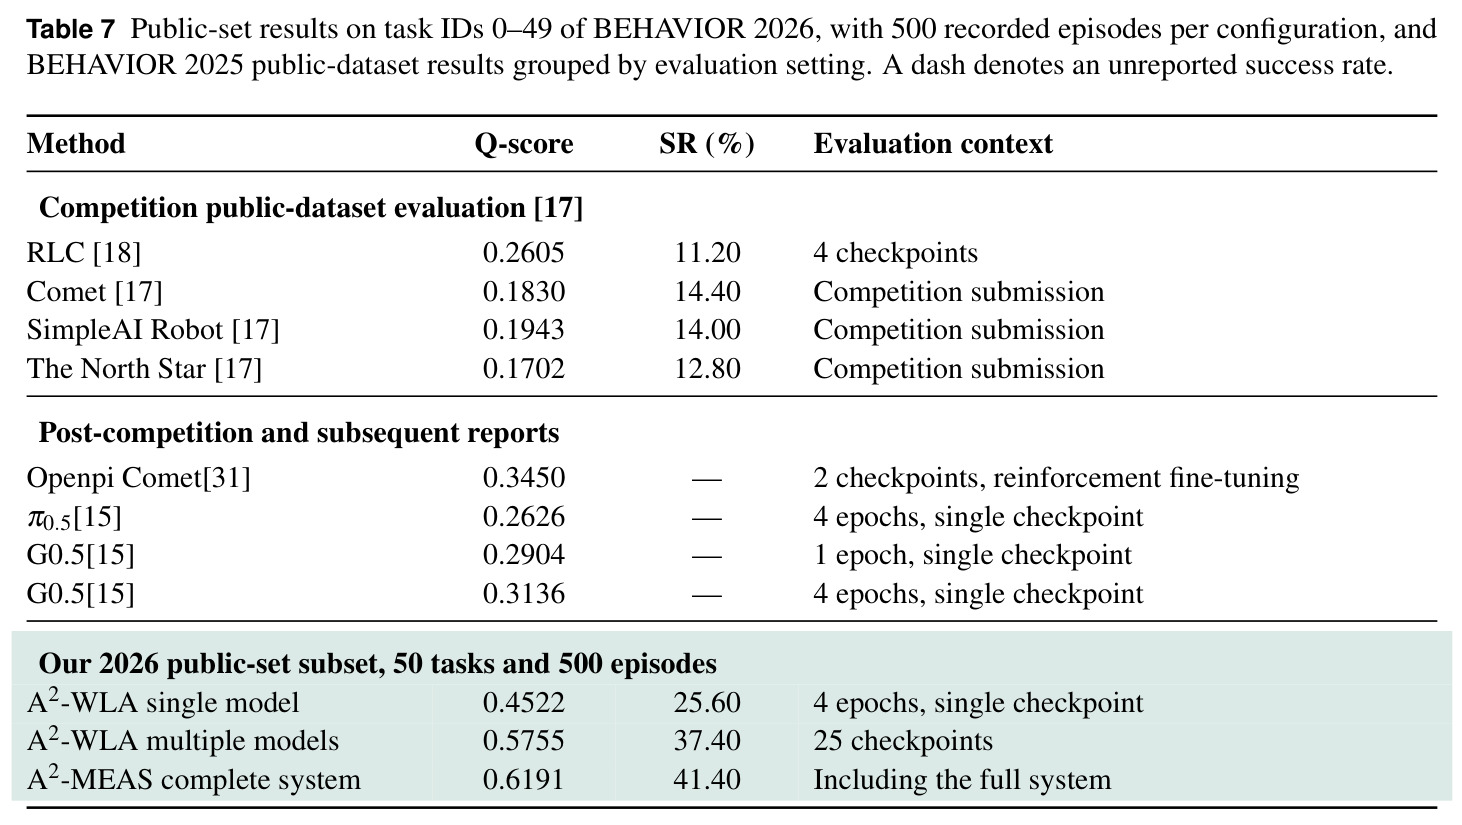
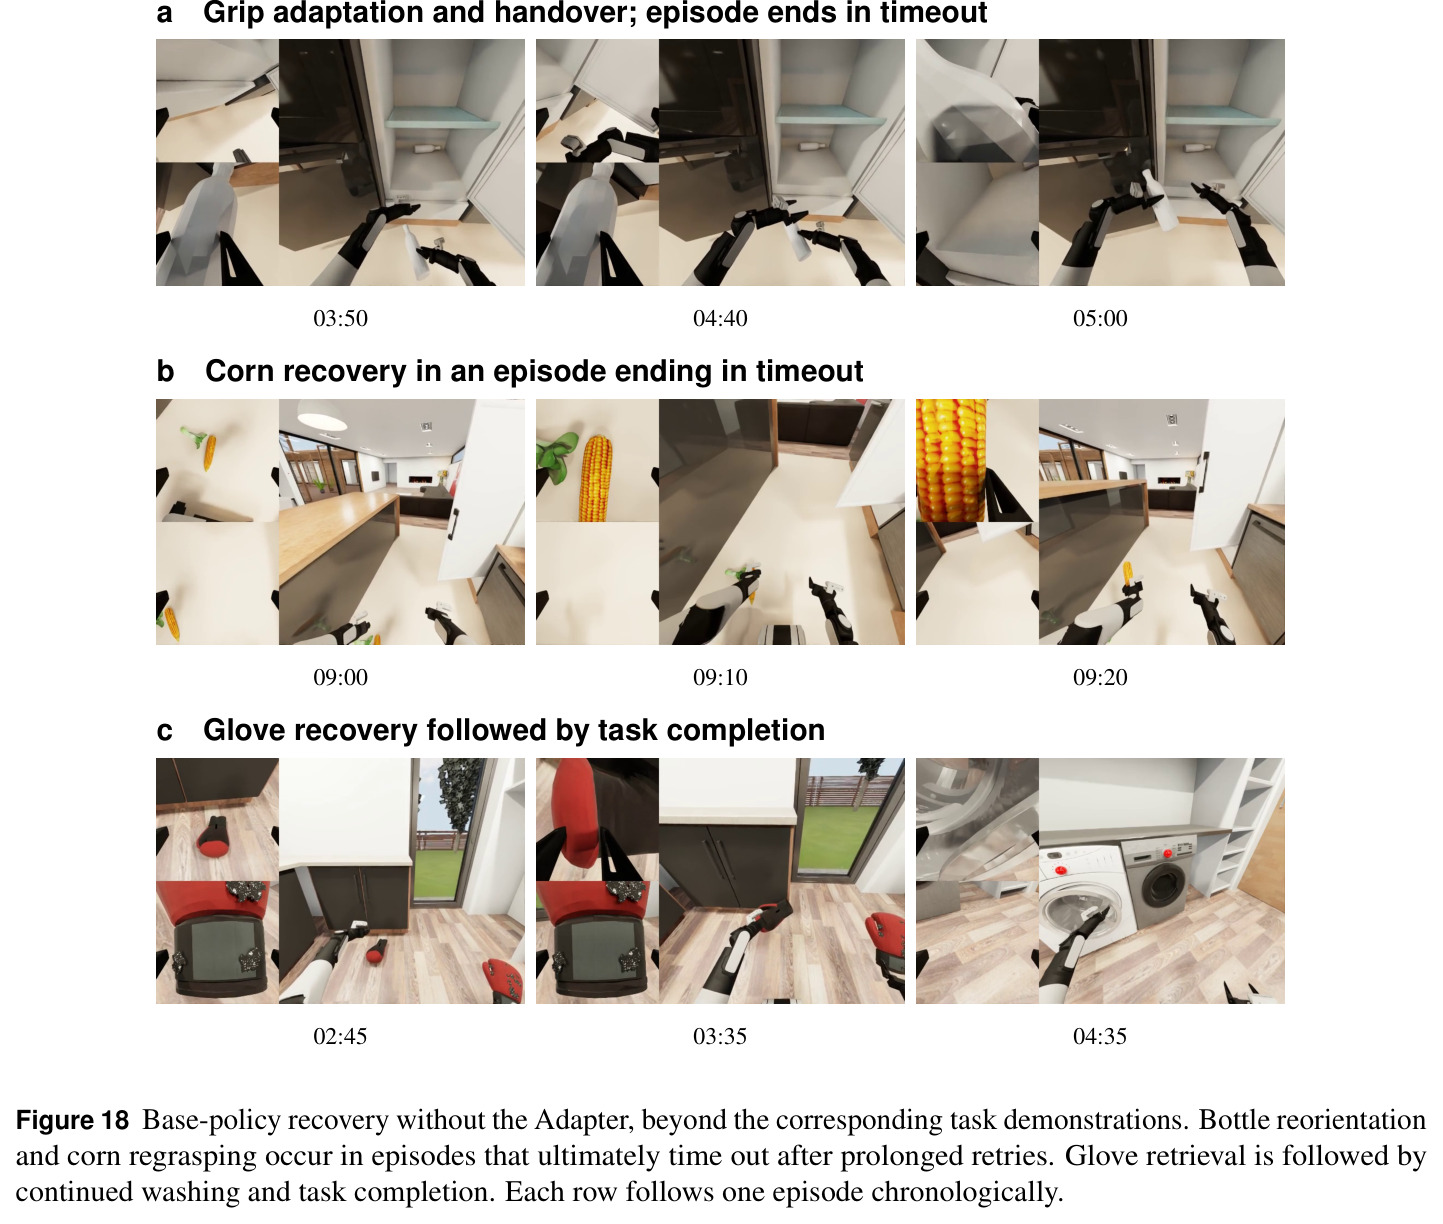
现有通用基础模型已能为机器人生成动作——在 42 任务的 RoboDojo 评测中 GPT-6 Astra 排名超过参与对比的 40 个公开策略,但精度与动态控制仍是公认短板;专用动作模型控制高效,却难以应对训练分布之外的失败。真正的痛点在失败恢复:抓取失败后“决定重试”并不决定“下一次尝试应如何不同”,控制器必须依据失败交互的证据调整接近方向、对齐目标或夹爪时序。长时程任务放大了这一问题:一次恢复后的抓取姿态可能使后续放置无法进行,局部成功不等于任务完成。基准成绩也说明差距巨大——BEHAVIOR 2025 竞赛冠军 RLC 公开分仅 0.2605 Q、11.2% 成功率,π0.5 只有 0.2626。更普遍的是“部分完成 vs 可靠完成”的鸿沟:即使 Q 分很高(满足了多数子目标),整任务成功率仍可能极低,失败重试往往只是重复同样动作直到超时。
本文的目标是本文的目标是构建一个能同时兑现基础模型两种价值的具身系统:一是把基础模型中的纠正性知识“吸收”进可训练的动作策略权重,获得高效的连续控制(紧凑策略优于每次调用大模型);二是部署时遇到新失败时能“调用”基础模型的推理,把诊断结论转化为对下一条动作轨迹的具体修改,同时保持任务目标不被破坏。量化目标是在 BEHAVIOR 2026 的 100 个长时程家务任务上同时提升 Q-score 与完全成功率,在双臂操作(RoboTwin 2.0)与真机桌面任务上验证动作模型本身的竞争力,并让整套 1000 回合评测能压缩到一天之内以支撑日常研发迭代。为此需要动作模型 A2-WLA、任务级推理协调器 MetaBrain、提供感知/时空/交互证据的诊断 agents 三部分,以及把它们连接到连续控制的统一接口协同工作。
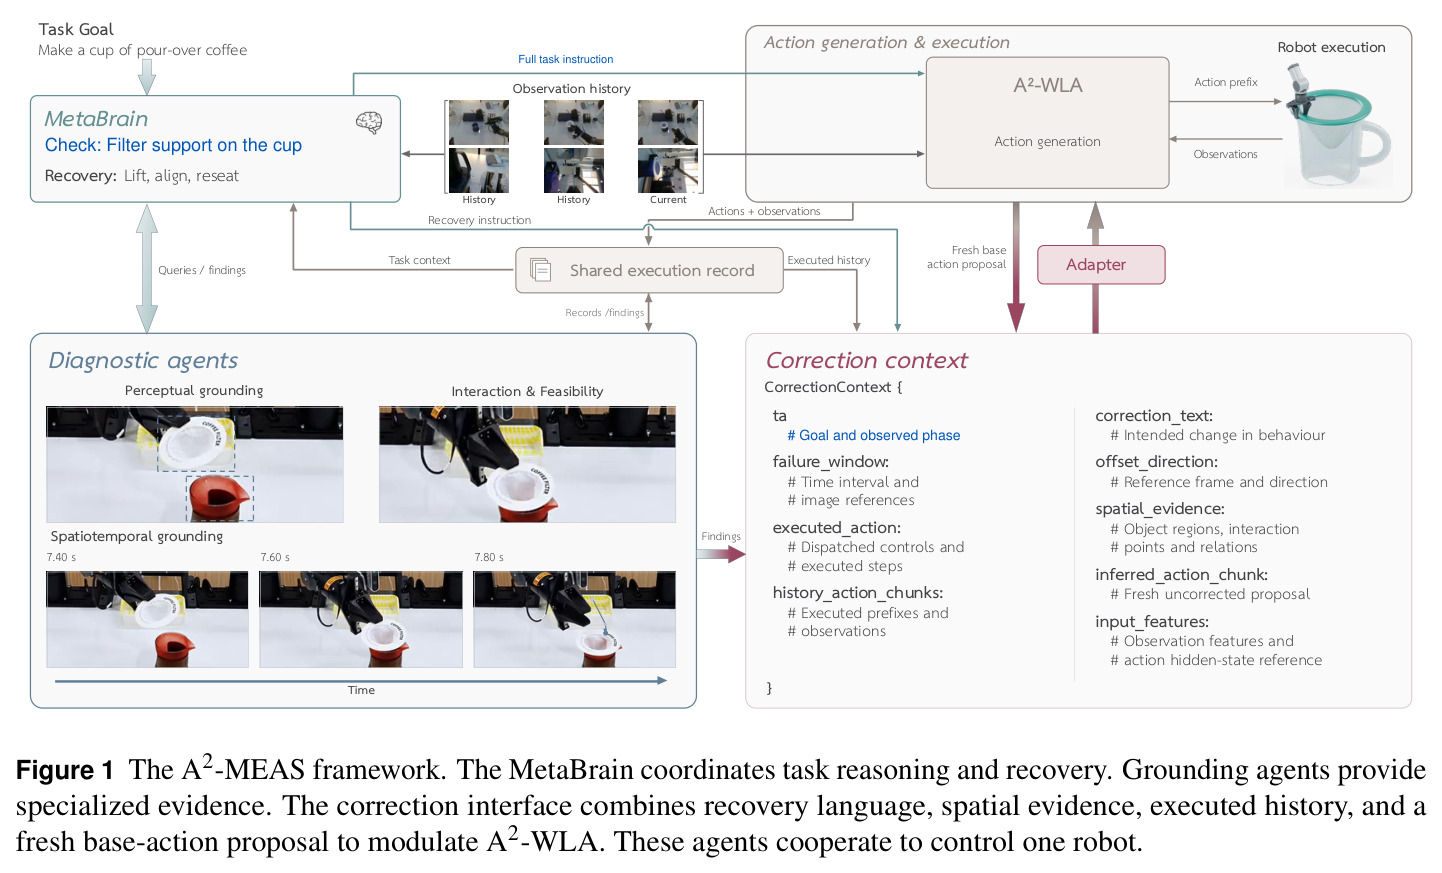
与已有工作不同的是,本文的独特切入是“代码即扩展接口”(code as a scaling interface)。已有路线要么做语言引导的技能选择与重规划、要么在失败后用逆运动学做几何修正,但一句“对准开口”本身无法回答是哪个开口、它在当前图像哪个位置、上一次尝试做了什么。本文把纠正上下文形式化为一个学习到的条件表示——纠正代码 $c_t=E_\phi(u_t,G_t,R_t,\hat{A}^{base}_t)$,同时编码恢复指令、接地的空间证据、已执行历史与基座策略的未执行动作提案,再经残差 adapter 在动作专家的隐状态空间注入修正。训练阶段由 MetaBrain 生成的指令与专家续作教 encoder 和 adapter 学会“纠正性推理如何改变动作”,把纠正知识吸收进可训练参数;部署时权重全部冻结,只有代码随新鲜证据变化。这统一了“从基础模型学习”与“运行时使用基础模型推理”两条路线,并让异构智能体无需共享架构即可影响连续控制。
核心方法
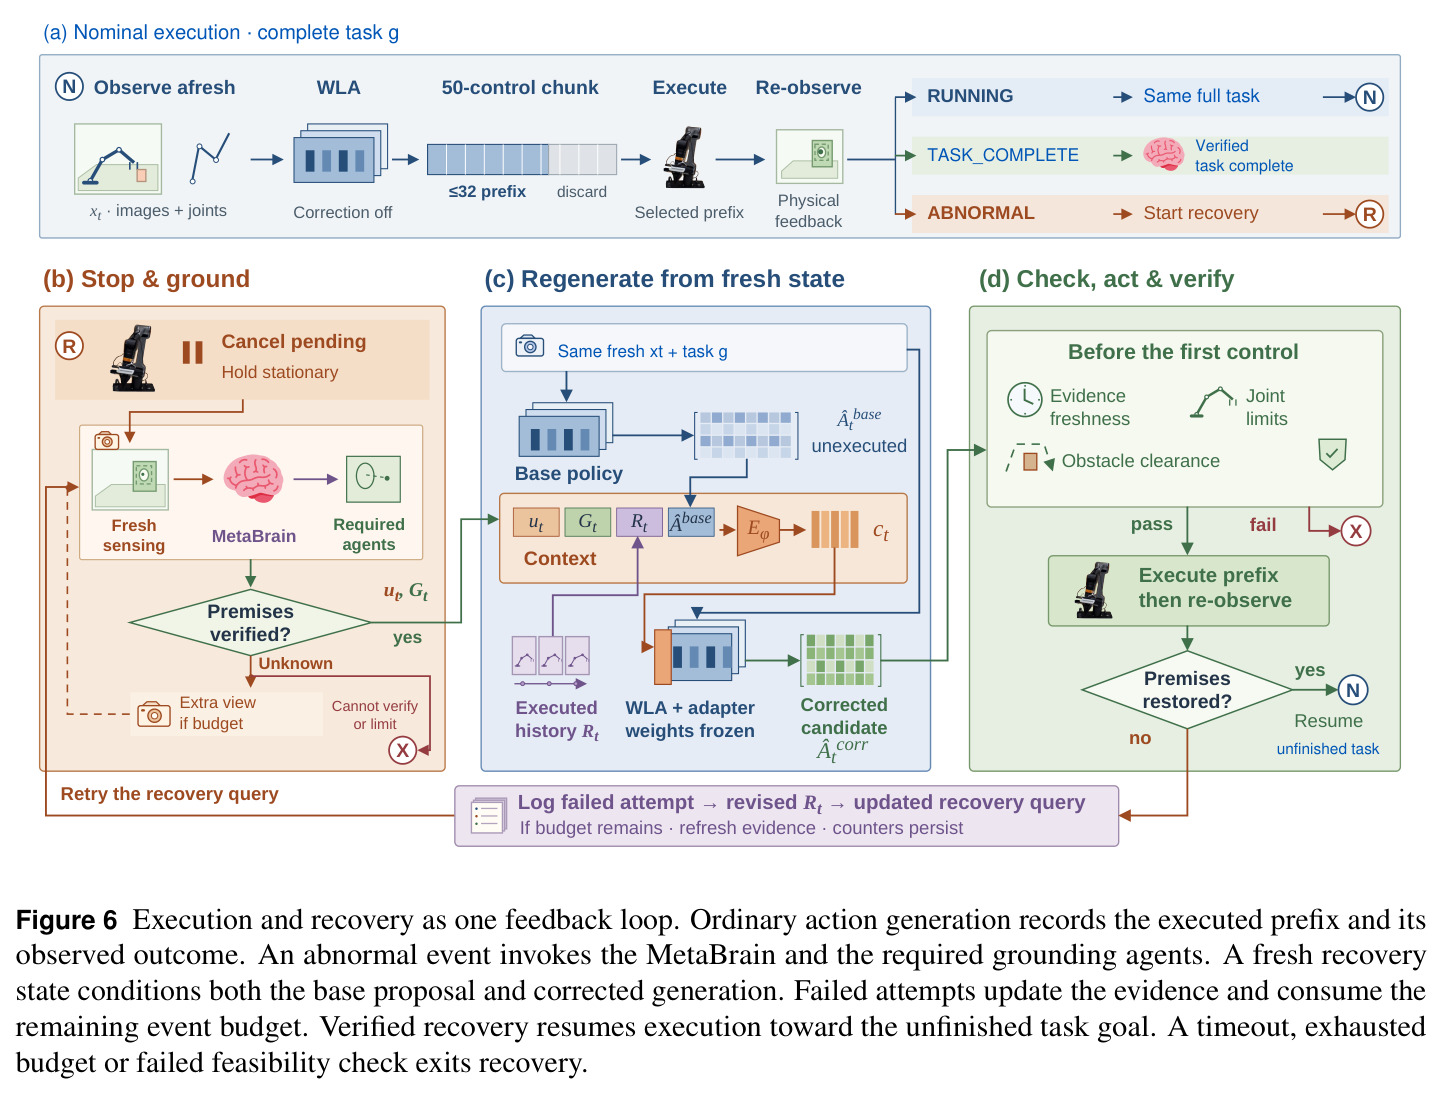
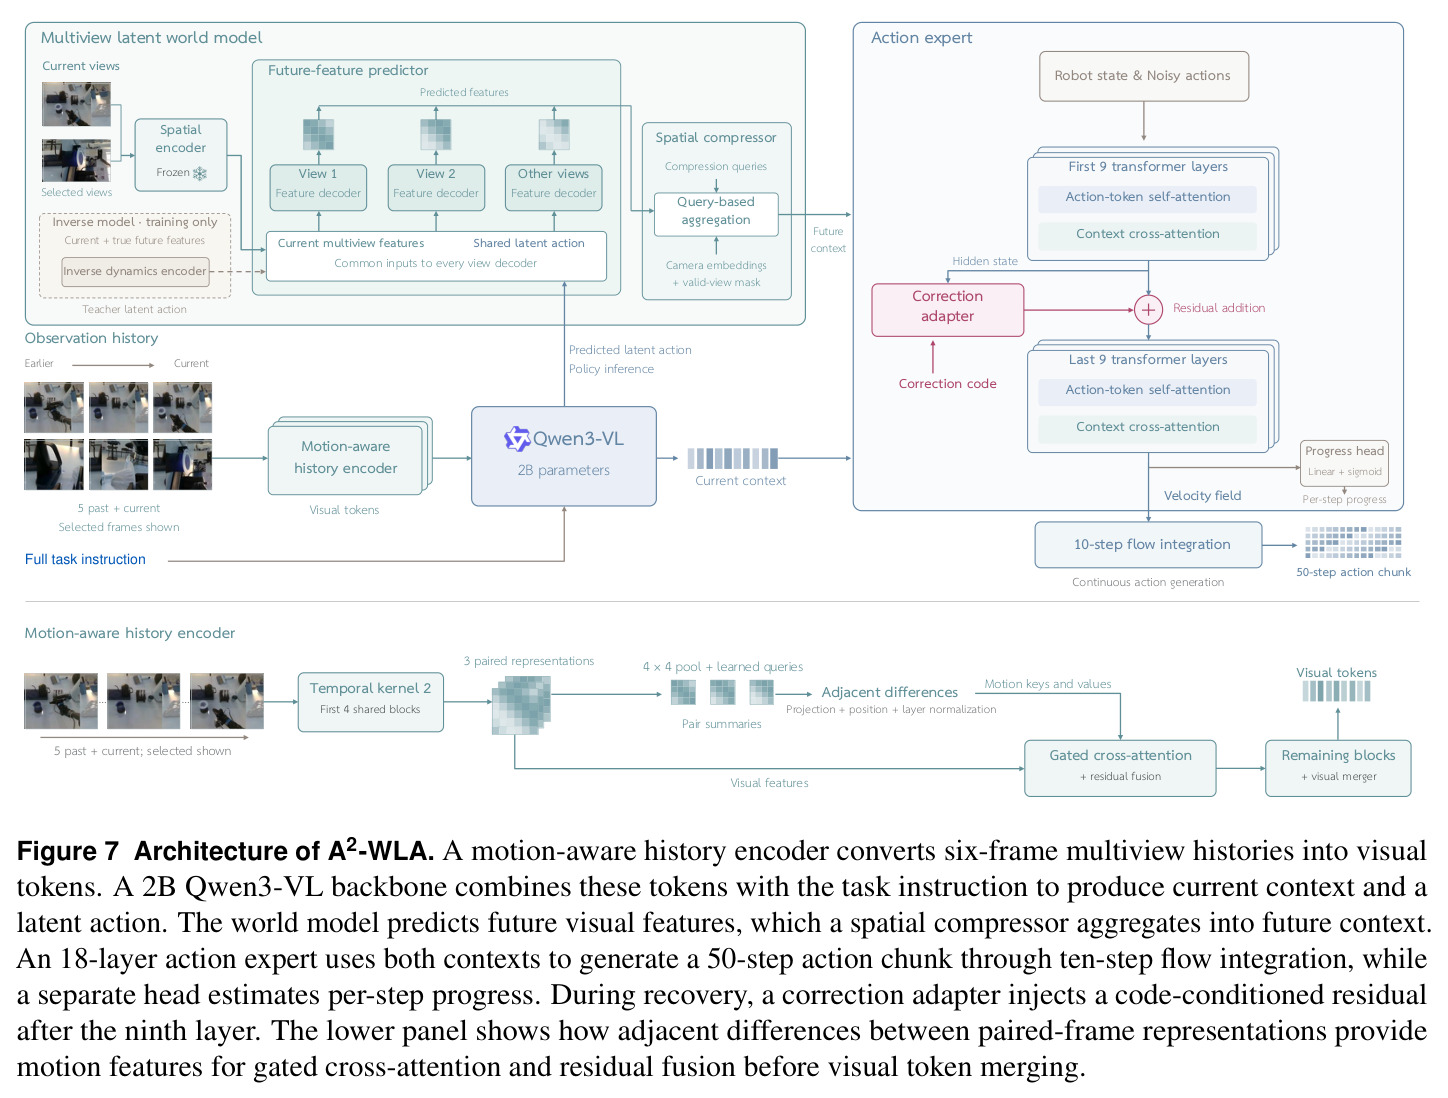
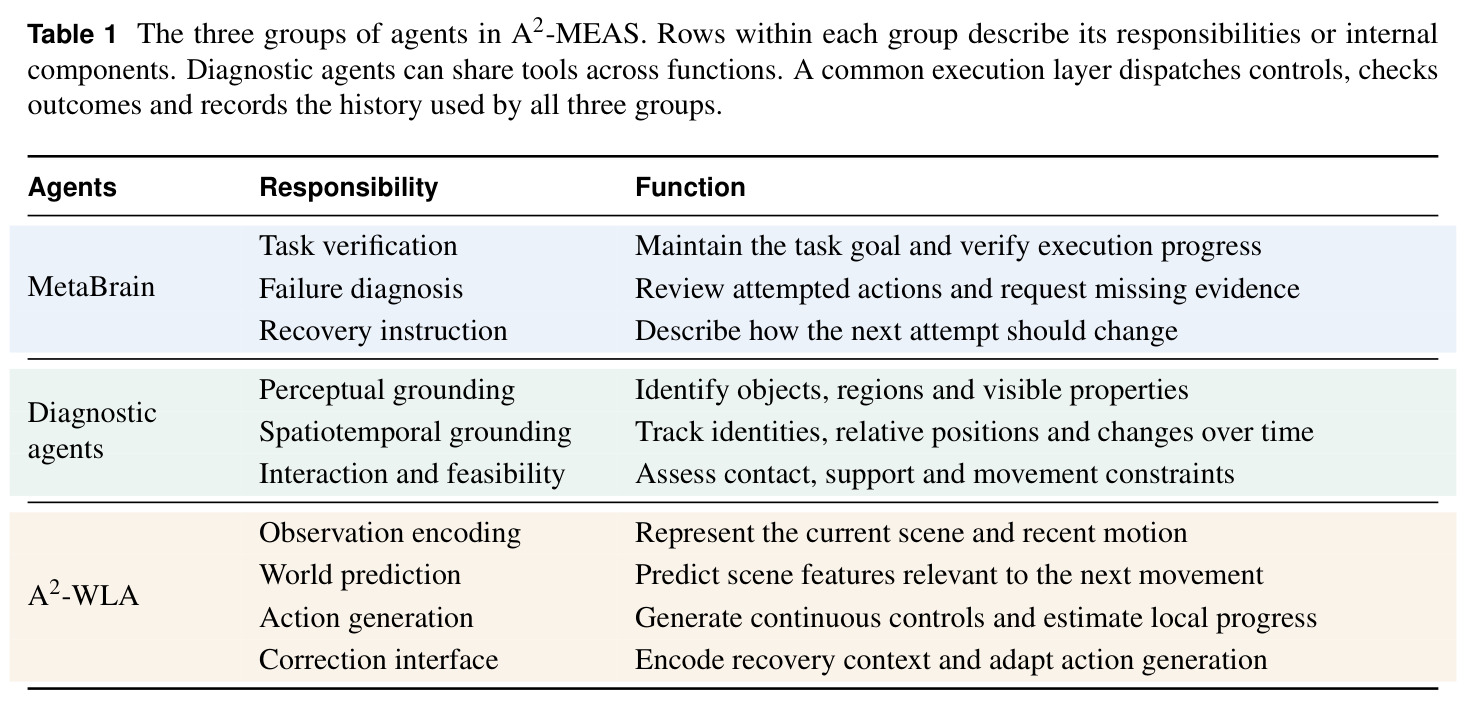
直觉上,A2-MEAS 让“会推理的”与“会动手的”分工协作。A2-WLA 由 2B 参数 Qwen3-VL 骨干、运动感知历史编码器、多视角潜世界模型和约 300M 参数的 18 层 Gemma 风格动作专家组成,以 30Hz 生成 50 步动作块并只执行前 32 步;Qwen3.8-27B 的 MetaBrain 维护完整任务目标、对照共享执行记录审查异常 outcomes;诊断 agents 用 DINO 特征、SAM 分割、跟踪、深度与机器人状态回答状态属性、空间关系、交互接触、时序变化、实例身份、可行性六类问题,并区分“否定”与“证据不足”。三者通过共享执行记录 $R_t$(目标、已派发控制、前后观测、时间戳、坐标系)协调:局部环反复观测-动作,任务级环在检测到 ABNORMAL 时暂停待发控制、冻结恢复状态、审查从最后正常态到异常之间的失败窗口、验证恢复前提后生成指令。技术上,纠正以代码为媒介:每个候选编码一次 $c_t$,adapter 在每个流积分步重算位置依赖残差 $h'_\tau=h_\tau+\alpha\odot C_\phi(h_\tau,c_t)$ 并注入第 9 层之后,由后 9 层把修改后的表示转成修正后的流速度。训练分四阶段:世界模型预训练→视觉语言预训练→联合策略优化→冻结基座的纠正学习。
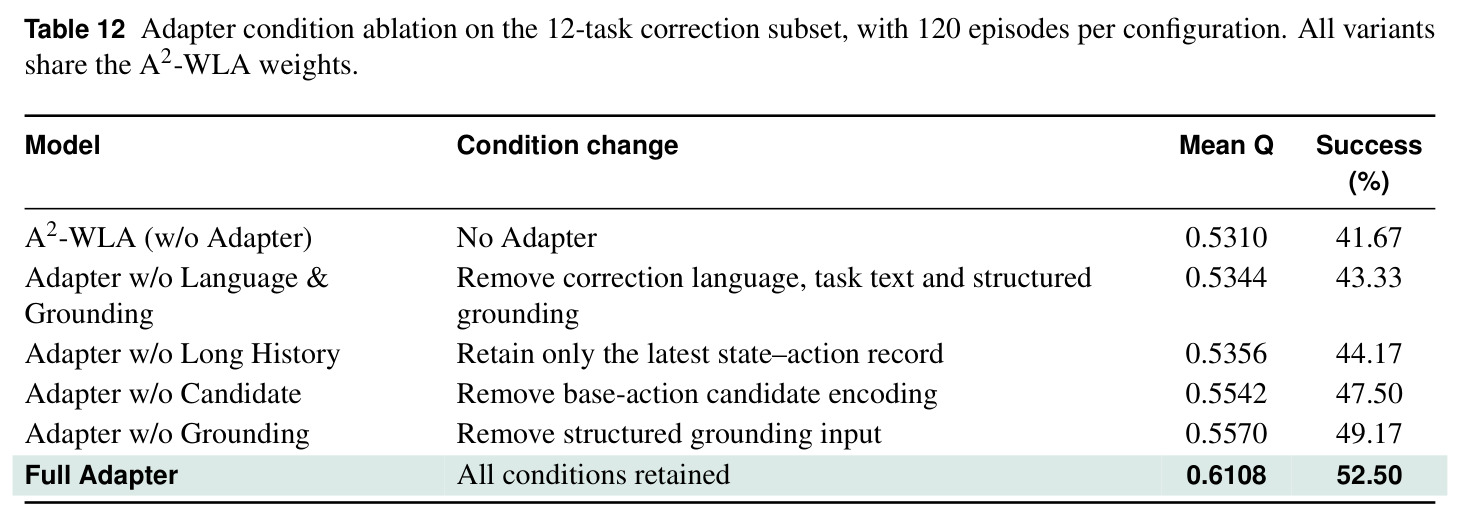
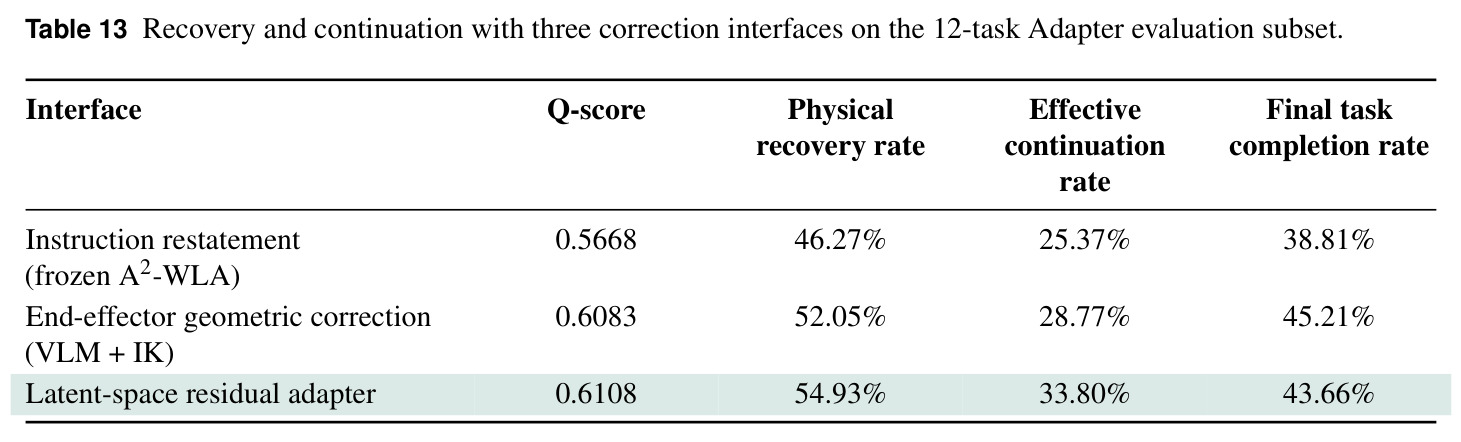
核心创新是把“纠正”从一句话升级为可学习的多模态表示与注入机制,与已有方法的本质区别有三。其一,接口输入远不止语言:$c_t$ 同时携带结构化空间证据(相机/坐标系/物体区域/交互点)、失败窗口内实际派发的控制历史、以及基座提案 $\hat{A}^{base}_t$,使同一句“对准开口”在不同证据下产生不同修正——消融显示去掉语言+接地掉到 0.5344、只留单条历史掉到 0.5356、完整条件达 0.6108。其二,注入位置与粒度:残差作用于隐特征空间而非关节空间,代码对整个候选固定但残差在每个流积分步、每个动作位置重新计算,因此一个动作块内可以先抬起再重新接近,实现位置依赖的修正;这与 VLM+IK 的端执行器几何修正形成对照(Q 分 0.6108 vs 0.6083,物理恢复率 54.93% vs 52.05%)。其三,学习与使用的耦合:训练时 MetaBrain 生成指令、专家续作提供目标,把纠正知识吸收进不足 100M 的 $\phi$ 参数而基座 $\theta$ 冻结;部署时所有参数固定,新代码即可改变行为。此外,运行时在派发前检查证据新鲜度、关节限位与障碍间隙,验证环节明确区分“条件不成立”与“条件未知”,后者在感知预算内补充观测而非贸然执行。
方法步骤详情
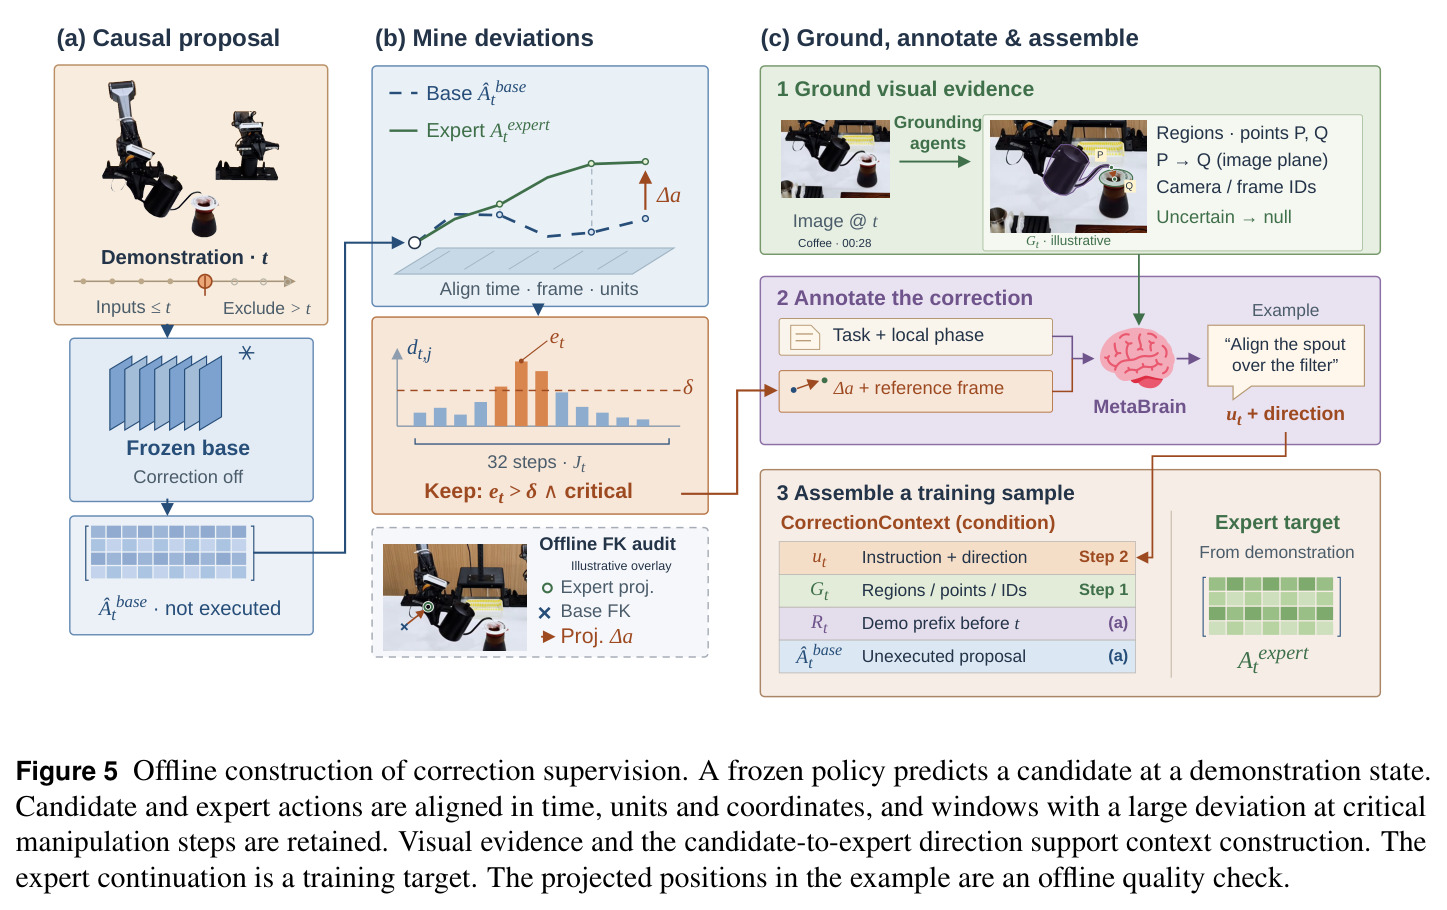
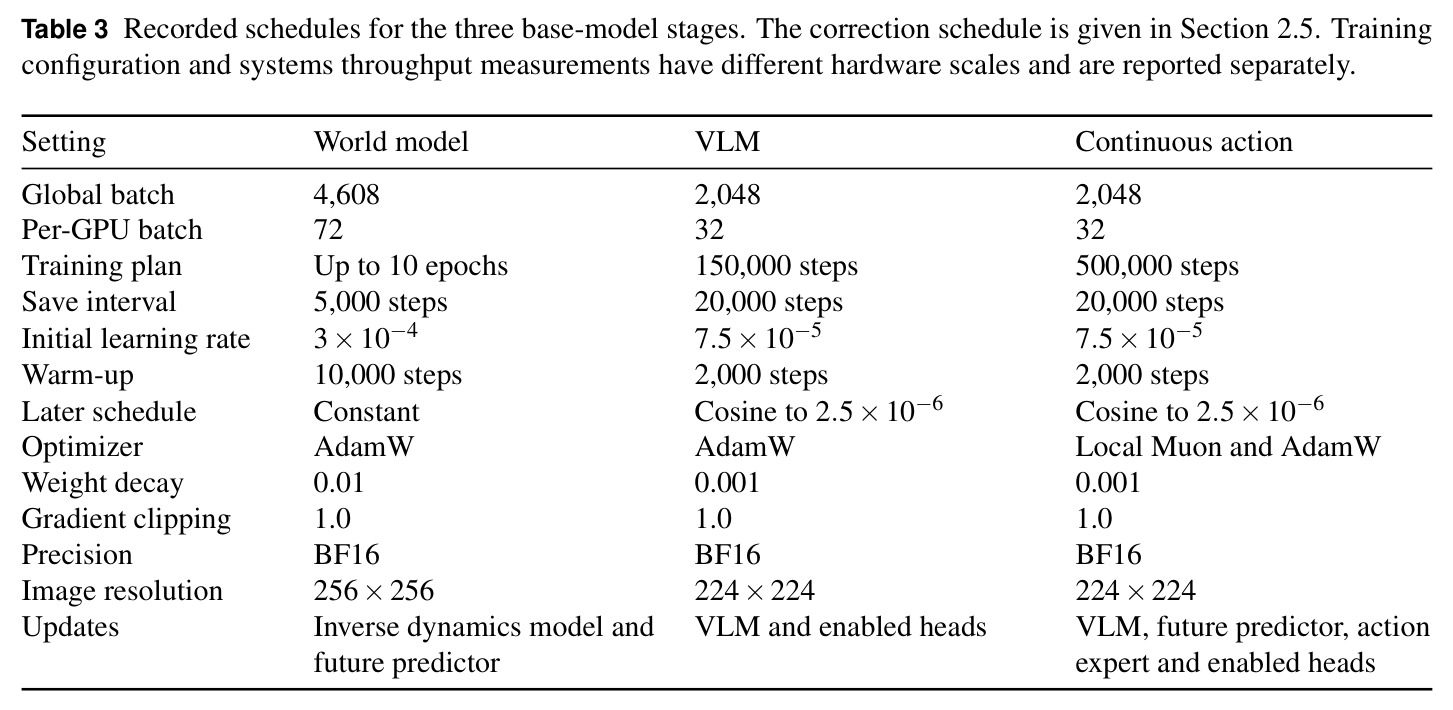
第一步(世界模型预训练):冻结视觉编码器,逆动力学编码器从多视角当前/未来特征推断共享潜变量 $z^*=E_{inv}(F,F^+)$,各视角解码器 $\hat{F}^+_v=D_v(F,z^*)$ 以 SmoothL1 重建未来特征并加潜变量正则,全局 batch 4608、学习率 3e-4、至多 10 epochs;之后冻结逆编码器作为潜在动作教师。第二步(VLM 预训练,150k 步):损失 $\mathcal{L}_{pre}=\mathcal{L}_{FAST}+\lambda_{AQ}\mathcal{L}_{AQ}+\lambda_{LA}\mathcal{L}_{LA}+\lambda_{VQA}\mathcal{L}_{VQA}$,包括 FAST 离散动作 token(2048 词表、256 token 预算)、潜在动作蒸馏 $\|\hat{z}-sg(z^*)\|_2^2$、N 条连续动作候选加误差打分头、具身问答与局部目标语言。第三步(联合策略优化,500k 步,Local Muon+AdamW):主损失为条件流匹配 $\mathcal{L}_{FM}=\mathbb{E}\,\mathrm{MSE}(v_\theta(A_\tau,\tau\mid s,C,C^+),\epsilon-A)$,辅以未来特征一致性、动作块表示对齐、端执行器位姿几何(位置权重 5e-6、旋转 1e-3)、任务身份分类与逐技能进度 $\hat{p}_{t,j}=\mathrm{clip}((t+j-t_0+1)/(t_1-t_0),0,1)$,并在当前上下文通路上做知识绝缘($\gamma=0.1$);难例自适应流采样每条演示 2–8 个噪声-时间对。第四步(纠正学习):离线在演示状态上用冻结策略生成未执行候选,按 32 步窗口内关键步骤的归一化偏差 $\Delta a_{t,j}=a_{t,j}-\hat{a}^{base}_{t,j}$、$e_t=\max_{j\in J_t}d(\cdot,\cdot)>\delta$ 挖掘(上限为 1,950 小时语料的 2%,约 39 小时),用开放词汇定位+SAM 掩码+MetaBrain 注释构造 CorrectionContext;8 GPU、batch 256、6000 步只训练 $E_\phi$ 与 adapter(零初始化、$\alpha=0.1$、瓶颈 256、学习率 1e-4 余弦至 1e-5)。部署闭环:异常→暂停→失败窗口诊断→前提验证→生成指令与方向→基座提案→编码 $c_t$→逐流步残差修正→新鲜度/限位/障碍检查→执行前缀→验证恢复条件→继续未完成任务;每次异常预算为 2 个额外视角(各 5 秒)、3 次物理重试、60 秒上限,超限即中止恢复。
技术新颖性
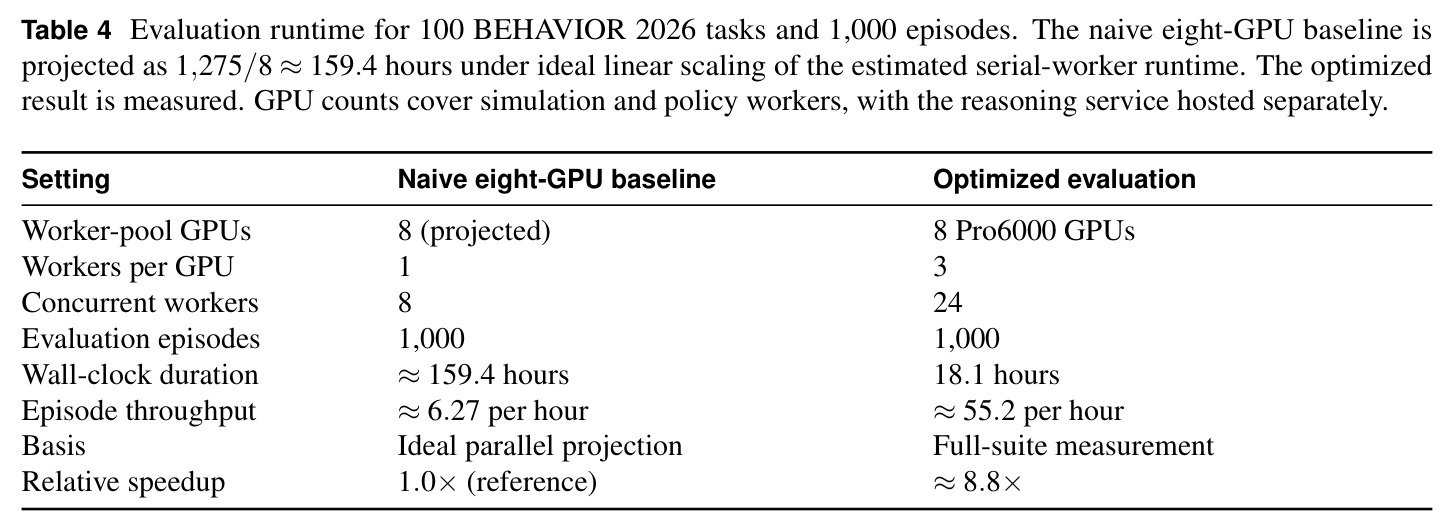
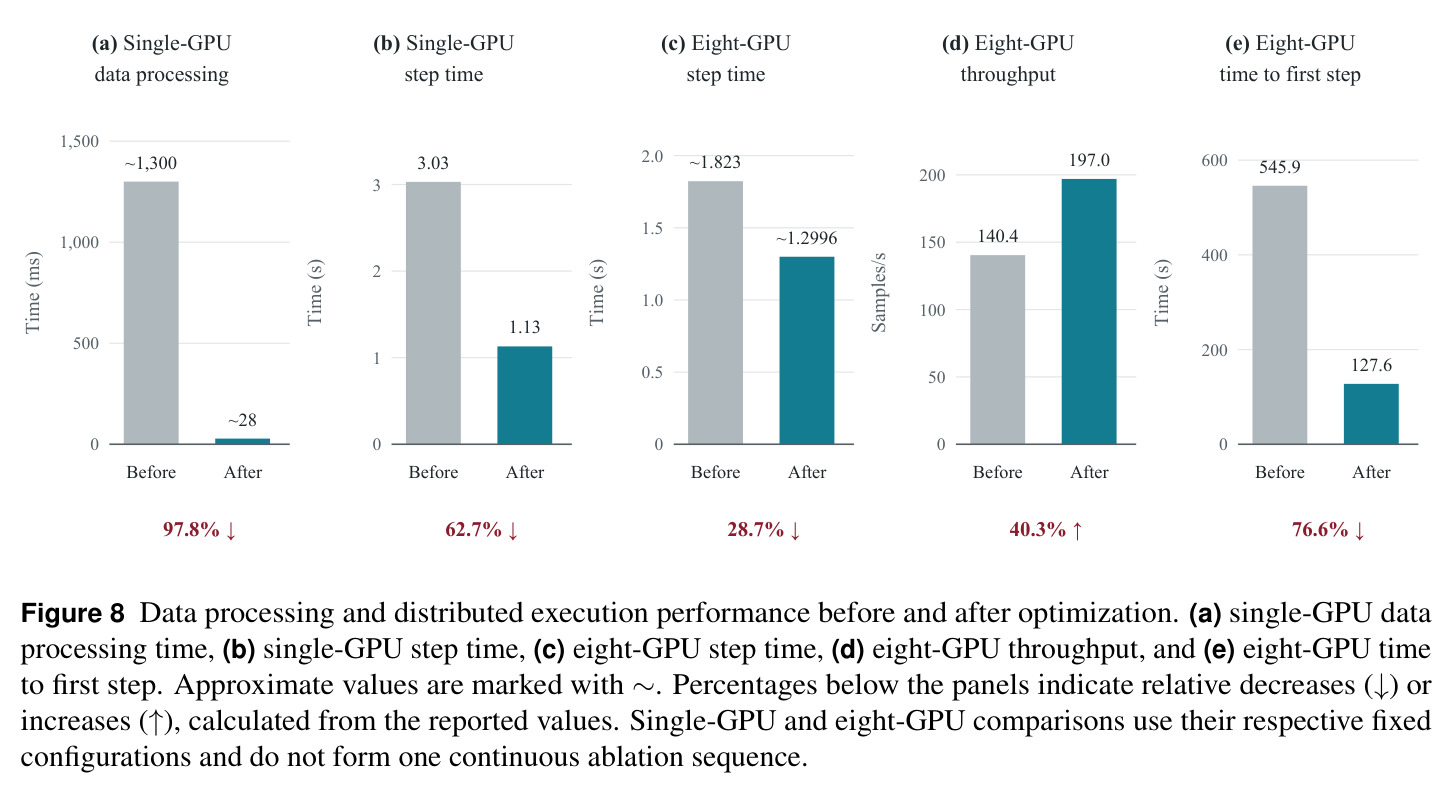
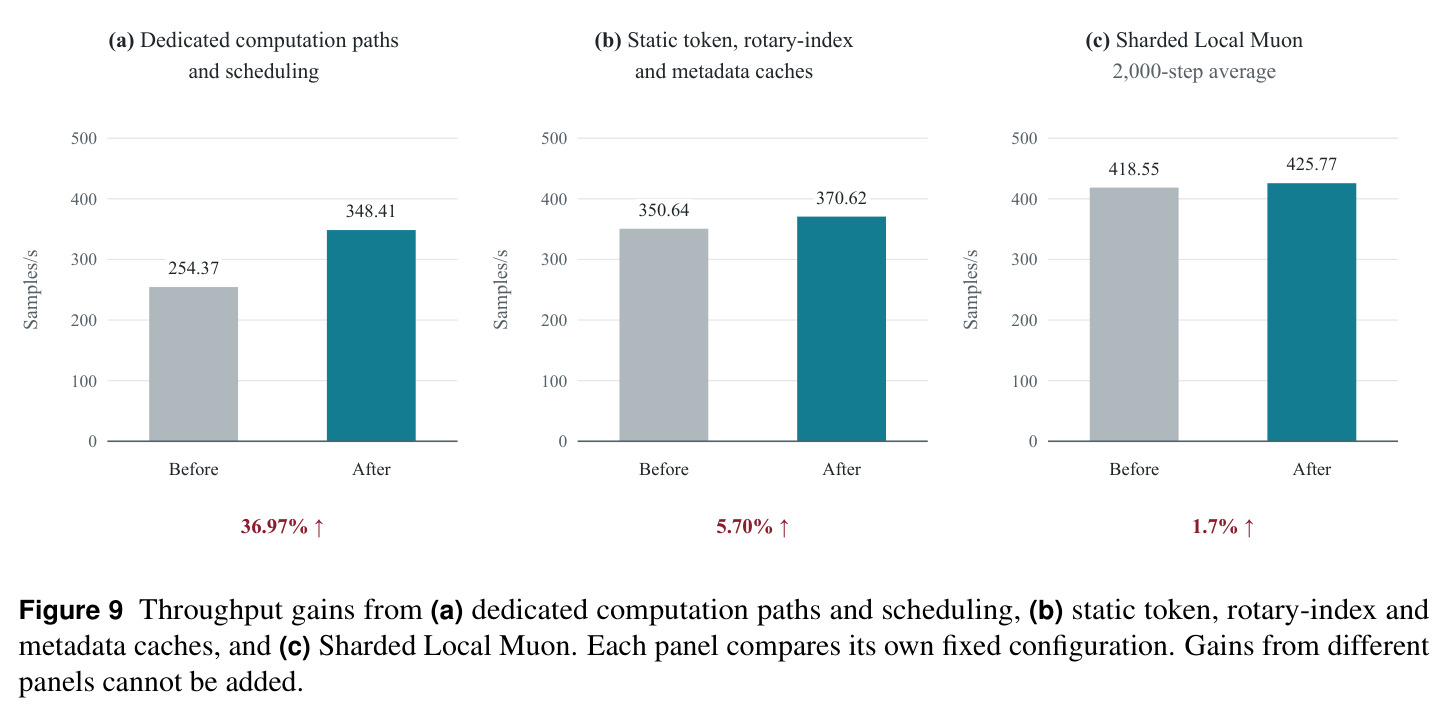
技术新颖性体现在四个层面。一是“代码作为扩展接口”的概念本身:纠正知识的学习吸收(训练时用 MetaBrain 指令监督 $\phi$)与运行时使用(部署时只改 $c_t$、权重冻结)被统一在同一机制中,任何 agent 只要按 CorrectionContext schema 填写字段即可影响控制,天然支持诊断工具可插拔与多本体扩展。二是数据构造方式:纠正监督来自“未执行的策略偏差”而非观测到的物理失败——用冻结策略在演示状态的提案与专家续作之差构造训练对,避免了刻意在真机/仿真制造失败的代价;作者坦诚这留下与真实失败状态的分布差距。三是架构上的克制带来的信息量:A2-WLA 只在标准 VLA 上加运动感知历史(相邻帧对差分 $d_k=\mathrm{LN}\,W(f_{k+1}-f_k)+\mathrm{PE}(k)$ 经门控交叉注意力注入)与潜世界模型预测的未来上下文(动作专家奇偶层交替交叉注意当前/未来两路 token),却在 50 任务子集达到 2025 冠军 2.21 倍的 Q 分,说明大量长时程能力可以在策略内部学得。四是系统层面的可复现贡献:共享 VLM 前缀跨流样本复用、Arrow 共享内存缓存(输入准备 1.30s→28ms)、分片 Local Muon(67.0→19.7ms)、三 worker/GPU 动态调度评测等,把训练吞吐推到 427.1 样本/秒(4.03×)并把千回合评测压到 18.1 小时。
实验结果
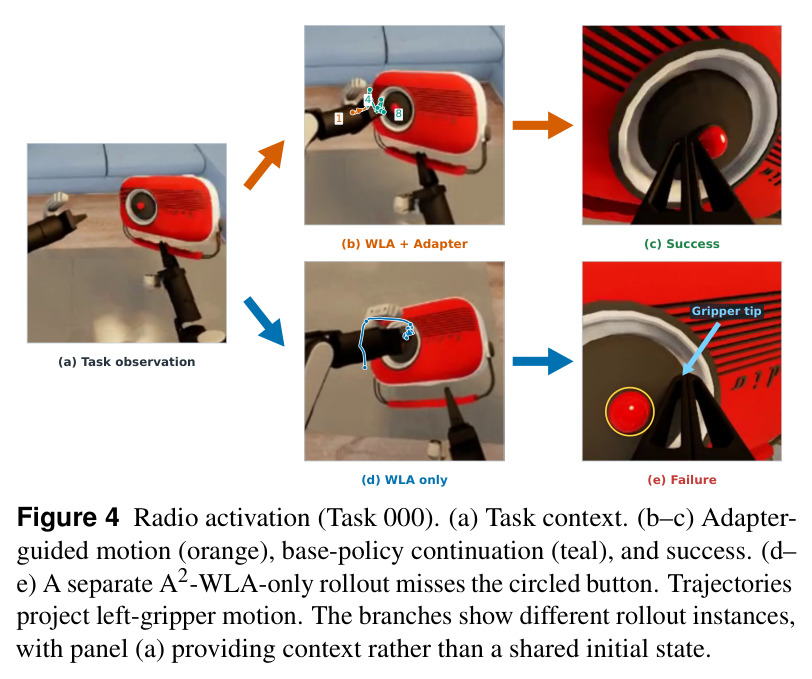
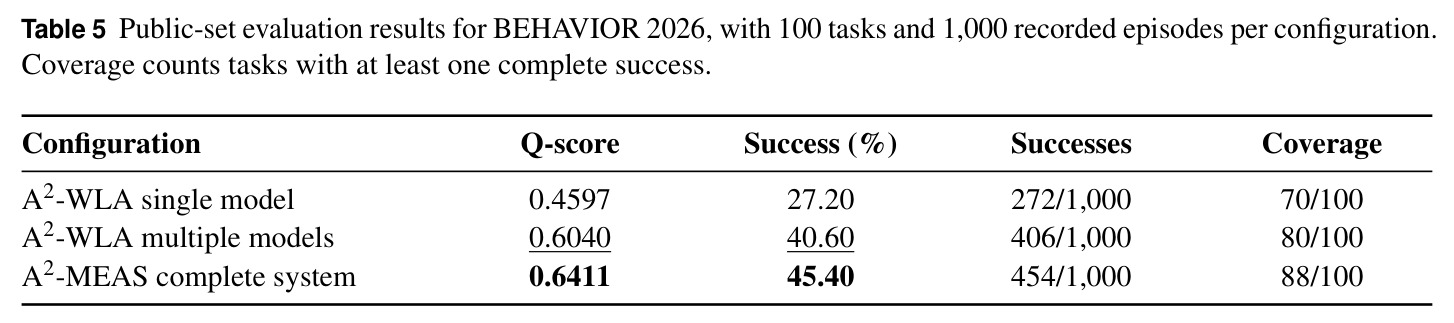
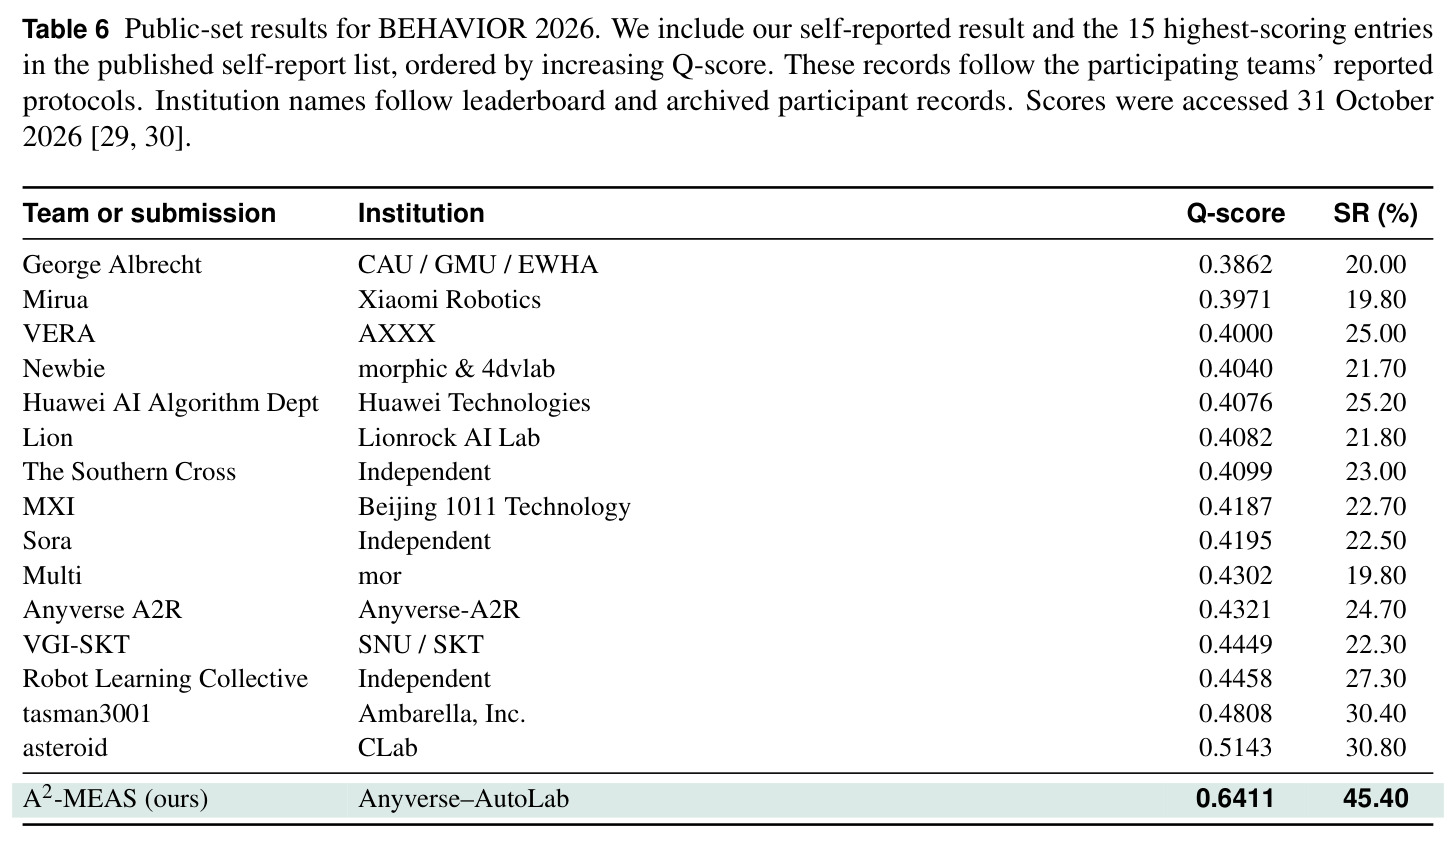
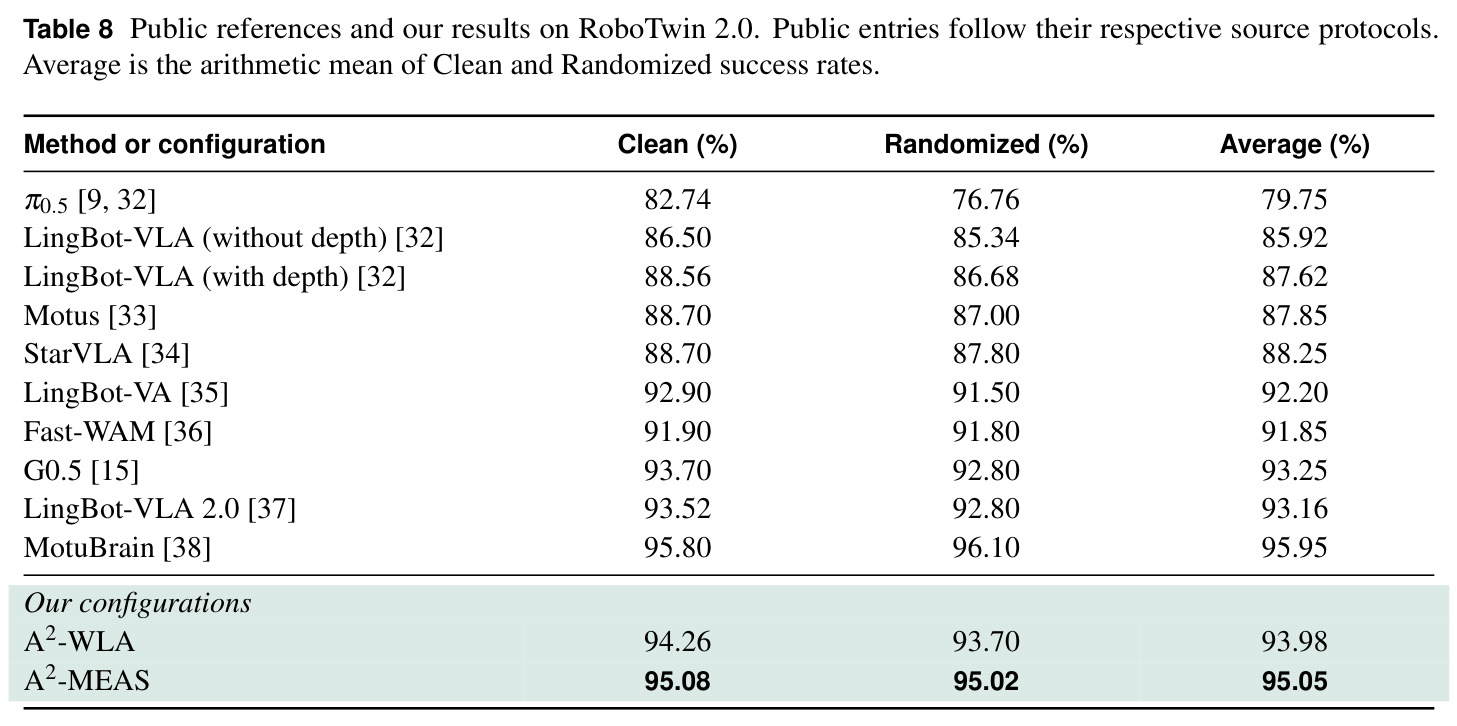
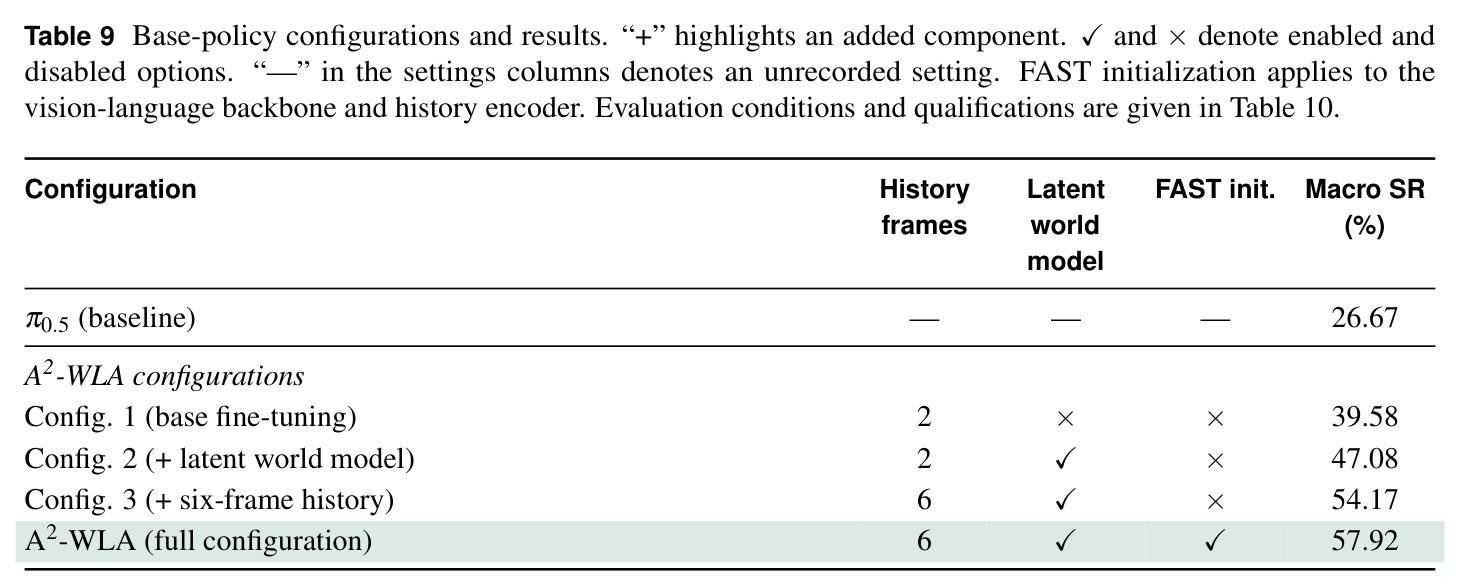
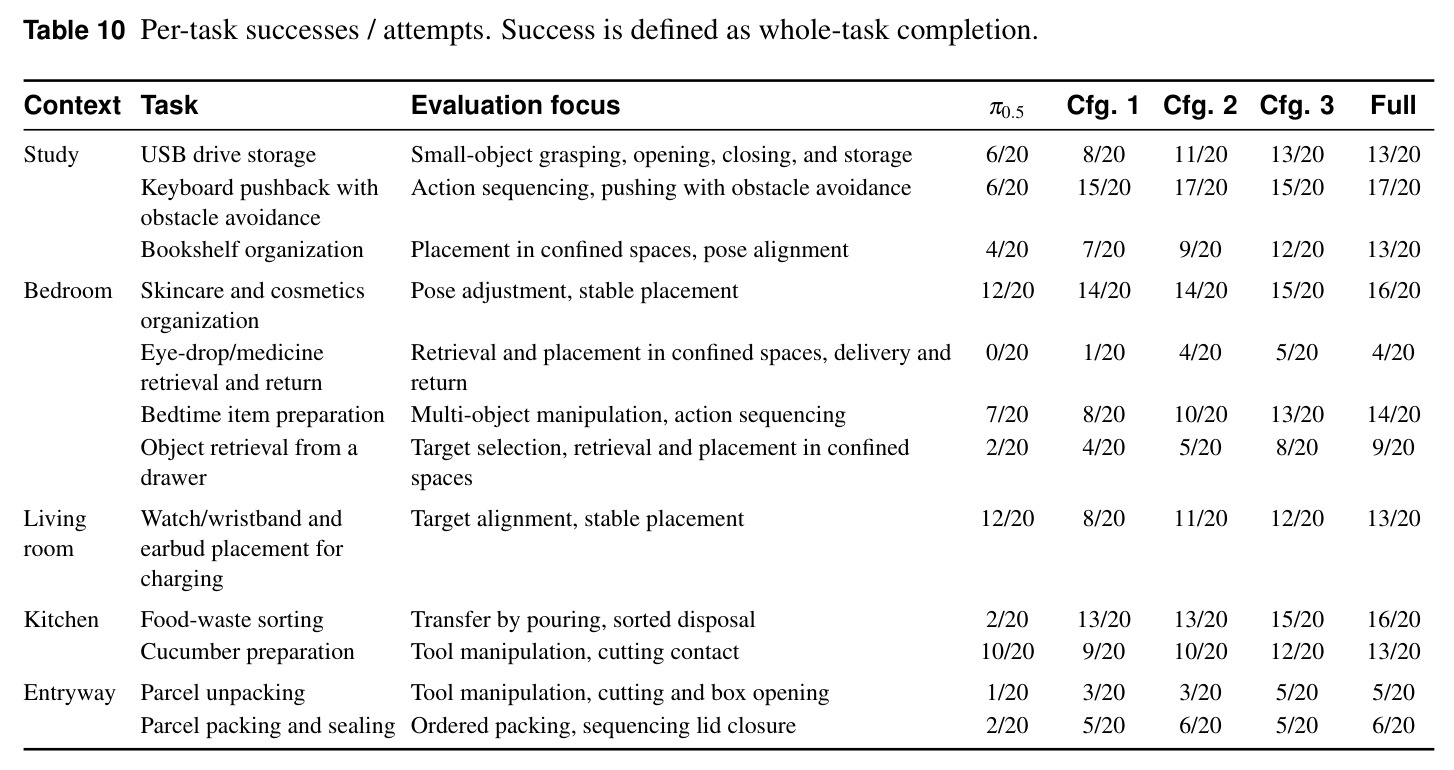
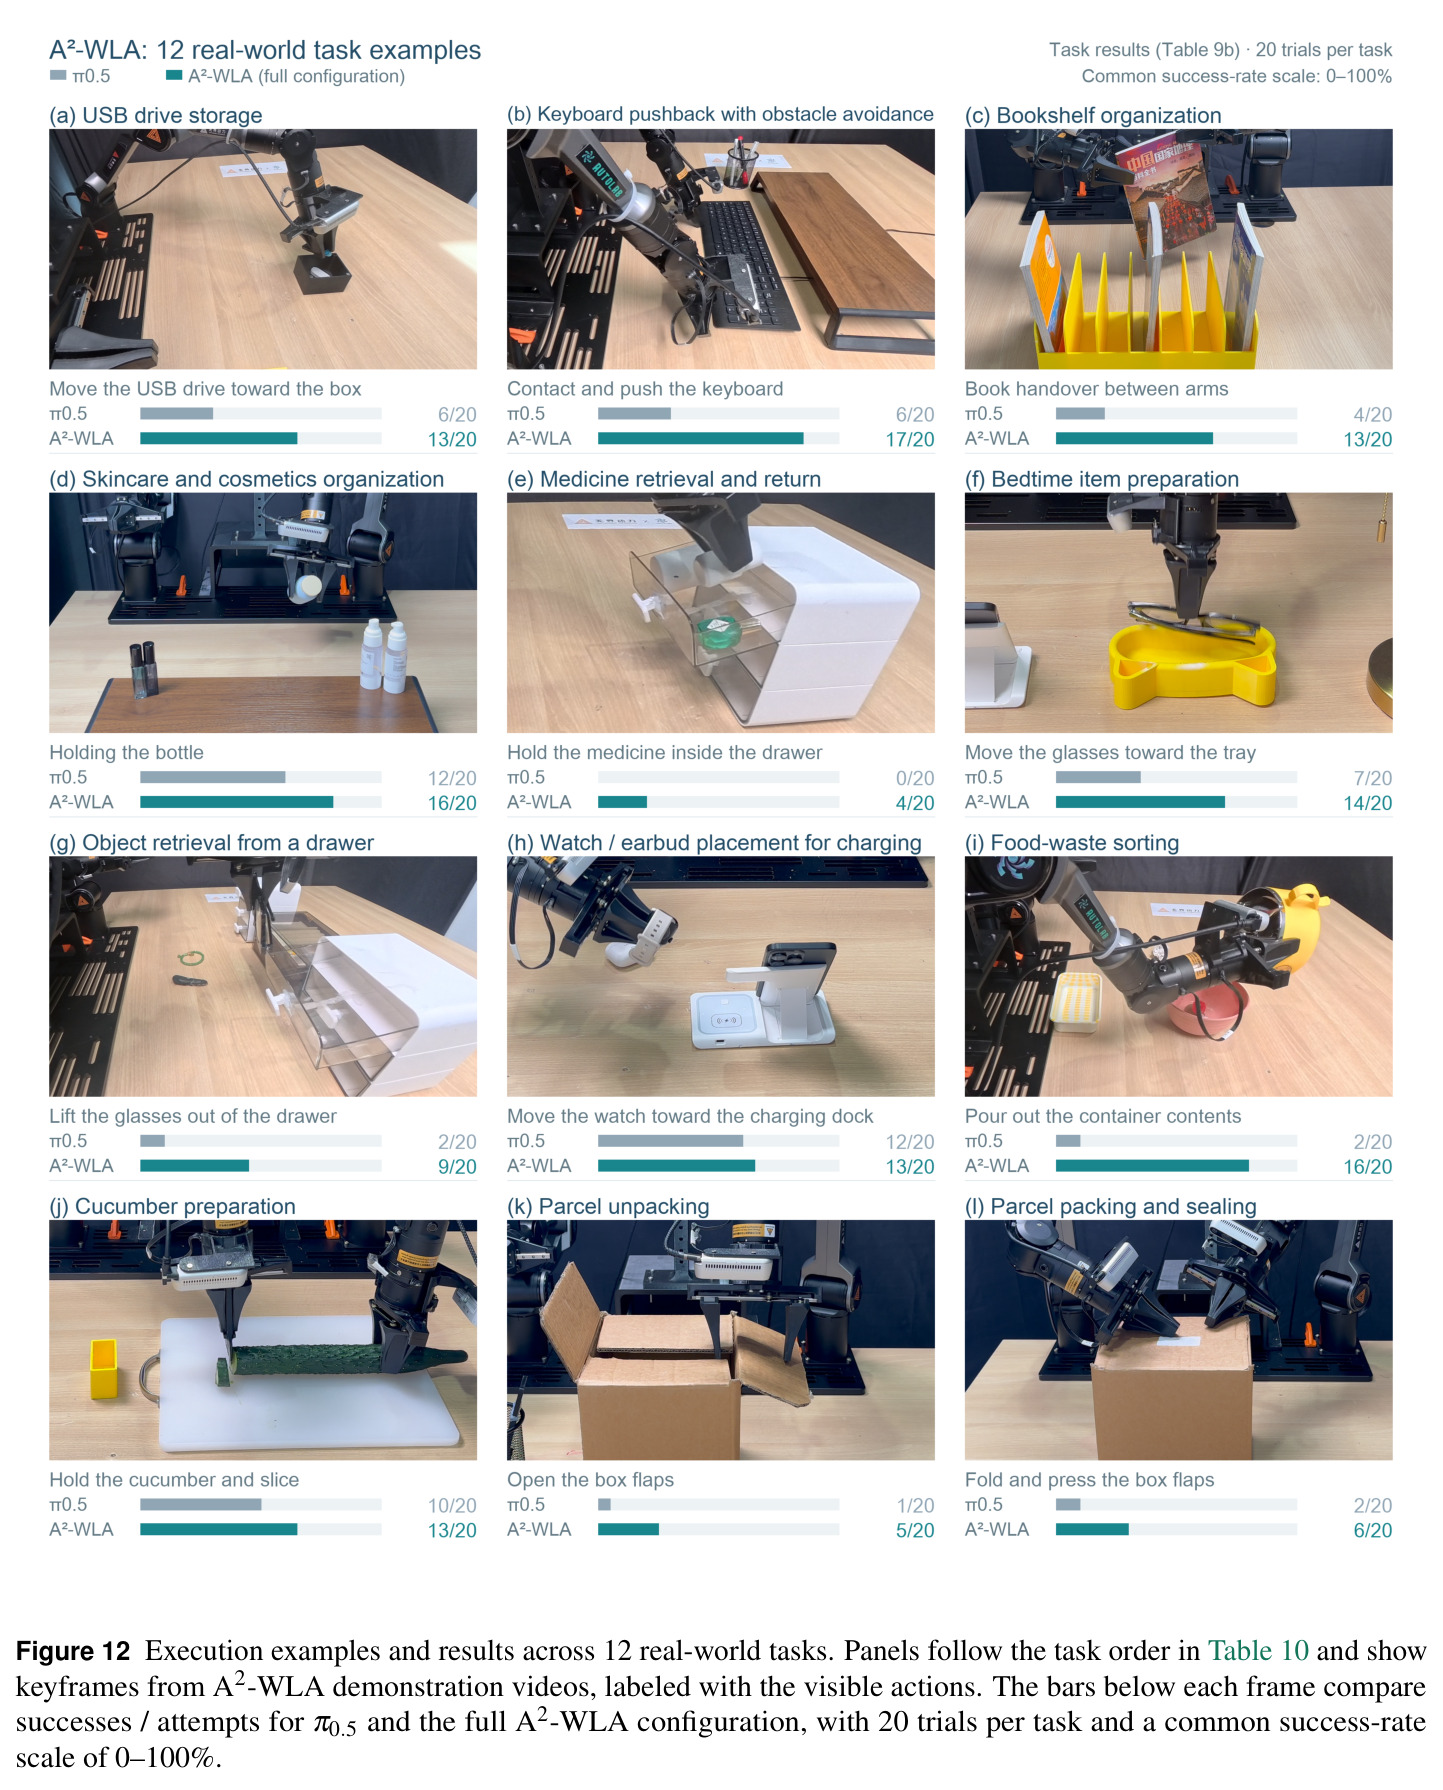
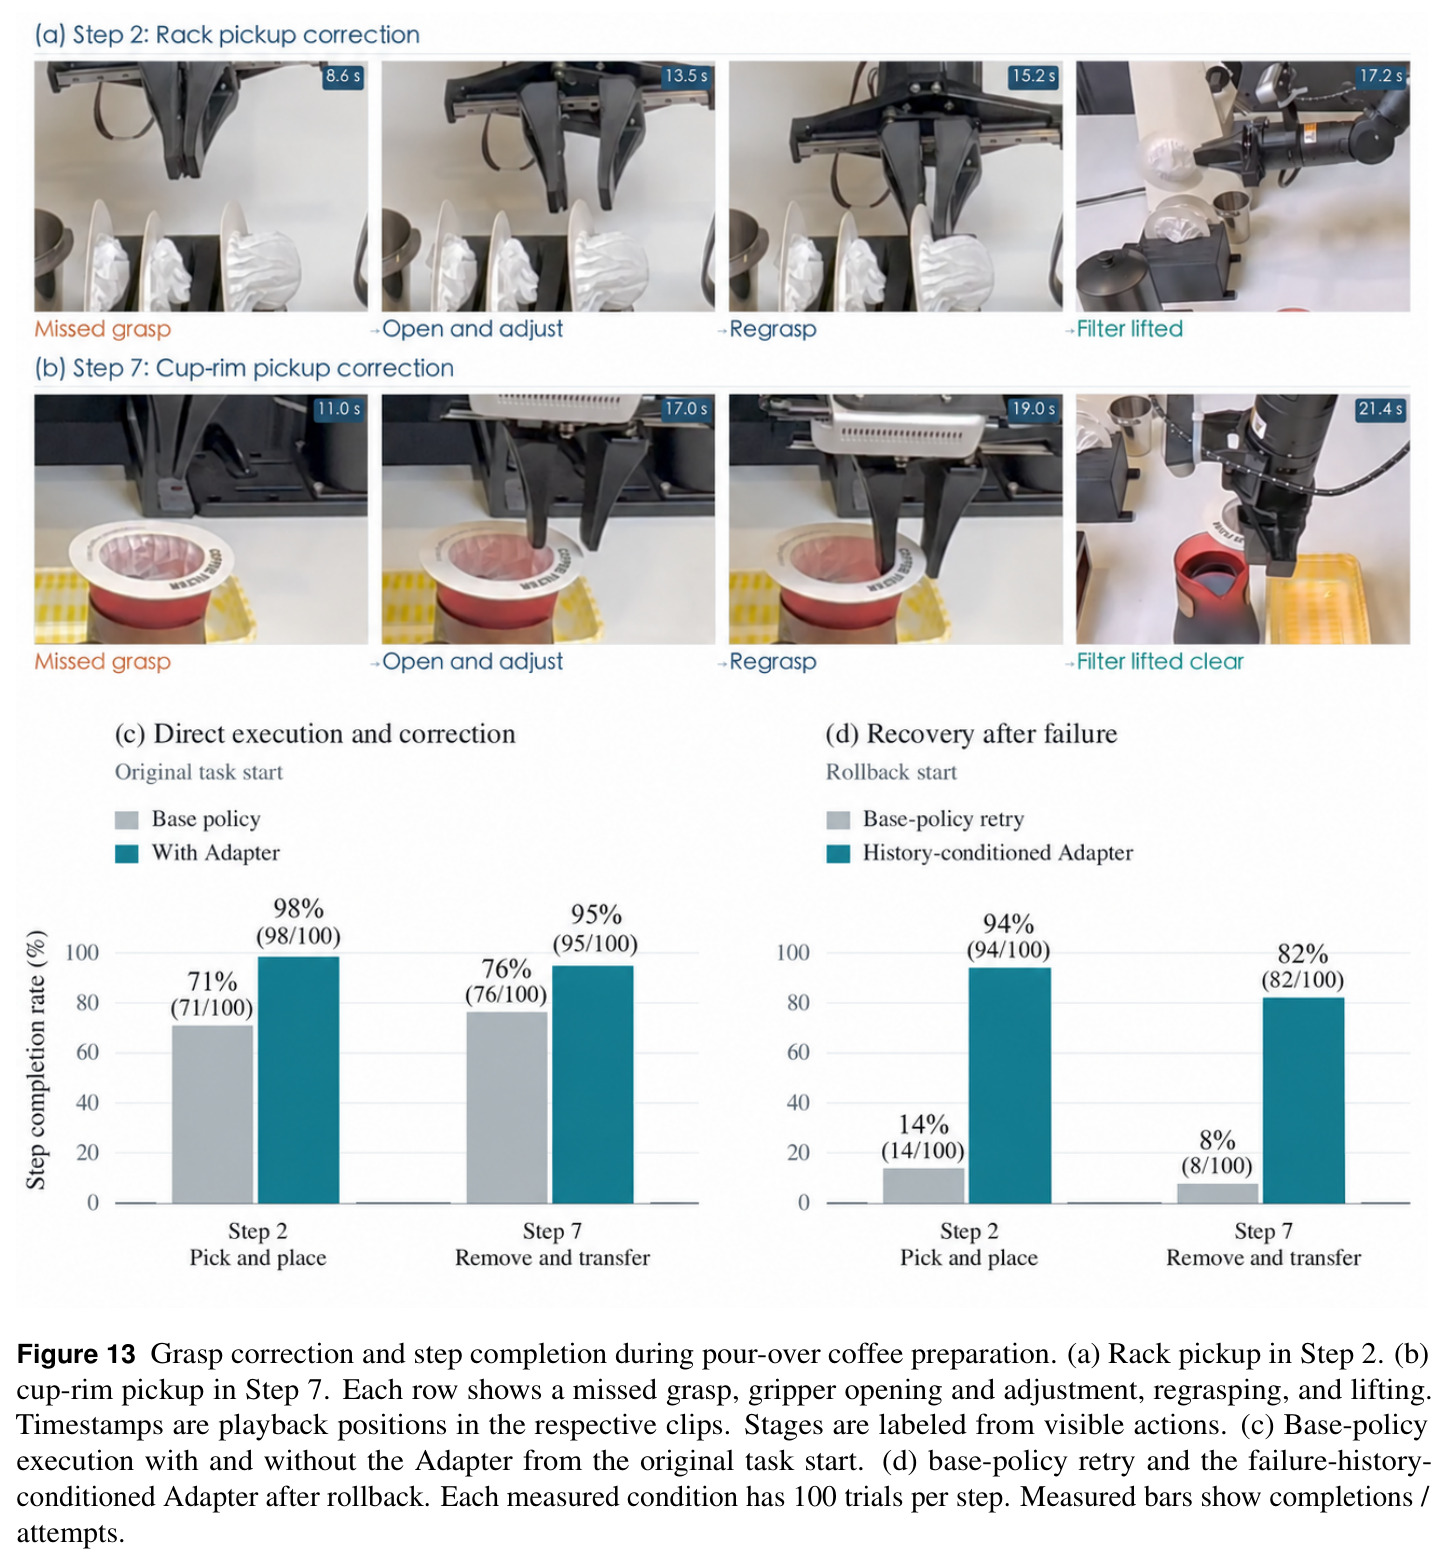
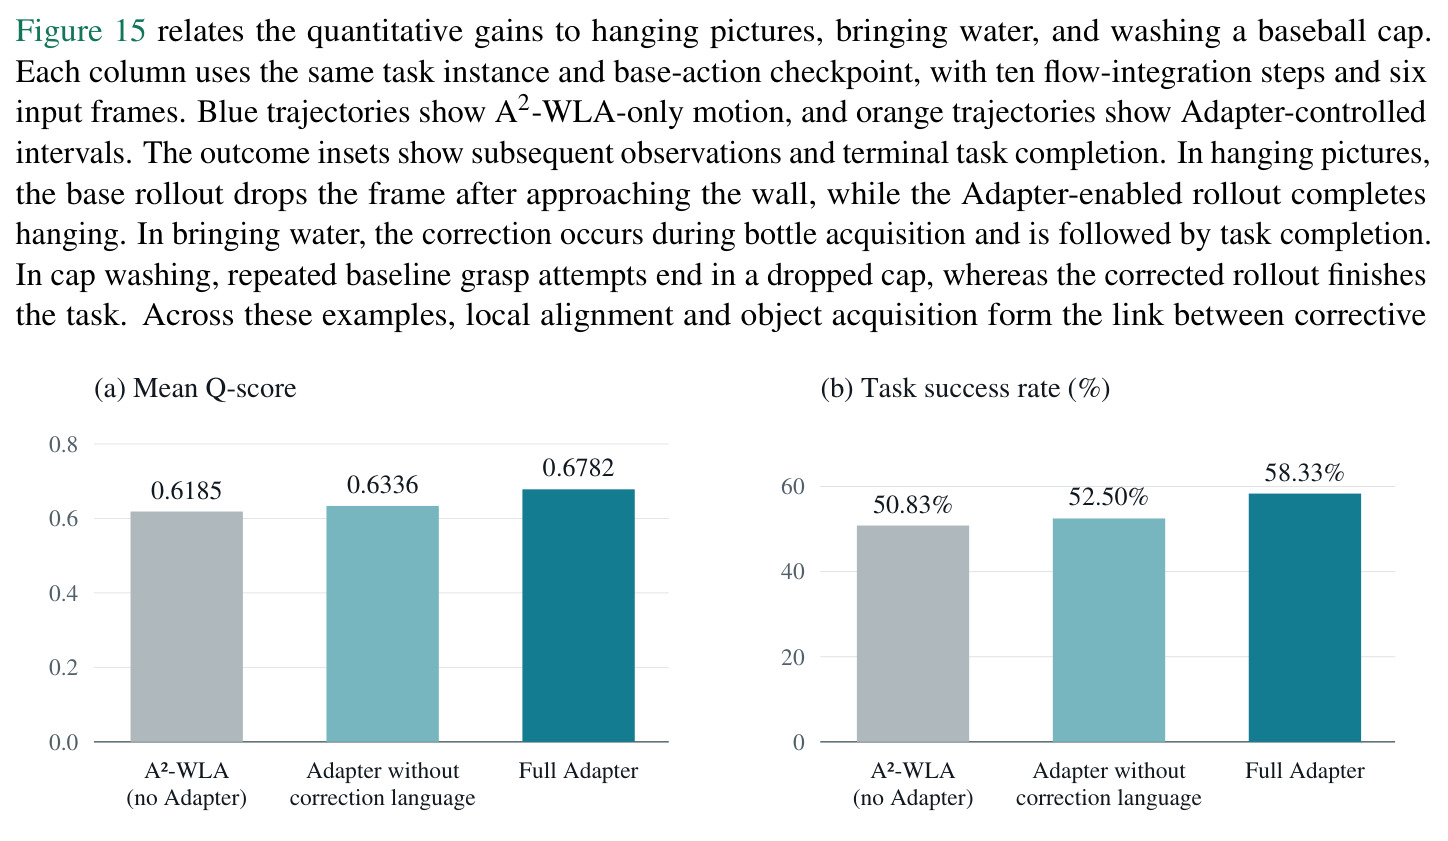
长时程(BEHAVIOR 2026 全 100 任务、每任务 10 实例共 1000 回合):完整系统 Q 0.6411、完全成功率 45.40%(454/1000)、88 个任务至少一次成功;多模型 A2-WLA 0.6040/40.60%/80 任务;单模型 0.4597/27.20%/70 任务;Q≥0.8 的任务数从 17→30→34。该成绩显著高于公开自报榜第 15 名 asteroid 的 0.5143/30.80%。50 任务子集:单模型 0.4522、任务专用 25 检查点 0.5755(约为 2025 冠军 RLC 0.2605 的 2.21 倍)、完整系统 0.6191/41.40%。官方 hidden set 因 24GB 显存限制被迫用 Qwen3.5-2B 协调器,得 0.4975/32.05%,仅略高于纯 A2-WLA 的 0.4951/30.95%。双臂(RoboTwin 2.0,50 任务共 10,000 回合):A2-WLA 平均 93.98%(Clean 94.26%/Randomized 93.70%),加协调 95.05%,超 π0.5(79.75%)14.23 个百分点、超 G0.5(93.25%)0.73 点,接近 MotuBrain 95.95%。真机 12 桌面任务×20 次:完整配方 57.92% vs π0.5 26.67%(+31.25pp),12/12 任务全胜,如厨余分拣 2/20→16/20、键盘推开 6/20→17/20;组件逐级增益 39.58→47.08→54.17→57.92%。真机恢复(手冲咖啡,约 4 分钟/杯):历史条件 Adapter 使失败后完成率从 14.00%→94.00%(Step 2 滤杯安放)与 8.00%→82.00%(Step 7 滤杯转移)。消融(Selected12 三轮平均):动作预训练初始化 0.4846/39.72% → +世界模型 0.5183/42.50% → +运动历史 0.5279/45.56% → +技能边界采样 0.5546/46.67% → +2400 条成功扰动轨迹 0.5905/50.28%。Adapter 条件消融:完整 0.6108/52.50% vs 无 Adapter 0.5310/41.67%;在不相交的 120 个新实例上 0.6782/58.33% vs 基座 0.6185/50.83%(成功回合 61→70)。基础设施:8 GPU 训练吞吐 427.1 样本/秒(π0.5 参考实现 106,4.03×);1000 回合评测实测 18.1 小时 vs 理想八卡投影 159.4 小时(约 8.8×),总仿真控制步 15,113,902(约 140 小时仿真时间,平均每回合 8.40 分钟)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BEHAVIOR 2026 全 100 任务(公开集,1000 回合) | Q-score | 0.6411(A2-MEAS 完整系统) | 0.6040(多模型 A2-WLA)/ 公开榜最高 0.5143(asteroid) | +0.0371 vs 自家多模型;+0.1268 vs 公开榜最高 |
| BEHAVIOR 2026 全 100 任务 | 完全成功率 SR | 45.40%(454/1000,88 任务有成功) | asteroid 30.80%;单模型 A2-WLA 27.20% | +14.60pp vs 公开榜最高;+18.20pp vs 单模型 |
| BEHAVIOR 2026 任务 0–49(500 回合) | Q-score | 0.5755(任务专用 25 检查点) | RLC(2025 冠军)0.2605;π0.5 0.2626;G0.5(4 epochs) 0.3136 | 约 2.21× RLC |
| RoboTwin 2.0 双臂 50 任务(10,000 回合) | 平均成功率(Clean/Randomized 均值) | 93.98%(A2-WLA);95.05%(完整系统) | π0.5 79.75%;G0.5 93.25%;MotuBrain 95.95% | +14.23pp vs π0.5;+0.73pp vs G0.5 |
| 真机 12 桌面任务×20 次 | Macro 成功率 | 57.92%(完整 A2-WLA) | π0.5 26.67%;基础微调 39.58% | +31.25pp vs π0.5;+18.34pp vs 基础微调 |
| 真机手冲咖啡恢复(Step 2 / Step 7,各 100 次) | 失败后完成率 | 94.00% / 82.00%(历史条件 Adapter) | 冻结 A2-WLA 重试 14.00% / 8.00% | 约 6.7× / 10.25× |
| 训练吞吐(8 GPU,匹配分辨率与 horizon) | 演示样本/秒 | 427.1 | π0.5 参考实现 106 | 4.03× |
| BEHAVIOR 1000 回合评测 | 墙钟时间 | 18.1 小时(8×Pro6000,24 并发) | naive 八卡理想投影 159.4 小时 | 约 8.8× |
局限与改进
作者承认的局限:纠正采用“暂停-诊断-再执行”,不适合需要即时反应的事件(如物体开始滑落的瞬间);纠正训练用演示状态挖掘的未执行偏差,与部署时真实失败(会改变物体布局与抓取构型)存在分布差距;定量评测集中于家居仿真,真机只覆盖 12 个短任务与咖啡序列;hidden set 因带宽与 24GB 显存限制用 2B 协调器,其判断何时介入的准确性低于 27B 版本、有时不必要地打断执行,故官方成绩低估系统能力。我自己的观察:第一,任务级两极分化严重——11 个任务 10/10 全对,但 8 个任务 Q<0.2(做披萨与清理露台为 0 分),同族任务内波动巨大(微波炉爆米花 100% vs 煎培根 20%);34 个 Q≥0.8 的任务中 5 个成功率不超过 40%(食物储存 Q 0.8375 却只有 1/10 成功),说明“接近完成”与“可靠完成”仍是两个问题。第二,多模型 0.6040 的结果依赖按 benchmark 任务 ID 预先选择的 25 个检查点与执行配置,与“通用智能体”叙事有张力,作者也承认需要 router/蒸馏来验证。第三,接口对比(Table 13)未匹配参数量与算力,且 Adapter 的最终任务完成率 43.66% 并未超过 VLM+IK 的 45.21%,物理恢复的领先没有完全转化为任务完成。第四,评测对比基线是“理想线性缩放投影”而非同硬件实测,作者自己指出需要实测基线来分离各优化贡献。第五,真机实验禁用了高层反馈与测试时纠正,完整多智能体系统在真机上的验证只有轻量 history-conditioned Adapter(约 86 万参数)这一变体。
独立分析的弱点
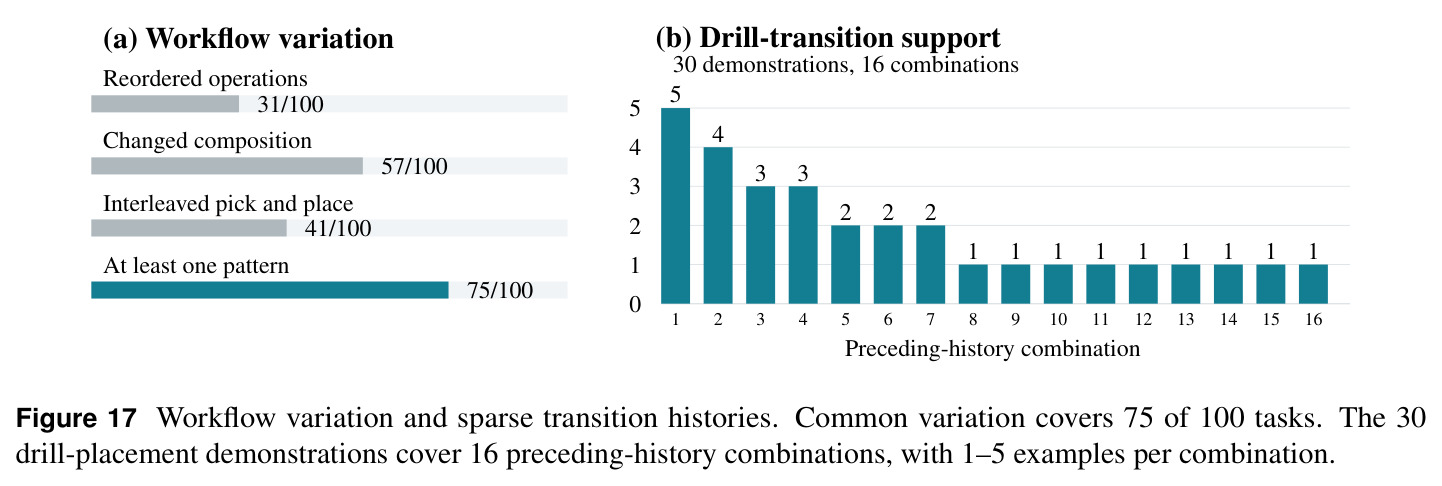
弱点一:恢复延迟。暂停加 27B 模型推理(单次请求超时 10 秒、整个恢复事件上限 60 秒)无法处理接触瞬间的失稳,例如运输中物体开始滑落的那几百毫秒。改进方向:把纠正执行蒸馏进策略权重、训练对接触动力学敏感的前馈式策略内恢复,或用小模型做实时接触监控、只在必要时升级到大模型。弱点二:纠正监督的分布差距——离线候选偏差不等于真实失败状态,部署时失败往往已经改变了物体排列。改进:建立闭环数据管线,把失败检测、纠正指令与后续任务成败链接为在线监督(作者已提出此方向)。弱点三:任务专用化依赖固定的 task→model 映射(25 个检查点),遇到新任务组合无法自动路由。改进:共享视觉/世界模型骨干加多个小动作专家、由观测与语言条件化的学习路由器,或在匹配参数预算下蒸馏为单一模型。弱点四:长尾历史稀疏——6,849 个“以前两步操作为条件”的转移组合中 62.8% 只有不超过 5 条演示支撑(仅占 3.7% 的窗口出现率),策略难以学到转移前的物理前提(如“拿螺丝刀再拿电钻”只有 5 条演示)。改进:工作流多样性主动采集、生成式数据增广、把转移前提显式建模为调度器状态约束。弱点五:即使恢复成功也可能无法继续——推车翻倒、台灯落入家具缝隙、食材散入水槽等场景改变超出机械臂可达范围、关节行程或夹爪能力(Figure 19),推理-诊断-纠正无法弥补硬件边界。改进:运输容器化等主动稳定策略、派发前可达性预检,以及作者强调的策略-编排-硬件一体化设计。
未来方向
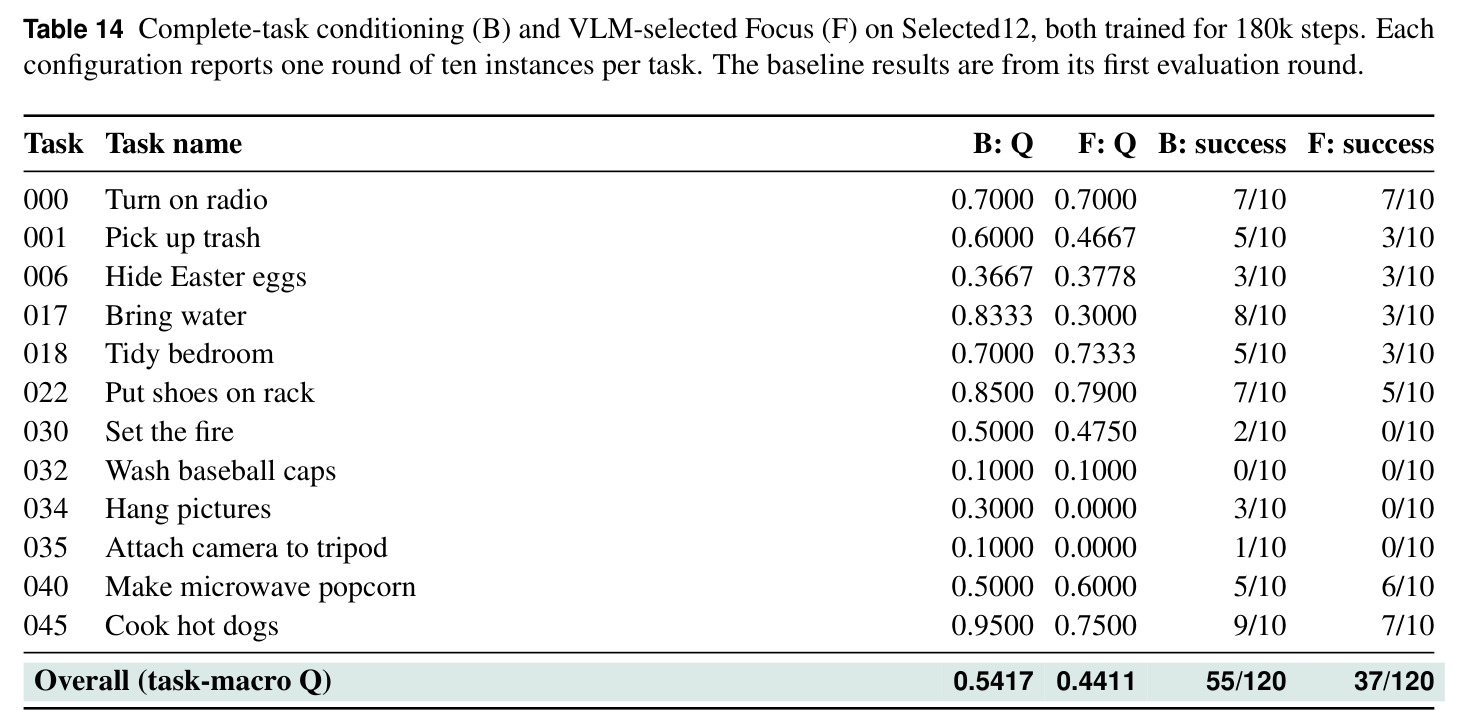
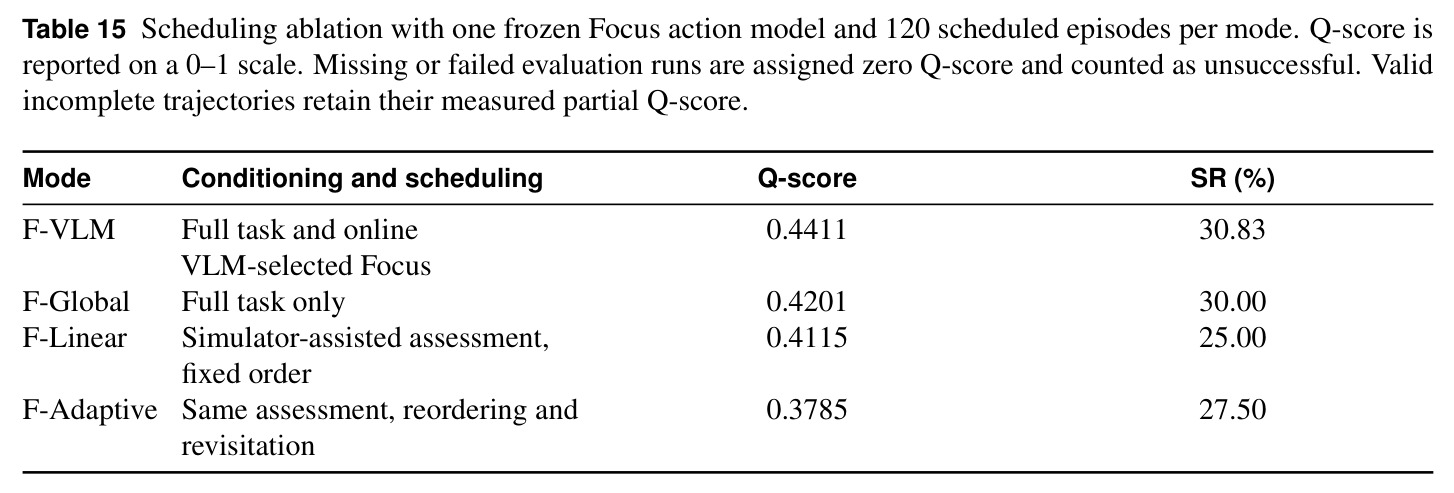
作者提出的方向:规模化并多样化交互数据,覆盖不同物体属性、接触构型、成功与失败尝试及恢复后续,让策略从视觉观测与执行历史学会及时反应;建立链接“失败检测→纠正指令→任务后续成败”的数据管线,把监督扩展到纠正真正被需要的场景;把更广的任务推理与成功纠正执行蒸馏进主策略权重,减少重复审议;加快推理与控制之间的交互速度;扩展到更多任务族、机器人本体与物理环境,并跨独立训练/评测轮次检验增益一致性;继续同时报告目标满足与完全成功两类指标。基于成果可延伸的方向:其一,Section 6.2 给出蓝图的共享骨干+专属动作专家+学习路由器架构,以及在匹配参数/算力预算下蒸馏专用策略;其二,把潜世界模型用于在“想象中”验证恢复候选(model-based rollback check),减少真试错;其三,6.4.2 的仿真辅助调度实验表明显式子任务调度劣于全任务条件化,值得研究转移前提的隐式学习而非显式调度;其四,masked action 表示已支持跨本体共享架构,可向移动操作、双臂精细装配扩展;其五,把 18.1 小时的评测进一步压缩后,强化微调(如 Openpi Comet 的 RFT 路线)与纠正接口的联合训练成为可能。
复现评估
开源情况:承诺渐进发布系统代码、模型 checkpoints、训练脚本、纠正监督构建代码与优化后的训练/评测基础设施(GitHub: AutoLab-SAI-SJTU/A2MEAS),并会发布 Qwen3.8-27B 版 MetaBrain 供进一步评测;训练数据为 BEHAVIOR-1K 官方公开的 20,000 条遥操作演示,纠正监督由官方演示按文中流程构造。算力需求:基础模型三阶段各用 64 GPU(世界模型至多 10 epochs、VLM 150k 步、连续动作 500k 步,均为 BF16);纠正阶段较轻(8 GPU、batch 256、6000 步、可训练参数不足 100M);部署时 MetaBrain(27B,张量并行 2 卡)与 A2-WLA 各占独立 GPU;评测需 8 张 RTX Pro 6000(每卡 3 个 worker、共 24 并发)加单独托管的推理服务。难度评估:完整复现属于重工程——需要 BEHAVIOR 仿真栈、JoyLo 式全身遥操作(若自采数据)、多阶段训练流水线与分布式系统工程;但分级复现可行:只训纠正接口(冻结公开 checkpoint)成本很低,多数消融结论可在更小算力上以时间换取;RoboTwin 与真机部分需要对应机器人硬件。论文还给出了与 π0.5 参考实现的吞吐对比细节(匹配分辨率与 horizon、各自选择 batch),有利于公平复现效率数字。
论文图表
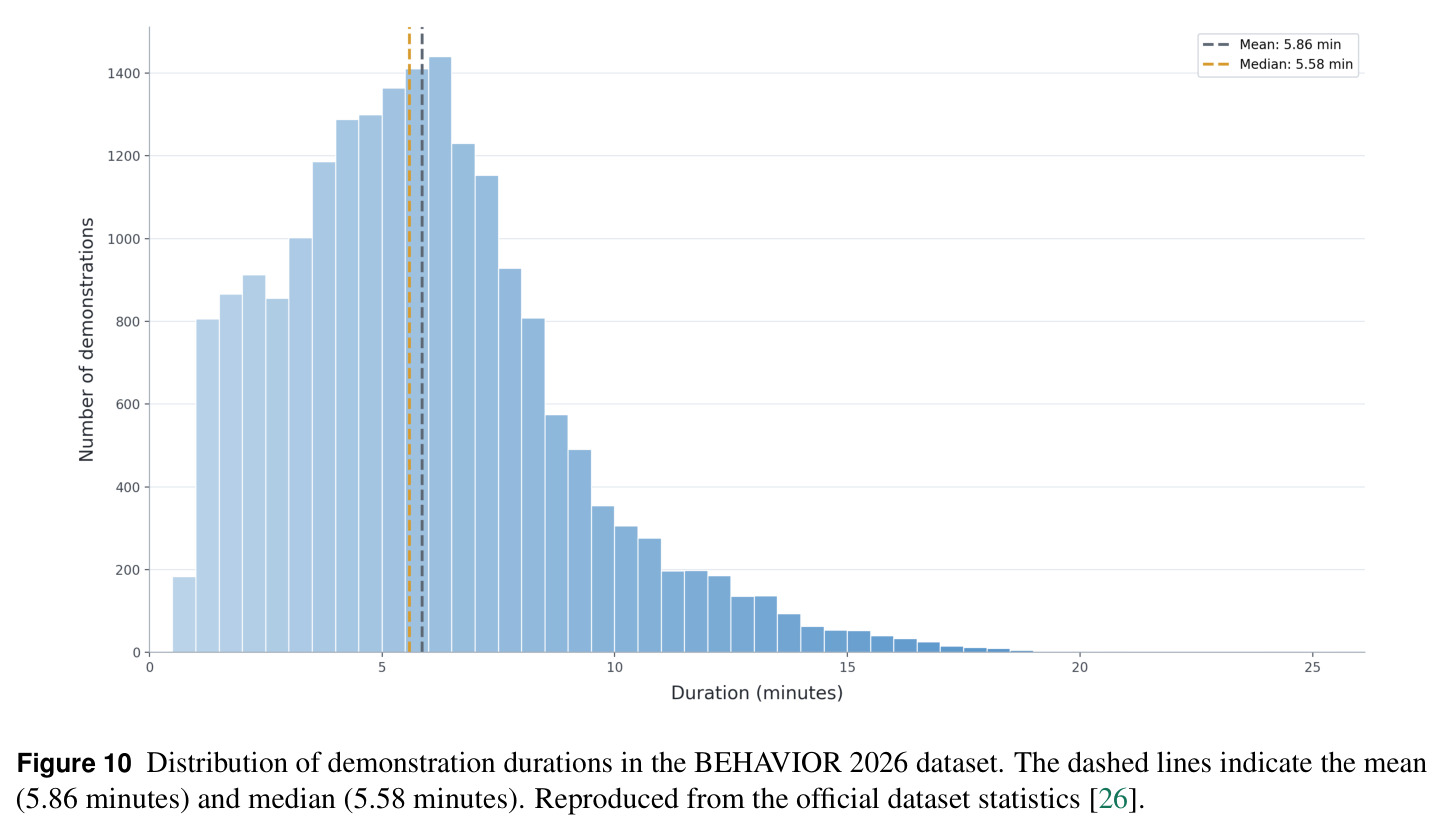
官方 20,000 条演示的时长分布直方图,虚线标出均值 5.86 分钟与中位数 5.58 分钟,分布呈明显右偏长尾——部分演示远超均值,对应多阶段、多物体的复杂家务任务。
说明训练数据的长时程性质与长尾难度,是理解技能边界加权采样、自适应流采样等训练设计的数据背景。
100 个任务按 Q 分降序的双栏大表:顶部 11 个任务 1.000/10 全对(开收音机、做热狗、装调制解调器、铺瓷砖等);底部 8 个任务 Q<0.2,做披萨与清理露台为 0.000/0;中段大量“高 Q 低成功”案例——食物储存 Q 0.838 但仅 1/10 成功、礼物篮组装 Q 0.650 却 0/10。
揭示性能两极分化与“部分满足 vs 可靠完成”鸿沟的全貌,是论文任务级分析(5.2.2 节)的核心证据。
在 12 个纠正任务各自后 10 个不相交实例(共 120 回合)上:基座 A2-WLA 0.6185/50.83%、去纠正语言的 Adapter 0.6336/52.50%、完整 Adapter 0.6782/58.33%(成功回合从 61 增至 70,两轴均从零开始)。
证明纠正增益不依赖消融所用实例、纠正语言本身有独立贡献,直接回答“学到的接口是否泛化”。
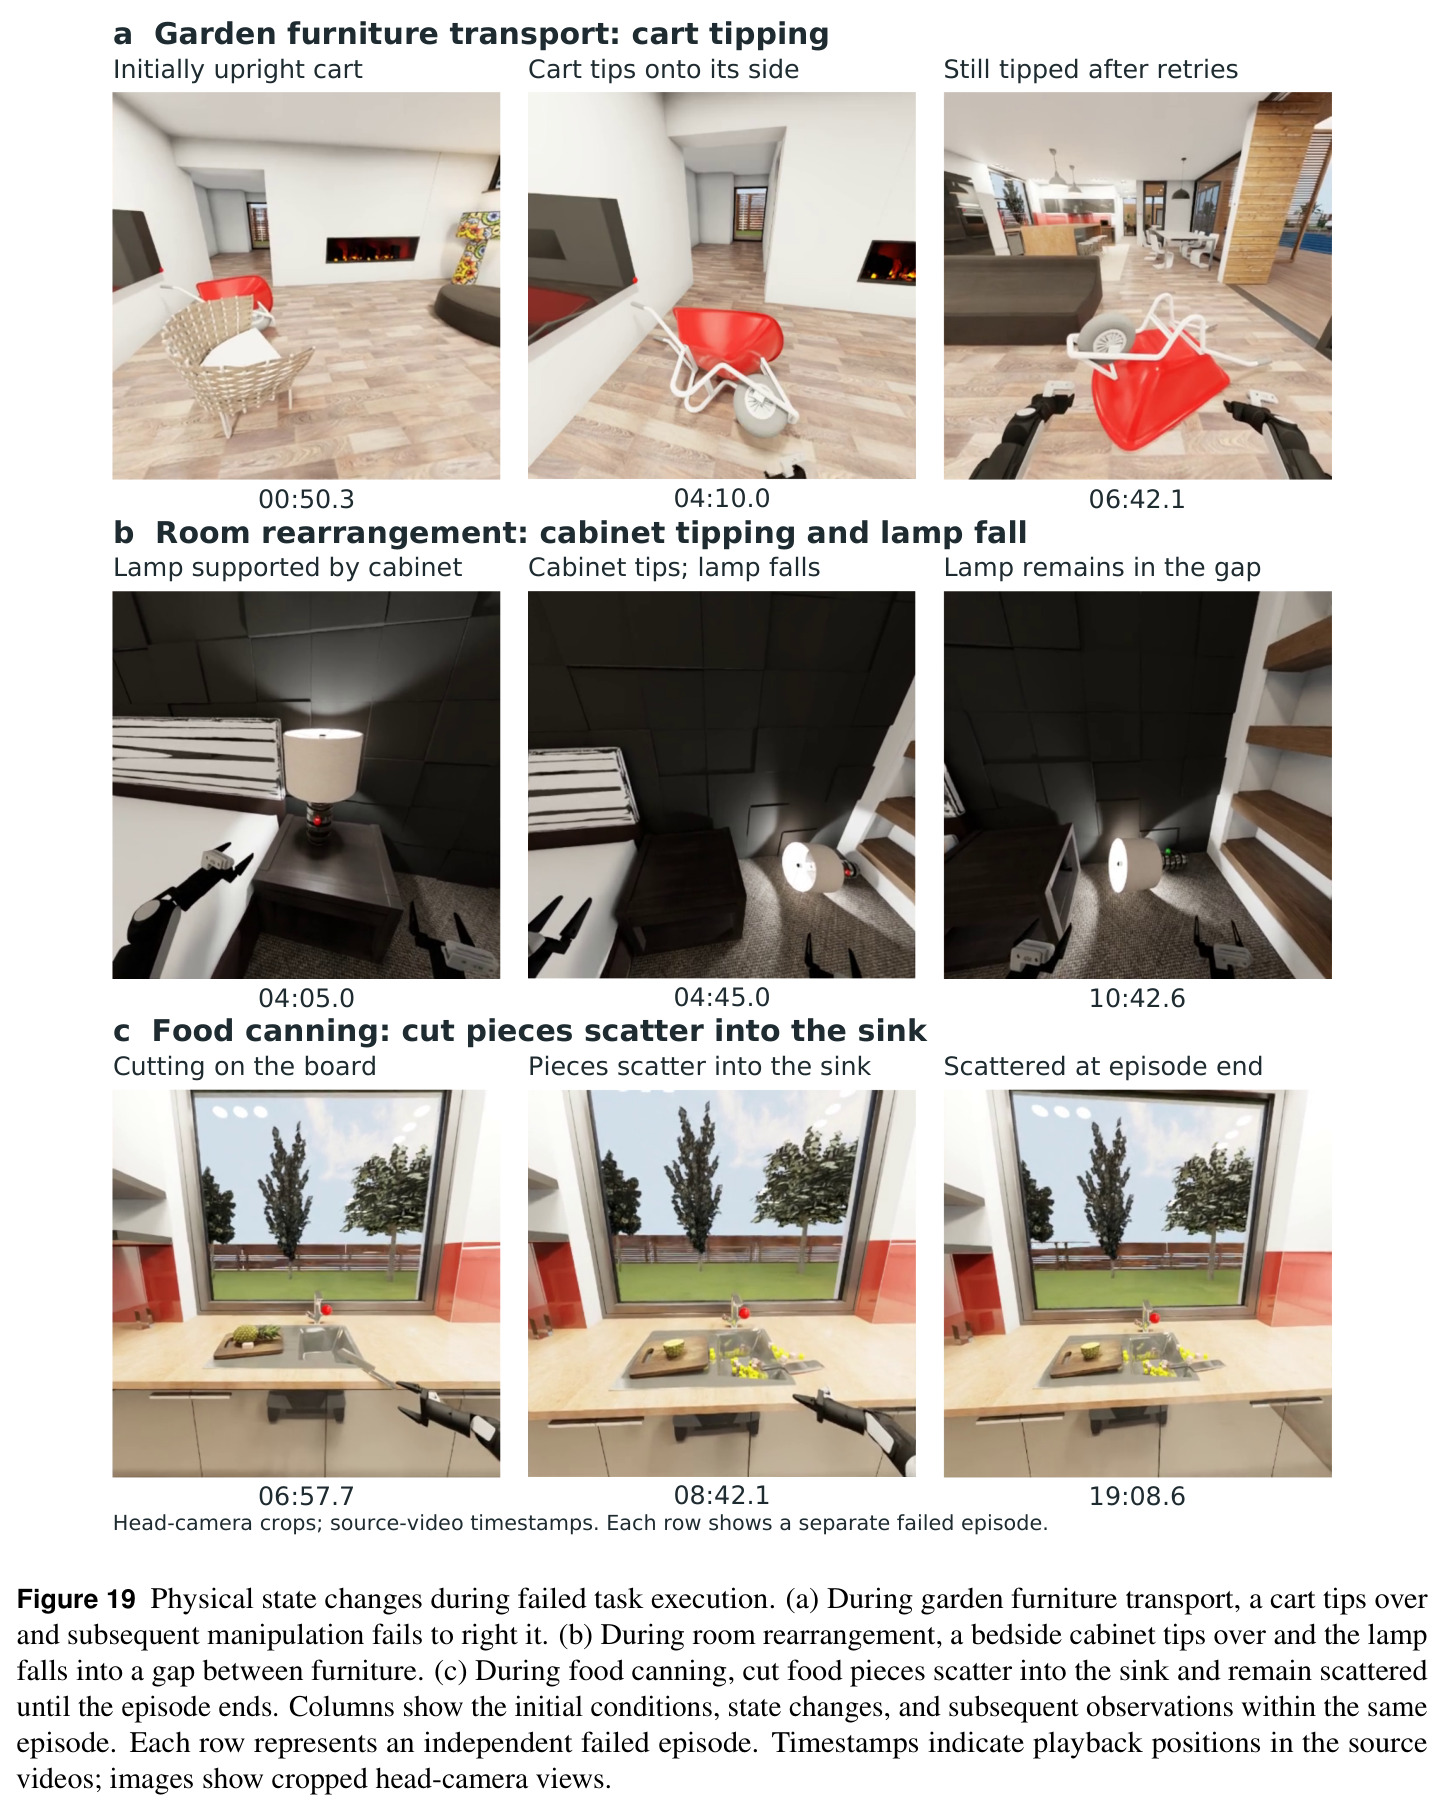
三类失败场景(头相机裁剪帧、源视频时间戳):(a) 搬运花园家具时推车翻倒(00:50→04:10→06:42),重试无法扶正;(b) 房间重排中床头柜倾倒使台灯落入家具缝隙(04:05→04:45→10:42),始终卡在缝隙;(c) 食品装罐时切好的食材散落入水槽(06:57→08:42→19:08),直到回合结束仍散落。
说明失败可造成超出机器人物理能力(可达性、关节范围、夹爪)的场景改变,界定推理-诊断-纠正框架的能力边界,支撑作者“策略-编排-硬件一体化”的主张。
CorrectionContext schema 的字段级定义:task(goal、observed_phase)、failure_window(起止时间、图像引用)、executed_action(chunk_id、executed_steps、actual_controls)、history_action_chunks(执行前缀与前后观测)、correction_text(意图改变)、offset_direction(参考系与方向)、spatial_evidence(相机/坐标系/图像引用/物体区域/交互点/空间关系)、inferred_action_chunk(未执行提案 $\hat{A}^{base}_t$)、input_features(观测特征与动作隐状态引用)。
“代码接口”的具体数据契约,训练与部署共用同一 schema,是实现可插拔工具与可复现性的关键。