前沿VLM智能体的机器人通才之路:具身智能体竞技场实证研究 Are Frontier VLM Agents Ready to Be Robot Generalists? An Empirical Study with the Embodied Agent Arena
构建千例五域具身评测场,用GeoProbe与执行轨迹诊断十大VLM智能体的真实失败模式。
前置知识
视觉-语言模型(VLM)智能体
以视觉-语言模型为核心、在闭环中工作的智能体:每轮接收图像/视频/文本观测,产出代码或动作(如调用操作物体的接口),再根据环境反馈决定下一步。与一次性问答不同,它需要维护持久状态、在多个可用操作中选择、并自行判断何时终止任务。
本文的评测对象就是 10 个这样的 VLM 智能体,理解 agent–environment 循环是读懂其最小化 harness 设计与执行轨迹分析的前提。
相机内参与相对位姿
内参 $(f_x, f_y, c_x, c_y)$ 描述相机把三维点投影到像素平面的几何;相对位姿由旋转 $R$ 与平移 $t$ 组成,描述两个相机坐标系之间的关系。两者是从图像恢复度量几何(深度、尺度、位移)的基础标定量。
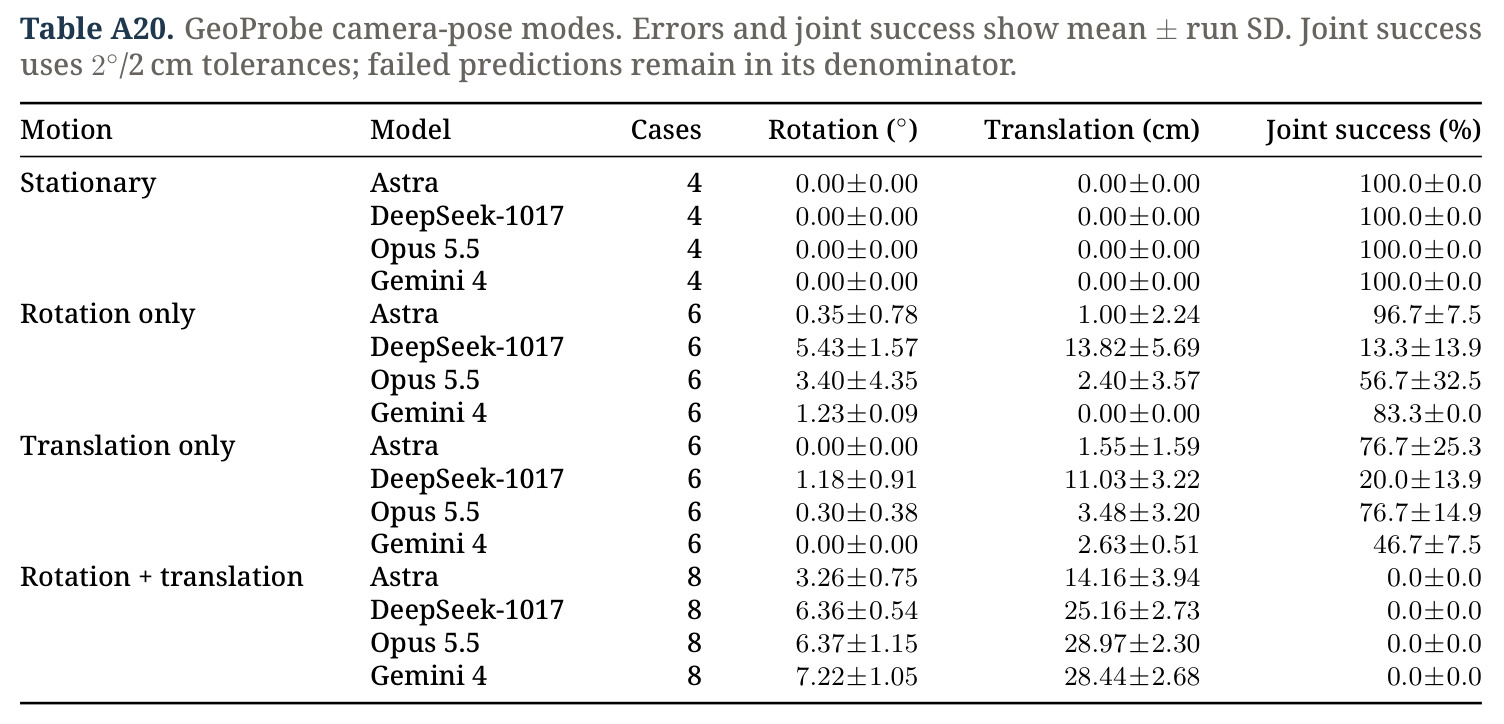
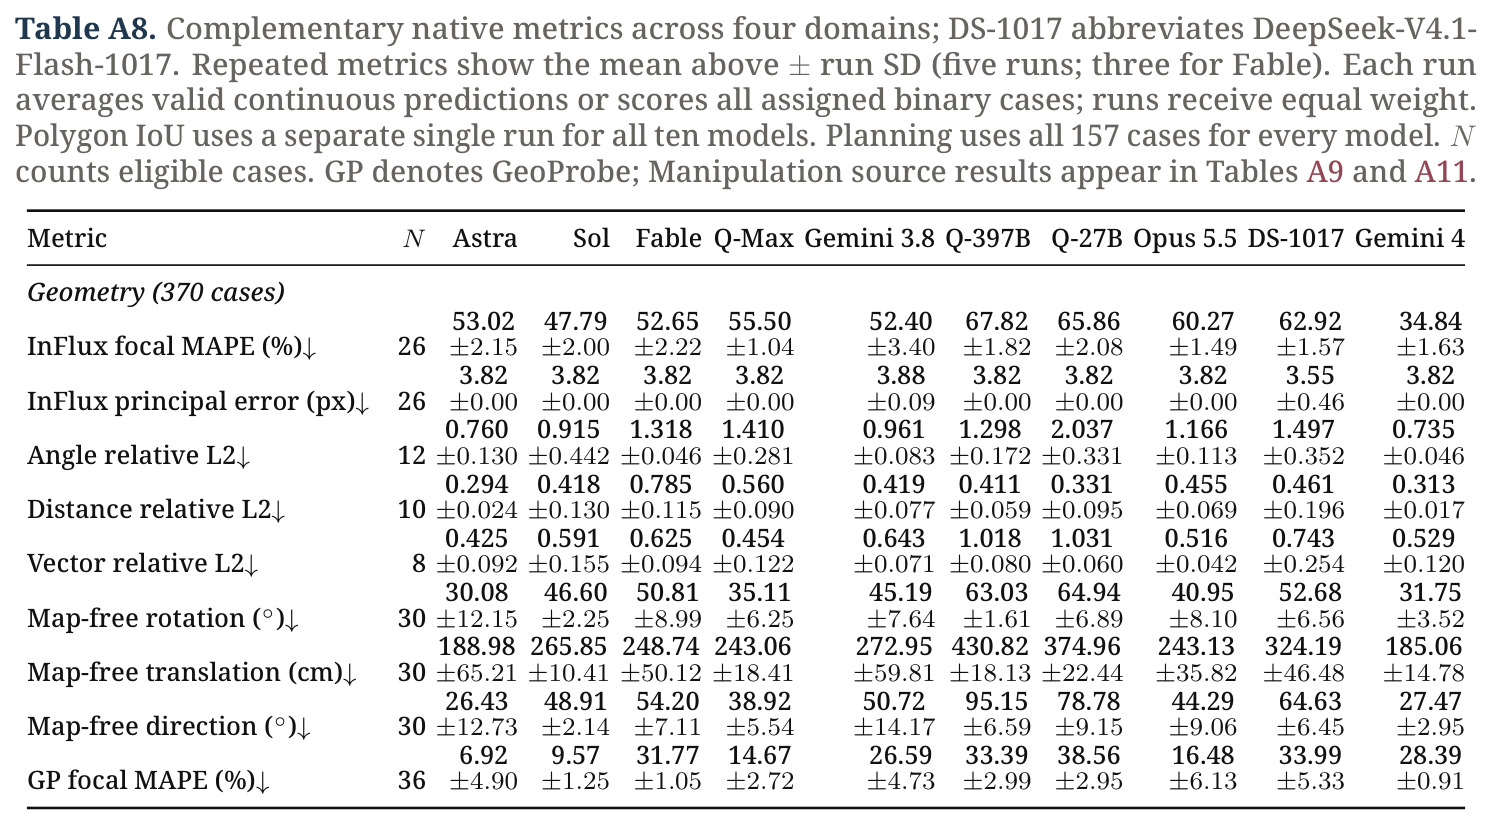
Geometry 域与自建的 GeoProbe 基准直接考察这些量的估计精度,主表中的旋转误差(度)与平移误差都定义在其上。
可供性
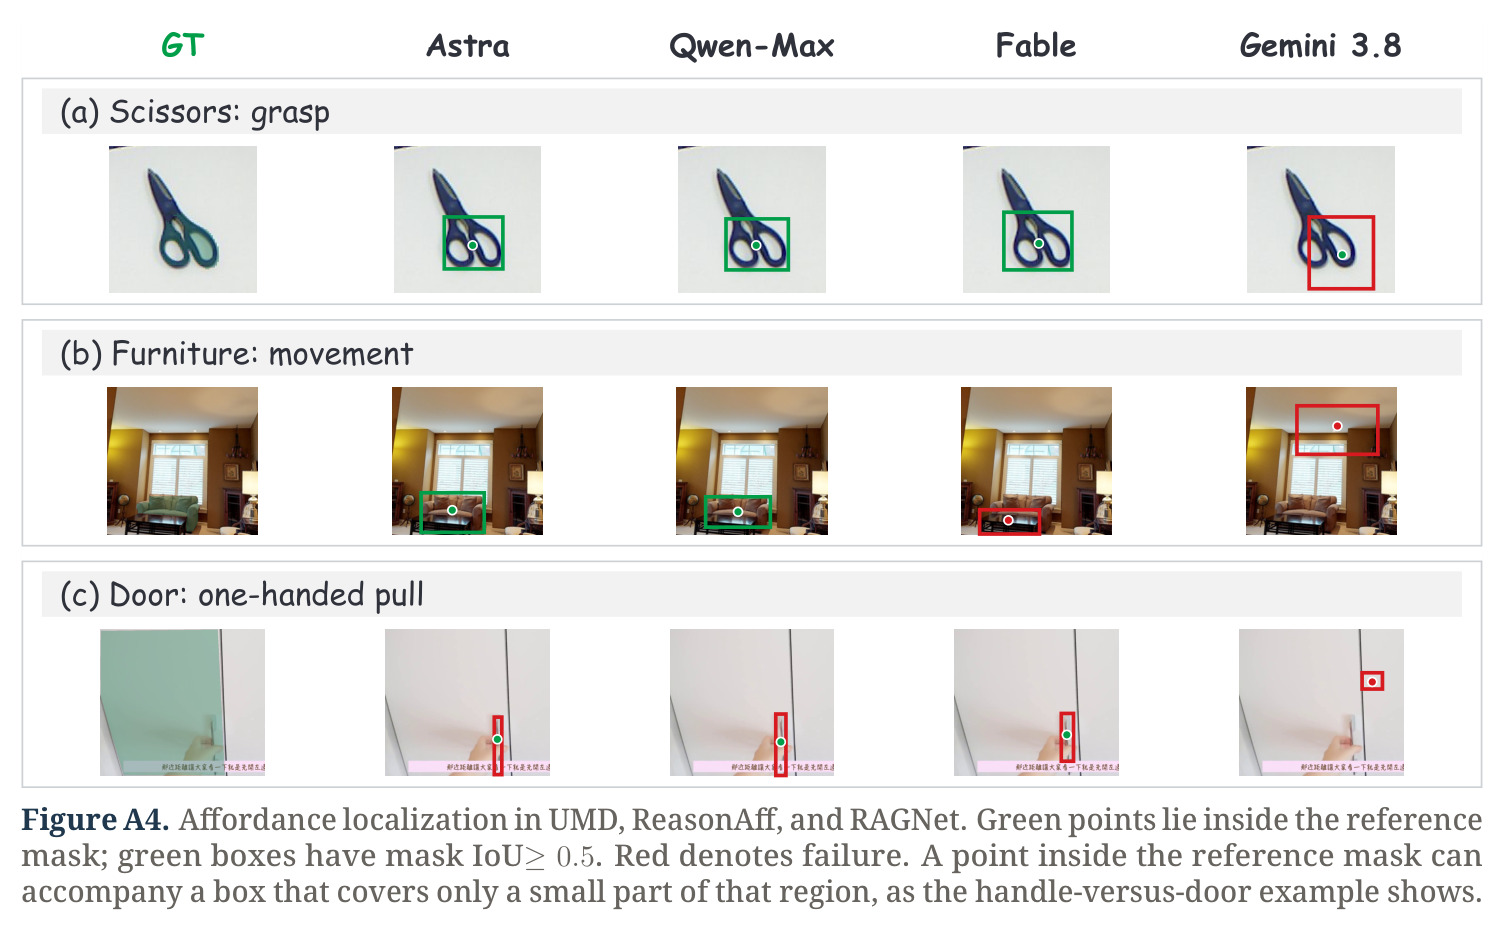
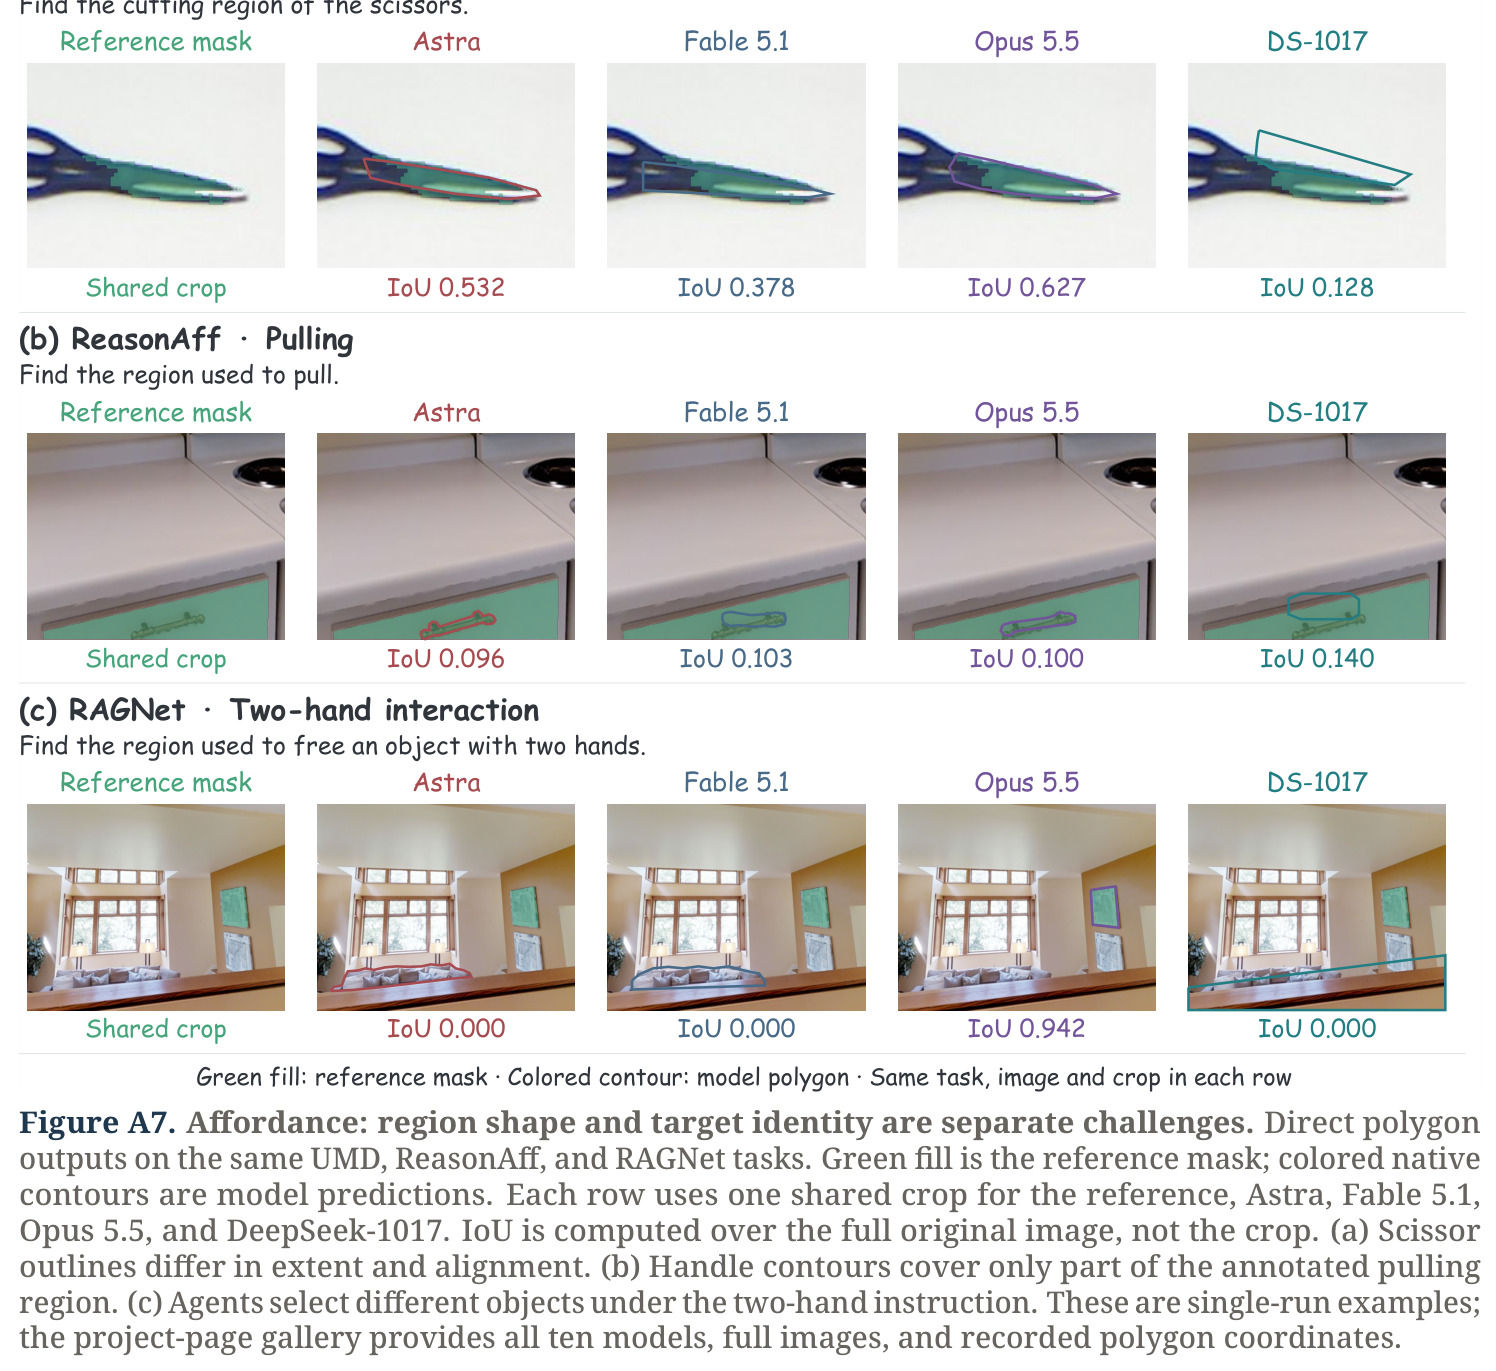
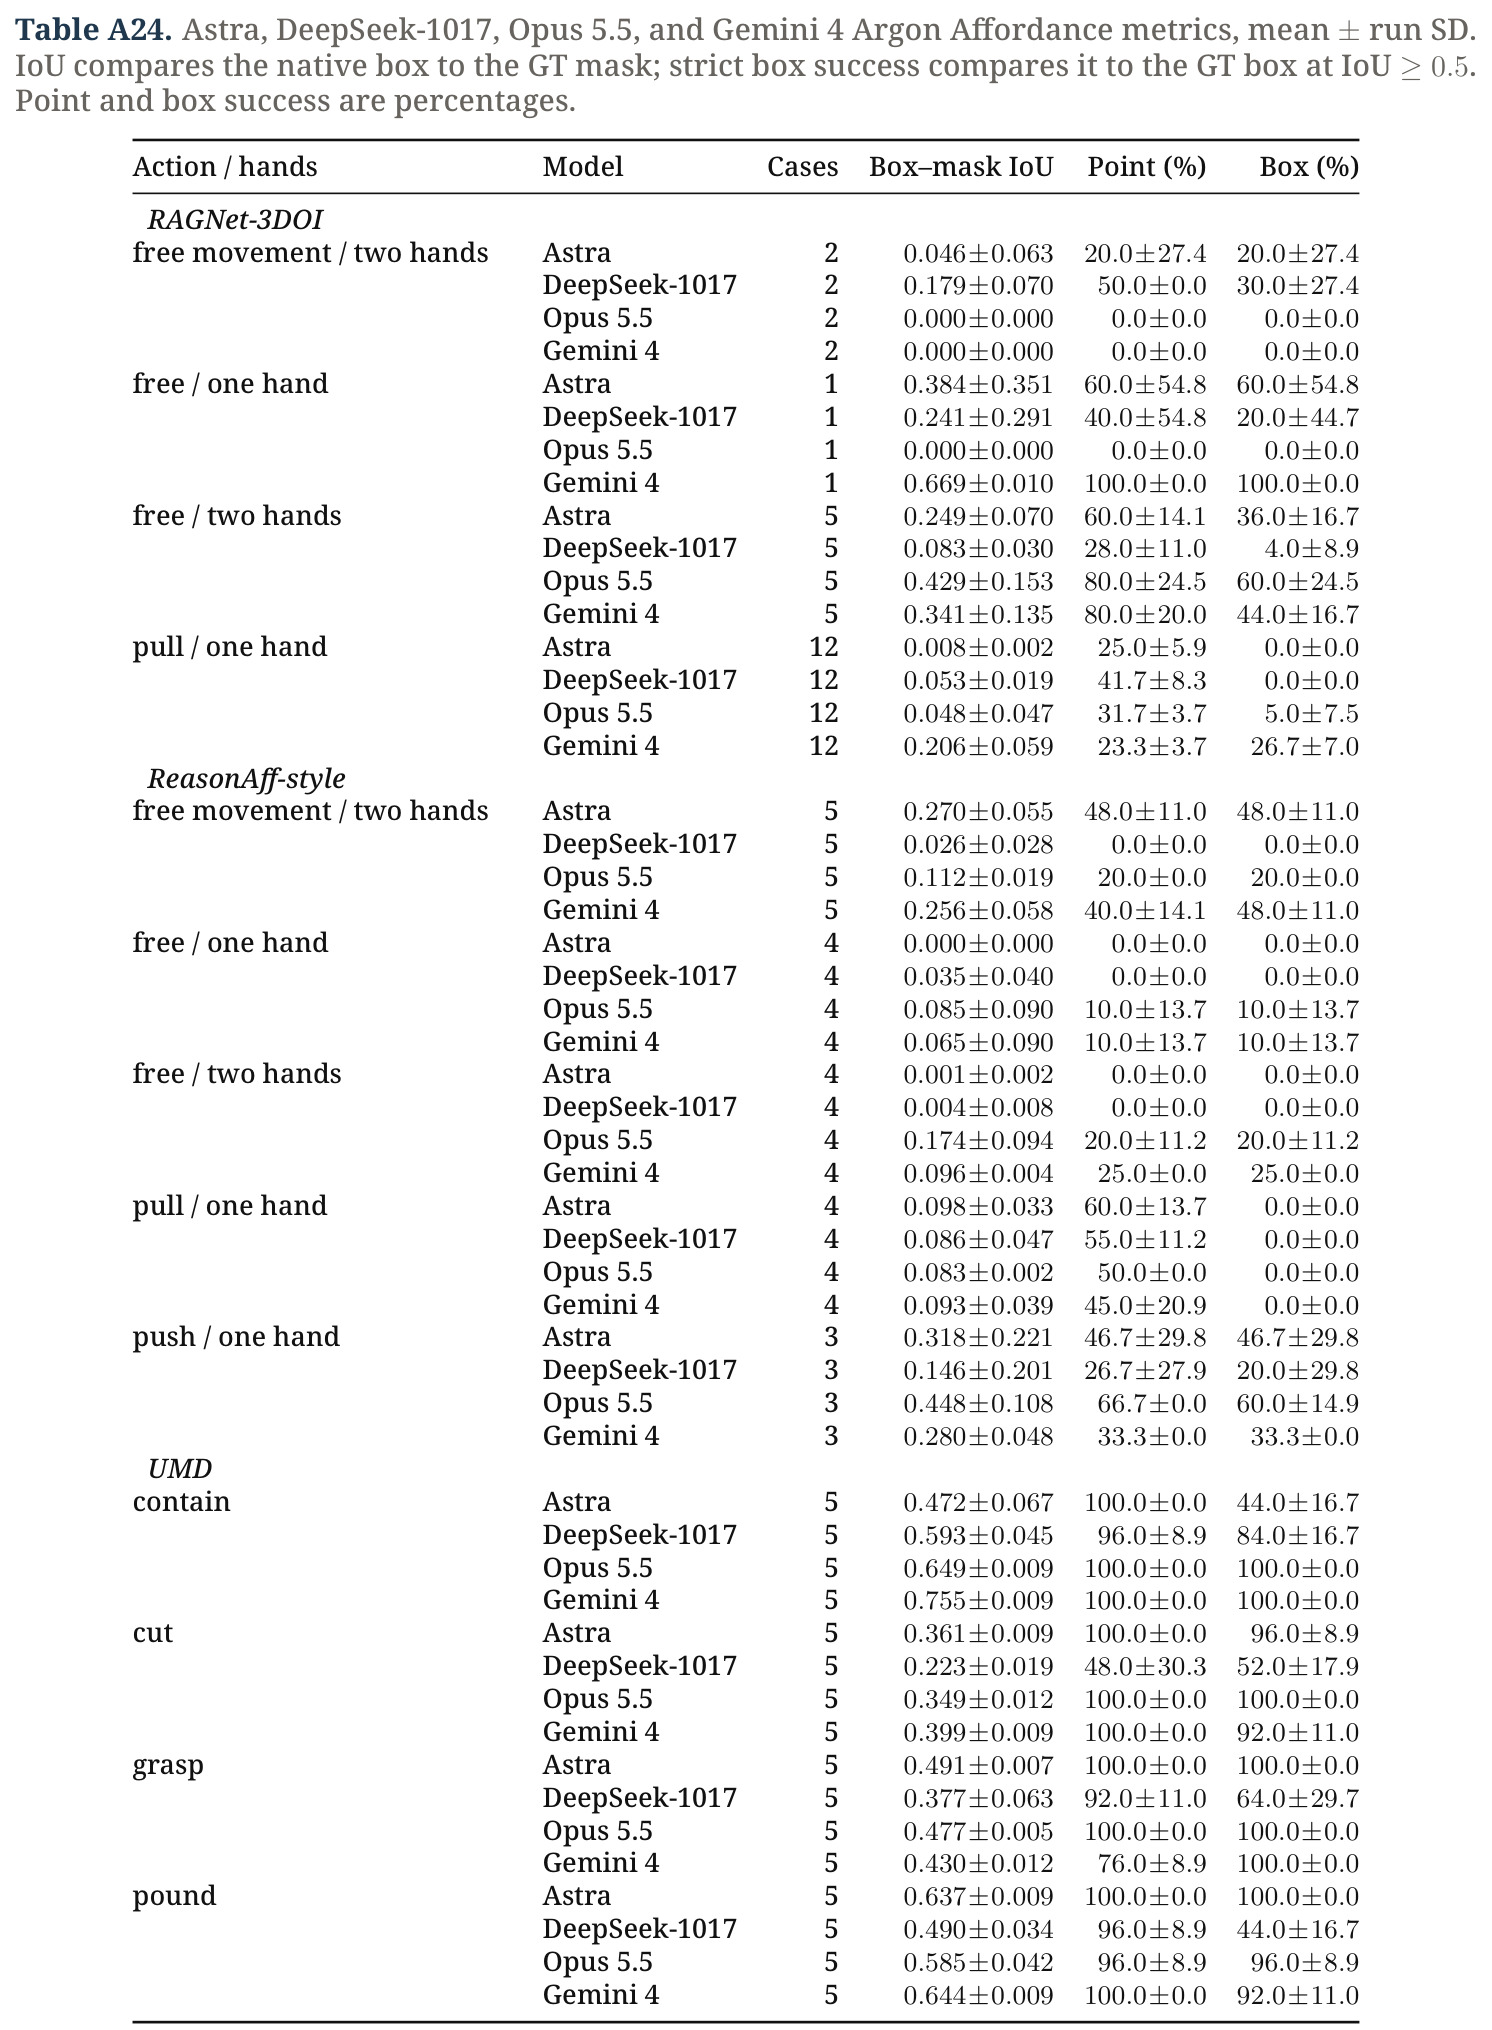
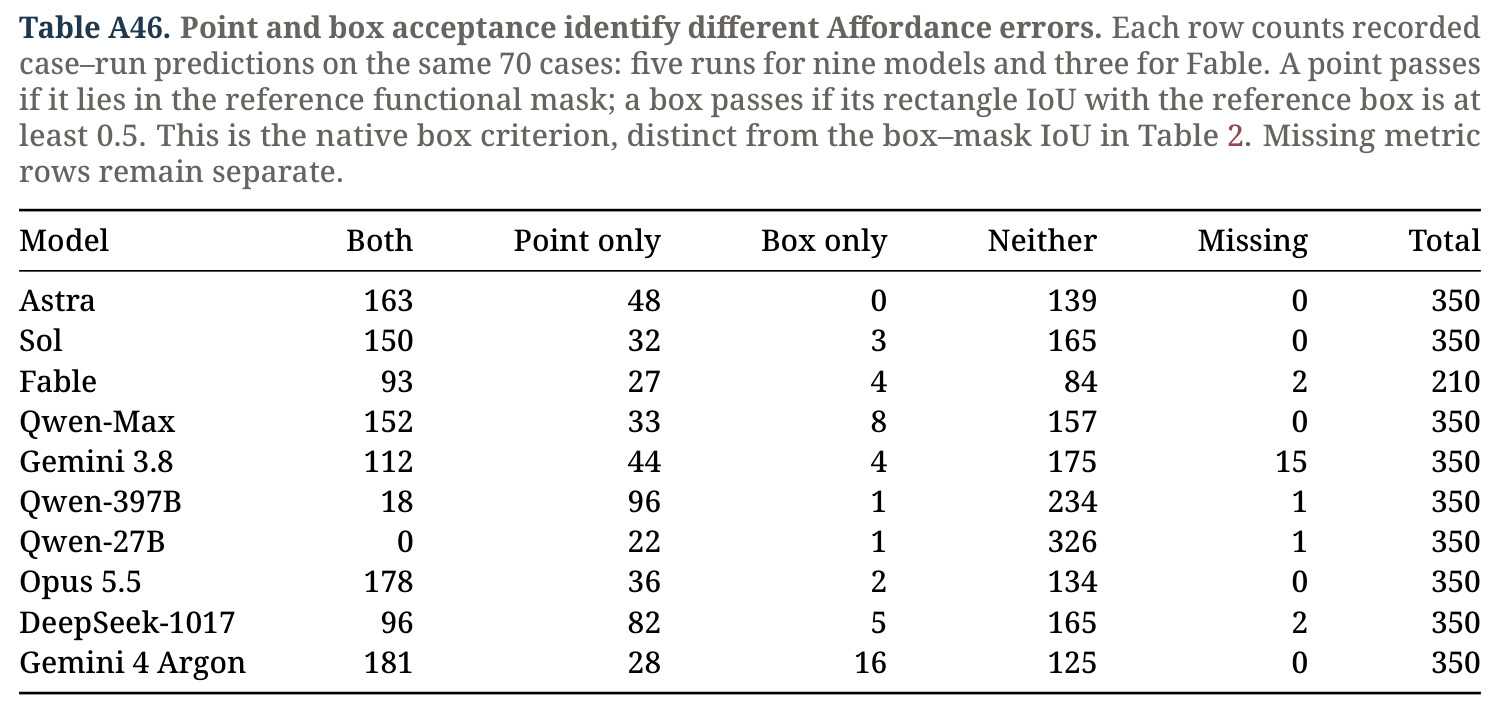
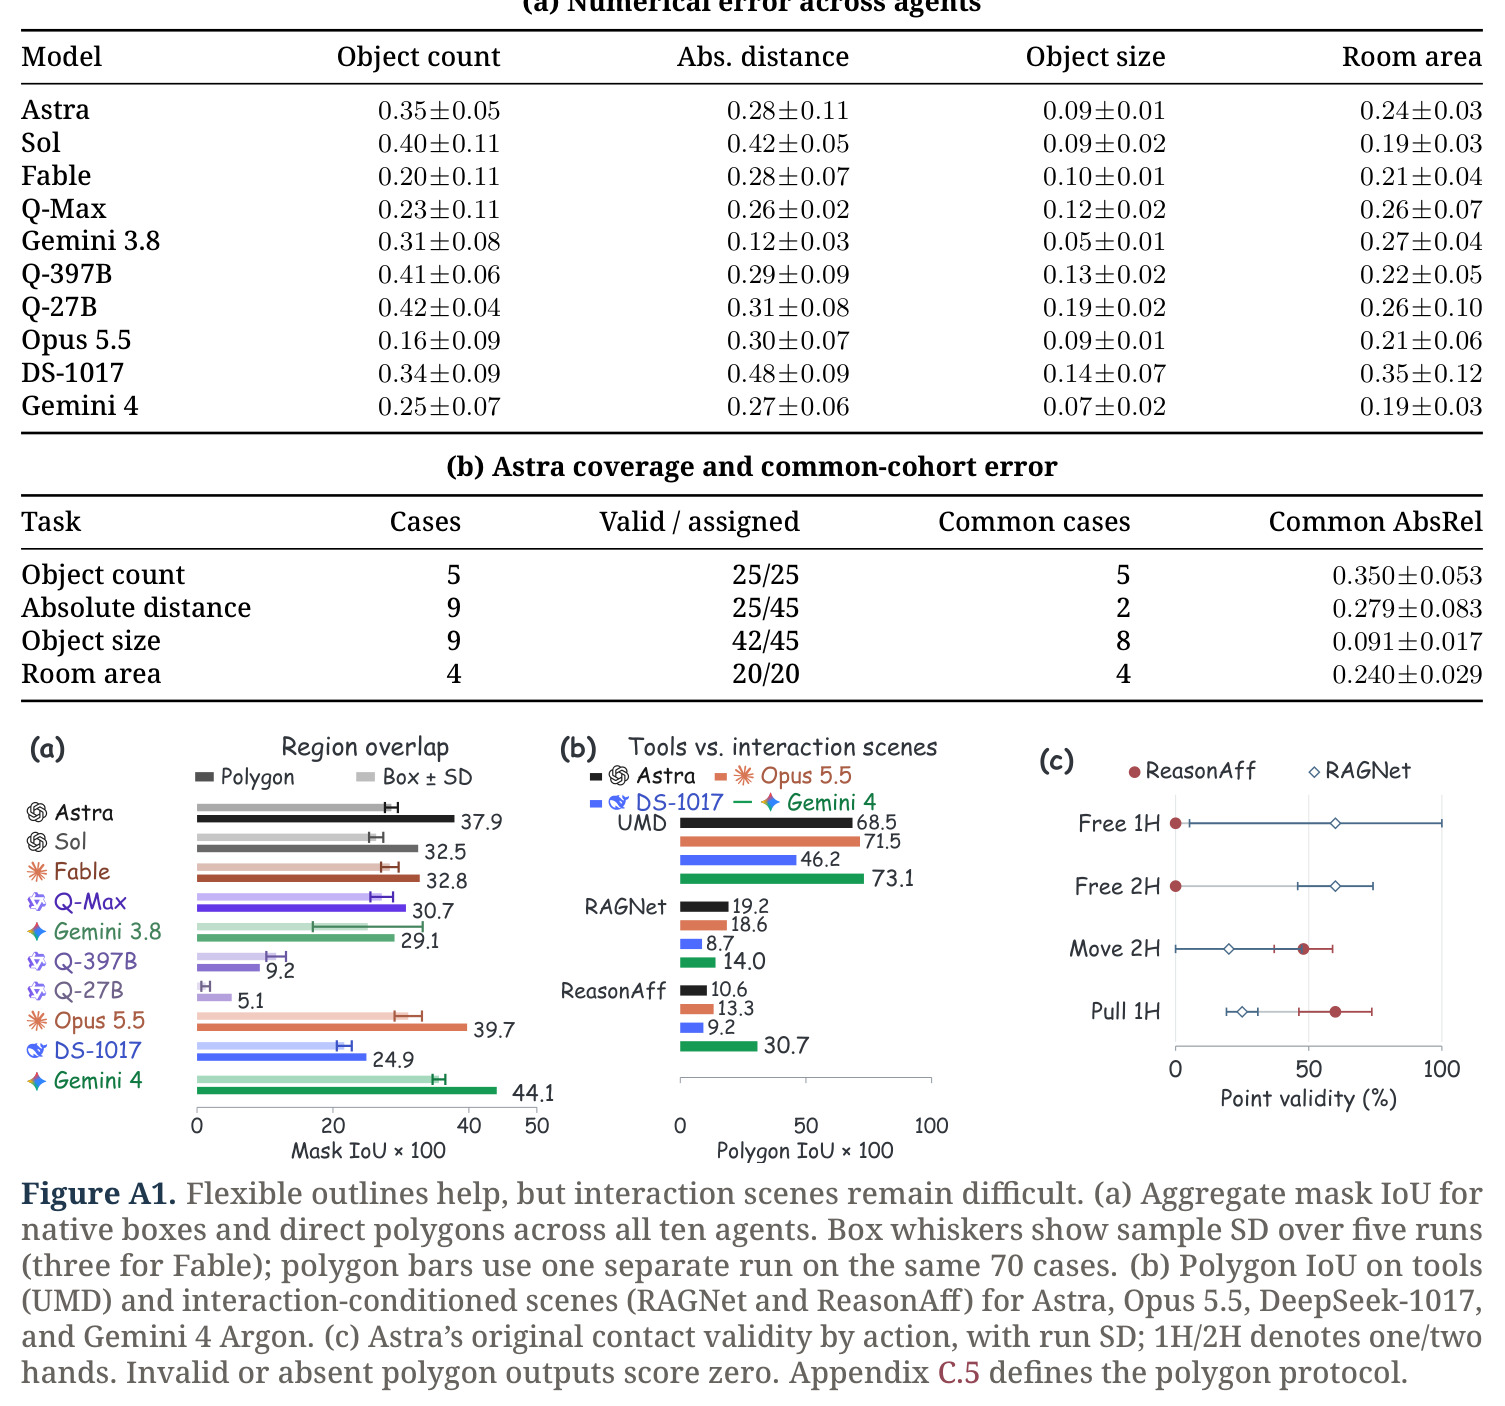
指场景中支持某个动作的功能区域:哪里能抓取、哪里能舀取、拉抽屉该接触哪个部位。评测上通常用接触点是否落在参考掩码内(point validity)与预测区域和参考掩码的重叠度(IoU)两个互补标准来度量。
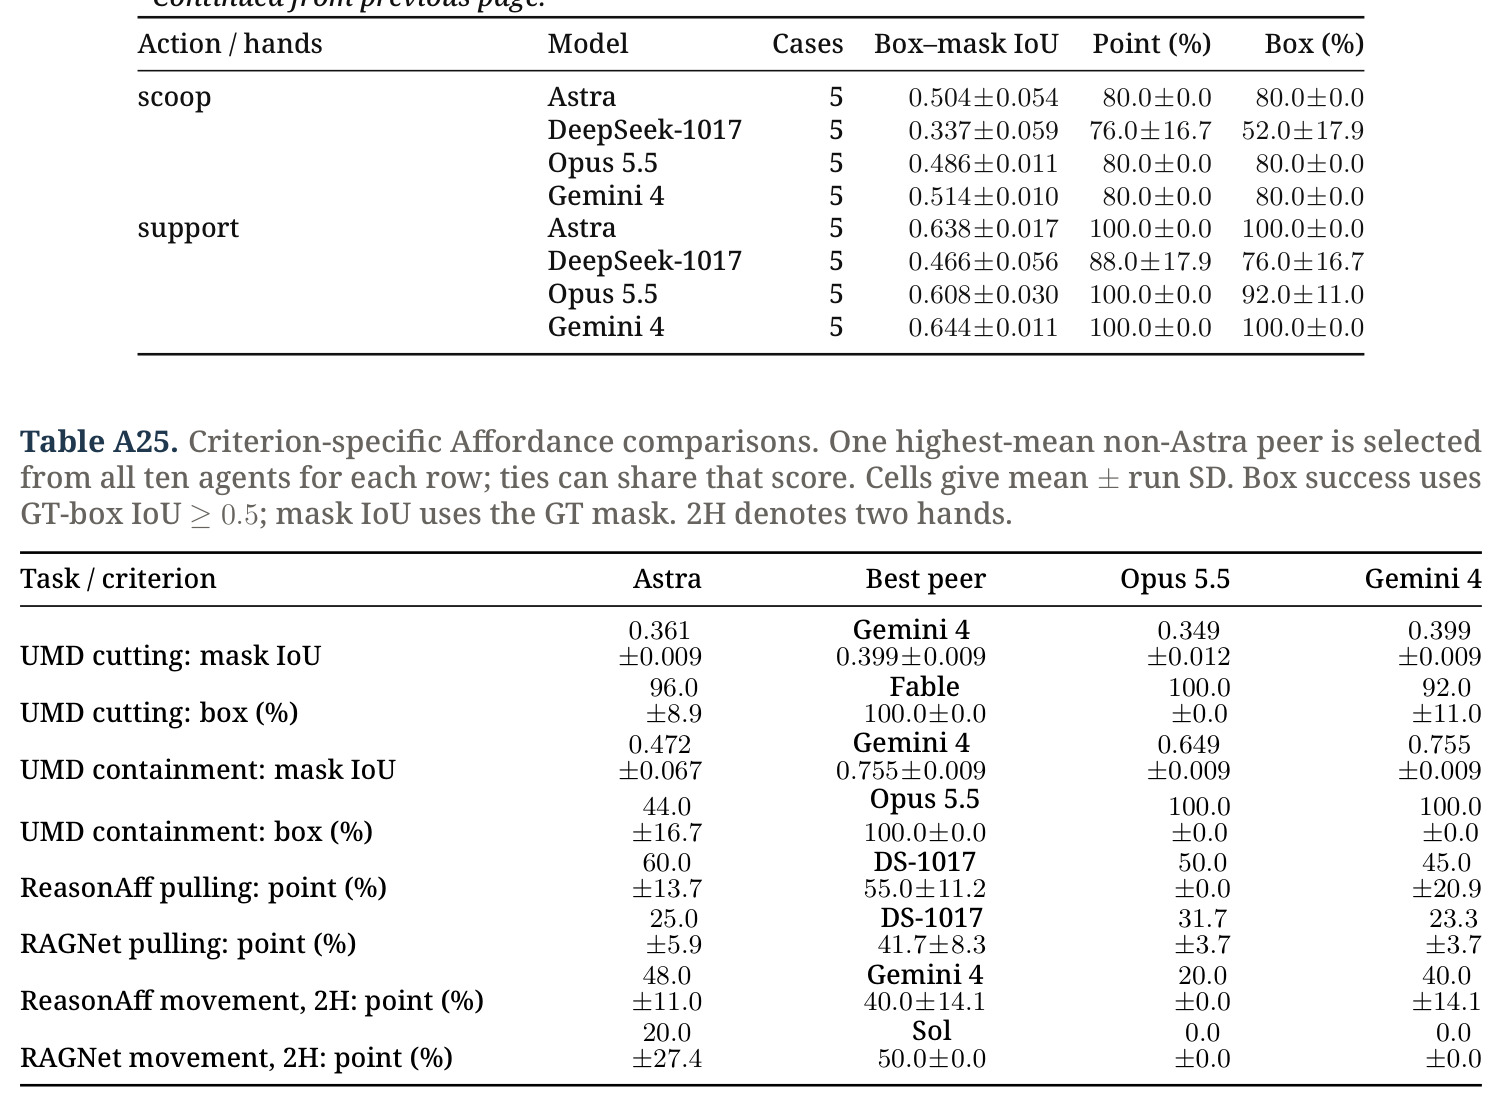
Affordance 域的核心概念;论文最重要的诊断之一是“区域框对了、动作点仍无效”也算失败,二者是不同的任务要求。
AbsRel 与 MAE 误差指标
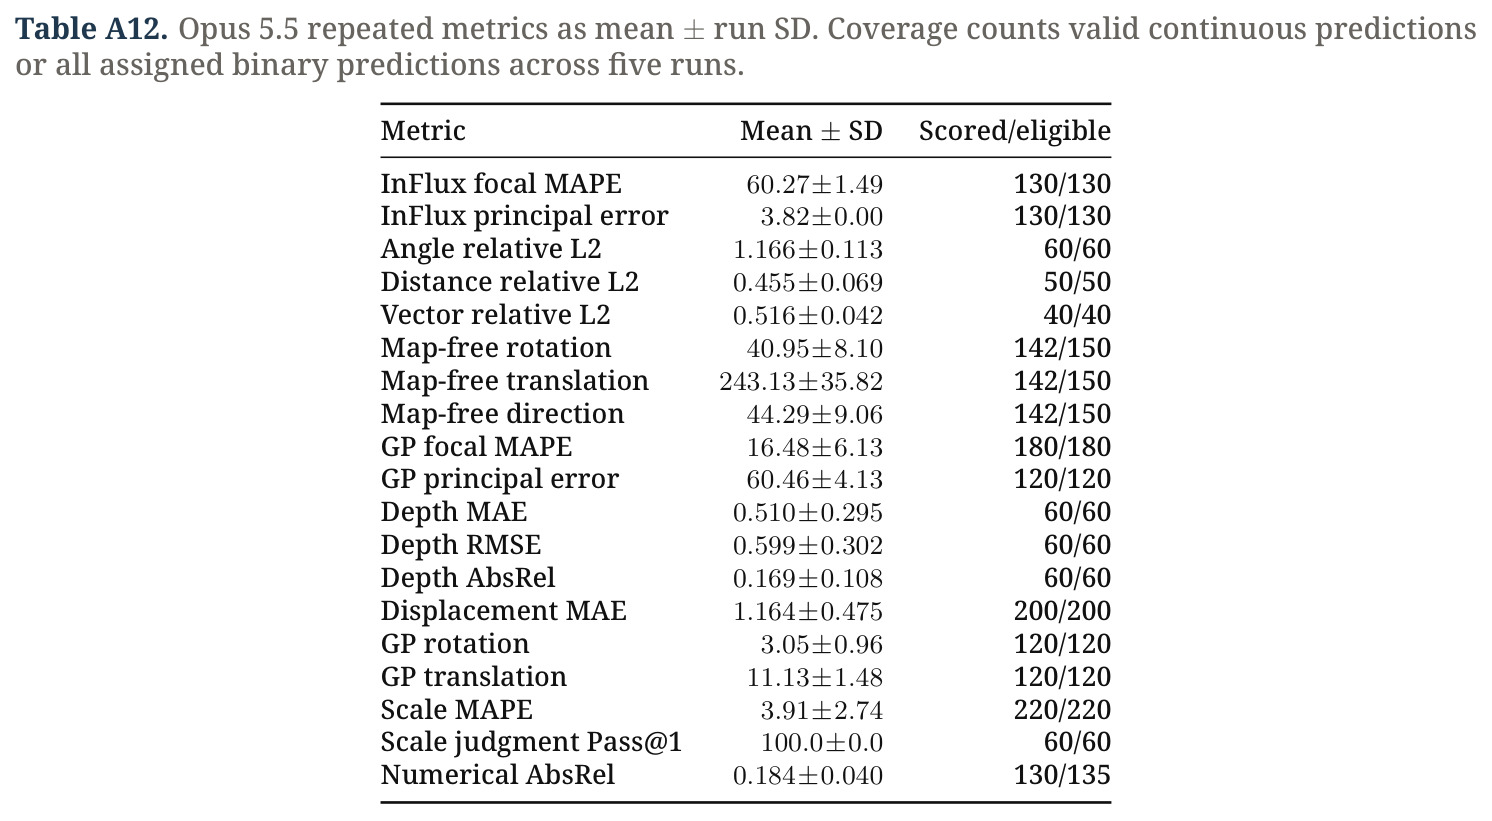
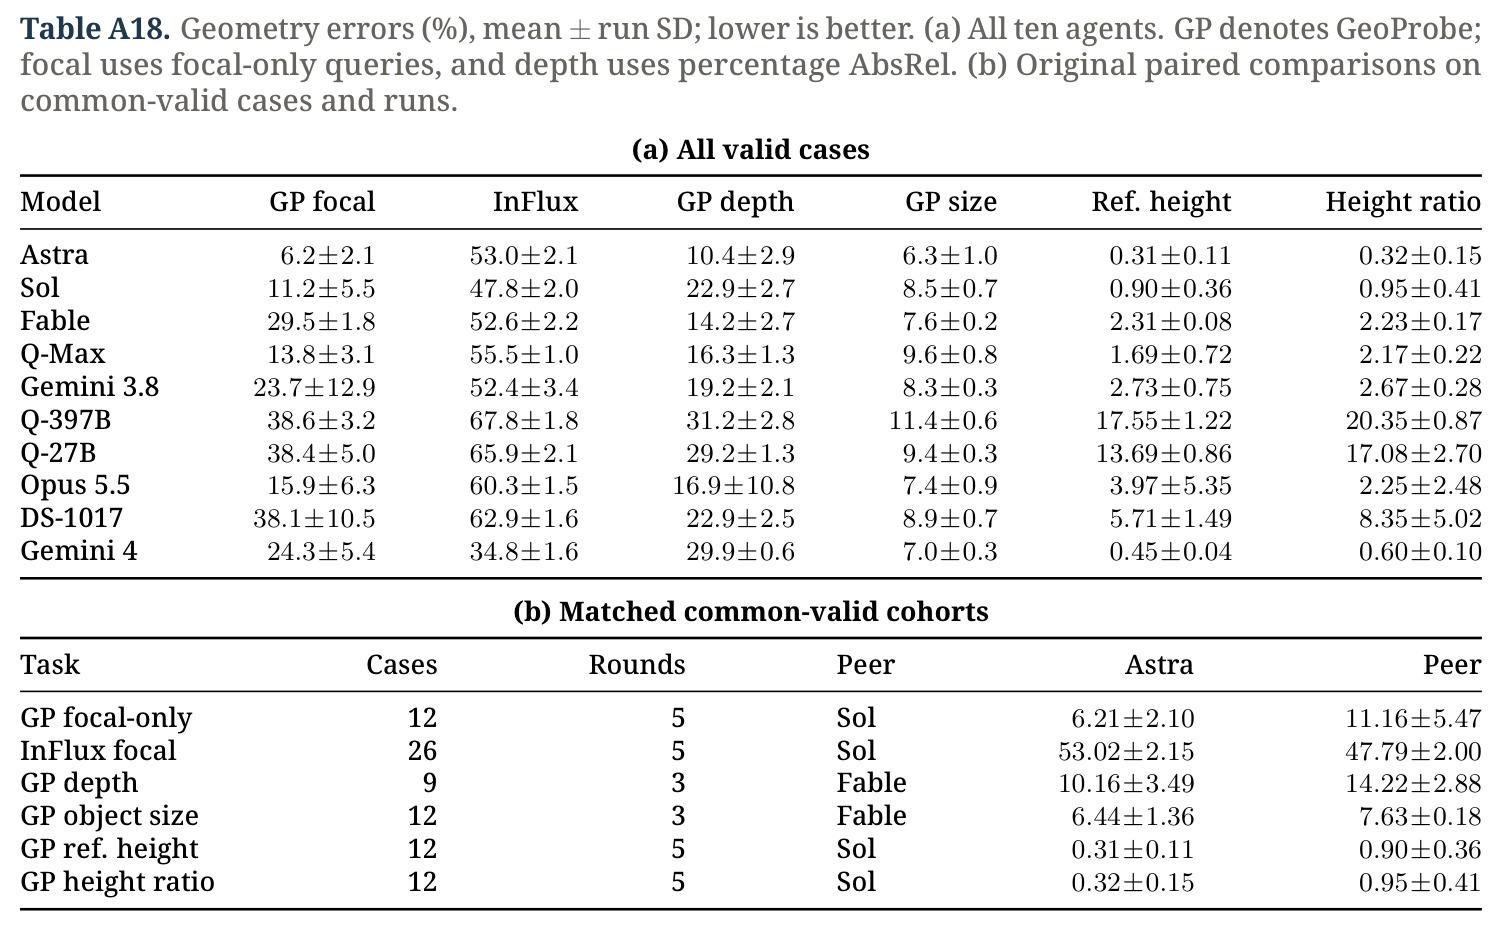
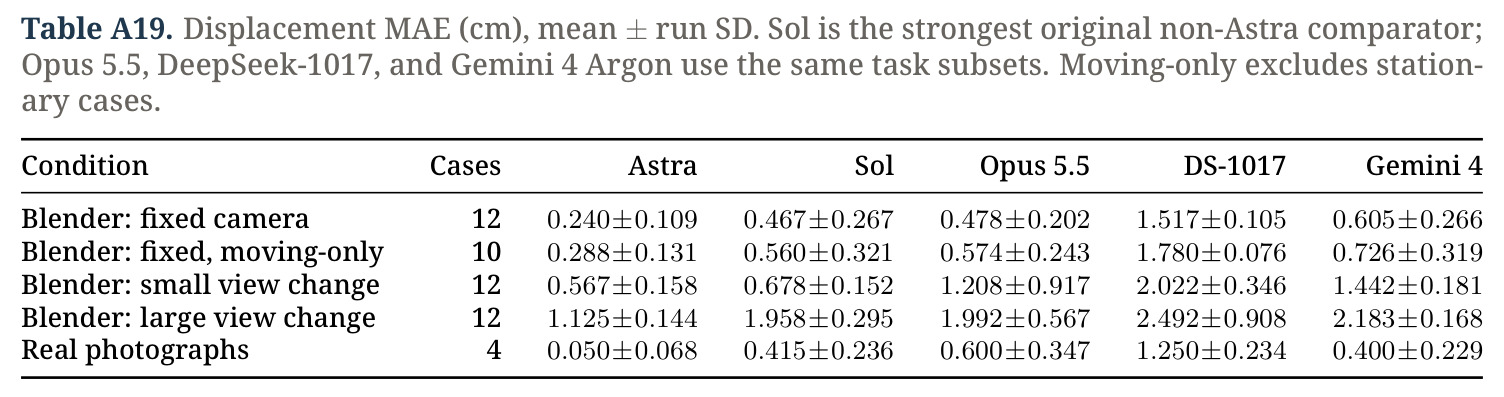
AbsRel 是相对绝对误差 $\frac{1}{N}\sum_i \frac{|d_i-\hat{d}_i|}{d_i}$,常用于深度估计;MAE 是平均绝对误差,本文用于位移估计(单位 cm)。数值越小越好。论文还引入 oracle 尺度对齐:对每个案例乘以最优标量后再算误差,用于分离全局尺度偏差与残余形变。
Table 2 与 GeoProbe 诊断全部依赖这些指标;不做尺度对齐分析,就会把病因完全不同的模型混在同一平均分里。
IoU(交并比)
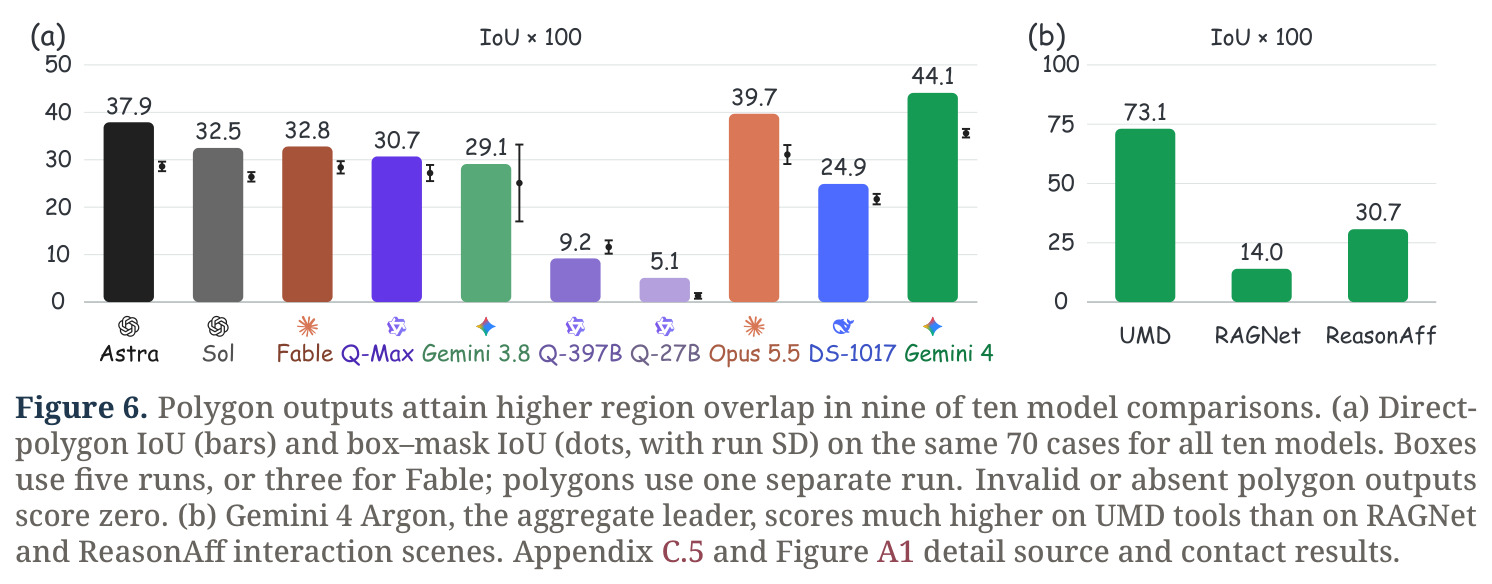
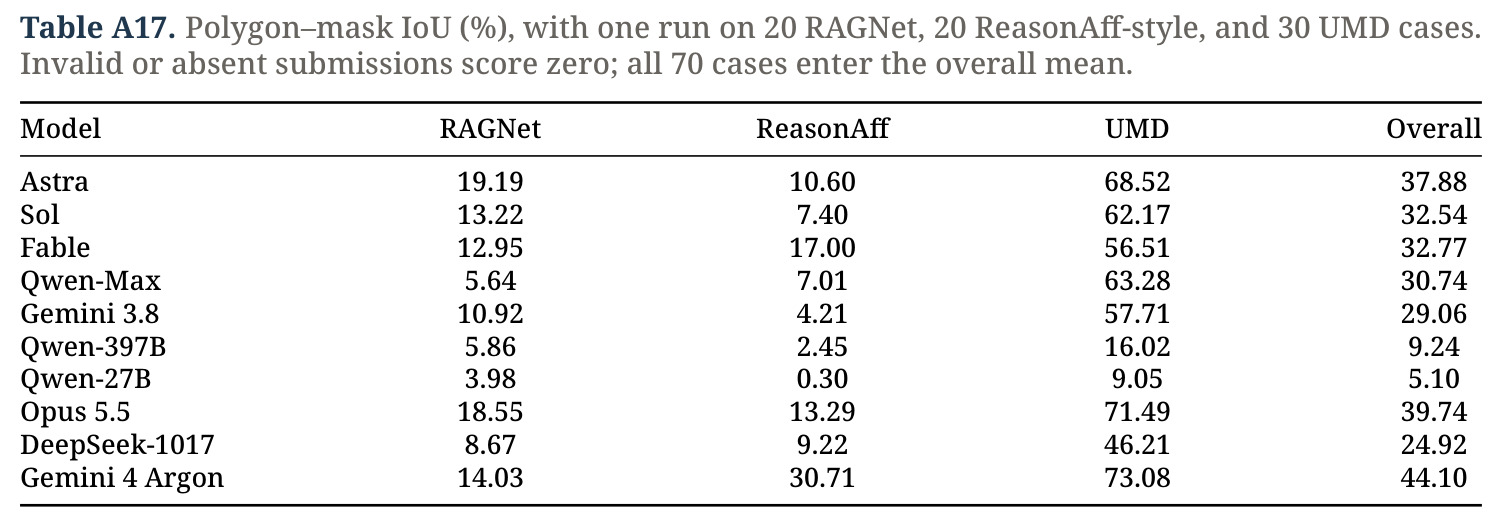
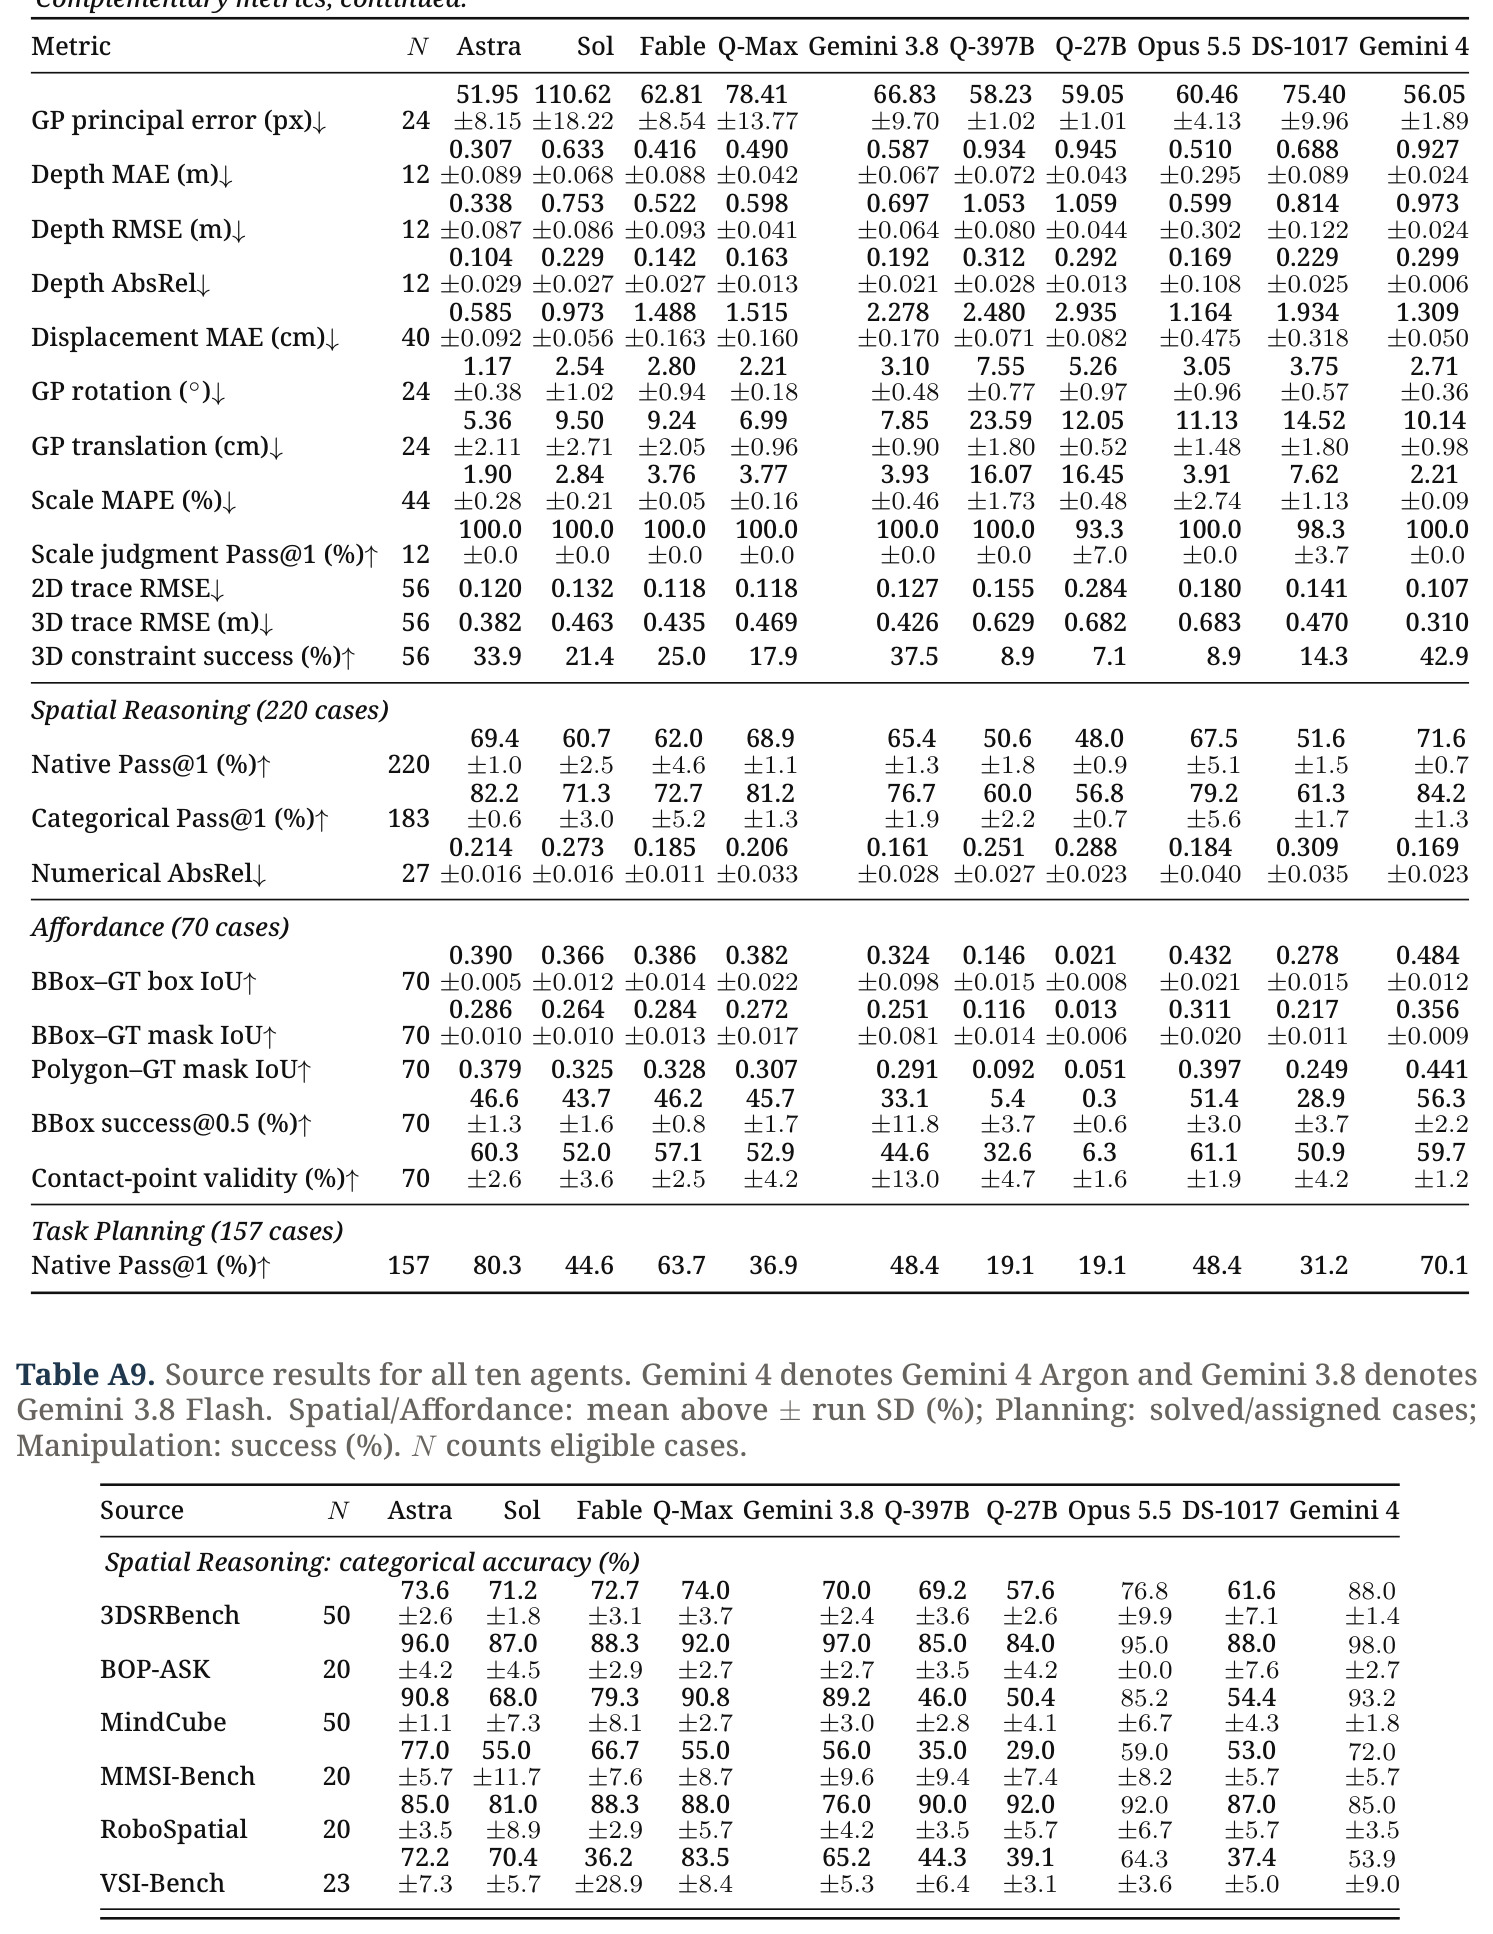
两个区域的交集面积与并集面积之比 $IoU=\frac{|A\cap B|}{|A\cup B|}$,取值 0 到 1,衡量预测掩码或外接框与参考掩码的重叠程度。本文在同一批 70 个可供性案例上分别用原生矩形(box–mask IoU)与直接多边形(polygon–mask IoU)两种输出格式计算。
可供性域的主指标;论文用它区分“框住了对象”与“覆盖了功能支撑区域”这两种精度层级。
Pass@1 与任务成功率(SR)
Pass@1 表示单次尝试即通过判据的比例;任务成功率 SR 要求环境终态满足全部目标谓词 $g_1,\dots,g_K$,是比“代码执行无报错”严格得多的标准。本文的完整成功判据为 $\mathrm{Success}(s_T,g)=\mathbb{1}\big[\bigwedge_{k=1}^{K} g_k(s_T)\big]$。
Planning 与 Manipulation 的排名口径;“终止不等于成功”这一关键设计就落在这两个指标的定义上。
研究动机
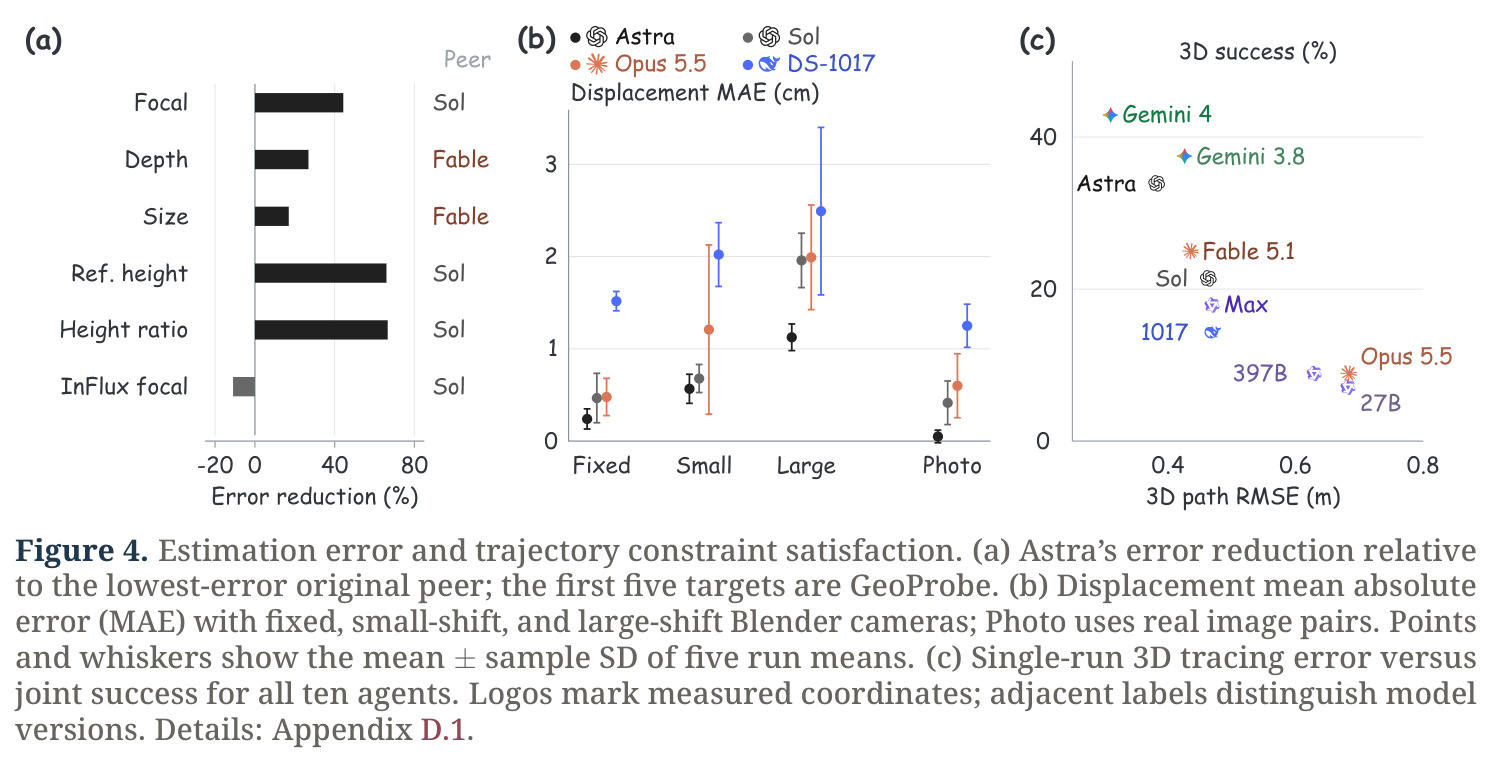
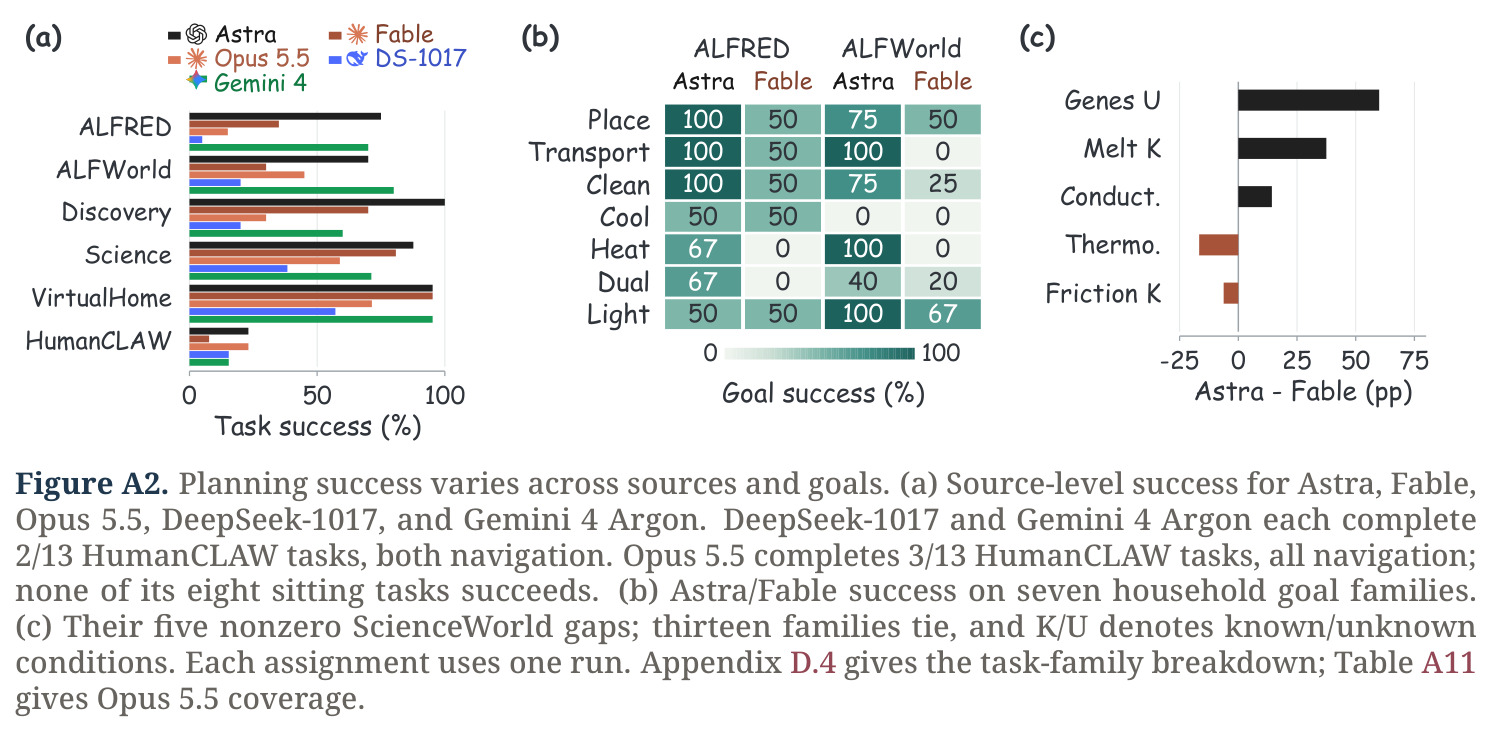
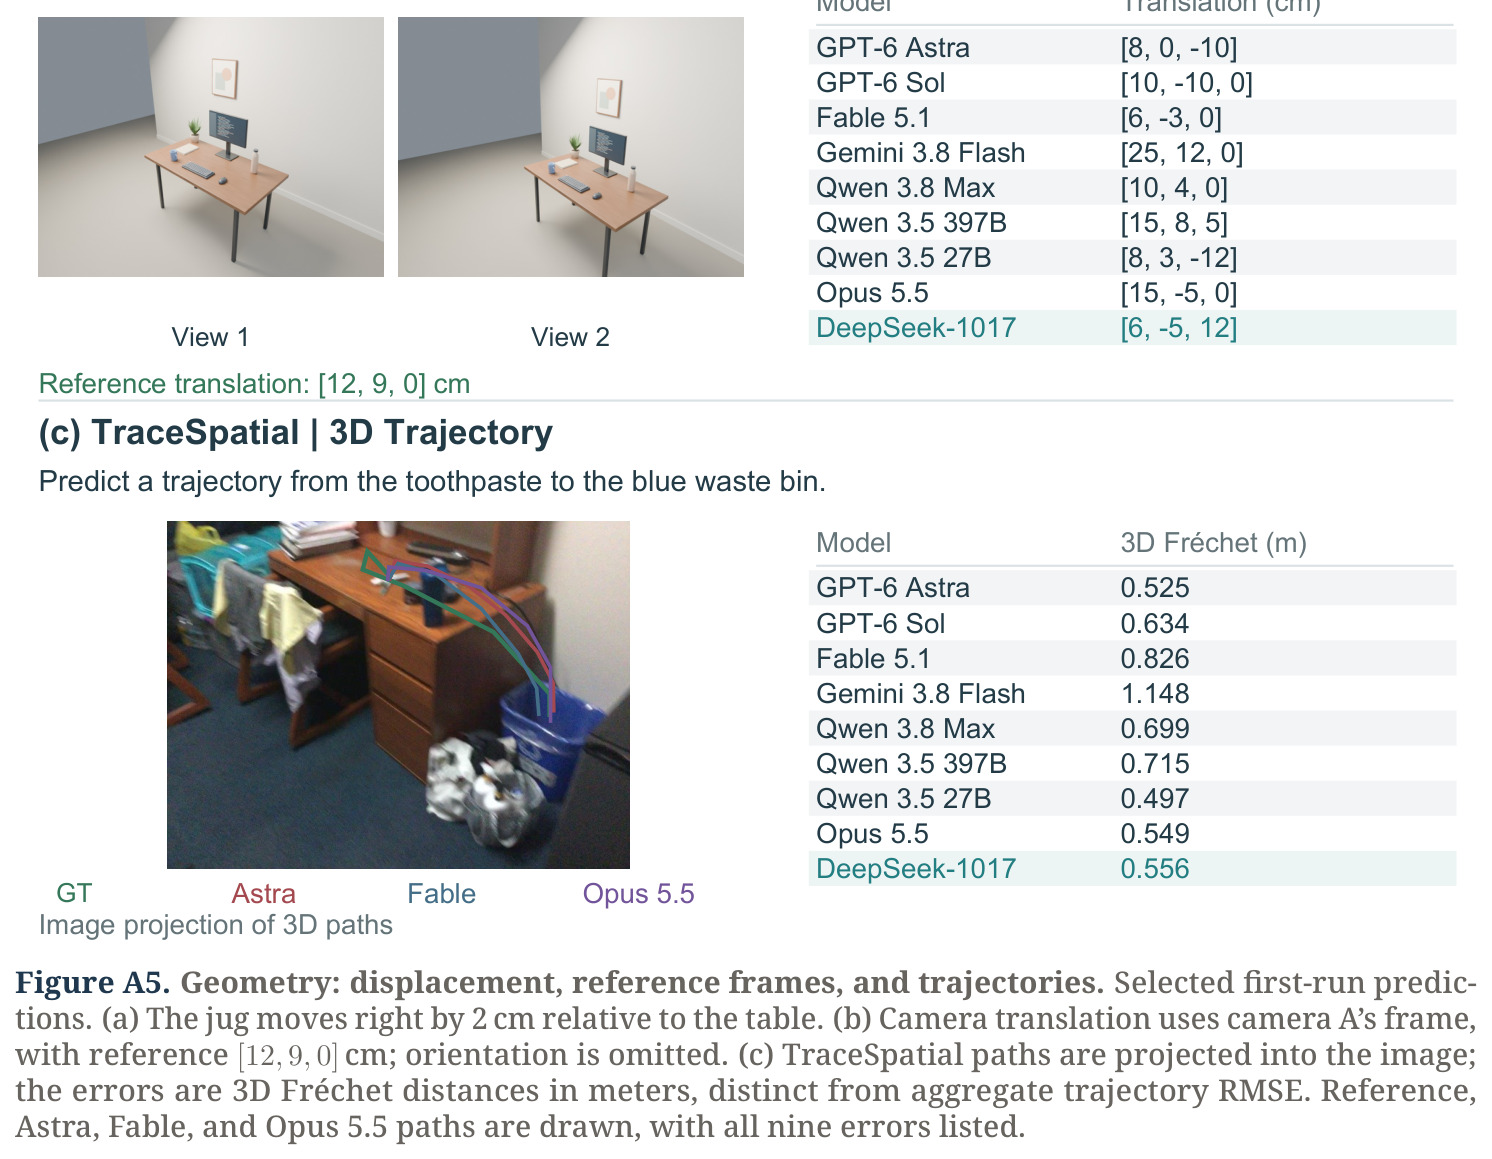
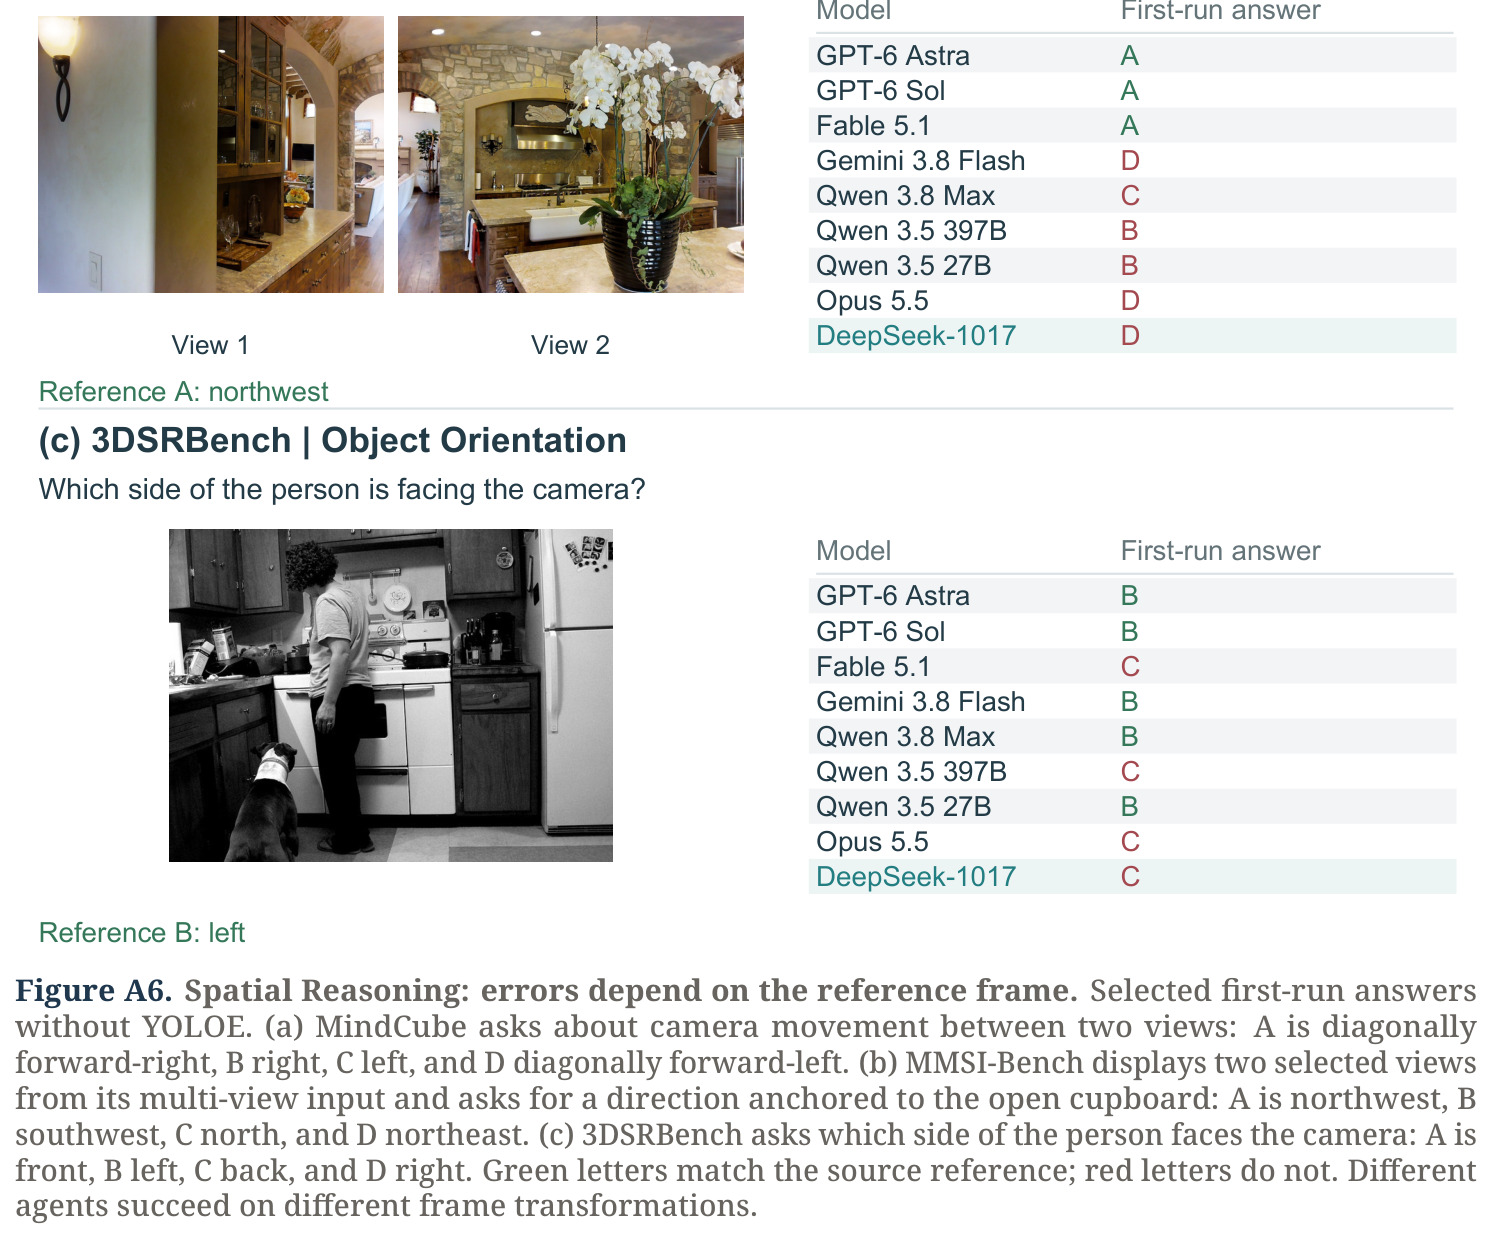
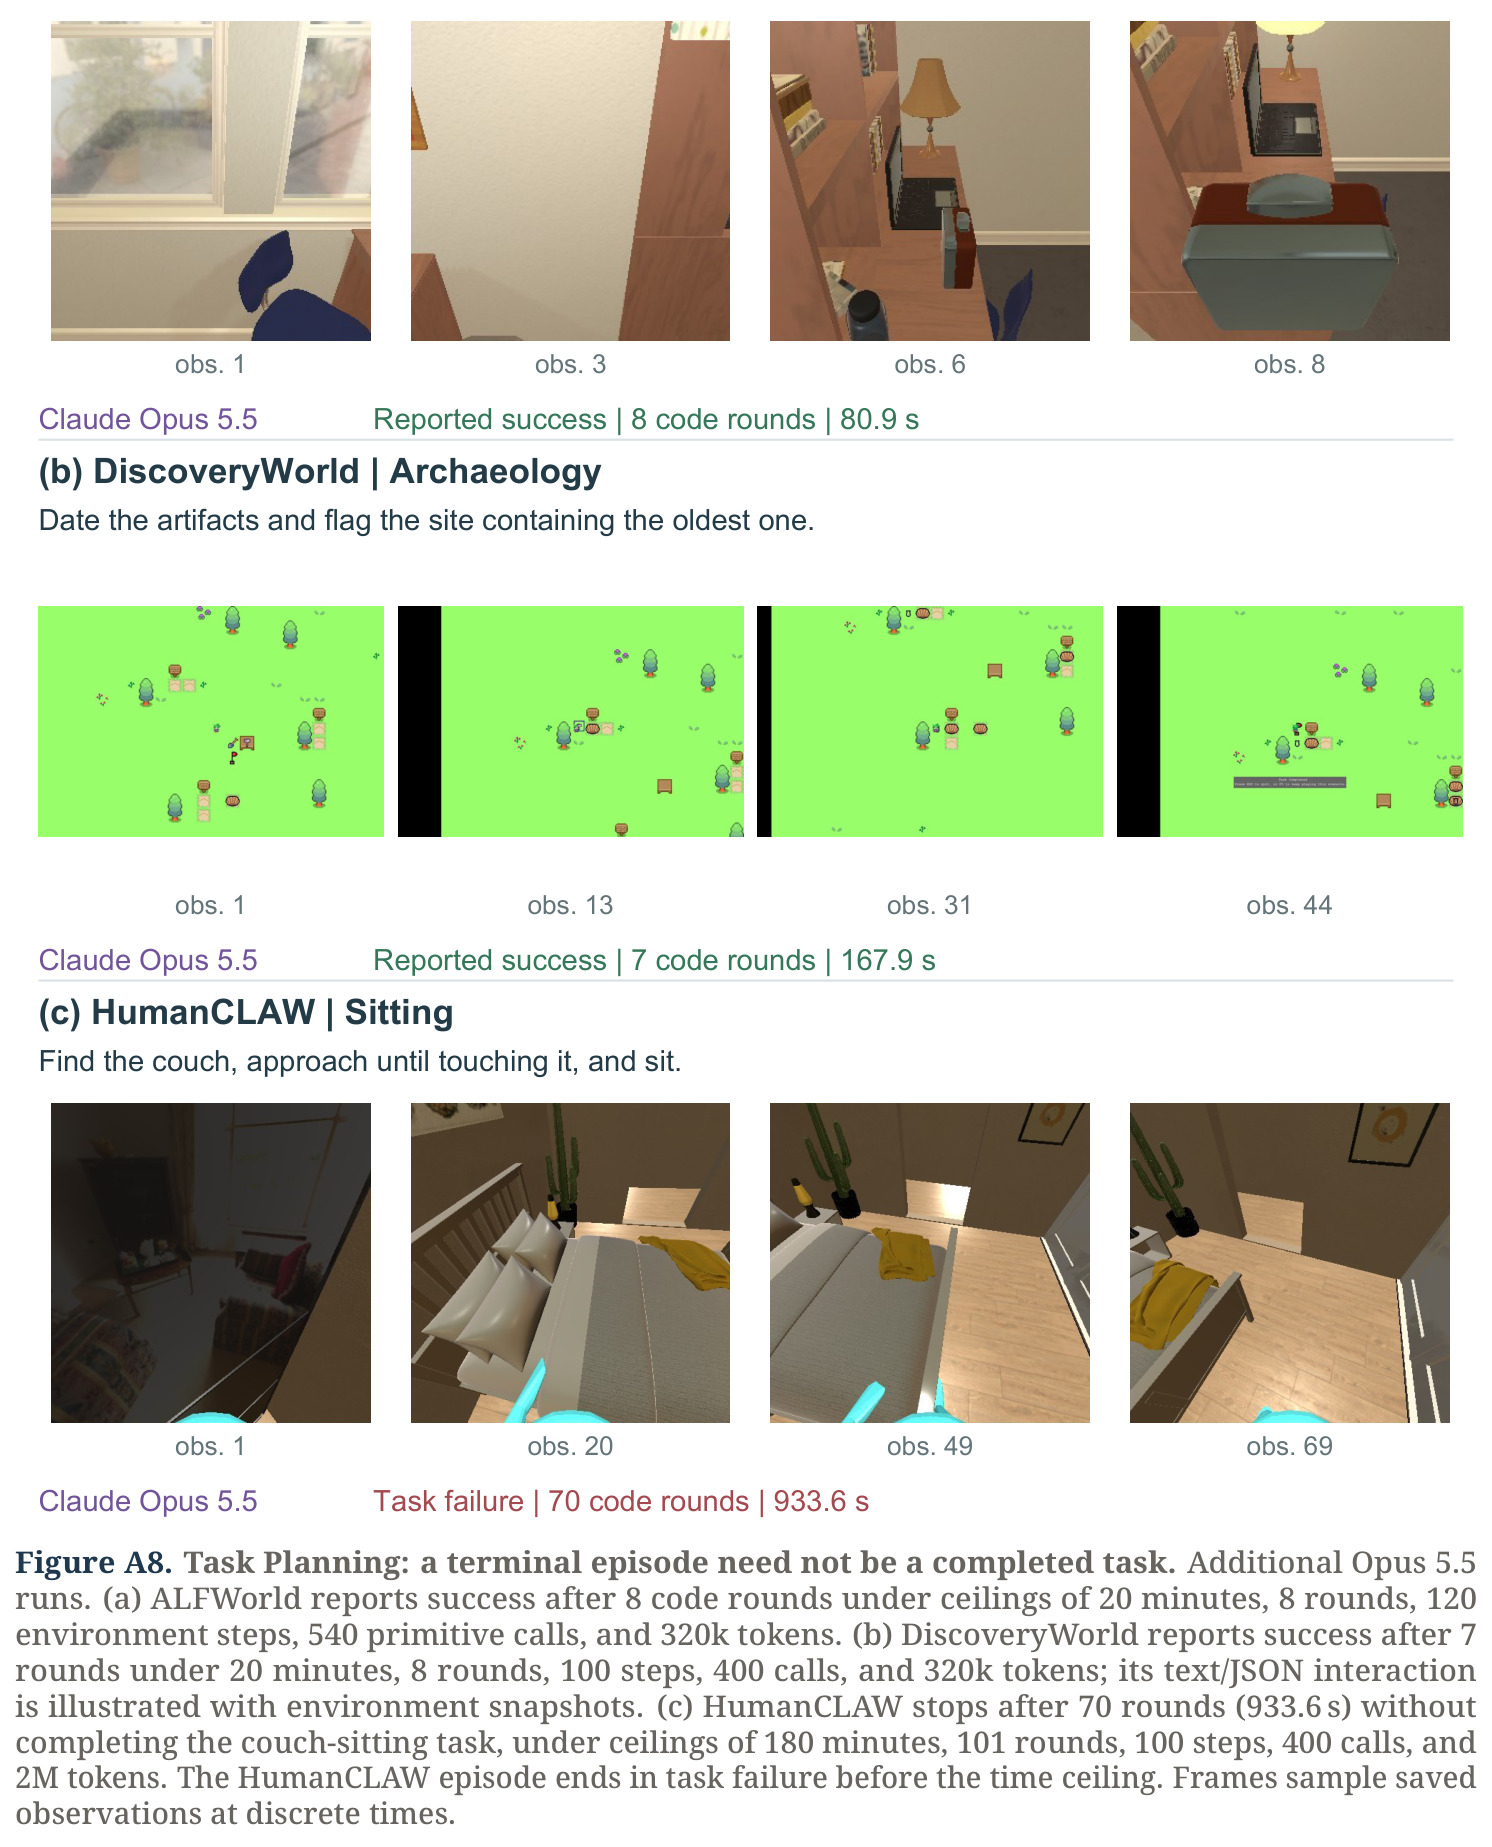
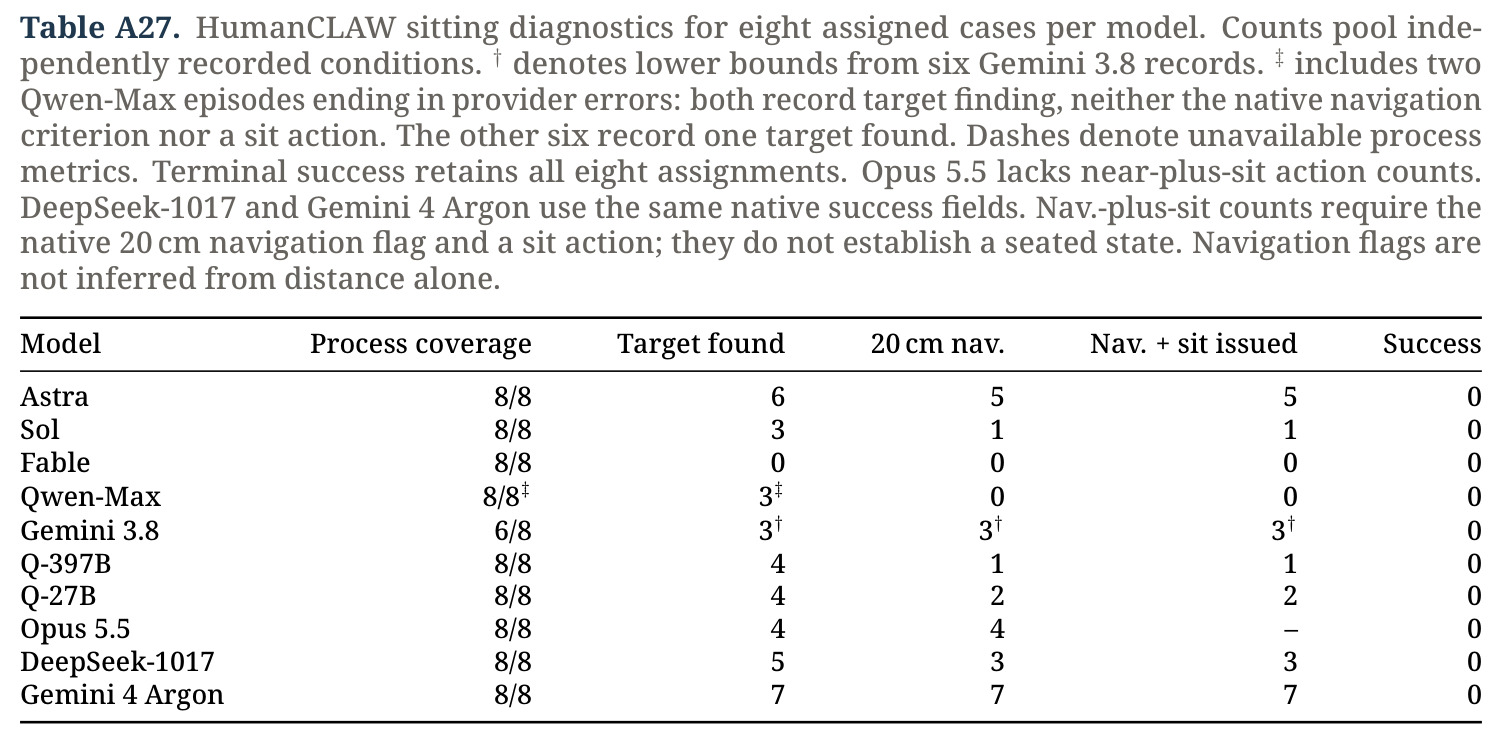
现有具身评测分裂为三类互不衔接的体系:控制套件(LIBERO、RLBench、RoboCasa 等)只测执行与迁移,视觉诊断基准(3DSRBench、MMSI-Bench、VSI-Bench 等)只测空间推理,具身 QA(OpenEQA 等)只测场景级决策。这种割裂造成一个具体盲区:聚合成功率掩盖了失败的结构。论文给出三个典型场景——一条 3D 轨迹可以紧贴参考路径却错过终点区域(Astra 在 56 条 TraceSpatial 路径上命中 35 条的图像端点,其中 21 条仍违反 3D 边界条件);一个智能体可以逼近沙发并发出 sit 指令、甚至自报“已坐下”,但从未建立坐姿这一物理状态(HumanCLAW 的 8 个坐姿任务在所有模型上零成功);两个模型的深度误差相近(Gemini 4 的 AbsRel 0.299 与 Qwen-397B 的 0.312),成因却完全不同——一个是可修复的全局尺度偏差,一个是残余形变。只看最终成功会隐藏已完成的子目标,只看最终失败会隐藏未满足的具体条件,而“预测精度、子目标达成、最终成功”从未被同一框架同时度量,也没有基准同时覆盖标定位姿探针与机械臂操作全链路。
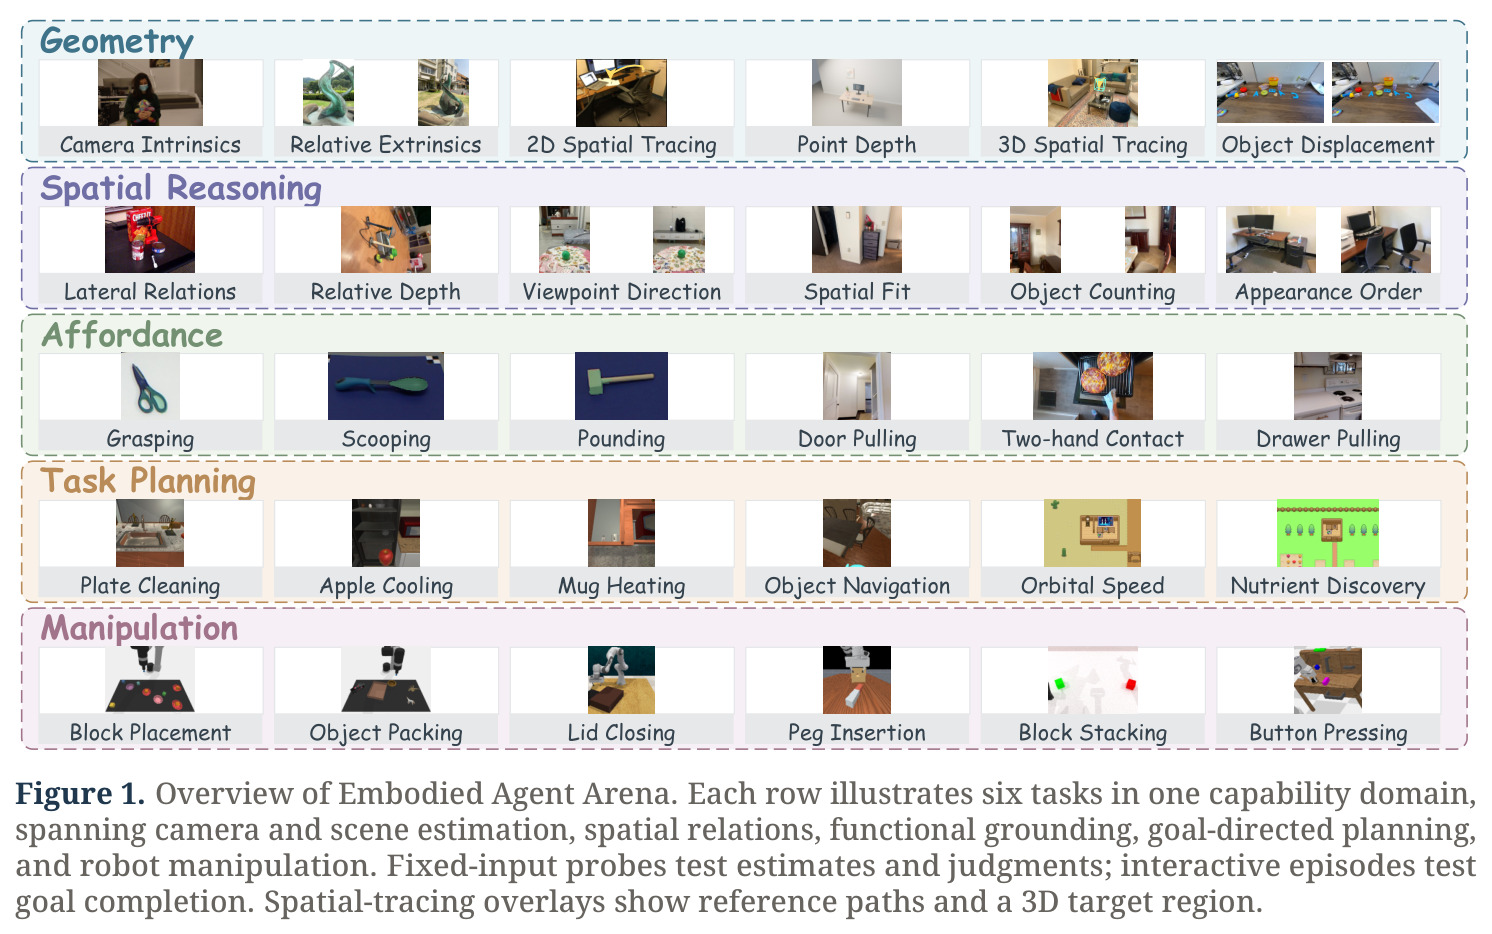
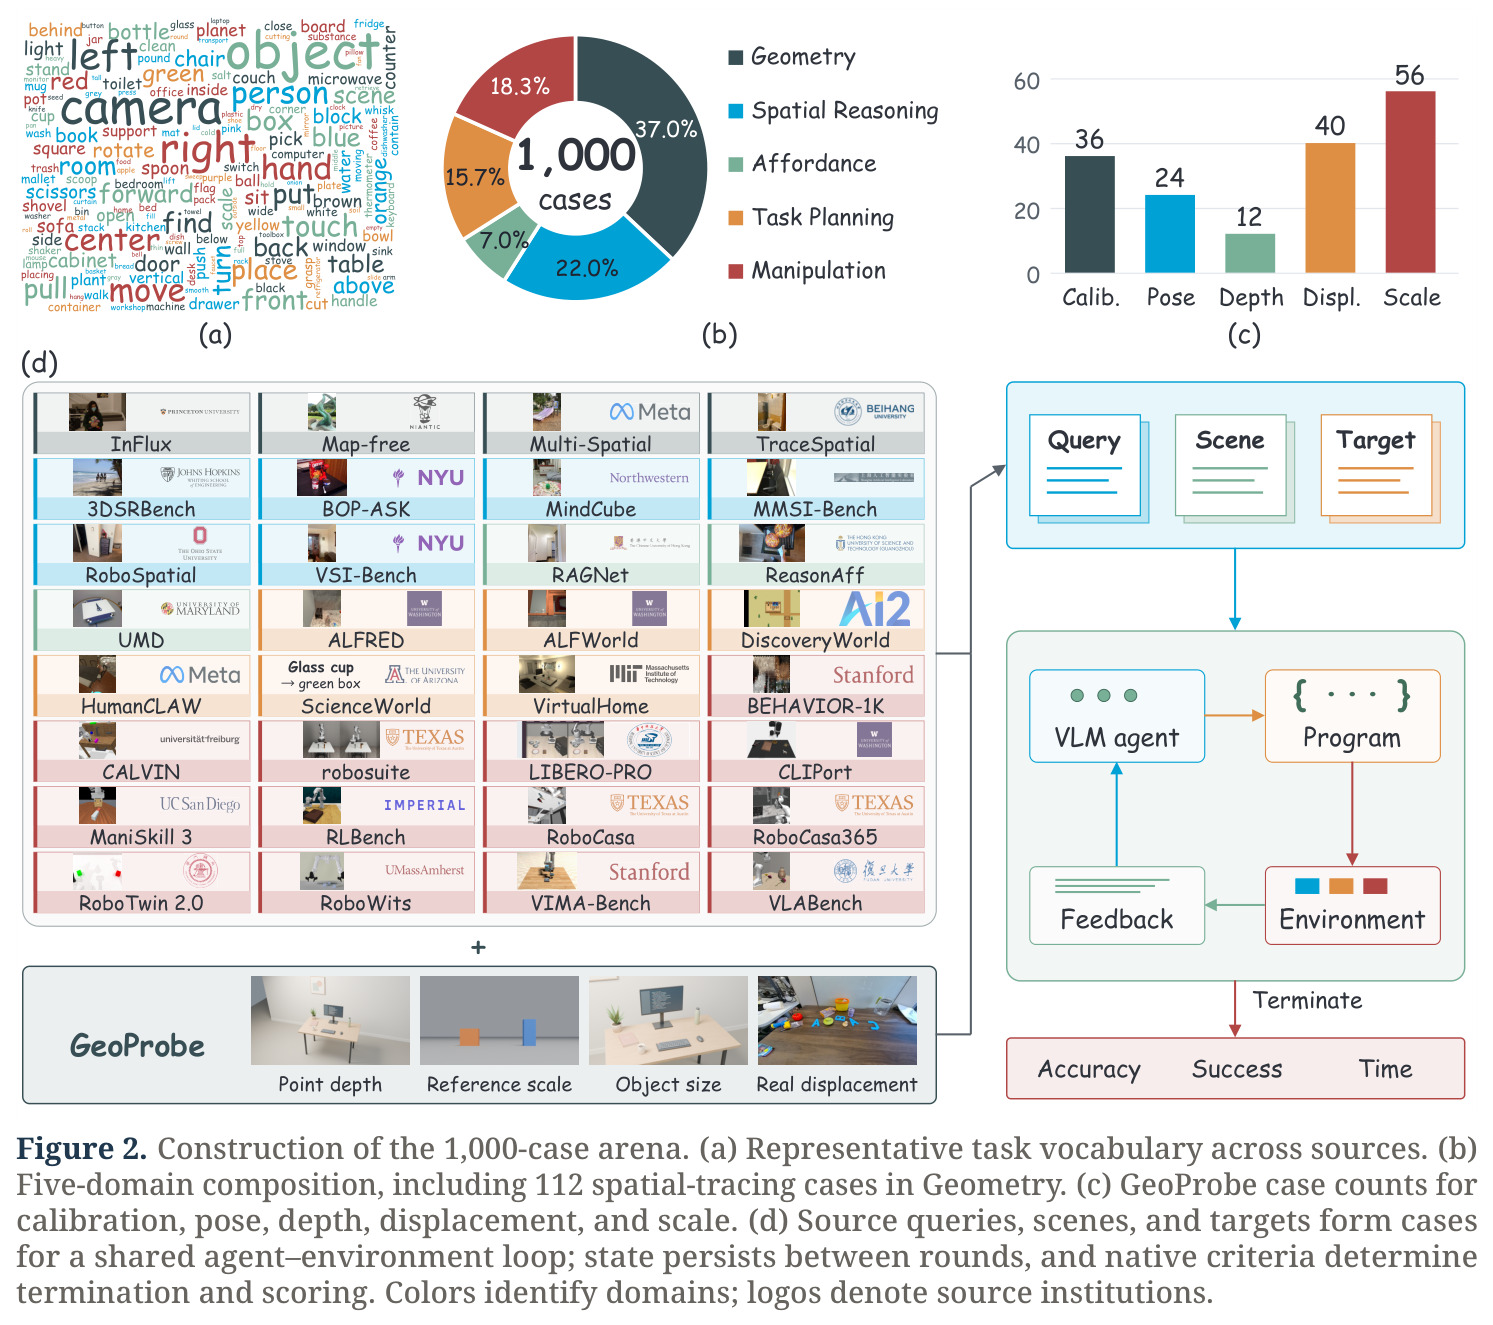
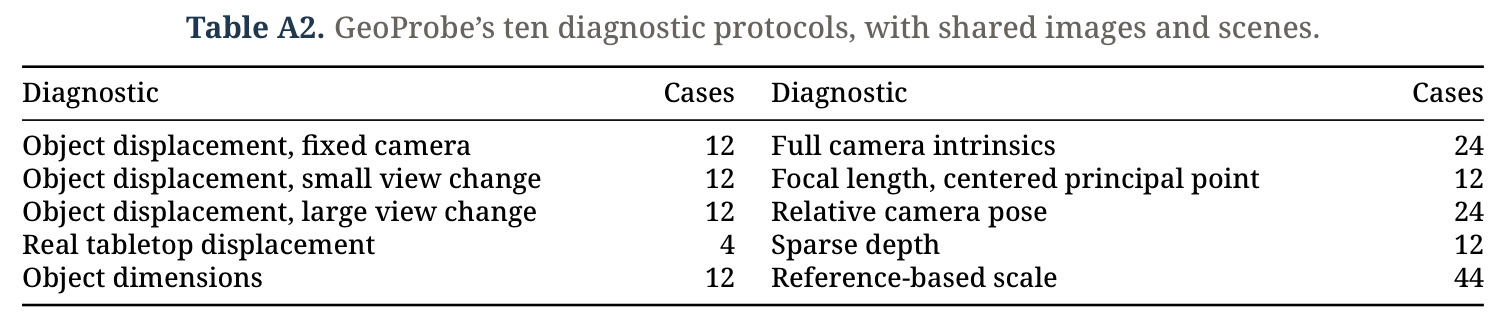
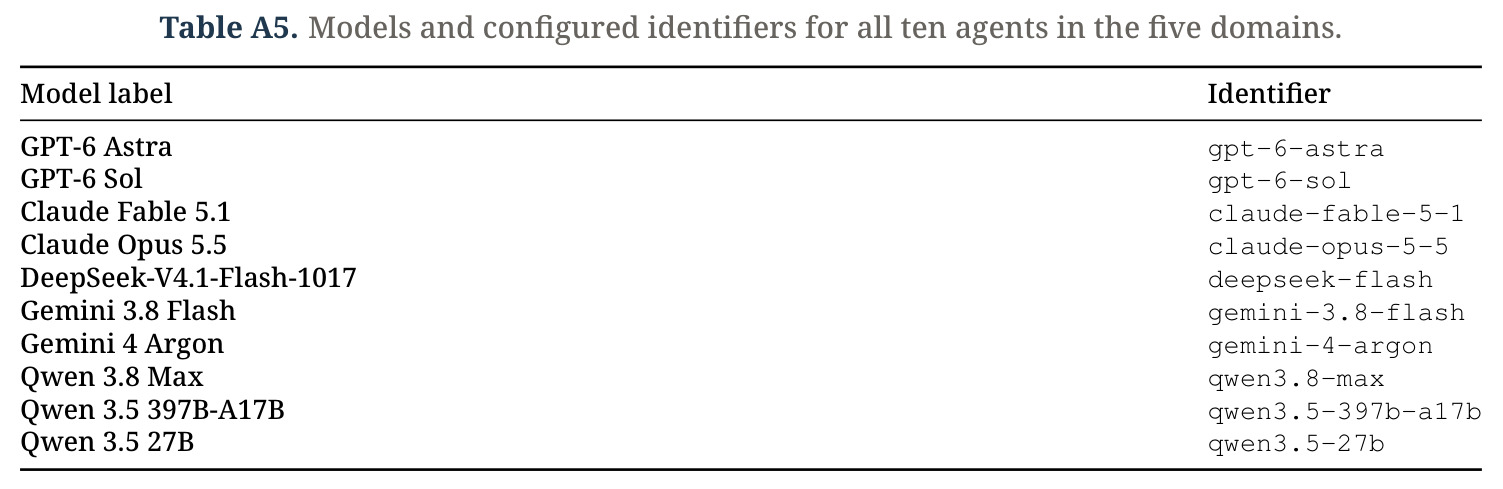
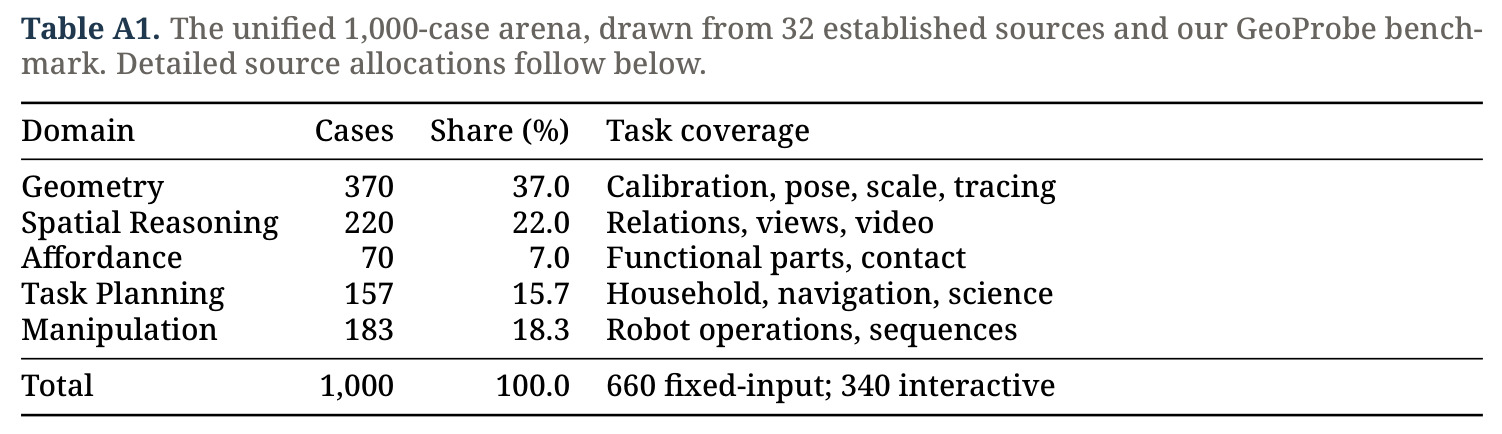
本文的目标是本文要系统回答:前沿 VLM 智能体离“机器人通才”还有多远,具体差在哪些任务需求上。为此作者构建 Embodied Agent Arena:将 32 个既有来源与自建的 GeoProbe(168 例受控几何探针)合并为 1000 个案例,覆盖 Geometry、Spatial Reasoning、Affordance、Task Planning、Manipulation 五个能力域,用同一套最小化 harness 评估 10 个 VLM 智能体。评测刻意区分四个层次——预测精度(MAE、AbsRel、IoU)、功能接地(接触点与区域有效性)、子目标达成(条件级记录)与最终任务成功 $\mathrm{Success}(s_T,g)=\mathbb{1}\big[\bigwedge_{k=1}^{K} g_k(s_T)\big]$;并通过逐回合执行轨迹定位失败的具体病因:是绑错了目标实体、缺失先决物理状态,还是基于无效证据误判了完成。
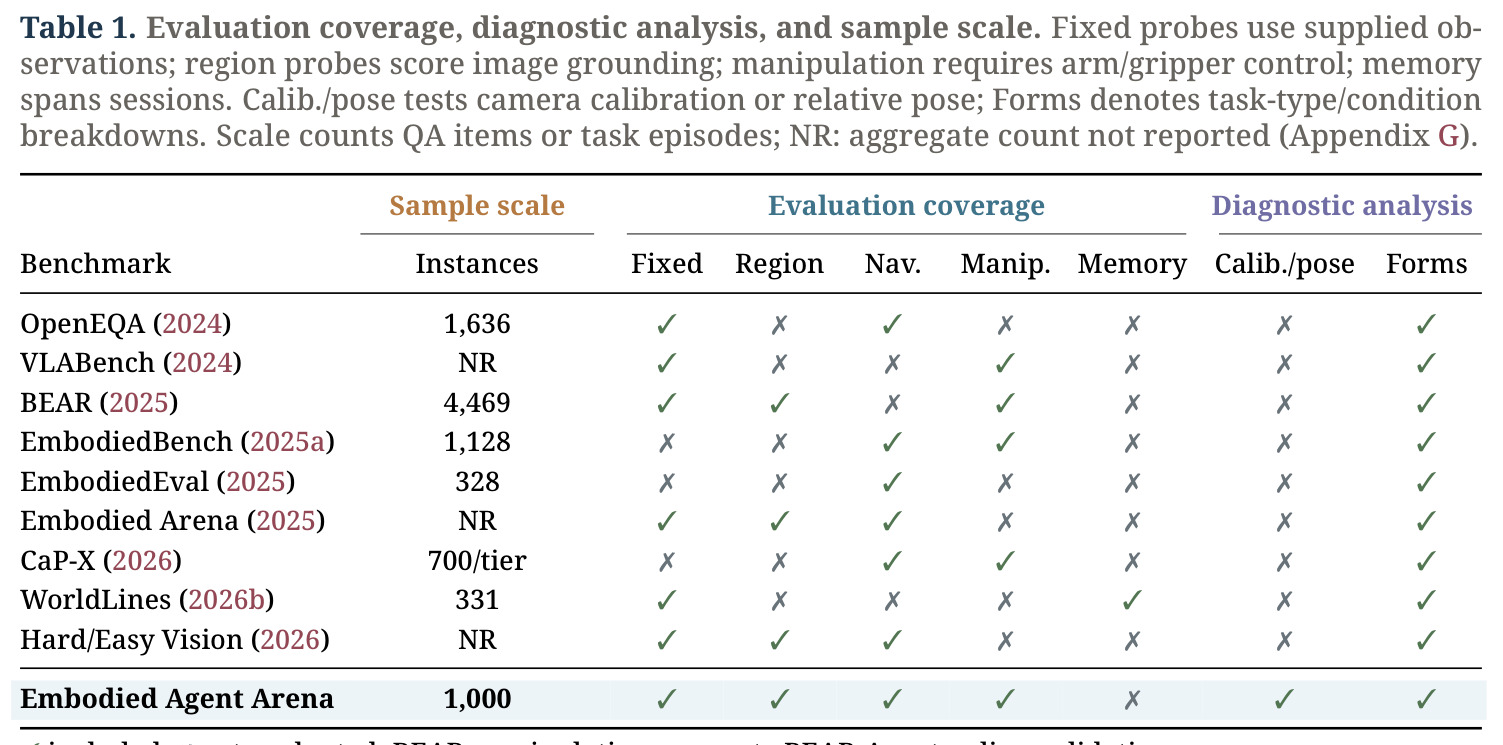
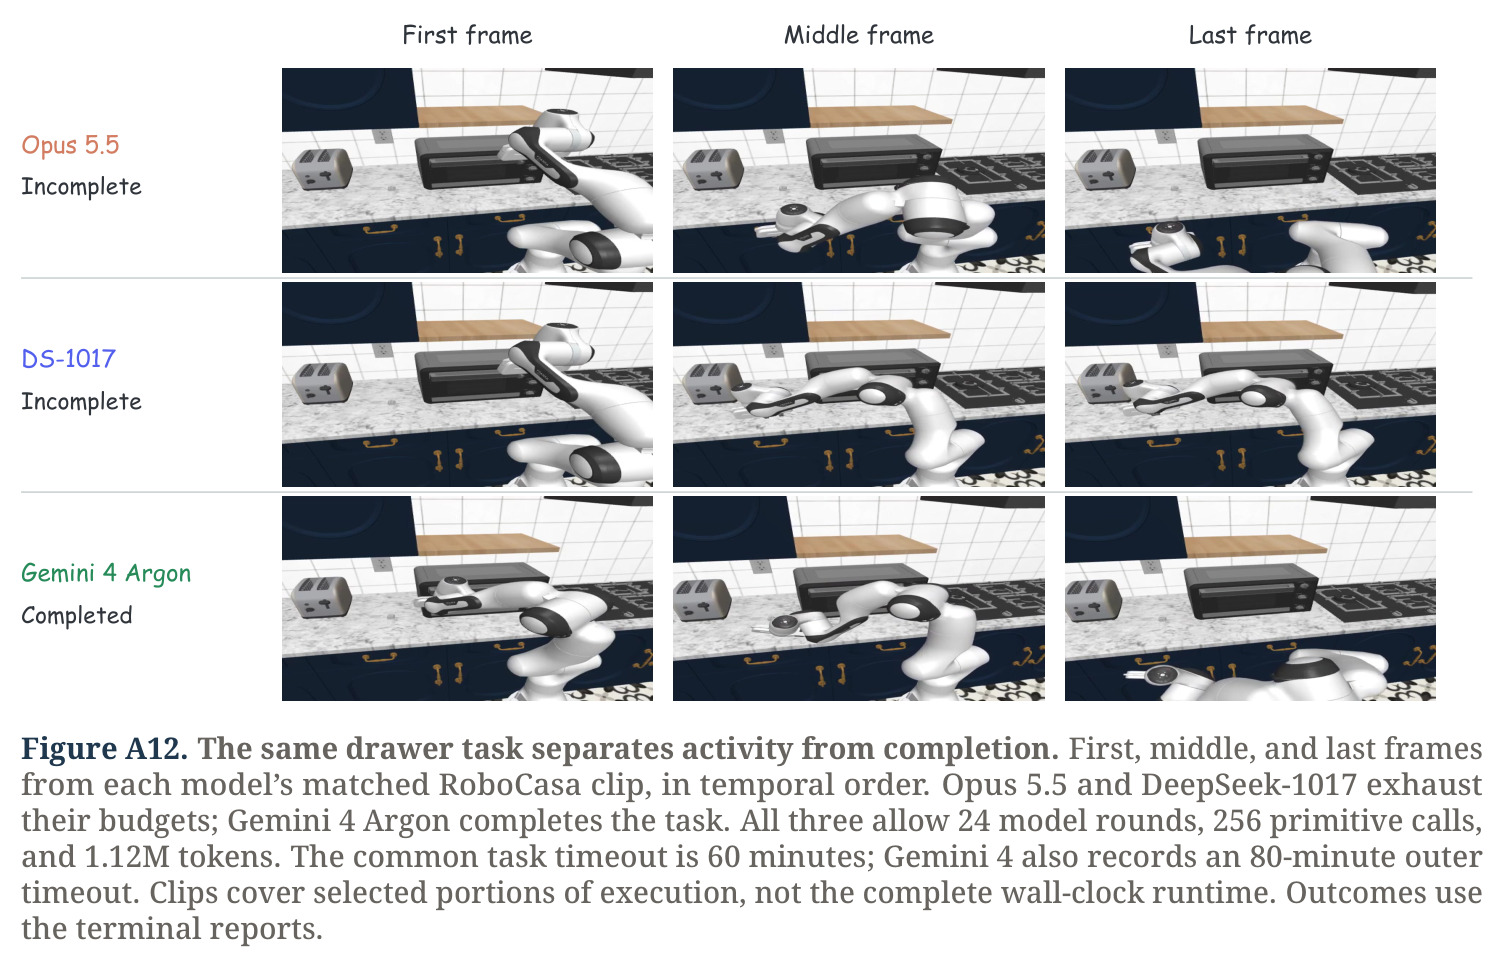
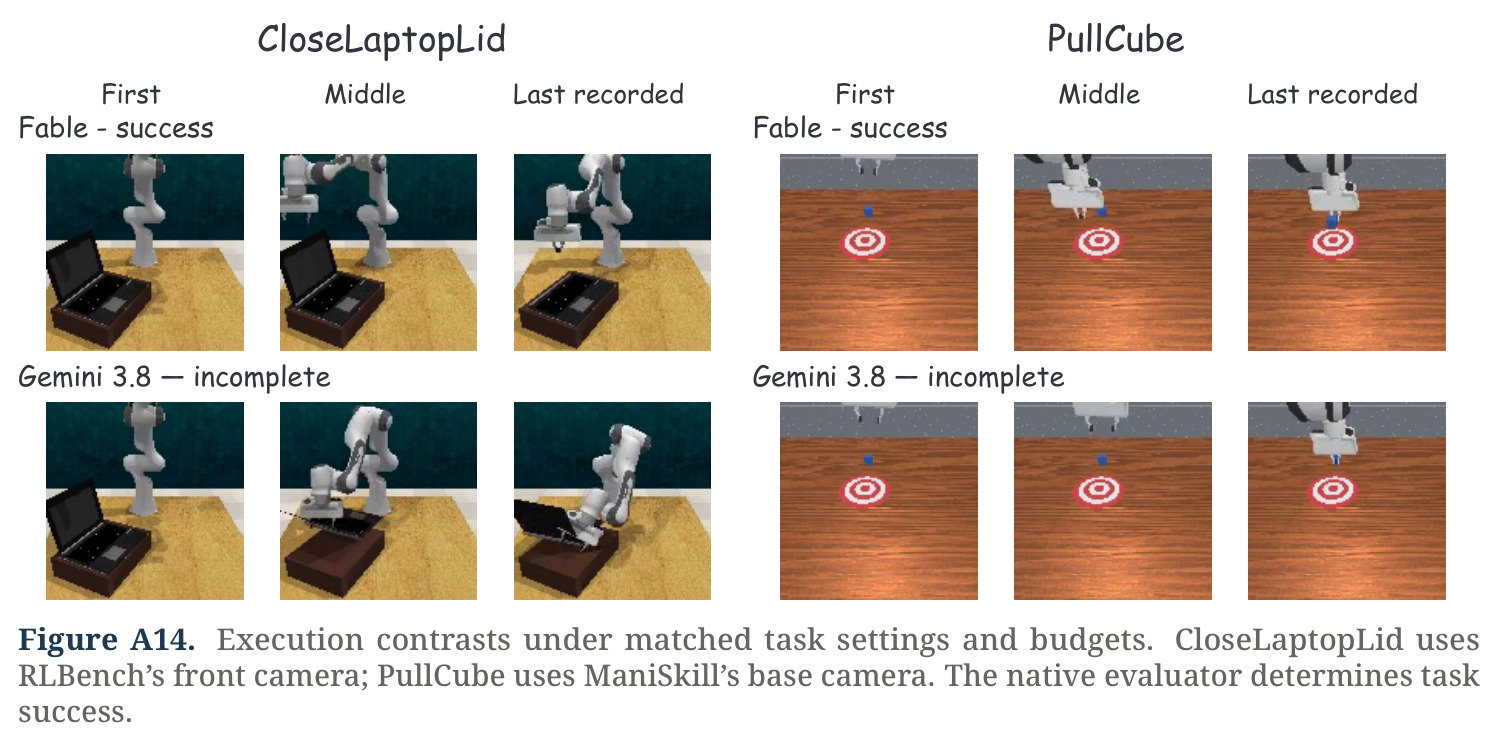
与已有工作不同的是,与 Table 1 对比的 9 个既有基准(OpenEQA、BEAR、EmbodiedBench、EmbodiedEval、CaP-X、WorldLines 等)不同,Arena 是唯一同时覆盖固定输入探针、区域接地、导航、机械臂操作、相机标定/位姿探针与任务类型分解的评测(1000 例)。独特之处有三:其一,最小 harness——除各来源原生接口外不加任何感知或控制模块,任务决策完全留给模型,避免“辅助模块代打”污染结论;其二,终止与成功严格分离——交互回合可由模型自报完成、环境终态、预算耗尽或错误终止,但评分由评估器独立检查环境状态,模型宣布完成不能替代满足目标;其三,GeoProbe 用 Blender 受控改变相机运动、物体运动与尺度参照,把“分数相近”的误差分解为尺度偏差与残余形变两类需要不同修复手段的失败,再配合匹配轨迹分析把恢复机制归类为改绑目标、修复先决状态或撤回无依据的完成声明。
核心方法
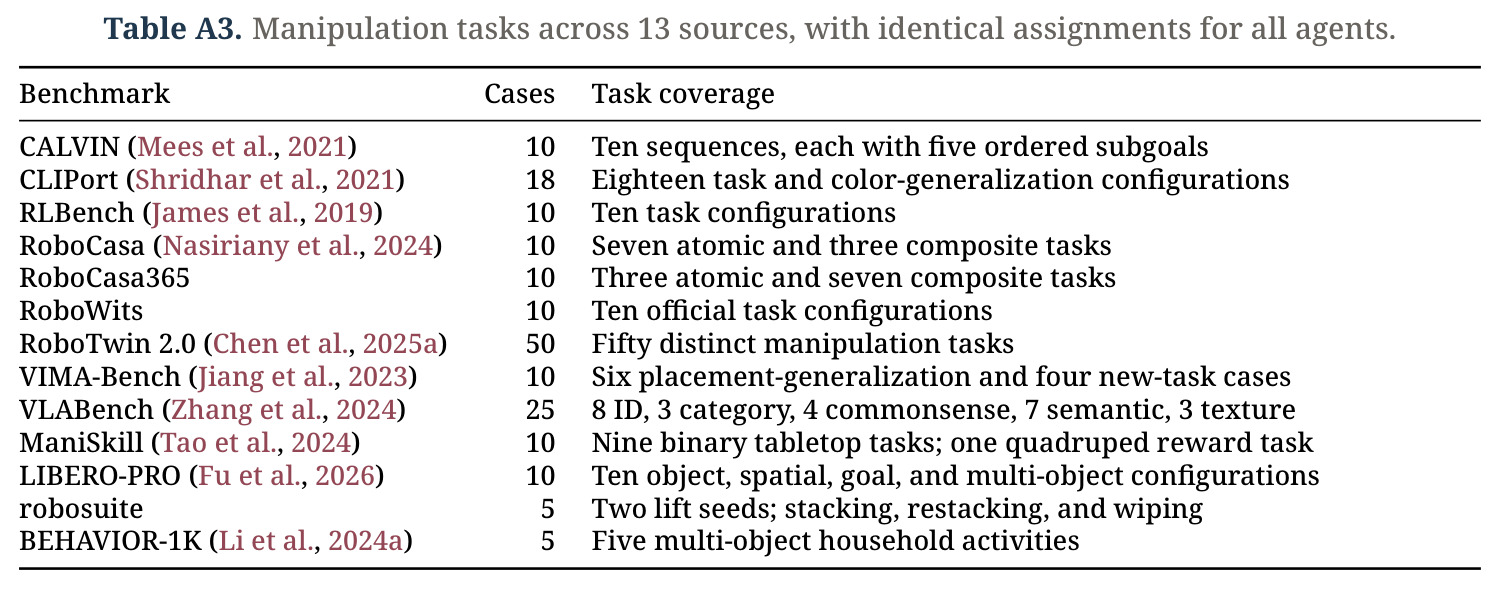
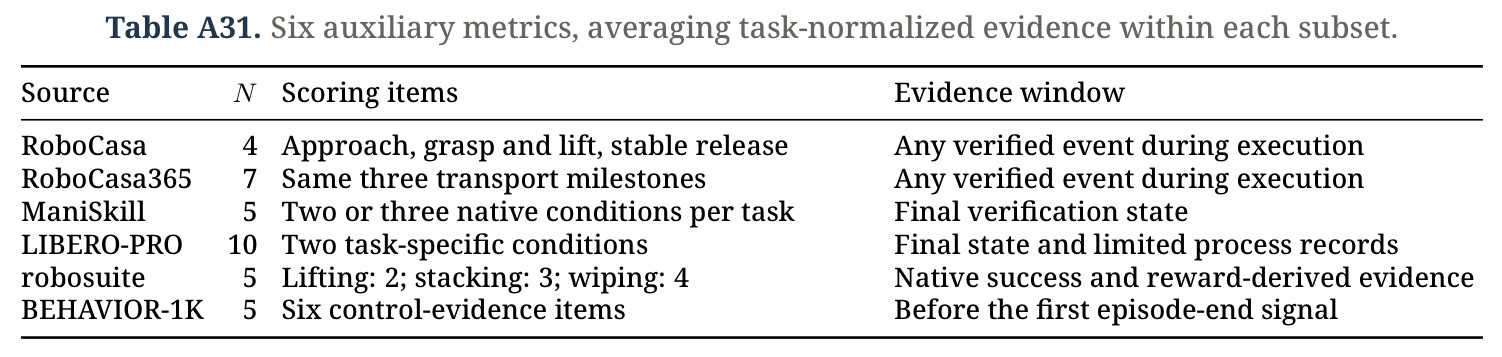
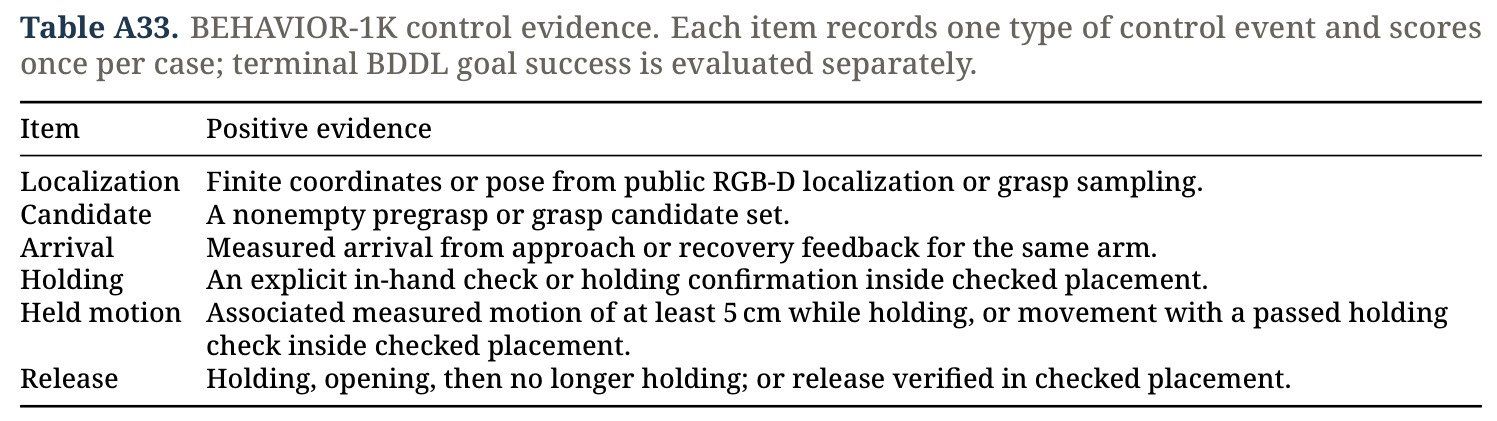
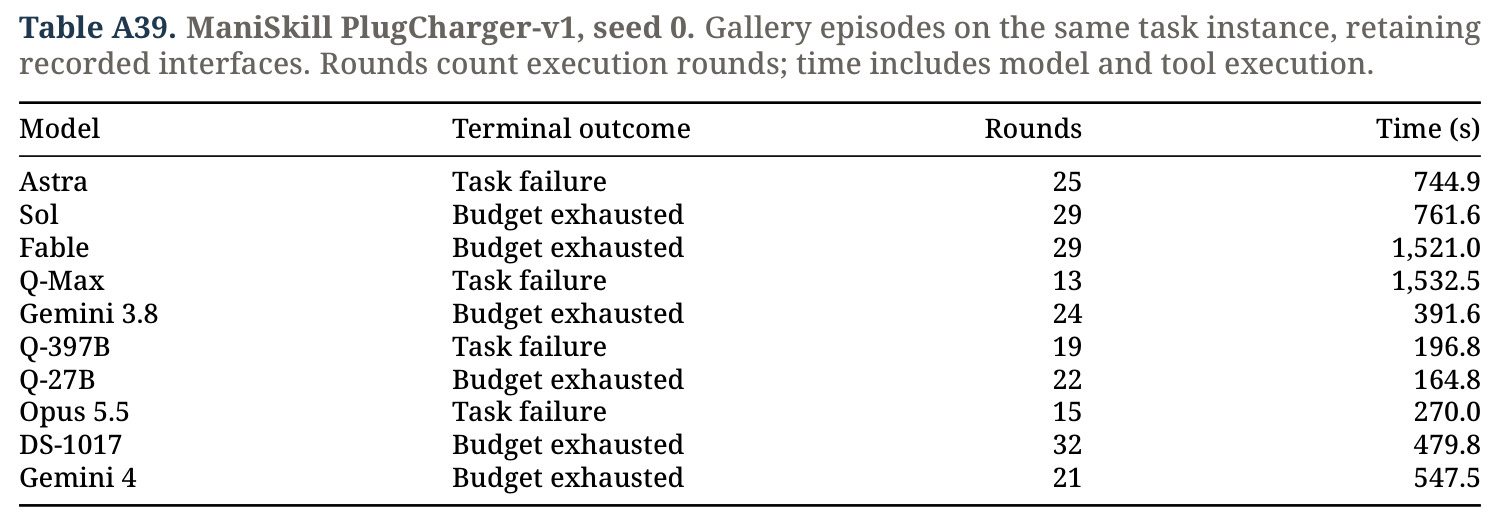
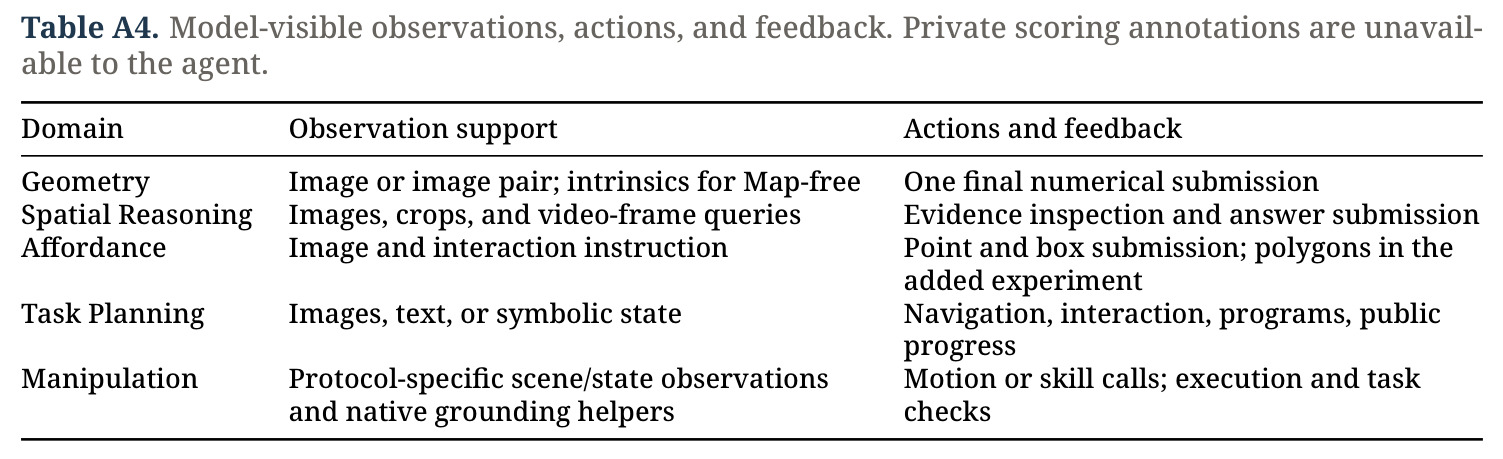
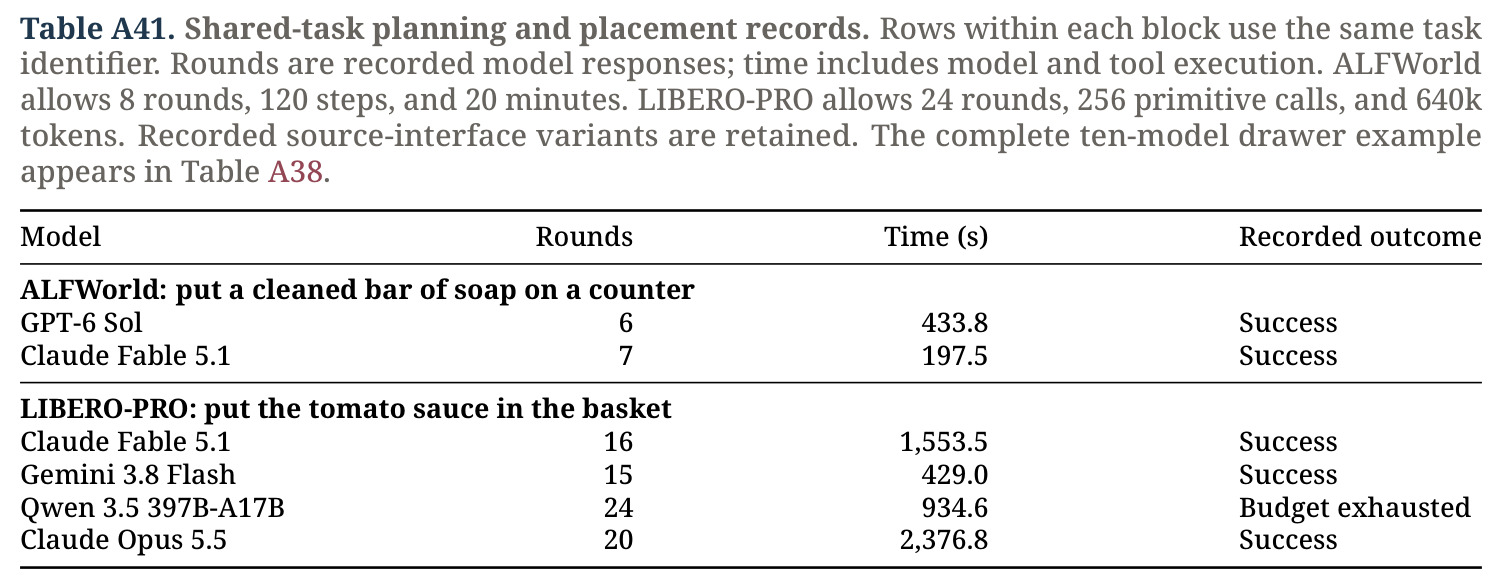
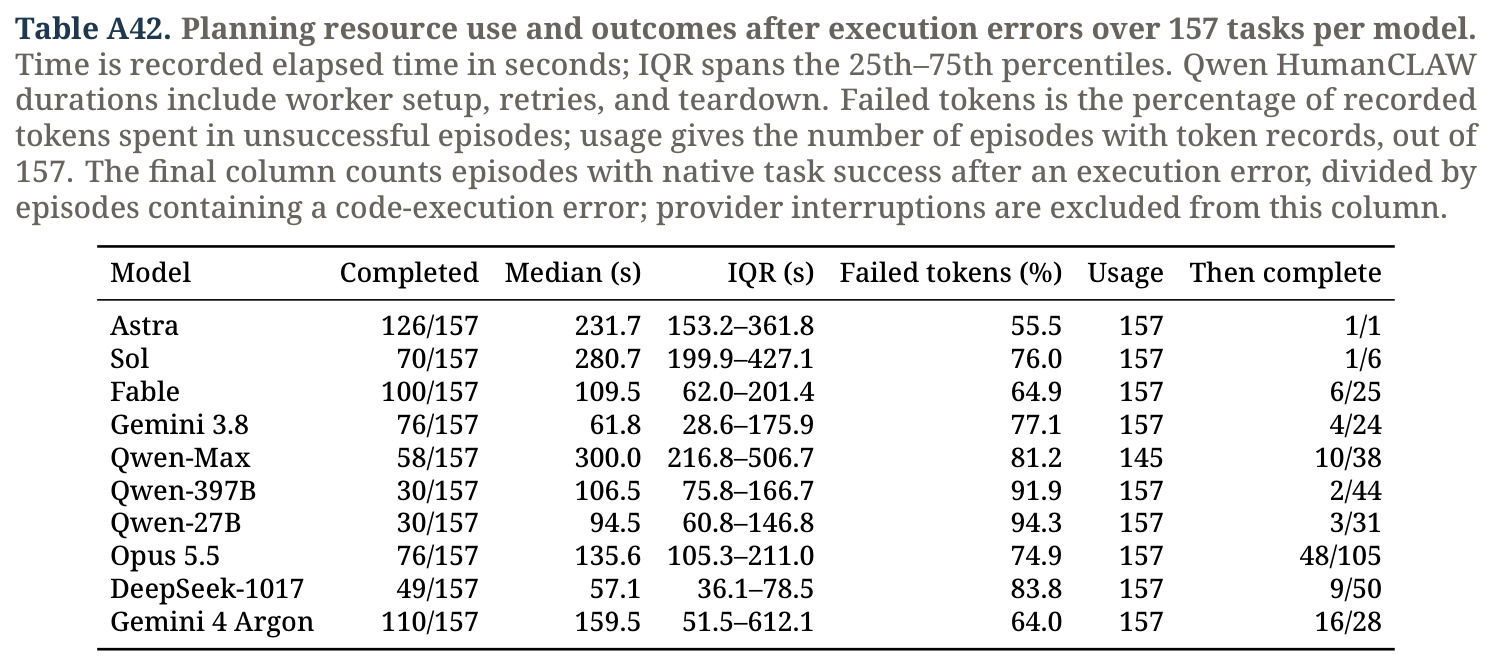
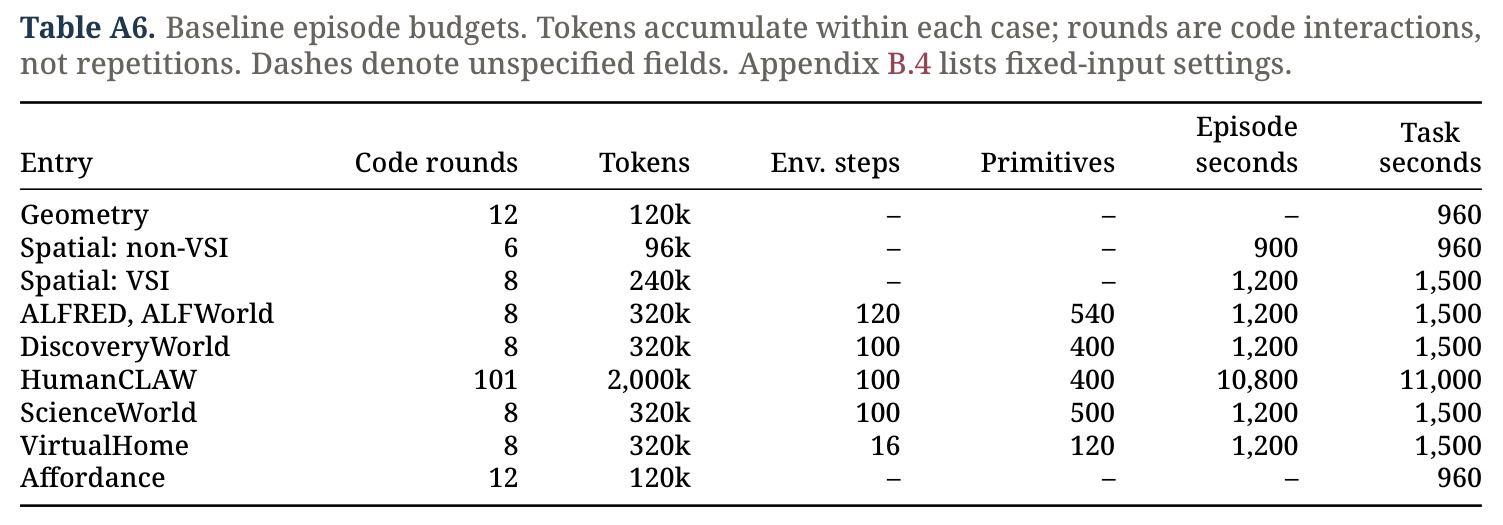
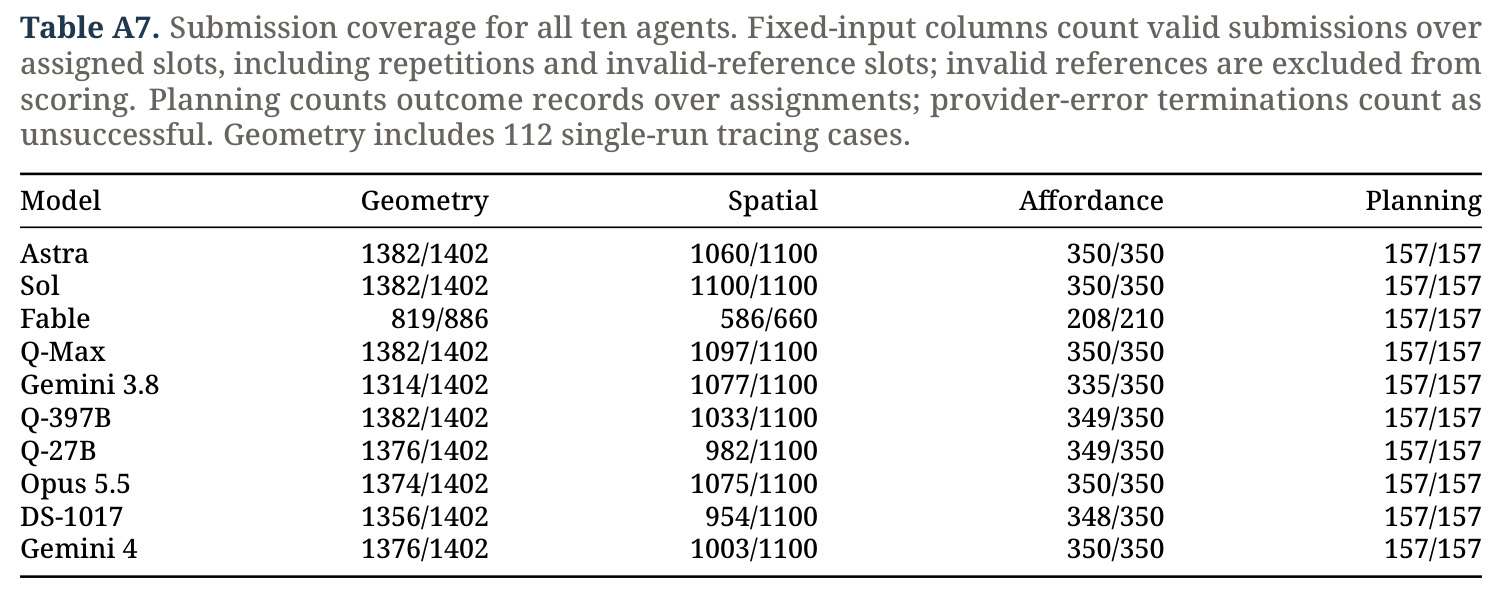
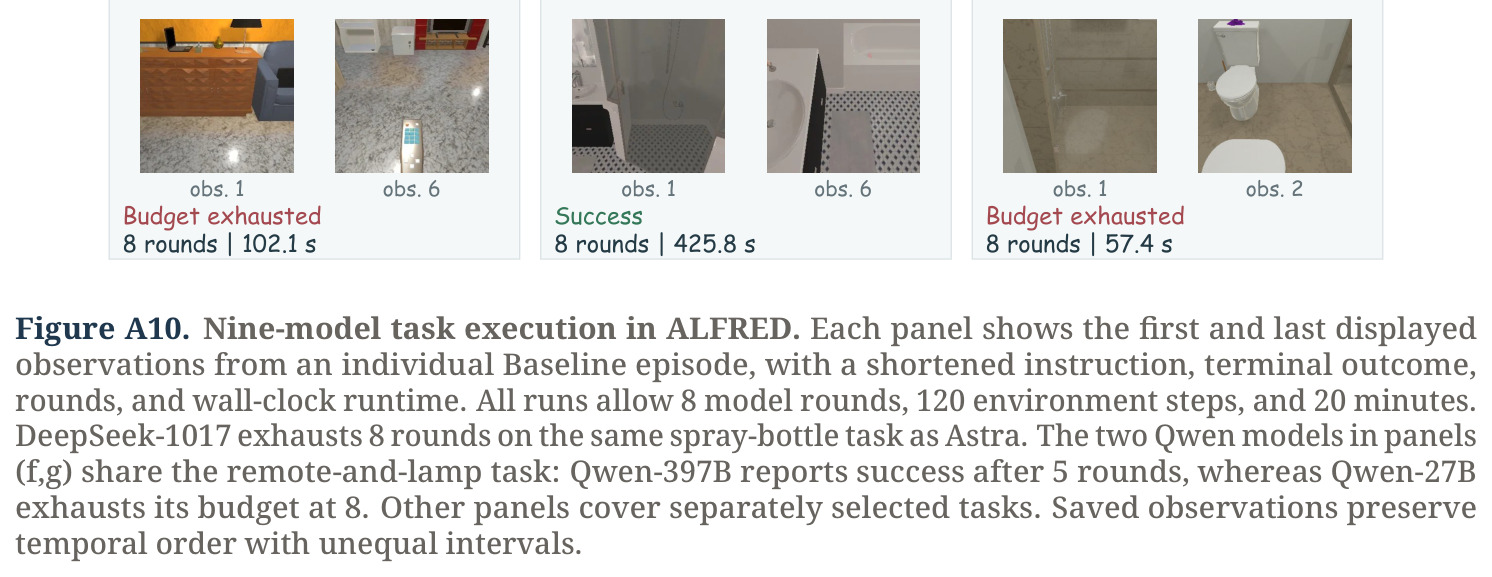
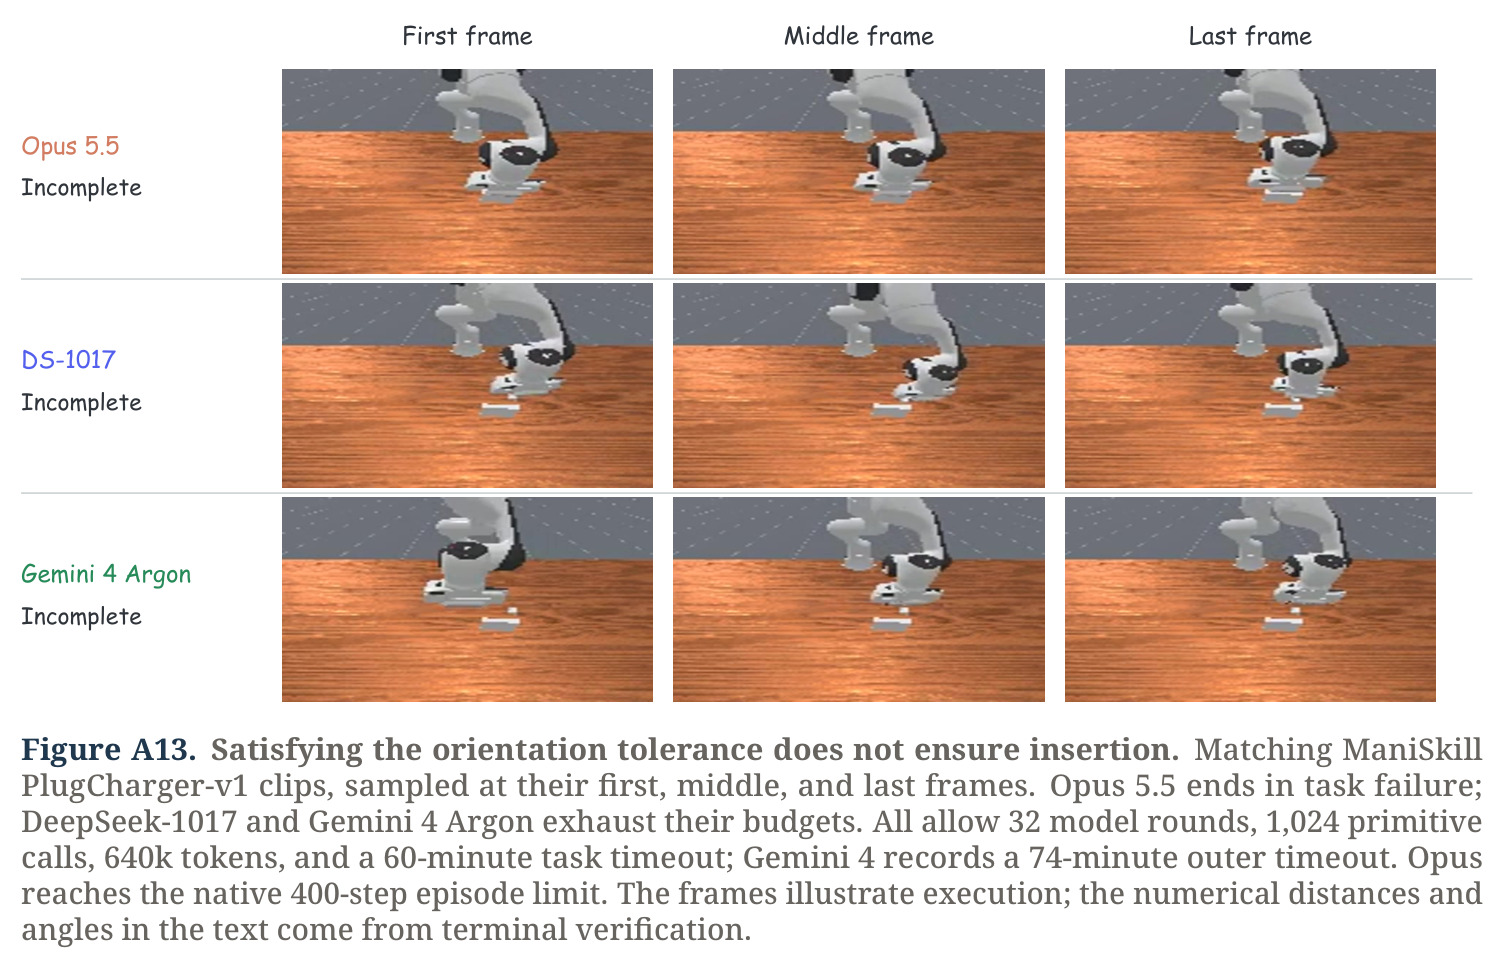
直觉上,论文把“会做题”与“会干活”拆开测:前三个域用固定输入的预测题度量感知与接地精度,后两个域用交互回合度量能否真正改变环境状态。技术路线分四步。第一步,汇总 32 个来源(InFlux、Map-free、3DSRBench、RoboSpatial、VSI-Bench、ALFRED、ALFWorld、ScienceWorld、VirtualHome、BEHAVIOR-1K、CALVIN、robosuite、LIBERO-PRO、RLBench、RoboTwin 2.0、VIMA-Bench 等)并新建 GeoProbe 的 168 例 Blender 受控案例(标定、位姿、深度、位移、尺度),其中 112 条空间描迹案例归入 Geometry 域。第二步,把每个来源的观测、查询/目标、可用操作与原生判据接入统一的 agent–environment 循环:VLM 智能体产出程序,环境回传反馈,状态跨回合持久,期间生成的图像进入下一轮请求。第三步,按协议运行:非描迹类任务每模型重复 5 次(Fable 3 次),Planning(157 例)与 Manipulation(182 例)单回合,API/执行错误终止的回合计为失败。第四步,统一核算 token、动作调用、模型回合数与墙钟时间。
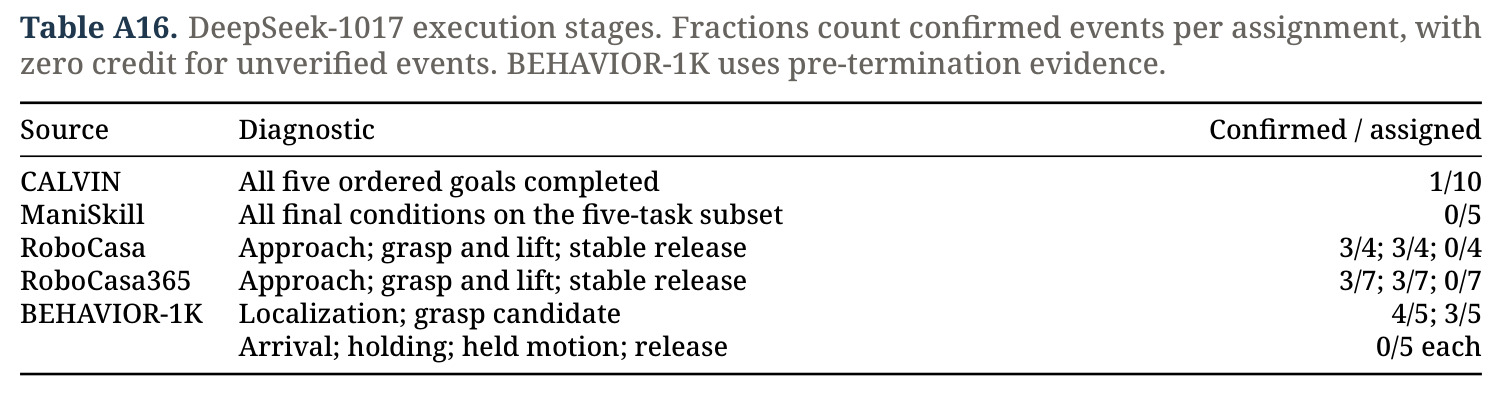
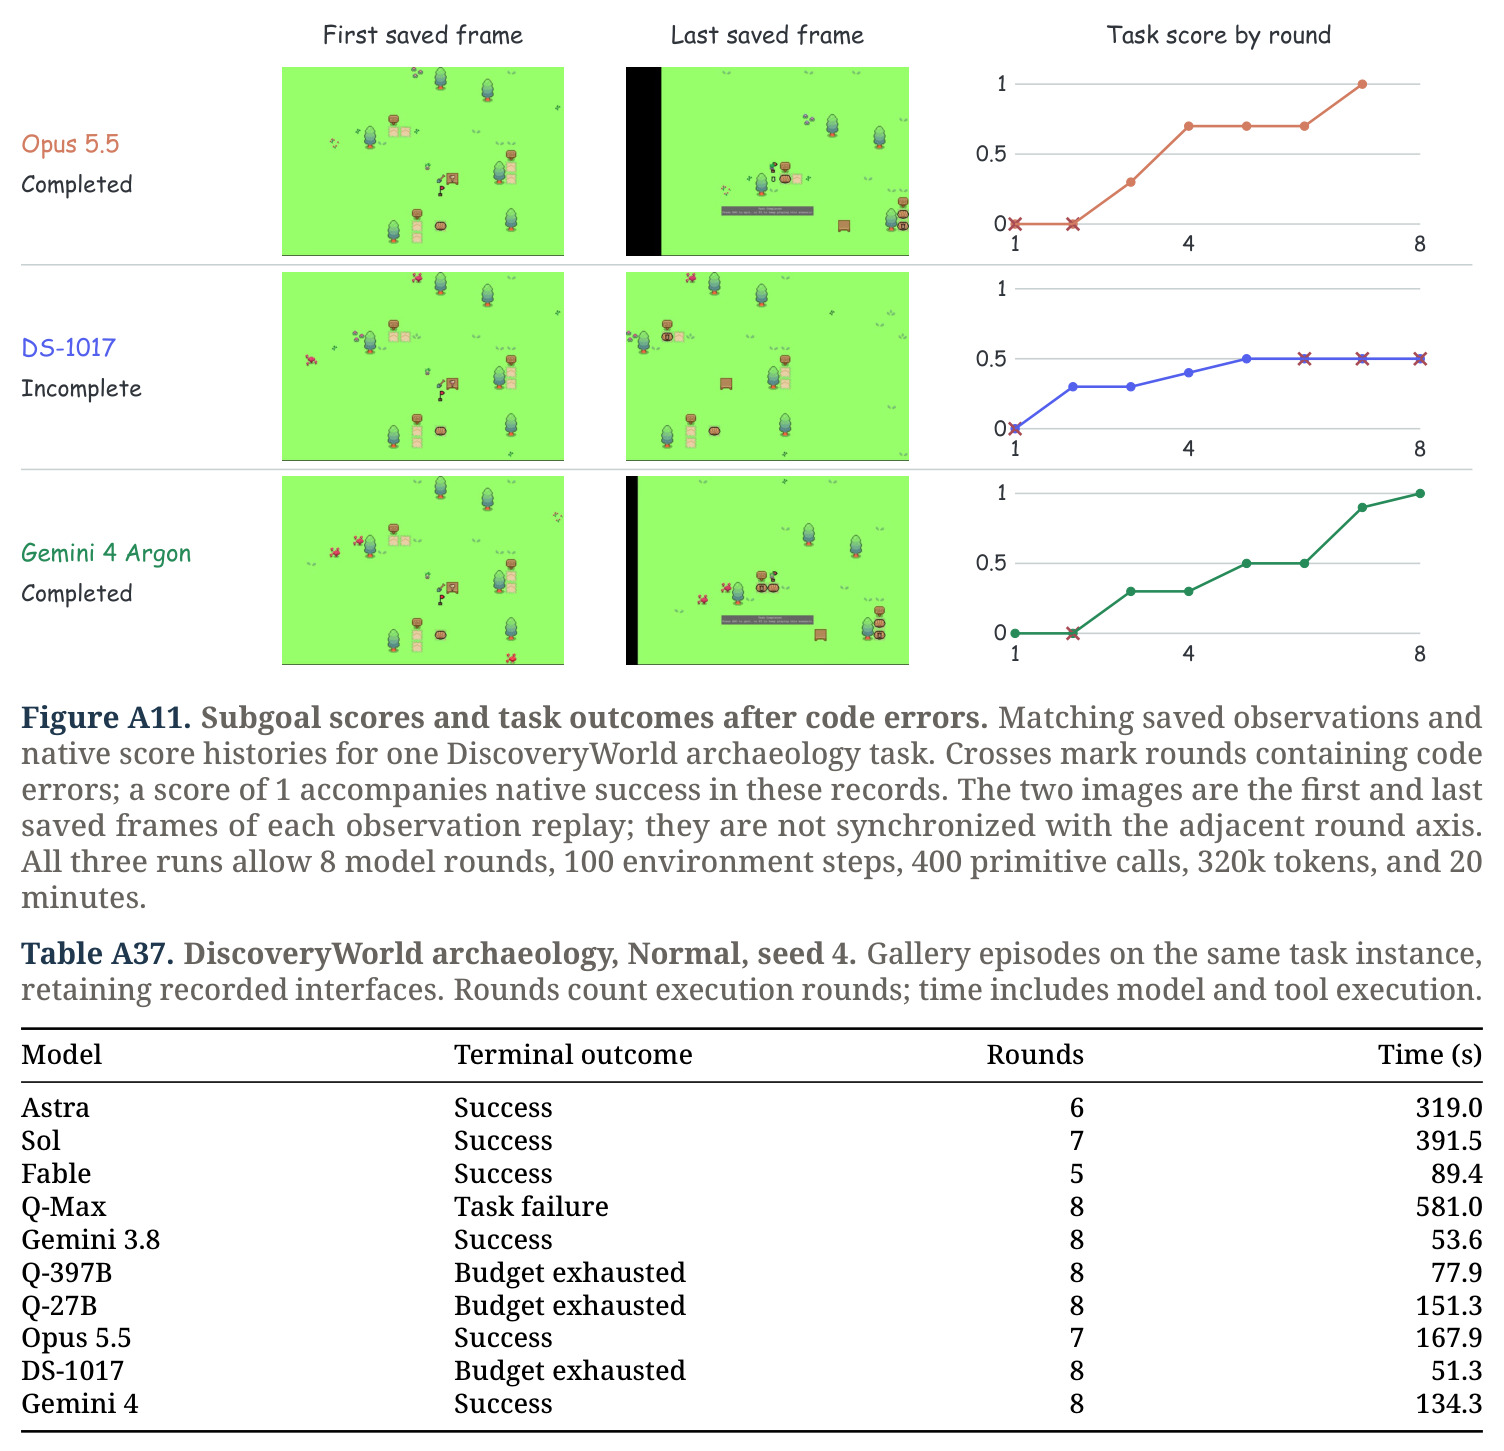
核心创新是“面向完整任务需求”的评测观,与只报最终成功率的基准有本质区别。公式层面,任务成功要求全部目标谓词同时成立:$\mathrm{Success}(s_T,g)=\mathbb{1}\big[\bigwedge_{k=1}^{K} g_k(s_T)\big]$,条件级记录进一步指出具体哪个 $g_k$ 未满足。由此派生两个关键设计:一是终止不等于成功——模型自报完成必须通过评估器对环境状态的独立校验,HumanCLAW 坐姿任务中 Gemini 4 与 DeepSeek 分别在 44 与 70 回合后自认“已坐下”仍被判失败;二是误差可分解性——GeoProbe 用 oracle 尺度对齐把度量误差拆成公共尺度分量与残余形变,例如 Gemini 4 的深度 AbsRel 从原始 0.299 降到对齐后 0.065,说明其主要误差是全局尺度偏差而非几何理解错误,而 Qwen-397B 对齐后仍残留 0.203。这两个机制共同把“分数相近、病因不同”的模型区分开来,让每类失败都能对应到具体的修复手段。
方法步骤详情
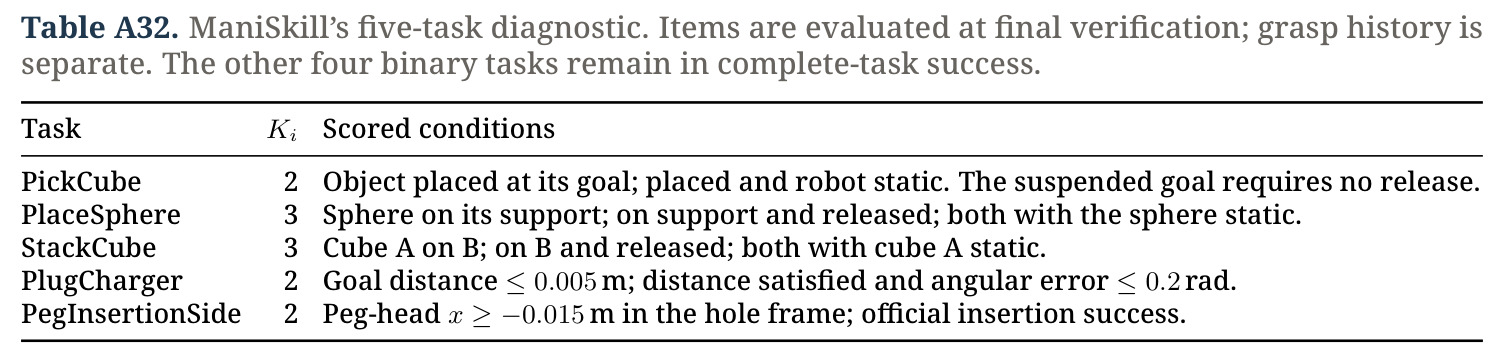
第一步(构建案例):为每个来源保留原生观测格式、操作接口与成功判据;GeoProbe 额外在 Blender 中控制相机运动(固定/小幅/大幅位移)与物体运动生成配对案例,并辅以真实图像作为 Photo 条件。第二步(统一循环):每回合向模型提供观测与历史,模型提交代码或动作,环境执行后回传文本与图像反馈;持久变量让模型复用先前计算。固定输入题直接提交预测;交互回合的结束条件为模型终止、环境终态、预算耗尽或未恢复的 API/执行错误。第三步(评分):Geometry 报旋转误差(度)与平移误差(cm)、AbsRel 等;Spatial 与 Planning 报 Pass@1(五次运行取均值±样本 SD);Affordance 在同一批 70 例上分别报 box–mask IoU 与 polygon–mask IoU,接触点有效性作辅助诊断;Manipulation 报原生任务成功率与条件级得分;描迹任务用轨迹 RMSE 加离线 3D 约束满足(起点/终点、边界、碰撞)联合检查。第四步(资源核算):分别记录 token、动作调用次数、模型回合数与墙钟时间,并按来源分解失败 token 份额,定位计算被浪费在何处。
技术新颖性
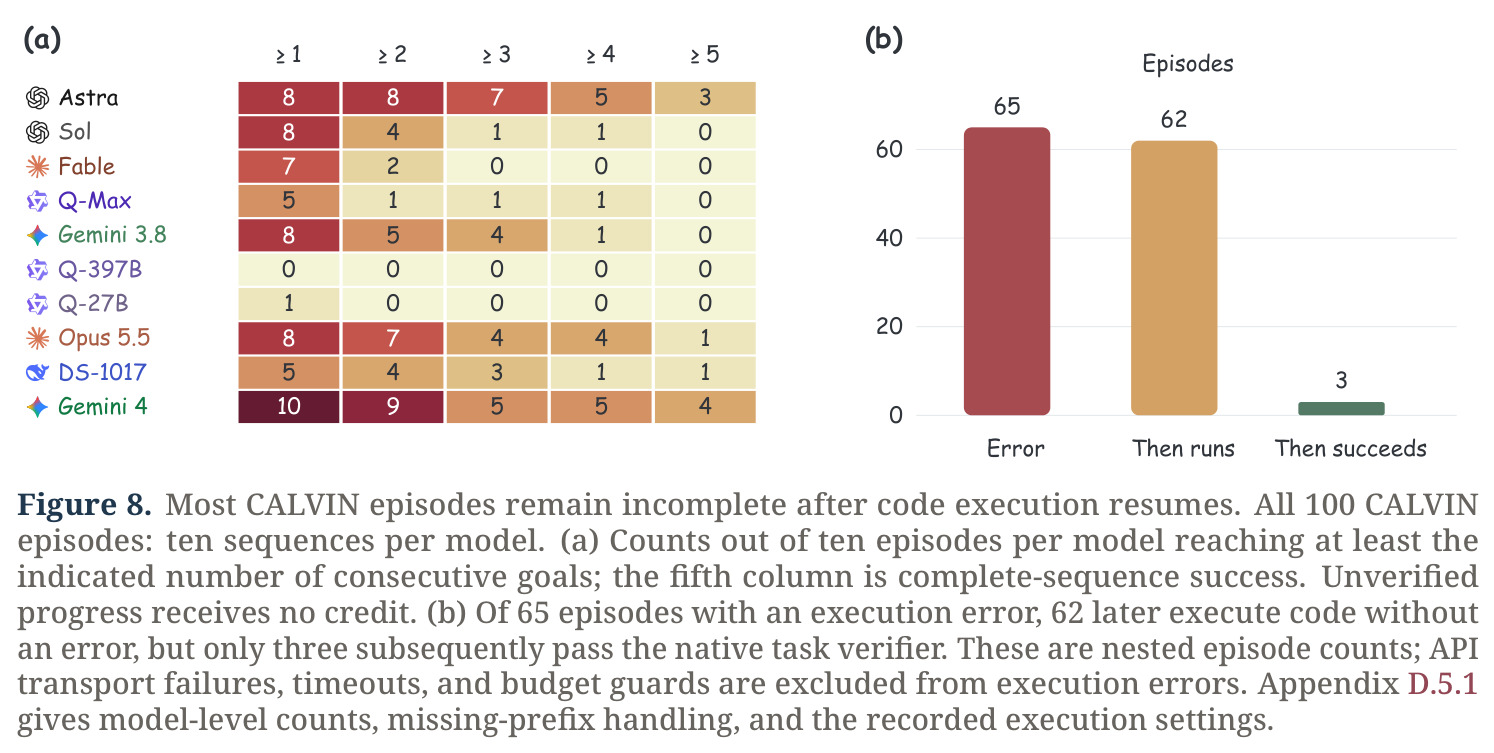
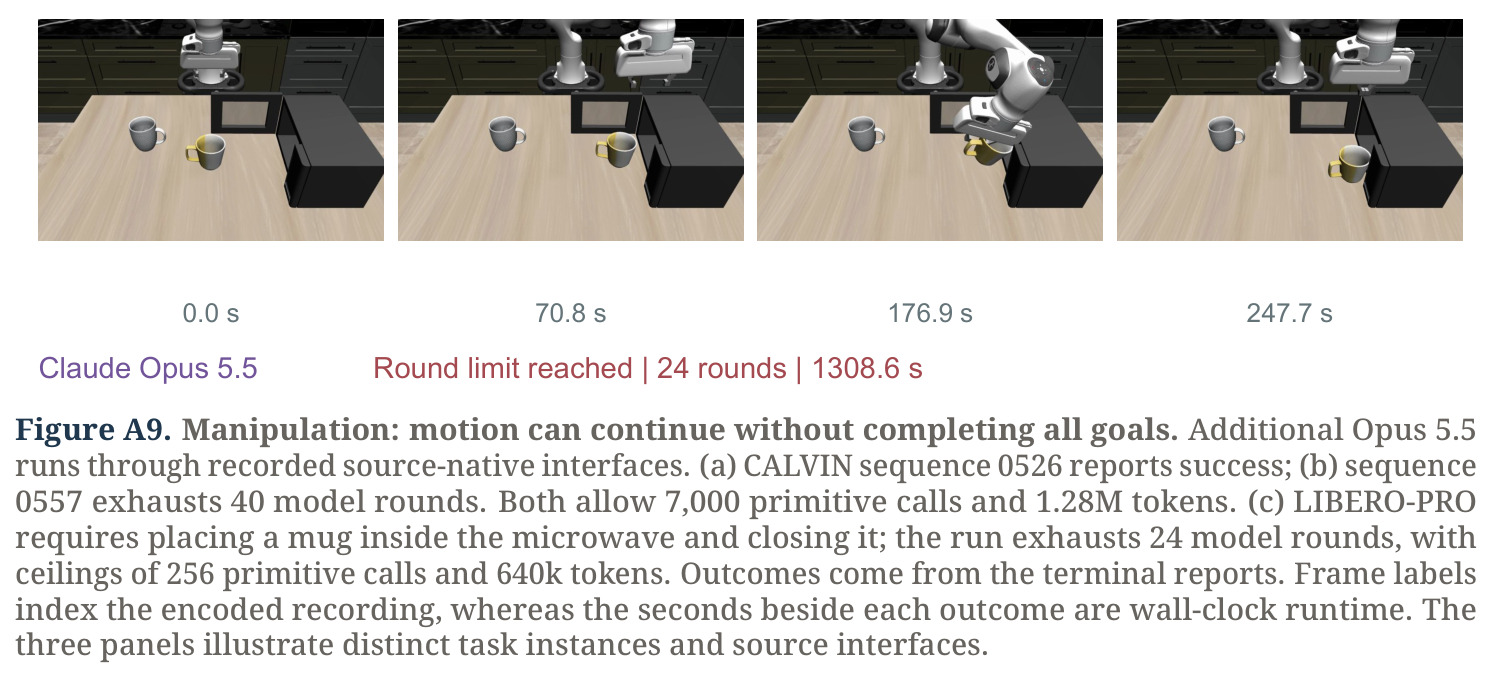
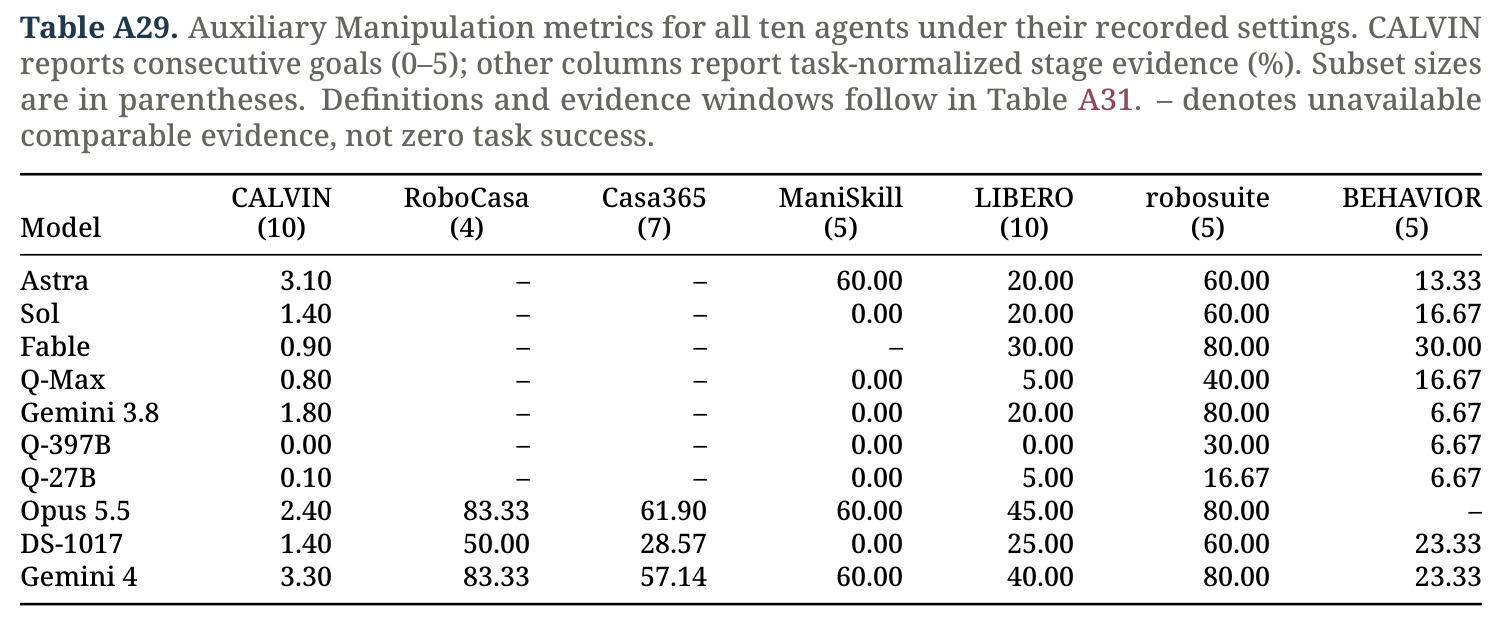
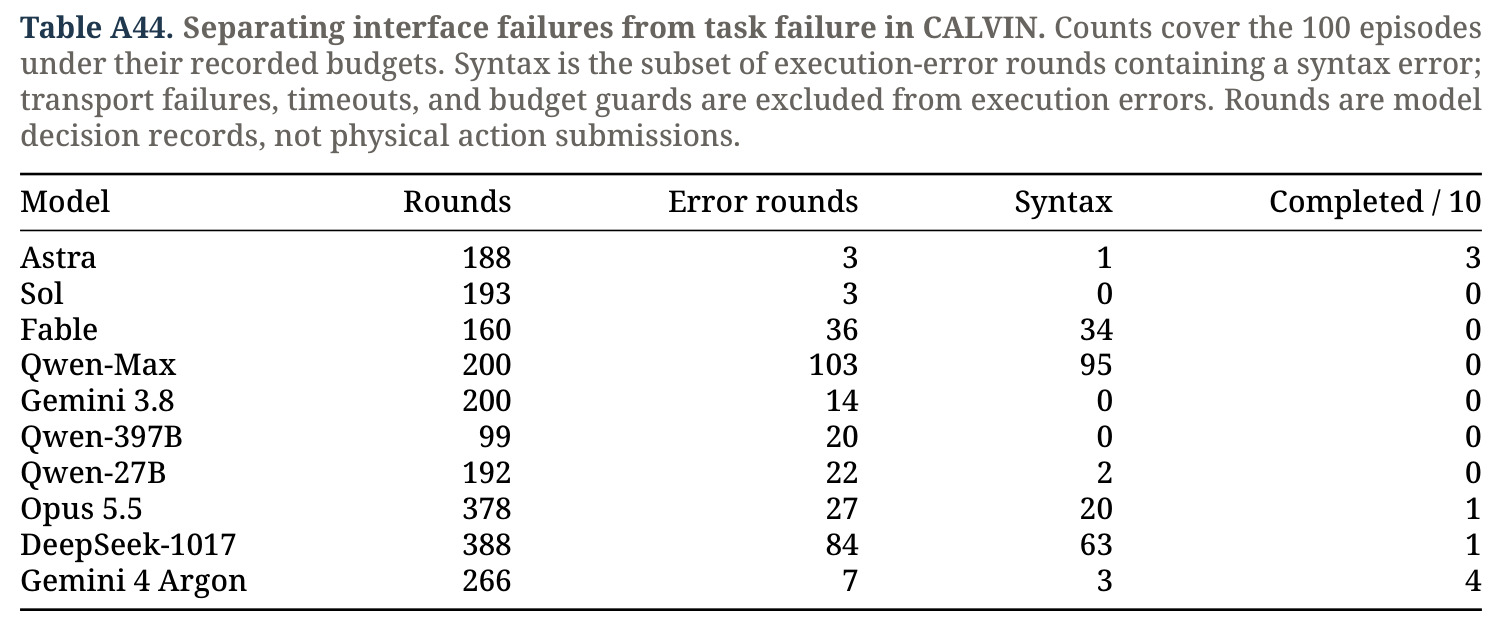
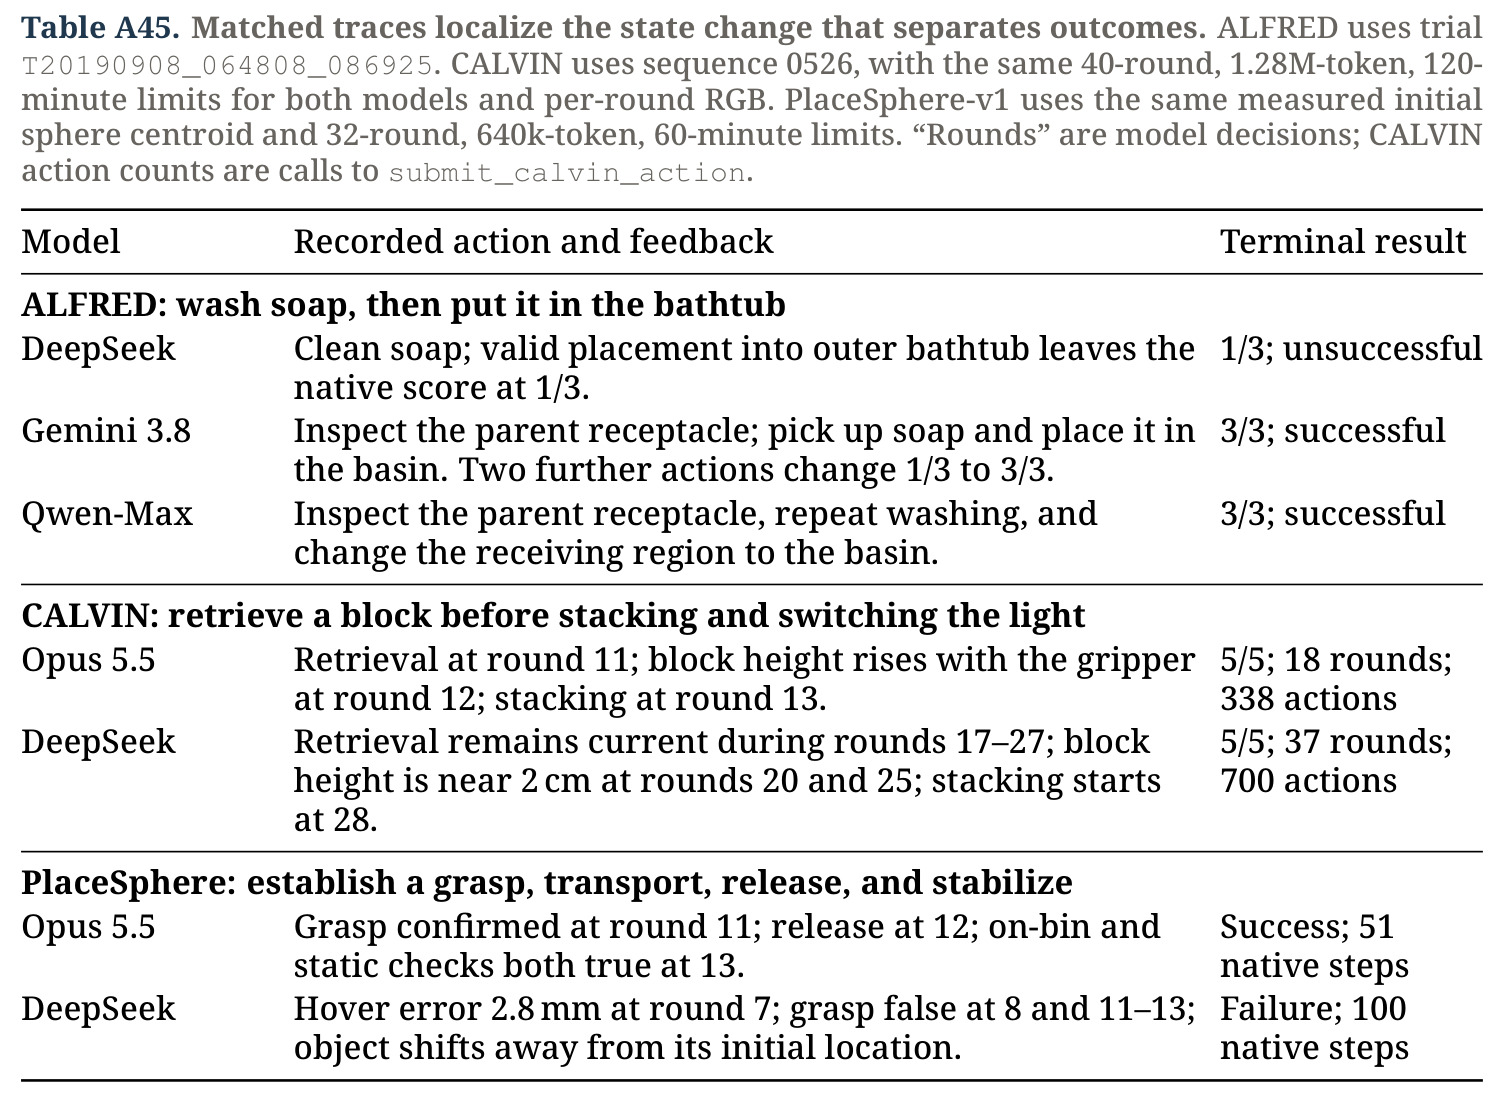
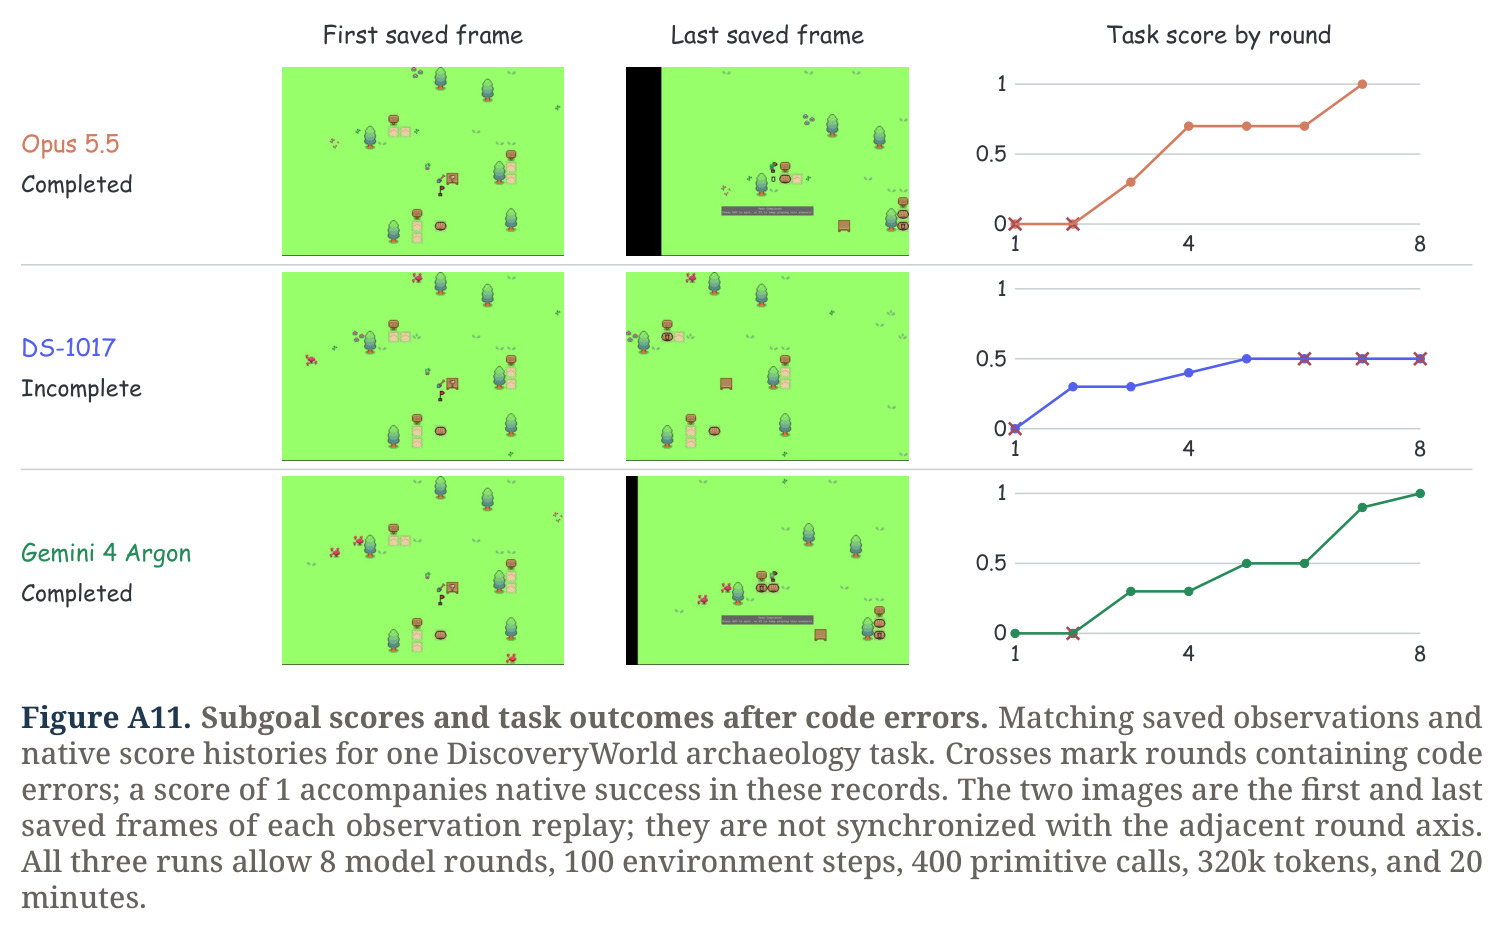
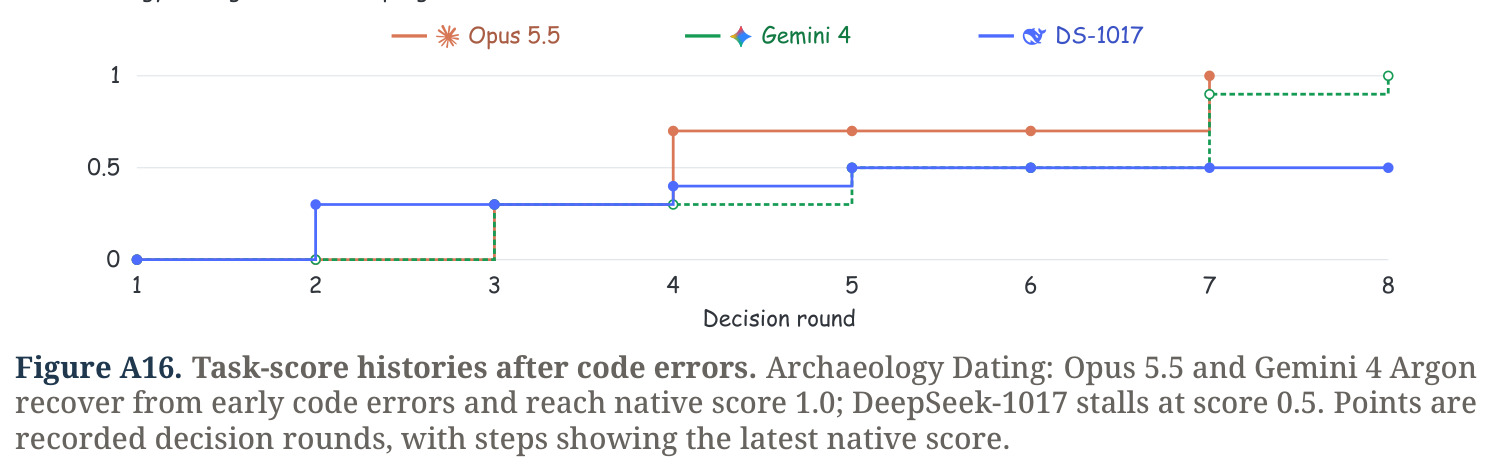
技术新颖性体现在三层。第一,覆盖与诊断的组合是独有的:Table 1 显示现有基准(OpenEQA、BEAR、EmbodiedBench、CaP-X、WorldLines 等)各只覆盖部分维度,无一同时具备标定/位姿探针与全链路操作覆盖,而 Arena 以 1000 例实现全覆盖。第二,失败类型学是新的:论文不满足于排名,而是给出可操作的失败分类——几何误差分“尺度偏差 vs 残余形变”(对齐后 AbsRel 0.065 vs 0.203)、可供性分“区域正确 vs 动作点无效”(Gemini 4 有 16 次框通过而点落在功能掩码外,剪刀抓取案例 IoU 0.784 但点不在掩码内)、执行分“接口语法错误 vs 物理推理失败”(Qwen-Max 在 200 个 CALVIN 回合中 103 个含错误,其中 95 个是语法错误),每类对应不同的修复手段。第三,方法学上用匹配轨迹做对照分析:同一 CALVIN 序列 0526 上 Opus 5.5 用 18 回合、DeepSeek 用 37 回合完成,暴露出“搬运尝试丢失物体高度、需重新抓取”这类跨子目标的状态依赖,这在任何聚合指标里都不可见。
实验结果
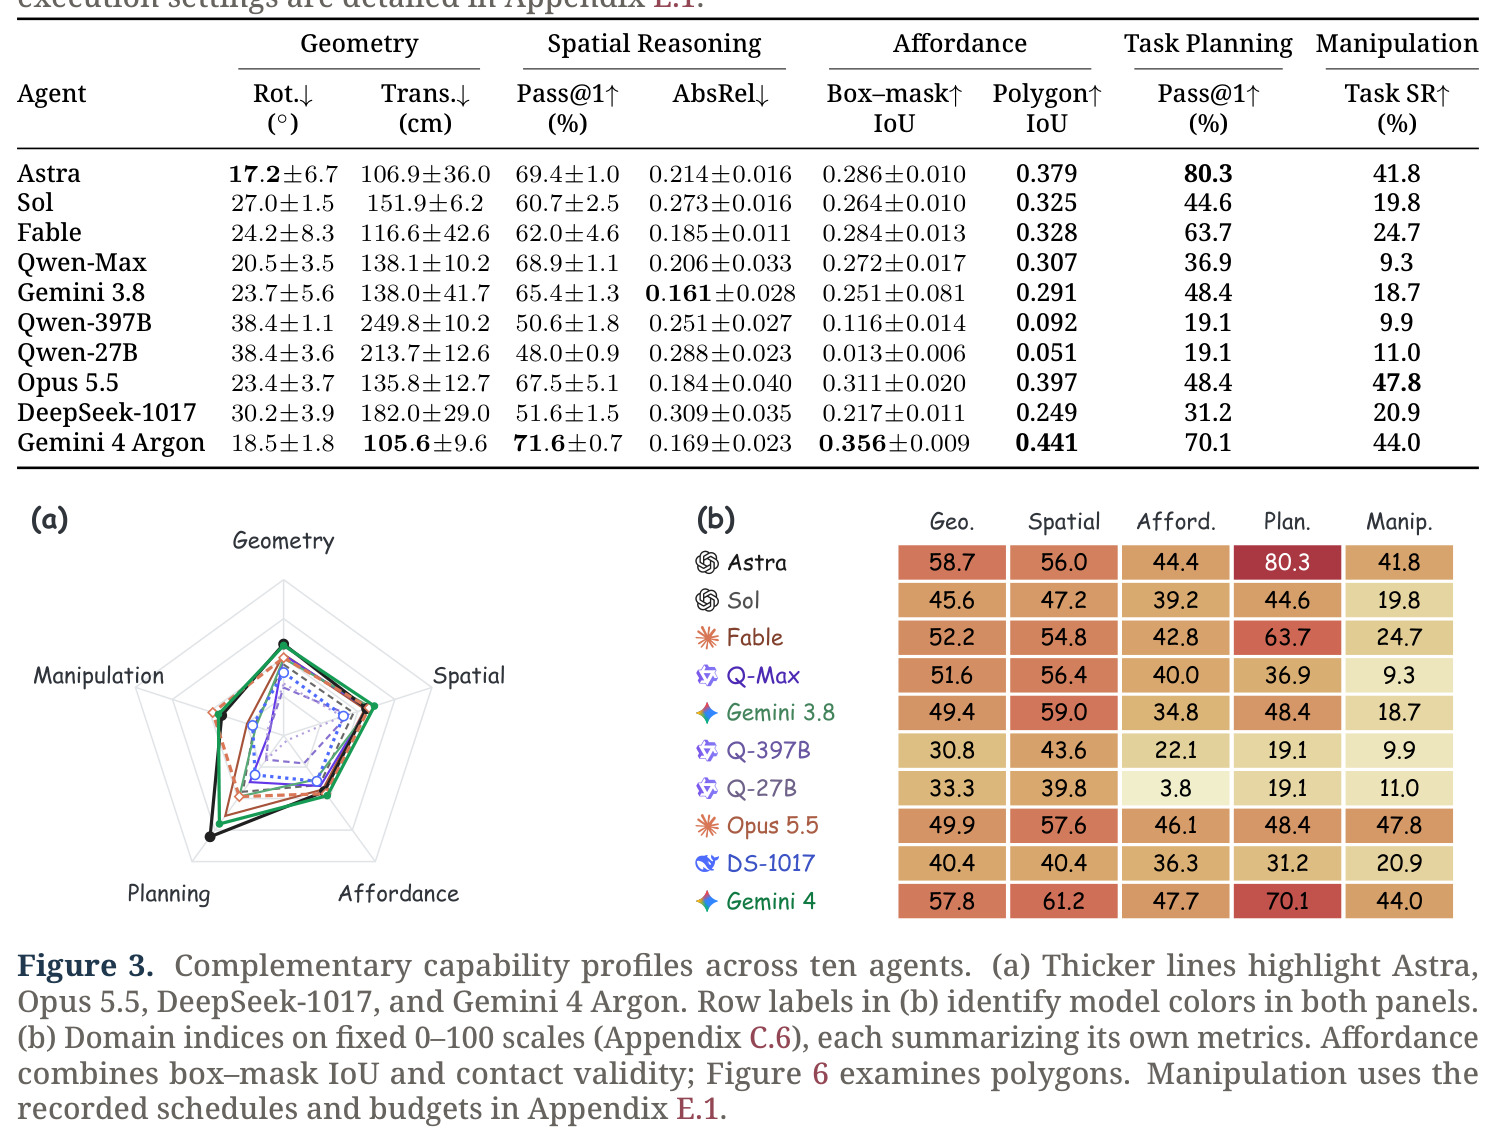
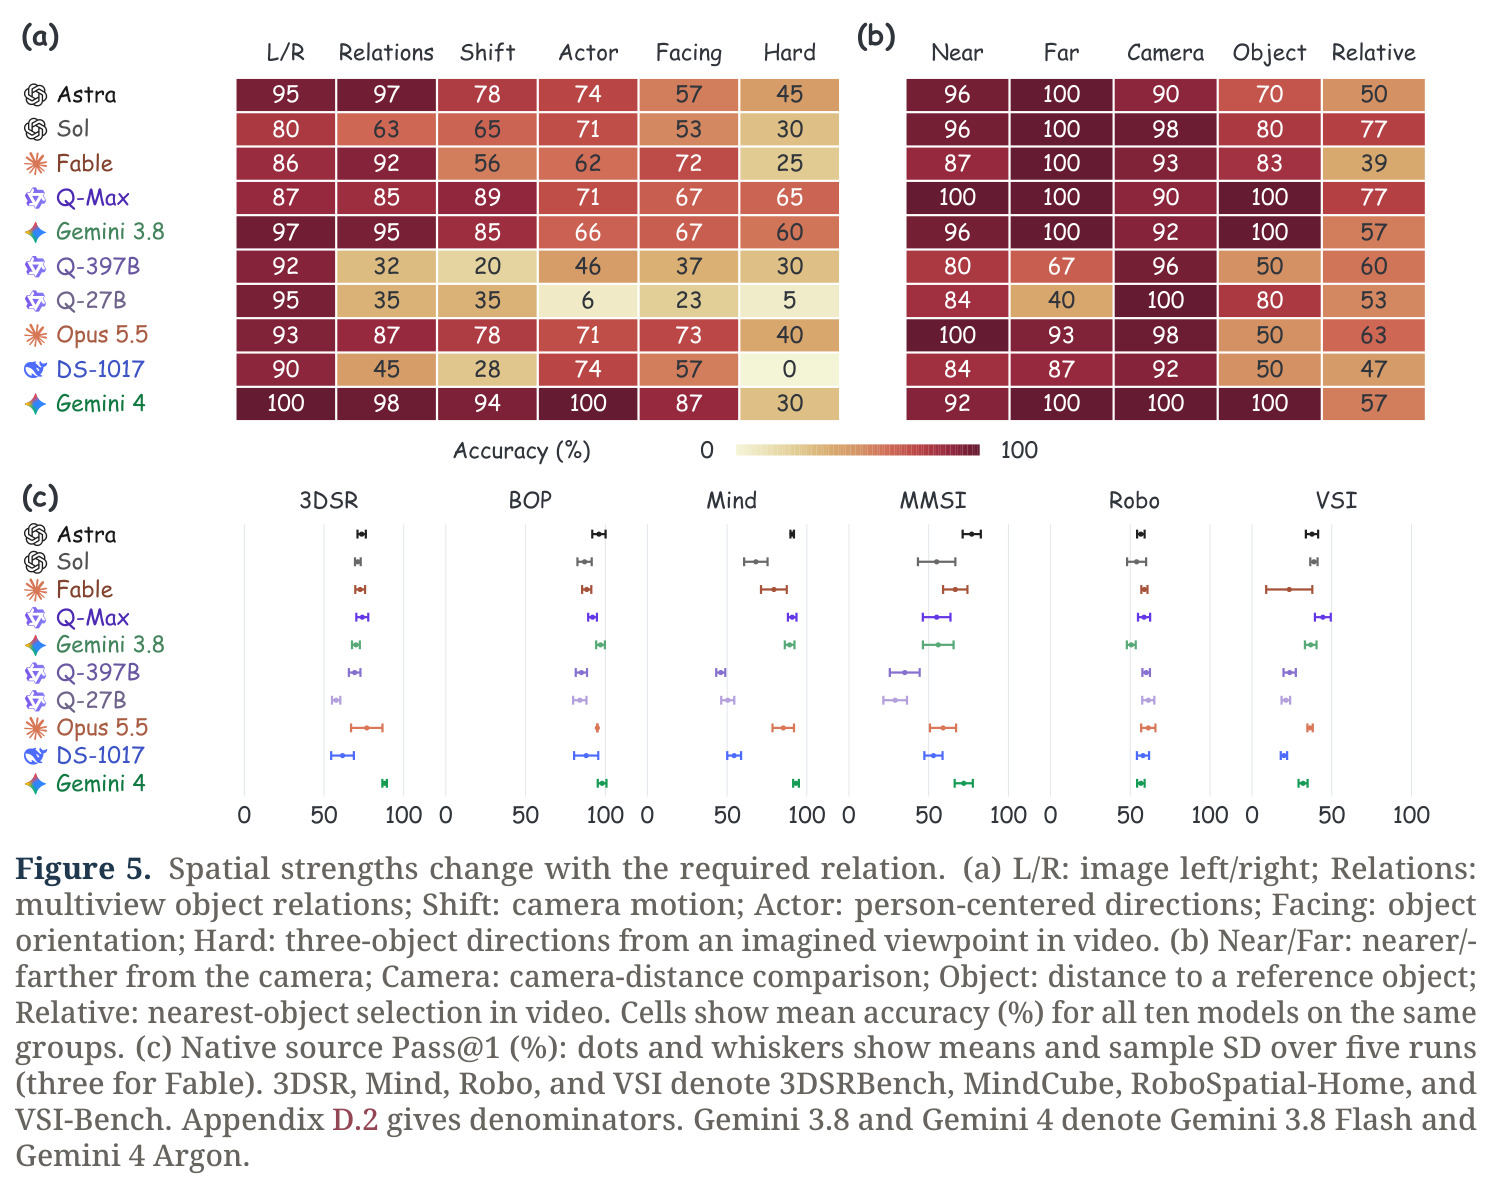
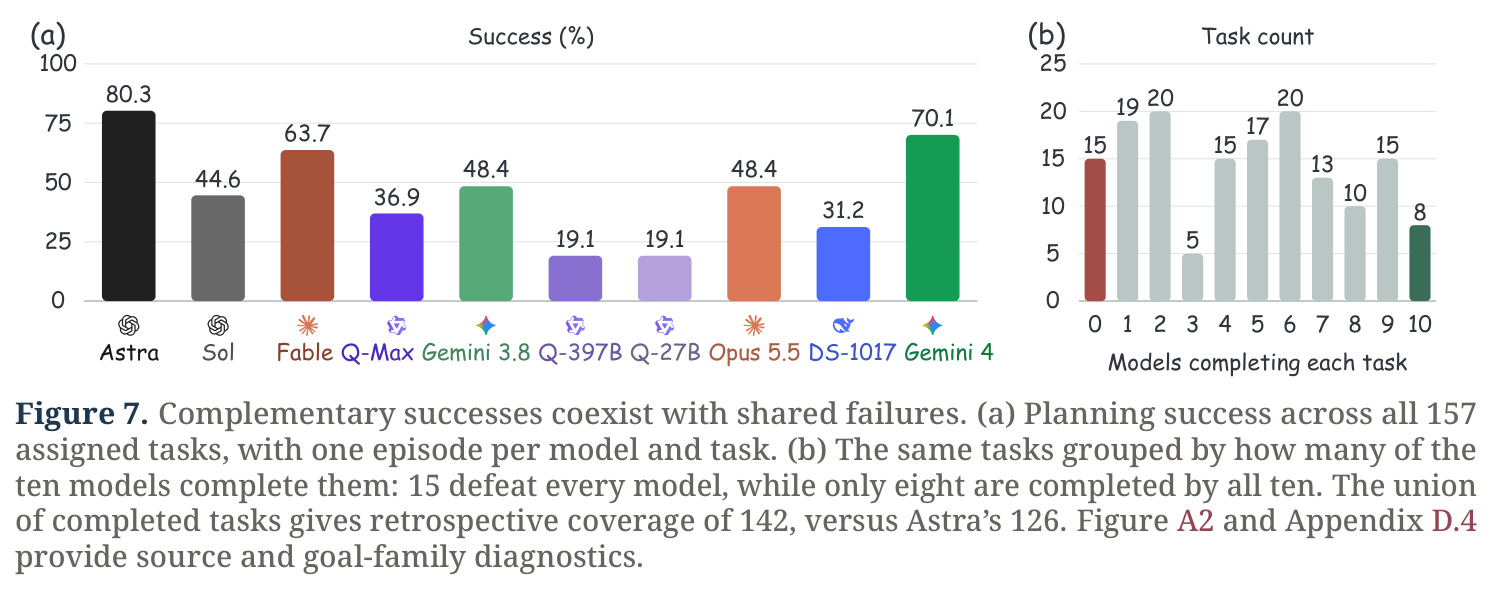
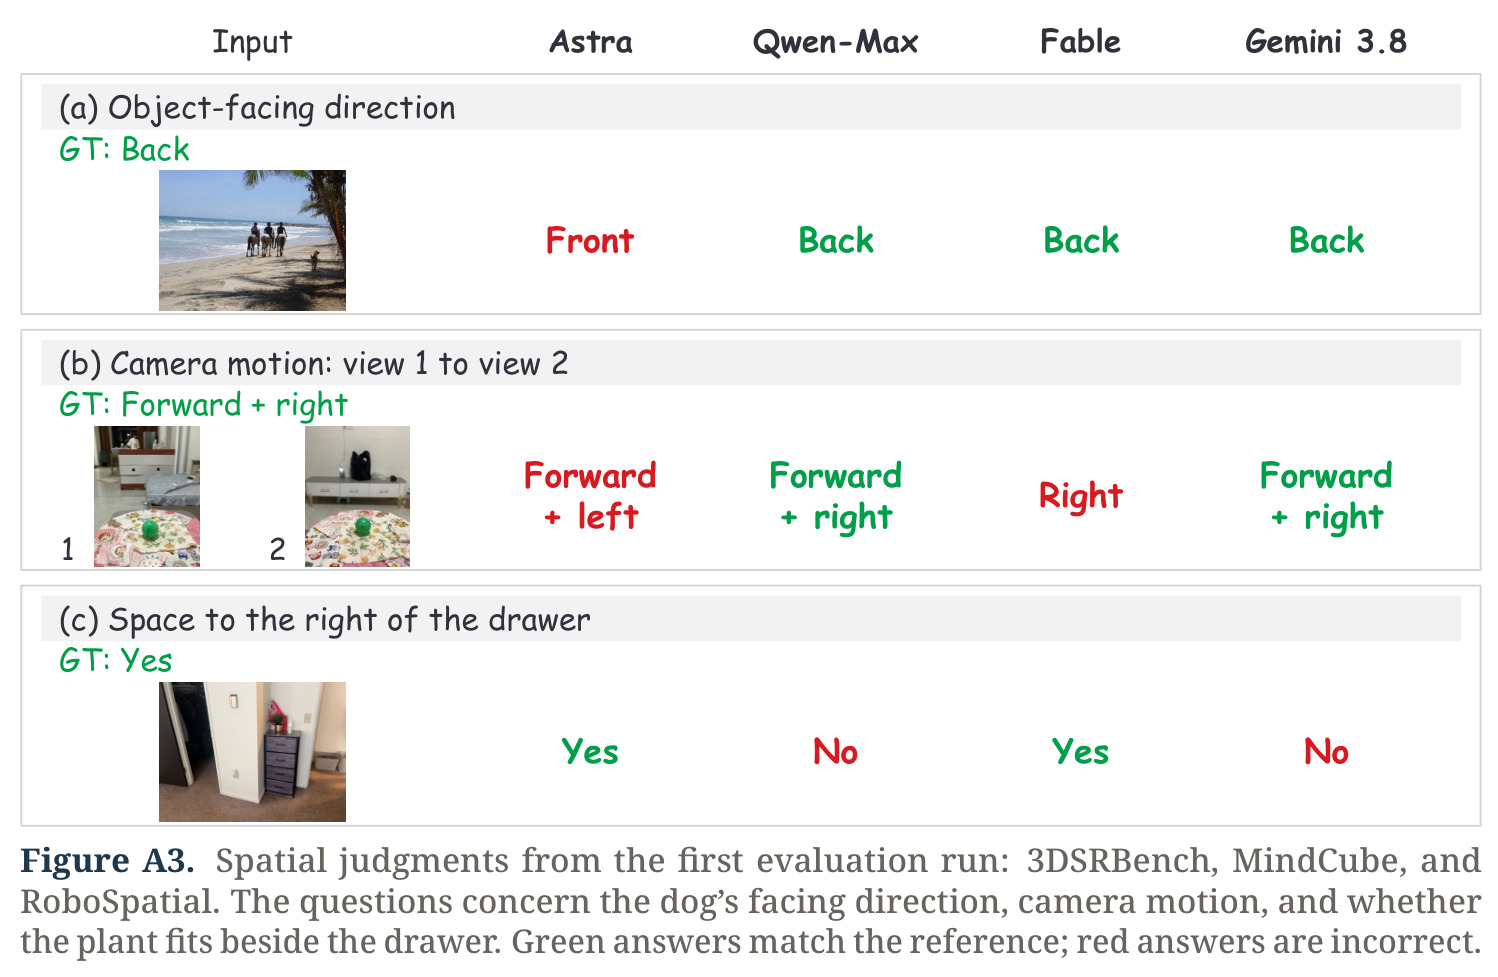
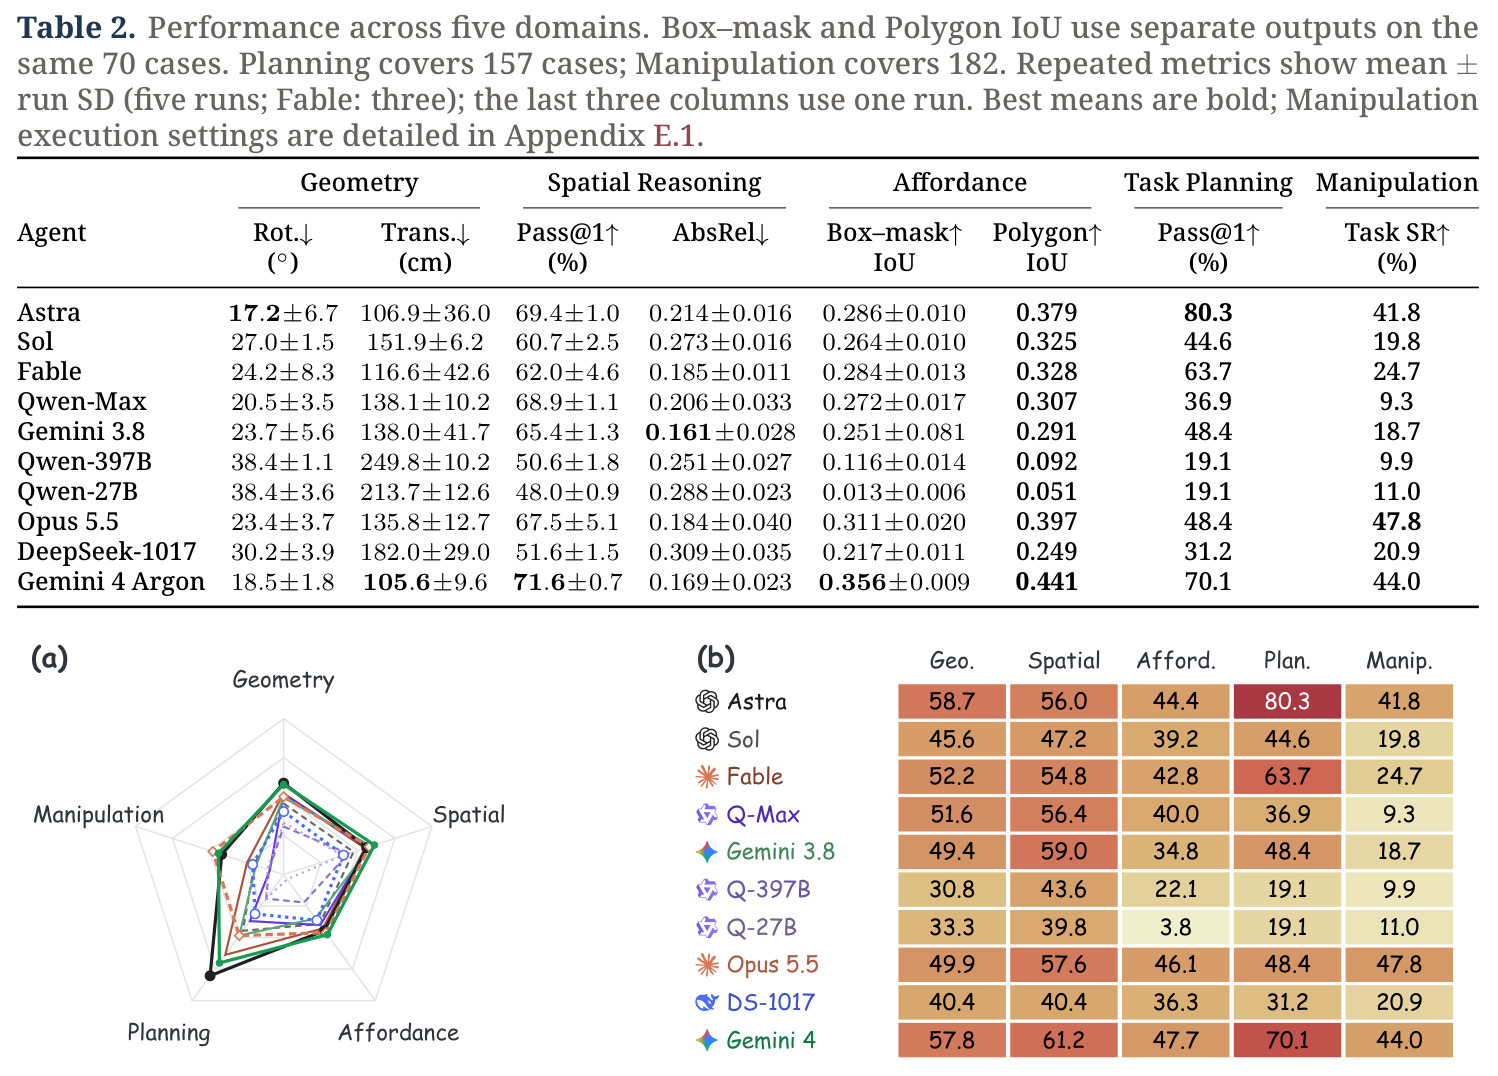
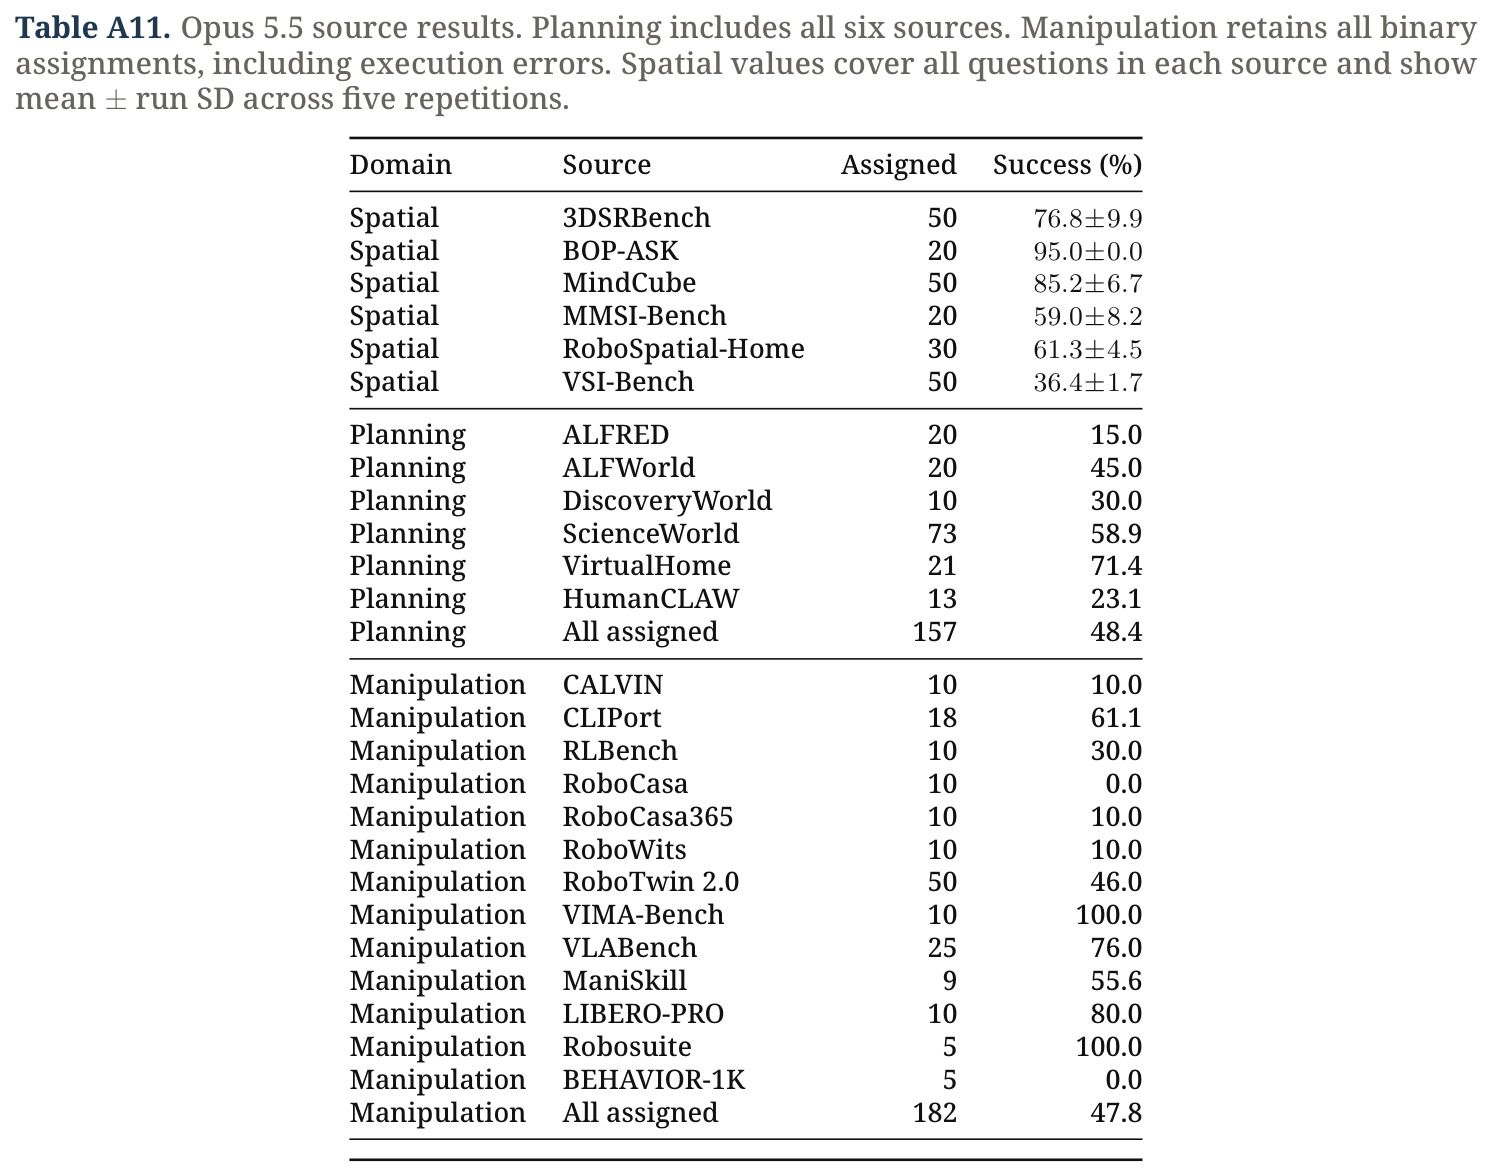
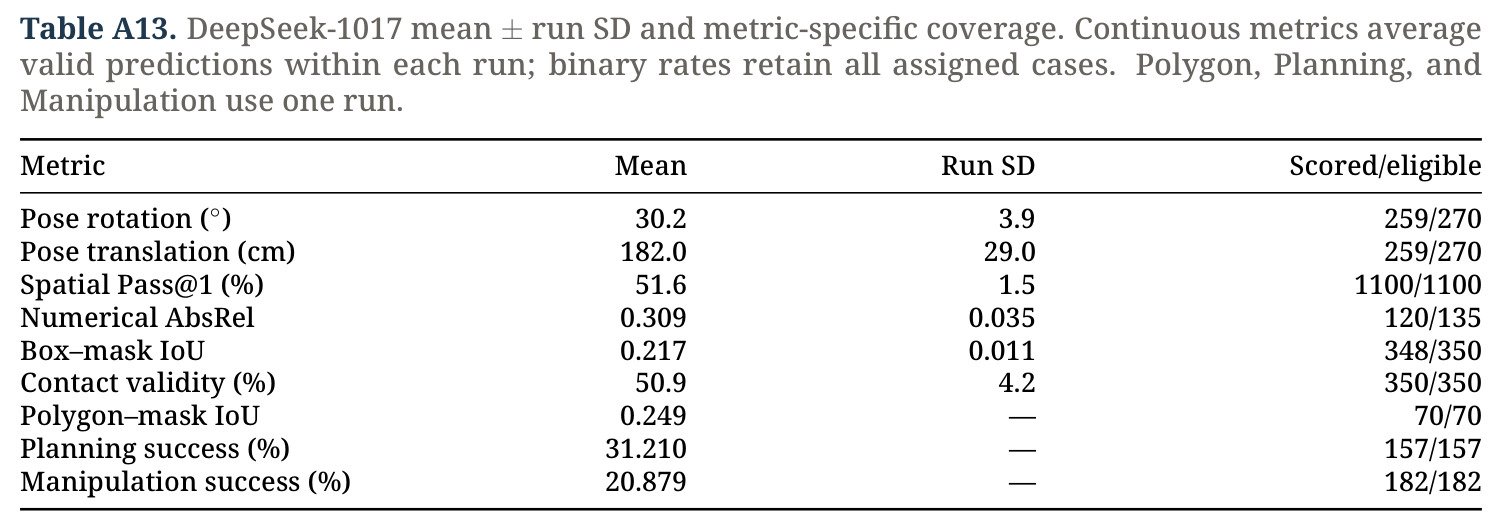
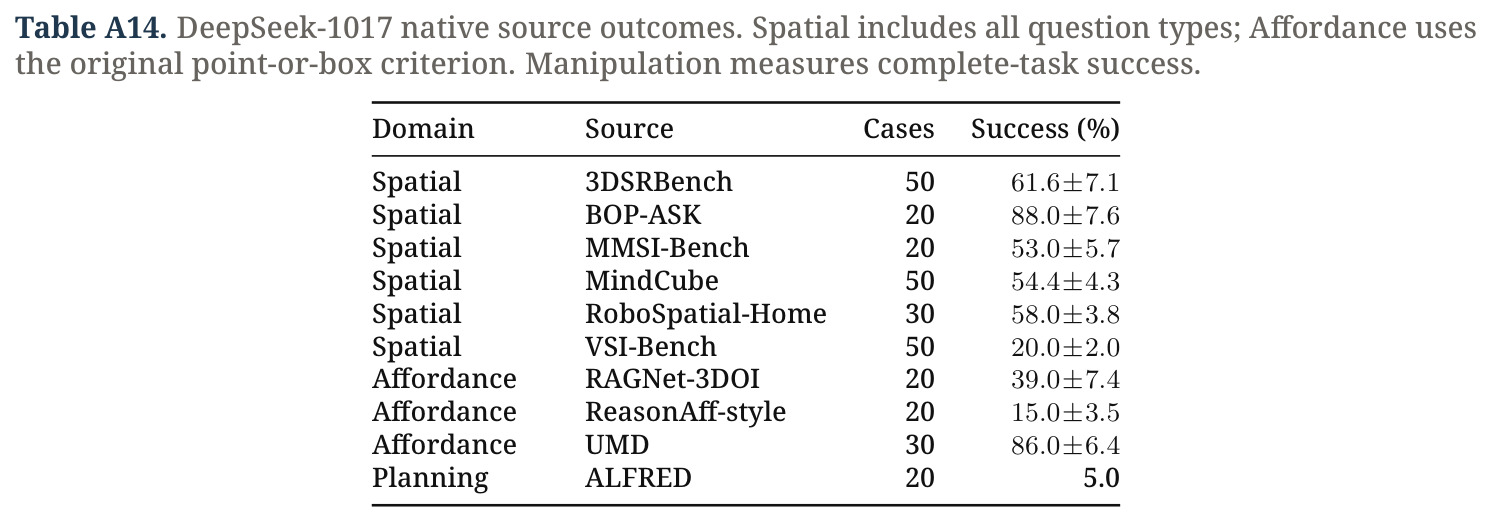
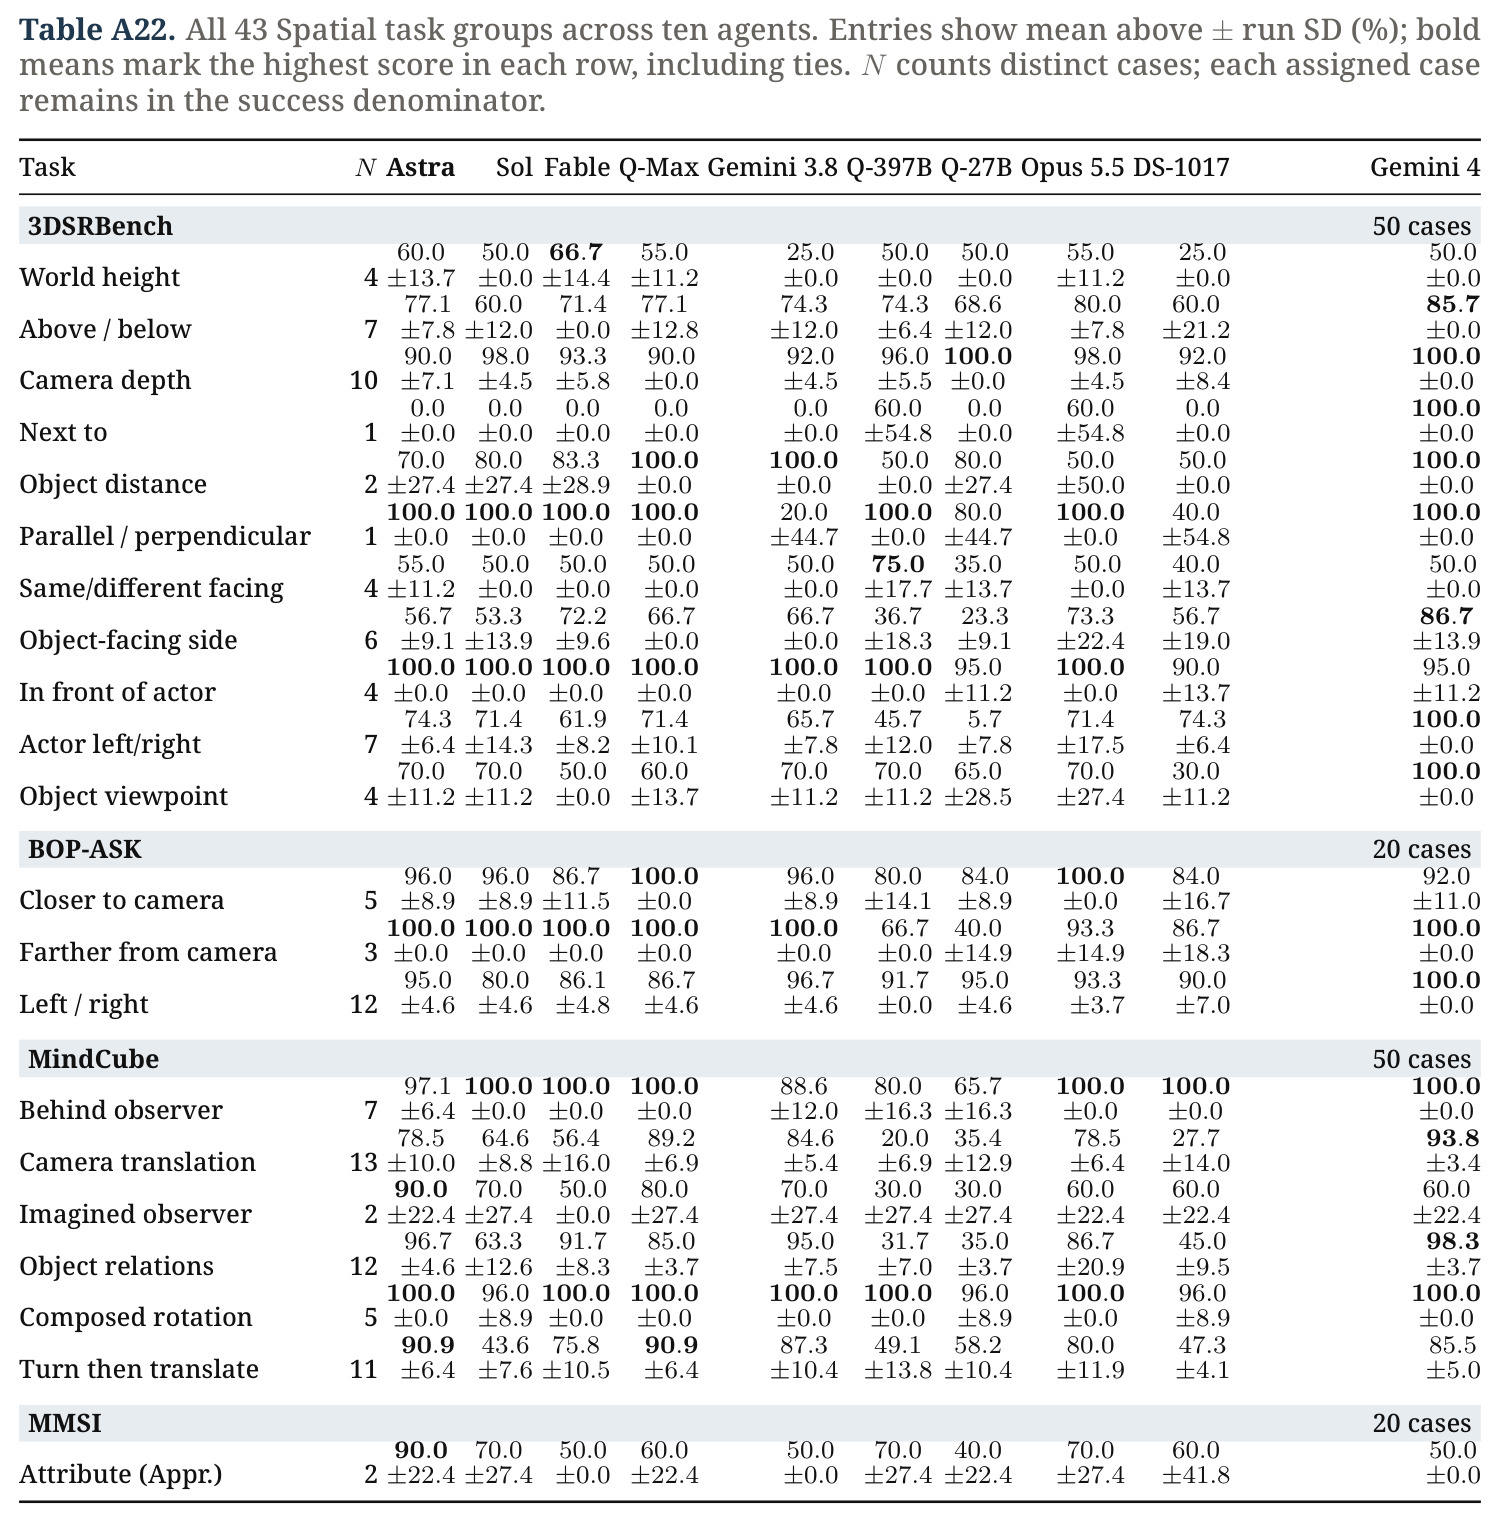
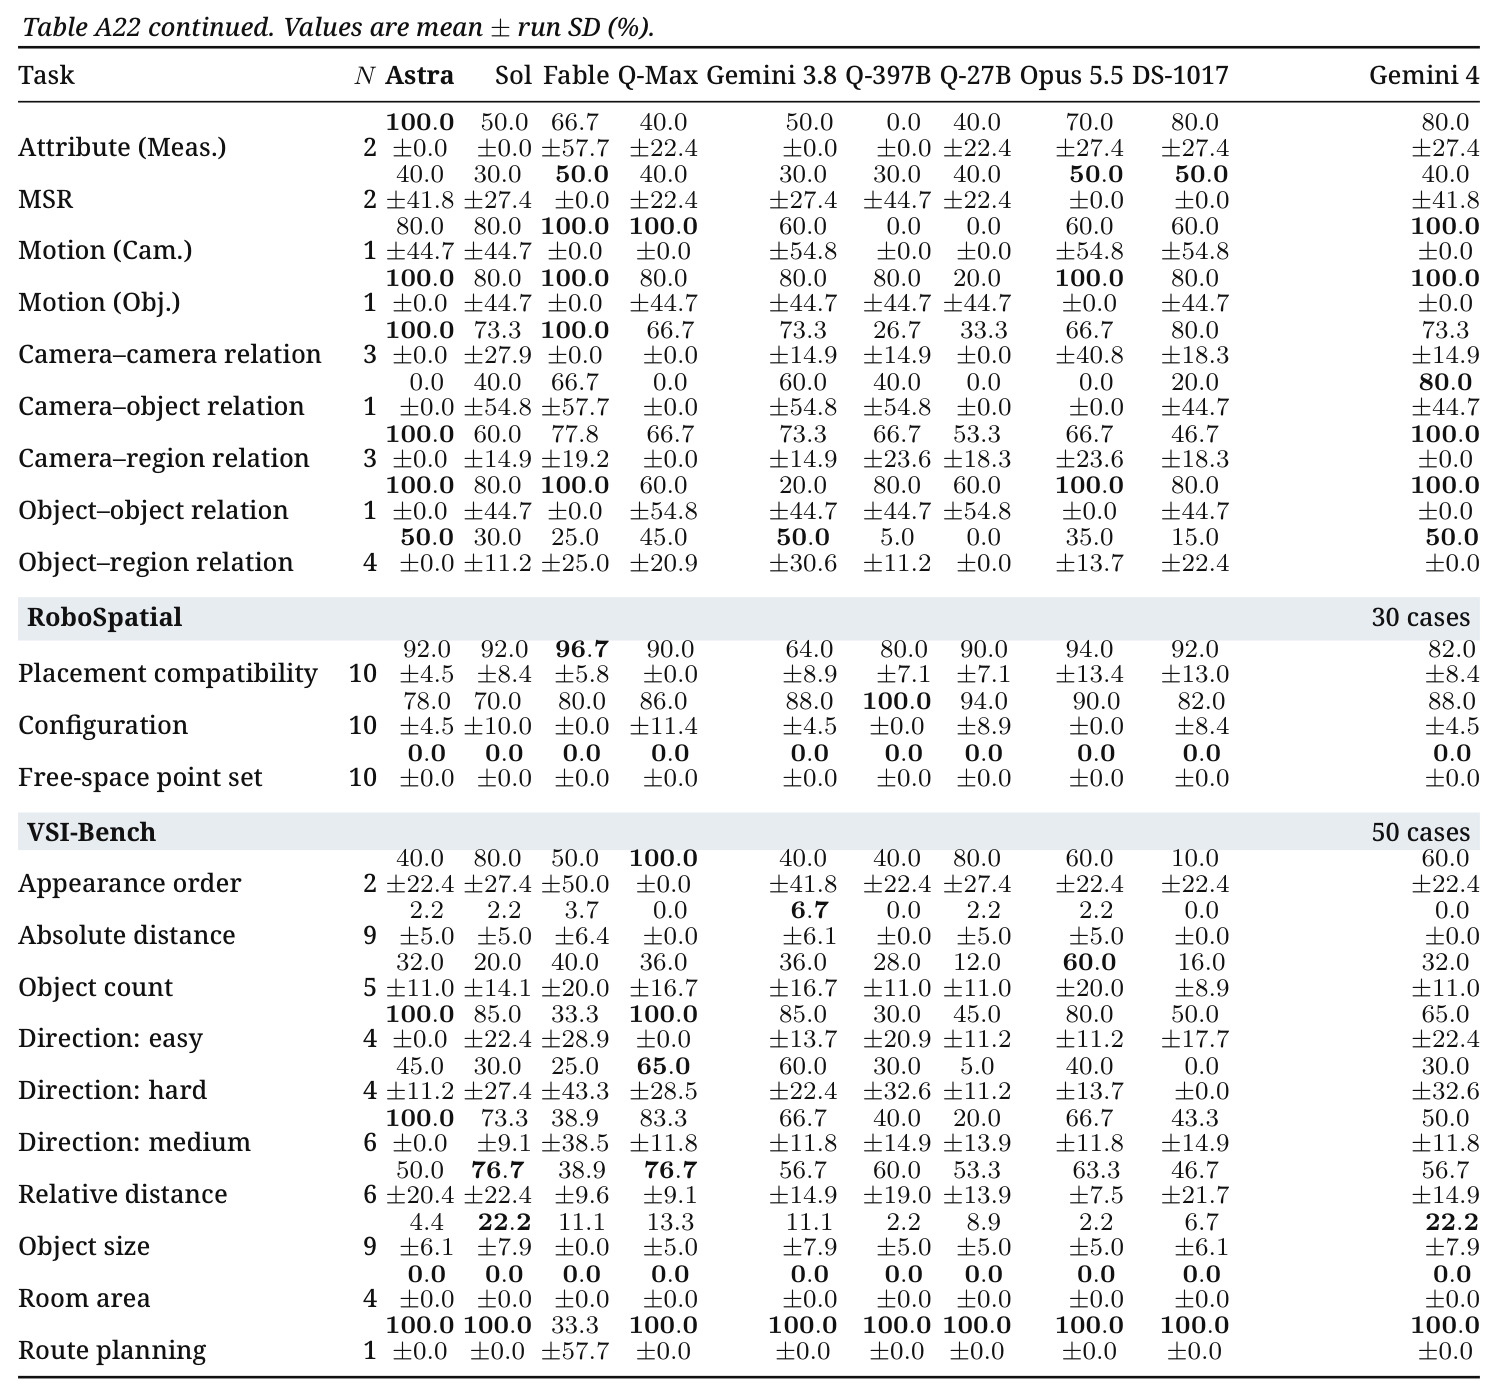
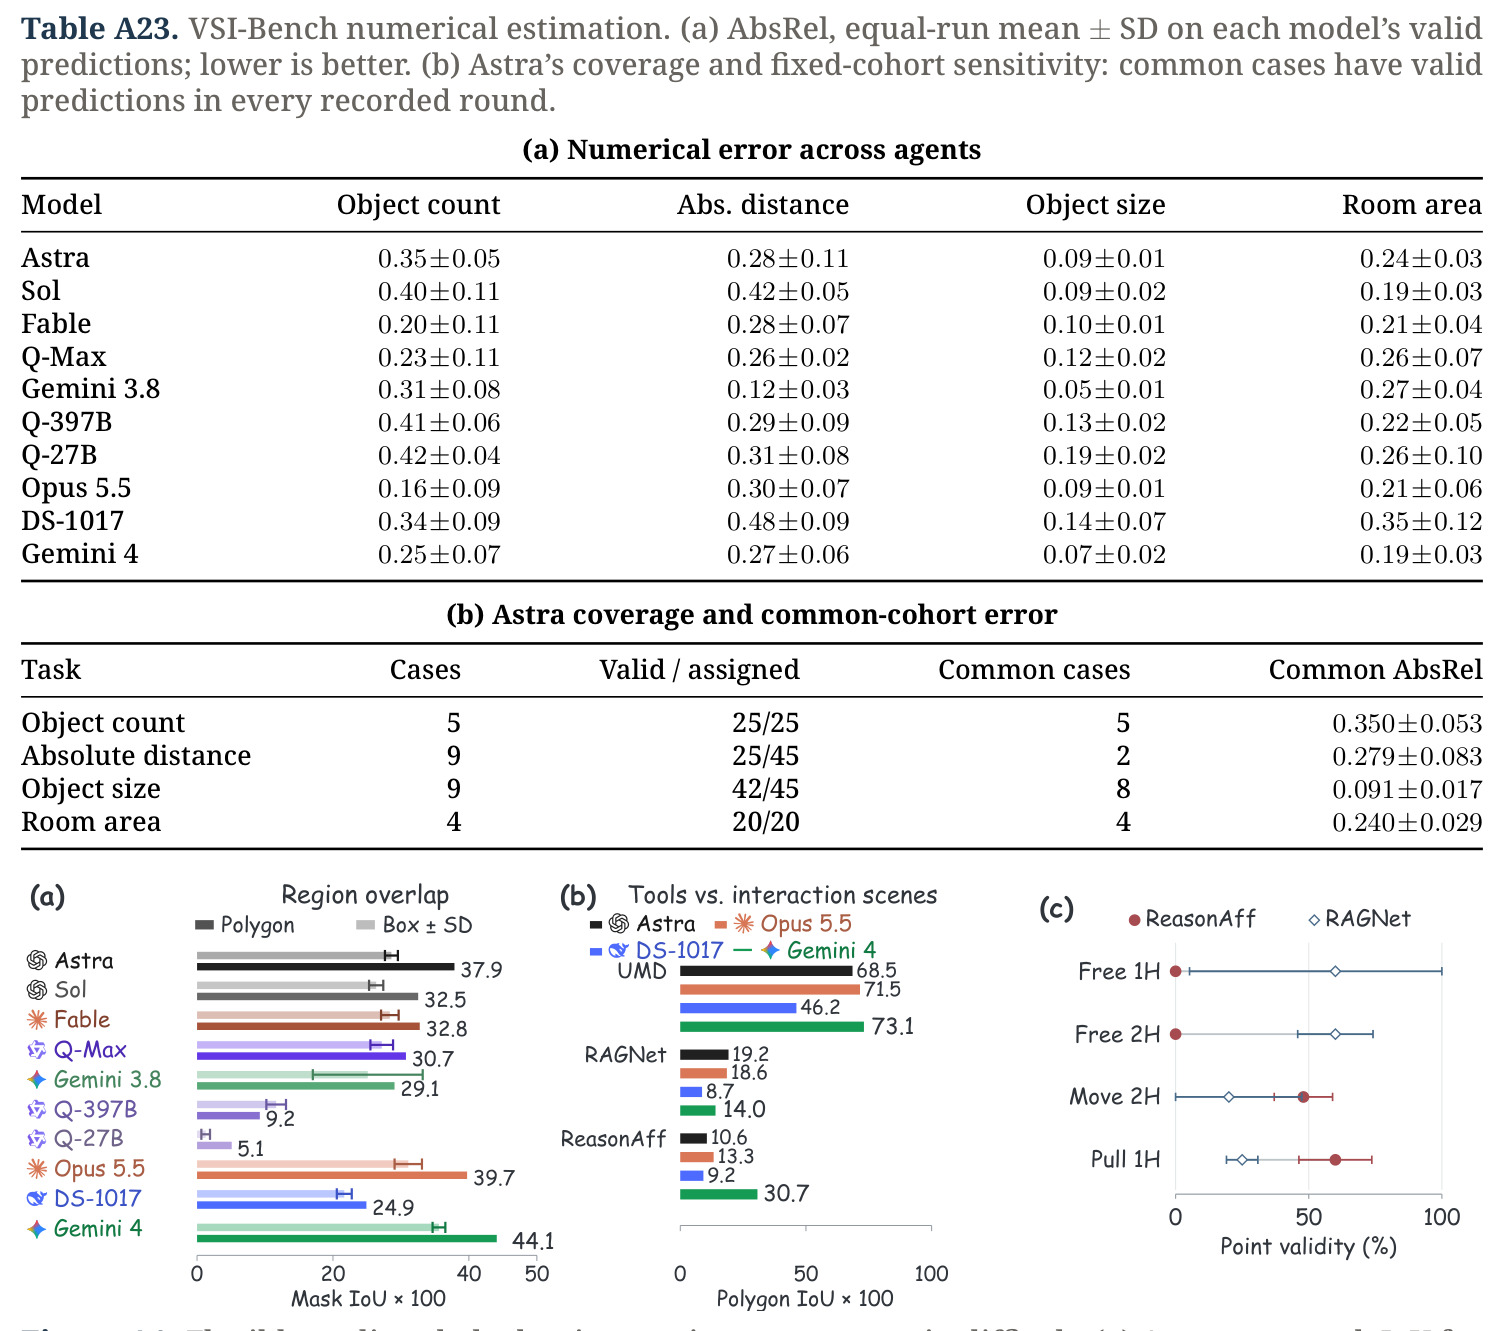
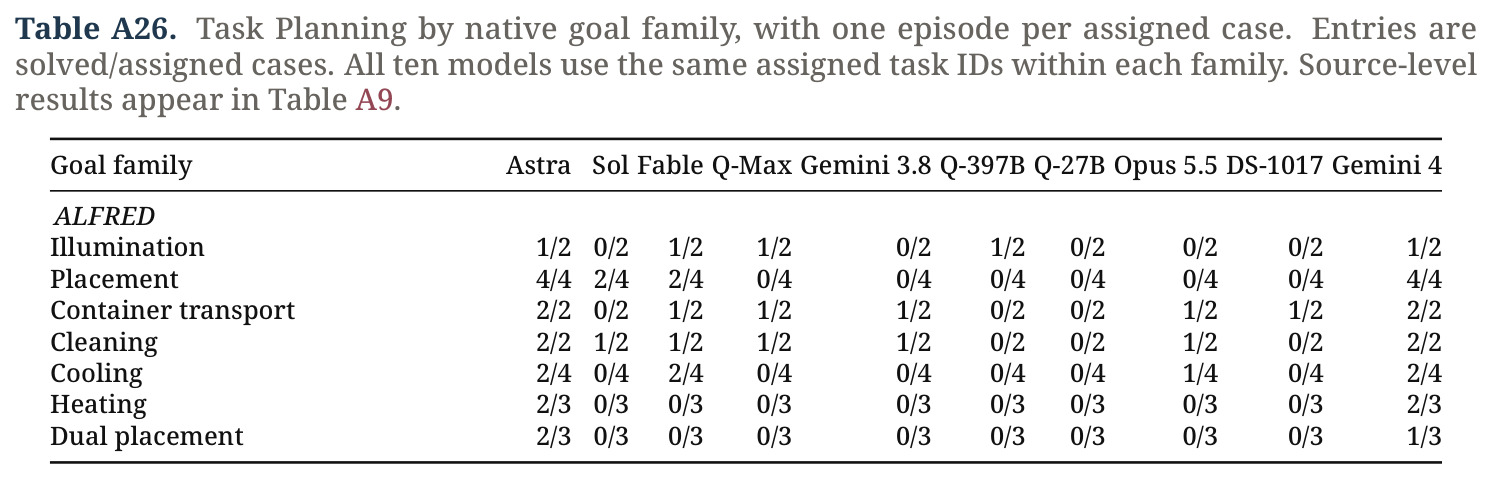
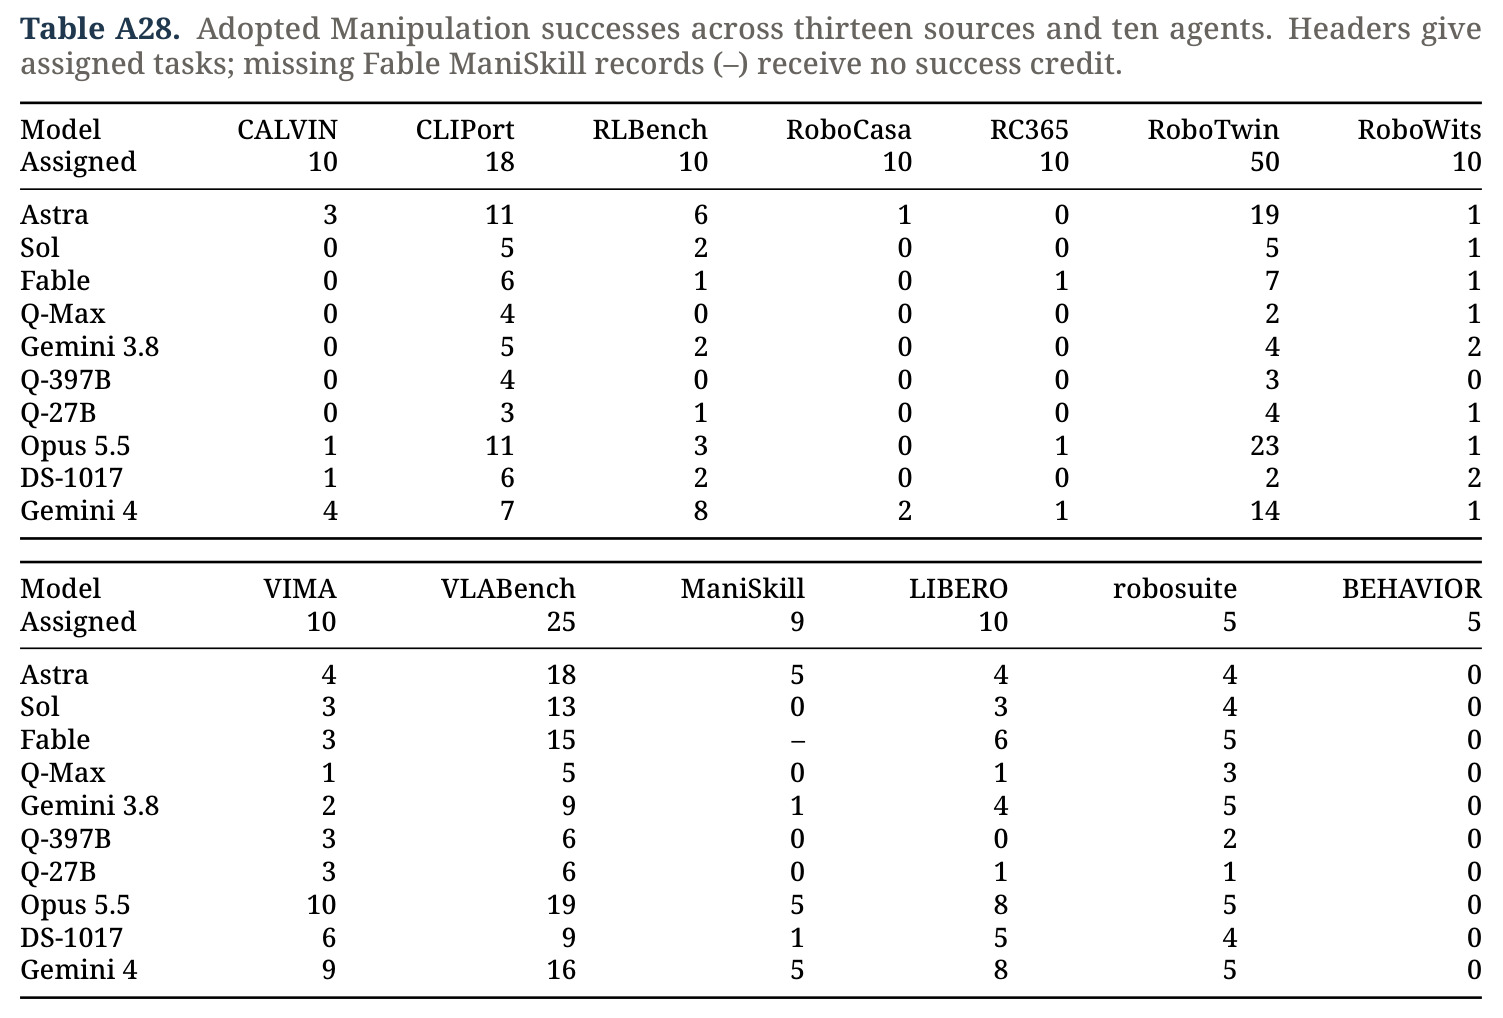
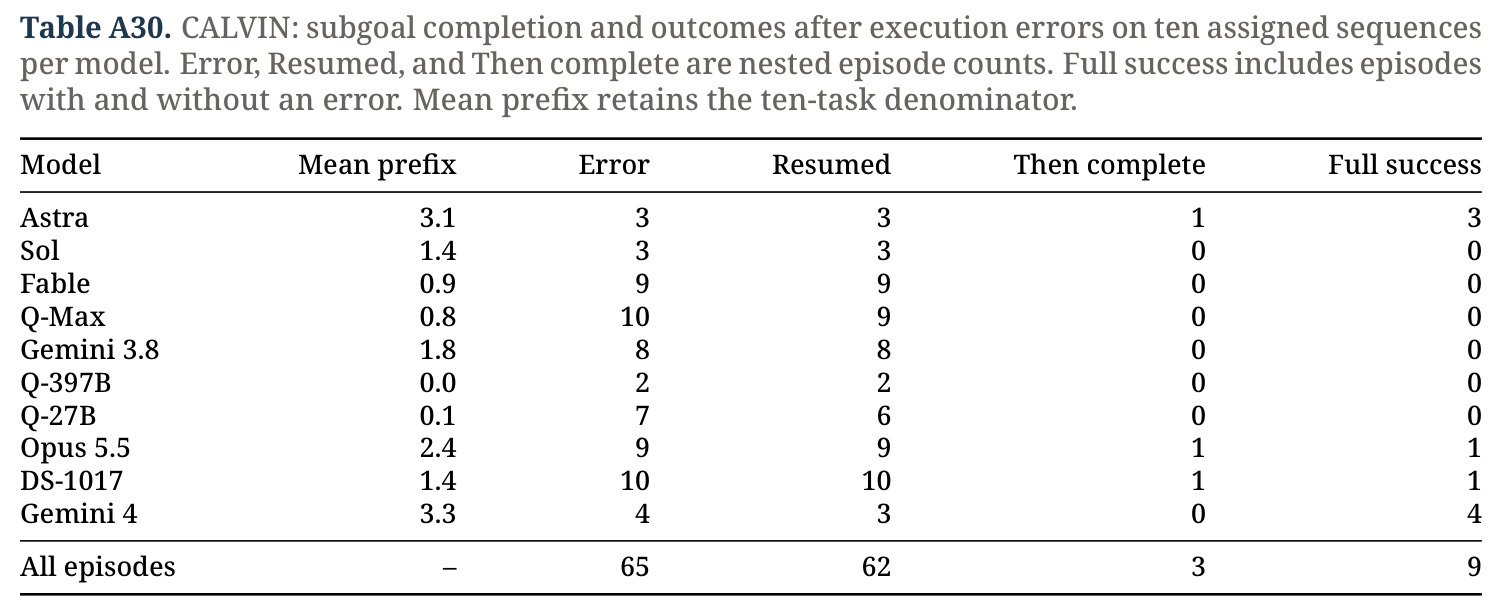
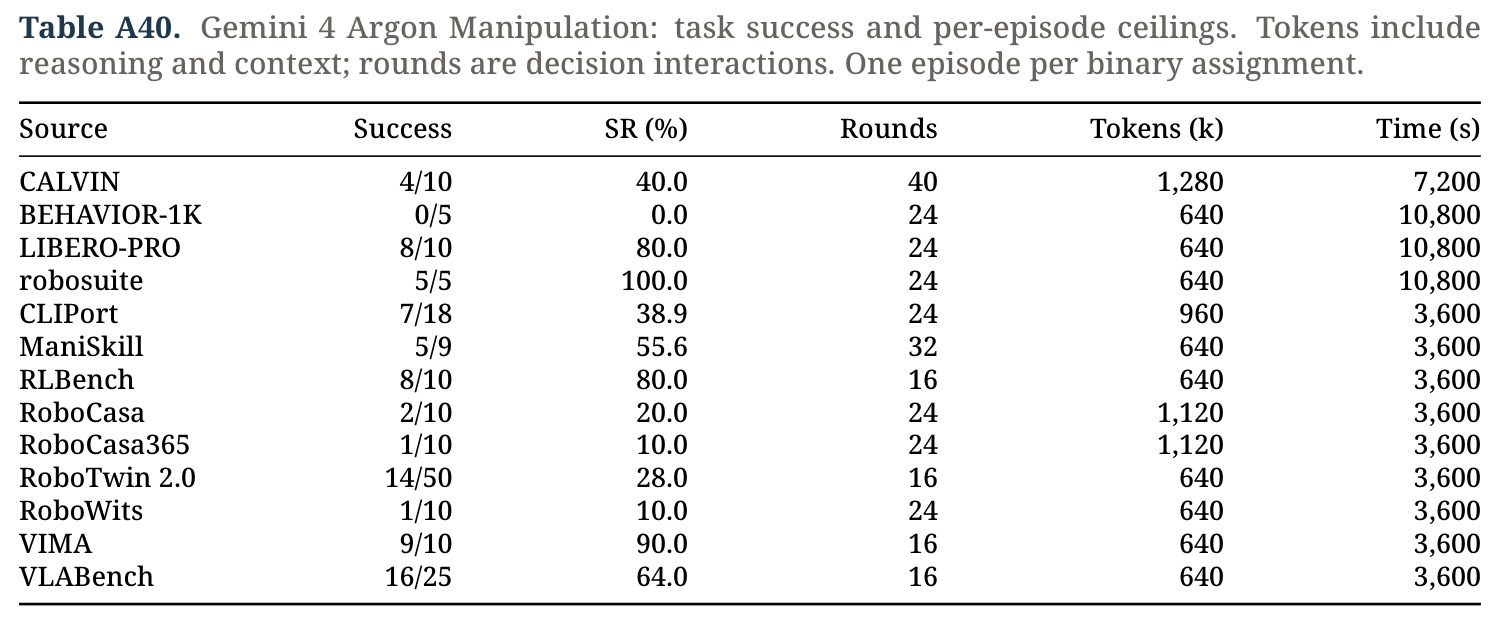
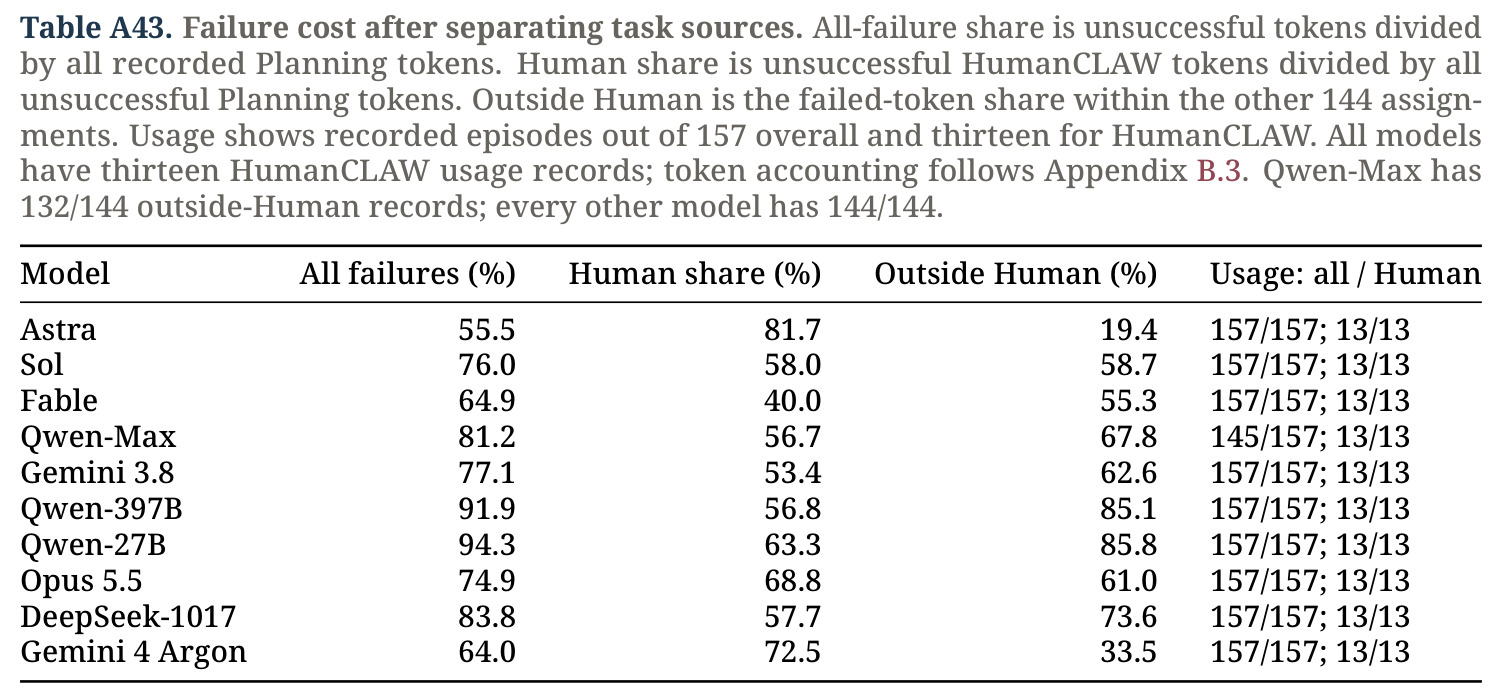
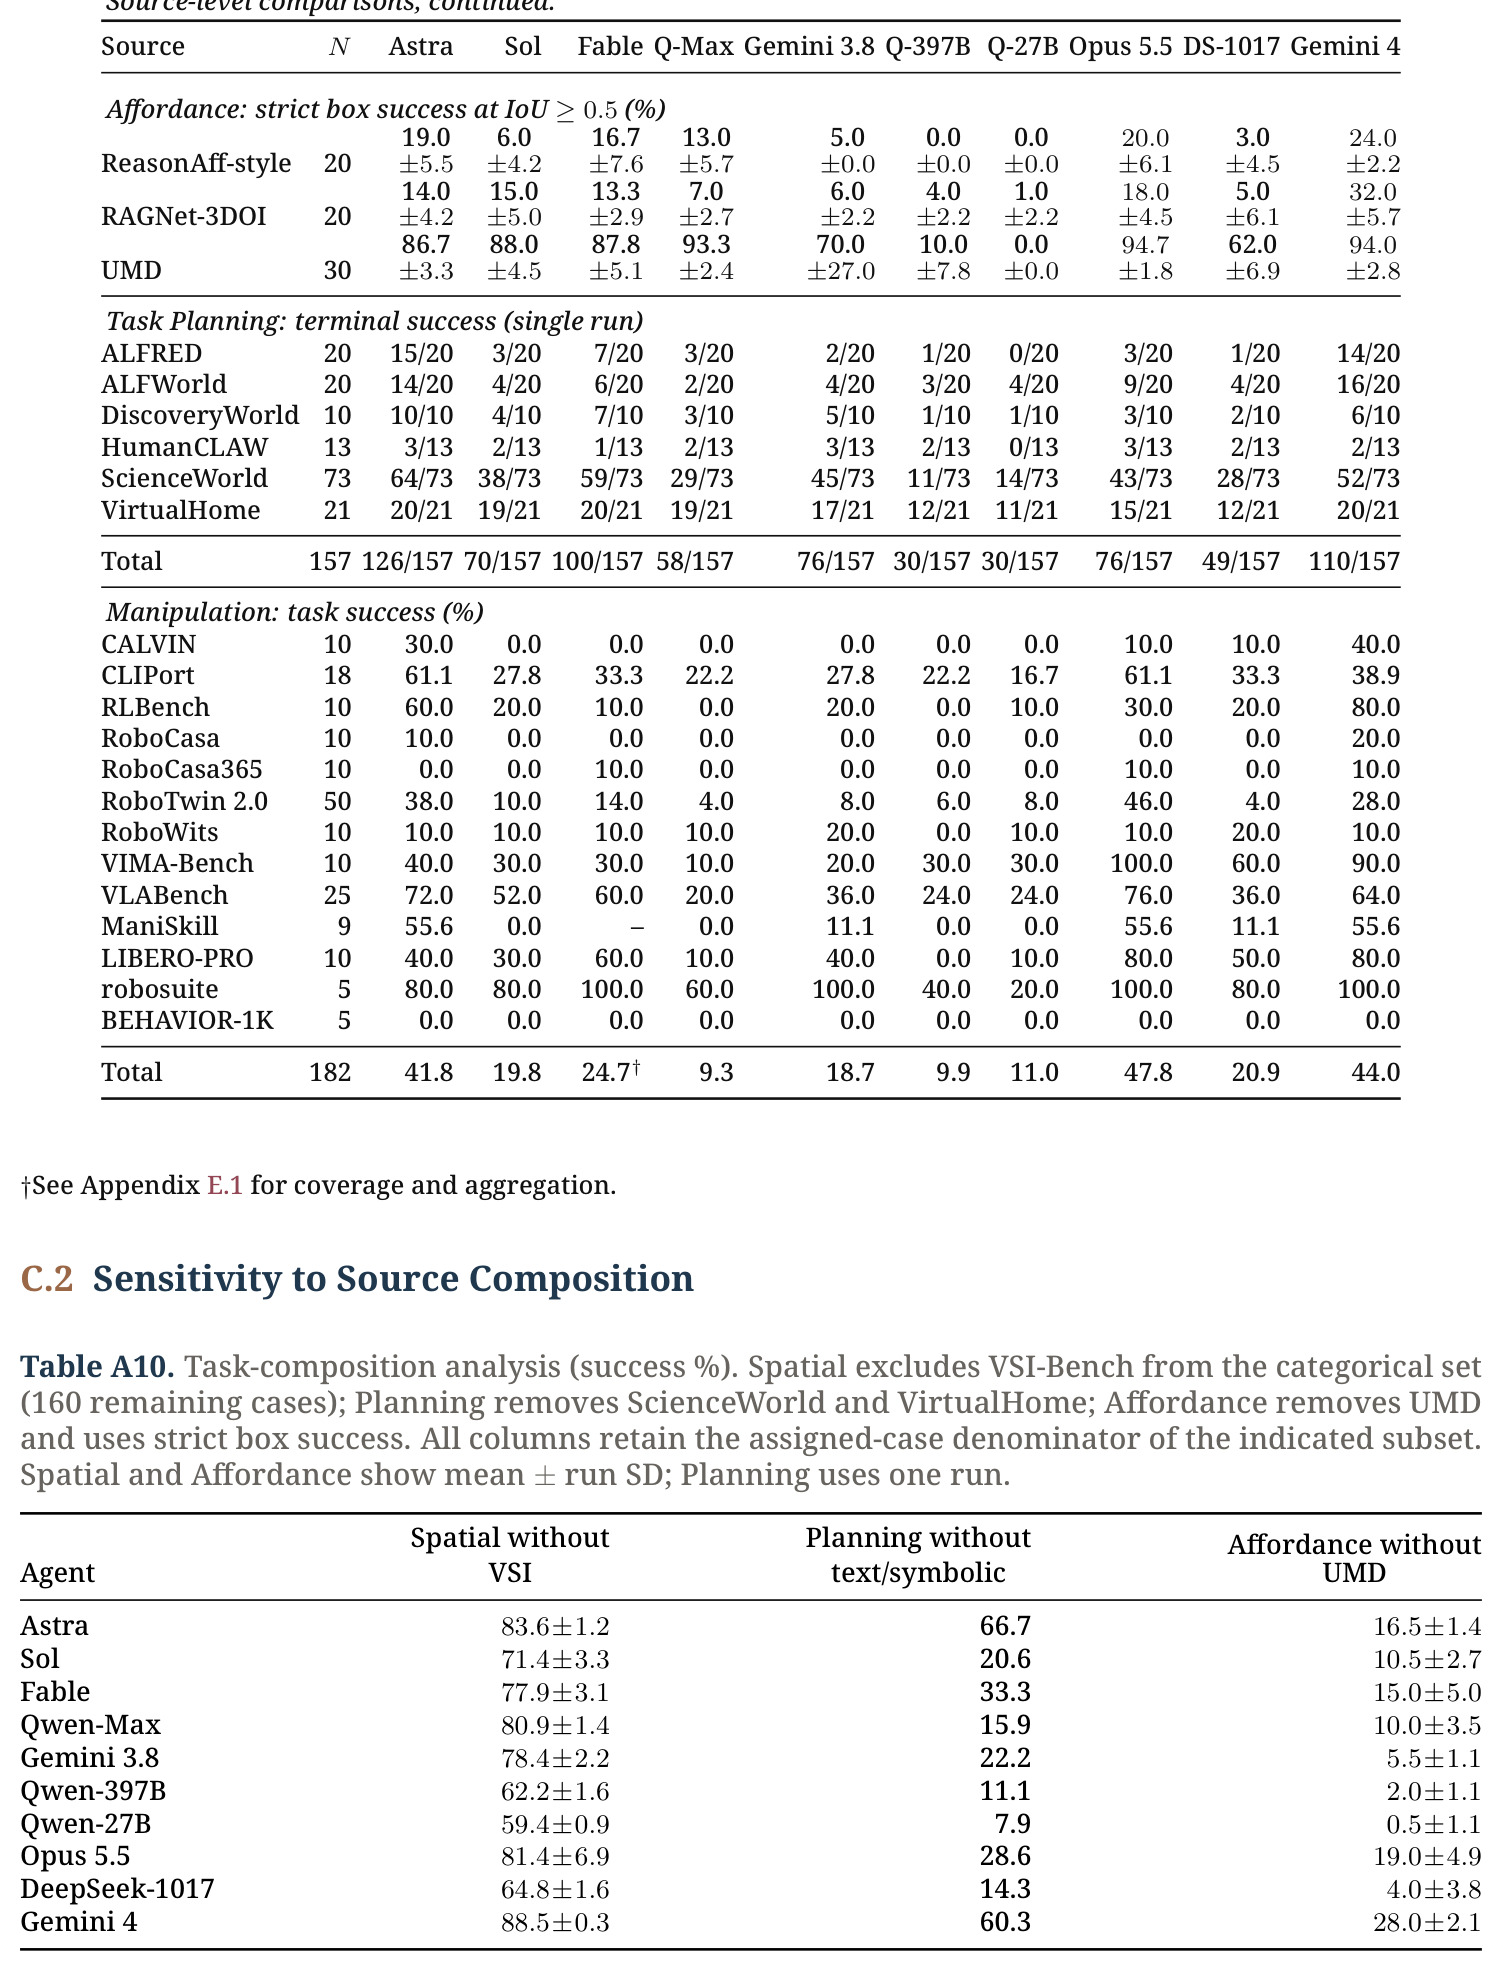
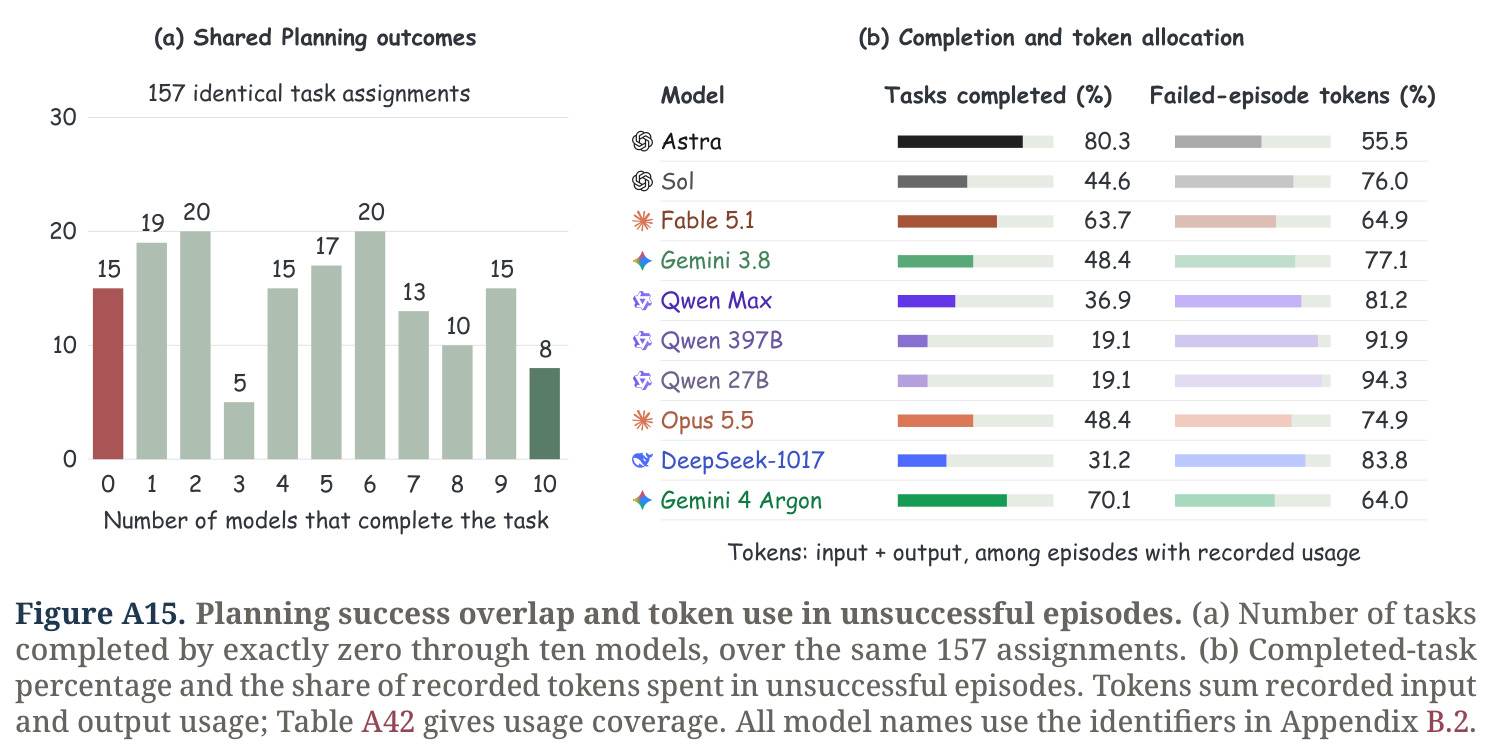
五域总榜:闭源模型包揽全部单项第一——空间推理 Gemini 4 Argon 71.6% Pass@1 居首(Astra 69.4%),规划 Astra 80.3% 最高(Gemini 4 70.1%),操作 Opus 5.5 以 47.8% 成功率领先(Gemini 4 44.0%);三个开放权重模型空间推理尚可(48.0–51.6%)但规划仅 19.1–31.2%、操作仅 9.9–20.9%。感知强不等于执行强:Qwen-Max 空间 68.9% 却只有 36.9% 规划成功率;任务配比还能改排名——按 13 个操作来源等权后 Opus(44.5%)反被 Gemini 4(47.4%)反超。互补性边际递减:157 个规划任务全员通过的仅 8 个(7 个来自 VirtualHome),39 题只有 1–2 家通过;Astra 单家解 126 题,加 Gemini 4 至 137,十家合计 142,另有 15 题全军覆没。GeoProbe 诊断显示误差本质各异:Gemini 4 与 Qwen-397B 原始深度 AbsRel 0.299 vs 0.312 几乎持平,oracle 尺度对齐后分化为 0.065 vs 0.203。执行层面,65 个含错误的 CALVIN 回合中 62 个后来代码可运行,但仅 3 个最终通过原生验证器。成本结构同样分化:HumanCLAW 仅占 Astra 13/157 个任务却贡献其 81.7% 失败 token(8 个坐姿任务独占 63.7%),剔除后份额从 55.5% 降至 19.4%,其余闭源模型维持 55.3–67.8%、开放权重高达 73.6–85.8%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 空间推理(Multi-Spatial、MMSI-Bench、VSI-Bench 等) | Pass@1 (%) | Gemini 4 Argon 71.6±0.7;Astra 69.4±1.0 | 开放权重最优 DeepSeek-1017 51.6 | 较开放权重最优高 20.0 个百分点 |
| 任务规划(157 例:ALFRED、ALFWorld、ScienceWorld、VirtualHome、BEHAVIOR-1K 等) | Pass@1 (%) | Astra 80.3;Gemini 4 70.1 | 开放权重最优 DeepSeek-1017 31.2;Qwen-Max 36.9 | 较开放权重最优高 49.1 个百分点 |
| 机器人操作(182 例:CALVIN、robosuite、RLBench、RoboTwin 2.0 等) | 任务成功率 (%) | Opus 5.5 47.8;Gemini 4 44.0(13 源等权后反超为 47.4 vs 44.5) | 开放权重最优 DeepSeek-1017 20.9 | 较开放权重最优高 26.9 个百分点 |
| 几何估计(InFlux、Map-free、GeoProbe、TraceSpatial 等) | 旋转误差 Rot.(°) ↓ | Astra 17.2±6.7;Gemini 4 18.5±1.8 | Qwen-397B 与 Qwen-27B 均为 38.4 | 误差降低约 53% |
| 可供性接地(同一批 70 例:UMD、3DOI、RAGNet、ReasonAff) | Box–mask IoU / Polygon IoU | Gemini 4 0.356 / 0.441 | Qwen-27B 0.013 / 0.051 | box 口径提升约 27 倍 |
| GeoProbe 深度估计(尺度诊断实验) | AbsRel(oracle 尺度对齐后)↓ | Gemini 4:0.299 → 0.065 | Qwen-397B:0.312 → 0.203 | 对齐后误差仅为对比模型的约 1/3,揭示其主误差为可修复的全局尺度偏差 |
局限与改进
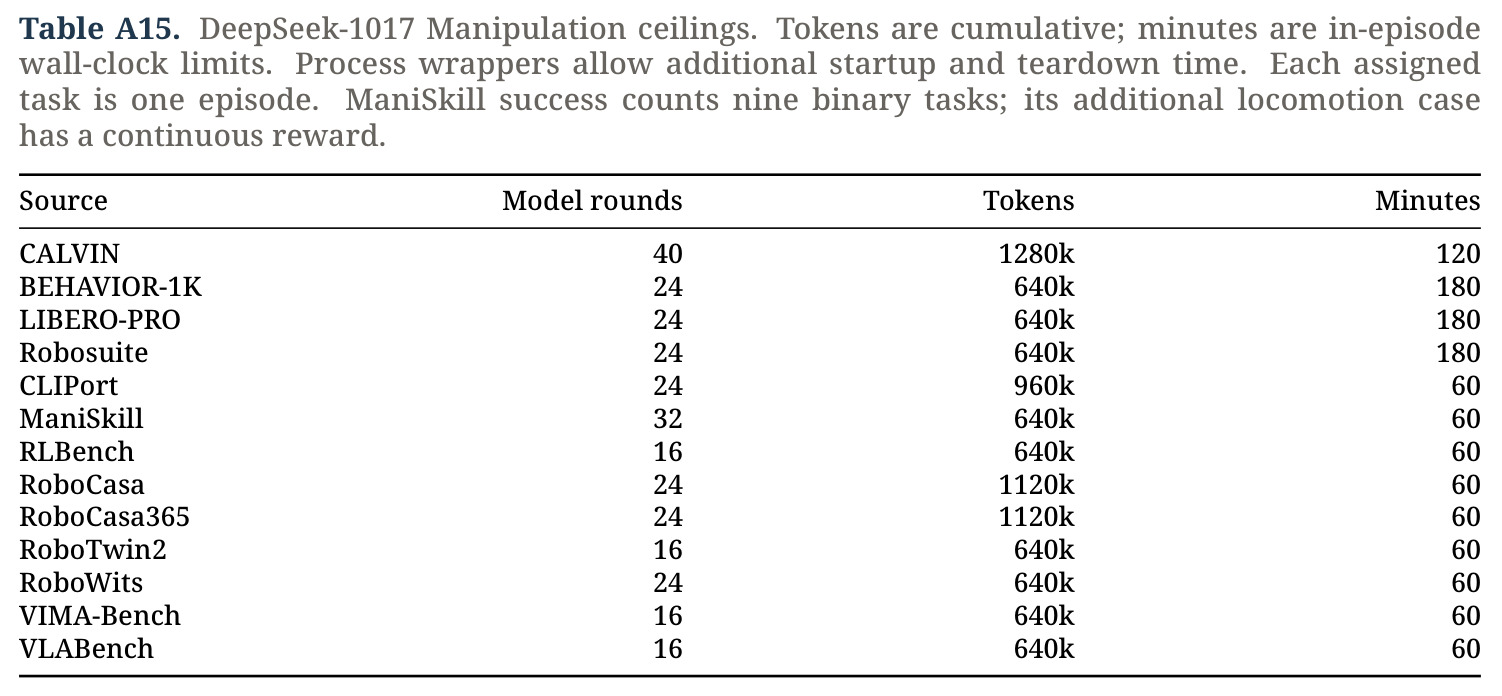
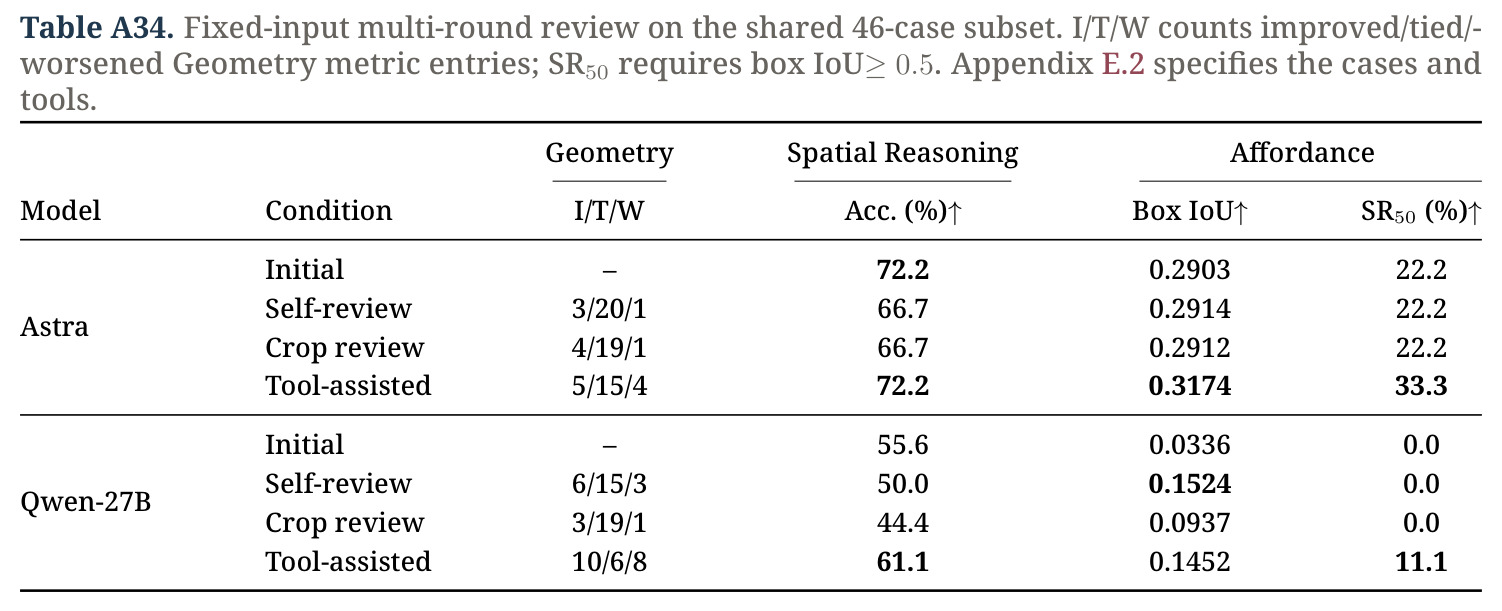
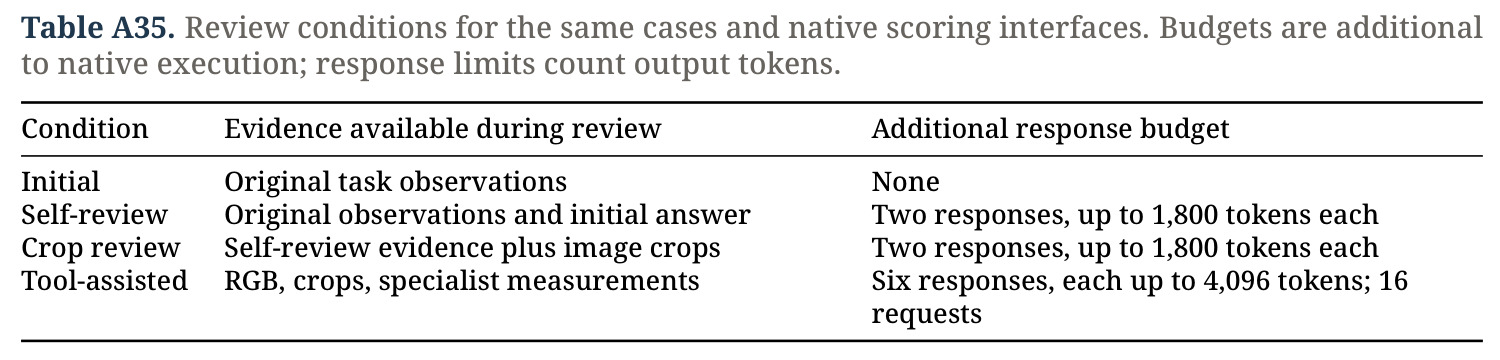
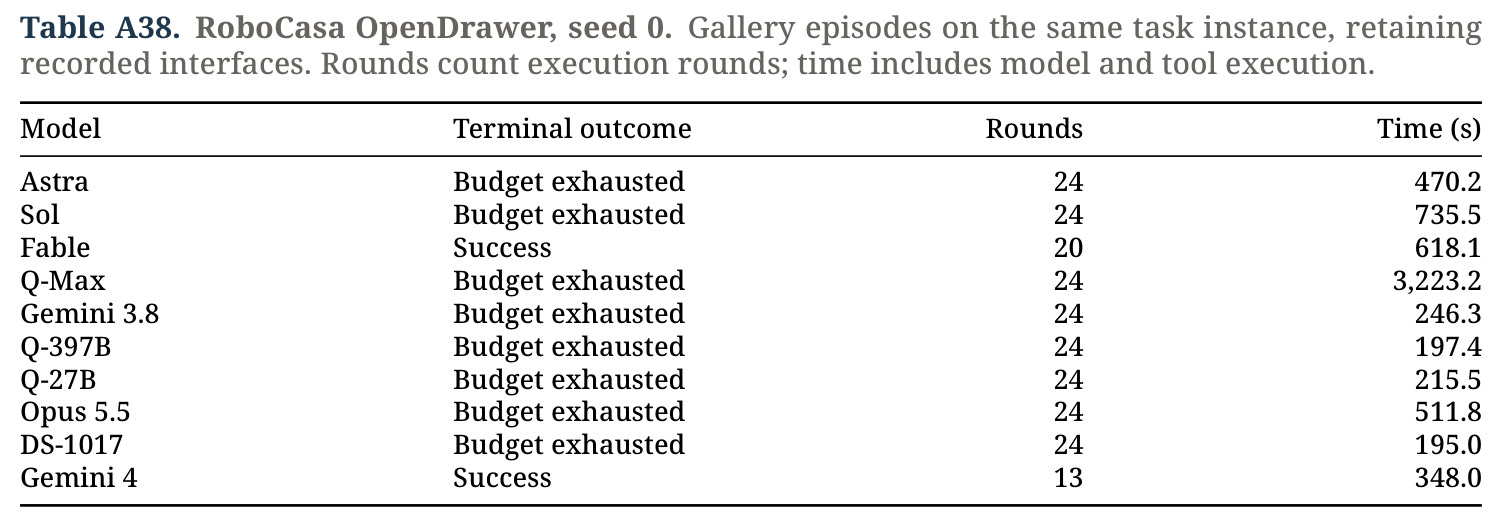
作者承认的局限:其一,Table 1 中 Memory 维度标记为未评测,长程跨会话记忆不在本轮范围;其二,Planning 与 Manipulation 每个任务只跑单回合,无法给出方差估计;其三,操作域沿用各评测批次的记录调度与执行上限(Appendix E.1 区分),跨源设置不完全统一,RoboTwin 占 50/182 且偏向 Opus(23 对 14 胜)这类配比直接左右排名;其四,HumanCLAW 坐姿任务的私有验证器不指明哪条位姿/接触条件未满足,只能确认“误判停止”,无法指导修复。我的补充观察:10 个模型是特定时间点快照,闭源 API 版本迭代快,结论时效性有限;70 例的 Affordance IoU 样本较小,polygon 又是单回合运行,波动被进一步放大;640k token、101 回合等预算设定会直接影响“谁失败得多”的成本结论;评测全部在仿真与静态图像上进行,缺少真实机器人物理部署验证;此外“原生能力”的 prompt 模板与 few-shot 选择未做敏感性分析,最小 harness 的结论可能依赖具体措辞。
独立分析的弱点
第一,最小 harness 把接口合规成本也压在模型身上:Qwen-Max 在 200 个 CALVIN 回合中 103 个含执行错误(其中 95 个语法错误),Fable 34/36 个错误回合是语法问题——这类失败被计为任务失败,混淆了“不会写合法代码”与“不会完成任务”。改进方向:报告时区分接口级与任务级失败,或提供一次免费语法反馈再评分。第二,自审/裁剪复审会翻转正确判断:Qwen-27B 自审修复 1 个错误却破坏 2 个正确答案,裁剪复审修复 2 个却破坏 4 个——无差别复审有净风险,应引入带验证门控的选择性复审。第三,聚合成本指标失真:HumanCLAW 占 Astra 81.7% 失败 token 且 98.23–99.46% 是 prompt token,说明重复输入处理主导开销,应按来源等权报告成本并区分输入/生成 token。第四,坐姿等任务的私有验证器是黑盒,模型无法得知缺的是姿态还是接触条件,建议输出未满足谓词的最小诊断信息。第五,操作域各来源观测调度与执行上限不统一,跨源可比性打折扣,可统一预算后再排名。
未来方向
作者明确指向的方向:把评测扩展到 Memory 维度(Table 1 预留但未实现),考察跨会话状态保持与历史利用;深化执行轨迹分析,把“改绑目标、修复先决状态、撤回完成声明”三类恢复机制自动化为诊断工具。基于其成果可延伸的研究:其一,构建“错误后恢复”专项基准——CALVIN 数据显示 62/65 个错误后恢复执行的回合仅 3 个完成任务,说明从故障中继续推进本身就是值得单独建模与训练的能力;其二,把 GeoProbe 的 oracle 尺度对齐改造成在线校准外挂,检验少量标定参照能否廉价修复闭源模型的主要深度误差(0.299→0.065 的空间很大);其三,推动等权报告协议成为社区规范,避免来源配比操纵排名(Opus 44.5% vs Gemini 4 47.4% 的反转即为例证);其四,把“区域正确但动作点无效”的接地误差与下游操作成功率做因果关联,量化可供性精度对执行的贡献;其五,在真实机器人上复测头部模型,弥合仿真结论与部署之间的差距;其六,为“过早宣布完成”训练显式的目标条件验证器,替代模型自报终止。
复现评估
开源情况:论文首页给出 Project Page 与 GitHub 链接;32 个组成来源绝大多数公开可得(ALFRED、CALVIN、robosuite、LIBERO-PRO、RLBench、RoboTwin 2.0、VIMA-Bench、UMD、ScienceWorld 等),GeoProbe 基于 Blender 生成、变量受控,理论上可复现。难点在模型侧:10 个被评模型中 7 个是闭源服务(Astra、Sol、Fable、Opus 5.5、Qwen-Max、Gemini 3.8/4),结论绑定具体 API 快照(如 DeepSeek 用 2026-10-17 的 deepseek-flash 端点),接口变更即结果漂移。算力与成本:固定输入题每模型重复 5 次(Fable 3 次),交互回合预算最高 101 回合/2M tokens(HumanCLAW),完整复现排行榜需要可观的 API 预算;三个开放权重 VLM(Qwen-397B/27B、DeepSeek-1017)可在多卡环境自托管。总体属于“数据易得、结论难复刻”:复现方法论(harness+判据+轨迹分析)工程量可控,精确复刻排名则依赖厂商配合。
论文图表