词向量被高估了吗:面向小型与三值语言模型的 16 MB 冻结词表 Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models
用 16 MB 冻结二值码表替换可学习词嵌入,三值模型整机 46 MB,CPU 提速 5 倍以上
前置知识
词嵌入表与输入输出绑定(tied embedding)
Transformer 语言模型用一张可学习的查找表把词元 ID 映射成向量(输入嵌入),通常还把同一矩阵转置当作输出头给词表中每个词打分(输入输出共享权重,即绑定)。这张表行数等于词表大小(如 Gemma 的 262,144),列数等于模型宽度(如 640),因此在小模型里参数占比极高。
本文的整个问题就源于这张表在小模型中占参数 62.6%,且现有量化方法都压不了它。
BitNet b1.58 与三值权重
BitNet b1.58 把线性层权重约束在 $\{-1, 0, +1\}$(平均 1.58 bit/权重),核心是 BitLinear 结构:输入先 RMSNorm,激活逐 token 量化为 int8 absmax,权重按 absmean 三值化,训练时用直通估计器(STE)绕过量化的不可导性;注意力算术与 KV cache 仍保持 16-bit。
本文 C 臂的身体直接由 BitLinear 构成,并借用了 BitNet 官方发布的两阶段学习率日程。
PCA 主成分分析与符号二值化
PCA 对中心化后的矩阵做分解,找到方差最大的正交方向。本文取 Gemma 嵌入矩阵 $E$ 的前 512 个主方向 $W$(保留 92.3% 方差),把每个词向量投影到这些方向上只保留符号,得到 512 维 $\pm 1$ 编码。这是一次性的确定性变换,不涉及任何可学习参数。
这是冻结词表的构造核心,理解它才能明白编码为何既保留语义又只有 512 bit。
一元词频先验(seal)
在输出打分时为每个词元加一个固定的对数一元频率偏置 $\log p(t)$,即输出层常见的 unigram bias,1 MB、零可训练参数。它直接取自训练语料的词频统计;B 臂将其冻结,C 臂允许从该起点继续训练(新增 262,144 个可训练数)。Meister 等人曾提出并训练过同类偏置。
它解释了冻结表在未训练语言上被惩罚的现象,也是 B、C 两臂的差异之一。
困惑度、nats 与零样本评测
语言模型验证损失常以 nats/token(自然对数)计,0.20 nats 的差距约对应 $e^{0.2}\approx 1.22$,即 23% 的困惑度差异。零样本评测用 lm-evaluation-harness 在 LAMBADA、HellaSwag、ARC-Easy、PIQA 上直接测准确率不做微调;逐题保存结果可做 10,000 次重抽的配对 bootstrap 检验。
论文所有结论以 nats 和零样本准确率表述,理解两者的换算与误差条来源才能正确解读结果。
研究动机
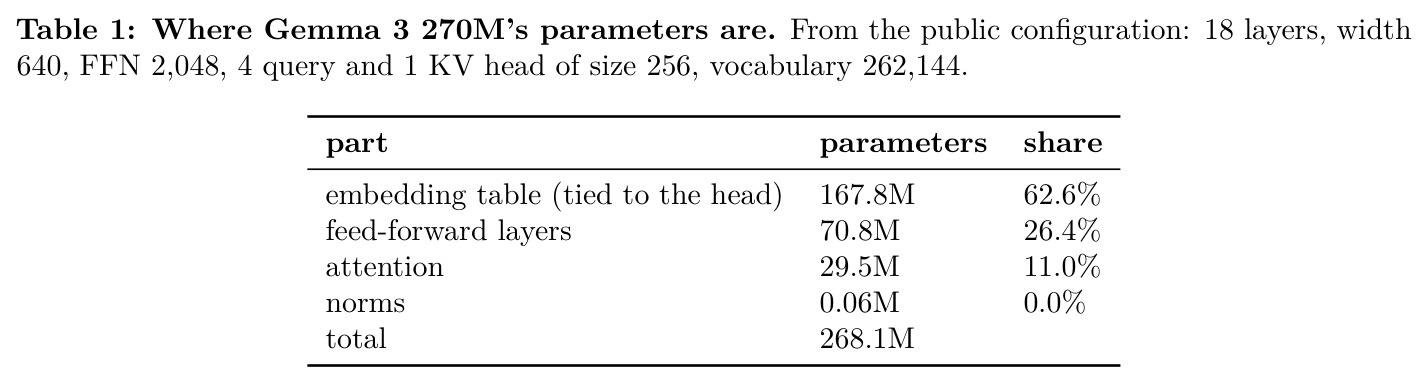
在小型语言模型里,词嵌入表是参数量最大的单一组件。以 Gemma 3 270M 为例:总参数 268.1M,其中嵌入表(与输出头绑定)占 167.8M,即 62.6%,而真正做计算的 FFN 层只有 70.8M、注意力只有 29.5M(Table 1)。更麻烦的是,主流压缩方案都不碰这张表:BitNet 的嵌入和输出头保持 16-bit,GPTQ 和 AWQ 明确跳过 embed_tokens 与 lm_head,llama.cpp 的输出头也存成 6-8 bit。结果是一旦身体被压成三值,剩下的体积几乎全是词表——三值身体约 20 MB,16-bit 词表却要 335 MB。连微软自己的 BitNet b1.58 2B4T 报告都只报『0.4 GB (non-embedding)』,把表排除在标题数字之外。整个社区默认词表是拥有一套词表的固定成本,没人系统量化过这 168M 可训练参数到底换来了什么。
本文的目标是本文要做一个受控实验回答一个被忽视的问题:可学习词表到底『买』到了什么?具体做法是固定一切其他变量——同样的 Gemma 3 270M 架构身体、同样的 2.05B FineWeb-Edu 训练 token、同样的 7,820 步、同样的随机种子和批次顺序,只把词表从可学习的 $262{,}144\times 640$ 浮点矩阵换成一张冻结的 512-bit 编码表(仅 16.8 MB、零可训练参数),然后在验证损失和四个零样本基准上对比。在此之上作者还追求三个工程目标:三值身体加冻结词表的整机文件压到 46 MB;在笔记本 CPU 上达到 615-740 token/秒、峰值内存 62 MB;以及训练结束后无需再训练就能向词表添加成千上万新词且代价可控。
与已有工作不同的是,本文的独特切入是『把词表当作函数而非参数矩阵』。此前没有工作做过同种子、同数据、只变词表的严格对照:量化路线(GPTQ/AWQ/llama.cpp)默认嵌入必须留在 16-bit;BitNet 干脆报不含嵌入的内存数;Bochkov 的冻结码来自 token 身份、不携带语义且保留浮点输出头。作者团队此前发布的 SHADOW-250M 与 SHADOW-50M 虽已使用冻结表,但一次改动了太多变量,从未与可学习词表对照过。本文的关键观察是:嵌入向量的两个职责——告诉身体来了哪个 token、给输出打分——未必需要每个 token 640 个可学习浮点数;而一张从预训练嵌入经 PCA 加符号化得到的编码,既保留语义(WordSim-353 相关性 0.617 对原嵌入的 0.614),又因为编码是『规则』的产物,天然支持训练后扩词表。
核心方法
直觉上,这相当于把每个 token 的『专属定制向量』换成一张通用 512 维坐标网格上的『门牌号』。技术路线:取 Gemma 3 270M 的预训练嵌入矩阵 $E \in \mathbb{R}^{262144 \times 640}$,中心化后做 PCA 取前 512 个主方向 $W$,只保留投影的符号:$\text{code}(t) = \operatorname{sign}(W^\top (E_t - \mu)) \in \{-1, +1\}^{512}$。每个 token 512 bit,整表 16.8 MB,训练期间永不更新。输入侧,编码经一个小的可训练线性映射(512 到 640)进入身体;输出侧,身体末层状态经另一映射(640 到 512)与全部 262,144 个编码做点积、除以 $\sqrt{512}$ 打分,再加一个固定的逐 token 对数词频先验(作者称为 seal,1 MB)。两个接口映射合计仅 0.65M 可训练参数。这张表保留了原嵌入 92.3% 的方差,10 近邻保持率 67%,语义相似度与人类评分的相关性 0.617,与浮点嵌入本身(0.614)持平。
核心创新是把词表从『训练出来的矩阵』变成『由规则推导出的函数』。与已有工作的本质区别有三层:其一,区别于所有量化方法(GPTQ、AWQ、llama.cpp),词表两侧不留任何浮点词表矩阵,输入与输出共用同一张 1-bit 码表;其二,区别于 Bochkov 的无语义身份码,这里的码来自预训练嵌入的 PCA 加符号化,携带真实语义结构,因此低频词不需要训练样本就已经『认识』;其三,区别于 tied embedding(Press & Wolf)、ALBERT 低秩分解、hash embedding 行共享等方案,表完全冻结、零可训练参数。最大的连锁收益在扩展性:因为编码是函数的输出,任何能映射进 $E$ 空间的向量都能立刻成为新 token——新词取 $\text{code}(\text{其各片段行向量的均值})$ 即可,而可学习表的新行在训练之前就是随机噪声,这正是第六节扩词表实验翻盘的根源。
方法步骤详情
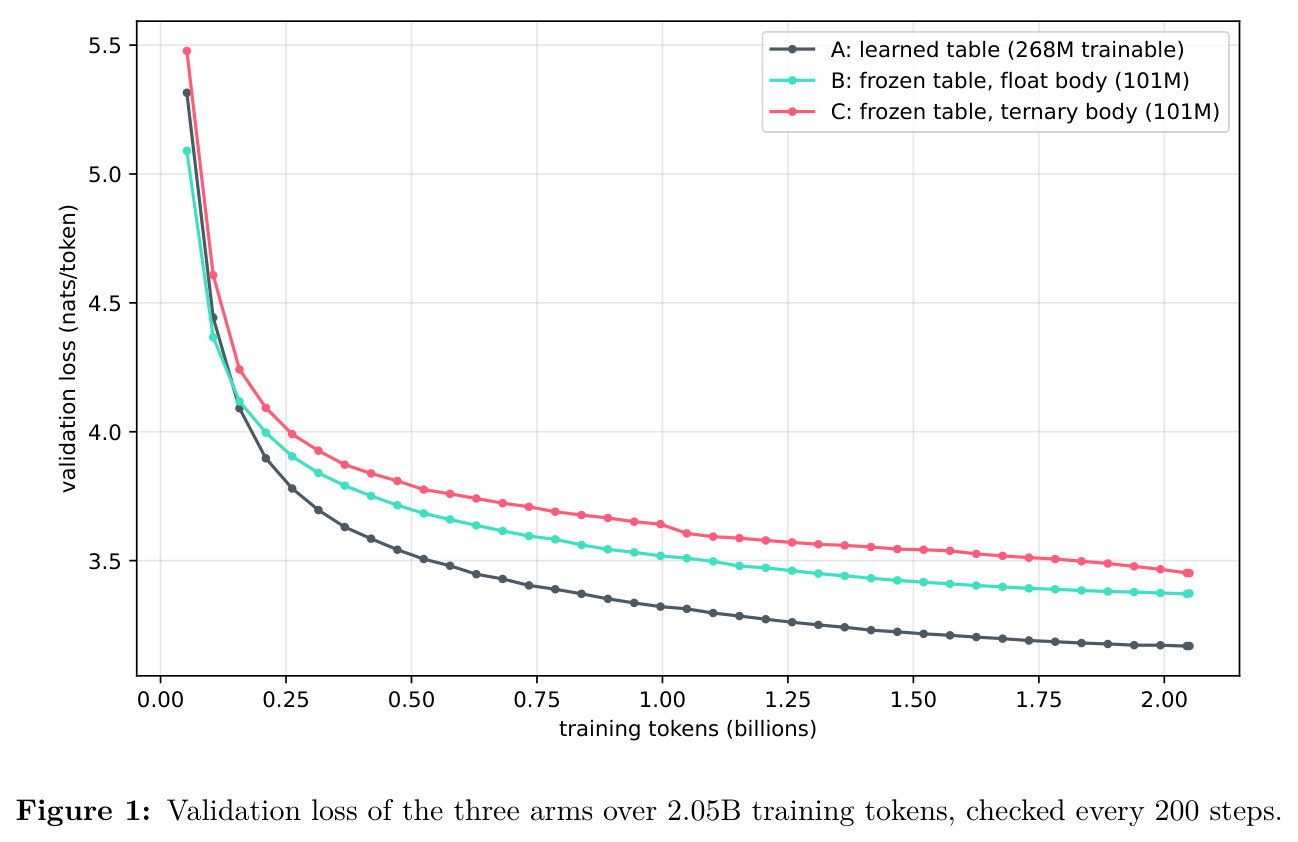
实验设三个对照臂,全部从零训练:A 臂用可学习绑定词表(268.1M 参数,Google 原法);B 臂用冻结表加固定 seal(101.0M 参数);C 臂把身体所有线性层换成 BitNet b1.58 的 BitLinear 三值层,注意力与 KV cache 保持 16-bit,seal 可训练(101.2M 参数)。数据为 2.05B FineWeb-Edu token,Gemma 分词器,序列长 1,024,每步 262,144 token,共 7,820 步,三臂同一种子同一批次顺序。A/B 用 AdamW 峰值学习率 $6\times 10^{-4}$、1% 预热加 cosine 衰减;C 用 BitNet 官方配方:峰值 $1.5\times 10^{-3}$ 线性衰减、中点降回 $1\times 10^{-3}$。评测用 512 条 1,024 token 验证序列测损失,lm-evaluation-harness 跑四个基准全测试集,逐题保存,做 10,000 次 bootstrap 同题配对检验。每臂单卡 RTX 5090 训 14-16 小时,约 18 美元。
技术新颖性
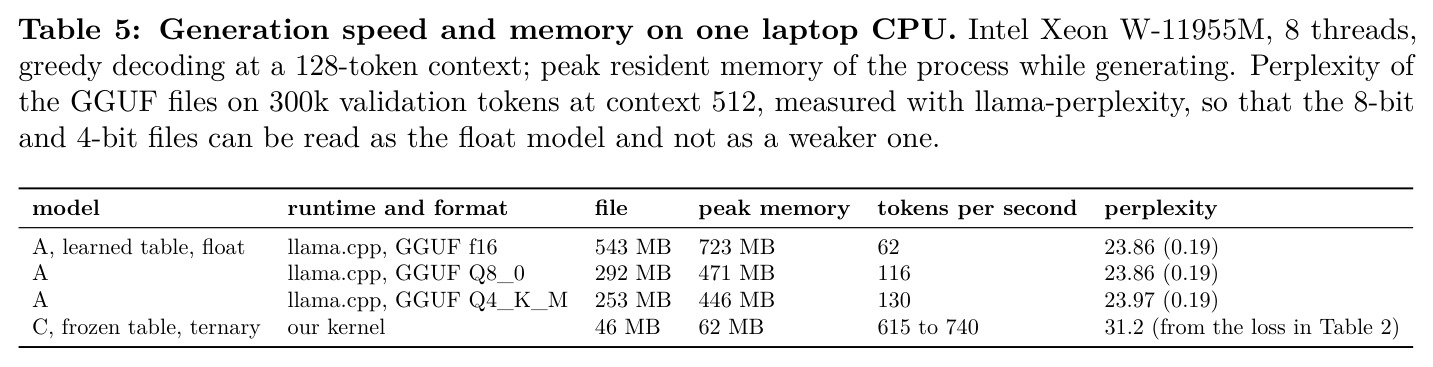
技术新颖性体现在三点。第一,问题重定义:以往工作把词表当压缩对象(GPTQ/AWQ 跳过嵌入、llama.cpp 存 6-8 bit),本文把它当成可整体替换的组件,并首次在严格受控条件下量化『可学习词表的边际收益』——0.20 nats。第二,构造方式:与 Bochkov 的无语义身份码、tied embedding、ALBERT 因式分解、hash embedding 行共享都不同,本文的码是预训练嵌入 PCA 主方向的符号化,输入输出两侧共用,两侧接口映射只有 0.65M 参数,并可与 Meister 等人的对数一元输出偏置组合(B 臂冻结它,C 臂训练它)。第三,系统工程闭环:作者为三值模型写了单文件 AVX2 的 C 内核,读出阶段直接从 1-bit 表流式读取 262,144 个编码打分,首次让无嵌入表的模型在笔记本 CPU 上做到比 llama.cpp Q8_0 快 5.3-6.4 倍、内存省 7.6 倍,且证明了瓶颈是内存带宽而非算力。
实验结果
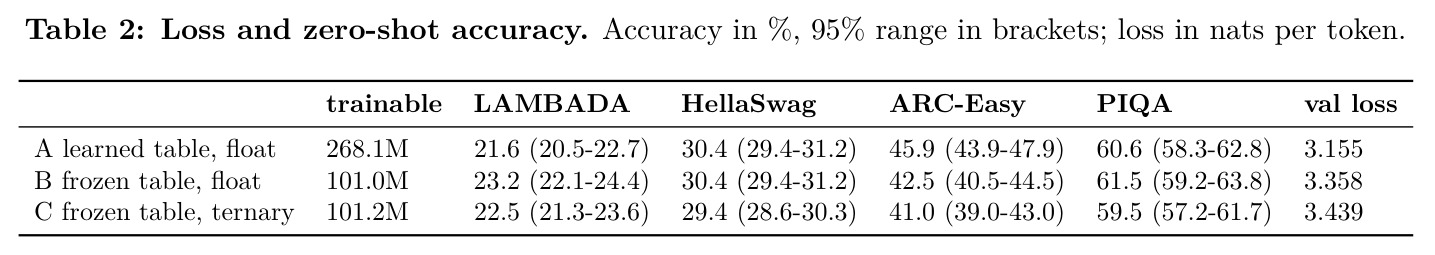
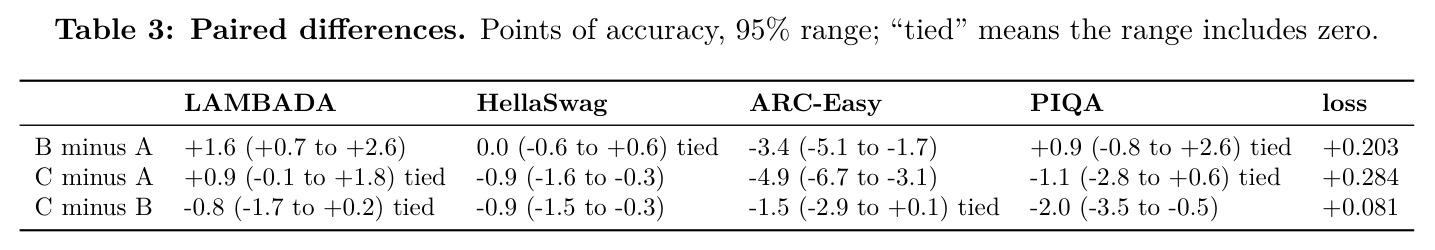
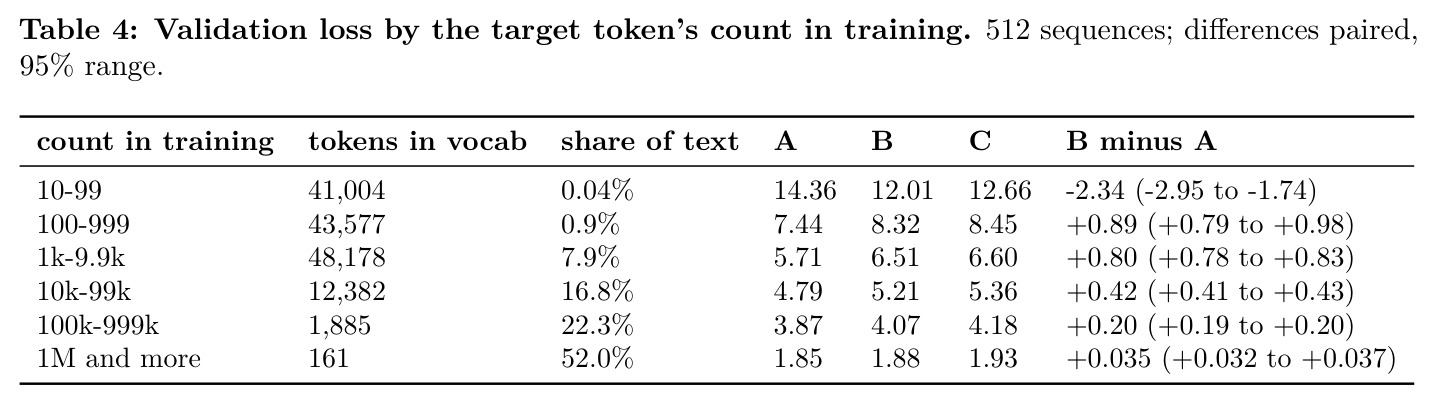
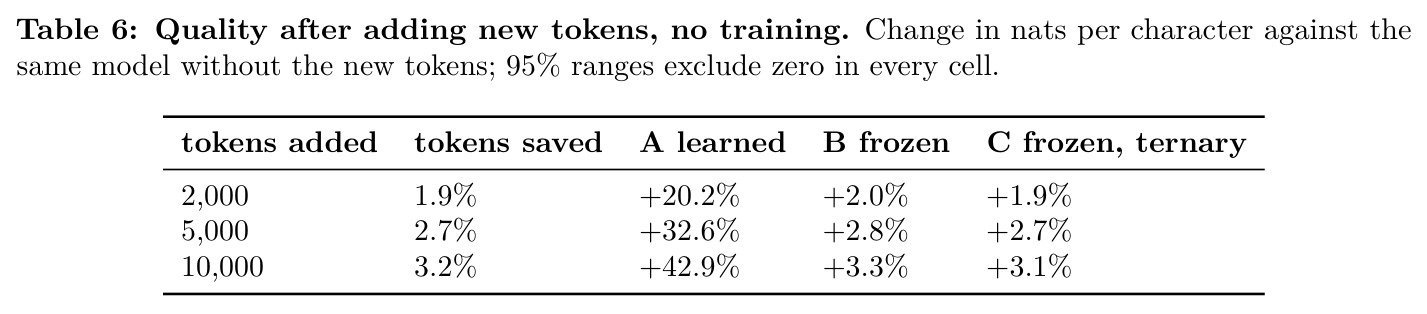
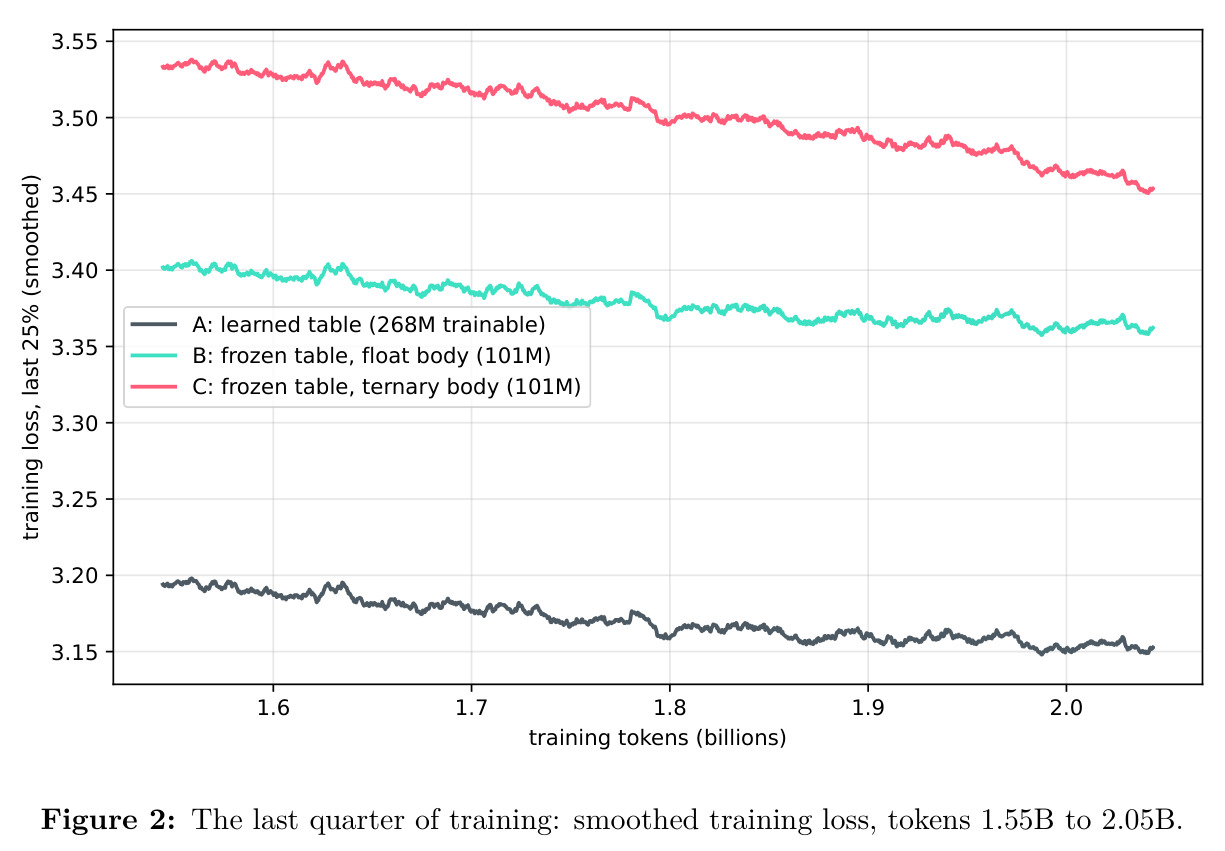
可学习词表的收益意外地小:验证损失 A 3.155、B 3.358、C 3.439,168M 可训练参数只买来 0.20 nats(23% 困惑度)。基准上更少:B 在 LAMBADA 反而好 1.6 点,HellaSwag 与 PIQA 打平,仅 ARC-Easy 差 3.4 点;三值 C 与 A 在 LAMBADA、PIQA 打平,ARC-Easy 差 4.9。A 在 600 步反超后差距稳定在 0.20,随数据增长。Table 4 分桶:低频词(10-99 次)上 B 反而赢 2.34 nats,占文本 52% 的超高频词差距仅 0.035,中频段可学习表占优 0.42-0.89。工程上 C 整机 46.2 MB,CPU 615-740 token/秒、62 MB 内存,比 Q8_0 快 5.3-6.4 倍、省 7.6 倍内存,代价是困惑度 31.2 对 23.86。扩词表:加 10,000 个 PubMed 新词,A 恶化 42.9%,冻结表仅 +3.1%,省 3.2% token。负结果:控制 token 五样本 B 88%/C 75%/A 73%,emoji 均在随机水平。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LAMBADA(零样本) | 准确率 % | B 23.2 / C 22.5 | A 可学习词表 21.6 | B +1.6(区间 +0.7~+2.6);C +0.9(打平) |
| HellaSwag(零样本) | 准确率 % | B 30.4 / C 29.4 | A 30.4 | B 打平;C -0.9 |
| ARC-Easy(零样本) | 准确率 % | B 42.5 / C 41.0 | A 45.9 | B -3.4;C -4.9(唯一可学习表胜出的基准) |
| PIQA(零样本) | 准确率 % | B 61.5 / C 59.5 | A 60.6 | B +0.9(打平);C -1.1(打平) |
| 验证损失 | nats/token | B 3.358 / C 3.439 | A 3.155 | A 好 0.203 nats(约 23% 困惑度优势) |
| 笔记本 CPU 生成速度 | tokens/秒 | C 615-740(自研内核) | A Q8_0 GGUF(llama.cpp)116 | 5.3-6.4 倍 |
| 端侧峰值内存 | MB | C 62 MB(文件 46 MB) | A Q8_0 471 MB | 7.6 倍 |
| 训练后扩词表(10,000 医学新词) | nats/字符 相对变化 | B +3.3% / C +3.1% | A +42.9% | 代价缩小约 14 倍,且节省 3.2% token |
局限与改进
作者坦承的局限:每臂只跑一个种子,误差条来自测试题目而非训练运行;2.05B token 对 101M 参数的 B/C 接近 Chinchilla 最优,但对 A 的 168M 词表是欠训练的,20B token 下 0.20 nats 的差距很可能更大,基准格局也可能随之改变;C 与 B 同时差三件事(三值身体、BitNet 日程、可训练 seal),其中 seal 的贡献被中途停止的对照跑测出为 0.003-0.022 nats,日程的贡献未分离;编码继承 Gemma 3 270M 嵌入的知识与盲区,发布受 Google Gemma 条款约束。我的补充观察:ARC-Easy 上 C 落后 4.9 点提示知识密集型任务可能受损更多;CPU 对比是单台笔记本、两套代码库、只比解码不比预填;B 臂没有专用内核,『冻结表 + 浮点身体』在端侧的真实表现仍是空白;方法对 Gemma 嵌入的依赖也构成一种循环——压缩小模型前先要一个大模型。
独立分析的弱点
独立分析几个弱点。其一,方法对 Gemma 嵌入存在循环依赖:要给小模型省空间,却要先养一个大模型的嵌入表,且许可证随码表传染;改进方向是作者提到但未测的『先训一个小模型带可学习表、再冻结其码』的自举流程,或用无监督聚类、产品量化(PQ)直接从语料构造码本。其二,中间频段词(训练中出现 100 到 100k 次,覆盖约 25.6% 文本)损失高出 0.42-0.89 nats,说明 512 bit 是容量瓶颈;可尝试 768/1024-bit 编码或非线性码本。其三,每臂单种子使 0.20 nats 的结论偏脆弱,而单臂成本仅约 18 美元,补两个种子的代价很低。其四,C 的对照被三个变量污染(身体、日程、seal),缺少『浮点身体 + BitNet 日程』的消融臂来分离贡献。其五,CPU 对比不含 B 臂、预填逐 token 进行,若引入投机解码或批量处理,5-6 倍的结论可能需要修正。其六,词表扩展在分词器已覆盖的词上永远是净损失,这一点对多语言场景的适用性存疑。
未来方向
作者预告的下一篇工作颇有野心:把同一张冻结 512-bit 表放到文本、图像、音频、视频之下,所有模态的输入输出落进同一码空间,一个小身体在没有任何可学习嵌入的情况下看图、听声、写句子,整机能跑在 CPU 上。基于本文成果可延伸的方向包括:把受控实验推到 20B token 和多个身体规模,检验 0.20 nats 差距的缩放规律;补齐消融分离 BitNet 日程与三值身体各自贡献;研究冻结码与小型可学习码本的混合方案收窄中频段差距;探索跨模型共享码表的生态——不同身体共用同一词表、蒸馏时师生码对齐、一次冻结处处复用;以及把『训练后零成本扩词表』用于持续学习与领域适配,例如在医疗、法律场景动态注入术语而无需重训身体。
复现评估
复现条件非常好。作者在 huggingface.co/QLNI/embeddings-are-overpriced 放出了全部资产:训练脚本与所有超参、冻结表、一元计数与 seal、带校验和的 2.05B 训练 token 与验证集、A/B/C 每臂每 800 步的中间与最终权重及优化器状态(含 B 臂带可训练 seal 的中途版本)、逐步训练日志、评测脚本以及每一道题的作答结果——论文中任何数字都可以重算。算力需求极低:单卡 RTX 5090,每臂 14-16 小时、约 18 美元,含评测的全部研究不到 75 美元。CPU 内核是单文件 C、AVX2、int8 激活,可直接编译。注意事项:C 臂的直通估计器训练对实现细节敏感,建议直接复用其脚本与 BitNet 日程;许可证为非商业研究加 Gemma 条款。总体属于『开源到开箱即跑』级别,复现难度低,甚至适合作为低成本复现实验的范本。
论文图表