面向输出头量化的Softmax重参数化 Softmax Reparameterization for Output-Head Quantization
利用softmax平移不变性在等价输出头中搜索量化后保真度最优的表示
前置知识
输出头(LM head / 输出投影)
Transformer 最后一层的线性投影 $W \in \mathbb{R}^{V \times d}$,把最终隐藏态 $h$ 映射为词表 logits $z = Wh$,再经 softmax 得到下一个 token 的概率分布。它包含 $Vd$ 个参数,与输入嵌入只需按行检索不同,每生成一个 token 都要完整评估全部 $V$ 行,是小模型配大词表架构中最大的单层权重访存开销。
本文的全部方法都作用在这一层:理解它的形状、访存模式和与 softmax 的耦合方式,才能理解为什么它难量化、以及为什么对权重做平移重参数化既能保持分布又能改变量化结果。
后训练量化(PTQ)与三种基线量化器
不重新训练、只用少量校准数据把全精度权重映射到低比特的技术。本文固定三种基线:RTN(直接舍入)、AW-MSE(按激活二阶矩 $m_j = E[h_j^2]$ 加权的逐组 MSE 选缩放)、GPTQ(用完整拟合 Hessian 传播舍入误差)。权重按 G128 分组,每组一个缩放因子并配合裁剪网格。
论文的所有对比都是“同一基线量化器、量化前后”的配对,KL 数字依赖量化器的具体实现(分组、裁剪、数值精度),且最优平移系数要按量化器分别选择——不懂基线量化器就读不懂实验设定。
KL 散度
度量量化后分布 $q$ 偏离源分布 $p$ 的指标 $D_{KL}(p\|q) = \sum_v p_v \log(p_v/q_v)$。相比困惑度 PPL,KL 直接刻画预测分布的偏离:PPL 可能因模型变得过度自信而“改善”,但预测反而更远离源模型(附录 I 的核心论点)。
平移系数 $t$ 的选择规则、所有主表指标、以及“为什么用 KL 而不是 PPL 做选择”都建立在 KL 上;机制分析中的 Fisher 二次型正是 KL 对 logit 扰动的局部展开。
softmax 的 Fisher 信息矩阵
对 logit 扰动 $e$,KL 有局部展开 $D_{KL}(p\|\mathrm{softmax}(Wh+e)) \approx \tfrac{1}{2}e^\top F(p)e$,其中 $F(p) = \mathrm{diag}(p) - pp^\top$。其二次型等于按源概率加权的相对 logit 误差方差 $\sum_v p_v(e_v - \bar{e}_p)^2$,衡量误差方向是否落在分布敏感的方向上。
第 4 章用它解释论文最反直觉的发现:总 logit 误差变大但 KL 反而下降。理解 Fisher 加权和概率分桶分解,是读懂“误差搬家”机制分析的前提。
权重绑定(tied embeddings)
小模型常让输入嵌入与输出头共享同一矩阵以省参数(如 Phi)。量化输出头会破坏共享,因此部署时保留 BF16 输入嵌入、单独量化一份输出副本(weight untie),这是既有的成熟做法。
它解释了 Phi 部署实验的显存记账(常驻权重从 7.17 增至 7.47 GiB)以及“平移只折进输出副本、不碰输入嵌入”的工程约束。
研究动机
现代小语言模型(SLM)用小解码器配超大词表:论文 Figure 1 统计的 23 个模型家族中,Gemma 词表已达 262K 行、XGLM 256K、BLOOM 251K,多数新模型超过 100K。对词表大小 $V$ 和隐藏宽度 $d$,输出投影每步执行约 $Vd$ 次乘加、BF16 下每 token 读取约 $2Vd$ 字节权重;batch-1 解码是访存受限的,这笔流量直接决定延迟(如 Llama 选定检查点约 2.07 GB/token、Phi 约 1.23 GB/token)。尽管代价巨大,vLLM 等主流部署方案仍把输出头留在高精度,原因有二:头直接决定下一个 token 的概率,后面没有学习层来吸收其量化误差;词表矩阵还常与输入嵌入绑定,另有部署约束。一旦粗暴地把头压到低比特,分布会严重失真:Phi-4-mini 在 W4 RTN 下 test KL 达 1.23、PPL 从 BF16 的 9.73 涨到 34.11;XGLM 在 W3 RTN 下 PPL 高达 $3.98\times10^6$,接近退化。剩下的选择只有放弃对头压缩,保留这笔最大的单层访存。
本文的目标是本文的目标是:在不重训练、不改解码器的前提下,把大词表输出头量化到 W4(并考察 W2/W3 极限),同时尽可能保持量化头与源模型下一 token 分布的一致性(用对源模型的 KL 和 PPL 度量),并且不牺牲压缩带来的延迟收益。方法被刻意限定为现有基线量化器的“即插即用前置步骤”:不动量化器本身(RTN、AW-MSE、GPTQ 原样使用),而是在量化之前从无数个预测完全等价的权重表示中,选出一个量化后最保真的表示。理想情况下,这个变换在推理时应零额外开销,并能推广到 soft-cap 等非线性 logit 路径和 tied-weight 部署。
与已有工作不同的是,函数保持的重参数化在量化里并不新鲜:SmoothQuant/AWQ 用通道缩放、QuaRot/SpinQuant 用旋转改造解码器层的权重-激活统计。但针对输出头,softmax 的加法不变性此前只被用于训练期稳定化(Output Embedding Centering 在预训练中做词表行均值中心化)或固定的中心化(SageAttention 对 key 做固定 mean-centering),没有人把它当作后训练阶段可搜索的量化自由度。本文的独特切入是抓住一个被忽视的错位:量化目标(有限网格、裁剪、舍入)对函数保持的重参数化不是不变的——两个全精度预测完全相同的头,量化后保真度可以差数倍。既然“哪个等价代表元量化后最好”取决于具体量化器,最自然的做法就是把这份自由度留给数据:在精确等价类内做一维标量搜索,用量化后在验证集上的 KL 挑代表元,且为每个量化器分别选择。
核心方法
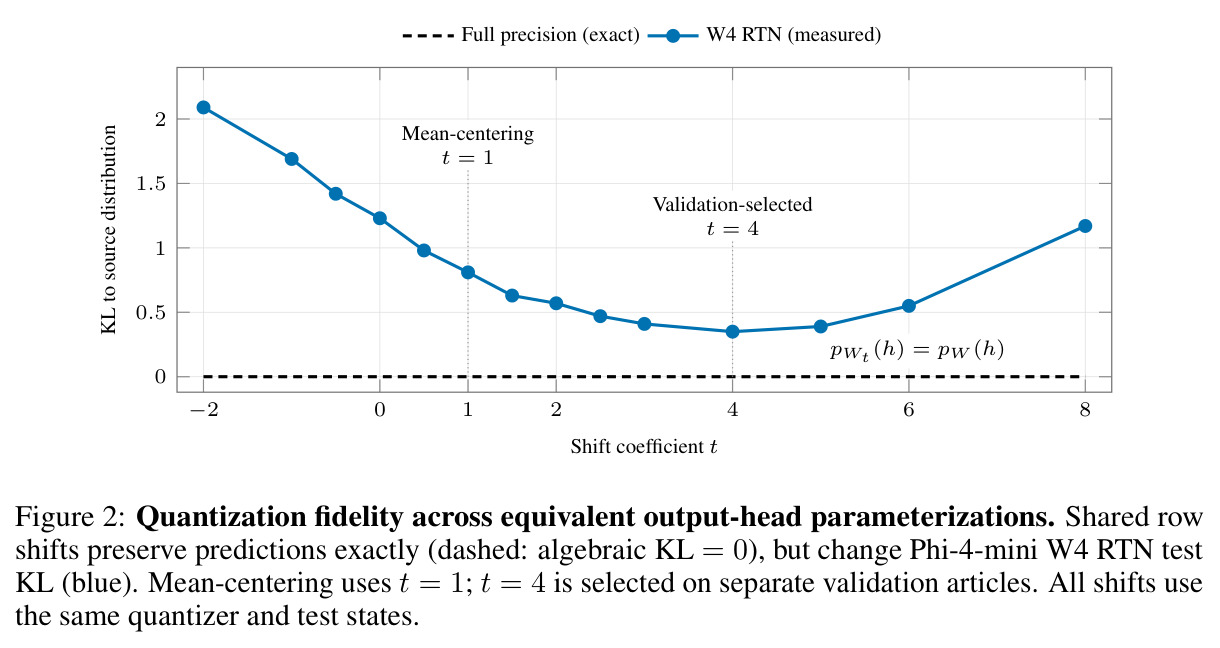
直觉先行:softmax 只看 logits 的相对大小,给词表每一行减去同一个向量不改变输出分布,但会改变每组权重的数值范围、裁剪和舍入决策,从而改变量化残差。技术路线上,取词表行均值方向 $\mu = W^\top\mathbf{1}/V$,构造单参数等价家族 $W_t = W - t\mathbf{1}\mu^\top$;在包含 $t=0$(原头)和 $t=1$(普通均值中心化)的 14 点网格 $T=(-2,-1,-0.5,0,0.5,1,1.5,2,2.5,3,4,5,6,8)$ 上逐点用同一基线量化器量化,在独立验证集上计算量化头对源模型的 KL,取 $t^\star = \arg\min_{t\in T} L_{val}(t)$。整个过程只用预训练权重和少量冻结模型隐藏态:128 篇 WikiText 文章(每篇 8 个状态,共 1024 个)拟合量化器矩,16 篇验证、16 篇测试互不相交。对含 tanh soft-cap 等非线性 logit 路径的模型(如 Gemma 4),把头分解为 $W = (W - t\mathbf{1}\mu^\top) + t\mathbf{1}\mu^\top$,只量化第一项,并在非线性变换前用秩一修正 $z_t = Q_t h + t(\mu^\top h)\mathbf{1}$ 恢复被减去的公共分量,保证等价精确成立。对线性 softmax 头,选出的平移直接折进打包权重,推理零额外算子。
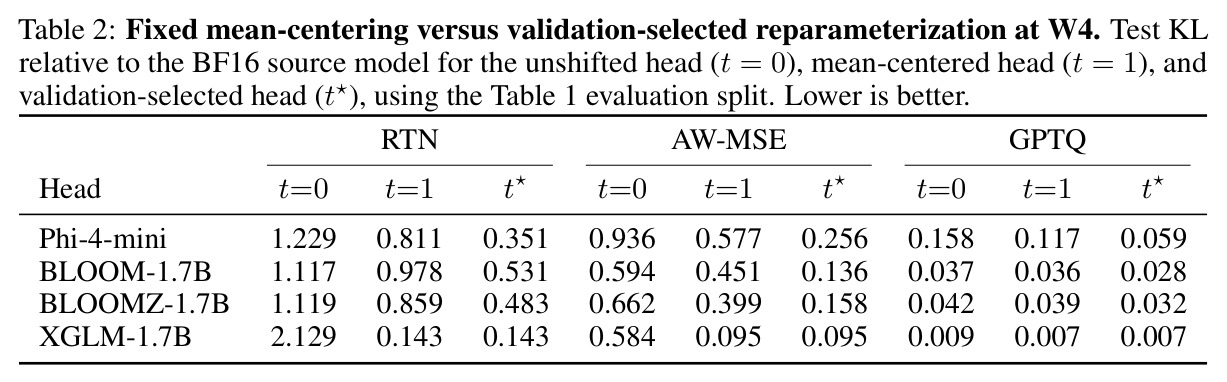
核心创新是把输出头的 softmax 加法对称性当作“免费的量化自由度”来搜索,而不是以固定方式使用它。与已有工作的本质区别有三。其一,前人(Output Embedding Centering、SageAttention)做的是固定中心化,本文是后训练地在精确等价类内、按量化后预测保真度搜索标量。论文证明了这种错位为何存在:$t=1$ 只最小化全精度 Frobenius 范数,$\|W_t\|_F^2 = \|W_c\|_F^2 + V(1-t)^2\|\mu\|_2^2$;而量化取决于有限网格、裁剪与舍入决策,最小范数代表元未必是量化后最保真的代表元——Phi 上验证 KL 选出 $t=4$ 而非 1。其二,选择规则自带安全网:因为 $0 \in T$,精确计算下 $L_{val}(t^\star) \le L_{val}(0)$,重参数化在验证 KL 上永远不会比不做事更差(该保证仅限所选量化器下的验证集)。其三,系数按基线量化器分别选——RTN 选出的 $t$ 拿给 AW-MSE 用会掉点(附录 E.1)——并且秩一修正把构造严格推广到非线性 logit 路径,修正只需一次 $d$ 维点积加标量广播,相对 $Vd$ 次乘加可忽略,还可融合进 soft-cap 算子。
方法步骤详情
完整流程即论文 Algorithm 1。第一步,数据与统计:从冻结 BF16 模型捕获隐藏态,划分 128 篇拟合文章(每篇取 8 个位置、前缀至多 512 token)、16 篇验证、16 篇测试,三者互不相交;计算 $\mu = W^\top\mathbf{1}/V$ 并用拟合态估计量化器激活矩(AW-MSE 用对角矩,GPTQ 用 $H = 2X^\top X/N$)。第二步,等价性检查:对每个候选 $t$ 验证未量化头与源模型 KL $\lesssim 10^{-9}$(Gemma 4 经秩一修正后约 $7\times10^{-10}$),soft-cap 模型在 softmax 前恢复 $t(\mu^\top h)\mathbf{1}$。第三步,网格搜索:对 $T$ 中每个 $t$ 构造 $W_t = W - t\mathbf{1}\mu^\top$,量化得 $Q_t = \mathcal{B}(W_t; H_{fit})$(各候选重用同一批拟合矩与 Hessian),在验证集上算 $L_{val}(t) = \frac{1}{|H_{val}|}\sum_h D_{KL}(p_W(h)\,\|\,p_{Q_t}(h))$。第四步,取 $t^\star$ 并在独立测试集上报告 KL、top-1 一致率与 PPL(FP32 读出、BF16 解码器状态)。第五步,部署:shift-compatible 路径把平移折进打包权重,无额外算子;tied 模型保留 BF16 输入嵌入、单独量化输出副本;非线性路径仅多存 $t$ 和 $\mu$($O(d)$ 开销)。搜索代价极低:四个头的 RTN/AW-MSE 搜索约 5 分钟(单张 A100),Phi 的 14 点 GPTQ 扫描约 12 分钟。
技术新颖性
新颖性在于“选择”而非“发明对称性”——论文明确承认 softmax 不变性和均值中心化本身都不是新东西,真正的贡献是:把等价类参数化为一维标量族并用量化后验证 KL 端到端选择,且逐量化器独立选择;证明了固定中心化($t=1$)优化的是与量化保真度错位的全精度范数目标;用秩一修正把精确等价严格扩展到 tanh soft-cap 等非线性路径并给出适用条件 $\mathrm{softmax}(g(z+c\mathbf{1})) = \mathrm{softmax}(g(z))$;机制层面首次用 Fisher 加权的概率分桶分解定量解释“重构误差变大但分布更准”的成因。附录 J 进一步把每头一个标量推广为每个量化组一个系数($W_{v,j}^{grp} = W_{v,j} - t_{g(j)}\mu_j$,16–24 组坐标式搜索),在九个模型上把 RTN/AW-MSE 的 KL 再降 2.3–22.2%。与同期工作相比:GaugeQuant 在训练中学习量化友好基,SoftWater 把 softmax 曲率放进量化器的码率分配目标,ARCHead 用低秩结构+残差压缩头;本文则保持基线量化器完全不动、只更换被量化对象,工程侵入性最小、与任何量化器正交。
实验结果
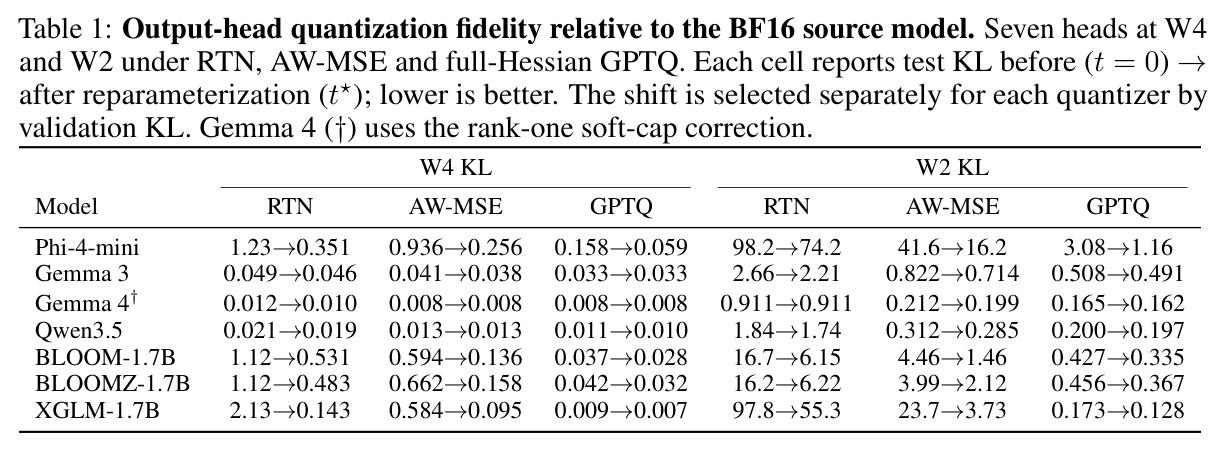
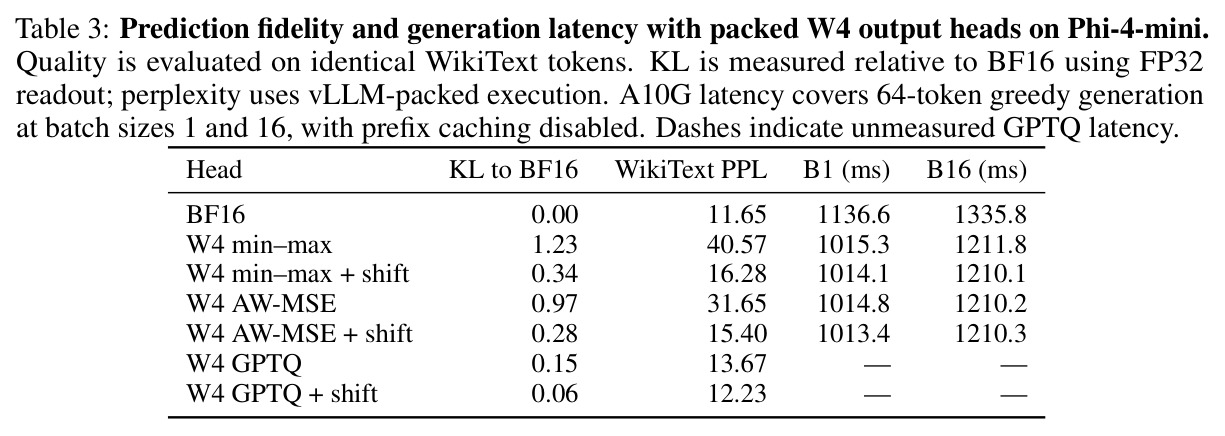
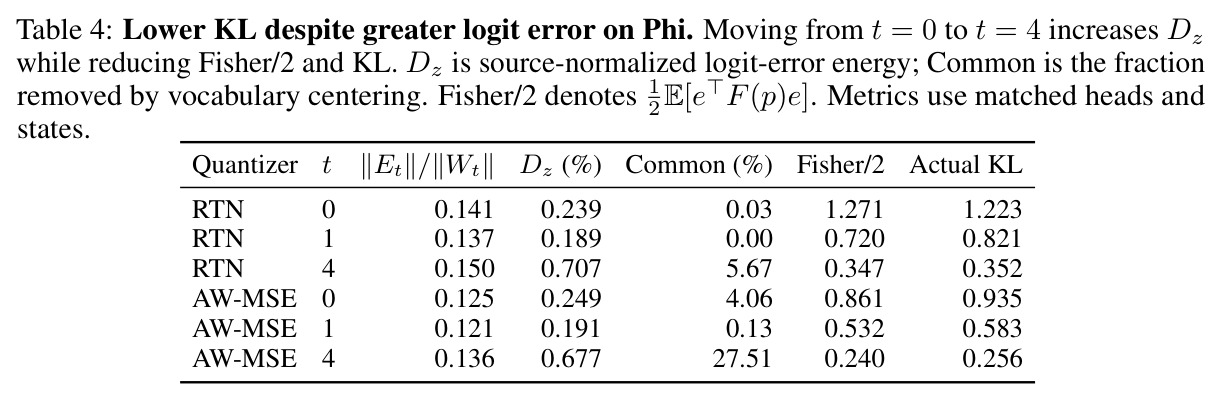
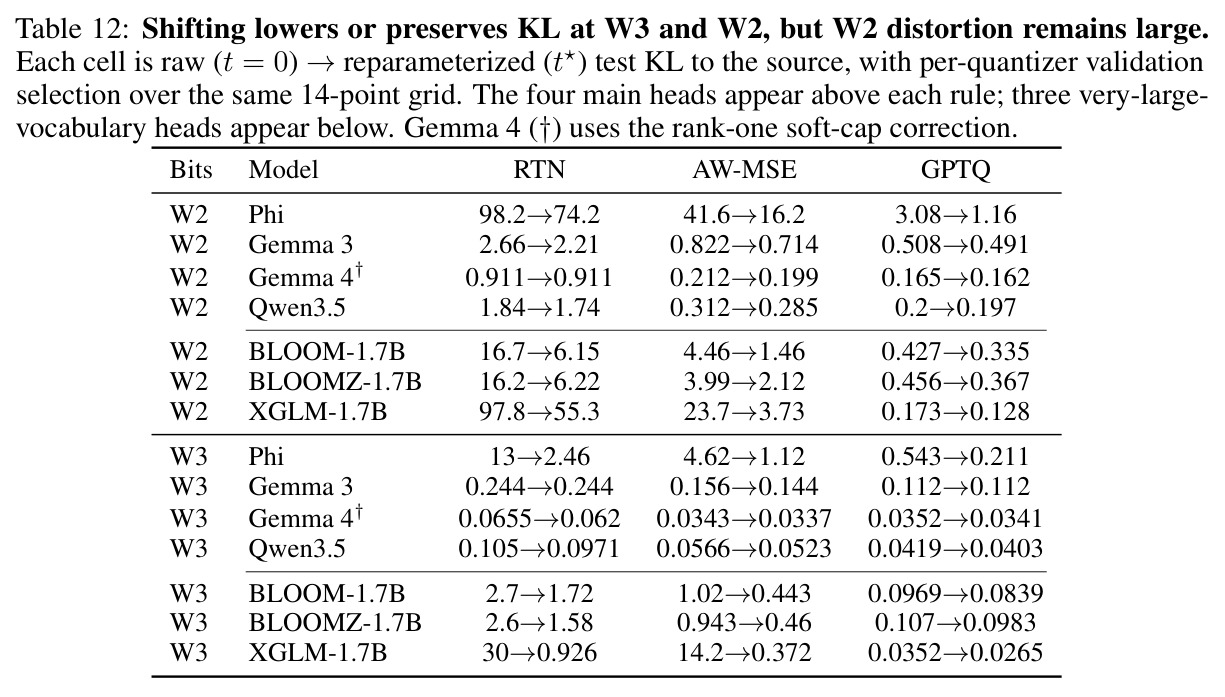
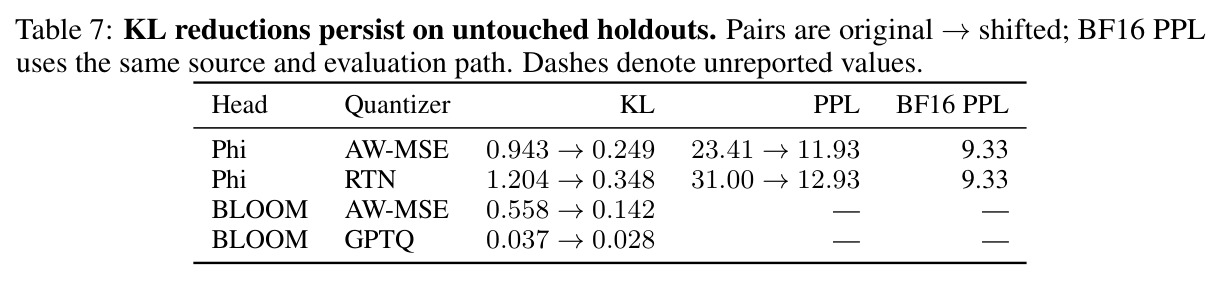
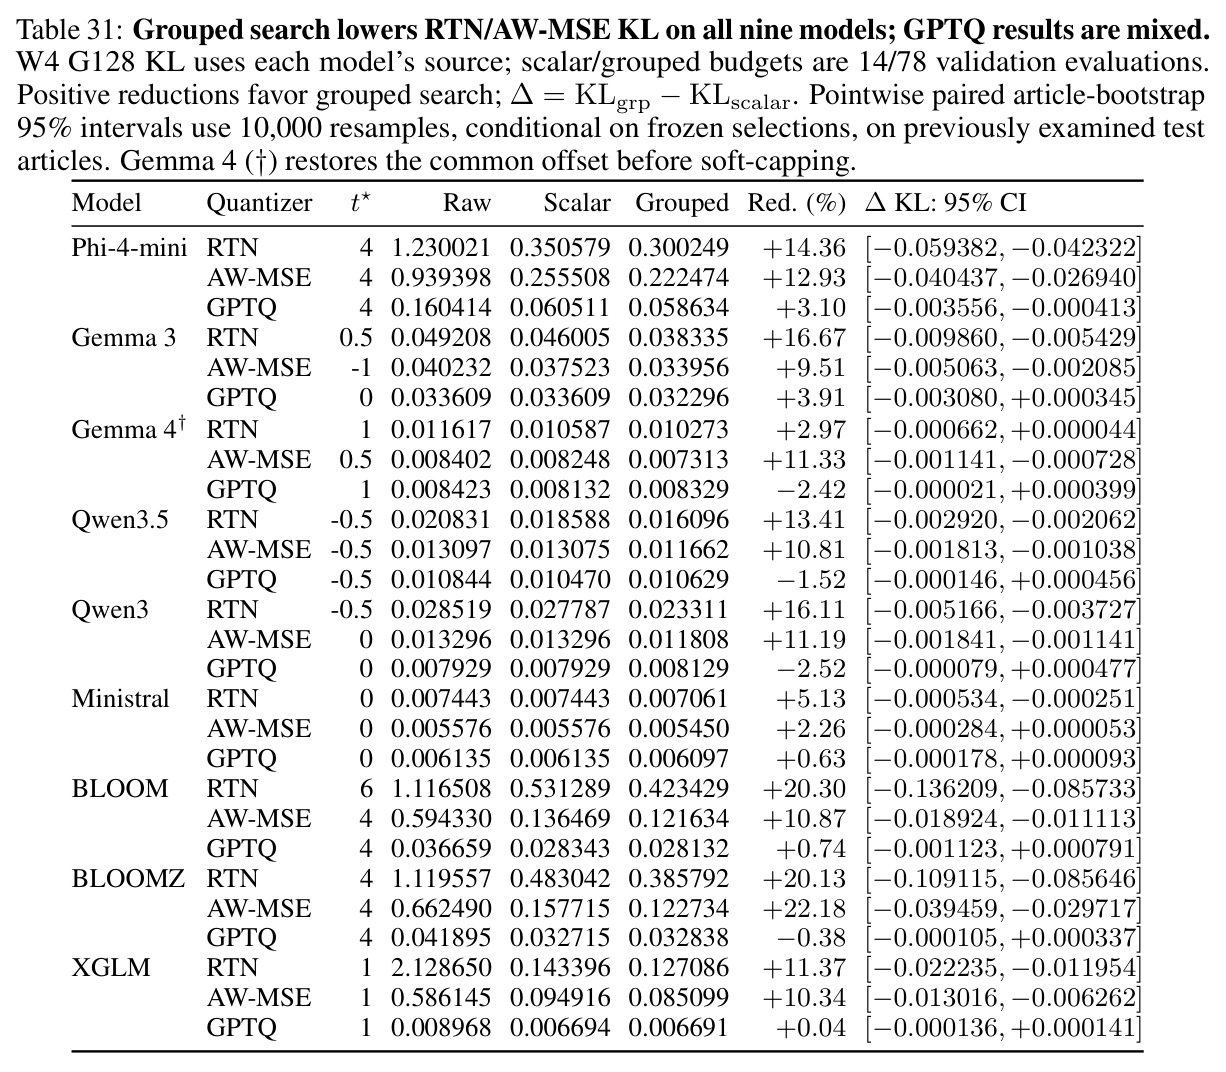
主实验(Table 1)覆盖 7 个输出头 × 3 个量化器 × W4/W2。W4 上收益集中在基线失真大的头:XGLM 在 RTN 下 KL 从 2.13 降到 0.143(−93%);Phi、BLOOM、BLOOMZ 在 AW-MSE 下分别从 0.936→0.256、0.594→0.136、0.662→0.158(−73–77%);GPTQ 基线本就较低但仍改善(Phi 0.158→0.059)。Gemma 3/4 与 Qwen3.5 的 W4 基线误差本来就小(如 Gemma 4 RTN 0.012→0.010),几乎不变。W2 作为压缩压力测试,收益扩展到几乎整个模型-量化器矩阵(Phi AW-MSE 41.6→16.2,XGLM AW-MSE 23.7→3.73,BLOOM RTN 16.7→6.15),但多数配置仍远未恢复源水平。消融(Table 2):Phi 上验证选择的 $t=4$ 比固定中心化 $t=1$ 再降 57%(RTN 0.811→0.351);XGLM 三个量化器都自己选出 $t^\star=1$。鲁棒性(Table 14):GPTQ 校准从 1,024 状态扩到 65,536,未平移 KL 0.160→0.089,平移后进一步降到 0.035(−61%);精确通道缩放后 RTN/AW-MSE 仍降 28%;仿射 RTN 降 65.5%,所有配对 bootstrap 95% 区间排除零。26 篇未触碰 holdout(13,286 token)复现:Phi 与 BLOOM 的 AW-MSE KL 均降约 74%。冻结 WikiText 系数直接迁移到 C4/OpenWebMath:24 组对比中 18 胜 6 平(平局均为 $t^\star=1$ 的 XGLM),且 1,024 验证文档下 10 个种子选出完全相同的系数。部署(Table 3):vLLM+Marlin 打包 W4 下,AW-MSE PPL 31.65→15.40、KL 0.97→0.28;GPTQ PPL 13.67→12.23、KL 0.15→0.06(相对 BF16 的 11.65 仅约 5% 困惑度超额);batch-1 延迟较 BF16 降 10.8%(1136.6→1013.4 ms)、batch-16 降 9.4%(1335.8→1210.3 ms),平移后加速保持不变。机制(Table 4/5):$t=4$ 使总 logit 误差上升(RTN 可见平方误差 ×2.8、AW-MSE ×2.1,GPTQ 65,536 下能量 ×2.66),但 Fisher 代价降 72–73%、KL 降 61%:高概率桶($p\ge10^{-2}$,占 84.766% 概率质量)贡献 71.8% 的 Fisher 下降,最低概率桶($p<10^{-6}$,0.196% 质量)误差翻倍却只占 <0.5% 代价;二次近似与实测 KL 偏差至多 12.4%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| W4 输出头量化保真度(XGLM-1.7B,最失真头) | 对 BF16 源模型的 test KL(越低越好) | 0.143(重参数化后) | 2.13(未重参数化 RTN,$t=0$) | KL 下降 93% |
| W4 输出头量化保真度(Phi-4-mini / BLOOM / BLOOMZ) | test KL,AW-MSE 量化器 | 0.256 / 0.136 / 0.158 | 0.936 / 0.594 / 0.662($t=0$) | KL 下降 73–77% |
| W4 GPTQ 强校准(Phi,65,536 校准状态) | test KL | 0.035($t=4$) | 0.089($t=0$,同校准) | KL 再降 61% |
| W2 压缩压力测试(XGLM-1.7B) | test KL,AW-MSE 量化器 | 3.73 | 23.7($t=0$) | KL 下降约 84% |
| 打包 W4 部署推理(Phi-4-mini,vLLM+Marlin,A10G) | WikiText PPL;batch-1 生成延迟 | AW-MSE+shift PPL 15.40、B1 1013.4 ms;GPTQ+shift PPL 12.23、KL 0.06 | BF16:PPL 11.65、B1 1136.6 ms;未平移 AW-MSE:PPL 31.65 | PPL 大幅接近 BF16(GPTQ 超额仅约 5%),同时延迟降低 10.8% |
| 独立 holdout 复现(26 篇未触碰 WikiText 文章) | AW-MSE test KL 相对降幅(bootstrap 95% CI) | Phi 约 74%(CI [72.9, 74.4]%);BLOOM 约 74%(CI [72.4, 76.2]%) | 未重参数化 $t=0$ | 四组配置的区间全部排除零 |
局限与改进
作者承认的局限:收益集中在基线失真大的头,Gemma 3/4、Qwen3.5 在 W4 几乎无收益(如 Gemma 4 RTN 0.012→0.010);W2 虽普遍受益但远未恢复源水平(Phi RTN W2 的 KL 仍高达 74.2,GPTQ PPL 30.0 对 BF16 的 9.73),只能当压力测试看;选出的系数不是普适常数——随量化器、校准数据与领域变化(更大数据集在 C4/OpenWebMath 上可选出不同系数;FLORES 多语言上 18 项 KL 全降但个别语言回退),冻结系数跨域只是“胜过固定中心化”而非全局最优;主测试集在方法开发期间被使用过,因此补做了 holdout;均值方向经对照实验(中位数、三个固定种子的高斯方向)支持但未被证明最优,随机方向也有效。我自己的观察:KL 与 PPL 可能背离(附录 I、Table 32 中 Gemma 3 AW-MSE 的 KL 改善而 PPL 从 38.086 升到 38.176),全文未评估生成质量、下游任务准确率或采样温度下的行为,KL 选优对终端体验意味着什么存在缺口;Fisher 二次近似对 KL 的偏差最大达 12.4%,且测试仅 16 篇文章、区间条件于已冻结的选择;grouped 扩展在 GPTQ 下九个模型中四个略微回退,说明与误差补偿类量化器的组合并不平凡;tied 模型需额外约 0.3 GiB 输出副本(7.17→7.47 GiB),实测延迟仅限 A10G 上的 Phi(外加 Qwen3.5 的 batch-1 9.6%),Gemma 4 的打包部署未测。
独立分析的弱点
其一,评价与体验脱节:全部质量指标是 KL/PPL,未测下游任务、长文生成退化或指令跟随;KL 下降但置信度改变可能影响温度采样行为。改进方向:补充标准任务基准与温度扫描的行为分析,验证“分布更近”确实转化为更好的生成。其二,搜索空间人为受限:只搜行均值方向上的标量,作者自己声明不声称该路径包含最优代表元(连随机方向都有效,暗示空间很大)。改进:把 $a \in \mathbb{R}^d$ 作为自由向量,用验证 KL 的坐标下降或梯度估计直接优化,或对 $\mu$ 做低秩扩展。其三,与强量化器的互补性不稳定:GPTQ 下收益明显变小(Phi W4 0.158→0.059),grouped 版在 GPTQ 下四个模型回退,说明误差补偿已部分占据了这个自由度。改进:把 softmax Fisher 加权直接写进 GPTQ 的重建目标,而不是前置选择代表元。其四,系数的领域敏感性:跨域冻结有效但非最优。改进:利用每头仅一个标量的事实,在服务时按请求域从两三个预量化候选间在线切换。其五,评估规模小:16 篇测试文章、部分置信区间较宽,且结论多来自 WikiText。改进:扩大 holdout 并做跨语料元分析。
未来方向
作者提出的方向:grouped 高容量参数化的深入探索(更细的组、更聪明的坐标优化、更大搜索预算下的系统对照),以及把本文的 KL 选择与 SoftWater 类曲率感知量化器视为互补组合。基于本文成果可延伸的:把等价类搜索与通道缩放/旋转变换联合优化(目前是先选 scale 再选 shift 的顺序搜索,未扫全网格);将该自由度推向 W2 以下的极低比特,或与低秩+残差方案(ARCHead 方向)结合做混合压缩;从理论上刻画 $t^\star>1$ 何时何故占优(例如残差的偏置-方差权衡随 $t$ 的变化);把“按分布保真度选代表元”推广到其他 softmax 读出层,如 MoE 路由器、分类头、价值头;研究选出的头在蒸馏或投机解码中作为目标分布时的效果;以及多语言场景下按语系选择或插值系数(FLORES 实验已显示语言间差异)。
复现评估
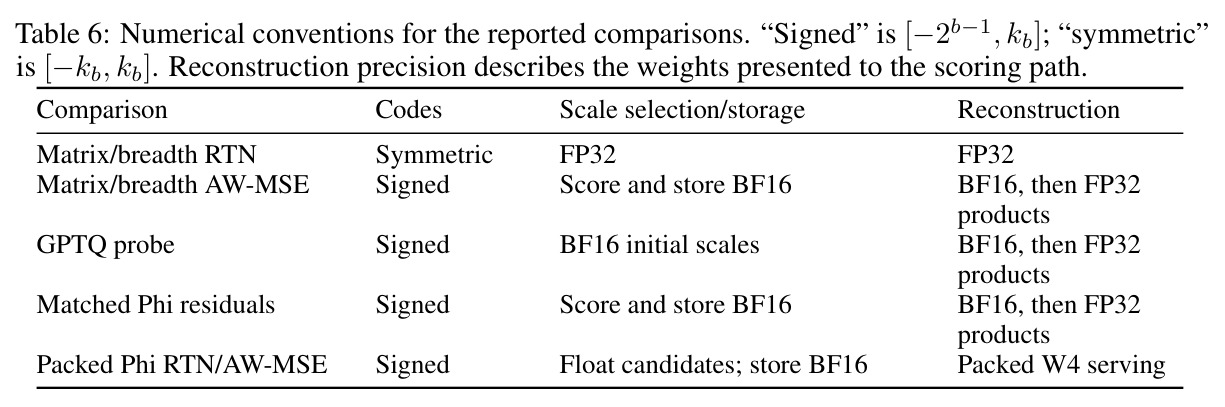
复现门槛很低、透明度高。代码、机器可读实验记录和重建主表的脚本承诺在发表时开源。所有检查点均为公开模型(Phi-4-mini、Gemma 3/4 E4B、Qwen3.5-4B、BLOOM/BLOOMZ-1.7B、XGLM-1.7B、SmolLM3 等,附录 H 列出头维度与 revision);数据集全部公开(WikiText、C4、OpenWebMath、FLORES)。算力需求极小:四个头的 RTN/AW-MSE 搜索约 5 分钟(单张 A100),Phi 的 14 点 GPTQ 扫描约 12 分钟,九模型重跑在 H100,延迟测试用 A10G + vLLM 0.28.0 + Marlin INT4。方法本身纯后训练、无需任何梯度训练。难点主要在位级对齐:论文固定了 llmcompressor 0.12.0.1、torch 2.12.0、transformers 5.10.1,并强调精确复现数字需匹配隐藏态哈希、检查点 revision 与数值约定(BF16 缩放存储、签名编码 $[-8,7]$、12 点裁剪网格、关闭 TF32);若只验证趋势则宽松得多。总体属于“一个下午可复现主表”的工作。
论文图表
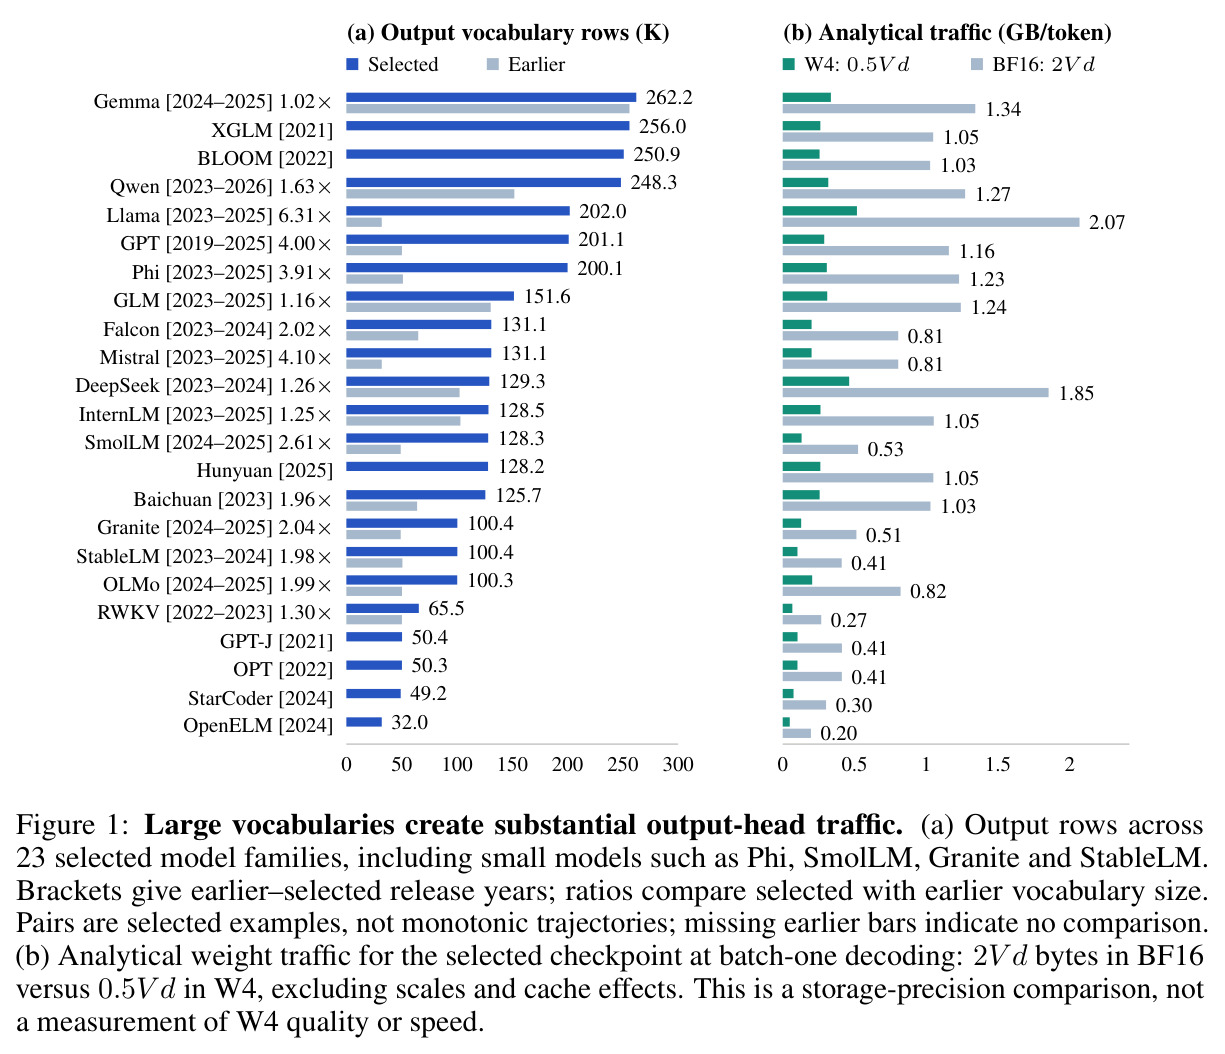
左图画出 23 个模型家族的输出行数 K:Gemma 262.2K、XGLM 256.0K、BLOOM 250.9K、Qwen 248.3K、Llama 202.0K、Phi 200.1K 等,并标注相对早期版本的词表增长倍数(如 Llama 6.31×、Mistral 4.10×);右图画出选定检查点 batch-1 解码的解析权重流量:BF16 约 $2Vd$ 字节/token 对 W4 约 $0.5Vd$(如 Llama 2.07 GB/token、Phi 1.23 GB/token,Gemma 1.34)。
一张图确立了问题规模:大词表使输出头成为单 token 解码的最大访存项之一,且注明这是存储精度对比而非质量测量——为“值得专门对输出头做 W4”提供了动机基础。
伪代码:计算 $\mu$、从拟合态估计量化器矩;按 logit 路径是否保持公共平移决定秩一修正开关 $r \in \{0,1\}$;对全部 $t$ 验证未量化等价;然后按序遍历网格 $T$——构造 $W_t$、量化 $Q_t$、计算验证 KL——保留最优 $(t^\star, Q^\star)$,仅当 $r=1$ 时推理期保留 $(t^\star, \mu)$。
给出方法的精确实现,包括非线性修正的施加位置和等价性检查,是把论文变成代码的最直接依据。