基于跨层隐向量量化的逐层嵌入极限压缩 Extreme Compression of Per-Layer Embeddings via Cross-Layer Latent Vector Quantization
OPTIC 跨层共享量化码,将 PLE 压缩约百倍仍保留 97.8% 性能
前置知识
Per-Layer Embeddings(逐层嵌入,PLE)
PLE 是 Gemma 3n/Gemma 4 引入的嵌入结构:普通输入嵌入只在模型入口为每个词元提供一个向量,而 PLE 为每个词元在每一个解码器层都保存一个可学习向量。层内该向量与由隐状态计算的门控向量逐元素相乘($\tau\, g_{i\ell} \odot e_{t\ell}$),再经输出投影 $W^{\mathrm{out}}_\ell$ 加回残差流,为每层注入词元级静态先验。Gemma 4 E4B 的 PLE 含 1100 万个宽 256 的词元-层向量,占全部参数 35.2%(E2B 占 45.8%),bfloat16 下高达 5.64 GB。
本文的压缩对象就是 PLE 张量 $E\in\mathbb{R}^{V\times L\times d}$,理解其「词元×层×维度」结构与门控用法是理解输出路径拟合的前提。
向量量化与乘积量化(VQ / PQ)
向量量化把连续向量替换为码本中最近的码字,只存码字下标;乘积量化(PQ)进一步把高维向量切成 $M$ 段,每段配一个含 $K$ 个码字的小码本,一个向量编码为 $M$ 个下标,存储为 $M\lceil\log_2 K\rceil$ 比特。本文的常规基线(PQ、RVQ、OPQ、AQ、AQLM 束编码器)都属于这一家族,对每个「词元-层」向量独立编码,100× 压缩时每个向量只摊到约 5 字节。
OPTIC 的存储形式仍是 PQ 式码本查表,本质区别在于码在层间共享、且拟合目标不同,理解 PQ 才能看清它省掉了什么。
输出路径感知压缩(output-path fitting)
传统压缩以「重建向量逼近原向量」为目标;GPTQ/AWQ 等输出感知方法则认为关键是压缩后模型输出不变。本文注意到 PLE 只通过「门控逐元素乘 + 输出投影」这条路径影响模型,于是把拟合损失定义为投影输出误差:$\Delta r_{i\ell}=W^{\mathrm{out}}_\ell\big(\tau\, g_{i\ell}\odot(\hat e_{t_i\ell}-e_{t_i\ell})\big)$,最小化 $\mathcal{L}_{\mathrm{path}}=\frac{1}{nL}\sum_{i,\ell}\|\Delta r_{i\ell}\|_2^2$,并由此推出层度量 $G_\ell=(W^{\mathrm{out}}_\ell)^\top W^{\mathrm{out}}_\ell\odot\frac{1}{n}\sum_i g_{i\ell}g_{i\ell}^\top$。
「拟合到输出路径而非存储向量」是 OPTIC 名字的由来,也是其相对常规量化器的主要性能来源之一。
交替优化:连续更新 + 离散重指派
码本量化问题同时包含连续变量(码本、解码器)与离散变量(每个词元的码字下标),无法联合求全局最优。标准做法是交替进行:固定下标时,用 AdamW 在小批量上梯度更新码本与解码器;固定码本时,逐组枚举为每个词元挑使目标函数最小的下标(类似 K-means 的分配步)。本文还加入无量化最优隐向量 $z_t^\star$ 的闭式更新和未用码字的再分配策略。
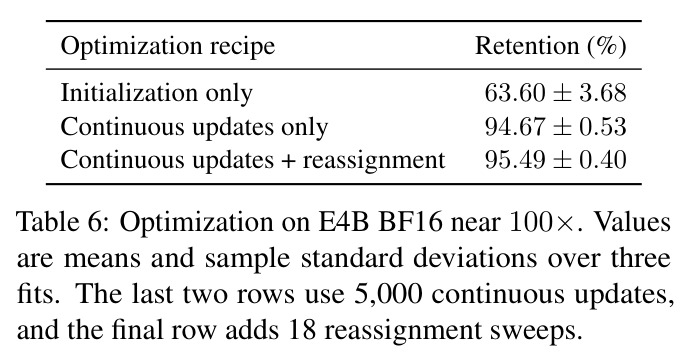
Algorithm 1 就是这一框架,消融实验显示连续更新贡献最大(保留率从仅初始化的 63.60% 升到 94.67%)。
PCA 初始化与 OPQ 坐标分组
初始化时把每个词元的 $L$ 层 PLE 行拼接成一个 $Ld$ 维向量,减去词表均值后按 $G_\ell^{1/2}$ 对层坐标加权,得到 $V\times Ld$ 矩阵;对其做 PCA 取前 $Z$ 个主方向作为词元隐向量 $z_t$ 的初始值,坐标按 $G_\ell^{-1/2}$ 缩放初始化解码器 $A_\ell$,词表均值初始化偏置 $b_\ell$;再用 OPQ(优化乘积量化)的特征值分配策略把 $Z$ 个坐标均衡分到 $M$ 组,组内 K-means 初始化码字与下标。
这套初始化单独就能达到 63.60% 的保留率,是整个交替优化流程能收敛到高性能的起点。
研究动机
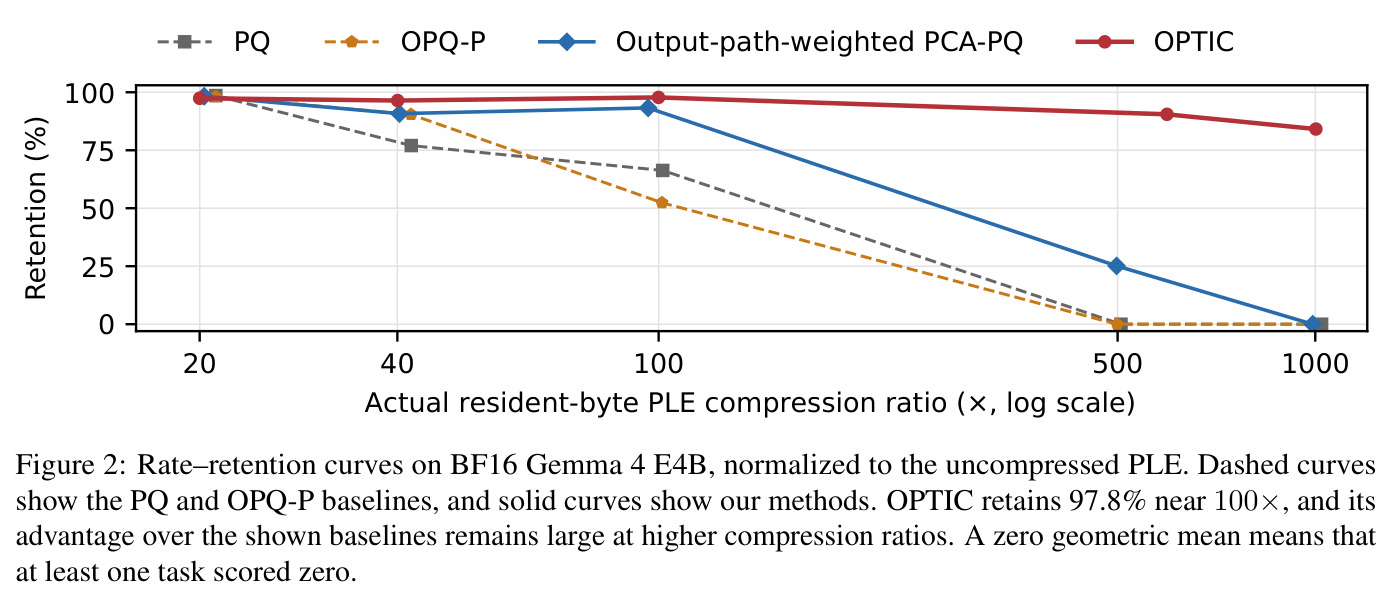
嵌入容量正在成为语言模型新的扩展维度:Over-Tokenized Transformers 与 SCONE 扩展 n-gram 表示,DeepSeek Engram 采用哈希寻址的 n-gram 查找记忆,Qwen3.8-Flash-Next 甚至在 51B 主干外挂 125B 参数的 n-gram 嵌入;Gemma 4 则用 PLE 为每个词元在每层提供一个向量。这带来真实的存储危机:PLE 占 Gemma 4 E2B 参数的 45.8%、E4B 的 35.2%,E4B 存储 1100 万个宽 256 的词元-层向量,bfloat16 下达 5,637,144,576 字节(约 5.64 GB)。在约 100× 压缩档位,每个向量只剩约 5 字节,常规量化器给每个词元-层对单独一个几字节小码,表示能力急剧退化——实验中六个常规基线(PQ、RVQ、OPQ-P、AQ、AQLM 欧氏束编码器、INT8 随机化低秩 SVD)在 E2B BF16 上的七任务保留率大多为 0%,最强的 PQ 在 E4B BF16 上也只有 66.3%。
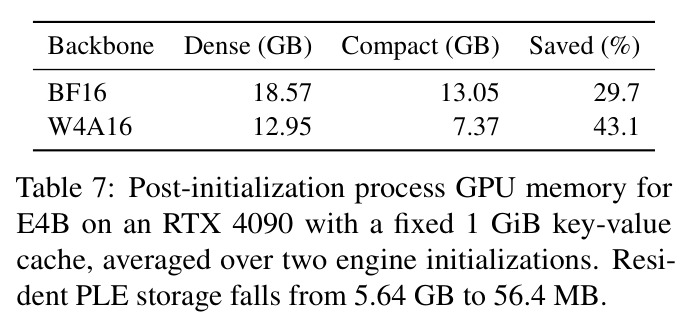
本文的目标是本文的目标是在基本不损失模型能力的前提下对 PLE 做极限压缩,且压缩结果可直接用于推理。量化目标包括:在 BF16 E4B 上约 100×(实测 99.94×,从 5.64 GB 压到 56.4 MB)压缩时,七基准等权几何平均保留率超过 97%,大幅超过最强常规基线;在 594× 与 1002× 的极端压缩下分别保留 90.5% 与 84.1%;在官方 W4A16 发布版上保留 96.9%;同时用紧凑表示直接推理时,BF16 E4B 的 GPU 进程显存降低 29.7%,额外墙钟延迟不超过 0.40%。
与已有工作不同的是,已有嵌入压缩工作(组合码本词向量压缩、CARVQ 等)只处理每词元一个向量的普通嵌入表,忽略了 PLE 的两个关键结构。第一,同一词元在 $L$ 层的 $L$ 个向量高度相关且共享同一词元身份,行级方法把字节切得过碎,而沿「层」与「词元」两个索引同时共享存储可以聚拢字节预算:所有层共用一份词元隐码,所有词元共用每层一个仿射解码器。第二,PLE 不直接进入损失,只通过门控与输出投影影响模型,因此拟合目标应设在投影输出处而非存储坐标本身。这两个被忽视的观察(跨层码共享 + 输出路径拟合)共同定义了 OPTIC。
核心方法
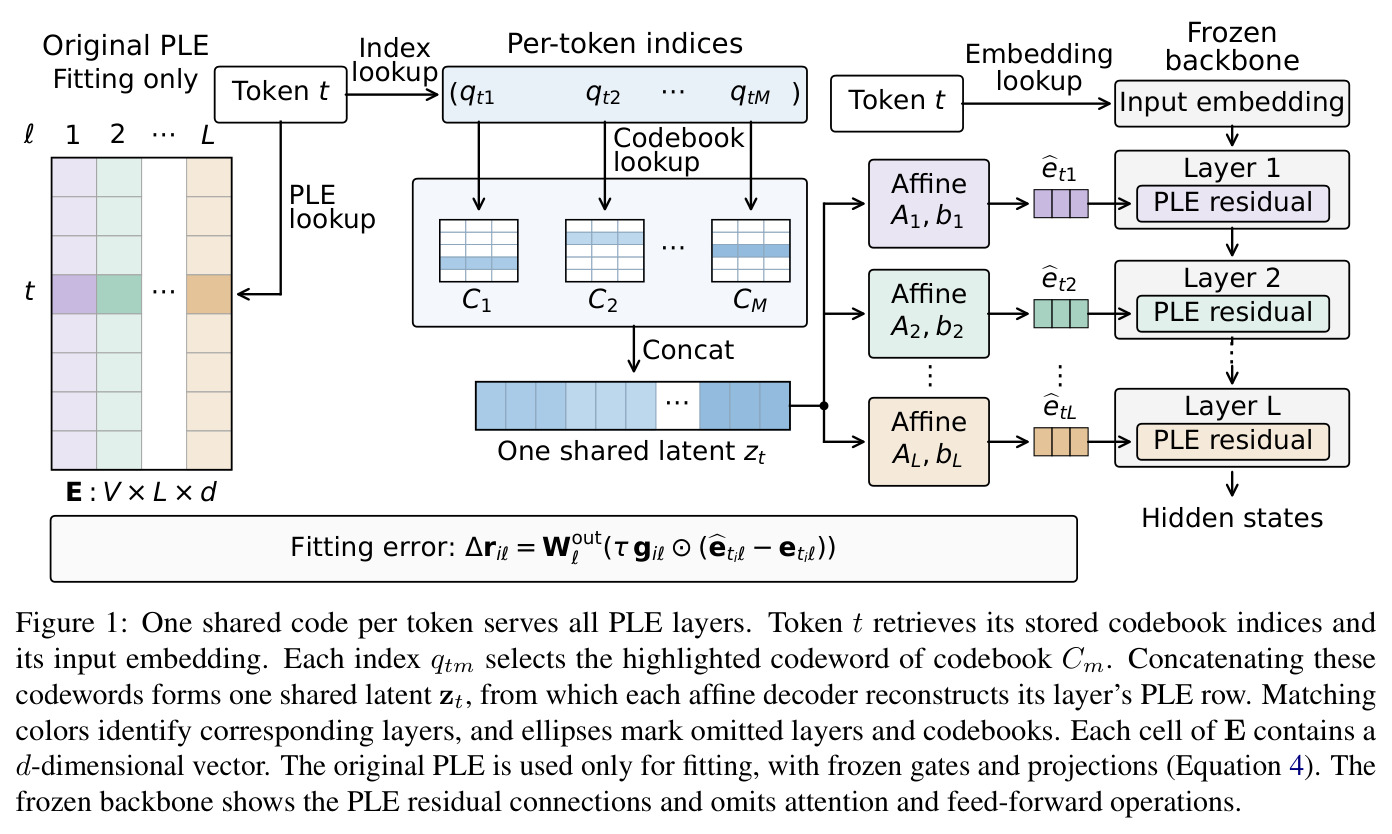
直觉上,OPTIC 把「一个词元的 42 份逐层档案」换成「一份共享档案 + 42 个各层专属的解读规则」:每个词元只存一个 PQ 式码组($M=161$ 个码字下标),查表拼接得到宽 $Z=644$ 的共享隐向量 $z_t$;第 $\ell$ 层用专属仿射解码器 $\mathrm{Dec}_\theta(t,\ell)=A_\ell z_t+b_\ell\in\mathbb{R}^{256}$ 重建该层 PLE 行。层间差异全部由解码器承载(其存储随层数线性增长但与词表无关),词元身份由共享码承载(存储随词表增长但与层数无关)。技术路线分三步:先按层误差度量 $G_\ell$ 做 PCA/OPQ/K-means 初始化;再交替执行连续更新(AdamW 更新码本与解码器)与离散重指派(逐组为每个词元选最优码字);整个拟合始终以门控之后、输出投影处的路径误差 $\mathcal{L}_{\mathrm{path}}$ 为目标,而非向量重建误差。
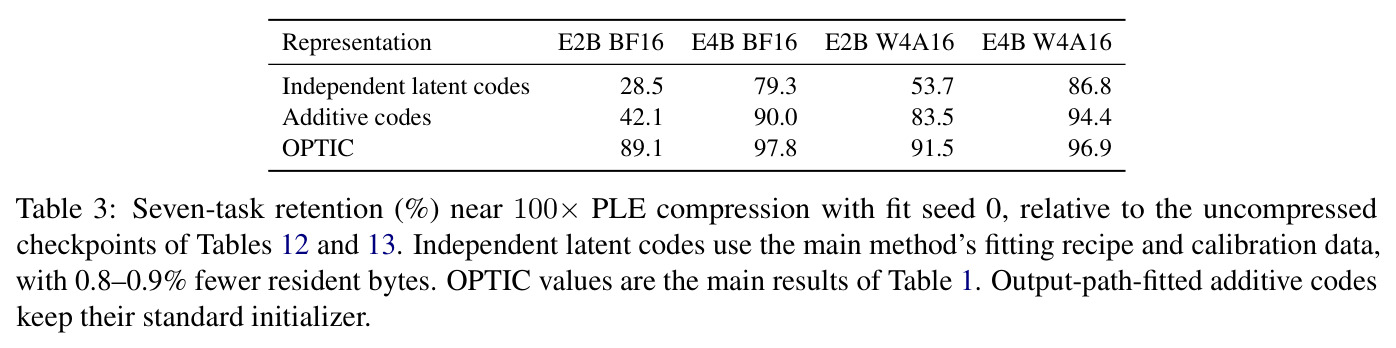
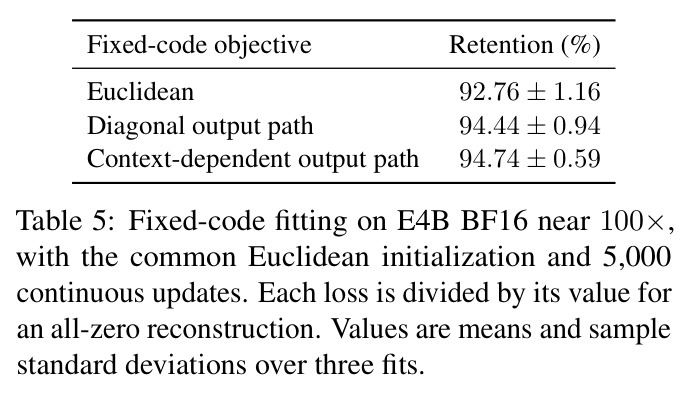
核心创新有两点,缺一不可。第一是跨层共享隐码:行级方法给每个词元-层对独立的几字节小码,字节被切得过碎;OPTIC 把一个词元在 42 层的向量捆绑成一个约 161 字节的大码组,让每层的仿射解码器负责恢复层间差异。消融证明其关键性:在同等拟合配方与近似存储下,把共享码换成每词元-层独立隐码,E4B BF16 保留率从 97.8% 跌到 79.3%。第二是输出路径拟合:PLE 只经门控 $g_{i\ell}$ 与投影 $W^{\mathrm{out}}_\ell$ 影响模型,OPTIC 直接最小化投影输出误差,层度量 $G_\ell$ 对坐标做输出感知的重加权。固定码本对照显示上下文相关输出路径目标比欧氏目标高 1.98 个百分点。这与 GPTQ/AWQ 的「输出感知」思想一脉相承,但对象不是线性权重矩阵,而是门控残差分支中的嵌入表,且同时利用了层轴上的结构冗余。
方法步骤详情
输入是冻结 PLE 张量 $E\in\mathbb{R}^{V\times L\times d}$(E4B:$V=262144,L=42,d=256$)、拟合记录集 $I_{\mathrm{fit}}$(每条含词元 ID 与各层门控向量 $g_{i\ell}$,自然文本记录的门控从未压缩模型缓存,合成记录用全一 Gates)以及配置 $Z=644,M=161,K=256$。第一步初始化:把每个词元的 L 层行拼接、去均值、按 $G_\ell^{1/2}$ 缩放成 $V\times Ld$ 矩阵,PCA 取前 $Z$ 个主方向得 $z_t$ 初值,坐标按 $G_\ell^{-1/2}$ 缩放初始化 $A_\ell$,词表均值初始化 $b_\ell$;OPQ 特征值分配把 $Z$ 个坐标分成 $M$ 组,组内 K-means 初始化码本 $C_m$ 与下标 $q_t^m$。第二步交替优化 $J$ 轮:每轮先做 $U$ 步连续更新(小批量记录-层对上 AdamW 最小化 $\mathcal{L}_{\mathrm{path}}$,下标固定);再对每个词元求式 (7) 的无量化最优隐向量 $z_t^\star$,按组逐一把下标换成最小化替代损失 $\bar{\mathcal{L}}_{\mathrm{assign}}=\frac{1}{VL}\sum_{t,\ell}\|\hat e_{t\ell}-e_{t\ell}\|_{G_\ell}^2+\lambda\|z_t\|_2^2$ 的码字;未用码字用最差拟合词元的 $z_t^\star$ 片段填补并重新指派。输出紧凑表示 $\theta$:词元下标加浮点码本与解码器,共 56,404,992 字节。推理时词元 $t$ 只取其 $M$ 个码字拼成 $z_t$,逐层应用 $A_\ell z_t+b_\ell$,无需物化完整 $V\times L\times d$ 张量。
技术新颖性
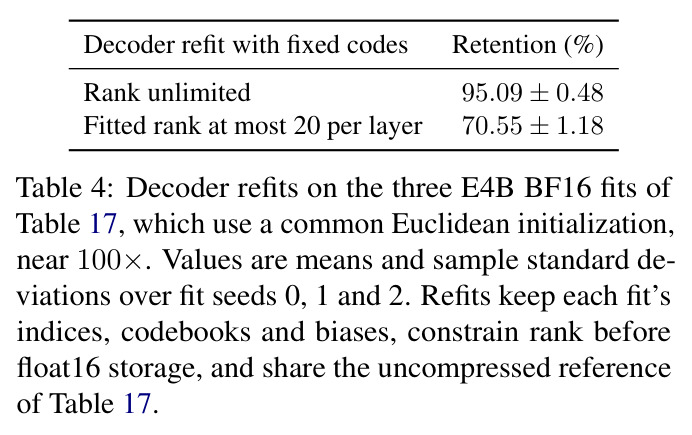
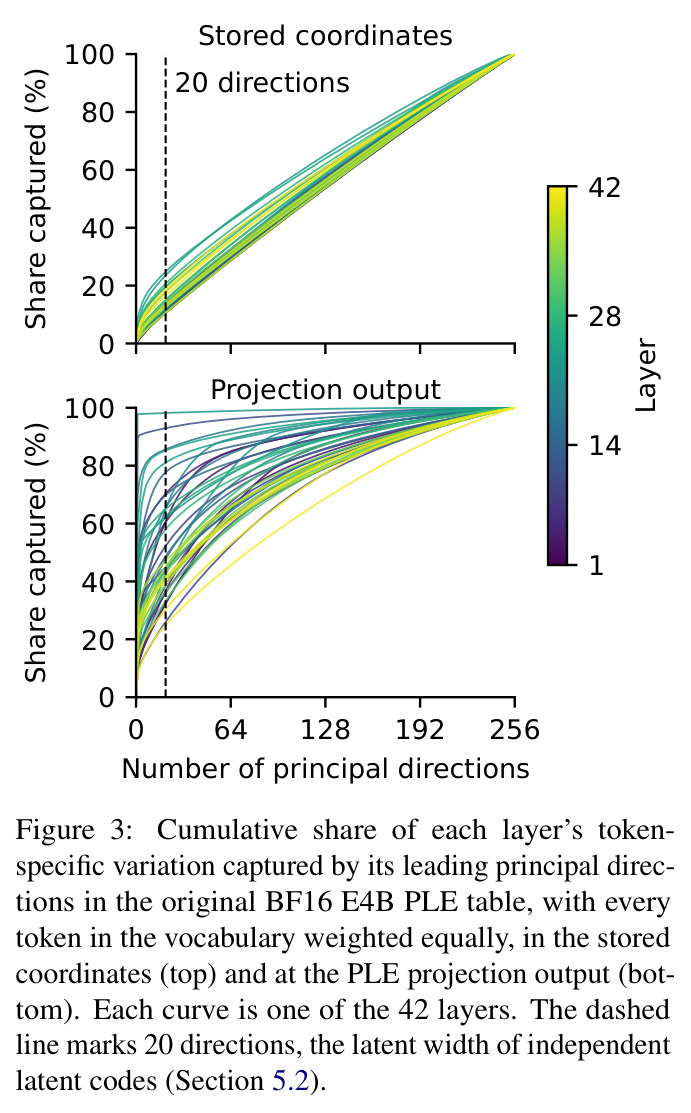
与已有技术可从三个维度区分。表示结构上:词向量组合码(Shu & Nakayama 2018)与 CARVQ 只处理每词元单向量、无层轴;PQ/RVQ/AQ/AQLM 对每个向量独立编码;OPTIC 首次利用「同一词元的 $L$ 层行对应同一词元身份」这一对应关系,用一个共享隐码经 $L$ 个层专属线性映射解码。目标函数上:常规量化器以欧氏重建误差为目标,本文以门控投影输出误差为目标,并推导出闭式层度量 $G_\ell$ 用于初始化与重指派。消融分离了各组件贡献:跨层共享带来 79.3%→97.8%;输出路径目标在固定码对照中比欧氏目标高 1.98 个百分点;而低秩对照(限制解码器秩不超过 20 时保留率从 95.09% 跌到 70.55%)说明收益来自「共享高维隐码 + 层专属满秩解码器」的组合而非单纯低秩分解。频率分层变体进一步让高频词元占用更多码组,把 E2B 保留率推到 90.0%(BF16)与 93.0%(W4A16)。
实验结果
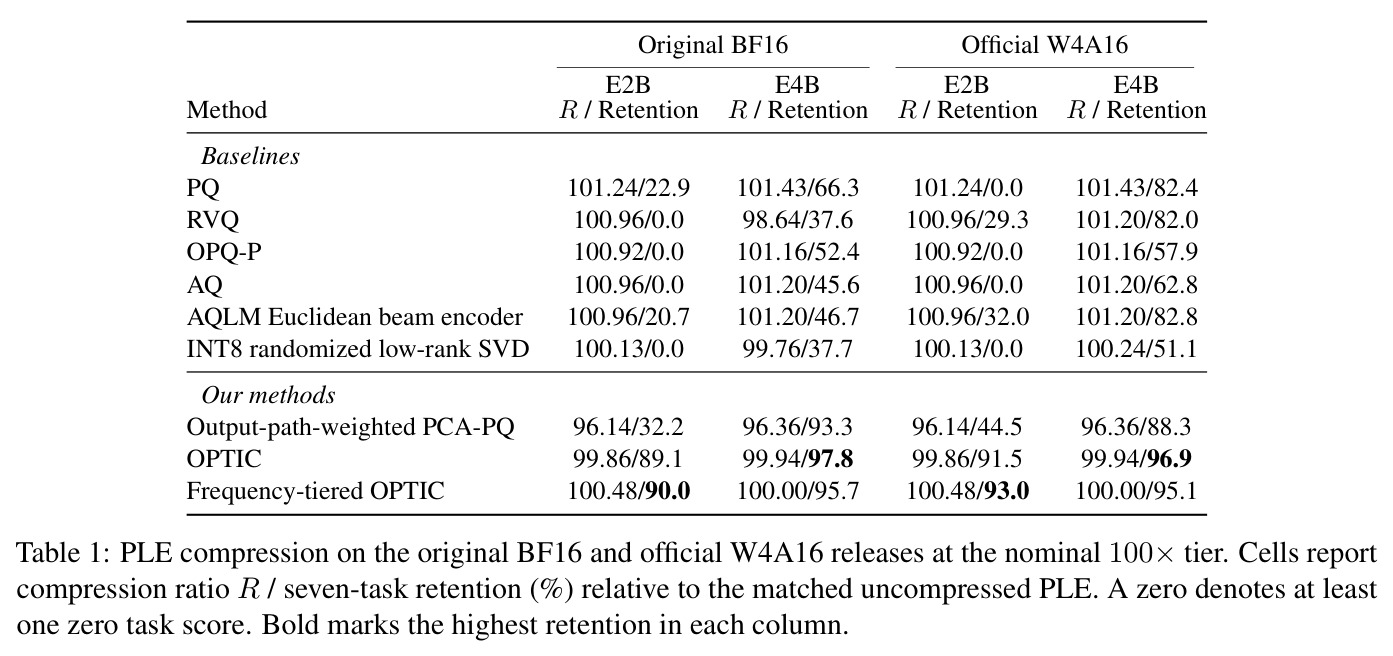
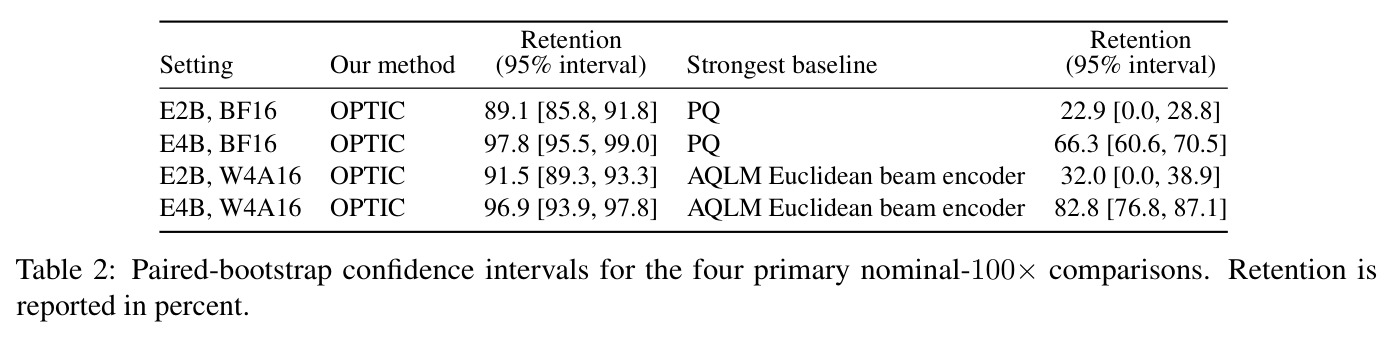
约 100× 档位(E4B BF16 实测 99.94×,紧凑表示 56,404,992 字节对未压缩 5,637,144,576 字节)上,OPTIC 在 PIQA、GSM8K、GPQA Diamond、AIME 2026、MMLU-Redux、IFBench、InfographicVQA 七个基准的封顶保留率几何平均达 97.8%,六个常规基线中最强的 PQ 仅 66.3%,领先 31.5 个百分点;W4A16 官方发布版上 OPTIC 96.9%,最强基线 AQLM 欧氏束编码器 82.8%。分任务看 E4B BF16:GSM8K 从未压缩 92.9% 几乎无损地保持 92.8%(PQ 仅 73.5%);IFBench 41.7%(未压缩 44.0%,PQ 16.0%);InfographicVQA 67.5%(未压缩 69.7%,PQ 38.4%)。配对 bootstrap 95% 区间确认差距显著:E4B BF16 OPTIC [95.5, 99.0] 对 PQ [60.6, 70.5]。更高压缩下优势扩大:594× 与 1002× 时 OPTIC 在 BF16 E4B 保留 90.5% 与 84.1%(W4A16 为 87.7% 与 81.8%),而输出路径加权 PCA-PQ 在约 500× 只剩 25.1%、1000× 归零。E2B 上频率分层 OPTIC 最优:BF16 90.0%、W4A16 93.0%。消融方面:独立隐码 79.3% 对 OPTIC 97.8%,证明跨层共享是关键;解码器秩对照(秩 ≤20 保留 70.55% 对不限 95.09%)说明解码器容量不可牺牲;优化消融显示仅初始化 63.60%、连续更新 94.67%、加重指派 95.49%。部署侧:vLLM 在单张 RTX 4090、固定 1 GiB KV 缓存下,BF16 E4B 进程显存从 18.57 GB 降至 13.05 GB(省 29.7%),W4A16 从 12.95 GB 降至 7.37 GB(省 43.1%),八种 prefill/生成负载墙钟时间最多慢 0.40%(W4A16 为 0.69%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 七任务聚合(E4B BF16,约100×压缩) | 封顶保留率几何平均 (%) | 97.8 | 66.3(PQ,最强常规基线) | +31.5 个百分点 |
| 七任务聚合(E4B W4A16,约100×压缩) | 封顶保留率几何平均 (%) | 96.9 | 82.8(AQLM 欧氏束编码器) | +14.1 个百分点 |
| 七任务聚合(E2B BF16,约100×压缩) | 封顶保留率几何平均 (%) | 90.0(频率分层 OPTIC) | 22.9(PQ) | +67.1 个百分点 |
| GSM8K(E4B BF16,约100×) | 准确率 (%) | 92.8 | 73.5(PQ)/ 92.9(未压缩) | 较 PQ +19.3,较未压缩仅 -0.1 |
| IFBench(E4B BF16,约100×) | 得分 (%) | 41.7 | 16.0(PQ)/ 44.0(未压缩) | 较 PQ +25.7 |
| 七任务聚合(E4B BF16,1002×压缩) | 封顶保留率几何平均 (%) | 84.1 | 0(输出路径加权 PCA-PQ) | 极端压缩下逐行基线完全失效 |
| 服务显存(E4B BF16,RTX 4090,固定1GiB KV缓存) | 初始化后进程内存 (GB) | 13.05(紧凑 PLE) | 18.57(稠密 PLE) | -29.7%,延迟最多 +0.40% |
局限与改进
作者承认的局限包括:只在 Gemma 4 E2B/E4B 两个检查点的 PLE 上验证;主对比与表 3 仅用单一拟合种子(种子 0),bootstrap 区间只刻画评测采样不确定性而非拟合方差;码共享消融在匹配字节预算时同时改变了码与解码器之间的字节分配,测的是「共享 + 拟合配方」的联合效应;输出路径损失在门控固定假设下只在每层投影输出处度量误差;包括 AQLM 在内的基线都是适配到 PLE 场景的改造版而非原版用法;几何平均保留率对单个零分任务极其敏感,一个低分任务即可把整体拉到很低。我的补充观察:结论能否迁移到 n-gram 查找记忆(Engram、SCONE)或普通输入嵌入仍是开放问题;拟合时门控取自未压缩模型缓存或全一替代,若部署分布与校准分布差异大,固定的 $G_\ell$ 度量可能失配;方法需要完整未压缩 PLE 与校准数据做一次性拟合,第三方难以对闭源权重复现;0.40% 额外延迟虽小,但需要修改 vLLM 支持 PLE 码本查表与逐层解码,工程集成成本不可忽略。
独立分析的弱点
第一,泛化范围窄:所有结论都基于 Gemma 4 的 PLE,其层间行相关性假设未与其他逐层嵌入方案交叉验证;改进方向是把「跨索引共享码 + 专属解码器」框架移植到 Engram 类 n-gram 记忆或普通输入嵌入表做对照实验。第二,门控固定假设:拟合时把 $g_{i\ell}$ 视为常数,忽略压缩本身会改变隐状态进而改变后续层的门控,长生成过程中误差可能累积;改进方向是迭代式校准(用压缩后模型重新收集门控再拟合)或在目标中显式建模多层误差传播。第三,超参数敏感性未报告:$Z=644,M=161,K=256$ 与正则系数 $\lambda$ 的权衡缺乏曲线,$Z$ 与 $M/K$ 如何随词表、层数缩放没有指南;改进方向是给出显存-质量帕累托前沿的调参建议。第四,评测集中在英文与数学/推理任务,多语言与代码场景缺席,而校准数据 FineWeb2 本身覆盖多语言,这条线索值得单独评测。第五,频率分层变体依赖固定 fitting stream 的词频统计并给高频词元额外码组,当部署领域词元分布漂移(新术语高频出现)时,低频词元共享的码字可能成为质量瓶颈;改进方向是支持码组的动态迁移或在部署域上做轻量适配。
未来方向
作者明确提出的方向是把「嵌入容量设计与压缩表示联合设计」纳入模型开发流程,以部署内存为硬约束,并把 PLE 压缩与骨干量化(W4A16)的组合推广到其他嵌入结构。基于本文成果可延伸的方向包括:把 OPTIC 与 AQLM 式端到端量化感知微调结合,让码本与解码器在反向传播中联合更新;对输出路径目标引入二阶信息(GPTQ 式 Hessian)替代当前对角近似 $G_\ell$;探索跨层解码器的低秩或共享参数化以进一步压缩解码器存储(42 层解码器权重占 $2LdZ\approx13.8$ MB);把共享码思想移植到 KV 缓存压缩或 MoE 专家参数压缩;以及研究紧凑 PLE 对下游继续训练(LoRA 等参数高效微调)的兼容性——解码器可微意味着压缩后的模型原则上可以直接微调而非只做推理。
复现评估
复现条件较友好。代码已开源(github.com/VILA-Lab/optic),方法属后训练压缩:只需对校准文本做一次前向缓存门控,无需训练或反传整个模型。校准数据全部公开:FineWeb、FineWeb-Edu、OpenWebMath、FineWeb2 各 1,536 条 × 512 词元共 786,432 个位置,外加每个词元一条合成记录;评测的七个基准(PIQA、GSM8K、GPQA Diamond、AIME 2026、MMLU-Redux、IFBench、InfographicVQA)全部公开,PCA-PQ 基线的拟合统计用 WikiText-2 训练集。算力上拟合为 $J$ 轮连续更新加重指派扫描,E4B 级别单张消费级/工作站 GPU 量级可承受,推理部署需改造 vLLM 支持码本查表与逐层仿射解码(代码库含实现)。风险点:Gemma 4 权重需从官方渠道获取;主结果只用种子 0,若要复现表 3/5/6 的三种子均值与标准差需多次拟合;Algorithm 1 与附录给出完整超参与更新日程,独立复现难度中等。
论文图表
拟合伪代码:构造边际层度量 $\{G_\ell\}$;按 $G_\ell$ 加权 PCA 初始化隐向量与解码器,OPQ 分组后组内 K-means 初始化码本;循环 $J$ 轮,每轮做 $U$ 步 AdamW 连续更新,随后对每个词元求无量化最优 $z_t^\star$ 并做两轮逐组码字重指派,未用码字用最差拟合词元的 $z_t^\star$ 片段填补。
方法流程的精确规范,包含初始化、连续/离散交替更新与未用码字处理等复现必需的细节。