两比特的N-gram记忆:大语言模型中查找表的量化压缩 N-Gram Memories at Two Bits: Quantizing Lookup Tables in Large Language Models
用共享高斯trellis解码器加逐行范数恢复,把条件记忆查找表压到2比特且性能几乎不掉
前置知识
条件记忆与N-gram查找表
一类把知识存在骨干网络之外的机制:表 $E\in\mathbb{R}^{N\times d}$ 的每一行存一个学习到的表示,输入 $x$ 的每个token按n-gram哈希独立计算地址,从表中取回固定数量的行(如DeepSeek每token读48行),经readout算子 $h'=h+R(h,e(x))$ 注入隐状态。因为 $|A(x)|\ll N$,计算量不随表容量增长。
整篇论文压缩的就是这种表。它的访问模式是稀疏、输入依赖、按行独立的,这决定了压缩表示必须保持单行可独立重构,也是CP与普通权重压缩的本质分歧点。
Trellis编码量化(TCQ)
通信领域的经典序列量化技术:把量化器建模为状态机,每个值对应一次状态转移并从共享码表中选一个重构值,相邻坐标的选择通过状态耦合。编码时用Viterbi动态规划在所有路径中搜索重构误差最小的路径,只存路径的转移符号。文中用16-bit状态、每步2个值、tail-biting、跑两遍Viterbi的HYB高斯trellis。
CP的共享解码器 $f$ 就是一个高斯trellis。理解TCQ才能明白为什么全表只需存一份解码规则、每行只存2比特的短码,以及离线编码为何是一次性Viterbi搜索。
高斯信源模型
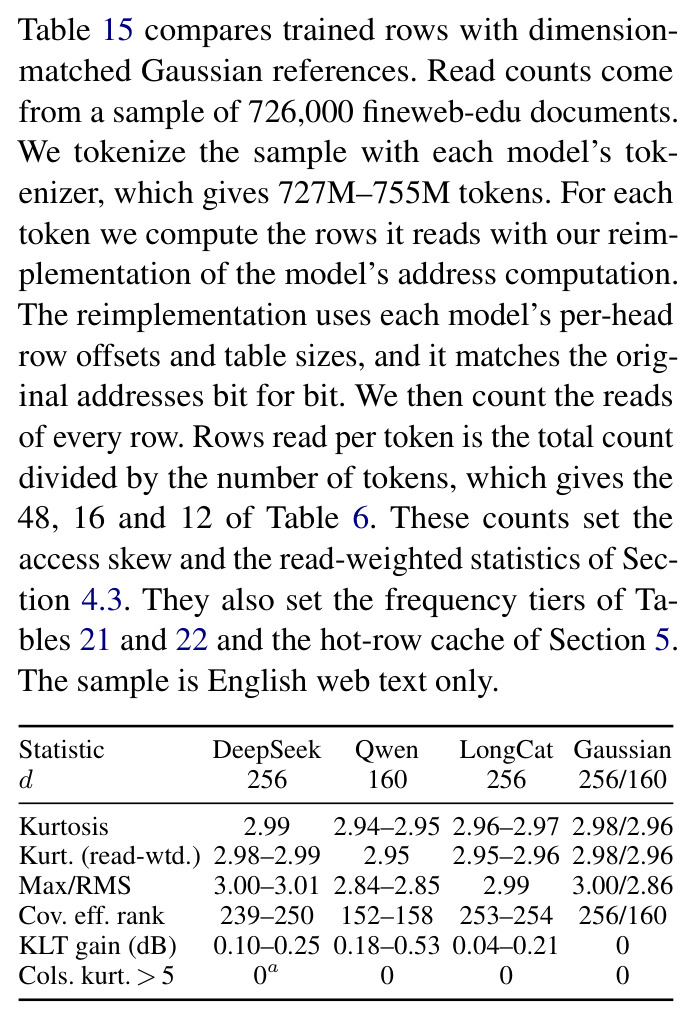
把待压缩数据近似为服从某分布的信源,再用该分布的最优编码器表示。论文的观察是:哈希表的行由许多不同训练信号累积而成,归一化向量 $z_i=\sqrt{d}\,e_i/\|e_i\|_2$ 的坐标近似标准高斯 $N(0,1)$(中心极限论证+实测kurtosis为2.94–2.99,高斯值为3)。高维下近似各向同性的方向归一化后坐标即近高斯。
这是全表共享一个解码规则的统计依据:既然所有行的归一化内容同分布,就无需为每张表拟合codebook,直接用一个高斯trellis表示所有行。
输出KL散度作为压缩保真度指标
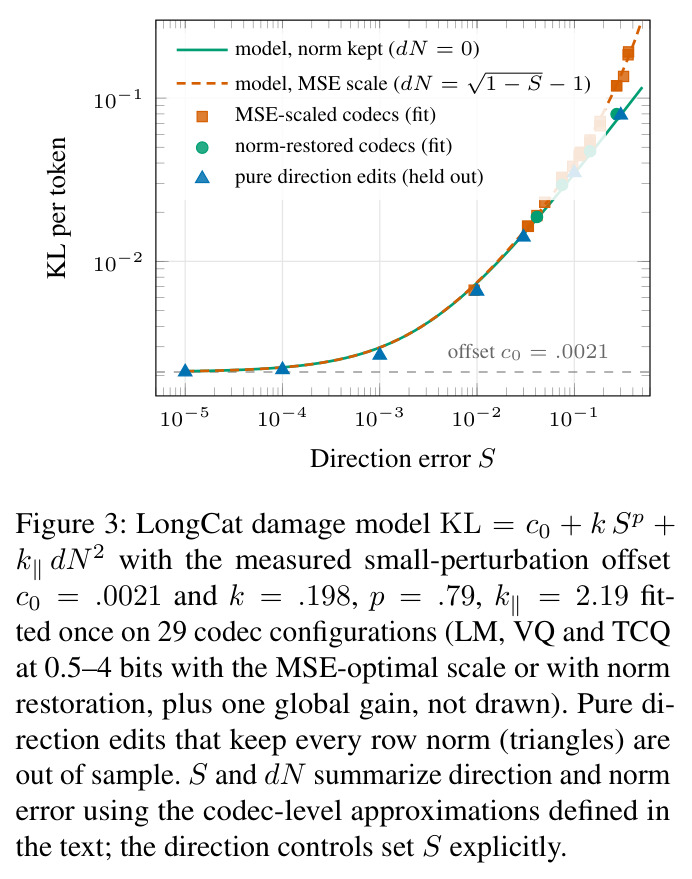
衡量压缩前后模型在同一输入上next-token分布差异的指标 $D_{KL}(p_E(\cdot|x)\|p_C(\cdot|x))$,论文在web、code、数学、chat、多语言六域上取几何平均。相比MSE,它直接度量'模型行为变了多少',能区分幅度误差与方向误差的不同影响。
论文反复证明MSE与KL给出不同的最优设计(如范数恢复增大MSE却降低KL)。读懂各实验表格中的KL数字及其配对比较,必须理解这一指标。
RTN/QTIP等LLM权重量化基线
RTN(round-to-nearest)逐值四舍五入到最近量化级;QTIP将坐标旋转去离群后用trellis编码稠密权重,采用tile布局把每行切碎到多个瓦片中、配一个全表全局scale。NVFP4/MXFP4是4-bit浮点格式。这些方法为稠密矩阵乘设计,默认整块权重一起被读取。
它们是论文的对照组:CP改造了QTIP的trellis但去掉了旋转和tile布局。理解基线的布局方式,才能理解CP'逐行独立记录'这一设计在查找延迟上的优势从何而来。
研究动机
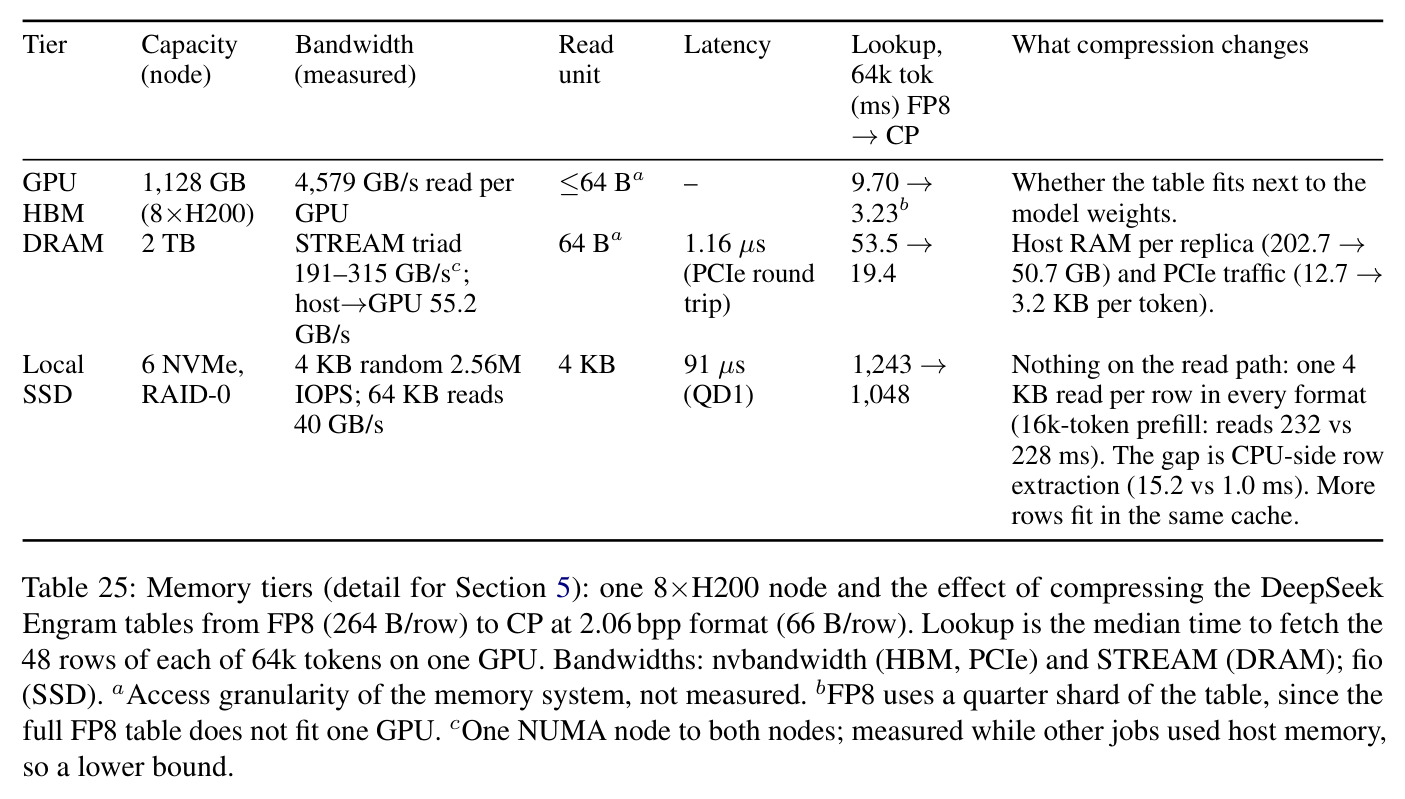
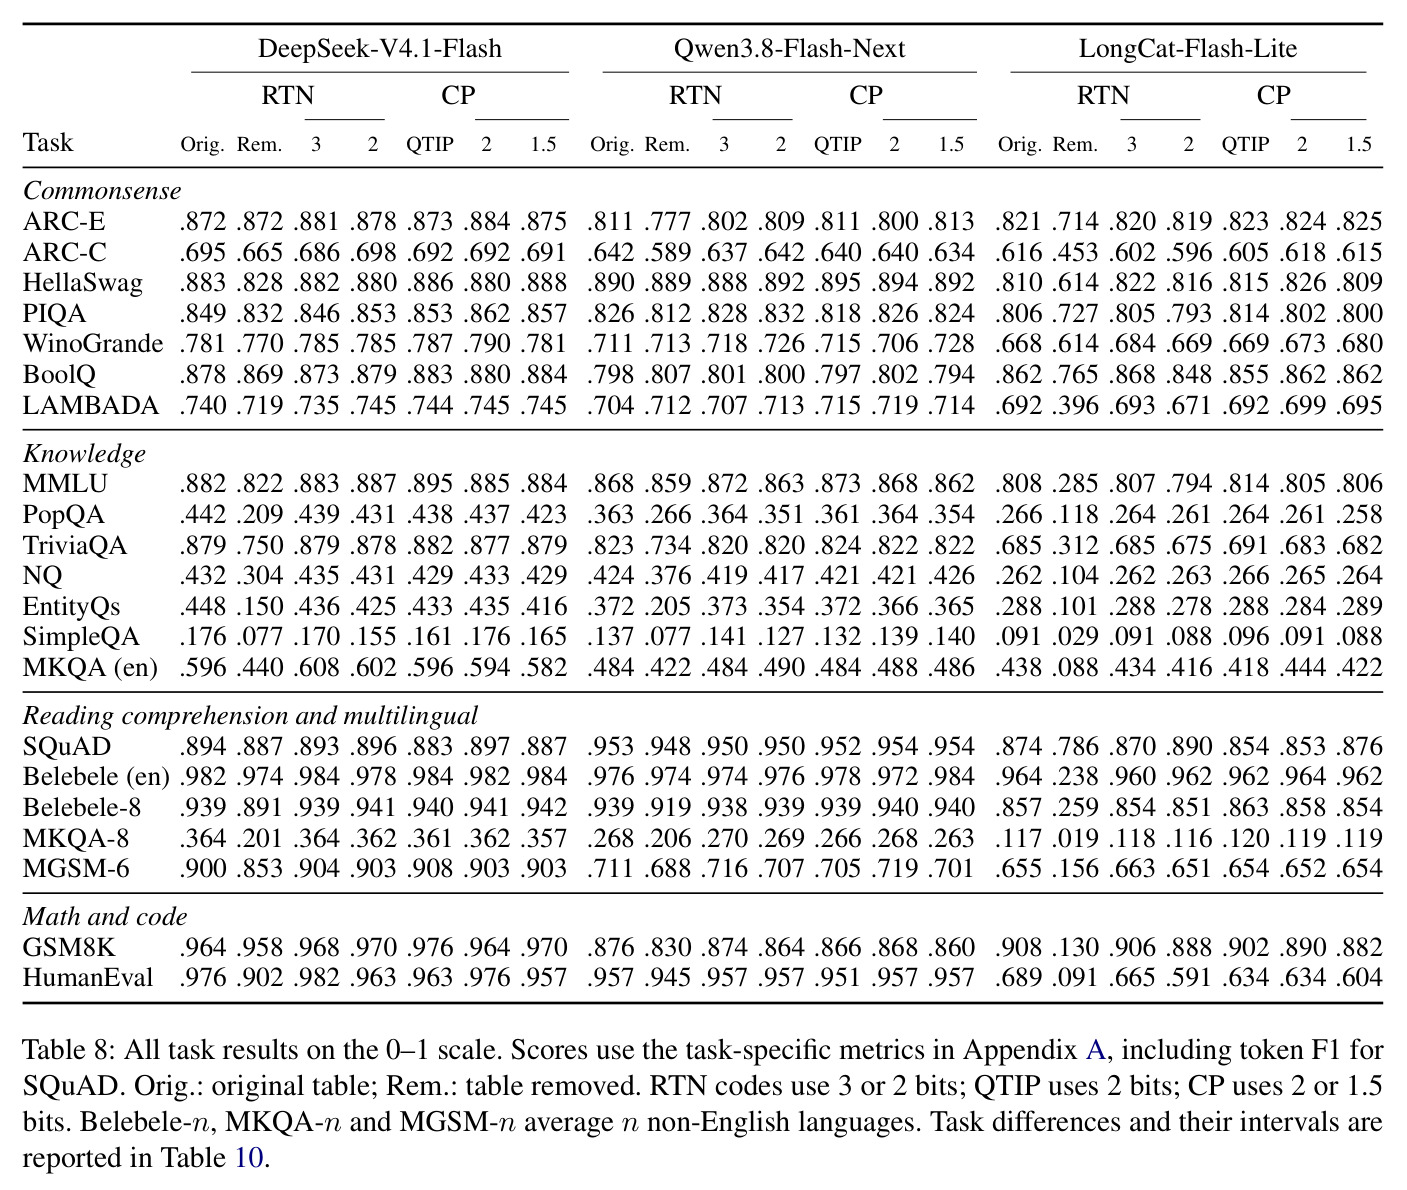
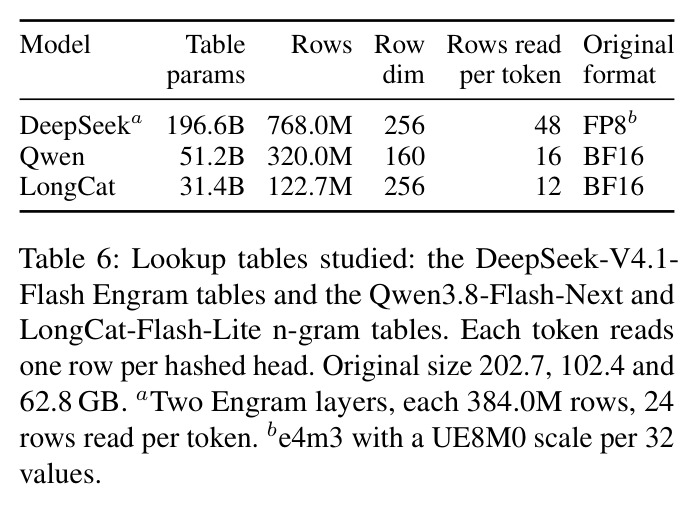
条件记忆让模型用很小的每token计算换取巨大容量,但表本身极大且必须常驻:DeepSeek-V4.1-Flash的Engram表有7.68亿行、每行256维,FP8存储202.7 GB;Qwen3.8-Flash-Next为3.2亿行、102.4 GB;LongCat-Flash-Lite为1.227亿行、62.8 GB。把表搬去主机内存或SSD只是转移成本而非消除——实测64k-token prefill时经PCIe查找就要53.5 ms。而现有LLM压缩方法(GPTQ、AWQ、QTIP等)面向稠密权重,常把多行耦合进更大的重构单元(如QTIP的tile),取一行要牵连无关数据,破坏了'按行独立取回'的访问模式。删表的对照实验说明这些表承载的知识信号真实且脆弱:LongCat去掉记忆后Overall从68.2崩到30.5,HumanEval从68.9跌到9.1;即便保留表,简单RTN 2比特也使LongCat HumanEval掉到59.1。
本文的目标是本文的目标是把整张查找表压缩约4到8倍,同时保住两件事:其一,选择性访问——每一行仍可被单独取回和重构,即对任意被请求的行号 $i$ 有 $\hat{e}_i=D(C(E),i)$,不需要解码或取回无关行;其二,下游行为不变。作者明确指出逐坐标均方误差 $D_{rec}=\frac{1}{N}\sum_i\|e_i-\hat{e}_i\|_2^2$ 不是好的目标,因为同样大小的坐标误差经readout和后续网络传播后对预测的影响可以截然不同(幅度误差与方向误差后果不同),因此把条件记忆压缩形式化为存储预算约束下的期望输出散度最小化:$\min_C \mathbb{E}_x[D_{KL}(p_E(\cdot|x)\|p_C(\cdot|x))]$,约束为 $S(C)\le B$,且地址函数、骨干参数和readout全部冻结。
与已有工作不同的是,本文的独特切入是把查找表当作一个信源编码问题,而不是权重压缩问题。作者注意到哈希n-gram表的每一行由多个n-gram碰撞共享、接收大量不同训练信号的累积更新,归一化后坐标近似标准高斯——实测三家模型的行内kurtosis为2.94–2.99,与高斯值3几乎重合,协方差KLT编码增益只有0.04–0.53 dB。既然所有行的'方向内容'统计上同分布,就可以用一个全表共享的重构规则(高斯trellis)表示内容,把每行的'幅度'拆出来单独存一个尺度。与QTIP不同,CP不做旋转、不用全局scale、不为选择性访问牺牲布局;与推荐系统嵌入压缩(CARVQ等)不同,CP不改训练、不学codebook、不做频率分配比特兜底,是纯后训练压缩。这种'信源统计驱动的共享解码器+行级幅度分离+独立行记录'的组合是本文独有的。
核心方法
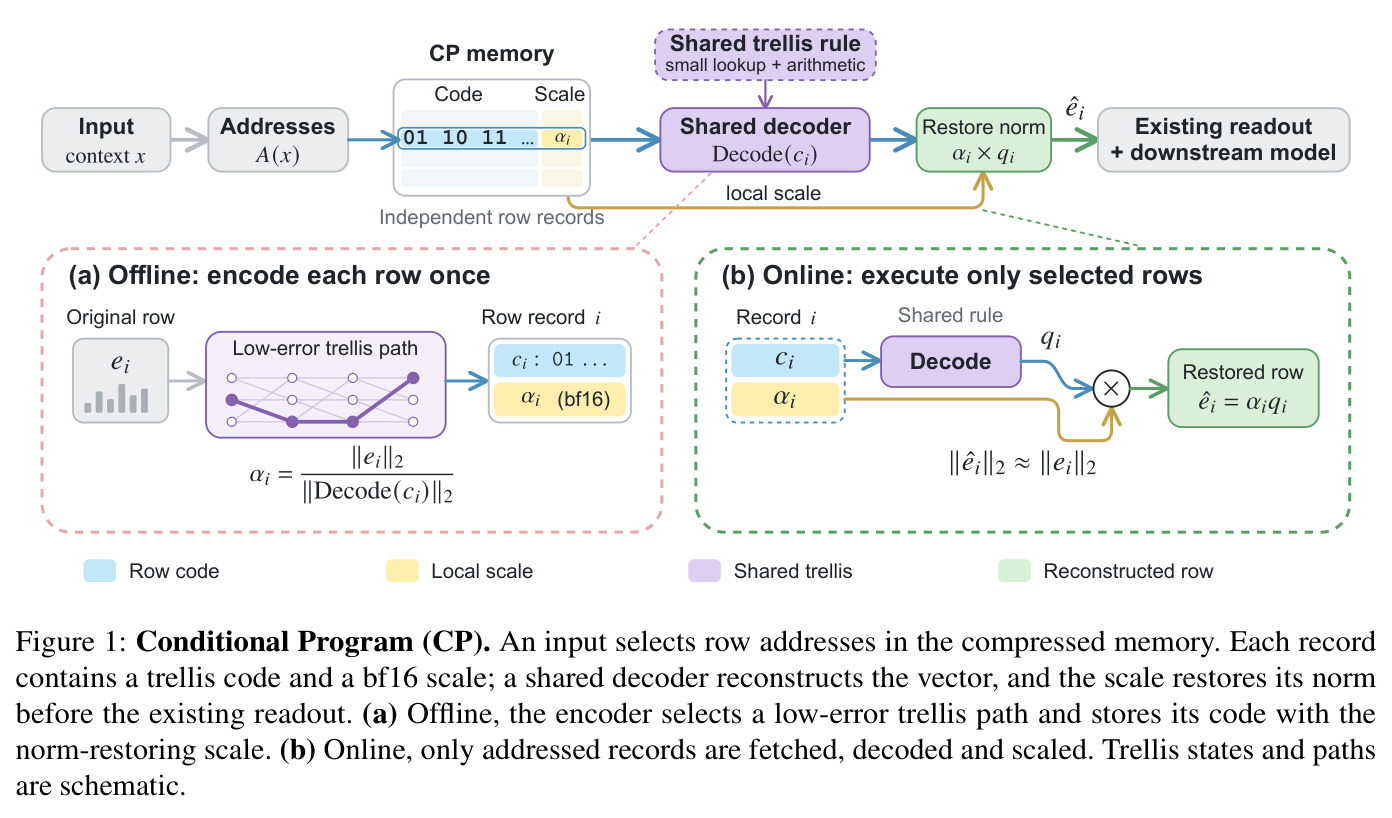
直觉上,这张几亿行的表里每行的归一化方向内容长得都像高斯噪声,真正携带模型特有信号的是方向细节和每行的范数。于是CP(Conditional Program)把每行拆成两份:一个很短的比特码 $c_i$(2比特/坐标)描述归一化内容,一个bf16局部尺度 $\alpha_i$ 记录幅度,用全表共享的解码函数 $f$ 重构 $\hat{e}_i=\alpha_i f(c_i)$。离线阶段对每行做一次Viterbi搜索,在共享trellis上找低错误路径,把路径的转移符号存为码字;在线阶段输入经原地址函数 $A(x)$ 找到所需行,只取回这些行的独立记录,fused kernel用一个小查找表加少量算术解码符号、乘尺度恢复范数,按原顺序交给原有readout。存储开销是 $b+16/d$ 比特/参数(2比特、$d=256$ 时为2.06 bpp,每行66字节),整表压缩4到8倍:DeepSeek从202.7 GB到50.7 GB,Qwen到13.4 GB,LongCat到8.1 GB。
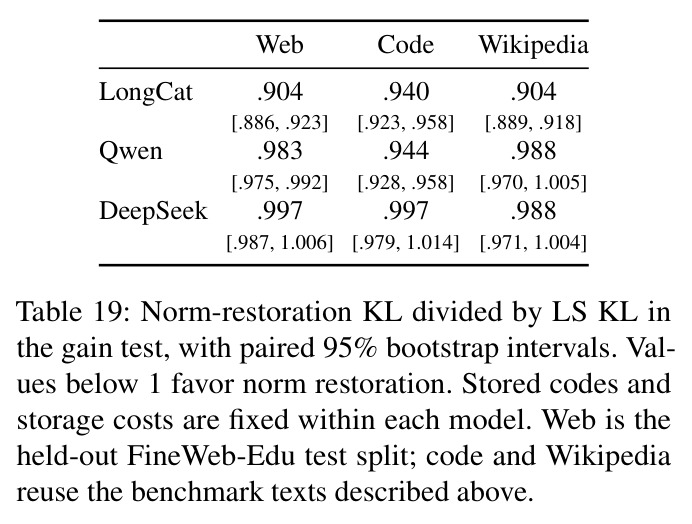
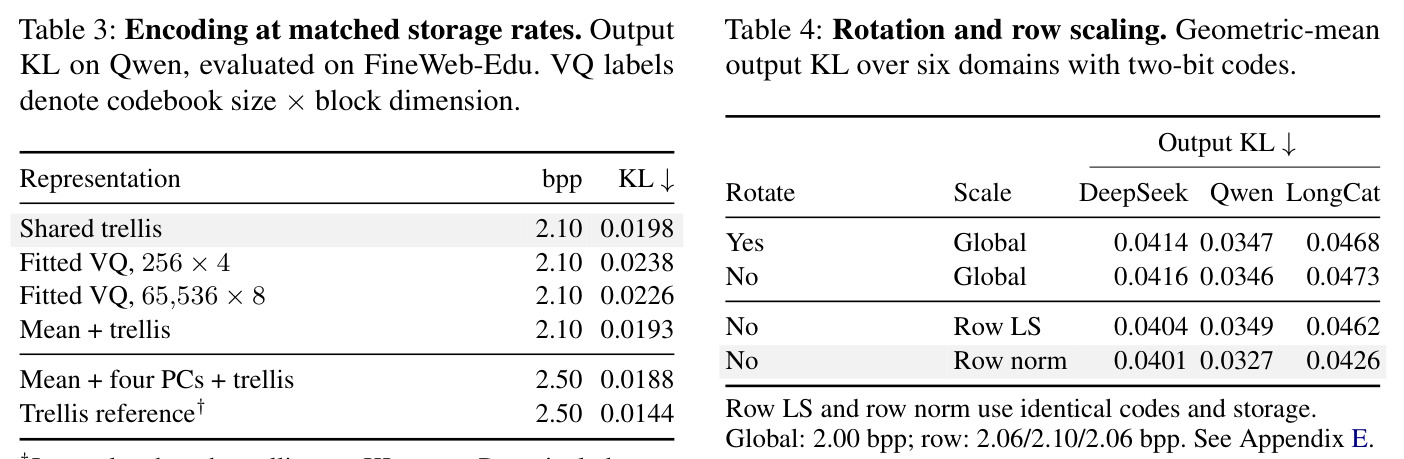
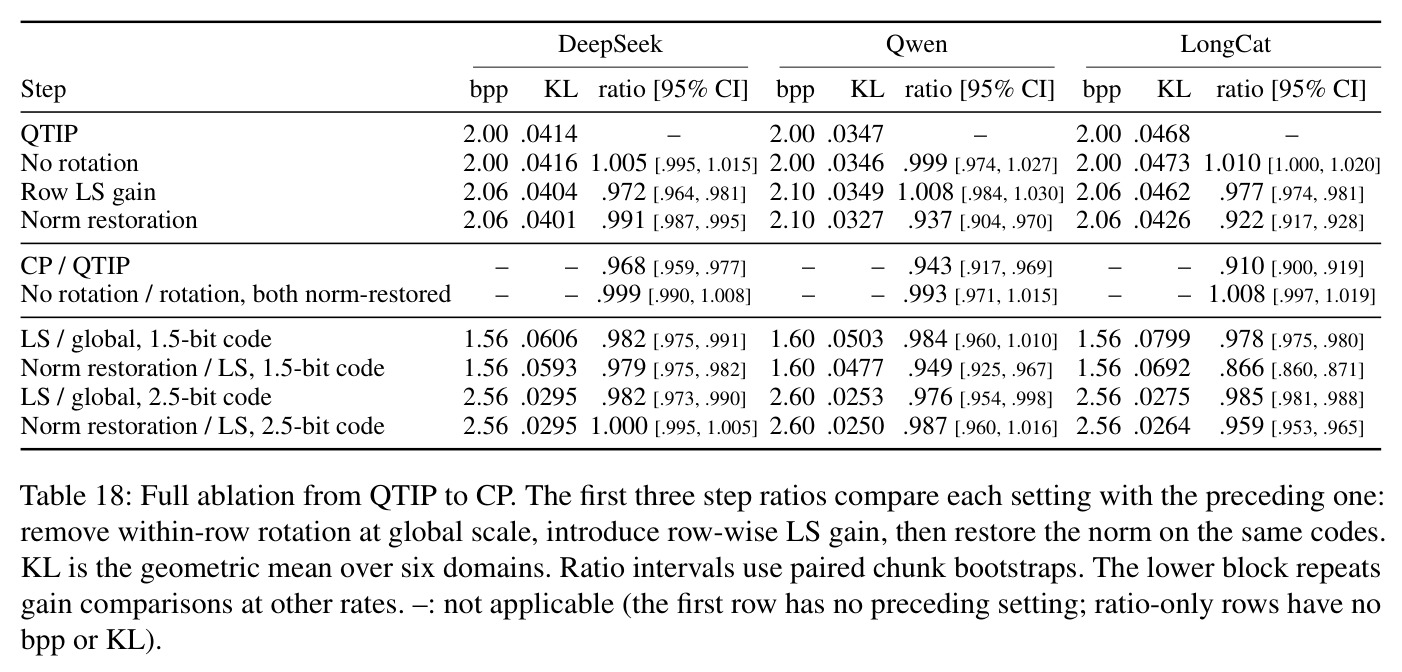
核心是两个分离。其一是内容与幅度的分离:解码出方向后,不用最小二乘尺度(它在方向不准时会整体缩短向量),而是取 $\alpha_i=\|e_i\|_2/\|f(c_i)\|_2$ 强行恢复原范数——哪怕这增大坐标MSE。附录F证明在下游局部二次度量 $D_H(g)=\frac12(gv-ru)^\top H(gv-ru)$ 下范数恢复优于LS的条件 $2v^\top Hu>(1+c)v^\top Hv$,实测Qwen的KL从0.0349降到0.0327。其二是共享规则与行级码字的分离:与其为每张表拟合codebook或低秩基,不如把归一化行建模为高斯信源,用一个全表共享的高斯HYB trellis(16-bit状态、每步2值、tail-biting、由512项2D高斯k-means码本构成)编码所有行。这与QTIP的本质区别在于:QTIP为稠密权重设计,tile布局+行内旋转+全局scale,单行被切碎在多个tile里;CP实测发现旋转无收益(KL比约1.0),于是去掉旋转、把全局scale换成逐行范数恢复、并把每行保持为固定大小的独立记录——把条件记忆的'选择性使用'本身编码进了压缩表示。
方法步骤详情
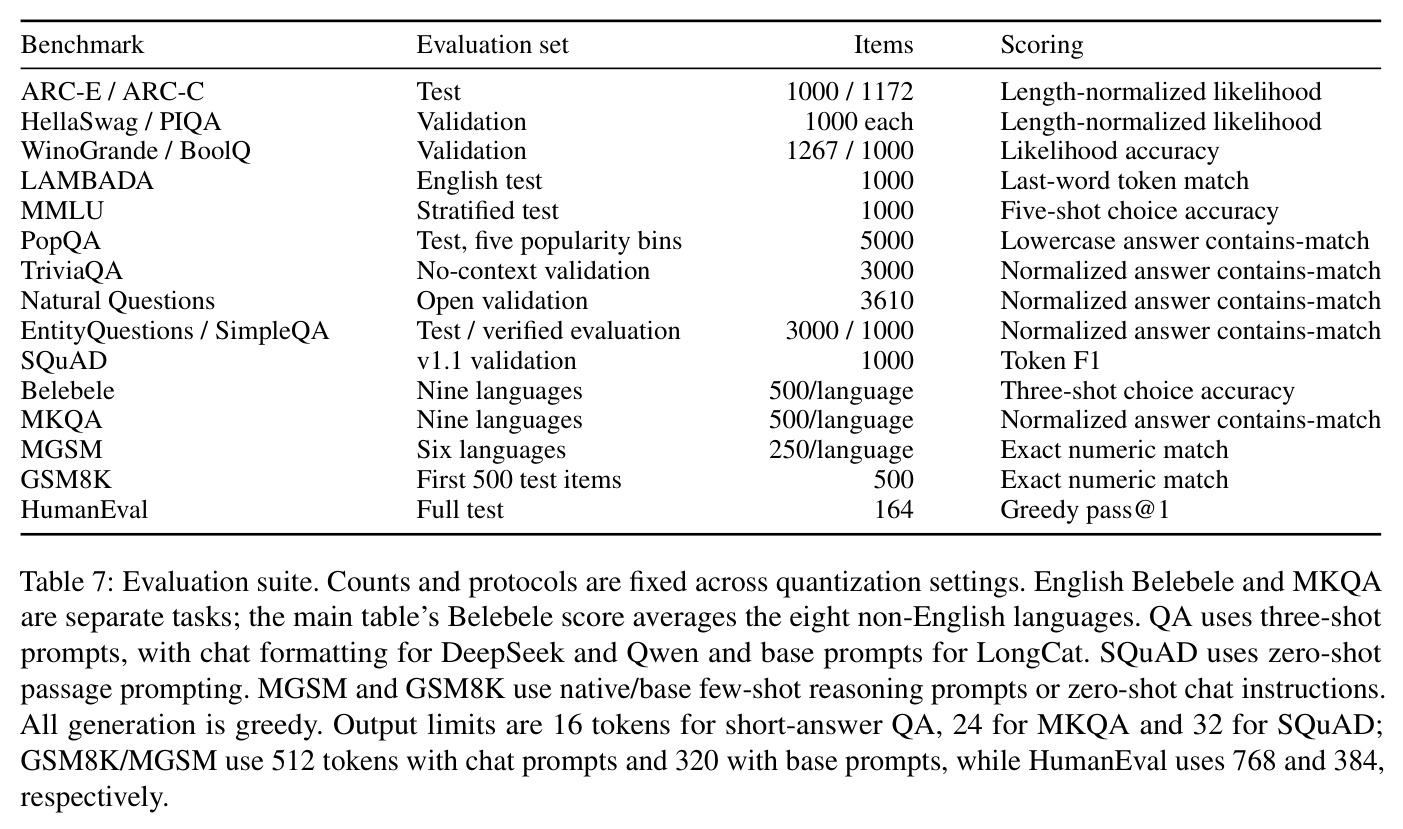
完整流程分五步。(1) 归一化:对每行计算 $z_i=\sqrt{d}\,e_i/\|e_i\|_2$,把内容与幅度分开,这是后续一切的前提。(2) 离线编码:在共享trellis上做tail-biting的两遍Viterbi搜索,为每行找最小化 $\|z_i-f(c)\|_2^2$ 的状态路径,其转移符号即码字 $c_i$;同时算好范数恢复尺度 $\alpha_i$。2比特码在 $d=256$ 时每行64字节码流+2字节bf16尺度=66字节(2.06 bpp),$d=160$ 时42字节(2.10 bpp);DeepSeek全表编码约3.1小时(4张H200,约12 GPU时),Qwen 0.83小时,LongCat 12张表合计5.18小时。(3) 存储:每行一个定长独立记录,SSD上对齐到不跨4 KB页,保证一行恰好一次读取。(4) 在线执行:n-gram哈希地址函数完全不变,对每个被请求行取回记录,fused kernel解码符号、乘 $\alpha_i$ 恢复范数,按原lookup顺序送入readout $h'=h+R(h,e(x))$,不解码任何无关行;骨干、地址、后续计算均不改。(5) 评估:只压查找表,其余组件不动,用40个任务的下游分数加六域输出KL双重验证。
技术新颖性
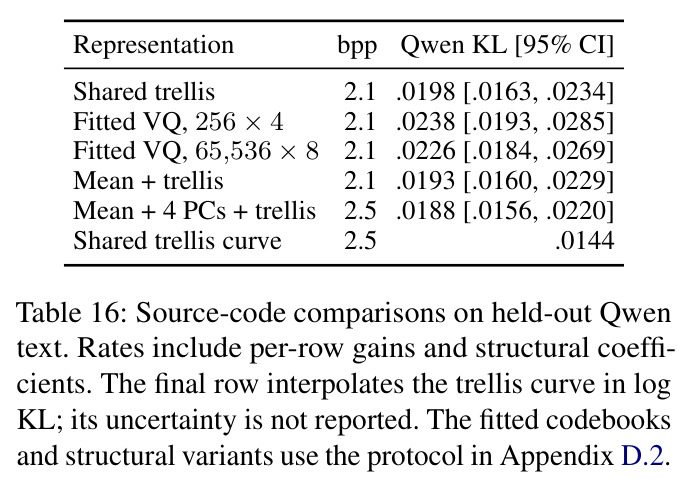
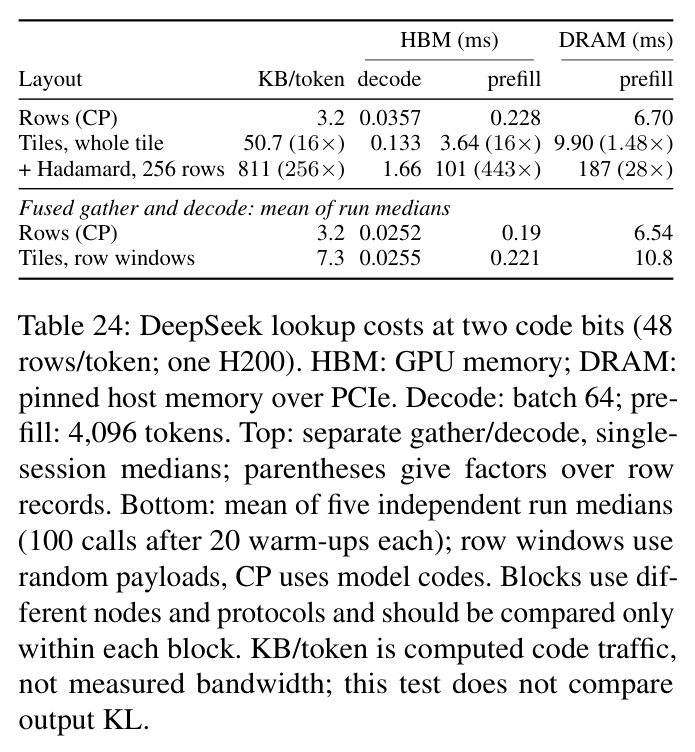
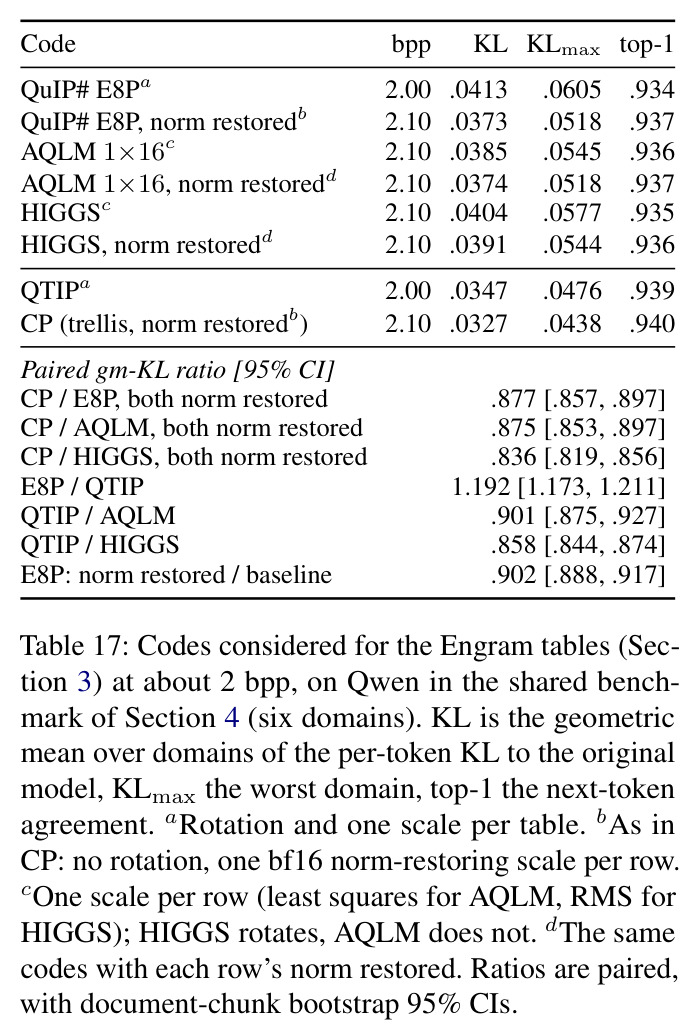
新颖性有三层。第一是问题定义:首次把'条件记忆压缩'形式化为带独立行访问约束的率失真问题,以输出KL而非MSE为保真指标,并实证二者导向不同设计——范数恢复增大MSE却降低KL(LongCat上范数恢复/LS的KL比低至0.866),这为压缩文献提供了一个'失真度量的选择决定最优编码'的干净案例。第二是表示设计:用中心极限论证把学习到的嵌入坐标近似为高斯信源,从而复用通信领域的TCQ而非拟合码本——匹配码率下共享trellis的行MSE为0.0724–0.0728,优于256×4 VQ的0.098–0.099和65536×8 VQ的0.091,Qwen KL为0.0198对0.0238/0.0226;进一步与QuIP#的E8P格点、AQLM、HIGGS在都加范数恢复后配对比较,trellis仍全胜(比值0.877/0.875/0.836),说明优势来自码本身而非尺度技巧。第三是系统布局:行级定长记录使fused kernel可在HBM/DRAM/SSD上只取所需行,查找延迟全面优于QTIP tile-window(HBM 0.190对0.221 ms,主机DRAM 6.54对10.78 ms),且不依赖任何频率统计或训练介入。
实验结果
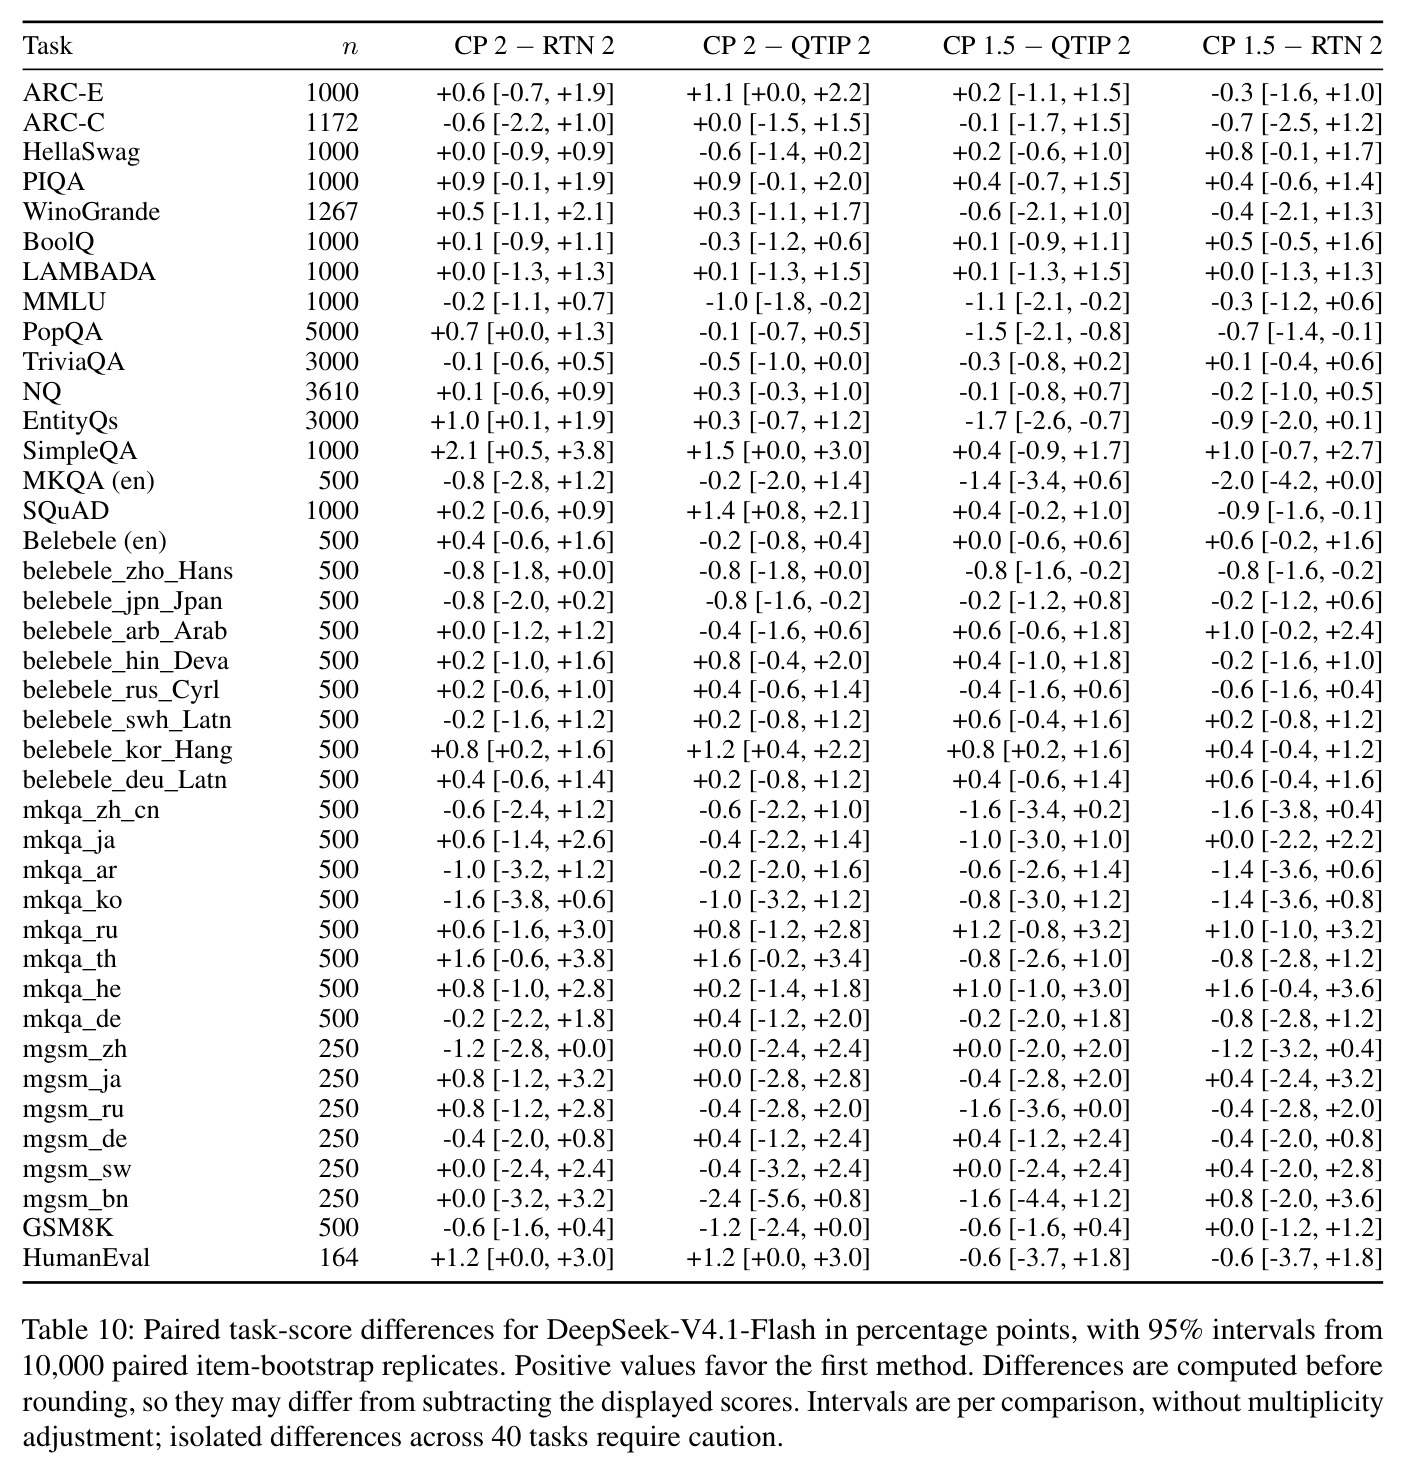
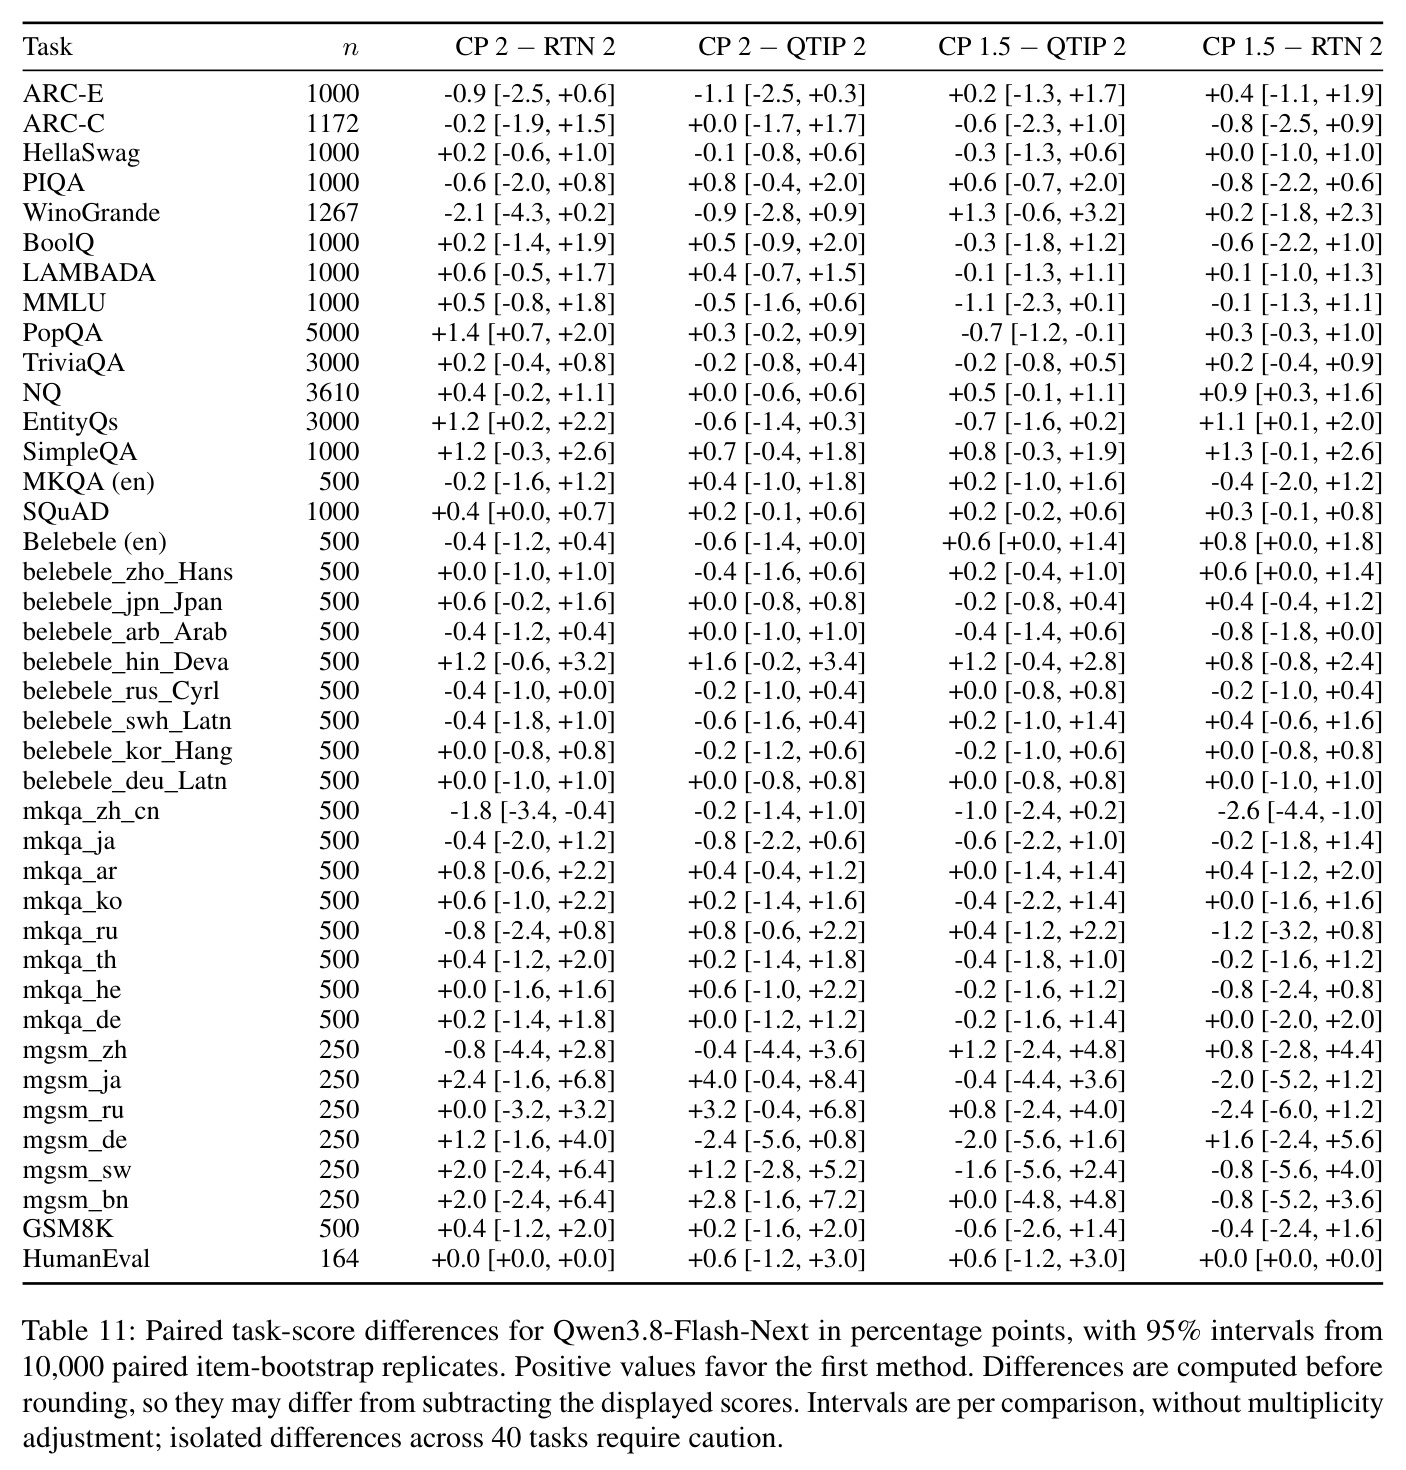
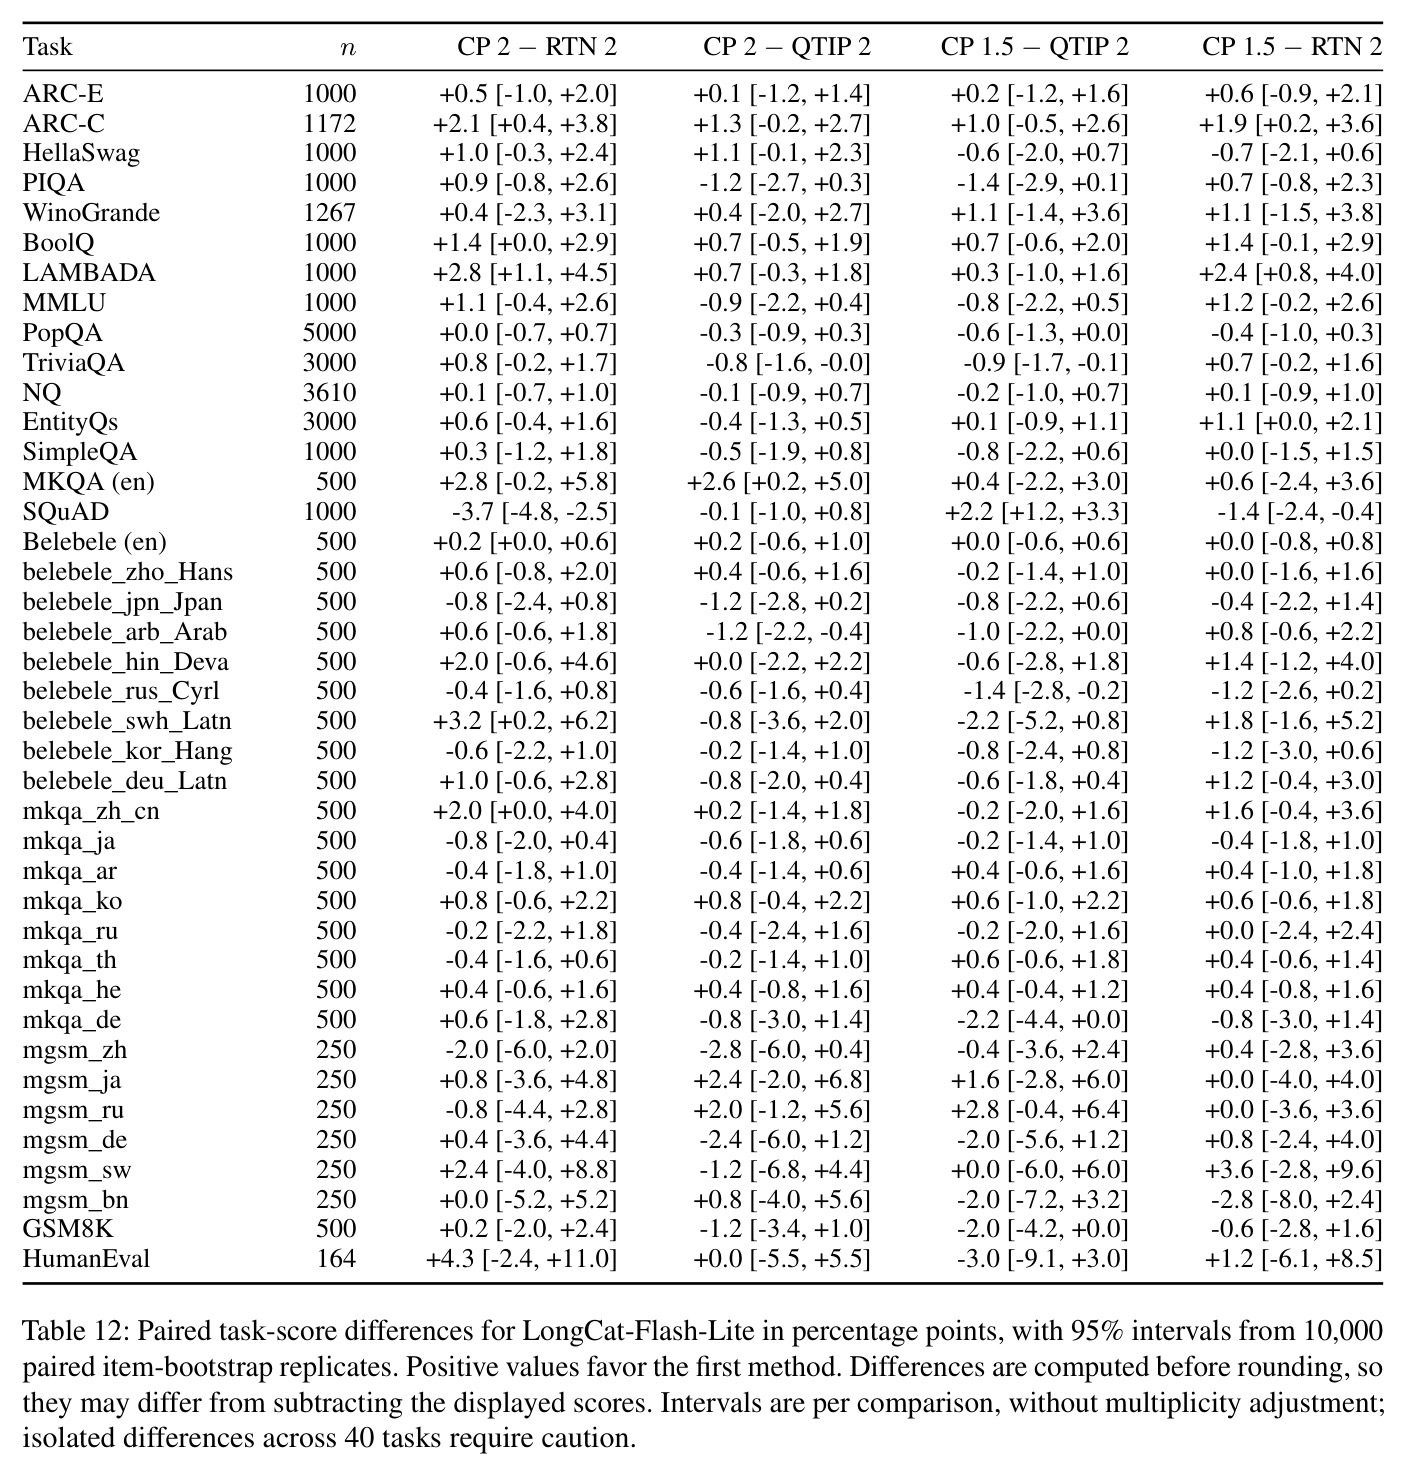
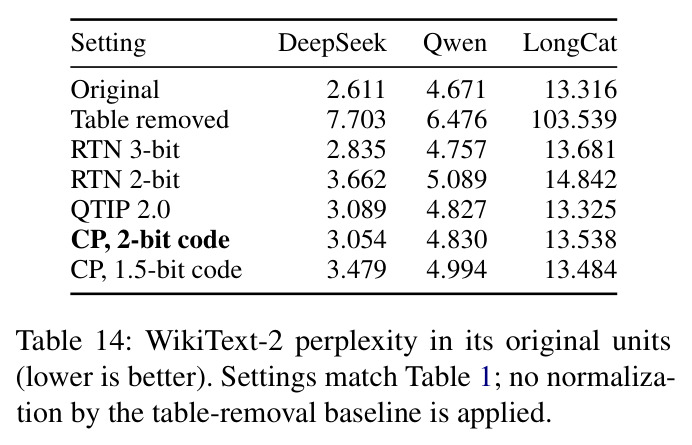
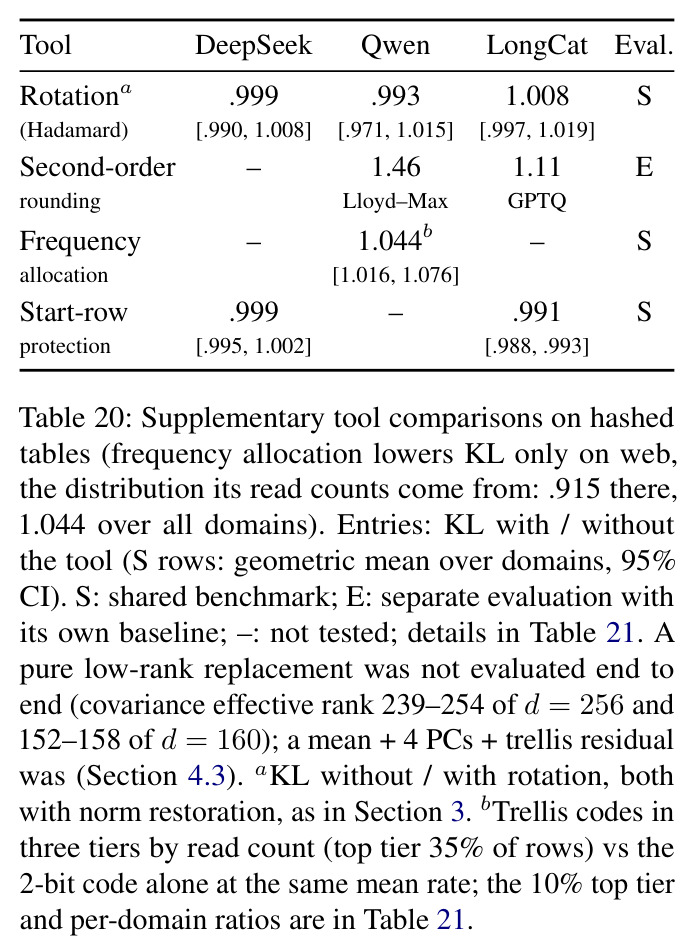
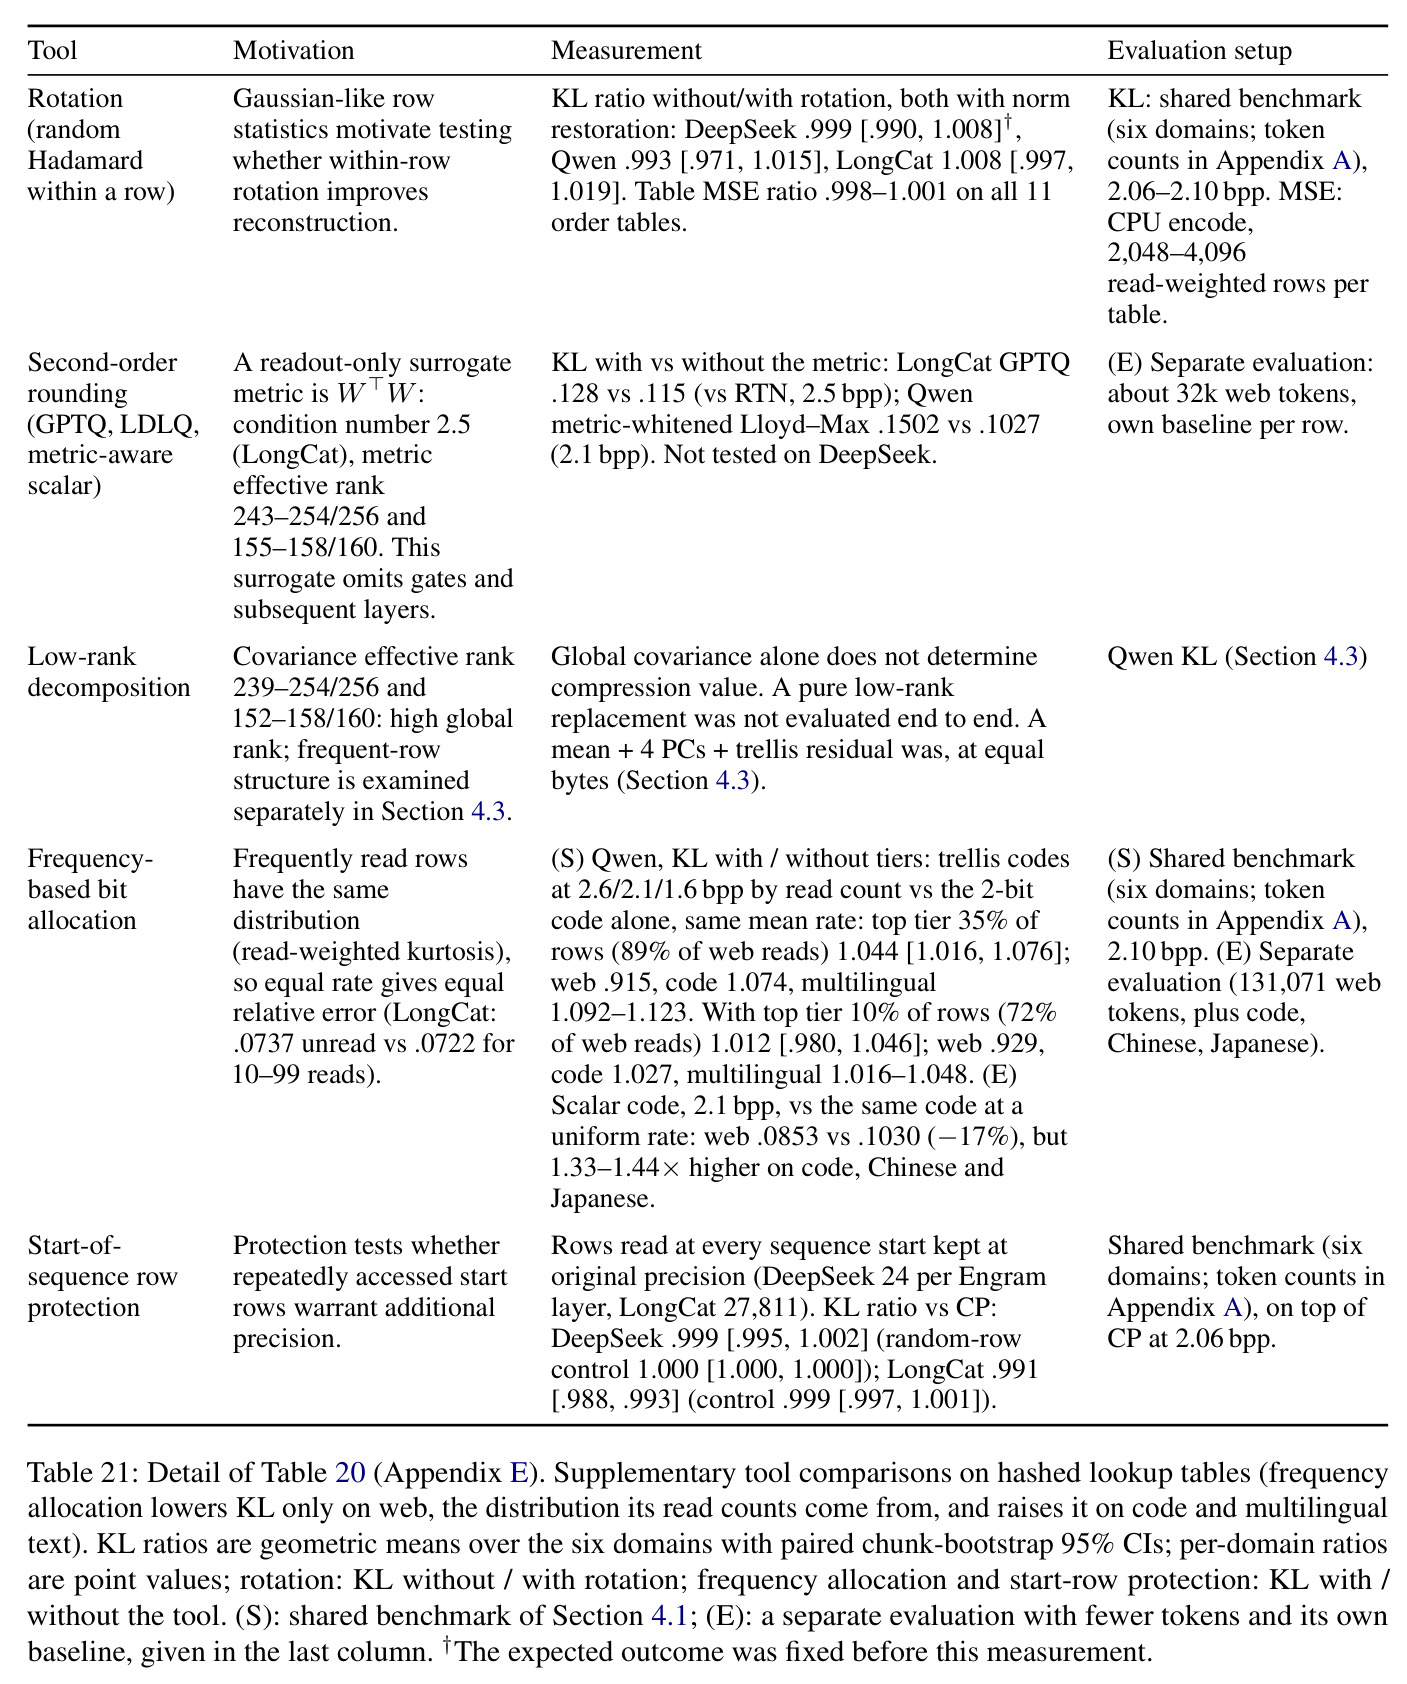
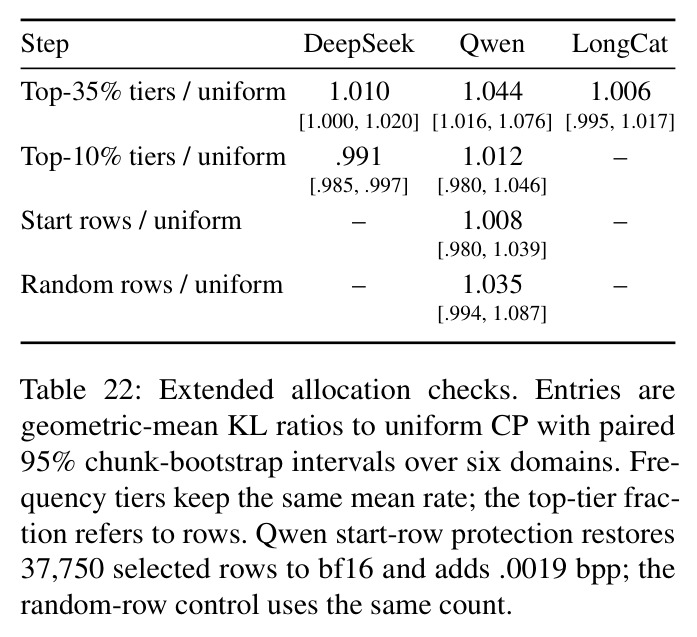
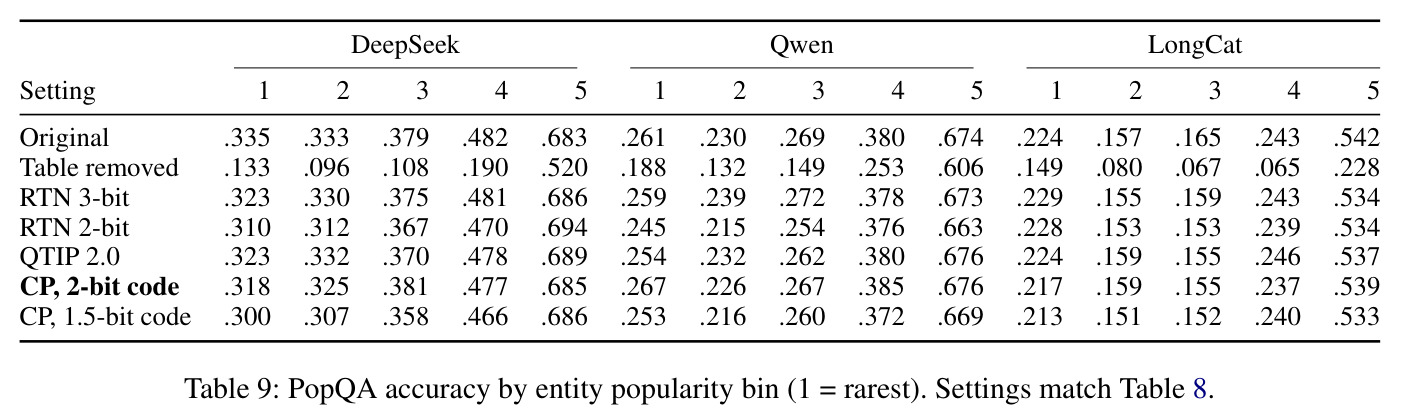
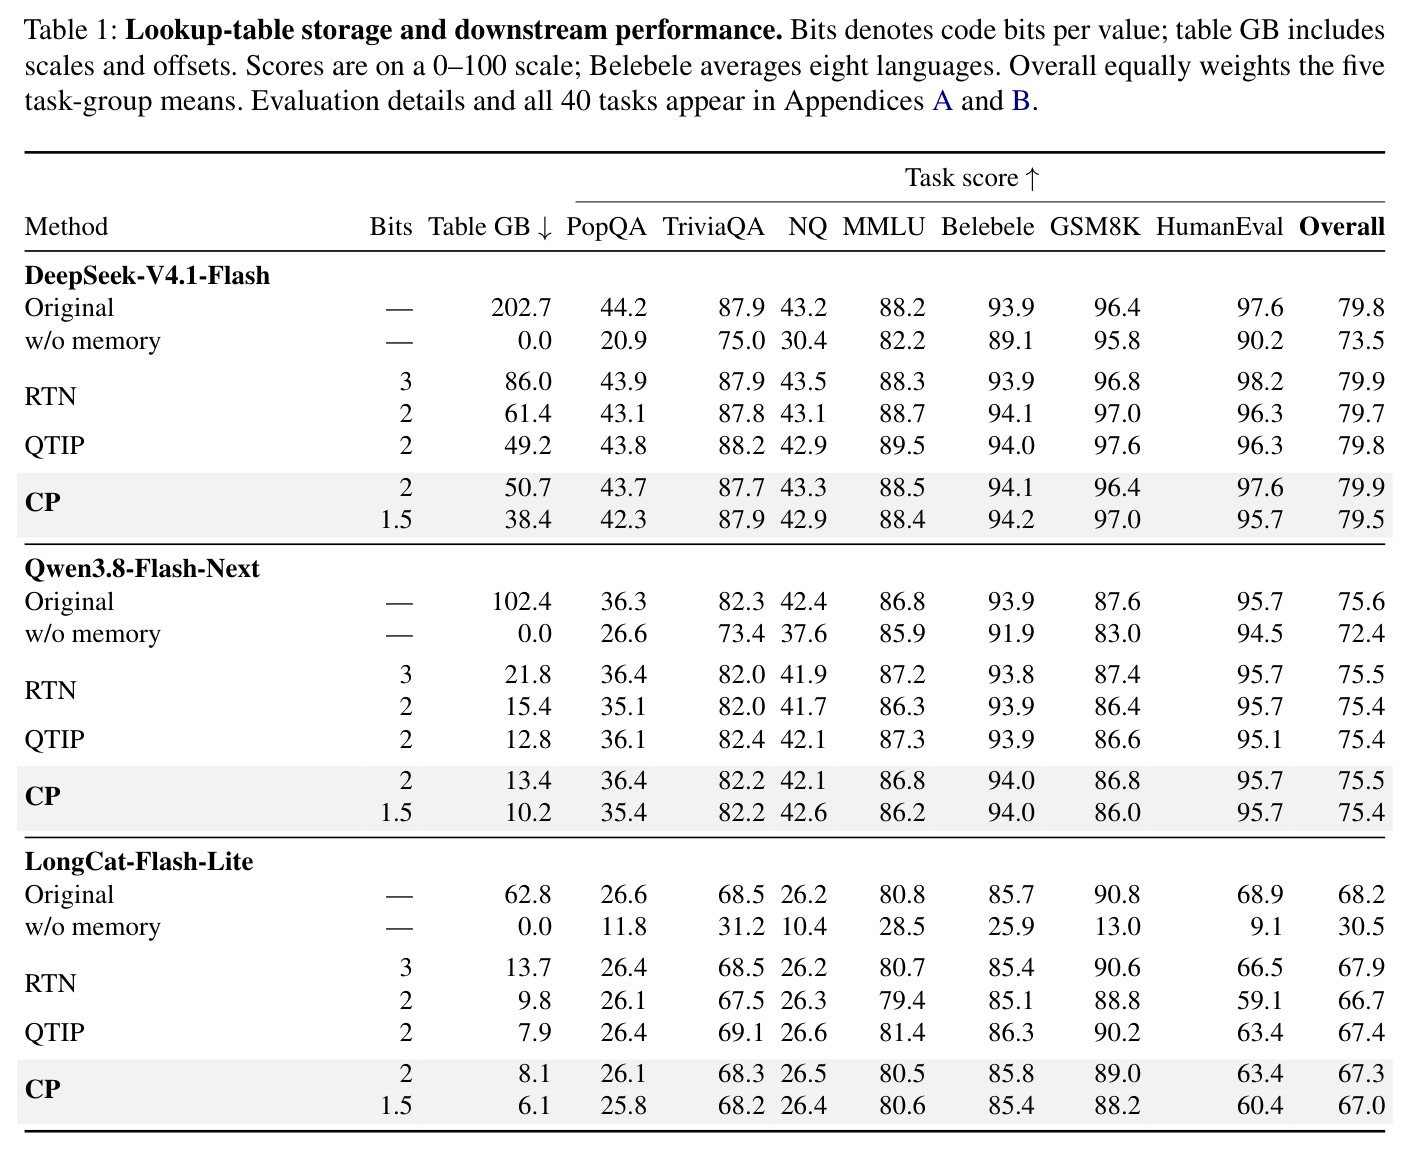
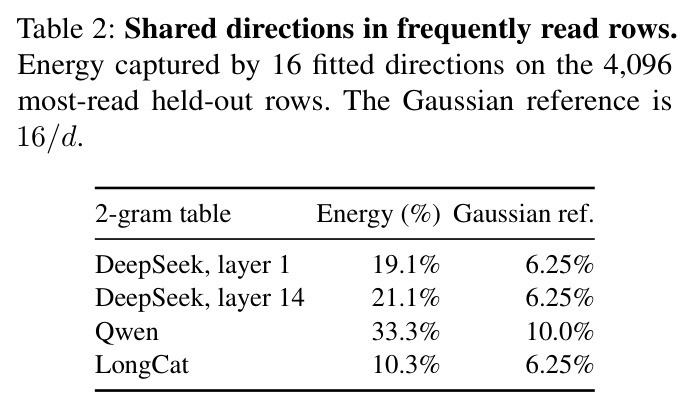
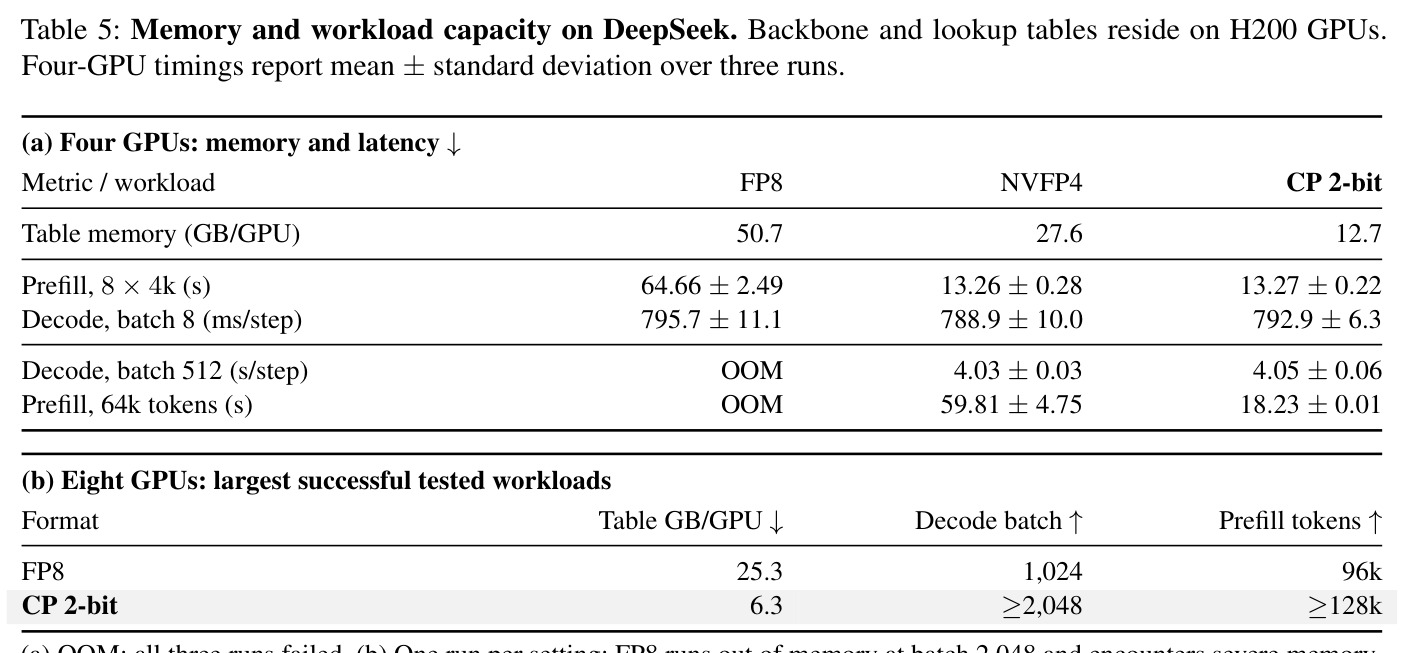
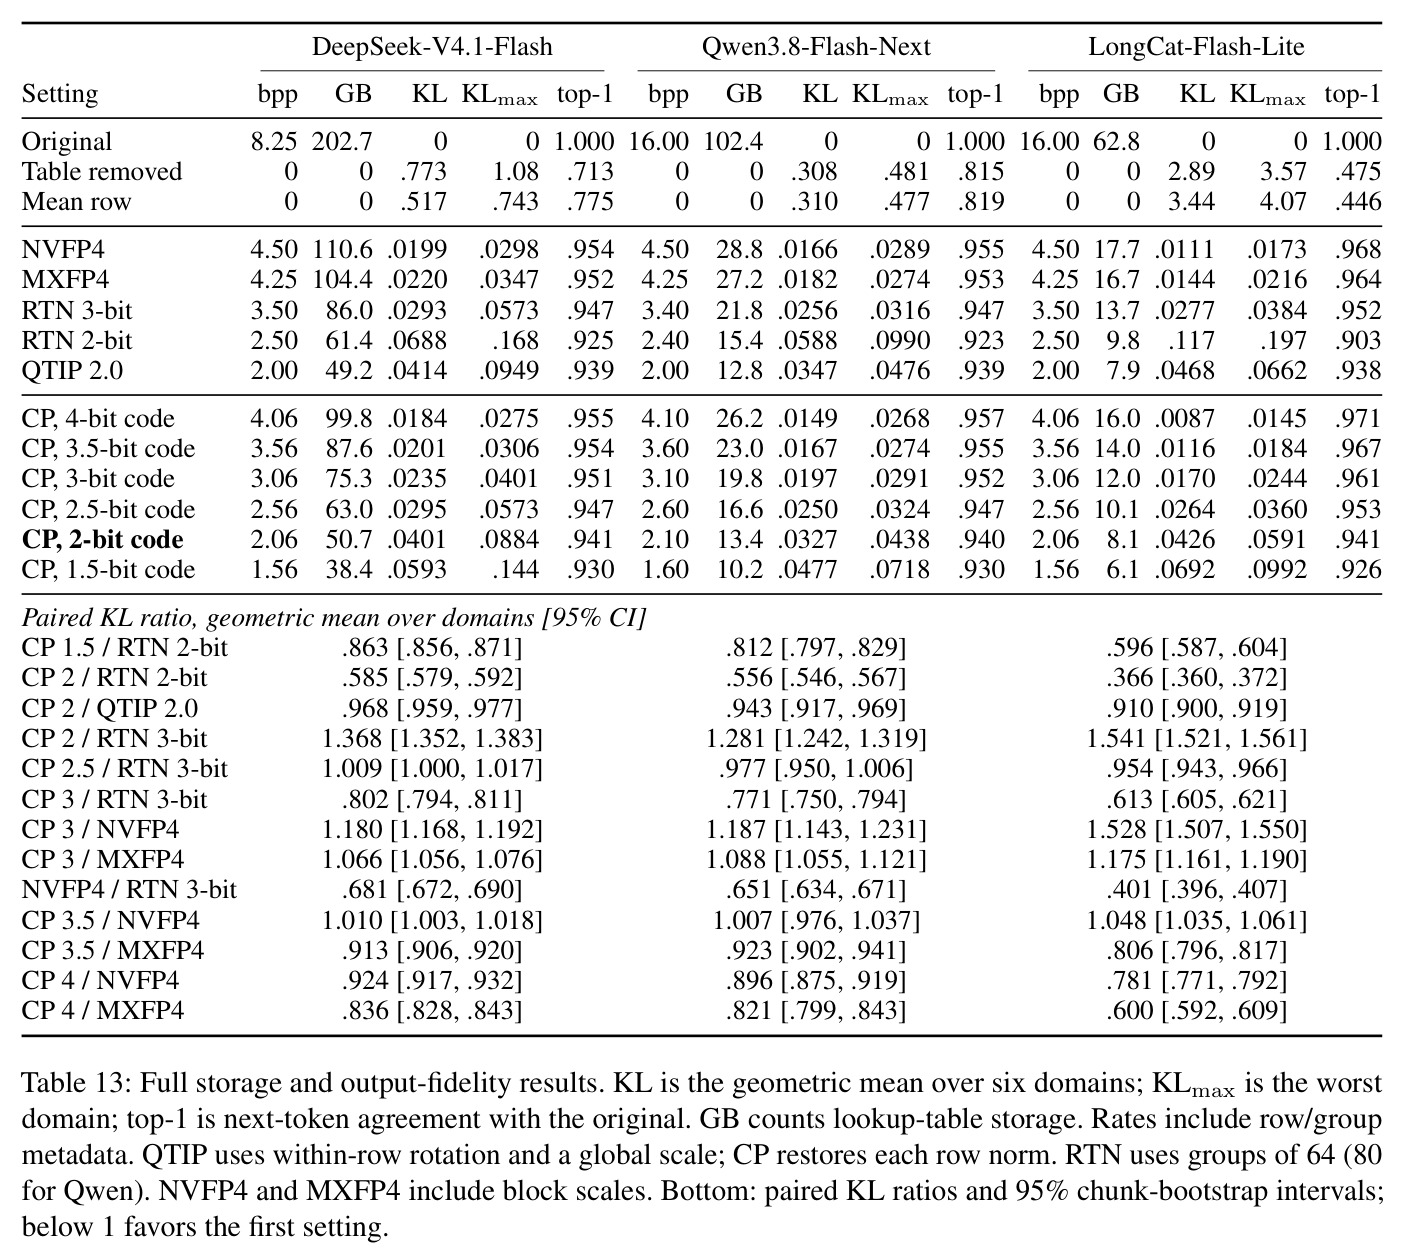
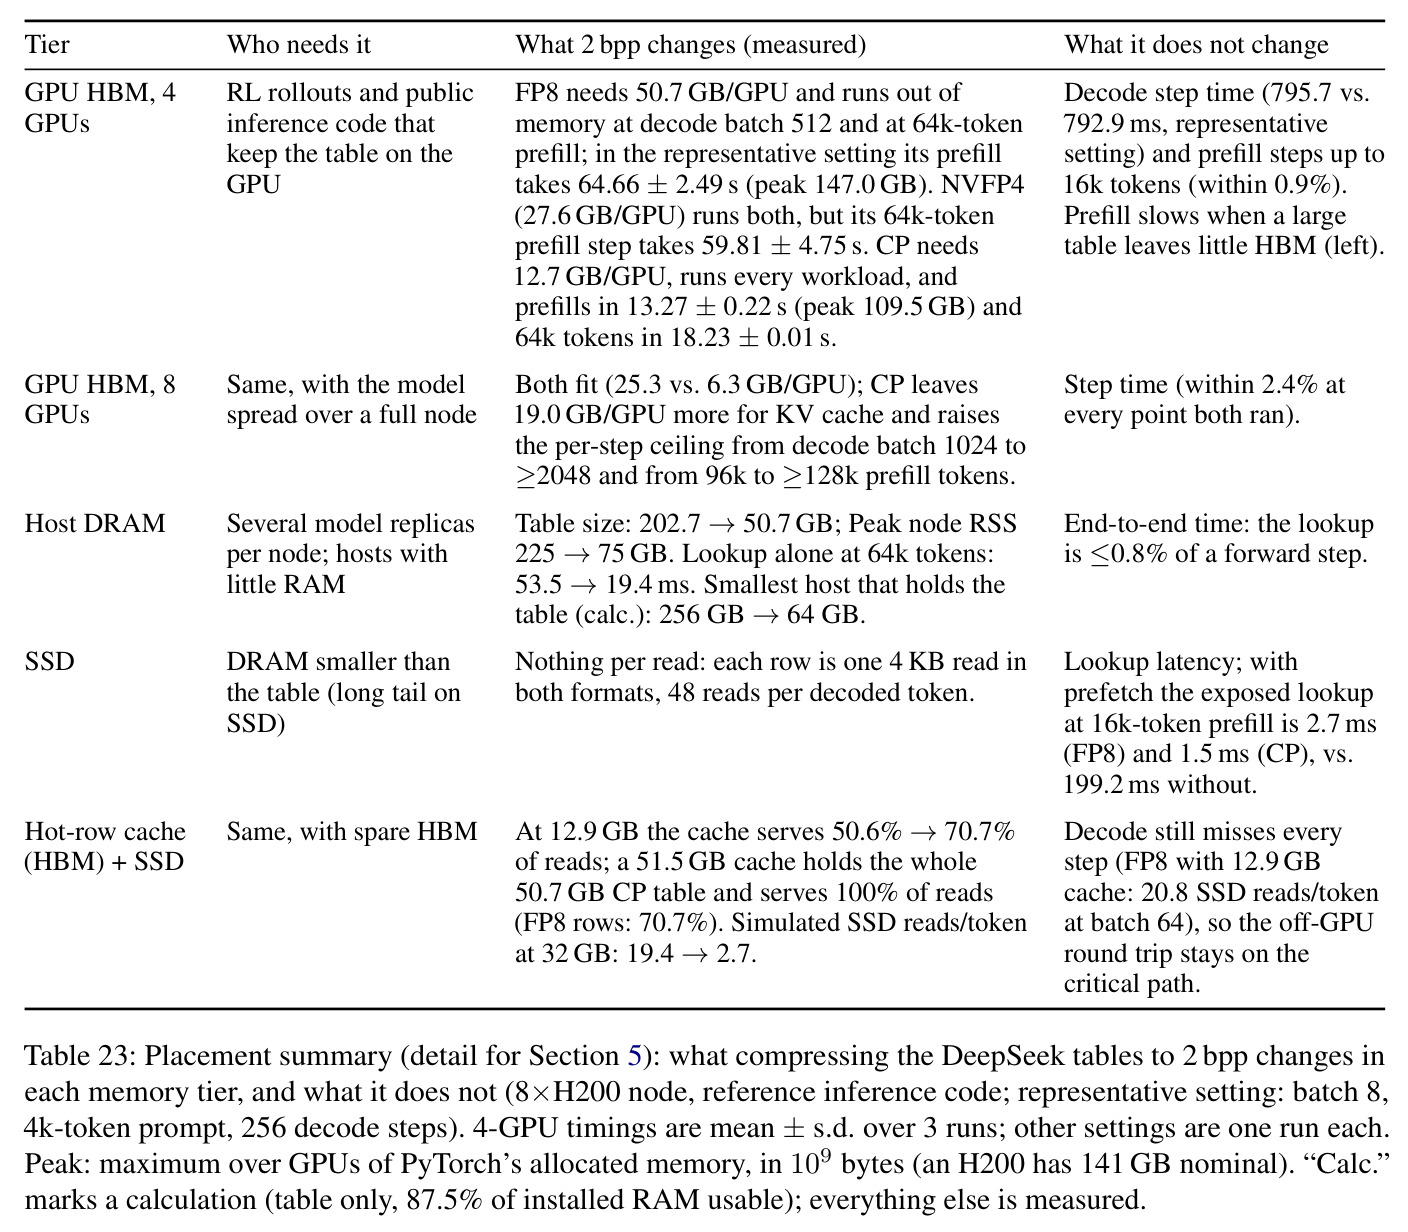
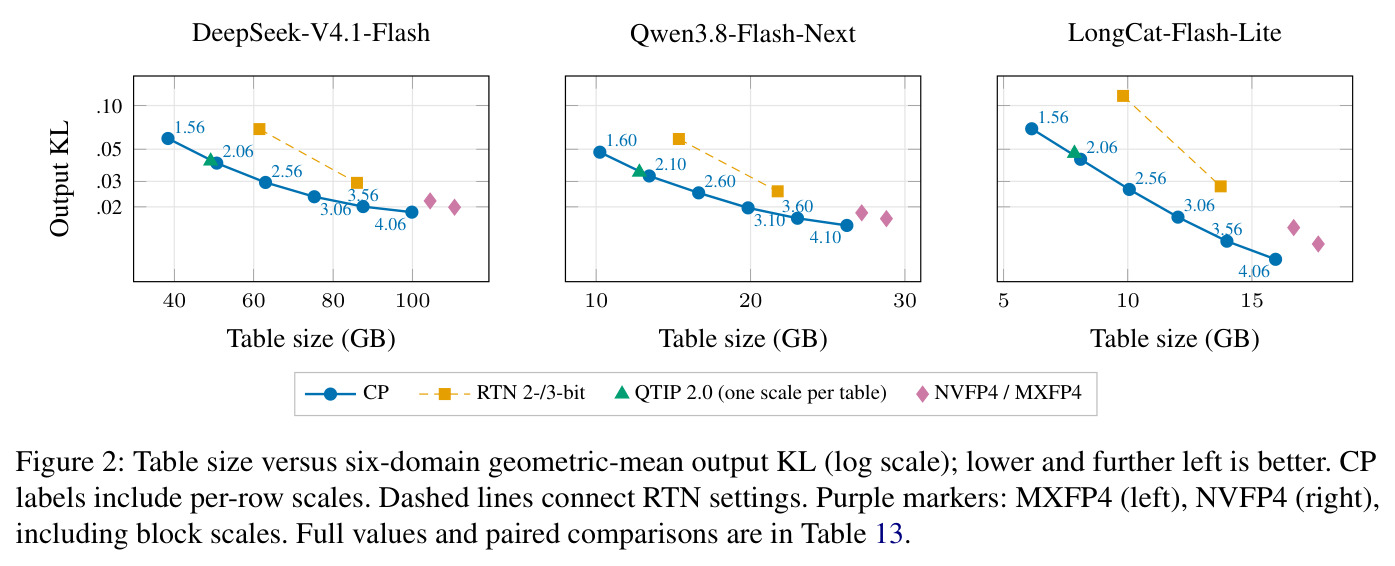
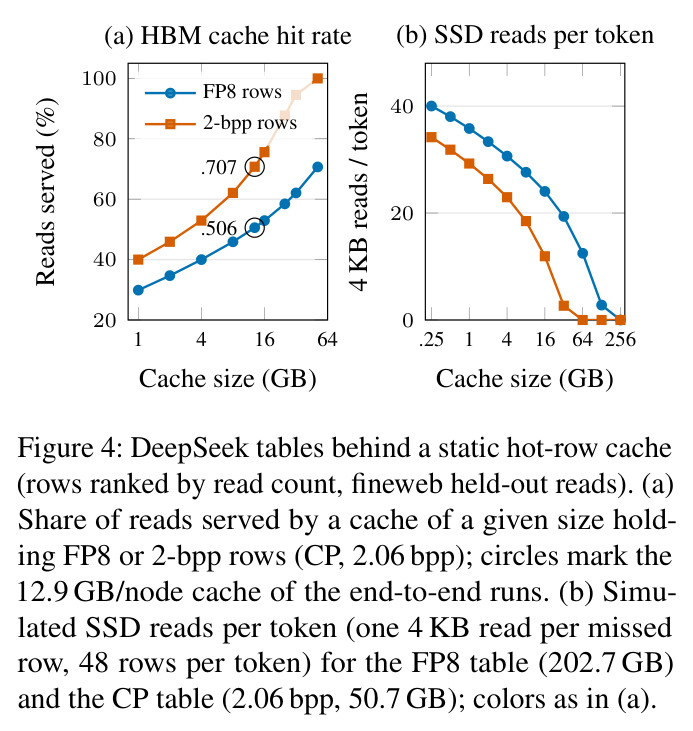
主结果(Table 1):2比特CP把DeepSeek表从202.7 GB压到50.7 GB(约4倍),40任务Overall从79.8到79.9;Qwen从102.4到13.4 GB(约8倍),75.6到75.5;LongCat从62.8到8.1 GB(约8倍),68.2到67.3(QTIP 67.4,RTN 2比特66.7),而删表会崩到30.5。继续压到1.5比特(38.4/10.2/6.1 GB),Overall仍有79.5/75.4/67.0。保真度(Figure 2与Table 13):2比特CP的六域几何平均KL相对RTN 2比特降41–63%(配对比值0.585/0.556/0.366),比QTIP再低3–9%(0.968/0.943/0.910);2.5比特CP追平RTN 3比特(1.009/0.977/0.954),3比特CP显著优于RTN 3比特(0.802/0.771/0.613),4比特CP优于NVFP4与MXFP4(对NVFP4为0.924/0.896/0.781)。设计消融:范数恢复一致优于LS尺度;旋转无统计显著收益;频率分级比特分配只在web域有益(0.915),在code与多语言域反而变差(1.074–1.123)。分析发现高频行确有共享结构——16个拟合方向覆盖DeepSeek第1/14层最高频行能量19.1%/21.1%、Qwen 33.3%、LongCat 10.3%(高斯参照仅6.25%/10%)——但共享trellis在匹配码率下仍胜过拟合VQ。服务(Table 5):4卡H200上FP8每卡占50.7 GB,8×4k prefill需64.66 s,CP降到12.7 GB与13.27 s;64k prefill下FP8 OOM、NVFP4需59.81 s、CP仅18.23 s;8卡下CP每卡6.3 GB,decode batch从1024提升到至少2048、prefill从96k到至少128k token。热行缓存模拟:12.9 GB缓存命中率从FP8的50.6%升至70.7%。PopQA按实体热度池化40任务:CP准确率仅-0.07点,RTN 2比特-0.34,删表-12.0。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash 全部40任务 | Overall得分(0-100)与表存储 | CP 2比特:79.9分,50.7 GB;CP 1.5比特:79.5分,38.4 GB | 原始FP8:79.8分,202.7 GB;RTN 2比特:79.7分,61.4 GB;QTIP 2.0:79.8分,49.2 GB;删表:73.5分 | 总分持平的同时存储降为约1/4;比RTN 2比特少17%存储且输出KL降41% |
| Qwen3.8-Flash-Next 全部40任务 | Overall得分(0-100)与表存储 | CP 2比特:75.5分,13.4 GB;CP 1.5比特:75.4分,10.2 GB | 原始BF16:75.6分,102.4 GB;RTN 2比特:75.4分,15.4 GB;QTIP 2.0:75.4分,12.8 GB | 存储降为约1/8,总分仅降0.1,与QTIP存储相近时分数持平或更优 |
| LongCat-Flash-Lite 全部40任务 | Overall得分(0-100)与表存储 | CP 2比特:67.3分,8.1 GB;CP 1.5比特:67.0分,6.1 GB | 原始BF16:68.2分,62.8 GB;RTN 2比特:66.7分;QTIP 2.0:67.4分,7.9 GB;删表:30.5分 | 在删表崩溃(68.2→30.5)的模型上保住67.3分,与QTIP相当且存储多省0.2 GB |
| 输出分布保真(六域几何平均KL,越低越好) | KL散度 | CP 2比特:DeepSeek 0.0401 / Qwen 0.0327 / LongCat 0.0426 | QTIP 2.0:0.0414/0.0347/0.0468;RTN 2比特:0.0688/0.0588/0.117;NVFP4:0.0199/0.0166/0.0111(但4.5 bpp) | 相对RTN 2比特KL降41–63%,相对QTIP再降3–9%;2.5比特CP≈RTN 3比特 |
| 查找延迟(DeepSeek 4096-token prefill,每token 48行) | 毫秒 | CP行式布局:HBM 0.190 ms;主机DRAM(PCIe) 6.54 ms | QTIP tile-window解码器:HBM 0.221 ms;DRAM 10.78 ms | HBM快约14%,跨PCIe快约1.6倍,主机内存场景收益最大 |
| 4×H200 服务(8×4k prefill / 64k prefill) | 秒 | CP 2比特:13.27 s / 18.23 s,表占12.7 GB/GPU | FP8:64.66 s / OOM(batch 512解码亦OOM),表占50.7 GB/GPU;NVFP4:13.26 s / 59.81 s | 相比FP8 prefill快4.9倍且可跑全部负载;64k prefill比NVFP4快3.3倍 |
| 8×H200 服务容量上限 | 最大可跑decode batch与prefill token数 | CP 2比特:每卡表6.3 GB,decode batch≥2048,prefill≥128k token | FP8:每卡表25.3 GB,decode batch 1024,prefill 96k token(batch 2048时OOM) | 释放19.0 GB/GPU给KV cache,decode容量至少翻倍、prefill容量至少提升33% |
局限与改进
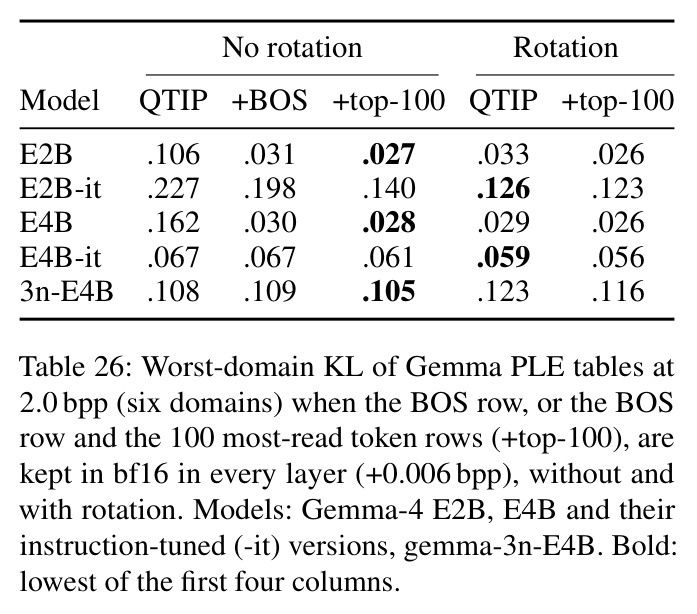
作者自己承认的局限:结论仅覆盖三个使用哈希查找表的模型且是后训练压缩,不能外推到token索引表——附录H的Gemma PLE实验显示BOS行与约100个高频token行呈重尾且敏感,需保留bf16(仅0.006 bpp即可把最差域KL从0.106/0.162降到0.027/0.028),而哈希表上同样的行保护几乎无效(KL比0.999/0.991);高码率下任务覆盖较少;拟合codebook与结构残差对比只在Qwen上做;部分等预算比较用log-linear插值且无不确定度;服务测量限于单节点eager推理(无graph capture),部分配置只跑一次,测试的工作负载上限不是精确容量阈值;读频统计来自英文web文本,换部署分布后频率分配与缓存结论可能改变。我的补充观察:(1) 绝大多数任务分数差异落在bootstrap区间内,作者无法声明等价,LongCat的HumanEval在2比特下掉5.5点(68.9→63.4),1.5比特下SimpleQA、EntityQs等知识任务也有超区间的下降;(2) 相对QTIP的KL改进只有3–9%,且要多付每行2字节尺度;(3) 内存充足时端到端延迟几乎不变(decode step差异在0.9%内),收益集中在显存/内存压力场景,论文对此很坦诚;(4) 高斯性是经验观察,附录F承认该论证'不解释训练如何产生这些统计',且在Gemma PLE上从表统计预测敏感度彻底失败(预测KL比0.21对实测0.877),说明缺乏对'哪些行重要'的事前理论。
独立分析的弱点
(1) 等价性从未被证明:绝大多数配对任务差异的95%区间包含0,且未做多任务多重校正;1.5比特下DeepSeek知识组比QTIP 2.0低0.80点[-1.23,-0.38]、PopQA低1.50点,说明低码率有真实代价,改进方向是引入等价检验(TOST)并按任务组报告可信区间。(2) 结论对读分布敏感:频率分级比特分配在web域有益(0.915)但在code与多语言变差(1.074–1.123),而读频统计完全来自英文web文本,实际部署分布不同则结论需重估;改进方向是在线估计读频、或按部署语料动态调整分层与缓存策略。(3) 缺乏敏感行机制:方法假设行近似同质高斯,但Gemma PLE实验表明少数重尾行可主导损失且无法从表统计预测(预测KL比0.21对实测0.877);改进方向是加入离群行检测+混合精度白名单——实验显示保留少量行为bf16只多花0.006 bpp却把最差域KL降约4倍。(4) 在线解码开销:每token要解码48行,HBM下decode优势不稳定(batch 64时5次运行有1次反序),改进方向是更深的kernel融合、CUDA graph或硬件解码单元。(5) 只压已训练表、不与训练协同,对比TN-gram在预训练时用张量分解替代哈希表,CP无法改变表的容量-存储前沿;改进方向是量化感知的记忆训练或码率-容量联合缩放。
未来方向
作者在limitation中隐含的方向:把CP扩展到token索引表与其他记忆架构(附录H只是边界测试);补全高码率下的任务覆盖;把拟合codebook与结构残差分析从Qwen扩展到三家模型并给出带不确定度的等预算比较;在多节点和带graph capture的优化引擎下重测服务收益;研究非英文部署分布下的读频、频率分配与缓存。基于其成果可自然延伸:(1) 与CXL/SSD分层系统(TF-Engram、SCONE)结合,用小表+热行缓存把单节点容量推到极限——Table 23显示2 bpp已把缓存命中率从50.6%提到70.7%,配合预取可进一步隐藏SSD延迟;(2) 利用'高频行共享16个方向、能量占10–33%'的观察设计混合码:频繁行用学习基+trellis残差,其余行用共享trellis,但需先解决作者发现的能量交叉点(合成实验中spike能量约0.45–0.5时结构码才占优);(3) 训练时协同设计:让表在训练中就落在可压缩结构附近,或与TN-gram式低秩参数化做容量-存储曲线对比;(4) 把'输出KL而非MSE作为失真度量'的视角推广到其他稀疏模块(MoE专家权重、KV缓存、检索索引)的压缩。
复现评估
论文正文与附录均未提及开源代码发布,但方法规格给出得异常完整:trellis为16-bit状态、每步2值、tail-biting、两遍Viterbi,HYB表由512项2D标准高斯的k-means码本构造,各码率的code scale因子(2–3比特0.95、1.5比特1.0/1.05等)、记录字节数(66/42 B)与4 KB页对齐方式都写明。离线编码成本很低:DeepSeek 2比特约12 GPU时(4×H200跑3.1小时),Qwen 0.83小时,LongCat 12张表合计5.18小时,软件为PyTorch 2.14与Transformers 5.17。评测协议可复现性高:40任务的物品、seed 1234、打分方式全部冻结并列在附录A/B,统计用95%百分位bootstrap(任务2,000次、KL配对2,000次、任务差10,000次重采样)。主要障碍有三:三个评测模型(DeepSeek-V4.1-Flash、Qwen3.8-Flash-Next、LongCat-Flash-Lite)的权重可得性;fused lookup kernel需自行实现(附录G给了Triton实现要点与bit-exact校验协议);服务实验需要8×H200节点、2 TB DRAM与NVMe RAID。总体判断:离线压缩与KL评测部分中等难度(单卡即可),服务与kernel部分中高难度。
论文图表