1.7B规模语言模型中固定极简Token编码对可训练输入嵌入表的替代研究 Do Language Models Need a Trainable Input Embedding Table? Fixed Minimal Token Codes at 1.7B-Class Scale
固定16位二进制码替代可训练嵌入表,1.7B模型仍获实质语言能力但整体略逊
前置知识
输入嵌入表
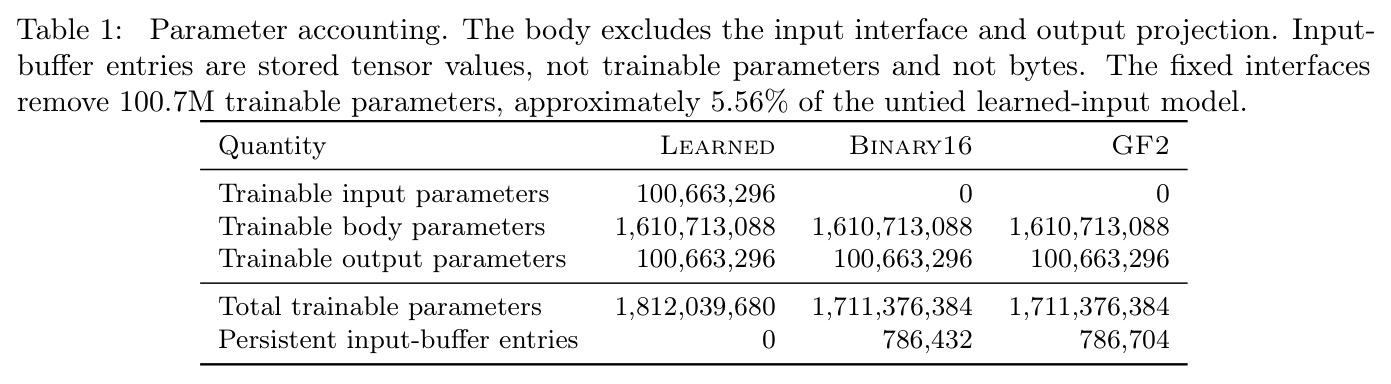
语言模型中每个词表条目对应一行独立可训练向量的查找表,形状为 $V \times d$(本文 $V=49152$、$d=2048$,约 1.007 亿参数)。模型收到 token ID 后查表得到输入向量,该表与主干网络一起用梯度优化。它是 Transformer 的第一层参数,也是词法信息的初始载体。
本文的全部问题就是检验这张表是否必需,理解其结构、参数量与训练方式才能读懂实验设计与参数核算。
解耦输出头
输出投影 $W_{out} \in \mathbb{R}^{V \times d}$ 不与输入嵌入共享权重,而是独立的可训练矩阵。权重复用是另一种常见选择,但本文三个模型都保持解耦,保证对比中唯一变化的是输入接口。
参数核算与结论范围都依赖这一点:删除输入表并未消除模型中词表级的可训练参数,输出头仍保留 1.007 亿参数。
GF(2) 上的可逆线性变换
在二元域 GF(2) 上定义的 16×16 可逆矩阵 $A$,对 token 的 16 位二进制码做 $\tilde{c}(t) = A\,c(t) \bmod 2$。可逆性保证单射即身份不丢失,但不保持汉明距离、输入范数和优化行为,会彻底改变码字几何;本文的 $A$ 由种子 12345 生成,要求每行每列最小汉明重量为 4。
GF2 模型检验固定码的可行性是否依赖特定码字分配,是论文稳健性论证与非规范码实验的关键。
lm-eval-harness 基准套件
EleutherAI 的标准评测框架,本文用 HellaSwag、ARC-Easy/Challenge、PIQA、WinoGrande、OpenBookQA、CommonsenseQA、MMLU、LAMBADA、WikiText 九个任务。多选题零样本评测,MMLU 另报五样本;区分任务定义准确率与长度归一化准确率,LAMBADA 困惑度只对目标续写计分。
论文所有能力结论都由这套基准量化,需要知道各指标含义与随机猜测水平(如 CommonsenseQA 约 20%、MMLU 约 25%)才能判断结果强弱。
研究动机
现代 Transformer 语言模型的标配是为每个 token 分配一行独立可训练的输入向量,对 $V=49152$、$d=2048$ 的配置这张表就有约 1.007 亿参数。此设计非常有效,但其成功从未回答一个更根本的问题:实质的语言建模能力是否真的需要“每个符号一个独立可调向量”这种参数化?此前已有组合码学习、ALONE、子词重构、哈希嵌入等共享词法参数化先例,说明词表边界的参数分配本身就是一种架构选择,但没有任何工作在最极端的受限点——固定极简二进制身份码、且不加任何可训练输入投影——用现代骨干网络和 100B token 预算做严格的对照检验。作者进一步指出,传统学习输入设置中,输入坐标与作用于其上的计算在训练中同时变化,导致“token 身份的表示”与“身份的使用”无法分开研究。
本文的目标是本文的目标是把三个经常被混为一谈的问题强制拆开:(1) 身份——输入接口能否区分不同 token(纯编码问题);(2) 可学习性——共享 Transformer 能否从固定身份接口学出有用的语言计算;(3) 实用性——独立调整每个 token 的输入向量能否带来可衡量的收益。作者在与学习输入基线骨干逐项匹配的条件下从头训练三个 1.7B 级模型,用标准基准测量移除全部 token 级可训练输入向量(1.007 亿参数、占解耦基线的 5.56%)后模型保留了多少能力、付出了多少质量代价,并明确把结果定位为“可行性”论证而非“性能持平”论证。
与已有工作不同的是,本文的独特切入角度有三点。其一,这是一次骨干匹配的组件干预:三个模型除输入参数化外,架构、数据、采样与优化配方完全相同,差异可干净归因于接口本身及其携带的容量。其二,工作点刻意选得极端——16 位小端二进制码是保持单射的最短定长编码,通过一个满秩、无参数的重复矩阵直接抬升到 2048 维,中间不插任何可学习码字向量或生成器,比所有已有共享嵌入方案更激进、更透明。其三,同时训练规范二进制码模型与一个 GF(2) 可逆重编码模型,检验“可行”是否依赖码字分配的偶然结构;作者同时诚实地声明这是特定操作点的实证结果,不推翻任何不可能性定理,也不声称对所有重编码不变。
核心方法
直觉上,语言模型必须能区分输入符号,但承载区分的载体不必可训练。对 $V=49152$ 的词表,最短单射定长二进制码宽为 $K=\lceil \log_2 V \rceil=16$ 位:token $t$ 的第 $j$ 位为 $\lfloor t/2^j \rfloor \bmod 2$(小端序)。由于模型宽度 $d=2048$,用一个无参数的重复矩阵 $R=[I_{16};\,\dots;\,I_{16}] \in \mathbb{R}^{2048 \times 16}$ 把 16 位码原样复制 128 倍得到输入 $x(t)=Rc(t)$,取值仅 0/1、尺度为 1,之后进入与基线完全相同的可训练主干。第三个模型把规范码换成 $\tilde{c}(t)=Ac(t) \bmod 2$,其中 $A \in GL(16,2)$,由种子 12345 生成、每行每列最小汉明重量 4、偏置 $b=0$。三个模型共享同一骨干与配方、各训练目标 100B 预测 token,再在同一评测协议下对比。
核心创新是把“身份、可学习性、实用性”三问题分离并构造受控边界:固定码模型中 token 的输入坐标在训练全程逐位不变,行为变化只能归因于共享主干对不变坐标的使用方式,这为研究“不动的输入之上表征如何形成”提供了实验仪器。与已有工作的本质区别在于:组合码、ALONE、子词重构、哈希嵌入等仍保留可学习的输入生成器或共享码字向量,而本文在标准主干前不插入任何可训练组件。作者同时谨慎指出,移除输入表并不移除“嵌入函数”——可训练的第一层仍可学出上下文无关的词法函数,因为 $Wx(t)=WRc(t)$ 显式暴露了共享结构;科学上相关的区分是“独立可调的输入行”与“固定身份上的共享学习计算”,而非“学过与没学过的表示”。
方法步骤详情
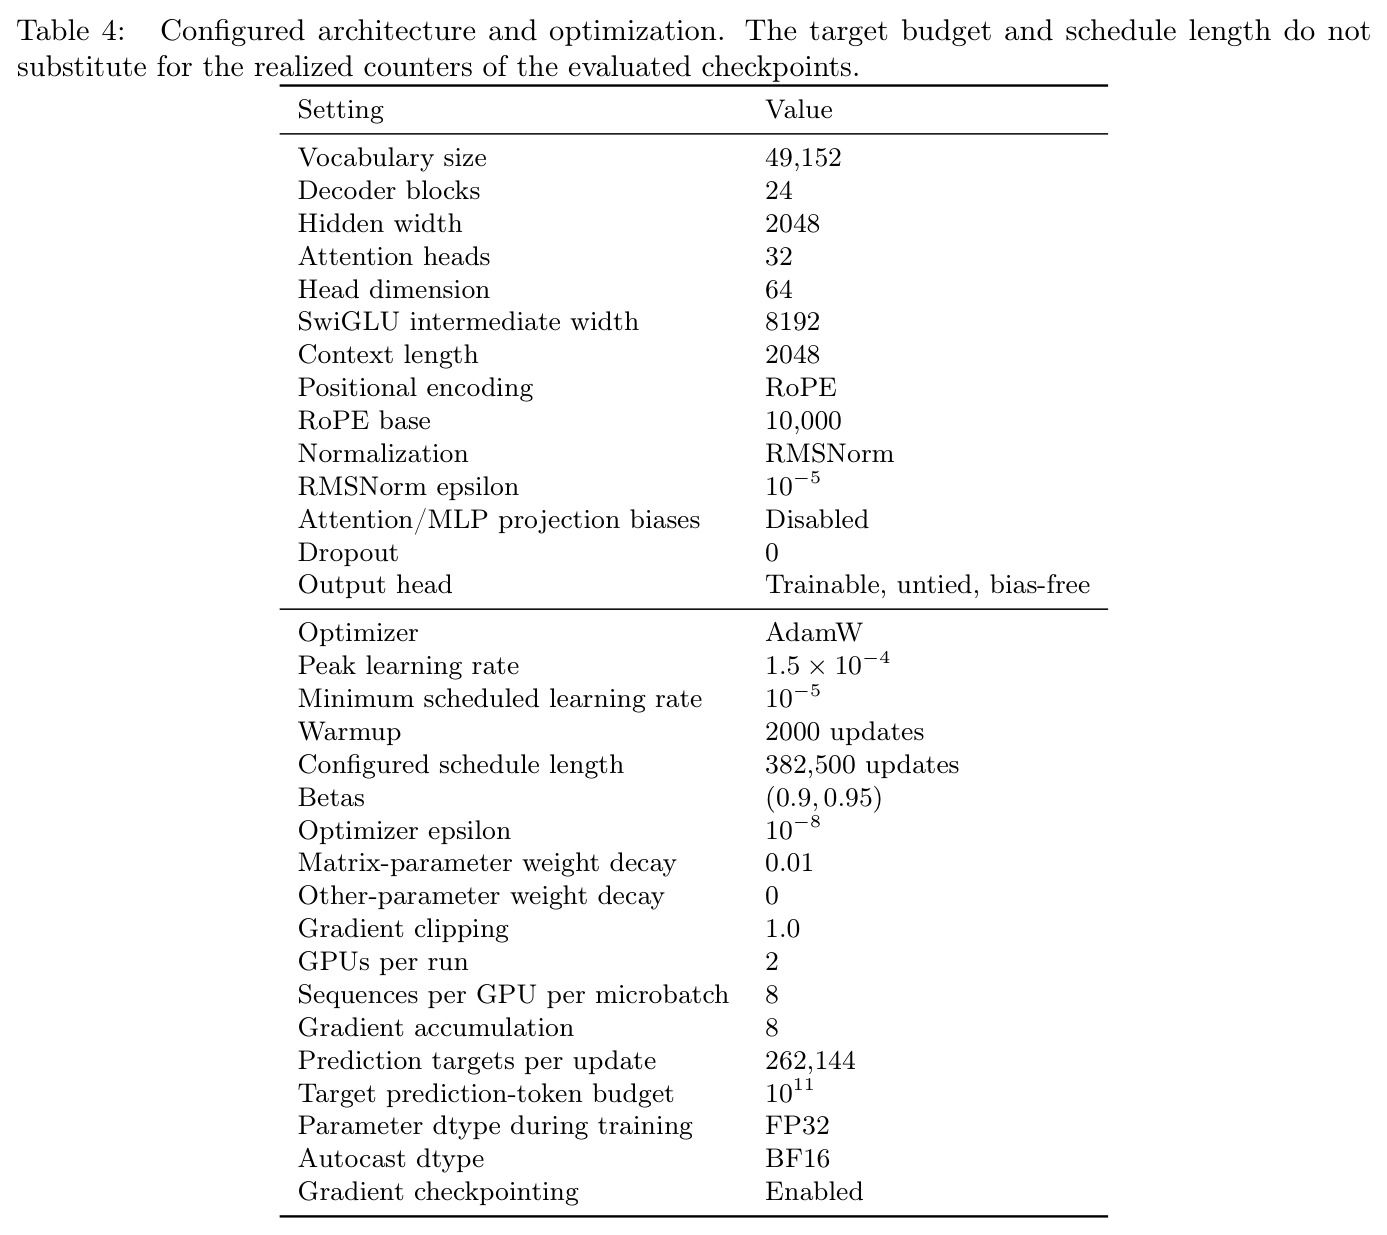
完整流程分五步。第一步接口设计:学习基线用 $x(t)=E_{in}[t]$;Binary16 用 $x(t)=Rc(t)$;GF2 用 $x(t)=R\tilde{c}(t)$;三者都保留可训练、解耦的输出头 $W_{out} \in \mathbb{R}^{V \times d}$,固定码书存为 $V \times 16$ 持久缓冲(存储值而非可训练参数)。第二步统一骨干:24 层解码块、宽度 2048、32 头、RoPE、RMSNorm、SwiGLU、FFN 8192、上下文 2048、无 bias、dropout 0、输出不 tied。第三步数据采样:fineweb-edu-dedup 全部 234 个 Parquet 分片,只取长度不少于 2049 token 的文档,分片内均匀采样文档与窗口起点,按文档 ID 种子哈希划分训练/验证集(阈值 0.001)。第四步优化:AdamW,峰值学习率 $1.5 \times 10^{-4}$、余弦衰减到 $10^{-5}$、2000 步预热,权重衰减 0.01 仅作用矩阵参数,梯度裁剪 1.0,全局每步 $2 \times 8 \times 8 \times 2048 = 262{,}144$ 个预测目标,FP32 权重加 BF16 autocast。第五步评测:lm-eval-harness 九任务零样本、MMLU 加五样本,并以 SmolLM2-135M/360M/1.7B 作外部参照。
技术新颖性
技术上并非首创“无输入嵌入表”:MaskBit 已在图像域用 bit token 实现无嵌入生成,Bochkov 2025 已研究冻结视觉 Unicode 表示与 token 身份消融。本文的新颖性在于三点。一是受限工作点的极端性与透明性:最短单射定长码加无参数确定性 lift,信息内容与可训练参数量都可精确说明(删 100,663,296 个参数),没有任何隐藏自由度。二是规模与完整性:首次在此类接口上以现代配方(RoPE、RMSNorm、SwiGLU)训练 1.7B 级模型 100B token,并跑完整标准基准套件与语料似然评估,而非只报告训练收敛或零散生成示例。三是范围控制的诚实性:只评估一个 GF(2) 矩阵、不声称对码字分配不变、承认 tokenizer 词表枚举可能携带语料派生的附带结构、区分“无可训练输入表”与“字面上无查找”(实现仍是缓冲区查找),并把结论定位为操作点证据。
实验结果
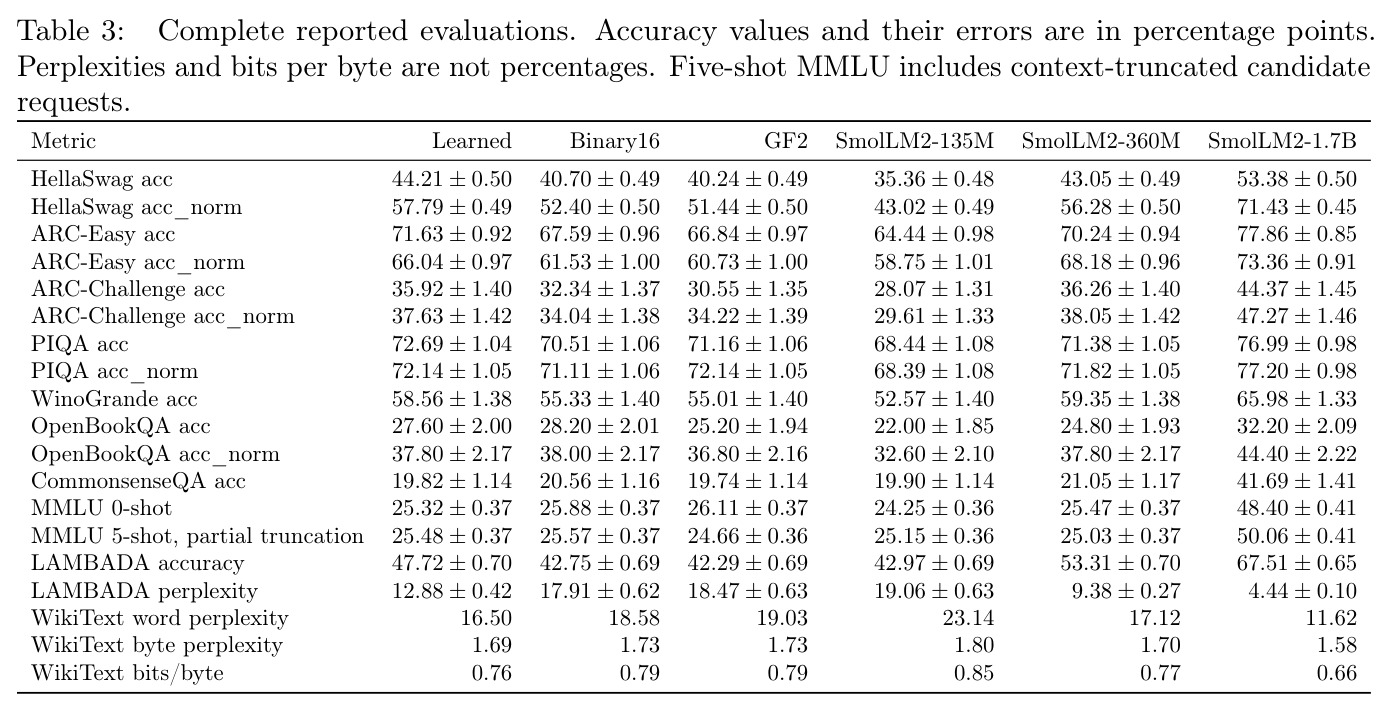
核心发现是“可行但不持平”。Binary16 模型取得 HellaSwag 归一化准确率 52.40%±0.50、PIQA 70.51%±1.06、LAMBADA 42.75%±0.69、ARC-Easy 61.53%、ARC-Challenge 34.04%、WinoGrande 55.33%;GF2 对应为 51.44%、71.16%、42.29%、60.73%、34.22%、55.01%;两者 WikiText 词困惑度分别为 18.58 与 19.03。学习输入对照在多数信息性任务上更好:HellaSwag 57.79%、LAMBADA 47.72%、PIQA 72.69%、WinoGrande 58.56%、WikiText 困惑度 16.50,仅 OpenBookQA 基本持平(37.80% 对 38.00%)。这证明移除全部 1.007 亿 token 级可训练输入参数后实质能力依然存在,但作者明确拒绝性能相当的说法。边界证据:三模型 CommonsenseQA 都约 20%、MMLU 都约 25–26%,接近随机水平。外部参照:Binary16 的 HellaSwag 52.40% 介于 SmolLM2-135M(43.02%)与 SmolLM2-360M(56.28%)之间,远低于同尺寸但训练 11T token 的 SmolLM2-1.7B。
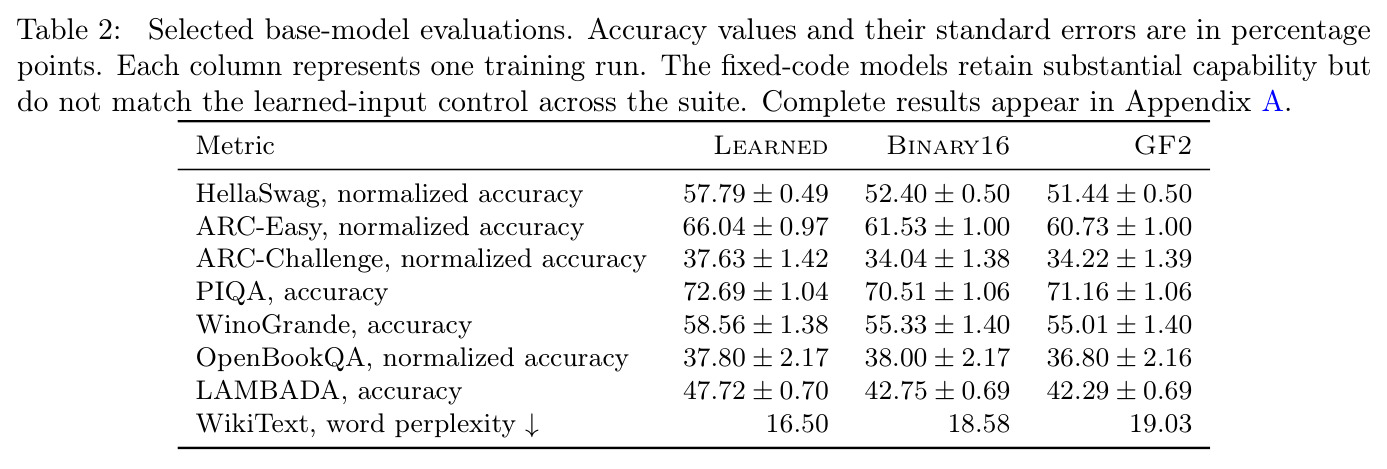
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HellaSwag | normalized accuracy | 52.40% (Binary16) | 学习输入对照 57.79% | -5.39 个百分点 |
| PIQA | accuracy | 70.51% (Binary16) | 学习输入对照 72.69% | -2.18 个百分点 |
| LAMBADA | accuracy | 42.75% (Binary16) | 学习输入对照 47.72% | -4.97 个百分点 |
| ARC-Easy | normalized accuracy | 61.53% (Binary16) | 学习输入对照 66.04% | -4.51 个百分点 |
| ARC-Challenge | normalized accuracy | 34.04% (Binary16) | 学习输入对照 37.63% | -3.59 个百分点 |
| WinoGrande | accuracy | 55.33% (Binary16) | 学习输入对照 58.56% | -3.23 个百分点 |
| OpenBookQA | normalized accuracy | 38.00% (Binary16) | 学习输入对照 37.80% | +0.20 个百分点 |
| WikiText | word perplexity (越低越好) | 18.58 (Binary16) | 学习输入对照 16.50 | 困惑度上升 2.08(更差) |
| MMLU / CommonsenseQA | accuracy | 约 25–26% / 约 20% (三模型) | 随机猜测水平约 25% / 20% | 三者均接近随机,无差异 |
局限与改进
作者承认的局限:每个接口只有一次训练运行,任务级标准误无法替代独立训练种子的方差估计,也无法做配对显著性检验;这是“完整的参数化干预”——可训练性、参数量、码几何与输入尺度同时改变,固定 0/1 向量的初始范数与随机初始化的学习向量不同,配方也未按接口分别调优,因此质量差距不能归因于单一机制;泛化受限——仅一种 tokenizer 家族、一个词表规模、2048 上下文、英文教育语料,未测多语言、长上下文与指令微调,MMLU 与 CommonsenseQA 接近随机尤其限制了关于广泛推理与知识的声明;未演示任何吞吐、能耗或延迟优势,优化器状态的节省不等于运行时优势,对 tied 权重基线删除输入使用未必删除存储矩阵;输出头仍是完整词表级可训练矩阵。我的补充观察:GF2 与规范码在 PIQA、OpenBookQA、部分指标上名次互换,暗示结果对码字几何敏感;tokenizer 词表枚举顺序可能隐含频率等语料派生结构,未被该设计排除;输入秩仅为 16,第一层的线性瓶颈可能与“固定性”同样关键,但论文没有做秩匹配对照来区分两者。
独立分析的弱点
独立分析出的弱点及改进方向:其一,单次运行加约 2–5 个百分点的差距难以与运行间噪声区分,“学习输入稳定更优”缺少统计支撑——应在同配方下跑 3–5 个种子并做配对检验。其二,0/1 固定输入的初始范数与随机初始化嵌入不匹配,差距可能主要来自优化初期动态而非缺乏可训练性——应增加范数匹配的固定随机连续码对照组,作者自己也把它列为未做的检验。其三,16 维输入在 2048 宽度主干前构成极端低秩瓶颈(原始输入秩为 16),虽然作者提醒秩约束不能外推到后续隐藏态,但缺少满秩正交 lift(如 Hadamard 扩展)或更高维冗余码的对照。其四,只测一个 GF(2) 矩阵且 $b=0$,无法分离固定性、维度限制与码字分配三种效应——应采样多个独立重编码矩阵并报告成绩分布。其五,基线为解耦参数核算,若对齐工业界常用的 tied embedding,“省 1.007 亿参数”的实际意义会缩水——应补充 tied 基线与等参数量、等 FLOPs 的对比。其六,训练器恢复时不还原每 rank 采样器游标,中断续跑会破坏可复现性,对长周期实验是实际风险。
未来方向
作者提出的方向有三:一是“不动的输入之上的表示形成”——在原始 token 坐标全程不变时,追踪词法与上下文区分如何随训练进度和深度变得可及,并把表示测量与因果干预(层消融、受控激活替换、匹配上下文测试)结合,区分“信息可及”与“信息被用于预测”,避免仅凭聚类可视化推断机制;二是把码几何与可训练性分离——引入学习型低维坐标、固定随机连续码、范数匹配对照和多个独立重编码采样,判断观测到的质量代价主要来自固定性、维度限制、输入尺度还是码字分配,从而解释为什么可行接口可行;三是把可复现的 token 身份接口作为模块化系统的稳定边界——上下文计算、记忆或可执行组件被独立替换与研究时,输入规范保持不变。基于本文成果可进一步延伸:在指令微调、多语料与长上下文设置检验固定接口的边界;把固定身份码作为 MoE 路由或检索对齐的稳定锚点;探索输出头的部分固定化;以及检验质量差距是否随规模或训练预算增大而缩小。
复现评估
复现条件总体较好。研究工件发布在 HuggingFace 的 Bochkov 账号,含三套模型(Learned/Binary16/GF2)的原始训练实现、模型配置与检查点加载工具;配套验证工具检查参数计数、完整固定码书、GF(2) 变换的秩与偏置、确定性 lift,以及加载、有限 logits 前向和短生成。数据为公开的 smollm-corpus 中 fineweb-edu-dedup 组件,预处理细节(234 个分片、哈希划分阈值 0.001)齐全,训练代码随补充材料提供。算力门槛:单模型 100B token,2 GPU、全局每步 262,144 个预测目标、最大 382,500 次更新,估算需数十 GPU 天(2×A100/H100 量级),对个人实验室偏重但并非不可及。关键注意事项:原训练器使用已移位的 target 标签,导出的推理适配器可能改用标准 Transformers 约定,复现必须区分(logit 对比不受影响);恢复时不还原采样器状态导致中断续跑不可复现;每接口仅一次官方运行,应预期种子级差异。综合难度评级:中等偏高。
论文图表