JockeyBench:面向LLM智能体赛马决策能力的评测基准 JockeyBench: Evaluating LLM Agents on Horse-Racing Decision-Making
用时间门控赛马回放基准分离LLM智能体的预测质量、修订增益与投注决策价值
前置知识
LLM 智能体(Agent)
以大语言模型为核心控制器的自主系统,能在环境中调用工具、编写并执行代码、读取反馈后迭代行动。本文中智能体要编写可执行的 Python 预测程序,通过受限 SDK 调用计价数据工具,在无网络的沙箱中运行并接受资源上限约束(如每场最多 40 次数据调用、5,000 个证据单元、120 CPU 秒)。
论文的评测对象就是这类智能体,两种工作流(写预测程序 vs 写证据采集程序)都建立在“LLM 写代码、环境执行、按结果修订”的机制上,不理解智能体架构就无法理解实验设计。
对数评分与适当评分规则
评估概率预测质量的严格适当评分规则:真实结果发生概率报得越高得分越高,且说真话是唯一最优策略。本文用相对均匀分布的对数增益 $g_r=\ln\sum_{i\in W_r}\tilde p_{ri}$(单位 nats),并对概率做平滑 $\tilde p_{ri}=0.98p_{ri}+0.02/n_r$。
对数增益是全文核心预测质量指标,论文反复强调“对数增益为正不等于投注盈利”,理解评分规则与结算规则的分离才能读懂其中心论点。
Kelly 公式与封顶 Kelly
Kelly 准则按赔率与胜率计算最大化资金对数增长的下注比例 $f=\max\{0,(pO-1)/(O-1)\}$。本文用 $B\min(f,0.01)$,即每场最多押日初资金的 1%,每条轨迹本金 10 万日元。实测约 96% 的下注触及 1% 上限,平均每条轨迹只对 166/324 场下注。
回溯投注实验(Figure 1、Table 15)用该规则结算,是检验“预测信号能否转化为决策价值”的最终关卡,也是“所有配置平均亏损”结论的出处。
数据泄露与时间门控回放
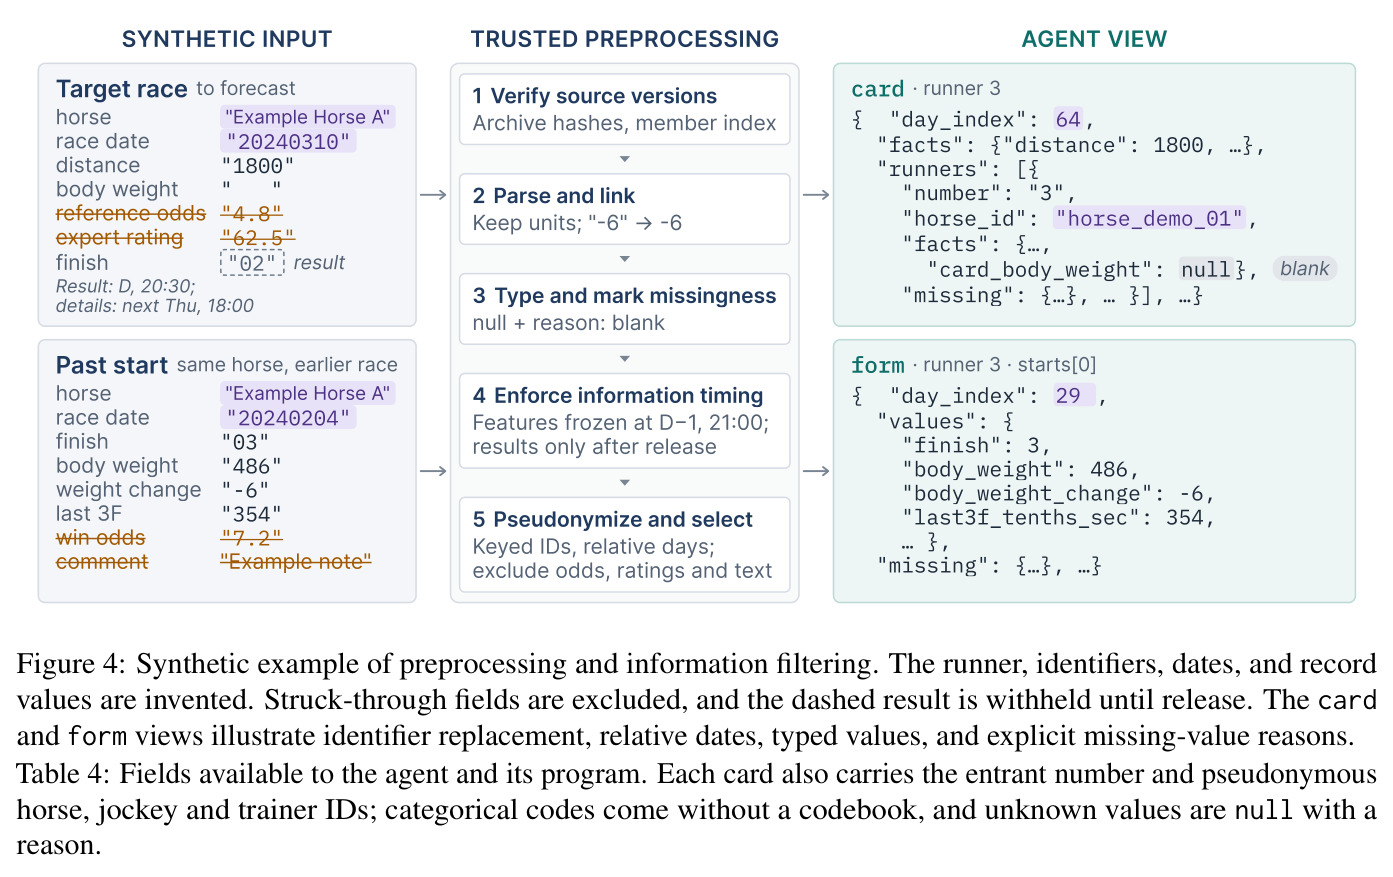
泄露指在预测时刻用到了不可能获得的信息(如未来结果)。时间门控回放为每条历史记录标注其公开时间,强制智能体在结果公布前封存预测,并禁止访问赔率、人气、分红、专家评分和自由文本,只开放 97 个客观字段。
这是基准可信度的基石:没有严格的信息时序控制,历史回放的预测分数会被“事后诸葛亮”污染,这正是作者引用 Kapoor & Narayanan (2023) 强调的坑。
条件逻辑回归(Conditional Logit)
赛马建模经典方法:把一场比赛视为选择集,马 $i$ 获胜概率为 $p_i=\exp(s_i)/\sum_j\exp(s_j)$,分数 $s_i$ 是特征的线性组合,按场内归一化。本文用它构建接口内参考程序 R1–R3(仅 87 场支持集拟合)和离线基线。
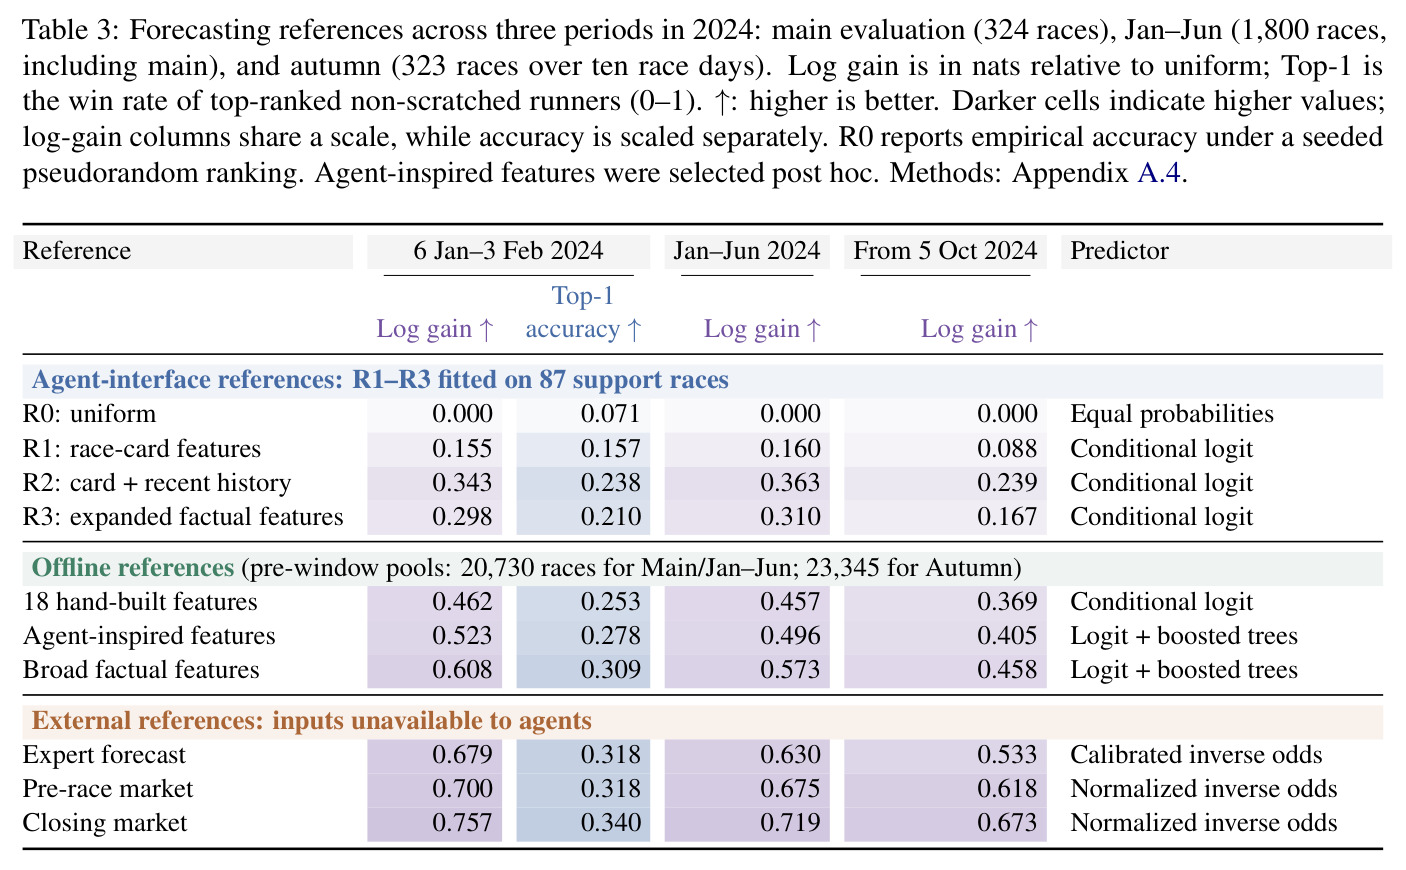
论文靠一整条“参考阶梯”(R2=0.343、宽事实特征=0.608、专家=0.679、收盘市场=0.757)给智能体的 0.525 定位,理解条件逻辑回归才能读懂 Table 3 的比较逻辑。
配对检验与 Holm 多重校正
对每条每日修订轨迹 A 与共享同一初始程序的冻结对照 S 计算配对差,按日聚类估计置信区间;由于同时对 28 个配置做检验,用 Holm 逐步拒绝法控制族错误率,避免把随机波动当成真实改进。
论文的关键结论“7 个显著修订增益、2 个显著下降”全部经过跨 28 个测试的 Holm 校正,不校正会高估智能体自我改进的能力。
研究动机
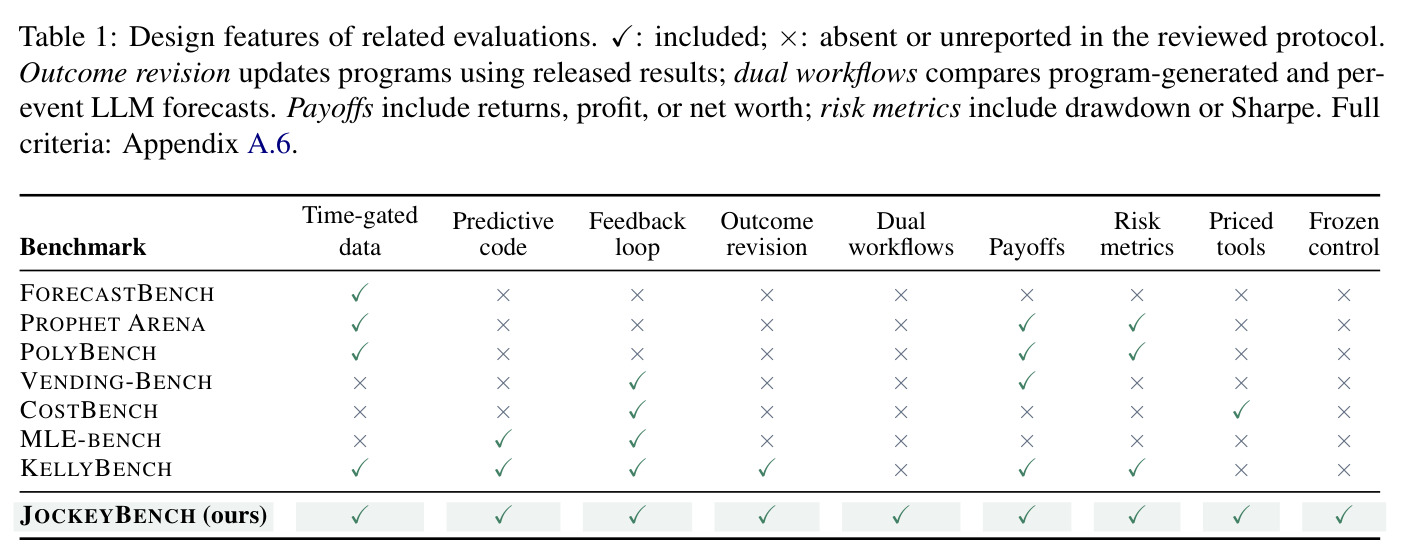
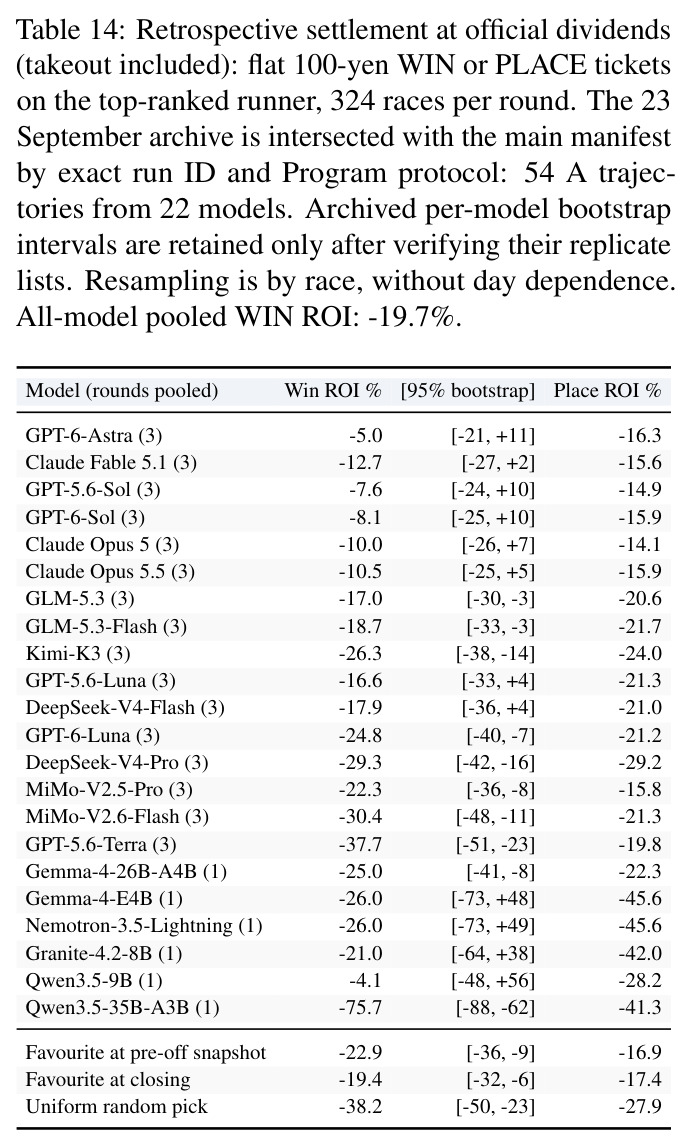
重复事件预测要求智能体从噪声历史证据中提取预测信号,并随结果发布不断修订方法,但现有评测把“预测得准”和“行动有价值”混为一谈。ForecastBench、Prophet Arena、PolyBench 只评概率质量,不涉及行动成本与收益;Vending-Bench、CostBench 评估长期决策却不含预测性代码;MLE-bench 有代码与反馈环但没有真实货币结算;KellyBench 虽把序贯预测与下注相连,却缺少冻结对照、计价工具和风险指标。赛马是放大这一矛盾的理想场景:日本中央竞马会(JRA)WIN 池含约 20% 的抽水(takeout),即使预测质量不错的模型也很容易亏钱。本文数据显示 28 个模型–脚手架配置在封顶 Kelly 结算下平均收益全部为负,22 个模型 54 条轨迹的平注合并 ROI 为 −19.7%,而个别“盈利”轨迹只是靠三张彩票式赢单撑起 55.35% 的回报——用单一聚合分数评价智能体会严重误导。
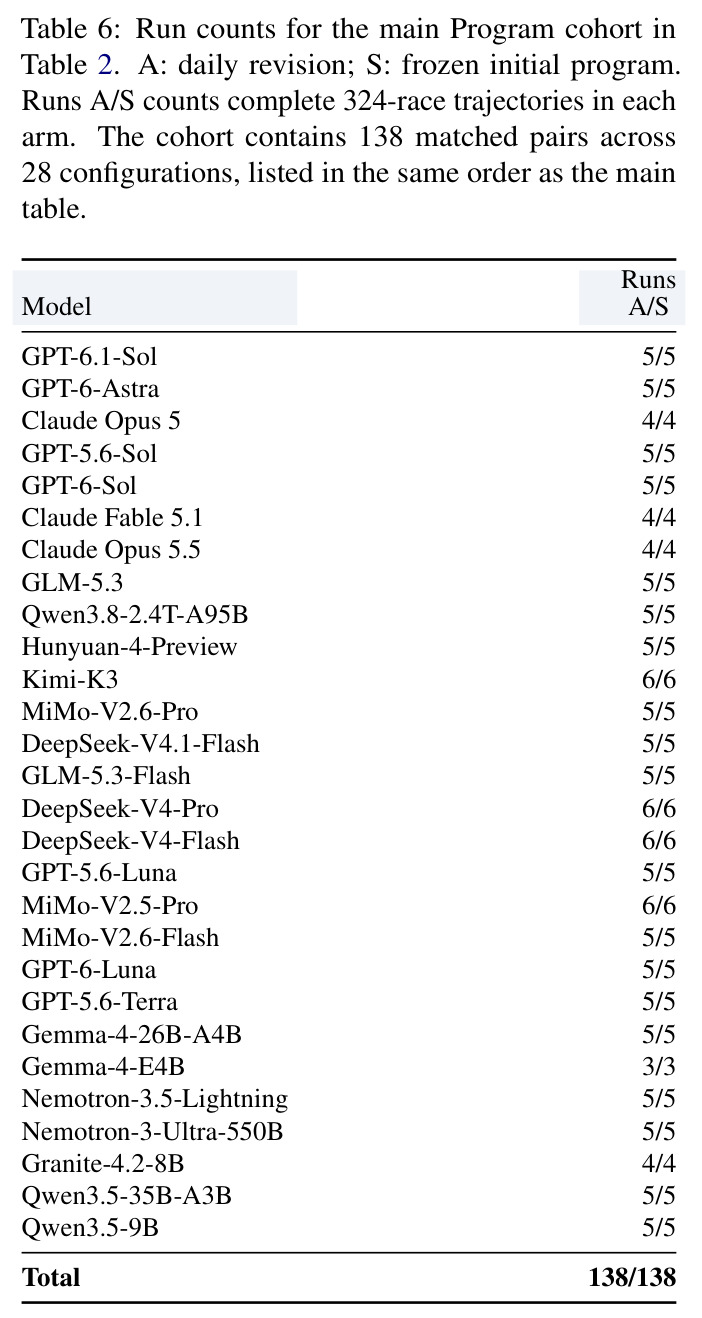
本文的目标是构建一个能严格分离五个维度的评测协议:交付(程序能否跑通并产出非均匀预测)、预测质量(平滑对数增益、Top-1、Top-3)、适应(相对冻结初始程序的配对修订增益)、资源使用(统一费率下的研究费)与决策结果(回溯投注利润、最大回撤、Sharpe)。具体做法是把 JRDB 十二年日本赛马档案清洗为带公开时间戳的回放数据库(40,357 场、564,224 条参赛记录、97 个白名单字段),在 2024 年 1 月 6 日至 2 月 3 日的 10 个赛日、324 场比赛上让 28 个配置以相同信息时钟、相同费率、相同结算规则竞赛,并用 138 组“每日修订 A vs 冻结初始程序 S”配对轨迹回答三个问题:智能体能否构建有用预测器?修订是否真的改进?预测优势能否扛住研究成本与 20% 抽水?
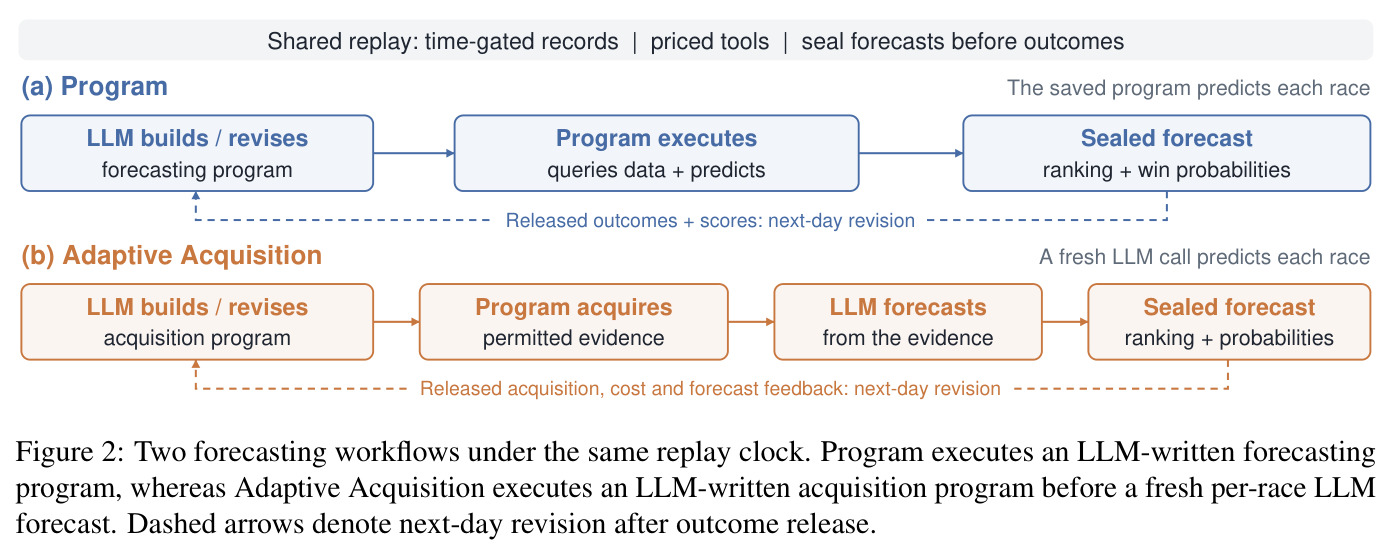
与已有工作不同的是,独特切入有三点。第一,把 LLM 推理安放在预测流水线的两个不同位置:Program 工作流让 LLM 编写并每日修订可执行预测程序(推理被“编译”进代码,逐场执行不再调 LLM),Adaptive Acquisition 工作流让 LLM 编写证据采集程序、再由全新 LLM 会话逐场预测,从机制上比较“可复用程序”与“每场重推理”的报酬与成本。第二,每条修订轨迹与同一初始程序 $P_0$ 的冻结对照配对,把“修订增益”从“最终预测质量”中剥离,且候选程序只验证接口与资源、绝不按预测准确率挑选,避免用验证集作弊。第三,所有数据工具按统一费率计价(证据单元 0.01、调用 0.5、CPU 秒 0.2 score-yen,再乘 0.5),净效用把研究成本直接从预测奖励中扣除;赔率与专家评分被排除出智能体输入,仅作事后外部参照,从而逼智能体从事实证据自建预测。
核心方法
直觉:把“运营一家赛马预测公司”压缩成一局可审计的历史回放游戏。技术上,作者把 JRDB 十二年档案(40,974 个定宽 Shift-JIS 日文件、6.45 GB)按字节位切片后以 CP932 解码,转写 1,100 个字段定义,清洗关联成 750 万条源记录的单一数据库,每条记录标注其公开时间;97 个客观字段分五组(比赛条件、参赛马属性、训练、历史出战、骑师/练马师统计)通过 9 个计价数据工具暴露,赔率、人气、分红、专家评分与自由文本被剔除。评测在 2024 年 1–2 月 324 场比赛上运行每日循环:前一天 21:00(JST)发布赛卡→预测封存→当日 20:30 公布结果并评分→LLM 反思并修订程序。28 个 Program 配置覆盖 GPT、Claude、GLM、MiMo、Qwen、Kimi、DeepSeek、Gemma、Nemotron、Granite、Hunyuan 十一个家族(OpenAI 走 Codex、Claude 走 Claude Code、其余走 DeepInfra 兼容 API,均请求高推理强度),另有四模型双工作流对比。
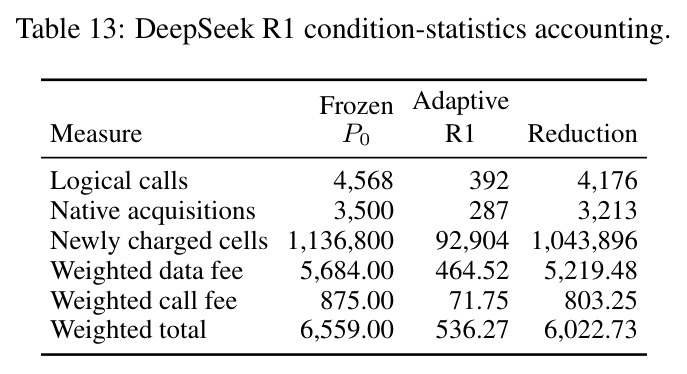
核心创新是“配对冻结对照 + 计价证据 + 双工作流”的三合一设计。与以往把智能体当黑箱只看最终分数不同,每条每日修订轨迹 A 都配有共享同一初始程序、同赛程、同费率的冻结对照 S,配对差 $A-S$ 直接度量修订过程(含反馈、分析、数据访问与调试)的贡献。修订预算为初始探索最多 40 次模型调用与 400,000 证据单元、每日反思 20 次与 100,000 证据单元;候选程序须两次通过接口验证(语法、签名、概率归一化、非确定性检测),但不看预测准确率;预测时执行失败逐级回退到旧有效版本再到均匀分布,且所有回退输出照样计分。净效用 $Net=100\sum_r[g_r+I_r(h_r-1/n_r)]-C$,其中 $I_r$ 门控程序交付的奖励项,$C=0.5(0.01N_{cell}+0.5N_{call}+0.2T_{CPU})$ 统一计量研究开销;合成 score-yen 与真实投注盈亏、供应商费用分开报告,互不混淆。
方法步骤详情
完整流程分五步。步骤一(探索):在评测窗口前用已公开结果的历史比赛构建初始程序 $P_0$。步骤二(每日预测):赛日 $d$ 的赛卡于前一天 21:00 可用,已保存程序对每场执行 $predict(sdk, context)$,通过计价工具读取卡片、训练与历史数据(每次执行上限 40 次调用、5,000 单元、120 CPU 秒),返回完整排名与概率并封存;当日 20:30 公布结果,按平滑对数增益 $g_r=\ln\sum_{i\in W_r}\tilde p_{ri}$ 与 Top-1/Top-3 评分,刮去的马从概率中重新归一。步骤三(反思修订):更新会话基于当日反馈产生候选程序,验证通过(含两次执行一致性检查)方可替换,否则保留旧版。步骤四(回溯结算):按 100 日元平注 WIN 与封顶 Kelly $B\min(f,0.01)$($f=\max\{0,(q_rO_r-1)/(O_r-1)\}$)结算,赔率用扣留的档案 TYB 报价,分红用官方含 20% 抽水的 WIN 赔付。步骤五(统计推断):按日聚类的配对 $t$ 检验加 Holm 校正,跨 28 个测试控制族错误率。
技术新颖性
新颖性体现在评测协议的系统性而非单一算法。Table 1 的九项设计特征对照显示,JockeyBench 是唯一同时具备时间门控数据、预测性代码、反馈循环、结果修订、双工作流、货币化收益、风险指标、计价工具与冻结对照的基准(KellyBench 缺后三项,ForecastBench 几乎全缺)。统计上采用 prequential 协议(Dawid 1984):先评分后吸收结果;用日聚类配对推断加 Holm 校正保证修订结论稳健;用 R0–R3(接口内参考,仅 87 场支持集拟合)与 F18/FAGENT/FV5(20,730 场离线强基线)、专家与赛前/收盘市场(外部参照)构成“参考阶梯”,回答“0.525 nats 到底算强还是弱”。附录 D 的代码级案例研究(如 Kimi-K3 七个版本只改温度不改排序、GPT-5.6-Terra 为省钱砍掉 form 查询反使净分跌 14.44)公开了实际执行策略,这种透明度在智能体评测文献中罕见。
实验结果
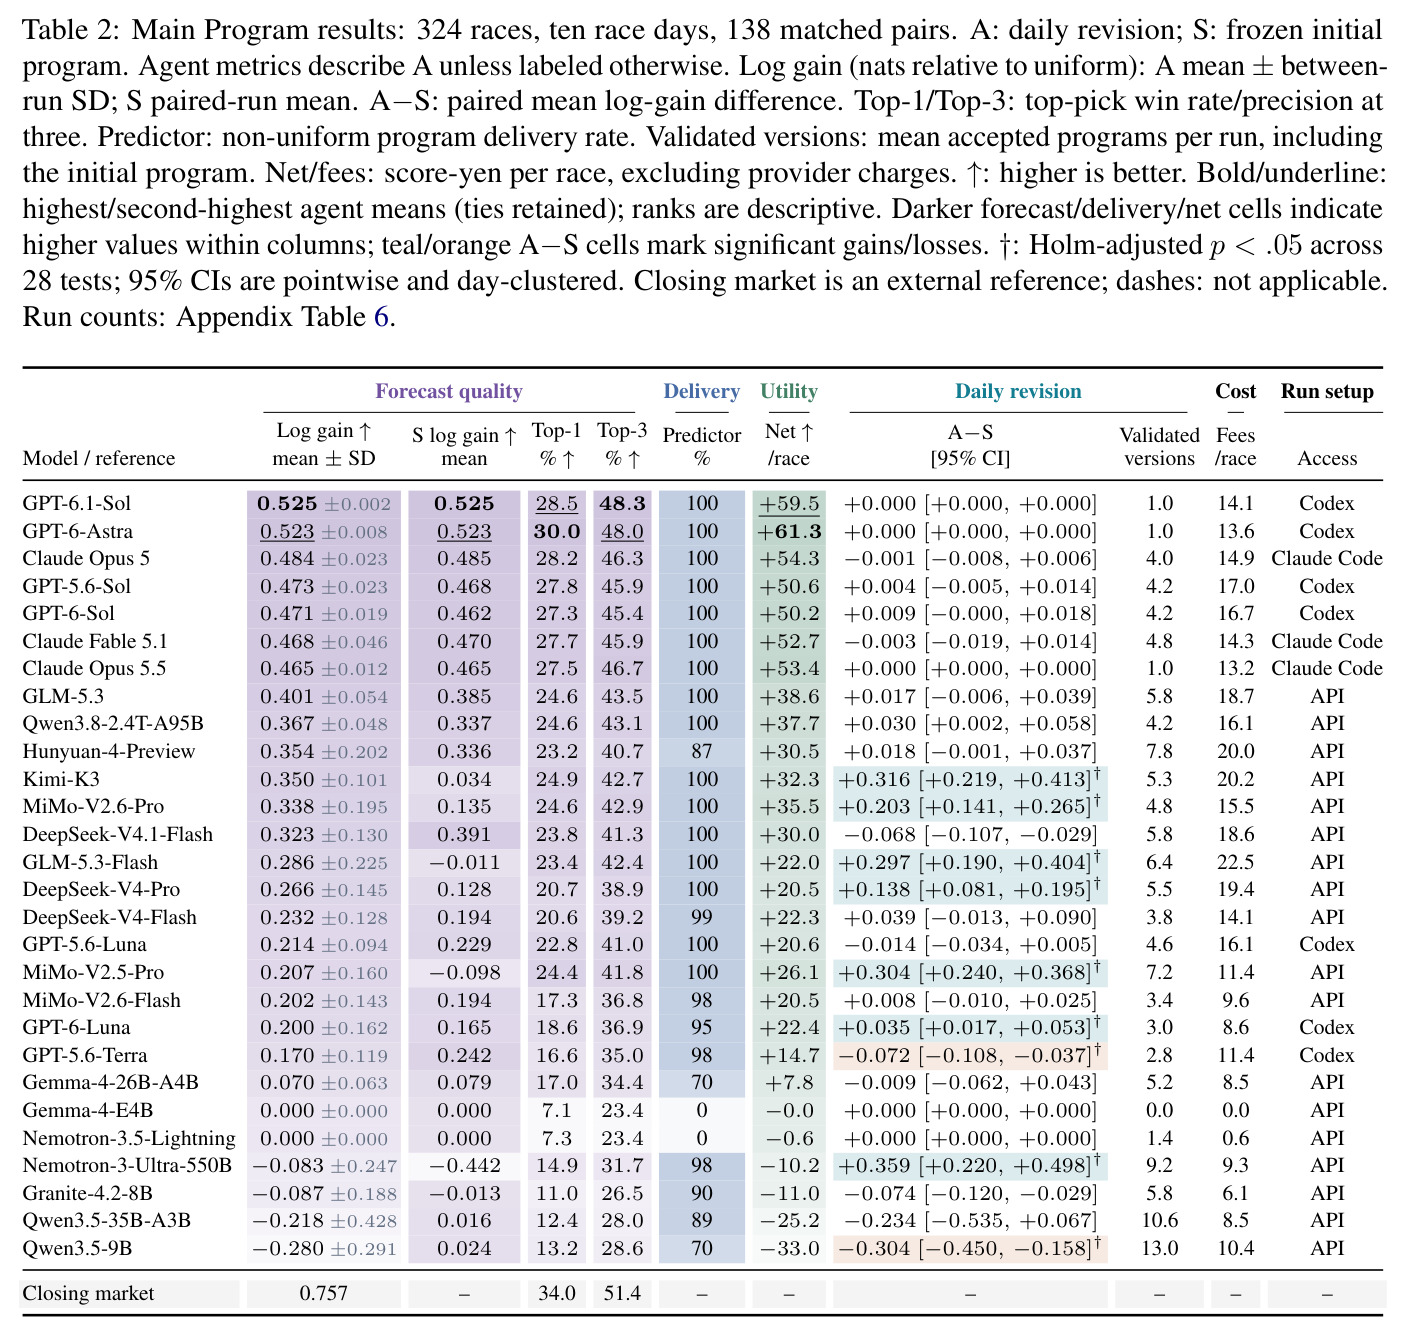
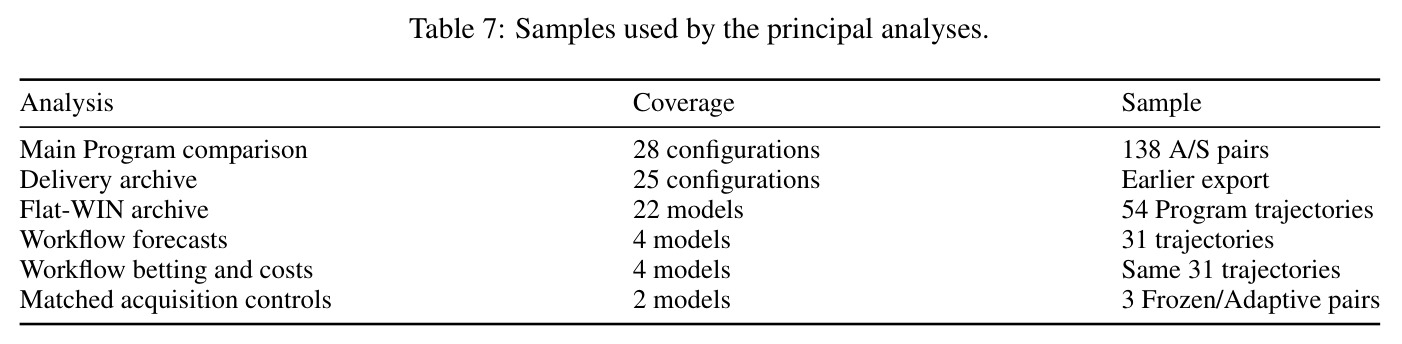
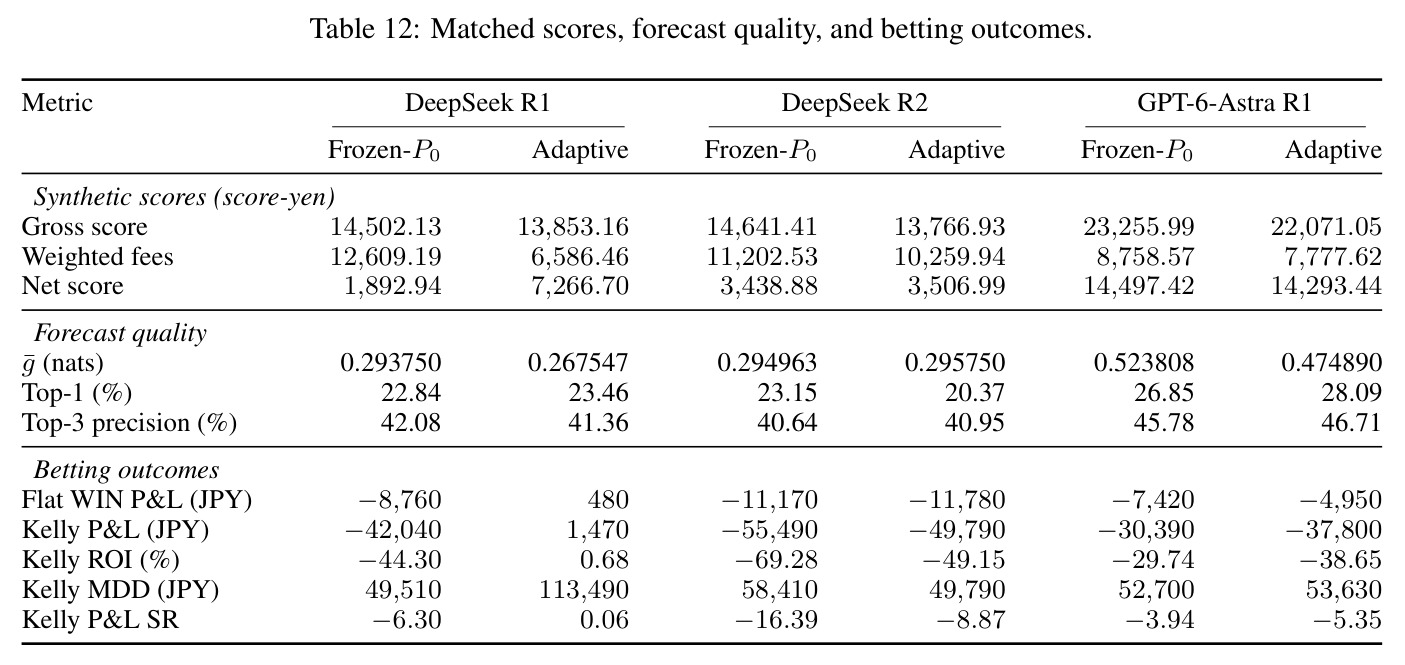
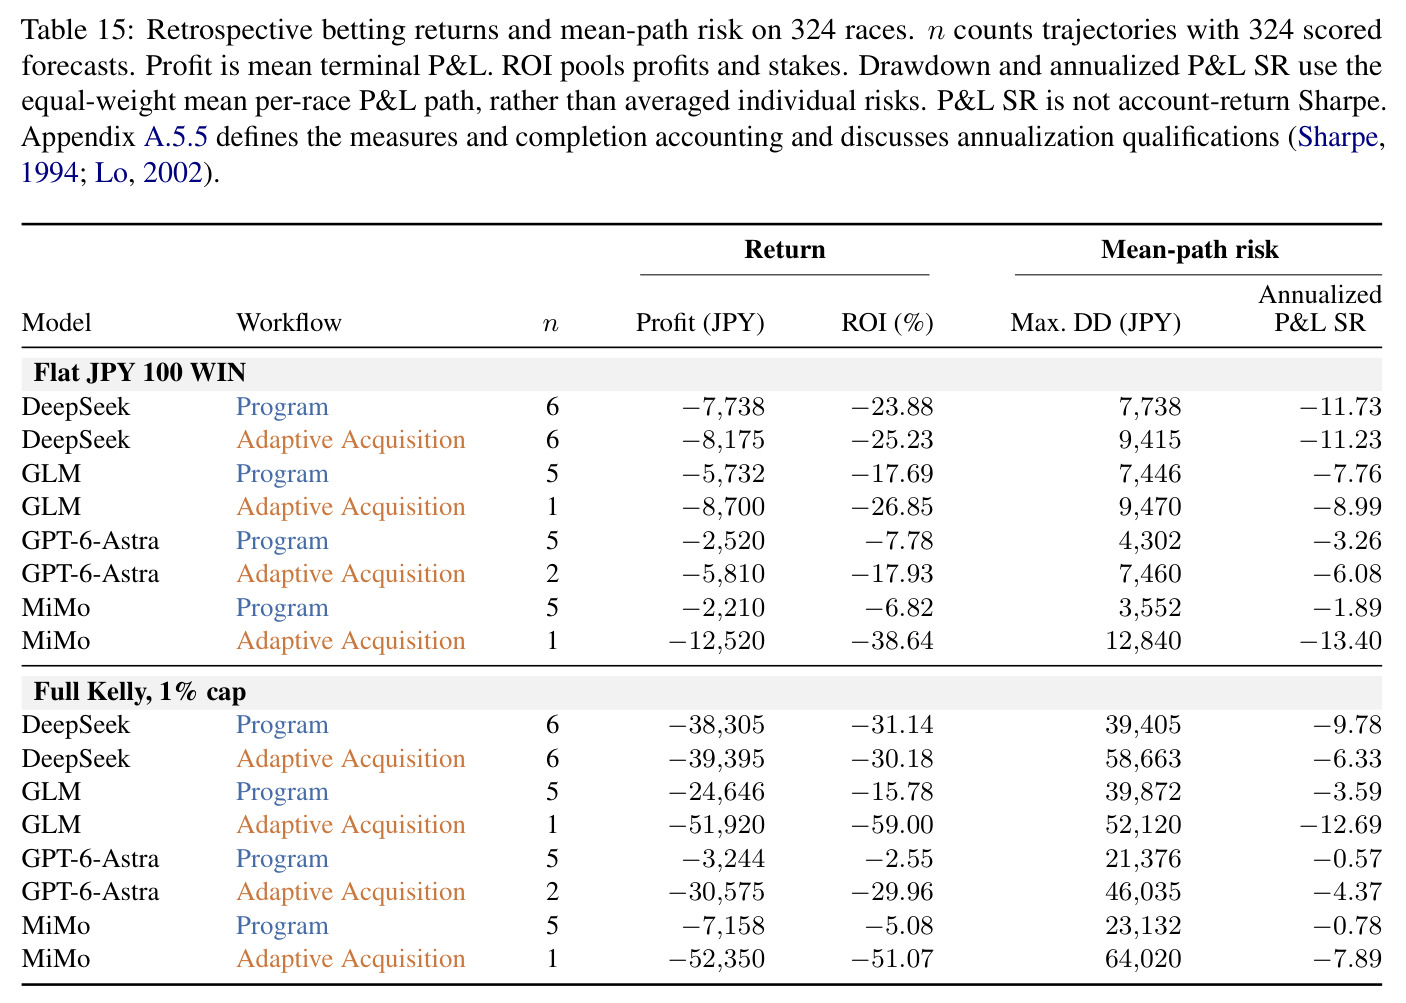
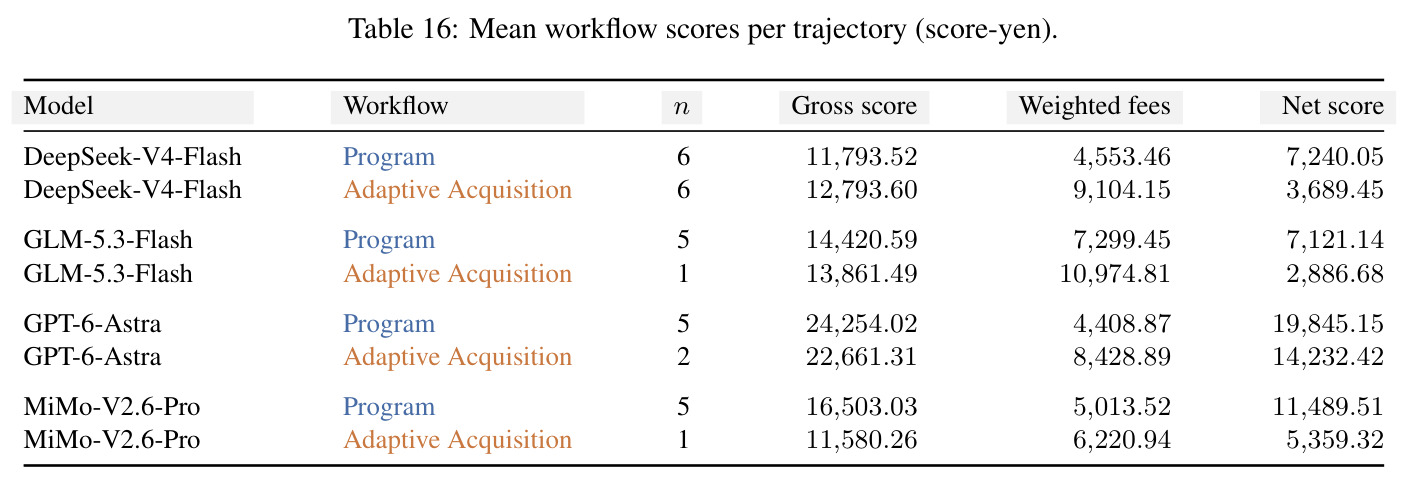
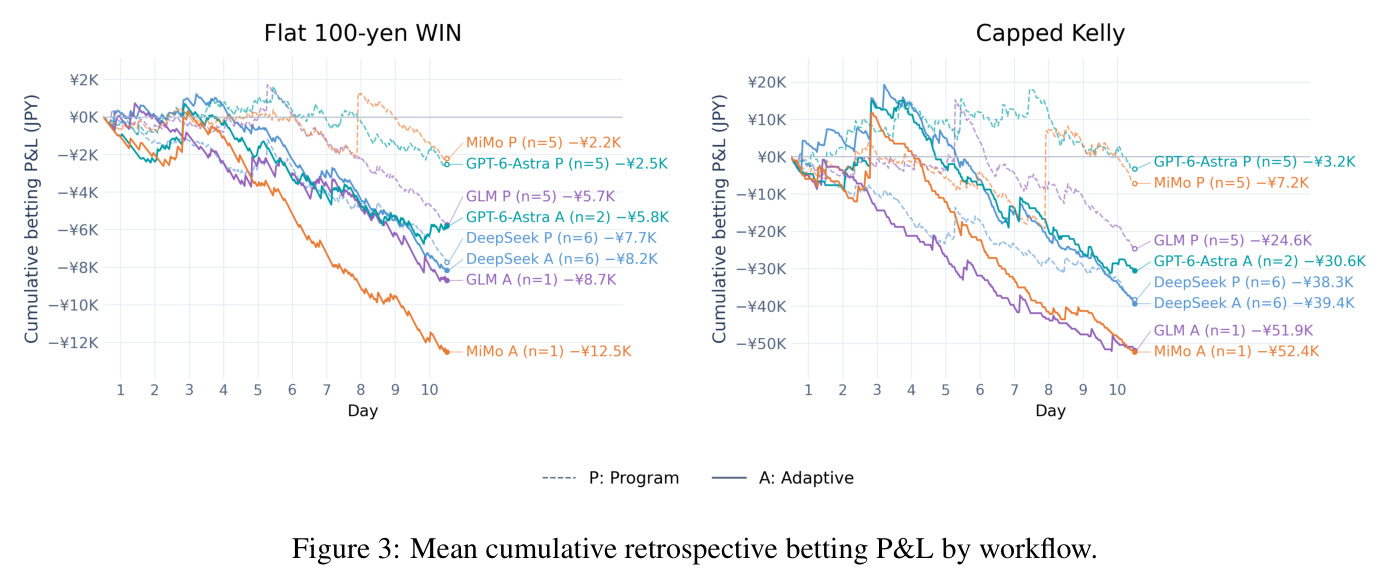
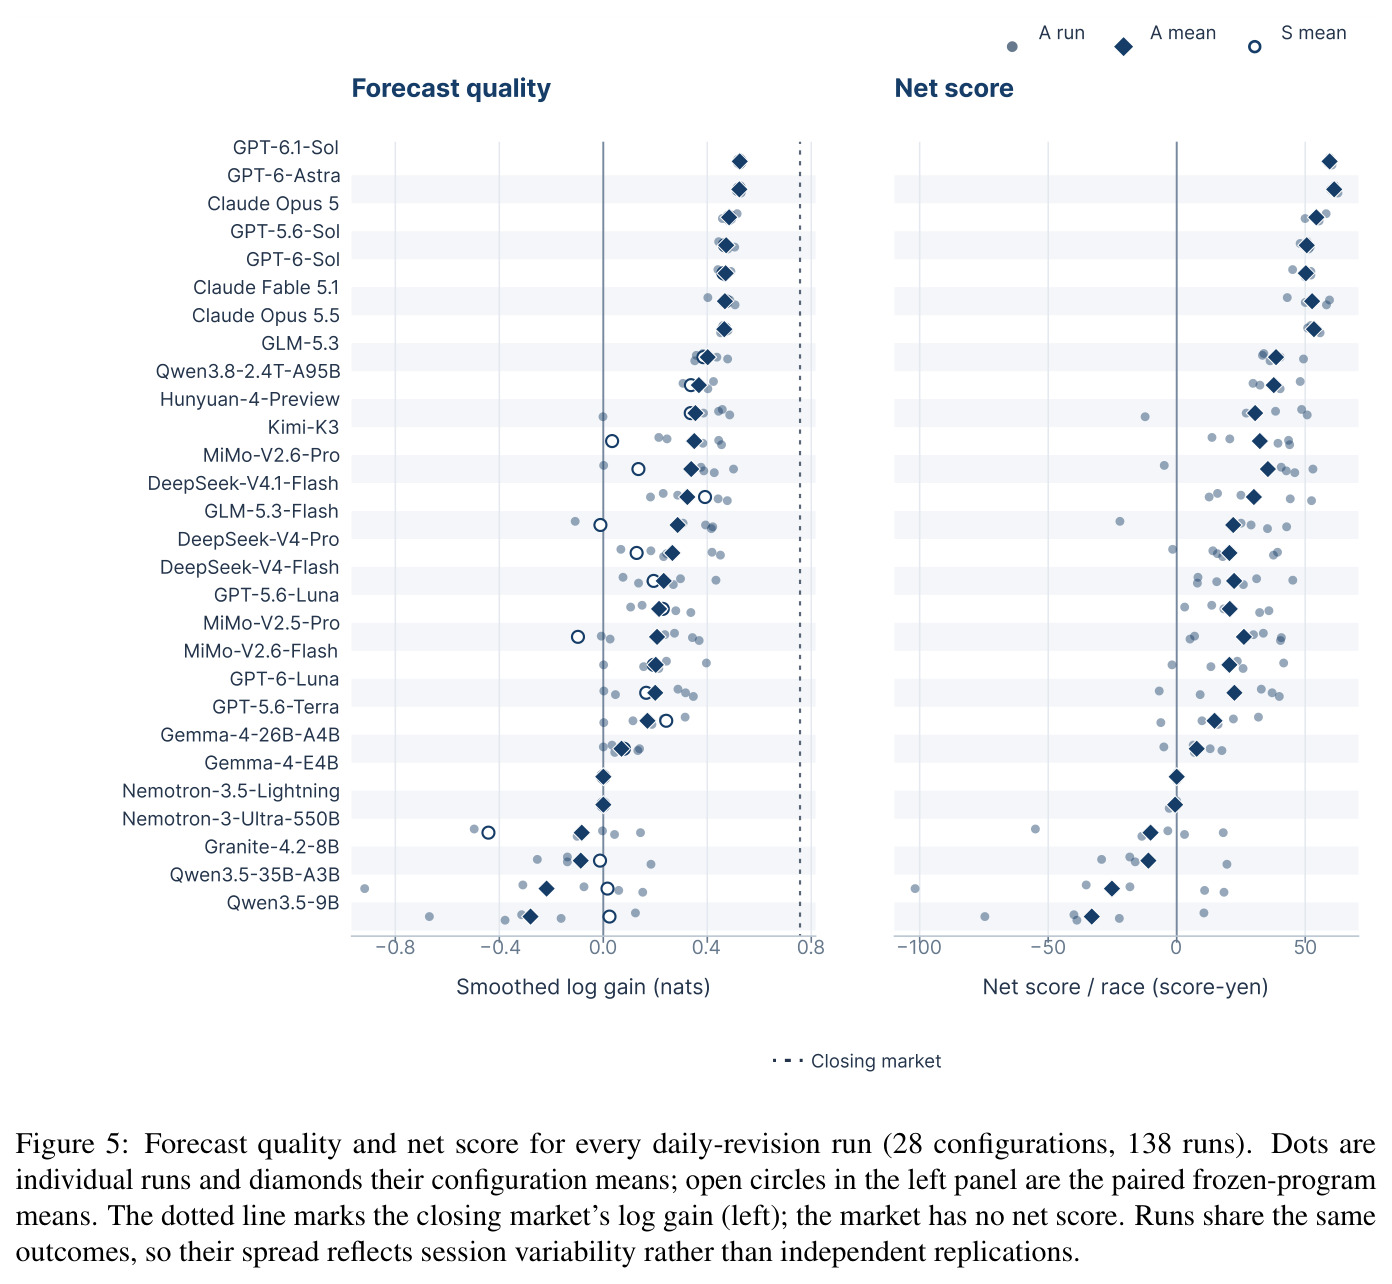
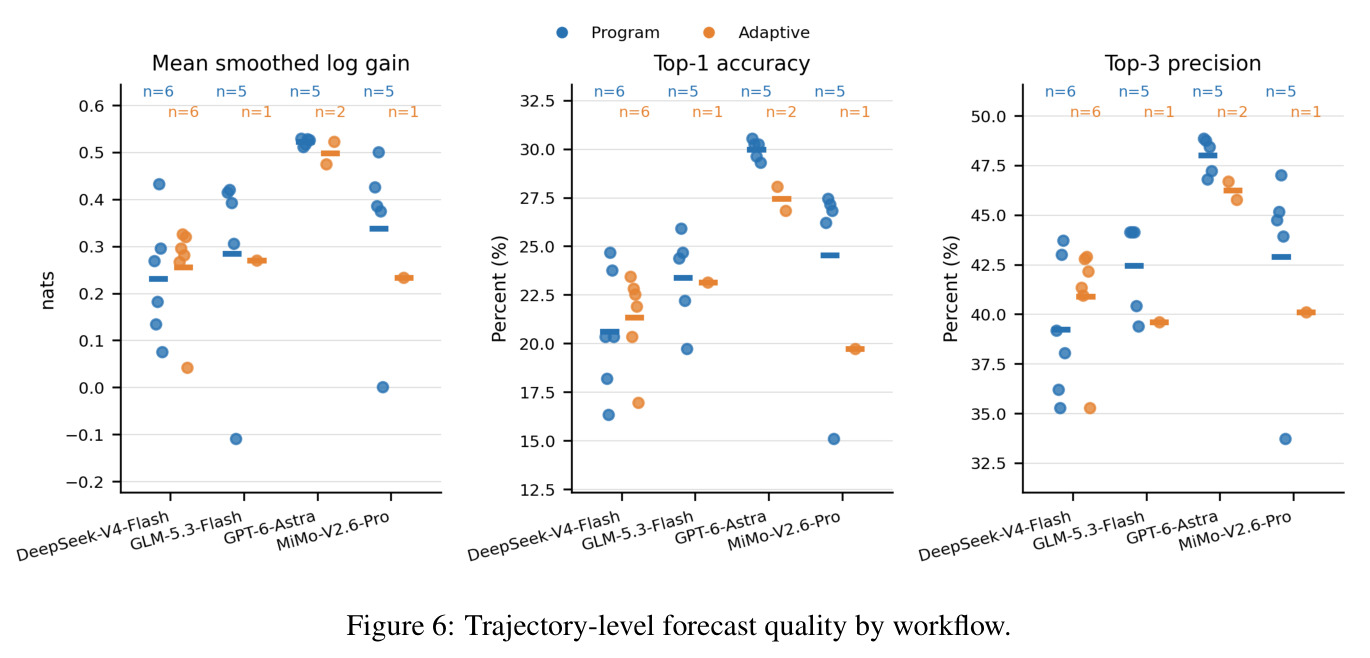
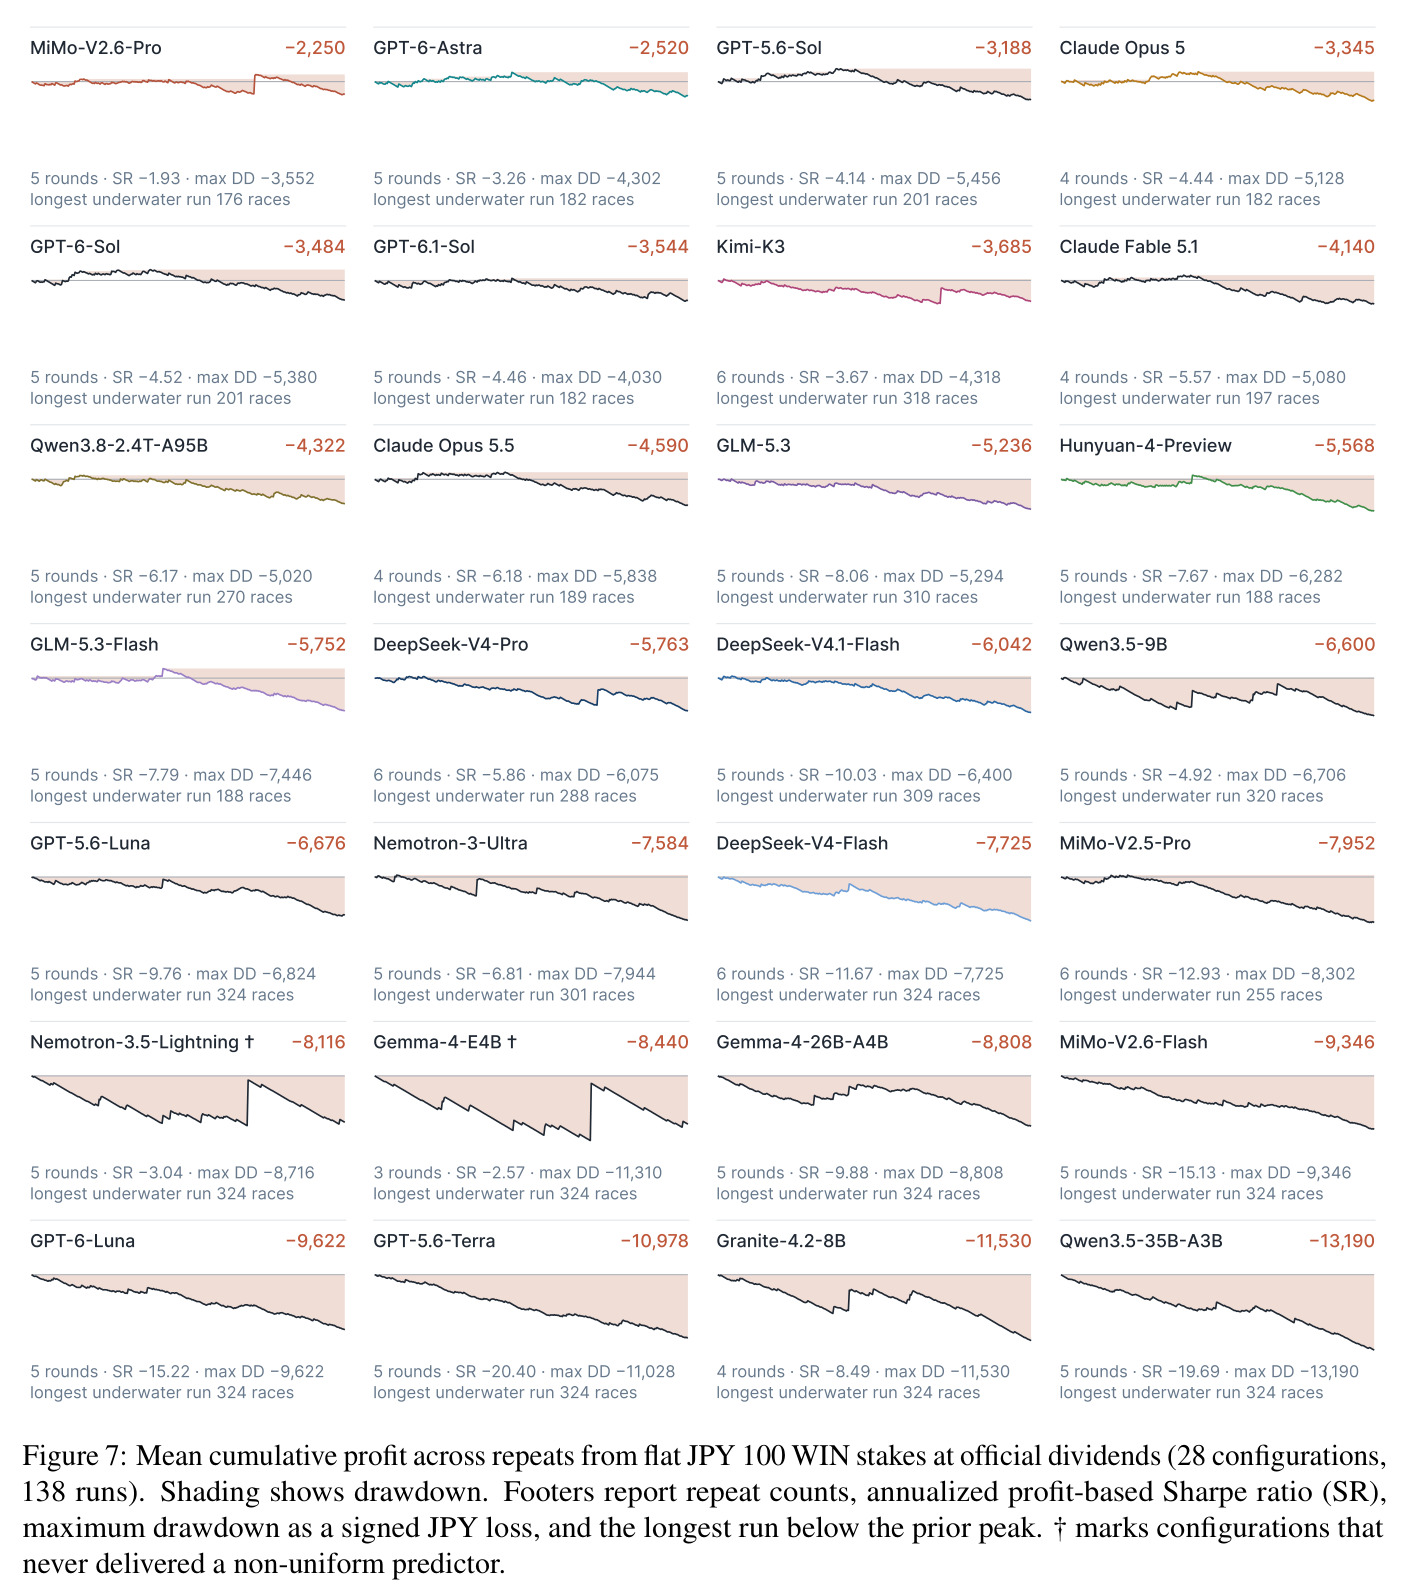
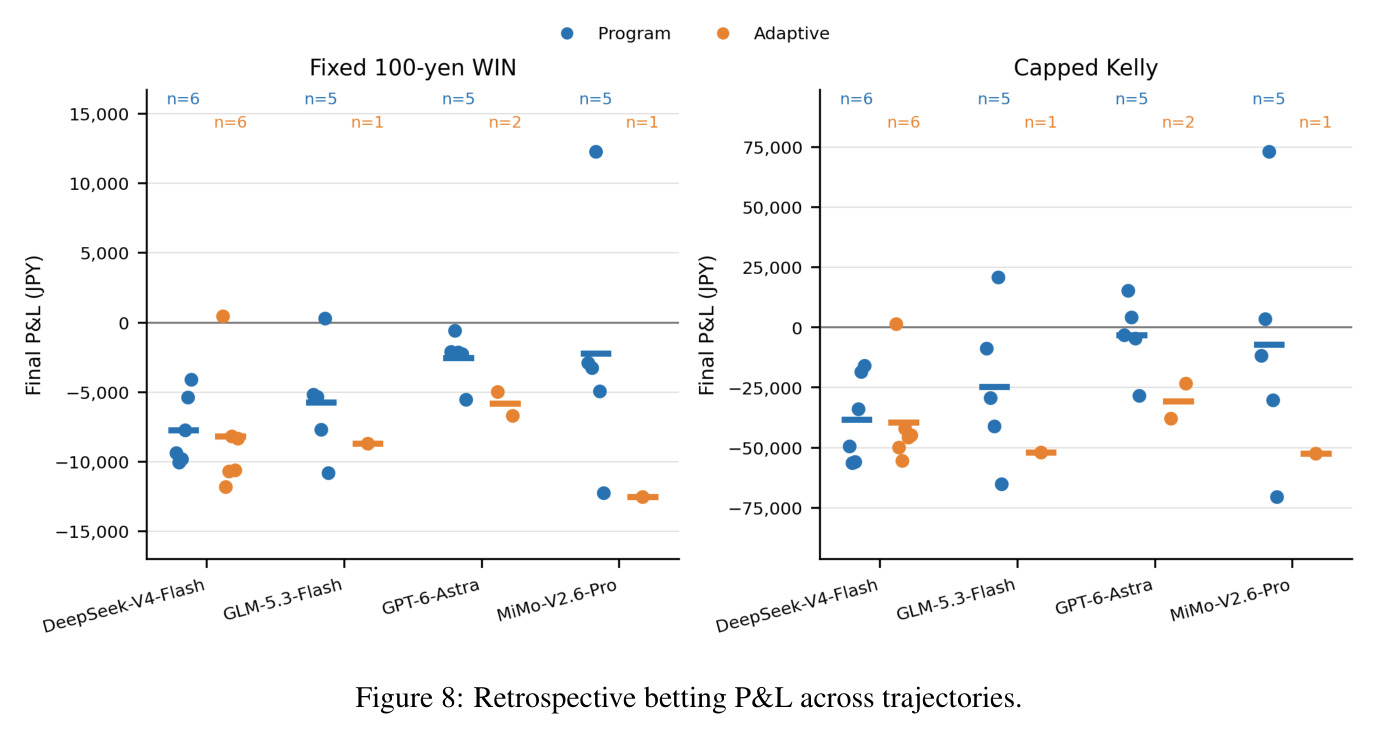
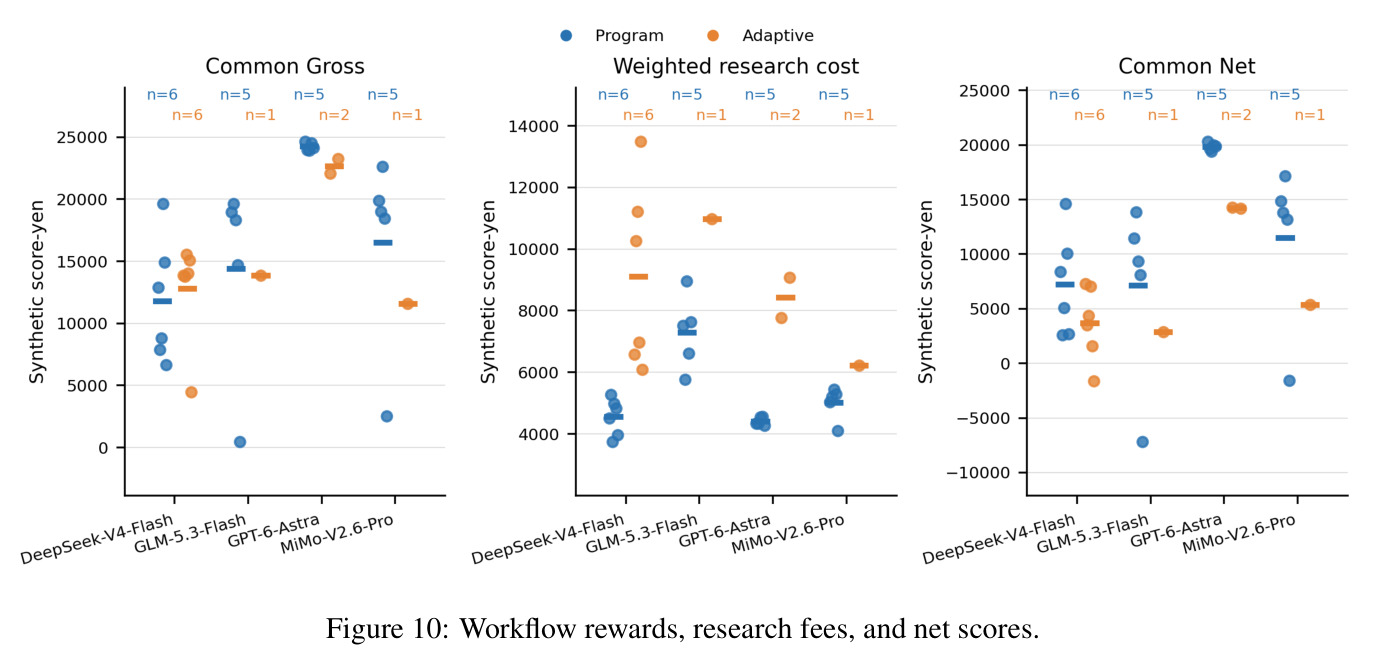
主实验覆盖 28 配置×324 场、138 组配对。预测质量:GPT-6.1-Sol 最高 0.525 nats、净分 +59.5 score-yen/场,GPT-6-Astra 净分最高 +61.3,但全部低于收盘市场 0.757 与离线宽特征基线 0.608,且部分小模型(Gemma-4-E4B 等)交付率为 0%。修订增益≠最终质量:Holm 校正后 7 个显著增益、2 个下降,最大的 Nemotron-3-Ultra-550B +0.359 但修订后均值仍为负(−0.083);Kimi-K3 仅调温度(1.0→3.0/2.0)就从 0.093 升至 0.383。决策价值:封顶 Kelly 下 28 配置平均全亏(仅 13/138 条轨迹盈利),平注同样全负、22 模型合并 WIN ROI −19.7%;Program 在四个模型上利润更高、费用更低(DeepSeek 费 4,553 vs 9,104),但两臂皆亏。诊断显示概率偏差在被选注上反转(DeepSeek 全体 18.14% vs 21.25%,Kelly 子集 17.83% vs 7.82%),盈利轨迹依赖集中回报。
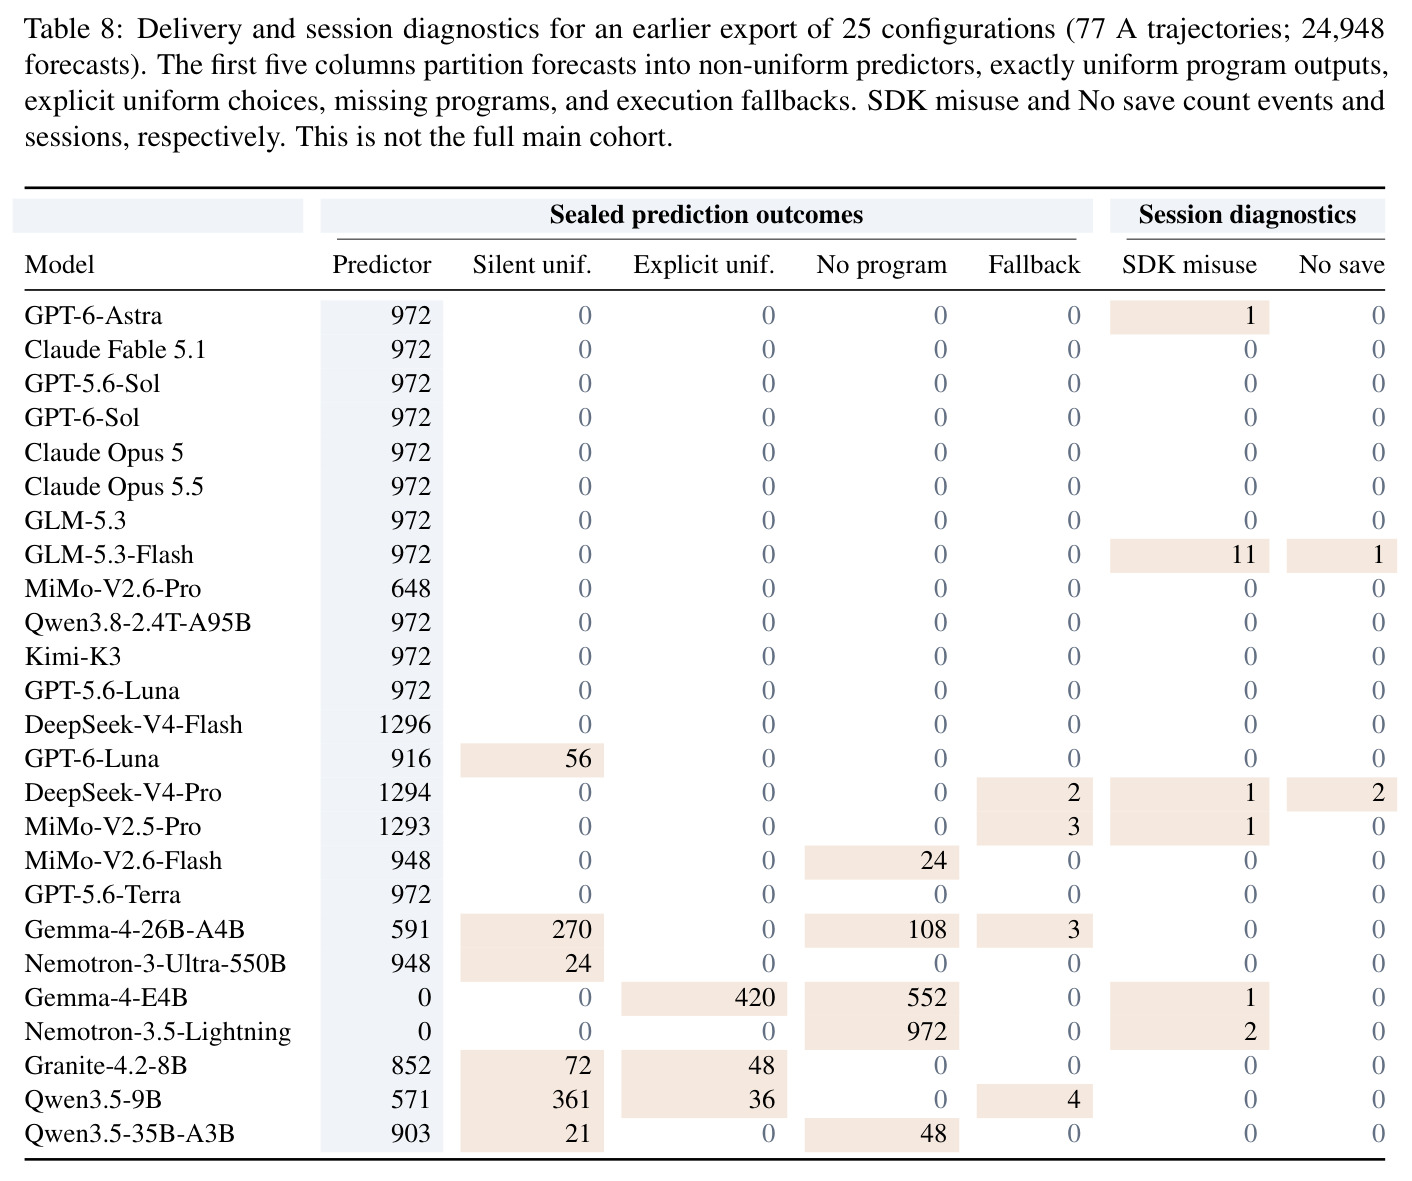
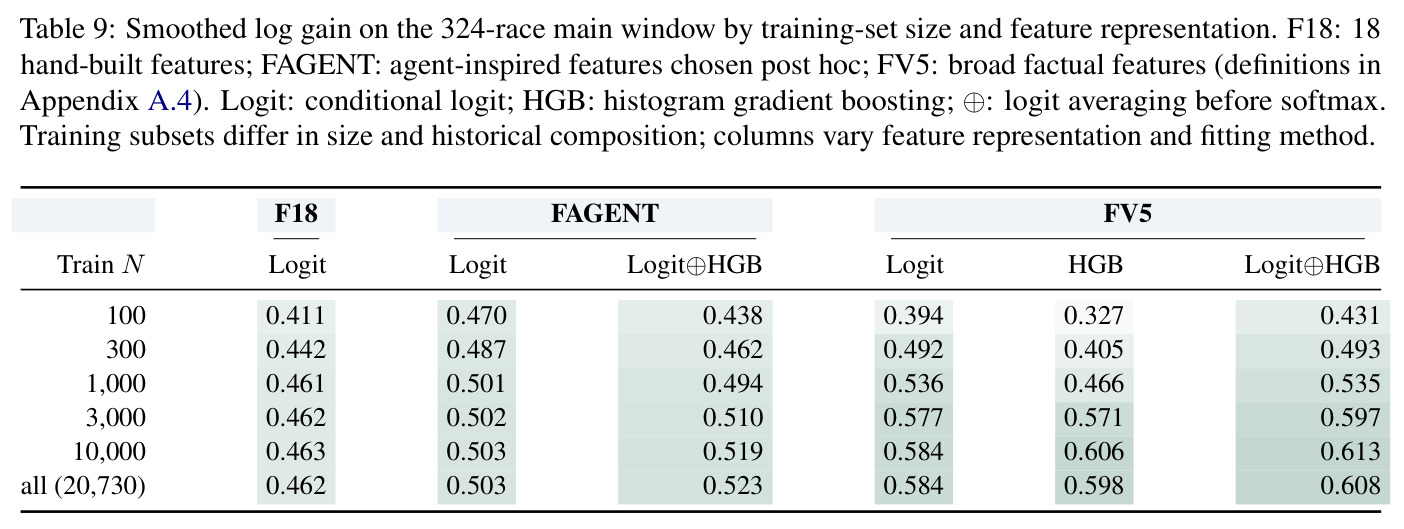
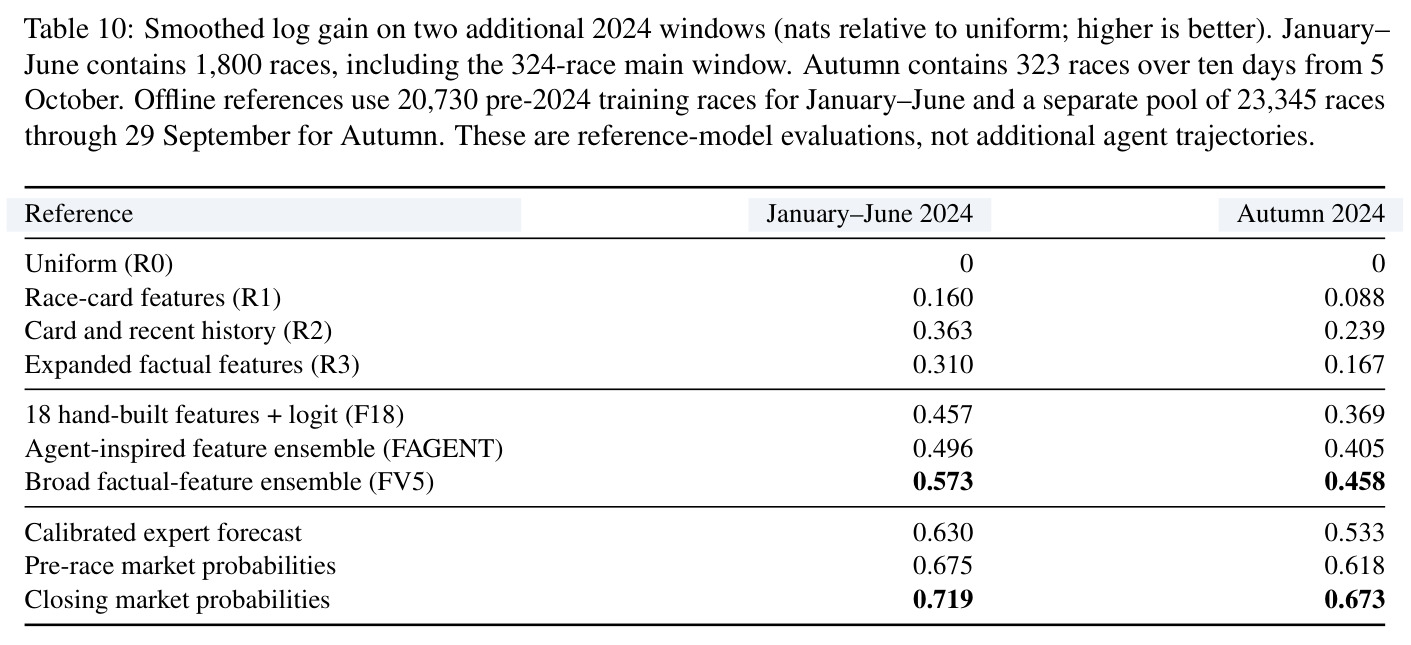
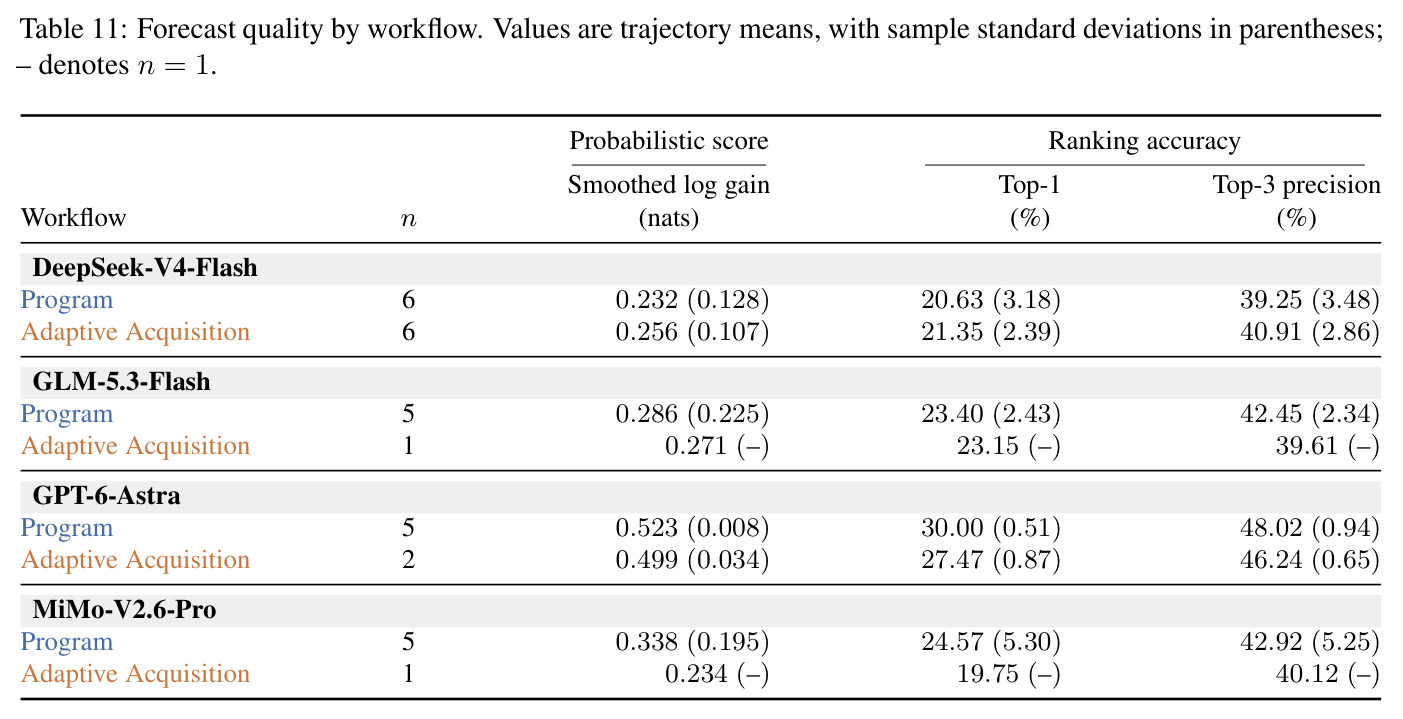
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 概率预测(324 场主窗口) | 平滑对数增益(nats,相对均匀) | GPT-6.1-Sol 0.525(±0.002),Top-1 28.5% | 收盘市场 0.757,Top-1 34.0%;宽事实特征离线基线 0.608 | 约为市场的 69%;比接口内参考 R2(0.343)高 53%,但仍落后离线强基线与市场 |
| 合成净效用(Program 协议) | Net,score-yen/场 | GPT-6-Astra +61.3(费 13.6),GPT-6.1-Sol +59.5(费 14.1) | 最差配置 Qwen3.5-9B −33.0;Gemma-4-E4B 与 Nemotron-3.5-Lightning −0.0/−0.6(未交付预测器) | 头部与尾部相差约 94 score-yen/场,头部费用仅为尾部的约 1.4 倍但奖励高一个量级 |
| 每日修订(对冻结初始程序的配对差) | A−S 对数增益差(Holm 校正) | 7 个显著增益,最大为 Nemotron-3-Ultra-550B +0.359(CI [+0.220,+0.498]);Kimi-K3 +0.316 | 对应冻结初始程序(如 Nemotron S 均值 −0.442,Kimi S 0.034) | 2 个显著下降(如 Qwen3.5-9B −0.304);注意最大增益者的修订后均值仍低于均匀(−0.083) |
| 回溯投注(封顶 Kelly,本金 ¥100,000) | 平均终端盈亏(JPY)/池化 ROI | 28 个配置全部为负:最好的 GPT-6-Astra Program −3,244(ROI −2.55%),最差 GLM-5.3-Flash 一类亏逾 ¥50,000 | 均匀随机选马平注 ROI −38.2% | 无任何配置平均盈利;13/138 条轨迹盈利且依赖集中回报 |
| 回溯投注(平注 ¥100 WIN) | 池化 turnover ROI | 22 模型 54 条轨迹合并 −19.7% | 赛前热门 −22.9%、收盘热门 −19.4%、均匀随机 −38.2% | 与收盘热门打平,但距盈亏平衡仍差约 20 个百分点(20% 抽水所致) |
| 工作流对比(4 模型,31 条轨迹) | 平均净分与研究费(score-yen/轨迹,324 场) | Program 四项全胜:DeepSeek 净分 7,240 vs 3,689,费 4,553 vs 9,104 | Adaptive Acquisition(LLM 采集证据 + 每场新 LLM 预测) | Program 费用约为 Adaptive 的一半;Adaptive 在 DeepSeek 上奖励多 ~1,000 但费多 4,551,净分反落 |
局限与改进
作者承认的局限:结果仅覆盖结构化预测任务与单一领域(日本赛马),向其他运动、非结构化信息环境和更广决策任务的外推未经验证;结论依赖具体的模型–脚手架组合(Codex/Claude Code/DeepInfra 路由),更换工具接口、推理预算或模型版本可能改变排序;统一费率是人为定价,智能体在替代定价方案下如何调整采集与分配行为未知;封顶 Kelly 结算依赖档案时钟的 TYB 报价且发布时序未经独立核实,属于回溯反事实而非真实下注。我的观察:10 个赛日 324 场样本太小,年化 Sharpe 从 −1.93 到 −20.4 的区分度有限——两个从未交付预测器的配置反而拿到 −3.04/−2.57 的“较好”Sharpe,说明风险指标在该窗口内几乎不分离配置;部分 Adaptive 队列只有 1 条轨迹(GLM、GPT-6-Astra 2 条、MiMo 1 条),工作流结论统计功效弱;LLM 供应商费用只部分记录且未并入净分,无法做端到端成本收益分析;合成净分含命中奖励与平滑项,并非严格适当评分规则,跨配置比较可能受激励设计影响。
独立分析的弱点
弱点一:评测窗口太短(10 天 324 场),配置间差异易被运气淹没,重复轨迹共享同一批结果、并非独立时间复制;应扩展到整年多窗口滚动评测并报告日级稳定性。弱点二:净分 $Net=100\sum_r[g_r+I_r(h_r-1/n_r)]-C$ 的命中项只奖励首选命中,平滑又使最优报告 $p=(q-\lambda/n)/(1-\lambda)$ 偏离真实信念,Net 并非严格适当规则,可能诱导押单一热门;应同时报告不含奖励项的纯对数增益分解。弱点三:工作流对比队列严重不平衡(Adaptive 仅 1–6 条轨迹),且两工作流交付类别不可直接等价比较,应补足配对样本。弱点四:两个工作流都稳定亏损,但协议未给出“预测要多准才能在 20% 抽水下盈利”的盈亏平衡分析,无法判断差距是能力问题还是结构性门槛。弱点五:赔率既被排除出输入又被用于 Kelly 结算与偏差诊断,选注偏差与赔率带的关系只在 GLM 队列粗略展示(赔率≥10 占 Adaptive 57.05% 周转额),应系统化为标准诊断。
未来方向
作者提出的方向:把协议推广到其他运动、非结构化文本证据(赛事评论、新闻)与更广的序贯决策任务;用匹配的反馈干预和独立结果窗口,把“从结果中学习”与“额外分析/调试/数据访问”的贡献分离开;在替代定价方案下研究智能体的信息采集与资源分配适应;评估难度路由对成本收益比较的影响。基于成果可延伸的:把冻结对照 + 计价工具的组合移植到金融、体育分析和运维预测等领域,形成通用“预测—行动—结算”评测族;引入在线(真正未发生)赛事消除回溯反事实疑虑;把“条件于决策规则的概率校准”发展成标准诊断指标(本文只做了描述性均值差);结合供应商费用绘制“每 1 日元研究费换来多少预测增益”的弹性曲线,回答最优推理投入;进一步模拟赔率内生形成的市场环境,检验预测优势在策略性对手与群体博弈中的衰减速度。
复现评估
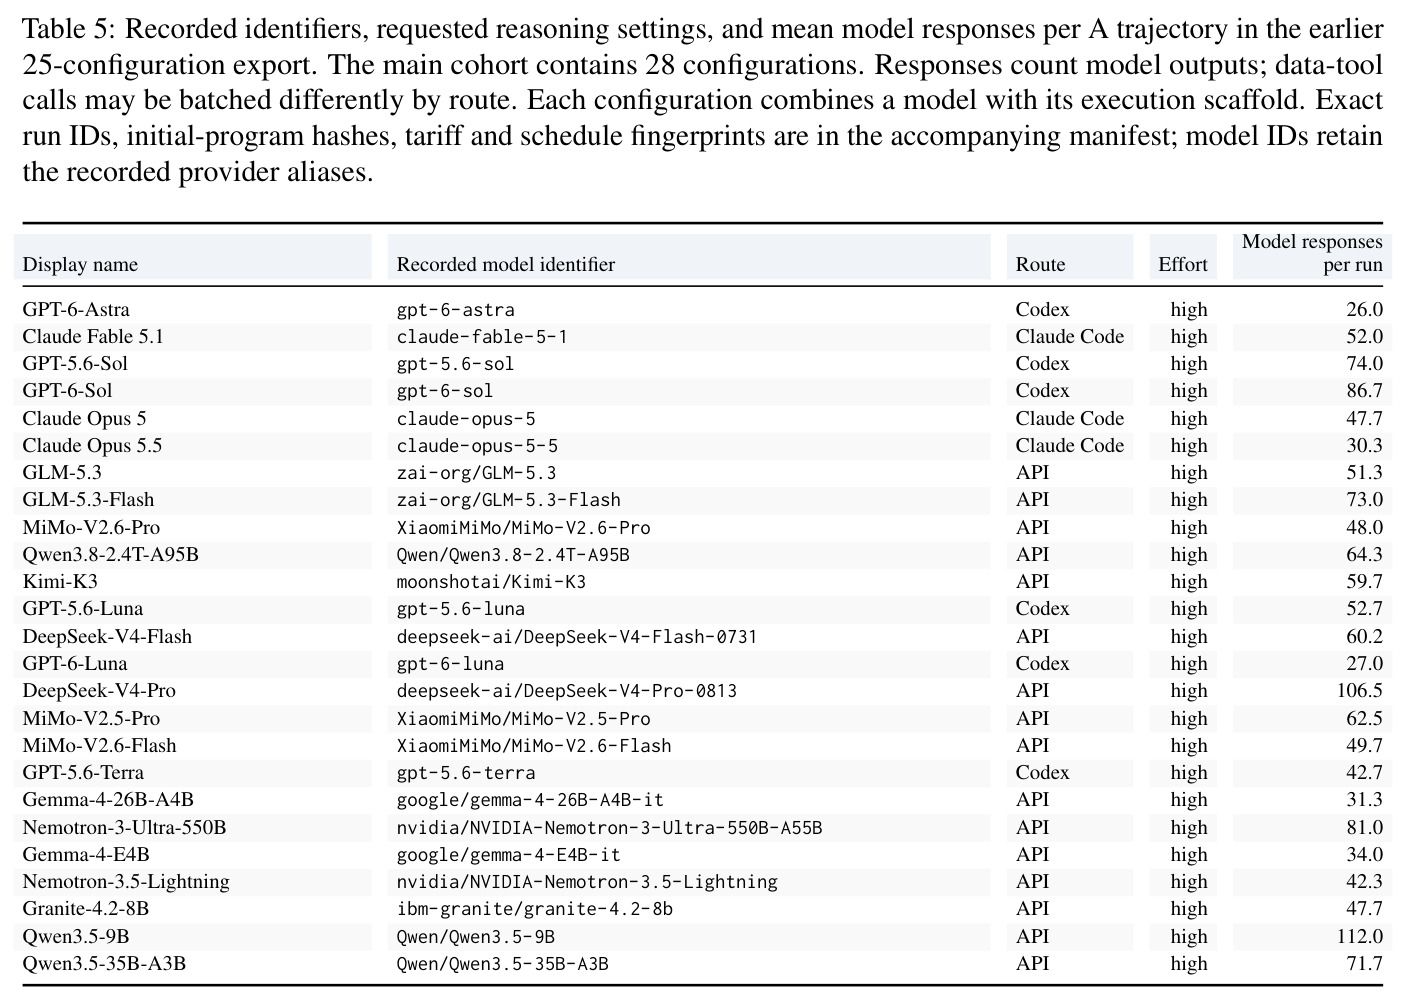
开源情况:代码库公开(github.com/HKUST-KnowComp/JockeyBench),附最小接口补充包,内含完整参考系统提示词、工具 schema、阶段指令、验证/评分/回退代码节选与小型测试套件;论文另给 SHA-256 清单、运行 ID、配对与费率指纹的聚合审计流程。数据门槛较高:JRDB 为商业会员制档案(6.45 GB、41 个文件系列、定宽 Shift-JIS 需按字节切片后 CP932 解码、1,100 个字段定义人工转写),伪匿名 HMAC 映射与原始文件留在评测主机,公开发布尚待授权。算力与成本:28 配置×约 5 条轨迹×324 场,每轨迹数十至上百次模型调用(DeepSeek-V4-Pro 平均 106.5 次/运行),外加 40,428 个程序化预测输出,API 开销不小但无需训练模型;沙箱为 Python 3.13.2 + NumPy/SciPy/scikit-learn 固定版本、无网络。综合难度:中高——协议工程(时间门控、计价账本、验证回退)实现复杂,完整数值复现还需授权档案访问。
论文图表
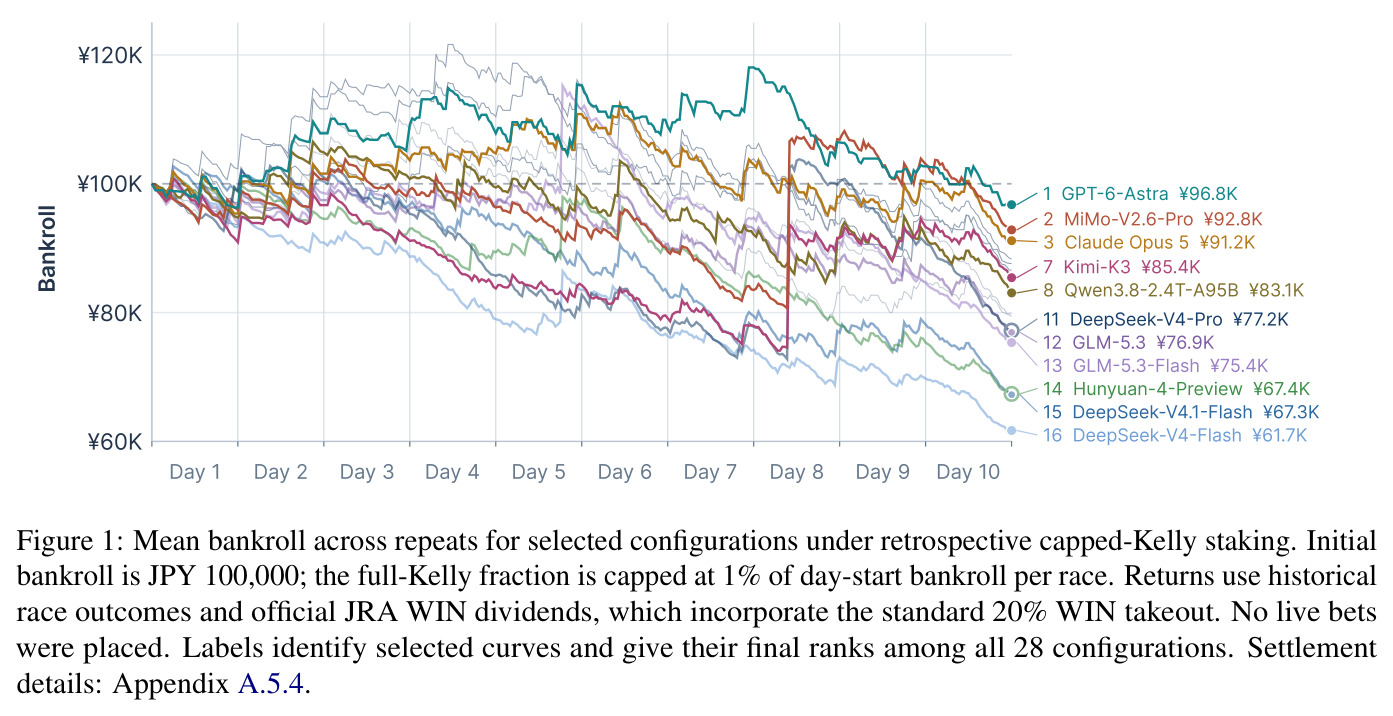
展示 10 个赛日中部分配置在封顶 Kelly 结算下的平均资金曲线(初始本金 10 万日元,每场押日初资金 ≤1%,官方含 20% 抽水的 WIN 分红),并标注 28 个配置中的最终排名:GPT-6-Astra ¥96.8K 居首、MiMo-V2.6-Pro ¥92.8K、Claude Opus 5 ¥91.2K,往下依次是 Kimi-K3 ¥85.4K、Qwen3.8 ¥83.1K、DeepSeek-V4-Pro ¥77.2K 等,所有曲线都收在 10 万本金之下。
一图点出全文核心结论:许多配置对数增益为正却全员亏损,直观呈现“预测质量≠决策价值”的鸿沟,是引言与摘要论点的可视化证据。
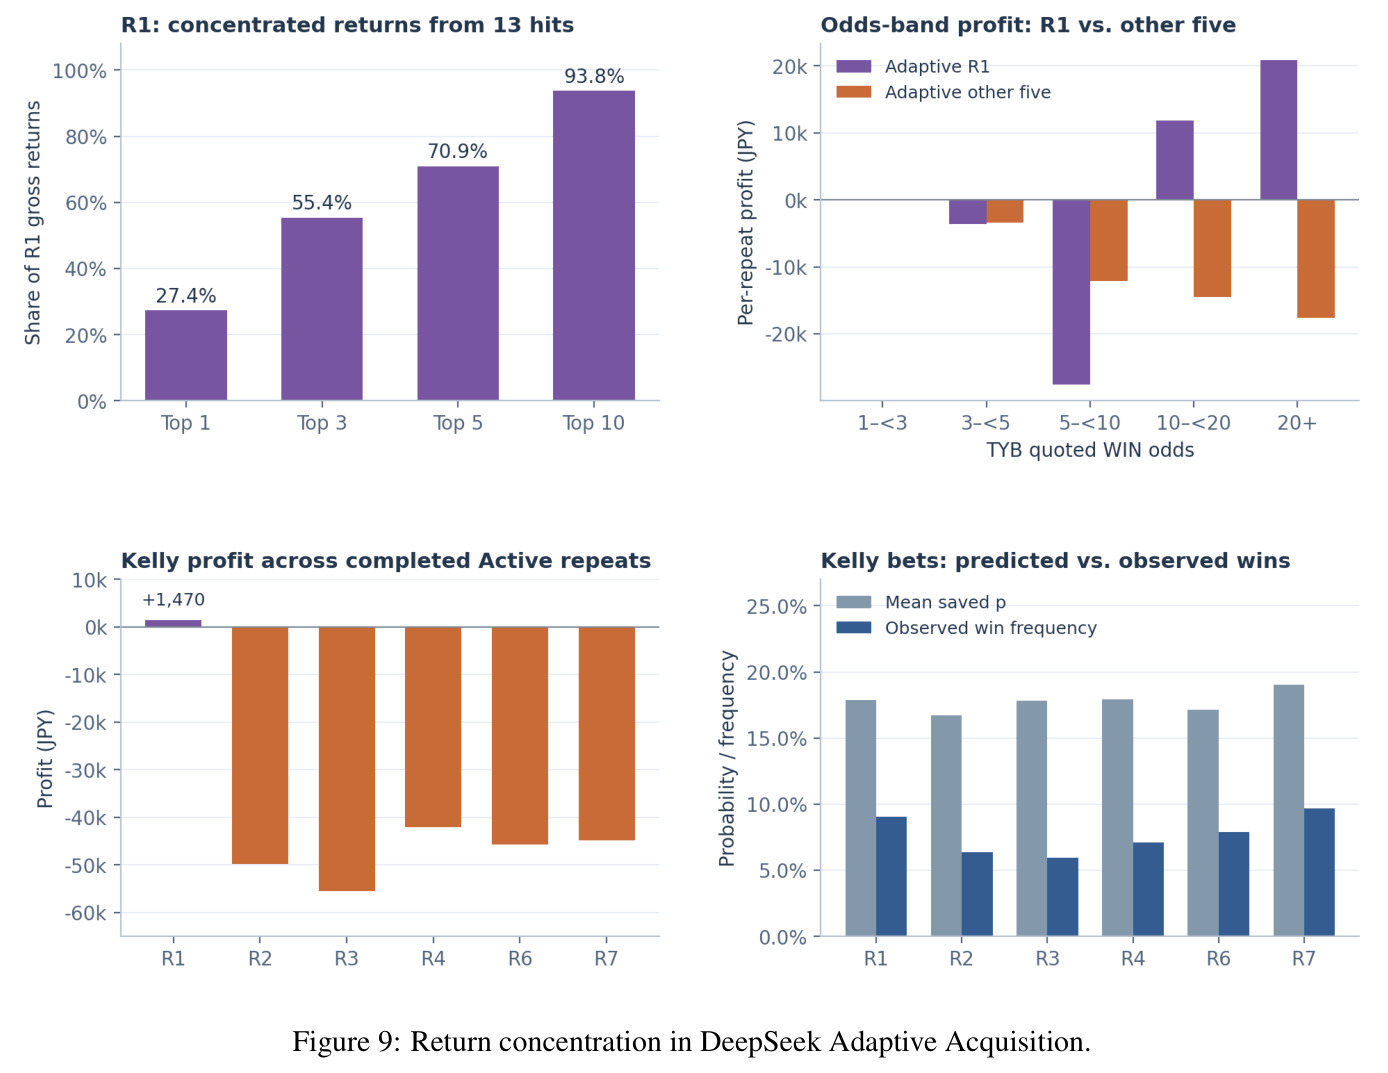
分解 DeepSeek Adaptive 六条轨迹的票券回报集中度:R1 三张最大赢单占总毛回报 55.35%,赔率 ≥10 的票在 R1 贡献 +¥32,700 净利而在其余五条平均 −¥32,050;R1 被 Kelly 选中的注平均概率 17.88% 对实际胜率仅 9.03%。
揭示个别盈利轨迹依赖集中彩票式回报而非整体概率优势,是“不要被单次盈利骗了”的关键诊断图,也暴露选注子集上的校准崩坏。
五组共 97 个白名单字段的完整清单:比赛条件 23、参赛马属性 25、训练 13、历史出战 30、骑师/练马师统计 6,并列出被扣留字段(赔率、人气、分红、专家指数与评分、预测位次、自由文本、真实姓名、绝对日期等)。
定义智能体的信息边界与数据工具契约,是理解“为何智能体难超市场”和复现实验的基础。