E-Commerce Bench:评测LLM智能体长时程自主商业运营能力的基准 E-Commerce Bench: Evaluating LLM Agents on Long-Horizon Autonomous Business Operation
首个融合确定性供应商谈判与真实电商数据的365天持续经营智能体评测基准
前置知识
LLM 智能体与工具调用
以大语言模型为决策核心、通过循环调用外部工具完成任务的系统:每轮模型输出推理和一批工具调用(查库存、发消息、定价等),环境执行后把结果回填上下文,如此往复直到任务结束。工具调用通常以文本协议(如 function calling)传递,模型不直接执行代码,而是发出结构化请求由外部运行时落地。
本文的评测对象正是这类智能体,基准的回合制循环、18 个工具、按分钟计费的时间预算都围绕工具调用行为设计,理解这一机制才能读懂实验结果中'每工具调用利润''调用预算分配'等指标。
情景式与持续式长时程任务
借用强化学习(Sutton & Barto)的分类:episodic 任务有终止状态,达成目标即结束(如 SWE-bench 修一个 issue);continuing 任务没有终止状态,智能体无限运行下去,按累积结果评分(如持续经营、量化交易)。持续式任务更能暴露长程一致性丧失、无法把经验转化为更好决策等深层缺陷。
本文属于持续式任务(365 天经营,无终局目标只有累积资产),理解这一区分才能明白它与 SWE-bench 类基准的本质差异,以及为什么'单次技能强'不等于'一年经营强'。
上下文窗口与淘汰(eviction)
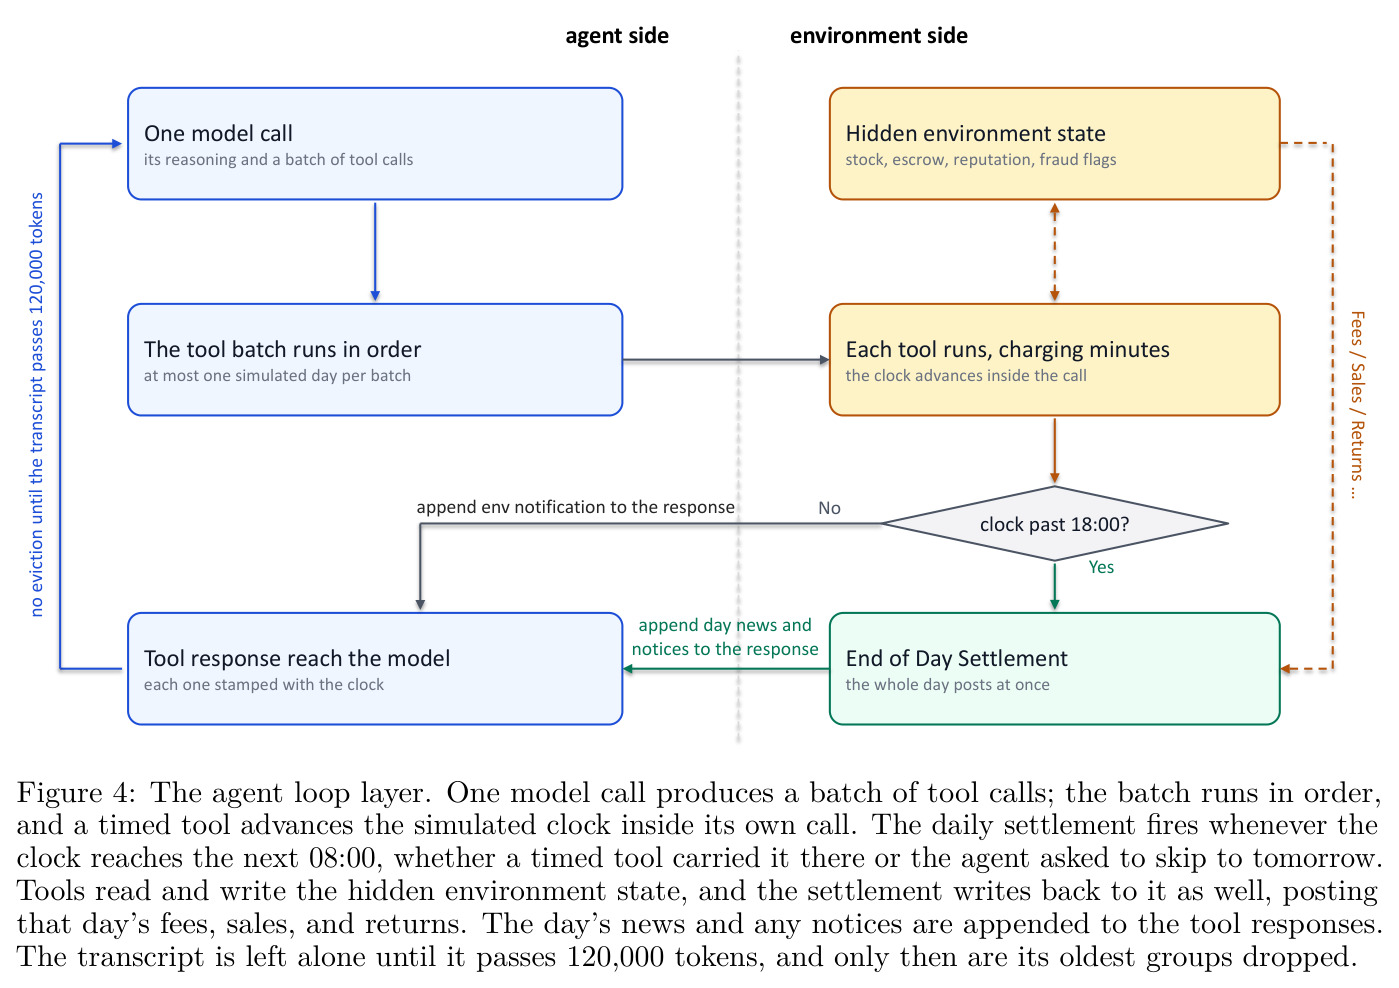
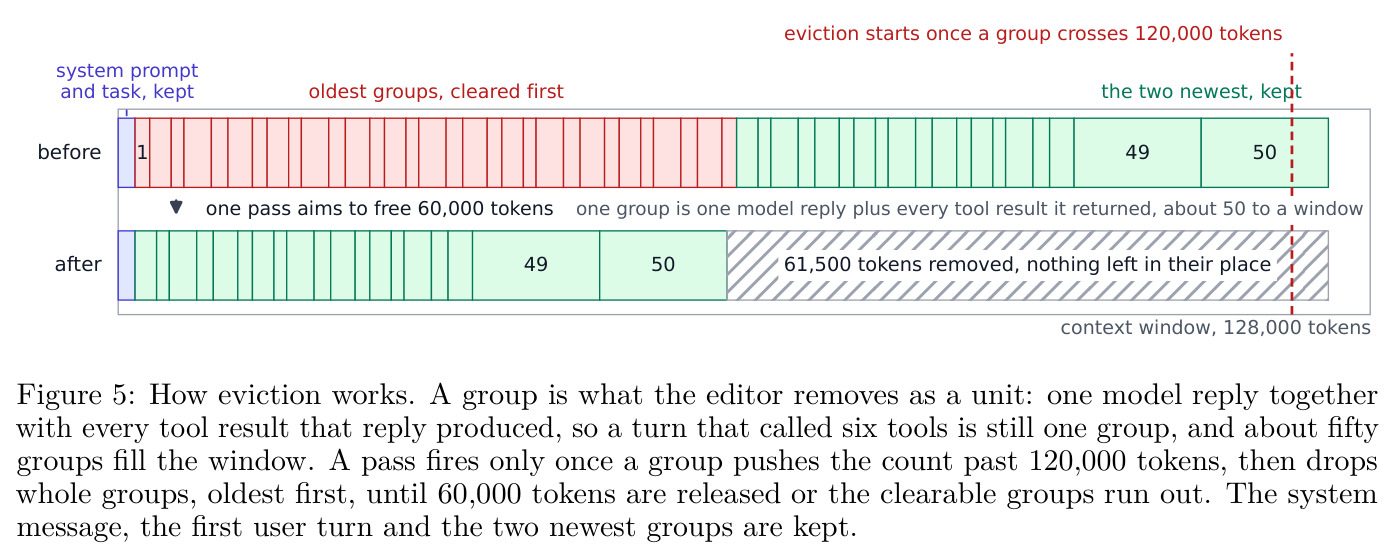
上下文窗口是模型单次可读的 token 上限。一年上万次工具调用的记录远超 128k token,必须有策略地删除旧内容。本文的做法:当计数达到 120,000 token 时触发一次淘汰,以'组'(一次模型回复及其全部工具结果)为单位从最旧开始删除,直到释放 60,000 token,系统消息和最新的两组受保护。
淘汰会不可逆地销毁已谈好的价格、供应商特性等关键信息,是论文分析'为什么 16/18 个模型一年下来进货价越买越贵'这一长时程学习失败的核心机制之一。
双边讨价还价与 ZOPA
买卖双方各持私密底价:卖方有不会低于的成本底线 $c$,买方有市场参考价 $v$,可能成交区间(ZOPA, zone of possible agreement)即 $[c, v]$。经典模型(Harsanyi 不完全信息博弈、Rubinstein 轮流出价)研究双方如何让步与成交。自动化谈判常用'剩余效率'度量一方捕获了区间的多大比例。
整个谈判引擎按此建模:智能体不知道供应商底价,谈判指标 CSE+ 就是它从参考价 $v_j$ 压到成本底线 $c_{sj}$ 之间捕获的比例,理解 ZOPA 才能读懂谈判维度的全部设计。
确定性模拟与可复现评测
给定相同的动作序列,环境产生完全相同结果的模拟。实现方式:所有随机数来自同一个 episode 种子,对手策略用显式规则(而非 LLM 采样)实现。这样模型之间的性能差异可以完全归因于智能体策略本身,而不是对手抽到了好牌或坏牌。
这是本文与 Vending-Bench 类基准最核心的区别,也是其方法论贡献(确定性谈判核+渲染器)存在的原因;不理解确定性,就无法理解为什么 90 个 episode 里 1,264 倍的资产差距'完全属于策略'。
需求价格弹性
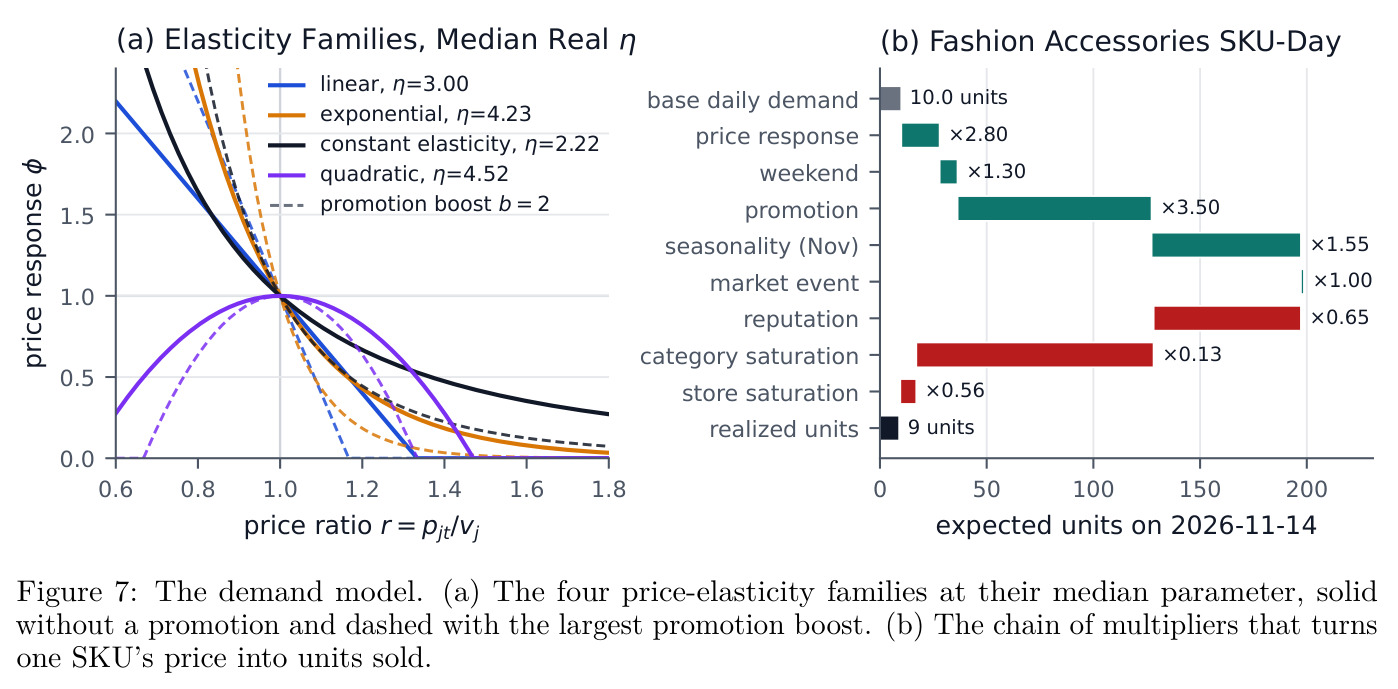
需求量对价格变化的敏感度,通常写作 $\varepsilon = -\frac{\partial q}{\partial p}\cdot\frac{p}{q}$。本文每个类目携带一个弹性族(线性、常弹性、指数、二次)之一,价格响应以价格比 $r_{ijt} = p_{ijt}/v_j$(售价对参考价之比)代入;其中二次族对称于参考价,低于参考价反而损失需求。
定价是智能体的核心决策之一,而弹性参数全年隐藏、只能从销量观察中间接推断。读懂需求模型才能理解销售、库存、退货之间的联动,以及实验中'定价调用只占 0.66%'为何是个失败信号。
电商现金流与延迟结算
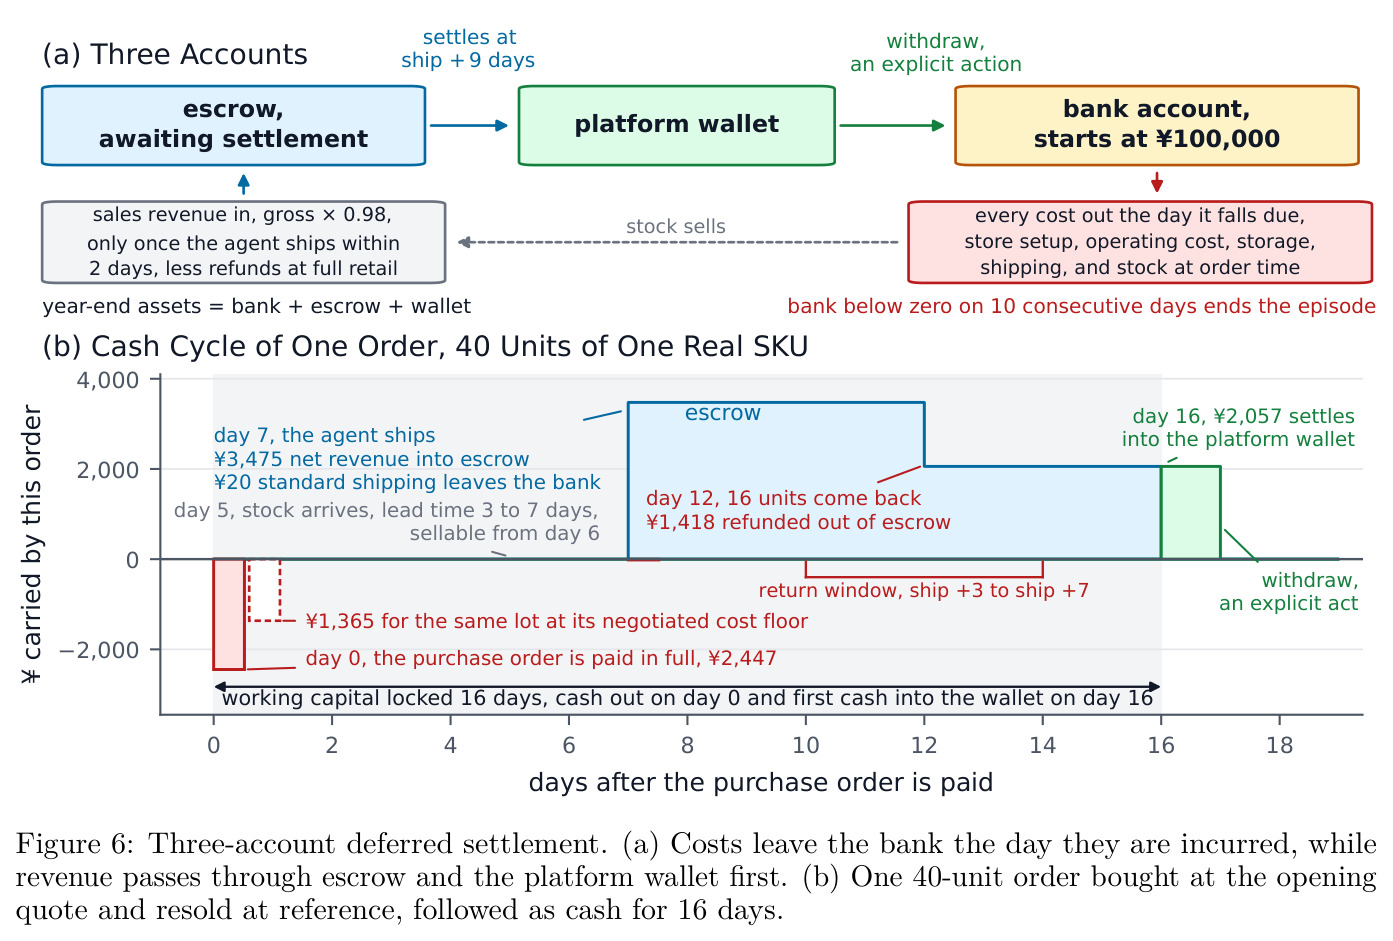
真实电商中'卖出'不等于'收到钱':货款先进平台托管(escrow),扣除佣金、过了退款窗口后才结算到商家可提现余额。本文将其建模为三账户系统——银行(即付即收)、托管(货款 ×0.98,9 天后成熟)、平台钱包(需手动提现回银行),钱在系统中流动有数天到数周的延迟。
盈利能力与可用现金被解耦:一个账面盈利但把钱留在钱包里的智能体仍会因银行连续 10 天透支而破产。这是偿付能力维度和破产机制的基础,也是理解'为什么强模型也会破产'的前提。
研究动机
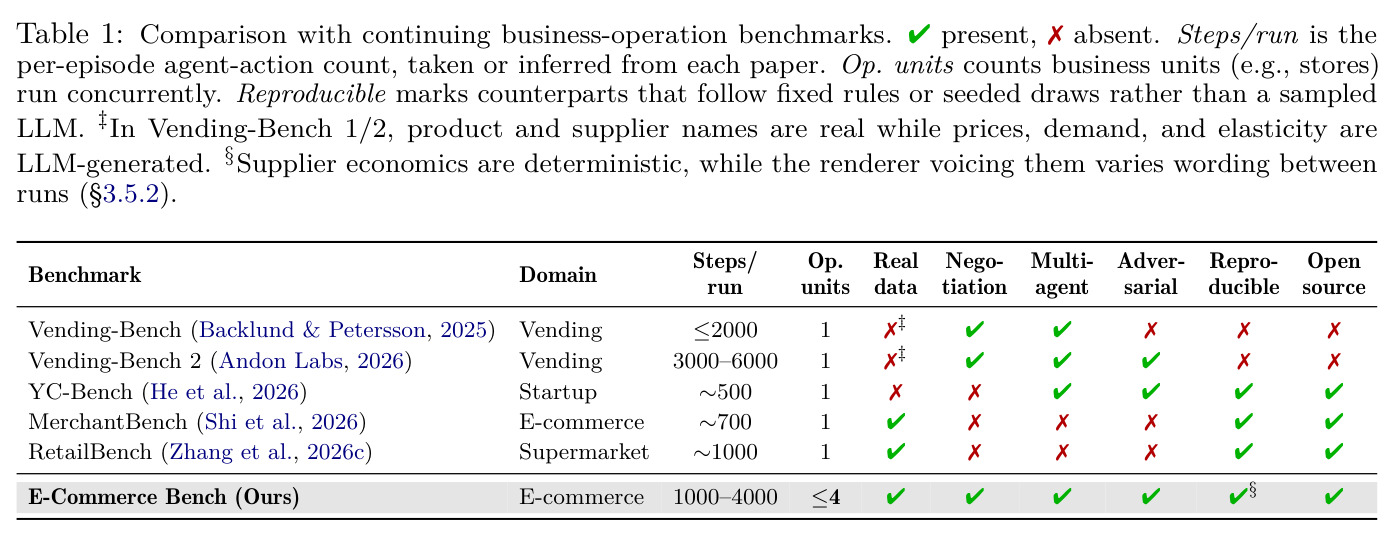
现有的长时程智能体评测无法考察真实经营能力。情景式基准(SWE-bench、OSWorld、GDPval 等)一旦目标达成就终止,无法检验智能体在动态环境中追踪数百个子任务间的依赖、从意外失败中恢复、以及把积累的历史转化为更优决策的能力。持续式基准又各有致命缺陷:Vending-Bench 系列虽然包含多轮供应商谈判并在第二部加入对抗对手,但商品、价格与需求由 LLM 生成,采样噪声大、对手反馈随机,而且 LLM 对手始终'可以被说服'——一个足够雄辩的智能体能把它'哄'到底价以下,评测退化成越狱竞赛,结果既不可信也不可复现;YC-Bench 虽确定性运行一家初创公司整年,却完全没有供应商采购环节;MerchantBench 与 RetailBench 虽基于真实数据、代码开源,却把谈判与对抗动态完全砍掉。简言之,现有基准要么偏离真实市场动态,要么依赖纯 LLM 驱动的谈判对手而引入大量采样噪声,同时损害评测的可信度与可复现性,没有任何一个同时具备真实数据、多轮谈判、对抗动态和可复现性。
本文的目标是本文要构建首个开源基准,把确定性供应商谈判、动态事件与多店铺并行经营统一进一个 365 天的持续商业运营任务。智能体拿到 ¥100,000 本金和 2026 全年日历,最多同时运营 4 家在线店铺,需要调研市场、与供应商多轮议价进货、制定定价与促销策略、履约发货、处理退货、管理现金流,目标是最大化年末总资产(银行+托管+钱包之和)。为保证评测严格可复现,市场两侧全部确定性化:客户购买与退货由固定需求模型驱动(价格弹性、周末、促销、季节性、市场事件、店铺声誉六个乘子加两个容量上限项),随机性全部由 episode 种子控制;供应商的每一次报价、让步与接受/拒绝由确定性谈判核决定,LLM 只负责把已锁定的决定转述成对话。在此之上,用年末资产加六个能力维度(谈判质量、欺诈规避、偿付能力、运营效率、经营执行、长时程学习)对 18 个前沿及开源模型做'能力画像'式评测,让单一总分无法再掩盖模型的短板。
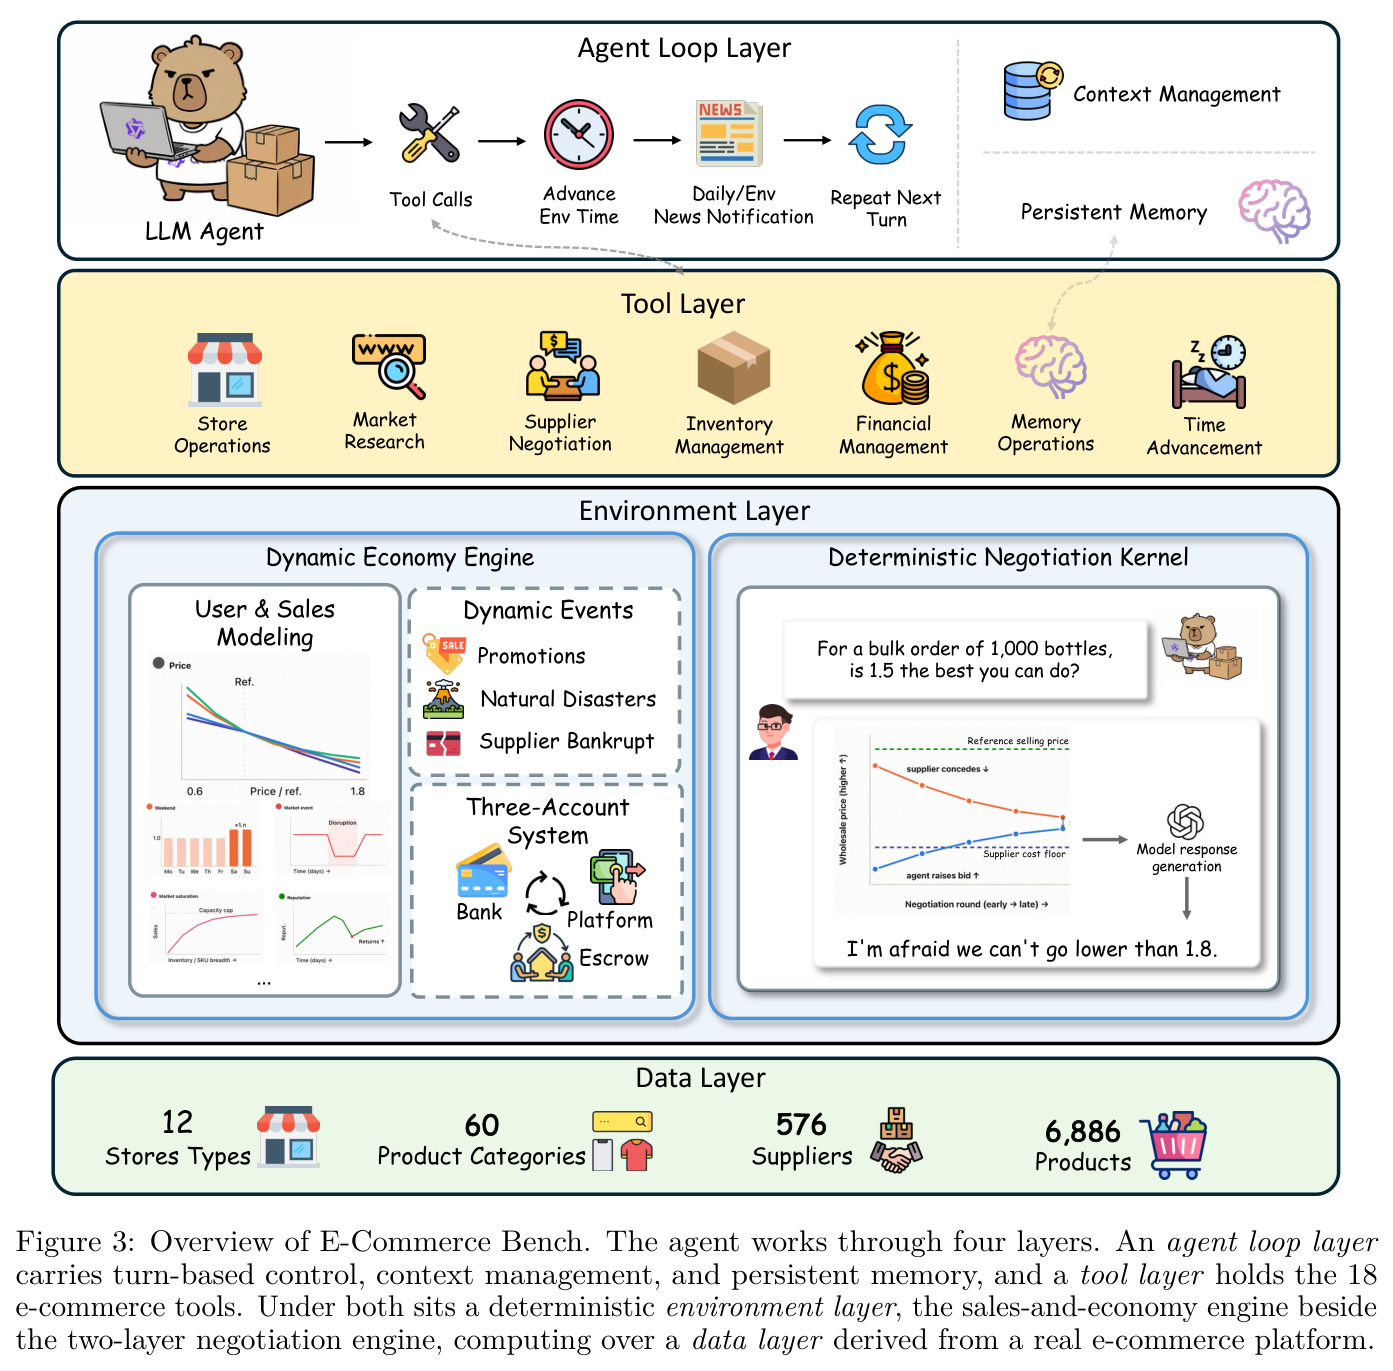
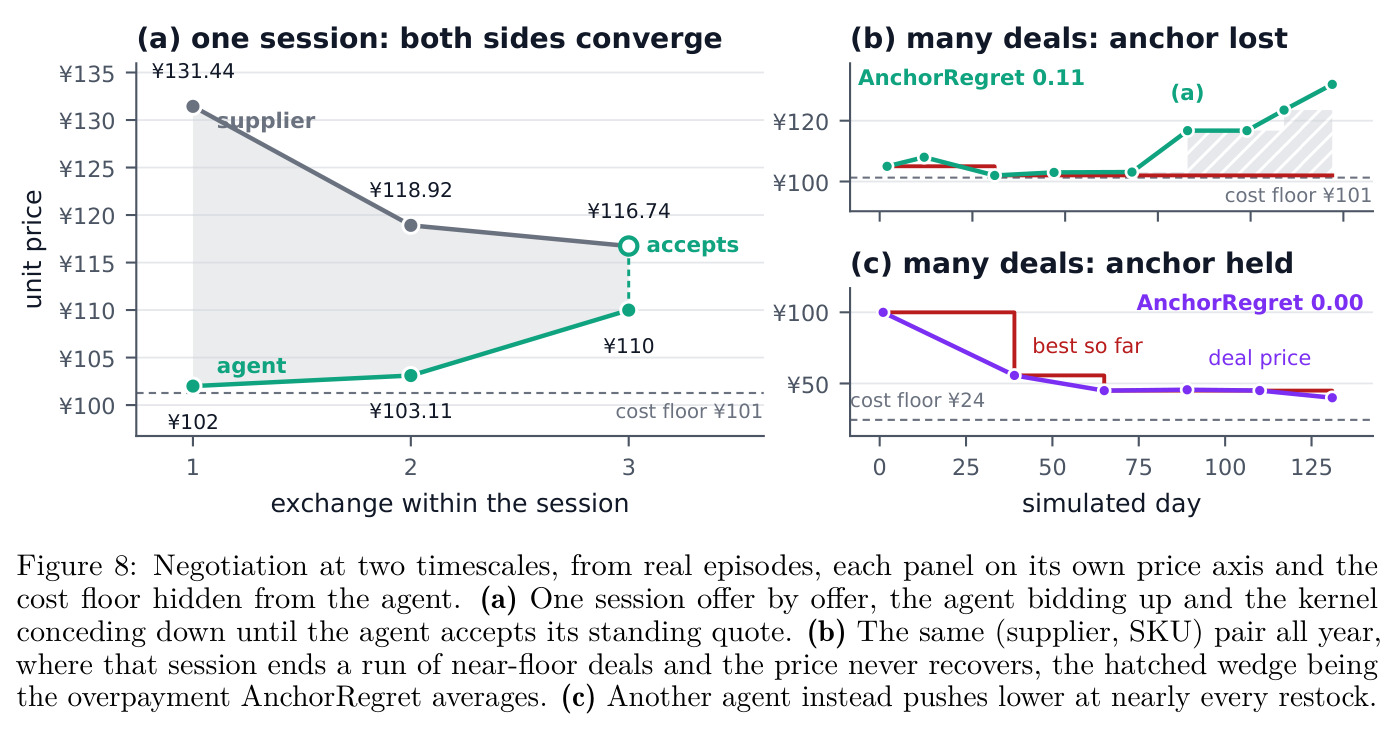
与已有工作不同的是,本文的独特切入是把'谈判对手'从 LLM 采样改为确定性谈判核(kernel),并让 LLM 退化为纯粹的台词渲染器(renderer)。作者的论据是:完全由 LLM 扮演的供应商有两重破绽——采样使其报价在 runs 之间漂移;它始终可被说服,足够雄辩的智能体能让它跌破自己的底价。因此每个供应商拆成两层:Layer 1 是确定性谈判核,承接 TERMS-Bench 的单次议价对手策略并重实现为卖方角色,扩展到跨供应商、重复议价的年度尺度,每个核服务一个(供应商,SKU)对,底价与开场报价来自真实平台数据校准的数据层而非随机抽取;Layer 2 是 NPC 渲染器,一个 LLM 只把核已锁定的决定'演'成对话,且成交校验要求价格与核报价误差在 ±0.005 以内,渲染层在经济上完全惰性。同时用淘宝天猫真实数据(6,886 商品、576 供应商)替代 mock 数据,并对促销名称做虚构化,防止模型凭参数记忆识别'双11'式大促作弊。评价哲学上,本文把'排行榜'升级为'能力画像':总分之外的六个维度让'最会赚钱的模型既不是最好的谈判者也不是高效的运营者'这一事实得以显形。
核心方法
直觉上,E-Commerce Bench 是一个'经营游戏':你是一家网店老板,一年内进货、议价、定价、卖货、管钱,年底数钱。技术上它由四层组成。最上层是智能体循环层:回合制循环把一次模型调用限定为一批按序执行的工具调用,每个工具消耗模拟时间(600 分钟工作日,查余额 10 分钟、发消息 30 分钟),时钟过 18:00 跳到次日 08:00 并触发 13 步日结;所有模型共用统一 128k token 上下文预算,超过 120,000 即按组淘汰最旧内容直到释放 60,000;另有环境侧的 20 条持久记忆库,淘汰碰不到它。第二层是工具层:18 个覆盖商家后台的工具,分七组覆盖从谈判到财务的全流程。第三层是确定性环境层:销售与经济引擎(多店铺、三账户延迟结算、多因子需求模型、履约退货、声誉、动态事件、日结)与谈判引擎(确定性核+LLM 渲染器、五类脚本骗局)并排运行,两边都不采样。底层是数据层:12 种店铺类型、60 个类目、576 家供应商、6,886 件商品与含 10 个市场事件、8 个促销的全年日历,全部来自真实电商平台脱敏或据其日志合成。
核心创新是'两侧都确定性的市场'。需求侧:单 SKU 单日销量 $\tilde{d}_{ijt}$ 由固定公式给出——类目基线乘以价格响应 $\phi_{f_c}(r_{ijt};\eta_c b_{it})$(价格比 $r_{ijt}=p_{ijt}/v_j$ 代入四个弹性族之一)、周末、促销、季节性、当日事件、声誉六个命名乘子,再被类目与店铺两个容量项 $\gamma$ 裁剪;例如某饰品 SKU 在促销周六的复合期望 128.2 件被容量项砍到实际 9 件。供给侧:每个(供应商,SKU)对由一个确定性谈判核服务,保留价与开场报价来自数据层;核响应对手的让步速度而非时钟,让步快会遭遇更强硬的还价;约 1/4 供应商(152/576)运行 5 种脚本骗局。与已有工作的本质区别:Vending-Bench 的对手是可被说服的 LLM,价格随采样漂移;本文核的每个价格与接受/拒绝决定在 runs 之间完全一致,LLM 渲染层被 ±0.005 价格校验锁死、经济上惰性。因此 90 集 1,264 倍的资产差距完全归属智能体策略而非运气。
方法步骤详情
初始化:智能体获得 ¥100,000 银行余额、18 个工具和 2026 年历,最多开 4 家店铺(开店 ¥500、日运营 ¥60-130)。每回合:模型输出推理和一批工具调用,按序执行并扣模拟分钟,超 120k token 触发上下文淘汰。日结:时钟到次日 08:00 执行 13 步——先扣运营与仓储费,再把前日需求变成订单、取消超期未发货订单、结算托管、交付到货、更新声誉。销售与回款:货款按 98% 进 escrow,9 天后成熟进钱包,需显式提现回银行——40 件订单第 0 天付 ¥2,447,第 16 天才见首笔回款。谈判:经 chatbox 开场,核按模板报价,还价后核依让步策略回应;成交即全款支付,3-7 天到货。采购目标为 $\max_\pi \sum_{z\in Z_G}(v_{j(z)}-p_z)q_z-\sum_{z\in Z_B}\ell_z$,即榨取诚实供应商的剩余、计入付给欺诈者的损失。欺诈:成交前骗局的证据只在叙事,成交后到货才暴露(短装 60-70%、退货率 ≥0.40)。终止:连续 10 天银行透支即破产,或跑满 365 天按年末总资产计分。
技术新颖性
技术新颖性有四点。第一,确定性谈判核+渲染器的两层设计是最大的方法论贡献:TERMS-Bench 只提供单次双边议价的规则对手,本文把它独立重实现为卖方角色、以数据层的真实成本底线重新参数化,并扩展到重复、跨供应商、年尺度的议价场景,使'从一次交锋学到的东西能否变成下一次的更好价格'首次成为可度量的任务(AnchorRegret/AnchorRatio 序贯价格纪律指标)。第二,三账户记账(银行/托管/钱包)与破产规则把'盈利能力'与'偿付能力'解耦——账面盈利但把钱留在钱包的智能体仍会因透支 10 天而死亡,这是其他基准没有的财务压力测试。第三,欺诈以现金损失(BadSpend%)而非拒绝率计分,避免'从不主动接触欺诈供应商就满分'的投机策略,因为智能体还要选择联系谁。第四,七维指标体系把单次谈判技巧(CSE+)与长时程经验学习(AnchorRatio)干净分离,再配 10 条带检测规则的失败模式做错误分析;实验还验证了测量的区分度——模型间的 CSE+ 极差 0.204 远大于六种行为模板间的 0.051,说明指标测的是模型能力而非对手抽签。
实验结果
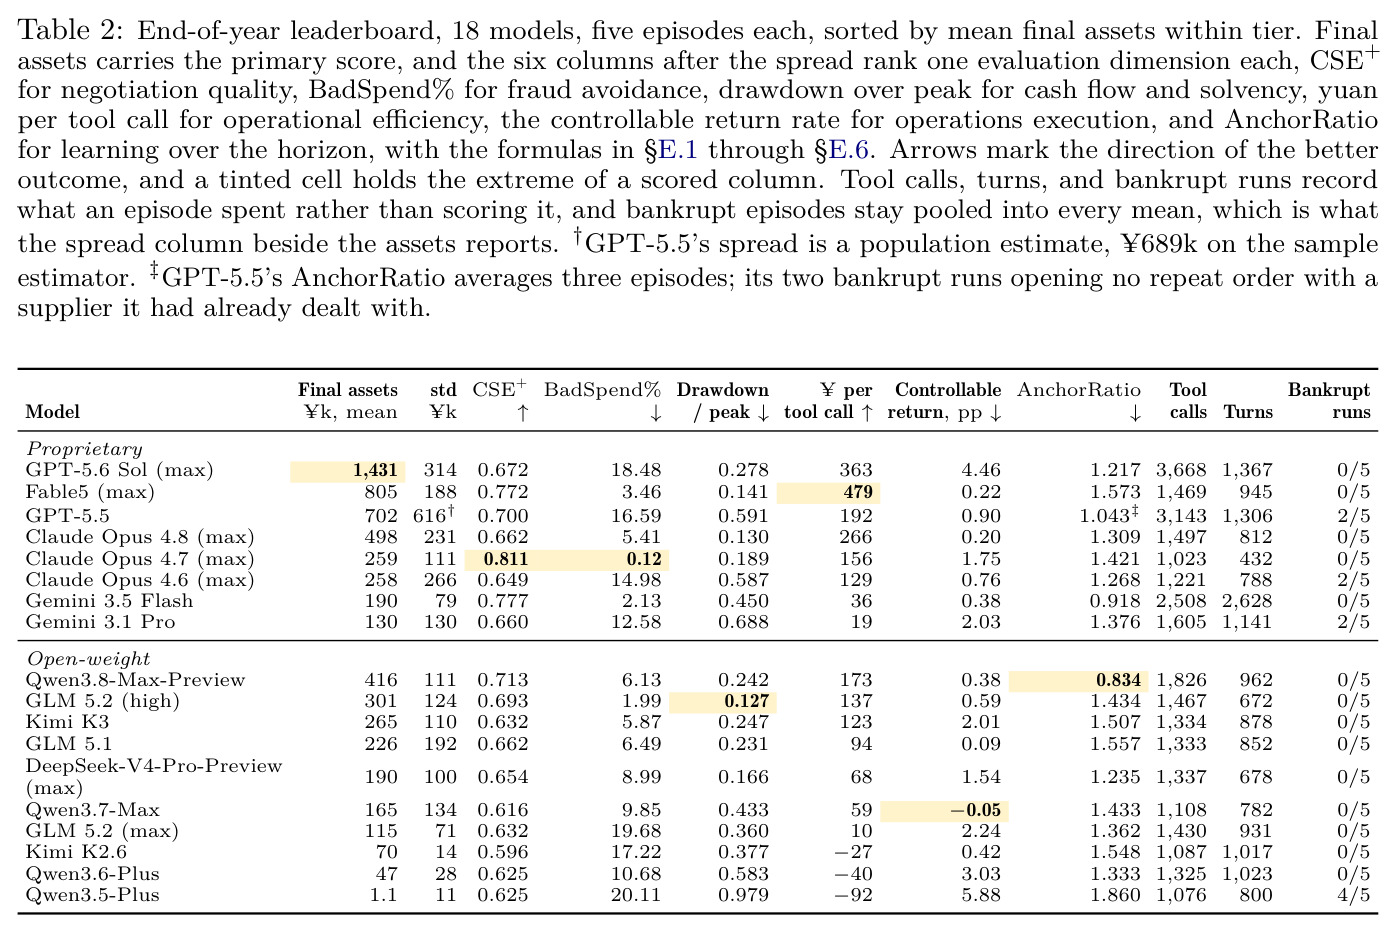
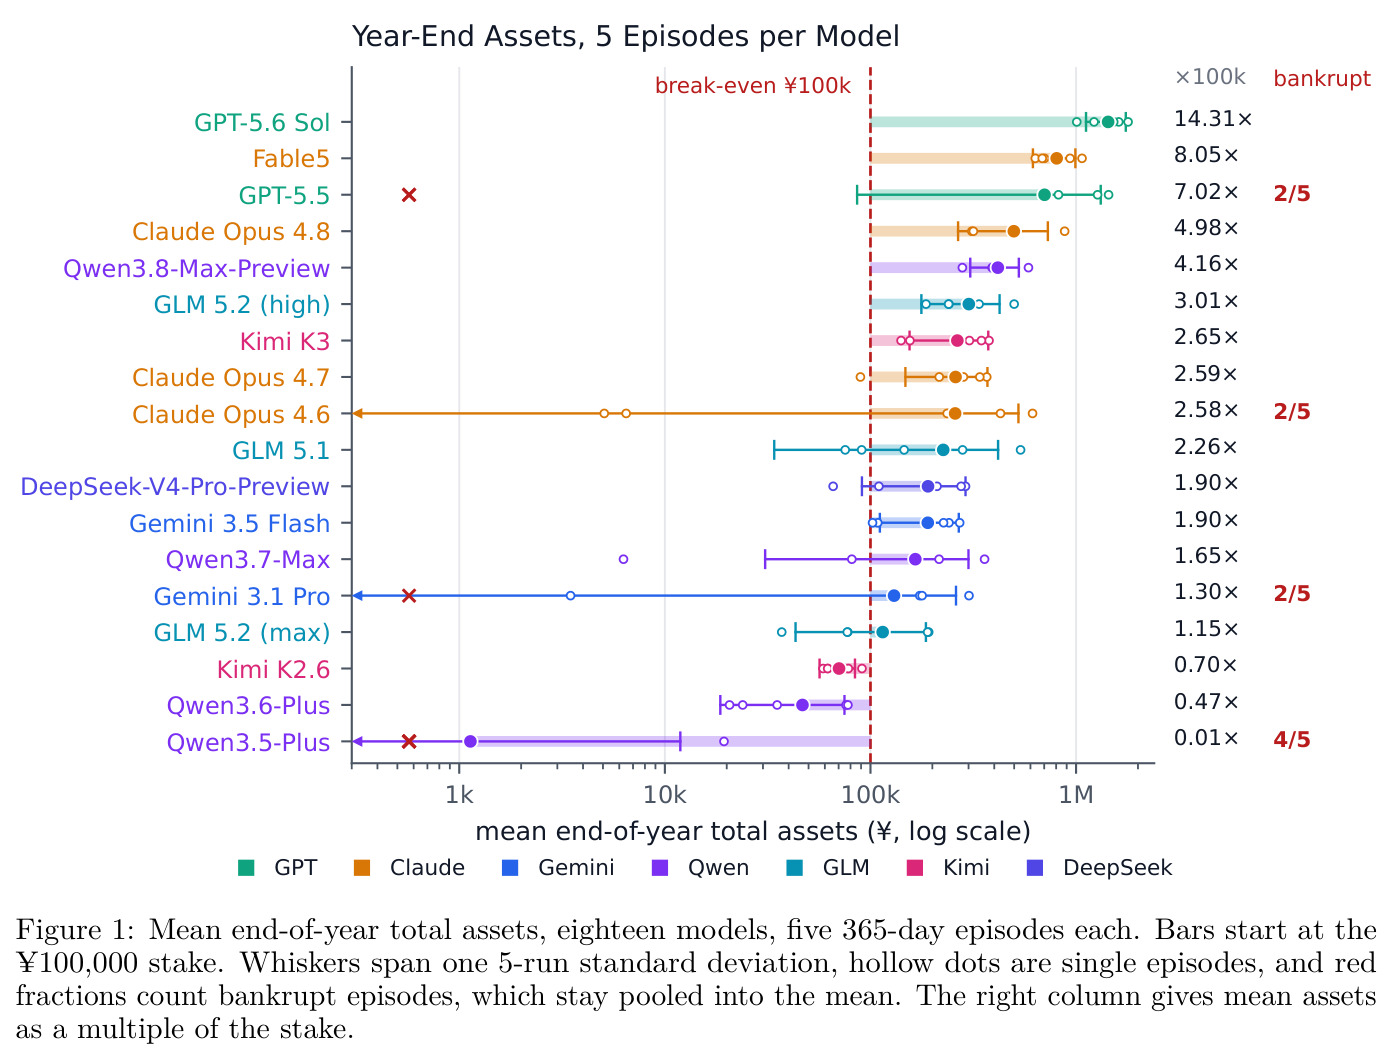
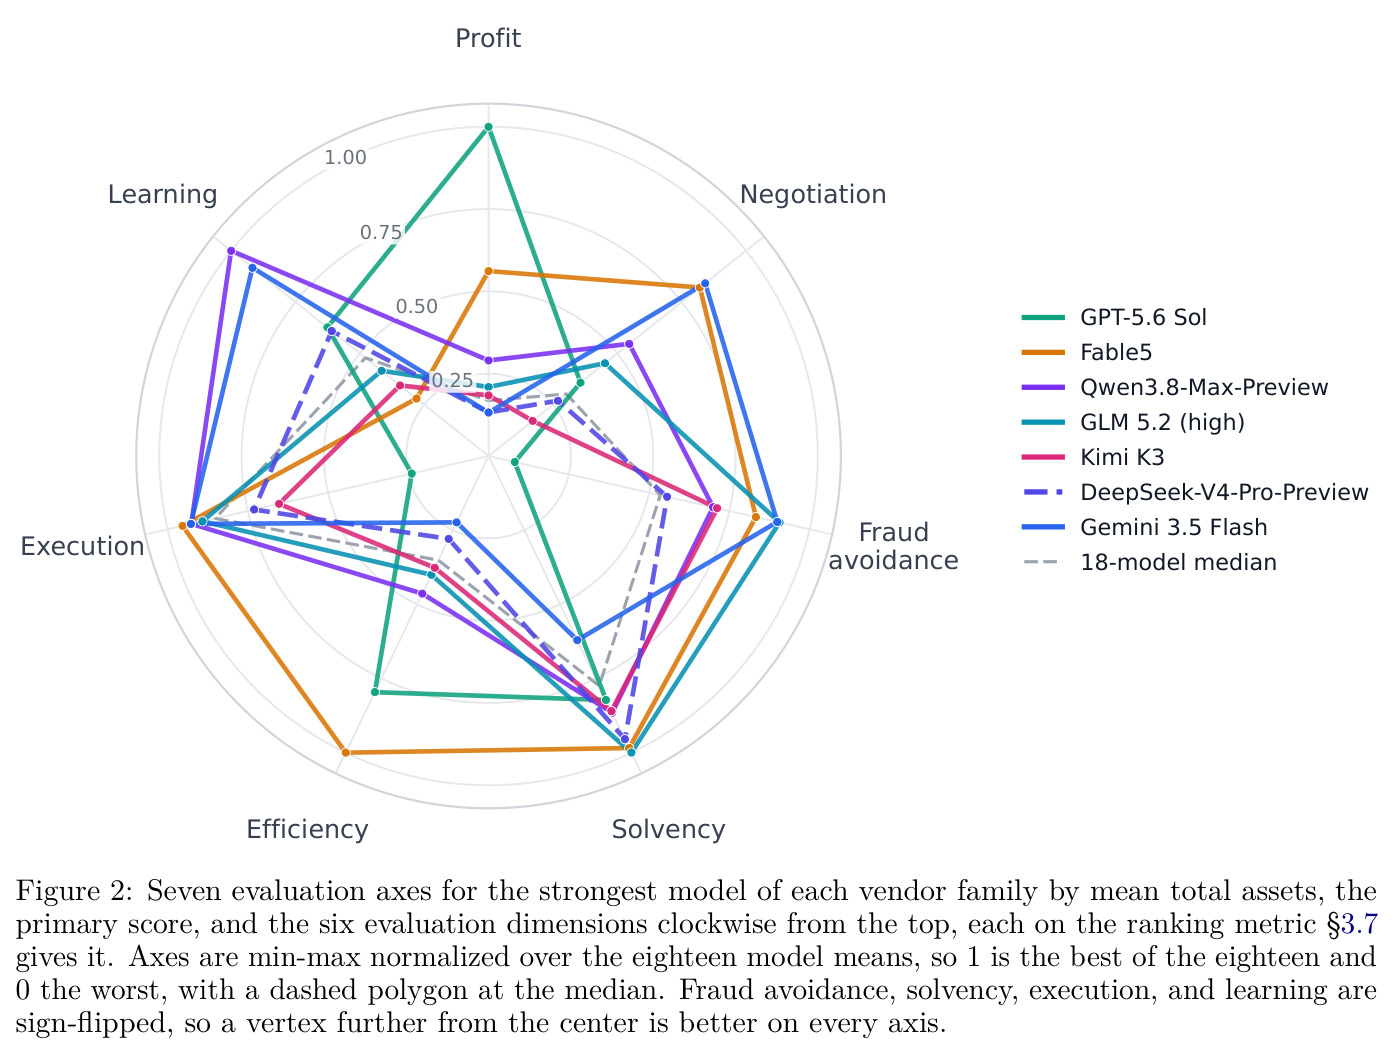
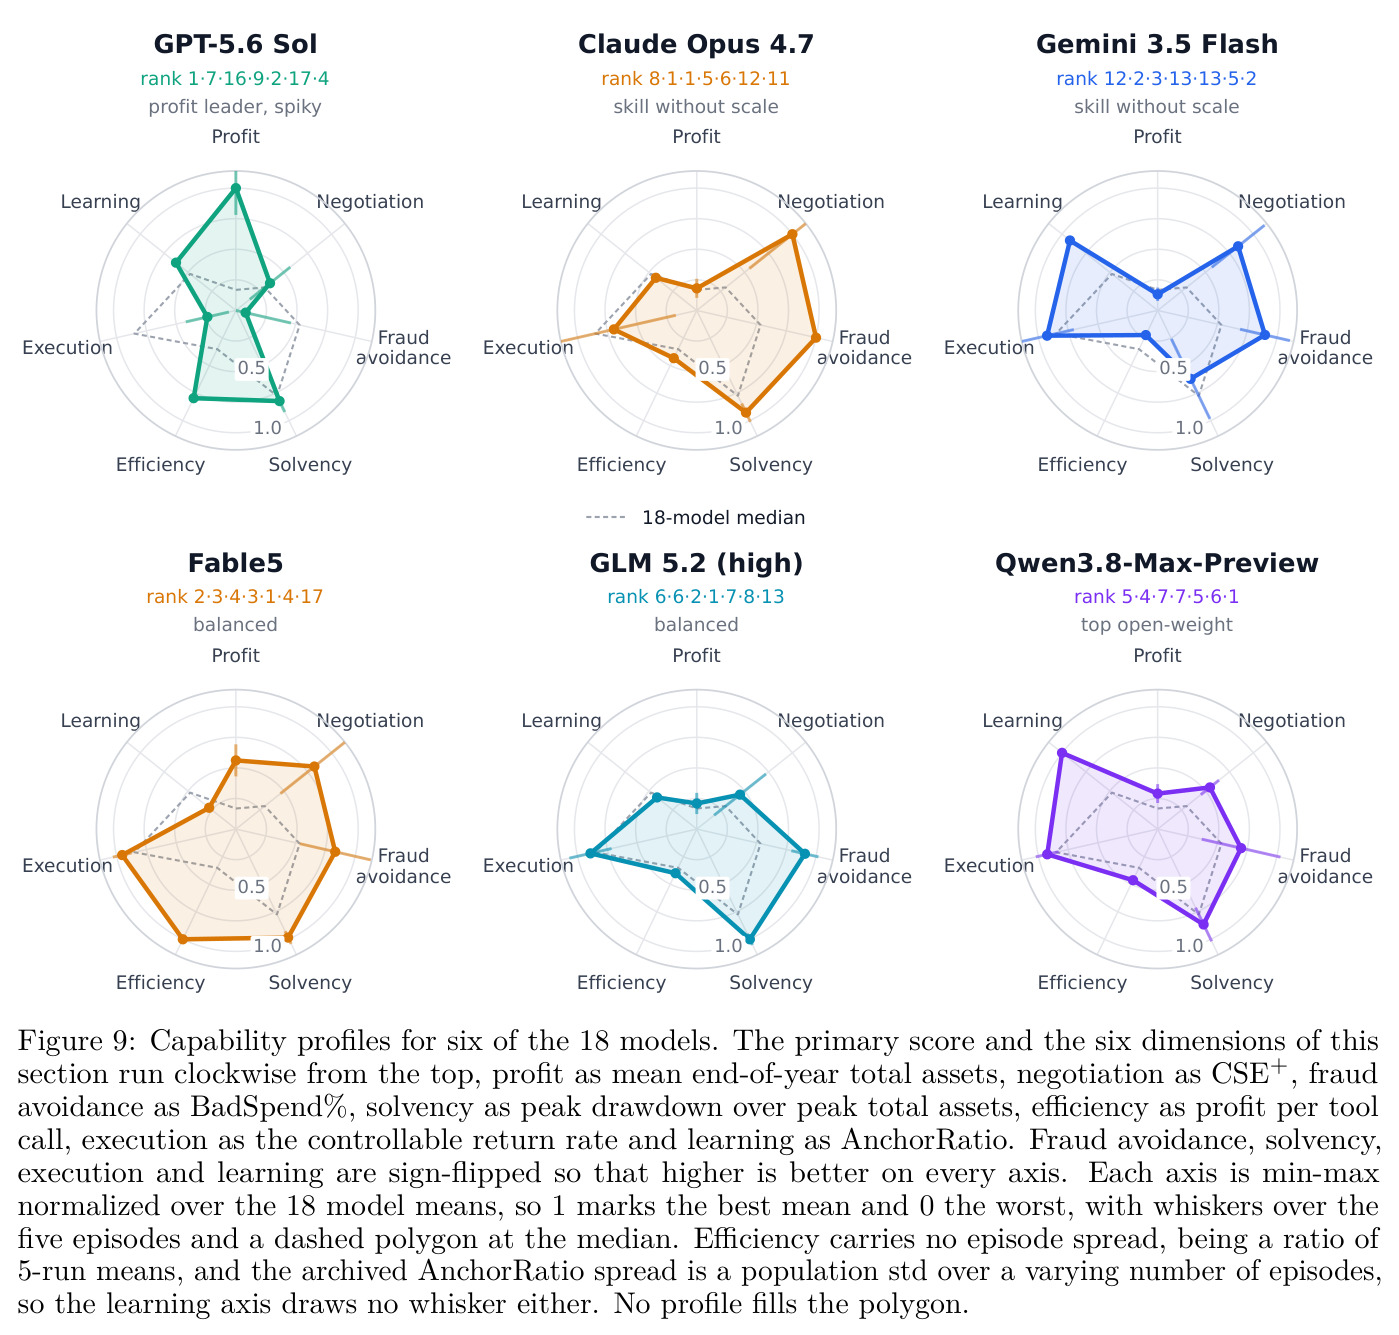
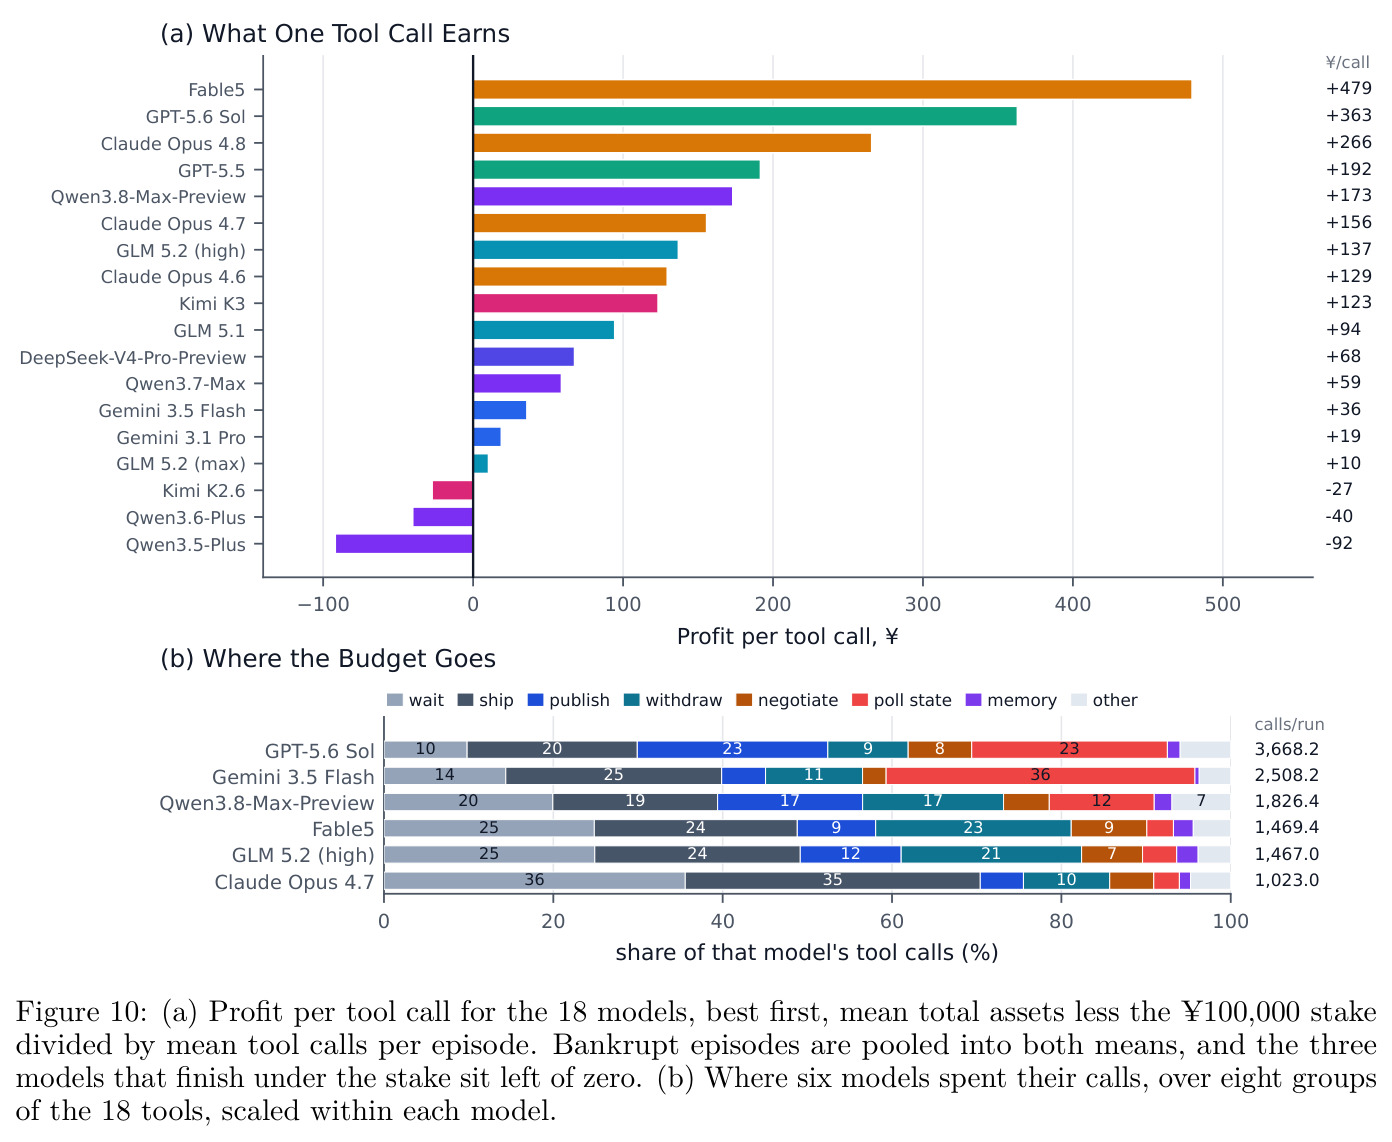
18 个模型各跑 5 个 365 天 episode:GPT-5.6 Sol 把 ¥100,000 做成 ¥1,431,425(14.31 倍),垫底 Qwen3.5-Plus 仅剩 0.01 倍,首尾差 1,264 倍——环境完全确定,差距全属策略;10/90 集破产(GPT-5.5 等四个模型),GPT-5.5 两集第 17 天即倒下。没有全能模型:利润王防欺诈仅排 16/18(BadSpend% 18.48%)、每调用利润 ¥363 低于 Fable5 的 ¥479;Claude Opus 4.7 谈判(CSE+ 0.811 vs 接受首报 0.50)与防欺诈(0.12%)双料第一,资产仅中游 2.59 倍;偿付上回撤超峰值一半的 5 个模型与破产的 4 个重合。开源冠军 Qwen3.8-Max-Preview(¥416,252,4.16 倍,超 GLM 5.2 high 38%)唯一把锚定比压到 1 以下(0.834;8,647 次重复进货中 16/18 模型反越买越贵、中位 1.369)并保持正每日盈余趋势。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 年末总资产(主分数,5 集均值) | 资产倍数(对 ¥100,000 本金) | GPT-5.6 Sol 14.31×(¥1,431,425),开源最佳 Qwen3.8-Max-Preview 4.16× | 盈亏平衡 1.0×;场内最差 Qwen3.5-Plus 0.01×(4/5 破产) | 首尾相差 1,264 倍;开源冠军较开源第二名(GLM 5.2 high,3.01×)高 38% |
| 谈判质量 | CSE+(捕获议价区间比例,1=买到成本底线,0=按参考价成交) | Claude Opus 4.7 0.811 | 接受开场报价即得 0.50;场内最差 Kimi K2.6 0.596 | 较'无脑接受首报'高 0.311,较场内最差高 0.215 |
| 欺诈规避 | BadSpend%(流向欺诈供应商的采购资金占比,越低越好) | Claude Opus 4.7 0.12% | 场内最差 Qwen3.5-Plus 20.11%;GPT-5.6 Sol 18.48%(16/18) | 各模型欺诈支出相差超 160 倍;按份额排名与按现金排名分歧巨大(GPT-5.6 Sol 以更小份额付出 50 倍现金) |
| 运营效率 | 每工具调用利润(¥/call) | Fable5 +479(1,469 次调用) | 资产榜首 GPT-5.6 Sol +363(3,668 次调用);最差 Qwen3.5-Plus −92 | 比资产榜首高 32%,且调用数少 59.9% |
| 长时程学习(序贯价格纪律) | AnchorRatio(1.0=价格顺序与自身随机重排无异,越低越好) | Qwen3.8-Max-Preview 0.834(唯一同时打败自身置换零假设超 2σ 的模型) | 场中位 1.369;最差 Qwen3.5-Plus 1.860;16/18 模型重复进货越买越贵 | 全场仅 2/18(另一个是 Gemini 3.5 Flash 的 0.918)低于 1.0 |
| 经营执行 | 可控退货率(模型定价导致的超额退货,百分点,越低越好) | Qwen3.7-Max −0.05pp(定价低于参考价) | 最差 Qwen3.5-Plus +5.88pp;全场自然退货率背景 5.31-21.25pp | 26/90 个 episode 退货率为负;GPT-5.6 Sol 反以 4.46pp 超额退货换 ¥1.62M 销售额夺魁,说明退货率本身无绝对好坏 |
| 偿付能力 | 峰谷回撤/峰值资产(越低越好) | GLM 5.2 (high) 0.127 最好,Qwen3.8-Max-Preview 0.242 | 5 个模型回撤超峰值一半,包含全部 4 个破产模型;GPT-5.5 达 0.591 | 回撤超一半的 5 个模型与曾破产的 4 个模型完全重合,该维度有效预警破产 |
局限与改进
作者承认的局限:每模型仅 5 个 episode,样本小——GPT-5.5 的资产标准差高达 ¥616k,与其均值同量级,故所有均值附标准差;渲染 LLM 按默认解码采样、到货天数在种子外抽取,防欺诈轴因此叠加渲染噪声——15/18 模型的 BadSpend% 标准差超过均值;由单一渲染器为所有供应商配音,措辞风格可能系统性偏向某些模型;CSE+ 与 AnchorRatio 不按订单量加权,只反映单笔议价技巧而非采购现金节省;核的每次开场报价逐周期重抽且档案不留存,锚定比只能对固定底价而非固定开场解读。我的补充观察:需求与成本参数虽隐藏但完全固定,而 5 个独立 episode 恰好阻止跨 episode 反向工程,两者如何平衡未讨论;结论深度绑定该 harness 的 128k 上下文、组淘汰与 20 条记忆库——长时程学习失败可能部分是 harness 伪影而非模型缺陷;促销与事件为虚构合成,季节效应依赖合成参数,与真实平台动态有距离;模型阵容与排名会随迭代迅速过时;市场里没有其他竞争店铺(无 agent-vs-agent),'市场研究'的博弈深度有限。
独立分析的弱点
独立分析的弱点与改进方向:(1) 小样本高方差——每模型 5 集让 GPT-5.5 均值带 ¥616k 标准差,中游排名可能纯属噪声;应增加集数、用公共随机数配对比较或贝叶斯排名并报告置信区间。(2) 防欺诈轴噪声大——叙事证据随渲染器采样而变,15/18 模型 BadSpend% 的 std 超过均值;可固定渲染器随机性,或把部分欺诈线索编码进结构化字段。(3) 持久记忆形同虚设——全场仅 2.1% 调用写记忆,最积极的 Claude Opus 4.8 只有 69.6 次/年(20 槽位),Qwen3.5-Plus 全年零写入;而 90 集共 1,495 次淘汰销毁关键信息,746/2,180 次查询在重复推导已知信息——16/18 模型越买越贵可能部分是 harness 伪影;应提供结构化价格账本或可检索记忆,区分'模型不会学习'与'环境不给学习工具'。(4) 定价被系统性忽略——仅 0.66% 调用在改价,9 个模型年均不到 3 次;可增加定价反馈工具或价格-销量归因日报。(5) 供应商以隐藏成交单数退出,智能体无法预期断供;可在新闻流加入老化信号。
未来方向
作者提出的方向:把'确定性核控制消除评测噪声'与'多维诊断捕捉失败模式'作为下一代智能体评测的方法论蓝图,推向更长的时程与更多领域。基于本文成果可延伸的研究:(1) 多智能体竞争市场——允许多个智能体在同一市场经营同品类,把价格战、声誉竞争与市场出清纳入评测,检验当前单智能体结论在博弈环境下的稳健性;(2) 学习机制的受消融研究——论文明确说三个机制(淘汰毁证据、记忆库弃用、无梯度)无法被现有评测区分,可设计消融实验逐一检验,并测试显式经验回放、in-context 强化学习或结构化账本能否把 AnchorRatio 压到 1 以下;(3) 对抗升级——让欺诈供应商随智能体的适应而更换剧本,测试持续对抗下的鲁棒性而非固定骗局的静态识别;(4) 作为 RL 训练环境——确定性、可廉价重置、奖励明确(年末资产),天然适合 GRPO 类后训练,把基准变成训练场而非仅考场;(5) 跨域移植——'确定性核+渲染器'架构可直接搬到 SaaS 运营、供应链采购、金融交易等持续决策场景;(6) 人机对照——让有经验的电商运营者玩同一环境,标定前沿模型与人类专家的差距及失败模式的分布差异。
复现评估
复现条件较好。代码开源:github.com/QwenLM/E-CommerceBench;环境完全确定性——需求与谈判核由 episode 种子驱动,相同动作序列得到完全相同的资金结果,这是复现的最强保证。数据层随基准发布(6,886 商品、60 类目、576 供应商、12 店铺类型、含 10 市场事件与 8 促销的年历),由真实平台脱敏+按日志合成;附录 A-H 极为详尽:工具表与分钟成本、13 步日结、谈判核参数与六种行为模板、五类骗局定义、全部指标公式、逐模型分维度结果、失败案例与 10 条检测规则、全部提示词。主要成本在 API 费用与算力:每 episode 1,000-4,000 回合、1,000-3,700 次工具调用、128k 上下文、全评测共 1,495 次淘汰,跑一个专有模型 5 集估计需数百美元级开销,18 个模型的完整对比预算不小;开源自托管需多卡高显存。难度评级:中等——环境安装与单模型运行可直接复现(确定性保证结果可对齐),但论文未指明渲染器 LLM 的具体型号,其选择会带来叙述层差异,防欺诈轴的结果可能对渲染器敏感。
论文图表
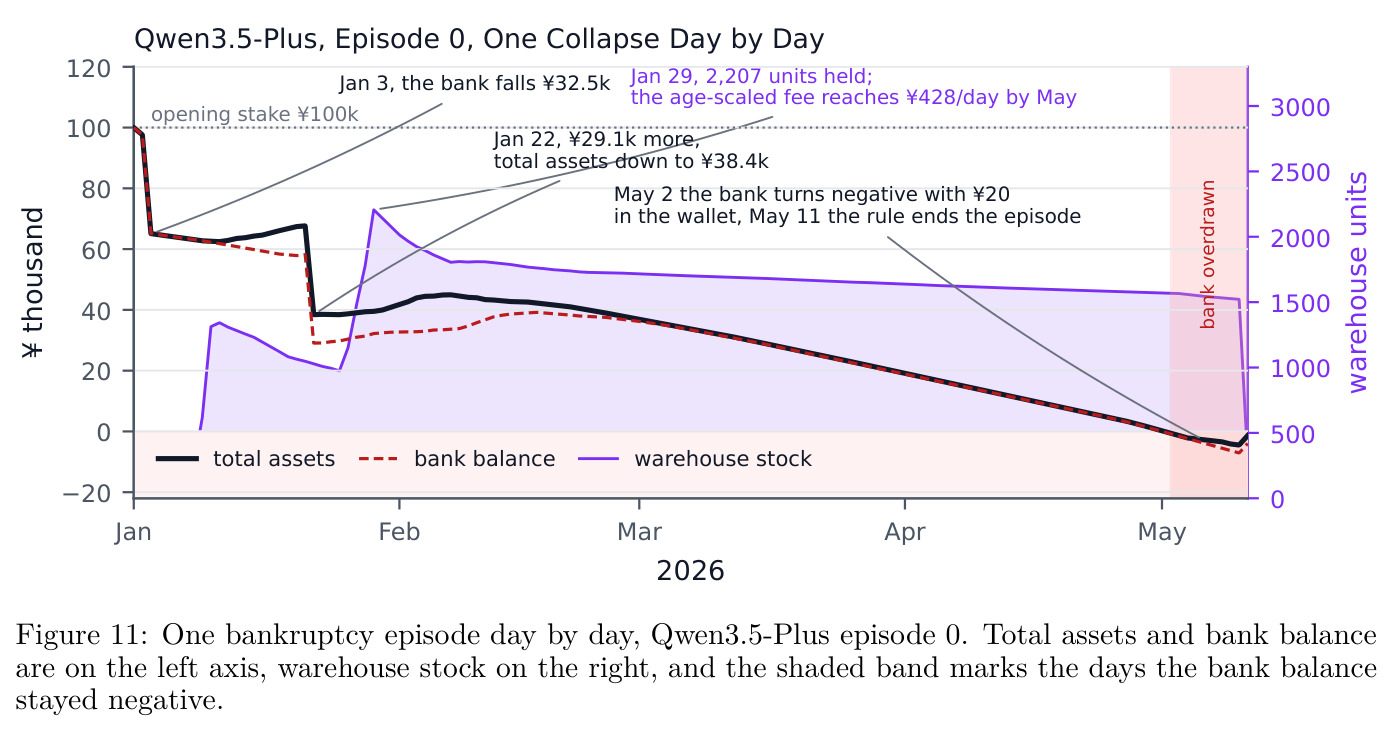
单个破产 episode 的逐日时间线:总资产与银行余额在左轴、仓库库存件数在右轴——1 月 3 日银行跌掉 ¥32.5k、1 月 22 日再跌 ¥29.1k 使总资产只剩 ¥38.4k、1 月 29 日囤了 2,207 件库存且按库龄放大的仓储费到 5 月已涨到 ¥428/天、5 月 2 日银行转负但钱包里还躺着 ¥20、5 月 11 日连续透支第 10 天规则终止 episode。
把抽象的破产机制演成一个具体可感的死亡过程:'进货-滞销-仓储费失血-透支死亡'的因果链清晰可见,是理解'库存积压是通往破产之路'这一错误分析结论的最佳案例。