AgentJudgeBench:面向智能体工具调用的多难度 LLM 评审可靠性基准 AgentJudgeBench: A Multi-Difficulty Benchmark for Evaluating LLM Judges on Agentic Tool-Calling
首个系统评测 LLM 裁判对智能体工具调用打分可靠性的基准,揭示无真值时 77–82% 对齐天花板。
前置知识
LLM-as-a-Judge(LLM 裁判)
用一个 LLM 给另一个模型的输出打分或排序,替代昂贵的人工评估。典型做法是把待评输出与评分标准一起放进提示词,让裁判模型输出分数或两两比较结论。MT-Bench 确立了这一范式,并发现位置偏好、冗长偏好、自我增强等系统性偏差。
本文研究的不是裁判的某处小偏差,而是把裁判本身当作被评测对象:只有理解裁判范式如何工作,才能理解核心指标——裁判判定与程序化参考的一致率(alignment)——的确切含义。
有向无环图(DAG)与工具调用依赖
在智能体工作流中,DAG 的节点是一次工具调用,有向边表示'上一调用完成并返回后才能开始下一调用',无环约束防止循环依赖。线性、扇出、扇入、菱形、可选增强、循环等拓扑刻画了真实企业工作流的依赖模式。
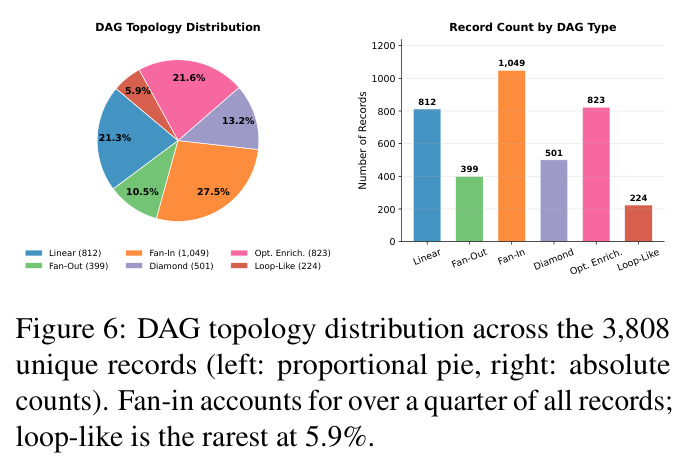
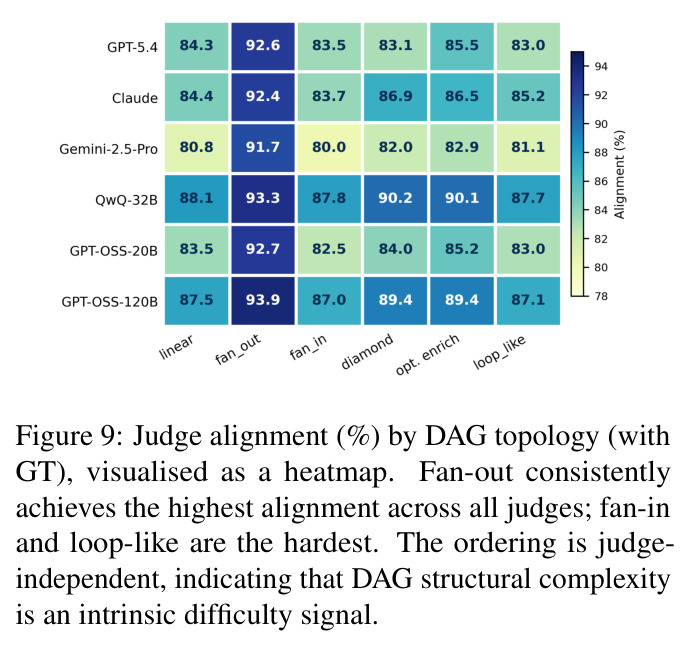
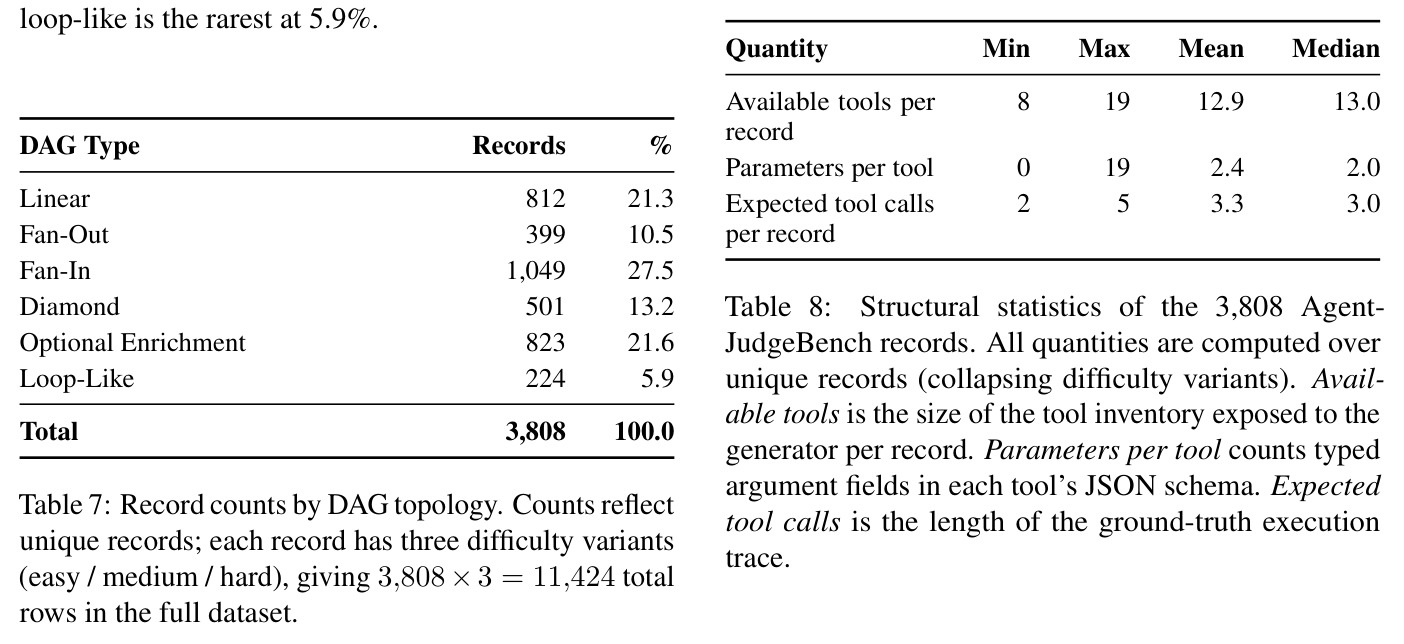
本文全部 3,808 条数据按六种 DAG 拓扑组织,拓扑是裁判难度的独立来源(扇出最易、循环/扇入最难),是读懂 RQ1 与难度分析的基础。
BFCL 风格函数调用
BFCL(Berkeley Function-Calling Leaderboard)确立了带类型化 JSON Schema 的函数调用评测格式:给定用户查询与一组工具签名(类型化参数、必填字段、返回类型),模型需输出结构化工具调用序列,并用 AST 与标准答案比对。
本文数据沿用 BFCL 式 schema 并扩展到多步 DAG 工作流。理解这种'结构化正确性'(而非文本流畅度)的评测对象,才能理解四个结构性指标的设计动机。
Cohen's $\kappa$ 与 Spearman $\rho$
Cohen's $\kappa$ 是校正随机一致后的评分者间一致度:0.2–0.4 为'尚可',0.4–0.6 为'中等',≥0.6 为'较高'。Spearman $\rho$ 是秩相关系数,衡量两个排序的单调关系,$\rho=1$ 完全同序,$\rho=-1$ 完全反序。
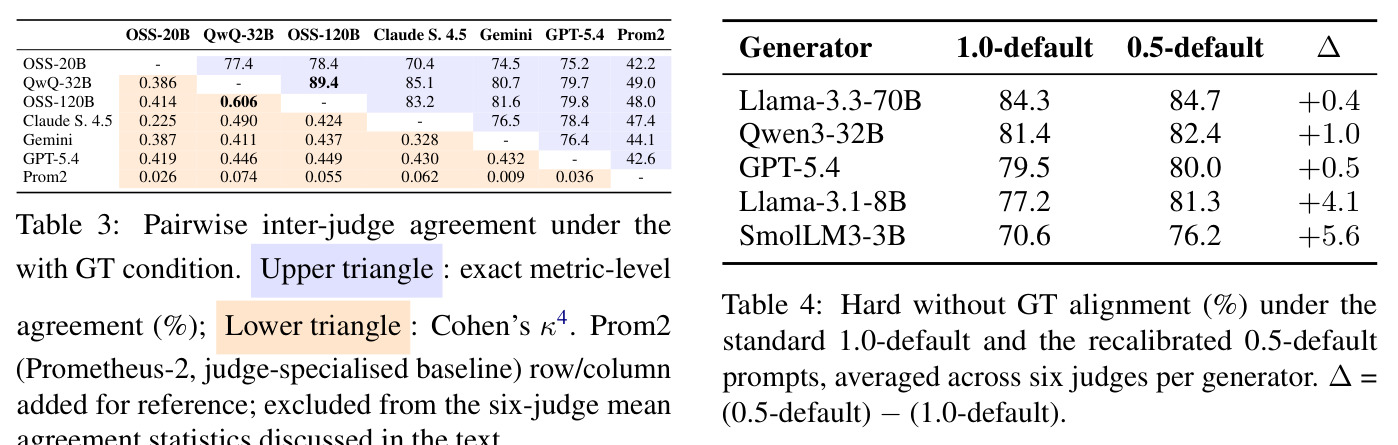
论文用 $\kappa$ 报告裁判两两一致度(0.225–0.606),用 $\rho$ 报告裁判档位差与 $\kappa$ 的负相关($\rho=-0.8253$)及指标加权的稳健性($\rho \ge 0.832$),不熟悉这两个统计量就读不懂 RQ2。
Ground-Truth 执行轨迹(GT trace)
指每条记录经程序化验证、可证明正确的完整工具调用序列,含每个调用的输入输出与步骤说明。'有真值(with-GT)'条件把该轨迹作为参考块展示给裁判;'无真值(without-GT)'条件只给查询和工具 schema,要求裁判自行重构正确性。
有/无真值的配对协议是本文核心实验设计:'真值曝光对前沿裁判反而有害(过度锚定)'这一反直觉发现,正是通过两种条件的对比得出的。
研究动机
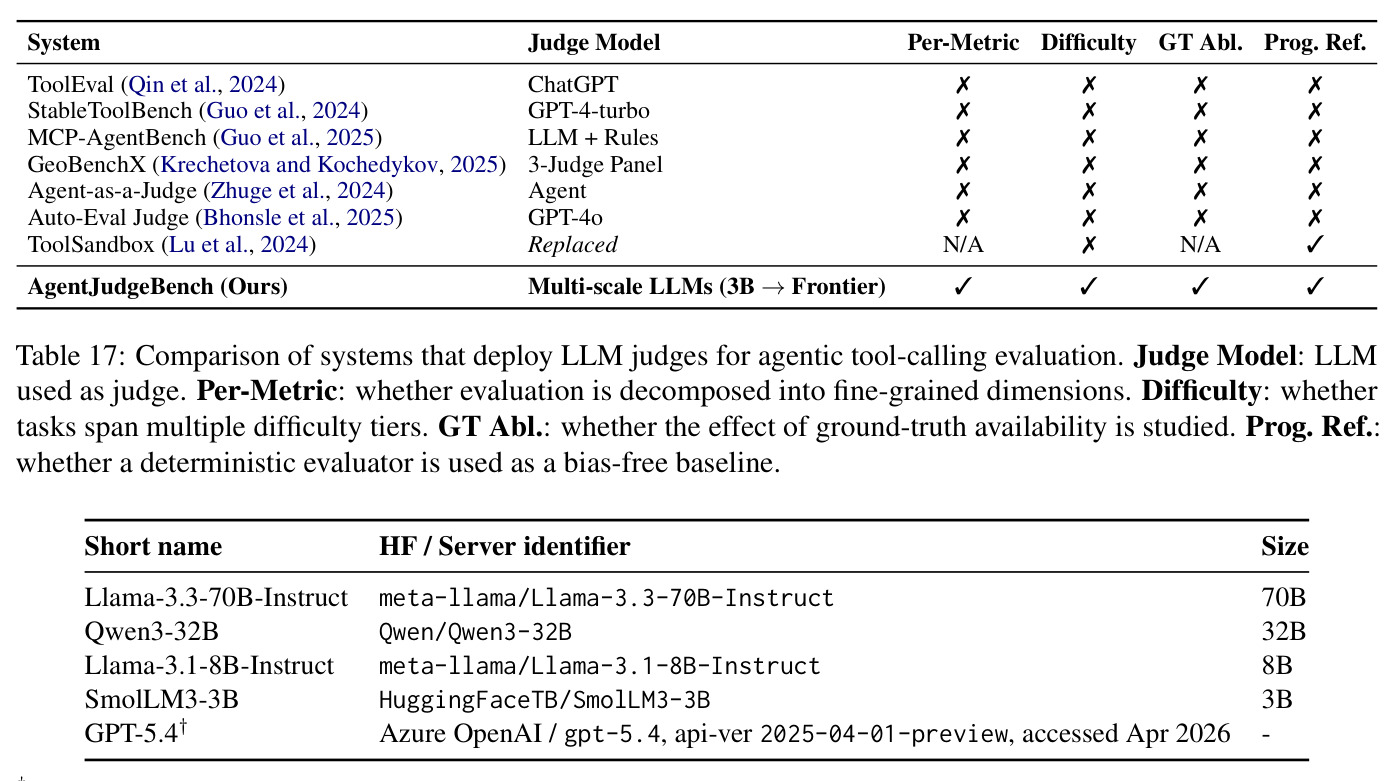
用 LLM 给 LLM 打分已成为评测智能体工具调用系统的标准做法:ToolLLM 用 ChatGPT 计算 API 轨迹通过率并报告 87.1% 的聚合人机一致率,StableToolBench 与 MCP-AgentBench 沿用类似方案,GeoBenchX 用三裁判小组拿到 88–96% 一致率。但这些工作都把裁判当作实现细节,只在小样本上报告单一聚合一致率,从不改变任务复杂度、难度与真值可得性。而工具调用的正确性是结构性的:需要从类型化 schema 中选对工具、生成格式合法的参数、按执行依赖排序调用、并覆盖用户意图的全部部分,因此可以在工具选择、参数结构、顺序正确性、查询覆盖四个正交维度上各自失败——一个在简单线性任务上校准良好的裁判,可能在并行分支必须汇合的扇入或菱形工作流上完全失灵。当没有真值执行轨迹时(最常见的部署场景),裁判只能凭查询与工具 schema 重构正确性,这是本质上更难的推断问题。面对结构化评测需求,实践者既不知道该选哪个裁判、如何配置它,也不知道如何解读它的输出。
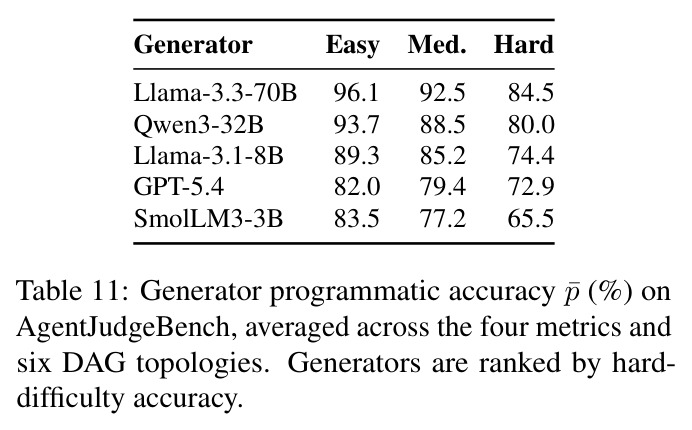
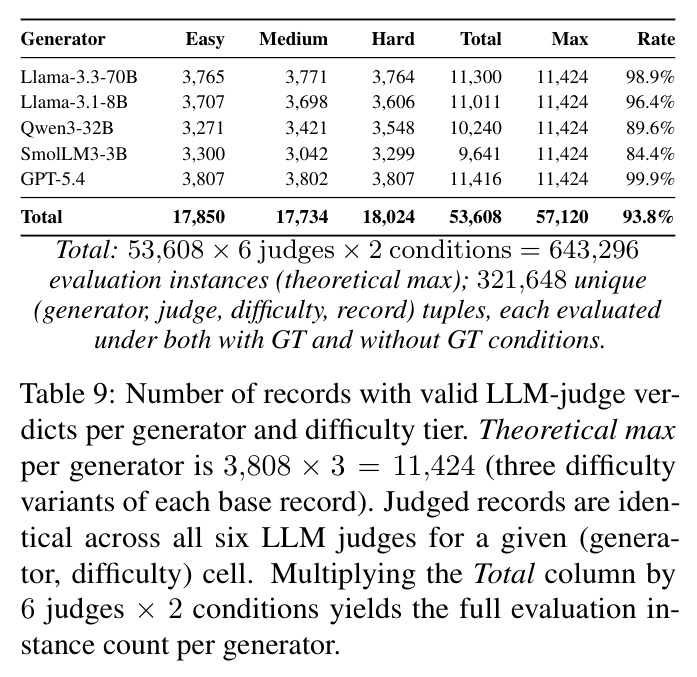
本文的目标是本文要填补的正是这个校准空白:构建第一个系统研究 LLM 裁判在智能体工具调用上可靠性的基准。具体目标有三:(1) 发布 3,808 条记录的数据集,覆盖六种 DAG 拓扑与三个受控难度层级(easy/medium/hard),每条记录都附带经程序化验证的真值轨迹并公开;(2) 建立四指标(工具选择、参数结构、顺序准确性、查询覆盖)评测框架与'有真值/无真值'配对协议,配合 bootstrap 置信区间;(3) 围绕六个研究问题(RQ1 哪些指标和拓扑最难、RQ2 裁判间一致度、RQ3 无真值收敛机制、RQ4 温度敏感性、RQ5 思维链作用、RQ6 提示词格式影响)开展全因子实验——5 个生成器 × 6 个裁判 × 3 个难度 × 2 种条件共 90 个格子、321,648 次成对评估——最终产出可操作的裁判选型与配置指南。
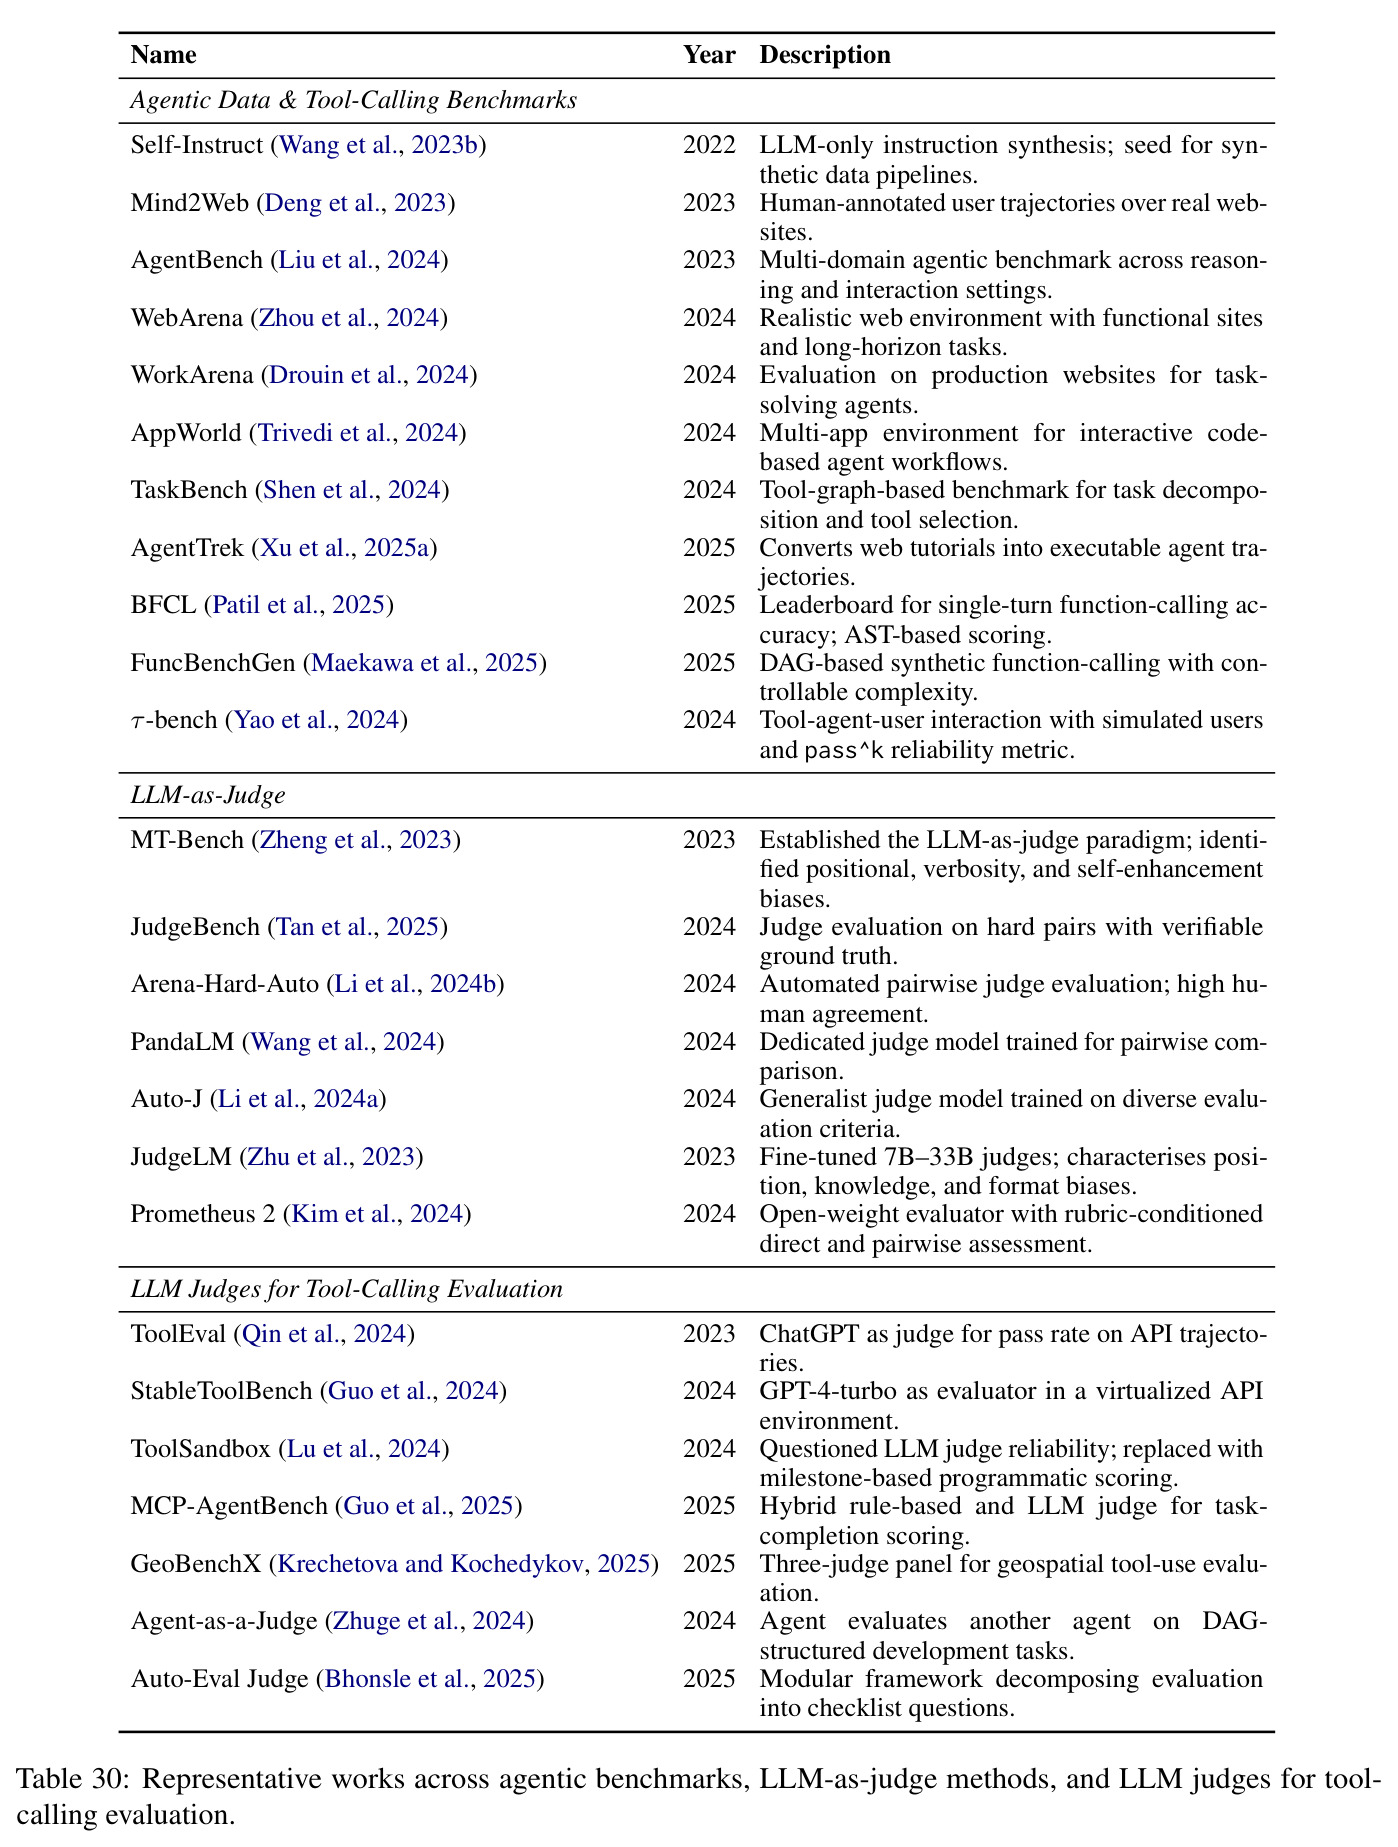
与已有工作不同的是,已有工作要么评测生成器而非裁判(BFCL 只做单轮函数调用,FuncBenchGen 沿 DAG 遍历评测智能体本身,TaskBench 关注分解质量),要么干脆用程序化评估替代裁判(ToolSandbox),裁判可靠性从未被当作研究对象。本文的独特之处在于立场反转:保留裁判范式,把它放到显微镜下逐维度测量。与文本侧的 LLM-as-judge 文献(MT-Bench、JudgeBench、Arena-Hard-Auto)也完全不同:那里的正确性归结为对流畅输出的偏好对齐,而这里的判定空间是 $\{0, 0.5, 1\}$ 的结构化打分,失败模式是多维且相互依赖的。方法上,它把合成数据生成、确定性程序化参考、配对真值条件与逐指标分解组合成一个'可靠性协议'——用作者的话说,衡量的是裁判可靠性而非智能体能力,这是对七 个相关系统的共同缺口的直接回应。
核心方法
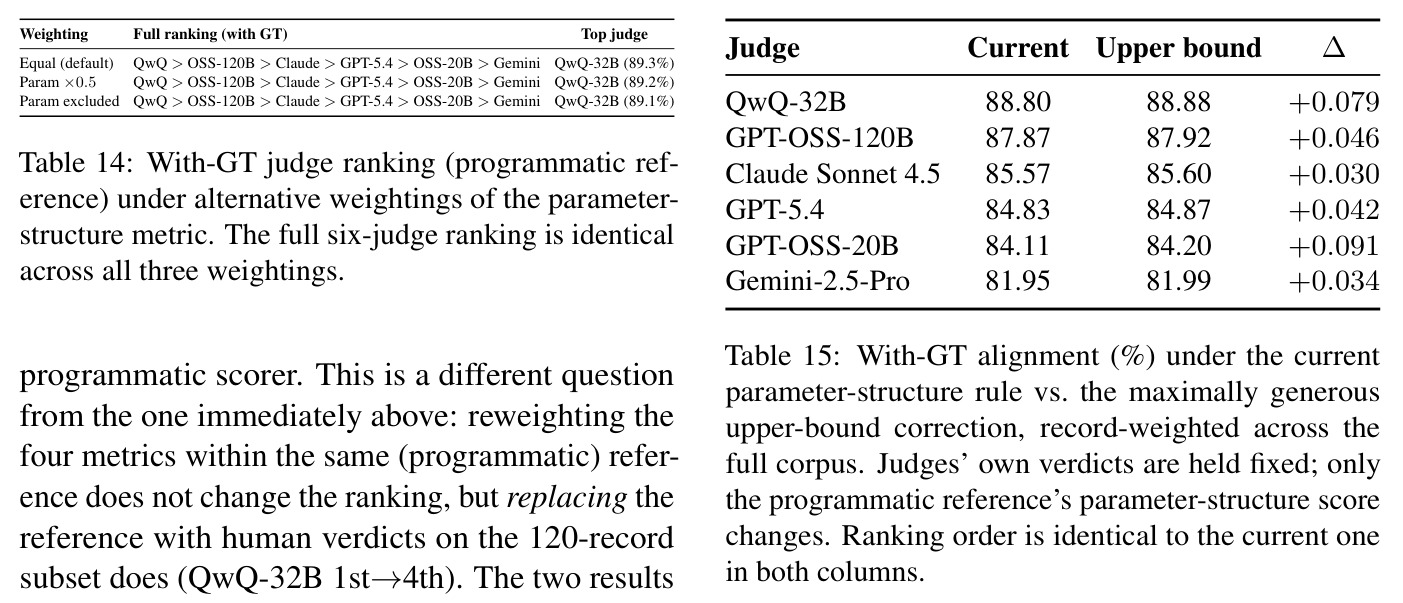
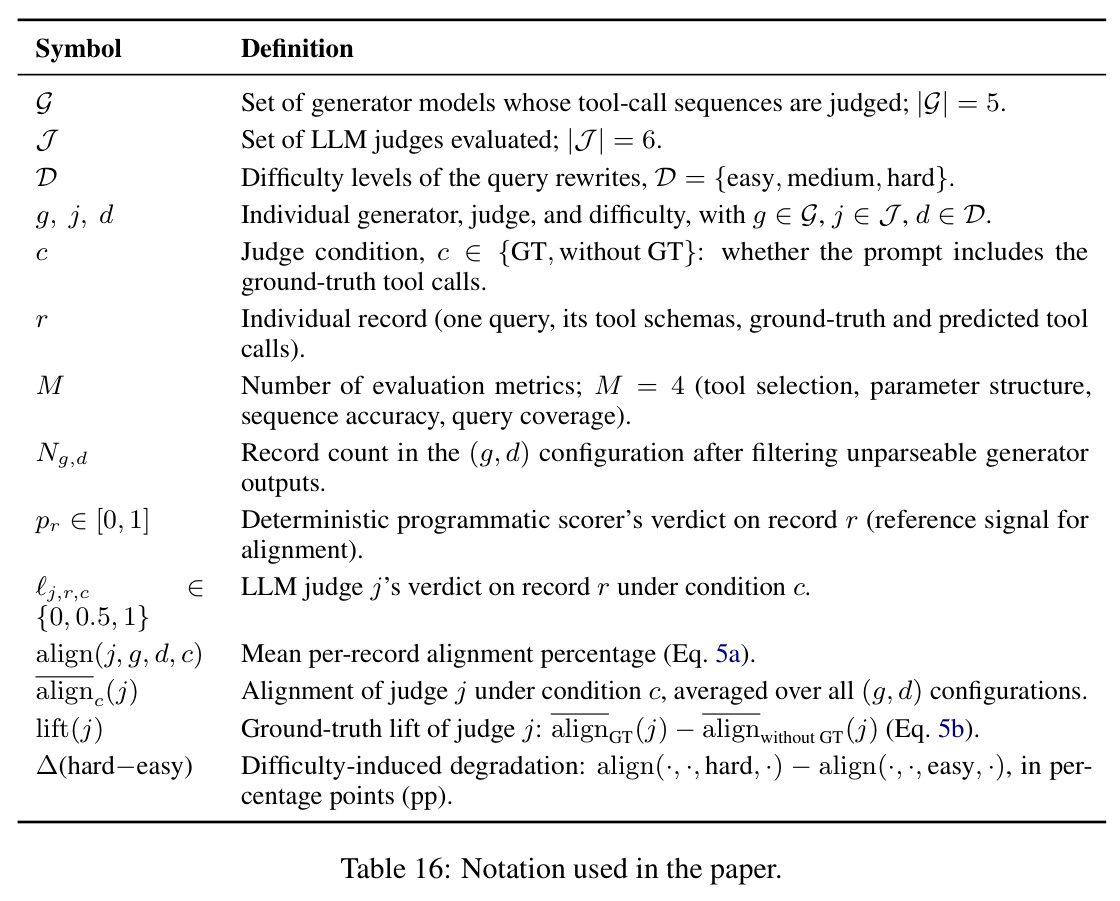
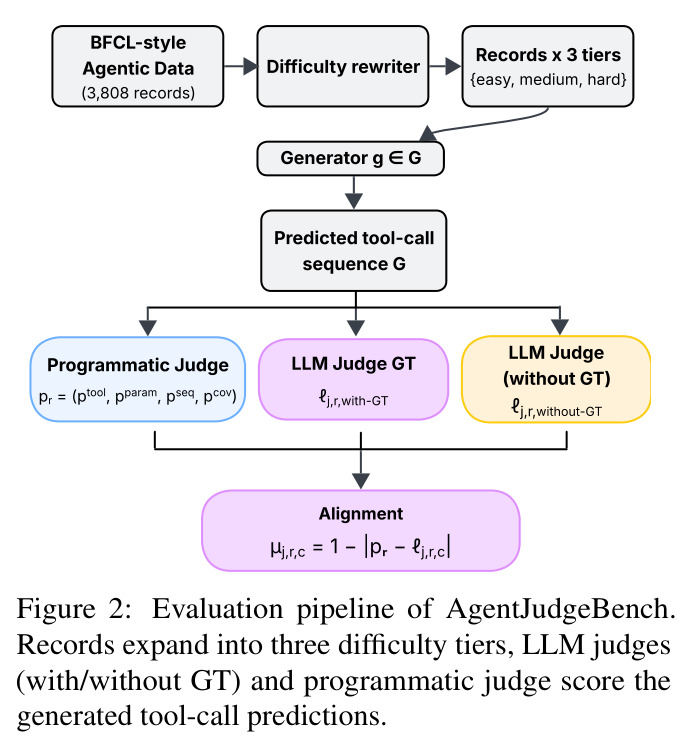
直觉上,要问'裁判可不可靠',必须有一个比裁判更可信的参照物。作者选择确定性程序化裁判:它对每条记录的每个生成器输出打四个 $[0,1]$ 分数($p_{\text{tool}}, p_{\text{param}}, p_{\text{seq}}, p_{\text{cov}}$),构成参考向量 $p_r$;每个 LLM 裁判 $j$ 在有真值/无真值两种条件下按四指标打 $\{0, 0.5, 1\}$ 判分 $\ell^j_{m,r,c}$;逐指标一致度 $\mu^j_{m,r,c} = 1 - |p_m^r - \ell^j_{m,r,c}|$,配置级对齐率 $\text{align}(j,g,d,c)$ 是其在记录上的均值,真值增益为两种条件均值之差。流水线在 SyGra 框架上实现为计算图:企业域场景合成 → DAG 与工具 schema 生成 → 两级验证与难度改写 → 生成器推理 → 程序化与 LLM 评分并行 → 对齐聚合。四指标等权的稳健性有保障:五种替代加权下裁判排序的 Spearman $\rho \ge 0.832$。
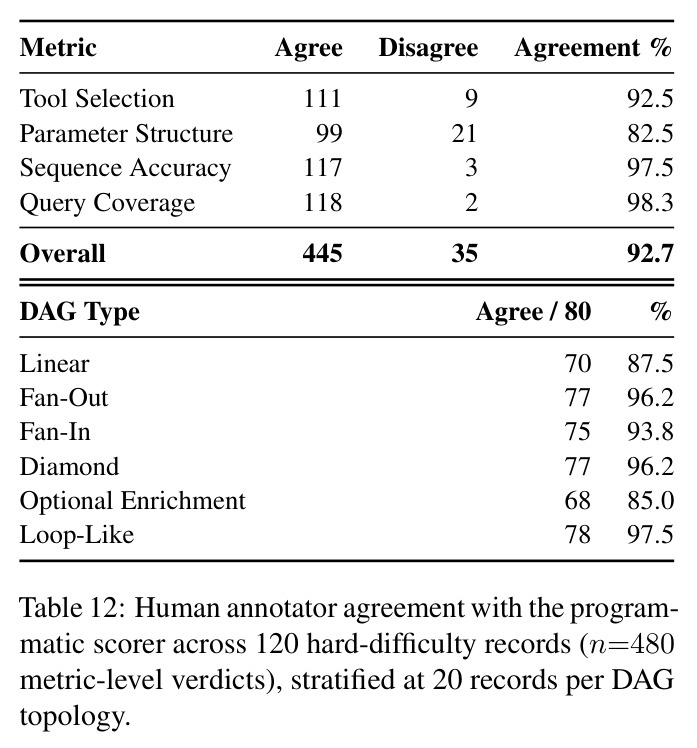
核心创新是'配对有/无真值协议 + 受控难度 + 逐指标分解'这一可靠性协议,以及用确定性程序化裁判而非人工或 LLM 充当参考信号。用 LLM 做参考会把待研究的可靠性问题原样抬升一层;人工标注无法扩展到 321,648 次全因子评估;只有规则化打分器能给每个格子一个可复现的参照。作者没有假设这个选择而是验证它:真值轨迹经过两道无 LLM 参与的质量门(第一道做 JSON Schema 校验、参数类型检查、轨迹一致性检查;第二道逐对检查论据充分性、接地对齐与查询自然度,不合格即重新生成),再由 120 条覆盖六种拓扑的硬难度记录人类标注验证,指标级一致率达 92.7%。难度控制同样精巧:改写只增加查询歧义而保持任务结构与真值轨迹不变,三个难度共享同一条真值,从而保证难度效应可归因。此外还引入裁判专用模型 Prometheus-2 作为基线,发现它与六个通用裁判近乎随机一致($\kappa=0.01$–$0.07$),自成一派。
方法步骤详情
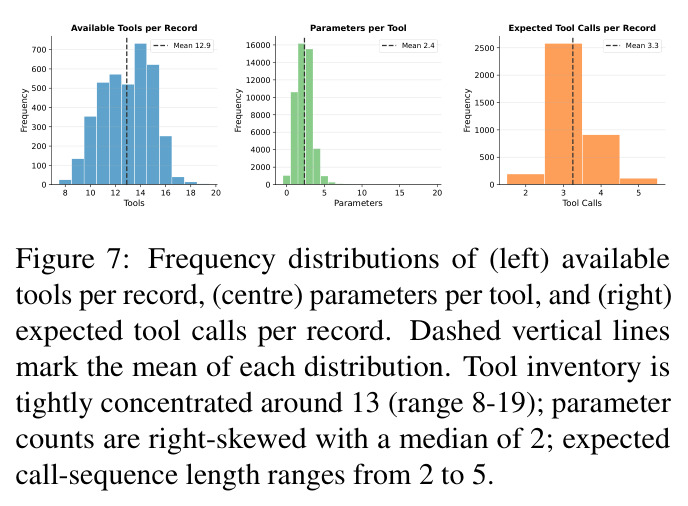
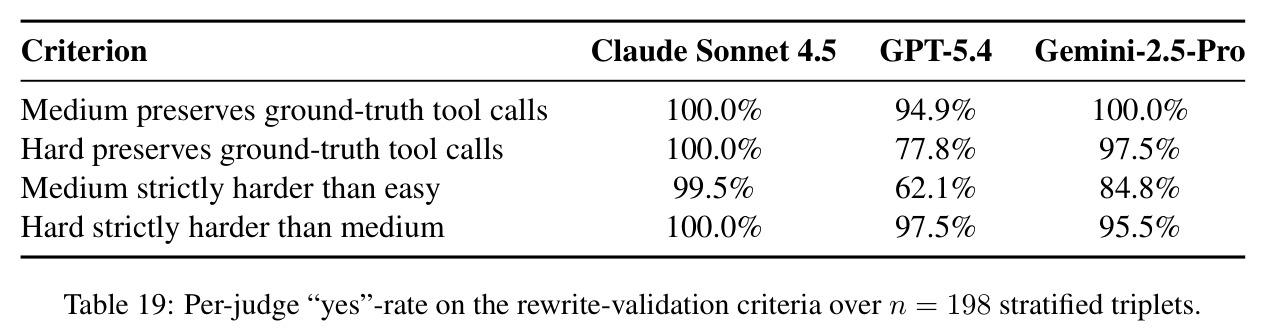
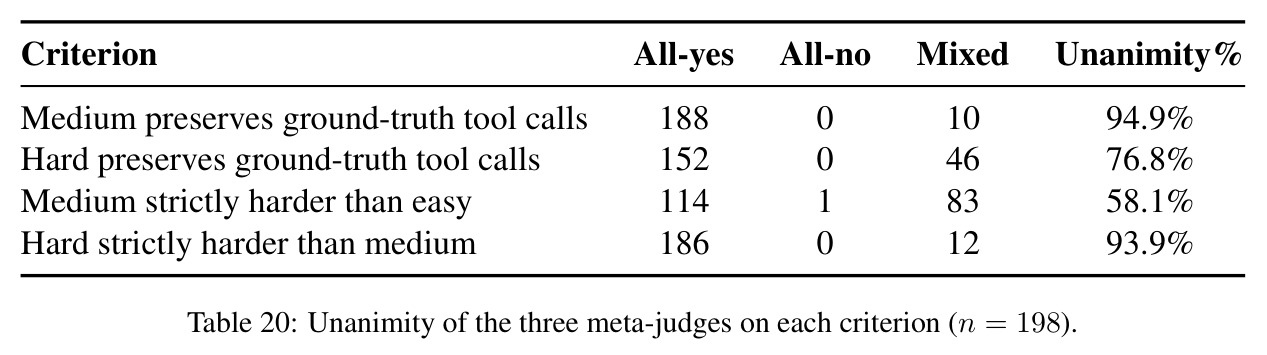
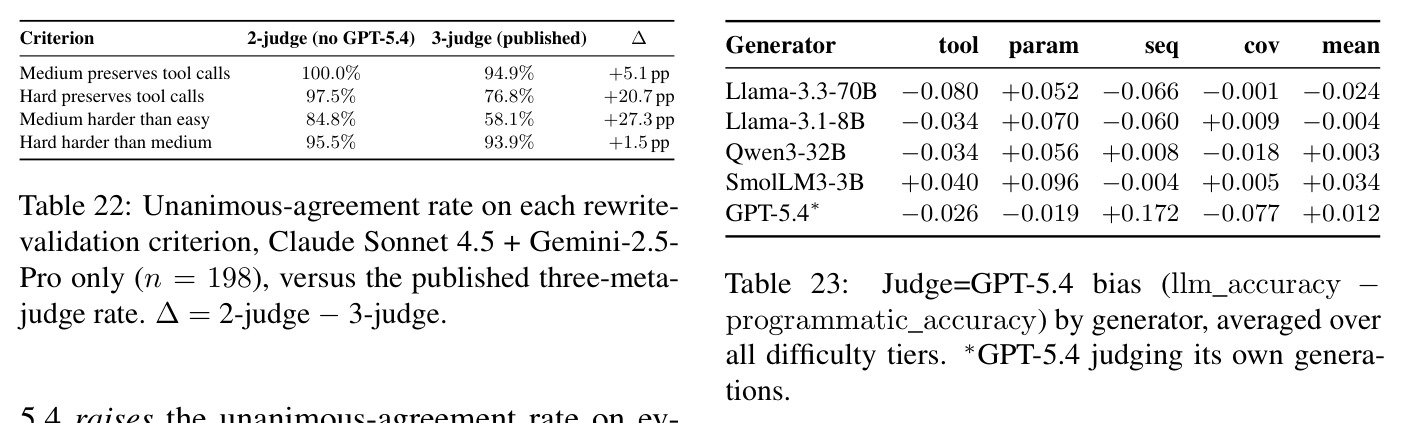
第一步,域与场景合成:从 15 个企业域(IT 服务管理、电网运行等)生成用例。第二步,DAG 与工具生成:按线性、扇出、扇入、菱形、可选增强、循环六种拓扑合成 8–19 个带类型签名的工具,产出可执行伪代码并形式化为 JSON Schema 与查询。第三步,验证与难度分级:真值轨迹过两道程序化质量门,每条记录改写成三个难度变体(medium→hard 93.9% 通过验证,easy→medium 仅 58.1%)。第四步,生成器推理:SmolLM3-3B、Llama-3.1-8B、Qwen3-32B、Llama-3.3-70B 与 GPT-5.4 各自产出调用预测。第五步,程序化评分:$p_{\text{tool}} = \max(0, 1 - \frac{|G \setminus E| + |E \setminus G|}{\max(|E|,1)})$ 惩罚集合失配,$p_{\text{seq}}$ 按位置逐点比对,$p_{\text{param}}$ 对参数键集合打 1.0/0.5/0.0(缺必填键归零、仅多余键打 0.5)后取均值,$p_{\text{cov}} = |G \cap E|/|E|$。第六步,LLM 裁判在两种提示条件下对四指标输出带理由的 JSON 判分。第七步,聚合出对齐率与真值增益。
技术新颖性
技术新颖性体现在四点。其一,研究对象反转:这是第一个不以智能体能力而以裁判可靠性为因变量的基准,判定空间是结构化的 $\{0, 0.5, 1\}$ 而非偏好排序,失败模式多维修了文本裁判文献的单一视角。其二,参考信号设计:程序化裁判 + 双质量门 + 120 条人类验证(92.7% 一致率)的三角验证,规避了 LLM 参考的自我强化偏差,这是让 321,648 次全因子评估在方法上成立的前提。其三,实验设计粒度:90 格全因子、321,648 次配对评估,支持把对齐率分解到(生成器, 裁判, 难度, 条件, 指标)任意切片——例如发现'真值增益集中在顺序准确性维度'这类聚合数字完全看不到的结构。其四,一整套配置杠杆的量化消融:裁判温度($T \in \{0.3, 0.7, 1.0\}$)、思维链开关、结构化 JSON 对比自由格式提示词、0.5-default 重校准提示,以及用其他记录的错误真值替换参考的 C3 锚定对照实验,每个杠杆都给出了效应量与适用边界,而非笼统的'提示词有影响'。
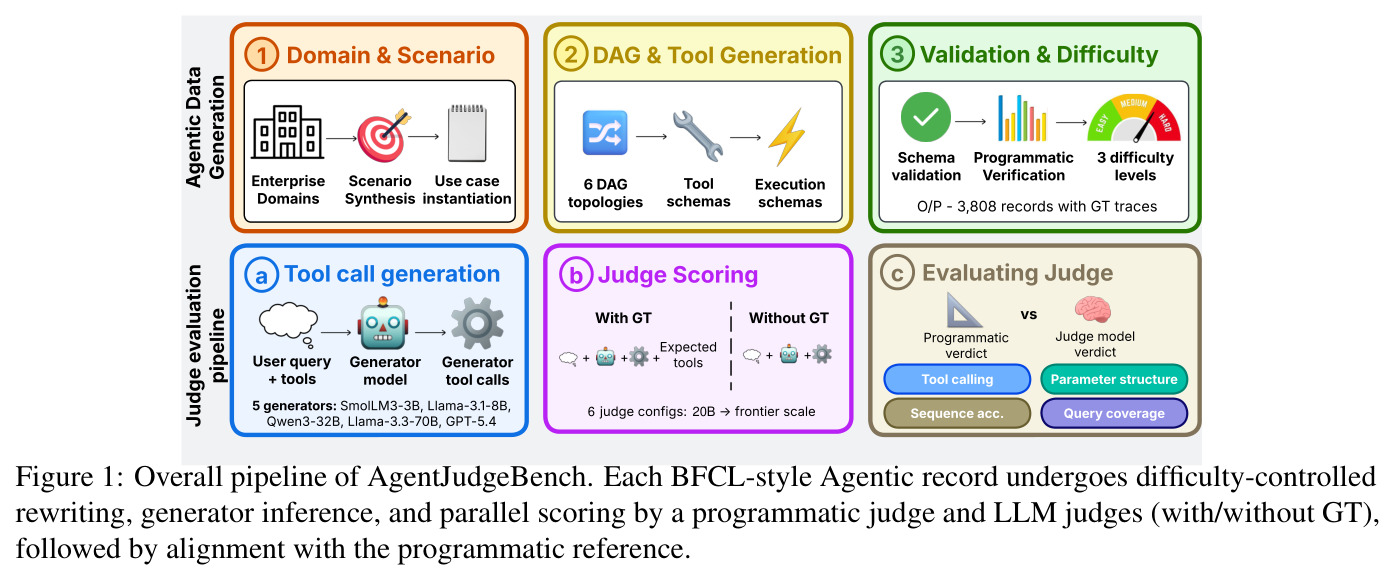
实验结果
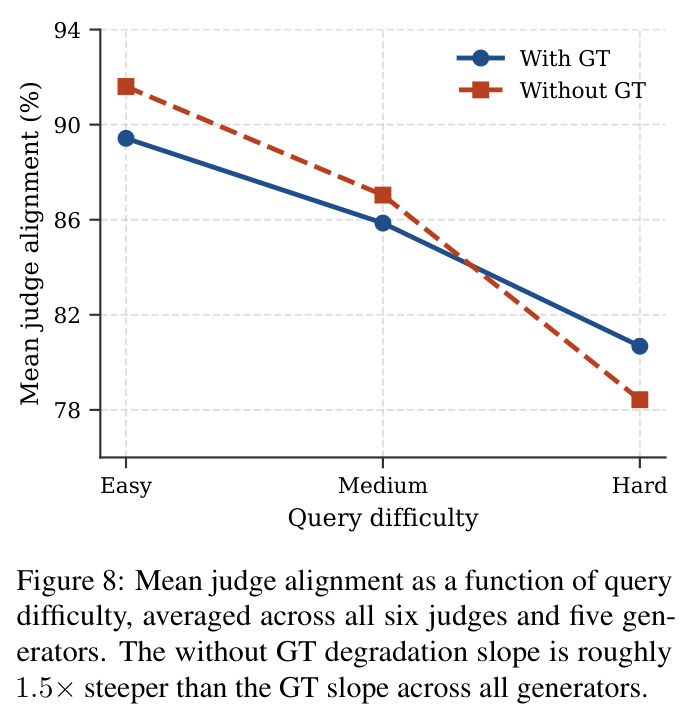
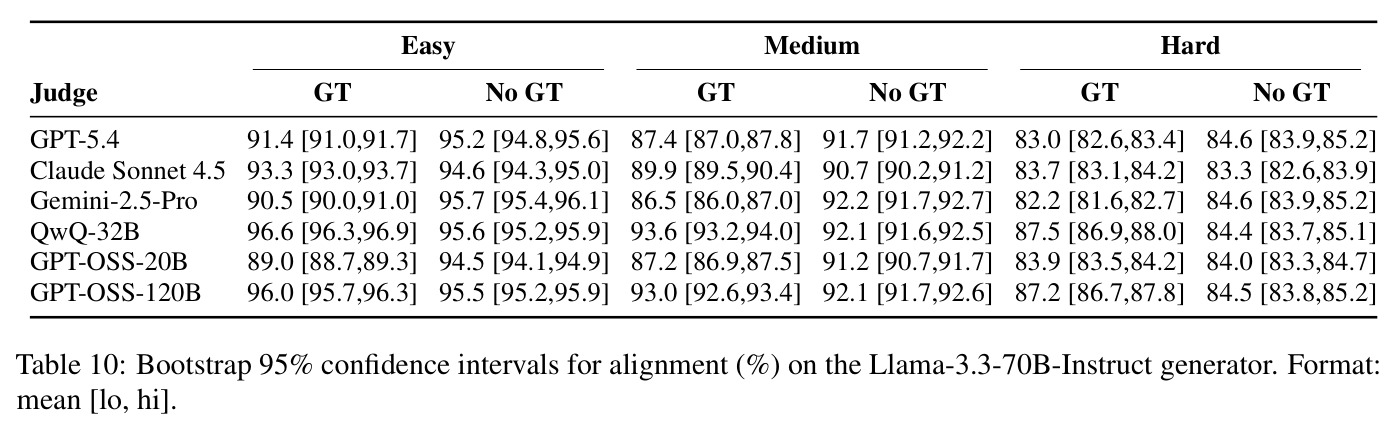
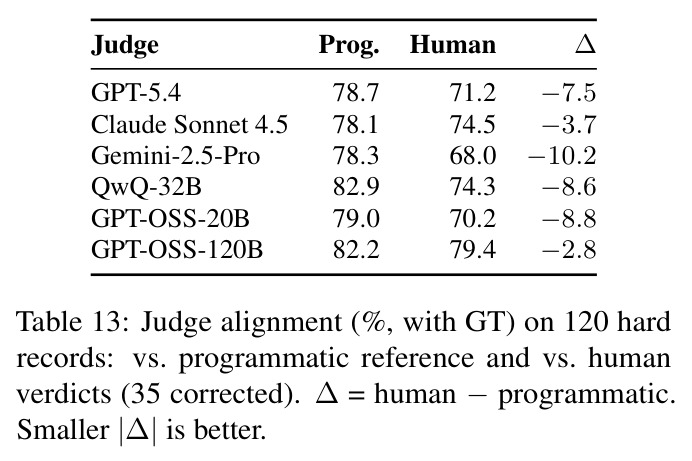
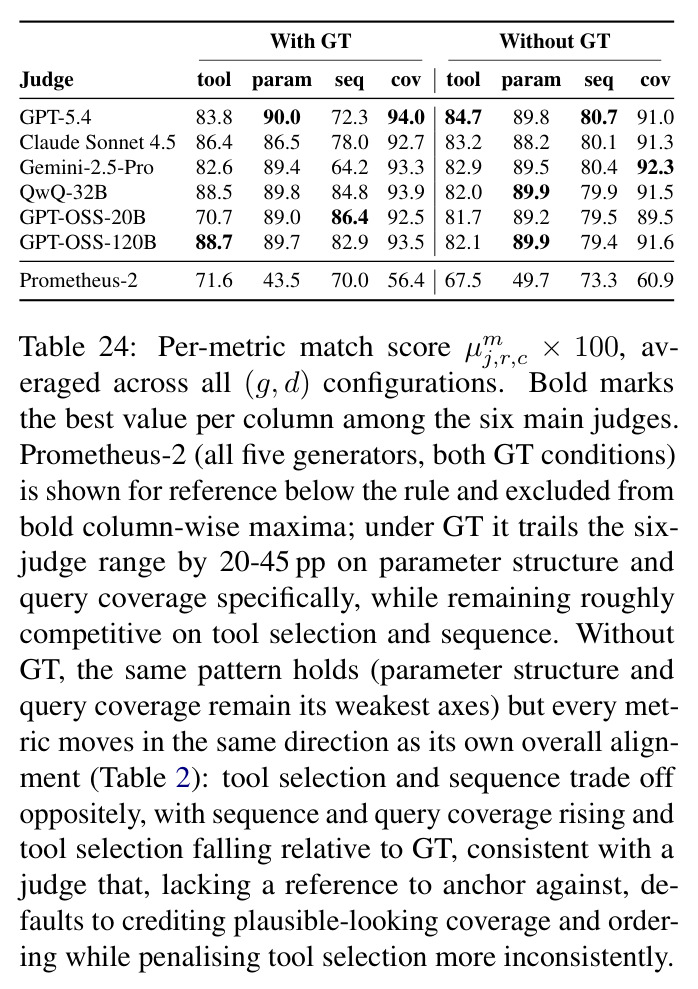
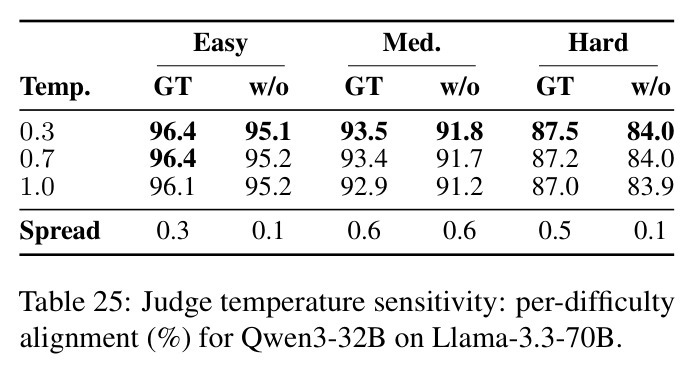
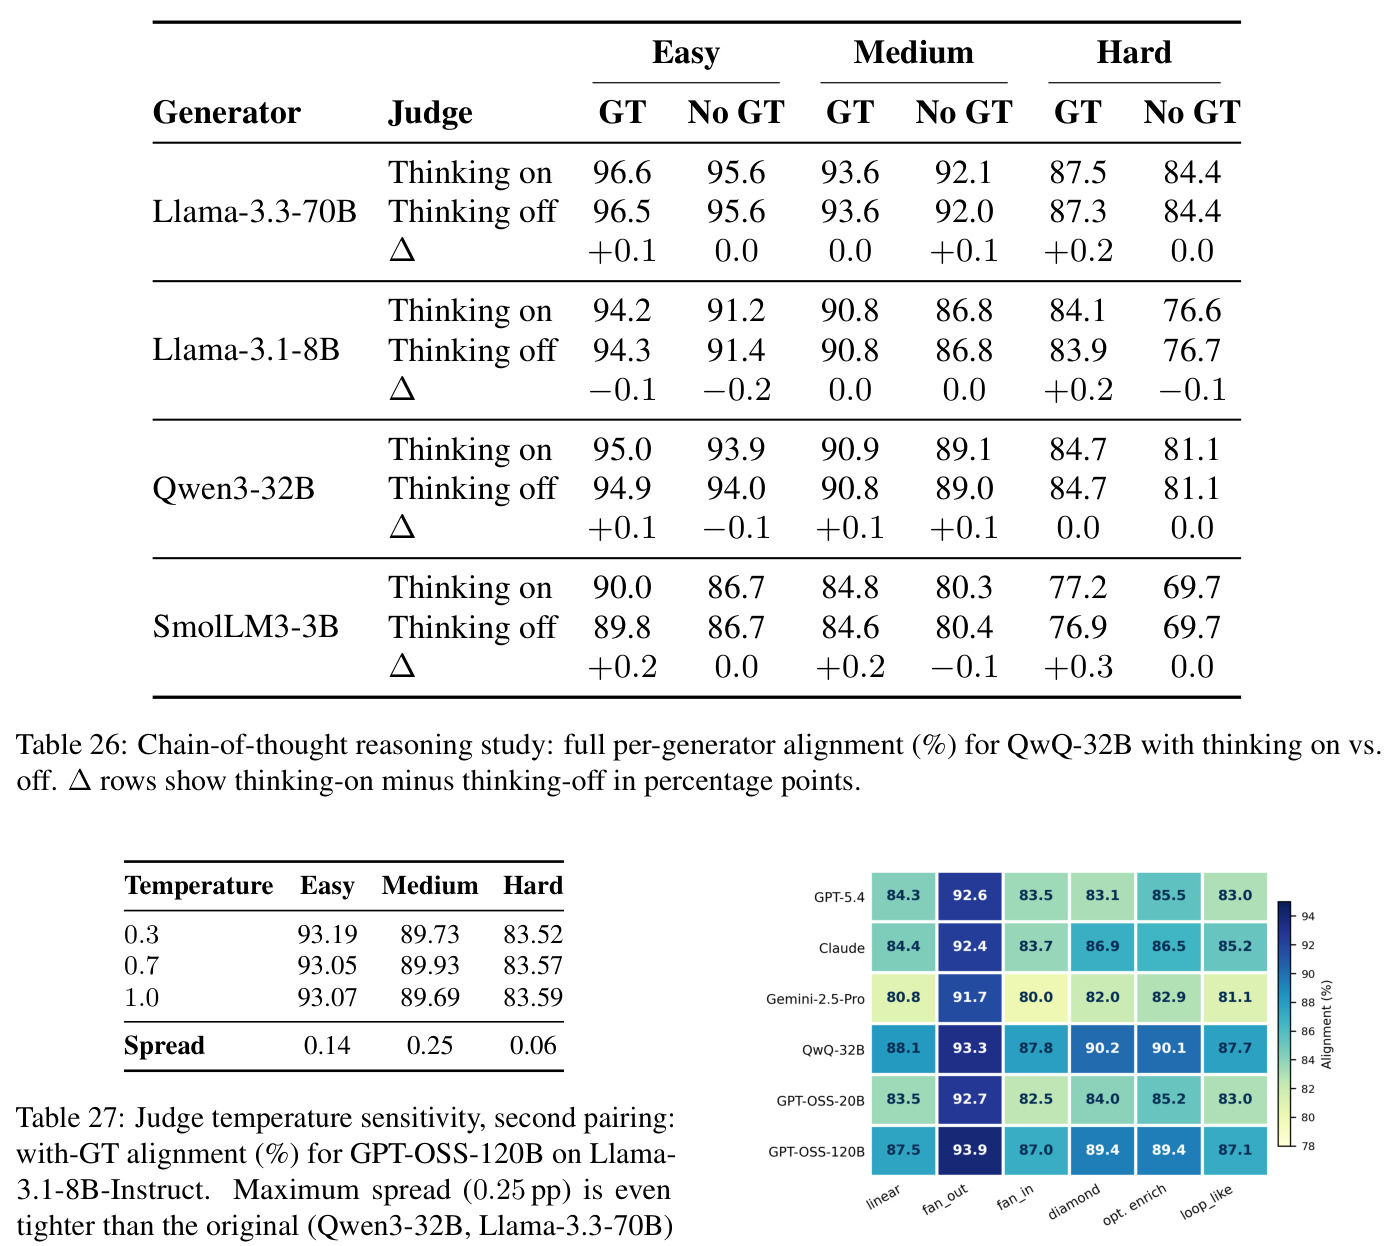
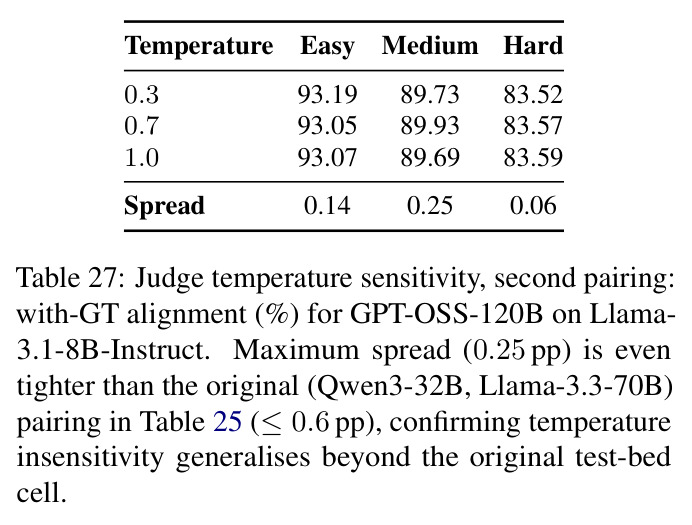
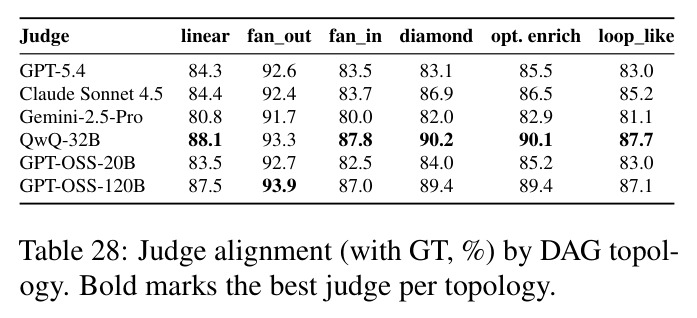
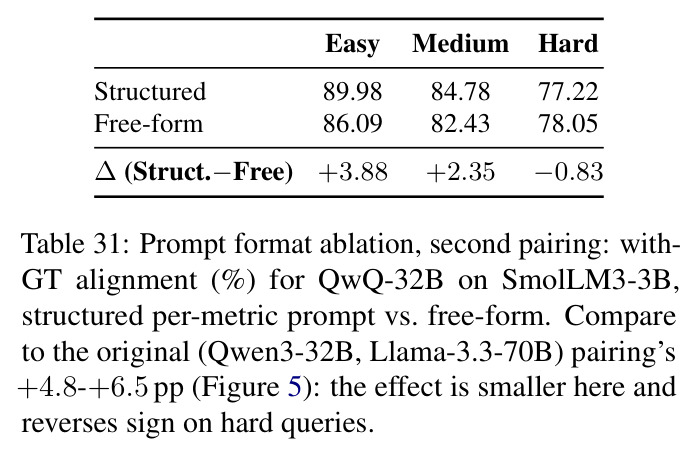
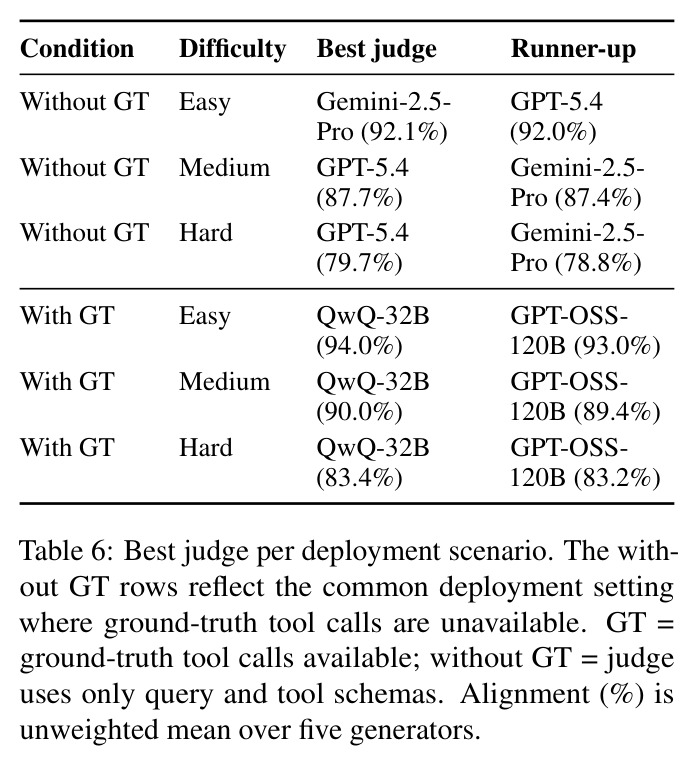
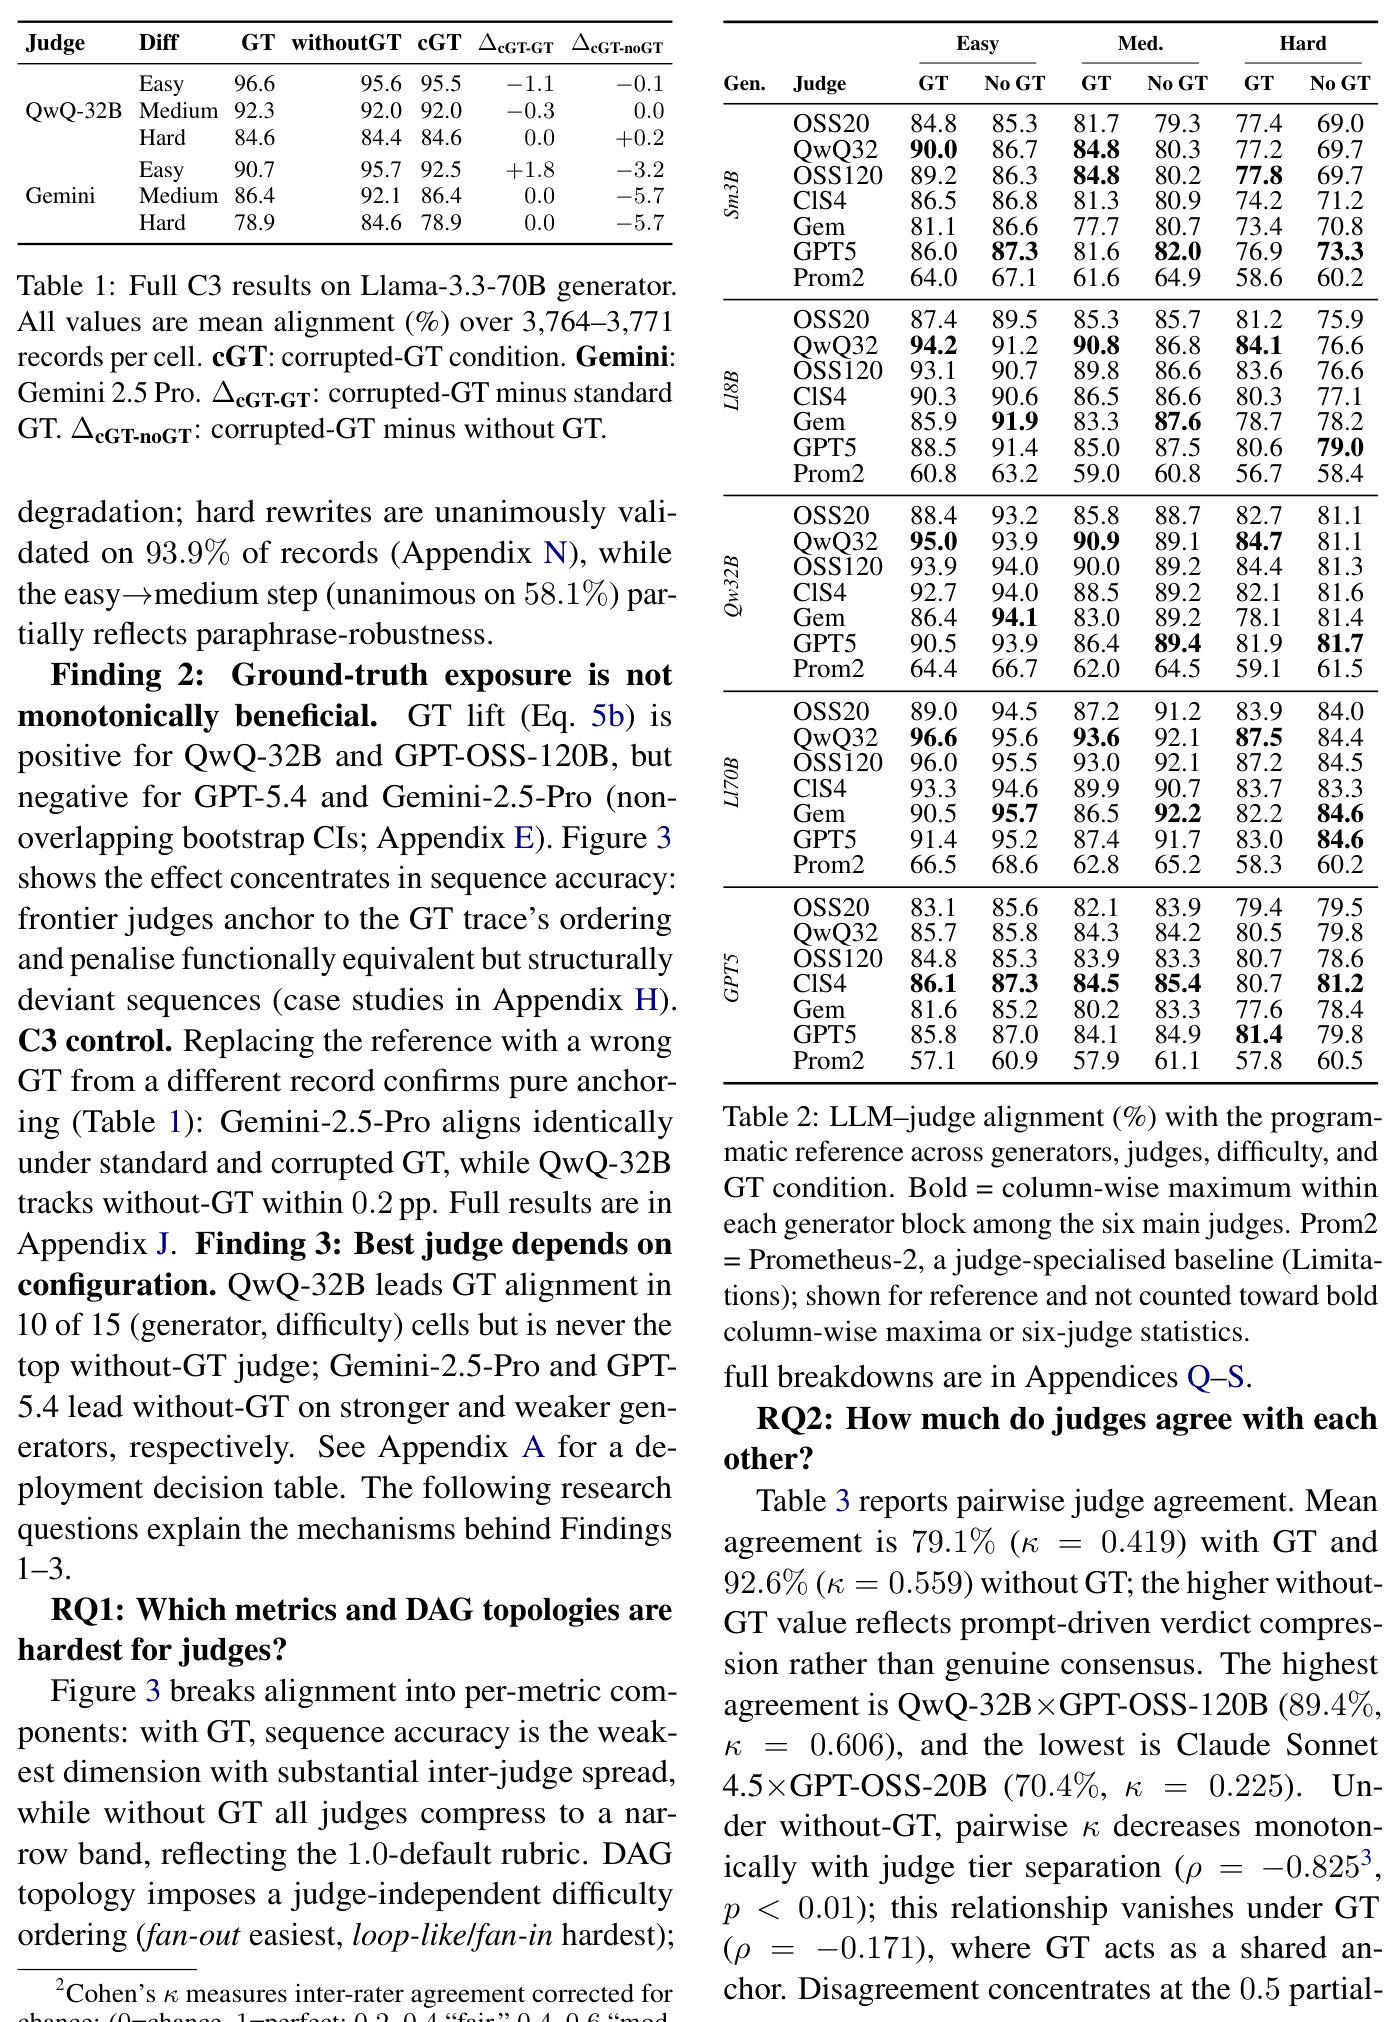
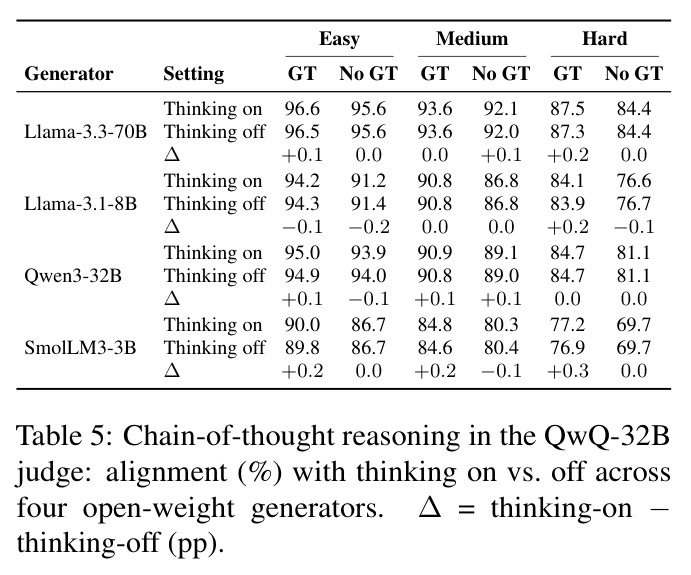
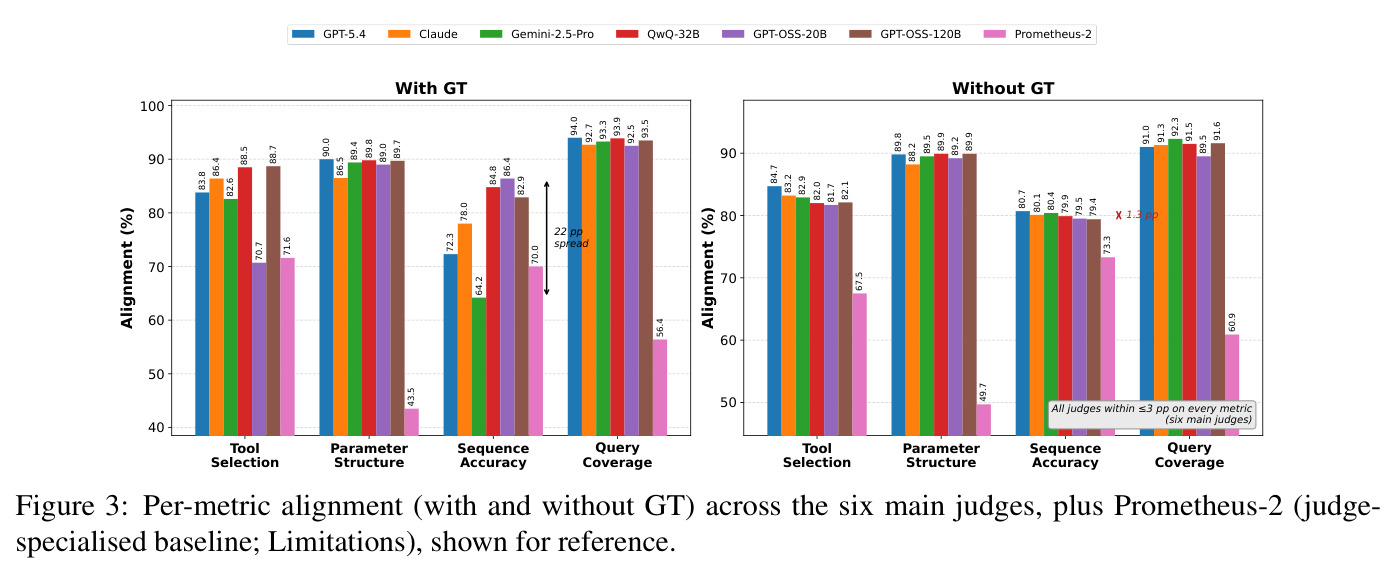
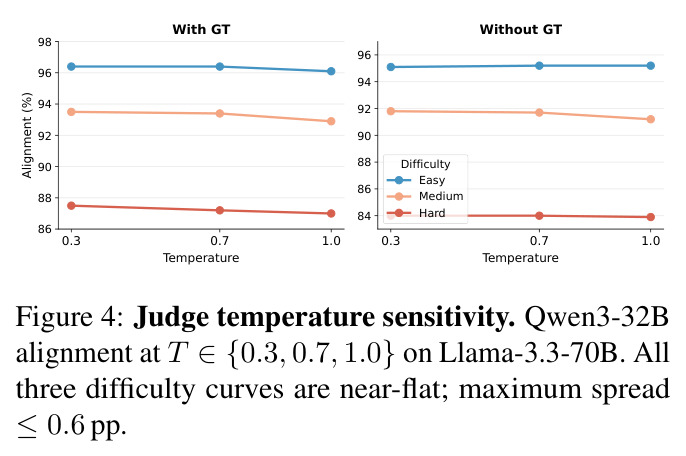
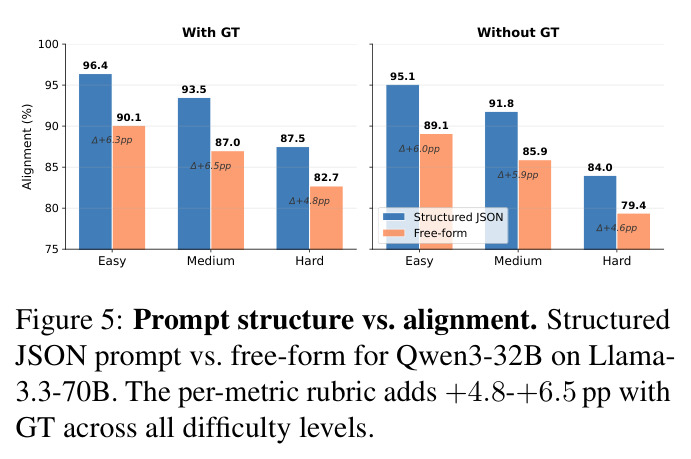
发现一(单调难度退化):全部 30 个(生成器, 裁判)对都从 easy 到 hard 严格单调退化,无真值退化约为有真值的 1.5 倍;硬难度无真值时六裁判在 4/5 个生成器上(含 GPT-5.4)收敛到 77–82% 窄带(SmolLM3-3B 约 70–76%),是任务级而非裁判级天花板。发现二(真值曝光非普遍有益):真值增益对 QwQ-32B、GPT-OSS-120B 为正,对 GPT-5.4(−1.5pp)与 Gemini-2.5-Pro(−3.9pp)为负;C3 对照中 Gemini 在污染真值下与标准真值对齐率完全相同(78.9%),证实纯粹锚定。发现三:QwQ-32B 在 15 个格子中的 10 个领跑有真值对齐(最高 96.6%),GPT-OSS-120B 最对齐人类判断。RQ1:有真值时顺序准确性最弱,扇出最易、循环/扇入最难。RQ2:裁判间一致率有真值 79.1%($\kappa=0.419$)、无真值 92.6%($\kappa=0.559$,源于判定压缩而非共识);$\kappa$ 随裁判档位差单调下降($\rho=-0.8253$);六裁判软 jury(82.5%)不超最佳个体。RQ3:收敛由 1.0-default 判定压缩与生成器错误峰值驱动,0.5-default 提示对强生成器仅 ≤+1.0pp、对弱生成器 +4.1–+5.6pp。RQ4:温度影响 ≤0.6pp。RQ5:思维链平均仅 +0.11pp。RQ6:结构化 JSON 提示词最大杠杆 +4.8–+6.5pp,但在第二配对的 hard 上反转为 −0.8pp。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 硬难度·无真值评审对齐(六裁判 × 多生成器) | 与程序化参考的对齐率 align (%) | 四个生成器上六裁判收敛于 77–82%,SmolLM3-3B 约 70–76% | 同条件 easy 难度约 85–96% | 揭示约 1.5× 于有真值条件的无真值退化与结构性天花板 |
| 有真值评审(Llama-3.3-70B 生成器,easy) | align (%) | QwQ-32B 96.6(六裁判最高) | 裁判专用模型 Prometheus-2 66.5 | +30.1pp,通用大模型裁判远超专用裁判基线 |
| 结构化 JSON 对比自由格式提示词(Qwen3-32B × Llama-3.3-70B) | 有真值对齐提升(pp) | +4.8 至 +6.5(easy/medium/hard 全部提升) | 自由格式提示词 | 所测配置中最大杠杆,但存在裁判/生成器依赖性 |
| 程序化裁判的人机一致性验证 | 指标级一致率 (%) | 92.7(120 条硬难度记录,覆盖六拓扑) | 此前工具调用裁判评测无人类验证环节 | 为 321,648 次评估提供了可扩展且经人类校验的参考 |
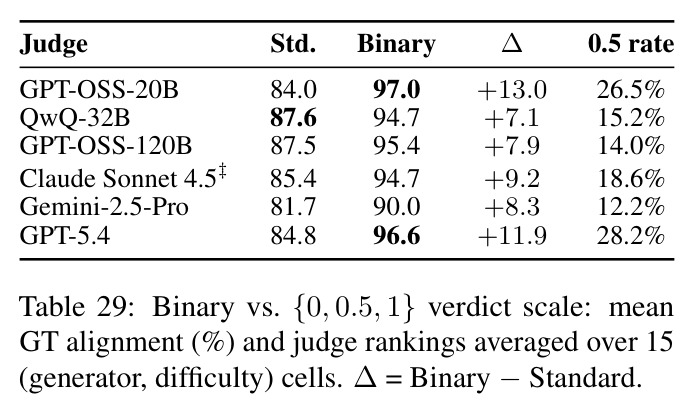
| C2:0.5-default 提示重校准(硬难度·无真值) | 对齐提升(pp) | 强生成器 ≤+1.0,弱生成器 +4.1 至 +5.6 | 标准 1.0-default 提示 | 证实强生成器上的 77–82% 天花板主要是结构性任务难度 |
局限与改进
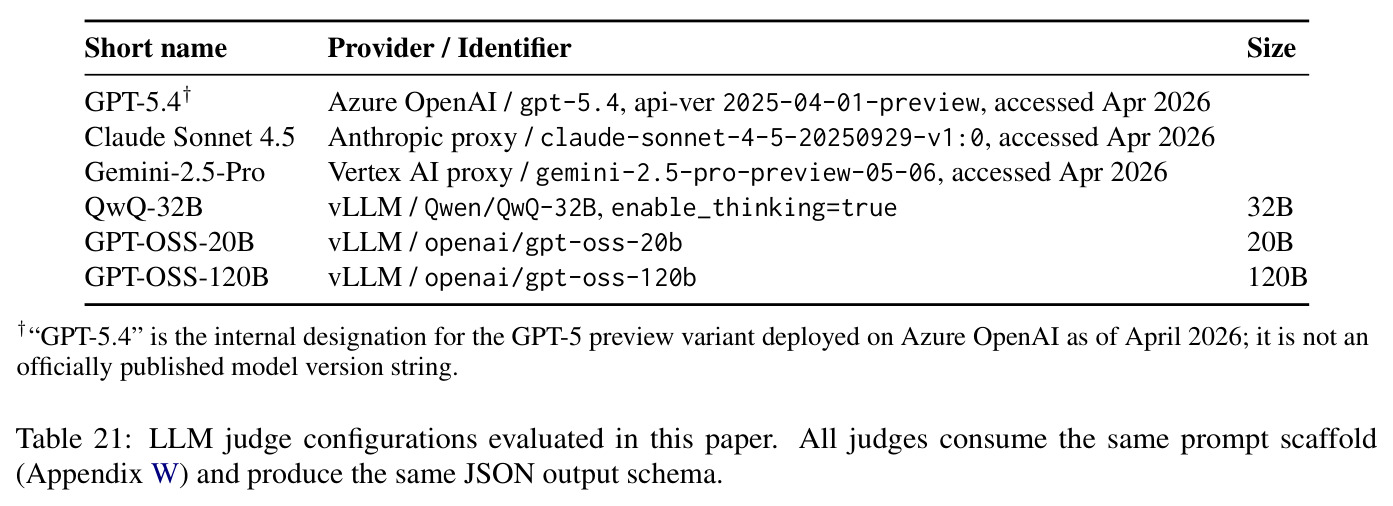
作者承认的局限:(1) GPT-5.4 是不可复现的 Azure 快照且兼任裁判与改写元裁判,自偏好无法完全排除(序列准确性 +0.172 对其他 ≤+0.008 的信号无法独立复核);(2) 合成数据继承生成管线偏差、可能低估非英语工作流,域漂移仍是开放问题;(3) 难度分级只有 medium→hard 高比例验证(93.9%),easy→medium 仅 58.1% 全票通过,medium 应读作鲁棒性检查而非校准中点;(4) 程序化打分器把 schema 合法的多余参数键判为扣分(参数结构上人类一致率仅 82.5%),虽最宽松修正下排名移动 ≤0.09pp,绝对数值仍依赖现行规则;(5) 只研究评测时可靠性,未测试失败模式作为训练信号(奖励模型、模型选择门)时是否延续。我的补充:四指标等权与 $\{0,0.5,1\}$ 判定较粗糙,0.5 边界集中了 94–97% 的裁判分歧;120 条单标注者的人类研究偏小;六主裁判全是通用模型,评估单一文化风险真实存在。
独立分析的弱点
独立分析的弱点:其一,1.0-default 判定压缩意味着无真值裁判在难题上系统性过誉——在电网、医疗等安全关键域,这会把错误工具调用认证为正确;改进方向是强制裁判输出逐指标显式置信而非默认满分,或如 C2 消融所示改用 0.5-default 提示(弱生成器场景 +4.1–+5.6pp)。其二,真值锚定对前沿裁判是双向刀:Gemini-2.5-Pro 在污染真值下对齐率分毫不变,说明它根本没有独立核验参考,改进方向是训练'先独立预测再比对真值'的裁判,或在推理时用分歧检测器标记锚定行为。其三,六个裁判在难题上收敛到同一失败模式($\kappa$ 与档位强相关),提示共享训练分布偏差,任何单一裁判的部署都应辅以程序化评分与人工抽查。其四,数据全为合成静态 DAG,缺少真实企业 trace 的多轮交互、工具报错重试与环境反馈场景,裁判在动态执行下的行为完全未覆盖。其五,$\{0,0.5,1\}$ 判定加四指标等权对严格顺序工作流等应用需要重加权——虽然排序稳健($\rho \ge 0.832$),绝对对齐率却会随权重漂移,跨论文比较时应谨慎。
未来方向
作者提出的方向:(1) 把评测时发现的三种失败模式——真值过度锚定、无真值判定压缩天花板、跨裁判相关失败——作为训练信号的研究(奖励模型或模型选择门),在附录 B 被明确标记为后续工作;(2) 缓解评估单一文化,鼓励 LLM 裁判与程序化评分、人工复核互补部署。基于本文成果可延伸的方向:其一,用 321,648 次配对判定作为监督数据微调'裁判对齐器',学习在无真值条件下逼近程序化参考;其二,把协议迁移到多轮交互与环境反馈场景,检验静态 DAG 结论的外推性;其三,把判定空间扩展到细粒度连续分数,绕开 0.5 边界上 94–97% 的分歧集中;其四,研究 jury 之外的去相关手段(异构提示、不同训练谱系裁判混合),因为现有软 jury 只与最佳个体持平(82.5%);其五,把难度改写协议推广到 SQL 生成、代码修复等其他结构化评测,考察同样的单调退化与天花板是否复现;其六,针对锚定行为设计'盲评先行'的两阶段裁判提示并量化收益。
复现评估
复现条件相当好。数据:HuggingFace 数据集 ServiceNow-AI/AgentJudgeBench 包含全部 3,808 条记录、五个生成器输出及七个裁判在两种条件下的全部判定,论文每张图表的原始数据都随附公开。代码:SyGra 框架开源(github.com/ServiceNow/SyGra 的 agent_judge_bench 分支),含数据生成、难度改写、程序化裁判(式 1a–5a 实现)、LLM 裁判运行器与全部提示词模板(附录 W 逐字给出),并附主结果复现脚本,宽松开源许可。算力:主要成本是 321,648 次 LLM 裁判调用,涉及 20B–120B 开源模型与三个前沿闭源 API,消融实验还需额外配对调用,需要多卡集群或可观 API 预算。风险点:GPT-5.4 不可复现且兼任生成器、裁判与元裁判,该格子无法逐位复现(作者声称主结论在纯开源生成器上独立成立);Gemini-2.5-Pro 与 Claude Sonnet 4.5 亦为闭源 API,版本漂移影响绝对数值。总体:材料齐全、路径清晰,复现难度中高,瓶颈在调用量而非信息缺口。
论文图表