LiveMACE:演化金融市场中 LLM 智能体能力的过程感知评测 LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
用实时演化市场做过程级诊断,揭示 LLM 智能体收益排名与真实能力严重脱节
前置知识
ReAct 交互范式
ReAct 是 LLM 智能体最常用的执行框架:模型在每一步交替输出“思考”(推理当前信息需求)和“行动”(调用工具),工具返回的观察结果进入上下文驱动下一步推理,循环直至输出终止符。它把推理过程外部化为可记录的轨迹,是绝大多数智能体系统的公共底座。
本文全部五个配置都构建在同一 ReAct 决策轮结构上,理解它才能理解“匹配配置”的实验设计如何隔离单一机制的贡献。
LLM-as-a-Judge(LLM 评审)
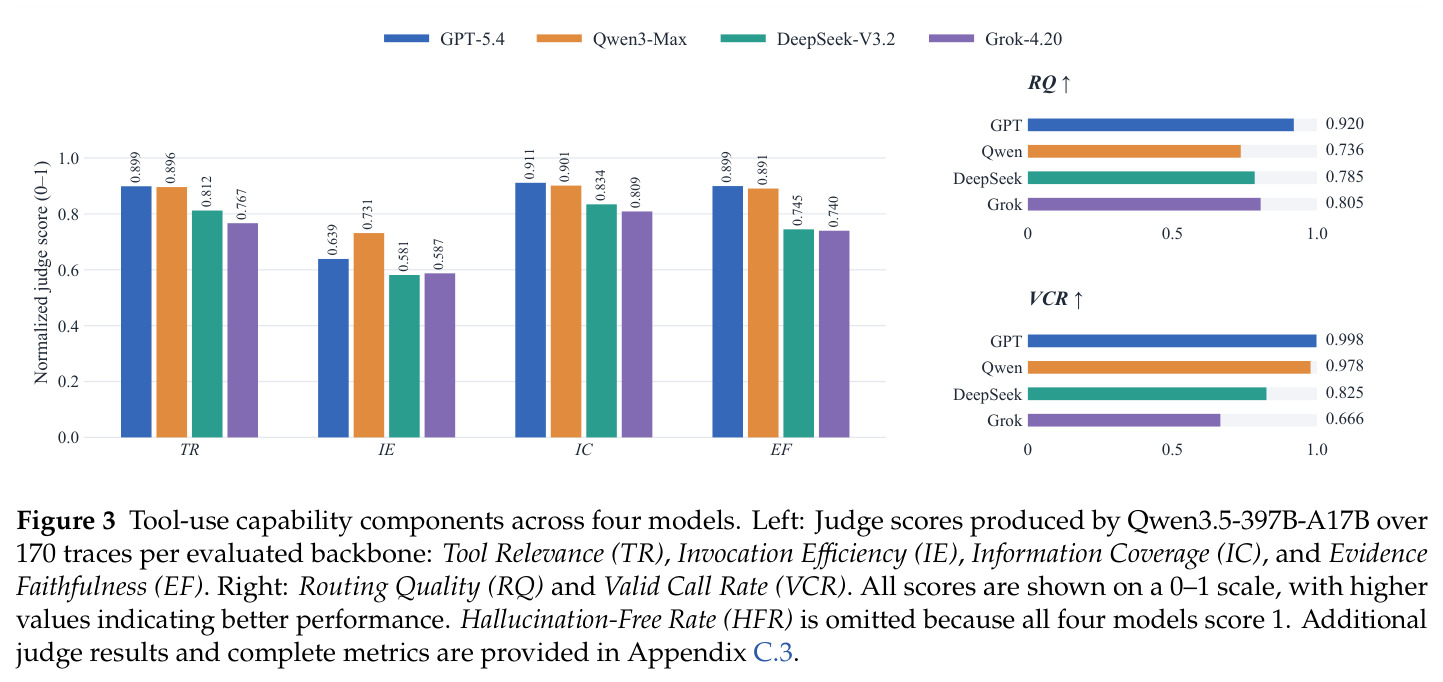
用另一个强 LLM 按照评分细则(rubric)对被评模型的输出或轨迹打分,替代昂贵的人工标注。本文用 Qwen3.5-397B-A17B 作主评审,对 680 条工具使用轨迹按 0-10 分评四个维度,并用 DeepSeek-V4-Pro 等第二评审交叉验证排序稳定性。
论文的过程诊断指标(TR/IE/IC/EF、MCQ/MUQ、RC/CH)全部依赖 LLM 评审,其鲁棒性分析(如 IE 一致率仅 69.4%)直接影响对这些分数可信度的判断。
最大回撤(MDD)与尾部损失(Tail Loss)
最大回撤指账户净值从历史最高点到其后最低点的最大跌幅,衡量最坏情形下的亏损深度;尾部损失取最差 5% 小时区间的平均收益率(带符号,越接近 0 越好)。两者都是下行风险指标,不依赖单次收益,适合度量“长期风险控制”能力。
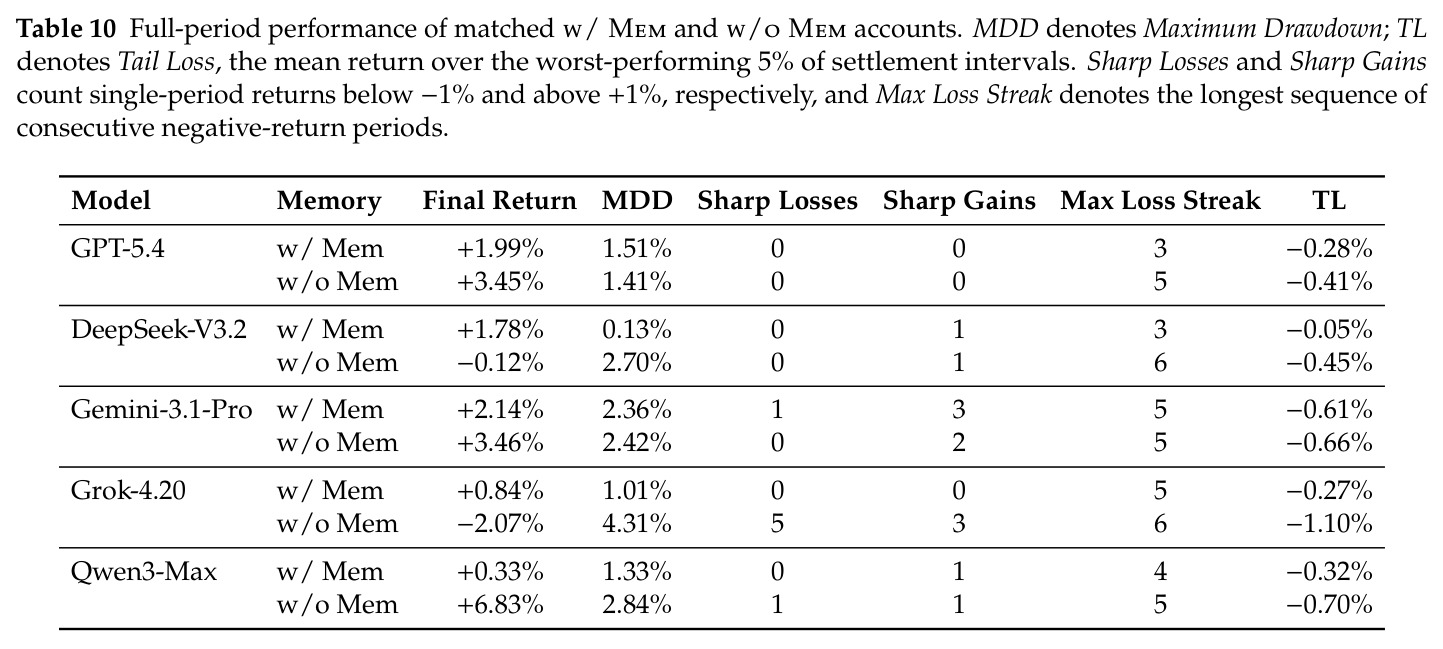
论文用相对配对无记忆账户的 $\Delta$MDD 与 $\Delta$TL 作为持久记忆的客观下游效应指标,是“记忆提升风险控制”这一核心结论的量化基础。
纸面交易与非重置账户
纸面交易(paper trading)用真实市场行情做模拟撮合,不投入真实资金。本文强调账户状态“不可重置”:每笔交易改变的持仓会持续暴露于后续所有市场波动,形成开放式长时程轨迹,而非每题独立、可回滚的静态任务。
动作有持久后果是本文环境区别于传统基准的关键,也是“过程评测”有意义的前提——早期决策的经验与错误会传导到 30 天后的行为。
结果评测 vs 过程评测
结果评测只看最终指标(任务成功率、累计收益)并据此排名;过程评测从完整决策轨迹中提取“怎么做到的”——调用了哪些工具、是否复用经验、是否检查规则、是否整合多方证据。两者可以背离:同样的结果可由截然不同的过程产生。
这是全文的核心概念框架:论文的贡献就是用三类信号(结果、受控机制效应、过程诊断)证明“结果–能力鸿沟”真实存在且可测量。
分层规则策略($R_0 > R_1 > R_2$)
把约束按优先级分层:$R_0$ 是系统硬约束(杠杆上限 5 倍、单笔名义值不超过 20% 权益、日内回撤 5% 硬止损),$R_1$ 是客户硬性政策(单资产敞口不超过 15%、现金储备至少 10%、黑名单行业),$R_2$ 是软偏好(现金比例 5%–15% 等)。冲突时必须先满足高优先级。
规则遵循配置的全部指标(HPR、SRS、RSS、RC、CH)都建立在这套分层政策上,案例分析中的典型失败(把 15% 上限当目标边界)也围绕 $R_1$-02 展开。
研究动机
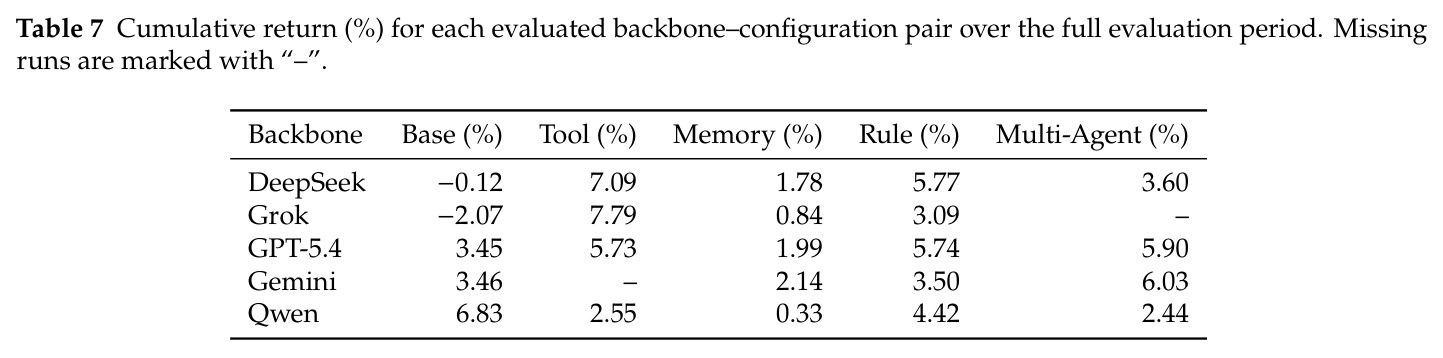
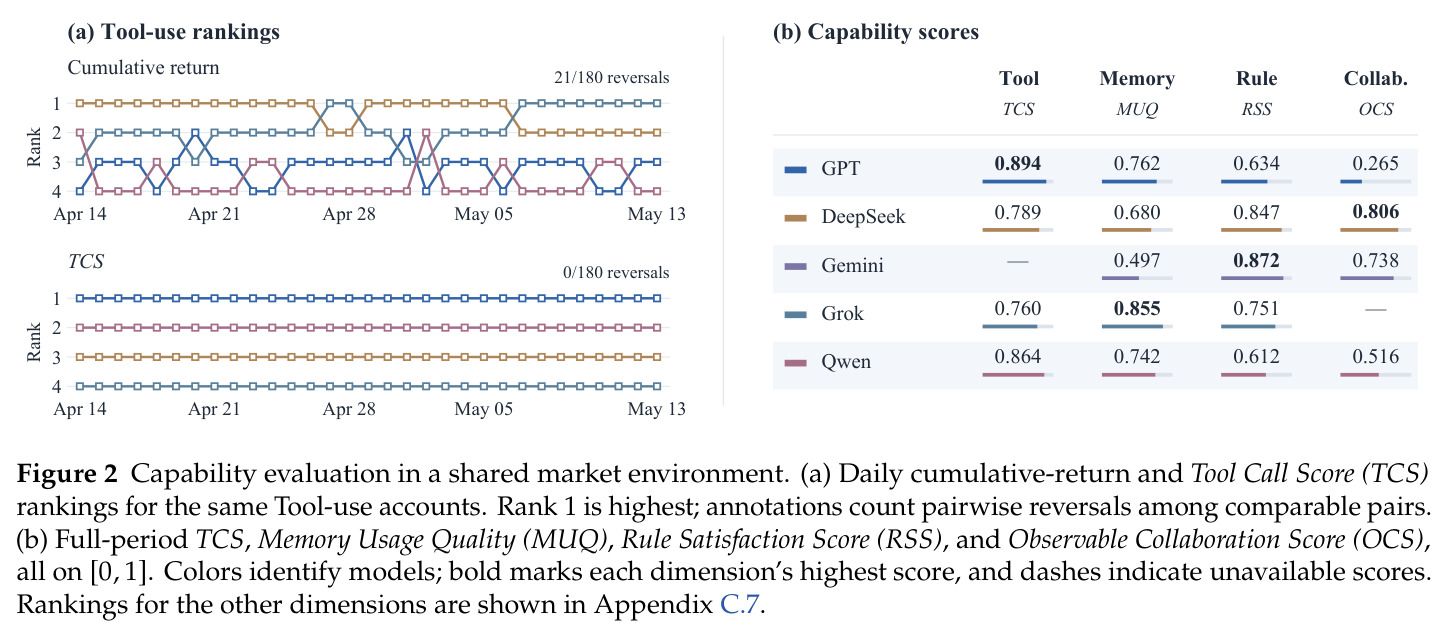
现有智能体评测大多以结果论英雄:AgentBench、WebArena、SWE-bench 等静态基准用最终成功率排名,而 Alpha Arena、Agent Market Arena、AI-Trader 等实时金融基准虽然引入了动态环境,比较对象仍是交易收益。收益是智能体行为与市场演化闭环交互的最终产物,无法归因到具体能力。论文的实测数据把这种“结果–能力鸿沟”展示得非常直观:在 2026 年 4 月 13 日至 5 月 13 日的 30 天实时评测中,累计收益排名极不稳定,在工具使用、记忆、规则遵循、多智能体协作四个配置下分别出现 21/180、19/280、19/300、29/180 次相邻观测点间的成对排名反转;Grok-4.20 在工具使用配置下收益最高(+7.79%),工具调用综合分 TCS 却最低(0.760)。反过来,静态任务环境又难以持续激发信息获取、经验复用、约束遵循与协调这些过程性行为,使能力根本无法被观察。
本文的目标是本文的目标是把“智能体取得了什么”与“智能体依靠什么能力取得”分离开,让实时市场从排行榜变成诊断环境。具体做法是构建 LiveMACEBench:在共享的实时加密货币与美股市场(6 个加密资产 + 17 支美股,共 23 个可交易资产,初始资金 $10,000)中,让 GPT-5.4、DeepSeek-V3.2、Gemini-3.1-Pro、Grok-4.20、Qwen3-Max 五个前沿模型在统一 ReAct 底座上沿 30 天连续轨迹运行,并构造 Base、Tool Use、Persistent Memory、Rule Following、Multi-Agent Collaboration 五个匹配配置。评测同时输出三类信号:任务结果(收益、回撤、尾部损失)、受控机制效应(如记忆开/关的配对账户差值)、以及从完整决策轨迹提取的机制特定过程诊断,从而把“机制接入、机制有效使用、实际收益”三个被结果评测混为一谈的量分开度量。
与已有工作不同的是,本文的独特之处在于视角反转:不把交易表现当作主要比较对象,而是把市场的持续演化交互本身当作“诊断基底”。与 Alpha Arena 等排行榜式实时金融基准互补——后者回答“谁赚得多”,本文回答“为什么赚、靠什么机制”。与 AgentBoard、AgentQuest 等过程级评测相比,LiveMACEBench 的环境外部动态完全非脚本化:市场独立于智能体持续演化,而动作有持久后果(账户不可重置),早期决策的经验与错误会传导至后续所有决策。更关键的是方法设计:通过同底座、同环境、同协议的受控机制变体,能力差异与失败模式可以被“定位”(如把工具失败定位到发现阶段的 RQ 与执行阶段的 VCR)而非从聚合表现“推断”,这是对现有实时评测只报告收益这一范式的补全。
核心方法
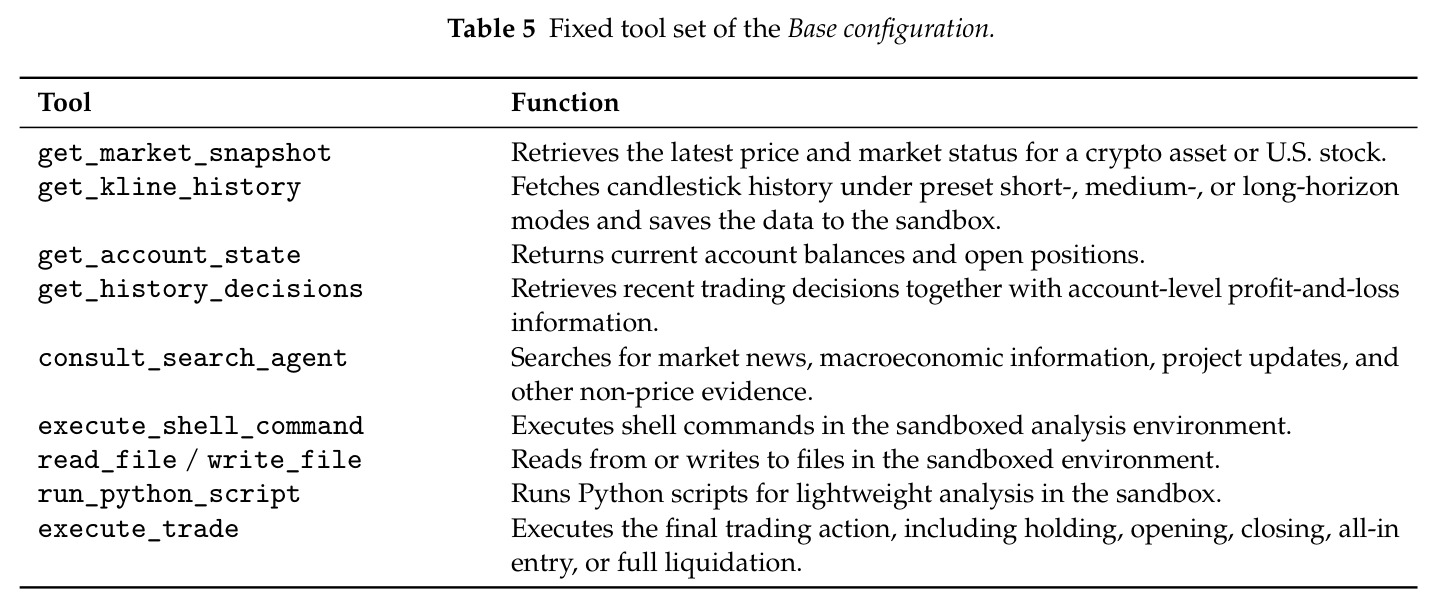
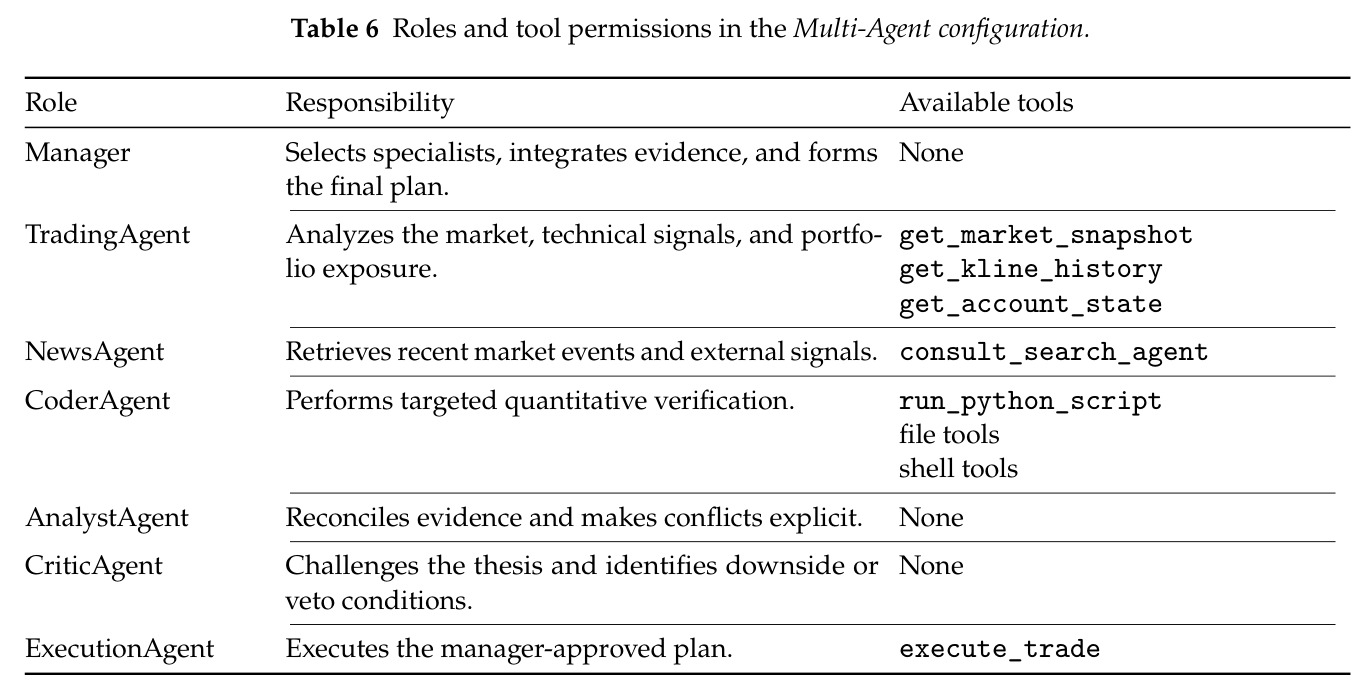
直觉上,评价一个交易员不能只看他年终赚了多少,还要看他怎么调研、怎么记笔记、怎么守纪律、怎么和团队配合。LiveMACEBench 把这一直觉工程化:五个前沿模型在完全相同的共享环境中沿持续轨迹运行——每 4 小时一个决策轮(一次完整智能体调用,可包含多步推理、工具交互与多笔交易),账户状态跨轮持久、不可重置。在此公共结构上,每个配置只引入一种目标机制:Tool Use 加入 305 个候选工具的动态路由;Persistent Memory 加入 memory_search/memory_add 双工具和「条件→观察→规则」格式的经验条目;Rule Following 提供分层交易政策 $R_0 > R_1 > R_2$ 并要求结构化合规陈述;Multi-Agent 用 Manager 加五个专家加独立 ExecutionAgent 替换单体推理。评测同时记录收益结果与完整决策轨迹(模型响应、工具调用、工具输出、动作的有序序列),前者用于排名,后者用于过程诊断。
核心创新是“匹配配置 + 三层信号”的受控诊断设计,把能力评测从观察推断升级为因果实验。第一层是任务结果:累计收益、最大回撤 MDD、尾部损失等;第二层是受控机制效应:例如记忆配置与无记忆配置在同一条市场轨迹上的配对差值 $\Delta$MDD、$\Delta$TL,多智能体与 ReAct 配对账户的收益差;第三层是过程诊断:从轨迹中提取 LLM 评审分与客观回放指标,如工具综合分 $\text{TCS} = 0.55J + 0.20\,\text{RQ} + 0.15\,\text{VCR} + 0.10\,\text{HFR}$($J$ 为四个评审维度的均值)。与已有方法的本质区别在于:结果评测用单一标量排名,把“有没有这个机制”与“用得好不好”混在一起;LiveMACEBench 通过控制变量让每个能力的接入、使用、收益三个量独立可测,进而发现三者可以完全脱钩——比如 Grok 收益最高但工具分最低、Gemini 记忆存量最大但使用质量最低。
方法步骤详情
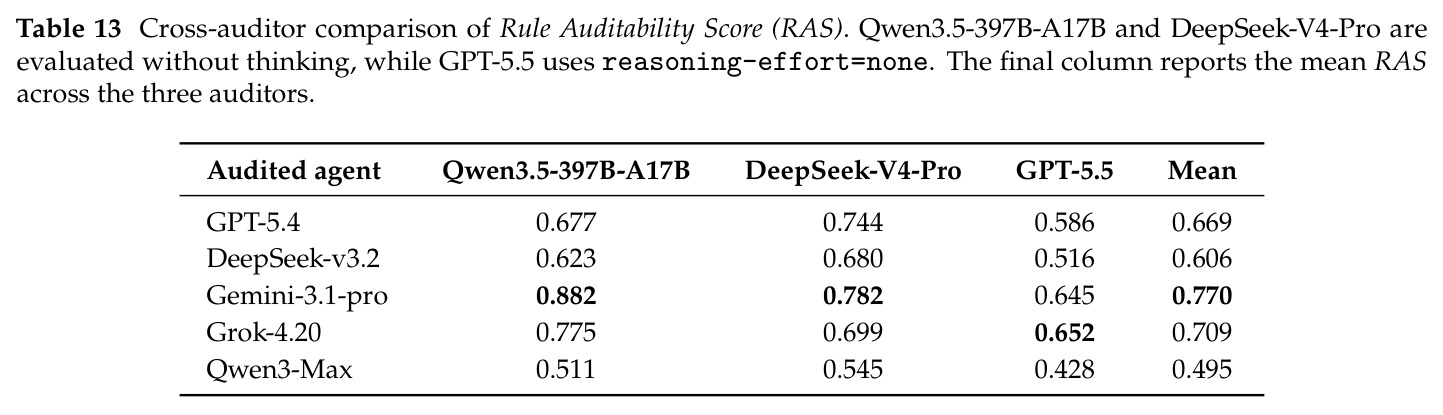
完整流程分七步。1) 共享环境:美股数据来自 Alpaca SIP 合并行情,加密数据来自 Hyperliquid;平台每 30 秒检查账户状态,在 15 分钟/1 小时/4 小时/1 天粒度写净值检查点,小时收益按 $\text{Return}_t = (AE_t - AE_{t-1})/AE_{t-1}$ 计算,总收益为小时收益几何连乘 $\prod_t (1+\text{Return}_t) - 1$,尾部损失取最差 5% 小时区间均值。2) Base:ReAct 循环调用 10 个固定工具(行情快照、K 线、账户状态、历史决策、搜索代理、沙箱文件/Shell/Python、交易执行)。3) Tool Use:新增 select_tools 路由元工具,从 295 个 APIVerve 公共 API 加 10 个基础工具共 305 个候选中按信息需求动态激活子集,基础行情与交易工具始终可用。4) Persistent Memory:检索打分 $\text{score}(m) = \alpha \cdot \text{sim}(q,m) + (1-\alpha) \cdot 0.5^{d/h}$,其中 $\text{sim}$ 为 BGE 嵌入余弦相似度、$d$ 为记忆年龄、$\alpha = 0.8$、半衰期 $h = 7$ 天;memory_add 写入前与同市场已有条目做 0.9 相似度去重。5) Rule Following:每轮决策必须输出含 [Compliance Audit] 的结构化理由;确定性检查器对已执行动作计算硬规则通过率 HPR 与软规则满足率 SRS,$\text{RSS} = \text{HPR} \times \text{SRS}$;独立 LLM 审计员评规则覆盖 RC 与冲突处理 CH(1-10 分),$\text{RAS} = (\text{RC}+\text{CH})/20$。6) Multi-Agent:Manager 无直接工具权限,Trading/News/Coder/Analyst/Critic 五个专家各持分区工具,输出统一为带来源的证据条目 $e_j = (\text{id}, \text{agent}, \text{summary}, \text{recommendation}, \text{risks}, \text{stance})$,Manager 预算 100 步,计划交 ExecutionAgent 顺序执行。7) 评测:工具用 Qwen3.5-397B-A17B 主评审(每骨干 170 条轨迹、共 680 条),记忆用 GPT/DeepSeek/Qwen 三个评审取均值,规则审计用三个模型交叉验证。
技术新颖性
技术新颖性体现在四个层面。其一,环境新颖:首个把实时演化市场用作能力诊断基底而非排行榜的基准,外部动态非任务脚本化且动作有持久后果,能力评测在开放式轨迹上进行。其二,实验设计新颖:匹配机制变体(同 ReAct 底座、同市场、同协议)让能力归因成为受控对照实验,可直接回答“引入记忆改变了什么”这类因果问题。其三,指标体系新颖:每个能力都拆成“执行层 + 理解层”双视角——工具拆成发现(RQ)与执行(VCR),记忆拆成构建(MCQ)与使用(MUQ),规则拆成满足(RSS)与可审计推理(RAS),协作拆成角色多样性(RD)与证据整合(EI),并用确定性回放指标锚定 LLM 评审的主观性。其四,评测协议新颖:31 个观测点的时序累积排名与成对反转计数,首次定量证明能力分数(反转 0-8 次)远比收益排名(反转 19-29 次)时间稳定,为“过程指标更可信”提供了元级证据。
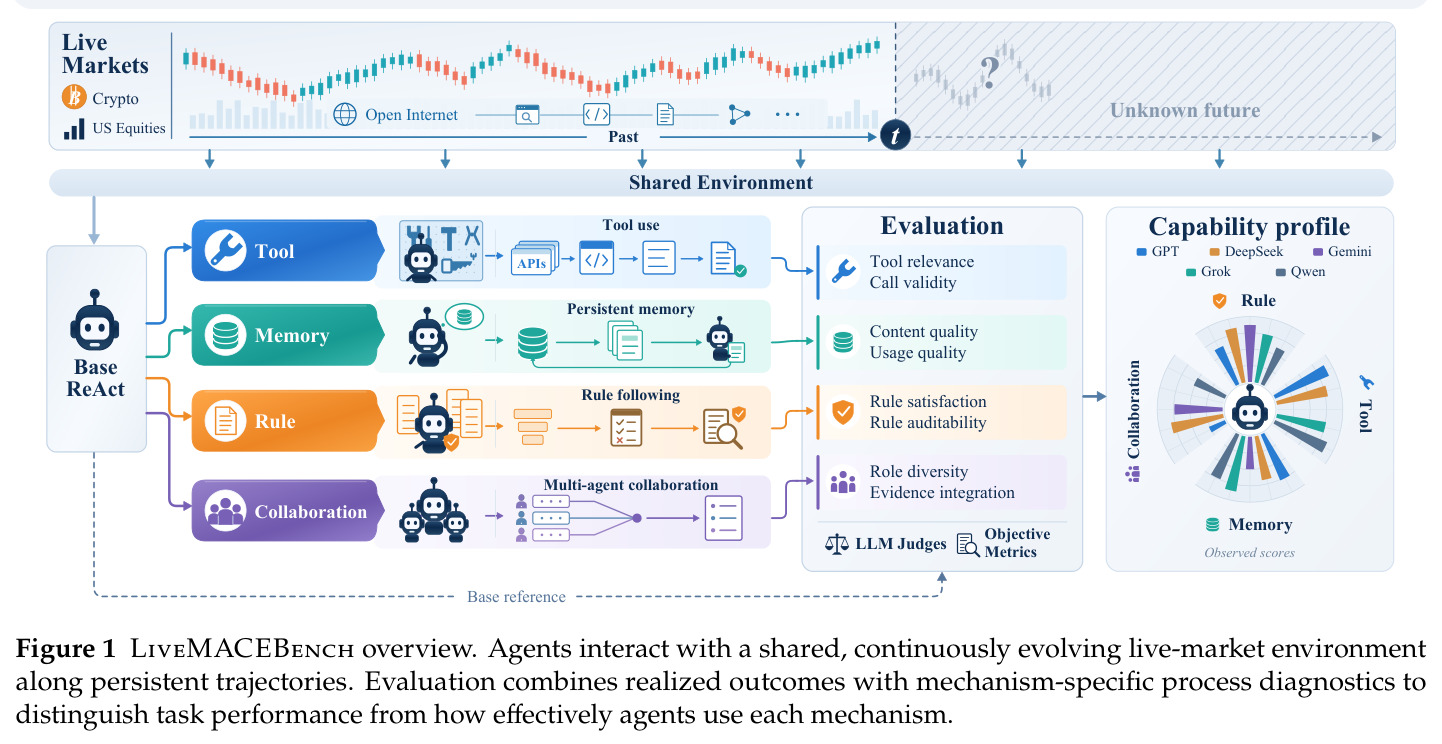
实验结果
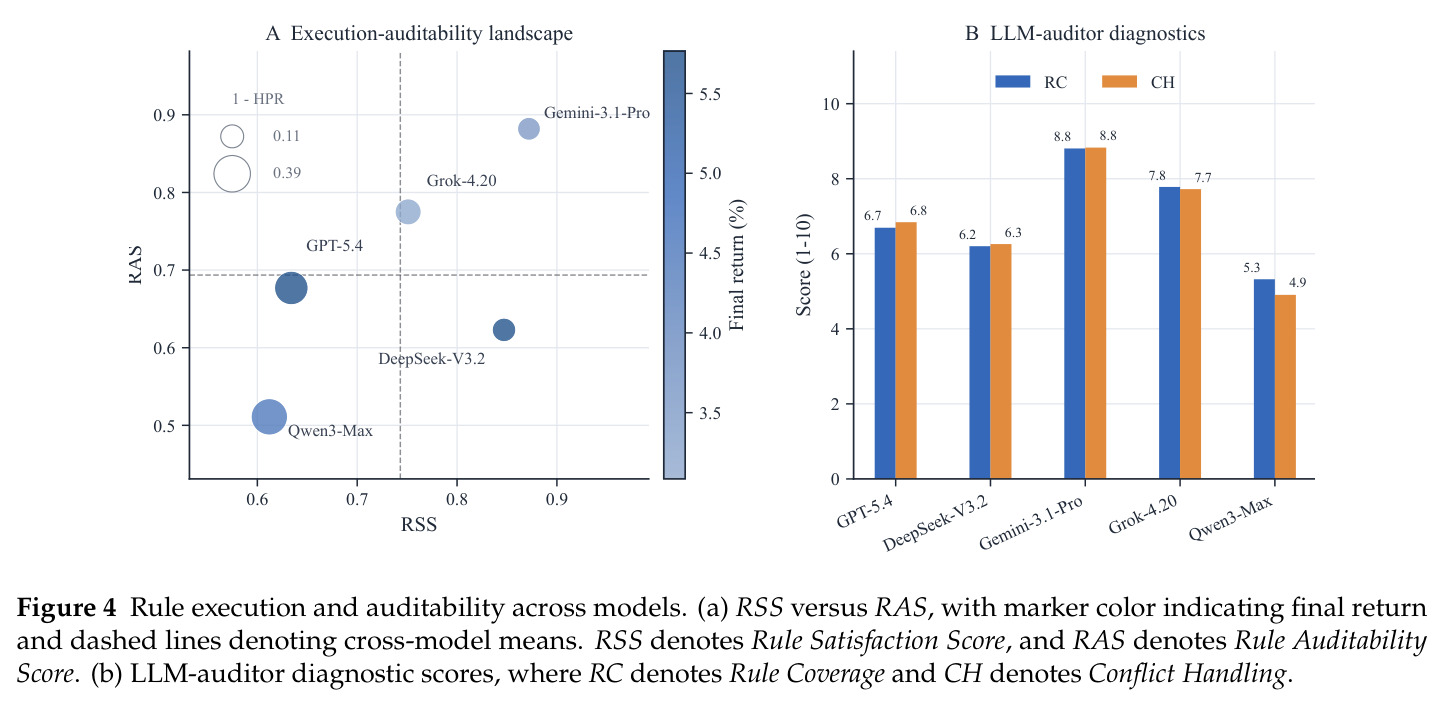
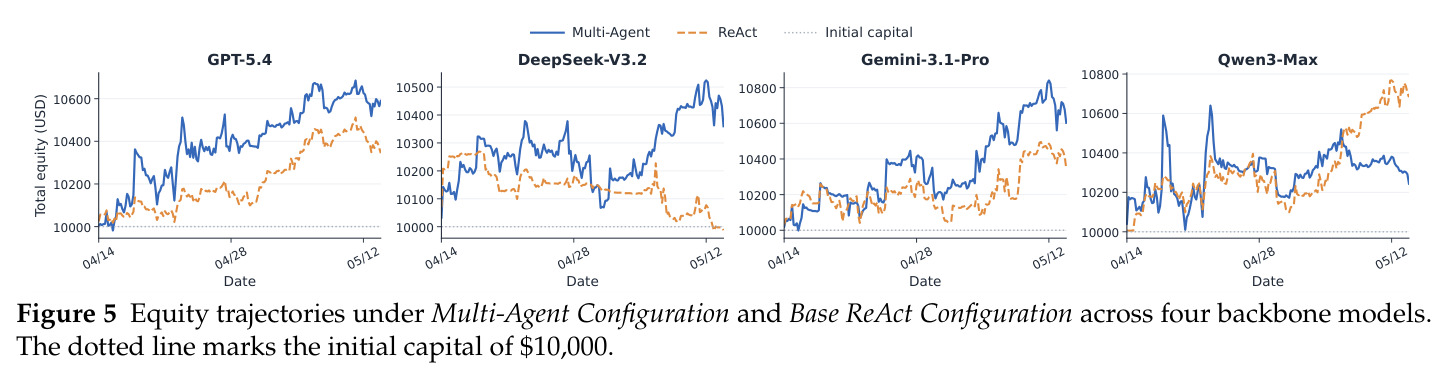
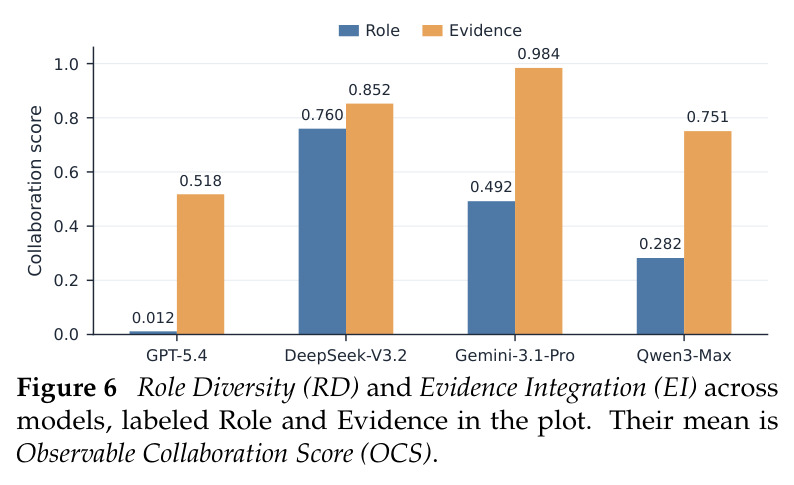
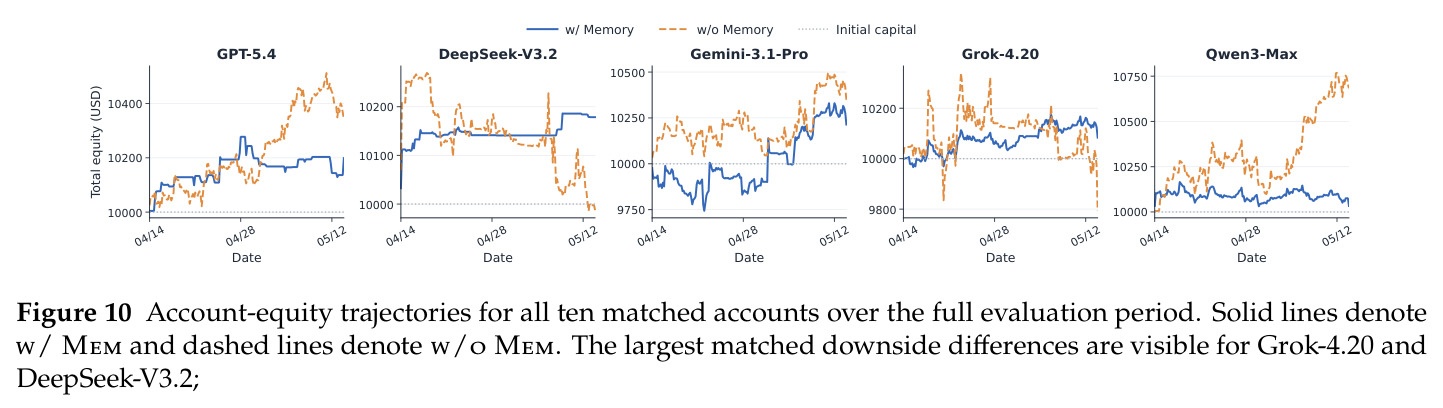
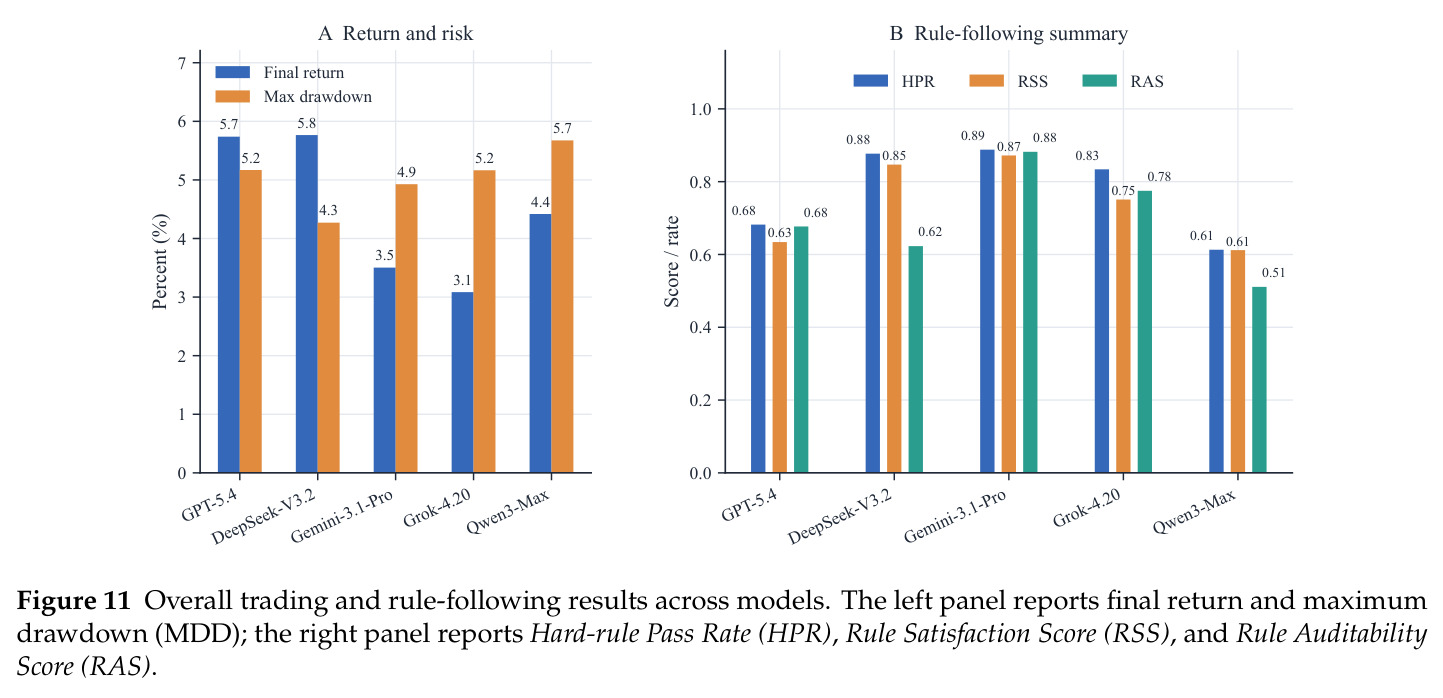
论文的核心发现是显著的结果–能力鸿沟,四个能力维度各有一个清晰的实验故事。(1) 时序稳定性:30 天内收益排名成对反转达 21/180(工具)、19/280(记忆)、19/300(规则)、29/180(协作),而对应能力分仅反转 0、5、8、2 次;且不存在全能模型——GPT-5.4 工具最强(TCS 0.894)、Grok-4.20 记忆使用最强(MUQ 0.855)、Gemini-3.1-Pro 规则最强(RSS 0.872)、DeepSeek-V3.2 协作最强(OCS 0.806)。(2) 工具使用:四模型信息覆盖 IC 均超 0.8(0.809–0.911)但调用效率 IE 全面最弱(0.581–0.731),说明“凑够证据”容易、“省着用工具”难;失败分阶段——Qwen3-Max 路由最差(RQ 0.736)但执行近乎完美(VCR 0.978),Grok-4.20 相反(RQ 0.805、VCR 0.666),GPT-5.4 双强(0.920/0.998),四模型幻觉率 HFR 均为 1;交叉评审显示模型排序稳定(DeepSeek-V4-Pro 均分系统性高 0.0481 但排序一致)。(3) 持久记忆:同一接口产生截然不同的动态——GPT 检索 332 次只存 1 条(88% 的决策判定无需新增,出现“记忆停滞”),Gemini 存 93 条但使用质量垫底(MUQ 0.497),Grok 仅 12 条却使用最好(0.855);下游效应上五模型尾部损失全部改善(Grok 从 −1.10% 到 −0.27%),4/5 改善 MDD,但收益效应异质(DeepSeek +1.78% vs −0.12%,Qwen +0.33% vs +6.83%),且效应随时间漂移(Gemini 收益差从全期 −1.32pp 转为后期 +0.53pp)。(4) 规则遵循:执行与可审计性分离——DeepSeek 收益 +5.765% 与 GPT +5.738% 几乎一致,但 HPR 0.877 vs 0.682、RSS 0.847 vs 0.634;Gemini 收益仅 +3.503% 却 HPR/RSS/RAS 全场最高(0.888/0.872/0.882);头号硬规则瓶颈是 R1-02 单资产 15% 集中度(GPT 31、Qwen 36 次违规/百决策),根因是把上限当目标边界、增量敞口算术错误(GPT 案例自称 13.66%+$600 仍低于 15%,实际达 19.44%)。(5) 多智能体:收益提升高度模型相关(GPT +2.45pp、DeepSeek +3.72pp、Gemini +2.57pp,Qwen −4.39pp)且四模型回撤全部变大;同一 harness 下协作模式迥异——GPT 角色多样性仅 0.012(近乎单角色),Gemini 证据整合 0.984(证据中心),DeepSeek 最均衡(RD 0.760/EI 0.852),OCS 与收益非单调。案例研究进一步揭示记忆的本质是风险控制经验而非收益最大化策略:Qwen 因“别追高”规则错过 SOL 约 10% 的趋势涨幅(+0.33% vs +6.83%)。
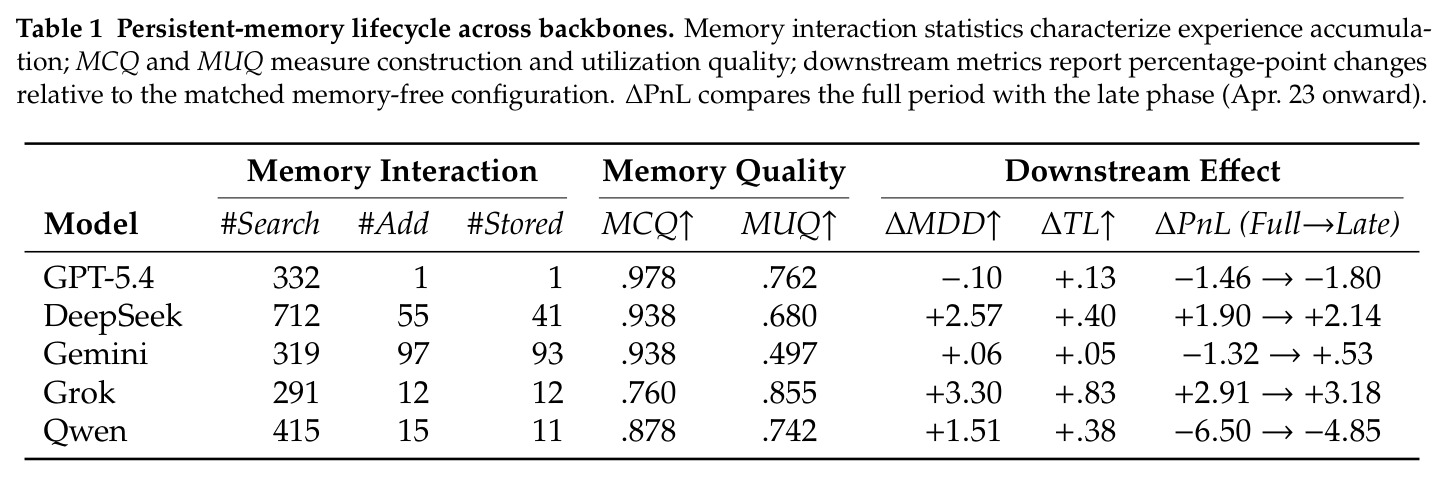
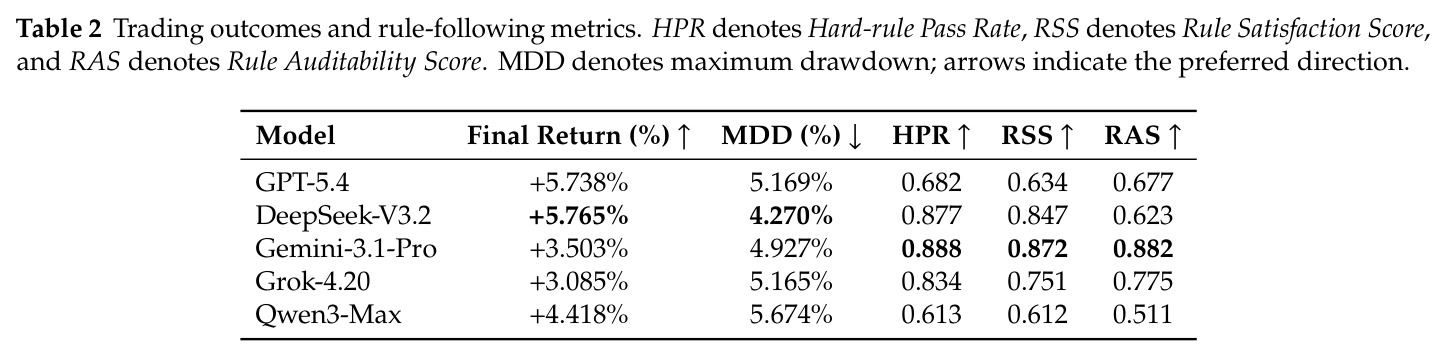
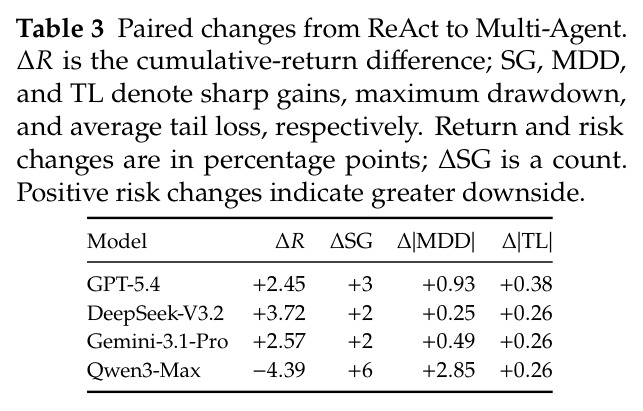
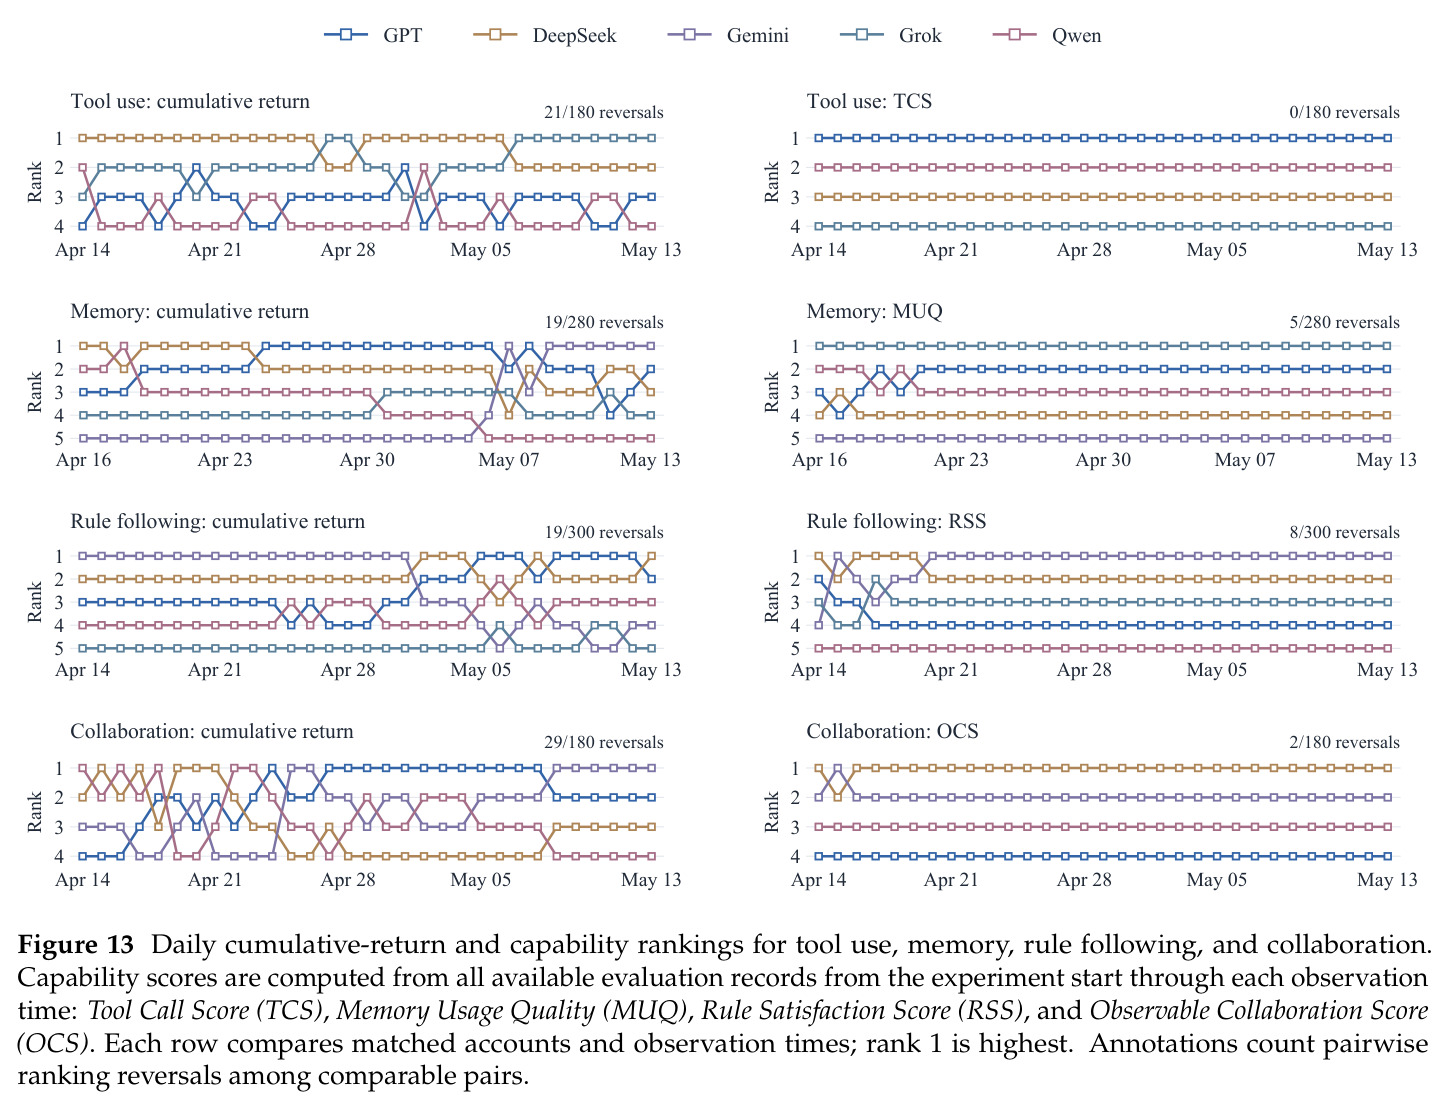
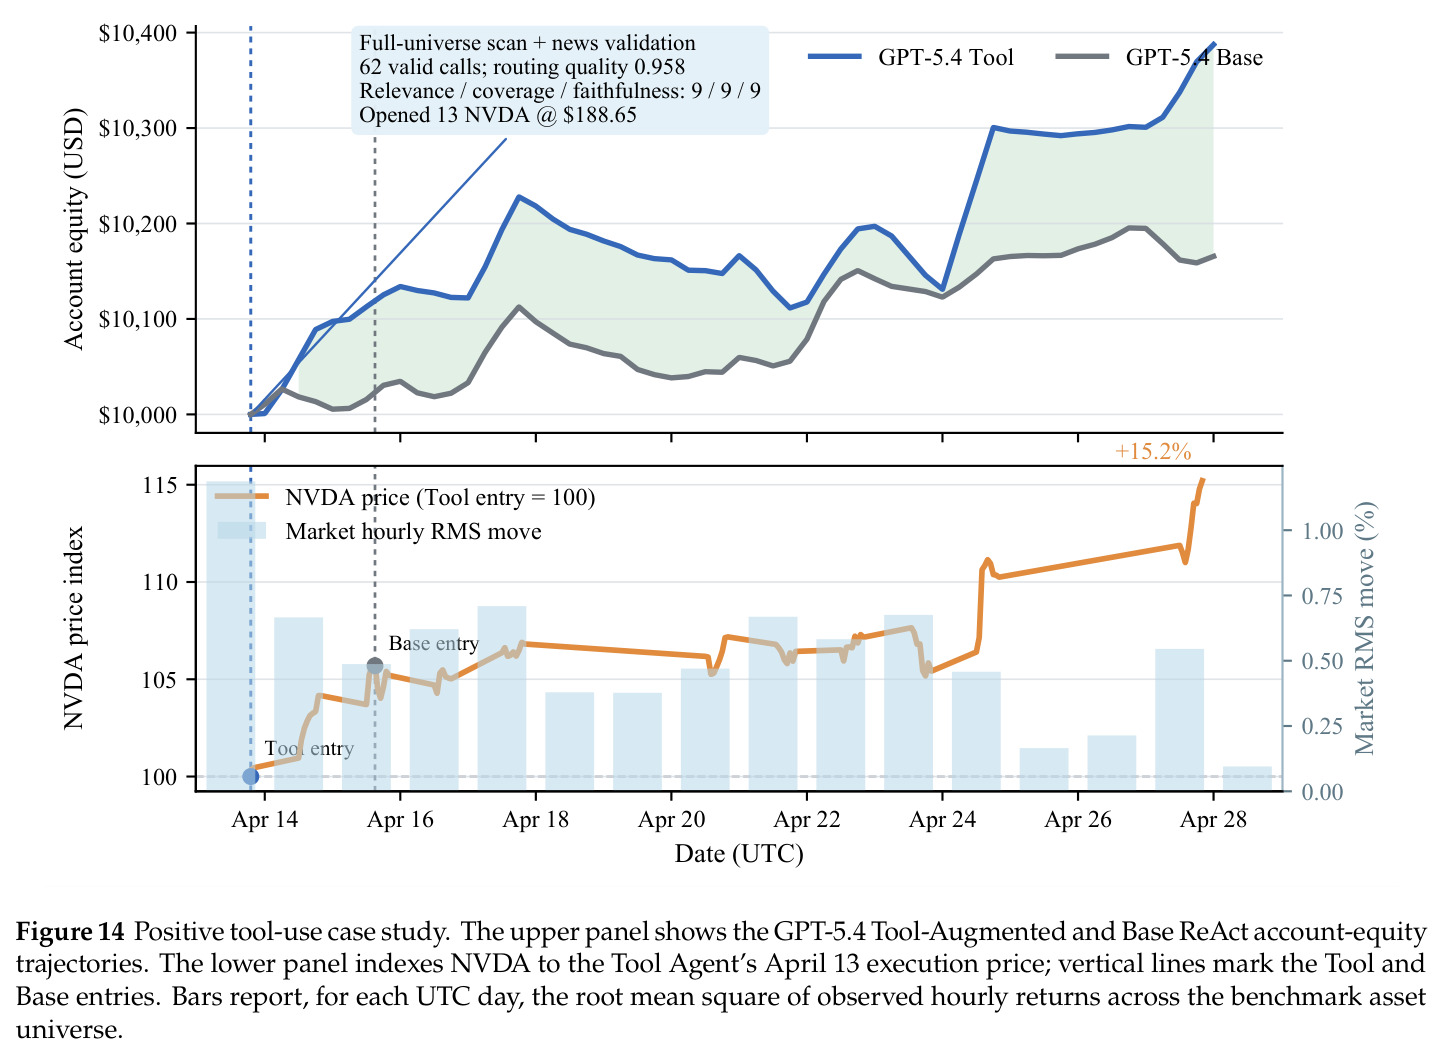
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 工具使用能力排名稳定性 | 30 天成对排名反转次数(180 个可比较对) | 能力分 TCS:0 次反转 | 累计收益:21 次反转 | 能力指标时间稳定性显著优于收益排名 |
| 多智能体协作排名稳定性 | 成对排名反转次数(180 对) | 能力分 OCS:2 次反转 | 累计收益:29 次反转 | 反转减少 27 次 |
| 工具使用综合能力 | Tool Call Score(TCS,0-1) | GPT-5.4:0.894 | Grok-4.20:0.760(同批最低) | 领先 0.134;注意 Grok 该配置收益反而最高(+7.79%),凸显结果与能力脱钩 |
| 持久记忆下游风险控制 | 尾部损失 Tail Loss(Grok-4.20) | 有记忆:−0.27% | 无记忆配对账户:−1.10% | 最差 5% 时段亏损收窄 0.83 个百分点;五模型全部改善 |
| 规则遵循执行 | 硬规则通过率 HPR | Gemini-3.1-Pro:0.888 | Qwen3-Max:0.613(同批最低) | 相差 0.275,且与收益排名无关(收益最高的 DeepSeek +5.765% 与 GPT +5.738% 的 HPR 为 0.877 vs 0.682) |
| 多智能体收益效应 | 相对配对 ReAct 账户的累计收益差 $\Delta R$ | DeepSeek-V3.2:+3.72pp | Qwen3-Max:−4.39pp(反例) | 机制效应高度模型相关,不能笼统断言协作有益;四模型回撤均增大 |
| 30 天最佳累计收益 | 最终累计收益 | Gemini-3.1-Pro 多智能体配置:+6.03% | Grok-4.20 Base 配置:−2.07% | 同一市场下收益由骨干×配置共同决定,极差达 8.1 个百分点 |
局限与改进
作者明确承认的局限:其一,两个运行因平台缺陷被剔除——Gemini 工具配置因状态观测滞后于成交导致重复下单,Grok 多智能体因单条 API 响应包含 1,363 个重复工具调用而超时失败,使两个“骨干×配置”格子缺失;其二,绝对分数依赖评审模型,调用效率 IE 的跨评审一致率仅 69.4%(MAE 0.1123),证据忠实性 EF 也只有 80.7%;其三,OCS 对角色集合约定敏感(更换 Critic/Coder 使 176/669 条轨迹的角色分变化),仅排序稳定。我的补充观察:第一,评测窗口仅 30 天且恰逢 buy-and-hold 为正的偏多头行情,未覆盖熊市与高波动 regime,风险类结论的外推性存疑;第二,每个“骨干×配置”只有单一账户、单条轨迹,收益差异没有任何统计显著性检验(协作 ±2-4pp 的收益差完全可能是市场噪音);第三,$10,000 纸面交易忽略了滑点、冲击成本与真实流动性约束;第四,LLM 评审的潜在自我偏好未被讨论(如 DeepSeek 系评审评 DeepSeek 系模型);第五,金融市场只是“演化环境”的一个实例,结论向软件仓库、运维系统等其他持续演化环境的迁移尚未验证。
独立分析的弱点
独立分析的弱点与改进方向:(1) 收益噪音未量化——论文仅对 OCS 做了 10,000 次自助抽样置信区间,建议对配对账户收益差同样做 bootstrap 检验,并用多随机种子与更长时间窗重复实验;(2) 评审主观性集中在 IE 与 EF 两个“解释性”维度(一致率 69.4%/80.7%)——建议构建人工标注校准子集、多评审加权集成,或用可计算的代理指标(重复调用率、每步调用数、无效调用占比)替代部分主观评分;(3) R1-02 集中度违规本质是“状态算术”失败而非规则理解失败——环境侧可提供确定性的仓位敞口计算工具,把算术从模型职责中剥离,让规则评测聚焦于真实的策略取舍;(4) 记忆“防跌也防涨”的双重性(Qwen 案例因保守规则错过 SOL 涨幅)提示需要 regime 感知的记忆检索,或把风控规则与动量规则分桶并按市况加权;(5) OCS 只度量形式参与不度量语义约束力——Qwen 案例三中风险警告被引用却被无视仍得 OCS=1,建议增加“证据-行动一致性”指标,检验 Critic 的看空意见是否实际降低仓位与杠杆;(6) 缺失格子(Gemini-Tool、Grok-MA)削弱覆盖完整性,可通过状态一致性断言、单响应工具调用数上限等防御机制避免。
未来方向
作者提出的方向:把过程感知评测扩展到更长时间窗口、更多市场 regime,以及其他持续演化环境。基于其成果可自然延伸的研究:(1) 跨域迁移——把“匹配配置 + 过程诊断”框架移植到代码仓库演进、运维事故响应、科学实验闭环等非金融演化环境,检验结论普适性;(2) 过程信号变训练信号——MCQ/MUQ、RAS、EI 等轨迹级指标天然适合作为过程奖励模型或强化学习的密集奖励,直接优化智能体的机制使用而非仅优化结果;(3) 记忆机制改进——针对“构建-检索-应用”三阶段脱钩(Gemini 存而不用、GPT 停滞),研究自动记忆整理、遗忘机制与 regime 分层检索;(4) 可审计规则推理作为合规基础设施——金融监管场景下 RAS 类指标可能成为智能体交易系统的准入门槛;(5) 协作语义深度——让 Critic 拥有硬否决权并度量其对风险行为的因果抑制;(6) 成本-能力联合画像——各骨干每轨迹平均消耗 18.6k-50.9k token 差异巨大,单位能力的 token 成本值得纳入能力雷达图。
复现评估
开源情况:代码仓库已公开(github.com/RaymondVoldemortFu/LiveMACE),论文附录异常详尽——附录 A 给出全部系统提示词、分层政策全文与评审 rubric,附录 B 给出运行时实现、可交易资产清单与全部指标的数学定义,附录 C/D 给出完整数据表与案例轨迹,复现评测协议所需的信息基本齐备。真正的障碍在于:(1) 需要五个前沿模型(GPT-5.4、DeepSeek-V3.2、Gemini-3.1-Pro、Grok-4.20、Qwen3-Max)以及三套评审/审计模型(Qwen3.5-397B-A17B、DeepSeek-V4-Pro、GPT-5.5)的 API,30 天 × 5 配置 × 5 模型的调用与 token 成本不低(仅工具评审就是 680 条轨迹 × 2 个评审);(2) 依赖 Alpaca SIP 与 Hyperliquid 实时数据接入,以及 30 天不间断运行的调度基础设施;(3) 市场不可重放,结果无法精确复现,只能复现协议——作者用配对账户设计和确定性检查器部分缓解了这一根本约束。综合评估:协议层面复现难度中等(文档充足),结果层面复现难度高(实时性 + API 成本),更适合作为二次分析或新环境适配的方法模板。
论文图表
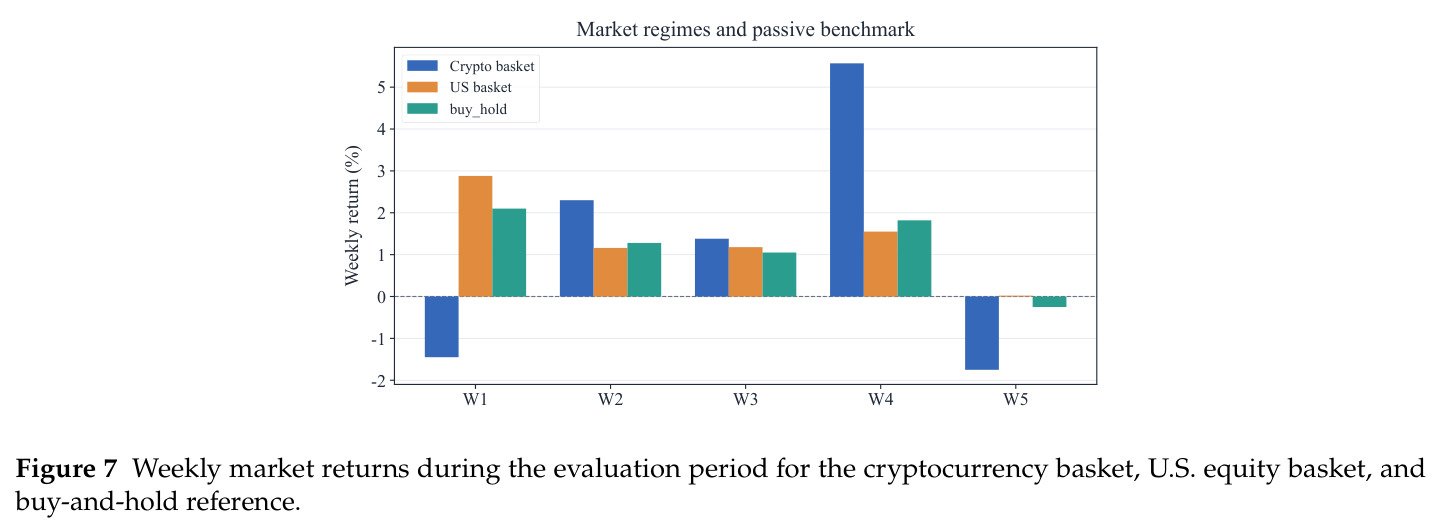
评测期内加密货币篮子、美股篮子与 buy-and-hold 基准的周度收益率:市场经历正负交替的阶段,但买入持有全期为正。
刻画评测窗口的市场 regime,说明结果–能力比较发生在非平稳但整体偏多的行情中,是解读收益数据的前提。
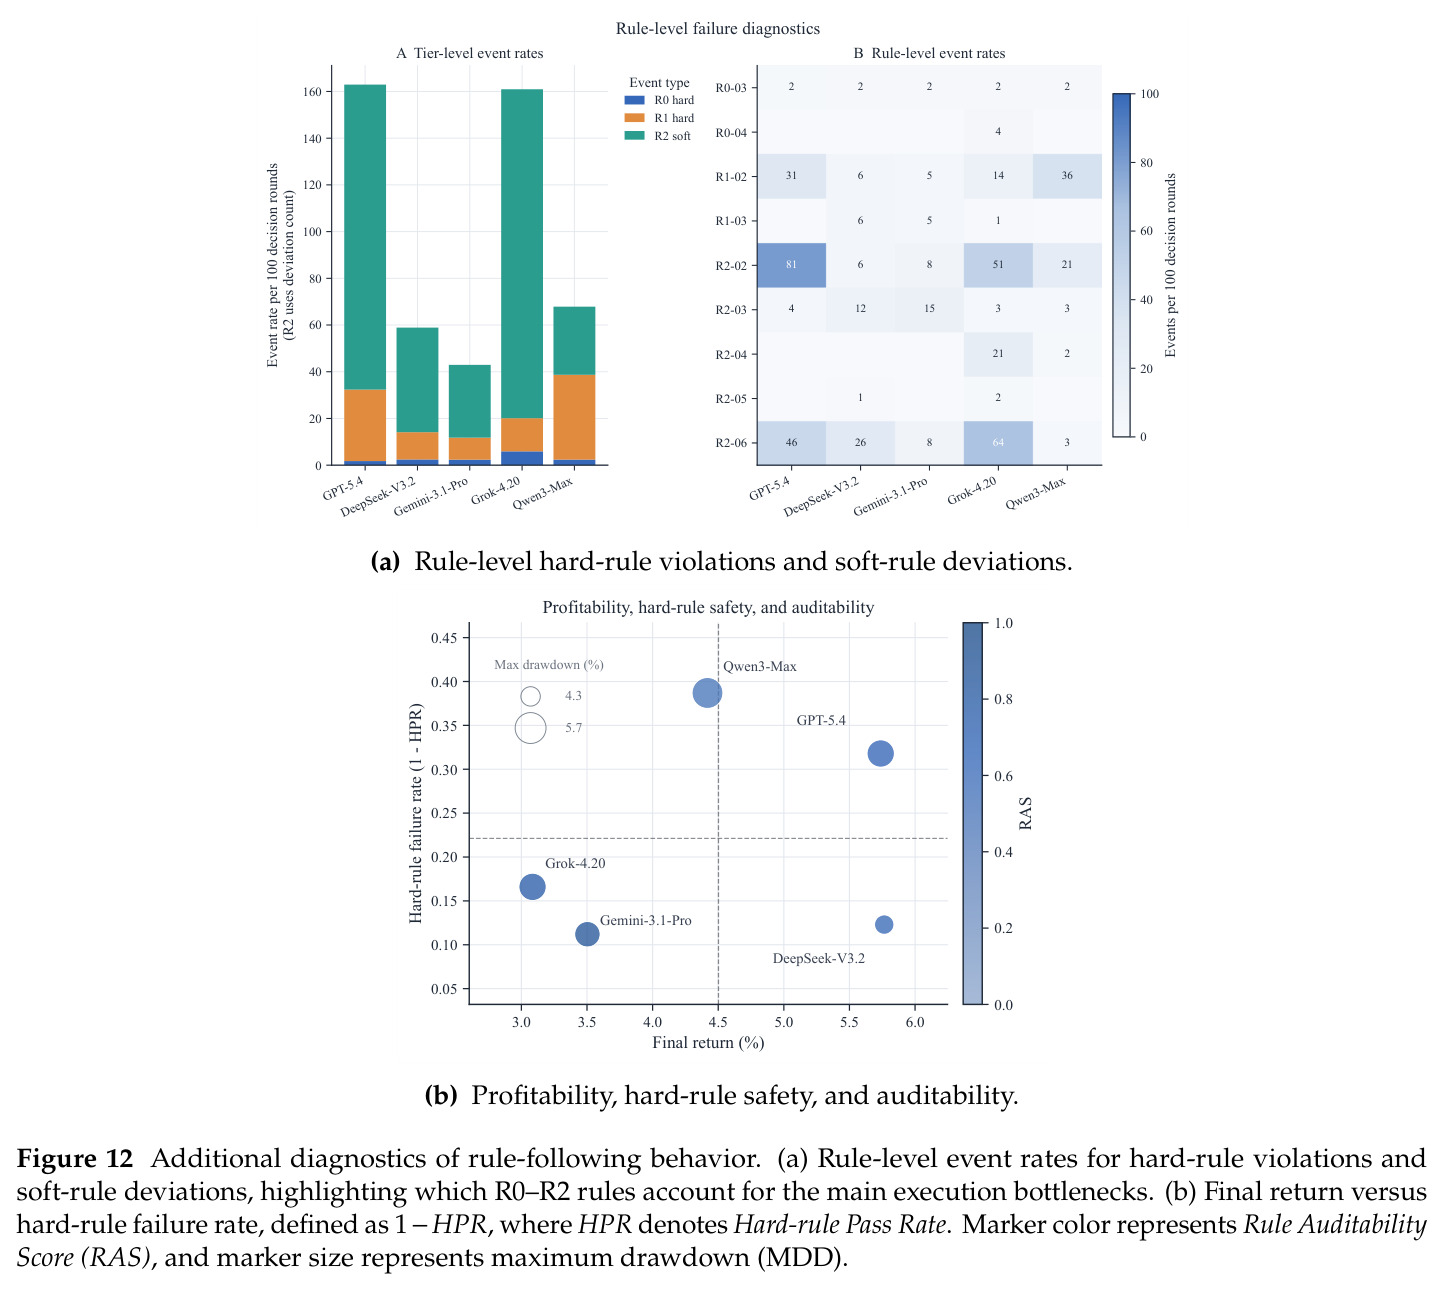
(a) 各规则层级的违规/偏离事件率:R1-02 集中度限制是主要硬规则瓶颈(GPT 31、Qwen 36 次/百决策),R2-02 现金利用率与 R2-06 活跃度是主要软偏好偏离;(b) 最终收益 vs 硬规则失败率散点,颜色为 RAS、大小为 MDD。
把规则失败定位到具体规则条款,支撑“失败源于状态算术而非忽视规则”的机理分析。