超越域路由监督:面向多教师在线蒸馏的跨教师守护方法 Beyond Domain-Routed Supervision: Cross-Teacher Guarding for Multi-Teacher On-Policy Distillation
用非路由教师担任跨域评审员,以词元加权与预防性梯度投影协调多教师蒸馏。
前置知识
在线蒸馏(On-Policy Distillation, OPD)
一种 LLM 后训练范式:学生模型按自身当前策略采样生成回复,强教师再对学生生成的轨迹做 teacher-forcing 打分,最小化序列级反向 KL 散度 $D_{KL}(\pi_\theta\|\pi_T)$。相比结果奖励 RL 只在整条回复末尾给一个 0/1 信号,OPD 在每个 token 上都提供密集监督,直接告诉学生『在你的上下文里教师会怎么做』,绕开了困难的探索与信用分配问题。
本文的全部技术框架都建立在 OPD 之上:目标函数、优势构造、梯度计算都是反向 KL 的词元级实现;多教师扩展 MOPD 与本文的 ROAD MOPD 都是 OPD 的变体,不理解 OPD 就无法理解任何一条公式。
反向 KL 与参考模型相对奖励
反向 KL $D_{KL}(p\|q)=\mathbb{E}_p[\log\frac{p}{q}]$ 衡量分布 p 偏离 q 的程度,具有 mode-seeking 性质。利用自回归链式法则,序列级反向 KL 可分解为词元级 KL 之和;再引入一个冻结参考模型 $\pi_{ref}$ 加减其对数概率,目标可重写为『最大化教师的相对奖励 $\lambda\log\frac{\pi_T(y|x)}{\pi_{ref}(y|x)}$ 减去对参考的 KL 惩罚』,形式上与 RLHF 的奖励+KL 正则完全同构,$\lambda$ 控制教师监督强度。
本文核心信号——教师一致性 $s_t$——定义为两个教师各自『相对参考模型的证据』的乘积,参考模型是跨教师比较偏好的公共标尺;不理解这层改写就无法理解公式 (4) 的设计动机。
梯度冲突与 PCGrad
多任务/多域联合训练中,若两个任务损失在共享参数上的梯度内积为负($\langle g_1,g_2\rangle<0$),沿一个任务下降会抬高另一个任务的损失,称为梯度冲突。PCGrad(Yu et al., 2020)是代表性的事后修正:检测到冲突时,把每个任务的梯度投影到冲突梯度的正交超平面上削去冲突分量,再求和更新。
论文 Figure 1 用『冲突层占比』诊断出 MOPD 的失败模式;本文的梯度保护机制正是针对 PCGrad 这类事后手术的预防式改进,实验中也与 PCGrad 直接对比(Figure 4)。不懂梯度冲突就无法理解『单独有效的监督为何联合失效』。
PPO 裁剪代理目标与重要性比率
PPO 是策略梯度 RL 算法:重要性比率 $r_t(\theta)=\exp(\ell^\theta_t-\ell^{old}_t)$ 度量新旧策略在采样动作上的概率比,损失取 $-\min(r_t A_t,\ \text{clip}(r_t,1\pm\epsilon)A_t)$ 的最小值,用裁剪限制单次更新幅度。优势 $A_t$ 通常由独立估计器给出并做 stop-gradient,梯度只经重要性比率回传。
ROAD MOPD 的词元级信用分配即实现于 PPO 式裁剪代理(公式 17-18):优势是被 $\lambda_t$ 调制、裁剪到 $[-10,10]$ 并 detatch 的教师相对奖励,训练细节($\epsilon_{PPO}=0.2$)全部基于此。
信用分配(Credit Assignment)
指确定『序列级的成功/失败应归因于哪些具体生成决策』的问题。稀疏结果奖励下 RL 只能给整条回复统一记功,优化低效;密集监督(如 OPD 的词元级教师分布)把信用分配变为词元级的对比问题。进一步对不同词元赋予不同权重或置信度,称为细粒度信用分配。
本文第一个机制就叫『跨教师引导的信用分配』:用教师一致性决定哪些词元放大监督、哪些衰减,正是对词元级信用做加权精修,是理解方法 (A) 部分的钥匙。
研究动机
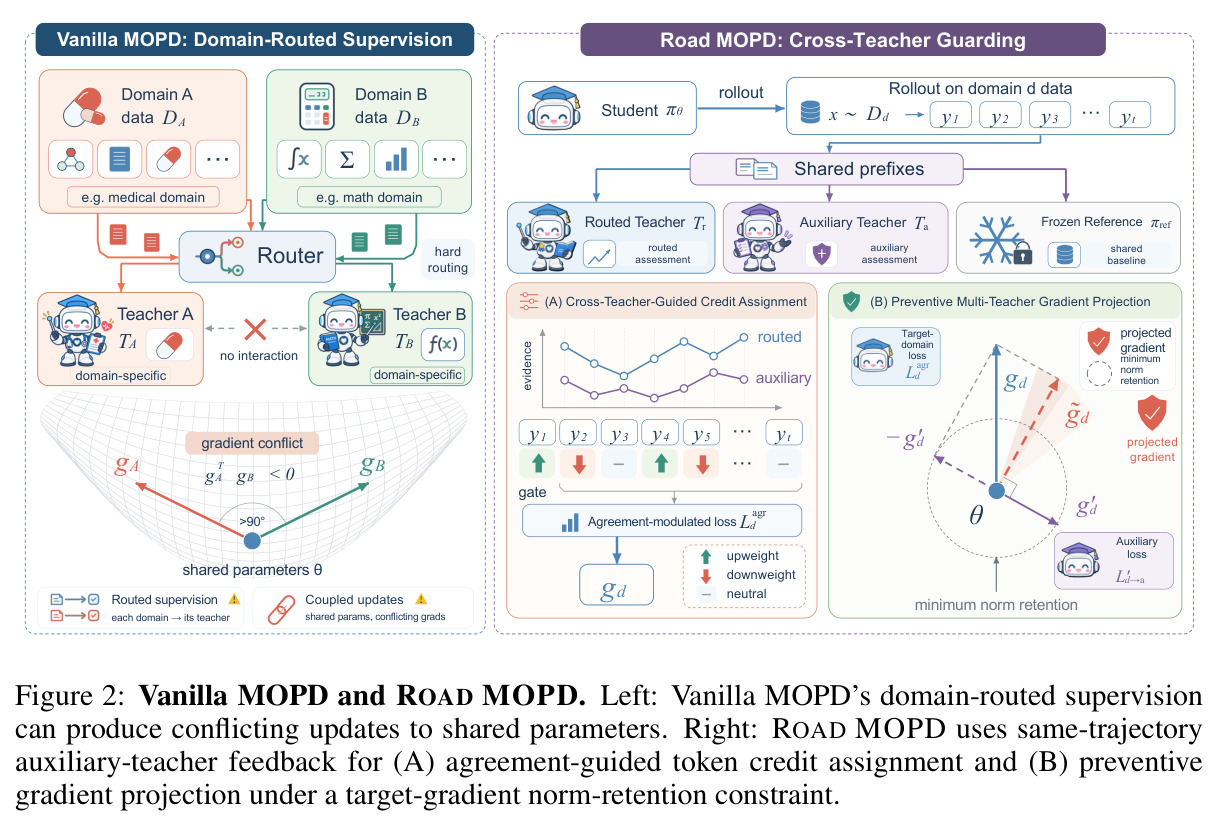
多教师在线蒸馏(MOPD)通常采用域路由:域 $d$ 的样本只由对应专业教师 $T_d$ 监督,而所有域的更新都作用在学生的同一组共享参数上。问题在于路由只区分了监督来源,没有协调更新的兼容性。论文 Figure 1 的诊断揭示出不对称的失败模式:Math+Code 组合是兼容的——联合训练整体优于各自单域 OPD,冲突层很少;而医学与数学或代码配对则是高冲突的——训练中冲突层占比平均达 45.2% 与 36.6%,且随训练后期继续攀升;性能上 Vanilla MOPD 使 Qwen3-4B 医学成绩从 41.01 跌至 39.45(Math×Medical)和 40.75(Code×Medical),1.7B 设置下更跌到 31.18 和 30.93,远低于医学单域 OPD 基线 35.67,最大跌幅达 14.45 个百分点。也就是说,单独训练时有效的监督,在联合优化中会在共享参数上诱发持续的梯度冲突,造成弱势域的能力退化,而现有的数据配比、损失加权类方法无法根治这种更新不兼容。
本文的目标是本文的目标是在保留路由教师领域专属密集监督的前提下,引入非路由教师作为跨域评审员来预判并缓解联合优化带来的更新干扰:利用它们对同一批学生轨迹的反馈,判断哪些修正是可迁移的、哪些可能与其他域能力冲突,进而在词元层面(信用加权)与梯度层面(更新方向约束)同时抑制冲突更新的有害成分,同时保住目标域的学习信号不被过度削弱。可度量的目标是:在 Math×Medical、Code×Medical 这类高冲突组合中让弱势的医学域不再退化甚至反超单域 OPD;在 Math×Code 这类低冲突组合中不输给现有多域方法;在三域联合训练中总体平均领先;并且这些优势要在 Qwen3-4B 与 1.7B 两个学生规模上同时成立。
与已有工作不同的是,现有方法各自只从一个层面切入。OPD 改进(词元过滤、重加权、可验证奖励、推理进度筛选、ExOPD 的参考外推)都在优化『单个指派教师』的证据如何被估计、筛选或放大,从不检验其与其他教师所代表能力的兼容性;MOPD 变体在数据与损失层面调度——Open-MOPD 平衡 token 份额与动态域权重、D3-MOPD 按剩余蒸馏差距排程、CaMOPD 分离能力恢复与域保持更新——但都不在同一轨迹上协调教师反馈;PCGrad、CAGrad 等梯度冲突方法则是对各自域数据上独立算出的任务梯度做事后手术。本文的独特切入是首次让路由教师与非路由教师同时评审同一条学生生成的前缀,把『跨教师一致性』当作更新潜在不兼容的局部信号,并用词元级奖励调制加梯度级预防投影构成从监督到更新的闭环防护,而非只调整数据配比或事后补偿。
核心方法
直觉上这是一个『 second opinion 』机制:学生在目标域生成轨迹时,如果另一域的辅助教师相对同一个冻结参考模型,与路由教师持有相同的修正方向,说明该修正很可能是可迁移的通用模式,可以放心放大;若两位教师意见相左,说明该修正可能是域特有的风格或知识,其更新可能与其他能力冲突,应当审慎衰减。技术路线上,方法先把 OPD 改写为带参考 KL 惩罚的相对奖励最大化 $J_\lambda(\theta)=\mathbb{E}[\lambda\log\frac{\pi_T(y|x)}{\pi_{ref}(y|x)}-D_{KL}(\pi_\theta\|\pi_{ref})]$,然后加两层防护:词元层面,用教师一致性 $s_t$ 把全局奖励尺度替换为词元系数 $\lambda_t=\text{clip}(1+\rho_g s_t,\,0.5,\,1.5)$,一致则放大、冲突则衰减;梯度层面,在同一批轨迹上额外计算辅助教师的 OPD 梯度 $g'_d$ 作为约束方向,当目标梯度 $g_d$ 与之内积为负时,在凸包线段上做范数受约束的部分投影,最多削去全部冲突分量、但至少保留 $m=0.6$ 倍目标梯度范数。最后仅对投影后的目标域梯度做域平均,全局裁剪后执行一步 AdamW。辅助教师从头到尾不提供额外拟合目标,只提供评审意见。
核心创新有两点。其一是教师角色重定义:非路由教师从不充当求解目标域任务的监督者——它的输出分布不被当作拟合对象,其相对偏好只被用作『该教师所代表能力的兼容性信号』。这与混合多教师输出分布或按权重叠加多教师损失的做法有本质区别:信号被降维成一个标量一致性,而非一套替代目标。其二是投影的预防性:PCGrad 比较的是各域在自己数据上独立计算的梯度,冲突已经形成后才做事后补偿;本文的辅助梯度 $g'_d$ 是辅助教师在当前目标域轨迹(同一批学生回复)上打分算出的,直接检验目标域更新与辅助教师对同一行为的偏好之间的局部相容性,因此能捕捉到『独立域梯度看起来对齐、但同一轨迹约束下仍然冲突』的情形。配合范数保持约束 $\|\hat v\|_2^2\ge m^2\|g\|_2^2$($m=0.6$)自适应控制投影强度:满投影若满足下限就用满投影,否则只削到下限允许的程度,避免两梯度近乎反向时满投影几乎抹掉目标梯度。
方法步骤详情
完整流程(Algorithm 1)每个优化步如下。(1) Rollout:旧策略 $\pi_{old}$ 对每个 prompt 生成一条回复(批 1,008,温度 1.0,回复上限 16,384 词元),记录旧对数概率。(2) 评分:路由教师、辅助教师与冻结参考(学生初始权重的副本)对相同词元 ID 做并行 teacher-forcing,得到 $\ell^r_t,\ell^a_t,\ell^{ref}_t$,无需额外 rollout,但要求分词器兼容。(3) 一致性加权:计算 $s_t=\tanh\frac{\ell^r_t-\ell^{ref}_t}{\tau}\times\tanh\frac{\ell^a_t-\ell^{ref}_t}{\tau}$($\tau=1$),得 $\lambda_t=\text{clip}(1+0.5s_t,0.5,1.5)$;优势 $A_t=\text{sg}[\text{clip}(\lambda_t(\ell^r_t-\ell^{ref}_t)-(\ell^\theta_t-\ell^{ref}_t),-10,10)]$。(4) 目标损失:PPO 裁剪代理($\epsilon=0.2$)、序列均值归约得 $L^{agr}_d$ 与梯度 $g_d$。(5) 辅助梯度:对每个辅助教师用同一批轨迹计算关闭调制的普通 OPD 损失 $L'_{d\to a}$ 及 $g'_d$。(6) 张量级投影:对每个参数张量,余弦 $c\ge0$ 则不动;$c<0$ 时取 $\hat g=g-\alpha^\star\frac{\langle g,g'\rangle}{\|g'\|_2^2}g'$,若 $\sqrt{1-c^2}\ge m$ 则 $\alpha^\star=1$,否则解 $1-(2\alpha-\alpha^2)c^2=m^2$;多教师时相对原始梯度共享保持预算、按最负余弦依次投影。(7) 更新:投影后梯度按域平均、全局裁剪 1.0,AdamW(lr $10^{-5}$)一步。工程上用 verl+FSDP+vLLM,BF16 快照、FP64 点积。
技术新颖性
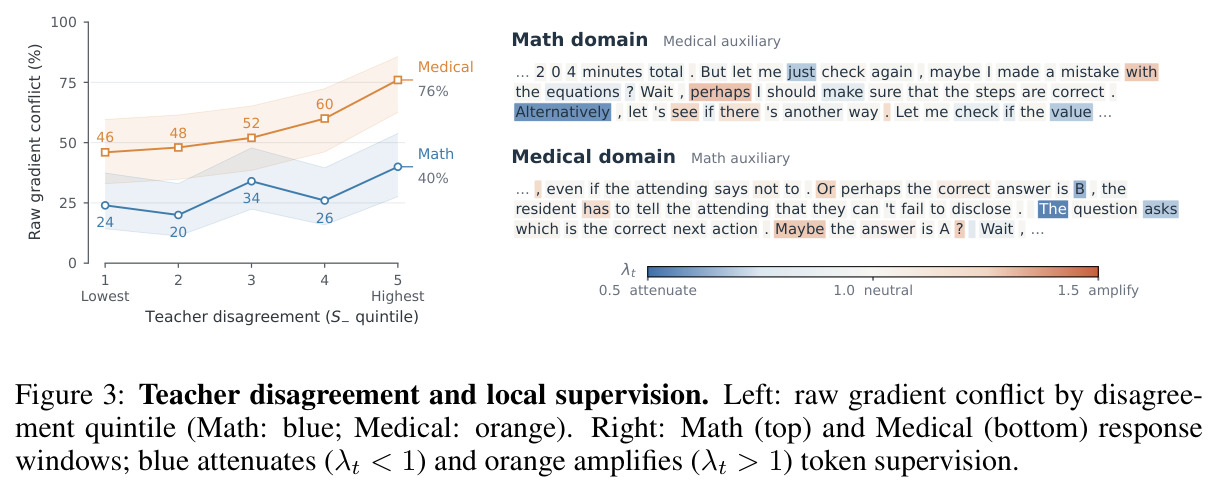
技术新颖性有四层。范式层:提出『跨教师守护』这一 MOPD 新视角——辅助教师不增加监督目标而是为既有监督提供约束,与 Open-MOPD 的平衡式、D3-MOPD 的调度式、CaMOPD 的恢复式方法正交,可组合使用。信号设计层:双 tanh 乘积形式使 $s_t\in[-1,1]$ 对称有界,任一教师相对参考无证据时得分趋零、$\lambda_t$ 自动回落到 1 退化为标准 OPD,这种软门控比硬性筛选或丢弃词元更平滑稳健。优化设计层:范数受约束部分投影有闭式解 $\alpha^\star$(公式 22);多教师情形使用相对原始梯度的共享保持预算(公式 24),避免了每轮独立施加比率导致的乘积式衰减;投影粒度细至每个 FSDP 参数张量并以 FP64 保证跨分片余弦一致。实证层:论文首次系统量化了教师分歧与原始梯度冲突率的正相关(分歧五分位上冲突率从 24% 升至 40%、46% 升至 76%),为跨教师信号作为兼容性预测器提供了探索性证据,并把『同轨迹约束 vs 独立域梯度约束』做成受控对比,清晰归因了增益来源。
实验结果
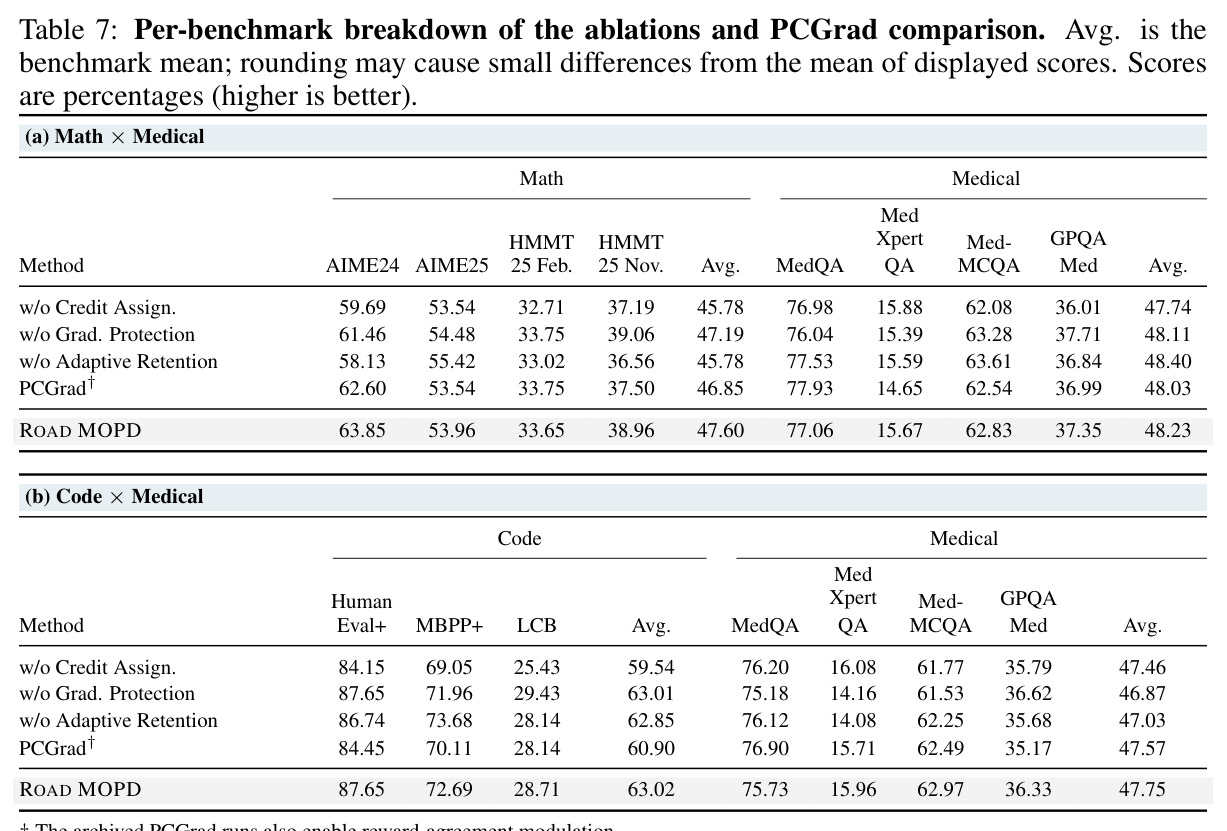
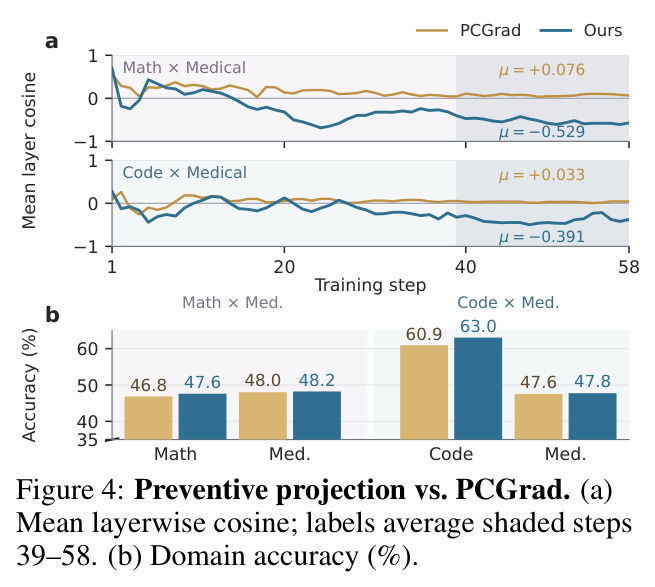
核心证据链如下。(1) 主实验(Table 1):在 2 组域对 × 2 个学生规模共四个设置中,ROAD MOPD 均取得最高两域平均,超出最强基线 0.72–2.89 分。Qwen3-4B 的 Math×Medical 中医学域均值 48.23,较 Vanilla MOPD 的 39.45 提升 8.78 分且超过单域 OPD 的 47.90,All Avg. 47.92;Code×Medical 中医学 47.75 vs Vanilla 40.75,代码 63.02,All 55.38。1.7B 学生收益更显著:医学 36.89/36.51,超最强基线 3.88/5.17 分且反超单域 OPD 的 35.67,两域平均领先 ExOPD 1.33/2.89 分。(2) 低冲突泛化(Table 2):Math×Code 的 All 55.40 超过 ExOPD 的 55.05,代码 63.07 为最佳。(3) 三域(Table 3):All 52.89 最佳,超 CaMOPD 51.71 达 1.18 分,三域全部领先。(4) 机制验证(Figure 3):教师分歧五分位与原始梯度冲突率正相关——数学从 24% 升到 40%,医学从 46% 升到 76%,支撑一致性作为兼容信号。(5) 预防式优于事后式(Figure 4):同轨迹梯度对层间余弦均值显著为负(Code×Medical $\mu=-0.529$),而 PCGrad 的独立域梯度对多为非负($\mu=+0.076$),ROAD MOPD 在四个域均值上全部优于 PCGrad 0.18–2.12 分。(6) 消融(Table 4、Figure 9):去掉信用分配使数学/代码掉 1.82/3.48 分;去掉梯度保护使医学掉 0.88 分;把自适应保持换成满投影使两域均值掉 0.83/0.44 分;Math 分支中满投影范数比在 58 步里有 40 步跌破 0.6(最低 0.253),而自适应始终保持 0.600,证明范数约束的必要性。
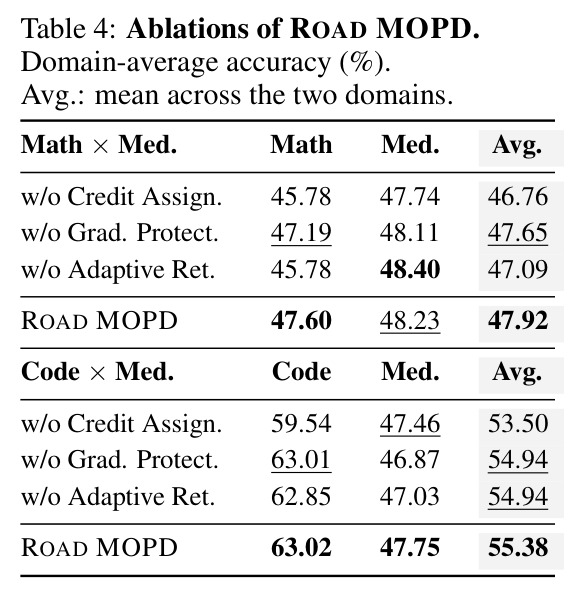
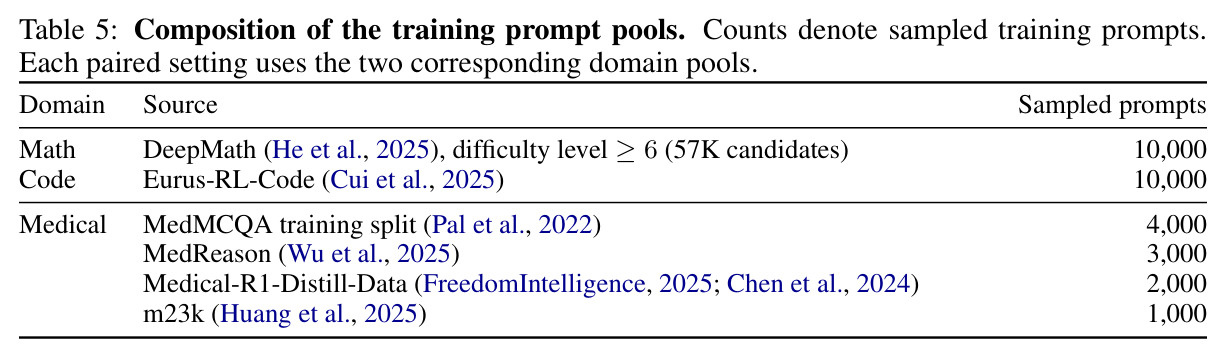
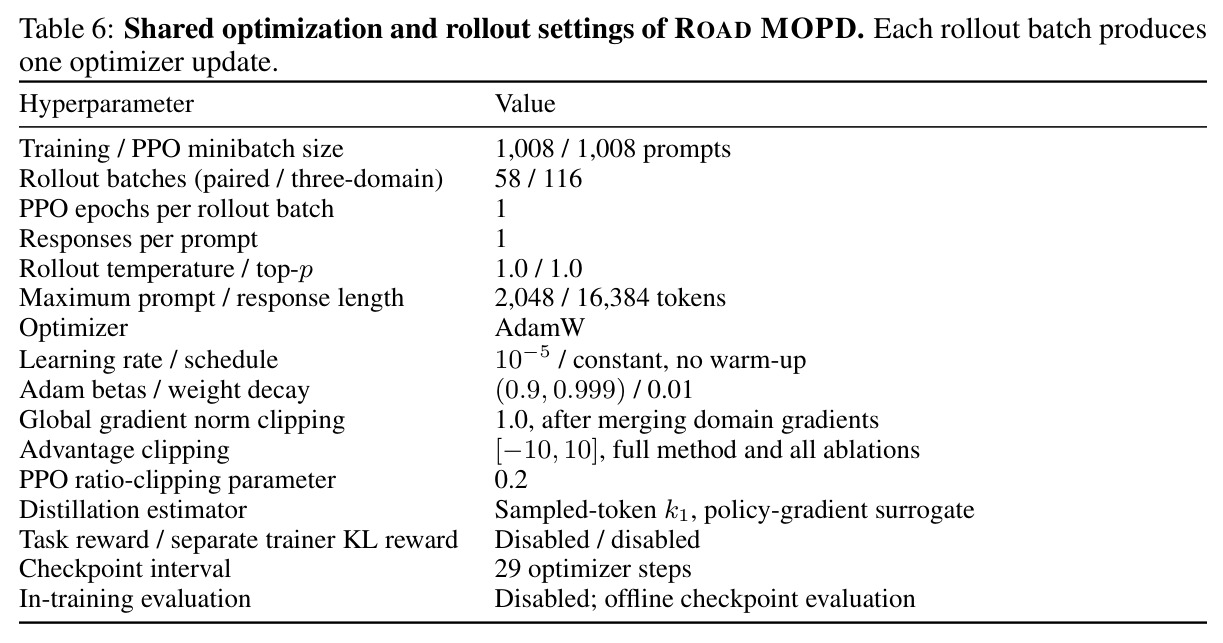
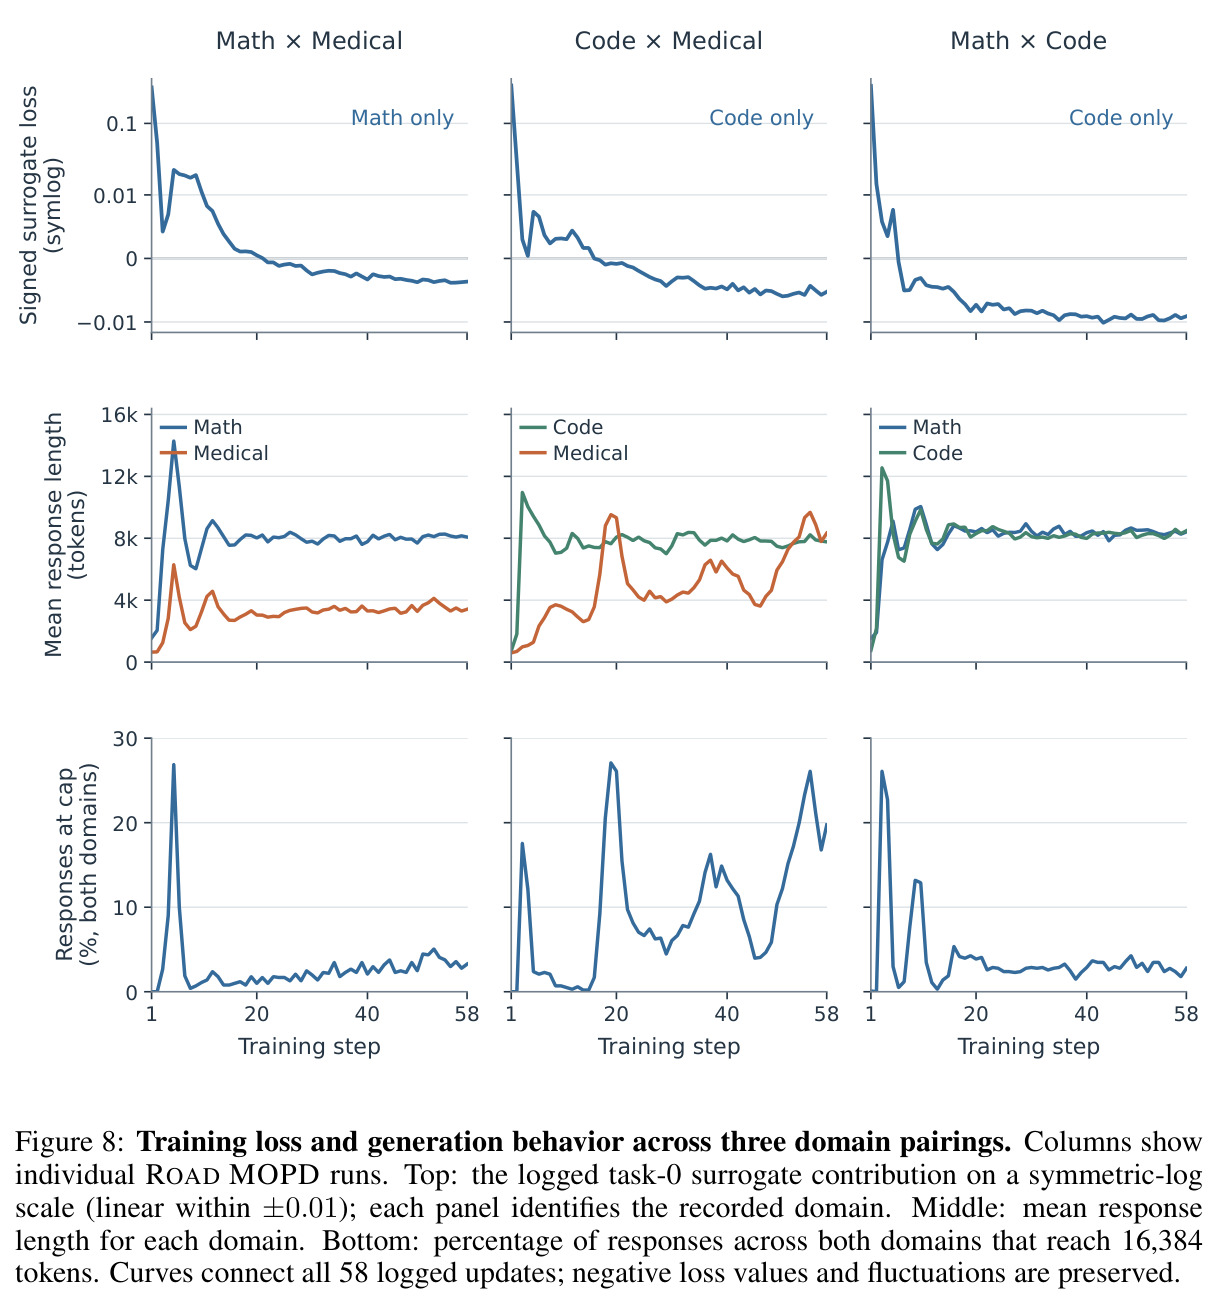
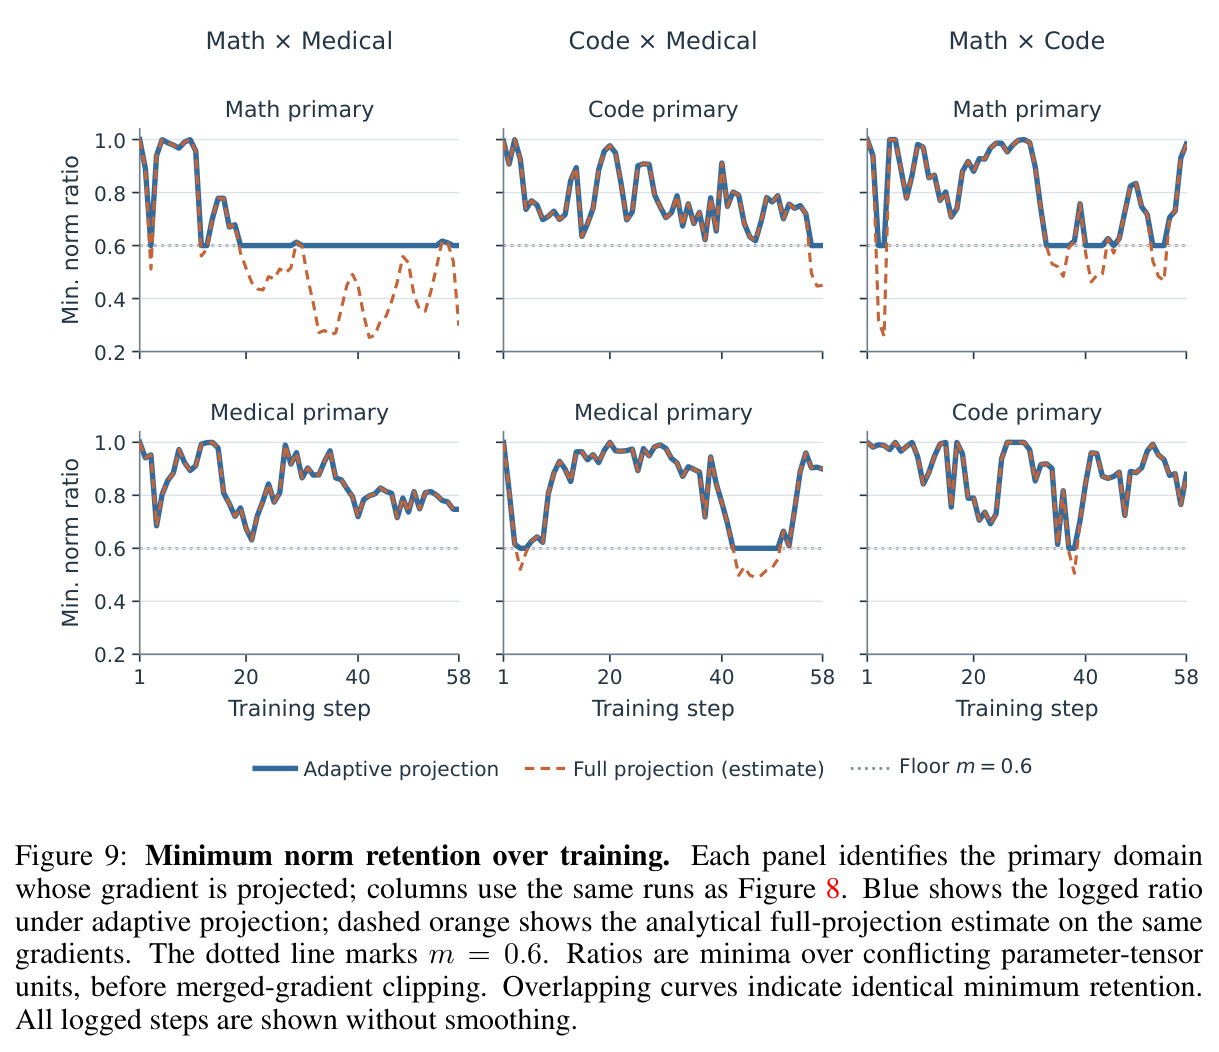
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Math × Medical 联合训练(Qwen3-4B)两域总平均 | All Avg. (%) | 47.92 | CaMOPD 47.20(最强多域基线);Vanilla MOPD 42.71 | +0.72(vs 最强基线);+5.21(vs Vanilla) |
| Code × Medical 联合训练(Qwen3-4B)两域总平均 | All Avg. (%) | 55.38 | Open-MOPD 54.09(最强基线);Vanilla MOPD 50.64 | +1.29(vs 最强基线);+4.74(vs Vanilla) |
| Math × Medical 医学域(Qwen3-4B) | Medical Domain Avg. (%) | 48.23 | Vanilla MOPD 39.45;单域 OPD 47.90;最强基线 CaMOPD 47.75 | +8.78(vs Vanilla);+0.33(vs 单域 OPD) |
| Math × Medical 医学域(Qwen3-1.7B) | Medical Domain Avg. (%) | 36.89 | ExOPD 33.01(最强基线);单域 OPD 35.67 | +3.88(vs 最强基线);+1.22(vs 单域 OPD) |
| Code × Medical 医学域(Qwen3-1.7B) | Medical Domain Avg. (%) | 36.51 | CaMOPD 31.34(最强基线);单域 OPD 35.67 | +5.17(vs 最强基线);+0.84(vs 单域 OPD) |
| Math × Code 联合训练(Qwen3-4B,低冲突) | All Avg. (%) | 55.40 | ExOPD 55.05(最强基线);Vanilla MOPD 53.68 | +0.35(vs 最强基线) |
| 三域 Math × Code × Medical(Qwen3-4B) | All Avg. (%) | 52.89 | CaMOPD 51.71(最强基线);Vanilla MOPD 49.76 | +1.18(vs 最强基线) |
| ROAD MOPD vs PCGrad†(两组域对共四个域均值) | Domain Avg. 差值(百分点) | 全部四个域均值领先 | PCGrad†(保留信用分配与范数保持机制的对称双任务投影) | +0.18 至 +2.12 |
局限与改进
作者承认两点局限:其一,评估仅覆盖数学、代码、医学三个文本推理域,三域已是上限,更广域集合与更大教师池下的收益和稳定性未经验证;其二,辅助教师评分与梯度处理相对 Vanilla MOPD 带来额外训练开销。我的补充观察:隐含同质性假设——所有师生都来自 Qwen3 家族且分词器一致,这是同轨迹词元级评分的硬前提,换用异构家族教师(如 Llama 系医学教师配 Qwen 学生)方法无法直接套用;一致性是不完美预测器——分歧五分位的冲突率只在 24%–76% 区间,教师一致≠更新兼容,且两位教师可能一致地认可错误方向,此时 $\lambda_t$ 反而会放大坏信号;范数保持下限 $m=0.6$ 是固定的单点超参,论文未报告对其取值的敏感性;理论保证是局部的——投影性质在全局裁剪与 AdamW 预条件之前成立,作者也明确说明不保证最终优化器步后辅助损失不增;医学教师是 8B 的 II-Medical-8B 而数学/代码教师是 4B,规模与风格差异本身可能就是冲突来源之一,论文未解耦;每个数学基准仅 30 题,Avg@32 下微小分差仍可能含较大方差;此外论文处于审稿阶段,尚无公开代码。
独立分析的弱点
弱点一:开销随教师数线性增长。每个优化步需要 $K-1$ 次辅助教师评分前向与同样数量的辅助梯度反传,域多时两两余弦与投影计算也随之膨胀。改进方向:只对高熵或决策点词元做辅助评分、用低秩近似或辅助教师 LoRA 头计算近似梯度、或按历史冲突预测只选 1–2 个最相关辅助教师。弱点二:分词器同质性硬假设。$s_t$ 定义在相同词元 ID 上,异构家族无法对齐,限制了混合教师池的落地。方向:把兼容信号改为响应级或语义空间的分布统计(如价值估计差),与具体词元表解耦。弱点三:信号质量缺乏把关。tanh 一致性只度量偏好一致性而非正确性,低专业重叠域中两教师可能『一致通过』坏修正,而 $\lambda_t$ 上限 1.5 会放大它。方向:用可验证奖励或教师置信度校准对放大操作再设门。弱点四:超参稳健性未探明——$m=0.6$、$\rho_g=0.5$ 均为单点取值且无敏感性消融,跨模型规模迁移时未必最优。方向:按域冲突统计自适应设定 $m$,或把 $m$ 作为拉格朗日变量在线学习。弱点五:冲突成因缺乏理论刻画——教师风格差异、知识边界差异、回复长度差异各占多少,投影在何种条件下会损失目标域能力,尚无分析框架。
未来方向
作者明确提出的方向包括:设计更高效的教师评估与梯度修正手段以降低开销;把实验扩展到更广的域集合与更大教师池,这需要高效的教师选择与兼容性估计机制。基于本文成果还可延伸:动态教师池管理——用历史步的冲突统计在线调度教师,仅对高冲突批次做完整跨教师评分,可望在保住高冲突域收益的同时削减大部分开销;更细粒度的信用分配——把词元级一致性升级为步骤级或过程级,并借助过程奖励模型区分『风格冲突』与『知识冲突』两类性质不同的信号;与 RLVR 结合——把预防性投影迁移到带结果奖励的多域 RL,辅助梯度改为策略梯度形式后框架大体可复用;与能力恢复统一——CaMOPD 的能力恢复目标与本文的预防式保护分别对应事后补偿与事前预防,两者的两阶段组合方法值得探索;异构教师适配——设计跨分词器兼容的评分协议(如在文本概率或语义嵌入层面对齐偏好),把方法推广到混合家族的开源教师生态;理论侧——给出范数保持投影在域聚合与自适应优化器后的目标域损失收敛界,并量化一致性信号作为冲突预测器的误差上界。
复现评估
复现信息详尽程度远超同类论文,但代码尚未开源(论文处于审稿状态)。有利条件:三个教师检查点均在 HuggingFace 公开(Qwen3-4B-Non-Thinking-RL-Math-Step500、Qwen3-4B-Non-Thinking-RL-Code-Step300、II-Medical-8B);数据配方完全披露(Table 5:DeepMath 难度≥6 过滤出 57K 池采样 10,000、Eurus-RL-Code 10,000、医学四源按 4,000/3,000/2,000/1,000 组成);超参数完整(Table 6:AdamW lr $10^{-5}$、批 1,008、$\epsilon_{PPO}=0.2$、$\tau=1$、$\rho_g=0.5$、$\lambda\in[0.5,1.5]$、$m=0.6$、配对 58/三域 116 个更新);Algorithm 1 给出完整伪代码,附录含投影闭式解推导、多教师顺序投影算法、全部基线的复现细节,评估协议(vLLM 温度 1.0、math-verify、EvalPlus、各基准解析规则)也逐条写明。算力门槛:单节点 8 张 NVIDIA B200(学生 FSDP + 3 个 vLLM rollout 副本占 6 卡、教师评分占 2 卡),配对设置 58 步更新。综合评估:算法描述足够忠实复现,属于中高难度——主要工程门槛在多教师评分基础设施与张量级 FSDP 投影实现,B200 算力亦不便宜;预算有限时从 1.7B 学生 + 两域配置起步最经济。
论文图表
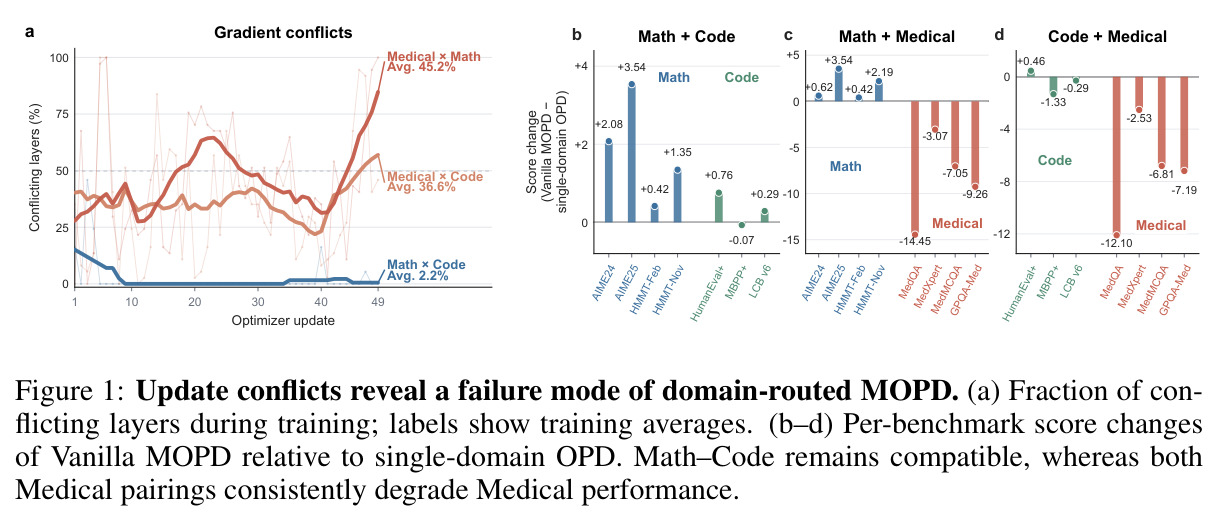
四个子图。(a) 训练过程中冲突层占比曲线,标注训练平均值:医学参与的两个组合平均达 45.2% 与 36.6%,且后期攀升;Math+Code 冲突很少。(b–d) Vanilla MOPD 相对单域 OPD 在各基准上的分数变化:Math+Code 基本兼容(多数为正),而 Math×Medical 中医学掉 -14.45,Code×Medical 中医学掉 -7.05/-9.26,呈现不对称退化。
这是全文的问题诊断图:用『冲突层占比』与『逐基准分数变化』两组证据确立了域路由 MOPD 的失败模式,直接导出『更新兼容性』这一核心研究问题,没有此图就无法理解方法动机。
把 Figure 3 右侧的 52 词元窗口扩展到 256 词元上下文,包含完整 prompt(Aya 散步数学题与骨科伦理医学题),每个词元按原始 $\lambda_t\in[0.5,1.5]$ 着色,衰减为蓝、放大为橙,并标注生成上限位置。
让读者在真实完整轨迹中看到信用分配的行为模式:教师分歧多集中在转折词与答案候选附近,这有助于判断信号是否有语义意义而非噪声。
对同一道 AIME2024 数学题的三条不同采样回复,分别展示开头、中段、结尾的 192 词元固定窗口,保留原始词元系数与 [0.5,1.5] 色标,空白词元以圆点标记。
补充展示调制系数在不同回复阶段(推理起点、计算中段、收尾验证)的分布,帮助评估该信号的一致性与稳定性,避免只看精挑样本产生偏差。
对 MedQA 骨科伦理题的三条不同采样回复的开头、中段、结尾窗口可视化,色标与规则与 Figure 6 相同;作者注明这些是生成的推理摘录而非经验证的答案解释。
与 Figure 6 对称地覆盖医学域,展示跨域行为的一致性,同时作者的诚实标注(非验证解释)提示读者这些只是机制展示而非质量证据。
主结果表,(a) Math×Medical 与 (b) Code×Medical 两部分,各含 Qwen3-4B 与 1.7B 学生。逐基准列出 Student、Single OPD、Vanilla/Ex/Open/CaMOPD 与 Ours 的分数及域均值、两域均值。Ours 在全部四个设置中取得最高 All Avg.(47.92/55.38/32.05/44.86),高冲突下医学域恢复最明显(如 4B 医学 48.23 vs Vanilla 39.45)。
论文最核心的证据表,支撑『最佳总体性能』这一主结论;域均值与 All Avg. 的拆分也让读者看到医学恢复与另一域增益并存,而非简单此消彼长。
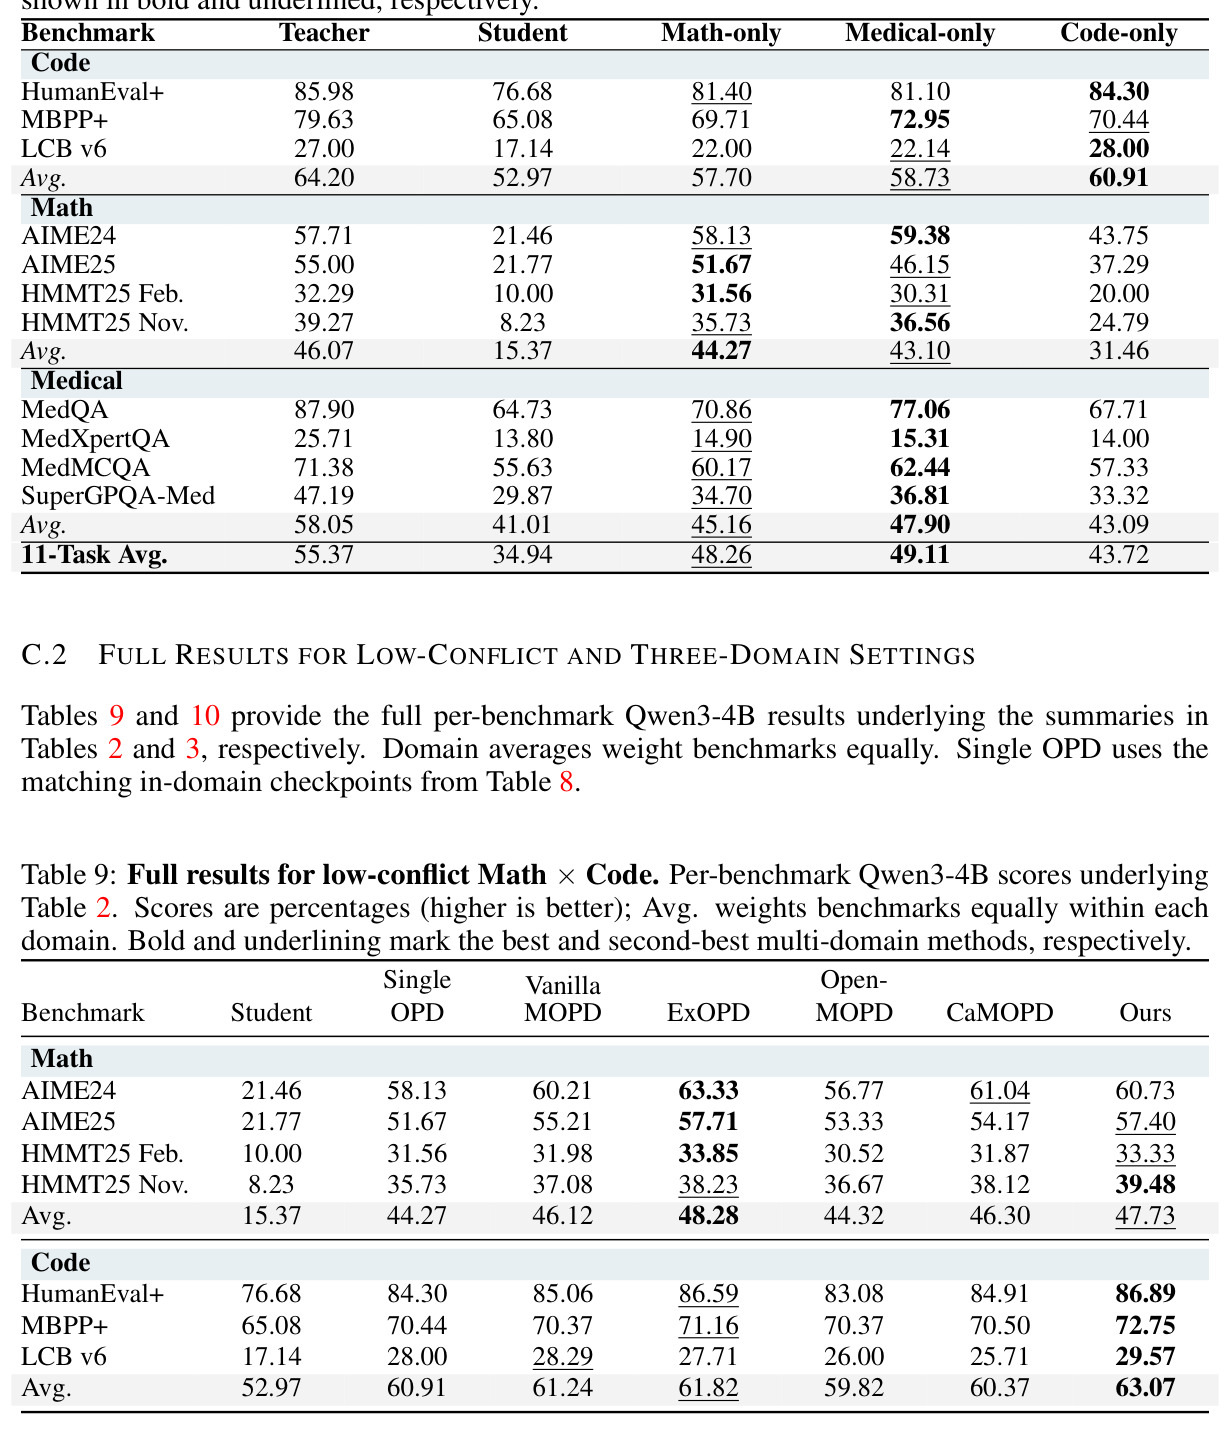
Qwen3-4B 在低冲突组合 Math×Code 上的域均值与总均值:Ours 数学 47.73(次优,落后 ExOPD 48.28 约 0.55)、代码 63.07(最佳)、All 55.40(最佳,超 ExOPD 0.35)。
检验方法是否靠牺牲优势域换取弱势域:结果显示在本来兼容的组合中方法仍略有净收益,支撑『保留低冲突增益』的主张。
Qwen3-4B 三域联合训练:Ours 在数学(47.29)、代码(62.94)、医学(48.45)三个域均值上全部领先,All 52.89 超 CaMOPD 51.71 达 1.18;而 Vanilla MOPD 的医学仅 41.03,几乎无恢复。
验证方法向更多教师与共享范数保持的顺序多教师投影扩展的有效性,是可扩展性主张的关键证据。
三个 Qwen3-4B 单域 OPD 检查点(数学/医学/代码)在全部 11 个基准上的交叉评估,附教师与原始学生参照:如数学-only 学生在 AIME24 达 58.13,但代码域均值仅 31.46;医学-only 学生 11 任务均值 49.11 最高。
它是单域 OPD 基线的来源表,也定量展示了单域训练的跨域外溢现象,为理解 Figure 1 中『联合 vs 单域』对比提供基准坐标。
Table 3 背后的逐基准 Qwen3-4B 分数:Ours 在 MedQA 77.61、SuperGPQA-Med 37.10、MBPP+ 72.95、AIME24 61.88 等多数基准领先;Vanilla MOPD 的 MedQA 仅 64.49,接近未训练学生。
三域结论的完整数据支撑,特别清晰呈现 Vanilla MOPD 在三域下医学几乎完全退化的现象,凸显冲突协调的必要性。