MOPD-Router:重新思考多教师在线策略蒸馏中的教师路由 MOPD-Router: Rethinking Teacher Routing in Multi-Teacher On-Policy Distillation
将多教师蒸馏的提示级硬路由改为逐token路由,ExpertAlign按专业化对齐选教师。
前置知识
On-Policy Distillation(OPD,在线策略蒸馏)
一种蒸馏范式:学生用自己当前策略生成轨迹(rollout),教师在学生访问过的每个上下文上对该轨迹提供稠密的 token 级监督(例如教师与学生 log 概率之差构成的采样 token 优势)。与离线蒸馏不同,训练信号集中在学生真正会走到的状态上,兼顾了分布一致性与学生自主探索。
MOPD-Router 的全部路由权重都作用在逐教师 OPD 优势 $A_t^{(i)}$ 上,不理解 OPD 就无法理解路由对象是什么。
PPO-clip 目标与优势
PPO 是一种策略梯度 RL 算法,通过重要性比 $\rho_t=\pi_\theta/\pi_{\theta_{old}}$ 复用旧轨迹,并用截断目标 $\min(\rho_t A_t, \mathrm{clip}(\rho_t,1-\epsilon,1+\epsilon)A_t)$ 限制单步更新幅度。本文没有 critic,路由聚合后的 $A_t$ 直接占据优势槽位。
论文式 (2) 的 MOPD 目标就是 PPO-clip 形式,理解它才能看清教师权重 $w_{i,t}$ 如何进入学生的参数更新。
Top-k 支持集与 JS 散度
Top-k 支持指分布中概率最高的 k 个候选 token 构成的集合(本文取 k=16);「限制到支持集」指把分布限制在该集合上再重整化为单位质量。Jensen-Shannon 散度是对称的分布差异度量,取值有界、对零概率稳健。
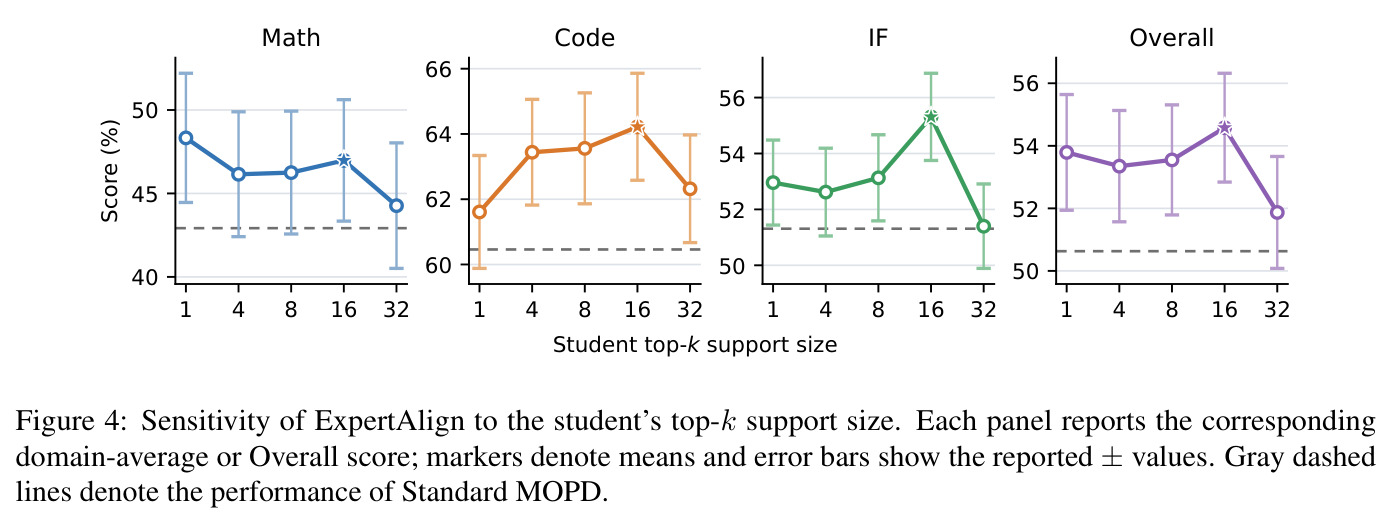
Novelty 和 ExpertAlign 的所有向量与统计量都定义在学生 top-16 支持集上,支持集的选择直接影响路由质量(附录 E.4 的敏感性分析)。
共享基座的 RL 位移(post-training shift)
工业界的领域专家模型通常从同一个预训练基座出发分别做 RL 后训练得到。$\log \pi_{teacher} - \log \pi_{base}$ 在词表上的差向量刻画了 RL 给这个教师带来的策略改变,被视为该教师「后天习得的专业能力」方向(delta 蒸馏、弱到强文献中的核心观察)。
ExpertAlign 正是用这个基座相对位移定义教师的专业化向量 $e_{i,t}$,这是本文核心创新的概念基础。
域标签硬路由与 Mean 聚合
硬路由指按 prompt 的领域标签选取唯一教师($w_{i,t}=\mathbb{I}[i=d(x)]$)并监督整条回复,是 Standard MOPD 的标准协议;Mean 聚合则是无标签时对 M 个教师信号取等权平均($w_{i,t}=1/M$)的朴素替代。
这两者正是 MOPD-Router 要替换的两个端点基线——前者可靠但粗粒度且依赖标签,后者无标签但把所有教师信号视为同等有用。
研究动机
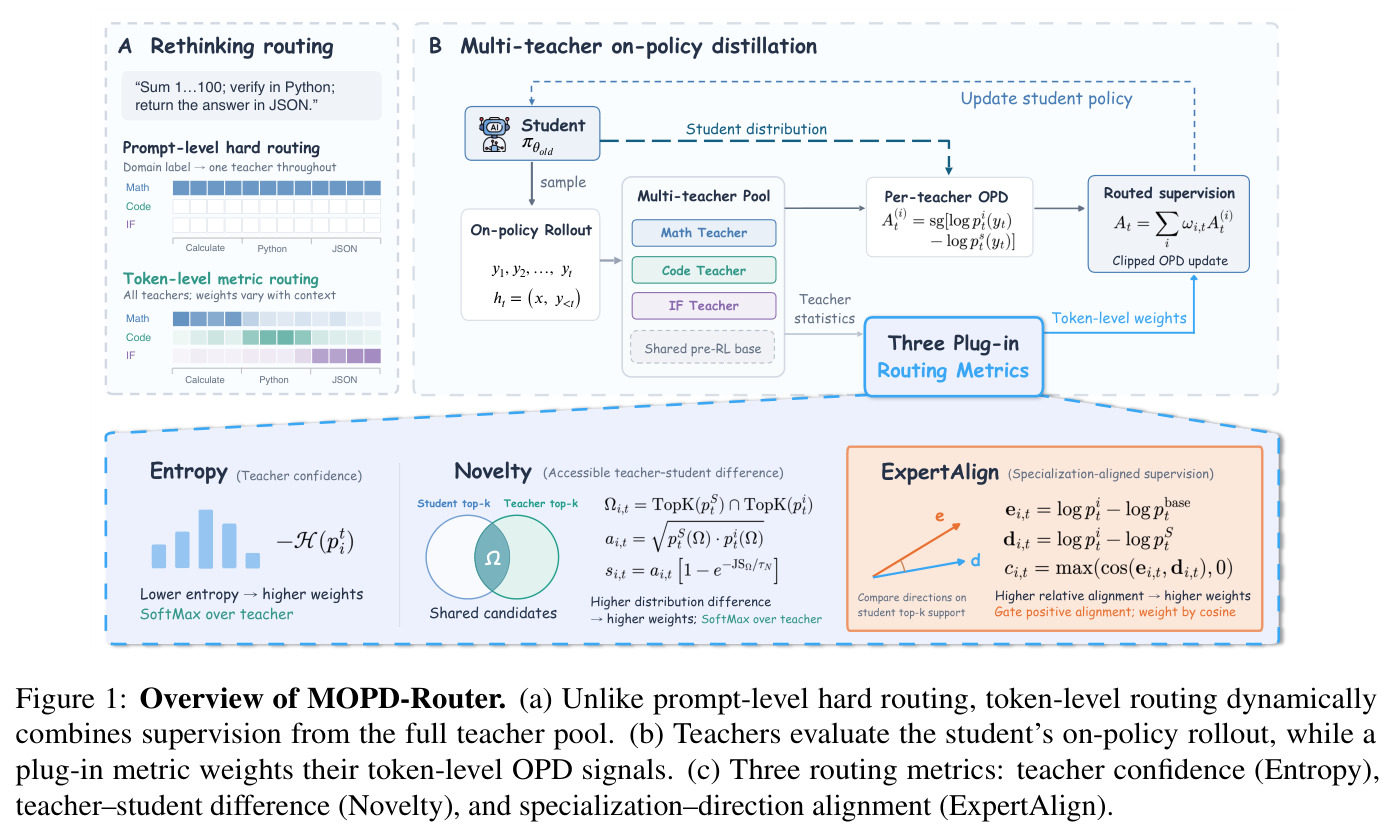
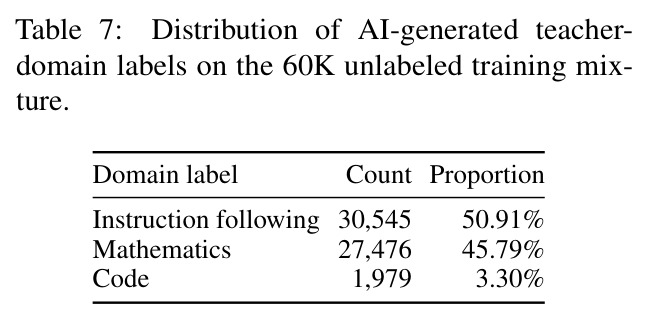
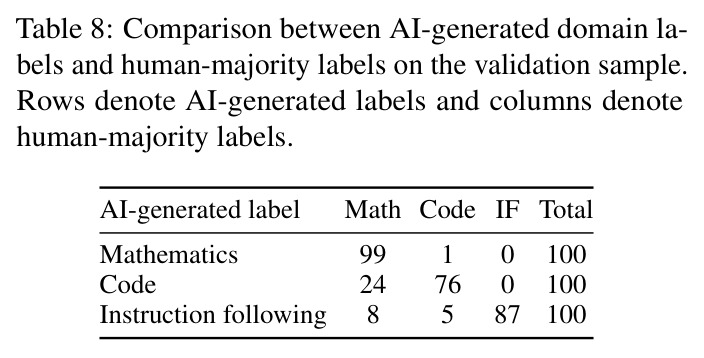
现有多教师在线策略蒸馏(MOPD)普遍采用论文所称的域标签硬路由:根据 prompt 的领域标签把它指派给唯一匹配的教师,由该教师监督整条 rollout。这带来两个具体问题。其一,真实训练混合数据往往没有可靠的域标签。论文用 60K 无标签混合集做实验(30K 来自 Nemotron-v3 的通用聊天 + 30K 来自 NuminaMath-TIR、需要可执行代码解题的数学题),即使动用 DeepSeek-V4-Flash 逐条打标,code 标签也只占 3.30%(1,979/60,000),因为「用代码解数学题」的样本按规则仍属数学;人工校验显示 AI 标签与五人多数投票的宏观一致率仅 87.33%(Fleiss κ=0.84),其中 code 类只有 76%,100 个 AI 标为 code 的样本里 24 个被判为数学。这印证了单一标签必须把交织的多技能内容压缩成一个教师选择,天然模糊。其二,域标签只识别主教师,完全忽略其他教师在具体 token 上的价值:数学 prompt 中代码教师可能在程序化推理片段处有用、指令遵循教师在满足输出格式约束处有用,且这种有用性随生成阶段和 token 位置变化,把整条 rollout 绑死给固定教师会浪费跨域互补监督。
本文的目标是本文目标是构建 token 级教师路由框架 MOPD-Router:在学生 rollout 的每个生成位置上,依据当前上下文从完整教师池中选择并加权各教师的 OPD 监督信号,且不依赖域标签、不训练任何独立的路由模型。具体包括三件事:一是把 sampled-token MOPD 形式化为「对逐教师 OPD 优势的路由聚合」,使教师分配问题变成在每个 token 上为每个教师分配非负权重的连续优化问题;二是提供 plug-in 指标接口,让不同路由度量能在同一 MOPD 流水线、同一教师池、同一优化预算下公平比较;三是实例化并检验三类信息来源的指标——教师置信度(Entropy)、可及的教师-学生分布差(Novelty),以及本文提出的专业化对齐(ExpertAlign)。最终要在两种数据体制(无标签混合、有域标签)和两种蒸馏场景(Qwen3-1.7B 学生的强到弱蒸馏、Qwen3-4B 学生的同尺寸蒸馏)共四个设定下验证:token 级路由能否不靠标签就达到甚至超过域标签硬路由,并定量确认跨域互补监督的价值。
与已有工作不同的是,本文的独特切入是把路由粒度从 prompt 级推到 token 级,且路由依据不来自外部标注器或训练出的路由器,而是从教师、学生和共享基座的分布统计量中即时计算。此前的多教师能力整合方案要么在 prompt 级分配(Standard MOPD 的域标签硬路由),要么做优化预算或域调度的再平衡(Open-MOPD 诊断能力失衡并平衡预算、D3-MOPD 做自适应域调度),要么在异构模态教师之间用置信度仲裁且停留在更粗粒度(H-OPD);而单教师 OPD 中的自适应监督工作(按熵、按可教性调制 token 权重)只研究如何修改单一教师的监督,不涉及在多个专业教师之间分配监督。ExpertAlign 的核心洞察更进一步:一个教师此刻值不值得听,不取决于它自身输出的置信度,也不只取决于它和学生的差异大小,而取决于它给学生的纠正是否体现了它在 RL 后训练中获得的专业能力——即「教学方向」与「专业化方向」是否对齐。这把「谁教」和「教的是不是它的专业」统一成一个向量几何问题,是已有文献没有的视角。
核心方法
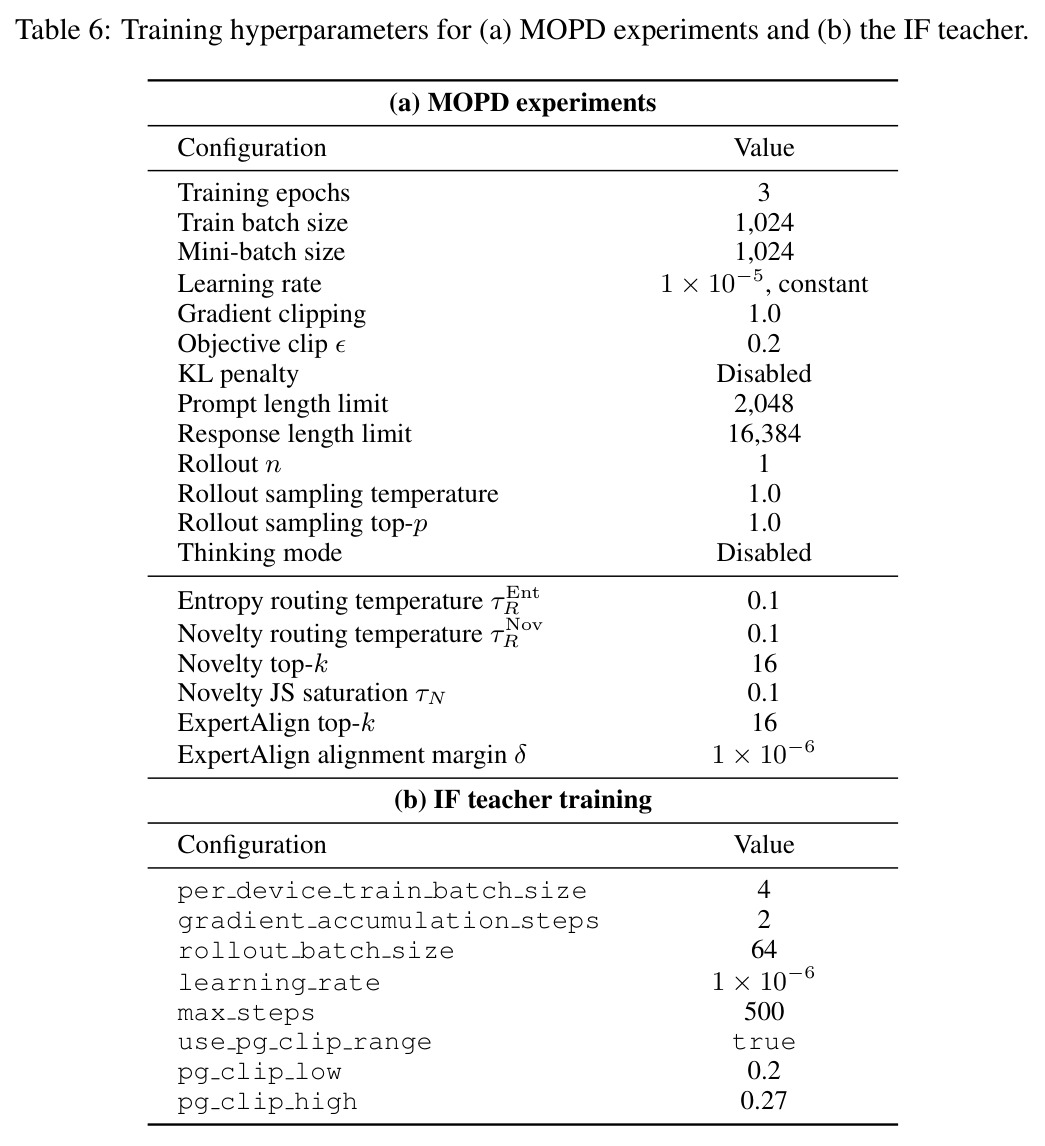
直觉上,多教师蒸馏中每个 token 都应回答「此刻谁教得最有价值、各占多少」,而不是整条 rollout 由一个教师包办。技术路线是保持 sampled-token MOPD 训练目标完全不变,仅把固定权重替换为逐 token 的动态权重。形式化:教师 $i$ 在位置 $t$ 的采样 token 优势为 $A_t^{(i)} = \mathrm{sg}[\log \pi_{\phi_i}(y_t|h_t) - \log \pi_{\theta_{old}}(y_t|h_t)]$($\mathrm{sg}$ 为 stop-gradient),路由优势 $A_t = \sum_{i=1}^{M} w_{i,t} A_t^{(i)}$,权重 $w_{i,t}\ge 0$ 由路由指标打分后 softmax 得到;学生按 PPO-clip 目标 $\min(\rho_t(\theta)A_t, \mathrm{clip}(\rho_t(\theta),1-\epsilon,1+\epsilon)A_t)$ 更新,$A_t$ 直接占据优势槽位,无 critic、无 KL 惩罚。指标接口为 $s_{i,t} = M(\pi_{\phi_i}, \pi_{\theta_{old}}, \pi_{\theta_{base}}; h_t)$,其中 $\pi_{\theta_{base}}$ 是教师们共享的 pre-RL 基座。三个实例:Entropy 用教师负预测熵(softmax 温度 0.1);Novelty 在学生 top-16 支持集上结合可达性与 JS 新颖度(温度均 0.1);ExpertAlign 比较专业化向量与教学向量的正余弦对齐并门控加权。训练共 3 个 epoch、批大小 1024、学习率 $10^{-5}$ 常数、响应上限 16,384 token。
核心创新有三层。第一,把「教师选择」从 prompt 级常量变成 token 级、上下文相关的量:同一个数学 prompt 的不同片段可以由不同教师主导,权重随语义阶段流动。第二,路由无需标签也无需训练路由器——所有信号都是教师、学生、基座在学生访问上下文上前向即可得到的统计量,即插即用。第三,也是最本质的:ExpertAlign 提出「专业化对齐」准则。定义教师 $i$ 在学生 top-$k$ 支持 $S_t^S$ 上的专业化向量 $e_{i,t} = [\log p_i^t(v) - \log p_{base}^t(v)]_{v\in S_t^S}$(它相对共享 pre-RL 基座学到的位移,是教师的内在属性),和教学向量 $d_{i,t} = [\log p_i^t(v) - \log p_S^t(v)]_{v\in S_t^S}$(它此刻会如何改写学生的 log 概率);仅当正余弦相似度 $c_{i,t} = \max(\langle e_{i,t}, d_{i,t}\rangle / (\|e_{i,t}\|_2 \|d_{i,t}\|_2), 0) > \delta$($\delta=10^{-6}$)时才保留该教师进入 $E_t$,再按 uniform 或 cosine 规则加权。这与 H-OPD 式置信度仲裁的本质区别在于:置信度只看教师自己的分布锐度,而专业化对齐检验「纠正是否源于专业」,能过滤掉与学生泛泛不一致、却与教师专长无关的噪声信号。论文还给出干净的几何分解 $\langle e_{i,t}, d_{i,t}\rangle = \|e_{i,t}\|_2^2(1 - r_{i,t})$,$r_{i,t}$ 是学生在专业化方向上的归一化进度,说明门控会随学生逼近教师而自然放松。
方法步骤详情
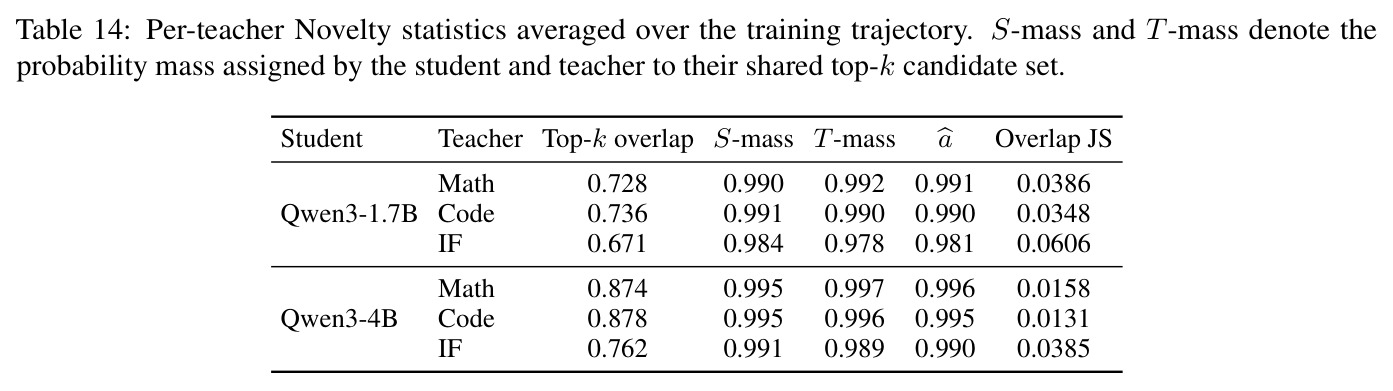
训练循环(Algorithm 1)每步如下。(1) 设 $\pi_{\theta_{old}} \leftarrow \pi_\theta$,从数据集 $\mathcal{D}$ 采样 prompt,学生以温度 1.0、top-p 1.0 自回归 rollout 出回复 $y=(y_1,\ldots,y_T)$。(2) 学生、全部 $M$ 个教师、共享基座在学生访问过的每个上下文 $h_t=(x, y_{<t})$ 上前向,得到 next-token 分布 $p_S^t$、$p_i^t$、$p_{base}^t$。(3) 按式 (1) 计算每个教师的采样 token 优势 $A_t^{(i)}$。(4) 用所选指标打分并归一为权重。Entropy:$s^{Ent}_{i,t} = \sum_{v\in\mathcal{V}} p_i^t(v)\log p_i^t(v)$(负熵),softmax 温度 $\tau^R_{Ent}=0.1$。Novelty:取师生双方 top-16 候选交集 $\Omega_{i,t}$,可达性 $a_{i,t}=\sqrt{p_S^t(\Omega_{i,t})\,p_i^t(\Omega_{i,t})}$,新颖度 $N_{i,t}=1-\exp(-\mathrm{JS}(p_S^t|_{\Omega}, p_i^t|_{\Omega})/\tau_N)$($\tau_N=0.1$),得分 $s^{Nov}_{i,t}=a_{i,t}N_{i,t}$ 后 softmax(温度 0.1;交集为空记 0)。ExpertAlign:在 $S_t^S$(k=16)上计算 $e_{i,t}$ 与 $d_{i,t}$,以 $\delta=10^{-6}$ 的正余弦门控得到保留集合 $E_t$,权重取 $1/|E_t|$(uniform)或 $c_{i,t}/\sum_j c_{j,t}$(cosine);$E_t$ 为空则跳过该 token 的监督。(5) 聚合 $A_t = \sum_i w_{i,t} A_t^{(i)}$。(6) 内循环 $K$ 个 minibatch:重算当前学生 log 概率与重要性比 $\rho_t$,最大化 PPO-clip 目标($\epsilon=0.2$,梯度裁剪 1.0,学习率 $10^{-5}$,KL 关闭)。所有方法共用同一目标、教师池、rollout 配置和优化预算,仅路由规则不同。
技术新颖性
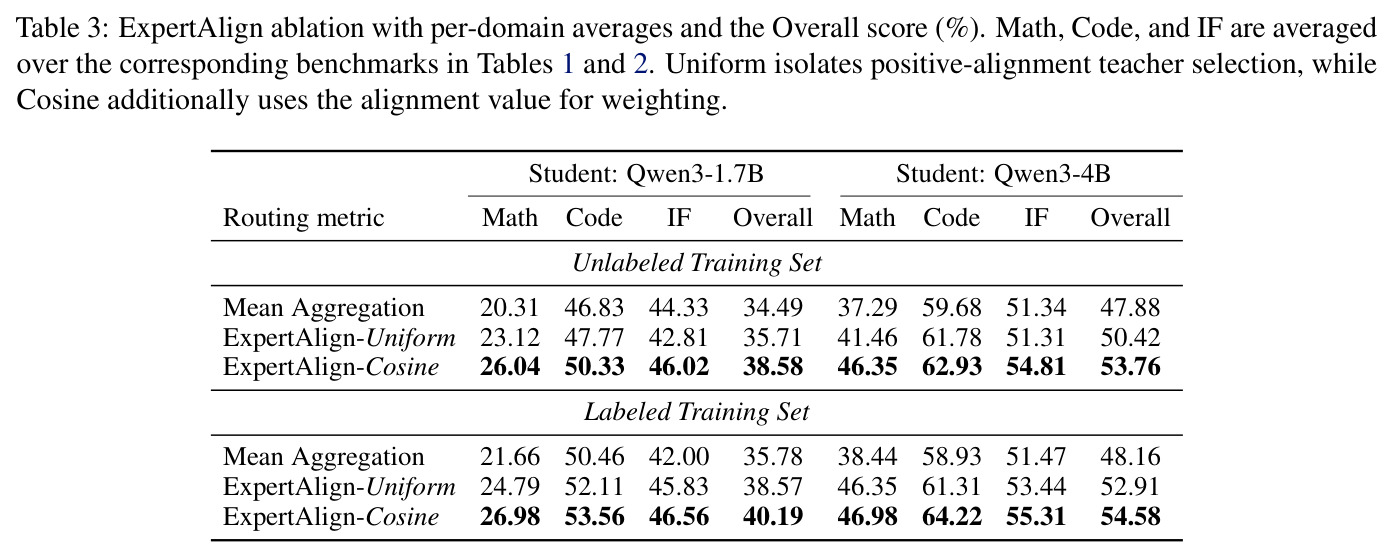
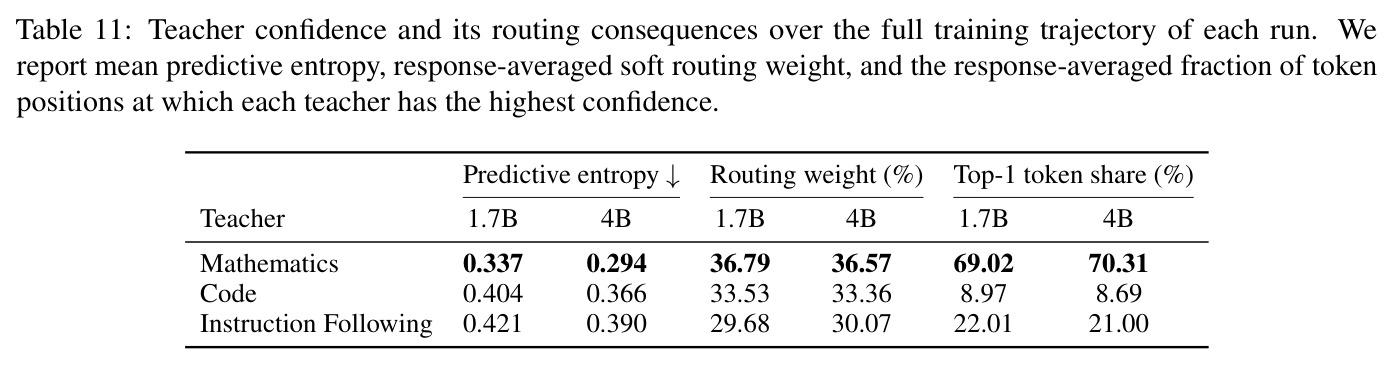
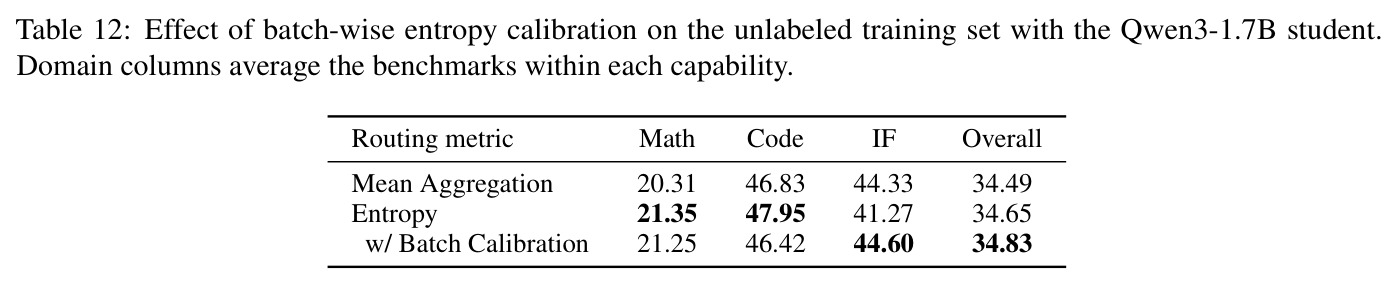
技术新颖性体现在四点。一是路由粒度:这是在 MOPD 中做无标签 token 级教师路由的工作,已有 MOPD 变体(Open-MOPD 的优化预算平衡、D3-MOPD 的域调度)仍停留在 prompt/response 级分配。二是度量信息源的拆解:论文把「监督价值」分解为三个正交来源——教师自身分布(Entropy)、教师-学生关系(Novelty)、教师相对基座的训练位移(ExpertAlign),并在同一 plug-in 接口下系统比较,得到可复用的结论:置信度不可靠、需要学生条件化度量。附录 E.1 显示数学教师 top-1 置信份额高达 69.02-70.31% 而 code 教师仅 8.69-8.97%,且批量熵校准只能把 Overall 从 34.65 提升到 34.83,说明问题是度量本身而非标定。三是 ExpertAlign 的几何构造:借用 delta 蒸馏/弱到强文献中「基座相对位移即后训练所学」的思想,把教师选择化为方向对齐问题,并给出几何分解 $\langle e_{i,t}, d_{i,t}\rangle = \|e_{i,t}\|_2^2(1-r_{i,t})$,使门控行为可解释、可监控。四是方法学上的可分离设计:正对齐门控(教师选择)与 cosine 加权(教师加权)通过 Uniform/Cosine 消融被干净地解耦,分别贡献 Overall 1.22-4.75 点和 1.62-3.34 点,证明两个组件各自有效且互补。
实验结果
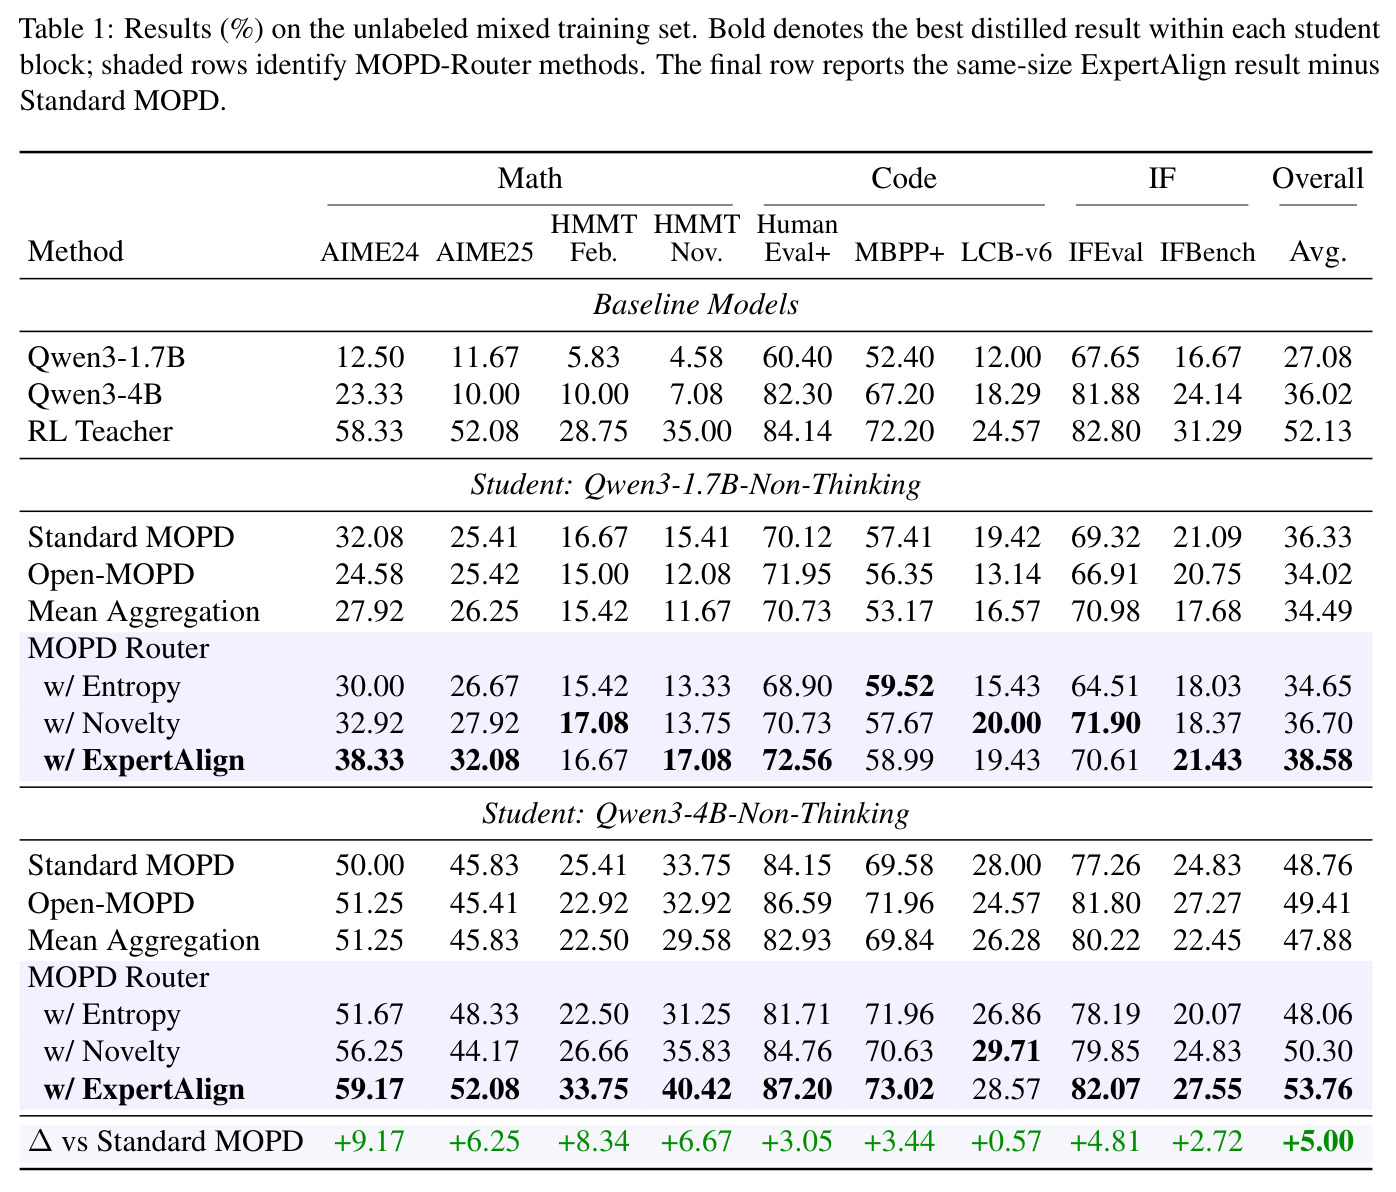
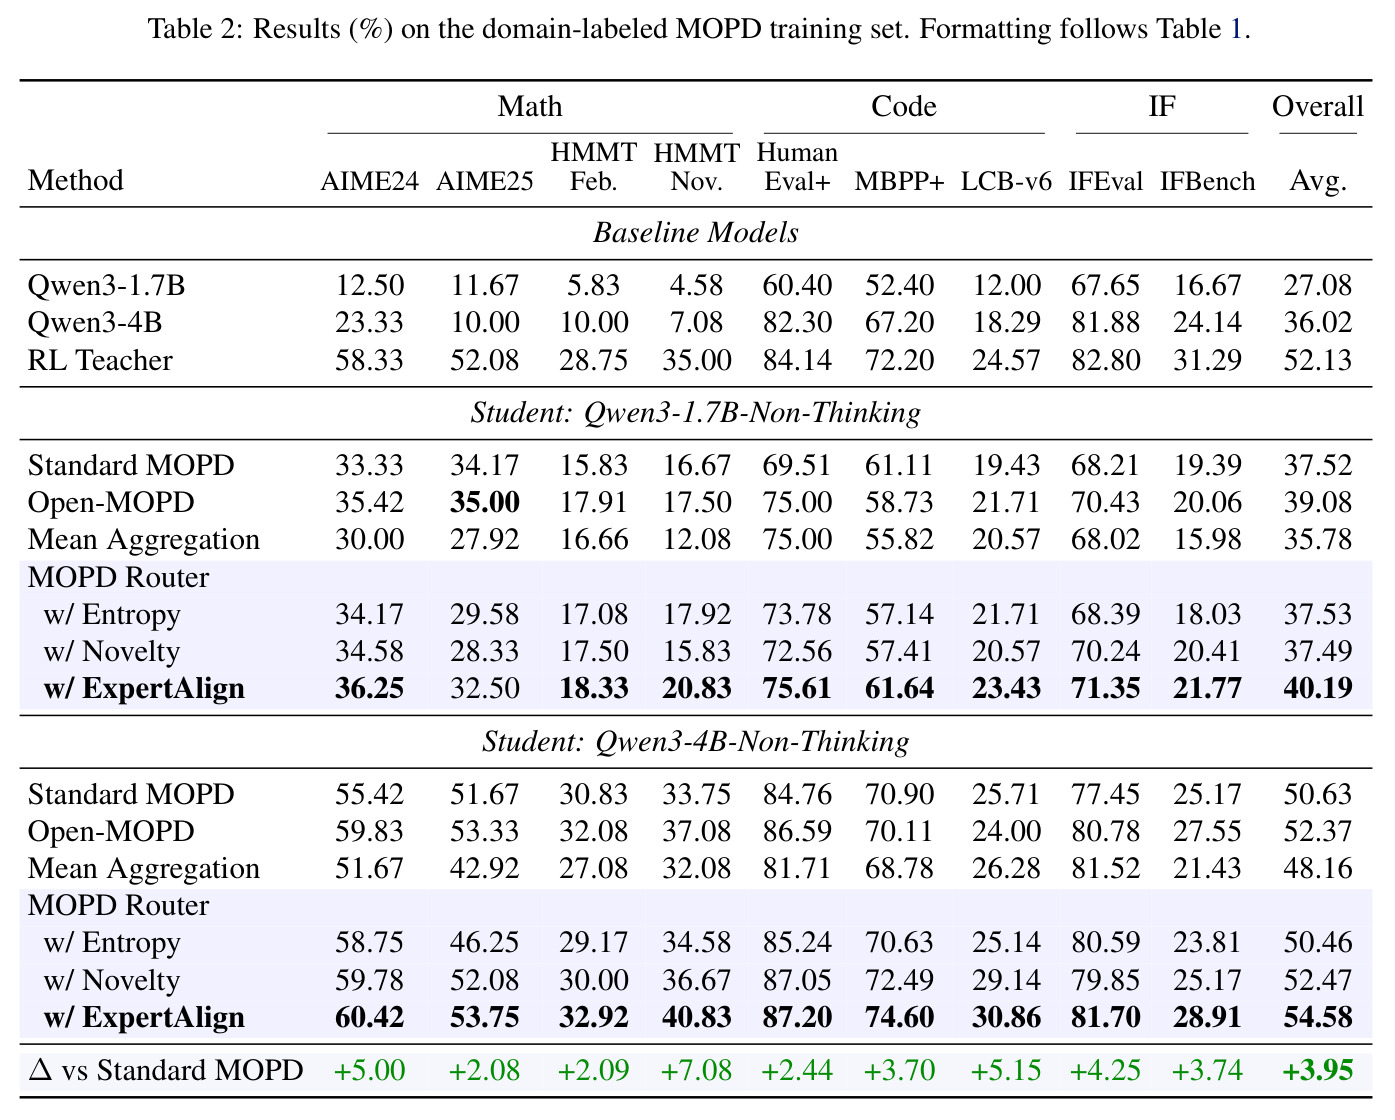
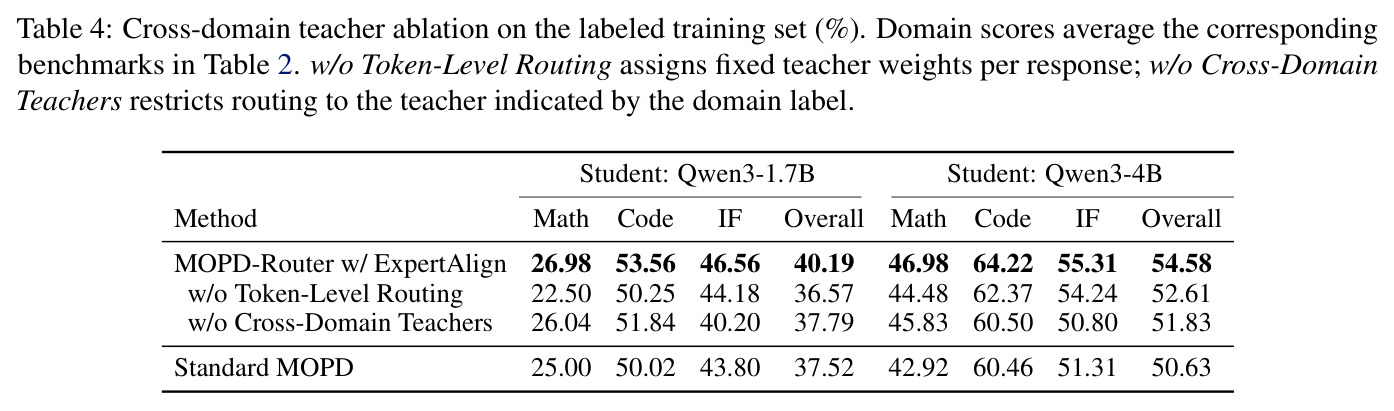
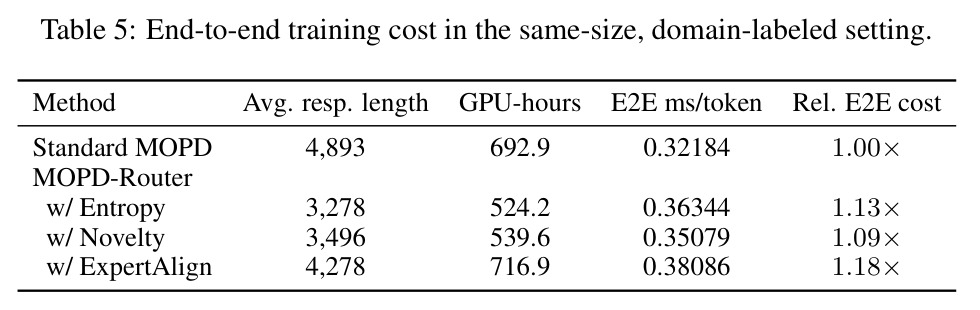
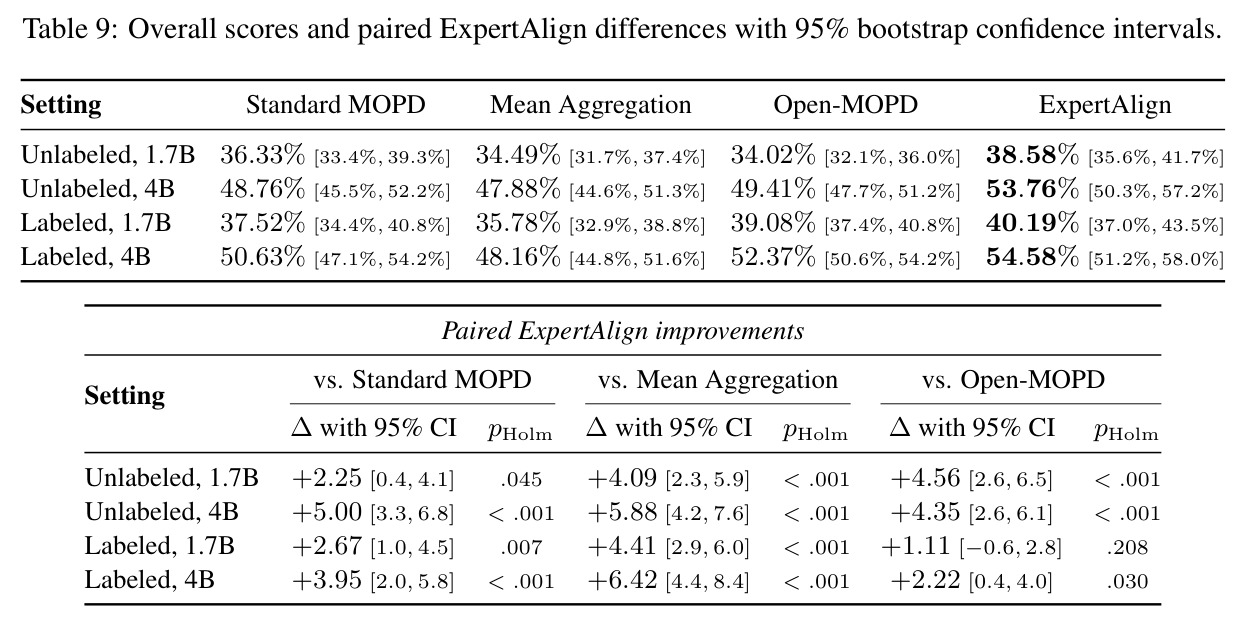
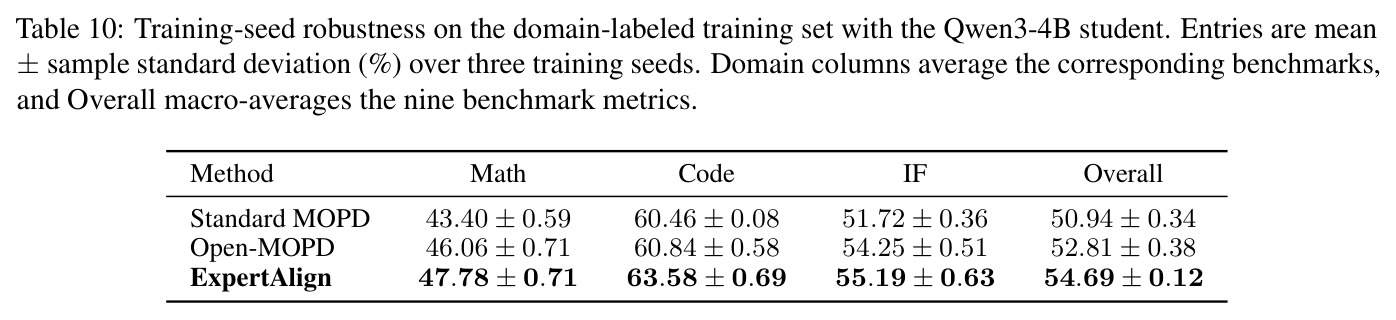
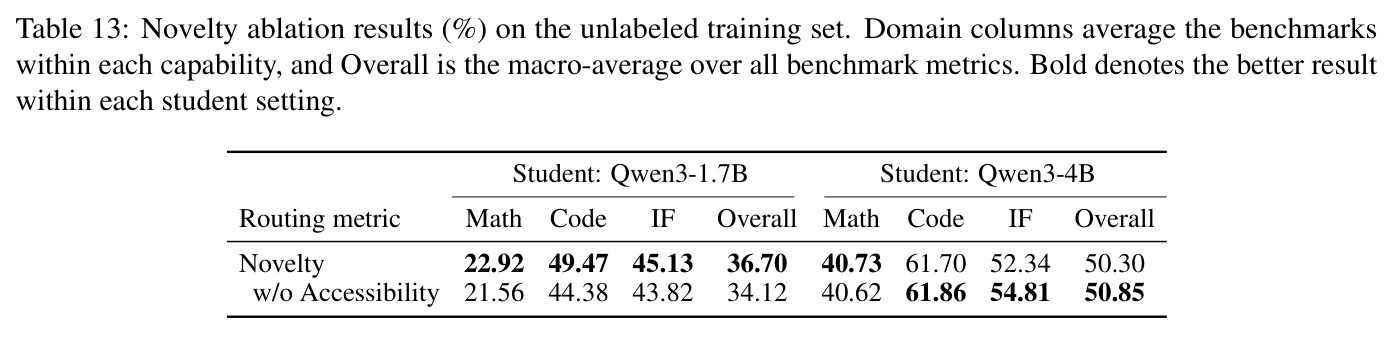
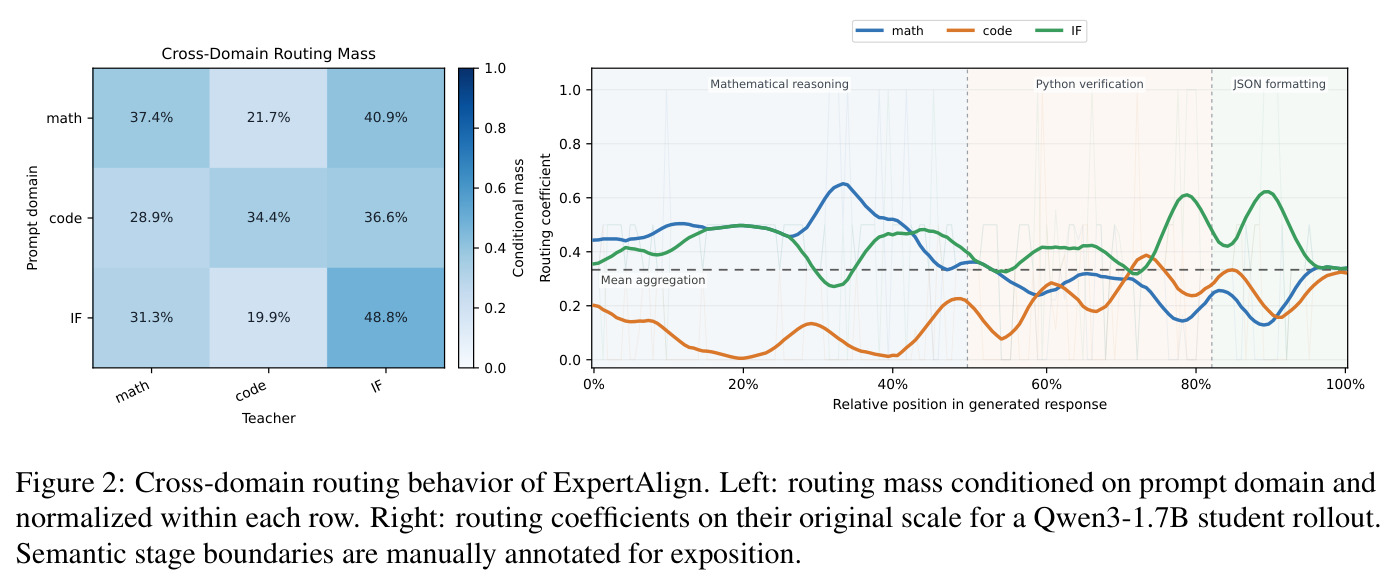
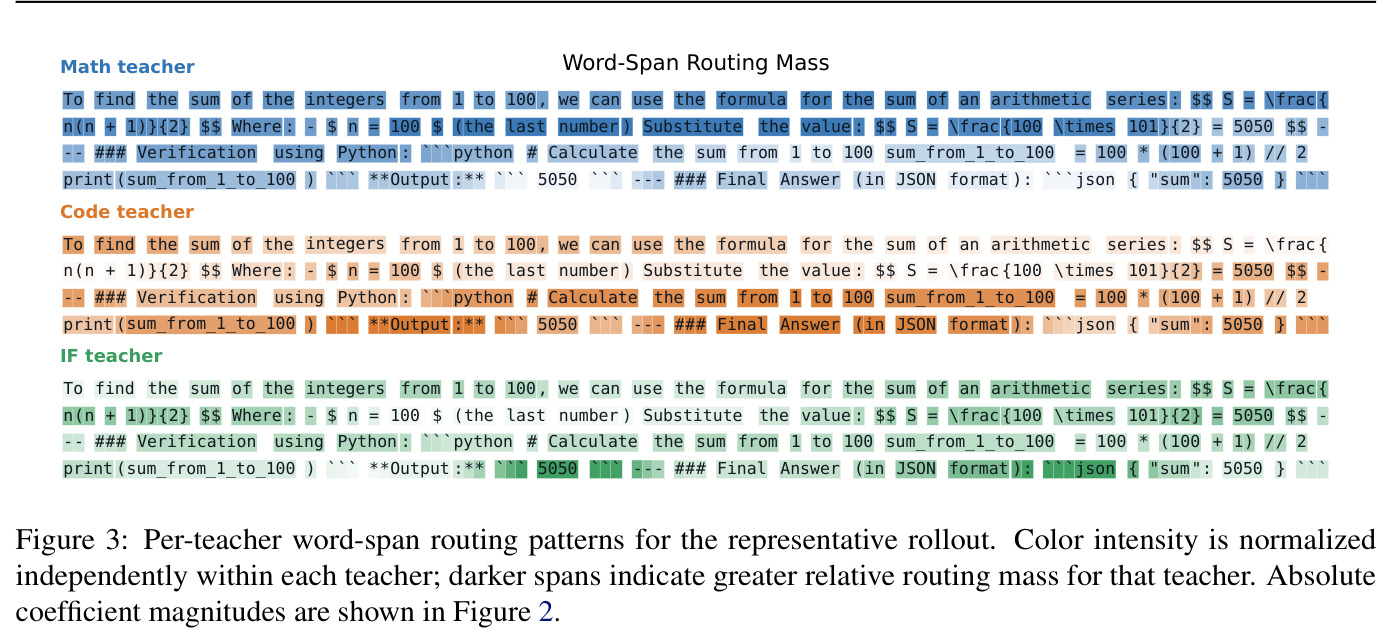
主结果覆盖 2 个数据体制 × 2 个蒸馏场景共四设定。(1) 无标签 60K 混合集:1.7B 学生 ExpertAlign Overall 38.58%,比 Mean 聚合 34.49% 高 4.09 点(配对 bootstrap,10,000 次重采样,Holm 校正 p<.001),比用 AI 标签的 Standard MOPD 36.33% 高 2.25 点(p=.045),比 Open-MOPD 34.02% 高 4.56 点(p<.001);4B 学生 53.76%,比 Mean 47.88% 高 5.88 点(+12.3%),比 Standard MOPD 48.76% 高 5.00 点,比 Open-MOPD 49.41% 高 4.35 点(均 p<.001)。Novelty 也超过全部标签基线(36.70/50.30)。(2) 有标签 66K 集(25K DeepMath-103K + 25K Eurus-RL-Code + 16K HiR-16K,MOPD-Router 忽略现成标签):1.7B 学生 40.19% vs Standard MOPD 37.52%(+2.67,p=.007),与 Open-MOPD 39.08% 统计持平(+1.11,p=.208);4B 学生 54.58% vs Standard MOPD 50.63%(+3.95 点,+7.8%,p<.001),vs Open-MOPD 52.37%(+2.22,p=.030)。4B 下九个基准相对 Standard MOPD 全部为正:AIME24 +5.00、AIME25 +2.08、HMMT Feb +2.09、HMMT Nov +7.08、HumanEval+ +2.44、MBPP+ +3.70、LCB-v6 +5.15、IFEval +4.25、IFBench +3.74。(3) 消融:正对齐门控(Uniform)比 Mean 高 1.22-4.75 点,cosine 加权再高 1.62-3.34 点;恢复全教师池比域限制版高 2.40/2.75 点(1.7B/4B),token 级比 response 级固定混合高 3.62/1.97 点,证明跨域教师互补且逐 token 分配最优。(4) 路由行为:各域 prompt 上非域教师合计获得超过 50% 的条件路由质量;案例中数学教师在数值推导段、代码教师在 Python 验证段、IF 教师在 JSON 格式化段分别达峰。同尺寸学生最终超过 RL 教师参考(52.13%)。(5) 成本:ExpertAlign 716.9 GPU-hours vs Standard MOPD 692.9(+3.5%),token 归一化端到端成本 1.18 倍。(6) 三种子重复实验:ExpertAlign 54.69±0.12 vs Standard MOPD 50.94±0.34、Open-MOPD 52.81±0.38,方差也更小。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 无标签混合数据(60K)· Qwen3-4B 学生 · Overall(9 基准宏平均) | Accuracy (%) | ExpertAlign 53.76 | Mean 聚合 47.88;Standard MOPD(AI 标签)48.76;Open-MOPD 49.41 | +5.88(+12.3%)vs Mean;+5.00 vs Standard MOPD;+4.35 vs Open-MOPD(三者 p<.001) |
| 无标签混合数据(60K)· Qwen3-1.7B 学生 · Overall | Accuracy (%) | ExpertAlign 38.58 | Mean 聚合 34.49;Standard MOPD(AI 标签)36.33;Open-MOPD 34.02 | +4.09 vs Mean(p<.001);+2.25 vs Standard MOPD(p=.045);+4.56 vs Open-MOPD(p<.001) |
| 有标签数据(66K)· Qwen3-4B 学生 · Overall(不用标签路由) | Accuracy (%) | ExpertAlign 54.58 | Standard MOPD 50.63;Open-MOPD 52.37;Mean 聚合 48.16 | +3.95(+7.8%)vs Standard MOPD(p<.001);+2.22 vs Open-MOPD(p=.030);+6.42 vs Mean(p<.001) |
| 有标签数据(66K)· Qwen3-1.7B 学生 · Overall(不用标签路由) | Accuracy (%) | ExpertAlign 40.19 | Standard MOPD 37.52;Open-MOPD 39.08;Mean 聚合 35.78 | +2.67 vs Standard MOPD(p=.007);+4.41 vs Mean(p<.001);vs Open-MOPD 统计持平(+1.11,p=.208) |
| 有标签数据 · Qwen3-4B · AIME 2024 | Avg@8 Accuracy (%) | 60.42 | Standard MOPD 55.42(RL 教师参考 58.33) | +5.00 |
| 有标签数据 · Qwen3-4B · HMMT 2025 Nov | Avg@8 Accuracy (%) | 40.83 | Standard MOPD 33.75(RL 教师参考 35.00) | +7.08 |
| 种子稳健性 · 有标签数据 · Qwen3-4B · Overall(种子 42/123/2026) | 三种子均值 ± 样本标准差 (%) | ExpertAlign 54.69 ± 0.12 | Standard MOPD 50.94 ± 0.34;Open-MOPD 52.81 ± 0.38 | 平均 +3.76 ± 0.32 vs Standard MOPD;+1.88 ± 0.31 vs Open-MOPD,且每个匹配种子下均更高 |
| 训练成本 · 同尺寸有标签设定 · 端到端(8×H20) | GPU-hours / 相对端到端成本 | ExpertAlign 716.9 GPU-hours,1.18× token 归一化成本 | Standard MOPD 692.9 GPU-hours,1.00× | 绝对开销仅 +3.5%(换取 Overall +3.95 点);Entropy/Novelty 为 1.13×/1.09× |
局限与改进
作者承认的限制(附录 A):实验只覆盖三个同家族教师(Qwen3-4B-Non-Thinking,专业为数学、代码、指令遵循),这个受控设置隔离了路由与架构/预训练差异,但向更大、更异构教师池的泛化未经验证;三个路由指标来自经验直觉而非统一设计框架;ExpertAlign 的专业化定义依赖教师共享 pre-RL 基座——虽是工业 MOPD 的标准配置,但仍是前提条件。我的补充观察:(a) 训练需同时前向 3 个教师加 1 个基座共 4 个 4B 模型,ExpertAlign 的 token 归一化成本已达 1.18 倍,教师池扩容时前向开销线性增长;(b) 无标签 1.7B 设定下 Uniform 门控让 IF 从 44.33 微降到 42.81,说明选择门控对「弱学生 × 软技能域」组合可能误伤;(c) 有标签 1.7B 设定中 ExpertAlign 对 Open-MOPD 仅统计持平(+1.11,p=.208),强到弱场景的优势(+2.25 到 +2.67)明显小于同尺寸场景(+3.95 到 +5.00),收益随学生能力变化的规律未充分讨论;(d) 超参 k=16、温度 0.1 等在 Qwen3-4B 有标签集上选出,k=32 时全域明显下降,跨模型族稳健性未报告;(e) 所有实验限定 non-thinking 模式,长思维链场景的路由统计可能不同;(f) Entropy/Novelty 产生明显更短的响应(3,278/3,496 vs 4,893 token),路由规则与生成长度的因果交互未被分析。
独立分析的弱点
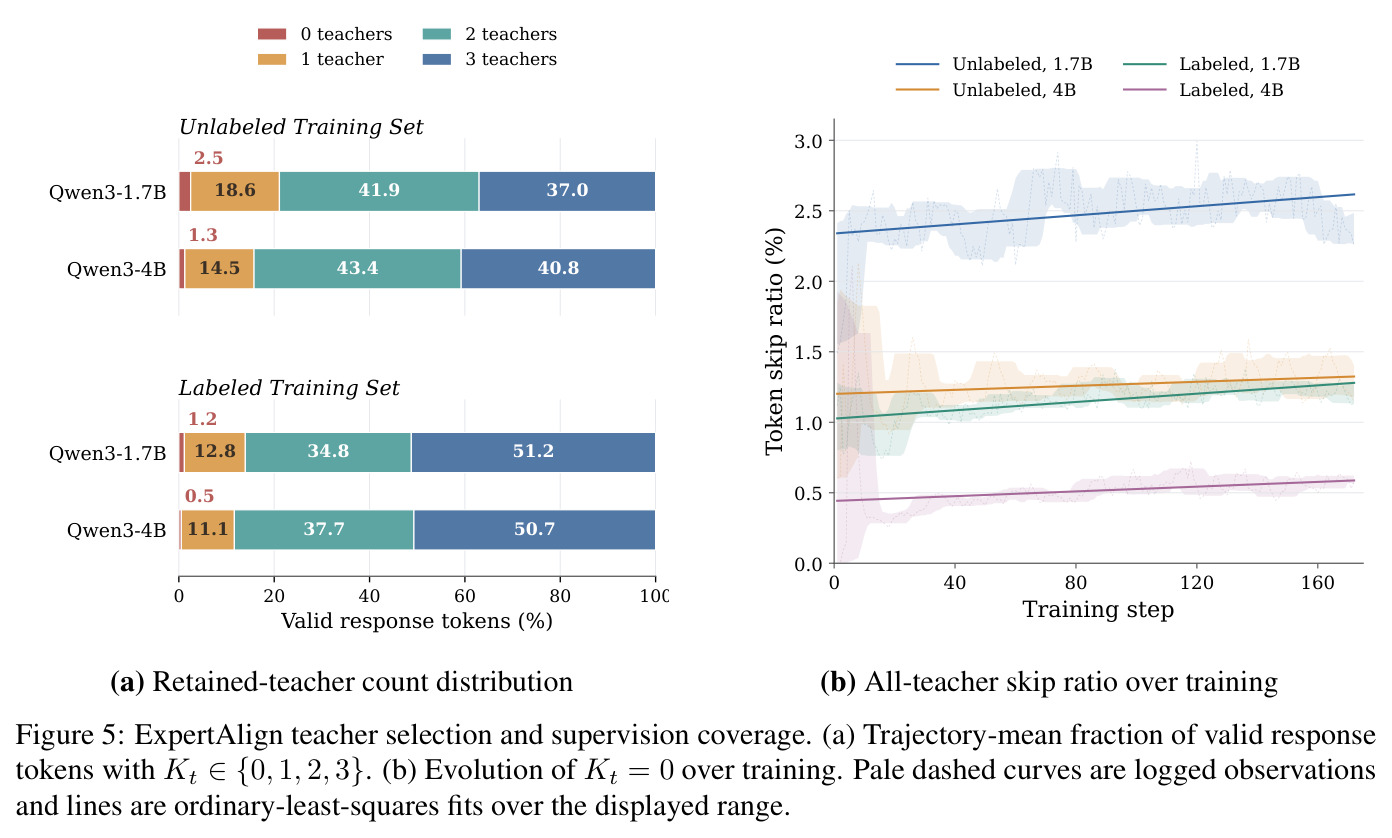
独立分析的弱点与改进方向:(1) 共享基座假设。异构教师(不同预训练或不同基座)无法直接构造 $e_{i,t}$。改进:如作者所提为每个教师使用其各自 pre-RL checkpoint;或在参数空间用权重位移 $\Delta\theta_i$ 的诱导方向近似专业化。(2) 专业化的定义遗漏基座已有能力。RL 只强化部分技能,教师靠基座继承的通用能力对应的 token 会因 $e\approx 0$ 而被过滤,通用聊天/软技能域可能监督不足——无标签集上 IF 恰是弱项。改进:用 $\|e_{i,t}\|$ 做软衰减而非硬门控,或引入验证器/奖励等外部信号兜底被过滤 token。(3) 门控随训练推进导致 $K_t=0$ 缓慢上升(每 100 步 +0.071 到 +0.161 个百分点)。当前仅 0.52-2.48%,但更长训练或多 epoch 下可能过度过滤。改进:为保留集合规模设下限,或对进度 $r_{i,t}$ 做温度化软化。(4) 三个教师的小池子下 softmax 权重行为未必随池规模缩放,逐 token 逐教师的 top-k 统计也会线性加价。改进:分组采样或层次路由(先粗域后 token)。(5) 评测与训练都在 Qwen3 non-thinking、数学/代码/IF 三域内进行,对 agentic、多模态、工具使用等真实混合数据的重要成分未验证。改进:扩展教师池并报告路由质量随域数的稳定性曲线。(6) 对 Open-MOPD 的比较在 1.7B 有标签设定只是持平,说明在弱学生场景可能还需要配合预算类调度才能全面占优。
未来方向
作者提出的方向:测试更多样的教师池与蒸馏场景;发展路由指标设计的系统化原则而非经验直觉;把 ExpertAlign 扩展到不同基座的教师(用各自 pre-RL checkpoint 定义专业化);在 plug-in 接口中纳入验证器反馈、奖励模型等外部信号。基于本文成果可延伸的方向:(1) 路由与调度互补——Open-MOPD 在 response 级平衡预算、MOPD-Router 在 token 级分配权重,可组合成分层路由方案;(2) 利用 $r_{i,t}=\langle e_{i,t}, q_t\rangle/\|e_{i,t}\|_2^2$ 作为学生「专业化吸收进度」的免费诊断量,用于早停、课程排序或按需加大某域采样密度;(3) 把门控的自然松弛(学生逼近教师后 $\langle e,d\rangle\le 0$)发展为「教师能力生命周期管理」,自动淘汰已无边际价值的教师以节省算力;(4) 在 self-distillation 与弱到强设定中检验专业化对齐(教师=同一模型加额外上下文/反馈的情形);(5) 理论刻画何种对齐度量在何种师生支持错配下最优——Novelty 可达性消融(强到弱 +2.58、同尺寸 -0.55)已暗示答案依赖支持重叠度;(6) 把 token 级路由扩展到多模态教师与 agentic 任务流,以及与 D3-MOPD 式域调度联合的动态课程。
复现评估
复现条件较好。代码已在 GitHub 开源(TURLEing/MOPD-Router)。数据全部公开:Nemotron-v3、NuminaMath-TIR、DeepMath-103K、Eurus-RL-Code、HiR-16K;评测基准(AIME 2024/2025、HMMT 2025 Feb/Nov、HumanEval+、MBPP+、LiveCodeBench v6、IFEval、IFBench)均可获取。教师方面:数学与代码教师直接使用 ExOPD 发布的 Qwen3-4B RL 检查点,IF 教师需自行训练,但附录 B 给出 ROLL 框架完整超参(500 步、lr $10^{-6}$、rollout batch 64、pg clip 0.2/0.27 等)。MOPD 训练超参完整(3 epochs、batch 1024、lr $10^{-5}$ 常数、$\epsilon=0.2$、KL 关闭、k=16、$\tau=0.1$、$\delta=10^{-6}$、prompt 上限 2048、响应上限 16,384)。评测协议明确:温度 0.7、top-p 0.8、top-k 20,数学/代码最大生成长度 16,384、IF 为 4,096,数学 Avg@8、代码 Pass@1、IF 每实例 5 次。算力门槛:同尺寸设定在 8×H20 上约 693-717 GPU 小时,强到弱(1.7B 学生)更低。潜在障碍:无标签基线的 AI 域标注依赖 DeepSeek-V4-Flash API(附录 C 给出完整标注 prompt 和 87.33% 人工一致率校验,可用开源大模型近似);1.18 倍的路由开销要求 4 个 4B 模型并行前向的基础设施。总体属于中等偏易的复现:无缺失关键信息,主要成本在训练基础设施。
论文图表