从梯度到能力:理解多教师在线策略蒸馏 From Gradients to Capabilities: Understanding Multi-Teacher On-Policy Distillation
解剖MOPD中损失加权、Adam动量与BF16精度如何筛选教师信号并决定任务收益
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
学生模型自己采样回复,冻结的教师在这些"学生自己的回复"的每个前缀上提供下一 token 概率分布,学生在这些前缀上最小化与教师的散度(通常是反向 KL)。与离线蒸馏用教师生成的固定数据不同,OPD 的训练分布随学生策略更新而漂移,教师能对学生实际会走到的每一步给分,因此样本效率高(GKD, Agarwal et al. 2024)。
本文所有实验都在 OPD 设定下进行:教师对学生生成的前缀打分是"监督信号"的来源,理解这一点才能明白为什么响应长度、前缀覆盖率会变成核心变量。
多教师在线策略蒸馏(MOPD)
OPD 的多教师扩展:每个 prompt 按所属领域(数学、代码、指令跟随、科学等)交给对应的 RL 教师打分,各响应损失加权求和后联合训练一个学生。目标是不做模型合并就把多个专家能力融合进单一学生,代表性工作包括 MOPD(Ma et al. 2026)与 Open-MOPD(Gao et al. 2026)。
本文的研究对象就是 MOPD:多个教师的损失共用同一组学生参数,因此"损失怎么加权、优化器怎么处理梯度"直接决定能力融合的成败。
反向 KL 与 PG 代理损失
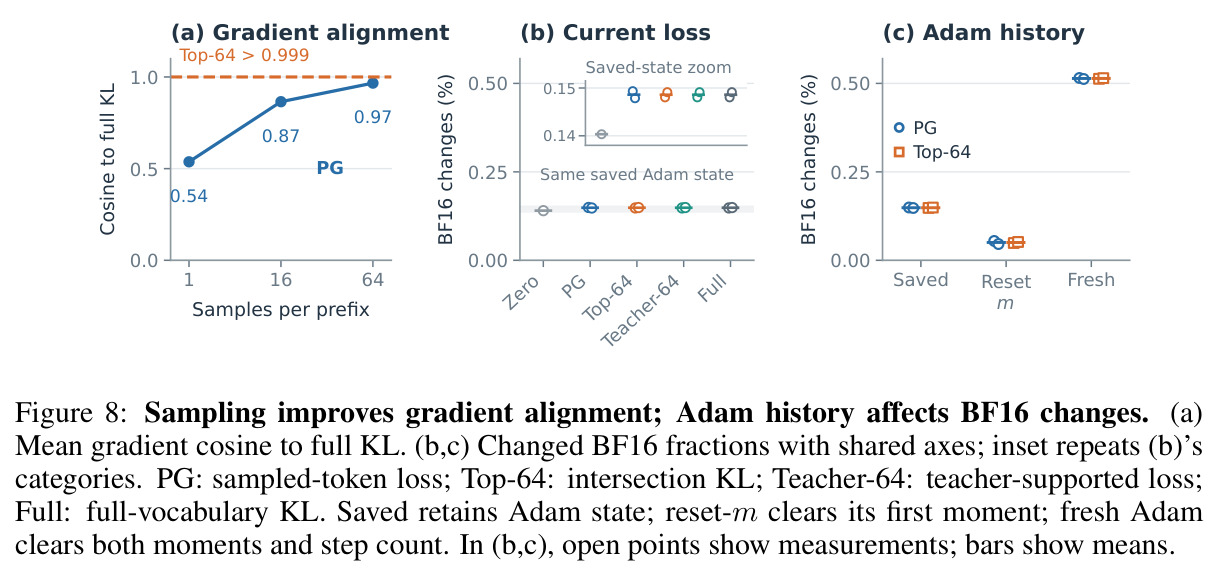
蒸馏常用全词表反向 KL $\ell_{\text{full}}=\sum_{v} p_\theta(v)\log\frac{p_\theta(v)}{q_d(v)}$,需要对每个位置查询教师全词表分布。PG 代理损失 $\ell_{\text{PG}}(y_t)=-\mathrm{sg}[\log q_d(y_t)-\log p_\theta(y_t)]\,\log p_\theta(y_t)$ 只需学生采样一个 token $y_t$:固定前缀下其期望梯度等于全词表反向 KL 梯度(论文命题 1),但单样本估计噪声大(梯度余弦仅 0.54)。
PG 与词表监督的对比是第 5 节主线:"无偏但高方差"与"有偏但高保真"的取舍直接决定任务收益,是论文反直觉结论的载体。
top-k 交集 KL 损失
只取学生 top-$k$ 集合 $S_k$ 与教师 top-$k$ 集合 $T_k$ 的交集 $I_k=S_k\cap T_k$,把两边概率在 $I_k$ 内重归一化后计算 KL:$\ell_{\text{top-k}}=\sum_{v\in I_k}\bar{p}^I_\theta(v)\log\frac{\bar{p}^I_\theta(v)}{\bar{q}^I_d(v)}$。交集外 token 梯度为零,交集为空则损失为零;监督密度介于 1(PG)与 $|V|$(全词表)之间。
它既是论文的工程方案(规避 SGLang 教师接口限制),又是"梯度保真度"的测量工具:在 Qwen 上与全词表梯度余弦 >0.999,用来检验"更接近全词表是否更好"。
三种损失平均规则(GT/DT/DR)
响应内先做 token 平均后,域间与域内权重有三种分配:全局 token 平均 GT 把权重按 token 数均摊(域权重等于其 token 份额);域 token 平均 DT 固定每域权重 $\lambda_d$、域内响应按长度加权;域响应平均 DR 保持 $\lambda_d$ 且域内响应等权。Open-MOPD 的 token 份额修正实际恢复的是 DT。
平均规则是本文第一个自变量:它决定"谁得到多少梯度",并通过协方差恒等式与响应长度耦合,进而改变各任务的实际收益。
Adam 的一阶矩与二阶矩
Adam 维护梯度指数滑动平均 $m_t$(一阶矩,动量)与平方梯度滑动平均 $v_t$(二阶矩),更新量 $\Delta\theta\propto m_t/(\sqrt{v_t}+\epsilon)$。一阶矩把历史梯度混入当前更新,使不同来源的梯度产生相似的更新方向;二阶矩做逐坐标的步长归一化。
论文发现教师间更新余弦 >0.83 主要由共享一阶矩造成,重置后近 0;而无历史的 SGD 反而均值分数更高。理解动量才能理解"优化器如何筛选教师信号"。
BF16 与 FP32 主权重
混合精度训练用低精度 BF16 存储模型权重,同时保留高精度 FP32 "主权重"(master weights)供优化器累加小更新,再舍入写回 BF16。BF16 只有 8 位尾数,相对精度约 $2^{-8}\approx 0.4\%$,小于该尺度的参数变化会被舍入直接抹掉。
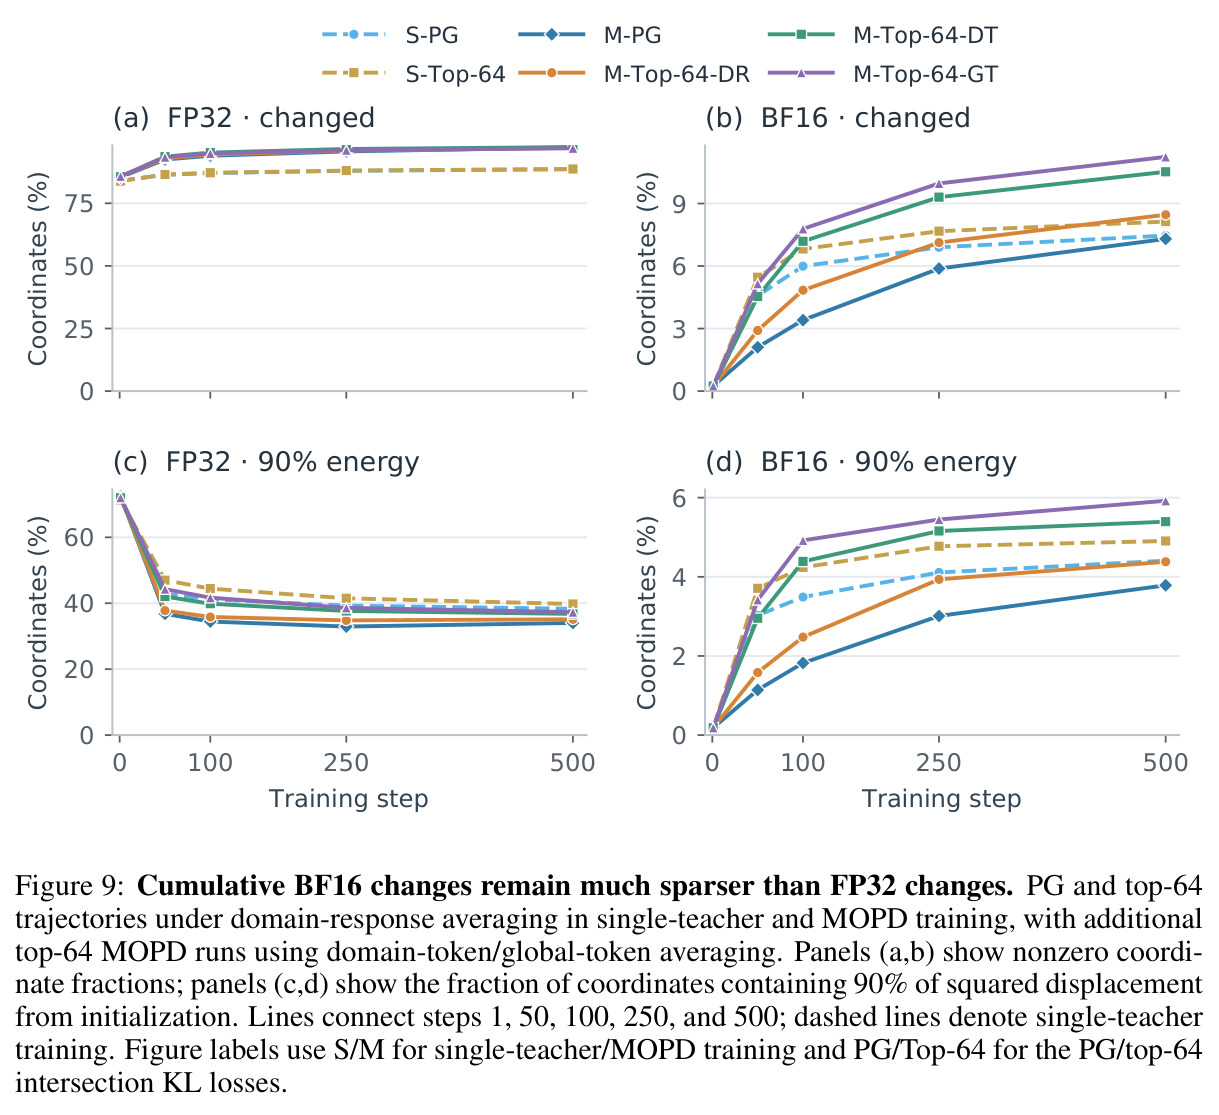
论文证明 FP32 中约 97% 的参数变化在 BF16 写回后只剩 7–11% 可见,说明文献中基于 BF16 权重的"更新稀疏"观察部分是数值伪影。
研究动机
强化学习已经能稳定训练出数学、代码、指令跟随、科学问答等领域的专家模型,但把多个教师的互补能力融合进一个学生仍然困难。多教师在线策略蒸馏(MOPD)让学生在自己生成的回复上最小化各领域教师的下一 token 分布,然而"教师强"并不保证"学生学到每种能力":Open-MOPD 报告 MOPD 学生在指令跟随上相对单领域学生存在明显缺口,其直接线索是长度失衡——数学/代码回复平均约 10,500 token,而指令跟随回复仅 409 token,若按全局 token 平均,长回复领域会以约 3 倍的权重支配总损失。另一组矛盾出现在蒸馏损失的选择上:一些工作比较采样 token 的 PG 损失与 top-k 词表监督,而 Nemotron 3 Ultra 的初步实验(其 3.3.5 节)报告更宽的词表监督并无性能优势,"更多候选 token 何时有用"悬而未决。最后,先前参数分析发现 RL/蒸馏的参数更新稀疏且集中,但这种稀疏有多少来自优化器与 BF16 数值精度的处理、而非监督信号本身的稀疏,此前缺乏受控测量。
本文的目标是本文的目标是把"教师监督 → 梯度 → 优化器更新 → 数值精度写回 → 任务能力"这条链路逐级拆开并定量测量。具体而言,作者在 Qwen3-1.7B 上使用与四个 RL 领域教师(数学、代码、指令跟随、科学)完全相同的初始化做 MOPD 训练,从而把"教师从哪里来"这一变量固定;在完全相同的学生参数、回复批次和优化器状态下,比较三种损失平均规则(全局 token 平均 GT、域 token 平均 DT、域响应平均 DR)、多种蒸馏损失(PG、top-16/64 交集 KL、teacher-top-k、全词表 KL)以及 Adam 与 SGD 两种优化器的差异。文章要回答三个具体问题:修正不均衡的损失权重何时真正改善能力融合?Adam 的动量在多教师信号融合中扮演什么角色、对最终分数有何影响?更接近全词表梯度的监督是否能带来更大的能力增益?
与已有工作不同的是,已有 MOPD 配方停留在"调整损失权重"的工程层面:Ma et al. 在响应内平均损失,Open-MOPD 在响应和域两级做归一化以修正 token 份额,UC-MOPD 按学习信号筛选样本,但都没有把"权重的改变"与"梯度经优化器和低精度写回后还剩下什么"定量联系起来。本文的独特切入有三点。其一,四个教师均由 RL 从与学生相同的初始化独立训练,使"教师差异"在可比框架内受控。其二,通过缓存同一批回复、token 掩码和 Adam 状态做一步对照实验,把损失选择、动量/裁剪/二阶矩等优化器处理、FP32/BF16 数值精度三个混淆因素逐一剥离。其三,用协方差恒等式把"长度加权"从经验规则变成可精确验证的数学对象,并用零梯度基线把"当前梯度"与"优化器历史"分离,从而第一次回答"教师差异究竟有多少真正写进了参数"。
核心方法
直觉上,多教师蒸馏的最终能力不是由"哪个教师的损失权重大"单独决定,而是由损失→梯度→优化器→低精度存储这条流水线中每一级的信息筛选共同决定。技术路线分四步。第一步,形式化 MOPD 目标:对来自域 $d$ 的 prompt $x$,学生采样回复 $y\sim p_\theta(\cdot\mid x)$,响应内先做 token 平均 $\ell_i=T_i^{-1}\sum_t \ell_{i,t}$,再以权重 $w_i$(满足 $\sum_i w_i=1$)组合成总损失 $\mathcal{L}(\theta)=\sum_{i\in B} w_i\ell_i$。第二步,定义三种平均规则:全局 token 平均(GT,域权重随 token 份额)、域 token 平均(DT,固定域权重 $\lambda_d$ 但响应按长度加权)、域响应平均(DR,域内响应等权)。第三步,定义蒸馏损失:全词表反向 KL、采样 token 的 PG 代理损失、以及只在学生与教师 top-$k$ 交集 $I_k=S_k\cap T_k$ 上重归一化计算的交集 KL。第四步,三线并行的测量:固定 batch 的梯度与一步更新余弦、500 步五种子任务训练曲线、以及 FP32/BF16 参数变化的全程记录。
核心创新是把多任务学习中的"损失加权"问题下沉到"监督经过优化器与数值精度处理后还剩多少差异"这一层分析,并得到三个反直觉结论。第一,协方差恒等式 $\frac{\sum_i T_i g_i}{\sum_i T_i}=\bar{g}_d+\frac{\mathrm{Cov}_d(T,g)}{\bar{T}_d}$ 表明:即便用 DT 把域间权重配平(Open-MOPD 的做法),域内按长度加权仍会把梯度系统性地拉向长回复,只有 DR 才实现响应级等权。第二,Adam 的一阶矩是教师信号的对齐器:不同教师的当前梯度近乎正交时,共享动量使一步更新余弦仍达 0.83–0.96,说明"更新方向相似"大部分来自优化器历史而非当前监督;与已有把更新对齐归因于任务梯度本性的解释有本质区别。第三,梯度保真度不预测能力:PG 损失对全词表梯度无偏、top-64 交集 KL 在 Qwen 上与其余弦超 0.999,但两者在不同平均规则下产生方向相反的任务收益(数学 +2.6 或 −2.1 个百分点),直接挑战"监督越接近全词表越好"的直觉。
方法步骤详情
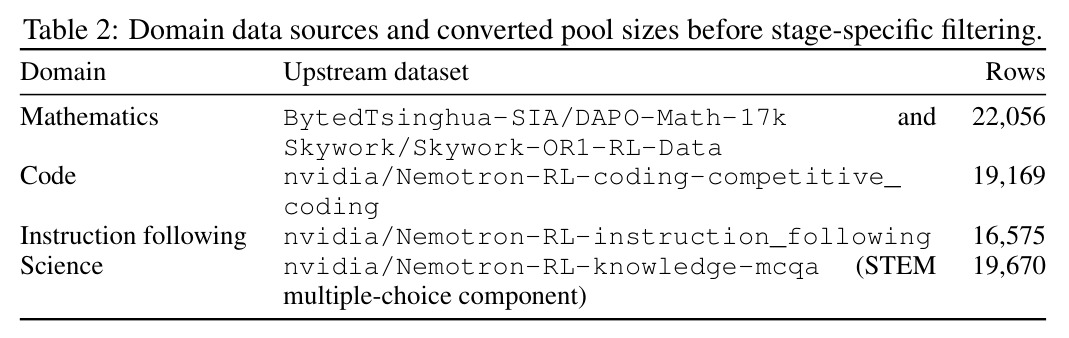
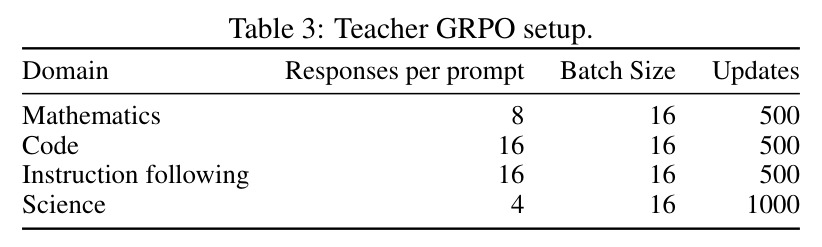
完整流程如下。(1) 教师构建:从 Qwen3-1.7B 公共初始化出发,用 GRPO(Slime 代码库)分别训练数学(每 prompt 8 个响应、500 次更新)、代码(16/500)、指令跟随(16/500)、科学(4/1000)四个教师,数据来自 Nemotron-3-Nano-RL-Training-Blend(数学 22,056 行、代码 19,169、IF 16,575、科学 19,670)。(2) MOPD 训练:每步 64 个 prompt(每域 16 个,目标域权重 0.25),温度 1 采样、响应上限 4,096 token(另有 8K 对照),学生生成后由各域教师在前缀上打分;优化器为 AdamW(lr $2.5\times10^{-7}$、$\beta=(0.9,0.98)$、全局范数 1 裁剪)或 SGD(lr $2.5\times10^{-2}$),训练 500 步、种子 42–46。(3) 诊断实验:在 step 100/250 缓存 6 个 batch,固定参数与 Adam 状态,计算各平均规则的原始梯度与一步更新余弦,并做重置一阶矩/双矩、范数匹配 SGD、零梯度基线 $\delta U_d=U(g_d;H)-U(0;H)$ 等对照。(4) 评估:MATH-500、LiveCodeBench v6、IFBench strict 各一次贪心解码,GPQA Diamond 每题 32 采样取平均,四基准等权。全程使用 10 张 RTX PRO 6000 Blackwell GPU。
技术新颖性
技术新颖性体现在四个层面。(1) 数学化:把任意非负响应权重 $f$ 对域梯度的影响统一写成 $\mathrm{Cov}_d(f,g)/\bar{f}$,长度只是 $f$ 的一个特例;该恒等式在 FP64 下对全部 24 个 batch-域组验证,最大相对残差 $1.53\times10^{-15}$,把 DAPO/Dr. GRPO 关于 token 平均偏差的讨论推广到蒸馏场景。(2) 方法论:"固定一切、只动一个变量"的一步对照设计(同参数、同回复、同 Adam 状态)是连接监督选择与参数变化的干净探针,此前多教师蒸馏文献没有做过这种梯度级解剖。(3) 概念澄清:证明 BF16 写回会让 97% 的 FP32 参数变化看起来只剩 7–11%,把文献中"更新稀疏"的结论部分归因于观测精度而非学习本身,并进一步区分教师差异与输入差异(路由输入余弦 <0.01,共同前缀 0.24–0.35)。(4) 工程洞察:top-k 交集 KL 源于 SGLang 接口只支持共享 token 列表的现实约束(token_ids_logprob),作者顺势把它变成研究对象,证明其梯度几乎无损(Qwen 上余弦 >0.999)且任务效果取决于平均规则——把实现限制上升为科学结论。
实验结果
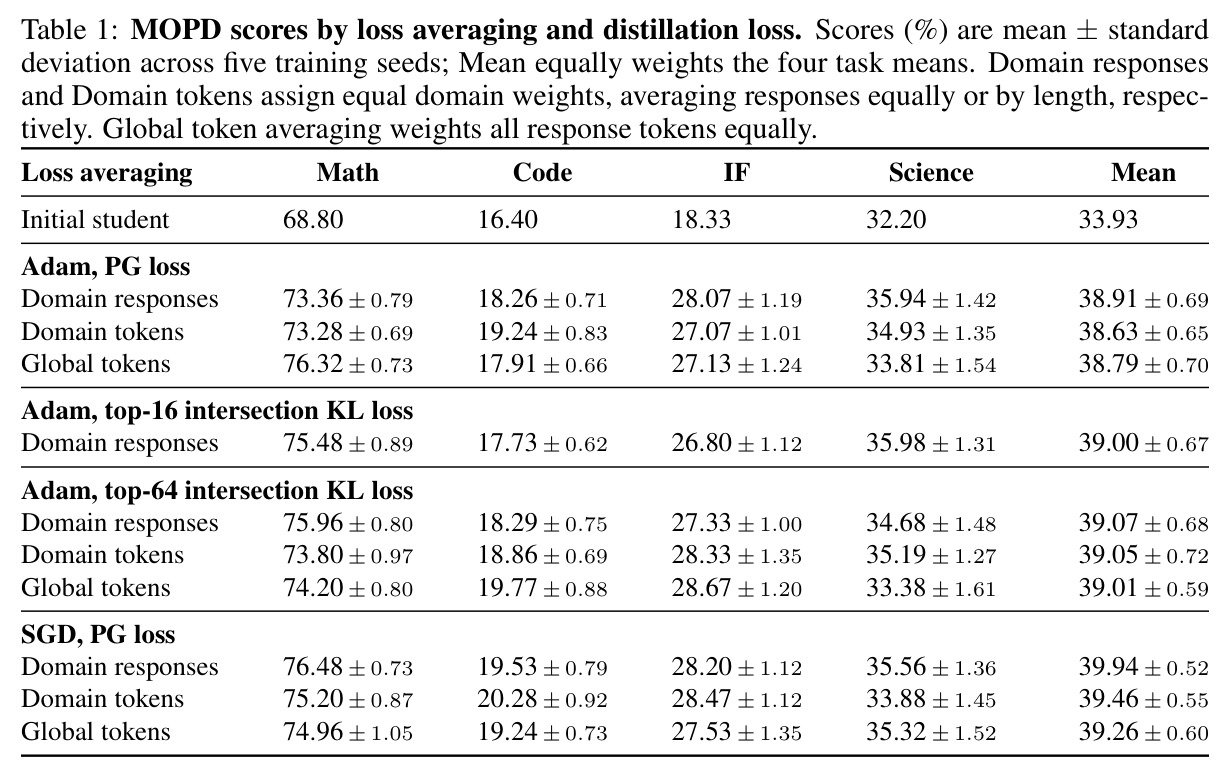
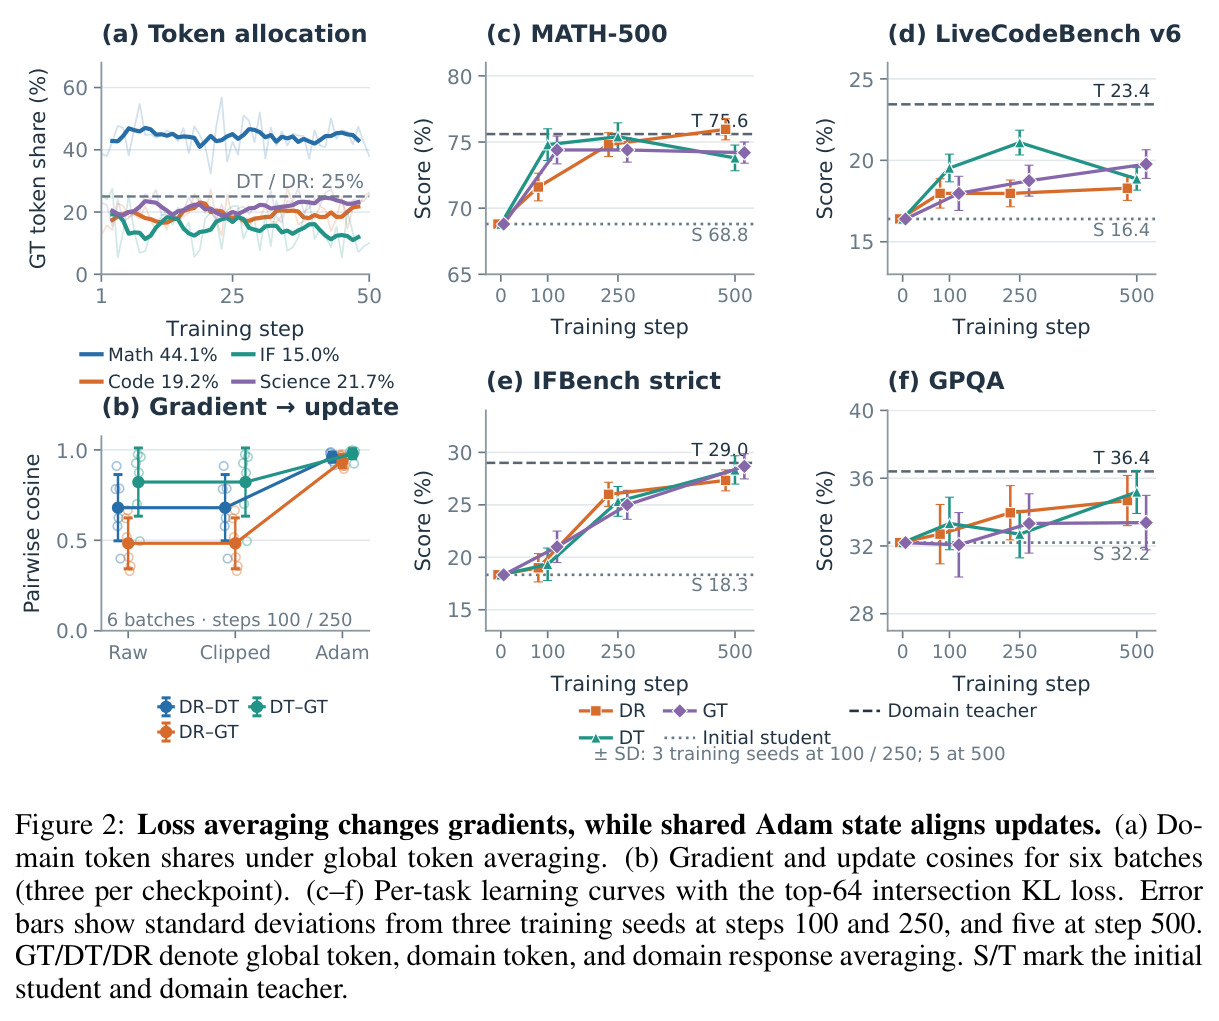
(1) 损失平均即隐式加权:GT 下数学占 44.1% 的 token 份额(代码 19.2%、科学 21.7%、IF 15.0%);DR 与 DT 的原始梯度余弦仅 0.68,共享 Adam 状态后一步更新余弦升至 0.96。三种平均规则的四任务均值差异很小(Adam+PG 0.28pp、Adam+top-64 0.06pp、SGD+PG 0.68pp),但任务级差异显著:PG 下 GT 相对 DR 使数学 +3.0pp、科学 −2.1pp;top-64 下 GT 数学反而 −1.8pp、代码 +1.5pp。(2) 动量对齐教师更新:教师对自身域数据打分时一步更新余弦 >0.83,重置一阶矩后降至近 0;扣除零梯度基线后路由输入余弦 <0.01、共同前缀 0.24–0.35。无动量的 SGD 在三种平均规则下四任务均值全面超过 Adam:39.94 vs 38.91、39.46 vs 38.63、39.26 vs 38.79。(3) BF16 遮蔽广泛变化:约 97% 的 FP32 主权重偏离初始化而 BF16 仅 7–11%;承载 90% 平方变化的参数从 FP32 的约 1/3 缩到 BF16 的 4–6%。(4) 词表监督不预测收益:top-64 交集保留 >99.9% 学生概率、与全词表梯度余弦 >0.999,但 DR 下数学 75.96 vs PG 73.36(+2.6pp),GT 下 74.20 vs 76.32(−2.1pp);PG 多采样把余弦从 0.54 提到 0.87/0.97;SmolLM3 上平均覆盖 97–99% 却仍有 3.65–8.42% 前缀 <90%,梯度相对误差 2.16–24.54%。
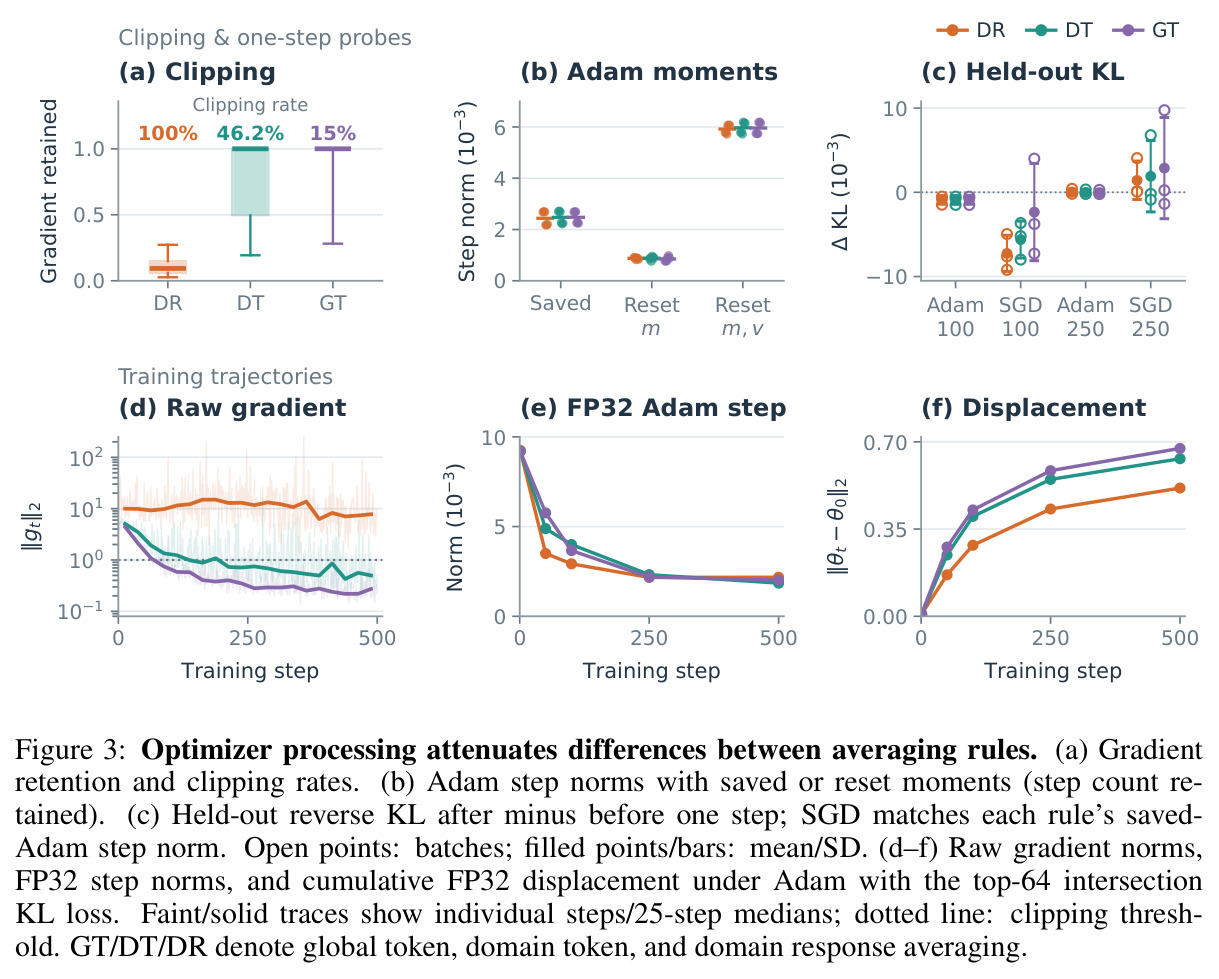
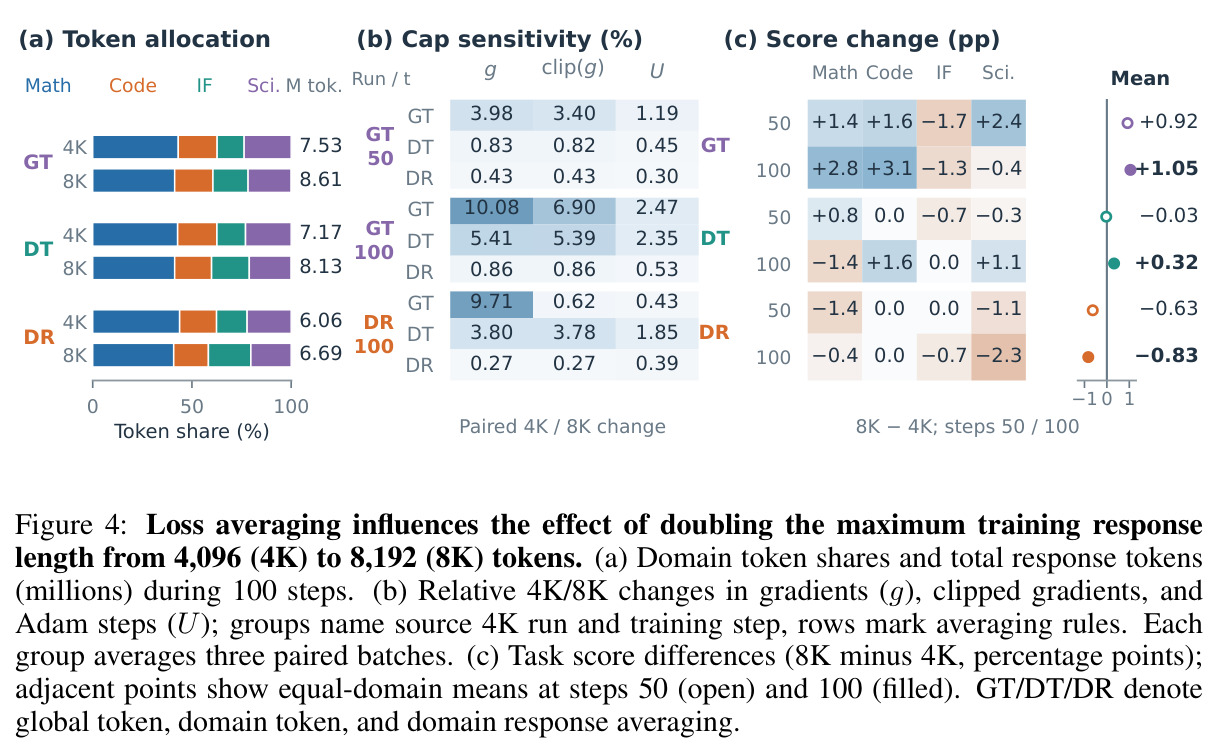
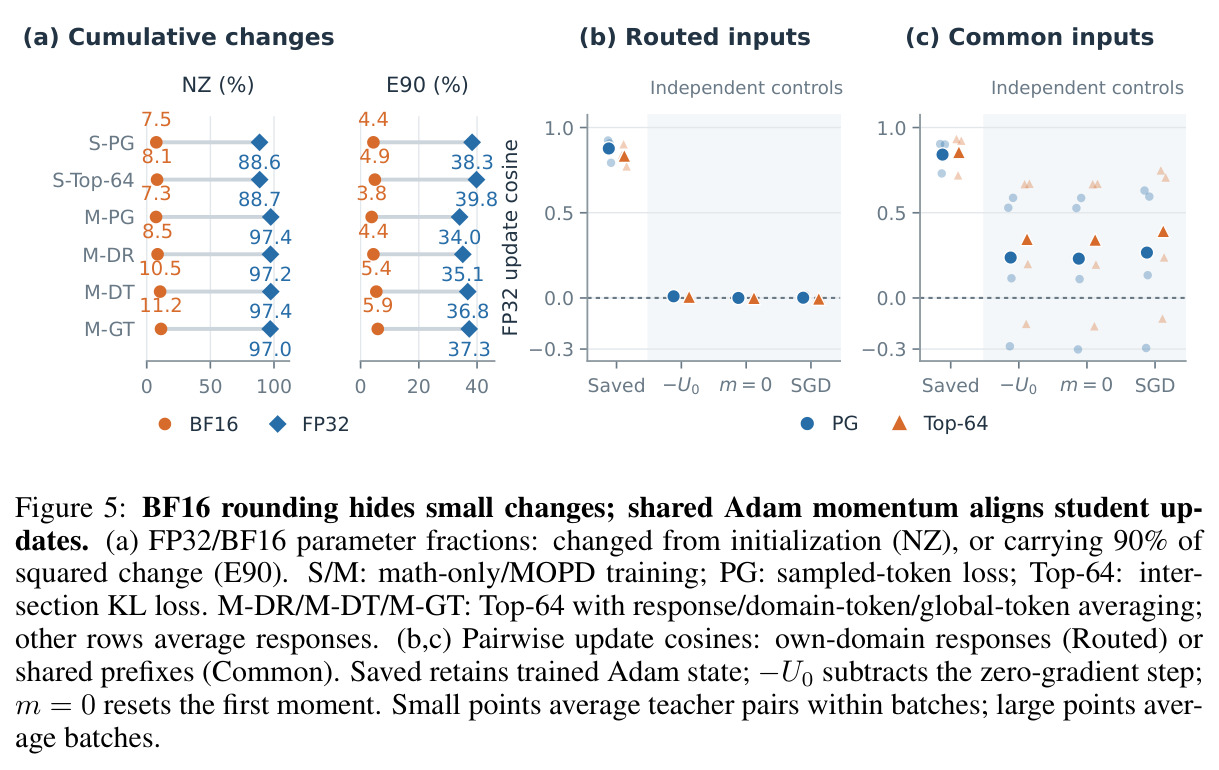
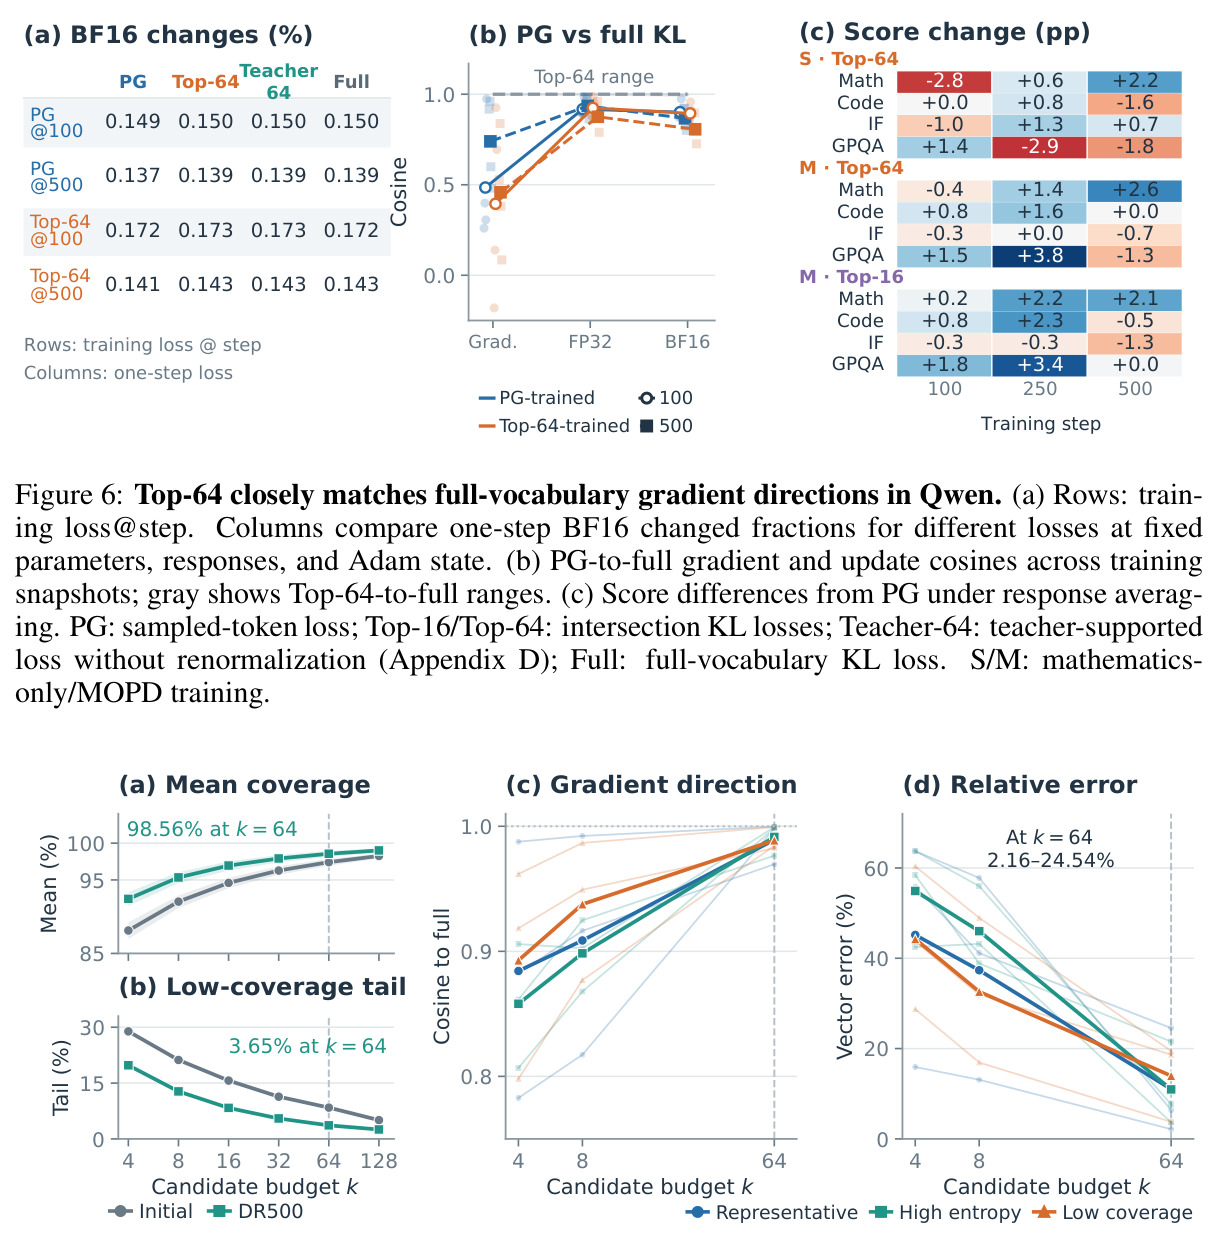
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(MATH-500,500 题) | 准确率 (%) | SGD+PG+域响应平均 76.48;Adam+top-64+DR 75.96(初始学生 68.80,教师 75.6) | Adam+PG+DR 73.36 | SGD 相对 Adam+PG+DR +3.12pp;top-64 交集 KL 相对 PG +2.6pp;超过数学教师 75.6 |
| 代码(LiveCodeBench v6,1,055 题) | 准确率 (%) | SGD+PG+域 token 平均 20.28(初始 16.40,教师 23.4) | Adam+PG+DR 18.26 | +2.02pp(相对 Adam+PG+DR);距教师 23.4 尚差约 3.1pp |
| 指令跟随(IFBench strict,300 题) | 严格通过率 (%) | Adam+top-64+GT 28.67(初始 18.33,教师 29.0) | Adam+PG+DR 28.07 | 各配置普遍较初始 +9~10pp,最高 28.67 已接近教师 29.0 |
| 科学问答(GPQA Diamond,198 题) | avg@32 准确率 (%) | Adam+top-16/top-64+DR 35.98(初始 32.20,教师 36.4) | Adam+PG+GT 33.81 | +3.78pp(相对初始);仍低于科学教师 36.4 |
| 四任务均值(四基准等权) | 平均分 (%) | SGD+PG+DR 39.94(初始 33.93) | Adam+PG+DR 38.91 | SGD 相对 Adam 在 DR/DT/GT 下分别 +1.03/+0.83/+0.47pp;最优与最差配置仅差约 1.3pp |
| 词表监督梯度保真(Qwen3-1.7B 前缀级诊断) | 与全词表 KL 梯度的余弦相似度 | top-64 交集 KL >0.999;PG 平均 64 采样 0.97、16 采样 0.87、1 采样 0.54 | PG 单采样 0.54 | top-64 几乎完全恢复全词表梯度方向,但任务收益仍取决于平均规则 |
局限与改进
作者明确承认结论来自有限的模型家族与规模(Qwen3-1.7B 主实验 + SmolLM3-3B 诊断),更大规模下观察可能不同。我的补充观察:其一,训练仅 500 步且教师与学生同初始化,外推到异源教师(不同预训练基座)或更长训练的结论未经验证;其二,多个关键对比的效应量与种子噪声同量级——四任务均值差异 0.06–0.28pp 而标准差约 ±0.5–0.7pp,"平均规则几乎不影响均值"的部分结论可能受统计功效限制;其三,SGD 优势依赖按 Mukherjee et al. 校准的学习率组合(SGD lr $2.5\times10^{-2}$ vs AdamW lr $2.5\times10^{-7}$),缺乏对两优化器各自学习率扫描的公平性分析;其四,top-k 交集 KL 的部分动机是 SGLang 接口限制,其他推理引擎下的实现差异可能改变结论;其五,教师分数(如 MATH-500 75.6)与学生最优分数(SGD+PG+DR 76.48)的关系未系统讨论,蒸馏是否已逼近教师上界不明;另外 AIME 2025 上三个模型各解出 4/30 题且仅 1 题重合,小样本结论说服力有限。
独立分析的弱点
独立分析的弱点:(1) "没有平均规则在所有任务上都最好"的结论虽然诚实,但没给出选择先验——读者仍不知道自己的场景该用哪种规则;改进方向是把响应长度分布、损失类型(PG vs KL)与任务收益建成可拟合的预测器,甚至在线自适应调整 $w_i$。(2) 动量对齐的证据主要来自一步模拟与相关性分析,为什么共享一阶矩会遮蔽教师差异、长训练中这种遮蔽为何不影响最终能力,缺乏机制性解释;可以做周期性重置 $\beta_1$ 或动量窗口扫描的因果实验。(3) SmolLM3 诊断发现低覆盖前缀梯度误差高达 24.54%,但没有把该误差与任何任务指标关联,"高均值覆盖掩盖误差尾部"只是警示而非可操作结论;可在低覆盖前缀上做加权训练对照实验。(4) BF16 分析只覆盖权重矩阵,未讨论优化器状态本身的低精度存储(如 8-bit Adam)与结论的交互。(5) PG 无偏性(命题 1)仅对固定前缀成立,而 MOPD 在线生成使前缀分布随策略漂移,理论保证与实际训练之间存在缺口。
未来方向
作者提出的方向:探索更小的 Adam $\beta_1$ 是否改善对当前教师信号的适应;研究梯度裁剪与 Adam 二阶矩归一化能否解释"期望梯度相似却任务结果不同";在更大模型家族和规模上验证。基于成果可延伸的方向:(1) 把协方差恒等式变成主动算法——按 $\mathrm{Cov}_d(f,g)$ 反向设计响应/位置权重 $f$,实现域内梯度去长度偏,而非事后诊断;(2) 研究异源教师(不同基座模型)下动量对齐是否仍成立,以及 task arithmetic 式的"教师向量合并"在 MOPD 设定下是否与多教师蒸馏等价;(3) SGD 获胜提示动量可能固化早期方向,可在 RL 后训练中系统比较动量系数与能力融合质量(呼应 Mukherjee et al. 2026 的线索);(4) 自适应候选预算:按覆盖率或熵动态选择每前缀的 $k$,而非固定 top-16/64,兼顾 SmolLM3 式低覆盖尾部;(5) 检验 FP32 中约 97% 参数的小幅变化是否有功能意义——例如把低于阈值的 FP32 变化置零后测任务分数,可直接裁决"广泛小变化 vs 稀疏大变化"之争。
复现评估
复现条件较为友好。数据完全公开:四个域池来自 Nemotron-3-Nano-RL-Training-Blend(DAPO-Math-17k、Skywork-OR1-RL-Data、Nemotron-RL 的 coding/instruction_following/knowledge-mcqa 组件),评测基准 MATH-500、LiveCodeBench v6、IFBench strict、GPQA Diamond 均为公开集。训练配置披露到种子级:教师用 Slime 实现 GRPO(含每域响应数与更新数),MOPD 用 5 个种子(42–46)、500 步、每步 64 prompt,AdamW 与 SGD 的全部超参齐全,诊断实验连缓存 batch 的种子(1042–1044)、TF32 禁用、FP64 验证残差都写明。算力为 10 张 RTX PRO 6000 Blackwell,1.7B 规模下估计数百 GPU 时可复现完整矩阵;只复现核心结论(3 平均规则 × PG/top-64 × Adam/SGD)约需 10 卡数天。主要不确定点是论文未明确声明开源代码,教师权重与缓存批次需自行重建,最耗时的是四个 GRPO 教师训练(最多 1,000 次更新)。总体属于中低难度、高确定性的复现。
论文图表
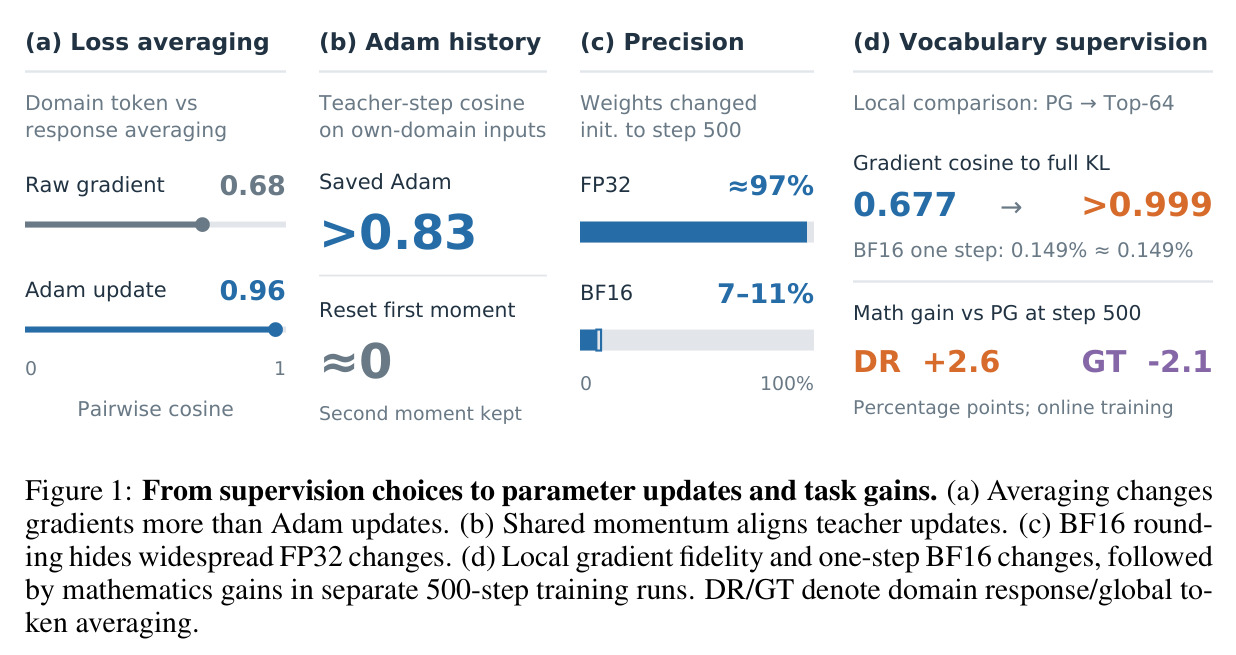
全文总览图,四个面板对应四大发现:(a) 损失平均对原始梯度的影响大于对 Adam 更新的影响(DR–DT 原始梯度余弦 0.68,Adam 更新余弦 0.96);(b) 共享动量使不同教师的更新对齐(教师一步更新余弦 >0.83,重置一阶矩后近 0);(c) FP32 约 97% 权重偏离初始化而 BF16 仅 7–11%,单步 BF16 变化约 0.149%;(d) top-64 交集 KL 与全词表 KL 梯度余弦 >0.999(PG 约 0.677),随后 500 步独立训练显示数学收益依赖平均规则:响应平均(DR)下比 PG 高 +2.6pp,全局 token 平均(GT)下低 −2.1pp。
这是论文的"路线图",把监督选择→参数更新→任务收益的完整证据链一图收拢,读者可据此快速定位四个发现对应的实验与章节。
SmolLM3-3B 诊断图。(a,b) top-64 交集的平均覆盖率(初始 97.42%、训练后 98.56%)与覆盖低于 90% 的加权前缀比例(8.42% 降至 3.65%)随候选预算 $k$ 的变化,显示高均值掩盖低覆盖尾部;(c,d) 训练后在代表性、高熵、低覆盖三组前缀上,交集 KL 相对全词表 KL 的梯度余弦与相对误差,$k=64$ 处相对误差范围达 2.16–24.54%。
证明"平均覆盖率高"不能保证梯度近似处处可靠,为把 Qwen 上的结论外推到其他模型家族提供了必要的边界条件与警示。
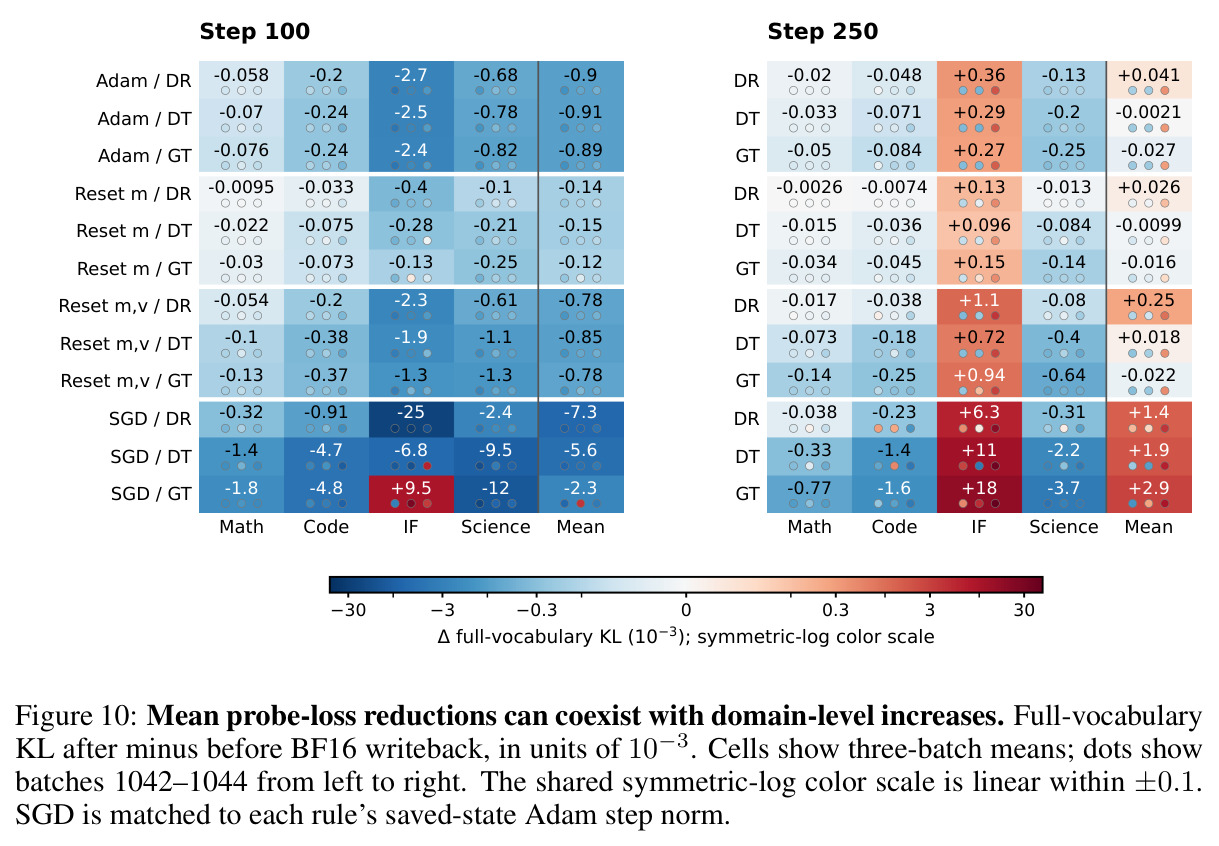
附录 G 图:12 种更新分支(保存 Adam/重置一阶矩/重置双矩/SGD × DR/DT/GT)一步 BF16 写回后的全词表 KL 变化,按数学、代码、IF、科学、均值分解展示。step 250 时保存状态 Adam 在 DT/GT 下四域均值改善(−0.002/−0.027 ×10⁻³),但 IF 的 KL 分别上升 +0.29/+0.27 ×10⁻³;即聚合的探针损失改善可以与单个域的恶化共存,SGD 分支的域间差异最为剧烈。
警示读者:均值层面的"变好"可能掩盖某个域正在远离教师,评估多教师融合必须逐域检查指标,这也是解读本文所有均值结论时应保留的怀疑。