Latent-MOPD:潜在空间多教师在线蒸馏 Latent-MOPD: Latent Multi-Teacher On-Policy Distillation
融合专家输出分布与隐藏状态双重监督,单个1.5B学生模型超越各领域专家教师
前置知识
在线蒸馏(On-Policy Distillation, OPD)
与用教师生成的固定文本做监督的传统离线蒸馏不同,在线蒸馏让学生自己采样生成回答,教师再对学生回答的每个前缀逐 token 打分,提供密集的逐 token 监督信号。学生在自己的分布上学习,减少了训练与推理分布不匹配(train-inference mismatch)的问题;教师只需在学生 rollout 的前缀上计算下一 token 分布,无需自己生成完整回答。
本文是 OPD 的多教师扩展,所有监督信号都定义在学生自己生成的 rollout 上,理解这一设定是读懂领域路由、表示对齐、交叉淡出等全部设计的前提。
隐藏状态表示对齐
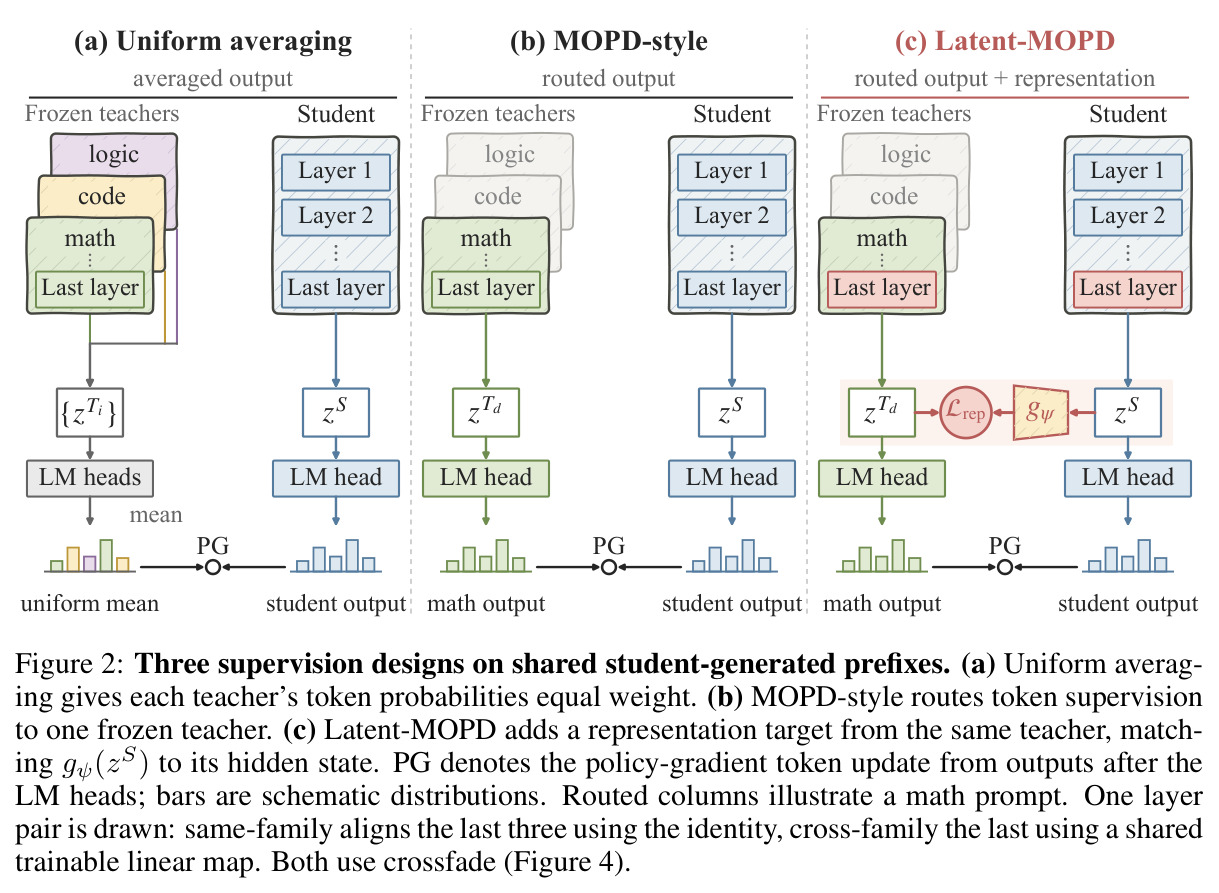
LM head 之前的最终层隐藏状态 $z$ 直接决定下一 token 分布。表示级蒸馏把学生隐藏态经投影映射 $g_\psi$ 变换后,与教师隐藏态做 $\ell_2$ 归一化再匹配,惩罚项形如 $\frac{\lambda}{d_T}\|\nu(g_\psi(z_S))-\mathrm{sg}[\nu(z_T)]\|_2^2$(sg 为停止梯度),把教师「如何计算」的内部信息传给学生,而非只传「预测什么」。
本文的核心创新就是把这个潜在监督通道从单教师扩展到多教师路由场景,层选择、批次组织、调度设计全都围绕它展开。
CKA(中心化核对齐)
一种度量两个神经网络表示相似性的指标,对正交变换和各向同性缩放不变,因此适合比较宽度不同的模型。线性 CKA 定义为 $\mathrm{CKA}(X,Y)=\|\tilde{X}^\top\tilde{Y}\|_F^2/(\|\tilde{X}^\top\tilde{X}\|_F\|\tilde{Y}^\top\tilde{Y}\|_F)$,其中 $\tilde{X},\tilde{Y}$ 是列中心化后的激活矩阵。本文用它逐块比较每位教师与基础学生的表示几何。
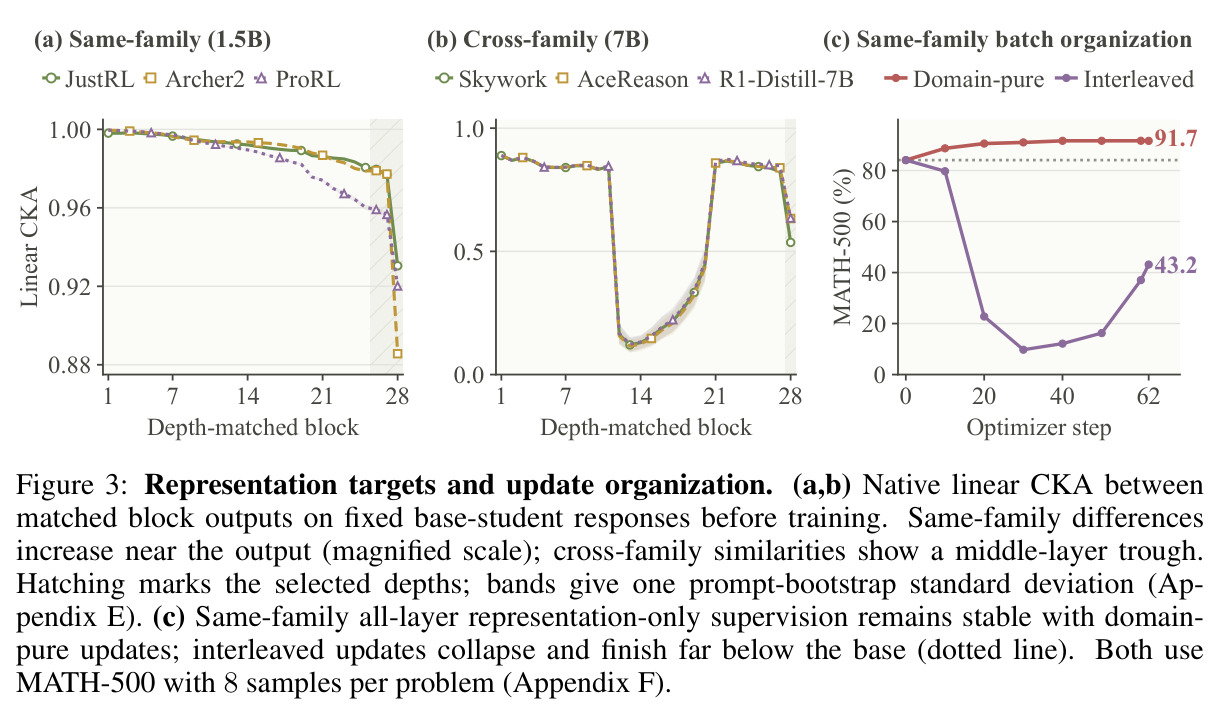
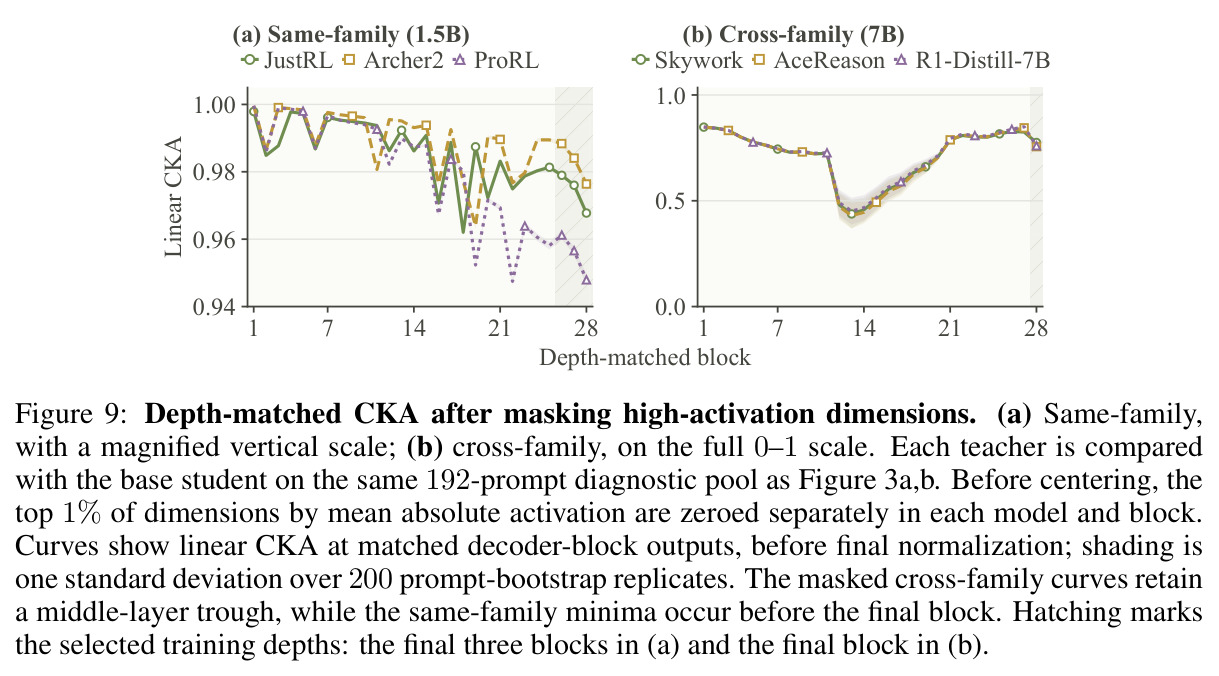
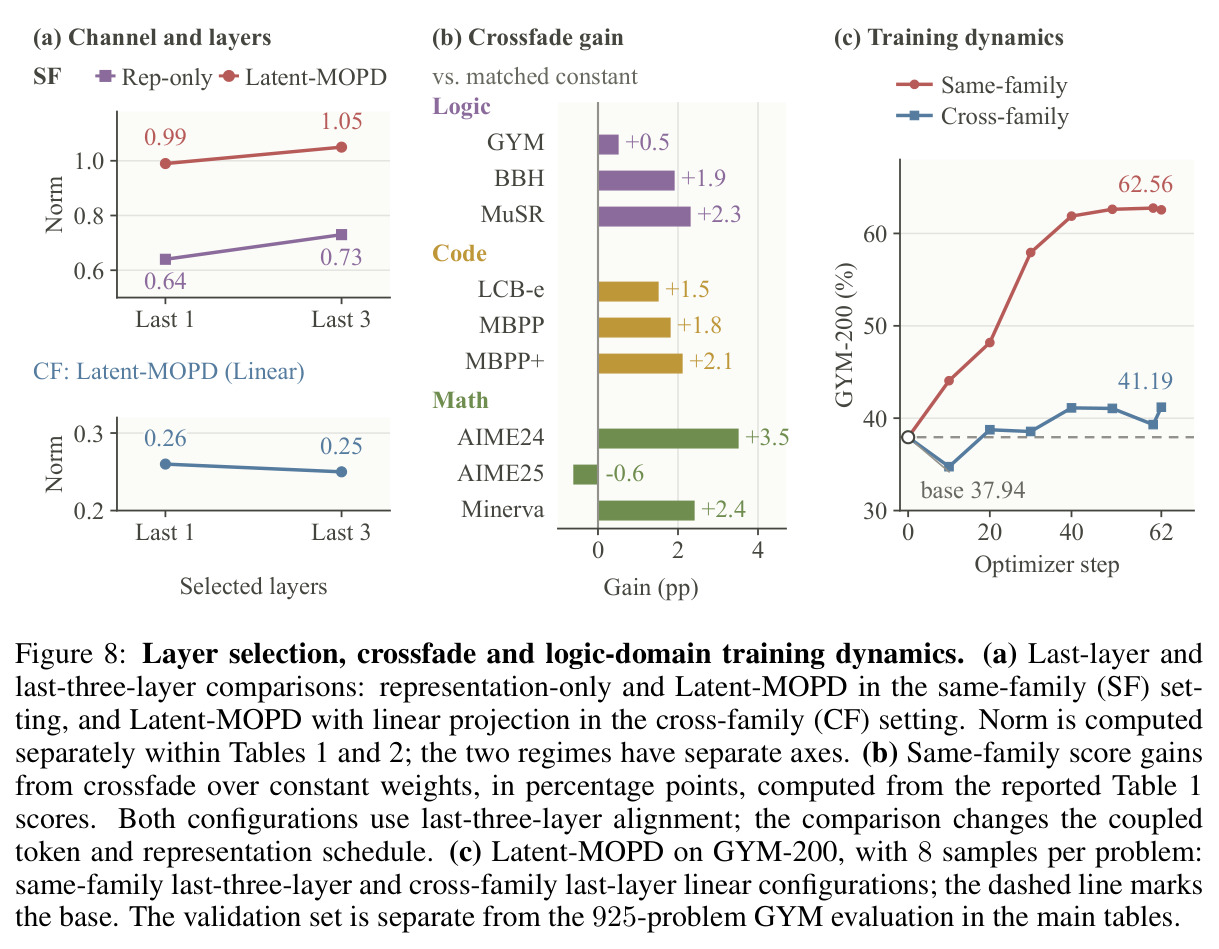
论文用 CKA 曲线决定对齐哪些层:同族模型前 25 层 CKA 高达 0.987-0.992、差异集中在末端,故选最后三层;跨族模型第 13 层有 0.116-0.124 的低谷,故只选最后一层。
策略梯度代理损失
本文 token 通道把教师-学生对数概率比当作奖励:在学生 top-16 候选集 $V_{k,t}$ 内取 $r_{t,v}=-w_{t,v}\log\bar{p}_t(v)-\log p_{T,t}(v)$,按域内标准差归一化为固定优势 $A_{t,v}=r_{t,v}/\sigma_d$,再最大化 $-\frac{1}{|M|}\sum_t\sum_v \mathrm{sg}[A_{t,v}]\log p_{\theta,t}(v)$。候选权重在支撑集内归一化,两个对数保留全词表归一化。
这是 Latent-MOPD 的 token 监督通道,与表示通道按公式 $\mathcal{L}=\alpha(u)\mathcal{L}^{OPD}+\beta(u)\mathcal{L}^{rep}$ 交叉淡出配合,不理解它就读不懂总损失。
参数合并
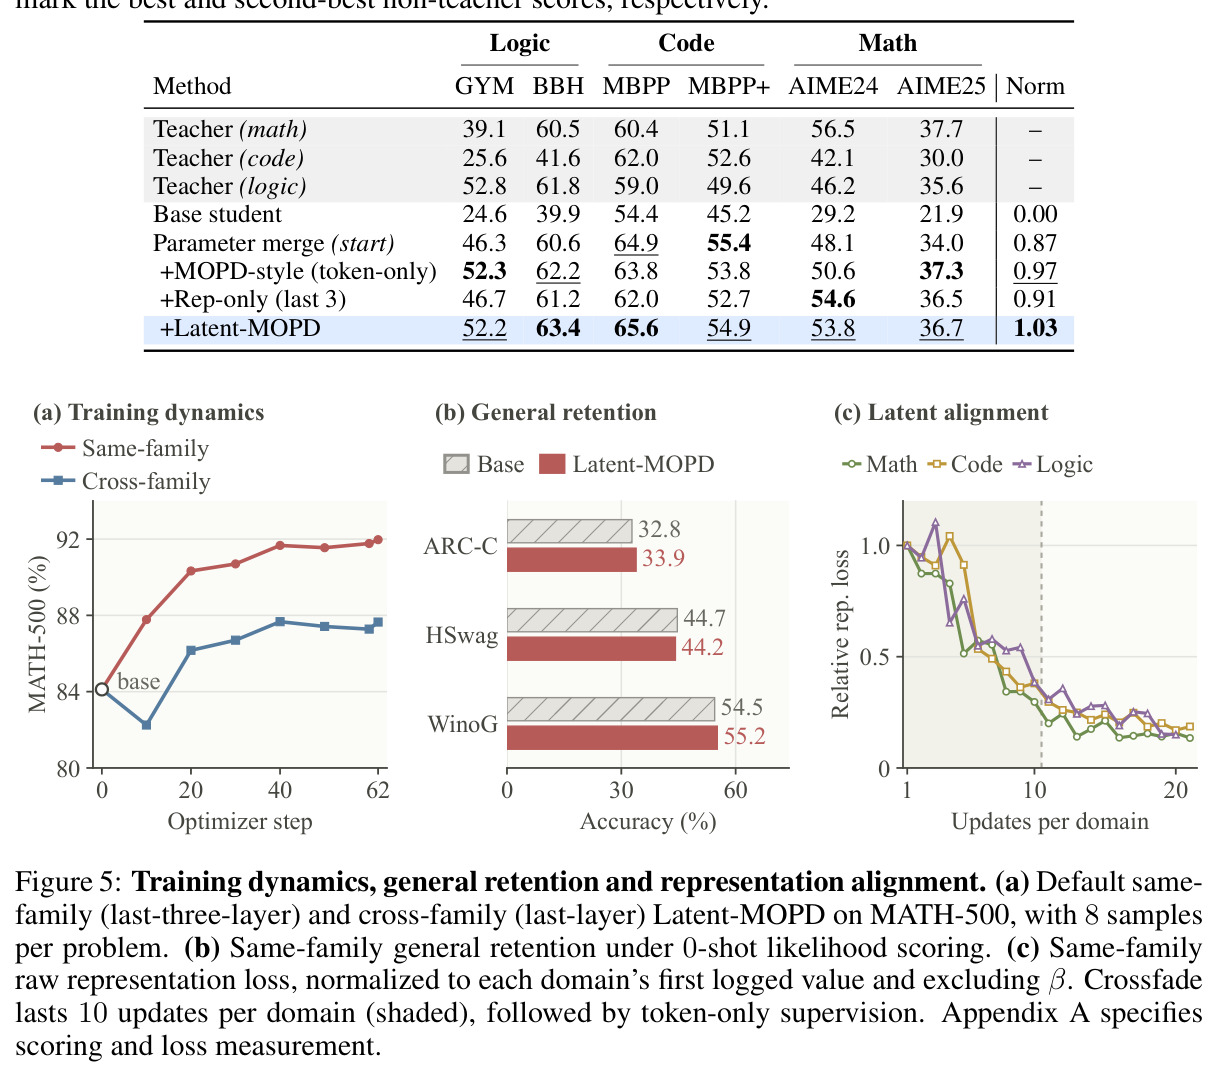
对同一预训练起点微调出的多个模型逐参数取算术平均,得到一个零训练成本的合并模型,同源微调模型的权重平均后通常能保留大部分能力。本文把三个同族 1.5B 教师均匀平均作为学生初始化,再做 62 步蒸馏,检验「合并后再对齐」是否能继续提升。
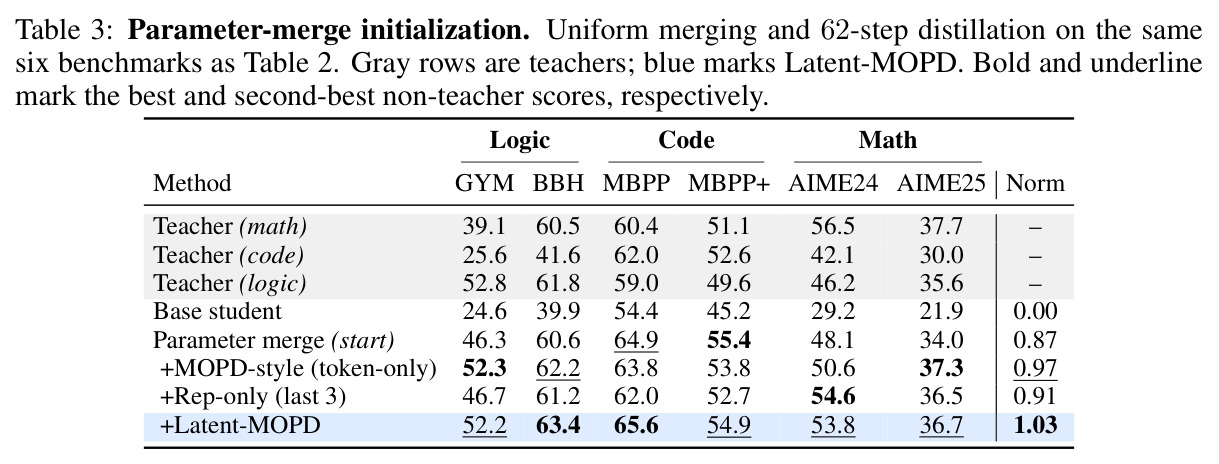
第 4.4 节的第三大实验设置以此为基础:合并起点 Norm 0.87,62 步 Latent-MOPD 蒸馏后升至 1.03,是论文实用性的重要证据。
研究动机
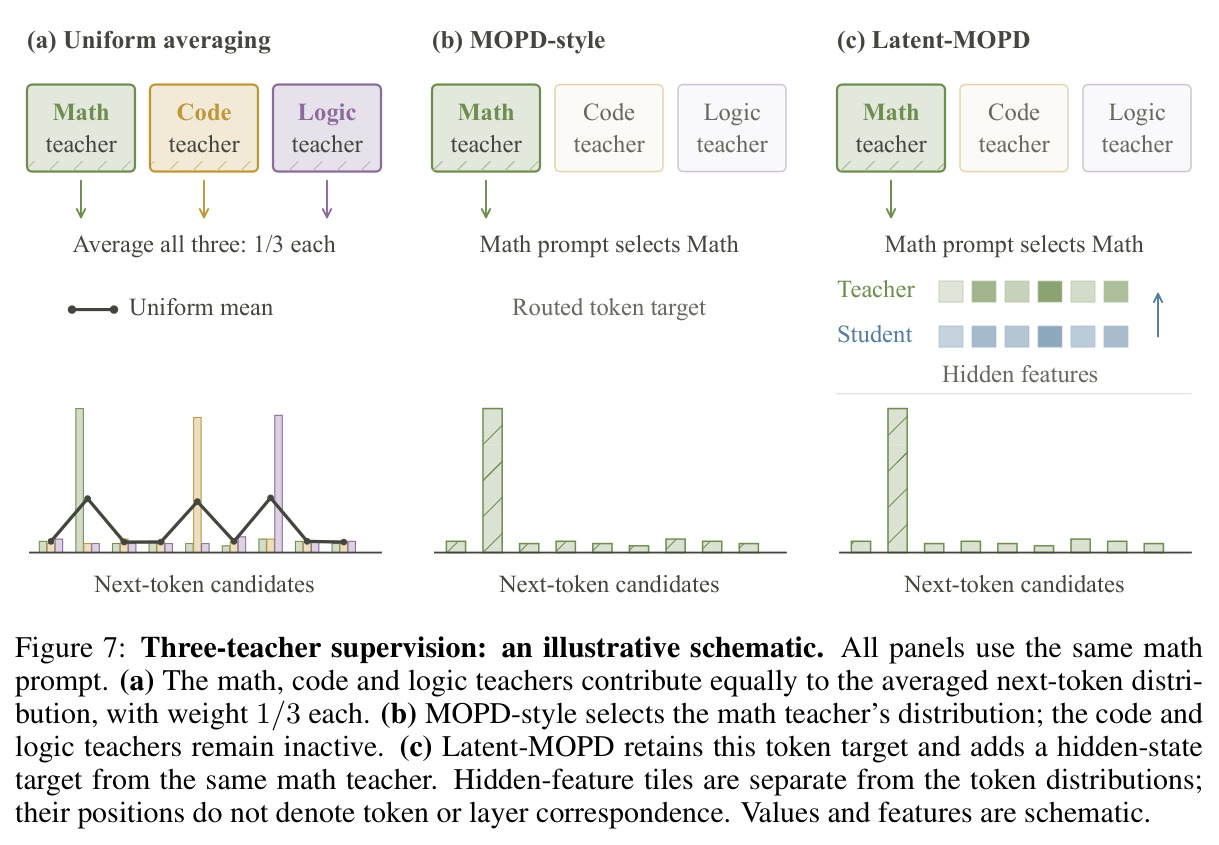
强化学习流水线已经能训练出各有所长的专家模型:数学推理、代码生成、逻辑推理各自都有强 checkpoint,但同时部署多个专家成本高,理想目标是单个模型兼收并蓄。现有多教师在线蒸馏 MOPD(Ma et al., 2026)通过领域路由把学生回答交给对应专家逐 token 打分,但监督完全停留在输出分布层面,只传递专家「预测什么」。可解释性研究(Anthropic 的归因图、Gurnee 等的全局工作区分析)表明,隐藏表示携带未被语言化的中间推理步骤并对后续计算有因果影响,输出预测只是内部计算的最终结果——仅对齐输出就丢失了专家「如何计算」的信息。已有的表示级 OPD 方法 OPRD 和 LastOPD 只研究单教师;一旦扩展到多教师,不同专家的表示目标要共同训练同一个骨干,路由只决定每条 prompt 由谁监督,却没有回答该选哪些层的表示、又该如何在训练中组织这些监督。论文还观察到:若把不同域的样本混入同一优化步做全层表示监督,训练会在 20 步内彻底崩溃(MATH-500 从 84.1 跌到 22.8),而域纯批次保持稳定。
本文的目标是本文要构建首个表示级多教师在线蒸馏方法:在不做任何额外教师训练的前提下,直接复用现成的冻结专家 checkpoint,让单个学生同时从多个专家的 token 预测和隐藏状态中学习。具体回答三个问题:其一,面对不同的教师-学生关系(同族同规模 vs 跨族跨规模),应选择哪些层的隐藏状态作为对齐目标;其二,多个专家的表示监督如何组织进同一个学生的优化过程(批次的域组织、通道权重的调度),避免训练崩溃或收益流失;其三,融合后的学生能否在数学、代码、逻辑三域的全部基准上超过 token-only、表示-only 和均匀平均三类基线,乃至超过每个单独的专家教师,实现「1+1+1>3」的能力整合。
与已有工作不同的是,独特切入角度有三层。第一,监督视角的转变:把多教师 OPD 的监督从 what(输出分布)扩展到 what+how(分布+产生分布的隐藏状态),且两个通道来自同一位被路由的专家,保证信号一致性。第二,诊断驱动的设计:训练前先用 CKA 测教师与基础学生逐层的表示相似性,发现同族模型前 25 层 CKA 达 0.987-0.992、差异集中在末端(末块降至 0.886-0.930),而跨族模型在第 13 层出现 0.116-0.124 的中层低谷——据此同族选最后三层(共享谱系提供了学习末端差异的基础)、跨族只选最后一层(末态直接馈入预测头,具有共同功能角色),层选择由模型关系与状态功能角色共同决定而非固定索引匹配。第三,组织问题的发现与解决:提出域纯批次(每个优化步只含一个域)稳定多教师表示监督,并把 LastOPD 的单教师 crossfade 改造成每位教师独立时钟的调度,让瞬态潜在信号适配域路由的多教师训练。
核心方法
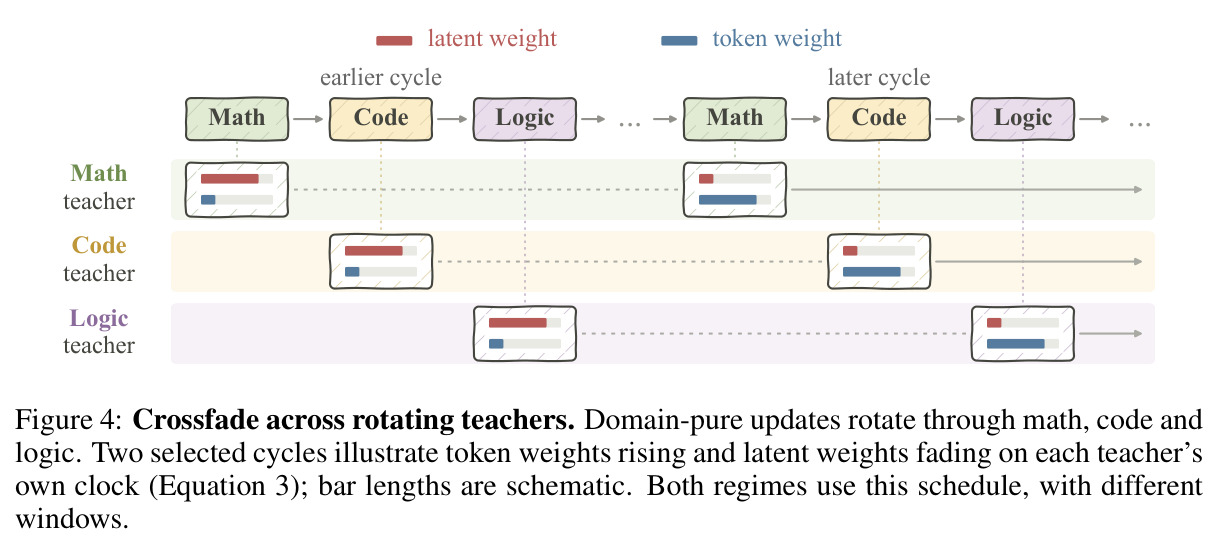
直觉上,Latent-MOPD 让每个领域专家既告诉学生「该预测什么」(token 分布),又示范「内部状态长什么样」(隐藏状态),且前者逐渐接管训练、后者只是初期的脚手架。技术路线上:每条 prompt 带域标签 $d\in\{\text{math},\text{code},\text{logic}\}$,学生以温度 1.0 为 32 条同域 prompt 各采样 4 条回答;路由到的冻结教师在这些回答的所有前缀上计算下一 token 分布(token 通道),并导出选定层的隐藏状态(表示通道)。token 通道用学生 top-16 候选上的师生对数比奖励、域内标准差归一化的固定优势做策略梯度更新;表示通道最小化归一化惩罚 $\frac{\lambda}{d_T}\|\nu(g_\psi(z_S))-\mathrm{sg}[\nu(z_T)]\|^2$,同族用恒等映射对齐最后三层,跨族用 ridge 初始化的共享线性映射 $g_\psi:\mathbb{R}^{1536}\to\mathbb{R}^{3584}$ 对齐最后一层。两通道按 $\mathcal{L}(s)=\alpha(u)\mathcal{L}^{OPD}_{route}+\beta(u)\mathcal{L}^{rep}_{route}$ 交叉淡出,$u$ 是活跃教师自己的更新计数。域纯批次按 math-code-logic 轮换共 62 步,教师全程冻结,推理只用学生、丢弃投影映射。
核心创新是「同一路由专家的双重监督 + 按教师关系选层 + 按域组织更新」的组合。与 MOPD 的本质区别:MOPD 只路由 token 分布,Latent-MOPD 让同一专家额外提供隐藏状态目标,直接监督教师的计算过程;与 OPRD/LastOPD 的本质区别:它们是单教师方法,Latent-MOPD 要解决多个专家的表示目标共同训练一个骨干的问题——通过域纯批次保证一个优化步只服务一位教师(受控实验证明混域插批 20 步内崩溃、域纯批次 62 步稳定),通过每教师独立时钟的 crossfade(同族窗口 10 步、跨族 7 步,三域轮换下分别覆盖 30 和 21 个全局步)避免持续的异构表示约束拖累训练。层选择也不照搬单教师结论:CKA 诊断显示同族差异集中在输出附近,故对齐最后三层;跨族中层相似度崩塌,只有末层具有「直接馈入下一 token 预测头」的共同功能角色,故只对齐最后一层并用共享线性映射桥接 1536→3584 的宽度差。
方法步骤详情
完整流程五步。第一步,数据准备:池含 17,856 条 prompt(DAPO-Math-17k、OpenCodeReasoning、Reasoning Gym 各 5,952 条),每条带域标签,训练与评测无重叠题目。第二步,采样:每个优化步取同一域的 32 条 prompt(不洗牌,math-code-logic 轮换),学生温度 1.0 各采样 4 条回答(上限 16,384 token),62 步共 1,984 次 prompt 呈现、7,936 条回答,无验证器奖励。第三步,token 通道:教师在每个前缀上给出分布,在学生 top-16 支持集内计算候选权重 $w_{t,v}$(支撑集内归一化)与奖励 $r_{t,v}=-w_{t,v}\log\bar{p}_t(v)-\log p_{T,t}(v)$(对数保留全词表归一化),按域池化得 $A_{t,v}=r_{t,v}/\max(\mathrm{std}(r),10^{-6})$,损失为 $-\frac{1}{|M|}\sum_{t\in M}\sum_{v\in V_{k,t}}\mathrm{sg}[A_{t,v}]\log p_{\theta,t}(v)$。第四步,表示通道:取最终归一化后、LM 头前的隐藏状态对,计算 $\ell^{rep}_t=\frac{\lambda}{d_T}\|\nu(g_\psi(z^S_t))-\mathrm{sg}[\nu(z^T_{d,t})]\|_2^2$,同族 $\lambda=1$、恒等映射、最后三层全部响应位置;跨族 $\lambda=2000$、ridge 初始化线性映射、最后一层的最后 2,000 个位置。第五步,调度与优化:$\alpha(u)=\min(1,u/T_w)$、$\beta(u)=\max(0,1-u/T_w)$,$T_w=10$(同族)或 7(跨族);AdamW 学习率 $10^{-5}$,betas (0.9,0.999)。跨族投影映射由 42 条 rollout 的 134,843 对状态以 $W=(S^\top S+\lambda_r I)^{-1}S^\top T$($\lambda_r=10^{-3}d_S$)初始化,训练后丢弃。
技术新颖性
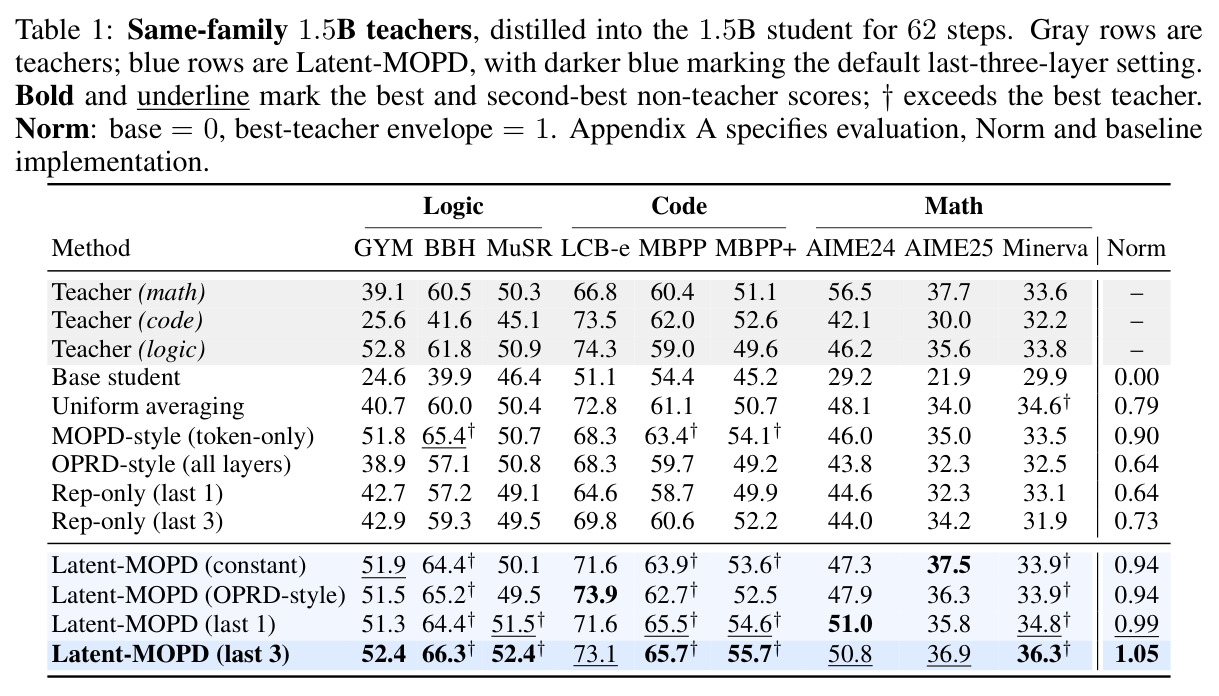
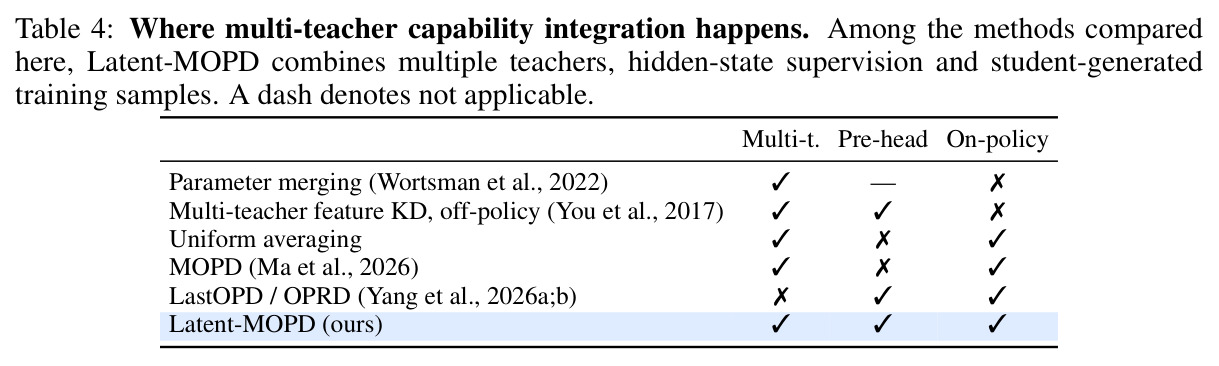
技术新颖性有四点。第一,首个表示级多教师 OPD:从 FitNets 以来的表示匹配、FuseLLM 的输出分布融合、OPRD/LastOPD 的单教师潜在 OPD,要么在固定数据上离线训练、要么只有单教师;论文 Table 4 显示同时具备多教师、头前隐藏态监督、on-policy 三要素的只有本文。第二,域纯批次作为稳定性条件:固定教师、损失、系数与预算,仅把 1:1:1 混域行改成域纯块,全层表示监督就从 20 步崩溃(MATH-500 由 84.1 跌至 22.8)变为 62 步稳定(91.7),且延长到 120 步混域仍追不上(84.50 vs 91.7),这是关于多教师训练组织方式的新实证发现。第三,CKA 驱动的面板特定层预算:同族三层在 9 个基准中的 8 个优于单层(Norm 1.05 vs 0.99),跨族单层即够(0.26 vs 0.25),且选 3/28 层比全层节省 89.3% 的选定状态存储(0.28 vs 2.63 GiB @16,384 位置 BF16)。第四,多教师时钟 crossfade:把 LastOPD 的单教师淡出改造成三教师轮换下各自的淡出窗口,比恒定联合权重提升 8/9 基准(Norm 1.05 vs 0.94)。此外用 Jacobian lens 读出深度诊断确认潜在对齐把 math 输出最大相似度从 code 教师转回 math 教师。
实验结果
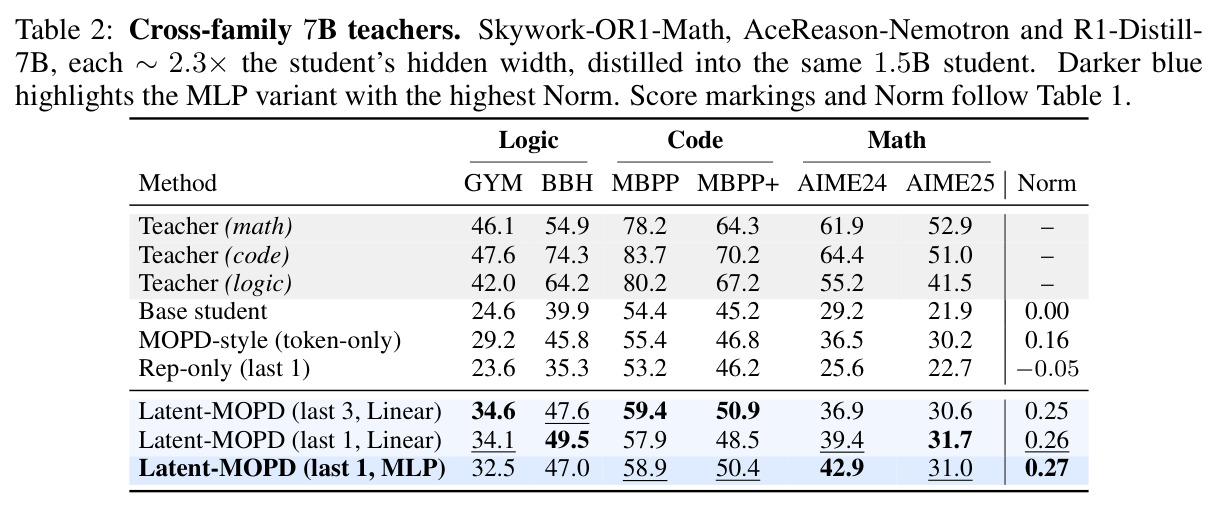
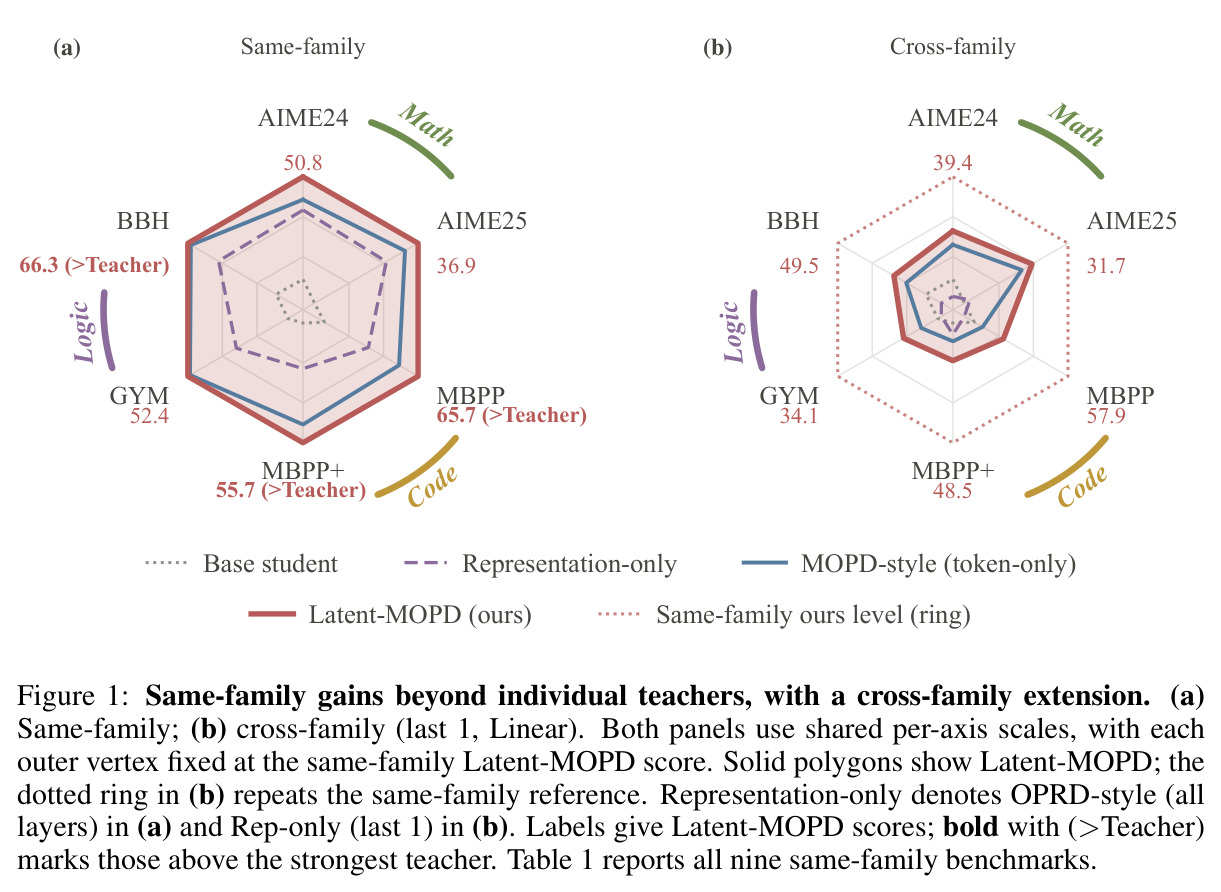
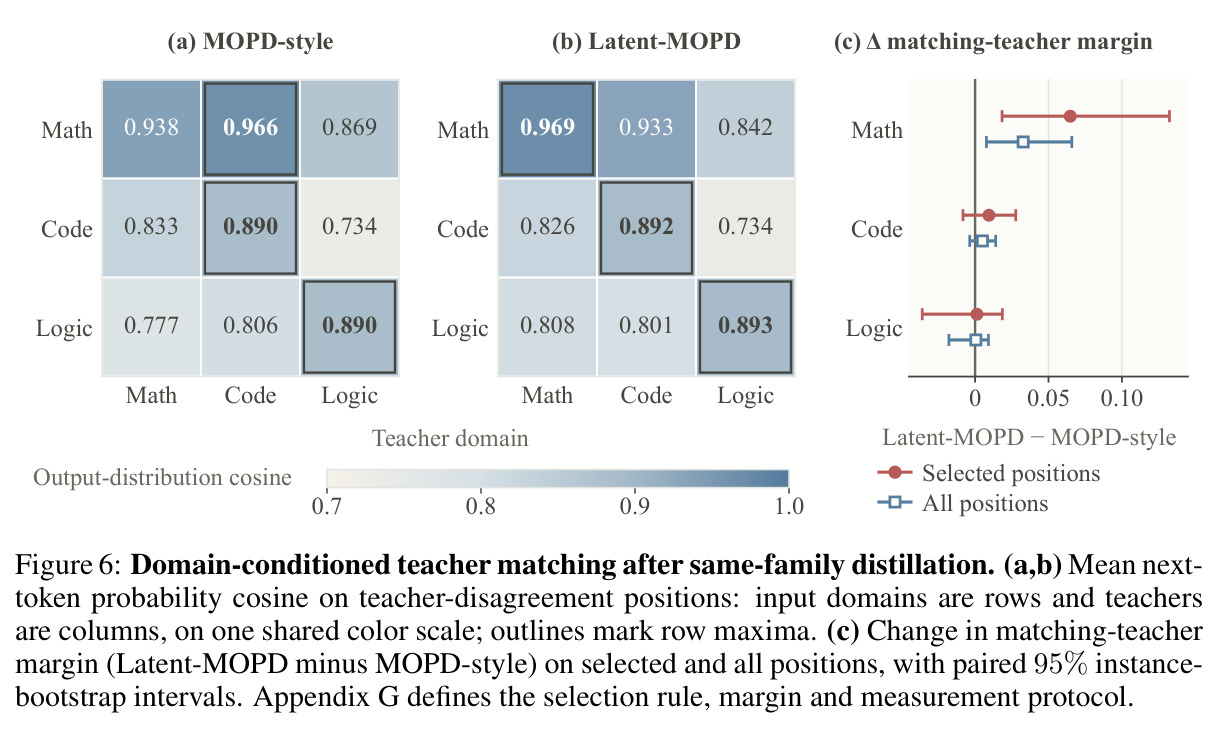
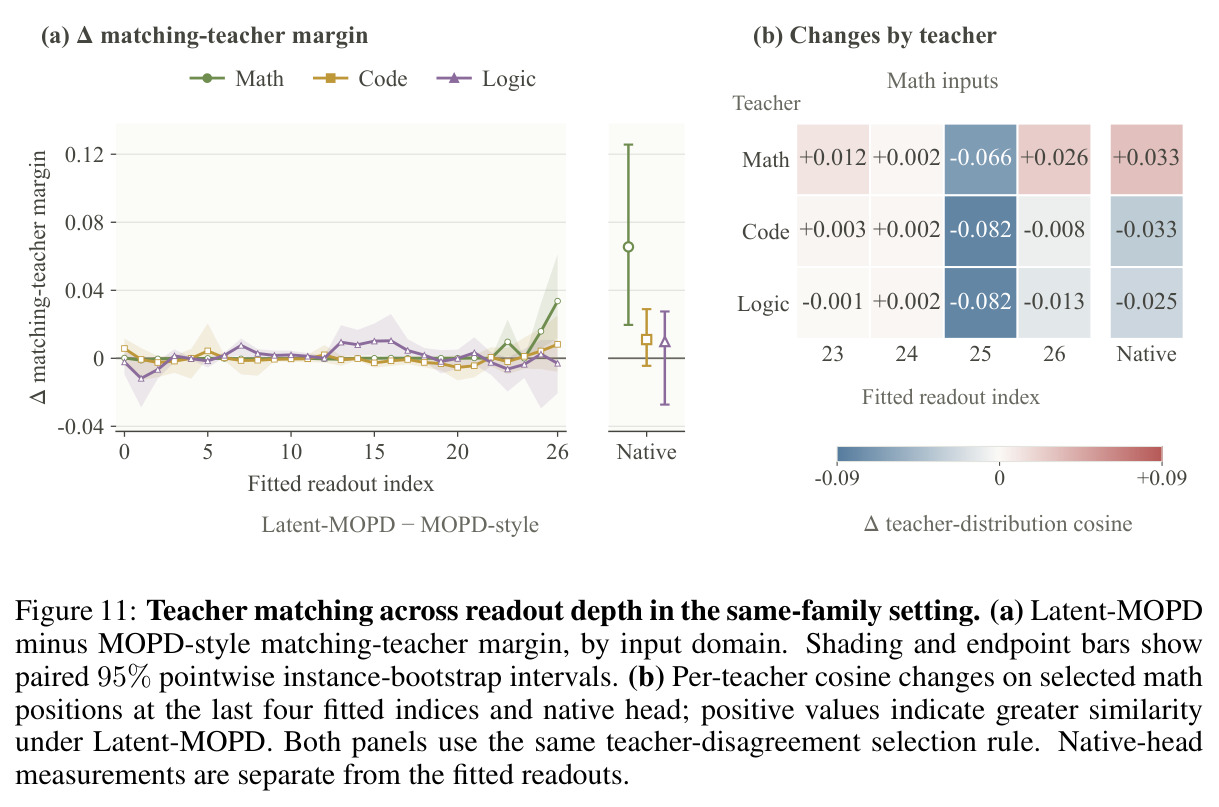
同族设置(三个 1.5B 教师→1.5B 学生,62 步):默认最后三层 Latent-MOPD 在全部 9 个基准上超过 token-only(Norm 0.90)、表示-only(0.64-0.73)与均匀平均(0.79),Norm 达 1.05,超过最佳教师包络线 1.0;并在 5 个基准上超过该基准最强教师:BBH 66.3(最强教师 61.8)、MuSR 52.4(50.9)、MBPP 65.7(62.0)、MBPP+ 55.7(52.6)、Minerva 36.3(33.8)。相对 MOPD-style,Minerva 33.5→36.3、LCB-e 68.3→73.1、MuSR 50.7→52.4;crossfade 比恒定权重在 8/9 基准更优(Norm 1.05 vs 0.94)。训练动态:MATH-500 从基座 84.1 升至第 20 步 90.3、第 62 步 92.0。跨族设置(三个 7B 教师→1.5B 学生):最后单层+线性映射在全部 6 个基准超过两个单通道基线,Norm 从 token-only 的 0.16 升至 0.26;AIME24 36.5→39.4、MBPP 55.4→57.9、GYM 29.2→34.1、BBH 45.8→49.5(对 Rep-only 领先 14.2 分);值得注意的是跨族 Rep-only 低于未训练学生(Norm -0.05),说明跨族潜在监督必须精心调度。参数合并初始化:62 步蒸馏把 Norm 从 0.87 推至 1.03,5/6 基准提升(GYM 46.3→52.2、BBH 60.6→63.4、AIME24 48.1→53.8),学生在 BBH/MBPP/MBPP+ 超过最佳教师。通用能力保留:ARC-C 32.8→33.9、HSwag 44.7→44.2、WinoG 54.5→55.2,变化在 1.1 分内。教师匹配诊断:math 域匹配边距在选定位置 +0.0648(95% CI [0.0184,0.1324])、全部位置 +0.0327([0.0077,0.0659])。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 同族九基准综合(逻辑/代码/数学) | Norm(headroom 加权归一化,基座=0、最佳教师包络=1) | 1.05(Latent-MOPD last-3) | MOPD-style token-only 0.90 | +0.15,且超过最佳教师包络 1.0 |
| BBH(同族 1.5B) | 准确率(27 任务 × 40 题) | 66.3 | 最强教师(logic)61.8 | +4.5,超过所有单个教师 |
| Minerva(同族 1.5B) | 准确率(4 样本均值) | 36.3 | MOPD-style 33.5 | +2.8,超过最强教师 33.8 |
| AIME24(跨族 7B 教师→1.5B 学生) | pass@1(16 样本均值) | 39.4(last-1 Linear) | MOPD-style 36.5 | +2.9 |
| GYM 逻辑(跨族) | 验证器准确率(925 题冻结集) | 34.1 | MOPD-style 29.2 | +4.9,跨族设置中最大增益 |
| 参数合并初始化六基准 | Norm | 1.03(合并 + Latent-MOPD) | 合并起点 0.87;合并 + token-only 0.97 | +0.16 / +0.06,5/6 基准提升 |
局限与改进
作者在附录 J 承认的局限:所有教师与学生共享 tokenizer 和 Qwen 骨干,跨 tokenizer 的潜在迁移未验证;域标签是给定的固定硬路由,未研究学习式路由;系数 $\lambda$ 需按设置分别设定(同族 1、跨族 2000,相差三个数量级)。我自己的观察:其一,跨族绝对增益有限,Norm 仅 0.25-0.27,学生离 7B 教师还很远(如 MBPP 上学生 57.9-59.4 vs AceReason 83.7),且表示-only 跨族甚至低于基座(Norm -0.05),说明跨族潜在监督对映射与调度设计高度敏感;其二,训练预算很小(62 步、7,936 条回答),主表只评最终 checkpoint、明确不选最优中间 checkpoint,对更长训练或更大学生的扩展性未验证;其三,「选 3 层省 89.3% 存储」是解析计算的特征存储而非实测 GPU 峰值显存,作者也声明了这一点;其四,MOPD-style 基线是作者自己的实现而非公开 MOPD 系统的复现(后者规模更大、用不同的 top-k 构造与逆 KL 估计器),与已发表数字不可直接比较;其五,域纯批次要求每个优化步只含一个域,在域边界模糊或需要混域数据的场景限制灵活性;其六,案例分析和教师匹配诊断只覆盖同族设置与小样本位置(math 选定位置仅 48-60 个)。
独立分析的弱点
独立分析四个弱点。第一,硬路由依赖准确的域标签,现实中很多任务横跨多域(例如需要写代码验证的数学题),错误路由会把 prompt 交给错误专家监督,输出分布和隐藏状态都会误导学生;改进方向:引入基于验证器或置信度的软路由(类似 MT-SDPO 的答案验证思想),或学习式门控按 prompt 特征选择教师。第二,域纯批次的稳定机理没有理论解释,论文只给出经验证据(附录 F 的三次复现 + 120 步扩展实验:表示损失从 $7.9\times10^{-5}$ 升到峰值 $2.8\times10^{-4}$、无 NaN),不明白为何混域会崩就难以判断该约束何时必要;改进方向:做梯度冲突分析(PCGrad 式的梯度正交投影诊断),或设计梯度手术允许混域共存。第三,同 tokenizer 要求把可用教师池限制在 Qwen 系,而 tokenization 对齐恰是多模型融合的现实瓶颈;改进方向:在潜在空间做跨 tokenizer 迁移(共享冻结嵌入空间或经文本重建对齐),或仅表示通道跨族。第四,crossfade 窗口 $T_w$ 与层数这两个关键超参靠网格枚举(同族三层好、跨族单层好),CKA 只能排除中层、不能预测最优层数与窗口;改进方向:训练中在线监测表示损失与下游指标的关系,自适应调整窗口和层选择。
未来方向
作者提出的方向:支持不同 tokenizer 的教师;学习式路由;在作为训练目标的状态(最终归一化后,与 CKA 读出位置不同)上测量学到的投影映射与更新方向,把表示几何与蒸馏收益连接起来;纳入更多样的教师面板。基于成果可延伸的:其一,把「一个优化步一个教师」的域纯批次发现推广到其他多教师后训练设定(如与 RL 奖励结合的 UI-MOPD 式框架、Open-MOPD 关心的能力失衡问题),检验其是否普遍必要;其二,跨族投影映射只试了线性和两层 MLP(参数 550 万 vs 3146 万,胜负 3:3),可尝试低秩、逐层映射或 OPRD-Bridge 式冻结对齐,并解释表示-only 跨族低于基座的机理;其三,学生 Norm 超 1(1.05)说明双通道产生了超越任一教师的组合效应,值得研究这种涌现来自表示通道的何种机制,例如用归因图分析潜在对齐改变了哪些内部回路;其四,扩大学生规模与训练步数验证 scaling 行为(当前仅 1.5B、62 步);其五,把 merge 初始化+短蒸馏发展成实用的「合并后再对齐」流水线,与 task arithmetic 组合用于模型产品化;其六,为跨族末层的「共同功能角色」建立理论刻画。
复现评估
复现条件很好。代码已开源(github.com/fangzy96/Latent-MOPD);六个教师全部是公开 HuggingFace checkpoint(JustRL-DeepSeek-1.5B、Archer2.0-Code-1.5B-Preview、Nemotron-Research-Reasoning-Qwen-1.5B、Skywork-OR1-Math-7B、AceReason-Nemotron-7B、DeepSeek-R1-Distill-Qwen-7B),学生 DeepSeek-R1-Distill-Qwen-1.5B 公开;训练 prompt 来自三个公开数据集。算力需求温和:仅 62 个优化步、8 worker(每 worker 局部 minibatch 16 条回答)、共生成 7,936 条回答,教师只做前向打分不训练;附录 A 给出全部超参(学习率 $10^{-5}$、AdamW betas 0.9/0.999、温度 1.0、top-16、$\lambda$、$T_w$、packing 预算、跨族映射的 ridge 初始化公式与 134,843 对样本来源)与环境 pin(torch 2.8.0、vllm 0.11.0、transformers 4.57.3)。评测协议详尽:GYM 冻结 925 题集(seed 4242 并把生成器冻结成文件以规避版本差异)、BBH 27 任务×40 题、AIME 16 样本、LCB 2024-08-01 后 67 题。难度评估:中等——主要成本在教师推理(跨族要跑三个 7B 教师打分)与多基准评测框架搭建,以及域纯轮换、每教师时钟等工程细节;但论文对每个细节均有精确描述,忠实复现可行。
论文图表
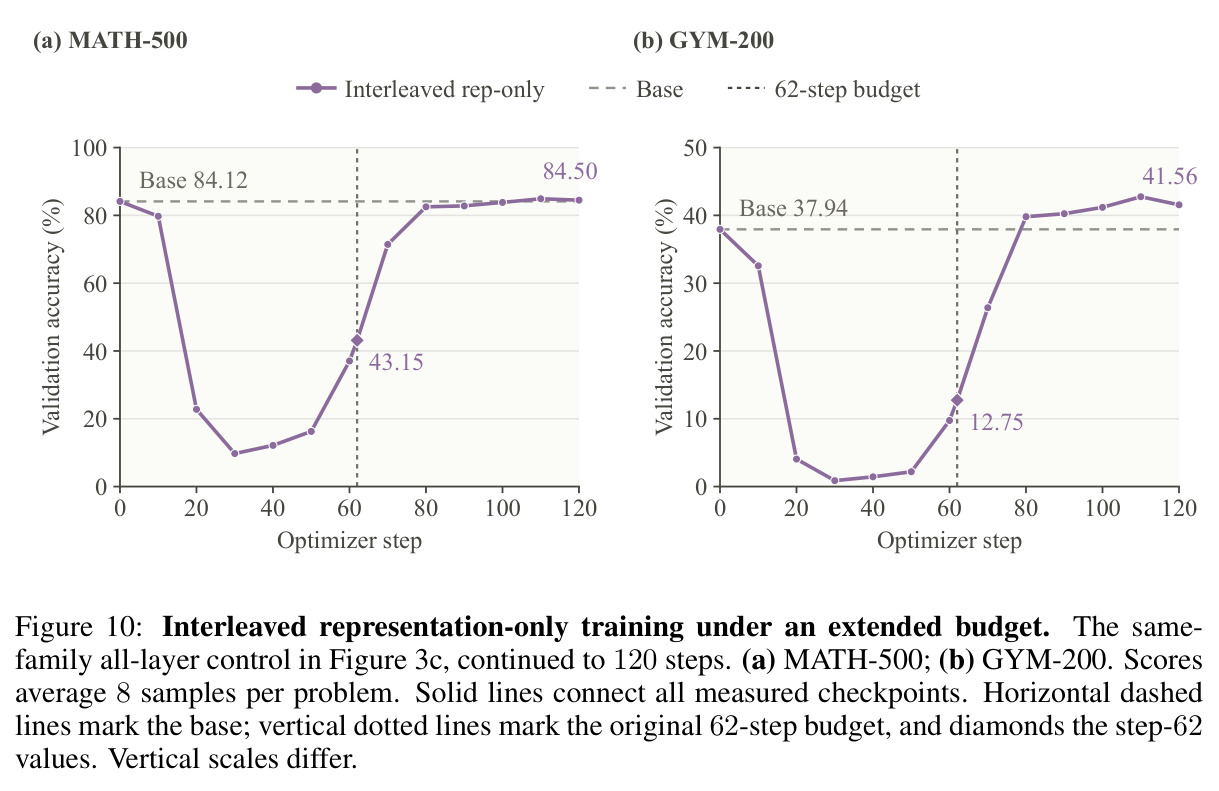
把混域崩溃实验延长到 120 步(1.94 倍预算):MATH-500 最终 84.50(峰值 84.90@110 步,基座 84.12)、GYM-200 最终 41.56(峰值 42.75,基座 37.94),仍远低于域纯 62 步就达到的 91.7/56.7;100→120 步的终点增益仅 0.67 和 0.37 个百分点,曲线已趋平。
排除「混域只是收敛慢」的解释:接近两倍预算也无法追平域纯批次,凸显该发现的强度。