组合每位教师所学:基于教师相对偏移的多教师在线策略蒸馏 Composing What Each Teacher Learned: Multi-Teacher On-Policy Distillation through Teacher-Relative Shifts
用教师减基座的偏移替代端点目标做MOPD,目标更近更均衡,省35%算力
前置知识
在线策略蒸馏(OPD)
让学生模型自己生成 rollout,再用冻结的教师模型在这些学生实际访问的状态(前缀)上对每个采样 token 打分,构造 $\log \pi_T - \log \pi_\theta$ 形式的奖励做策略梯度。与离线蒸馏(模仿教师生成的文本)不同,监督恰好落在学生自己会到达的状态分布上,消除了训练-推理分布错位。
本文全部实验都建立在 OPD 框架上,∆-MOPD 只是替换 OPD 中的目标分布 $q_t$,理解 OPD 的奖励构造才能看懂目标构造这条设计轴。
多教师在线策略蒸馏(MOPD)
把多个专家教师合并进一个学生的 OPD。两种设定:同域组合(composition)让所有教师给同一 rollout 打分、信号合并为单一目标分布;路由域蒸馏(routing)按提示所属域把状态分配给对应专家。前作(Ma et al. 2026)要求所有教师与学生共享初始 checkpoint。
本文研究的就是 MOPD 中'目标构造'这一维度,两种设定(组合/路由)是全部实验的组织框架。
端点(endpoint)与教师-基座偏移(shift)
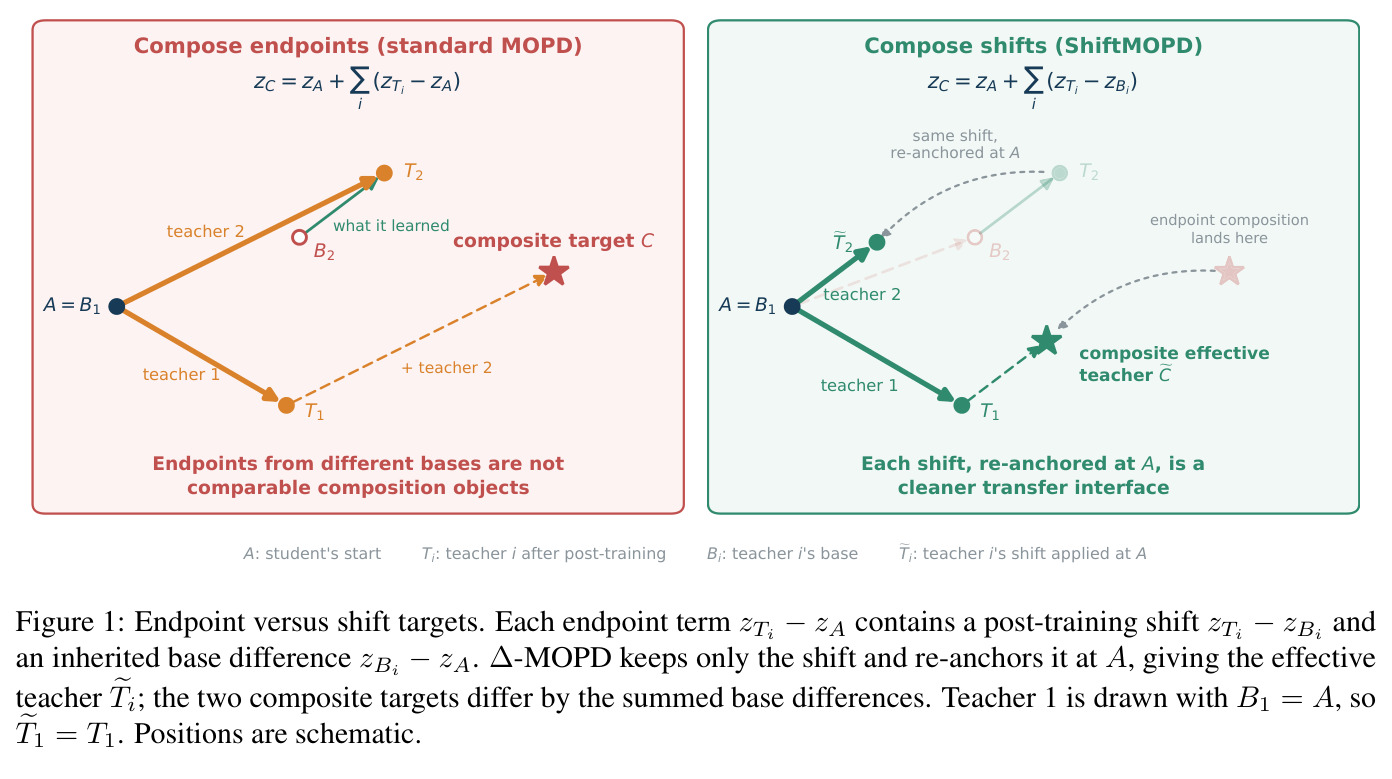
端点指教师后训练完成后的最终策略分布;偏移指 $\delta_i = z_{T_i} - z_{B_i}$,即教师 logits 减去其后训练前驱(基座)的 logits,代表后训练注入的净变化。端点可分解为偏移加继承基座差异 $z_{B_i} - z_A$。当教师基座与学生初始化不同(cross-origin)时,端点监督会把继承差异一并传给学生。
端点与偏移的对立是全文的核心对照:论文主张偏移才是更干净的迁移对象,所有实验都在验证这一点。
反向 KL 散度与采样 token 奖励
OPD 最小化 token 级反向 KL $D_{KL}(p_t \| q_t)$,其中 $p_t$ 是学生分布、$q_t$ 是目标分布。对采样出的 token $y_t$,$\log p_t(y_t) - \log q_t(y_t)$ 是逐状态反向 KL 的单样本估计;训练时最大化 $\log q_t(y_t) - \log p_t(y_t)$ 并做批内均值中心化,构成 REINFORCE 式策略梯度。
理解奖励如何从目标分布导出,才能明白为什么目标离学生越近、教师项越均衡,学习信号就越干净。
同源(same-origin)与异源(cross-origin)教师
若教师 $i$ 的基座恰好等于学生初始化($B_i = A$)则称同源,此时 $z_A + \delta_i = z_{T_i}$,偏移目标严格退化为端点,两种构造完全一致;否则为异源,两种目标恰好相差继承基座差异。例如 Nemotron 与 JustRL 同源,Polaris-7B(基座为 DS-R1-Distill-Qwen-7B)异源。
同源退化性质让论文能做干净的配对实验:组合中 Nemotron 项在两臂完全相同,性能差异只能归因于 Polaris 的表示方式。
研究动机
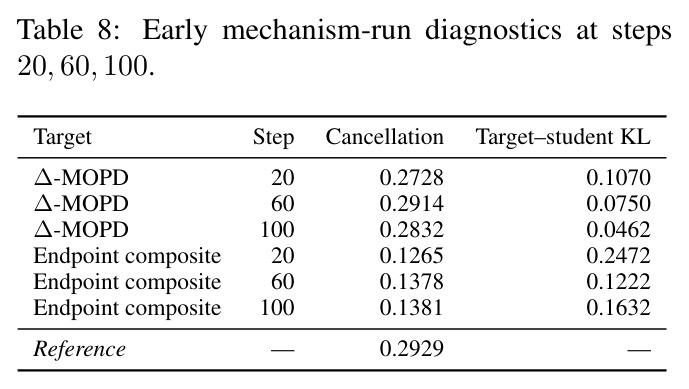
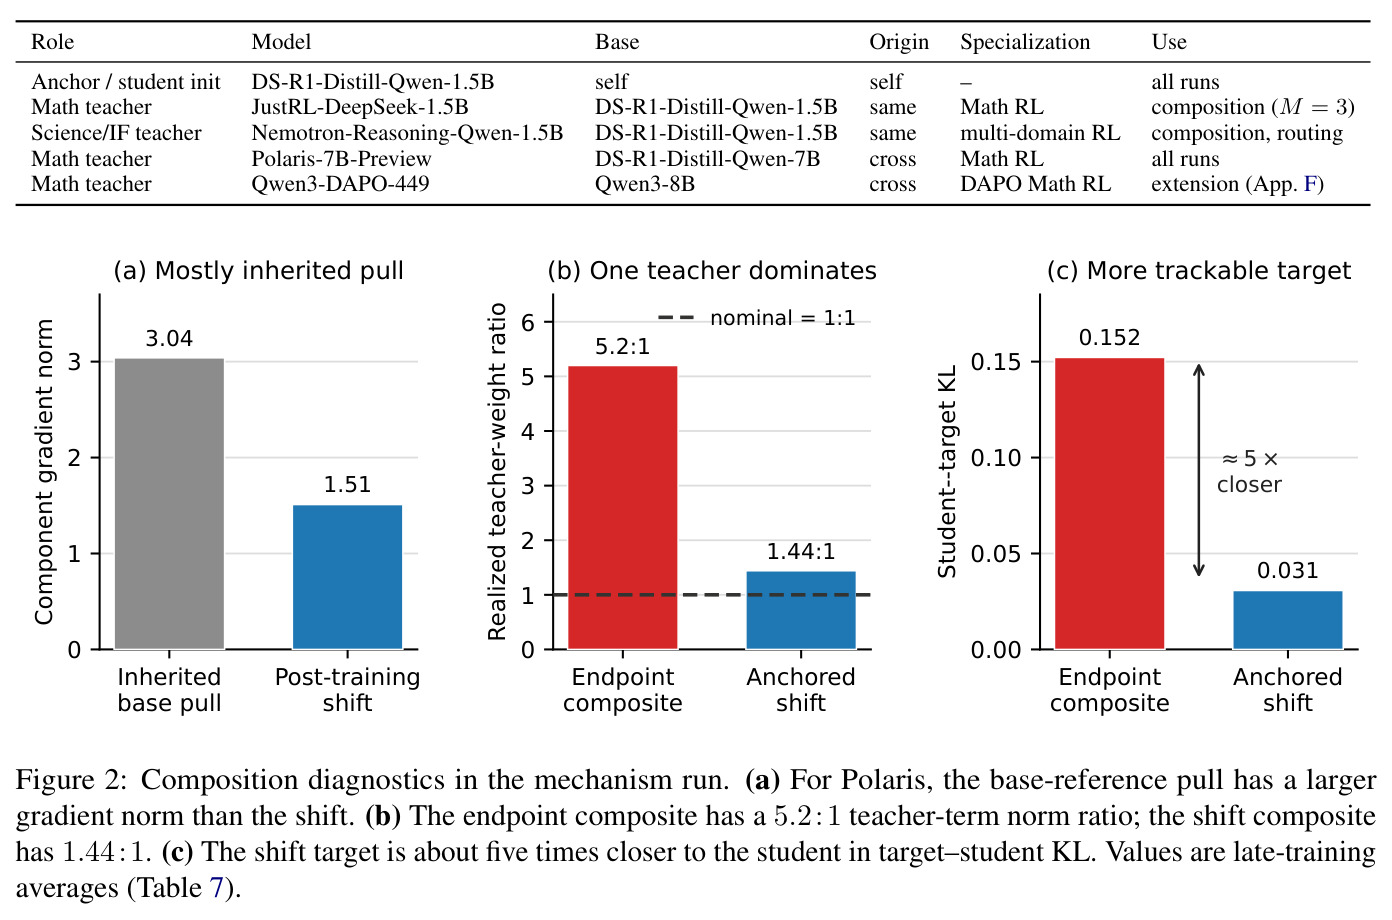
多教师在线策略蒸馏(MOPD)有两个常用设定:同域组合让多个教师给同一批学生 rollout 打分并合并为单一目标;路由域蒸馏把不同域的提示分配给对应专家。两类已有方法(如 Ma et al. 2026 的 MOPD、Chen et al. 2026 的反制感知组合)默认迁移的都是每个教师的端点策略,即后训练完成后的最终分布。问题在于端点是‘后训练带来的变化’与‘从基座继承的偏好’的混合物。论文的关键场景是:学生初始化为 DeepSeek-R1-Distill-Qwen-1.5B,而 Math 专家 Polaris-7B-Preview 是从 DS-R1-Distill-Qwen-7B 这一更大、不同的基座后训练而来,端点监督会把 7B 基座与 1.5B 学生之间的差异一并迁移。诊断实验证实危害:Polaris 的基座拉力梯度范数约为其后训练偏移的 2 倍($\Gamma_{\text{base}} \approx 2$);两教师组合时教师项范数比高达 5.2:1,一个教师主导整个信号;目标与学生的前向 KL 达 0.152。而继承成分恰恰在学习早期、专门化能力尚未习得时相对影响最大。
本文的目标是本文要在固定教师选择的前提下,把'目标构造'确立为 MOPD 中独立于教师选择的设计轴,并系统验证用教师相对偏移替代端点能否同时改善多个指标。具体目标有三:其一,证明继承基座差异确实扭曲学习信号,度量手段是教师项范数比(端点组合 5.2:1 对偏移组合 1.44:1)和目标-学生 KL(0.152 对 0.031);其二,检验更近的目标是否加速单教师能力习得并降低算力,预期是在更少分配 H100 小时内达到端点臂的最佳英文 Math 分数;其三,检验更均衡的教师项是否让第三个同源教师的加入产生实质收益,并把结论推广到分阶段路由、交错路由,以及经词表投影加入第四个跨 tokenizer 异源教师的扩展设定。
与已有工作不同的是,既有工作没有覆盖这一空白:MOPD 原始管线要求所有教师与学生共享初始 checkpoint,从而绕开异源问题,但公开发布的专家模型很少满足该条件;单教师 delta 蒸馏(Heo et al. 2026 的 on-policy delta distillation、Feng et al. 2026 的 weak-to-strong 直接 OPD、Yang et al. 2026 的 reward extrapolation)虽已使用教师-基座差异,却没有回答'这种差异在多教师两种设定下是否是更好的迁移对象';任务算术与 proxy tuning 则在离线参数或 logit 空间组合差异,不在学生访问的状态上。本文的独特切入是:在学生自己生成的前缀上、在同一个 softmax 下组合或路由多个偏移,并用配对对照(两臂中 Nemotron 同源项严格不变,只替换 Polaris 的表示)把性能差异干净地归因于目标构造本身。
核心方法
直觉上,专家教师的端点分布混着两样东西:后训练真正学到的能力,以及基座本来就有的偏好;用端点做监督等于把后者也塞给学生。除法是关键类比:把专家分布除以其基座分布,就'约掉'了基座已有的倾向,剩下的商正是后训练注入的净变化。形式化后即教师-基座 logit 偏移 $\delta_i = z_{T_i} - z_{B_i}$;再把这个偏移重新锚定在学生冻结的初始化 $A$ 上。组合目标为 $z_C = z_A + \sum_{i \in S(h_t)} \delta_i$,经一次 softmax 归一化得到 $\pi_C$,作为 OPD 的目标分布 $q_t$;同域组合对所有被选教师求和,路由蒸馏只加被路由教师的偏移。整个流程保持教师选择、提示、优化器、更新预算不变,只替换目标的表示方式。当教师与锚点同源($B_i = A$)时 $z_A + \delta_i = z_{T_i}$,目标严格退化为端点 OPD,因此该方法只作用于继承的基座差异,对同源教师信号零损伤。
核心创新是一个受控替换:把端点项 $z_{T_i} - z_A$ 换成偏移项 $z_{T_i} - z_{B_i}$,两者之差恰好是 $\sum_{i \in S}(z_{B_i} - z_A)$,即继承基座差异之和(Figure 1 的示意图)。这带来三个本质区别。第一,迁移对象从'教师最终是谁'变成'教师后训练改变了什么'——偏移携带能力、风格、校准的完整后训练效应,但不再假设纯化能力。第二,参考点统一为学生自己的初始策略:端点监督把每个教师拉向各自异质的基座,∆-MOPD 把所有拉力换成对同一个锚点的拉力,而该锚点在训练起点处为零,因此目标天然更近——初始化时端点目标在 16,384 个共享前缀状态上的目标-学生 KL 是偏移目标的 4.94 倍。第三,异源教师的继承差异不再决定其项在组合中的相对尺度。与要求全体教师同源的 MOPD 前作不同,本方法显式建模异源;与单教师 delta 方法不同,这里的偏移在同一 softmax 下被组合成单一目标分布。
方法步骤详情
第一步,checkpoint 配对:为每个教师锁定精确前驱(Table 1)——Nemotron 与 JustRL 的基座即锚点(同源),Polaris-7B 的前驱是 DS-R1-Distill-Qwen-7B(异源),Qwen3-DAPO-449 的前驱是 Qwen3-8B(异源且跨 tokenizer)。第二步,前向打分:学生按温度 1.0 采样 rollout,所有冻结模型在同一批前缀上输出 151,665 有效词表的 logits。第三步,目标构造:组合设定计算 $z_C = z_A + \sum_i \delta_i$,路由设定只加 $\delta_{\rho(h)}$,softmax 一次归一化。第四步,训练更新:采样 token 奖励 $R_C = \log \pi_C(y_t|h_t) - \log \pi_\theta(y_t|h_t)$ 减批内均值后乘学生 log 概率做策略梯度,学习率 $10^{-6}$。第五步,诊断:每 20 步记录 $\Gamma_{\text{base}}$、教师项范数比、cancellation、top-16 符号冲突、目标-学生/锚点 KL。第六步,跨 tokenizer 扩展:在 Qwen3 词表内算 DAPO 偏移,按 token 字符串重叠(151,660 个重叠、151,658 个同 id 共享 token)投影到锚点词表,非重叠坐标置零。
技术新颖性
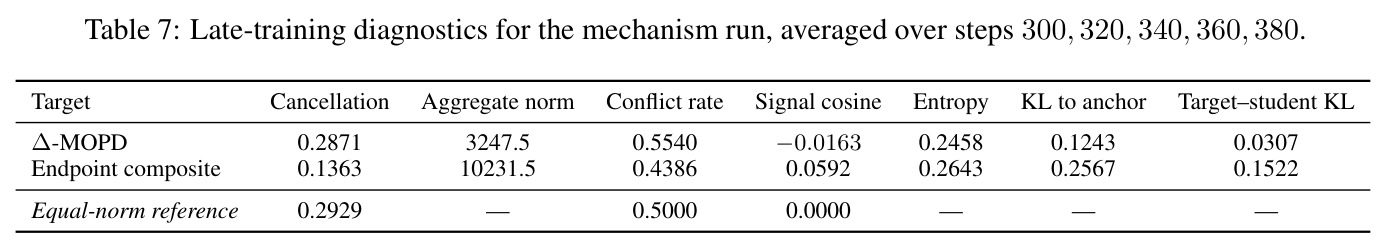
新颖性体现在四个层面。概念上,首次把'迁移什么'(目标构造)与'谁来教'(教师选择)拆成两个正交设计轴,并证明前者独立有效,这是对只动路由、调度、重演机制的 MOPD 文献的直接补充。机制上,给出可测量的解释链条:继承基座差异放大目标并在早期主导梯度($\Gamma_{\text{base}} \approx 2$),造成 5.2:1 的教师项失衡;基座相减后范数比降到 1.44:1,目标-学生 KL 从 0.152 降到 0.031(约 5 倍更近),cancellation 从 0.136 升到 0.287,接近等范独立向量的理论参考 0.2929。工程上,same-origin 退化保证使方法无需改动即可兼容同源教师,收益只来自异源项;配对对照设计(Nemotron 项在两臂中逐位相同)排除了教师选择与调度的混杂。扩展上,overlap 投影首次把偏移组合推广到词表不兼容的第四教师(Qwen3-DAPO-449),且以公式(16)明确投影规则并验证词表重叠一致性,使 MOPD 摆脱'全体同源'的强假设。
实验结果
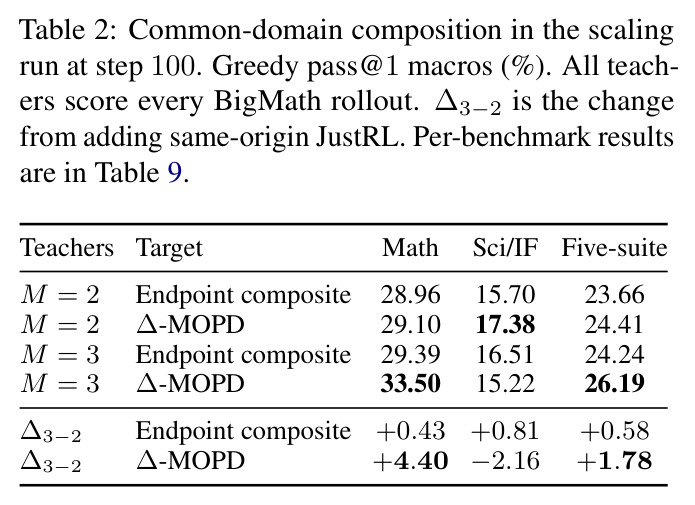
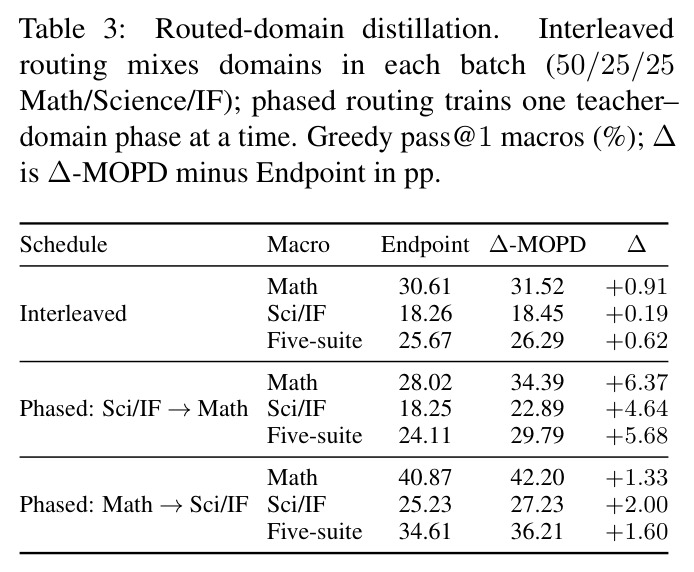
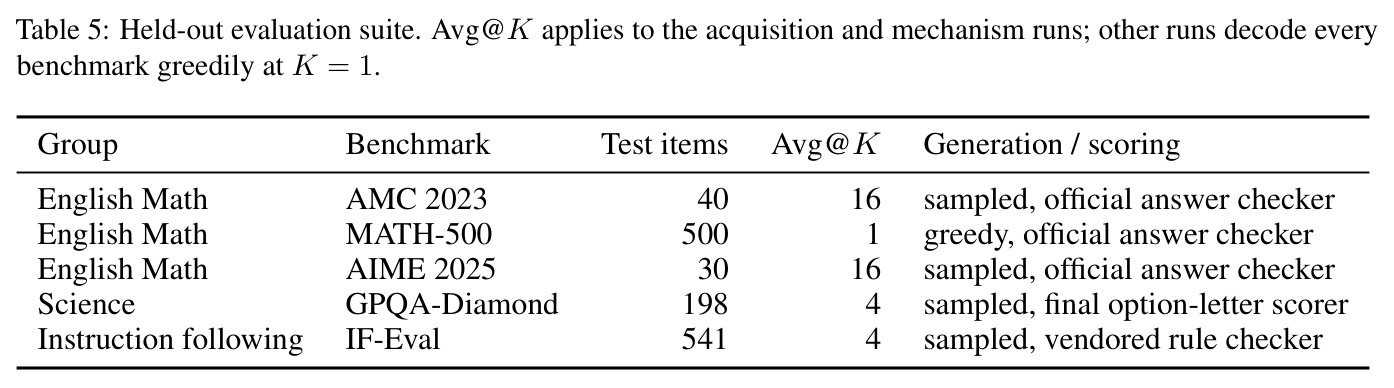
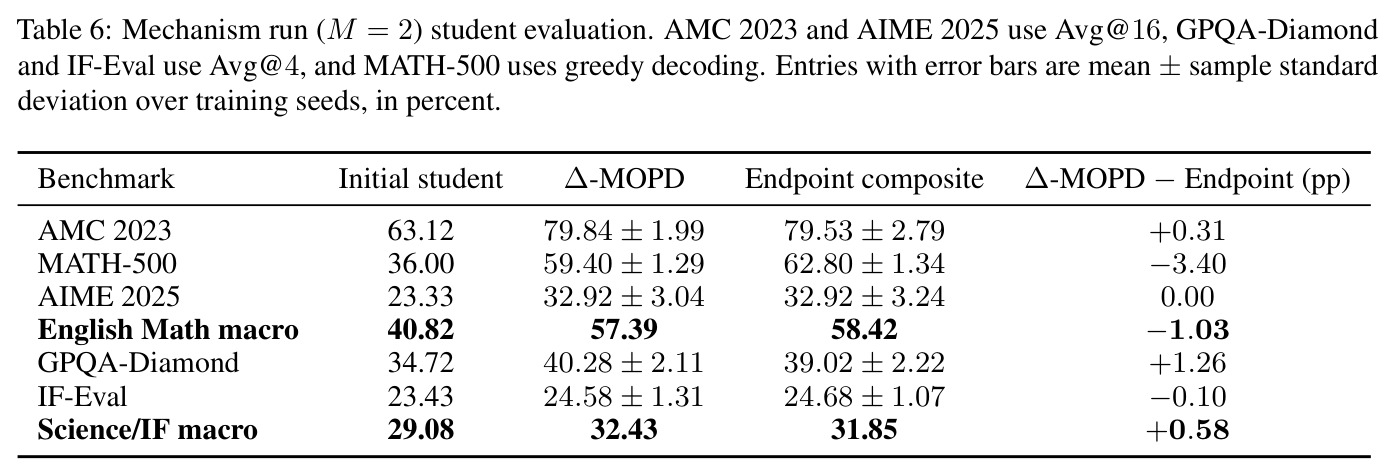
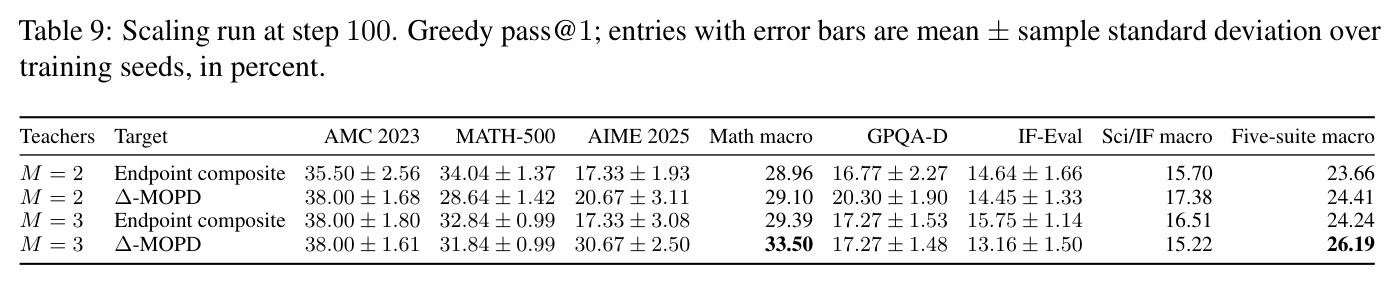
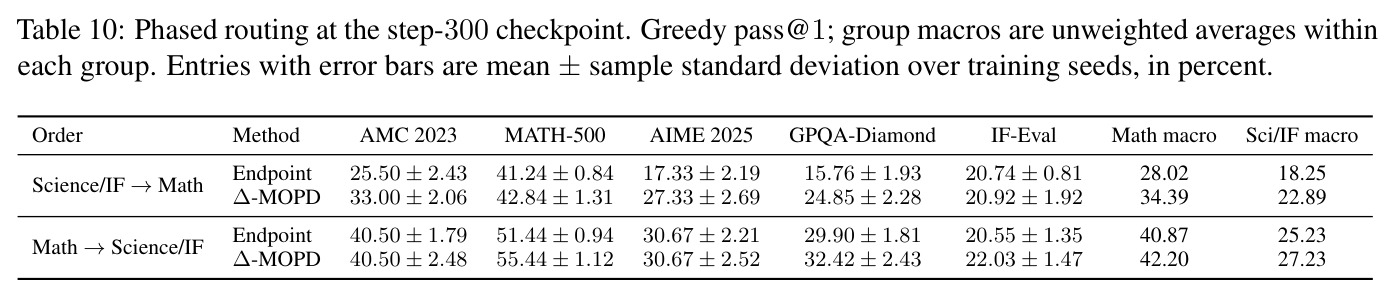
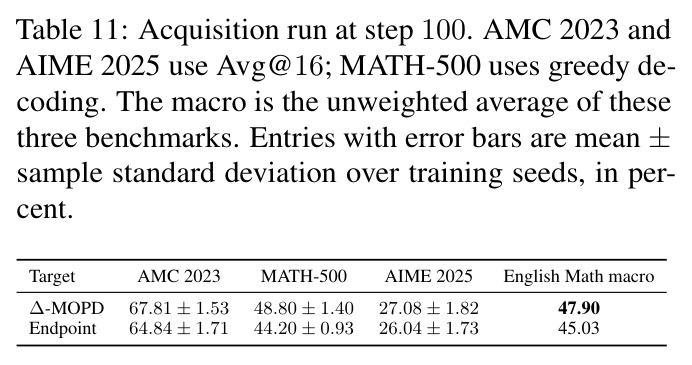
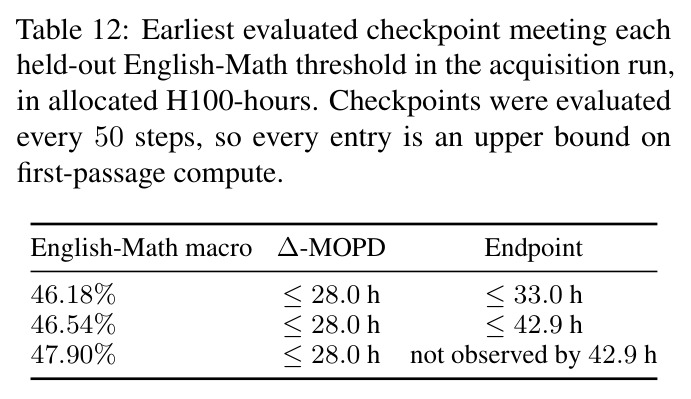
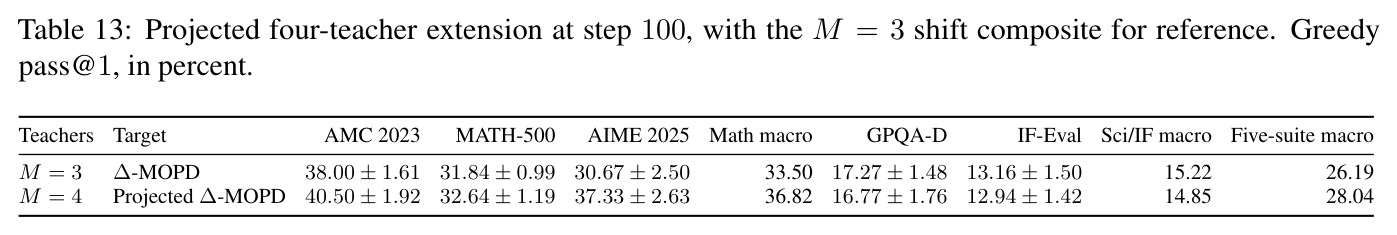
机制验证(§5.1):Polaris 基座拉力梯度范数约为偏移的 2 倍($\Gamma_{\text{base}} \approx 2$);换用偏移目标后教师项范数比从 5.2:1 降到 1.44:1,目标-学生 KL 从 0.152 降到 0.031(约 5 倍更近),cancellation 从 0.136 升至 0.287(等范参考 0.2929)。单教师习得(§5.2):$\Delta$-MOPD 第 100 步英文 Math 宏 47.90%,超过端点臂 195 步最佳 46.54%,分配算力 28.0 对 42.9 H100 小时(省 35%)。同域组合(§5.3):两教师时相当(Avg@K 44.91% 对 45.14%);三教师时领先 4.11pp Math 宏、1.95pp 五项宏(33.50/26.19 对 29.39/24.24),加入同源 JustRL 给偏移臂 +4.40 Math、给端点臂仅 +0.43,增益集中在 AIME 2025(30.67% 对 17.33%)。路由(§5.4):分阶段两顺序均领先(+5.68 与 +1.60pp),顺序差距从 10.50 缩到 6.42pp;交错路由相当。跨 tokenizer 扩展:投影第四偏移使 Math 宏再升 3.32pp 至 36.82%、五项宏升 1.85pp 至 28.04%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 三教师同域组合·英文 Math 宏(AMC 2023 + MATH-500 + AIME 2025) | greedy pass@1(%) | ∆-MOPD 33.50 | 端点组合 29.39 | +4.11pp |
| 三教师同域组合·五项宏(含 GPQA-Diamond、IF-Eval) | greedy pass@1(%) | ∆-MOPD 26.19 | 端点组合 24.24 | +1.95pp |
| 三教师组合·AIME 2025 | greedy pass@1(%) | 30.67 | 17.33(端点组合) | +13.34pp |
| 单教师习得·英文 Math 宏(Polaris) | Avg@K(%)@ step 100 | ∆-MOPD 47.90(step 100) | 端点最佳 46.54(step 195) | 更快达标;分配算力 28.0 对 42.9 H100 小时(省 35%) |
| 分阶段路由(Sci/IF → Math 顺序) | 五项宏 greedy pass@1(%) | ∆-MOPD 29.79 | 端点 24.11 | +5.68pp |
| 四教师投影扩展(M=4,跨 tokenizer)·AIME 2025 | greedy pass@1(%) | 37.33 | M=3 ∆-MOPD 30.67 | +6.66pp(Math 宏 +3.32,五项宏 +1.85) |
| 组合几何·教师项范数比 | norm ratio | 1.44:1 | 5.2:1(端点组合) | 趋近 1:1 等范参考 |
| 目标追踪·目标-学生前向 KL | $D_{KL}(\pi_C \| \pi_\theta)$ | 0.031 | 0.152(端点组合) | 约 5 倍更近 |
局限与改进
作者承认三点:评估限于公开推理专家与以 BigMath 为主的同域组合,Science/IF 只作 held-out;方法需要每个教师的精确前驱 checkpoint 和兼容 tokenizer 或显式投影规则,不像黑盒 OPD 即插即用;偏移范数同时反映后训练幅度与 logit 温度/置信度差异,未做校准。我的补充观察:其一,M=3 时 Sci/IF 宏反而低于端点组合(15.22 对 16.51,$\Delta_{3-2}$ 为 −2.16pp),Math 信号增强挤压非 Math 能力;其二,偏移构造带来结构性开销,M=1 时每次更新慢 27.3%,M=3 时慢 11.0%(167.1 对 150.6 秒);其三,分阶段路由只有两个域、两个顺序,MATH-500 的配对 McNemar 检验 p=0.047 未通过十重比较校正,‘信号跨阶段累积’只是支持性证据;其四,学生仅 1.5B、held-out 共 1,309 题,交错路由收益趋近于零(+0.62pp)提示收益集中在状态内组合场景。
独立分析的弱点
第一个弱点是能力挤压:三教师组合中 Sci/IF 宏下降 1.29-2.16pp,偏移求和没有内在的领域平衡,改进方向是按域归一化偏移范数,或引入可学习的每教师缩放系数 $\lambda_i$ 改写为 $z_C = z_A + \sum_i \lambda_i \delta_i$。第二个弱点是算力开销来自结构本身:每个异源教师都要求额外前向打分其前驱,改进方向包括离线缓存前驱 logits、蒸馏一个轻量偏移预测头、或对 $\delta_i$ 做低秩近似压缩。第三个弱点是校准缺失:不同 checkpoint 的 logit 尺度不同,M=2 时两偏移范数为 13,674 与 6,073,相差一倍以上,其中混合了能力与温度因素,作者也承认 cancellation 对整体缩放不变、无法校正温度,改进方向是显式的温度校准后再组合。第四个弱点是证据结构:phased 实验只覆盖两域两顺序且部分比较未过显著性校正,需要更多域、更多 phase 数与更多种子。第五个弱点是对前驱 checkpoint 的强依赖:若基座版本不可得或教师闭源,偏移无法计算,方法直接失效,黑盒场景只能退回端点。
未来方向
作者提出的方向:扩展到更广的专家家族与域混合组合;在 tool-use、GUI agent(引用 UI-MOPD)、expert-to-generalist 等设定中检验;做校准感知的组合以补偿 logit 温度差异;发展比 overlap 投影更一般的跨 tokenizer 对齐(文中指出其窄于 text-span likelihood alignment)。基于成果可延伸的:把目标构造与教师选择/调度联合优化,例如按状态动态选择教师子集并自适应决定偏移缩放;统一参数空间 task arithmetic 与 logit 空间偏移的理论框架;研究偏移的能力/风格分解,选择性迁移推理能力而剥离啰嗦或格式偏好;在 7B/14B 更大学生与更长训练曲线上验证收敛加速是否保持;从理论上刻画'更近的目标是否等价于更低方差的梯度估计';以及把偏移用于持续学习——按 phase 累积异源教师偏移而不发生遗忘,这与本文 phased 路由中信号跨阶段累积的初步证据直接衔接。
复现评估
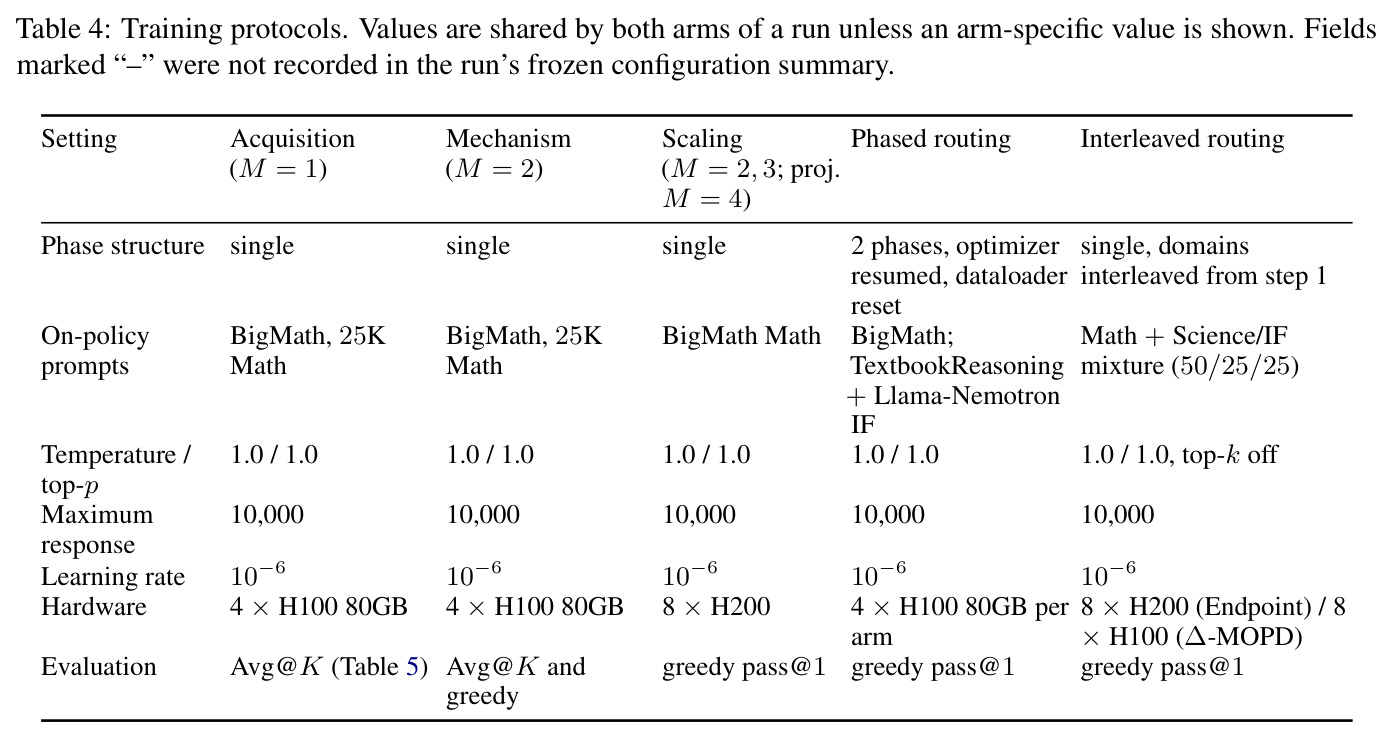
可复现性较好。所有模型均为公开 checkpoint 并钉死 revision:锚点 DeepSeek-R1-Distill-Qwen-1.5B,教师 Nemotron、JustRL、Polaris-7B-Preview,扩展教师 Qwen3-DAPO-449。协议透明(Appendix A/B):SGLang 评估、最大响应 16,384 token、greedy 与 Avg@K 设置明确、1,309 个固定 held-out 题;配对臂共享提示、优化器与评估,冻结模型打分相同前缀;诊断估计器全部给出公式。算力门槛中等:单臂 4×H100 或 8×H200,一次 run 数十 H100 小时(acquisition 两臂合计约 71 小时)。难点在前驱 checkpoint 的精确获取、151,665 有效词表对齐,以及 Qwen3 投影所需的 151,660 个 token 字符串重叠映射;文中未见代码开源声明,但数据集修订、chat 模板、解码与验证器版本均已固定,工程复现可行。
论文图表
列出全部公开 checkpoint 及角色:锚点/学生初始化为 DS-R1-Distill-Qwen-1.5B;Math 教师 JustRL-DeepSeek-1.5B(同源)、Science/IF 教师 Nemotron-Reasoning-Qwen-1.5B(同源)、Math 教师 Polaris-7B-Preview(异源,基座 DS-R1-Distill-Qwen-7B)、扩展 Math 教师 Qwen3-DAPO-449(异源跨 tokenizer,基座 Qwen3-8B),并标注各自用途(组合/路由/扩展)。
偏移 $\delta_i = z_{T_i} - z_{B_i}$ 的计算完全依赖'精确前驱'的选定,这张表是复现的起点,也是 same-origin/cross-origin 划分的依据。