ProgramGym:面向长程程序复现智能体的可扩展训练环境 ProgramGym: Scaling Training Environments for Long-Horizon Program Reproduction Agents
自动把开源仓库变成可验证训练环境,再用角色隔离工作流让模型学会从零复现程序
前置知识
SWE-bench 与 issue 修复范式
SWE-bench 是最具代表性的代码智能体基准:给智能体一个真实 GitHub 仓库和一条 issue,要求它生成补丁并通过仓库自带测试。该范式假设代码库已存在,智能体只做局部修改,SWE-Gym、SWE-smith 等训练环境也都围绕这一设定构建。
本文的任务定义正是从这个主流范式出发做对比。理解它的边界(依赖既有代码、无需需求发现和架构设计)才能明白作者为何要另起炉灶做从零复现。
从零程序复现
只给二进制可执行文件和使用文档、不给源码,要求智能体通过运行探索参考程序来发现其外部行为,再自行决定架构并从零写出能复现该行为的源码与编译脚本。ProgramBench 是该任务的主要基准(200 个任务),评分看候选程序在黑盒测试上的通过率。
这是本文的训练任务本身。环境四元组 $(B_i^\star, D_i, T_i, S_i)$ 的定义、"只可执行参考程序"等设定、以及所有评测指标都由此任务而来。
黑盒测试与测试预言
黑盒测试不读被测程序内部代码,只通过命令行参数、标准输入输出等公开接口喂入输入并断言输出。测试预言(oracle)指判定对错的准则:弱预言(如只检查退出码为 0、只检查输出非空)会让错误实现也通过,强预言才对错误实现有区分力。
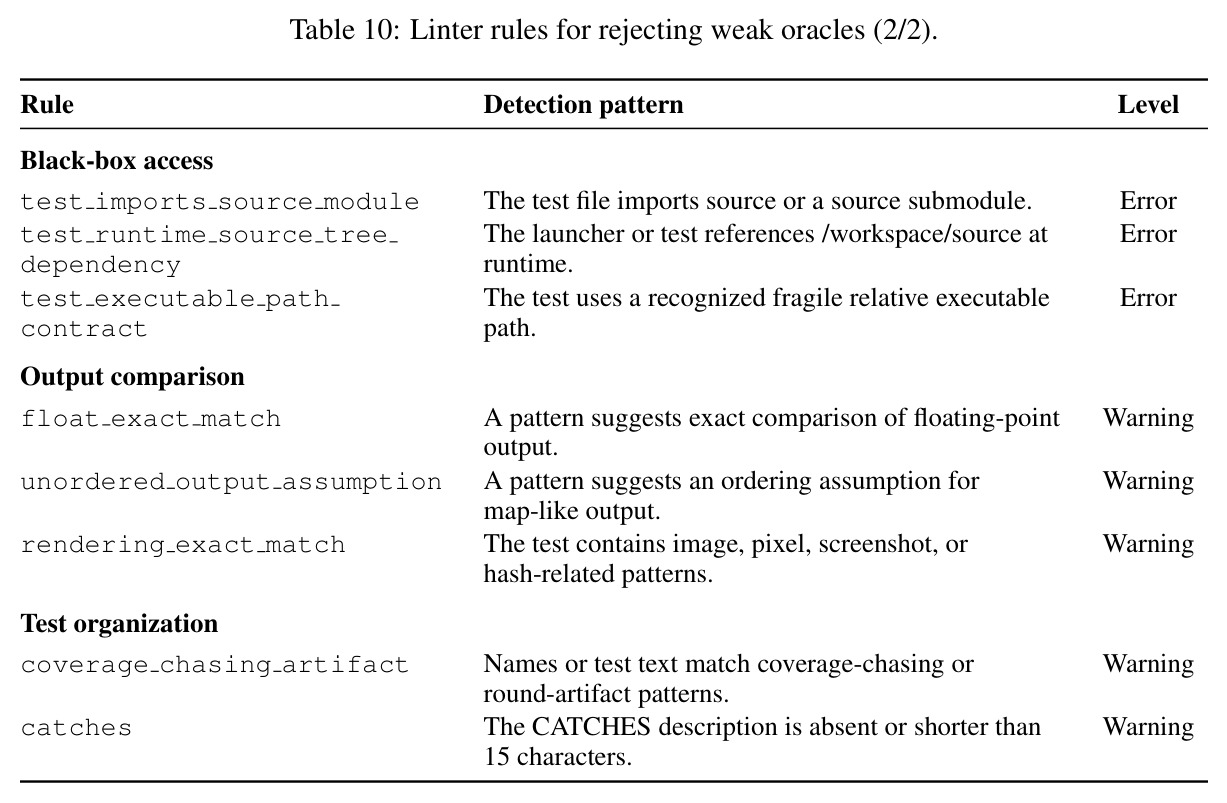
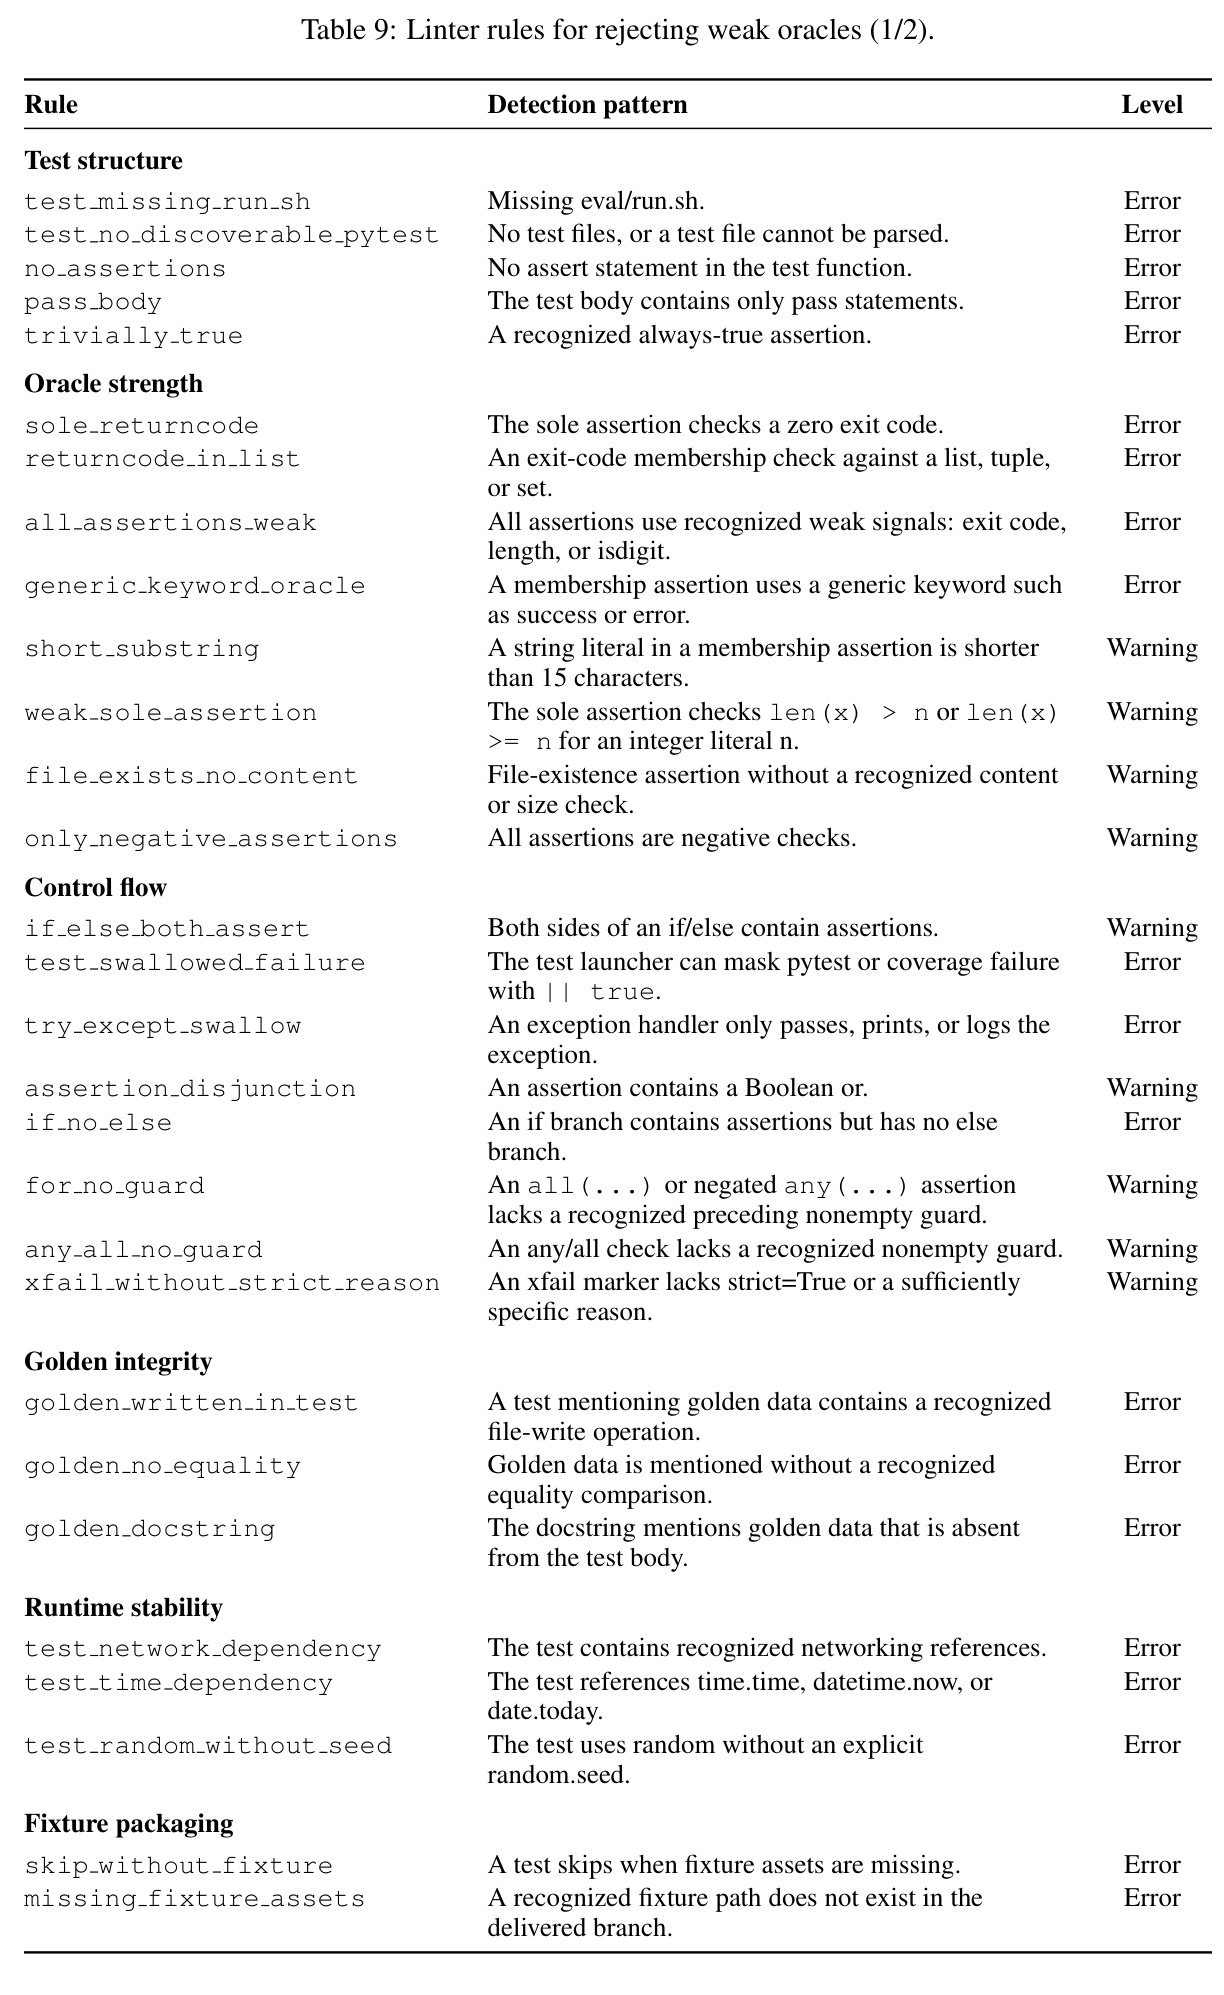
Program-Env 用黑盒测试套件作为训练的监督信号,测试质量直接决定训练标签是否可靠。论文的四重校验(pass/double/dummy/weak-assert)和 37 条 linter 规则全是为保证预言强度服务的。
覆盖率插桩
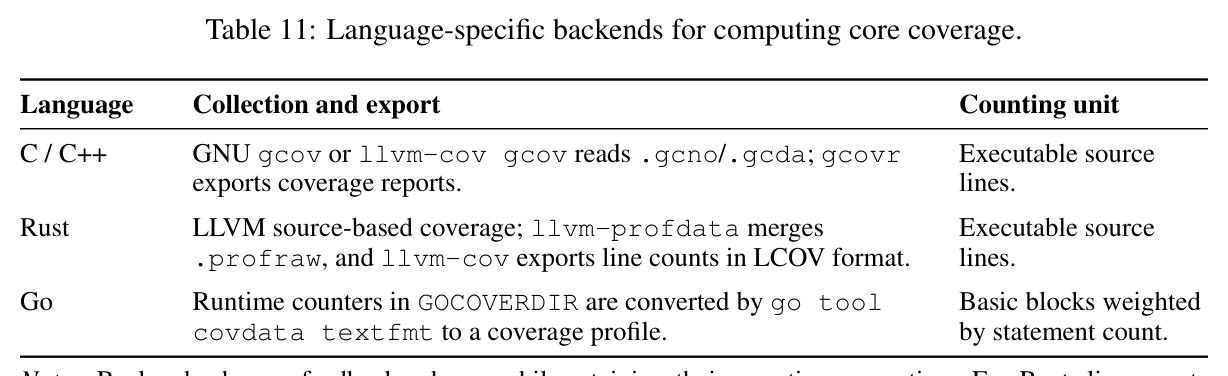
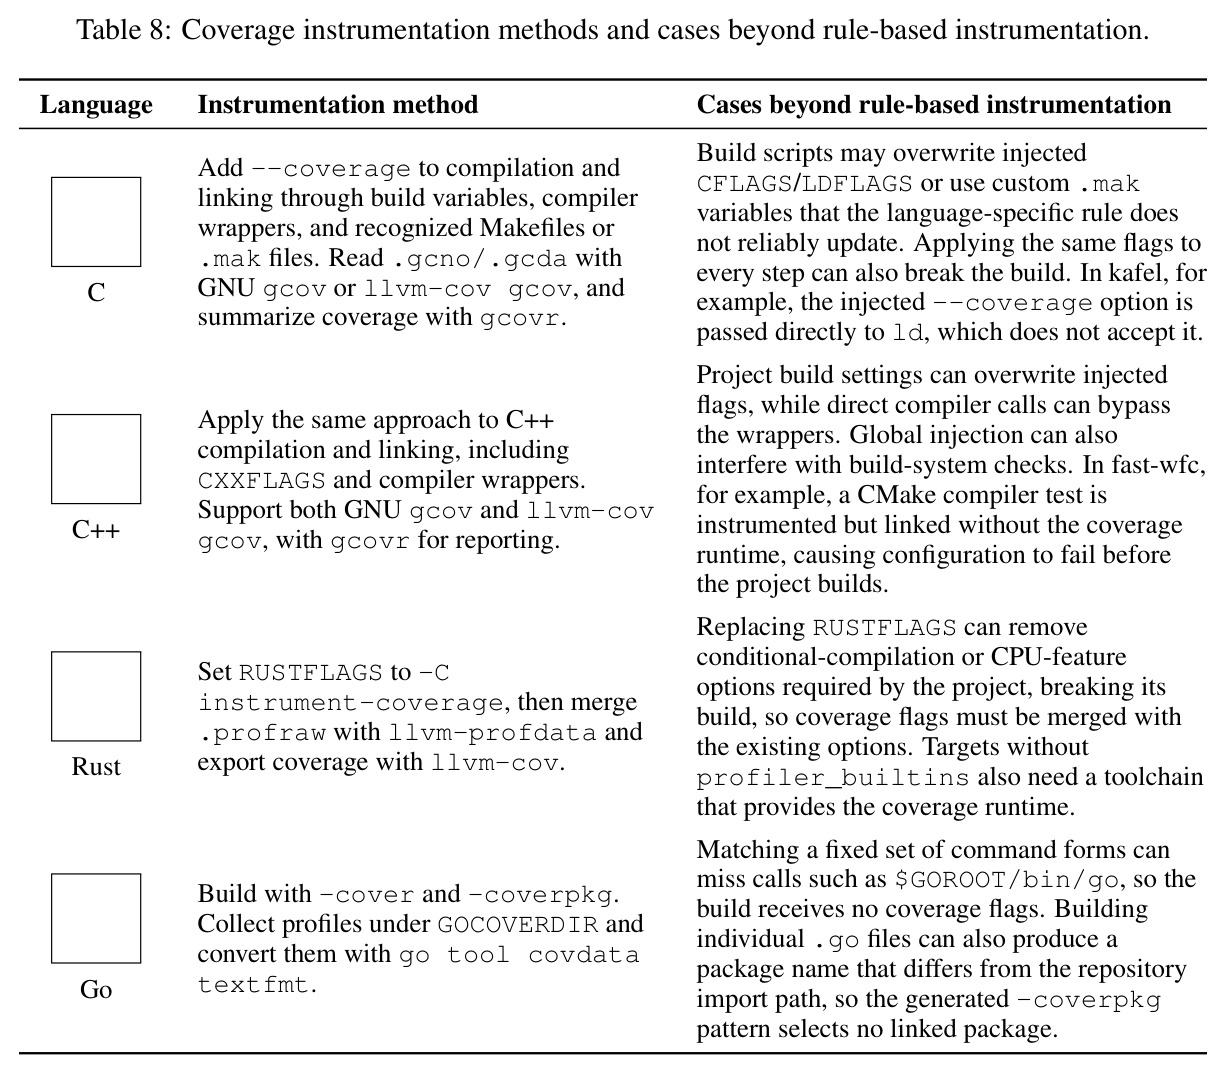
编译时向程序注入计数代码(C/C++ 用 gcov/llvm-cov、Rust 用 -C instrument-coverage、Go 用 -cover),运行后报告哪些源码行被执行过。未覆盖代码大致对应未被测试触达的功能,是测试生成最常用的反馈信号。
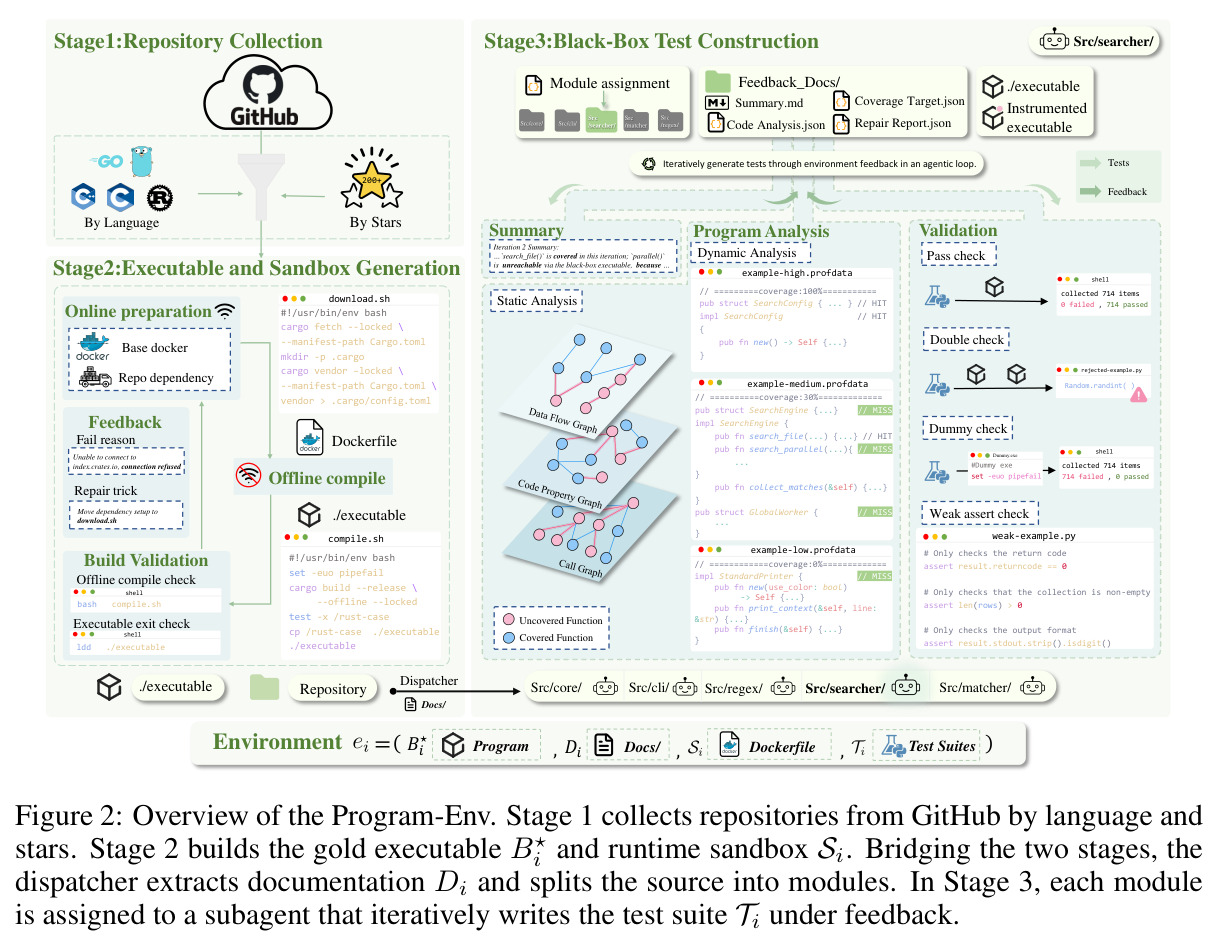
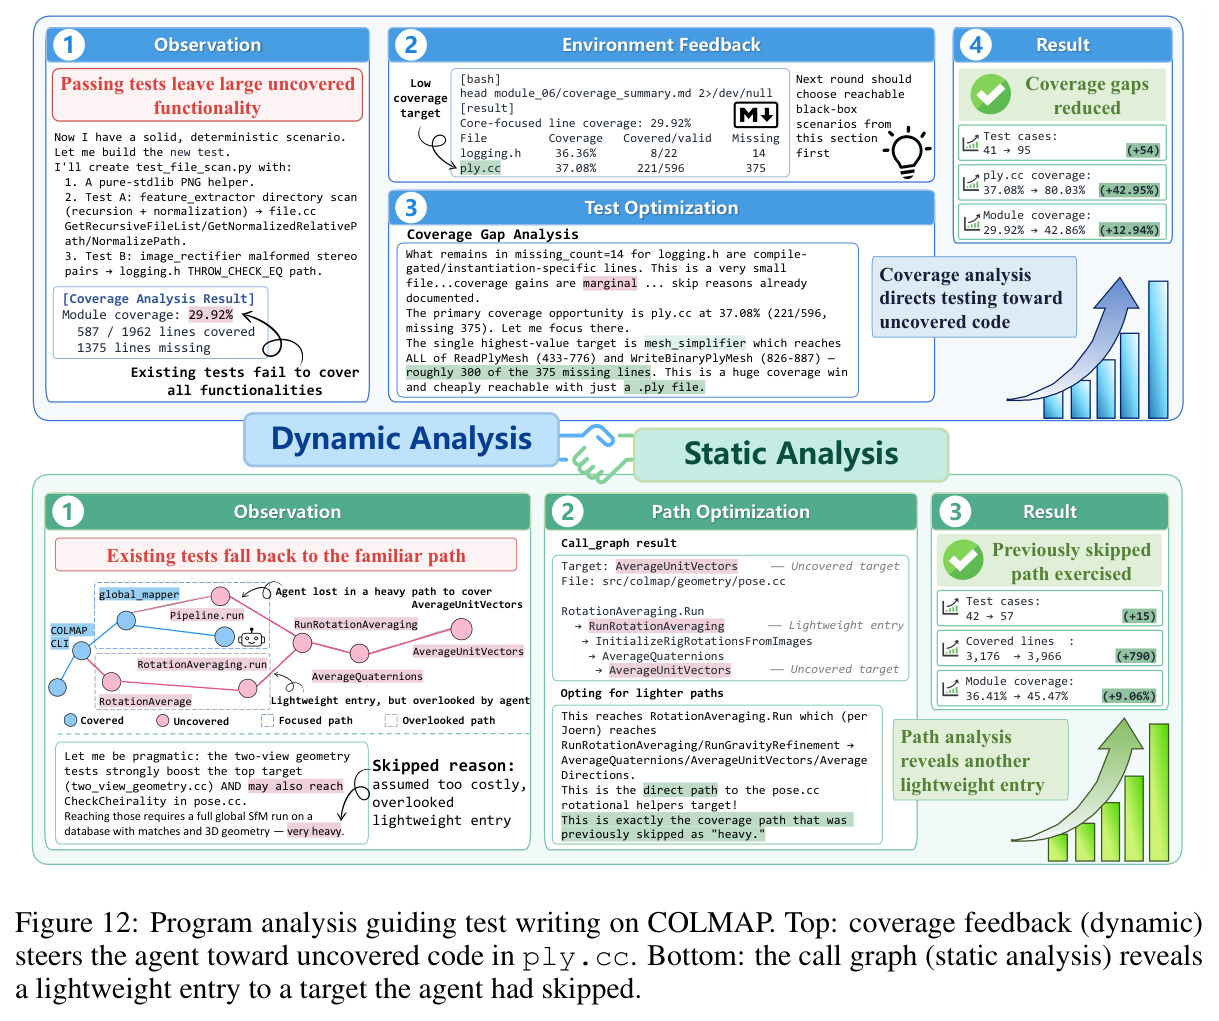
本文定义核心覆盖率 $C_{\text{core}}^{(t)}$ 并用部分覆盖文件生成下一轮测试目标(coverage_targets.json),插桩是环境反馈循环的技术基础,也是"规则优先、智能体兜底"设计的对象。
拒绝采样与监督微调(SFT)
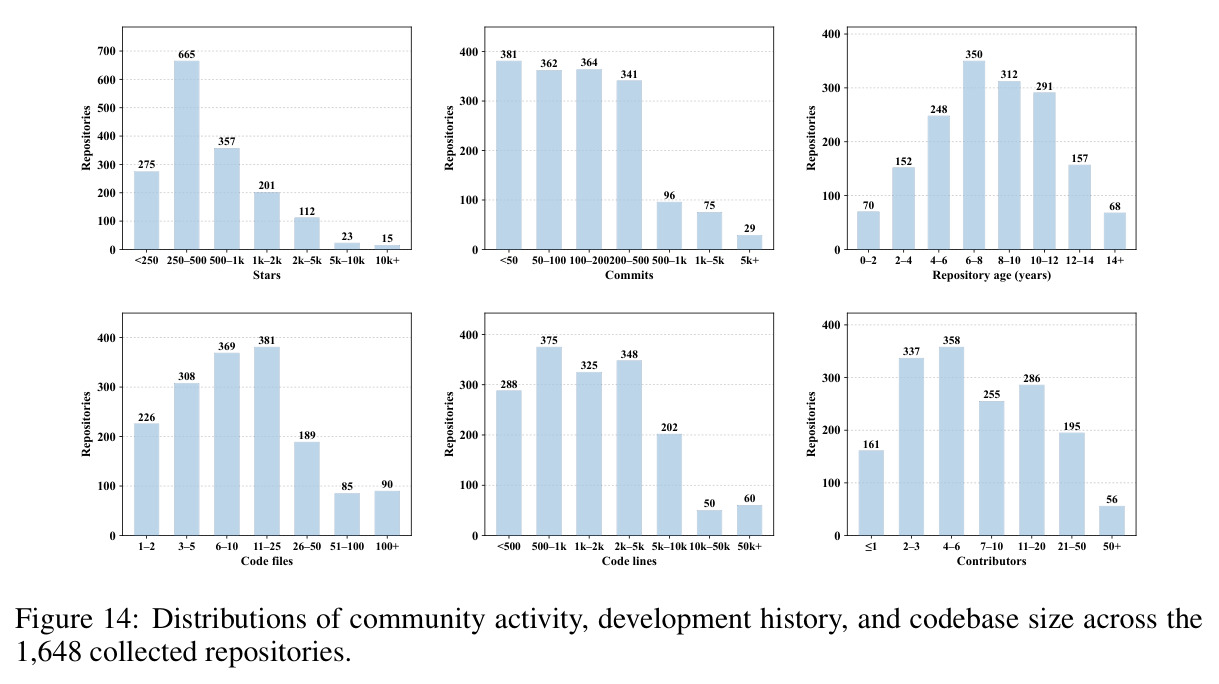
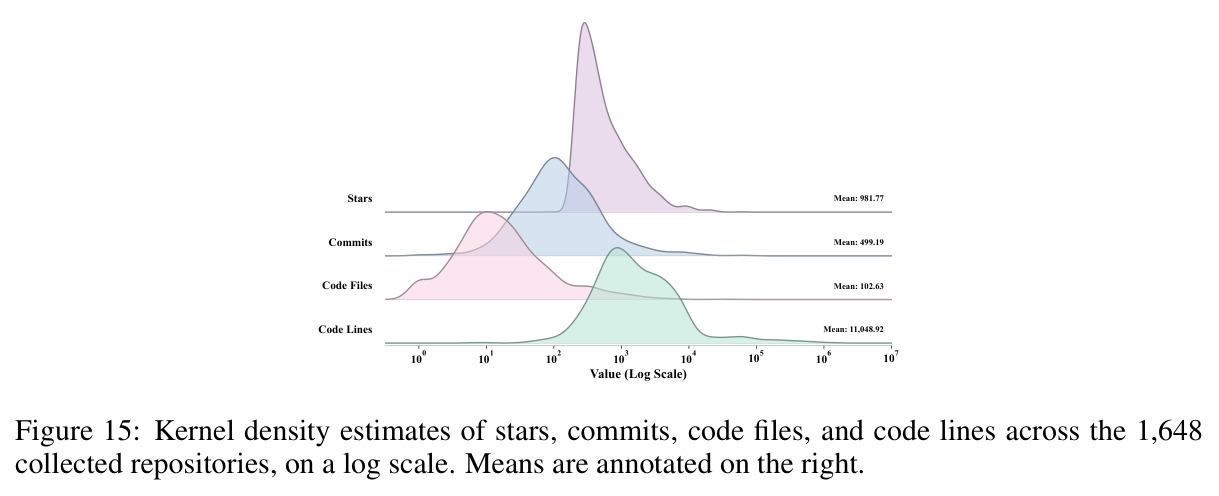
拒绝采样:让强模型在环境里多次解题,只保留通过验证器筛选的轨迹作为训练数据;SFT 在这些轨迹上做最大似然训练(只对助手 token 计损失)。本文用 DeepSeek-V4-Flash 在 1,648 个环境上以测试通过率过滤,得到 64,505 条轨迹全参微调 Qwen3.8-27B。
RQ1 的核心结论"SFT 让 Qwen3.8-27B 从 34.87% 升到 42.84% Tests Passed"建立在这套流程上,是 Program-Env 环境价值的直接检验,也是理解 SFT 与 Program-Agent 增益如何叠加的前提。
静态程序分析与调用图
不运行程序、直接分析源码的技术,典型产物有代码属性图(CPG)、调用图、控制流和数据流图。调用图记录"谁调用谁",对其反向遍历可以从深层未覆盖函数出发,找到黑盒测试可达的公共命令行入口。本文用 Joern(C/C++/Go)和 CodeQL(Rust)作为可插拔后端。
覆盖率只回答"哪里没测到",静态分析回答"怎么从公开入口到达它"。COLMAP 案例中 AverageUnitVectors 正是靠调用图发现了轻量可达路径,两者配合才能把测试目标变成可执行方案。
研究动机
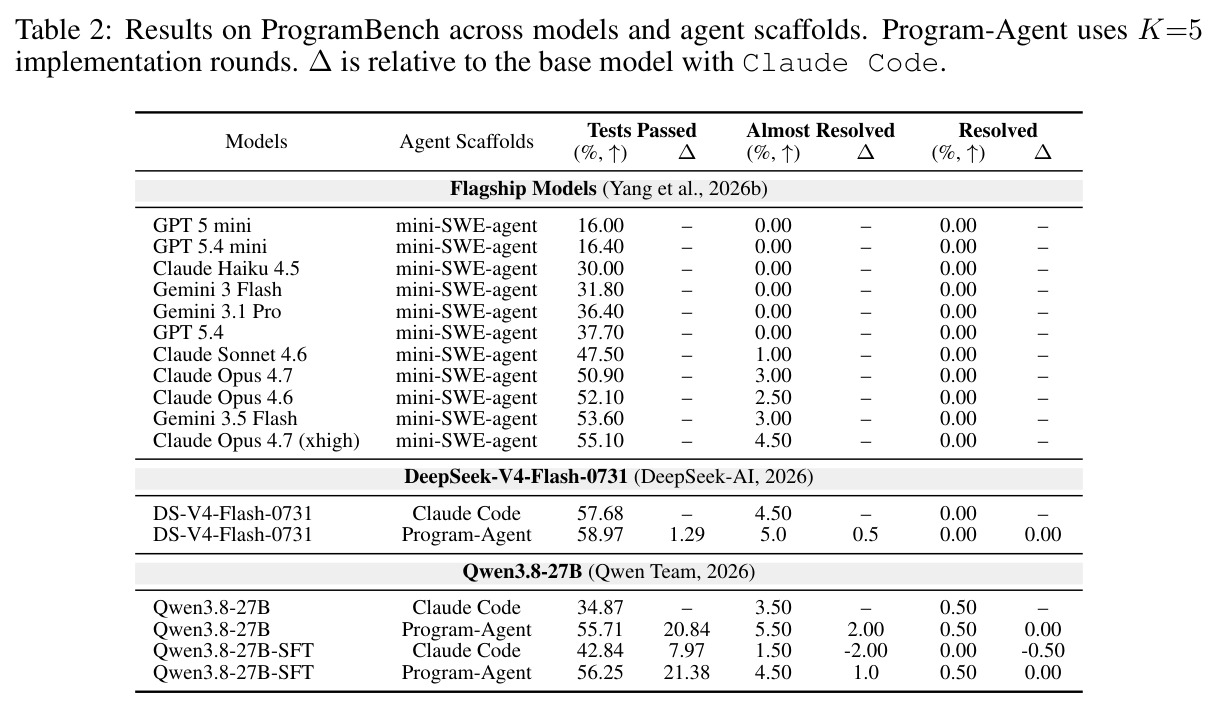
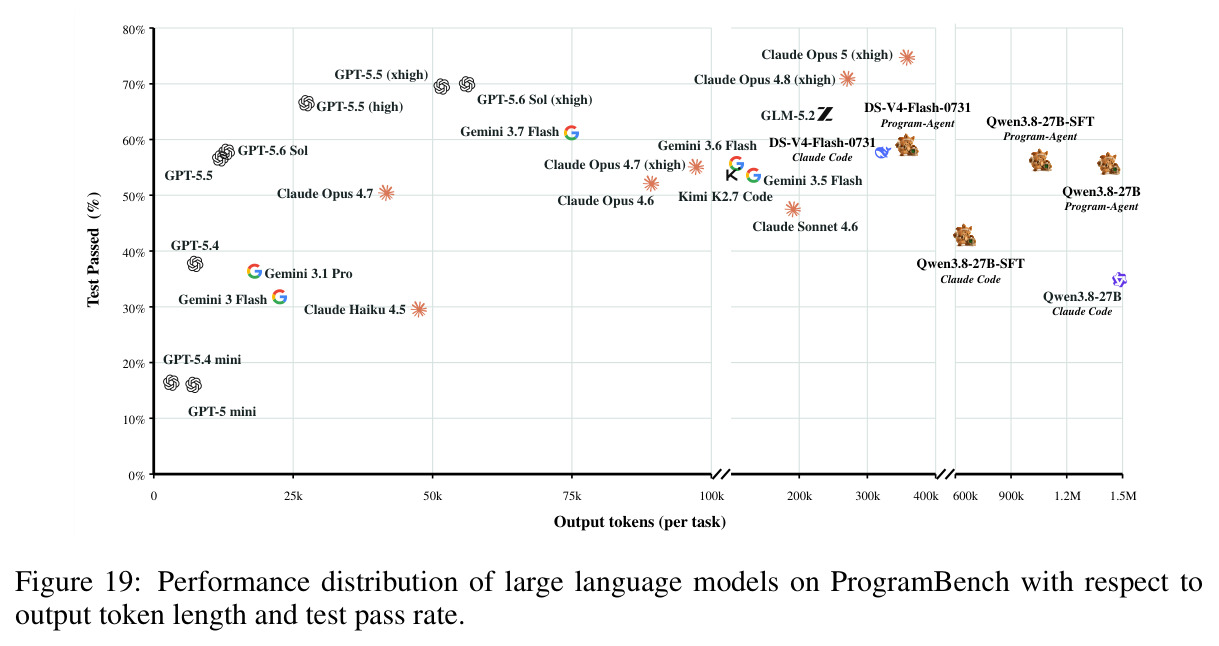
现有编码智能体的训练与评测几乎都围绕两类任务:以 SWE-bench 为代表的 issue 修复(给定代码库和 issue 打补丁)和以 NL2Repo-Bench 为代表的仓库生成(给定需求文档写实现)。两者都从既有代码或明确规格出发,智能体无需回答软件工程师最核心的两个问题——"需要什么"与"系统该怎么设计"。从零复现程序的任务(ProgramBench,200 个任务)只给二进制可执行文件和使用文档,要求智能体探索发现行为并从零实现,难度极高:原评测中没有任何旗舰模型完全解决任何一个任务(Resolved 全部为 0.00%),最强的 Claude Opus 4.6 也只有 52.1% Tests Passed。训练这种能力需要带可靠行为监督的交互环境,但现有资源不适用:SWE-Gym、SWE-smith 只支持 issue 修复式监督;MindForge 仅限命令行程序、不按恢复出的程序行为过滤轨迹,功能错误的复现也可能被当成成功样本。通用 harness 也撑不住长程开发:智能体常在探索不足时就开始实现,并随上下文增长遗忘早期观察到的需求。
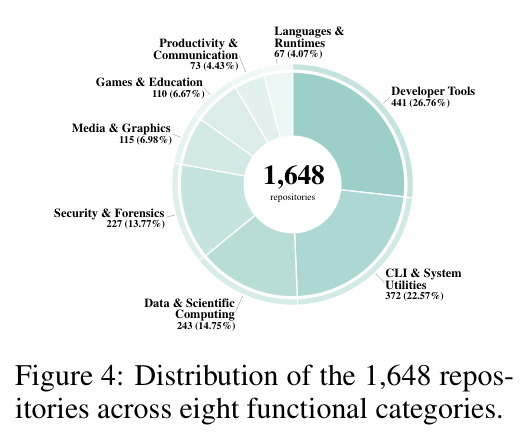
本文的目标是本文目标是把"从零复现程序"变成可规模化训练的任务,具体分两层。环境层:设计全自动流水线 Program-Env,把 GitHub 开源仓库批量转化为可验证训练环境,每个环境 $e_i = \Phi(P_i) = (B_i^\star, D_i, T_i, S_i)$ 包含只可执行的参考程序 $B_i^\star$、网络隔离的运行时沙箱 $S_i$、使用文档 $D_i$ 和黑盒行为测试套件 $T_i$,使训练信号由"候选程序与参考程序在测试上的行为一致性"自动给出,无需人工标注。智能体层:设计 Program-Agent 工作流,让模型能在远超 256K 上下文窗口的长程开发中保持探索与实现的协调,不丢失早期行为证据,且能从编译失败中恢复。最终在这些环境上收集轨迹做监督微调,在 ProgramBench 上验证效果:将 Qwen3.8-27B 从 34.87% Tests Passed 大幅提升,并让 27B 级开源模型搭配工作流后超越部分旗舰闭源模型。
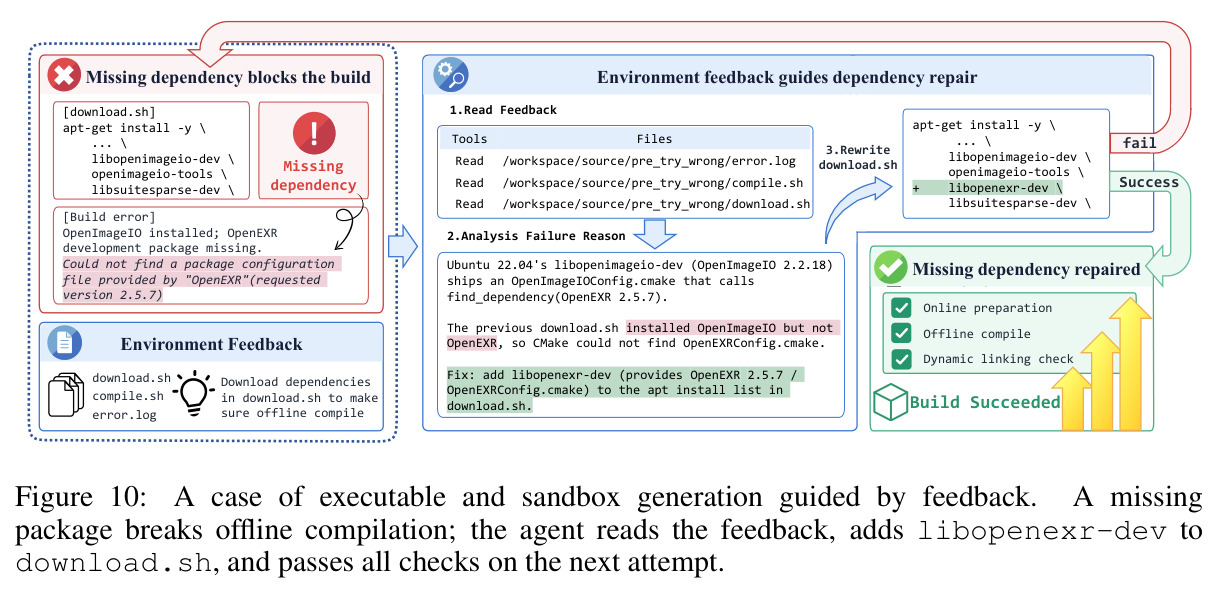
与已有工作不同的是,本文的独特切入是把"环境构建"本身当作可用反馈循环自动化的智能体任务,而非人工策划或脆弱的规则流水线。三个差异化设计: 其一,构建与求解解耦——构建阶段允许联网(download.sh 在线准备工具链与依赖),求解阶段完全断网(compile.sh 离线编译),用离线编译成功来验证环境自洽,这与直接把源码交给训练方的做法本质不同; 其二,测试质量用机器可校验的四重检查(pass/double/dummy/weak-assert,含 37 条 linter 规则)保证,拒绝"只检查退出码""在无功能 dummy 实现上也能通过"的弱断言测试,而 MindForge 并不按行为正确性过滤监督信号; 其三,测试扩展不靠盲目生成,而是动态覆盖分析定位未覆盖代码、静态分析(Joern/CodeQL 调用图反向回溯)找到黑盒可达的公共入口,把"接下来测什么"从猜测变成明确可达的目标。这套反馈驱动闭环让 30,459 个候选仓库最终产出 1,648 个可用环境,证明该思路可以规模化。
核心方法
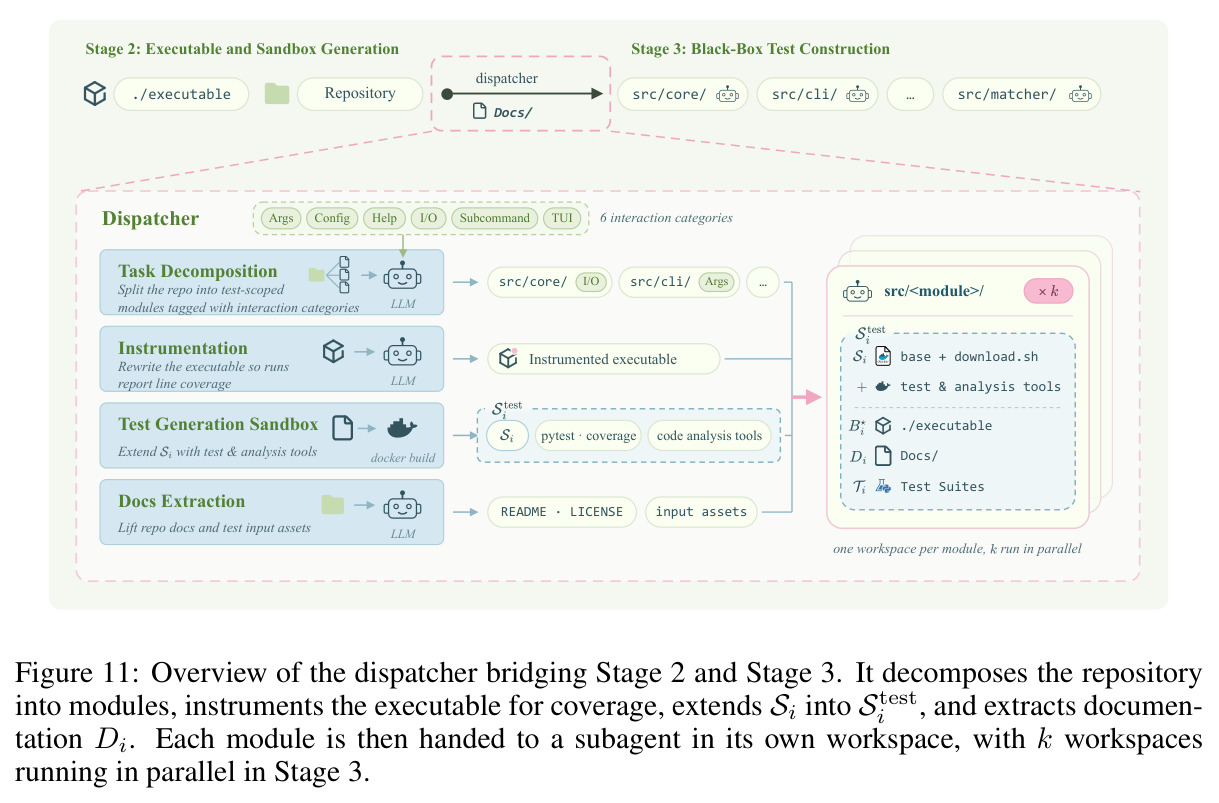
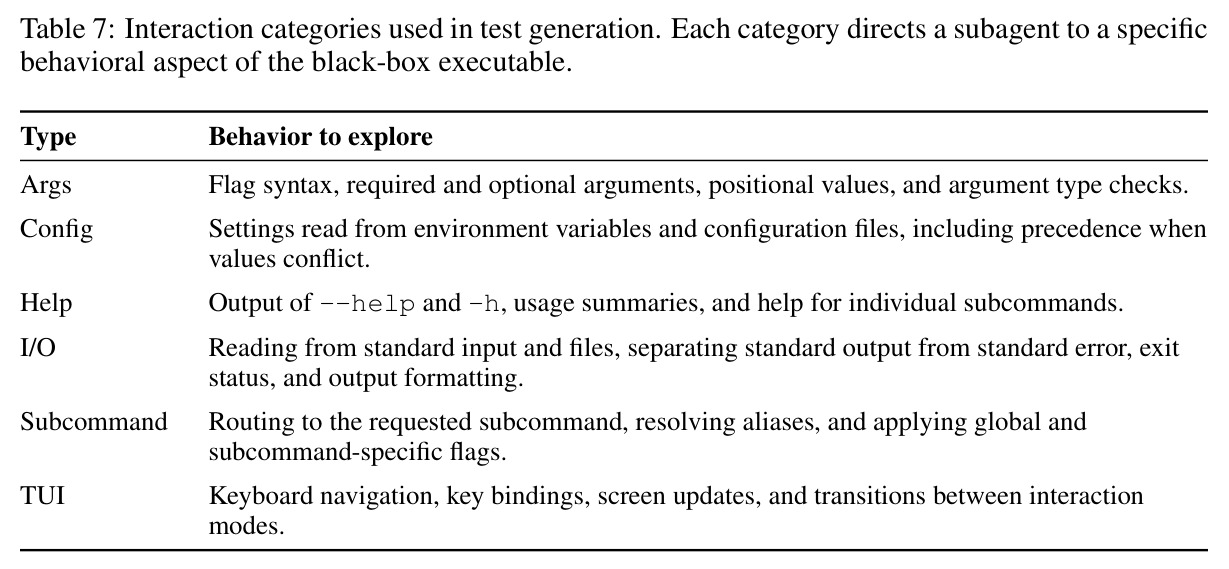
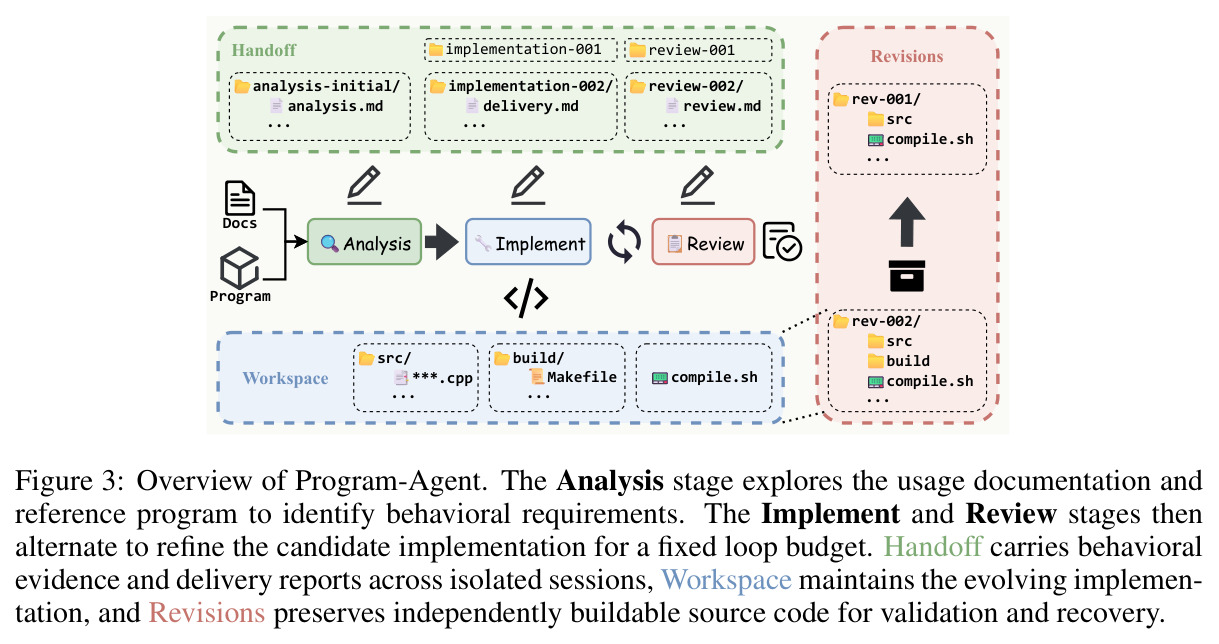
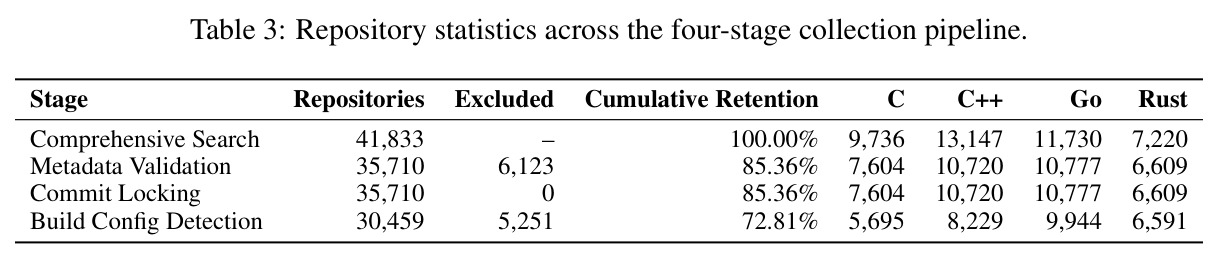
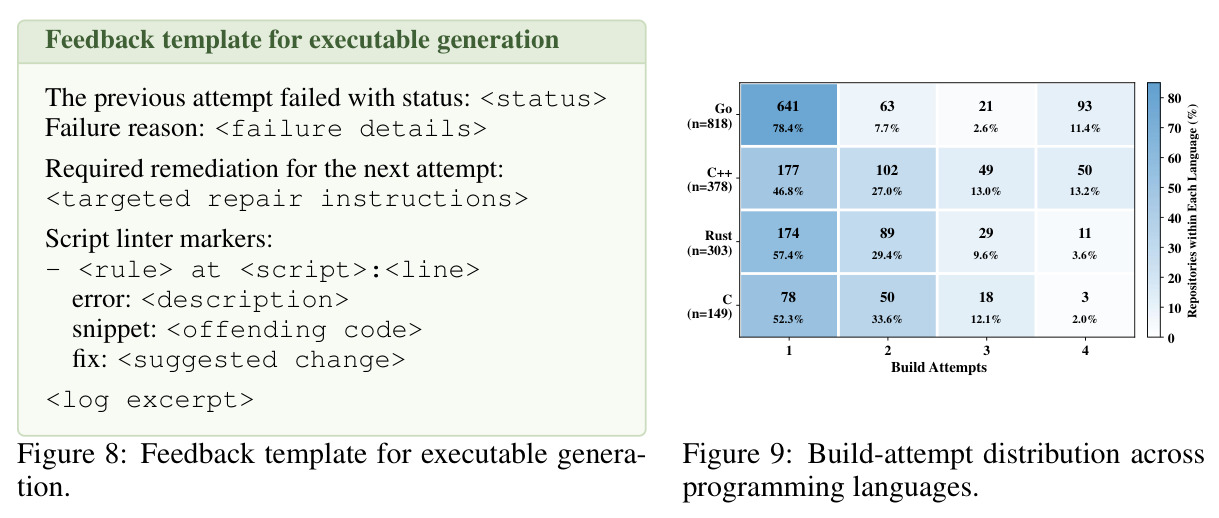
训练"从零造程序"的智能体需要两块拼图:能自动判分的环境,和能撑住长周期开发的工作流。ProgramGym 据此分为 Program-Env 与 Program-Agent。Program-Env 三阶段: 分层检索 GitHub(语言×star 区间),41,833 个仓库经元数据校验、commit 锁定、构建配置检测得 30,459 个候选; 以 Claude Code 为底层 harness 加外层校验循环,生成 download.sh(在线装依赖)与 compile.sh(离线编译),经静态 linter、在线执行、离线编译、ldd 链接检查后产出参考可执行文件 $B_i^\star$ 与冻结沙箱 $S_i$; dispatcher 按复杂度 $\xi = \text{clip}_{[0,10]}(\log_{10}\ell + \log_{10}(1+r) - 2)$ 分配 4–8 个并行子智能体,在"生成→四重校验→结构化反馈→修复/扩展"循环中迭代写所辖模块的测试。Program-Agent 采用分析→实现→评审的角色隔离迭代流程,配合独立编译门禁与失败回滚完成长程开发。
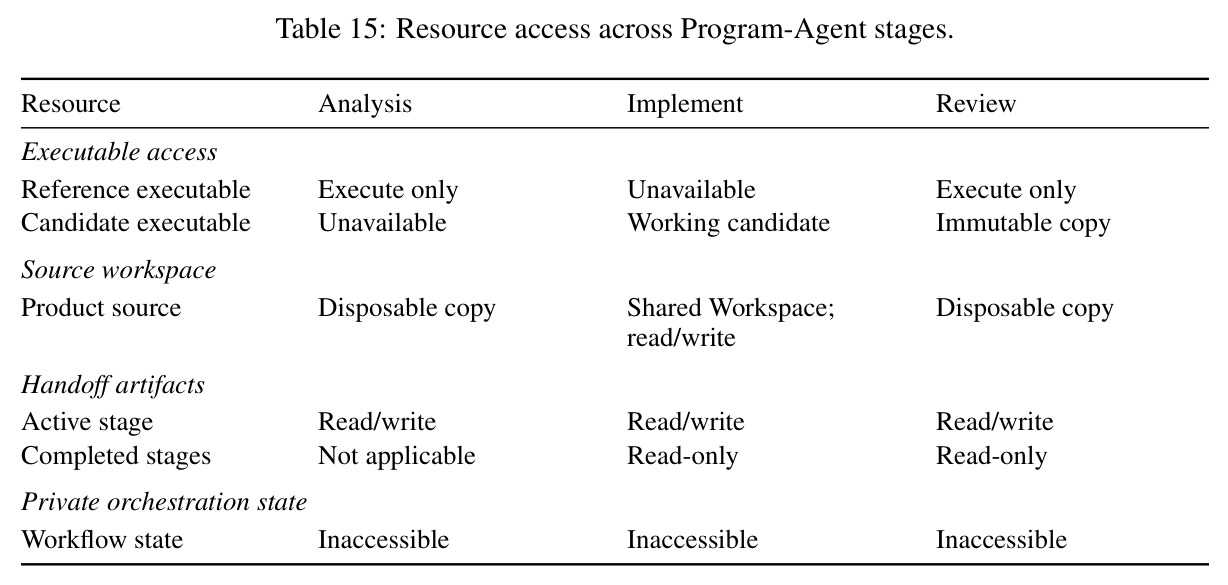
核心创新是把"可靠性"显式编码为机器可校验的循环,而非寄希望于单次生成质量。环境侧,测试 $t$ 必须同时满足四条件才保留:在参考程序上通过(pass)、两次独立运行结果一致(double)、在无功能 dummy 实现上必须失败(dummy)、不触发 37 条弱断言 linter 错误(weak-assert),即 $t(B_i^\star)=\text{PASS} \wedge t^{(1)}(B_i^\star)=t^{(2)}(B_i^\star) \wedge t(B_\varnothing)=\text{FAIL} \wedge L(t)=\varnothing$。智能体侧的本质区别是"角色隔离+会话分离":分析阶段独占参考程序执行权并把行为证据冻结为只读 Handoff 工件;实现阶段在文件系统层面接触不到参考程序,只能读冻结工件,杜绝"边对答案边写代码";评审阶段对比参考程序与不可变候选副本,只输出经核实的差异清单,且禁止改源码以防自证式修改。这与单会话 harness(上下文压缩后遗忘需求、易过早终止)形成鲜明对比。
方法步骤详情
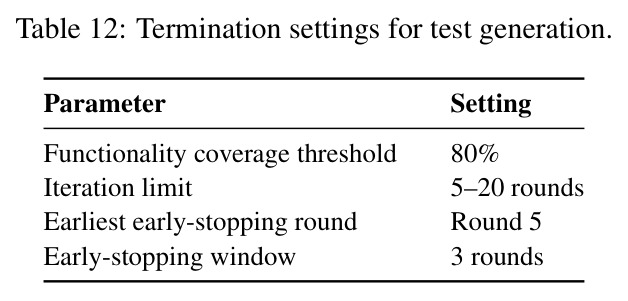
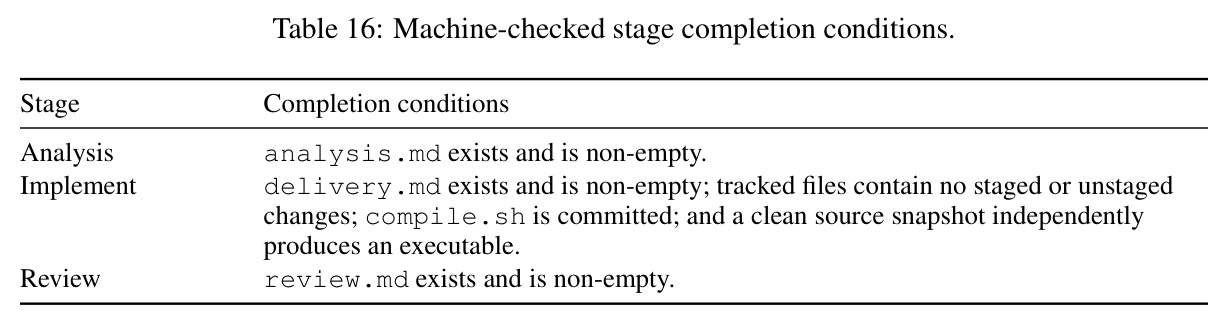
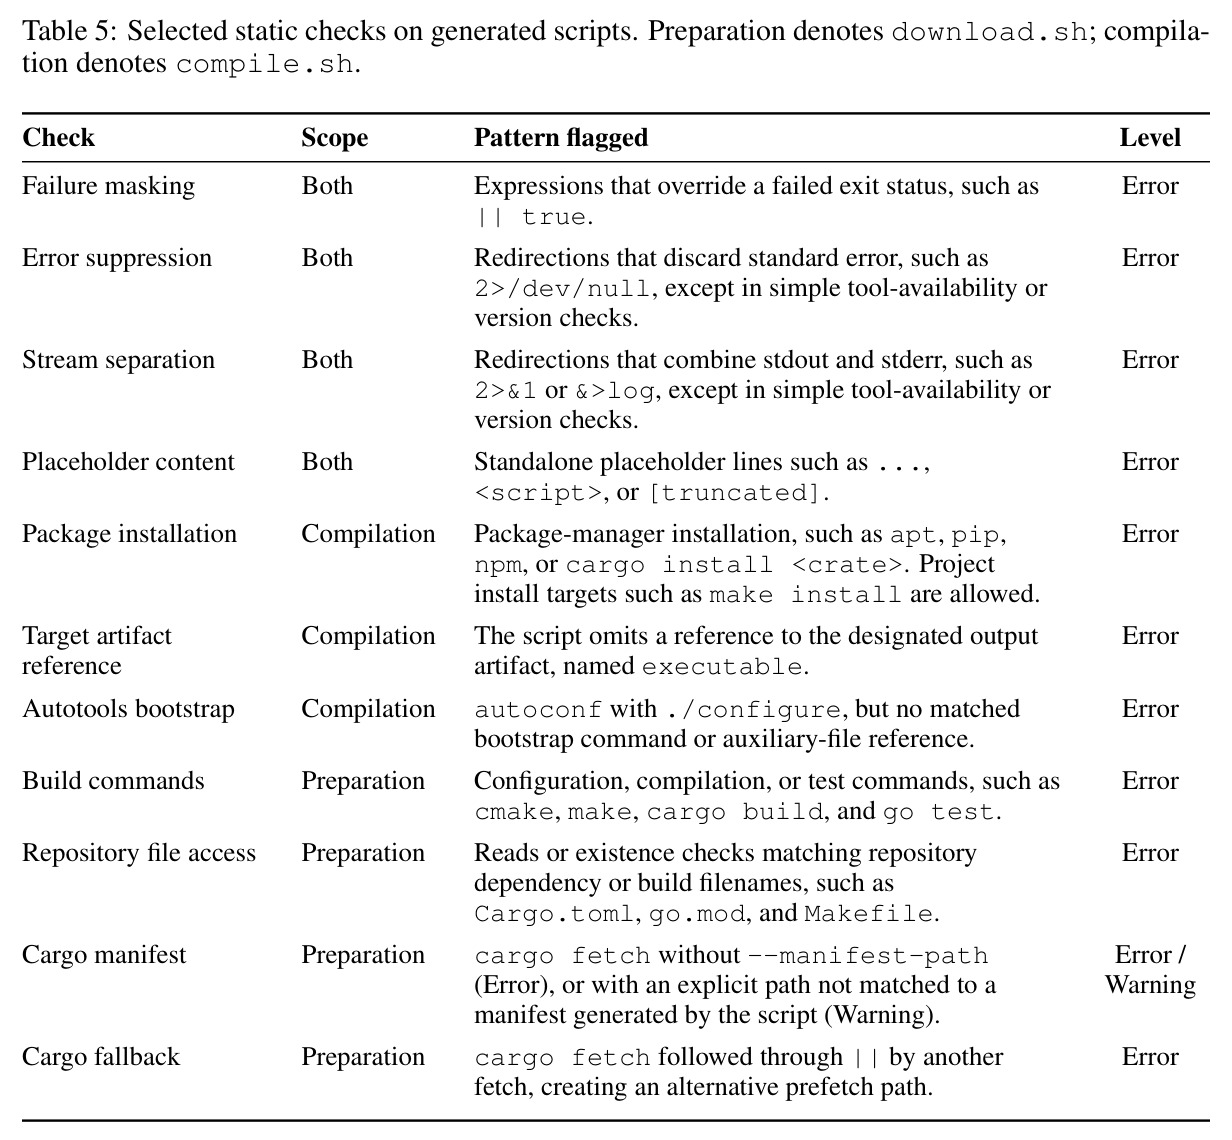
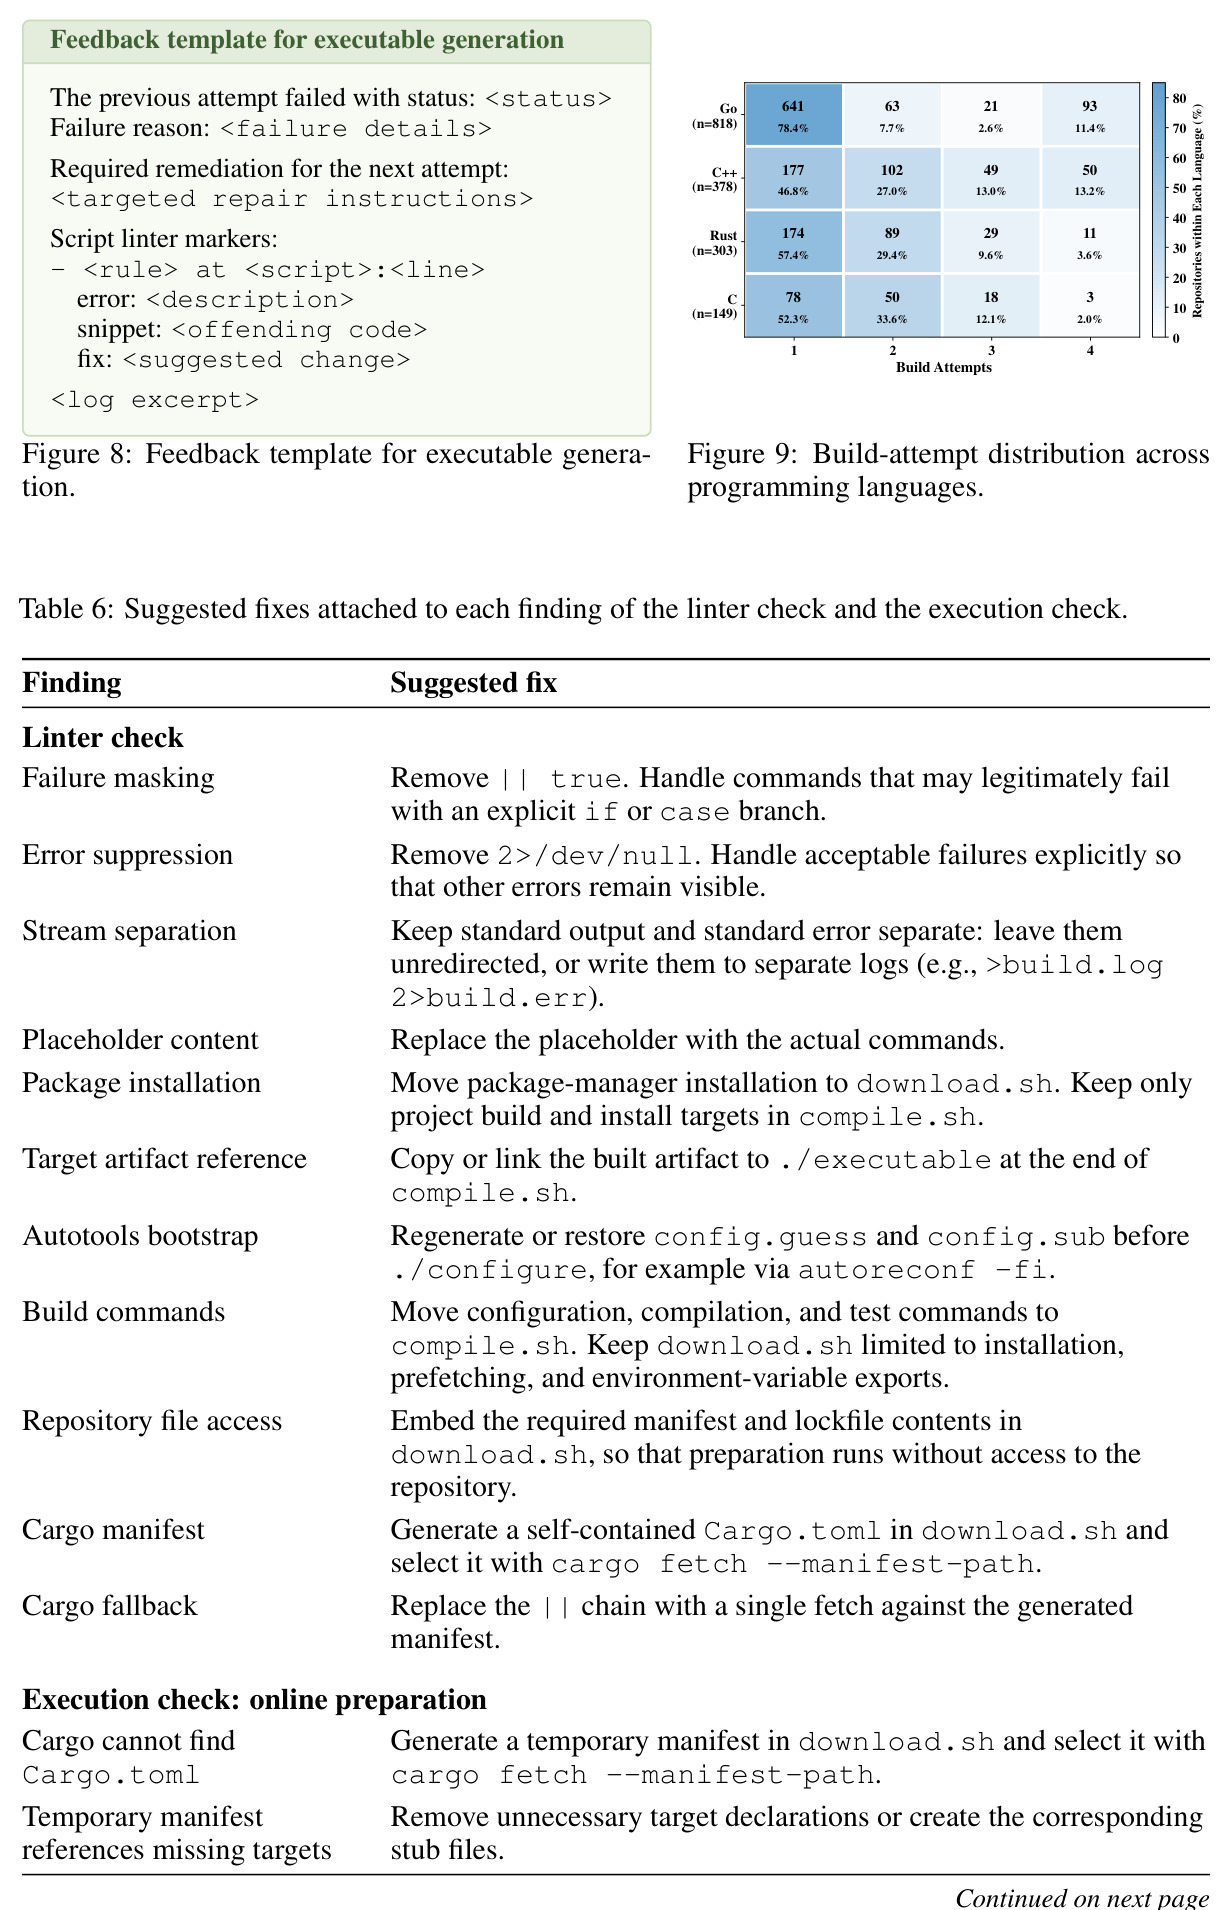
流程如下。 收集:GitHub Search API 按语言与 star 分桶分层检索,经元数据校验、commit 锁定、构建标记检测得 30,459 个候选。 构建:智能体生成 download.sh 与 compile.sh;系统先跑静态 linter(拒绝 || true 等失败掩蔽写法),再带网执行前者并冻结容器为 $S_i$,最后断网执行后者,校验产物为可用 ELF;失败带诊断反馈重试,至多 4 次。 测试:dispatcher 按复杂度拆分模块($\xi<2$/4 模块、$2\le\xi<4$/6、$\ge4$/8),每模块配一个子智能体;每轮先修复被校验标记的测试,再按覆盖目标(每轮至多 10%、上限 300 个)结合静态分析的公共入口写新测试;达 80% 覆盖或轮数上限(5–20 轮)终止,连续 3 轮覆盖增益<0.25% 则早停。 执行:预算 $K$ 下跑 1 次分析、$K$ 次实现、$K-1$ 次评审;每轮实现后导出干净快照在区外独立编译,失败则新会话重试(默认 2 次),仍失败回滚到最近稳定修订。
技术新颖性
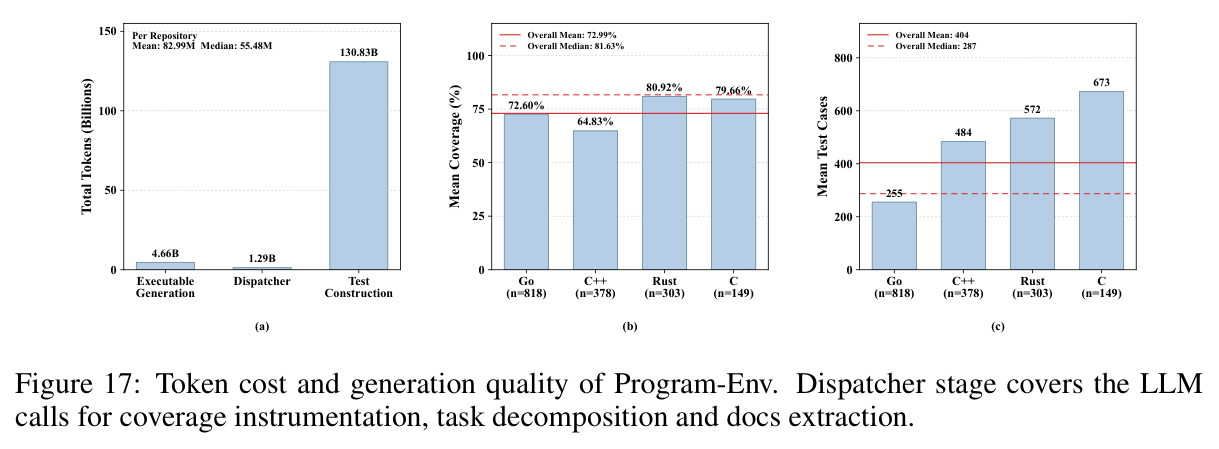
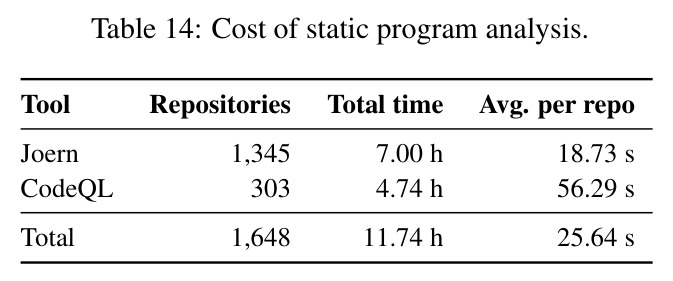
新颖性有四。 其一,可扩展的可验证环境合成:已有工作(SWE-Gym、SWE-smith)从既有代码库构造 issue 修复环境,Program-Env 则大规模把编译型语言仓库转化为"无源码、行为对齐"的复现环境,全程自动(均值约 82.99M token/环境)并实证 1,648 个。 其二,测试监督可信性的形式化:把"忠实、稳定、有效"三性质落成四重可执行检查的交集(式 (3)),从机制上排除"假通过"监督,直接对比 MindForge 不做行为过滤的缺陷。 其三,"规则优先、智能体兜底"的覆盖率插桩:语言级规则(gcov/llvm-cov、RUSTFLAGS、go -cover)先试,独立验证器确认失败才切换 LLM 修复,兼顾确定性与适应性。 其四,角色隔离的工程化落地:用文件系统权限(参考程序移出实现可见路径、Handoff 工件转 root 只读、评审用不可变副本)而非仅靠提示词约束角色边界,并用独立编译+last-stable 修订实现崩溃恢复;静态分析总成本仅 11.74 小时(25.64 秒/仓库)。
实验结果
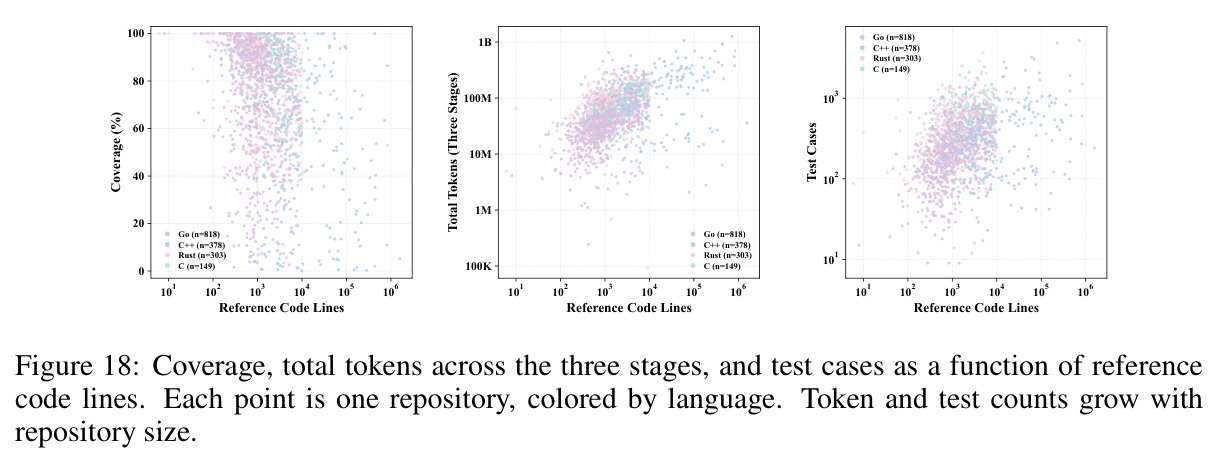
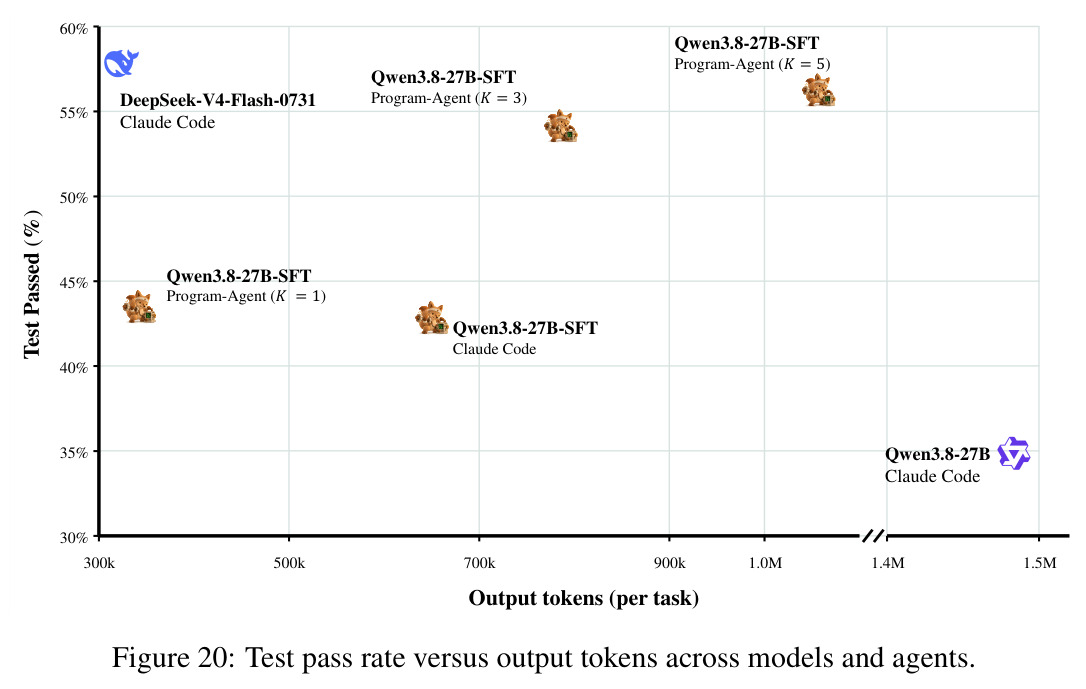
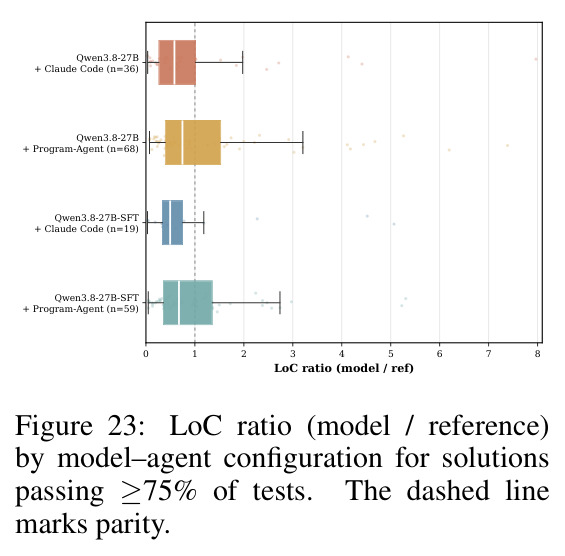
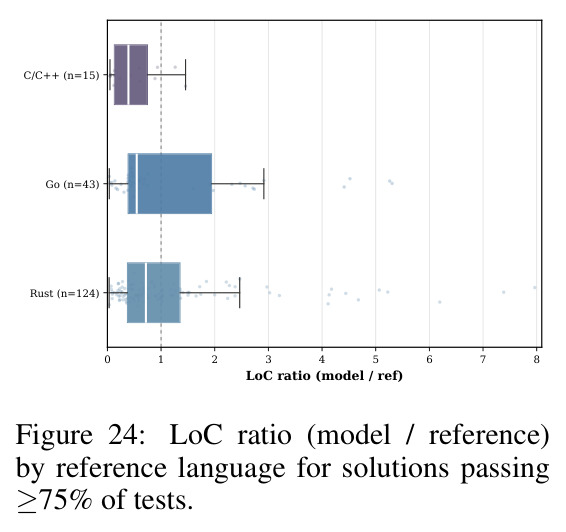
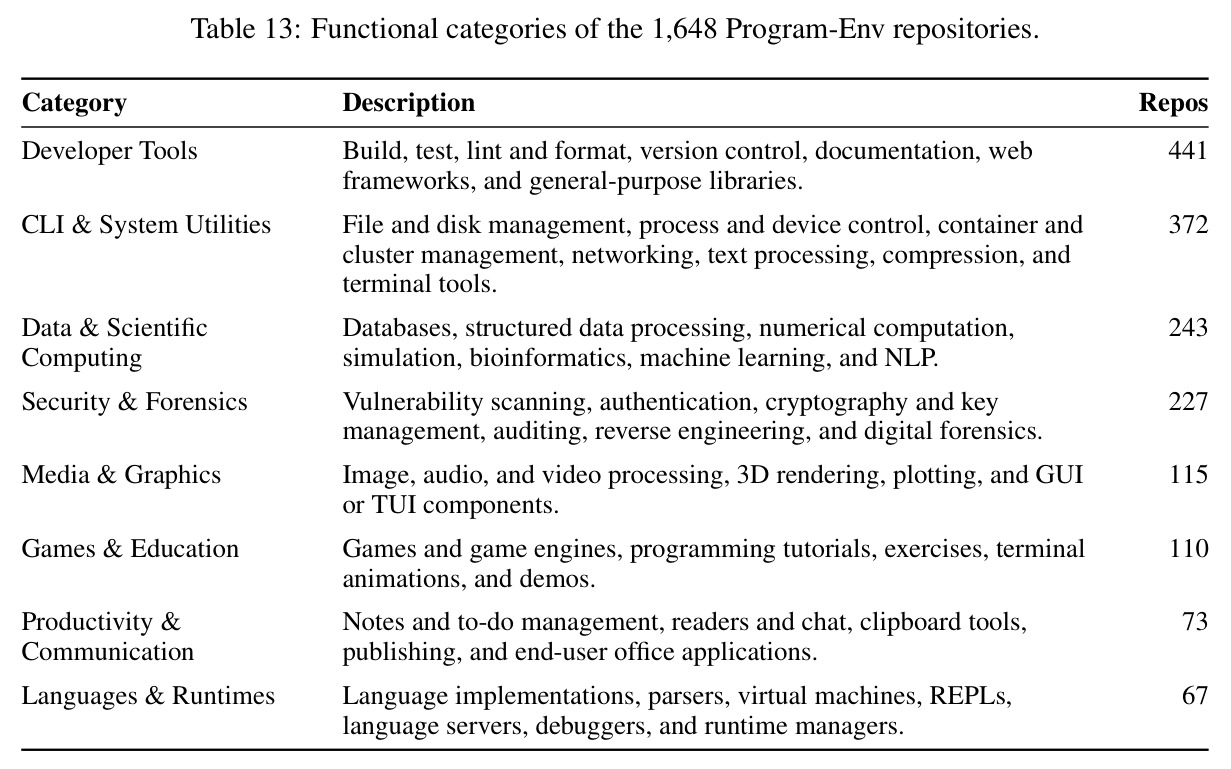
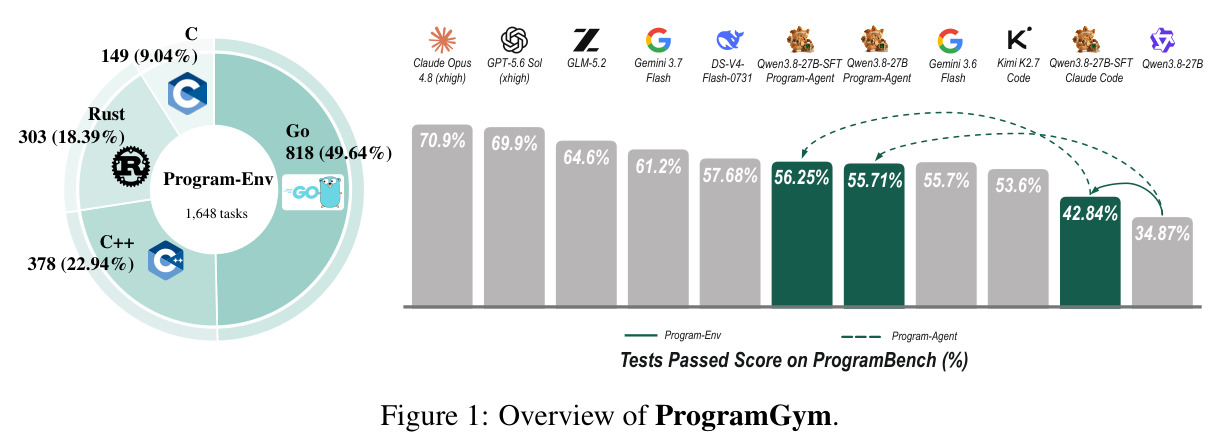
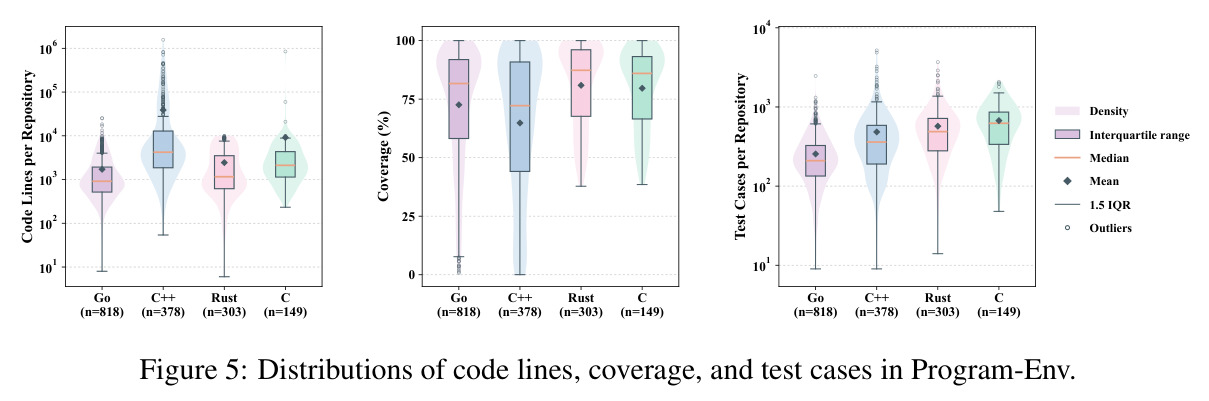
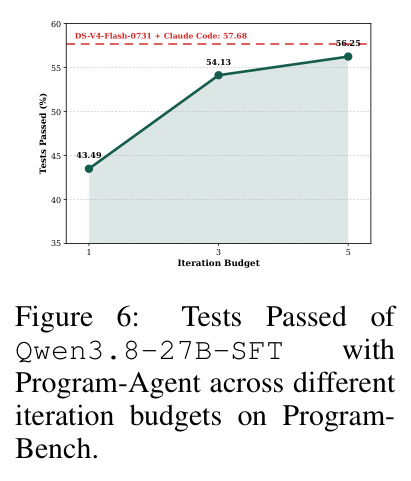
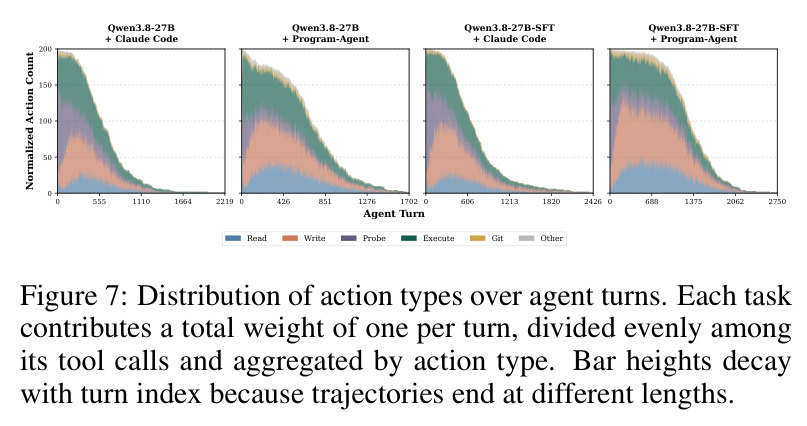
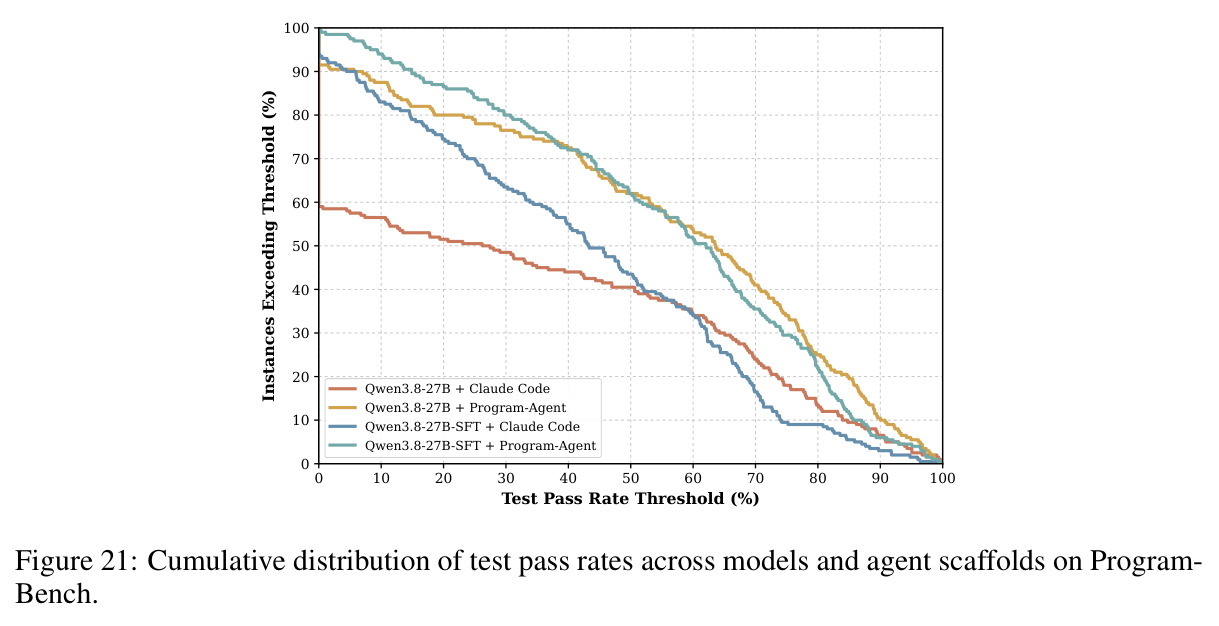
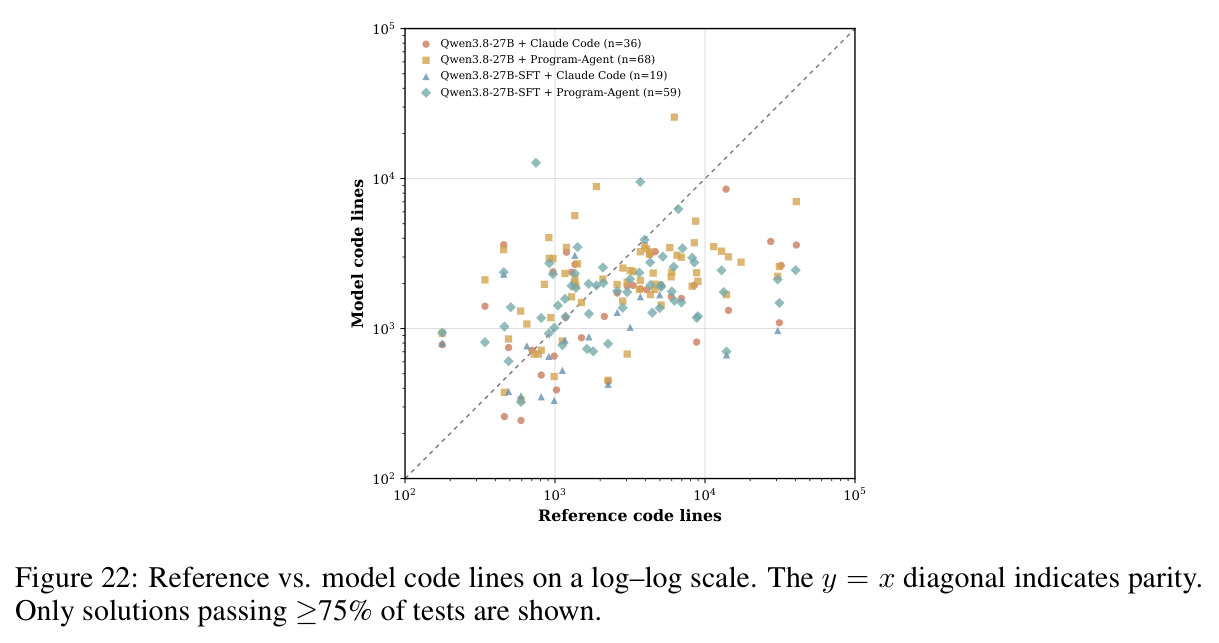
主实验在 ProgramBench 上展开。 RQ1:SFT 让 Qwen3.8-27B 从 34.87% 升至 42.84% Tests Passed(+7.97);换 Program-Agent 后基座达 55.71%(+20.84)、SFT 版达 56.25%(+21.38),均超 Claude Opus 4.7(50.90%)与 Gemini 3.5 Flash(53.60%)。但 Resolved 最高仅 0.50%,完整复现远未解决。 RQ2:1,648 个环境覆盖 C(149)/C++(378)/Go(818)/Rust(303),共 665,512 个测试(均值 404/仓库),平均覆盖率 72.99%。 RQ3:K=1/3/5 下 SFT 模型为 43.49%/54.13%/56.25%,增益主要在前 3 轮。 RQ4:Program-Agent 使 read/git 操作占比上升;≥75% 通过率的任务份额从 18.0%→34.0%(基座)、9.5%→29.5%(SFT);高质量解中位 1,881 行 vs 参考 2,596 行,收益来自更完整的行为覆盖。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ProgramBench 程序复现(Qwen3.8-27B-SFT,最佳配置) | Tests Passed (%) | 56.25(Program-Agent, K=5) | 34.87(同模型 + Claude Code) | +21.38 个百分点;另超过 mini-SWE-agent 下的 Claude Opus 4.7(50.90)与 Gemini 3.5 Flash(53.60) |
| ProgramBench 程序复现(Qwen3.8-27B 基座) | Tests Passed (%) | 55.71(Program-Agent) | 34.87(Claude Code) | +20.84 个百分点,工作流增益远大于 SFT 增益(+7.97) |
| Program-Env 轨迹监督微调(同 harness 对比) | Tests Passed (%) | 42.84(Qwen3.8-27B-SFT + Claude Code) | 34.87(Qwen3.8-27B + Claude Code) | +7.97 个百分点,且超过 GPT 5.4(37.70,mini-SWE-agent) |
| ProgramBench 程序复现(DS-V4-Flash-0731) | Tests Passed (%) | 58.97(Program-Agent) | 57.68(Claude Code) | +1.29 个百分点,强模型上工作流增益边际递减 |
| ProgramBench 部分解决(Qwen3.8-27B) | Almost Resolved (%)(≥95% 测试通过) | 5.50(Program-Agent) | 3.50(Claude Code) | +2.00 个百分点;但完全解决 Resolved 始终 ≤0.50% |
| 测试时扩展(Qwen3.8-27B-SFT + Program-Agent) | Tests Passed (%) 随迭代预算 K | K=1: 43.49 / K=3: 54.13 / K=5: 56.25 | K=1(43.49) | K=1→K=5 提升 12.76 个百分点,增益主要在前 3 轮 |
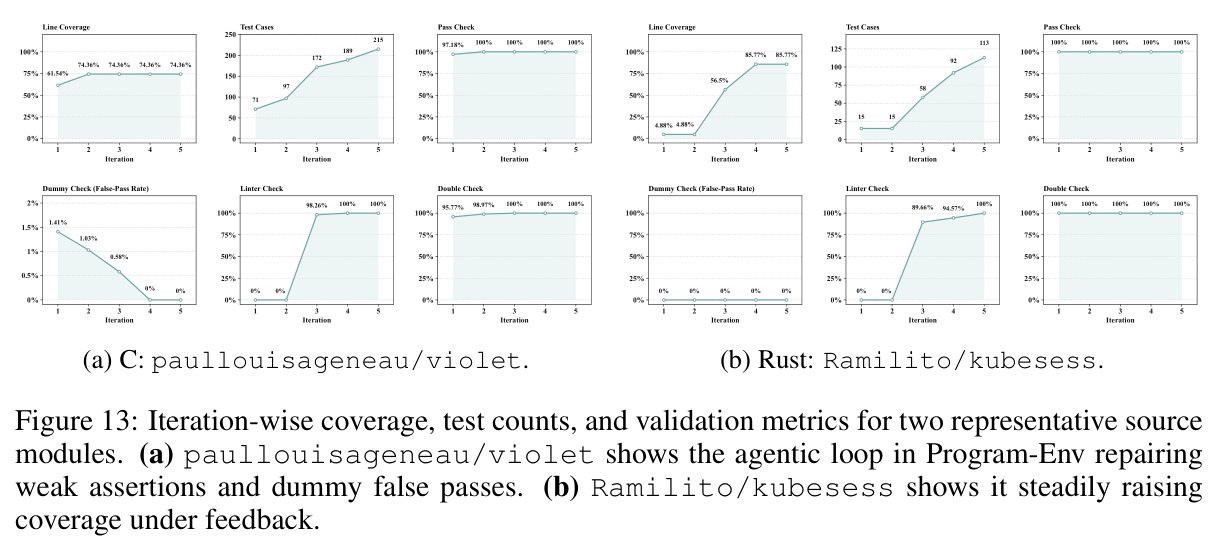
| 训练环境构建质量(Program-Env 本身) | 核心覆盖率 / 测试用例数 | 平均 72.99%(中位 81.63%)/ 665,512 个验证用例(404/仓库) | 单次生成测试(弱断言、低覆盖,论文 Figure 13 案例中 linter 通过率 0%、覆盖 4.88%) | 反馈循环把 violet 的 linter 通过率从 0% 提到 98.3%、假通过率 1.41%→0%,把 kubesess 覆盖率从 4.88% 提到 85.77% |
局限与改进
作者承认的局限: Resolved 最高 0.50%、Almost Resolved 最高 5.50%,Tests Passed 的提升主要来自部分行为恢复,从零复现整个程序远未解决; 任务难度严重偏易——按复杂度分数 $\xi$ 划分,1,648 个任务中 1,492 易、151 中、仅 5 难,作者辩解 $\xi$ 度量仓库规模而非复现难度,且过难任务采不出有效轨迹; 测试只覆盖有限输入,通过测试仅保证已测行为一致而非完整语义等价; 未与 MindForge 直接对比(对方未开源环境与轨迹,无法同协议评测)。我的补充观察: 全链路对 Claude Code 强依赖(环境构建、测试生成、轨迹收集、Program-Agent 底座都是它),结论可能混杂该 harness 的特定行为,换底座只测了 DS-V4 一个额外骨干; SFT 在 Almost Resolved 上反而从 3.50% 降至 1.50%,暗示拒绝采样轨迹可能强化"部分正确"的局部模式; 评测成本高(每任务 8 核 16GB、8 小时时限、K=5 迭代); 5 个 hard 任务难以支撑"可扩展到更难仓库"的论断。
独立分析的弱点
弱点一:验证的"有限输入"本质带来 reward hacking 风险。$T_i$ 只能采样有限输入,训练轨迹又按测试通过率过滤,模型可能过拟合测试可观察行为而非真正理解语义(SFT 后 Almost Resolved 下降即警示)。改进:引入属性测试/模糊测试,或训练行为差异判别器作辅助验证。弱点二:黑盒不可达代码被系统性放弃。平均覆盖 72.99% 且有低覆盖长尾,大量代码无法经公开接口触达,永远得不到监督。改进:白盒约束分析或带桩混合接口扩大可测面。弱点三:环境构建昂贵且不可增量。均值 82.99M token/环境、共 136.77B token,commit 锁定意味着上游演进后环境即过时。改进:差分式更新、跨仓库共享测试模式库。弱点四:固定迭代预算 K 不自适应,简单任务浪费、复杂任务不足,K=5 已近饱和。改进:由评审输出"剩余差异估计"驱动动态预算。弱点五:SFT 学到的可能是特定 harness 的操作习惯——轨迹全部来自 Claude Code+DeepSeek-V4-Flash。改进:跨 harness 混合收集,或转向以四重校验为奖励的强化学习(RLVR)。
未来方向
作者方向: 发布 ProgramGym(环境、构建代码、训练工件),支持社区研究"发现需求、从零设计系统"的编码智能体; 随模型能力增长用同一全自动流水线扩展到 medium/hard 仓库(当前仅 151 中/5 难); 隐含方向是把这些可验证环境用于强化学习——四重校验天然构成过程奖励,论文只做了拒绝采样 SFT。我的延伸: 把"覆盖率反馈+调用图入口回溯+四重校验"范式迁移到其他长程域,如游戏引擎、前端 UI、科学计算库的复现; 用变异测试系统量化测试套件区分错误实现的能力,弥补 dummy check 只有单一 dummy 实现的不足,建立"测试充分性"标准; 多智能体协作:当前实现/评审串行交替,可引入并行多实现者竞争投票或跨任务复用已验证架构方案; 研究成本-质量帕累托前沿:136.77B token 成本绝大部分花在写测试,可用更强早停或"小模型写测试+大模型复审"压缩; 增加"设计质量"评测维度(模块划分、抽象选择),真正度量"从零设计"区别于"按规格实现"的能力——这正是该任务设定最有价值的部分。
复现评估
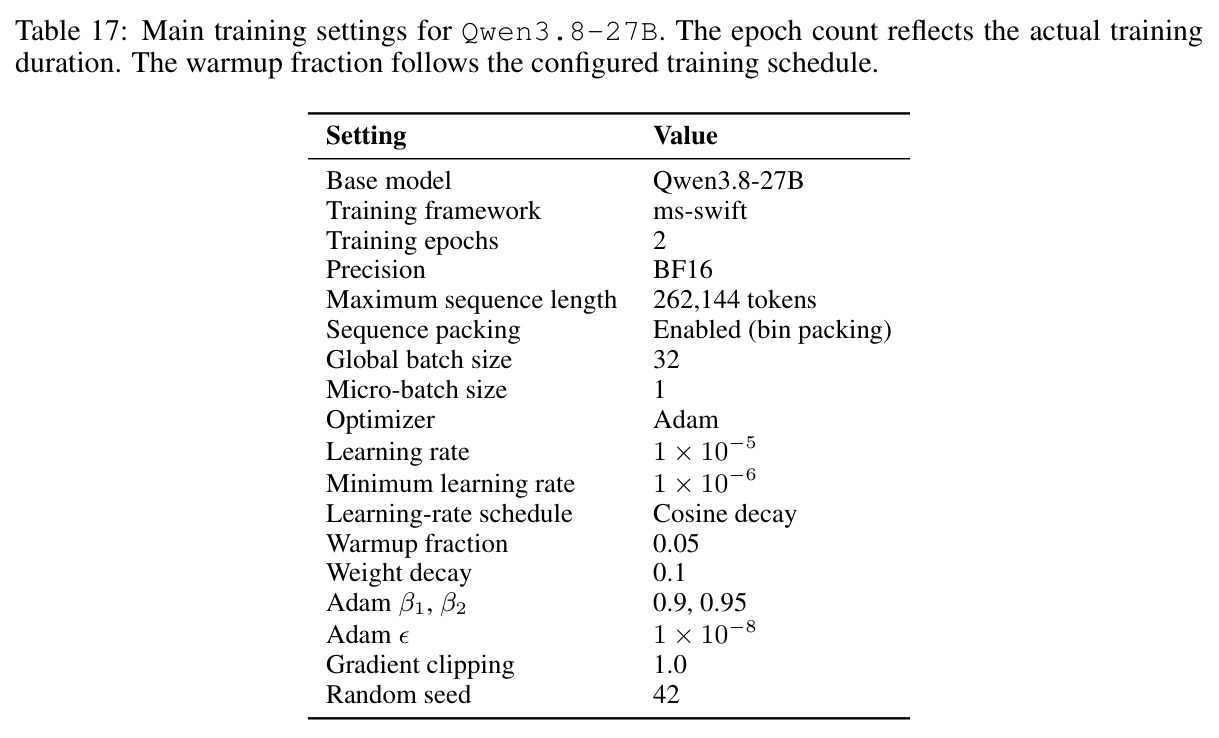
开源与文档:作者承诺在 huggingface.co/ProgramGym 与 programgym.github.io 发布全部工件,Reproducibility Statement 逐环节给出指引:仓库收集四阶段过滤(附录 B.1、表 3)、构建与沙箱(B.2,linter 规则表 5、修复建议表 6)、dispatcher 与插桩(B.3)、测试四重校验(B.4,37 条规则与式 (3))、Program-Agent 编排(附录 C,算法 1、访问矩阵表 15)、训练超参(表 17:Qwen3.8-27B 全参、ms-swift、2 epoch、BF16、序列 262,144、lr $1\times10^{-5}$ 余弦衰减)。实际复现评估:管道全自动但极昂贵——1,648 环境耗 136.77B token,个人难复制全集,但自动化意味着可选小子集构建;27B 全参微调需多卡集群;评测容器规格明确(8 核/16GB/30GB/8 小时)。工件兑现后中等规模实验室可用子集环境+高效微调复现核心结论;目前工件尚未放出,最终取决于承诺兑现。
论文图表