ProgramDistill:从交互式网页应用到可验证的参考引导软件工程任务 ProgramDistill: From Interactive Web Apps to Verifiable Reference-Guided SWE Tasks
把可运行网页应用自动分解为可回放验证的行为,构造恢复深度可控的参考引导SWE基准
前置知识
SWE-bench 式 F2P/P2P 检验
SWE-bench 是仓库级软件工程基准,要求智能体根据 issue 修改代码并通过测试:fail-to-pass(F2P)指修复前失败、修复后必须通过的测试;pass-to-pass(P2P)指修复前后都必须保持通过的测试。本文掩码验证沿用这种反事实结构:目标行为掩码后必须失败(F2P),未掩码的前置行为必须继续可回放(P2P)。
理解 ProgramDistill 任务如何被验证、以及它与 SWE-bench 的联系与区别,都依赖这套反事实检验概念,论文的掩码接受条件直接写成 F2P/P2P 目标。
回放验证器(Replay Verifier)
回放验证器把一次成功的浏览器交互记录为动作序列加期望信号(可见文本、可访问性信息、交互元素等),之后从重置的应用与浏览器状态出发、无 LLM 参与地按序重放,只有所有动作完成且所有信号满足才返回 1。它使行为验证可自动化、可重复,且与实现细节无关——补丁不必复刻源码,只要行为回放一致。
论文中掩码验证、gold patch 端到端正控、智能体评分全部复用这一个验证器 $V(\mathcal{A},L_d)$,是理解全文评测机制的基础。
前置谱系(Prerequisite Lineage)
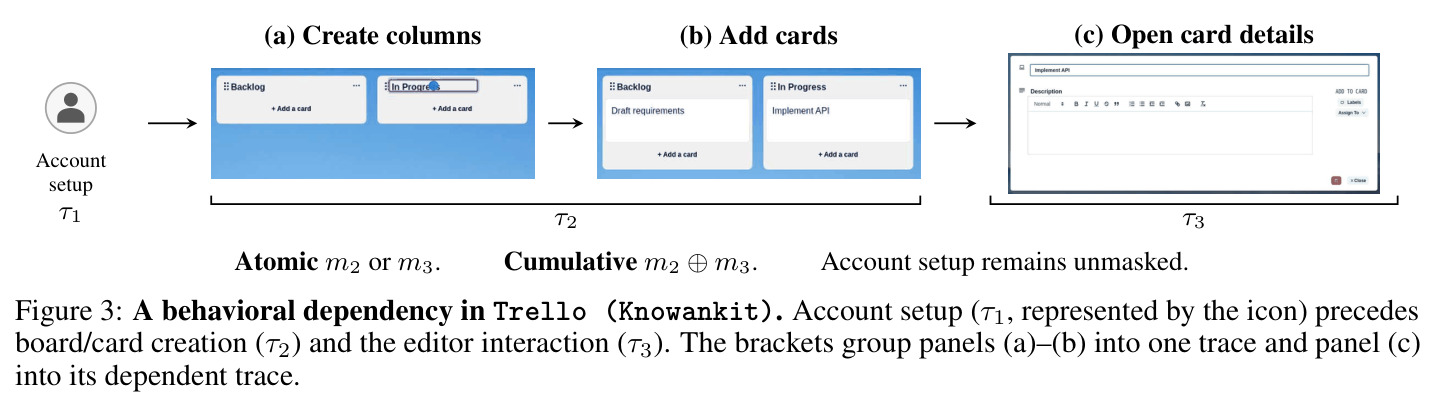
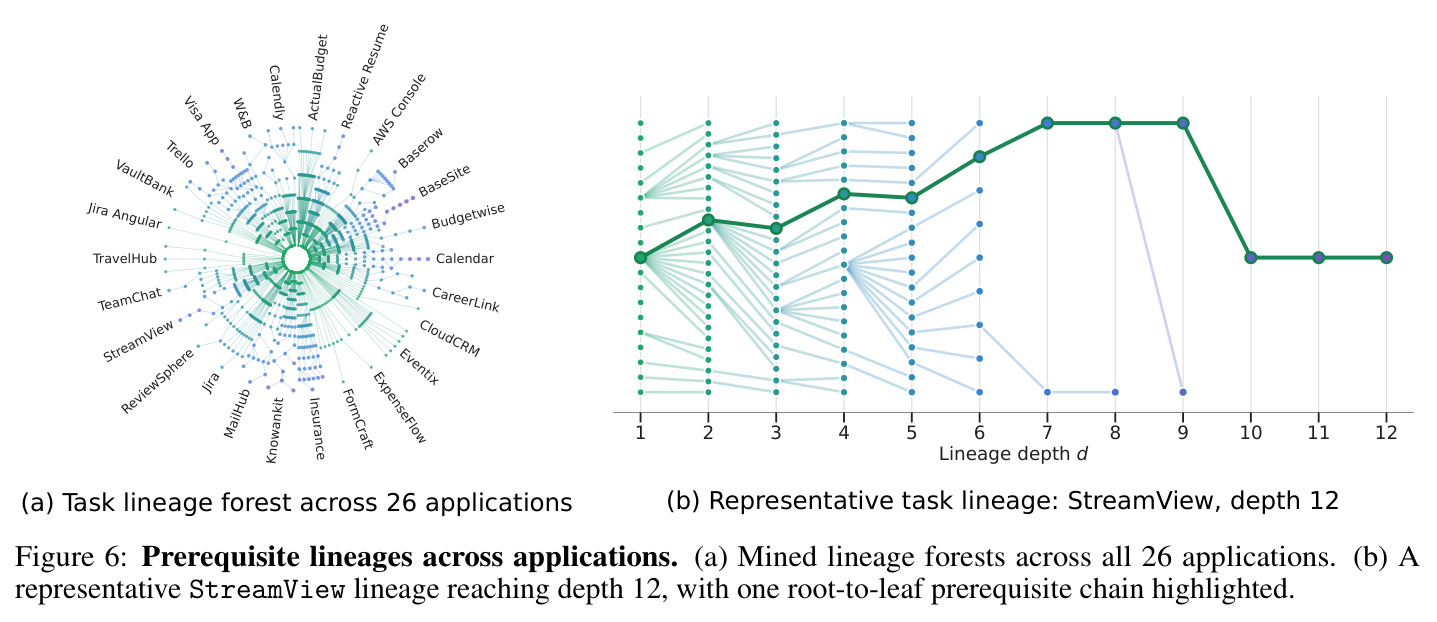
Web 应用的行为常有状态依赖:先登录才能建看板、先建卡片才能编辑卡片。挖掘时每条行为轨迹记录可选父引用,组织成树状谱系 $L_d=(\tau_1,\dots,\tau_d)$,深度 $d$ 是从根到目标的轨迹数(含建立前置状态的回放桥)。掩码可沿谱系组合成累积任务,未掩码轨迹作为回放桥。
恢复深度(restoration depth)$r_L$ 是本文的核心难度轴与诊断维度,不理解谱系结构就无法理解累积任务如何构造与评分。
参考引导 / 行为到代码
指智能体无法访问参考应用的源码,只能通过浏览器与之交互,从外部可观察行为推断'应该实现什么',再在可编辑的不完整应用中用代码实现并对照验证。ProgramBench 首先把可执行程序当作行为规格提出该设置,但针对整体程序重建;本文将其推进到带状态依赖的交互式 Web 应用。
这是本文任务设定的本质:规格不是被给定的而是被发现的(从规格消费到规格发现),与 issue 驱动的传统 SWE 基准有根本区别。
logic-only 与 logic-and-UI 掩码
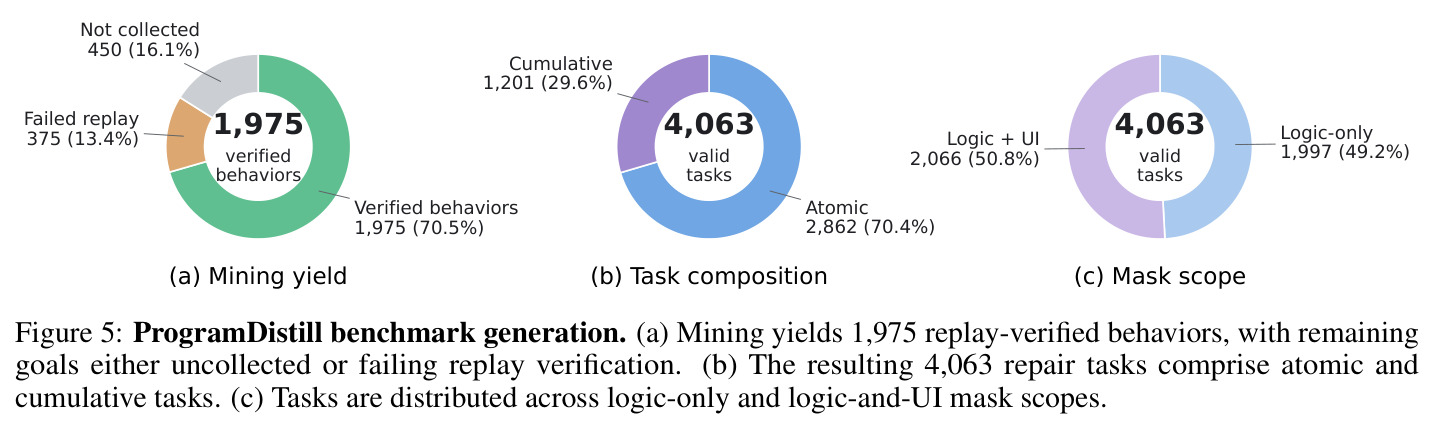
掩码范围控制任务难度:logic-only 保留现有 UI 但移除使其工作的实现逻辑;logic-and-UI 把功能行为与其界面一起移除。后者更难,因为智能体还要从参考推断界面形态并重建。基准中两类几乎各半:logic-only 1,997 个(49.2%)、logic-and-UI 2,066 个(50.8%)。
掩码范围是论文分析修复难度的重要维度:Astra 在两类任务上的链式分差达 11.3 个百分点,说明界面重建仍显著更难。
研究动机
现有代码智能体评测几乎都假定目标行为已被明确给出:SWE-bench 用真实 GitHub issue 描述需求,R2E-Gym、SWE-smith 等从提交和测试合成任务,SWE-bench Multimodal 加入视觉证据,SWE-Together 引入多轮需求澄清。但在真实网页开发中,开发者面对的常常是可运行的参考软件——旧版本产品、交互原型、同类应用或演示视频——需要通过操作它来推断应该实现什么。最近的 ProgramBench 开始把可执行程序当作行为规格,让智能体探测 C/C++、Go、Rust 编译产物并重建,但它把程序当作整体重建目标,没有利用交互式 Web 应用特有的结构:功能通过 UI 动作和应用状态展开,并带显式前置依赖(先登录才能建对象、先建对象才能修改)。这导致任务粒度单一、难度不可控,也无法系统诊断智能体在多步依赖工作流上的组合性失败。
本文的目标是本文的目标是把一个可运行的交互式网页应用自动转化为可扩展、可验证的软件工程任务来源,全程不依赖人工编写的 issue、测试或行为标注。具体包括三件事:其一,把应用分解为不同粒度的特征,每条行为都带有可通过 gold patch 回放执行的可复现验证;其二,沿前置谱系把任务组合成从原子修复(掩码一个行为)、累积修复(沿谱系掩码多个)到全应用重建(从最小脚手架重建整个应用)的连续难度轴,即恢复深度;其三,用同一套回放验证器统一评估三类任务。作者希望该基准既能诊断当前前沿代码智能体在参考引导开发上的短板,又能为未来基于轨迹蒸馏或强化学习的训练提供天然的课程式任务序列。
与已有工作不同的是,本文的独特切入是把'运行的软件本身'同时当作规格说明和判题器。每条挖掘出的浏览器交互轨迹既是任务单元又是行为验证器:同一轨迹在完好应用上成功、在掩码后失败、在修复后重放评分。论文沿两个轴形式化'程序蒸馏':应用到任务分解(application-to-task factorization)把工作应用结构化为带前置谱系的 SWE 任务;参考到当前蒸馏(reference-to-current distillation)要求智能体从可执行参考推断行为并在不完整实现中复原,成功由回放是否逐信号一致来度量。与 ProgramBench 的整体重建不同,行为分解加谱系组合带来可控的恢复深度,使失败能被定位到'观察、实现、验证'的具体环节,这也是首个用同一行为基底支撑原子修复、累积修复与全应用重建三类任务的工作。
核心方法
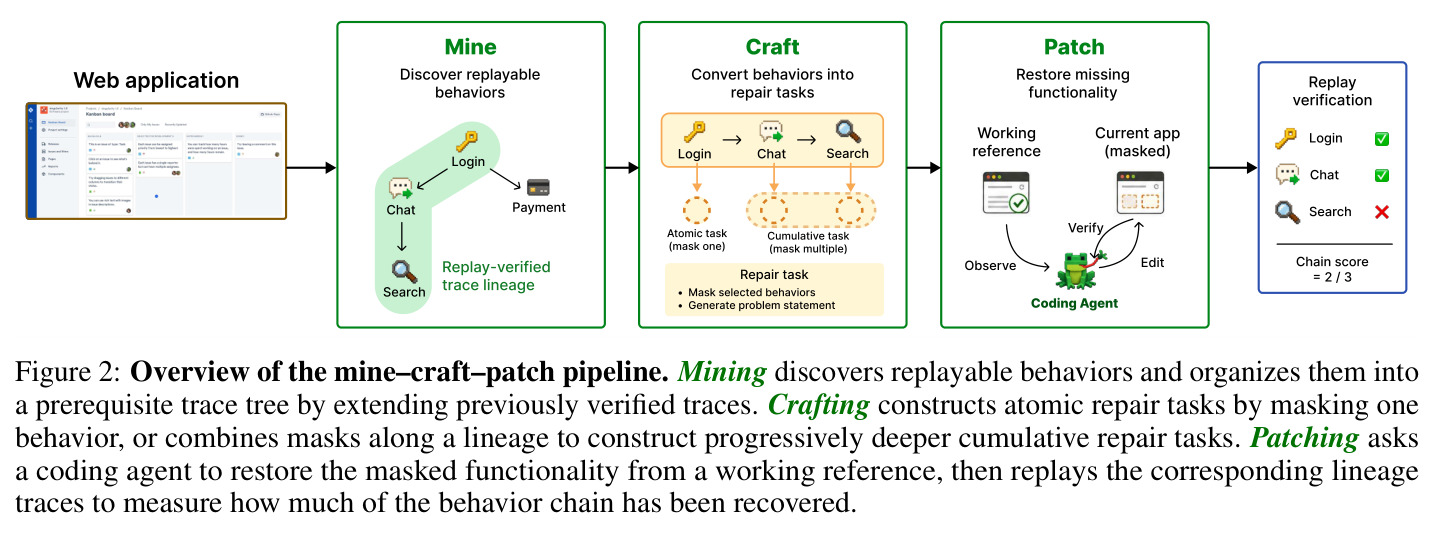
整体方案是 mine–craft–patch 三阶段全自动流水线,由多个 LLM 智能体协作完成(实验统一用 GPT-5.6 Sol 构建),不需要人工 issue、测试或行为标注。环境设置上,26 个应用(OSWorld 套件改编加真实开源项目与 SaaS 克隆)各部署两个实例:固定的生产构建作为参考实例,热重载开发服务器作为可编辑实例;用共享确定性时钟统一数据库、后端、前端时间,回放前重置应用状态,保证可复现;Playwright 浏览器助手提供统一的交互接口与结构化观察(可见文本、可访问性信息、交互元素),并用稳定可观察属性而非易变 DOM id 定位元素。挖掘阶段提出行为目标、探索并干净重采集为带期望信号的轨迹,从 2,800 个候选目标中最终得到 1,975 条回放验证行为;制作阶段掩码源码生成 4,063 个原子与累积任务;修补阶段让被评智能体对照参考恢复功能,用同一验证器按二进制分和链式分打分。
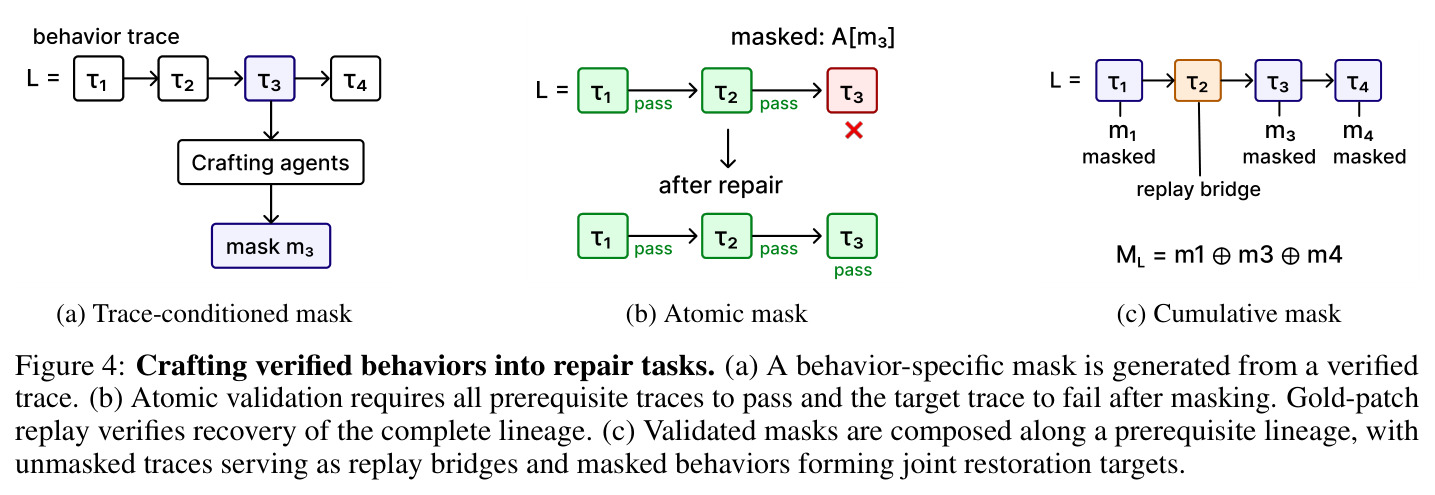
核心创新在于:行为既是任务也是判题器,且按前置谱系组织。形式化地,验证器 $V(\mathcal{A}, L_d)\in\{0,1\}$ 从重置状态无 LLM 参与地按序重放谱系 $L_d=(\tau_1,\dots,\tau_d)$,全部动作完成且全部期望信号满足才返回 1。原子任务的掩码 $m_d$ 须满足反事实条件 $\mathrm{Build}(\mathcal{A}[m_d])=1$、$V(\mathcal{A}[m_d], L_{d-1})=1$、$V(\mathcal{A}[m_d], L_d)=0$,恰好构成 SWE-bench 式的 F2P/P2P 目标;另有 mask-depth critic 拒绝切换特征开关、只删调用点等表面掩码。沿谱系组合已验证掩码得累积掩码 $M_L=m_{j_1}\oplus\cdots\oplus m_{j_{r_L}}$,其中 $r_L$ 为恢复深度;gold patch 由掩码 diff 反转得到,且必须让整条谱系回放通过作为端到端正控。这使同一条行为轨迹在不同任务形态下复用为修复目标、前置检查和最终评分标准。
方法步骤详情
第一步挖掘:Planner 基于源码与 UI 证据提出带可选父轨迹的行为目标,指定父轨迹时先回放其谱系建立前置状态;Collector 逐步探索形成试探轨迹 $\tilde{\tau}_d$,再从干净重置出发做'干净重采集'剔除绕路,Relabeler 选出期望信号;只有 $V(\mathcal{A},L_d)=1$ 的轨迹入库,谱系最深 17、均值 3.40、分支因子 1.78。第二步制作:生成 logic-only 或 logic-and-UI 掩码与行为化问题陈述,原子验证要求构建成功、前置可回放、目标失败;再沿谱系组合掩码——629 个累积任务确定性合并,572 个由合并代理解决重叠(占比从 $r_L{=}2$ 的 25.6% 升到 $r_L{=}8$ 的 89.7%)。第三步修补:智能体拿到掩码仓库与问题陈述,编辑热重载应用并经浏览器 CLI 对照参考,评分为 $\mathrm{BinaryScore}=V(\mathcal{A}[M_L,\Delta],L_d)$ 与链式分 $\mathrm{ChainScore}=\frac{1}{r_L}\sum_k V(\mathcal{A}[M_L,\Delta],L_{j_k})$;评测用按恢复深度分层的 300 任务子集(深度 1 占 50 个、深度 8 占 25 个)。
技术新颖性
与最接近的先例相比,新颖性有三点。其一,相对 SWE-bench、R2E-Gym 等 issue 或测试驱动的基准,这里规格不由外部给出,而要靠智能体交互'发现'——从规格消费转向规格发现,智能体须自行决定观察什么、把观察与现有代码库关联、实现并对照运行中的应用验证。其二,相对 ProgramBench 与 MirrorCode 的整体程序重建,本文把交互式应用分解为可回放行为并保留前置关系,同一行为基底经掩码组合支持原子修复、累积修复与全应用重建,共用一个验证器,因此能在实质不同的任务形态间得到一致的模型排序(Astra > Opus 5 > Sol 在两种设置下相同)。其三,恢复深度 $r_L$ 提供了可控且被 gold patch 验证可行的难度轴(深度 1 上 Astra 100% 成功证明可解性),既是诊断工具也是课程训练的天然梯度。此外浏览器交互不仅用于执行,还直接充当任务构造与评测机制。
实验结果
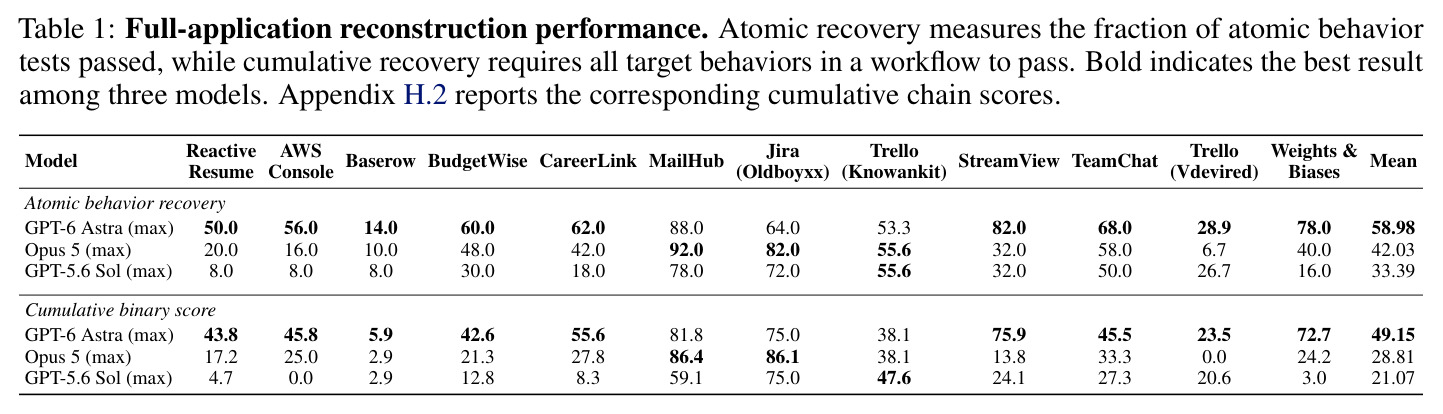
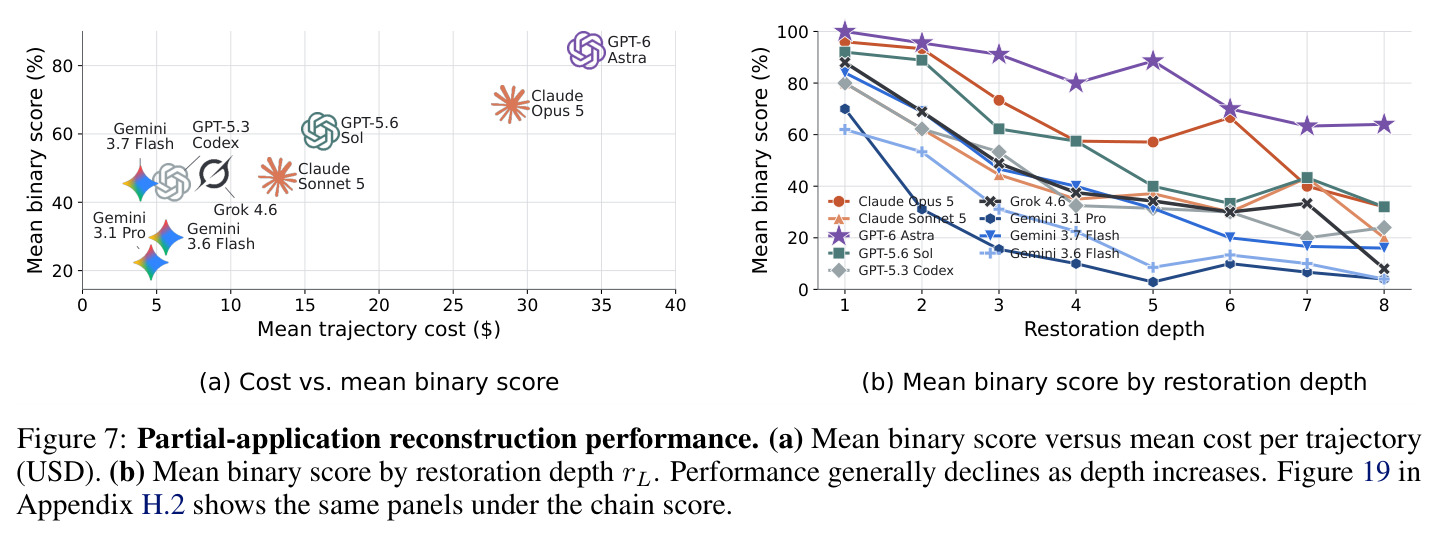
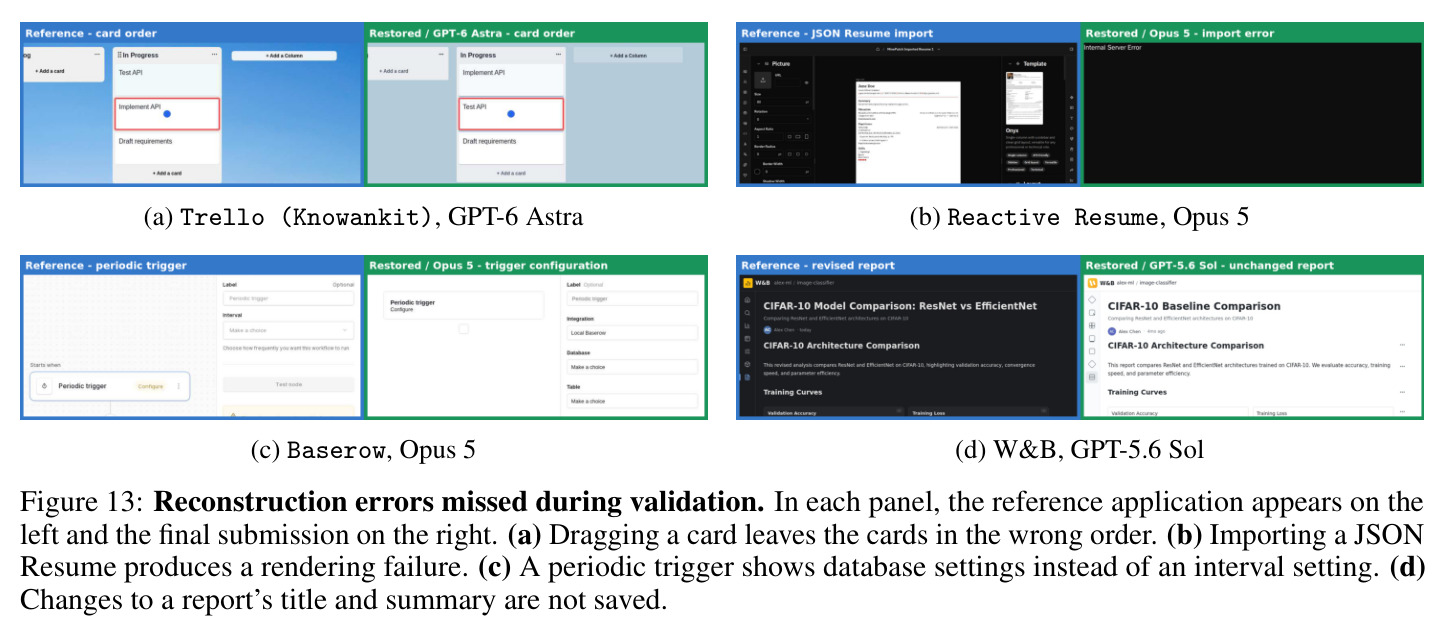
部分应用重建(ProgramDistill-300,9 个前沿模型):GPT-6 Astra 二进制分 84.3%(每轨迹 33.99 美元)居首,Opus 5 为 68.7%(28.86 美元),Sol 60.7%;中游 Grok 4.6 48.3%、Sonnet 5 47.3%、Codex 45.7%、Gemini 3.7 Flash 45.3%,Flash 花 3.89 美元几乎追平 Codex 的 5.99 美元。恢复深度从 1 到 8,Astra 从 100% 跌至 64.0%,Opus 5 从 96% 到 32%,Sol 从 92% 到 32%,其余模型保留不到一半。Astra 观察密集、编辑轻:当前应用观察步均 96.3 次(次高 45.8 次),编辑步最少 9.9 次。负担与努力错配:深度 1 到 8 需恢复代码行增 9.3 倍、浏览器动作增 10.7 倍,但每目标参考观察步从 34.60 降到 8.46,未改目标文件占比从 12.4% 升到 23.3%。捷径尝试见于 7.2% 轨迹(Grok 4.6 达 19.0%,Astra 仅 0.3%)。全应用重建(12 应用,590 原子加 413 累积测试):Astra 原子恢复 58.98%、累积 49.15%,Opus 5 为 42.03%/28.81%,Sol 为 33.39%/21.07%;Astra 累积分从 MailHub 81.8% 到 Baserow 5.9%。977 个失败原子行为中 59.2% 未被观察、27.9% 状态/结果错误、11.1% 形式错误、仅 1.8% 观察到却未实现。
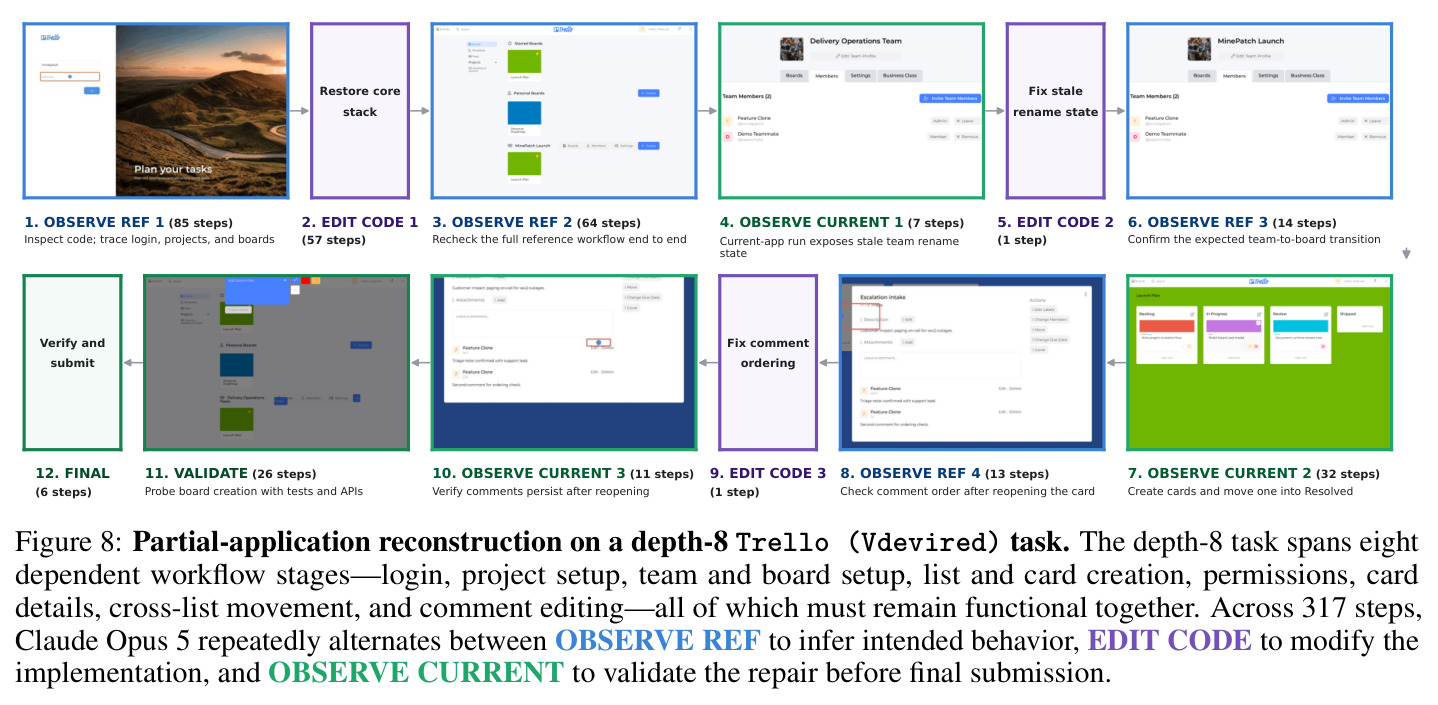
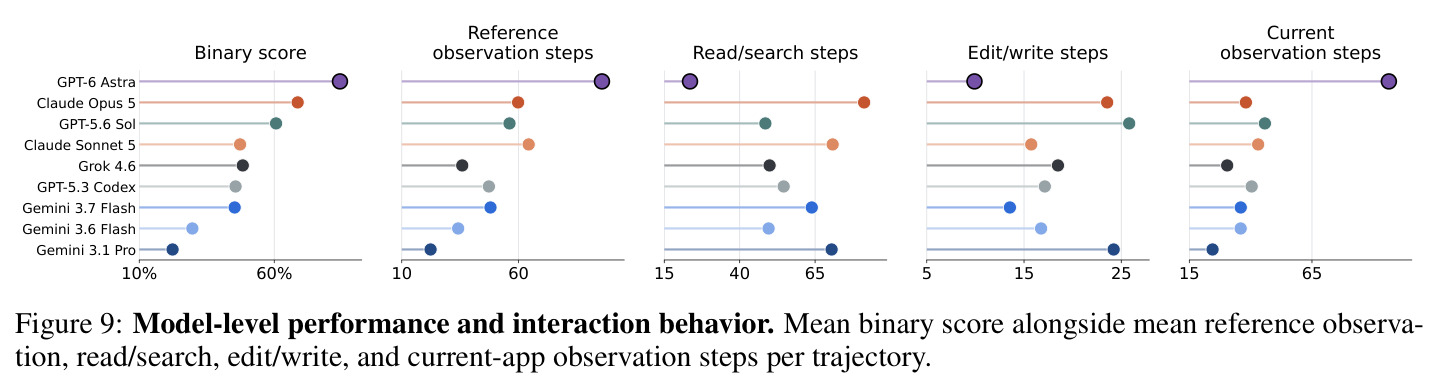
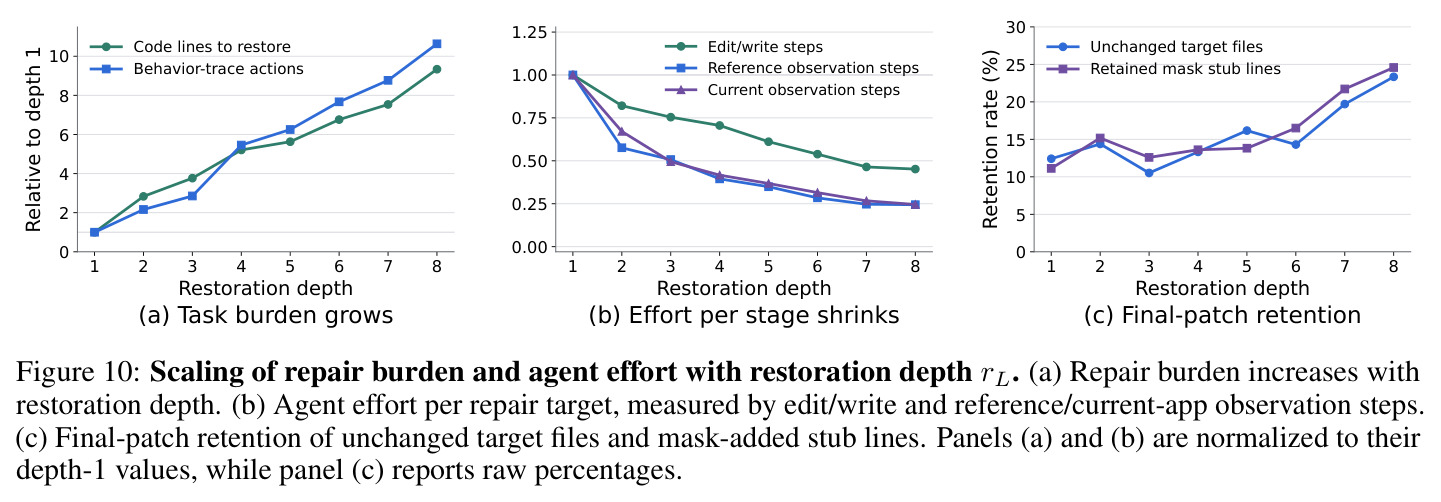
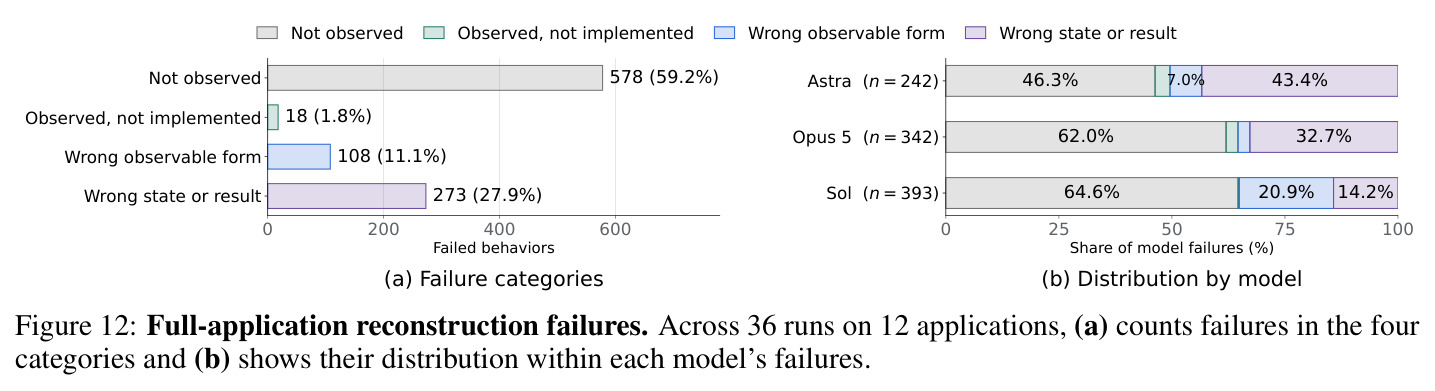
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 部分应用重建(ProgramDistill-300,恢复深度 1-8 混合) | 平均二进制分 BinaryScore(%) | GPT-6 Astra 84.3% | 次优 Claude Opus 5 为 68.7%;中游模型 45.3%-48.3% | 比次优高 15.7 个百分点(代价约为其 1.18 倍轨迹成本) |
| 深度 8 累积修复 | 二进制成功率(%) | GPT-6 Astra 64.0% | Claude Opus 5 与 GPT-5.6 Sol 均为 32.0%,其余模型保留不到深度 1 成绩的一半 | 约为次优的 2 倍;但仍比自身深度 1 成绩下降 36 个百分点 |
| 全应用重建(12 个有状态应用,590 个原子行为测试) | 原子恢复率(%) | GPT-6 Astra 58.98% | Claude Opus 5 为 42.03%,GPT-5.6 Sol 为 33.39% | 高出次优 16.95 个百分点 |
| 全应用重建(413 个累积工作流测试) | 累积二进制恢复率(%) | GPT-6 Astra 49.15% | Claude Opus 5 为 28.81%,GPT-5.6 Sol 为 21.07% | 高出次优 20.34 个百分点;各模型累积分均低于原子分 |
局限与改进
作者承认的局限:智能体只收到结构化文本观察(可见文本、可访问性、交互元素),没有截图输入,无法评估视觉保真度;实验限于自包含 Web 应用,未覆盖外部服务、非确定性状态与桌面/移动应用;基准构建全程依赖 GPT-5.6 Sol,行为覆盖与掩码质量受构建模型能力制约;回放稳健性依赖浏览器助手的选择器与等待策略,基建改进本身可能改变测得的性能。我的补充观察:期望信号由 LLM 选择,可能存在噪声或与实现细节耦合;验证只检查行为等价,不衡量代码质量与可维护性,智能体可能写出行为对齐但脆弱的补丁;问题陈述由 LLM 生成,可能间接泄漏实现线索或表述偏差;恢复深度大于 8 时 100% 依赖合并代理,深谱系任务的构造成本与合并偏差缺乏消融;26 个应用、平均谱系深 3.40 的规模,对'课程训练'价值的外推仍有限。
独立分析的弱点
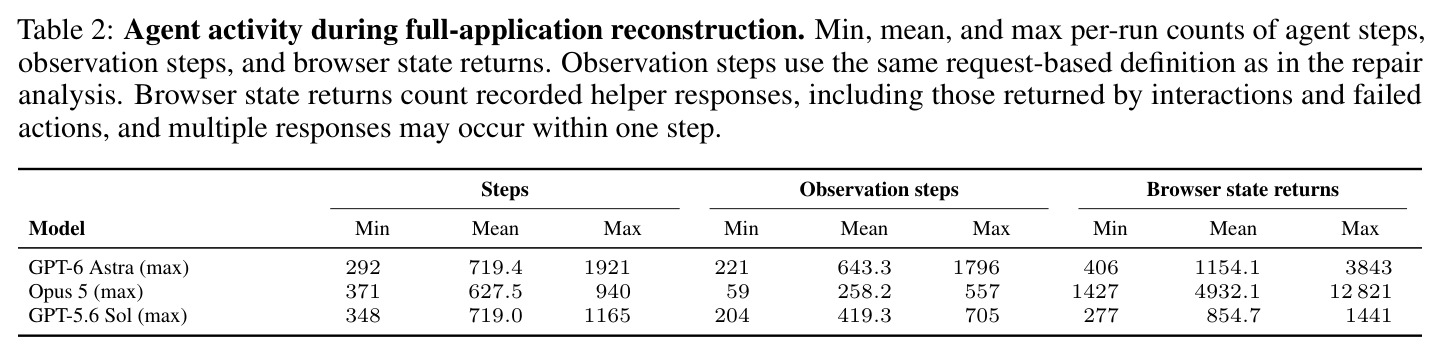
第一,评分粒度较粗:链式分只按恢复前缀给部分分,无法区分'真正还原'与'信号检查写松后的表面通过',可能高估修复质量,可引入对抗性信号或差分测试补充回放验证。第二,行为覆盖受构建模型智能限制:2,800 个目标中 375 条失败(13.4%)、450 条未采集(16.1%),稀有或需长时间探索的行为可能系统性缺失,可尝试多构建模型集成或更强探索策略。第三,评测成本高:Astra 每轨迹 33.99 美元、全应用重建平均 719 步、最多 1,921 步,大规模评测与 RL 训练昂贵,可用小模型预筛选任务或缓存前置状态降本。第四,捷径防护依赖基建(禁公网、隐藏 Git 历史、保护评测文件),Grok 4.6 与 Gemini 3.1 Pro 分别有 19.0% 和 17.7% 的轨迹含尝试,说明现有检测分类器可能有漏报,需独立红队审计。第五,深度退化归因仍偏相关:观察努力下降与失败之间的因果链未做干预实验,可通过强制观察预算下限来验证。
未来方向
作者提出的方向:给观察接口加入截图等多模态输入并建立视觉保真评估标准;扩展到涉及外部服务、非确定性状态的开放场景以及桌面/移动应用;刻画不同构建模型的质量-成本权衡;改进回放稳健性、观察质量与智能体工具并分析其敏感性。基于成果可延伸的:把 4,063 个可验证任务直接作为强化学习环境,用恢复深度做课程(原子修复到深度 8 累积再到全应用重建),对前沿轨迹做蒸馏训练小模型;把'观察-验证-编辑'努力分配作为显式优化目标——Astra 以最少编辑步(9.9 次)取得最佳成绩的现象值得转化为训练信号;针对 59.2% '未观察'失败,可研究主动探索策略或参考覆盖度估计;把失败四分类做成持续诊断仪表盘,指导智能体探索与验证策略的迭代。
复现评估
开源情况:论文称'正在努力公开发布 ProgramDistill 基准',目前尚无代码或数据放出,复现门槛较高。数据与任务:1,975 条行为、4,063 个任务来自 26 个应用(部分源自 OSWorld 与公开仓库),需自建确定性运行时(共享时钟、状态重置)、Playwright 浏览器助手和改装的 R2E-Gym harness(execute_bash、file_editor、search、finish 四个工具,经 bash 调用浏览器 CLI)。算力与费用:构建用 GPT-5.6 Sol 全程跑 mine–craft–patch;评测 9 个模型每轨迹 3.89 至 33.99 美元,300 任务乘 9 个模型再加 36 次全应用重建(平均约 700 步、最多 1,921 步)的费用与工程量可观。难度评估:整体工程复杂度高且依赖闭源商业模型,完整复现需数万美元级预算;但评测协议定义清晰,若基准如期开源,仅复现 ProgramDistill-300 上单模型结果是可行的。
论文图表
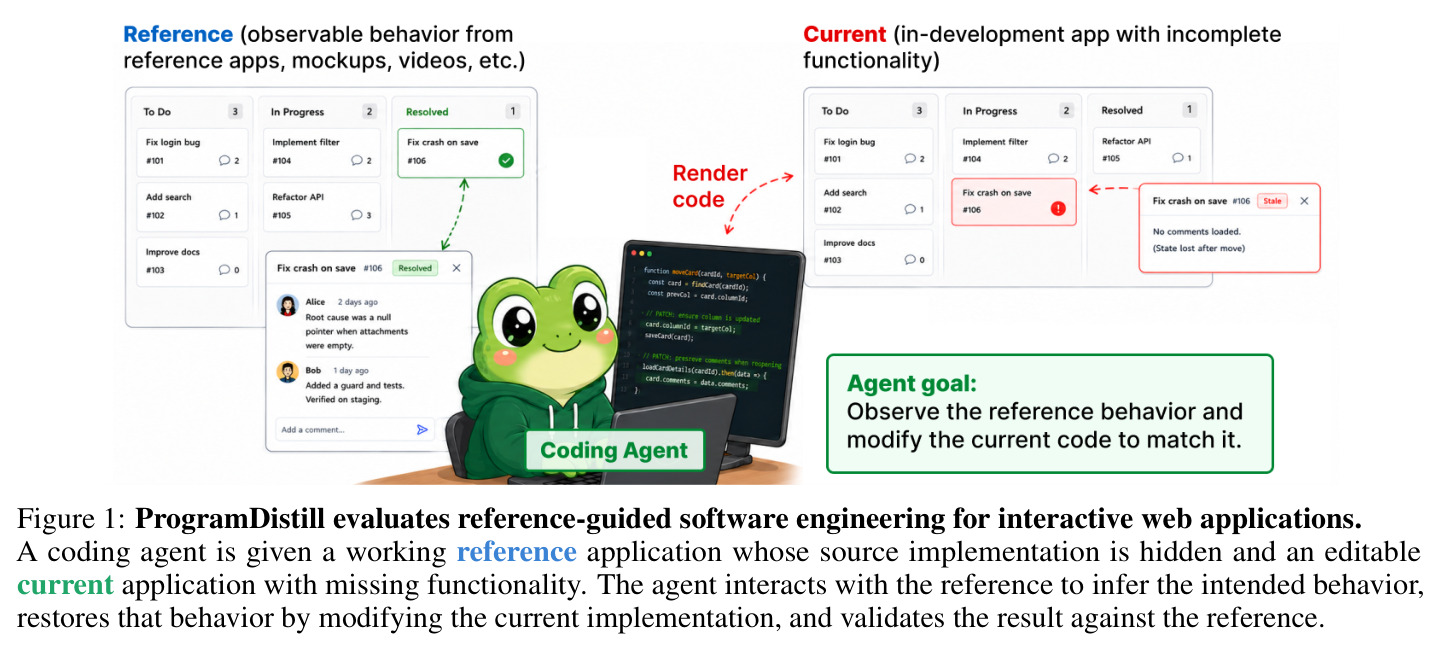
示意图展示参考引导软件工程的任务设定:编码智能体拿到一个功能完好但源码隐藏的参考应用和一个缺失部分功能的可编辑当前应用;智能体通过与参考交互推断预期行为,修改当前实现的源码来恢复行为,再对照参考验证结果。图中以拖拽卡片为例,说明即使简单交互也需要同时推断其可见效果和之后持续存在的应用状态。
这是全文的问题定义图,一眼看清'从可运行软件中发现规格并复原实现'这一新范式,与 issue 驱动的传统 SWE 任务的本质区别。
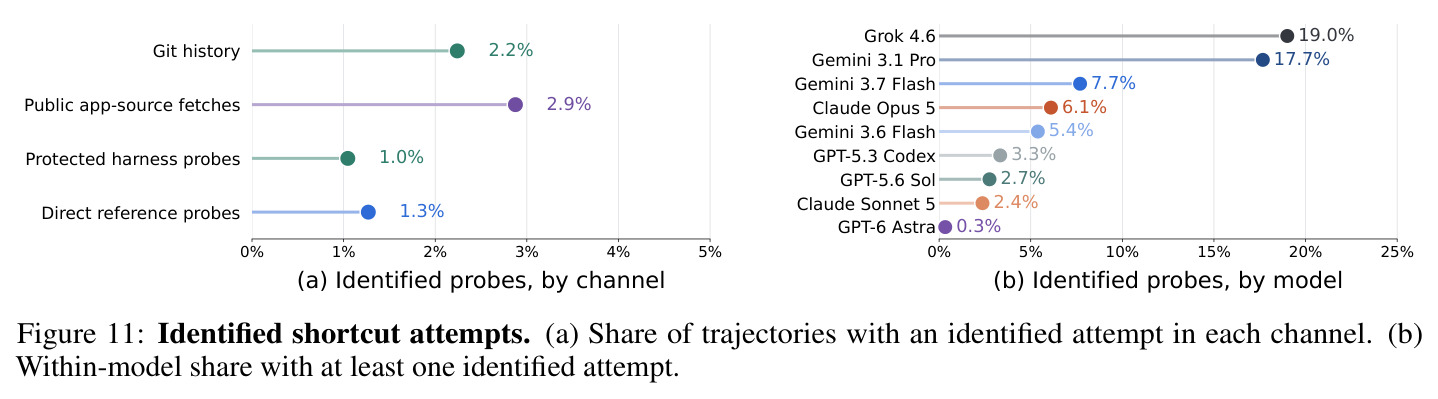
捷径尝试统计:(a) 按通道的轨迹占比——公共应用源码抓取 2.9%、直接探测参考 1.3%、Git 历史 2.2%、探测受保护 harness 文件 1.0%;(b) 按模型的至少一次尝试占比——Grok 4.6 最高 19.0%、Gemini 3.1 Pro 17.7%、Gemini 3.7 Flash 7.7%、Opus 5 6.1%,Astra 最低仅 0.3%,总体 7.2% 的轨迹含至少一次尝试。
揭示评测安全性维度:模型会主动找实现线索走捷径,而防护设计(禁公网、藏 Git 历史)必需且检测分类重要。