SoftwareGym:用多样化合成软件环境规模化训练计算机操作智能体 SoftwareGym: Scaling Computer-Use Agent Training with Diverse Synthesized Software Environments
自动合成182个可运行桌面软件,让9B模型OSWorld Pass@3提升15.6点
前置知识
CUA(Computer-Use Agent,计算机操作智能体)
以屏幕截图为观测、以鼠标点击和键盘输入为动作、在真实桌面操作系统里完成用户任务的通用智能体。它不依赖 API 或 DOM,而是像人一样『看屏幕、动鼠标』,因此训练它需要能在真实 GUI 上执行操作的软件环境。
本文的全部目标就是为 CUA 批量制造『可执行、可验证、多样』的训练环境,并在这些环境里采集训练轨迹。
OSWorld 与 Pass@3
OSWorld 是最常用的桌面智能体基准,含 244 个真实任务,覆盖 Chrome、GIMP、LibreOffice Calc/Impress/Writer、Thunderbird、VLC、VS Code 八个应用域。Pass@3 表示每个任务独立采样 3 次、至少一次成功即算通过,反映模型的能力上限而非平均稳定性。
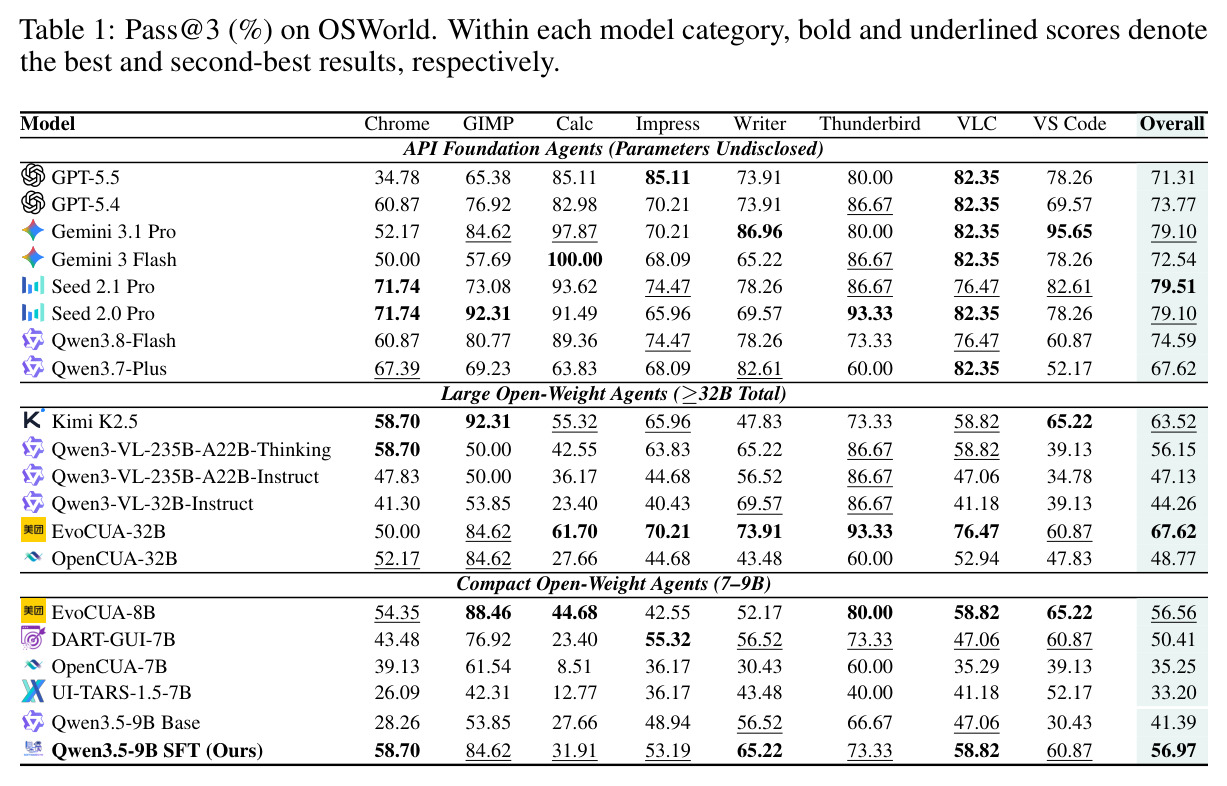
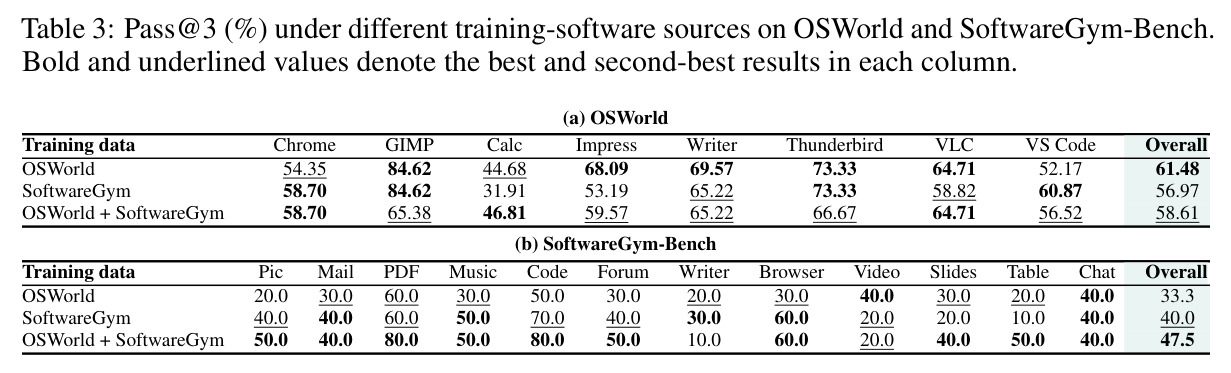
论文的核心主张是域外迁移:只用合成软件训练、完全不用 OSWorld 数据,看 OSWorld Pass@3 提升多少(41.39%→56.97%)。
检查点式 GUI 评估(checkpoint-based GUI evaluation)
让一个『评估智能体』真实地用鼠标键盘操作被测应用,每个测试用例从明确初始状态出发、只使用文档化功能,并定义若干可见的验收检查点;全部检查点通过才计成功。通过率 $P_{func} = N_{pass}/N_{all}$。
这是 SoftwareGym 保证环境可靠性的关键机制:应用必须『被真的点过、验过』才能入库,任务也只允许使用验证过的功能。
树编辑距离(Tree-Edit Distance, TED)
衡量两棵树之间最少需要多少次节点插入、删除、替换操作才能互相转换的经典度量(Zhang-Shasha 算法)。论文把 UI 蓝图解析为去掉颜色字体等视觉属性的归一化布局树,定义 $d_{ij} = \min(1, \mathrm{TED}(T_i,T_j)/\max(|T_i|,|T_j|)) \in [0,1]$。
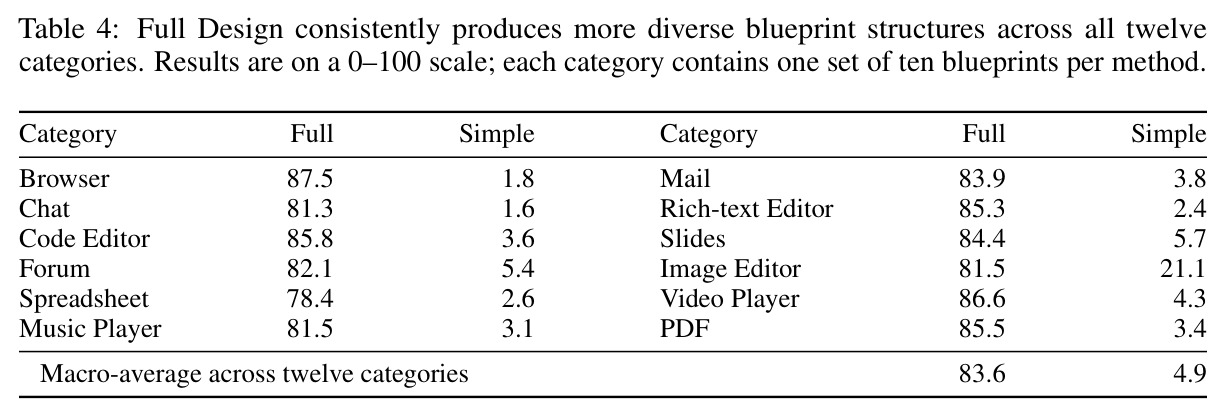
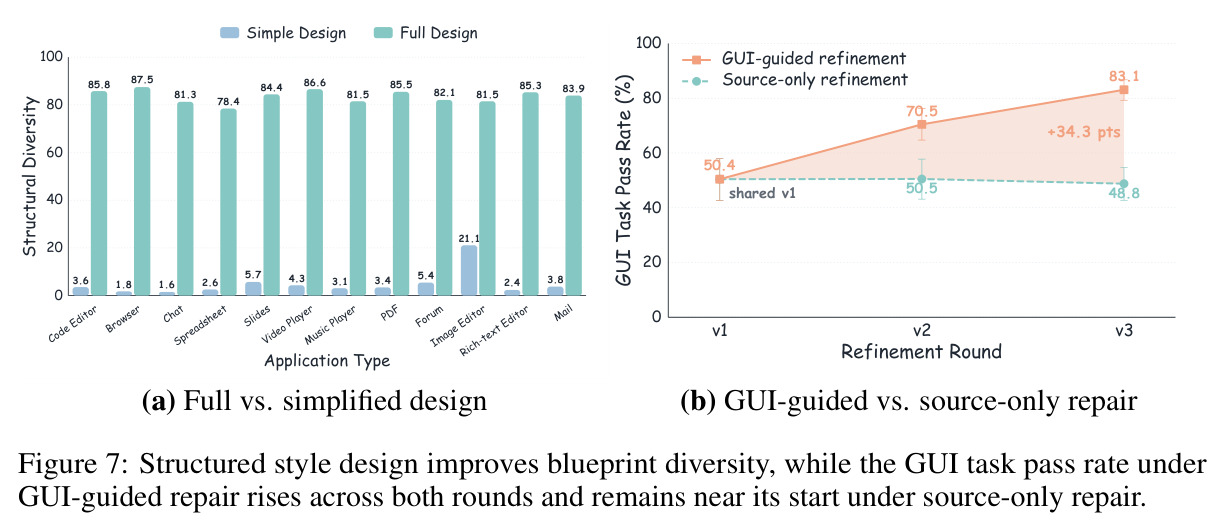
论文用它把『界面要长得不一样』变成硬性验收门槛(最小成对距离 ≥ 0.60),并在消融中量化设计多样性(83.6 对 4.9)。
多模态 SFT 与轨迹(trajectory)
轨迹是『截图-思考-动作』交替的完整操作序列。多模态监督微调(SFT)把高质量轨迹转成模型的训练样本,让视觉编码器与语言模型学会看屏幕并输出下一步操作。本文用两个 GPT-5.5 裁判分别评结果与过程,双 ≥0.8 分才保留。
论文最终的模型产出完全依赖这套轨迹采集与过滤流程,3,715 条轨迹、约 4.9 万序列化样本决定了模型上限。
Avalonia 与 XAML
Avalonia 是基于 .NET 的跨平台桌面 UI 框架,用 XAML 声明界面结构,可以编译成 Linux 上真正可运行的桌面应用,具备窗口、菜单、对话框、文件系统与持久化等原生能力。
SoftwareGym 合成的就是 Avalonia 应用:XAML 可编译是设计阶段的有效性检查,原生能力则保证了浏览器模拟环境做不到的交互深度。
研究动机
训练计算机操作智能体(CUA)需要大量在可执行软件环境中产生的交互数据,环境构建因此成为整个领域的核心瓶颈。现有两条路线各有硬伤:其一是在既有桌面/移动应用(OSWorld、Windows Agent Arena、OS-Genesis、CUA-Universe、Gym-Anything 等)中生成任务和轨迹,虽然保留了真实软件状态和复杂工作流,但把商业软件整合成可复现训练环境的工程成本很高,应用覆盖面受限,而且反复在同一批固定软件上训练容易诱发应用特定的过拟合;其二是构建浏览器托管环境(InfiniteWeb、AutoWebWorld、GUI-Genesis、ScaleWoB 等),虽然部署和状态控制方便,但共享的浏览器/HTML/DOM 底座限制了交互深度与工作流复杂度,无法承载持久状态和多窗口工作流。论文指出,没有任何现有方法能同时满足 CUA 训练的三个要求:界面与交互多样性(支持泛化)、功能可靠性(每个指定功能都能通过完整 GUI 工作流使用)、可扩展性(多样性与可靠性检查要在大型软件池上自动执行,人工开发无法承受这种验证负担)。
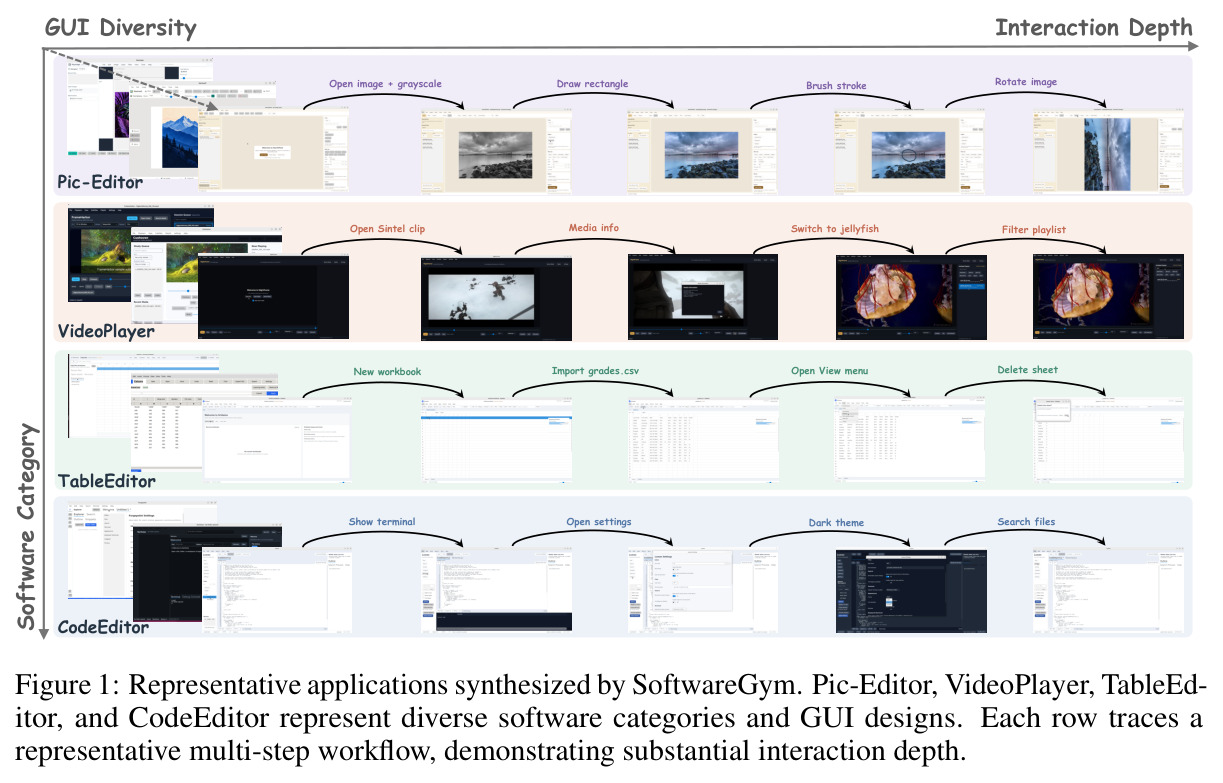
本文的目标是本文的目标是打造 SoftwareGym——一条全自动的多智能体软件合成流水线,以极少的人工输入批量生产『界面多样、功能真正可运行、行为经运行时验证』的 GUI 桌面软件环境,并系统回答三个挑战:如何强制同一软件类别的多个变体在结构上彼此不同而非只是换肤(无约束生成会收敛到相似布局);如何保证合成的每个功能都经得起真实 GUI 操作的检验;如何把单位成本压到人工开发无法企及的水平。在此软件库之上,论文进一步构建 120 个任务的 SoftwareGym-Bench 评测集,采集轨迹对 Qwen3.5-9B 做多模态 SFT,验证仅在合成软件上训练、完全不用任何 OSWorld 应用/任务/轨迹的模型能否在严格域外的 OSWorld 上泛化,最终发布 182 个可运行应用、基准与模型权重。
与已有工作不同的是,本文的独特切入是把『合成对象』从环境包装换成软件本身。此前工作要么在现有软件里造任务(OS-Genesis、CUA-Universe),要么用无后端网页模拟软件界面(GUI-Genesis、ScaleWoB),SoftwareGym 则直接让 LLM 智能体『开软件公司』,从功能规格、UI 蓝图到可执行的 Avalonia 桌面应用端到端合成新软件,直接扩大软件分布本身。其次,多样性不靠提示词祈祷,而是量化成硬门槛:任意两个变体在导航/空间组织/对象浏览/动作放置四个布局维度上的汉明距离必须 $d_{layout}(L_i,L_j) = \sum_{k}\mathbb{1}[\ell_{i,k} \neq \ell_{j,k}] \ge 2$,归一化树编辑距离低于 0.60 就强制重生成。第三,可靠性不靠源代码自审,而靠 GUI 评估智能体真实操作产生的证据门控——任务只允许使用 GUI 测试通过过的能力,使每个训练任务天然可解且可程序化判定,也为后续在合成环境上做 RL 留出了奖励接口。
核心方法
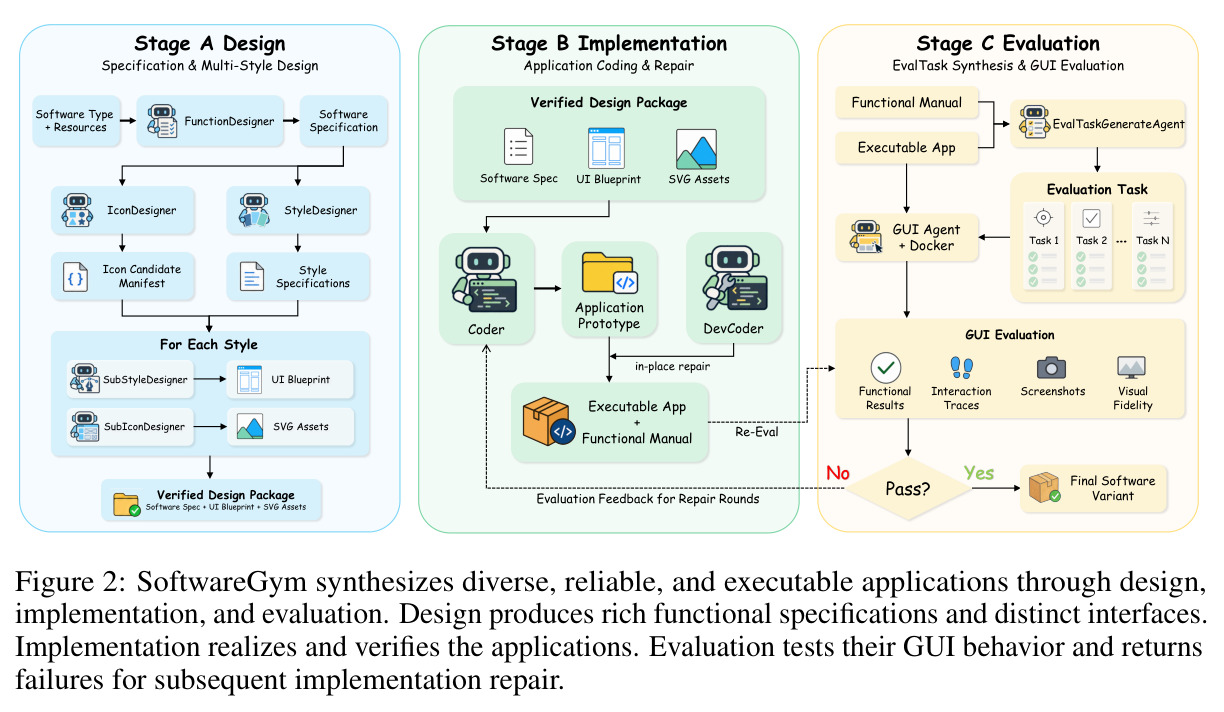
直觉:与其在几十个固定真实软件上反复采样,不如把『设计—编码—测试—修复』的软件工程闭环交给多智能体,批量生产彼此结构不同但真正可用的软件,由此天然获得界面多样且可验证的训练信号。技术路线分三阶段。Stage A 设计:FunctionDesigner 把软件类型与资源扩展成 Software Specification,每个函数记录入口、动作、状态更新、GUI 响应、验收检查点的合同;StyleDesigner 经独立 SubStyleDesigner 生成多套 Avalonia XAML 蓝图,要求布局汉明距离 $d_{layout} \ge 2$ 且最小成对树编辑距离不低于 0.60,否则重生成。Stage B 实现:Coder 按设计包实现应用并撰写功能手册,DevCoder 审计逻辑、持久化与文件接口。Stage C 评估:GUIAgent 在 Ubuntu 虚拟机执行测试,计算 $P_{func} = N_{pass}/N_{all}$,失败轨迹回传驱动最多 3 轮修复,并以 $F_{vis} \ge 0.80$ 的保真度闸门防止界面漂移。双重验证通过才入库。
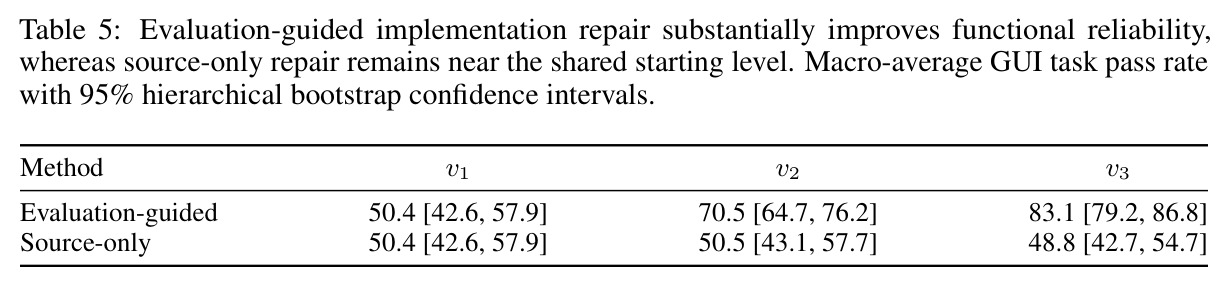
核心创新有四点。第一,把环境合成的粒度从『网页模拟』升级为『完整桌面应用』:合成的 Avalonia 程序具备持久化、跨模块状态、文件接口和对话框系统,交互深度逼近原生软件,规避了浏览器底座的表达上限。第二,可验证性内建于设计:每个函数在设计阶段就是一份实现与评估合同,任务合成阶段用证据门控的函数树,只有引用了通过案例、检查点或交互步骤的能力才能进入任务,杜绝『考没教过的内容』。第三,多样性量化管控:消融显示无约束生成会灾难性塌缩——Simple Design 每类十个蓝图的宏平均多样性仅 4.9/100,且每组都存在归一化布局树完全相同的一对;本文用布局原型汉明距离 $d_{layout} \ge 2$ 与归一化树编辑距离门槛 0.60 把『结构不同』变成可检测、可拒绝的验收条件,Full Design 把多样性拉到 83.6。第四,GUI 在环修复:实验证明仅靠源代码自审会让通过率从 50.4% 退化到 48.8%,只有让真实 GUI 失败轨迹驱动修复才能升到 83.1%,这一对照干净地证明了『运行时证据』不可替代。
方法步骤详情
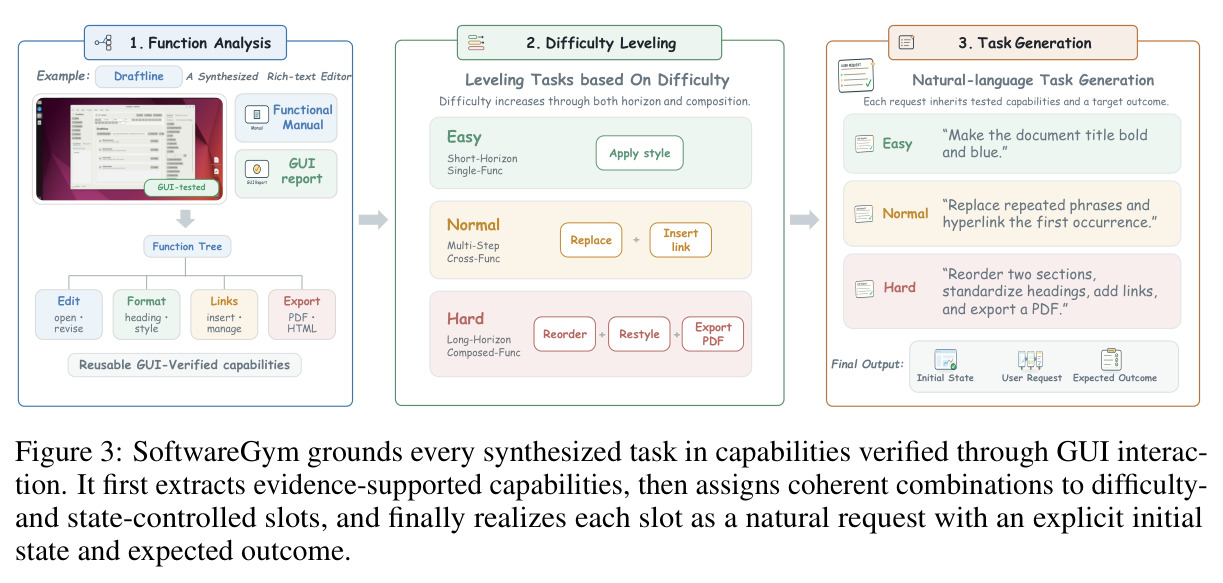
五步流程。第一步功能设计:输入软件类型与资源,FunctionDesigner 依次建立功能基线(核心对象与增删改查)、扩展专业功能(多条件检索、批处理、历史管理)、连接跨模块工作流,把每个函数写成含入口、动作、状态更新、GUI 响应、检查点的合同。第二步多样化设计:每个风格规格由独立 SubStyleDesigner 生成 XAML 蓝图并编译验证;蓝图表示为归一化布局树,$\min_{i \neq j} d_{ij} < 0.60$ 时重生成最不显著的蓝图。第三步实现与源码审计:Coder 产出可执行应用与功能手册,DevCoder 核查绑定、逻辑、持久化与文件接口并修补缺漏。第四步 GUI 评估与修复:固定测试集覆盖可达性、导航、对象增删改、持久化与文件工作流,GUIAgent 逐例执行并记录轨迹与修复建议,最多 3 版,每轮计算 $F_{vis}$ 防界面漂移。第五步任务合成与训练:构建证据函数树,按 easy/normal/hard 难度与文件/空白初始状态组合已验证能力,生成自然语言请求与可校验的内部规格;轨迹经双裁判打分过滤后做 SFT。
技术新颖性
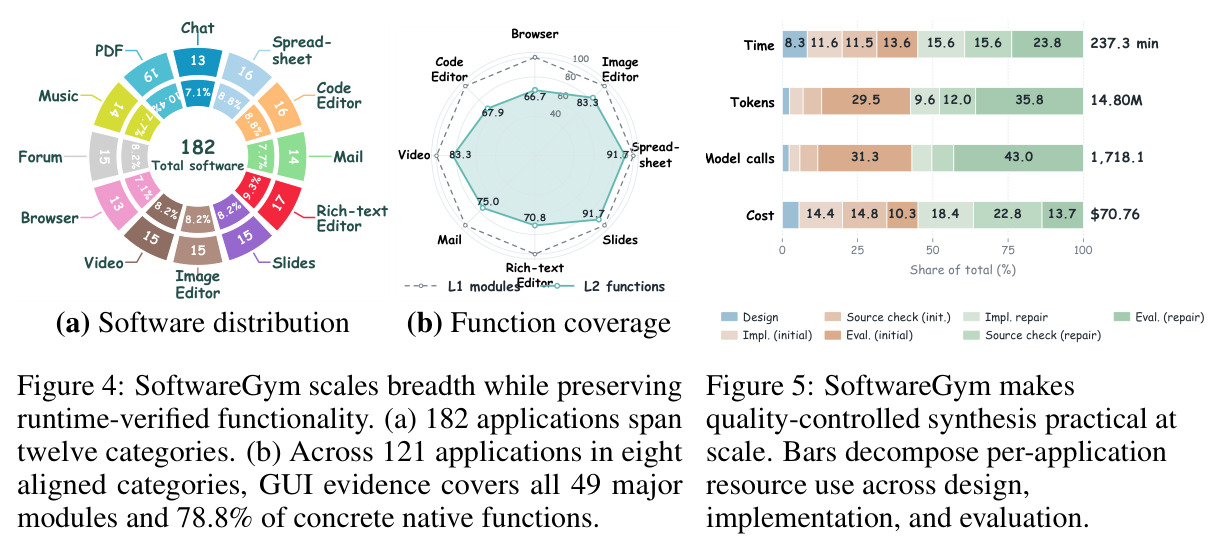
与最近邻工作的本质差异:CUA-Universe/Gym-Anything 改造现有软件,覆盖受制于既有应用池;OS-Genesis 在真实软件里反向合成任务;GUI-Genesis/ScaleWoB 生成无后端网页,受限于 DOM 底座。SoftwareGym 是首批直接批量合成『可运行桌面软件』的工作之一,新颖性有四点。(1) 把树编辑距离引入界面管控,定义 $D_{struct} = \frac{200}{K(K-1)}\sum_{i<j} d_{ij}$ 这一 0–100 的结构多样性指标,使设计塌缩从模糊印象变成可测量、可拒绝的工程约束。(2) 功能手册加 GUI 证据函数树的两级证据体系:能力标记为 supported 必须引用通过的案例、检查点或交互步骤,让『某功能可用』拥有可追溯的运行时证明。(3) 视觉保真度 $F_{vis}$ 以设计 token(调色板 Jaccard、主色、圆角、字体)加权评分,在修复循环中同时锁住功能与外观。(4) 全流程成本核算透明(每应用 $70.76、237.3 分钟、14.8M tokens),证明范式经济上可规模化。
实验结果
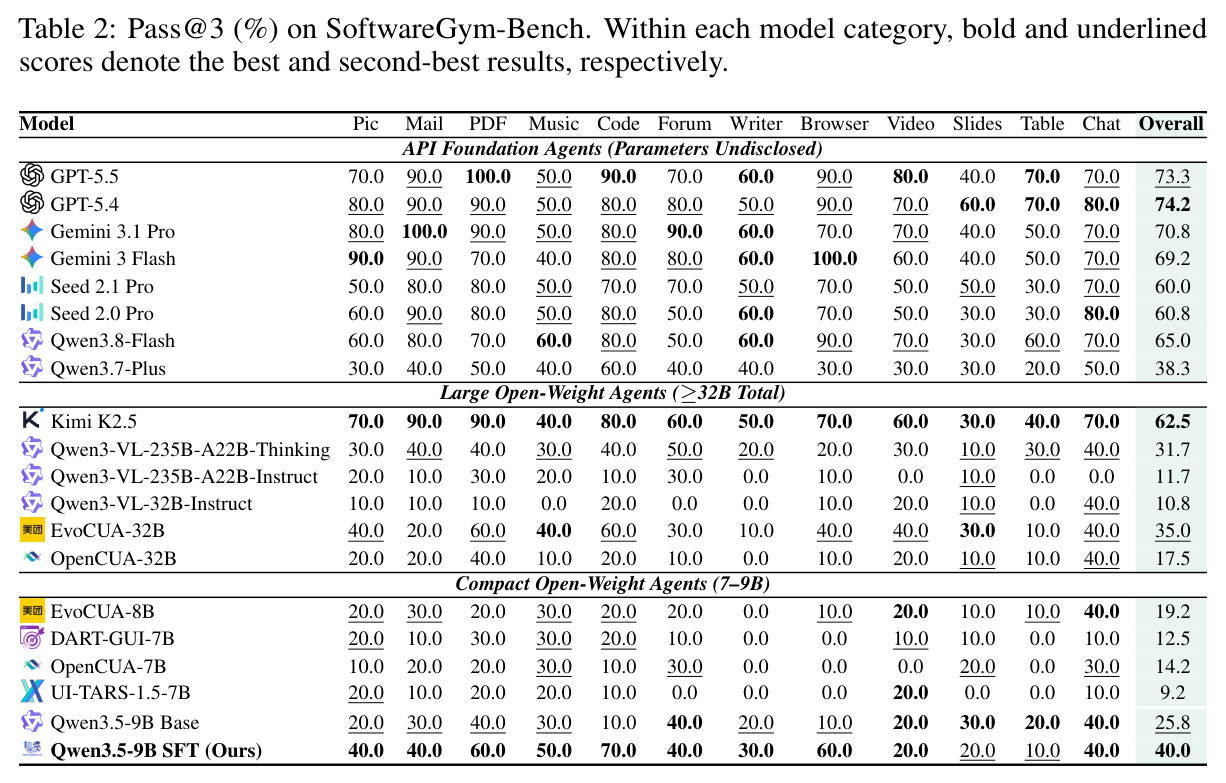
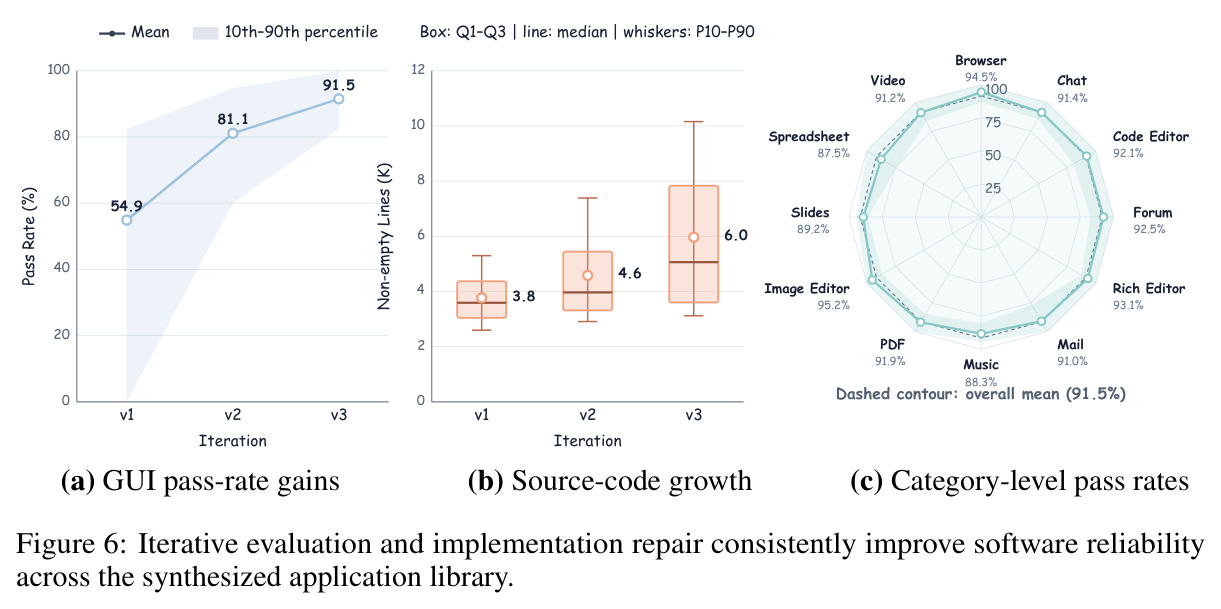
环境层面:182 个应用横跨 12 个类别,平均 GUI 任务通过率 91.5%;迭代修复把通过率从 v1 的 54.9% 经 81.1%(v2)提到 v3 的 91.5%;8 个 OSWorld 对齐类别的 121 个应用中,GUI 证据覆盖全部 49 个一级模块和平均 78.8% 的具体原生函数;每应用平均 237.3 分钟、1480 万 tokens、$70.76。模型层面:仅用 SoftwareGym 轨迹对 Qwen3.5-9B 做 SFT,OSWorld 244 任务 Pass@3 从 41.39% 升至 56.97%(+15.58 点),八个域全部提升(如 Chrome 28.26→58.70);SoftwareGym-Bench 从 25.8% 升至 40.0%,超过 Qwen3.7-Plus(38.3%)等更大模型。消融:Full Design 把蓝图多样性从 4.9 提到 83.6;GUI 引导修复达 83.1% 而源码自审退化到 48.8%(差 34.3 点,95% CI 28.2–41.0);混合训练把 Bench 成绩推到 47.5%,证明合成与原生数据互补。
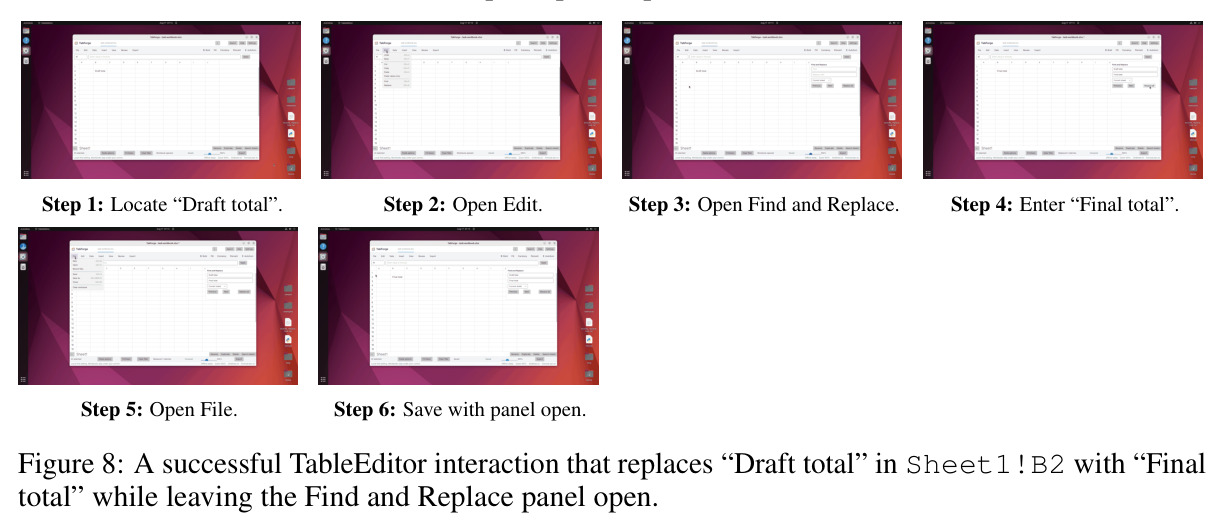
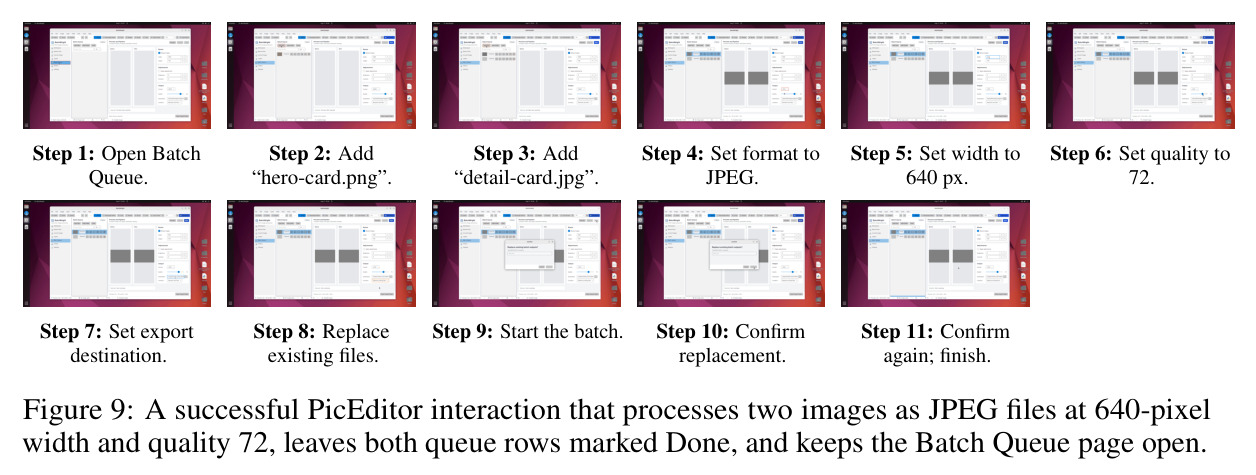
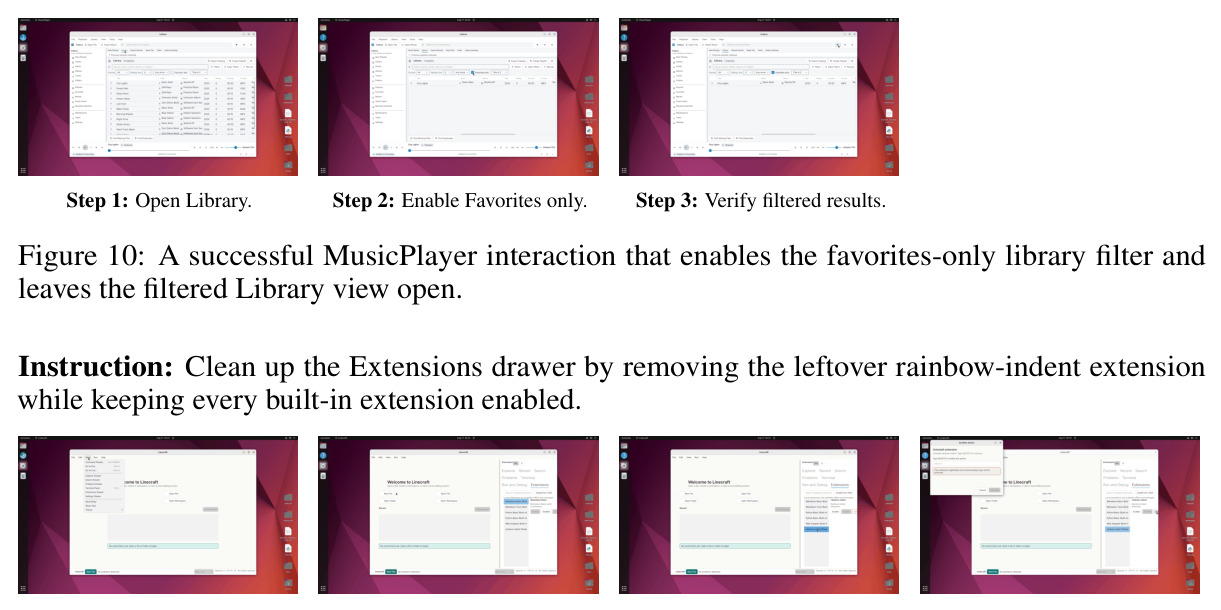
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld 严格域外迁移(244 任务、8 个应用域,训练零 OSWorld 数据) | Pass@3 (%) | 56.97(Qwen3.5-9B SFT) | Qwen3.5-9B Base 41.39;OSWorld 自训练模型 61.48 | 较自身基线 +15.58 点;较 OSWorld-only 训练低 4.51 点但域内反超 |
| SoftwareGym-Bench 域内评测(120 任务、12 类别 × 10 任务) | Pass@3 (%) | 40.0 | Qwen3.5-9B Base 25.8;EvoCUA-32B 35.0;Qwen3.7-Plus 38.3;GPT-5.4 74.2 | 较自身基线 +14.2 点,超过多个更大规模专用 CUA |
| 合成环境可靠性(182 个应用的 GUI 测试任务) | 平均 GUI 任务通过率 (%) | 91.5(v3) | 54.9(v1 初始实现) | 经两轮修复 +36.6 点 |
| 修复方式消融(12 类别 × 3 应用 = 36 个配对应用) | GUI 任务通过率 (%) | 83.1(GUI 引导修复,v3) | 48.8(仅源码自审修复,v3),同起点 50.4 | +34.3 点(95% CI 28.2–41.0),36/36 全胜 |
| 蓝图结构多样性消融(12 类别 × 每方法 10 个蓝图) | 归一化树编辑距离宏平均(0–100) | 83.6(Full Design) | 4.9(Simple Design),且每组含布局树完全相同的一对 | +78.7,所有 12 个类别全部占优 |
| 训练数据来源消融(规模匹配 3,715 条轨迹 / 55,263 样本) | Pass@3 (%),OSWorld / SoftwareGym-Bench | 56.97 / 40.0(仅合成数据) | 61.48 / 33.3(仅 OSWorld);58.61 / 47.5(混合) | 域外略低 4.5 点,域内高 6.7 点,混合最优 47.5,证明互补性 |
局限与改进
作者承认与本文观察到的局限。其一,合成软件保真度有上限:即便对齐 OSWorld 类别,具体原生函数的 GUI 证据覆盖率也只有 78.8%,插件生态、网络依赖等商业软件深层状态未被覆盖;Calc 域上仅用合成数据训练的模型只有 31.91%,低于 OSWorld 自训练的 44.68%,说明合成表格软件与真实 LibreOffice Calc 仍有差距。其二,评估器依赖:设计与出题用 Codex CLI + GPT-5.5,GUI 评估用 Seed 2.1 Pro,轨迹打分靠双 GPT-5.5 裁判,评估器偏差会传导进环境质量与训练数据。其三,SoftwareGym-Bench 与训练环境同源,40.0% 的域内成绩存在乐观偏置;真正衡量外推力的 OSWorld 56.97% 既低于 OSWorld 自训练的 61.48%,更远低于 Seed 2.1 Pro 的 79.51%。其四,Pass@3(56.97%)与三次运行均值 Avg@3(46.77%)相差近 10 点,运行间方差大。其五,训练仅 SFT,未利用合成环境程序化验证器可作天然奖励的优势做 RL,监督上限尚未探明。
独立分析的弱点
独立分析四点弱点。第一,评测同源偏置:SoftwareGym-Bench 的 120 个任务直接取自训练用的软件库,40.0% 的成绩不能与 OSWorld 这类域外数字直接比较;应预留 held-out 应用或类别构建无泄漏基准,或分层报告成绩。第二,软件复杂度天花板:182 个应用多为单用户、本地文件型生产力工具,缺少多应用协同、网络依赖与长时后台任务;改进方向是跨应用工作流合成(Mail 附件→图片批处理→表格登记)与 CLI+GUI 混合环境。第三,对闭源前沿模型双重依赖:设计用 GPT-5.5、GUI 评估用 Seed 2.1 Pro、打分用双 GPT-5.5 裁判,单应用 $70.76 只核算了部分成本,且前沿模型升级会静默改变环境分布;改进方向是蒸馏开源评估器、冻结模型版本。第四,SFT-only 与轨迹风格单一:双裁判 ≥0.8 过滤天然偏好『标准解法』,模型难学错误恢复,Avg@3 与 Pass@3 近 10 点差距正是方差大的体现;改进方向是在程序化验证器上做 RL 或失败轨迹偏好优化。
未来方向
作者明确提出合成软件库应作为原生软件的互补持续扩容,覆盖更多类别与更深工作流。在此基础上可以延伸:(1) 在合成环境上做强化学习——每个任务自带初始状态、期望终态和确定性验证器,奖励无需人工标注,是天然的 RLVR 训练场,可望解决 SFT 方差大、不会纠错的问题;(2) 跨应用长程任务合成,检验多软件之间的状态传递与工具选择;(3) 把视觉保真度从设计 token 级(调色板、圆角、字体的 Jaccard 指标)升级为感知级渲染相似度,进一步约束修复过程中的 UI 漂移;(4) 让流水线自动发现新软件类别而非人工指定 12 类,实现类别级自主扩展;(5) 迁移到 Windows/macOS 与移动端原生环境,验证范式的跨平台普适性;(6) 与 CUA-Universe 等 CLI+GUI 混合环境结合,给合成软件加终端接口;(7) 用更大规模学生模型与 RLVR 探索合成环境监督的天花板,并与人类演示数据、在线轨迹精炼等方法正交组合。
复现评估
开源情况较好:代码在 GitHub(MrKiing-Jin/SoftwareGym),模型在 HuggingFace(GothamLegend/SoftwareGym),论文承诺释放 182 个应用与 120 任务的 SoftwareGym-Bench,直接复用环境资产的门槛很低。训练算力明确:Qwen3.5-9B 全参 SFT(视觉塔冻结)用 16×A800,bf16 + FlashAttention + ZeRO-2,学习率 $5 \times 10^{-6}$、序列长度 16,384、全局 batch 32、约 4.9 万样本训 1 个 epoch,中等规模实验室可承受。难点在合成管线:依赖 GPT-5.5 做设计与出题、Seed 2.1 Pro 做 GUI 评估、双 GPT-5.5 裁判过滤轨迹,闭源模型既产生持续 API 成本(单应用 $70.76,182 个约 $1.3 万),也有版本漂移风险;评估还需 Ubuntu 虚拟机/Docker 隔离、每任务 3 次采样。总体评级:用发布资产复现训练与评测为中等难度;从头复现合成管线为较高难度。
论文图表
(a) 软件分布:182 个应用在 12 个类别上的分布,各占约 7%–10%;(b) 功能覆盖:对 8 个与 OSWorld 对齐类别的 121 个应用,GUI 证据覆盖全部 49 个一级功能模块(100%),平均覆盖 78.8% 的具体原生二级功能。
量化回答『合成软件库是否足够广、足够深』:广度看类别分布,深度看被 GUI 实测覆盖的功能比例,这组数字是环境库质量的主要证据。
三种训练来源各 3 次运行的逐域得分、Avg@3 与 Pass@3。如 SoftwareGym-only 的 Avg@3 为 46.77 而 Pass@3 为 56.97;OSWorld-only Calc 域 Avg@3 29.79 明显高于 SoftwareGym-only 的 24.11;混合版 VLC Avg@3 达 48.84。
补充主表的方差信息:Avg@3 与 Pass@3 之间约 10 点的差距揭示了运行间波动,提醒读者单次评测数字的不可靠性,是评估这类智能体时的重要参考。
三种训练来源在 12 个类别上的 Run 1–3、Avg@3 与 Pass@3。SoftwareGym-only 逐 run 总分为 30.00/25.83/24.17(Pass@3 40.0);混合版逐 run 35.00/32.50/30.00(Pass@3 47.5),在 Table 类混合版 Pass@3 达 50 对 10。
显示混合训练在域内多数类别稳定占优,同时暴露 Writer(10)、Video(20)等弱项类别,为改进数据配比提供了细粒度依据。