ProgAgent:用程序化训练学习工具编排 ProgAgent: Learning Tool Orchestration through Programmatic Training
以215个可验证任务训练模型用代码编排工具,64k环境状态下通过率30.7%而同规模基线为0
前置知识
POMDP(部分可观测马尔可夫决策过程)
智能体与环境的交互被建模为 $M=(S, A, O, P, R)$:智能体每轮只能看到观测 $o_t$ 而非完整状态 $s_t$,据此产出动作 $a_t$,环境转移到 $s_{t+1}$ 并返回新观测。本文进一步把状态分解为环境状态 $s_t^E$(数据库、工作区文件、可执行工具)与交互历史 $s_t^H$(指令、观测、推理上下文),动作空间分为 $A = A_{tool} \cup A_{resp}$,回合结束时验证器给出 $R(s_T^H, s_T^E) \in \{0,1\}$ 的二值奖励。
这是论文的形式化基础:DTC 与 PTC 两种 harness 的差异正是被定义为『哪些内容进入交互历史 $s_t^H$』,理解这个框架才能读懂第 2 节的统一表述和奖励设计。
Direct Tool Calling(DTC,直接工具调用)
最常见的智能体工具使用方式:模型每轮生成一个结构化(JSON)工具调用,环境执行后把原始返回直接拼进上下文($s_{t+1}^H = s_t^H \oplus a_t \oplus o_{t+1}$),控制流只能靠多轮顺序调用实现。上下文长度随回合数与观测大小持续累积,当环境很大时海量原始观测涌入上下文,导致 context rot(上下文腐烂)与编排崩溃——长上下文下模型注意力被稀释、早期指令与约束被遗忘,这是当前智能体在长程任务上的核心瓶颈。
DTC 是全文的对照范式:论文用 DTC pass@8 从 0.95 跌到 0.42 的实测数据说明其失败模式,所有 PTC 的收益都要与它对比才有意义。
Programmatic Tool Calling(PTC,程序化工具调用)
模型生成的动作是一段 Python 程序 $\rho_t$,在沙箱中执行并通过 $tools[\"tool_name\"]()$ 调用环境工具。程序内可以自由使用循环、条件分支、异常处理,中间结果存入运行时变量并跨轮保留,只有程序本身和 $print$ 出来的输出 $r_{\rho_t}$ 进入交互上下文:$s_{t+1}^H = s_t^H \oplus \rho_t \oplus r_{\rho_t}$。一轮代码可以完成 DTC 需要几十轮才能完成的批量操作。
这是本文的核心研究对象:训练栈的任务设计、运行时、SFT/RL 全部围绕『让模型学会用 PTC 编排工具』展开,实验也在 DTC/Hybrid/PTC 三种 harness 间做对照。
MCP(Model Context Protocol)
连接 LLM 与外部工具、数据源的开源协议,工具以 MCP server 形式暴露统一的调用接口。本文的 PTC 运行时就是一个 MCP server:向模型暴露 $programmatic\ tool\ call$ 工具,内核中的工具代理再把程序里的调用路由到真正的环境工具并返回原生 Python 对象。评测基准 MCPMark、MCP-Atlas、Toolathlon 都基于真实 MCP server。
运行时实现与四个评测基准都建立在 MCP 之上;而且第 5.4 节的局限性分析(server 不合规省略 isError 字段导致静默失败)直接源于 MCP 生态的现实问题。
可验证奖励强化学习(RLVR)与 GSPO
RLVR 不用人类或模型打分,而是用程序化验证器给出奖励;本文奖励是二值的 $R(s_T^H, s_T^E) \in \{0,1\}$,只在回合结束时给出。GSPO(Group Sequence Policy Optimization)是序列级策略优化算法,本文设置裁剪参数 $\epsilon_{low}=3\times10^{-4}$、$\epsilon_{high}=4\times10^{-4}$,不用 KL 惩罚,学习率 $10^{-6}$,每步采样 32 个任务、每任务 16 条 rollout。
这是第二阶段训练的核心方法;奖励稀疏且二值,如何让 rollout 仍能拿到奖励(如 DTC 训练只能用 v0 环境)是理解实验设计的关键。
pass@k 指标
评测指标:对同一任务独立采样 $k$ 条轨迹,只要有至少一条让验证器返回 1 即判定该任务通过,pass@k 为通过任务占全部任务的比例,衡量模型在多次尝试下的成功上界。本文主要用 pass@8 度量任务难度:合成阶段用 DeepSeek V4 Pro 在每个任务、每个规模下采 8 条 PTC 轨迹,只保留通过率落在 $(0, 0.8)$ 区间的任务——既非不可能完成,也非轻而易举,从而保证 RL 阶段存在可学习的奖励信号。
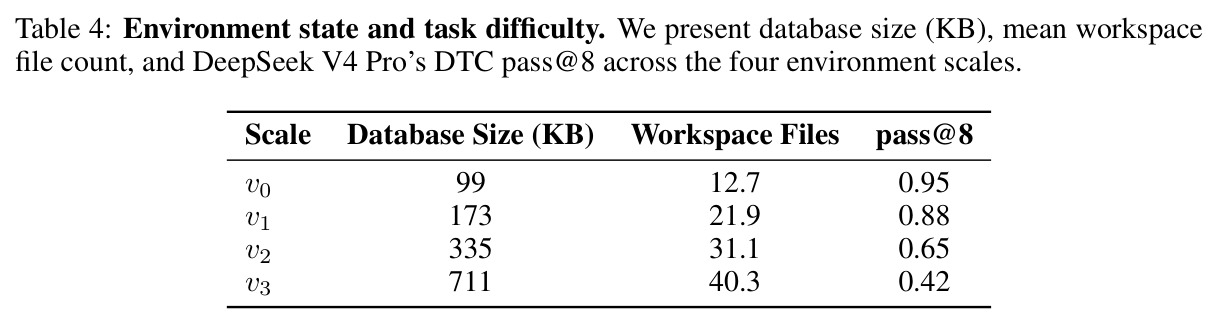
它是任务难度筛选的门槛,也是『环境状态缩放确实控制了难度』这一核心主张的证据载体(DTC 下 pass@8 随规模单调下降)。
研究动机
LLM 在深度研究和软件工程上已表现出色,但在长程开放世界工具环境中仍然挣扎。主流的直接工具调用(DTC)范式把每一步工具调用及其原始返回都拼进上下文($s_{t+1}^H = s_t^H \oplus a_t \oplus o_{t+1}$),随着任务变长、环境变大,原始观测不断累积,引发 context rot 和编排崩溃。论文给出了具体证据:当环境状态从 v0 扩到 v3(数据库从 99KB 增至 711KB,工作区文件从平均 12.7 个增至 40.3 个),强模型 DeepSeek V4 Pro 的 DTC pass@8 从 0.95 单调跌至 0.42;在 LOCA-bench 上,Qwen3-8B/14B 乃至 Qwen3-235B-A22B 在 32k/64k 环境状态下通过率几乎全部为 0,最好的开源模型 DeepSeek-V3.2 也从 78.7%(8k)跌到 45.3%(64k)。此外,复杂工具编排所需的数据变换、条件分支和错误处理,很难用一轮一次的顺序工具调用表达,控制流散落在多轮对话中极易出错。
本文的目标是本文要把程序化工具调用(PTC)从一个推理时的工程技巧升级为训练范式,并回答三个递进的问题:第一,训练模型使用 PTC 能否真正提升长程工具编排能力,还是只换了层皮?第二,能否用尽可能少的训练任务达成这一目标?第三,PTC 训练获得的编排能力能否迁移回 DTC 界面?为此目标是构建 ProgAgent 完整训练栈:(1) 一条能合成可验证长程任务、并通过『环境状态缩放』精确控制难度的流水线;(2) 一个跨轮保持执行状态、回合之间严格隔离、适合 RL rollout 的轻量 PTC 运行时;(3) 冷启动 SFT + 强化学习的两阶段训练配方。最终仅用 215 个任务(每个 4 个环境规模,共 860 个实例)训练 Qwen3-8B/14B,使其在 MCPMark、LOCA-bench、Toolathlon-Verified、MCP-Atlas 四个基准上全面超越同规模基线。
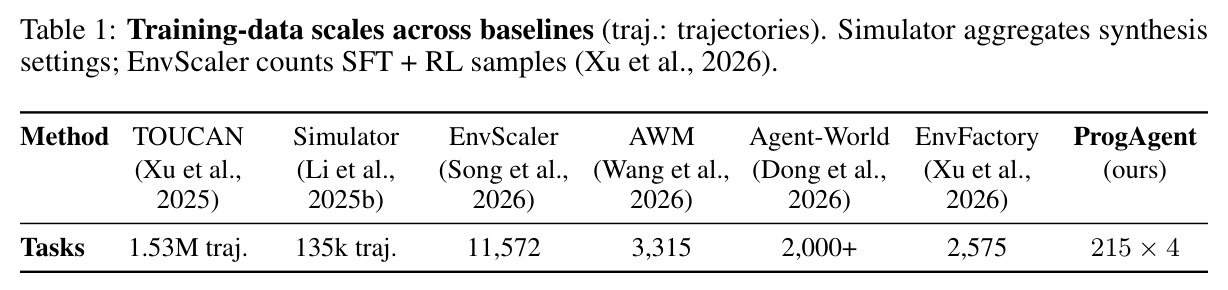
与已有工作不同的是,此前存在三个空白。其一,面向 PTC 训练的公开可验证任务稀缺;现有环境合成工作(EnvScaler、Agent-World、EnvFactory 等)靠增加工具多样性或编排复杂度来提升难度,无法直接控制环境状态规模,也就无法针对性地研究和训练 context rot 下的行为。其二,开源 PTC harness(如 Prime Agent)内嵌在通用智能体系统中,不提供 RL 所必需的跨轮状态保持与回合间隔离。其三,PTC 一直被当作推理时优化(如 Anthropic 的 code execution with MCP),没人验证过『训练程序化智能体』是否优于『仅提供程序化接口』。本文的独特切入是把描述长度思想引入任务设计:保持指令 $u_i$、任务逻辑、工具模式和验证器 $R_i$ 完全不变,只按约 2 倍逐级放大环境状态,使任务难度与环境上下文长度之间形成一条干净的因果链,从而把 context rot 从烦恼变成可控的训练信号。
核心方法
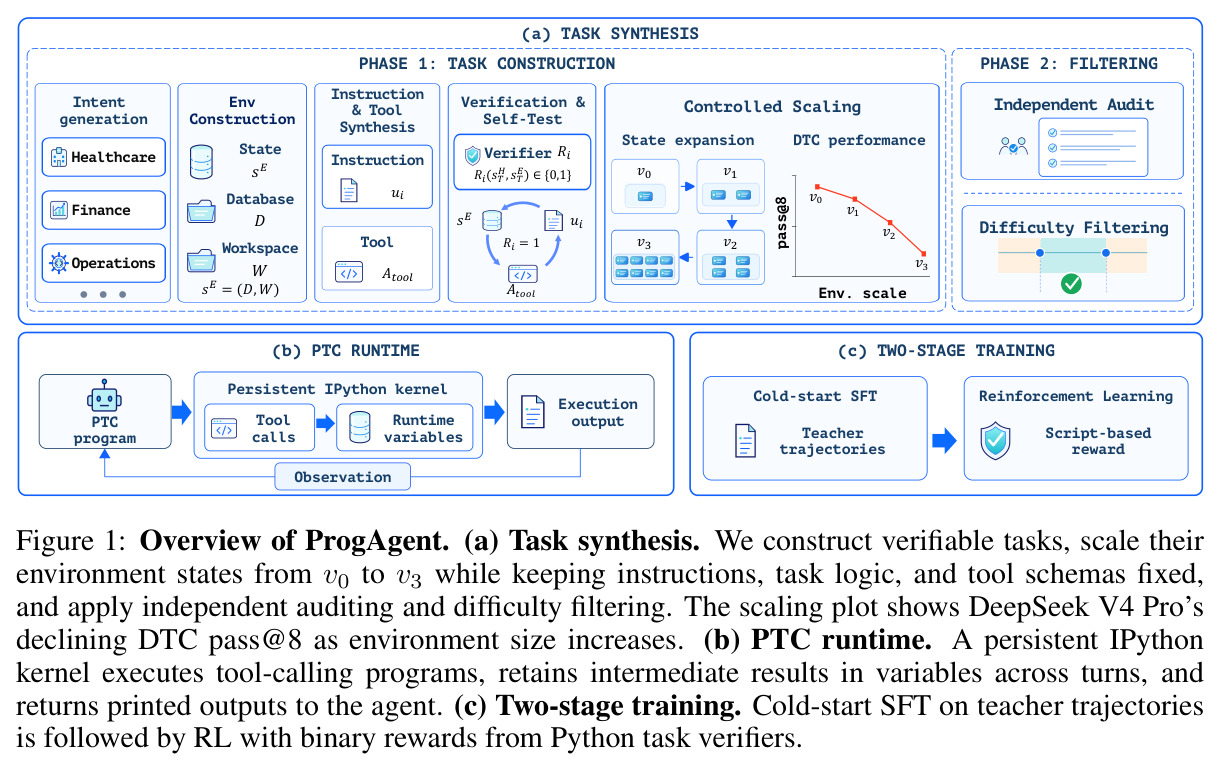
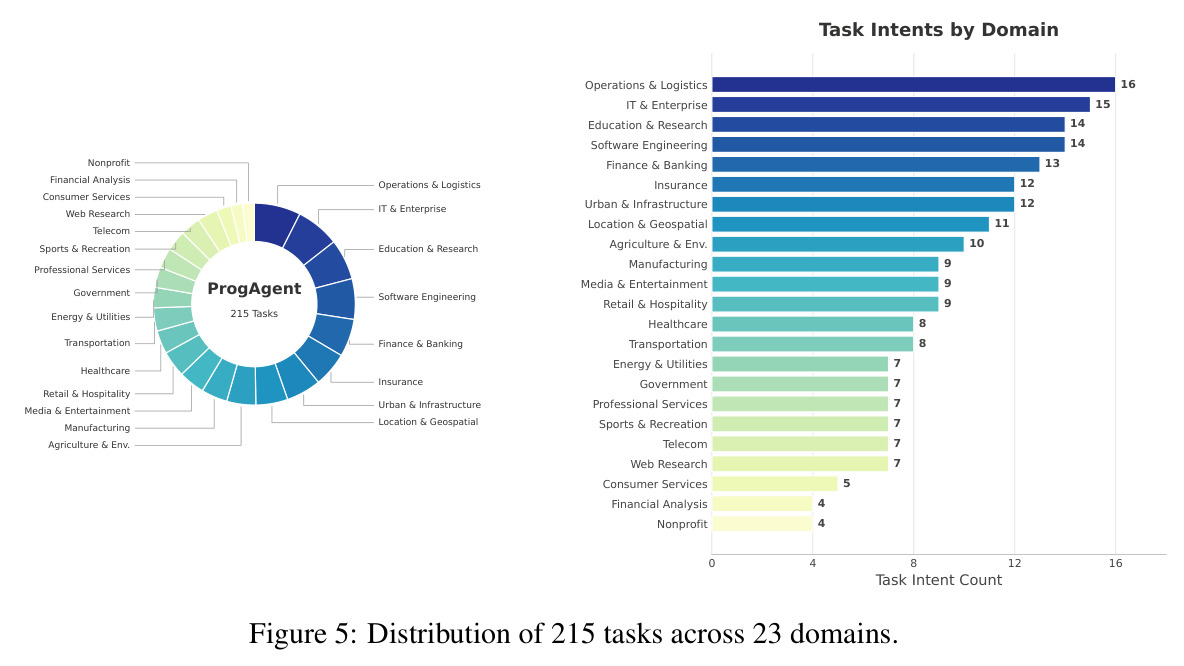
直觉很简单:工具编排本来就该用代码写。循环、条件分支、异常处理这些编排刚需是编程语言的原生结构,模型在预训练中早已掌握;同时把中间结果留在沙箱变量里、只 print 摘要,可从源头抑制上下文膨胀。技术路线分三块。(a) 任务合成:LLM 从 23 个领域生成用户意图,构造器智能体搭建关系数据库加文件工作区的环境、单用途工具集、指令、Python 验证器与 oracle 解;每个任务在 v0–v3 四个规模实例化(数据库行数 1×/2×/4×/8×),经独立审计与难度过滤(DeepSeek V4 Pro 在 PTC 下每规模采 8 条轨迹,只保留 pass 率在 $(0,0.8)$ 的任务)得到 215 个任务。(b) 轻量 PTC 运行时:持久化 IPython 内核执行模型生成的程序,工具代理路由调用并返回原生 Python 对象,Bubblewrap 沙箱隔离。(c) 两阶段训练:DeepSeek V4 Pro 教师轨迹冷启动 SFT(3 epoch),再用 GSPO 做 150 步 RL,奖励为二值验证信号。三种 harness 用同一任务池与超参平行训练以隔离界面效应。
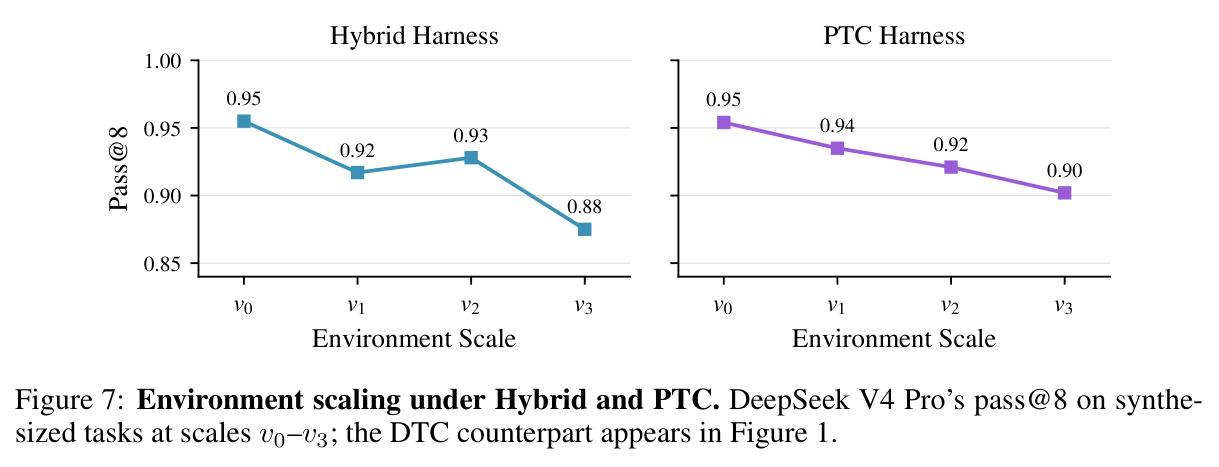
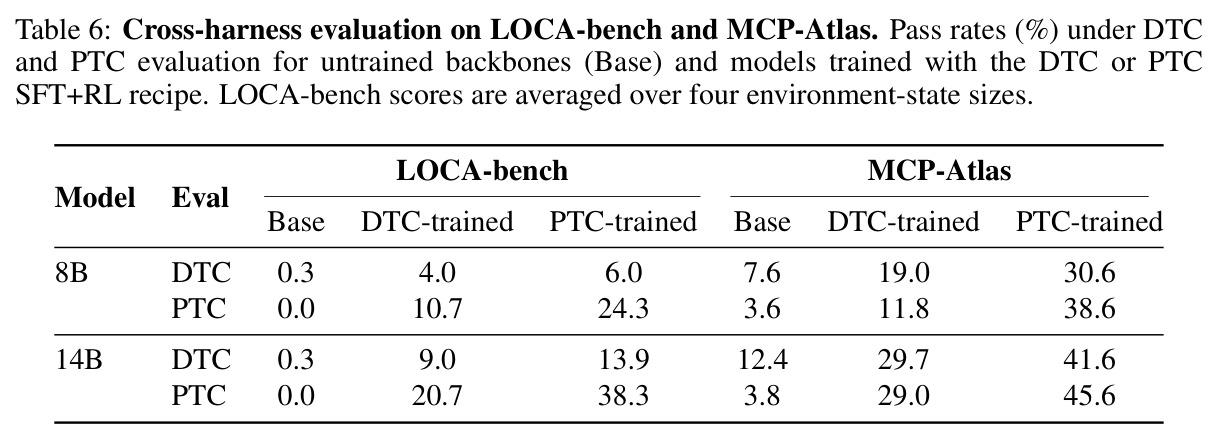
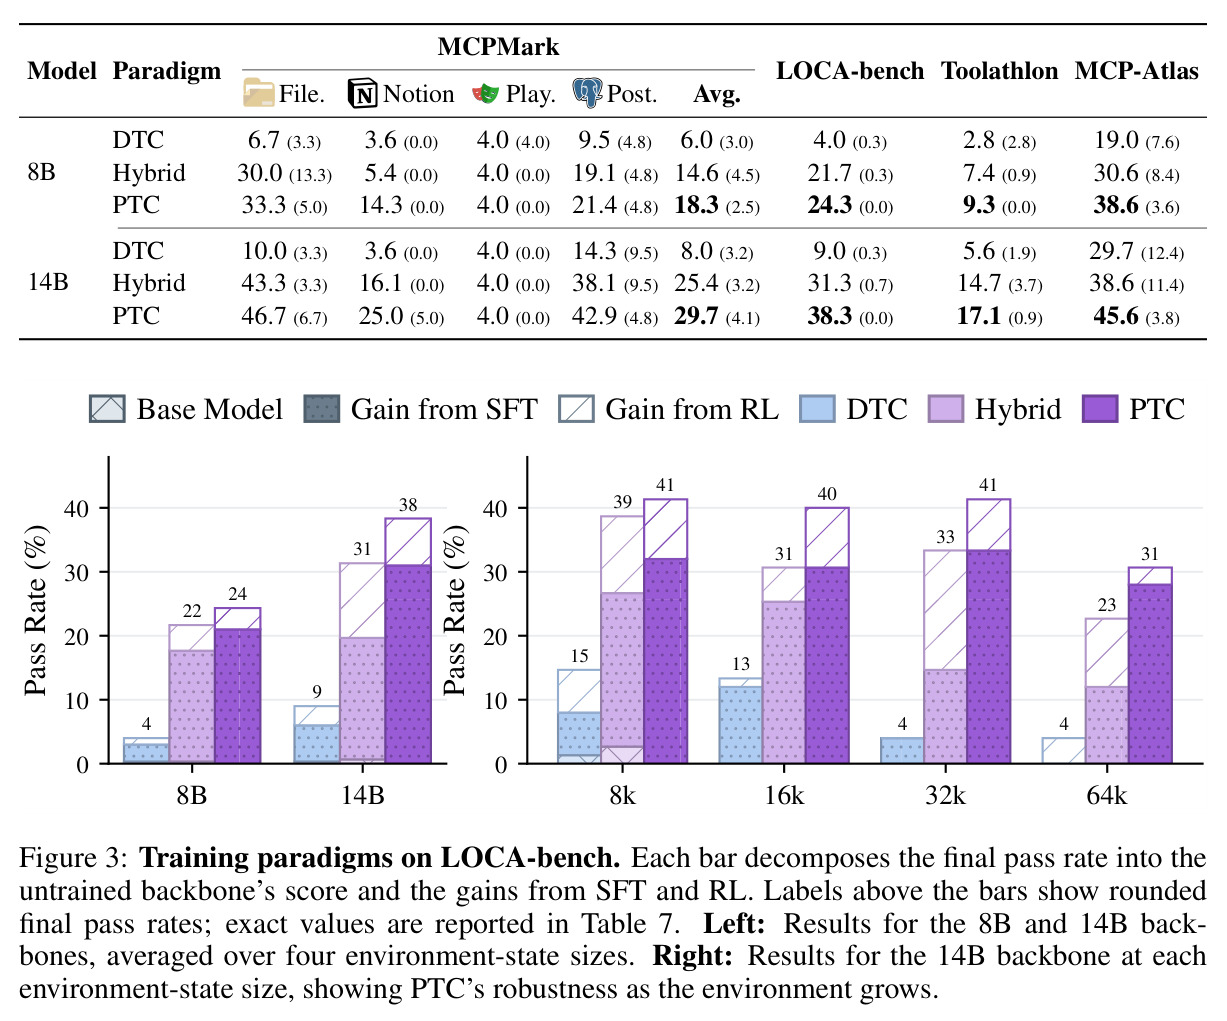
核心创新有两条。第一条是『环境状态缩放』作为难度旋钮:固定指令、任务逻辑、工具 schema 和验证器,只让 $|s_{(j+1)}^E| \approx 2|s_{(j)}^E|$ 逐级翻倍,使『从更大环境中检索并加工信息』成为唯一的难度来源,直接制造 context rot 压力。这与 EnvScaler 等靠加工具提升难度的路线本质不同,提供了难度与上下文长度之间可控的因果关系(DTC pass@8 从 0.95 单调降到 0.42,而 PTC 保持 0.90 以上)。第二条是把 PTC 定位为训练范式而非推理接口:统一程序化动作空间降低了学习难度,让模型把预训练编程能力系统性地迁移到工具编排上。一个有力的对照是 Hybrid(同时提供 DTC 和 PTC 两种接口)反而全面逊于纯 PTC,说明动作空间的一致性本身就是红利;而 PTC 训练的模型在 DTC 评测下也更强(MCP-Atlas 上 14B 领先 DTC 训练模型 11.9 个百分点),说明学到的是编排能力而非界面适配。
方法步骤详情
任务构造五步走:(1) Gemini 3.0 Flash 从 23 个领域生成用户意图;(2) Claude Opus 4.6 编写 data.py 生成数据库 $D$ 与工作区 $W$,SCALE 控制规模;(3) 合成隐藏实现的单用途工具集 $A_{tool}$ 与指令 $u_i$;(4) 生成验证器 $R_i \in \{0,1\}$ 与 oracle 解,oracle 不满分则自动修复,独立智能体在 v3 审计一致性;(5) 复制出 v1–v3 并过滤,250 个候选删 35 个留 215 个。运行时:数据生成器初始化 $s_0^E$,持久 IPython 内核执行程序 $\rho_t$,输出截断 5 万字符;Bubblewrap 加 cgroup v2(2GiB 内存、256 进程)隔离,验证器与 oracle 不挂载防作弊。训练:教师轨迹(判据分 $\tilde{R}_i \ge 0.7$)SFT 3 epoch(batch 64、lr $10^{-5}$),GSPO 150 步(每步 32 任务×16 rollouts、lr $10^{-6}$)。
技术新颖性
技术新颖性体现在四个层面。训练范式层面:首次系统证明 PTC 不只是推理接口而是更优的训练范式——相同任务池、相同超参下,PTC 训练在全部四个基准上超过 DTC 与 Hybrid 训练,且跨 harness 评测显示其优势延伸到 DTC 界面,这超出了 Anthropic 等推理时报告能给出的结论。数据效率层面:215×4=860 个实例对抗数量级更大的对手(TOUCAN 153 万条轨迹、Simulator 13.5 万条、EnvScaler 11572 个任务),证明了可验证任务设计的杠杆作用。任务合成层面:环境状态受控缩放是一条干净的新维度,不动任务语义、只动数据规模,让『上下文长度』第一次成为可精确调节的训练变量。工程层面:持久 IPython 内核(变量跨轮存活)+ Bubblewrap 多命名空间隔离 + cgroup v2 资源限制的组合,同时满足了 RL rollout 需要的执行状态保持、回合隔离与防作弊(验证器与 oracle 不进入沙箱),这是一个可复用的轻量基础设施,而非内嵌于庞大智能体框架的黑箱。
实验结果
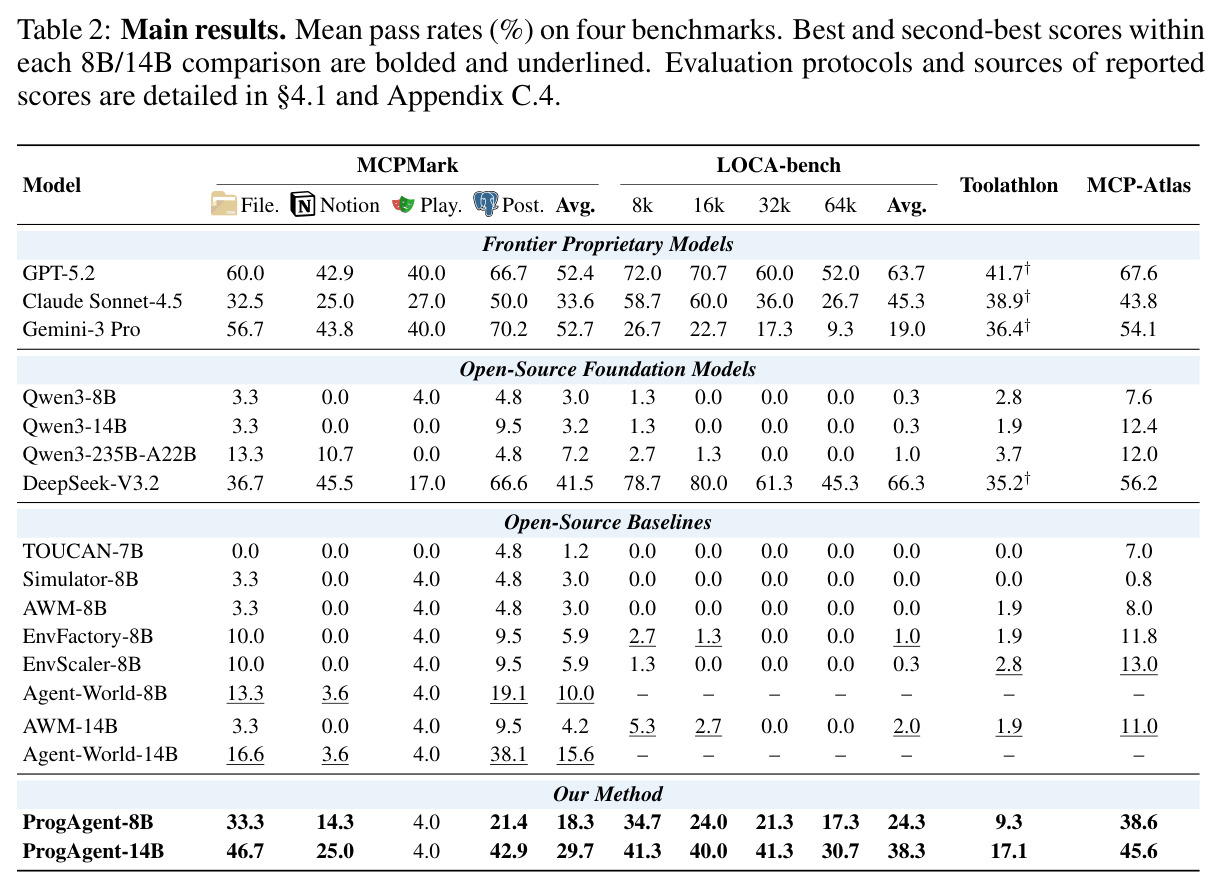
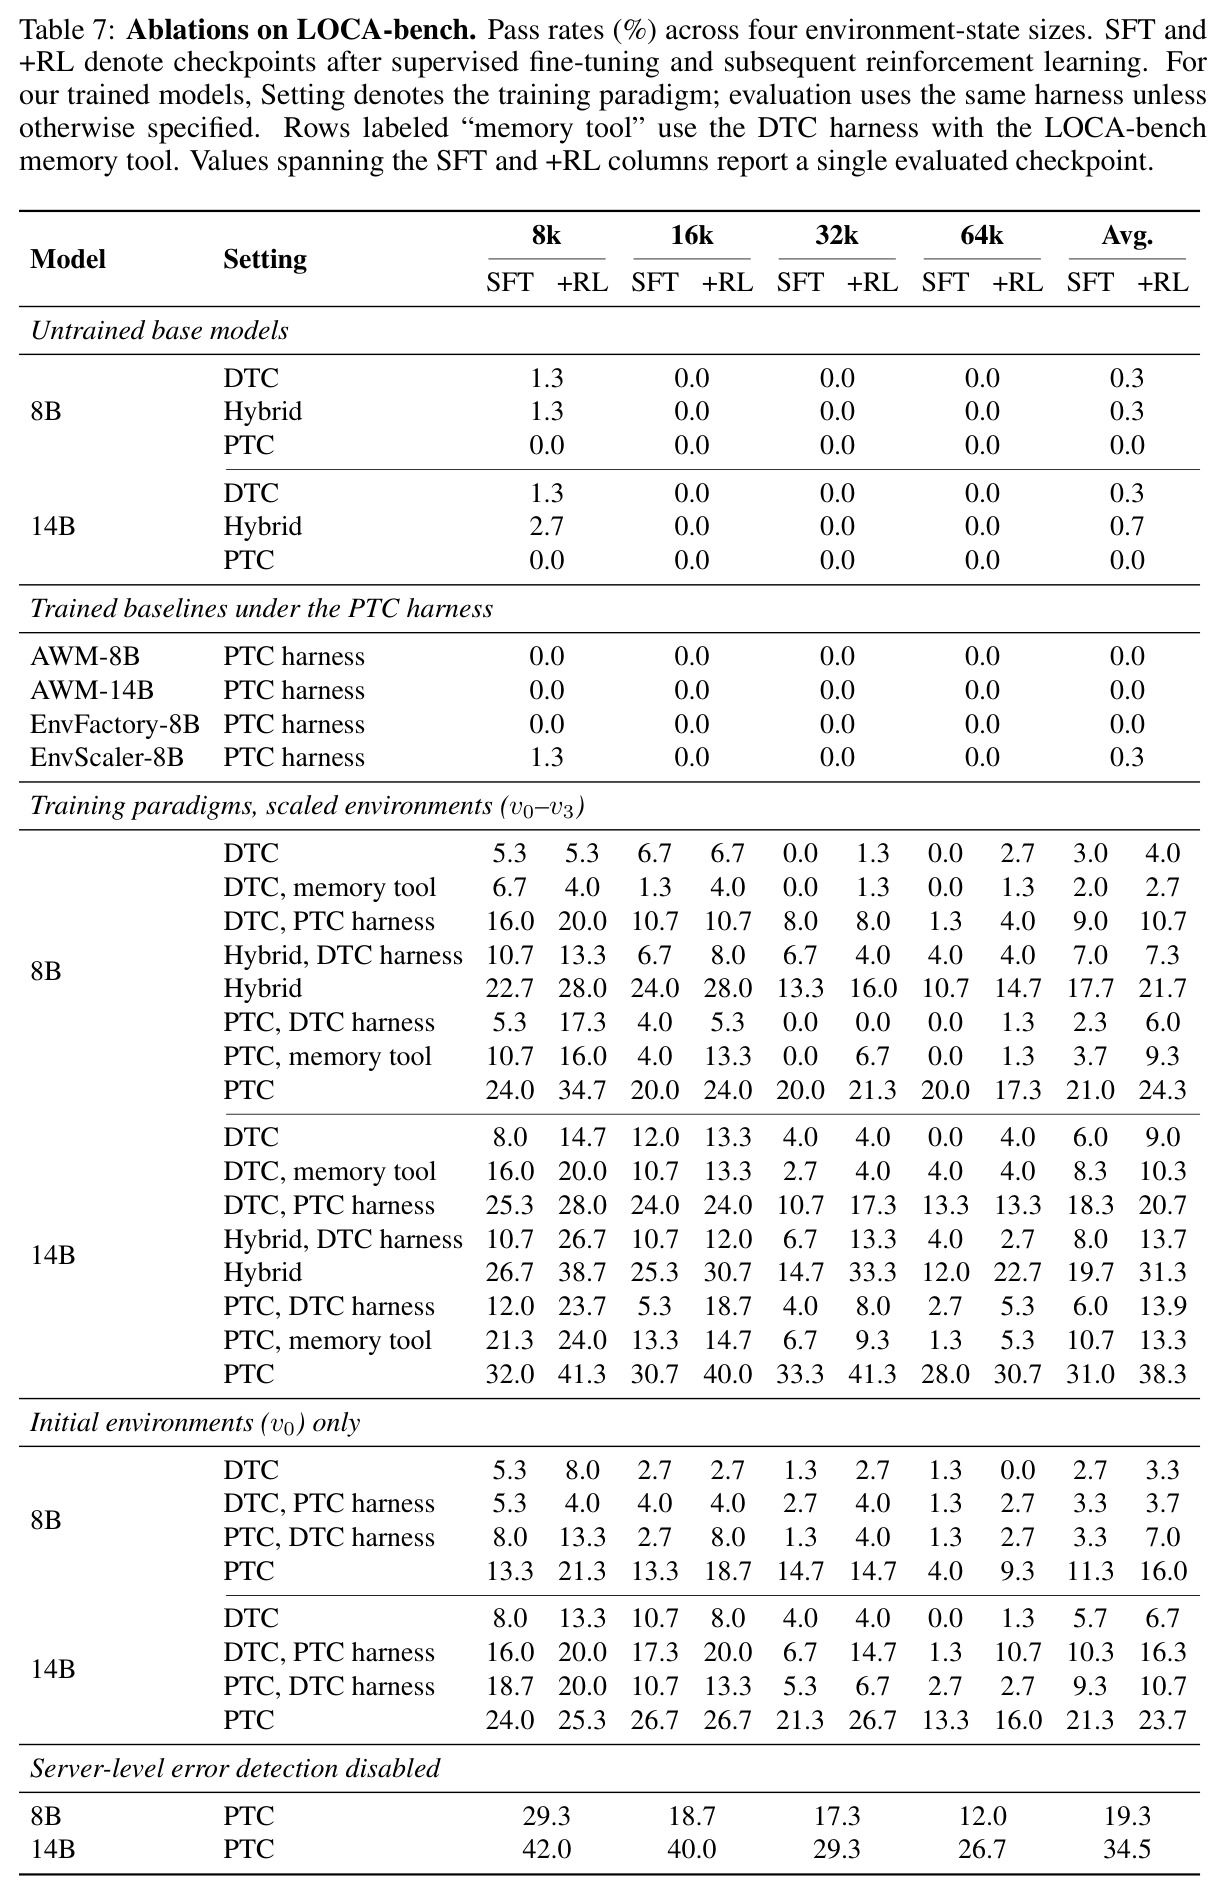
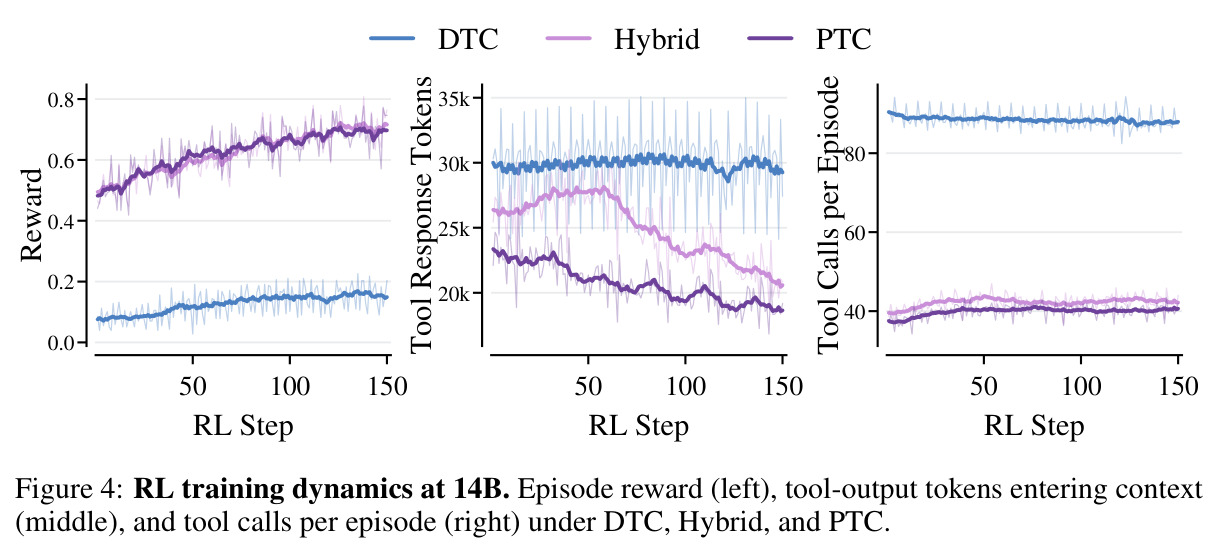
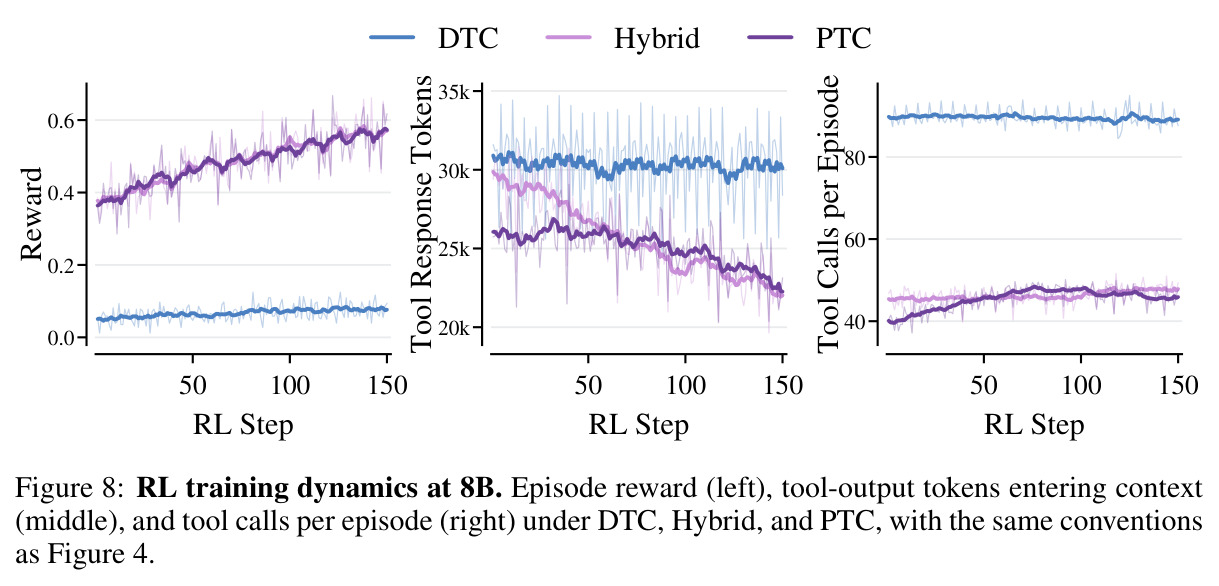
四个基准,每项 4 次运行平均。MCPMark:8B/14B 平均 18.3%/29.7%,基线最佳 Agent-World 为 13.3%/15.6%。Toolathlon-Verified:9.3%/17.1%,基线最高仅 2.8%/1.9%。MCP-Atlas:14B 达 45.6%,与 DTC 下的 Claude Sonnet-4.5(43.8%)相当。LOCA-bench 差距最大:基线 32k/64k 全为 0 分,ProgAgent-14B 64k 处仍有 30.7%、平均 38.3%(8B 24.3%)。范式对比(表 3):PTC 全面第一,如 14B 的 MCPMark 29.7 对 DTC 8.0。训练动态(图 4):DTC 奖励仅 0.08→0.15,PTC 达 0.70;PTC 工具输出 token 降约 20%,调用数约为 DTC 一半,错误从 6.4 降至 3.6。跨 harness(表 6):PTC 训练模型在两种界面下都更强。消融(表 7):只训 v0 使 14B 平均从 38.3% 降至 23.7%;AWM 等基线即使换 PTC 界面仍近 0 分。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MCPMark(Filesystem/Notion/Playwright/PostgreSQL 四套件平均) | 平均通过率 (%) | 29.7(ProgAgent-14B,PTC 训练并评测) | 同规模最佳基线 Agent-World-14B 15.6;同任务池 DTC 训练 8.0 | 较最佳同规模基线 +14.1 个百分点,较 DTC 训练 +21.7 |
| LOCA-bench,64k 环境状态 | 通过率 (%) | 30.7(ProgAgent-14B);8B 亦有 17.3 | 全部同规模基线(EnvScaler-8B、AWM-14B、Agent-World-14B 等)为 0 | 从 0 到 30.7,属量级差异,直接证明 PTC 缓解 context rot |
| LOCA-bench,四规模(8k–64k)平均 | 平均通过率 (%) | 38.3(14B)/ 24.3(8B) | AWM-14B 2.0;同一训练配方下 DTC 9.0、Hybrid 31.3(14B) | 较 DTC 训练 +29.3,较 Hybrid 训练 +7.0 |
| Toolathlon-Verified | 通过率 (%) | 17.1(14B)/ 9.3(8B) | 14B 基线最高 1.9(AWM-14B);8B 最高 2.8(EnvScaler-8B) | 约为最佳同规模基线的 9 倍 |
| MCP-Atlas(真实 MCP server 工具使用) | 通过率 (%) | 45.6(14B) | Claude Sonnet-4.5(DTC)43.8;同规模 DTC 训练 29.7、Hybrid 训练 38.6 | 14B 开源模型追平前沿闭源模型;较 DTC 训练 +15.9 |
| RL 训练动态(14B,自建环境) | 回合奖励(0–1) | PTC 从约 0.50 升至 0.70(Hybrid 0.72) | DTC 仅从 0.08 升至 0.15 | 训练信号相差 4–5 倍,解释了为何 PTC 是更可学的训练范式 |
局限与改进
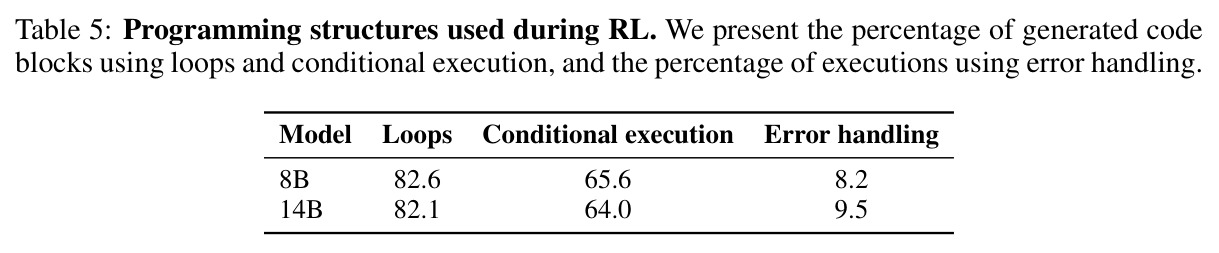
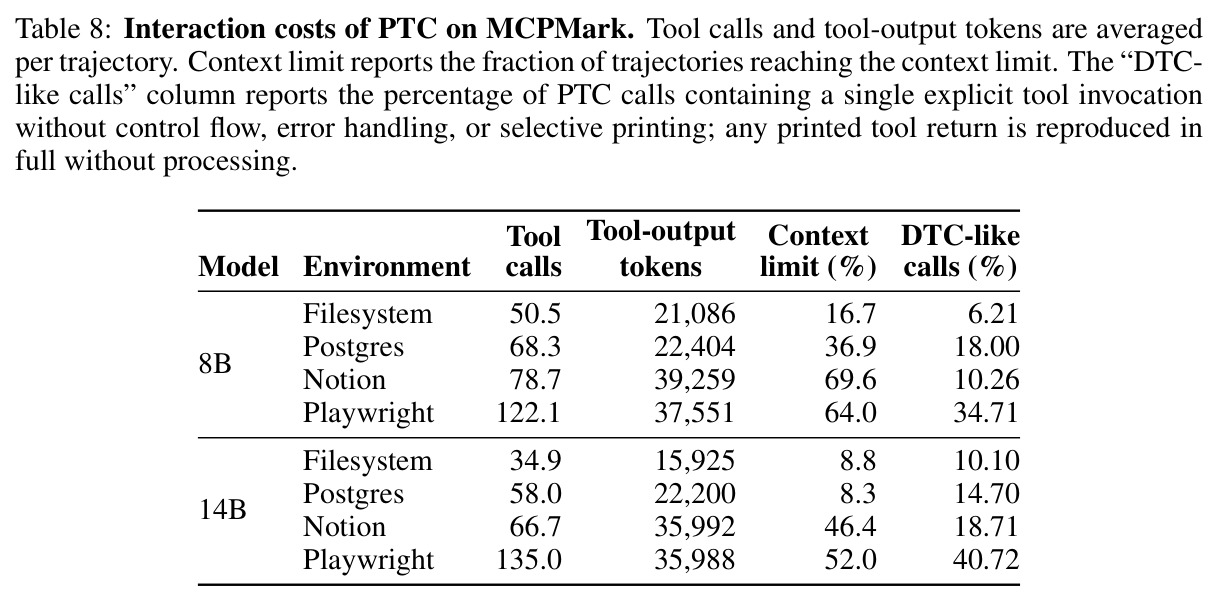
作者承认两条局限。其一,复杂环境中退化为 DTC 式行为:当环境返回不可预测、高度非结构化的内容(如 Playwright 网页快照)时,模型倾向于一次 PTC 调用只包一条工具指令,无控制流、异常处理或选择性打印——14B 在 Playwright 上 40.7% 的 PTC 调用是 DTC 式(表 8),对应 Playwright 得分仅 4.0%、52% 轨迹触到上下文上限。其二,静默服务器失败:运行时依赖 MCP 的 isError 字段抛异常,不合规 server 常省略该字段,绕过基于异常的恢复;关闭 server 级错误检测后,LOCA 平均从 38.3% 跌到 34.5%(14B)、24.3% 跌到 19.3%(8B)。我的补充观察:错误处理结构使用率仅 8.2%–9.5%(表 5),异常恢复是明显短板;即便 PTC,64k 处通过率也从 41.3% 降到 30.7%,上下文管理只是缓解而非消除规模压力;Notion 套件 46.4%(14B)的轨迹触顶,说明『选择性打印』学得不彻底。
独立分析的弱点
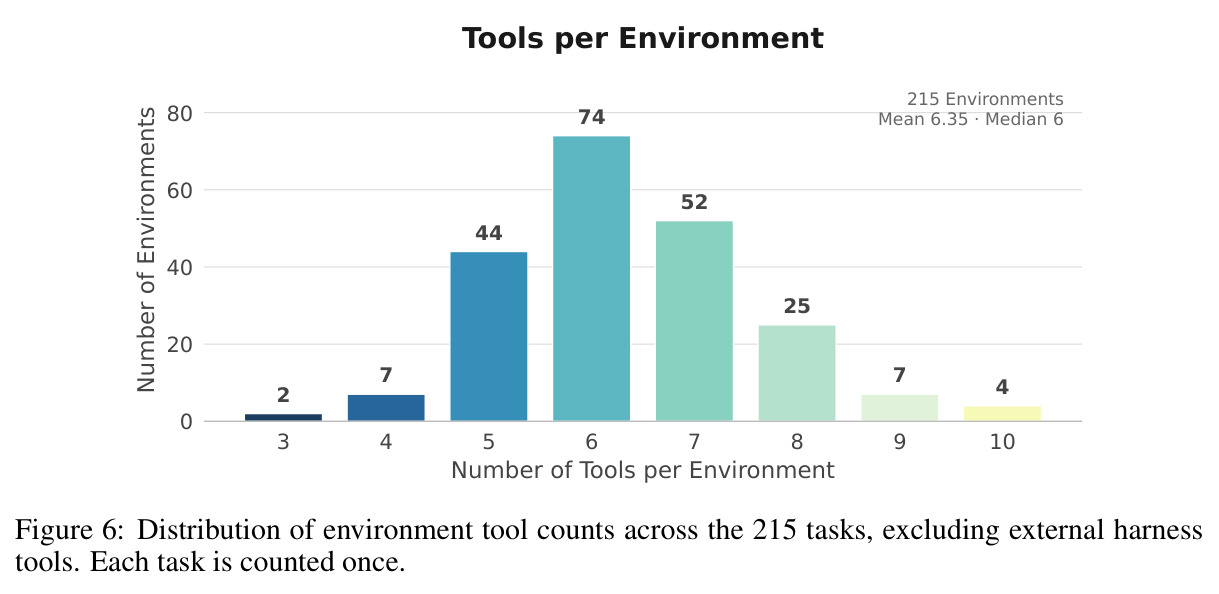
独立分析出五点弱点。第一,DTC 式退化的根因未解决:Playwright 场景需先读懂快照才能决定下一步,模型退化成逐条调用,改进方向是设计 shaped reward 惩罚『无处理直接打印原始返回』的模式,或在训练环境中加入更多非结构化返回逼模型先解析再决策。第二,错误处理薄弱(仅 8%–9% 执行使用 try/except),而真实 MCP server 行为不可靠,改进方向是把 server 错误规范化转译为 Python 异常做成运行时默认层,并在 SFT 轨迹中显式加入错误恢复片段。第三,二值奖励只看最终状态、不看过程,模型可能靠猜中终态得分,改进方向是利用判据级分数 $\tilde{R}_i$ 构造部分奖励或过程奖励。第四,训练池只有 215 个任务、每环境平均 6.35 个工具,与真实环境(数十个工具、跨 server 组合)差距明显,Toolathlon 绝对分数仅 17.1%;应扩大领域与工具组合覆盖。第五,上下文效率未被直接优化,可在奖励中加入上下文占用正则,显式优化『少打印、打要点』。
未来方向
作者提出的方向:研究程序化训练如何跨界面塑造工具使用行为——为何 PTC 训练在 DTC 评测下也能涨 11.9 个百分点(MCP-Atlas,14B),其迁移机制值得深入剖析;并把任务合成流水线与运行时作为研究平台,支持跨环境规模、跨训练设置的系统实验。基于成果可延伸的方向:(1) 把环境状态缩放与课程学习结合,按模型当前 pass 率动态分配 v0–v3,替代固定配比;(2) 混合奖励——二值验证器加上下文效率正则,直接优化选择性打印行为,可能修复 Playwright 上的退化;(3) 把 PTC 与外部记忆或递归语言模型(RLM)结合,进攻 64k 以上规模,目前 64k 处 30.7% 的下降说明纯变量保留不够;(4) 从理论上解释 Hybrid 为何不如 PTC——统一动作空间降低了表征学习的复杂度,这一假说值得可控实验验证;(5) 在非 MCP 工具生态(浏览器自动化、IDE、物理仿真 API)检验迁移性;(6) 用拒绝采样 + 针对性 SFT 专门修复 DTC 式调用模式,成本远低于重跑 RL。
复现评估
文档层面可复现性好:附录给出任务合成的完整 prompt(意图生成、任务构造、harness 审计)、三种 harness 的系统提示与工具描述、运行时关键参数(输出截断 5 万字符、2GiB 内存、256 进程、评测 120 秒超时)、训练超参(SFT 3 epoch/batch 64/lr $10^{-5}$;GSPO 150 步/每步 32 任务×16 rollouts/lr $10^{-6}$、温度 1.0)与硬件配置(SFT 2 节点×8 张 H200,RL 8 节点×8 张 H200,verl + Megatron-LM + vLLM rollout),任务另提供 Harbor 兼容格式。需注意:正文未明确承诺开源代码与数据;合成流水线依赖闭源商业模型(Gemini 3.0 Flash、Claude Opus 4.6、DeepSeek V4 Pro)与 Claude Code,任务构造与审计的 API 成本不低;64 卡 H200 级 RL 对普通实验室门槛偏高。复现难度:跑评测中等(需复刻运行时),完整复刻训练偏难,瓶颈在教师轨迹收集成本与算力。
论文图表
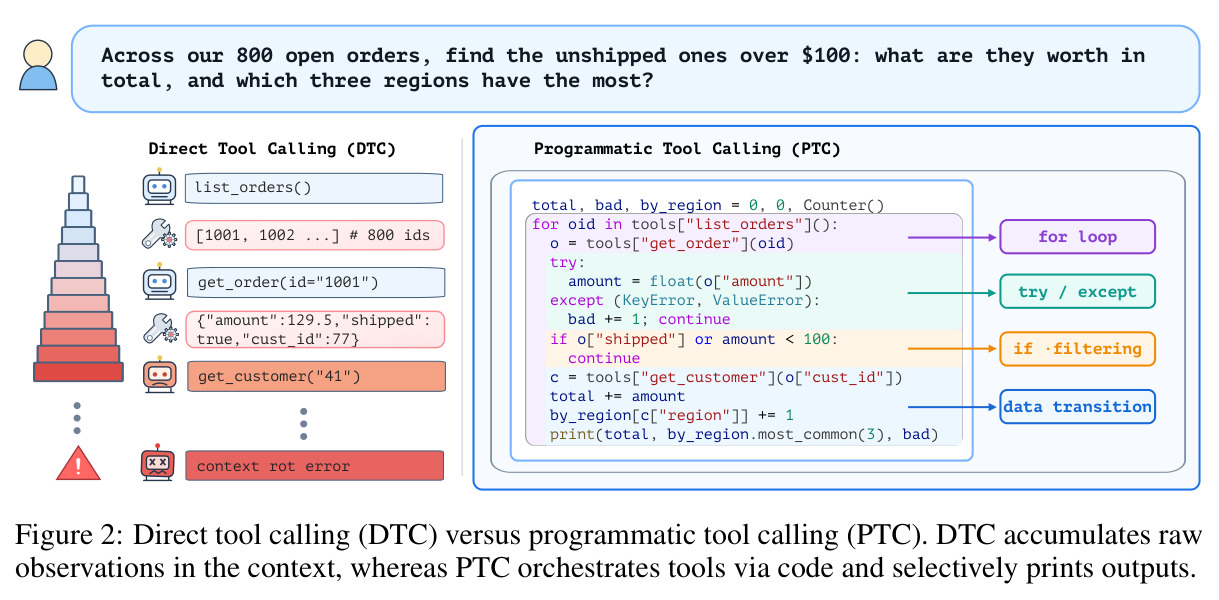
同一任务(800 个订单中找未发货且金额超 100 的订单,求总额与最多的三个地区)下两种界面的对照:左侧 DTC 逐个调用 list_orders、get_order、get_customer,原始返回全部堆进上下文,最终因 context rot 出错;右侧 PTC 用一段带 for 循环、try/except 和过滤逻辑的 Python 程序一次完成,只 print 最终摘要。
最直观地展示了问题的根源(原始观测累积)与 PTC 的解法(控制流内聚、上下文精简),是全文动机的具象化。
同一任务池、同一超参下 DTC/Hybrid/PTC 三种训练范式的对比,括号内为对应未训练基座在同 harness 下的分数。PTC 在全部四个基准、两个模型规模上都最优,例如 14B 的 MCPMark 29.7 对 DTC 8.0、MCP-Atlas 45.6 对 29.7;未训练基座下 PTC 接口反而常常最低分。
直接回答核心问题:收益来自『训练范式』而非『推理接口』——训练前给 PTC 接口没用,训练后才反转格局。