AgentGarten:面向演化智能体的代码世界 AgentGarten: Code Worlds for Evolving Agents
引擎管状态、共享神经渲染器管画面,预训练智能体4轮学会建庇护所
前置知识
视频扩散模型与流匹配
在潜空间对视频加噪再去噪的生成模型。流匹配(flow matching)是其训练范式之一:把干净潜变量 $z$ 与噪声 $\epsilon$ 按时间 $t$ 插值为 $z_t=(1-t)z+t\epsilon$,训练网络预测速度 $v=\epsilon-z$,采样时沿速度场从噪声走到数据。本文渲染器即在 Wan 视频 VAE 的潜空间上做几何条件化的流生成。
本文渲染器的三阶段训练(几何条件化、教师强制适应、蒸馏)全部围绕速度预测展开,公式 (6)(7)(8) 都建立在这套记号上,不懂流匹配就读不懂损失函数。
Self Forcing 与滚动蒸馏
让自回归生成模型在自己滚动(rollout)产生的输出上训练,而非在真实前缀上训练,以缩小训练与推理的分布差;配合双向教师对滚动样本打分的分布匹配蒸馏(DMD),学生几步去噪即可出片。SGF(Self Gradient Forcing)进一步引入第二遍前向,把梯度传进历史编码的计算。
Adversarial Forcing 直接在 Self Forcing/DMD2/SGF 这一谱系上改进:exact replay 是对 SGF 二遍重放的精确化,真实数据对抗损失承自 DMD2,理清这条脉络才能定位本文的贡献点。
GAN 的 R1/R2 梯度惩罚
GAN 稳定性技术:对判别器输出 $D_\phi(x)$ 关于输入求梯度,惩罚其在真实样本(R1)和生成样本(R2)上的平方范数 $\mathbb{E}\|\nabla_x D_\phi(x)\|^2$,抑制判别器过陡。其参数梯度通常需要对反向传播再求导(double backward),而 FlashAttention 等融合注意力核并不支持这种操作。
本文提出了免 double backward 的精确 R1/R2 方案(冻结骨干 + JVP 构造),是其三大技术贡献之一,不熟悉 R1/R2 就无法理解这一设计的动机。
块因果注意力与 KV 缓存
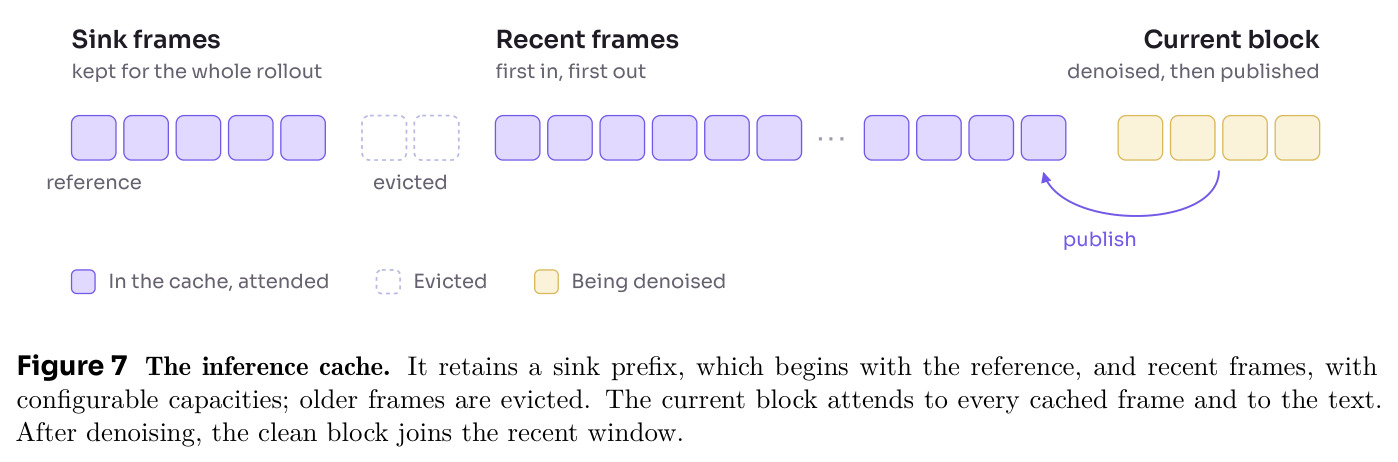
自回归 Transformer 把序列切成块(本文每块 4 个潜帧),块内双向注意、块间只能看过去,已算过的 key/value 存入缓存避免重算。缓存无限增长会耗尽显存,故常用「锚点帧+滑动窗口」的有限缓存,并配合旋转位置编码(RoPE)重映射来支持超出训练视界的长滚动。
这是实时交互渲染的工程基础:本文的流式推理(sink 前缀 + FIFO 窗口 + top-aligned 位置重映射)和 exact replay 的逐块执行方式都建立在块因果注意力之上。
JVP 与 VJP
前向模式微分的 Jacobian–vector product($v\mapsto Jv$,沿切向量一次前向传播导数)与反向模式微分的 vector–Jacobian product($u\mapsto J^\top u$)。JVP 只跟随前向计算、每个算子带一个切线,不需要构建反向图,因此可以在不支持二阶导的融合核上照常执行。
公式 (11)–(13) 的精确 R1/R2 全靠「一次 VJP 得 $g$、一次 JVP 得 $v$、再对判别器头部做显式 JVP」这一组合,不理解 JVP 就无法看懂他们如何绕开 double backward。
OpenAI 躲猫猫实验
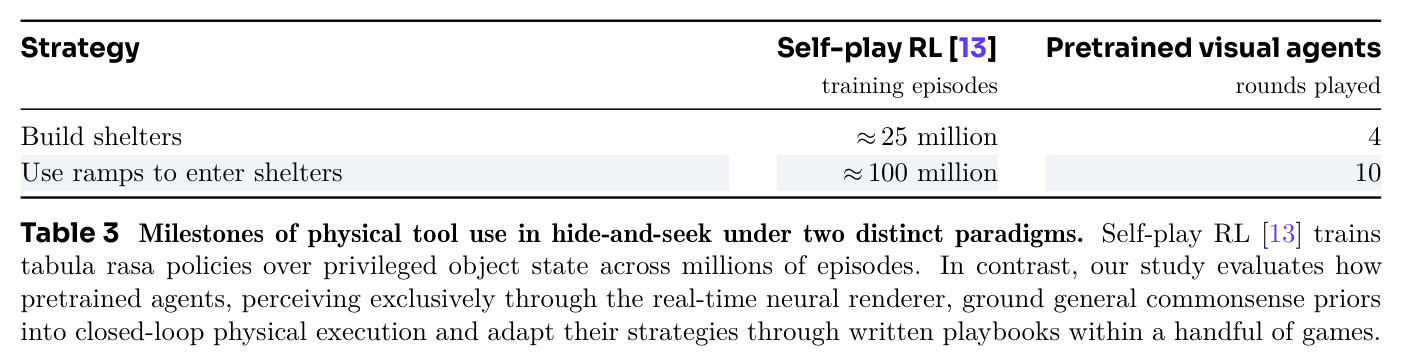
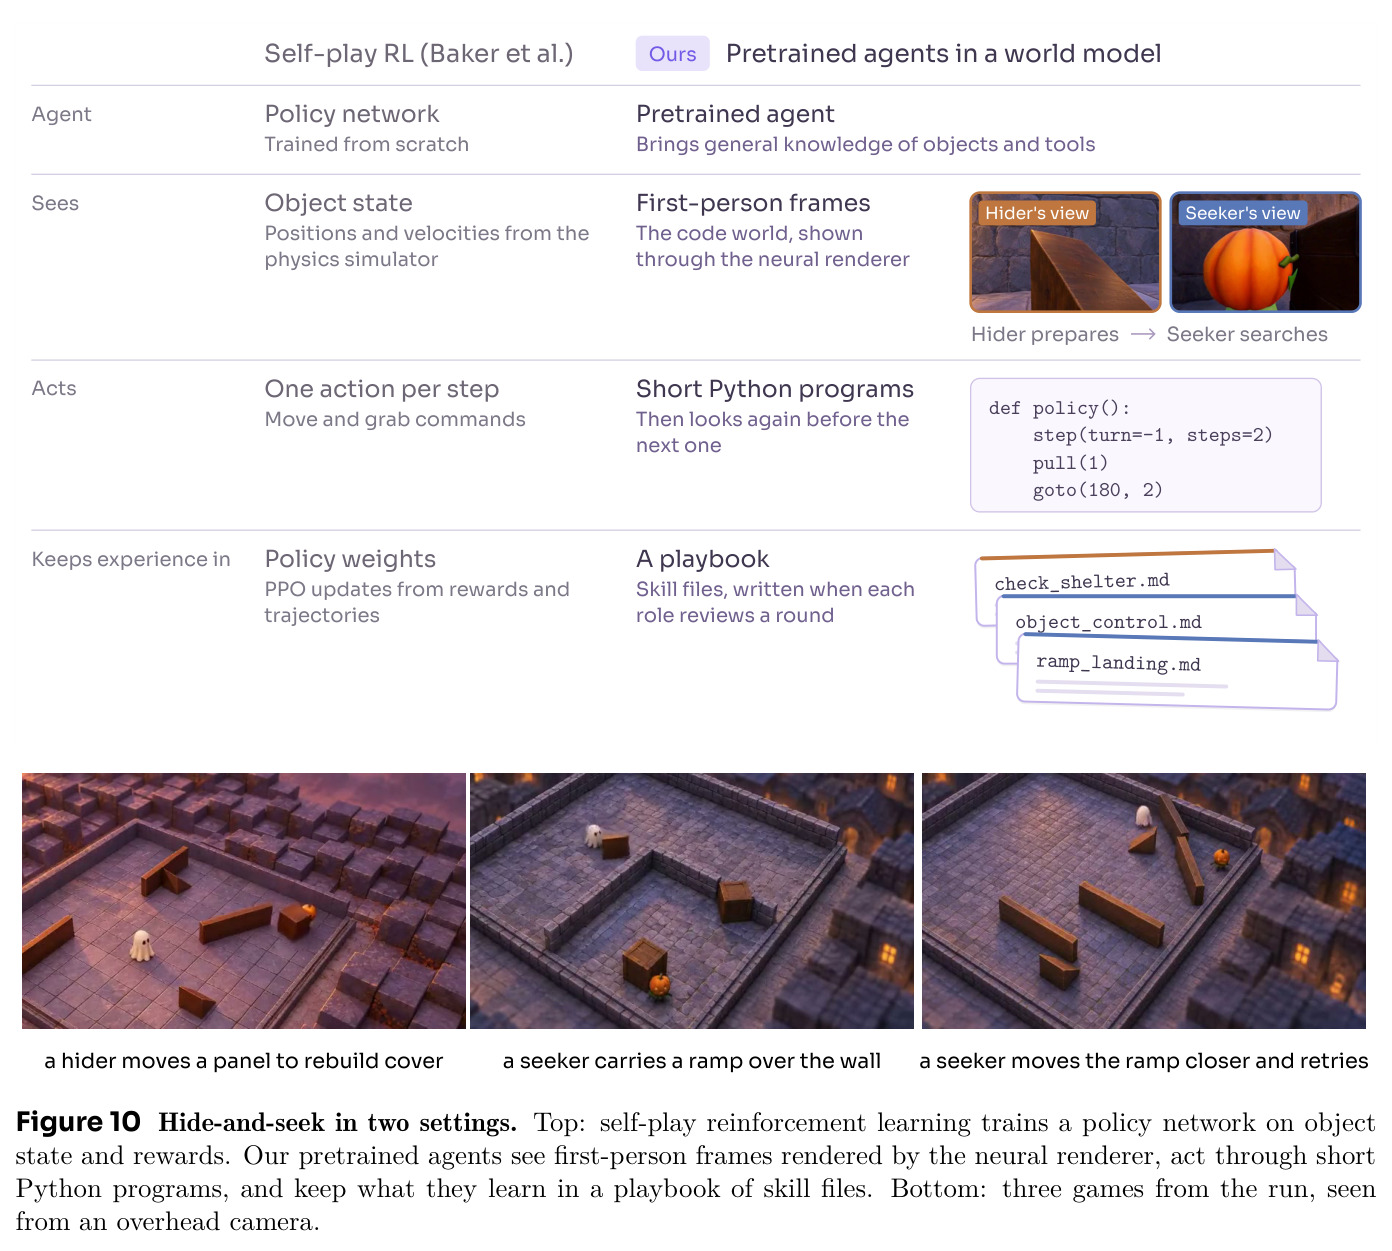
2019 年 OpenAI 用多智能体自我博弈强化学习训练 hider/seeker:从随机策略出发,约 2500 万局后涌现「搬箱子建庇护所」,再约 7500 万局后(累计约 1 亿局)涌现「用坡道越墙」等工具使用与反制策略,是涌现复杂行为的标志性工作。当时的智能体直接读取物理引擎的物体状态(坐标与速度)。
本文将其作为对照锚点:同一环境换成预训练智能体、只看神经渲染的第一人称画面后,第 4 轮就建庇护所、第 10 轮就用坡道,凸显两种学习范式的本质差异。
研究动机
构建智能体训练环境长期存在两难。一类做法是模拟器与游戏引擎(Habitat 2.0、ManiSkill2、ProcTHOR 等):状态显式、规则可编程、行为可检查,但要扩展视觉多样性就必须制作大量 3D 资产、走复杂的图形渲染管线,每个新场景成本高昂;OpenAI 2019 年的躲猫猫实验里,智能体在这种环境上自我博弈约 2500 万局才涌现建庇护所行为。另一类是视频世界模型(Genie、GameNGen、Matrix-Game 系列、Genie 3 等):能从数据合成视觉丰富的画面,但任务相关状态和物理规则隐含在生成历史与学到的表示里,无法直接检查、编辑和测试环境行为,长滚动后世界状态还会随生成误差漂移。要在导航、操控、工具使用、多智能体交互等任务上规模化训练环境,需要同时具备可控可查的动力学和符合真实视觉分布的观察,而现有方法只能在「忠实」与「真实」之间取舍。
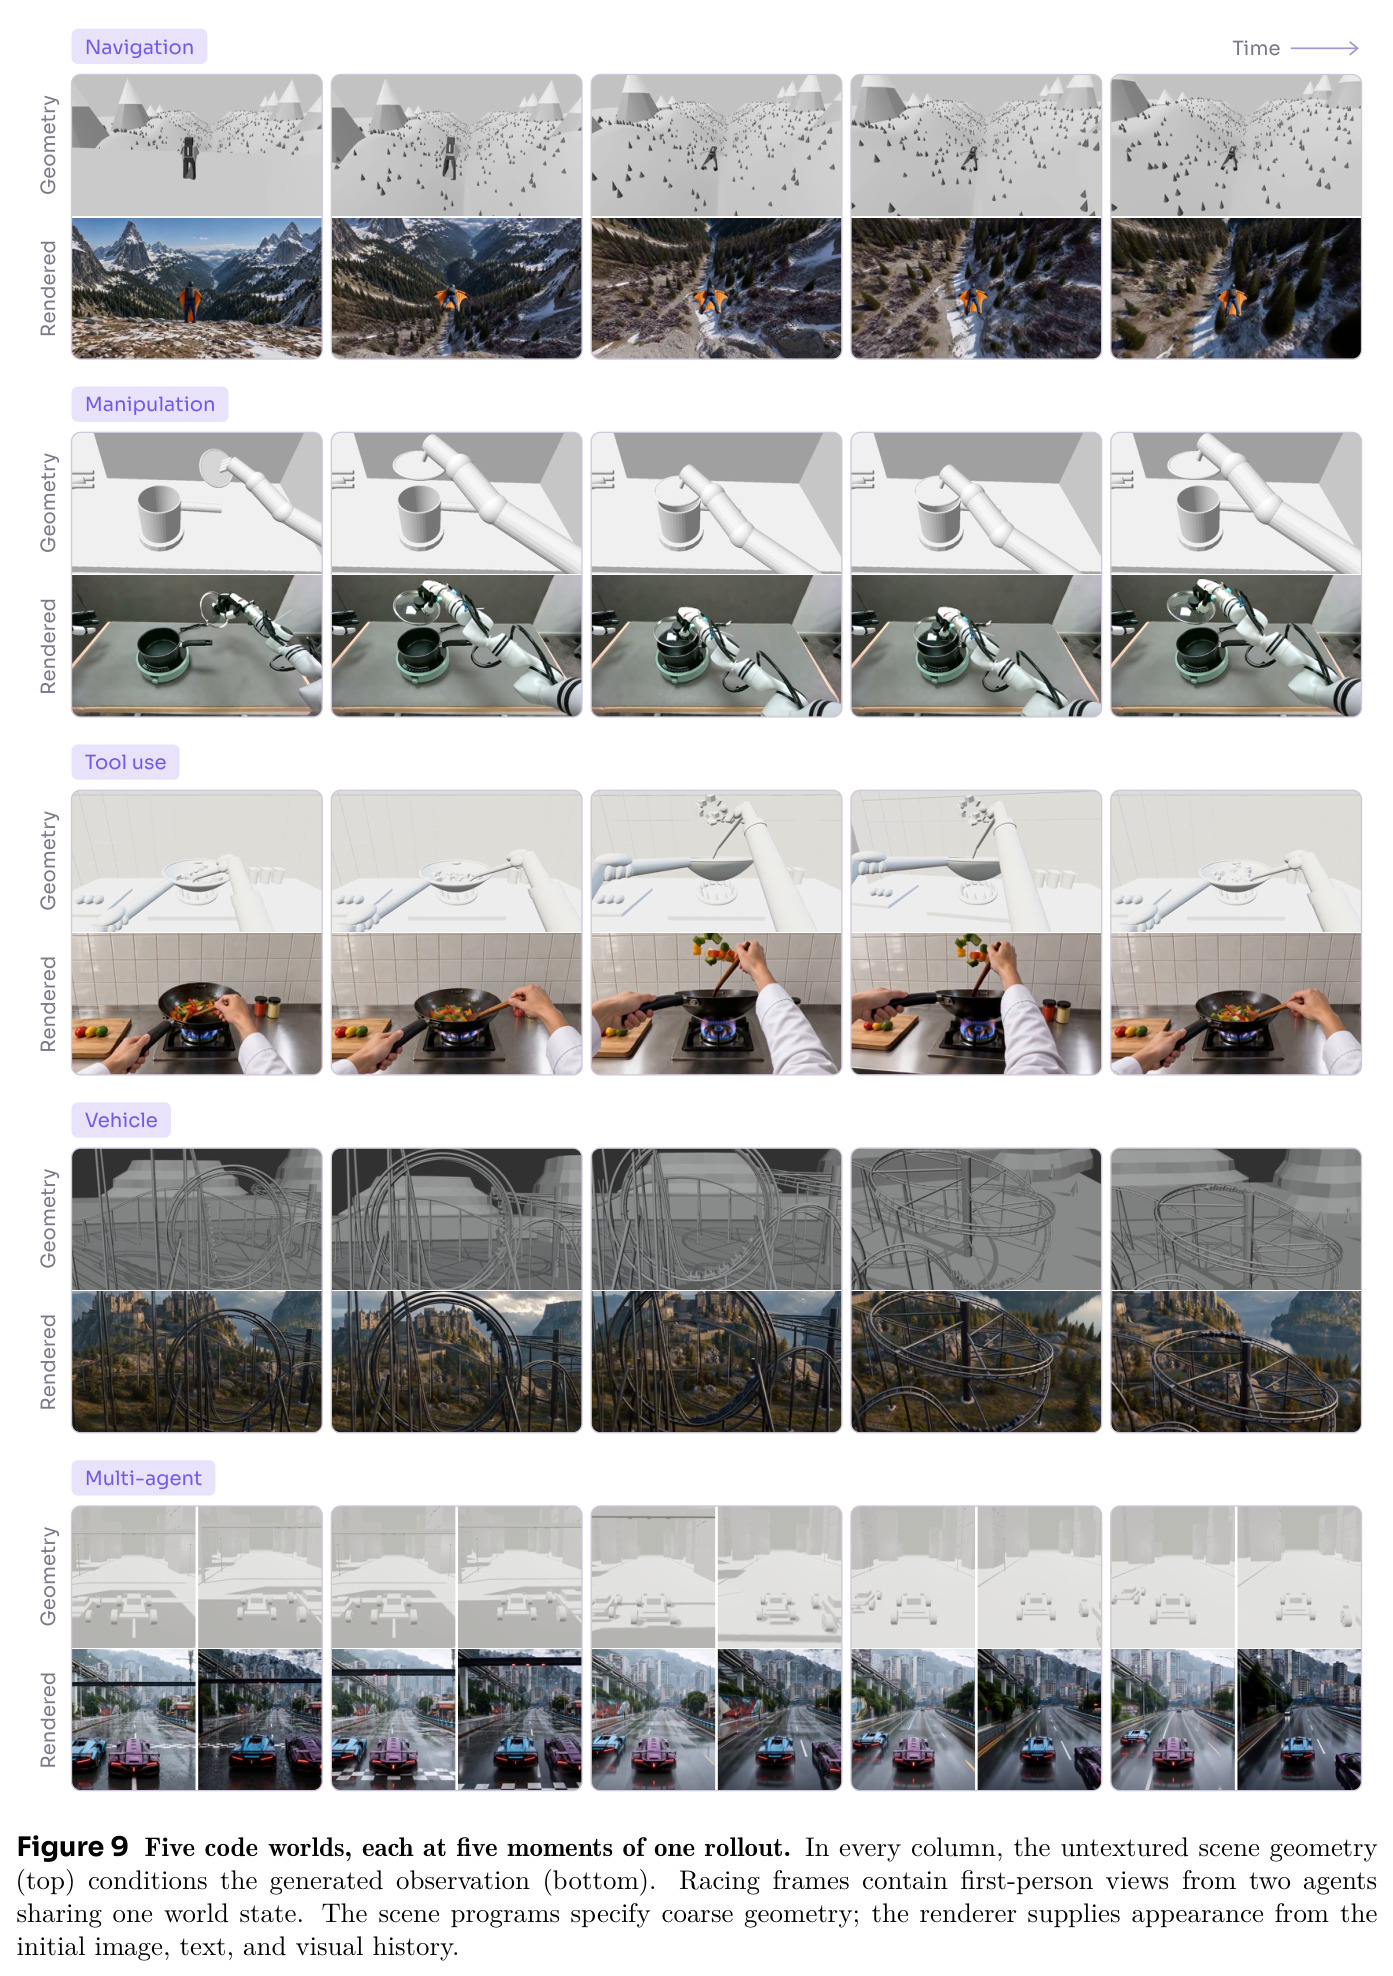
本文的目标是本文目标是打造既忠实又真实的可扩展交互环境:忠实指状态、规则、动力学持久一致,动作的后果可以被依赖;真实指观察符合真实世界的视觉分布。具体拆成三件事。其一,提出 code world(代码世界)框架:把环境写成可执行的场景程序,由引擎维护持久状态、由一个共享的神经渲染器生成画面,新世界只需写代码而无需逐场景制作视觉资产,环境可以随智能体在数量和难度上共同增长。其二,训练一个几何条件化的实时神经渲染器,在单张 H100 上以 36.5 帧/秒生成 480×832 画面,支撑智能体「行动—观察—再行动」的闭环交互。其三,让预训练基础模型智能体只能通过渲染画面感知世界,通过轮次化的「练习—复盘—写 playbook」流程持续改进,验证这类环境能否真正支撑智能体演化。
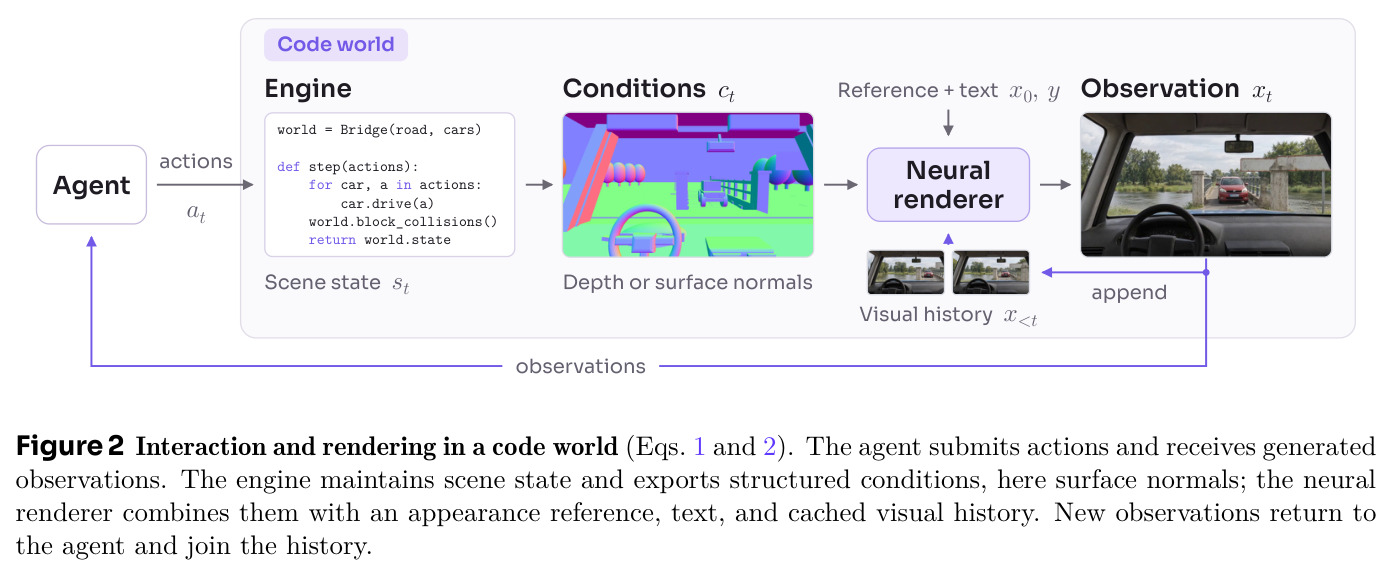
与已有工作不同的是,独特切入点是动力学与外观的职责分离:引擎只维护状态和执行规则,渲染器只负责「长什么样」。状态转移 $f_p$ 不吃任何渲染画面,渲染误差无法累积进世界状态;同一段状态轨迹可以换外观参考、换机位重新渲染而不改变事件本身。接口选的是任何带 3D 场景的模拟器都能导出、又能从真实视频估计的彩色深度图或表面法线,从而让多个不同引擎共享同一个渲染器。与既有「视频模型背后藏一个显式状态」的工作相比,本文的差异在于:状态是一个完整可执行、可检查可修改的程序化环境而非学习出来的隐变量;渲染器是块因果、短块、实时的,新动作能在滚动中途随时注入;且智能体只凭渲染画面感知和改进,从不读取引擎真值坐标,这使「预训练知识如何落地为闭环感觉运动能力」成为可研究的问题。
核心方法
直觉上,这套系统是「代码当世界的物理与规则,神经网络当世界的皮肤」。形式化为:场景状态 $s_t$、相机位姿 $\pi_t$、动作 $a_t$ 满足 $(s_{t+1},\pi_{t+1})=f_p(s_t,\pi_t,a_t)$,引擎从相机导出结构化条件 $c_t=h_p(s_t,\pi_t)$(彩色深度或表面法线);渲染器再合成观察 $x_t=R_\theta(x_{<t},c_{\le t},x_0,y)$,其中 $x_0$ 是外观参考图、$y$ 是文字描述。渲染器从预训练双向视频模型 Cosmos 3-Nano(36 层、宽 4096)出发,分三阶段训练:阶段 1 用深度/法线条件化;阶段 2 改造成块因果自回归生成(并行教师强制);阶段 3 用 Adversarial Forcing 蒸馏成 4 步去噪的实时渲染器。推理时用有限 KV 缓存(5 个锚点帧+44 个近期帧)、自定义 Triton 融合核、CUDA graph 和小于 10ms 的 tiny decoder 支撑流式实时输出,画面经 WebRTC 推给智能体或浏览器。
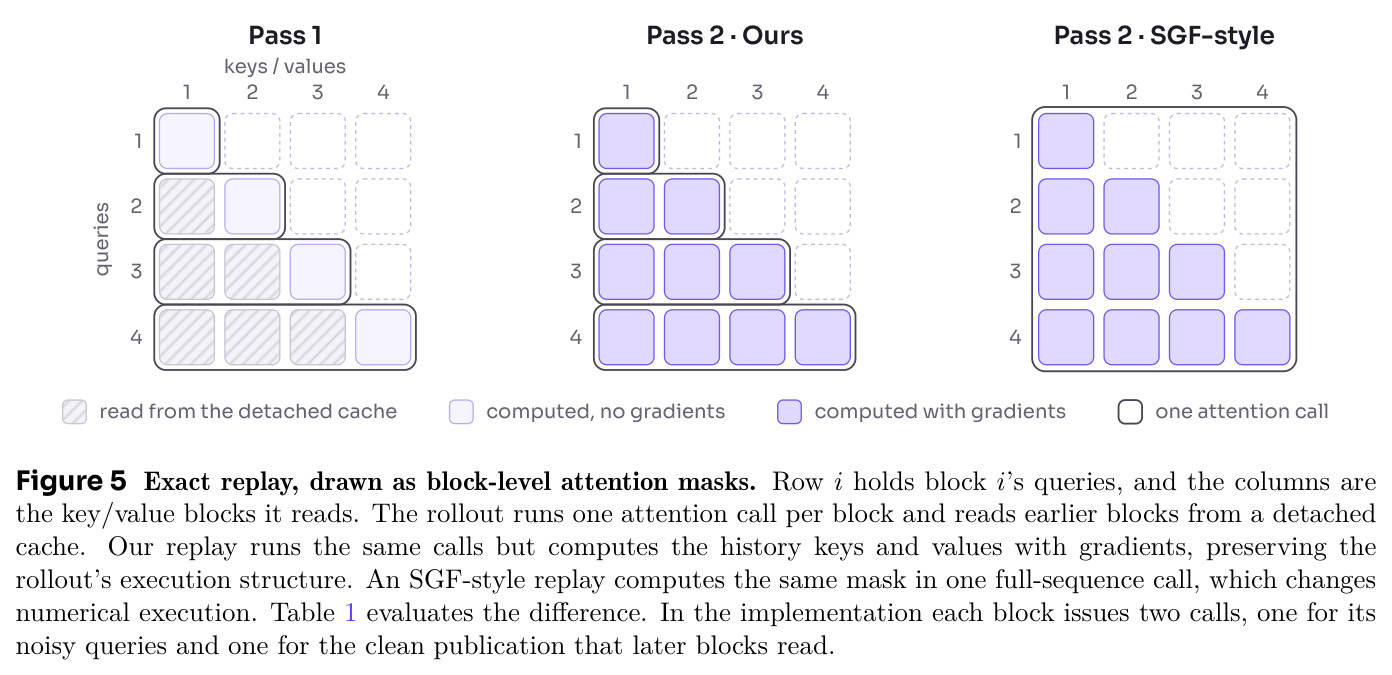
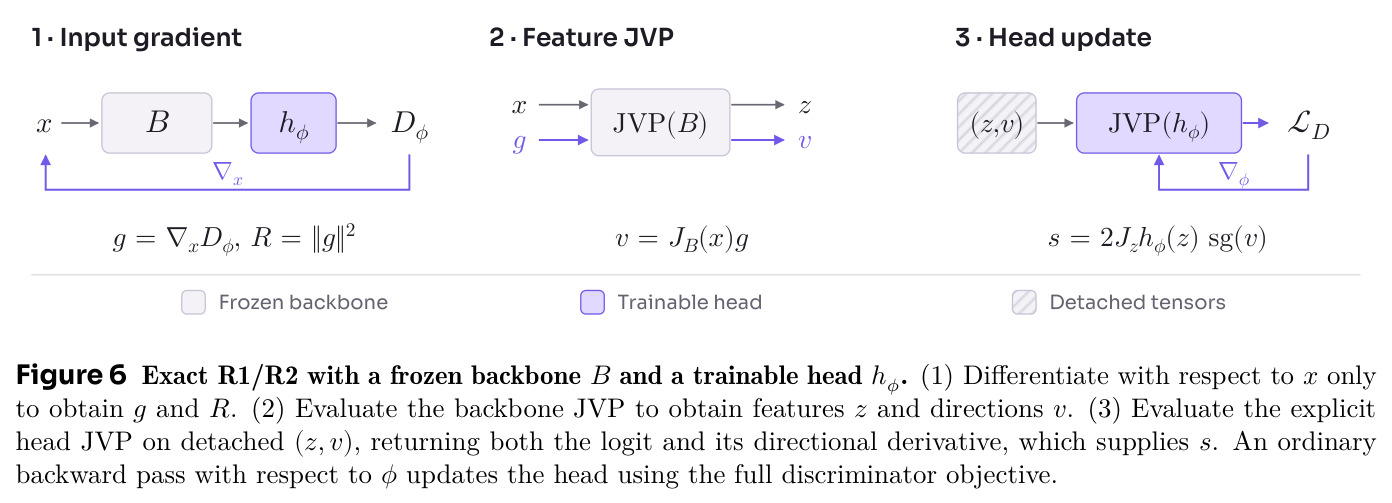
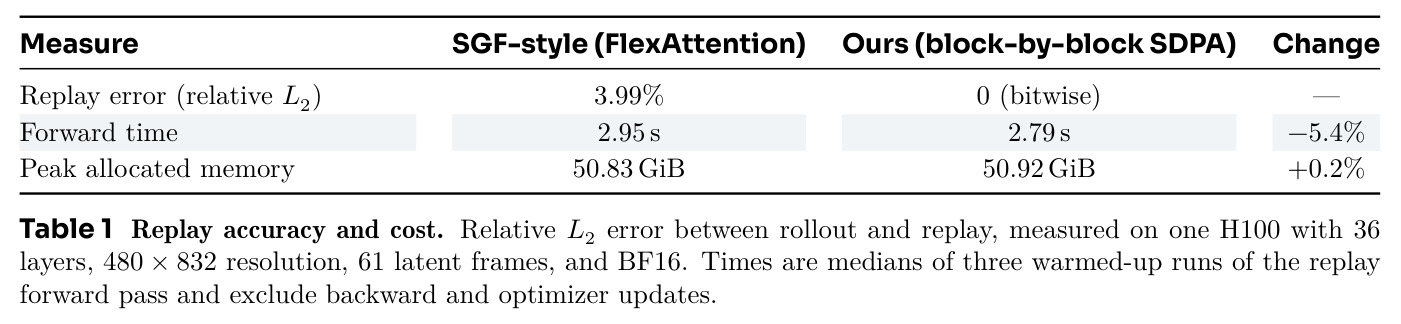
核心创新是 Adversarial Forcing 蒸馏,在 Self Forcing/DMD2/SGF 谱系上做了两项本质改进。第一是 exact replay:标准 Self Forcing 把已完成块编码进脱离梯度的 KV 缓存,后续损失只能监督「从缓存读历史后的预测」,无法更新「历史如何被写入缓存」的计算;整条滚动保持可微又需巨额显存。本文用两遍训练——第一遍无梯度滚动并记录每块输入 $U_j$ 与干净输出 $Z_j$,第二遍以与滚动逐位一致的执行方式(逐块 SDPA、相同 key–value 顺序与张量形状)在计算图内重算历史编码,使 $\tilde z_{\theta,j}=\mathrm{sg}(U_j)-t^* v_\theta(\mathrm{sg}(U_j),t^*\mid\mathrm{sg}(Z_{<j}),\mathcal{C};\mathcal{M}_{TF})$ 能被后续损失反传更新,且重放与采样 bitwise 一致——SGF 式全序列 FlexAttention 重放因核与归约顺序不同存在 3.99% 相对 $L_2$ 数值发散。第二是精确 R1/R2 正则:利用判别器骨干冻结这一事实($z=B(x)$ 与 $A=J_B(x)$ 不依赖头部参数 $\phi$),一次 VJP 得 $g=A^\top u$、一次 JVP 得 $v=Ag$,构造代理 $\tilde R=\mathrm{sg}(\|g\|^2)+s-\mathrm{sg}(s)$,其中 $s=2J_z h_\phi(z)\,\mathrm{sg}(v)$,其函数值和关于 $\phi$ 的一阶梯度都与真实惩罚一致,完全绕开 FlashAttention 不支持的 double backward,也不需要 APT 那样的随机扰动近似。
方法步骤详情
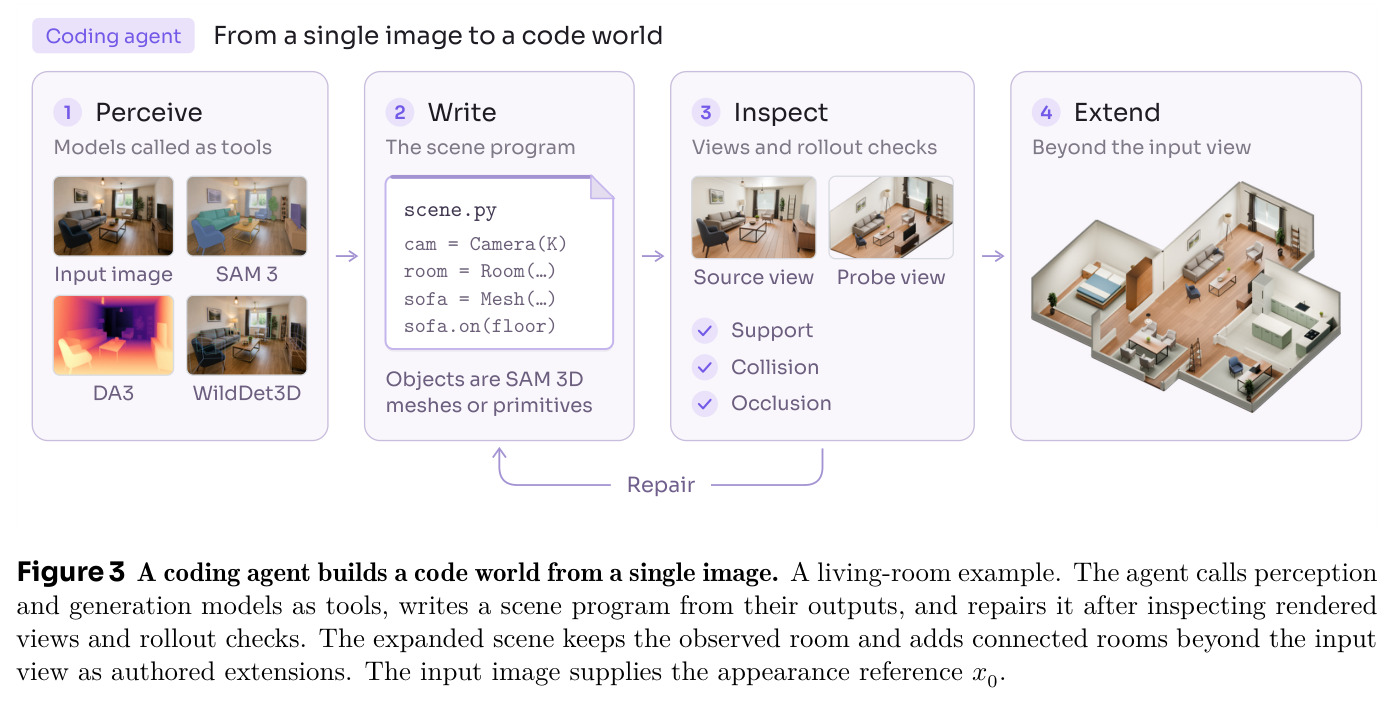
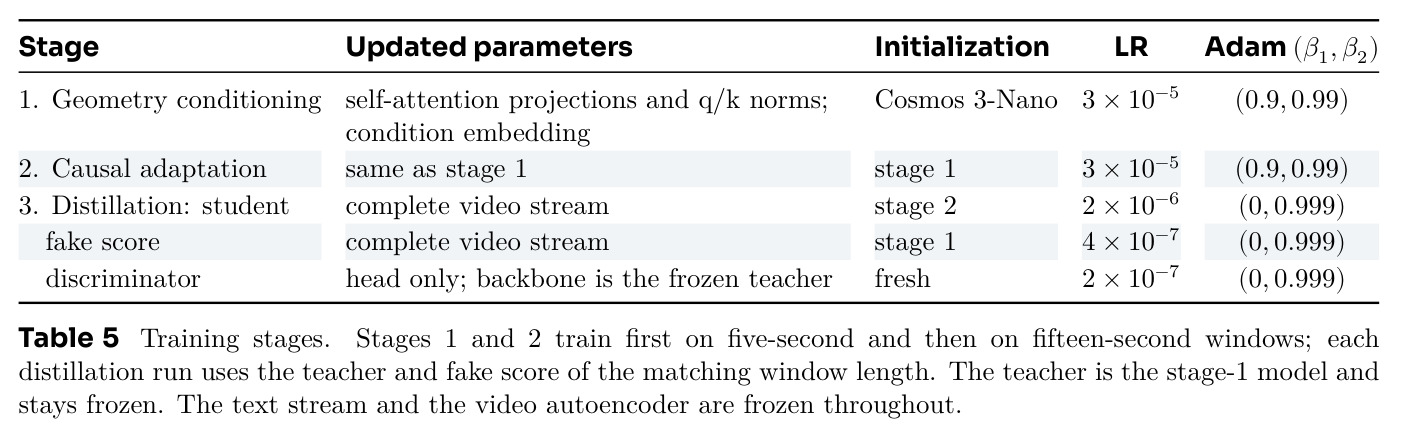
流程分五步。①建世界:编码智能体从单张图(用 SAM 3、Depth Anything 3、WildDet3D 等感知模型提取实例掩码、单目深度、3D 框、物体网格)或纯文本写出 scene.py 场景程序,只需粗几何(布局、轮廓、遮挡、运动);再经探针相机滚动测试与接触/碰撞/遮挡验证查询迭代修复;输入图或保布局的图像编辑结果充当外观参考 $x_0$。②几何条件化:深度按 $u(d)=1-(1+\alpha d/10)^{-2}$ 上色,法线编码为 $(n+1)/2$,经冻结视频编码器与空间池化得 $G_t=W_{in}\mathcal{P}([E(S(c))]_t)+e_{geo}$,每潜帧仅 28 个条件 token(RGB 为 390 个),与 RGB token 沿序列拼接做联合注意力;训练时随机丢模态(10% 全丢)、抑制纹理、扰动对齐并加潜空间噪声以增强鲁棒性。③块因果适应:每块 4 潜帧,块内维护干净副本 $P_j$ 与噪声副本 $Q_j$,掩码为 $P_j\to A_0\cup P_{\le j}$、$Q_j\to A_0\cup P_{<j}\cup Q_j$,所有目标块以独立采样的流时间并行训练流匹配损失 $\mathcal{L}_{TF}$。④Adversarial Forcing:4 步采样调度 $\mathcal{E}=(1600/1601,15/16,5/6,5/8,0)$,学生对自身滚动样本做 DMD 分布匹配(冻结教师打分 + fake-score 模型学学生分布),叠加相对论对抗损失 $\mathcal{L}_G$ 与精确 R1/R2,判别器聚合冻结教师第 11/23/35 层特征;全部训练在 32 张 H100 上完成(条件化/适应学习率 $3\times10^{-5}$,蒸馏 student $2\times10^{-6}$、fake-score $4\times10^{-7}$、判别器头 $2\times10^{-7}$)。⑤流式推理:缓存保留以参考帧开头的锚点前缀加滑动窗口,超视界滚动用 top-aligned 旋转位置重映射($H=61$、$b=4$);Triton 核与 CUDA graph 消除启动开销,tiny decoder 8.8ms 出帧。
技术新颖性
技术新颖性有三点。其一,exact replay 把「重放必须与采样数值一致」变成显式设计约束:SGF 用全序列 FlexAttention 重放,虽然注意力掩码等价,但核、张量形状与归约顺序不同,BF16 下产生 3.99% 相对 $L_2$ 偏差且会随网络放大;本文坚持逐块 SDPA、相同的调用形状与分组顺序(先参考,再每块的条件 token 加 RGB token),做到 bitwise 一致,同时前向还快 5.4%。其二,精确 R1/R2 是首个在冻结大规模视频骨干上完全精确、无 double backward、无随机近似的梯度惩罚实现:数学上仍是头部的二阶导数,计算上通过显式头部 JVP 与冻结骨干的 fused attention-JVP 核完成,从不微分任何反向核。其三,架构上拒绝通道拼接和控制分支,改用序列拼接的联合注意力配零初始化模态嵌入 $e_{geo}$,避免像素对齐归纳偏置;接口选深度/法线而非外观图,让多个引擎共享一个渲染器,颜色材质全部交给 $x_0$、文字与视觉历史携带;这套设计与「编码智能体写世界+playbook 复盘」组合成完整闭环,也是此前工作没有同时做到的。
实验结果
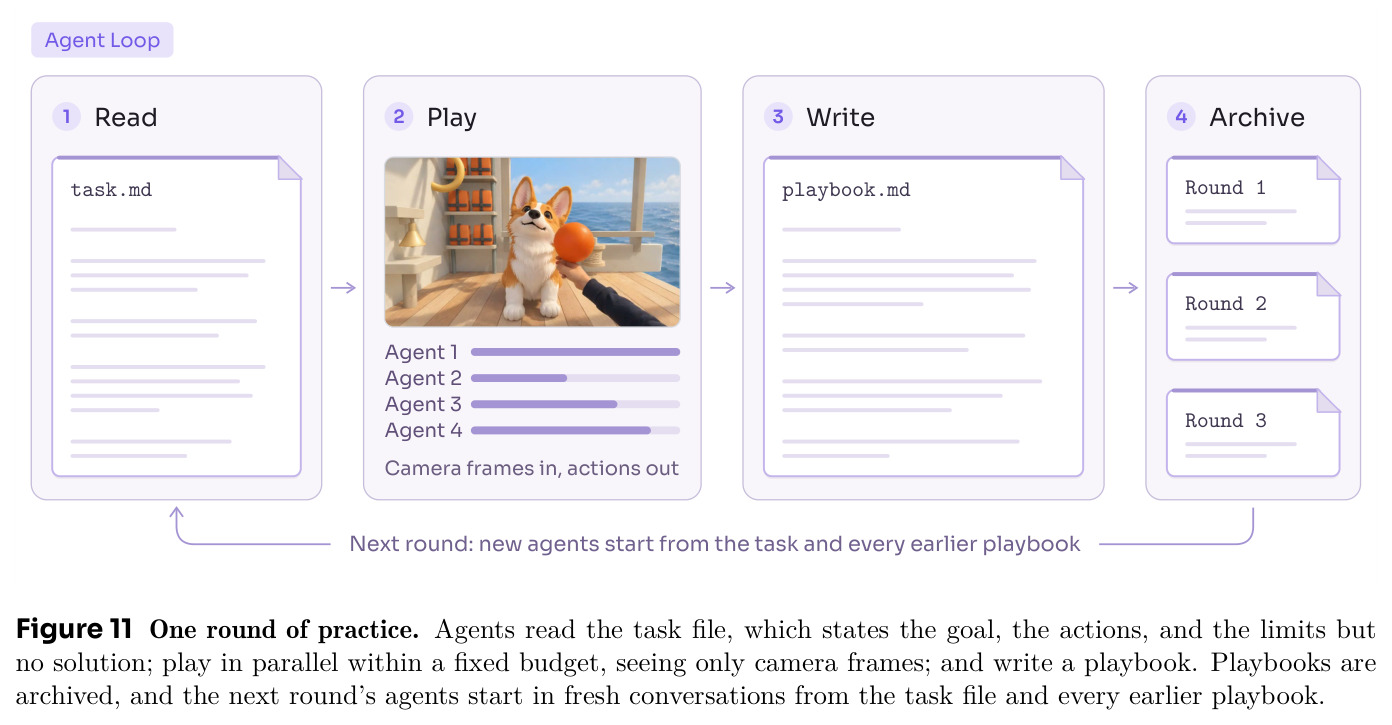
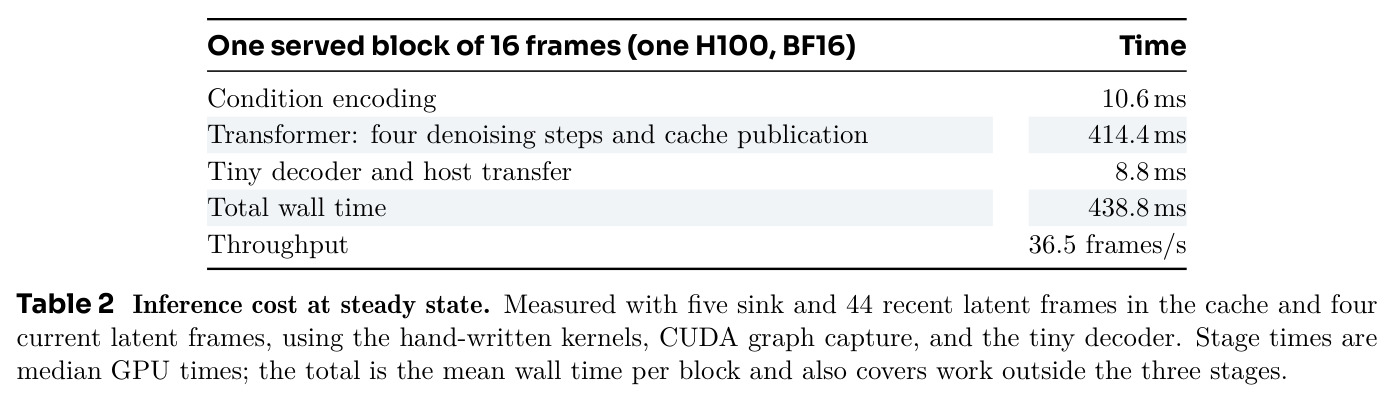
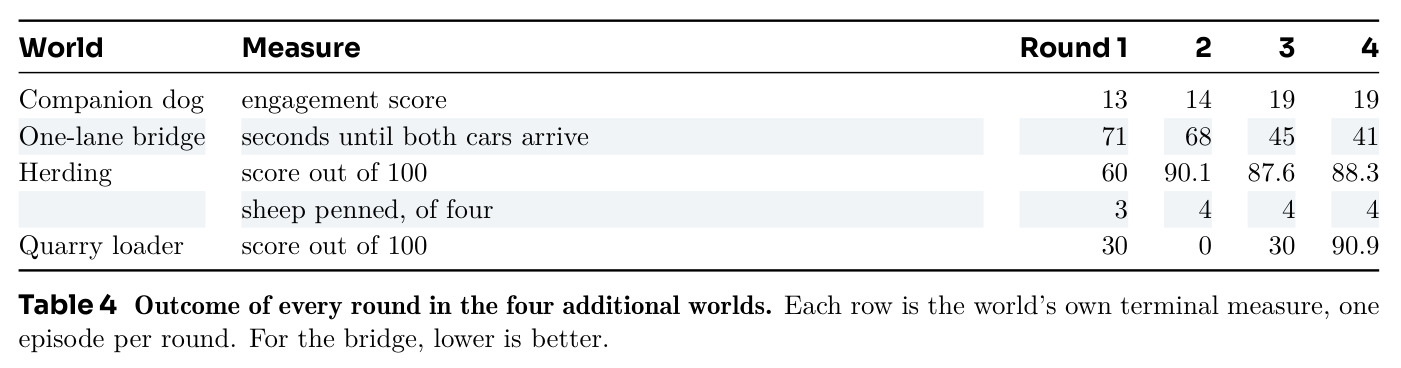
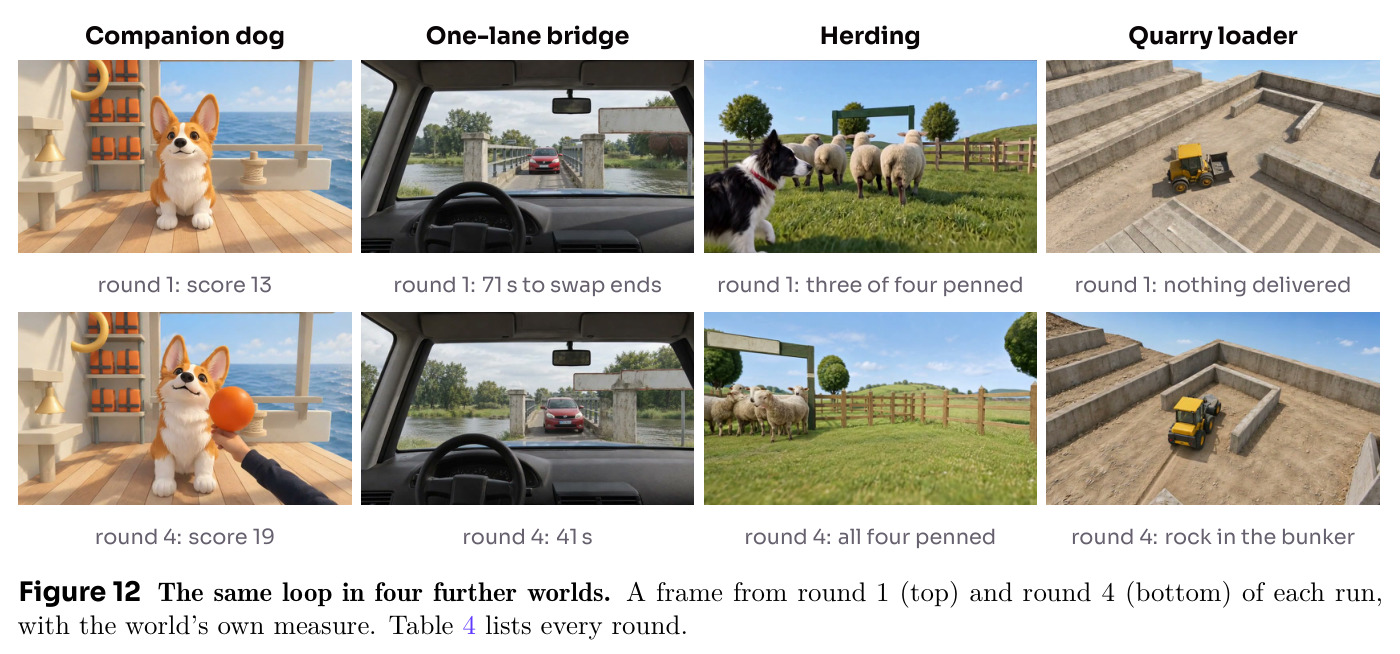
实验覆盖渲染器质量与智能体演化两端。渲染器端:(1) 重放精度(Table 1):SGF 式 FlexAttention 重放与滚动相差 3.99% 相对 $L_2$,本文逐块 SDPA 重放 bitwise 一致(误差为 0),前向时间 2.95s→2.79s(−5.4%),峰值显存 50.83→50.92 GiB(+0.2%)。(2) 长滚动质量(Figure 8):同一 30 秒条件轨迹,Self Forcing 渲染在 10–30 秒出现重复表面纹理并丢失场景细节,Adversarial Forcing 全程保持自然纹理。(3) 吞吐(Table 2):单张 H100 上 480×832、16 帧一块的服务耗时 438.8ms(条件编码 10.6ms、Transformer 四步去噪加缓存发布 414.4ms、tiny decoder 加主机传输 8.8ms),稳态 36.5 帧/秒,缓存 49 帧(5 锚点+44 近期)。智能体端:(4) 躲猫猫(Table 3、Figure 10):预训练智能体只看渲染第一人称画面、动作为短 Python 程序,hider 第 4 轮(每轮 5 局)就搬面板建庇护所,seeker 第 10 轮学会搬坡道越墙并会在跳跃失败后把坡道挪近重试;对照 2019 年自我博弈 RL 从随机策略起训分别需约 2500 万和 1 亿局,作者强调这是范式差异而非样本效率直比。(5) 四个新世界(Table 4、Figure 12):伴侣犬参与度 13→19;独木桥双车换端 71s→41s(−42%);牧羊第 1 轮 3/4 只入栏(60 分)、第 2 轮起全部入栏(90.1/87.6/88.3 分);采石场装载机得分 30→0→30→90.9,第 4 轮在 329/360 秒内完成清石、投递与停车三步。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 重放精度(36 层、480×832、61 潜帧、BF16) | 滚动与重放的相对 L2 误差 | 0(bitwise 一致) | SGF 式 FlexAttention 重放:3.99% | 完全消除数值发散 |
| 重放前向耗时(单张 H100) | 单次前向时间 | 2.79 s | 2.95 s(SGF 式) | −5.4% |
| 实时渲染吞吐(单张 H100,含条件编码、4 步去噪、解码与传输) | 帧/秒 @ 480×832 | 36.5 帧/秒 | —(无同设置实时基线) | 满足实时交互闭环 |
| 躲猫猫·建造庇护所 | 涌现所需经验 | 4 轮(每轮 5 局,预训练智能体) | 自我博弈 RL 约 2500 万 episodes(从零训练) | 预训练先验+复盘远超从零探索(范式差异) |
| 躲猫猫·坡道越墙 | 涌现所需经验 | 10 轮 | 约 1 亿 episodes | 同上 |
| 伴侣犬互动 | 参与度得分 | 19(第 3–4 轮) | 13(第 1 轮) | +46% |
| 独木桥协作换端 | 双车换端用时(秒,越低越好) | 41 s(第 4 轮) | 71 s(第 1 轮) | −42% |
| 牧羊 | 得分 / 入栏羊数(满分 100、共 4 只) | 88.3 分、4/4 只(第 4 轮) | 60 分、3/4 只(第 1 轮) | 第 2 轮起稳定全部入栏 |
| 采石场装载 | 总分(100 分制:清石 30+投递 35+停车 25+至多 10 早完成) | 90.9(第 4 轮,329/360 秒完成全部三步) | 30(第 1 轮)、0(第 2 轮) | +203% |
局限与改进
作者承认的局限集中在条件接口:深度/法线视频高度冗余——刚体形状已知后运动只需几个位姿参数,条件却在逐像素逐帧重复表面,空间池化又会抹掉细杆、窄缝、微小接触变化等精确控制所需的细节;几何也不决定一切——旋转对称物体自旋时深度法线不变(画了标记的表面转了却看不出来),颜色、材质、物体身份不在条件里,只能靠视觉历史携带,长遮挡或滑窗驱逐后可能丢失。整套世界的质量检查(可解性、粗心策略会失败、有可迁移教训)也还不能自动运行。我自己的观察:智能体实验规模太小——每个世界只有 4 轮、每轮 1 个 episode,没有多种子重复,也没有「无 playbook」或「看引擎真值帧而非渲染帧」的消融,Table 4 的提升难以与随机波动区分;躲猫猫与 2019 RL 的对比是范式对比,作者虽明确声明,但「4 轮 vs 2500 万局」的表述仍易被误读为样本效率倍数;实时渲染依赖 H100 级硬件;渲染瑕疵与感知误差耦合在智能体的失败归因里(任务文件甚至要提醒智能体「不要把渲染瑕疵当结论」),说明观察通道仍是行为实验的性能瓶颈。
独立分析的弱点
独立分析四个弱点。①条件带宽瓶颈:几何条件丢失自旋、材质、身份等状态,凡任务依赖这些属性(例如分辨转动的轮子和静止的轮子)今天就无法构建,滑窗驱逐还会让长遮挡后的外观漂移;改进方向是作者提出的结构化文本/latent 条件,且代码世界「状态本来就显式」是天然优势,可把引擎内交互状态直接喂给渲染器。②评估统计薄弱:每世界 4 轮×1 episode、每世界只有一份任务文件,playbook 机制的价值缺乏对照支撑;改进方向是每设置跑多个独立智能体谱系(fresh conversations 已具备条件)、加入消融组(无复盘、渲染帧换真值帧、移除对抗损失),并报告方差与显著性。③与 RL 的比较框架不严谨:预训练智能体 vs 从零策略网络、渲染观察 vs 真值状态,两个变量同时变化,无法归因;改进方向是补一组「预训练智能体+真值状态」的对照,分离渲染通道与预训练先验各自的贡献。④工程门槛与世界构建未自动化:实时需要 H100 并手写 Triton 核与 CUDA graph;世界靠人工逐个编写,探针相机+验证查询的修复循环效果未量化;改进方向是把「任务可解、粗心会输、教训可迁移」做成渲染器上的自动验收测试,让编码智能体批量生产并通过筛选的世界。
未来方向
作者第七节给出三条路线。其一,更紧凑更完整的条件:用结构化文本描述物体属性与交互状态(如子弹绕长轴自旋的朝向与角速度,深度法线无法表达),或用高维 latent 特征,并解决与代码世界状态的对齐以及预训练视频模型适配问题。其二,规模化世界生成:既然世界是程序,下一步是让编码智能体自动写世界、共享渲染器出外观;难点不在生成而在验收——任务能否凭所见解决、粗心策略是否会失败、有没有可带入下一轮的教训,作者希望这些检查在任何智能体练习之前自动运行。其三,规模化经验:跨多个世界时智能体要决定保留、合并或丢弃哪些教训,并快速检索适用于当前场景的少数几条;代码世界可精确重置重放,因此教训可以在传递之前先被测试;跨世界成立的教训(如确认抓握成功的方法、哪些视觉线索会误导)沉淀为通用物理行动知识,而未见过的世界反过来测量这份知识——环境与经验一起生长。基于成果还可延伸:用真实视频估计的深度/法线接入真实场景扫描;按智能体失败点课程式地生成下一个世界;把多世界的 playbook 蒸馏进模型权重而非外部文本。
复现评估
复现条件较好但算力门槛不低。代码在 GitHub 开源(MirroS-Lab/AgentGarten),项目页与博客公开;附录给出近乎完整的训练配方:骨干 Cosmos 3-Nano(36 层、宽 4096、32 查询头/8 KV 头)、冻结的 Wan VAE 与文本塔、数据混合(DL3DV-10K 场景、OpenDV 驾驶、互联网游戏/导航/机器人视频加少量合成场景)、三阶段的更新参数与学习率(条件化/适应 $3\times10^{-5}$,蒸馏 student $2\times10^{-6}$、fake-score $4\times10^{-7}$、判别器头 $2\times10^{-7}$)、4 步采样调度、判别器读第 11/23/35 层特征,以及四个世界任务文件的逐字附录。训练全部在 32 张 H100 上完成(FSDP、每卡一 clip、64 clip 每次更新),完整复现渲染器需要同规模集群和较强工程能力(自定义 Triton 核、CUDA graph、fused attention-JVP 核);但推理只需单张 H100 即达 36.5 帧/秒。智能体行为实验门槛低得多:拿到渲染器权重后,任意强 LLM 智能体加任务文件加 playbook 循环即可复现躲猫猫与四个世界,主要不确定因素是基础模型自身能力差异。综合评估:渲染器训练一档难度高,行为实验一档中等。
论文图表
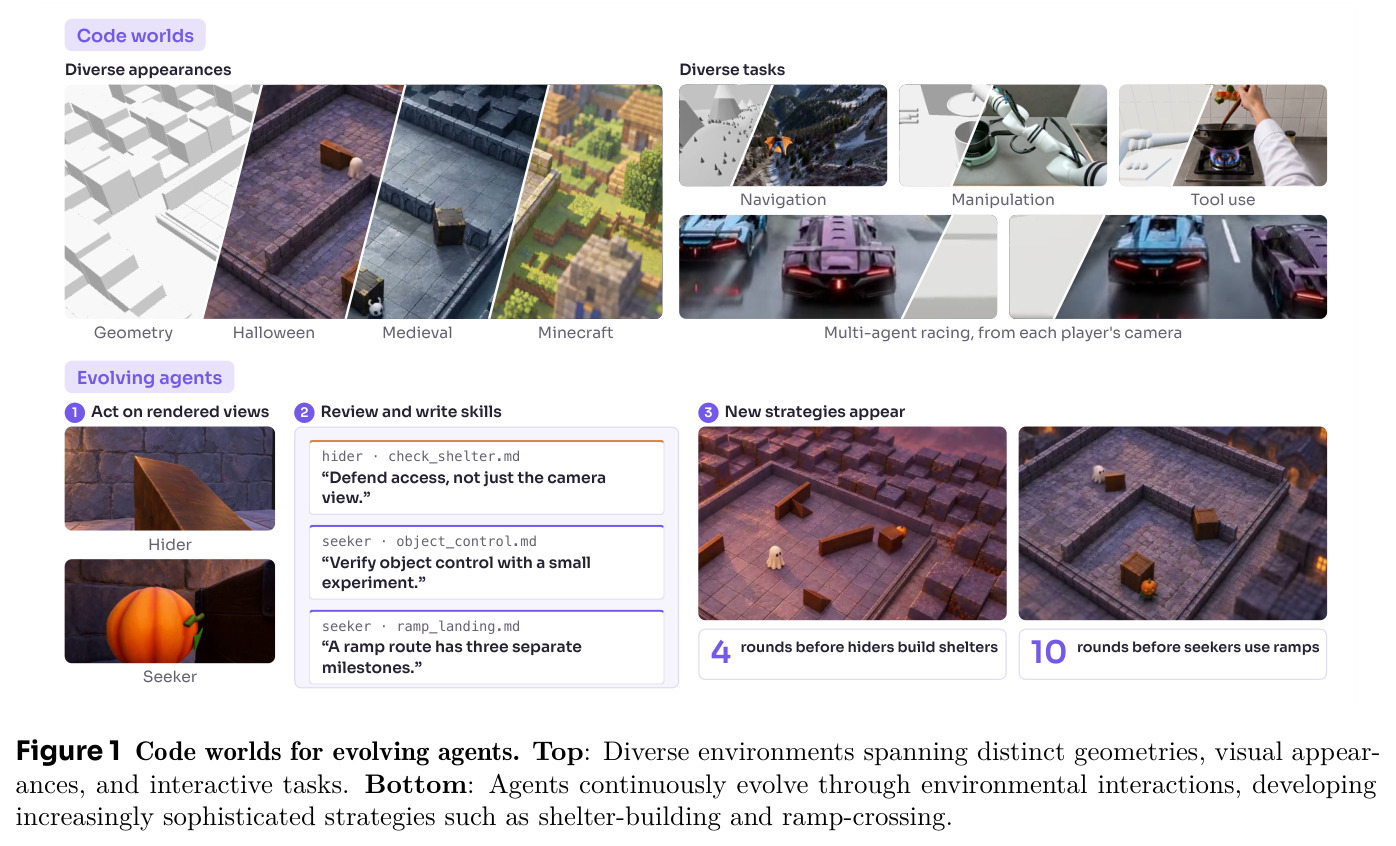
总览图。上半部分展示代码世界的多样性:同一渲染器支撑不同几何(原始几何、万圣节、中世纪、Minecraft 风格)和不同任务(导航、操控、工具使用、双玩家第一人称赛车)。下半部分展示智能体演化:第 4 轮 hider 建庇护所、第 10 轮 seeker 学会用坡道,并展示双方 playbook 中的技能文件(如「防守入口而不只是摄像头视野」「用小实验验证物体可控」)。
一图概括全文两条主线:共享渲染器支撑的世界多样性与智能体跨轮演化,是理解论文动机和成果的最佳入口。
块因果教师强制注意力掩码:干净副本 $P_j$ 编码历史,可见参考 $A_0$、更早的干净块和自身;噪声副本 $Q_j$ 可见参考、块 $j$ 之前的干净块和自身,但永远看不到自己的干净目标。同一布局在 Adversarial Forcing 的重放阶段被复用。
公式 (5) 的可视化,是理解并行教师强制训练和后文 exact replay 复用掩码的基础。
五组场景(每个场景一列)在 1s/10s/20s/30s 四个时刻的对比:用 Self Forcing 训练的渲染器随滚动变长出现重复表面纹理并丢失场景细节;用 Adversarial Forcing 训练的渲染器在 30 秒全程保持自然纹理与细部。
渲染器质量的核心定性证据,直接说明加入真实数据对抗项和精确重放带来的长时程视觉稳定性收益。