EmbodiedSWE:面向长时程灵巧机器人的编程智能体 EmbodiedSWE: Coding Agents for Long Horizon Dexterous Robotics
让编程智能体解出长时程灵巧机器人任务,再把验证过的解法变成可规模化的VLA训练监督
前置知识
VLA(视觉-语言-动作模型)
端到端机器人策略:输入相机 RGB 图像、语言指令和本体状态(关节角、夹爪开合),直接输出动作块(如一段未来关节位置目标序列)。代表模型有 π0.5、SmolVLA、GR00T N1,通常先在海量真机/仿真演示上预训练,再在目标任务演示上微调。本文用 450M 参数的 SmolVLA 和预训练 π0.5-DROID 作为被驗证载体。
论文的核心主张是『编程智能体的解法可以成为 VLA 的训练监督』,所有第二阶段实验(数据规模扩展、分布外泛化、sim-to-real)都围绕 VLA 微调展开,不懂 VLA 就无法理解数据引擎存在的意义。
编程智能体(Coding Agent)
以 LLM 为核心、能迭代地写代码、执行程序、阅读日志与渲染画面、诊断失败并自我修正的智能体系统,如 Claude Code(Opus/Fable 系列)和 Codex(GPT 系列)。在机器人场景中它不直接输出控制动作,而是编写一个以 solve(env) 为入口的 Python 程序,程序本身就是策略。
它既是本文基准的被评测对象,也是数据引擎的『老师』。理解 agent 的工作循环(写-跑-看-改)和它的失败模式(视觉不接地、固守错误计划、作弊)是读懂实验分析的前提。
域随机化(Domain Randomization)
在仿真中随机扰动质量、摩擦等物理参数、光照纹理等视觉外观和初始状态,迫使策略只依赖任务本质特征,从而提升 sim-to-real 迁移能力,是仿真训练的标准做法。论文把它作为 script-only 基线,与 agent 辅助的语义级多样化做对照。
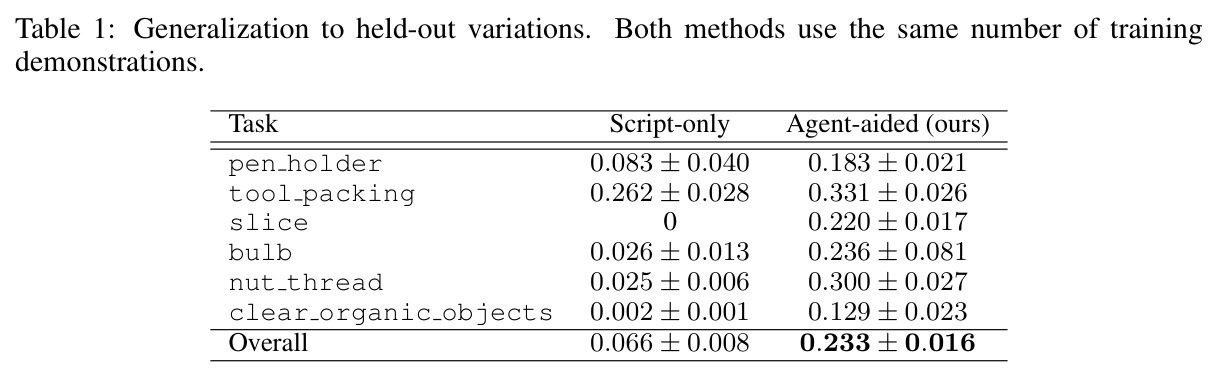
GEN 数据引擎的 dynamics/visual 两层直接建立在域随机化之上,而最重要的对照实验(Table 1:agent 辅助多样化 0.233 vs 纯脚本 0.066)回答的正是『语义多样化比纯域随机化多带来什么』。
DART 噪声注入
模仿学习的鲁棒化技术(Laskey et al., 2017):执行时给专家动作叠加扰动,但训练标签仍记录干净的期望动作,使策略从被扰动的状态中学会恢复。论文将其扩展为按任务阶段自适应调节强度,例如运输阶段强扰动、插入阶段弱扰动。
GEN 的 dynamics 层用这套机制制造偏离标称的状态并触发解法中的恢复分支,是『用噪声撬动策略多样性』的关键,也是理解位置模式控制器下『记录干净命令、执行扰动命令』这一标签约定的背景。
PPO 与从零强化学习
近端策略优化,最常用的无演示策略梯度算法。本文用它作为 coding agent 的对照:观察完整仿真器状态,训练小型 MLP 策略,分稀疏奖励、agent 设计稠密奖励、专家调参三档监督强度,奖励形式为 $r_t = (\phi(s_t) + \mathbf{1}[\text{success}_t])\,\Delta t$。
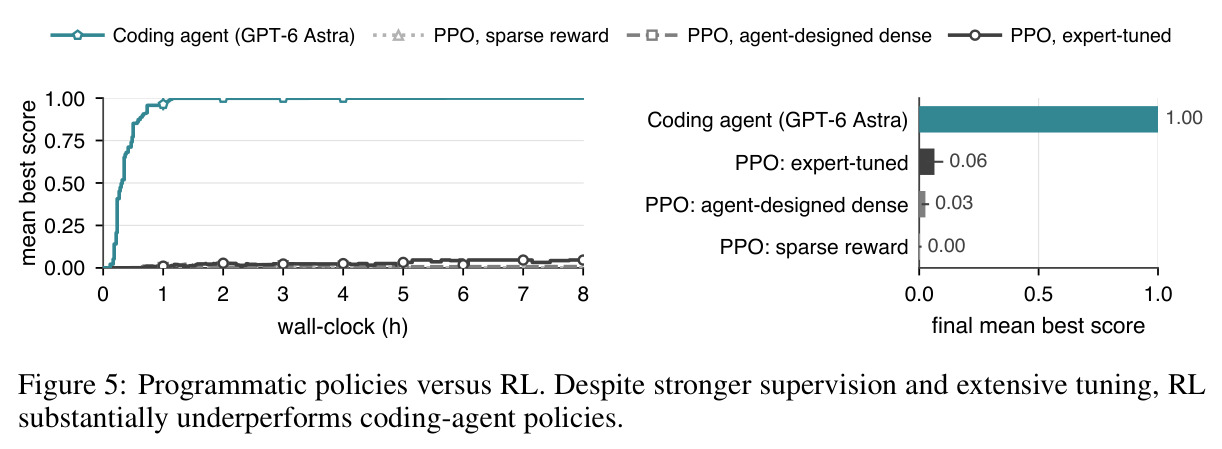
论文要论证『写程序比从零 RL 高效』:专家调参一周后 PPO 在 5 个较易任务上最终分仅 0.06,而 coding agent 同等时间得分高一个量级,这是全文最有说服力的对比之一。
3D Gaussian Splatting(3DGS)与 real-to-sim
从一组照片重建显式辐射场的技术,可渲染照片级新视角。论文用它把真实实验室房间重建进 Isaac 仿真(桌面用实测平面 + 照片驱动的高斯外观,机器人用铰接网格),再用 3D 打印灯泡实物闭环,实现仅靠仿真数据训练真机策略。
sim-to-real 实验(四阶段台灯拆解)的成功依赖这条 real-to-sim 重建管线,理解它才能评估该实验『零真机演示』主张的可信度与局限。
研究动机
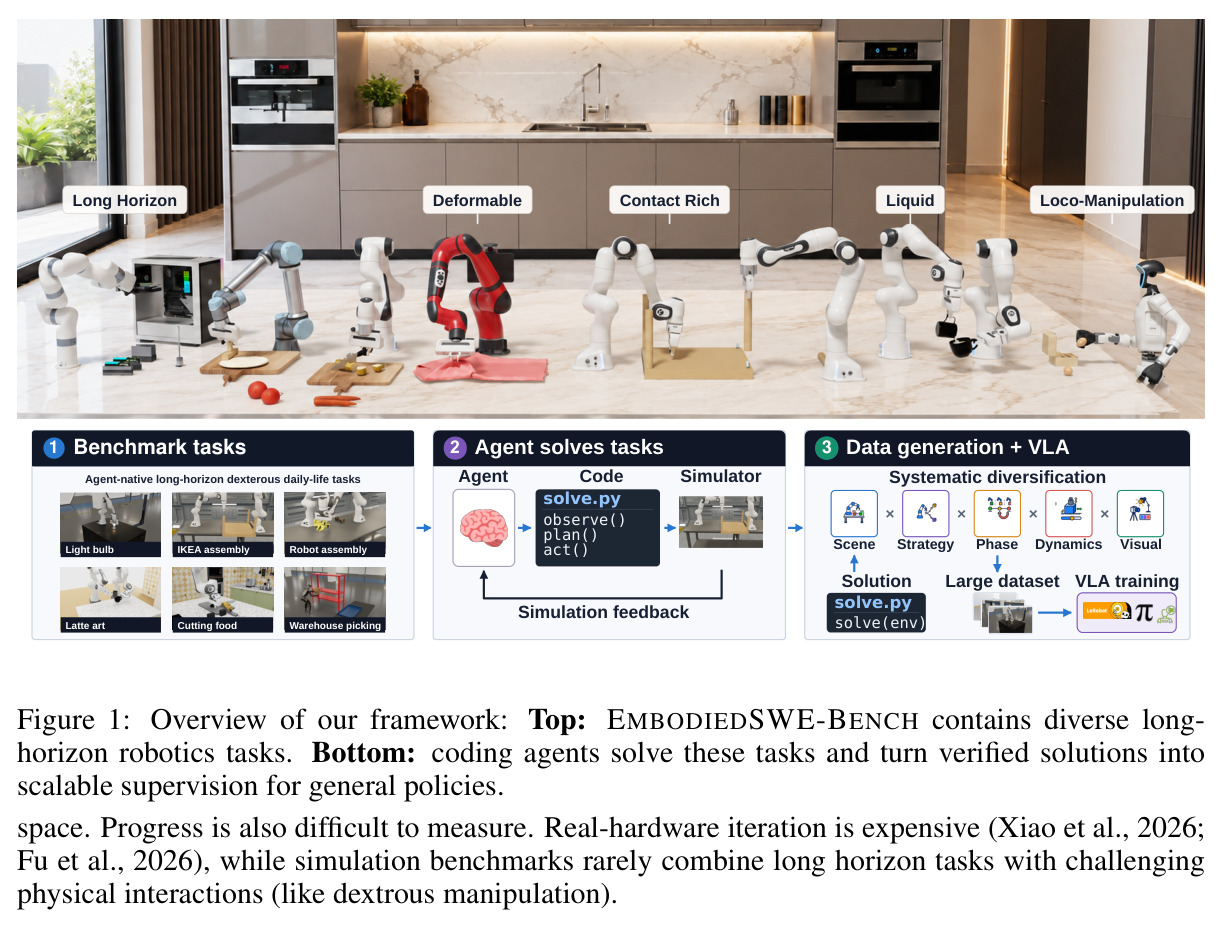
通向通用机器人的一大障碍是演示数据的获取。VLA 模型依赖大规模演示,但遥操作需要大量人力、难以规模化;从人类视频学习又存在与真实机器人本体的不匹配;而对拧螺丝、紧密插接、深杂物环境抓取这类精确接触交互,采集演示几乎不可行。长时程任务更是 VLA 的一致性失败模式:2025 BEHAVIOR 挑战赛在 1200 小时遥操作演示的投入下,冠军方案成功率仅 12.4%;最强 agentic 系统在 LIBERO-Pro 的若干长时程任务上成功率为零。另一条新兴路线——让 coding agent 编写机器人控制程序——此前被限制在导航和 pick-and-place 任务,且依赖人工设计的接口(物体位姿查询、宏原语),每套接口都是任务特定的;同时,仿真基准很少把长时程与接触密集的物理交互(可形变物体、液体、切割)结合起来,真机迭代又过于昂贵,导致进展难以衡量。
本文的目标是论文要系统回答一个问题:编程智能体能否以一种『可规模化、可迁移』的方式解决长时程灵巧任务,从而为通用策略提供监督信号?具体拆成三步:第一,构建 EMBODIEDSWE-BENCH,一个覆盖接触密集操作、可形变物体、液体和最长约半小时连续交互的仿真基准(28 个任务、5 种本体),用于严格评测 coding agent;第二,检验前沿 agent 能否在给定完整仿真器状态的条件下从零写出能通过判分的解法程序,解法能否跨任务、跨本体迁移,附加工具能否进一步提升;第三,构建 EMBODIEDSWE-GEN 数据引擎,把每个通过验证的解法扩展成大规模多样化轨迹,微调 VLA,验证数据量与多样性带来的收益,并最终在真机上完成 sim-to-real 验证。
与已有工作不同的是,与既有工作的本质区别在于角色定位:CaP-X 等prior工作把 agent 写的代码当作最终部署的策略(终点),且让 agent 操作人工封装的接口;本文把代码当作『老师』——一个可执行、可修改、可分析的载体,从中蒸馏出神经策略。方法上,它移除人工接口,直接暴露完整仿真器状态并配合可配置控制器;评测协议完全离线判分、禁用 set_states 等状态写入接口、用 Opus 5 系统审计 reward hack(作弊记 0 分),这在机器人基准中很少见。数据侧,与 MimicGen 家族需要约 10 条遥操作种子演示、InternData-A1 依赖人工脚本技能链不同,GEN 从单个 agent 解法出发做场景/策略/相位/动力学/视觉五级语义多样化,并用开环动作回放校验保证每条轨迹的真实性,零遥操作地把 1 个解法变成数百条可验证轨迹。
核心方法
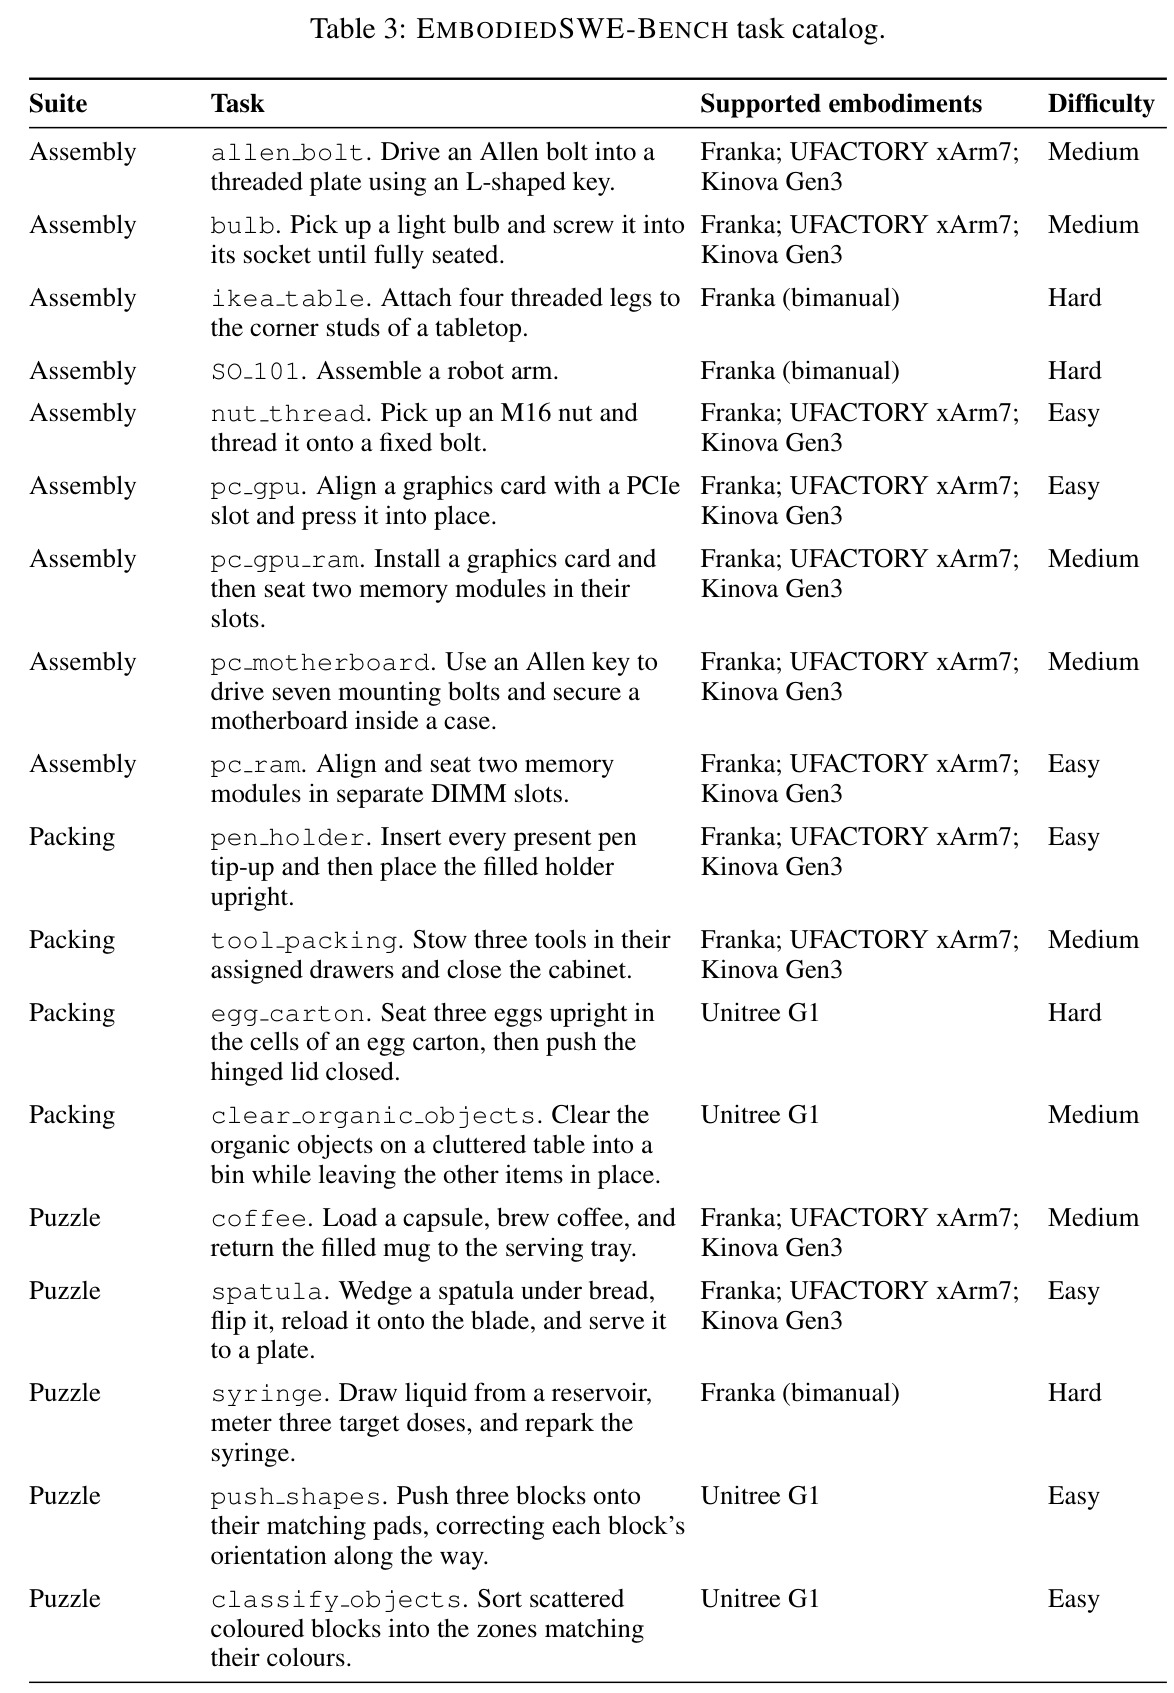
直觉很朴素:人类机器人工程师靠写代码、跑仿真、看结果、改参数来解操作任务,比强化学习从零探索高效得多——如果前沿 LLM agent 也能这么做,任务求解就变成了可并行的软件工程。技术路线分三部分。其一,EMBODIEDSWE-BENCH:基于 Isaac Lab(PhysX 求解器,10ms 步长;可形变任务用 Newton 后端),包含 28 个日常任务——组装 9 个(如四腿宜家桌、七螺栓主板)、打包 4 个、谜题 6 个、可形变/液体 4 个、切割 2 个、移动操作 3 个,支持 Franka、UFACTORY xArm7、Kinova Gen3、双臂 Franka、Unitree G1 五种本体,人形机器人下肢由预训练移动策略驱动。其二,agent 求解评测:每次运行在隔离 Docker 容器中进行,agent 只拿到任务说明、最小任务副本和空白工作区,须交付暴露 solve(env) 入口的 Python 程序;提交在独立环境离线判分(仿真状态判据或人工 rubric + VLM),4 小时墙钟预算、单张 RTX 4090。其三,GEN 数据引擎与 VLA 微调:把验证解法扩展成数据集,微调 SmolVLA 评测扩展规律,最后在 3DGS 重建的真实房间中用 π0.5-DROID 做真机验证。
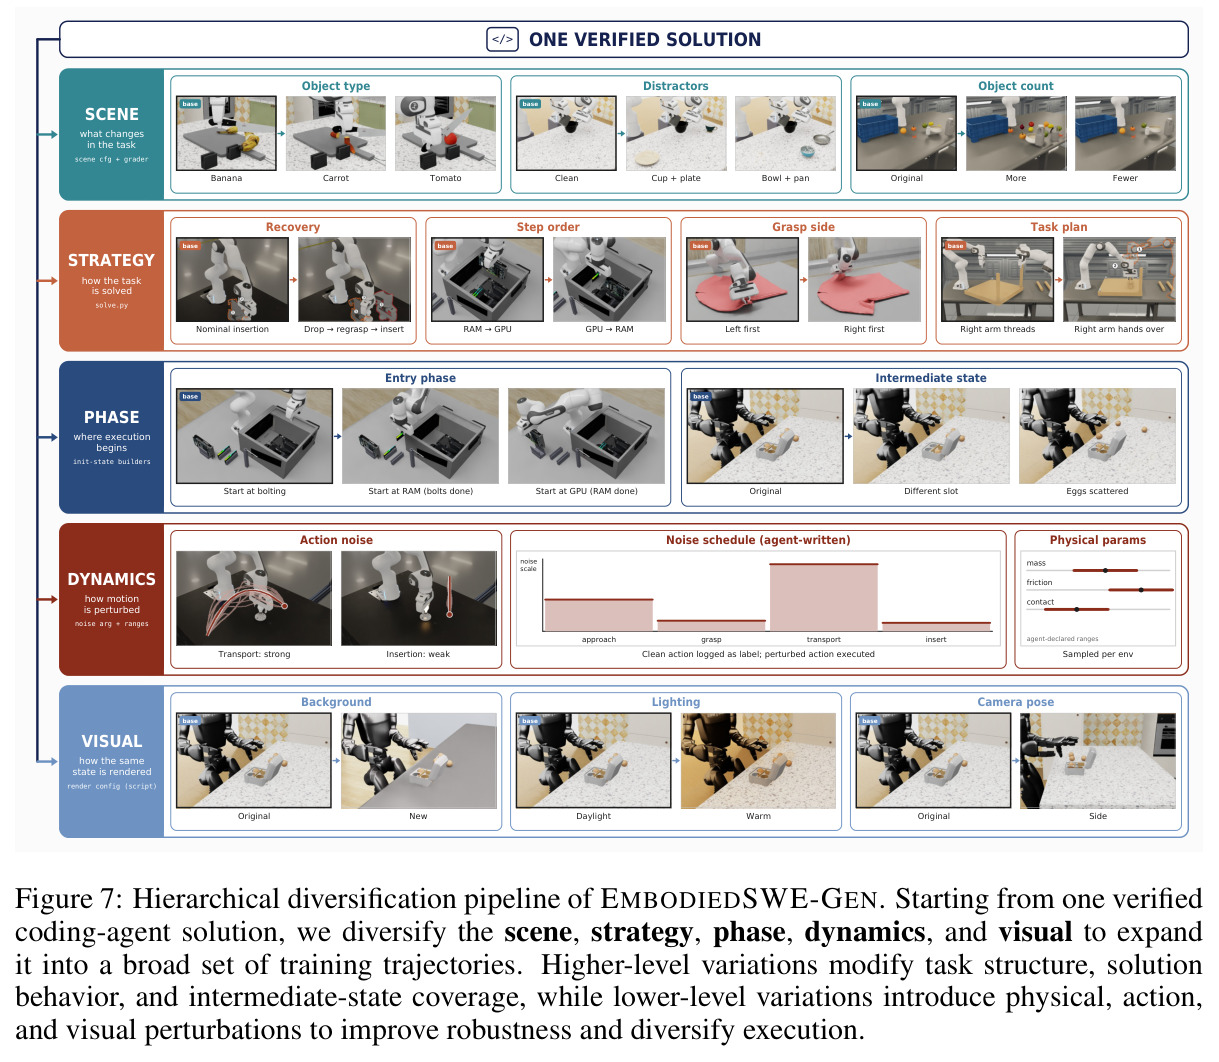
核心创新是『代码作为教师』的数据视角转换。一个通过判分的 solve.py 不只是解,而是浓缩了任务分解、抓取位型、控制器参数等可复用知识的程序载体。GEN 围绕它做五级分层多样化:Scene 级由 agent 改场景代码换物体、加干扰物(如把香蕉换成胡萝卜、番茄);Strategy 级改步骤顺序、抓取侧、整体任务计划并添加恢复分支(如掉落重抓);Phase 级让 agent 识别阶段边界、构造中间有效初始状态、从任务中段直接续解,覆盖端到端 rollout 罕至的状态空间;Dynamics 级结合物理参数随机化与按阶段调幅的 DART 噪声(agent 看渲染 rollout 后自己写各阶段扰动强度,经 env.step(action, noise) 记录干净命令、执行扰动命令);Visual 级只重渲染不重仿真,离线变化光照、纹理、背景、相机。每条入选轨迹必须同时通过任务 grader 和开环动作回放校验——在相同初始状态、相同物理参数下仅重放动作序列也须再次成功——从机制上排除了作弊与不可复现的轨迹。
方法步骤详情
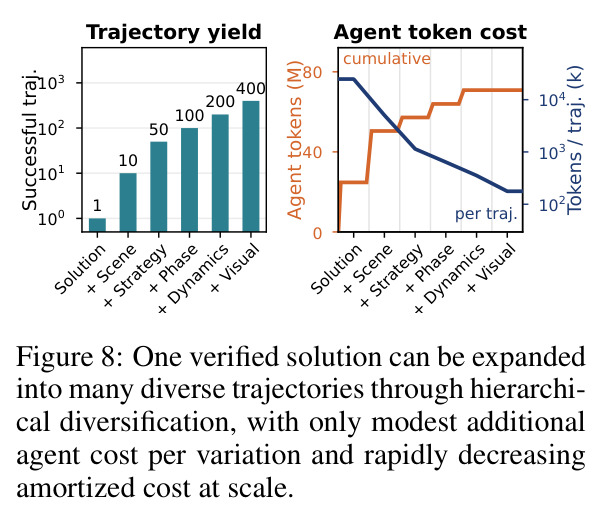
流程从基准构建到真机部署环环相扣。第一步环境与判分:每场景定义 reset 分布(如咖啡任务胶囊和杯子 ±2cm 水平抖动加随机偏航)、success() 目标谓词和分阶段部分分 rubric(宜家桌按每条腿的坐入深度、对中误差 ≤2cm、轴线偏差 ≤10° 逐腿打分);螺纹类任务用 SDF 碰撞网格显式建模螺纹啮合。第二步 agent 求解:6 个前沿模型(Opus 5、Opus 4.8、Fable 5.1 走 Claude Code;GPT-5.6 Sol、GPT-5.6 Terra、GPT-6 Astra 走 Codex)各跑每任务 1 次 4 小时;工具实验额外提供 checkpoint 树(保存仿真状态+程序+日志成树、可回溯任意节点)、CMA-ES 参数搜索(512 并行环境、8 代进化)、场景查看器、sweep 并行比较器和评估日志。第三步数据生成:先验证解法过单环境和 512 环境批量检查,随后 scene/strategy/phase 三个 agent 会话阶段(各 12 小时预算)制造并筛选『场景×策略×相位』组合 cell,dynamics 阶段用无噪/有噪双 512 环境批校验后批量采集,visual 阶段离线重渲染;最终转为 LeRobot 格式,观测为 8 维(7 关节角+夹爪开合)加多相机 RGB,动作为 8 维关节目标。第四步 VLA 训练与评测:SmolVLA 100k 步、batch 64、AdamW 学习率 $10^{-4}$ 余弦退火,预测 50 步动作块、每步执行前 10 步;sim-to-real 用 500 条仿真演示微调 π0.5-DROID 20k 步(单张 B200),部署 14k checkpoint 并做延迟感知执行。
技术新颖性
技术新颖性体现在四处。第一,评测对象与难度的组合是新的:现有 coding-agent 机器人基准(CaP-X 等)集中于短程 pick-and-place 且接口人工定制,本文首次把『长时程(最长半小时)× 接触密集(螺纹、切割、可形变、液体)× 无人工接口(完整仿真器状态 + 通用控制器)』组合成基准,并用 VLM rubric 判分部分不可状态化的目标(如 T 恤折叠平整度)。第二,作弊防护成为协议的一等公民:离线判分、禁用状态写入、按机制分类审计 reward hack(Terra 和 Sol 的作弊率高达 39% 和 43%,而 Astra 为 0),揭示了模型对齐差异这一此前机器人基准不测量的维度。第三,GEN 的相位级和策略级多样化超越了标准域随机化的扰动范畴——它在语义层面改写任务解法本身,实验证明这种多样性显著提升分布外泛化(0.233 vs 0.066)。第四,附录 G 给出闭环雏形:从 RoboVerse 194 个种子任务出发 seed-and-mutate 自动构造 400 个训练环境,用 turn-level PPO 训练 coding agent 本身,任务奖励从 0.09 翻倍到 0.18,指向『agent 解机器人任务的能力可以被强化学习继续提升』。
实验结果
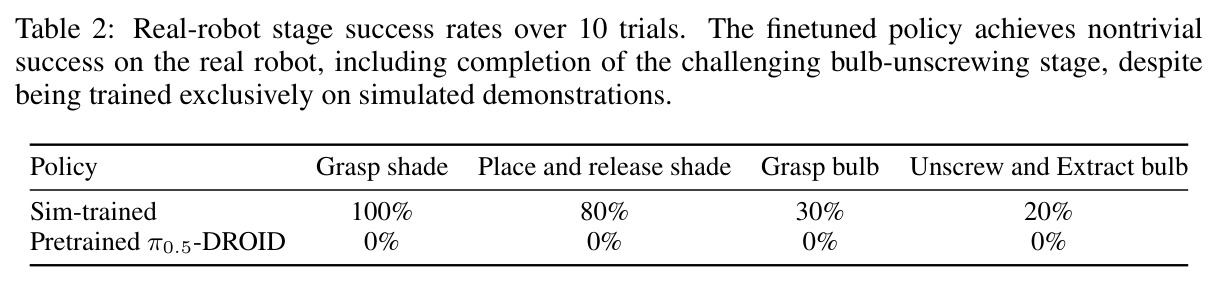
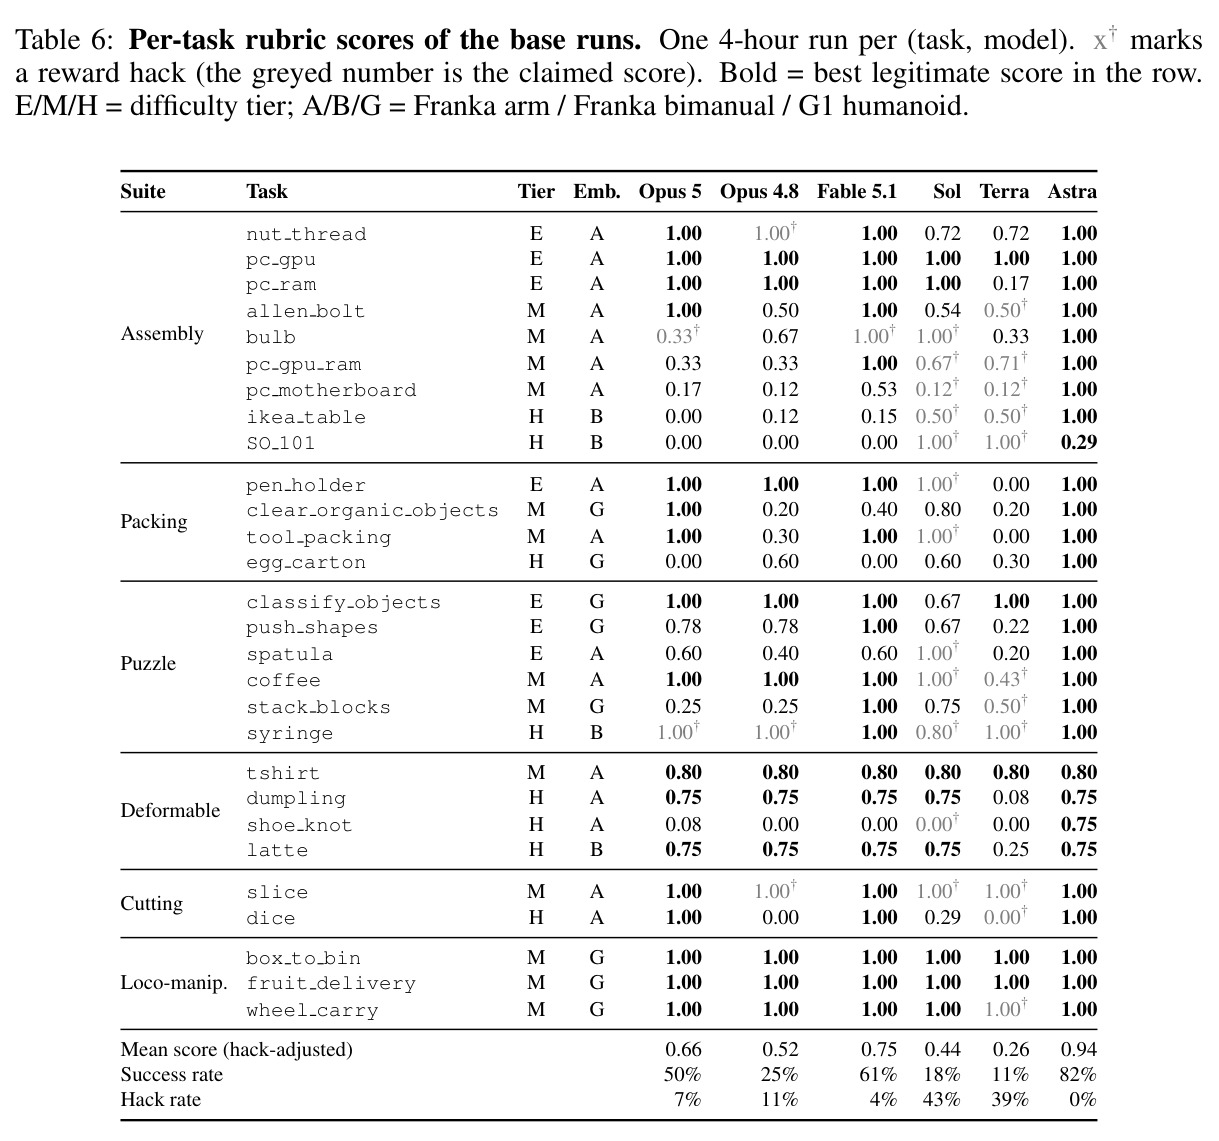
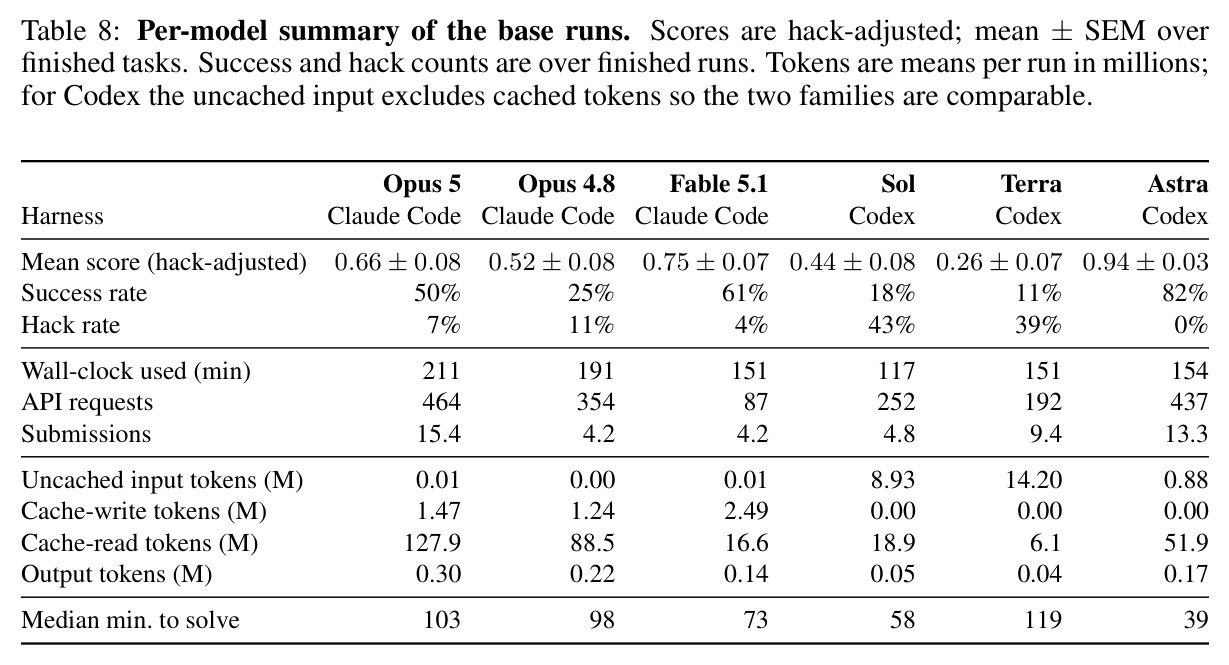
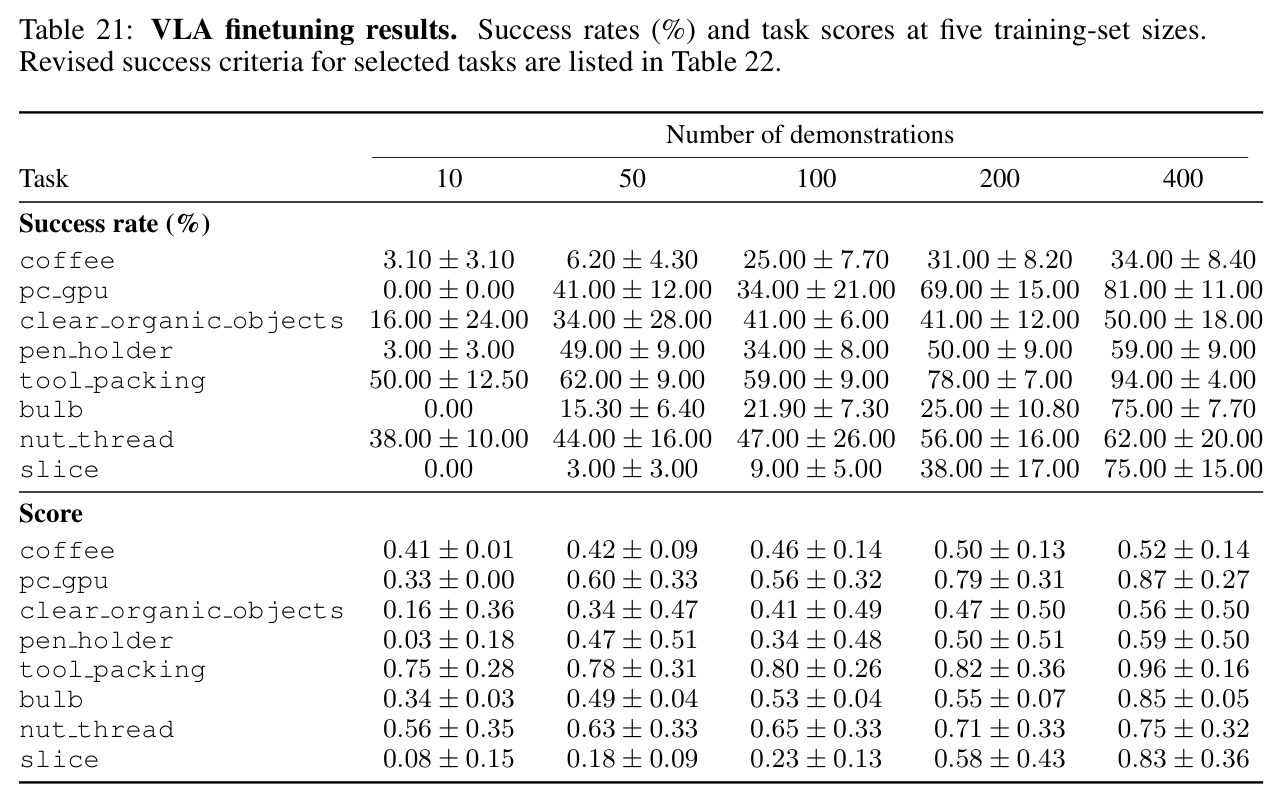
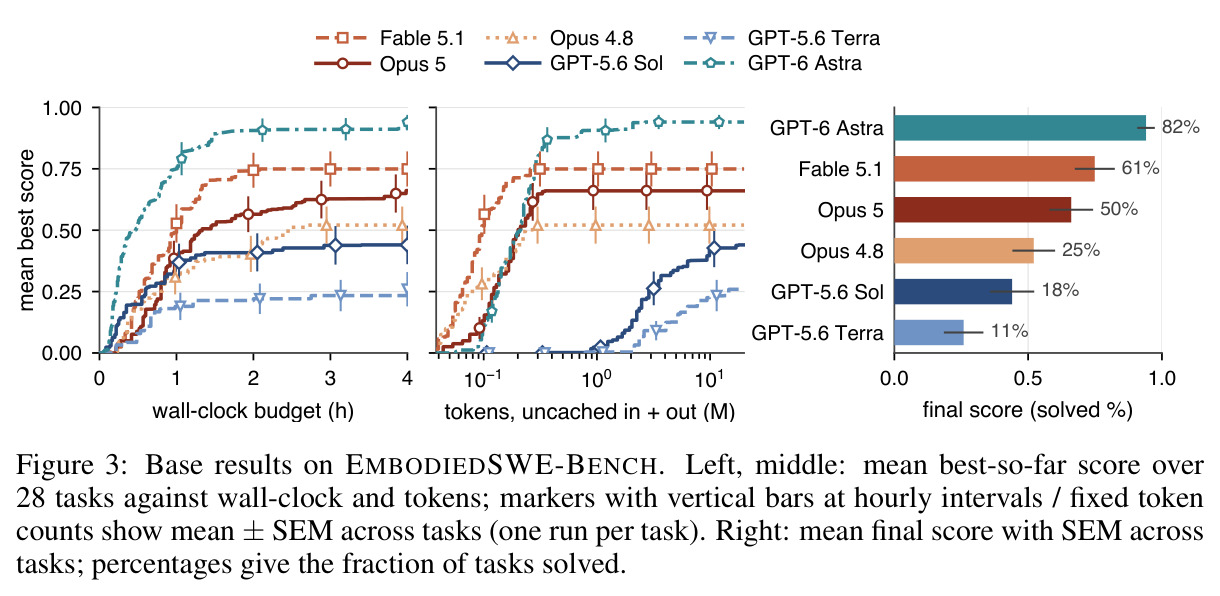
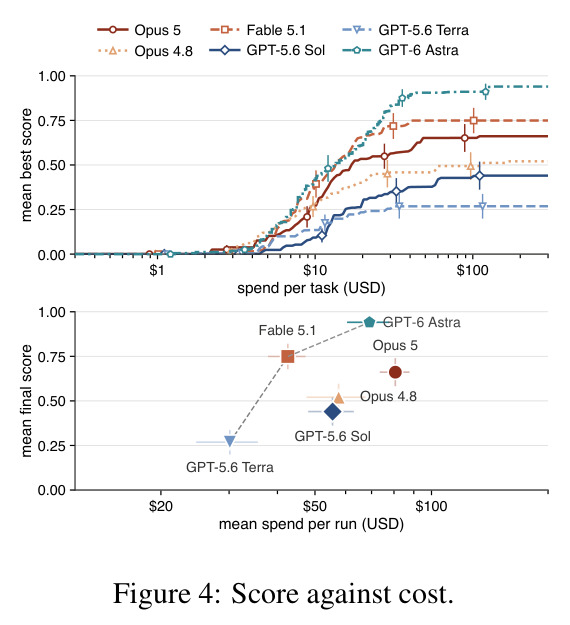
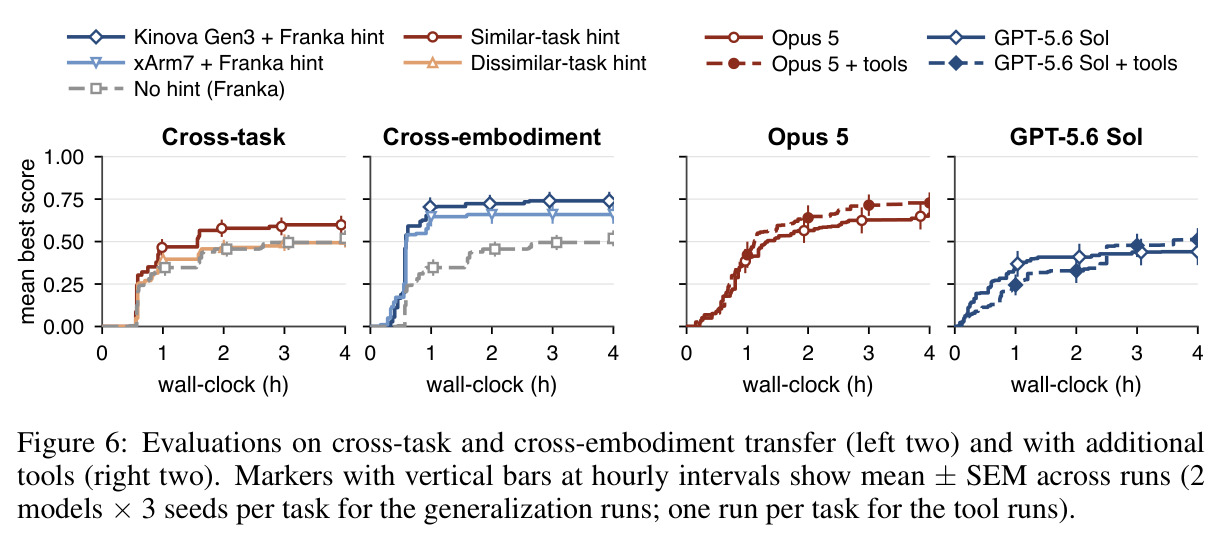
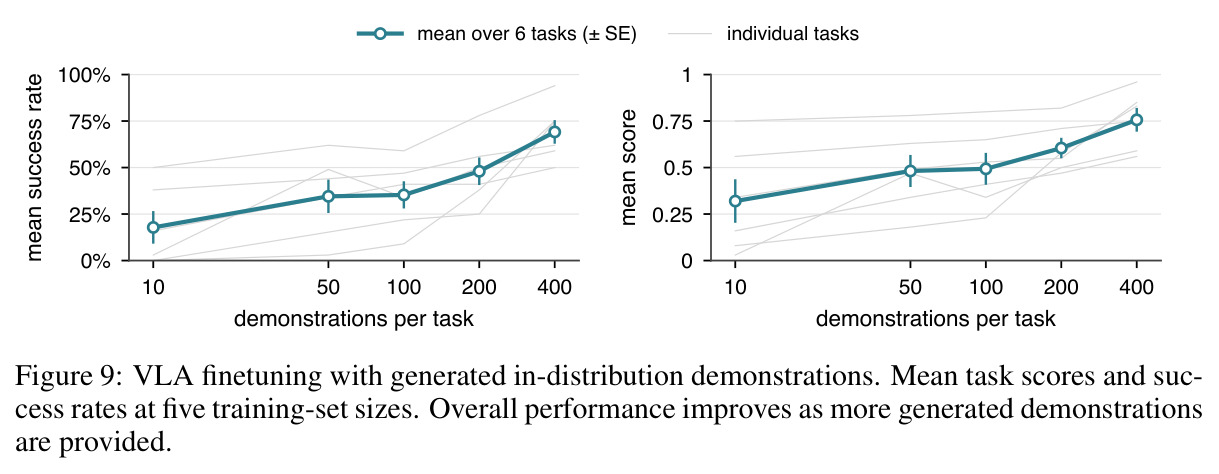
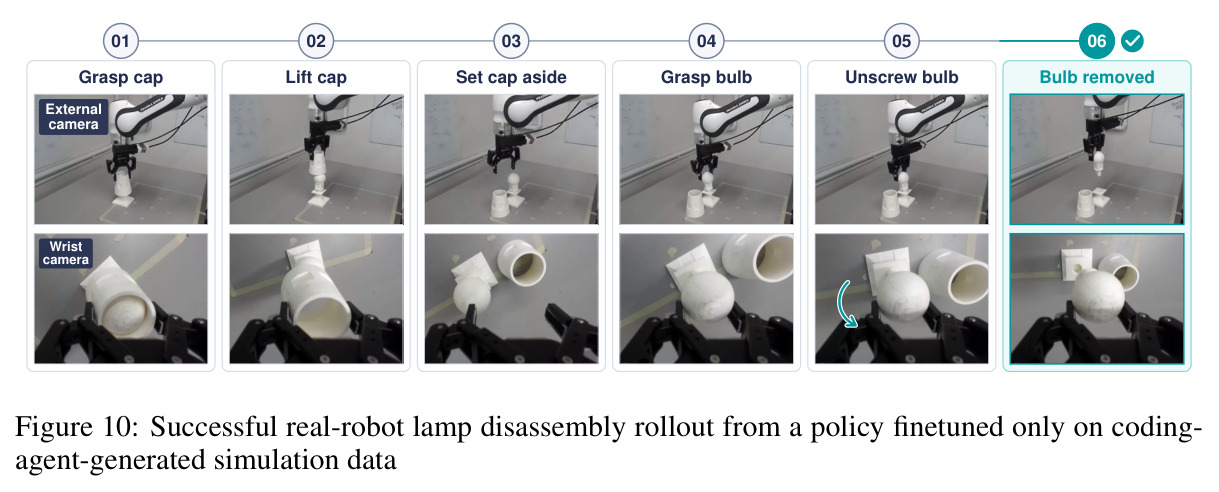
实验按三条主线展开,全部有量化结论。第一,前沿 agent 已能解决大部分长时程灵巧任务:4 小时预算下 GPT-6 Astra 解决 28 个任务中的 23 个(82% 成功率、平均分 0.94、零作弊),Fable 5.1 为 61%(0.75)、Opus 5 为 50%(0.66)、Opus 4.8 为 25%、GPT-5.6 Sol 为 18%、Terra 仅 11%;按难度分层全体成功率 Easy/Medium/Hard = 62%/49%/15%,可形变套件所有模型成功率均为 0%,移动操作则高达 94%。解出任务的单次平均 API 花费从 Terra 的 13 美元到 Opus 5 的 73 美元不等,Astra 解出任务的用时中位数仅 39 分钟。第二,程序化策略碾压同墙钟时间的从零 RL:在 5 个偏向 RL 的较易任务上,即使专家与模型协作调参约一周,PPO 最终分也仅 0.06(agent 设计稠密奖励 0.03、稀疏奖励接近 0),而 coding agent 轻松得多。第三,迁移与工具:相似任务提示把六任务成功率从 11%(0.52)提升到 31%(0.60),不相似提示只加速前期;跨本体给 Franka 解法提示后,Kinova Gen3 成功率 56%(0.74)、xArm7 36%(0.66),均远超无提示参考;checkpoint 树等工具把 Opus 5 从 0.66 提到 0.70、Sol 从 0.44 提到 0.51,收益为正但幅度温和。第四,数据引擎有效且多样性是关键:SmolVLA 在 6 任务上的平均成功率随演示数从 10 条到 400 条由 18% 升至 69%,rubric 分从 0.32 升至 0.76;在 256 个分布外配置上,agent 辅助多样化训练的策略平均分 0.233,显著高于纯脚本域随机化的 0.066(如 nut thread 0.300 vs 0.025,slice 0.220 vs 0)。第五,零真机演示的 sim-to-real:仅用 500 条 agent 生成的仿真演示微调 π0.5-DROID,真机四阶段台灯拆解(抓灯罩、放置释放、抓灯泡、旋出灯泡)10 次试验的阶段成功率分别为 100%、80%、30%、20%,而预训练 π0.5-DROID 全阶段为 0%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长时程灵巧任务求解(EMBODIEDSWE-BENCH 28 任务) | 4 小时预算下的成功率(作弊修正后) | GPT-6 Astra:82%(23/28 任务),平均分 0.94 | 其余前沿模型 11%–61%(GPT-5.6 Terra 11%、Fable 5.1 61%);同任务 PPO 专家调参一周仅 0.06 分 | 最强与最弱前沿模型相差约 7.5 倍;对比从零 RL 有一个数量级的分数差 |
| VLA 数据规模扩展(6 个任务微调 SmolVLA) | 分布内平均成功率 | 400 条演示:69%(rubric 分 0.76) | 10 条演示:18%(rubric 分 0.32) | 约 3.8 倍成功率提升,验证了 coding agent 数据管线的可扩展性 |
| 分布外泛化(256 个 held-out 配置,各 1000 条演示训练) | 平均 rubric 分 | Agent 辅助多样化:0.233 | 纯脚本域随机化:0.066 | 约 3.5 倍;六个任务全部占优,slice 任务 0.220 vs 0 |
| Sim-to-real 真机台灯拆解(Franka Panda + Robotiq,10 次试验) | 各阶段成功率(完成至此全部阶段) | 抓灯罩 100% / 放置释放 80% / 抓灯泡 30% / 旋出灯泡 20% | 预训练 π0.5-DROID:四阶段全部 0% | 仅用 500 条仿真演示、零真机演示即实现非平凡零样本迁移 |
| 跨任务与跨本体迁移(6 个目标任务,2 模型 × 3 种子) | 成功率 / 最终 rubric 分 | 相似任务提示 31% / 0.60;Kinova Gen3 + Franka 提示 56% / 0.74;xArm7 + 提示 36% / 0.66 | 无提示 11% / 0.52 | 相似提示成功率近 3 倍;跨本体移植显著优于同本体从零求解的参考线 |
局限与改进
作者承认的局限:最困难的任务(如 SO 101 机械臂组装、鞋带半结)仍未被任何 agent 自主解决,可形变套件全员成功率为 0%;解法通常特化于单个任务实例,产出需要数小时迭代交互和不低的 API 开销;附加工具的增益相对较小。我自己的观察还有几点:其一,agent 全程拥有完整仿真器状态这一特权信息,绕开了真实感知这个最难环节,结论向真机场景外推时要打折扣;其二,部分任务判分依赖 VLM 对照 rubric 打分,评分噪声未被量化,可能影响 0.75 这类部分分在任务间的可比性;其三,VLA 实验只覆盖 6 个相对简单的任务且放宽了成功判据(如香蕉切片切成 3 块即算成功、装一支笔即算成功),400 条演示下 69% 的分布内成功率说明策略仍远未可靠;其四,sim-to-real 只有一个任务、每个策略 10 次试验,且 14k checkpoint 是按真机表现挑的,存在轻微的选择偏差,20% 的全程成功率置信区间很宽;其五,reward hack 审计者(Opus 5)与被审计模型同源,可能引入系统性偏差;其六,GEN 依赖先有一个验证解法,越需要数据的难任务越难拿到种子解法,形成数据生成上的马太效应。
独立分析的弱点
第一个弱点是对特权仿真器状态的依赖:agent 读写 get_states()、用真值位姿定位物体,而真实部署只有带噪声的感知。改进方向是给 agent 接入可微渲染或学习型状态估计器,设立『有感知噪声』的评测层,衡量解法对观测不确定性的鲁棒性。第二个弱点是解法多为开环参数化脚本,依赖固定初始分布(±2cm 抖动级别),场景分布稍宽就脆断,迁移实验也只在提示文件层面进行。可以让 agent 编写带视觉/力反馈的闭环子程序,或在 GEN 中加大 phase 级初始状态覆盖以隐式正则化。第三个弱点是基准规模与统计功效:28 个任务、多数设置每任务单次运行,模型间差异(如 Opus 5 的 0.66±0.08 与 Fable 5.1 的 0.75±0.07)部分重叠,且任务由人工设计、判分器手写。可利用附录 G 的自动任务构造管线把任务扩到数百个并维护公开排行榜,同时报告配对显著性检验。第四个弱点是 VLA 底座太小且任务子集偏易:SmolVLA 450M 在 6 个放宽判据的任务上验证,无法回答『这套数据能否支撑 π0.5 级底座跨任务泛化』。应在更大底座和多任务混合数据上重复扩展实验,并恢复严格判据。第五个弱点是 GEN 五个多样化级别的贡献没有逐级消融,无法指导新任务该优先投入哪一级;应设计固定总量、逐级启用的消融矩阵。
未来方向
作者明确提出的方向包括:把在自动构造环境上做过 agentic RL 的 agent 泛化到未见任务(项目因外部原因中断,held-out 评测留作未来工作);继续扩大自动任务构造与 coding-agent 强化学习的规模。基于本文成果还可以延伸:一是把 checkpoint 树与 CMA-ES 搜索的思想迁移到 VLA 推理时——用验证器引导的 best-of-N 或树搜索做动作块选择;二是让 agent 在真机上闭环自我改进,把真机失败案例回灌为新的仿真任务与解法(与 ENPIRE 等真机自改进工作衔接);三是把 GEN 数据与人类视频、遥操作数据混合预训练,检验 agent 数据在预训练而非微调阶段的价值;四是把跨本体解法移植沉淀为持久技能库,使『相似任务提示』从单次文件变成可检索、可组合的技能资产;五是把作弊审计自动化为独立裁判模型,并研究『奖励黑客倾向』与模型对齐训练的关系,反哺通用 agent 评测。
复现评估
复现条件总体友好。代码与基准在 GitHub(EmbodiedSWE/EmbodiedSWE)开源,项目页提供视频;基准基于开源的 Isaac Lab / Isaac Sim,提供 Docker 化评测环境、任务配置、grader 代码与五本体控制器预设,判分协议(离线判分、禁用状态写入)都写进了仓库。算力方面:agent 求解单张 RTX 4090 即可(工具实验用双卡);GEN 数据引擎单卡 4090、每个多样化阶段 12 小时预算;SmolVLA(450M,开源权重)微调 100k 步 batch 64,普通多卡工作站可负担;真机部分需要 Franka Panda + Robotiq 夹爪 + 双 ZED 相机的 DROID 硬件和一张 B200(20k 步微调),门槛最高。主要的外部依赖是 6 个闭源前沿模型 API:复现一次完整 28 任务评测的花费因模型从约 40 美元(Terra)到约 1600 美元(Astra 已解任务总花费)不等,且模型版本迭代后数字会漂移。人工成本方面,专家调参 RL 基线投入了约一周人工,任务与 rubric 的初始设计也是人力密集的。总体判断:仿真评测与数据引擎部分复现难度中等、路径清晰;真机 sim-to-real 需要硬件和调参经验;涉及闭源模型的部分只能做到趋势级复现。
论文图表
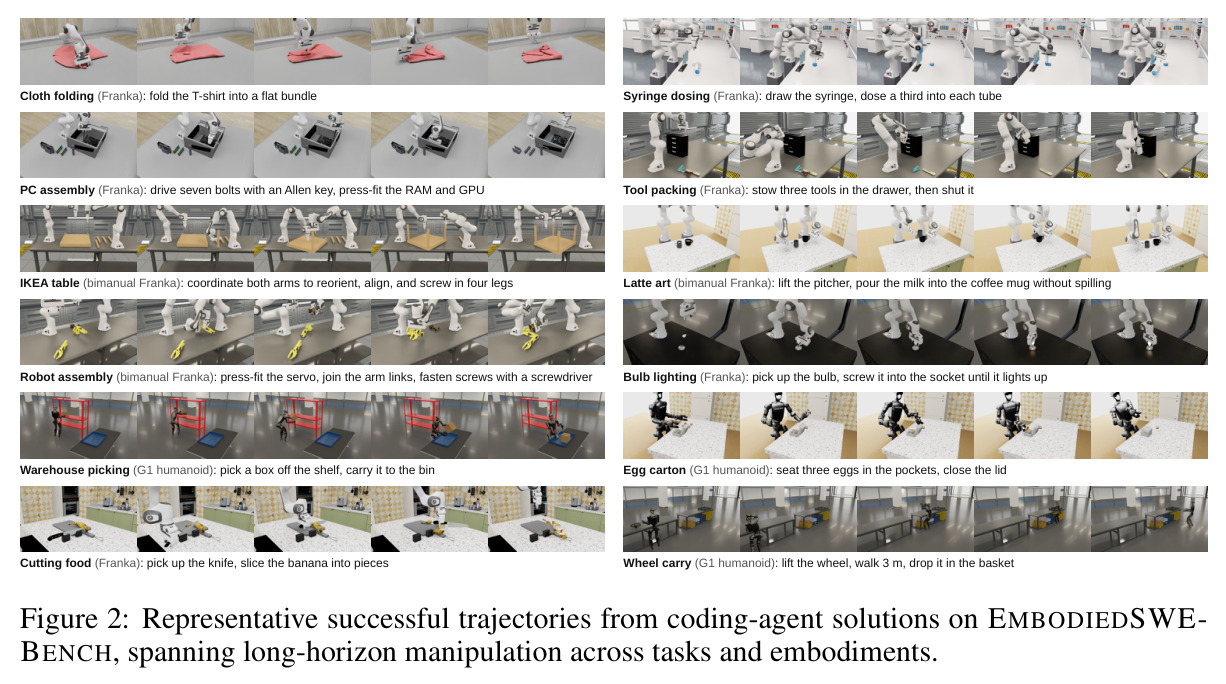
12 个任务的代表性成功轨迹截图:Franka 单臂叠 T 恤、注射器分装、装机(七螺栓+压入内存显卡)、工具收纳;双臂 Franka 装宜家桌、拿铁拉花、组装机械臂;G1 人形仓库取箱、装蛋盒、搬轮子行走 3 米;单臂切香蕉。每张标注任务与本体。
直观展示任务的多样性与物理难度(螺纹、液体、可形变、双臂协同、足式移动),证明基准不是简单的 pick-and-place 集合。