自进化编码智能体:从数字程序到物理世界智能 Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
把世界状态与机器人执行都写成可执行代码,让物理智能体可验证地观察、行动并自我进化
前置知识
VLA(视觉-语言-动作模型)
VLA 模型接收相机图像和自然语言指令,直接输出一小段机器人动作序列(action chunk),如 RT 系列、π0、GR00T 等。它们在大规模机器人演示数据上端到端训练,把「看到什么—做什么」压缩进一个网络。本文的关键证据是:在 LIBERO 上训练的 QwenGR00T 把指令掩蔽后成功率仍有 92.3%,与带指令的 96.2% 相差无几,说明其学到的主要是「场景→轨迹」映射而非指令理解。
本文把 VLA/WAM 降级为可调用、可验证的动作工具,全部论证建立在理解 VLA 的输入输出形式与其失效模式之上。
WAM(世界-动作模型)
在 VLA 基础上加入视频预测目标的模型,先「想象」未来画面再产出动作。本文指出其视频目标奖励的是看起来合理的帧而非正确的物理:预测出的帧本身不可检验——烤箱里是否真有两样食材仍需另一个模型判断,且视频模型在分布外会模仿最近的训练案例而失效。
论文论证 WAM 的隐式表示同样无法承载状态检查与恢复,是 Physical Coding 要改造的直接对象之一。
动作分块与隐式状态
动作分块指策略一次输出多步动作(如未来一段时间的关节/末端轨迹),系统在块之间只接收继续或停止信号。任务分解、完成条件、失败恢复全部隐式编码在网络权重里,接口上不可见:一个 $n$ 步任务的开环成功率约为各步成功率的乘积 $\prod_{i=1}^{n} p_i$,中间出错既无法定位也无法修复。
这是论文对现有方法「结构性缺陷」诊断的核心,理解它才能理解为何要把状态显式写成代码。
编码智能体与 Harness
软件编码智能体(如 Codex 类系统)围绕一个 Harness 工作:Harness 提供工具沙箱、终端与测试套件,测试是独立于模型的验证器,智能体通过写代码—跑测试—修代码迭代。其能力上限很大程度由 Harness 决定,通过测试的轨迹还能训练下一代模型,形成持续改进。
本文正是把这套「工具+独立验证+可版本化脚手架」的范式搬到物理世界,HexaAnything 的 Harness 就是其物理版实现。
Code as Policies(代码即策略)
让 LLM 直接写 Python 程序,程序组合感知调用、控制原语与控制流并在机器人上运行。后续 CaP-Bench/CaP-Agent0 发现:一旦移除人工设计的抽象原语,成功率急剧下降(designer scaffolding 依赖);感知原语不被检验、错误沿程序链式累积、收益不跨回合持久。
本文自称超越该路线:验证对象从原语输出改为世界程序 $W$,且改进以版本化工件形式跨回合保留。
VCode(视觉的代码化表示)
把图像理解转化为生成 SVG 代码的任务:模型写出的代码经渲染必须保住图像的符号内容,由另一个模型从渲染图回答问题来评分。错误因此变得可见(少画一个物体会暴露在渲染里),且可调用检测器等工具修正,把模型推理的内容与工具测量的内容分开。
HexaAnything 正以 VCode 方式从图像写出世界程序 $W$,不读仿真器内部状态,这是其能部署到真实机器人的关键。
研究动机
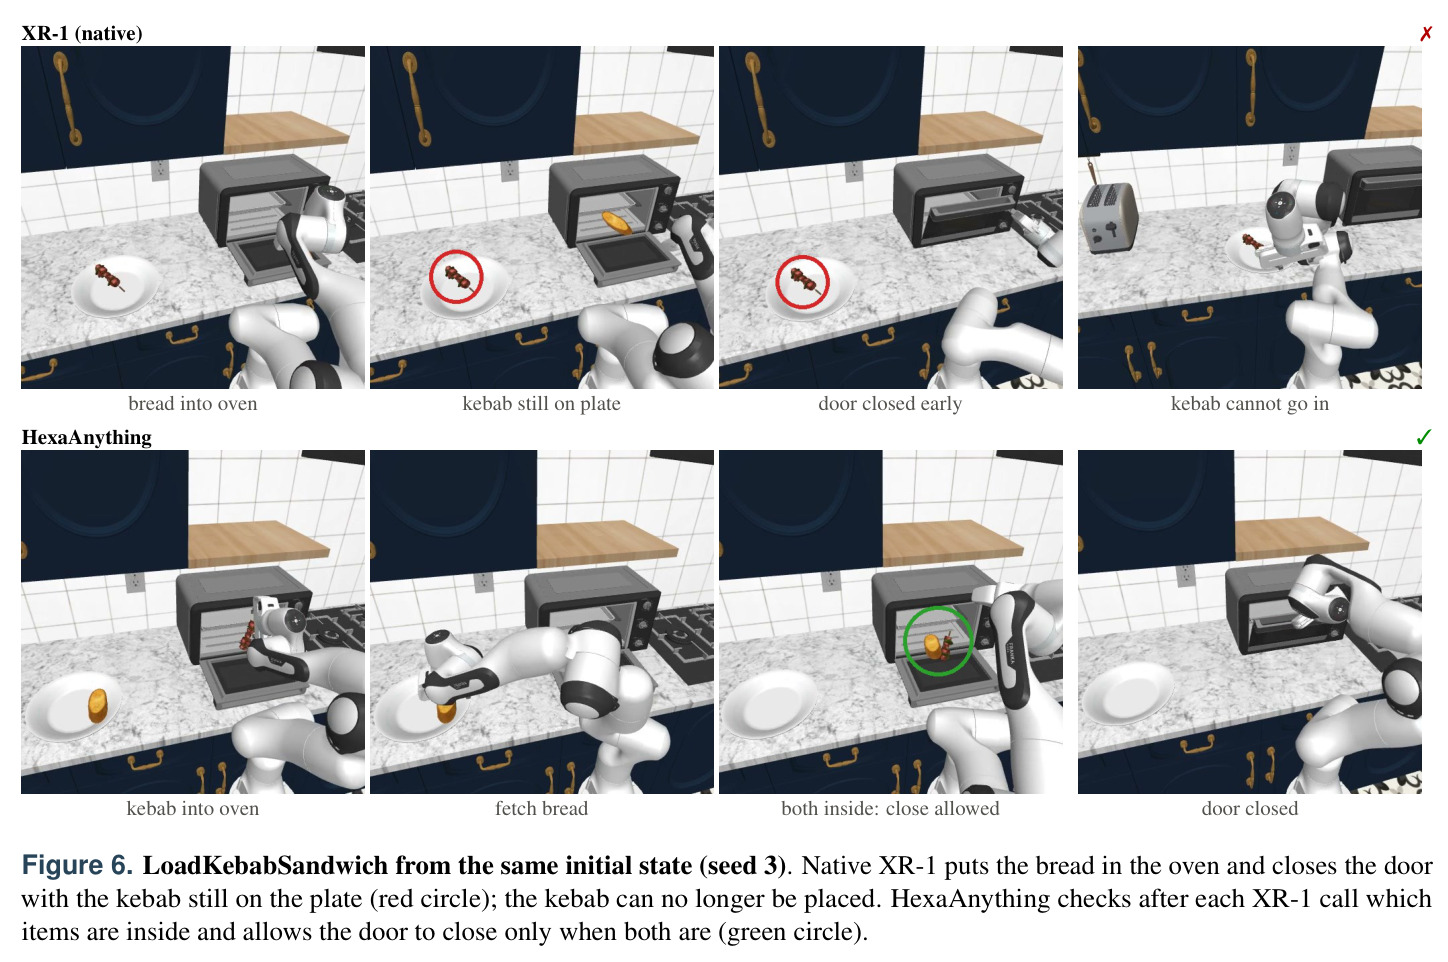
现有 VLA/WAM 把(观测, 指令)直接映射到动作块和停止信号,任务分解、进度追踪、完成判定与失败恢复全部隐式编码在权重里,接口上不可检查。论文给出三组证据:其一,在 LIBERO 上用 StarVLA 训练的 QwenGR00T(Qwen3-VL-4B 骨干、GR00T 式动作头)把指令掩蔽后平均成功率仍有 92.3%,带指令为 96.2%,任一套件差距至多 6.0 个百分点,说明基准高分主要来自「场景→轨迹」拟合而非遵循指令;其二,已发布的 VLA 在视角或机器人初始状态的微小改变下损失超过一半成功率,物体布局被扰动后成功率趋近于 0,且增加数据或模型容量都不能可靠消除该失效;其三,WAM 的视频预测奖励「看起来合理」的帧而非正确的物理。对 $n$ 步、每步成功率 $p_i$ 的开环任务,成功率近似 $\prod_{i=1}^{n} p_i$:烤箱门提前关闭导致食材再也放不进去这类错误,在动作序列和停止信号里无迹可寻,唯一的改进手段只有补演示数据。
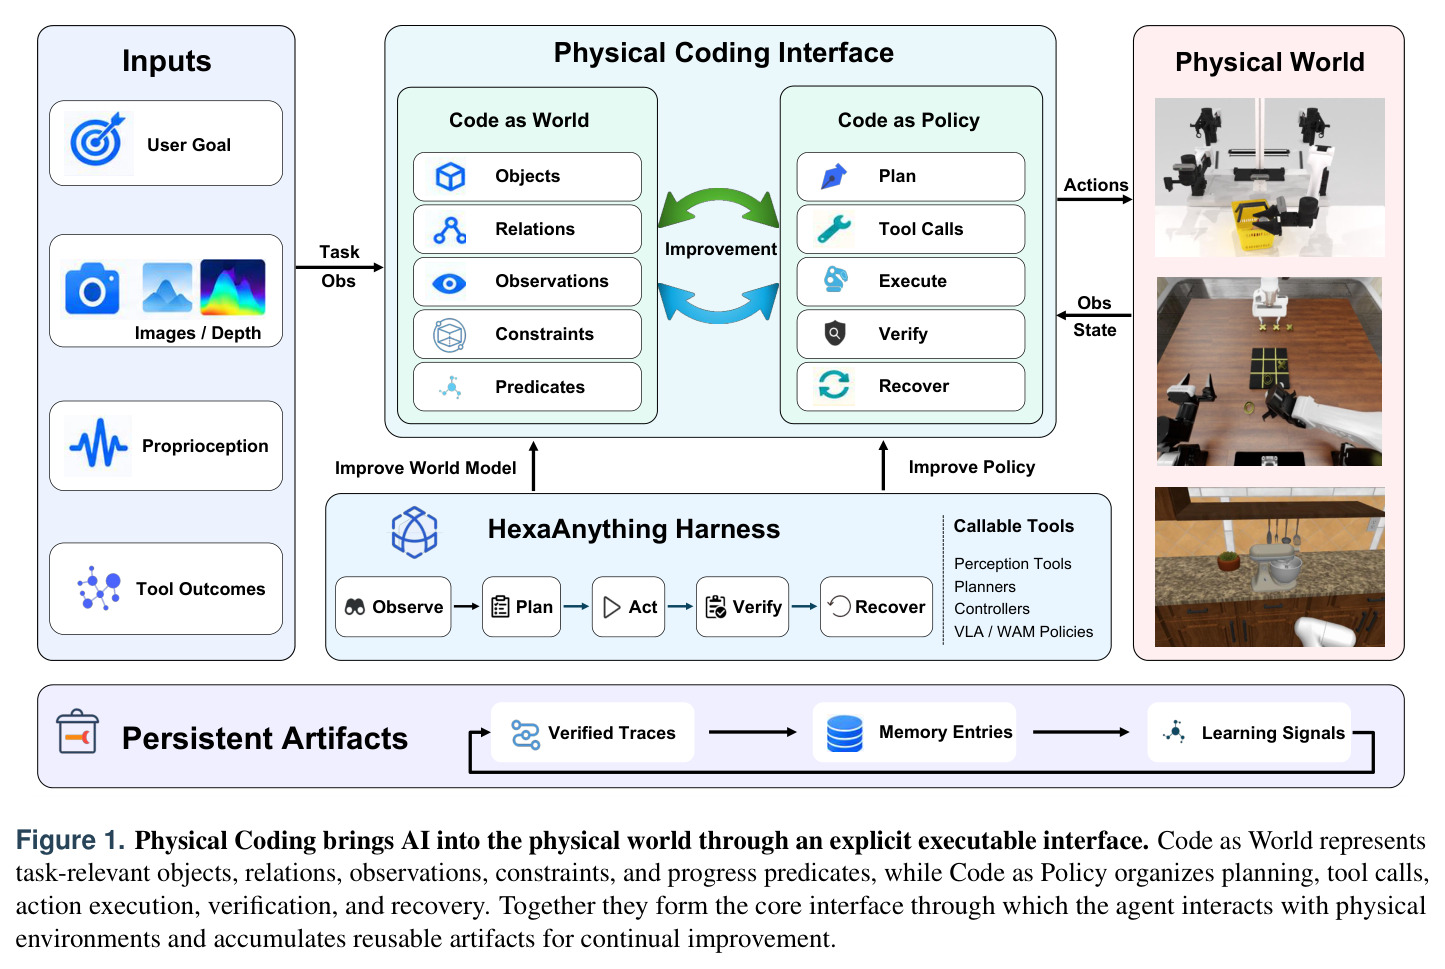
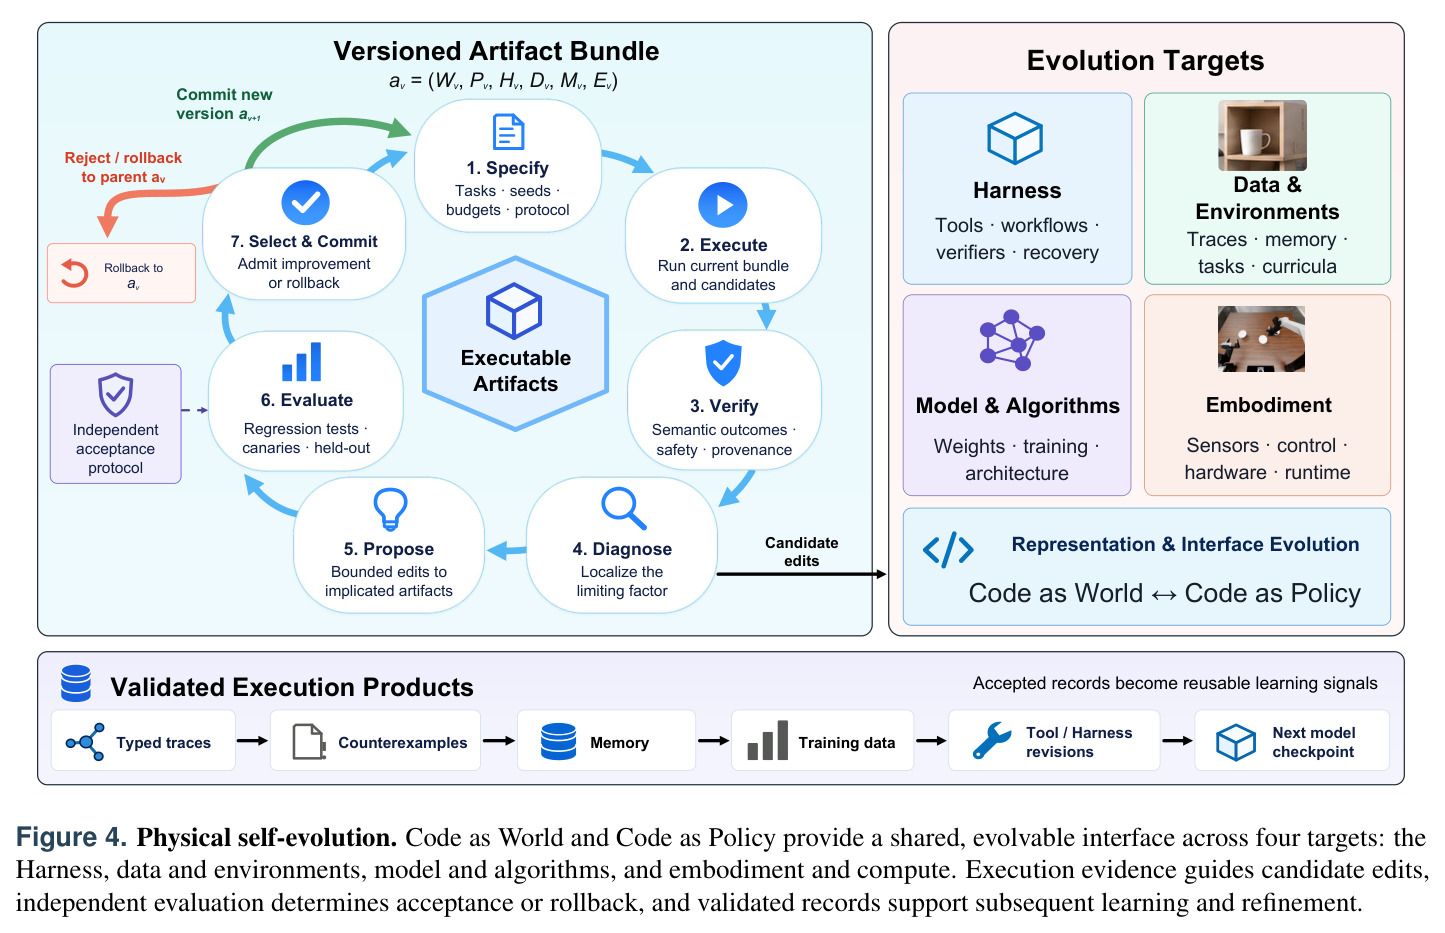
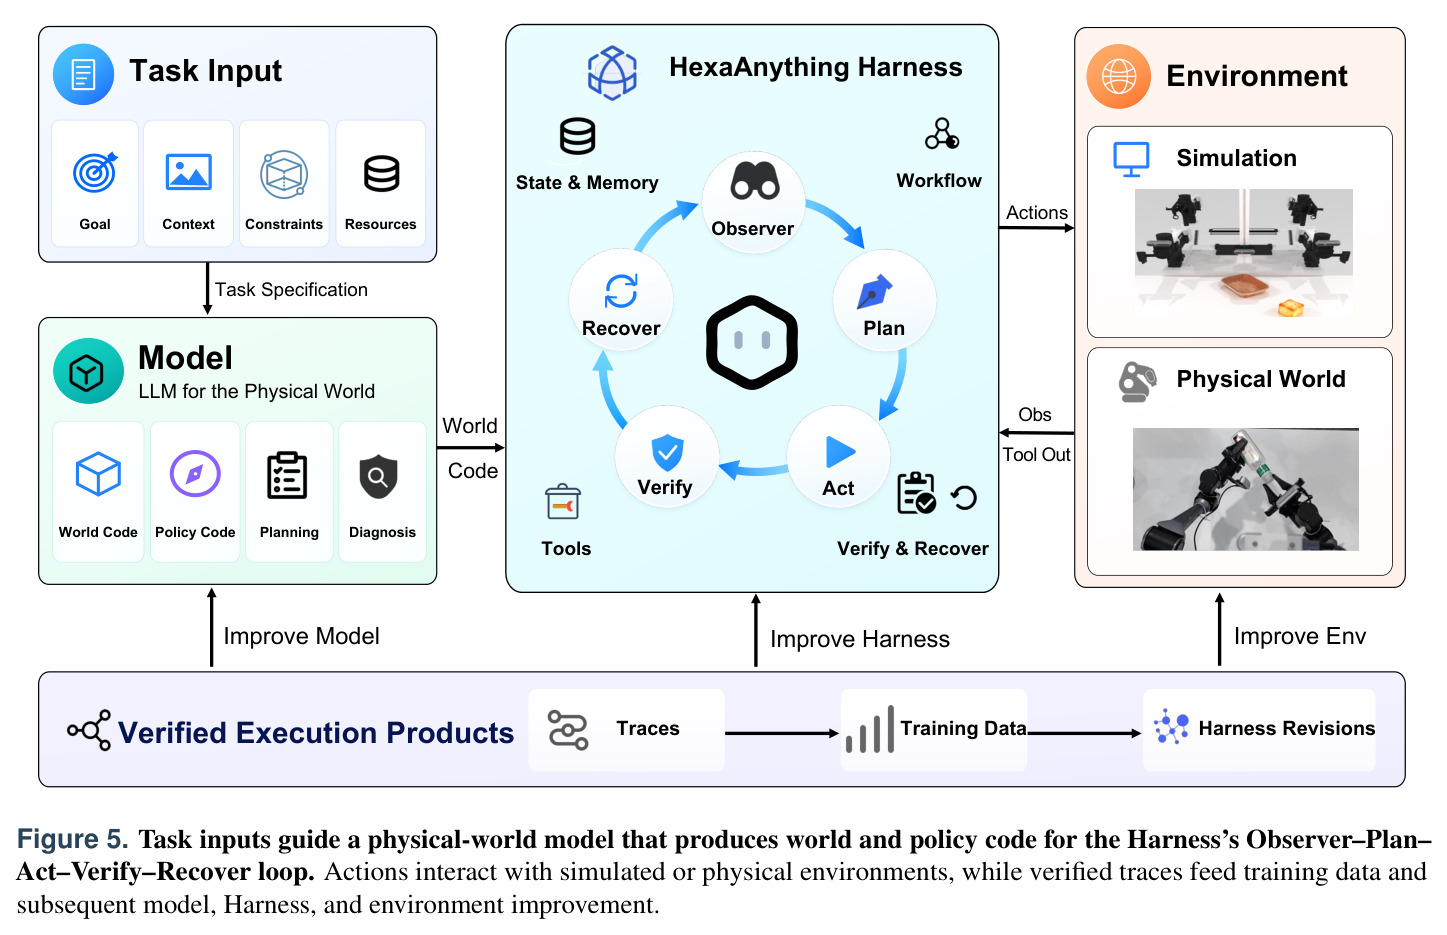
本文的目标是本文要把问题从「模型能否预测更好的动作」改写为「系统能否在整个执行过程中维护一个可检查、可修改的表示」。具体目标分三层:表示层,提出 Physical Coding 范式,用 Code as World 把任务相关的物体、关系、观测、约束与进度谓词写成可执行程序,用 Code as Policy 把规划、工具调用、验证与恢复组织成程序;系统层,构建 HexaAnything 物理编码智能体,把 VLA/WAM 降级为可调用工具,由独立验证器返回 PASS/FAIL/INSUFFICIENT_EVIDENCE/BLOCKED/SAFETY_STOP 五类类型化判定,使物理执行可检验、失败可定位;进化层,给出 Harness、数据与环境、模型与算法、本体与算力四个耦合进化目标以及 E0–E4 证据阶梯,并在 RoboCasa365 长时程操作、RoboDojo 工具修订、自建 PhyBench 物理实验基准和 AgileX 双臂真机上验证 Harness、数据、模型、工具四个层面的初步自进化。
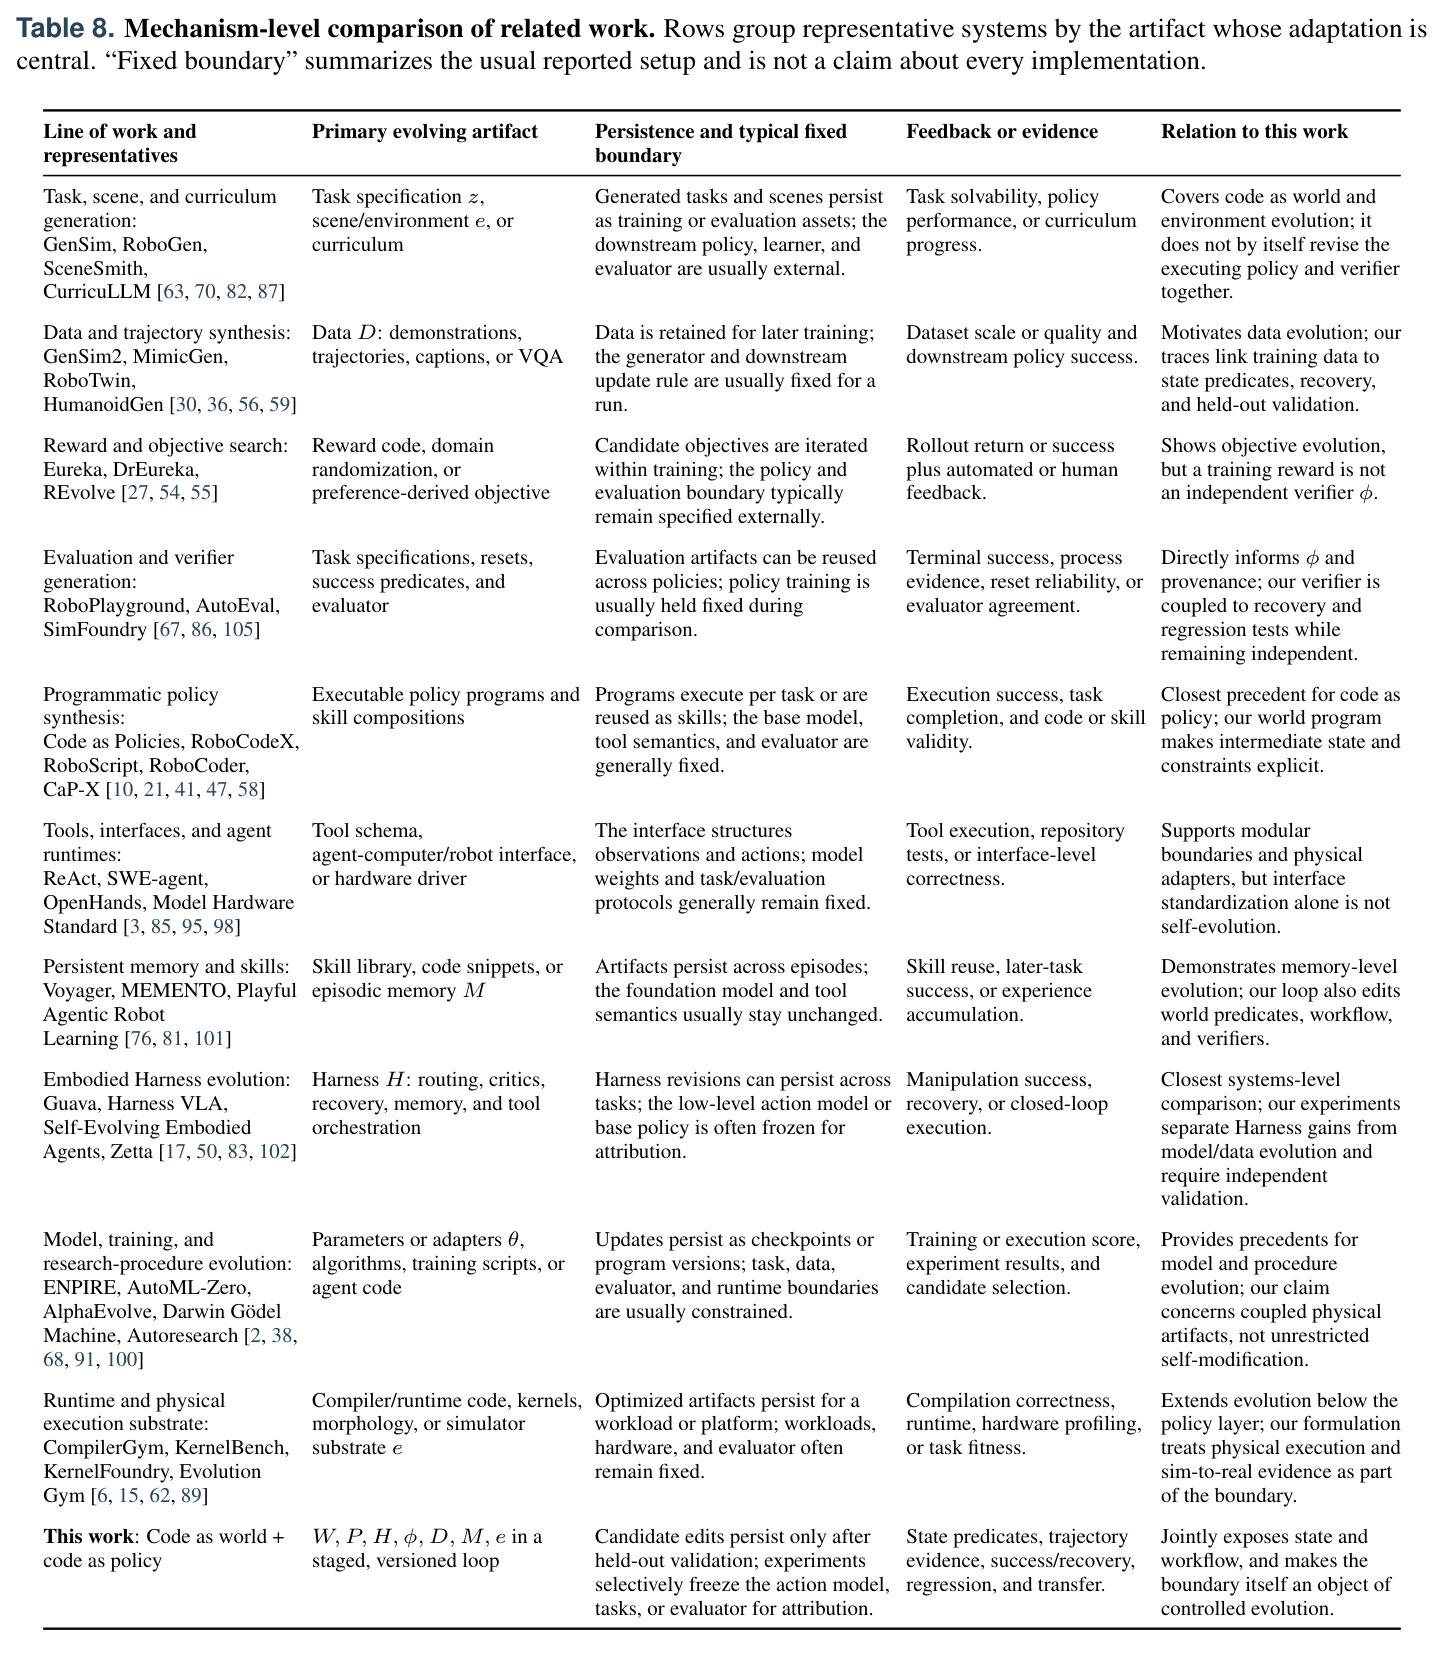
与已有工作不同的是,本文的独特切入是把数字世界编码智能体的成功要素——可执行介质、独立测试、版本化工件——系统性移植到物理世界,并与四条已有路线明确划界。相对端到端 VLA,它拒绝把任务智能压进动作块,而让动作模型只充当被调用、被验证的工具。相对 Code as Policies 一系,验证对象从感知原语输出改为可独立校验的世界程序 $W$,验证、停止与恢复成为策略程序中可静态检查的节点,且改进以版本化工件跨回合保留,而 CaP 系的测试期策略每个回合都要重新付费。相对 Zetta 等在视觉证据不足时回退到仿真器内部状态、接触力的 embodied harness,HexaAnything 只用图像、深度、本体感知与工具输出写世界程序(VCode 方式),因此可直接搬到真机。相对 Voyager、SHAPER 等把知识存在模型之外的技能库或记忆里、基座模型始终冻结的做法,本文让 Harness 同时充当数据采集器,通过独立验证的轨迹直接训练下一代 HexaModel,在物理领域首次闭合「数据→模型→Harness」的递归回路。
核心方法
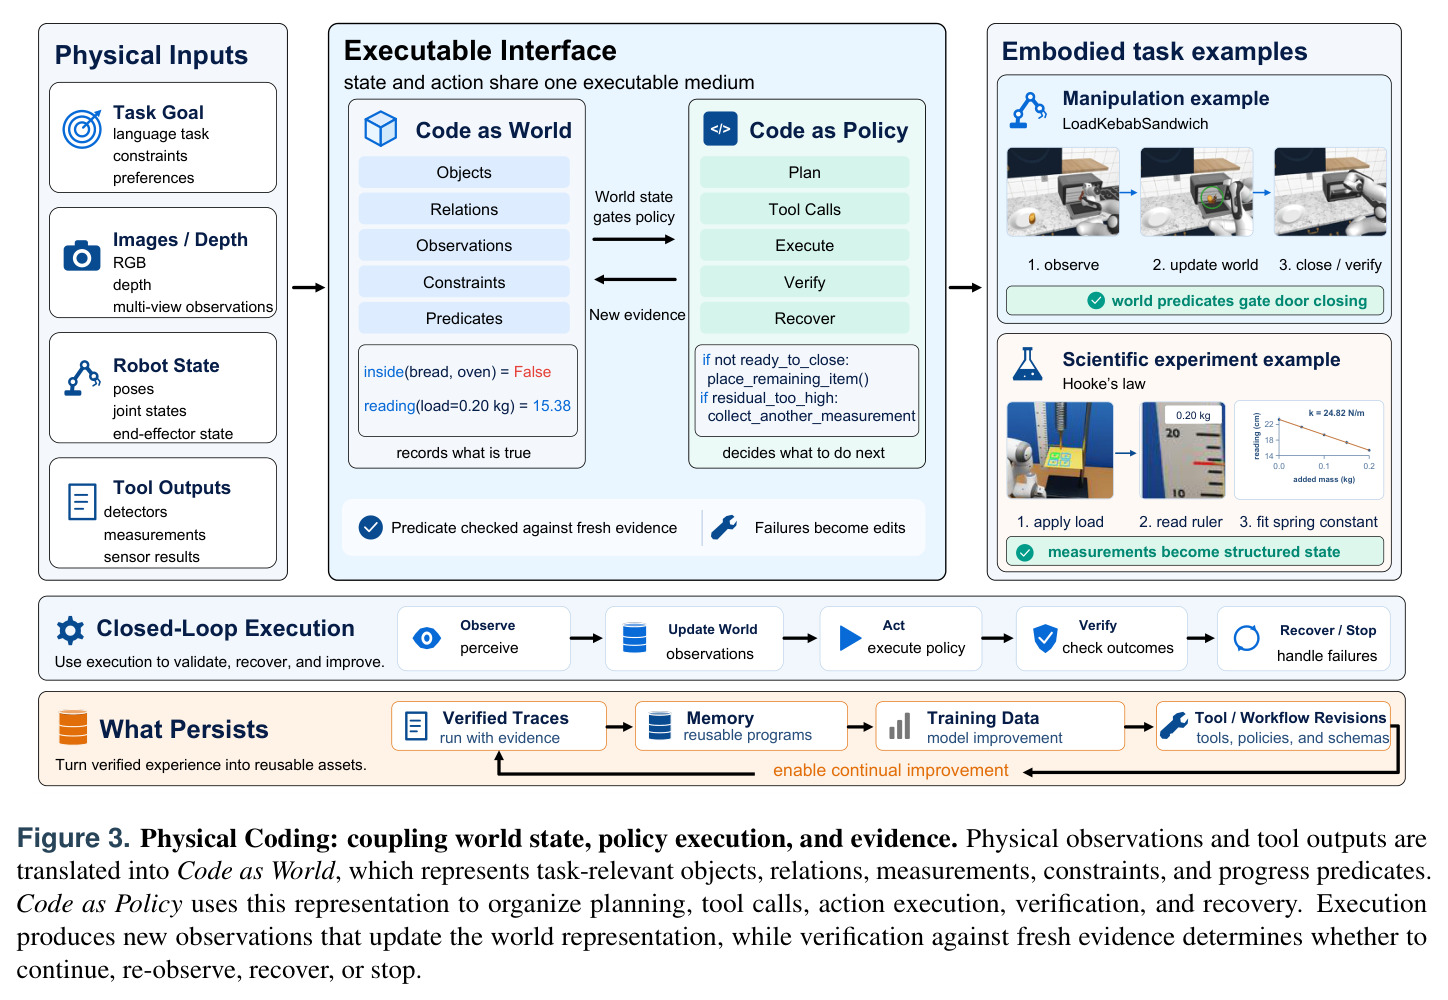
直觉先行:软件编码智能体之所以能持续改进,是因为任务本身就是代码——仓库是状态、编辑是动作、测试是验证、修复以版本形式保留。物理世界默认没有这些:状态读不到、动作不返回成功值、没有测试判定完成。Physical Coding 的做法是为物理世界补上这套可执行介质:智能体通过代码观察(把图像、深度、本体感知、工具输出写成世界程序 $W$,含物体、关系、约束与进度谓词,每条记录带出处 provenance);通过代码行动(策略程序 $P$ 调用感知/运动/抓取工具乃至 VLA/WAM,含分支、循环、中断与恢复节点);通过代码接收反馈(独立验证器对照新鲜证据评估谓词,而非采信模型自称完成)。技术上系统形式化为 $H_t=(O_t,T_t,V_t,R_t,M_t,\Gamma_t)$(观察接口、工具注册表、验证器、恢复算子、记忆与执行合约),每步生成类型化策略节点 $n_t=\pi_{\theta_t}(z,W_t,P_t,O_{\le t},M_t)$,派发工具后按 $W_{t+1}=\mathrm{UpdateWorld}(W_t,O_{t+1},y_t)$ 更新世界程序,验证判定 $q_t=V_t(W_{t+1},y_t,z)$ 决定继续、重观测、恢复或终止,完整轨迹 $\xi$ 是归因与后续更新的基本单元。
核心创新是把「物理状态、动作与证据的连接」显式化为两个耦合的可执行工件:$W$ 记录什么是真的,$P$ 决定下一步做什么,任一工件或对其的修改都必须通过独立于模型的验证器检验。与已有方法的本质区别有三。第一,验证对准世界程序 $W$ 而非感知原语输出或模型自评:模型的「我完成了」不算成功,工具返回 finished 也不算证据,证据不足时返回 INSUFFICIENT_EVIDENCE 而非猜测。第二,闭环方法(ReAct、Inner Monologue)和技能库方法(Voyager)的循环都活在程序之外——验证是模型读观测、恢复是重新提示——本文把验证、停止条件、恢复写成 $P$ 中可静态检查的节点,且改进以版本化工件(工具、谓词、工作流)跨回合保留。第三,自进化被形式化为对耦合组 $(z,e,W,P,H,\theta,\phi,D,M)$ 的带门更新:每轮产生版本化工件束 $a_v=(W_v,P_v,H_v,D_v,M_v,E_v)$,按 Specify→Execute→Verify→Diagnose→Propose→Evaluate→Select/Commit 七步循环,只有通过静态检查、回归测试、独立评测与回滚检查的修改才被接纳,被拒修改的轨迹留作反例。
方法步骤详情
方法可概括为一个回合内的执行循环加回合间的进化循环。回合内五步:(1) 观测——Harness 提供图像/深度/本体感知,模型以 VCode 方式从图像写或更新世界程序 $W$,逐条更新而非整体重生成,新旧观测矛盾因此可见;(2) 规划——生成类型化策略 $P$,节点种类限定为观测/动作/VLA 调用/判别/验证/恢复/分支/循环/顺序九种,可在执行前静态检查;(3) 行动——派发工具(感知、运动规划、抓放、接触控制、终端/Python,或以局部指令调用 XR-1 等 VLA/WAM);(4) 验证——验证器对照新证据评估目标谓词(如两样食材都在烤箱内),每个工具调用后执行 monitor–verify–continue/intervene 决策;(5) 恢复——失败触发安全停止、重试、重观测或重规划,且 fail-closed:未完成或歧义状态不会默默升级为成功。回合间:每步留下类型化轨迹 $\xi$(世界条目、策略节点、工具结果、判定),失败被定位到某个谓词/工具/分支并产生有界修改提案,通过回归与留出评测后提交;通过验证的轨迹进入训练语料——HexaModel v0.1 即 Qwen3.8-27B 在 178.6M token(其中 38.8% 由 Harness 返回)上微调一轮得到的下一版规划器。
技术新颖性
技术新颖性在于三点叠加。其一,表示层面:此前代码进机器人的工作要么只代码化策略(Code as Policies、VoxPoser、ReKep),要么只代码化世界但服务于单次查询或单回合(VCode、Statler、ConceptGraphs);本文让状态与动作共享同一可执行介质并由同一个验证器检查,且 $W$ 跨回合持久化,失败可以直接转化为加一条谓词、改一条约束的编辑。其二,验证层面:因为轨迹将被用于训练,验证器必须独立于策略模型,返回五类类型化判定并强制证据出处——训练奖励或同一模型输出的退出码都会确认自身错误,而奖励利用不等于可迁移能力。其三,进化层面:把此前各自为政的自进化组件(任务生成、演示合成、奖励搜索、技能库、参数高效微调、内核优化、形态搜索)统一为一个七步、可归因、可回滚的循环,并给出 E0–E4 证据阶梯(工件能运行/能完成任务/能区分策略/训练新模型有效/迁移到真机),明确本文只示范到其中部分环节,协调的全栈共进化留作长期纲领,这种诚实的归因框架本身就是贡献。
实验结果
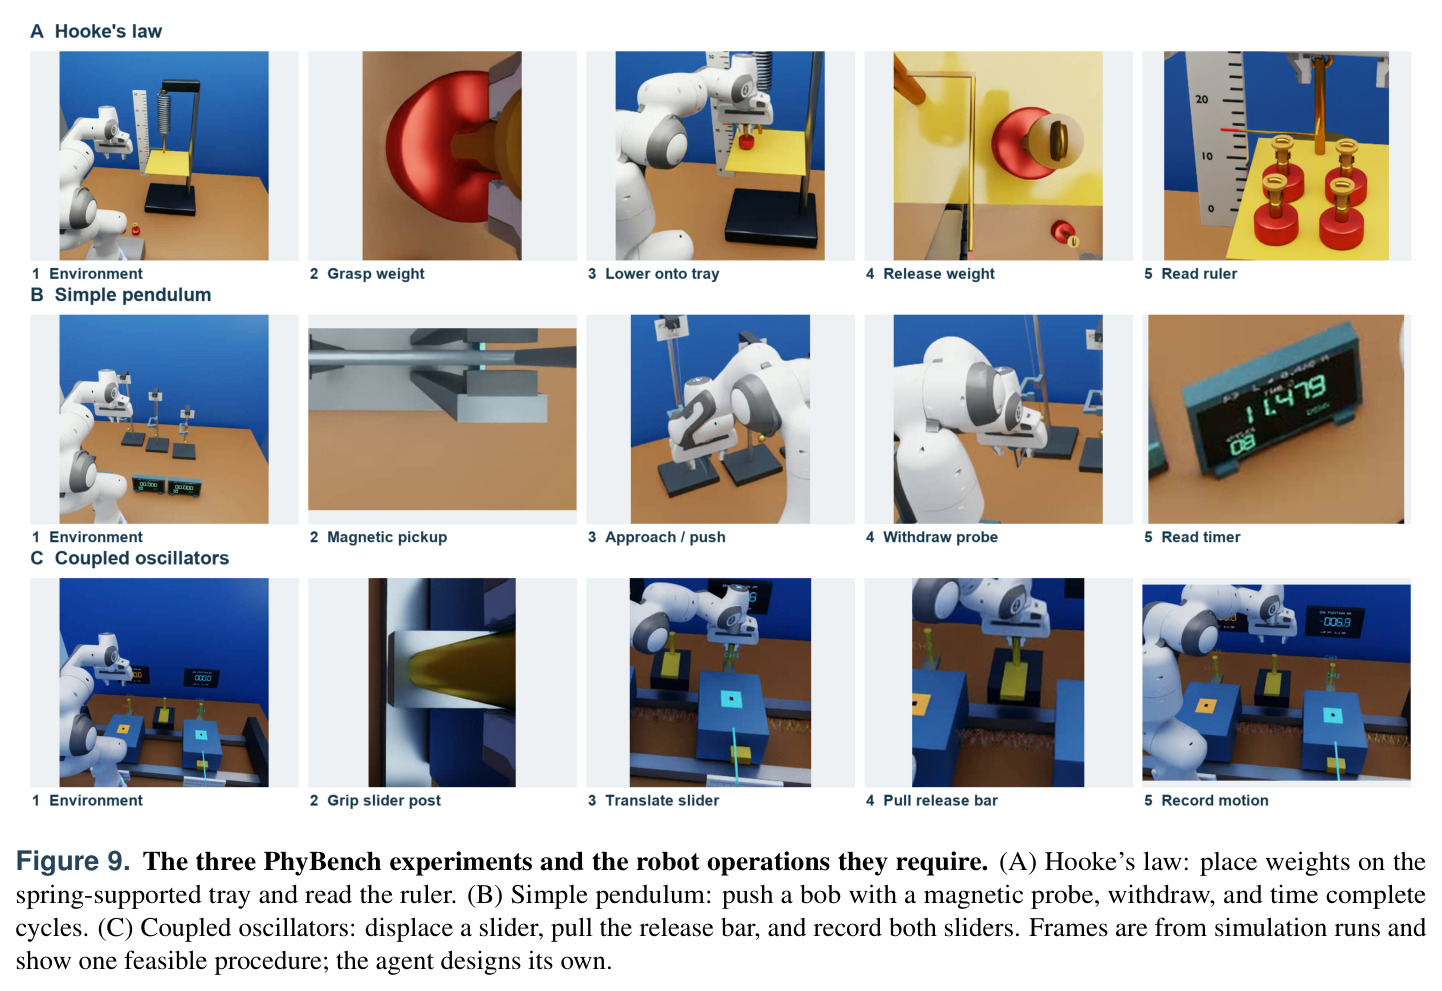
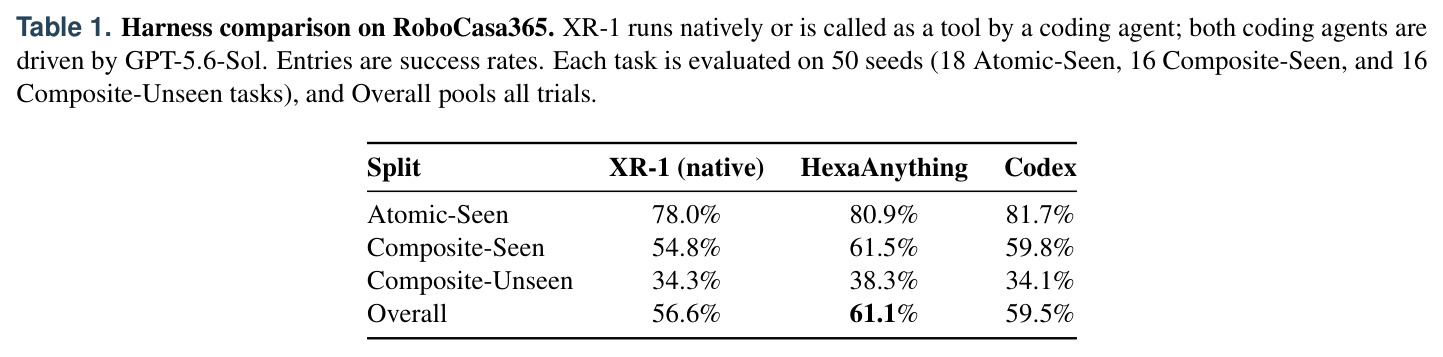
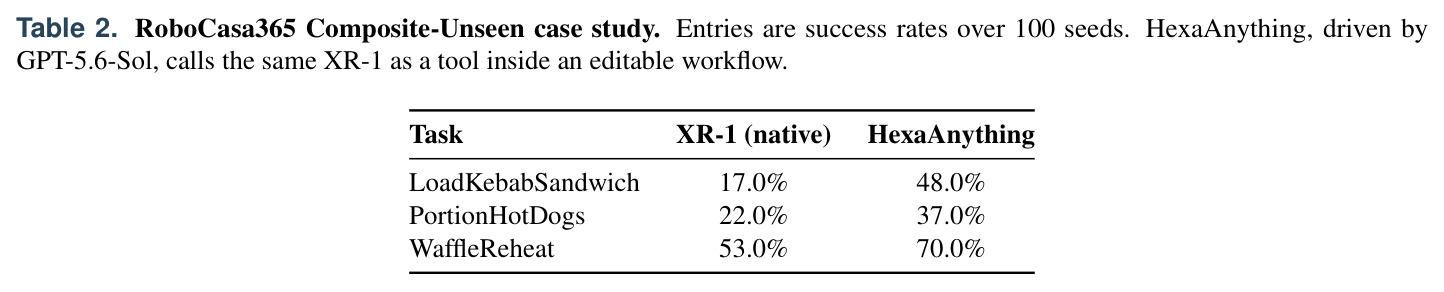
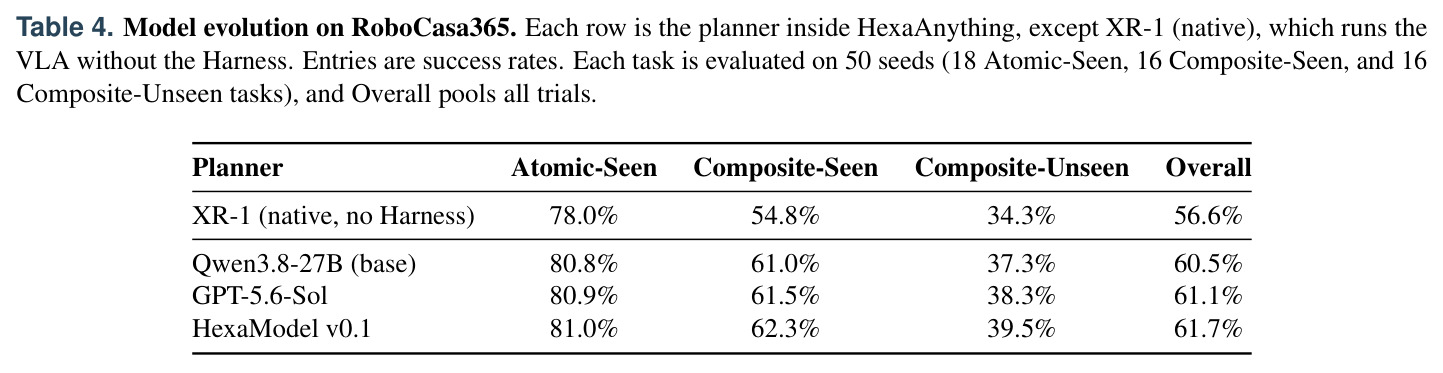
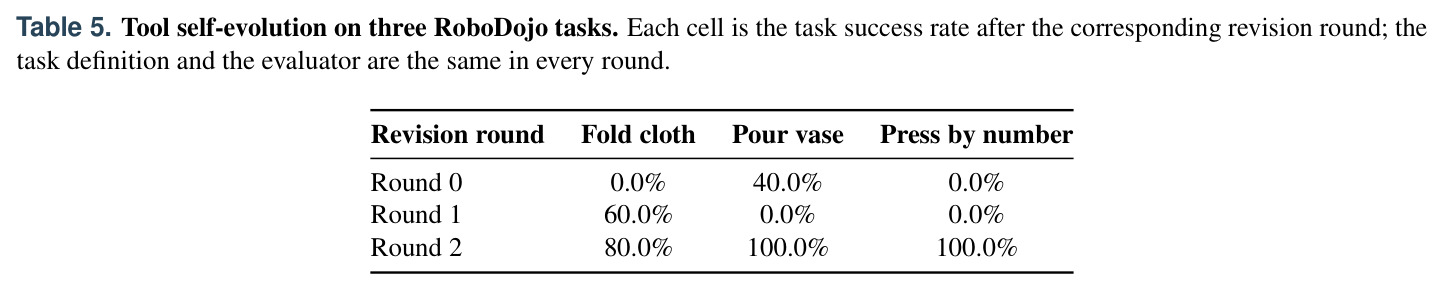
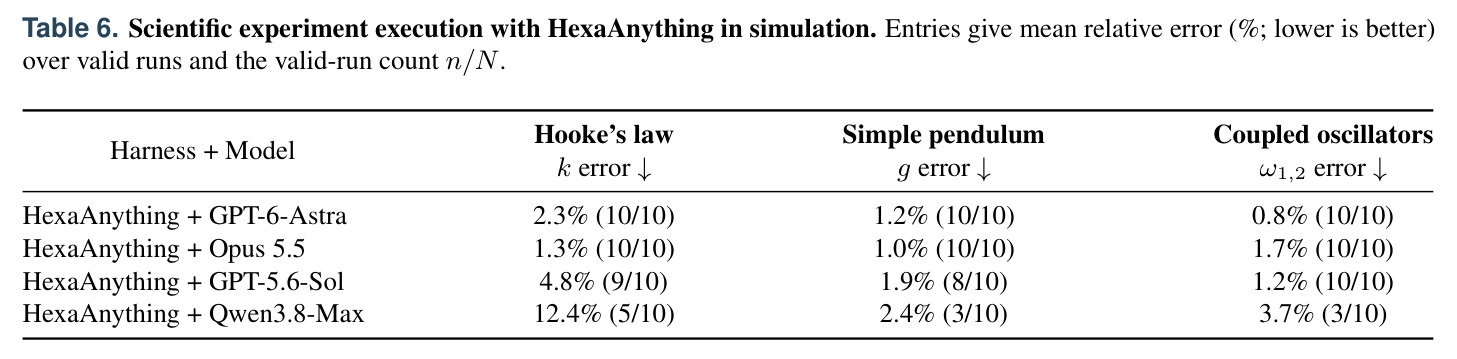
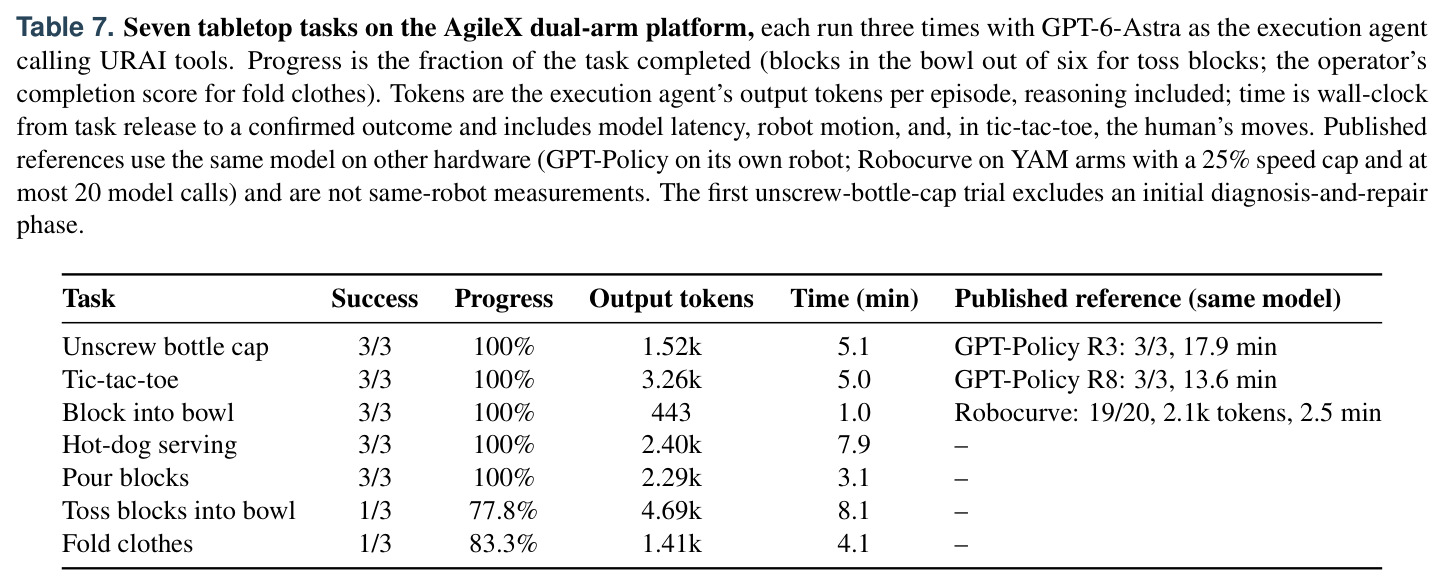
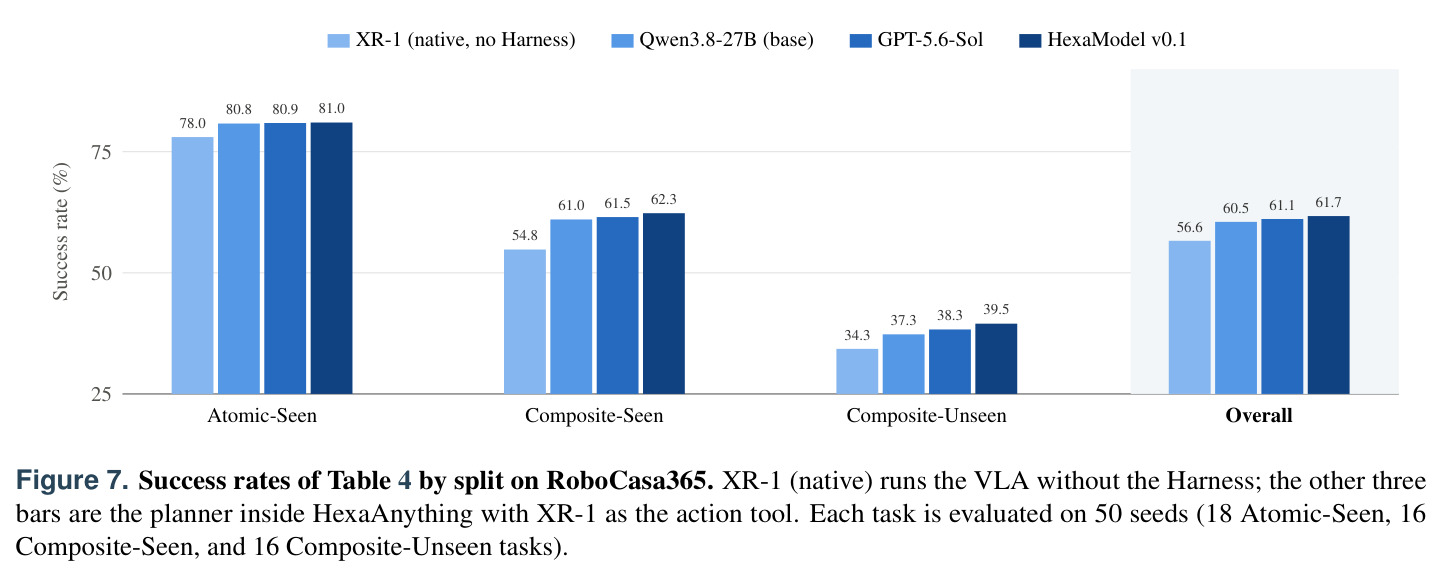
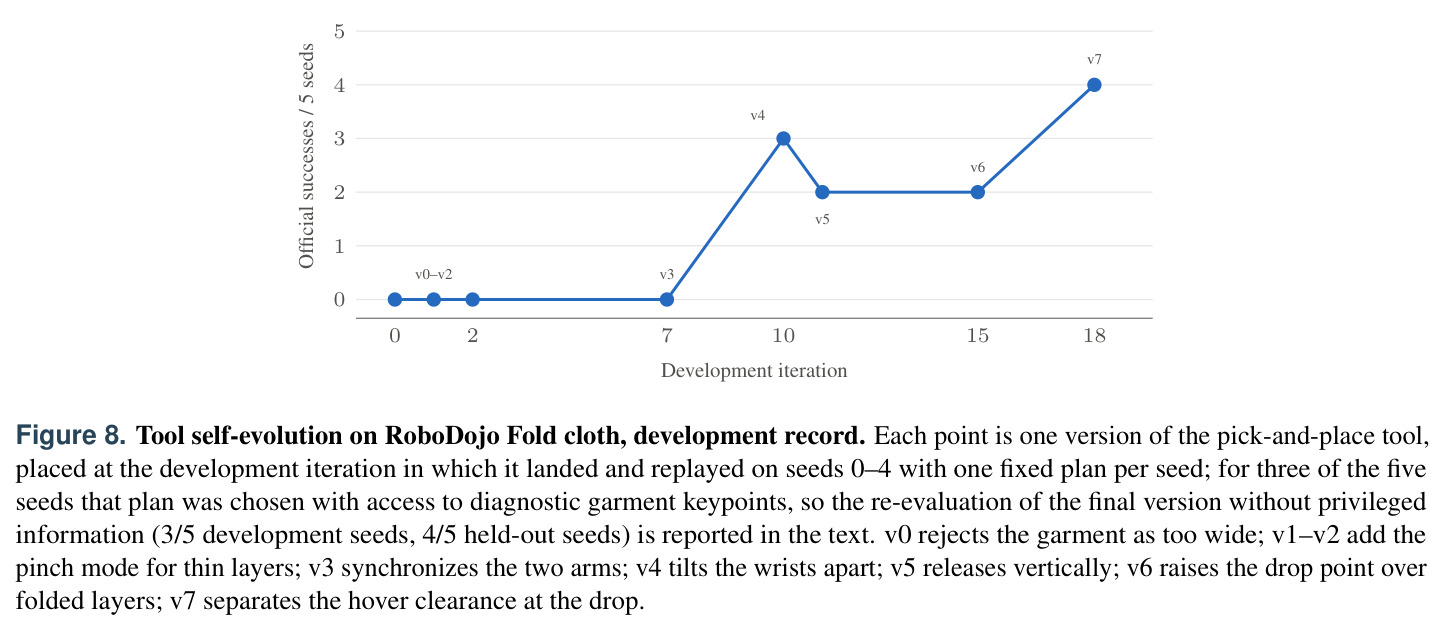
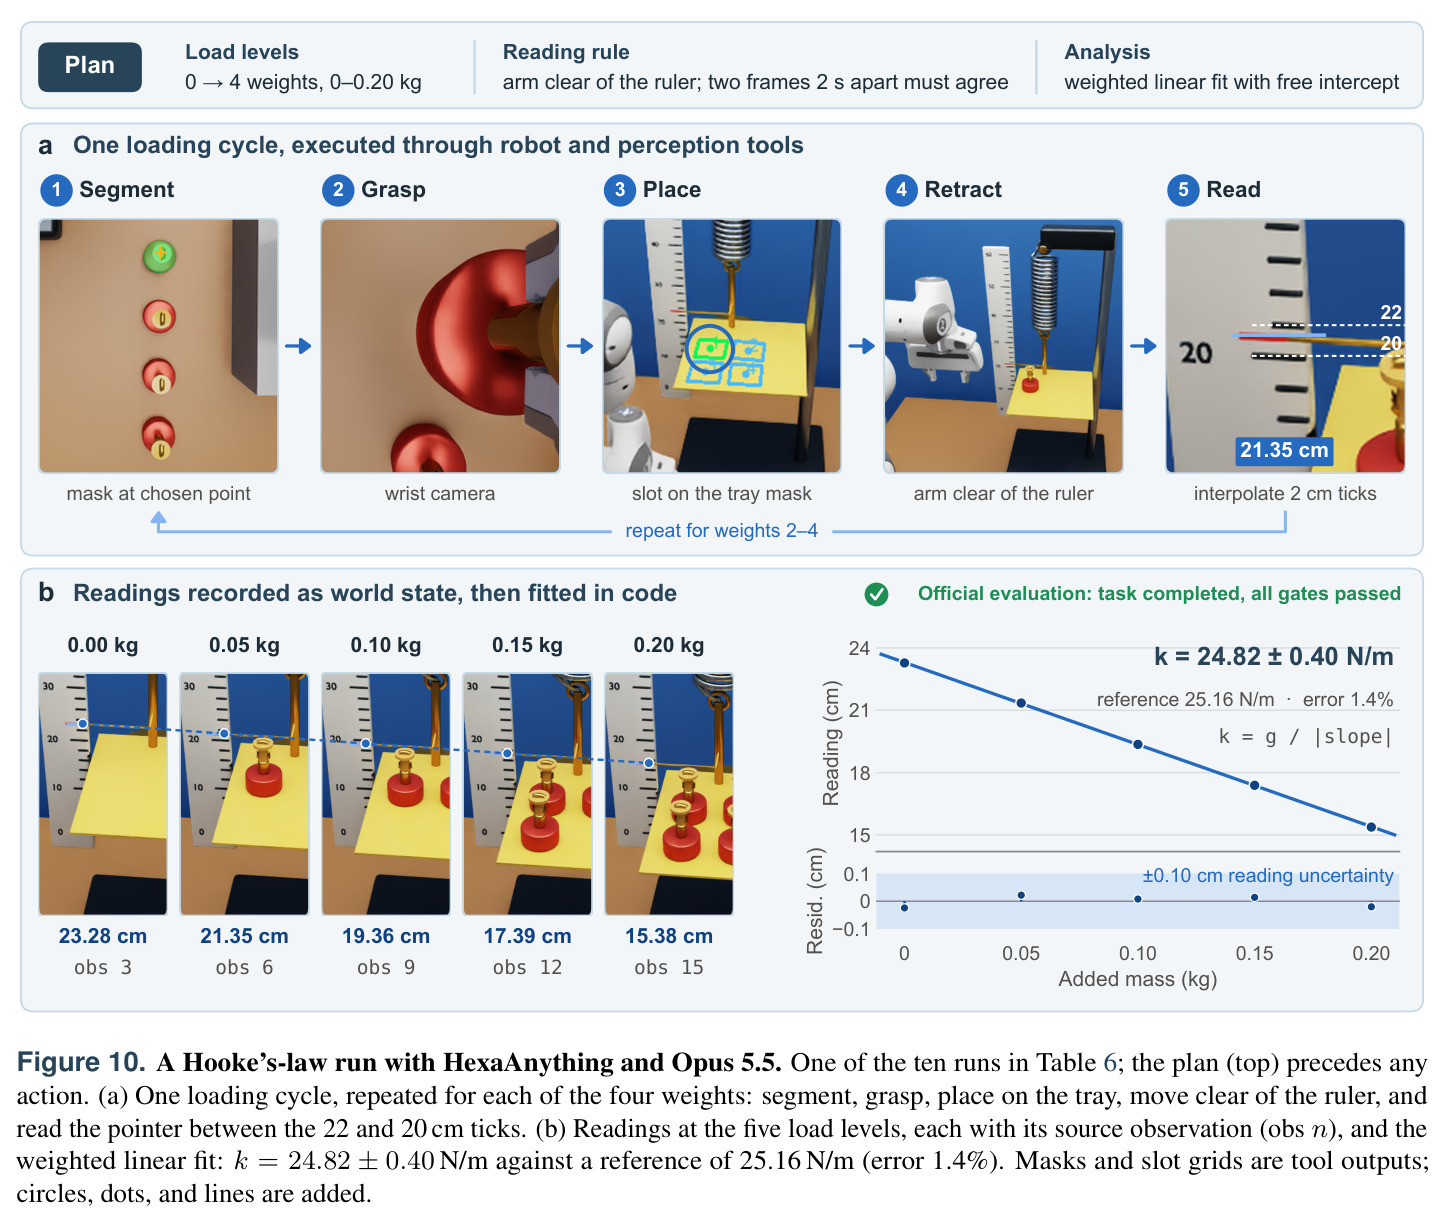
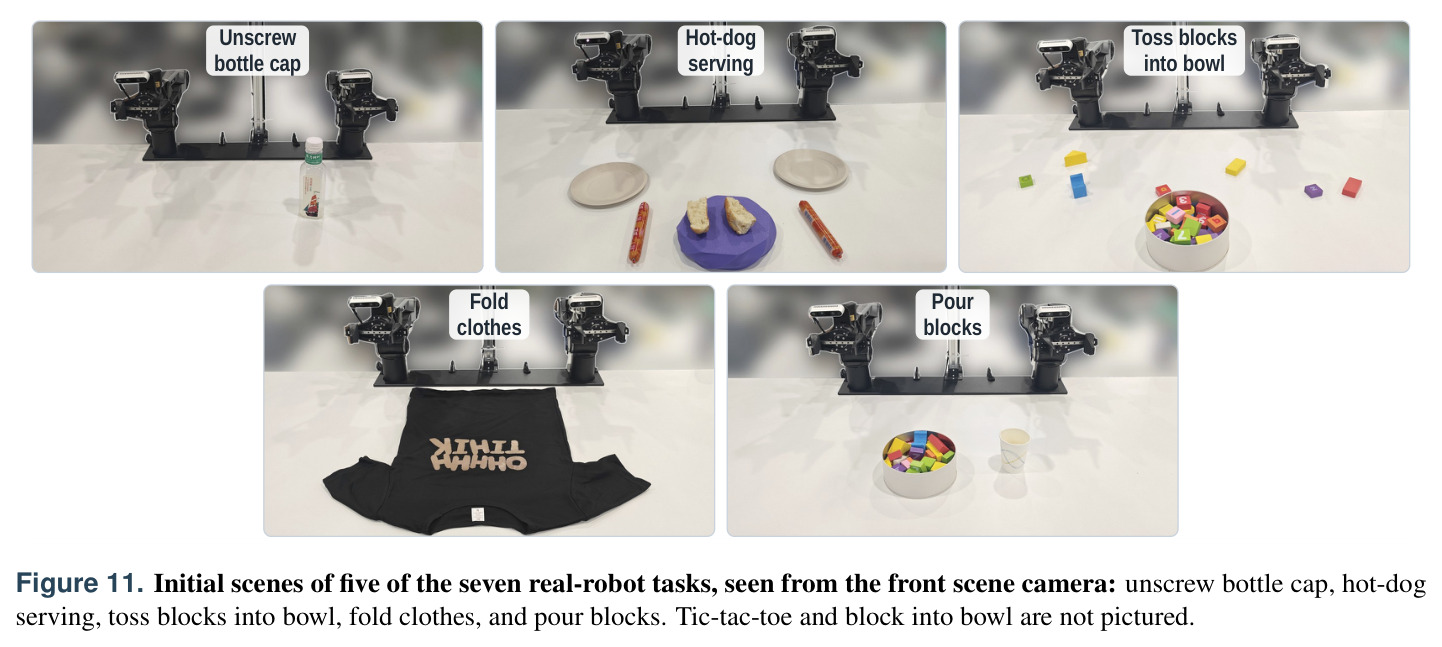
五组实验各有明确数字。(1) Harness 效应:动作模型固定为 XR-1(每任务 50 seeds),HexaAnything(GPT-5.6-Sol 规划)把 RoboCasa365 Composite-Unseen 从 34.3% 提到 38.3%(+4.0),Composite-Seen 54.8%→61.5%(+6.7),Overall 56.6%→61.1%;同模型驱动的通用编码智能体 Codex 总体 59.5%,其 Composite-Unseen 仅 34.1%,未超原生 VLA;换用开源 Qwen3.8-27B 规划也有 37.3%(+3.0)。(2) 长时程案例(各 100 seeds):LoadKebabSandwich 17%→48%(+31)、PortionHotDogs 22%→37%(+15)、WaffleReheat 53%→70%(+17);收益不是步数预算所致——PortionHotDogs 上把 VLA 动作预算翻倍,原生仅 21/100(标准设置 22/100),智能体条件 37/100;CloseFridge 50%→79%,TurnOffStove 0/8→18%;上下文经按需摘要从约 190K 压缩至 30–35K token。(3) 模型进化:HexaModel v0.1(Qwen3.8-27B 微调一轮)在相同 Harness 内全部 split 超基座:Composite-Unseen 37.3%→39.5%(+2.2),Overall 60.5%→61.7%,还以 0.6 分领先 GPT-5.6-Sol,说明代码轨迹部分内化了物理执行能力。(4) 工具进化(RoboDojo,评测器冻结、权重不变):Fold cloth 0%→60%→80%,Pour vase 40%→0%→100%(首轮回退),Press by number 0%→0%→100%。(5) PhyBench 与真机:GPT-6-Astra 与 Opus 5.5 各 30/30 有效且全部平均相对误差低于 5%(胡克定律最好 1.3%、单摆 1.0%、耦合振子 0.8%),Qwen3.8-Max 仅 5/10、3/10、3/10 有效;案例运行拟合 $k=24.82\pm0.40$ N/m 对参考 25.16 N/m 误差 1.36%。AgileX 双臂 7 任务中 5 个 3/3 全成:拧瓶盖 5.1 分钟对 GPT-Policy 的 17.9 分钟(3.5 倍),井字棋 5.0 对 13.6 分钟(2.7 倍),积木入碗 1.0 分钟/443 token 对 Robocurve 的 2.5 分钟/2.1K token;投掷积木与叠衣仅 1/3。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboCasa365 Overall(每任务 50 seeds) | 任务成功率 | 61.1%(HexaAnything:GPT-5.6-Sol 规划 + XR-1 动作) | 56.6%(XR-1 原生) | +4.5 个百分点 |
| RoboCasa365 Composite-Unseen | 任务成功率 | 38.3% | 34.3%(XR-1 原生);同模型 Codex 仅 34.1% | +4.0 个百分点,且是唯一在 Unseen 上超过原生 VLA 的智能体 |
| RoboCasa365 Composite-Seen | 任务成功率 | 61.5% | 54.8%(XR-1 原生) | +6.7 个百分点 |
| LoadKebabSandwich(Composite-Unseen 案例研究,100 seeds) | 任务成功率 | 48.0% | 17.0%(XR-1 原生) | +31.0 个百分点 |
| PortionHotDogs(100 seeds) | 任务成功率 | 37.0% | 22.0%(原生;动作预算翻倍后仍仅 21%) | +15.0 个百分点,排除步数预算解释 |
| WaffleReheat(100 seeds) | 任务成功率 | 70.0% | 53.0%(XR-1 原生) | +17.0 个百分点 |
| 模型进化:HexaModel v0.1(相同 Harness 内) | Overall 成功率 | 61.7%(Qwen3.8-27B 于 178.6M token 微调一轮) | 60.5%(Qwen3.8-27B 基座);61.1%(GPT-5.6-Sol) | +1.2 个百分点;Composite-Unseen +2.2(37.3%→39.5%),并在每个 split 上超过 GPT-5.6-Sol |
| RoboDojo 工具进化(Fold cloth / Pour vase / Press by number) | 任务成功率(两轮工具修订后) | 80% / 100% / 100% | 第 0 轮 0% / 40% / 0% | +80 / +60 / +100 个百分点,任务定义、评测器与权重全程冻结 |
| PhyBench 胡克定律(每模型 10 次运行) | 刚度 $k$ 平均相对误差(阈值 15%) | 1.3%(Opus 5.5,10/10 有效);案例运行 1.36% | 自建基准无外部基线;Qwen3.8-Max 为 12.4% 且仅 5/10 有效 | 前沿模型误差与有效率显著占优 |
| PhyBench 单摆 / 耦合振子 | $g$ 与 $\omega_{1,2}$ 平均相对误差(阈值 3% / 10%) | 单摆 1.0%(Opus 5.5)、振子 0.8%(GPT-6-Astra),均 10/10 有效 | 自建基准;Qwen3.8-Max 仅 3/10 有效 | 前沿模型全部低于 5%,验证端到端自主科学实验 |
| 真机拧瓶盖(AgileX PiPER-X 双臂,3 次试验) | 成功次数与用时 | 3/3,5.1 分钟 | GPT-Policy R3:3/3,17.9 分钟(同模型、异硬件) | 3.5 倍提速 |
| 真机井字棋 / 积木入碗 | 用时与输出 token | 5.0 分钟;1.0 分钟、443 token | 13.6 分钟(GPT-Policy R8);2.5 分钟、2.1K token(Robocurve) | 2.7 倍提速;2.4 倍提速且 token 减少 4.7 倍 |
局限与改进
作者明确承认的局限:Harness 效应只在单一动作模型(XR-1)与单一基准上测量,且对 Codex 的总体优势只有 1.6 分,Atomic-Seen 上反落后 0.8 分;长时程证据仅来自 RoboCasa365 内置复合任务,自设计的 10,000 步超长时程任务集只设计未评测;RoboDojo 工具进化种子极少(Fold cloth 仅 5 seeds),且叠衣任务由编程智能体改工具、人类操作员替每次调用选像素,测的是工具与接口而非自主感知,操作员还曾在开发中读过评测器源码,靠事后去除特权信息补测缓解;PhyBench 在仿真中每模型每任务仅 10 次试验;真机每任务仅 3 次,且已发表参照来自其他硬件与不同运行限制(Robocurve 有 25% 限速与 20 次调用上限),不可直接比较。我的补充观察:模型进化的绝对增益很小(Overall +1.2 分),且训练数据混有 GPT-5.6-Sol 的 204 条恢复轨迹与上一代 checkpoint 的 103 条,难以把增益干净归因于「代码轨迹内化」;规划器与验证器的 API 成本和端到端延迟未系统报告;「验证器独立于模型」在开放进化中如何长期保持(防共适应)仍只靠流程约束而非机制保证。
独立分析的弱点
独立分析的弱点与改进方向:(1) 延迟与成本——Vibe as Policy 模式下模型只在工具调用之间行动,真机单任务耗时 1.0–8.1 分钟,无法进入实时控制回路;改进方向是论文提到的多时间尺度架构(模型离线生成并优化已验证策略,实时控制器或 VLA 在线执行),以及把 HexaModel 蒸馏为更小更快的规划器。(2) 统计功效不足——对 Codex 的 +1.6 分与模型进化的 +1.2 分都处于种子噪声量级,50 seeds/任务虽然不小,但任务数只有 50 个,应扩充任务覆盖并报告置信区间与显著性检验。(3) 感知是隐性瓶颈——真机两个未全成的任务(投掷积木 77.8%、叠衣 83.3%)都源于深度不可靠与臂展边缘,世界程序 $W$ 的视觉写入环节缺少不确定性建模;可在 $W$ 条目中加入深度置信度字段,低于阈值时自动触发多视角重观测。(4) 人在回路依赖——工具修改中操作员选像素、判断拒绝版本、录制人类投掷视频,尚未完全自主;可让编程智能体自动设计像素选择规则并将其纳入回归测试,把人类演示也变成可版本化工件。(5) 验证器共适应风险——当模型在验证器反馈上训练多轮后,可能过拟合评测器;除独立评测套件外,可引入对抗性红队轨迹库与周期性评测器轮换。
未来方向
作者提出的方向:权重内化——用更大规模验证轨迹训练,使模型在减少 Harness 辅助、面对留出组合任务时仍保持能力,目前只做了第一步;表示与接口进化——让系统自主发现更好的任务模式、Physical Coding 语言构件(分支、时序条件、类型化原语)、评测器与状态-动作对齐标准;自主重设计架构乃至硬件——把模型架构搜索、训练流程、传感器与机器人形态纳入同一评估门控的进化循环;面向制造与科研的真实部署——以任务完成时间、返工率、故障率、安全事故与总成本衡量,而非笼统的生产力声明;以及评测其设计的 10,000 步超长时程任务集。基于成果可延伸的方向:把 E0–E4 证据阶梯推广为社区共享的「物理编码数据集」标准;研究世界程序 $W$ 的增量一致性与冲突消解(新观测推翻旧条目时的自动仲裁与回滚);把 PhyBench 扩展到化学/生物实验流程并叠加安全门控与伦理约束;探索多智能体分工——规划智能体、验证智能体与工具编写智能体的对抗协作能否比单模型更快通过回归测试;以及把 VLA 的操作范围学习(如 Harness VLA 思路)纳入同一版本化工具框架,实现动作模型自身的在线适配。
复现评估
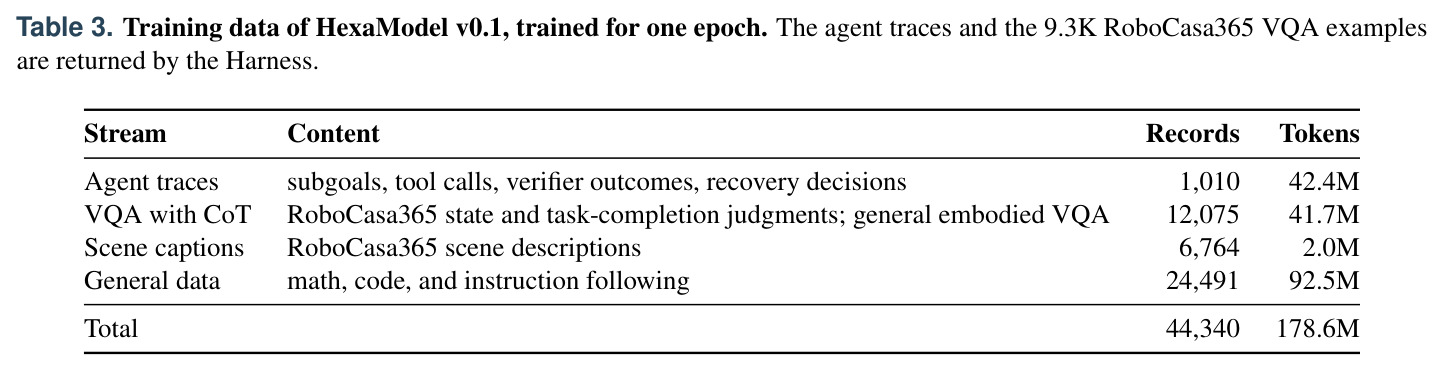
复现评估:截至阅读时论文未提供开源代码、数据或轨迹的链接(正文与摘要均未见仓库),这是复现的最大障碍。算力与依赖门槛分层明显:仿真侧需要 NVIDIA Isaac Sim(PhyBench 自建,含 240 Hz 物理与 120 Hz 双通道位移记录)以及 RoboCasa365、RoboDojo 环境,动作模型 XR-1 为已发布的 SOTA VLA;但核心结果高度依赖闭源前沿模型——规划器 GPT-5.6-Sol、GPT-6-Astra、Opus 5.5、Qwen3.8,工具编写用 Claude Fable 5.1/Opus 5,均为 API 模型,PhyBench 单次运行预算 7,200 秒墙钟与 18,000 仿真帧,API 成本可观。相对最可复现的是模型进化部分:HexaModel v0.1 是 Qwen3.8-27B 的单轮微调,共 44,340 条记录、178.6M token,训练数据配方在 Table 3 披露得很细(1,010 条智能体轨迹 42.4M token、12,075 条带 CoT 的 VQA 41.7M、6,764 条场景描述 2.0M、24,491 条通用数据 92.5M),多卡消费级集群即可承担。真机部分需要 AgileX PiPER-X 双臂平台、4 台 RealSense D435 与 URAI 工具集。总体判断复现难度中等偏高:框架思想、执行合约与数据配方可借鉴,但完整复刻需要前沿模型 API、多套仿真器与真实机器人;最值得请求作者开源的是 Harness 合约定义、类型化轨迹格式与验证器实现。
论文图表
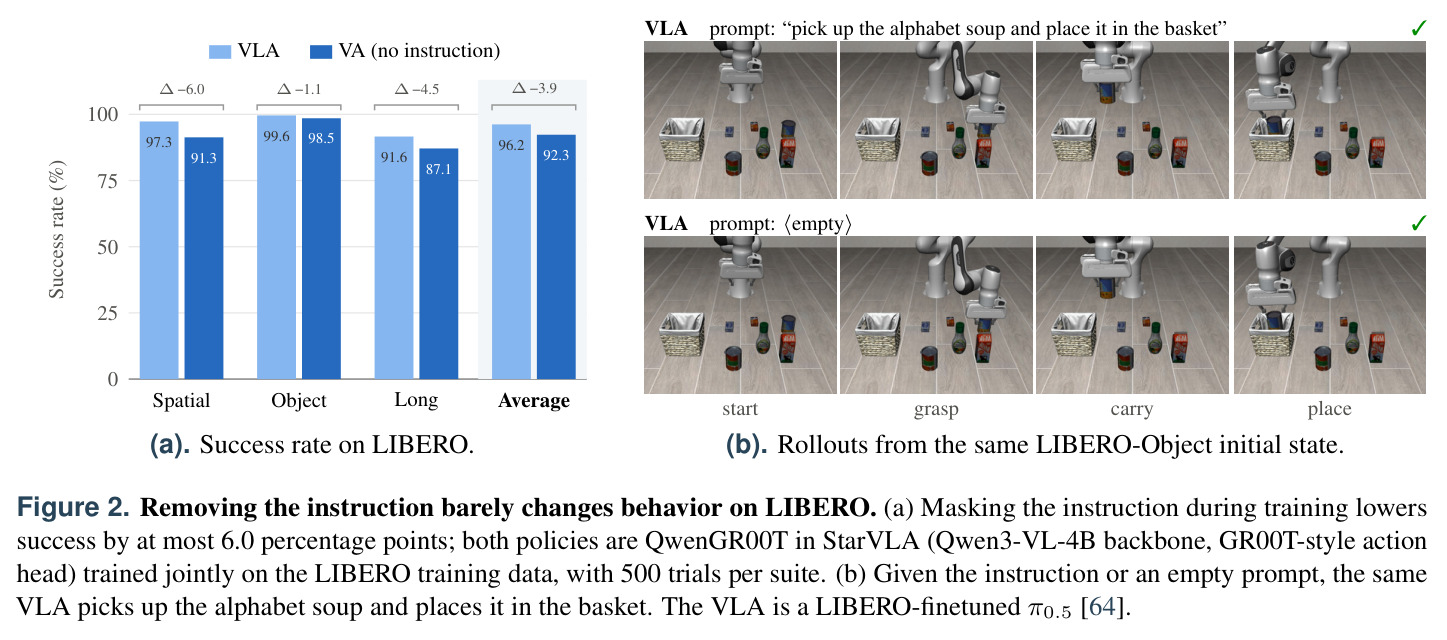
(a) LIBERO 三套件成功率柱状图:带指令训练的 QwenGR00T 平均 96.2%,指令掩蔽后平均 92.3%,最大差距 6.0 个百分点(Spatial 套件),LangForce 独立报告差值 1.1 分;(b) 同一 LIBERO-Object 初始状态下,LIBERO 微调的 π0.5 在给定指令与空提示时都完成「拿起 alphabet soup 放进篮子」。
全文动机的关键证据:动作模型对指令几乎不敏感,基准高分来自场景到轨迹的拟合,说明问题出在表示而非动作容量。