迈向带声部分配的声部感知合唱转录 Toward Part-Aware Choral Transcription with singing voice assignment
首个端到端框架 PawCT,从合唱音频联合识别 SATB 声部并分部转录音符。
前置知识
自动音乐转录(AMT)
把音频信号转换为符号化音乐表示(piano roll、MIDI、乐谱)的任务。现代方法多采用 onset/offset/frame 三通道表示:frame 表示某音高是否正在发声,onset 表示音符开始,offset 表示音符结束,再配合 onset-and-frame 解码器从概率图中恢复出离散的音符事件。
本文的输出表示、网络头设计与全部评测指标(frame F1、50/100ms onset 容差 note F1)都建立在这套 AMT 惯例之上,不理解三通道表示就看不懂方法与实验。
SATB 四声部与音域重叠
合唱按女高音 S、女低音 A、男高音 T、男低音 B 组织,典型 MIDI 音域约为 S:[60,88]、A:[55,79]、T:[48,72]、B:[40,67]。四个声部同为人声、音色几乎相同,且相邻声部音域区间大量重叠,同一时刻可能出现音高相同甚至交叉的音符,声部归属天然模糊。
音域重叠正是合唱声部分配比多乐器转录难的根本原因,也是本文范围先验 RP 与有序连续性 OC 的设计出发点。
CRNN 与高分辨率钢琴转录架构
卷积循环网络:CNN 提取时频局部特征,BiGRU 建模时序上下文,头部逐帧输出 sigmoid 概率。Kong et al. 的高分辨率钢琴转录进一步用 onset/offset 条件化 frame 预测(把 detached 的 onset/offset 拼进 frame 精修分支),显著提升音符级切分精度。
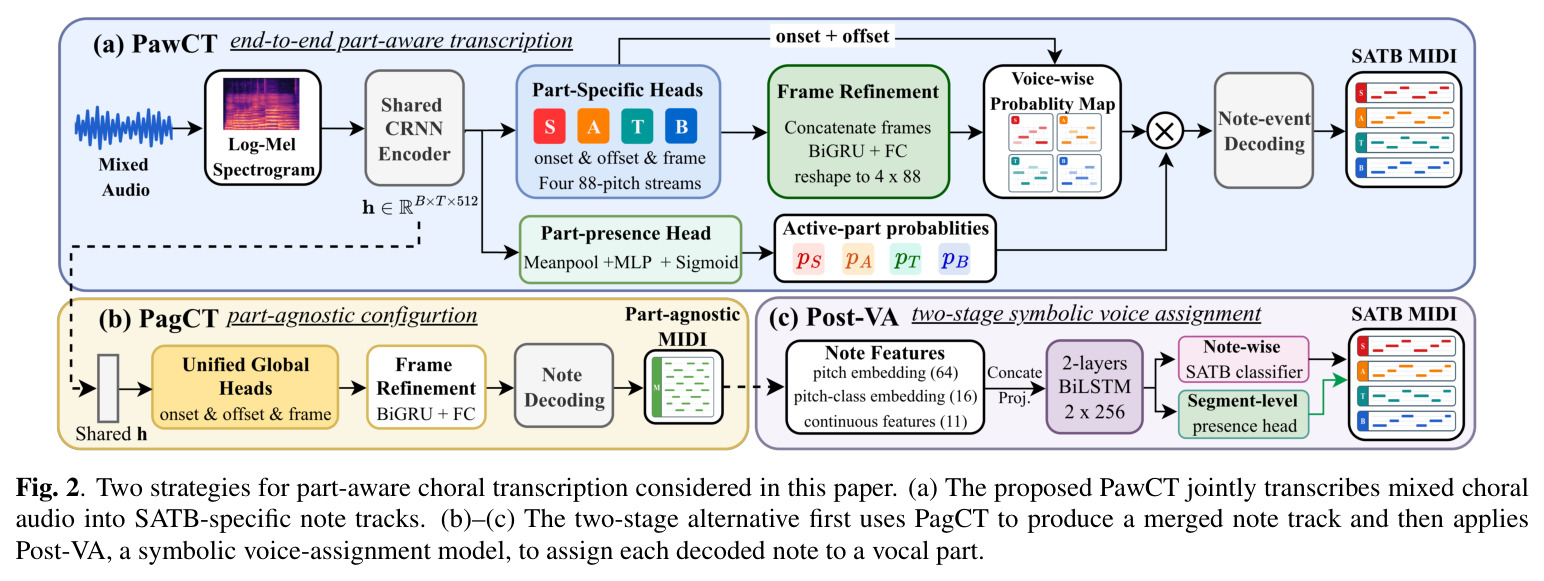
PawCT/PagCT 的主干(4 个卷积块 + BiGRU + onset/offset 拼接精修 frame)直接沿用这一范式,理解它才能看懂 Fig. 2 的架构与各消融项的含义。
声部分配(Voice Assignment)
把同时发声的音符划分到不同声部线的任务,经典线索是音高邻近与时间连续性,传统做法用 HMM 或规则,近年有神经网络在符号域(已解码的 MIDI 音符序列上)做音符级分类,例如 Dong et al. 的 automatic instrumentation 模型。
本文对比的两阶段基线 PagCT+Post-VA 正是“先转录出合并轨、再在符号域做声部分配”,理解该任务才能体会端到端联合建模的本质差异。
研究动机
合唱自动转录长期落后于钢琴等单乐器 AMT:钢琴领域有 Onsets and Frames、高分辨率钢琴模型以及 MAESTRO、GiantMIDI 等大规模配对数据集支撑,而合唱音频软起音多、音高过渡平滑,音符边界本身难以检测。更关键的是合唱按女高音 S、女低音 A、男高音 T、男低音 B 四个声部组织,四个声部同为人声、音色相近、音域大范围重叠,把并发音符分回正确声部极其困难。已有的 note-level 合唱 AMT(Yu et al., ISMIR 2024)只能输出一条合并音符轨,在 YouChorale 上 50ms onset 容差下 note F1 仅 0.237;多乐器模型 MT3、YourMT3+ 在该任务上 50ms note F1 只有 0.127。合并输出无法区分声部,满足不了合唱排练、教学和乐谱重建对分声部乐谱的实际需求。
本文的目标是本文提出并形式化“声部感知合唱转录”任务:从混合合唱音频中联合判断 S/A/T/B 哪些声部当前活跃,并把每个活跃声部分别转录成独立的音符级 MIDI 轨,最终最多输出四条带声部标签的轨道,而非一条合并轨。为此构建首个端到端神经框架 PawCT,把声部特定的 onset/offset/frame 预测、声部存在性估计、union 级监督,以及基于 SATB 音域的范围先验(RP)和有序连续性(OC)结构化训练目标结合在一起。实验目标是在主数据集 YouChorale 上同时提升两项性能:part-agnostic 音符转录质量(由变体 PagCT 承担)与 part-aware 分部转录质量(超越适配后的基线和两阶段 PagCT+Post-VA 管线),并在 CSD、Cantoría 上检验跨数据集泛化能力。
与已有工作不同的是,多乐器 AMT 之所以能输出分轨结果,是因为乐器音色差异提供了强线索(MT3、YourMT3+ 等据此做轨道指派);而合唱四个声部属于同一乐器类别,音色线索极弱,此前没有任何端到端方法把“声部识别”与“音符转录”联合建模,只能靠先转录后声部分配的两阶段管线。本文的独特切入是用“训练期累积先验”而非可微损失层或事后符号模型来构造声部化训练目标:先由基于 SATB 音域的 RP 给出粗粒度音区指派,再用 OC 在其上叠加声部内旋律连续性、时间重叠与跨声部音高排序约束,从真值标注直接生成结构化监督信号;同时用 union 级全局监督兜底,保证声部指派不确定时音高内容不被丢弃。
核心方法
PawCT 的直觉是:与其先转录出一条合并轨再事后分配声部,不如让网络直接从混合音频中“按声部听”。架构继承高分辨率钢琴转录:输入 16kHz 音频的 229-bin log-Mel 频谱(NFFT=2048、hop=160),经四个卷积块(每块两层 3×3 卷积+BN+ReLU、频率维平均池化)编码,投影后接两层双向 GRU(每向 256),得到帧对齐表示 $h\in\mathbb{R}^{B\times T\times 512}$。随后 S/A/T/B 四个声部各有一组 sigmoid 头,在 88 个 MIDI 音高上输出 onset、offset 与初步 frame 概率;初步 frame 与全部声部 detach 后的 onset/offset 拼接,经一层 BiGRU 精修并线性映射到 $V\times P=4\times 88$ 维的声部分 frame 概率。并行的声部存在性头对 $h$ 做时间平均池化,过两层 MLP(256、4 维)输出 sigmoid 门控,把不活跃声部的三路预测全部置零,使其解码为空 MIDI 轨。
核心创新是用“训练期累积先验”把声部结构注入训练目标,而非可微损失层。范围先验 RP 按音域逐音符指派,代价 $C_{RP}(e,v)=\max(0,l_v-p_e)+\max(0,p_e-u_v)+0.25|p_e-m_v|/12+\lambda_{part}\mathbb{1}(v\neq v_{src})$,音域 S:[60,88]、A:[55,79]、T:[48,72]、B:[40,67]。OC 在 RP 上加声部内旋律连续性与重叠惩罚 $C_{OC}=C_{RP}+\lambda_{cont}|p_e-\tilde p_v|/12+\lambda_{ov}\mathbb{1}(t_{one}<\tilde t_{off_v})$,对 onset 帧内至多 4 个音符按音高降序做保序一对一最优指派 $A_t^*=\arg\min\sum_{e\in G_t}C_{OC}(e,A_t(e))$。union 监督对各声部预测 max-pool 后与合并真值比对,防止指派不确定时丢音符。这与两阶段 PagCT+Post-VA 本质不同——后者仅做符号域分类,无法恢复漏检或碎片化事件。
方法步骤详情
①特征:16kHz 音频 → 229-bin log-Mel(NFFT=2048,hop=160)。②编码:4 个卷积块 + 投影 + 两层 BiGRU(256/向)得 $h$。③预测:每声部头输出 88 音高 onset/offset/初步 frame。④精修门控:初步 frame 与 detach 的 onset/offset 拼接,经一层 BiGRU + 线性层输出 4×88 精修 frame;presence 头(池化 + MLP 256→4)门控,非活跃声部输出空轨。⑤损失:RP/OC 从真值构造声部化目标,$\mathcal{L}=\mathcal{L}_{voice}+\mathcal{L}_{union}+0.2\mathcal{L}_{pres}$,先验参数 $(\lambda_{part},\lambda_{cont},\lambda_{ov})=(2,0.35,4)$。⑥训练解码:±1–3 半音移调增强扩容 7 倍(129.6 小时);AdamW、batch 8、lr $10^{-4}$、200k 迭代、30k 早停;解码阈值 0.03/0.01/0.005。
技术新颖性
技术新颖性体现在四点。其一,任务层面首次端到端求解 part-aware 合唱转录,此前最接近的只有 pitch 级多 F0/声部线估计和产生合并轨的 note-level 模型。其二,RP/OC 以离散最优指派的方式在训练前构造声部化目标,避免了可微指派层的优化困难,属于“先验进目标、不改架构”的轻量设计;OC 的 onset 组内保序一对一指派($|G_t|\le 4$,超组退化为独立最小成本指派)把跨声部音高排序这一音乐学约束编码进监督。其三,union 级监督用 max-pool 桥接声部级与全局目标,消融显示它把 macro note F1 从 0.190 提到 0.217,是纯声部监督在歧义场景下的有效正则。其四,对照系统的 Post-VA 是符号域 BiLSTM 音符级分类器(64 维音高嵌入 + 16 维音高类嵌入 + 11 个连续特征投影到 192 维,两层 BiLSTM 256/向 + 4 类头),作为两阶段基线凸显了联合建模利用声学证据的优势。
实验结果
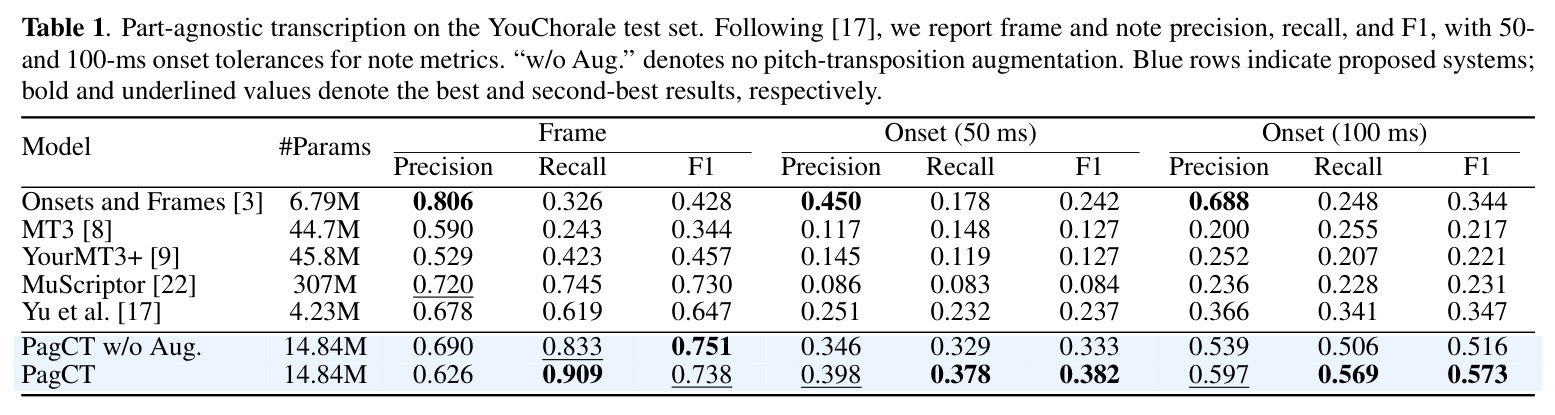
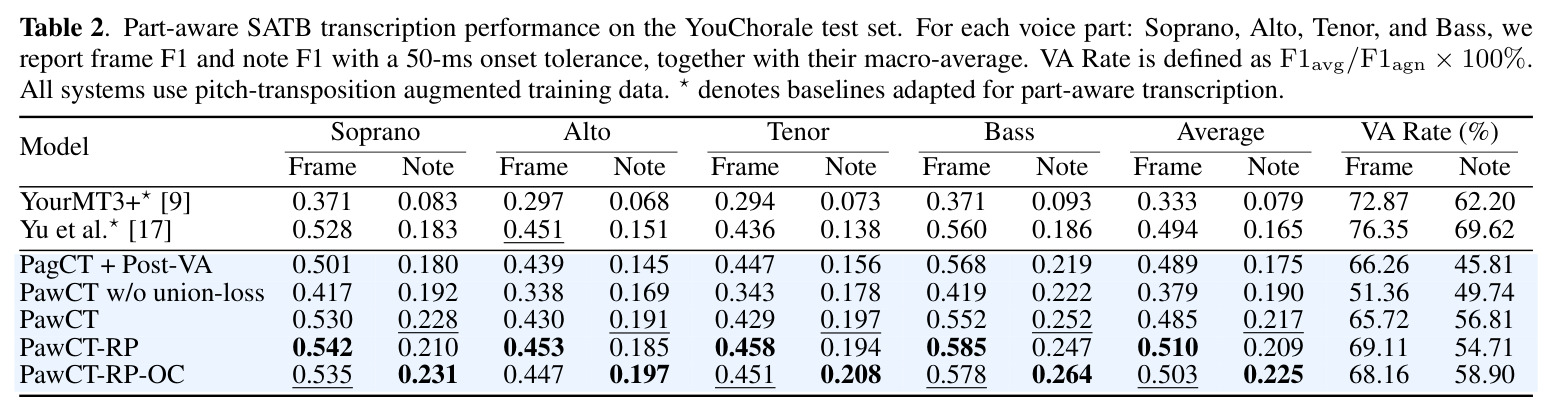
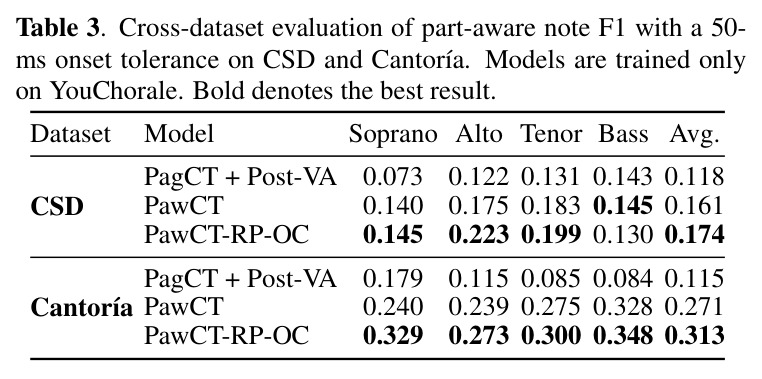
三组实验支持联合建模。①part-agnostic(Table 1):PagCT(14.84M)在 YouChorale 上 50ms note F1 0.382、frame F1 0.738,较此前 SOTA(Yu et al. 0.237)提升 61.2%;MuScriptor 帧级 0.730 但 note 仅 0.084(跟踪好≠切分好)。②part-aware(Table 2):PawCT-RP-OC macro note F1 0.225,高于 Yu et al. 适配版 0.165(+36.4%)、YourMT3+ 0.079 与两阶段管线 0.175;消融:去 union loss 降至 0.190,RP 升帧级 0.510 但 note 降 0.209,加 OC 恢复 0.225,Bass note 最高 0.264,VA Rate 45.81%→58.90%。③跨数据集(Table 3):CSD/Cantoría 上 PawCT-RP-OC 达 0.174/0.313、PawCT 0.161/0.271,均高于 Post-VA(0.118/0.115)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 合唱音符级转录(part-agnostic,YouChorale 测试集) | 50ms onset 容差 note F1 | 0.382(PagCT,带移调增强;100ms 为 0.573) | 0.237(Yu et al., ISMIR 2024,此前 SOTA;100ms 0.347) | 相对提升 61.2% |
| part-aware SATB 分部转录(YouChorale 测试集) | macro part-aware note F1(50ms onset 容差) | 0.225(PawCT-RP-OC,frame F1 0.503) | 0.165(适配的 Yu et al.)/ 0.175(PagCT+Post-VA)/ 0.079(适配 YourMT3+) | 相对最强基线提升 36.4% |
| 跨数据集 part-aware 转录(CSD) | 平均 part-aware note F1(50ms) | 0.174(PawCT-RP-OC) | 0.118(PagCT+Post-VA) | 相对提升约 47% |
| 跨数据集 part-aware 转录(Cantoría) | 平均 part-aware note F1(50ms) | 0.313(PawCT-RP-OC) | 0.115(PagCT+Post-VA) | 相对提升约 172% |
局限与改进
局限明显。首先绝对性能仍低:最强的 PawCT-RP-OC 在 YouChorale 上 macro note F1 也只有 0.225,跨数据集 CSD 降到 0.174,离实用尚远。作者承认 RP 只提升帧级(0.510)却降低音符级(0.217→0.209),说明静态音域先验无法解决 SATB 音域重叠处的指派歧义。Cantoría(0.313)明显好于 CSD(0.174),作者归因于录音与标注协议差异,暴露出对域偏移敏感;且推理阈值在 YouChorale 验证集选定后跨数据集固定,缺少解码校准。我的补充观察:训练数据仅 22 小时 25 分钟 a cappella 合唱,未覆盖带伴奏场景;YouChorale 中 92.48% 为完整 SATB,稀疏声部场景训练不足;OC 假设每个 onset 组至多 4 个音符且音高可排序,密集和声处会退化;硬性 presence 门控可能在声部中途休止再进入时整体丢失该声部。
独立分析的弱点
弱点一:RP/OC 是人工设计的静态规则,S:[60,88]、A:[55,79] 等区间覆盖不了假声男高音、童声或跨声部交叉演唱,越界演唱会在训练目标层面引入系统性错误;改进方向是学习数据驱动的软音域分布(如每声部拟合高斯混合)或让指派先验可学习。弱点二:OC 的保序一对一指派仅在 $|G_t|\le 4$ 时可行,超过四个并发音符退化为独立最小成本指派,丢失全局一致性;可换成 Sinkhorn/可微最优传输,把声部指派当作潜在变量端到端训练。弱点三:跨域性能骤降(CSD 0.174)且阈值跨数据集固定,解码未校准;应引入域自适应、测试时阈值搜索或置信度校准。弱点四:presence 头是片段级硬门控,声部中途进出时可能整轨丢失;可改为帧级或软门控并与 onset 证据耦合。弱点五:架构假定固定 SATB 四声部,无法处理三声部、五声部等开放编制;可推广为可变声部数的集合预测并用匹配损失训练。
未来方向
作者明确提出的方向是域适应与解码校准,以缓解 CSD 上的性能下降。在此基础上有多条可延伸路线:把 OC 的离散指派替换为可微最优传输或结构化预测层,让声部指派与转录真正端到端可导;将歌声分离(多轨合唱源分离)作为前置或联合模块,引入音色线索缓解声部歧义;在 CSD、Cantoría、Dagstuhl ChoirSet 等多语料上做联合训练或伪标签自训练;把 ±1–3 半音移调增强扩展到音高、混响、麦克风格联合增强;下游可探索合唱排练与教学应用,例如用分部 MIDI 做跟唱评估、错音检测与乐谱自动重建;还可把 presence 估计推广到开放声部数与带伴奏合唱,并在更严格容差与 offset 精度上完善评测协议。
复现评估
复现条件较好。代码与 demo 开源于项目主页 https://hanyu-meng.github.io/Paw_Choral_AMT_Demo/。主数据集 YouChorale 公开(22 小时 25 分钟、452 段录音、261 首歌,92.48% 含完整 SATB),CSD 与 Cantoría 也可公开获取,Post-VA 用 YouChorale 训练集真值音符加声部标签训练。模型仅 14.84M 参数,单卡即可训练:AdamW、batch 8、lr $10^{-4}$、至多 200k 迭代(30k 早停);离线移调增强把数据扩到约 129.6 小时,需要一定预处理与磁盘开销;Post-VA 至多 80 epochs、batch 32、patience 10。论文给出全部超参(损失权重 (1,2,1) 与 (1,1,1)、$\lambda_{pres}=0.2$、$(\lambda_{part},\lambda_{cont},\lambda_{ov})=(2,0.35,4)$)和推理阈值 0.03/0.01/0.005。总体复现难度中等偏低,主要成本在数据下载与增强预处理。
论文图表
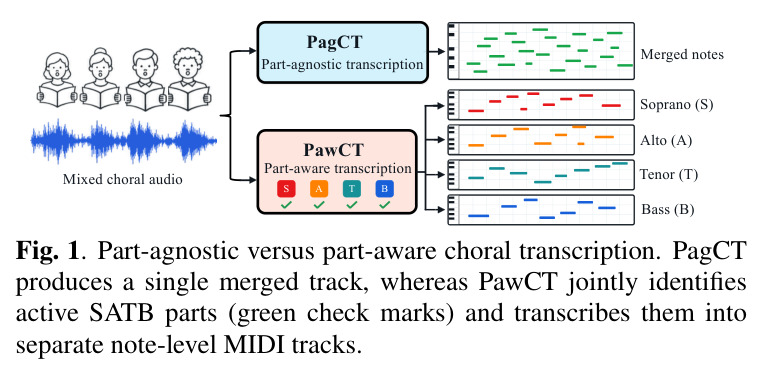
对比图:上半部分是 part-agnostic 转录(PagCT),把混合合唱音频转录成一条合并音符轨,不区分声部;下半部分是本文的 part-aware 转录(PawCT),先用绿色对勾标出当前活跃的 S/A/T/B 声部,再把各活跃声部分别转录成独立的音符级 MIDI 轨。
一图说清论文要解决的任务定义与新 setting 的差别,是理解全文动机(合并轨无法用于排练/教学/乐谱重建)的最直接入口。