SheetSage2:基于合成监督的连贯主旋律谱音频转录 SheetSage2: Coherent Lead-Sheet Transcription with Synthetic Supervision
MIDI合成监督+结构化解码+自回归蒸馏,从音频直接转录连贯完整的主旋律谱
前置知识
主旋律谱(Lead Sheet)
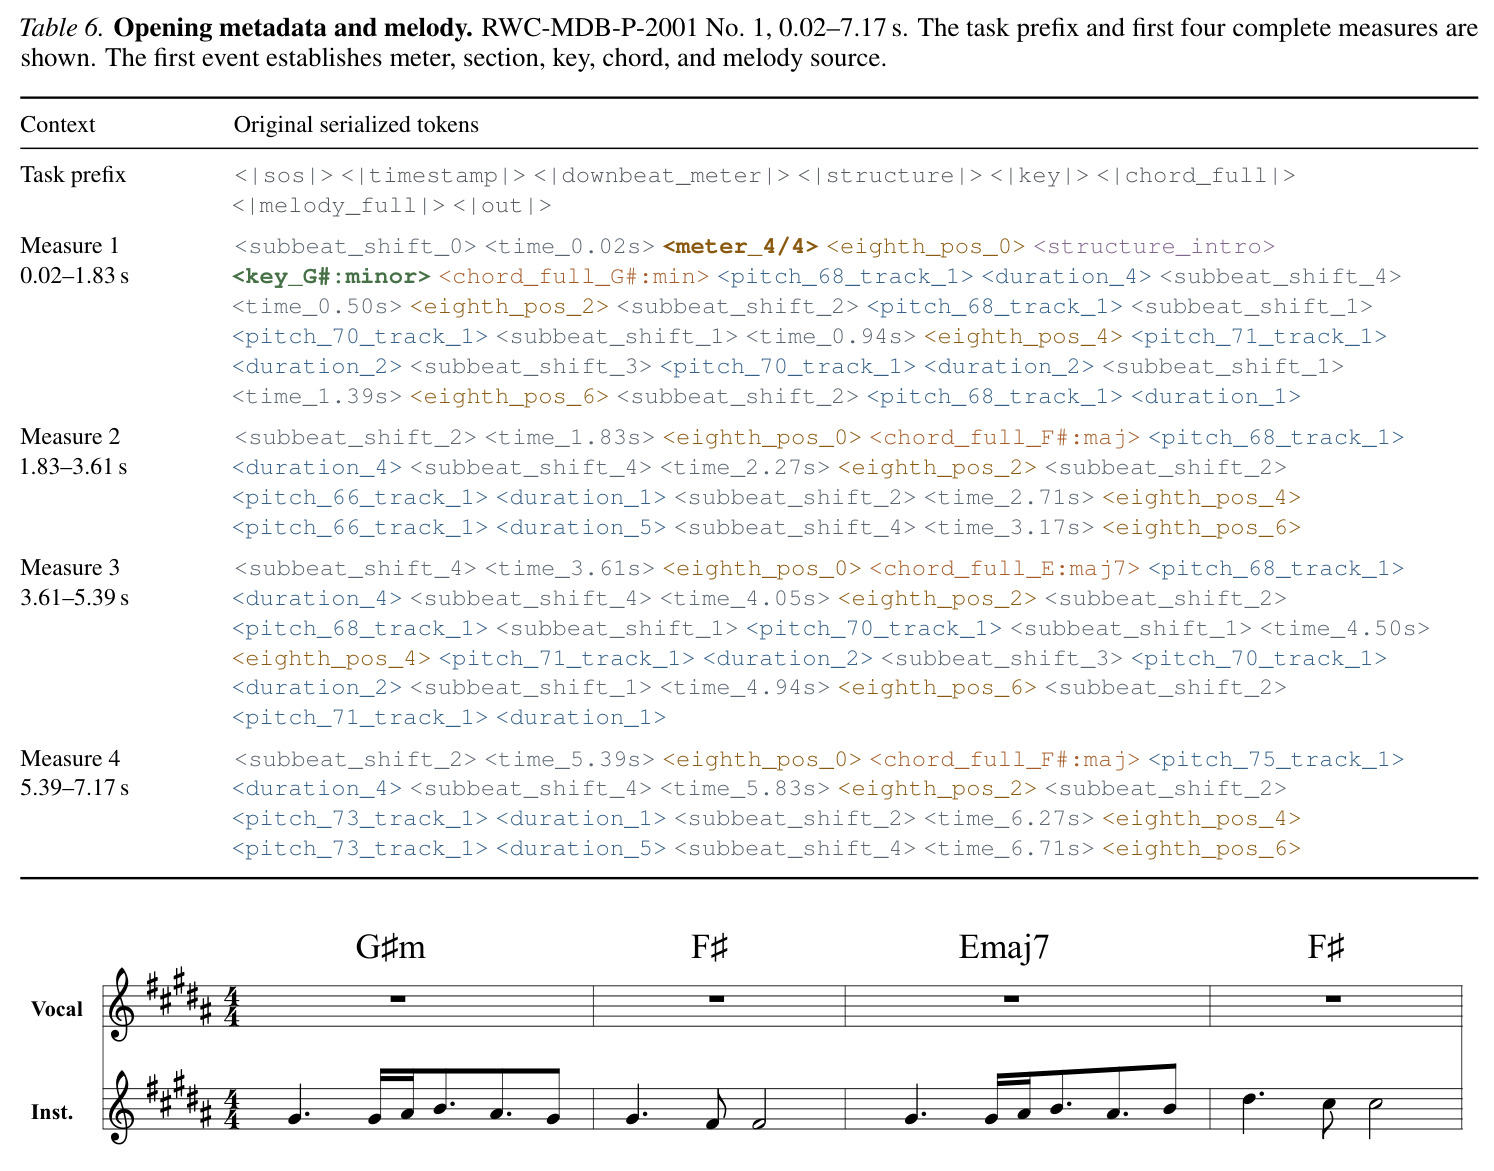
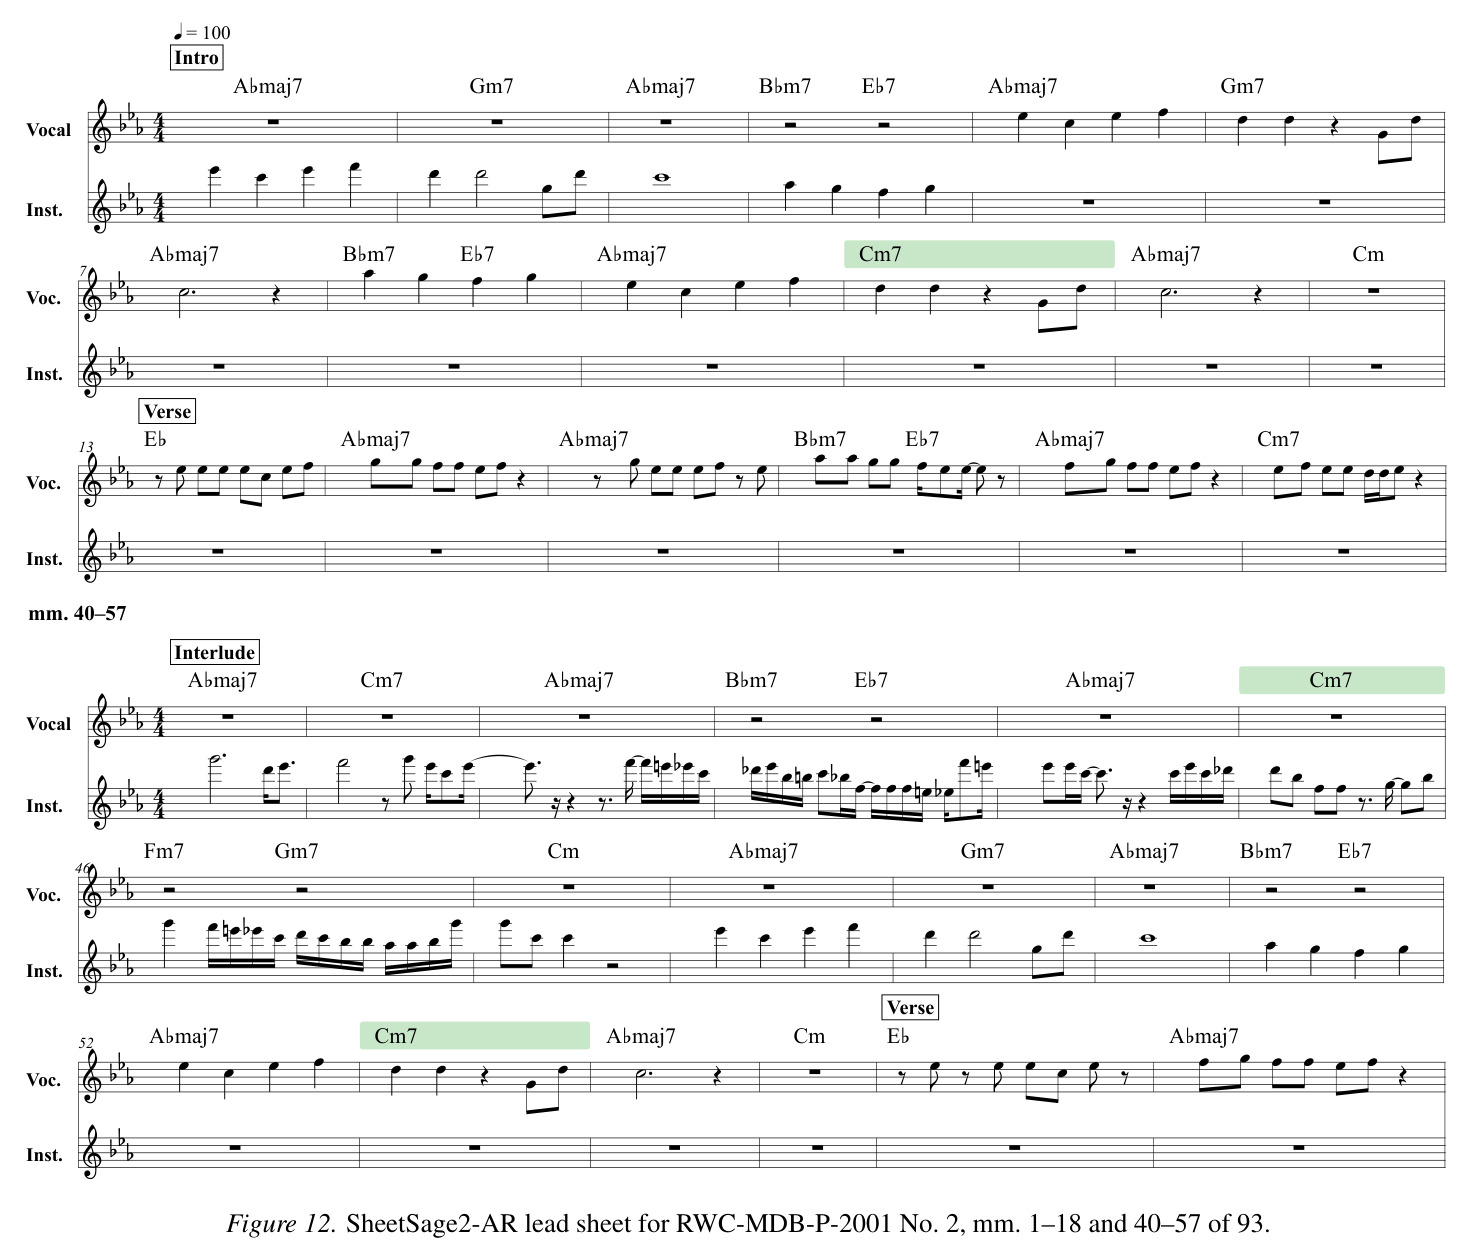
一种紧凑的乐谱表示:单行旋律加和弦符号、调号、拍号、速度和段落标记(主歌/副歌等),是爵士与流行乐手即兴演奏的标准"菜单"。它同时编码节奏(音符位置与时值、小节线、拍号)、和声(和弦与调性)、旋律与曲式四个维度。
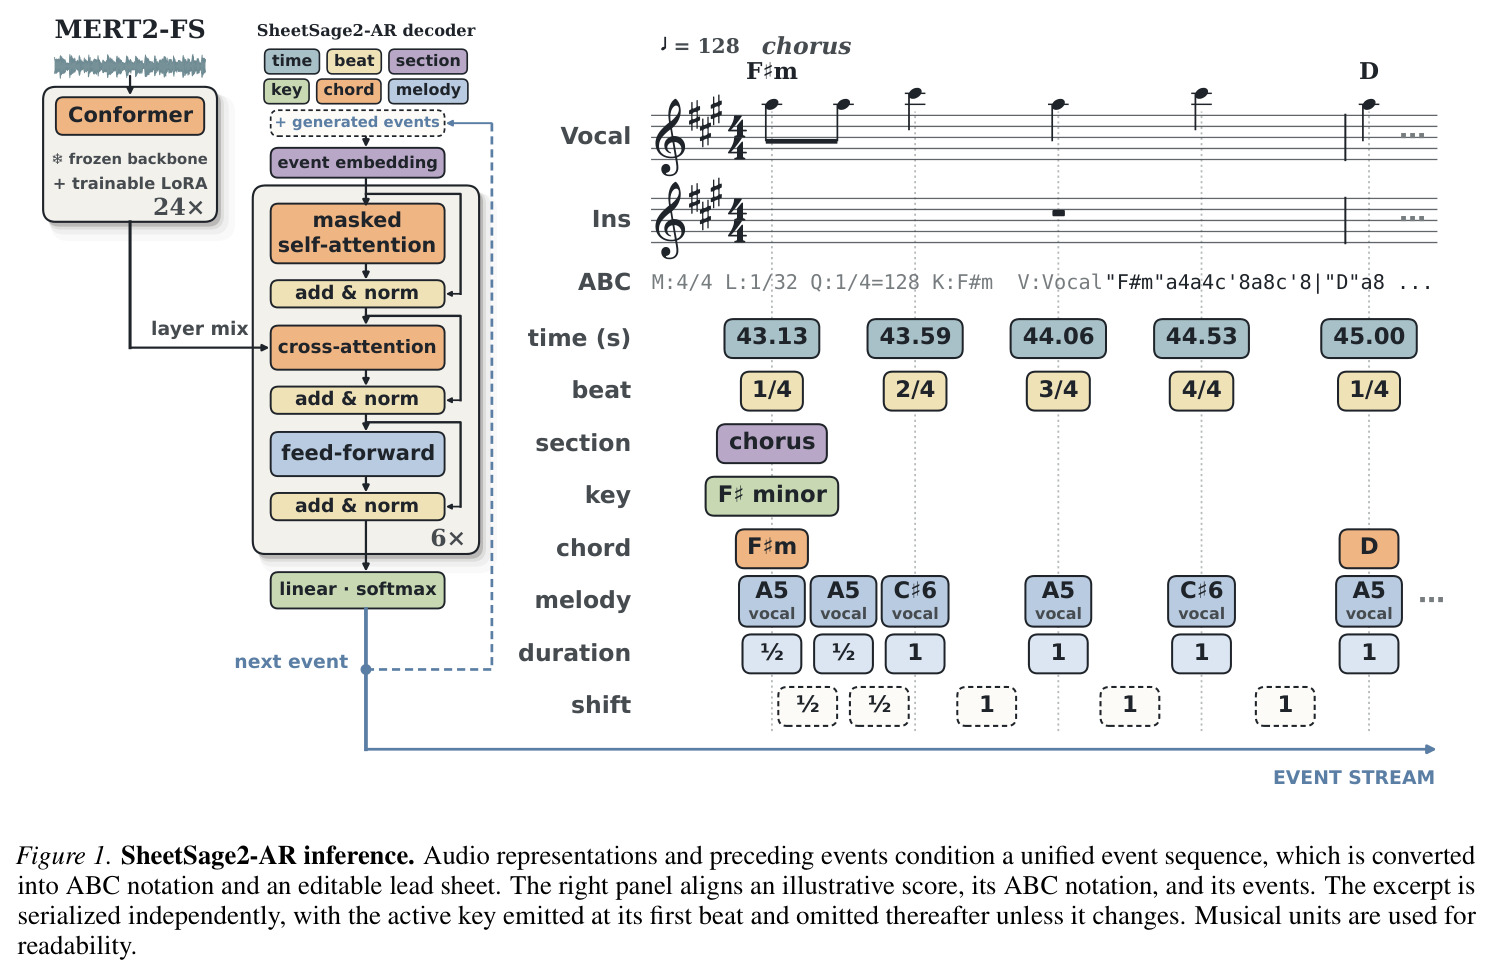
本文的目标输出就是主旋律谱,读懂统一事件语言(time/beat/chord/key/melody token)如何映射为 ABC 乐谱,是理解方法与 Figure 1 的前提。
MIDI 与合成监督
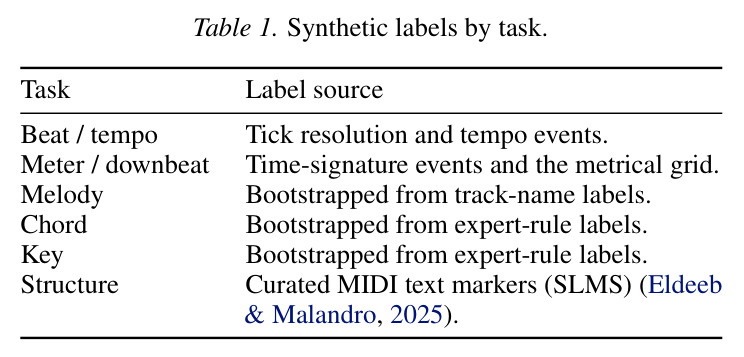
MIDI 是符号化音乐格式,显式记录音符音高、时值、乐器与时间。用软音源(如 FluidSynth + SoundFont)把 MIDI 渲染成音频,即可获得时间完美对齐的"音频-标签"配对,绕开人工标注瓶颈,这被称为合成监督。
本文核心数据策略就是把 40 万级无标注 MIDI 先自动打标签、再渲染成音频当训练集,理解 MIDI 渲染是理解其可扩展性的关键。
帧级预测与结构化解码(DP/HMM/DBN)
MIR 系统常先用神经网络输出每帧各类别的概率,再用序列模型(维特比式动态规划、HMM、DBN、CRF)把帧级概率转成满足硬约束的离散标签序列,例如拍位置必须周期出现、调号变化只能发生在小节线。
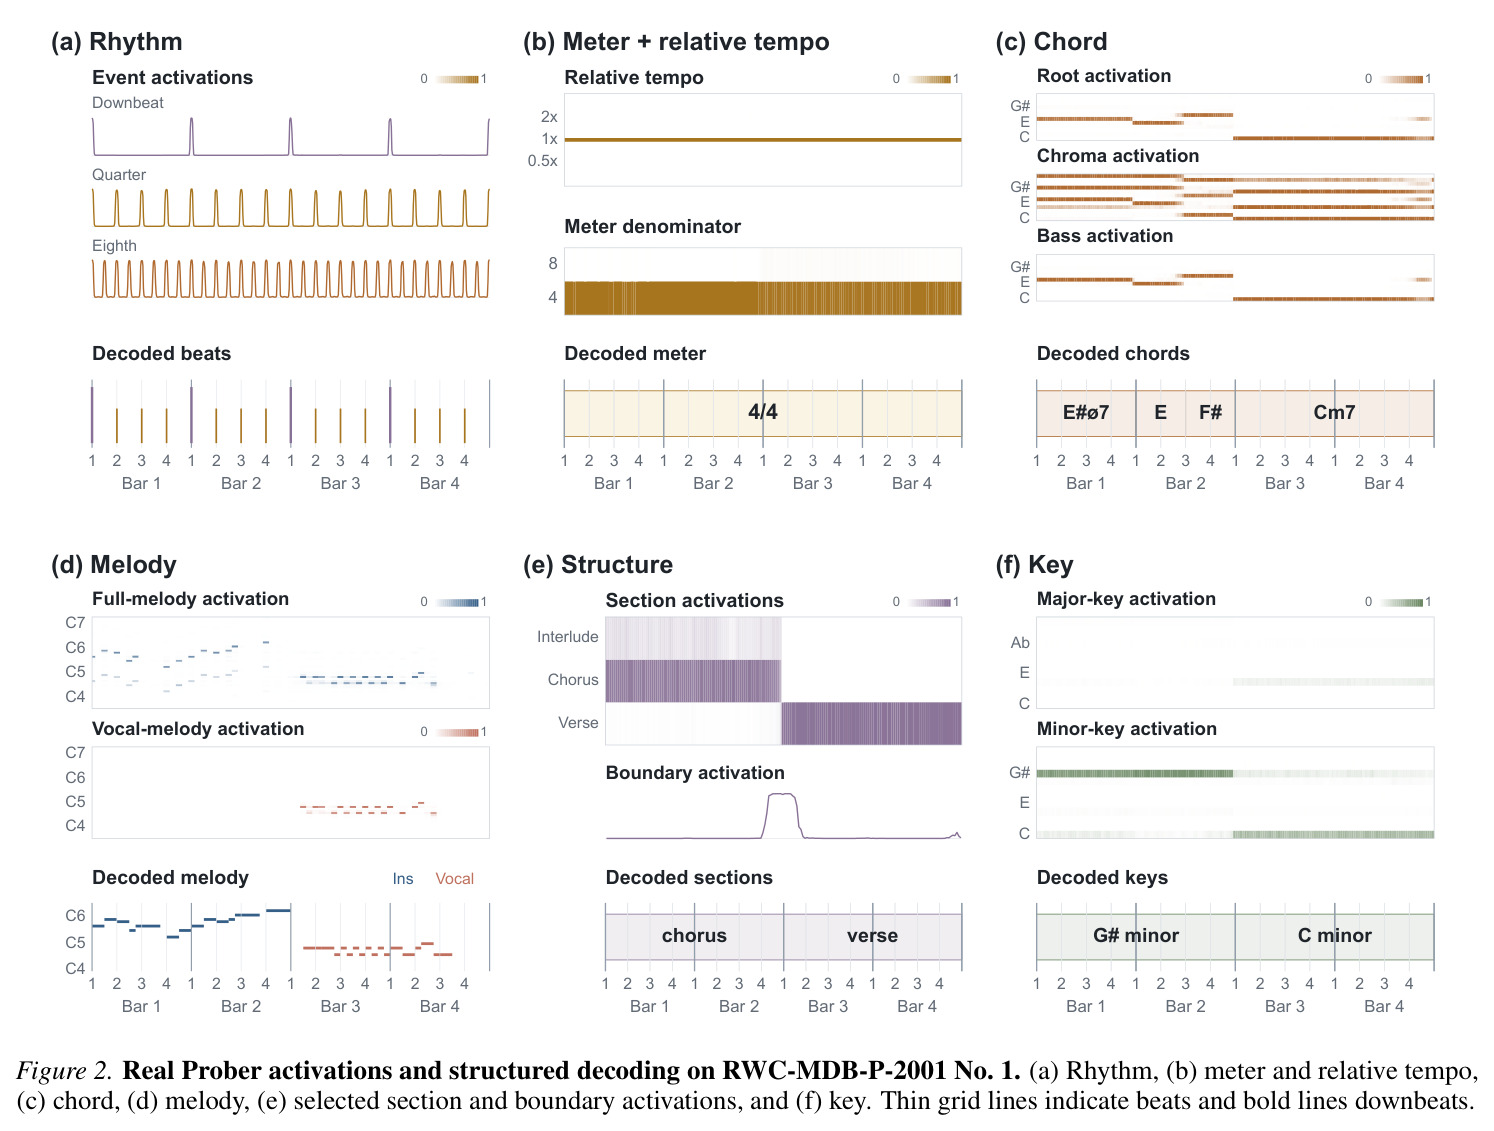
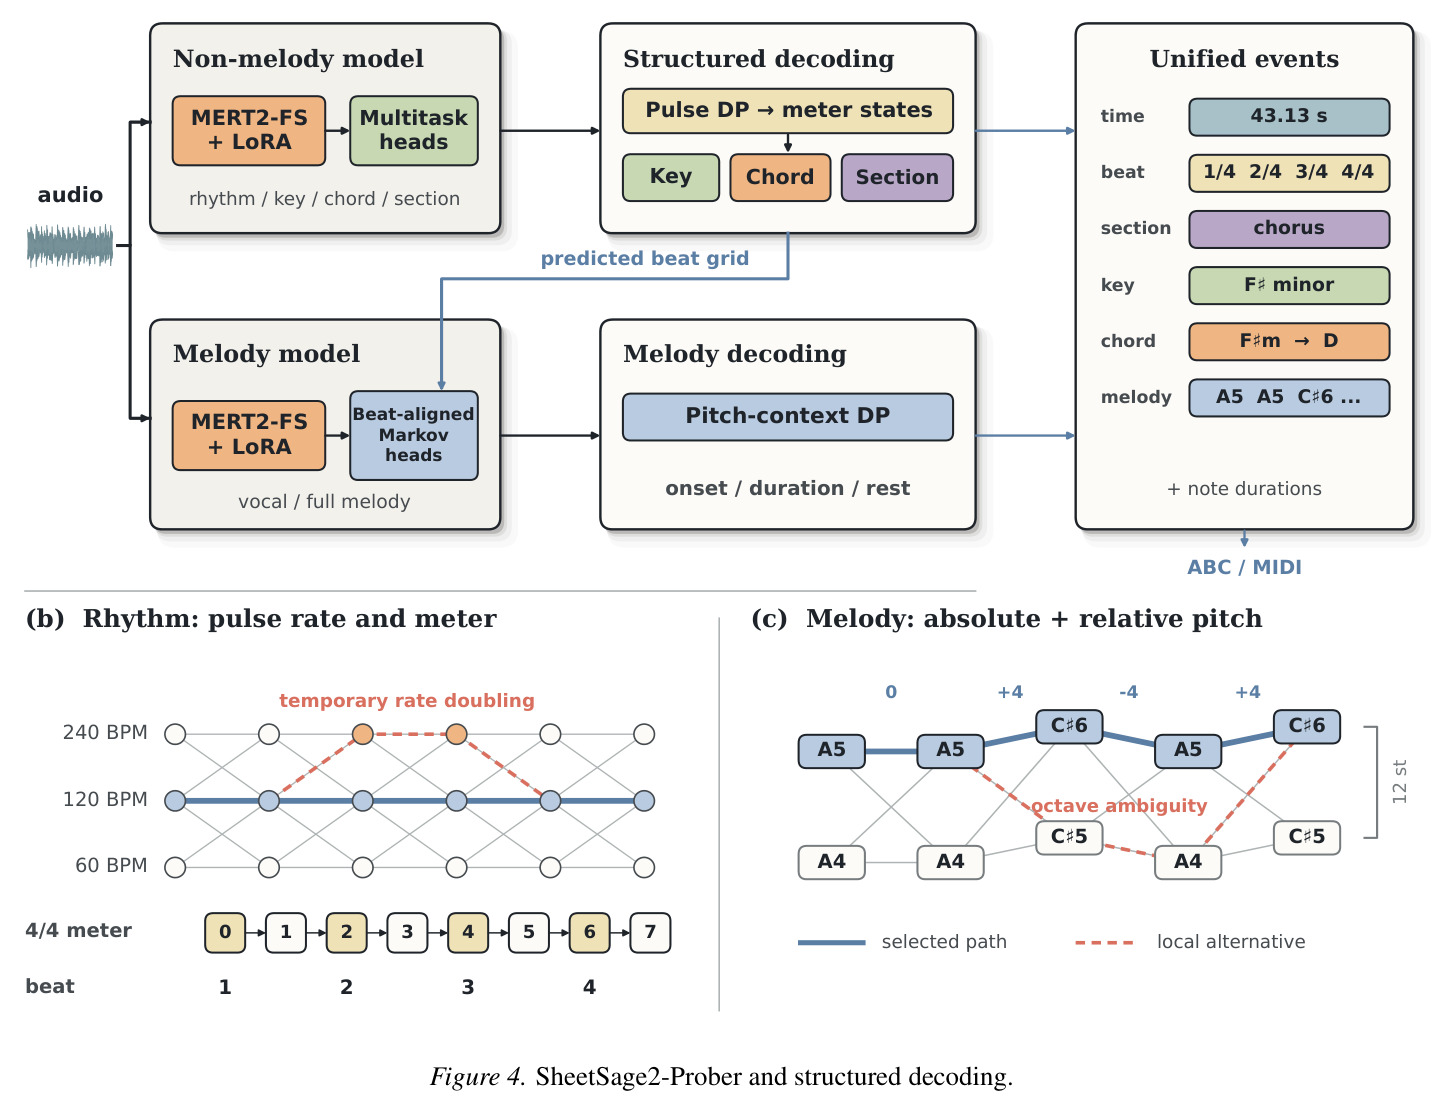
SheetSage2-Prober 的六阶段结构化解码(速度锚点→脉冲→小节→调/段落→和弦→旋律)是全文方法核心,全部由动态规划递推实现(附录 C)。
MERT 音频基础模型与 LoRA 适配
MERT 是在大规模无标注音乐上自监督预训练的音乐理解编码器;LoRA 在冻结主干旁边挂低秩可训练矩阵(本文 rank 64、α=128),用极少量参数把通用表示适配到具体任务,避免全量微调的开销。
SheetSage2 的三个声学模型(非旋律 Prober、旋律 Prober、AR 解码器)全部基于冻结的 MERT2-FullSong 编码器加各自的 LoRA 副本。
自回归事件语言与序列级蒸馏
把乐谱编码成一个事件 token 序列,自回归解码器逐 token 预测 $p_\theta(y_n \mid y_{<n}, x)$;序列级知识蒸馏(Kim & Rush, 2016)用教师模型输出的完整序列作为学生的硬训练目标,让学生推理时不再需要教师的复杂流程。
SheetSage2-AR 只在 Prober 结构化解码出的事件序列上训练,学会了一致性先验,推理时免去全部任务专用动态规划。
节拍层级与速度歧义
同一段音乐可以在 1×、2×、½× 等不同节拍层级上解释(如 80 vs 160 BPM),且都貌似合理。转录系统若在同一首歌中途切换层级,相同乐段会得到不同的节拍网格和记谱时值,直接破坏乐谱可读性。
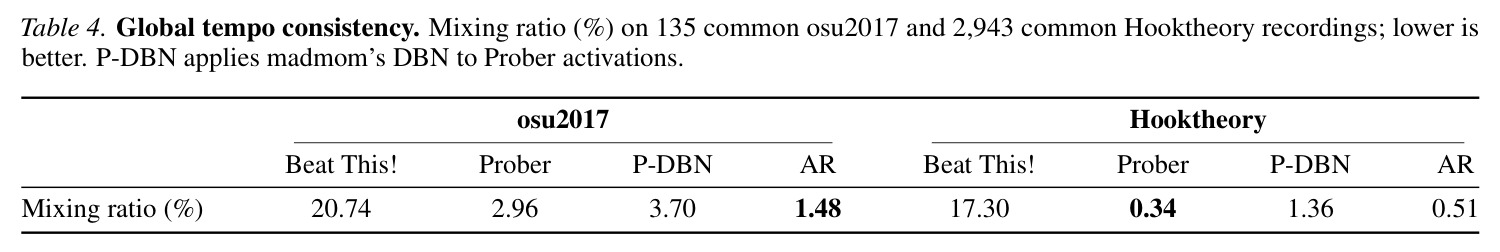
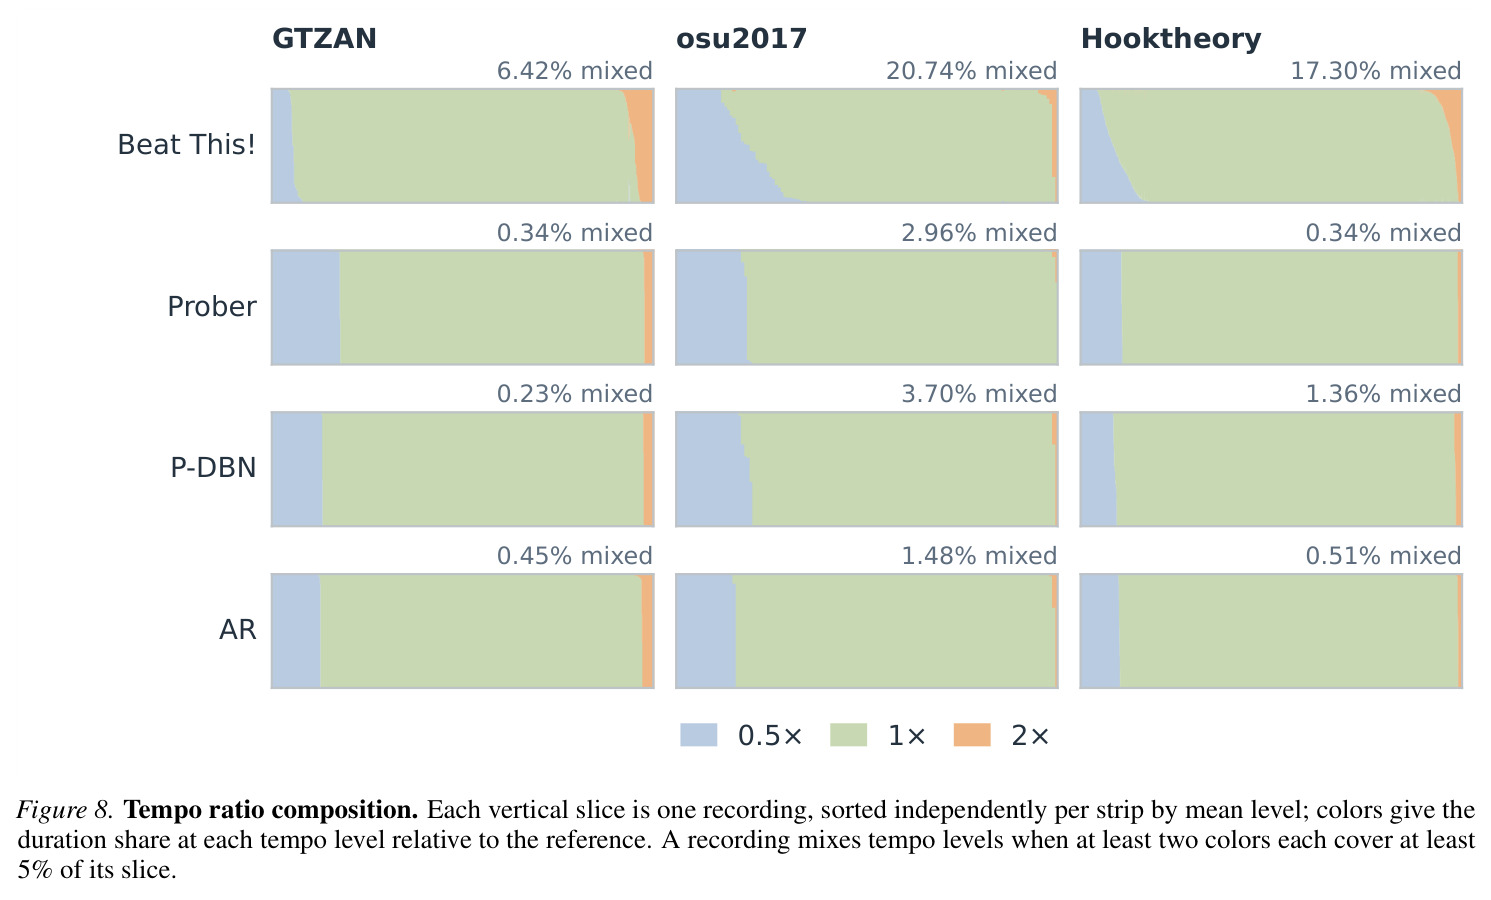
论文专门设计全局速度锚点解码解决此问题,并定义了混层率(mixing ratio)这一新指标来量化它,这是实验部分的关键证据链。
研究动机
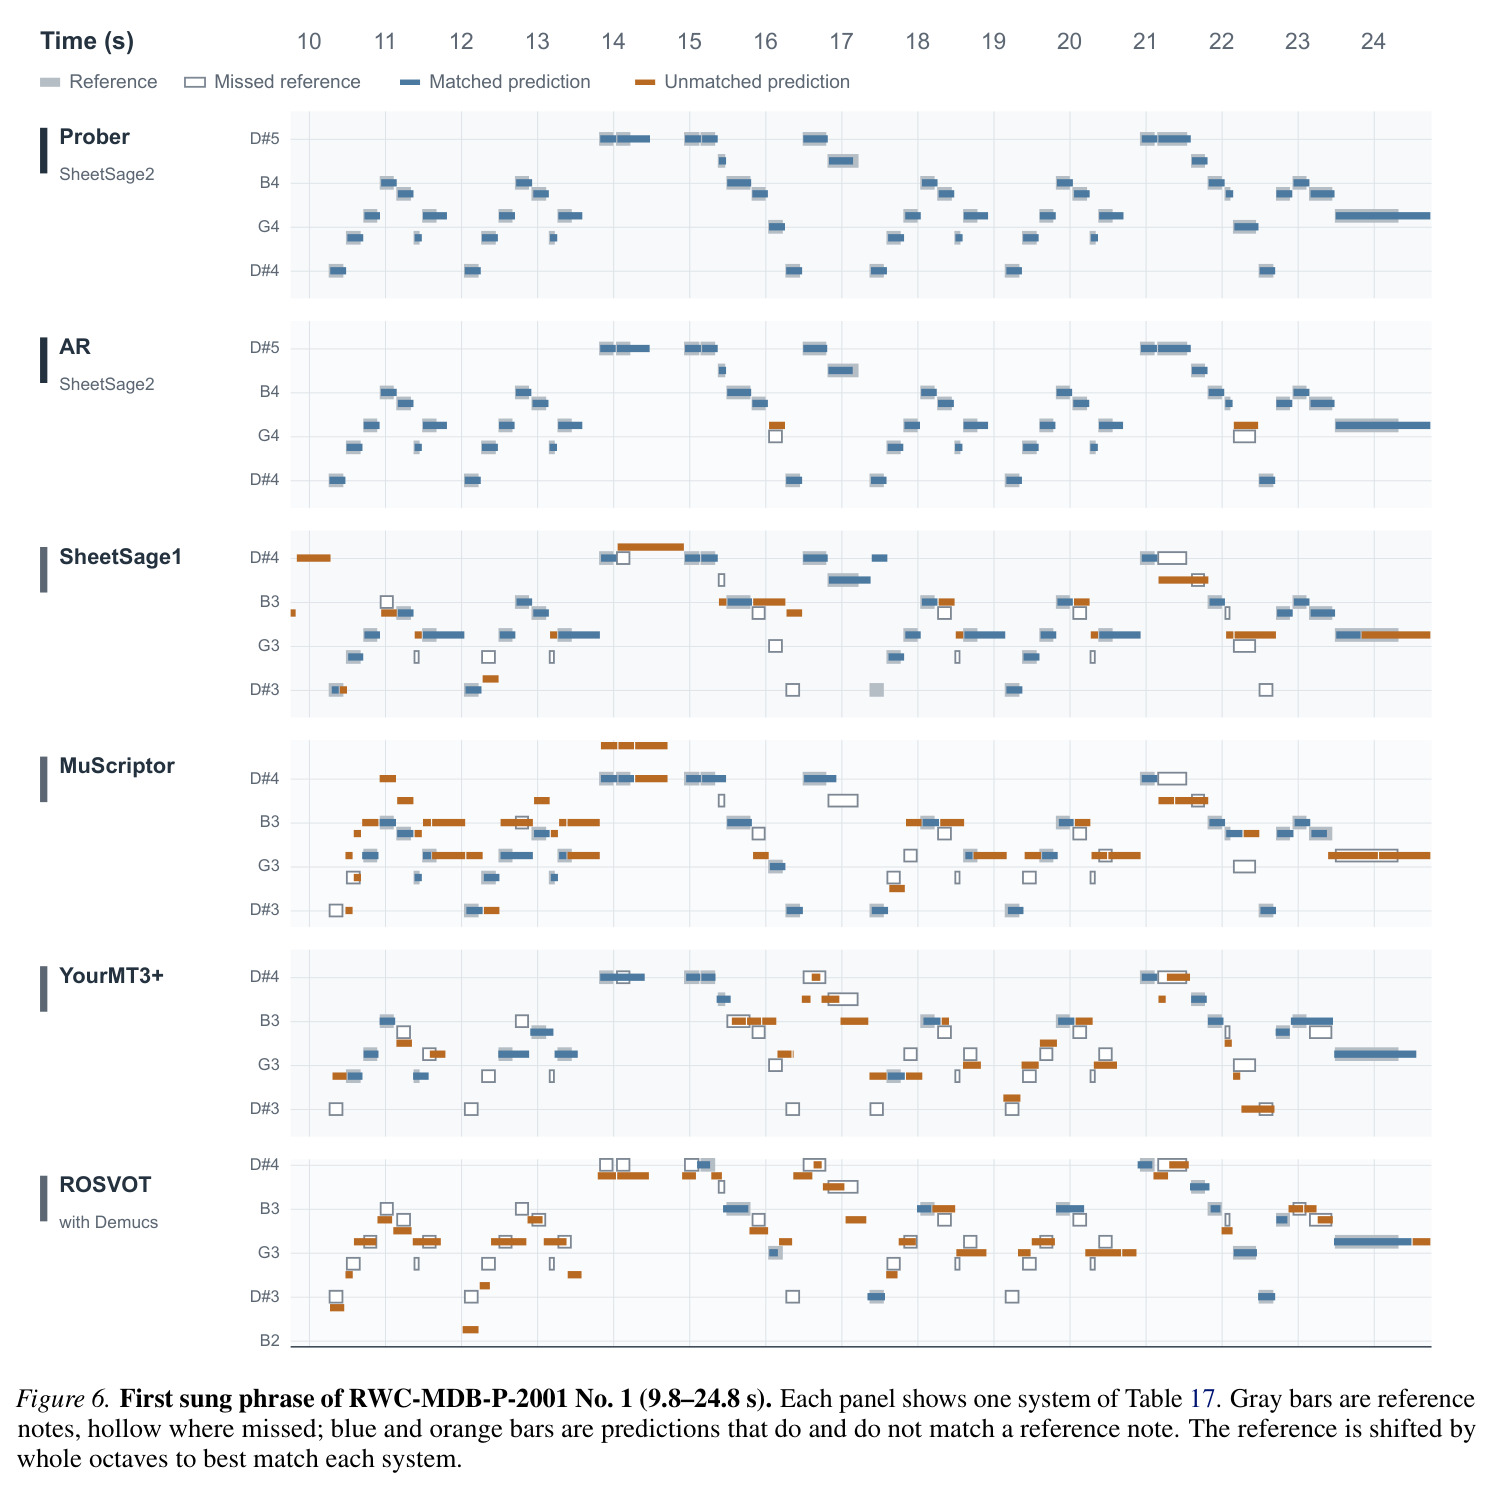
主旋律谱转录面临两大障碍。其一是标注稀缺:现有 MIR 数据集往往只标注部分属性(节拍、和弦、调性或旋律),而非完整主旋律谱,且已有标注的时间也不精确(人工敲击的节拍标注可偏差数十毫秒,超过系统 10 毫秒的输出分辨率);带精选和弦/旋律标注的资源极小,如 RWC-Pop 仅 100 首歌。MIDI 文件自带的高层标签同样缺失或不可靠:Raffel & Ellis 报告 Beatles MIDI 的 MIREX 加权调性得分仅 0.400,剔除 C 大调元数据污染后也只有 0.842,仍低于人工精选标注。其二是"局部正确、全局不一致":一段音乐可在不同速度层级上解释,当鼓声只出现在第二个主歌时,逐帧预测可能在前半段判 80 BPM、后半段跳到 160 BPM,导致两个节奏内容相同的乐段被记成不同时值;旋律提取器也常混淆八度,把 C4–E4–G4 记成 C5–E4–G4(Hooktheory 标注只给相对八度,无法校正)。这些不一致使各任务独立预测的简单聚合无法产出人类可读的乐谱。
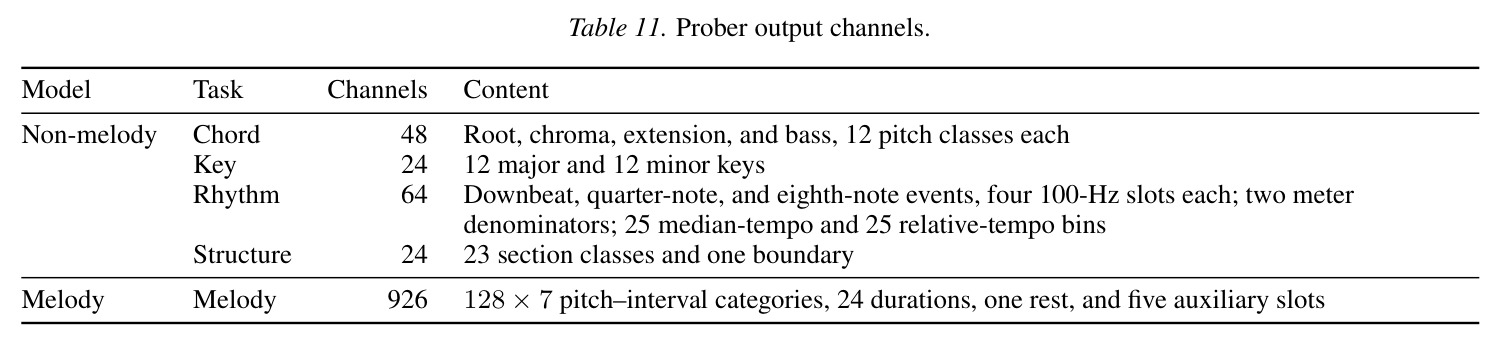
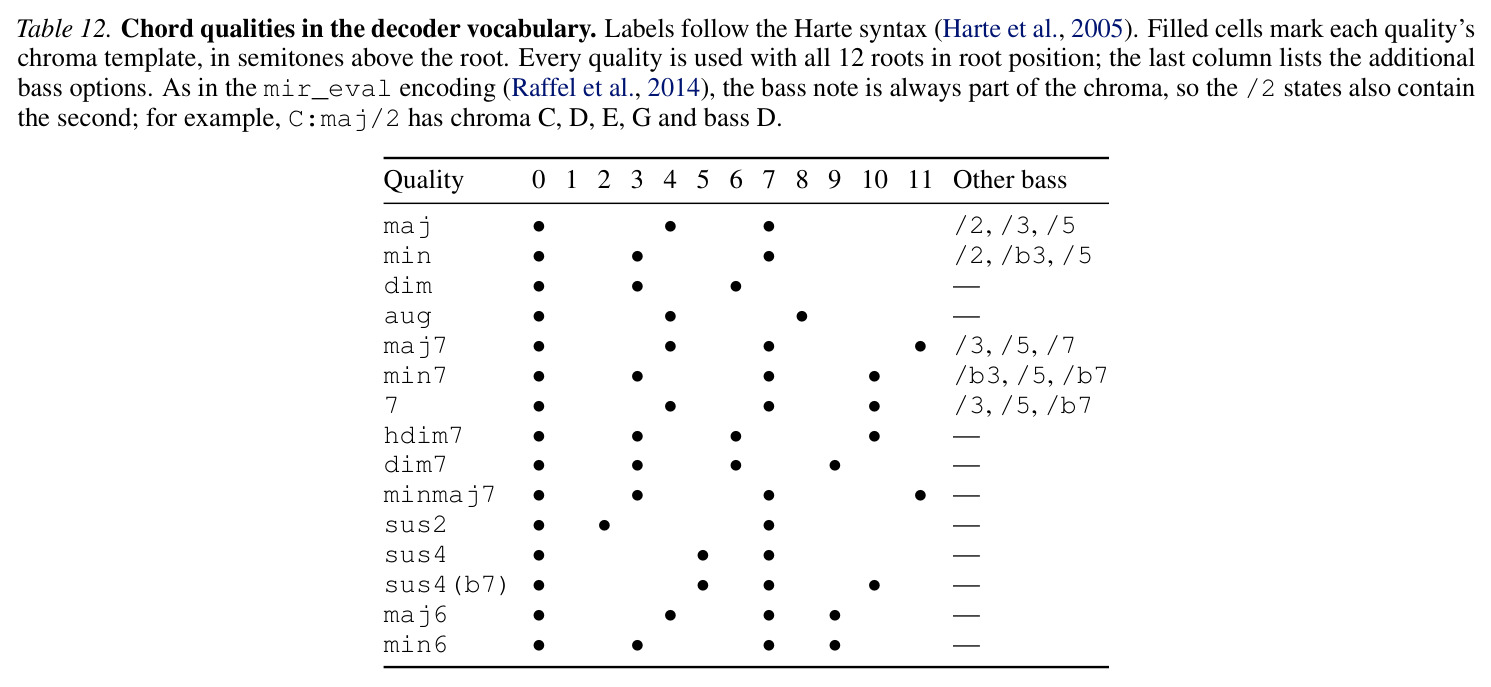
本文的目标是本文要构建一个统一的音频→主旋律谱转录系统,同时输出节奏(音符、节拍、重拍、拍号、速度)、和声(361 类和弦符号、24 种调)、旋律(人声/乐器双声部音高与时值)与曲式(23 类段落标签),并保证这些维度在整首歌内相互兼容、时间上连贯。具体拆成三个可验证的子目标:(1) 用大规模 MIDI 集合的符号分析加伪标签自举构造可扩展的合成监督,弥补真实对齐标注的稀缺;(2) 设计任务特定的结构化解码器,把帧级概率转成内部一致的离散事件——统一速度层级、稳定八度、合法小节结构;(3) 通过自回归蒸馏把结构化解码的能力迁移到单个 AR 模型 SheetSage2-AR,使其推理时不需要任何任务专用动态规划就能保持精度与连贯性,并在 8 个基准集合的 15 个基准-指标对上与最强的任务专用系统竞争。
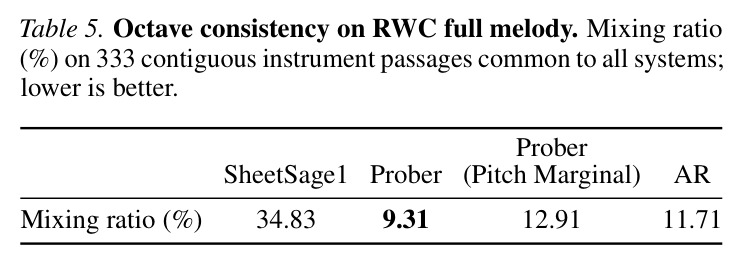
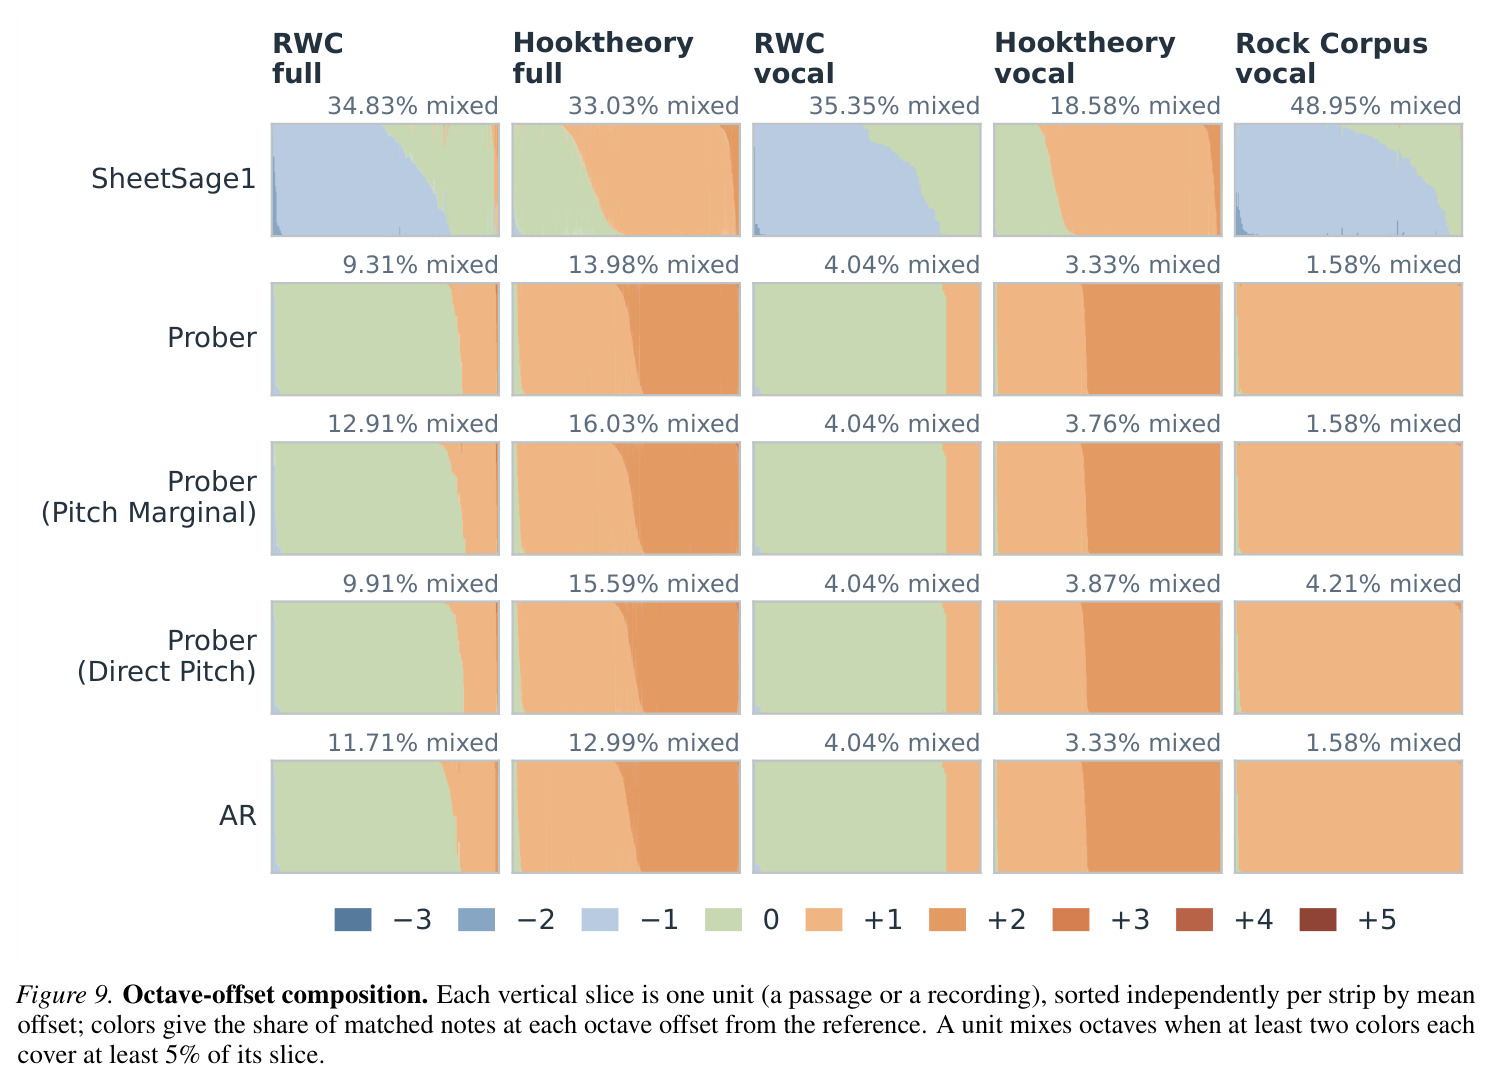
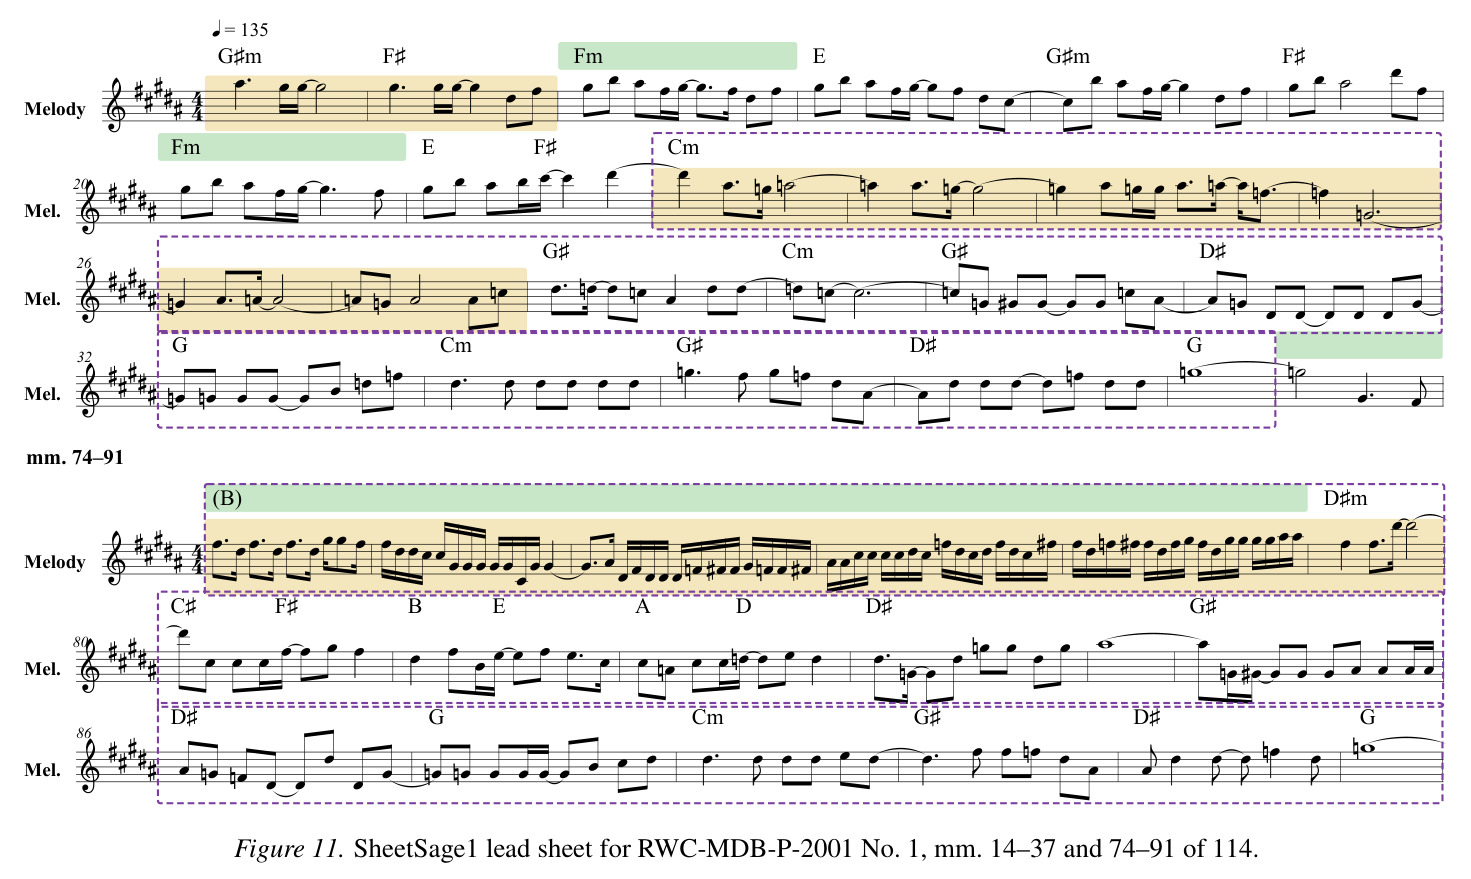
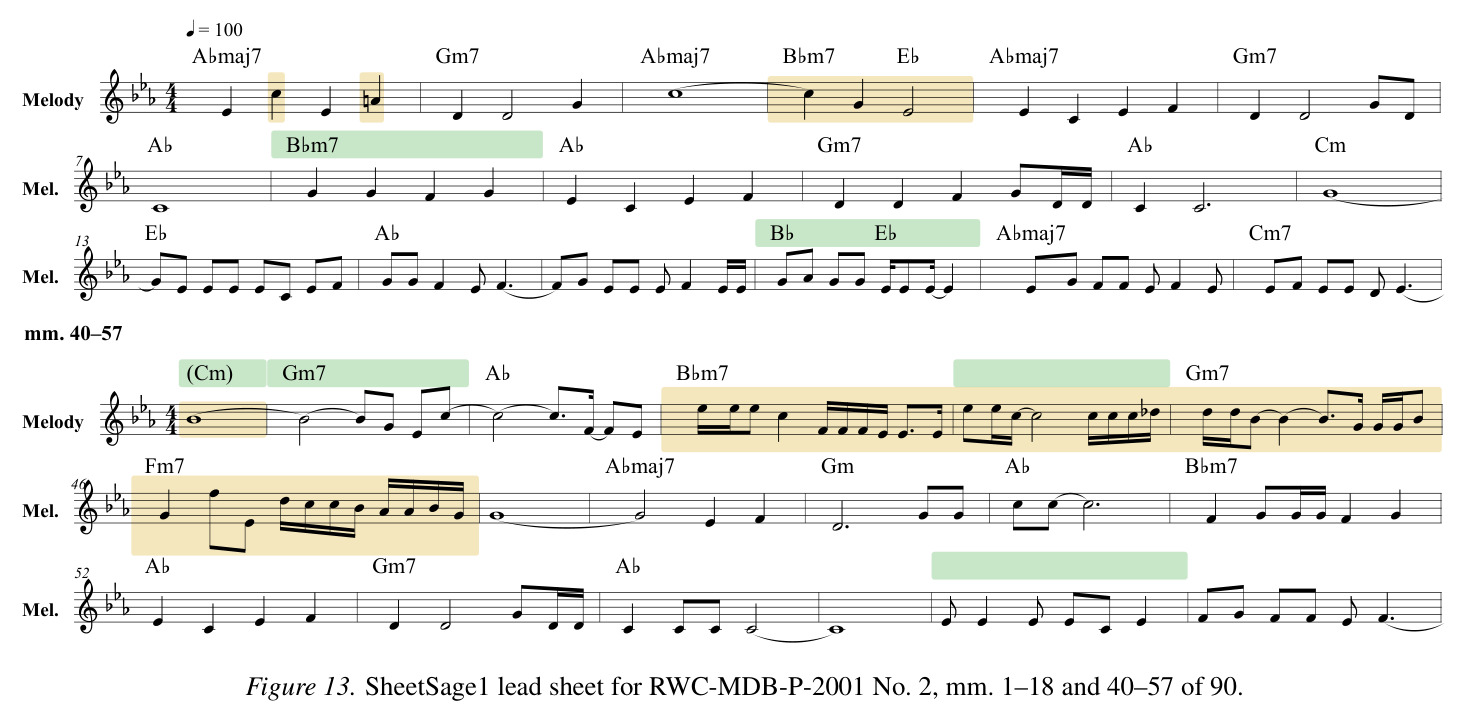
与已有工作不同的是,此前工作分两条路线且各有短板:任务专用路线(madmom/Beat This! 拍跟踪、ChordFormer 和弦、S-KEY 调性、SongFormer 结构)各自输出无法保证相互兼容;统一模型路线(SheetSage1、TUTTI、MT3、MuScriptor)受制于对齐标注规模——SheetSage1 全曲只有一个调号一个速度、旋律在 34.83% 的 RWC 器乐片段里混八度。本文的独特切入有三点:(1) 把"内容驱动的 MIDI 自我标注"扩展成可规模化的合成音频监督流水线——用 MIDI 内部显式信息(轨道名、持续柱式和弦、低音线等)训练符号分析器,反过来给 40 万级无高层标注的 MIDI 全集打标签再渲染成音频;(2) 不追求一步到位的端到端,而是先用能容忍缺失与带噪标签的帧级 Prober 消化异构数据,再用带显式音乐先验(全局速度锚、音程条件旋律打分)的结构化解码保证连贯;(3) 用蒸馏把六个解码器的约束"内化"进 AR 学生,兼顾数据效率、音乐连贯与推理简洁。
核心方法
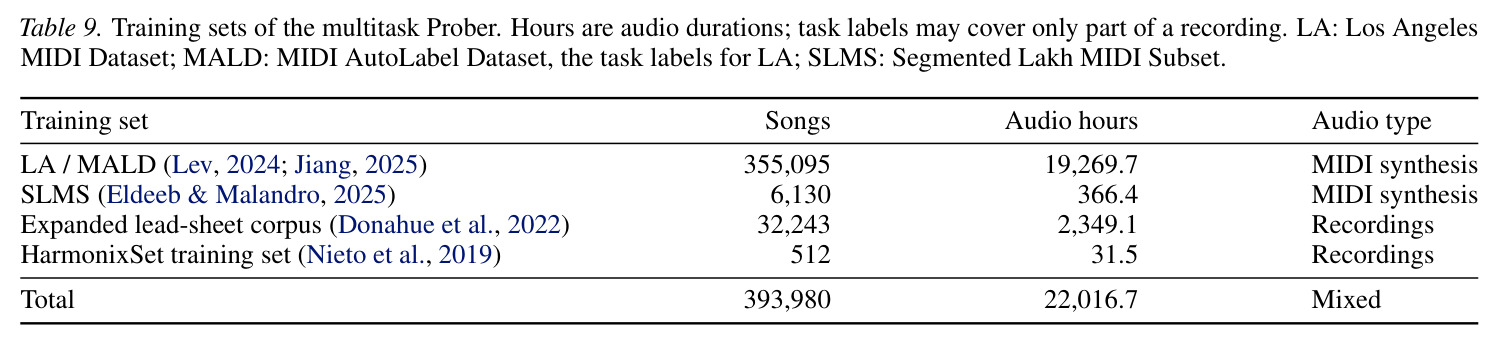
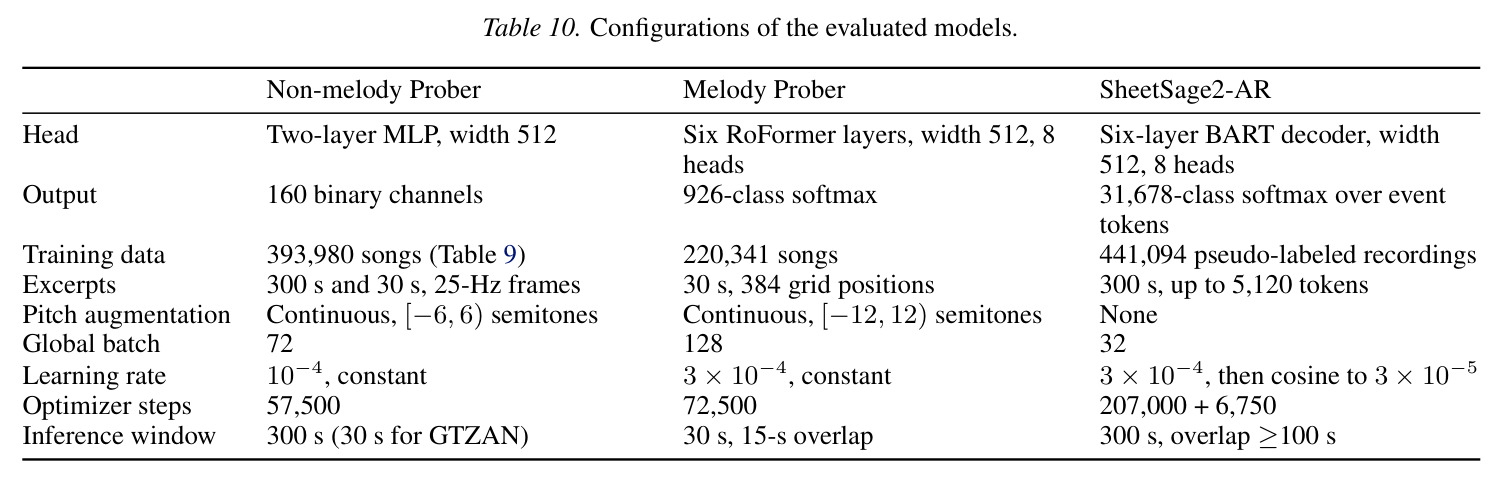
直觉上系统分两步:先"听清"——帧级 Prober 从音频读出各任务的概率证据;再"写谱"——结构化解码器把证据组织成音乐上合法且全局一致的离散事件;最后把"写谱"能力教给自回归模型。技术路线分三阶段。第一阶段合成数据创建:用专家规则或轨道名挑选高精度种子标签,微调预训练符号模型(RoFormer+LoRA)得到 MIDI 自动标注器,给 Los Angeles MIDI 数据集 355,095 首歌打上旋律/和弦/调/节拍标签,连同 SLMS 共约 36.1 万合成源记录,用 FluidSynth+FluidR3 GM 渲染成 24 kHz 音频。第二阶段 Prober 训练:非旋律 Prober 在 25 Hz 预测 160 个二元通道,旋律 Prober 在十六分网格预测 926 类分布,两者均基于冻结 MERT2-FS+LoRA,在 393,980 首(22,016.7 小时)混合数据上用掩码损失兼容部分标注。第三阶段自回归蒸馏:仅用 Prober 解码的伪标签事件序列(441,094 段、28,434.3 小时)训练六层 BART 解码器的 SheetSage2-AR(词表 31,678),推理时对 300 秒窗口做语法掩码贪心解码,输出 ABC 乐谱或 MIDI。
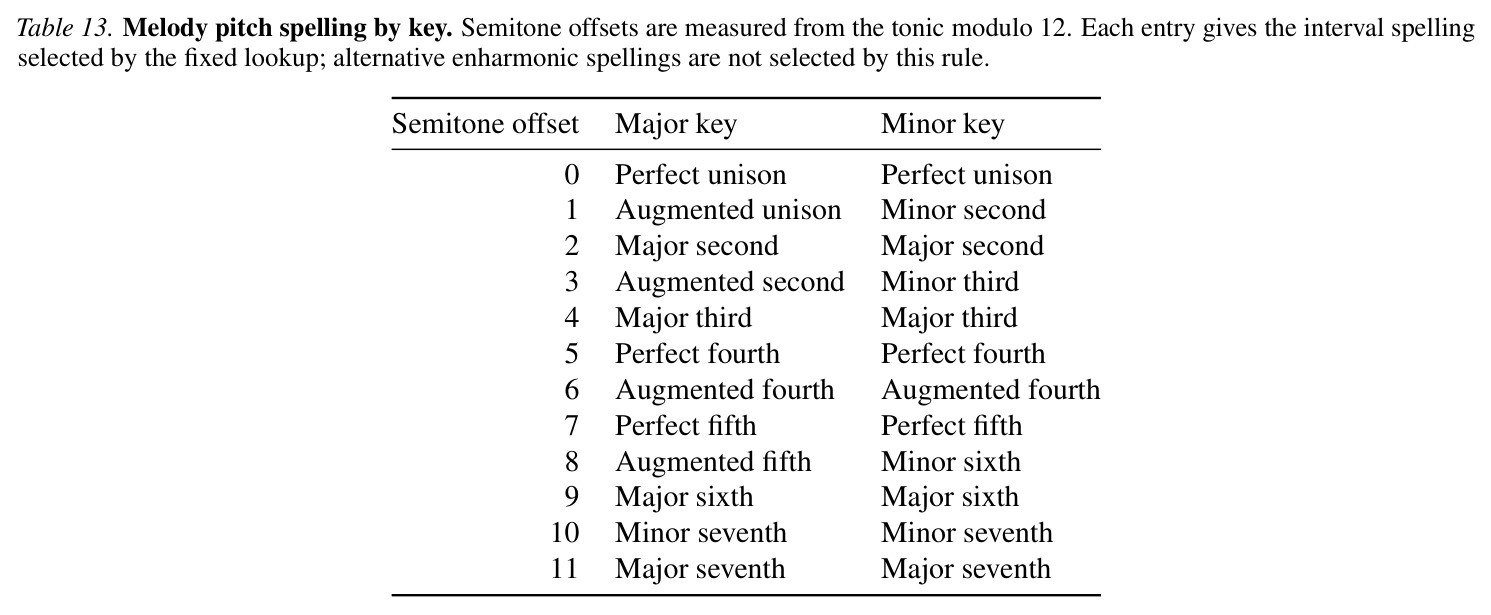
核心创新有三层。第一,速度一致性的"全局锚点 + 相对速度"参数化:传统 DBN 拍跟踪器只建模局部速度,允许一首歌在 1×/2× 层级间漂移;SheetSage2 先把全曲中位速度预测 $g^{(i)}$ 池化,选出唯一速度锚点 $\hat{g}$(60–240 BPM),再用相对速度激活 $r^{(i)}_\kappa$(中心 $2^{(\kappa-12)/6}$)描述局部速度,强制前后乐段共享同一速度层级,脉冲 DP 的 $-10\log_2(\delta/\delta')$ 项惩罚相邻脉冲间隔突变。第二,旋律八度一致性的"音程条件打分":不直接预测绝对音高,而预测音高×音程桶联合分布 $\mu^{(i)}_{p,b}$(7 个音程桶),解码转移分 $s^{(i)}_{\text{on}}(p'\to p)=\log\bar{\mu}^{(i)}_{p,B(p-p')}$ 依赖前一音 $p'$,使 C4–E4 与 C5–E4 走不同得分路径,抑制局部八度跳变。第三,结构化解码蒸馏:AR 学生只在教师解码出的完整事件序列(硬目标)上训练,把速度与八度一致性内化为生成先验,推理时免去六阶段 DP,区别于 SheetSage1 等先前统一模型。
方法步骤详情
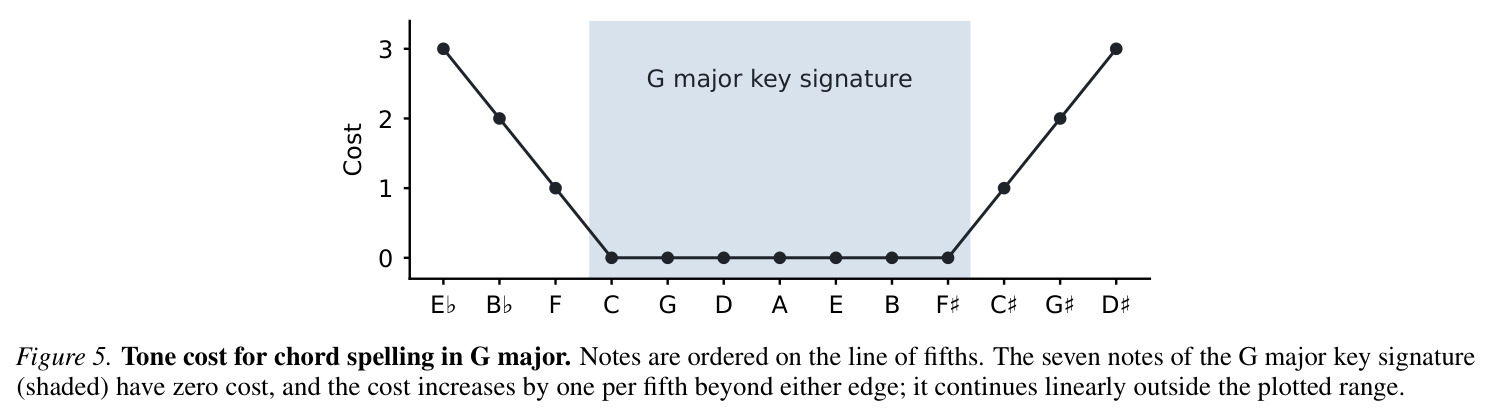
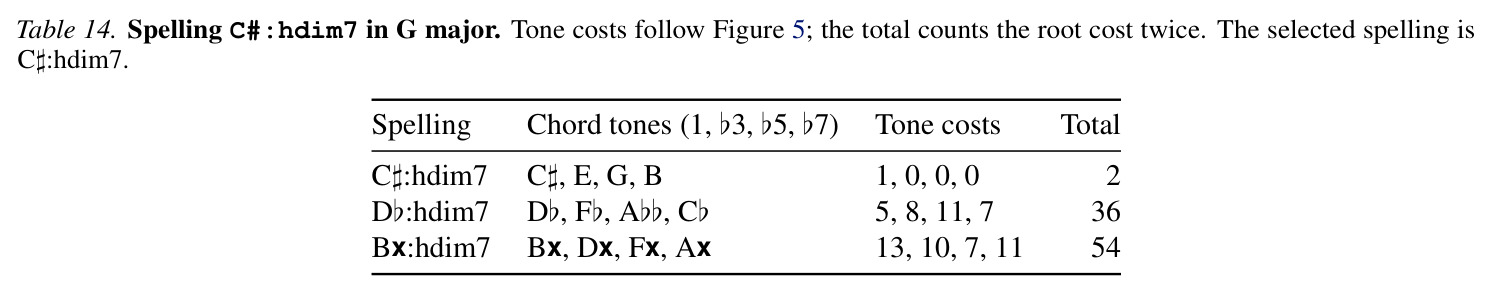
第一步 MIDI 自动标注:专家规则挑出近乎显式给标签的片段作和弦/调种子,移除供标签轨道后训练预测器恢复标签并给全集合打标;旋律以轨道名为种子微调预测器,标注时选与预测 onset F1 ≥0.7 的轨道,扩到 185,887 首(10.8 倍),再渲染成对齐音频。第三步 Prober 训练:非旋律模型取 300s+30s 片段、批内半音增广,lr $10^{-4}$ 训 57,500 步;旋律模型加 beat/hint 嵌入预测 926 类,lr $3\times10^{-4}$ 训 72,500 步。第四步六阶段解码:(1) 池化中位速度激活选唯一锚点;(2) 脉冲-局部速度联合 DP:证据项加 $-10\log_2(\delta/\delta')$ 突变惩罚,$\mathrm{BPM}(\delta)=3000/\delta$;(3) 小节-拍号联合 DP(27 个 meter 状态);(4) 按小节 HMM 解 24 调与 23 段落类;(5) 按拍和弦模板匹配(361 状态)加拼写校正;(6) 音程条件 DP 解旋律与时值。第五步 AR 蒸馏:教师解码序列提前 30ms 作目标(31,678 词表);推理用语法掩码贪心解码,长音频 ≥100s 重叠滑窗。
技术新颖性
与已有工作的本质区别有四点。(1) 数据侧:Slakh、MuScriptor 等只渲染 MIDI 并依赖其自带显式标签,而本文的伪标签自举让无高层标注的 MIDI 也变成全任务训练数据(旋律标注 10.8 倍扩容、35.5 万首全集标注),并证明纯合成音频训练的模型在真实录音上可达 57.76% 的 RWC-Pop 人声旋律 F1——尽管其训练音频里根本没有人声。(2) 解码侧:Beat This! 等最新拍跟踪器用前馈网络抛弃 DBN,本文反向而行,用显式多阶段 DP 把音乐先验(统一速度层级、完整小节、换调只能在重拍)作为归纳偏置注入——作者判断标注不足时这些长程一致性无法靠网络隐式学到。(3) 蒸馏侧:Kim & Rush 的序列级蒸馏原本用于省掉 beam search,本文用它省掉六个任务专用解码器,且教师信号是结构化算法的输出序列而非教师的概率分布。(4) 表示侧:统一事件语言把绝对时间戳(10ms 量化)与乐理位置(十六分位移、小节内 eighth_pos)混编,既有绝对对时又保留节拍结构,支持拍号分子 1–32、24 种调、361 类和弦、23 类段落与人声/乐器双音轨,直接导出可编辑 ABC 乐谱。
实验结果
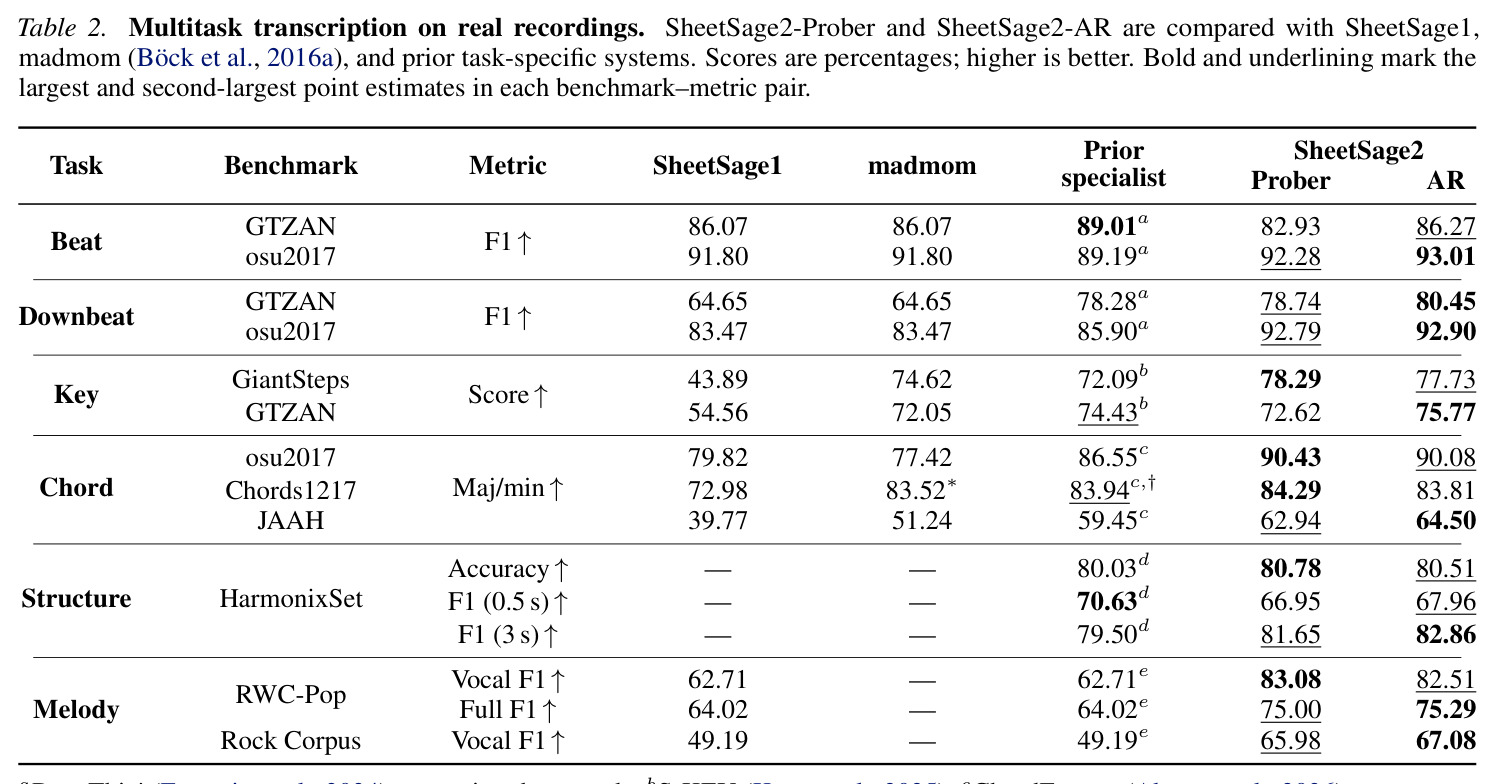
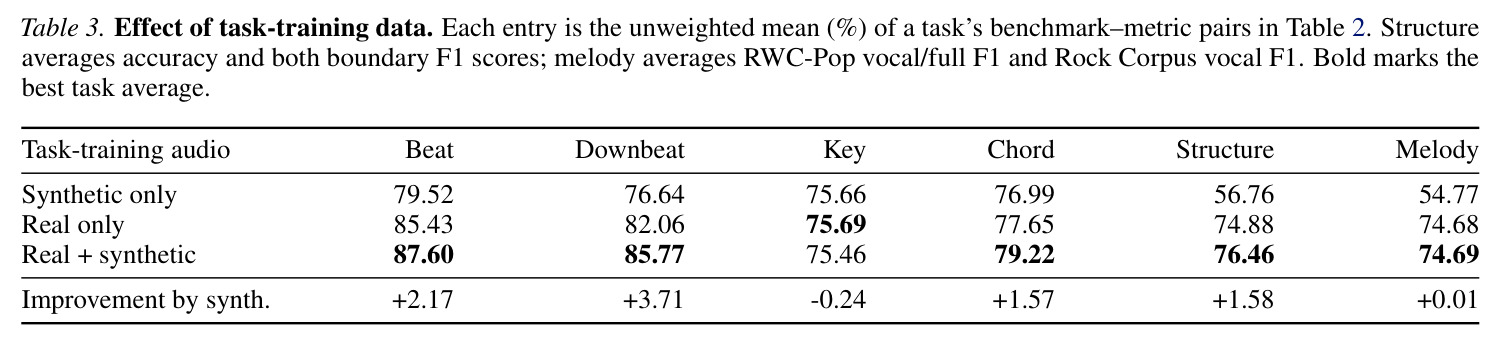
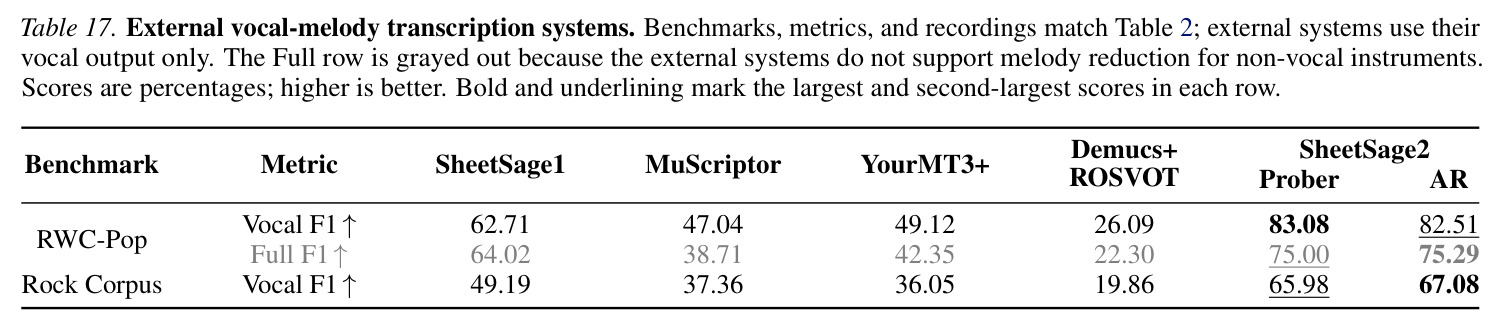
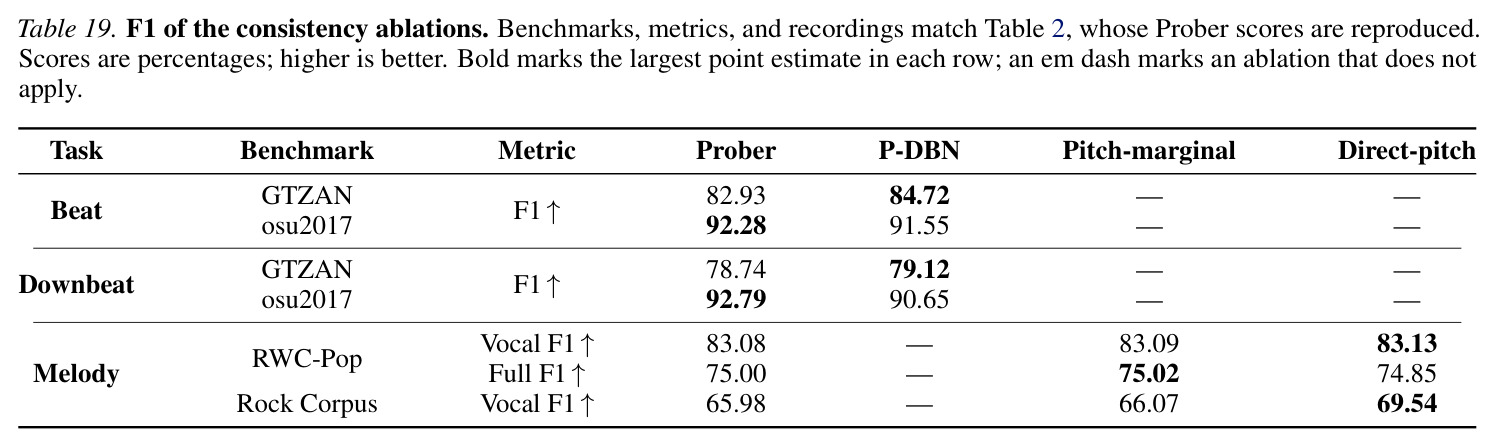
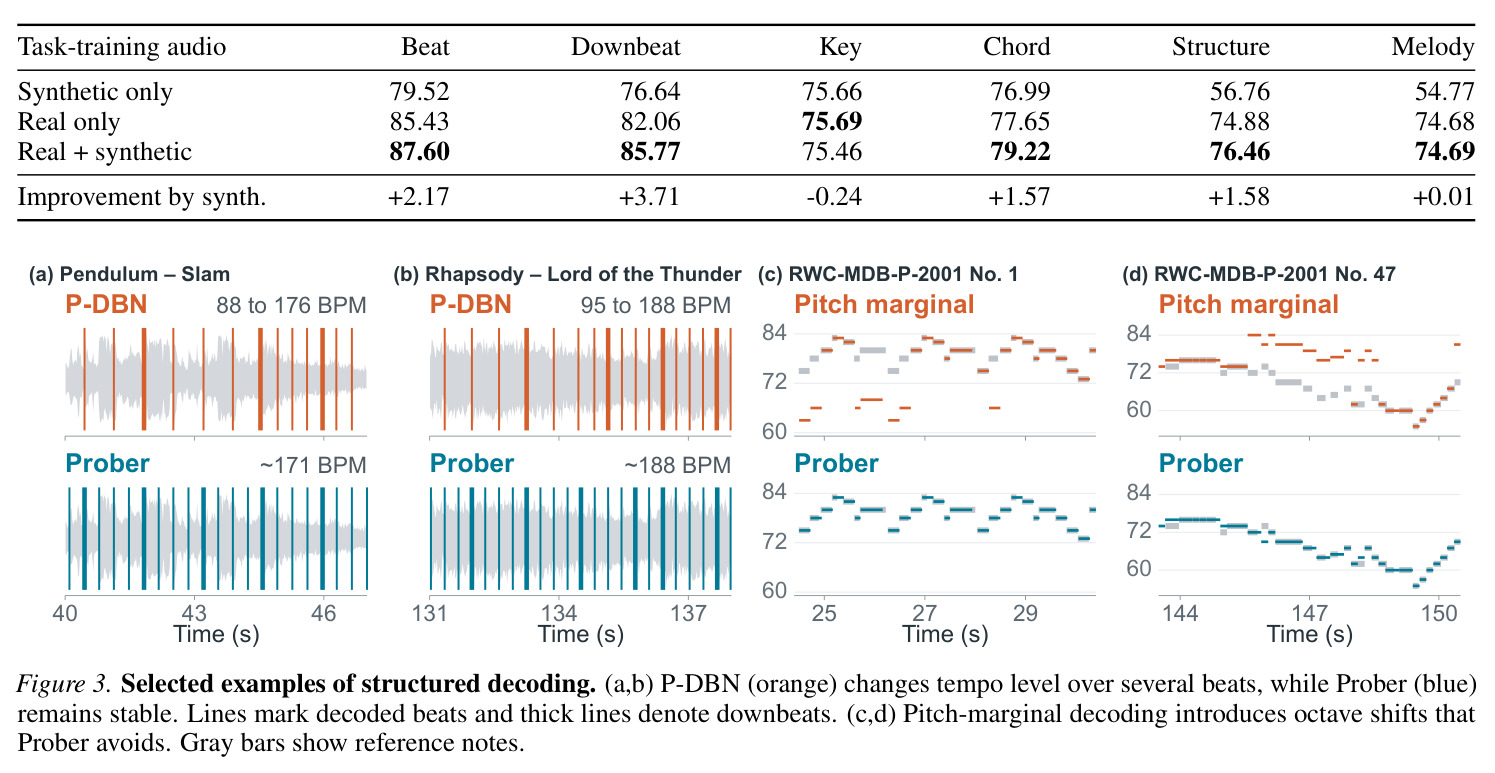
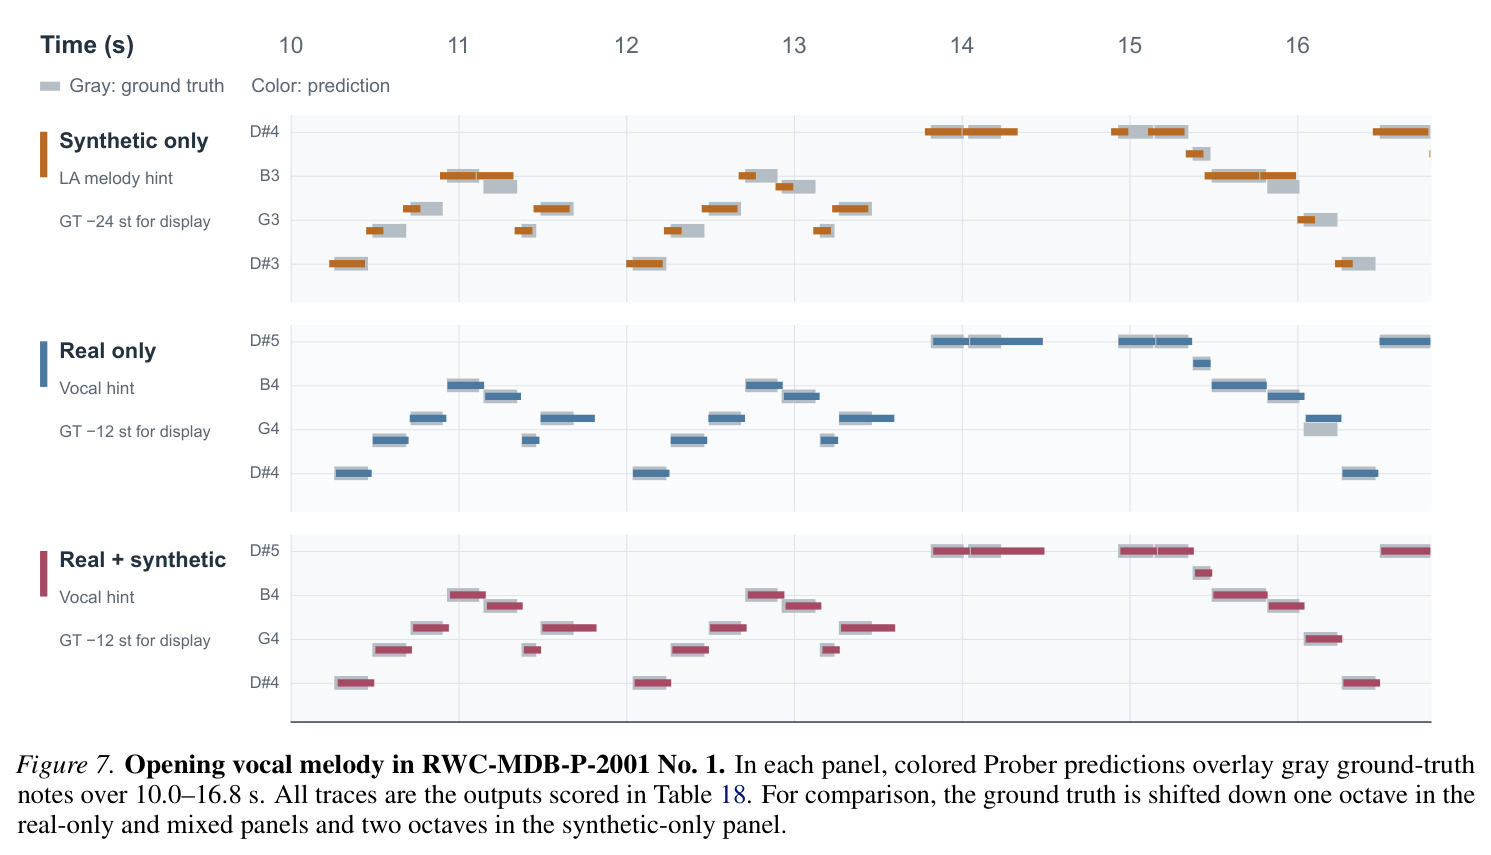
主结果:AR 在 8 个基准、15 个基准-指标对中的 12 个超过最强先验系统,10 个对上超过教师 Prober。旋律提升最显著:RWC-Pop 人声 F1 62.71%→82.51%,外部最强 YourMT3+ 仅 49.12。和弦 JAAH 领先(maj/min 64.50 vs 59.45);osu2017 节拍/重拍 93.01/92.90 超 Beat This! 89.19/85.90。三项未赢:GTZAN beat、Chords1217 maj/min、HarmonixSet 0.5s 边界 F1(86.27/83.81/67.96 vs 89.01/83.94/70.63)。一致性诊断:速度混层率(osu2017,Beat This!/Prober/AR)20.74%/2.96%/1.48%;八度混层率(RWC 333 段,SheetSage1/Prober/AR)34.83%/9.31%/11.71%。数据消融:加合成数据节拍 +2.17、重拍 +3.71、和弦 +1.57、结构 +1.58,旋律持平、调 −0.24;纯合成模型仍达 57.76% RWC 人声 F1。Table 19 显示一致性几乎不牺牲 F1。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 节拍检测(GTZAN) | Beat F1 | 86.27(AR) | 89.01(Beat This!) | −2.74(未超越,本文 3 个落败项之一) |
| 节拍检测(osu2017) | Beat F1 | 93.01(AR) | 91.80(madmom/SheetSage1) | +1.21 |
| 重拍检测(GTZAN) | Downbeat F1 | 80.45(AR) | 78.28(Beat This!) | +2.17 |
| 重拍检测(osu2017) | Downbeat F1 | 92.90(AR) | 85.90(Beat This!) | +7.00 |
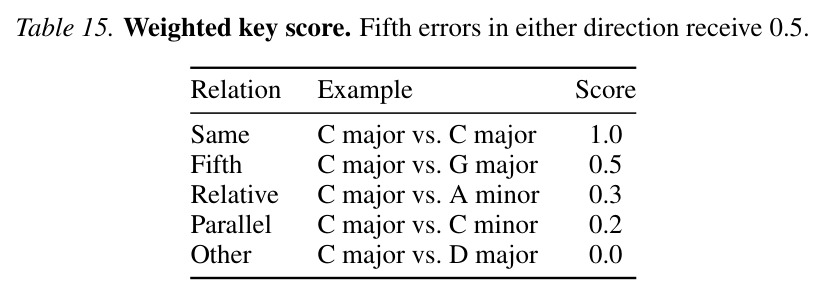
| 调性估计(GiantSteps) | Weighted Score | 77.73(AR)/ 78.29(Prober) | 74.62(madmom) | +3.11(AR)/ +3.67(Prober) |
| 调性估计(GTZAN) | Weighted Score | 75.77(AR) | 74.43(S-KEY) | +1.34 |
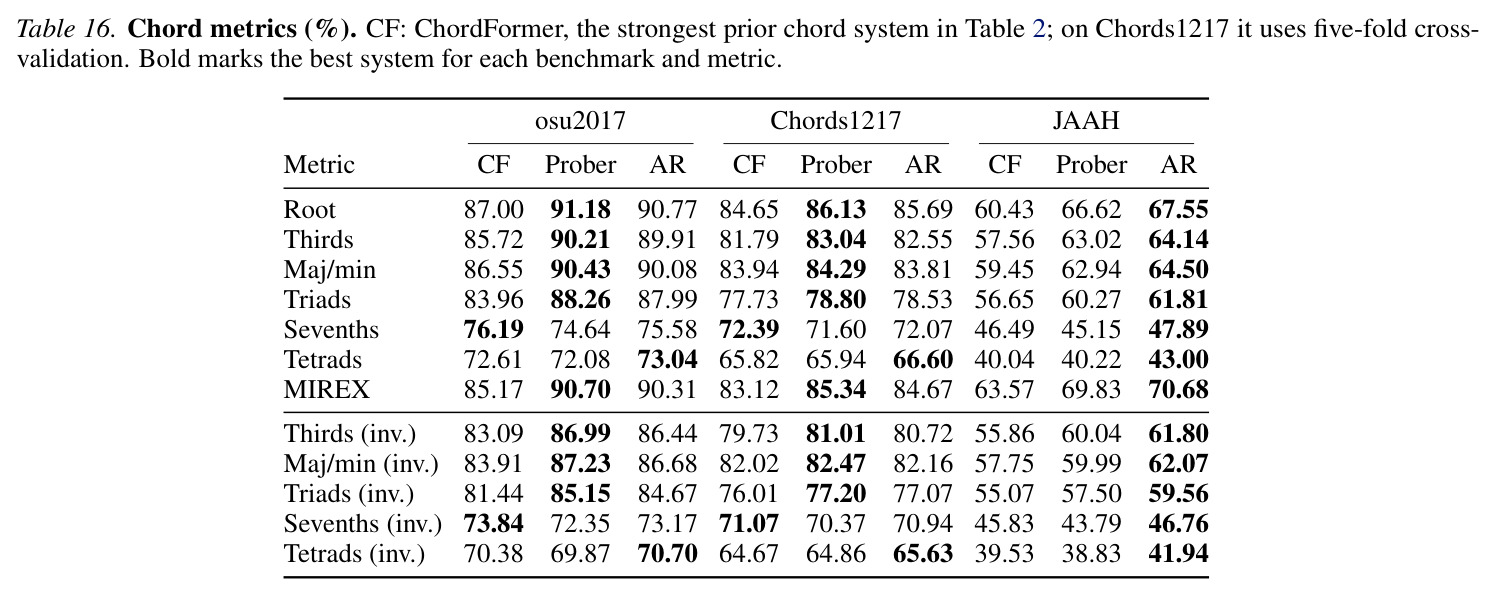
| 和弦识别(osu2017) | Maj/min | 90.08(AR)/ 90.43(Prober) | 86.55(ChordFormer) | +3.53(AR)/ +3.88(Prober) |
| 和弦识别(Chords1217) | Maj/min | 83.81(AR)/ 84.29(Prober) | 83.94(ChordFormer,5 折交叉验证) | −0.13(AR)/ +0.35(Prober) |
| 和弦识别(JAAH 爵士) | Maj/min | 64.50(AR) | 59.45(ChordFormer) | +5.05;MIREX 上 70.68 vs 63.57(+7.11) |
| 曲式分析(HarmonixSet) | Segment Accuracy | 80.51(AR)/ 80.78(Prober) | 80.03(SongFormer) | +0.48(AR)/ +0.75(Prober) |
| 曲式边界(HarmonixSet) | F1 @3s | 82.86(AR) | 79.50(SongFormer) | +3.36;F1 @0.5s 为 67.96 vs 70.63(−2.67,落败项) |
| 人声旋律转录(RWC-Pop 100 首) | Vocal F1 | 82.51(AR)/ 83.08(Prober) | 62.71(SheetSage1) | +19.80(AR);外部最强 YourMT3+ 仅 49.12 |
| 全旋律转录(RWC-Pop) | Full Melody F1 | 75.29(AR) | 64.02(SheetSage1) | +11.27 |
| 人声旋律转录(Rock Corpus 200 首) | Vocal F1 | 67.08(AR) | 49.19(SheetSage1) | +17.89 |
| 全局速度一致性(osu2017,135 首) | 速度混层率(越低越好) | 1.48%(AR)/ 2.96%(Prober) | 20.74%(Beat This!)/ 3.70%(P-DBN) | 相对 Beat This! 降低 19.26 个百分点 |
| 全局速度一致性(Hooktheory,2,943 首) | 速度混层率(越低越好) | 0.51%(AR)/ 0.34%(Prober) | 17.30%(Beat This!)/ 1.36%(P-DBN) | 相对 Beat This! 降低 16.79 个百分点 |
| 八度一致性(RWC 全旋律,333 段) | 八度混层率(越低越好) | 11.71%(AR)/ 9.31%(Prober) | 34.83%(SheetSage1)/ 12.91%(Pitch-marginal 消融) | 相对 SheetSage1 降低 23.12 个百分点 |
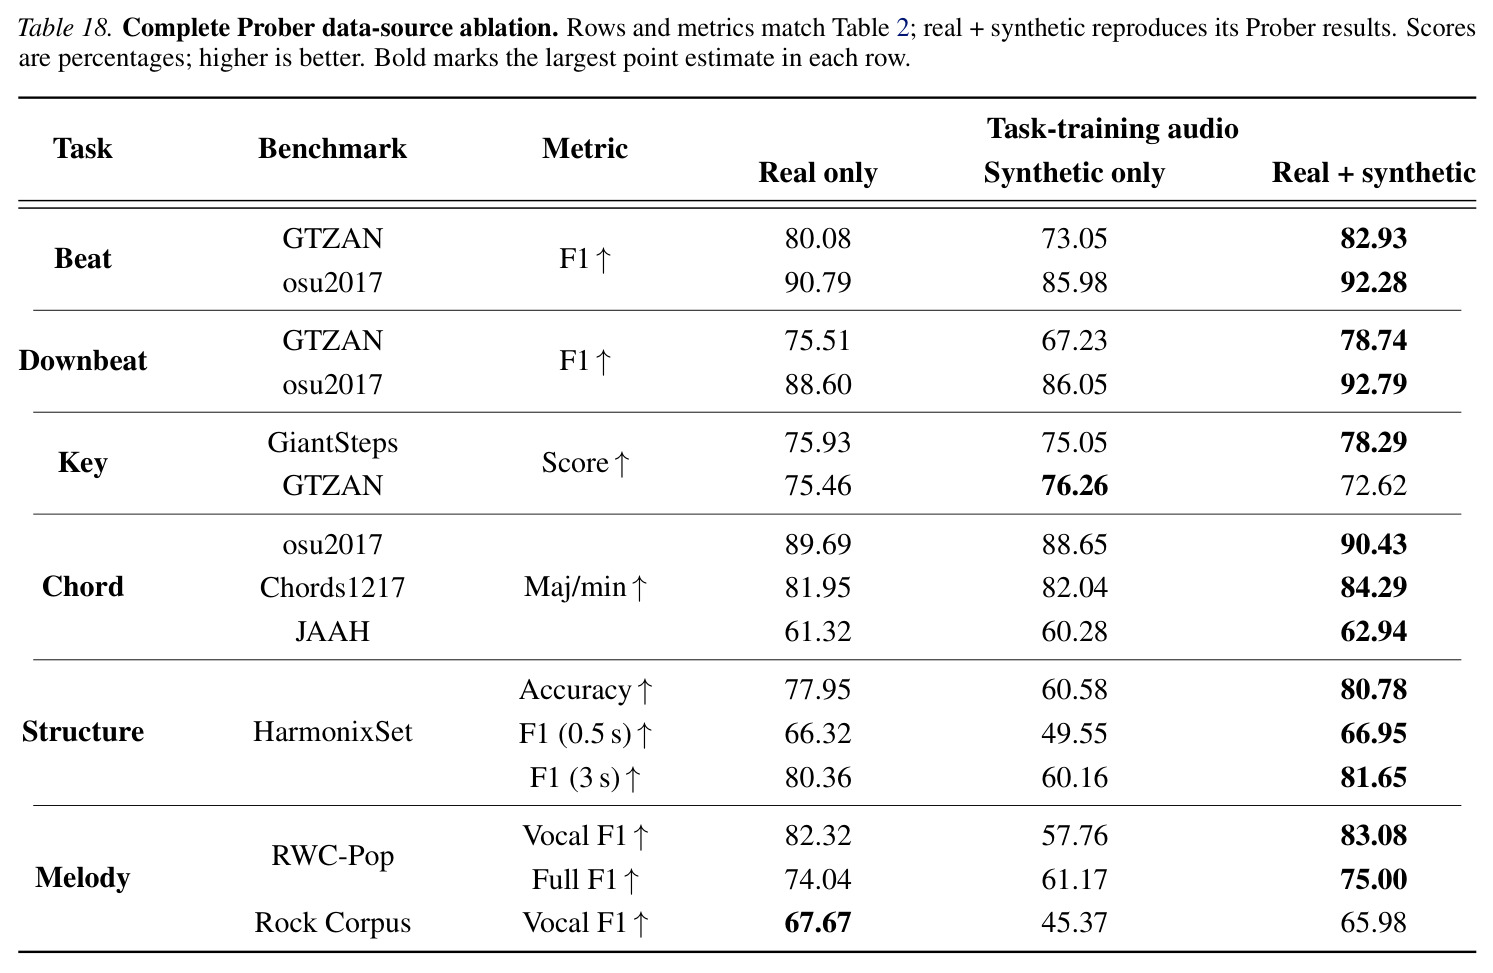
| 合成数据消融(各任务均值) | Real→Real+Synth 提升 | Beat 87.60 / Downbeat 85.77 / Chord 79.22 / Structure 76.46 | Real-only:85.43 / 82.06 / 77.65 / 74.88 | +2.17 / +3.71 / +1.57 / +1.58;Key −0.24、Melody +0.01 |
| 纯合成训练迁移(RWC-Pop 人声) | Vocal F1 | 57.76%(训练音频中无人声) | 83.08%(Real+Synth 完整版) | 证明合成监督可跨域迁移到真实人声录音 |
局限与改进
作者明确承认(Section 5):(1) 节奏假设——音符只能落在十六分音符网格上,三连音与更细划分只能近似,附录 F 中快速吉他 solo 被系统性简化;(2) 全曲单一速度锚点加局部相对速度的设计适合恒速流行乐,不适合大幅速度变化的曲目,可评估拍号清单也有限;(3) 和声假设——基于 12 平均律,和弦词表只覆盖三和弦、挂留、六和弦与七和弦(15 种 quality),无法表示九和弦及扩展/变化和弦;(4) 流派局限——训练数据与主旋律谱格式都面向有稳定节拍的流行音乐,不适合多声部弹性速度的古典音乐或自由节奏音乐。我的补充观察:(1) Hooktheory 一致性评估与训练数据重叠,作者也承认并非 held-out 测试,那部分数字可能偏乐观;(2) 蒸馏使训练信号完全来自教师解码结果,系统性错误会遗传甚至放大;(3) 旋律 F1 指标忽略八度与时值 offset,会掩盖绝对音域错误;(4) AR 词表支持拍号分子 1–32,但 Prober 解码器的拍号清单窄得多,实际能力可能受限;(5) GM 音色渲染与真实制作的分布差异,可能正是旋律与调性收益停滞的原因。
独立分析的弱点
弱点一:十六分音符网格假设,swing、shuffle、三连音律动会被强行量化变形,附录 F 的吉他 solo 简化即实证;改进方向是加入网格偏移 token 或毫秒级 onset 回归头。弱点二:单速度锚点,对 ritardando/rubato 曲目会整段错位,锚点选错层级则全曲时值翻倍;可允许每 N 小节重估锚点但约束层级不变。弱点三:和弦词表封顶于七和弦,JAAH 上 sevenths 仅 47.89% 已成瓶颈;可改为 root+音程集合的开放表示,或从 chroma/extension 通道生成自由音程组合。弱点四:蒸馏误差遗传——Prober 的系统性错误成为 AR 的唯一训练信号,学生无法在教师错误处自我修正;可混入小规模高质量真实标注做正则,或按 Prober 置信度加权伪标签。弱点五:GM 音色渲染与真实制作的差距可能正是旋律(+0.01)与调(−0.24)收益停滞的原因;可引入多渲染器、随机混音/EQ 增广或歌声合成生成人声轨。弱点六:种子标签依赖轨道命名与专家规则,自举偏差无法量化,错误标签可能形成回声;建议人工抽检与多标注器交叉验证。各弱点均有明确实验抓手。
未来方向
作者在结论中提出两个方向:(1) 随训练数据增多,部分显式音乐约束(结构化解码)可能变得不再必要——即规模化能让网络隐式学到长程一致性;(2) 真实标注仍稀缺,扩大高质量标注的合成数据是最有前景的路线,这依赖符号音乐分析与生成技术的进步。基于本文成果可自然延伸的方向:(3) 把 SheetSage2-AR 作为生成模型(如作者团队的 YuE2)的符号-语义监督源,形成"理解支撑生成、生成反哺标注"的闭环;(4) 利用统一事件语言做条件化乐谱任务:给定前奏续写和弦进行、按曲式标签重和声化、跨段落旋律补全;(5) 扩展到多声部/多乐器乐谱转录,与 MuScriptor、TUTTI 的多轨输出或钢琴转录精确 onset 对接;(6) 数据飞轮:AR 在新录音上的输出经人工校对后回流训练集,逐步用真实数据替换合成偏差;(7) 混合离散-连续表示处理三连音与微时值;(8) 把混层率(mixing ratio)推广为社区标准连贯性指标——本文已证明 F1 与连贯性可以解耦(Table 19),推动节拍/旋律系统从"单点准确"走向"序列一致"的评估范式。难度上 (3)(4) 最接近落地,因为模型权重已开源且事件语言天然支持条件前缀。
复现评估
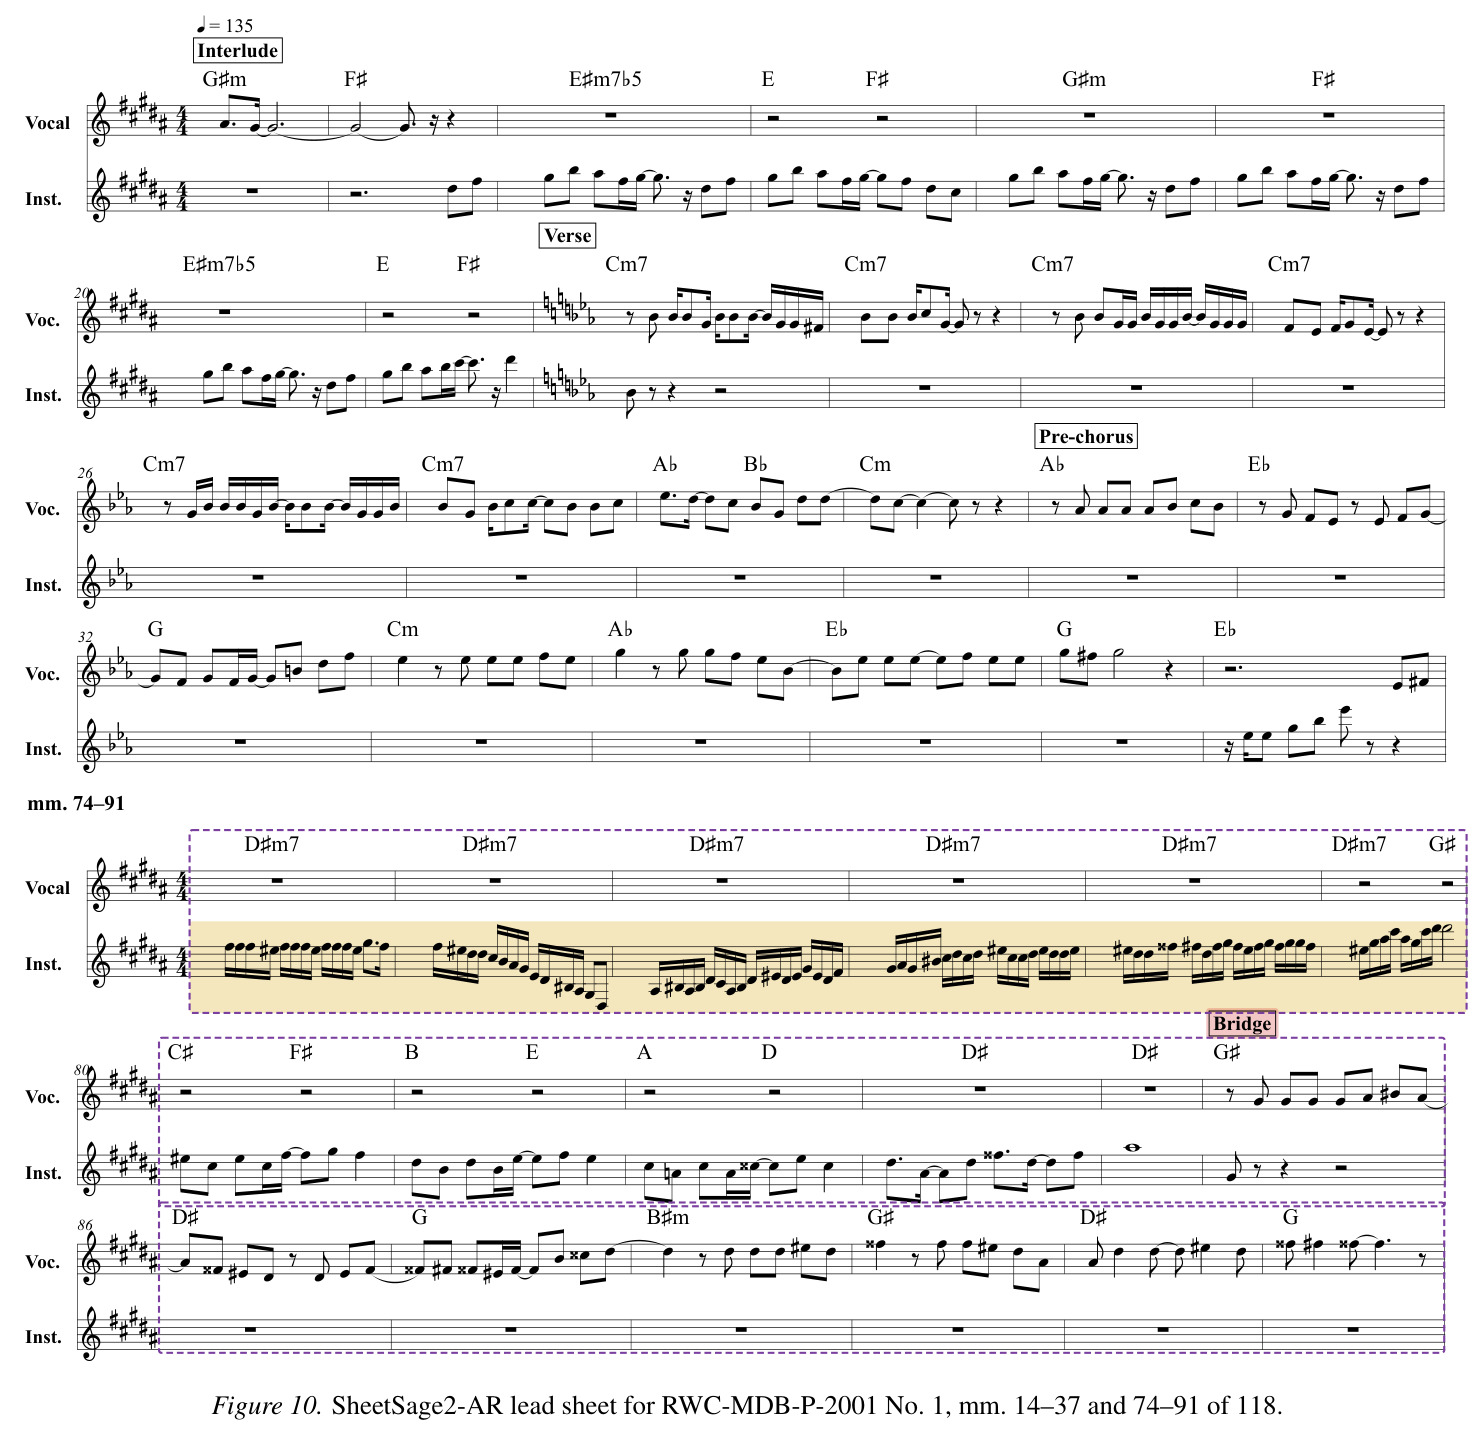
开源情况:模型权重与推理代码(含论文推理设置 preset 与基准分数)已在 huggingface.co/m-a-p/SheetSage2 公开;事件格式与解码约束(附录 A 含逐 token 示例)、六个解码器的完整递推与超参(附录 C)、训练配置(附录 B)、评测协议与基线来源(附录 D)披露细致,可复现性设计在 MIR 论文中属上乘。数据是主要短板:部分训练数据私有或需授权(私有主旋律谱集、Tokenwave.AI 授权合成音乐、Hooktheory 授权标注),LA/MALD、SLMS、HarmonixSet 等公开部分可自行获取,部分基准音频只能在提供方条款下使用。算力:论文未披露 GPU 数量与时长,但可从配置推断——LoRA rank 64、六层任务头、AR 词表 31,678、BF16 混合精度,步数合计约 29 万、批 32–128,单机 8 卡 A100 量级数天内可完成。难度评估:复现推理与评测容易(权重开源 + 协议详尽,低难度);完整复现训练需重建约 36 万首规模的 MIDI 自举标注与渲染流水线,工程量大,总体中等偏高难度。另注意作者声明用生成式 AI 辅助了代码与写作。
论文图表
Table 3 的 15 对完整版:Real only / Synthetic only / Real+synthetic 的逐基准得分。亮点:纯合成在无真实音频时 GTZAN beat 73.05、osu2017 chord 88.65、RWC 人声 57.76;合成加入后 osu2017 重拍从 88.60 升至 92.79,Rock Corpus 人声反而从 67.67 降至 65.98。
合成监督收益与代价的最细粒度证据,支撑对数据配方的批判性讨论。
一致性变体的准确率代价检查:P-DBN 在 GTZAN beat 84.72 高于 Prober 82.93、osu2017 上 91.55 低于 92.28,无统一趋势;旋律各变体 F1 差异小于 0.1 点;direct-pitch 在 Rock Corpus 达 69.54(vs 65.98)但作者为一致性放弃。
证明"连贯性与准确率可以兼得"这一反直觉结论,是方法价值的关键辩护。