StepAudio 3 Music:支持 ABC 显式编曲规划的大规模长时歌曲生成模型 StepAudio 3 Music Technical Report
MoE 自回归 + 单码本音乐 token + ABC 显式编曲规划的长时音乐生成模型
前置知识
流匹配与 DiT
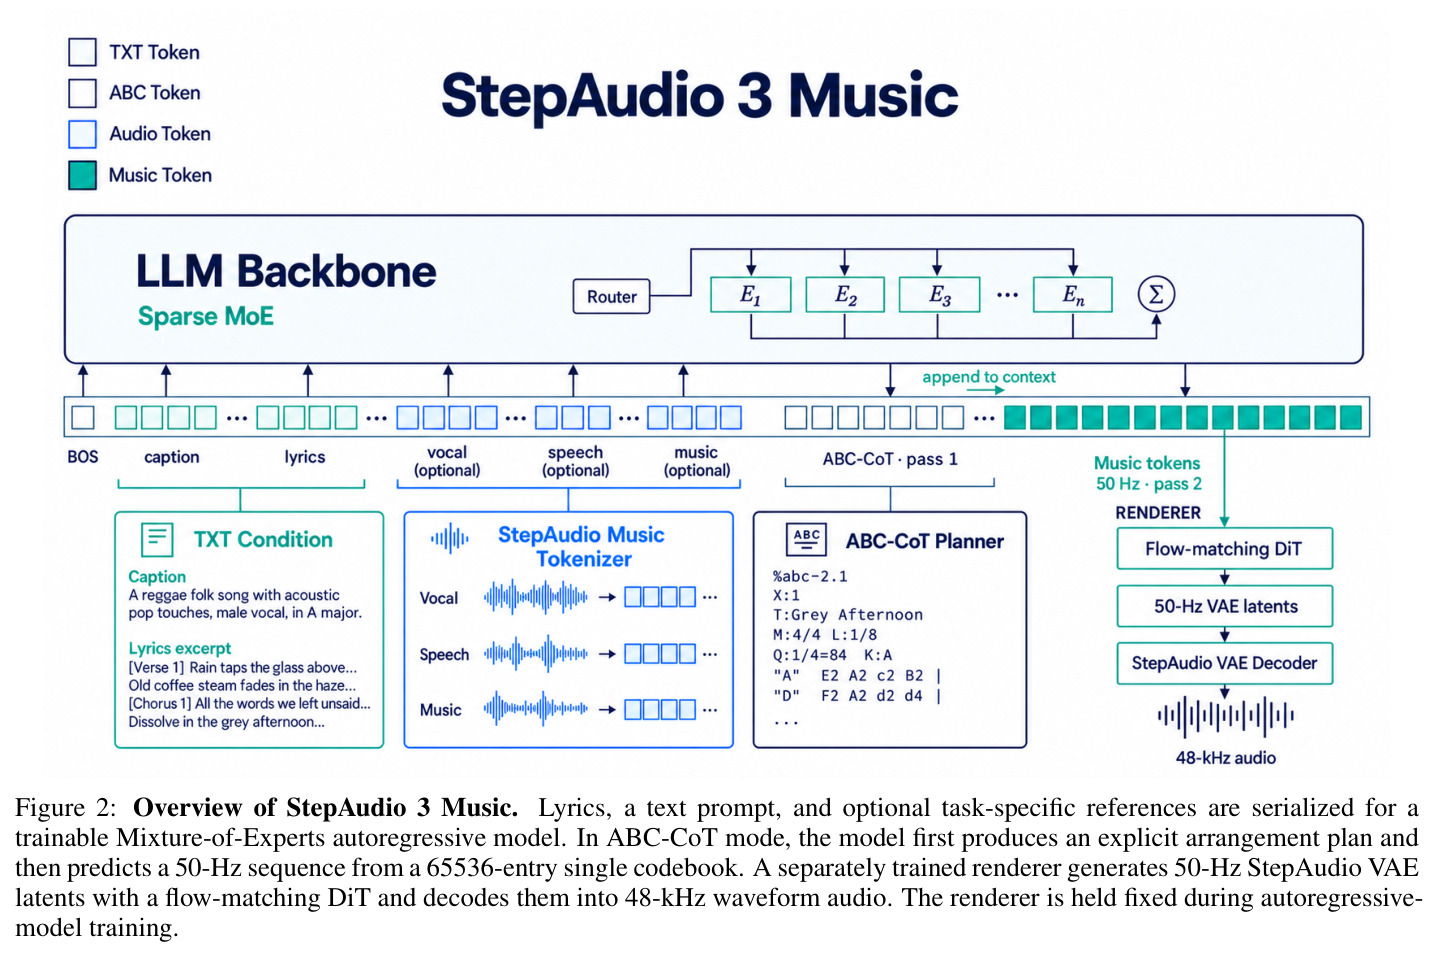
流匹配是一种生成连续数据的训练范式:训练一个网络预测从噪声分布到数据分布的近似直线路径上的速度场,推理时沿该场做数值积分即可采样。DiT(Diffusion Transformer)是把这一去噪网络实现为 Transformer 的架构,擅长建模长时序上下文。本文用 0.9B 的 DiT 在 StepAudio VAE 的 50Hz、64 通道潜变量空间中做流匹配,把离散音乐 token 渲染成连续潜变量,再由冻结的 VAE 解码为 48kHz 波形。
本文的声学渲染层完全建立在流匹配 DiT 之上,理解它才能明白 token 到音频的第二阶段如何工作,以及为何把 DiT 从 0.9B 扩到 8B 也无法突破 tokenizer 瓶颈。
残差向量量化(RVQ)
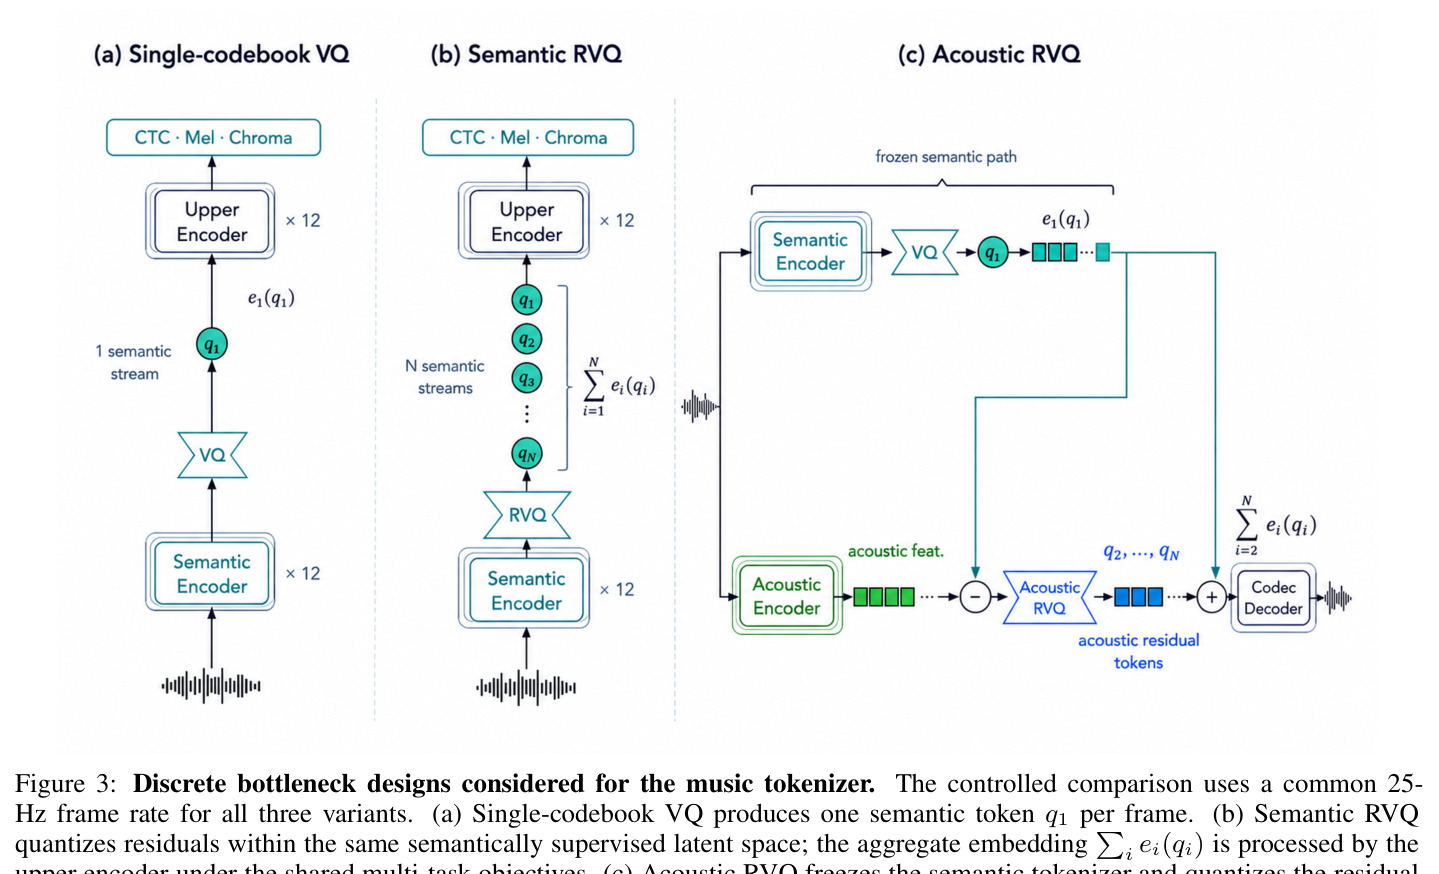
向量量化把连续特征映射到最近的离散码字;残差向量量化则串联多个码本,每个码本量化前一级的残差,逐步逼近原始特征,用多个低容量码本获得高保真表示,是 EnCodec、SoundStream 等音频编解码器的标准结构。本文对比了在语义监督空间内做残差量化的 Semantic RVQ,与先冻结语义流、再量化声学残差的 Acoustic RVQ,发现二者重建虽好,但语言模型难以可靠预测。
论文的核心论证就是单码本 VQ 与两种 RVQ 在统一 25Hz 条件下的受控对比,不懂 RVQ 的误差累积机制就无法理解『重建最优不等于生成最优』这一关键结论。
ABC 记谱法
ABC 是一种用纯文本表示音乐的符号记谱系统:以字母指定调性、数字指定拍号,按小节书写音名、时值与和弦标记,人和程序都能直接阅读,相当于五线谱的文本等价物,在民谣与传统音乐社区广泛使用。ChatMusician 等工作已证明语言模型可以直接生成和处理 ABC 序列。本文用它作为编曲计划的载体,包含速度、拍号、调性、小节数、和弦进行与旋律序列。
ABC-CoT 是本文的核心创新:模型生成、外部 LLM 编辑、最终条件合成的对象都是 ABC 文本,不理解 ABC 就无法理解显式音乐规划如何实现。
混合专家(MoE)
MoE 是一种稀疏激活架构:把 Transformer 中的前馈层替换为多个专家网络,由路由器为每个 token 只激活少数专家,在计算量近似不变的情况下大幅增加总参数量。本文的自回归音乐模型由一个 MoE 文本语言模型初始化,负责融合歌词、文本提示与任务参考,并以两遍方式先生成编曲计划再逐帧预测音乐 token。
论文的生成主干是 MoE,但其总参数量与专家配置未完整披露,理解 MoE 的容量-成本关系有助于评估该系统的规模量级。
直接偏好优化(DPO)
DPO 是一种免强化学习循环的对齐方法:给定同一提示下人类标注的偏好对(chosen 与 rejected),通过基于参考模型的闭式损失直接优化策略,使其偏向被偏好的回答,省去训练奖励模型和 PPO 采样的复杂度。本文由音乐专家对同一 caption-lyrics 条件下采样的四个候选音频排序,取偏好差距最大的一对,共构建约 2,000 个偏好对用于 DPO。
论文的后训练流程与 5.4.2 节消融都围绕 SFT 与 DPO 前后对比展开,是理解最终模型质量提升来源的关键。
BEST-RQ 自监督预训练
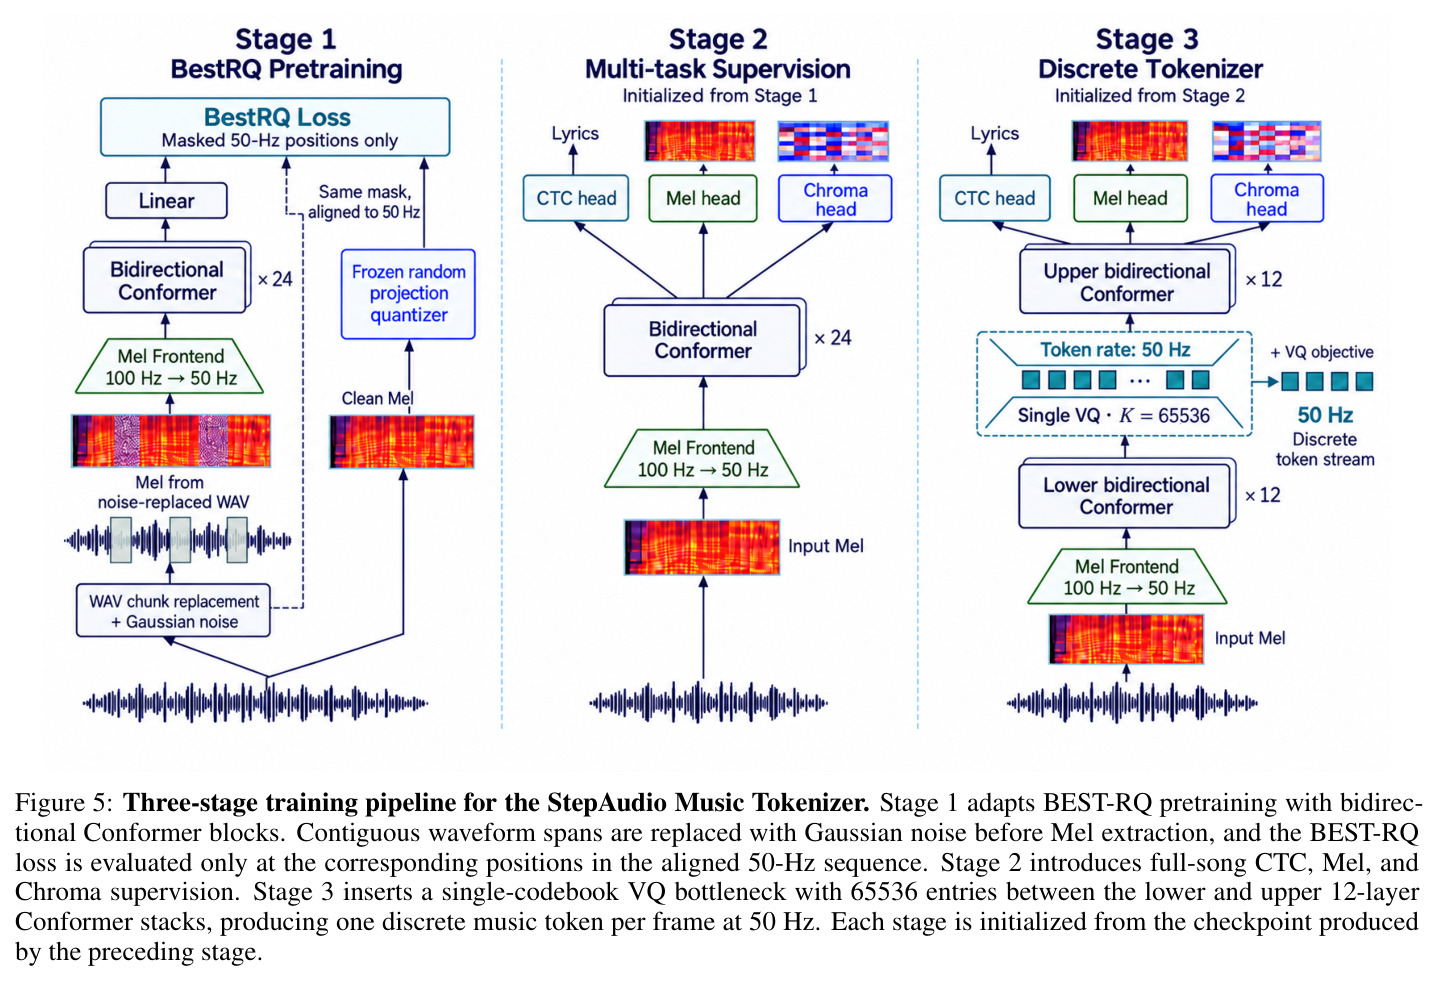
BEST-RQ 是一种极简的语音自监督预训练目标:用随机初始化且永久冻结的投影矩阵与码本把输入特征量化为预测目标,模型对加噪或掩码后的输入预测这些目标。由于目标器不参与训练,预训练简单且稳定。本文将其适配到音乐域:在线分支向连续波形段注入高斯噪声,目标分支用冻结随机投影量化干净 Mel 特征,作为 tokenizer 三阶段训练的第一阶段。
音乐 tokenizer 能同时保留语义结构与声学细节,靠的就是 BEST-RQ 预训练加 CTC/Mel/Chroma 多任务的三阶段方案,这是复现 tokenizer 的第一步。
研究动机
音乐生成正从几十秒的片段走向完整歌曲,这带来多尺度协调难题:模型既要处理旋律发展、段落转换、歌词与音乐关系等长程结构决策,又要在音色、人声质感、瞬态等细粒度声学实现上做到位。现有方法存在三类具体问题。第一,主流高保真编解码器普遍采用多码本 RVQ,例如 MiniMax Music 3 使用一个 16,384 项主码本加七个 1,024 项残差码本,这类表示重建保真度高,但语言模型需同时预测多条残差流,预测误差会在码本间聚合累积,损害生成音频的音乐性。第二,已有音乐思维链方法的中间表示缺乏可读性:MusiCoT 使用量化的 CLAP 向量,Qwen-Music 的 Melody-CoT 只规划旋律轮廓,创作者既看不懂这些中间表示,也无法在音频合成前检查和修改编曲决策。第三,全局文本提示只能笼统描述风格、情绪和配器,无法表达具体创作意图——比如某个乐句如何发展、和弦在哪里变化、副歌旋律与主歌如何呼应——缺少可检查、可编辑的结构化控制接口。
本文的目标是本文的目标是构建 StepAudio 3 Music——一个支持显式音乐规划与开放域文本控制的大规模长时音乐生成模型。具体任务能力有四项:最长 5 分 30 秒的完整歌曲生成(歌词加文本提示)、器乐生成、从干声生成完整伴奏混音(vocal-to-mix),以及保留参考旋律而改变风格的翻唱合成。为实现这些能力,论文设定三个技术子目标:其一,设计面向生成(而非面向重建)优化的音乐 tokenizer,在保留声学信息的同时让语言模型易于预测;其二,引入人类可读、可编辑的显式编曲规划接口,使和弦、节奏、旋律、曲式在声学合成之前以结构化符号形式存在;其三,通过大规模渐进式训练课程(大规模预训练、多任务中期训练、高质量退火、SFT、DPO)让模型同时具备生成、理解与参考条件化能力,并在 MuQ-MuLan、AudioBox-Aesthetics、SongBench 与盲测竞技场中取得有竞争力的表现。
与已有工作不同的是,本文的独特切入角度有两个。第一是『瓶颈优先』的编解码器诊断范式:作者不以重建保真度作为选型标准,而是先固定离散表示、检验增强连续渲染器(更大 VAE 潜空间或更大 DiT)能否提升端到端生成质量,发现增益无法传导到 token 条件化通路上,从而确认离散表示才是有效瓶颈,再在统一 25Hz 帧率、相同 Conformer 骨干与多任务监督的受控条件下对比单码本 VQ、Semantic RVQ 与 Acoustic RVQ。由此得到反直觉的核心发现:重建最好的表示不一定是生成最好的表示——RVQ 从真值 token 重建更好,但对自回归语言模型更难预测。第二是把标准音乐符号记谱 ABC 引入思维链:不同于 MusiCoT 的不可读 CLAP 向量或 Melody-CoT 的旋律 token,ABC 记谱是人类可读的乐谱等价物,能显式表达和弦、拍号、调性、小节结构与旋律,且可直接被外部文本 LLM 阅读和编辑,形成『生成计划—修改计划—合成音频』的可解释创作工作流,这是与以往隐式中间表示的本质区别。
核心方法
方法的直觉是把音乐生成分解为『组织音乐序列』与『渲染声学细节』两个解耦阶段,并用一个可读的符号计划桥接二者。技术路线分三层。第一层是 StepAudio Music Tokenizer:24kHz 音频经 100Hz Mel 前端下采样到 50Hz,送入 24 层双向 Conformer(约 0.6B 参数,隐藏维度 1024),在中间第 12/13 层之间插入 65536 项单码本 VQ,每帧输出一个离散 token,标称码率为 50 帧/秒 × 16 比特 = 800 bit/s。第二层是 MoE 自回归模型(由文本 LLM 初始化),条件于歌词、文本提示和可选的任务参考预测音乐 token;在 ABC-CoT 模式下采用两遍因子分解 $p_\theta(a, m_{1:T} \mid c) = p_\theta(a \mid c) \prod_{t=1}^{T} p_\theta(m_t \mid c, a, m_{<t})$,其中 $c$ 是歌词与文本条件,$a$ 是 ABC 编曲计划,$m_t$ 是音乐 token:第一遍先写计划,第二遍把计划拼入上下文再逐 token 预测。第三层是流匹配 DiT 渲染器(0.9B):以 50Hz token 为条件预测 StepAudio VAE 的 50Hz、64 通道潜变量,冻结的 VAE 解码器输出 48kHz 波形;长曲采用 30 秒分块渲染,每块以前一块末尾 2 秒潜变量作为上下文保持声学连续性。tokenizer 与渲染器先独立训练并冻结,LLM 只优化序列预测。
核心创新有两点。第一是『面向生成的表示选择』:在统一 25Hz 帧率、相同骨干与多任务监督的受控对比中,Semantic RVQ 与 Acoustic RVQ 从真值 token 解码的重建保真度显著优于单码本 VQ,但端到端生成结果相反——Acoustic RVQ 的声学残差特征未经预聚类,FastLM 几乎无法预测,生成音频保真度与音乐性都差;Semantic RVQ 可被可靠预测,但残差码本间的误差聚合导致内部专家评价音乐性弱;单码本 VQ 仅牺牲少量保真度却保持良好音乐性。进一步的 25Hz 对 50Hz 消融显示 50Hz 凭借双倍 token 级预测目标提升音乐性(同一语料提供两倍训练 token),最终采用 50Hz、65536 项单码本。这与『多码本容量决定质量』的行业直觉相反,是全文最重要的设计依据。第二是 ABC-CoT:MoE 模型先用 ABC 记谱生成包含和弦、速度、拍号、调性、小节数与旋律序列的编曲计划,再条件于该计划预测音乐 token。与 MusiCoT、Melody-CoT 等隐式中间表示不同,ABC 计划可被人直接检查,还可交由外部文本 LLM 编辑后再送回同一模型合成,把显式音乐决策放进生成上下文,形成可干预的创作接口。
方法步骤详情
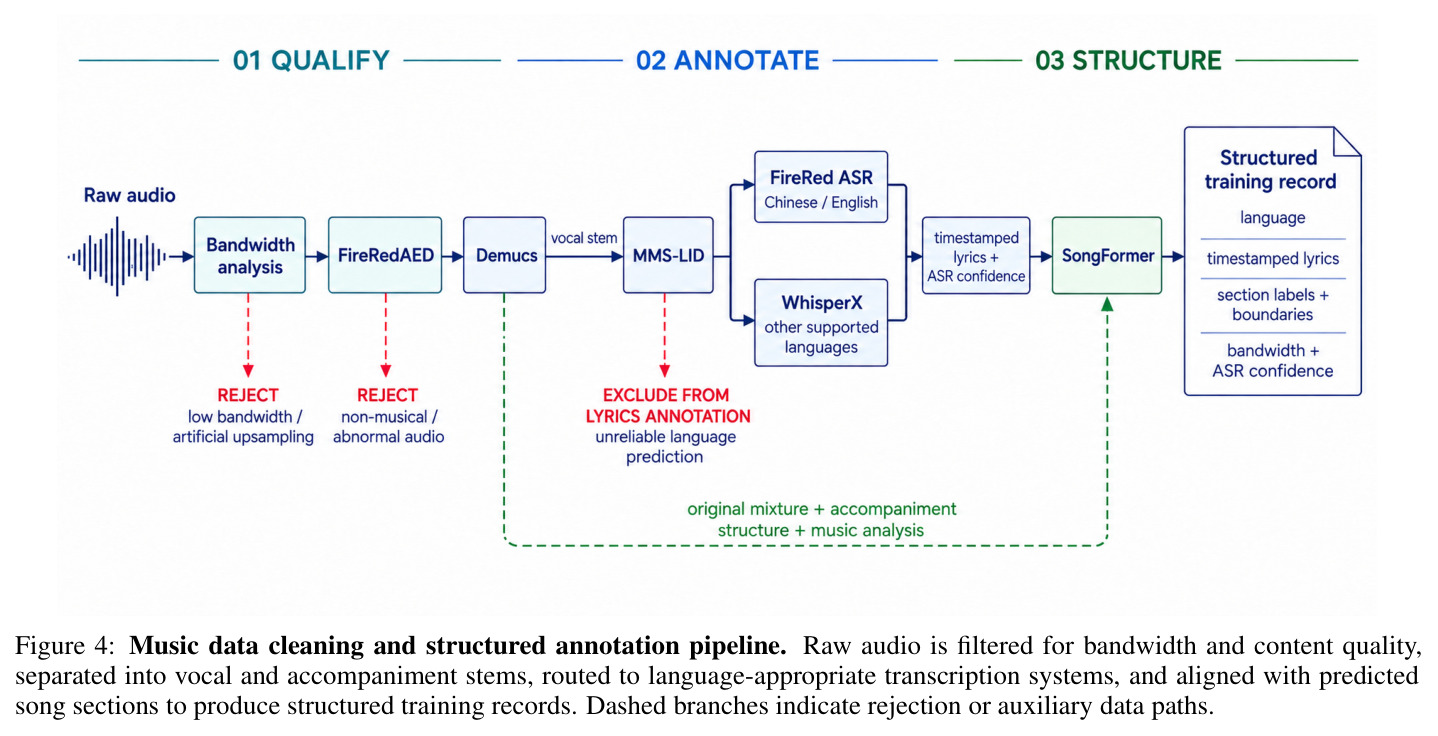
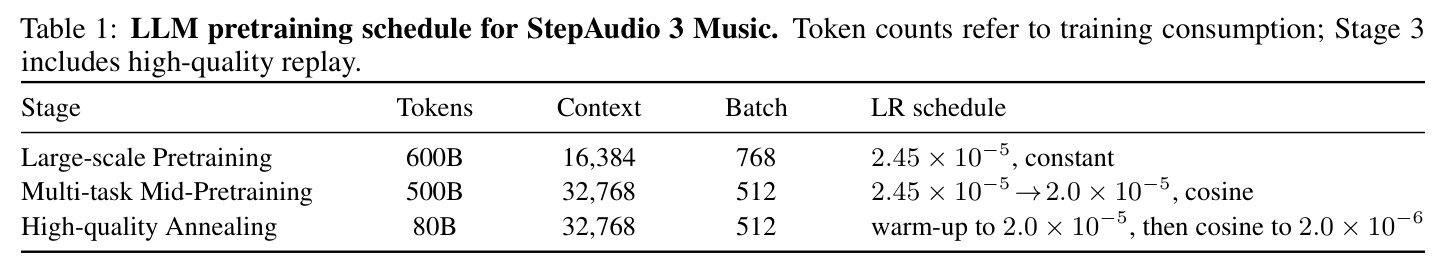
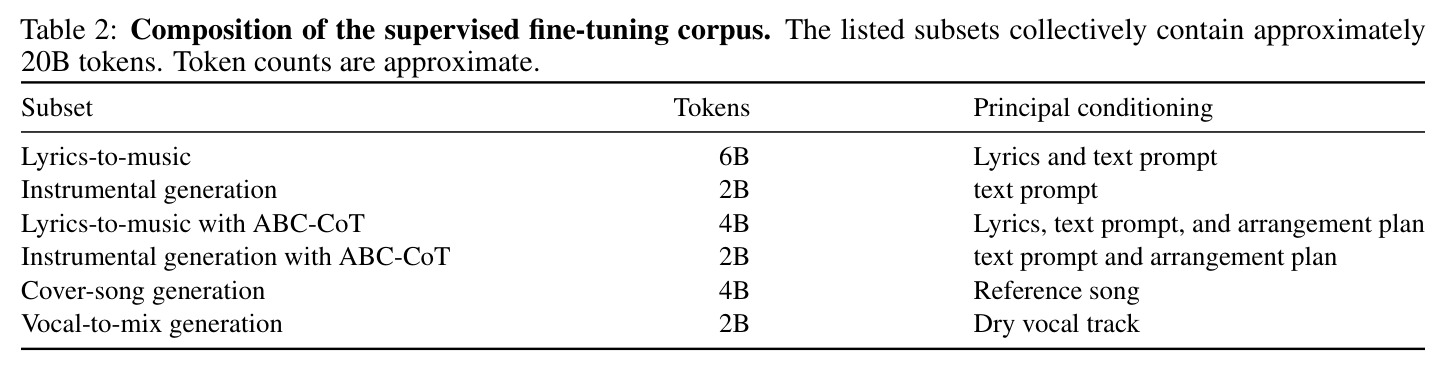
实施分五步。第一步,数据管道:原始音频经频谱带宽分析过滤低带宽或疑似人工升采样录音;用 FireRedVAD 的音频事件检测模块识别语音、歌唱、音乐并过滤非音乐内容;Demucs 分离人声与伴奏;MMS-LID 识别主要人声语言后,中文和英文歌曲用 FireRed ASR 转写、其他语言用 WhisperX 转写,保留每段歌词的时间戳与置信度;SongFormer 将整曲切分为前奏、主歌、副歌、桥段、尾奏,按时间重叠把歌词段对齐到段落,形成含质量信号的结构化训练记录。第二步,tokenizer 三阶段训练:Stage 1 用 BEST-RQ 自监督目标(在线分支向连续波形段注入高斯噪声,预测冻结随机投影量化出的干净 Mel 目标,损失只在 50Hz 对应位置计算);Stage 2 加入整曲 CTC 歌词、Mel 重建与 Chroma 重建多任务监督;Stage 3 在第 12/13 层 Conformer 之间插入 65536 项单码本 VQ,总损失 $\mathcal{L}_{tokenizer} = \lambda_{CTC}\mathcal{L}_{CTC} + \lambda_{Mel}\mathcal{L}_{Mel} + \lambda_{Chroma}\mathcal{L}_{Chroma} + \lambda_{VQ}\mathcal{L}_{VQ}$。第三步,冻结 tokenizer,训练 0.9B 流匹配 DiT 从 50Hz token 预测 VAE 潜变量,训练样本为 2 秒潜变量上下文加 30 秒目标段,推理时用前块生成的潜变量替代真值上下文。第四步,LLM 三阶段预训练:Stage 1 约 600B token(上下文 16,384、全局 batch 768、常数学习率 $2.45\times10^{-5}$,500B 歌词到音乐生成 + 100B 音乐到歌词识别);Stage 2 约 500B token(上下文 32,768,引入 ABC-CoT 与参考条件任务,32% 生成、16% ABC-CoT、20% 理解、32% 其他);Stage 3 约 80B 高质量退火 token(学习率先 warm-up 至 $2.0\times10^{-5}$ 再余弦衰减至 $2.0\times10^{-6}$)。第五步,后训练:约 20B token 的 SFT(6B 歌词到音乐、4B ABC-CoT 歌词到音乐、4B 翻唱、2B 器乐、2B ABC-CoT 器乐、2B 干声转混音,按流派分组用 SongBench 音乐性排序筛选),随后基于约 500 个提示、每提示 4 个条件实例各采样 4 个候选的专家排序构建约 2,000 偏好对做 DPO。
技术新颖性
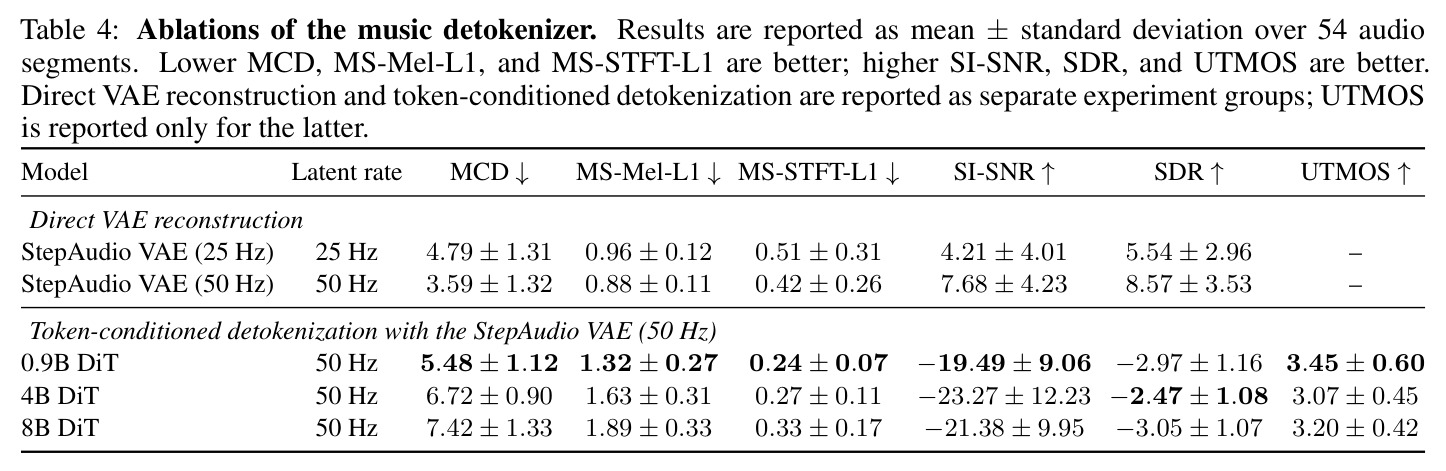
技术新颖性体现在三个层面。第一,提出以端到端生成质量为准绳的瓶颈优先诊断法:先固定离散表示,检验更大的 VAE 潜空间(25Hz 对 50Hz)与更大的 DiT(0.9B、4B、8B)能否改善最终音频,结果容量增益无法传导到 token 条件化通路上(0.9B DiT 的 MCD 5.48 反而优于 4B 的 6.72 与 8B 的 7.42),从而科学定位了离散瓶颈——这与音频编码领域普遍追求重建保真度的做法形成方法论对比。第二,首次系统证明在音乐生成场景下单码本 VQ 优于多码本 RVQ,把语言模型对 token 序列的可预测性提升为一等设计标准,修正了『多码本容量决定质量』的直觉,并用 50Hz 高帧率在不牺牲单流预测结构的前提下增加监督密度。第三,ABC-CoT 是首个以标准符号记谱作为音乐思维链中间表示的方案:训练同时覆盖音乐到 ABC(理解)与 ABC 到音乐(生成)双向任务,把符号描述与声学实现连接;推理时可引入外部文本 LLM 编辑 ABC 计划再送回同一模型合成,形成可解释、可干预的创作接口。相比之下,MusiCoT 的 CLAP 量化向量与 Melody-CoT 的旋律 token 均不可读不可编辑,InstructME 等只在条件端使用和弦而未把计划作为显式中间产物。
实验结果
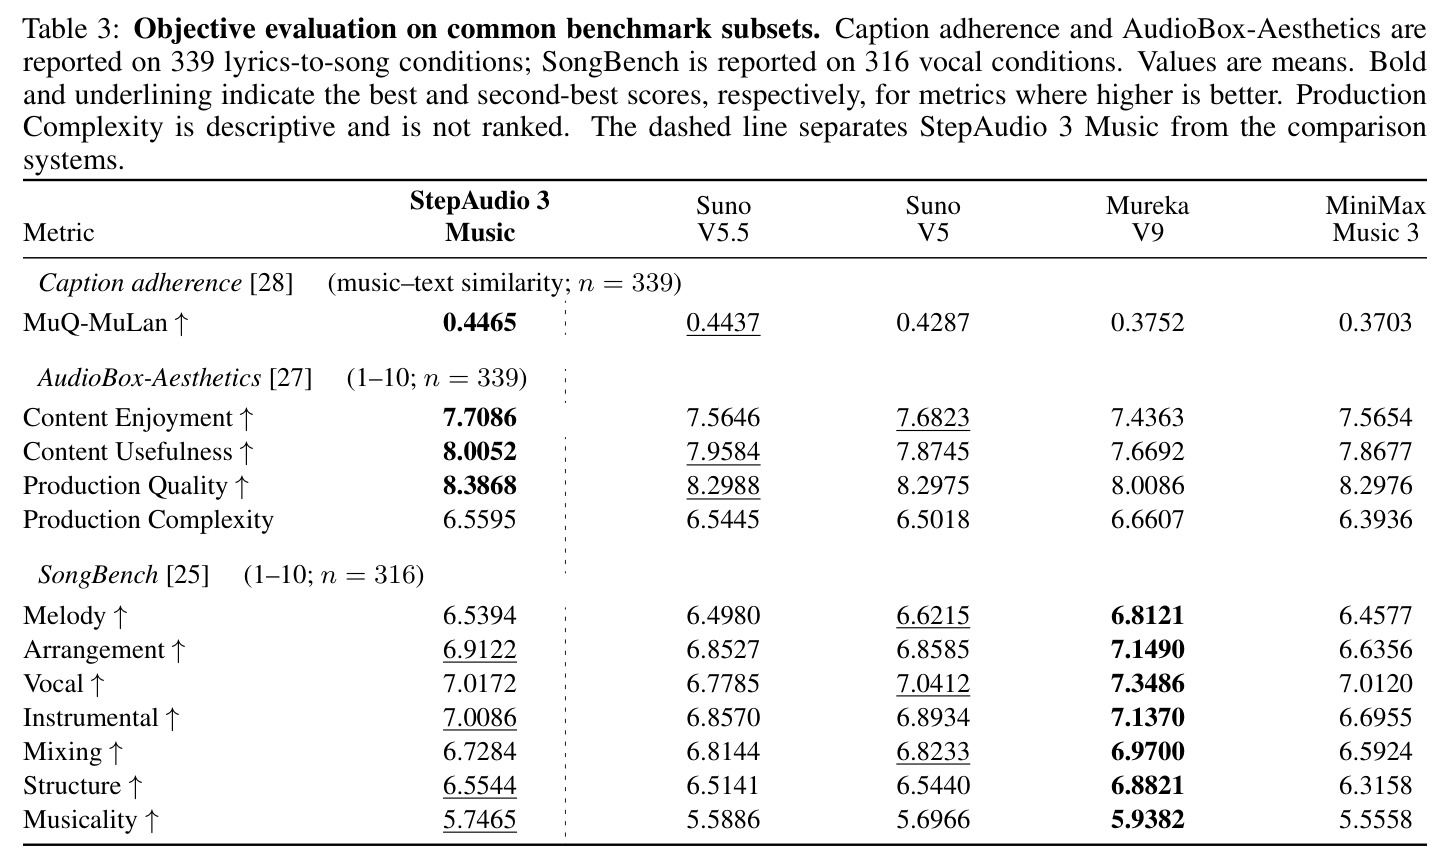
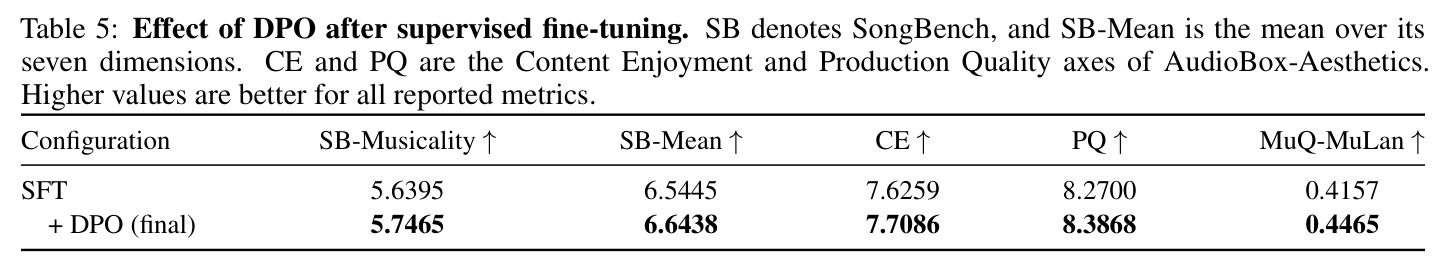
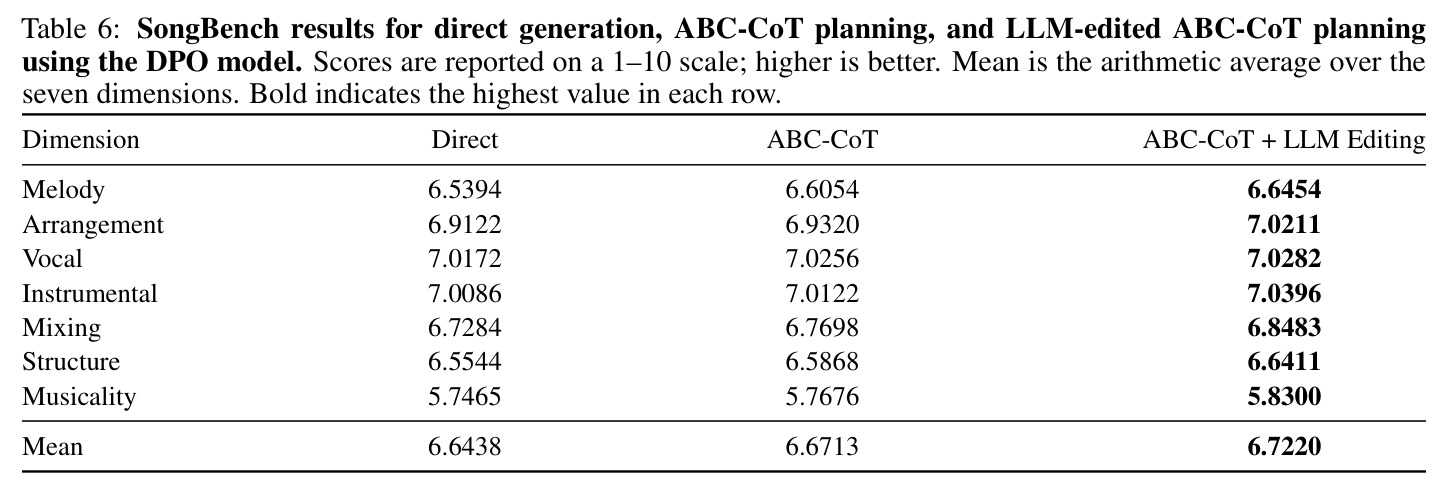
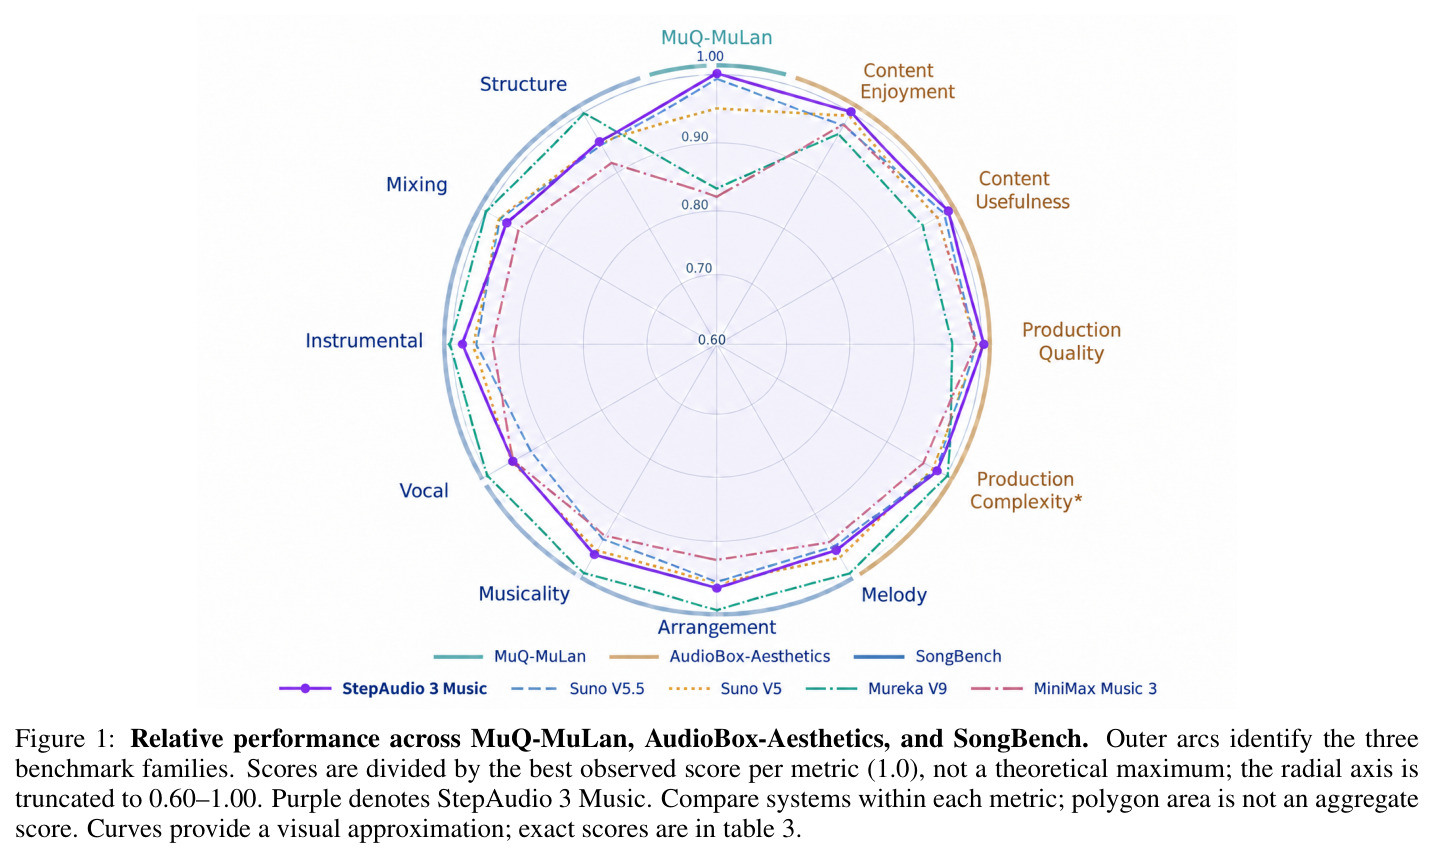
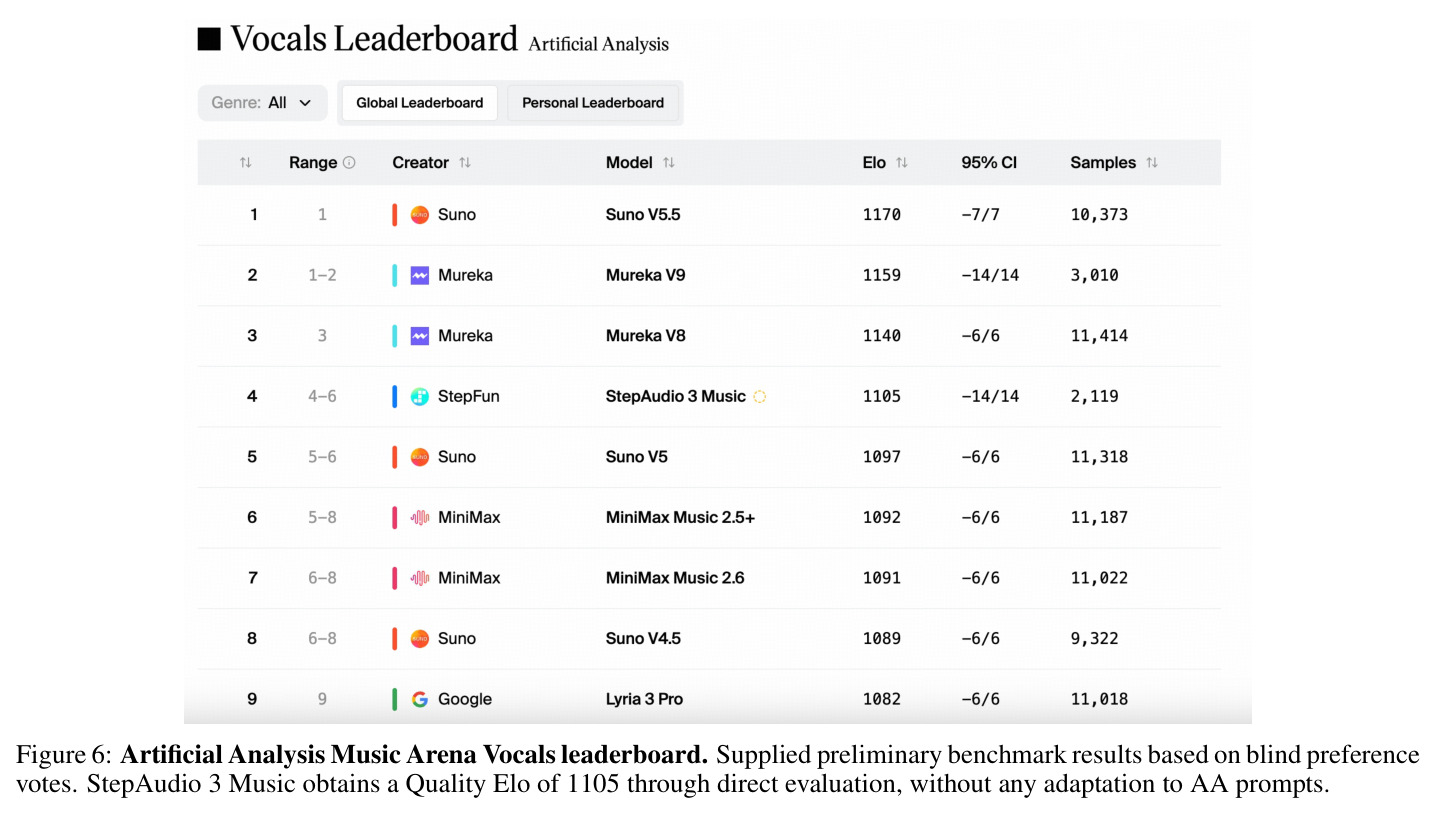
核心发现分五组。其一,客观评测(339 个歌词到歌曲公共子集):StepAudio 3 Music 的 MuQ-MuLan 相似度 0.4465 为评测系统最高(Suno V5.5 0.4437、Suno V5 0.4287、Mureka V9 0.3752、MiniMax Music 3 0.3703);AudioBox-Aesthetics 的内容愉悦度 7.7086、内容有用性 8.0052、制作质量 8.3868 三项均列第一;SongBench(316 个人声条件)上 Mureka V9 各维度领先(如 Musicality 5.9382 对本文 5.7465),本文处于第二梯队,说明不同评测族排序并不一致。其二,盲测竞技场:Artificial Analysis Music Arena Vocals 榜 Quality Elo 1105,位列第四,落后 Suno V5.5 与 Mureka,超过 Suno V5、MiniMax 等系统,且未经任何 AA 提示适配。其三,渲染器消融(54 段音频):50Hz VAE 直接重建优于 25Hz(MCD 3.59 对 4.79,SI-SNR 7.68 对 4.21);固定 tokenizer 后 DiT 从 0.9B 扩到 4B、8B 无一致增益(0.9B 的 MCD 5.48、UTMOS 3.45 反而最好),证实 tokenizer 是信息瓶颈。其四,DPO 使全部五项报告指标提升:SongBench 七维均值 6.5445 升至 6.6438,Musicality 5.6395 升至 5.7465,内容愉悦度 7.6259 升至 7.7086,制作质量 8.2700 升至 8.3868,MuQ-MuLan 0.4157 升至 0.4465。其五,规划与编辑消融(基于 DPO 模型):SongBench 均分从 Direct 6.6438 到 ABC-CoT 6.6713(+0.0275),再加一轮文本 LLM 编辑计划后达 6.7220(累计 +0.0781),其中 Mixing +0.1199、Arrangement +0.1089、Melody +0.1060、Structure +0.0867、Musicality +0.0835,七个维度全部改善。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 歌词到歌曲生成(339 条件) | MuQ-MuLan 文本-音乐相似度 | 0.4465 | Suno V5.5 0.4437 / Suno V5 0.4287 / Mureka V9 0.3752 / MiniMax Music 3 0.3703 | 较最强基线 Suno V5.5 高 0.0028,五系统中第一 |
| 歌词到歌曲生成(339 条件) | AudioBox-Aesthetics 内容愉悦度 CE(1-10) | 7.7086 | Suno V5 7.6823 / Suno V5.5 7.5646 / MiniMax 7.5654 | 较最强基线 Suno V5 高 0.0263,排名第一 |
| 歌词到歌曲生成(339 条件) | AudioBox-Aesthetics 制作质量 PQ(1-10) | 8.3868 | Suno V5.5 8.2988 / MiniMax 8.2976 / Suno V5 8.2975 | 较最强基线 Suno V5.5 高 0.0880,排名第一 |
| 歌曲细粒度质量(316 人声条件) | SongBench 七维均分(1-10) | 6.6438(Direct)/ 6.7220(ABC-CoT + LLM 编辑) | Mureka V9 在各单一维度领先(如 Musicality 5.9382 对本文 5.7465) | 对商业系统具竞争力;规划+编辑较自身 Direct 提升 +0.0781 |
| 盲测人偏好(Artificial Analysis Music Arena Vocals) | Quality Elo | 1105 | Suno V5.5 与 Mureka 排名更高;Suno V5、MiniMax 等排名更低 | 总榜第四,且未做任何 AA 提示适配 |
局限与改进
作者明确承认的局限包括:SongBench 同时用于 SFT 数据筛选,评估分数与数据选择不完全独立;主对比每个条件只生成一个样本,未测量采样种子间方差;基线通过 Suno、Mureka、MiniMax 的托管服务接口收集,无法本地复现其服务端推理配置;公共子集保留了原始七系统的共同有效条件,排除了任一系统失败的条件;评测集中于人声与歌词条件任务,不能外推到器乐生成、翻唱合成、干声转混音;MuQ-MuLan 相似度与整体质量不能证明生成音频对 ABC 计划中具体音符、和弦、小节的遵循;ABC-CoT 与 LLM 编辑比较的是完整推理工作流,未隔离各组件贡献;音乐理论知识的解释只是对结果的推测,定性听感观察不构成受控听音实验。我的补充观察:DPO 偏好对仅约 2,000 个,规模小且完全依赖内部专家排序;ABC-CoT 单独增益很小(+0.0275),说明模型自生成计划的音乐理论质量有限,强依赖外部编辑 LLM 的能力;Arena 排行榜是初步快照,且任务格式(系统自写歌词)与内部评测(固定歌词)不同,两类证据不可直接互证;MoE 主干的总参数量、专家数等关键配置未披露,影响对系统规模的判断。
独立分析的弱点
独立分析发现以下弱点。第一,ABC 计划遵循度完全未量化:论文自己指出无法确认生成音频是否遵循计划中的音符与和弦,若模型『无视』计划,ABC-CoT 的价值就只剩间接的正则化效应,改进方向是引入和弦检测、调性识别、旋律轮廓抽取等指标构建计划遵循度评测集,并把它作为优化目标。第二,单样本评测掩盖采样方差:温度 0.9、top-p 0.95 的一次性生成可能高估或低估系统间差异,应对每条件多样本生成并报告均值与方差,尤其 SongBench 各维度差距多在 0.1 量级,方差可能改变排序。第三,分块渲染的 2 秒上下文是短记忆:30 秒块之间仅靠 2 秒潜变量衔接,超长曲式(如再现部呼应前奏主题)可能断裂,可引入层级化记忆或全曲粗结构条件向量。第四,DPO 数据工程量大而规模小:约 500 提示 × 16 候选的专家盲听排序仅得 2,000 对,难以覆盖风格空间,可结合 AI 反馈或训练离线偏好模型扩充。第五,token 条件渲染明显弱于直接 VAE 重建:DiT 渲染的 SI-SNR 为 -19.49、UTMOS 仅 3.45,说明离散瓶颈损失了大量声学信息,可探索推理时只预测语义流、渲染时联合残差流的混合表示,或在更高帧率与码率上重新权衡。第六,推理成本高:ABC-CoT 需要两遍自回归生成加一次外部 LLM 编辑,50Hz 序列长度翻倍,实时性存疑,论文未报告推理延迟。
未来方向
作者在结论中提出的方向包括:加强对符号音乐计划的遵循度,同步改进 tokenizer 与潜变量渲染器,扩展基于 ABC 的控制能力,并改进长时一致性、复杂编曲、人声自然度与高频重建。基于论文成果还可延伸:其一,把 ABC-CoT 从一次性计划升级为人机协同的交互式编曲工作流,用户在合成前直接修改 ABC 计划(换和弦、加速、转调),这是与端到端黑盒系统差异最大的产品化机会;其二,用更强音乐理论能力的 LLM 做多轮迭代计划优化,或训练专门的计划评审模型替代通用文本 LLM 编辑;其三,把计划遵循度指标(和弦准确率、旋律轮廓相关性)纳入 DPO 或 GRPO 类在线强化学习的奖励函数,使『按计划生成』成为可显式优化的目标,弥补当前遵循度不可测的缺口;其四,探索语义-声学双流折中方案,如推理时只自回归预测语义单码本、渲染时以真值风格的残差流为辅助目标训练;其五,系统评测器乐生成、翻唱合成、干声转混音三个未被主评测覆盖的任务,并扩展到纯器乐长篇、流式实时生成等场景。
复现评估
复现难度评估:极高。论文未提及开源代码、模型权重或训练数据,仅在项目页(stepaudiollm.github.io/step-audio-3-music)提供音频演示。算力与数据门槛方面,预训练语料超过 1 亿首歌、500 万小时音频、约 1 万亿 token,LLM 三阶段共消耗约 1180B token,MoE 主干规模未披露(已知 tokenizer 约 0.6B、DiT 0.9B),远超学术实验室可负担范围。数据管道依赖多个第三方模型(Demucs、MMS-LID、FireRed ASR、WhisperX、SongFormer、FireRedVAD),这些模型的获取、路由与组合调优本身就有相当工作量。基线对比需通过 Suno、Mureka、MiniMax 的商业产品接口在统一时间窗口内收集输出;339/316 条件的公共评测子集、约 2,000 个专家偏好对均未公开。相对可复现的是方法论:瓶颈优先诊断协议、25Hz 统一帧率的 VQ 对 RVQ 受控对比、tokenizer 三阶段训练配方、ABC-CoT 的 Direct/CoT/编辑三模式推理流程,以及 SongBench、AudioBox-Aesthetics、MuQ-MuLan 的评测协议,研究者可在自训的小规模模型上复用这些设计,但完整复现论文数字基本不可行。
论文图表