YuE2:在前沿质量下统一符号与音频音乐生成 YuE2: Unifying Symbolic and Audio Music Generation at Frontier Quality
单模型先写可读乐谱再渲染全曲,作曲显式化且质量比肩 Suno
前置知识
ABC 记谱与符号音乐表示
ABC 是一种纯文本的音乐记谱法,用头部字段声明速度($Q$)、拍号($M$)、调性($K$),用小节线、段落标签组织曲式,用和弦符号标记和声,并以人声/器乐声部写出旋律,例如 $\texttt{ABC M:4/4 K:F\#m "F\#m"a4a4c'8a8}$。因为它是文本,可与普通语言模型共享 BPE 词表,模型能像写代码一样逐 token 生成乐谱,人也像读代码一样检查和修改它。
YuE2 的全部故事建立在'乐谱是可读可编辑的文本序列'之上:符号规划、乐谱编辑、agentic editing 都以 ABC 序列作为生成接口,不懂 ABC 就无法理解模型的中间产物与控制方式。
AR–NAR 混合架构与 Mixture-of-Transformers (MoT)
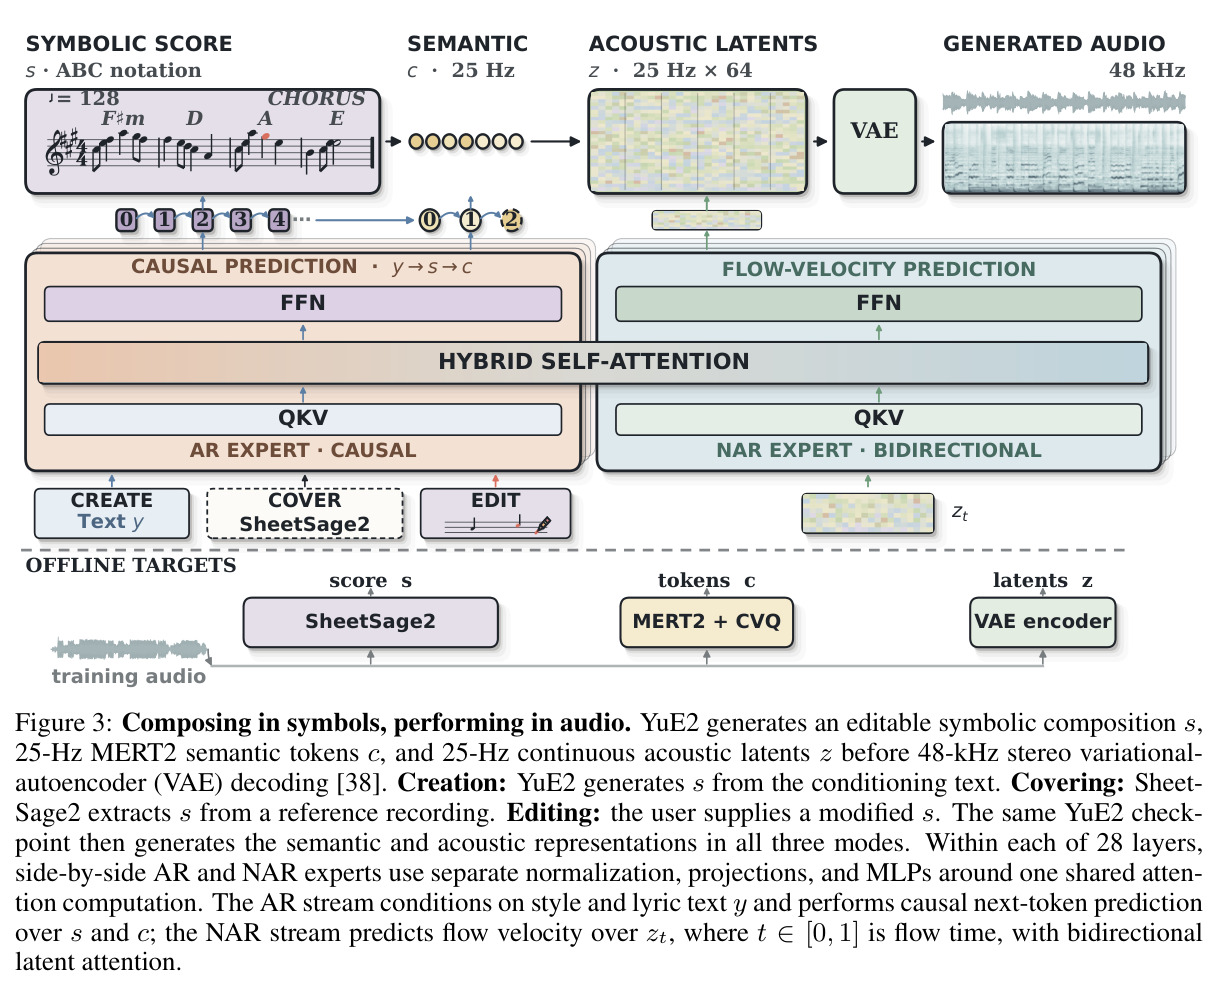
自回归(AR)逐 token 因果预测离散序列,非自回归(NAR)用双向注意力一次性并行生成整个连续序列。Mixture-of-Transformers 在同一 Transformer 骨干的每一层放两套并行的专家——各自的 RMSNorm、QKV/输出投影和 MLP,但共享同一次注意力计算与位置方案,再用混合掩码控制信息流:AR 位置对 AR 因果、对 NAR 遮蔽;NAR 位置可看全部 AR token 且 NAR 内部双向。
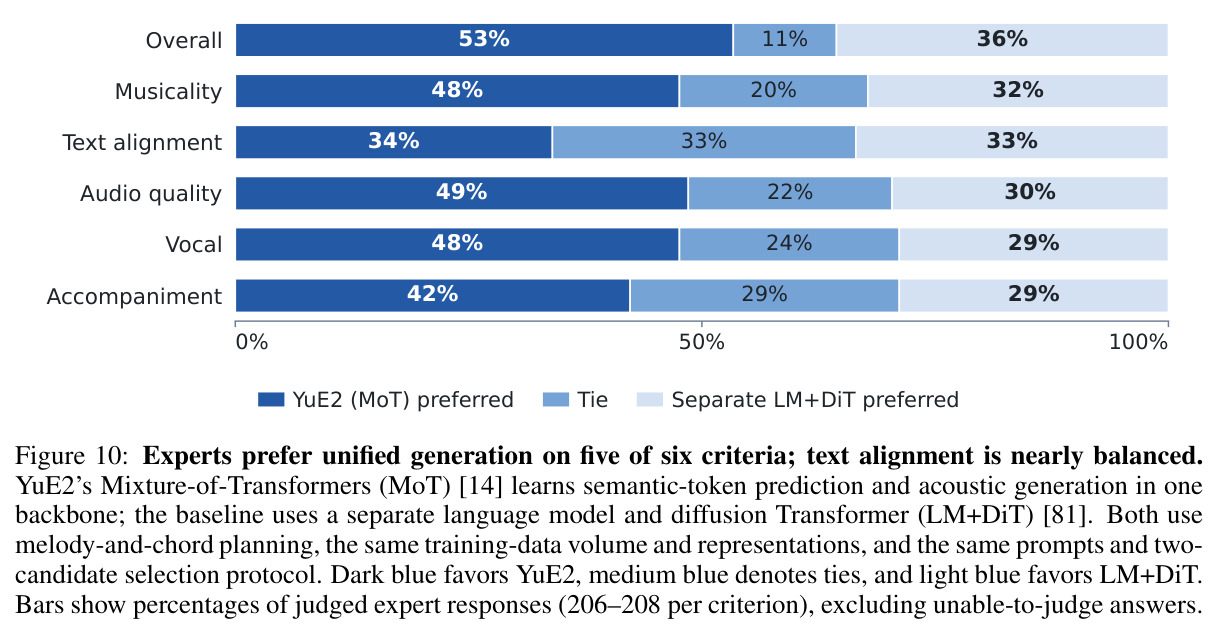
YuE2 用 28 层 MoT 在一个 3.58B 模型里同时完成'因果地写乐谱和语义 token'与'双向地生成声学 latent',并与 LM+DiT 分离架构做对照实验,这是理解其架构贡献的前提。
条件流匹配 (Conditional Flow Matching)
一种连续生成范式:定义从噪声到数据的线性插值路径 $z_t=(1-t)z_0+t\epsilon$,训练网络预测流速 $v_\theta(z_t,t)=\epsilon-z_0$,推理时从纯噪声出发沿速度场积分还原数据。相比扩散模型,训练目标是最小化 $\mathcal{L}_{FM}=\frac{1}{64|Z|}\sum_i\|v_\theta(z_t,t,y,s,c)_i-(\epsilon_i-z_{0,i})\|_2^2$,形式简单且允许少步采样。
YuE2 的 NAR 流用它从文本、乐谱、语义 token 条件并行生成 25 Hz×64 维声学 latent,再交 VAE 解码成 48 kHz 立体声波形;音频质量的口碑主要来自这一路。
语义音乐 token 与 RVQ/神经音频编解码
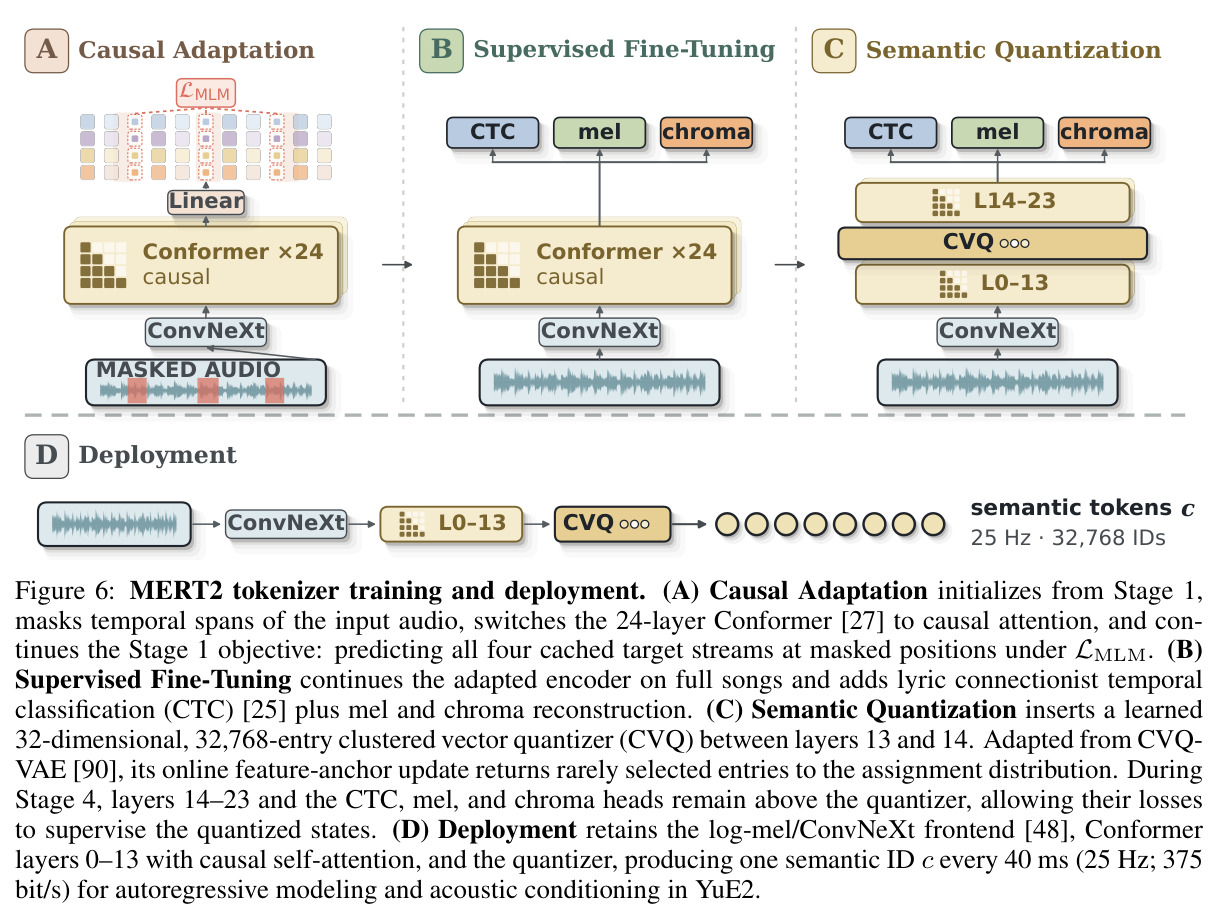
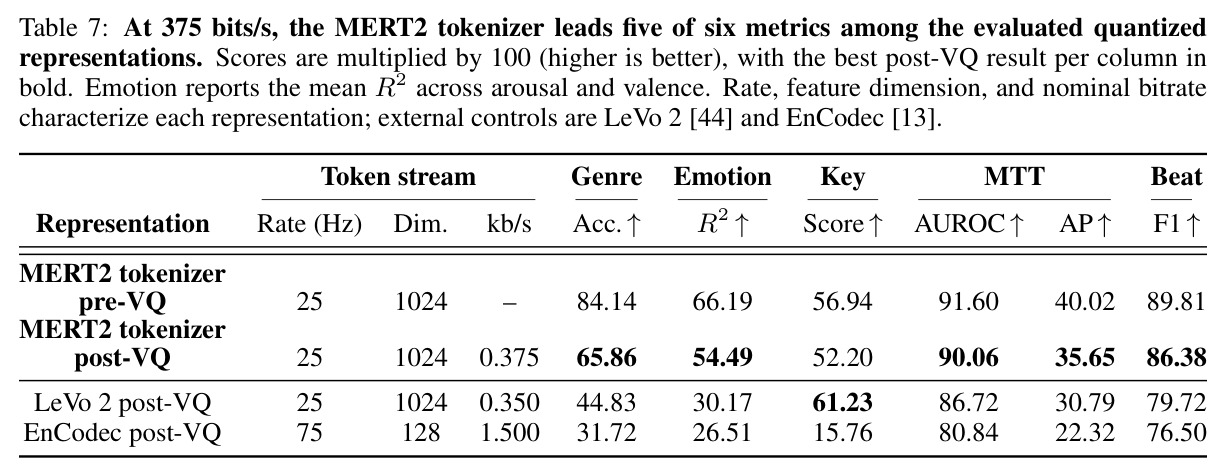
将音频压缩为离散 token 序列供语言模型建模。EnCodec 类声学编解码器用残差向量量化(RVQ)保波形细节但码率 high、语义弱;语义 token 则追求低码率下的高层音乐信息(MERT2 tokenizer 为 25 Hz、32,768 码本、375 bit/s)。CVQ 等在线码本更新策略通过把冷门码位拉回分配分布来维持码本利用率。
论文的关键配角是 375 bit/s 的 MERT2 语义 token:它既要支撑自回归生成,又要保留足够音乐结构(保留 pre-VQ 探针性能的 78.3–98.3%),这是全曲长序列建模可行的核心。
Lead-sheet 转写与 CRF 结构化解码
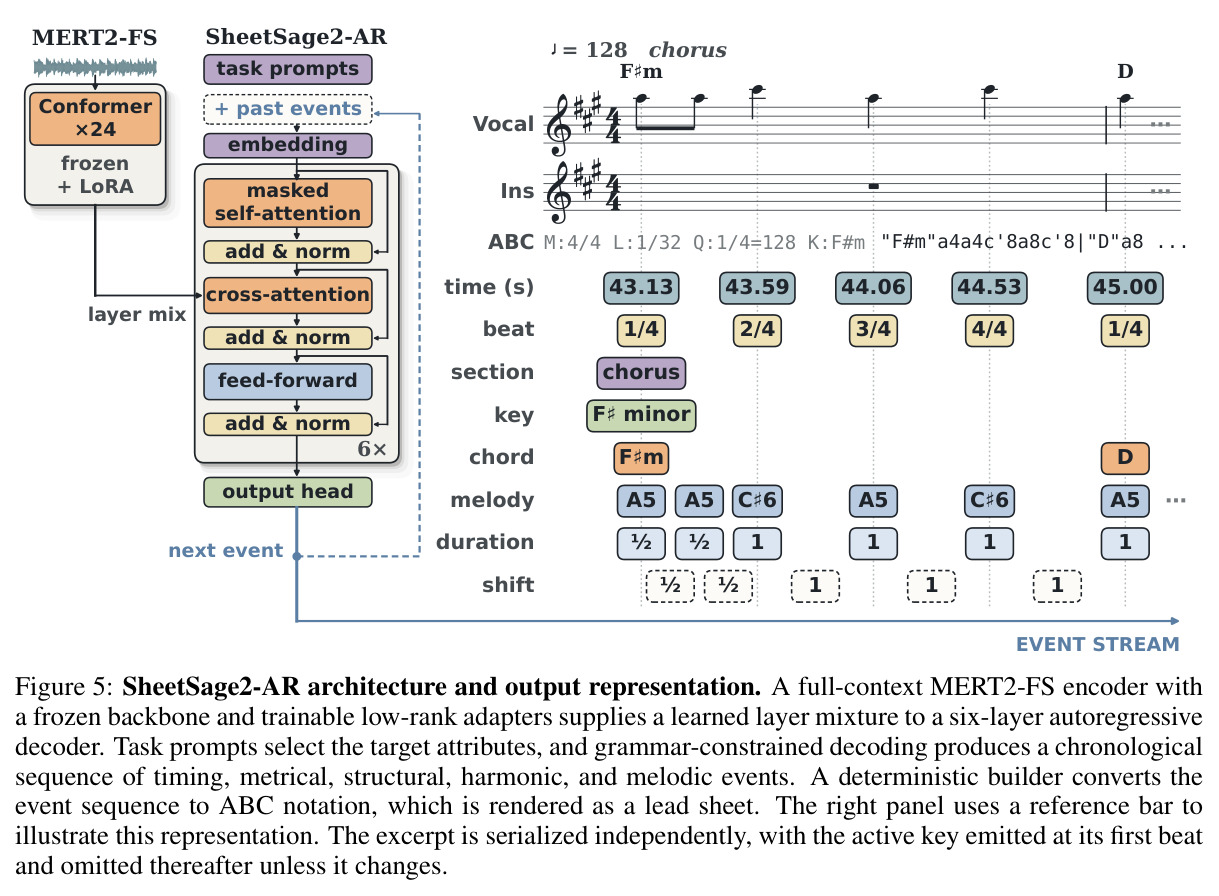
Lead-sheet 是流行音乐常用的简谱:主旋律+和弦+调性+节拍+曲式。音频转写需联合输出多属性;条件随机场(CRF)在神经网络的逐帧打分上加入时序约束(如节拍先于和弦、和弦须落在节拍网格上)做全局解码。SheetSage2-Prober 用 CRF 逐属性解码,SheetSage2-AR 则把所有属性编成一个按时间排序的统一事件词表,自回归生成。
YuE2 的训练乐谱标签全部由 SheetSage2 从无标注录音自动生成,'用模型造标签再让更强的学生反超教师'是其数据引擎,也是复现其训练管线必须理解的部分。
Classifier-Free Guidance (CFG) 与候选选择
训练时以一定概率随机丢弃条件(文本、歌词),推理时用有条件与无条件预测的外推放大条件影响,提升文本遵从度。另一个实用技巧是 best-of-N:同一 prompt 采样 $N$ 个候选,用自动指标(如 SongBench Musicality,再按 Q3O、PER 决胜)挑一个,以推理算力换质量。
YuE2 的对比协议统一采用'两候选取低 PER'、Bo8 则是八选一;理解这两个机制才能正确解读表格中 YuE2 与 YuE2 (Bo8) 两行数字的差别。
研究动机
现有音乐生成模型沿两条互不相通的路线发展,各卡在一个层级上。符号阵营(Music Transformer、SymPAC 等)显式生成旋律、和声、节奏与曲式,可读可改,但止步于乐谱,给不出带人声与混音的成品录音;音频阵营(MusicLM、MusicGen、YuE、Suno 等)直接产出完整歌曲,但作曲决策被隐式压进音频表征——想改一个和弦或重写一句副歌旋律,只能整体重新生成碰运气。论文用 Figure 2 的"渐进式音乐承诺"层级指出:文本说意图、乐谱定旋律和声节奏曲式、音频解决时值音色表情,而现有系统要么只覆盖上半层,要么跳过乐谱层直接落音频。更根本的障碍在数据:普通音频语料没有对齐的音符、和弦、节拍、段落标注,"先作曲后演奏"的范式因此长期无法在数十万小时规模上训练。此外,主流开源歌曲生成器(HeartMuLa、Qwen-Music、LeVo 2 等)普遍采用自回归 LM 加扩散 Transformer 的两模型串联架构,规划与渲染割裂在两个网络里,级联误差难以避免。
本文的目标是本文要构建一个单一模型,沿'渐进式音乐承诺'层级自上而下完成全曲生成:先写出人类可读的符号乐谱 $s$(含旋律、和弦、调、拍号、速度、曲式),再展开为 25 Hz 语义音乐 token $c$ 补足乐谱没规定的细节,最后实现为 48 kHz 立体声 latent $z$ 并解码成波形。具体目标有四层:其一,验证'符号作曲规划'能提升而非 merely 不损害成品质量——即先承诺旋律与和声,音频阶段在剩余自由度上做解释,会产生更好听的歌;其二,证明统一的 AR–NAR MoT 优于广泛使用的分离式 LM+DiT;其三,同一 checkpoint 要支持创作、乐谱编辑、零样本翻唱三种模式,让乐谱成为 generative interface;其四,为了让这一切从无乐谱标注的录音学出来,配套造出 MERT2(语义监督)与 SheetSage2(符号监督),并在 WildSongBench 自动指标与 4439 条专家盲听上达到与 Suno v4.5/v5 竞争的前沿水平。
与已有工作不同的是,独特切入是把"乐谱"从可选的外部控制条件升格为模型自己生成的第一等中间产物——模型既作曲又演奏,乐谱同时是计划、说明书和可编辑接口。与已有工作的差异清晰:Music ControlNet、JASCO 只跟随用户给定的控制信号,自己不做作曲;MusiCoT 规划量化音频-文本嵌入,ACE-Step 1.5 只规划速度、调性、结构等元信息,都不能以可读记谱完整指定旋律+和弦;Seed-Music 描述过专有 lead-sheet-to-song 流水线但无公开实现;符号系统(BACH 等)生成记谱后要靠外部工具合成。架构上,YuE2 用一个 28 层 AR–NAR Mixture-of-Transformers 把离散因果预测与连续流匹配融进同一次注意力计算,替代 LM+DiT 串联,直接回应"规划与渲染是否必须分开学"。数据上提出"监督自举":SheetSage2-Prober 造标签训练 SheetSage2-AR,学生反超教师;MERT2 用多视图量化目标让一个 632M 编码器同时服务理解与生成 token,两者共同把乐谱-音频层级变成可规模化学习。
核心方法
直觉上,写歌是先有草稿再进棚录音,录音阶段保留解释空间——时值微移、音色、表情都留给表演。YuE2 将其形式化为 $p_\theta(s,c,z\mid y)=p_{\theta,\text{AR}}(s,c\mid y)\,p_{\theta,\text{NAR}}(z\mid y,s,c)$:$y$ 是文本+歌词,$s$ 是 ABC 乐谱,$c$ 是 25 Hz 语义 token,$z\in\mathbb{R}^{T\times64}$ 是声学 latent(Oobleck VAE 从 48 kHz 立体声压缩 1920 倍)。AR 流与文本共享 BPE 词表,因果生成乐谱与语义 token,类型专属掩码防互串;NAR 流以含噪 latent 投影替换词嵌入,双向注意力并行预测流速,由 VAE 解码 48 kHz 立体声。三种模式只是 $s$ 来源不同:创作时模型自写,编辑时用户改好的 $\tilde{s}$ 作固定前缀,翻唱时 SheetSage2 从参考录音转写 $\hat{s}$ 再按新风格渲染——渲染接口完全一致,故无需翻唱专门训练。
核心创新两个层次。第一,"符号规划作为生成状态":乐谱不是控制信号,而是与语义 token 同流、同分词器的被生成中间产物;训练时四种任务(有/无乐谱 × 有/无语义 token)等比混合,同一 checkpoint 既能规划也能跳过规划,可做严格同权重消融。第二,AR–NAR MoT:28 层每层配 AR/NAR 两套专家(各自 RMSNorm、QKV/输出投影、MLP),共享同一次注意力,混合掩码实现"离散区因果、声学区双向、声学可读全部离散计划"——离散 token 看不见声学目标,声学帧则同时利用完整乐谱、语义轨迹与全局声学上下文。损失 $\mathcal{L}=0.25\,\mathcal{L}_{AR}+\mathcal{L}_{FM}$,前者为符号与语义 token 的交叉熵,后者为条件流匹配 $\mathcal{L}_{FM}=\frac{1}{64|Z|}\sum_i\lVert v_\theta(z_t,t,\cdot)_i-(\epsilon_i-z_{0,i})\rVert_2^2$,$z_t=(1-t)z_0+t\epsilon$。与 LM+DiT 的本质区别:串联架构中渲染器看不到规划器内部状态、级联误差累积;MoT 里声学专家每层都直接读乐谱与语义 token 的隐状态,联合训练使表示对齐。
方法步骤详情
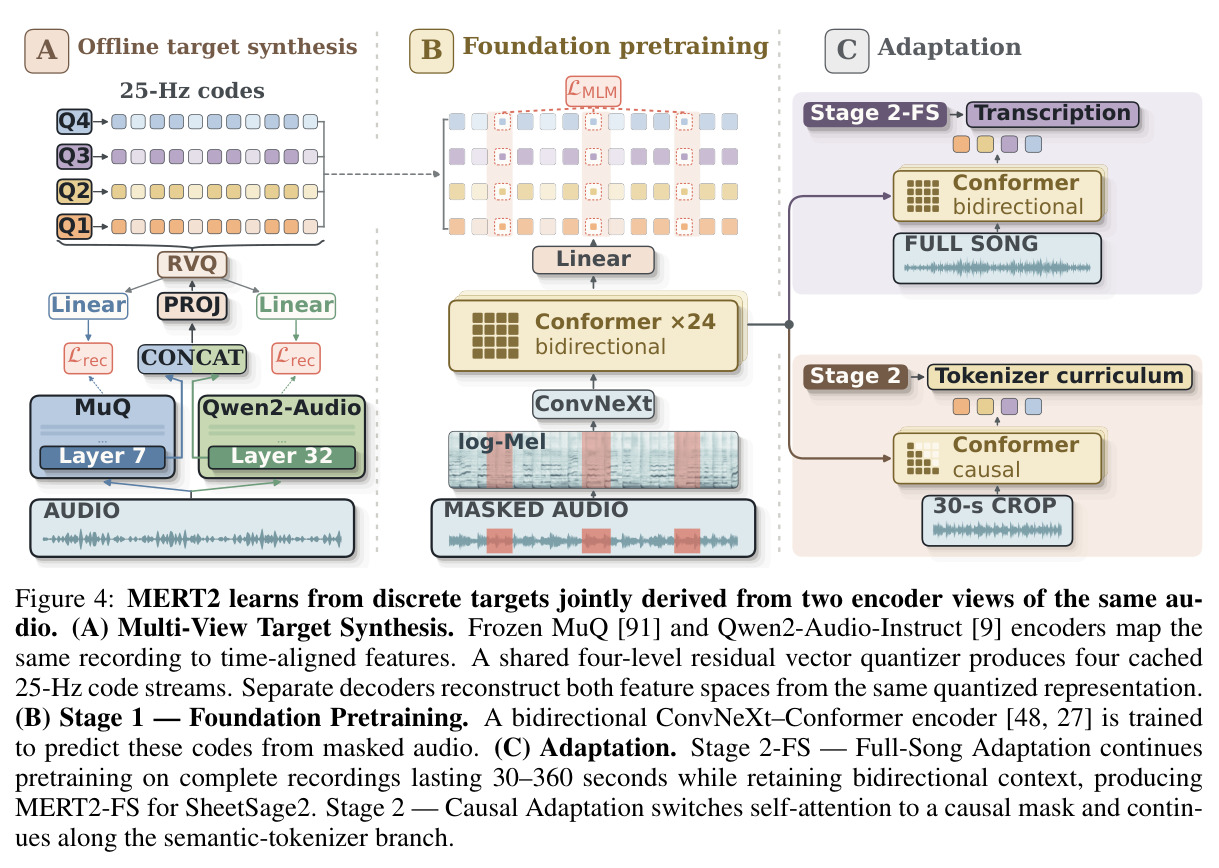
四条生产线。一,MERT2 目标合成与预训练:冻结 MuQ 与 Qwen2-Audio 编码同一录音,特征经融合网络与 4 级 RVQ 缓存为 4 路 25 Hz 码流;24 层 Conformer 在 70 万小时上对遮蔽帧预测这 4 路码。二,分叉适配:全曲分支保持双向注意力续训得 MERT2-FS(供 SheetSage2);tokenizer 分支切因果注意力,加歌词 CTC+mel/chroma 重建微调,再在 Conformer 第 13 层后插入 32,768 码本 CVQ 量化器,部署输出 25 Hz/375 bit/s token,码本利用率超 99%。三,SheetSage2:先训非自回归 Prober(CRF 解码,按节拍→调→和弦→结构→旋律顺序),以人类标注与 MIDI 渲染音频混合监督;再用 Prober 生成统一词表与时间约定的标签,训练自回归 SheetSage2-AR(冻结 MERT2-FS+LoRA,6 层 RoFormer 逐事件生成时间戳、节拍、音高、时值、和弦、调、结构),构建器转 ABC。四,YuE2 主模型:34.6 万小时、24,576 位置整曲打包、64 张 H800、三阶段(AR 预训练 6 万步→联合 4 万步→退火 6 千步),NAR 专家从 AR 层初始化,条件可丢弃支持 CFG;推理时 AR 写谱与语义 token,NAR 并行积分速度场,VAE 解码。
技术新颖性
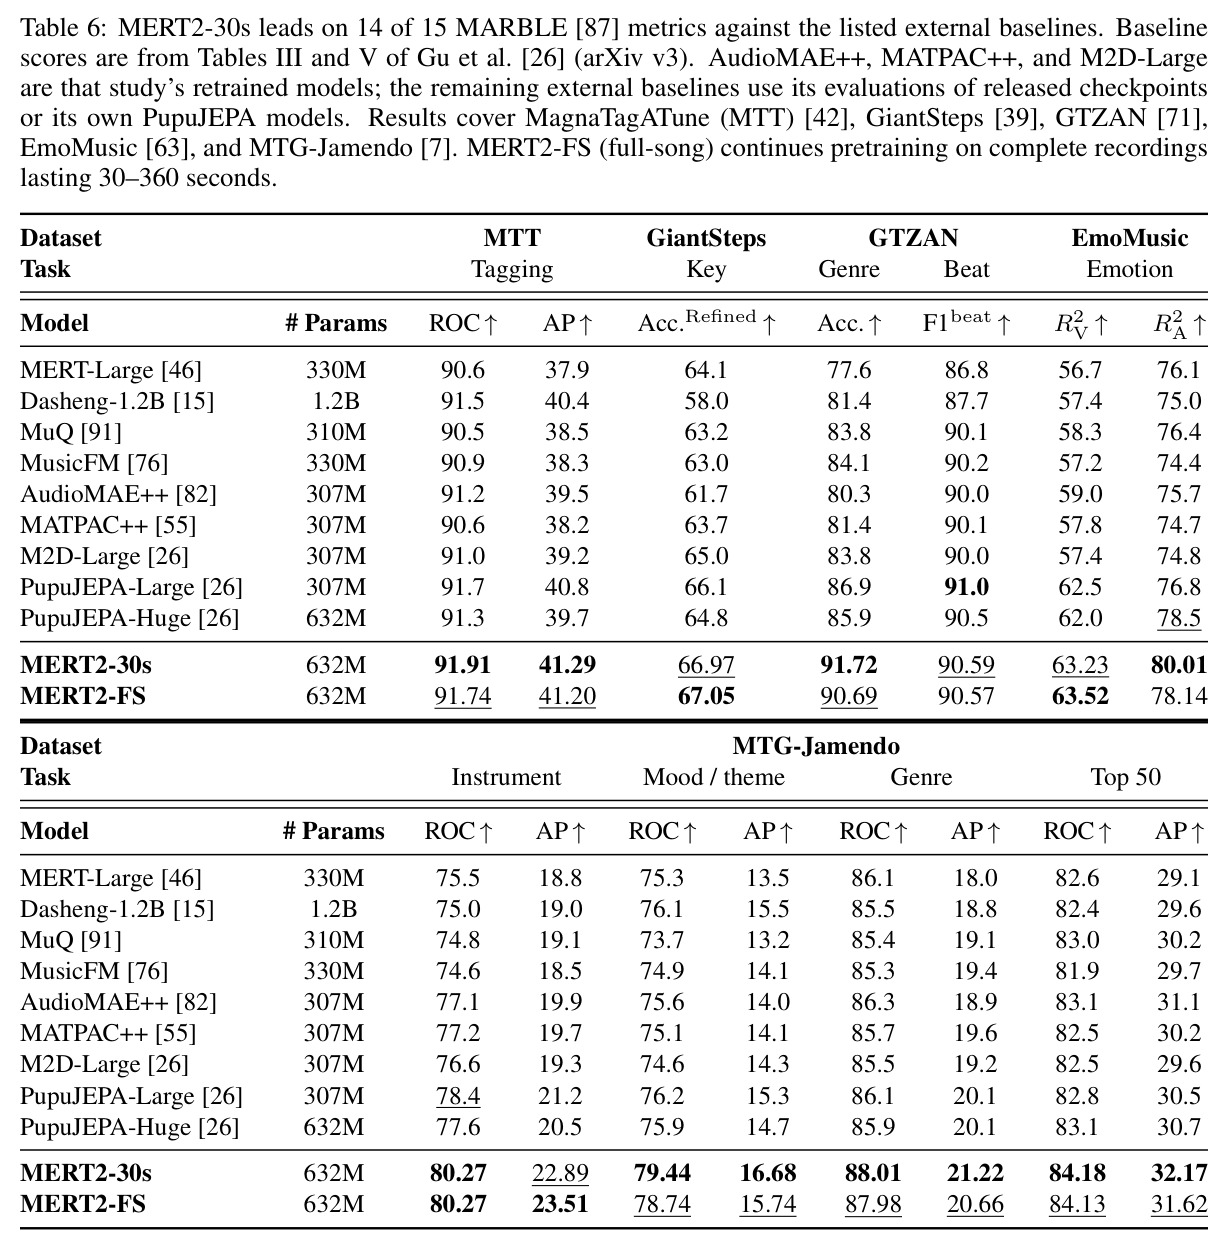
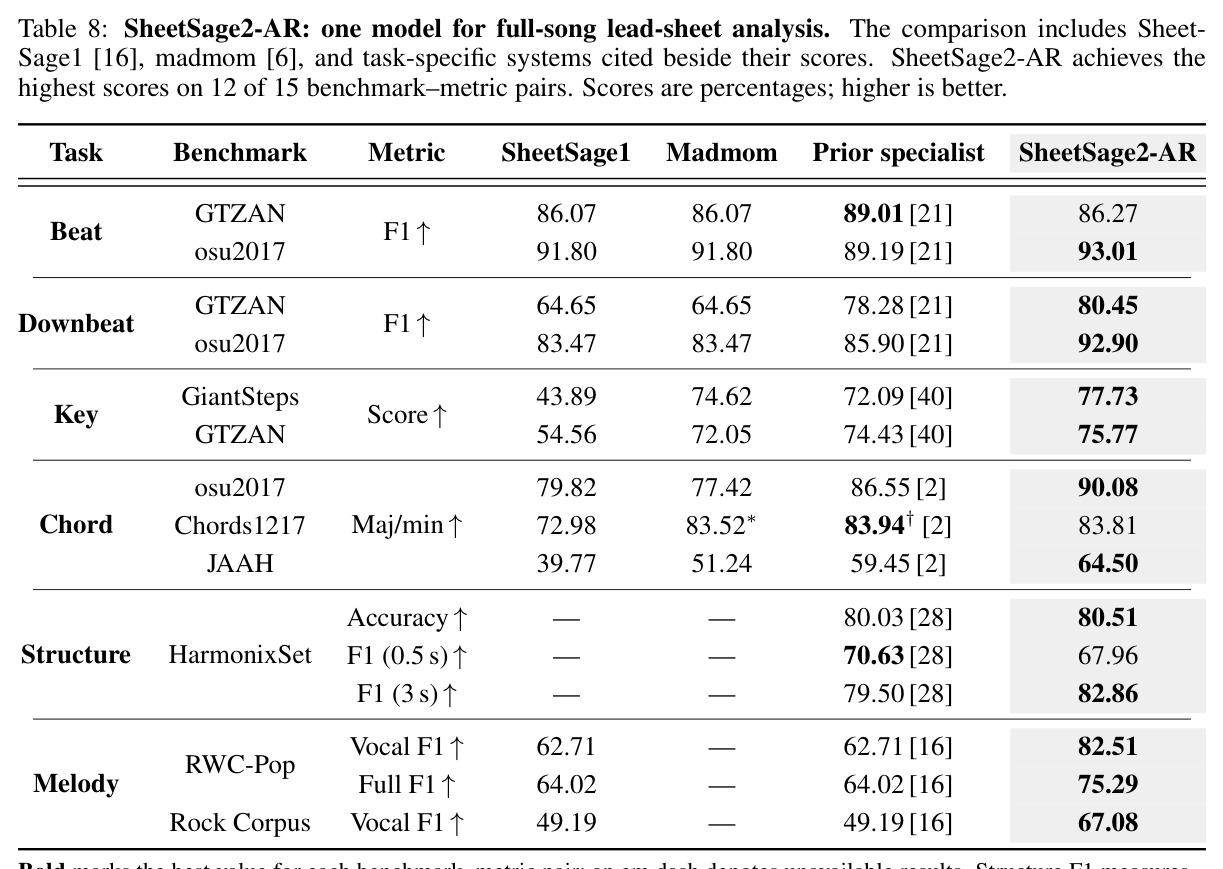
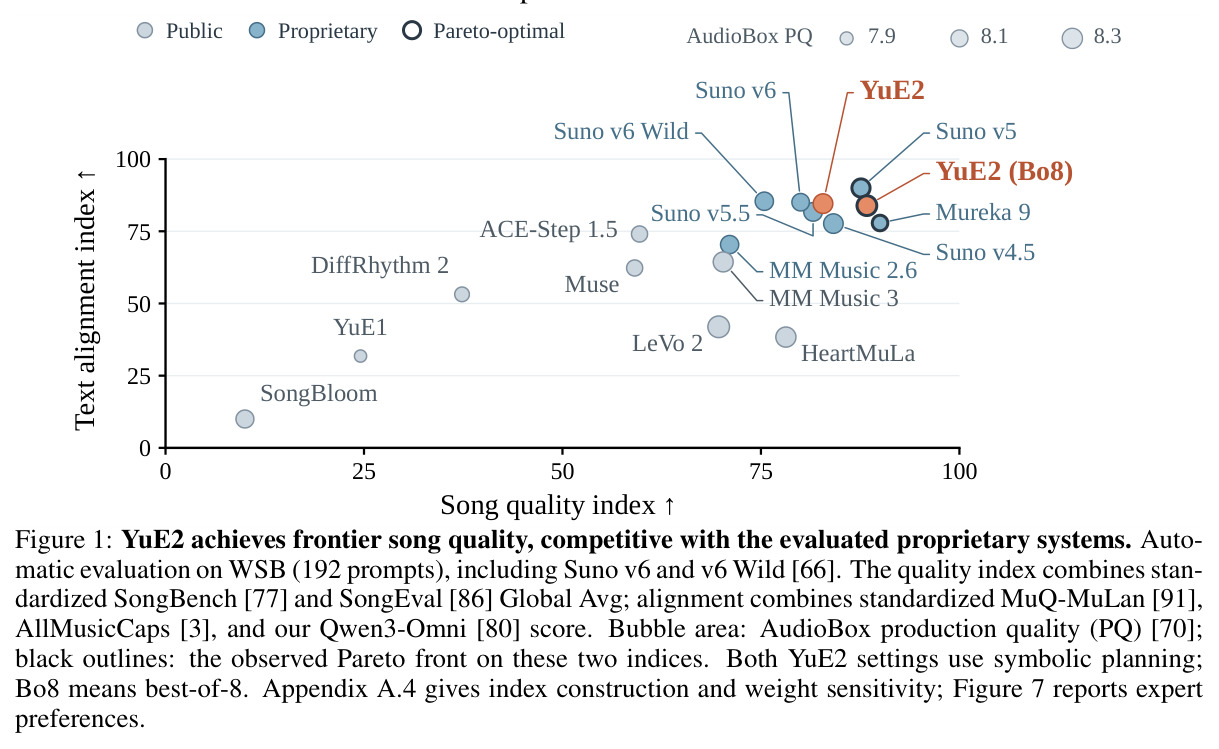
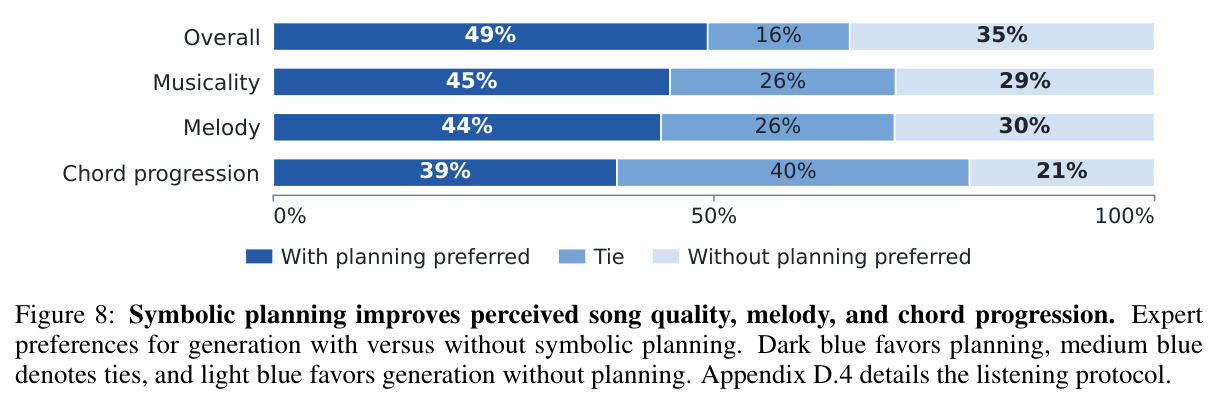
四点新颖性。其一,可读乐谱成为被生成的质量来源而非控制附件:此前规划类工作(MusiCoT、ACE-Step 1.5)的规划是隐式或元级,YuE2 用文本记谱完整规划旋律+和弦,并首次在全曲歌声生成规模以同权重对照证明规划带来 49.3% 对 34.6% 的整体质量偏好——把语言模型 CoT 的直觉移植到音乐。其二,AR–NAR MoT:用在"离散 token + 连续 latent"的异质组合上,一个骨干内同时获得因果生成与双向去噪;同数据、相近参数下整体偏好 53.4% 对 35.6% 胜过 LM+DiT。其三,"学生反超教师"的监督自举:SheetSage2-AR 完全用 Prober 标签训练,却在 15 个基准-指标对中 10 个反超教师、12 个领先所有对比系统(RWC-Pop 人声旋律 F1 从 62.71 到 82.51),证明自回归事件建模可超越 CRF 逐属性解码。其四,多视图目标合成:用 MuQ 与 Qwen2-Audio 两个独立编码器共同约束一套 RVQ 目标码,使 MERT2 一个底座同时产出 SOTA 理解表征(MARBLE 15 项指标 14 项领先)和 375 bit/s 生成 token(保住 pre-VQ 性能的 78.3–98.3%)。
实验结果
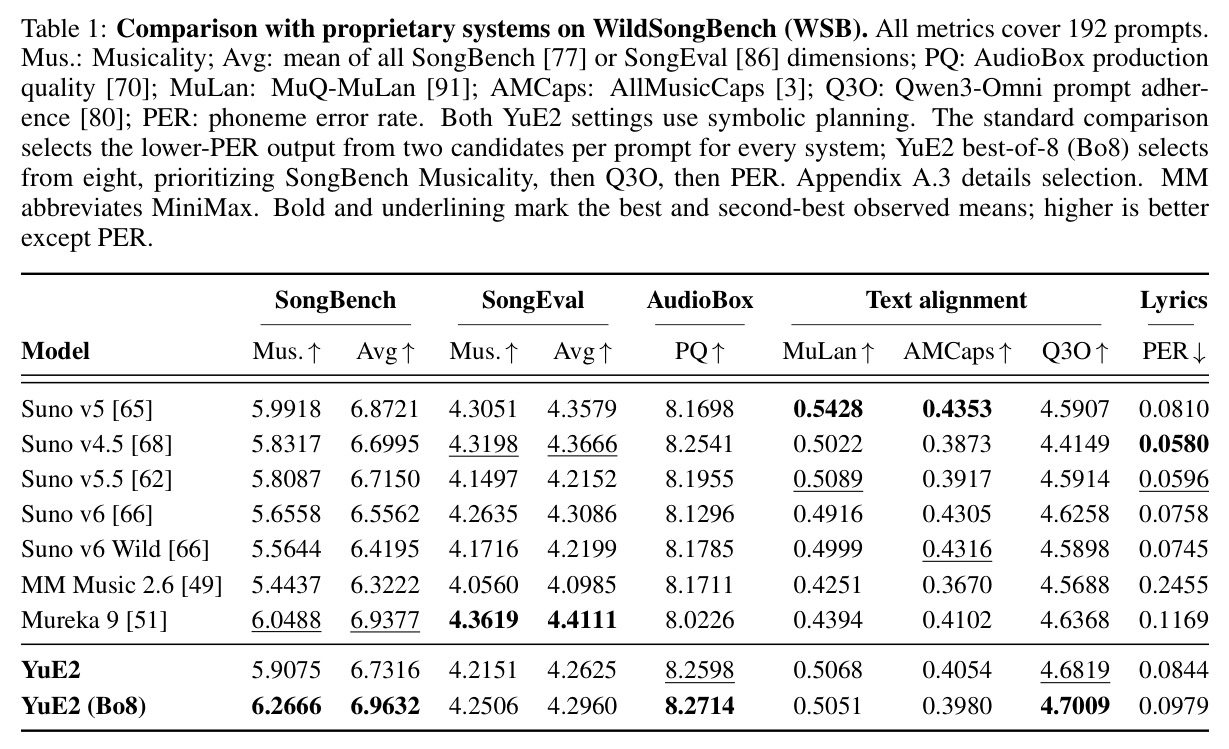
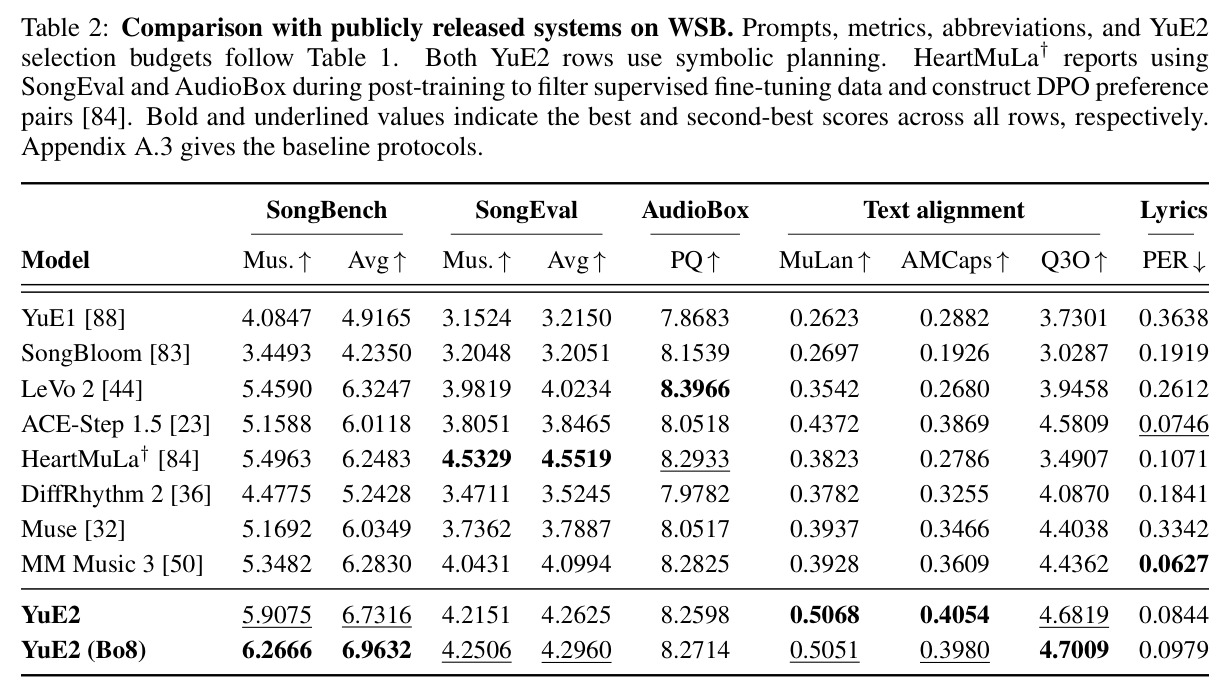
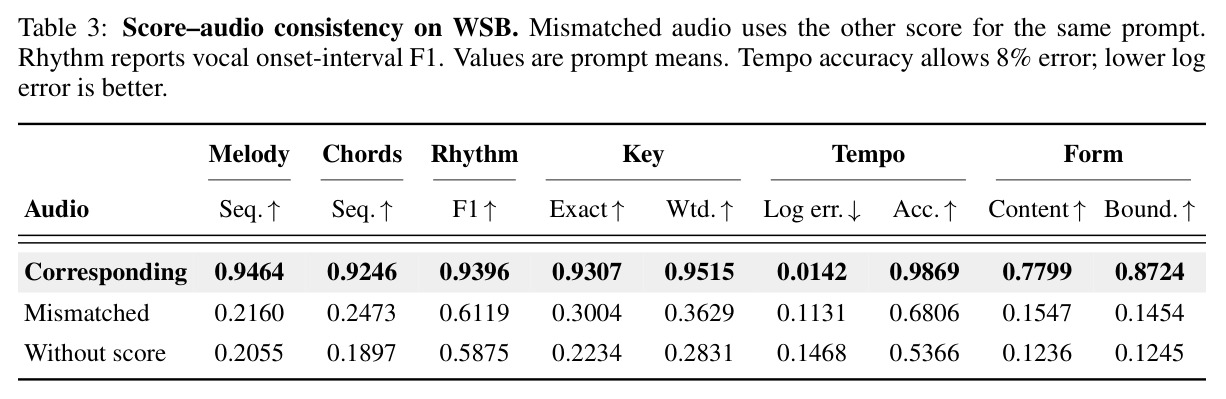
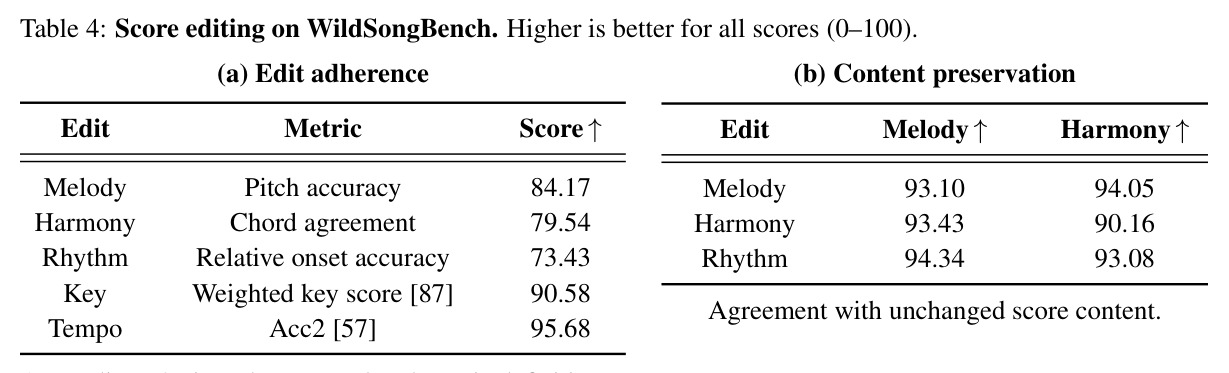
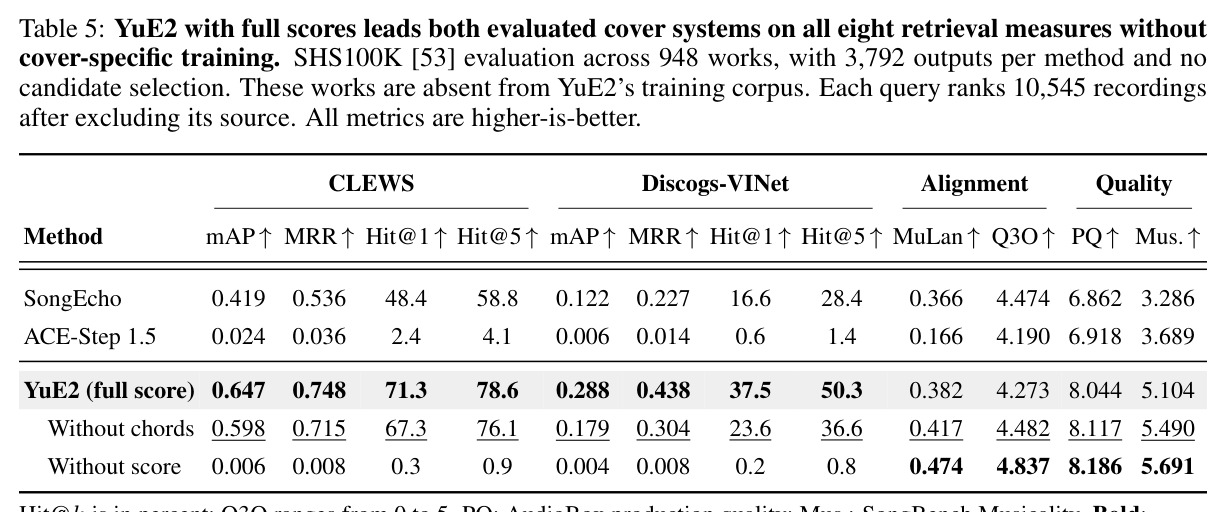
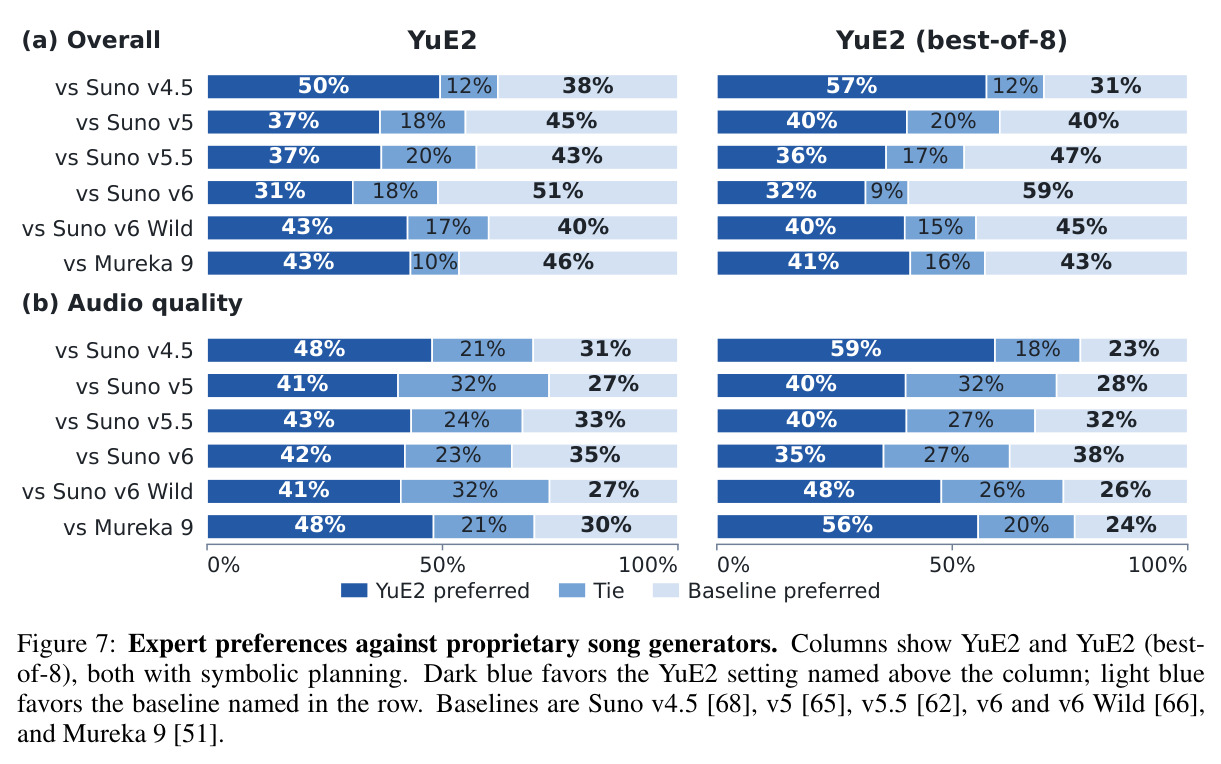
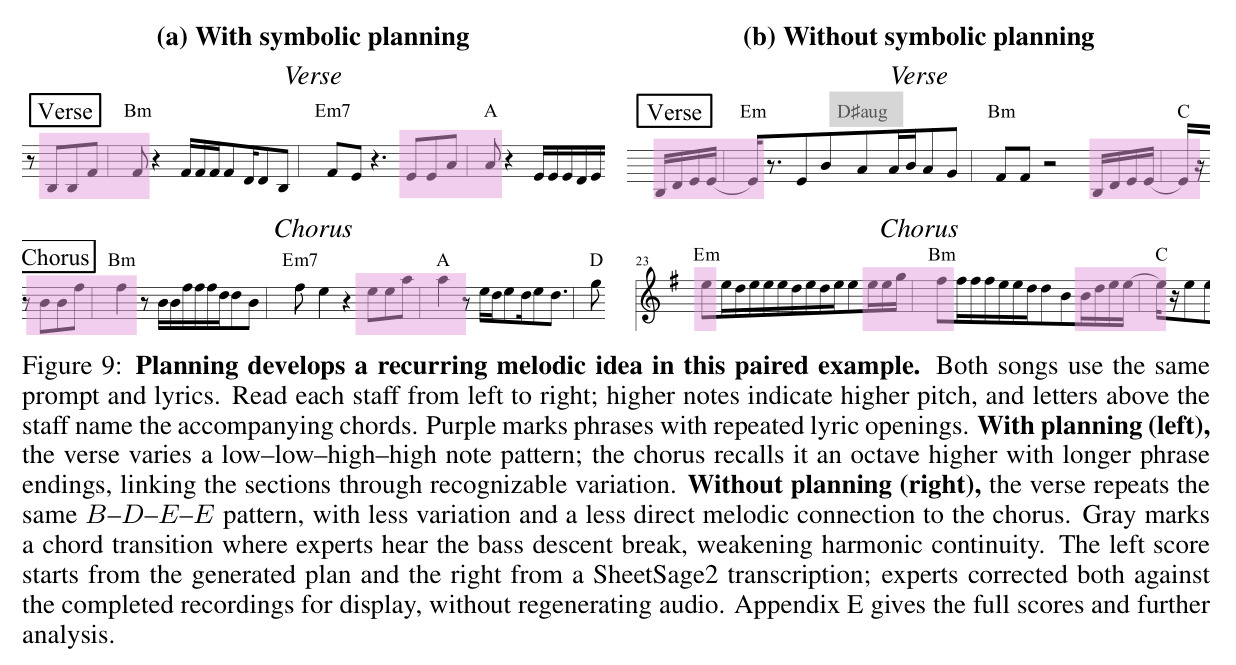
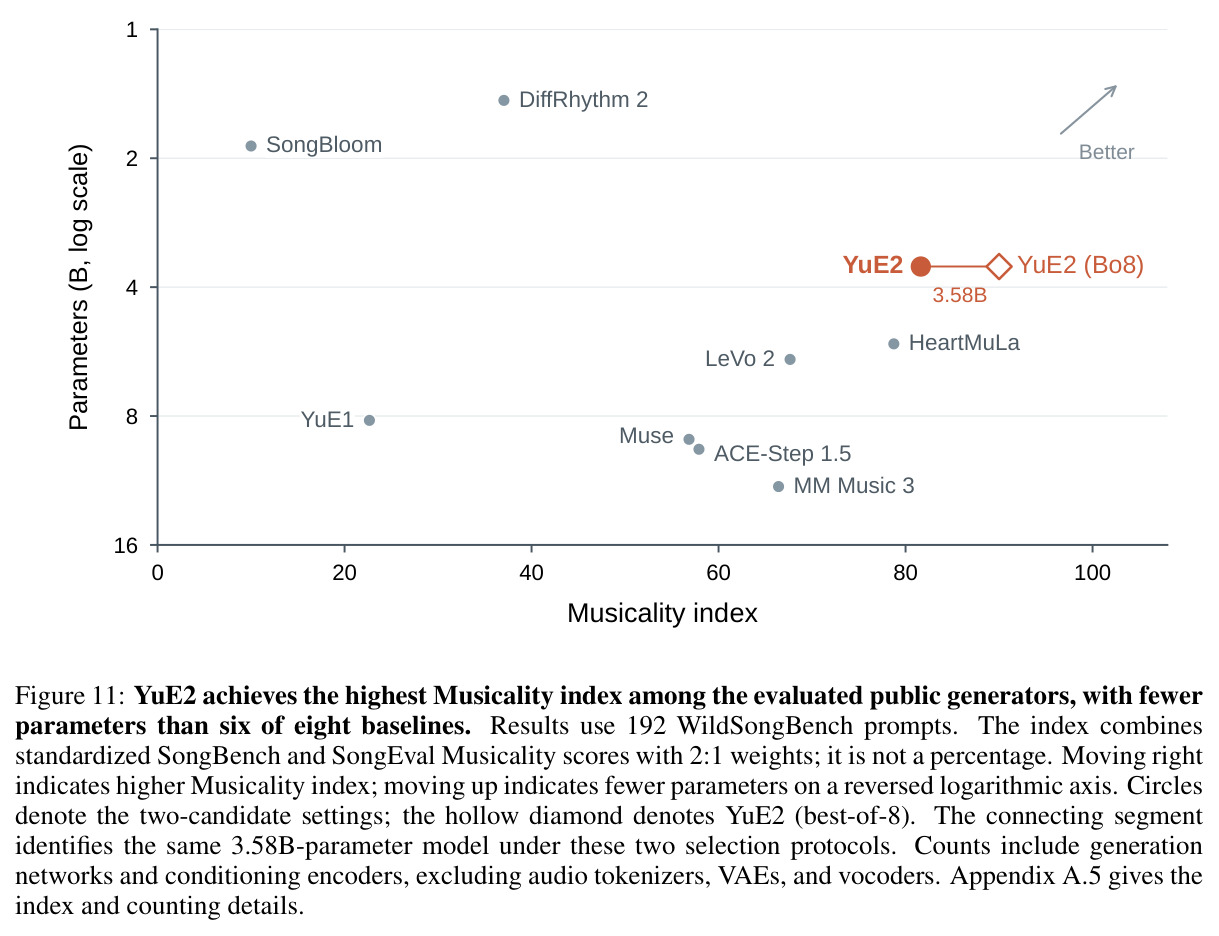
证据链六组。一,WSB 自动评测(192 条 prompt):YuE2 在公开系统中以 SongBench Musicality 5.9075、Global Avg 6.7316 双第一,超 LeVo 2 等八个基线;best-of-8 达 6.9632,为含 Suno v6 在内全部被评系统的最高观测均值(Mureka 9 为 6.9377);AudioBox PQ 8.2714 超过全部七个专有系统。二,专家盲听(351 人、4439 对):Bo8 对 Suno v4.5 整体 57.3% 对 30.5%,对 Suno v5 接近平手(40.4% 对 39.9%),对 Suno v6 落后(31.6% 对 59.3%);音频质量对六专有系统平均偏好 58.9%。三,符号规划消融(同 checkpoint):整体 49.3% 对 34.6%($p=0.0070$),音乐性、旋律、和弦进行全面偏好规划;案例显示规划版发展"低-低-高-高"动机并在副歌高八度再现,无规划版只机械重复。四,架构消融:统一 MoT 对 LM+DiT 整体 53.4% 对 35.6%($p=0.0084$)、音频质量 48.5% 对 29.6%,六维五胜。五,乐谱接口:谱-音对应录音旋律/和弦相似度 0.9464/0.9246(错配对照约 0.2),配对指派 100%;局部编辑遵从旋律 84.17%/和声 79.54%,未编辑内容保留 90% 以上;零样本翻唱(948 未见作品)CLEWS mAP 0.647 对 SongEcho 0.419,去谱崩至 0.006。六,底座:MERT2 在 MARBLE 15 指标中 14 项领先;375 bit/s token 探针六项五胜(beat F1 86.38 对 LeVo 2 的 79.72);SheetSage2-AR 15 对转写指标 12 项最高。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全曲歌曲生成(WildSongBench,192 prompts) | SongBench Global Avg | YuE2 6.7316;best-of-8 6.9632(全场最高观测均值) | 公开最强 LeVo 2 6.3247;专有最强 Mureka 9 6.9377、Suno v5 6.8721 | 公开系统第一;Bo8 超过全部专有系统约 +0.03~0.42 |
| 全曲歌曲生成(WSB) | SongBench Musicality | YuE2 5.9075;Bo8 6.2666 | Mureka 9 6.0488;Suno v5 5.9918 | Bo8 高出最强专有系统 +0.22 |
| 符号规划消融(同 checkpoint) | 专家整体质量偏好 | 有规划 49.3% | 无规划 34.6%(其余平局) | +14.7 个百分点,$p=0.0070$ |
| 统一 MoT 对 LM+DiT(同数据/表征) | 专家整体质量偏好 | 统一 MoT 53.4% | 分离 LM+DiT 35.6% | +17.8 个百分点,$p=0.0084$ |
| 对专有系统盲听 | 专家整体质量偏好(Bo8) | vs Suno v4.5 57.3%;vs Suno v5 40.4% | Suno v4.5 30.5%;Suno v5 39.9% | 胜 Suno v4.5 +26.8pp;对 v5 接近平手;vs Suno v6 落后(31.6% 对 59.3%) |
| 音频质量盲听 | 对六个专有系统平均 tie-adjusted 偏好(Bo8) | 58.9% | 50% 为平手线 | CR1 95% CI 55.6–62.2%,$p=1.70\times10^{-6}$ |
| 生成乐谱-音频一致性(WSB 384 谱/768 录音) | 旋律/和弦序列相似度(1−归一化编辑距离) | 对应录音 0.9464 / 0.9246 | 错配乐谱录音 0.2160 / 0.2473 | 乐谱身份可从音频唯一恢复,配对指派 100% 正确 |
| 零样本翻唱(SHS100K 948 未见作品) | CLEWS mAP / Discogs-VINet mAP | 全乐谱 0.647 / 0.288 | SongEcho 0.419 / 0.122;ACE-Step 1.5 0.024 / 0.006 | 八项检索指标全领先,无翻唱专门训练 |
| 音乐理解(MARBLE,9 任务 15 指标) | 领先指标数 | MERT2-30s 领先 14/15(GTZAN 91.72、MTT AP 41.29 等) | 此前最强 PupuJEPA-Large/Huge、MuQ、MusicFM | 新 SOTA,632M 参数 |
| 375 bit/s 语义 token 音乐结构保留 | 冻结探针(GTZAN beat F1 等 6 项) | beat F1 86.38,5/6 指标第一;保留 pre-VQ 78.3–98.3% | LeVo 2(350 bit/s)beat F1 79.72;EnCodec(1.5 kbit/s)76.50 | 码率低于 EnCodec 4 倍仍全面领先 |
| 全曲 lead-sheet 转写(8 个基准) | 15 个基准-指标对最高分个数 | SheetSage2-AR 12/15;RWC-Pop 人声旋律 F1 82.51 | SheetSage1 62.71;ChordFormer JAAH 59.45 | 人声旋律 +19.8pp,JAAH 和弦 +5.06pp |
| 乐谱编辑(WSB,3844 条录音) | 编辑遵从/内容保留 | 旋律 84.17%、和声 79.54%、调 90.58/100、速度 95.68% Acc2;未编辑内容保留 90.16–94.34% | 未编辑 SongBench 6.70–6.73 | 编辑后质量 6.64–6.73,基本无损 |
局限与改进
论文无专门局限性章节,以下结合数据与作者表述归纳。可从数字直接读出的:一,对 Suno v6 盲听明显落后(31.6% 对 59.3%),尽管 Bo8 的 SongBench Avg 更高,说明自动指标与专家感知有缺口,作者也只主张"competitive";二,PER 0.0844 非最低(MM Music 3 为 0.0627),且 ASR 评测有噪声;三,SongEval 上 Bo8(4.2960)落后 HeartMuLa(4.5519),而后者自述用 SongEval 做后训练过滤与 DPO,存在指标对齐便利;四,翻唱中乐谱与音乐性存在张力——全谱保身份(mAP 0.647)但 Musicality 仅 5.104,去谱 Musicality 升至 5.691 而 mAP 崩至 0.006,自适应折中未解决;五,SheetSage2-AR 结构边界 F1(0.5 s)67.96 落后专项 SongFormer(70.63);六,编辑评测限于第一段副歌内最多四小节。我的观察:训练语料以 CC0 与授权合成数据为主,与真实商业音乐分布有差距;评测工具链(Qwen3-Omni、SheetSage2)与训练标注管线同源,存在自我偏好风险;Bo8 需 8 次采样加多轮 ASR,推理成本被协议放大。
独立分析的弱点
独立分析六点。一,编辑必须整曲重生成:改四小节也要重采样全部语义 token 与 latent,交互延迟高,未编辑部分无法逐帧一致;改进方向是训练乐谱-音频掩码任务,支持固定已生成段落的局部 inpainting。二,评估循环性:WSB 参考乐谱由 SheetSage2 生成、一致性实验用冻结 SheetSage2 判定、标注用 Qwen3 系模型,与被评系统数据构造同源,自动指标可能隐性偏向自家表示;应引入第三方转写器交叉验证。三,翻唱的身份-风格权衡只有全谱/去和弦/无谱三档,缺连续可控的和声保真度旋钮;可在条件注入处加和声 dropout 或插值,或由 agent 显式改写和声。四,长曲结构:24,576 位置按 25 Hz 约合 16 分钟,组曲与跨段落主题发展未测,曲式相似度 0.7799 偏低;可引入段落级记忆或分层曲式规划。五,乐谱错误传播:训练目标与翻唱输入都来自 SheetSage2,其转写错误(爵士和声 JAAH 也仅 64.5%)成为天花板;可对标签做置信度加权损失或用高精子集微调。六,人声表现力缺位:自动评测无音准、呼吸、转音指标,PER 只测咬字;应加入歌唱性指标。
未来方向
作者铺出两条延伸线:其一,agentic music editing——The Last Train 案例展示外部 LLM agent 把"改成英文爵士、加一段基于小星星的萨克斯间奏"等自然语言反馈翻译成对乐谱、风格、歌词的具体修改,九步对话产出十四个版本,乐谱接口天然适合与 LLM 工具链组合,可系统化为多轮音乐创作 agent 基准;其二,翻唱中的和声松弛——作者指出可"生成时放松和声条件"或"通过 agentic editing 显式改谱"来在风格适应与作品身份间取舍。基于其成果还可延伸:把符号规划与自检结合,让模型生成-审谱-改谱-再渲染;对流匹配蒸馏把两阶段推理压到数步,服务实时交互;扩展到多轨多歌手、器乐全曲与 MIDI/DAW 双向接口,让乐谱直接进数字音频工作站的编辑流;在乐谱空间做强化学习,用偏好奖励优化和弦进行与旋律发展;用 SheetSage2 的统一事件词表构建百万级曲式-和声语料反哺音乐学研究;把 WSB 协议扩展到多语言翻唱与现场改编,检验跨语言、跨文化的工作身份保持。
复现评估
开源程度在同类工作中属第一梯队。权重:HuggingFace 发布 YuE2-3B 主模型、YuE2-Vae、MERT-v2-30s 与 MERT-v2-FullSong、SheetSage2 checkpoint 及推理代码;代码在 GitHub(multimodal-art-projection/YuE);WildSongBench 的 prompt、参考乐谱与评测代码公开;Demo 页提供 agentic editing 案例的对话、乐谱与音频。复现分层:推理复现容易——3.58B 模型单张 80 GB GPU 可跑三种模式,配合公开代码可复算 WSB 自动指标;组件级复现中等——MERT2 需 70 万小时音频与四阶段课程,SheetSage2 需 Prober 标签管线,探针协议写得够细;完整训练复现困难——34.6 万小时语料大部分来自 CC0 与 Tokenwave.AI 授权合成数据,后者不完全可得,且需 64 张 H800、约 10.6 万步三阶段训练;专家听评(351 人、4439 对)几乎不可复刻,但协议与统计细节在附录 D.4 完整公开。总体:基于开源权重做推理与下游研究可行性高;重现指标结论可行;重现训练全程不现实。
论文图表
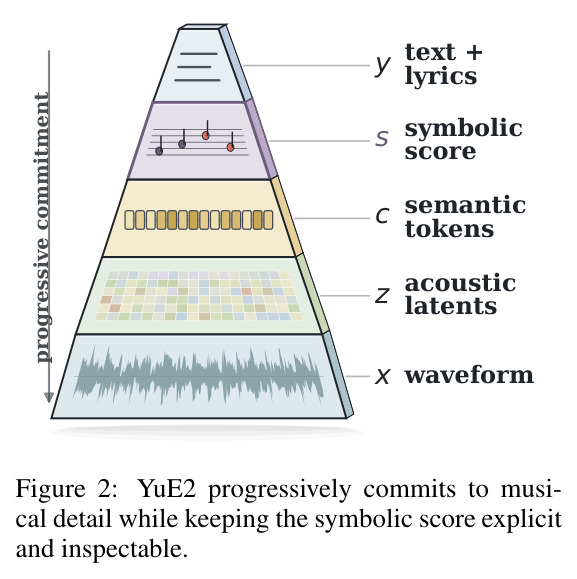
展示'渐进式音乐承诺'层级:文本+歌词(意图)→ 符号乐谱 s(旋律/和声/节奏/曲式的承诺)→ 语义 token c(25 Hz 细节轨迹)→ 声学 latent z → 波形,箭头表示逐级增加的音乐决策承诺。
这是全文的概念骨架:所有设计(先写谱再渲染、乐谱作为接口、消融对照)都建立在这个层级分解上,理解它才能理解论文动机。