WorldSonus:为世界模型带来实时可控的空间立体声 WorldSonus: Bringing Sound to Worlds
面向交互式世界模型的模块化框架,因果流式合成100ms立体声并支持中途改写文本指令
前置知识
整流流(Rectified Flow)
一类生成建模范式:把真实数据 $a$ 与高斯噪声 $\epsilon$ 用线性插值 $x_{t,s}=(1-s)\epsilon+sa$ 连成路径,训练网络预测速度场 $(a-\epsilon)$,推理时从纯噪声出发沿预测速度场做 ODE 积分(如 Euler 法)逐步还原数据。相比传统 DDPM 扩散,训练目标更简单、路径更直、所需采样步数更少。本文的流头(flow head)用 15 步 Euler 采样对每个 100ms 音频块去噪。
WorldSonus 的生成核心正是 AR 主干条件化的整流流头,读不懂流匹配损失与采样过程就无法理解方法设计和消融实验的含义。
分块自回归与 KV 缓存
自回归模型逐段生成序列,并把历史 token 的注意力 Key/Value 缓存下来避免重复计算。本文用 Ring-KV 环形缓冲把上下文限制在 $W=50$ 块(5 秒)内:新块覆写最旧槽位,内存与计算开销恒定,不随流长增长;训练期采用同样的因果滑窗注意力掩码,保证训练与推理的上下文策略一致。
有界持久状态是实时流式生成、以及把音频模块挂接到世界模型的基础,也是 30 秒长程不漂移结论的关键机制。
立体声与一阶环境声(FOA)
立体声用左右两声道的能量差表达声源方位;一阶环境声(First-Order Ambisonics)则用全向分量 $W$ 与三个方向分量 $X/Y/Z$ 编码完整球面声场。本文把全景 FOA 声场旋转对齐主声源后,按 $\pm 45^\circ$ 解码为与 $90^\circ$ 透视裁剪对齐的立体声:$L=W+\frac{\sqrt{2}}{2}(X+Y)$,$R=W+\frac{\sqrt{2}}{2}(X-Y)$。
这是本文空间对齐监督数据的核心来源,理解该公式才能明白全景数据如何被转化为相机对齐的立体声训练信号。
FAD、DeSync、BiasSkill 等评测指标
FAD(Fréchet Audio Distance)在 VGGish/OpenL3 等音频特征空间中度量生成集与真实集的分布距离,越低越好;DeSync 是 Synchformer 模型测得的音画同步偏移秒数;S-FDO 用侧信号 $(L-R)/2$ 评估立体声分布质量;BiasSkill 统计 1 秒窗口内生成音频与参考音频的左右通道偏向一致率(经置换基线归一化,剔除模型固有通道偏置)。
论文的全部实验结论都建立在这些指标上,不熟悉其定义容易误读表格中斜体加粗的含义与各模型的强弱项。
对比学习与 InfoNCE 损失
通过拉近正样本对、推远负样本对来训练表示,典型形式为 $\mathcal{L}=-\log\frac{\exp(\text{sim}(\text{正})/\tau)}{\exp(\text{sim}(\text{正})/\tau)+\sum_{\delta}\exp(\text{sim}(\text{负}_\delta)/\tau)}$。本文 ShiftNCE 把 AR 隐状态投影到冻结 Synchformer 同步专家的嵌入空间,正例是当前对齐窗口嵌入,负例是同一视频时移 $\delta\in\{\pm1,\pm2,\pm4\}$ 块的嵌入。
ShiftNCE 是本文零推理开销实现音画同步的核心创新,其本质就是带假负例过滤的对比学习,不理解 InfoNCE 就无法把握其设计动机。
研究动机
世界模型(如 GameGen-X、LingBot-World 2.0、Matrix-Game 2.0)已能根据用户操作动态合成视觉环境,但生成的世界基本是无声的。为交互式世界模型配音面临三大挑战:一是实时性,音频必须跟上交互式视频流的节奏持续生成;二是交互控制,用户会在会话中途修改声音指令(如让引擎从怠速切换到加速再远去),模型必须即时响应且不重置会话;三是空间对齐,左右声道平衡需随场景几何与相机运动变化。现有两条路线各有缺陷:基于联合音视频基础模型(如 LTX-2)扩展长程流式的方法把音频合成耦合进视觉主干,无法作为独立音频模块挂接到纯视觉世界模型,且长自回归展开易累积误差;专用 V2A 模型方面,V-AURA 每步依赖双向视觉窗口且只输出单声道,SoundReactor 实现了实时立体声但不支持中途文本控制且权重未公开,SwanSphere 面向全景视频与一阶环境声而非标准透视视频流。
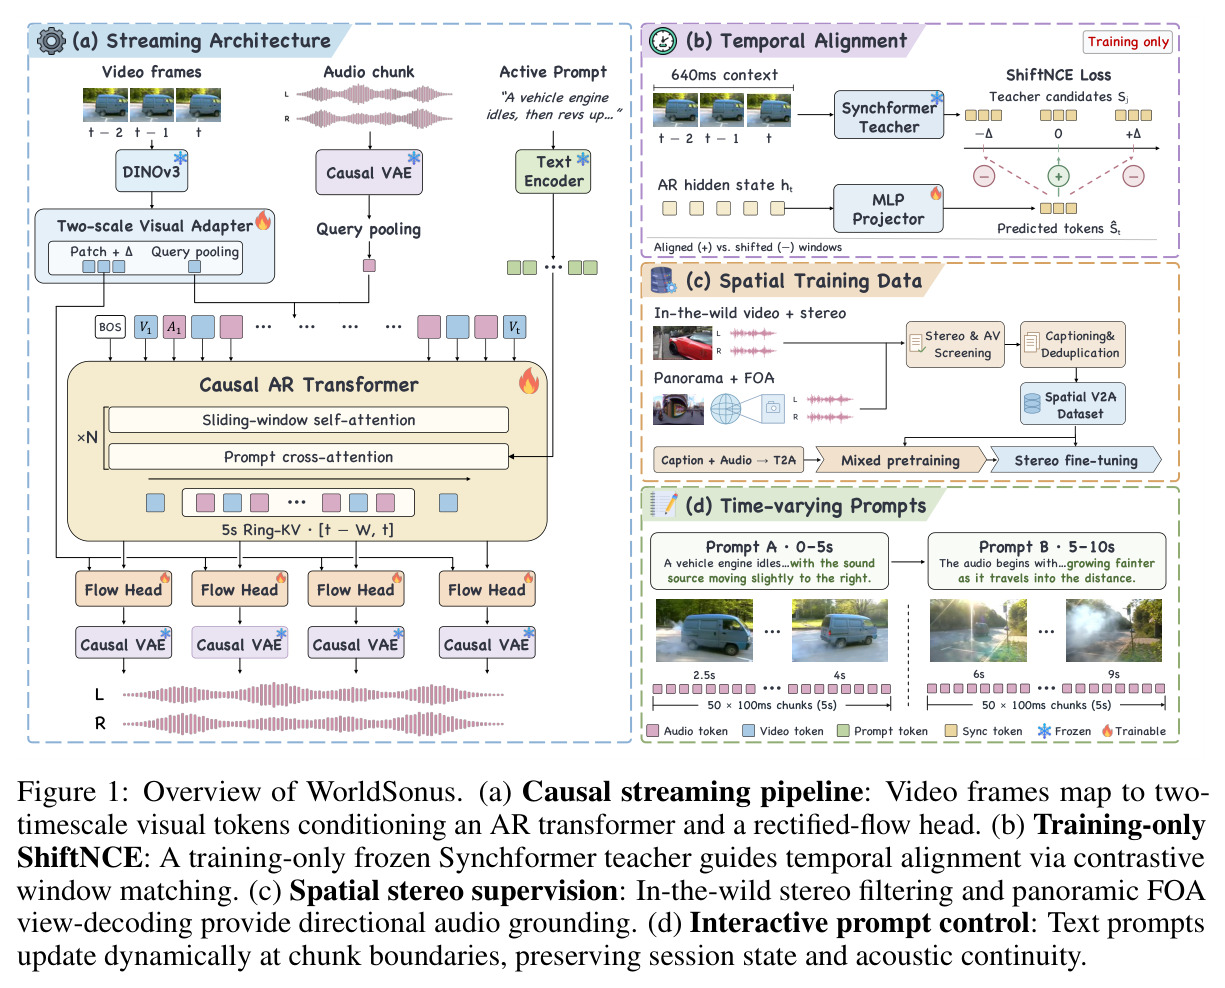
本文的目标是本文的目标是构建一个模块化的视频转音频(V2A)框架 WorldSonus,同时满足三项需求。第一,因果实时生成:仅使用过去和当前帧,以 100 毫秒为粒度流式合成 48kHz 立体声,单块执行延迟 41.2 毫秒(实时因子 RTF=0.41,单张 NVIDIA H100),且随流变长内存与计算恒定。第二,中途交互控制:用户或智能体可在不间断会话、不重算历史帧的前提下动态改写文本声音指令,涵盖指令切换、中途撤回与中途到达三种情形。第三,空间对齐立体声:左右声道能量分布需与画面中声源方位及相机运动一致。同时,作为因果模型,其声学质量要能追平甚至超过需要完整视频上下文的双向离线模型(AudioX、ThinkSound、PrismAudio),并在开放域 VGGSound 与自建的交互式(游戏+实拍)基准上系统验证。
与已有工作不同的是,本文的独特切入点在于把「为世界模型配音」拆解为实时、可控、空间对齐三个正交子问题,并给出与已有工作本质不同的组合方案。立场上的差异:不把音频耦合进音视频联合基础模型,而是坚持模块化——上游视觉世界模型只暴露已生成的帧,音频作为独立因果模块挂载,无需访问其动作空间或内部架构,用户与智能体可独立更新音频提示。技术上的独特设计有三:其一,用固定容量 Ring-KV 缓存(5 秒窗口)实现常数内存的持久会话状态,训练推理共享同一上下文策略;其二,提出双时间尺度视觉条件化,把块级语义摘要(供 AR 主干)与帧级局部特征(直通流头)解耦;其三,ShiftNCE 仅在训练期用冻结的 Synchformer 同步专家做对比蒸馏,推理零开销,区别于以往在推理期挂载同步模型的做法。数据上则通过全景 FOA 视角解码合成相机对齐的立体声监督,缓解真实立体声数据稀缺。
核心方法
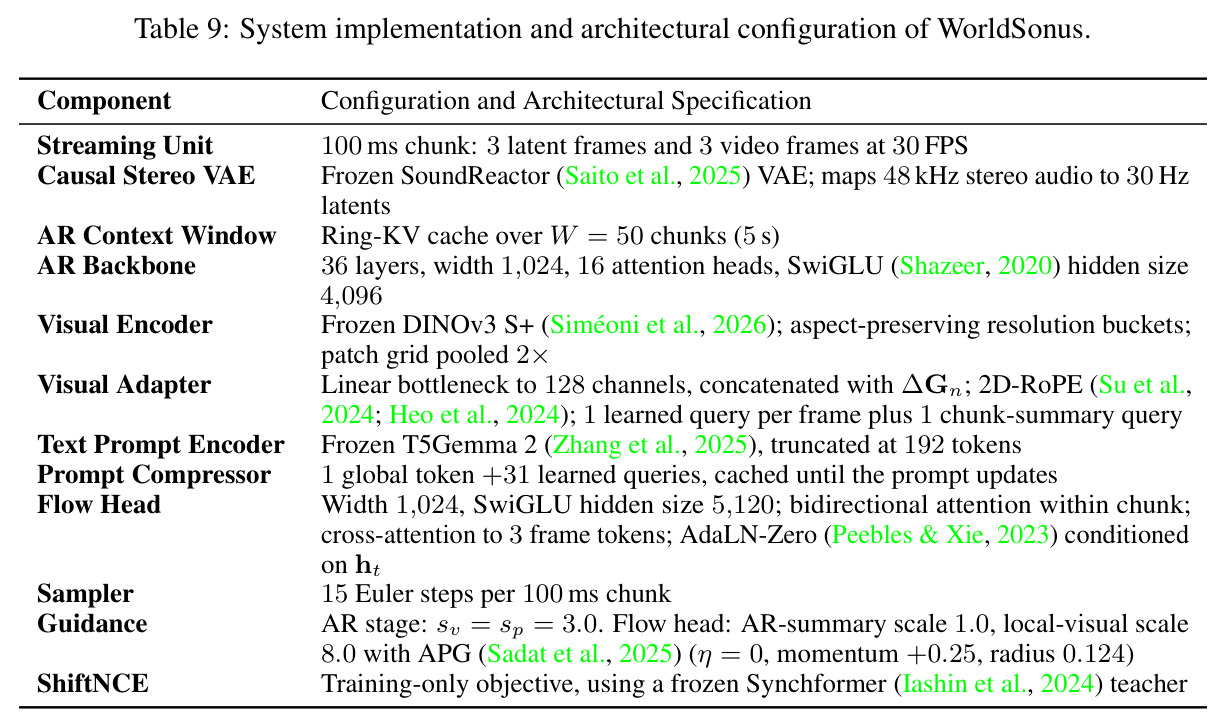
直觉上,WorldSonus 像一位给直播画面即兴配音的拟音师:每 100 毫秒看一眼过去与现在的画面,依据当前有效的文字指令「演奏」一小段立体声,仅靠固定容量的记忆维持连贯。技术路线是分块自回归扩散:音频在冻结的因果立体声 VAE(改编自 SoundReactor)的连续潜空间中生成,该 VAE 把 48kHz 立体声编码为 30Hz 推进的潜变量,状态化解码器可在流式中直接出波形、无需重解码历史;一个 100 毫秒块对应 3 个潜帧,与 30FPS 视频的 3 帧严格时间对齐。联合分布按因果链分解 $p(a_1,\dots,a_T)=\prod_t p(a_t\mid M_{t-1},v_t,p_t)$:36 层 decoder-only Transformer 作 AR 主干,输入上一音频块摘要与当前视频块摘要维护会话状态,采用因果滑窗注意力与 $W=50$ 块(5 秒)的 Ring-KV 缓存;AR 隐状态 $h_t$ 经 AdaLN-Zero 条件化一个紧凑流头,在块内双向注意力下用整流流目标去噪 3 个潜帧,15 步 Euler 采样。
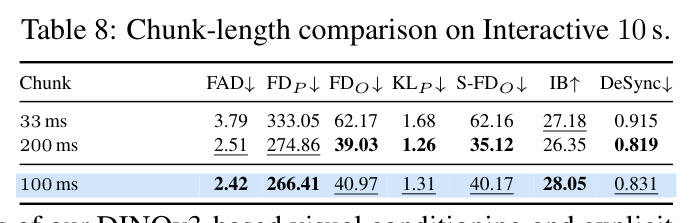
核心创新有三。第一,双时间尺度视觉条件化:冻结 DINOv3 S+ 把每帧编码为 patch 网格 $G_n$,拼接时间差分 $\Delta G_n=G_n-G_{n-1}$ 捕捉运动,查询池化得每帧一个 token;块级摘要 token 进 AR 主干维持长程语义(节省上下文预算),3 个帧级 token 绕过主干直送流头提供细粒度时空证据。消融显示去掉帧级直连后 FAD 从 2.42 暴涨至 15.82,证明该解耦是有界状态流式设计的关键。第二,ShiftNCE:训练时用冻结 Synchformer 把 640ms 视觉窗口编码为 8 个有序 token,2 层 MLP 将 $h_t$ 投影到该空间,对比对齐目标 $S_t$ 与时移候选 $S_{t+\delta}$,并对教师相似度 $\ge 0.97$ 的候选过滤以防静态画面产生假负例;推理时完全移除、零开销。第三,原地提示控制:T5Gemma 2 编码的提示经压缩器(1 全局 + 31 学习查询)缓存交叉注意力键值,指令更新时在最近块边界原地替换缓存,Ring-KV 与视听状态不动,配合 60% 切换 / 10% 撤回 / 10% 到达 / 20% 保持的时变提示计划训练。
方法步骤详情
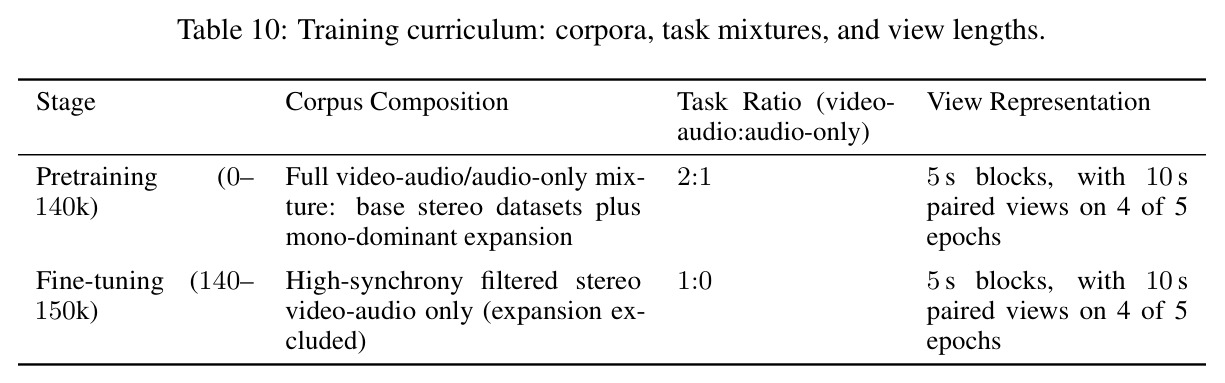
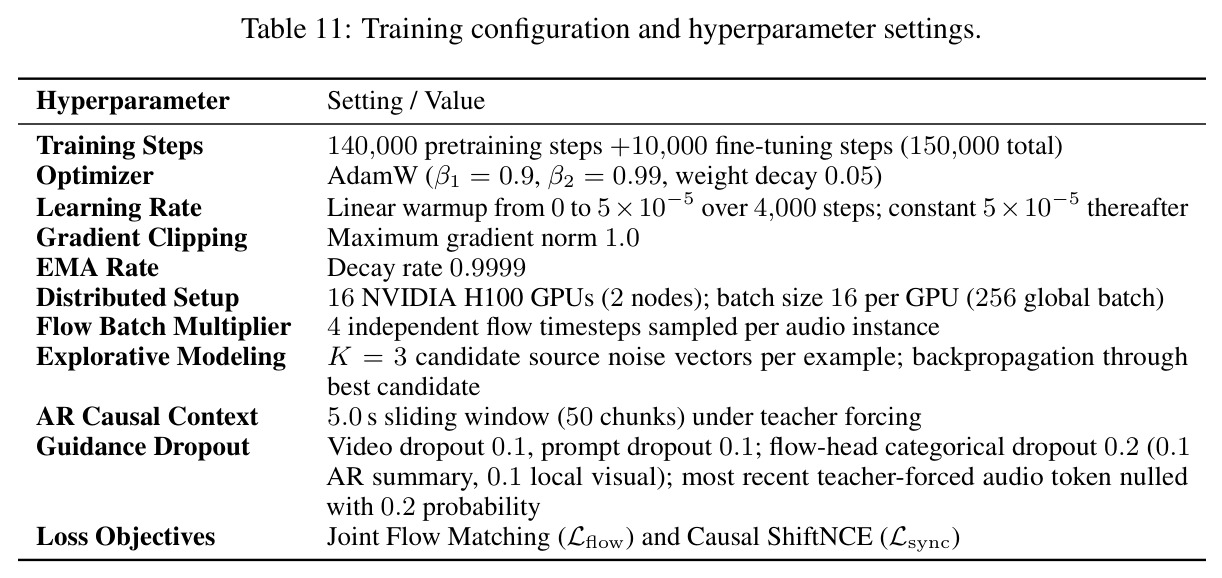
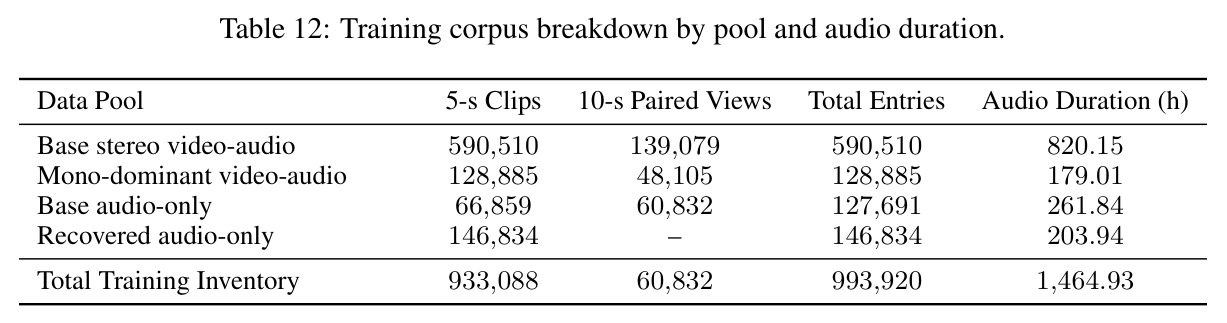
分五步。步骤一(数据构建):汇集 1465 小时音频——999 小时配对视音数据(野外立体声 254.5h、游戏与仿真场景 188.2h、全景环境声 Sphere360+YT-AmbiGen 210.1h、动作视频 Kinetics-700+HD-EPIC 167.3h)与 466 小时纯音频;信号过滤剔除静音、相位损坏($|\rho|>0.98$)、窄立体声与双单声道,Qwen3-Omni 打分低于 4 分或含非剧情音乐者剔除;全景片段按声场能量估计声源方向,以 $L=W+\frac{\sqrt{2}}{2}(X+Y)$、$R=W+\frac{\sqrt{2}}{2}(X-Y)$ 在 $\pm45^\circ$ 解码出与透视裁剪对齐的立体声,并生成音频中心描述。步骤二(预训练):14 万步最小化 $\mathcal{L}_{\text{flow}}=\|f_\theta(x_{t,s},s\mid C_t)-(a_t-\epsilon)\|_2^2$,配合 Explorative Modeling(每步 3 个候选噪声取最优反传)与 ShiftNCE($\tau=0.07$,同步梯度权重约为流梯度 5%),16 张 H100、全局批 256。步骤三(微调):1 万步高同步性立体声子集。步骤四(流式推理):每块生成 1 个块摘要 token 与 3 个帧 token,AR 主干输出 $h_t$,流头 15 步 Euler 去噪 3 个潜帧,CFG 视觉/文本尺度 3.0、局部视觉尺度 8.0(APG)。步骤五(交互更新):指令改写时在下一块边界原地替换提示缓存,延迟仅从 41.2ms 升至 45.3ms。
技术新颖性
本质区别在于「全因果、有界状态、可插拔」的完整闭环。V-AURA 虽号称流式,但每步依赖 2.56 秒双向视觉窗口与非因果 DAC 解码,并非端到端因果;SoundReactor 有因果 AR 加扩散头,但无中途文本控制且权重未公开;SwanSphere 面向全景 FOA 而非透视立体声;OmniForcing、Ripple 等联合生成方案牺牲了模块独立性。WorldSonus 的新颖性有四:其一,Ring-KV 环形缓存原地覆写最旧槽位,训练与推理共用同一 5 秒上下文策略,换来 30 秒连续生成无漂移——rollout 尾部 FAD 2.51 反而略优于冷启动的 2.63;其二,双时间尺度条件化化解「有界记忆与帧级精度」的矛盾,块摘要管语义、帧 token 管细节;其三,ShiftNCE 以时移负例、假负例过滤($\text{sim}\ge0.97$ 剔除)与教师可分锚点筛选(top 40%)把同步专家蒸馏进生成器内部状态,属训练专用对齐而非推理期引导,且直接注入 640ms Synchformer 特征的对照实验证明蒸馏更契合 100ms 块粒度;其四,时变提示计划配合交叉注意力缓存原地替换,首次在持久因果会话中实现指令的切换、撤回与到达。
实验结果
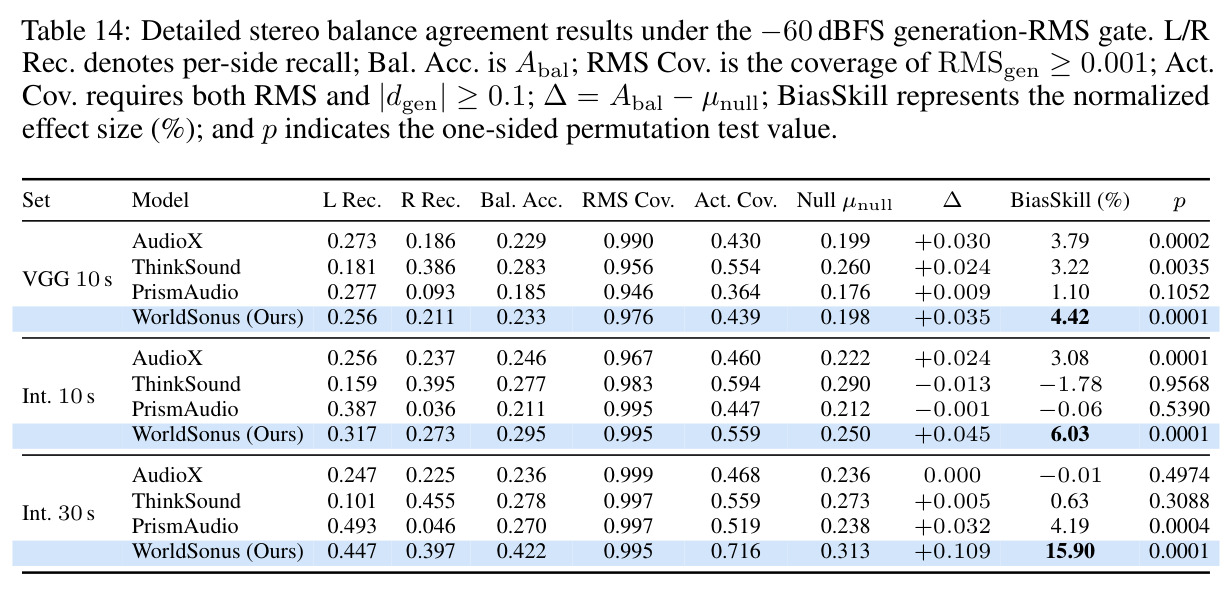
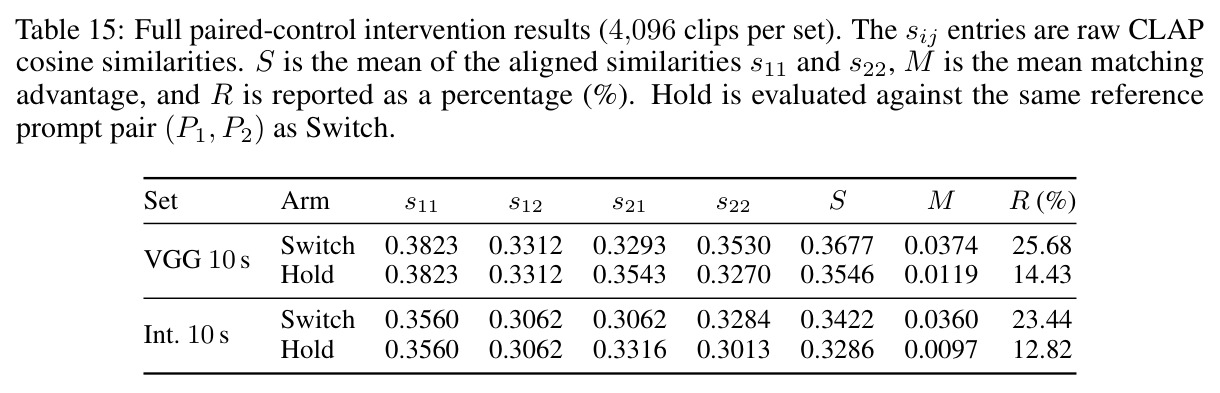
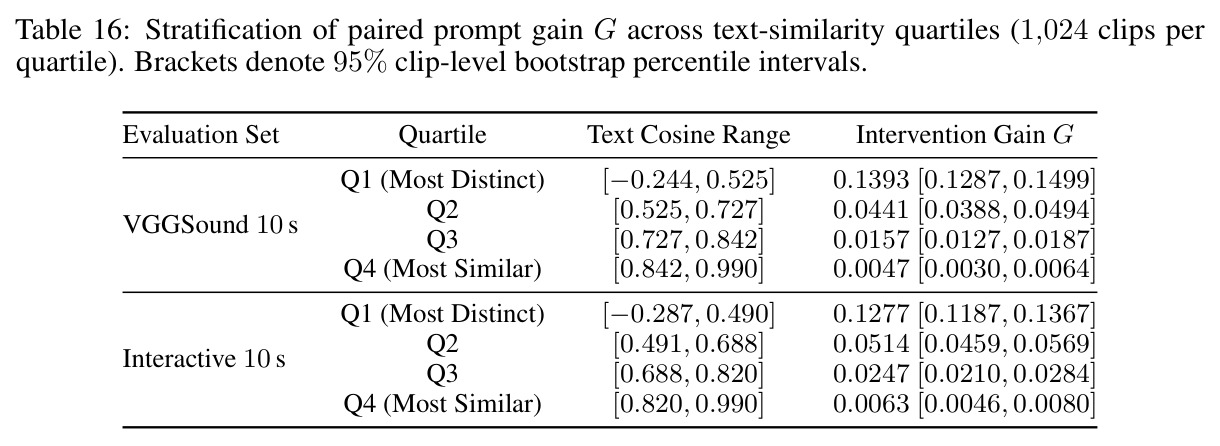
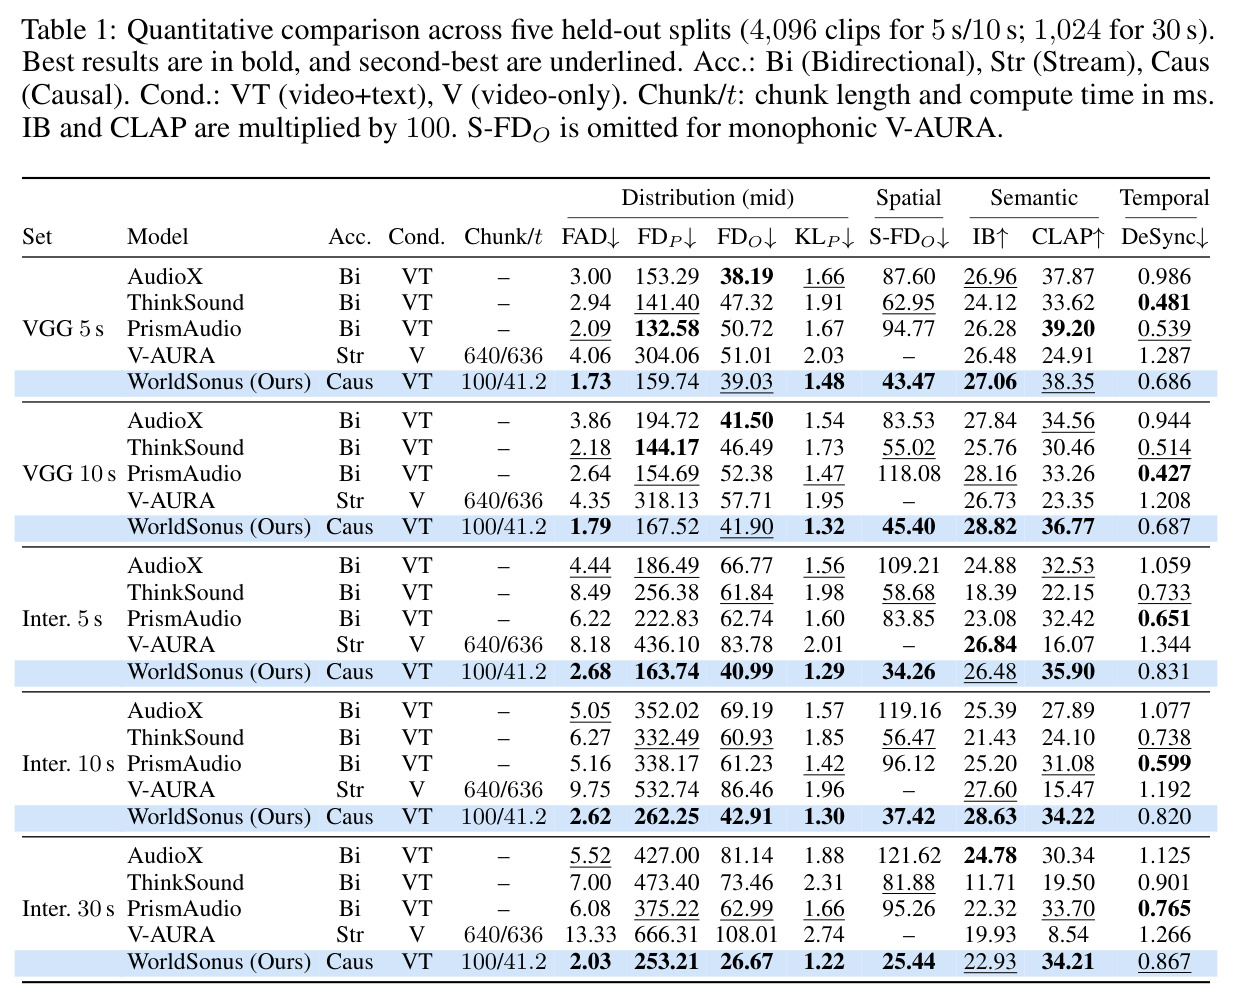
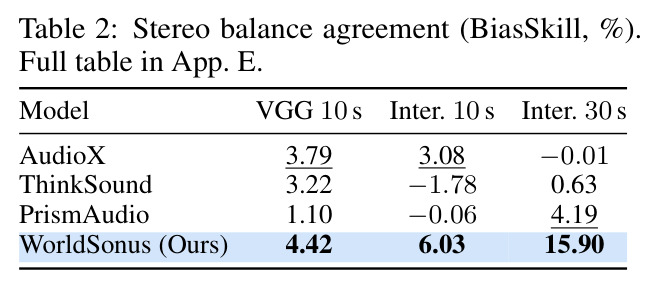
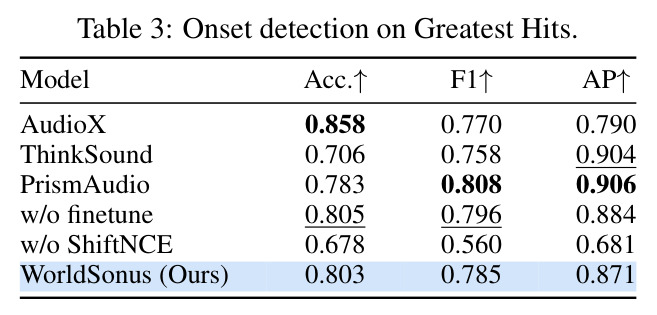
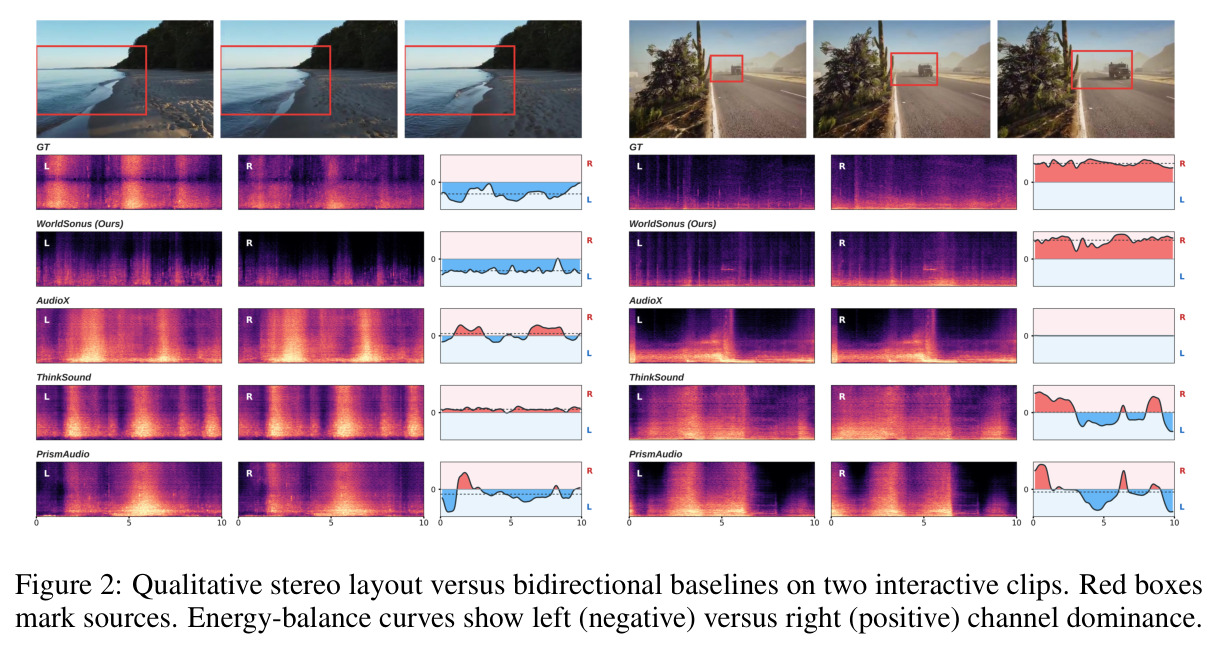
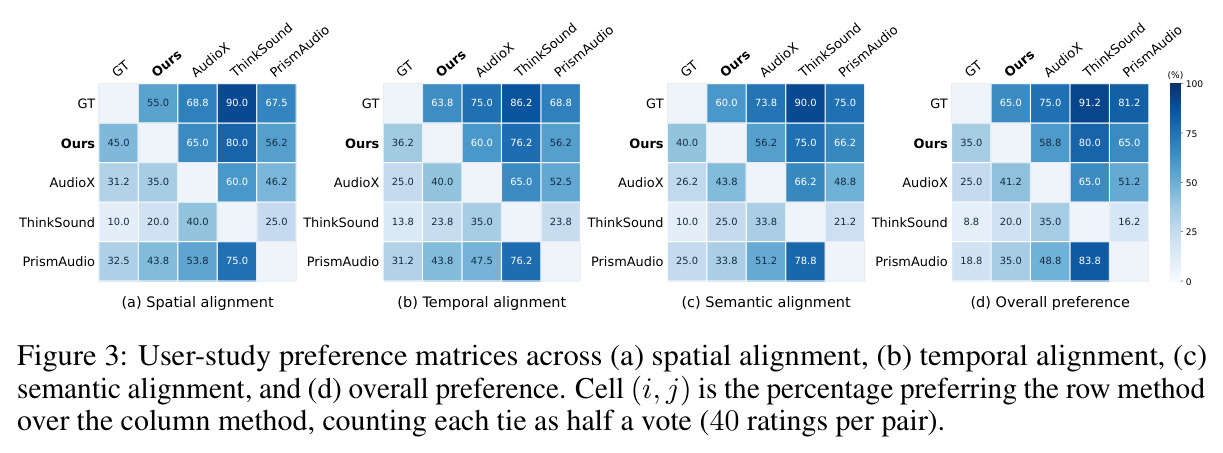
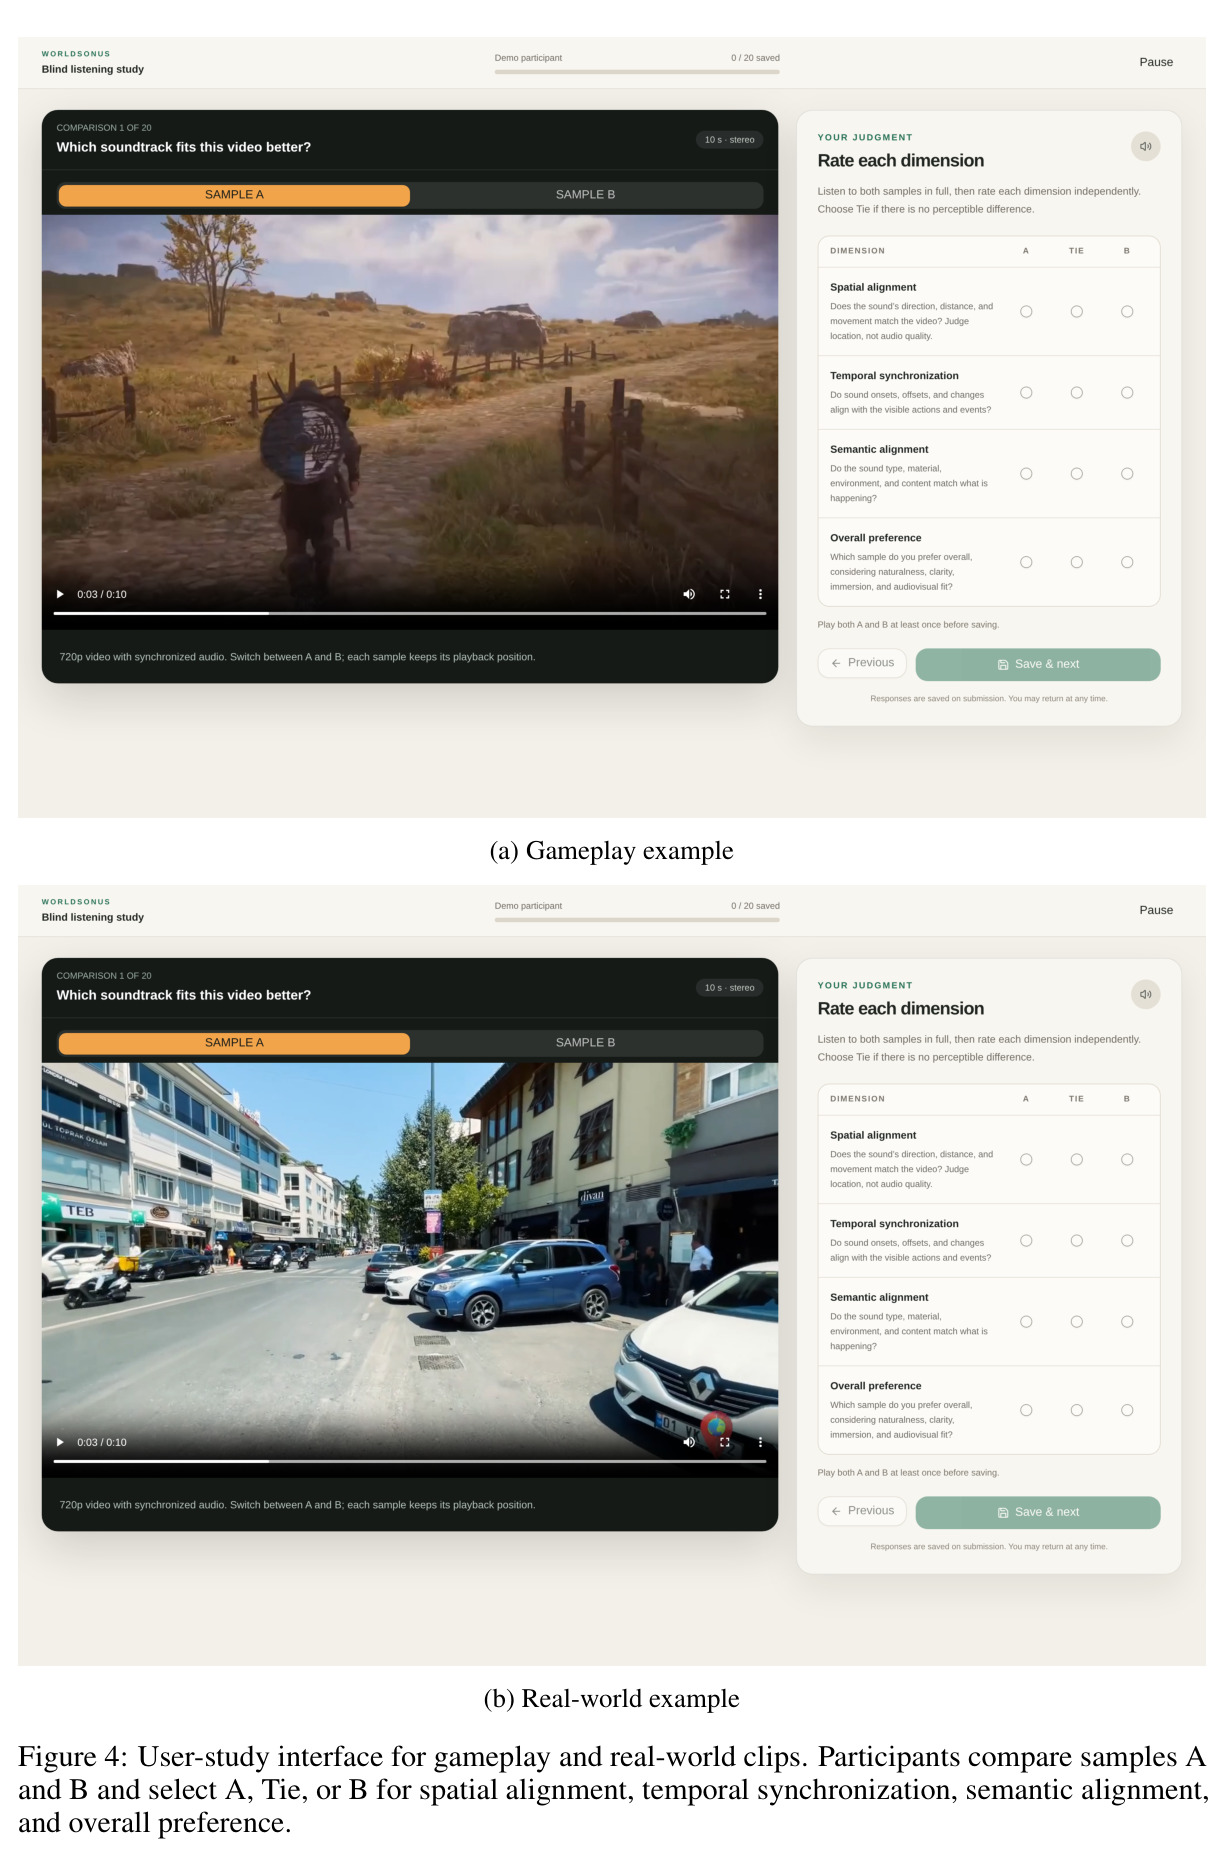
实验覆盖五个保留测试集(VGGSound 5s/10s、交互式 5s/10s 各 4096 条、30s 1024 条)。声学质量:VGGish FAD 为 1.73(VGG 5s)、1.79(VGG 10s)、2.68(Inter 5s)、2.62(Inter 10s)、2.03(Inter 30s),全面优于双向模型 AudioX(3.00/3.86/4.44/5.05/5.52)、ThinkSound、PrismAudio 与流式单声道 V-AURA(4.06-13.33);30 秒交互集优势最大(2.03 对 PrismAudio 6.08),侧信号 S-FDO 25.44 亦显著最低。空间对齐:BiasSkill 达 4.42%/6.03%/15.90% 全部第一,30 秒集远超 PrismAudio 的 4.19% 与 AudioX 的 -0.01%。时间对齐:双向基线 DeSync 更低(ThinkSound 0.481 对本文 0.686),但在无模型偏倚的 Greatest Hits 碰撞基准上 Acc 0.803、F1 0.785、AP 0.871 仍具竞争力,去掉 ShiftNCE 后 AP 跌至 0.681。长程稳定性:30 秒 rollout 尾部 FAD 2.51、DeSync 0.827,与冷启动(2.63/0.880)相当,无漂移。文本控制:双相对匹配率 25.68%/23.44% 远超次优 PrismAudio 的 16.16%;同视觉同种子的反事实干预增益 $G=+0.051/+0.053$,置信区间不含零,且随提示语义差异单调上升(最异四分位 0.139)。主观盲测:总体偏好本文对 AudioX 58.8%、ThinkSound 80.0%、PrismAudio 65.0%,仅逊于真实音频。
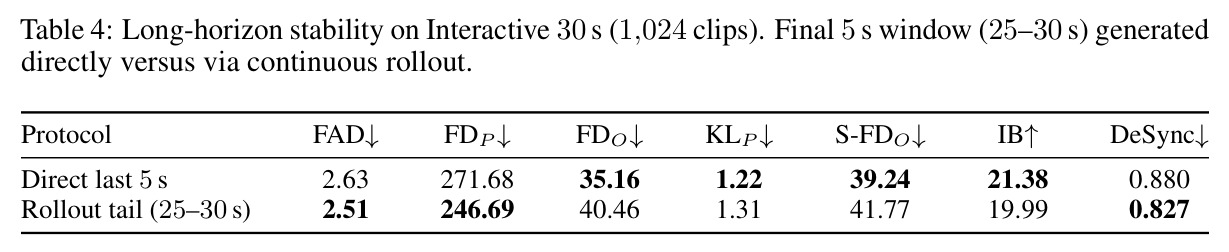
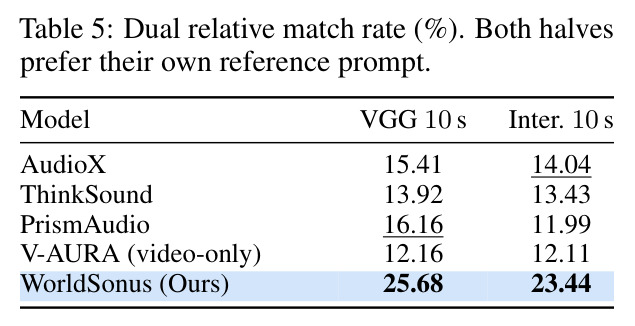
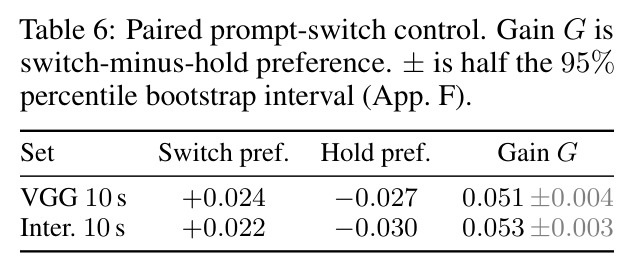
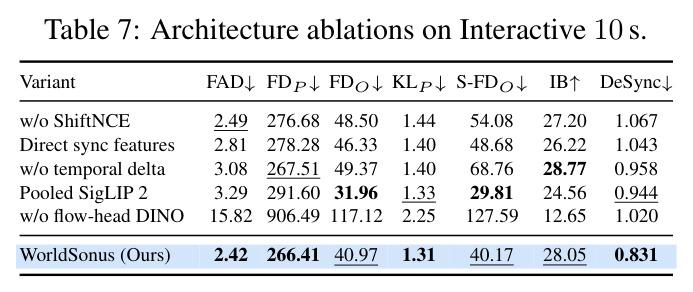
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 开放域 V2A(VGGSound 5s 清晰立体声) | VGGish FAD ↓ | 1.73 | PrismAudio 2.09;ThinkSound 2.94;AudioX 3.00;V-AURA 4.06 | 较最优双向基线降低约 17%,较流式基线降低约 57% |
| 交互式视频 V2A(30s 游戏+实拍,1024 条) | VGGish FAD ↓ | 2.03 | AudioX 5.52;PrismAudio 6.08;V-AURA 13.33 | 较最佳基线降低约 63% |
| 立体声左右平衡一致性(Inter 30s) | BiasSkill ↑ (%) | 15.90 | PrismAudio 4.19;ThinkSound 0.63;AudioX -0.01 | 全部评测集第一,30s 集上约为次优的 3.8 倍 |
| 物理碰撞事件同步(Greatest Hits,244 条) | Onset AP ↑ | 0.871 | PrismAudio 0.906;AudioX 0.790 | 因果条件下具竞争力;消融显示去掉 ShiftNCE 后跌至 0.681 |
| 中途文本控制(10s 双提示段) | 双相对匹配率 ↑ (%) | 25.68(VGG)/ 23.44(Inter) | PrismAudio 16.16/11.99;AudioX 15.41/14.04;V-AURA 12.16/12.11 | 较次优基线提升约 6-9 个百分点 |
| 流式推理效率(单张 H100) | RTF(每 100ms 块延迟) | 0.41(p50 41.21ms,p95 41.38ms) | V-AURA:640ms 块耗时 636ms(RTF≈0.99) | 时间分辨率提高 6.4 倍且稳定满足实时 |
局限与改进
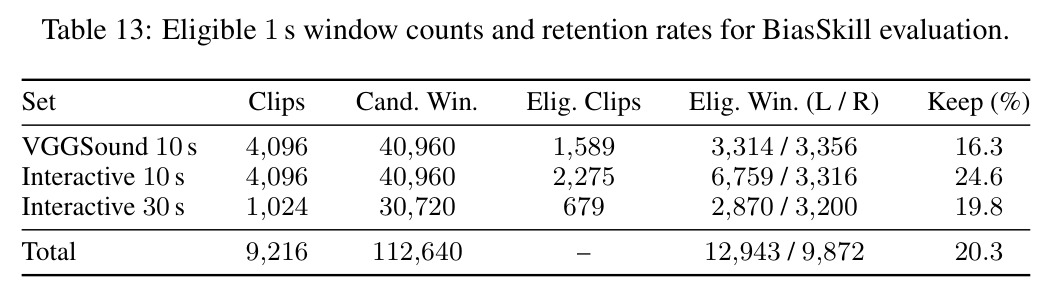
作者承认两点局限。其一,因果音频表示:生成依赖改编自 SoundReactor 的冻结因果立体声 VAE,而原论文已报告其因果解码器重建质量低于非因果版本,音质天花板被编解码器锁死;其二,立体声数据规模:高质量空间音频远少于海量单声道语料,许多公开立体声视频的声道分离是人工或噪声性的,并不能真实反映物体运动。笔者的补充观察:其一,DeSync 上本文(VGG 5s 0.686)确实落后于直接在 Synchformer 特征上优化的 ThinkSound(0.481),细粒度事件同步仍有差距;其二,BiasSkill 的合格窗口保留率仅 16%-25%(表 13),且作者自述 ITD 类指标在现有数据上不可靠而弃用,空间评价体系本身尚不完善,结论强度受度量覆盖面限制;其三,30 秒基准上 AudioX 与 PrismAudio 受最大上下文限制需拆成三段 10 秒拼接生成,与本文连续流式相比存在协议层面的细微不对等;其四,文本控制主要依赖 CLAP 余弦类度量,对「声音变大/变近」这类连续声学属性的敏感度有限,快速粒度(如逐块切换)的控制稳定性未验证。
独立分析的弱点
弱点一:受 30Hz 因果 VAE 重建上限约束,音质天花板被编解码器锁死,应训练大规模原生因果立体声编解码器并联合端到端微调。弱点二:因果模型看不到未来帧,事件起始时刻容易略迟,DeSync 落后于双向模型,可引入极短前瞻缓冲(如 200ms 发出延迟的 lookahead)或更密的时移偏移集合强化时间监督。弱点三:Ring-KV 仅 5 秒,超出窗口的长期声景一致性(持续环绕的环境声、反复的主题动机)只能靠 100ms 块摘要隐式维持,超长会话可能遗忘,可引入层级记忆或检索增强状态。弱点四:控制评测以 CLAP 相似度与 5 秒粒度切换为主,CLAP 对「声音变大/变近」等连续属性不敏感,逐块粒度切换的稳定性未测,需更细粒度、多维度的控制基准。弱点五:全景数据仅水平面 $\pm45^\circ$ 解码,俯仰与距离衰减主要靠文本间接监督,几何精确性有限,可扩展基于 HRIR/SOFA 的完整空间渲染。弱点六:训练需 16 张 H100 共 15 万步,且过滤与描述依赖 Qwen3-Omni 等第三方大模型,重训成本高、管线受外部模型版本牵制。
未来方向
作者提出的方向:开发更具表达力的大规模因果音频编解码器,缩小与非因果解码器的重建差距;扩大真实立体声数据规模。基于本文成果可延伸的研究:其一,把 WorldSonus 实际接入交互世界模型(如 Matrix-Game 2.0、LingBot-World 2.0)做端到端闭环评测,让智能体自动生成并更新音频提示;其二,探索反向或双向任务——音频引导视频生成、或音视频联合因果生成,与 Ripple、OmniForcing 正面对比验证模块化路线的长短;其三,将 ShiftNCE 推广为「任意冻结专家蒸馏为训练期对比目标」的通用配方,应用于唇音同步、口型驱动等跨模态对齐;其四,扩展输出格式至双耳 binaural、5.1 或 FOA,结合头部相关传递函数支持听者头部转动;其五,用户研究中真实音频仍以 55%-90% 的偏好胜出,说明生成质量上限明显,可探索更大容量模型、更优采样器与基于人类偏好的奖励微调;其六,研究如何在 33ms 细粒度块下恢复质量(当前 FAD 劣化至 3.79),进一步压缩交互延迟。
复现评估
复现信息完整度在同类工作中属上乘:附录给出完整架构表(36 层、宽 1024、16 头 AR 主干;宽 1024 流头;15 步 Euler;CFG 尺度与 APG 参数)、训练配方(AdamW、学习率 $5\times10^{-5}$ 预热 4000 步、EMA 0.9999、16 张 H100 全局批 256、14 万预训练加 1 万微调步)、ShiftNCE 全部细节($\tau=0.07$、偏移 $\{\pm1,\pm2,\pm4\}$、0.97 假负例过滤、top 40% 锚点)、逐数据池时长明细(表 12)、提示计划比例、评测集与训练库零重叠审计,以及延迟 p50/p95 测量协议。不利因素:截至发文为 Preprint,生成器权重与代码未提及开源,仅说明复用了 SoundReactor 公开的因果 VAE;自建交互式基准未说明公开渠道;数据管线依赖 Qwen3-Omni、T5Gemma 2、DINOv3、Synchformer、CLAP 等多个第三方模型;16 卡 H100 量级算力对学术实验室门槛很高。综合属「文档可依、成本高昂」级别:指标与协议可自行复现,模型本身暂难复现。
论文图表