LiveFoley:面向沉浸式交互世界的动态实时视频转音频生成 LiveFoley: Dynamic Real-Time Video-to-Audio Generation for Immersive Interactive Worlds
用尾随滑窗与加宽去噪窗口,让流式视频转音频在对齐与音质上逼近离线模型
前置知识
视频转音频(V2A)生成
给定视频像素流,自动合成语义相关且时间对齐的音效(Foley)。离线模型(如 MMAudio、AudioX)一次性看到整段视频,用全局双向注意力联合去噪所有音频片段,质量最好;流式模型则必须边收视频边出音频,服务于游戏、AR/VR 等无法等待全片的交互场景。
全文围绕『流式 V2A 如何逼近离线模型的质量与对齐』展开,先分清这两类系统的差异才能理解其动机与实验分组。
Synchformer 与段级同步编码器
一个自监督音视频同步模型:把视频切成 16 帧(0.64s)的段,段内用双向注意力编码,与音频特征做 AV-CLIP 式对比学习(式 1),再训练轻量分类头预测音视频偏移。它是 MMAudio、V-AURA 等离线系统的视觉时序条件来源,但段内双向注意力使其天然非因果——必须等整段帧到齐才能输出 token。
LiveFoley 的第一个核心创新(Trailing Sliding Window)就是把冻结的 Synchformer 零重训练地改造成流式模块,读懂它必须先懂 Synchformer 为何慢。
整流匹配(rectified flow)
一类连续生成建模方法:训练网络 $u_\theta$ 预测速度场,把噪声沿插值轨迹 $x_t = (1-t)x^0 + t\epsilon$ 推回干净数据 $x^0$($t=1$ 为纯噪声、$t=0$ 为干净数据)。相比离散 codec token 的自回归,连续潜变量没有量化损失,能表达更细腻的声学细节。
LiveFoley 的音频后端就是『因果 LM + 局部整流流头』,其训练目标(式 5)、时间步采样与去噪过程都建立在这套框架上。
局部扩散头(LocDiT)与因果自回归
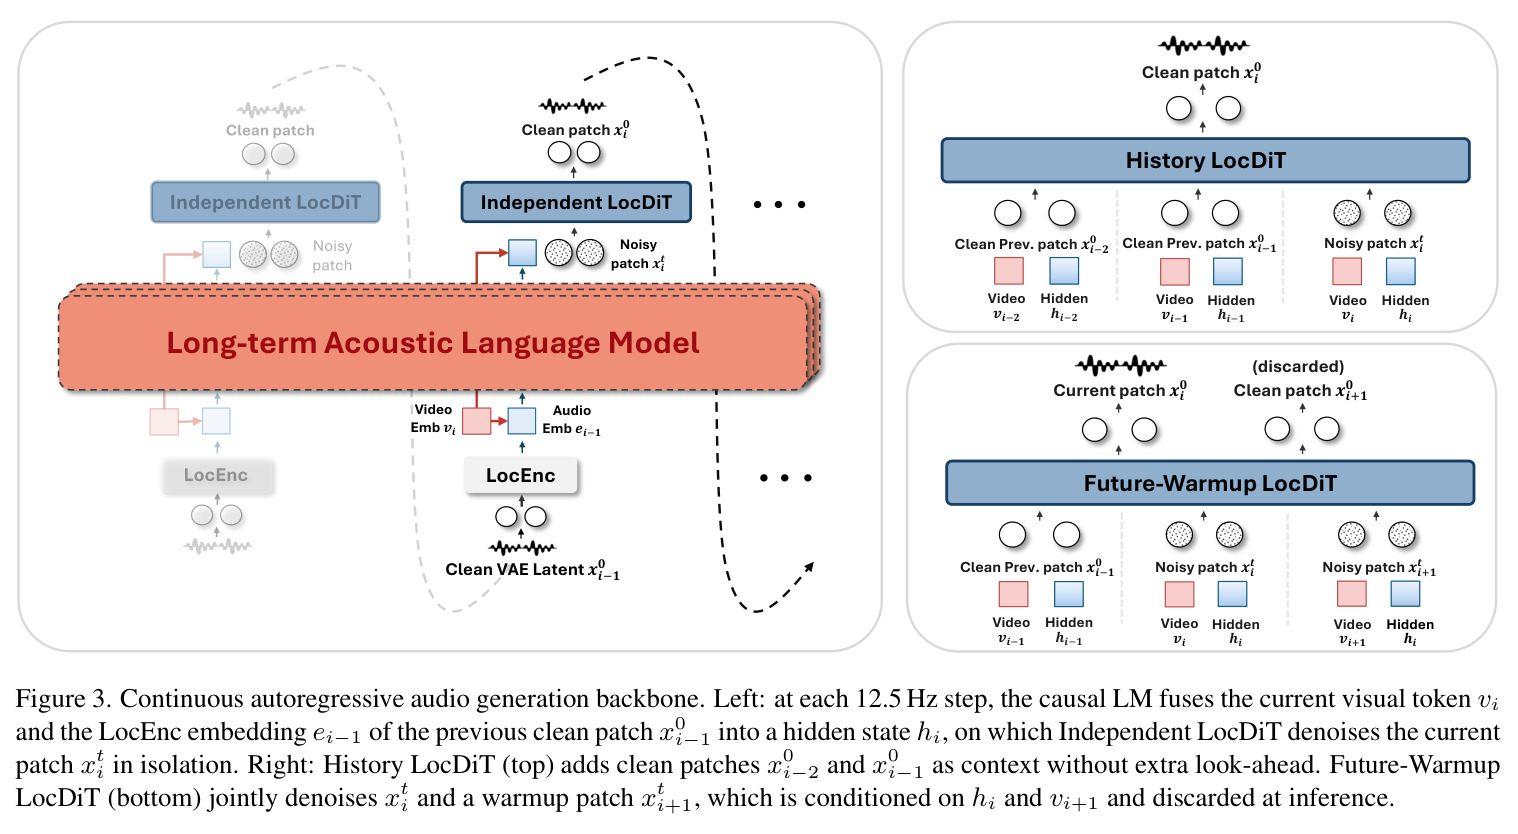
流式 V2A 的主流架构:因果语言模型按 12.5Hz(每 0.08s 一步)逐 patch 产生隐状态,一个轻量扩散 transformer(LocDiT)再用双向注意力在单个音频 patch 内部去噪。受因果约束,LocDiT 既看不到之前的 patch 也看不到未来的 patch,跨 patch 交互只能靠 LM 隐状态间接传递。
本文指出这正是流式系统音质落后的第二个瓶颈,History 与 Future-Warmup 两种 LocDiT 改造直接针对它设计。
前瞻延迟(look-ahead)与感知阈值
流式系统中『必须先缓存多少秒视频才能开始编码/生成』的等待,是算法属性、与硬件无关。Synchformer 一次编码 16 帧使 V-AURA 有 0.64s 前瞻,帧级 DINOv2 只有 0.08s 但对齐差。本文用户实验测得动作音效的感知阈值约 0.34s,为端到端延迟划定了硬预算。
全文的延迟论述(前端 0.08s、端到端 156/236ms)都以这个概念与 Figure 1a 的阈值测量为标尺。
研究动机
交互式虚拟环境(游戏、AR/VR)要求声学反馈与用户动作实时同步,但现有流式视频转音频(V2A)系统远落后于离线模型,根源在两个瓶颈。其一是视觉前端的前瞻延迟:精确对齐通常依赖段级编码器(Synchformer),它必须等整个 16 帧(0.64s)片段到齐才能编码,V-AURA 因此携带 0.64s 前瞻;而帧级编码器(如 SoundReactor 用的 DINOv2)前瞻仅 0.08s 却严重损害对齐。作者的控制实验(Figure 1b)揭示了根因:随着 Synchformer 感受野缩小,下游生成的音视频对齐持续恶化(DeSync 从 0.67 恶化到 0.88),说明对齐取决于每个片段覆盖的时间上下文,而非语义强弱。其二是因果自回归扩散后端:与全局双向扩散的离线模型不同,现有流式系统孤立地对每个音频 patch 去噪,音质显著落后。与此同时,用户实验测出动作音效的感知延迟阈值仅约 0.34s、语音约 0.49s、漫游环境音约 0.85s,为端到端延迟划定了严格预算。
本文的目标是本文要构建 LiveFoley:一个流式因果自回归扩散架构,在『不可感知延迟』约束下同时做到三件事。第一,在不重训练的前提下把现成的非因果段级编码器 Synchformer 改造成流式模块,保住其完整感受野带来的精确对齐,并把前端前瞻从 0.64s 压到 0.08s。第二,提供可配置的 hop size($s\in\{1,2,4\}$,对应前瞻 0.08/0.16/0.32s)与统一多延迟模式框架,让一个检查点能在射击/节奏游戏(严格延迟)与开放世界漫游(可容忍 0.85s)等场景间按延迟-算力预算灵活切换。第三,通过向过去与未来两个方向加宽局部扩散头的去噪窗口,缩小与离线模型在音频质量上的差距,最终在单张 A800 上实现端到端 156ms(默认)或 236ms(可选升级)的延迟,作为即插即用的声音引擎服务于交互世界。
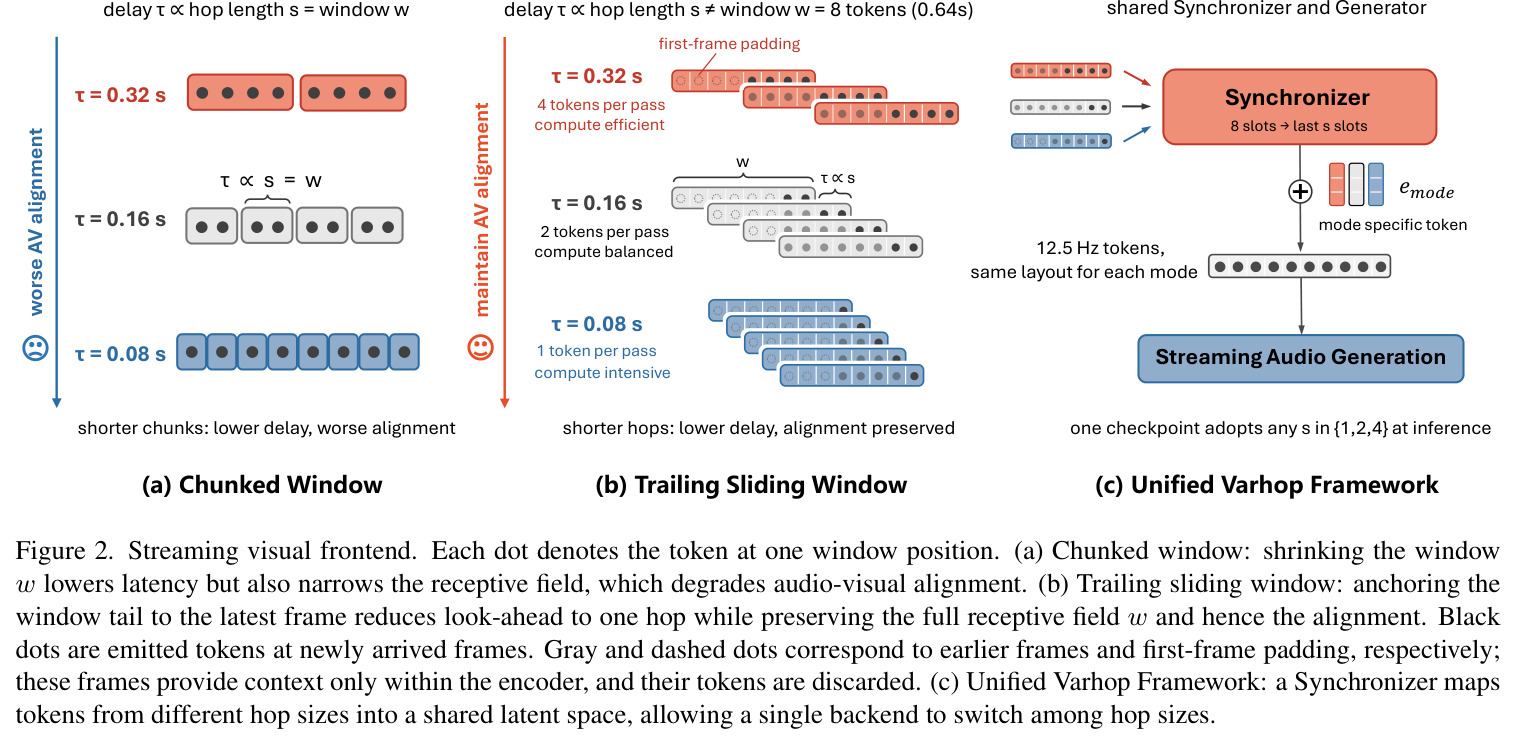
与已有工作不同的是,已有工作的切入各有局限:V-AURA 直接用 Synchformer 换来 0.64s 前瞻;SoundReactor 换成帧级 DINOv2 保住 0.08s 前瞻但牺牲对齐;WorldSonus 用时间偏移对比损失把自回归骨干蒸馏对齐到冻结的 Synchformer 教师,仅在 100ms 的 chunk 级延迟下部分缓解取舍,仍落后离线模型。LiveFoley 的独特之处在于换了一个问题表述:不问『如何缩小窗口来降延迟』,而是问『窗口的哪一部分才真正需要等待』——答案是把窗口尾部锚定到当前帧、让窗口沿时间滑动,前瞻从窗口长度 $w$ 解耦为小且可配置的 hop size $s$。这一重参数化把延迟-对齐困境变成延迟-算力的可配置权衡。后端侧,本文也不是简单堆模型,而是系统探索 LocDiT 去噪窗口在过去与未来两个方向的加宽,并用近似未来条件打破自回归死锁。
核心方法
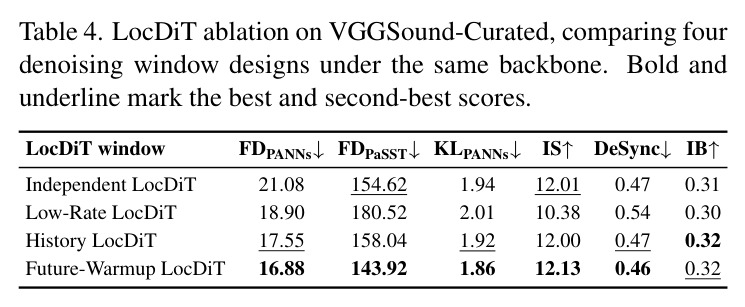
直觉上 LiveFoley 的核心是两句话:视觉侧『让窗口跟着最新帧走,而不是等满窗』,音频侧『让去噪器看到更多邻居 patch』。技术路线:视觉前端复用冻结的 Synchformer,把输入构造成尾随滑窗 $F_n = [f_{n-2w+1}, \dots, f_n]$($w=8$ token,对应 4 个 16 帧段),窗口每前进 2s 帧输出 $s$ 个尾部 token,$s\in\{1,2,4\}$ 对应前瞻 $\tau\in\{0.08,0.16,0.32\}$s;历史不足时用首帧填充,首帧到达即可出 token。随后两层 transformer 的 Synchronizer 把不同 hop 的尾部 token(注入位置嵌入、窗口内聚合与延迟模式嵌入 $e_{\text{mode}}$)映射为恒定 12.5Hz token 流,供同一后端在推理时按场景切换 hop。音频后端是 12.5Hz 因果 MiniCPM 与局部整流流 transformer LocDiT 的组合:LM 逐步融合当前视觉 token 与上一 patch 的音频嵌入产生隐状态,LocDiT 据此去噪当前 VAE 潜变量 patch;History LocDiT 再把过去两个干净 patch 加入去噪窗口,可选的 Future-Warmup LocDiT 把下一 patch 也拉进来联合去噪。
核心创新有二。第一是 Trailing Sliding Window:既有流式方法把视频切成固定不重叠窗口、靠缩小窗口 $w$ 降延迟(同时缩小感受野、损害对齐),而它保持感受野 $w$ 不变,只把窗口尾部锚定在当前帧 $f_n$,前瞻因此从 $w$ 解耦为滑动步长 $s$——Synchformer 的双向段内注意力原封不动,等价于把非因果段级编码器零重训练地变成因果流式模块。第二是去噪窗口的加宽:以往流式 V2A 的局部扩散头对每个 patch 孤立去噪,跨 patch 交互只靠 LM 隐状态间接传递;History LocDiT 把过去两个干净 patch $x^0_{i-2}, x^0_{i-1}$ 纳入双向注意力上下文(零额外延迟),Future-Warmup LocDiT 用当前隐状态与下一个视觉 token 构造近似条件 $c_{i+1}=\text{Concat}(h_i, v_{i+1}, \phi(t))$,绕过『$x_{i+1}$ 依赖尚不存在的 $x^0_i$』的自回归死锁,使当前与未来 patch 真正双向协同去噪。两点合起来,把流式系统的对齐与音质同时推向离线水平。
方法步骤详情
流水线六步。(1)视觉编码:25fps 视频逐帧到达,冻结的 Synchformer 在尾随滑窗 $F_n=[f_{n-2w+1},\dots,f_n]$(8 token)上编码,每滑 2s 帧输出 $s$ 个尾部 token,$n<2w$ 时首帧填充。(2)同步化:Synchronizer(两层 transformer)先注入位置嵌入并做窗口内聚合,再切出最后 $s$ 个 token 加延迟模式嵌入 $e_{\text{mode}}$,输出恒定 12.5Hz 流;训练时三个 hop 等比轮换,单套权重学会所有模式。(3)因果建模:16kHz Oobleck VAE(25Hz 潜变量、$P=2$)或 48kHz 立体声 VAE(50Hz、$P=4$)提供连续潜变量;LocEnc 把上一 patch 的 $P$ 个潜帧压成嵌入 $e_{i-1}$;28 层 MiniCPM 融合 $v_i$ 与 $e_{i-1}$ 产出隐状态 $h_i$。(4)局部去噪:12 层 LocDiT 以 $c_i=\text{Concat}(h_i, v_i, \phi(t))$ 经 adaLN 注入,用整流流目标 $\mathcal{L}(\theta)=\mathbb{E}\sum_{k\in T_i}\|u_\theta(x^t_k;\cdot)-(\epsilon_k-x^0_k)\|^2$ 训练,$t$ 采自 logit-normal;History 版 $T_i=\{i\}$、$H_i=\{i-2,i-1\}$,Future-Warmup 版 $T_i=\{i,i+1\}$、$H_i=\{i-1\}$,推理时丢弃 warmup patch。(5)防误差累积:训练时历史潜变量以概率 0.5 做 VP 噪声混合 $\tilde{x}=\sqrt{\gamma}\eta+\sqrt{1-\gamma}x^0$($\gamma\sim U(0,0.5)$),推理固定 $\gamma=0.15$;CFG 丢弃 0.1,引导尺度 6,20 步 Euler。(6)长时推理:124 token 滚动 KV cache 加 4 个 attention sink,KV 不存 RoPE、按相对距离动态施加,滑窗退化为指针运算。
技术新颖性
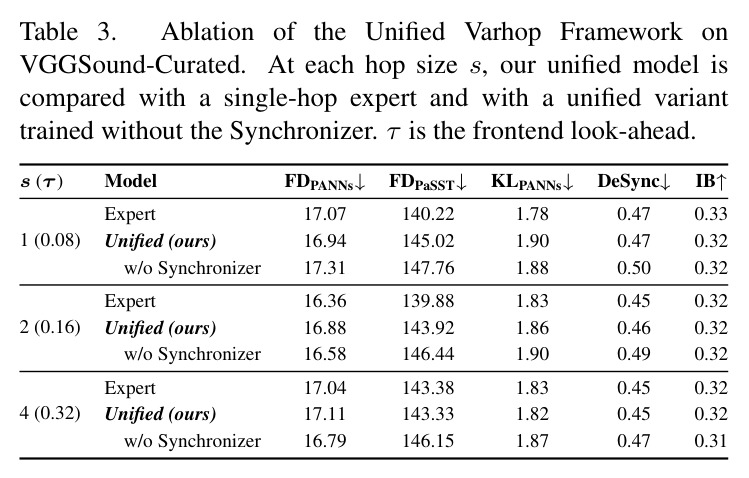
新颖性可从四层评估。重参数化层面:Trailing Sliding Window 把『编码结果何时可用』从『帧何时到齐』中解耦——同一冻结编码器、同一感受野,只改变窗口与当前帧的相对位置就消除前瞻;这种零训练成本的因果化对所有段级双向编码器通用,方法论上优于 WorldSonus 的知识蒸馏路线。架构层面:Unified Varhop 用一个 Synchronizer(而非每个 hop 训一个专家)统一三种延迟模式的特征分布,模式嵌入显式编码档位,消融显示统一模型与专家指标仅差约 0.3-0.7(FDPANNs)。生成建模层面:Future-Warmup LocDiT 的近似条件(以 $h_i$ 代替尚不存在的 $h_{i+1}$、搭配 $v_{i+1}$)是打破连续自回归扩散死锁的干净方案,优于把自回归速率减半的 Low-Rate 替代(其 DeSync 恶化到 0.54、FDPaSST 到 180.52);它延续 VoxCPM/DiTAR『因果 LM + 局部流头』配方并首次系统化拓展去噪窗口。工程层面:无 RoPE 缓存加 attention sink 的滚动 KV 设计,使无限长流式推理无需重算历史条目。
实验结果
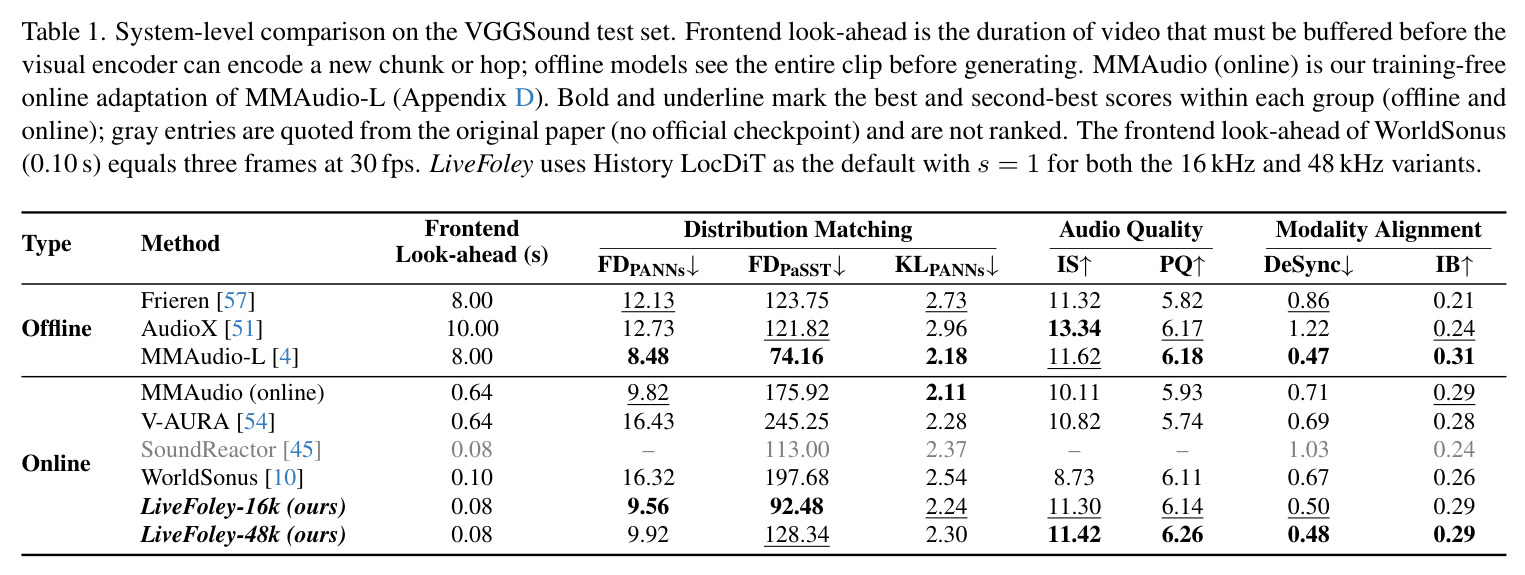
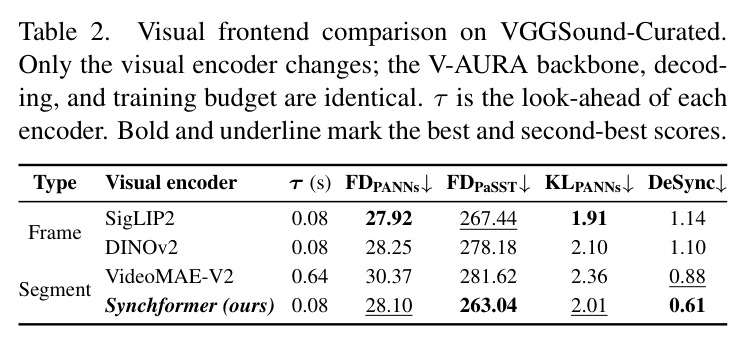
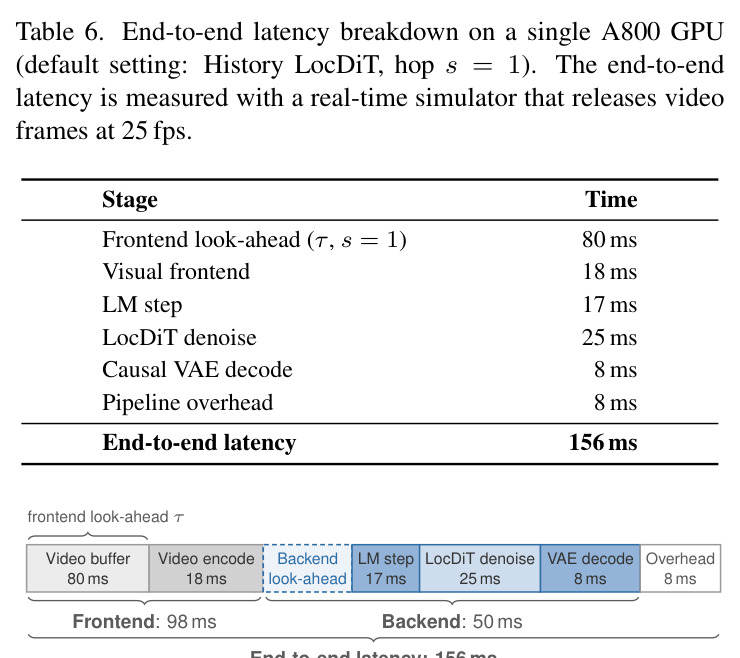
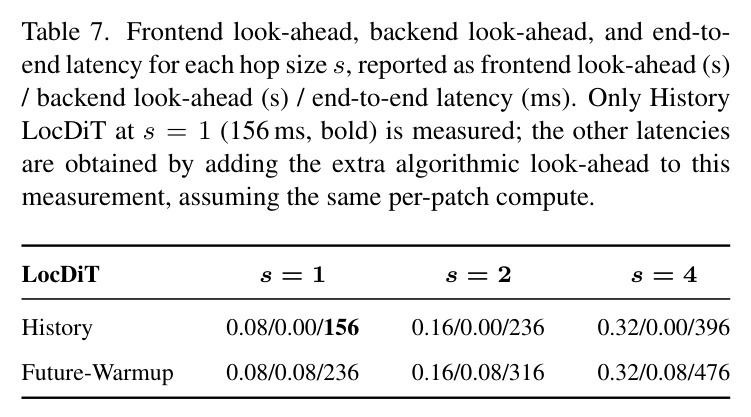
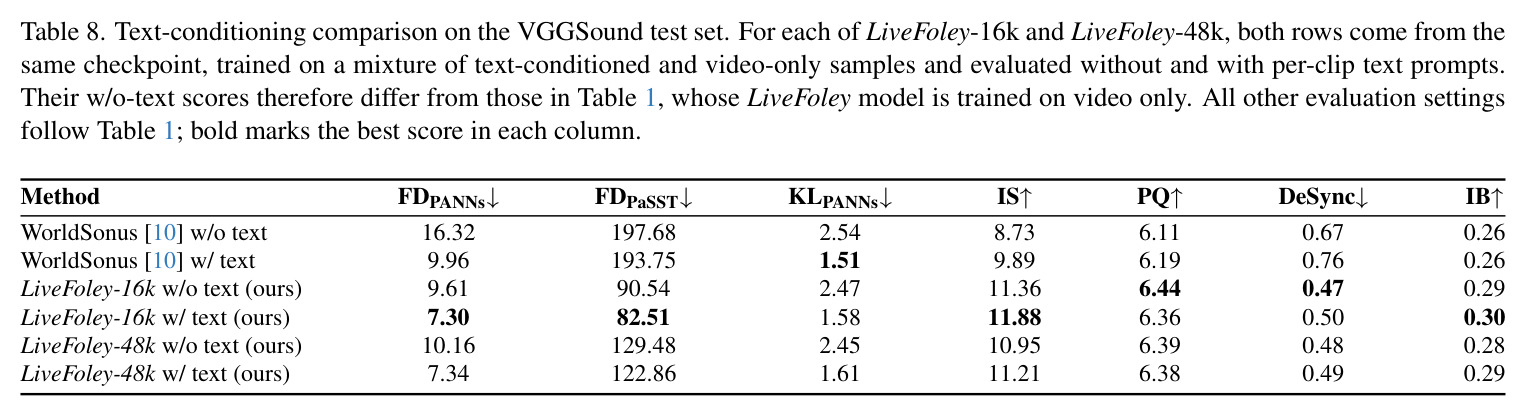
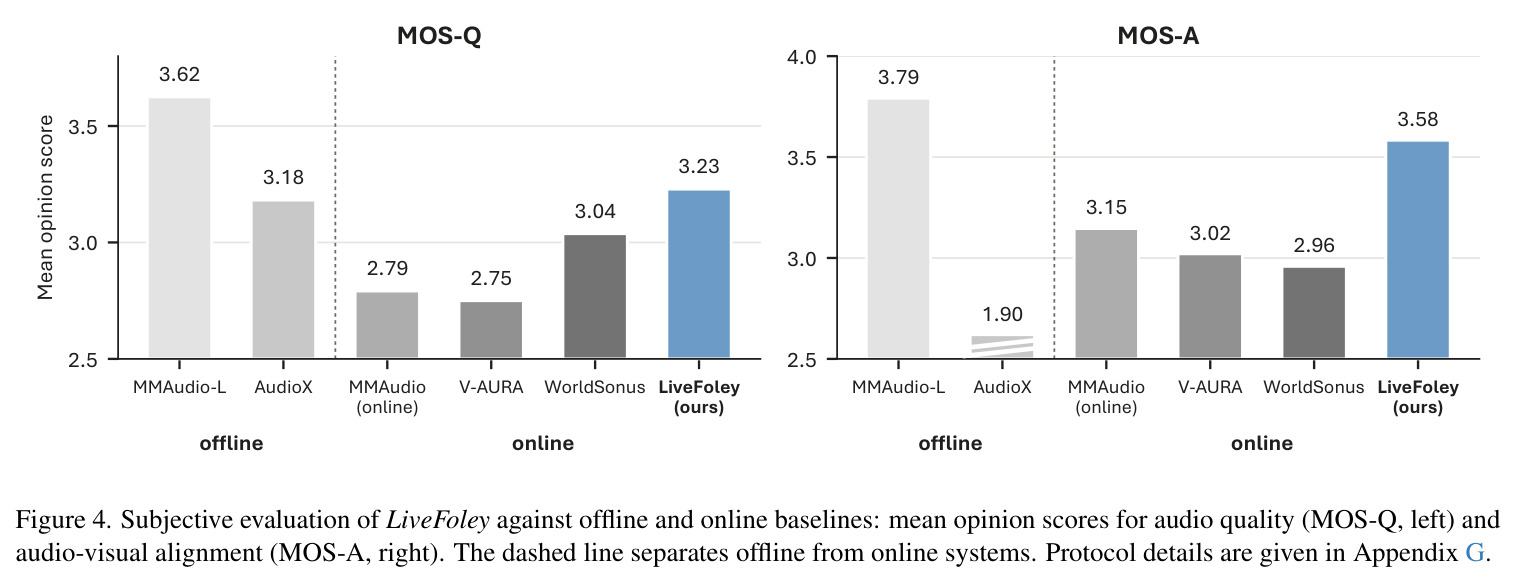
结果分五组。系统级对比(Table 1,VGGSound):LiveFoley-48k 的 DeSync 0.48 与离线 MMAudio-L 的 0.47 持平,远超流式基线(MMAudio online 0.71、V-AURA 0.69、SoundReactor 1.03、WorldSonus 0.67),而前端前瞻仅 0.08s(V-AURA 为 0.64s);16k 版取得流式最佳 FDPANNs 9.56 与 FDPaSST 92.48,48k 版取得流式最佳 IS 11.42 和全场最高 PQ 6.26;与离线的音质差距仍在(FDPaSST 92.48 vs 74.16、IS 11.30 vs 11.62、IB 0.29 vs 0.31)。前端消融(Table 2,VGGSound-Curated 1485 段):同样 0.08s 前瞻下 SigLIP2/DINOv2 的 DeSync 高于 1.0,尾随滑窗版 Synchformer 达 0.61 且 FDPaSST 263.04 最佳;Figure 1b 显示窗口从 0.32s 缩到 0.08s 时 chunked 方式 DeSync 0.67→0.88,尾随滑窗仅 0.60→0.61。Varhop 消融(Table 3):统一模型与单 hop 专家基本持平(s=2 时 FDPANNs 16.88 vs 16.36),去掉 Synchronizer 则 DeSync 恶化约 0.03;s=4 前端算力省 4 倍。LocDiT 消融(Table 4):Independent→History 使 FDPANNs 21.08→17.55、IB 0.31→0.32,Future-Warmup 把 FDPaSST 压到最佳的 143.92、DeSync 0.46;Low-Rate 反而恶化(FDPaSST 180.52、DeSync 0.54)。主观测试(Figure 4):MOS-Q 3.23、MOS-A 3.58 均为在线最佳,对齐接近 MMAudio-L 的 3.79。部署(Table 6/7,A800):端到端 156ms(80ms 前端缓冲+18ms 编码+17ms LM+25ms LocDiT+8ms VAE+8ms 开销),Future-Warmup 236ms,均低于 0.34s 感知阈值。文本扩展(Table 8):FDPANNs 9.61→7.30,除带文本 KLPANNs(1.58 vs 1.51)外全面超过 WorldSonus。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式 V2A 时序对齐(VGGSound 测试集) | DeSync↓(Synchformer 预测的音视去同步分数) | LiveFoley-48k:0.48(前端前瞻 0.08s) | 离线 MMAudio-L:0.47;在线最佳 WorldSonus:0.67 | 追平离线 SOTA;比在线最佳低 0.19(约 28%) |
| 分布匹配(VGGSound 测试集) | FDPANNs↓ | LiveFoley-16k:9.56(流式最佳) | 在线最佳 WorldSonus:16.32;离线 MMAudio-L:8.48 | 较在线最佳降低 41%;距离线仅差 1.08 |
| 分布匹配(VGGSound 测试集) | FDPaSST↓ | LiveFoley-16k:92.48 | V-AURA:245.25;WorldSonus:197.68;离线 MMAudio-L:74.16 | 较在线最佳降低约 53%,仅次离线 MMAudio-L |
| 音频质量与多样性 | IS↑ / PQ↑(Audiobox Aesthetics 制作质量) | IS 11.42(48k,流式最佳);PQ 6.26(48k,全场最高) | IS:WorldSonus 8.73、离线 MMAudio-L 11.62;PQ:MMAudio-L 6.18 | IS 较在线最佳提升 2.69;PQ 超过所有离线与在线系统 |
| 主观评测(16 段剪辑、6 人) | MOS-Q↑ / MOS-A↑ | MOS-Q 3.23;MOS-A 3.58(均为在线系统最佳) | MOS-Q:WorldSonus 3.04、离线 MMAudio-L 3.62;MOS-A:WorldSonus 2.96、MMAudio-L 3.79 | 在线最佳;对齐逼近离线 MMAudio-L(3.58 vs 3.79) |
| 端到端延迟(单张 A800,25fps 实时模拟) | 首帧到达→首段可播放音频(ms) | 156ms(History, s=1);236ms(Future-Warmup, s=1) | 感知阈值:动作音效约 0.34s;ITU-R BT.1359 可接受阈值约 185ms | 低于动作音效感知阈值,默认配置也满足广播级可接受阈值 |
局限与改进
作者承认的局限:一是与离线模型的音质差距仍在——FDPaSST 92.48 vs MMAudio-L 74.16、FDPANNs 9.56 vs 8.48、IS 11.30 vs 11.62、IB 0.29 vs 0.31,因离线模型可全局双向联合去噪所有 patch,而因果模型只能依据已见帧做承诺,作者直言在流式约束下消除差距仍是开放方向;二是感知阈值实验规模小:仅 6 名被试、9 段剪辑,环境音类别 18 次阶梯中 7 次直到 1.0s 上限仍未察觉,0.85s 只是下界。我的观察:其一,评估用 8s 剪辑,分钟到小时级长流的稳定性只靠噪声注入和 attention sink 保证,缺少漂移的量化证据;其二,VGGSound 含大量画面外声音,自建的 VGGSound-Curated(1485 段、ImageBind>0.3、排除语音与人脸)更严格但过滤可能引入分布偏移,且主表对比仍在原 VGGSound;其三,48kHz 版并非全面优于 16kHz(FDPANNs 9.92 vs 9.56 更差);其四,延迟数据基于 A800,消费级设备无数据;其五,Future-Warmup 的近似条件用 $h_i$ 代替真实 $h_{i+1}$,视觉快速变化时可能引入相邻 patch 的不一致。
独立分析的弱点
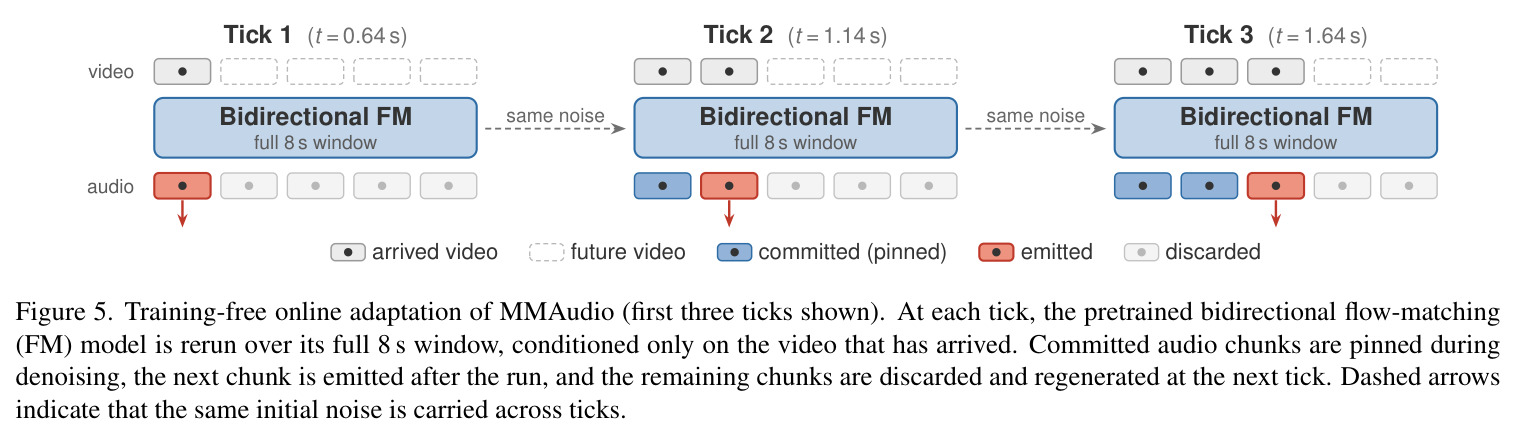
独立分析可见几个弱点。第一,音质瓶颈是结构性的:因果 LM 每 0.08s 必须立即提交音频,无法回看全局重修细节,History/Future-Warmup 只是缓解;改进方向包括更大 LM 骨干、多候选采样加质量评估重排,或允许少量延迟的多步精修。第二,感知阈值研究覆盖面窄:动作类只有网球、砍柴、小号三种,游戏高频事件(脚步、枪声、UI 音)未测,0.34s 预算对电竞级场景是否保守未知,建议扩大被试与刺激类别并按事件骤变度建模阈值。第三,Varhop 的三个 hop 档位是预设的 $\{1,2,4\}$,无法按内容动态调整(战斗降 hop、漫游升 hop),可加基于视觉事件密度的在线控制器——统一框架已铺路但论文未实现。第四,视觉条件只有 0.64s 的 Synchformer 窗口,长程音景记忆全压在 LM 隐状态上,长流可能遗忘场景一致性,可引入检索式记忆或分层摘要 token。第五,MOS 测试仅 6 人 16 剪辑;MMAudio(online) 客观 FDPANNs 2.11 不差但听感有明显接缝,说明缺少流式专用度量(如块边界不连续度)。第六,文本条件需预知提示词,交互场景中外部 VLM 生成提示又会引入额外延迟,实用性限于内容生成场景。
未来方向
作者明确提出的方向:缩小流式与离线模型的音质差距(原文称在流式约束下消除差距仍是 open direction);文本条件扩展(附录 F 已给出 Flan-T5 加交叉注意力的单检查点双模式方案,文本主要改善分布匹配 FDPANNs 9.61→7.30,代价是 DeSync 0.47→0.50)。基于本文成果可延伸:其一,把 Trailing Sliding Window 推广到其他非因果骨干(VideoMAE 系列、大规模视听对齐模型),系统比较窗口重排与蒸馏、流式注意力掩码等因果化技术;其二,动态 hop 调度——结合视觉事件检测在运行时切换 $s$,实现算力自适应的沉浸音频;其三,空间音频扩展:与声场建模系统结合,让音效携带用户位姿相关的空间衰减与遮挡;其四,把感知阈值研究扩展为更大规模的延迟心理学基准,覆盖更多声音类型与个体差异,为流式生成建立类似 BT.1359 的行业标准;其五,与交互式世界模型(HelixWorld、EchoWM 类)端到端联合训练,让音频梯度反哺视觉生成的物理合理性;其六,探索 speculative 式生成:低速率模型草拟、高速率模型验证修正,在不破坏 12.5Hz 承诺语义的前提下缩小质量差距。
复现评估
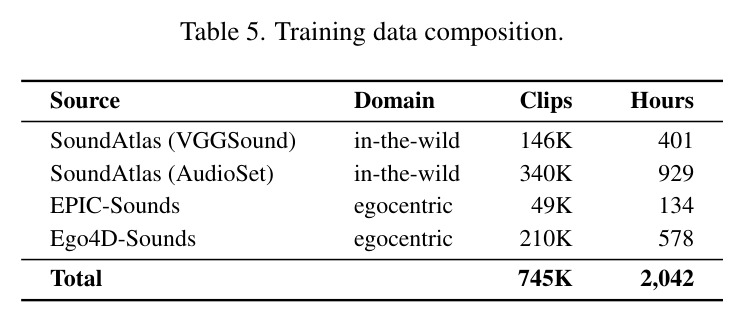
复现条件评估:项目页为 https://dalision.github.io/livefoley-page/,附录提供罕见的详尽细节——训练数据组成(Table 5:VGGSound 401h、AudioSet 929h、EPIC-Sounds 134h、Ego4D-Sounds 578h,共 745K 段 2042 小时,均基于公开数据集)、架构超参(28 层 MiniCPM、hidden 2048;LocEnc/LocDiT 12 层、hidden 1024、16 头;16k/48k 两版 Oobleck VAE)、训练配置(AdamW β=(0.9,0.99)、wd 0.05、lr 1e-4、200K 步、batch 64、16×A800、CFG 丢弃 0.1、引导尺度 6、20 步 Euler、噪声注入 γ~U(0,0.5))、推理管线(三线程异步、124 token 滚动 KV + 4 个 sink)、评估协议(av-benchmark、8s 剪辑、-23 LUFS 归一、MOS 流程)及 VGGSound-Curated 构造规则。Synchformer、Stable Audio Open、MiniCPM、Flan-T5 等组件均有公开权重。主要门槛:训练需 16 张 A800 共 200K 步,算力成本高;WorldSonus、SoundReactor 无官方检查点(Table 1 部分数字引自原文),MMAudio(online) 需按附录 D 自行实现 pinned denoising;感知阈值与 MOS 实验需自行招募被试。综合判断:拿到官方代码后复现评估与消融属中等难度;从零复现训练难度较高,但协议完整,障碍主要在算力而非信息缺失。
论文图表
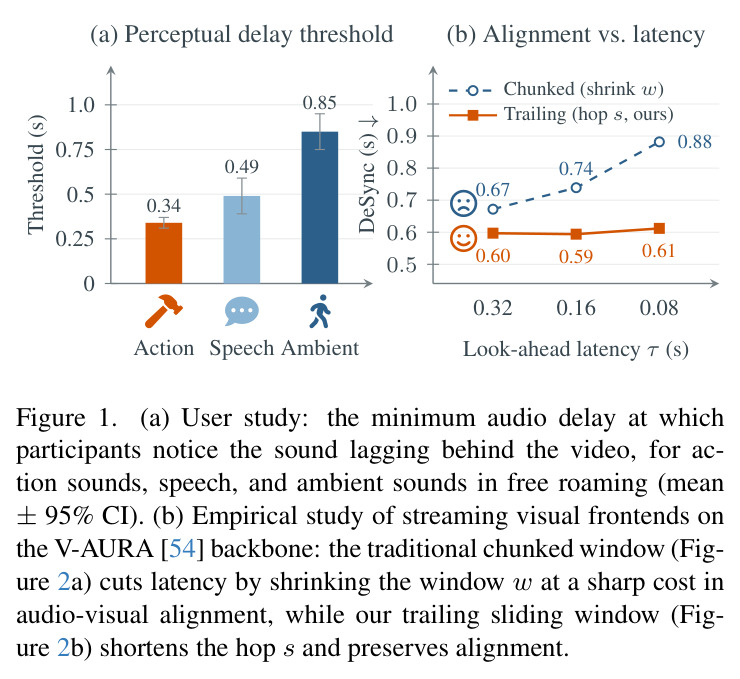
(a) 用户实验测得三类声音的感知延迟阈值:动作音效约 0.34s、语音约 0.49s、自由漫游环境音约 0.85s(均值 ± 95% 置信区间);(b) 在 V-AURA 骨干上,chunked 窗口把前瞻从 0.32s 压到 0.08s 时 DeSync 从 0.67 恶化到 0.88,而尾随滑窗几乎不变(0.60→0.61)。
同时给出全文的延迟预算标尺(感知阈值)与核心动机证据(缩窗损害对齐而滑窗不损害),是理解问题定义与方法有效性的钥匙。
默认配置下端到端 156ms 的组成:前端缓冲 80ms(前瞻 τ,$s=1$)+ 视觉编码 18ms + 后端前瞻 0ms(History)+ LM 步 17ms + LocDiT 去噪 25ms + VAE 解码 8ms + 管线开销 8ms;前端合计 98ms、后端合计 50ms。
逐项量化『不可感知延迟』的声明,并展示算法等待与计算开销的占比,对实际部署最有直接参考价值。