聆听立体世界:面向沉浸式联合视频-音频生成的动态空间对应学习 Hear the World in Stereo: Learning Dynamic Spatial Correspondence for Immersive Joint Video-Audio Generation
StereoBind用运动轨迹绑定视觉源运动与立体声生成,实现声画空间一致
前置知识
双耳定位线索(ITD 与 ILD)
人类水平方向的声源定位主要依赖双耳时间差(ITD,声音到达两耳的时间差)和双耳强度差(ILD,到达两耳的能量差)。立体声的空间感正是来自左右声道之间这种结构化的差异,而不是简单地输出两条声道。
论文的核心概念“动态空间对应”就定义为视觉源运动与 ITD/ILD 等双耳线索随时间演化的一致性,VMB/STE/RT-RoPE 三个模块本质上都在间接操纵这些线索,理解它们才能读懂动机与评测指标。
RoPE(旋转位置编码)
Transformer 中把位置信息以复数旋转相位的形式注入注意力 query/key 的机制,任意两个 token 之间的相对位置表现为二者的相位差,因此天然适合编码相对位置关系。
RT-RoPE 直接在预训练音频自注意力的时间 RoPE 上叠加由轨迹决定的残余相位,靠相位差 $\theta^h_{j,r}-\theta^h_{i,r}$ 编码相对位移,不懂 RoPE 就无法理解相对运动建模这一核心创新。
LoRA(低秩适配)
参数高效微调技术:冻结预训练权重,只在注意力/前馈层旁路注入一对低秩矩阵增量 $\Delta W = BA$(秩 $r$ 很小),训练时只更新这些增量,大幅降低显存与算力需求。
本文在视频分支插入冻结的 Motion Track IC-LoRA、音频分支加 rank-32 LoRA、RT-RoPE 改变旋转几何后配套训练 Stereo LoRA,三处都依赖该技术实现“冻结骨干 + 新增空间能力”。
双流视频-音频联合生成(VA DiT)
以 Diffusion Transformer 为骨干的联合生成范式:视频和音频各自有潜变量流与 Transformer 分支,通过 Joint VA Attention / Cross-Attention 交互,实现语义对应(听到什么)与时间同步(何时听到)。
StereoBind 构建在 LTX-2.3 双流骨干之上,所有新模块(VMB 块、STE 调制、RT-RoPE)都以“插入双流之间”的方式实现,需要这一架构背景才能理解各组件在何处生效。
房间脉冲响应(RIR)与音频空间化
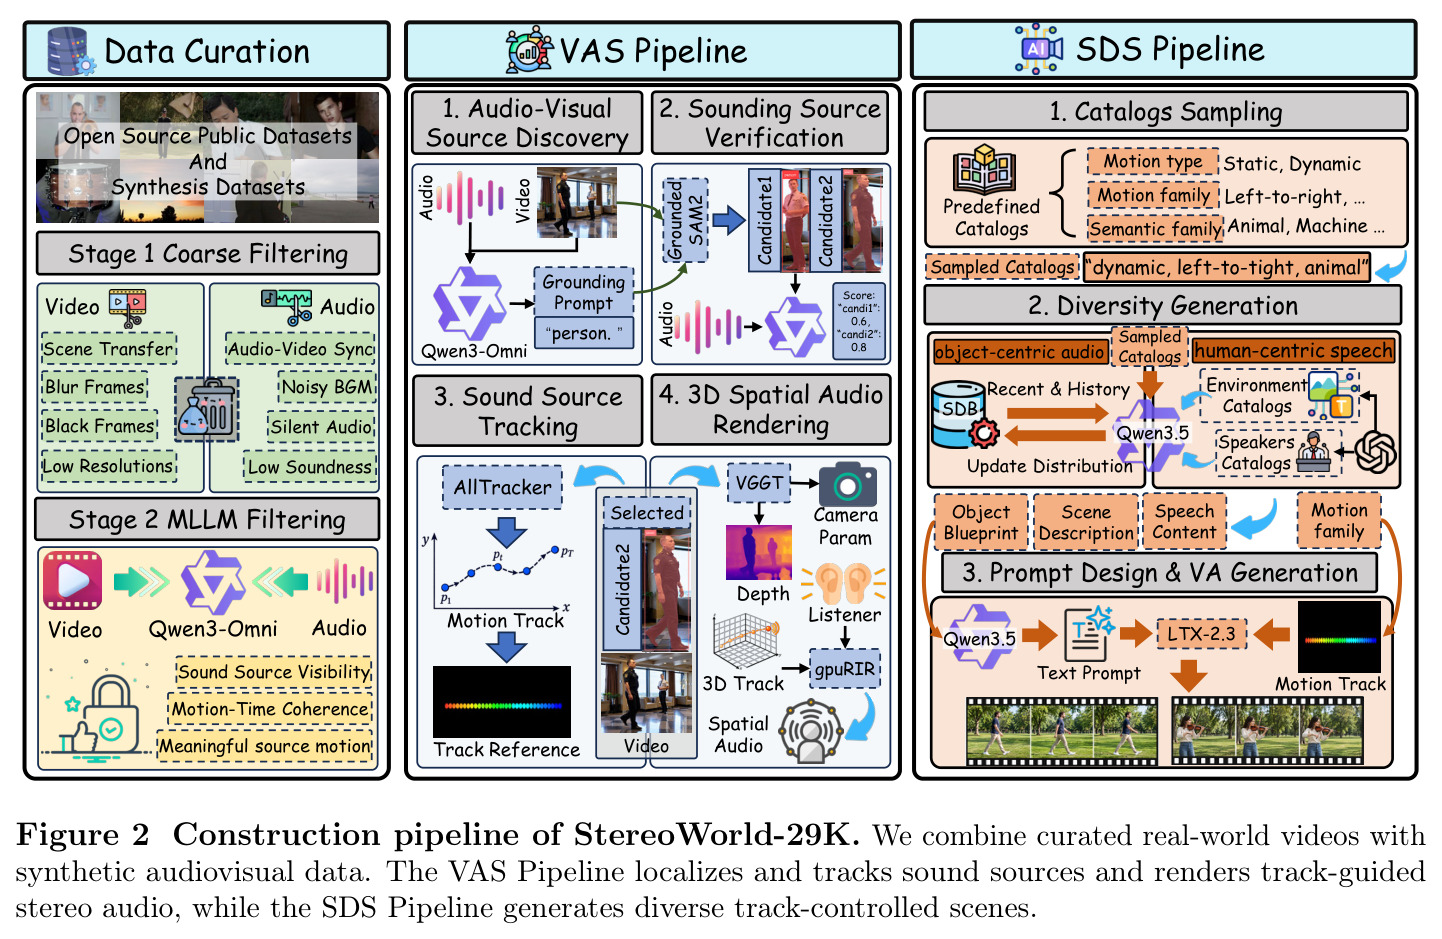
RIR 刻画房间声学对从声源到接收点信号的线性作用;把单声道音频与沿源轨迹采样的一串 RIR 逐帧卷积,就能物理正确地渲染出双耳立体声,其 ITD/ILD 自然随源位置演化(gpuRIR 是常用的 GPU 加速 RIR 仿真库)。
这是 StereoWorld-29K 真实分支(VAS Pipeline)构造空间监督的核心手段,也是评测时把生成音频重新空间化得到参考立体声的方法。
视觉定位与跟踪工具链(Grounded-SAM / AllTracker / VGGT)
Grounded-SAM 用文本提示分割出指定实例;AllTracker 在整段视频中稠密跟踪目标像素得到运动轨迹;VGGT 从视频前馈估计深度与相机参数。三者结合可把 2D 轨迹反投影为相机坐标系下的 3D 源轨迹。
论文的数据管线大量复用这些现成模型从真实视频自动提取“声源在哪、怎么动”的监督信号,是理解 StereoWorld-29K 构建流程的基础。
研究动机
现有联合视频-音频生成基础模型(Seedance、LTX-2、MOVA、Minimax-H3 等)已经解决了两个维度:通过语义对应决定“听到什么”,通过时间同步决定“何时听到”,但“声音从哪里来、其位置如何随源运动演化”这一空间维度基本被忽略。虽然 Ovi、LTX-2 等模型能输出双声道音频,但双声道输出并不保证存在有意义的立体空间线索——立体声的空间感知恰恰来自左右声道间的结构化差异,即双耳时间差(ITD)与双耳强度差(ILD)需随可见声源的运动一致变化。这在 AR/VR 与互动游戏等沉浸式场景是刚需。更棘手的是数据:VGGSound、OpenHumanVid 等大规模数据集只支持语义与时间对应,几乎不含可靠立体声线索;用标定好的空间录音设备大规模采集真实数据成本极高;而现有视听分割(AVS)模型在无约束场景上泛化差,难以自动提取可靠的声源轨迹。空间对应因此长期停留在“未被充分探索”的状态。
本文的目标是本文提出并系统解决“动态空间对应”(Dynamic Spatial Correspondence)问题:给定文本描述 $c$ 与归一化运动轨迹 $P=(p_i)_{i=1}^{T_p}$(其中 $p_i=(x_i,y_i)\in[0,1]^2$),生成可见发声源严格跟随轨迹运动的视频 $V$,以及感知声像位置随视觉源运动一致演化的立体声音频 $A=(A_L,A_R)$,即建模条件分布 $p_\theta(V, A \mid c, P, R(P))$,其中 $R(P)$ 是由轨迹渲染的视觉参考。目标具体化为三位一体的交付:(1) 提出首个轨迹条件化的立体 VA 生成框架 StereoBind;(2) 构建首个带显式空间监督的大规模立体声数据集 StereoWorld-29K(含配对运动轨迹);(3) 提出首个衡量视听空间一致性的评测基准 StereoWorldBench(SWBench),并在与 Ovi、MiniMax-H3、LTX-2.5/2.3 及 PrismAudio、See2Sound 等基线的对比中验证空间对齐显著提升且整体音视质量不退步。
与已有工作不同的是,本文的独特切入角度是:不把立体声当作生成后的事后处理,而是把“运动轨迹”作为桥梁条件,显式桥接视觉与听觉这两种异构表示。运动轨迹描述的是画面坐标里的位置,而听觉位置只能通过 ITD/ILD 等间接线索体现,二者无法直接翻译——这正是已有方法回避的鸿沟。对比之下:V2SA 方法(PrismAudio、See2Sound)只能对给定视频转空间音频、不能生成视频;VA 联合生成模型(Ovi、LTX-2)不接受任何空间输入;Spatial-Sonic 等立体声工作只用静态方向标签。StereoBind 首次让“随时间演化的连续轨迹”同时提供绝对位置(Spatial Track Encoder)与相对位移(Residual Track RoPE)两种互补的空间条件,并通过可学习 token 的源绑定机制把轨迹与具体视觉实体关联,而不是全局条件拼接。
核心方法
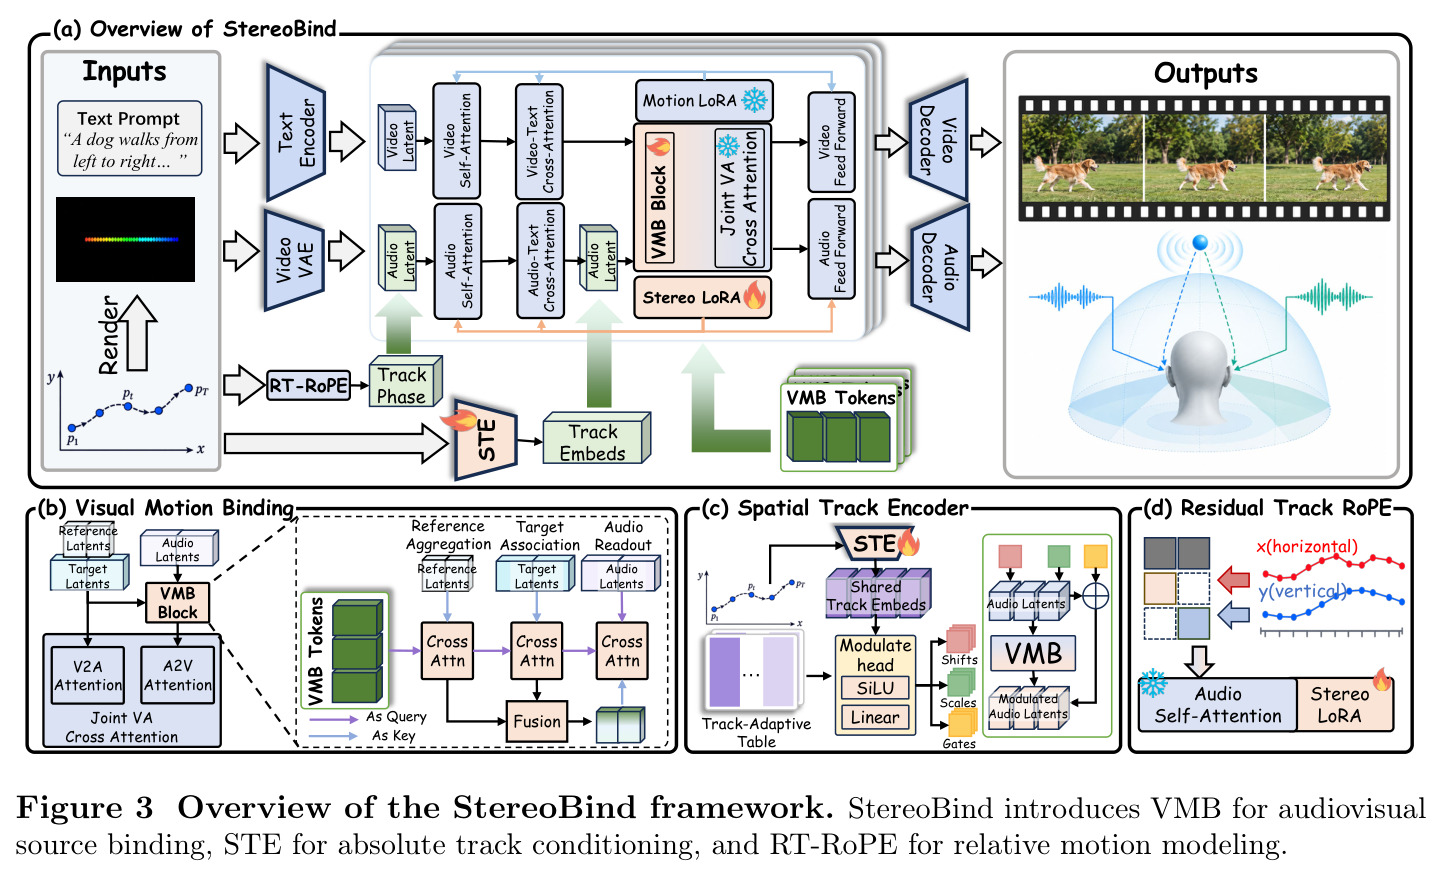
直觉上,要让声音“跟着画面里的东西走”,音频流需要同时知道三件事:哪个视觉实体在发声(源绑定)、它当前的绝对位置、它相对上一时刻怎么动。技术路线上,StereoBind 基于 LTX-2.3 双流 VA 骨干:视频分支插入冻结的 Motion Track IC-LoRA,使画面主体跟随轨迹渲染的参考 $R(P)$;音频分支注入三个互补模块。其一是 Visual Motion Binding(VMB):每个 Transformer 块在 Joint VA Attention 之前放一个 VMB 块,用 $N_{VMB}=64$ 个可学习 token 依次与运动参考、去噪中的视频状态做交叉注意力,再让音频流读取融合结果,形成“参考-目标-音频”通路。其二是 Spatial Track Encoder(STE):把轨迹 $P$ 编码为跨层共享的时序表示 $H$,再经逐层可学习的 Track-Adaptive 表 $B_\ell$ 生成 shift/scale/gate,以门控残差方式调制音频 query。其三是 Residual Track RoPE(RT-RoPE):在预训练时间 RoPE 相位上叠加 tanh 约束的轨迹残余相位,并配套可训练的 Stereo LoRA 适配被改变的旋转几何。训练上,主干与视频 LoRA 全部冻结,只训练音频 LoRA 与新模块:在 StereoWorld-29K 上训练 8000 步、8 张 NVIDIA H20 约两天,AdamW 学习率 $2\times10^{-4}$($\beta_1=0.9$,$\beta_2=0.999$)线性调度,每样本 121 帧、640×384 分辨率,沿用 LTX-2.3 原始训练目标。
核心创新是把视觉源运动与听觉空间线索之间的异构表示鸿沟显式桥接,并拆成“绑定 + 绝对 + 相对”三个互补子问题。VMB 的关键设计是用 64 个可学习 token 作跨模态中介:先聚合运动参考编码“规定的运动”($S^r_\ell = S^0_\ell + A^r_\ell(\text{LN}(S^0_\ell), \text{LN}(X^{ref}_\ell))$),再关联目标视频状态获取“正在生成的实体”($S^t_\ell = S^r_\ell + A^t_\ell(\text{LN}(S^r_\ell), \text{LN}(X^{tar}_\ell))$),并显式保留残差 $S^t_\ell - S^r_\ell$ 刻画目标上下文对参考表征的修正,最后由音频交叉注意力读取($D^s_\ell = A^a_\ell(\text{LN}(X^a_\ell), \text{LN}(S^\ell))$)——这形成了源感知(source-aware)的绑定。与已有方法的本质区别在于:以往 VA 模型不给任何空间条件,立体声方法只给静态方向标签;StereoBind 首次让连续轨迹同时提供绝对位置与相对运动两种监督——STE 通过门控残差 $\tilde{X}^{a,+}_\ell = \tilde{X}^a_\ell + g_\ell \odot D^s_\ell$ 注入绝对位置,RT-RoPE 通过相位差 $\theta^h_{j,r}-\theta^h_{i,r} = (\theta^{h,time}_{j,r}-\theta^{h,time}_{i,r}) + \tanh(a_x)\omega^x_r(\bar{x}_j-\bar{x}_i)$ 编码带符号的相对位移。整个设计始终保护预训练音频残差通路:轨迹条件被严格限制在 VMB 通路内,经门控 $g_\ell$ 注入,避免破坏学到的生成能力。
方法步骤详情
第一步,条件构造:输入文本 $c$ 与轨迹 $P\in\mathbb{R}^{T_p\times 2}$,把轨迹渲染成视觉参考图输入视频分支(经冻结的 Motion Track IC-LoRA),使生成视频的主体沿轨迹运动。第二步,VMB:每层用 $N_{VMB}=64$ 个可学习 token $S^0_\ell$,依次做参考聚合、目标关联、残差拼接 $[S^r_\ell, S^t_\ell, S^t_\ell - S^r_\ell]$ 经 MLP 得 $S^\ell$,音频读出 $D^s_\ell$ 送入 Joint VA Cross-Attention。第三步,STE:$H = \text{LN}(\text{TemporalTransformer}(\text{Linear}_p(P)))$ 为全层共享表示;逐层查 Track-Adaptive 表得 $[\beta_\ell, \gamma_\ell, g_\ell] = U_3(U_u(\text{SiLU}(H)) + B_\ell)$,按 $\tilde{X}^a_\ell = \text{RMSNorm}(X^a_\ell)\odot(1+\gamma_\ell) + \beta_\ell$ 调制后再加门控更新。第四步,RT-RoPE:把轨迹线性重采样到音频 token 长度并归一化到 $[-1,1]^2$,每个注意力头的旋转对均分为水平/垂直子集,用对数间隔频率网格 $\omega^k_d = \frac{\pi}{2}\theta_{track}^{k/(n_{rp}/2-1)}$($\theta_{track}=2$,匹配归一化轨迹范围),残余相位 $\varphi^h_{j,r} = \tanh(a_x)\,\omega^x_r \bar{x}_j$ 加到时间相位上,$a_x, a_y$ 可学习,音频自注意力配 rank-32 Stereo LoRA 协同适配。第五步,数据构造:VAS 管线对真实视频(VGGSound、OpenHumanVid、FoleyBench、LU-AVS)先两阶段过滤(时长/分辨率/信噪比 + Qwen3-Omni 运动感知语义过滤),再用 Qwen3-Omni 定位声源并做候选级音视一致性验证,Grounded-SAM 取掩码,AllTracker 全程跟踪得 2D 轨迹,VGGT 估计深度与相机参数后反投影为 3D 轨迹,把相机当虚拟听者、左右放置固定间距虚拟接收器,用 gpuRIR 沿轨迹渲染 RIR 并与单声道音频卷积得到立体声;SDS 管线由 Qwen3.5 采样立体声配置(静态/动态运动类型、运动族、语义族),分对象中心(配持续更新的 Scene Distribution Bank 控制多样性)与人类中心(GPT-5.6 预定义 47 个说话人档案 × 41 个环境目录)两分支生成提示,Stage 1 高温度求多样、Stage 2 低温度忠实执行,最终由 LTX-2.3 合成场景。第六步,训练:8K 迭代、每样本 121 帧 640×384,仅训练音频分支 LoRA 与新模块。
技术新颖性
技术新颖性体现在四个层面。任务层面:这是首个轨迹条件化的立体 VA 联合生成框架,配套首个显式空间监督数据集与首个空间一致性基准,把“动态空间对应”从被忽略的属性变成可训练、可评测的任务。结构层面:VMB 的“参考-目标-音频”三段通路与显式残差 $S^t_\ell - S^r_\ell$ 是新的跨模态绑定机制,不同于 AV-DiT 的轻量 VA 模块、Ovi/LTX-2 的对称双流联合注意力,也不同于 JavisDiT 的时空先验——它把“哪个实体在发声”作为一阶问题求解。位置编码层面:RT-RoPE 对 RoPE 的扩展方式非常规且有细节——用对数间隔低频网格($\theta_{track}=2$)匹配归一化轨迹范围、tanh 参数化限制对预训练相位的扰动幅度、并明确意识到旋转几何被改变后需要 LoRA 协同优化注意力投影,这组设计在此前工作中未出现。条件注入层面:STE 的“共享表示 + 逐层 Track-Adaptive 表 $B_\ell$ + 门控残差 $g_\ell$”组合解决了“同一轨迹嵌入在逐层演化的音频表示之间失配”的问题,同时把新条件限制在 VMB 通路内,是“冻结骨干加空间能力”的干净方案。数据层面:VAS 管线的候选级音视验证(用 Qwen3-Omni 逐候选判断音画一致性后再跟踪)是对 AVS 模型泛化差这一痛点的针对性工程创新。
实验结果
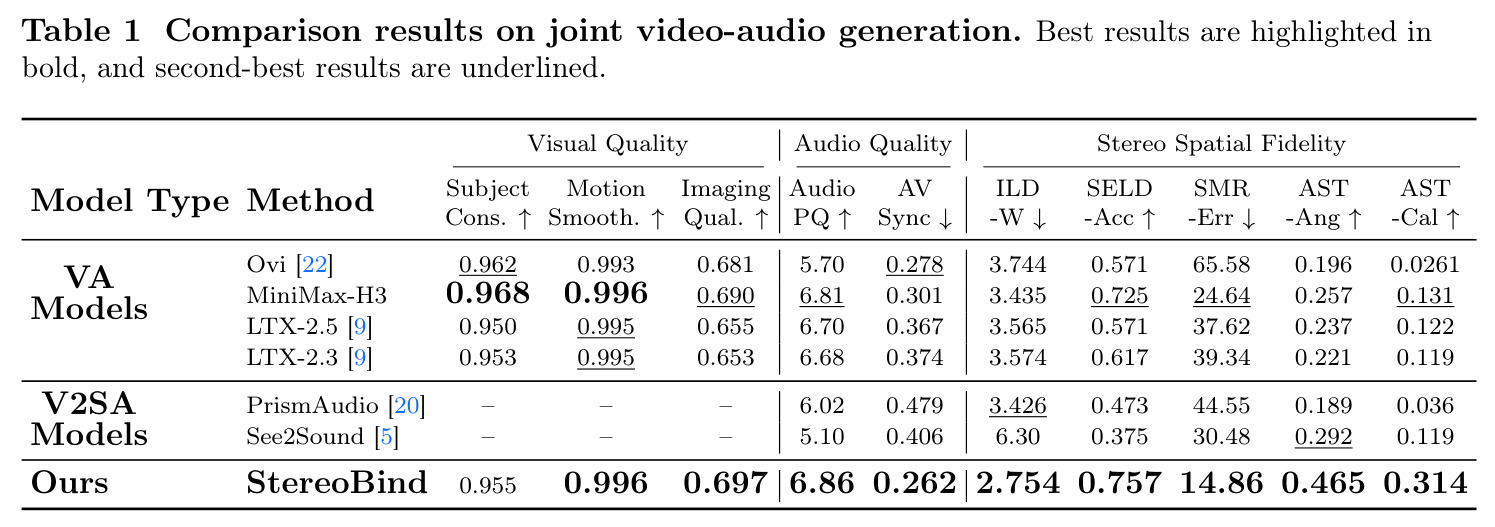
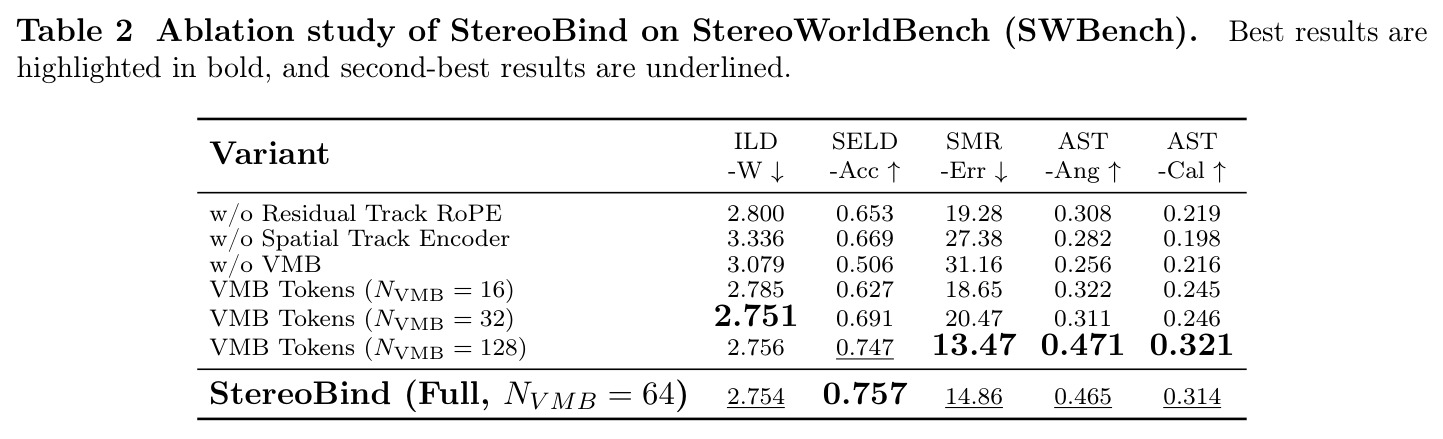
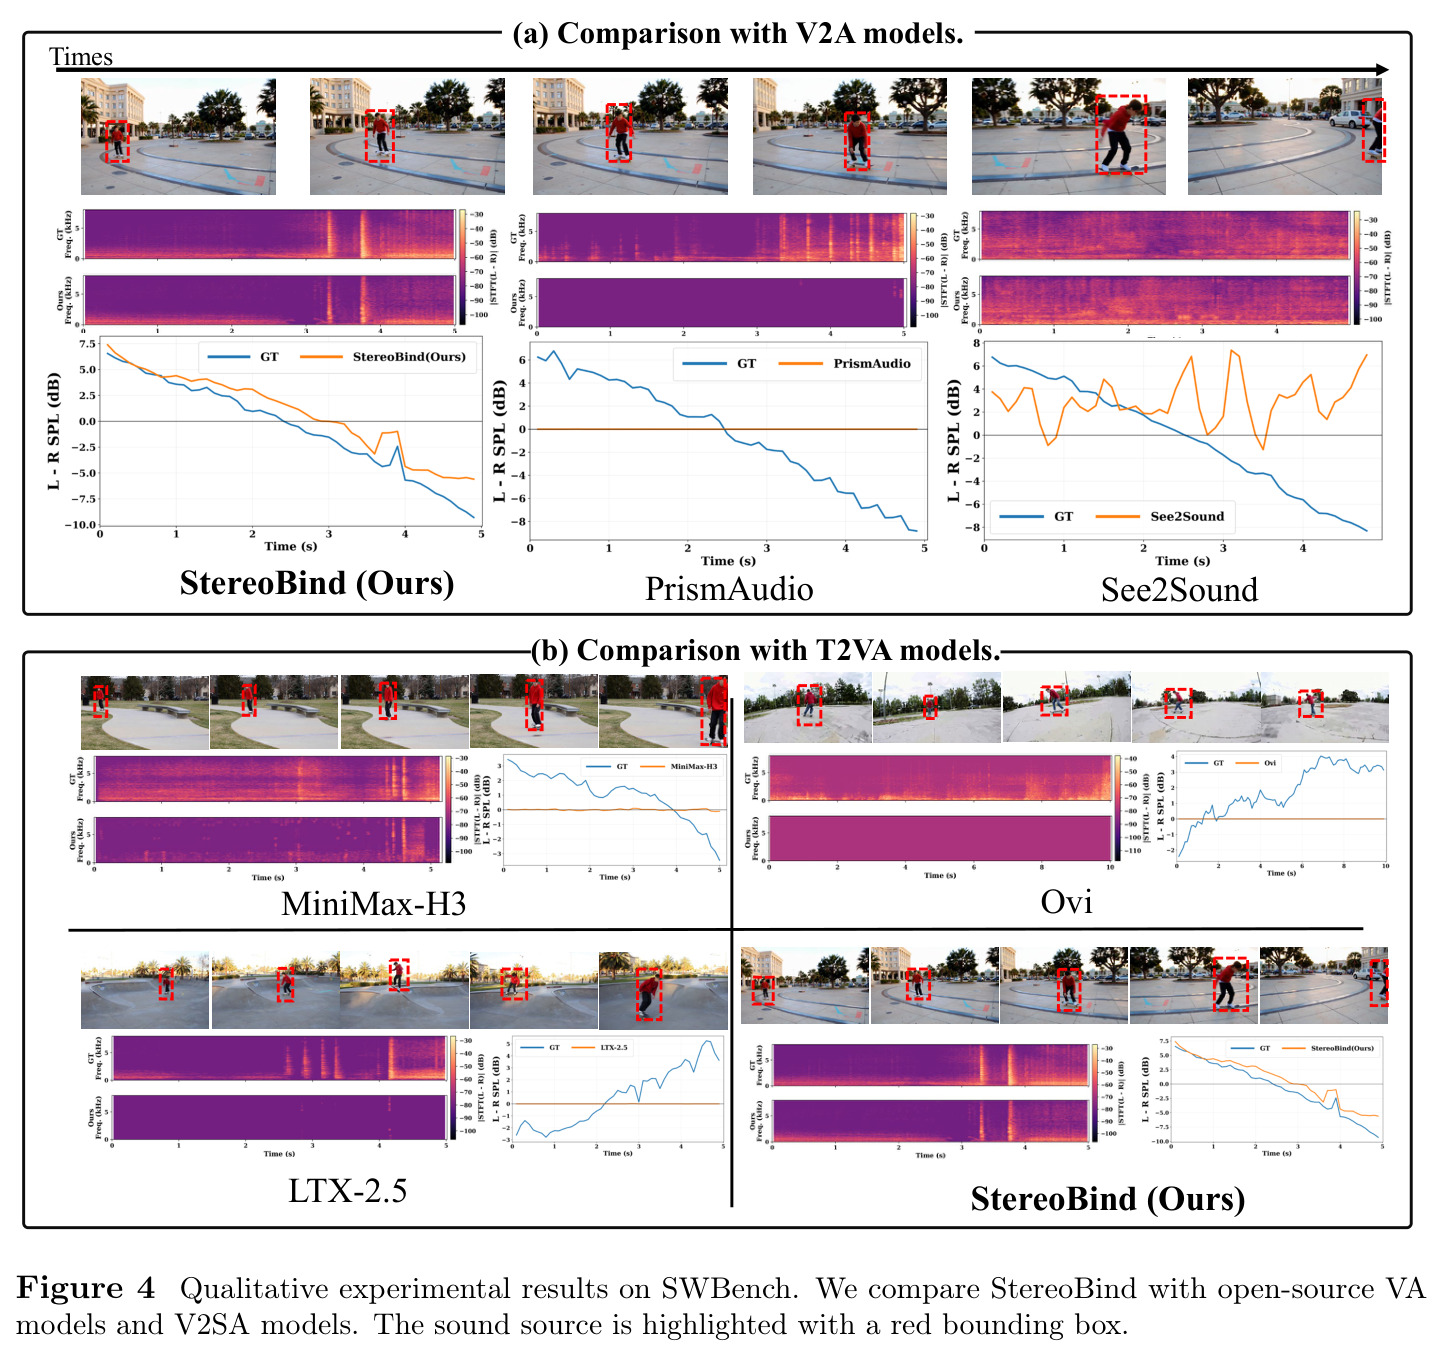
主实验(Table 1,对比 4 个 VA 模型与 2 个 V2SA 模型)显示 StereoBind 在全部五项立体空间保真度指标上第一:ILD-W 2.754(最佳 VA 基线 MiniMax-H3 为 3.435,降低约 20%)、SELD-Acc 0.757(次优 MiniMax-H3 0.725)、SMR-Err 14.86(次优 24.64,降低约 40%)、AST-Ang 0.465(次优 0.257,提升 81%)、AST-Cal 0.314(次优 0.131,约 2.4 倍)。同时生成质量不退步:Motion Smoothness 0.996 与 Imaging Quality 0.697 为全场最优,Audio PQ 6.86 与 AV Sync 0.262 也是最佳,Subject Consistency 0.955 与最优的 MiniMax-H3(0.968)可比;V2SA 模型因不生成视频,仅作音频侧参考。消融实验(Table 2,均在 SWBench 上)逐一验证组件:去掉 RT-RoPE 后 AST-Ang 0.465→0.308、AST-Cal 0.314→0.219,说明相对运动建模对学习型空间表示关键;去掉 STE 使 SMR-Err 14.86→27.38 且 AST 双降,证明绝对位置信息对立体声道平衡至关重要;去掉 VMB 损失最重——SELD-Acc 跌至 0.506、SMR-Err 升至 31.16,说明源绑定是整个空间对应的基石。VMB token 容量扫描:$N_{VMB}$ 从 16→32→64→128,SELD-Acc 为 0.627→0.691→0.757→0.747,128 时 SMR-Err/AST(13.47/0.471/0.321)略优于 64 但显存开销更大,作者权衡后取 64。定性结果(Fig. 4)用 SILD(带符号声道级差曲线)与 IDS(声道差 STFT 时频谱)可视化:基线的声道差轨迹明显偏离参考空间演化、时频结构不一致,而 StereoBind 的立体声动态紧随红框标注的源运动;人工感知评测(附录 E)同样最优。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 立体声空间一致性(SWBench,与 VA 生成基线对比) | ILD-W ↓(双耳强度差 Wasserstein 距离) | 2.754 | MiniMax-H3 3.435(Ovi 3.744 / LTX-2.3 6.68 附近段) | 较最佳 VA 基线降低约 20% |
| 视听空间对齐 | SELD-Acc ↑(声源定位检测准确率,SAVGBench) | 0.757 | MiniMax-H3 0.725 | +0.032(约 +4.4%) |
| 立体声空间平衡 | SMR-Err ↓(立体声幅度比误差) | 14.86 | MiniMax-H3 24.64 | 降低约 39.7% |
| 学习型立体一致性 | AST-Ang ↑(Spatial-AST 角度一致性) | 0.465 | MiniMax-H3 0.257 | 提升 81%,约为基线 1.8 倍 |
| 学习型立体一致性 | AST-Cal ↑(Spatial-AST 校准度) | 0.314 | MiniMax-H3 0.131 | 约 2.4 倍 |
| 视觉质量(VBench) | Imaging Qual. ↑ | 0.697 | MiniMax-H3 0.690 | +0.007,同时 Motion Smoothness 0.996 并列最优,空间提升未牺牲画质 |
| 音频质量与同步 | Audio PQ ↑ / AV Sync ↓ | 6.86 / 0.262 | MiniMax-H3 6.81 / Ovi 0.278 | 两项均为全场最优 |
| 组件消融(SWBench) | SELD-Acc ↑ | 0.757(完整模型,$N_{VMB}=64$) | w/o VMB 0.506 / w/o STE 0.669 / w/o RT-RoPE 0.653 | VMB 贡献最大单项(+0.251),证明源绑定是空间对应的基石 |
局限与改进
作者明确承认的局限写在结论:当前只覆盖单一框架与简化场景,未来需扩展到更丰富的 3D 场景、多声源以及更复杂的源-听者动态。我的补充观察有六点。其一,方法隐含“单一主导发声源”假设,轨迹条件只绑定一个实体,街道、乐队等多源并发场景无法处理。其二,VAS 管线把相机当作固定的虚拟听者(静态听者假设),无法覆盖第一人称听者自身移动的 VR 场景。其三,空间监督依赖 VGGT 深度/相机估计与 gpuRIR 几何声学仿真,估计误差会传导为标签噪声,且基于镜像源的 RIR 模型不含复杂衍射与散射。其四,评测协议先把生成音频下混为单声道、再用自家 VAS 管线重新空间化作为参考,与训练数据分布存在一定循环偏好,可能高估自家方法。其五,输出为 121 帧、640×384 的短片段,长视频与高分辨率下的空间漂移未验证;消融中 $N_{VMB}=128$ 在 SMR-Err(13.47)与 AST(0.471/0.321)上其实优于 64,说明性能未饱和,取 64 是显存取舍而非性能上限。其六,数据与评测管线依赖 Qwen3-Omni-30B、Qwen-3.5-35B-A3B、GPT-5.6 等大模型,链条长、部分闭源,第三方完整复现数据构建成本高。
独立分析的弱点
独立分析的弱点及改进方向:(1) 单源假设——真实沉浸场景中多声源并存且各自运动,改进方向是把轨迹条件扩展为“轨迹集合 + 逐源注意力掩码”,在 VMB 中为每个源维护独立 token 组,最后做空间混音,类似 ISDrama 的多说话人思路。(2) 静态听者——VR 第一人称头部转动是刚需,改进方向是把 RIR 渲染扩展为“源-听者相对轨迹”,或在 RT-RoPE 中加入听者运动相位项,使 $\tanh(a)\omega(\bar{x}_j - \bar{x}_i)$ 中编码相对位姿而非仅源位姿。(3) 评测循环风险——参考立体声由自家 VAS 管线生成,改进方向是引入真实双耳录音(如 binaural 剧场/街采数据)做外部验证,并报告 ITD/ILD 的直接物理测量而非仅学习型指标(AST 基于 Spatial-AST,天然偏向学习型模型)。(4) 空间维度粗糙——轨迹只有水平/垂直两轴的归一化坐标,缺少距离轴与混响感控制,改进方向是加入深度条件与近距离 ILD 非线性效应建模。(5) 计算开销——每层 64 个 VMB token 引入三次额外交叉注意力,可探索跨层 token 共享、剪枝或仅在部分层启用。(6) 短片段限制——121 帧训练窗口内空间一致,长视频需研究轨迹分段拼接时的相位与声像连续性。
未来方向
作者提出的方向:把动态空间对应扩展到更丰富的 3D 场景、多声源,以及更复杂的源-听者动态。基于本文成果可自然延伸的工作:(1) 与一阶高保真立体声(FOA/ambisonics,如 ViSAGe 方向)结合,从左右双耳扩展到全方向声场生成;(2) 面向互动游戏与 VR 的流式/实时立体声生成,以及用户可拖拽轨迹的交互式控制界面——轨迹条件天然适合作为用户控制信号;(3) 把 StereoWorldBench 扩展为包含真实双耳录音的公开榜单,消除自建管线的循环偏好;(4) 空间音频编辑:利用同一轨迹条件框架对已有视频重新声像化(改变声源位置而不改内容),与 V2SA 模型形成互补;(5) 源分离与空间化的级联:先用分离模型拆出各源,再逐源绑定轨迹后空间混音;(6) 距离与混响解耦控制,把 STE 的绝对位置条件从 $(x,y)$ 扩展到 $(x,y,z)$ 并显式建模房间声学参数;(7) 用更大规模 SDS 合成数据研究空间条件下的 scaling 行为。
复现评估
项目页为 https://vivocameraresearch.github.io/Stereo-Bind-Project/,正文未逐条声明代码与数据全部开源,需以项目页实际发布为准。复现要素已充分披露:骨干 LTX-2.3;训练 8×NVIDIA H20、8000 迭代、约两天,AdamW 学习率 $2\times10^{-4}$($\beta_1=0.9$,$\beta_2=0.999$)线性调度,LoRA rank 32 / scaling 32,每样本 121 帧、640×384;训练目标沿用 LTX-2.3 不改。难点在数据与评测资产:VAS 管线依赖 Qwen3-Omni-30B、Grounded-SAM、AllTracker、VGGT、gpuRIR;SDS 管线依赖 Qwen-3.5-35B-A3B、GPT-5.6(闭源)与 LTX-2.3 生成,完整重建 StereoWorld-29K 成本高且含非确定性大模型调用。若项目页发布数据集与 SWBench,则模型训练(本质是 LoRA 微调)与评测复现相对直接;否则复现难度中偏高。整体评估:算力门槛不高(单机 8 卡两天),主要障碍是数据管线的工程链条与闭源依赖。
论文图表
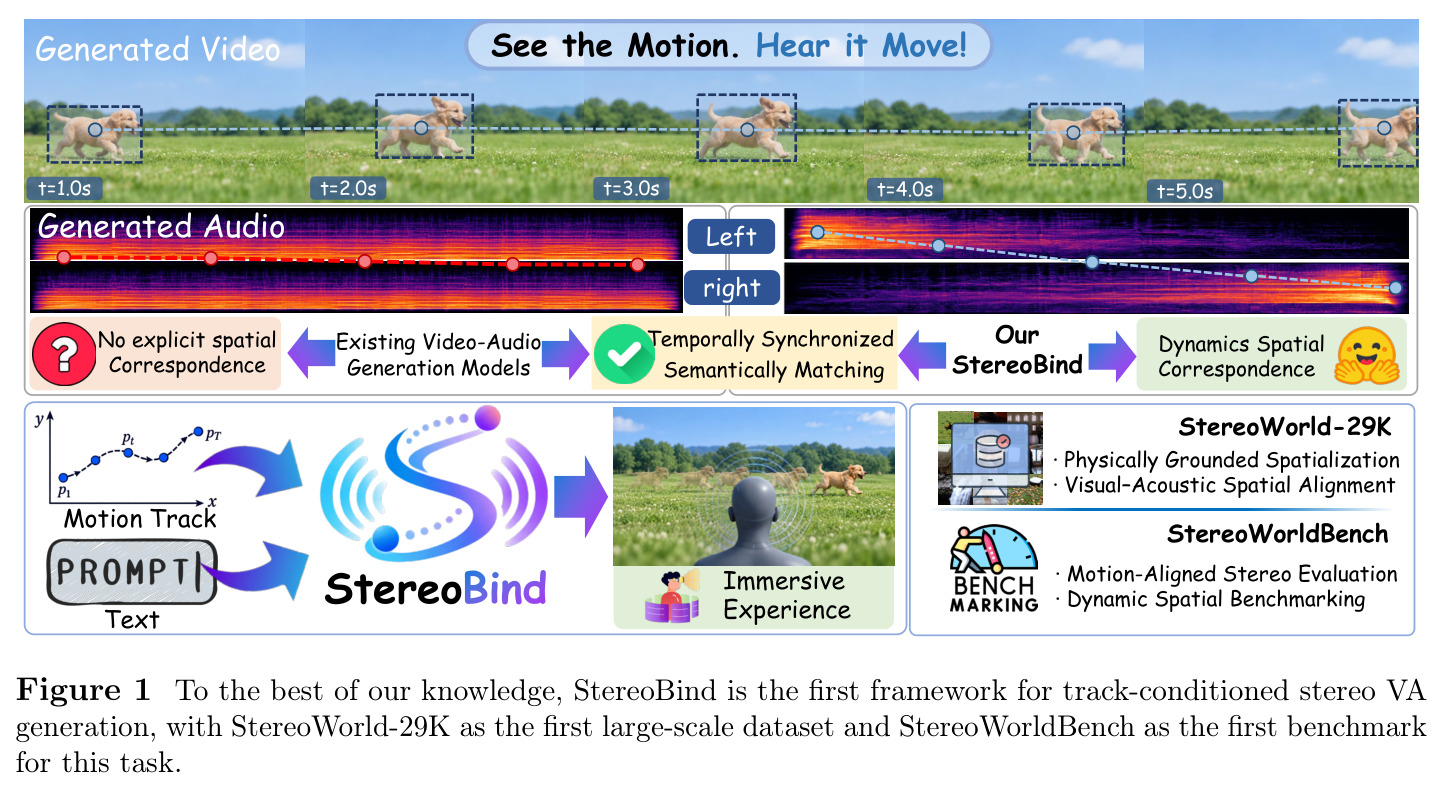
引导图:上半部分展示同一文本“狗从左走到右”在四类系统下的对比——无显式空间对应、现有视频-音频生成模型(仅时间同步+语义匹配)、StereoBind(实现动态空间对应),每列给出 1.0s–5.0s 的视频帧与左右声道音频;下半部分展示技术闭环:文本 + 运动轨迹 → 经 StereoWorld-29K(VAS/SDS 双管线、物理合理空间化、音视空间对齐)训练 → 用 StereoWorldBench(运动对齐的动态立体声评测)验证 → 沉浸式体验。
一图定义了“动态空间对应”这一新任务并给出了与现有模型的可视化差异,同时标明数据集与基准两个配套贡献在整个故事中的位置,是理解论文定位的入口。