HelixWorld:实时交互式视听世界模型 HelixWorld: A Real-time Interactive Audio-Visual World Model
首个相机对齐空间音频的实时交互视听世界模型,单卡24FPS同步生成画面与立体声
前置知识
交互式世界模型
一类根据用户输入(键盘离散动作或相机轨迹)实时生成未来环境观测(通常是视频帧)的生成模型,可以理解为“可玩的神经模拟器”:用户每给一个动作,模型自回归地渲染下一帧画面,形成可自由探索的虚拟环境,代表工作有 Matrix-Game、LingBot-World、Genie 系列等。
本文的核心贡献正是把这一范式从纯视觉扩展到视听联合生成,理解世界模型才能明白“实时交互”“因果生成”“动作跟随”这些术语在本文语境下的含义。
6-DoF 相机轨迹与 PRoPE
相机在三维空间的位姿由平移加旋转共六个自由度描述,6-DoF 轨迹即逐帧记录相机位置与朝向的时间序列。PRoPE(投影相对位置编码)把每帧的相机投影矩阵 $P_t=\mathrm{diag}(K_{f,t},1)W_t$ 作用于视觉注意力的 query/key,使注意力天然感知几何视角变化。
HelixWorld 用 PRoPE 注入连续相机轨迹,让立体声随相机旋转平移而声像摆动,这是“相机对齐空间音频”的技术根基,也是它与 EchoWM 等无相机条件模型的本质区别。
流匹配与 PF-ODE
流匹配(flow matching)训练扩散模型学习把噪声分布搬运到数据分布的速度场 $v_\theta$;对应的概率流 ODE(PF-ODE)描述从噪声到数据的确定性积分路径,任意噪声水平 $\sigma$ 处积分到 $\sigma=0$ 即得干净数据估计 $\tilde{x}_0$,该端点也常被用作蒸馏的回归目标。
本文提出的在线轨迹蒸馏损失 $L_{traj}$ 就是在学生 rollout 的中间状态上积分教师的 PF-ODE 并以其隐含速度场监督学生,不掌握 PF-ODE 就无法读懂核心损失的构造。
Self-Forcing 与因果蒸馏
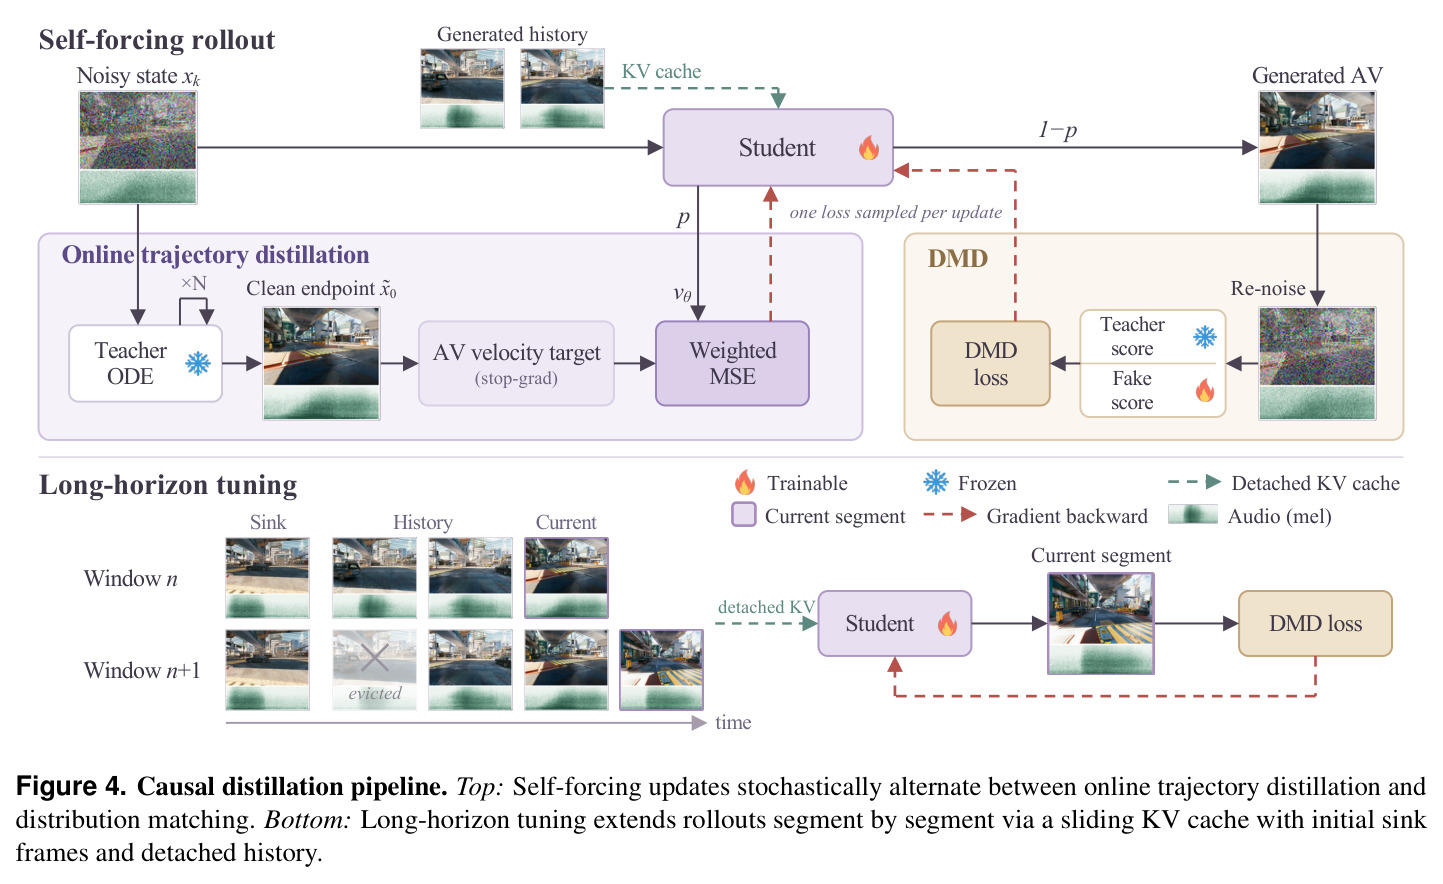
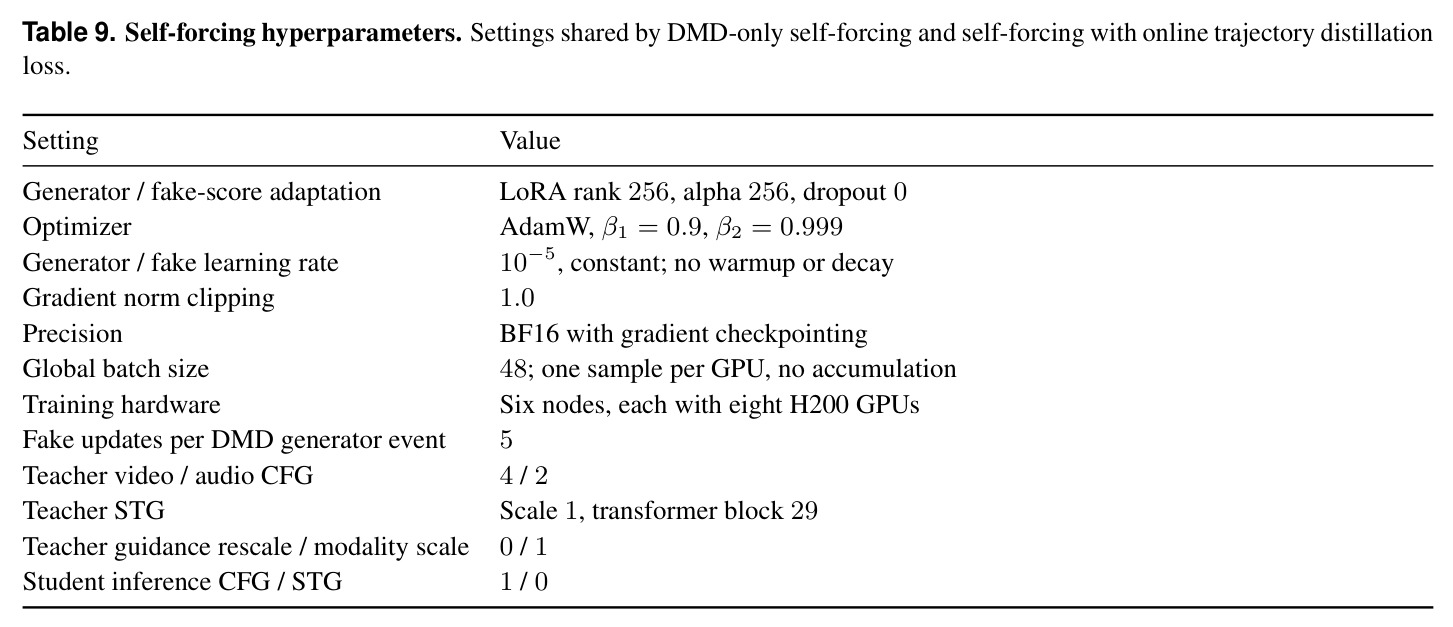
把双向扩散模型改造成逐块自回归生成(块内双向注意力、跨块因果、滑窗 KV cache)的训练技术:学生用自己生成的历史继续展开 rollout,并在 rollout 状态上用分布匹配损失(DMD,用冻结教师与学习中的假分数模型之差)对齐真实分布,从而缓解训练-推理的暴露偏差。
HelixWorld 的实时能力来自把双向教师蒸馏成少步因果学生,正是构建在 self-forcing 框架上;本文的 $L_{traj}$ 是对该框架在联合视听场景下失效问题(模式坍缩)的关键修正。
立体声、声像与伪立体声
双声道音频通过左右声道能量差营造空间感:声源方位变化时声音在左右声道的能量分布(声像 pan)随之改变,是最基本的空间听觉线索。伪立体声指把单声道复制成两个相同声道或仅做后期拓宽的音轨,不携带任何真实空间线索。
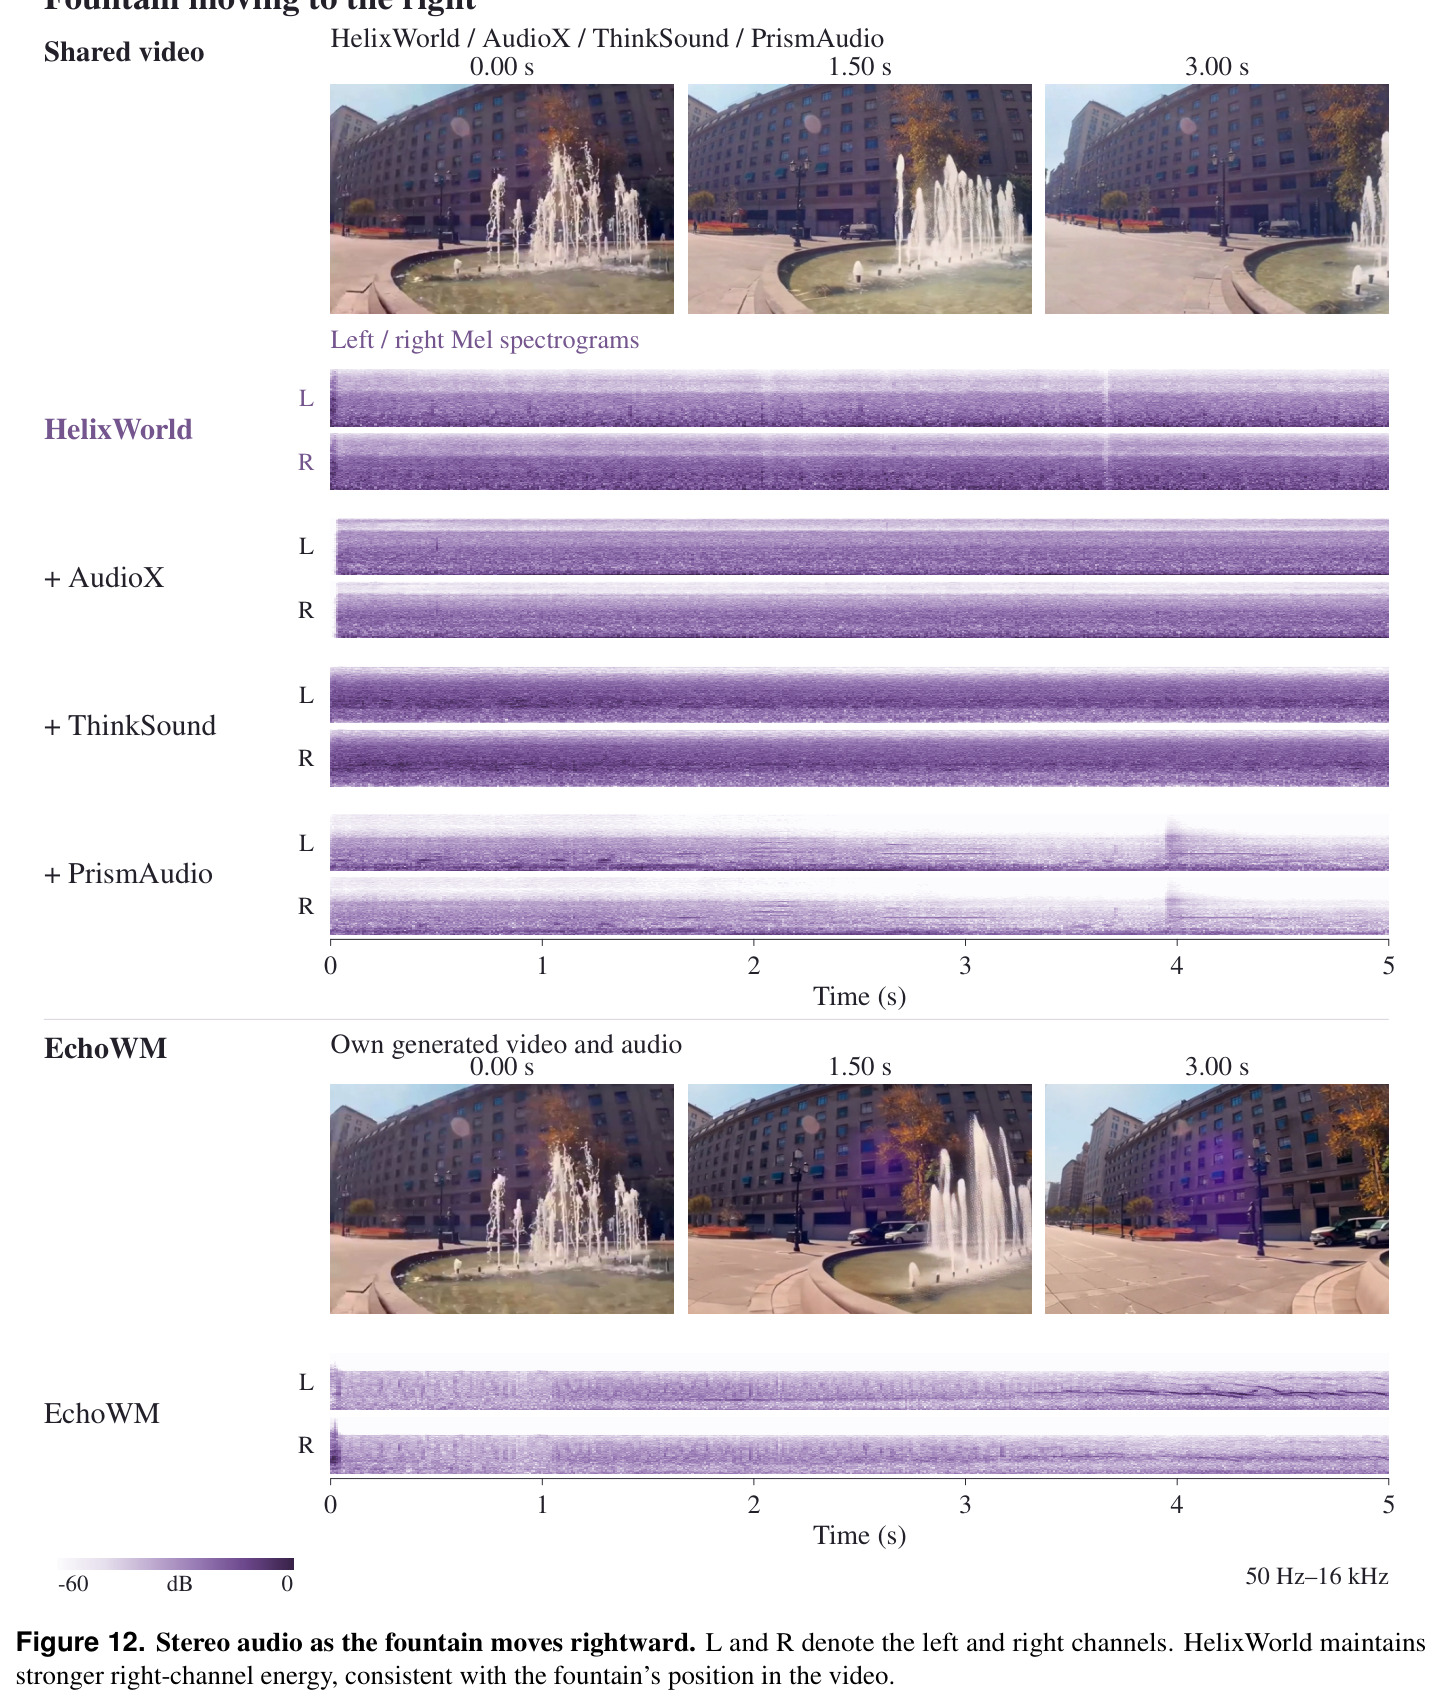
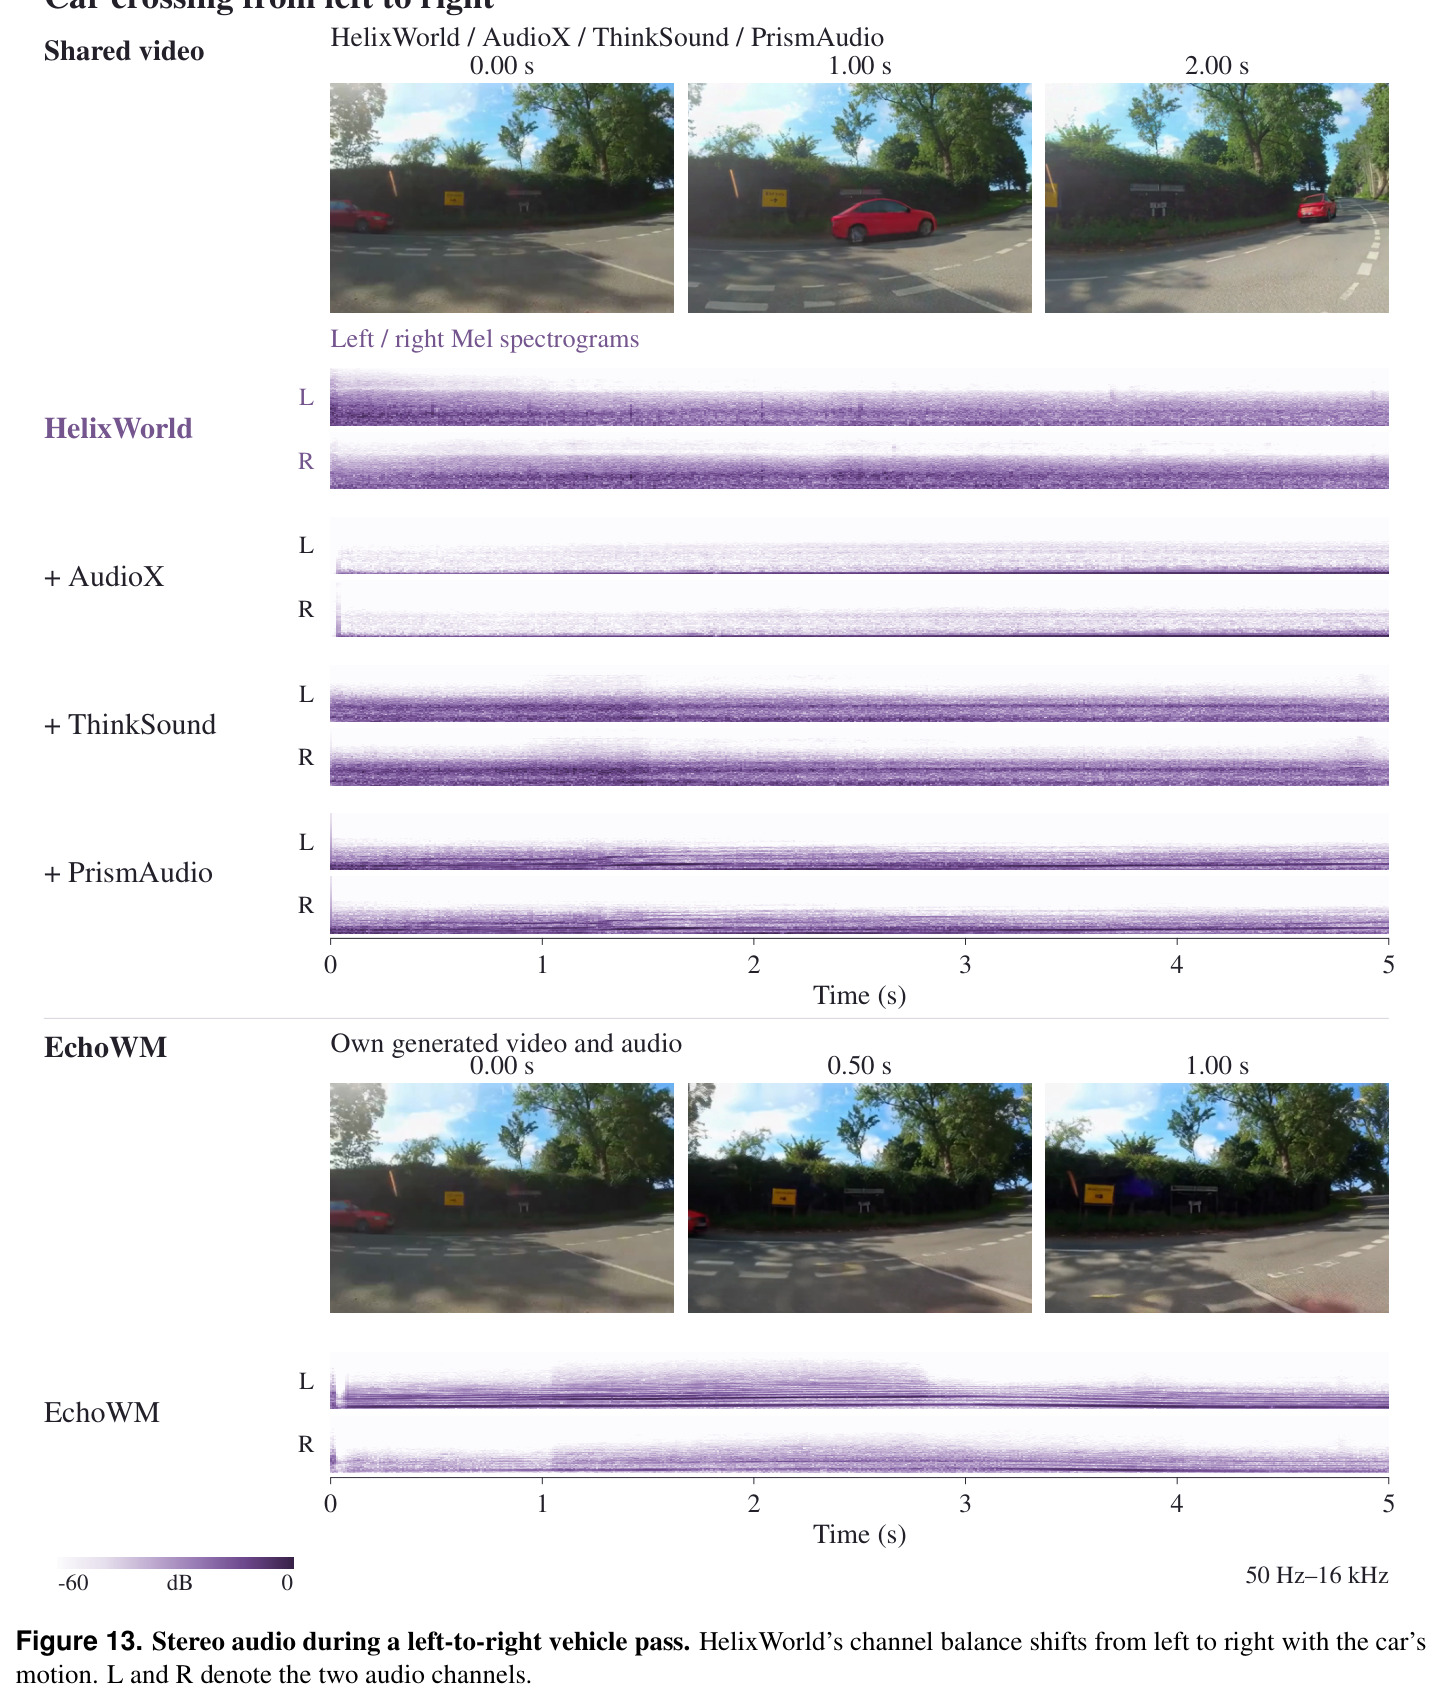
论文核心评测维度“空间-声学一致性”度量合成声场是否随相机自我运动正确 pan;数据管线第一步就要靠双通道能量探针剔除伪立体声,否则模型学不到真实空间线索。
AdaLN-Zero 条件注入
DiT 系扩散 Transformer 常用的条件注入机制:把条件(时间步、类别标签等)映射成逐通道的缩放与平移系数,自适应调制各层归一化的输出,并以零初始化门控保证训练初期不破坏预训练表征。本文将 81 类离散动作的嵌入与扩散噪声等级嵌入相加后经此机制注入骨干。
AdaLN-Zero 是与 PRoPE 并列的两大控制信号注入通道之一,负责离散键盘动作,读懂它才能理解方法章节“条件注入”部分的完整设计。
研究动机
交互式世界模型近年发展迅速,但几乎所有主流系统都是“无声”的,只做视觉渲染与动作控制,而物理交互本应产生传递表面材质、接触力和画外事件等关键线索的声音,缺失音频使沉浸感大打折扣。少数纳入音频的尝试存在三类硬伤:其一,级联式视频到音频(V2A)配音系统拿不到相机轨迹与用户动作,声音对自我运动毫无感知,串行推理延迟也谈不上实时;其二,双向视听基础模型没有外部控制接口,直接改成因果自回归 rollout 会遭遇灾难性多模态漂移——历史误差累积迅速毁掉视觉稳定性与声学保真;其三,训练与评测双双缺位:现有视频语料中的音频被后期配乐、旁白和伪立体声严重污染,而世界模型基准(如 WBench)完全不评音频,传统视听基准只评无相机运动的静态短视频,无法检验“声音是否跟着镜头转”。
本文的目标是本文目标是构建 HelixWorld:一个视觉场景与相机对齐空间立体声在用户交互下原生协同演化的实时交互视听世界模型。目标拆解为四条:模型上,统一连续 6-DoF 相机轨迹与离散键盘动作两类控制输入,实时输出同步且响应控制的视听 rollout;训练上,建立一套消除复合 rollout 漂移、支撑单卡 24 FPS 流式生成的因果蒸馏配方;数据上,构建带真实立体声、逐帧度量相机位姿与解耦三轨字幕的高保真视听语料;评测上,提出首个交互视听世界模型基准 HelixBench(1015 个人工校验用例),形式化“空间-声学一致性”维度,直接量化合成声场是否随相机自我运动物理地旋转。
与已有工作不同的是,本文的独特切入是把“联合生成”而非“级联配音”作为视听世界模型的正解:音视频 token 在同一 Transformer 内联合去噪,通过跨模态注意力把视觉几何与声学特征绑定,相机自我运动自然迁移为真实的立体声摆动。训练策略上采取“先双向教师、后因果学生”的两阶段路线:先在双向架构上建立动作可控性与空间声学保真,再蒸馏成少步流式学生,绕开直接训练因果视听模型的稳定性陷阱,并针对 DMD 在联合视听扩散上的模式坍缩引入轨迹级修正。评测上,作者首次把“屏上声源位置与立体声 pan 的相关性”形式化为可计算指标,在评价层面把交互世界模型与被动视听生成区分开来,填补了 WBench 只评视频、传统视听基准只评静态片段的双重空白。
核心方法
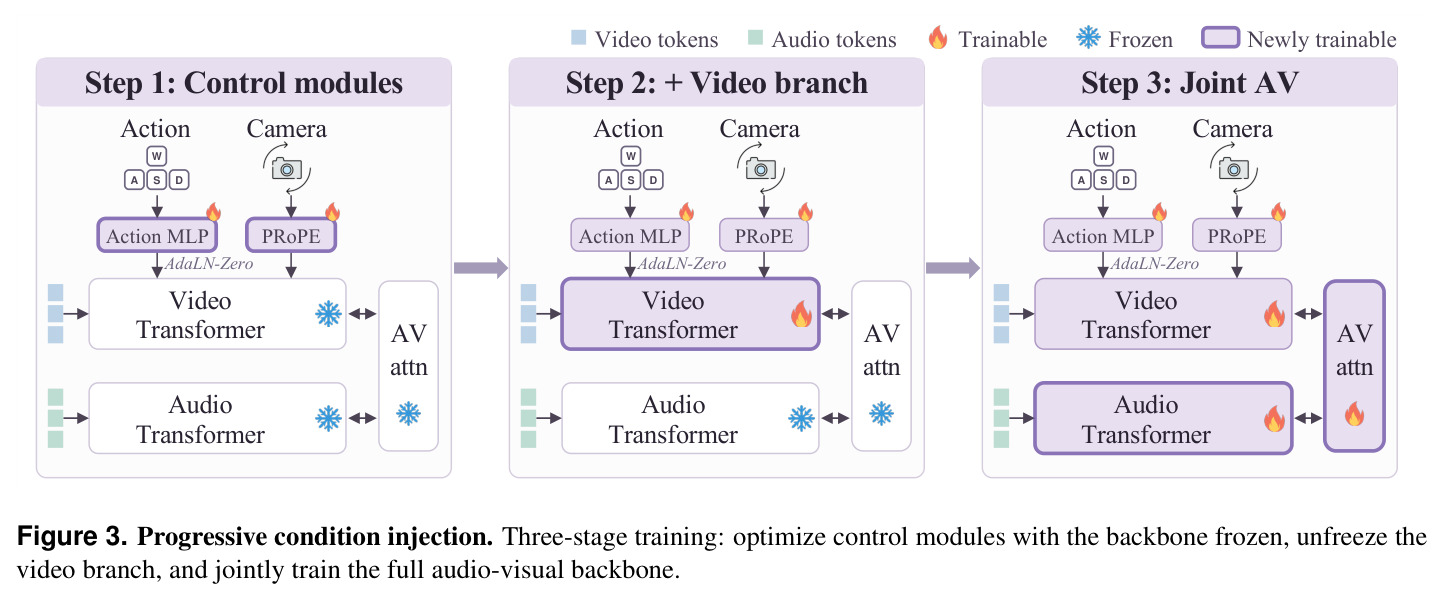
直觉上,要让声音跟着镜头转,模型必须同时知道相机在哪、画面内外的声源在哪。HelixWorld(构建于开源 LTX-2.3 底座)用一个共享骨干联合去噪视频 latent 与音频 token:连续 6-DoF 相机位姿经 PRoPE 以投影矩阵 $P_t=\mathrm{diag}(K_{f,t},1)W_t$ 变换视觉注意力的 query/key;离散动作(9×9 网格上的 81 类平移/旋转速度 bin)经 AdaLN-Zero 与扩散噪声等级嵌入 $h_{cond,t}=\mathrm{Emb}_\sigma(\sigma)+\mathrm{MLP}_\phi(a_t)$ 相加注入;跨模态注意力再把两种控制从视频分支传导到音频分支,实现自我运动到立体声 pan 的迁移。训练分两阶段:先渐进式训练双向教师,建立可控性与空间声学保真;再经因果初始化、在线轨迹蒸馏与长程流式微调三步,蒸馏成单卡 H800 上 768×512@24FPS、稳态 RTF 0.77 的少步因果学生。
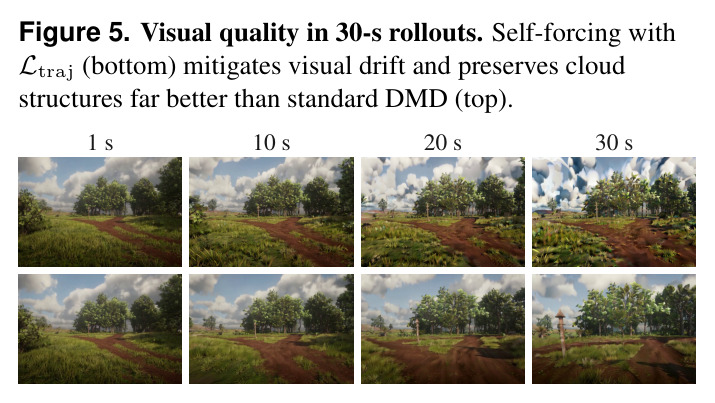
核心创新是在 self-forcing 框架中加入“在线轨迹蒸馏”损失 $L_{traj}$。标准 self-forcing 只靠 DMD 分布匹配更新学生,长程 rollout 会漂移并模式坍缩——色彩退化、声学丢失。做法是:在学生自展开到第 $k$ 步的中间状态 $x^k=(x_V^k,x_A^k)$ 处,积分冻结教师的 PF-ODE 到 $\sigma=0$ 得到干净端点 $\tilde{x}_0$,再用教师隐含流监督学生速度:$$L_{traj}(\theta)=\sum_{m\in\{V,A\}}\lambda_m\left\|v_\theta^m(x^k,\sigma^k)-\mathrm{sg}\left(\frac{x^k_m-\tilde{x}^m_0}{\sigma^k}\right)\right\|_2^2$$ 其中 $\mathrm{sg}(\cdot)$ 为停梯度,梯度只在当前步计算,历史 KV 缓存全部截断。每次更新以概率 $p$ 采样 $L_{traj}$、以 $1-p$ 采样 DMD,随机路由避免梯度冲突,兼顾样本锐度与 rollout 稳定性。
方法步骤详情
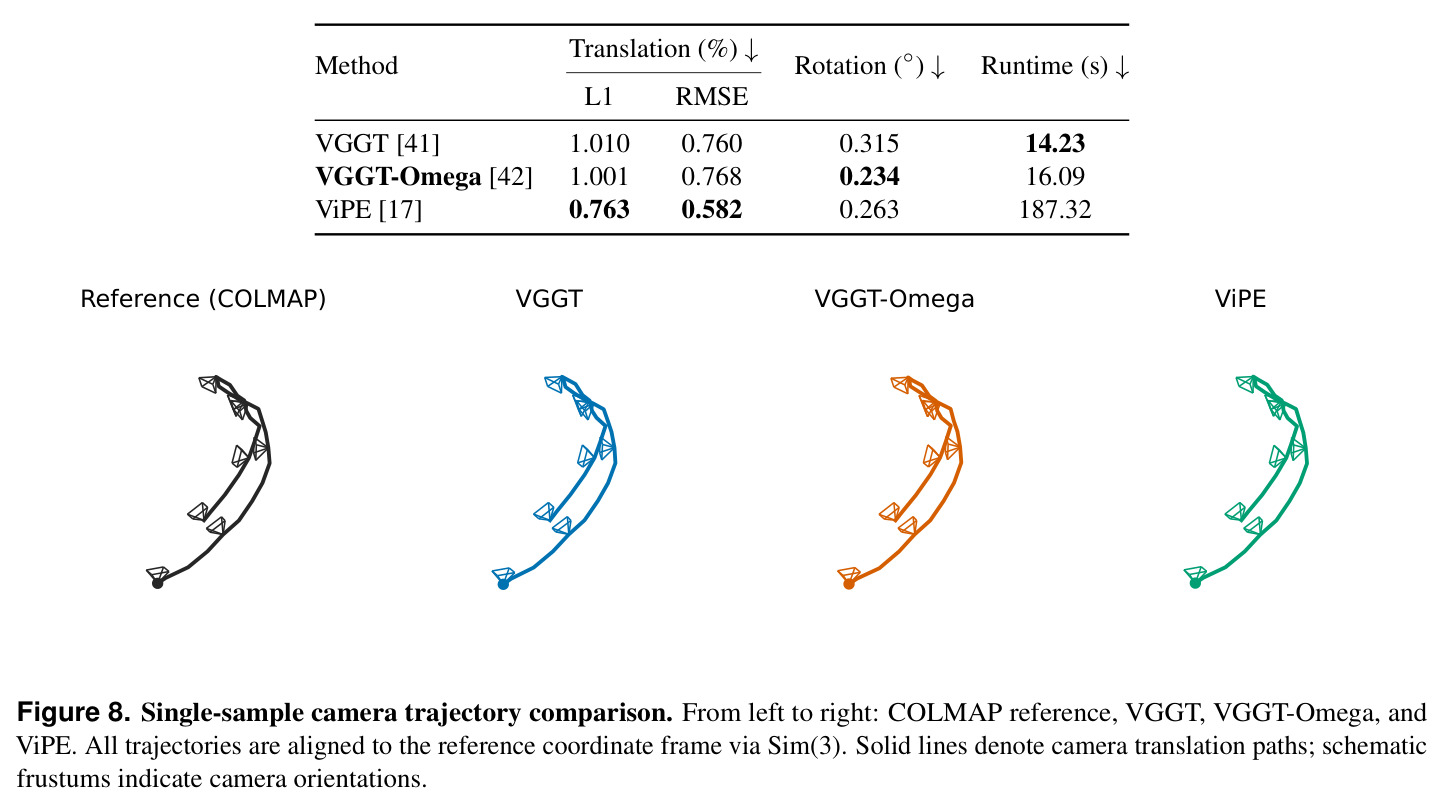
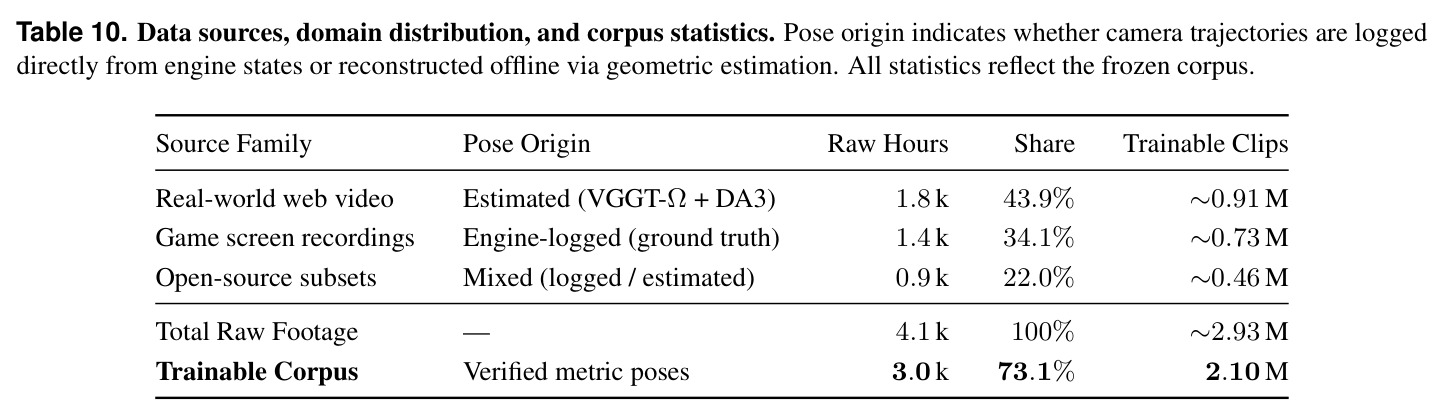
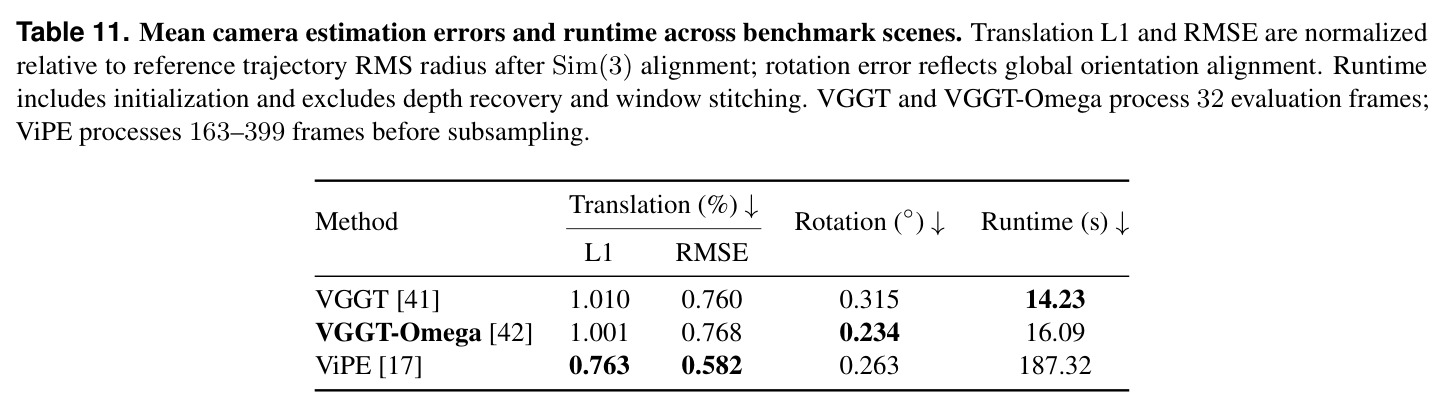
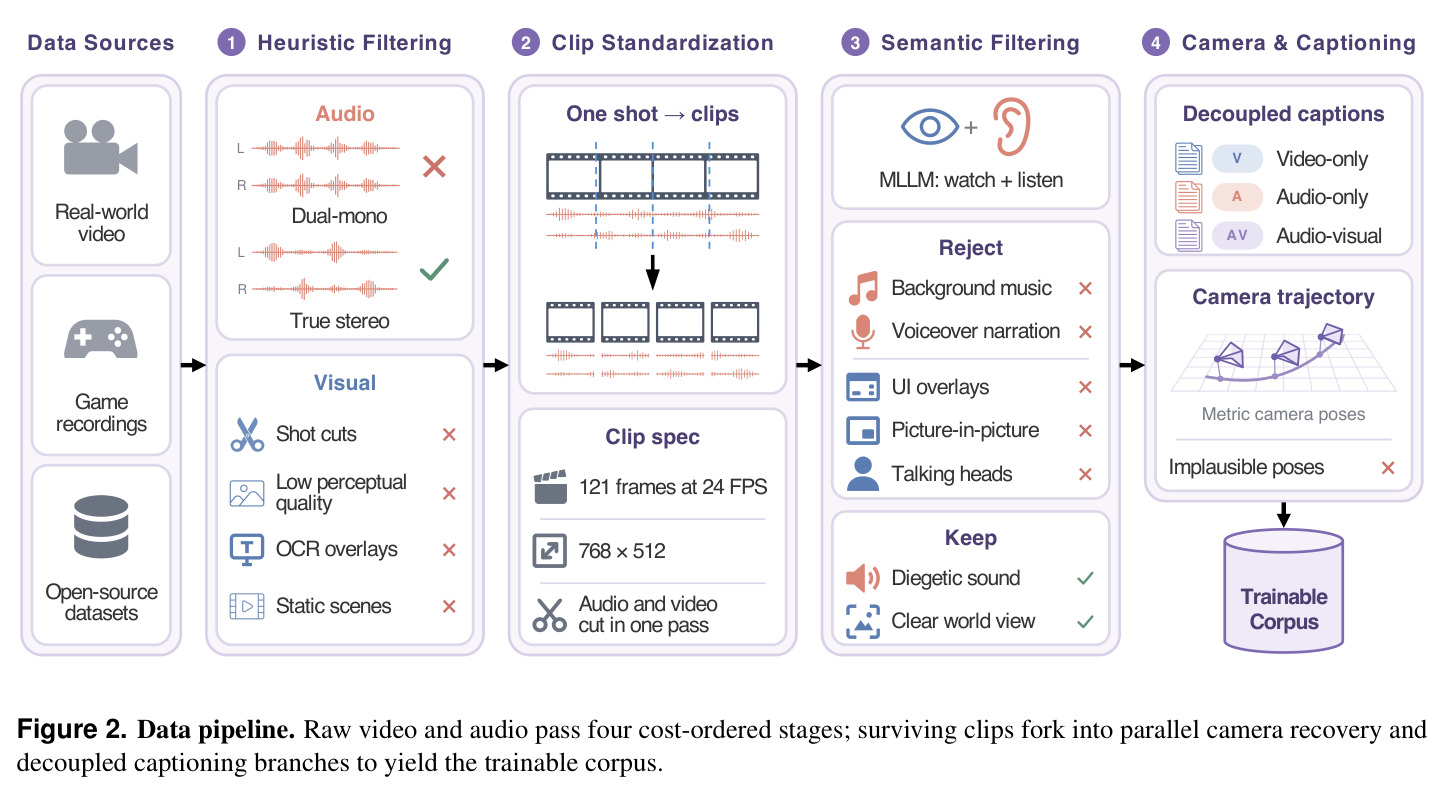
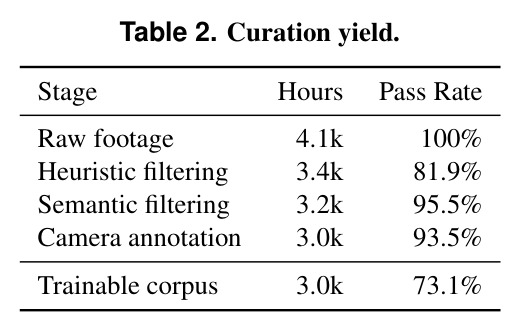
第一步数据管线按算力成本四阶段处理 4.1k 小时原始素材:启发式过滤用场景切分、双通道能量探针剔除伪立体声、OCR 去叠层、感知质量评分,产出 3.4k 小时(通过率 81.9%);片段标准化切成 121 帧@24FPS、768×512 的同步片段;MLLM 语义过滤按“因果起源而非可见性”剔除配乐、旁白与非具身画面,保留画外音(95.5%);相机与字幕分支并行——VGGT-Ω 估位姿、Depth Anything V3 恢复度量尺度(游戏用引擎真值),动作离散为 81 类词表,字幕合成视频/音频/视听三轨描述,最终得 3.0k 小时、210 万片段语料(总通过率 73.1%)。第二步渐进训练双向教师:先冻结骨干只训控制模块(动作 MLP 与 PRoPE),再解冻视频分支,最后全量联合优化 $\mathcal{L}_{FM}=\mathcal{L}_{FM}^V+\lambda_A\mathcal{L}_{FM}^A$。第三步因果蒸馏:把视频 latent 与同时刻音频 token 切成长度 $\Delta t$ 的时间块,块内双向、跨块因果滑窗 KV cache;先用真值历史适配教师,再把学生单步预测回归到教师 PF-ODE 端点完成初始化;随后 self-forcing 中随机路由 $L_{traj}$ 与 DMD;最后长程流式微调逐段展开、保留 sink 帧锚点、对历史停梯度。
技术新颖性
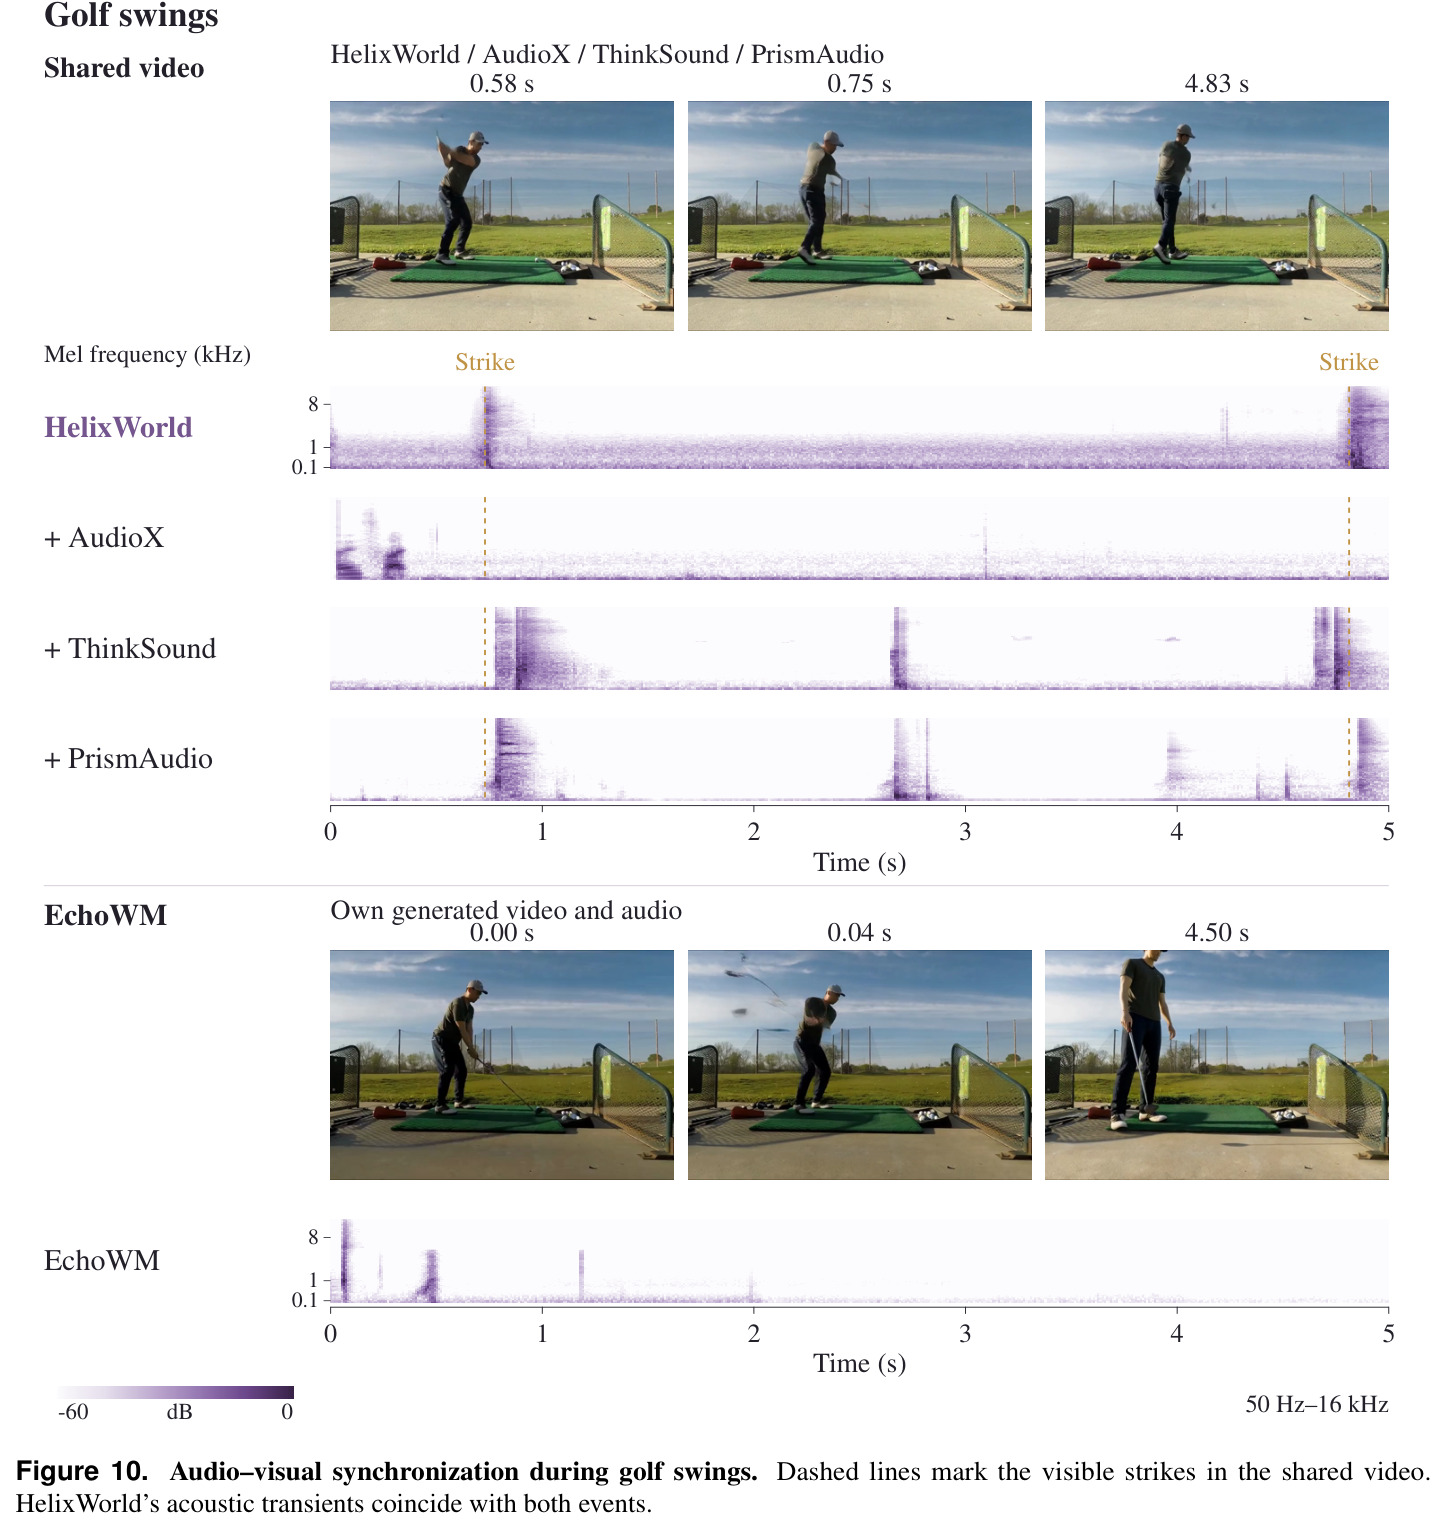
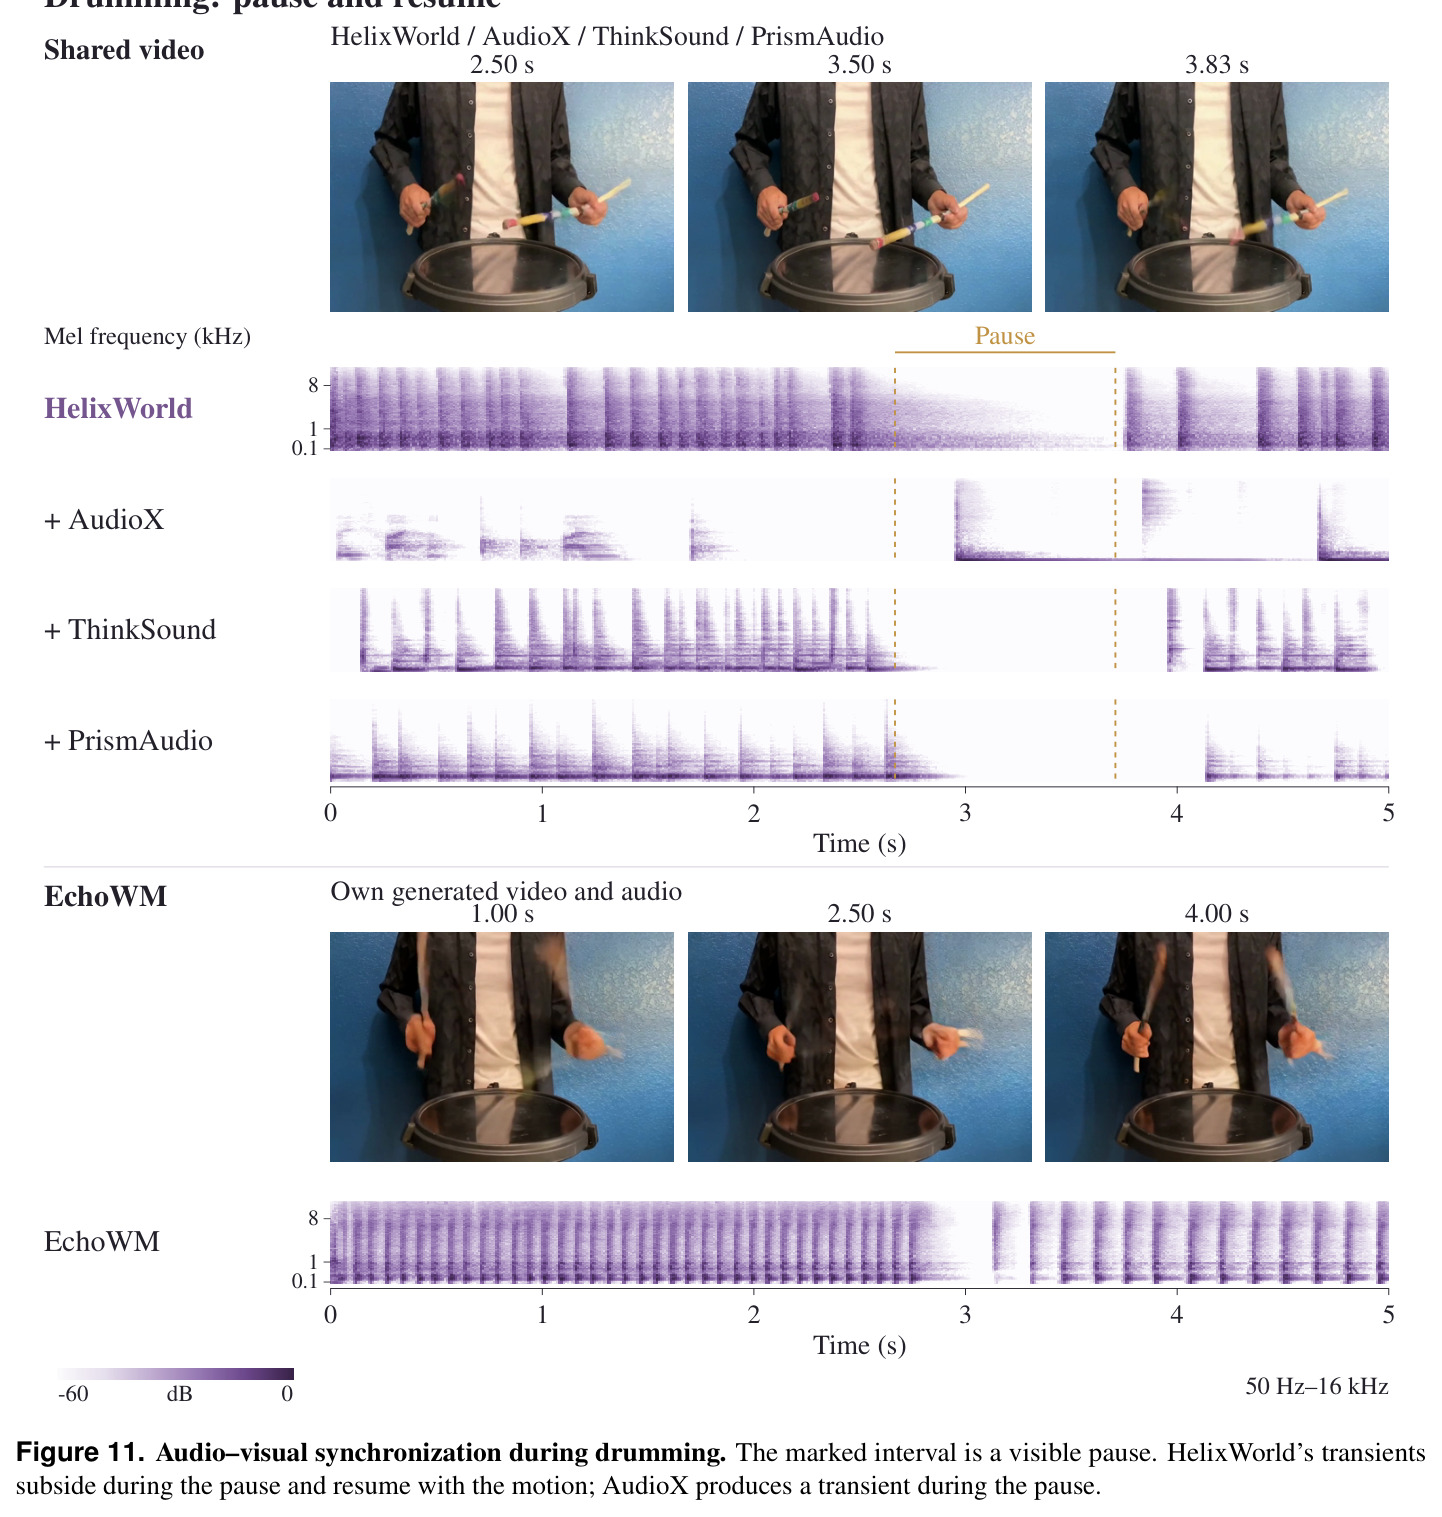
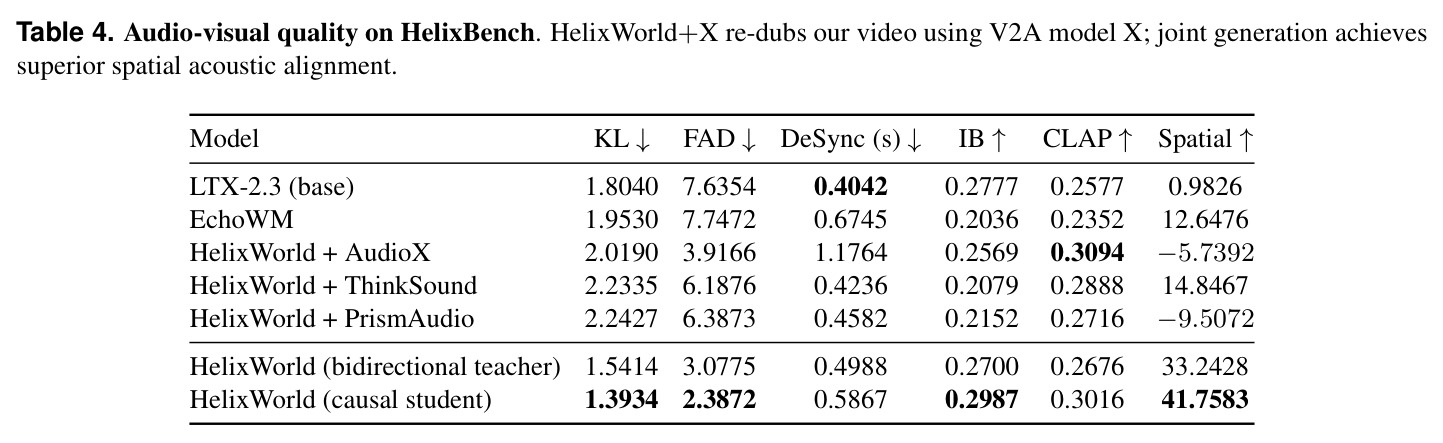
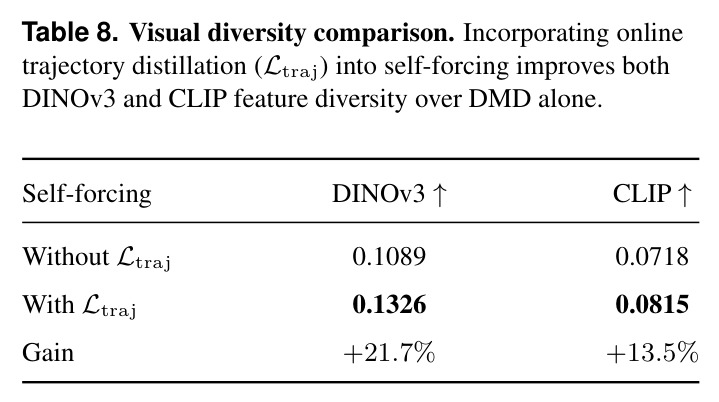
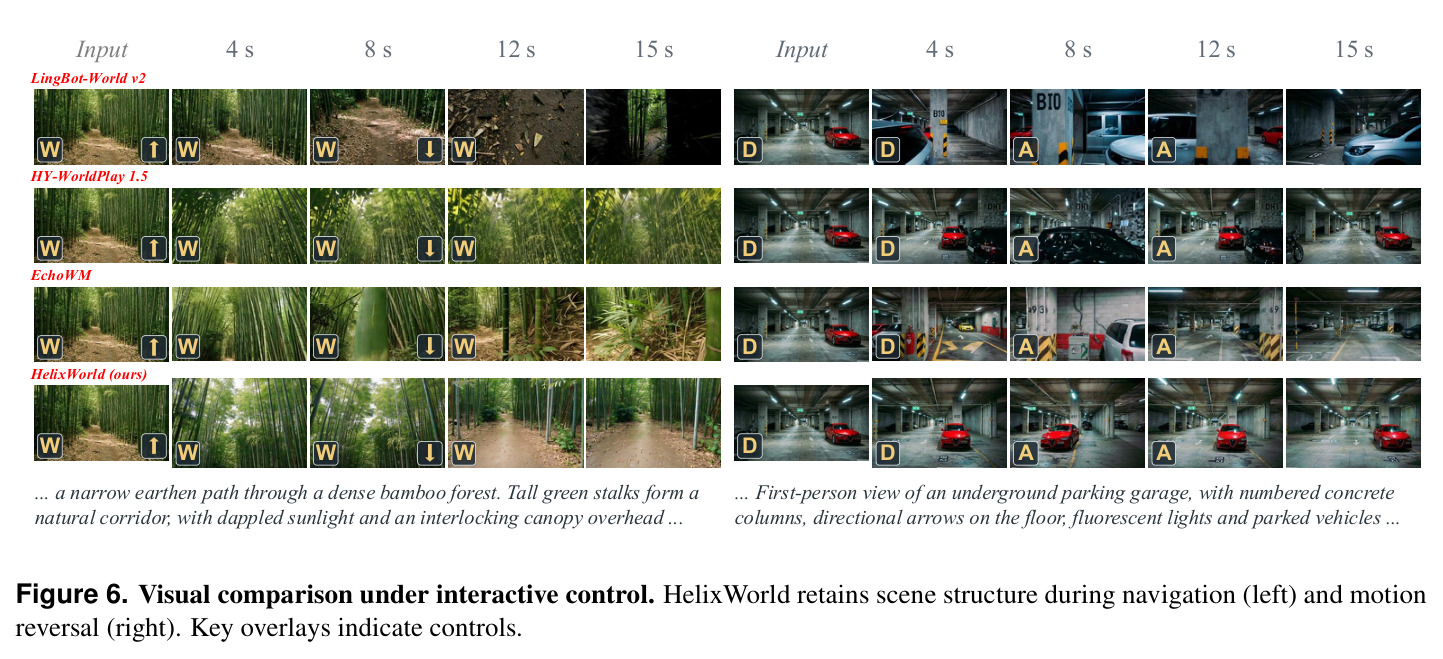
新颖性体现在四个层面。架构上,HelixWorld 是首个把连续相机轨迹(PRoPE)与离散动作(AdaLN-Zero)同时注入联合视听扩散骨干并实现相机条件化空间声学的模型,此前 EchoWM 虽纳入音频但缺乏相机条件。蒸馏上,$L_{traj}$ 是对 self-forcing 的原理性修正:DMD 在联合视听扩散上会模式坍缩,轨迹损失把学生 rollout 锚定在教师概率流上,实验显示 DINOv3 特征多样性提升 21.7%、CLIP 提升 13.5%,证明避免了坍缩而非简单正则。数据上,管线按计算成本排序,把廉价的双通道能量探针放在入口剔除伪立体声,并以“因果起源而非可见性”标准判定剧情声,系统保留了画外音与自然语音,总通过率 73.1%。评测上,HelixBench 以 1015 个人工校验用例首次把空间-声学一致性(屏上声源与立体声 pan 的相关性)作为可计算维度,Table 4 中 V2A 配音基线空间分为负、HelixWorld 达 41.76,直接验证了该维度区分联合生成与级联配音的能力。
实验结果
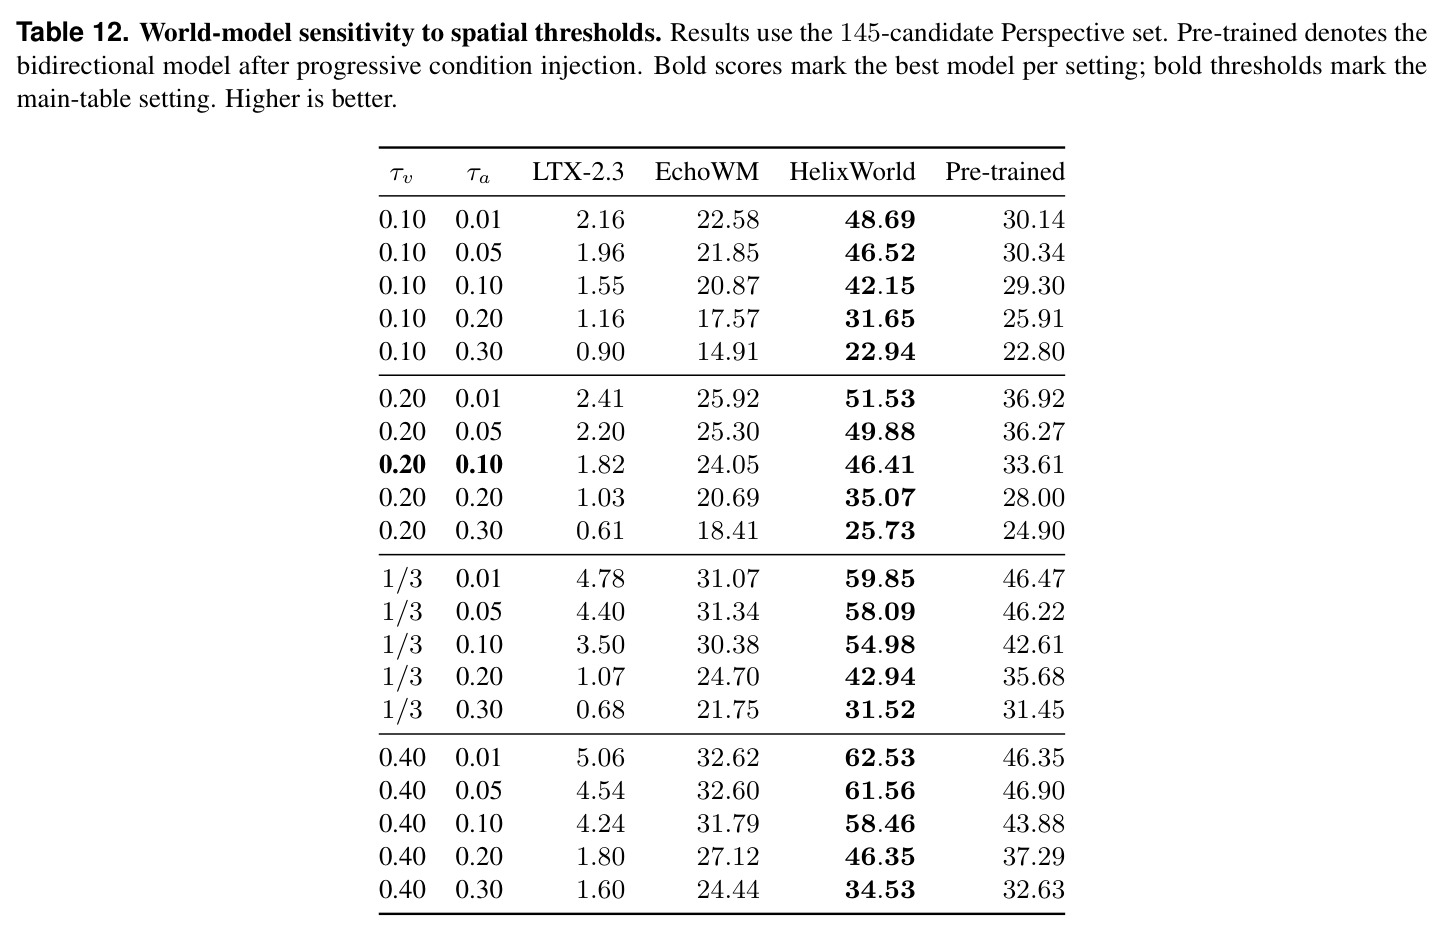
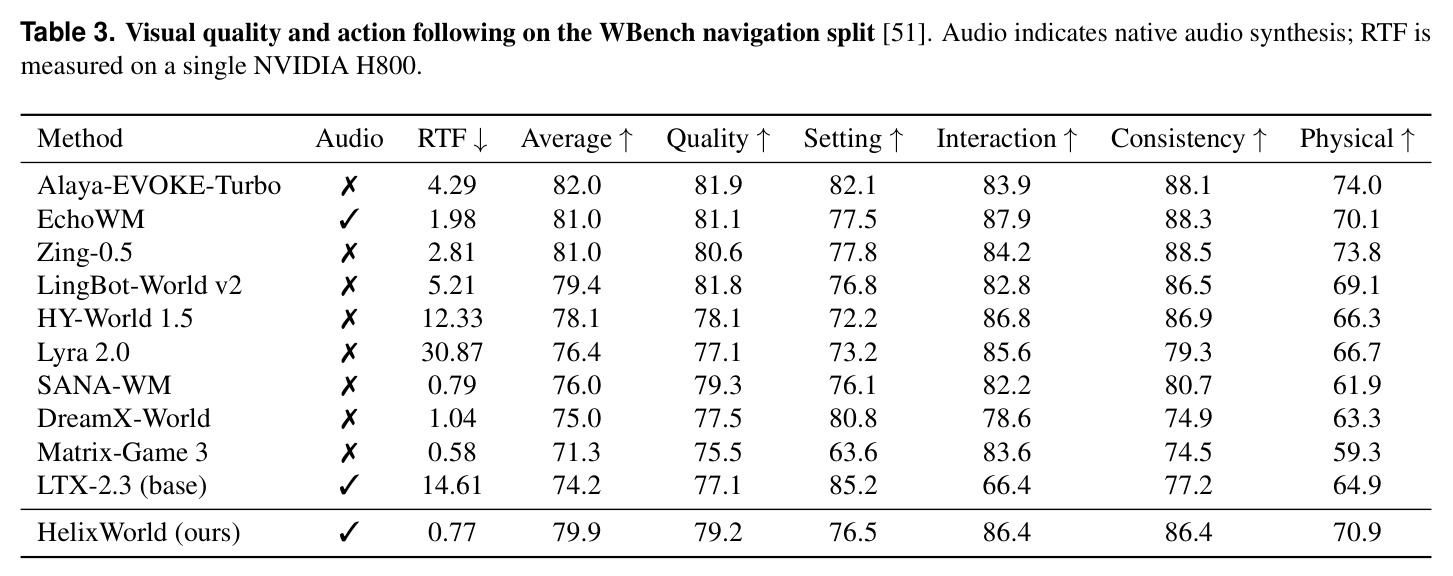
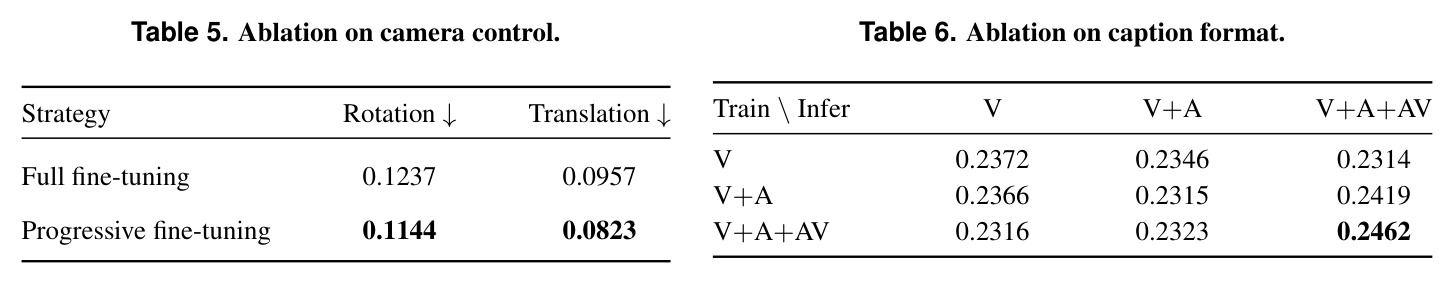
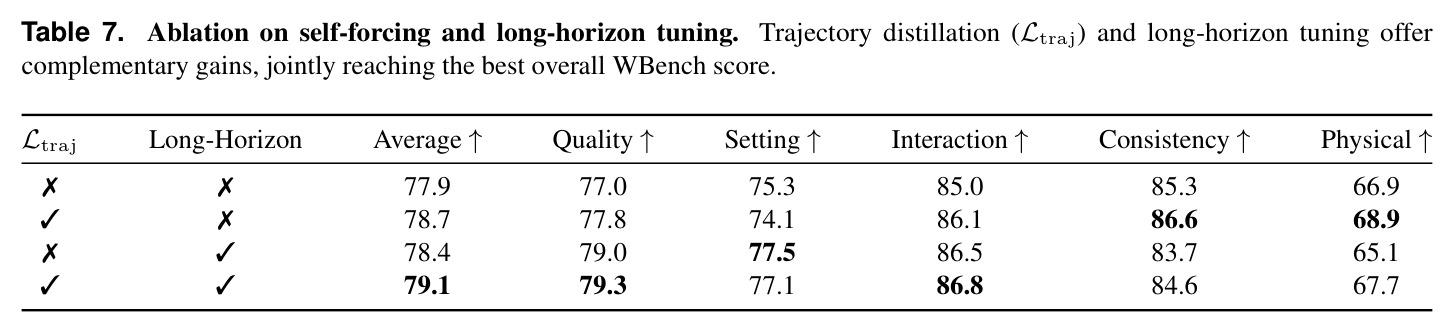
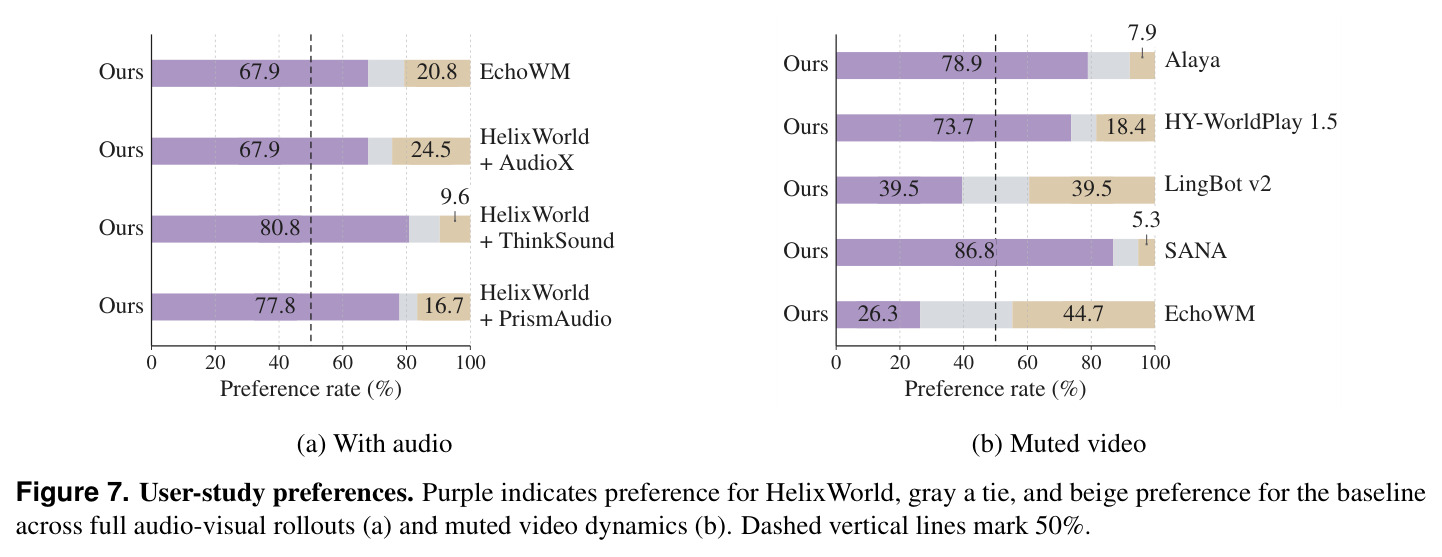
视觉与控制:WBench 导航 split 上平均 79.9 分(交互 86.4、一致性 86.4、物理 70.9),超过 LingBot-World v2(79.4)等静默基线,略低于 Alaya(82.0)与 EchoWM(81.0),但 RTF 0.77 远快于 EchoWM 的 1.98,是全场最快的带音频模型。音频与对齐:HelixBench 上因果学生全面最优——KL 1.3934、FAD 2.3872(EchoWM 为 1.9530/7.7472)、DeSync 0.5867s、ImageBind 0.2987、CLAP 0.3016;空间得分 41.76 对 EchoWM 的 12.65,而 V2A 配音空间分全为负(AudioX -5.74),证明级联配音无法捕捉声源方位;因果学生还优于双向教师(空间 33.24)。消融:渐进微调把相机旋转/平移误差从 0.1237/0.0957 降至 0.1144/0.0823;三轨字幕把 ImageBind 推至 0.2462;$L_{traj}$ 使一致性 85.3→86.6、物理 66.9→68.9,30 秒 rollout 下 DINOv3 多样性 +21.7%;$L_{traj}$ 与长程微调正交互补,组合达最佳 79.1。效率与主观:单张 H800 上 768×512@24FPS 稳态 RTF 0.77;用户研究中带音频对所有基线明显胜出(对 EchoWM 73.7% vs 18.4%),静音时仅负于 EchoWM。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 交互视频生成(WBench 导航 split) | Average 综合分 / RTF | 79.9 / 0.77 | EchoWM 81.0 / 1.98;Alaya-EVOKE-Turbo 82.0 / 4.29;LingBot-World v2 79.4 / 5.21 | 超过多数静默开源基线,落后 EchoWM 1.1 分,但推理速度快约 2.6 倍(对 Alaya 快 5.6 倍),以极小质量代价换取实时 |
| 音频保真 | KL ↓ / FAD ↓(VGGish 嵌入) | 1.3934 / 2.3872 | EchoWM 1.9530 / 7.7472;LTX-2.3 基座 1.8040 / 7.6354 | KL 相对 EchoWM 降低约 29%,FAD 降低约 69%,为所有对比方法中最低 |
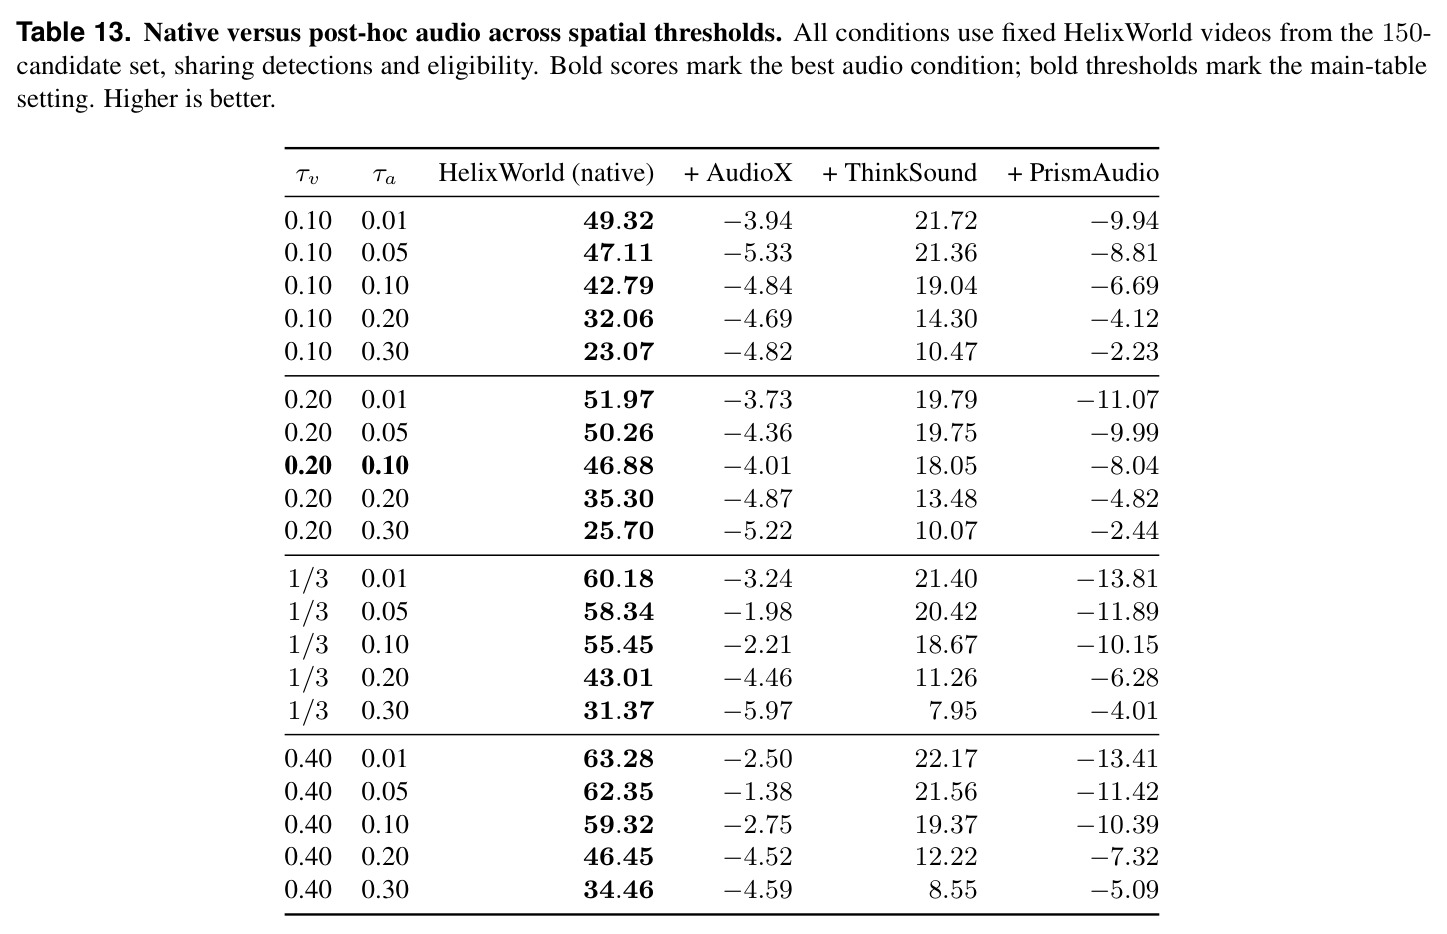
| 空间-声学一致性 | Spatial ↑ | 41.76(因果学生;双向教师 33.24) | EchoWM 12.65;V2A 配音为负值(AudioX -5.74、ThinkSound 14.85 波动、PrismAudio -9.51) | 约为 EchoWM 的 3.3 倍,证明级联配音无法跟随相机运动,联合生成方向正确 |
| 视听语义对齐 | ImageBind ↑ / CLAP ↑ | 0.2987 / 0.3016 | LTX-2.3 基座 0.2777 / 0.2577;EchoWM 0.2036 / 0.2352 | 两项指标均为全场最高 |
| 时间同步(Event 子集) | DeSync (s) ↓ | 0.5867 | LTX-2.3 基座 0.4042;ThinkSound 配音 0.4236;EchoWM 0.6745 | 优于 EchoWM,略逊于若干配音方案,保持亚秒级同步 |
| 推理效率(单张 NVIDIA H800,768×512@24fps 含解码) | RTF ↓ | 0.77 | EchoWM 1.98;Alaya-EVOKE-Turbo 4.29;LTX-2.3 (base) 14.61 | 带音频模型中最快,首次实现单卡实时交互视听生成 |
局限与改进
可从实验中观察到的局限:第一,视觉综合分并未登顶——WBench 上 79.9 低于 Alaya(82.0)与 EchoWM(81.0),静音用户研究中也输给 EchoWM(16.7% vs 77.8%),说明“蒸馏换实时”的质量代价真实存在;第二,空间声学主要建模为随相机的立体声 pan,缺少混响、遮挡衰减、多普勒等更精细的声传播物理,长 rollout 的声学 fading 仍依赖长程流式微调兜底;第三,81 类动作词表是对连续速度的 9×9 网格离散化,精细控制分辨率受限;第四,DeSync 0.5867s 略逊于 LTX-2.3 基座(0.4042)与部分配音方案;第五,我的补充观察:HelixBench 为作者自建且含针对性维度,Spatial 指标基于屏上声源与 pan 的相关性,对无声像变化以外的声学缺陷可能不敏感;4.1k 小时语料与 768×512 分辨率相对现代视频生成偏保守;RTF 0.77 依赖 H800,消费级 GPU 可行性未验证。
独立分析的弱点
第一,随机路由概率 $p$($L_{traj}$ 与 DMD 的采样比例)只有定性描述,缺少敏感性消融,复现者难以判断超参鲁棒区间——建议补充不同 $p$ 下的 WBench/HelixBench 曲线。第二,音频以 mel 谱 token 表示,论文未报告语音清晰度或对白音质指标,而语义过滤明确保留了自然语音,生成语音是否可用缺少量化。第三,相机位姿链路(VGGT-Ω + Depth Anything V3,必要时回退 Metric3D v2)在快速运动、弱纹理场景的失败率只在附录提及,主文未给逐场景统计,位姿噪声对空间声学上限的影响不明。第四,训练成本不透明:论文未披露总 GPU 时数与卡数,但三阶段(教师预训练、因果蒸馏、长程流式微调)叠加,算力门槛难以估计。第五,蒸馏策略消融只在 WBench(纯视觉)上评估,未验证 $L_{traj}$ 对声学漂移(声学 dropout)的抑制在 HelixBench 长时程上是否同样显著——建议补充视听联合的 30 秒 rollout 消融。第六,HelixBench 与 WBench 的评测都未覆盖多人同时发声、遮挡声学等复杂场景。
未来方向
作者方向上,结论把空间-声学一致性确立为区分交互世界模型与被动生成的基础判据,自然延伸包括:扩展 HelixBench 到更长时程与更多交互模式;引入几何声学或可学习混响以超越简单 pan 建模。基于本文成果的延伸方向:其一,$L_{traj}$ 是与模态无关的 self-forcing 修正,可迁移到纯视频、音乐、3D 生成等联合扩散蒸馏场景;其二,带度量位姿与三轨字幕的 3.0k 小时视听语料可直接服务于具身导航、视听定位与声源分离研究;其三,空间声学一致性指标可移植为机器人听觉感知与仿真器的评测协议;其四,结合对话系统探索画外说话人的语音生成,或引入物理仿真驱动的遮挡、混响与多普勒建模,朝真正多感官的世界模拟演进;其五,在更小显卡上通过进一步量化/蒸馏降低部署门槛。
复现评估
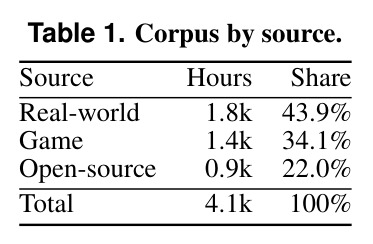
开源情况:论文提供项目页(helixworld.org)与 GitHub 仓库(github.com/NoizAI/HelixWorld),底座为开源 LTX-2.3,代码与权重可用性需以仓库实际发布为准。数据方面,4.1k 小时素材来自真实拍摄(43.9%)、游戏录屏(34.1%)与开源语料(22.0%),管线全自动但串联多个大型模型——MLLM 语义过滤、VGGT-Ω 位姿、Depth Anything V3/Metric3D v2 深度估计,复现数据管线需要这些模型的权重与可观的 GPU 预处理预算;游戏素材的引擎真值位姿需自行录制。训练方面,论文未披露总 GPU 时数与卡数,含教师预训练、因果蒸馏与长程流式微调三个大阶段,预计需 H800 级多卡集群,个人实验室难以完整复现。推理门槛低:单张 H800 即可 24 FPS,因果结构与 KV cache 对工程部署友好。HelixBench 的 1015 个人工校验用例若随仓库发布将显著提升可复现性。综合评估:推理复现容易,数据与训练复现困难。
论文图表