通过投机执行隐藏端侧级联语音智能体的工具延迟 Hiding Tool Latency in On-Device Cascaded Voice Agent through Speculative Execution
边听边猜:在流式识别期间预测并提前执行工具调用,把工具延迟藏进说话时间
前置知识
级联语音助手(Cascaded ASR-LLM-TTS)
将自动语音识别(ASR)、大语言模型(LLM)、语音合成(TTS)三个模块按文本接口顺序串联的语音助手架构:语音先被完整转写成文字,再由LLM理解意图、决定是否调用工具并生成回复,最后TTS合成语音。相比端到端语音模型,每个环节都是文本,便于插入工具调用和人工校验,可靠性更高,但总延迟是各模块延迟之和。
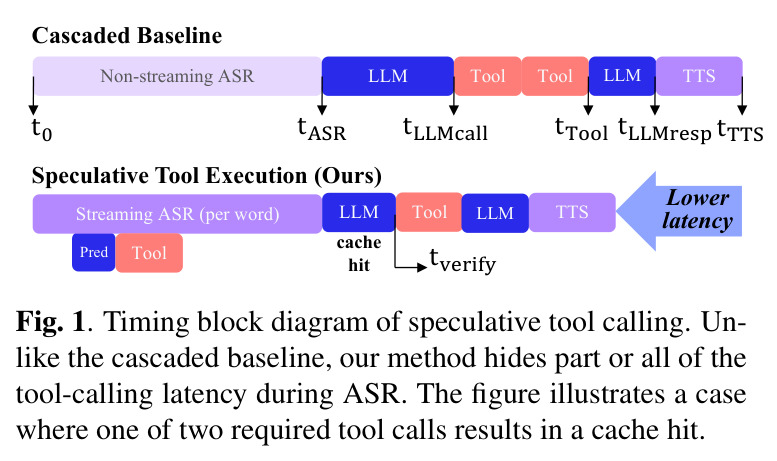
本文的全部优化都发生在级联架构内部。只有理解其串行时序 $t_0 < t_{ASR} < t_{LLM\text{-}call} < t_{Tool} < t_{LLM\text{-}resp} < t_{TTS}$,才能明白要隐藏的正是 $t_{Tool} - t_{ASR}$ 这一段。
流式ASR与部分转写假设
流式语音识别在用户还在说话时就持续输出中间转写结果(partial hypothesis),随着音频流入不断修正。这意味着在转写定稿时刻 $t_{ASR}$ 之前,系统就已经能看到部分文字;如果用户意图在前几个词就明朗,系统完全有机会提前行动。
本文的核心洞察是把流式语音当作'预知计算的机会窗口'而非单纯的输入模态,投机执行的全部机会都来自部分转写文本提前暴露了用户意图。
投机执行(Speculative Execution)
体系结构的经典思想:按预测'赌一把'提前执行可能需要的操作并缓存结果,真正需要时若猜中则直接命中,猜错则丢弃或走正常路径。设计要点是必须有兜底路径,保证最坏情况下不比不投机更差,以及投机操作本身要廉价或无副作用。
本文把投机执行的对象从CPU指令/token搬到了'外部工具调用'层。'预测-执行-缓存-注入-验证-兜底'这套机制是贯穿全文的主线,不懂投机执行就无法理解其系统设计。
TTFA(Time-To-First-Audio)
从用户说完话的瞬间到TTS播出第一段音频的耗时,是衡量语音助手响应速度的核心体验指标。本文还配套定义了FT(ASR结束到首次工具调用)、Wasted calls(结果从未被使用的投机调用数)、Ready rate(需要工具结果时缓存已就绪的比例)、False read(不需搜索却使用了搜索结果的轮次比例)等指标。
论文所有实验数据都围绕这些指标展开(如TTFA中位数5.79s降到4.60s),不理解指标定义就无法读懂Table 1-4的对比结论。
W4A16量化与端侧NPU推理
将LLM权重压到4比特、激活保持16比特的量化方案,使Llama-3.2-3B这样的小模型能塞进手机的神经处理单元(NPU)。本文用高通QAIRT/QNN栈在骁龙平台上运行量化LLM,ASR和TTS跑CPU,正是端侧算力紧张使得'等LLM选完工具再执行'的串行延迟问题格外突出。
理解端侧资源约束才能理解论文的关键设计取舍:为什么预测器用规则而不用LLM(离线实验证明LLM预测更准但推理太慢、还与主模型争抢NPU)。
研究动机
现有级联语音助手严格串行执行:用户说完话($t_0$)→ASR定稿($t_{ASR}$)→LLM第一次推理决定调用哪个工具($t_{LLM\text{-}call}$)→工具执行完成($t_{Tool}$)→LLM第二次推理生成回复($t_{LLM\text{-}resp}$)→TTS合成($t_{TTS}$)。这意味着工具延迟只有在用户说完、LLM识别出工具请求之后才开始累积。本地简单工具尚可容忍,但网页搜索等远程操作动辄10秒量级且网络延迟不稳定。在端侧手机上问题更尖锐:LLM是量化后的小模型、算力有限,而网络往返延迟占比极高。实测级联基线在三星Galaxy S26 Ultra上中位首音频延迟(TTFA)为5.79秒,p99高达19.76秒,标准差3.49秒,意味着约1%的请求用户要等近20秒才有声音回应,延迟高度不可预测。论文给出的典型场景是:一条15秒的长查询伴随约10秒的搜索工具执行,基线TTFA达到17秒,用户全程干等。
本文的目标是本文的目标是把工具执行延迟'藏'进用户还在说话的时间里。具体拆解为三点:其一,设计一个预测器模块,在流式ASR过程中持续观察部分转写假设,一旦从子句中推断出可能的长延迟工具请求(尤其是远程网页搜索),就立即发起投机执行并把结果写入投机结果缓存;其二,用户说完后($t_{ASR}$时刻)把定稿转写和已完成的投机结果直接注入LLM提示词,让模型跳过工具调用环节直接生成回答;其三,保留LLM标准工具调用路径作为兜底,保证最坏情况下端到端延迟仍以串行基线为上界,投机只作用于只读工具以避免副作用。量化目标是降低TTFA的均值、中位数和方差,同时不降低甚至提升工具调用准确率——最终实测中位TTFA从5.79秒降到4.60秒,标准差从3.49秒降到2.81秒,F1从44.8%升到60.6%。
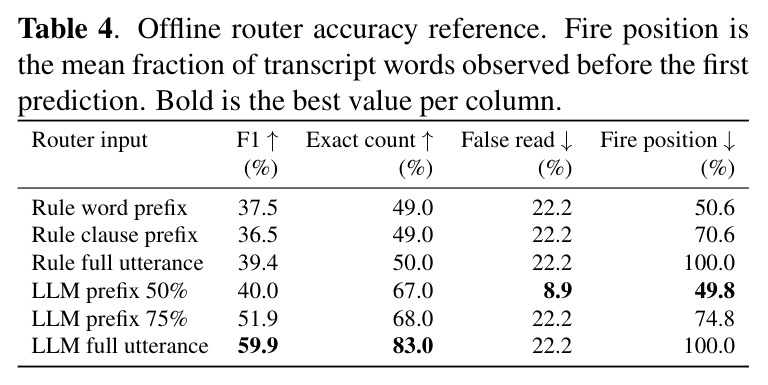
与已有工作不同的是,本文的独特切入角度有三层。第一,视角转换:把流式语音不只当作输入模态,而是当作'预知计算的机会窗口'——用户意图往往在说完之前就显现(例如听到'查一下明天去首尔的机票'时搜索意图已明确),此前anticipatory computing的思想没有被用于提前发起外部工具调用。第二,架构坚守:与StreamRAG等依赖端到端语音模型的方案不同,本文坚持级联架构(可在模块间做文本编辑、可靠性更高),在架构内部做跨模块流水线化,而非推翻架构。第三,工程取舍的量化依据:离线实验显示LLM做工具路由预测确实更准(F1 59.9%对比规则的39.4%),但在端侧NPU上推理太慢、无法在ASR定稿前完成预测,还会与主LLM争抢算力,因此轻量规则预测器才是'提前量'与'预测成本'之间的实用平衡点——这是一个反直觉但有数据支撑的设计决策。
核心方法
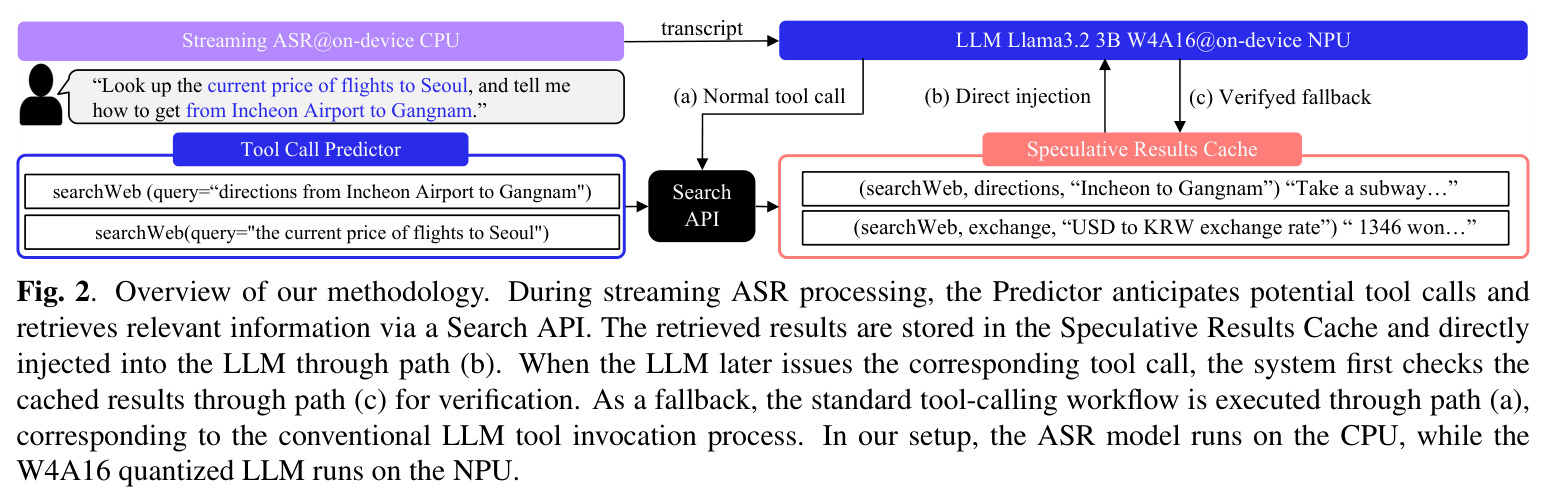
直觉上,等用户说完再开始搜网页,就像客服等对方把整句话讲完才去查资料;其实听到'查一下明天去首尔的机票价格'前几个词时就可以动手了。技术路线是在级联管线中插入两个新组件:预测器和投机结果缓存。预测器在流式ASR的每个触发点检查部分转写文本,按子句切分并映射为(工具,主题,参数)候选元组,随即直接发起工具调用(如EXA网页搜索API),结果写入缓存。到达 $t_{ASR}$ 时,系统把定稿转写与已完成的投机结果拼接进LLM提示词(直接注入路径),LLM在解码开始前就'看到'了搜索结果,直接生成最终回答。若LLM仍然发出工具调用(实测13%的轮次),系统先做缓存匹配(验证兜底路径),命中则复用缓存结果返回给LLM,未命中则走原生工具执行路径。整个框架要压缩的正是 $t_{Tool}-t_{ASR}$ 这段时间,用ASR期间的空闲算力和网络时间抵消它。系统在三星Galaxy S26 Ultra上端到端实现:流式Conformer ASR跑CPU,W4A16量化的Llama-3.2-3B经QAIRT/QNN跑NPU,TTS跑CPU,HTTP调用EXA搜索API。
核心创新有三点。第一,规则化投机工具调用预测器:不训练任何神经模型,纯粹观察部分ASR假设,在累计 $N_{min}=6$ 个词之后、此后每增加 $\Delta N=5$ 个词、或检测到超过 $\tau_{pause}=300$ 毫秒的停顿时触发预测;用句末标点和并列连词(and、but、also、then、while)把部分转写切成互不重叠的子句,每个子句独立映射到固定的12个粗粒度主题类别之一,生成候选工具元组。子句级分析使一句话里的多个独立意图可以被并行投机分发。第二,直接注入而非缓存查询:与等LLM发出工具调用再查缓存的思路不同,本文在解码开始前就把投机结果写进提示词,这对3B量化小模型产生了强烈的上下文学习效应——工具选择F1从44.8%涨到63.0%,因为小模型在拿到任务相关信息后选择更准,这是'延迟优化'与'准确率优化'意外耦合的关键发现。第三,可证明的安全兜底:LLM保留原生工具调用路径,投机仅限只读工具,最坏情况下延迟上界就是串行基线。
方法步骤详情
第一步,流式预测与投机执行:CPU上的Conformer流式ASR逐词输出部分假设;预测器在每个触发点(首 $N_{min}=6$ 词后、每增 $\Delta N=5$ 词、或300毫秒停顿)把当前假设切成子句。例如'Check the weather in Boston, then find nearby restaurants, and tell me the yen exchange rate'被切成三个子句,分别生成 (searchWeb, weather, "weather in Boston")、(searchWeb, place, "nearby restaurants")、(searchWeb, exchange, "JPY–USD exchange rate"),随即经HTTP调用EXA搜索API,结果进入投机结果缓存。第二步,直接注入:$t_{ASR}$ 时刻,定稿转写与缓存内容拼接进LLM(Llama-3.2-3B W4A16,NPU上的QAIRT/QNN栈)提示词,LLM基于两者直接生成回答。第三步,验证兜底:若LLM仍发出工具调用(评测集13%的轮次,另有7%是冗余请求),先做缓存匹配——命中则把缓存结果当工具输出返回LLM,未命中走原生工具路径。第四步,TTS合成并流式播放。评测集约1.5小时音频,完整跑一轮约3小时。
技术新颖性
技术新颖性体现在四个方面。其一,投机单元的迁移:此前投机执行用于CPU流水线或大模型推测解码(speculative decoding),本文首次把'远程网络请求'作为端侧语音助手中的投机对象,收益直接来自网络延迟与用户说话时间的重叠,例如15秒查询+10秒搜索的TTFA从17秒降到8秒。其二,子句级并行投机:不对整句做一次预测,而是用标点和连词切分出多个子句独立预测,复用了增量口语理解与子句边界检测的思想,支持单句话内多意图并行分发。其三,直接注入的解耦发现:消融显示投机预取本身完全不提升工具选择准确率(prefetch only的F1仍是44.8%),但把结果注入提示词让小模型F1升到63.0%——本质上是用检索增强的上下文学习弥补3B小模型的工具选择能力,把系统延迟优化与模型能力提升打通。其四,系统级安全设计:只读工具白名单、缓存验证、LLM原生路径兜底三重保险,使错误投机的代价被限制在网络流量层面,不会误改闹钟、日历等用户数据。
实验结果
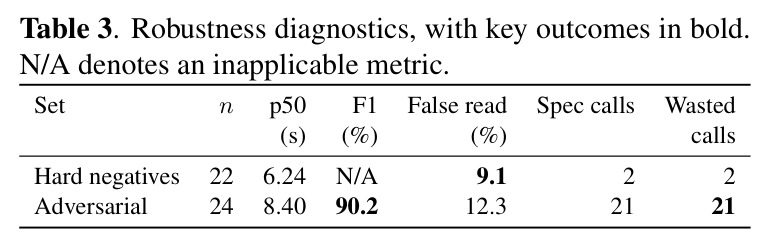
主实验(Table 1,146条评测样本实机测试):投机系统中位TTFA为4.60秒,对比级联基线5.79秒(降低20.5%);p99从19.76秒降到15.10秒;均值±标准差从6.69±3.49秒降到5.99±2.81秒;FT p99从22.44秒降到11.71秒;工具调用F1从44.8%升至60.6%。典型场景下,15秒长查询+约10秒搜索,TTFA从17秒降到8秒。消融(Table 2):仅投机预取时p50微升至6.03秒、F1不变(44.8%)、浪费47次调用;只加验证兜底p50为5.72秒、F1为43.5%,接近基线,因工具选择仍发生在ASR之后;直接注入使均值降到6.17±2.68秒、F1升至63.0%,是主要收益来源;完整方法取得最低p50(4.60秒)、均值(5.99±2.81秒)、最高Ready率(47.7%)、最少浪费调用(5次)。鲁棒性(Table 3):22条困难负样本误读率仅9.1%;24条对抗样本F1保持90.2%、误读率12.3%,21次浪费调用只耗流量、无用户数据副作用。预测器对照(Table 4):LLM全句路由F1 59.9%、精确匹配83.0%确实更高,但在模拟真实时序的前缀输入下(prefix 50%)F1仅40.0%,与规则词前缀的37.5%接近,支持规则预测器的选择。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端响应延迟 TTFA(语音助手问答) | 中位数 p50 (s) | 4.60 | 5.79(级联基线) | 降低 20.5% |
| 端到端响应延迟 TTFA(语音助手问答) | p99 (s) | 15.10 | 19.76 | 降低 23.6%,长尾延迟显著缓解 |
| 端到端响应延迟 TTFA(语音助手问答) | 均值±标准差 (s) | 5.99 ± 2.81 | 6.69 ± 3.49 | 标准差降 19.5%,延迟更可预测 |
| 首次工具调用延迟 FT | p99 (s) | 11.71 | 22.44 | 降低 47.8% |
| 搜索工具选择(read请求是否被正确使用) | F1 (%) | 60.6 | 44.8 | +15.8 个百分点 |
| 困难负样本(含搜索词但不需搜索,22条) | False read 误读率 (%) | 9.1 | N/A(无对照) | 极少因关键词误触发搜索 |
| 对抗样本(修正/撤回/话题变更,24条) | F1 (%) / False read (%) | 90.2 / 12.3 | N/A(无对照) | 意图变化时投机结果大多被正确丢弃 |
| 缓存利用(消融完整方法) | Ready率 (%) / 浪费调用数 | 47.7 / 5 | 0.0 / 0(级联基线无缓存) | 近半所需工具结果在需要前已就绪,且浪费最少 |
局限与改进
作者承认的局限:LLM预测器离线准确率远高于规则(F1 59.9%对39.4%,精确匹配83.0%对50.0%),但端侧推理太慢、无法在ASR定稿前完成,还会与主LLM争抢NPU,只能退而用规则;对抗样本上21次浪费调用仍带来网络成本;完整方法p95(11.39秒)和F1(60.6%)略逊于纯直接注入(11.35秒、63.0%)。我的观察:第一,评测集仅146条人工编写英文、经Gemini TTS合成,无真实用户噪声、口音和多人场景,外部效度存疑;第二,任务限于网页搜索、日历、闹钟等只读操作,交易、发消息等写操作工具不在投机范围,收益边界受限;第三,数据与代码未开源,12类主题和触发超参($N_{min}=6$、$\Delta N=5$、$\tau_{pause}=300$毫秒)均为手调,跨语言泛化需重调;第四,13%的LLM仍发工具调用、7%属冗余请求,3B量化模型工具选择仍不可靠,更强端侧模型可能推翻规则vs神经预测器的结论;第五,实验硬件是最新旗舰SoC,中低端机型NPU/CPU更慢,重叠窗口可能藏不住10秒级搜索。
独立分析的弱点
独立弱点分析:第一,规则预测器依赖英文标点和并列连词切分子句,在中文(无空格分词、口语常无标点)或其他语言上会失效,12个固定主题类别也绑定了工具生态;改进方向是改用轻量级增量子句边界模型(如论文引用的神经化子句检测[17])或蒸馏小模型做子句意图分类。第二,缓存结果可能过期:股价、汇率、机票价格等时变查询在说话期间检索的结果到生成回答时可能已失效,论文未讨论新鲜度;改进方向是给缓存条目加TTL并在 $t_{ASR}$ 后做一致性校验。第三,多轮对话未覆盖:'那第二个呢'这类指代依赖对话历史,投机预测难度陡增;改进方向是把对话状态纳入预测器输入。第四,对抗场景浪费率高(24条样本21次浪费调用),说明自我修正场景下网络开销可观;改进方向是为候选元组加意图置信度门槛,低于阈值不投机,或引入指数退避。第五,TTFA只测首音频,答案正确性仅通过read是否被使用间接衡量,缺少答案质量的直接评测;改进方向是加入人工或LLM评分的答案质量维度。第六,未与文本侧异步函数调用方案(LLM Compiler、AsyncLLM等)做横向对比,无法判断在相同硬件上哪类并行化收益更高。
未来方向
作者提出或暗示的方向:第一,神经预测器的实用化——Table 4给出了LLM路由的离线上限(F1 59.9%、精确匹配83.0%),未来可蒸馏出能与流式ASR并行运行的轻量预测模型,或用早退机制在准确率与时延间自适应权衡。第二,投机执行向更多工具类型扩展,并与流式TTS更深度协同(当前TTS仍在最后阶段执行,首音频之后没有继续流水线化)。基于成果可延伸的方向:第三,多模态先验投机——结合屏幕上下文、位置、时间信号预测日历、导航类工具(这类请求天然有时间地点先验),可进一步提高Ready率。第四,两级投机管线:工具结果注入后,首token生成延迟还可用推测解码压缩,形成'投机工具调用+投机解码'的叠加。第五,跨轮与个性化缓存:用户重复问相似查询时跨会话命中缓存,把Ready率从47.7%继续推高。第六,自适应触发参数:用bandit算法根据历史Ready率在线调整 $N_{min}$、$\Delta N$、$\tau_{pause}$,替代手工固定值。第七,成本与隐私形式化:投机调用给第三方搜索API带来额外流量(对抗集上平均每条约1次浪费调用),值得建立成本-收益模型并给用户开关控制。
复现评估
复现评估:论文未提供开源代码、数据集或评测脚本,全文没有任何代码链接,这是最大的复现障碍。所需资源包括:一台骁龙8 Elite Gen 5旗舰机(文中为三星Galaxy S26 Ultra SM-S948N)、CPU上运行的流式Conformer ASR与TTS模型、经Qualcomm AI Hub提供的QAIRT/QNN量化的Llama-3.2-3B W4A16 NPU包、付费的EXA搜索API密钥、以及用Gemini-2.5-Flash-Preview-TTS合成评测语音(100条正常+22条困难负样本+24条对抗样本需自行重写标注,因为数据集未公开)。算力方面全部推理在端侧完成,无需GPU训练,完整评测一轮约3小时(1.5小时音频)。总体判断:复现精确数字难度偏高——硬件和商业API依赖强,预测器的12类主题表、缓存匹配的具体相似度准则、注入提示词模板等关键实现细节未完全给出;但复现方法思想(在自家管线加预取+注入+兜底)属中等难度,每个组件都有现成替代品(其他流式ASR、llama.cpp量化模型、任意搜索API)。更适合作为系统设计参考,而非可直接对标的公开基准。
论文图表
两类困难场景的诊断结果:困难负样本22条(误读率9.1%、仅2次投机调用);对抗样本24条(p50 8.40秒、F1 90.2%、误读率12.3%、21次浪费调用)。
展示系统在'含搜索关键词但不需搜索'与'说话中途修正/撤回/换话题'两类最难情形下的安全性:很少误触发搜索,投机结果在意图变化时大多被正确丢弃,且只读工具保证错误无用户数据副作用。
规则预测器与LLM预测器在不同输入前缀下的离线路由准确率:LLM全句F1 59.9%、精确匹配83.0%最高;规则全句F1 39.4%;前缀条件下LLM prefix 50%的F1为40.0%、规则词前缀为37.5%;Fire position列给出首次预测时已见转写词比例(规则词前缀50.6%最早触发)。
解释了'为什么选规则预测器'这一核心设计决策:LLM准确率上限虽高,但在端侧无法保证在ASR结束前完成预测,前缀输入下两者差距很小,这是整个方法成立前提的量化依据。