面向工具调用智能体的轨迹级推测与语义验证 Trajectory-Level Speculation with Semantic Verification for Tool-Using Agents
弱模型真实执行读操作起草轨迹,强模型单次预填充语义验证,质量逼近强模型、省一半内存时间
前置知识
投机解码
一种大模型推理加速技术:小模型快速草拟若干 token,大模型在一次前向中并行验证这些草稿,接受与自身分布一致的前缀,被拒处回退并由大模型重新生成。因为验证可以一次前向处理多个 token,而逐 token 解码每生成一个 token 都要完整读取一遍模型权重,所以能在保持大模型输出分布不变的前提下获得 2-3 倍加速。
SpecAgent 把这一 draft-verify 范式从 token 级提升到轨迹级,理解它才能明白论文'验证替代生成'的核心主张,以及与 Leviathan et al. 2023 等经典投机解码工作的本质区别。
预填充与解码(prefill vs decode)
Transformer 推理分两阶段:预填充一次性并行处理整段输入 token,计算密集但只读一次权重;解码则逐 token 自回归生成,每个 token 都要重新流式读取一遍全部模型权重,因此受 GPU 显存带宽限制。于是'用一次预填充替换长串解码'在墙钟时间和显存流量上都划算,代价是总算力(FLOPs)增加。
论文全部效率论证建立在'解码受带宽约束、预填充受算力约束'的不对称之上,Proposition 1/2、成本模型和所有资源实验都由此展开,不懂这个二分法就无法理解为什么省时间却不省 FLOPs。
POMDP 与智能体轨迹
部分可观测马尔可夫决策过程:环境有隐藏状态 $s$(如数据库或工作区),智能体只能通过动作 $a_t$(工具调用)获得观察 $o_t$,策略依赖任务 $u$ 与历史 $H_t=(u,(a_1,o_1),\dots,(a_t,o_t))$。工具调用分为只读(搜索、查询,不改变状态、可撤销)与状态变更(改记录、退款、提交,不可撤销)两类。
SpecAgent 的可逆性原则——读块免审、写前必审——完全建立在动作分类之上,这是理解 Algorithm 1 中'暂存第一个写动作'设计与验证时机选择的必要前提。
过程奖励与语义验证
与只看最终答案的结果奖励不同,过程验证器逐步判断推理或动作是否合理(如 PRM、verifier 模型)。'验证比生成容易'这一不对称性是验证方法的核心依据;对智能体而言,语义验证问'这一步是否是朝任务的合理进展'而非'是否与我自己会写的完全一致',从而可以保留多条等价但不同的正确轨迹。
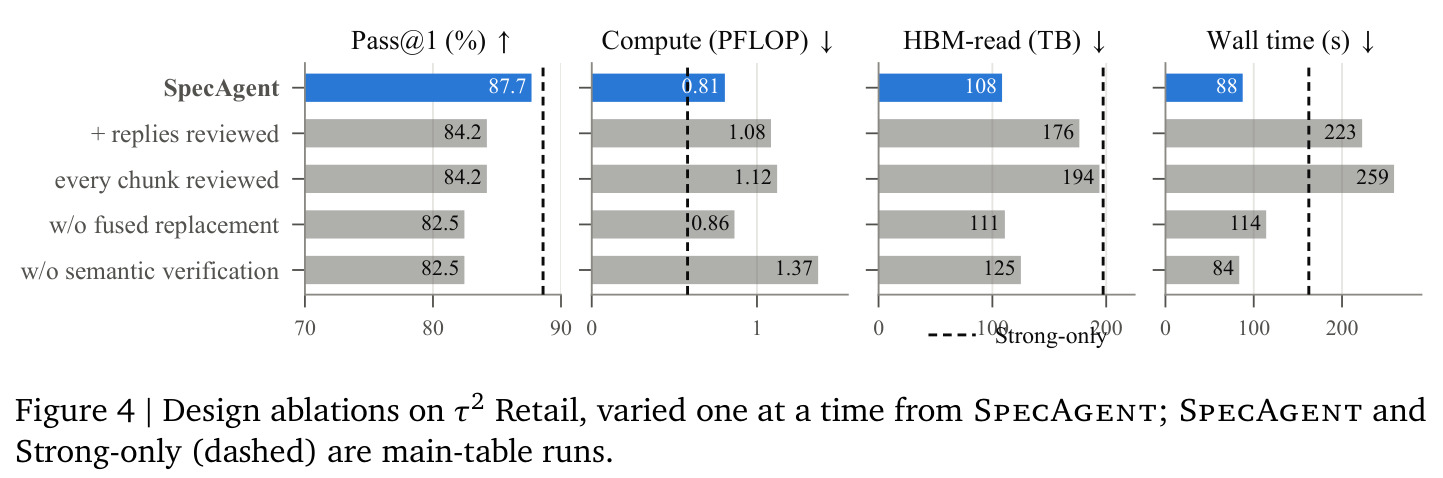
SpecAgent 的接受标准正是语义验证:消融实验显示换成精确匹配会使 Retail 的 Pass@1 从 87.7 降至 82.5 且 FLOPs 反升 70%,说明'语义前缀接受'是质量保持机制的关键。
前缀缓存与 KV 缓存
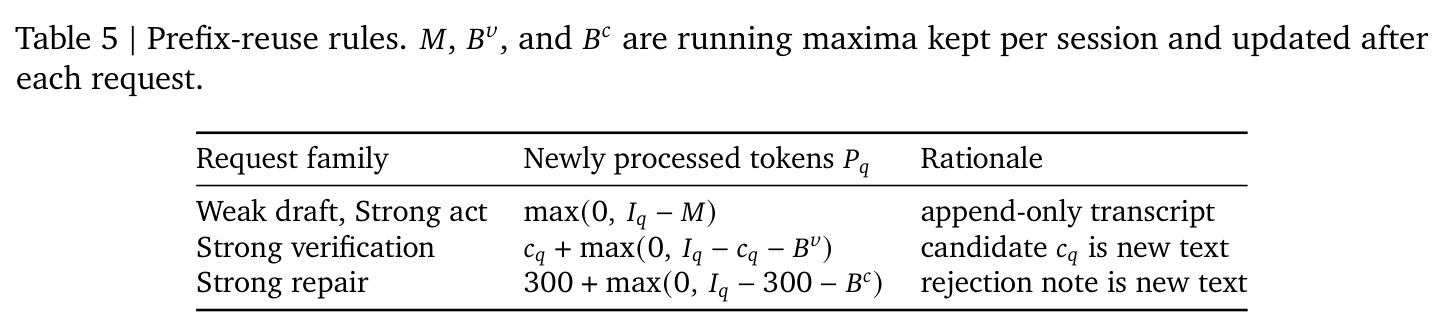
推理服务会复用已处理 token 的键值缓存(如 SGLang 的 radix tree 前缀缓存),相同前缀只需计算一次预填充。本文按'会话内前缀复用一次'的模型来估计 HBM 读取流量,并指出验证与修复提示模板互不共享前缀,导致 VitaBench 上每任务约 28.4k 不可缓存 token(Strong-only 仅 12.5k),是 FLOPs 上涨 87% 的主因。
理解前缀缓存才能解读'FLOPs 上升但时间下降'的反直觉结果,以及 API 按输入 token 计费使成本降幅(59-81%)小于输出 token 降幅(36-50%)的原因。
研究动机
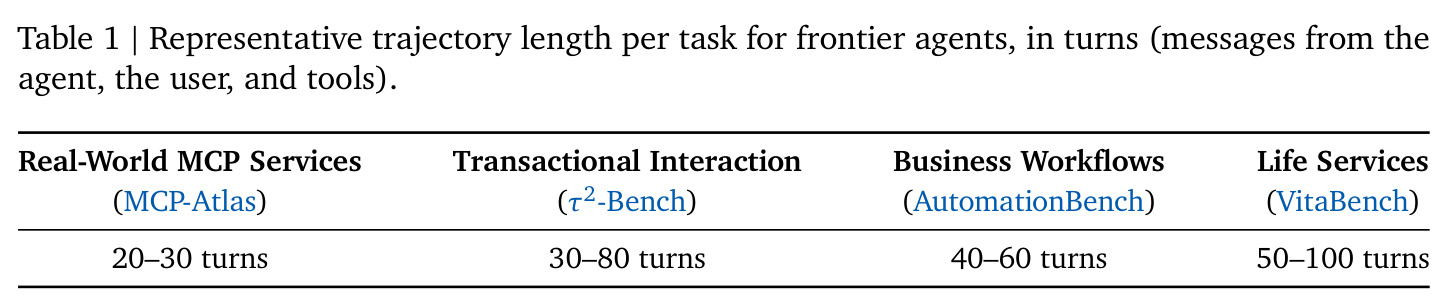
当前工具调用智能体的主流设计是由一个强模型逐步生成整条轨迹:客服场景动辄 30-80 轮交互,生活服务类任务可达 50-100 轮(作者统计 MCP-Atlas 真实 MCP 服务约 20-30 轮、AutomationBench 业务流程 40-60 轮),服务成本随轨迹长度线性增长,且被强模型逐 token 的自回归解码主导。现有分工方式都没有改变'强模型是作者'这一前提:路由器按查询选模型、协作式智能体按步切换控制权,每一步仍由某个模型从零生成;投机式智能体(Speculative Actions)虽借鉴投机解码,但通常要求草稿与强模型自己会写的那一步匹配才保留,于是强模型仍要生成每一步参照,工作只是被重叠隐藏而非消除;后续的步级评论家方法一次只检查一步,且多用于动作不改变环境的搜索类任务。对智能体而言精确匹配本身过于严苛:查询措辞、检索顺序或参数选择不同都可能同样有效,与强模型选择不同但正确的进展会被白白丢弃。
本文的目标是本文的目标是让强模型从'每一步的作者'转变为'弱模型草稿的审稿人':弱模型廉价地起草并落地执行一段轨迹,强模型只负责判断草稿中哪些步骤语义有效、保留有效前缀、并修复第一处错误,从而在几乎不损失质量的前提下大幅削减强模型的解码量。量化目标非常明确:在 τ²-Bench 上让 Pass@1 与 Strong-only 相差一个点以内(Airline 86.0 对 86.0),同时把强模型显存读取流量降到 Strong-only 的 43-57%、端到端墙钟时间降到 41-54%;在 AutomationBench 和 VitaBench 上分别收回弱强质量差距的 44% 和 75%;在边云部署中把云端强模型输出 token 压到至多一半、API 费用降到 59-81%。作者还希望建立一个能预测收益的成本模型,说明何时'用预填充替换解码'真正省钱省时、何时不划算。
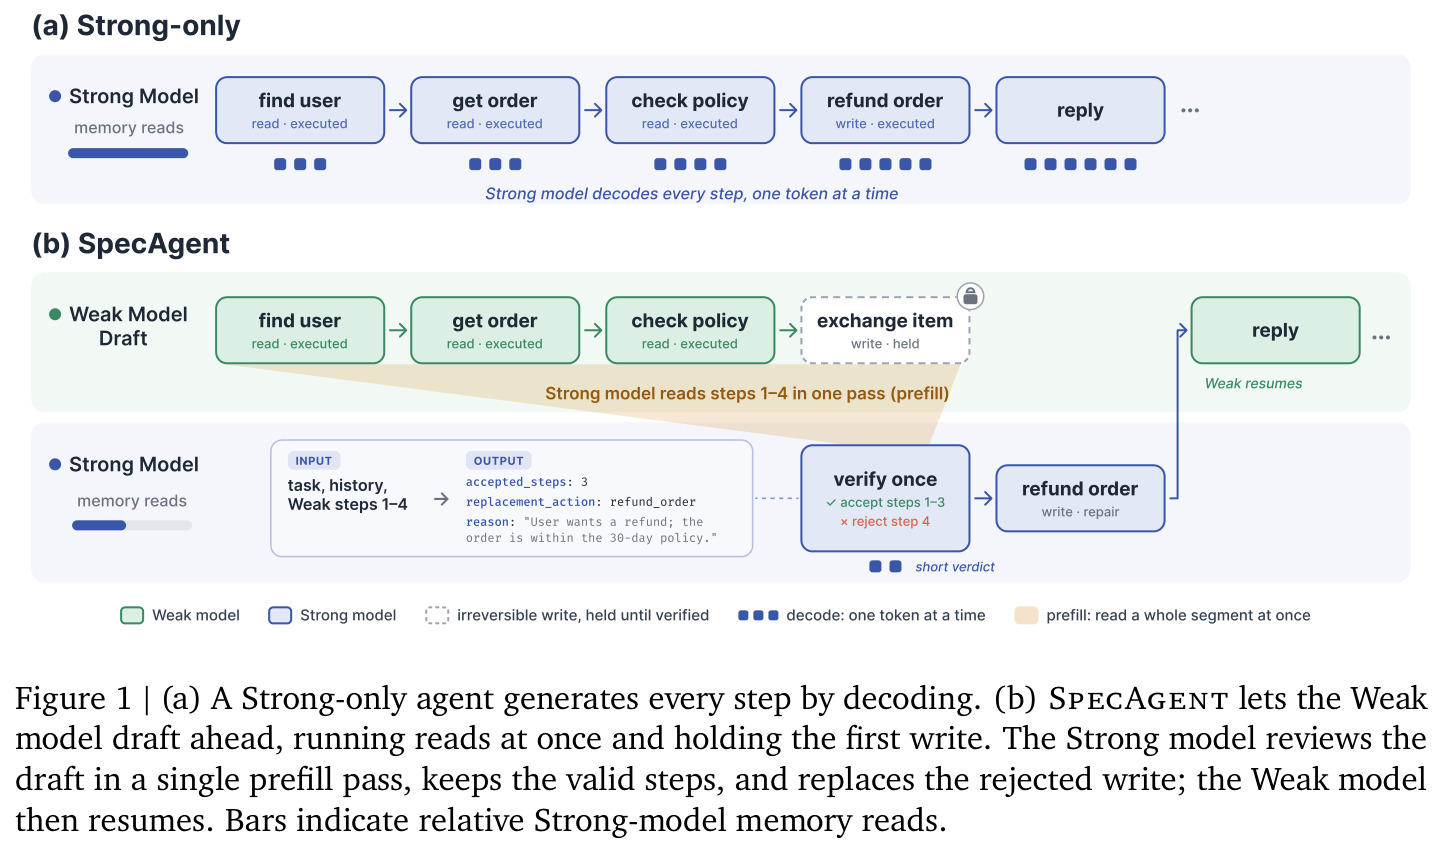
与已有工作不同的是,本文的独特切入在于三重角色反转与验证时机选择。其一,验证对象从'单步'变为'整段':强模型用一次并行预填充通读整段草稿,而非逐 token 解码或逐步审查,利用了'检查比生成便宜'的不对称性。其二,验证时机由可逆性决定:读操作(查订单、搜索)不改变环境状态,错了只需从历史中删除即可恢复,因此弱模型可以直接真实执行;只有第一个不可逆的状态变更动作(改记录、退款、提交)才需要停下来等强模型审查——过早检查浪费强模型算力,过晚则错误已铸成。其三,接受标准从精确匹配改为语义前缀有效:验证器只判断每步是否是朝任务推进的合理一步,而非是否与自己所写一致,从而保留大量'不同但同样正确'的弱模型进展。三者共同把强模型的工作量从'写整条轨迹'压缩到'写简短裁决加偶尔修复'。
核心方法
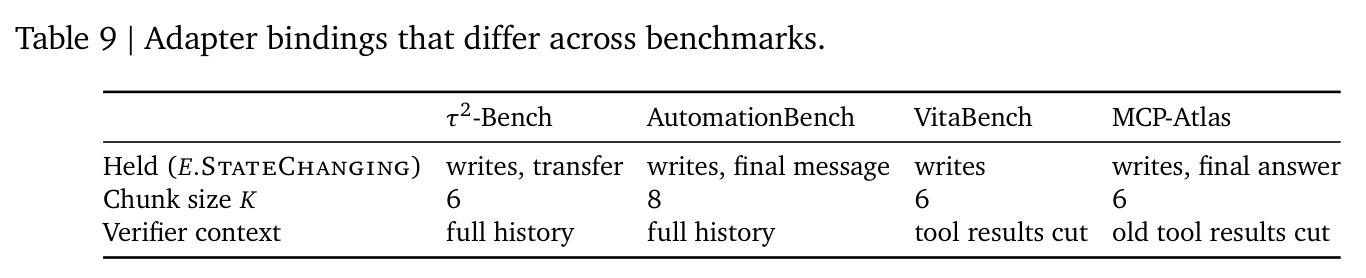
SpecAgent 是一个弱强协作协议,按可逆性把轨迹切块处理。直觉上:既然后续步骤都依赖前面工具的真实返回,草稿就必须'落地',所以弱模型起草时真实执行只读工具调用;既然只有写操作不可撤销,就只在第一个写动作前请强模型把关。具体流程为:弱模型从当前历史 $H_t$ 起草至多 $K$ 步(τ² 与 VitaBench 取 $K=6$,AutomationBench 取 $K=8$),读操作立即执行并把观察并入草稿,遇到第一个状态变更动作则暂存不执行;若凑满 $K$ 步全是读操作,该块无需审查直接提交。强模型随后用一次预填充通读历史与草稿,输出裁决 $(j, r, \tilde{a})$:$j$ 是最长可接受前缀长度,$r$ 是首个被拒步骤的原因,$\tilde{a}$ 是可选的融合修复动作。若 $j=n$ 则整块提交并执行暂存的写操作;否则提交前缀 $j$、丢弃后缀,优先用 $\tilde{a}$ 修复,$\tilde{a}$ 未通过适配器有效性检查时强模型才单独生成一步修复。
核心创新是把投机解码的 draft-verify 范式迁移到'轨迹级 + 语义级',并用可逆性重新划定验证边界。与已有方法的本质区别有三:其一,已有投机智能体让强模型继续充当执行者、用精确匹配决定去留,强模型的解码工作只是被隐藏而非消除;SpecAgent 让强模型彻底退出逐步生成,只解码一个简短裁决(和偶尔的修复),整段验证在一次预填充中完成,使强模型显存读取从'每 token 重读一遍权重'变成'一次权重读处理整段 token'。其二,语义接受标准:工具任务存在大量等价轨迹,验证器只问'这一步是否合理进展',使与强模型选择不同但正确的步骤得以保留——消融显示去掉语义验证后 Retail 的 Pass@1 从 87.7 掉到 82.5。其三,可逆性原则:读块免审、写前必审,把强模型介入频率压到约每 7 个提交步一次(Airline 上强模型调用从 13.8 次降到 3.1 次),且修复合并进裁决本身,多数拒绝不额外花费强模型生成。
方法步骤详情
完整循环(Algorithm 1)如下,输入为任务 $u$、弱策略 $\pi_W$、强验证器 $V_S$、强策略 $\pi_S$、块大小 $K$ 与工具适配器 $E$。第一步(起草):把 $H$ 初始化为 $(u)$,弱模型依据 $H\oplus\hat{\tau}$ 产出下一动作 $\hat{a}$;若适配器判定 $\hat{a}$ 状态变更,就把 $(\hat{a},\perp)$ 追加进草稿并跳出;否则真实执行 $\hat{a}$ 得观察 $\hat{o}$ 并追加 $(\hat{a},\hat{o})$;草稿满 $K$ 步且全是读操作时直接并入历史,不惊动强模型。第二步(验证):强模型一次预填充读入 $H$ 与草稿,返回 $(j,r,\tilde{a})$,$j\in\{0,\dots,n\}$ 为最长可接受前缀长度;裁决只取前缀,是因为被拒步骤之后的步骤建立在错误观察之上、即使看起来对也不可信。第三步(提交与修复):$j=n$ 时整块提交并执行暂存写;否则提交前 $j$ 步、丢弃其余,若融合替换 $\tilde{a}$ 通过适配器有效性检查 $E.Valid(\tilde{a})$ 则直接采用(不增加强模型调用),否则强模型从 $(H,r)$ 生成修复步 $\pi_S(H,r)$;修复是强模型自己的步骤,无需二次审查,执行后弱模型从新历史继续起草,直至任务完成。
技术新颖性
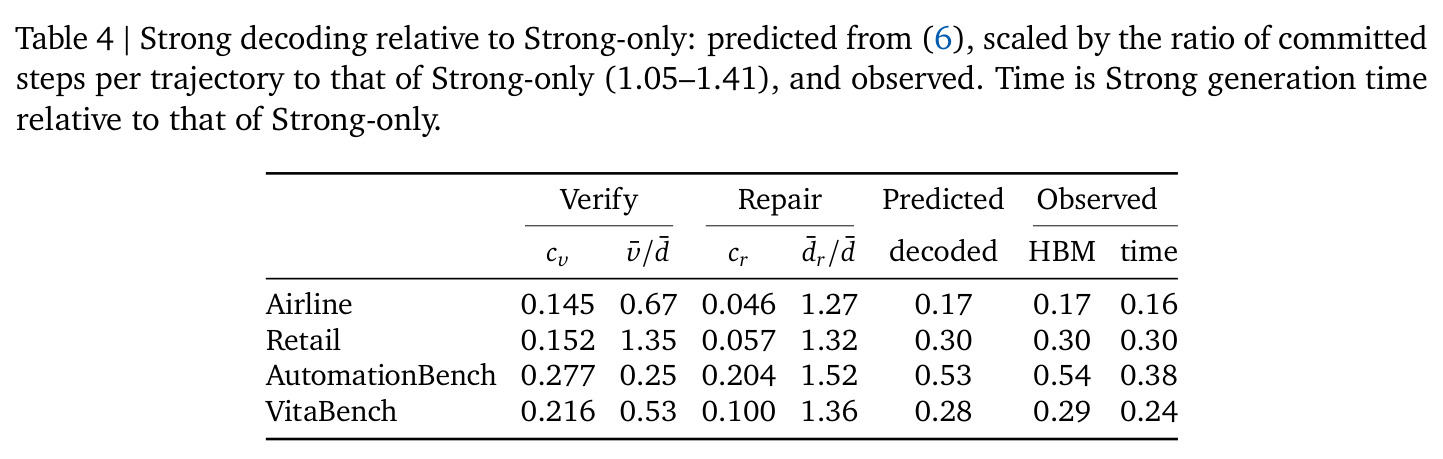
技术新颖性体现在三个层面。协议层:首次把'多步、落地、语义'的段级验证作为强模型的主要工作方式,而此前投机智能体(如 Speculative Actions)要么逐步检查、要么要求与强模型自身动作一致;步级评论家方法只处理动作不改环境的搜索任务,SpecAgent 则覆盖读写混合的真实工具环境,并在 MCP-Atlas 上跑通真实 MCP 服务器(搜索、代码执行、数据库、办公工具)。理论层:给出两条可检验命题——在解码受显存带宽约束(Assumption 1)与任务级接受率 $p_u$(Assumption 2)下,强模型每提交步的流量比为 $R_u=\frac{1-p_u}{1-p_u^n}\cdot\frac{v}{d}+\rho(1-p_u)$,端到端时延比为 $L_u=R_u+\kappa\frac{n(1-p_u)}{1-p_u^n}$,其中 $d$ 为强模型单步解码的权重读取次数、$v$ 为裁决的权重读取次数、$\rho$ 为拒绝需独立修复的概率、$\kappa$ 为弱模型步时延比;实测与预测在所有基准上误差不超过 0.01。度量层:把计算(FLOPs)、显存流量(HBM-read)、墙钟时间、GPU·s、调用次数作为独立坐标,完整报告质量—资源操作点,揭示'省时间与流量但不省 FLOPs'的 trade-off 结构。
实验结果
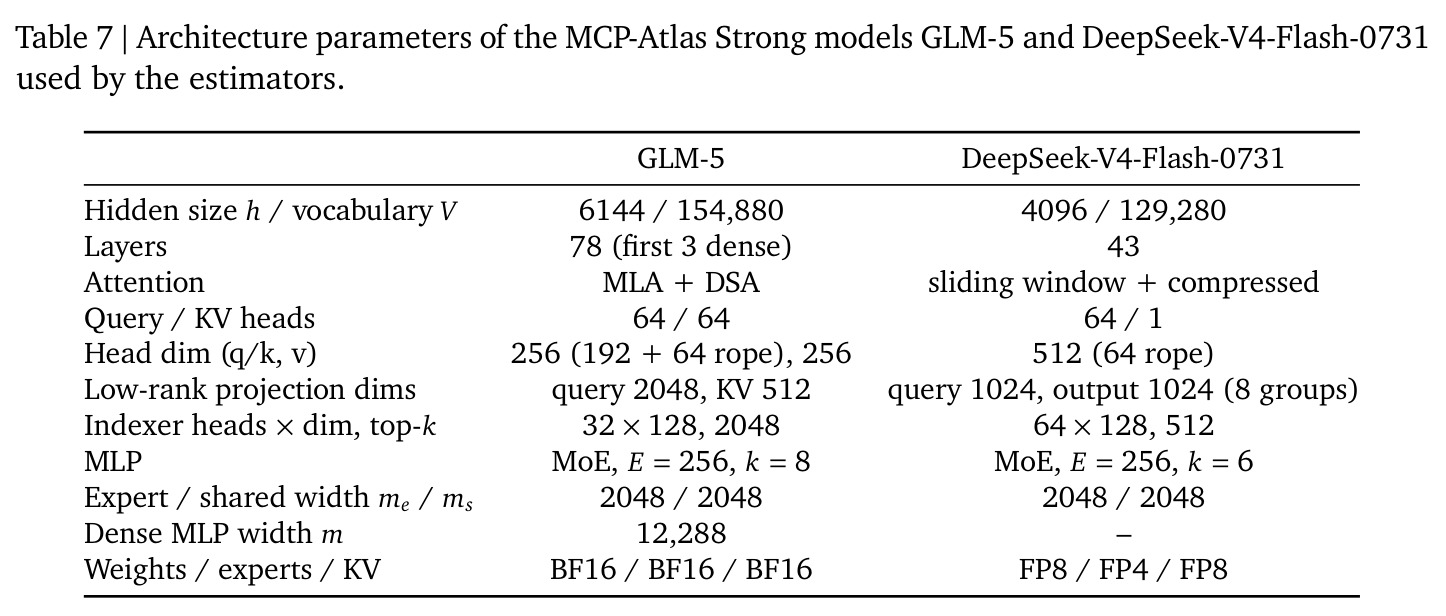
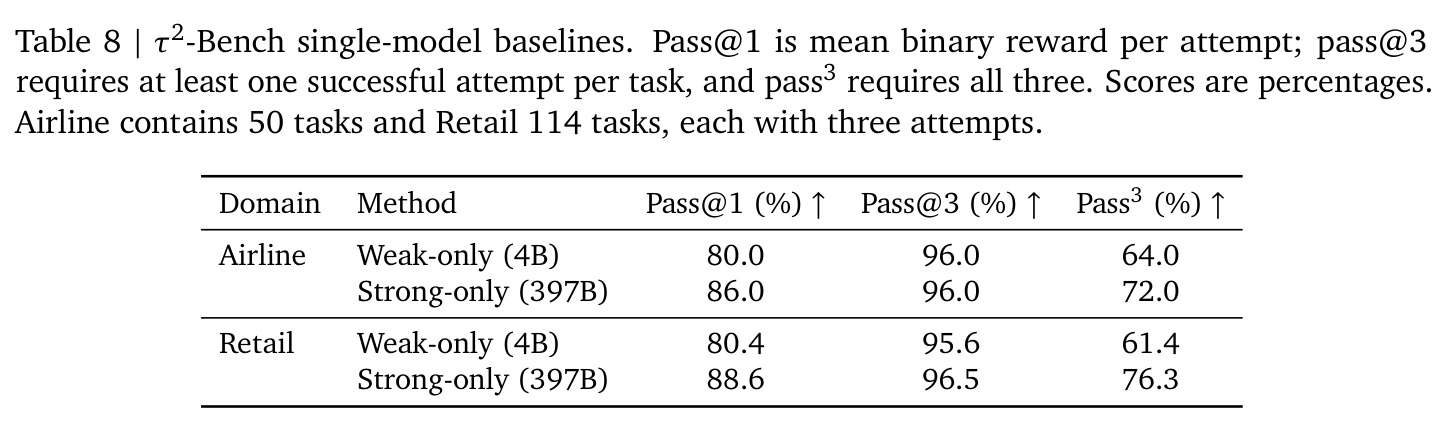
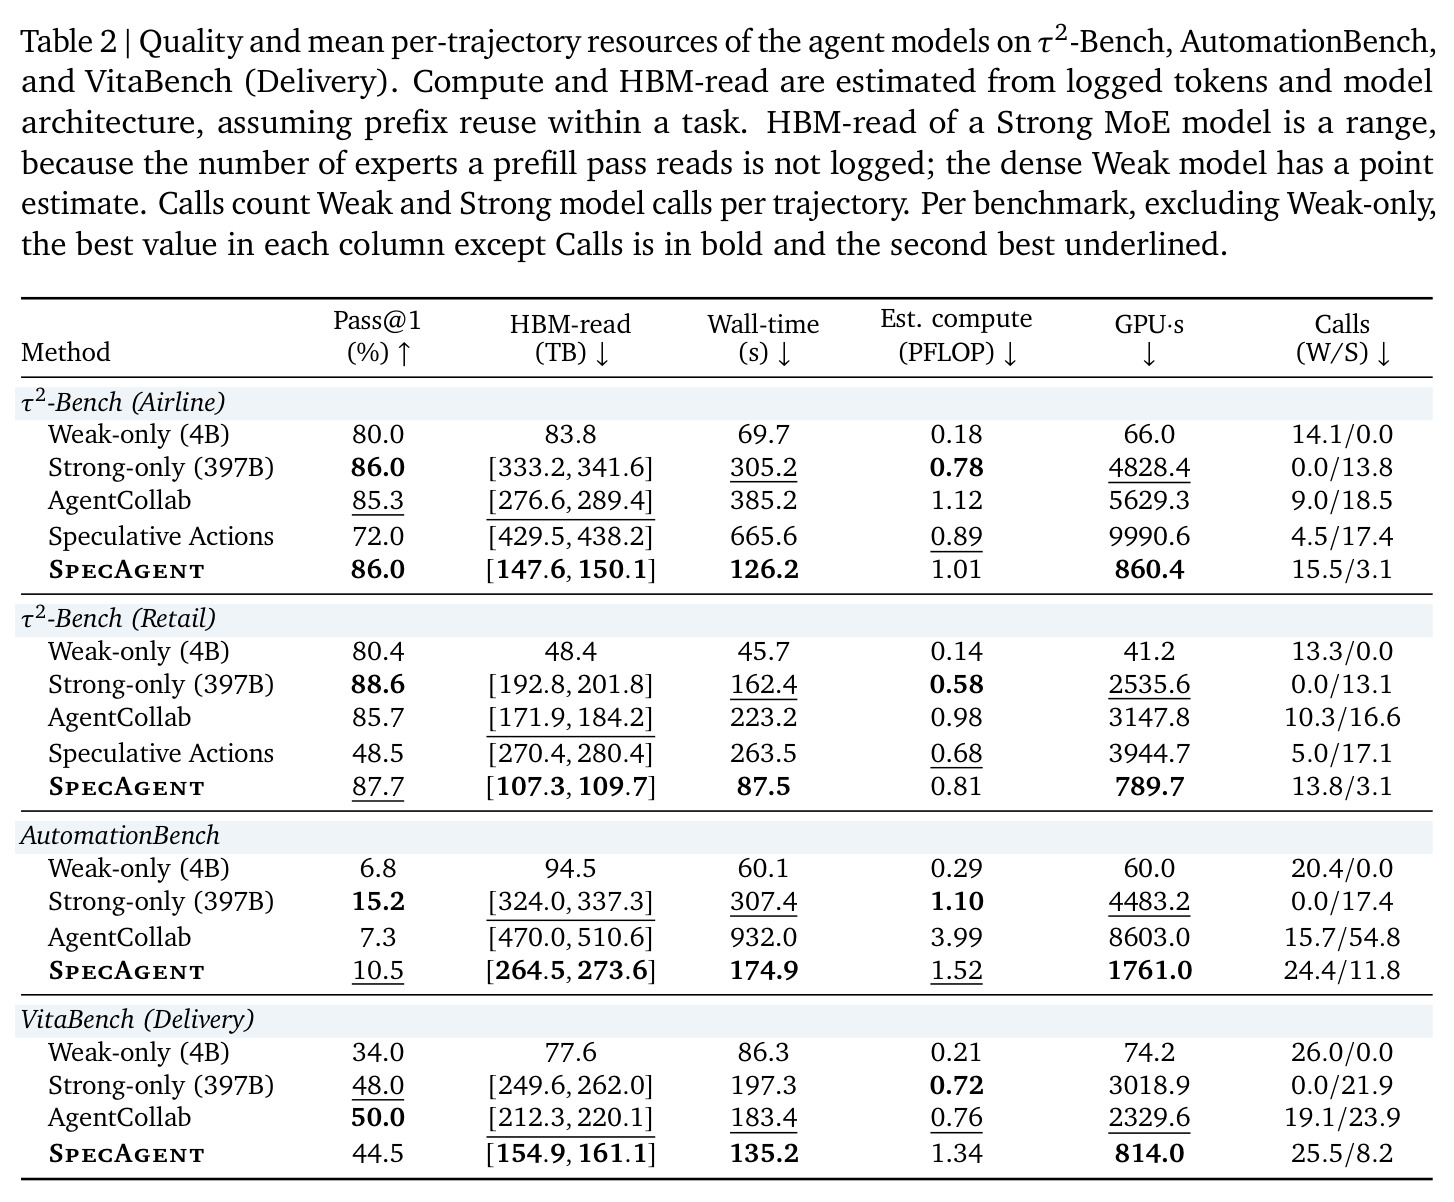
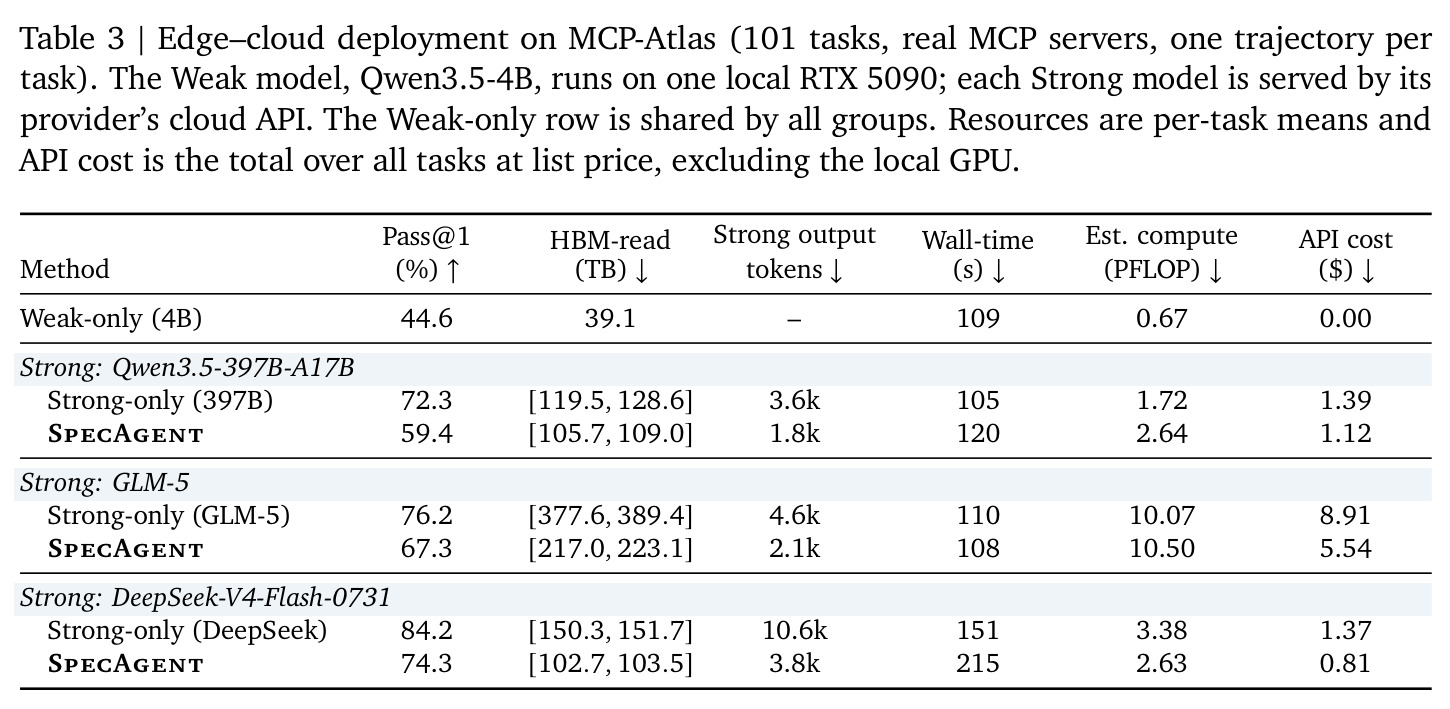
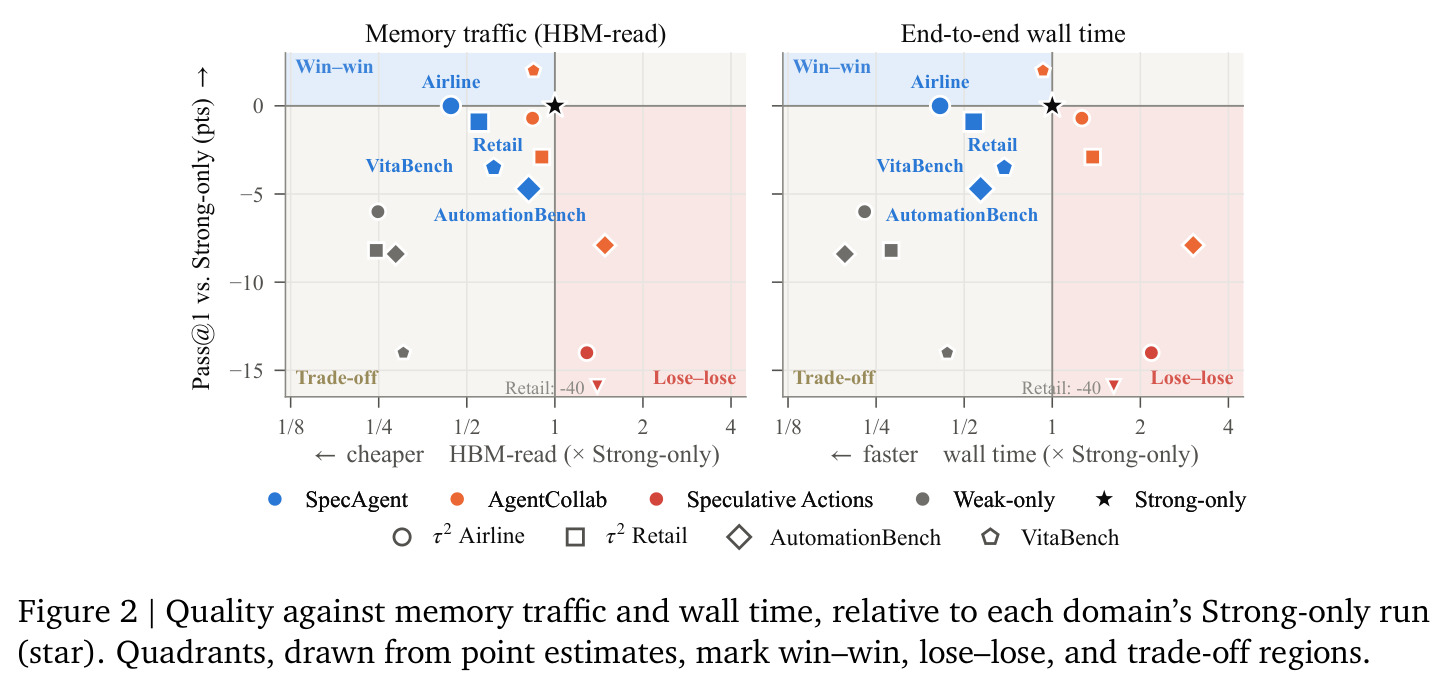
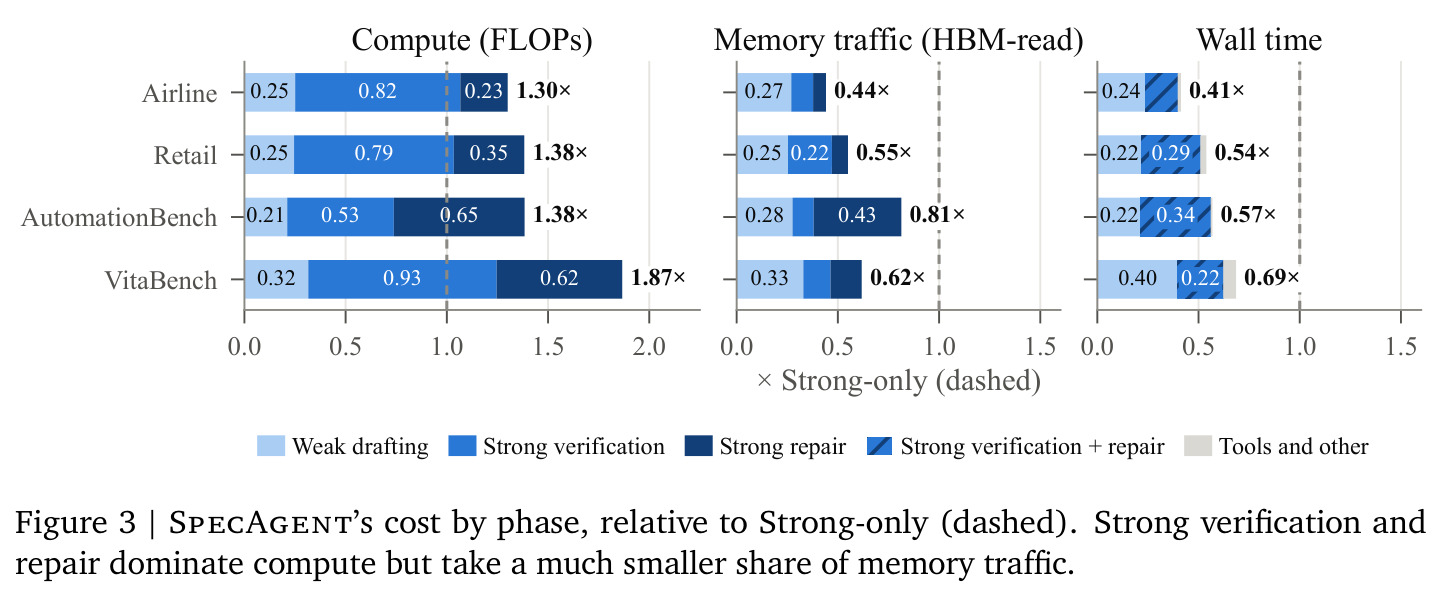
核心结论是'质量近乎无损、强模型解码大幅削减'。τ²-Bench Airline(50 任务×3 轨迹):SpecAgent 86.0%,追平 Strong-only 86.0%(Weak-only 80.0,AgentCollab 85.3,Speculative Actions 仅 72.0),HBM-read 从 [333.2, 341.6] TB 降至 [147.6, 150.1] TB(43-45%),墙钟 305.2s→126.2s(41%),强模型调用 13.8→3.1 次;配对自助法给出与 Strong-only 差 0.0 点(95% CI [−5.3, +5.3])。Retail(114 任务):87.7% 对 88.6%,收回 89% 差距(Weak-only 80.4),墙钟 162.4s→87.5s。AutomationBench(600 任务):10.5%,介于 Weak-only 6.8 与 Strong-only 15.2 之间,收回 44% 差距,墙钟 307.4s→174.9s,但 HBM 只降到 78-84%,因拒绝率高、独立修复多(每次约 $1.5\bar{d}$ token)。VitaBench Delivery(100 任务):44.5%,收回 75% 差距(Strong-only 48.0),墙钟降至 69%,AgentCollab 虽 50.0 但耗 1.4× 资源。边云 MCP-Atlas(101 任务,弱模型跑本地 RTX 5090):对 Qwen3.5-397B、GLM-5、DeepSeek-V4-Flash 分别达 59.4/67.3/74.3(Strong-only 72.3/76.2/84.2),收回 53-75% 差距,云端输出 token 降至 36-50%,API 费用 $1.39→$1.12、$8.91→$5.54、$1.37→$0.81;每 1 个强模型 token 在协议内买到的质量高于其单独工作。代价是估计 FLOPs 上升 30-87%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| τ²-Bench Airline(多轮客服,50 任务×3 轨迹) | Pass@1 (%) + HBM-read + 墙钟时间 | 86.0%,[147.6, 150.1] TB,126.2s,强模型调用 3.1 次 | Strong-only 86.0% / [333.2, 341.6] TB / 305.2s / 13.8 次;Weak-only 80.0%;AgentCollab 85.3%;Speculative Actions 72.0% | 追平 Strong-only 质量同时流量降至 43-45%、时间降至 41%;比 AgentCollab 省 1.6-1.9× 流量与约 3× 时间 |
| τ²-Bench Retail(多轮客服,114 任务×3 轨迹) | Pass@1 (%) | 87.7%,墙钟 87.5s | Strong-only 88.6% / 162.4s;Weak-only 80.4%;AgentCollab 85.7% | 收回弱强差距的 89%(差 0.9 点,95% CI [−4.7, +2.9]),墙钟降至 54%,HBM 降至 53-57% |
| AutomationBench(长业务工作流,600 公开任务) | Pass@1 (%) | 10.5%,墙钟 174.9s,强模型调用 11.8 次 | Strong-only 15.2% / 307.4s;Weak-only 6.8%;AgentCollab 7.3%(HBM 1.5×、时间 3.0× Strong-only) | 收回 44% 差距,墙钟降至 57%、HBM 降至 78-84%;因弱模型弱、拒绝率高,收益小于其他基准 |
| VitaBench Delivery(生活服务,100 任务×2 轨迹) | Pass@1 (%) | 44.5%,墙钟 135.2s,强模型调用 8.2 次 | Strong-only 48.0% / 197.3s;Weak-only 34.0%;AgentCollab 50.0%(但资源为 SpecAgent 的 1.4×) | 收回 75% 差距,HBM 降至 59-65%、时间降至 69%;约 77% 审查边界被拒但裁决与修复合计仍省 |
| MCP-Atlas 边云部署(真实 MCP 服务器,101 任务) | Pass@1 (%) / 强模型输出 token / API 费用 | 对 Qwen3.5-397B / GLM-5 / DeepSeek-V4-Flash 分别 59.4 / 67.3 / 74.3%,token 1.8k / 2.1k / 3.8k,费用 $1.12 / $5.54 / $0.81 | Strong-only 分别 72.3 / 76.2 / 84.2%,token 3.6k / 4.6k / 10.6k,费用 $1.39 / $8.91 / $1.37;Weak-only 44.6% | 收回 53-75% 差距,强模型输出 token 降至 36-50%,API 费用降至 59-81%;边云下墙钟时间无优势(120-215s 对 105-151s) |
局限与改进
作者坦承并可被观察到的局限如下。第一,计算不降反升:估计 FLOPs 在 τ² 与 AutomationBench 上升 30-38%、VitaBench 上升 87%,原因是验证与修复提示模板互不共享前缀(VitaBench 每任务约 28.4k 不可缓存 token,Strong-only 仅 12.5k),因此收益只存在于显存带宽受限的解码场景;Assumption 1 要求解码 batch 低于算力—带宽平衡点(H20 上约 37 条序列),大批量服务下节省将消失。第二,边云部署中墙钟时间不降反升或持平(120-215s 对 Strong-only 的 105-151s),因为本地弱模型每步耗时与云端强模型相当,Proposition 2 的时延项 $\kappa$ 失去优势。第三,收益强依赖弱模型能力:AutomationBench 上 Weak-only 仅 6.8%,拒绝率升高、每次拒绝需独立修复,差距收回率降到 44%;质量上限始终跟随所选强模型(59.4/67.3/74.3 对应 72.3/76.2/84.2)。第四,评估主要依赖模拟用户与 LLM 评委(τ²、VitaBench),读写分类依赖适配器规则;分析用的任务子集样本量小(Airline 18 个、Retail 44 个任务),结论统计功效有限。
独立分析的弱点
独立分析出以下弱点。其一,验证器就是强模型本身,最贵的模型仍要通读全部上下文做预填充;若先由一个训练过的校准评论家(结合过程奖励模型)初筛,强模型介入可进一步减少。其二,语义接受标准完全靠提示词约束,没有从数据中学习接受边界——VitaBench 上 77% 的审查边界被拒说明弱模型与验证器偏好严重不匹配,用历史轨迹微调弱模型或训练接受率预测器可直接提升 $p_u$。其三,读写分类依赖适配器的静态规则,遇到'只读操作有副作用'(触发缓存、计费、限流)或'写操作可安全撤销'的工具语义会误判,需要工具副作用的形式化标注或在线学习,这对安全至关重要。其四,块大小 $K$ 固定(6 或 8),未按任务难度或弱模型置信度自适应:低难度任务可以整段放行、高难度任务应缩小块并提前请审。其五,草稿在第一个写动作即停,多个相互独立的写操作或无依赖的读写本可更激进地并行起草、批量裁决。其六,墙钟评估统一 8 任务并发,真实生产负载(几十上百并发)下 MoE 强模型的调度行为可能不同,结论外推需谨慎。
未来方向
作者明确指出的方向:更强的弱模型起草器(引 Xu et al., 2026)与更校准的验证器可把接受率 $p_u$ 的提升直接转化为更多显存与时延节省,协议本身无需任何改动。基于本文成果还可延伸:其一,把裁决与修复提示设计成共享前缀模板或让验证器复用 KV 缓存,压掉 30-87% 的 FLOPs 增量,使方法在 compute-bound 场景也成立;其二,训练专用中小型验证器(如 8-30B)做第一道语义审查,强模型只在争议处出场,形成弱模型—小验证器—强模型三级投机链;其三,自适应块大小与动态验证时机,用弱模型 token 熵或自置信度决定何时提前请审;其四,推广到多智能体与并行工具调用场景,包括对多个暂存写的批量裁决;其五,在大 batch、PD 分离等 compute-bound 服务架构下重新推导成本模型,研究投机与连续批处理的相互作用;其六,让弱模型在草稿阶段自我纠错(测试时搜索或轻量 RL),降低修复项 $\rho(1-p_u)$;其七,把不可逆动作按风险分级,高风险写要求更强验证或多票裁决,向生产安全靠拢。
复现评估
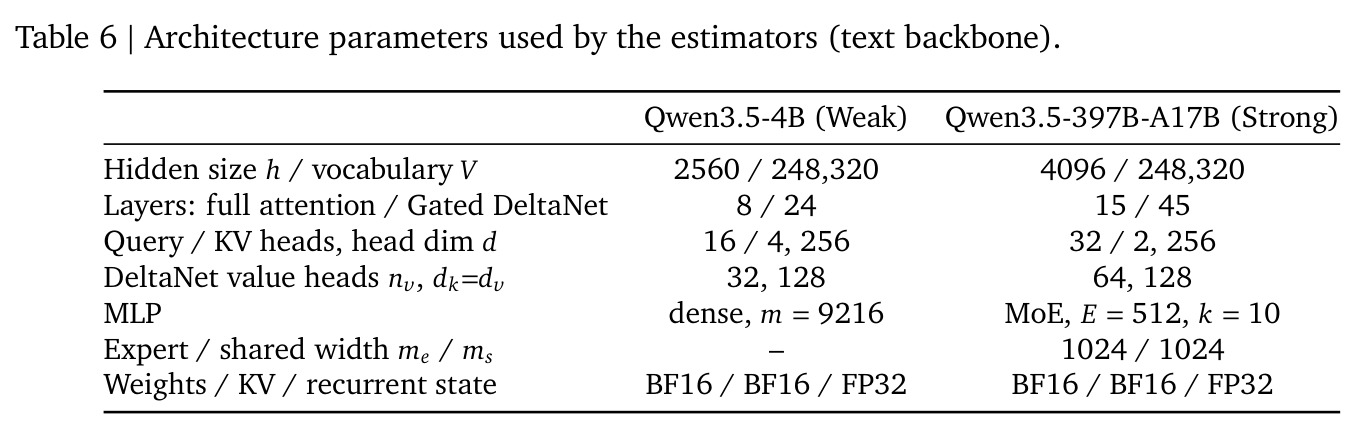
复现条件中等偏上。有利因素:代码已在 GitHub 开源(LARK-AI-Lab/SpecAgent),所用基准全部公开——τ²-Bench Airline 50 / Retail 114 任务、AutomationBench 600 个公开任务、VitaBench Delivery 100 任务、MCP-Atlas 101 个无需私有 API key 的任务;全部提示词与适配器设置在附录 D,用户模拟器与解码设置在附录 A,成本估算方法与命题证明在附录 B/C,便于核算与核对。硬件门槛较高:主实验的强模型 Qwen3.5-397B-A17B 需要 16 路张量并行(H20),弱模型 4B 单卡即可;边云复现还需 Qwen、GLM、DeepSeek 三家云 API 按量付费(论文中每组 101 任务总费用 $0.81-$5.54)。主要不确定性:墙钟时间对并发度敏感(所有方法统一 8 任务并发),复现需保持相同负载;MoE 强模型的 HBM-read 因专家路由未被记录只能给区间估计;τ² 与 VitaBench 依赖用户模拟器和 LLM 评委,存在随机性,建议按论文设置跑 3 条/2 条轨迹取均值,并做配对自助法检验。
论文图表