心跳思考:实时语音智能体在聆听过程中的推测性推理与工具执行 Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
用周期性心跳在用户说话时并行推理与调用工具,语音一结束就能快速作答
前置知识
实时语音智能体(Realtime Voice Agent)
由流式 ASR(语音转文本)、LLM 推理、外部工具执行和 TTS 组成的对话系统:用户边说系统边听,VAD 判断说完之后再作答。传统级联流水线(如 Pipecat、LiveKit)把推理和工具调用全部安排在语音结束之后,造成用户说完话后的明显等待。
本文要解决的延迟问题就发生在这种流水线里,理解其先听完再干活的时序是理解一切改进的前提。
推测执行(Speculative Execution)
在用户请求尚未说完时,基于部分转写提前启动推理或工具调用的策略。类比 CPU 分支预测:赌早期信息足以确定意图,赌对了计算被提前完成,赌错了丢弃或修正重来。SHANKS、Stream RAG、SIA 都是这类方法的代表。
Heartbeat 本质是一种推测执行调度策略,理解提前算与赌错代价的权衡是读懂动机和指标设计的关键。
SHANKS 与 Window Thinking
SHANKS 是边听边想的代表方法:每收到一个语音块就暂停,让模型推理并可能发出工具调用再继续。它把每次生成限定在一个语音块窗口内,参数较长的工具调用可能在 JSON 中途被截断而无法派发。本文以 Window Thinking 作为 SHANKS 风格的主要对照基线。
论文所有核心实验都拿 Window Thinking 对比,清楚它的截断缺陷才能看懂 Heartbeat 的覆盖率和延迟优势从何而来。
VAD 与语音端点检测
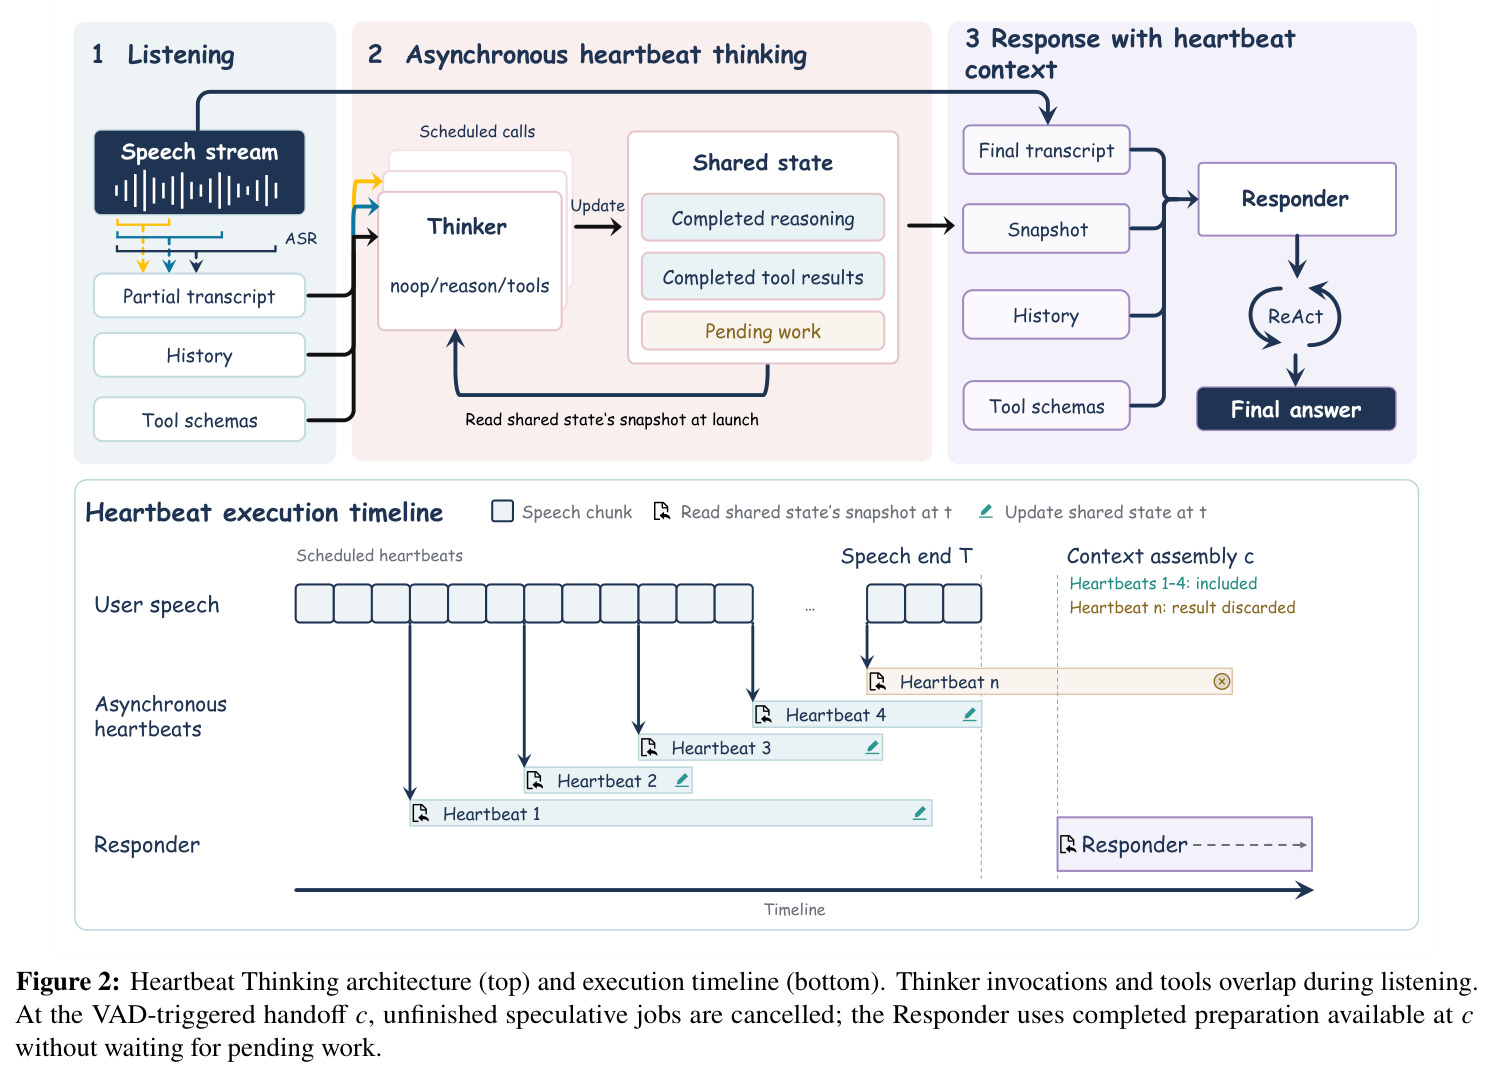
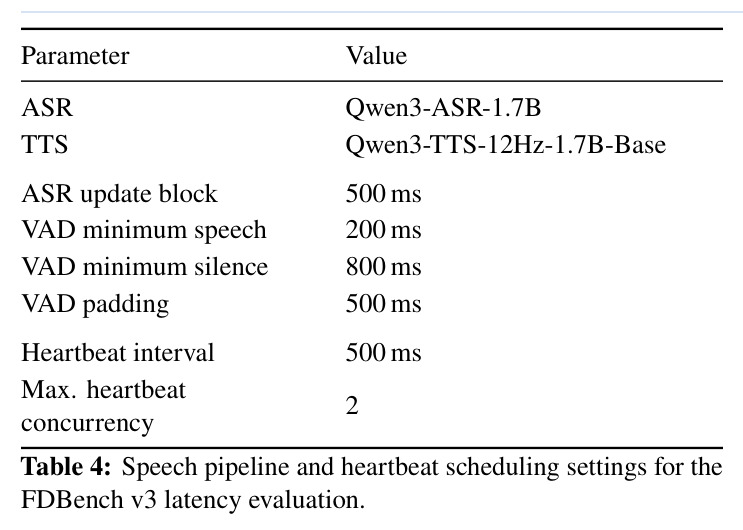
Voice Activity Detection,从音频流中判断说话开始与结束。本文配置为最短语音 200ms、最短静音 800ms、padding 500ms。VAD 触发的语音结束时刻 $c$ 是 Heartbeat 中取消未完成推测任务、组装 Responder 上下文快照的分界点。
语音结束时刻决定了哪些推测工作能保留进快照 $R_c$,是理解方法可用性边界(availability boundary)的核心变量。
推测工具覆盖率(STC)
Speculative Tool Coverage:参考工具调用中被已完成的匹配推测调用覆盖、且结果进入 Responder 上下文而 Responder 未重复调用的比例。匹配要求工具名与完整参数一致,Responder 重复同参调用会从覆盖中扣除。AudioCRAG 上 STC 改为衡量复用已完成检索结果、无需额外检索的样本比例。
STC 是本文主要指标,同时衡量提前完成了多少与最终真的省掉了多少,不看懂它就无法解读主结果表。
ReAct 推理模式
Reasoning + Acting 的迭代范式:模型交替产生思考步骤和工具调用,观察工具返回结果后继续推理,直至给出最终答案。本文 Responder 用 ReAct 流程核对推测准备、补发缺失调用并生成最终回答。
Responder 端如何复用或重做推测结果完全建立在 ReAct 流程之上,方法步骤与 prompt 设计都依赖这一背景。
研究动机
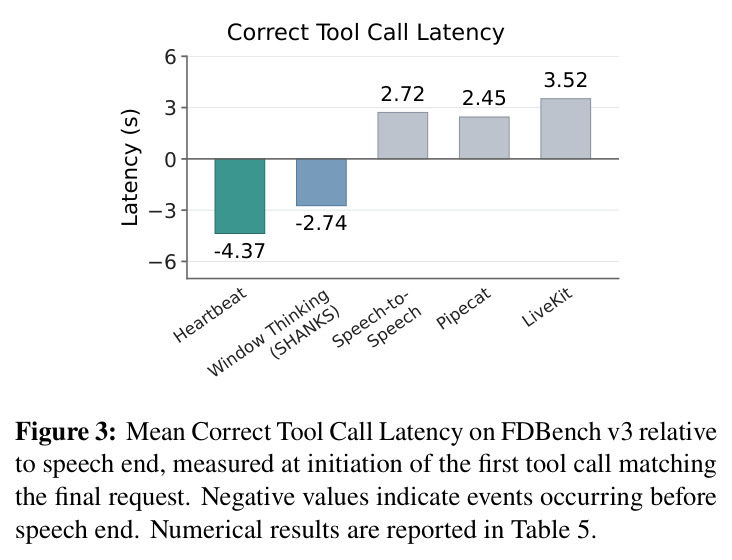
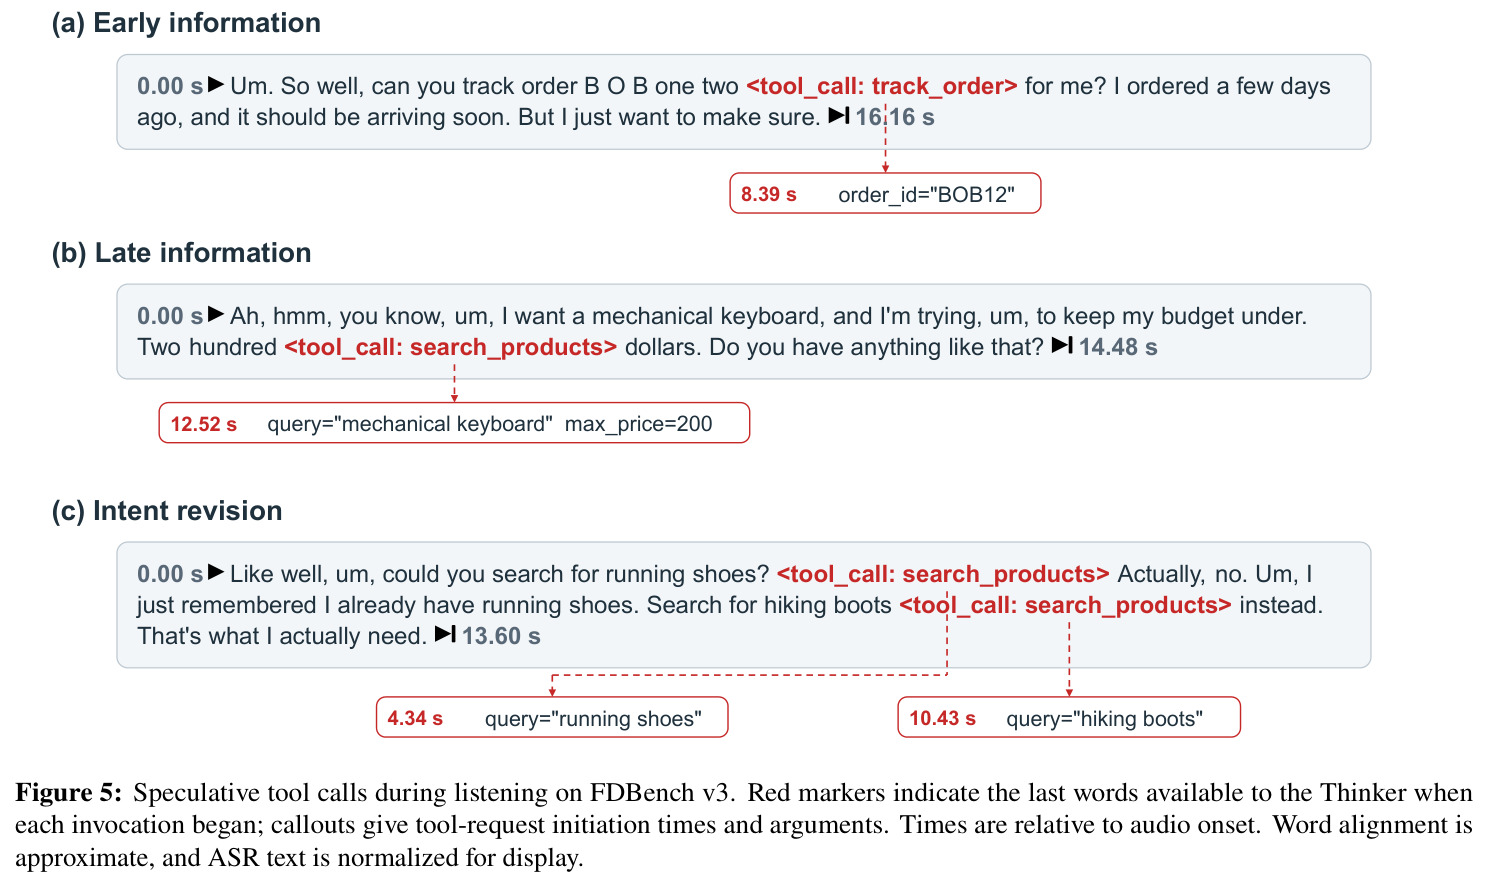
工具增强的语音智能体长期存在说完还要等的问题:级联流水线把推理和工具调用全部排在语音结束之后。例如用户说帮我查订单 BOB12,订单号早在句中就已出现,但 Speech-to-Speech、Pipecat、LiveKit 等基线仍要等语音结束后 2.45 至 3.52 秒才发起正确的工具调用。已有推测方法试图提前干活,却把计算时长与语音更新强耦合:SHANKS 用语音块限定每次生成,长参数的工具调用可能在 JSON 中途被截断;SIA 采用新事件即中断的策略,调用可能在发出前就被打断。ASR 每 500ms 更新一次部分转写,频繁更新意味着没有足够的不被打断的时间来形成一次完整调用,而早期完成的搜索结果还可能因用户后补预算等约束而失效。结果是用户说完话后可复用的准备工作非常有限,最终响应延迟居高不下。
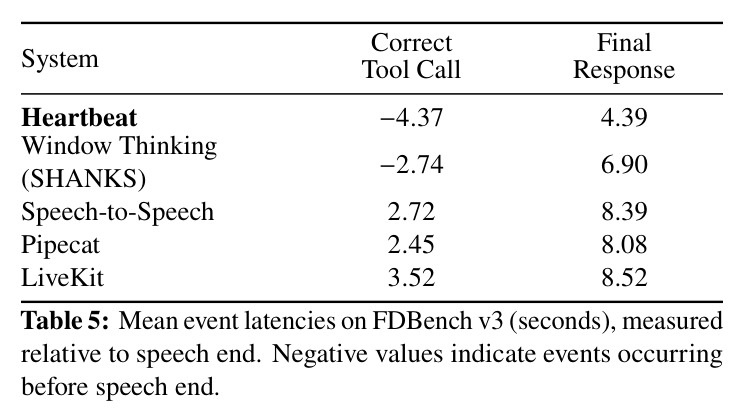
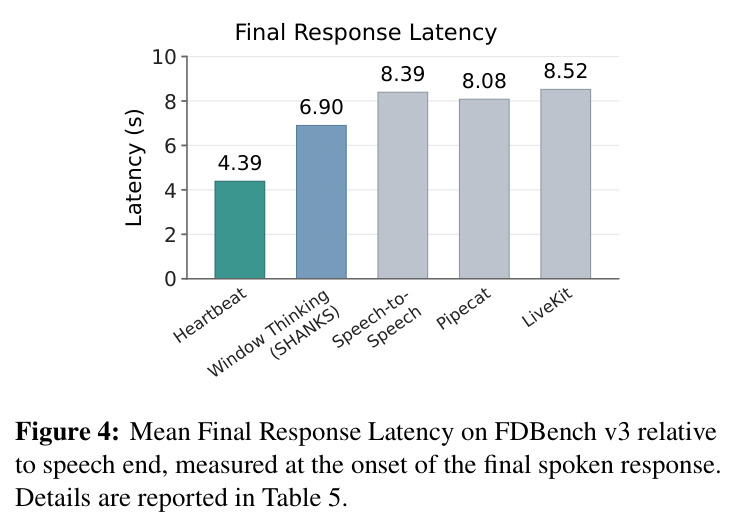
本文的目标是本文的目标是把聆听时间变成可复用的准备工作:在用户还在说话时就开始推理和工具调用,且允许计算跨语音更新持续完成,而不是每次输入更新就掐断重来。具体要做到三点:一是早期调用(如先查订单)在后续语音补充约束(如加预算)时不拖垮整体进度,新一轮 Thinker 可以基于已完成结果发起修正或依赖调用;二是语音结束时刻 Responder 能直接继承所有已完成的推理记录和工具结果,只补做剩余工作;三是 Thinker 与 Responder 可选用不同模型,分别针对勤快推测与可靠收尾优化。量化目标是在 SpeechFCEval、FDBench v3、AudioCRAG 三个基准上提高推测工具覆盖率或检索复用率,并在 FDBench v3 上把语音结束后的最终响应延迟从 6.90 秒压缩到 4.39 秒。
与已有工作不同的是,现有推测方法的共同点是让输入更新成为计算的死线:SHANKS 把生成限制在块窗口内,SIA 在新事件到来时中断生成,Stream RAG 会终止上一个查询未完成的检索。Heartbeat 的独特切入是彻底解耦——语音更新不再打断任何正在进行的调用,而是触发一个全新的 Thinker 实例;正在跑的推理和已派发的工具继续执行,结果写入共享状态供后续实例使用。第二个独特之处是共享状态不只是备忘录:已完成工具的返回值可以补全后续调用的缺失参数、触发依赖调用,即使部分转写没有新内容,准备工作也能继续推进。第三,语音结束时通过显式快照交接(只保留 $a_j \le c$ 的完成项,未完成的一律取消),Responder 无需等待即可开工,且两个角色可独立选型。这种周期实例加外部共享状态加快照交接的组合在已有工作中没有出现过。
核心方法
Heartbeat Thinking 的直觉是:与其让每次语音更新掐断计算,不如让心跳周期性派新工人,老工人的活干完算数。系统分两个角色:Thinker 在聆听期每隔 $\Delta=500$ 毫秒被调用一次(最多 $K=2$ 个并发),读取对话历史 $H$、工具 schemas $\mathcal{T}$、最新部分转写 $x_{[0,t]}$ 以及共享状态里已完成的推理记录和工具结果,输出 noop(无需动作)、纯推理或带工具请求的推理;工具异步执行,结果按 tool-call ID 回填共享状态。VAD 检测到语音结束后,调度器停止派新实例并取消所有未完成的 Thinker 和推测工具任务,Responder 拿到最终转写和快照 $R_c = \{r_j : r_j \text{ 已完成且 } a_j \le c\}$,经 ReAct 流程核对准备、复用匹配结果、补发缺失调用并生成最终回答。主实验 Thinker 用 Qwen3.6-35B-A3B、Responder 用 DeepSeek-V4-Flash,FDBench v3 上最终响应延迟从 6.90 秒降到 4.39 秒。
核心创新是不截断、不打断、可积累的准备策略。与 SHANKS 以语音块为生成边界、SIA 以输入更新为中断信号不同,Heartbeat 让每次语音更新只产生新的 Thinker 实例,旧实例和已派发工具照常跑完,计算时长与语音节奏彻底解耦。更关键的是共享状态的链式作用:先发出的调用(如查询 running shoes)完成后,后续实例读到结果即可补全参数发起修正或依赖调用(如改为 hiking boots),甚至在没有新转写时也能推进准备。已完成推理先记录、后派发工具的设计保证模型计算与工具执行天然重叠。可用性边界也定义得很干净:只有完成时间 $a_j$ 早于上下文组装时刻 $c$ 的结果才进 Responder 快照 $R_c$,之后返回的一律丢弃,Responder 不等待任何 pending 工作,从而把提前完成真实地转化为响应延迟的节省。
方法步骤详情
第一步,流式 ASR(Qwen3-ASR-1.7B,500ms 更新块)持续产出累积部分转写。第二步,每 500ms 心跳触发调度:若活跃实例少于 $K=2$ 就启动新 Thinker,输入为 $H$、$\mathcal{T}$、最新部分转写、此前实例的推理记录及已返回的工具结果,prompt 禁止重复发起与 pending 或已完成调用同名同参的请求。第三步,Thinker 输出严格 JSON:noop、纯 think、或带 tools 数组的 think;推理记录先写入共享状态,随后工具异步派发(派发不限并发,由执行后端排队),结果返回后按 tool-call ID 挂到对应请求上。第四步,后续实例读到新结果即可补全缺失参数、发起依赖调用,即使转写无变化也能推进。第五步,VAD(最短静音 800ms)触发语音结束:停止新实例、取消未完成的 Thinker 与推测工具(含排队项),按 $R_c = \{r_j : r_j \text{ 完成且 } a_j \le c\}$ 组装快照。第六步,Responder 以 ReAct 流程核对准备与完整请求,拒绝被后续语音推翻的解读,复用名称与参数都匹配的已完成调用,缺的自己补做,最终经 TTS 输出回答。
技术新颖性
从相关工作的接口维度看新颖性:LiveMind 存储前缀推理、PredGen 起草候选回复、LTS-VoiceAgent 维护思考状态,都属于单模型内部的准备,缺少跨实例的工具结果链接;SHANKS 用块边界交换推理与调用但承受截断风险;Stream RAG 平行检索但会终止旧查询的未完成调用;SIA 用中断管理新事件;AsyncLM 与 AsyncReasoning 把协调做在模型 token 流或注意力状态内部,绑死了模型选型。Heartbeat 的技术新颖性有三点:一是以周期实例加并发上限加跳过而非排队的调度,把推测计算做成可重叠的独立单元;二是共享状态成为跨实例的推理与工具结果存储,使依赖调用和参数补全成为可能;三是 Thinker 与 Responder 通过显式文本记录交接而非共享模型内部状态,因此可以独立选模型(实验覆盖 DeepSeek-V4-Flash、Qwen3.5-397B-A17B、Qwen3.8-Flash-Next 三个 Responder),为工程落地和模块化优化提供了此前方法不具备的自由度。
实验结果
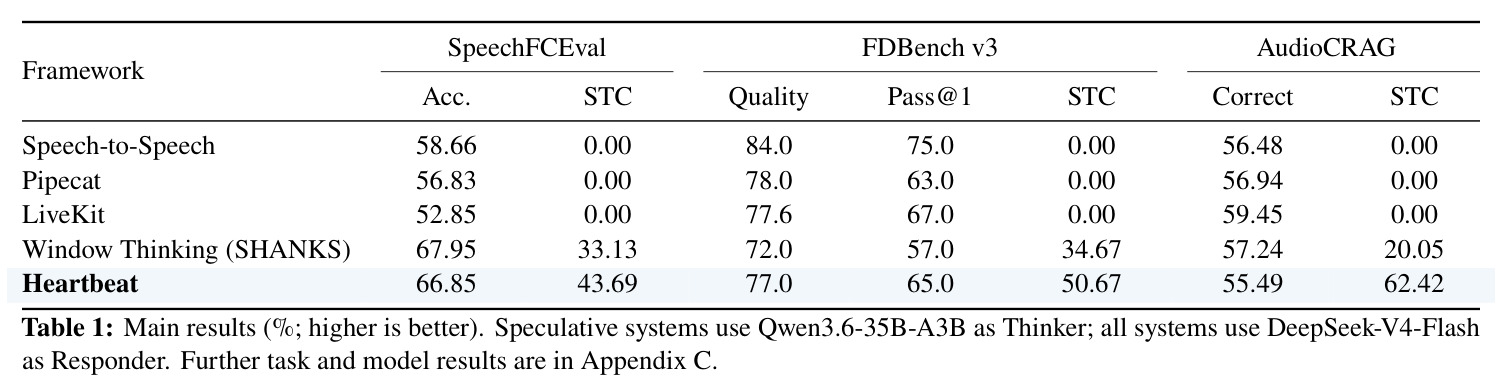
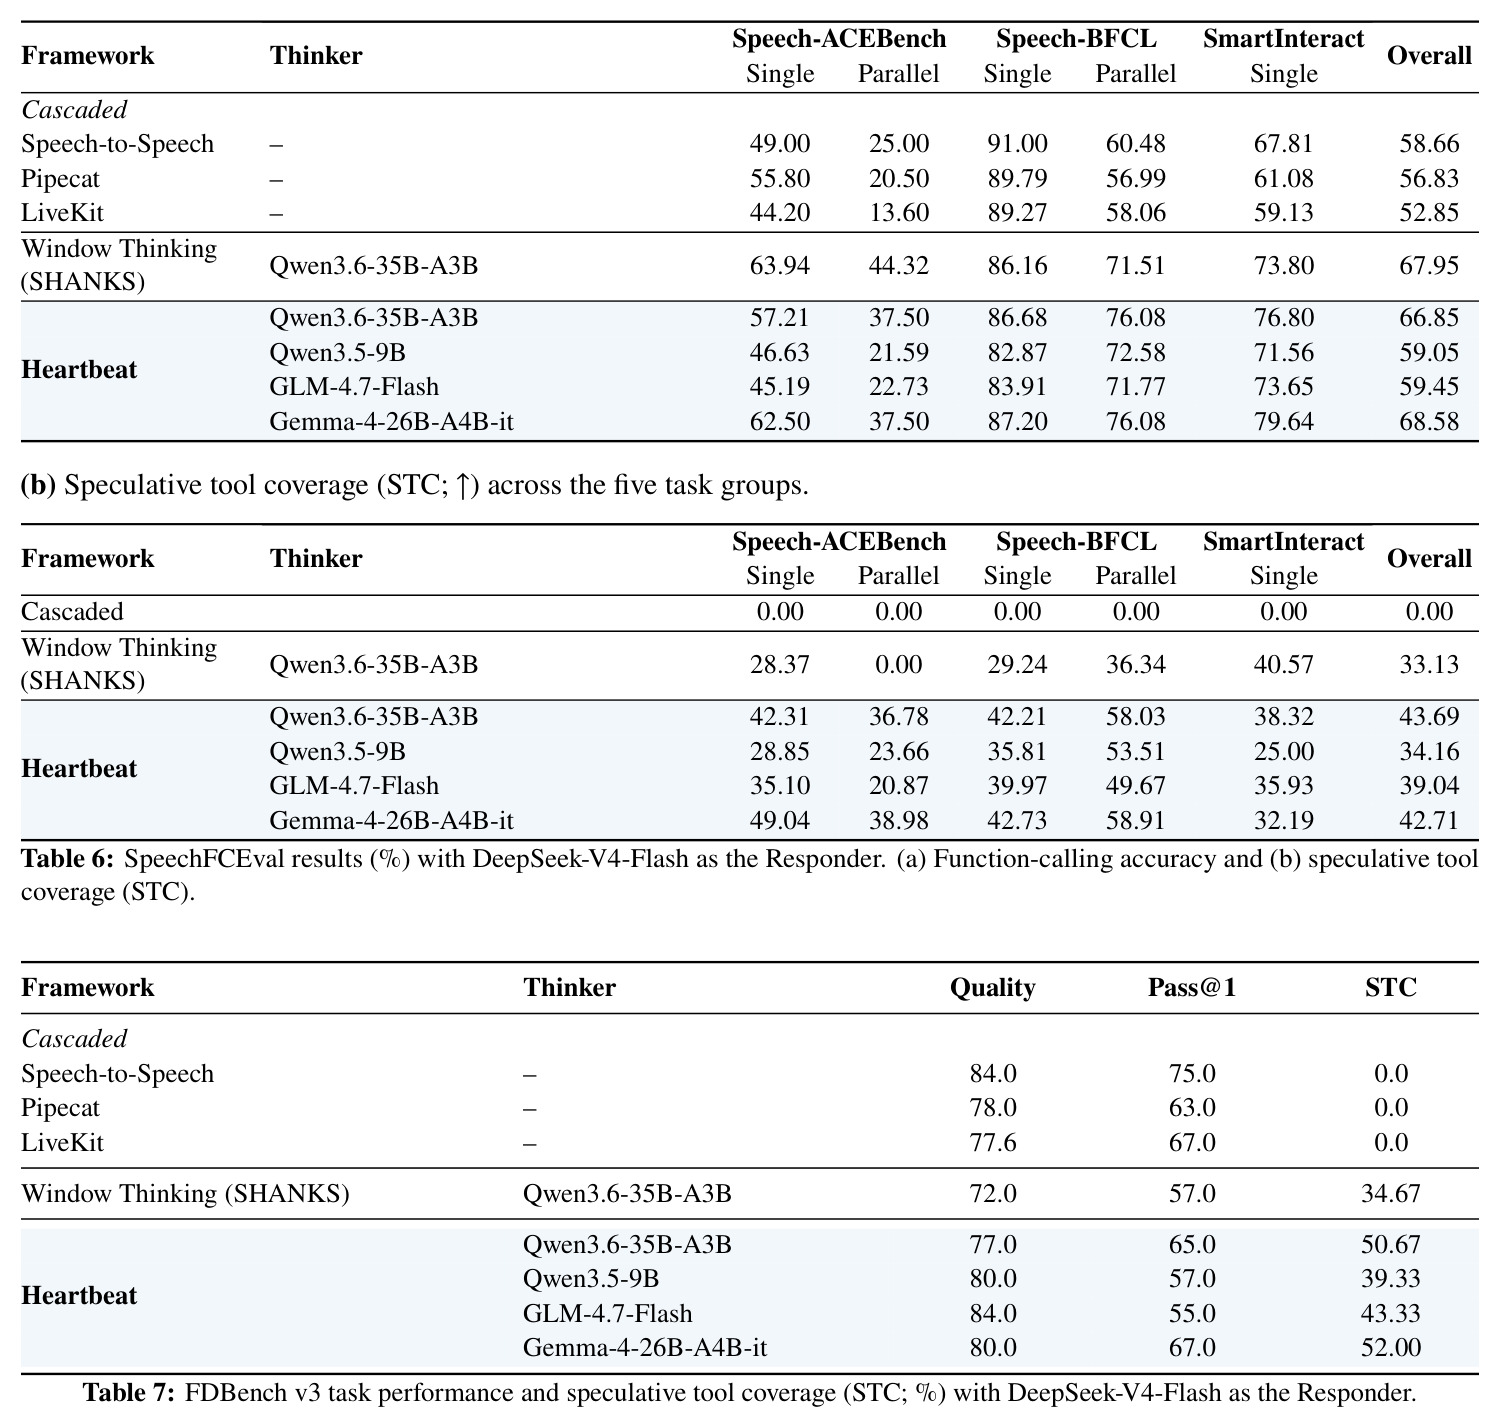
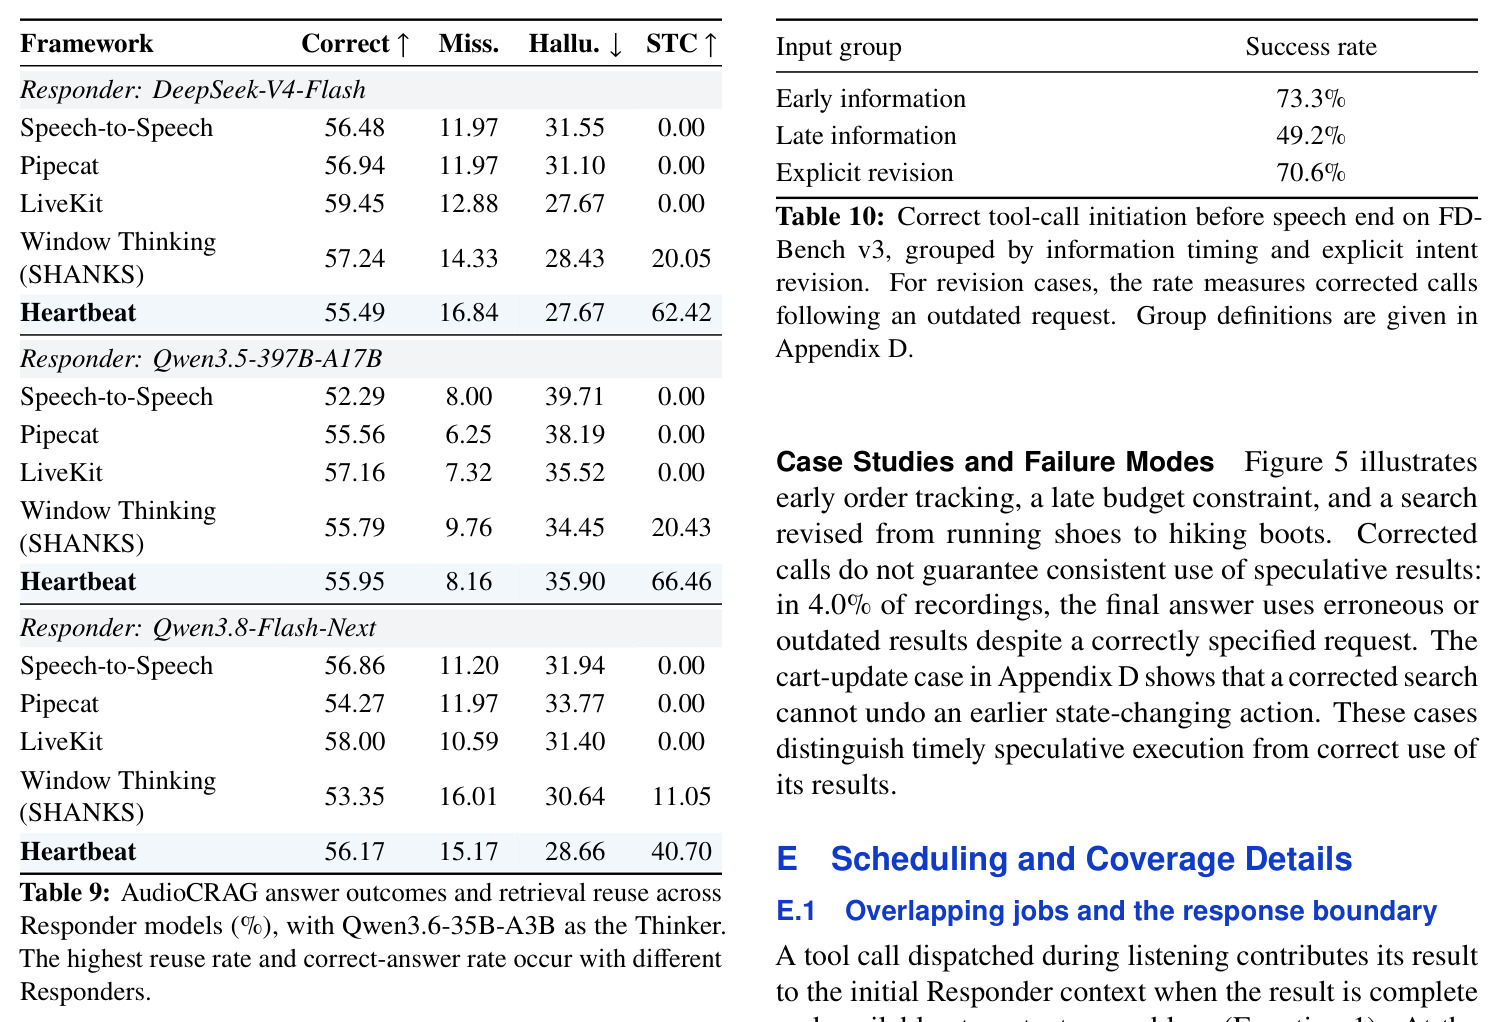
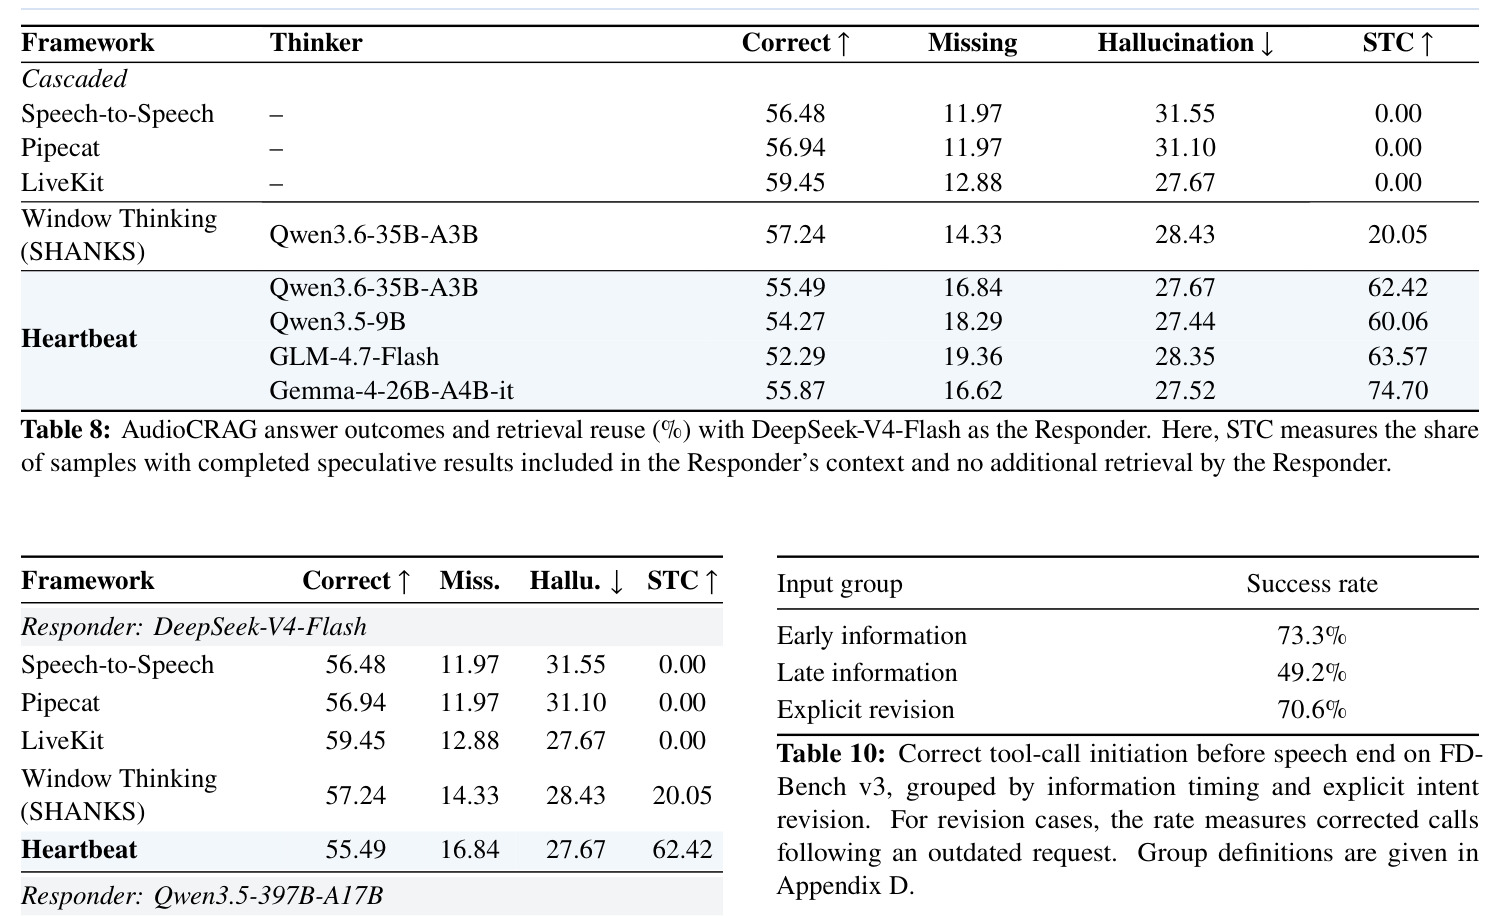
主配置(Thinker Qwen3.6-35B-A3B、Responder DeepSeek-V4-Flash)下:SpeechFCEval 的 STC 从 33.13% 升到 43.69%(+10.56pp),但准确率 66.85% 略低于 Window 的 67.95%;五个任务组中四个覆盖率上升(Speech-BFCL 并行调用 36.34% 升至 58.03%),SmartInteract 反而降至 38.32%。FDBench v3 质量与速度双升:Quality 72.0% 升至 77.0%,Pass@1 57.0% 升至 65.0%,STC 升至 50.67%(+16pp),最终响应延迟 6.90 秒降至 4.39 秒(-36.4%),比最快的级联基线 Pipecat(8.08 秒)低 45.7%;首个正确工具调用在语音结束前 4.37 秒发起(Window 为 -2.74 秒,级联为结束后 2.45 至 3.52 秒)。AudioCRAG 的 STC 从 20.05% 暴涨到 62.42%(+42.37pp),但正确率微降至 55.49%,漏答率升至 16.84%。消融显示 STC 优势在三个 Responder 上全部保持(如 Qwen3.8-Flash-Next 下 55.27% 对 44.05%),但高 STC 不保证高分。信息时机分析:早期信息组正确调用提前发起率 73.3%,晚期信息组仅 49.2%,显式改口组 70.6% 能在语音结束前发出修正调用;另有 4.0% 的录音参数完全正确却把错误或过时结果写进答案。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SpeechFCEval 函数调用 | STC 推测工具覆盖率 | 43.69% | Window Thinking (SHANKS) 33.13% | +10.56 个百分点 |
| SpeechFCEval 函数调用 | 整体准确率 | 66.85% | Window Thinking (SHANKS) 67.95% | -1.10 个百分点(略降,但两者均高于级联基线) |
| FDBench v3 口语意图跟随 | Quality / Pass@1 | 77.0% / 65.0% | Window Thinking (SHANKS) 72.0% / 57.0% | +5.0 / +8.0 个百分点 |
| FDBench v3 口语意图跟随 | STC | 50.67% | Window Thinking (SHANKS) 34.67% | +16.00 个百分点 |
| FDBench v3 最终响应延迟 | 语音结束至最终回答起始(秒) | 4.39 秒 | Window Thinking 6.90 秒;Pipecat 8.08 秒 | 较 Window 降低 36.4%,较 Pipecat 降低 45.7% |
| AudioCRAG 知识型口语问答 | STC(检索复用率) | 62.42% | Window Thinking (SHANKS) 20.05% | +42.37 个百分点 |
| AudioCRAG 知识型口语问答 | 正确率 | 55.49% | Window Thinking (SHANKS) 57.24% | -1.75 个百分点(略降),漏答率升至 16.84% |
局限与改进
作者承认且数据支持的局限:第一,保留更多推测结果不等于任务质量更好——SpeechFCEval 准确率 66.85% 低于 Window 的 67.95%,AudioCRAG 正确率 55.49% 低于 57.24%,FDBench 的 Pass@1(65.0%)仍低于 Speech-to-Speech(75.0%)和 LiveKit(67.0%),说明解读和正确使用推测结果是未解决的独立难题。第二,4.0% 的 FDBench 录音在调用参数完全正确时答案仍用错结果:用户预算 $50 尚未说完,系统已把 $99.99 咖啡机加入购物车,之后检索到 $40 商品,回答宣称加了便宜货却报出 $99.99 的购物车总额——修正后的搜索无法撤销已执行的状态变更动作。第三,固定 500ms 间隔与 $K=2$ 并发是手工设置,缺少基于转写变化或工具完成的自适应调度;快照在时刻 $c$ 定格,之后返回的长时工具结果全部丢弃。第四,延迟分析只在 FDBench v3 上进行。我的补充观察:STC 无法区分有用覆盖与冗余覆盖;Thinker 每次心跳都读历史与共享状态,推理开销随心跳次数线性增长,论文未报告 token 成本。
独立分析的弱点
独立分析四个弱点。其一,推测的状态变更动作存在不可逆风险:购物车案例表明参数正确的早期调用(加入购物车)在用户改口后无法靠再发一次正确调用来修复,这类场景应引入两阶段提交、软删除或补偿动作机制,而不是盲目提前执行写操作。其二,固定心跳造成冗余推理:用户停顿或长工具执行期间心跳仍在消耗 GPU,Thinker 可能产出 noop 或近似重复的推理,论文自己也承认未探索自适应调度,改进方向是把转写增量、工具完成事件或意图稳定性用作触发条件。其三,快照边界过于刚性:在 $c$ 之后完成的结果一律丢弃,对执行时间方差大的工具(如深度检索)极不友好,可改为 Responder 运行中增量注入晚到结果,或对 pending 调用设置短时宽限窗口。其四,评测主要依赖 LLM-as-judge 和转写文本,缺少真实用户端到端研究;且 STC 奖励 Responder 不重复调用,可能诱导系统保留低质量结果进而伤害答案质量(AudioCRAG 漏答率升至 16.84% 或与此相关),指标设计本身值得商榷。
未来方向
作者提出的方向包括:基于部分转写变化或工具调用完成事件的自适应心跳调度,减少无新信息时的冗余推理;把组装时刻 $c$ 之后返回的工具结果增量投递给 Responder,尤其针对执行时间不可预测的工具;把延迟分析扩展到 FDBench v3 之外的更多工具负载,刻画覆盖率、推理成本与响应延迟的三方权衡。基于其成果可自然延伸的方向:一是可撤销推测,为状态变更类工具设计补偿事务或延迟提交窗口,把 4.0% 的参数对但结果用错的失败类别压下去;二是训练专门的推测 Thinker,而非依赖 prompt 约束(四款通用模型的 STC 波动很大,AudioCRAG 上 Gemma 达 74.70% 而 Qwen3.5-9B 仅 60.06%);三是把推测准备延伸到回复草稿与首句音频(结合 PredGen、LTS-VoiceAgent 思路),实现语音结束即开口;四是用意图稳定性估计动态调整 $\Delta$ 与 $K$,在早期信息组(发起率 73.3%)激进、晚期信息组(49.2%)保守。
复现评估
复现难度中等偏高,但信息披露充分。数据全部公开:SpeechFCEval(Apache-2.0,HuggingFace FunAudioLLM,1914 样本)、FDBench v3(CC BY-NC 4.0,100 条录音、79 场景、12 名说话人)、AudioCRAG(1312 样本,源自 CRAG)。模型组合明确:Thinker 为 Qwen3.6-35B-A3B(消融含 Qwen3.5-9B、GLM-4.7-Flash、Gemma-4-26B-A4B-it),Responder 为 DeepSeek-V4-Flash 0731 版(消融含 Qwen3.5-397B-A17B、Qwen3.8-Flash-Next),ASR 用 Qwen3-ASR-1.7B、TTS 用 Qwen3-TTS-12Hz-1.7B-Base,判分用 DeepSeek-V4-Flash 最大推理档,全部实验在 NVIDIA H200 上完成。Appendix G 给出完整的 Thinker 与 Responder prompt 模板和共享上下文格式,Appendix A 至 E 描述调度、快照公式与计时协议。未提及开源代码,调度器、异步工具队列、VAD 交接等工程组件需自行实现;单卡跑 35B 级 Thinker 可小规模复现延迟趋势,但多模型消融算力门槛不低。
论文图表
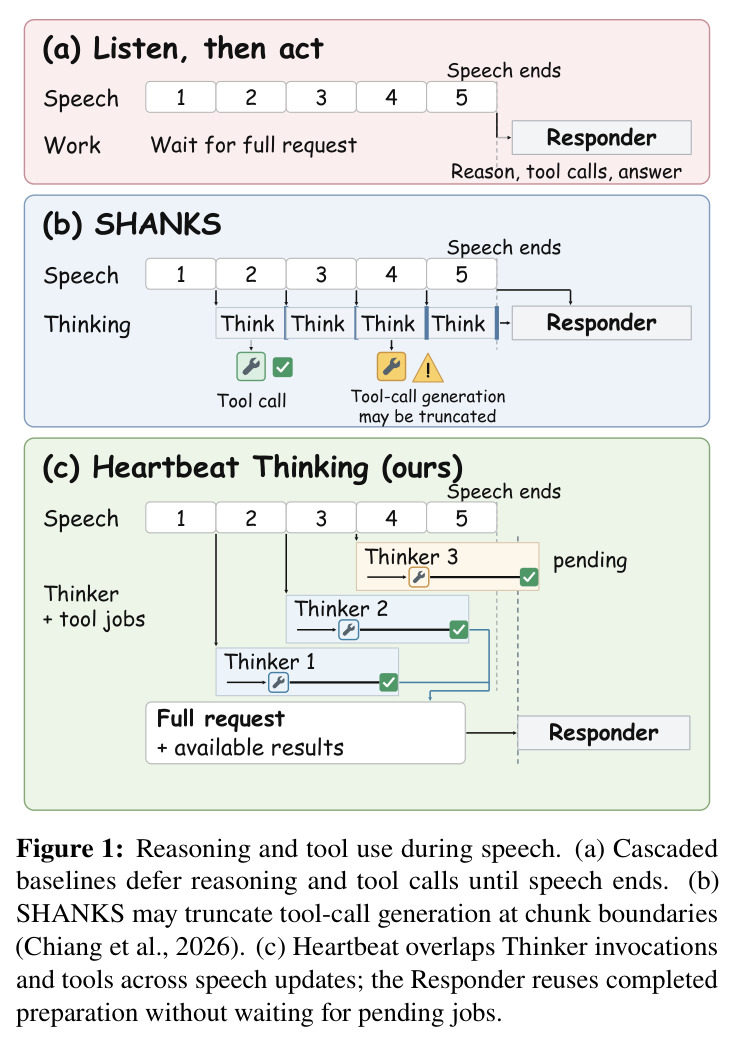
三栏对比图:(a) 级联基线在整个语音期间等待,语音结束后 Responder 才开始推理、调用工具和作答;(b) SHANKS 在每个语音块之间穿插思考,但工具调用生成可能在块边界被截断;(c) Heartbeat Thinking 中 Thinker 1/2/3 与工具任务跨语音更新重叠执行,语音结束时 Responder 基于完整请求和已完成结果直接开工,不等待 pending 工作。
一张图讲清三类范式(先听完再干、块窗口推测、心跳并行推测)的本质差异,是论文的核心故事线,也是 Figure 2 架构图的铺垫。
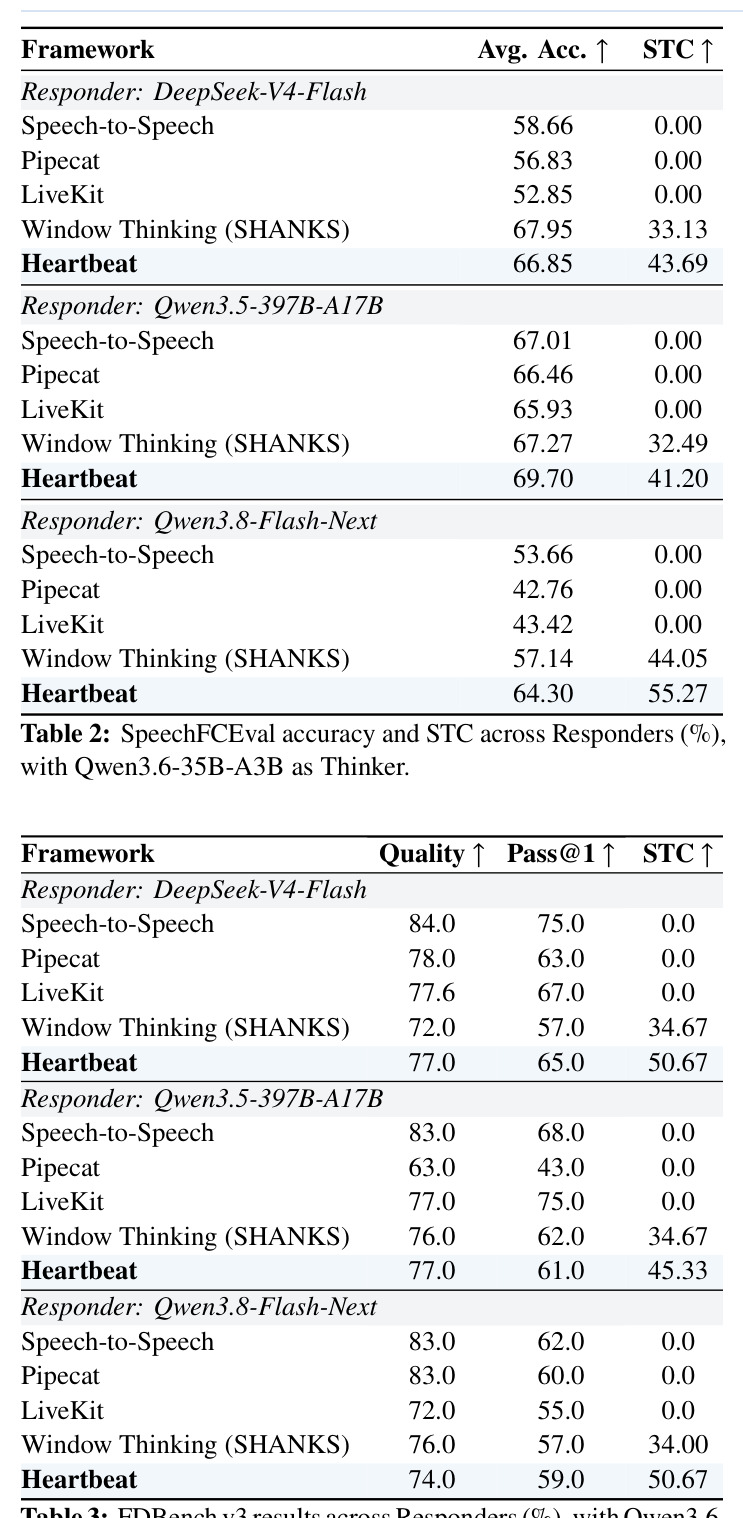
FDBench v3 上更换 Responder 的结果:DeepSeek-V4-Flash 下 Heartbeat Quality/Pass@1/STC 为 77.0/65.0/50.67,优于 Window 的 72.0/57.0/34.67;Qwen3.5-397B-A17B 下 STC 45.33 对 34.67 但 Pass@1 略降(61.0 对 62.0);Qwen3.8-Flash-Next 下 STC 50.67 对 34.00,Quality 略降(74.0 对 76.0)。
展示 FDBench 上质量提升并不在所有 Responder 下都成立,帮助读者准确界定结论的适用范围。
SpeechFCEval 五个任务组上更换四种 Thinker 的准确率与 STC:默认 Qwen3.6-35B-A3B 达到总体准确率 66.85%、STC 43.69%;Gemma-4-26B-A4B-it 准确率最高(68.58%)但 STC 略低(42.71%);Speech-BFCL 并行调用组的覆盖率从 Window 的 36.34% 升至 58.03%,而 SmartInteract 组从 40.57% 降至 38.32%。
展示 Thinker 选型对推测质量的影响以及各组覆盖率的细分变化,提示周期触发并非对所有任务类型都有利。
AudioCRAG 上四种 Thinker 的正确率、漏答、幻觉与 STC:Heartbeat 默认配置正确率 55.49、漏答 16.84、幻觉 27.67、STC 62.42;Gemma 的 STC 高达 74.70,但所有 Heartbeat 配置的正确率(52.29 至 55.87)大多低于 Window 的 57.24,漏答率也普遍更高。
这是检索复用率暴涨而答案质量不升反降的最强证据,直接支撑论文关于解读推测结果是独立难题的核心论断。