投机监听:先于音频到达的分块交错全双工语音模型解码加速 Decode Before You Hear: Speculative Listening for Chunk-Interleaved Full-Duplex Speech Language Models
利用分块间静音空闲预解码下一块,音频到达时一次前向验证,提速2.6-2.8倍、工具调用最高23.4倍
前置知识
分块交错全双工语音语言模型(chunk-interleaved full-duplex SLM)
让模型边听边说的端到端语音对话架构。它把流式对话切成固定时长的时间块(本文四个模型均为 1 秒),把每个块新到的音频 token、模型自己的语音/文本输出以及工具调用拼进同一条因果序列处理。每个块内第一个输出 token 决定模型继续倾听、开始说话还是调用工具,其余 token 承载内容(供声码器合成语音或构成结构化工具调用)。块的固定时长是一条硬截止期:一个块解码超时就会推迟后续所有块,使对话落后于真实时间。
整篇论文的问题定义、指标(post-audio latency、deadline miss)和方法设计都建立在这个架构的时间块结构上,不理解分块与截止期就无法理解为什么可以和值得预解码。
投机解码(speculative decoding)
一种无损加速大模型推理的技术:用一个廉价的起草方(小模型、额外解码头或模型自身浅层)先猜出若干候选 token,再让目标模型用一次前向传播同时验证整段草稿,接受前缀直到第一个不一致处并由目标模型修正。当草稿正确时,一次前向可提交多个 token,而这次前向的耗时与解码单个 token 几乎相同(推理瓶颈是显存带宽而非算力),从而成倍缩短延迟。代表工作包括 Leviathan et al. 的原始方法、Medusa、EAGLE、Draft & Verify。
本文是投机解码在全双工语音模型上的变体,但把起草时机从'输入到达后'挪到'输入到达前',必须先懂标准投机解码的起草—验证范式才能看出这一挪动的意义。
KV cache 与 prefill/decode 两阶段
Transformer 推理把已处理 token 的注意力键值缓存下来避免重复计算。prefill 指一次性吞入一整段输入 token 并产生每位token的下一词分布,decode 指逐 token 自回归生成、每次前向只进一个新 token。关键事实是:prefill 一段短序列的耗时与解码单个 token 相当(两者都受权重和 KV cache 的显存带宽限制),因此'预填充音频+验证草稿'可以合并在同一次前向里几乎免费完成。
本文方法的成本模型完全基于这一事实:验证草稿搭了音频 prefill 的'顺风车',这正是后音频延迟几乎不随输出长度增长的技术根源。
无损性(lossless)与两种验证方式
无损指加速后的输出分布与原模型完全一致。贪心验证用于贪心解码:接受草稿前缀直到第一个与目标分布 argmax 不符的位置,用目标模型的 argmax 修正该位置,输出与自回归解码逐 token 相同。speculative sampling 用于随机采样:按草稿分布与目标分布的比值设计接受/拒绝概率,保证从目标分布采样。本文用前者处理贪心主实验,用后者处理温度采样实验。
论文反复强调方法 training-free 且 lossless,这是其相对 Chronological Thinking 等需要训练的方案的核心卖点,实验里的质量对比(judge 分数差异小于 0.1)也依赖这一性质。
研究动机
分块交错全双工语音语言模型(如 MiniCPM-o 4.5、Gander、Realtime-Venus、LWS)以固定时长(1 秒)的时间块为单位处理流式对话,每个块必须赶在下一段音频到达前算完,否则对话会持续落后于真实时间。作者对四个这类模型逐块剖析后发现负载严重不对称:listen 块只处理新到的音频并输出几个控制 token,计算在块时长的 70-89% 内完全闲置(作者称之为 idle window);而 speak 和工具调用块则需要串行自回归生成,每次前向传播受显存带宽限制、耗时与生成单个 token 相当,输出越长串行前向越多。后果非常具体:一个工具调用需要几十次串行前向,音频到达后要 1.8-2.6 秒才完成,实测所有被评估的工具调用都错过了 1 秒截止期;LWS 这类可在说话块同时解码文本通道的模型,在 95% 的说话块上超时。此外自回归解码还给每个响应增加 417-1089 毫秒的起始延迟,而人类对话者之间的轮次间隔只有约 200 毫秒,模型因此显得反应迟钝、答非所'时'。
本文的目标是本文的目标可以概括为:在不训练、不加参数、不改变模型输出分布(无损)的前提下,把 listen 块闲置的 idle window 变成下一个块的预计算窗口,使得音频到达后的计算量只随'真正发生变化的 token'增长而非随输出长度增长。具体可量化的目标是:说话块的后音频延迟平均提速 2.5 倍以上;几十 token 长的工具调用能在一个块时长内就绪而不是错过截止期;响应起始延迟从 417-1089 毫秒压缩到接近人类 200 毫秒的轮次间隔;同时消除或大幅减少会话中落后于实时音频的最大滞后。附带目标是为这类模型建立一个统一的、按块截止期度量的解码方法评测基准。
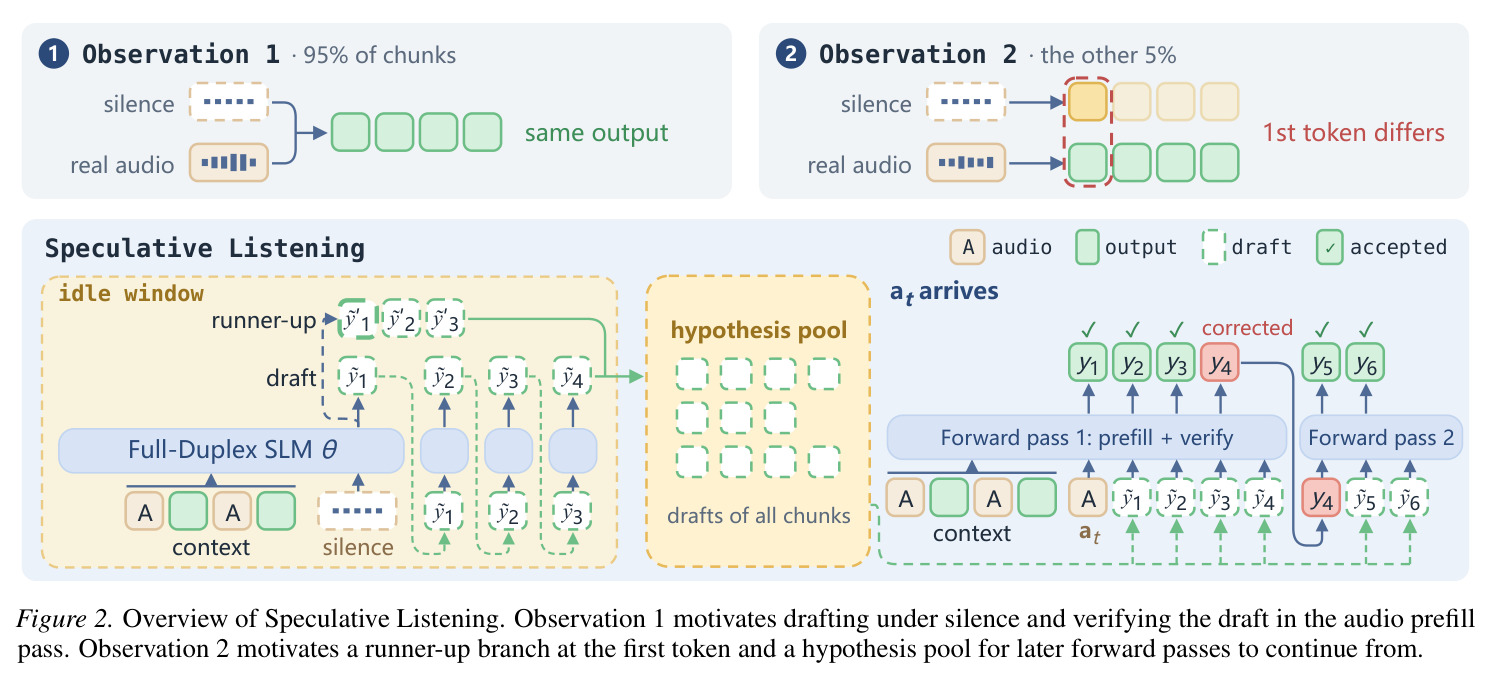
与已有工作不同的是,已有工作从相邻位置切入这个问题:经典投机解码(draft 模型、Medusa、EAGLE、Draft & Verify)在输入已就绪后加速串行生成;PLD、Token Recycling、lookahead 等免训练方法在上下文中找 n-gram 重复;语音侧的 Chronological Thinking 需要训练模型在倾听时输出推理 token,PredGen 在级联流水线中预生成候选响应,RelayS2S 用快速双工模型起草回复开头。这些方法要么需要训练、额外模型或流水线,要么都在输入可用之后才开始投机。本文抓住了一个被忽视的结构性事实:全双工分块模型的 idle window 是一段免费的预计算时间,而且'下一个块的音频'这个尚未到达的输入,在绝大多数情况下并不改变模型输出——四模型合计 95.3% 的块在静音假设下输出逐 token 一致,发生改变时又有 87.7% 集中在第一个输出 token。这两个统计性质让'用静音当输入假设提前起草、音频到达时一次性验证'成为既便宜又高命中率的方案。
核心方法
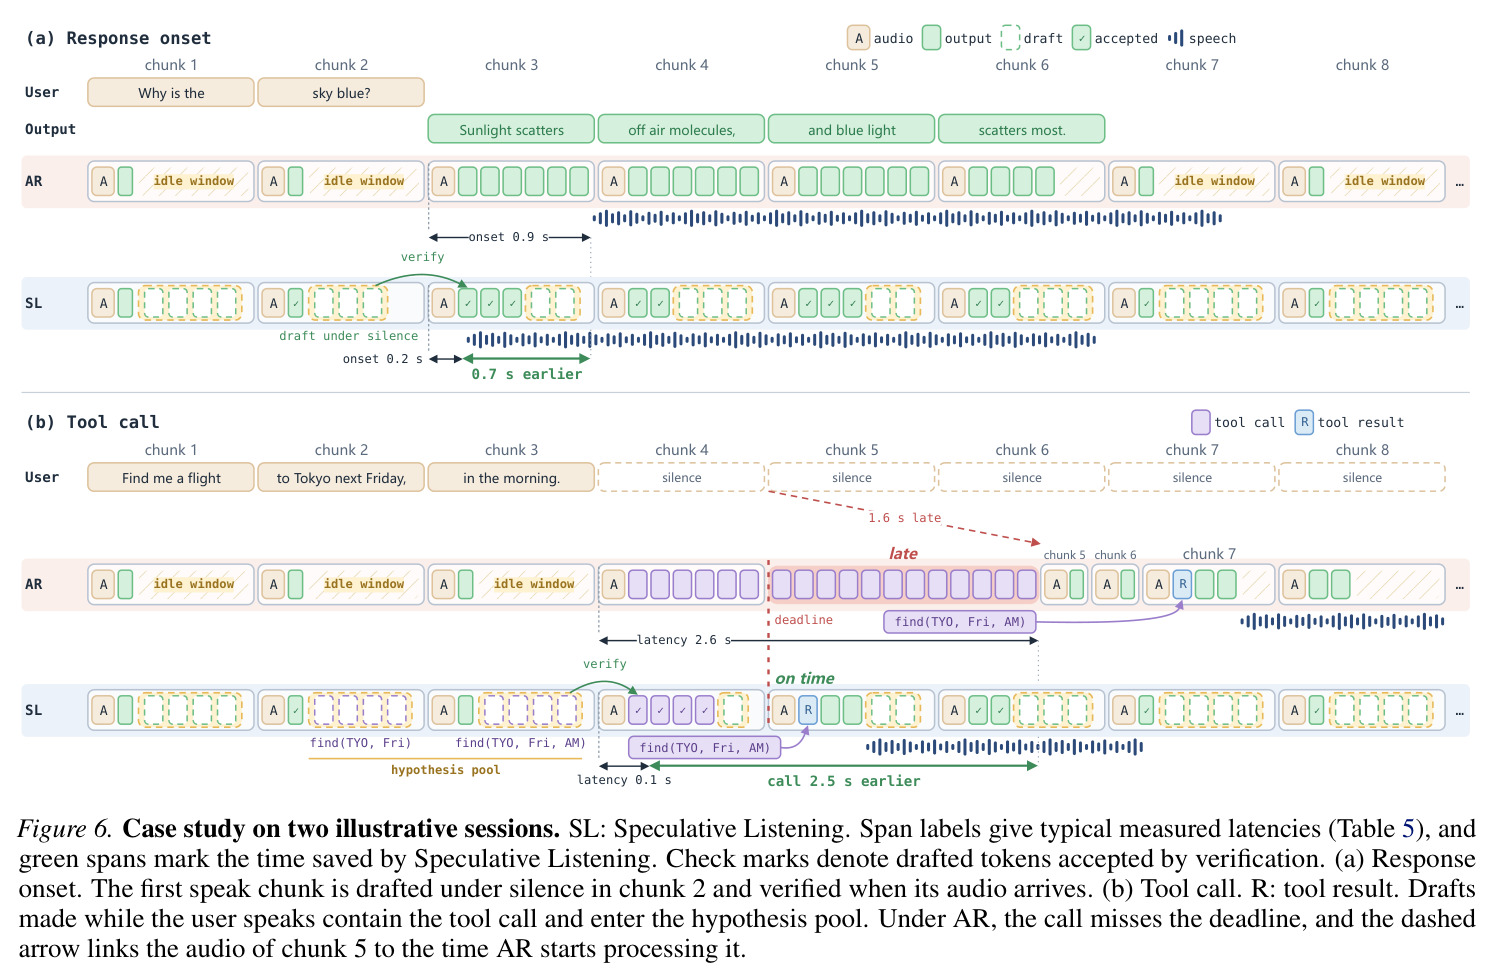
直觉上,人类说话者会在还在听的时候就开始计划自己的回应,这正是人际对话轮次间隔只有约 200 毫秒的原因;本文让模型也'边听边打草稿'。技术路线是把标准投机解码的起草阶段从'输入到达后'挪到'输入到达前':在 listen 块留下的 idle window 里,把下一个块的音频输入假设为静音(silence hypothesis),用目标模型自己(不加任何参数)在自己的 KV cache 上贪心解码出一份草稿;当真实音频到达时,回滚 KV cache,用一次前向传播同时完成音频 prefill 和整份草稿的验证,接受前缀并在第一个分歧处用目标模型的 argmax 修正。为了覆盖一个 idle window 装不下的长工具调用,方法把会话中所有历史草稿存进一个按 N-gram 索引的跨块 hypothesis pool——用户请求往往横跨多个块,早期块在用户还在说话时的草稿往往已经包含了最终工具调用的大部分内容。为了覆盖'输出改变'的情形(88% 集中在第一个 token),再从第一 token 的次优候选出发多起一条 runner-up 分支。这样音频到达后的每次前向只需处理所有草稿都没有覆盖的 token,后音频前向次数从随输出长度线性增长变成近似常数。
核心创新是把投机解码变成 input-time self-speculation:用未经修改的目标模型在一个假设的输入(静音)上、于真实输入到达之前起草。它与已有方法的本质区别有三层。第一,起草时机不同:Leviathan/Medusa/EAGLE/Draft & Verify 都在输入可用后起草,PLD/Token Recycling/lookahead 在上下文里找可复用的 n-gram(对新响应几乎无效,实测加速只有 0.96-1.23 倍),而本文的草稿是在'用户还没说完话'时就生成的。第二,验证几乎免费:音频到达后本来就要做一次 prefill 前向,把草稿拼进同一次前向即可完成验证,等于验证搭了顺风车;又因为 95.3% 的块草稿与真实输出完全一致,这条顺风车路径绝大多数时候全额命中。第三,变化处理是常数成本:Observation 2 指出 87.7% 的分歧发生在第一个 token(它决定听还是说),于是只需一条从次优第一 token 出发的备选分支加一个跨块草稿池就能兜住绝大多数变化。整个过程 training-free 且 lossless——贪心验证保证输出与自回归逐 token 相同,随机采样下用 speculative sampling 保证分布不变。
方法步骤详情
完整流程分六步。(1)起草:块 t-1 的计算一结束就进入 idle window,模型在自身 KV cache 上按 $\tilde{y}_i = \arg\max_{y \in V} p_\theta(y \mid x_{<t}, a_{\text{sil}}, \tilde{y}_{<i})$ 贪心解码,直到出现块结束 token 或窗口时间用尽,得到主草稿 $\tilde{y} = (\tilde{y}_1, \ldots, \tilde{y}_\gamma)$;起草超出窗口预算的部分会计入下一块的后音频延迟。(2)备选分支:若窗口还有剩余时间,从第一 token 的次优候选 $\arg\max_{y \in V \setminus \{\tilde{y}_1\}} p_\theta(y \mid x_{<t}, a_{\text{sil}})$ 再解码一条 runner-up 分支,覆盖'决定听还是说'这一常见分歧点。(3)入池:本块草稿连同会话中所有更早的草稿存入按 N-gram 索引的 hypothesis pool。(4)一次前向验证:真实音频 $a_t$ 到达,KV cache 回滚到 $x_{<t}$ 末尾,单次前向吞入 $(a_t, \tilde{y})$,同时完成音频 prefill 和各位点的目标分布 $p_i = p_\theta(\cdot \mid x_{<t}, a_t, \tilde{y}_{<i})$ 计算;按 $n = \min(\{i-1 \mid 1 \le i \le \gamma,\ \tilde{y}_i \neq \arg\max p_i\} \cup \{\gamma\})$ 接受前 n 个草稿 token,并提交修正 token $\arg\max p_{n+1}$。(5)池查找续写:若输出尚未结束,后续每次前向先在池中查找与已输出后缀匹配的最长 N-gram,把其延续拼进输入,于是后音频前向次数只随'所有草稿都没覆盖的 token 数'增长。(6)随机采样时改用 speculative sampling 验证,保证输出分布与自回归解码一致。整条流水线保证每次前向至少提交一个 token,后音频前向次数永不超过自回归解码。
技术新颖性
技术新颖性体现在四个方面。其一,input-time speculation 是范式级挪动:把投机解码的输入从'已到达的真实输入'换成'假设输入',这在文本投机解码文献中没有先例,与 PredGen 这类级联流水线的预生成也不同——本文没有第二条流水线,草稿和验证用的是同一个模型和同一份上下文。其二,观察驱动的系统设计:论文先做了无时间限制的 oracle 探针(每块用真实音频和静音各解码一次对比),用 95.3% 匹配率和 87.7% 首 token 分歧率这两个数字反推出 runner-up 分支和草稿池两个机制,属于'先测性质再设计机制'的少见做法。其三,跨块 hypothesis pool 利用了全双工对话特有的结构:工具调用横跨多个块、用户说话期间的静音草稿已包含调用的前缀(case study 中 chunk 2 起的草稿就含 find(TYO, Fri)),这使几十 token 的调用在真实音频到达时几乎整个已在池中,带来 23.41 倍的极端加速——文本投机解码没有这种跨请求复用结构。其四,TickTock-Bench 首次为分块全双工模型建立了以块截止期为核心度量的统一解码评测协议,类似 Spec-Bench 之于文本投机解码。
实验结果
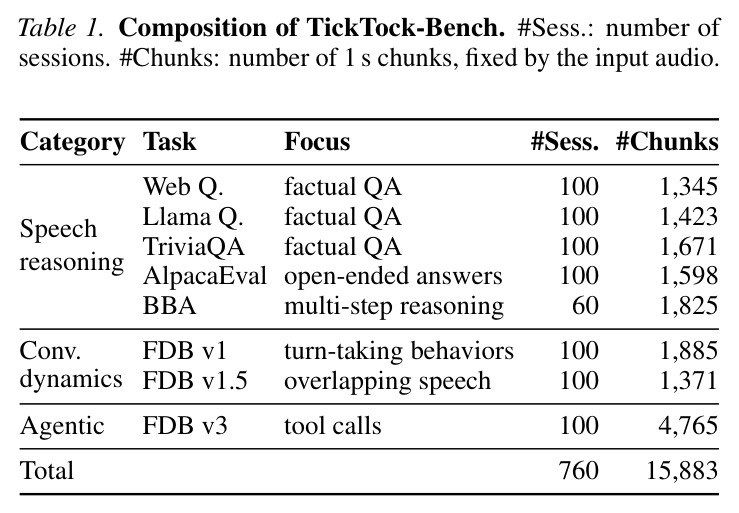
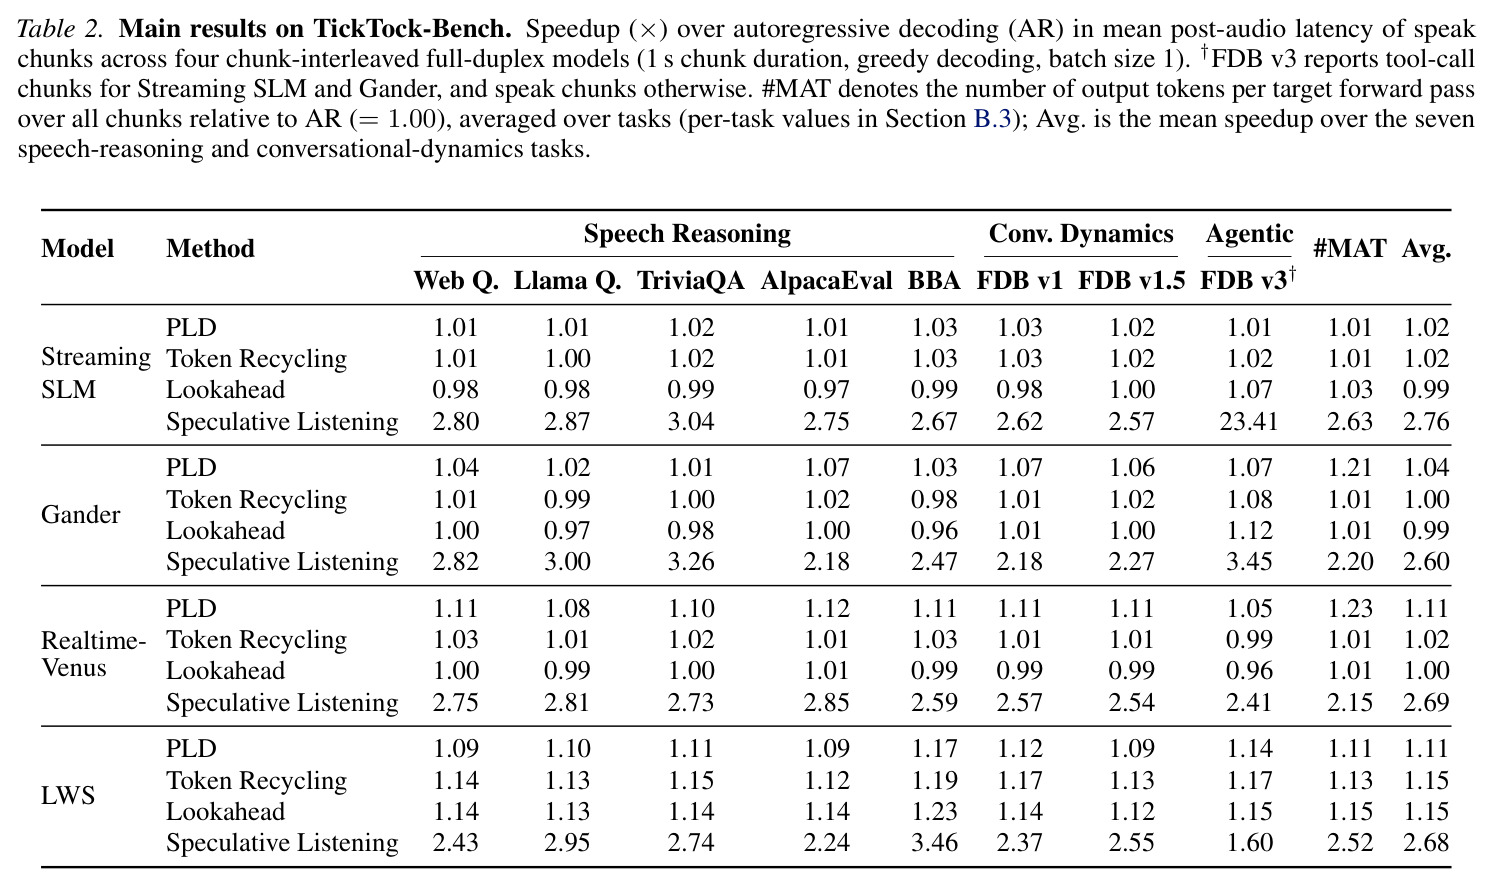
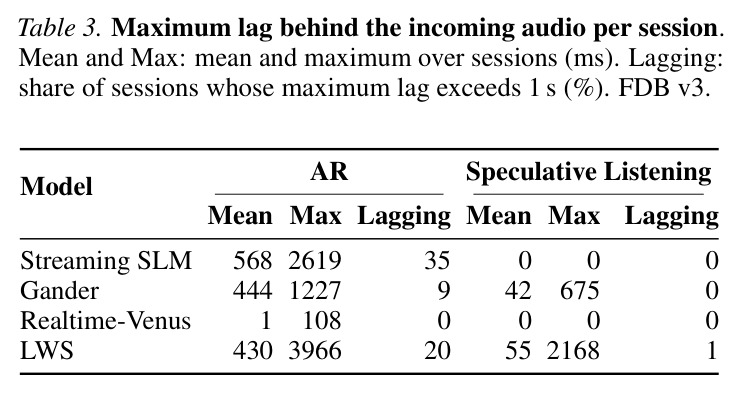
主实验在 TickTock-Bench 上进行:8 个任务、760 个会话、15,883 个 1 秒块,覆盖 Streaming SLM(自训,基于 Qwen2.5-Omni-7B Thinker)、Gander、Realtime-Venus、LWS 四个模型,单块 A100、bfloat16、贪心解码、batch size 1。发现一:说话块平均加速 2.6-2.8 倍(四模型分别为 2.76、2.60、2.69、2.68 倍),三个免训练基线 PLD/Token Recycling/lookahead 只有 0.96-1.23 倍,部分设置甚至比 AR 还慢;每目标前向提交 token 数 #MAT 本文为 2.15-2.63,基线仅 1.01-1.23。发现二:FDB v3 工具调用块上 Streaming SLM 达 23.41 倍、Gander 3.45 倍,加速随输出长度增长——说话块几 token 提速 2.6-3.0 倍,工具调用几十 token 提速 23.41 倍;深度分析显示 2-128 token 输出下本文只需 1.0-1.4 次后音频前向,AR 从 2.0 次(1 token)涨到 73.6 次(65-128 token),仅靠静音草稿也要 52.9 次。发现三:实时性大幅改善,会话最大滞后平均降低 94.4%(Streaming SLM 从平均 568ms/最大 2619ms/35% 会话超 1 秒降到全零;LWS 从 430/3966ms 降到 55/2168ms)。发现四:用户感知延迟上,响应起始延迟从 417-1089ms 降到 74-241ms(平均降 73%,已接近人类 200ms 轮次间隔),工具调用延迟从 2623ms 降到 112ms、1827ms 降到 513ms(降 72-96%)。发现五:方法在随机采样下仍然有效(T=0.3 时说话/工具 2.1/13.3 倍,T=1.0 时 1.4/5.4 倍),多会话下收益递减但不消失(N=4 时 2.0/10.5 倍,工具调用 deadline miss 率从 100% 降到 2.9%)。发现六:质量无损——bfloat16 下 AlpacaEval judge 分数(1-5 分)与 AR 差异均小于 0.1(如 Streaming SLM 3.10 对 3.13)。
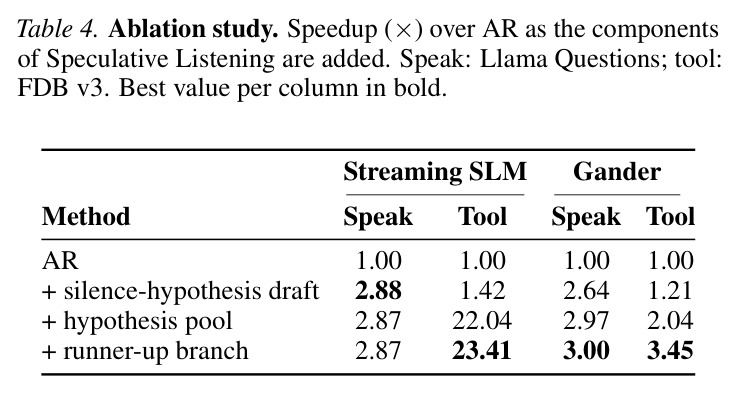
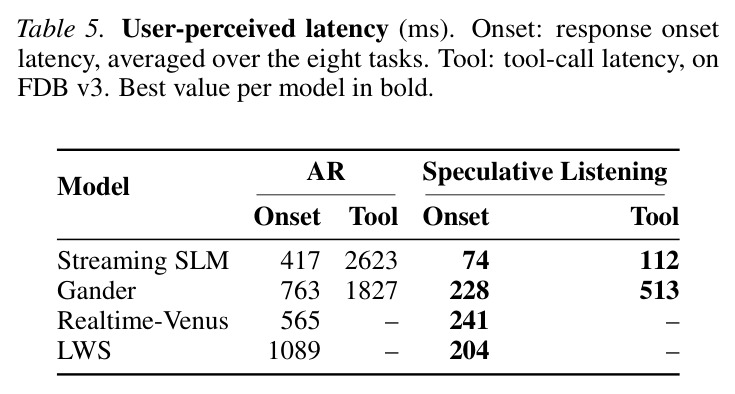
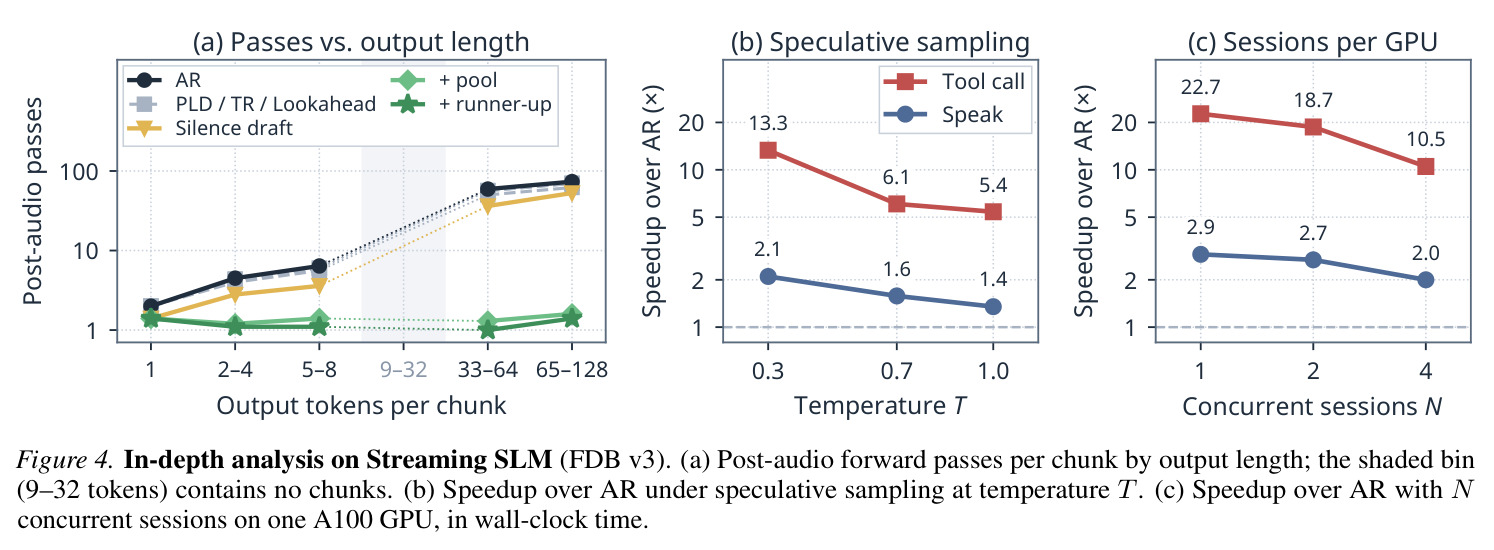
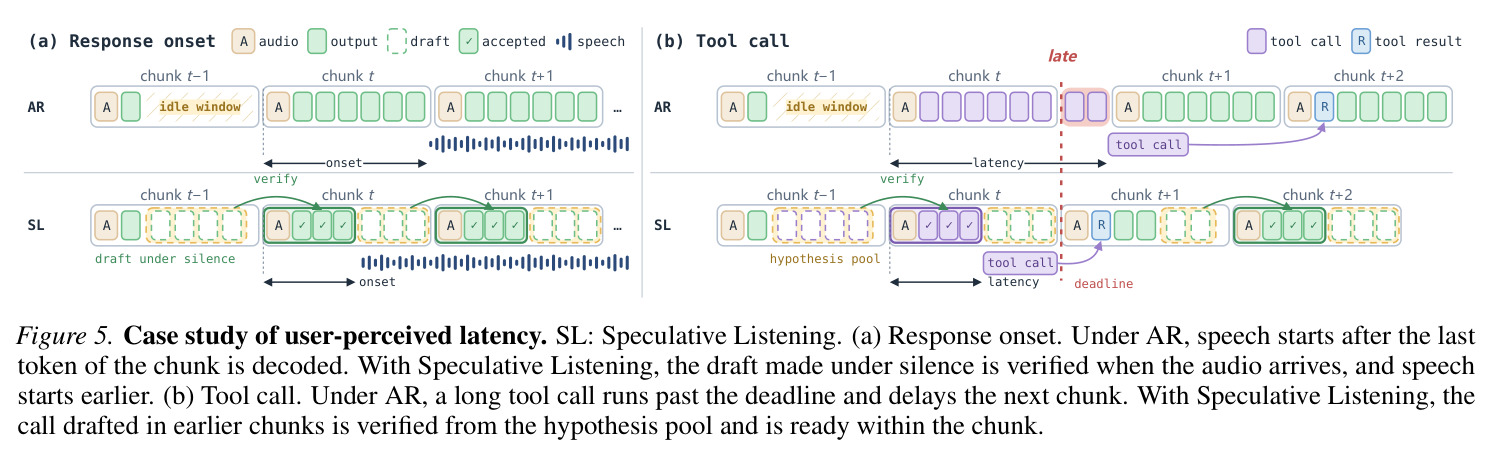
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 说话块解码(speak chunks,跨 4 模型 × 8 任务) | 后音频延迟加速比(×) | 2.6-2.8×(Streaming SLM 2.76 / Gander 2.60 / Realtime-Venus 2.69 / LWS 2.68) | AR 1.00×;PLD 1.02-1.11×;Token Recycling 1.00-1.15×;Lookahead 0.99-1.15× | 较 AR 约 2.6 倍,较最佳免训练基线约 2.3 倍 |
| 工具调用块解码(FDB v3 tool-call chunks) | 后音频延迟加速比(×) | Streaming SLM 23.41×,Gander 3.45× | AR 1.00×;基线方法 0.96-1.23× | 最高 23.4 倍 |
| 响应起始延迟(8 任务平均,4 模型) | onset latency (ms) | 74-241 ms | AR 417-1089 ms(人类轮次间隔约 200 ms) | 平均降低 73% |
| 实时滞后(FDB v3 每会话最大滞后) | max lag (ms) / 超过 1s 的会话占比 | 均值 0-55 ms,滞后超 1s 的会话至多 1% | AR 均值 1-568 ms,最大 3966 ms,最多 35% 会话超 1s | 平均降低 94.4% |
| 每目标前向提交 token 数 | #MAT(相对 AR = 1.00) | 2.15-2.63 | PLD/Token Recycling/Lookahead 1.01-1.23 | 约 2 倍 |
| 响应质量(AlpacaEval,DeepSeek-V4.1-Flash 评分 1-5) | judge score | 3.13 / 3.63 / 3.00 / 3.07(四模型) | AR 3.10 / 3.56 / 2.98 / 3.02 | 差异 ≤0.1,统计上无损 |
局限与改进
作者承认三点局限。第一,方法面向低并发、延迟敏感的部署:预计算依赖 idle window,一旦多会话共享 GPU 或做批处理,窗口被挤占,并发 N=4 时工具调用加速从 22.7 倍降到 10.5 倍。第二,实验只测了 Thinker(文本 token 解码部分),四个模型的 Talker(语音合成器)实现各异、无法公平比较,而用户实际听到的延迟还包含合成时间。第三,公式化只适用于块间存在 idle window 的分块交错架构,Moshi 这类按 80ms 音频帧解码的并行流架构需要不同的表述。我的补充观察:静音假设是最弱的输入假设,Table 7 显示 Realtime-Venus 在用户说话时静音草稿验收率骤降到 37.9%,Gander 的工具调用块只有 34.0%,说明噪声环境或用户语速快时命中率会恶化;runner-up 只覆盖第一 token 分歧,仍有约 12% 的变化发生在中途,只能靠草稿池兜底;所有收益都在 greedy + bfloat16 + A100 + batch 1 下测得,高温采样(T=1.0)时说话块收益缩水到 1.4 倍,其他硬件和量化配置未验证;另外加速定义不含语音合成,端到端体感提升会小于表中数字。
独立分析的弱点
弱点一:静音假设在声学条件偏离假设时退化。具体场景:咖啡馆背景音乐、键盘声、用户抢话(overlap speech)都会让 $a_{\text{sil}}$ 与真实输入差异巨大,Realtime-Venus 用户说话时 37.9% 的验收率已经预示了这一点——此时草稿几乎全废,方法退化为普通 AR 甚至因浪费的起草前向略慢。改进方向:用流式声学特征而非数字静音作输入假设(作者已提出),或维护按音频能量门控的多个假设分支(静音/低能量/高能量),音频到达后选择最接近的分支验证。弱点二:并发可扩展性。具体场景:云端客服同时服务数百路会话时,每路会话独占 GPU 的 idle window 不存在,预计算与实时块互相争抢。改进方向:设计草稿预算调度器,按会话延迟优先级动态分配 idle window;或用 chunked prefill 把多会话的音频 prefill+验证合并进同一批,摊薄验证成本。弱点三:机制建立在'分歧集中于第一 token'的经验观察上,缺少理论保证。若未来模型带显式推理 token、中途反转决定(先说后改听)比例上升,runner-up 的边际收益会缩水。改进方向:按第一 token 的 top-k 建树形草稿(spec tree),一次性覆盖多个可能起点。弱点四:评测口径只计 Thinker,未把 Talker 合成延迟计入端到端体感;且在单卡 bfloat16 batch=1 下测得,对生产环境(量化、vLLM 类服务框架、多卡)的外推性未知。改进方向:补测 BF16/INT8、torch.compile 或 vLLM 下的端到端(含合成)延迟。
未来方向
作者明确提出的方向:在静音之外的输入假设下起草,例如用流式声学特征(streaming acoustic features)作假设输入,让起草时已有部分声学信息,进一步提高高噪声和用户连续说话场景的验收率。基于本文成果可延伸的方向:(1)把 hypothesis pool 思想移植到 Moshi 式并行流架构的轻量版本,在帧级解码中做短窗口预解码;(2)树形/多分支草稿覆盖更分散的分歧分布,结合高温采样场景做自适应分支预算;(3)多会话服务下的草稿预算调度与抢占式验证,研究预计算与批处理调度器的协同;(4)推广到带书面通道的多通道模型(LWS 已涉及)以及更长的结构化 agentic 输出(代码、多步 API 调用序列),这些输出重复模式更强、草稿池收益可能更大;(5)与 Chronological Thinking 这类训练方法正交结合:训练时鼓励模型在倾听时产出与最终响应一致的中间表示,可同时提高草稿命中率与推理质量;(6)把 TickTock-Bench 扩展出更多 agentic 任务和噪声条件,形成解码方法的标准竞技场。
复现评估
复现条件总体较好。作者声明发布 session manifests、replay harness 和评测脚本;四个模型中 Gander、Realtime-Venus、LWS 是公开模型并使用其官方发布的 runtime,Streaming SLM 基于 Qwen2.5-Omni-7B Thinker 自行训练,权重未必开放,这一支的精确复现可能受影响,但其余三个公开模型足以验证主要结论。数据全部来自公开数据集:WebQuestions、Llama Questions、TriviaQA(OpenAudioBench)、AlpacaEval(VoiceBench)、Big Bench Audio、Full-Duplex-Bench v1/v1.5/v3,合计 760 会话、15,883 个块。算力需求为单块 A100、bfloat16、batch size 1、7B 级模型,学术实验室完全可负担。方法 training-free,无需训练环节,核心工程量在于对接各模型自有 runtime、实现 KV cache 回滚、逐块截止期计时与草稿池 N-gram 索引;附录 A 给出了滞后递推公式 $b_t = \max(0, b_{t-1} + \ell_t - \text{chunk duration})$ 和起草预算的定义等协议细节,透明度较高。综合评估:复现难度中等,对做过推理系统/投机解码工程的人来说约一到两周可跑通公开模型部分;需要留意作者提示的'其他硬件或 CPU 负载下延迟数字会不同'。
论文图表
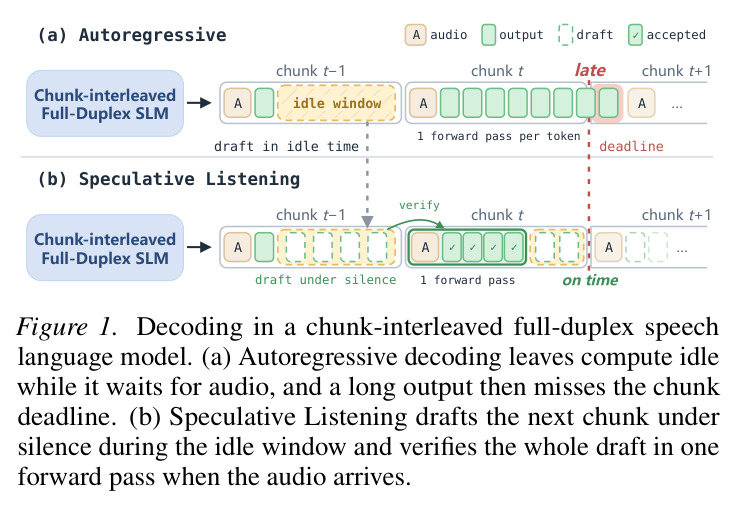
对比图。(a) 显示自回归解码下:listen 块算力闲置等待音频(idle window),而随后的长输出(如工具调用)串行生成、超过块截止期、把后续块全部推迟;(b) 显示 Speculative Listening 在 idle window 里于静音下起草下一块,音频到达后用一次前向验证整份草稿。
一图讲清问题(负载不对称+截止期)和方法直觉(空闲期预解码),是读者理解全文的第一入口。
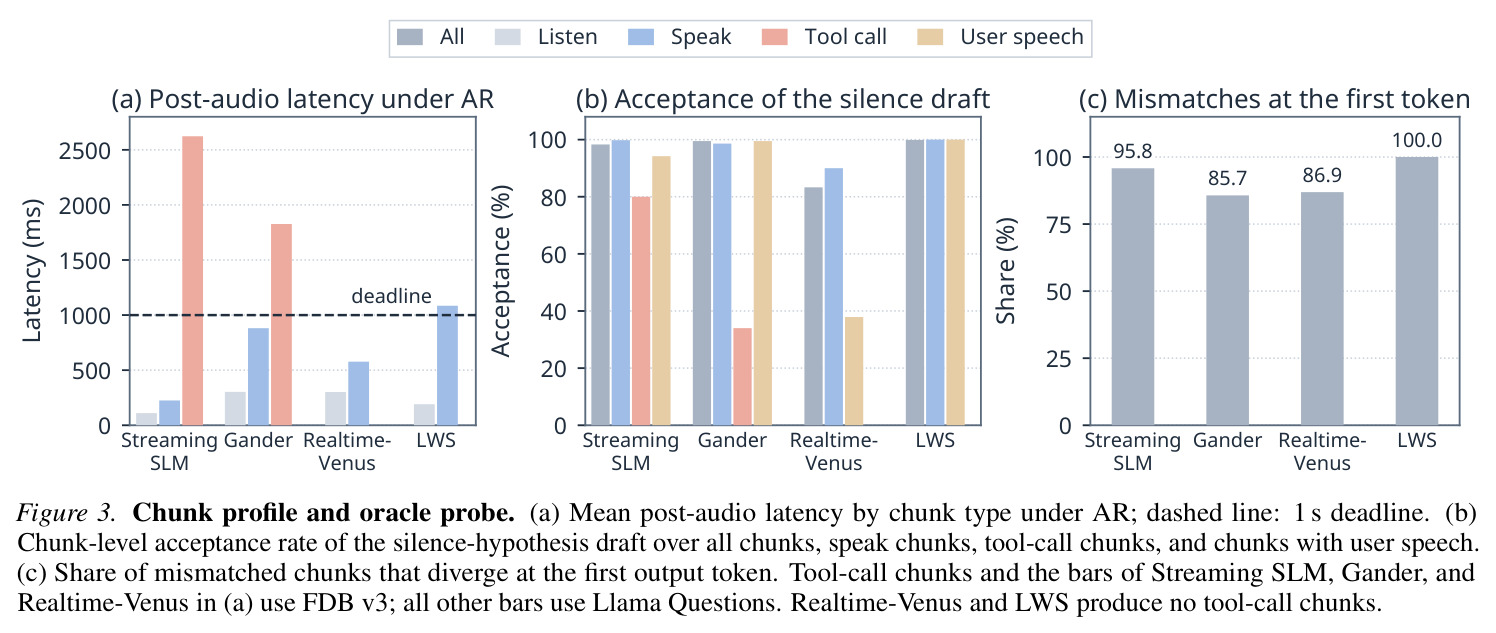
三联图。(a) 四个模型按块类型的平均后音频延迟,虚线为 1 秒截止期:listen 块远低于截止期(存在 idle window),工具调用块 1.8-2.6 秒全部越线;(b) oracle 探针测得的静音草稿块级验收率(全块 83.3-99.9%,用户说话时最低 37.9%);(c) 不匹配块中第一 token 分歧占比(85.7-100%)。
支撑论文两大经验观察的全部证据都在这张图里,同时量化了 idle window 的存在,是动机部分的实证基石。