TAO:面向LLM智能体服务的工具感知联合调度框架 TAO: Tool-Aware Joint Scheduling for LLM-Based Agentic Serving
用缓存信用、工具就绪度与token足迹三元组加动态规划联合调度智能体会话,延迟最高降26.8%
前置知识
KV缓存与前缀复用(Prefix Reuse)
LLM推理时会把已处理token的注意力键值(KV)缓存下来。同一会话的后续请求通常只在其历史前缀上追加新内容,因此若新请求被调度到仍保留该前缀KV的节点,即可跳过大部分预填充(prefill)计算,直接解码。PagedAttention/RadixAttention等机制在引擎内管理物理KV的分配与淘汰,而调度器只能根据各节点报告的缓存观测来估计复用机会。
本文调度价值三元组的第一个分量就是按时间衰减的节点级缓存信用,理解前缀复用才能明白为什么把会话放回原节点很值钱、以及为什么缓存价值要随中断时间衰减。
智能体会话与工具调用循环(Agent Session)
一个智能体会话由多轮『LLM推理→调用外部工具→观察结果→再推理』交替构成,工具如编译器、检索器、终端等跑在分布式CPU上,耗时从亚秒到数十秒不等。工具执行期间会话不需要GPU,调度器可以在工具边界安全地中断会话(释放GPU资源),待工具返回后再重启会话(重新选节点准入),中断的会话进入等待池与新请求一起竞争资源。
正是『工具执行使GPU需求变成可中断的间歇性需求』这一特性,催生了本文定义的CGDC服务场景和整个调度框架;不理解会话生命周期就无法理解调度决策发生在哪些时机。
TTFT与解码吞吐(Serving指标)
TTFT(Time To First Token)指客户端从发出请求到收到第一个输出token的等待时间,是交互响应性的核心指标;解码吞吐(Decode Throughput)指整个集群单位时间生成的token数(TPS),反映资源利用效率;任务端到端延迟则包含推理和工具执行的总耗时。CGDC场景下TTFT主要由『排队等待+预填充』构成,而工具返回后能否立刻获得准入直接决定TTFT。
论文所有实验结论都用这三个指标表达,且改进来源分析分别对应缓存复用(prefill/TTFT)、工具就绪度(tool-end到首token延迟)和联合放置(吞吐)。
多重背包与广义分配问题(Multiple Knapsack / GAP)
多重背包问题指在多个容量受限的背包中选择物品以最大化总价值,是NP难的经典组合优化问题;广义分配问题进一步允许物品放入不同背包时获得不同价值。对固定容量预算做量化的容量状态动态规划可以在离散化后精确求解:逐个候选决定『跳过或放入某个背包』,状态记录各背包已用容量下的最优目标值,最后回溯恢复方案。
TAO把『从等待池选哪些会话、各放到哪个GPU节点』直接建模为该问题,用精确DP替代启发式;附录的损失界分析也建立在这一形式化之上。
字典序优化(Lexicographic Optimization)
字典序比较按分量的优先级逐位比较:先比第一分量,只有第一分量相等才比第二分量,依此类推。相比加权和,它不需要为不同目标人为设定权重系数,天然表达『优先级严格高于』的语义。本文用三元组 $v_{i,b}=(k_{i,b}, r_i, t_i)$ 的字典序作为优化目标,配合量化DP中的向量嵌入实现精确比较。
三元组字典序是TAO避免『多信号加权融合需要调参』这一启发式痛点的核心机制,也是其与所有基于固定打分公式或阈值的前置系统的本质区别。
研究动机
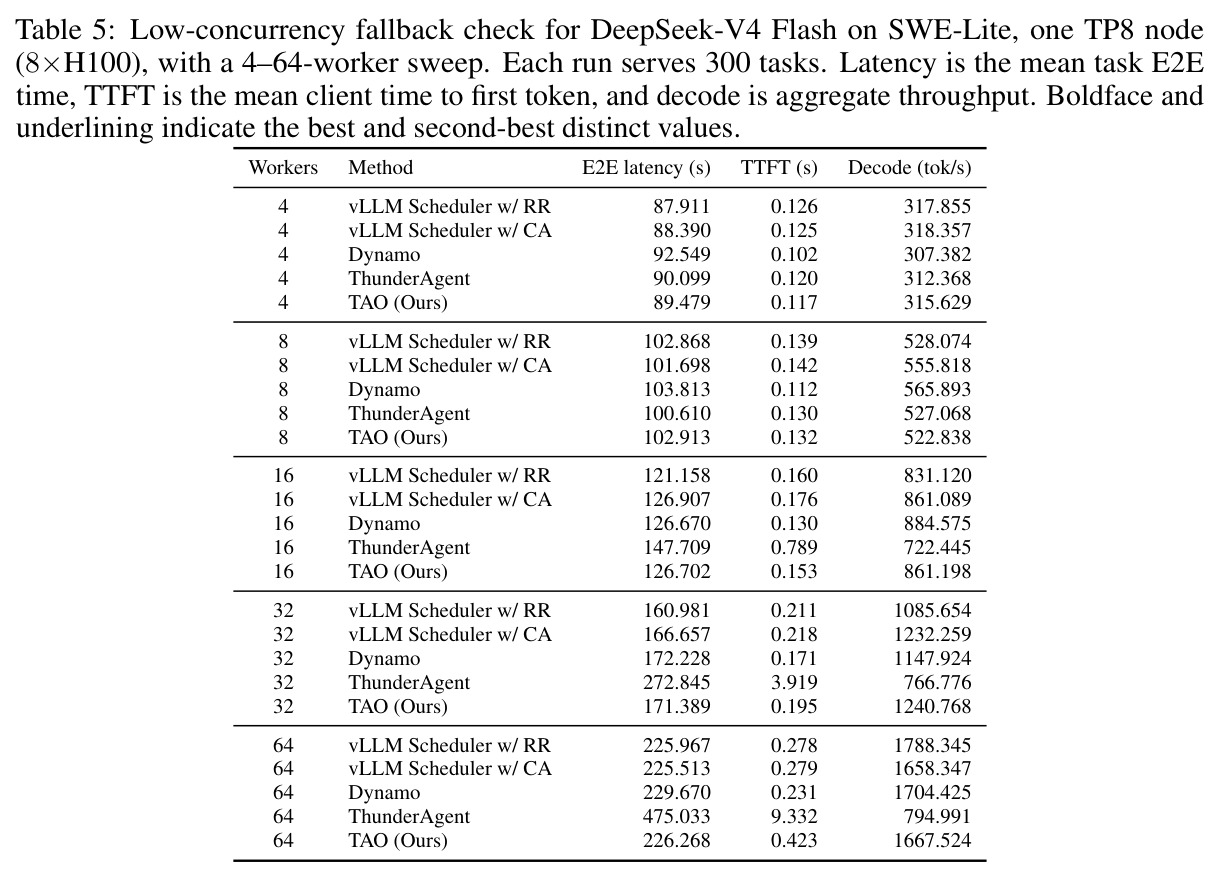
LLM智能体服务已经从简单聊天机器人演进为多步骤任务执行器:一个会话在集群GPU上做推理,在分布式CPU上调用编译器、检索器等外部工具,两者交替进行,工具延迟成为与推理并列的延迟来源。作者把这种『集群GPU+分布式CPU』场景称为CGDC。现有系统普遍采用『evaluate-then-decide』模式,存在两类问题。其一,会话评估忽视工具返回就绪度(tool-return readiness):cache-aware系统(SGLang、Dynamo等)只管前缀复用与负载均衡,workflow-aware系统预判未来调用,latency-aware调度器用延迟估计排优先级,工具时序即便被利用也只是间接代理——Continuum(Li et al. 2025)预测工具时长只为选择KV保留TTL,ThunderAgent(Kang et al. 2026)只是随时间折减token占用,这些特征最终都进入固定打分公式或人工阈值,没有一个信号显式回答『这个会话是不是马上就要回来要GPU了』。其二,决策阶段用逐会话的启发式路由(llm-d、SGLang的每会话打分规则),忽视会话间的容量竞争:先到一个低价值会话可能占满节点,挤掉后续一个价值更高的会话组合,放置选择也可能次优。实验中ThunderAgent在DeepSeek SWE-Lite 64并发下TTFT高达7.447秒,而本文方法只需0.224秒,正是这种短视决策的体现。
本文的目标是本文要在CGDC场景下构建一个工具感知的联合调度框架,同时改进评估与决策两个阶段:评估上,把『工具何时返回、会话近期是否需要推理』作为显式一等信号,与KV缓存复用、token足迹等既有特征统一成一个可比较的会话价值;决策上,不再逐会话贪心路由,而是把等待池中所有会话的准入与放置作为一个整体组合优化问题,在节点剩余容量约束下最大化总价值。框架还需满足三个工程约束:与底层推理引擎的KV管理解耦、调度开销可忽略(运行时开销低于0.12%)、评估接口可扩展(未来加入新信号不改优化器),并最终在真实模型与工作负载上同时改善延迟、TTFT和解码吞吐。
与已有工作不同的是,本文的独特切入有三点。第一,把工具返回时间从『缓存管理的代理变量』升格为『调度准入的直接信号』:之前工作用工具时长决定KV保留多久(Continuum)或折减token占用(ThunderAgent),而TAO的readiness直接回答『下一秒谁需要GPU』,连接了CPU工具域与GPU准入域两个原本割裂的资源域。第二,决策从启发式升级为精确优化:虽然多重背包DP是1957年Bellman以来的经典工具,但把它用在LLM智能体调度的准入+放置联合决策上、并用字典序三元组 $v_{i,b}=(k_{i,b}, r_i, t_i)$ 避免权重调参,是新的组合;坐标随缓存年龄和工具进度演化,无需加权和。第三,工程上用冻结快照+异步求解+应用前重校验的架构解决『优化时系统在变』的矛盾,并给出异步快照损失的理论上界 $A_{s,t}+2\epsilon_{s,t}+T_{s,t}$,把计划陈旧度与保留价值联系起来。
核心方法
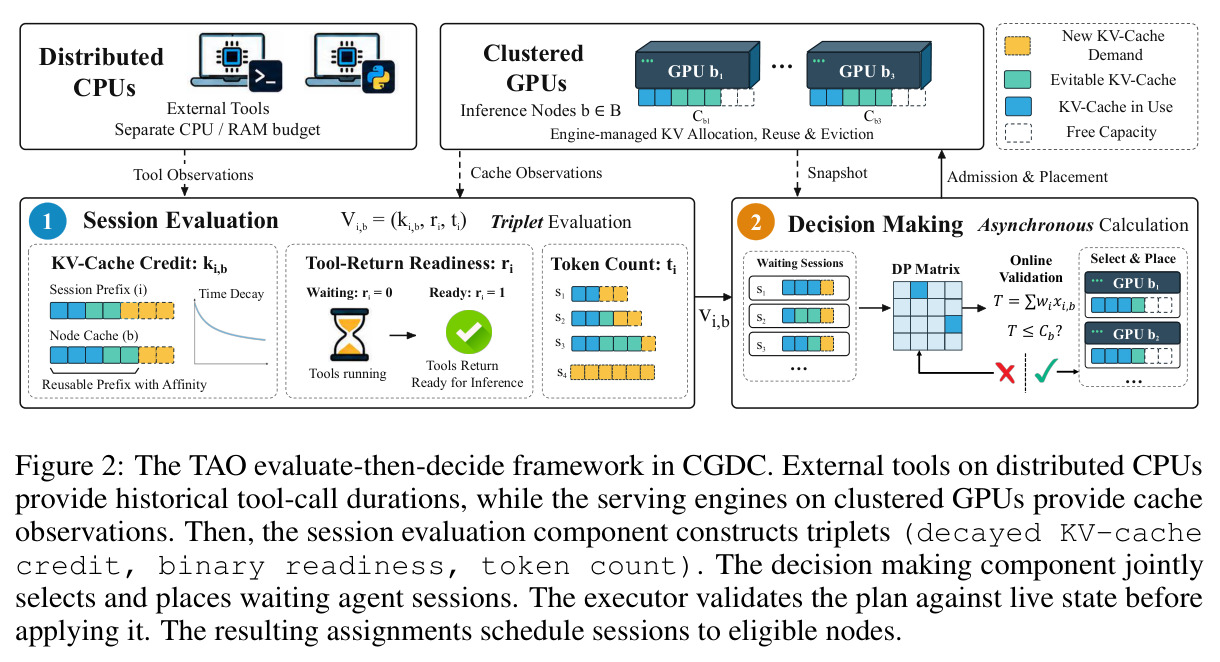
直觉上,TAO要解决的问题是:当多个智能体会话同时在等工具返回或新到达时,下一批宝贵的GPU容量应该给谁、给哪个节点。作者观察到两个事实:一是会话刚结束工具调用时若能被立即放到仍持有其KV前缀的节点上,就能省掉昂贵的prefill;二是这个机会随时间衰减——工具拖得越久,缓存越可能被淘汰,而一旦快到返回时间,优先安置它就能显著压缩工具结束到首token的延迟。技术路线延续evaluate-then-decide范式但改造两端。评估端(3.2-3.4节):调度器在每个重启决策时刻对等待池 $\mathcal{P}$ 中每个会话与快照中的每个节点 $b\in\mathcal{B}$ 计算字典序价值三元组 $v_{i,b}=(k_{i,b}, r_i, t_i)$,分别是带半衰期的时间衰减缓存信用、二值工具返回就绪度、token占用;决策端(3.5节):把联合选会话与放节点建模为容量约束下的多重背包/广义分配结构,用量化动态规划精确求解 $x^\star\in\arg\operatorname{lexmax}\sum_i\sum_b x_{i,b}v_{i,b}$,在隔离的异步worker中运行,应用前对活体状态重校验。评估与决策解耦,使新评估信号可以即插即用。
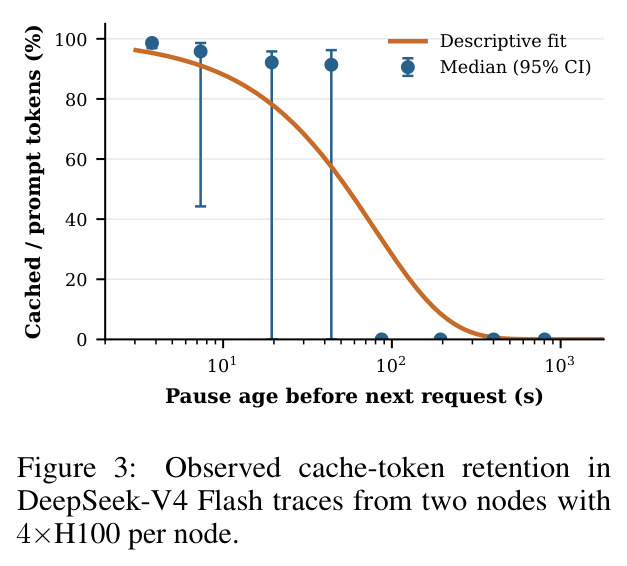
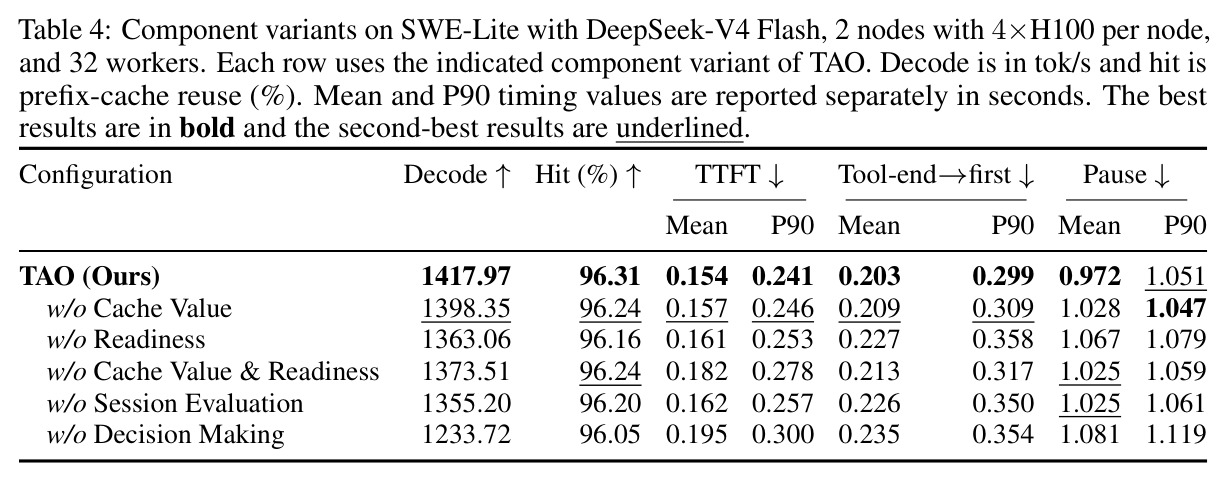
核心创新是把『工具返回就绪度』作为显式调度信号,并把逐会话启发式替换为联合精确优化,本质区别体现在三处。第一,readiness是二值的、面向调度窗口的前瞻信号:$r_i(t)=1$ 当观察到工具完成,或过期触发探针,或预测剩余时间 $\hat{d}_i(t)=\max\{0,\hat{D}_f-e_i(t)\}$ 落入视野 $H=1$ 秒内——它把CPU侧工具进度翻译成GPU侧的『马上要人』旗标,此前系统最多把工具时长用于KV保留TTL或token折减。第二,三元组字典序代替权重融合:缓存信用优先但快速衰减(半衰期 $h=10$ 秒,$k_{i,b}(t)=k^0_{i,b}2^{-\tau_{i,b}/h}$,衰减依据Figure 3实测的缓存token保留曲线),未刷新信用衰减后由readiness区分『快回来的』与『还早的』,再由token足迹在并列时偏向更大上下文——固定顺序让不同信号随时间各自主导决策,不需要任何加权调参。第三,DP联合决策看到全局:与llm-d/SGLang逐会话打分不同,优化器同时权衡『准入这个会话会不会剥夺更有价值的会话组合』,消融实验显示仅把DP换成best-fit-decreasing贪心,解码吞吐就从1417.97掉到1233.72 tok/s,证明联合性本身贡献巨大。
方法步骤详情
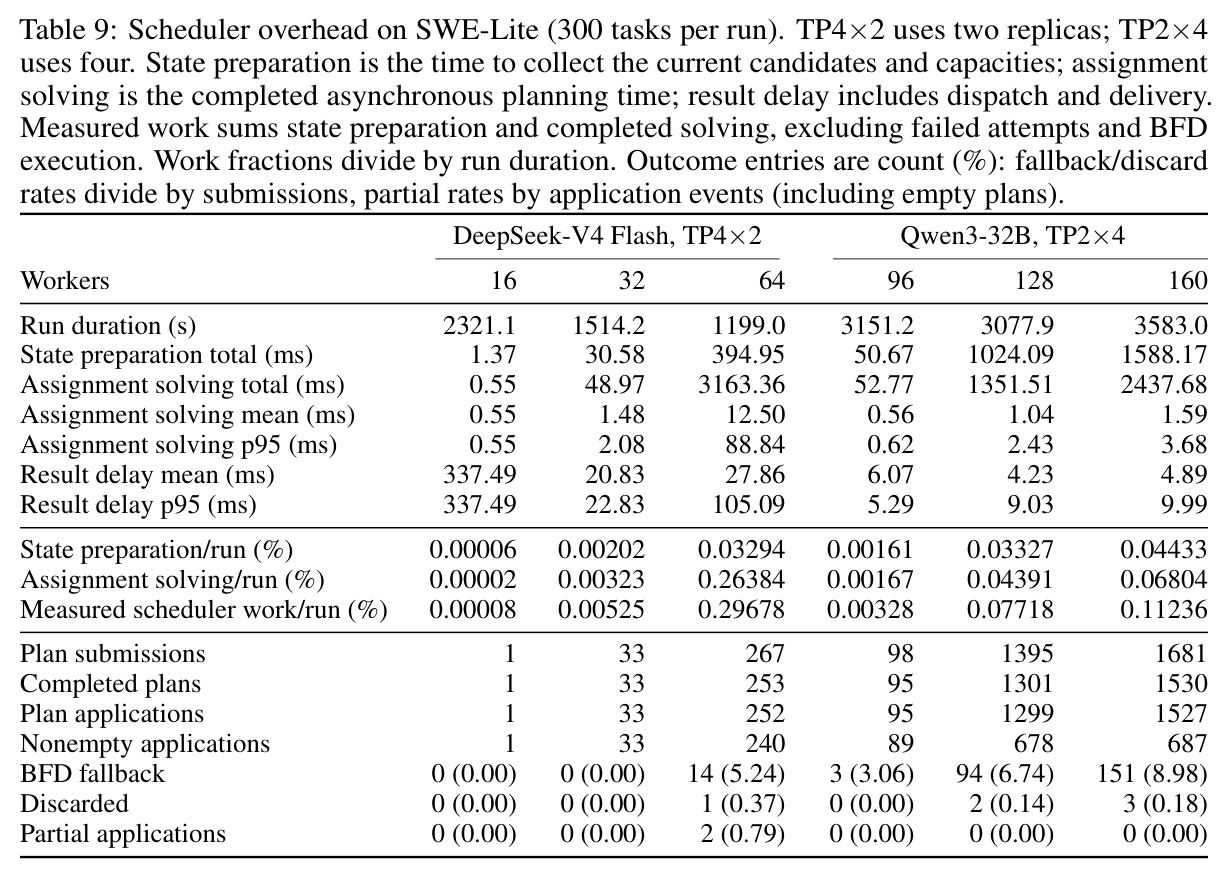
完整流程分四步。第一步,会话中断:工具边界处调度器按会话价值排序决定中断,释放GPU资源,被中断会话与新到达会话一起进入等待池;这一步与重启决策共用同一套评估。第二步,会话评估:对每个(会话 $i$,节点 $b$)对计算三元组——(a) 缓存信用 $k_{i,b}$:优先用节点观测到的缓存token数,否则由token量与缓存率估计,无匹配证据记零,并按观察年龄以 $k_{i,b}(t)=k^0_{i,b}2^{-\tau_{i,b}/h}$($h=10$秒)折减;(b) 就绪度 $r_i$:融合工具接口暴露的进度/截止提示(如Claude Code的Monitor事件、OpenCode的Bash超时)、解析的sleep命令、结构化工具历史时长——历史估计用带有限样本边际的保守上界 $\hat{D}_f=\bar{d}_f+\frac{2s_f^2\log(3/\delta)}{n_f}+\frac{3R_f\log(3/\delta)}{n_f}$($\delta=0.2$),减去已耗时得剩余时间,预测需30秒内刷新,找不到证据时回退到全局历史再到5秒默认值;(c) token足迹 $t_i$ 即总token数减共享部分。第三步,联合DP放置:容量按量子 $\Delta$ 离散化,$\bar{w}_i=\lceil w_i/\Delta\rceil$,递推 $D_j(s)=\operatorname{lexmax}\big(D_{j-1}(s),\ \max_{b}\,[D_{j-1}(s-\bar{w}_j e_b)+u_{j,b}]\big)$,逐候选枚举『跳过或放入某合格节点』,缓存等价节点可分组聚合为不超过 $m$ 个容量维度;预算耗尽时回退BFD。第四步,异步执行与重校验:规划在隔离worker中进行(实测平均1.59 ms、P95 3.68 ms),应用前核对选中会话的活体签名与资格,状态变化则丢弃计划或只应用在当前容量下可行的最长前缀。
技术新颖性
技术新颖性可以从四个层面评估。信号层面:把工具时序转化为『近期模型服务机会』而非仅作KV保留或token折减的代理,是本文对agentic serving评估特征的实质补充;配合半衰期衰减的节点级缓存信用,把『复用机会随中断变陈旧』这一物理事实量化进价值。优化层面:虽然DP本身是经典工具(作者也明确引用多重背包与Shmoys-Tardos近似框架),但用向量字典序而非标量化目标做精确组合优化,避免了「多特征加权」这条需要调参且信号间互相干扰的老路,且坐标随时间演化让同一目标函数在不同时刻自然强调不同维度,这在LLM调度文献中少见。系统层面:冻结快照+异步求解+签名重校验+最长可行前缀部分应用,配合理论损失界 $\max_x U_t(x)-U_t(y_t)\le A_{s,t}+2\epsilon_{s,t}+T_{s,t}$,把『计划期间状态漂移』从工程隐患变成可分析量,调度总开销实测低于运行时间的0.12%。泛化层面:框架与具体agent harness(MiniSWE、Claude Code)、引擎(vLLM、TokenCake)、模型(DeepSeek-V4 Flash、Qwen3-32B、GLM-4.7)解耦,兼容聊天机器人等非agent负载。新颖性不算革命性算法突破,属于『正确形式化+工程闭环』型贡献。
实验结果
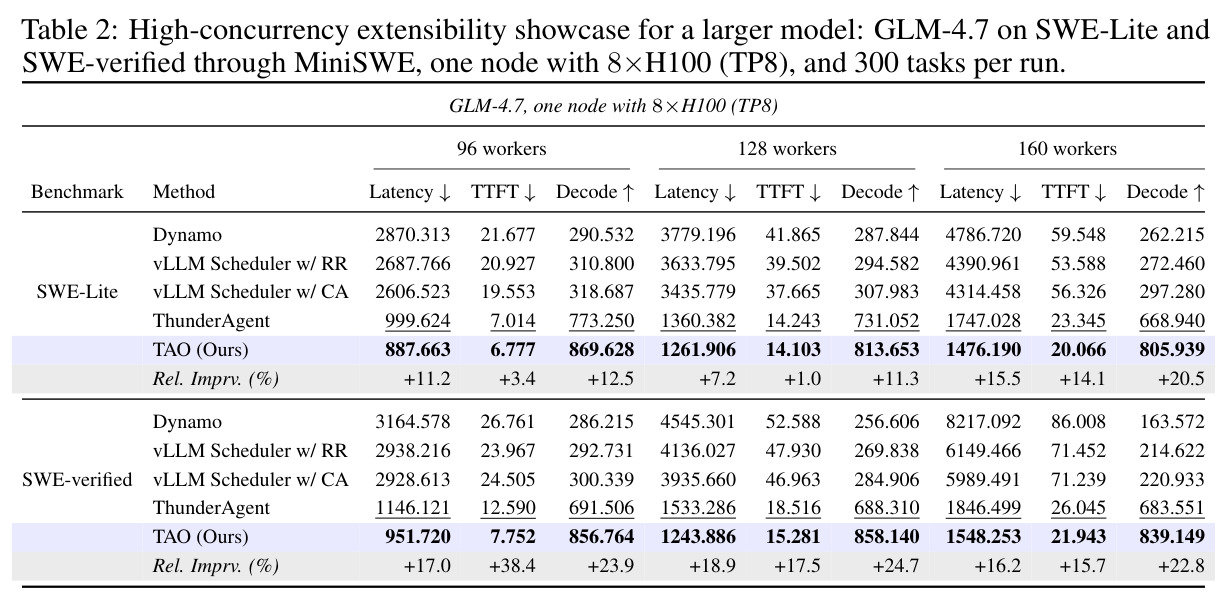
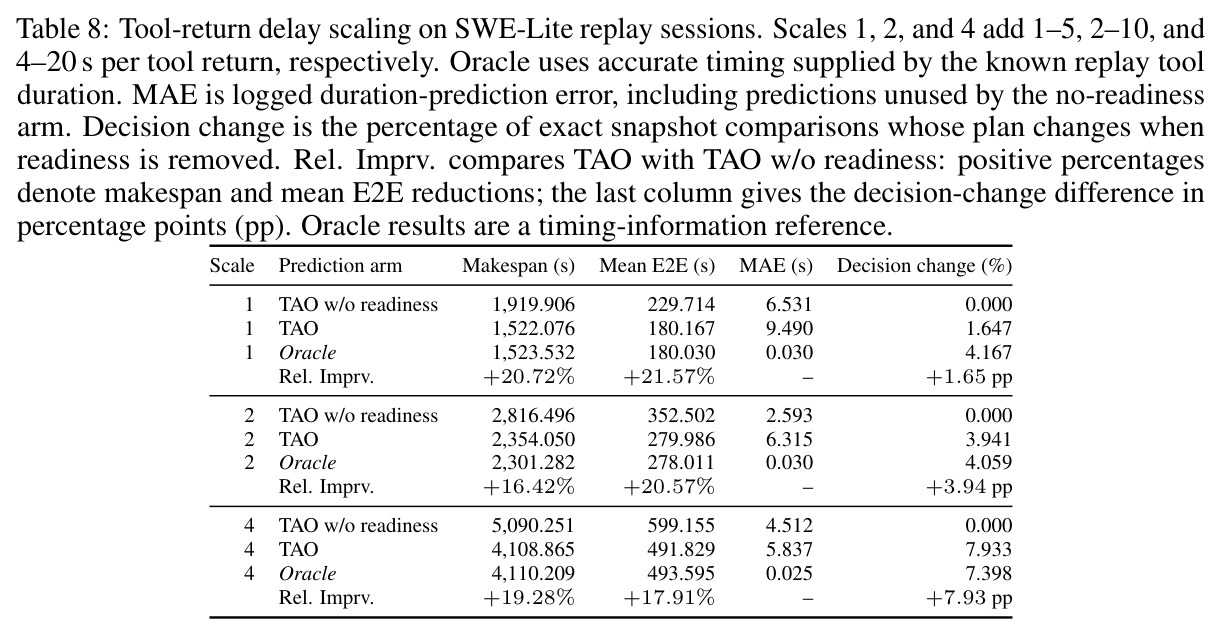
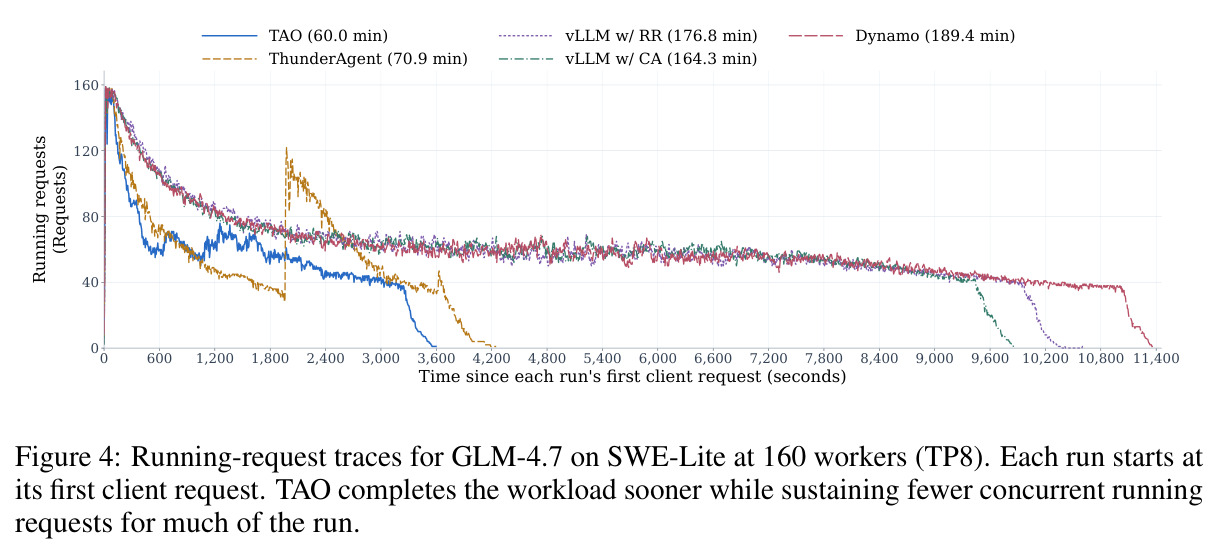
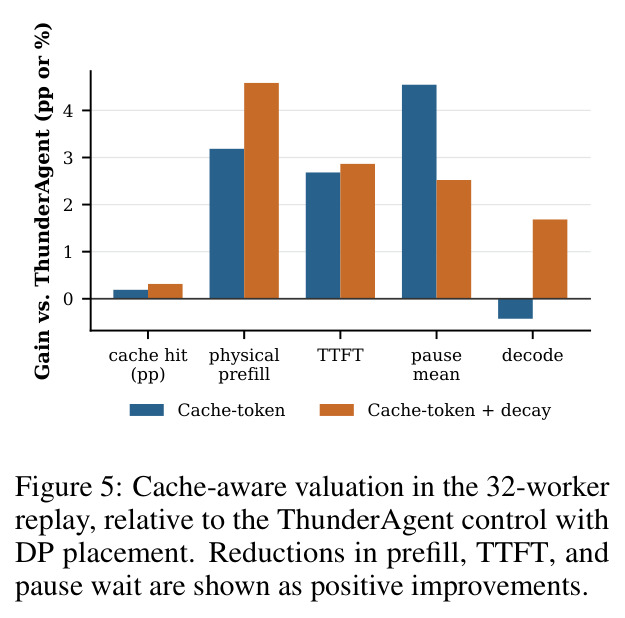
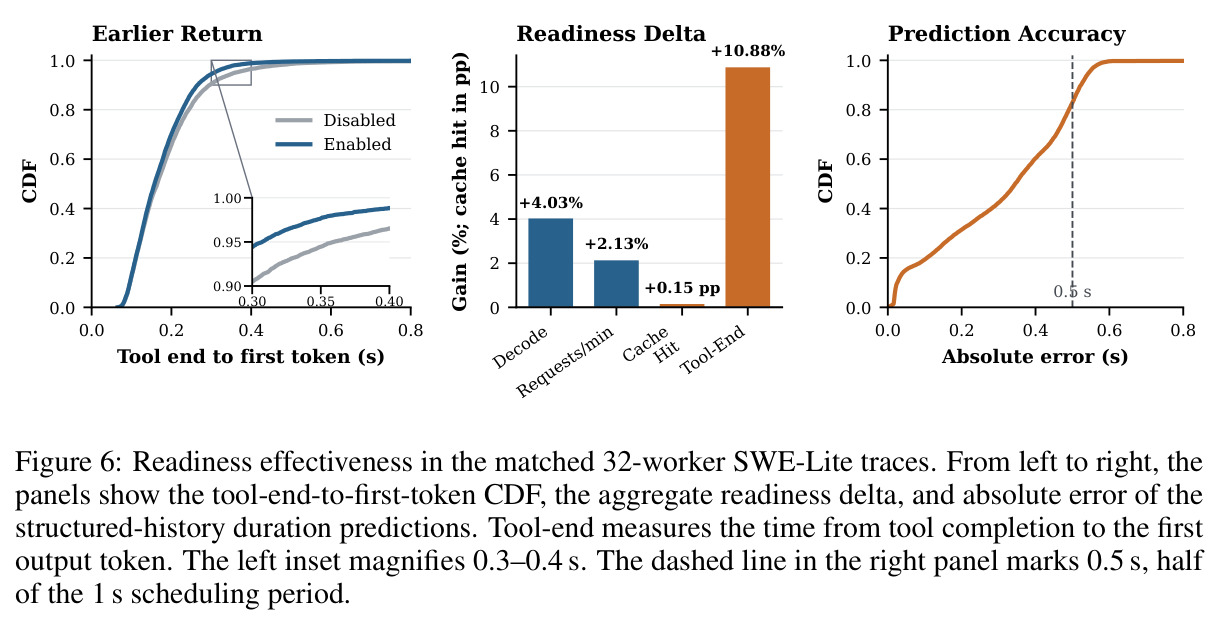
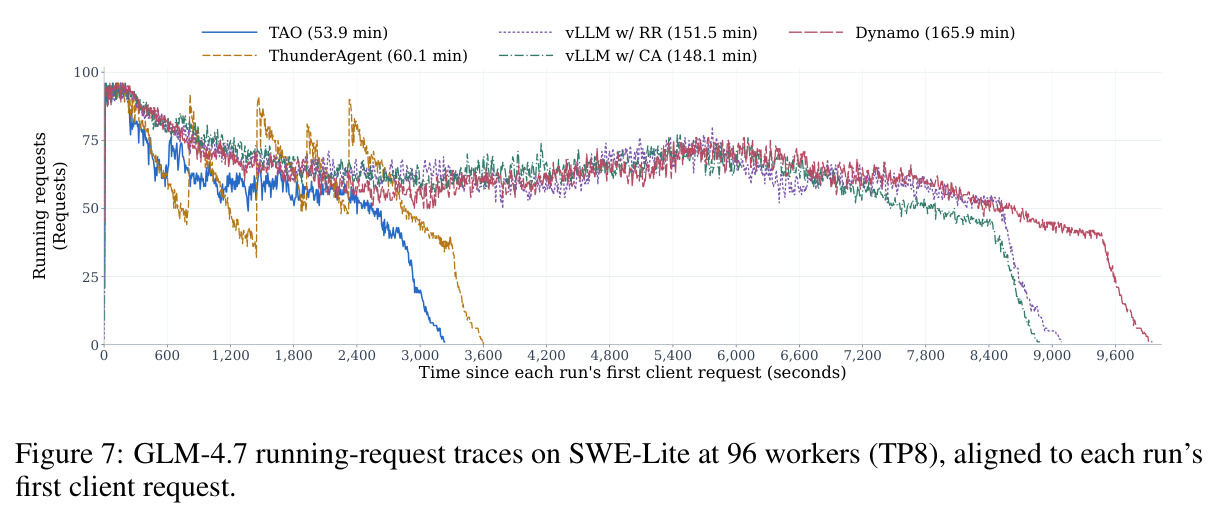
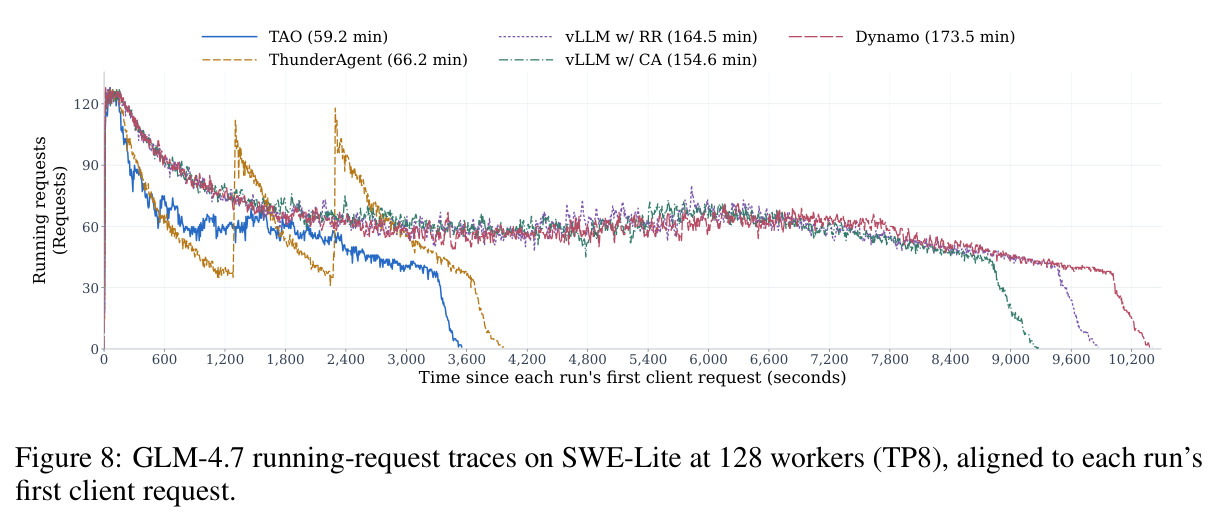
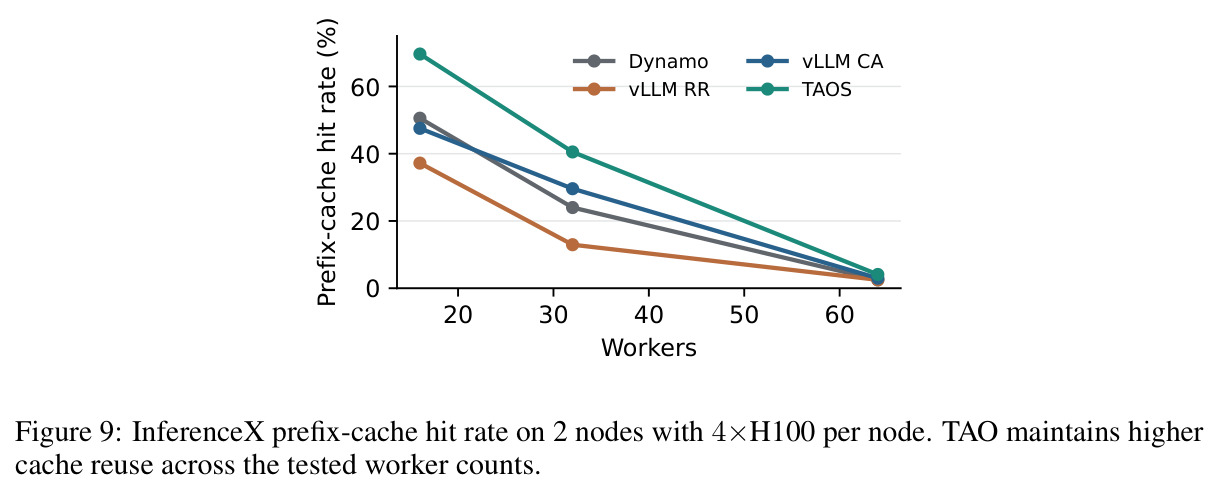
主实验(Table 1)覆盖12个模型-工作负载-并发组合,TAO相对各指标最优基线:延迟最高降26.8%、TTFT最高降36.3%、解码吞吐最高升29.5%。具体地,DeepSeek-V4 Flash(2节点×4×H100)在SWE-Lite 64并发下三项同时大幅领先:延迟185.410 vs 次优253.228秒(-26.8%)、TTFT 0.224 vs 0.351秒(-36.3%)、吞吐2021.523 vs 1561.307 tok/s(+29.5%);但在Terminal-Bench上吞吐有两次输给ThunderAgent(16并发798.624 vs 876.138,-8.8%;64并发1551.387 vs 1654.108,-6.2%),延迟和TTFT则全程领先。Qwen3-32B(4节点×2×H100)在SWE-verified上TTFT降12.9-29.9%、吞吐升4.0-7.8%,128并发时延迟比ThunderAgent高2.5%。GLM-4.7单节点8×H100大模型高并发展示(Table 2)中,SWE-verified全三档并发延迟降16.2-18.9%、TTFT降15.7-38.4%、吞吐升22.8-24.7%;Figure 4显示TAO用60.0分钟完成160并发的SWE-Lite全程,而ThunderAgent需70.9分钟、vLLM CA需164.3分钟、Dynamo需189.4分钟,且TAO大部分时间维持更低的并发运行请求数。混合负载(Table 3)显示自动化任务(AutomationBench)64并发下延迟降17.1%、TTFT降48.5%,但128并发时TAO反而全面落后(延迟-7.0%、TTFT相对最优基线恶化达-504%)。机制拆解(4.3节):32-worker重放中缓存token排序使前缀命中率+0.19pp、衰减再+0.31pp并带来+1.68%吞吐;readiness使吞吐+4.03%、工具结束到首token延迟-10.88%、平均暂停等待从1.067降至0.972秒,10697次工具时长预测MAE仅0.410秒、82.9%误差在0.5秒内;DP在23个多候选快照中改进6个(26.1%)。消融(Table 4)确认每个组件都有贡献:完整TAO 1417.97 tok/s,去DP决策掉到1233.72,去会话评估掉到1355.20,去readiness掉到1363.06。InferenceX轨迹重放(Table 7)三档并发吞吐升4.2%/1.8%/10.1%。附加工具延迟1-20秒的压力测试(Table 8)中TAO对历史配置makespan降16.42-20.72%,且结构化历史预测与Oracle计时的端到端差距仅-0.36%~+0.71%。
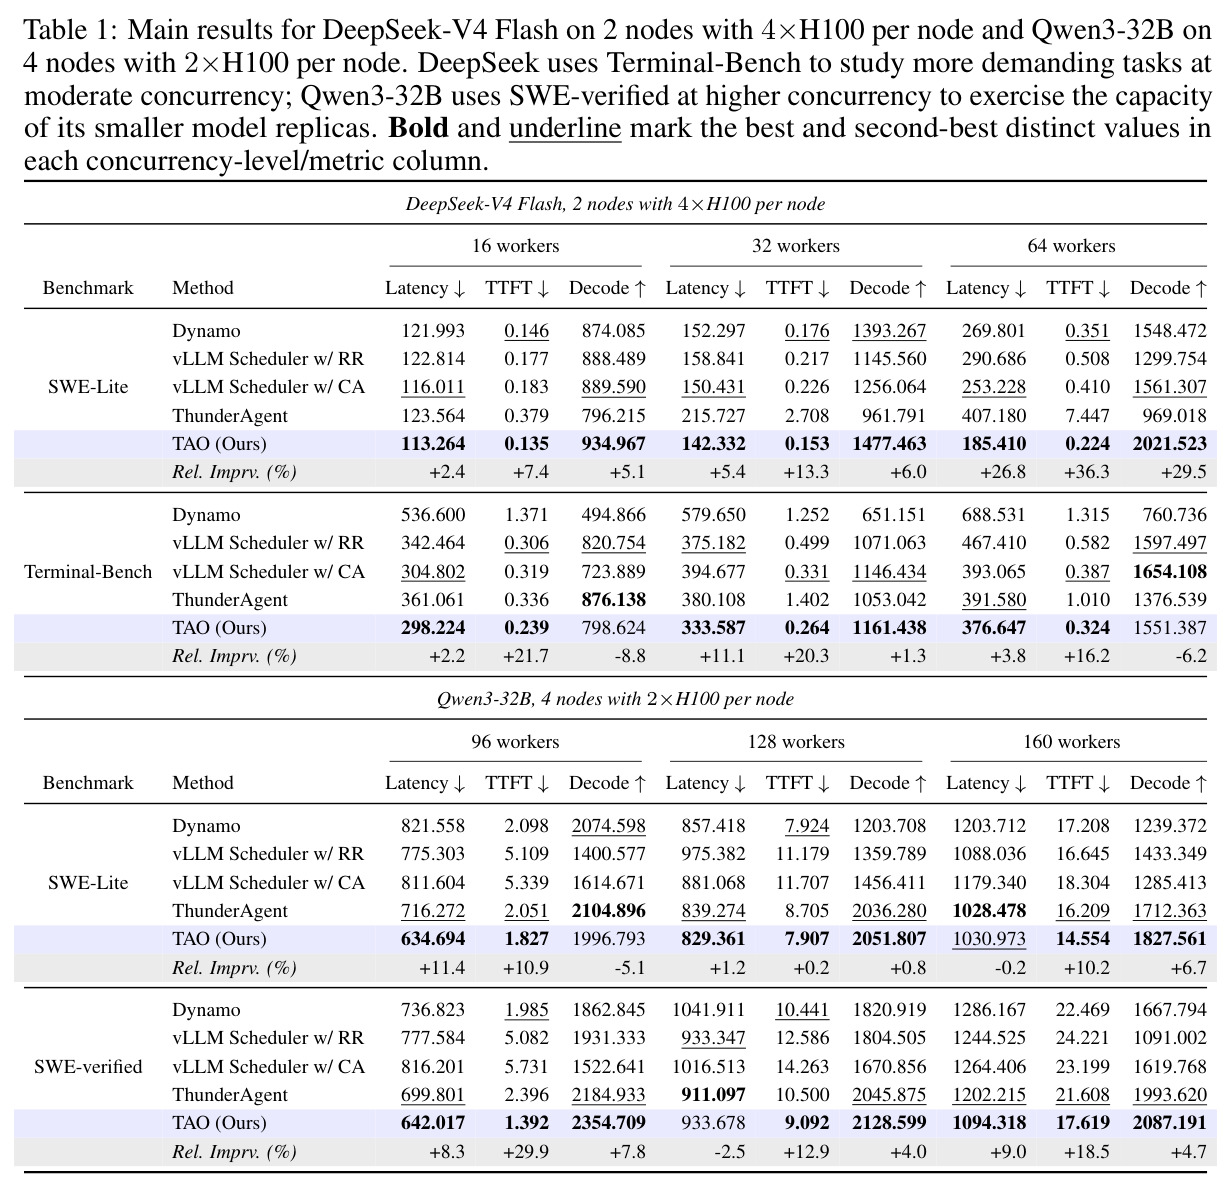
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepSeek-V4 Flash,SWE-bench Lite(MiniSWE harness,2节点×4×H100)64并发 | 任务端到端延迟(秒,越低越好) | 185.410 | 次优 vLLM Scheduler w/ CA:253.228 | -26.8% |
| DeepSeek-V4 Flash,SWE-Lite 64并发 | Mean TTFT(秒) | 0.224 | 次优 Dynamo:0.351 | -36.3% |
| DeepSeek-V4 Flash,SWE-Lite 64并发 | 解码吞吐(tok/s) | 2021.523 | 次优 vLLM Scheduler w/ CA:1561.307 | +29.5% |
| DeepSeek-V4 Flash,Terminal-Bench 2.0(Claude Code)32并发 | Mean TTFT(秒) | 0.264 | 次优 vLLM Scheduler w/ CA:0.331 | -20.3% |
| Qwen3-32B,SWE-verified(4节点×2×H100)96并发 | Mean TTFT(秒) | 1.392 | 次优 ThunderAgent:2.396(另:Dynamo 1.985) | -29.9%(vs ThunderAgent) |
| Qwen3-32B,SWE-verified 96并发 | 解码吞吐(tok/s) | 2354.709 | 次优 ThunderAgent:2184.933 | +7.8% |
| GLM-4.7(单节点8×H100 TP8,300任务)SWE-verified 96并发 | Mean TTFT(秒) | 7.752 | 次优 ThunderAgent:12.590 | -38.4% |
| GLM-4.7,SWE-verified 128并发 | 解码吞吐(tok/s) | 858.140 | 次优 ThunderAgent:688.310 | +24.7% |
| 混合负载 Terminal-Bench+SWE-Lite(389任务)DeepSeek 64并发 | 任务端到端延迟(秒) | 398.911 | 次优 vLLM Scheduler w/ CA:519.631 | -23.2% |
| AutomationBench(800任务)DeepSeek 64并发 | Mean TTFT(秒) | 0.539 | 次优 vLLM Scheduler w/ CA:1.046 | -48.5% |
| InferenceX轨迹重放(393条AgentX轨迹)64并发 | 解码吞吐(tok/s) | 120.469 | 次优 vLLM Scheduler w/ CA:109.413 | +10.1% |
| 组件消融:TAO vs 去掉DP决策(换BFD贪心),DeepSeek SWE-Lite 32并发重放 | 解码吞吐(tok/s) | 1417.97(完整TAO) | w/o Decision Making:1233.72 | +14.9% |
| 附加工具返回延迟2-10秒的重放压力测试 | Makespan(秒) | 2354.050(TAO+readiness) | TAO w/o readiness:2816.496 | -16.42% |
局限与改进
作者承认或隐含的局限:一是关键超参手工设定——缓存信用半衰期 $h=10$ 秒、就绪视野 $H=1$ 秒、预测刷新窗30秒、5秒默认工具时长,论文只说这是调度器参数而非拟合自trace,未做敏感性分析;二是快照优化与活体系统的偏差,靠重校验丢弃计划或部分应用来兜底,Table 9显示BFD回退占提交的3.06-8.98%,被丢弃/部分应用的处理未计入时间统计;三是延迟与吞吐存在权衡(4.3节明确指出最低延迟出现在最小并发而峰值吞吐在更高并发),单次部署只能选一个平衡点。我自己的观察:第一,混合负载AutomationBench 128并发下TAO延迟-7.0%、TTFT相对最优基线恶化-504%(19.123秒 vs Dynamo 3.166秒),说明就绪度视野1秒与缓存衰减10秒的参数组合在超高压、工具耗时更长的自动化负载上失灵,论文对这一严重退化只轻描淡写地报告了数字;第二,Terminal-Bench两个并发档的解码吞吐输给ThunderAgent 6-9%,说明高难度任务的放置优化并不总能同时赢三项指标;第三,binary readiness把连续的工具进度压成0/1,视野1秒内外的会话被同等对待,粗粒度可能损失信息;第四,实验均基于SWE类编码负载与H100集群,对检索密集、长尾工具延迟的其他agent形态未验证;第五,未提供开源代码链接,复现依赖私有工程细节。
独立分析的弱点
弱点一:超参缺乏自适应与敏感性分析。$h=10$ 秒的缓存半衰期直接来自DeepSeek-V4 Flash在H100上的实测保留曲线(Figure 3),换硬件(更大的节点内存、不同淘汰策略)或换引擎(RadixAttention vs PagedAttention语义不同)曲线形态会变,固定半衰期可能错配;改进方向是让 $h$ 在线拟合各节点实测的缓存保留分布。弱点二:就绪度预测器过于保守粗糙。有限样本边际($\delta=0.2$)只是启发式、无逐次校准保证,二值化+1秒视野使长工具会话几乎永远 $r_i=0$,AutomationBench 128并发的TTFT恶化很可能是大量会话同时接近返回造成的准入风暴而readiness无法区分先后;改进方向是把readiness从二值升级为连续的『剩余时间分布/分位数』并允许视野随负载自适应伸缩。弱点三:DP规模与回退策略。容量量子 $\Delta$ 离散化在高并发下可能耗尽状态预算(回退率最高8.98%),回退到BFD贪心恰恰回到了论文批评的启发式;改进方向是引入近似DP或LP松弛(如Shmoys-Tardos式舍入)保证有界次优而非硬回退。弱点四:混合负载与聊天场景的信号缺失——聊天请求没有工具调用,readiness恒定,退化成纯缓存+token调度,Table 3中389任务混合负载32并发TTFT还比基线差5.5%;改进方向是为非agent负载设计补充价值分量。弱点五:评估端到端延迟包含工具执行时间,调度改进与agent任务本身的并行度纠缠,缺乏对『同一会话内部串行工具链』的建模,workflow-aware的Parrot/Helium类信息尚未纳入三元组。
未来方向
作者方向:论文3.1节与贡献列表明确指出TAO可推广到多智能体编排(multi-agent orchestration)和Looped Agents等负载,且评估-决策解耦的接口允许未来加入新价值分量(如workflow依赖、程序感知信息);附录G显示工具延迟越长readiness影响的放置决策越多(1.65%→7.93%),暗示在长工具负载上深化时序建模收益更大。基于成果可延伸的方向:其一,在线学习half-life与readiness视野,把Table 3暴露的超压失灵场景做成自适应参数机制;其二,把工具侧CPU/RAM也纳入联合优化——目前CPU预算独立于GPU准入(TAO只管GPU),工具本身的调度与GPU准入联合可进一步压缩端到端延迟;其三,扩展理论部分,当前损失界需要值漂移上界 $\eta_{s,t}\le L(t-s)$ 等假设,readiness的跳变只能单独放宽,可以发展对跳变鲁棒的在线重优化理论;其四,与投机执行类工作(PASTE、Conveyor的工具-推理重叠)正交组合,readiness提供的返回时间分布可作为投机预填充的触发器;其五,跨集群/广域部署下的异步快照损失界可能需要重推,因为网络延迟会放大计划陈旧度;其六,开源并验证在不同推理引擎(SGLang、TensorRT-LLM)上的可移植性。
复现评估
复现难度中等偏高。论文未提供开源代码链接(全文仅引用外部仓库如InferenceX、OpenCode),也未提及artifact发布,实现细节分散在正文与附录:三元组计算、DP递推、重校验逻辑在3.2-3.5节与附录B有伪代码(Algorithm 1),就绪度估计器在附录A有完整公式(含 $\delta=0.2$、30秒刷新、5秒默认值),异步损失界在附录B.2/C有推导,这些足够指导重新实现。算力门槛较高:需要H100集群——DeepSeek-V4 Flash配置2节点×4×H100、Qwen3-32B为4节点×2×H100、GLM-4.7为单节点8×H100,其中DeepSeek-V4 Flash与GLM-4.7是2026年模型,普通实验室难以获得;退路是用Qwen3-32B复现核心对比。数据方面工作负载公开可得(SWE-bench Lite/Verified、Terminal-Bench 2.0、AutomationBench)但需要跑mini-SWE-agent或Claude Code harness产生真实agent轨迹,依赖真实的工具调用延迟分布, Paper中cache保留曲线来自DeepSeek-V4 Flash实测trace,换模型需重新采集。若目标仅是验证机制拆解(缓存衰减、readiness、DP三分量),附录F/G的trace重放协议(固定prompt与工具记录、live生成、重放校验器)设计得很可复现,是较好的切入点;但要复现Table 1全表需要每格完整跑300+任务的多并发扫描,成本不菲。
论文图表
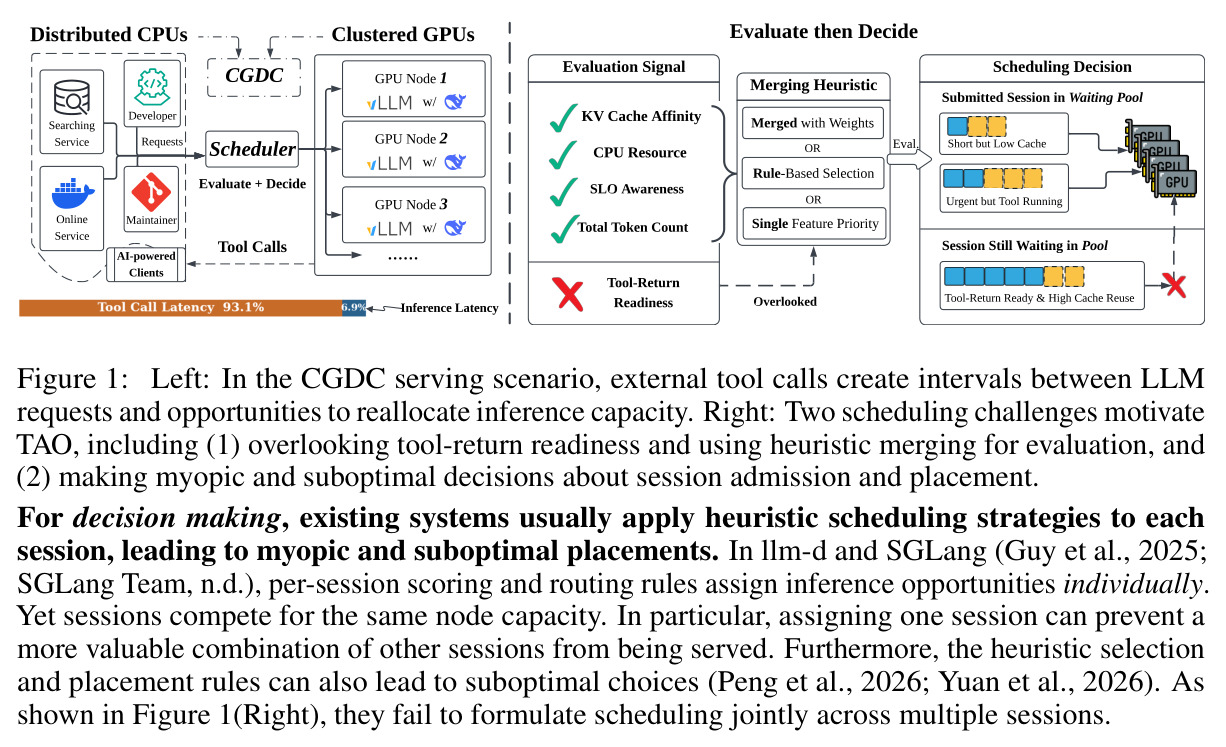
左图画出CGDC场景:集群GPU(多个节点)提供共享推理容量,开发者和AI客户端发出的智能体会话在执行中调用外部工具(分布式CPU),工具调用在LLM请求之间制造空窗,这既是延迟也是重新分配GPU的机会;右图展示两大挑战:评估信号(KV缓存亲和、SLO感知、推理延迟、总token数、工具返回就绪度被忽视)经规则或加权合并成启发式决策,以及『紧急但工具还在跑』『短但缓存低』这类会话被规则逐个评判导致的短视放置。
一张图同时交代了问题场景定义(CGDC)和现有系统两大缺陷,是理解论文动机和问题形式化的入口。
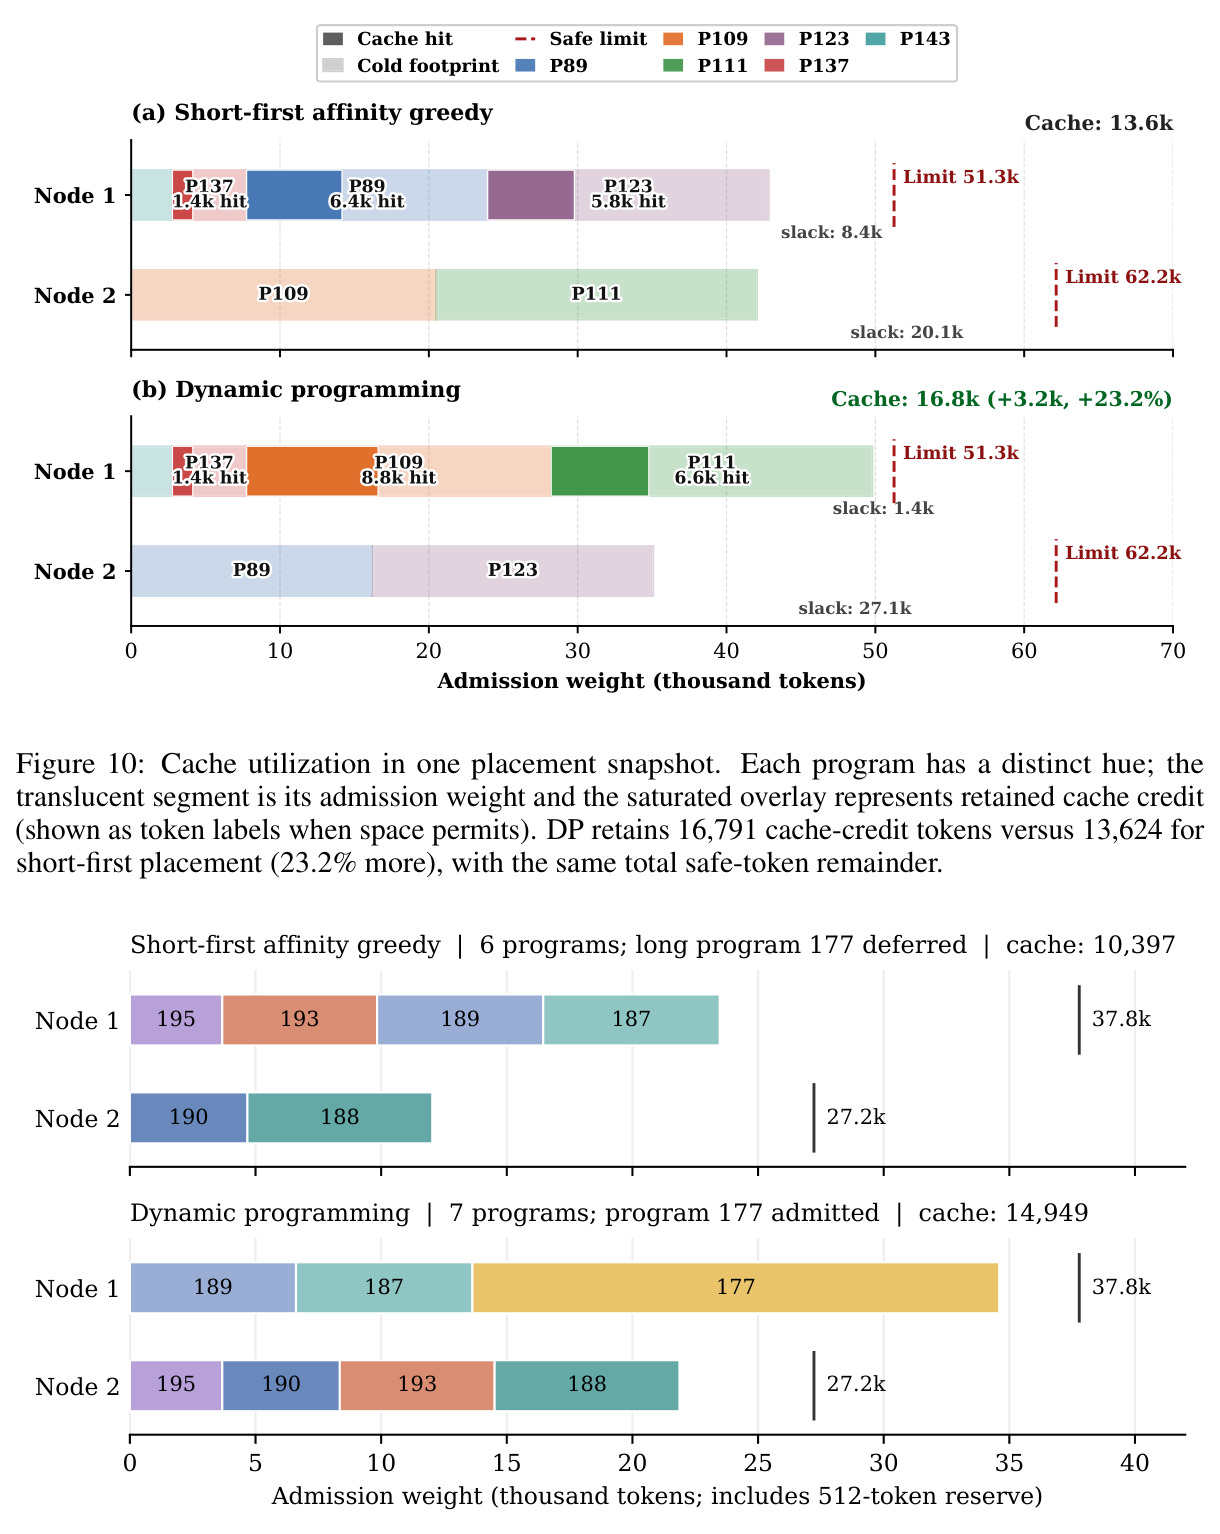
重构的重放快照对比:动态规划在同一状态下准入7个会话,而短作业优先启发式准入的会话更少(文中提到短优先只部分胜出),展示联合优化对准入数量与组合质量的提升。
具体案例说明DP『看到全局组合』的价值,是对4.3节DP改进26.1%快照这一统计的可视化注脚。
混合负载兼容性:DeepSeek-V4 Flash 2节点×4×H100,389个Terminal-Bench+SWE-Lite任务与800个AutomationBench自动化任务,32/64/128并发。混合编码负载64并发下TAO延迟-23.2%、TTFT-22.5%;AutomationBench 64并发下延迟-17.1%、TTFT-48.5%;但128并发时TAO三项全面落后(延迟-7.0%、TTFT相对最优基线-504%即19.123秒、吞吐-11.2%)。
既展示异构负载兼容性,也暴露了方法在超高压自动化负载上的失效模式,是评估局限性的关键证据。
附录F的固定轨迹重放:393条AgentX轨迹、1M token上下文上限、1800秒分析窗,16/32/64并发。TAO解码吞吐在所有并发下最高(+4.2%/+1.8%/+10.1%),16并发TTFT最低(4.756秒),但32/64并发TTFT输给vLLM CA(-14.4%/-8.1%),32并发延迟持平。
在第三方轨迹语料上独立验证吞吐优势,同时诚实暴露了cache-aware基线在纯重放场景的TTFT竞争力。