SoK:网络控制环路中的语义决策引擎 SoK: Semantic Decision Engines in Network Control Loops
系统梳理139个论文家族,揭示语义决策引擎进入网络控制环路的证据缺口,并给出准入测量与设计规则
前置知识
O-RAN RIC 与控制时延层级
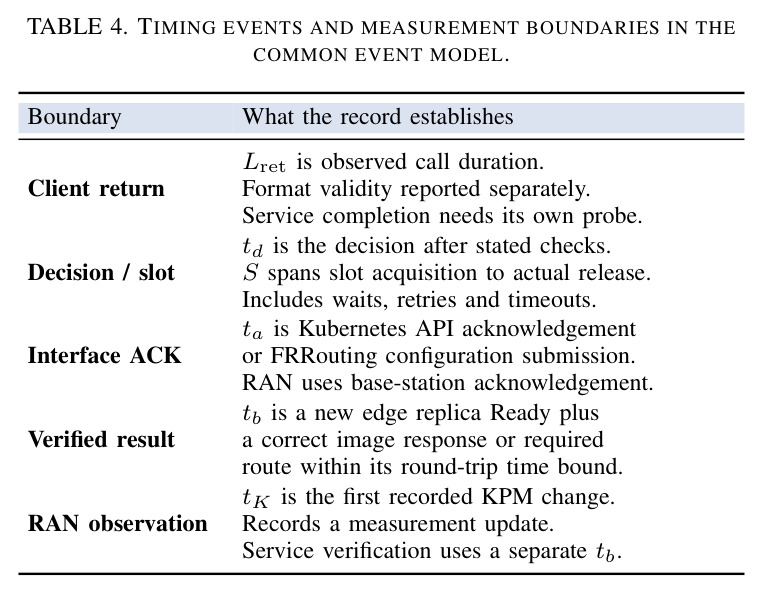
O-RAN 架构把 RAN 智能控制器分为非实时 RIC(rApps,约 1s 以上,负责策略)与近实时 RIC(xApps,约 10ms–1s),设备内部还有更快的实时控制。rApps 通过 A1 接口下发策略,xApps 通过 E2 接口读取测量(如 KPM 关键性能测量)并下发控制;控制确认与后续 KPM 变化是两个不同的里程碑,服务验证还需要独立的探针。
论文用这套层级定义控制环路预算的锚点:语义决策引擎的解释时延(0.286–2.352s)必须与 A1/E2 的毫秒级时间放在一起评估,文中所有 RAN 实验数据都在这一框架内解读。
意图网络与意图驱动管理
意图网络(IBN)让运维者用自然语言或声明式意图表达目标,由系统完成翻译、验证与持续保障。相关标准包括 3GPP TS 28.312(意图驱动管理服务)、TS 23.288/28.104(NWDAF/MDA 分析功能)、TM Forum TMF921 意图管理 API,以及 IRTF 的 RFC 9315/9316(概念与意图分类),ETSI ZSM 架构进一步定义闭环自动化治理。
本文综述的对象正是语言接口进入网络决策,这些标准定义了意图在管理、编排、控制各层的职责边界,是三轴系统化中执行路径轴的映射目标。
决策接口三分类:选择/生成/确定性计算
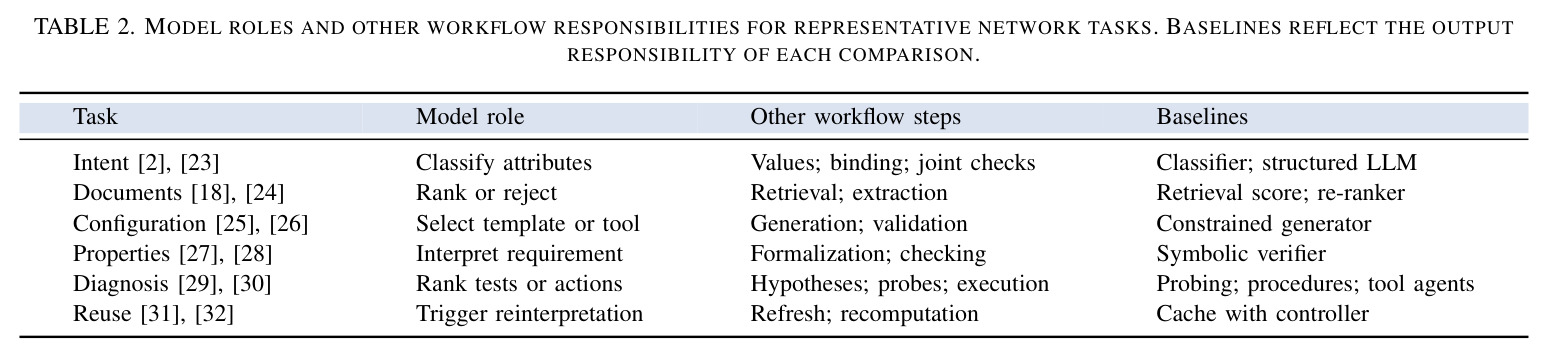
按输出责任划分:选择(Selection)从控制器给定的候选集中选一个成员,可包含拒绝、澄清或升级;生成(Generation)构造原本不存在的内容(字段、配置、计划),格式由 schema 或语法约束,语义由任务谓词决定;确定性计算(Computation)用规则、求解器或验证器求值或合成满足解。一个工作流可以同时使用三种接口。
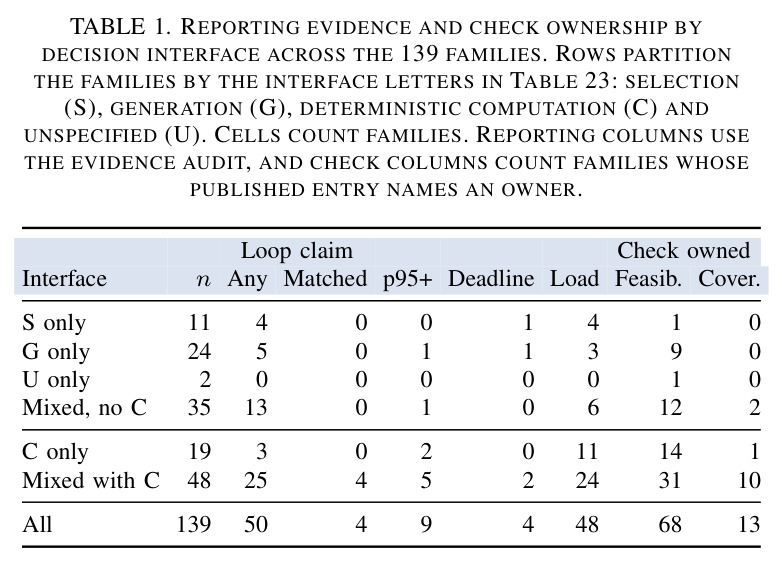
这是系统化的第一条轴。审计发现检查归属和负载证据集中在含确定性计算步骤的家族(可行性归属 45/67 vs 23/72),接口分类直接决定哪些环路声明可信。
统一事件模型与负载指标 ρ
论文把一次决策拆成事件序列:意图到达 $t_0$、离开决策队列 $t_q$、决策通过 schema 检查 $t_d$、执行接口确认 $t_a$、探针验证结果 $t_b$,记 $Q=t_q-t_0$、$D=t_d-t_q$、$T_a=t_a-t_0$、$T_b=t_b-t_0$;负载用 $\rho=\lambda E[S]/c$(到达率乘以平均槽占用时间除以决策槽数),$\rho<1$ 是开放负载不积压的必要条件,截止期达成率为 $b_{pe}(B)=\frac{1}{|A|}\sum_{i}\mathbf{1}\{T_{e,i}\le B\}$。
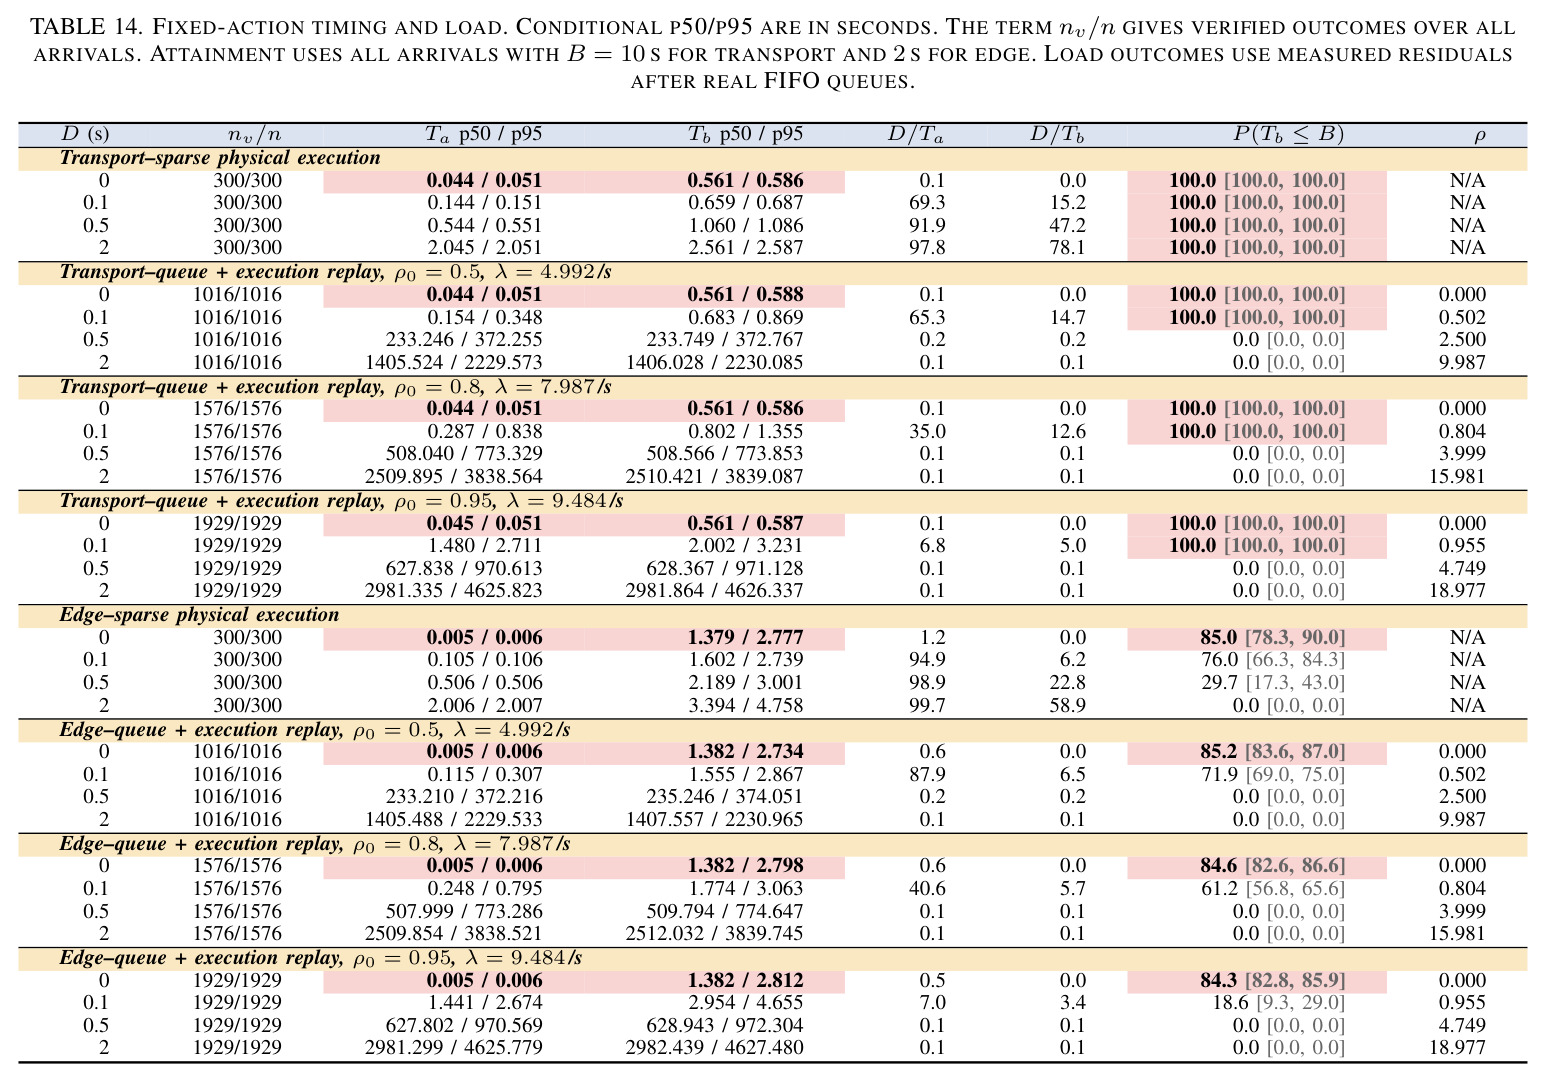
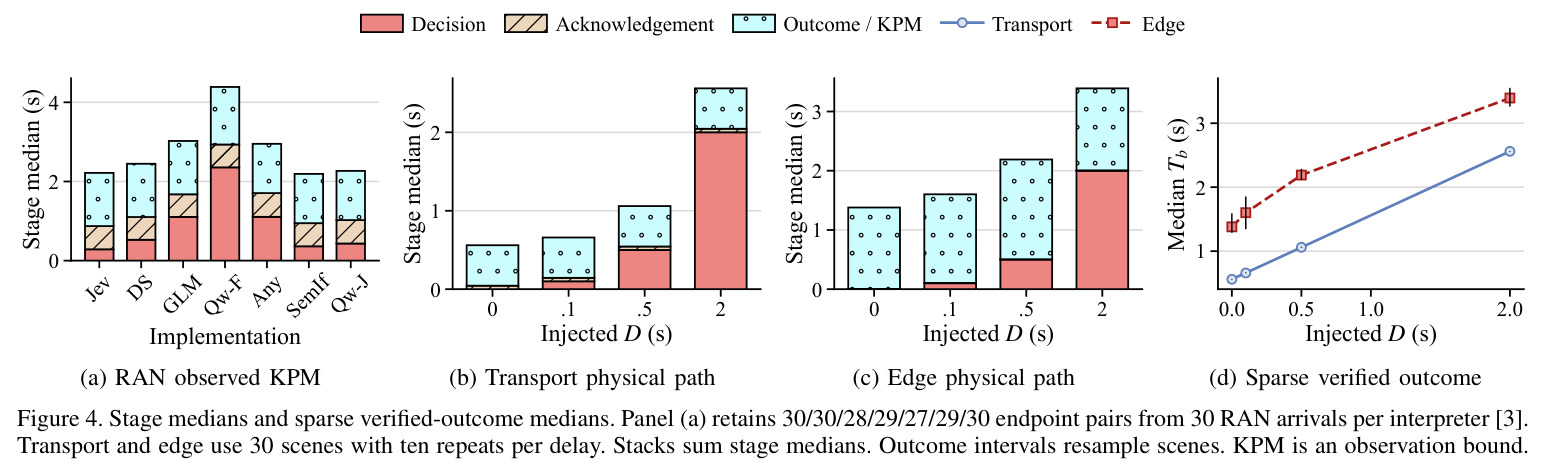
端点不同,决策占整个时延的比例完全不同(0.5s 决策占传输确认的 91.9%、验证结果的 47.2%),论文全部负载实验与队列放大结论都建立在这套记号上。
三道正确性关卡 G1/G2/G3
G1 是 schema 或接口格式有效性,分母是全部到达请求;G2 是任务谓词满足性,包括任务要求最小代价选择时的代价检查,分母是适用到达;G3 是经探针验证的正确终态,失败、超时、回退都保留在分母内。任务谓词允许时,有依据的拒绝或升级也算正确终态。
语义决策引擎的典型失败正是格式对但语义错(G1 过 G2 不过)或决策对但服务未生效(G3 缺失),三关分的分母是论文最低报告记录的核心,也定义了实验的正确性指标。
SoK 证据审计与编码信度
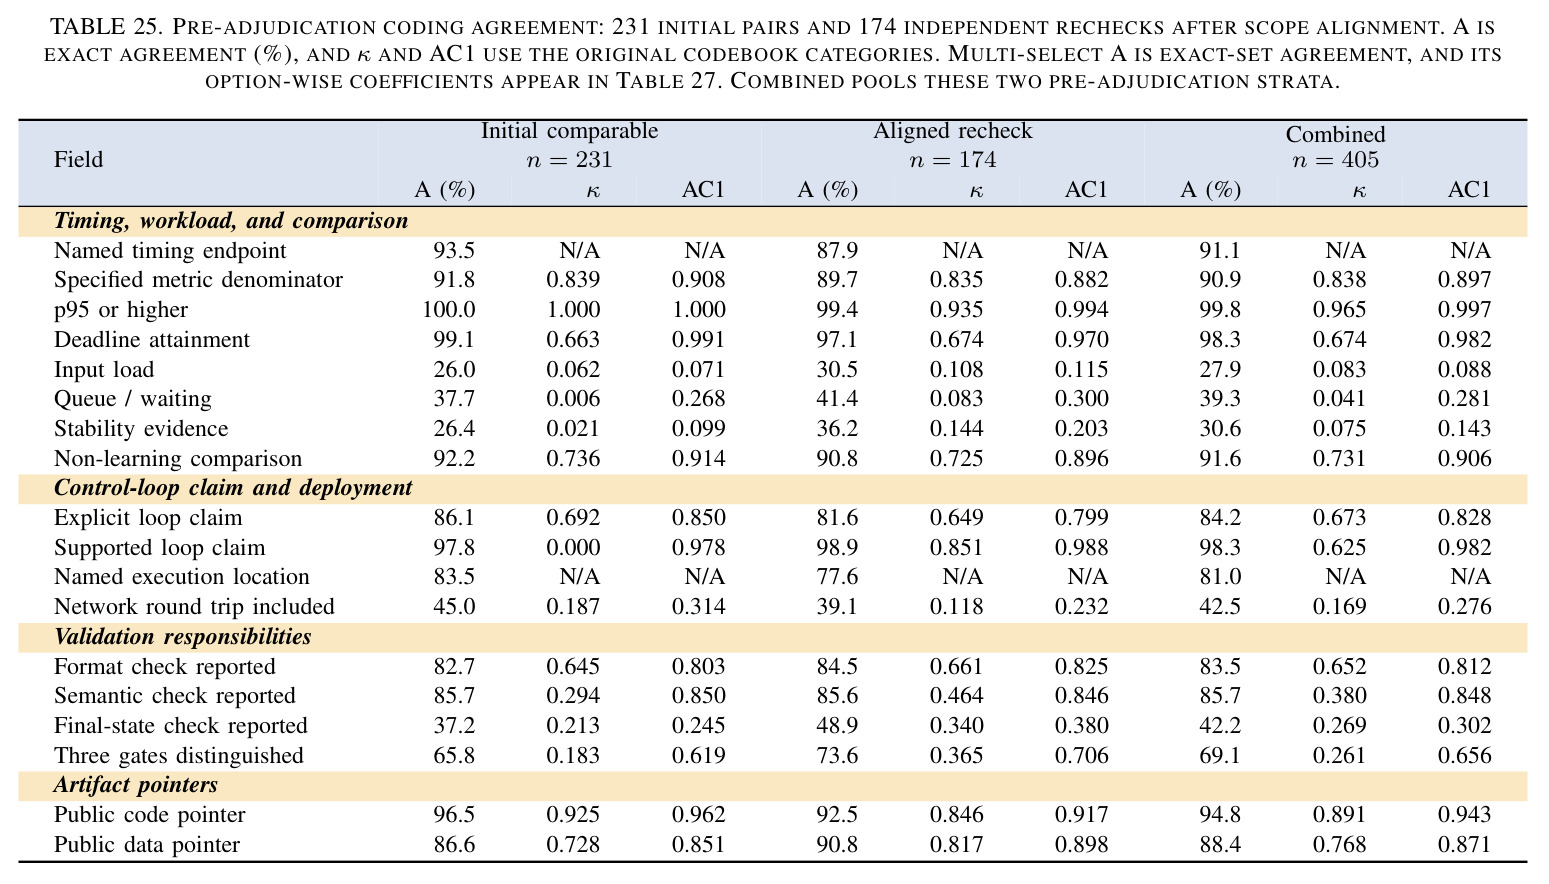
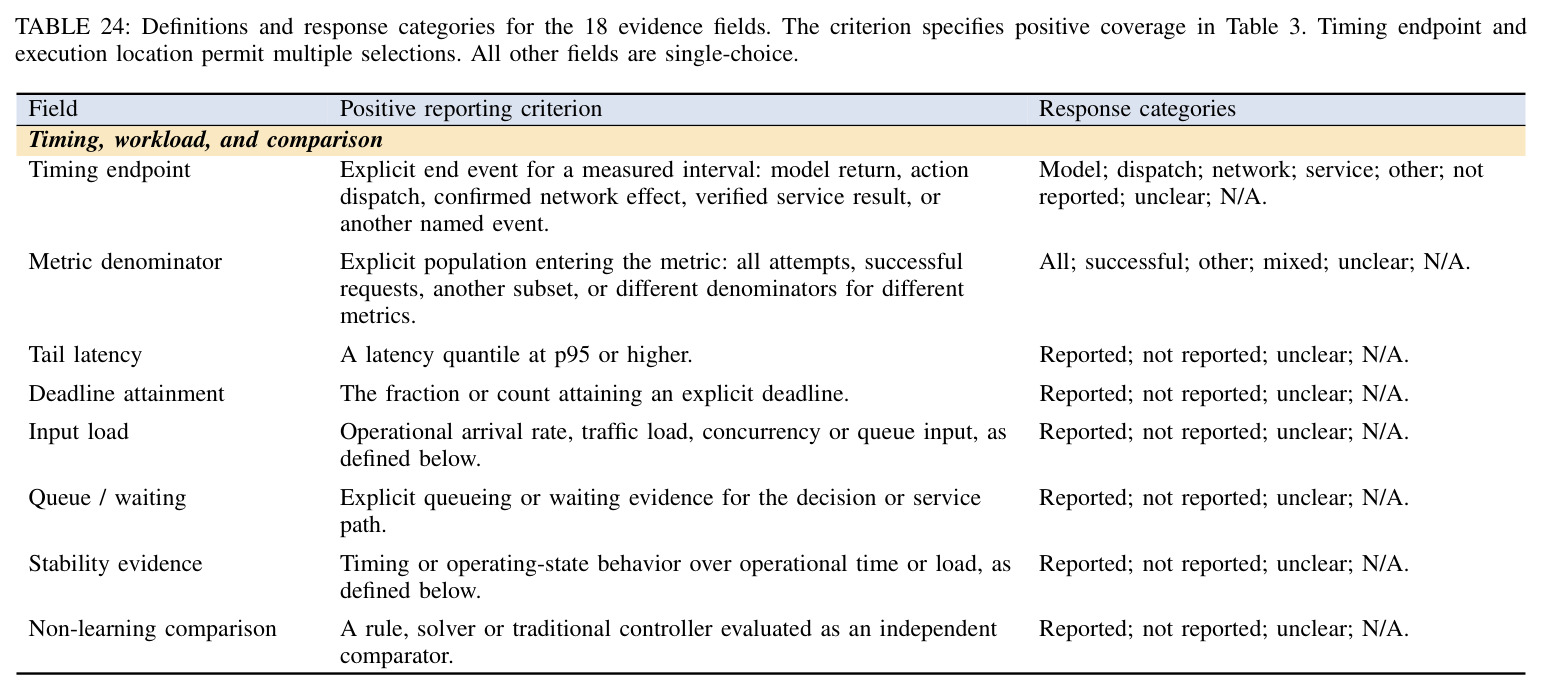
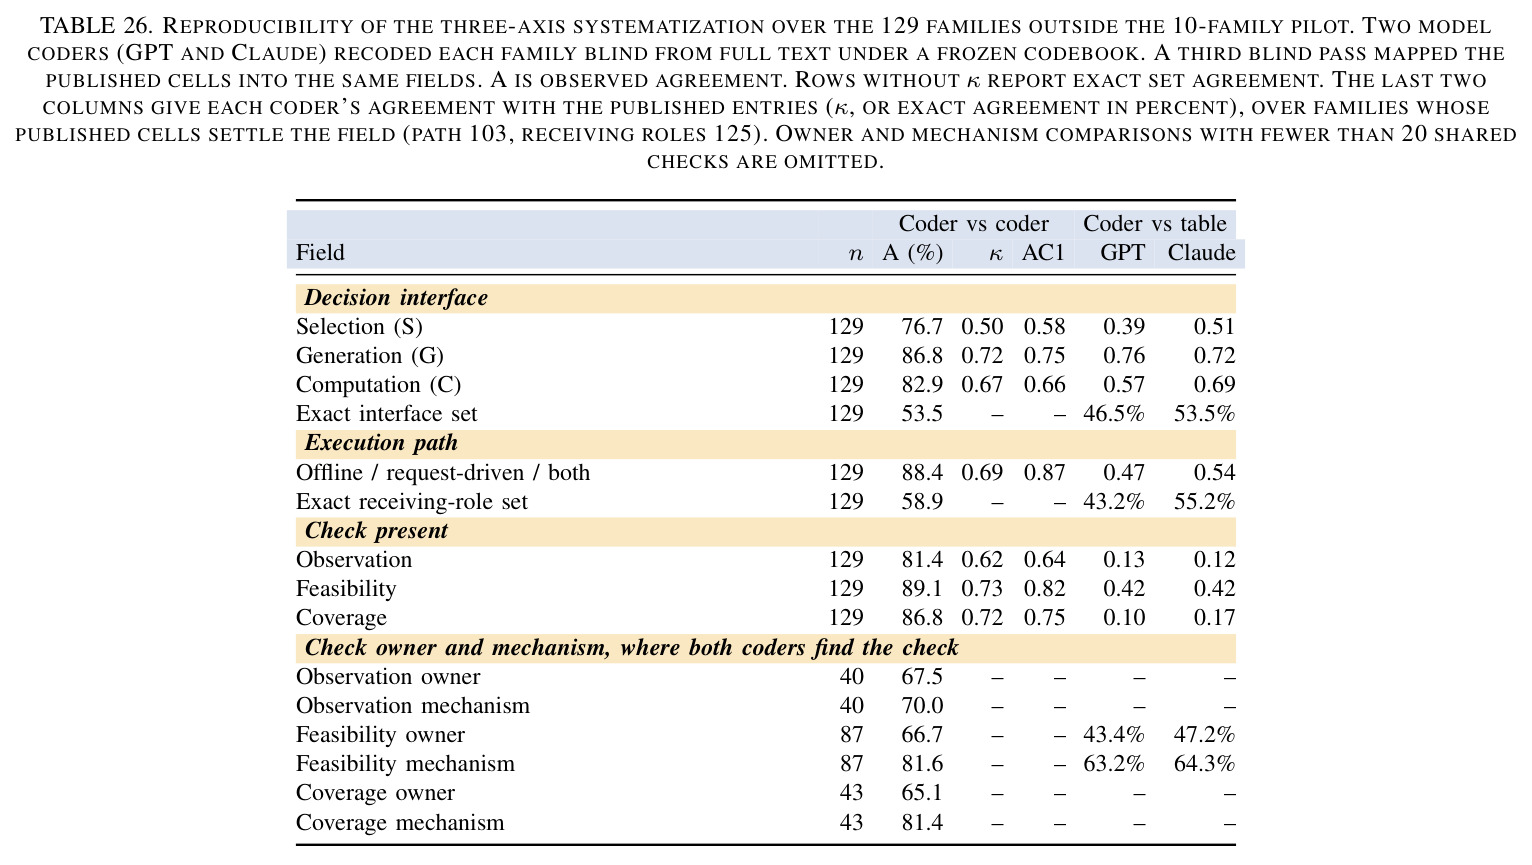
系统化知识(SoK)论文要求对文献做可复现的梳理。本文使用 18 字段编码簿、两位研究者独立编码加仲裁,并让 GPT 与 Claude 两个模型编码器盲重编码检验可复现性;覆盖率用 10000 次 bootstrap(种子 42)按整个论文家族重采样给出 95% 区间,编码信度用 Cohen 的 κ 与 Gwet 的 AC1 度量,低信度字段明确拒绝给出覆盖率结论。
读懂 50/139、4/139 这类数字的分母与可信度需要理解这套方法学,也才能明白为什么队列证据(κ≈0.041)这类字段被作者主动降权处理。
研究动机
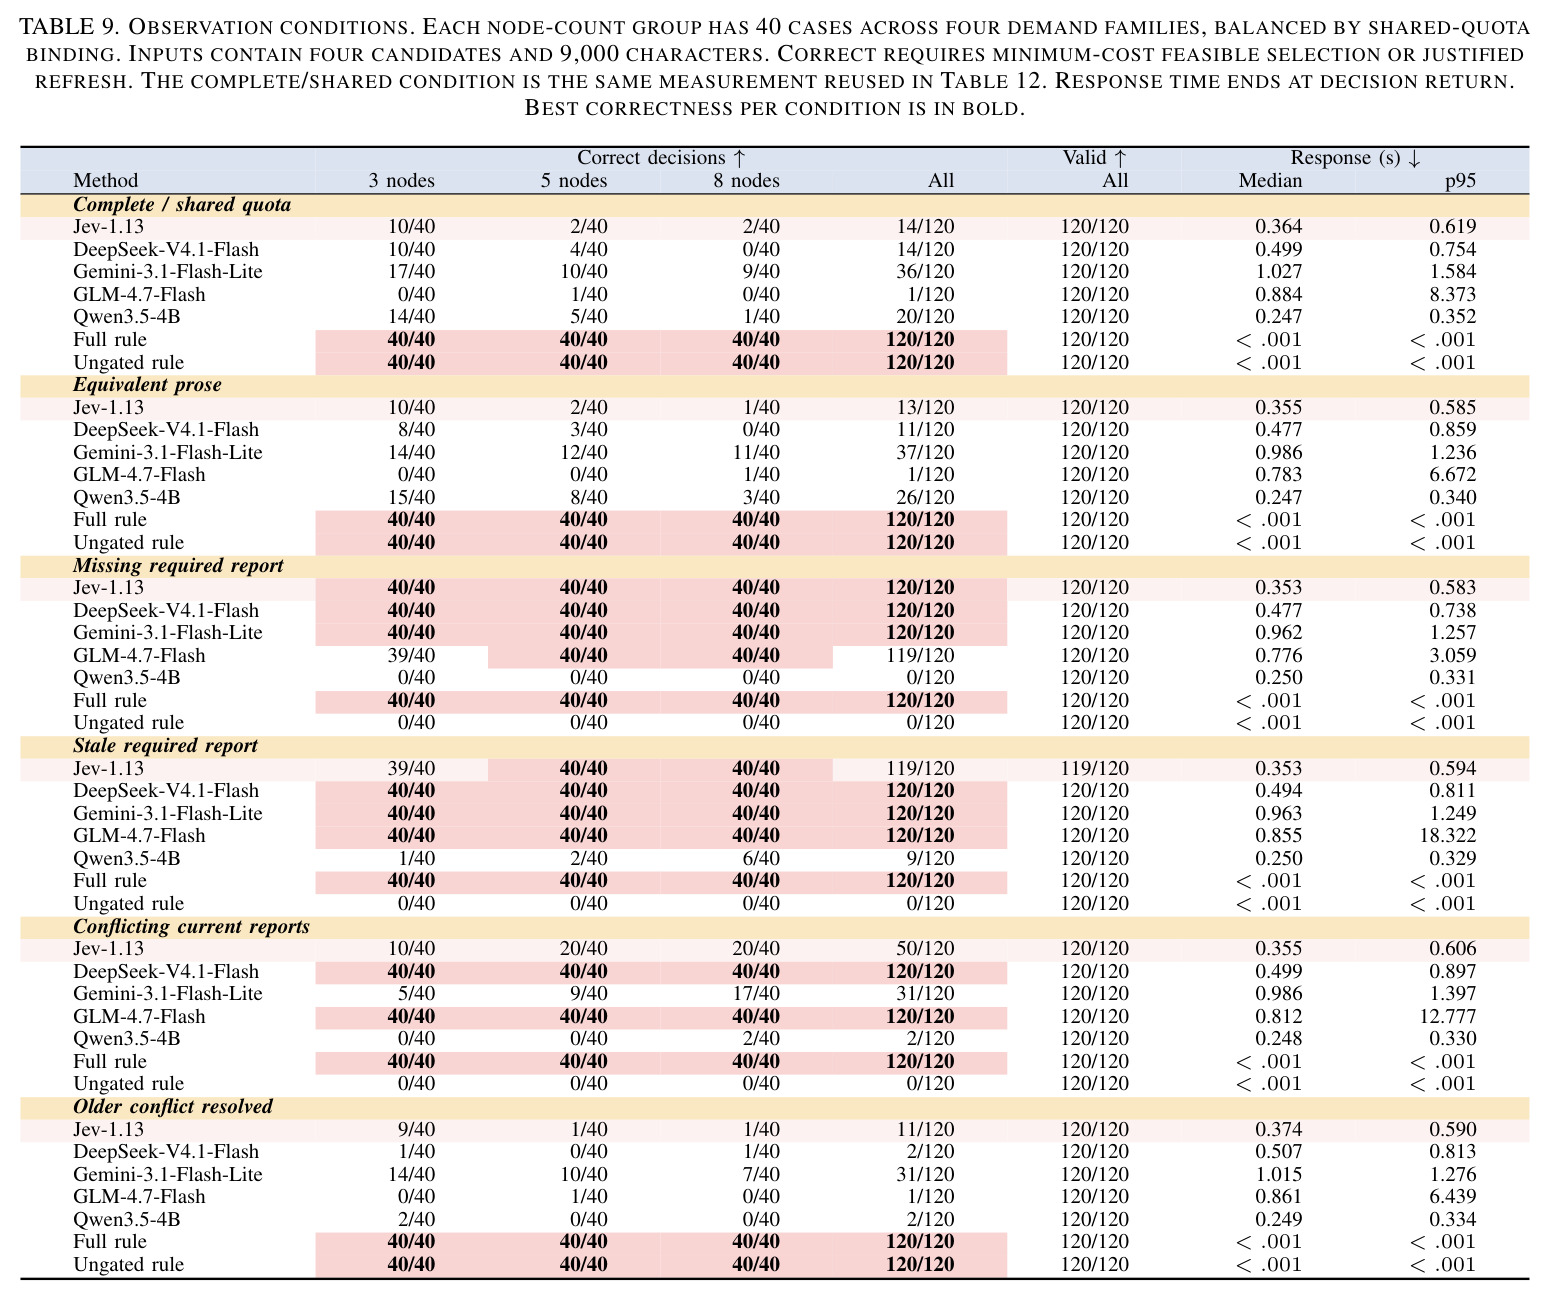
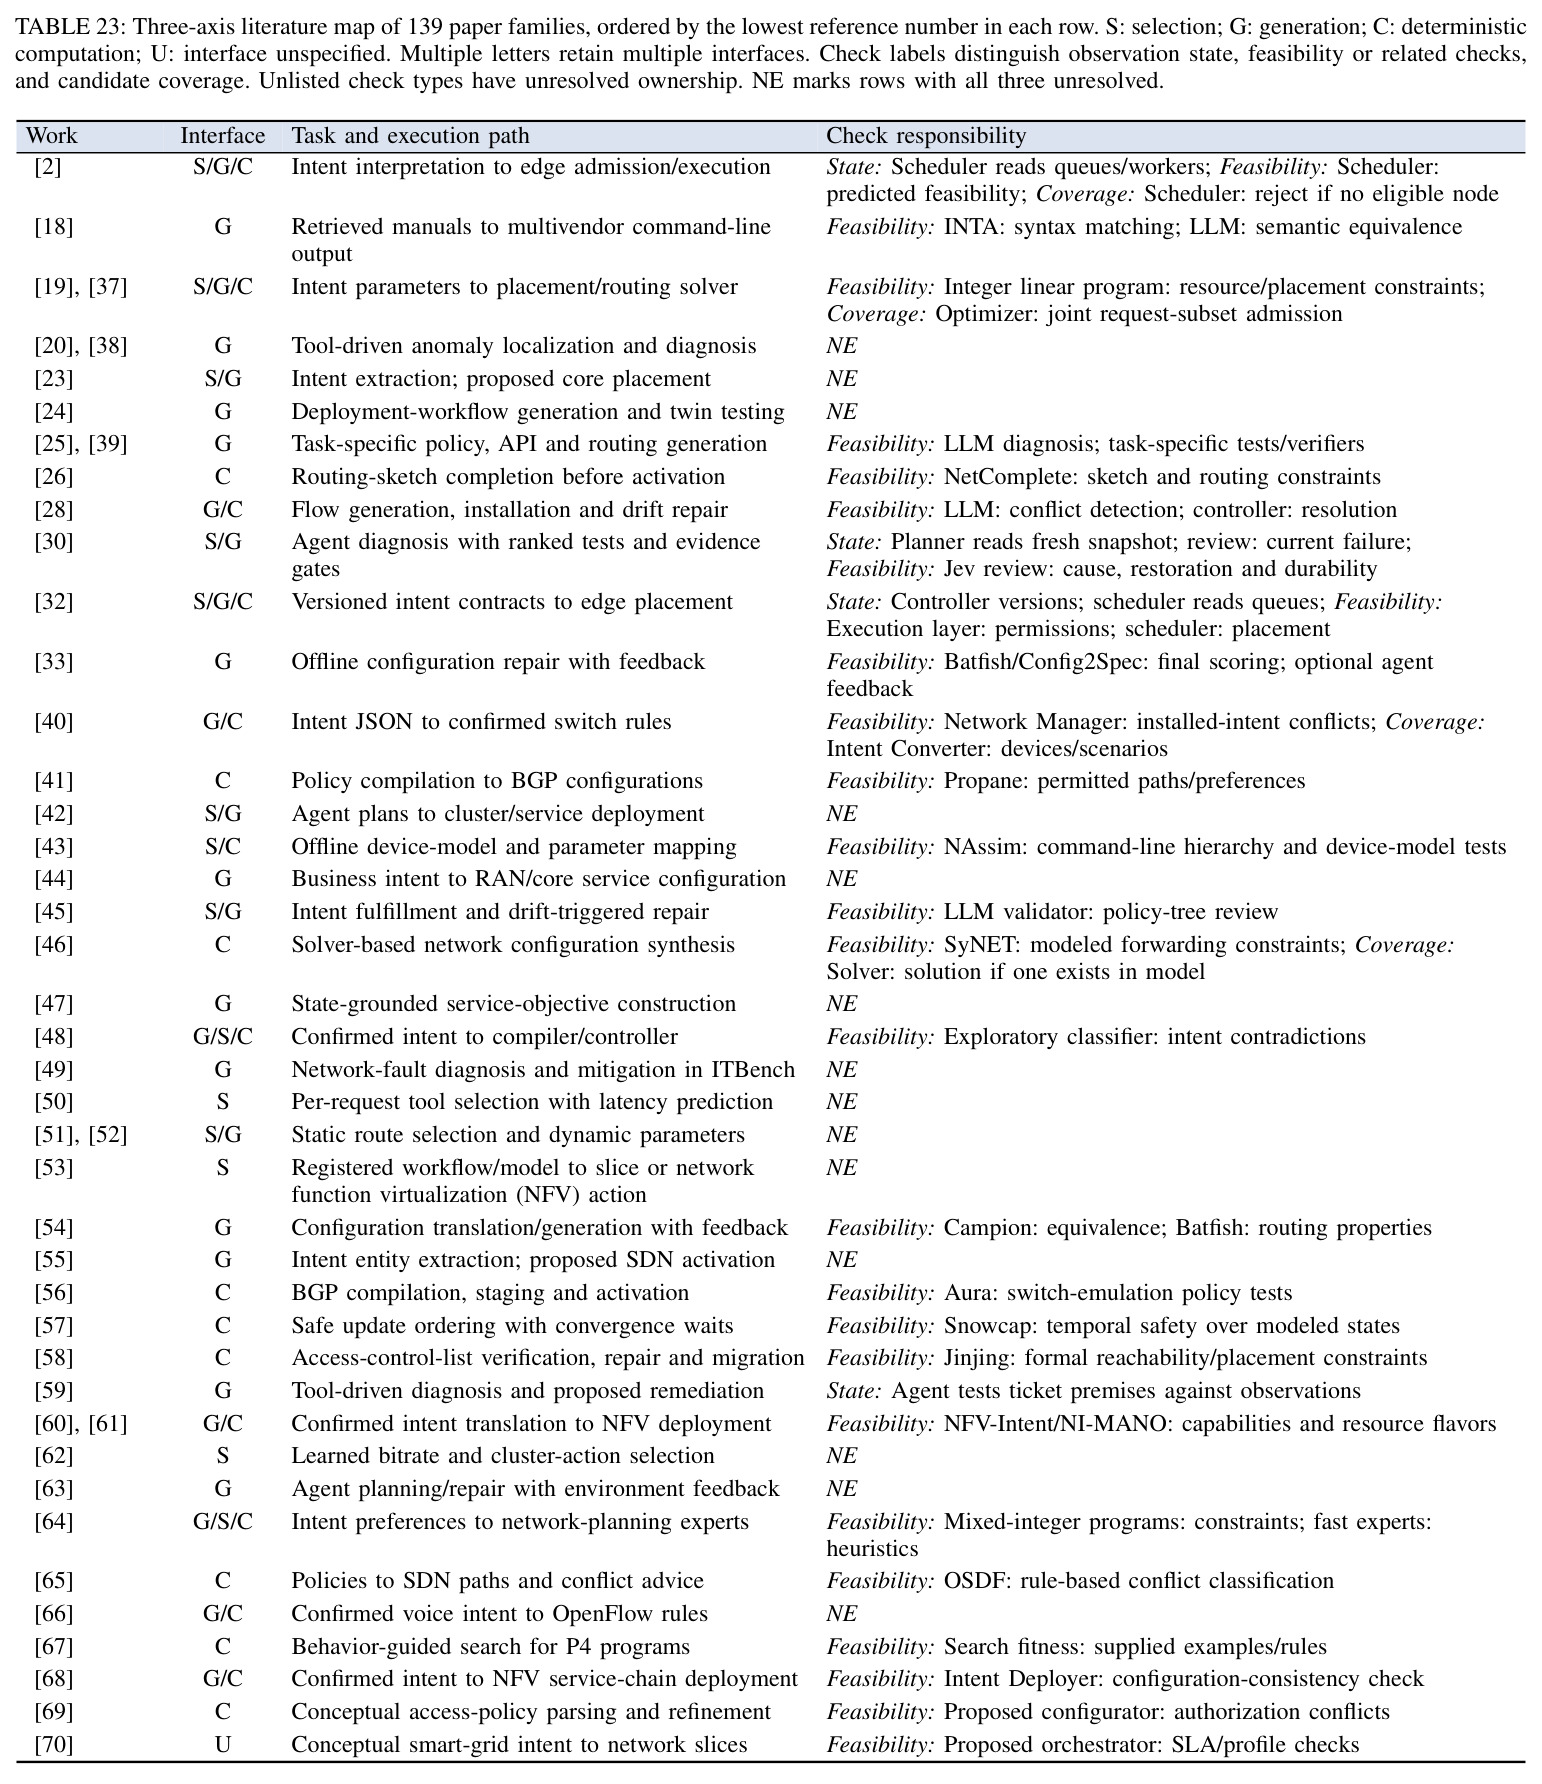
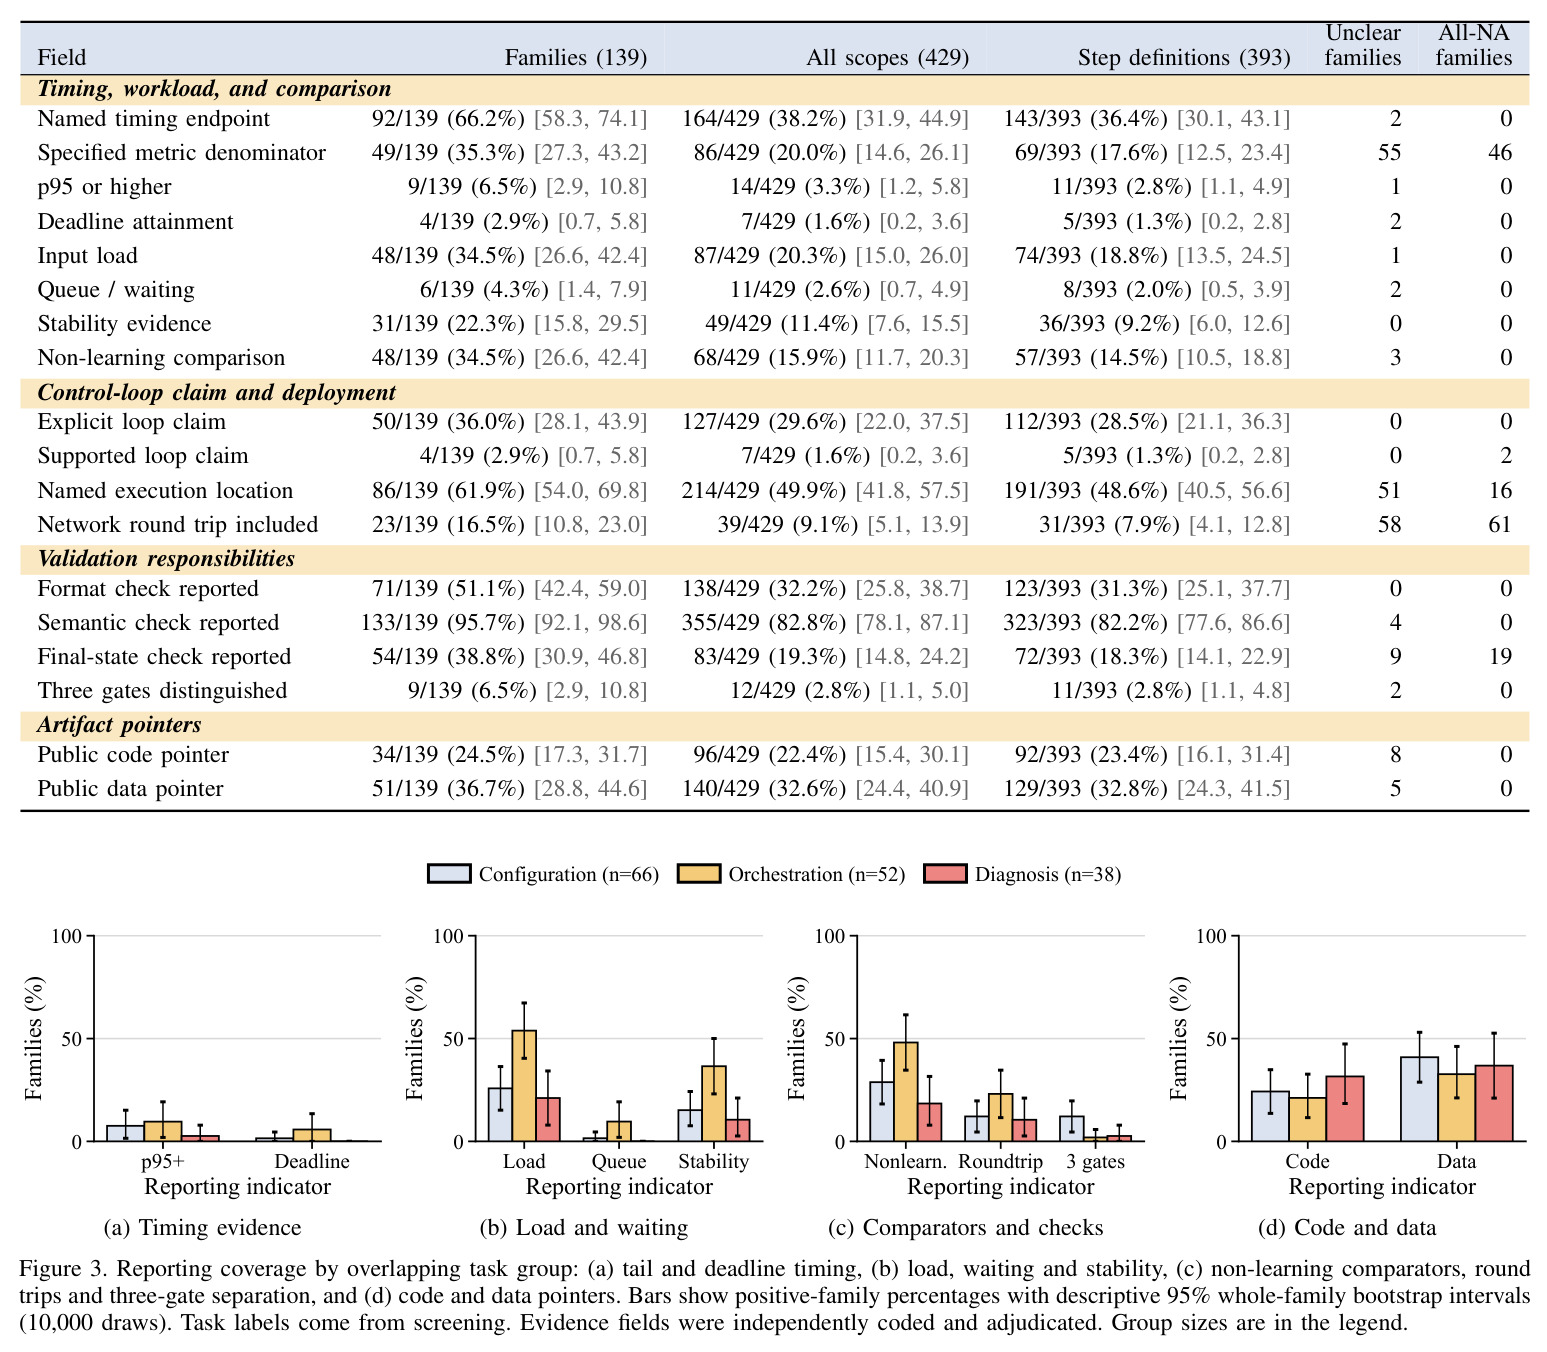
语言接口让网络运维请求更容易表达,但同时也把控制器的一部分职责转移给了解释器:它可能要在控制器给的候选集中做选择、补全请求缺失的字段、或把请求形式化后交给规则或求解器。问题在于,一个 schema 合法的输出仍可能对网络是错的——它可能超出共享配额、来自不完整的目录、或建立在相互矛盾的观测之上;反之,一次有依据的拒绝也可能才是正确结果。时间上更苛刻:O-RAN 近实时 RIC 在 10ms–1s 量级运行,状态收集、通信、决策等待、控制下发和观测都要分享这份预算。而文献几乎从不测量完整路径:本文审查的 139 个论文家族中,50 个声称其引擎适配某控制环路或时间预算,但只有 4 个用在所声称边界上的匹配测量支持了声明;只有 9 个报告 p95 及以上尾延迟,仅 4 个报告截止期达成率。更严重的是,72 个决策没有确定性计算步骤的家族贡献了 50 条声明中的 22 条,且无一有匹配测量,其中只有 23 个指明可行性检查归属、仅 2 个指明覆盖检查归属。
本文的目标是本文要回答两个问题:哪些网络控制环路可以接纳语义决策引擎(LLM 或 Jev 类决策模型),以及接纳时控制器必须保留哪些检查。为此它产出四件东西:其一,一个可复现的三轴系统化——按决策接口、控制与执行路径、检查归属对 139 个论文家族编码,并映射到 O-RAN、3GPP、ETSI 的标准化网络功能;其二,一次带独立编码和显式分母的证据审计,找出哪些环路声明真的有测量支持,并给出一份最低报告记录;其三,一组有界实验,证明缺失的测量和检查会实际翻转准入判定而不仅是理论风险;其四,从每个审计缺口推导出的引擎准入设计规则与研究议程。
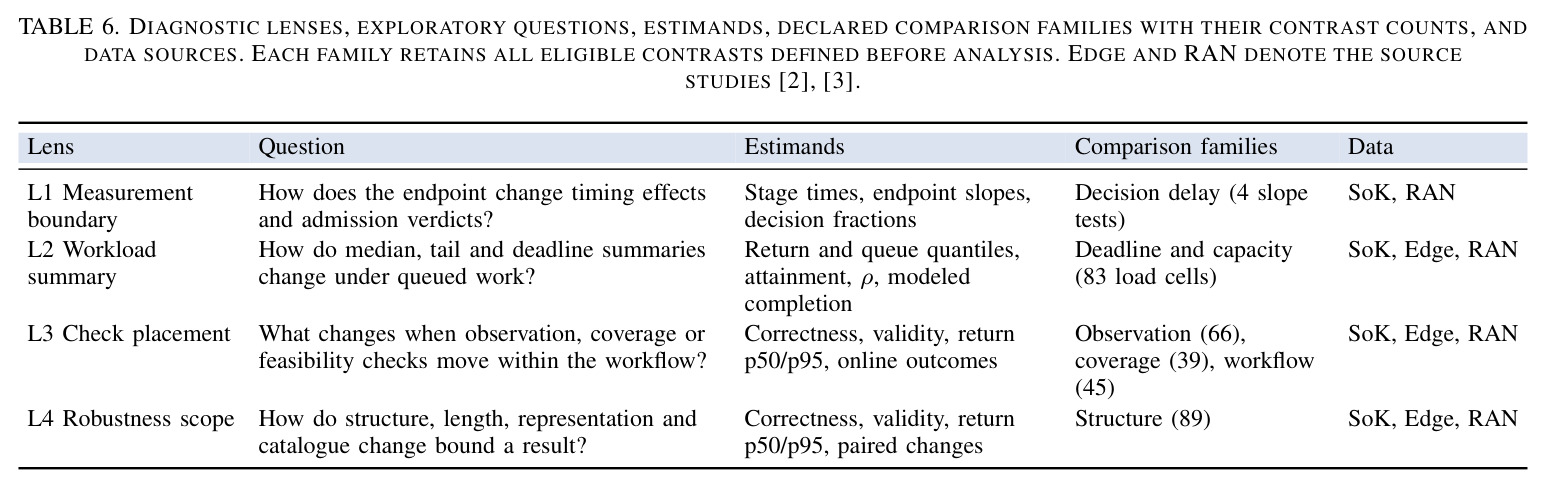
与已有工作不同的是,已有综述通常按是否使用 LLM 或按网络域分类,本文的独特切入有三点。第一,按输出责任而非模型类型分类接口(选择、生成、确定性计算),使不同实现可以在相同输出、相同信息、相同下游检查的条件下比较,与厂商和内部是否用语言模型无关;第二,把检查归属(观测核对、联合可行性、候选覆盖)作为一等编码维度,并发现它系统性集中在有确定性计算步骤的家族,这解释了纯语言方案的声明为何普遍缺乏支撑;第三,不满足于统计缺口,而是构造统一事件模型下的四个诊断透镜(测量边界、负载汇总、检查位置、鲁棒性范围),把服务编排研究、RAN 研究和自建应用任务实例化为同一框架,用固定动作延迟干预隔离决策延迟的影响,逐个演示每个缺口如何把一次准入判定从通过翻转为拒绝。
核心方法
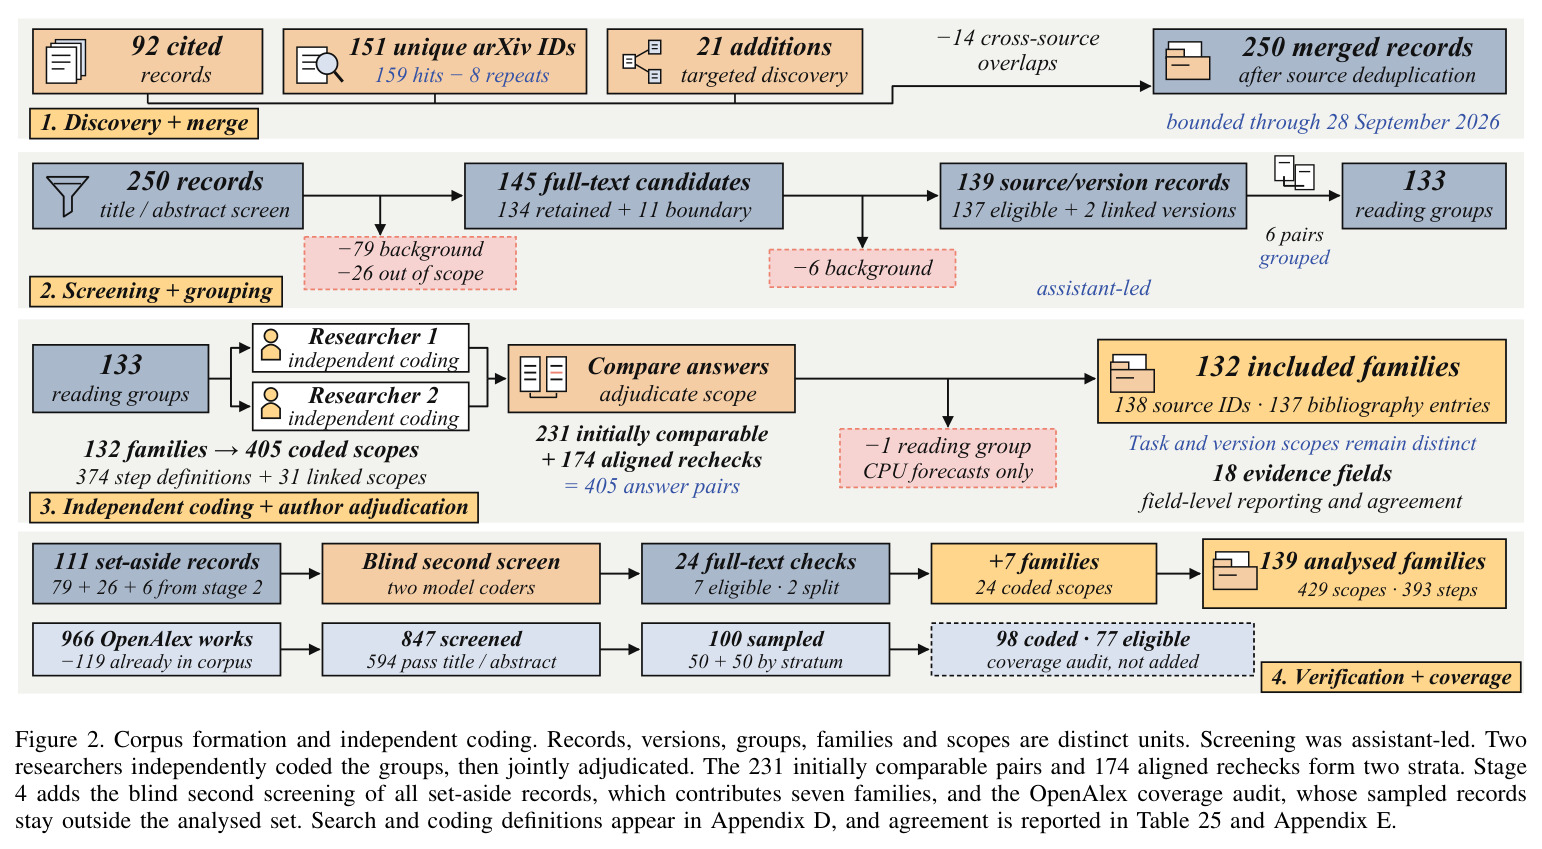
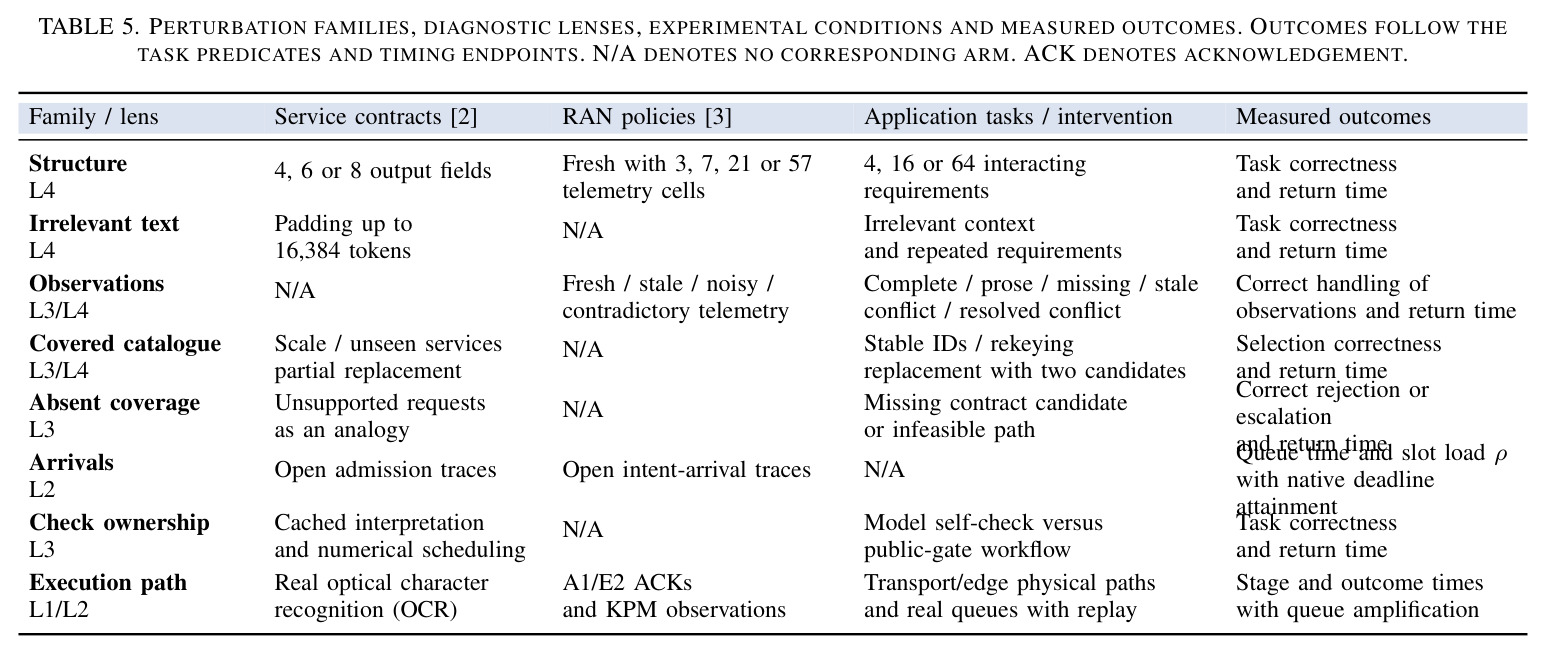
直觉上,语义决策引擎能否进入控制环路,不取决于它在孤立请求上的平均表现,而取决于三件事:从到达 $t_0$ 到验证结果 $t_b$ 的完整路径是否在预算内、负载排队后截止期达成率是否还成立、以及可行性、覆盖、观测三类检查由谁负责。技术上论文分四步:第一步,以 92 条引文种子加三条固定 arXiv 检索式、出版商页面发现和一轮回溯引文得到 250 条记录,筛出 139 个论文家族(133 个阅读组),编码为 429 个范围(393 个步骤定义加 36 个链接范围);第二步,两位研究者按 18 字段编码簿独立编码并仲裁,另有 GPT 与 Claude 两个模型编码器盲重编码三轴以验证可复现性;第三步,在统一事件模型下用四个透镜做有界实验——传输域用 containerlab 加 FRR 的八路由器环形拓扑,边缘域用 k3d/k3s 的五镜像工作负载,RAN 数据借自已发表研究;第四步,把每个缺口的测量后果归纳成六条设计规则。
核心创新是验收点加检查归属的框架转换。与已有工作不同,论文坚持在引擎输出改变网络工作流的那一点评估引擎:用 $b_{pe}(B)$ 这样的截止期达成率(未到达端点记为失败、失败原因保留)替代平均或孤立延迟;用 $\Pr(\hat{a}_i\in A_i)=\Pr(K_i=1)\,\Pr(\hat{a}_i\in A_i\mid K_i=1)$ 把存在可接受输出(覆盖指示 $K_i=\mathbf{1}\{C_i\cap A_i\neq\varnothing\}$)与有覆盖时选对分开,从而说明引擎自检无法替代控制器对覆盖缺失的处理。实验上的关键技巧是固定动作延迟干预:30 个固定动作场景注入 0、0.1、0.5、2s 四档决策延迟,稀疏臂测各端点斜率,负载臂把延迟放入真实 FIFO 决策槽并重放测得的执行残差,从而把决策变快省多少时间、决策变慢毁掉多少截止期归因到队列放大本身。
方法步骤详情
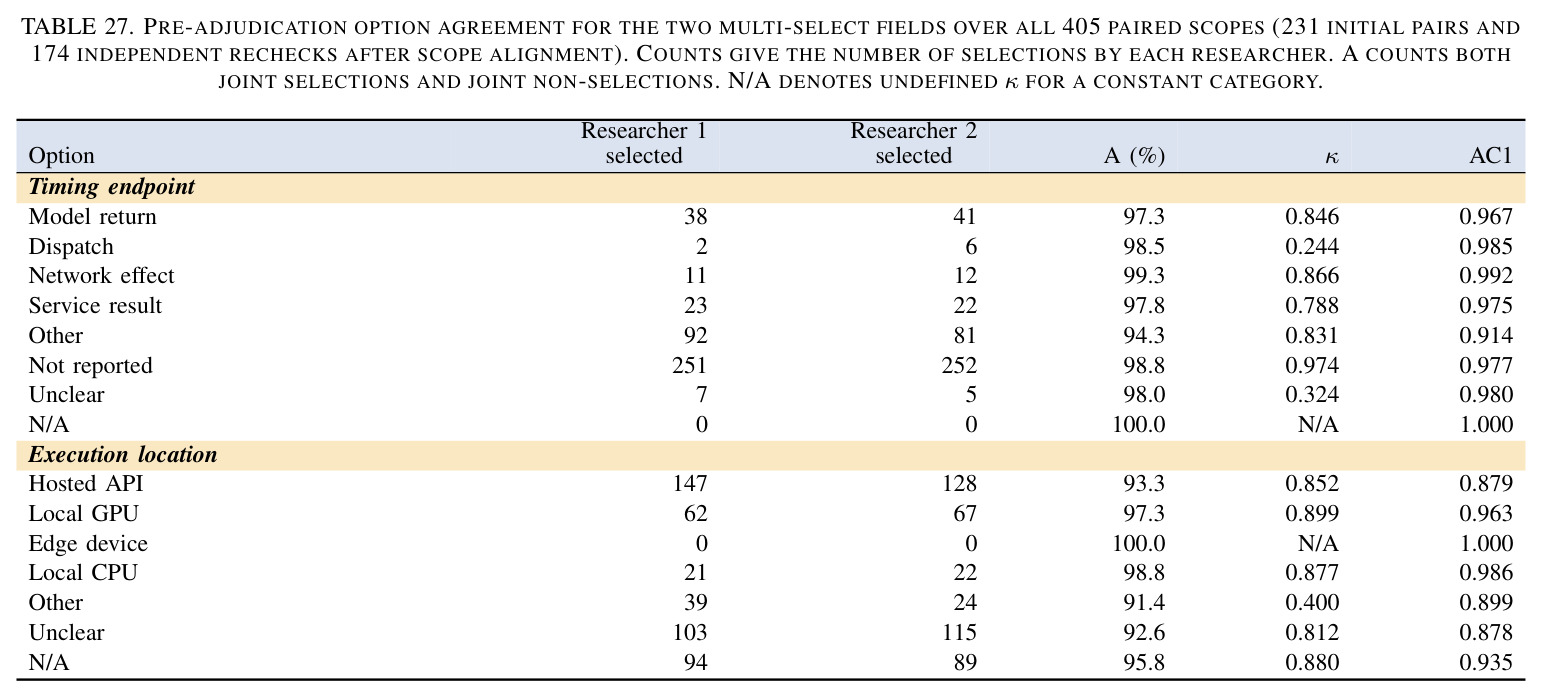
步骤如下。第一步检索与合并:92 条引文种子加三条 arXiv 检索式(159 命中、151 个唯一 ID)加出版商发现与回溯引文,去重得 250 条记录,筛出 139 个家族与 429 个范围(393 个步骤定义加 36 个链接范围);对 111 条被搁置记录做盲二次筛查(GPT 与 Claude 模型编码器,κ=0.661),找回 7 个家族;OpenAlex 覆盖审计的加权召回率与语料库一致。第二步编码:两位研究者独立编码 405 个范围(231 个初始对加 174 个对齐复检),18 字段覆盖时延、负载、环路声明、正确性关卡与公开指针。第三步实验:L1 稀疏物理臂每域 30 场景 × 10 次重复 × 4 档延迟(0/0.1/0.5/2s),负载臂以 200 次实测的 100ms 基线定 4.992/7.987/9.484 到达/s 三档,84 个真实 FIFO 队列排空 166432 个到达、分析预热后 126588 个;L2 复用 83 个负载单元;L3 在 120 个访问策略案例上做 public-gate 对照,配对 McNemar 加 Holm 校正;L4 沿输出字段、遥测小区、需求三条轴做结构扰动。第四步把每个缺口的测量后果归纳成六条设计规则。
技术新颖性
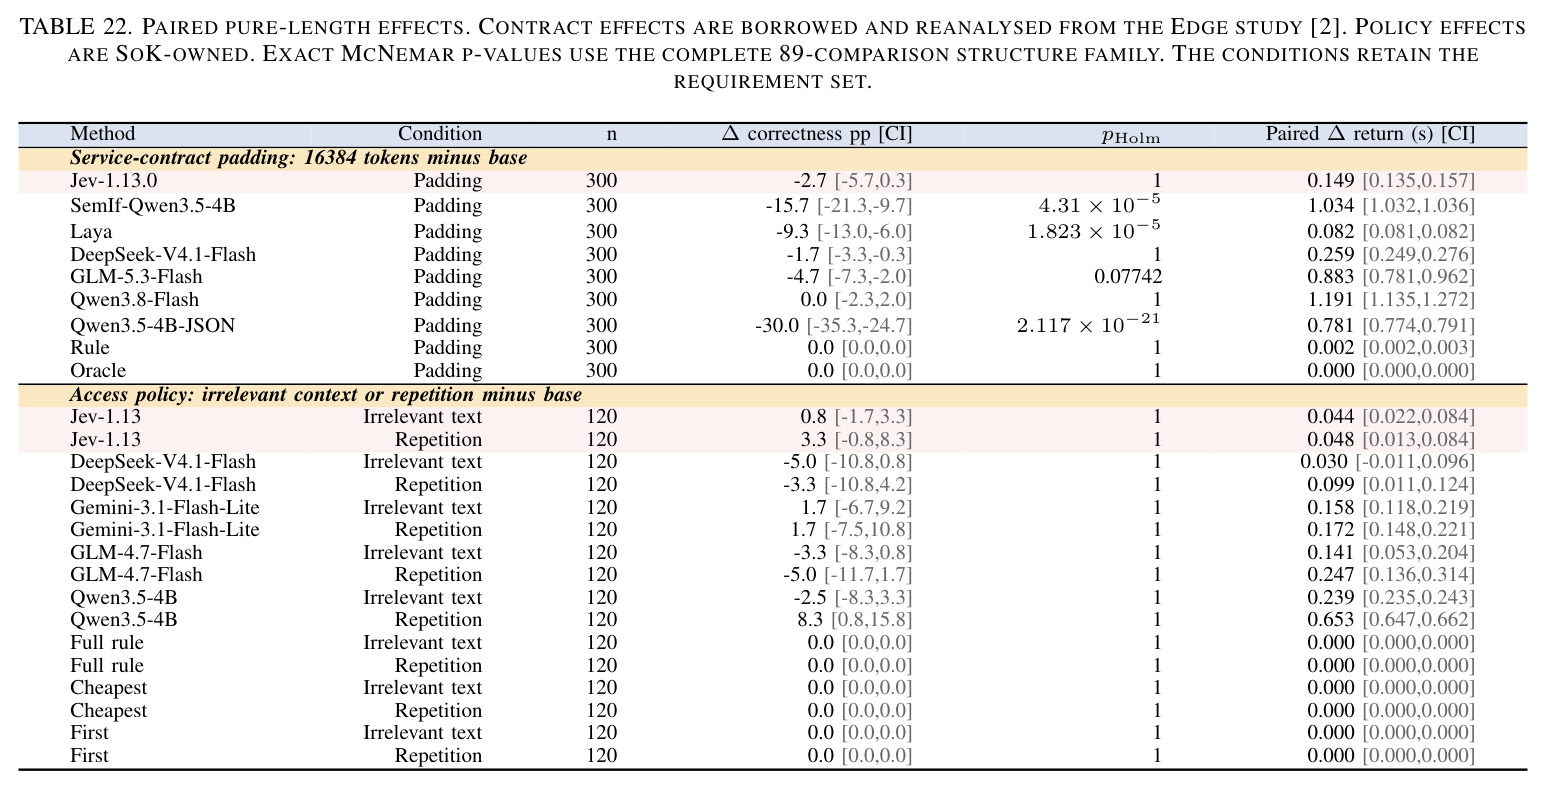
技术新颖性有四点。其一,验收指标从延迟分布换成指定端点的截止期达成率,并把观测窗口、分母(全部到达对观测到端点者)与失败原因显式化,直接击中文献只报中位延迟的惯例。其二,检查归属被证明不可省略:同一引擎在一项覆盖检查上得 45/48、在另一项上只有 4/120,说明引擎是否可靠不是引擎的属性而是工作流设计的属性。其三,系统化本身做了可复现性实验:让 GPT 与 Claude 两个模型编码器对 129 个家族盲重编码三轴,执行路径 κ=0.69、生成与计算接口 κ=0.72/0.67,同时坦承检查归属与负载字段信度低(κ 低至 0.041–0.083)并拒绝从中得出覆盖率结论,这种负结果披露在 SoK 中少见。其四,把三个来源研究放进一个事件模型且不合并效应,每个结论标注三段式判定(可重复、任务相关、未解决)与数据所有权(SoK 自有、借用再分析),把证据强度分层呈现。
实验结果
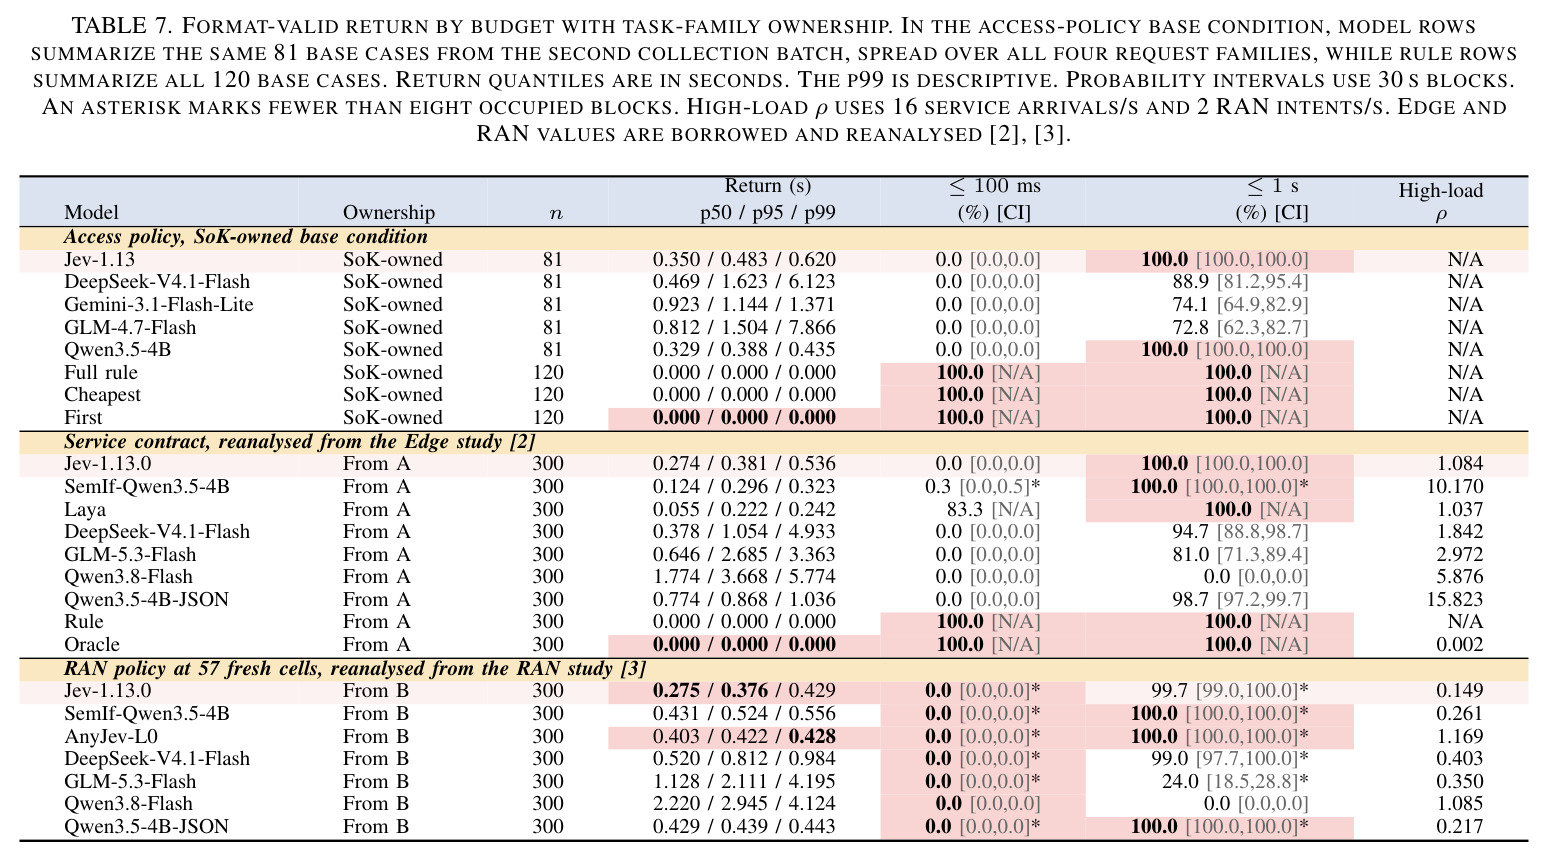
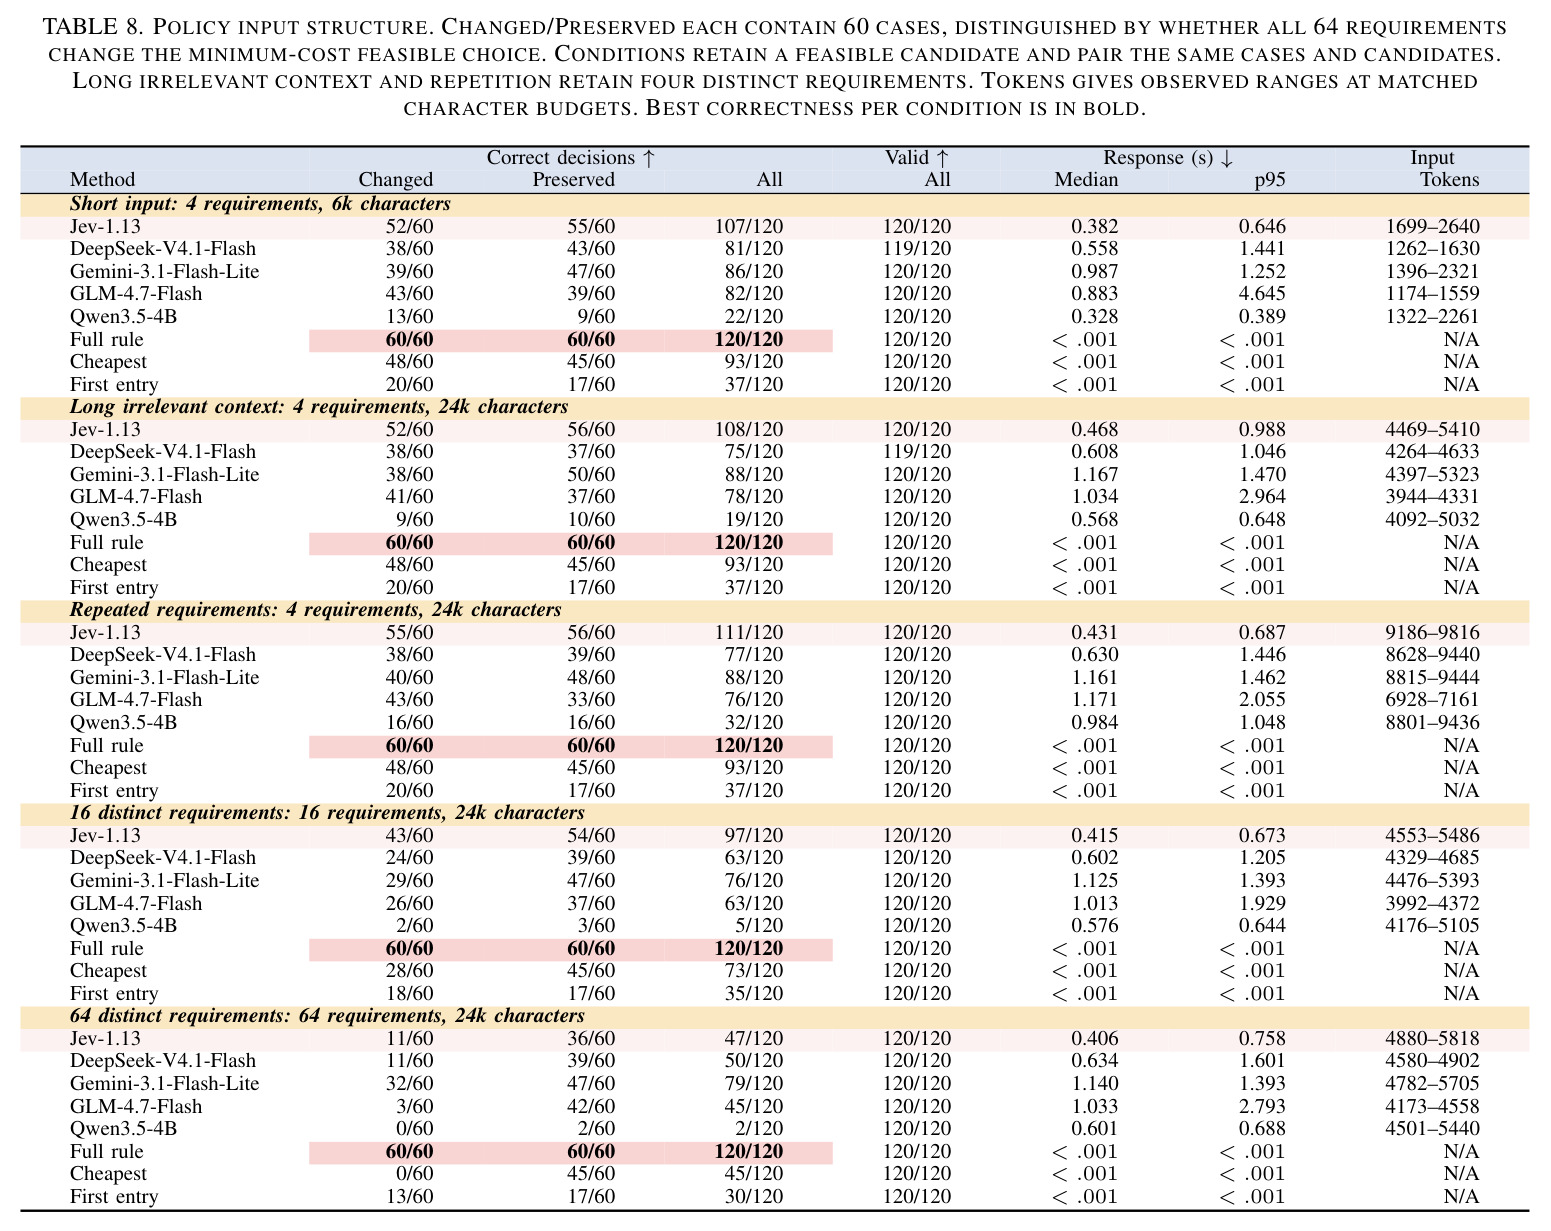
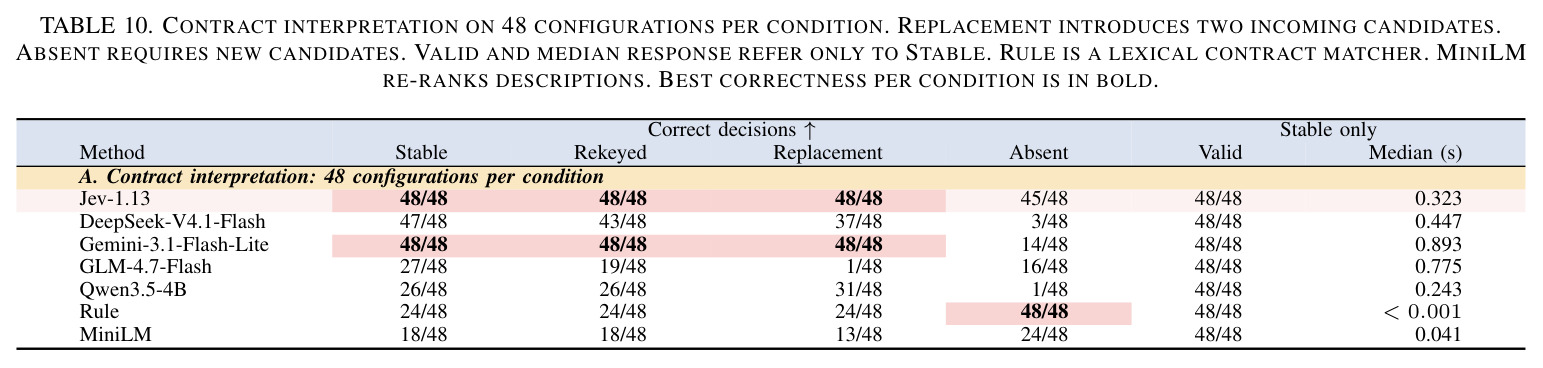
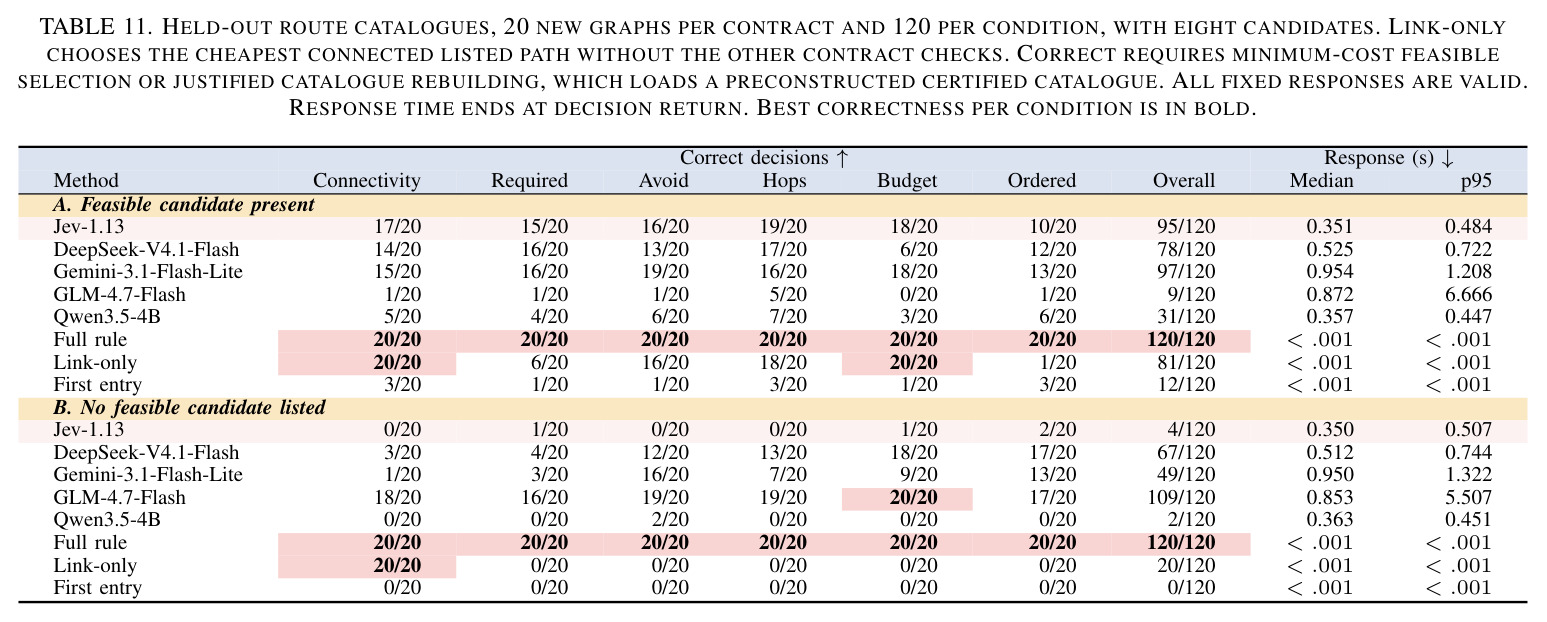
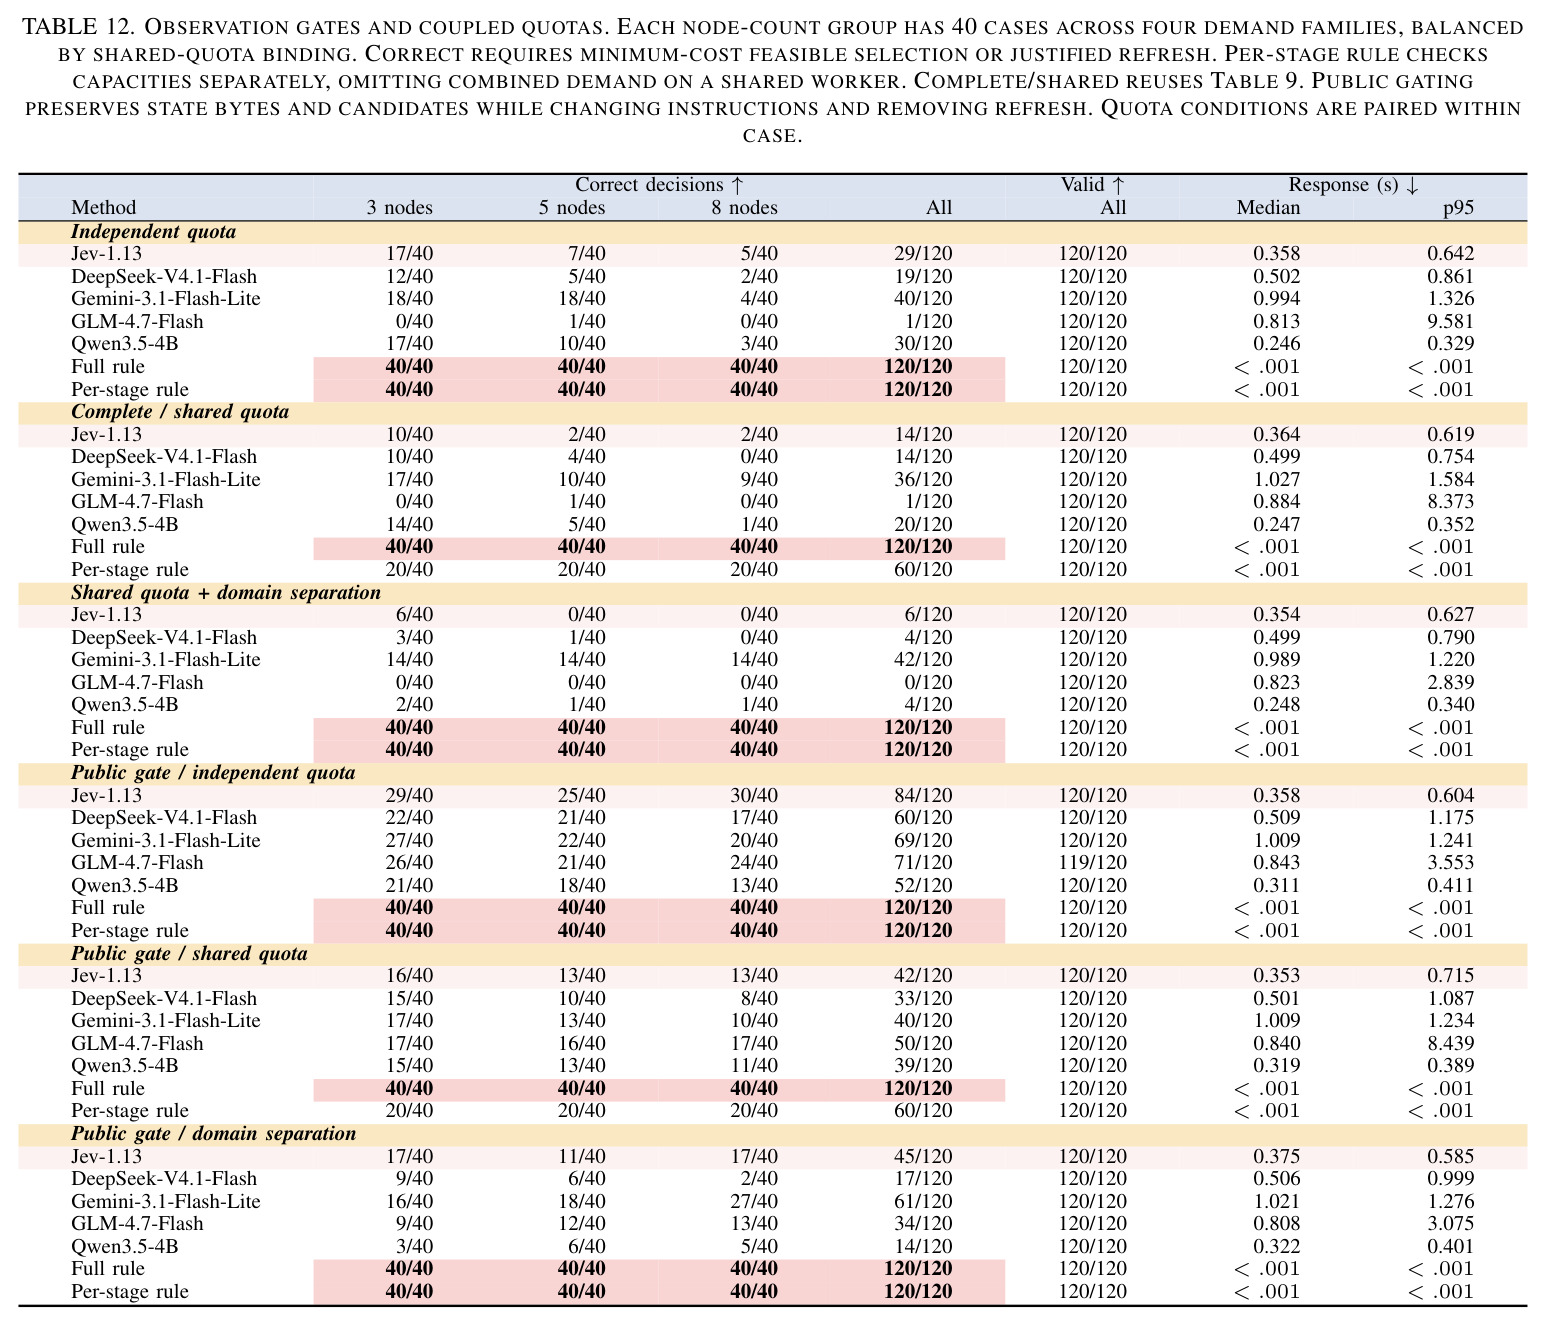
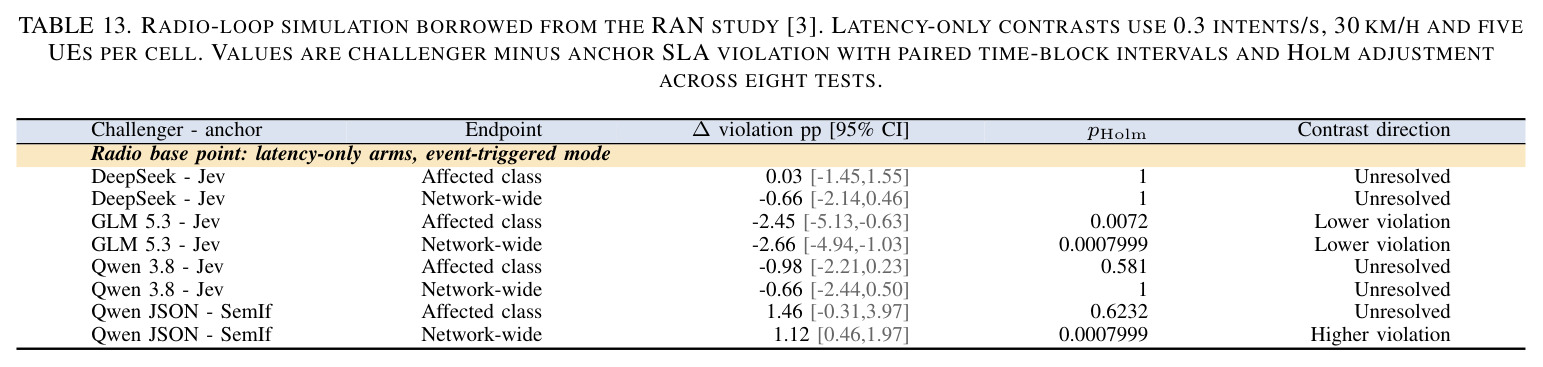
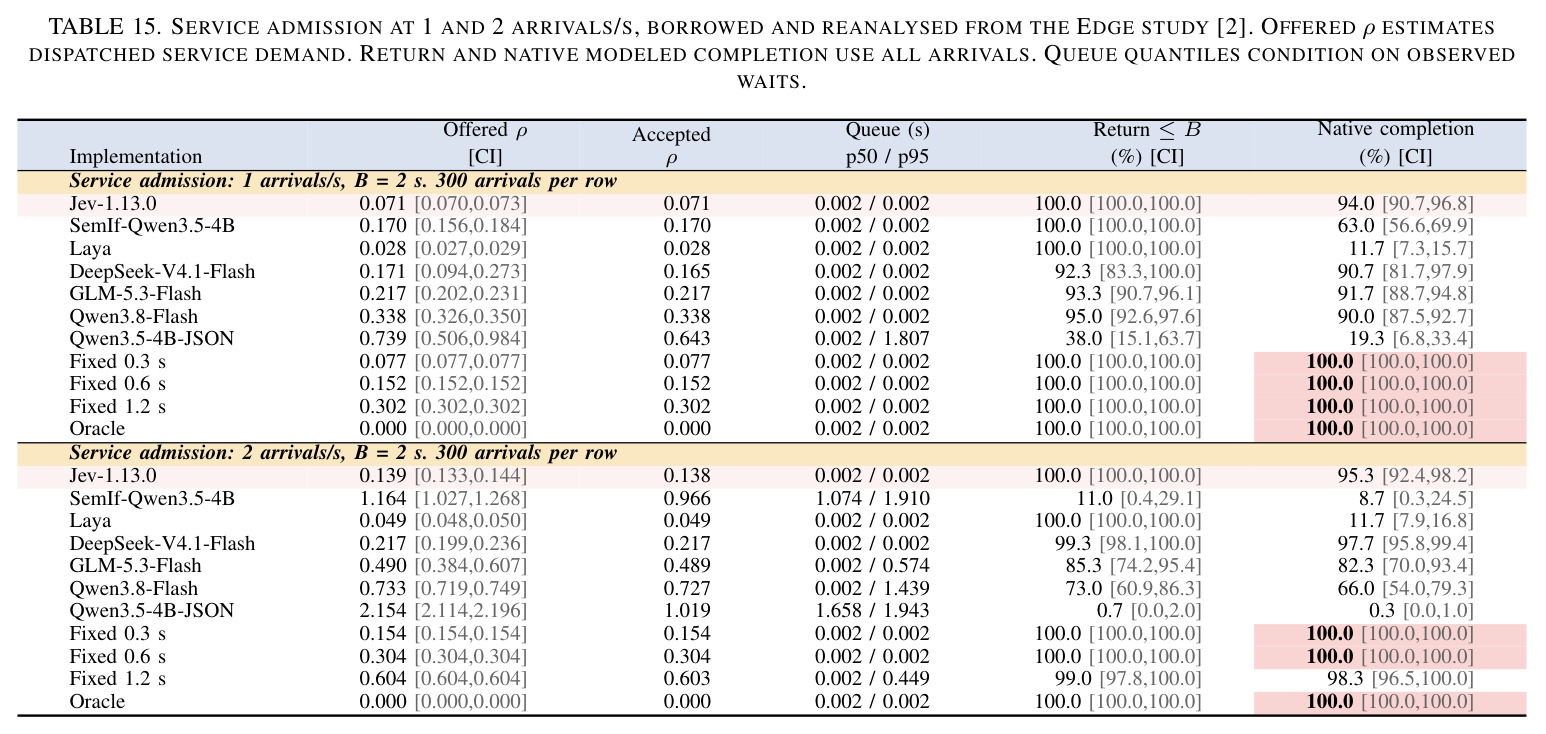
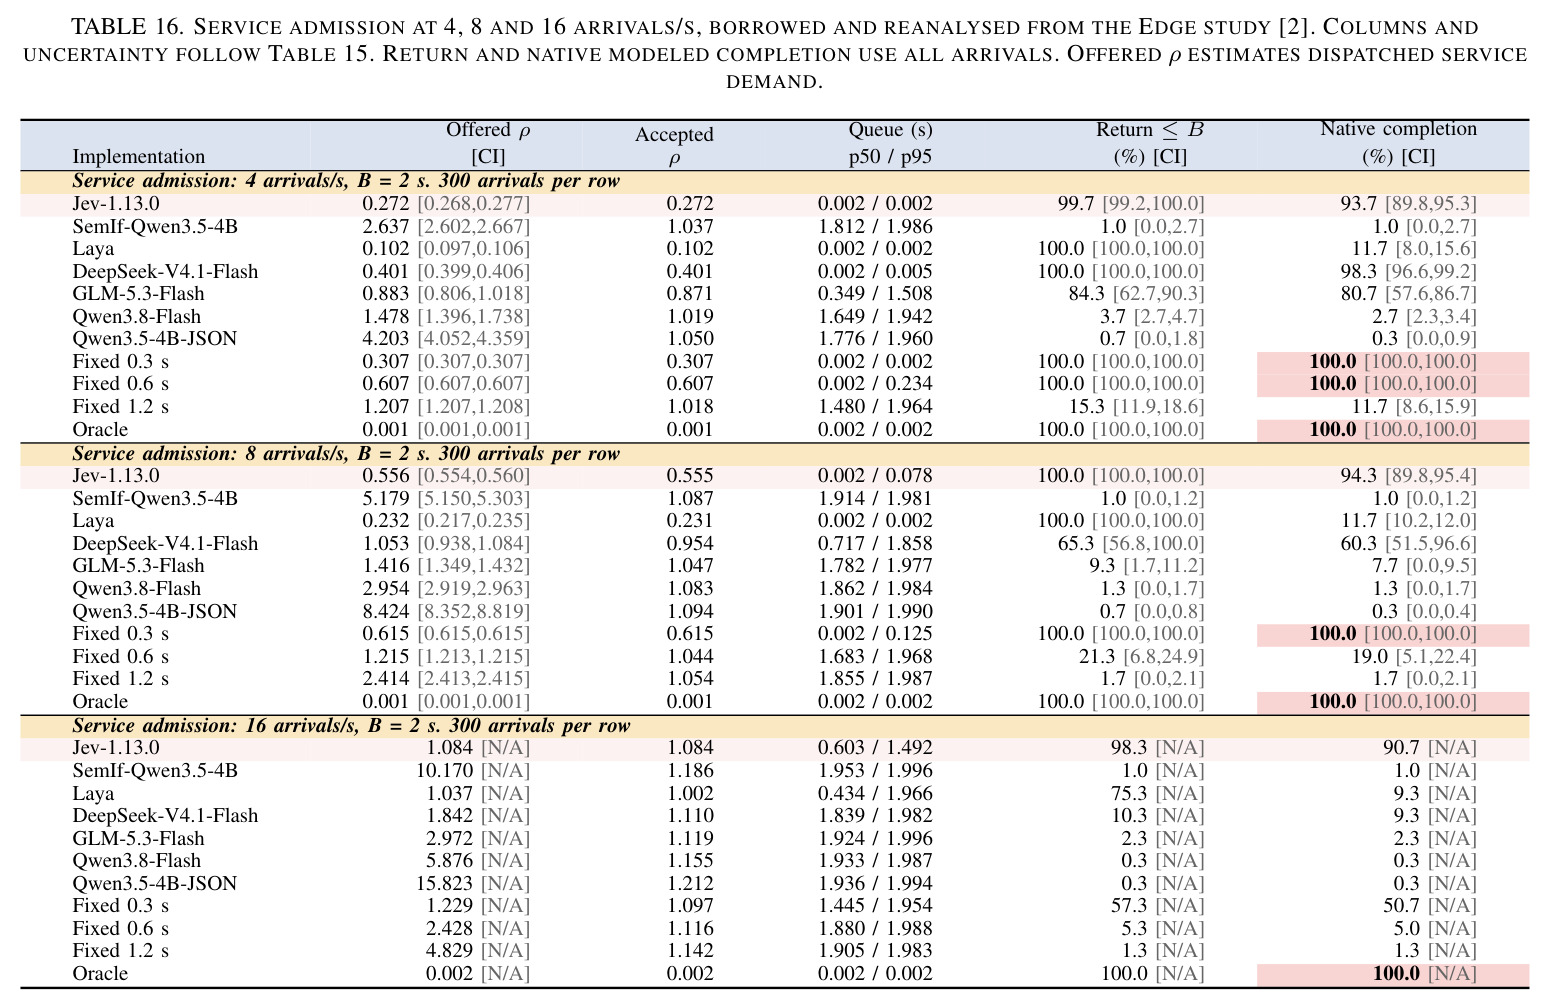
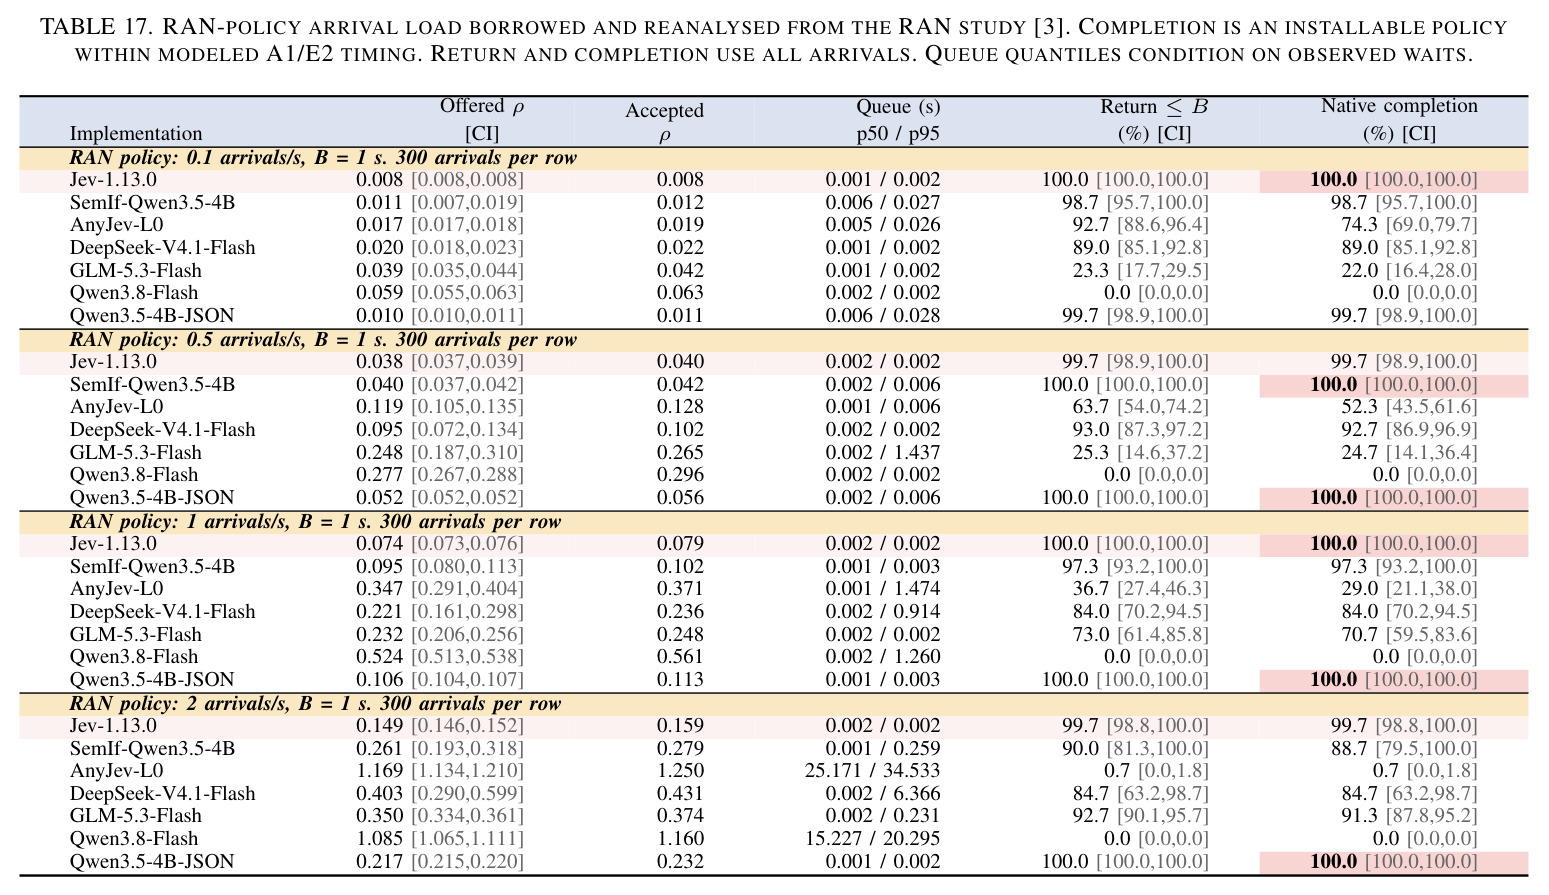
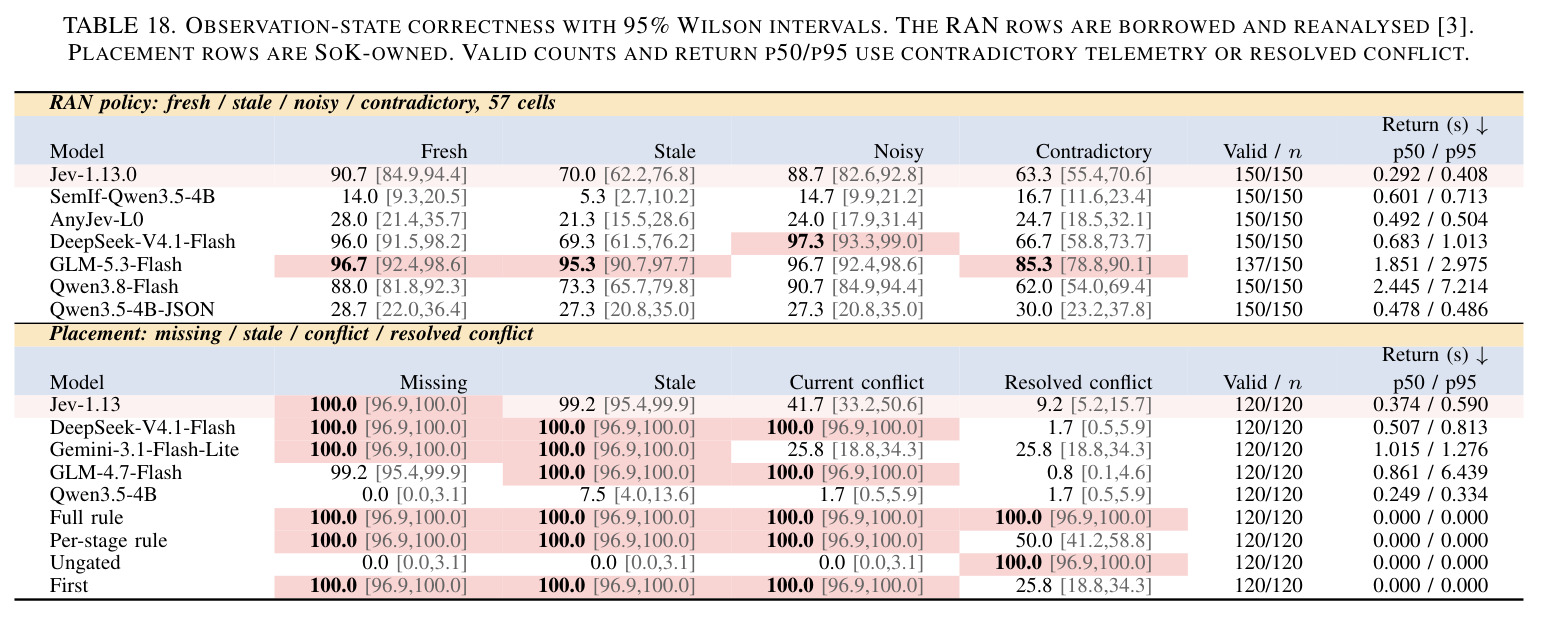
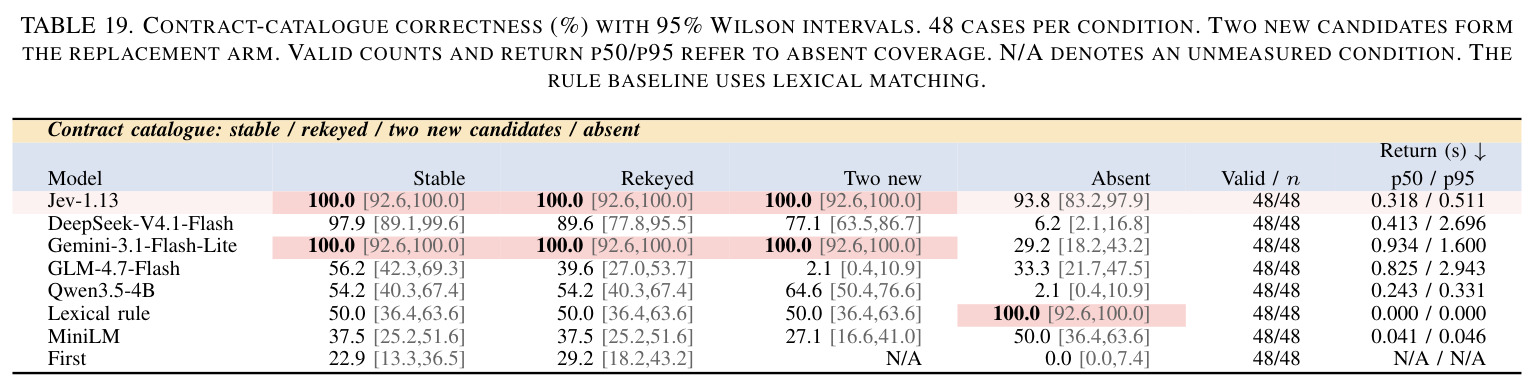
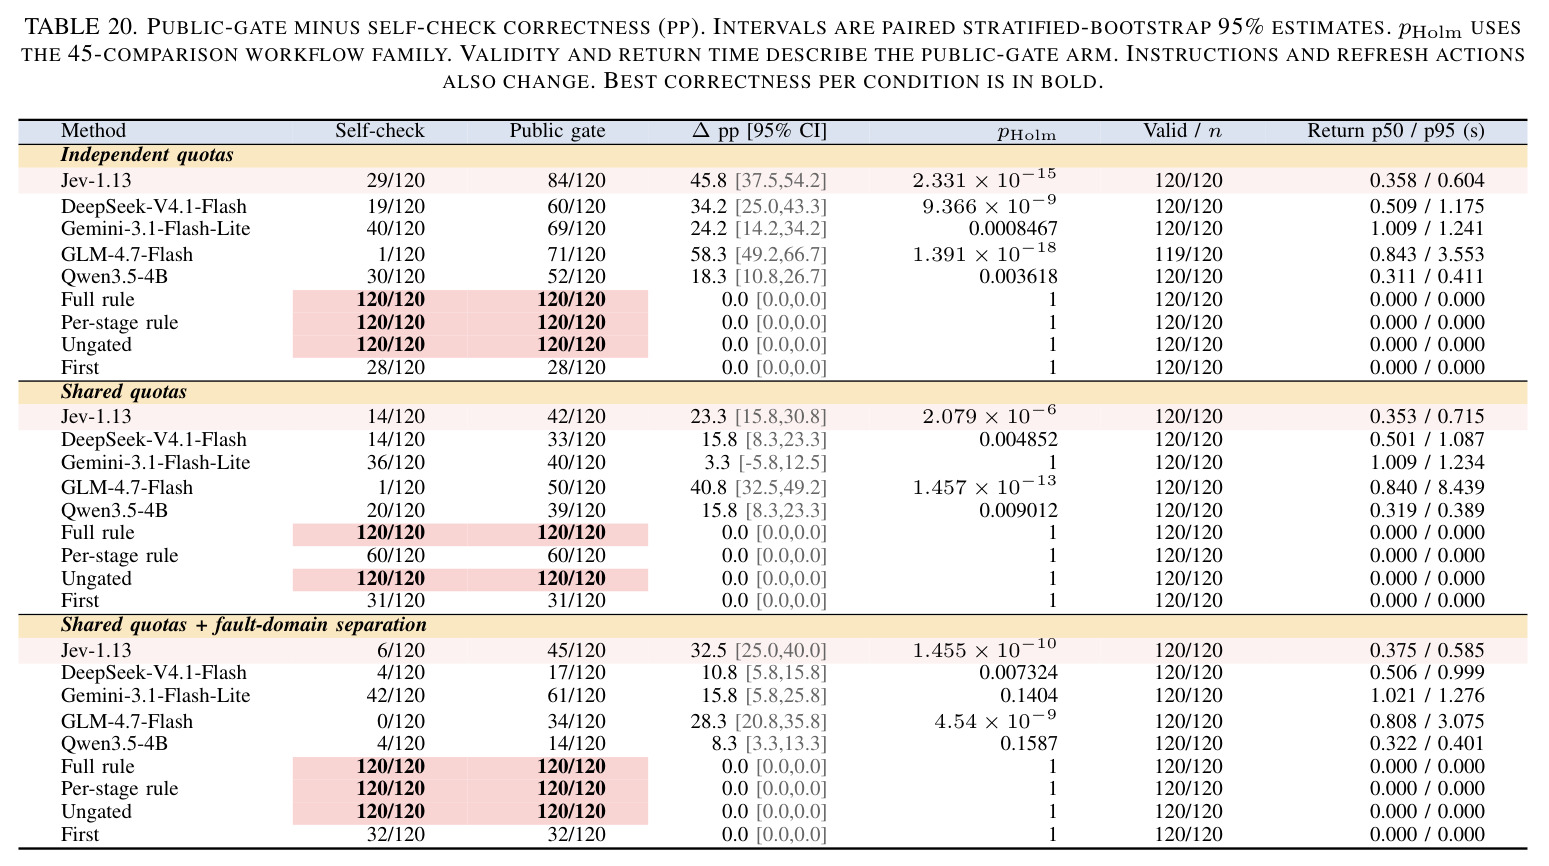
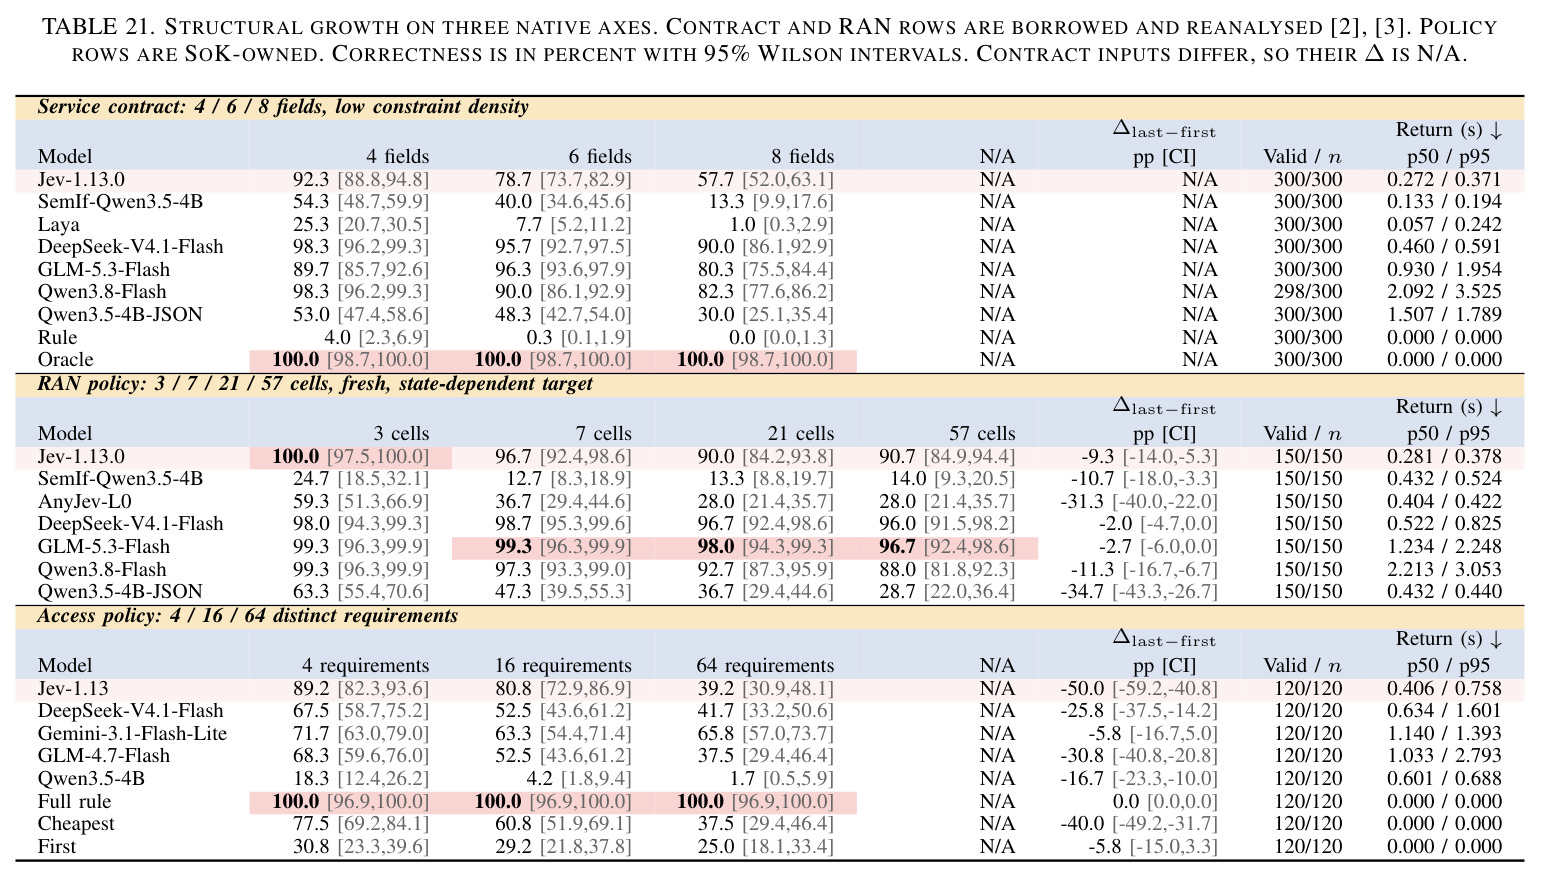
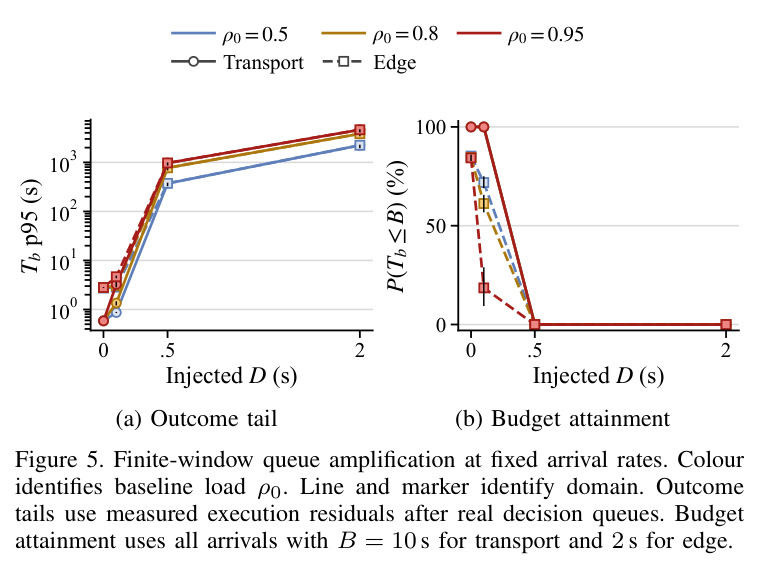
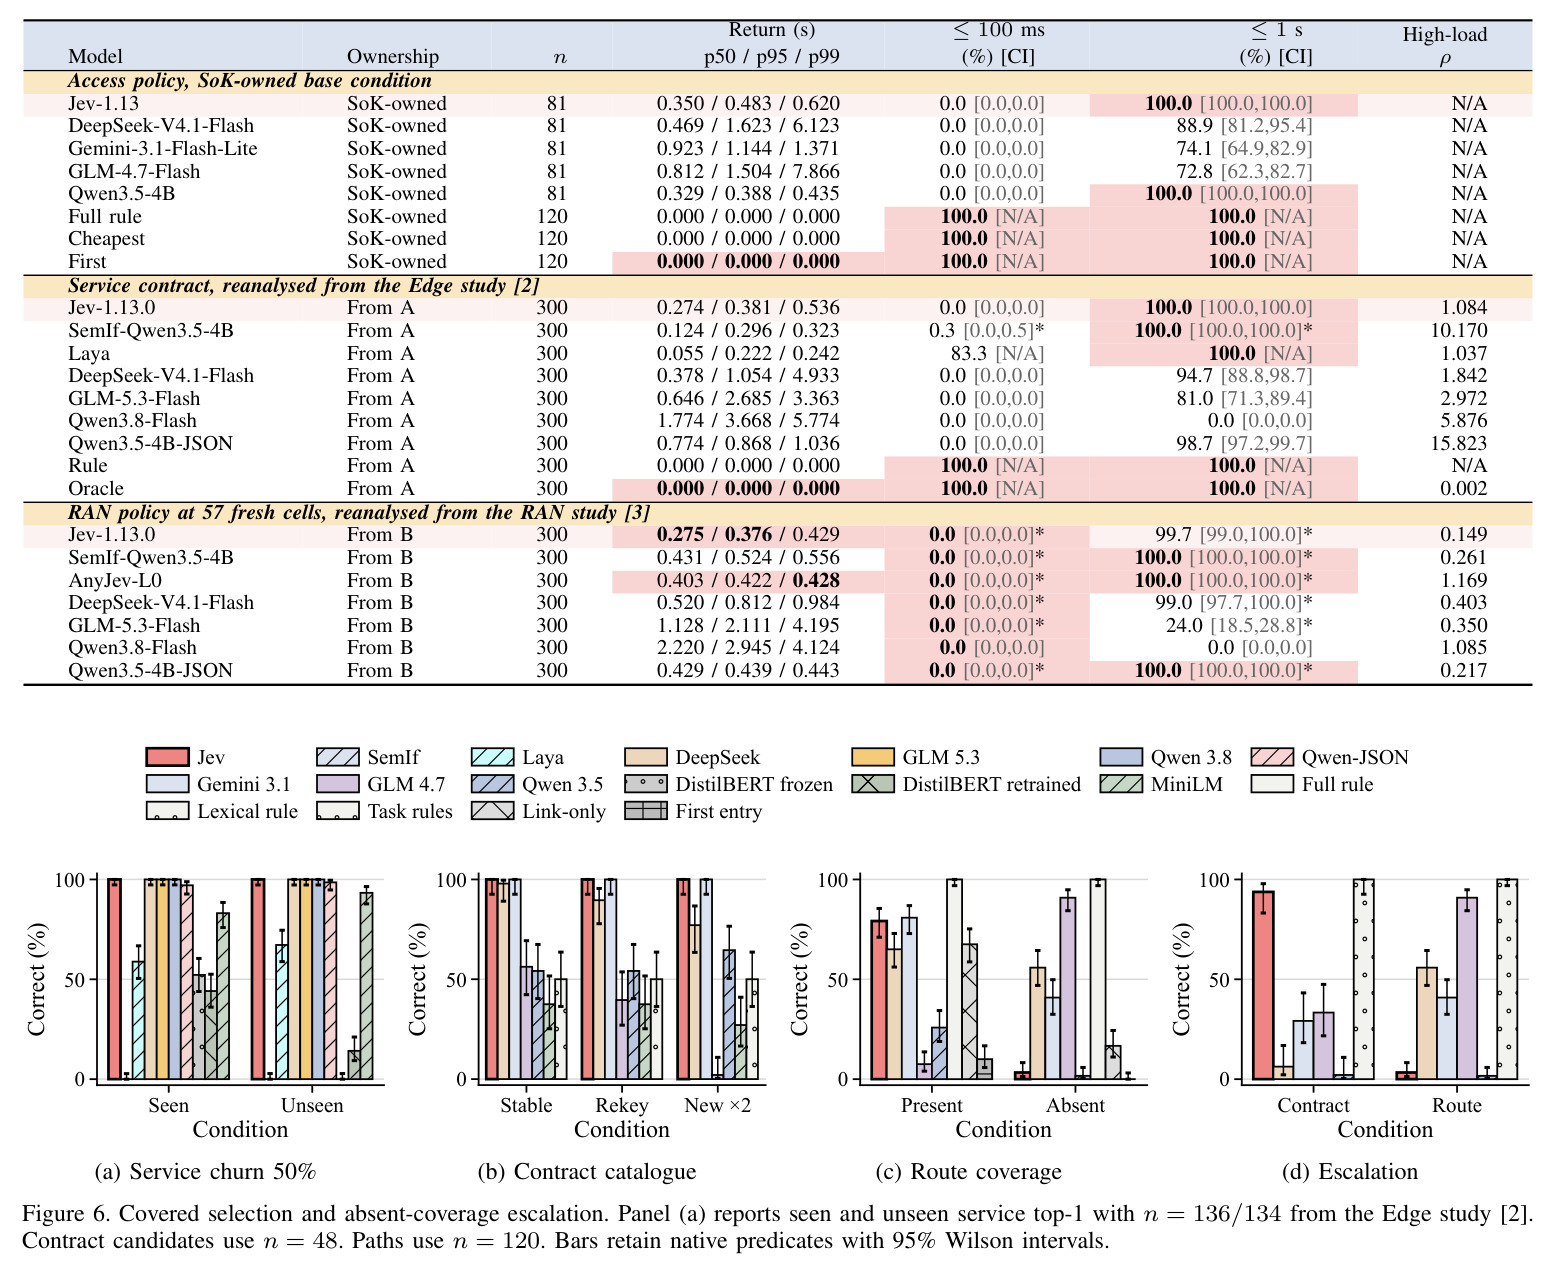
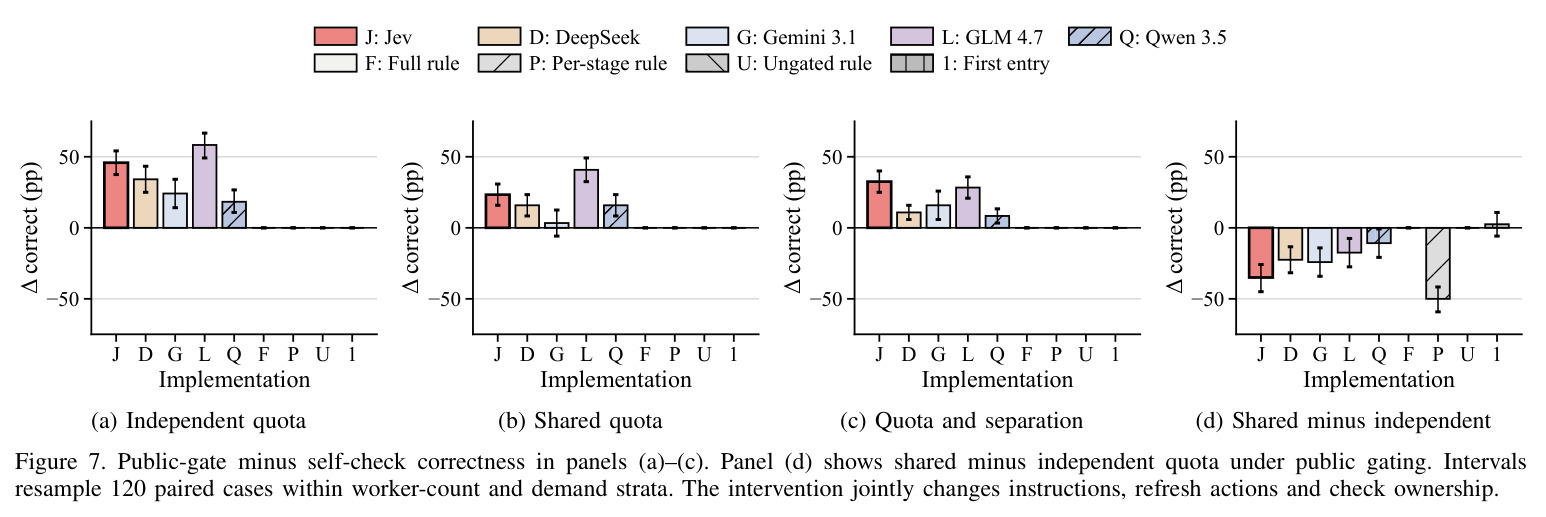
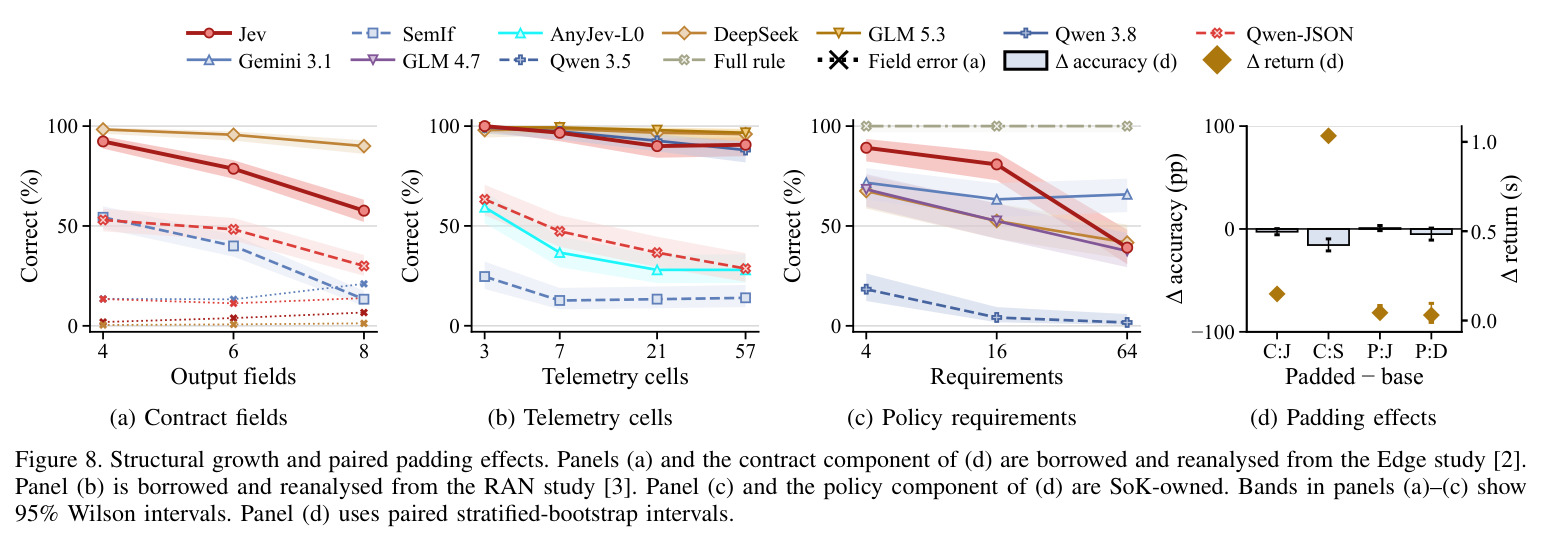
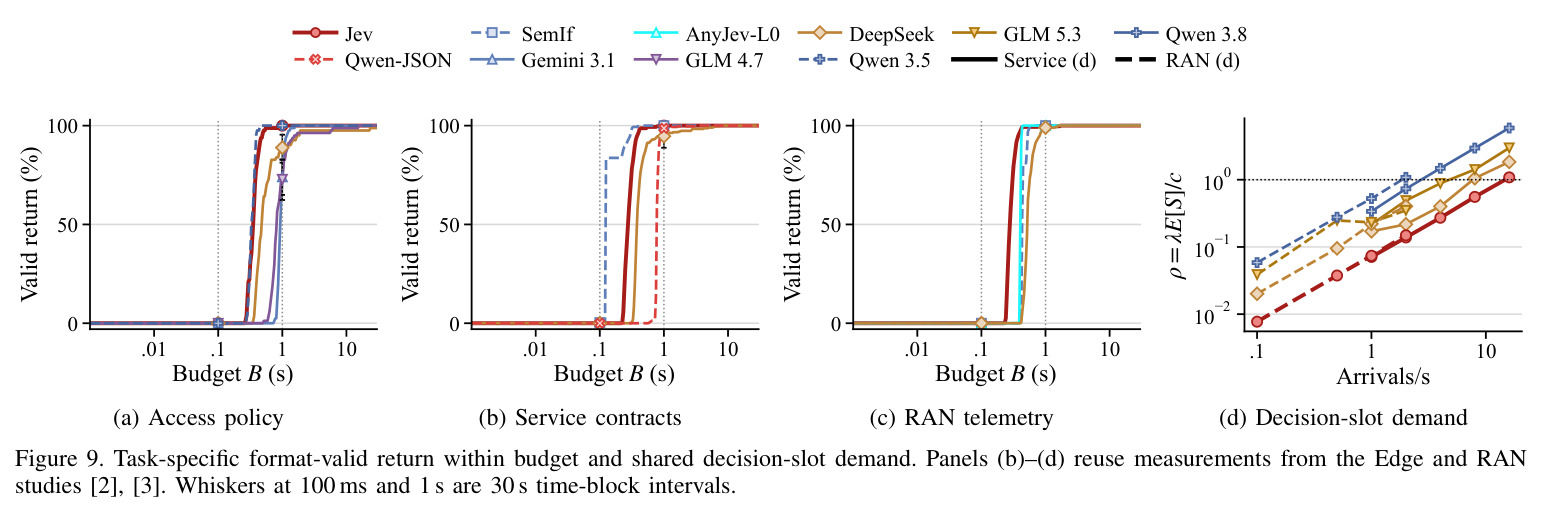
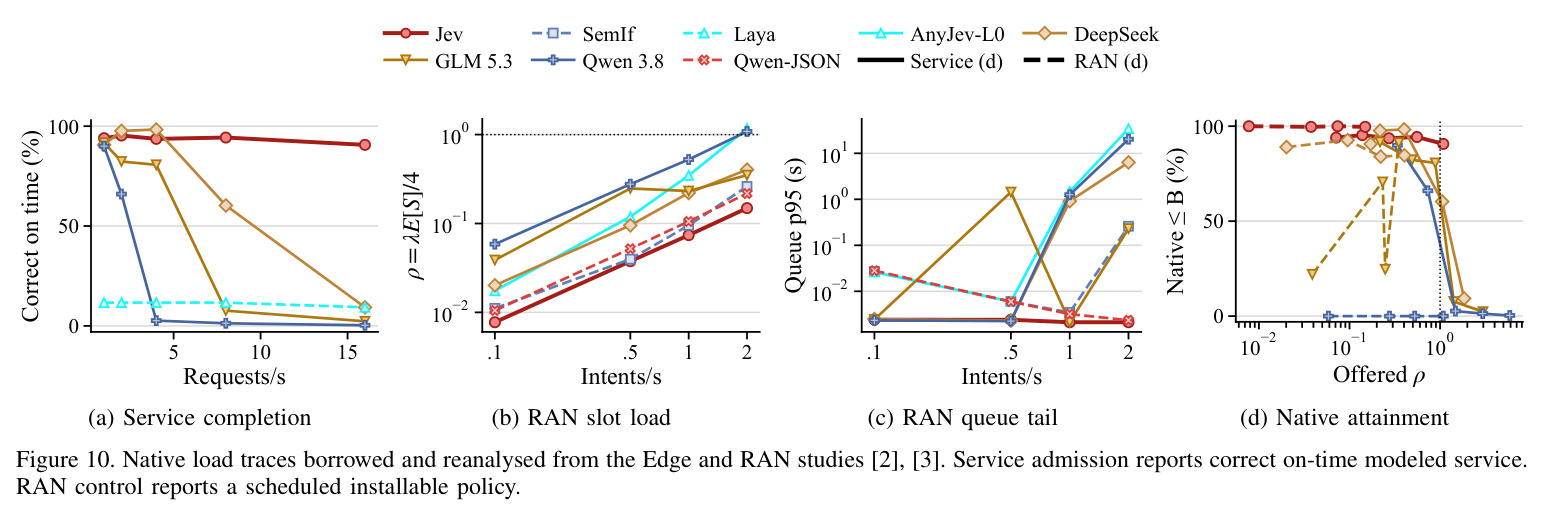
逐条看核心发现。(1)证据审计:139 个家族中 50 个(36.0%)声称引擎适配控制环路或时间预算,仅 4 个(2.9%)有匹配测量支持,且全部来自含确定性计算的家族;仅 9 个报 p95+ 延迟、4 个报截止期达成率、48 个报输入负载、6 个报队列证据。(2)L1 测量边界:验证结果时间随决策延迟约 1:1 传递(传输斜率 1.00025、边缘 0.99096);0.5s 决策占传输确认时间的 91.9%、验证结果的 47.2%,边缘为 98.9% 与 22.8%;RAN 解释耗时 0.286–2.352s,而 A1 确认 15.5–19.1ms、E2 控制 2.4–3.1ms,且确认端超预算的解释器在服务结果端并无可分辨的违约惩罚。(3)L2 负载:0.5s 决策对 300 个孤立请求 100% 满足 10s 传输预算,在 4.992 到达/s(ρ=2.500)下达成率 0%、中位验证结果 233.749s;边缘 ρ0=0.95 时 100ms 决策把 2s 达成率从 76.0% 砍到 18.6%;2s 臂队列 p95 达 4623.773s。(4)L3 检查归属:Jev 对 45/48 个无候选契约正确请求新候选,却只对 4/120 个不可行路径升级;当前冲突观测 50/120 正确、已解决冲突仅 11/120;public-gate 重构把 Jev 从 29/120 提到 84/120(+45.8pp,95%CI 37.5–54.2),共享配额 +23.3pp、加故障域分离 +32.5pp,逐段规则在共享配额下仅 60/120。(5)L4 鲁棒性:契约精确匹配 277/300→173/300(4→8 字段);策略 107/120→47/120(4→64 需求);RAN 选择 3→57 小区降 9.33pp(p=0.00757);完整规则基线恒 120/120 且亚毫秒级。
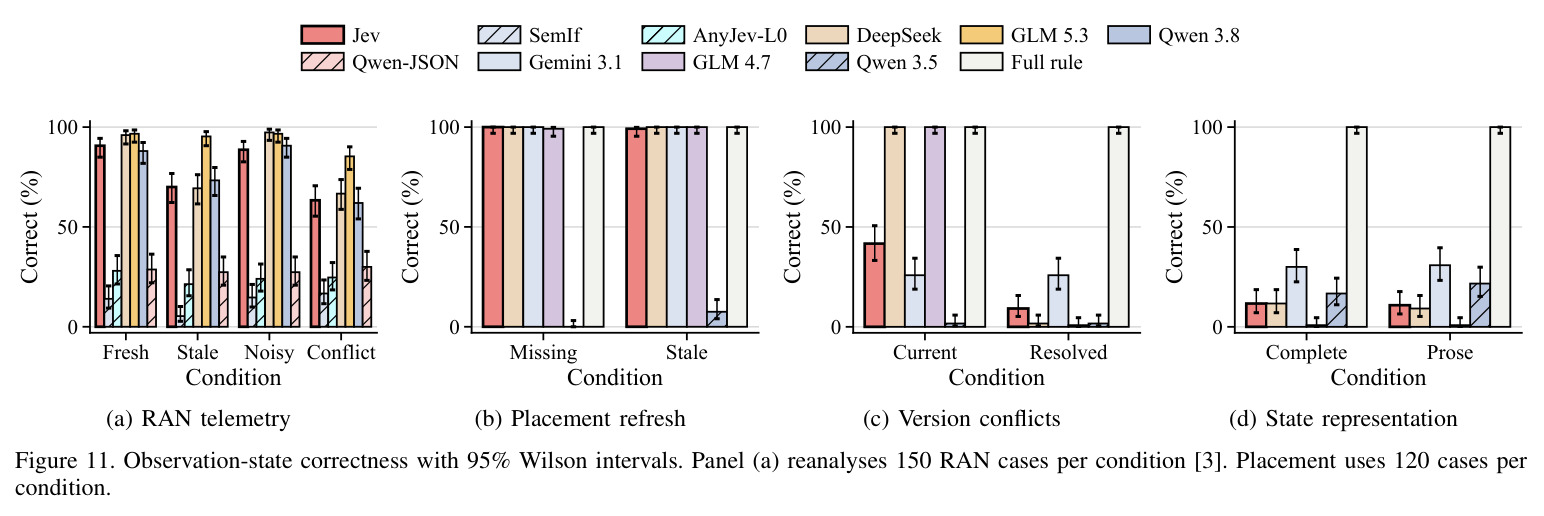
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 控制环路声明的证据审计(139 个论文家族) | 有匹配测量支持的环路声明数 | 4/139(2.9%,95%CI 0.7–5.8),全部来自含确定性计算的家族 | 声称适配环路或时间预算的家族 50/139(36.0%,95%CI 28.1–43.9) | 揭示 92% 的环路声明缺乏匹配测量;72 个无计算步骤家族的 22 条声明支持率为 0 |
| 传输域固定动作延迟干预(containerlab+FRR 八路由器环,30 场景) | 验证结果时间 $T_b$ 对注入决策延迟 $D$ 的斜率 | 1.00025(95% 场景区间 0.99970–1.00080);去除 2s 延迟节省 2.00070s | 实用无影响带 [0.9, 1.1];边缘域斜率 0.99096(0.95906–1.02186) | 证实决策延迟约 1:1 传递到验证结果,端点决定决策占时比例(0.5s 占确认 91.9%、占验证 47.2%) |
| 传输域 10s 预算在 4.992 到达/s(ρ0=0.5,真实 FIFO 决策队列) | 截止期达成率 $P(T_b\le B)$ | 0.5s 决策臂:0.0%,中位验证结果 233.749s(ρ=2.500);2s 臂队列 p95 4623.773s(ρ=18.977) | 同延迟孤立请求 100%(300/300),0 延迟负载臂 100% | 负载把孤立请求全部达标的引擎变成全部超时,直接翻转准入判定 |
| 边缘域 2s 预算在 ρ0=0.95(k3d/k3s,30 个迁移与扩缩容场景) | 达成率 | 100ms 决策 18.6%(95%CI 9.3–29.0) | 同延迟孤立执行 76.0%(66.3–84.3) | 排队使达成率下降 57.4 个百分点,说明孤立汇总不可用于准入 |
| 访问策略任务检查归属干预(120 个案例,public-gate 对照) | 正确决策数 | public-gate 下 Jev 84/120;共享配额 42/120;共享配额加故障域分离 45/120 | 模型自检下 Jev 29/120(独立配额) | 配对 +45.8pp(95%CI 37.5–54.2,pHolm=2.3e-15);GLM-4.7 提升 +58.3pp |
| RAN 遥测小区规模扩展(借自 RAN 研究,150 案例每条件) | 目标选择正确率的配对差 | 57 小区相对 3 小区 −9.33pp(95%CI −14.00 至 −5.32,Holm p=0.00757) | 3 小区 150/150(100%),7 小区 145/150,21 与 57 小区 135–136/150 | 证明每个判定只在测得的结构范围内成立,必须随判定报告鲁棒性范围 |
| 覆盖缺失升级(120 个不可行转发路径,8 候选目录) | 正确升级或拒绝率 | Jev 仅 4/120 正确升级;DeepSeek 67/120;GLM-4.7 反转达 109/120 | 同一 Jev 在 48 个无候选契约上 45/48 正确请求新候选 | 同一引擎通过一项覆盖检查、挂掉另一项,检查归属不能默认交给引擎 |
局限与改进
作者承认的局限:证据审计测量的是文献报告了什么,缺编码的家族实际可能在声称的环路内工作,因此审计只确立缺失支持而非不可行;第 7 节的测量后果部分来自 Edge 与 RAN 源研究,其他作者的已调查系统未测试;每个实验只用一个随机流,区间来自运行内重采样(按输入、场景、时间块),不描述独立重复间的变异;综合问题和比较族是在查看测量记录之后制定的,检验属于探索性;Holm 校正只在每个声明族内控制错误。我自己的观察:自建的访问策略、放置、转发任务是带完整谓词的构造任务,图成本不代表实测网络延迟,结论向开放词汇、欠规范意图外推有限;public-gate 对照同时改指令、刷新与检查归属,估计的是工作流重构的打包效应而非移动单个检查的因果效应;负载臂在真实 FIFO 队列后串行执行动作,近饱和时的区间只描述有限观测窗而非稳态;传输与边缘在拓扑、动作、栈、探针上都不同,跨域比较只能是描述性的;RAN 闭环结果是已发表研究的借用再分析,且论文自己把负载(κ=0.083)、队列(κ=0.041)、稳定性(κ=0.075)标为低信度字段,相应覆盖率数字要谨慎引用。
独立分析的弱点
独立分析出以下弱点。第一,审计以报告为证据,可能低估真实系统的能力——一些系统工程论文习惯把时延放附录或干脆不写,无匹配测量部分是发表文化问题;改进方向是把最低报告记录做成投稿清单或 artifact evaluation 项,让声明与证据绑定。第二,实测任务集偏窄:三个域(服务契约、RAN 策略、访问策略/放置/转发)都是可形式化谓词的任务,而 LLM 引擎的真正卖点在开放词汇意图,论文没有测谓词本身不完整或随目录演化的场景;改进方向是构造谓词由操作者反馈逐步精化的任务。第三,单槽 FIFO 决策队列是最保守的负载模型,没有测多槽并发、优先级抢占与准入丢弃,而槽数 c>1 时 ρ 的放大行为会缓和;改进方向是按作者自己的跨部署议程变化到达过程与并发物理动作。第四,端到端结论建立在 30 个固定动作场景与 120–300 个案例的小样本上,置信区间虽给出但外部效度未知,且只有 20 个 10s 测量块。第五,完整规则基线之所以全胜,是因为访问策略、放置、转发任务事先拥有完整的可行性与代价谓词,论文没有量化构建与维护这些谓词的工程成本——这恰是语义引擎存在的理由,公平比较应把谓词构建成本计入基线。
未来方向
作者提出的开放问题有四个。卫兵互补性:解析器、配置验证器与执行探针检查不同性质,需要测每个卫兵检出什么、误报多少、组合后还有哪些违规漏网,配置翻译与路由栈语义也应纳入比较,三关卡提供其事件与分母。候选构造与认证:类型化选择要求候选集包含可接受输出,如何在约束变化下认证覆盖、何时该合成新候选而非升级、构造与认证的全成本如何测,都是开放的。依赖驱动的刷新与跨域冲突:缓存解释何时可跳过决策调用、依赖跟踪如何识别一次状态变化使什么失效、跨域意图如何仲裁竞争资源与权威并验证共享结果。跨部署复现:决策槽占用与执行重叠如何随站点与实现变化,独立流量实现如何把负载变异与物理重复变异分开。基于本文成果可延伸的方向:把最低报告记录变成社区基准的强制元数据 schema;用 ρ 驱动的达成率模型做在线准入控制与过载卸载决策;给覆盖认证以形式化语义并与符号验证结合;研究引擎与确定性求解器的混合调度成本分摊(引擎做解释、求解器做可行性、引擎做升级对话)。
复现评估
复现条件较好。论文给出 GitHub 仓库 OniReimu/SoK-JEV 与机读补充材料:497 个任务条件单元、239 个匹配对照、580 个时延层、83 个原生负载单元、176 行执行路径表等,JSON 编码列保存区间与原生元数据。实验栈版本齐全:传输域 containerlab 0.79 加 FRRouting 10.5.1(八路由器环形、OSPF 加全网状 iBGP),边缘域 k3d 5.9 加 k3s 1.35.5(两工作节点、Pillow 灰度服务),随机种子 42、10000 次 bootstrap;模型版本明确(Jev-1.13.0、DeepSeek-V4.1-Flash、GLM-5.3/4.7-Flash、Qwen3.8/3.5-Flash、Gemini-3.1-Flash-Lite 等)。但 Edge 与 RAN 域测量借自两篇姐妹论文(arXiv:2609.22753、2609.23136),完整复现需要那些研究的设置,RAN 部分依赖已发表的模拟摘要。总体难度中等:应用层任务与审计管线算力要求不高(含本地 Qwen3.5-4B),物理栈需要 Linux 网络与 Kubernetes 环境;文献编码可依附录 D 的完整检索式与编码簿复用。注意论文尚未经同行评审,五个低信度编码字段的数据使用需谨慎。
论文图表
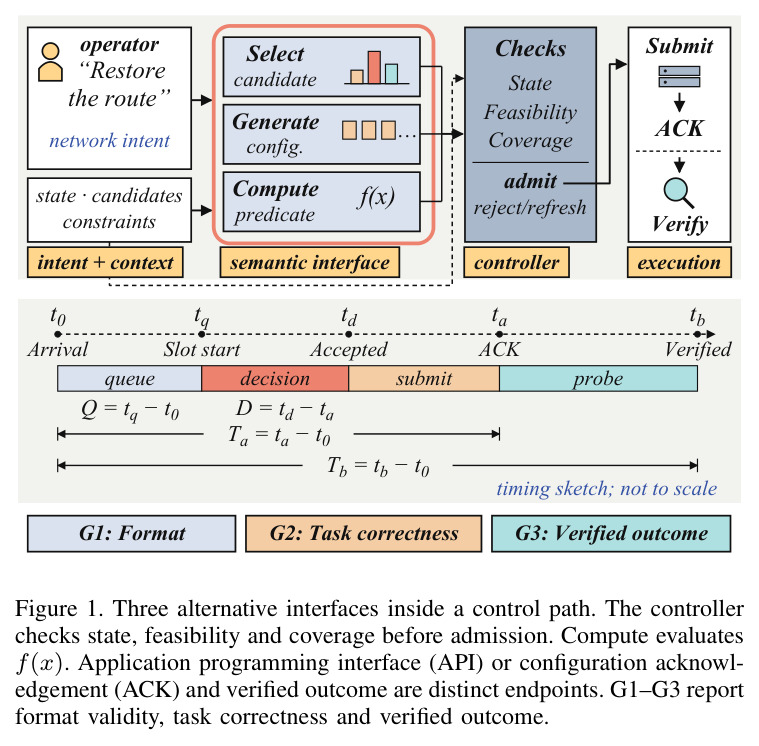
展示控制器在准入前依次检查状态、可行性与候选覆盖,解释器可以以三种接口参与:选择控制器给的候选、生成缺失配置、或把形式化请求交给计算 $f(x)$ 的规则/求解器;API 或配置确认(ACK)与验证结果是不同端点,G1–G3 分别报告格式有效性、任务正确性与验证结果,下方时间轴标出 $t_0$、$t_q$、$t_d$、$t_a$、$t_b$ 与 $Q$、$D$、$T_a$、$T_b$。
一张图定义了全文的概念框架:三轴系统化的接口分类、三道关卡、统一事件模型的时间记号全部挂在这条控制路径上,后文每个实验都对应图中某个缺口。
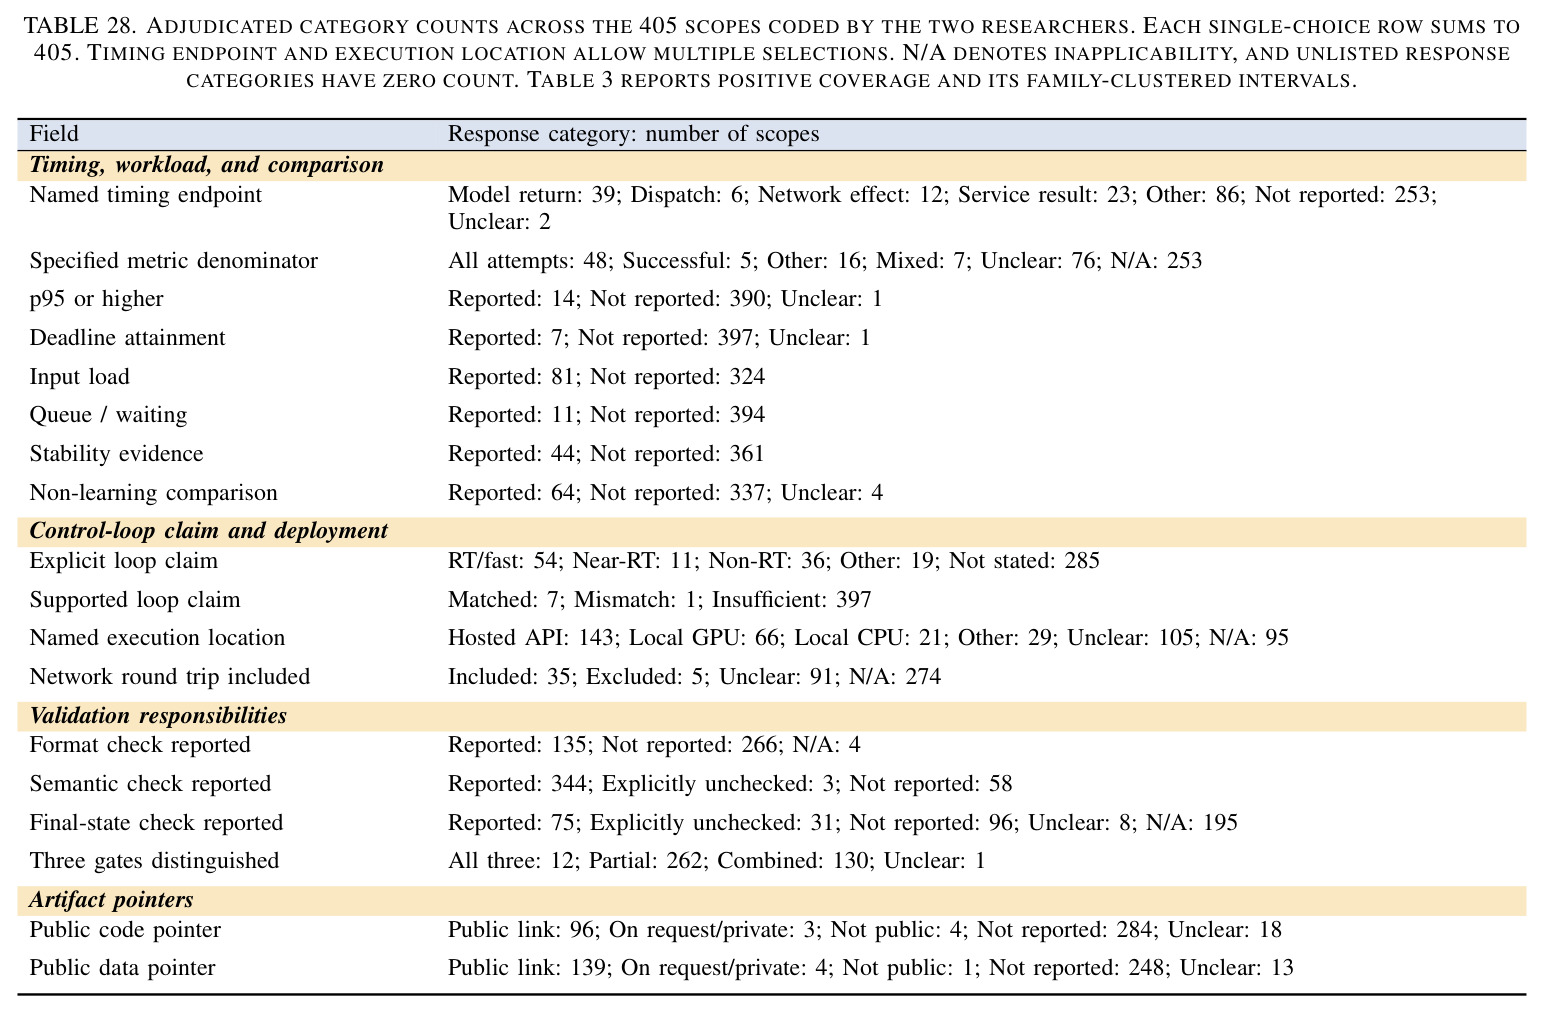
仲裁后各单选字段的类别计数分布(每行各类之和等于范围数),包括显式排除、unclear 与 N/A 的区分,如度量分母字段有 55 个 unclear 家族、网络往返字段 61 个 all-NA 家族。
证据审计的原始分布数据:供二次分析者复算覆盖率、检验分类敏感性,也是理解分母为何因字段而异(139 对 429 对 393)的入口。