JEV 即评审:自信时采纳、存疑时升级的决策型低成本评审级联 JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
决策型评审 JEV 以 0.36% 的费用比肩最强 LLM 评审,置信度级联保留 99% 精度。
前置知识
LLM-as-a-Judge
用一个大语言模型按照自然语言评分标准(rubric)给其他模型的输出打分、排序或裁决对错。只需更换 rubric 和输入就能适配对话、推理、代码、安全等不同任务,因此被广泛用于基准评测、候选回答筛选和训练数据质量评估,代表工作有 MT-Bench 与 Chatbot Arena。
本文的研究对象就是评审器本身——它的精度、稳定性、置信度质量与费用。读者需要先理解评审器在现代 LLM 研发流水线中的角色,才能理解为什么评审成本与可靠性在大规模使用时成为关键问题。
决策型评审接口(decision-only judge)
评审器不生成解释文字,而是通过类型化原语直接返回结构化裁决:Choice 返回指定标签集合上的完整概率分布,Noul 返回是/否概率,Score 返回有序评分档位上的概率。最大标签概率 $q=\max_k p_k$ 自然充当置信度。
JEV 的全部价值主张都建立在“原生决策+概率”这一输出契约上。理解它与让生成式模型口头报告概率(verbalized confidence,校准是经验问题)的区别,是看懂本文实验设计与核心论证的前提。
置信度校准(Brier / ECE / NLL)
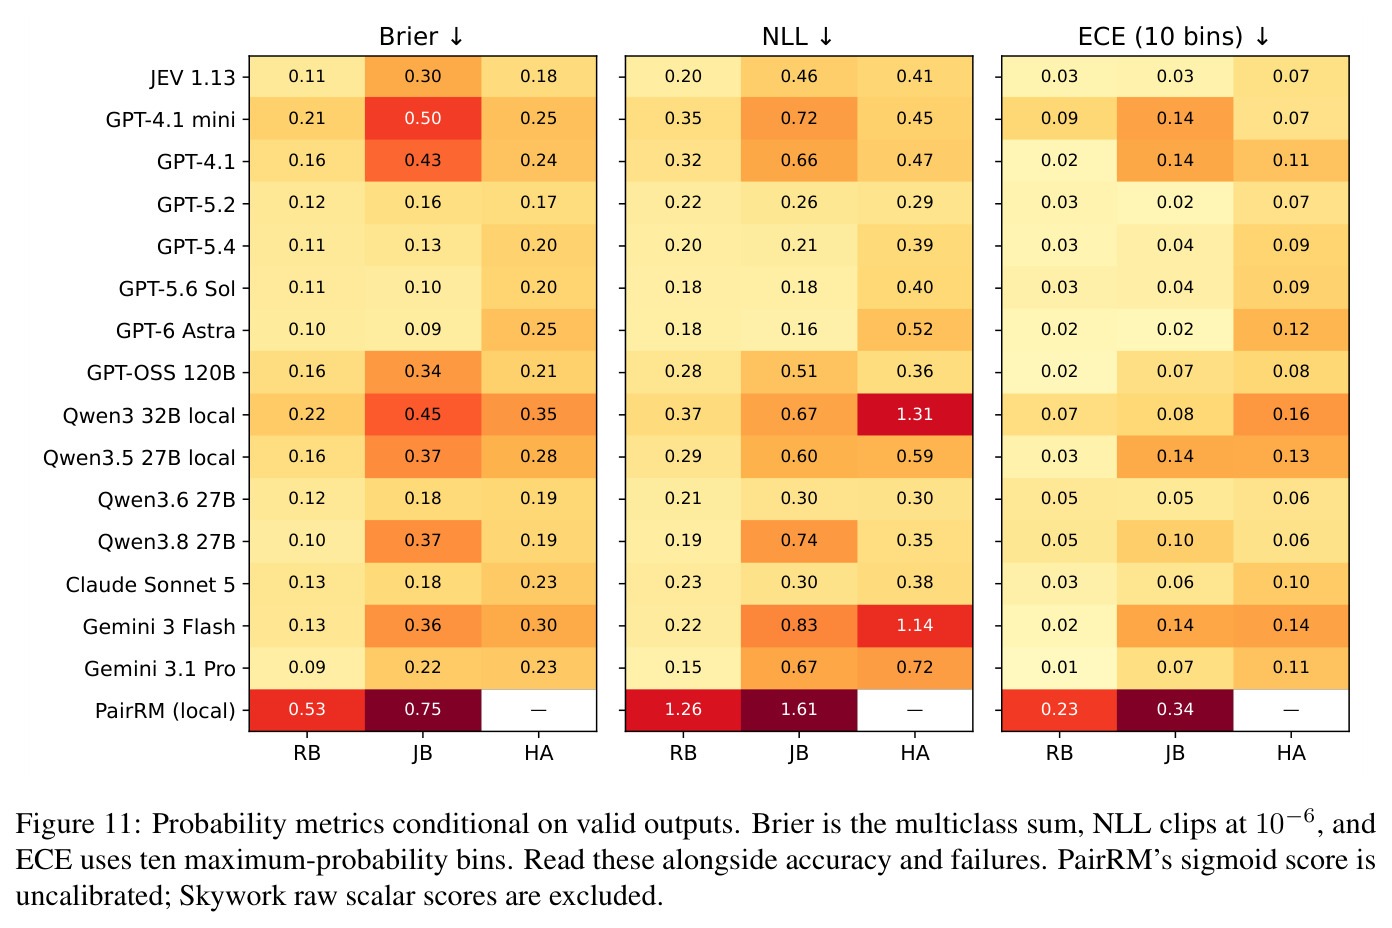
校准衡量模型报告的概率与实际正确频率是否吻合:Brier 分数是预测概率向量与真实标签的均方误差,期望校准误差(ECE)把判定按置信度分箱后比较每箱精度与平均置信度,NLL(概率裁剪到 $10^{-6}$ 下限)惩罚赋给正确标签的低概率。
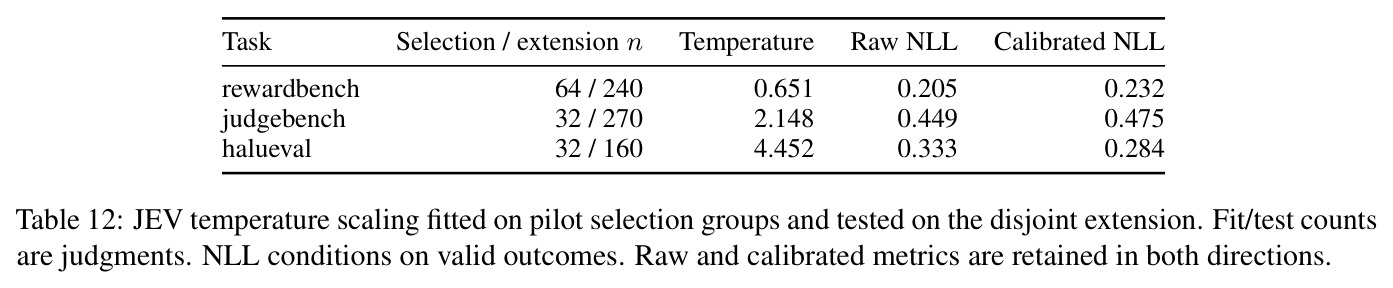
论文用这三个指标系统评估 JEV 的概率质量,并发现温度缩放跨工作负载不可迁移(拟合温度分别为 0.65、2.15、4.45,方向不一致)。没有校准概念就无法理解这些结论及其对级联的含义。
误差检测 AUROC
把“判定错误”视为正类、以 $1-q$ 作为分数计算的 AUROC,衡量置信度把错误判定排到低置信端的排序能力:0.5 等于随机,1.0 表示所有错误判定的置信度都低于正确判定。它与准确率、校准是三种互相独立的性质。
级联能否省钱的唯一关键是这个排序能力。论文正是用 AUROC 从常态约 0.86–0.92 跌到风格对抗对上的 0.770,解释了“接受/升级”策略在哪里失效。
选择性分类与级联(selective prediction / cascade)
用覆盖率换风险的选择性预测:当第一级(便宜)评审的置信度 $q \ge \tau$ 时接受其判定,否则把样本升级给更强的兜底模型;阈值 $\tau$ 在本地选择集上拟合。收益取决于“低置信样本恰好是易错样本”的程度,用按标签升级的 oracle 作为上界。
这是论文标题“自信时采纳、存疑时升级”的全部技术内容:作者不发明新算法,而是给出冻结阈值、实测费用的可部署级联策略,并验证置信度信号确实携带信息。
位置偏差与双序评价
成对评审中候选答案的呈现顺序会影响判定(位置偏差/冗长偏差)。检验方法是交换 A/B 顺序重复评审,统计判定翻转率与“双序一致正确率”;偏好任务用 $\bar{p}(A)=\frac{1}{2}[p_1(A,B)+1-p_1(B,A)]$ 把两个顺序的概率对齐后平均,消除位置效应。
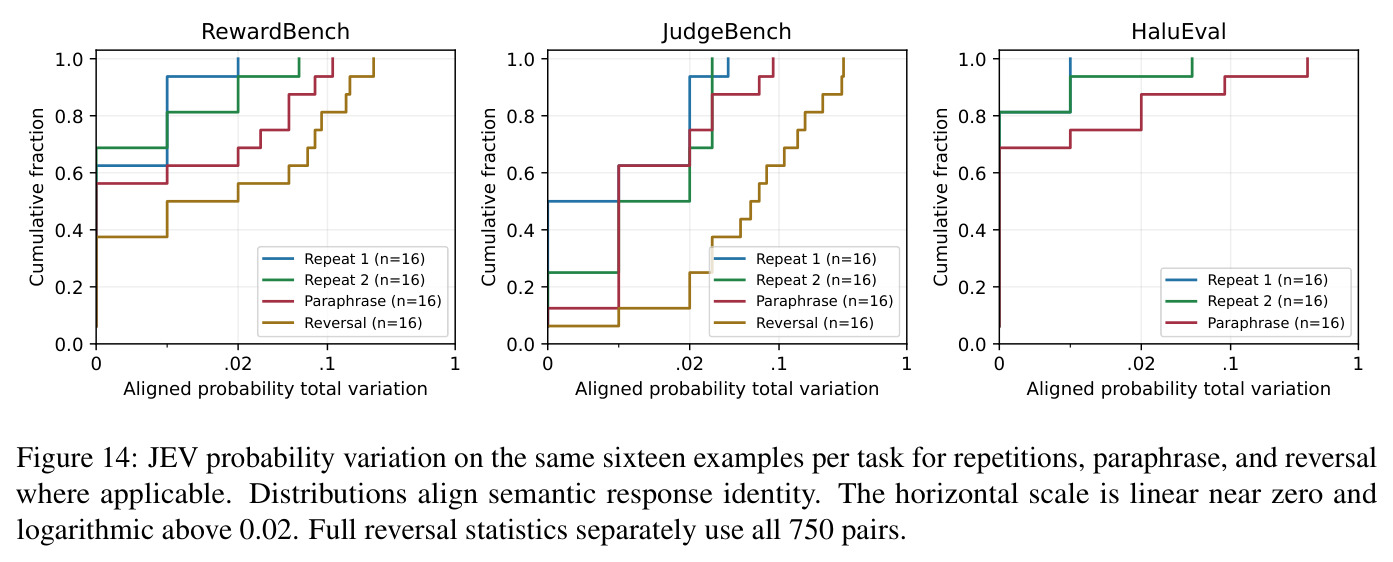
论文用 894 条诊断(750 对逆序、96 次重复、48 次改写)和全量双序判定量化 JEV 的稳定性与方向性偏好,这是判断其置信度与判定是否可信的重要证据链。
研究动机
评估已从固定任务上的指标打分演化为对开放式输出的评审,而把 LLM(尤其是推理模型)当评审器时出现两大压力。其一是成本:更长的思维链确实能提升困难判定的准确率,但按 token 计费时费用与串行生成时延随之上升,连简单问题也可能被分配大量推理计算却收益甚微(过度思考现象);当评估要在成千上万个回答上反复进行、每次模型修订后都要重评时,评审器的费用就成为系统研发与运营成本的一部分。其二是信任:LLM 自报置信度普遍过度自信,会把高概率赋给错误答案;更好的提示与更强的推理能改善估计,但校准始终是模型、任务与引导方式的经验性质。因此自动评审器需要一个能区分“常规判定”与“需要进一步审查”的不确定性信号,而提供这个信号本身又要花钱——精度、置信度质量与费用三者必须被同时测量,缺一不可。
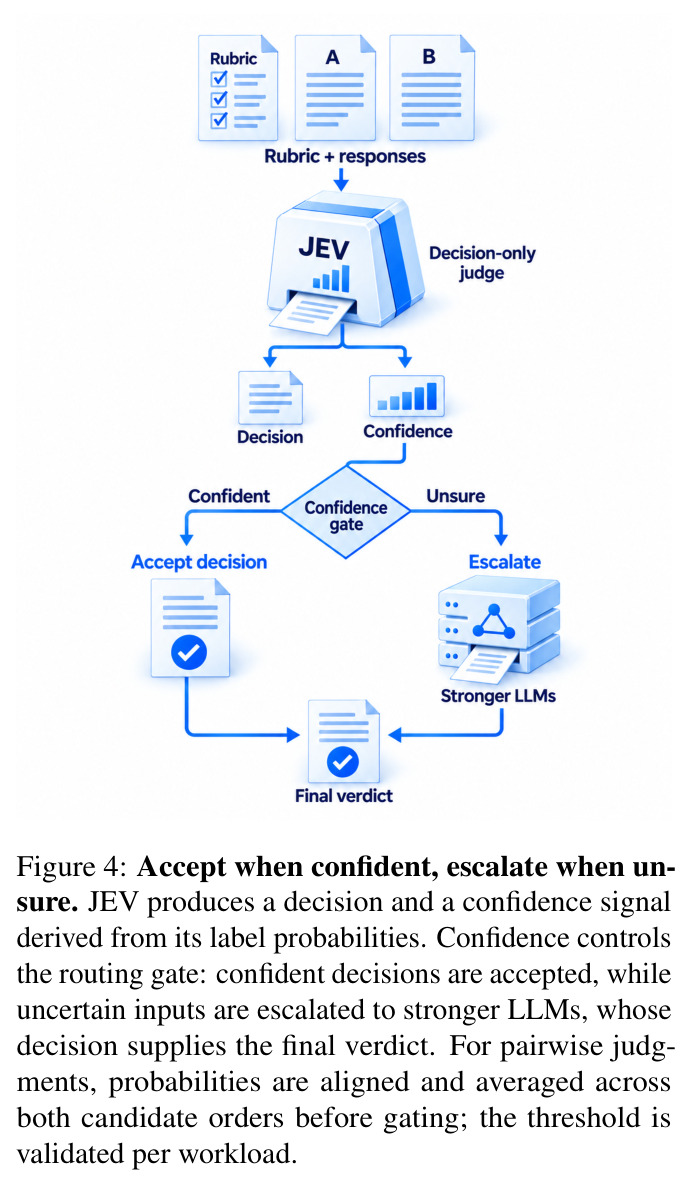
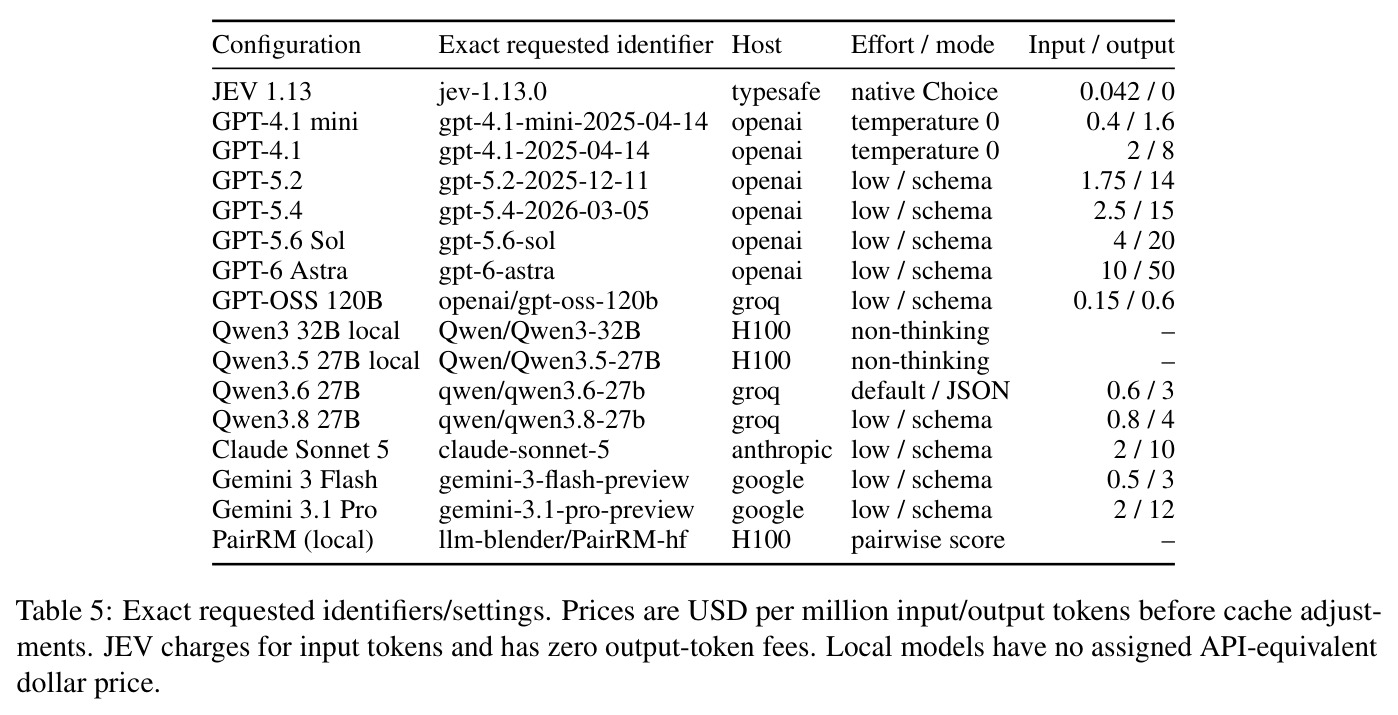
本文的目标是本文的具体目标是回答:一个只输出决策与标签概率、不生成任何理由的托管评审服务(TypeSafe JEV 1.13.0),能否充当“廉价的第一道评审”,并且用它的置信度识别哪些输入值得交给更强的 LLM 复核。为此作者在统一的“决策+概率”输出契约下,把 JEV 与 16 个生成式评审器和奖励模型(GPT-4.1 mini 到 GPT-6 Astra、GPT-OSS 120B、Qwen 系列、Claude Sonnet 5、Gemini 3 Flash/3.1 Pro、PairRM、Skywork-Reward-V2-8B)在偏好排序、证据事实性、最终答案裁决、困难正确性、风格对抗选择、四选一选择和自然散文等任务上比较精度、概率质量(Brier/NLL/ECE/误差检测 AUROC)、稳定性(重复/改写/逆序)、时延与费用;用盲评人类裁决区分评审器错误与基准标签噪声;最终交付冻结阈值、实测费用的可部署级联,以及一张“何时用 JEV、何时升级、何时都不行”的操作包络表。
与已有工作不同的是,最接近的已有工作分两类:Jung et al. (2025) 的“信任或升级”级联为 LLM 评审提供人类一致性保证,Xu et al. (2025) 在奖励模型不确定时把样本路由给强 LLM 评审,但它们的贡献是新路由算法。本文的独特切入是把一个专有的决策型评审当作黑盒,给出“操作画像”:不提出新算法,而是在推理前冻结的数据分区(642 试点项 + 670 扩展项)、冻结的阈值拟合规则与实测费用下,系统回答“廉价评审在哪里够用”。方法上它固定输出契约——生成式基线同样只拿决策+概率、不给理由——从而把接口差异与评审能力分开;测量上它首次对同一评审系统同时量化判定逆转、rubric 改写与答案风格三类失稳,以及接口原语(Choice/Noul/Score)之间的概率不一致;结论上它把工作负载明确划为“用 JEV / 需升级 / 都不支持”三档,并指出置信度在每档内的行为。
核心方法
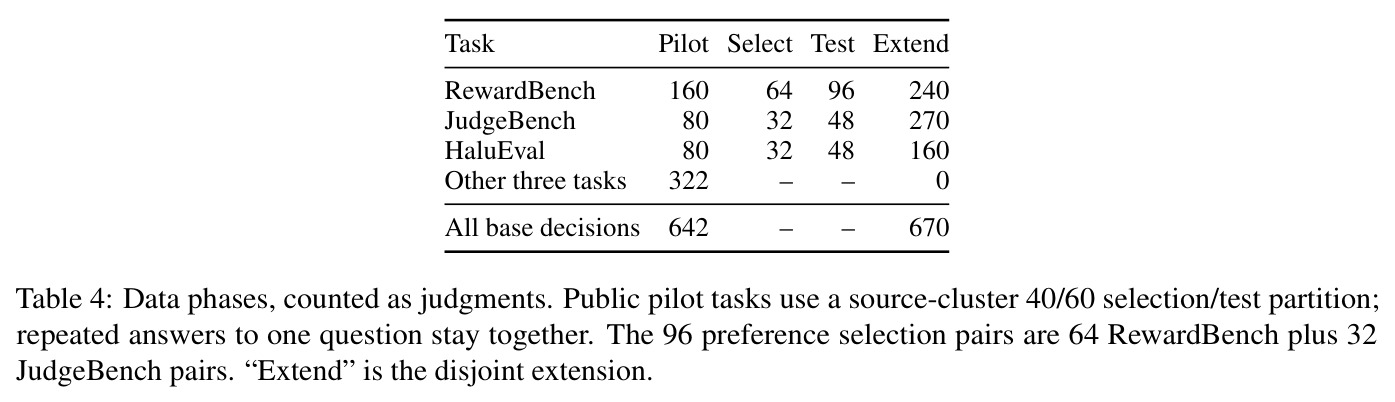
直觉上,评审可以退化成一个分类问题:给定问题与候选答案,输出“哪个更好/是否幻觉/答案对不对”以及各标签概率。JEV 就是这样一个托管服务:输入结构化状态与自然语言 rubric,经 Choice/Noul/Score 原语返回标签概率,按输入 token 计费(每百万 0.042 美元、输出免费),主面板上中位延迟仅 0.152 秒。技术路线分四步:第一步,构建主面板——990 个公共判定(RewardBench 400 对、JudgeBench 350 对、HaluEval 240 项)加 150 条已有标签回复与两组饱和控制(108 条 GSM8K 九轮轨迹、64 条合成证据判断),并按源问题 40/60 切成选择集与试点测试集,670 项扩展(含 RewardBench 2 与 RM-Bench)在试点精度被检查前冻结;第二步,13 个托管评审加 4 个本地基线在相同指令与 JSON 契约下跑同一面板,逐项验证输出有效性;第三步,测量置信度质量与稳定性(894 条诊断:750 对逆序、96 次重复请求、48 次 rubric 改写),成对差分用 2,000 次源问题聚类 bootstrap;第四步,定义并模拟单序与冻结两级级联策略。
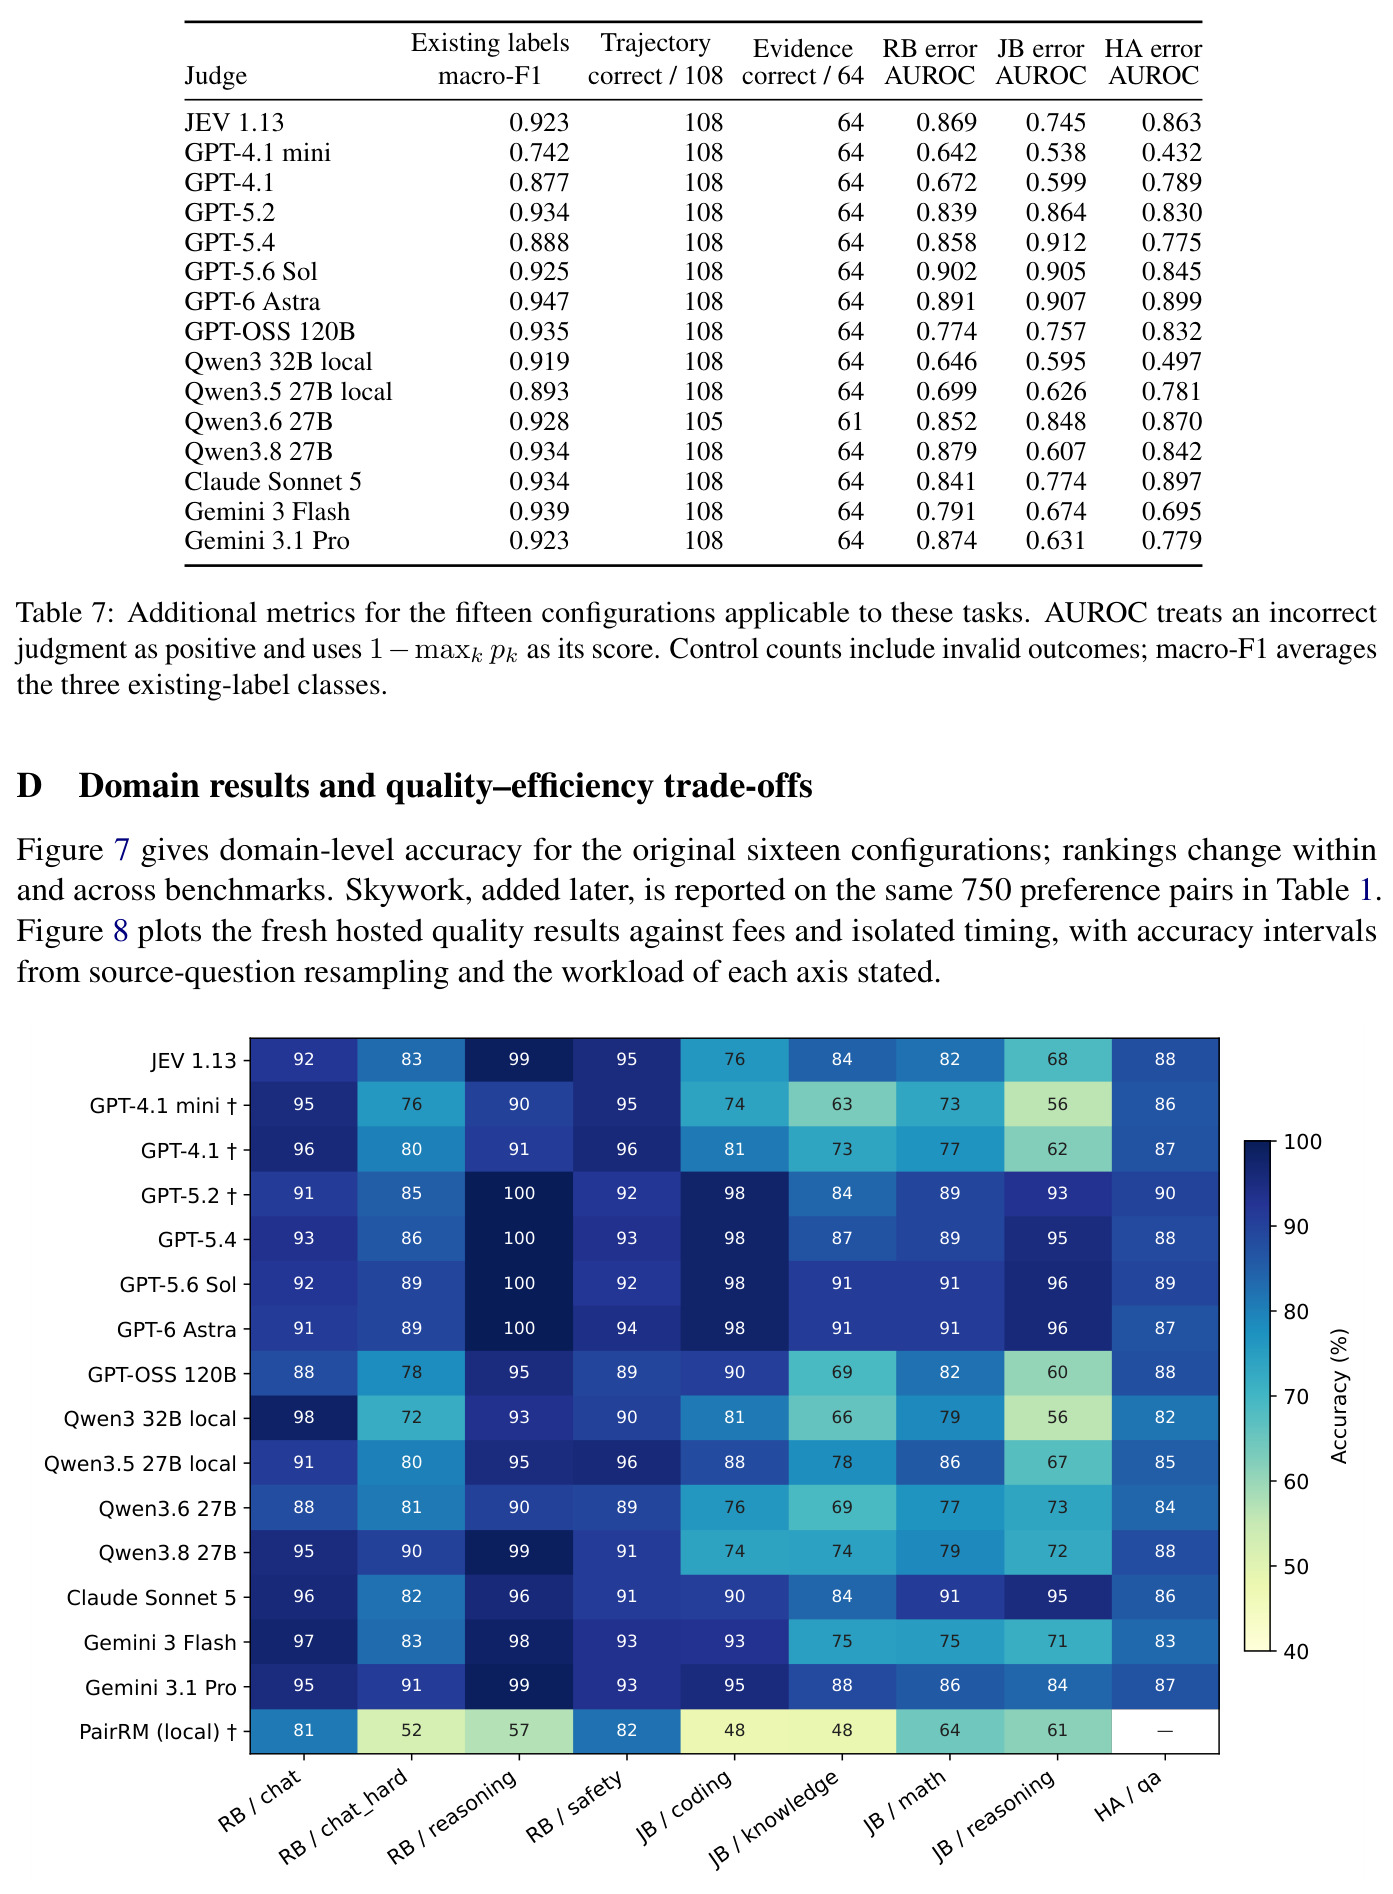
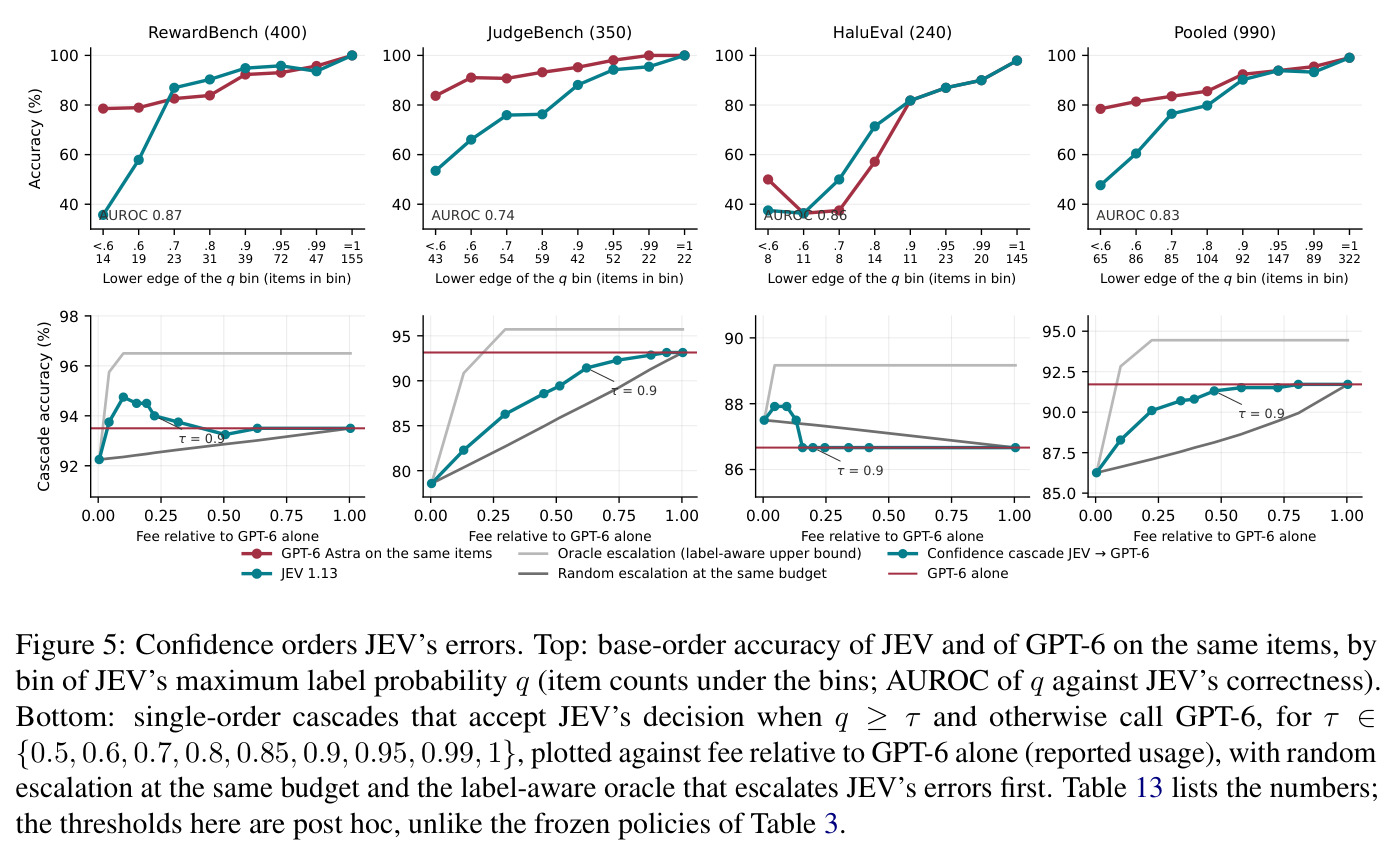
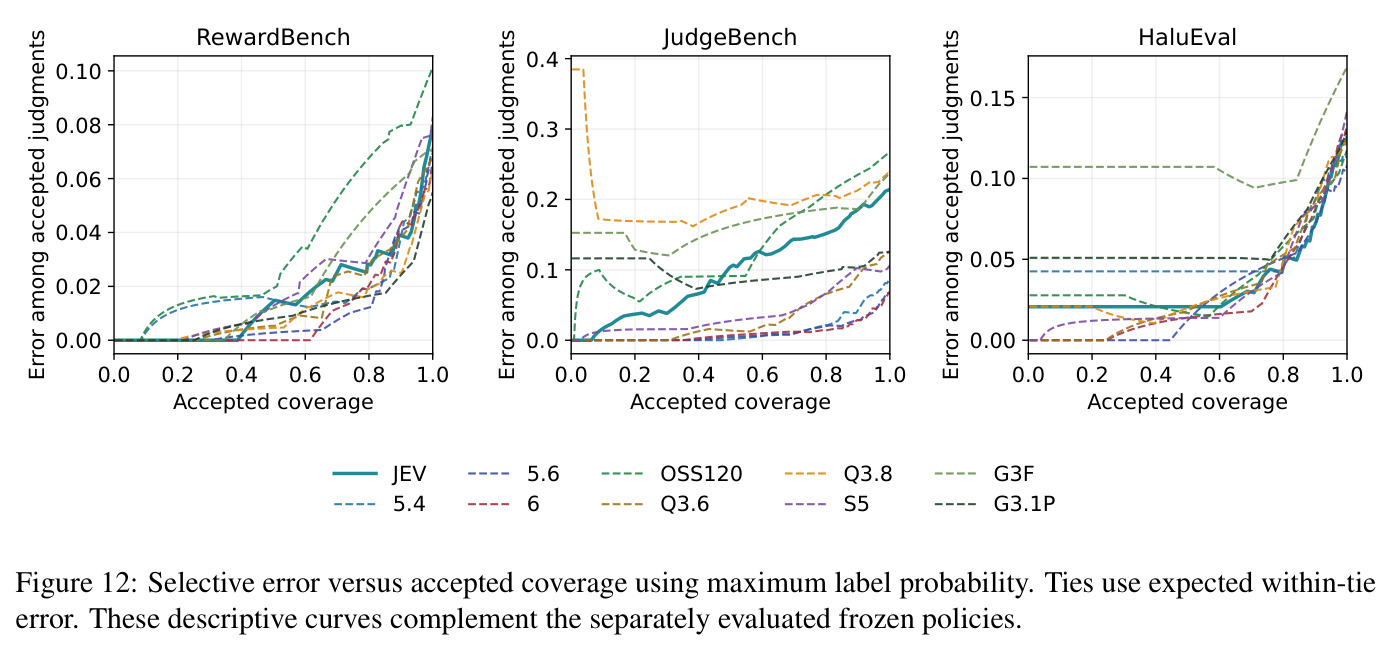
核心思想是“原生置信度让选择性评审变便宜”。与让 GPT 类评审口头报告概率不同(口头化概率的校准是经验问题),JEV 的接口本身返回标签分布,$q=\max_k p_k$ 与厂商原生置信度的 Spearman 相关高达 0.971/0.999/0.948(RewardBench/JudgeBench/HaluEval),因此置信度是接口的免费副产品而非额外提示工程的产物。论文随即证明这个信号真的能排序错误:990 项汇总精度随 $q$ 单调上升($q<0.6$ 时 47.7%,$q=1$ 时 99.1%),汇总误差检测 AUROC 0.83,于是“自信时接受、存疑时升级到 GPT-6”的级联能以一小部分费用保留 99% 以上的精度。与已有级联研究的本质区别在立场:本文不学习路由器、不追求新机制,而是提供冻结阈值加实测费用的经验操作剖面,并明确划出置信度失效的边界——需要核查推导的 JudgeBench、风格对抗的 RM-Bench 困难对、以及所有评审都近随机的无参考散文。
方法步骤详情
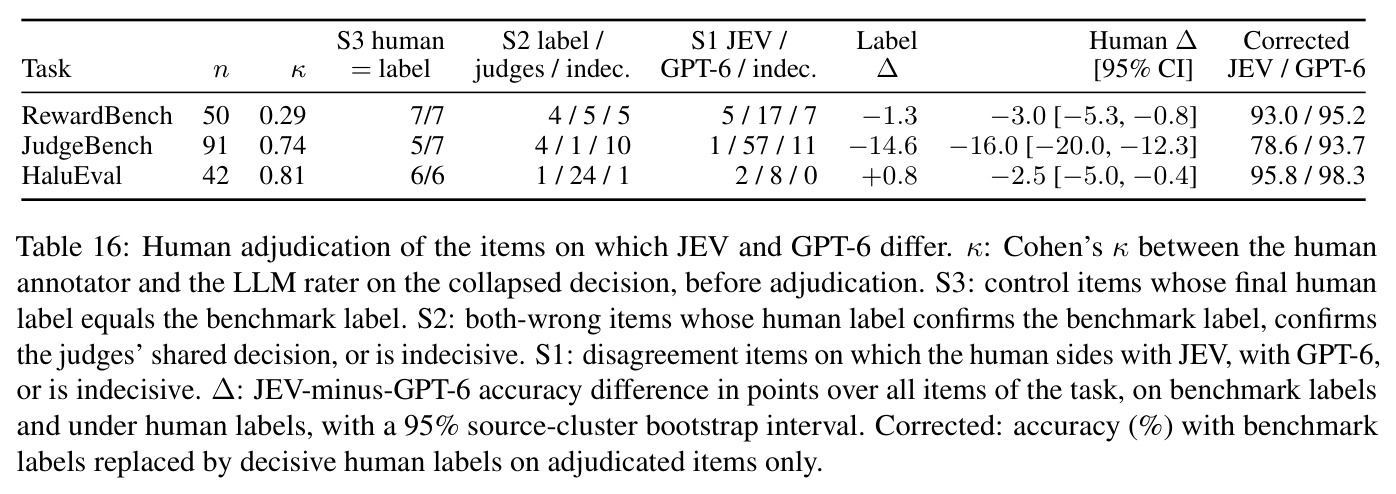
第一步(任务与数据):RewardBench 400 对(chat/困难对话/安全/推理各 100)、JudgeBench 完整 GPT-4o 分片 350 对、HaluEval 240 项证据判断、150 条来自六个生成器的多轮实验留存回复(correct/incorrect/no_answer 标注 99/25/26)、108 条 GSM8K 九轮轨迹与 64 条合成证据控制;随后冻结 RewardBench 2 四选一 100 提示和 RM-Bench 80 提示乘以 9 种风格组合乘以 2 顺序(共 1,440 判定)以及 160 条自然散文样本。第二步(评审调用):向每个评审发送含 rubric 与标签含义的 JSON 状态;生成式基线被明确要求“返回 verdict 与每个允许标签的概率,不要解释”,由 JSON schema 约束(GPT-4.1 系温度 0,推理模型 low effort);JEV 使用原生 Choice 原语。第三步(测量):输出经 schema 字段、标签合法、概率有限、归一化(和容差 0.025)与 verdict–argmax 一致性验证,无效计为错误;偏好任务双序评价后用 $\bar{p}(A)=\frac{1}{2}[p_1(A,B)+1-p_1(B,A)]$ 对齐两序概率;指标包括准确率、macro-F1、Brier、裁剪 NLL、十箱 ECE 与误差检测 AUROC。第四步(裁决与级联):一位对条目级标签盲视的团队成员裁决 183 项分歧(S1 分歧 108 / S2 双错 55 / S3 控制 20 三阶层);级联阈值在 64 个 RewardBench 加 32 个 JudgeBench 试点选择对上最大化覆盖率、精度损失不超过 2 点,全部在 510 个互斥扩展对上评估。
技术新颖性
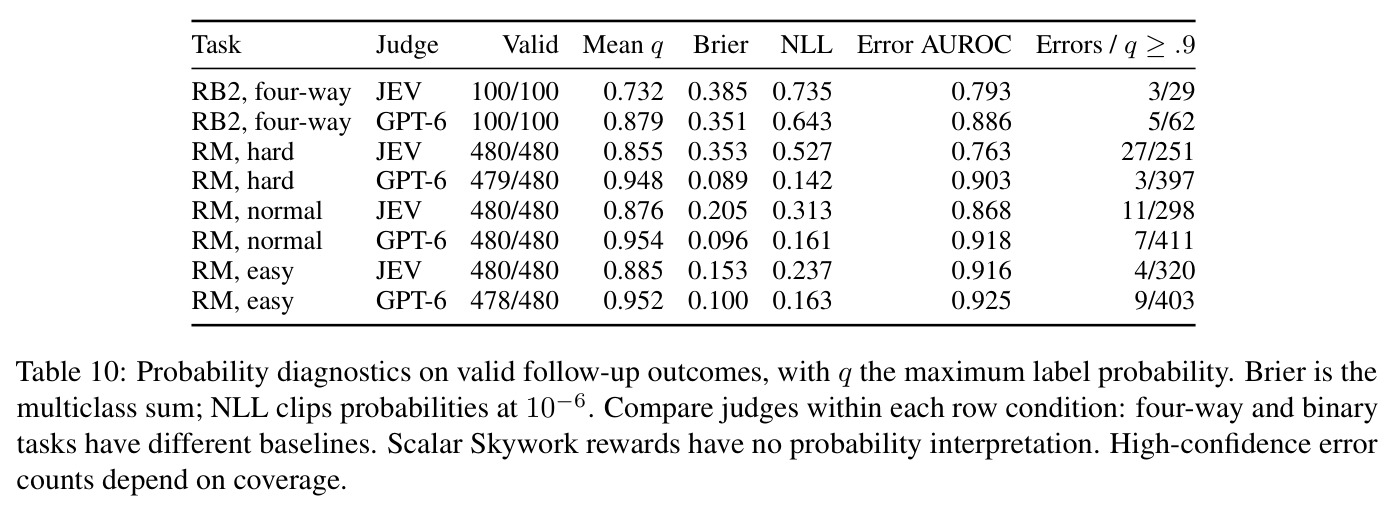
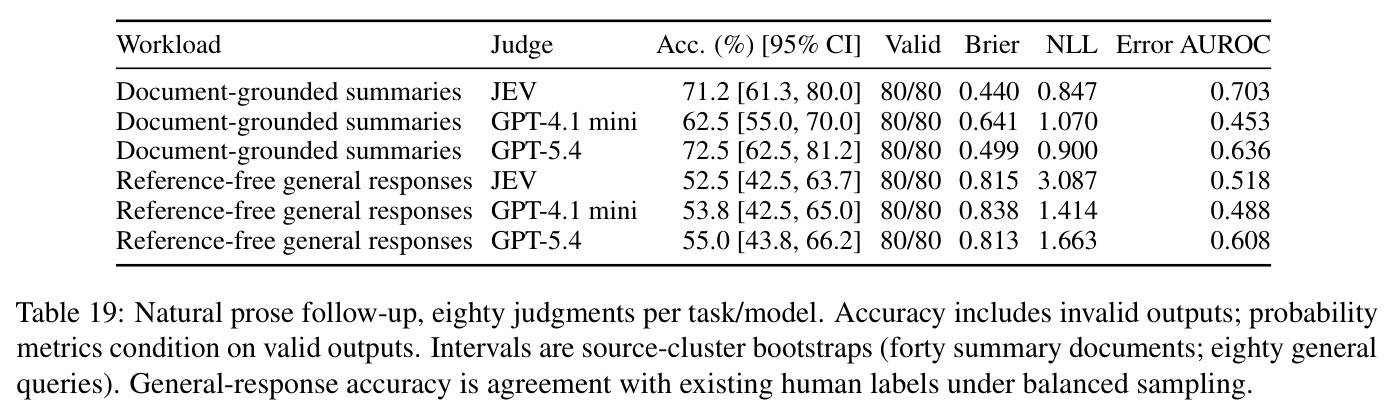
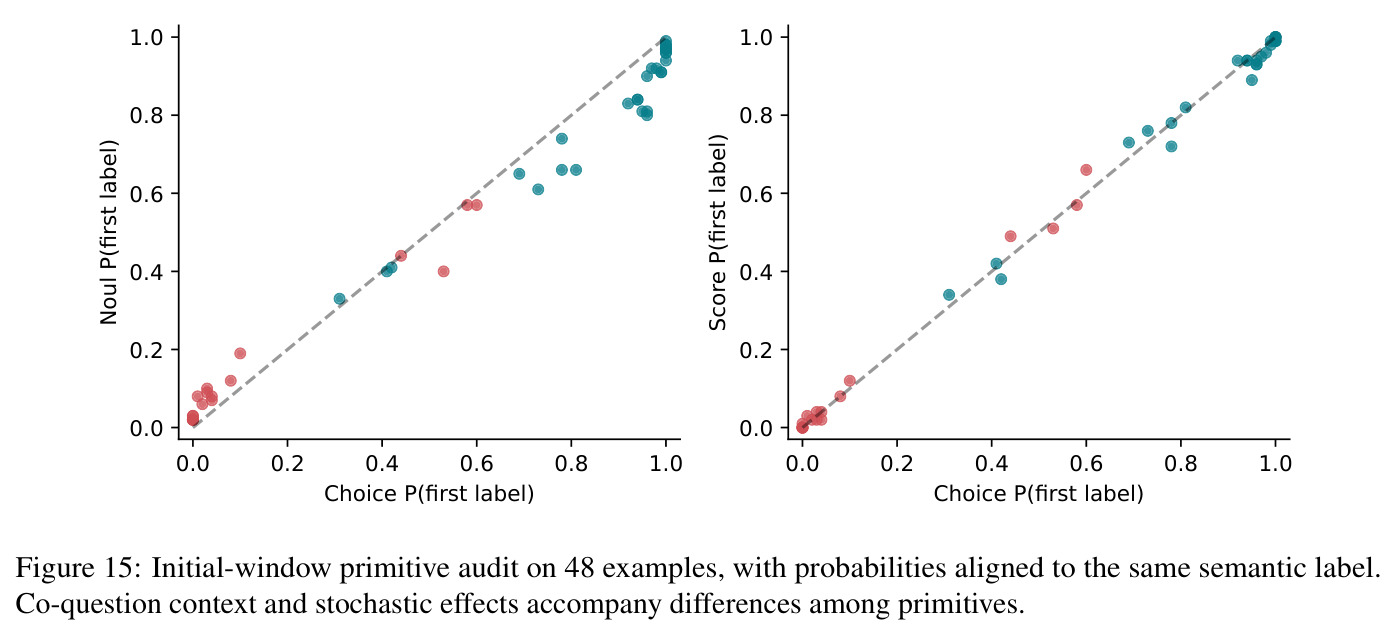
新颖性不在算法而在测量制度的完整性。第一,这是首个对托管“决策型”评审的端到端操作研究:有效性(JEV 在 1312/1312 个基础项上全部返回有效裁决)、精度、校准、稳定性、时延、费用在同一冻结协议下联合测量,而以往工作几乎只报精度。第二,预注册的盲评人类裁决(183 项、三阶层、协议与修订日志随论文发布)把“JEV 落后 GPT-6”分解为评审能力与标签噪声两部分:HaluEval 上 26 个“双错”项中 24 个实为标签错误(校正后 JEV 95.8%、GPT-6 98.3%),而 JudgeBench 上人类以 57:1 站边 GPT-6,差距从 −14.6 点扩大到 −16.0 点——两个方向都让结论更扎实。第三,若干此前未被系统记录的经验事实:温度缩放跨工作负载不可迁移且方向不一(0.65/2.15/4.45);接口原语间概率不一致(Choice 与 Noul 平均差 0.055);风格对抗使置信度 AUROC 从 0.902 跌至 0.770;以及所有被测评审在无参考散文上都“高置信地接近随机”(JEV Brier 0.815、AUROC 0.518)。
实验结果
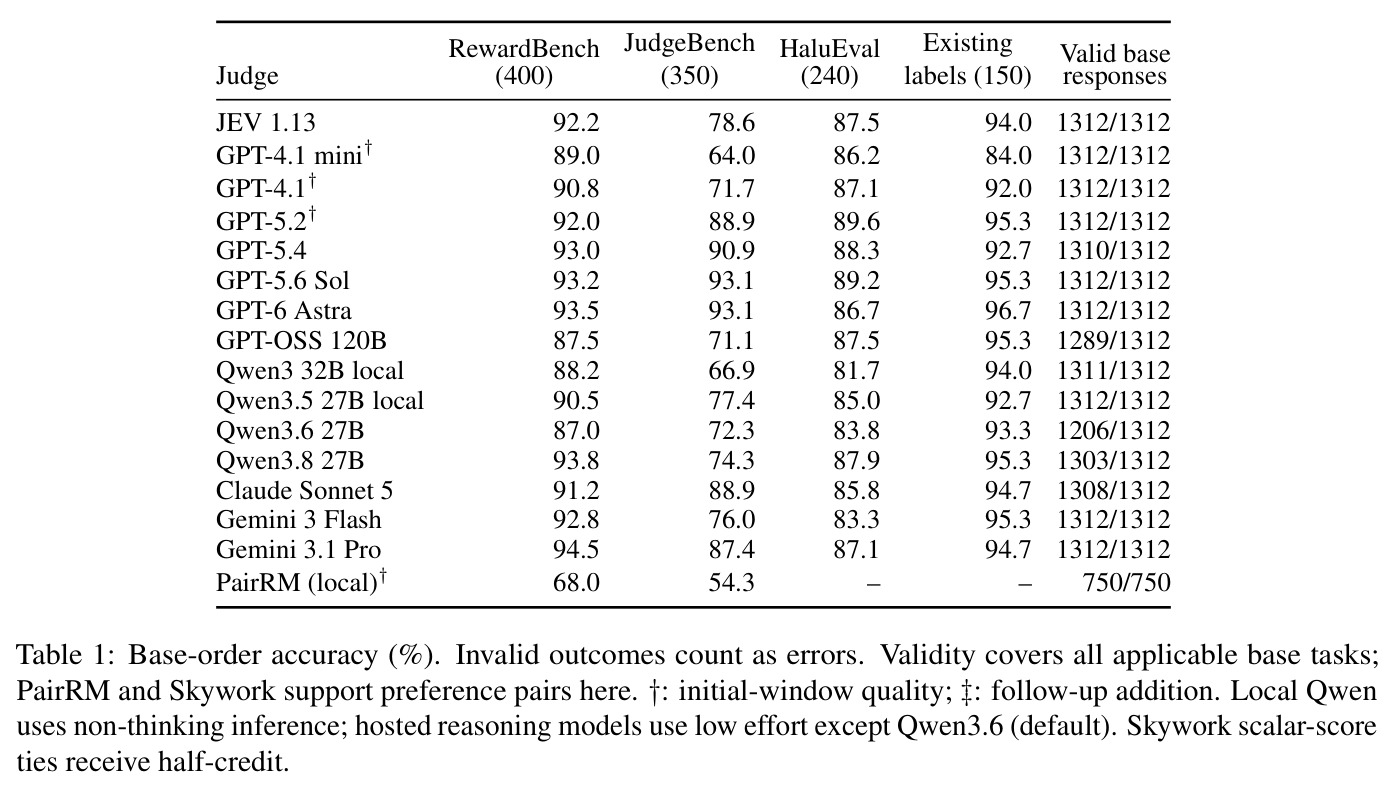
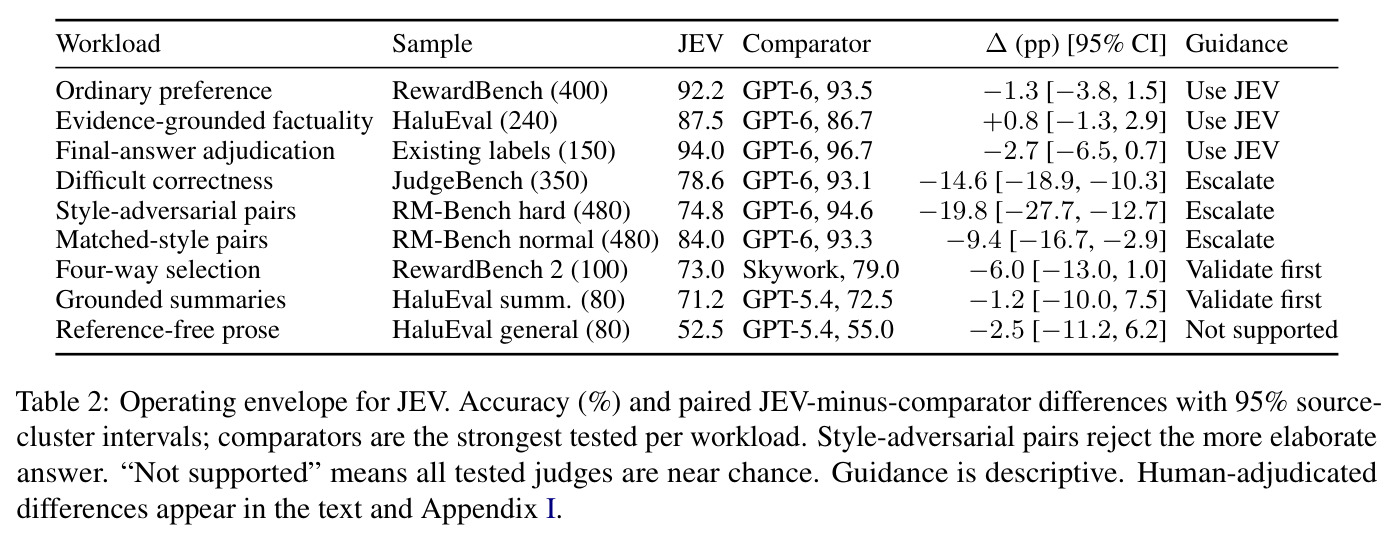
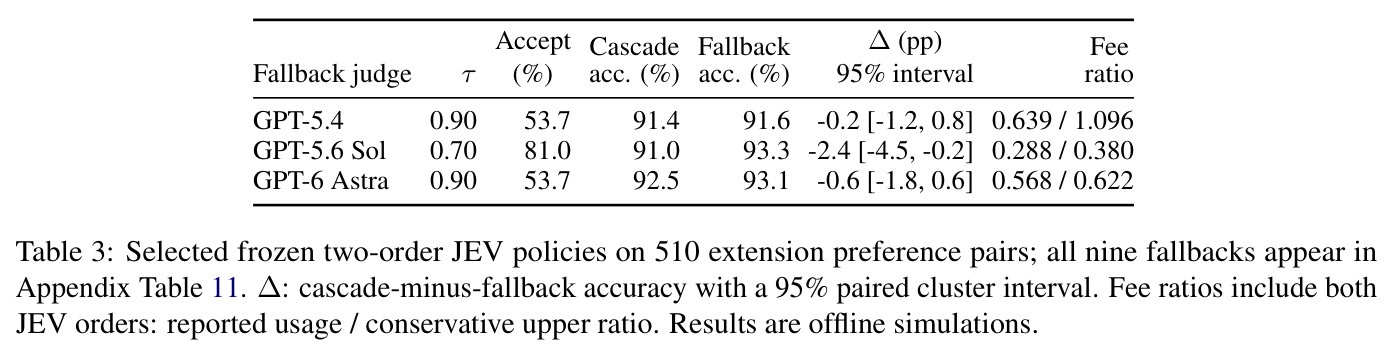
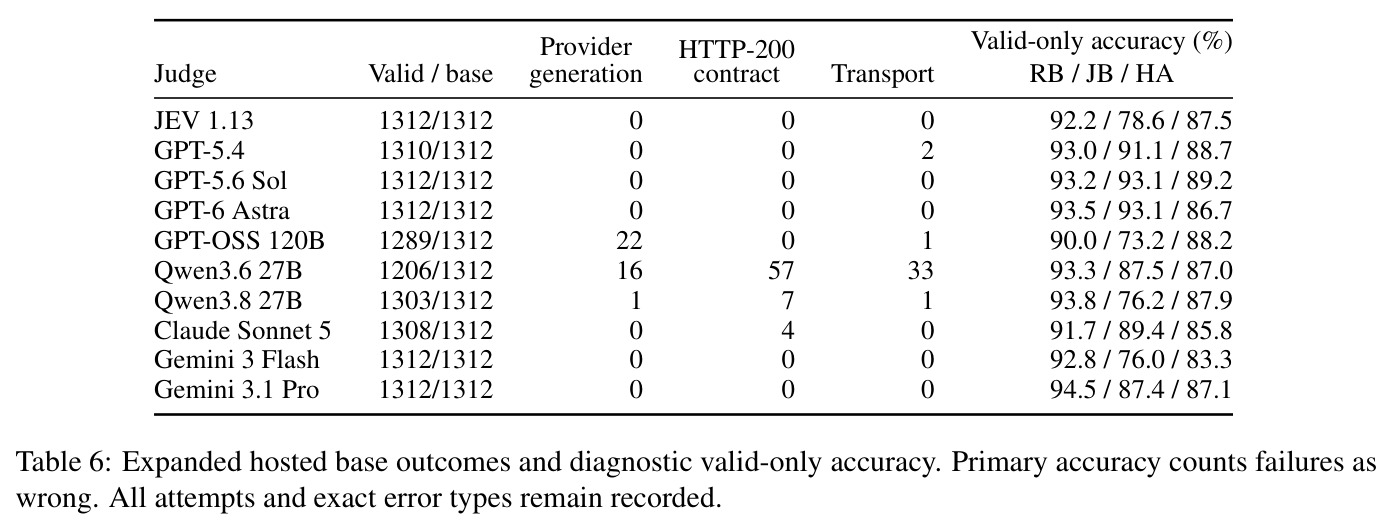
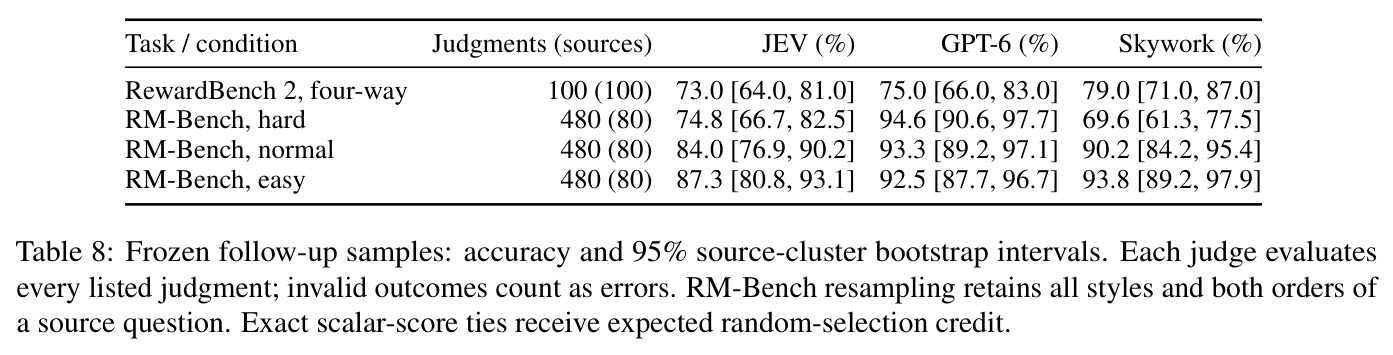
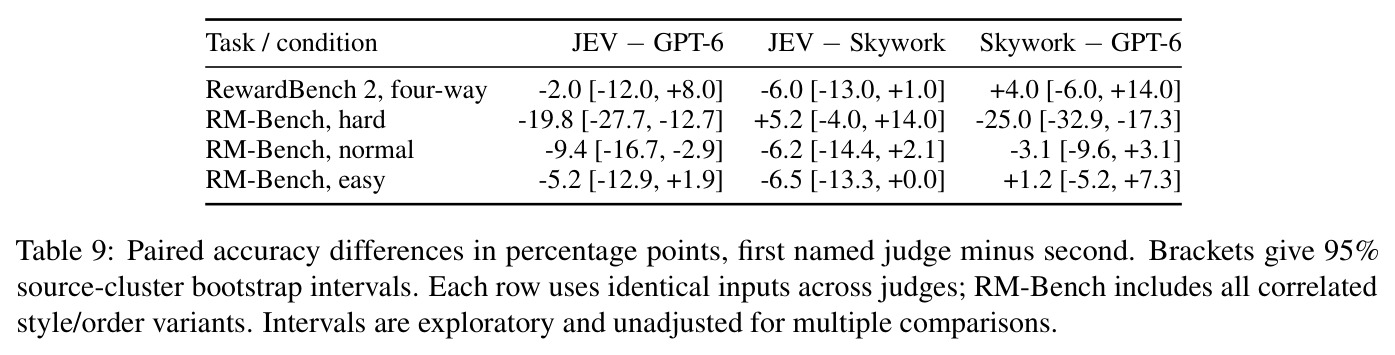
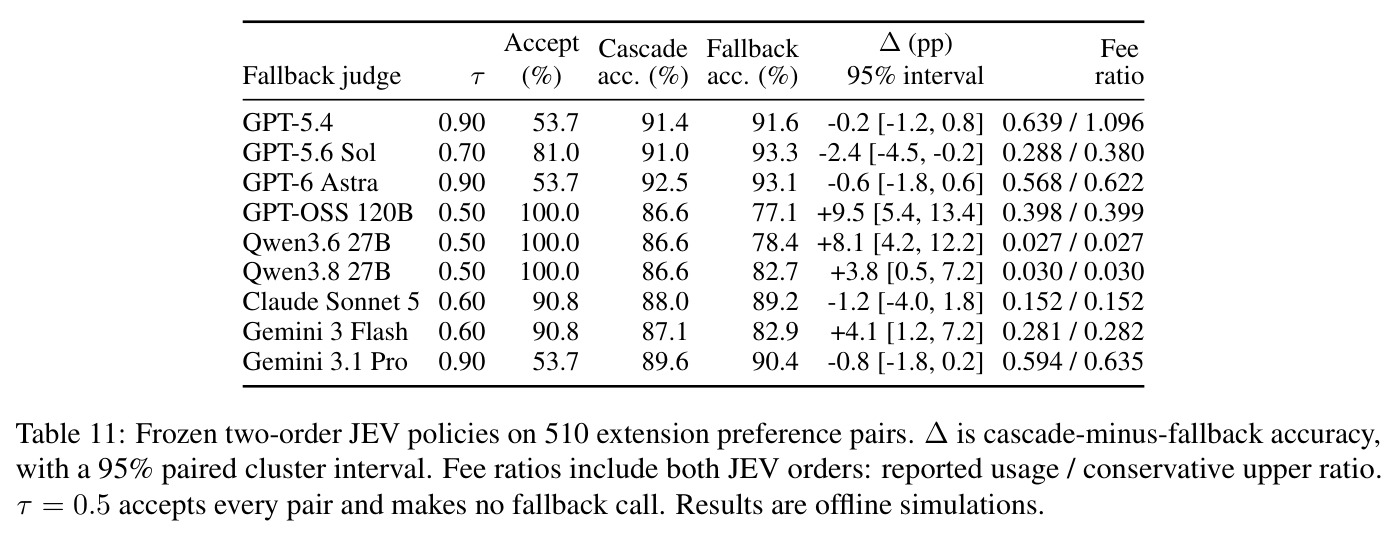
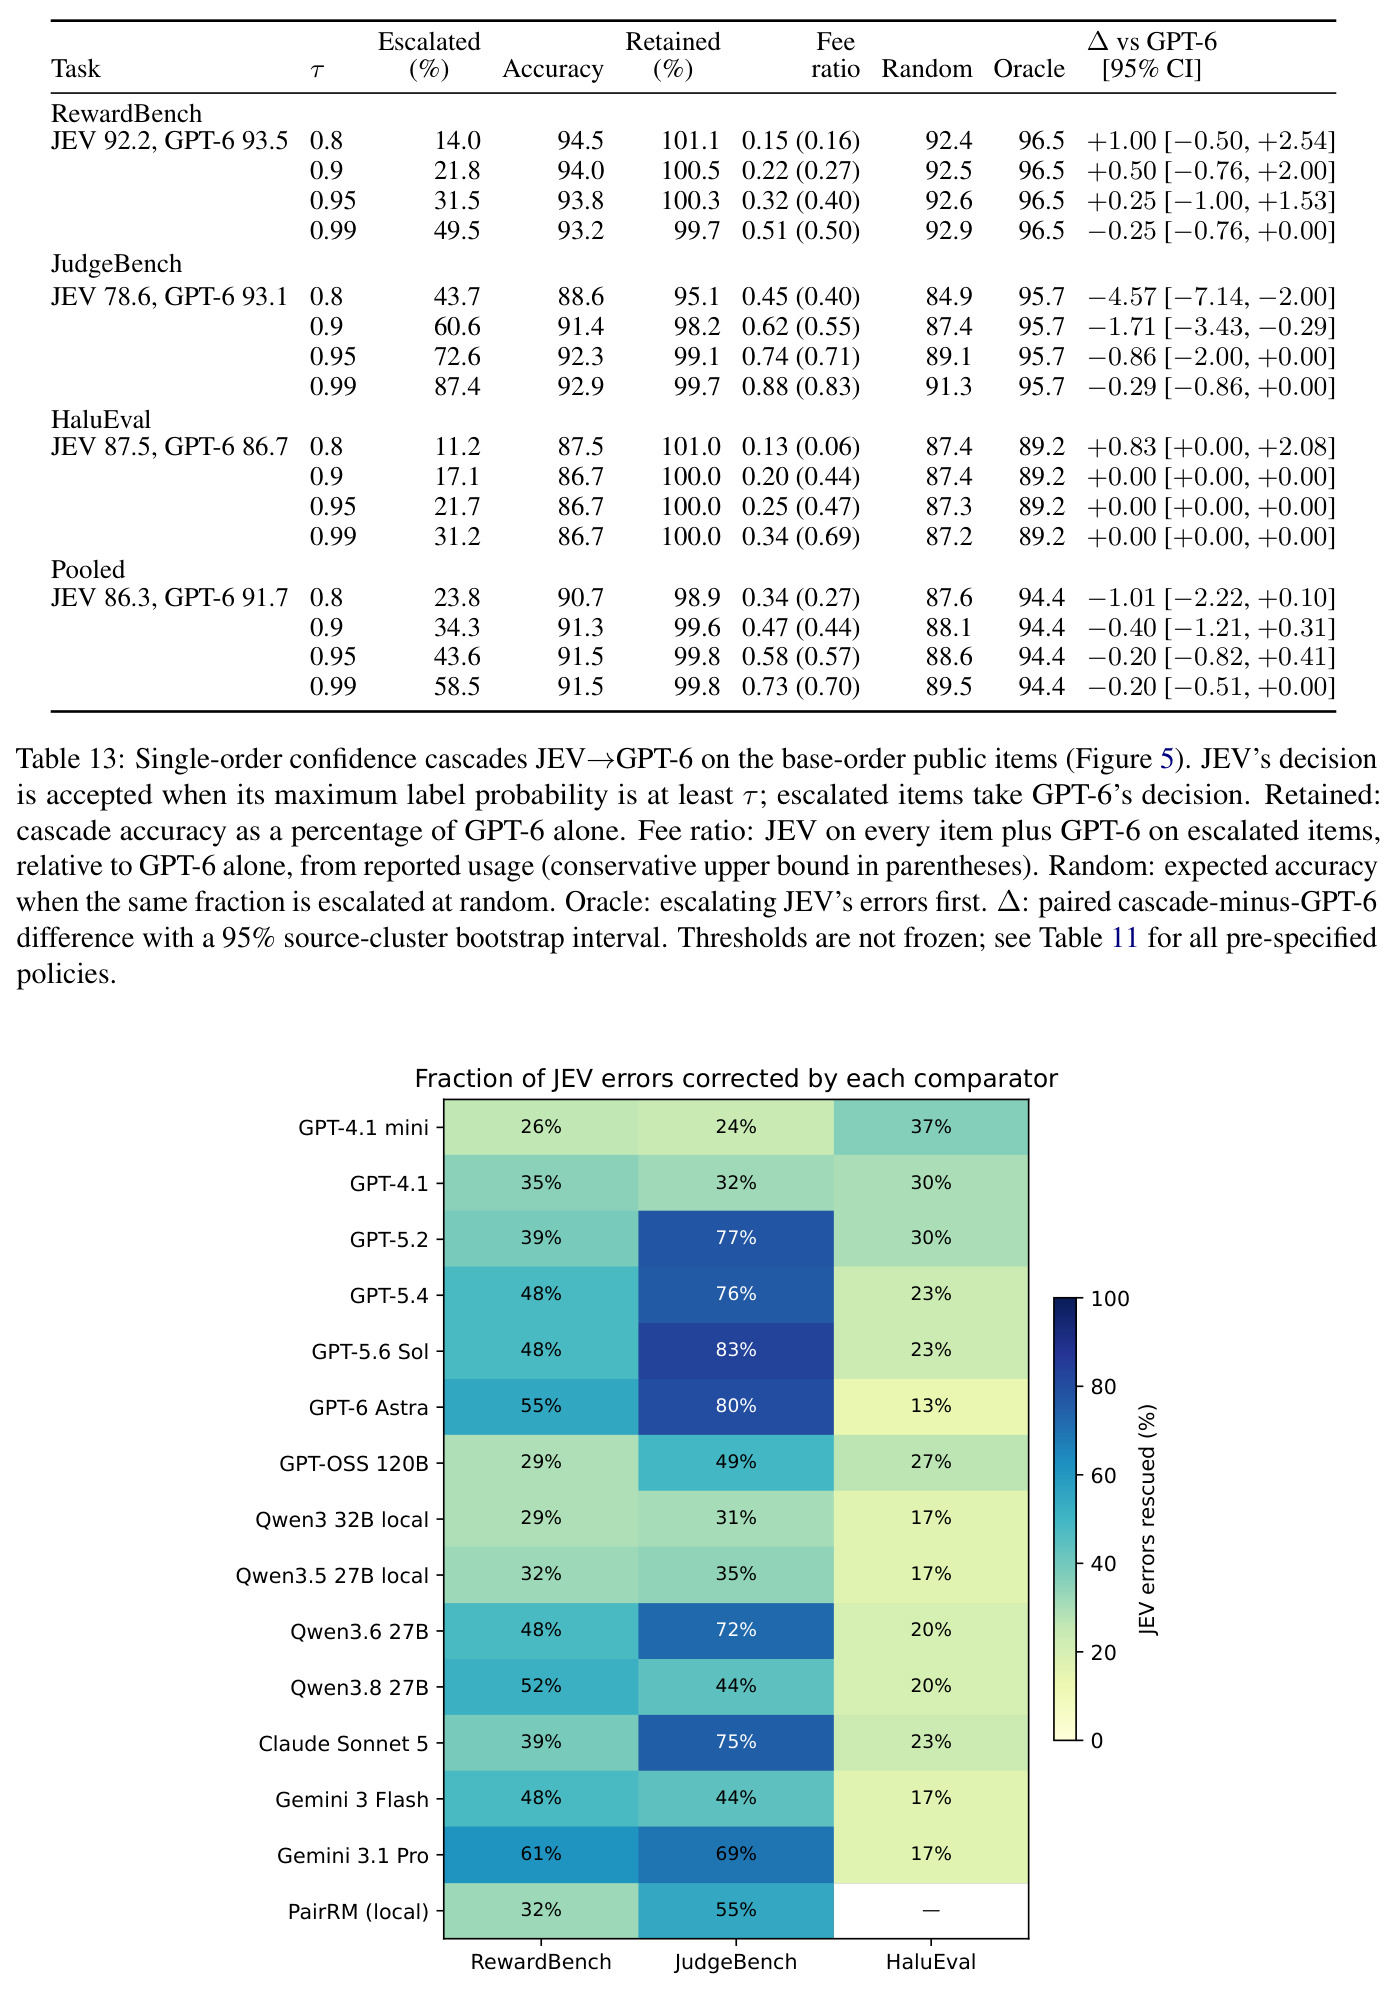
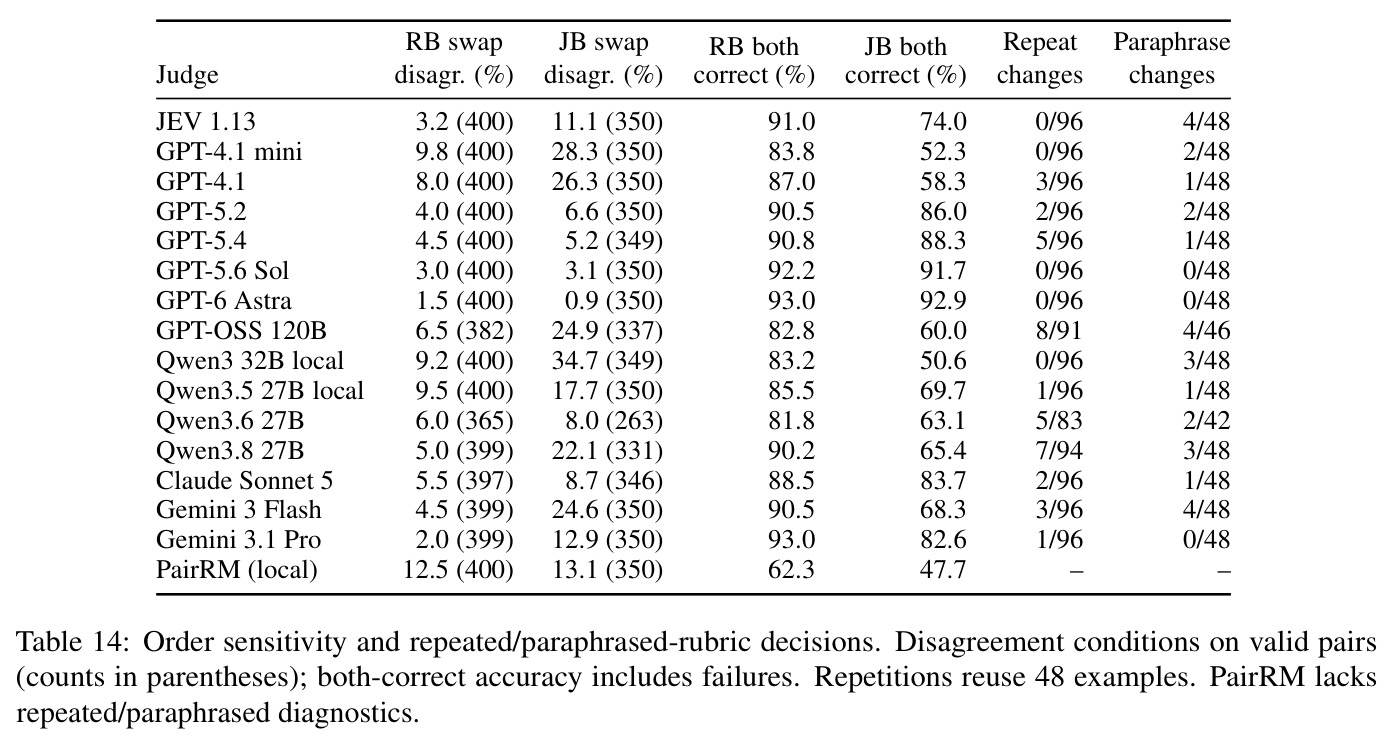
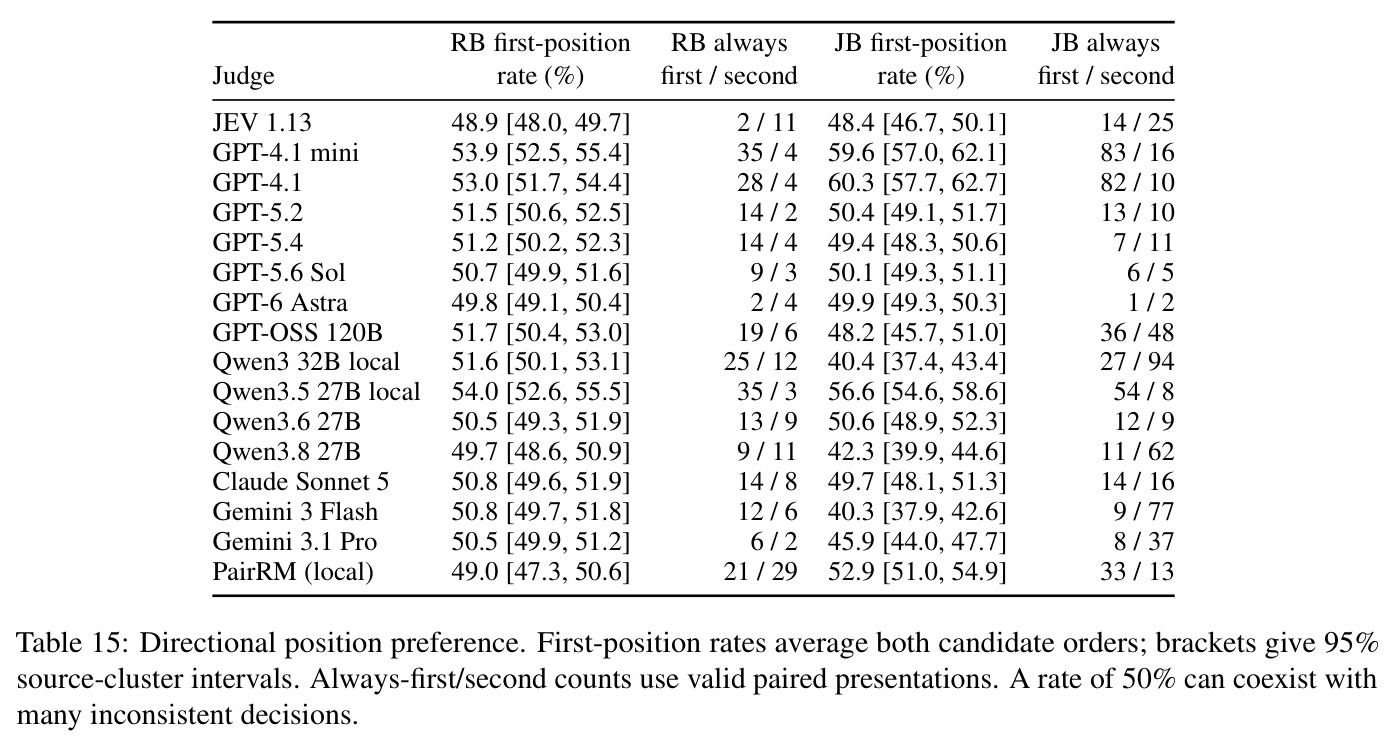
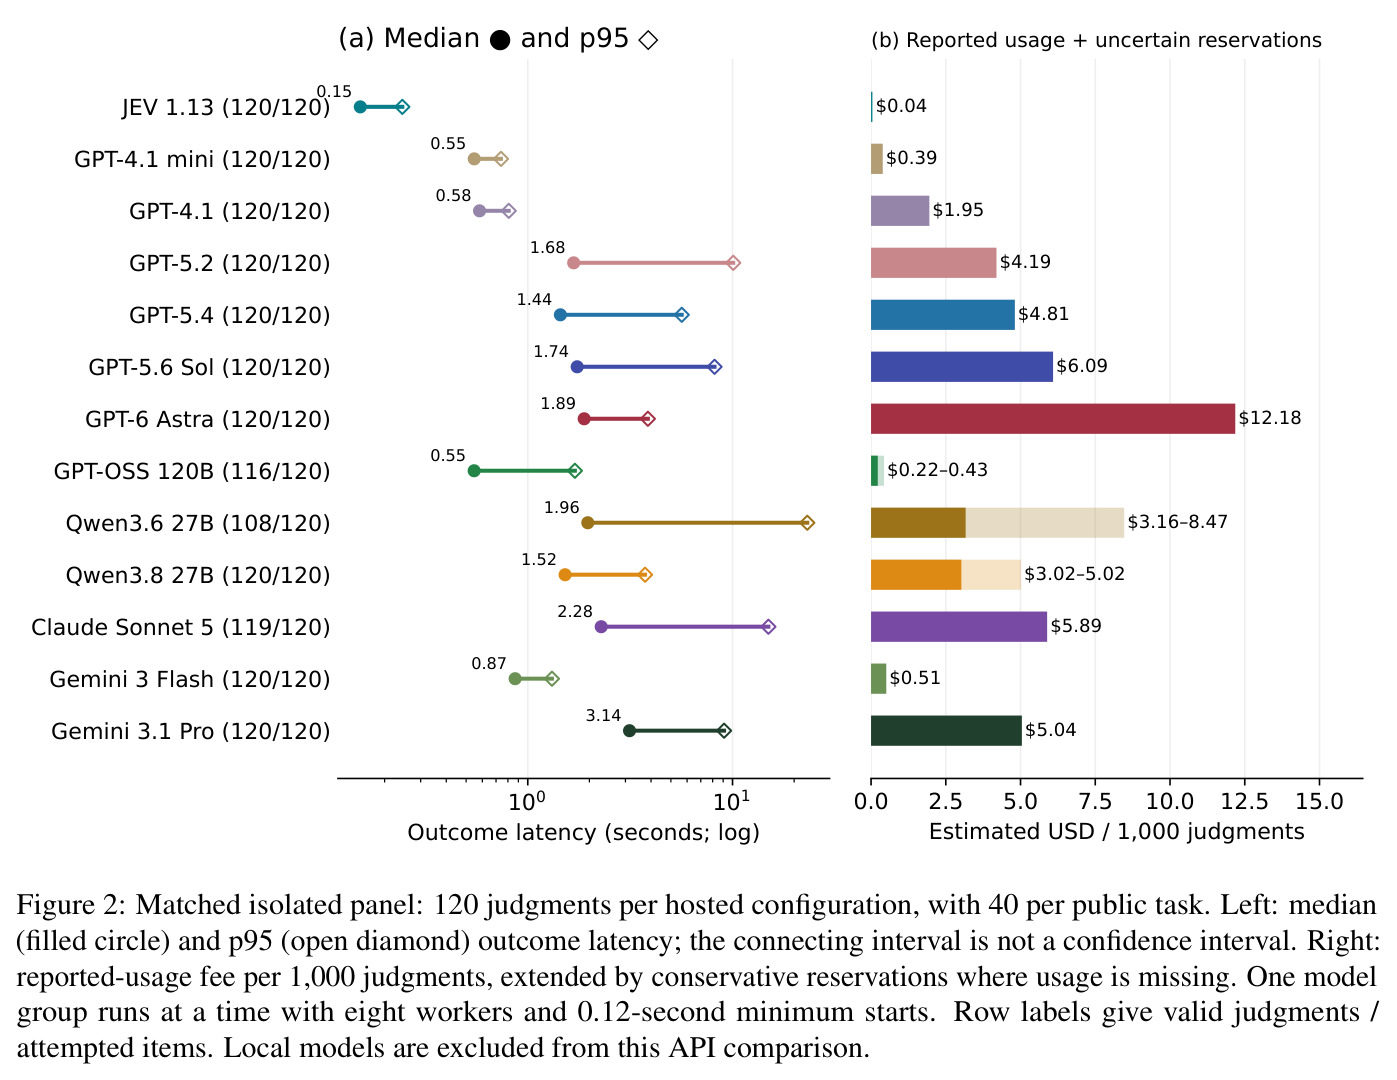
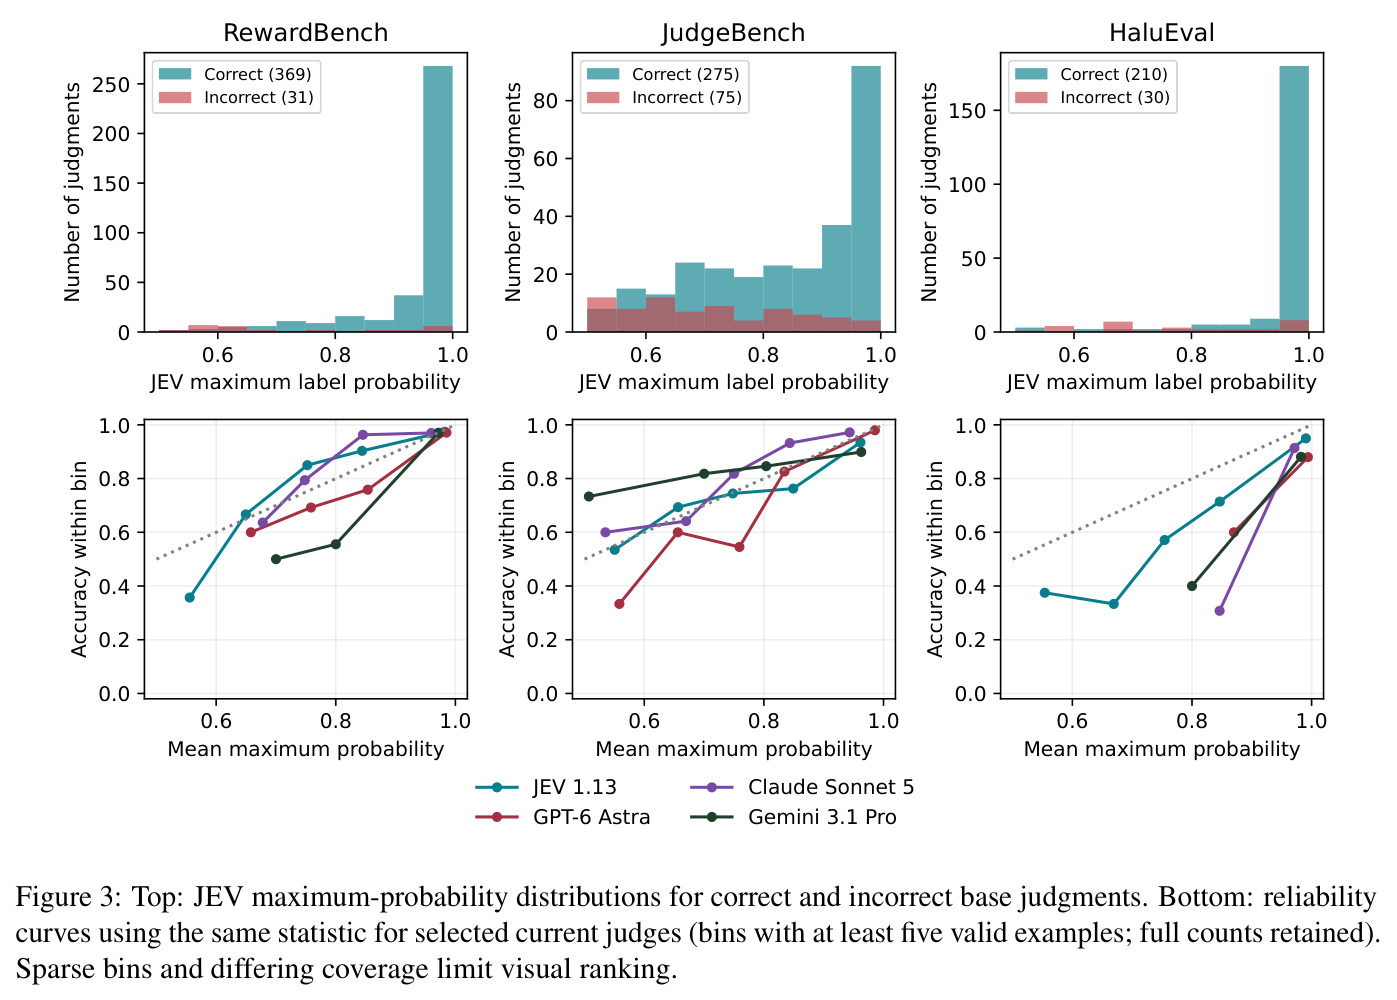
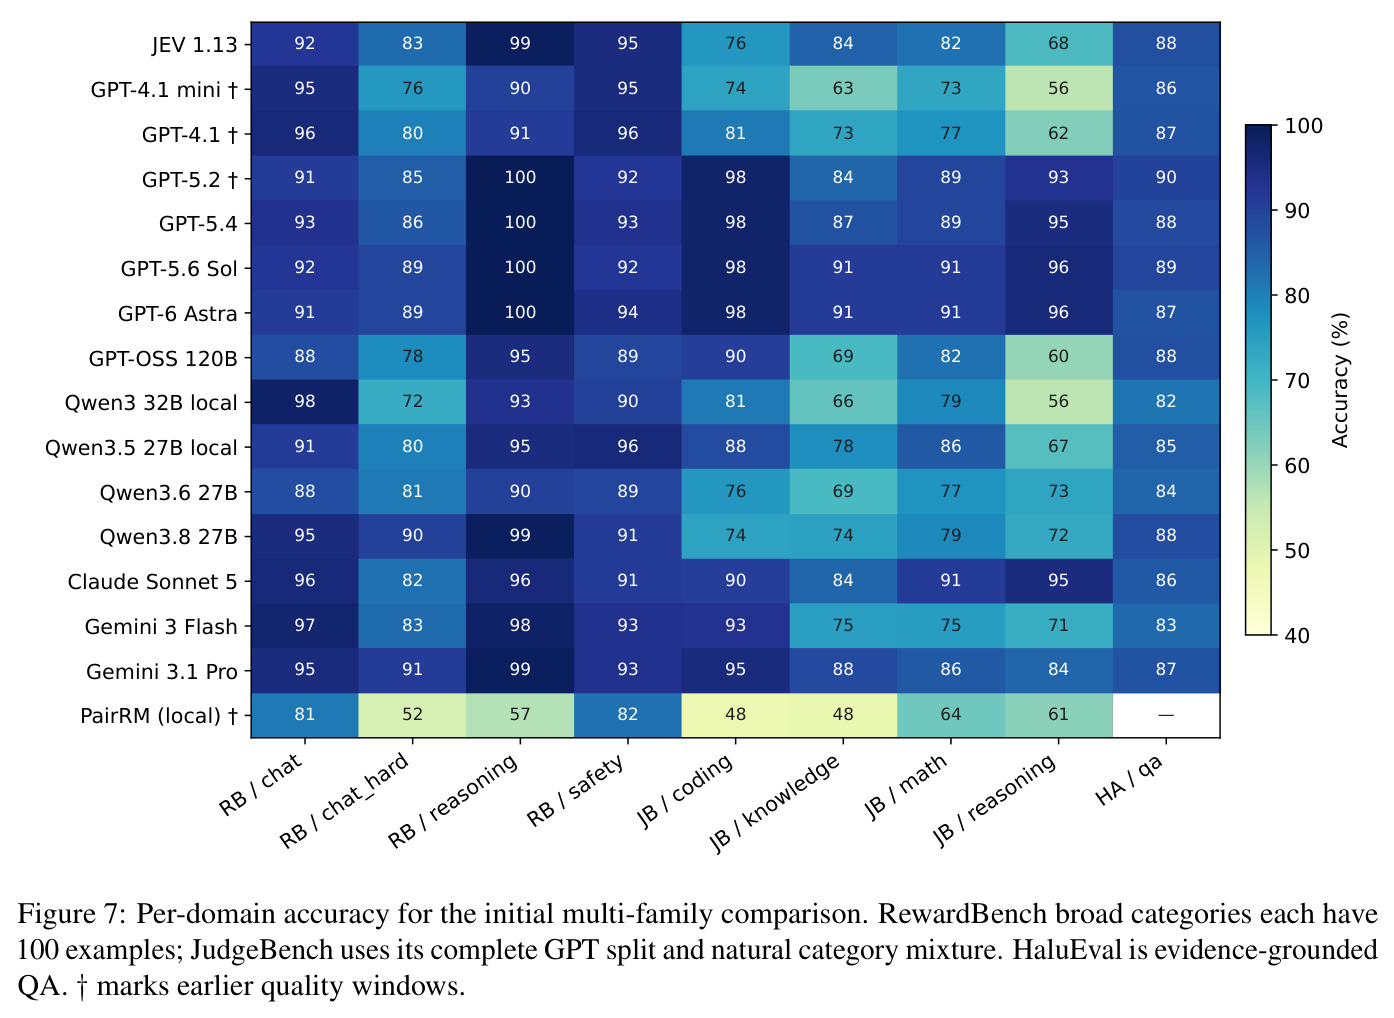
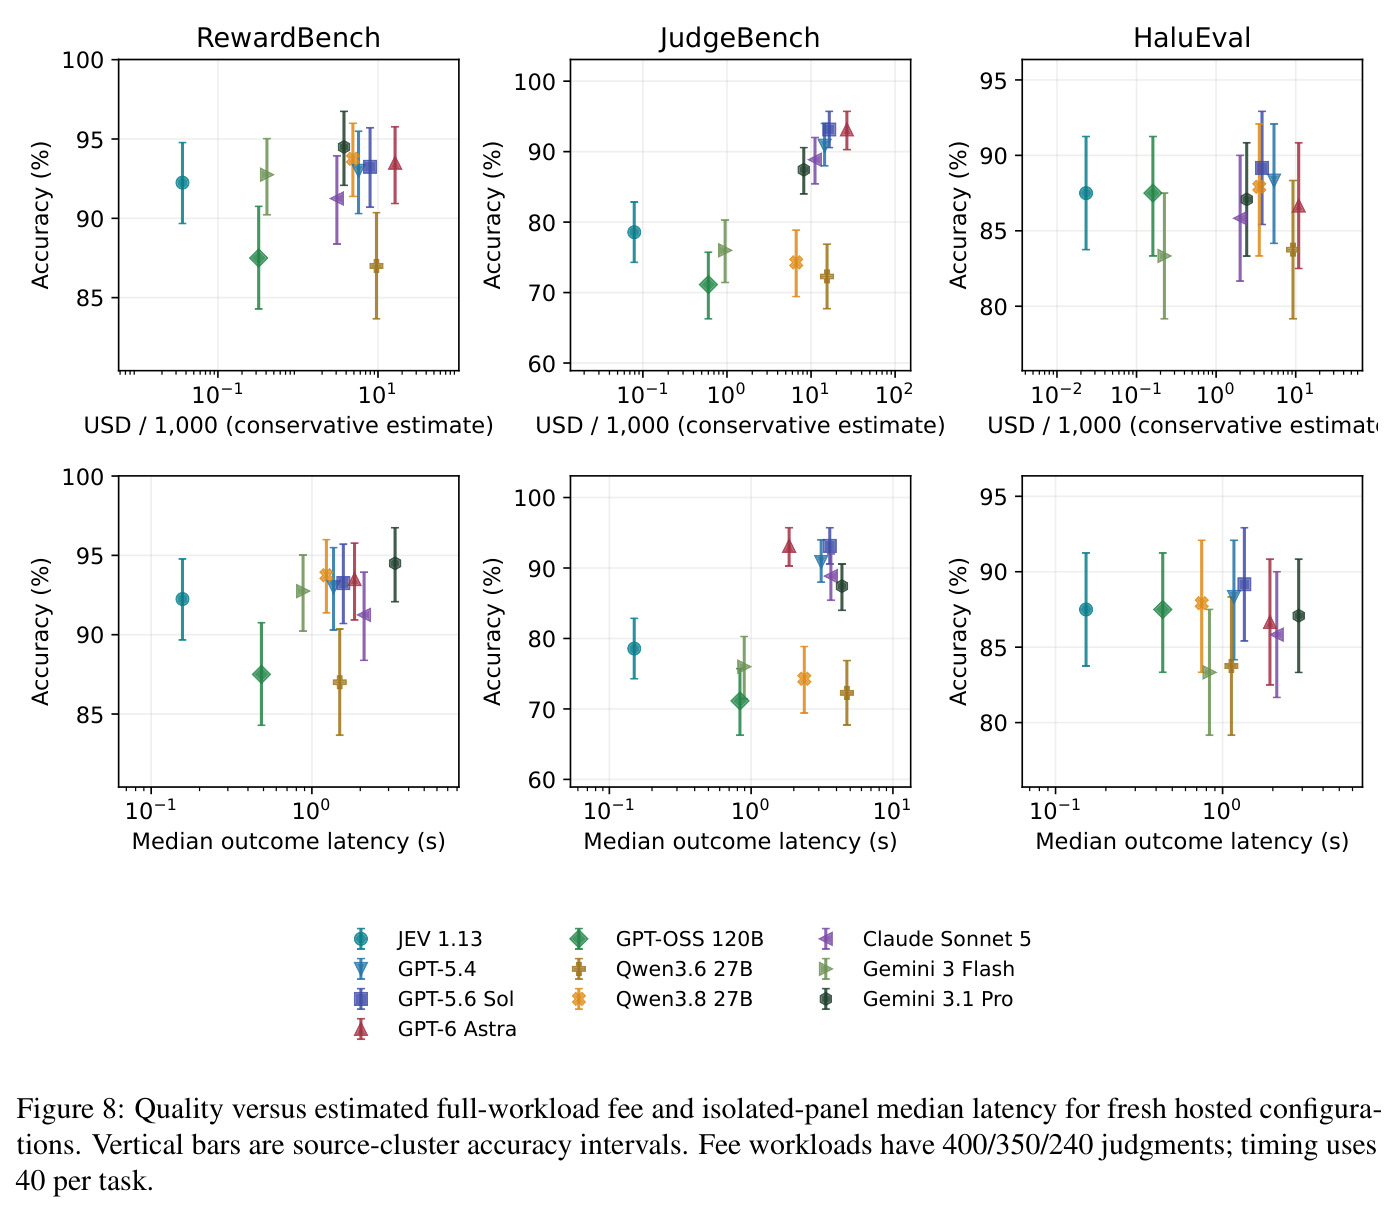
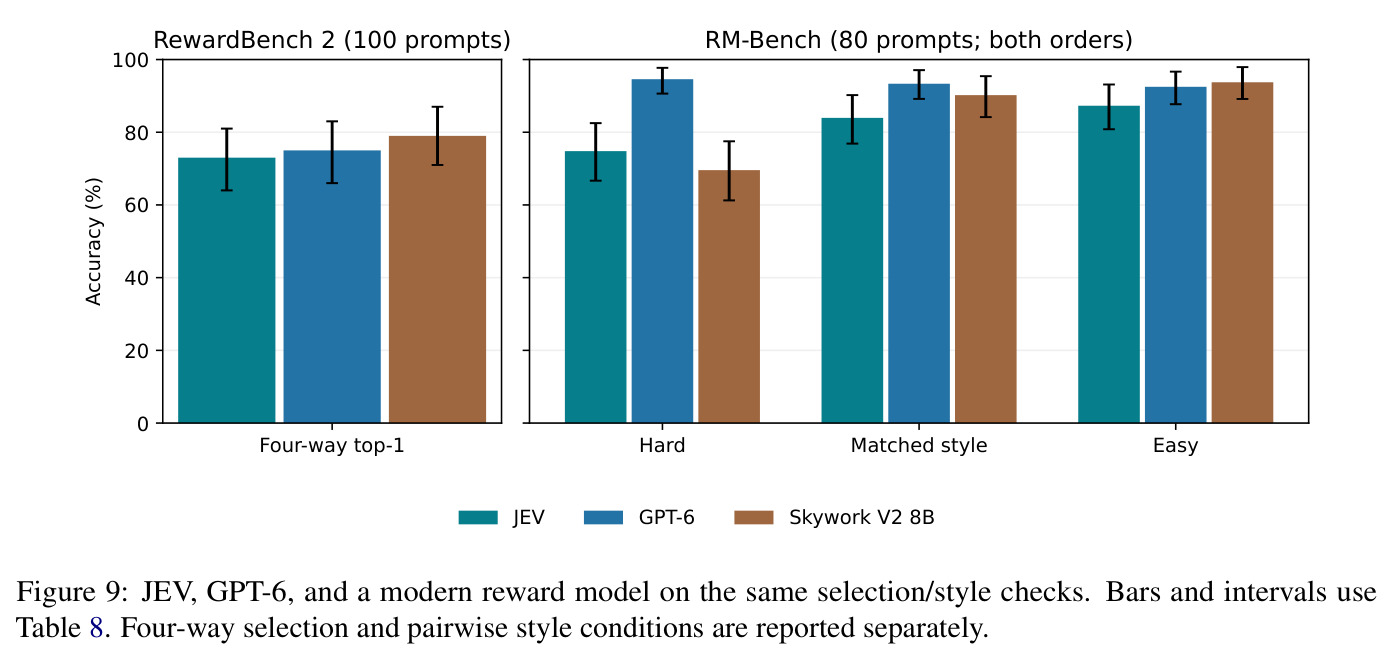
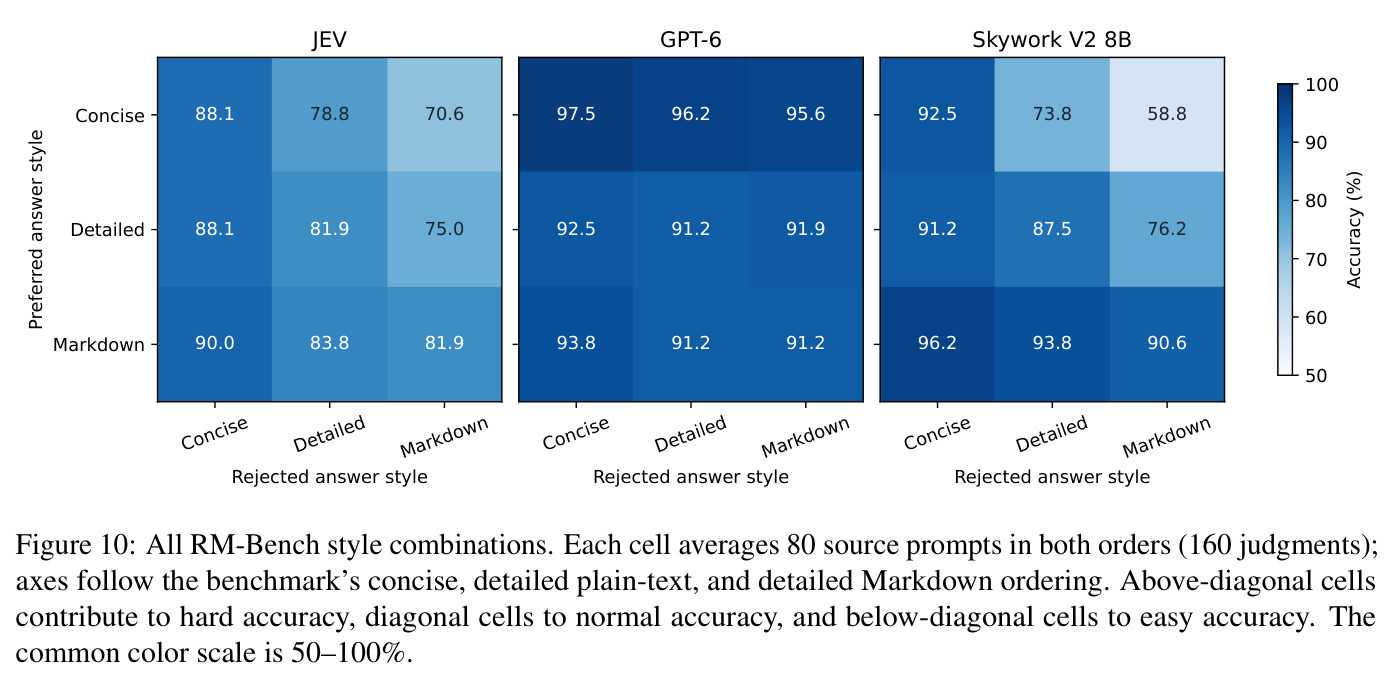
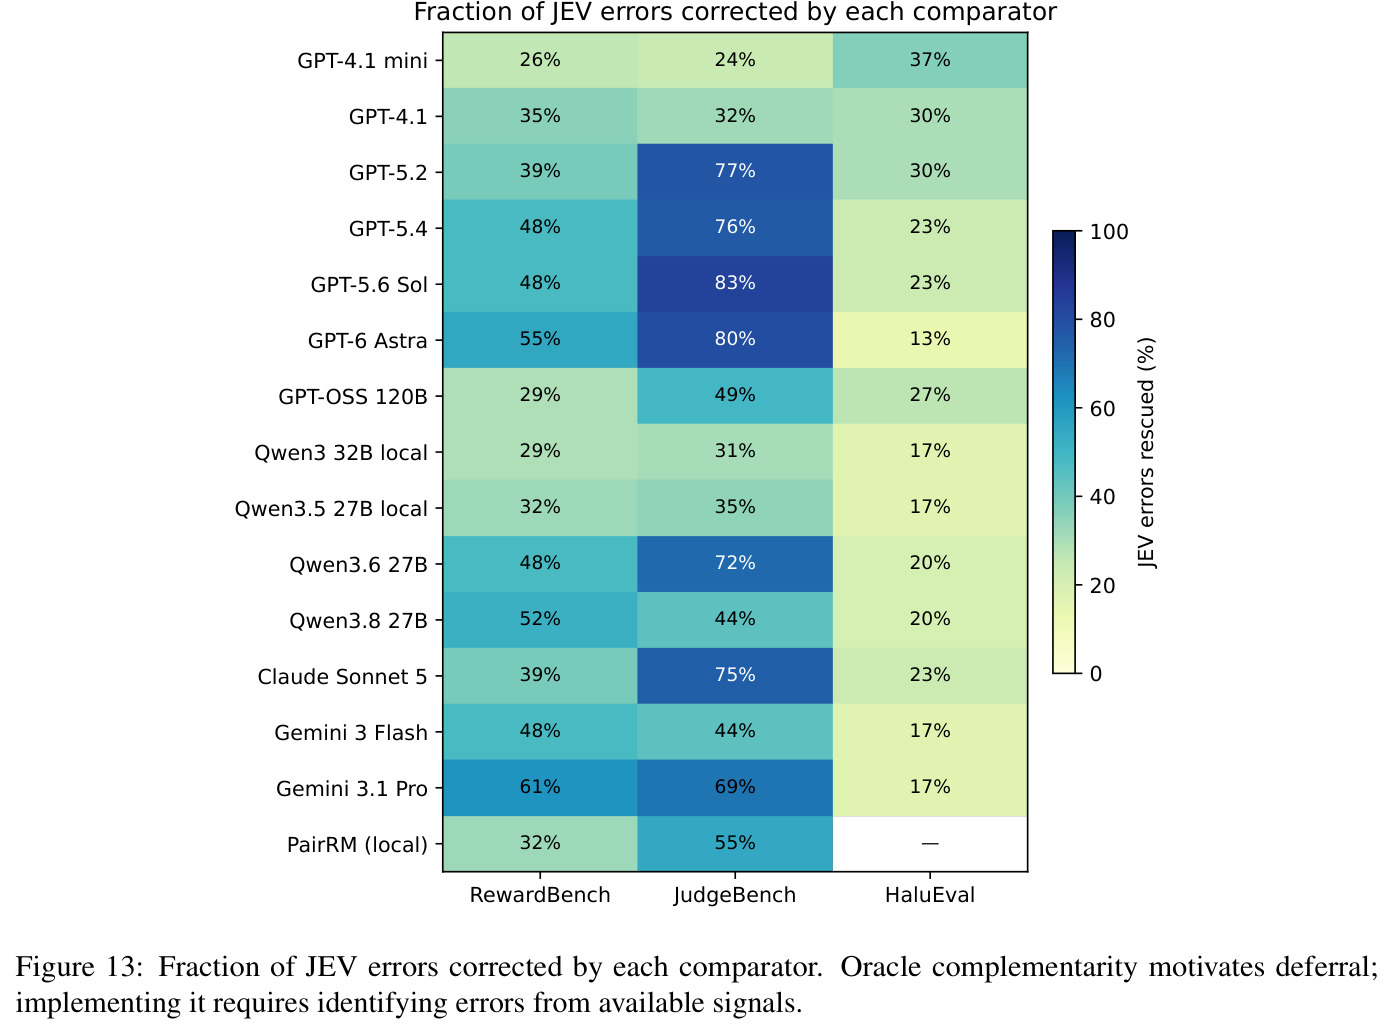
分工作负载看:RewardBench 上 JEV 得 92.2% 对 GPT-6 的 93.5%(成对差 −1.25 点,95% CI [−3.8, 1.5]);HaluEval 上 87.5% 对 86.7%(+0.83 [−1.25, 2.92],但人类校正标签后为 95.8% 对 98.3%);150 条已有标签回复上 94.0%(macro-F1 0.923)对 GPT-6 的 96.7%——这三类属于“用 JEV”。JudgeBench 上 JEV 仅 78.6% 对 93.1%(−14.6 [−18.9, −10.3]),推理域最悬殊(68.4% 对 95.9%,$n=98$)、编码 76.2% 对 97.6%;RM-Bench 风格对抗对上 74.8% 对 94.6%(−19.8),匹配风格时收窄到 84.0% 对 93.3%(−9.4)——这两类“必须升级”。成本上 JEV 每千次判定 0.044 美元、中位 0.152 秒,GPT-6 为 12.182 美元、1.885 秒(便宜约 277 倍),即摘要所称 0.36% 的费用。置信度方面:JEV 的 Brier 为 0.111/0.297/0.176(RB/JB/HA),GPT-6 为 0.104/0.095/0.245——GPT-6 更准且校准更好,但两者误差排序互有胜负;汇总精度随 $q$ 单调上升,$q\ge0.9$ 时 JEV 与 GPT-6 几乎可互换(95.8% 对 96.5%),而需升级项上 GPT-6 领先 15 点。级联结果:$\tau=0.9$ 的汇总级联升级 34% 项,得 91.3% 对 GPT-6 单独 91.7%(保留 99.6%),费用为其 47%(约 6.3 美元/千次);同比例随机升级仅 88.1%,标签感知 oracle 94.4%,说明 $q$ 捕获了约一半可获得增益。冻结两级策略(GPT-6 兜底、$\tau=0.9$)在 510 个扩展对上接受 53.7%,92.5% 对 93.1%,费用 56.8%;但规则不总迁移——GPT-5.6 兜底 $\tau=0.7$ 接受 81% 却损失 2.35 点、超出容差。稳定性:96 次重复 0 次变化、48 次改写 4 次变化;逆序使 RewardBench 翻转 3.25%、JudgeBench 翻转 11.14%,双序一致正确率 91.0% 与 74.0%,首位率 48.9%/48.4% 说明无位置偏好而是真实不稳定。错误互补性:JudgeBench 上 GPT-6 修正了 JEV 75 个错误中的 60 个,oracle 并集达 95.7%。
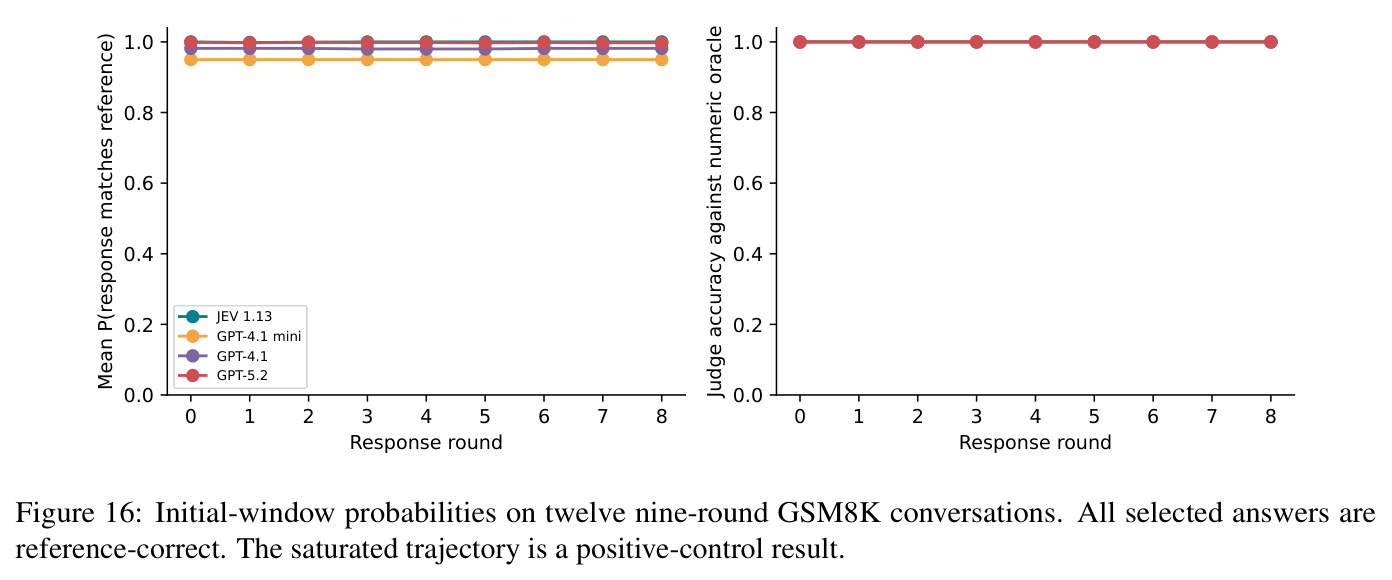
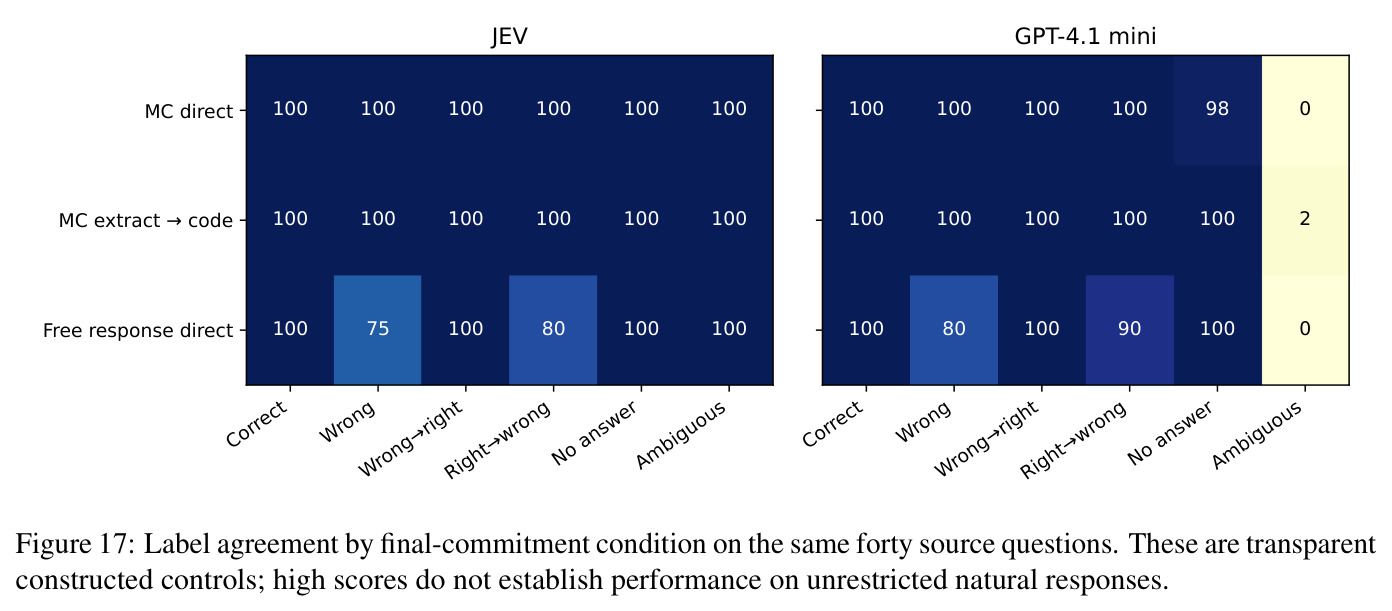
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 偏好对排序(RewardBench,400 对) | 基序准确率 | 92.2% | GPT-6 Astra 93.5% | −1.3 点 [−3.8, 1.5],基本打平,而费用约为其 0.36% |
| 证据事实性(HaluEval,240 项) | 准确率 | 87.5% | GPT-6 Astra 86.7% | +0.8 点 [−1.3, 2.9];人类校正标签后 95.8% 对 98.3% |
| 最终答案裁决(150 条已有回复) | 准确率 / macro-F1 | 94.0% / 0.923 | GPT-6 Astra 96.7% / 0.947 | −2.7 点 [−6.5, 0.7],仍在 3 点内 |
| 困难正确性(JudgeBench,350 对) | 准确率 | 78.6% | GPT-6 Astra 93.1% | −14.6 点 [−18.9, −10.3];人类裁决后差距扩大为 −16.0 点,需升级 |
| 风格对抗选择(RM-Bench hard,480 判定) | 准确率 | 74.8% | GPT-6 Astra 94.6% | −19.8 点 [−27.7, −12.7];匹配风格时差距收窄为 −9.4 点 |
| 四选一选择(RewardBench 2,100 提示) | 四选一 top-1 准确率 | 73.0% | Skywork-Reward-V2-8B 79.0% | −6.0 点 [−13.0, 1.0],与 GPT-6 的 −2.0 点不可分辨,建议先本地验证 |
| 无参考散文幻觉判断(80 条通用回复) | 与人类标签一致率 | 52.5% | GPT-5.4 55.0% | −2.5 点;所有评审均在机会水平附近且过度自信,不支持使用 |
| 成本与时延(120 判定隔离面板) | 中位延迟 / 每千次判定费用 | 0.152 秒 / $0.044 | GPT-6 Astra 1.885 秒 / $12.182 | 快约 12 倍、便宜约 277 倍(0.36% 费用) |
| 置信度级联(990 项汇总,τ=0.9 升级 GPT-6) | 准确率(相对 GPT-6 保留率)/ 费用比 | 91.3%(保留 99.6%)/ 47% 费用 | GPT-6 单独 91.7% | 同比例随机升级仅 88.1%,标签感知 oracle 94.4%,置信度信号捕获约一半可得增益 |
局限与改进
作者承认的限制:只评估了一个专有 JEV 版本,训练重叠与基准污染未知;各评审在推理力度、模型规模、上下文长度与部署系统上均不同,这不是计算匹配的架构比较;扩展窗口是在检查初步结果后加入的,多家族比较属探索性;延迟只来自单一客户端位置的 120 项面板,费用是按文档价目的估算而非发票,级联只是离线费用模拟、无实时顺序时延;人类裁决由团队成员一人完成、第二遍由 LLM 替代、裁决者是一位作者,且只覆盖评审分歧项而非随机审计(36/183 项优柔寡断,RewardBench 人机 κ 仅 0.29 说明偏好本身主观);决策型提示未覆盖解释忠实性与更丰富的评分 rubric。我自己的观察:所有费用优势都绑定采集时点的价目快照,模型定价与能力漂移很快——论文自己记录了两个采集窗口间 JudgeBench 有 7 个判定翻转;0.36% 的费用比依赖“JEV 输出免费”的定价结构,实际成本会随输入长度变化;此外专业领域(法律、医疗)与超长上下文评审完全未测,而这些恰是评审器最常见的真实负载;对开源社区而言,核心对象 JEV 是黑盒,机制层面无法归因。
独立分析的弱点
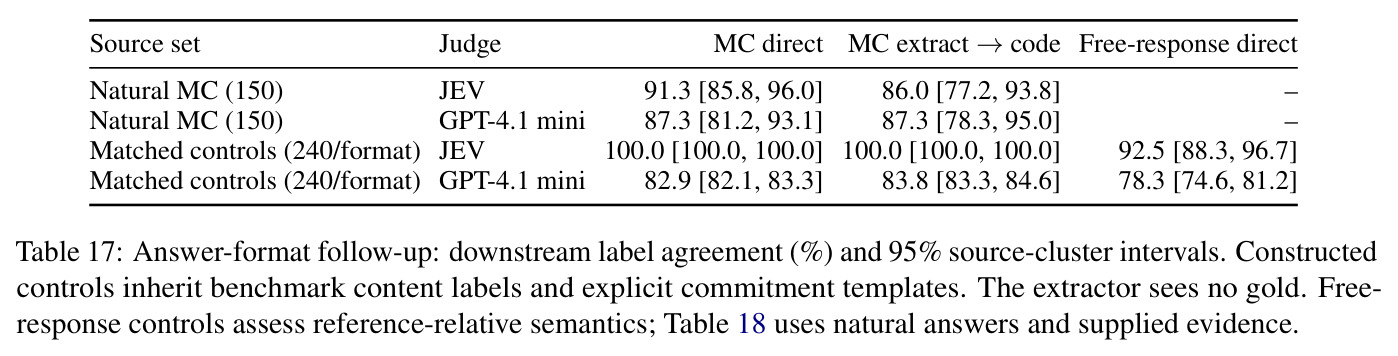
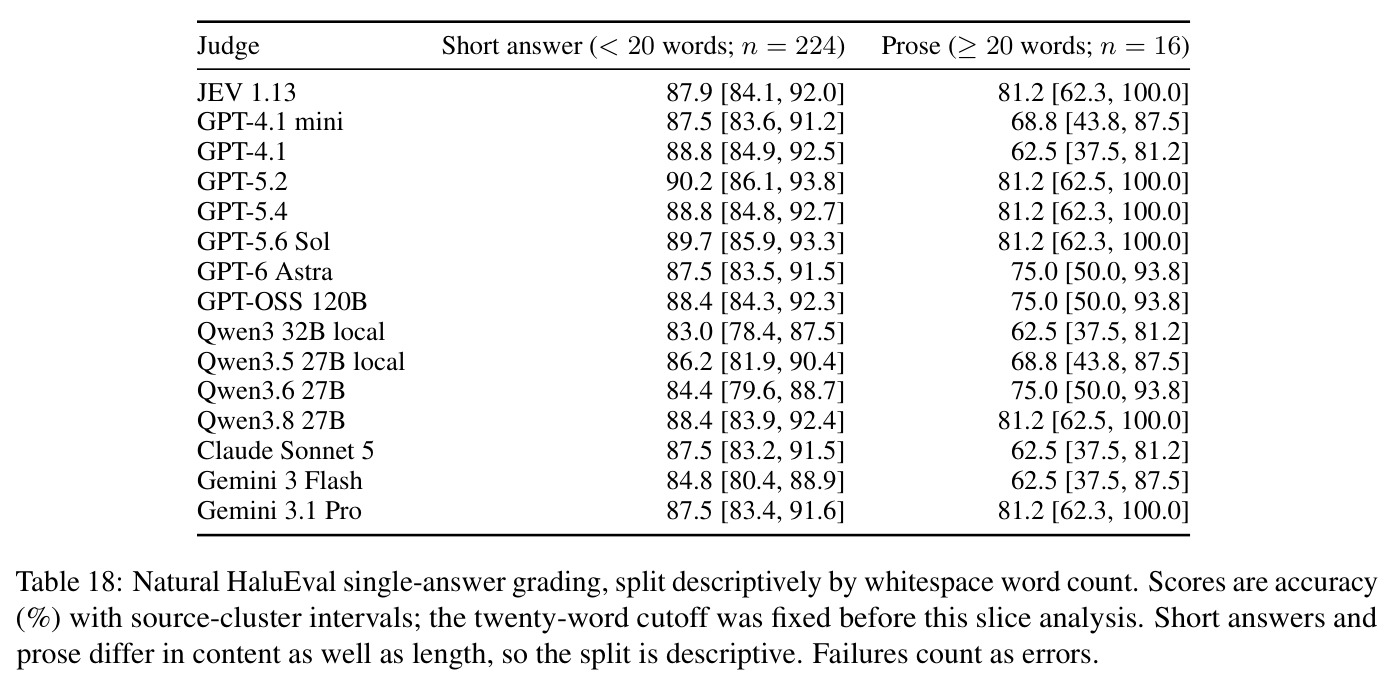
第一,风格对抗脆弱性:RM-Bench hard 对上 JEV 有 27/251 个高置信($q\ge0.9$)错误,置信度 AUROC 跌至 0.770,$\tau=0.9$ 级联在该子集只保留 96.5% 精度(90.8% 对 94.2%);改进方向是把双序概率差、长度比、Markdown 密度等风格对称特征纳入升级门槛,或先对候选做风格归一化再评审。第二,顺序不稳定:JudgeBench 逆序翻转 11.14%、RM-Bench 8.75%(GPT-6 仅 1.53%),双序平均虽修复偏好判定但使推理成本翻倍;可训练排序对称的评分头或对概率做逆序校准。第三,校准不可迁移:三个任务的拟合温度为 0.65、2.15、4.45 且方向不一,说明概率生成机制与内容强耦合;改进方向是基于输入特征(领域、长度、题型)的分层条件校准。第四,无参考散文全盲:所有评审近随机且高置信(JEV Brier 0.815、误差 AUROC 0.518),级联在此完全失效;应给评审器接入检索或工具验证,并在输出契约中增加“无法判定/需人工”标签。第五,格式敏感性:金标盲提取使一致率从 91.3% 降到 86.0%,自由格式比多选题低 7.5 点;可通过要求回复以显式最终承诺格式结尾来缓解。第六,黑盒依赖:无法架构归因,版本漂移直接威胁结论的外推有效期。
未来方向
作者明确留下的测量包括:实时顺序级联的时延(本文只有离线费用模拟)、升级阈值的外部验证(GPT-5.6 策略在冻结测试上未能迁移)、以及向专业领域的扩展。基于本文成果可直接延伸的方向:把 $q$ 与双序一致性、风格特征一起作为特征训练学习型路由器(与 RouteLLM 结合),用每个工作负载几十条本地标注样本拟合专属阈值;把“接受/升级”策略用于 RLHF 偏好数据筛选与在线 A/B 评估,刻画大规模标注管线中的成本–质量前沿;研究接口原语间不一致(Choice–Noul 平均差 0.055)能否免费融合成更好的不确定性估计;把这套盲评三阶层裁决协议推广为基准标签质量审计工具(本文已用它发现 HaluEval 24/26 个标签错误);以及在开源小模型上复现“决策+概率”评审头,检验原生置信度优势是否依赖专有实现,并研究风格对抗鲁棒化训练对困难对与级联阈值的影响。
复现评估
复现条件相当好。随附匿名补充 ZIP 包含公共任务全部输入与 rubric、决策级结果、指标表、模型版本与哈希、可执行复现代码,且明确声明复现公开结果“既不需要 API 调用也不需要 GPU”;人类裁决的冻结协议、修订日志、盲评包、注释表与分析脚本一并公开。若要重新收集数据,则需要 JEV 托管账号、十余个托管模型的 API 权限(论文自身面板上 GPT-6 约 12.2 美元/千次判定,全量重跑估计数百美元量级)、一张 H100 以 vLLM/BF16/非思考模式服务本地 Qwen-32B/27B,以及一张 V100 跑 Skywork-Reward-V2-8B。难度中等:协议高度文档化、数据分区与阈值拟合集全部冻结,非专业团队也能照做;但结论对时间窗敏感——模型别名、价格与服务行为都会漂移,论文自己记录了两窗口间 7 个 JudgeBench 判定翻转,且 JEV 是专有黑盒、无法锁定其版本行为,长期复现需以论文发布的决策级结果为准。
论文图表
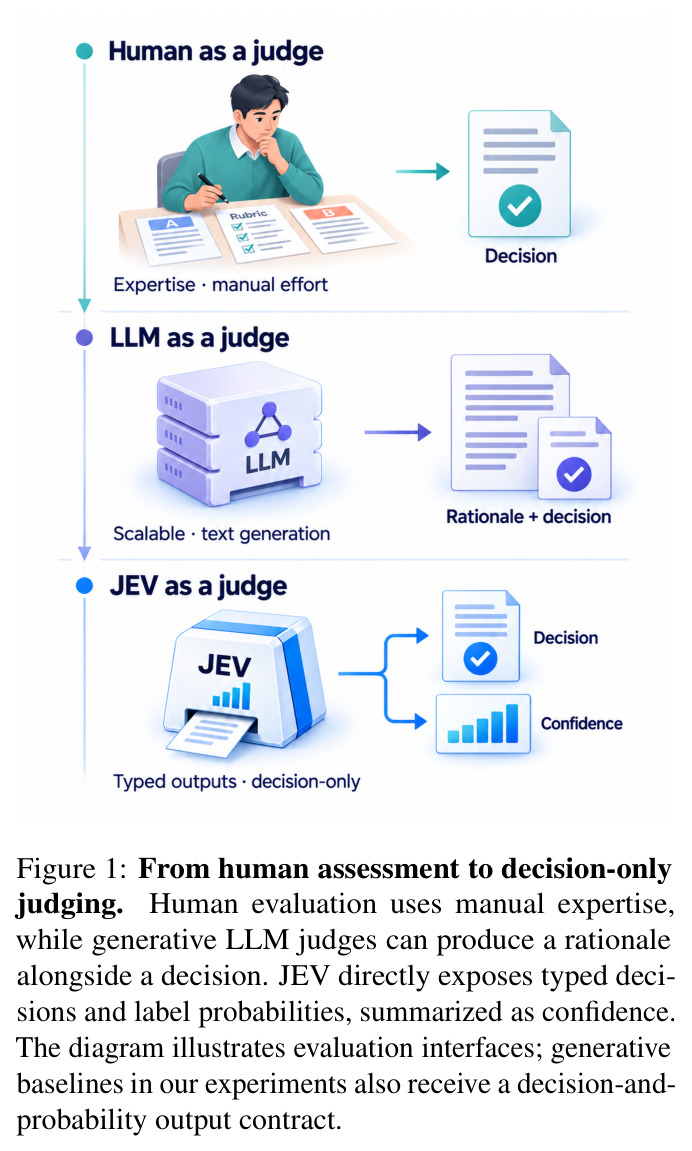
对比三种评估接口的示意图:人类专家人工评估(靠专业知识)、生成式 LLM 评审(输出决策并附理由)、JEV 决策型评审(直接暴露类型化决策与标签概率,汇总为置信度);并注明本文的生成式基线也接受“决策+概率”输出契约。
一图讲清本文的研究对象在评估范式演化中的位置,以及决策型接口与生成式评审的接口差异,是理解全文问题设定的入口。
一条真实的 JEV 请求与响应原文:请求含证据、主张、带标签准则的问题定义;响应返回 Choice 裁决(supported)、置信度 1.0 与各标签概率及用量元数据。
让读者精确理解决策型接口的输入输出长什么样,包括隐藏标签如何与请求隔离,是复现与理解契约细节的关键。
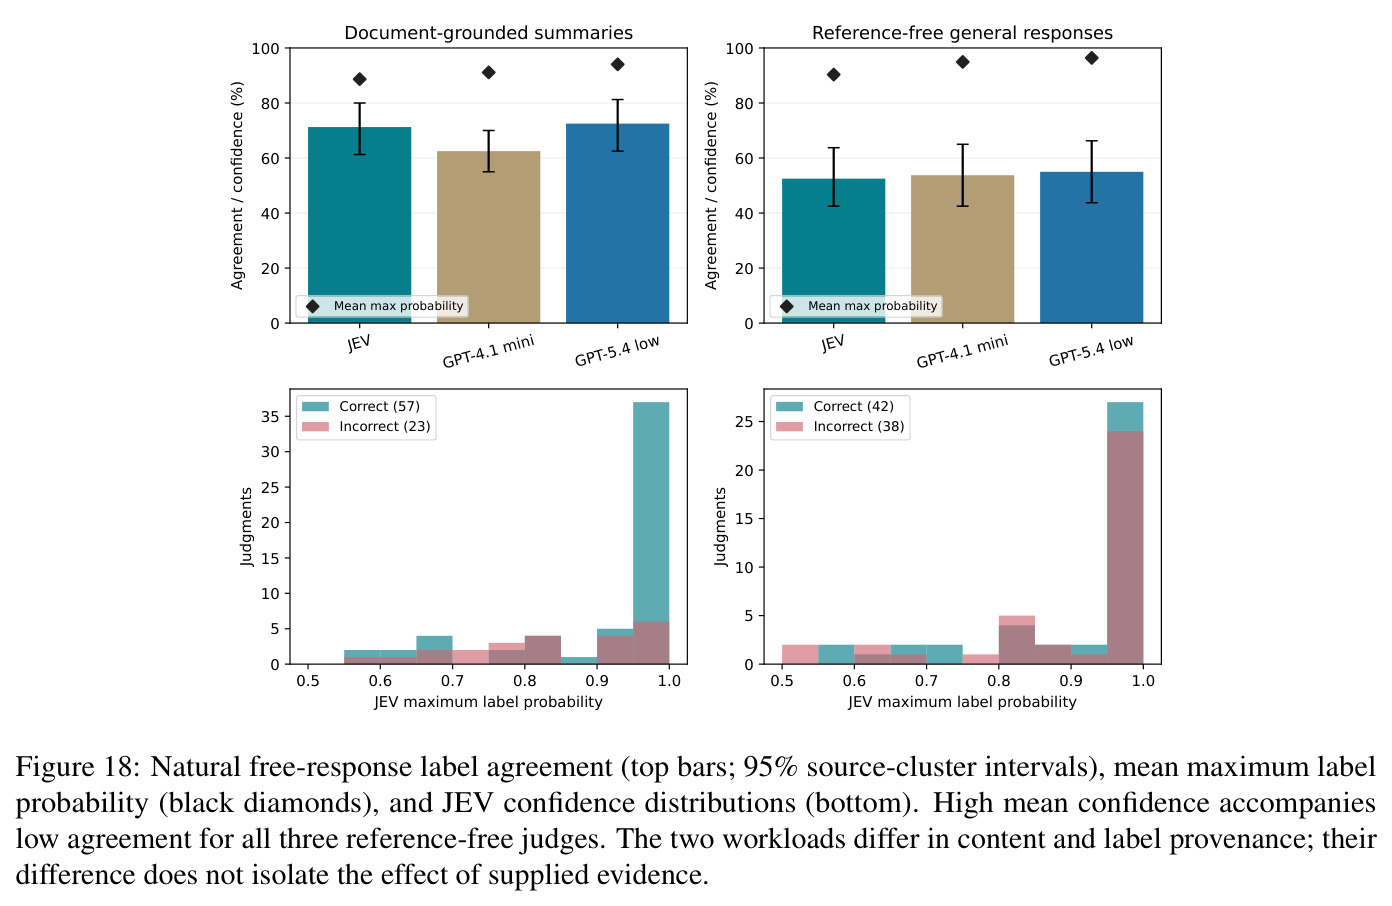
文档摘要与无参考回复两个工作负载上,JEV/GPT-4.1 mini/GPT-5.4 的标签一致率(上条形)、平均最大概率(黑菱形)与 JEV 置信度分布(下方):无参考时一致率 52.5–55.0% 而平均置信度高达 0.90–0.96。
一图呈现“高置信+近随机”的失效模式,是论文划出的最重要边界(无参考散文不可用)的视觉证据。