STEPQuant:Delta规则循环状态量化中误差的时空感知压缩框架 STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
按误差寿命分配精度、按关键行影响做双轴缩放,6bit状态量化近无损且省显存68.7%。
前置知识
线性注意力与循环状态
与softmax注意力随序列长度增长的KV缓存不同,线性注意力把历史token压缩进一个固定尺寸的矩阵状态 $S_t \in \mathbb{R}^{d_k \times d_v}$(本文中 $d_k=d_v=128$),读出时只需 $y_t = S_t^\top q_t$。状态大小与上下文长度无关,只随模型层数、头数变化,但每个并发请求都要独占一份常驻状态。
本文压缩的对象正是这个循环状态;不理解固定尺寸状态在并发服务下显存随请求数线性增长,就无法理解为什么需要压缩它。
门控Delta规则(Gated Delta Rule)
Gated DeltaNet(GDN)和Kimi Delta Attention(KDA)的状态更新规则:$S_t = (I - \beta_t k_t k_t^\top) D_t S_{t-1} + \beta_t k_t v_t^\top$,其中 $D_t$ 是保留门(GDN用每头标量 $\alpha_t I$,KDA用逐通道对角阵),$\beta_t \in [0,1]$ 控制写入强度。先用门衰减旧记忆,再用当前key检索旧值、沿key方向写入残差修正,实现联想记忆的"覆盖式更新"。
量化误差正是通过这个递推式一步步反馈累积的,$D_t$ 的保留强度直接决定误差能"活"多久,是本文时间维度分析的出发点。
后训练量化(PTQ)与对称均匀量化
PTQ在训练完成后把浮点张量映射到低比特整数以省显存。对称均匀量化用组内共享尺度 $s$ 把实数 $x$ 编码为 $b$ 比特整数:$Q_{b,s}(x) = s \cdot \mathrm{clip}(\mathrm{round}(x/s), -q_b, q_b)$,$q_b = 2^{b-1}-1$。位宽越低,量化网格越粗,重建误差越大。
论文的基线(INT4/6/8)和STEPQuant本身都是PTQ方法,理解尺度(scale)与位宽的关系是理解位分配和双轴缩放的前提。
混合精度量化
不给所有张量统一位宽,而是给敏感组件分配更多比特、不敏感组件更少比特,在平均位宽预算下最小化总失真。经典做法如GPTV/SPQR按权重敏感度分配;本文把"敏感度"重新定义为量化误差经递归传播后的长期影响,而非单步重建误差。
STEPQuant的时间组件本质就是一个以"寿命加权失真"为目标函数的混合精度分配问题,这是它与所有已有方法的核心差异。
平滑缩放(SmoothQuant式尺度变换)
当张量的离群值集中在某些通道时,直接absmax量化会让整体网格过粗。平滑类方法给每个通道乘一个缩放因子 $r_i$,把大幅值通道压小,使量化网格对所有通道更均匀;常用 $\sqrt{\cdot}$ 或分数幂来平衡动态范围。
本文的空间组件把这种思想推广到状态矩阵的两个轴:行因子 $r_i = m_i^{1/2} w_i^{-1/2}$ 同时考虑行幅度 $m_i$ 和行影响分 $w_i$,列因子 $c_j$ 通过加权最小二乘闭式解拟合。
SGLang与并发服务状态池
SGLang是主流LLM服务引擎。对GDN/KDA混合模型,它为每个并发请求维护常驻的FP32状态槽位,且为缓存与调度预留额外槽位(本文设定每请求5个槽位)。状态池显存 = 并发数 × 槽位数 × 单请求状态大小,与上下文长度无关但随并发线性增长。
论文的动机(状态池在70并发时超过权重显存)和最终落地(SGLang融合内核、5×状态压缩、68.7%总显存下降)都发生在SGLang里,系统实现是论文三大贡献之一。
研究动机
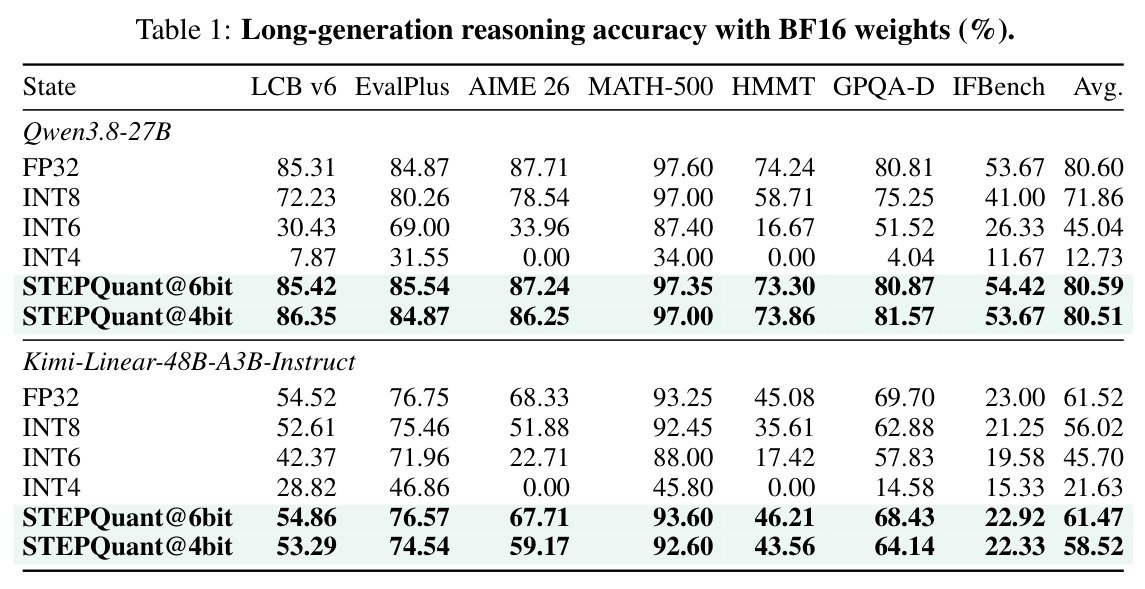
线性注意力模型(Gated DeltaNet、Kimi Delta Attention)用固定尺寸循环状态 $S_t \in \mathbb{R}^{d_k \times d_v}$ 取代随序列长度增长的KV缓存,但"固定尺寸"不等于"显存可忽略":每个并发请求都要独占一份常驻状态,SGLang还要为缓存和调度预留额外状态槽位。在官方SGLang部署下,Qwen3.8-27B的FP32状态池在约70个并发请求时显存占用就超过了BF16权重本身(图1a),短上下文高并发场景下状态池成为主要瓶颈。更糟的是,直接对状态做均匀量化会严重掉点:每步Delta更新都在近似状态上进行、再输出一个新的量化状态,误差经递归不断累积。实测Qwen3.8-27B七个长生成任务的平均准确率从FP32状态的80.60%跌到INT8的71.86%、INT6的45.04%、INT4的12.73%;Kimi-Linear-48B从61.52%跌到56.02%、45.70%、21.63%——即使8bit仍有约5~9个点的差距,6bit以下基本不可用。
本文的目标是本文的目标是回答两个被忽视的问题:循环状态量化误差"何时"有害(时间维度)与"何地"有害(空间维度),并据此构建一个时空联合的后训练量化框架STEPQuant,在远低于8bit的名义预算下保持接近FP32状态的精度。具体拆成三件事:(1)从理论上刻画量化误差经门控Delta递归的传播规律,找到能预测误差风险的状态特征——门控寿命与key行读出影响;(2)据此提出寿命感知位分配(时间组件)与关键行感知双轴拟合(空间组件),在固定平均位宽约束下最优地分配精度与缩放尺度;(3)把方案集成进SGLang服务系统,用融合GPU内核避免常驻FP32影子状态,实现真实并发服务下可测量的显存压缩与吞吐提升——目标是在6bit预算下状态压缩超过5倍且精度几乎无损。
与已有工作不同的是,已有工作没有为GDN循环状态量化给出系统方案:Transformer侧的PTQ(SmoothQuant、AWQ、KV缓存量化如KIVI)假设离群值沿单一主轴(通道或token)分布;Mamba侧的Quamba2只把缓存状态量化到8bit,Q-Mamba的双轴状态量化(DSQ)虽做行列缩放但不考虑读出敏感性;并行的DAMP用衰减感知选FP16保护通道、其余INT8,有效位宽高达9.9bit。本文的独特切入是把两个互补维度统一起来:时间上, Proposition 1 给出误差传播递推 $E_t = A_t E_{t-1} + \varepsilon_t$($\|A_t\|_2 \le 1$),说明旧误差按保留门衰减、且Delta修正项会主动消除与后续key对齐的分量,由此推导出寿命权重 $L_u = \sum_{j=0}^{H-1}\exp(2j\ell_u)$ 并用实验证实门半衰期与INT6累积误差的Spearman $\rho \approx 0.80$;空间上,首次发现状态矩阵在key行和value列两个轴上同时存在10.3×/19.4×的最大-中位RMS对比,且不同key行对读出误差的影响差异极大。"何时+何地"两个正交视角共同决定了位分配和缩放设计,这是与所有先前方法的本质区别。
核心方法
直觉上,状态量化失败不是因为单步误差大,而是因为误差会"活下去"并且"打在要害上"。时间维度:每步更新经 $A_t$ 传递旧误差并叠加新量化误差 $\varepsilon_t$,门控保留越强、寿命越长的单元积累误差越多——在2304个Qwen头上,门半衰期与INT6累积状态误差的Spearman相关达0.8004,寿命最长的四分之一单元贡献了52.5%(Qwen)甚至78.8%(KDA)的总误差。空间维度:相同大小的误差落在不同key行上对输出的影响差异巨大(同组内最高与最低影响八分位的等范数扰动读出误差对比达117.4×/35.1×),且状态幅度在key行与value列两轴都存在离群结构(10.3×/19.4×对比)。技术路线是把这两个观察转化为两个互补组件:STEPQuant = 寿命感知位分配(时间)+ 关键行感知双轴拟合(空间)+ SGLang融合内核(系统)。先用32段2048 token的WikiText-2校准数据离线估计每个单元(Qwen为整个头,KDA为key行)的候选位宽失真 $d_u(b)$ 与平均对数保留率 $\ell_u$,解混合精度分配问题并选出FP16支点;在线解码时对每步更新后的状态 $X_t$ 按行因子 $r_i = m_i^{1/2} w_i^{-1/2}$ 与拟合的列因子 $c_j$ 做双轴缩放,再低比特量化打包写回。
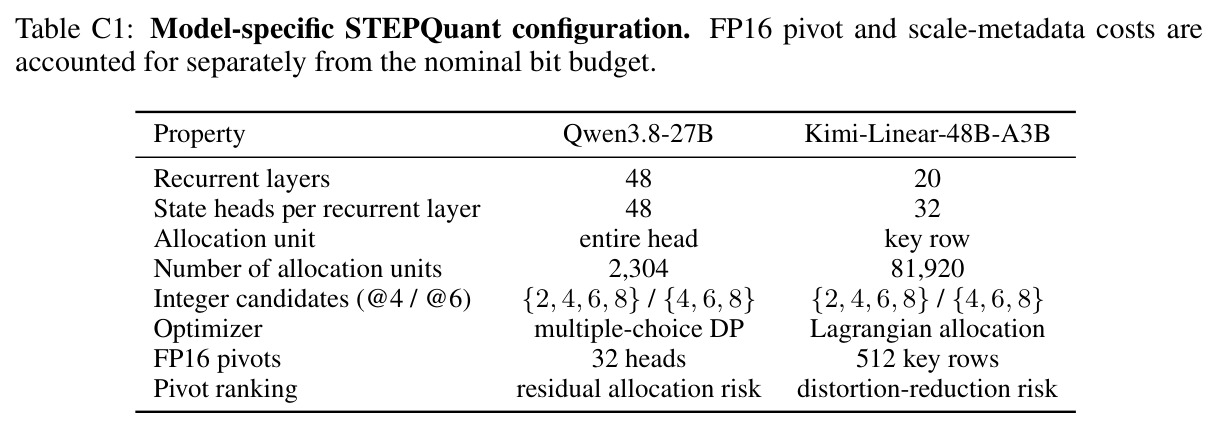
核心创新有两点,都与已有方法有本质区别。第一,把混合精度位分配的目标函数从"单步重建失真"改成"寿命加权失真":由Proposition 1的传播律 $E_t = A_t E_{t-1} + \varepsilon_t$ 及 $\|A_t\|_2 \le \|D_t\|_2 \le 1$,旧误差的平方按保留率衰减,$j$ 步后约为 $\exp(2j\ell_u)$ 倍,于是对时间求和得到单元 $u$ 的寿命权重 $L_u = \sum_{j=0}^{H-1}\exp(2j\ell_u)$,最终最小化 $\sum_u L_u d_u(b_u)$,约束为 $\sum_u n_u b_u \le \bar{b} \sum_u n_u$;Qwen用多选动态规划、KDA用拉格朗日分配求解,并把最高风险单元(Qwen 32/2304个头即1.39%,KDA 512/81920个key行)留作FP16稀疏支点。这意味着一个失真不大但寿命极长的单元会被分配比失真更大但速朽的单元更高的精度——这是单步失真驱动的传统混合精度做不到的。第二,指出现状矩阵与常见LLM张量的几何差异:离群值同时沿key行和value列分布,单一轴缩放不够。因此在 $\hat{X}_{ij} = r_i c_j z_{ij}$ 中,行因子 $r_i = m_i^{1/2} w_i^{-1/2}$ 同时吸收行幅度 $m_i$ 与校准的行影响分 $\omega_i = \mathbb{E}_{\mathrm{cal}}[g_{t,i}^2]$($g_t = A_t^\top q_t$ 是把状态扰动映射为读出误差的敏感向量,$w_i$ 为其 $\gamma=0.25$ 分数幂归一化),列因子 $c_j$ 通过最小化影响加权误差 $\sum_{i,j} w_i^2 (X_{ij} - r_i c_j z_{ij})^2$ 联合拟合——高影响行被赋予更大的惩罚权重,从而获得更细的量化分辨率。
方法步骤详情
完整流程分离线校准与在线解码两段。离线校准(用32段2048 token的WikiText-2训练文本回放真实输入流):(1)对每个分配单元 $u$(Qwen整个头、KDA一个key行)在各候选位宽 $\{2,4,6,8\}$ 下重建状态样本,计算失真 $d_u(b)$——Qwen用行影响加权的MSE(式17),KDA用逐元素MSE且每8次递归采样一次(式18);(2)由门控值计算平均对数保留率 $\ell_u = \mathbb{E}[\log r_{t,u}]$ 与寿命权重 $L_u$;(3)解式(8)的预算约束优化得到每单元位宽,Qwen的支点按残差分配风险选32个头,KDA按失真降低风险选512行,支点保留FP16;(4)用独立校准估计行影响分 $\omega_i = \mathbb{E}[g_{t,i}^2]$ 并归一化为 $w_i$(几何均值归一,$\gamma=0.25$)。在线解码每步(表C2的七步流程):输入为压缩状态包与当前的 $q_t, k_t, v_t, D_t, \beta_t$,以及冻结的精度图、支点掩码和行影响分。第一步,融合内核从整数码与尺度重建上一状态(支点单元直接读FP16);第二步计算Delta更新 $X_t = D_t \hat{S}_{t-1} + \beta_t k_t (v_t^\top - k_t^\top D_t \hat{S}_{t-1})$;第三步,在再量化之前输出读出 $\hat{y}_t = X_t^\top q_t$,后续层立即继续计算;第四、五步,在独立CUDA流上做双轴拟合:行因子按 $r_i = m_i^{1/2} w_i^{-1/2}$ 计算,KDA在每头内跨所有非支点整数码行用闭式解 $c_j = \frac{\sum_{i} w_i^2 v_{ij} X_{ij}}{\sum_i w_i^2 v_{ij}^2}$ 联合拟合共享列因子,Qwen按各头指派精度独立拟合;第六步打包整数码与FP16尺度写回,旧页保留到所有读者完成;第七步在下一次递归读取前完成写回。整个服务路径中不存在常驻的全矩阵FP32影子状态。
技术新颖性
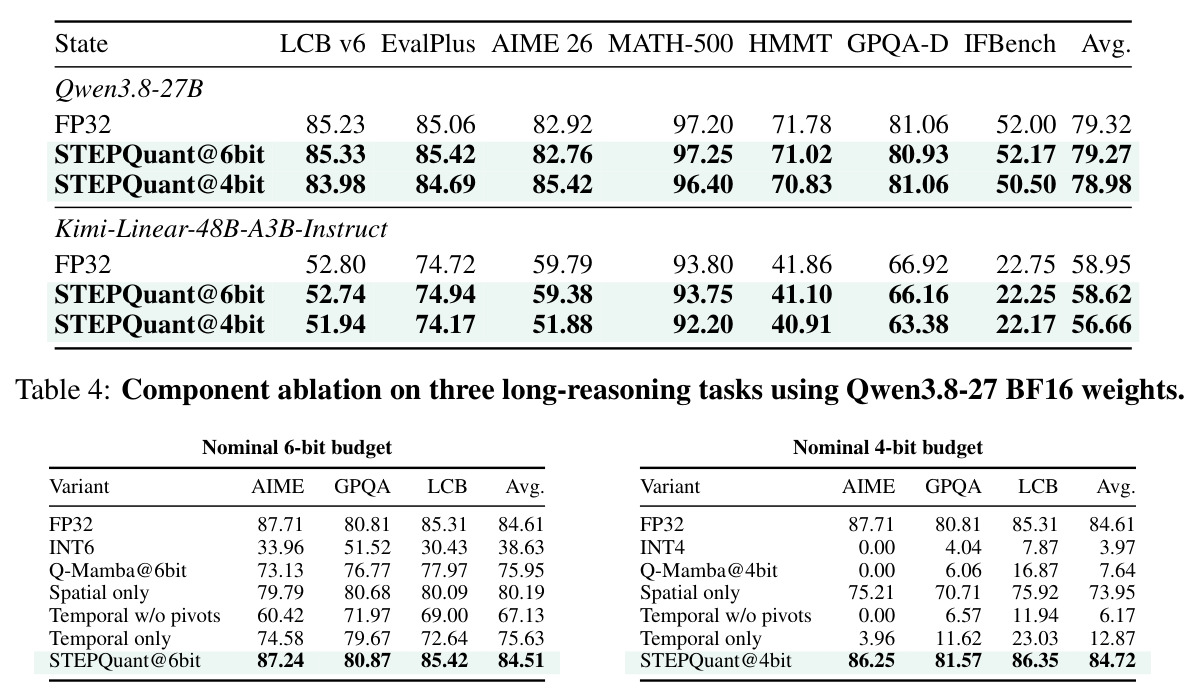
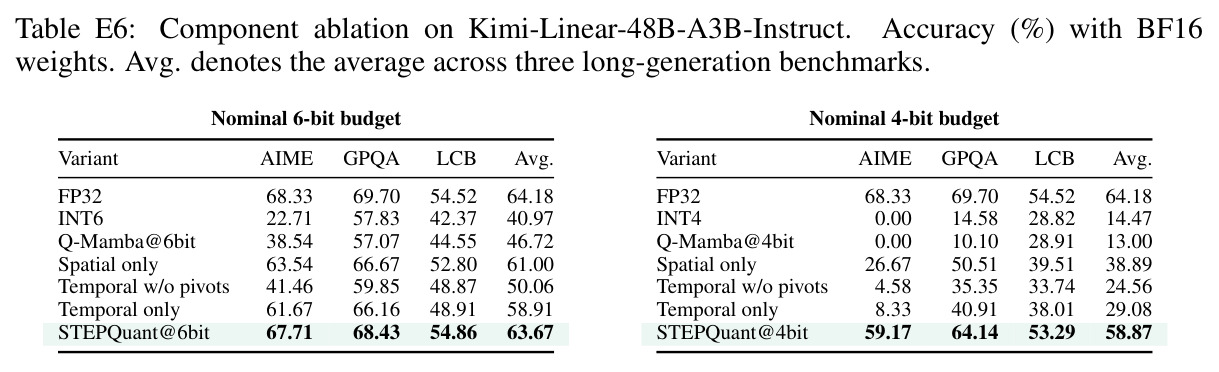
与已有方法的区别可归纳为四点。(1)相对Q-Mamba的双轴状态量化(DSQ):本文首次把"读出影响"引入双轴缩放——消融实验中同为4bit,Qwen上Spatial only达73.95%而Q-Mamba仅7.64%,差距近66个点;6bit下也是84.51%(完整版)对75.95%。(2)相对Quamba2的固定8bit状态量化:本文证明6bit甚至4bit可行,关键在于用理论(Proposition 1的条件误差传播 + 累积平方输出误差的Gram矩阵 $\mathrm{tr}(Z^\top W_{t,H} Z)$ 推导)把"门控寿命"变成可优化的位分配权重,而不是启发式保护。(3)相对并行的DAMP(衰减感知FP16通道保护+INT8,9.9bit):本文用混合精度+双轴拟合把有效位宽压到6.30bit仍保持100.51%的相对精度保留率。(4)系统层面首次在SGLang实现压缩状态的常驻服务:融合"重建+Delta更新+读出"的单内核减少一次全状态遍历,尺度拟合与打包写回在独立CUDA流上与后续层计算重叠,写回在下一次递归读取前完成。此外论文的机制级分析在量化文献中少见:exact-read oracle对照实验显示若去掉Delta反馈的误差自修正,INT6/INT8的累积平方输出误差会放大26.82×/18.65×,定量证明了"误差被后续key方向主动擦除"这一Delta规则特有的动力学,为时间分析提供了实证支撑。
实验结果
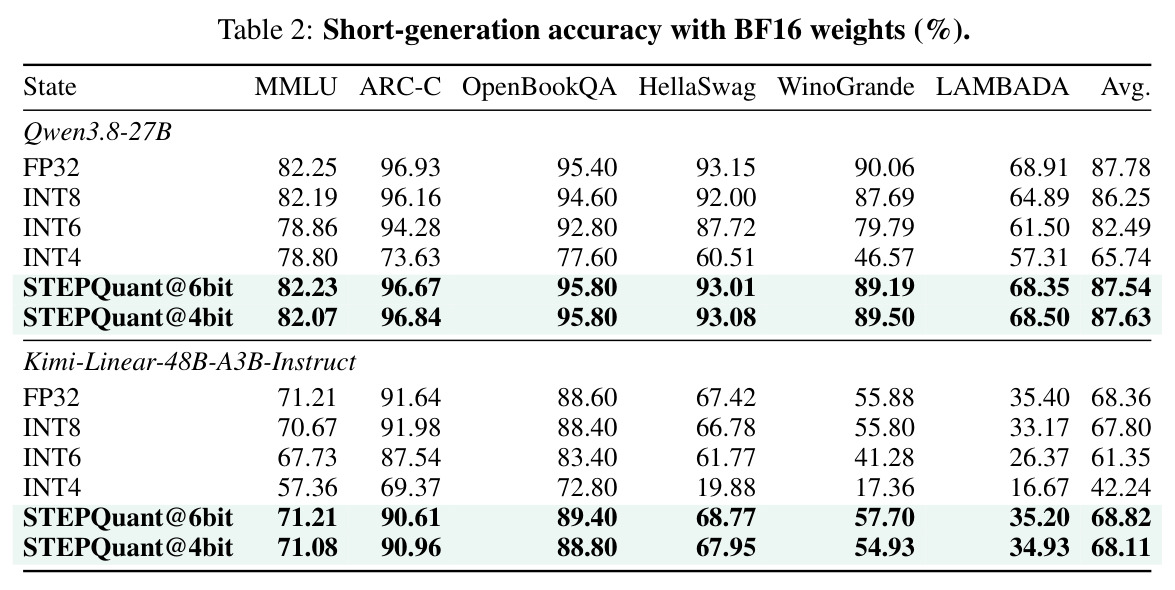
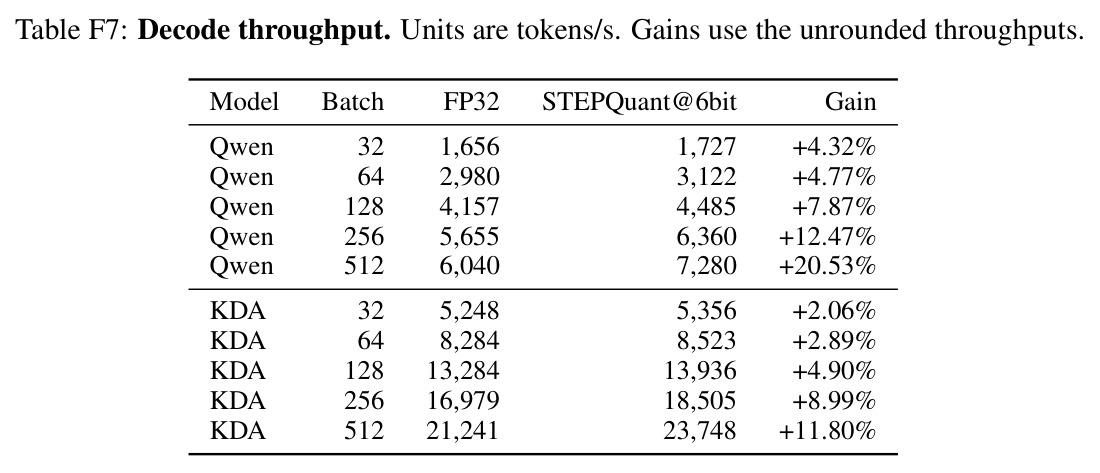
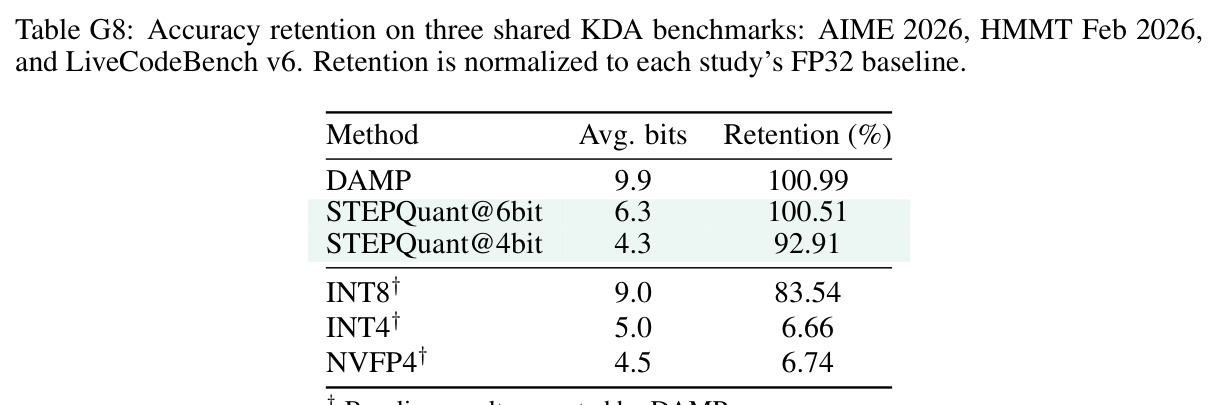
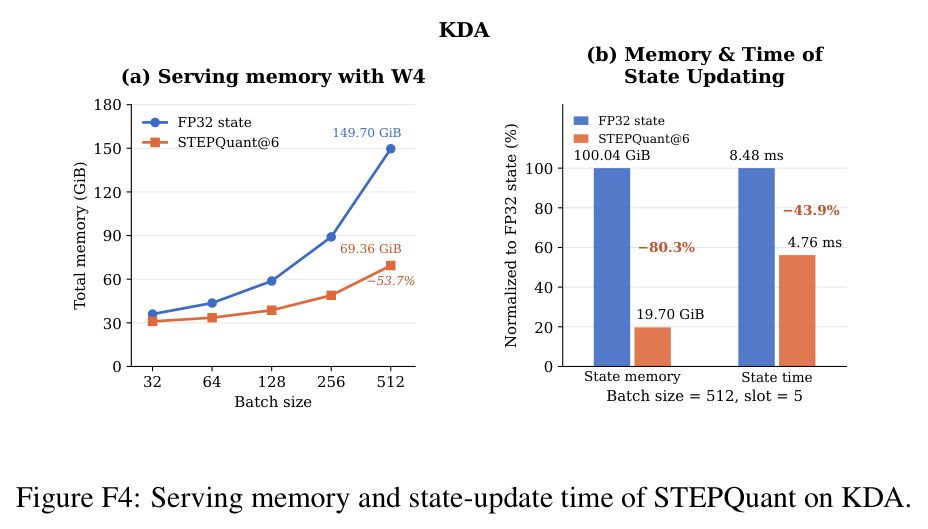
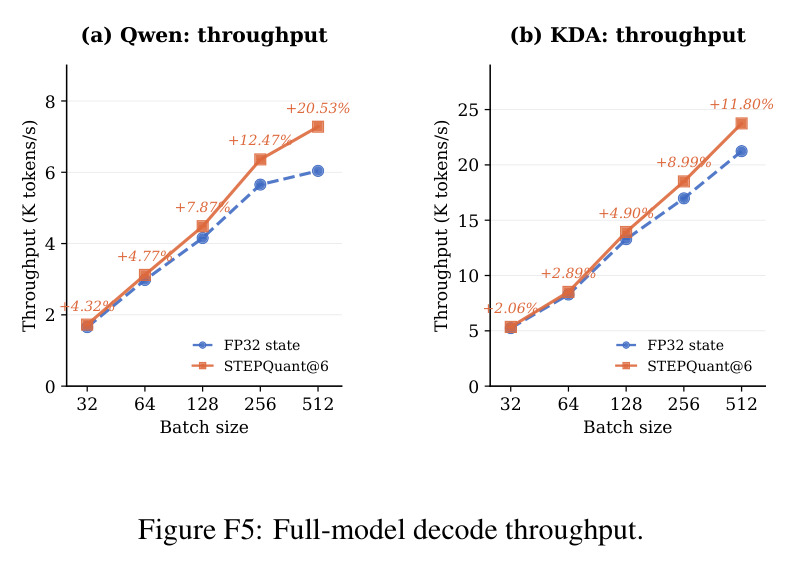
逐一分析七组实验。(1)长生成推理(表1,BF16权重,7任务平均):Qwen上STEPQuant@6bit为80.59%,几乎等于FP32状态的80.60%(均匀INT6仅45.04%);@4bit仍有80.51%,超过均匀INT8的71.86%。分任务看Qwen@6的LiveCodeBench 85.42%、AIME 87.24%、GPQA 80.87%,与FP32持平甚至略超。Kimi上@6bit 61.47%对FP32的61.52%,@4bit 58.52%对INT8的56.02%。(2)短生成(表2,6任务):Qwen@4bit平均87.63%只比FP32低0.15点,Kimi@4bit 68.11%低0.25点;而均匀INT4分别崩到65.74%和42.24%,Kimi的WinoGrande甚至只有17.36%——低于二选一的随机水平,因为模型已无法生成合法答案格式。(3)与4bit AWQ权重组合(表3):Qwen@6bit 79.27%仅比FP32状态低0.05点,Kimi@6bit 58.62%低0.33点,说明状态量化与权重量化可叠加。(4)组件消融(表4/表E6,AIME+GPQA+LCB三任务):4bit下两个组件单独都远弱于组合——Qwen上Spatial only 73.95%、Temporal only 12.87%、STEPQuant 84.72%(FP32为84.61%);FP16支点贡献显著,仅保护1.39%的Qwen头就把4bit三任务均值提升6.70点、6bit AIME提升14.16点。(5)服务效率(图3cd/图F4/表F7):batch 512、W4权重下Qwen总显存419.73→131.18 GiB(−68.7%),状态显存−80.1%(5.03×压缩),状态更新时间29.63→10.20 ms(2.91×),全模型吞吐6040→7280 tokens/s(+20.53%);Kimi总显存149.70→69.36 GiB(−53.7%),状态5.08×压缩,更新时间1.78×,吞吐+11.80%。(6)生成长度(图3ab/表E4):均匀INT4让Kimi在AIME/HMMT上平均生成63.40K/64.22K token、逼近65536上限但准确率接近0——典型的"过度思考";STEPQuant的输出长度与FP32基本一致。(7)与DAMP对比(表G8,KDA三个共享任务、按各自FP32基线归一化的精度保留率):DAMP为100.99%@9.9bit,STEPQuant@6bit为100.51%@6.30bit、@4bit为92.91%@4.30bit,而DAMP报告的INT8/INT4/NVFP4基线仅83.54%/6.66%/6.74%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长生成推理7任务平均(Qwen3.8-27B,BF16权重) | 平均准确率 (%) | STEPQuant@6bit 80.59;@4bit 80.51 | FP32状态 80.60;均匀INT8 71.86;INT6 45.04;INT4 12.73 | 6bit几乎无损(−0.01);4bit超过均匀INT8达8.65点 |
| 长生成推理7任务平均(Kimi-Linear-48B-A3B,BF16权重) | 平均准确率 (%) | STEPQuant@6bit 61.47;@4bit 58.52 | FP32状态 61.52;均匀INT8 56.02;INT6 45.70;INT4 21.63 | 6bit无损(−0.05);4bit比均匀INT8高2.50点 |
| 短生成6任务平均(Qwen,BF16权重) | 平均准确率 (%) | STEPQuant@4bit 87.63 | FP32状态 87.78;均匀INT4 65.74 | 仅比FP32低0.15点,比INT4高21.89点 |
| 4bit AWQ权重+状态量化(Qwen,7任务) | 平均准确率 (%) | STEPQuant@6bit 79.27 | FP32状态 79.32 | 仅低0.05点 |
| 组件消融(Qwen,AIME/GPQA/LCB,4bit预算) | 三任务平均准确率 (%) | STEPQuant 84.72;Spatial only 73.95;Temporal only 12.87 | FP32 84.61;Q-Mamba@4bit 7.64;均匀INT4 3.97 | 比Q-Mamba高77.08点;证明两组件互补 |
| 服务显存(Qwen W4权重,batch 512,每请求5状态槽) | 总显存 / 状态显存 | 总419.73→131.18 GiB(−68.7%);状态−80.1%(5.03×) | FP32状态池 419.73 GiB | 状态5.03×压缩,总显存省68.7% |
| 解码吞吐(Qwen BF16,TP4,batch 512) | tokens/s | 7,280 | FP32状态 6,040 | +20.53%(batch 32时+4.32%,增益随并发增大) |
| 与DAMP跨研究对比(KDA共享3任务) | 相对FP32精度保留率 (%) @ 有效位宽 | 100.51% @ 6.30bit;92.91% @ 4.30bit | DAMP 100.99% @ 9.9bit;其INT8基线 83.54% @ 9bit;INT4 6.66%;NVFP4 6.74% | 用6.3bit达到DAMP 9.9bit的精度保留水平 |
局限与改进
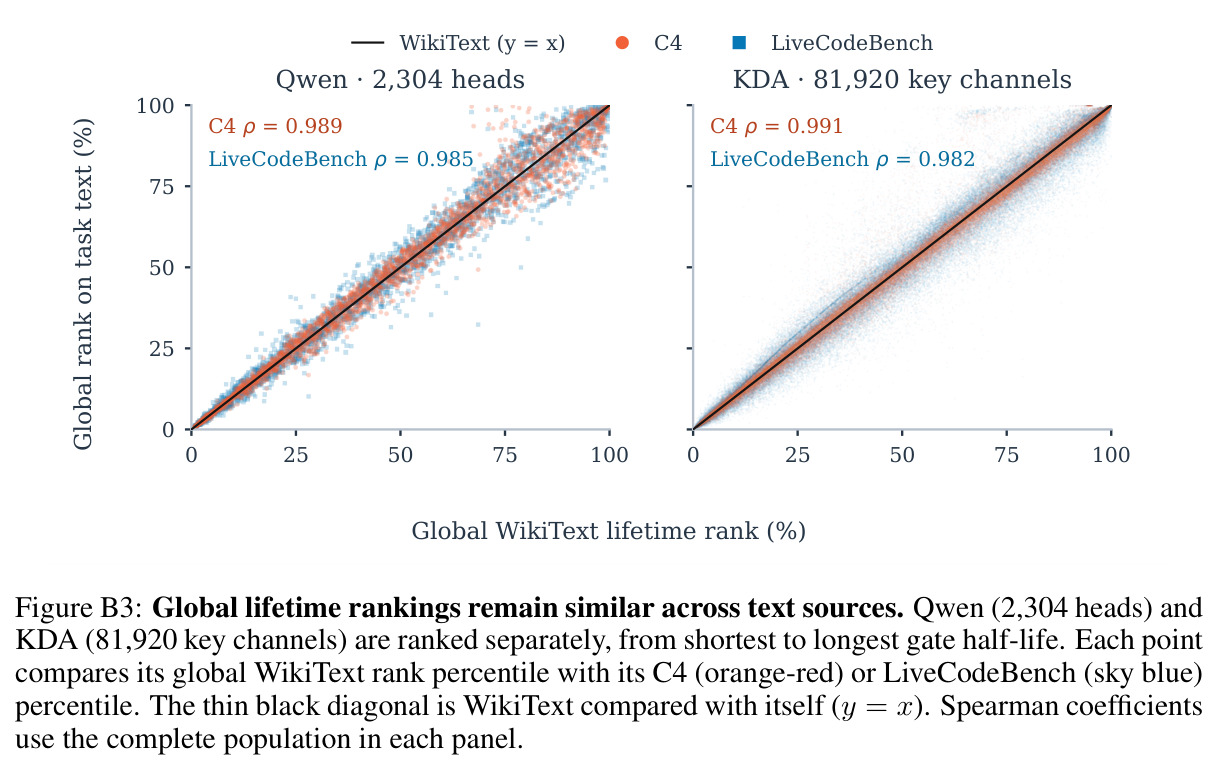
作者在附录H承认三点局限:寿命权重仅用门控衰减 $\exp(2j\ell_u)$ 近似误差持续性,没有完全建模随时间变化、依赖key的状态转移 $A_t$(Delta修正对与key对齐误差分量的主动擦除和正交分量的保持被简化了),因此不能完全捕捉量化误差的长期效应;BF16权重下4bit KDA在长生成任务上仍有明显损失(61.52%→58.52%,AIME从68.33掉到59.17),Qwen@4bit虽保持平均精度但生成变长(W4A16下平均从7.22K增至9.50K token,+31.6%);评测只覆盖两个GDN/KDA模型、固定硬件(4×A800)与固定工作负载,其他架构和动态服务负载下的效果未验证。我的补充观察:校准仅用32段WikiText-2且精度图/支点在所有请求间固定,虽然图B3显示寿命排序跨文本源高度稳定(Spearman ρ≈0.98+),但行影响分 $\omega_i$ 是否随任务分布漂移缺乏敏感性分析;与DAMP的对比是从原论文摘录数字再归一化的跨研究比较,生成设置不同,并非严格受控;状态更新时间与吞吐只在batch 512详细报告,小批量下量化写回开销占比可能明显更高(batch 32时吞吐增益仅+2.06%/+4.32%)。
独立分析的弱点
弱点一:寿命模型过于粗糙。$L_u = \sum_j \exp(2j\ell_u)$ 只用平均对数门控,完全忽略了 $A_t = (I - \beta_t k_t k_t^\top) D_t$ 中Delta项对误差的方向性收缩——与后续key对齐的误差分量被主动消除,正交分量则原样保留。改进方向:在校准期用真实key轨迹估计每个单元误差与未来key的对齐度,对 $L_u$ 乘以方向修正因子;或像B.2的NLL漂移探针那样做在线误差监测,动态调整位宽。弱点二:静态分配。精度图和支点在请求间固定,无法适应不同请求的负载特征(长上下文推理vs短问答)。改进方向:按预填充阶段的统计量在线重排位宽,或利用槽位复用的间隙做轻量再校准。弱点三:双轴拟合的计算开销。每步都要重算行/列尺度并写回,小批量下开销占比大——batch 32时吞吐增益只有+2.06%(KDA)/+4.32%(Qwen)。改进方向:让尺度跨多个token共享(每N步更新一次),或用低精度近似更新因子。弱点四:4bit下KDA的高难度长链推理仍退化(AIME 68.33→59.17),说明极低比特下最难题目的推理链对状态误差仍然敏感。改进方向:结合旋转/Hadamard类预处理(如QuaRot、DuQuant思路)进一步压平双轴离群值,把4bit也推向无损。弱点五:生态局限。只在SGLang 0.5.12上实现,向vLLM等其他推理引擎的移植性和内核复用性未验证;且方法依赖GDN/KDA的状态结构,对状态几何不同的循环架构(如Mamba-2的SSM状态)需要重新推导行影响分。
未来方向
作者明确提出的方向:(1)更精确的误差传播模型——把key依赖的时变转移 $A_t$ 纳入寿命估计,例如沿校准轨迹直接估计 $L_u$ 而非只用门控衰减近似;(2)扩展到其他循环架构(Mamba-2、纯线性注意力、不同混合比例的模型)并在动态服务负载下验证精度与系统收益。基于论文成果可以延伸的方向:(1)把"寿命感知"思想推广到KV缓存量化(缓存条目同样有留存时间与被读取频率之分)以及激活量化;(2)量化感知训练版STEPQuant——在预训练或后训练中注入状态量化噪声,让模型天然对低比特状态鲁棒,可能解锁2~3bit;(3)与权重-激活联合低比特(W4A4/W8A8)栈叠加,逼近全整数推理服务;(4)利用Proposition 1的线性结构设计误差反馈补偿项(类似误差反馈SGD的一阶修正),在存储之外用极小计算量抵消累积误差;(5)状态量化的scaling law研究——状态位宽、并发数、上下文长度、批时延之间的最优权衡曲线,为服务部署提供配置指南;(6)探索把FP16支点从"头/行"粒度细化到元素粒度,进一步压低支点显存开销。
复现评估
开源情况:代码在 https://github.com/Dreamer-Toby/STEPQuant,基于SGLang 0.5.12,包含检查点专属精度图、支点身份、预条件器和打包状态内核。数据与校准成本极低:只需32段WikiText-2训练文本(每段2048 token),完全公开;评测为7个长生成+6个短生成的公开基准。论文的复现细节披露异常充分:附录A给出传播律证明和全部校准统计量定义;附录C.2给出两模型的单元划分(Qwen 2304头/KDA 81920行)、候选位宽集合、优化器(Qwen多选动态规划/KDA拉格朗日分配)与支点数量(32头/512行);C.3给出解码七步伪代码;附录D给出解析位宽核算(Qwen@6为6.3611 bit/value、@4为4.6209,KDA为6.30/4.30,含FP16尺度与支点替换的开销);附录F给出SGLang集成方式、计时协议(连续CUDA事件间隔、取最慢rank、三次取中位数)和内存记账公式。算力需求:4×NVIDIA A800 TP4,Qwen3.8-27B和Kimi-Linear-48B均为多卡级模型,个人研究者难以完整复现服务级实验。难度评估:算法本身(校准+位分配+双轴拟合)中等偏易,按附录描述可实现;系统工程是主要门槛——需要修改SGLang内核、实现融合重建-更新-读出核与双CUDA流写回同步;长生成评测本身也耗时(AIME/HMMT每题64样本、单样本最多65536 token)。总体:方法可复现性好、描述诚意高,核心结论用单机多卡可以在中等工作量内验证。
论文图表
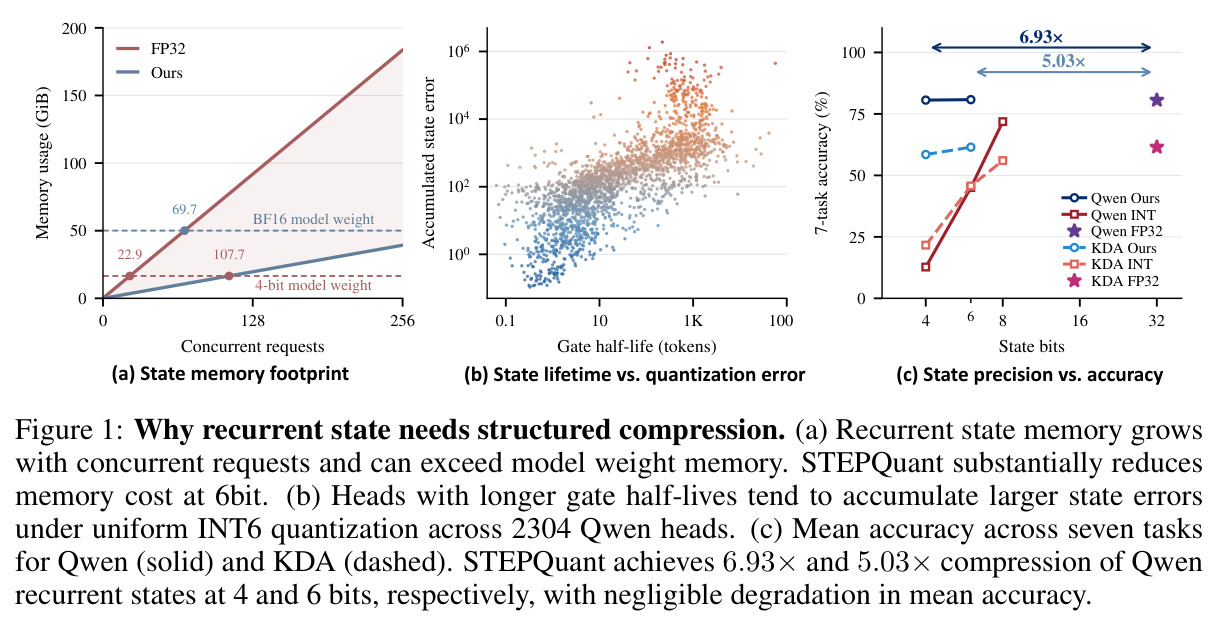
三联图:(a) Qwen循环状态显存随并发请求数增长,FP32状态池在约70并发时超过BF16权重显存,STEPQuant@6bit把状态成本大幅压低;(b) 在2304个Qwen头上,门控半衰期越长的头在均匀INT6量化下累积的状态误差越大(Spearman ρ≈0.80);(c) 七任务平均准确率随状态位宽的变化,Qwen(实线)与KDA(虚线)上STEPQuant在4/6bit分别实现6.93×和5.03×的状态压缩且精度几乎不掉。
这是全文动机的浓缩:同时展示了"为什么状态是瓶颈"(并发显存增长)、"为什么均匀量化会失败"(寿命-误差相关性)、"STEPQuant为什么有效"(低bit精度曲线),一张图讲清问题-观察-方案三步逻辑。
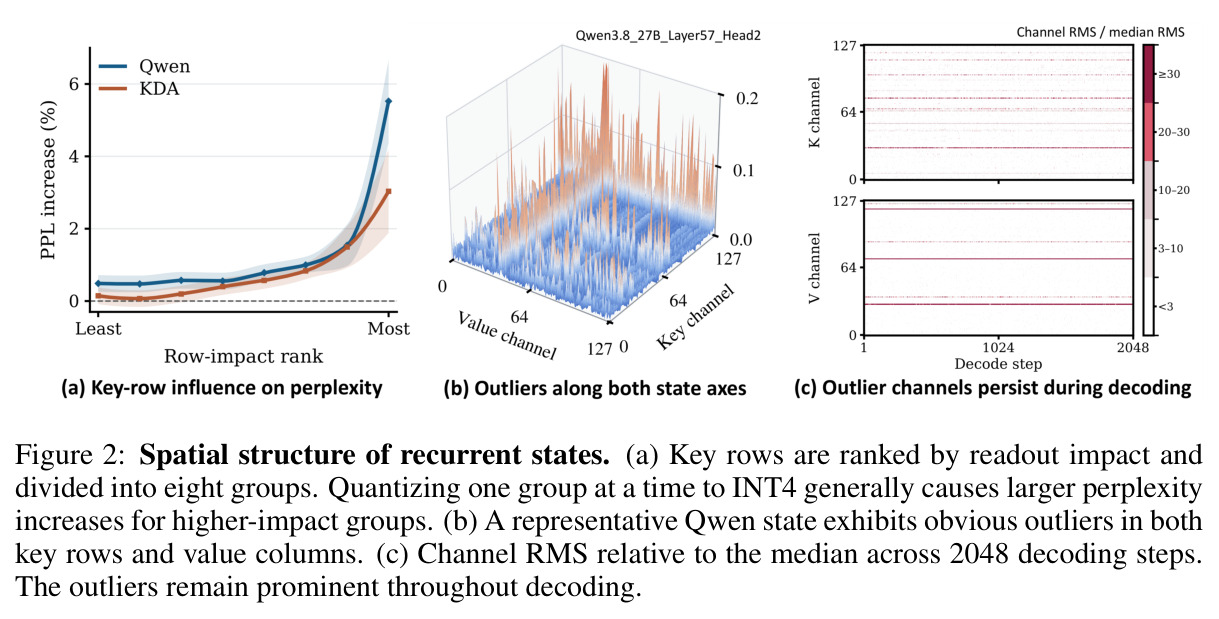
三联图:(a) 把key行按读出影响分 $\omega_i$ 排序分成八组,每次把一组量化到INT4、其余保持全精度,影响越大的组导致的困惑度上升越大(两个模型均如此);(b) 一个代表性Qwen状态在key行和value列两个方向都有明显离群值;(c) 跨2048个解码步的通道RMS相对中位数的比值,显示双轴离群结构在整个解码过程中持续存在。
空间组件(关键行感知双轴拟合)的全部经验依据都在这张图:它验证了行影响分确实预测量化危害,并揭示了状态矩阵与普通LLM张量不同的"双轴离群"几何,是理解方法设计合理性的关键。
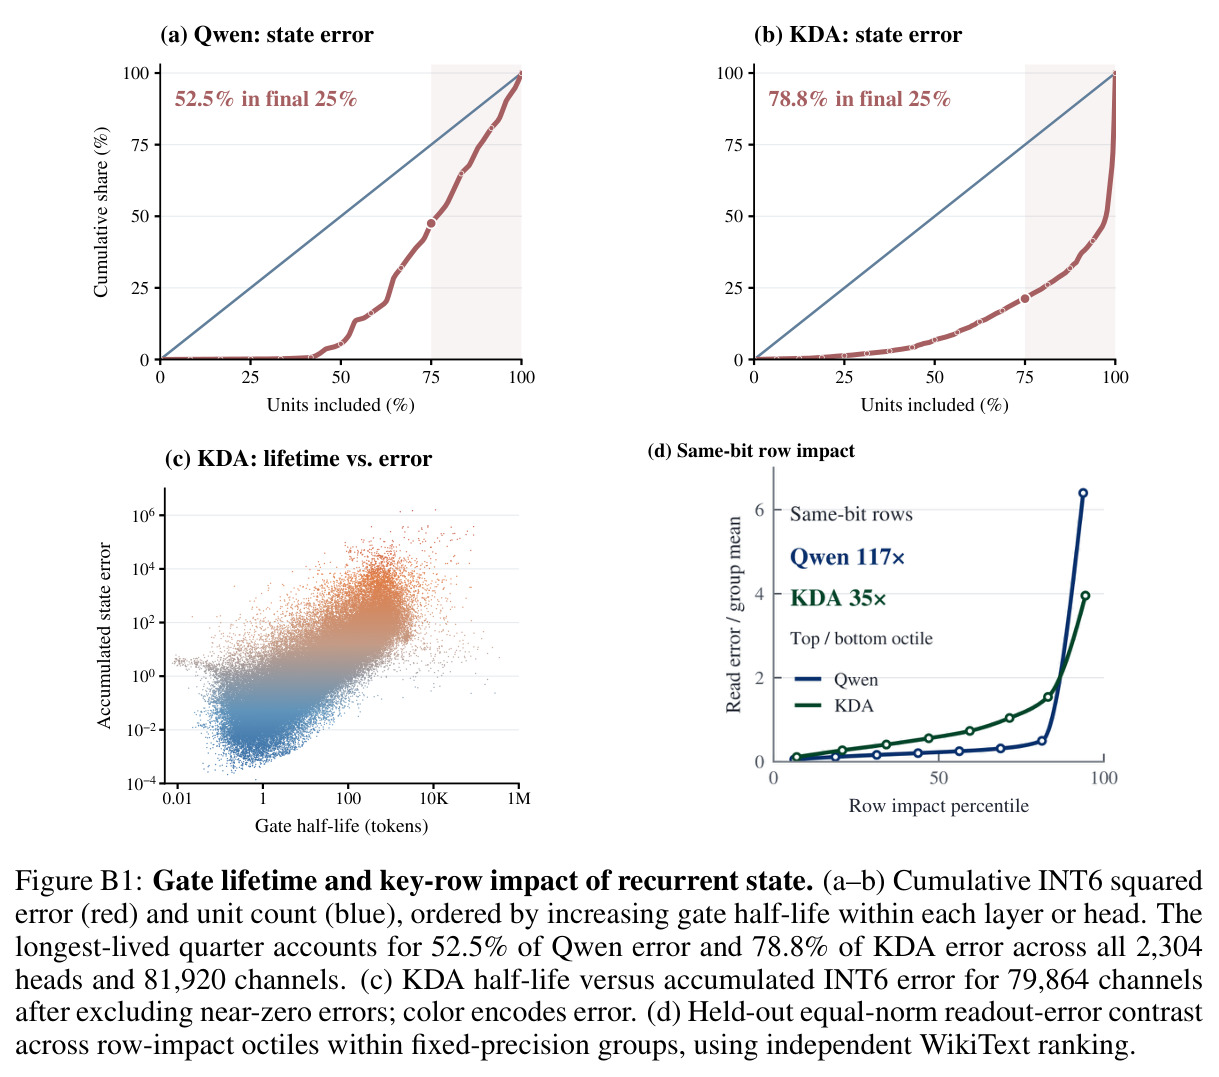
四联图:(a-b) 按门半衰期从短到长排序的INT6平方误差与单元数累积曲线,寿命最长的四分之一单元贡献了52.5%(Qwen)和78.8%(KDA)的总误差;(c) KDA 79,864个通道的半衰期与累积INT6误差散点(对数轴);(d) 固定精度组内按行影响八分位的等范数读出误差对比,Qwen最高/最低组比值117.4、KDA 35.1。
提供正文Fig.1(b)和行影响分 $\omega_i$ 的完整统计证据,包括全总体Spearman相关(0.8004/0.8017),是时间与空间两个核心假设最严格的实验支撑。
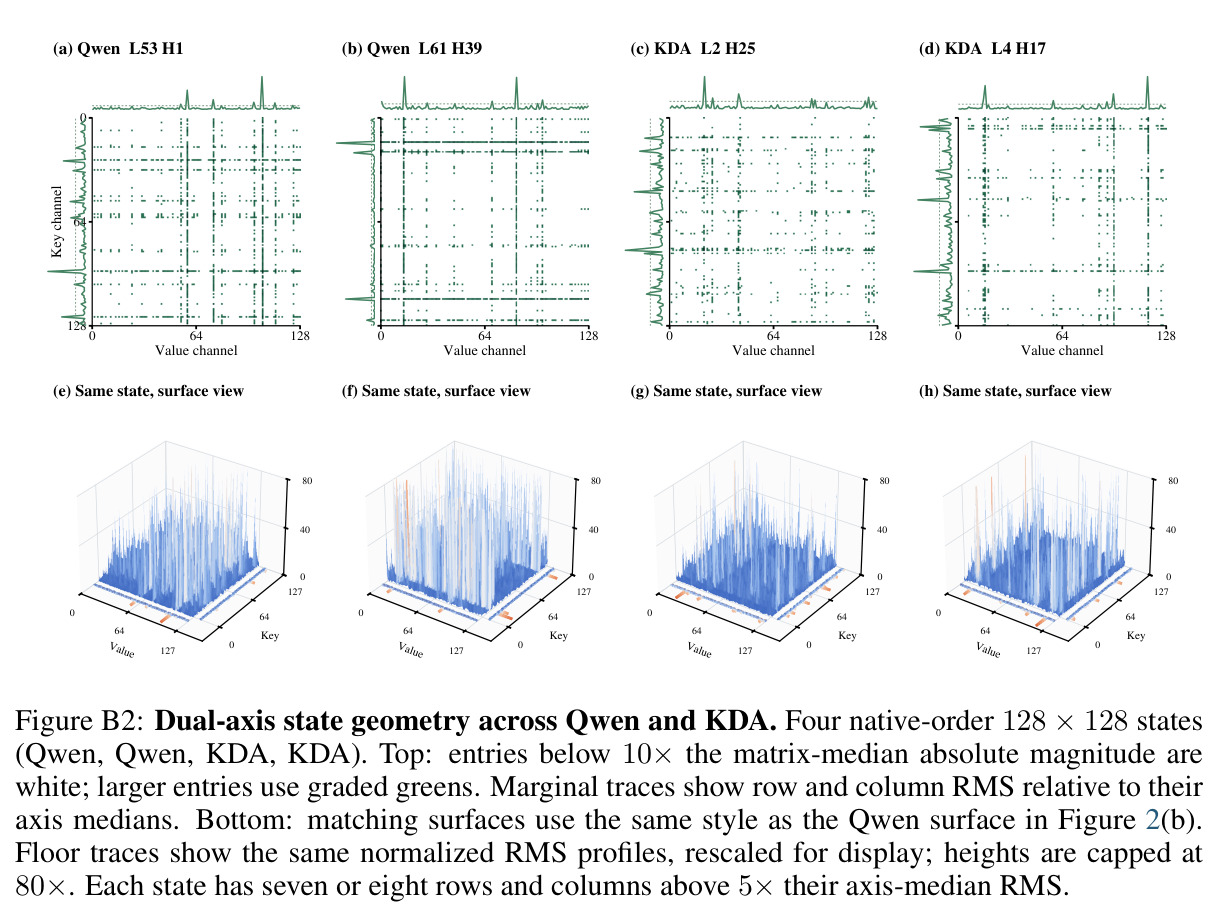
四个128×128原生状态矩阵(Qwen两个、KDA两个)的热图与表面图,标注低于10×矩阵中位幅度的元素为白色、边缘轨迹显示行/列RMS相对轴中位数的分布;每个状态都有7~8个行和列超过轴中位RMS的5倍。
直观展示"双轴离群"不是个别现象而是跨模型、跨层的普遍几何特征,补充了正文的10.3×/19.4×统计对比,帮助读者建立对状态结构的具体直觉。