门控DeltaNet为何能在4比特量化中幸存:混合架构27B大模型循环半区的NVFP4 W4A4量化 Why Gated DeltaNet Survives 4-Bit Quantization: NVFP4 W4A4 for the Recurrent Half of a Hybrid 27B LLM
首次把混合架构LLM的循环层全部压到4比特:精度无损、模型最小,并从机制上解释为何可行
前置知识
NVFP4 与 W4A4 量化
NVFP4 是 NVIDIA 的 4 比特浮点格式:数值用 E2M1(1 位符号、2 位指数、1 位尾数)存储,每 16 个元素共享一个 E4M3 缩放因子(取块内最大值/6),每个张量再配一个 FP32 全局 scale。W4A4 表示权重和激活都以该格式量化,GEMM 直接跑在原生 4 比特张量核心上。块内 max/RMS 不超过 4,一个离群值最多拖坏自己所在的 16 元素块。
论文全部实验围绕'把哪些层压到 NVFP4 W4A4'展开,理解块缩放如何局域化离群值是读懂机制研究(§5.1)的前提。
Gated DeltaNet(门控 DeltaNet, GDN)
一种线性注意力算子:每头状态 $S_t\in\mathbb{R}^{K\times V}$ 按门控 delta 规则递推 $S_t=\alpha_t S_{t-1}+\beta_t k_t(v_t-S_{t-1}^\top k_t)^\top$,其中 $\alpha_t\in(0,1)$ 是逐 token 遗忘门、$\beta_t\in(0,1)$ 是写入强度。delta 规则的写入是用 $v_t$ 覆盖状态对当前 key $k_t$ 的预测,而非盲目累加。Qwen3.8-27B 有 48 层 GDN、16 层全注意力。
论文的主角。要理解'为什么循环半区反而是好量化的一半',必须先理解它的状态更新、门控参数化和覆盖式写入。
残差流离群值与块缩放
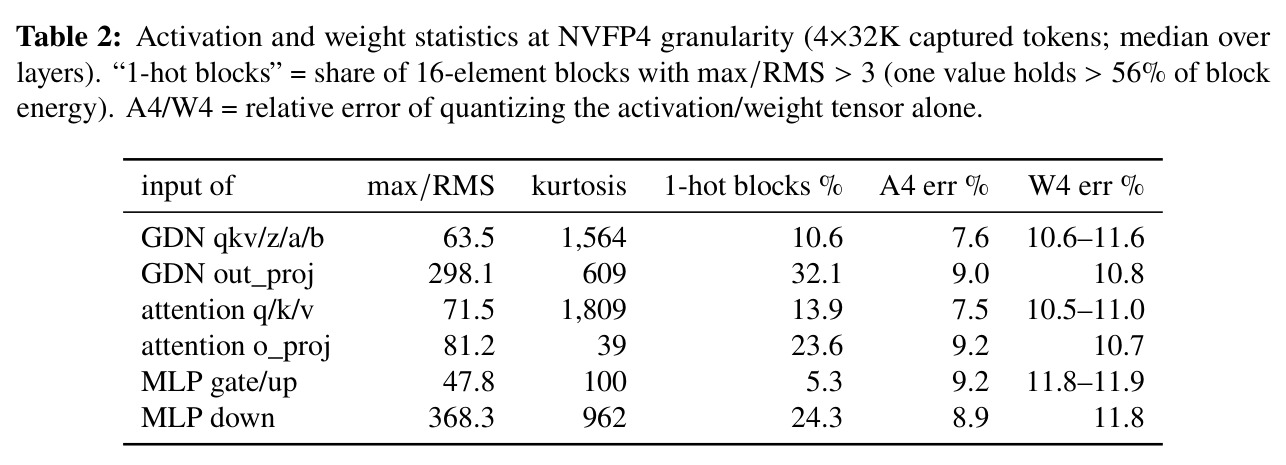
大模型激活分布含极端离群值:本文 GDN 输入的中位层 max/RMS 达 63.5、峰度约 1564、10%–32% 的 16 元素块被单个值主导(1-hot 块)。NVFP4 的逐块缩放把每个离群值的破坏限制在自己块的 15 个邻居内,因此实测 A4 量化误差在所有层角色上均匀分布(7.5–9.2%),与层类型无关。
它排除了'GDN 输入更干净所以好量化'这一最简单的解释,是四段机制链的第一环。
门控的对数空间参数化
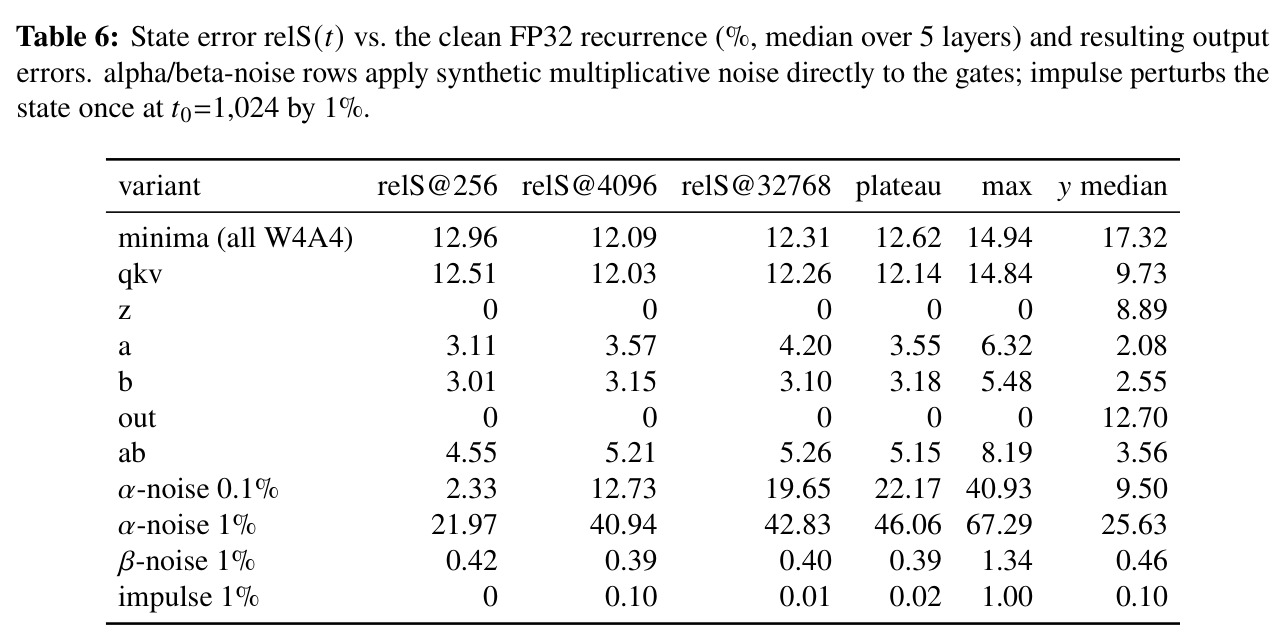
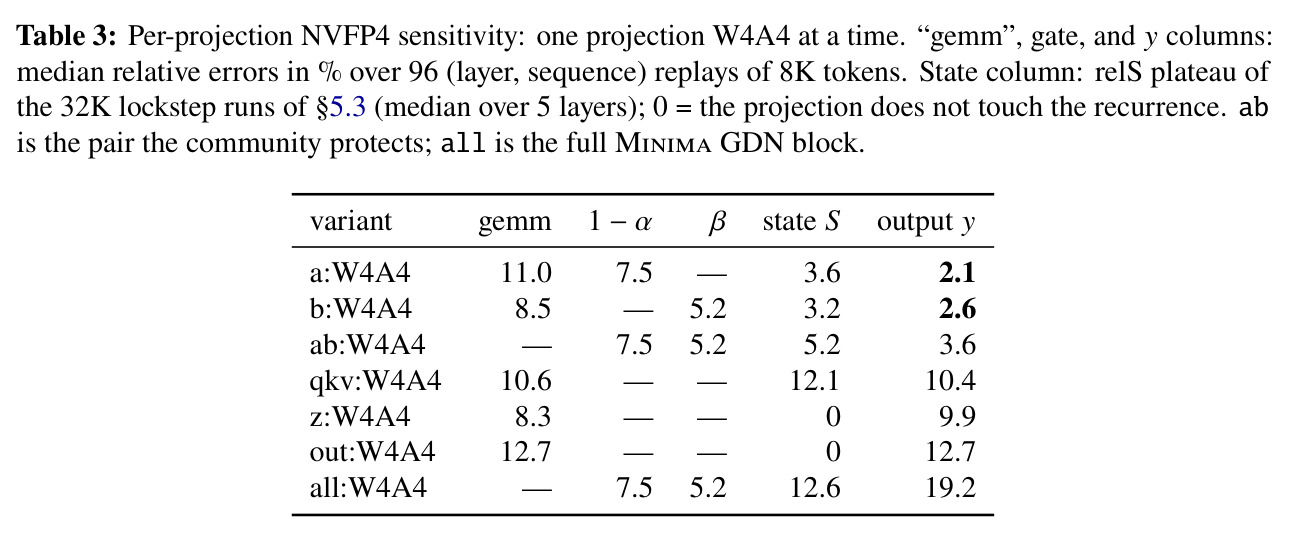
GDN 的门在 log 空间参数化:$g_t=-\exp(A_{\log})\,\mathrm{softplus}(a_t+\mathrm{dt\_bias})$,$\alpha_t=e^{g_t}$,$\beta_t=\sigma(b_t)$。softplus 与 sigmoid 的非线性把 pre-activation 上约 11% 的 GEMM 误差压缩为 $1-\alpha$ 上 7.5%、$\beta$ 上 5.2% 的误差;而直接对 $\alpha$ 加 0.1% 乘性噪声就会造成 22% 状态误差。
这是'被保护的门投影其实最不敏感'(§5.2)的直接原因,也划定了结论能否推广到其他循环架构的边界。
困惑度(Perplexity)与逐 token NLL 分解
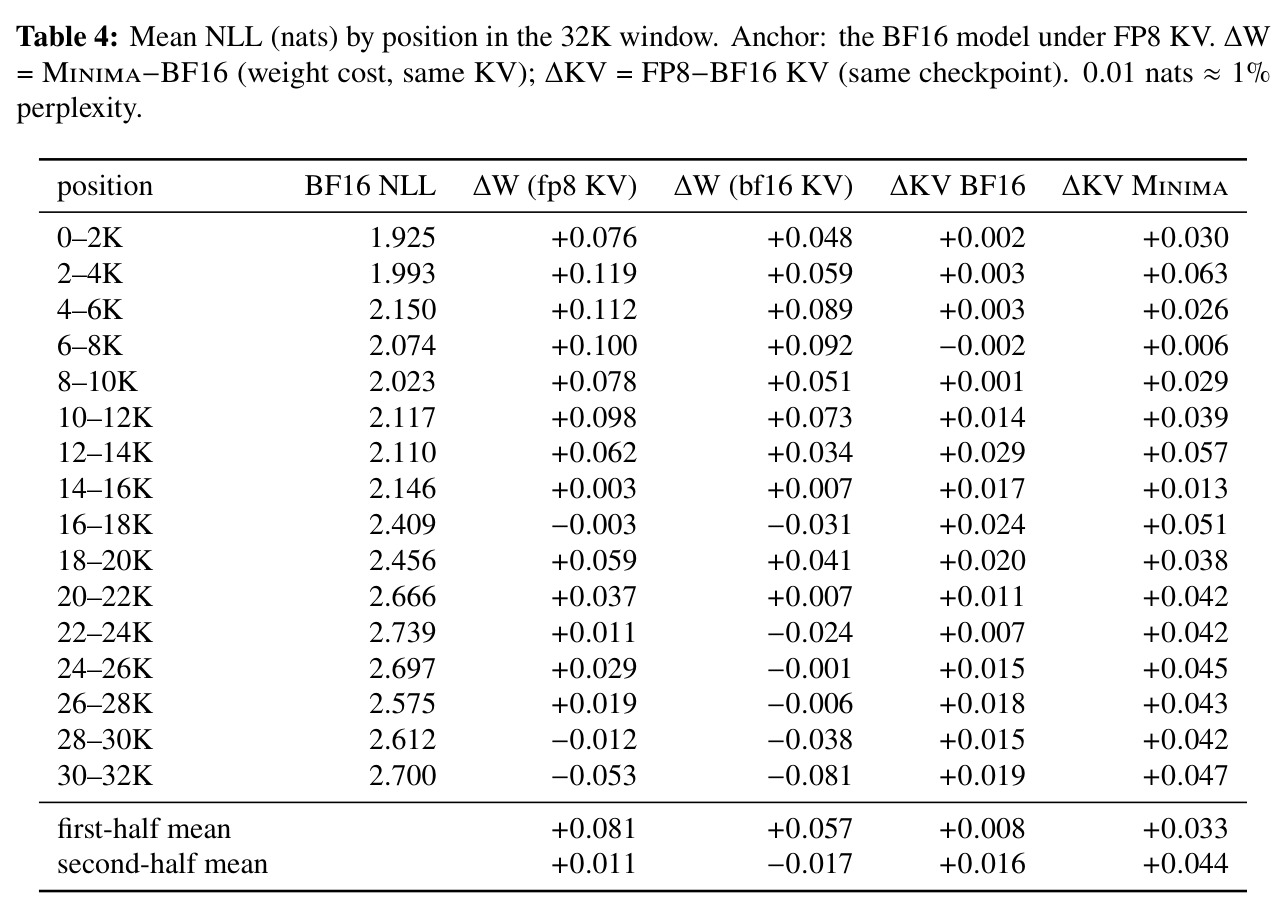
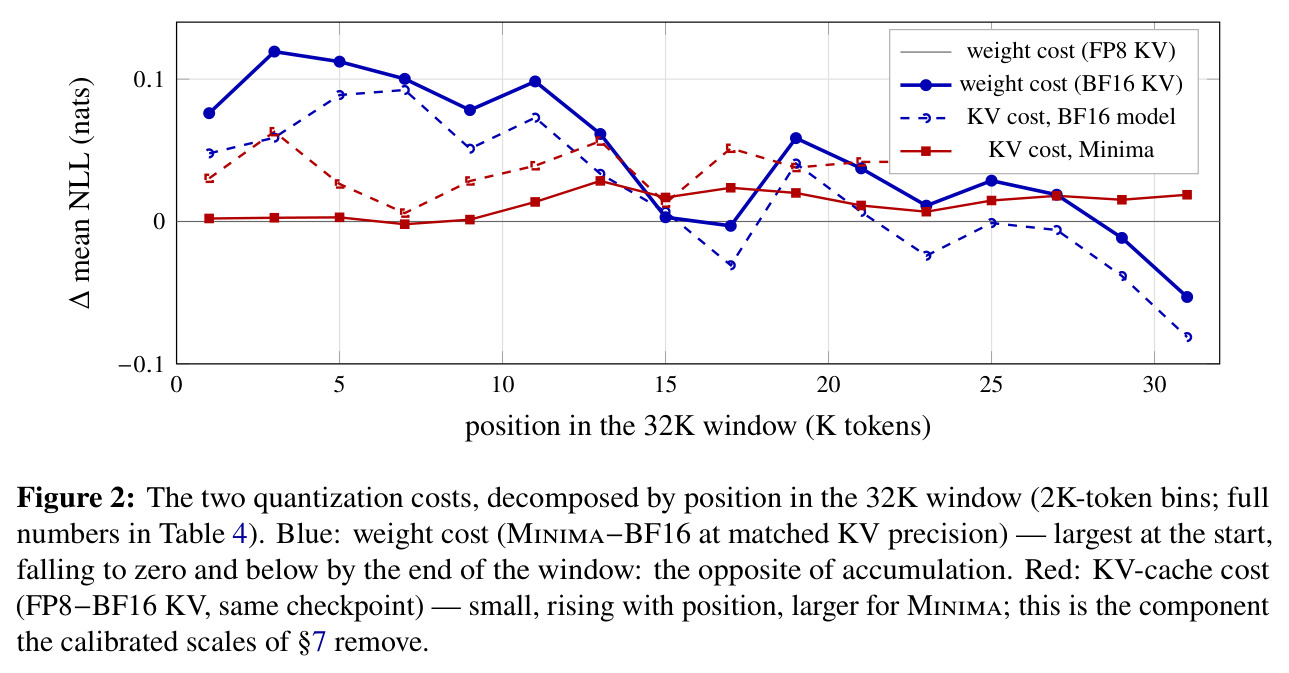
困惑度是语言模型建模质量的标准指标,等于测试集平均负对数似然的指数。本文在 4K 和 32K 两种窗口测 WikiText-2 PPL,并把 32K 请求内逐 token 的 NLL 按 2K 位置分箱拆成权重量化成本与 KV 缓存成本,观察差距随上下文位置的变化。
量化成本随位置递减(前半 +0.081 nats → 后半 +0.011)是'误差不累积'结论的直接证据,读懂数据才能理解论证。
FP8 KV 缓存与校准 scale
混合模型只有 16 个注意力层需要缓存 KV。用 FP8 存 KV 可把缓存显存减半、容量增至 1.8–1.9 倍,但需要每层缩放因子把数值映射进 FP8 动态范围:scale=1.0 简单但长上下文 PPL 变差;llm-compressor 可离线校准每张量静态 scale,推理时零开销。
论文落地配方'quantize everything, ship KV scales'的另一半在这里:校准 scale 免费找回 83% 的长上下文 PPL 损失。
融合 GEMM 与全局 scale 错配
vLLM 服务时会把 GDN 的 in_proj_qkv+z、in_proj_b+a 各融合成一个 NVFP4 GEMM,直接取成员模块全局 scale 的最大值而不重缩放局部 scale;而 llm-compressor 按模块单独校准。本文检查点中配对 scale 相差 1.82×(qkv/z)与 2.75×(b/a),48 层全部如此,导致门控计算静默出错。
这是最重要的服务栈发现:不修复它,AIME 从 86.7 掉到 80.8,还会伪装出'PPL 优于 BF16'的假象(6.86 vs 真实 10.84)。
研究动机
4 比特权重+激活(W4A4)量化已成为大模型推理降本的实用目标,但主流做法对混合架构格外保守。Qwen3.8-27B 是典型代表:64 层中有 48 层是 Gated DeltaNet(GDN)这类线性注意力、只有 16 层是全注意力。作者审查的所有公开 4 比特版本(Unsloth Dynamic v3、RadixArk/ModelOpt)连同官方 FP8 发行版,都激进量化 MLP,却把整个 GDN 块保护在 8/16 比特——尤其把控制遗忘门 $\alpha_t$ 的投影 $a$ 和控制写入强度的投影 $b$ 保留在 BF16。背后的直觉是:递推 $S_t=\alpha_t S_{t-1}+\beta_t k_t(v_t-S_{t-1}^\top k_t)^\top$ 携带状态跨越数万 token,每步注入的量化误差理应复合,而门控误差复合最快。这一直觉从未被严格检验,也没有人给出机制层面的解释;同时如何把这类模型'测对'本身就充满陷阱:融合 GEMM 的 scale 处理、多模态复合服务路径、thinking 模型的评测 harness 都可能悄悄毁掉测量结果。
本文的目标是论文要回答两个问题:GDN 循环块到底能不能整块做 NVFP4 W4A4 量化?如果能,为什么?具体目标包括:(1) 构建 Minima——对 Qwen3.8-27B 全部 496 个线性层(240 个 GDN、64 个 attention、192 个 MLP 投影)做训练后 NVFP4 W4A4 量化,门控投影也不例外;(2) 在完全统一的服务体制(FP8 KV 缓存、vLLM 0.27.1、TP=1、单张 RTX PRO 6000)下与 BF16 及两个社区配方在 MMLU-Pro、GSM8K、AIME'25、GPQA-Diamond、LiveCodeBench v6、RULER 到 64K 检索上严肃对比,同时比较显存占用与预填充/解码速度;(3) 用捕获的真实 32K 激活做四部分机制研究,把'碰巧能行'变成架构层面的因果解释;(4) 排查并修复会悄悄毁掉测量的服务栈问题,并给出可直接落地的 KV 缓存量化配方。
与已有工作不同的是,切入点独特在三层。第一,研究对象是空白:此前低比特量化研究全部针对 transformer 的 attention 与 MLP,大规模混合模型中循环状态混频器的量化无人研究,公开配方干脆豁免它们;本文首次把'循环半区'当作量化对象,并证明它反而是容易量化的一半。第二,方法上'先证伪、再解释':不是量化完看分数了事,而是捕获 48 层 GDN 的真实 32K 输入、逐投影隔离重放、在 FP32 lockstep 中追踪误差传播、按 token 位置分解困惑度差距,形成一条可检验的机制链。第三,结论反直觉:社区精心保护到 BF16 的门投影 $a$、$b$ 恰是全模型敏感性最小的投影,保护图谱保护错了对象;同时首次揭示的'逐模块校准 vs 融合 GEMM 全局 scale 错配'bug 影响今天所有混合模型 NVFP4 部署,且会伪装出'长上下文困惑度优于 BF16'的假象(6.86 vs 真实 10.84),因为坏掉的遗忘门让状态记住一切。
核心方法
直觉:如果架构自身能'消化'量化误差,应表现为四件事——输入端离群值被块缩放局域化、误差经门控非线性被压缩、递推把状态误差压在平台上并主动擦除、端到端困惑度差距随上下文位置缩小。技术路线分两支。量化侧:用 llm-compressor 对除 lm_head、embeddings、卷积、归一化外的全部 496 个线性层施加 NVFP4 W4A4 训练后量化,在冻结的 128 样本×32K token 校准集上校准;服务前先做全局 scale 和谐化修复(§6),再以 vLLM 0.27.1、TP=1、FP8 KV 缓存单卡部署。机制侧:不重训、不微调,靠 fake quantization(量化-反量化后继续高精度计算)把恰好 4 比特舍入误差注入捕获的真实激活,配合 FP32 lockstep 递推隔离每一层、每个投影的误差贡献,最后再回到端到端评测验证机制预测——PPL 差距确实随位置缩小。
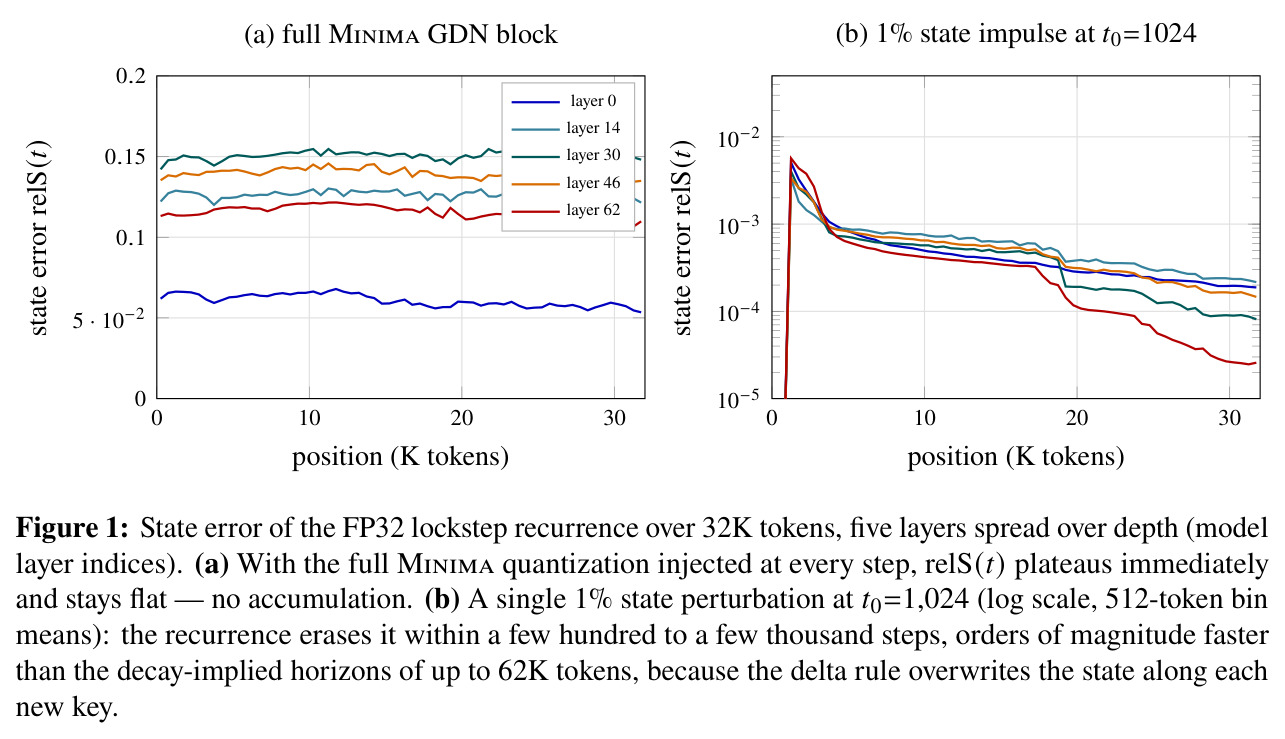
核心创新是一条四段因果链,以及'保护错了对象'的结论反转。(i) 输入不是原因:GDN 与 attention 读同一残差流,输入同样极端离群(中位层 max/RMS 63.5、峰度约 1564、10.6% 的块被单值主导),但 NVFP4 块缩放把离群值限制在自身块内,A4 误差在所有层角色均匀落在 7.5–9.2%。(ii) 门投影最不敏感:$a$、$b$ 量化后 GEMM 误差 11.0%/8.5%,但经 $g_t=-\exp(A_{\log})\,\mathrm{softplus}(a_t+\mathrm{dt\_bias})$ 与 $\beta_t=\sigma(b_t)$ 的非线性压缩,输出只动 2.1%/2.6%。(iii) 递推有界且主动遗忘:状态误差停在 12.6% 平台(token 256 处 12.96%、32768 处 12.31%);1% 脉冲在 80–1382 步衰到 $1/e$,远快于视界 $1/(1-\alpha)$ 的 44K–62K,因为每次写入都沿当前 key 方向覆盖状态。(iv) 端到端权重成本随位置递减:+0.081→+0.011 nats,最后 2K 反而 −0.053。
方法步骤详情
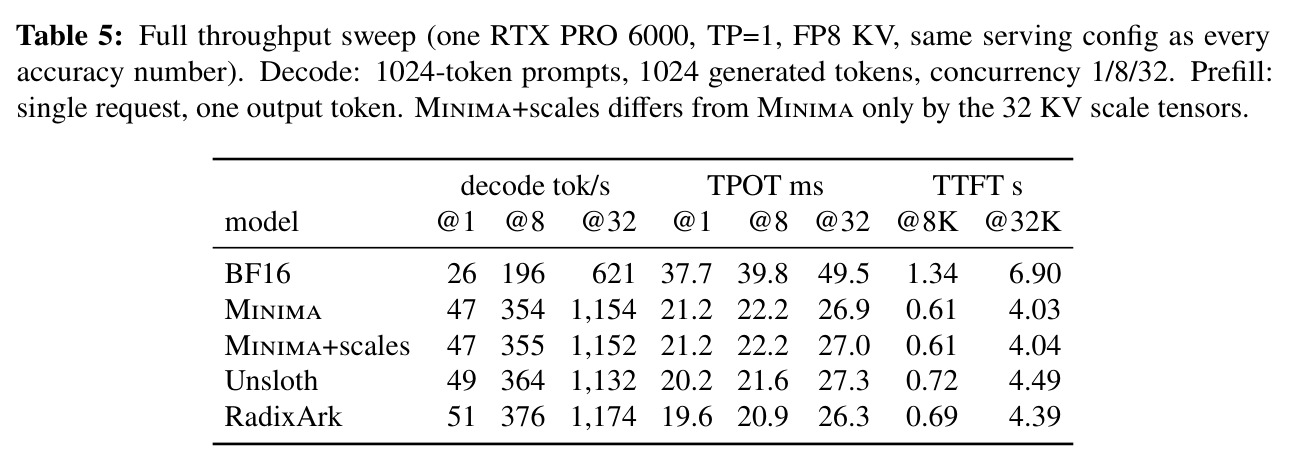
流程:(1) 量化:llm-compressor NVFP4 W4A4 应用于 496 个线性层(240 GDN + 64 attention + 192 MLP),128×32K 冻结校准。(2) 修复服务栈:vLLM 把 in_proj_qkv+z、in_proj_b+a 融合成单 GEMM 并取成员全局 scale 最大值;论文把每个融合组改写为共享全局 scale、比值折进逐块 E4M3 scale(94 组,最坏 2.81×,重舍入 ≤6.2%),GEMM 探针确认误差 0.35/0.57→0.002。(3) 捕获激活:BF16 读 8 篇 32K 文档,记录 48 层 GDN 输入。(4) 独立重实现单层 GDN,对齐到 6×10^-3 中位相对差。(5) fake quant 注入纯舍入误差。(6) 逐投影重放:96 个(层,序列)×8K token,单投影量化测误差。(7) FP32 lockstep:1 条干净+11 条扰动轨迹跑 32K(5 层),另做 1% 状态脉冲与加在 $\alpha$/$\beta$ 上的合成噪声实验。(8) 位置分解:逐 token NLL 按 2K 分箱拆成权重/KV 成本。(9) KV 配方:16 个注意力层 32 个 KV 张量加静态 FP8 scale,得发布版 Minima+scales。
技术新颖性
其一,问题新:首个针对大规模混合 LLM 循环状态混频器(GDN 类线性注意力)的 W4A4 量化研究,此前该算子类完全缺席量化文献、公开配方一律豁免;并证明校准式 PTQ 无需 QAT 即达 BF16 级精度——同时期 QUASAR 需蒸馏式量化感知训练才做到的事,PTQ 就够。其二,论证方式新:捕获真实激活 + fake quant + FP32 lockstep 重放构成可复现的机制实验而非黑箱评测,还给出独立性证据——五投影误差按平方合成 19.4% vs 实测 19.2%,说明误差源近似独立可加;权重误差(10.5–11.9%)处处大于激活误差也是新观察。其三,工程发现新:首次揭示逐模块校准与融合 GEMM 之间的全局 scale 错配(qkv/z 差 1.82×、b/a 差 2.75×,48 层全部如此),其隐蔽性在于坏模型推理下降(AIME 80.8 vs 86.7)却伪装出优于 BF16 的长上下文 PPL 6.86(真实 10.84)——坏掉的遗忘门让状态记住一切、恰好利于 WikiText 下一 token 预测;Unsloth/RadixArk 未中招只因它们保护了 GDN。
实验结果
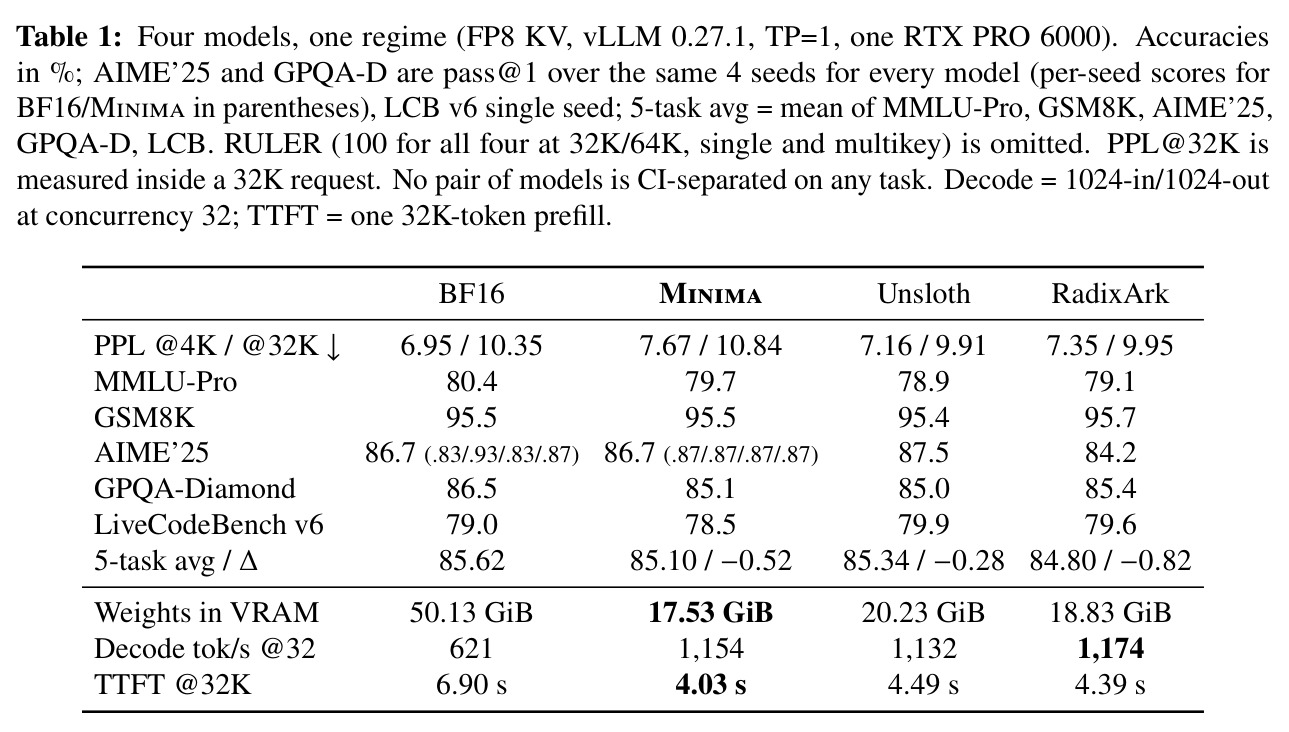
表 1:统一体制下 Minima 五任务平均 85.10 vs BF16 85.62(−0.52,种子噪声内),三个量化配方彼此仅差 0.54 分(不到一道 AIME 题的 3.3 分),最大单任务差(RadixArk AIME −2.5)也在 BF16 自身种子波动 83.3–93.3 内;Minima 的 AIME'25 与 BF16 完全持平(四种子均 26/30);RULER 32K/64K 四模型全 100。效率:显存 17.53 GiB(BF16 50.13,缩小 2.9×,比社区配方小 7–13%)、KV 容量 1.81M token/卡最大、TTFT@32K 4.03s vs 6.90s、8K 预填充 +14–19%、decode 1,154 vs 621 tok/s。PPL 是唯一分出高低的指标:4K 7.67 vs 6.95、32K 10.84 vs 10.35。机制链逐环验证:GDN 输入 max/RMS 63.5、峰度约 1564 但 A4 误差均匀 7.6%(表 2);$a$/$b$ 的 GEMM 误差 11.0%/8.5% 被压成输出 2.1%/2.6%,五投影合计 19.2% 吻合平方合成的 19.4%(表 3);lockstep 显示状态误差停在 12.6% 平台、1% 脉冲 80–1382 步衰到 $1/e$ 而视界 $1/(1-\alpha)$ 达 44K–62K;对 $\alpha$ 加 0.1% 噪声即致 22% 状态误差、对 $\beta$ 加 1% 仅 0.4%;权重成本 +0.081→+0.011 nats、最后 2K −0.053。KV 侧:FP8 使 PPL@32K +0.13/+0.41,校准 scale 后 10.84→10.50 找回 83%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五任务平均(MMLU-Pro/GSM8K/AIME'25/GPQA-D/LCB v6) | 平均准确率 (%) | 85.10(Minima) | BF16 85.62;Unsloth 85.34;RadixArk 84.80 | −0.52,在种子噪声内持平,且显存与速度大幅领先 |
| AIME'25 | pass@1,4 种子平均 (%) | 86.7 | BF16 86.7 | 完全持平(各种子均 26/30),平均生成长度仅差 1 token |
| 权重显存占用 | GiB | 17.53 | BF16 50.13;Unsloth 20.23;RadixArk 18.83 | 比 BF16 缩小 2.9×,比社区配方小 7–13% |
| 32K 单请求预填充(TTFT) | 秒 | 4.03 | BF16 6.90;Unsloth 4.49;RadixArk 4.39 | 比 BF16 快 42%,8K 预填充吞吐比社区配方高 14–19% |
| Decode 吞吐(1024入/1024出,并发 32) | tok/s | 1,154 | BF16 621;Unsloth 1,132;RadixArk 1,174 | 比 BF16 快 86%,量化配方间差距在 4% 内 |
| RULER NIAH 单/多 key 检索 | 准确率 (%) @32K/64K | 100 | BF16 100 | 四个模型全部满分,长上下文检索无损 |
| WikiText-2 困惑度 @32K | PPL(越低越好) | 10.84(Minima+scales 为 10.50) | BF16 10.35;Unsloth 9.91;RadixArk 9.95 | +0.49;校准 KV scale 后差距缩至 +0.15,低于 BF16 自身 FP8 开销 |
| KV 缓存容量(单卡) | 可缓存 token 数 | 1.81M | 其余三个配方更小 | 四配方中最大,支持最长可服务上下文 |
局限与改进
作者承认的局限:证据只覆盖一个模型族与规模(Qwen3.8-27B)、一种量化格式(NVFP4),评测到 32K 困惑度与 64K 检索,128K 以上是机制外推而非实测;并发的 QUASAR QAT 检查点属于不同配方类别,未做受控对比;Minima+scales 的任务分继承自 Minima 而非重测;decode 比 RadixArk 慢 2–4%,归因于小批量 NVFP4 激活量化的 kernel 开销。我的补充观察:门屏蔽论证严格依赖 log 空间 softplus/exponential 参数化——对 $\alpha$ 直接 0.1% 噪声就有 22% 状态误差,线性参数化衰减门的循环混频器不能直接套用结论;机制统计以层中位数与 5 层 lockstep 采样为主,深度维度覆盖有限;结论绑定 llm-compressor/vLLM 生态,SGLang、TensorRT-LLM 等其他推理栈的融合行为与 scale 处理未审计;单卡 TP=1 的结论在多卡 tensor parallel 下也未验证。
独立分析的弱点
独立分析的弱点:(1) 泛化性未验证——全部结论建立在单一模型上,Qwen3-Next、Mamba2 混合等不同门控参数化架构是否同样'循环半区好量化'未知,改进方向是在至少两类递推算子上复现机制链;(2) PPL 在量化配方中最差(4K +0.72),任务分持平说明基准对困惑度不敏感,但对 PPL 敏感的应用(长文档打分、检索式生成的重排器)可能受影响,应补充对困惑度敏感的下游评测;(3) decode 反而比保护型配方慢 2–4%,削弱'量化更多=更快'的叙事,需要 fused activation-quant kernel 优化;(4) scale 错配的修复是 checkpoint 侧手术(比值折进 E4M3,重舍入误差最高 6.2%),治本之策是让 llm-compressor 与 vLLM 原生支持融合感知校准;(5) 门控误差独立性只有统计证据(平方合成 19.4% vs 实测 19.2%),缺乏逐通道因果分析;(6) 评测样本量有限(AIME 30 题×4 种子),对 ±2 分量级差异的分辨力不足,'种子噪声内持平'的表述略显宽松。
未来方向
作者提出的方向:同组后续工作已把配方推到全模型 NVFP4 W4A4(含 embeddings、lm_head、多 token 预测头),并进一步做 3 比特 MLP 码本 + 蒸馏修复的低秩残差——权重仅 12.3 GiB(BF16 的 1/4.1),128 并发下输出超 1,200 tok/s,且把本文结果当作基础。可延伸的研究:(1) 把平台机制推到 128K–1M 上下文直接验证,特别是衰减视界 44K–62K 的层在超长窗口的平台行为;(2) 把四段机制链工程化为'量化前敏感性审计工具',对新架构预测哪些投影可安全量化;(3) 对 QUASAR QAT 检查点做同 harness 受控对比,回答 PTQ 与 QAT 是否等价;(4) 将融合感知 scale 校准上游化,并审计 SGLang/TensorRT-LLM 等推理栈是否存在同类错配;(5) 对 Mamba2、RWKV 等不同门控参数化的混频器做 gate-shielding 分析,界定结论适用边界;(6) KV scale 与 W4A4 权重联合校准,压掉残余 +0.07 PPL。
复现评估
复现条件较好。量化检查点已开源(huggingface.co/minima-ai/mnma_qwen3.8_27b_nvfp4),全流程使用开源工具链:llm-compressor 做量化与 KV scale 校准,vLLM 0.27.1 做服务(GPU 利用率 0.85、32K 生成上限、FP8 KV);硬件为单张 RTX PRO 6000(96 GB,SM120,原生 NVFP4),TP=1,是单卡可复现的配置。校准集为冻结的 128 样本×32K token;评测协议描述充分:chat-template harness、thinking disabled、逐样本有效性门(空答案、泄漏的 块)、AIME 与 GPQA 用相同 4 种子(温度 0.6、top-p 0.95)。难度中等的部分是机制研究:需自行实现 standalone GDN 层(对齐阈值 6×10^-3 中位相对输出差)、捕获 32K 激活、fake quant 注入与 FP32 lockstep 递推,工程量不小但每步有明确验收标准。未公开的只有评测脚本与捕获数据,多模型×6 套件×多种子的长上下文评测算力是主要成本。
论文图表