PACE:四比特循环状态的周期性与通道对齐编码 PACE: Periodic and Channel-Aligned Encoding of Four-Bit Recurrent States
降低舍入频率并按通道对齐分组,免训练实现四比特线性注意力状态量化
前置知识
线性注意力与循环状态
线性注意力去掉 softmax,把注意力改写成对状态矩阵 $S_t \in \mathbb{R}^{d_k \times d_v}$ 的递推:每个 token 把外积 $k_t v_t^\top$ 写入状态,读出时计算 $o_t = S_t^\top q_t$。状态大小固定、不随上下文增长,从而取代 Transformer 的 KV 缓存,但代价是每生成一个 token 都要读写一次状态。
论文量化和加速的对象正是这个循环状态;理解它的固定大小与逐 token 读写特性,才能明白服务端内存占用从哪来、量化误差为何会随解码逐步累积。
门控增量规则
Gated Delta Rule 是线性注意力的一种变体:写入前先用数据相关衰减 $a_t$ 收缩旧状态,再减去旧状态沿当前 key 的分量,最后写入新值:$S_t = a_t(I-\beta_t k_t k_t^\top)S_{t-1} + \beta_t k_t v_t^\top$。其增量形式 $S_t = a_t S_{t-1} + k_t u_t^\top$ 中的 $u_t$ 称为增量值(delta value),是本文结构分析的关键对象;衰减 $a_t$ 是每头一个标量。
本文的理论界依赖每头的衰减率 $a_h$,通道结构发现源自增量值 $u_t$,头级精度分配之所以成立也 because 衰减是标量——整套方法都建立在这个数学形式上。
分块内核
逐 token 递推是串行且访存受限的。分块内核把序列切成块,用块内累积衰减 $\alpha_i = \prod_{j \le i} a_j$ 把 $C$ 次外积累加改写成稠密矩阵乘和三角求解:$S_C = \alpha_C S_0 + \sum_i (\alpha_C/\alpha_i) k_i u_i^\top$。只有块首块尾的状态被写成张量,块内中间状态从不落盘。
prefill 阶段每 chunk 只写一次状态,说明『低频舍入』在 prefill 本来就是事实;解码端 PACE 也靠同一分块公式把缓冲的多个 token 一次推进,这是方法可行性的数学基础。
解码缓冲区
解码时内核每 token 调用一次、状态每步都写,分块结构就丢失了。解码缓冲区把最近若干 token 的 key/value(及衰减)暂存,攒够一批再一次推进状态,把状态写从每 token 一次降为每批一次。KVBuffer、ReplaySSM、DeltaLog 等 serving 工作用它加速解码,但都不量化状态。
PACE 的周期舍入直接搭建在缓冲区之上:舍入周期 $d_P$ 就是缓冲区长度,而缓冲区自身占用的内存也必须计入公平比较,这催生了本文的 resident bits 口径。
分组量化与 resident bits
分组量化把矩阵切成每组 $g$ 个元素的组,组内共享一个缩放因子后按低比特舍入,等效位宽约为 $b + 16/g$。本文进一步定义 resident bits:把状态载荷与解码缓冲区一起折算到每个状态值上的比特数,缓冲区成本为 $c^{d_P} = \frac{b_k d_k/\gamma + b_v d_v + 32}{d_k d_v} \cdot d_P$。
论文所有对比(如 PACE-4/8 的 6.82 对 DAMP INT8 的 9.90)都基于 resident bits;不理解这个口径,就无法判断『用约 2/3 内存打平』的结论是否公平。
定点滤波与误差累积
对衰减因子为 $a$ 的递推系统每步注入方差 $\sigma^2$ 的舍入噪声,噪声会沿递推被滤波并累积到 $\sigma^2/(1-a^2)$,这是经典的定点滤波问题。PACE 把注入频率降为每 $d_P$ 步一次,得到第 $h$ 个头保留误差的上界 $E_h = e_h/(1-a_h^{2 d_P})$:周期越长,两次注入之间被衰减掉的误差越多。
这是全文的理论核心:它预测『降低舍入频率有效』,并且由于门控增量规则的衰减是头级标量,$E_h$ 天然是头级量,直接导出了按头分配精度的设计。
研究动机
线性注意力语言模型用固定大小的循环状态取代 KV 缓存,推理服务要为每个并发解码的序列保存一份状态副本:在 64 路并发下,fp32 状态会占到『权重+状态』总内存的 10%–41%,因此把状态存到低精度能直接提升单卡可容纳的并发序列数。但已有状态量化器(Quamba2、Q-Mamba、DAMP 等)都在每生成一个 token 后就把状态重新舍入一次,舍入误差沿递推不断累积,导致四比特方案普遍掉点:例如重实现的 Q-Mamba DSQ 在 Qwen3.5-9B 上五项基准平均只有 72.8 分(全精度 84.5),DAMP INT4 也掉到 79.7。已发表的补救办法要么把位宽提到 8 比特(DAMP INT8 实际占 9.9 bits/value,还把 16 个风险最大的 key 通道留在 fp16),要么像 Q-Mamba 那样微调约 2% 的模型权重,前者费内存、后者费训练成本。
本文的目标是本文的目标是在完全不训练(post-hoc)的前提下,把门控增量模型的循环状态压到四比特,并让精度接近甚至追平八比特方案。具体拆成四件事:其一,给出舍入周期与误差累积之间的理论界,据此降低舍入频率而不是改进单次舍入;其二,弄清状态中大数值的空间分布,据此设计量化分组的轴向;其三,把有限的精度预算分配给『保留舍入误差最久』的头;其四,建立把解码缓冲区额外内存计入的统一比较口径(resident bits),保证与 DAMP 等基线的对比是内存公平的,同时不牺牲解码缓冲区带来的吞吐收益。
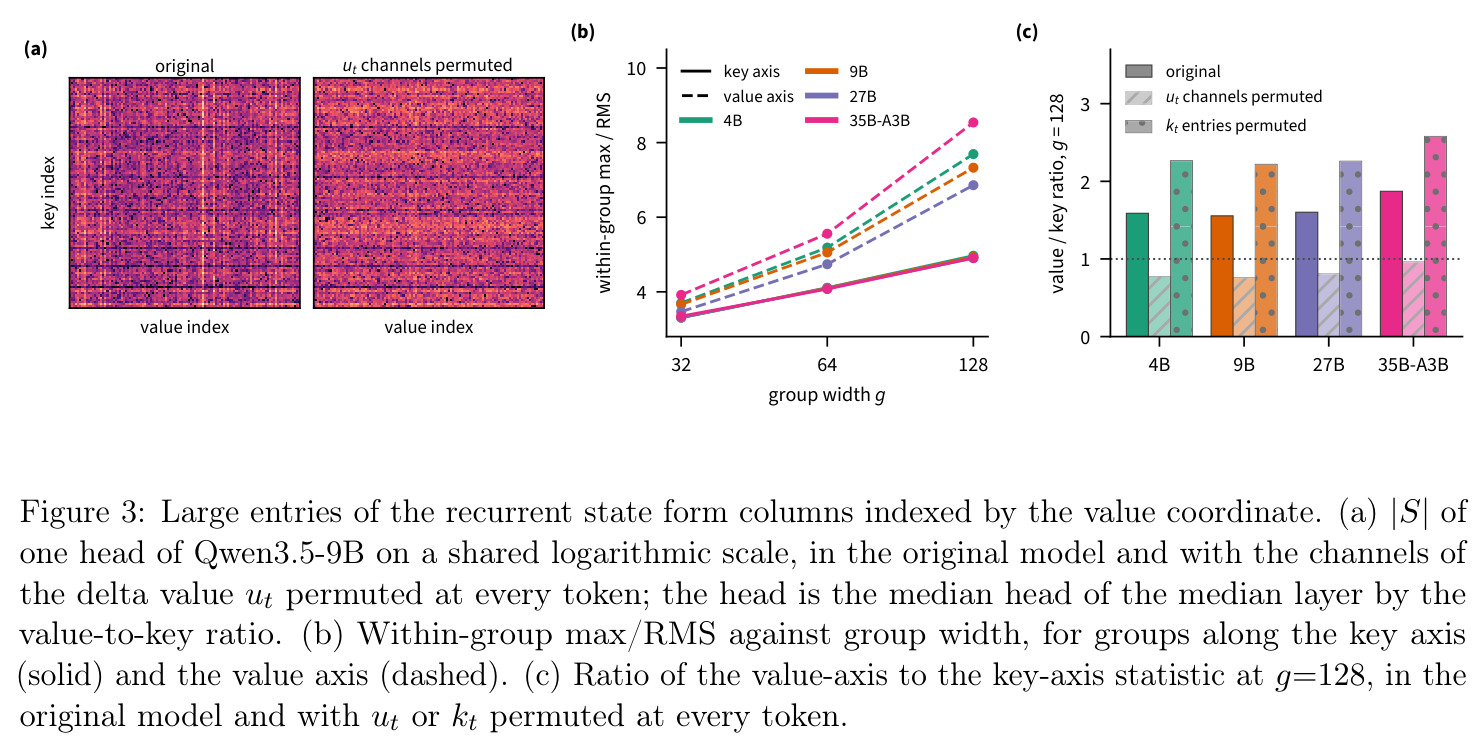
与已有工作不同的是,本文的独特切入是『少舍入』而非『舍得好』。作者注意到分块内核在 prefill 阶段本来就每 256 个 token 才写一次状态,即所有已发表量化器已经隐式地在 prefill 按 chunk 舍入;而解码端借助近期 serving 工作提出的解码缓冲区,状态同样可以每 $d_P$ 个 token 才推进并舍入一次——但此前没有任何工作在八比特以下改变舍入周期(NVIDIA 等只在 8 比特以上做过仿真),也没有人把缓冲区内存计入对比口径。第二个独特观察来自状态结构分析:门控增量状态的大数值按『列』聚集,且置换实验证明其来源是增量值 $u_t$ 中跨 token 持续偏大的通道——这直接启发了沿键轴(列内共享缩放因子)的分组设计,而 DAMP、Q-Mamba 等先前工作都沿值轴分组。
核心方法
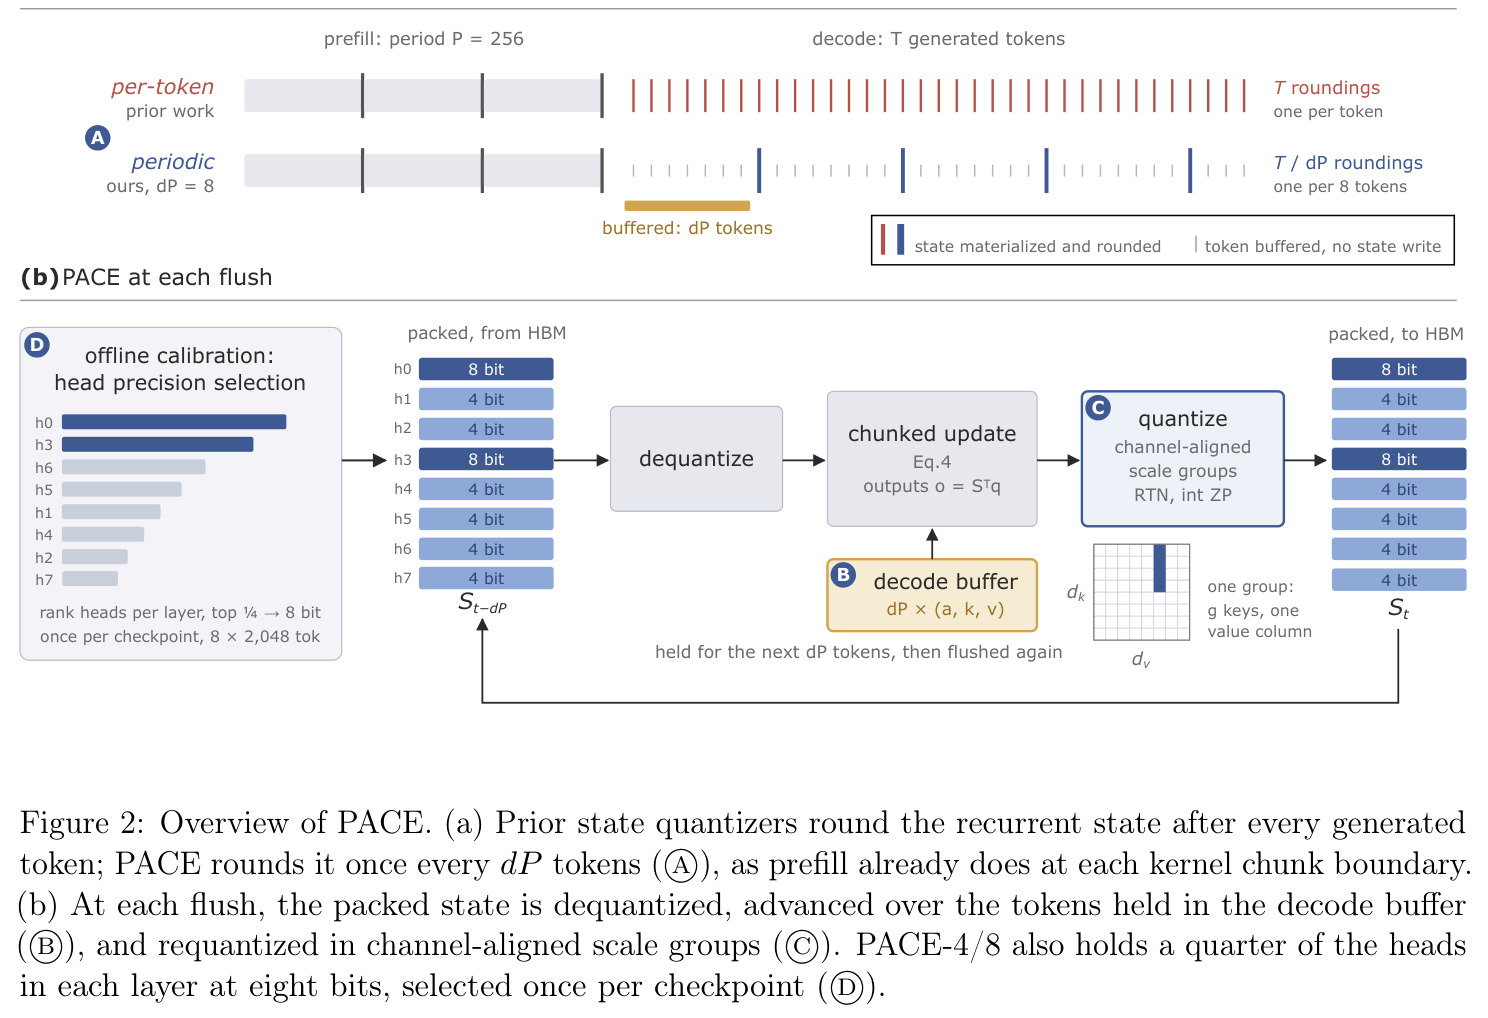
直觉起点是定点滤波:每次舍入向递推系统注入一份误差能量 $e_h$,误差随衰减被逐步滤除。设第 $h$ 个头的平均衰减为 $a_h$、舍入周期为 $d_P$,则独立注入的误差累积到 $E_h = e_h/(1-a_h^{2 d_P})$(式 5)——周期从 1 拉长到 8,注入间隔内的衰减变多,保留误差自然下降。技术路线上 PACE 由四个组件构成:①周期舍入+解码缓冲区:缓冲最近 $d_P$ 个 token 的 $(a_t,k_t,v_t)$,每 $d_P$ 步把反量化后的状态用分块公式一次推进再重新舍入;②通道对齐缩放组:每个缩放组只取同一列(键轴方向)的 $g$ 个连续元素,共享一个 fp16 缩放因子;③头级精度分配:按校准测得的 $E_h$ 排序,每层保留误差最大的四分之一头用 8 比特;④统一内存口径 resident bits,把状态载荷与缓冲区一起计数。PACE-4 只含①②,PACE-4/8 再加③。
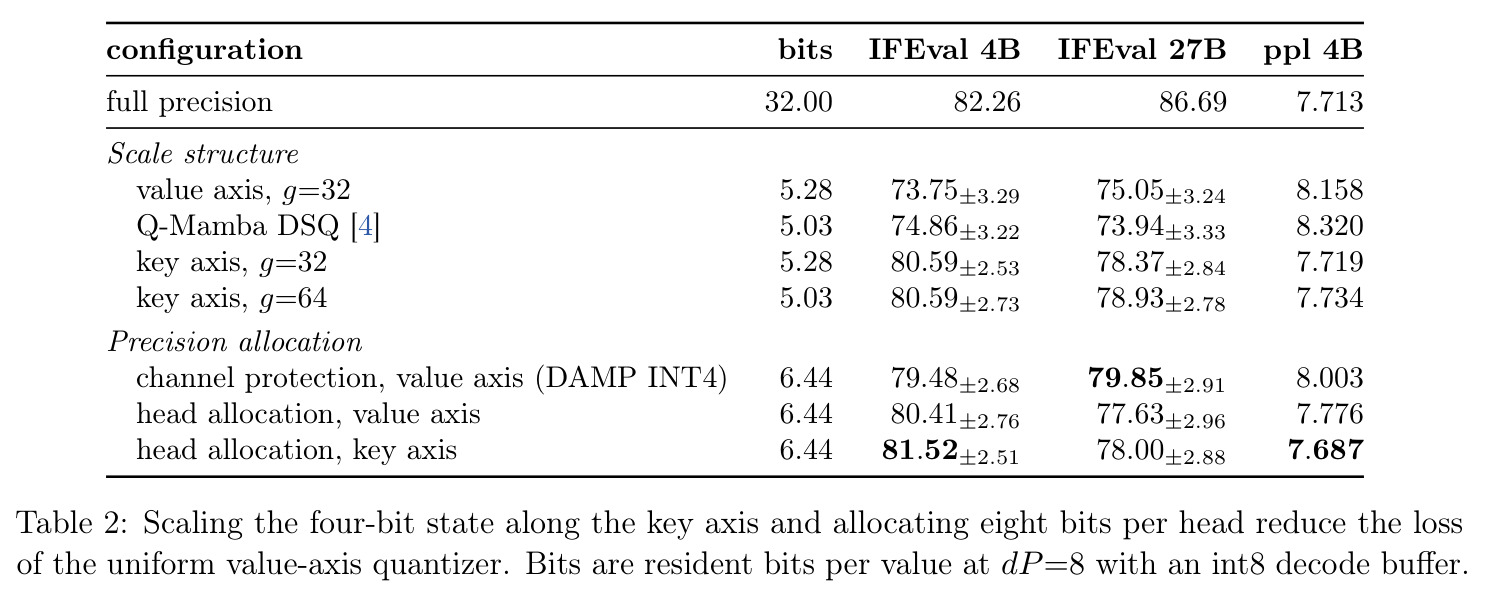
核心创新有三点。第一,把误差控制的杠杆从『每次舍入的误差大小』(DAMP 用通道保护、Q-Mamba 用微调降误差)换成『舍入的次数』:配合解码缓冲区,在不损失吞吐的情况下把舍入频率降低 8 倍以上,并给出随周期与衰减率变化的保留误差界(式 5),理论预测与实验一致。第二,通道对齐分组:通过通道置换实验建立了因果链——$u_t$ 的某些值通道跨 token 持续偏大,外积累加使状态大数值成列;因此每个缩放组只含一列,避免大数值把组内小元素的量化步长拉粗。这与先前沿值轴分组的做法本质不同,消融显示同宽下键轴分组把 Qwen3.5-4B 的困惑度从 8.158 降到 7.719。第三,头级混合精度:把 DAMP 的『通道级保护』提升到『头级分配』,依据是门控增量规则中衰减是每头一个标量,$E_h$ 天然是头级量。
方法步骤详情
①离线校准(每检查点一次):在 8 个 2048-token 的保留窗口上前向,测量每个头一次舍入注入的误差能量 $e_h$,按式 5 算出保留误差 $E_h$ 并排序;PACE-4/8 取每层误差最大的 1/4 头设为 8 比特,其余 4 比特,载荷为 $0.75 \times 4.625 + 0.25 \times 8.75 = 5.66$ bits/value。②Prefill:沿用分块内核,chunk 长度 $P=256$,每个 chunk 末尾把状态量化写入。③解码:每步只把当前 token 的 $(a_t,k_t,v_t)$ 追加进缓冲区(均匀配置用 int8 键值;PACE-4/8 用 4 比特键 + bf16 值),不写状态。④每 $d_P=8$ 个 token 触发一次 flush:从 HBM 读回打包状态并反量化,用分块公式(式 4)把缓冲的 token 一次推进,再以通道对齐缩放组重新舍入(均匀配置 $g=64$ 的对称 round-to-nearest;混合配置 $g=32$ 且带整型零点),写回 HBM;读出 $o_t = S_t^\top q_t$ 仍逐 token 进行。⑤内存核算:resident bits = 状态载荷 + 缓冲区成本(式 6),与只报载荷的先前工作不同。
技术新颖性
技术新颖性体现在五个层面。(1) 首次在八比特以下系统研究舍入周期对精度的影响,证明『每 8 个 token 舍一次』在四个骨干、所有低于 8 比特的位宽上都优于逐 token 舍入,把 prefill 既有的低频写入习惯推广到解码端。(2) 首次把解码缓冲区纳入量化状态的内存核算(resident bits,式 6),修正了先前工作只报载荷造成的口径偏差。(3) 通道对齐缩放组是新的分组几何:不是经验选择,而是由『大数值成列』的测量加『置换 $u_t$ 通道后列结构消失』的因果实验共同确立。(4) 头级精度分配把误差-持续性打分从通道粒度(DAMP INT4 在 128 个 key 通道中保 32 个)提升到头粒度,与门控增量规则中标量衰减的结构匹配,同 resident bits 下困惑度 7.687 优于 DAMP INT4 的 8.003。(5) 配套 Triton 内核证明在 4 比特打包状态下周期解码仍保持缓冲区的解码加速。
实验结果
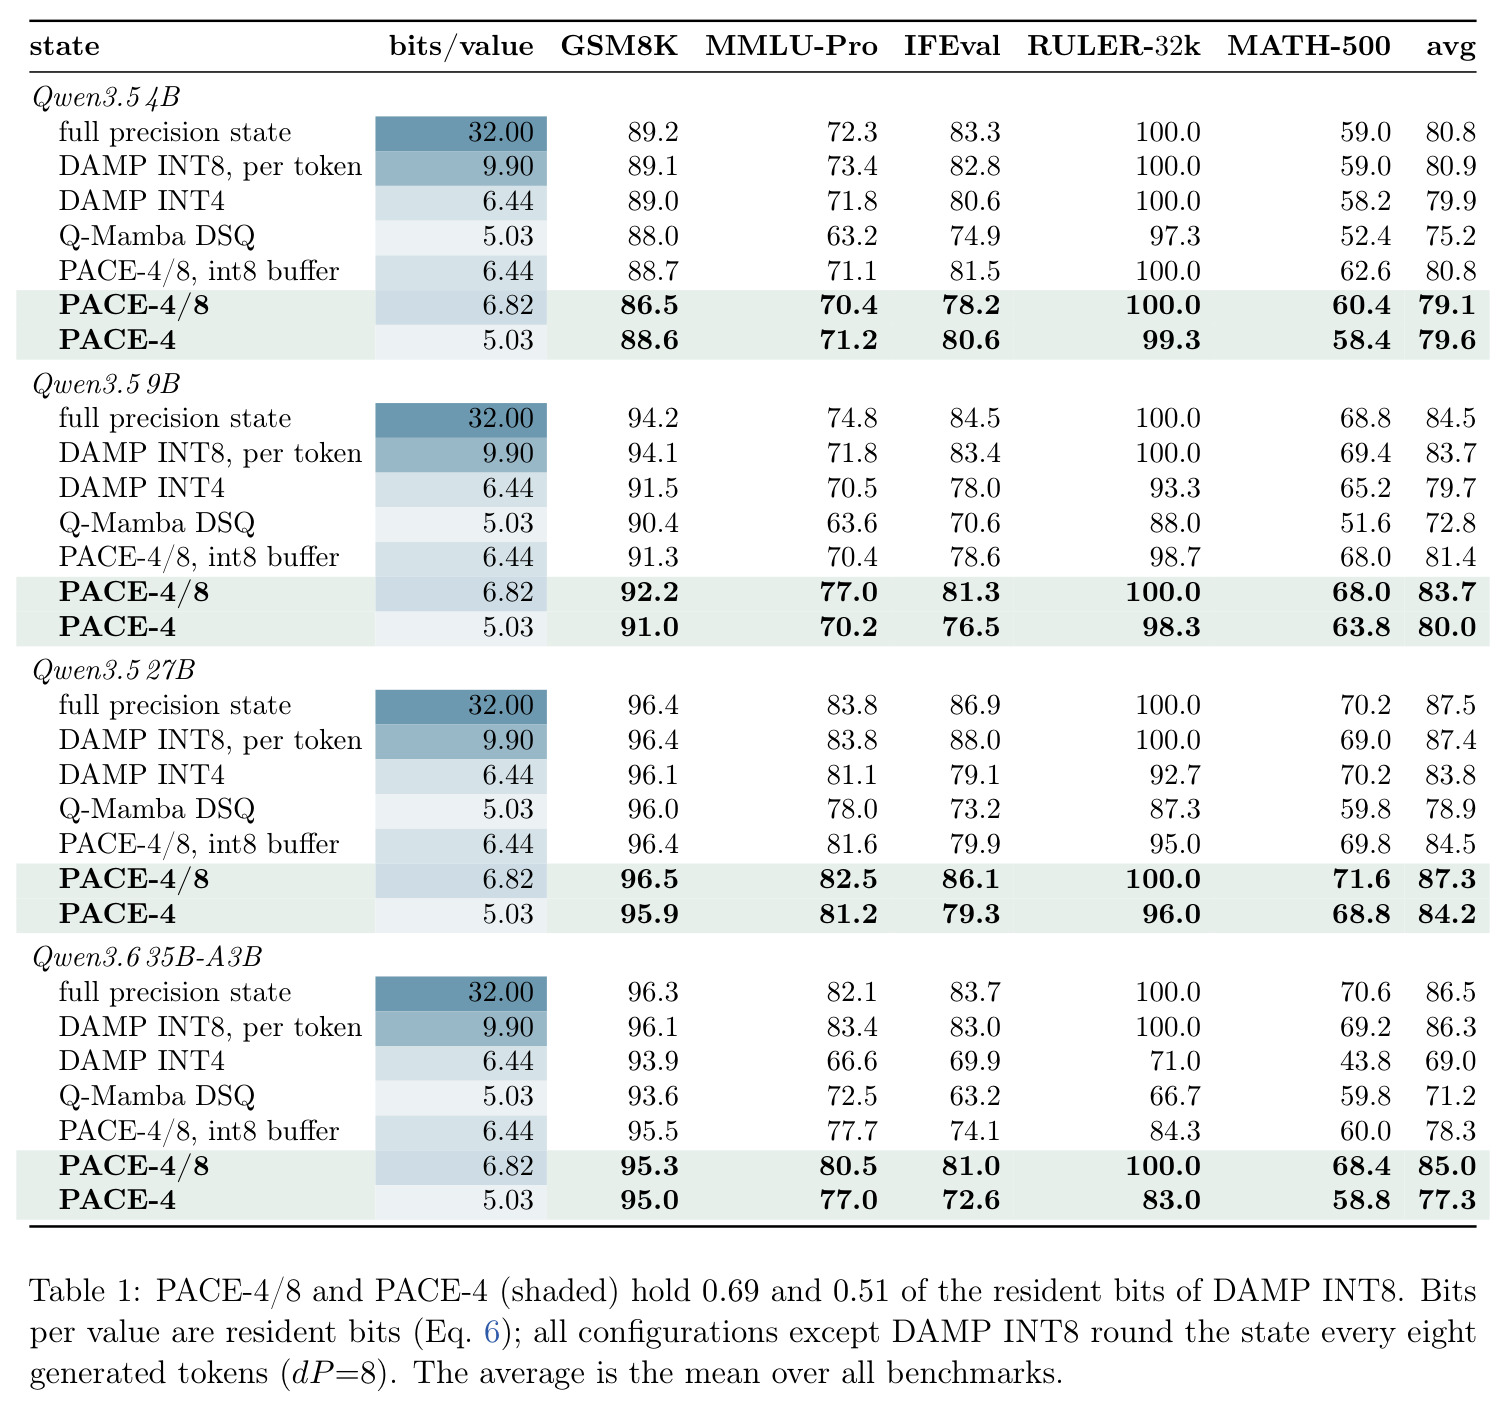
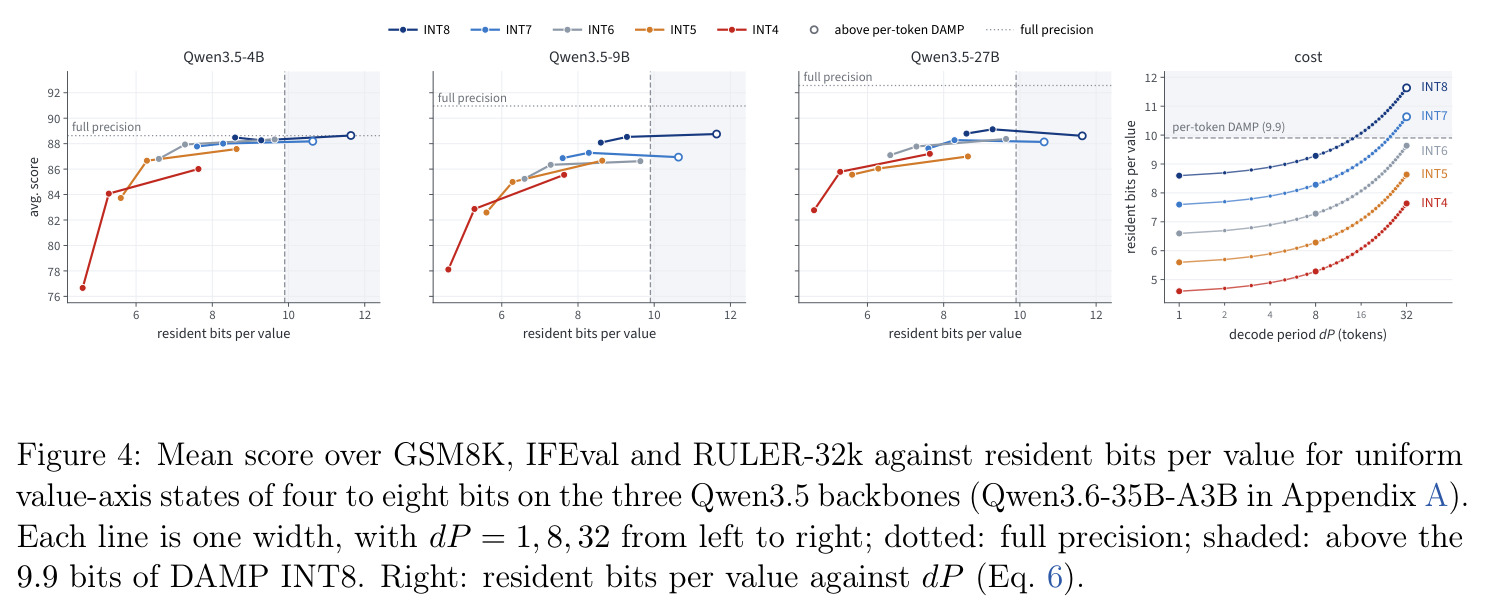
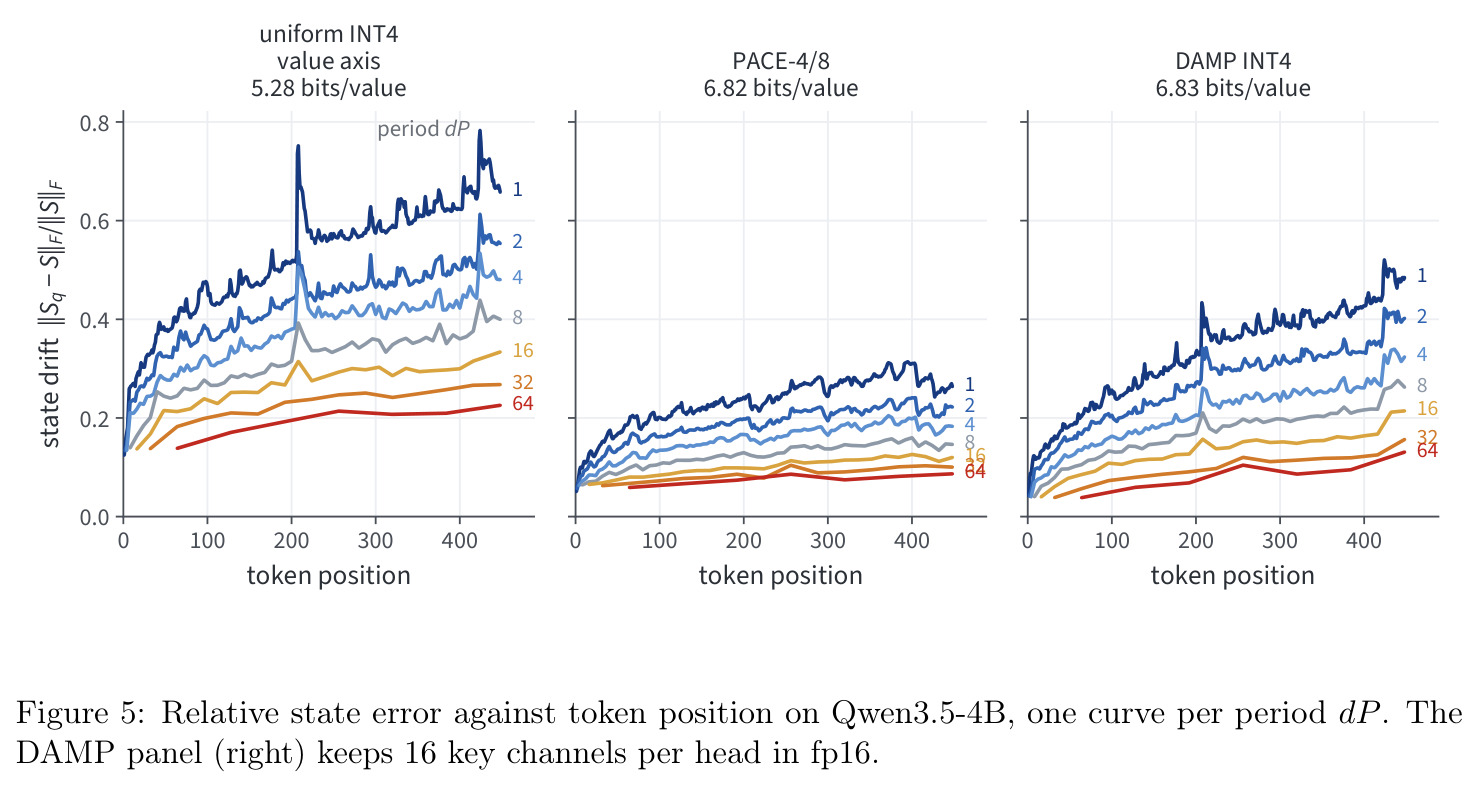
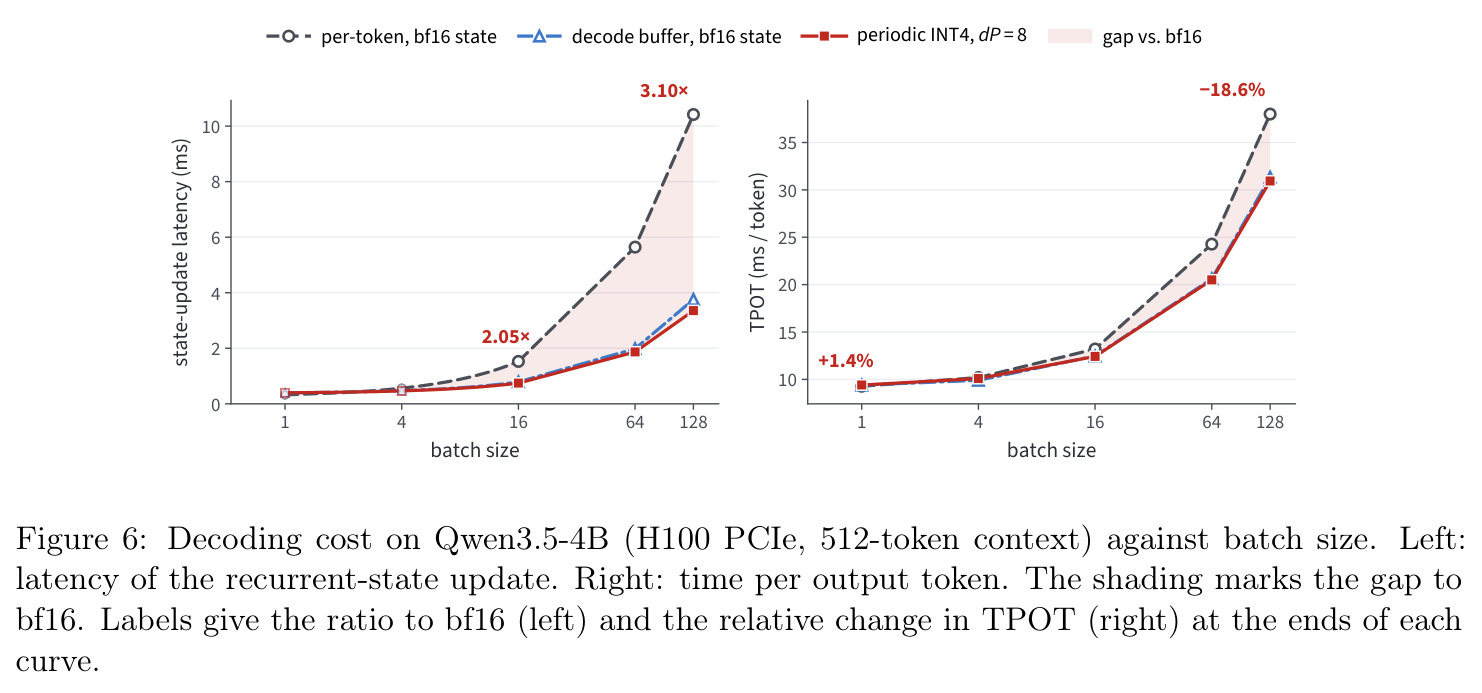
核心发现分四块。①舍入周期(图 4):用最朴素的均匀值轴量化器隔离变量,$d_P=8$ 在 Qwen3.5-4B/9B/27B 与 Qwen3.6-35B-A3B 四个骨干、所有低于 8 比特的位宽上都优于逐 token 舍入;$d_P=8$ 能拿到 $d_P=32$ 的大部分收益而只花四分之一缓冲内存。②主对比(表 1,除 DAMP INT8 外全部 $d_P=8$):PACE-4/8(6.82 resident bits,为 DAMP INT8 9.90 的 0.69 倍)在三个较大骨干上与 DAMP INT8 打平或接近——9B 平均 83.7 对 83.7,27B 87.3 对 87.4,35B-A3B 85.0 对 86.3;同为 5.03 bits 时 PACE-4 全面超过 Q-Mamba DSQ:4B 79.6 对 75.2、9B 80.0 对 72.8、27B 84.2 对 78.9、35B-A3B 77.3 对 71.2;同为 6.44 bits 的 PACE-4/8(int8 缓冲)在每个骨干上都高于 DAMP INT4,35B-A3B 差距最大(78.3 对 69.0)。③消融(表 2):键轴分组把 4B 困惑度从值轴的 8.158 降到 7.719,IFEval 从 73.75 提到 80.59;头级分配加键轴在 6.44 bits 时 ppl 7.687、IFEval 81.52,优于 DAMP INT4 的 8.003 与 79.48。④漂移与吞吐(图 5、6):状态相对误差 $\|S_q - S\|_F/\|S\|_F$ 随 $d_P$ 增大在所有 token 位置单调下降;H100 PCIe 上批量 128 时周期化 INT4($d_P=8$)的状态更新延迟较逐 token bf16 加速 3.10×,TPOT 降 18.6%,基本保住解码缓冲区的全部加速(与 bf16 缓冲配置相差约 1.4%),而此前 NVIDIA 的低频方案只在 8 比特以上可行。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五基准平均(Qwen3.5-9B:GSM8K/MMLU-Pro/IFEval/RULER-32k/MATH-500) | 平均分,越高越好 | PACE-4/8:83.7(6.82 resident bits/value,dP=8) | DAMP INT8:83.7(9.90 bits/value);全精度状态:84.5 | 精度完全打平 DAMP INT8,常驻内存降至其 0.69 倍 |
| 五基准平均(Qwen3.5-27B) | 平均分 | PACE-4/8:87.3(6.82 bits) | DAMP INT8:87.4(9.90 bits);全精度:87.5 | 仅差 0.1 分,内存 0.69×;RULER-32k 恢复到 100.0 |
| 五基准平均(Qwen3.6-35B-A3B) | 平均分 | PACE-4/8:85.0(6.82 bits);PACE-4:77.3(5.03 bits) | DAMP INT8:86.3;DAMP INT4:69.0(6.44 bits);Q-Mamba DSQ:71.2(5.03 bits) | 超同位宽 Q-Mamba 6.1 分;比 DAMP INT4 高 16.0 分且内存更少 |
| 五基准平均(Qwen3.5-9B,同为 5.03 resident bits) | 平均分 | PACE-4:80.0 | Q-Mamba DSQ:72.8;全精度:84.5 | +7.2 分,且无需 Q-Mamba 的 2% 权重微调 |
| RULER-32k 变量跟踪(Qwen3.6-35B-A3B) | 准确率 % | PACE-4/8:100.0 | DAMP INT4:71.0;Q-Mamba DSQ:66.7;全精度:100.0 | 长上下文能力完全恢复到全精度水平,领先 DAMP INT4 29 分 |
| WikiText-103 困惑度(Qwen3.5-4B,32k 上下文,6.44 resident bits) | PPL,越低越好 | 头级分配 + 键轴分组:7.687 | DAMP INT4(通道保护 + 值轴):8.003;全精度:7.713 | 低于全精度的 7.713,IFEval 同时高 2.04 分(81.52 对 79.48) |
| 解码吞吐(Qwen3.5-4B,H100 PCIe,512 上下文,批量 128) | 状态更新延迟加速比 / TPOT 相对变化 | 周期化 INT4(dP=8):状态更新加速 3.10×,TPOT −18.6% | 逐 token bf16 状态(TPOT 基准);bf16 解码缓冲:状态更新 2.05×,TPOT −18.6% | 4 比特状态下几乎保留缓冲区全部加速(与 bf16 缓冲约差 1.4%) |
局限与改进
作者承认的局限:所有实验限于 Qwen3.5/3.6 四个混合架构模型(门控增量层与全注意力层交错),误差界中的头衰减、列结构观察和头排序都只在这些模型上测量,未证明能迁移到其他模型家族、纯递归模型或别的 token mixer;未测试静态缩放、随机舍入、状态旋转等量化技术配合周期舍入的表现;配置空间(prefill/decode 周期、状态与缓冲位宽、分组轴与宽度、8 比特头比例)很大而只探索了一角,尤其 prefill 周期固定为内核 chunk 的 256,从未测量更长或更短的取值;吞吐只在均匀四比特配置上计时,PACE 的键轴分组与头分配未计时。我自己的观察:4B 模型上 PACE-4/8(混合缓冲版)平均 79.1 明显低于 DAMP INT8 的 80.9,且混合缓冲反而伤害小模型(int8 缓冲版 80.8 更好),说明缓冲精度与头比例需要按模型规模自适应;IFEval 与 RULER-32k 的残差损失集中在 prefill 侧但未被解决;MMLU-Pro 子集仅 560 题、IFEval 仅 541 条,统计功效有限;flush 每 8 个 token 一次,论文只报平均 TPOT,未报告周期性延迟尖峰对尾延迟的影响。
独立分析的弱点
独立分析几点弱点。①小模型失配:4B 上 PACE-4/8(79.1)反而低于 int8 缓冲版(80.8)和 DAMP INT8(80.9),说明『1/4 头升 8 比特 + 4 比特键/bf16 值缓冲』这套固定配方与模型规模相关,改进方向是按校准得到的 $E_h$ 分布自动选择头比例与缓冲精度,而非全局固定 1/4。②周期一刀切:$d_P=8$ 对所有头统一,但式 5 表明保留误差随衰减 $a_h$ 上升,高衰减头理应更短周期、低衰减头可更长周期,头级周期调度是自然的改进。③prefill 盲区:prefill 周期固定为 256,而 RULER-32k 的残差损失在三个 $d_P$ 下几乎不变、疑似源自 prefill,初始状态与 prefill 舍入值得单独研究。④系统评估不全:吞吐未覆盖 PACE 完整配置(键轴 $g=32$ 加头分配),混合精度打包的访存模式更复杂,真实部署收益未知;且未报 P99 尾延迟,flush 尖峰对在线服务的影响不明。⑤校准依赖:头排序需保留窗口数据,对分布漂移(如长上下文、多语言)的鲁棒性未测。
未来方向
作者提出的方向:把周期舍入推广到其他可分块推进的线性注意力层(门控线性注意力、Mamba-2、DeltaNet 变体),验证头衰减、列结构与头排序是否迁移到其他家族或纯递归模型;在周期舍入框架下测试静态缩放、随机舍入与状态旋转;系统探索配置空间,尤其是 prefill 周期的影响。基于本文成果可延伸:①按式 5 做头级自适应周期——高衰减头短周期、低衰减头长周期,把 $E_h$ 从排序依据升级为调度依据;②与权重/激活量化联合,构建全链路低精度推理栈并分析误差耦合;③在 vLLM/SGLang 类服务框架中集成,研究连续批处理与 flush 尖峰的调度、P99 尾延迟;④联合优化 $d_P$ 与缓冲区精度(借鉴 KVBuffer 对约 23 token 最优缓冲的推导);⑤探索解码缓冲区与投机解码、前缀共享的相互作用,以及校准窗口的分布外鲁棒性。
复现评估
复现评估:正文未明确承诺开源(仅提及作者为周期化解码实现了 Triton 内核),复现需自行实现两部分。方法侧门槛不高:量化器本身是分组 round-to-nearest 加 fp16 缩放(混合配置加 $b$ 比特整型零点),头排序校准只需 8 个 2048-token 窗口的前向统计,完全无需训练;主要工程量在基于 fla 门控增量内核改造周期化 flush 与 4 比特打包存取的 Triton 内核。评测侧完全可对齐:模型(Qwen3.5-4B/9B/27B、Qwen3.6-35B-A3B)公开,基准走 LM Evaluation Harness 贪心解码(GSM8K flexible-extract、IFEval strict、RULER 变量跟踪 32k、MMLU-Pro 每学科 40 题子集),困惑度用 WikiText-103,状态漂移实验只需 4B 模型跑 512 token。算力上:吞吐实验单张 H100 PCIe 即可(512 上下文、批量至 128),27B/35B 的精度评测需要多卡或 80G 级显存。总体难度中等,指标可逐项核对。
论文图表
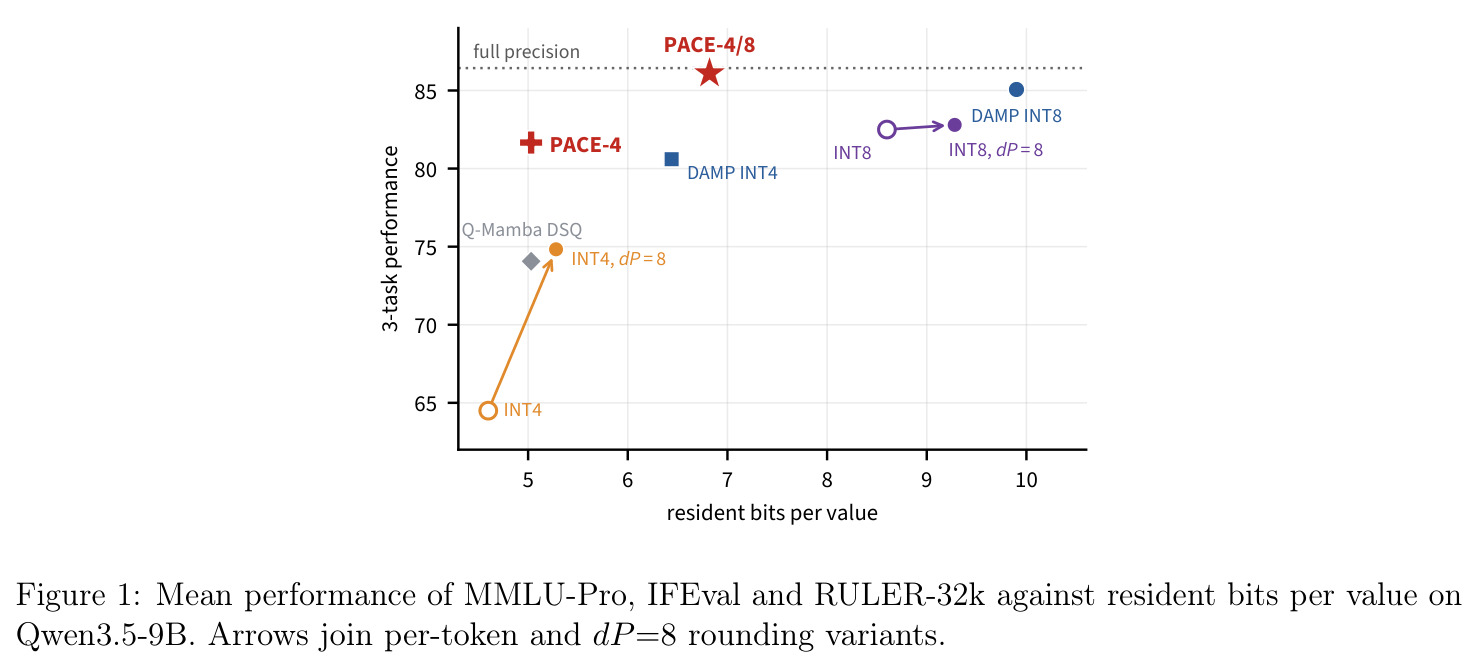
全文导览图:横轴是 resident bits per value(含解码缓冲区的每值比特数),纵轴是 Qwen3.5-9B 上 MMLU-Pro、IFEval、RULER-32k 三项平均分。全精度约 85 分;DAMP INT8 在 9.9 bits 处;PACE-4/8 在约 6.8 bits 处几乎追平 DAMP INT8;PACE-4 与 Q-Mamba DSQ 同在 5.03 bits,但 PACE-4 明显更高。箭头连接同一配置在逐 token 舍入与 dP=8 舍入下的两个点,直观展示降低舍入频率带来的免费收益。
一张图同时呈现论文的两个卖点:通道对齐+头分配带来的内存效率(2/3 内存打平 DAMP INT8),以及周期舍入带来的精度提升(同 bits 下箭头向上)。读图即可把握全文结论。