VideoJev:面向视频理解与交互的系统一(System One)模型 VideoJev: System One Model for Video Understanding and Interaction
用共享打分头替代自回归解码,统一时序定位与视频问答,推理提速最高129倍
前置知识
System One / Jev 范式
Jev 范式主张模型输出「类型化的概率判断」而非逐 token 生成文本:模型对一组候选直接给出打分或概率,软件可直接消费这些数值做决策。它借用心理学的「系统一」概念——快速、直觉式的判断,与之相对的是慢速推演的「系统二」(自回归思维链推理)。
本文标题与立论即在此范式上:VideoJev 是把 Jev 从文本/图像扩展到视频的模型家族,理解这个范式才能理解为什么它放弃生成时间戳和答案文字,改用候选打分。
视频时序定位(Temporal Grounding)
给定一段视频和一句自然语言查询,在时间轴上定位出描述事件发生的起止区间。标准评测指标为 R1@tIoU(预测区间与真值交并比超过阈值 0.3/0.5/0.7 的召回率)和 mIoU(平均交并比)。本文用 TimeLens-Bench 精修标注版的 Charades-STA、ActivityNet、QVHighlights 三个基准。
时序定位是 VideoJev 统一的两类任务之一,也是 mIoU 提升 6.7/10.8 分、延迟 0.276 秒等核心数字的来源,不懂这个任务就无法解读实验部分。
多模态大语言模型(MLLM)与 MoE 骨干
MLLM 是连接视觉编码器与语言模型的统一模型,能对视频帧序列做语义理解。MoE(混合专家)模型总参数量大但每个 token 只激活少量参数,如本文骨干 Qwen3.6-35B-A3B 表示总参数 35B、每 token 激活约 3B;Qwen3.5-4B 则是稠密小模型。
VideoJev 不是从零训练,而是改造这两个预训练骨干,论文反复对比「骨干 Instruct 模式」「骨干 Thinking 模式」与 VideoJev 的质量和延迟,需要知道骨干指什么。
前缀缓存(Prefix Caching / KV Cache)
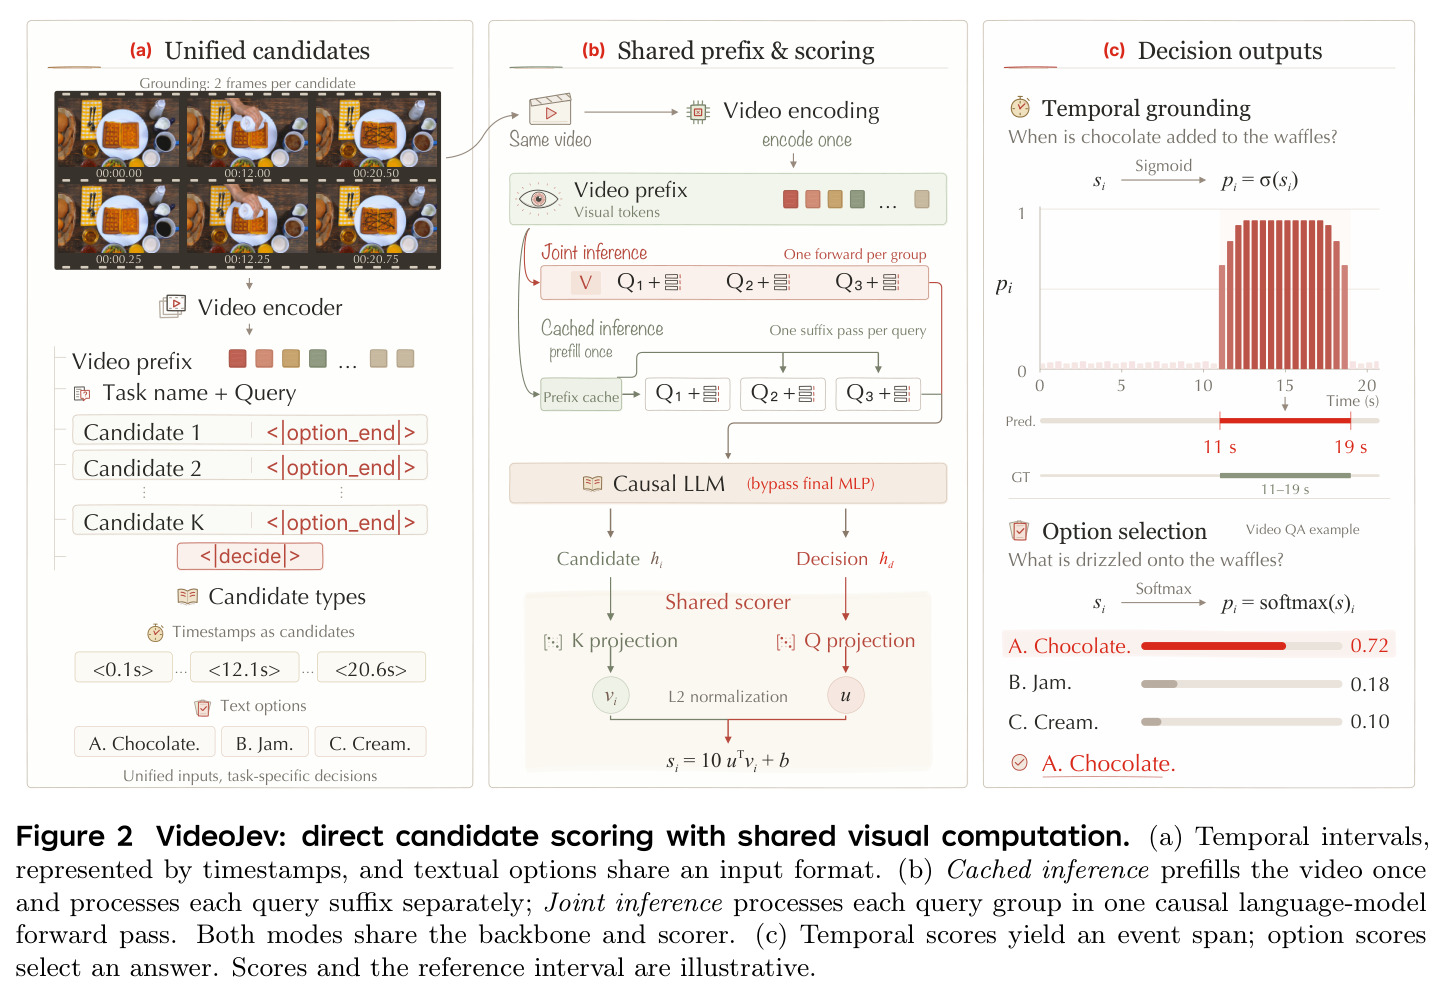
Transformer 自回归推理中,已处理 token 的键值缓存可以复用:同一段前缀(这里是编码后的视频 token)只需编码和预填充(prefill)一次,后续每个新查询作为后缀拼接在缓存之后,只需对后缀做一次前向,避免重复计算整段视频。
VideoJev 的 Cached 推理和 Joint 推理都建立在「视频前缀只算一次」之上,这是它实现 100 倍以上加速的结构基础;因果注意力保证前缀与后续查询无关,复用才合法。
多标签 BCE 损失与软 IoU 损失
BCE(二元交叉熵)对每个候选区间独立判断「中点是否落在真值事件区间内」,适合多个候选同时为正的情形,公式为 $\mathcal{L}_{BCE}=-\frac{1}{K}\sum_{i=1}^{K}[y_i\log p_i+(1-y_i)\log(1-p_i)]$。软 IoU 损失进一步用区间时长加权的预测概率与真值算交并比,奖励整体覆盖事件、惩罚越界响应。
这两个损失构成时序定位的监督核心,消融显示 Soft IoU 单项贡献 +4.6 mIoU,是理解「成员资格 + 覆盖度」双监督设计的关键。
Kadane 算法与区间解码
Kadane 算法是求最大子数组和的经典动态规划,复杂度 O(K)。本文把每个候选区间的 logit 减去 $\log\frac{\tau}{1-\tau}$($\tau=0.25$)后视作数组元素,用 Kadane 找出得分和最大的连续候选段,其边界即预测的事件起止时间。
它是把逐候选的 sigmoid 概率组装成单一连续时间区间的解码规则,理解它才能明白 VideoJev 如何从「逐段打分」得到「一个事件区间」这一输出。
研究动机
现有视频多模态大模型(MLLM)虽然语义理解能力强,但表达决策的方式几乎都是自回归文本生成:时序定位要逐 token 生成时间戳字符串,视频问答要逐字生成答案文本,哪怕输出只是一个紧凑的结构化决策。这在视频 agent 场景下代价极高——一个跟随烹饪流程的助手需要不断对同一段视频历史发起新查询(「某配料加了吗?」「下一步该做什么?」),每次查询都要付出完整的自回归解码成本。论文实测:Qwen3.5-4B 的 Thinking 模式在 LVBench 上单题前向耗时高达 144.9 秒,Qwen3.6-35B-A3B Thinking 也要 149.8 秒;即使 Instruct 模式只生成一个选项 token,10 个查询仍需数秒。另一侧,判别式视觉模型虽然预测高效,却依赖任务专属设计和固定标签空间,缺乏 MLLM 的开放语义接口。两类模型一个太慢、一个太死,视频 agent 缺少一种「又快又能理解语义」的统一决策接口。
本文的目标是本文的目标是构建视频领域的「系统一」模型家族 VideoJev:把视频理解与交互统一建模为结构化决策任务,用直接候选打分取代自回归答案解码,同时保留预训练 MLLM 的语义表征能力。具体要同时做到三点:其一,用一套共享打分头统一时序定位(对每个候选时间段判断是否属于查询事件,并组装成连续区间)与多选视频问答(判断哪个文本选项被视频证据支持);其二,通过 Cached 与 Joint 两种推理模式复用同一视频前缀上的昂贵视觉计算,让后续查询的边际前向成本降到几十毫秒;其三,在三个时序定位基准与四个视频 QA 基准上,同时超越 Instruct 骨干的质量,并大幅超越 Thinking 模式的效率,且通过与自回归微调的对照实验证明增益来自架构而非单纯数据。
与已有工作不同的是,本文的独特切入点是 System One 范式从图像到视频的系统性迁移。Jev 已证明语言模型可以直接输出程序可用的类型化概率判断而无需逐 token 生成,Visual Jev、PixelJev 把它扩展到图像分类与选择题 VQA,但视频带来两个此前未被处理的新挑战:决策必须反映时间结构(事件发生在何时),且 agent 的多次查询共享同一份昂贵的视觉上下文,边际查询成本成为交互响应性的核心。VideoJev 的应对是把「时间结构」编码进候选机制——用时间戳字符串标识帧对区间、把区间变成打分对象——并把「多查询共享计算」作为一等公民:训练时就按共享视频前缀拼接多个查询,使训练布局与 Cached/Joint 推理严格一致。以往生成式时序定位工作(TimeChat、Grounded-VideoLLM、TimeLens2、DisTime 等)从未系统处理过这个维度。
核心方法
VideoJev 的直觉是:视频 agent 需要的多数判断本质上是「从候选集合里挑选或筛选」,不需要开放式生成。技术路线上,它改造预训练 MLLM(稠密的 Qwen3.5-4B 与 MoE 的 Qwen3.6-35B-A3B):删除语言模型最终 MLP(消融证明移除无损),用候选打分头替换输出头。引入两个新 token:$\langle|option\_end|\rangle$ 标记每个候选的读出位置,$\langle|decide|\rangle$ 作为查询级决策读出,均从预训练的 $\langle|im\_end|\rangle$ 嵌入初始化。两个读出位置的隐状态经独立线性投影映射到 512 维并 L2 归一化,得到决策向量 $u$ 与候选向量 $v_i$,打分为 $s_i = 10\,u^\top v_i + b$(尺度 10 固定、偏置 $b$ 可学习)。输入布局固定为:视频 token 在前,随后是任务指令、查询和候选列表;时序定位用 sigmoid 逐候选打分后解码连续区间,QA 用 softmax 在选项间归一化后取最高分选项。
核心创新有三。其一,「候选即任务」:时序定位的候选是从视频前缀复制进输入的时间戳字符串(每个标识一个帧对区间),QA 的候选是答案文本,二者共用同一打分架构,任务差异完全由候选类型与输出规则(sigmoid+区间解码 vs softmax+选最大)决定——这与 Moment-DETR 式专用回归头、TimeChat 式生成时间戳有本质区别。其二,「成员资格 + 覆盖度」双监督:多标签 BCE 训练逐区间判断 $y_i=\mathbb{1}\{t_i\in G\}$,再加软 IoU 损失用区间时长加权奖励覆盖、惩罚越界,消融显示 Soft IoU 贡献 +4.6 mIoU。其三,训练-推理一致的计算复用:训练时把同一视频的多个查询拼在共享视频前缀后,推理对应 Cached(每查询一次后缀前向)与 Joint(每组一次因果前向)两种模式;实验发现 Joint 反而比 Cached 略准(4B 提升 0.8/0.5 分),因为与训练布局对齐。
方法步骤详情
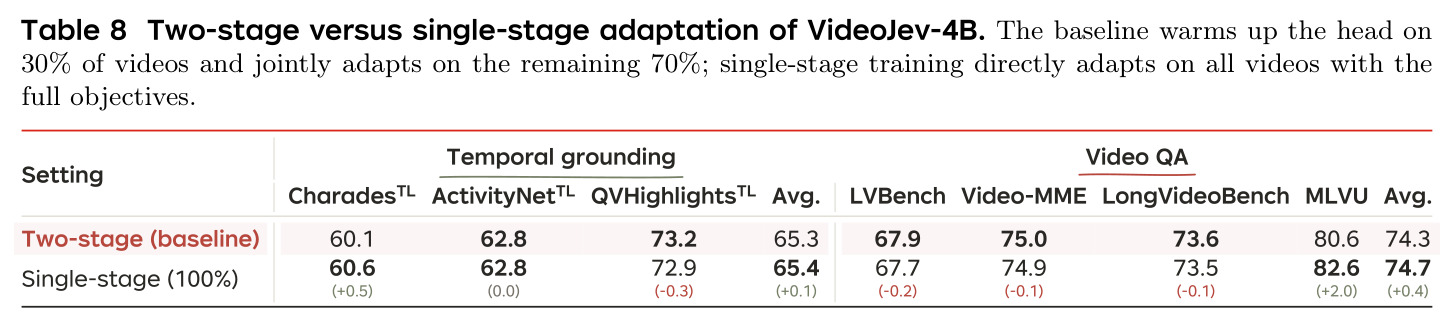
训练分两阶段。数据:定位用 TimeLens-100K/TimeLens2-93K,区间按帧对划分候选转成 0/1 标签;QA 用内部约 24 万道选择题(1.9 万视频),同视频查询按前缀分组,并做答案无关置换以降位置偏置。阶段一(30% 视频)只训打分头,冻结骨干与标记嵌入,损失为 $\mathcal{L}_{TG}=\mathcal{L}_{BCE}$、$\mathcal{L}_{QA}=\mathcal{L}_{CE}$,头学习率 $3\times10^{-4}$,跑 160 步。阶段二(其余 70%)联合适应骨干与打分头,损失升级为 $\mathcal{L}_{TG}=\mathcal{L}_{BCE}+2\mathcal{L}_{IoU}$,骨干学习率 4B 用 $5\times10^{-6}$、35B 用 $2\times10^{-6}$,跑 375 步。全程 64 张 H200、2 fps、144K token 上限,视觉编码器冻结。推理编码视频前缀一次,按 Cached/Joint 打分,用 $\tau=0.25$ 调整 logit 后以 Kadane 算法 O(K) 解码连续区间。
技术新颖性
技术新颖性体现在四点。第一,这是首个把 System One/Jev 范式系统迁移到视频时序决策的模型家族:输出是程序可直接消费的类型化概率判断(区间成员概率、选项概率分布),而非需要解析的文本,这在视频领域是范式级的新尝试。第二,共享打分头统一了两类输出结构迥异的任务(多正例的区间成员判定 vs 单正例的选项选择),且消融证明联合训练互惠(grounding +0.7、QA +1.3 分),暗示时序监督锐化证据定位、QA 强化语义判别,二者在共享表征上相互促进——这为「一个读出头管多任务」提供了实证。第三,Cached/Joint 双推理模式与训练拼接布局严格对齐,作者明确验证了 Joint 中后面的查询能看到前面查询文本但不会泄漏答案(不插入任何参考或预测答案),且 14 组对比中 13 组 Joint 更优,这是对「因果注意力下多查询共享前缀」的系统性检验。第四,对照实验设计严谨:用完全相同的数据和日程微调自回归 Qwen3.5-4B 作为控制组,隔离出 1.3/1.9 分的纯架构增益,直接回应了「收益是否只来自训练数据」的质疑。
实验结果
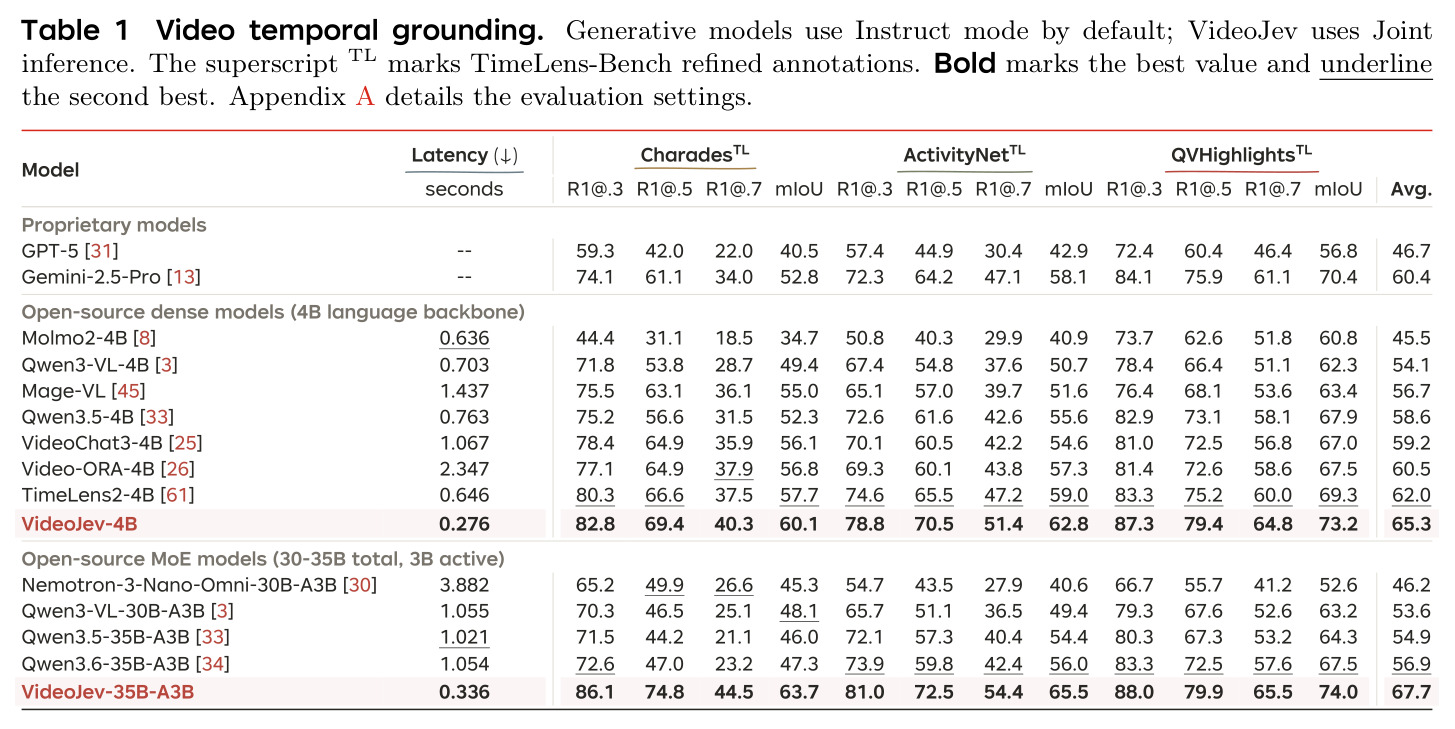
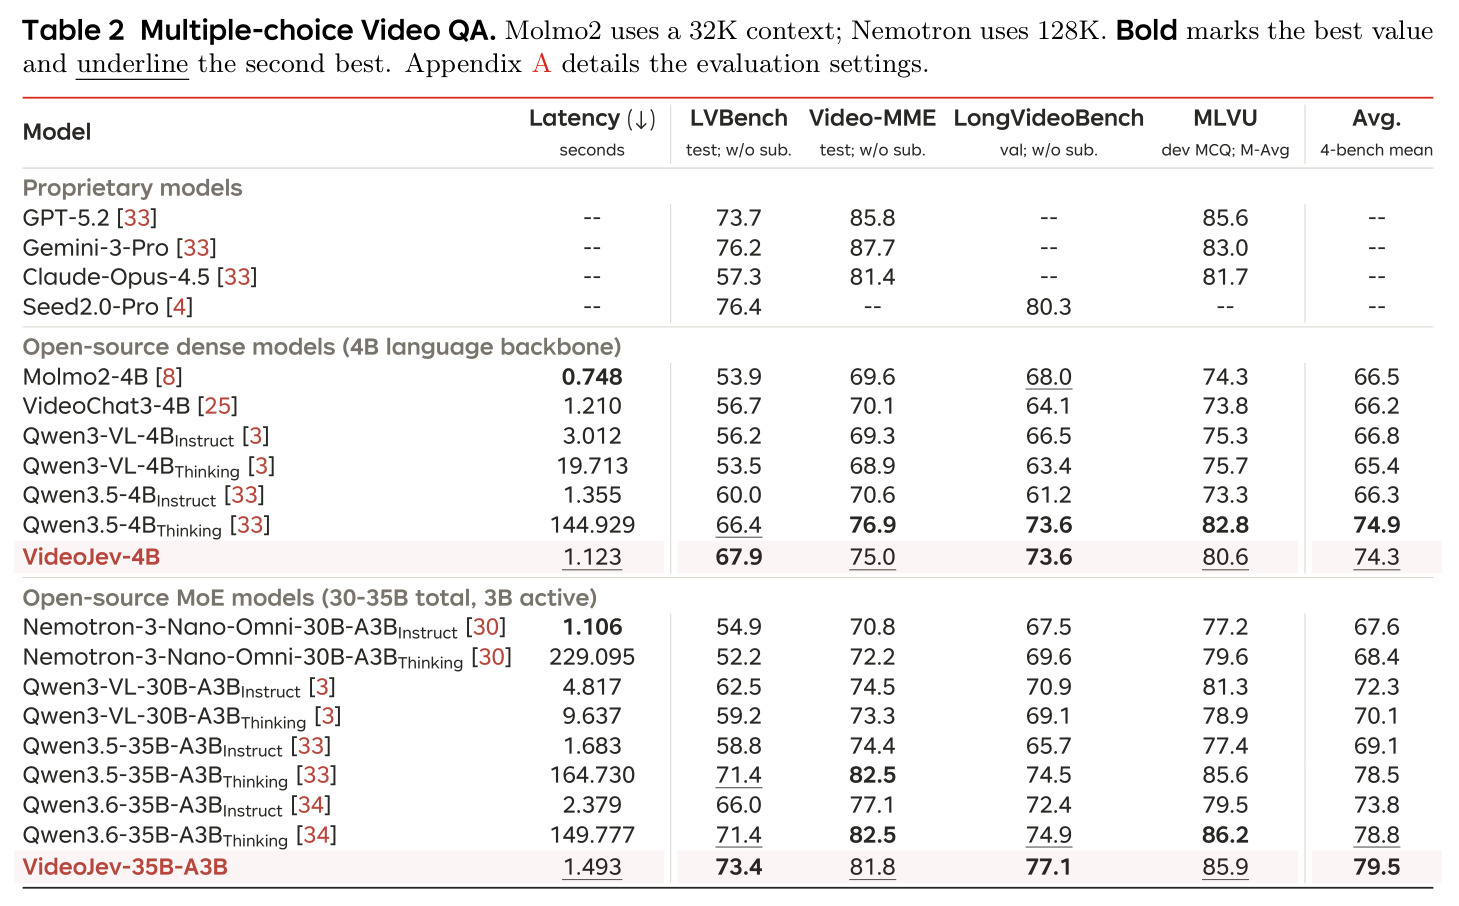
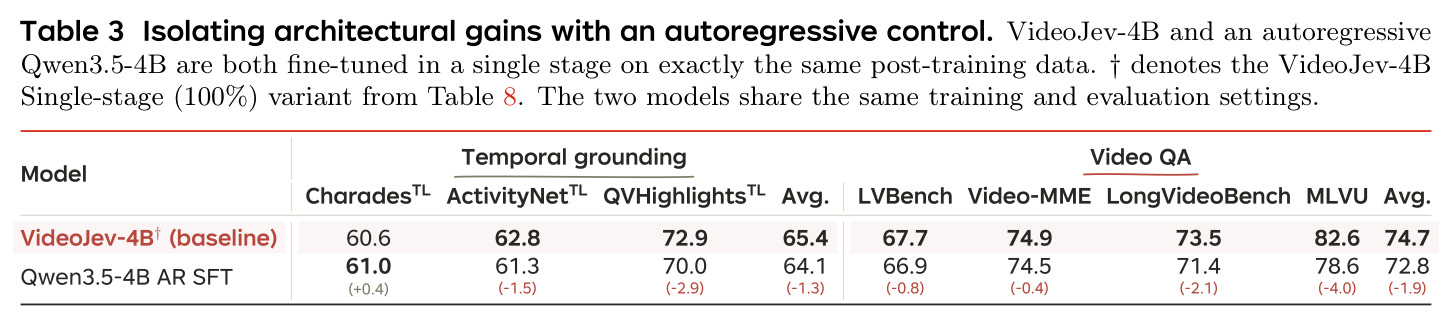
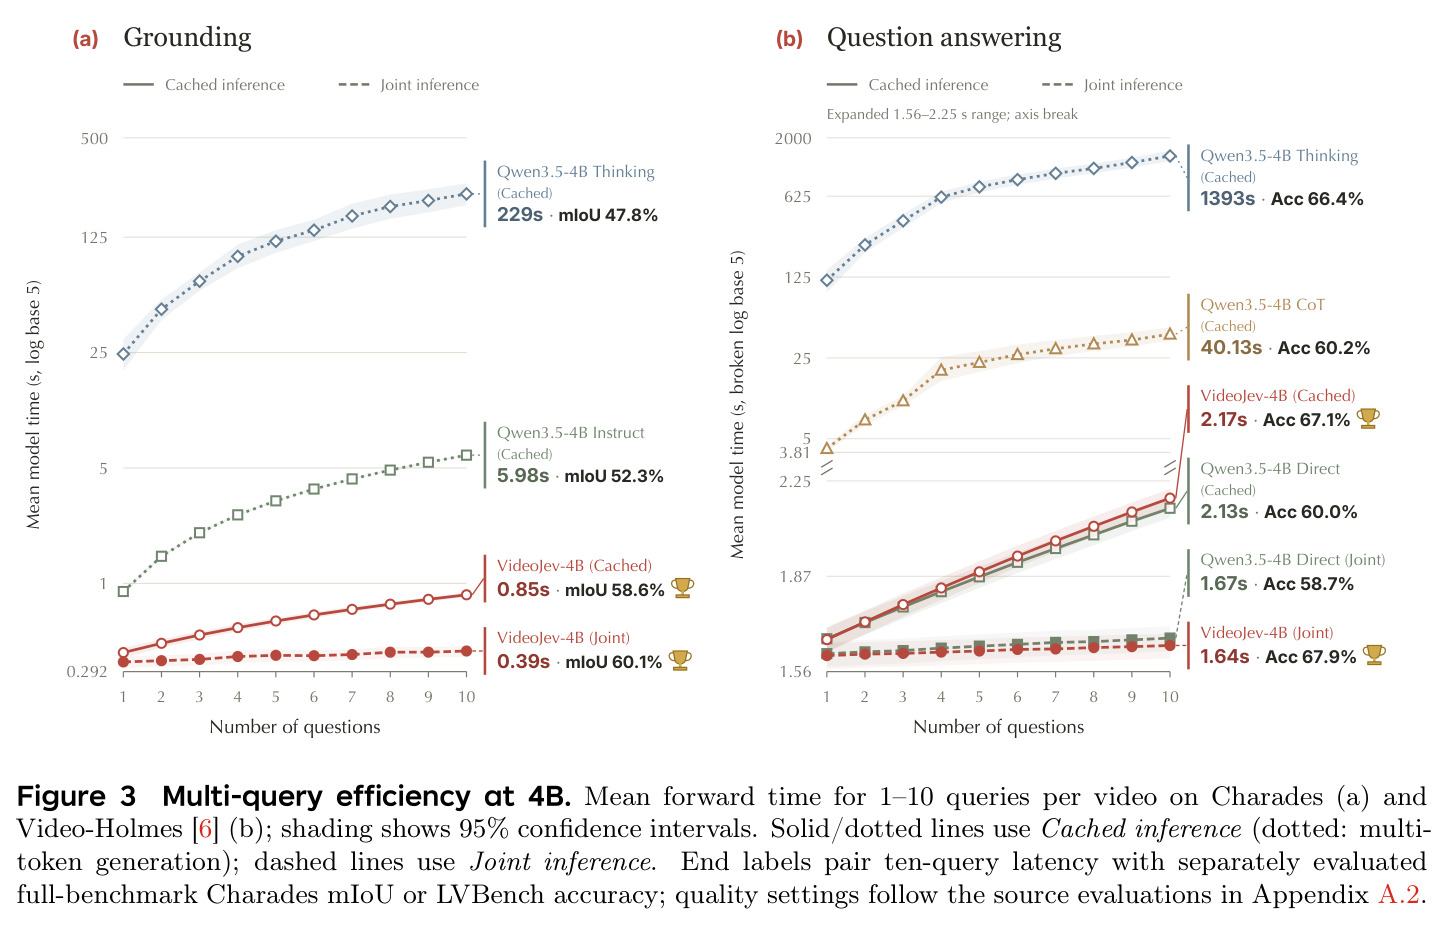
时序定位(Table 1):VideoJev-4B 平均 mIoU 65.3,超骨干 Qwen3.5-4B(58.6)6.7 分、超 TimeLens2-4B 3.3 分,延迟 0.276 秒对骨干 0.763 秒;35B 达 67.7(+10.8 分),延迟 0.336 对 1.054 秒,提速 2.8–3.1 倍,超 Gemini-2.5-Pro(60.4)与 GPT-5(46.7)。视频 QA(Table 2,四基准平均):4B 得 74.3(Instruct 骨干 66.3,+8.0),35B 得 79.5(73.8,+5.7);4B 距 Qwen3.5-4B Thinking(74.9)仅 0.6 分,35B 反超 Qwen3.6 Thinking(78.8)0.7 分,延迟仅 1.1/1.5 秒对 144.9/149.8 秒,提速 129/100 倍。消融(Tables 3–6):同数据超自回归微调 1.3/1.9 分;Joint 优于 Cached;双任务联合训练互惠;Soft IoU 贡献 +4.6 mIoU。多查询(Figure 3):10 查询时 Joint 仅增 55ms/31ms,总前向 0.39s/1.64s,精度还比 Cached 高 1.5/0.8 分,Thinking 需 1393 秒。
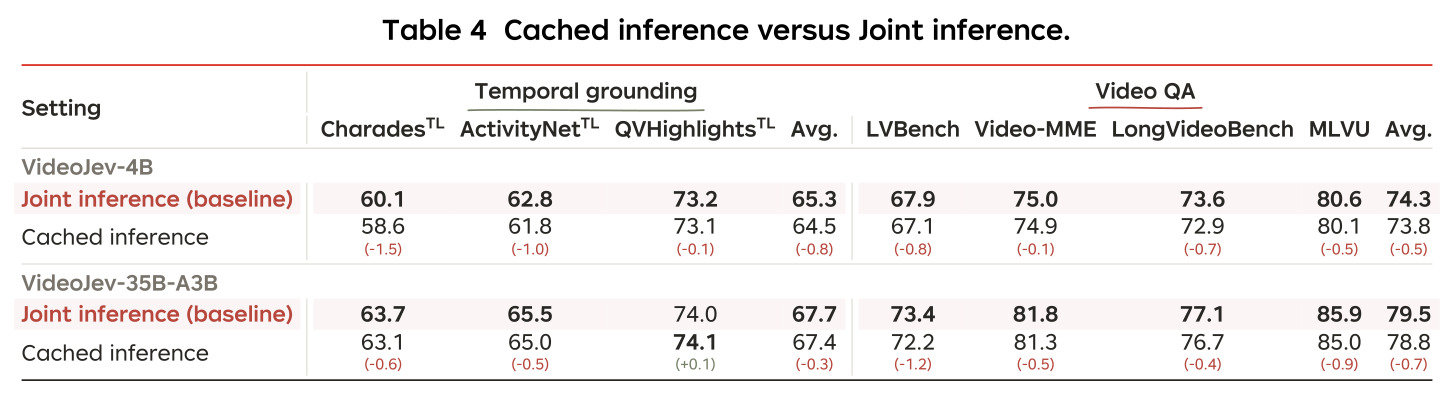
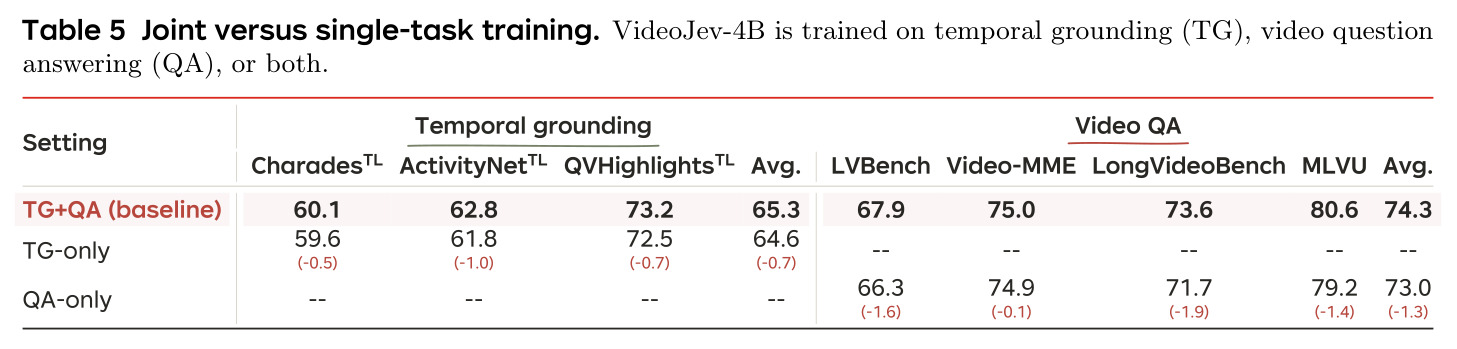
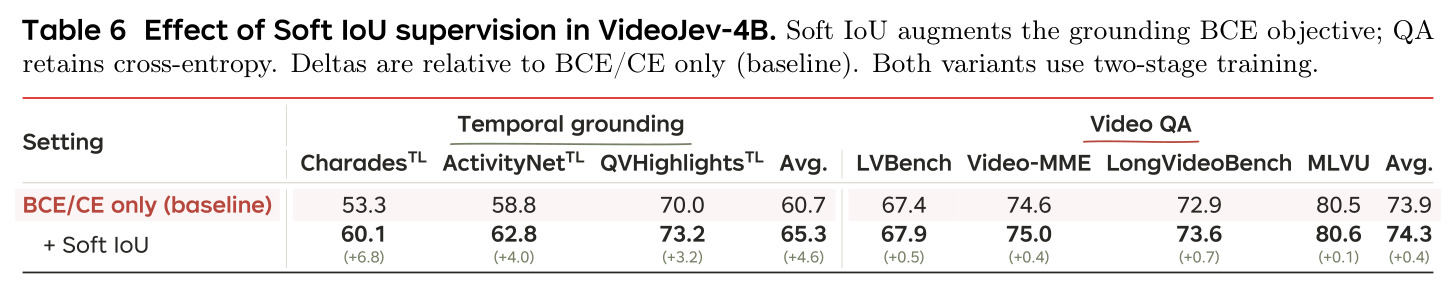
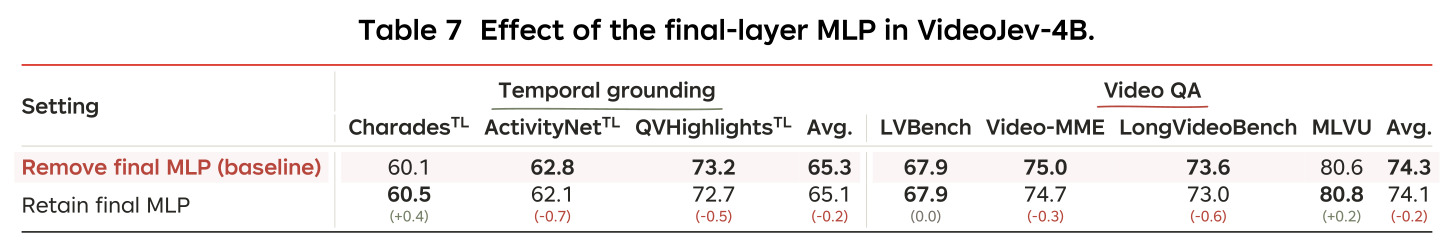
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频时序定位(Charades/ActivityNet/QVHighlights 三基准平均) | 平均 mIoU (%) | VideoJev-4B 65.3;VideoJev-35B-A3B 67.7 | 骨干 Qwen3.5-4B 58.6;Qwen3.6-35B-A3B 56.9;最强基线 TimeLens2-4B 62.0 | 4B +6.7(vs 骨干)/ +3.3(vs TimeLens2);35B +10.8(vs 骨干) |
| 视频时序定位单查询延迟(全量 Charades) | 前向时间(秒/查询) | VideoJev-4B 0.276;VideoJev-35B-A3B 0.336 | Qwen3.5-4B 0.763;Qwen3.6-35B-A3B 1.054 | 实测提速 2.8–3.1 倍 |
| 多选视频问答(LVBench/Video-MME/LongVideoBench/MLVU 四基准平均) | 四基准平均分 | VideoJev-4B 74.3;VideoJev-35B-A3B 79.5 | 骨干 Instruct 66.3 / 73.8;骨干 Thinking 74.9 / 78.8 | vs Instruct +8.0 / +5.7;vs Thinking +(-0.6) / +0.7,同时提速 129 倍 / 100 倍 |
| 同数据自回归对照(4B 单阶段) | grounding / QA 平均分差 | VideoJev-4B 65.4 / 74.7 | 同数据微调的自回归 Qwen3.5-4B:64.1 / 72.8 | +1.3 / +1.9(隔离出架构增益) |
| Soft IoU 覆盖监督消融(4B) | grounding 平均 mIoU | 65.3(BCE + 2×Soft IoU) | 仅 BCE/CE:60.7 | +4.6(七个基准全部提升) |
| 多查询扩展(同视频 1→10 个查询,Joint 推理) | 10 查询总前向时间 | grounding 0.39s / QA 1.64s(相对 1 查询仅 +55ms / +31ms) | Qwen3.5-4B Thinking 需 229s(grounding)/ 1393s(QA) | 数量级差距,且 Joint 精度还优于 Cached 1.5 / 0.8 分 |
局限与改进
作者承认的局限:一是置信度校准不佳,四个 QA 基准的平均期望校准误差(ECE,10 等宽分箱)分别为 8.65(4B)与 8.13(35B-A3B)个百分点,预测概率系统性高估正确性,因为模型没有接受任何校准专项训练;二是任务范围目前限于时序定位与多选 QA,开放式生成、描述等仍需组合其他模型。我自己的观察:其一,QA 训练语料是内部构建的约 24 万题专有数据(1.9 万视频),外界无法核实其构成与质量控制,也与公开评测基准存在潜在的域重叠风险;其二,grounding 评测统一采用 TimeLens-Bench 精修标注,与部分基线原始论文数字的可比性依赖这套标注的一致性;其三,Joint 推理中后面的查询能注意到前面查询的文本,虽然作者验证了无答案泄漏且无干扰,但查询间存在强依赖或对抗性组合的分布外行为未充分探索;其四,候选区间粒度由骨干的帧对时间压缩决定,亚秒级精确定位仍有上限——Charades 上 R1@0.7 只有 40.3(4B);其五,固定解码阈值 $\tau=0.25$ 与平滑窗口 1 未报告对不同数据集/时长的敏感性。
独立分析的弱点
弱点一:校准缺陷直接制约「可靠性路由」——若系统要决定何时接受系统一的快速判断、何时升级到慢速推理,前提是概率无偏;改进方向是论文已建议的温度缩放(在独立校准集上拟合),或像原 Jev 那样引入校准感知的强化学习目标,把 ECE 纳入训练。弱点二:时序候选是骨干帧对压缩出的固定粒度区间,长视频中的短事件只占少数候选且边界刻度粗糙;改进方向是构建多尺度候选(相邻区间层次化合并/细分),或对高分区间做边界感知的二轮精修。弱点三:多选 QA 形式把开放问答压缩为封闭选项,字幕生成、开放描述、自由作答仍无法处理;改进方向是把共享打分头扩展到排序式候选(如对检索出的候选字幕/片段打分),打通与检索增强的接口。弱点四:约 24 万题的内部 QA 语料不公开,占训练数据大头,社区难以复现 QA 侧结果;改进方向是构建并开源等效规模的多源 MCQ 语料。弱点五:流式场景未处理——视频持续到来时 KV 缓存线性膨胀,论文自己也把增量编码与记忆管理列为开放问题;可行路径是滑动窗口缓存压缩或分层记忆摘要。
未来方向
作者在第五节提出三个方向:一是把候选接口推广到更多可判定的视觉决策任务,如动作识别、事件检测、场景状态分类、视觉条件验证,减少对任务专属预测头的依赖;二是与「系统二」高层 agent 协同——由规划器(标准作业程序或生成式计划)把开放式目标分解为待验证的候选事件/动作/状态,交给 VideoJev 打分,再用判断结果引导规划与执行,应用于程序化监控、交互助手、具身智能与 computer-use 系统;三是流式输入下的增量视觉编码、高效记忆管理与决策上下文及时更新,同时通过校准感知训练、不确定性估计与选择性预测提升可靠性,让系统知道何时该把判断升级给更高层推理。基于本文成果还可延伸:把 Joint 推理的查询拼接机制用于自一致性估计(同一问题多种扰动打分取均值/方差作为不确定性);让 VideoJev 充当慢速 Thinking 模型输出的快速仲裁器或蒸馏目标;以及探索候选打分与视觉检索的结合——先检索候选时刻再用共享头精排。
复现评估
复现难度评估为中高。有利因素:架构与训练细节披露非常完整——两个特殊 token 的设计与初始化、512 维投影、$s_i=10\,u^\top v_i+b$ 打分、BCE+2×Soft IoU、$\tau=0.25$ 的 Kadane 解码、两阶段 160/375 步与各学习率均有明确数值;骨干 Qwen3.5-4B 与 Qwen3.6-35B-A3B 公开可得;grounding 数据 TimeLens-100K/TimeLens2-93K 公开;七个评测基准全部公开;论文首页标注 PROJECT/CODE/MODELS 将开源(当前为占位)。不利因素:约 24 万题的内部 QA 语料未公开,是训练数据大头,QA 侧难以完整复现;完整训练需 64 张 H200;grounding 评测依赖 TimeLens-Bench 精修标注而非原始标注;验证延迟数字需复现论文的计时协议(只计模型前向、批大小 1、共享前缀)。总体:缩小规模的 grounding 单任务复现可行,QA 与完整性能复现受制于专有数据与算力。
论文图表
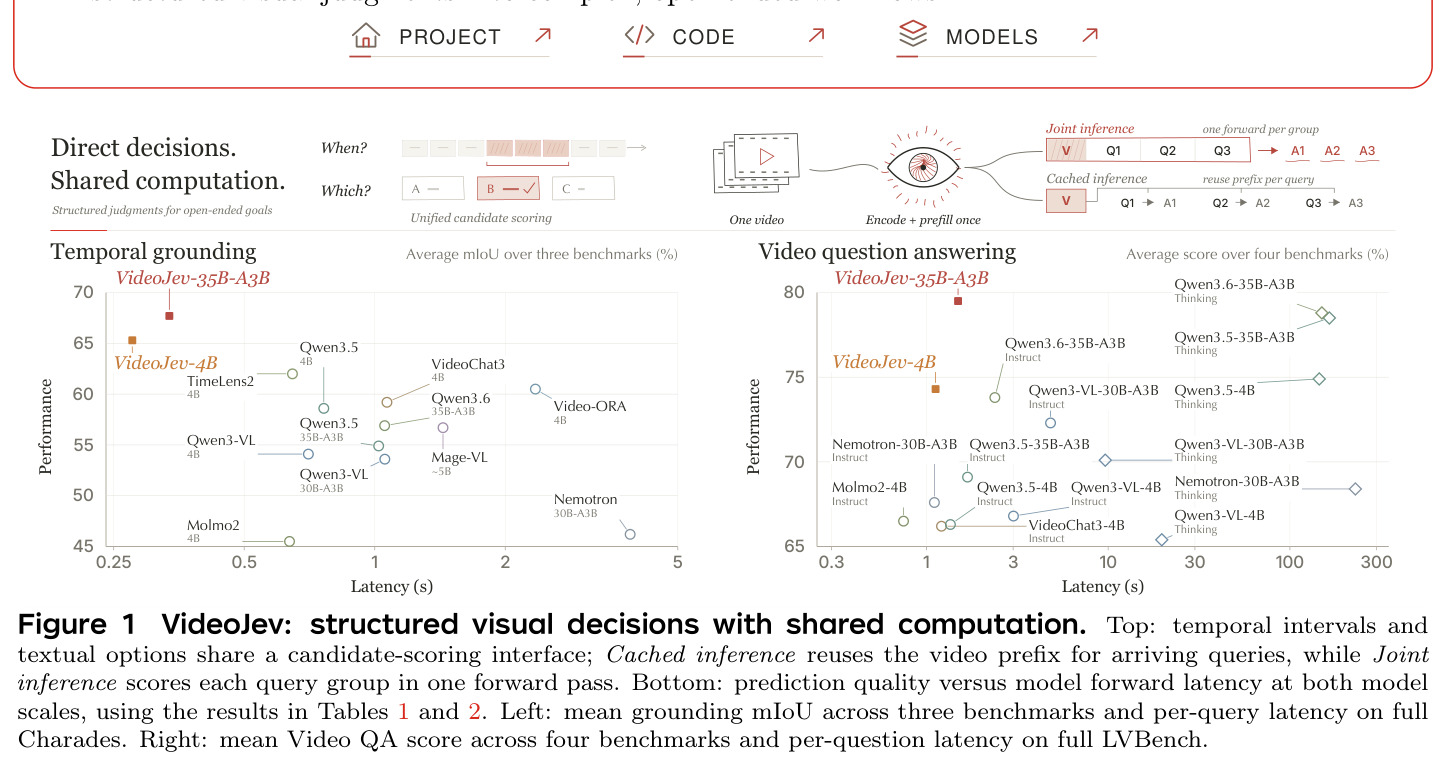
论文总览图。上半部分示意核心概念:直接决策(何时?)、共享计算(哪个选项?A/B/C),时序区间与文本选项共用同一候选打分接口,Cached 推理为到达的查询复用视频前缀,Joint 推理在单次前向中为一组查询分别打分(视频只编码和预填充一次)。下半部分是两张质量-延迟散点图:左侧为三个基准的平均 grounding mIoU 对全量 Charades 的单查询延迟,右侧为四个基准的平均 QA 分数对全量 LVBench 的单题延迟,覆盖 4B 与 35B-A3B 两档模型及各基线(含 Thinking 模式)。
这张图一张图讲清了论文的全部卖点:统一打分接口 + 两种计算复用模式,以及最直观的核心结论——VideoJev 的点都落在「左上/右上」(更准且更快)区域,尤其 QA 图中 Thinking 基线的延迟高出两三个数量级。看懂这张图就抓住了论文的价值主张。
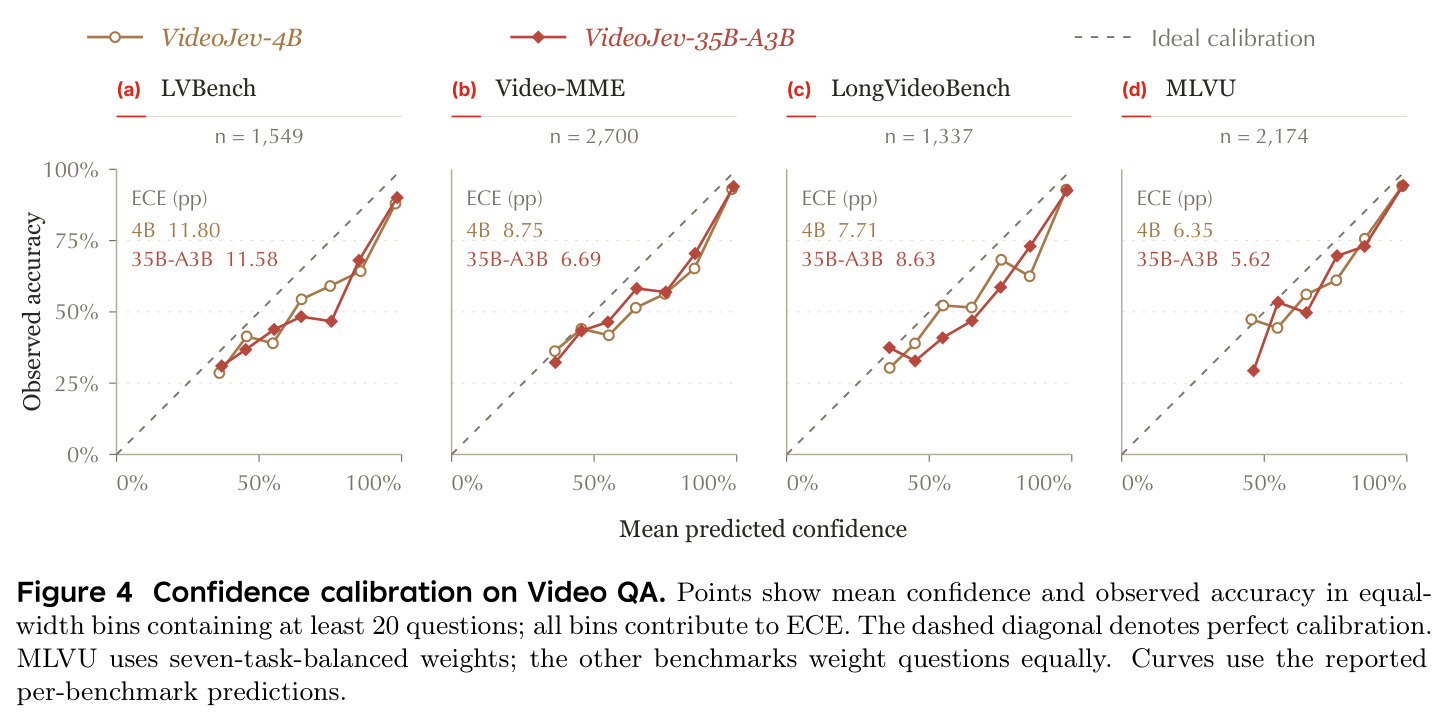
四个 QA 基准(LVBench、Video-MME、LongVideoBench、MLVU)上两个模型的置信度校准可靠性图:横轴为最高选项概率(预测置信度),纵轴为观测准确率,虚线对角线为理想校准,每个点为至少含 20 题的等宽分箱。各图标注 ECE:4B 为 11.80/8.75/7.71/6.35 个百分点,35B-A3B 为 11.58/6.69/8.63/5.62。曲线整体位于对角线上方,表明模型过度自信;但区分度良好——35B 在 LVBench 上置信度≥99% 的 591 个预测准确率达 95.8%,远高于总体 73.4%。
这张图诚实地展示了模型概率「可用但有偏」的双重性质:绝对校准差(ECE 约 8 个百分点)限制了直接用概率做自动决策,但排序意义上的区分度很好,支持「高置信接受、低置信升级」的选择性预测策略。它是论文局限性讨论的核心证据。