StepAudio 3 Gen:基于 RVQ 离散自回归建模的统一通用音频生成模型 StepAudio 3 Gen Technical Report
用 12.5Hz RVQ 离散码与单个大语言模型统一生成语音、歌声、音乐与音效
前置知识
RVQ(残差向量量化)
把每帧音频的连续特征先用第一个码本量化,再把量化误差(残差)交给第二个码本,如此逐层叠加。本文用 16 层、每层 2048 个码字,即用 16 个离散 ID 近似一帧声学特征,层数越深重建越精细。配合因子化余弦相似度查表稳定码本利用率,量化器 dropout 则随机丢弃深层、迫使浅层承载更粗但更语义化的信息。
本文架构与损失完全围绕 16×2048 RVQ 展开:主 LLM 沿时间轴只预测第 0 层码本,其余 15 层由小型预测器沿码本轴生成;不理解层级残差结构,就无法理解 time-depth 分解与 $\mathcal{L}_{sp}$ 按深度求和的设计。
解码器式 LLM 与下一 token 预测
GPT 类模型把文本切成 token 序列,用因果注意力(只能看历史)训练预测下一个 token,其词表、上下文长度与数据混合决定能力边界。把新模态编码成新 token 加入词表,就能与文本在同一条序列里交错建模,让理解与生成共享同一个 softmax 输出层。
StepAudio 3 Gen 的本质就是把第 0 层 RVQ 码变成 LLM 词表中 2048 个连续音频 token,文本与音频共享一条自回归流和一个 LM head,这是全文'离散自回归统一建模'路线的基础。
灾难性遗忘与模态干扰
在预训练大模型上引入新模态时存在两条破坏通道:一是大量随机初始化的新嵌入与原词表嵌入统计不匹配,二是新任务(尤其幅度更大的声学损失)的梯度会把骨干参数拉离原有语言分布,导致推理、知识等能力下降。常见对策包括冻结部分模块、旧数据回放、分阶段课程与梯度隔离。
本文把'防止文本能力退化'当作一等设计目标:零初始化的 RVQ Adaptor 针对嵌入失配,四阶段课程(50% 文本回放、断开预测器梯度)针对梯度干扰,表 3 的消融专门验证了这套配方对 MMLU、MATH 等文本基准的保护作用。
GAN 声码器与因果流式解码
用生成器加判别器(如多周期波形判别器、多分辨率谱判别器)对抗训练,把离散码或声学特征重建为波形,配合特征匹配与多尺度 mel 损失提升音质。Vocos 式 Transformer 解码器配 RoPE 与滑动窗注意力可做到无前瞻的因果重建,经 iSTFT 头直接输出波形,天然支持低延迟流式合成。
理解 StepAudio Tokenizer 的两阶段训练(先大规模预训练、再只精调解码器)以及为什么 24 kHz 波形能从 12.5 Hz 离散码增量式实时重建,都需要这套背景知识。
GRPO(组相对策略优化)
一种免价值网络的强化学习算法:对每条指令采样 G 个候选输出(本文 G=16),用组内奖励均值 $\mu_R$ 和标准差 $\sigma_R$ 把奖励归一化为优势 $\hat{A}_i=(R_i-\mu_R)/(\sigma_R+\eta)$,再用 PPO 式裁剪目标更新策略,辅以小的 KL 项约束不偏离参考策略;DAPO 式动态采样会丢弃组内方差过小、没有可靠偏好信号的组。
StepAudio 3 Gen 在 SFT 之后用 GRPO 做指令跟随对齐,奖励由'音频 caption + 文本 LLM 打分'与 ASR 错误率指数惩罚相乘构成,读懂式 (4) 与式 (5) 需要先掌握这套框架。
研究动机
语音合成、音效合成与音乐/歌声生成长期沿不同技术路线各自为战:TTS 系统优化语言保真度、说话人相似度与韵律控制,text-to-audio 系统从文本描述合成环境声与声景,text-to-music 和歌声合成关注曲式、音色与长程连贯性。专业化让每个领域都有强模型,但需要多种音频的应用(如带配乐的多角色有声剧)不得不拼接互不兼容的表征、条件格式和生成流水线。近年的统一化尝试分两大阵营:以扩散/流匹配为核心的连续潜空间模型,以及把音频离散化后做语言模型式建模的离散模型。直接对 RVQ 建模又有两难——沿时间轴展平 16 层码本会让序列过长,只用粗粒度语义 token 又丢声学细节;更关键的是,把大量新增音频嵌入和幅度远超文本项的 15 层声学损失直接灌入预训练文本 LLM,会通过嵌入失配与梯度侵蚀两个通道损害其继承的语言智能。
本文的目标是本文的目标是构建通用音频生成模型 StepAudio 3 Gen,在统一框架内同时支持零样本 TTS、voice design(按文本描述定制音色风格)、歌声生成、音效生成、音乐生成、vibe speech(复合声景中带氛围与背景声的说话)以及多类音频的混合生成,全部在共享的 12.5 Hz、16×2048 RVQ 离散码空间中完成,不引入任务专属 tokenizer 或扩散/流匹配声学渲染器。质量目标是在语音与人声任务上达到 SOTA:中文拟人度盲测超过五个商用 TTS 系统,InstructTTSEval 风格一致性中英文均领先现有开源方案。同时要求预训练后骨干的语言与推理能力(MMLU、GSM8K、MATH 等)尽量不退化,为把音频理解、生成与文本智能放进同一个模型奠定工程基础。
与已有工作不同的是,本文的独特切入有三处。其一,放弃近期通用音频模型主流的扩散式连续生成,坚持对共享语义-声学 RVQ 表征做纯离散自回归建模,使音频天然兼容 LLM 的词表、因果训练目标与交错上下文,为最终统一理解与生成留出空间。其二,在 RVQ 组织方式上选择 time-depth 分解而非 MusicGen 式 delayed pattern:主 LLM 只沿时间轴预测语义最集中的第 0 层码本并负责长程规划,15 层残差码本交给一个四层小因果 Transformer,声学梯度被隔离在小模块内,避免了 delayed pattern 需要多流输出接口、且让预训练 LLM 直接吸收所有声学损失的问题。其三,显式针对上述两个干扰通道设计训练配方——零初始化 RVQ Adaptor 化解嵌入统计失配,四阶段课程(冻结骨干对齐、50% 文本回放、临时梯度断开、低学习率联合冷却)防止 15 码本声学损失在预测器未收敛时就重塑骨干;而最相近的 UniAudio 2.0 采用推理/重建 token 分家加流式重建解码器,路线明显不同。
核心方法
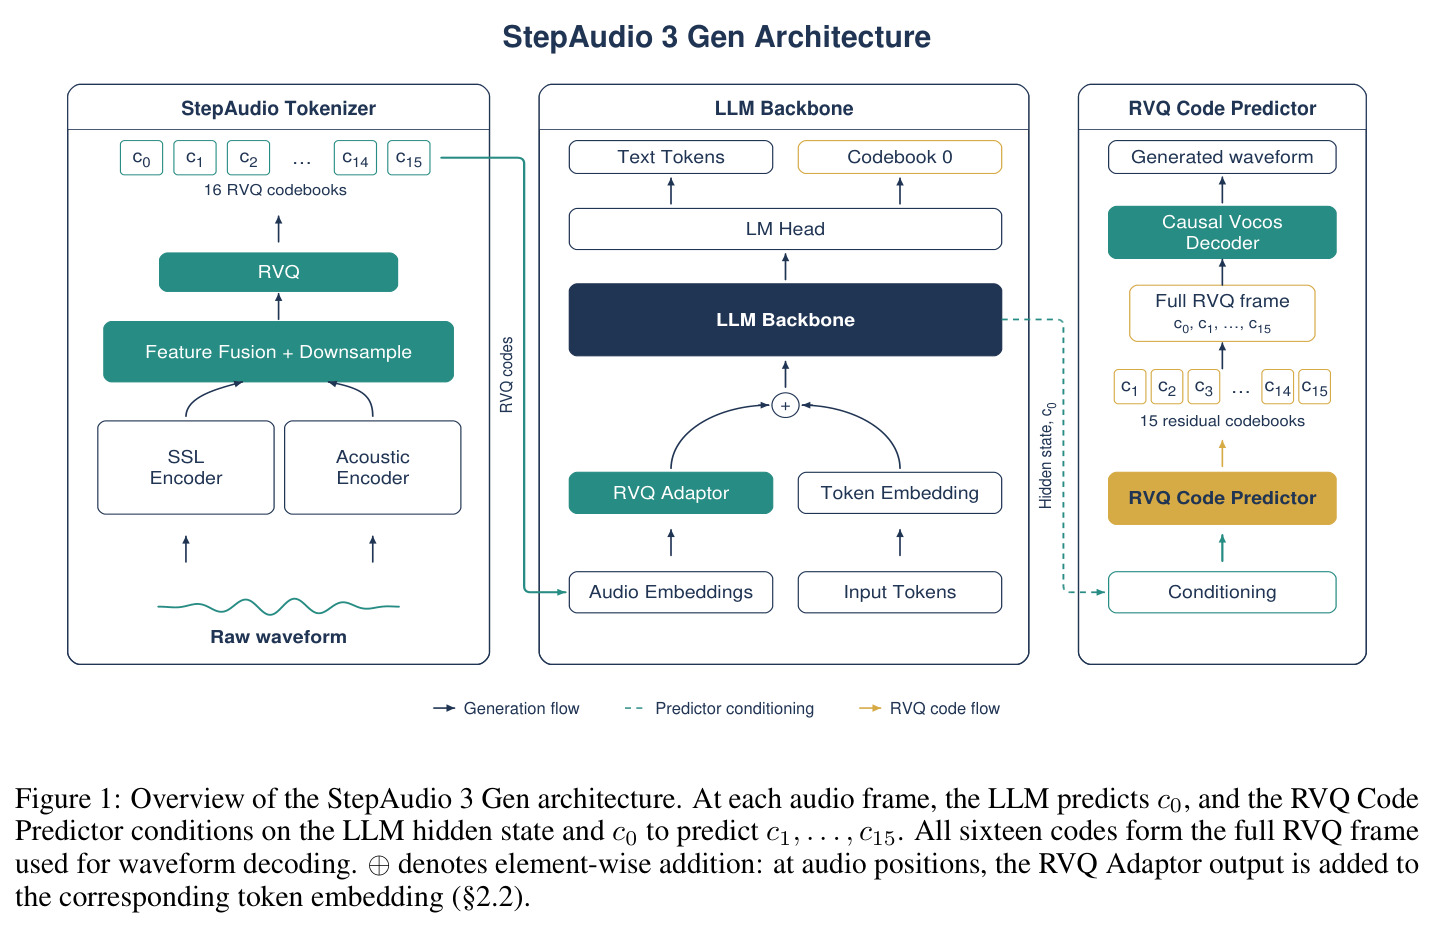
模型由三部分组成。StepAudio Tokenizer 把语音、音乐、环境声统一离散化:冻结 SSL 编码器提供语义特征,带 SnakeBeta 激活的卷积编码器从原始波形提 50 Hz 声学特征,两者沿通道轴融合后用跨步卷积压到 12.5 Hz,由单个共享的 16×2048 RVQ 量化,使每层码都同时含语义与声学信息;解码器是全因果 Vocos 式 Transformer(RoPE + 25 帧滑动窗注意力 + iSTFT 头),输出 24 kHz 波形、可增量流式重建。LLM 骨干把第 0 层码本提升为词表中 2048 个连续音频 token,与文本共享同一自回归流,沿时间轴预测 $c_{t,0}$。RVQ Code Predictor 是四层轻量因果 Transformer,在每帧以骨干隐状态 $z_t$(线性投影)与刚生成的 $c_{t,0}$ 为前缀,沿码本轴自回归产出 $c_{t,1},...,c_{t,15}$,完整 16 码帧送解码器出声。生成路径分解为 $p(c_{t,0},...,c_{t,15}|z_{<t},c_{<t})=p(c_{t,0}|z_{<t},c_{<t})\prod_{k=1}^{15}p(c_{t,k}|z_t,c_{t,0},...,c_{t,k-1})$;由于历史帧十六个码嵌入都求和进帧嵌入、$z_t$ 已编码 $c_{<t}$,该分解是精确的。直觉:'说什么、按什么节奏'留给预训练 LLM,'声学细节'全部在小模块内的离散码空间完成。
核心创新是'表示 + 优化'双管齐下地驯服多码本音频与文本 LLM 的结合。表示侧:Tokenizer 联合量化 SSL 语义特征与卷积声学特征到同一 16 层 RVQ,配合量化器 dropout 0.5 与语义蒸馏分支,把对时间规划有用的信息集中到前几层码本——于是第 0 层可直接进入 LLM 词表,一个 LM head 同时覆盖文本与音频。输入侧,16 个码本嵌入求和成帧嵌入后经过零初始化的 RVQ Adaptor(pre-norm + SwiGLU 残差块),输出仅在音频位置逐元素加到 $c_{t,0}$ 的 token embedding 上;零初始化使模块初始为严格恒等映射,配合冻结骨干让第一阶段文本能力漂移严格为零。优化侧:15 层残差码本损失 $\mathcal{L}_{sp}$ 按深度求和、幅度远超 token 项,第三阶段对预测器的条件隐状态做 stop-gradient,使声学目标只训练预测器;待预测器收敛的第四阶段才恢复端到端梯度,并把损失权重 $\lambda$ 从 1.0 降到 0.1。总损失 $\mathcal{L}=\mathcal{L}_{tok}+\lambda\mathcal{L}_{sp}$ 中 $\lambda$ 是跨阶段唯一改动的权重。这与把全部声学损失直接压在共享骨干上的常规做法本质不同。
方法步骤详情
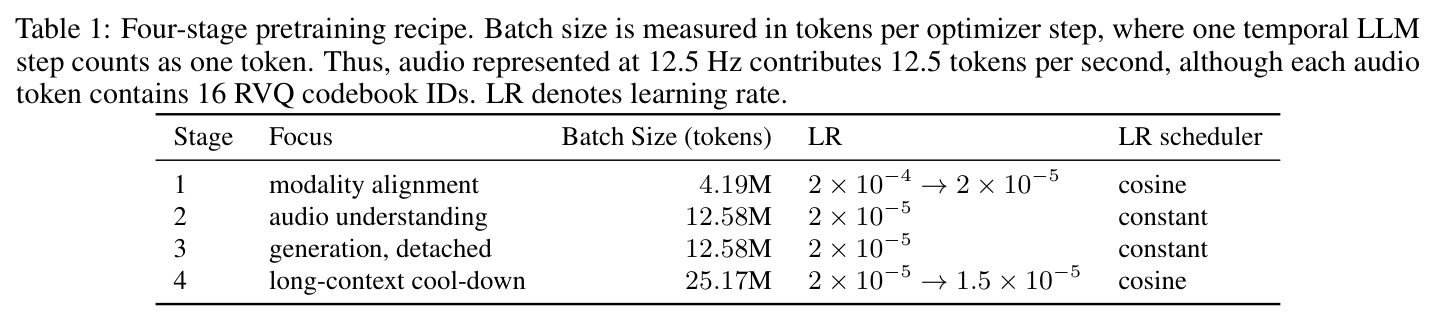
第一步训练 Tokenizer:约 70 万小时语音/音乐/音效,GAN 框架(多周期波形判别器 + 多分辨率谱判别器),损失含特征匹配、多尺度 mel 与 RQ commitment;先大规模预训练,再冻结编码器/量化器/语义分支只精调解码器,提升音质且不改变码空间。第二步四阶段 LLM 预训练(约 2.7T token):阶段 1 模态对齐,只训音频嵌入与 Adaptor,骨干与 LM head 学习率为零、token embedding 0.1 倍;阶段 2 音频理解,全模型解冻,理解任务与文本 1:1 混合,学习率恒定 $2\times10^{-5}$,新模块 10 倍;阶段 3 生成训练,text:TTS:交错对话=3:1:2(文本恒占 50%),断开预测器梯度,$\lambda=1.0$;阶段 4 联合冷却,恢复梯度、$\lambda$ 降至 0.1、序列经上下文并行扩到 32,768(约 44 分钟音频)。第三步 SFT:约 5,000 小时多任务音频,序列长 16,384、批量 64,学习率 $1.0\times10^{-5}\to1.0\times10^{-6}$ 余弦,音频嵌入/Adaptor/预测器保持 10 倍。第四步 GRPO:每条指令采 G=16 个音频,StepAudio R1.5 打 caption、文本 LLM 独立打 4 次 0-100 分取均值 $\bar{s}_i$;语音任务奖励 $R_i=\frac{\bar{s}_i}{100}\exp(-\tau e_i)$($\tau=3$,$e_i>0.5$ 记 0),丢弃 $\sigma_R<0.02$ 的组,学习率 $10^{-6}\to10^{-7}$。
技术新颖性
新颖性可分四点评估。(1) Tokenizer 设计:'语义与声学联合量化到同一 16 层 RVQ、每层同时携带两类信息'不同于常见的语义 token 与声学 token 分家结构,12.5 Hz 的压缩率与共享码空间使语音、歌声、音乐、音效能用一套 token 统一建模。(2) RVQ Adaptor 是 token-wise 零初始化残差模块,区别于插入独立序列编码器或替换骨干,消融显示它带来 CoVoST En→Zh BLEU 从 12.05 到 30.56、SpeechMMLU 从 12.13% 到 58.76% 的巨大差距。(3) 梯度断开 + $\lambda$ 从 1.0 到 0.1 的调度构成一套可复用的防遗忘配方:MATH 相比三阶段基线高 8.45 个百分点、HumanEval 高 6.71,且理论上第一阶段文本漂移严格为零。(4) 指令格式用 ROLE/DIRECTOR/SCRIPT 三字段把多说话人身份、音色、情绪、口音、笑声呼吸等副语言特征与音效/音乐的时间排列组织成纯文本,使单条指令即可描述复杂声景——这把'多轨混音'问题转化为序列排列问题。
实验结果
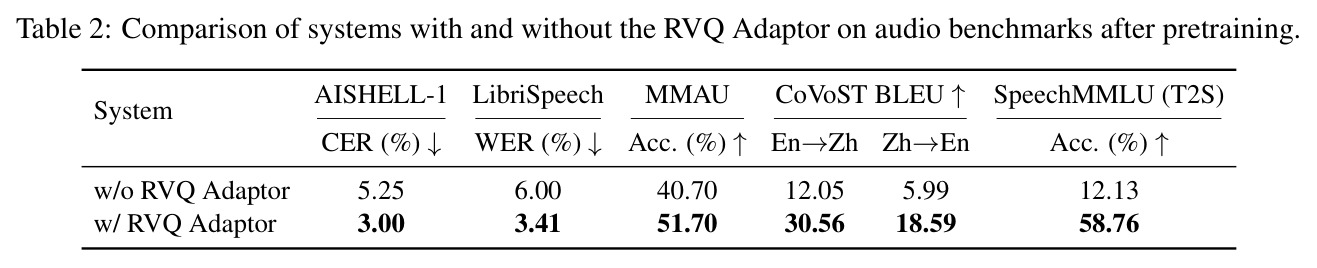
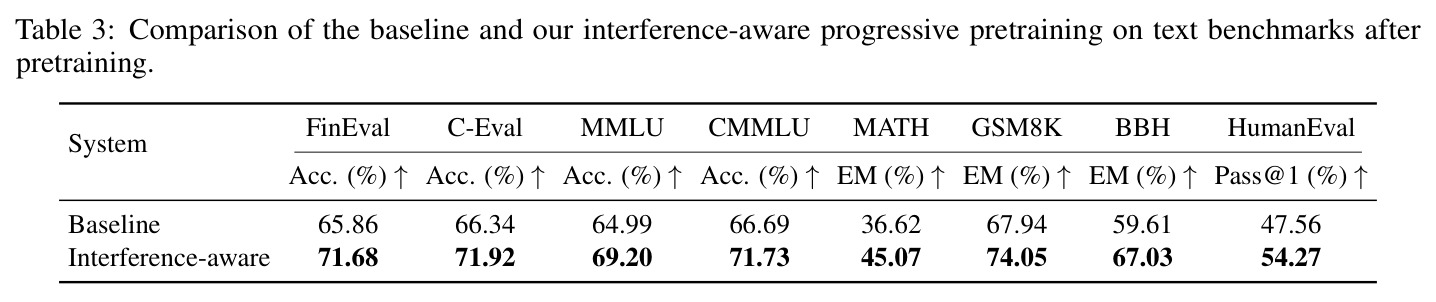
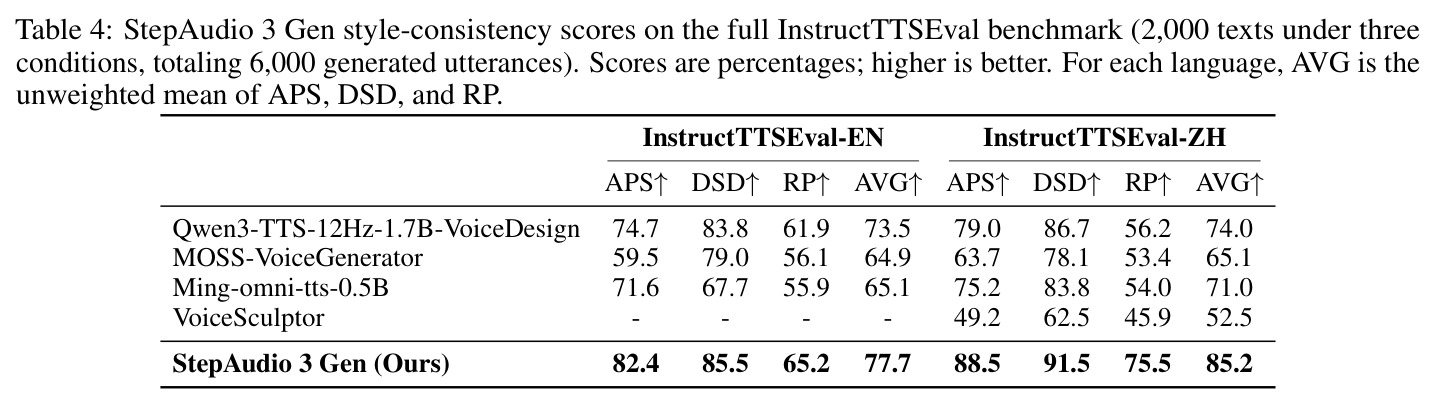
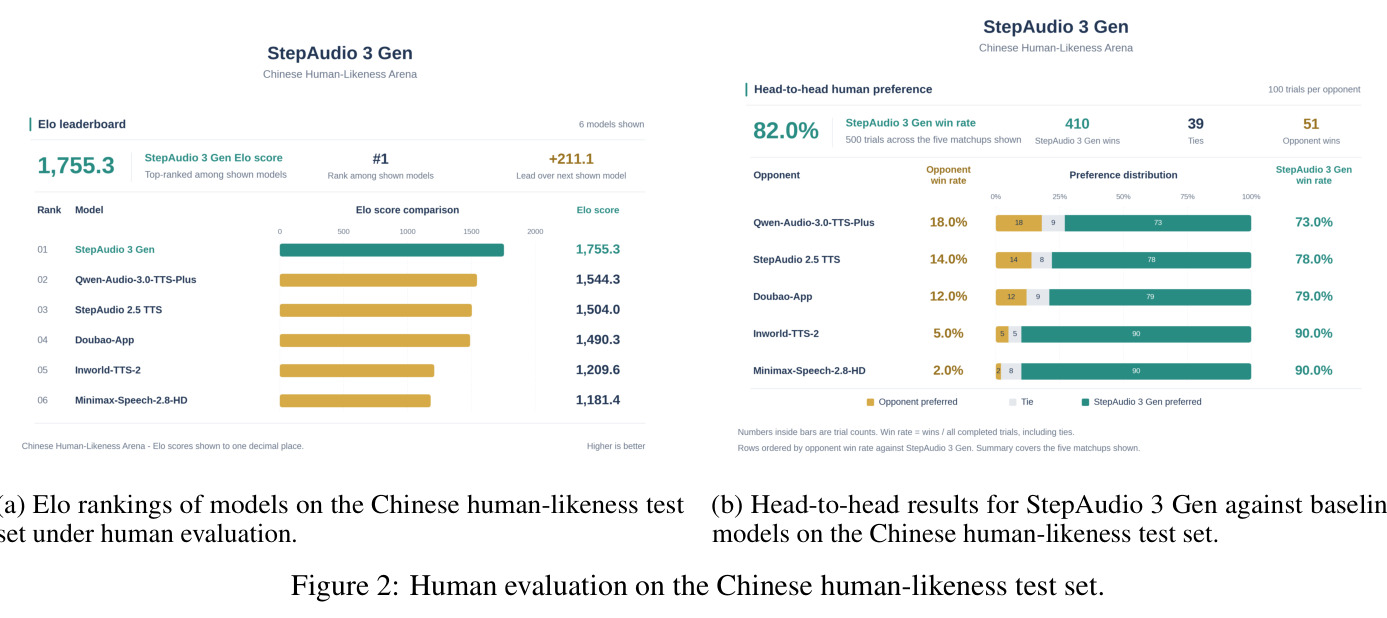
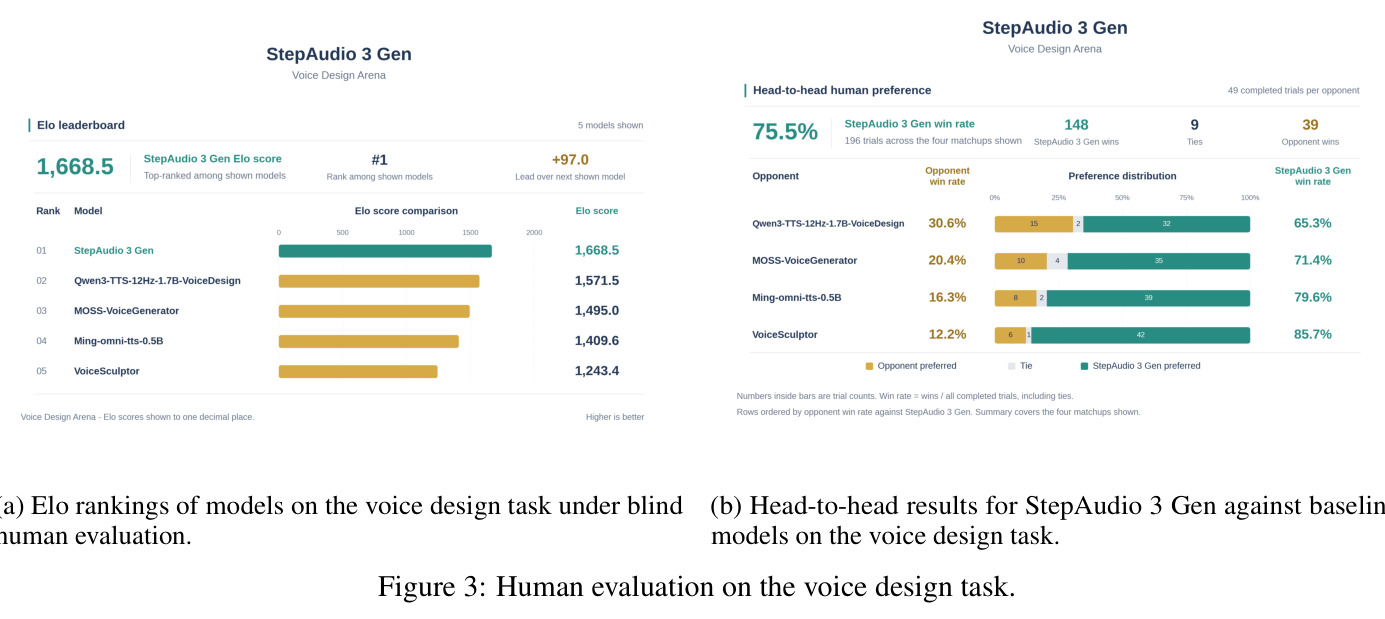
核心发现分五块。RVQ Adaptor 消融(表 2):加入后 AISHELL-1 CER 从 5.25% 降到 3.00%,LibriSpeech WER 从 6.00% 降到 3.41%,MMAU 从 40.70% 升到 51.70%,CoVoST En→Zh BLEU 从 12.05 升至 30.56(Zh→En 5.99→18.59),SpeechMMLU 从 12.13% 跃升至 58.76%,音频-语言指标全面受益。防遗忘消融(表 3):相比无 Adaptor 的三阶段基线,干扰感知四阶段在八个文本基准全面占优——MMLU 69.20 对 64.99、C-Eval 71.92 对 66.34、MATH 45.07 对 36.62、GSM8K 74.05 对 67.94、BBH 67.03 对 59.61、HumanEval 54.27 对 47.56,语言与推理能力被有效保住。TTS 中文拟人度(图 2):1,500 对 Arena 式盲测 Elo 1755.33 居首,对 Qwen-Audio-3.0-TTS-Plus、Doubao-App、MiniMax-Speech-2.8-HD、Inworld-TTS-2、StepAudio 2.5 TTS 五个商用系统总胜率 82.0%,单对手区间 73.0%–90.0%。Voice design(表 4、图 3):InstructTTSEval 全量 6,000 条生成上中文均分 85.2%(APS 88.5 / DSD 91.5 / RP 75.5)、英文 77.7%,均列第一,比最强基线 Qwen3-TTS 的中文 74.0% 高 11.2 分;490 对人类盲测 Elo 1668.5、总胜率 75.5%(65.3%–85.7%)。扩展能力上,模型可生成超过 60 秒且结构连贯的器乐曲,并支持多说话人与音效交织的复合声景及 vibe speech。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 中文语音识别 AISHELL-1(预训练后) | CER (%) ↓ | 3.00(含 RVQ Adaptor) | 5.25(无 Adaptor) | 降低 2.25 个百分点 |
| 英文语音识别 LibriSpeech test-clean | WER (%) ↓ | 3.41 | 6.00(无 Adaptor) | 降低 2.59 个百分点 |
| MMAU 音频理解与推理 | 准确率 (%) ↑ | 51.70 | 40.70(无 Adaptor) | +11.0 |
| CoVoST 英→中语音翻译 | BLEU ↑ | 30.56 | 12.05(无 Adaptor) | +18.51 |
| CoVoST 中→英语音翻译 | BLEU ↑ | 18.59 | 5.99(无 Adaptor) | +12.60 |
| SpeechMMLU 知识问答 (T2S) | 准确率 (%) ↑ | 58.76 | 12.13(无 Adaptor) | +46.63 |
| MMLU 文本知识 | 准确率 (%) ↑ | 69.20 | 64.99(三阶段基线) | +4.21 |
| MATH 数学推理 | EM (%) ↑ | 45.07 | 36.62(三阶段基线) | +8.45 |
| GSM8K 数学应用题 | EM (%) ↑ | 74.05 | 67.94(三阶段基线) | +6.11 |
| HumanEval 代码生成 | Pass@1 (%) ↑ | 54.27 | 47.56(三阶段基线) | +6.71 |
| 中文 TTS 拟人度盲测(1,500 对) | Elo / 总胜率 | 1755.33 / 82.0% | 五个商用 TTS(Qwen-Audio-3.0-TTS-Plus、Doubao-App、MiniMax-Speech-2.8-HD、Inworld-TTS-2、StepAudio 2.5 TTS) | 对每个对手胜率 73.0%–90.0%,全部 matchup 保持明显多数 |
| InstructTTSEval-ZH 风格一致性(3,000 条) | AVG (%) ↑ | 85.2(APS 88.5 / DSD 91.5 / RP 75.5) | 74.0(最强基线 Qwen3-TTS-12Hz-1.7B-VoiceDesign) | +11.2 |
| InstructTTSEval-EN 风格一致性(3,000 条) | AVG (%) ↑ | 77.7(APS 82.4 / DSD 85.5 / RP 65.2) | 73.5(Qwen3-TTS-12Hz-1.7B-VoiceDesign) | +4.2 |
| Voice Design 人类偏好盲测(490 对) | Elo / 总胜率 | 1668.5 / 75.5% | 四个主流 voice design 模型(含 Qwen3-TTS、MOSS-VoiceGenerator、Ming-omni-tts-0.5B、VoiceSculptor) | 单对手胜率 65.3%–85.7%,Elo 榜第一 |
局限与改进
作者承认的局限较少直接陈述,但可从文中推断:主观评测占主导,TTS 甚至明确放弃 CER 与说话人相似度等客观指标,理由是它们只覆盖有限维度;音乐、歌声、音效部分只有能力描述与少量样例,没有给出 MOS 或与专用模型(如音乐生成 SOTA)的量化对比。风格一致性完全依赖 Gemini 3.1 Pro 的二元判断,judge 偏差未做校准或与人评一致性验证。我自己的观察:第一,数据合成管线深度依赖闭源内部组件——StepAudio Music Model 造音乐与部分 SFT 数据、StepAudio R1.5 做 caption 与 RL 奖励、内部 TTS 与 SVC 造 speech2vocal 伪配对,第三方难以复用;第二,关键评测集多为自建(中文拟人度集合从真实人声抽文本、每对手仅 100 对),缺乏第三方基准交叉验证;第三,tokenizer 上限 24 kHz、12.5 Hz 的激进行内压缩对极高频音色细节(气声、齿音)的影响未讨论;第四,离散 AR 逐帧生成天然慢于扩散式并行渲染,报告未给 RTF 或端到端延迟数字,'流式'只体现在解码器的因果结构上,生成器侧的实时性存疑。
独立分析的弱点
弱点一:RL 奖励链路是'音频 caption → 文本 LLM 打分',caption 丢掉的声学伪影(节奏错位、金属音色)不会进入奖励,GRPO 可能系统性强化 caption 可描述的属性而放过不可描述的缺陷;改进方向是并联基于嵌入距离或判别器的声学保真奖励。弱点二:$\mathcal{L}_{sp}$ 对深度求和导致幅度天然高出 token 项一个量级,需手工把 $\lambda$ 从 1.0 调到 0.1,这种平衡脆弱,可换不确定性加权或梯度范数归一化。弱点三:防遗忘策略只与自家三阶段基线比较,缺少对'冻结若干层 + 文本回放'、LoRA 式旁路等经典方案的控制实验,归因不够干净。弱点四:voice design 评测的 judge 是单一模型(Gemini 3.1 Pro),模型可能过拟合 judge 偏好;应引入多 judge 集成并报告与人评的相关系数。弱点五:帧内 15 层残差码的错误无法反馈修正(预测器输出不回流骨干),高频细节可能随长序列漂移;可考虑轻量反馈通道或对残差码局部重打分。弱点六:四阶段课程超参极多(学习率倍率、混合比、断开时机),迁移到小模型或小数据时的鲁棒性未知。
未来方向
作者在结论中把方向概括为:证明离散自回归建模可以作为连续生成范式之外实用且可扩展的替代路线。据此可延伸:把生成侧也做成流式并报告端到端首包延迟,结合其因果解码器实现全双工语音对话;把 32,768 token(约 44 分钟)的上下文继续扩展到小时级有声书与播客,并研究超长序列下残差码漂移的抑制;利用理解与生成共享表征的特点做音频编辑、inpainting、按指令的声景重排等可控任务;把 RL 奖励从'caption 一致性'扩展到音乐结构、歌声 MOS 等感知维度,让音乐/歌声质量也进入优化闭环;在公开基准上与其他统一模型(如连续路线的代表)做受控对比以厘清两条范式的真实差距;以及检验 RVQ Adaptor 与四阶段课程在视觉等离散模态上的可迁移性。
复现评估
完全复现难度很高。技术报告未提及开源代码或模型权重,音频样例只在项目页 https://stepaudiollm.github.io/step-audio-3-gen/。训练资源门槛巨大:tokenizer 约 70 万小时音频,LLM 预训练约 2.7T token、四阶段批量 4.19M–25.17M token/步、上下文并行到 32,768,SFT 约 5,000 小时音频,RL 每指令采 16 个完整音频——这需要大规模 GPU 集群。更大的障碍是数据闭源:预训练与 SFT 语料未公开,且管线深度依赖内部模型(StepAudio Music Model、StepAudio R1.5、内部 TTS/SVC 造伪配对数据)。可复用的是方法论层面:零初始化 Adaptor、四阶段课程、$\lambda$ 调度、GRPO 奖励公式与丢弃阈值 $\delta=0.02$ 都描述得足够细,中小团队可以在较小模型和数据上验证这些思想的有效性;论文还给出每个消融的具体数字,便于对照检查自己的实现。
论文图表