音乐音频生成模型教程:从文本生成音乐到现场演奏 A Tutorial on Generative Models for Music Audio
以共享记号统一讲解音乐生成的表示、范式、控制、评估与数据法律问题
前置知识
神经音频编解码器与残差向量量化(RVQ)
把波形压缩成离散 token 序列的编码器-解码器网络。编码器把波形切成帧(如 MusicGen 所用 EnCodec 以 640 采样点为帧距,在 32 kHz 下每秒 50 帧),每帧在 $Q$ 个大小为 $K$ 的码本中逐级量化:第一级近似帧向量,后续各级对残差继续量化,解码器从 token 网格重建音频。决定系统成本的三个属性是 token rate(每秒 token 数,等于 $f_{fr}\cdot Q$)、语义内容(token 是否携带语言模型可预测的结构信息)与优雅降级(截断深层码本是否只受控地丢失细节而非破坏信号)。
几乎所有系统的表示与成本都由编解码器决定,全文的贯穿算例(MusicGen 每秒 200 个 token)完全建立在这个概念上。
自回归 token 语言模型与 codebook interleaving
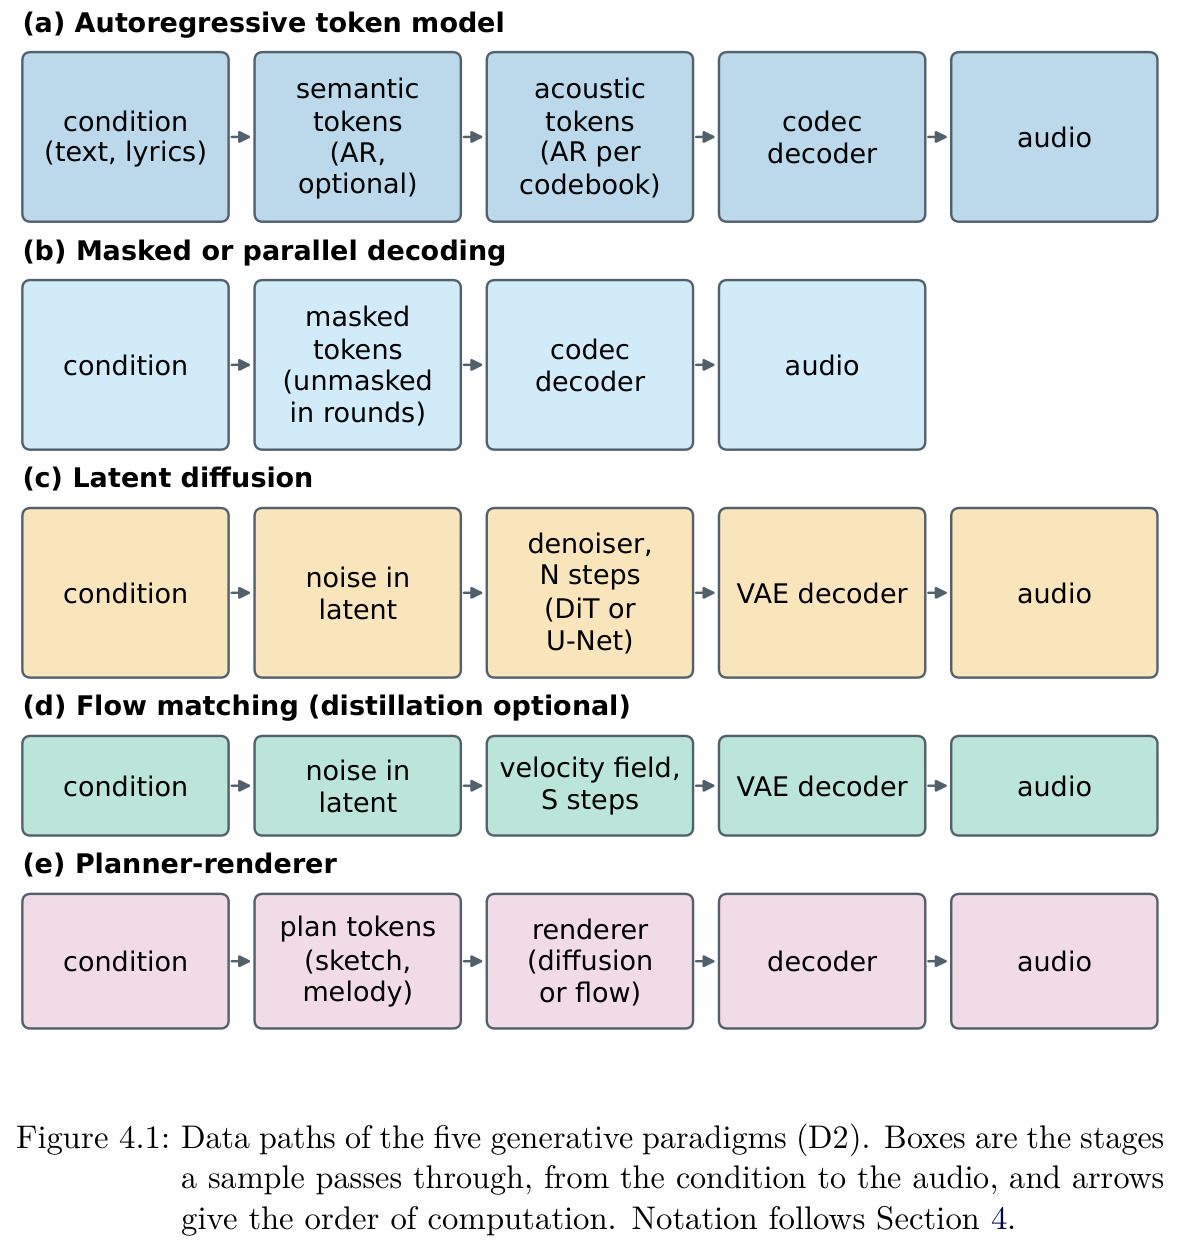
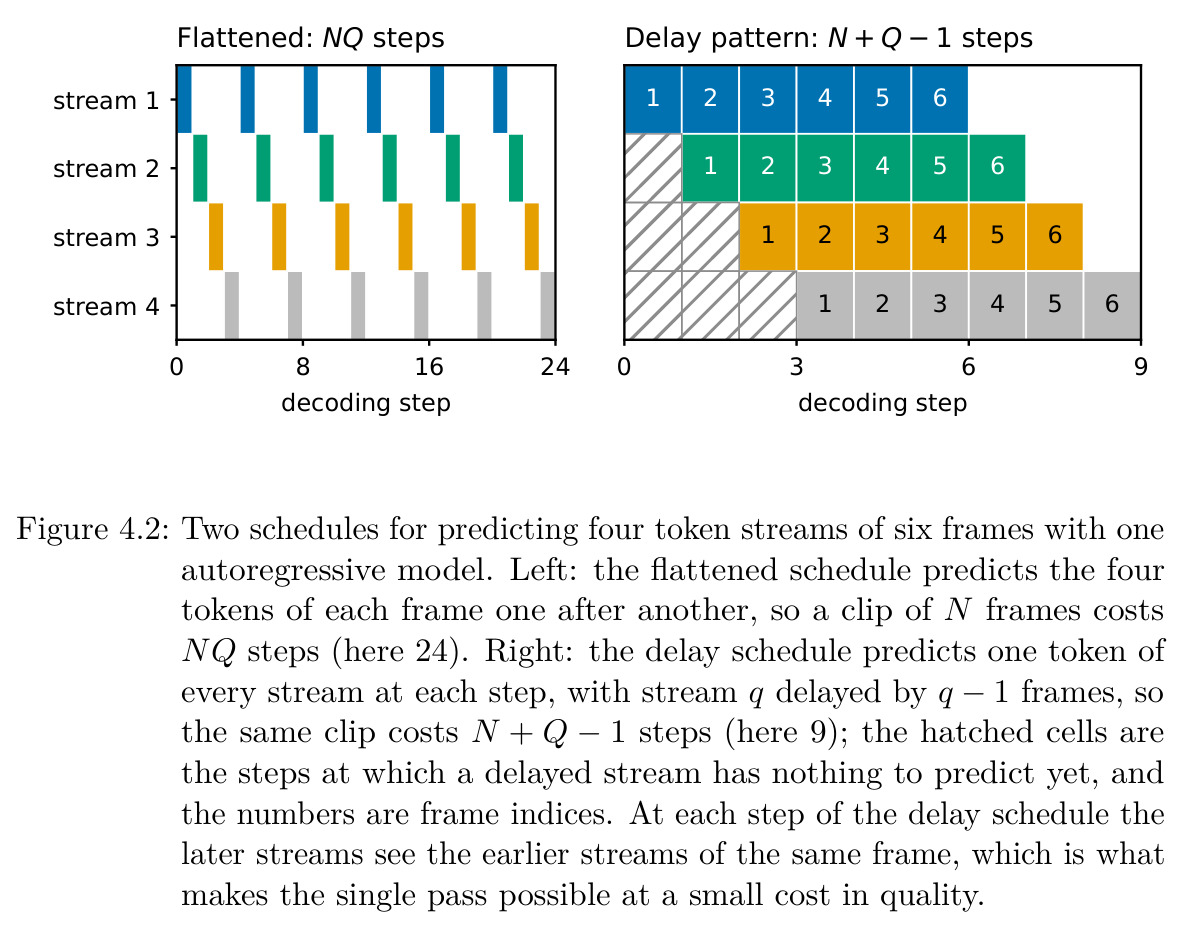
把生成变成按交错模式逐组预测 token:$p_\theta(z\mid c)=\prod_s\prod_{(q,n)\in P_s}p_\theta(z^{(q)}_n\mid z_{<s},c)$。多个码本流如何排布直接决定顺序解码步数:flatten 展平调度需要 $NQ$ 步;MusicGen 的 delay pattern 把第 $q$ 个流推迟 $q-1$ 步,每步并行预测所有已启动的流,成本降为 $N+Q-1$ 步;MusicLM 则用语义→粗声学→细声学的三阶段层次。
token 模型是器乐与歌曲生成的两大谱系之一,理解 delay pattern 才能读懂文中 1503 步对 6000 步的成本算例。
潜在扩散与流匹配
两者都在压缩 latent 上学习时间依赖的向量场。扩散对干净 latent 加噪 $h_t=\alpha_t h_0+\sigma_t\varepsilon$ 并训练噪声预测器 $\mathcal{L}_{DM}=\mathbb{E}\|\varepsilon-\varepsilon_\theta(h_t,t,c)\|^2$,采样时反向积分;流匹配沿指定路径(常用线性路径 $y_t=(1-t)\varepsilon+t h_0$)回归速度场 $\mathcal{L}_{FM}=\mathbb{E}\|v_\theta(y_t,t,c)-(h_0-\varepsilon)\|^2$,再与 reflow、一致性蒸馏、对抗后训练组合达到少步甚至快于实时的生成。条件注入常用 classifier-free guidance:$\tilde\varepsilon=\varepsilon_\theta(h_t,t,\varnothing)+w(\varepsilon_\theta(h_t,t,c)-\varepsilon_\theta(h_t,t,\varnothing))$。
歌曲与长音频生成的连续表示谱系基座,全文的速度对比(快于实时与离线)都取决于这条技术线。
偏好对齐(RLHF 与 DPO)
主训练之后用人类偏好数据继续微调。给定奖励 $r(x,c)$,强化学习目标为最大化 $\mathbb{E}[r(x,c)]-\beta\,\mathrm{KL}(p_\theta\|\pi_{pref})$;DPO 去掉显式奖励,直接用偏好对 $(x^+,x^-)$ 的策略比率构造 logistic 损失。扩散模型似然无闭式解,Diffusion-DPO 从证据下界推出代理目标(偏好与不偏好样本的去噪损失之差)。音乐领域由 MusicRL 首次大规模应用,此后歌曲系统广泛采用。
文中记录 2025-2026 年的 25 个歌曲系统里 11 个报告了偏好/强化阶段,这是本文梳理的核心后训练趋势。
Fréchet Audio Distance(FAD)
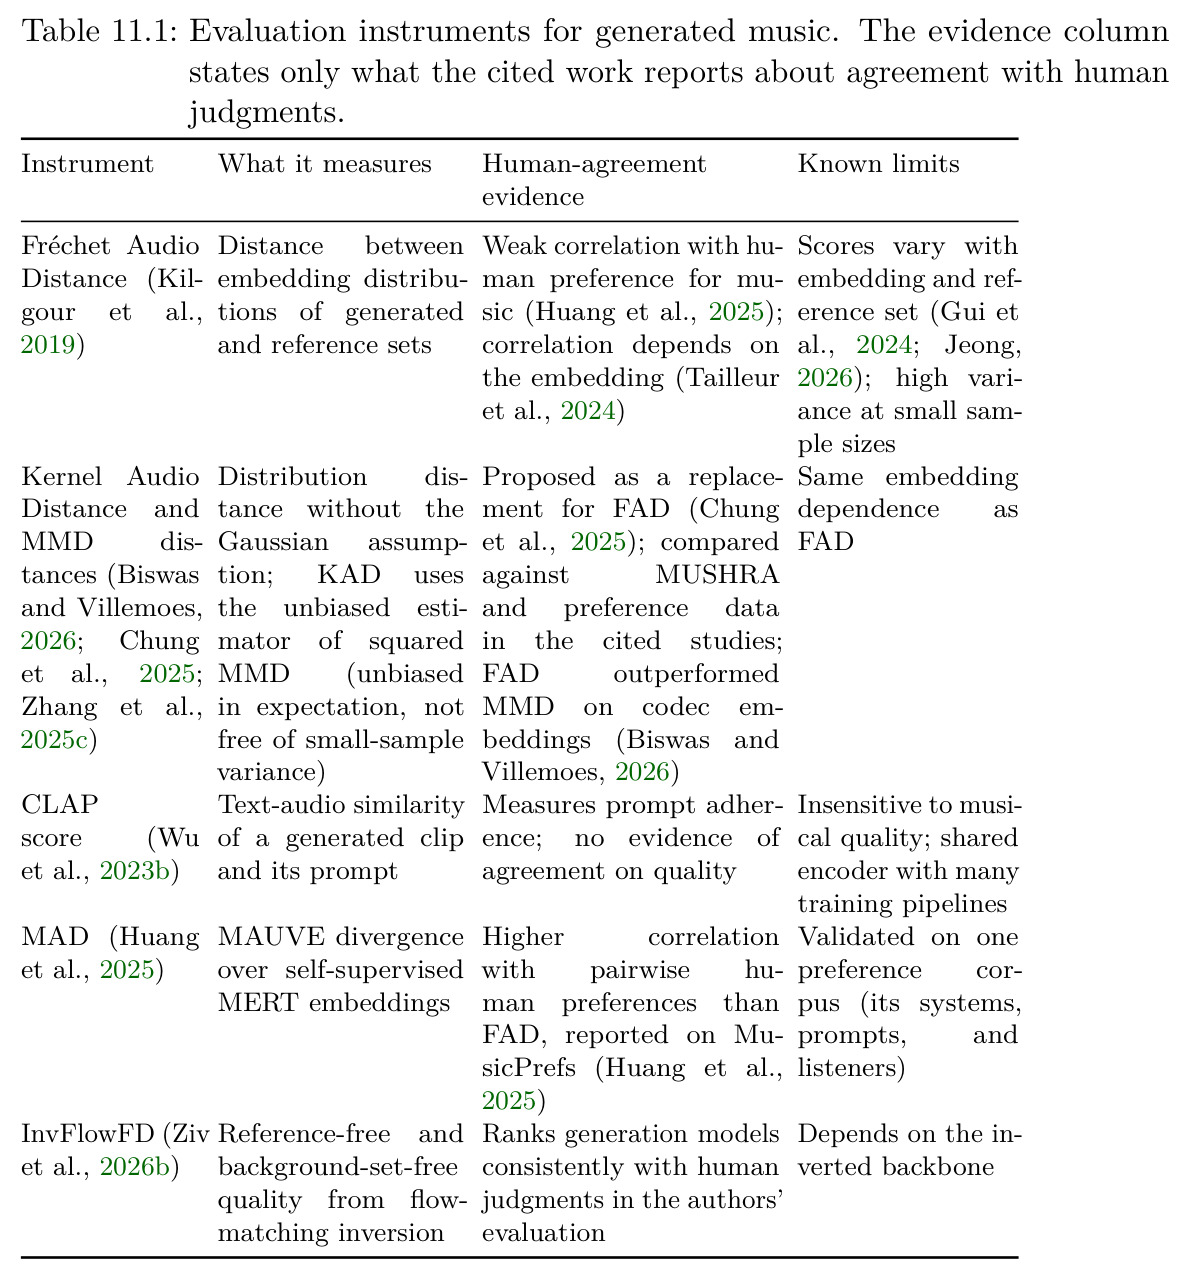
本领域默认的自动指标:用固定音频编码器分别嵌入生成集与参考集,各拟合一个高斯,报告两者间的 Fréchet 距离 $\|\mu_g-\mu_r\|^2_2+\mathrm{tr}(\Sigma_g+\Sigma_r-2(\Sigma_g\Sigma_r)^{1/2})$。它免配对、计算便宜,但对编码器与参考集的选择敏感,有限样本下 plug-in 估计有偏(通常偏高),且被证明与现代文本到音乐输出的人类偏好仅弱相关。
理解第 11 章对评估的批判、以及社区为何转向 MAD 指标、learned judges 与人类偏好竞技场,都以 FAD 的局限为前提。
研究动机
2023 年之前,神经音乐生成基本停留在概念验证:Jukebox 能在音频域生成带人声的完整歌曲,但保真度低且采样以小时计;更早的自回归波形模型每个采样点都要做一次顺序预测,成本上不可能实用。转折发生在 2023 年初:MusicLM 把文本到音乐做成离散音频 token 上的层次化语言建模,潜在扩散路线(AudioLDM 等)证明连续表示同样可达相当质量,MusicGen 则证明单阶段 token 语言模型加 codebook 交错就是强开放基线。此后文献在整曲人声、细粒度控制、指令编辑、实时演奏等方向同时爆发,方法散落在默认读者熟悉早期工作的各论文里。评估明显滞后:默认指标 FAD 对嵌入与参考集敏感、小样本有偏,且与现代系统输出的人类偏好仅弱相关,全曲、编辑与实时交互至今没有公认评估协议。数据与法律同样尖锐:唱片公司起诉 Suno 与 Udio,慕尼黑法院就 OpenAI 歌词复制与 Suno v3.5/v4 六首作品作出侵权判决,而 105 个被比较系统中 43 个训练数据完全未披露。能帮读者进入领域并判断系统报告可信度的系统性教材此前阙如。
本文的目标是这本 monograph 的目标是让熟悉神经网络训练但刚进入音乐生成领域的读者(研究生、研究员、工程师,以及对工具背后方法好奇的音乐人)具备四项可检验的能力。第一,能在任何系统报告中识别四个槽位——生成什么表示、用什么范式分解分布、条件经什么路径进入、用什么采样器及其加速手段——并写出该范式的训练目标与采样过程;第二,能从编解码器参数算出 token rate、序列长度和步数,进而推断成本与可达时长,书中以 MusicGen 做了完整示范(50 帧/秒 × 4 个码本 = 每秒 200 个 token,30 秒片段在 delay pattern 下需 1503 个解码步、码率 2200 bps);第三,能依据第 6-9 章的证据在 token 与 latent 谱系、adapter/控制分支/推理时优化/显式规划、大模型蒸馏与小专用模型之间做出面向具体部署的选型;第四,能判断评估报告中哪些数字经过人类判断校验、按书中九条协议设计并报告听测,并能读懂模型卡中关于数据、许可和记忆化的陈述及其与法律记录的关系。
与已有工作不同的是,已有综述各有侧重:早期综述按目标、表示与架构组织,成文时音频域系统尚未达到可用质量;较新的综述要么横跨理解与生成的音乐基础模型(Ma 等 2024),要么只覆盖单一分支(符号生成、视频配乐、评估、伦理、实时交互等)。与本文范围最接近、按引导模态组织的综述(Li 等 2026a)符号部分更广,但最新系统只到 2025 年初。本文的独特切入有四点:其一,按应用类别(器乐文本到音乐、歌曲、控制与编辑、实时交互)而非范式组织系统评述,把模型设计直接对应到音乐需求;其二,比较框架显式纳入发布工件维度 D5——权重开放性、数据来源代码、许可、撤回状态,且以有日期的模型卡/仓库检查为准而非论文自述,因此能记录 LeVo 权重 2026 年 7 月被撤回这类发表后的变化;其三,用表示、成本、条件、规划、测量、工件六个贯穿性问题串起全部章节;其四,文献收集过程完全透明,附录 A 公开 19 个主题组的检索字符串、1115 个候选的筛选流程与来源优先级规则,并严格区分法院判决、诉讼主张与公司公告三类证据。
核心方法
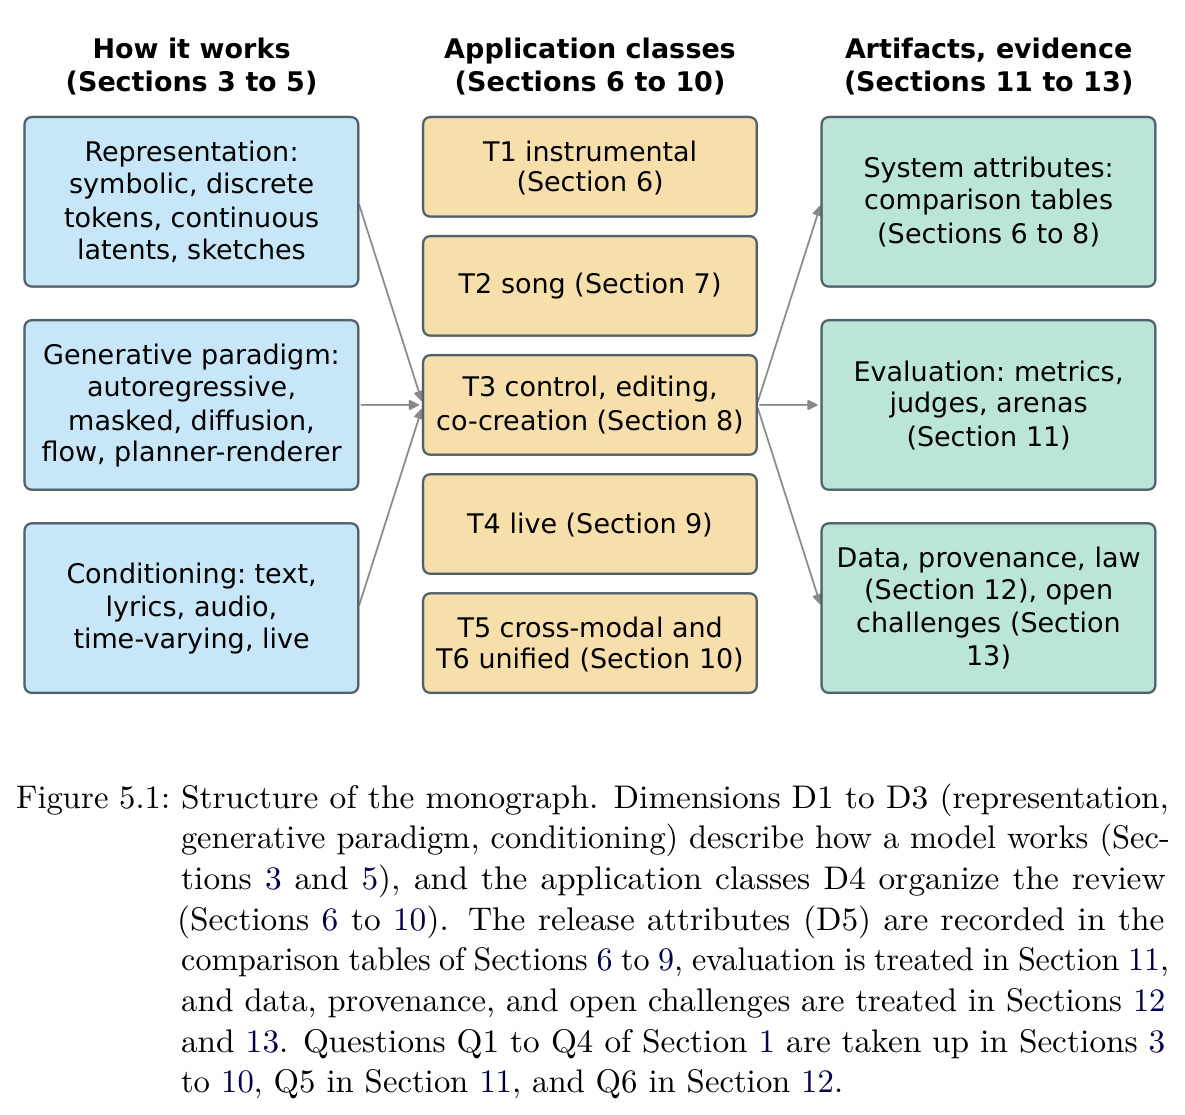
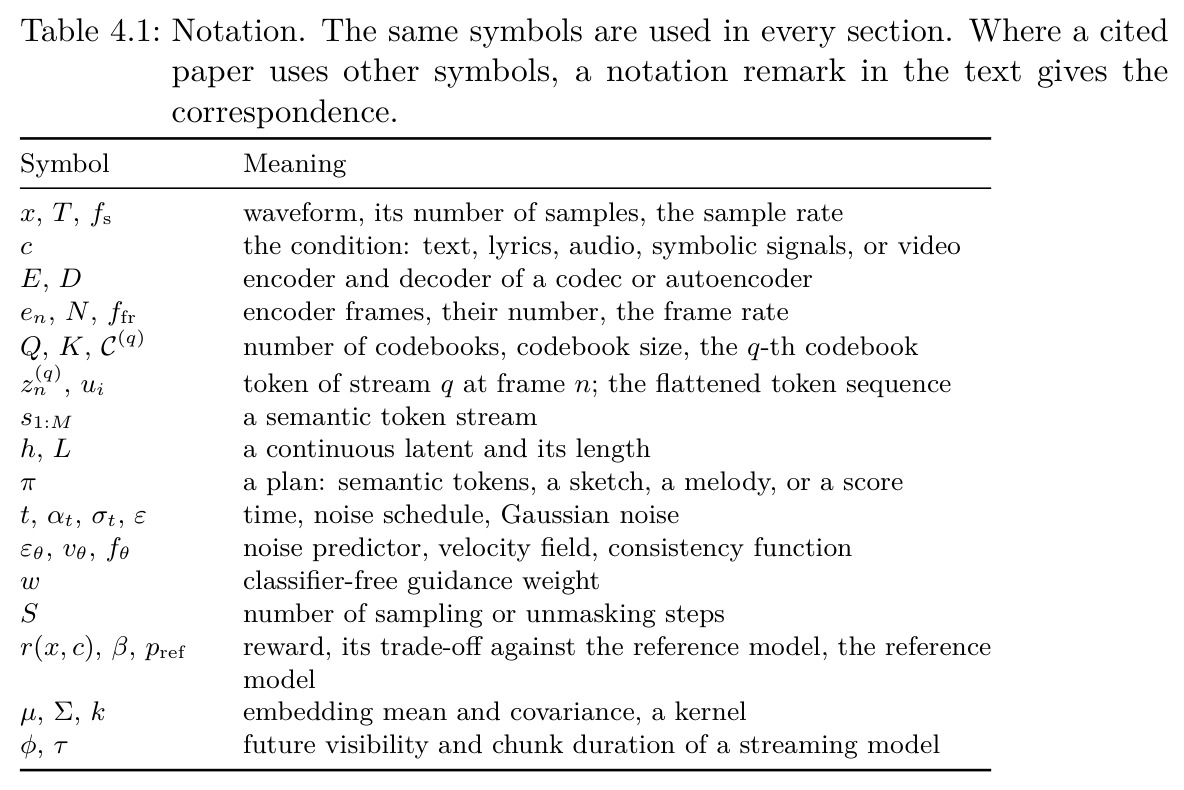
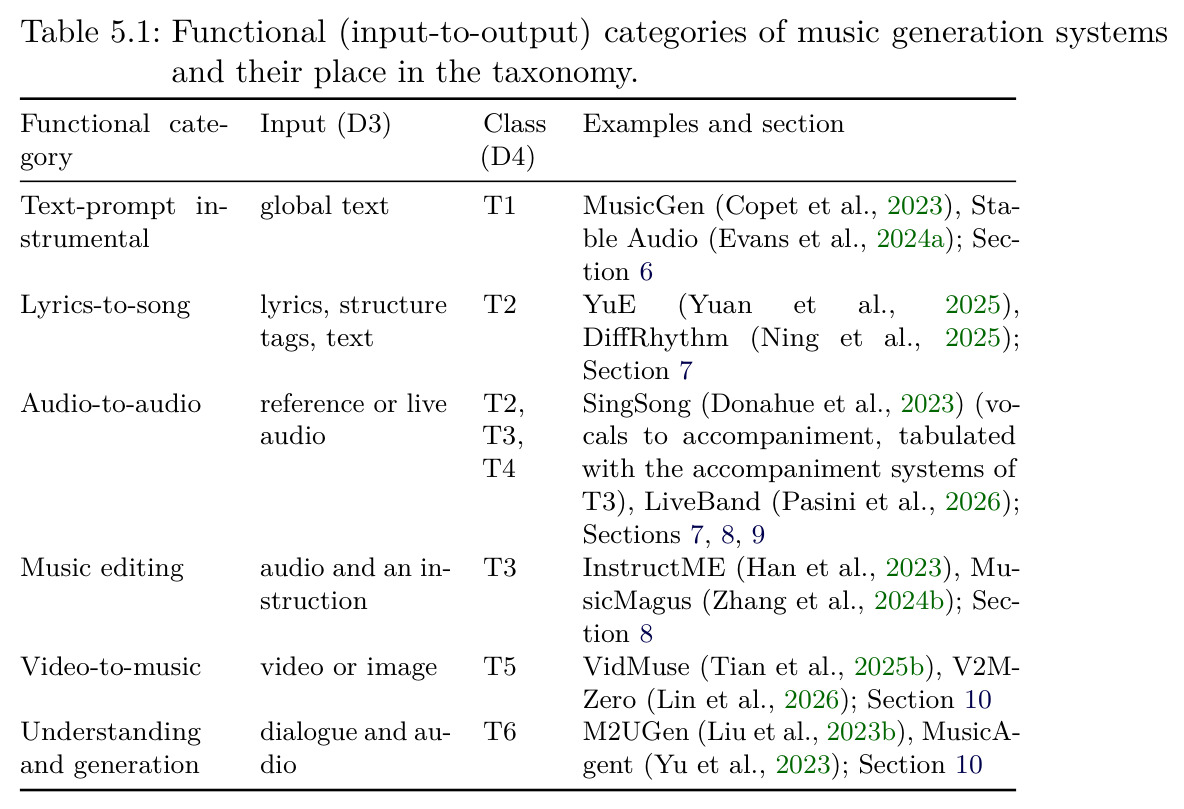
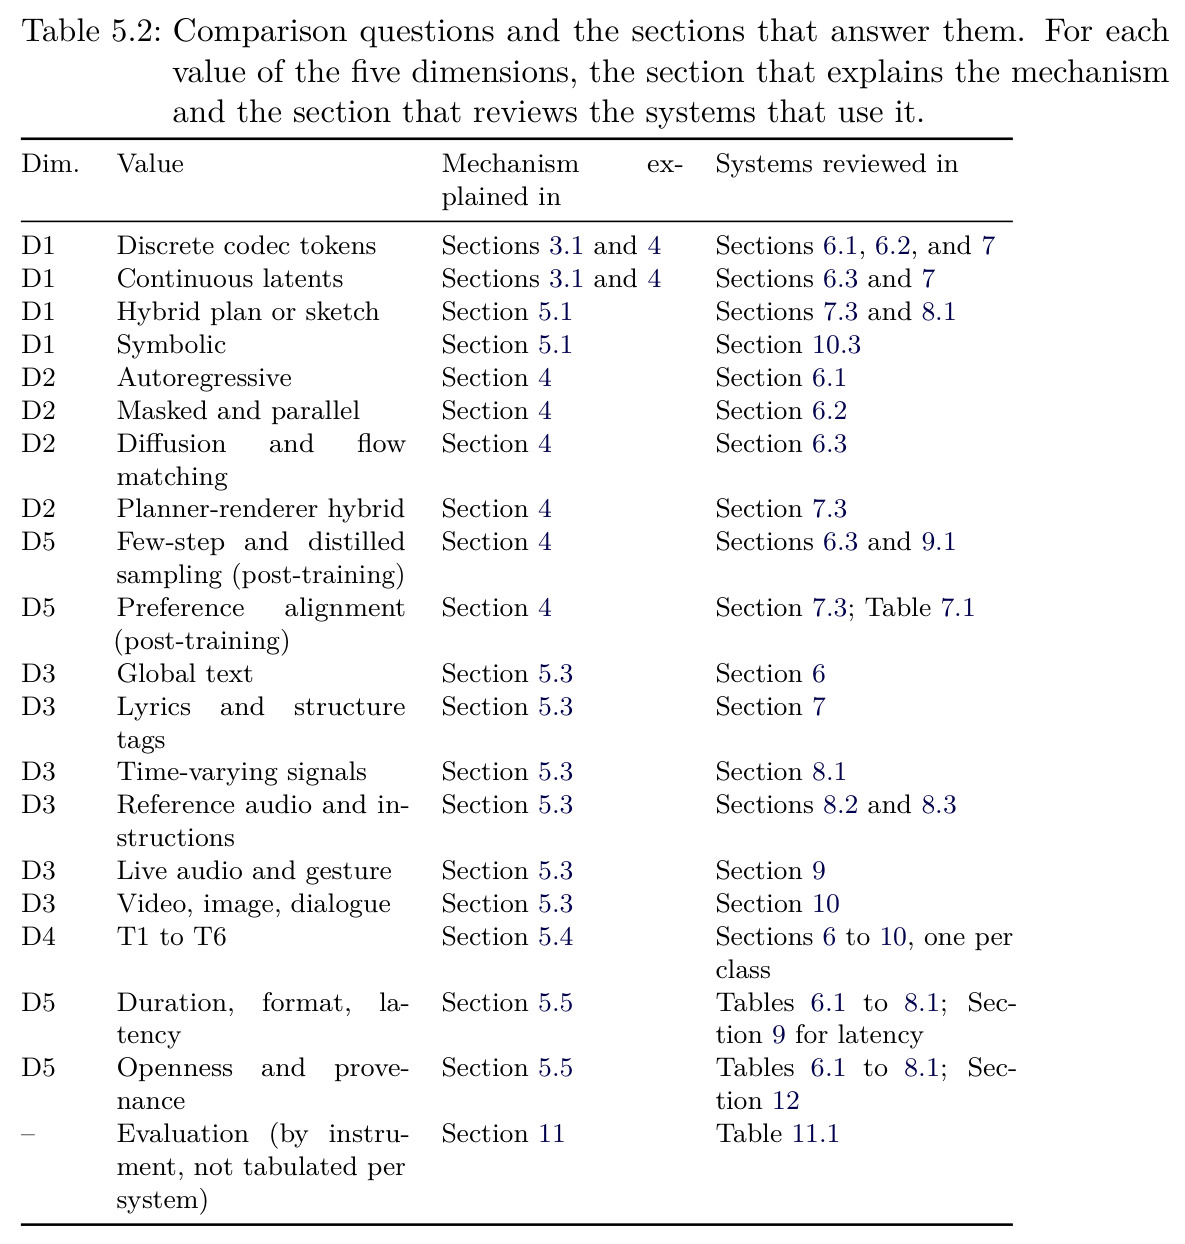
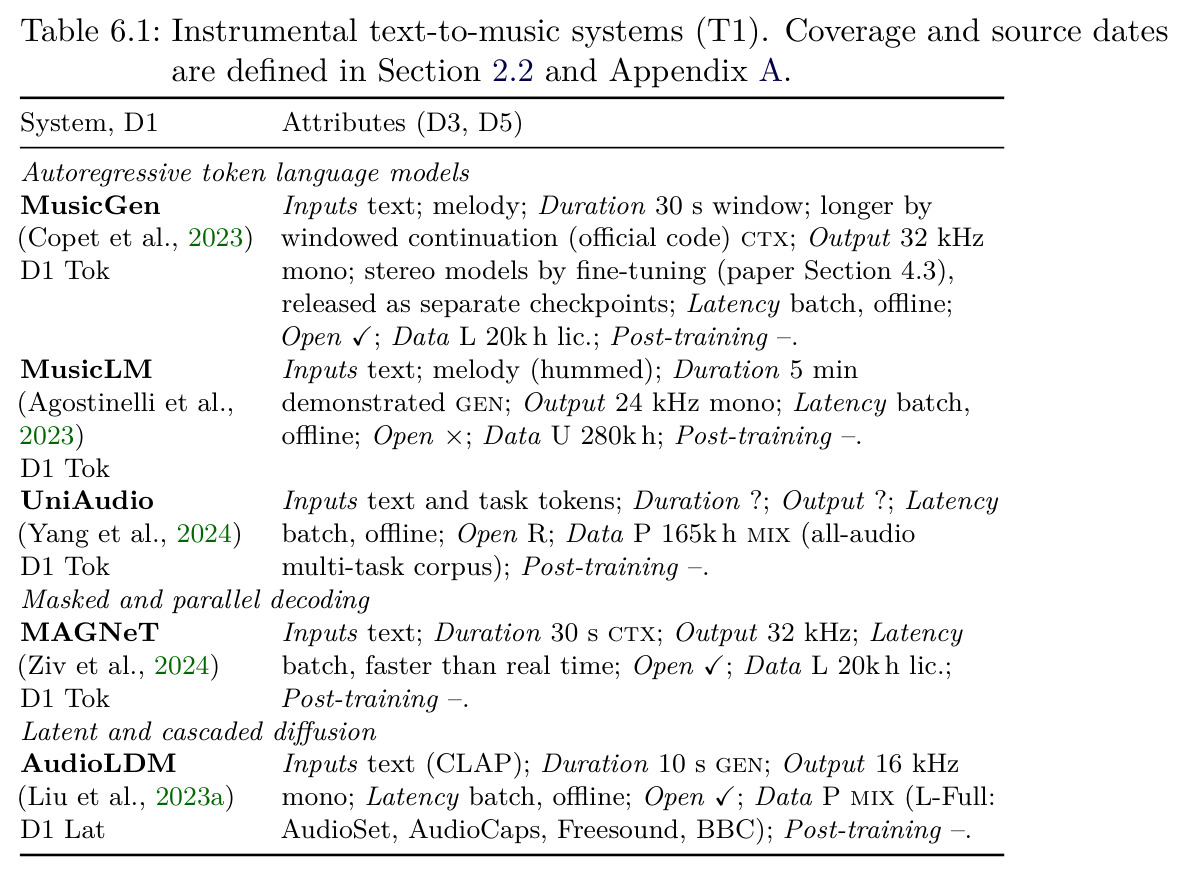
直觉上,这本教程把五花八门的音乐生成系统还原成同一个问题的四次填空。任何系统都要填四个槽位:表示(波形映射成离散 codec token、连续 latent、符号序列或中间草图 plan);因子分解(给定条件如何分解分布——自回归、并行 unmask、链式去噪、流积分或先规划后渲染);条件路由(全局嵌入、时间对齐序列、参考音频前缀或经由 plan);采样器(步数与加速手段)。教程用共享记号统一写出五范式的目标函数,如扩散的 $\mathcal{L}_{DM}=\mathbb{E}\|\varepsilon-\varepsilon_\theta(h_t,t,c)\|^2$ 与流匹配的 $\mathcal{L}_{FM}=\mathbb{E}\|v_\theta(y_t,t,c)-(h_0-\varepsilon)\|^2$,再以 MusicGen 为贯穿算例,把抽象记号落到每秒 200 个 token、30 秒 1503 步这类可计算的数字上。第 5 章把前三个槽位加上应用类别与工件属性扩展成 D1-D5 五维比较框架,供第 6-9 章的逐类系统表使用。
这篇教程最重要的不是提出新模型,而是一套让系统可比较、可审查的共享框架与一个可验证的核心论断:表中每一个生成范式在 2023 年前就已存在,此后的系统差异集中在三处——在什么之上生成(表示与编解码器设计)、训练之后做什么(偏好对齐、一致性/对抗蒸馏等后训练)、以及渲染器之前是否有显式规划器。教程用 MusicGen 把抽象落到算术:其 EnCodec 以 640 采样点为帧距,在 32 kHz 下每秒 50 帧、每帧 4 个码本,语言模型每秒要预测 200 个 token,码率 $50\times4\times\log_2 2048=2200$ bps;采用 delay pattern(第 $q$ 个流延迟 $q-1$ 步)后,30 秒音频只需 $N+Q-1=1503$ 个顺序解码步,而 flatten 调度需要 $NQ=6000$ 步。作者同时点明比较的极限:各系统在数据、规模与评估上互不相同,表格无法确定哪项变化造就了报告的增益——唯一一次固定数据与架构、只变范式的受控对比(Tal et al. 2025)发现的也是权衡而非赢家。
方法步骤详情
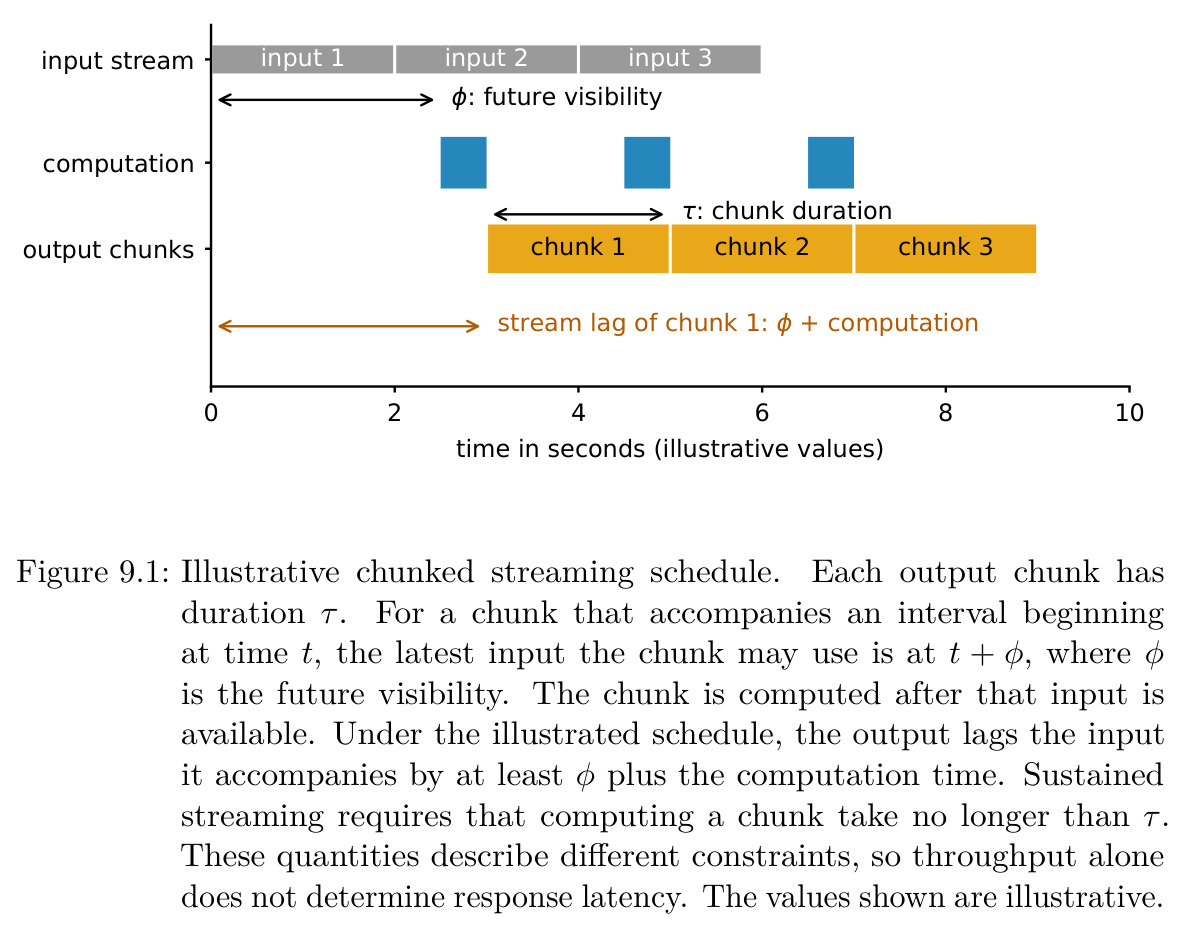
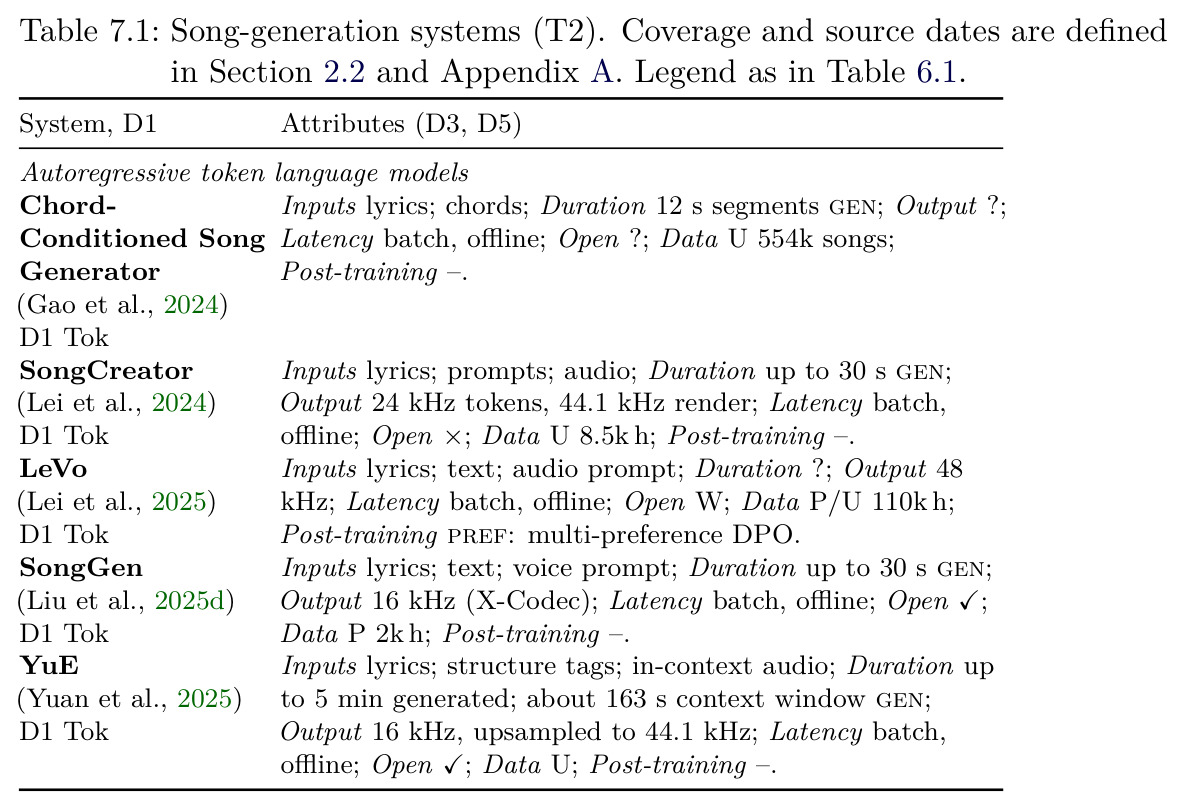
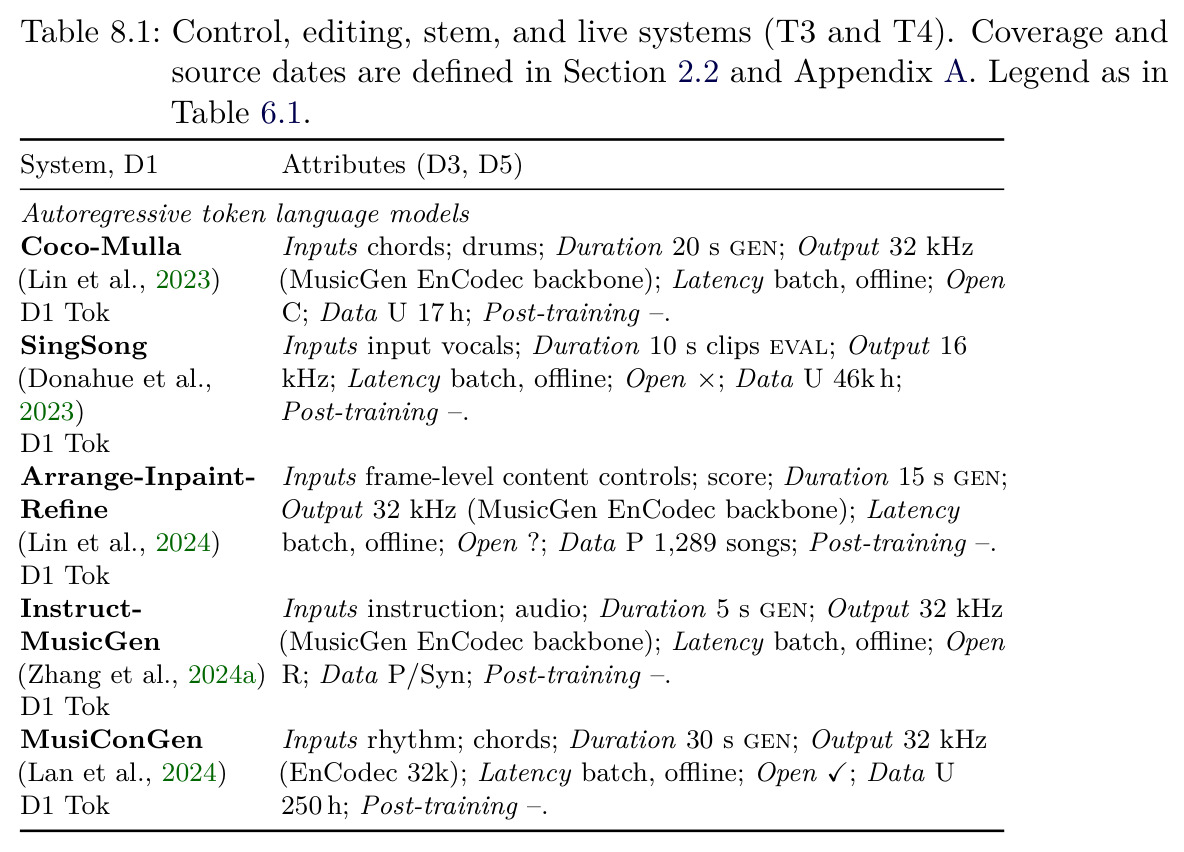
全书按基础→框架→应用→边界→评估→数据→趋势展开。第 3 章讲基础构件:RVQ 编解码器的 token rate、语义内容、优雅降级三要素,联合嵌入如何同时充当条件与提示遵从分数,以及数据层面的字幕稀缺与语料不透明问题。第 4 章统一五范式的目标与采样,含 CFG 外推、一致性蒸馏与对抗后训练,定义流式的 future visibility $\phi$ 与 chunk 时长 $\tau$(输出滞后至少 $\phi$ 加计算时间),偏好对齐的 RL 与 DPO 目标,以及 FAD/MMD 指标。第 5 章定义 D1-D5 与 T1-T6 及边界规则。第 6-9 章逐类评述并以“经验与未决权衡”收尾:T1 器乐(MusicGen、MAGNeT、Stable Audio 系)、T2 歌曲(YuE、DiffRhythm、ACE-Step、SongBloom、Qwen-Music)、T3 控制编辑(ControlNet 分支、adapter、DITTO、反演编辑)、T4 实时(Lyria、LiveBand、RAVE 乐器)。第 10-14 章覆盖边界领域、评估、数据与法律、趋势与建议。
技术新颖性
与既有综述相比,其新颖性体现在比较维度与证据纪律上。第一,D1-D5 框架把“发布工件属性”提升为与架构同维的一级信息:105 个系统行逐一记录时长类型、输出格式、延迟类别、开放性(✓/S/R/W/×/A 等编码)、数据代码与后训练类型,无来源的单元格明确填 unknown 而非推断,使开放性随时间的变化(如 LeVo 撤回)可见。第二,把 real-time factor、latency、future visibility $\phi$ 三个常被混用的量严格拆开:批式快于实时不代表可用流式,流式还需吞吐(每 chunk 计算不超过 $\tau$)与响应延迟同时满足。第三,评估章按“测量什么、有哪些人类一致性证据、已知失效模式”三列整理工具(Table 11.1),明确指出用作训练奖励的 judge 不能同时充当独立评估证据的循环性风险,并给出九条最低听测协议。第四,法律章为每类证据给出“能支持什么、应避免什么推断”的对照(Table 12.1),区分慕尼黑两项判决、AFM 起诉、各和解公告与 Suno v6 发布各自的证明边界。
实验结果
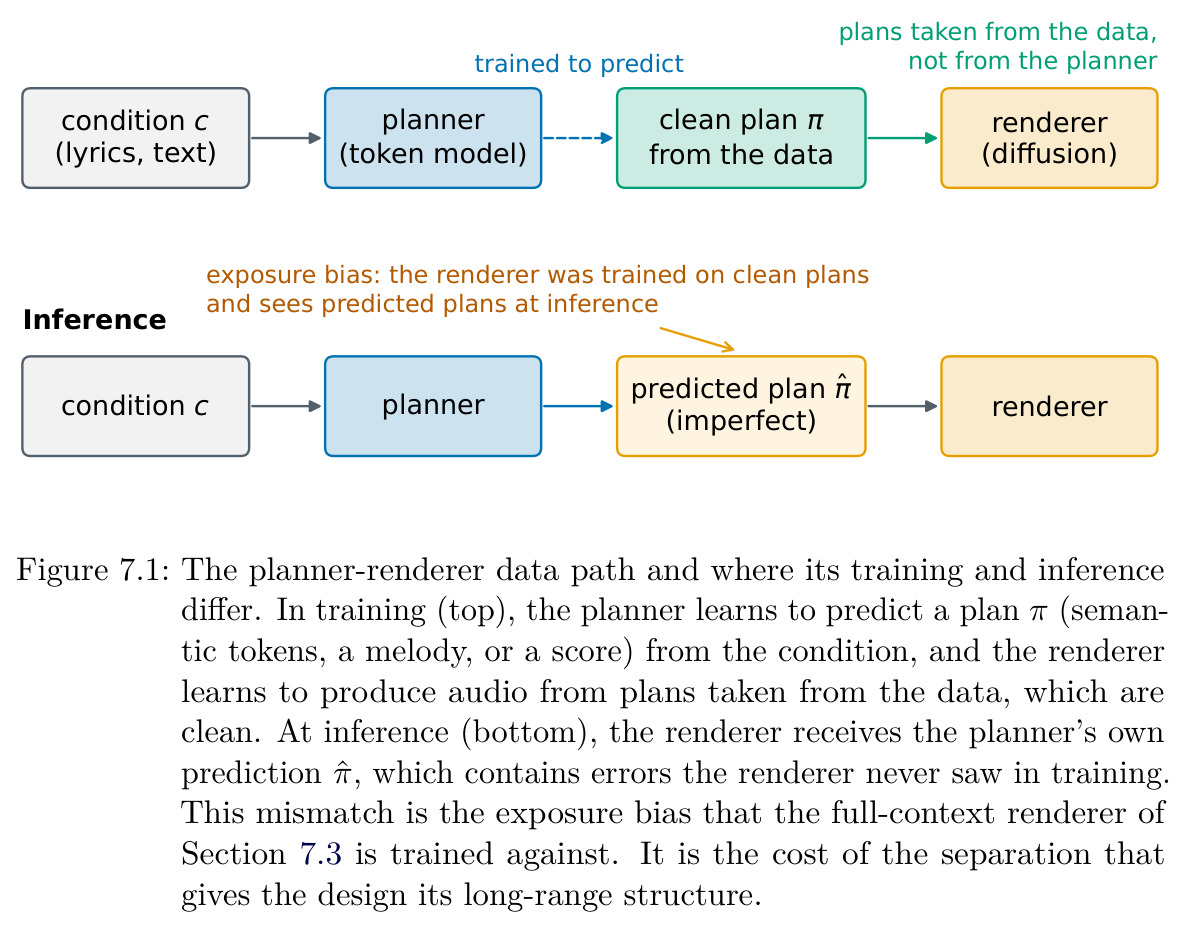
作为综述,其结果是对 105 个系统行的结构化发现。歌曲生成取代器乐成为最活跃类别:Table 7.1 无 2023 年系统而 2025-2026 有 25 个;两谱系收敛为 planner-renderer(如 Qwen-Music 的 3B 规划器加 DiT 渲染器,语料超 500 万小时),代价是渲染器的 exposure bias。速度上:Table 6.1 仅 6 行快于实时且无一 AR 模型;Live Music Diffusion Models 以 8 步实现延迟小于 1 秒的流式。偏好对齐:2025-2026 歌曲系统 25 个中 11 个报告该阶段。评估上:FAD 与人类偏好弱相关,MAD 排名与听众更一致;SongBench judge 与专家结构分数的 Spearman 达每曲 0.824、每系统 0.893,但有流派捷径。数据与开放性:43/105 行仅 U(未披露)、20 行 L/CC;YuE 在商业产品一年内开源。法律上:慕尼黑法院认定 OpenAI 复制歌词、Suno 就六首作品侵权并拒绝 fair use,美国新诉讼涉及 60,202 件录音。
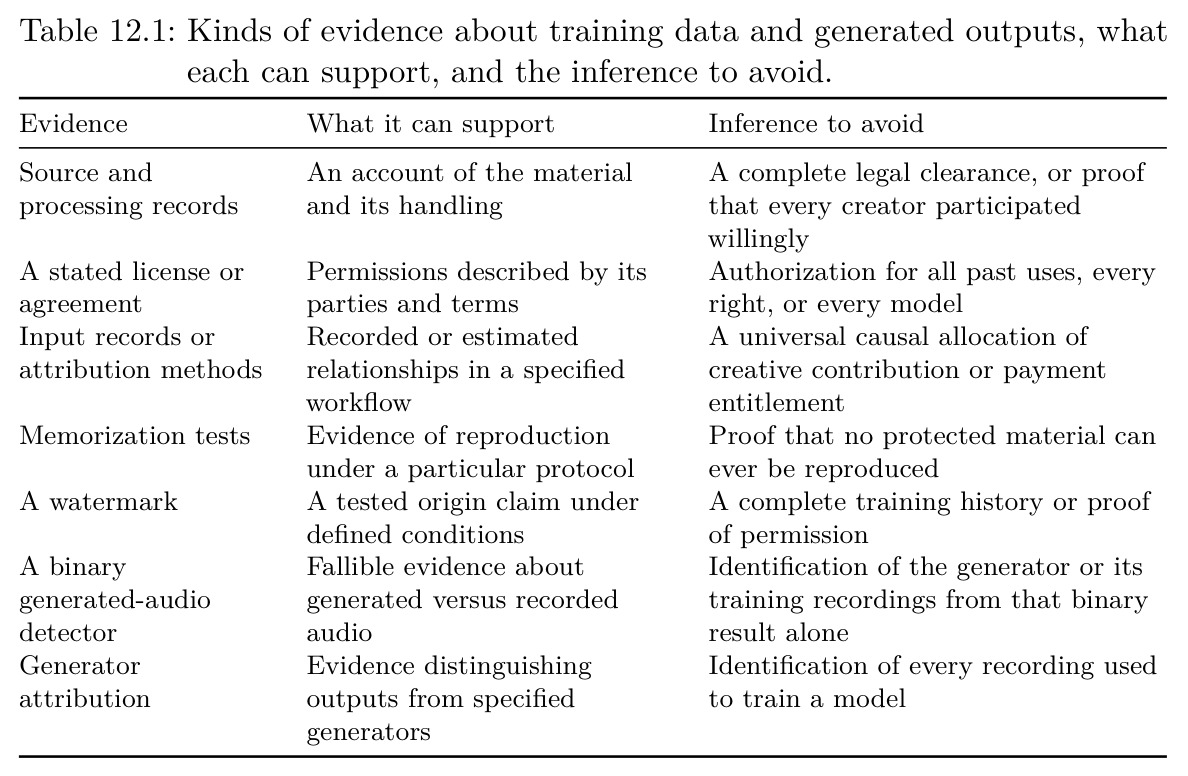
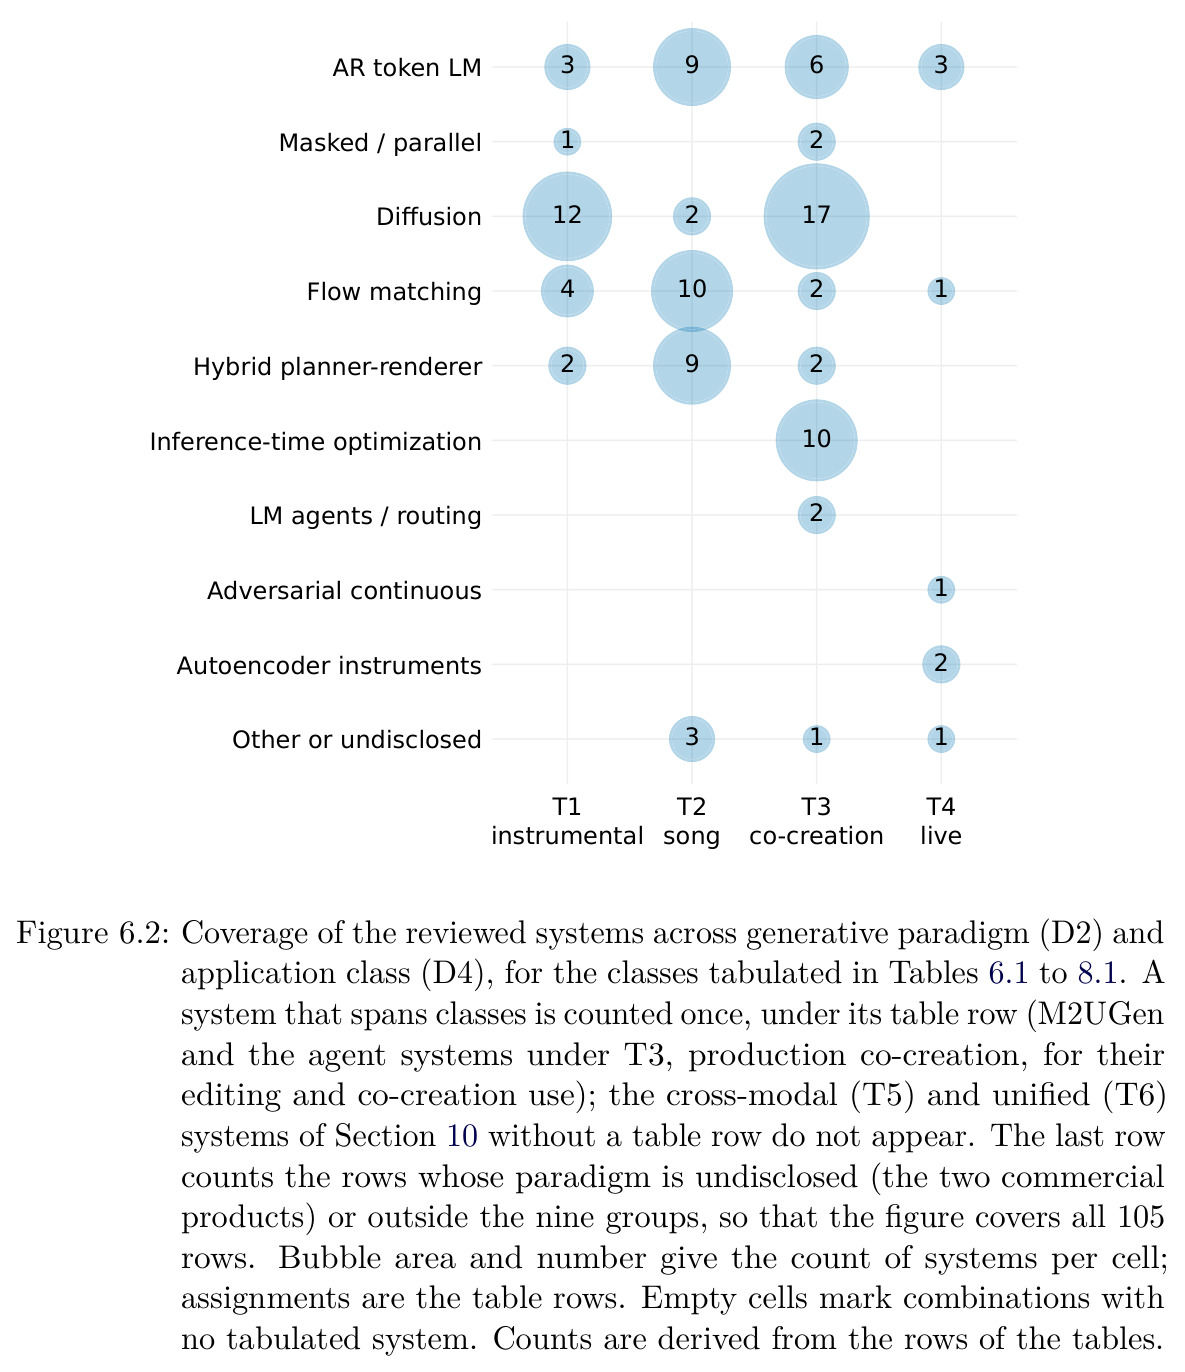
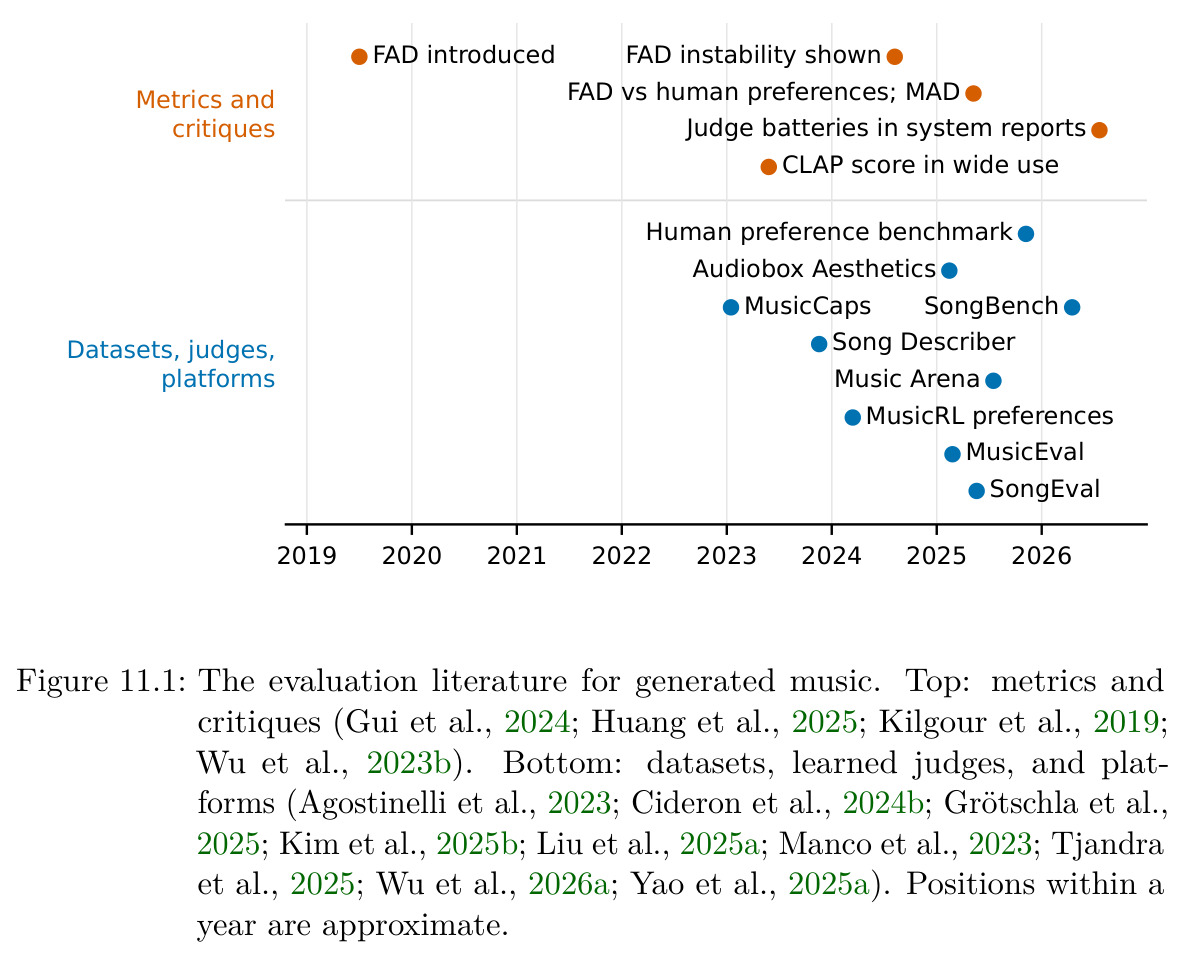
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 30 秒器乐片段的顺序解码成本(MusicGen 贯穿算例) | 顺序解码步数 / 每秒 token 数 | delay pattern 下 1503 步;token rate 200/秒,码率 2200 bps | flatten 展平调度 6000 步(同一模型同一片段) | 顺序步数约 4 倍缩减,质量代价很小 |
| 自动指标与人类偏好的一致性 | 系统排名与 MusicPrefs 成对人类偏好的一致度 | MAD(MERT 嵌入上的 MAUVE 散度)排名与听众更一致 | FAD(VGGish 等固定编码器 + 指定参考集) | 替代弱相关的默认指标,但仅在单一偏好语料上验证 |
| 全曲自动评判 | 与专家结构分数的 Spearman 相关 | SongBench 类多维度全曲 judge:每曲 0.824、每系统 0.893 | FAD / 单一 CLAP 分数(不评结构) | 首次对旋律/编曲/人声/混音/结构分轴打分并给出人类一致性证据 |
| 文本条件下流式音乐生成 | 端到端延迟 / 步数 | Live Music Diffusion Models:8 步采样、延迟 <1 秒、开源权重(消费级 GPU) | 闭源实时 token 模型 Lyria RealTime(2 秒 chunk、10 秒上下文流) | 开源扩散路线追平并在推理成本上改进实时 token 路线 |
| CPU/嵌入式神经乐器合成 | 实时因子(生成时长/耗时) | RAVE:48 kHz 合成约 20 倍实时(笔记本 CPU),部分模型可嵌入硬件合成器 | 大型文本到音乐模型(需 GPU,多数未报实时因子) | 以小时级小语料训练换取 CPU 实时与可演奏性 |
局限与改进
作者明确承认的局限:比较表记录的是文档化版本而非持续更新的产品规格;由于各系统在训练数据、模型规模与评估协议上互不相同,表格无法确定哪项设计变化造就了报告的增益,第 6.4 节特别说明唯一一次范式受控对比发现的是权衡而非赢家;商业歌曲系统全部闭源,表格不对其与开放系统的质量做比较;2026 年是部分出版年,两个检索表达式触达 100 条结果上限可能漏掉较旧的合格文献,5 个本应收录的工作在分类定稿后才被发现而留待下版;多数新工作未被系统性搜索记忆化或水印信息(仅 10/105 有记录)。我自己的观察:作为约百页的 monograph,它对单个系统的描述深度有限,多数系统只有一两句话加表格行,读者仍需回到原文才能复现;九条听测协议是作者建议而非已被社区采纳的标准,其操作性(样本量、功效计算)未给出工具支持;开放性单元格的快照日期为 2026-09-14,此后的变化无从反映;相当比例引用为预印本(文中以标记区分但数量未汇总);作者声明使用 AI 助手检索文献、汇集表格属性并润色语言,虽逐项核对并声明负责,这对引用密度如此之高的综述仍是需要读者留意的因素。
独立分析的弱点
第一,因果证据稀薄:除 Tal et al. (2025) 一次固定数据与架构的范式对比外,几乎所有系统比较都混淆了范式、数据、编解码器与规模,“规划-渲染是否真带来更好的长程结构”没有受控答案;改进方向是建立固定语料(Muse 授权语料或 ICME 2026 挑战设定)、固定算力与评估电池的范式基准。第二,覆盖偏差被点名但无解法:歌曲模型集中于英语和普通话流行音乐,非西方传统在已记录数据中占比极小,评测集带器乐、短片段与西方调性偏置;改进方向是把多语言多文化评测集写进挑战赛与基准的硬性要求。第三,评估建议缺乏操作化工具:九条听测协议没有配套开源框架、功效计算模板或统计代码;改进方向是发布可复用听测脚手架,并把“judge 未被用作训练奖励”做成可声明的元数据标准。第四,planner-renderer 的 exposure bias 只有一个系统提出补救,plan 内容从未在统一协议下比较;改进方向是统一 plan 表示做消融并测量渲染器对退化 plan 的鲁棒性。第五,延迟评估碎片化:实时数字在不同硬件上报告且无共享程序;改进方向是标准化延迟基准并纳入能耗报告。
未来方向
作者在 13.2-14 章列出的开放挑战可直接当作研究议程:流式交互的稳定强化后训练(治理已观察到的 reward hacking——模型趋向重复但连贯的输出)与音乐家共同设计的界面;细粒度控制的统一框架,把 adapter、轻量 conditioner、推理时优化与显式 plan 在同一协议下比较;长程结构(曲式、动机发展、张力)需要经专家验证的评估协议,替代目前仅有自相似矩阵检视和单个 judge 结构轴的现状;共享全曲评估电池,歌词、人声、编曲、结构分轴且 judge 独立于被比系统的训练奖励;把来源披露、记忆化测量、水印及其测试条件做成发布规范;非西方音乐传统与语言覆盖;把稀疏自编码器等可解释性发现连接到可控可审计生成。在此之上可延伸:基于六问题框架自动解析新系统报告并填充比较表;数据归属的市场设计与“输入记录加输出审计”工作流的规模化验证;把符号生成的分布指标引入带符号 plan 的音频系统,打通 D1 的 sketch 类表示;检测侧在 codec 重合成、变速变调、人机混合轨道与广播条件下的鲁棒性仍是公开难题。
复现评估
这篇 monograph 本身无需算力复现,其可复现对象是文献收集与比较表:附录 A 公开 19 个主题组的 arXiv 检索字符串、起始日期与候选数(1115 个候选、1032 个进入筛选,163 个获专门句子、90 个入分组引用)、来源优先级(同行评审 > 预印本 > 模型卡 > 产品文档 > 新闻/法律报告,唯开放性与撤回状态以卡片/仓库为准)及关键日期(检索关闭 2026-09-11、工件观察 2026-09-14),ISMIR 2026 名单监测也一并记录,读者可用相同检索串重复收集并扩充表格。对想复现系统的读者,文中给出选型路线:学术规模从头训练可用 Muse 的授权合成语料与管线,或 ICME 2026 挑战固定数据算力的设定;微调开放基座可选 MusicGen(adapter 生态最全)、ACE-Step、Stable Audio Open、YuE 与 HeartMuLa(连 codec 与训练流程一并开源);CPU/嵌入式部署走 RAVE 系乐器与 Neutone SDK。需注意比较数据以静态表格发布、无配套代码仓库,开放性单元格会随时间漂移,引用时应注明观察日期。
论文图表
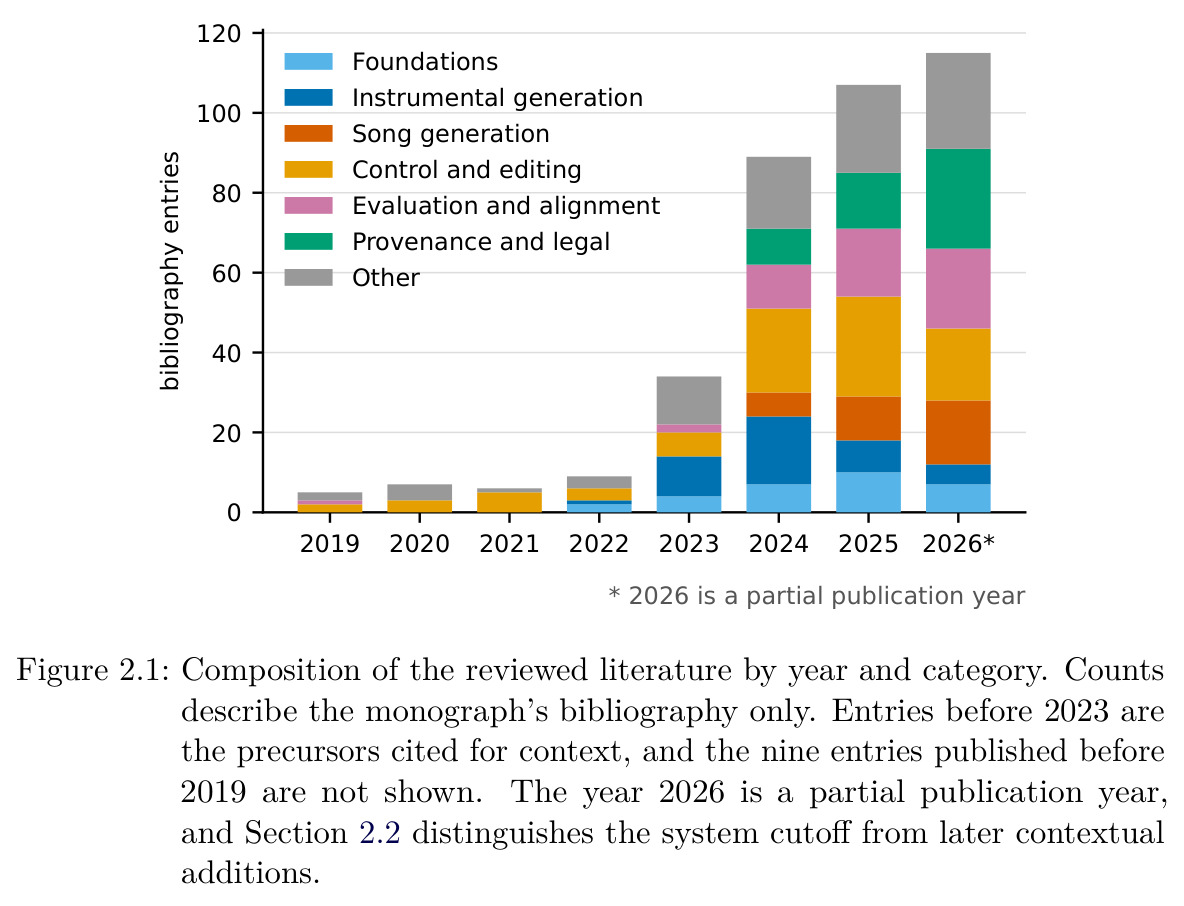
堆叠柱状图,按年份(2019-2026)和类别(基础构件、器乐生成、歌曲生成、控制与编辑、评估与对齐、来源与法律、其他)展示 monograph 参考文献的构成。2023 年前的条目是引言性前身文献,2026 年为部分出版年。
一眼看出该领域文献的爆发时间点:2023 年起每年条目陡增,且歌曲生成与评估/来源类别在 2025-2026 占比显著上升,说明教程选起点(MusicLM)与终点的依据。
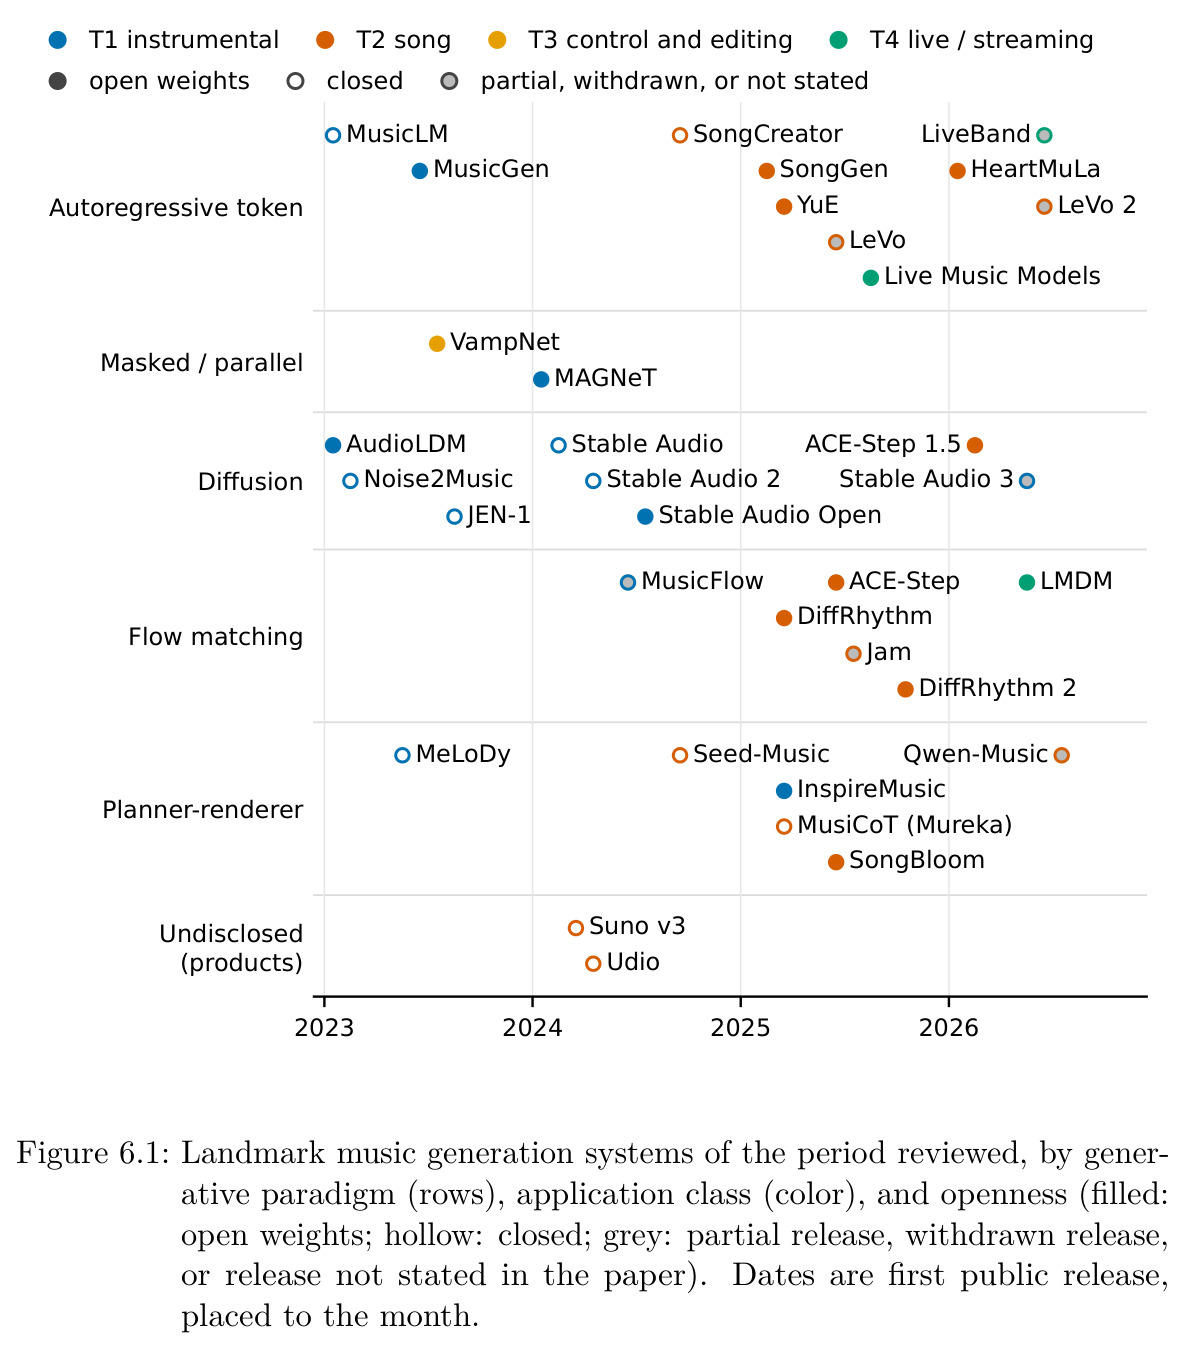
2023-2026 年里程碑系统时间轴:行是生成范式(AR、masked、扩散、流匹配、规划-渲染、未披露产品),颜色是应用类别(T1-T4),实心为开放权重、空心为闭源、灰色为部分/撤回/未说明。
直观呈现领域演化:器乐(2023 起)到歌曲(2024-2025 起)再到实时系统的时间顺序,以及每条范式线上开源与闭源的分布,一张图浓缩了第 6-9 章的系统史。