CARE:面向视觉-语言-动作策略的经验引导原子级纠错执行框架 CARE: Experience-Guided Atomic Corrective Execution for Vision-Language-Action Policies
从失败经验中学习纠错:经验引导数据合成+3D监控原子级纠错,大幅提升VLA恢复成功率
前置知识
VLA(Vision-Language-Action)模型
将视觉观测与语言指令映射为机器人动作序列的通用操作模型,通常以预训练视觉-语言骨干为基础,通过扩散/流匹配或自回归动作 token 化输出连续动作块。它接收图像与指令、输出低层控制,是当前机器人操作的主流范式。
CARE 不改变 VLA 架构本身,而是为其补上“执行失败后如何恢复”的能力。理解 VLA 的输入输出形式(观测+指令→动作)是理解“同一个执行器既做名义动作又做纠错动作”这一设计的前提。
π0 与 π0-FAST
π0 是基于流匹配的 VLA 基座模型,以扩散式生成连续动作块;π0-FAST 使用 FAST 动作 tokenization 自回归地生成离散动作 token,推理更高效。两者分别代表连续生成与 token 化两类主流骨干。
论文所有主实验(RoboTwin 2.0、RoboFactory、真机 SO-101)都围绕这两个骨干做 Base/CARE 成对对比,并在 FSR-Bench 上额外加入 RDT-1B,用以证明 CARE 与底层 VLA 架构正交。
AIC 与 KS 检验
赤池信息准则(AIC)在拟合优度与模型复杂度之间权衡,值越小模型越好;KS 检验比较经验分布与候选参数分布的最大距离,用于 goodness-of-fit 检验。二者常联合用于统计分布选型。
CARE 的核心是失败偏差先验 $p(d\mid k)$:对每个原子阶段的 $\Delta x,\Delta y,\Delta z,\Delta r$ 在 6 种参数分布中用 AIC+KS 选最优拟合。理解这套统计选型流程才能看懂“经验引导”到底引导了什么。
点云几何谓词监控
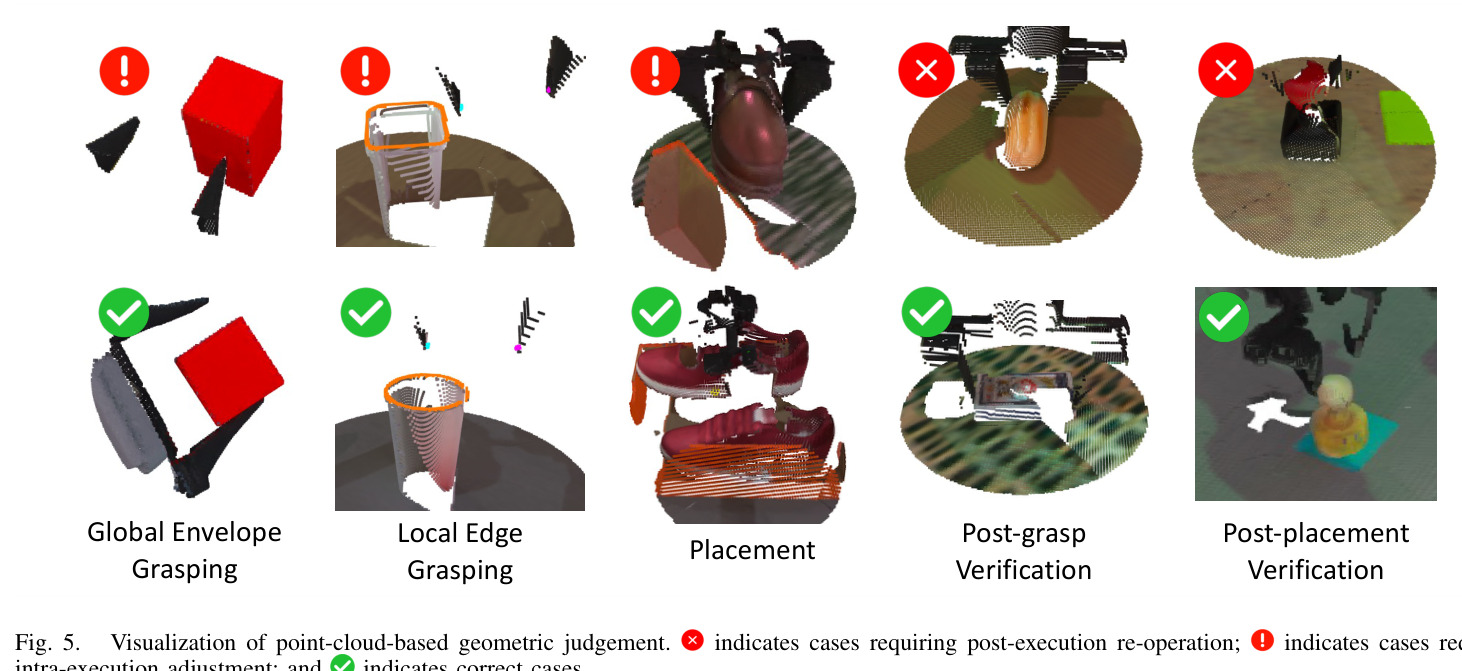
把 RGB-D 观测经分割与深度估计反投影为夹爪、物体、目标区域的点云,再用手工定义的几何关系(距离阈值、投影对齐、支撑面距离等布尔谓词)判断执行状态是否正常,是一种免学习的物理接地监控方式。
CARE 的 3D 监控器就是一个点云谓词检查器(93.8% 准确率、0.24s 延迟),负责在线决定继续执行、触发调整还是重操作,是闭环纠错执行的“什么时候动手”那一半。
失败恢复与 RSR
失败恢复指策略从中间失败状态(如抓空、放偏、物体倾倒)出发,把任务拉回可行轨道的能力。RSR(Recovery Success Rate)定义为在场景规定的恢复步数预算内达到恢复目标的 trial 比例。
FSR-Bench 用 RSR 独立于常规任务成功率地评估恢复能力,且训练用均匀扰动、测试用经验失败分布采样初始化。不理解 RSR 和这一训练/测试解耦设计,就无法正确解读实验部分。
原子阶段分解(Atomic Stages)
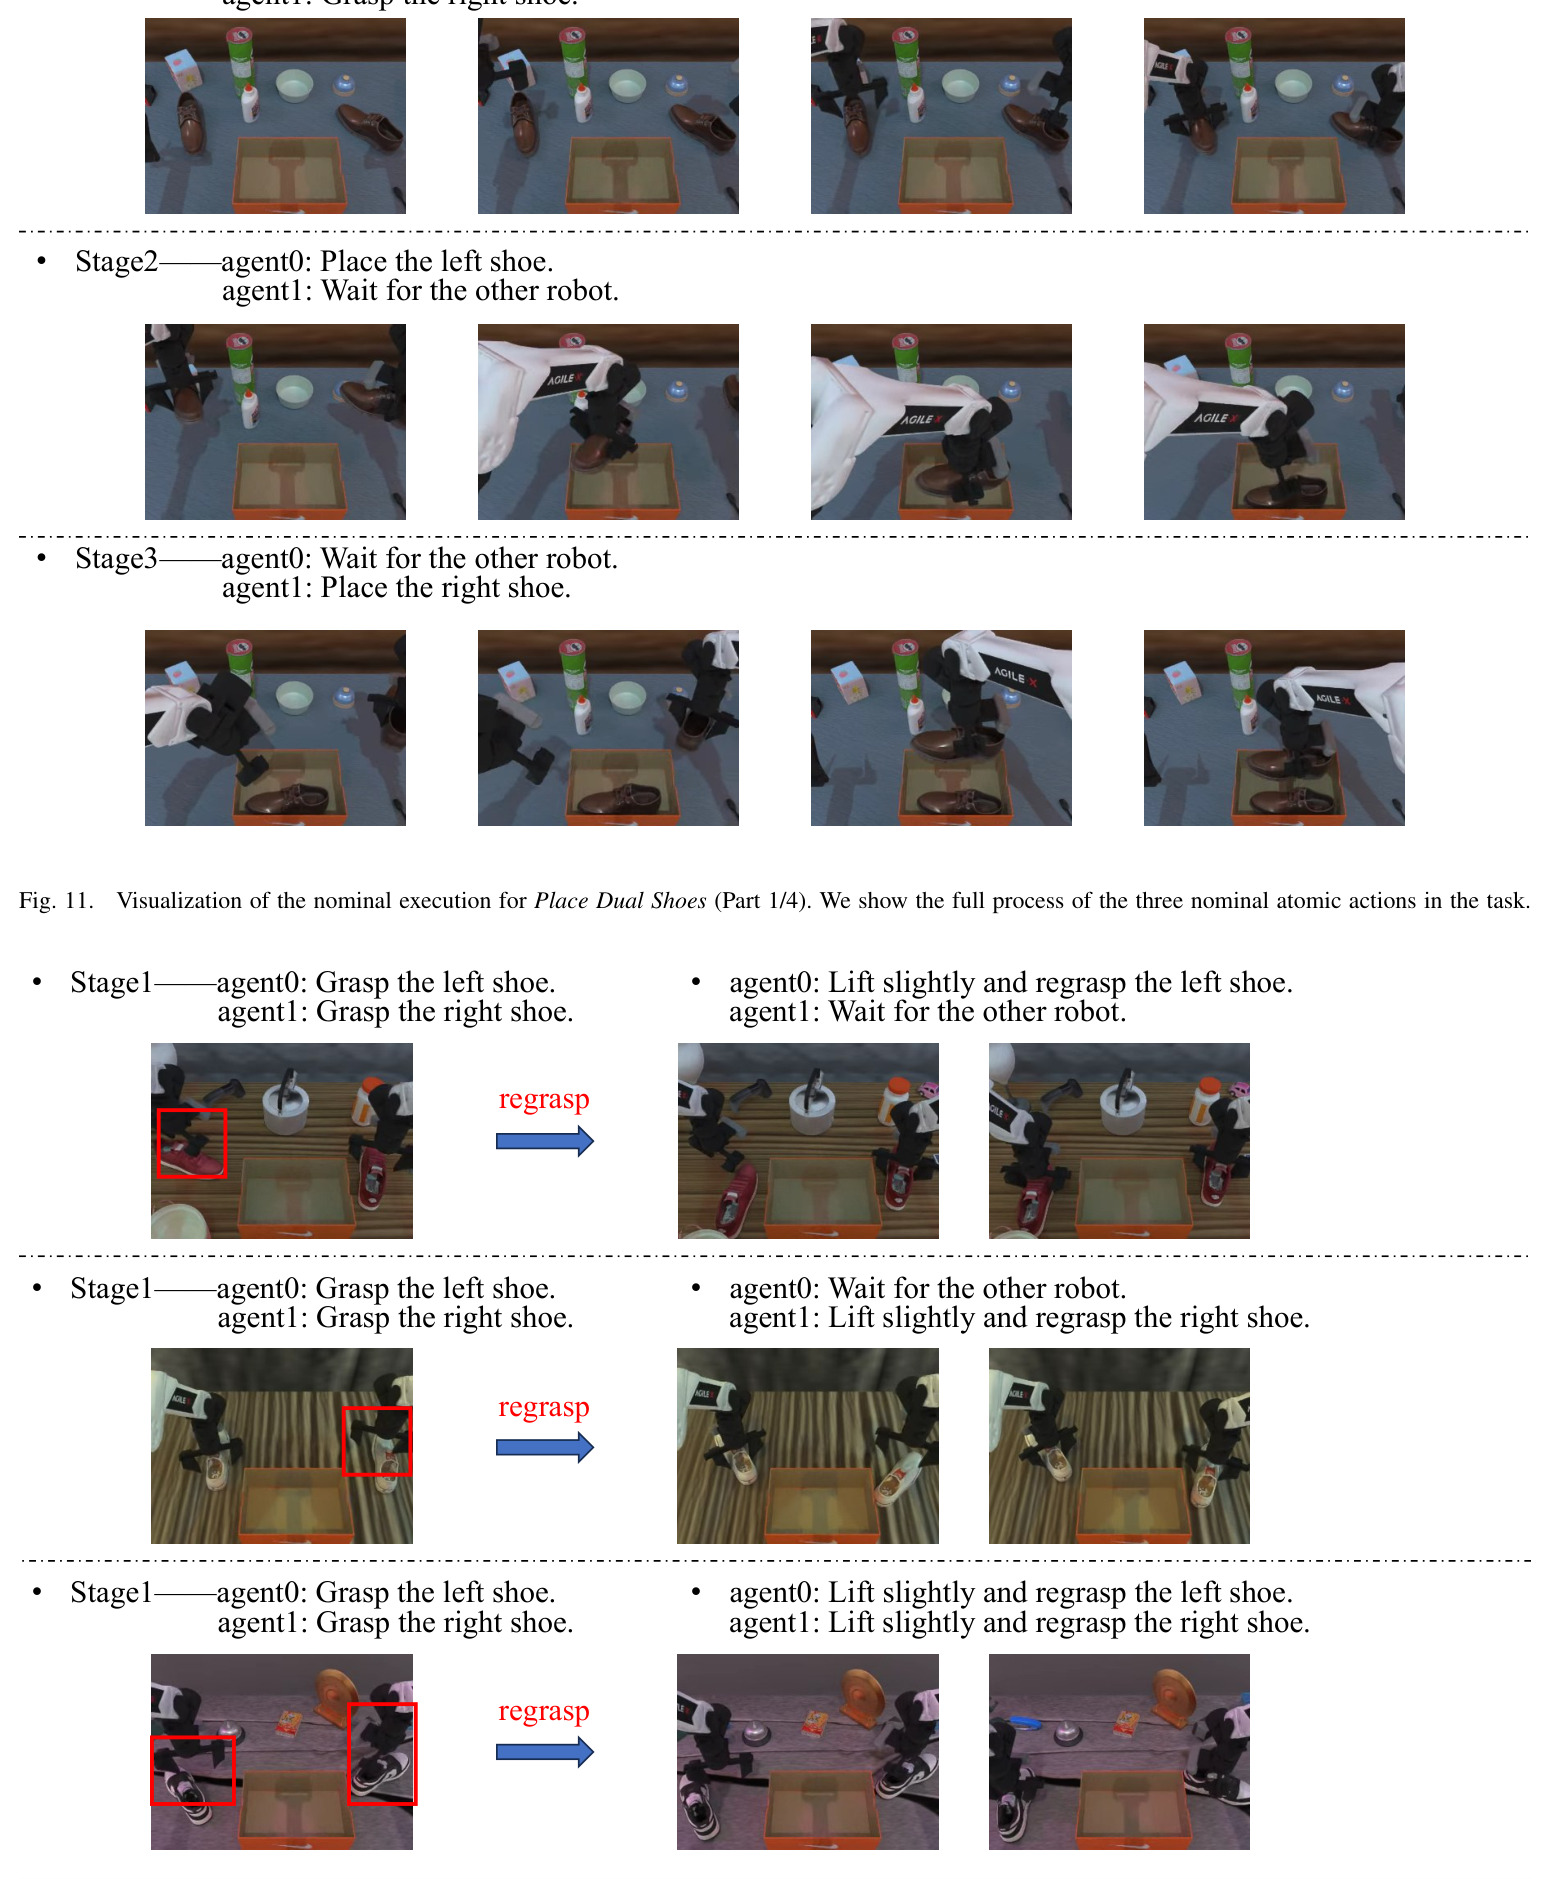
将长程多臂任务拆成抓取、抬升、放置、交接等原子技能的有序序列,每个阶段带名义指令、几何提示、终止谓词和纠错指令池,由规划器一次性生成,执行器逐阶段推进。
CARE 的失败建模是“阶段条件化”的($p(d\mid k)$),数据合成、监控触发、纠错指令调度全部以原子阶段为单位,这个概念贯穿方法与实验的每个环节。
研究动机
VLA 策略几乎只在“标称初始状态+成功演示”上训练,而物理操作中物体打滑、倾倒、放错位置、双臂失同步等偏差司空见惯。以 RoboTwin 2.0 的 7 个硬双臂任务为例,即使最强的 π0 平均成功率也只有 39.6%,π0-FAST 仅 17.4%,ACT 只有 21.1%——一旦执行偏离标称轨迹,策略就进入训练分布中几乎没见过的状态并迅速失败。现有恢复方案各有缺陷:回滚/重规划(如世界模型方法)把失败当异常抹掉,且存在延迟与幻觉;FailSafe、RACER 等用随机或人工设计的扰动生成纠错数据,没有建模“哪些偏差真正由策略自身执行诱发”,监督分布与真实失败分布错配;VLM 检测器缺乏物理接地(本文实测 GPT-4.1 判断准确率仅 71.4%、单次 3.40s),已有 3D 点云监控又局限于单臂场景。
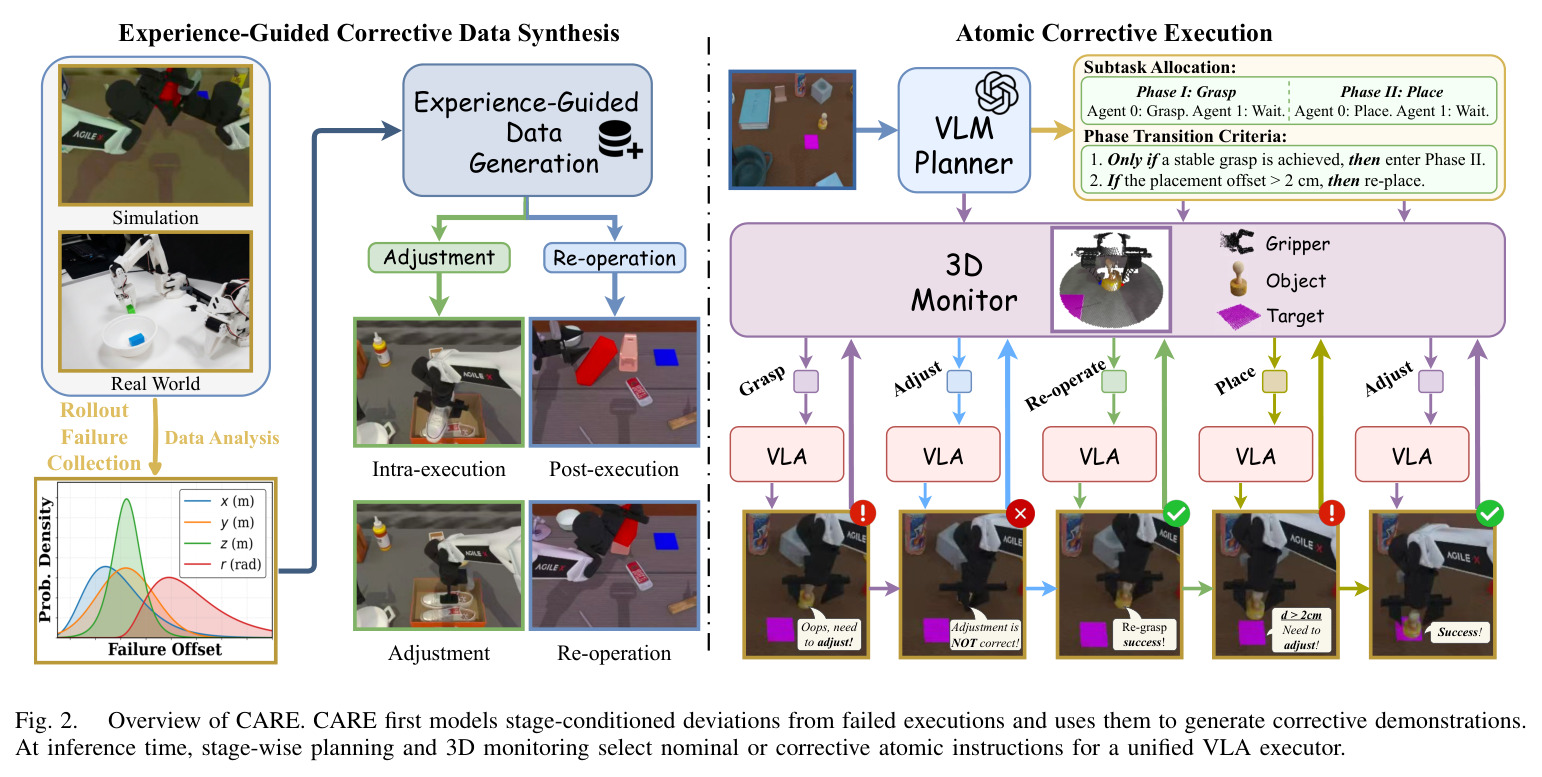
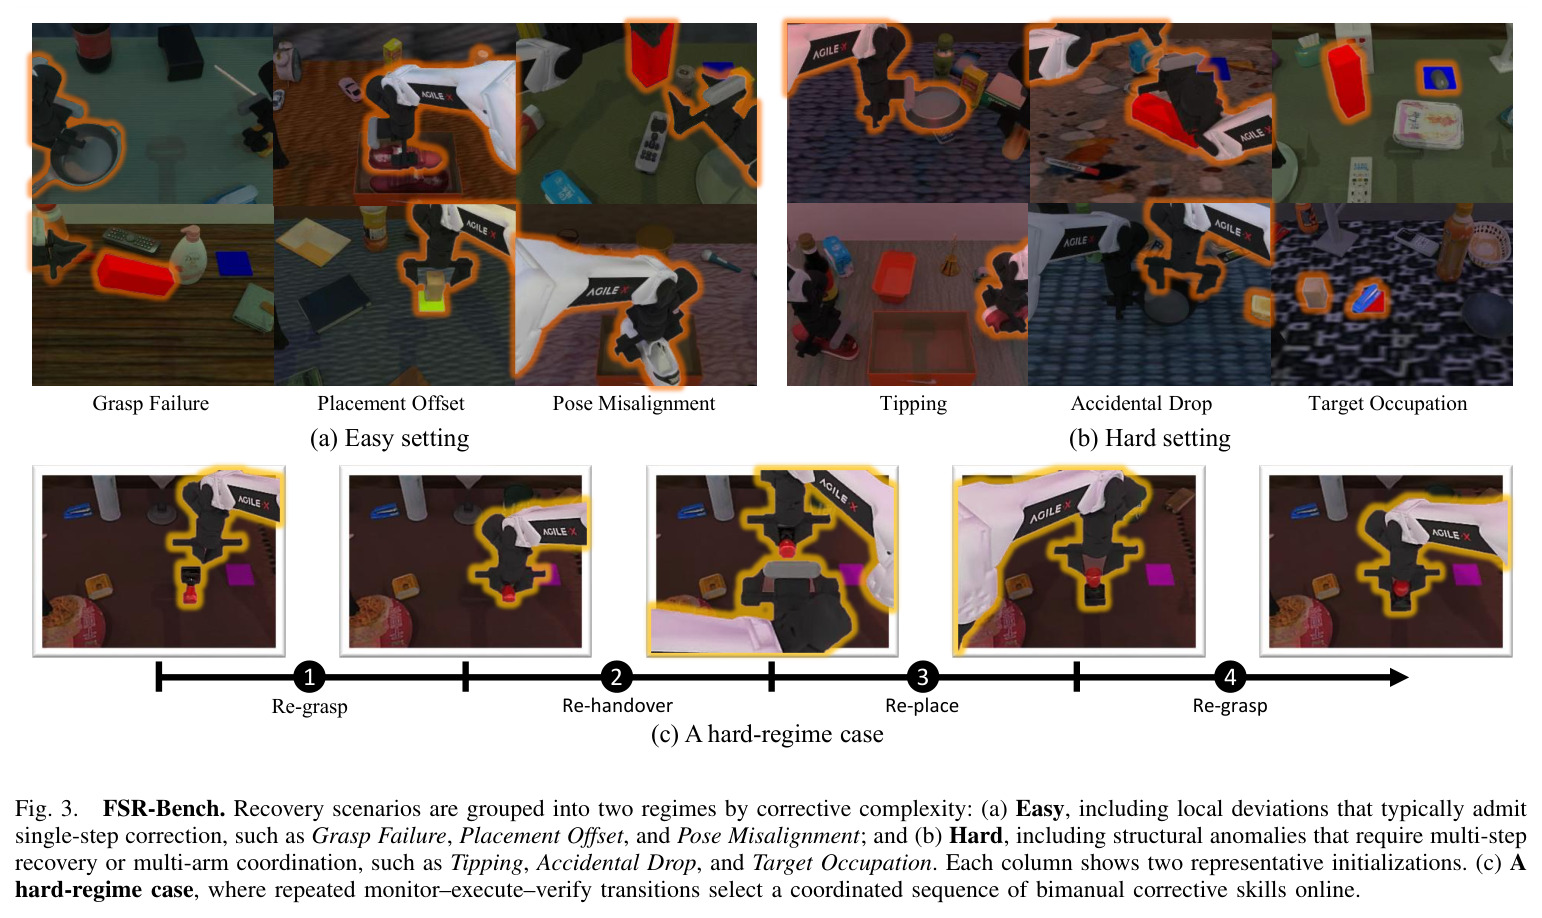
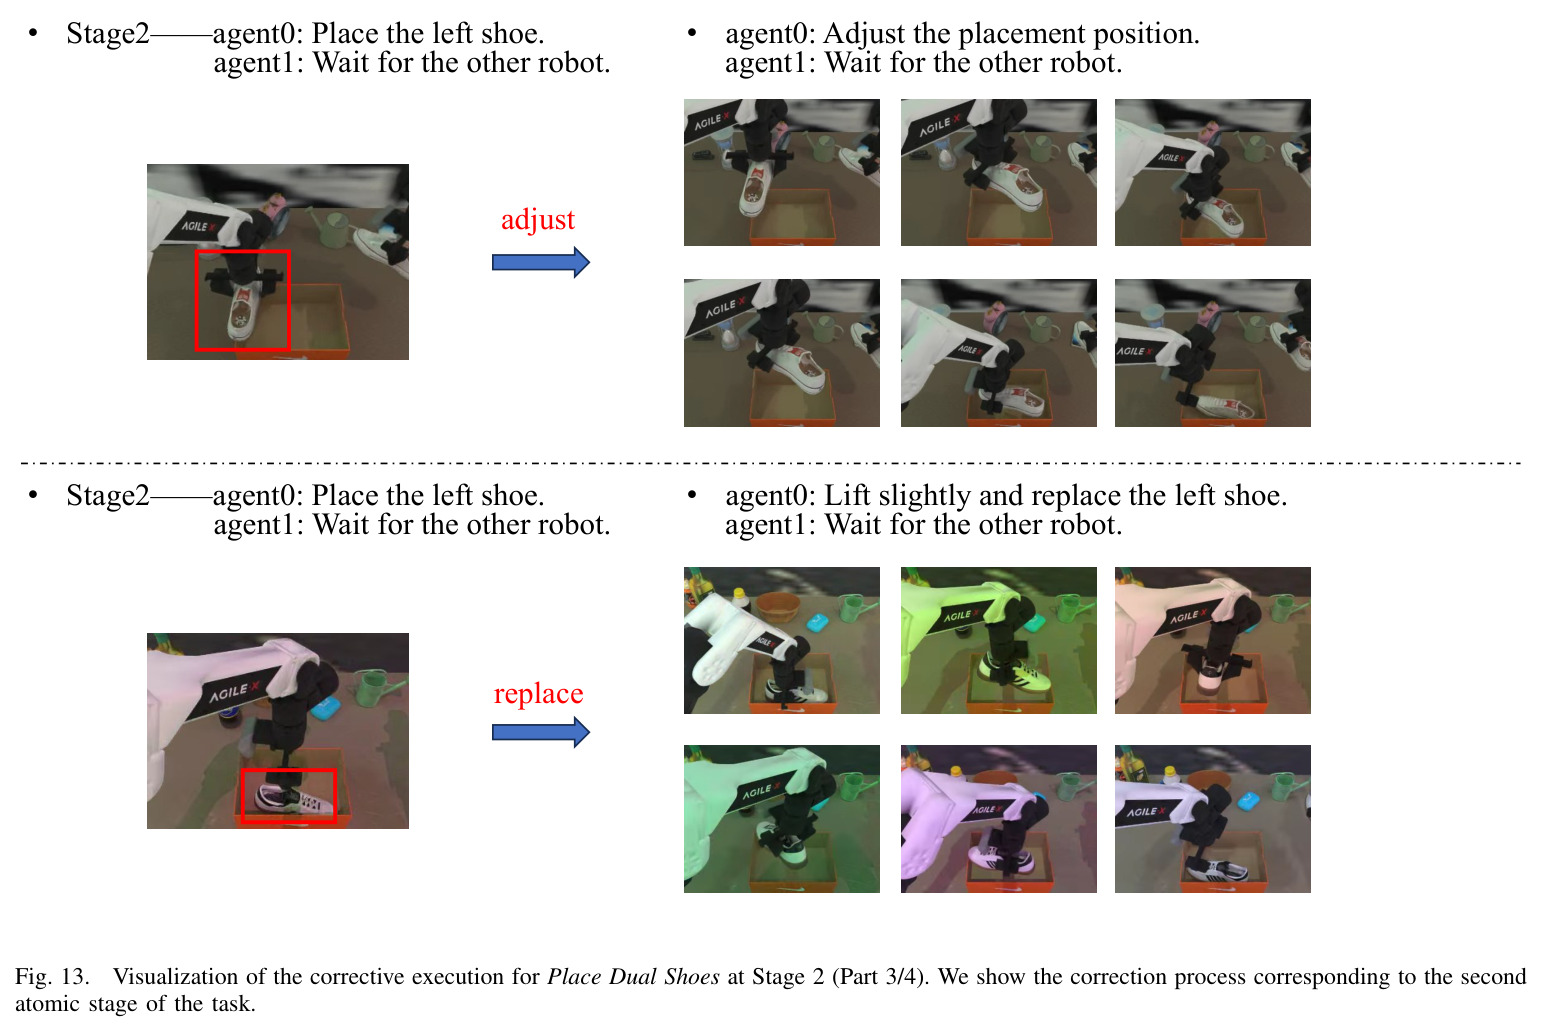
本文的目标是本文回答一个明确的问题:执行失败本身能否为恢复学习提供结构化监督?具体目标有三层。第一,从失败 rollout 中建模阶段条件化的几何偏差分布 $p(d\mid k)$,并据此合成有代表性的新失败状态和短程纠错演示,让 VLA 在自己真实会跌入的失败邻域内学会恢复。第二,构建原子纠错执行框架:GPT-4.1 规划器在任务开始时一次性做原子阶段分解,物理接地的 3D 监控器在阶段关键事件触发“执行内调整”(保留进度就地修正)或“阶段后重操作”(重做当前原子阶段),名义与纠错动作由同一个 VLA 执行器完成,无需切换独立恢复策略。第三,提出 FSR-Bench 基准,从经验失败分布采样初始化,把“恢复能力”从常规任务成功率中独立出来评估。
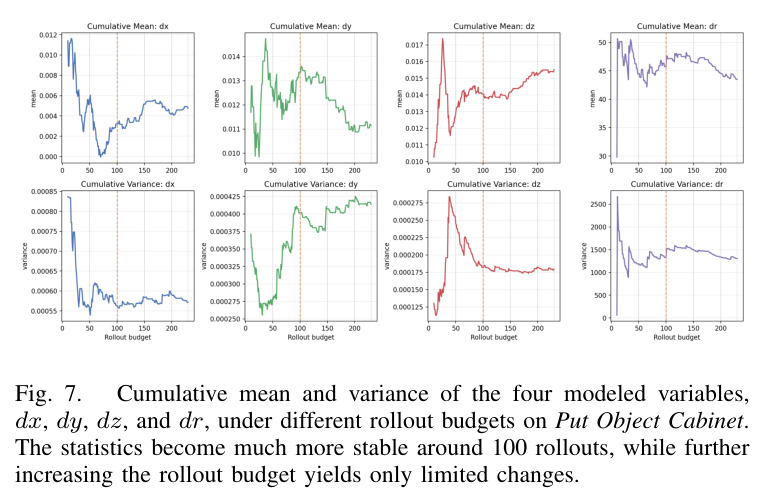
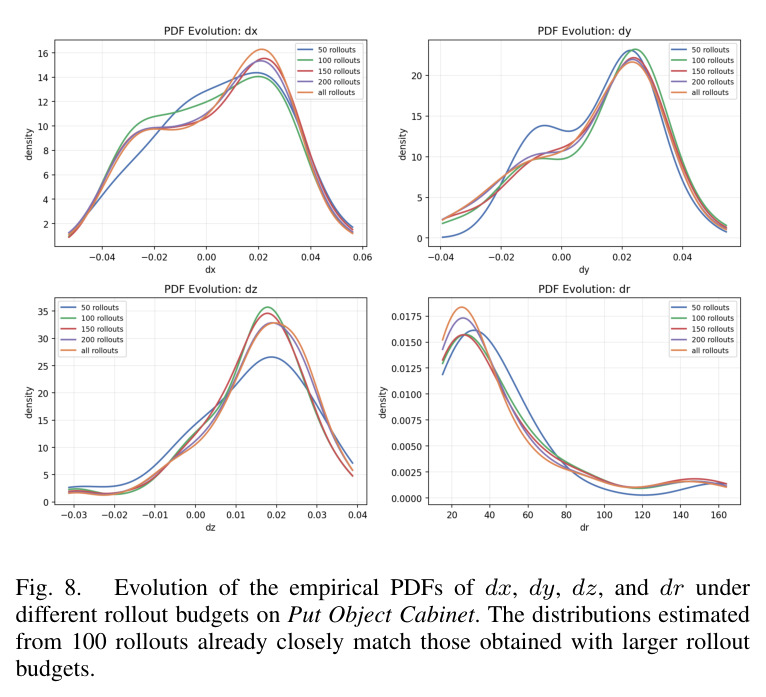
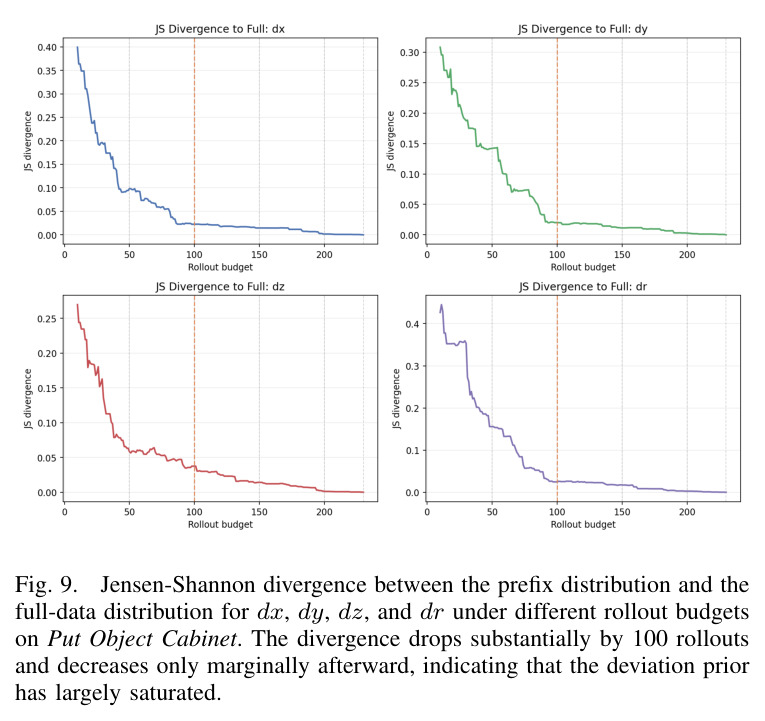
与已有工作不同的是,独特切入是把失败当“经验”而非“异常”。数据侧,与 FailSafe 式均匀随机扰动本质不同,CARE 对每个任务、每个原子阶段独立拟合一组偏差分布($\Delta x,\Delta y,\Delta z,\Delta r$ 各自在 Gaussian/Beta/Gamma/Weibull/Log-Normal/Uniform 六族中用 AIC+KS 选优),只采样策略自己真正会犯的失败,并用 JS 散度分析证明 100 次 rollout 足以稳定先验(散度从 50 次时的 0.058–0.156 降到 0.020–0.037)。执行侧,与 RACER/FailSafe 训练独立恢复策略不同,CARE 的名义、调整、重操作指令共享同一个 VLA 执行器,恢复时不发生策略切换;监控侧用事件触发的点云几何谓词替代 VLM 判断,准确率 93.8%、延迟 0.24s,比 VLM 快 14.1 倍。评估侧,FSR-Bench 刻意让训练用均匀扰动、测试用混合名义策略的经验失败分布,解耦“学什么”和“考什么”。
核心方法
直觉是“从自己的错误中学习”,方法分离线数据合成与在线纠错执行两半。离线半区回答“恢复监督从哪来”:先跑 100 次无纠错的名义执行收集失败,在阶段关键事件(合爪、释放)处记录偏差 $d_i=(\Delta\tau_i,\Delta R_i)$,对每任务每阶段逐标量拟合出经验分布 $p(d\mid k)$;采样新偏差注入标称执行的阶段相关相对位姿($\tau_k\leftarrow\tau_k+\Delta\tau$,$R_k\leftarrow\Delta R R_k$),在物理动力学下前滚得到全新失败状态,再由仿真 IK/运动规划 oracle 或真机遥操作收集只覆盖当前原子恢复目标的短纠错段。在线半区回答“何时调用恢复”:GPT-4.1(温度 0)在任务开始时一次性把指令分解为 $K$ 个原子阶段;3D 监控器在关键事件融合 SAM 3 掩码与 Depth Anything 3 深度为点云,计算几何状态 $q_t$,决定继续、调整或重操作;所有动作由同一个 VLA 以 $a_t\sim\pi(a_t\mid o_t,\tilde{u}_t)$ 生成。
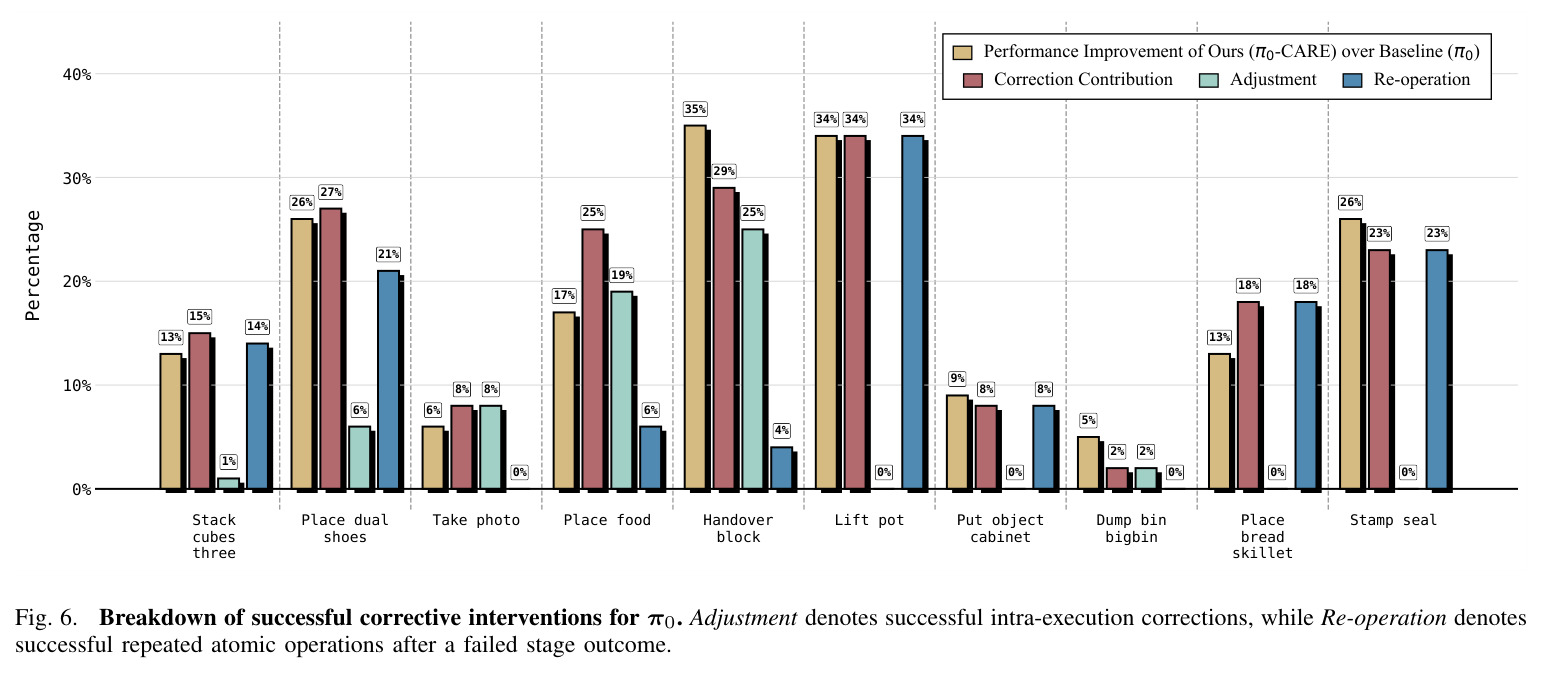
核心创新有三。其一是“经验引导的失败先验”:显式建模策略自身诱发、阶段条件化的失败几何分布 $p(d\mid k)$,而不是拍脑袋的均匀扰动。消融证明在偏差维度、幅度范围、轨迹数量、训练设置完全一致的前提下,仅把均匀采样换成经验拟合分布,平均成功率就提高 12.2(π0)/8.8(π0-FAST)个点——增益来自“先验正确”而非“数据更多”。其二是“原子级纠错执行”:不训练独立恢复策略、不让 VLM 直接给修正动作,而是把恢复拆成执行内调整与阶段后重操作两类原子指令,由 3D 几何监控器在线选择,成功后立即回到标称计划,最大限度保留任务进度。其三是把“学什么”(数据合成)与“何时用”(监控触发)解耦:组件消融显示仅数据 +9.2 点、仅执行 +4.2 点、合用 +23.2 点,二者互补且缺一不可。
方法步骤详情
第一步(失败建模):输入 100 次名义 rollout,某原子阶段不满足终止条件即记失败,在关键事件处计算 $d_i=(\Delta\tau_i,\Delta R_i)$——抓取在合爪瞬间量测夹爪-物体错位,放置在开爪瞬间量测物体-目标错位,旋转简化为偏航 $\Delta R_i=R_z(\Delta r_i)$。第二步(分布拟合):对 $\Delta x,\Delta y,\Delta z,\Delta r$ 各自在 Gaussian/Beta/Gamma/Weibull/Log-Normal/Uniform 六族中拟合,AIC+KS 选优得到 $p(d\mid k)$。第三步(数据合成):采样 $d\sim p(d\mid k)$,扰动 $\tau_k\leftarrow\tau_k+\Delta\tau$、$R_k\leftarrow\Delta R R_k$ 后物理前滚生成新失败状态;仿真用 IK/运动规划 oracle、真机用遥操作收集纠错演示,轨迹达到当前原子恢复目标即截断。第四步(VLM 规划):GPT-4.1 读初始全局图像与指令,一次性输出每阶段 $\Pi_k=(u_k,\gamma_k,\psi_k,\mathcal{U}_k)$,$\mathcal{U}_k=\mathcal{U}^{adj}_k\cup\mathcal{U}^{re}_k$ 为调整与重操作指令池。第五步(3D 监控):事件触发地用 SAM 3+Depth Anything 3 融合点云 $P_{g,t},P_{o,t},P_{tar,t}$,计算 $q_t=\Phi(\cdot)$,按 $\tilde{u}_t=f_{mon}(\Pi_{k_t},q_t)$ 选择指令;几何一致则继续,阶段内偏差触发调整,阶段失败触发重操作;$\psi_{k_t}$ 满足则推进到 $k_t+1$,重试预算耗尽则恢复失败。第六步(VLA 执行):$a_t\sim\pi(a_t\mid o_t,\tilde{u}_t)$,观测含机器人状态、全局与腕部 RGB。
技术新颖性
与 FailSafe 的区别不在数据量而在采样分布:Table VI 控制变量实验表明,同样的偏差维度、范围、轨迹数与训练设置下,仅换采样分布就带来 +12.2/+8.8 点,说明先验本身是收益来源。与回滚方法相比(Table XI:回滚 45.7% vs CARE 64.0%),回滚只能撤销累积误差,教不会策略在当前失败状态如何行动。与 RACER/FailSafe 的独立恢复策略不同,CARE 保持单一执行器,避免名义/恢复策略切换带来的分布跳变,且对骨干无关(π0、π0-FAST、RDT-1B 一致受益)。监控侧不学分类器、不依赖 VLM:技能级谓词模板一次定义、跨任务复用,数值容差(如 $\delta_{geg},\delta_{safe},\delta_{place}$)从 rollout 统计校准,在物体繁多的 Put Object Cabinet 上仍达 96% 准确率,比 GPT-4.1 判断高 22.4 点、快 14.1 倍。此外合成失败是物理前滚产生的新状态而非重放,FSR-Bench 的训练/测试分布解耦进一步排除了“背题”效应。
实验结果
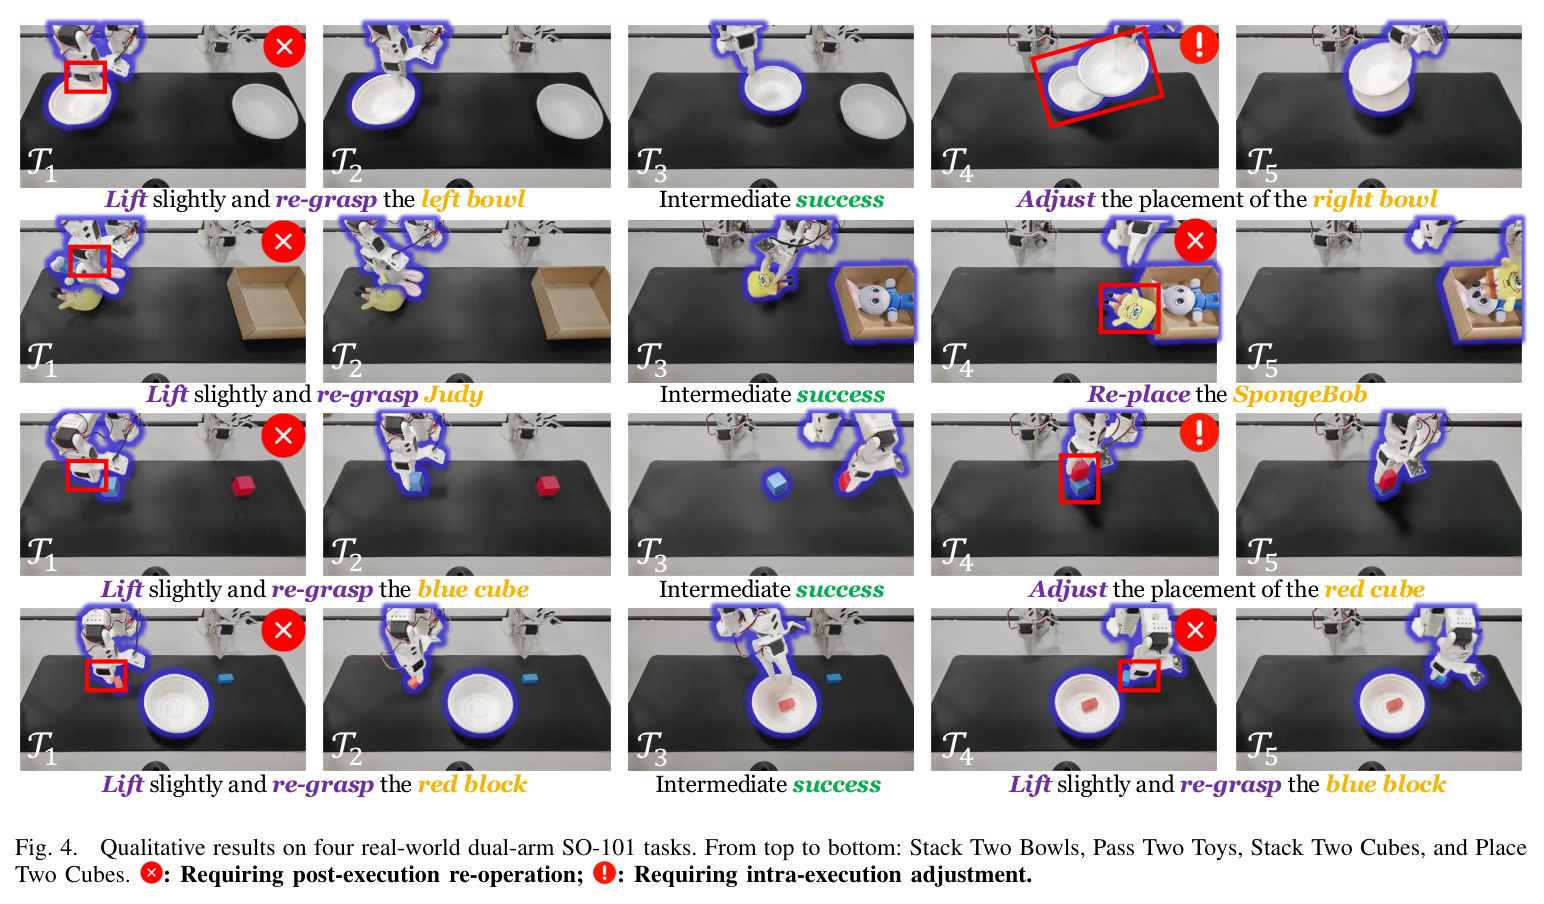
RoboTwin 2.0 七个硬双臂任务:CARE 把 π0 平均成功率从 39.6% 提到 60.7%(+21.1 点),π0-FAST 从 17.4% 提到 33.1%(+15.7 点),远超 ACT(21.1%)、DP(25.4%)、DP3(28.1%)等基线。RoboFactory 多臂协作(2/3/4 臂):π0 62.0%→74.0%(+12.0 点),π0-FAST 26.7%→36.0%(+9.3 点),四臂拍照上 π0 82%→88%。FSR-Bench 为隔离执行机制贡献而禁用经验引导合成、三骨干统一用 50 条/恢复类型的均匀纠错轨迹:π0 的 RSR 在 Easy 38.8%→57.2%、Hard 15.8%→21.2%;π0-FAST 24.4%→32.6%、4.6%→10.8%;RDT-1B 21.8%→25.2%、2.6%→6.0%,平均恢复提升 7.5 点。真机 SO-101 四个双臂任务:π0 30.8%→50.0%、π0-FAST 18.8%→31.3%,超专门恢复方法 FailSafe 13.7/7.3 点。汇总仿真平均 +14.5 点、真机 +15.9 点。消融:仅纠错数据 π0 31.6%→40.8%(+9.2),仅执行框架 35.8%(+4.2),全 CARE 54.8%(+23.2),两者互补。监控消融:3D 监控准确率 93.8% vs VLM 71.4%,延迟 0.24s vs 3.40s(14.1 倍)。经验 rollout 数:50/100/150 次对应 45.0%/51.5%/51.0%,100 次为拐点,JS 散度已从 50 次的 0.058–0.156 降至 0.020–0.037。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboTwin 2.0 硬双臂任务(7 个,短+长程平均) | 任务成功率 | 60.7%(π0+CARE) | 39.6%(π0 原版) | +21.1 点 |
| RoboTwin 2.0 硬双臂任务(π0-FAST) | 任务成功率 | 33.1%(π0-FAST+CARE) | 17.4%(π0-FAST 原版) | +15.7 点 |
| RoboFactory 多臂协作(2/3/4 臂平均,π0) | 任务成功率 | 74.0%(π0+CARE) | 62.0%(π0 原版) | +12.0 点 |
| RoboFactory 多臂协作(π0-FAST) | 任务成功率 | 36.0%(π0-FAST+CARE) | 26.7%(π0-FAST 原版) | +9.3 点 |
| FSR-Bench Easy 域(5 个恢复任务,π0) | 恢复成功率 RSR | 57.2%(π0+CARE) | 38.8%(π0 原版) | +18.4 点 |
| FSR-Bench Hard 域(π0) | 恢复成功率 RSR | 21.2%(π0+CARE) | 15.8%(π0 原版) | +5.4 点 |
| 真机 SO-101 双臂任务(4 个,π0) | 任务成功率(100 trials/任务) | 50.0%(CARE) | 30.8%(原版 π0);36.3%(FailSafe) | +19.2 点;超 FailSafe +13.7 点 |
| 真机 SO-101 双臂任务(π0-FAST) | 任务成功率 | 31.3%(CARE) | 18.8%(原版);24.0%(FailSafe) | +12.5 点;超 FailSafe +7.3 点 |
| 纠错数据采集策略消融(经验引导 vs 均匀随机) | 平均任务成功率 | 56.6%(π0)/24.6%(π0-FAST) | 44.4%(π0)/15.8%(π0-FAST) | +12.2 / +8.8 点 |
| 回滚恢复 vs CARE(3 个仿真任务,π0) | 平均任务成功率 | 64.0%(π0+CARE) | 39.7%(原版);45.7%(回滚) | 超回滚 +18.3 点 |
局限与改进
作者承认或可从数据直接读出的局限:(1) Hard 域绝对恢复率仍低——FSR-Bench 上 π0+CARE 的 Hard 平均 RSR 仅 21.2%,面对倾倒、目标被占、意外掉落这类需要多步或多臂协同的结构性失败,恢复能力远未解决;(2) 重试预算耗尽后恢复直接判失败,系统没有计划级的反思与重规划;(3) 偏差先验只建模平移三分量加偏航角($\Delta R_i=R_z(\Delta r_i)$),俯仰/横滚类失败(如物体倾倒)不在分布支撑内;(4) 谓词模板需为每个新原子技能手工定义一次、容差靠 rollout 统计校准,跨具身与跨技能泛化未验证;(5) FSR-Bench 的训练刻意用均匀扰动、测试用经验分布,这个保守设计实际上低估了完整 CARE(经验引导+执行框架)在恢复场景的上限;(6) 真机验证只有 4 个双臂任务、单一 SO-101 平台,未涉及液体、柔性物等接触丰富场景。
独立分析的弱点
独立分析的弱点及改进方向:(1) 多步结构性恢复薄弱——Seal Stamp Recovery Hard 上 π0+CARE 仅 24%,短程纠错段数据难覆盖级联失败,可引入 RL 微调或树搜索式多步恢复规划。(2) 旋转建模过度简化——放置类失败中俯仰/横滚错位常见(FSR-Bench 的 Pose Misalignment 类型),标量偏航 $\Delta r$ 无法表达,应扩展到完整 $SO(3)$ 或 6D 旋转分布。(3) 几何谓词脆弱——真机 Pass Two Toys 监控准确率仅 86%,遮挡、反光或异形物体下阈值化谓词会误触发/漏触发,可加谓词置信度估计与多帧时序滤波,或用学习式残差判别器兜底。(4) 规划一次成型不可修正——若 GPT-4.1 初始分解违反物理依赖,监控无法触发重规划,可设计“终止谓词连续失败 N 次即回调规划器重分解”的机制。(5) 失败先验按“任务×阶段”独立估计、无跨任务迁移,每个新任务都要 100 次预 rollout,可在技能层面建共享先验库。(6) 分布外失败(新物体、新干扰)不在 $p(d\mid k)$ 支撑内,可在线检测 novel failure 并增量更新先验。
未来方向
作者明确提出的方向是将强化学习集成进 CARE 以进一步增强恢复能力。基于其成果还可延伸:(1) 用已合成的失败-恢复配对做 offline RL 或偏好优化,替代昂贵的 IK oracle 与人工遥操作演示;(2) 把经验先验从平移+偏航扩展到全 6D 位姿并引入力/触觉信号,覆盖打滑、倾倒等接触丰富失败;(3) 监控-规划闭环:谓词反复失败时触发 VLM 在线重规划,处理计划级错误与重试预算耗尽问题;(4) 跨任务、跨具身的技能级先验迁移与谓词模板库建设,降低新任务 100 次 rollout 的数据门槛;(5) 在 FSR-Bench 中加入可变形物体、动态干扰与更长的失败级联,检验先验的外推极限;(6) 与世界模型结合,用学习到的前滚预测替代物理引擎做失败状态合成,把经验引导框架推广到没有精确仿真的真实场景。
复现评估
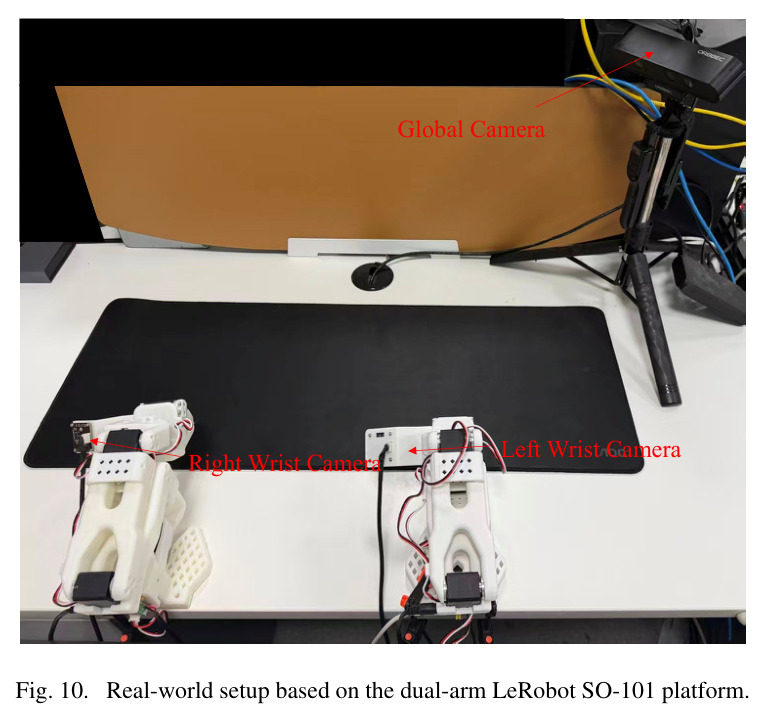
复现条件较好:代码、模型、数据开源在 https://github.com/xiaojunlan/care,补充材料给出完整协议——标准任务每方法 150 条名义演示+每错误类型 50 条额外轨迹,经验先验需每任务 100 次预 rollout;FSR-Bench 每恢复类型 50 条均匀纠错轨迹、20k 步训练;π0/π0-FAST 训练 40k 步、batch 32、动作视野 50、学习率分别为 $3\times10^{-5}$ 与 $5\times10^{-5}$,硬件 2×A800 80GB,ACT/DP/DP3/RDT-1B 配置也逐表列出。监控侧 SAM 3 与 Depth Anything 3 在单张 RTX 4090 即可运行,VLA 由 A800 服务器远程推理。仿真复现门槛主要是双卡 A800 算力与闭源 GPT-4.1 API;真机复现需双臂 LeRobot SO-101(12 自由度、30Hz 全局+腕部相机)、遥操作采集(每任务 50 条名义+每错误类型 20 条)与每任务 100 次预执行,人力成本较高。FSR-Bench 的 36 个失败场景全部图示、每任务-域 100 次评估且所有方法共享预生成失败初始化,对比公平。总体:仿真中等偏易,真机中偏高但协议足够细。
论文图表
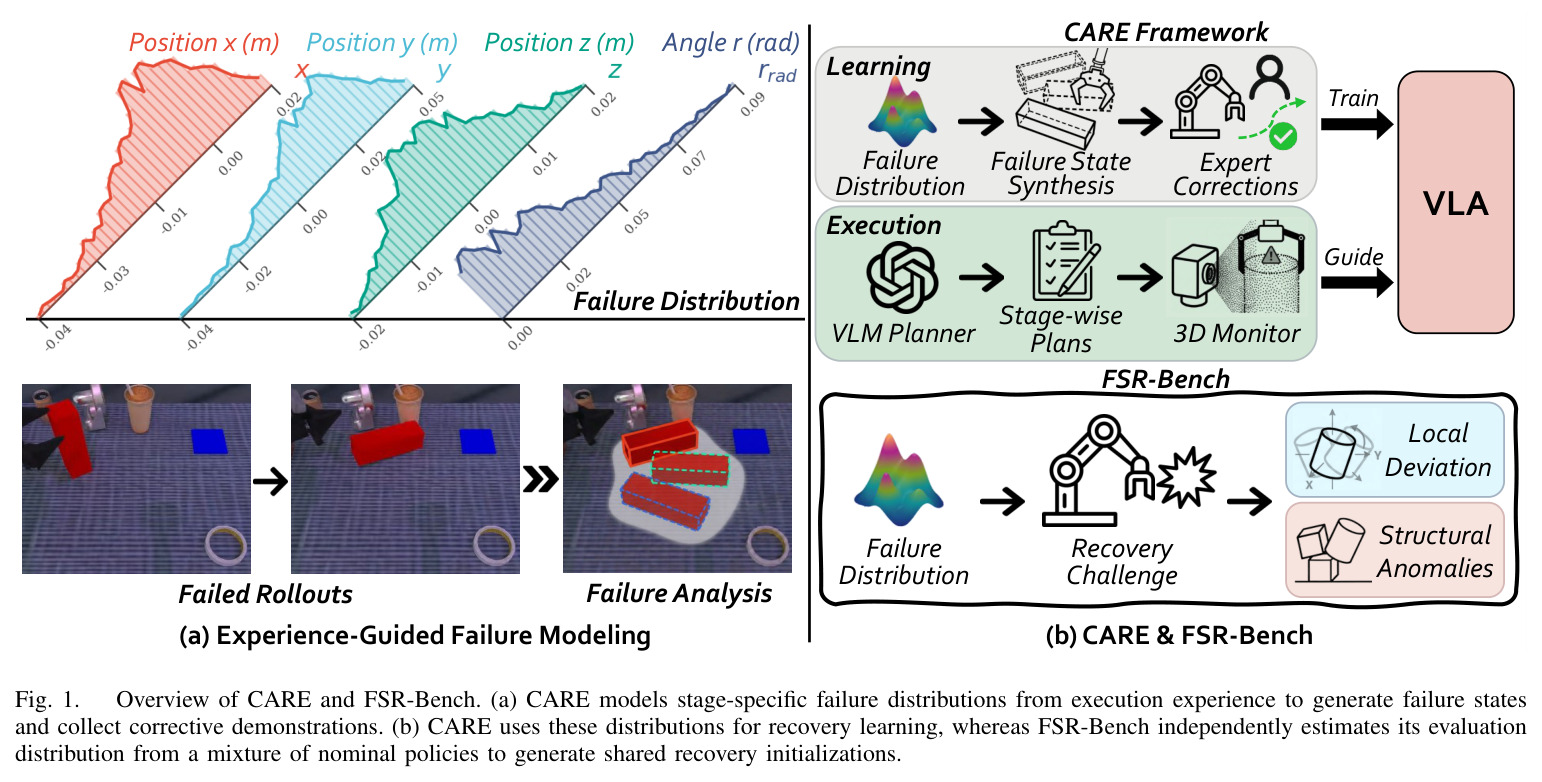
左半展示 CARE 的经验引导失败建模流程:收集失败 rollout、分析失败分布、合成失败状态并采集专家纠错演示;右半展示 CARE 与 FSR-Bench 的关系:CARE 用这些分布做恢复学习,FSR-Bench 则从混合名义策略独立估计评估分布以生成共享的恢复初始化。
一图看清论文两大贡献的分工与联系:训练监督来自经验分布,评估初始化来自另一套独立估计的经验分布,这种解耦设计是理解实验公平性的关键。
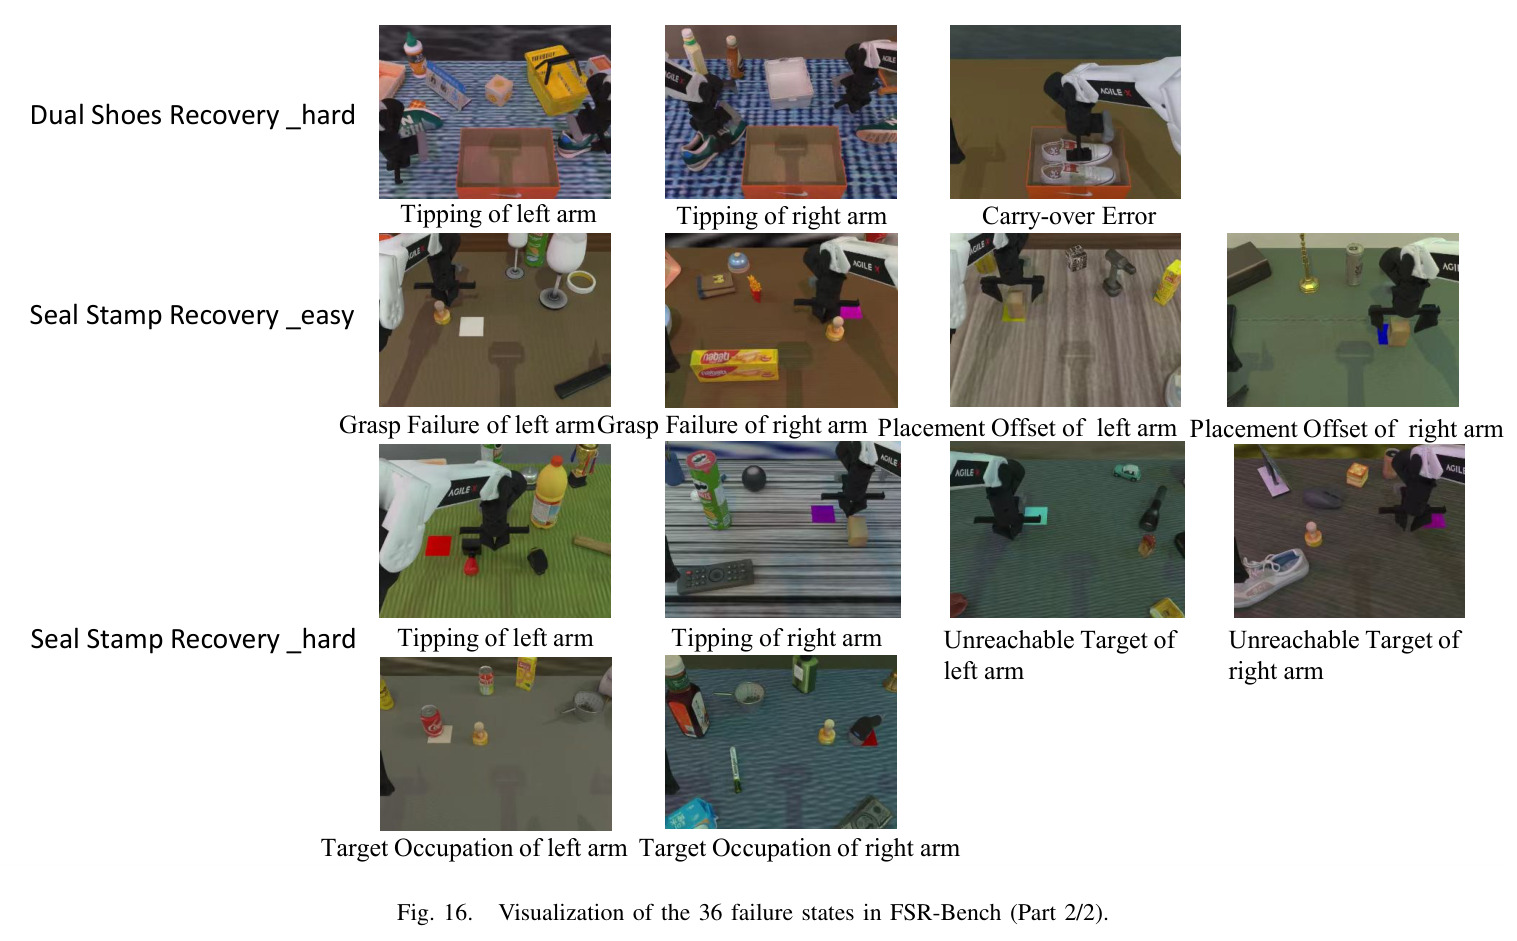
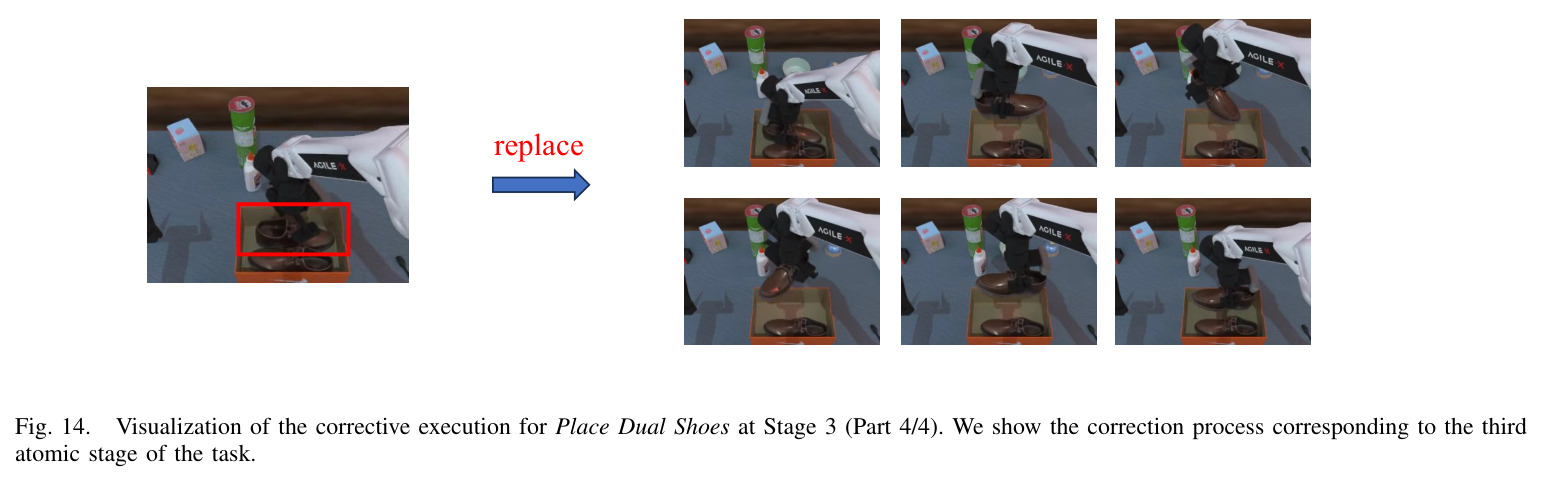
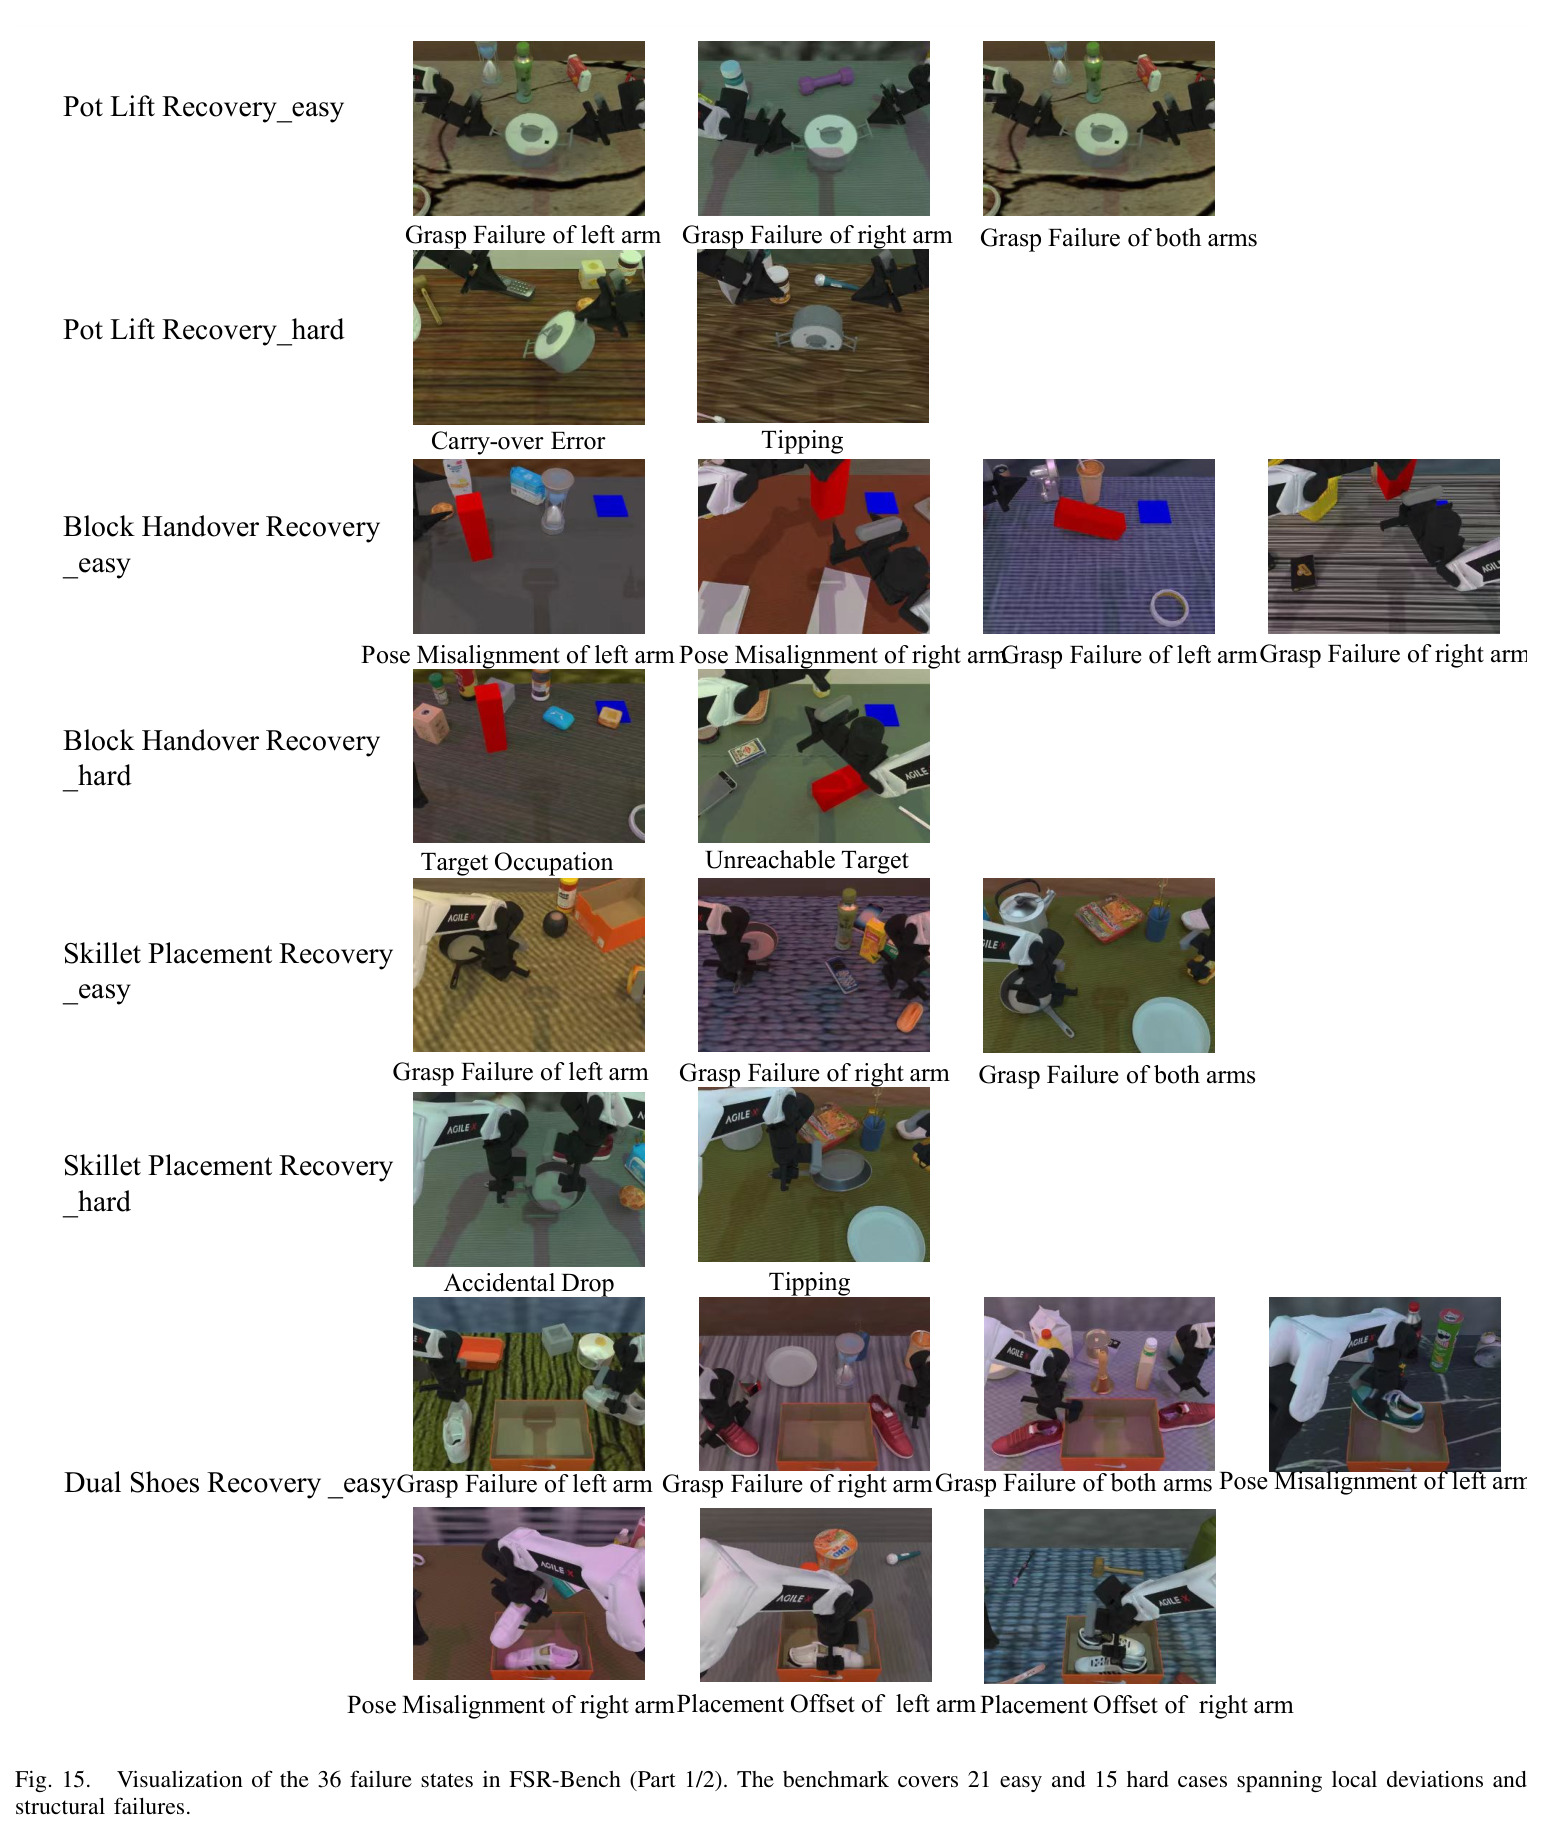
36 个失败状态图集后半部分:覆盖 Dual Shoes Hard、Seal Stamp Recovery 的 Easy/Hard 场景,包括双臂倾倒、遗留错误、放置偏移、不可达目标、目标被占等失败状态的实物照片。
与 Fig. 15 合起来完整公开基准的失败状态空间,保证 FSR-Bench 的可复现性与评估透明度。
RoboTwin 2.0 七个硬双臂任务(LP/SS/PBS/PDS/POC/HB/DBB)上 8 个方法的成绩:ACT 21.1%、RDT-1B 18.0%、DP 25.4%、DP3 28.1%、π0-FAST 17.4%→CARE 后 33.1%、π0 39.6%→CARE 后 60.7%,其中 Place Dual Shoes 从 14% 升到 40%、Handover Block 从 27% 升到 62%。
主结果表,量化 CARE 在最难的仿真双臂基准上对两类 VLA 骨干的一致提升幅度,是论文核心声明的第一证据。
RoboFactory 三个多臂协作任务(双臂放置食物、三臂堆三个方块、四臂拍照):DP 20.7%、π0-FAST 26.7%→36.0%、π0 62.0%→74.0%,CARE 在 2/3/4 臂设置下全面提升,如双臂放置食物 π0 56%→73%、三臂 48%→61%。
证明方法可扩展到双臂之外的多臂协同场景,这是多数已有失败恢复工作(多为单臂)无法覆盖的设置。
FSR-Bench 上 RDT-1B/π0-FAST/π0 三骨干的原版与 CARE 版在 5 个恢复任务的 Easy/Hard 域 RSR:π0 Easy 平均 38.8%→57.2%、Hard 15.8%→21.2%;π0-FAST 24.4%→32.6%、4.6%→10.8%;RDT-1B 21.8%→25.2%、2.6%→6.0%;如 PLR_easy 上 π0 30%→78%。
该表刻意禁用经验引导合成、三骨干统一均匀纠错数据,从而把执行框架本身的贡献隔离出来,是方法两部分贡献分解的关键证据。
真机 SO-101 四个双臂任务上 π0 与 π0-FAST 的原版、FailSafe、CARE 三种配置对比(每任务 100 trials):π0 平均 30.8%→FailSafe 36.3%→CARE 50.0%;π0-FAST 18.8%→24.0%→31.3%;如 Pass Two Toys 上 π0 15%→CARE 42%。
真机主结果表,且包含与专门恢复方法 FailSafe 的系统级对比,证明 CARE 的优势不只是离线数据更好,在线执行机制同样关键。
组件消融:π0 基线 31.6%,仅加纠错数据(Data)40.8%(+9.2),仅加执行框架(Execution)35.8%(+4.2),全 CARE 54.8%(+23.2);π0-FAST 同样趋势(11.8%→20.8%/13.8%/31.6%);全 CARE 与 Data-only 之间 14.0/10.8 点的差距隔离出在线原子纠错执行的净贡献。
证明经验引导数据与原子纠错执行缺一不可且大致互补,是理解方法为何要同时做两件事的核心表。
纠错数据采集策略消融:均匀随机(FailSafe 式)vs 经验引导,两者偏差维度、范围、轨迹数与训练设置完全一致,只差采样分布。经验引导使 π0-CARE 平均 44.4%→56.6%(+12.2),π0-FAST-CARE 15.8%→24.6%(+8.8),如 LP 任务 π0 66%→91%。
直接验证论文最核心的主张——失败分布先验本身(而非数据量)是收益来源,是“经验引导”这个名字的实证支撑。
监控机制消融:在相同触发观测与人工决策标签下,GPT-4.1 VLM 监控平均准确率 71.4%、延迟 3.40s/次,3D 监控准确率 93.8%(+22.4 点)、延迟 0.24s(快 14.1 倍);如 Handover Block 上 VLM 仅 50% vs 3D 监控 96%。
论证用物理接地的点云谓词替代 VLM 判断的合理性,准确率与延迟双优势是系统能在线闭环的前提。
FSR-Bench 每个任务 Easy/Hard 域的最大恢复步数预算:Pot Lift 100/400、Skillet Placement 200/250、Block Handover 400/500、Seal Stamp 200/500、Dual Shoes 200/400,Hard 域预算更大以容纳结构性异常所需的多步纠错。
定义 RSR 的评估口径(恢复目标与步数预算跨方法共享),是正确解读 Table III 数字的协议基础。
FSR-Bench 失败类型到任务的映射:位姿错位、抓取失败、放置偏移属 Easy 域;倾倒、不可达目标、目标被占、意外掉落、遗留错误等结构性失败属 Hard 域,如遗留错误出现在 PLR_hard 与 DSR_hard。
给出基准的失败分类体系,解释 Easy/Hard 两域的定义边界以及为什么 Hard 域需要多步或多臂恢复。
经验 rollout 数消融(纠错监督量固定为每错误类型 50 条):LP/PDS/HB 三任务平均成功率 50 次为 45.0%、100 次 51.5%、150 次 51.0%;如 Lift Pot 上 π0 从 83%(50 次)升至 91%(100 次)。
确定先验估计的数据成本拐点,说明方法在实际部署中“100 次预 rollout”是性价比最优配置。
回滚恢复对比(回滚用同一 3D 监控检测偏差后恢复到上一原子阶段末状态再继续名义执行):π0 原版平均 39.7%、回滚 45.7%、CARE 64.0%;如 Place Dual Shoes 上回滚仅 18% vs CARE 40%。
证明“只撤销误差不教新行为”的回滚路线收益有限,凸显显式纠错监督+原子执行组合的必要性。
技能级 3D 监控在 11 个仿真/真机任务上的判定准确率:多数任务 94–98%,物体繁多的 Put Object Cabinet 96%,最难的真机 Pass Two Toys 86%,全部平均 93.2%。
验证谓词模板跨任务复用的鲁棒性(尤其是多物体类别场景),支撑监控器无需任务特定学习分类器的设计选择。