驯服机器人执行误差下的视觉-语言-动作模型:自补偿与压力测试 Taming VLAs under Robot Execution Errors: Self-Compensation and Stress Testing
用指令-执行残差在线适应VLA预补偿机器人执行误差,并提出RoboStress压力测试基准
前置知识
VLA(视觉-语言-动作模型)
将摄像头图像与语言指令直接映射为机器人动作的大规模多模态策略,代表工作有π0、π0.5、OpenVLA。通常由视觉-语言骨干(如PaliGemma)加一个动作专家(action expert)组成,输出末端执行器的增量位姿或关节指令,可完成抓取、放置、开抽屉等通用操作。
本文的研究对象就是VLA:自补偿方法和RoboStress基准全部围绕π0/π0.5这类模型展开,必须先清楚其输入(图像+指令+本体状态)与输出(动作块)的形式。
动作分块(action chunking)
策略每次预测一段长度为K的未来动作序列(本文K=50),机器人只执行其中前nexec步(仿真nexec=5、真机nexec=10)再重新预测。分块让动作平滑连贯,但代价是大部分预测动作并未真正执行,也就得不到关于它们的执行反馈。
残差只对已执行的那几步可观测,伪目标块的构造(未执行步保留原值)和在线缓冲区设计都直接依赖这一机制。
流匹配(flow matching)
一种生成式建模框架:学习速度场 $v_\theta$,把高斯噪声 $\epsilon$ 沿流匹配时间 $u\in[0,1]$ 连续输运到数据(这里是动作块),训练目标是回归预测速度与目标速度 $(\epsilon-a)$ 的差异。π0/π0.5正是用流匹配生成动作的策略。
自补偿的训练目标 $\mathcal{L}_{comp}$ 就是把流匹配的回归目标从原动作块替换为补偿后的伪目标块,不懂流匹配就看不懂损失函数。
LoRA 低秩适配
冻结预训练权重,只训练注入线性层的低秩矩阵乘积 $AB$(秩 $r$ 很小)。本文给π0约3.24B参数中300M的Gemma动作专家的全部线性投影加秩4的LoRA,可训练参数仅276万(占0.085%),且 $B=0$ 初始化使适配器初始等效于恒等映射。
只有约276万参数在线更新,方法才能在20–30Hz的控制循环里异步完成适配而不拖垮推理,这是部署期可行的关键。
本体感知与SO(3)对数映射
本体感知指机器人经编码器读到的自身关节/末端位姿,无需外部传感器。旋转位移在SO(3)流形上不能直接相减,需用对数映射 $\mathrm{Log}_{SO(3)}(R_{t+1}R_t^{-1})$ 转成轴角向量,再除以指令缩放系数 $(c_p,c_r)$ 折算到归一化动作空间,才能与指令做残差。
补偿信号 $\eta^{obs}=\Delta x-a^{policy}$ 的计算完全依赖本体感知和这套坐标系/尺度对齐,是整个方法正确性的基础。
关节级执行误差:摩擦/齿隙/柔性/重力补偿误差
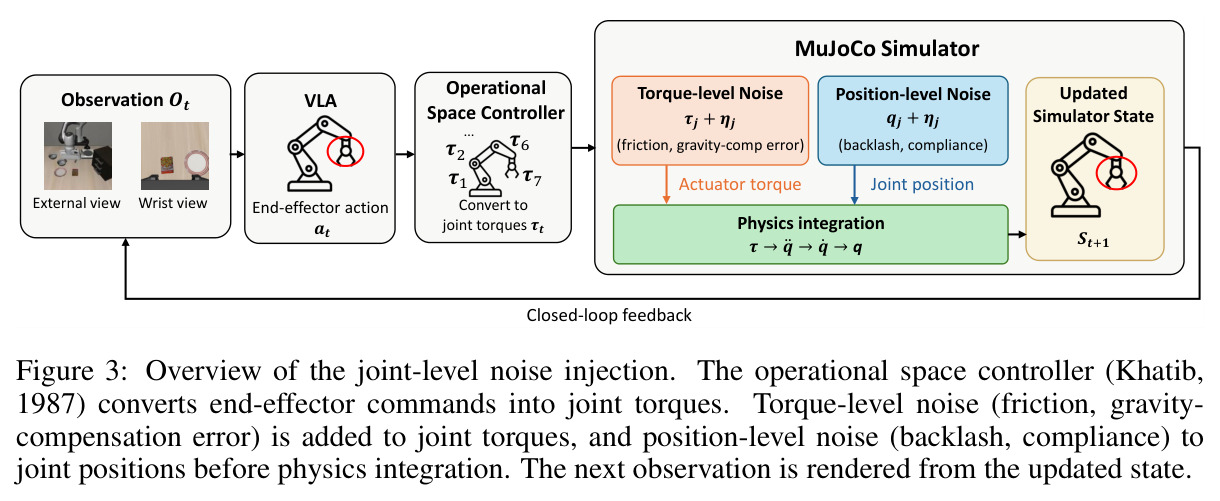
真实机械臂因机械与工况产生的四类典型误差:Stribeck摩擦(低速静摩擦抬高)、齿隙backlash(换向死区,电机转而连杆不动)、关节柔性compliance(负载下弹性形变,二阶弹簧-阻尼动态)、重力补偿误差(惯量或负载估计不准留下构型依赖的残余力矩)。它们依赖机器人当前状态乃至运动历史。
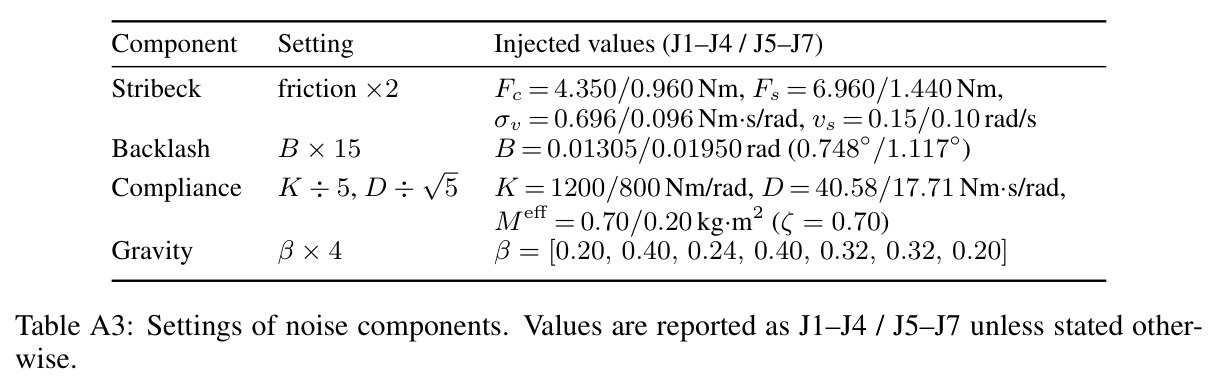
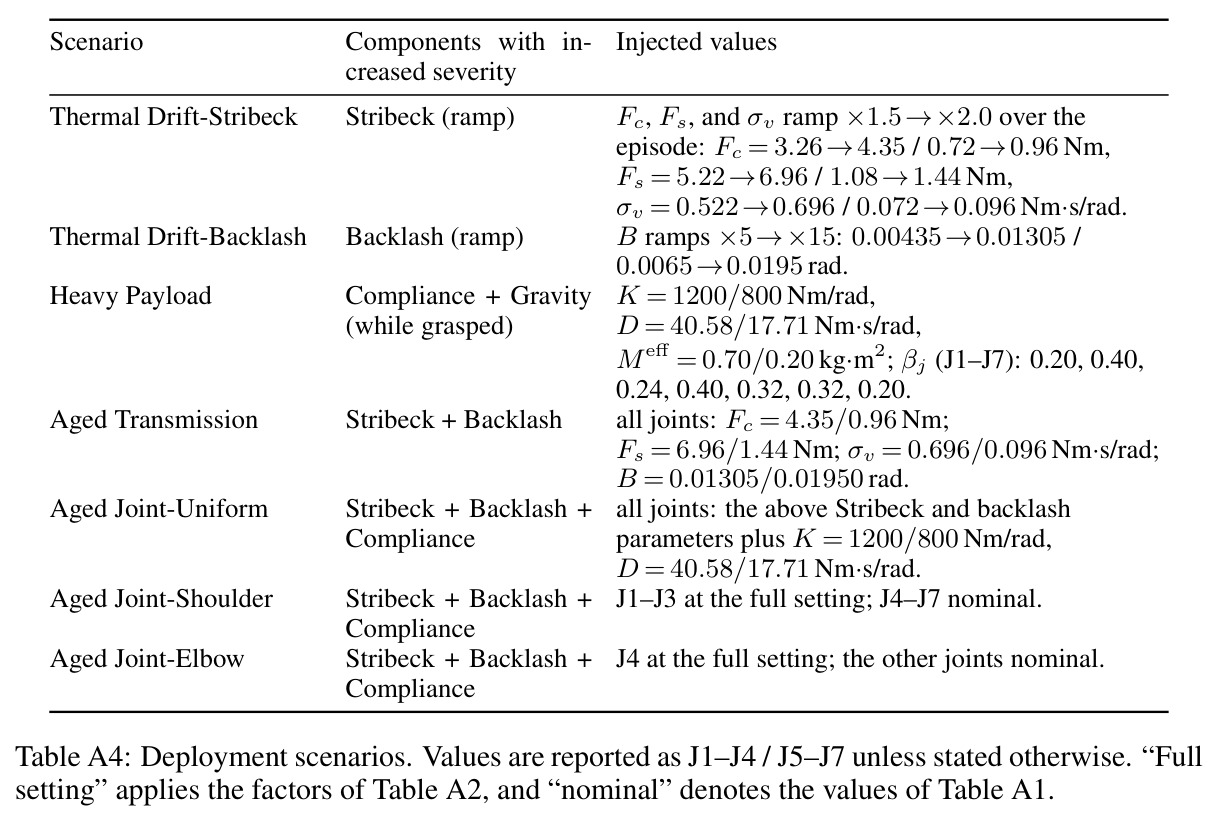
RoboStress就是在仿真控制管线的对应环节注入这四类噪声并组合出七个部署场景,理解它们才能看懂基准设计和各场景考察的鲁棒性维度。
域随机化与对抗鲁棒训练
域随机化(DR)在训练期给动作指令加高斯噪声(本文 $\sigma\sim U[0,0.05]$),希望策略天生对执行扰动鲁棒;RobustVLA则用PGD对抗样本在 $\ell_\infty$ 半径 $\varepsilon=0.03$ 球内做鲁棒强化后训练。两者都在训练期生效,与本文的部署期自适应正交。
它们是论文的主要对比基线,主结果表中Base/DR/RobustVLA/Ours四列的比较是核心证据,需理解其与本文方法的本质差别。
研究动机
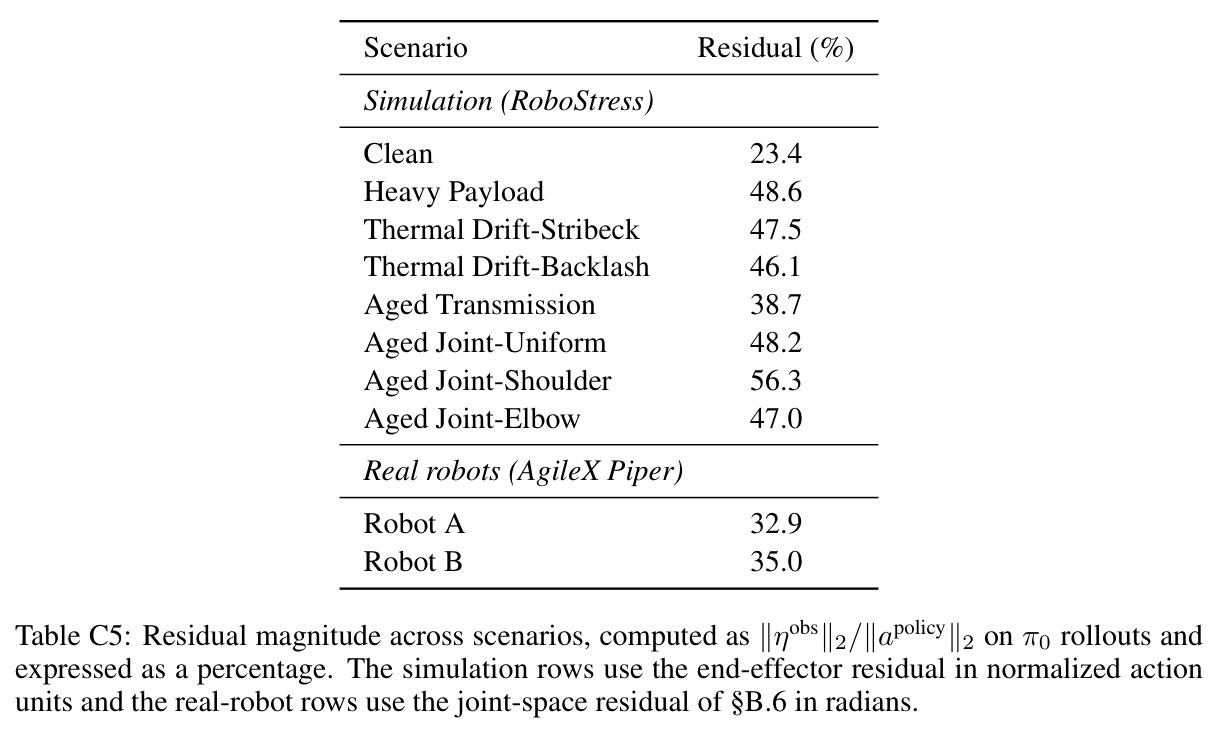
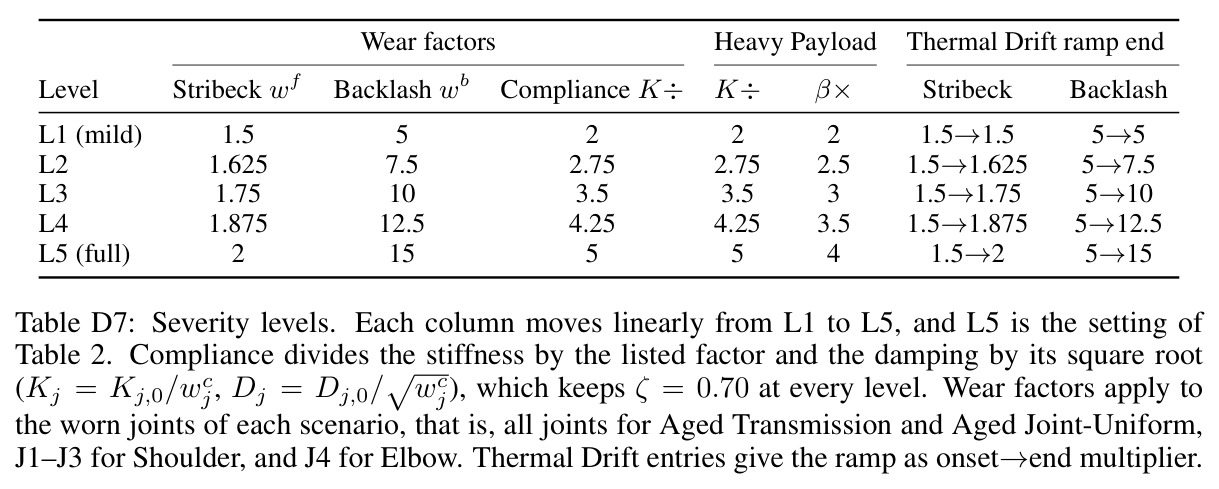
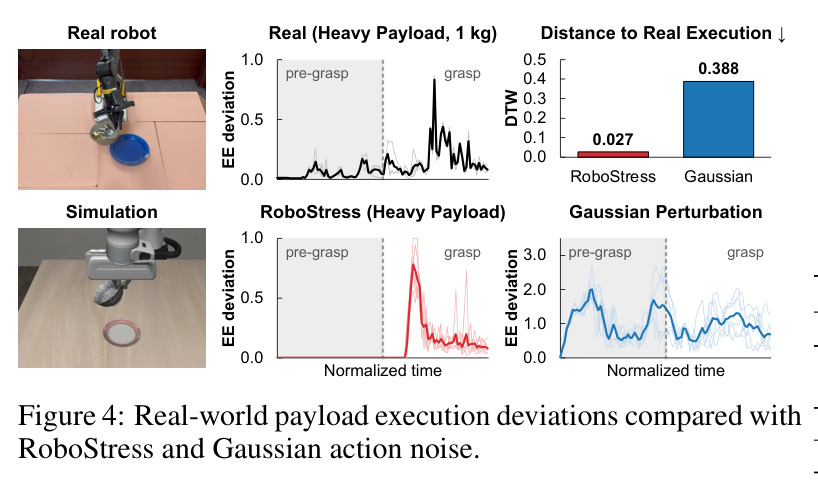
VLA走向真实部署时,已有鲁棒性研究主要关注视觉损坏、干扰物、指令改写等输入扰动,以及人为注入到动作指令上的合成噪声。但物理部署中还存在另一类被忽视的误差:机器人实际执行的运动偏离VLA发出的指令。这类执行误差源于机械与工况——磨损、重负载、温度变化——并且随机器人个体和使用历史不同而不同。作者实测发现,即使是全新的AgileX Piper机械臂,指令与执行的平均归一化残差也高达32.9%,使用一年的旧臂为35.0%;在无任何注入噪声的仿真Clean设定下,π0的残差也有23.4%。更关键的是,这些误差依赖机器人当前状态(构型、负载)和近期运动历史(齿隙换向死区、柔性形变的时间演化),而现有仿真基准直接在末端指令上加高斯噪声,既不建模状态/历史依赖,也不反映各关节误差经运动学与动力学耦合后的不同贡献。要在真实机器人上系统评估这类误差,需要一支机械状态各异、工况可控的机器人群,成本极高且极端设定有损坏硬件的风险。
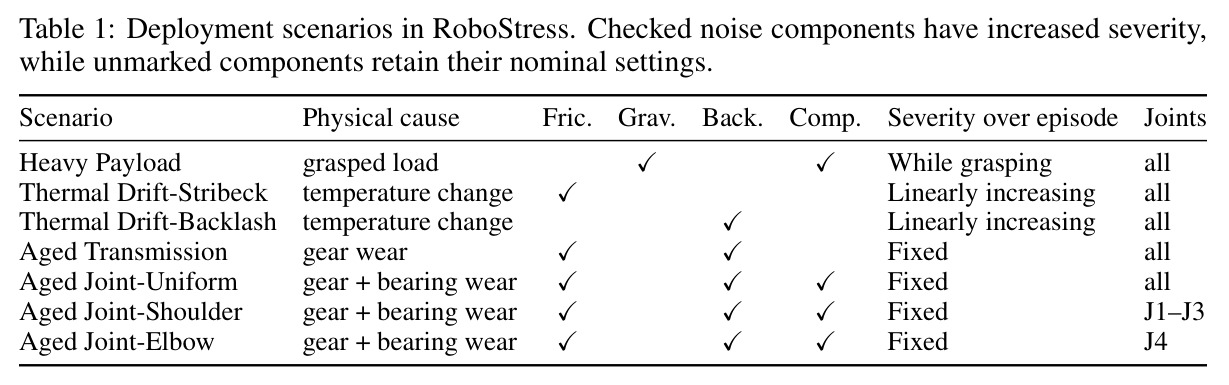
本文的目标是本文目标分两层。方法层面:提出一种部署期自适应方法,让VLA在无需任务奖励、无需人工标注、也无需知道误差来源的情况下,利用自身发出的指令与实际执行运动之间的残差作为自监督信号在线更新策略,使其后续指令能预先补偿(pre-compensate)这台机器人的执行误差,同时完全不改动机器人底层控制器。基准层面:构建RoboStress——一个可控的仿真压力测试基准,把摩擦、齿隙、柔性、重力补偿误差四类成熟的关节级动力学模型按其物理来源注入控制管线,组合成七个部署场景(重负载、热漂移×2、传动老化、关节老化×3),误差强度随机器人状态和运动历史变化,从而在不依赖真实机器人群的前提下系统评估VLA对执行误差的鲁棒性,并在两台不同使用历史的真实Piper臂上验证方法的有效性与泛化性。
与已有工作不同的是,独特切入点是把「指令-执行残差」当作免费的自我监督信号:VLA发出指令、编码器回报实际运动,二者之差不需要任何额外标注就揭示了这台机器人的系统性执行偏差,可直接构造伪目标 $a^{target}=a^{policy}-\eta^{obs}$ 用于策略更新。与以往工作有三点本质区别:其一,已有鲁棒性方法(DR、RobustVLA)在训练期注入与具体机器人无关的通用扰动,本文则在部署期针对当前这台机器人在线适应;其二,已有控制器层面的补偿(如扰动观测器DOB)修改控制输入,本文在策略层适应、底层控制器保持不动,且二者可叠加(DOB+Ours达80%);其三,已有仿真评估把噪声直接加在末端指令上,RoboStress则把噪声注入其物理发生的位置——力矩层(摩擦、重力补偿误差)与位置层(齿隙、柔性)——并经质量矩阵耦合传播到其他关节,误差因此具备状态依赖与历史依赖,与真实部署更一致。
核心方法
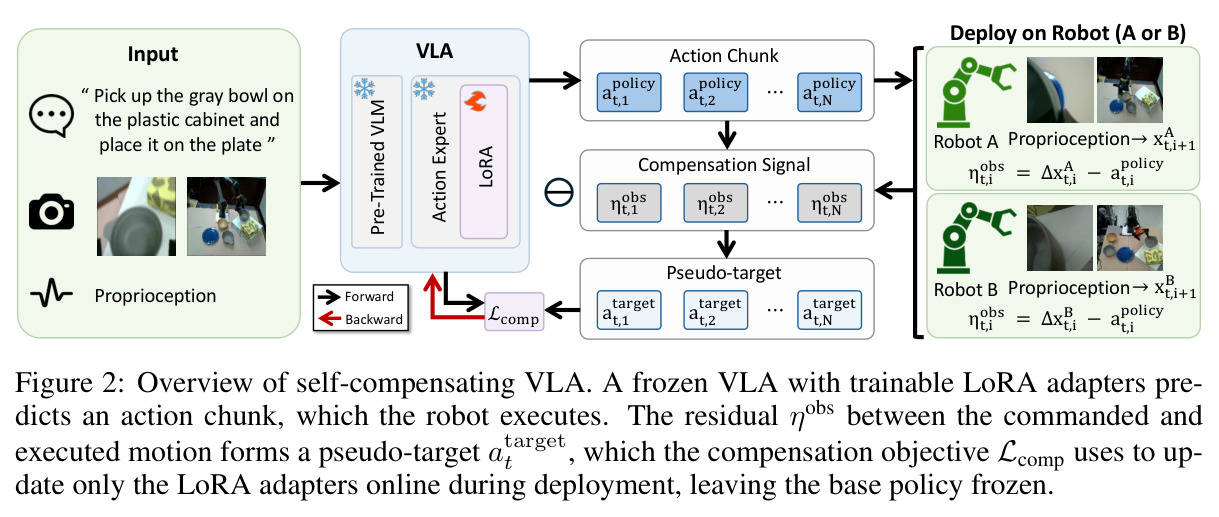
直觉:如果机器人总是「少走」指令量(例如摩擦造成滞后)或在换向时存在死区,那么把之后的指令朝反方向多给一点,实际执行出的运动就会落在原本想要的位置——自补偿VLA就是让策略自己学会这种提前补偿。技术路线分三步:第一步,利用本体感知计算补偿信号,即每个执行步的残差 $\eta^{obs}_{t,i}=\Delta x_{t,i}-a^{policy}_{t,i}$,其中 $\Delta x$ 是实际达到的位姿变化(旋转经SO(3)对数映射并按缩放系数折算到归一化空间);第二步,构造补偿伪目标 $a^{target}_{t,i}=a^{policy}_{t,i}-\eta^{obs}_{t,i}$,存入在线FIFO缓冲区;第三步,冻结π0/π0.5主干,仅对其动作专家上的秩4 LoRA适配器在线优化,用流匹配目标 $\mathcal{L}_{comp}$ 回归伪目标的速度场,并加锚定项 $\lambda_{anc}\|\phi-\phi_0\|_2^2$ 防止参数漂移。整个更新以异步方式进行,底层控制器始终不变。
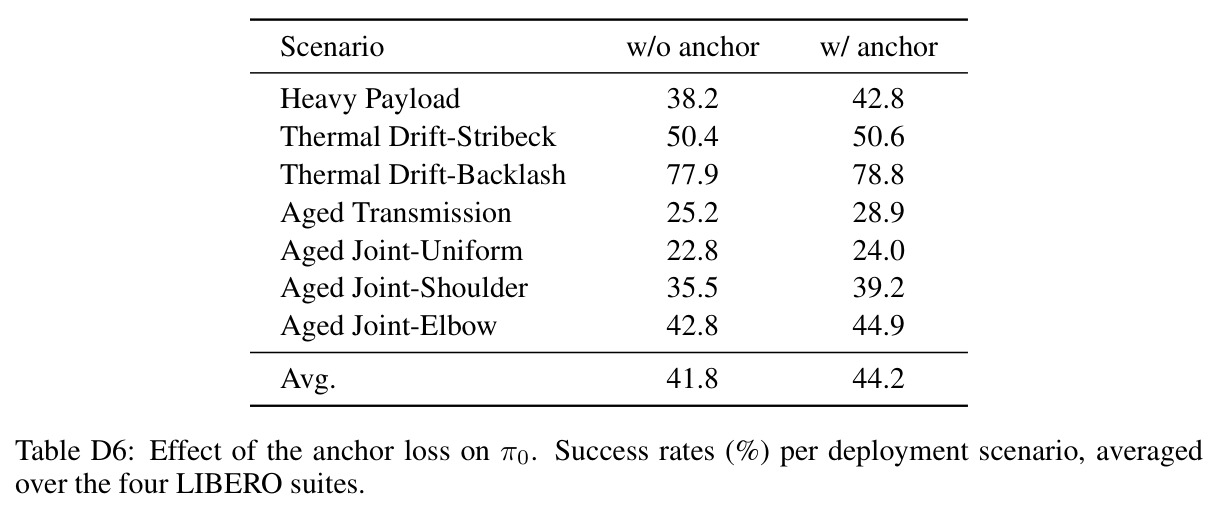
核心创新是把「策略层部署期适应」与「残差自监督」结合起来。与已有方法的本质区别有三点。第一,信号来源:不靠任务奖励(如EVOLVE-VLA、TT-VLA用任务进度做反馈)、不靠人工标签、不靠动力学参数辨识,只用已发出指令与本体感知测得的执行运动之差——这是任何闭环系统都免费拥有的信号。第二,适应位置:补偿被学进策略权重而非控制器,策略看到观测 $s_t$ 后输出的是观测条件化的补偿指令,能学会依赖构型与运动历史的复杂补偿模式;对比实验显示,简单的chunk级平均残差修正(直接从下一块指令中扣掉上一块的平均残差)只有23.6%成功率,反而远低于基线41.7%,说明「学进权重里的、随观测变化的补偿」才是增益来源,而非残差数值本身。第三,锚定正则:$\lambda_{anc}\|\phi-\phi_0\|^2$ 把LoRA参数拉向初始化,抑制在线小样本更新的灾难性漂移,消融显示去掉锚定项平均掉2.4个百分点。
方法步骤详情
完整流程(仿真设定):(1) VLA在观测 $s_t$(双视角图像、本体状态、语言指令)下生成K=50步的增量位姿动作块,执行前nexec=5步;(2) 每个执行步用本体感知读取 $x_{t,i+1}$,平移做欧氏差、旋转做 $\mathrm{Log}_{SO(3)}$ 并按缩放系数折算到归一化动作空间,得到 $\Delta x_{t,i}$,按式(1)算残差(夹爪维度排除);(3) 按式(2)构造伪目标块,未执行的45步保留原策略值,存入容量32块的FIFO缓冲区;(4) 缓冲满后每8个chunk做一次Adam更新(批量4、学习率 $10^{-6}$),损失为流匹配回归加 $\lambda_{anc}=10^{-4}$ 锚定项,只更新动作专家全部线性投影上的秩4 LoRA(276万参数,占主干0.085%);(5) LoRA与Adam状态在同一任务的评估回合间保持,任务边界重置。真机上改为关节空间残差 $\eta^{obs}_{t,i}=q_{t,i+1}-q^{ref}_{t,i}$,30Hz、nexec=10,反馈经独立WebSocket异步送回策略服务器。
技术新颖性
技术新颖性可从方法与基准两面看。方法上,把指令-执行残差升级为VLA的自监督训练信号是新的:与测试时强化学习(需要任务进度奖励)和RMA类适应模块(需要预训练的推断模块)都不同,残差无需任何额外建模即可用流匹配目标直接回归;同时锚定项与极小学习率的组合让276万参数的在线更新在少量回合内稳定收敛而不损害无噪性能(π0.5的Clean仅从97.0%微降至95.8%)。基准上,RoboStress的新意在「噪声注入位置」:摩擦与重力补偿误差以力矩形式加在操作空间控制器输出的关节力矩 $\tau_j$ 上,齿隙与柔性作为位置偏移加进物理积分前的关节坐标,柔性由受扰后的负载力矩 $\tau^{load}_j$ 驱动二阶弹簧-质量-阻尼方程在线积分,能产生瞬态超调与振荡;各关节扰动经质量矩阵耦合传播,策略观察到的残差是噪声经整机动力学作用后的结果而非注入值本身。七个场景还区分磨损部位(肩J1–J3/肘J4)与随episode线性增大的热漂移,这是以往末端加噪基准做不到的。
实验结果
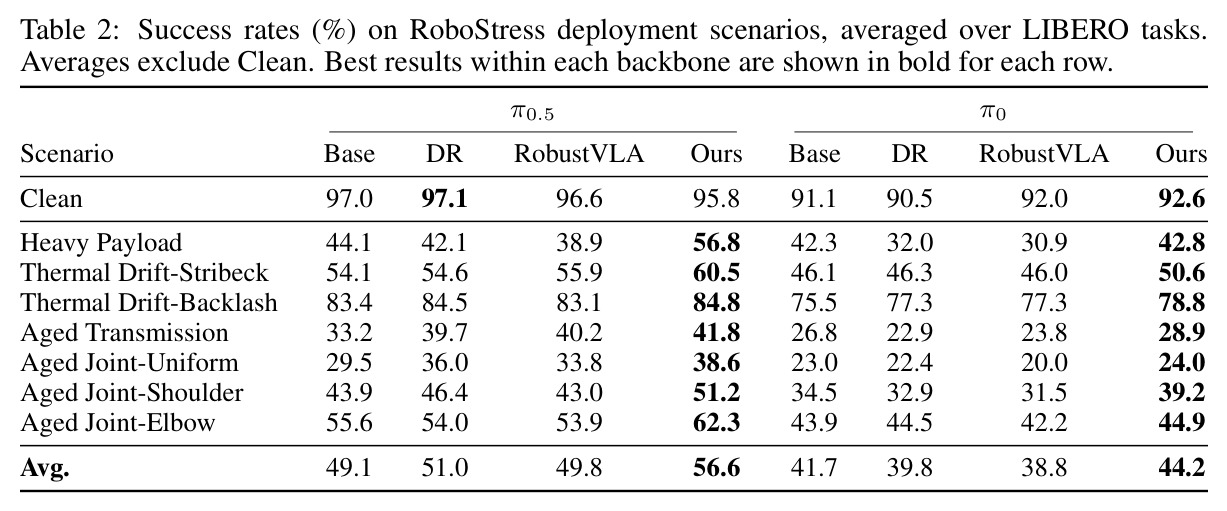
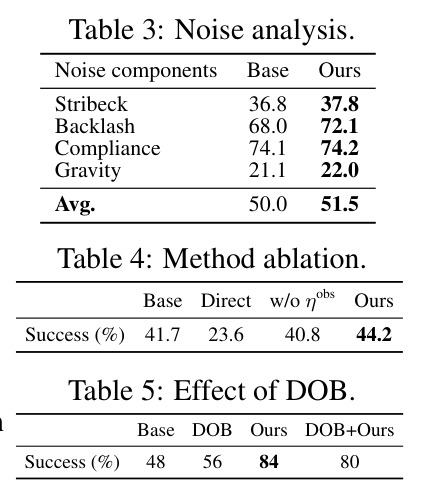
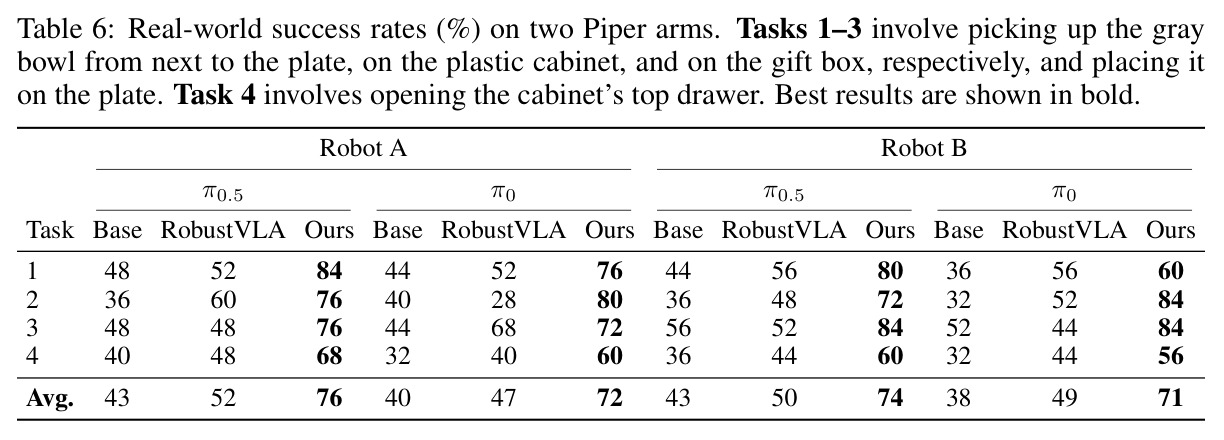
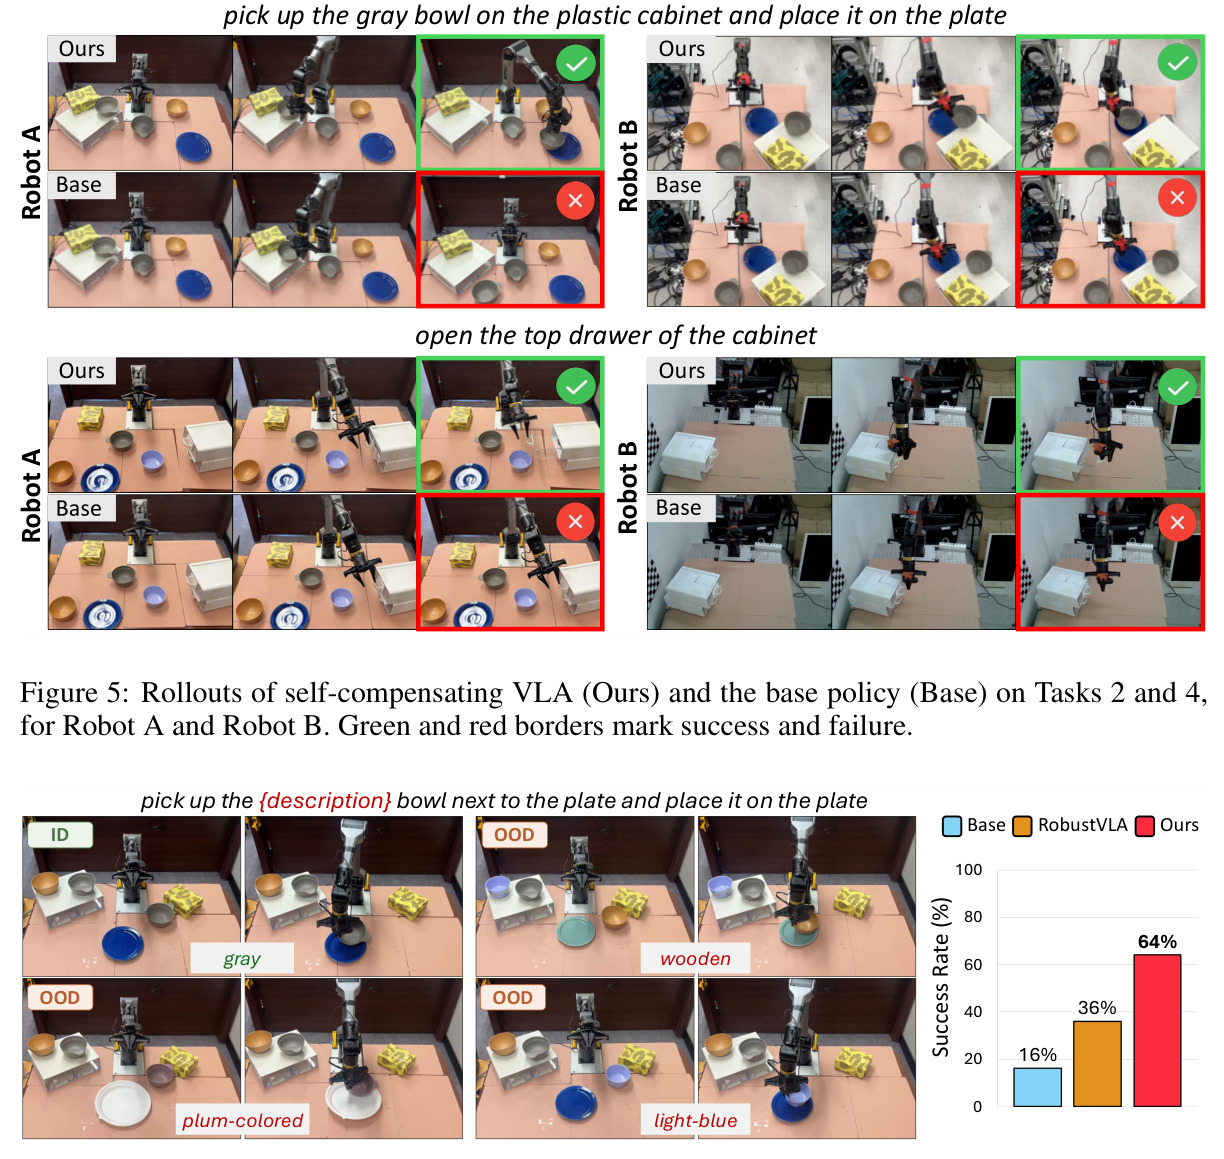
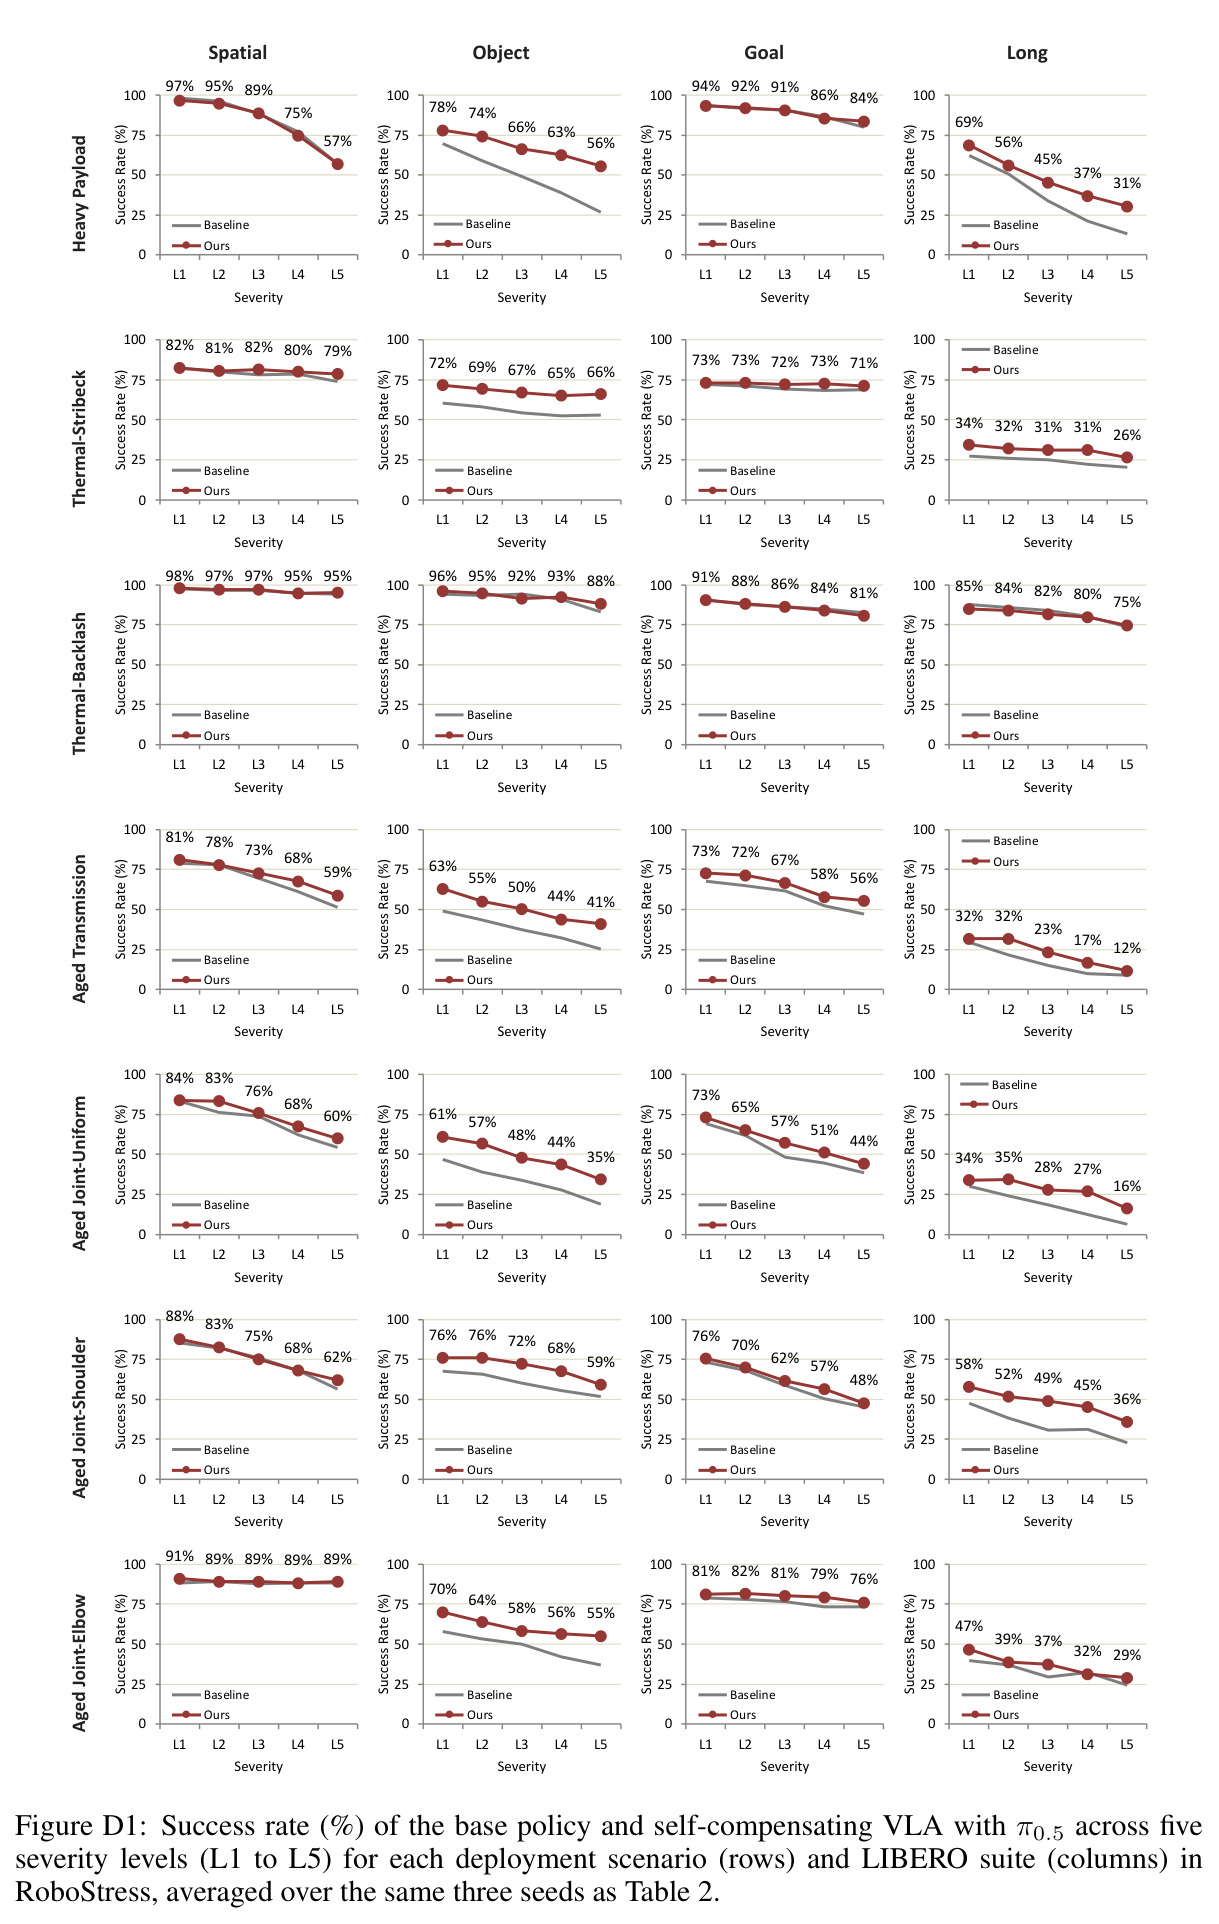
仿真RoboStress(Table 2,LIBERO四套件平均成功率):π0.5基线49.1%→本文56.6%(DR 51.0%、RobustVLA 49.8%),七场景全第一,最大增益Heavy Payload 44.1%→56.8%、Aged Transmission 33.2%→41.8%;π0为41.7%→44.2%,DR与RobustVLA(39.8%/38.8%)反而低于基线;Clean几乎无损(97.0%→95.8%)。真机(Table 6):新臂Robot A上π0.5由43%升至76%、π0由40%至72%;旧臂Robot B上π0.5由43%至74%、π0由38%至71%,均超基线与RobustVLA,平均提升超30个百分点。OOD泛化(Figure 6):5种未见碗,本文64%、基线16%、RobustVLA 36%。叠加DOB(Table 5):基线48%、DOB 56%、本文84%、DOB+本文80%。消融(Table 4,π0):chunk级残差直接修正仅23.6%,$\eta^{obs}=0$为40.8%,完整方法44.2%。残差(Table C5):Clean 23.4%,七场景38.7%–56.3%,真机32.9%/35.0%。严重度(Figure D1):Heavy Payload最敏感(84.3%→56.8%,L1→L5),长时域LIBERO-Long受影响最大。
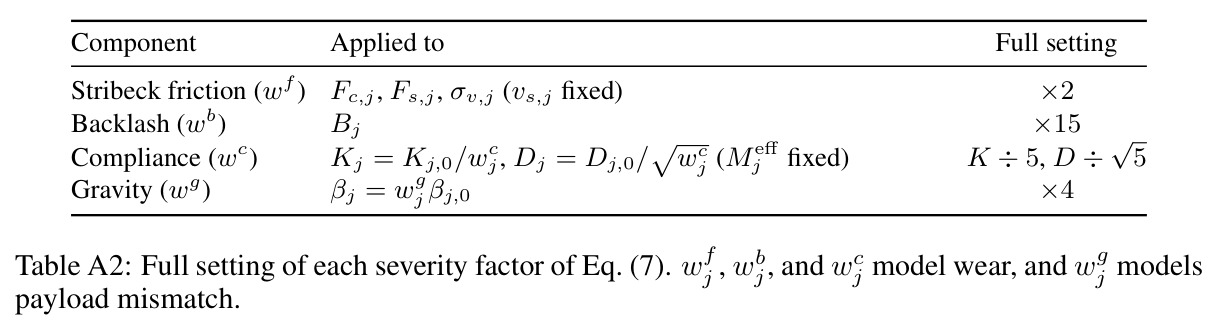
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboStress 七场景平均(π0.5) | 任务成功率 | 56.6% | Base 49.1%(DR 51.0%,RobustVLA 49.8%) | +7.5个百分点,且七个场景全部第一 |
| RoboStress 七场景平均(π0) | 任务成功率 | 44.2% | Base 41.7%(DR 39.8%,RobustVLA 38.8%) | +2.5个百分点;两个训练期鲁棒基线均低于基线 |
| Heavy Payload 场景(π0.5) | 任务成功率 | 56.8% | 44.1% | +12.7个百分点(单场景最大增益) |
| 真机 Robot A 四任务平均(π0.5) | 任务成功率(每任务25回合) | 76% | Base 43%(RobustVLA 52%) | +33个百分点 |
| 真机 Robot B 四任务平均(π0) | 任务成功率 | 71% | Base 38%(RobustVLA 49%) | +33个百分点 |
| 未见物体泛化(Robot A,5种OOD碗,π0.5) | 任务成功率(25回合) | 64% | Base 16%(RobustVLA 36%) | +48个百分点 |
局限与改进
作者承认并可从数据看出的局限:其一,对柔性(compliance)场景几乎无增益(π0上74.1%→74.2%),因为基线在此噪声下本就表现最好,说明方法对「低层控制器已能部分补偿」的误差类型贡献有限;其二,重力补偿误差场景绝对成功率仍很低(21.1%→22.0%),大幅度的构型依赖力矩残差难以仅靠秩4 LoRA修正;其三,Clean下π0.5从97.0%微降到95.8%,在线更新存在轻微负迁移风险。我的补充观察:残差来自本体感知,只能反映编码器可见的运动偏差,无法感知物体打滑、接触力等;夹爪维度被排除在残差之外,抓取相关的执行误差未被补偿;评估回合同时充当适应数据(无单独适应期),缓冲区填满前的若干回合实际是基线在跑,报告的成功率混合了「适应中」与「适应后」的表现;LoRA/优化器状态在任务边界重置,跨任务经验不积累;真机实验只有Piper一种6自由度臂、四个短时程任务,未验证接触丰富任务与长时程慢漂移;此外残差是经底层控制器闭环后的跟踪误差,控制器行为差异可能影响学到的补偿向其他平台的迁移。
独立分析的弱点
独立分析的弱点与改进方向:(1) 本体感知盲区——残差只含编码器可见的偏差,物体打滑、软接触变形等「看起来像执行误差」的现象会被错误补偿,改进方向是引入力/触觉或视觉运动信号做门控,仅在无接触或抓持稳定阶段更新;(2) 低秩加强正则的表达上限——秩4 LoRA与 $\lambda_{anc}$ 锚定对大幅度、强构型依赖的误差欠拟合(重力场景成功率仅22%),可按误差类型使用多个条件化适配器,或提高秩并动态调节锚定权重;(3) 更新滞后——每8个chunk才更新一次且学习率 $10^{-6}$ 极小,对episode内快速漂移(热漂移)跟踪有限,可用误差变化率触发的自适应更新频率;(4) 任务边界重置——每个任务从 $\phi_0$ 重新适应,浪费已学知识,可做跨任务的adapter库或元学习初始化,让新任务几个回合内收敛;(5) 监督稀疏——每个50步chunk只有5步有残差监督,其余45步的伪目标仍是无补偿的原值,可能稀释学习信号,可用模型自一致性对未执行步做正则。
未来方向
作者明确提出的方向是引入外部传感器的运动估计以降低对本体感知的依赖,例如用视觉追踪末端实际位姿计算残差,从而覆盖打滑、柔性物体等本体感知不可见的误差。基于成果可延伸的方向:其一,与控制器层方法更紧的耦合——DOB+Ours(80%)略低于Ours单独(84%),说明简单串联并非最优,联合训练策略适应与扰动估计、或在残差中显式扣除DOB补偿量值得探索;其二,把RoboStress扩展到力控任务、移动操作、人形机器人与更多臂型,并引入随时间缓慢演化的磨损过程,研究数月尺度的持续适应;其三,多机群学习——在多台机器上并行收集残差,训练「机器人条件化」的适配器,实现新机器人的零样本/少样本个性化;其四,理论层面分析残差自监督的不动点与稳定性:补偿后的指令会改变未来轨迹分布,这种自指的闭环训练在何种条件下收敛到真实误差之逆而非发散;其五,把残差信号用于离线数据筛选或预训练,形成「执行误差感知」的训练范式,作为部署期适应之外的补充。
复现评估
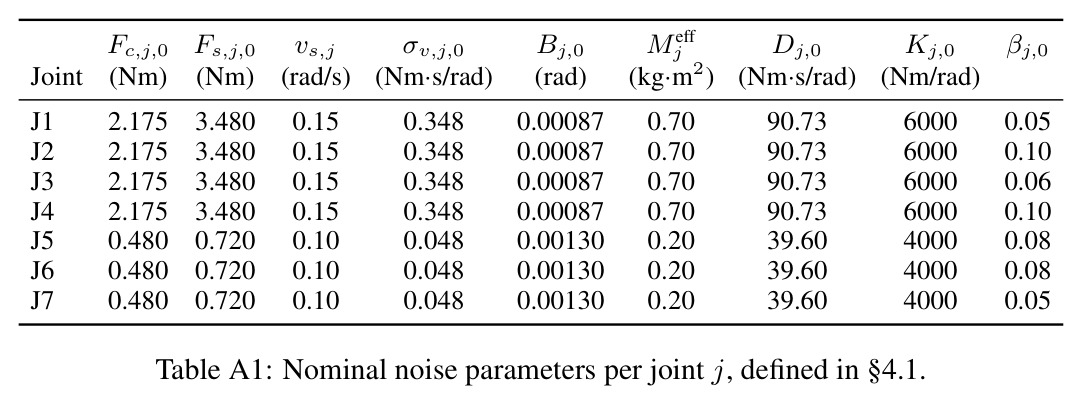
复现条件较好。作者承诺开源自补偿VLA与RoboStress的完整代码,包括场景配置与评估脚本;基座模型π0/π0.5有公开权重,仿真基于开源的LIBERO+MuJoCo 3.7.0+robosuite 1.4.1+JAX 0.5.0栈。附录把超参数写得非常细:秩4 LoRA挂载动作专家全部线性投影(276万可训练参数),Adam学习率 $10^{-6}$、$\lambda_{anc}=10^{-4}$、梯度全局 $\ell_2$ 裁剪1.0,FIFO缓冲32块、每8块更新一次、批量4,K=50/nexec=5(真机nexec=10),以及七场景每个关节的噪声参数(Table A1–A4)。算力上单张A6000 48GB即可(每chunk推理约80ms、一次LoRA更新约50ms),仿真部分复现难度低。真机部分需要AgileX Piper臂(新/旧各一)、两路相机、每任务30条遥操作示教并微调2万步,硬件与示教成本中等;换其他臂型需自行适配关节空间残差与控制循环。总体判断:仿真结果容易复现,真机结果需同款或类似硬件,难度中等。
论文图表
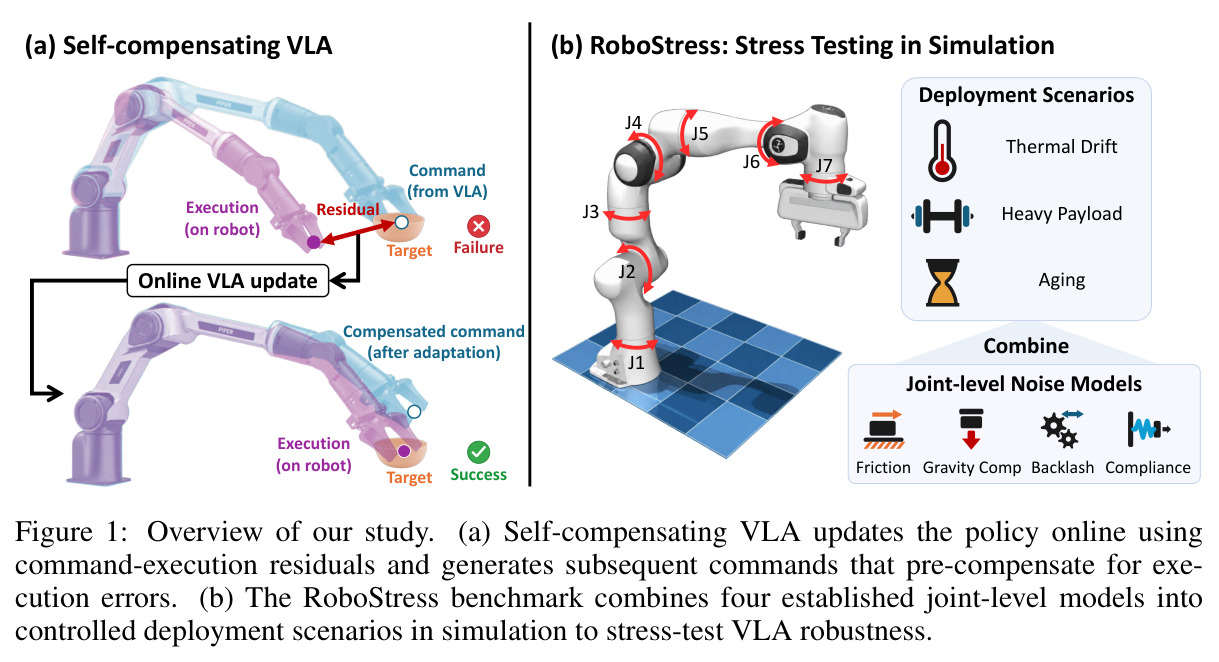
分(a)(b)两部分。(a)自补偿VLA闭环:VLA发出指令→机器人在其上执行→经本体感知测得残差→在线更新VLA→产生预补偿后的指令使执行命中目标;右侧示意RoboStress把摩擦、重力补偿、齿隙、柔性四类关节级噪声模型组合成热漂移、重负载、老化等部署场景。
一图看懂全文两大贡献的定位:方法如何闭环工作、基准如何构造压力条件,是理解论文的入口。
π0上的消融:Base 41.7%、直接chunk级残差修正23.6%、保留在线更新但 $\eta^{obs}=0$ 为40.8%、完整方法44.2%。
证明增益同时来自残差信号与策略级适应:只修正指令会灾难性变差,没有残差的更新也无益。
Robot A任务1(π0.5):Base 48%、DOB 56%、本文84%、DOB+本文80%。
验证策略层适应与控制器层扰动观测器的互补性与可叠加性,回应「底层控制器已能补偿」的质疑。
左侧为本文在灰碗(分布内)与木质、梅色、浅蓝等OOD变体上的轨迹;右侧柱状图为全部OOD变体的成功率:本文64%,RobustVLA 36%,Base 16%(π0.5,每变体5回合共25回合)。
说明补偿能力泛化到微调数据中未见的物体外观,而非对特定示教的过拟合。