CarryOn:面向个性化与可靠机器人辅助的双循环执行框架 CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance
双循环框架围绕冻结VLA实现个性化规划、主动安全屏蔽与失败恢复
前置知识
VLA 模型(视觉-语言-动作模型)
在视觉-语言模型基础上接上动作输出头的通用机器人策略,输入相机图像与语言指令,直接输出机器人动作(通常以固定频率的动作块形式)。π0.5、OpenVLA-OFT、StarVLA 都属此类,本文中它们作为冻结的基础策略被外层框架调用。
CarryOn 的全部设计都围绕'不改动 VLA 权重'展开,必须先理解 VLA 是什么、以动作块为单位输出,才能理解 shield 过滤与恢复接管的对象。
Harness(外围执行框架)
包裹基础模型的运行时系统,负责编排执行:决定模型如何规划、感知与管理上下文、存储产物与评估结果。类比语言代理中 agent 框架之于 LLM:LLM 权重固定,记忆、工具调用、反思都在框架层完成。
本文的贡献是一套机器人 harness 而非新模型,全文的规划环与执行环都在这一层实现,这是理解论文定位的关键。
动作块(Action Chunk)
VLA 一次推理输出的连续 $H$ 步动作序列 $U_t=(u_0,\dots,u_{H-1})$,控制器逐步执行。块内动作在被执行前可以被下游模块审查或截断,本文 shield 正是按预测碰撞风险只释放安全前缀 $(u_0,\dots,u_{g-1})$。
屏蔽公式与'释放前缀/短撤退'机制都定义在动作块粒度上,不懂动作块就看不懂式 (2)。
RGB-D 与点云投影
RGB-D 相机同时提供彩色图与逐像素深度,把掩码内像素按相机内外参反投影即得三维点集。论文用它构建障碍几何:文本提示分割得到目标/目的地掩码,深度投影为点云,再用机器人模型剔除自体几何并识别支撑面。
shield 的最小距离约束、障碍集构建全部建立在这套 3D 感知之上,是安全机制的数据来源。
临界阻尼二阶动力学
形如 $\ddot{p}=\omega_n^2(p_{goal}-p)-2\omega_n\dot{p}$ 的二阶系统,能无超调地趋近目标位置,自然频率 $\omega_n$ 决定响应速度。论文用它近似控制器对 VLA 动作目标的跟踪响应,从当前运动状态外推未来 $H$ 步末端位姿。
这是 shield 运动预测的核心模型,理解它才能明白碰撞预测为什么比'把动作增量直接当位移'更准确。
LIBERO 系列基准
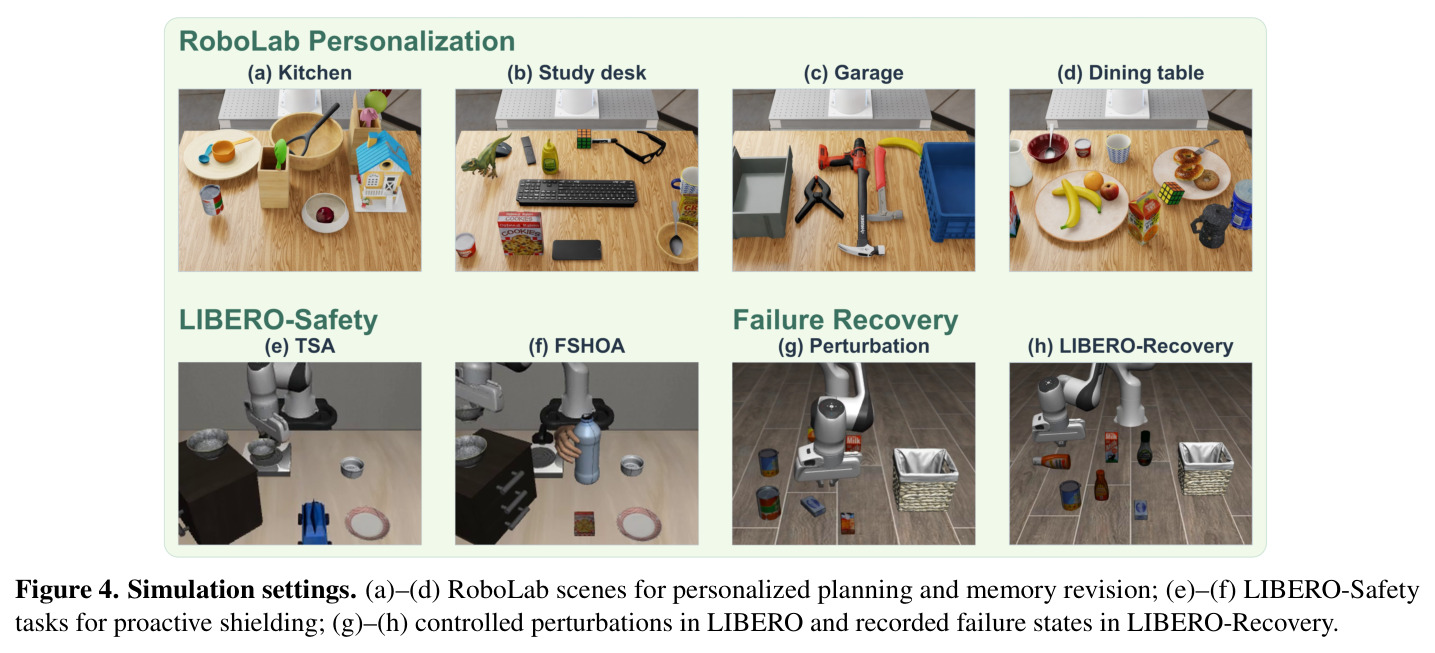
基于仿真桌面操作的任务套件集合(LIBERO-Object 等),广泛用于评测操作策略;衍生版本 LIBERO-Safety 评测安全约束违规(每套件 450 回合),LIBERO-Recovery 提供记录好的执行失败初始状态用于评测恢复。
论文的安全结果(Table 3)与恢复结果(Table 4/5)分别在这些套件上测得,需要知道各自评测什么才能读懂实验。
研究动机
通用视觉-语言-动作(VLA)模型虽然在多样操作指令上表现强大,但日常机器人辅助还要求它们目前欠缺的两种能力。其一是个性化:同样是'给我做吃的',素食用户要的是胡萝卜而非火腿,子任务分解必须锚定在持久的用户偏好上,而非依赖单一通用解;且场景会变(记得胡萝卜在蓝盖下,掀开却是肉),记忆必须能被观测修正。其二是可靠执行:即使指令正确,物理世界仍会引入风险与扰动。论文的数据非常直白——经过 19,664 条安全演示微调的 π0.5-SFT,在其 900 个评估回合中仍有 52.6% 违反安全约束(未微调的原始 checkpoint 高达 71.1%);在 LIBERO-Object 扰动探针中,把已被抓起的物体人为移开 12 cm 后,冻结的 StarVLA 仅在 26/200(13.0%)回合完成任务。这说明单靠策略微调无法同时解决'做什么符合用户'与'怎么做不出事、坏了能修'。
本文的目标是本文目标是构建名为 CarryOn 的双循环 harness,在不改动冻结 VLA 权重的前提下,把个性化任务决策与可靠物理执行耦合成一个系统。规划环负责'做什么':维护持久的用户级记忆(偏好、习惯、个人物品参考图)与场景级记忆(物品位置清单),随对话和观测持续修正,支持跨对话、跨场景、跨查询模态(用文字或照片指称个人物品)的个性化子任务分派。执行环负责'怎么做可靠':先由几何 shield 在动作下发前预测夹爪与携带物的运动并过滤危险接触;失败发生后调用可复用的控制级恢复技能修复物理状态,让 VLA 从中断点继续;回合之间再用离线反思从失败证据中修订恢复技能的参数与策略,形成版本化技能库。量化目标非常明确:把安全微调后仍高达 52.6% 的违规率大幅压低,把仅 13% 的扰动后恢复成功率提升到可用水平。
与已有工作不同的是,已有 harness 类工作各有侧重:RoboHarness 用记忆编排异构策略,Harness VLA 用记忆引导重试配合解析操作,Zetta 围绕冻结策略演化运行时批评器与恢复技能——但它们主要聚焦于提升 VLA 在分布外(OOD)场景的性能。安全方向(VLSA、AnySafe)只做动作级安全过滤,恢复方向(RecoveryChaining、FailSafe)只做事后修复,个性化方向(TidyBot、Bring My Cup)只做偏好记忆,三者从未在同一任务上下文中打通。CarryOn 的独特切入是把'任务上下文与恢复行为的持久性、可修正性'作为设计中心:记忆参与反馈回路(记忆指导行动,行动产生的观测证据强制回写记忆,规划器漏写 update_scene 操作会被验证器打回);恢复技能作为带版本的库(参数记忆 P + 策略记忆 S)跨回合迭代,而 VLA 与几何 shield 全程冻结——即时保护、事后修复、经验积累三层解耦又共享同一任务目标。
核心方法
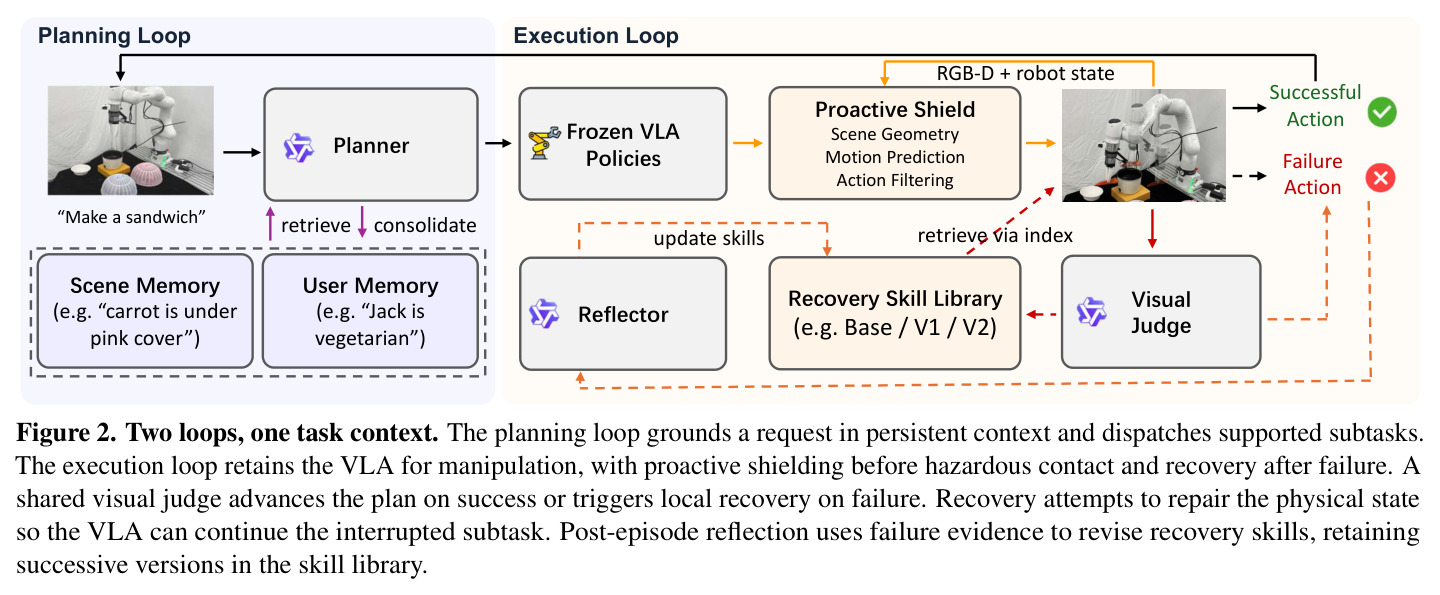
直觉上,CarryOn 像给一位'手艺固定但经验可积累的工人'配了一名懂你的调度员,外加安全员和维修工。技术上是双循环架构:给定请求 $c$ 与可选参考图,规划器组合用户记忆 $M^u$、场景记忆 $M^s$ 与可用技能描述生成计划,每个子任务指定指令 $\ell_i$、提供该技能的端点及对早前子任务的依赖;端点还包括信息收集工具,可以先请求观测再决定操作。在操作端点,冻结 VLA 从观测 $o_t$ 和指令 $\ell_i$ 预测动作块 $U_t=\pi_\theta(o_t,\ell_i)$,几何 shield 依据任务相关接触约束过滤后才下发控制器。Visual Judge 对比子任务开始前后的相机图像,输出 running/success/failed:成功则推进计划,失败则挂起 VLA、调用恢复技能库中的控制级技能修复物理状态,随后 VLA 从 standoff 位姿继续原子任务。回合结束后,离线反思器检查失败回合,修订恢复技能的参数记忆(P)与策略记忆(S)并存为下一版本库。部署开销实测:几何过滤 21.06 ms、VLA 推理 47.82 ms、感知 170.82 ms。
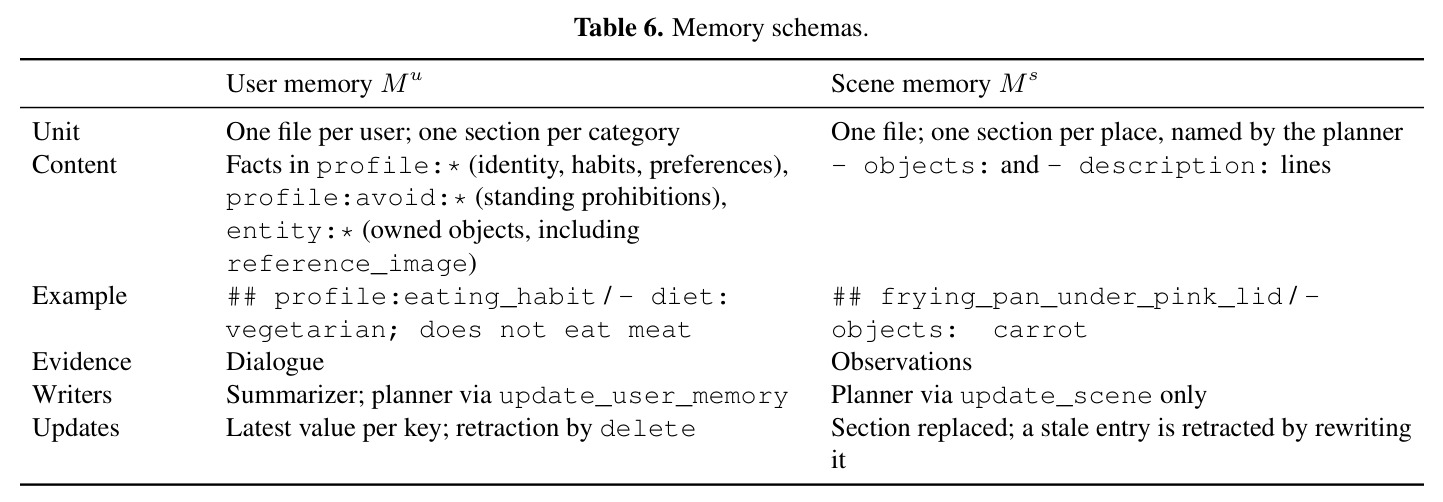
核心创新是把'持久且可修正'贯穿两个环,并把三种时间尺度的干预统一在同一任务上下文里。第一,记忆不是静态知识库而是反馈回路:对话更新用户记忆(区分持久偏好与临时指令,回合后由后台总结器补充漏记的用户事实,偏好被修改或撤回时替换/删除对应条目);观测强制更新场景记忆——发现目标或记忆位置为空/过期时,规划器必须在下一计划中写明 update_scene 操作,漏写会被计划验证器打回重规划。第二,执行侧分回合内快慢两层:快的是主动 shield(动作级,预测运动并过滤),慢的是事件触发的反应恢复(子任务级,修复物理状态后把控制权交还 VLA)。第三,恢复本身可跨回合改进:失败证据驱动离线反思,修改参数记忆 P(如抓取高度偏移 $-0.02$ m)与策略记忆 S(如加重试、VLM 辅助重定位),经准入检查后存为下一版本技能库。与 VLSA 这类被动安全层、FailSafe 这类一次性恢复相比,本质区别在于:恢复通路在不改 VLA 与 shield 的前提下持续演化,且恢复完成后的目标是继续用户最初的任务而非重新开始。
方法步骤详情
全流程七步。(1) 规划:输入请求、用户记忆 $M^u$、场景记忆 $M^s$ 与技能描述,输出子任务序列(可含观察端点),多用户按请求者档案隔离。(2) 记忆更新:持久偏好写入档案、临时指令留在会话,回合后总结器补记;观测与记忆冲突时规划器写出 update_scene 操作修订场景记录并删除过期关联。(3) 动作生成:冻结 VLA 输出动作块 $U_t=\pi_\theta(o_t,\ell_i)$。(4) 主动屏蔽:VLM 推断目标/目的地描述,文本提示分割+深度投影构建 3D 障碍集(剔除自体几何,接触规则豁免目标/支撑面/目的地),用临界阻尼模型 $\ddot{p}=\omega_n^2(p_{goal}-p)-2\omega_n\dot{p}$ 预测未来 $H$ 步末端位姿并传播携带物几何,按 $g=\min\{k:\min_a(d_{a,k}-\delta_a)\le 0\}\cup\{H\}$ 释放安全前缀,$g=0$ 时短撤退重评估;动作历史仅由实际执行的动作更新。(5) Visual Judge 判 running/success/failed。(6) 反应恢复:重定位→生成抓取候选→抓取→夹爪开度检验持有→至 standoff 位姿二次检验→VLA 续做原子任务;失败则退回 pre-grasp 或 pre-failure 位姿并张开夹爪。(7) 离线反思:审视失败回合,修订参数记忆 P(如高度偏移 $-0.02$ m)与策略记忆 S(如加重试、VLM 重定位),准入检查后存为下一版本库。
技术新颖性
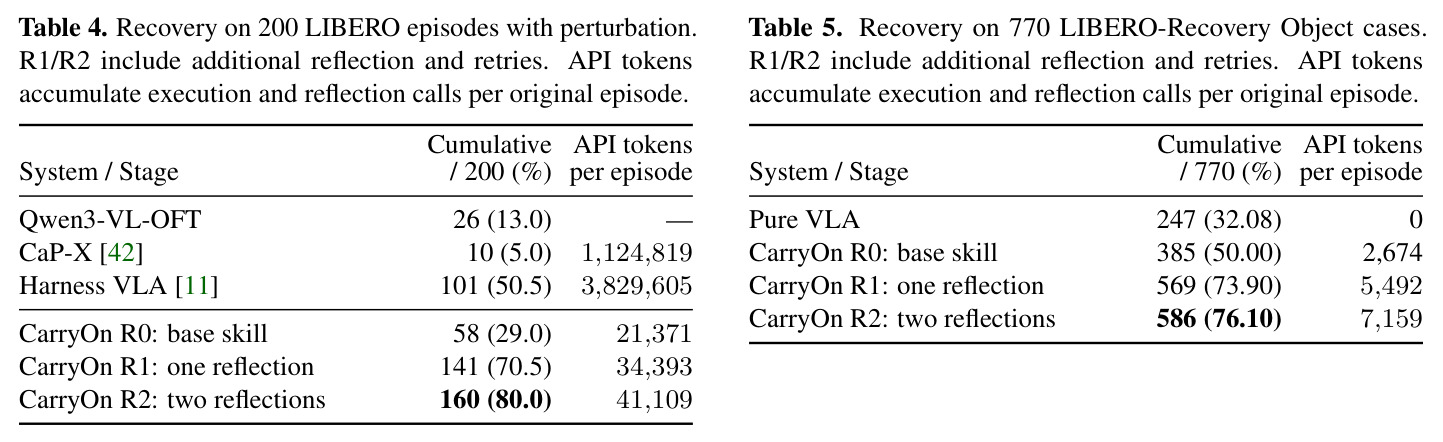
技术新颖性体现在四处。(1) 双环共享任务上下文:恢复后 VLA 从 standoff 位姿继续被中断的子任务,用户条件化目标贯穿始终——真机实验中'胡萝卜被打翻→恢复重抓→继续上菜'与'掀开发现是肉→更新记忆并拒绝上菜'是同一套上下文机制的两种走向。(2) 屏蔽的运动预测考虑控制器响应与持续运动,用临界阻尼响应模型外推 $H$ 步,而非把动作增量天真地当作位移,几何过滤仅 21.06 ms/次。(3) 关注点分离的反思设计:只对控制级恢复做离线迭代,VLA 权重与几何 shield 冻结,不破坏已验证的安全层;参数记忆 P 与策略记忆 S 分开记录数值与控制流修订,准入检查拦截非法修改并保留 successive versions。(4) Token 效率:LIBERO-Object 扰动实验达到 80.0% 累计完成率的同时,每回合累计 API 开销仅 41,109 tokens(含反思 2,609),远低于 CaP-X 的 1,124,819 与 Harness VLA 的 3,829,605;一轮反思(R1)就把成功率从 29.0% 拉到 70.5%。
实验结果
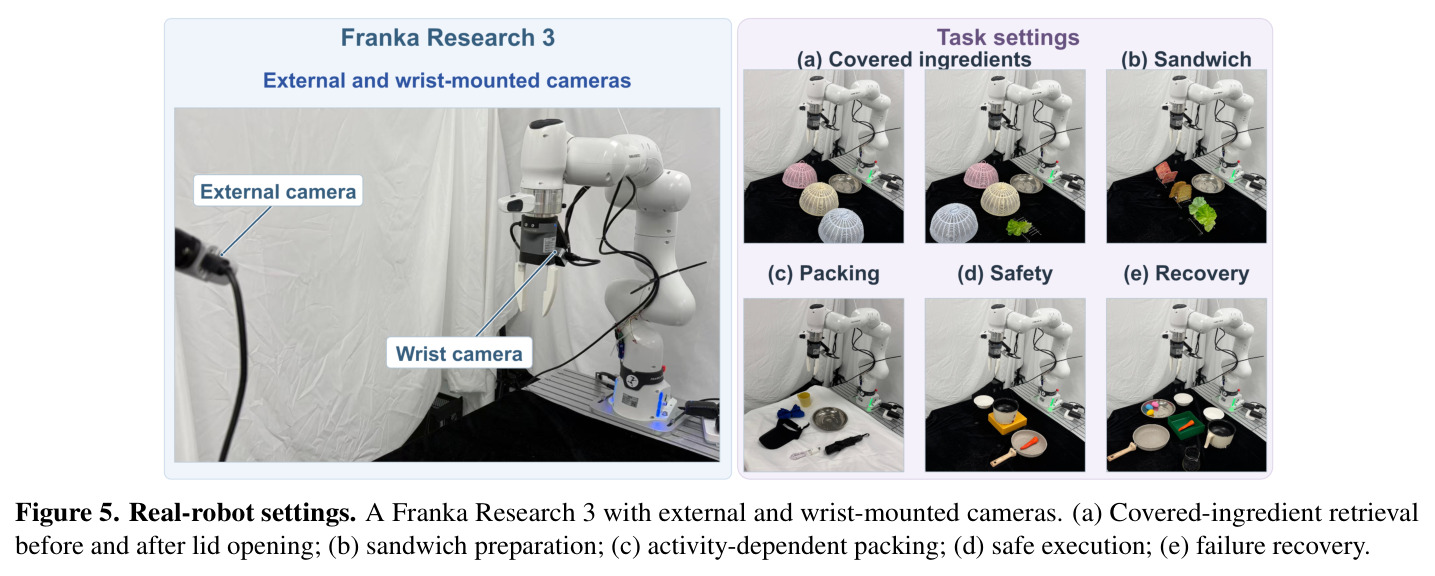
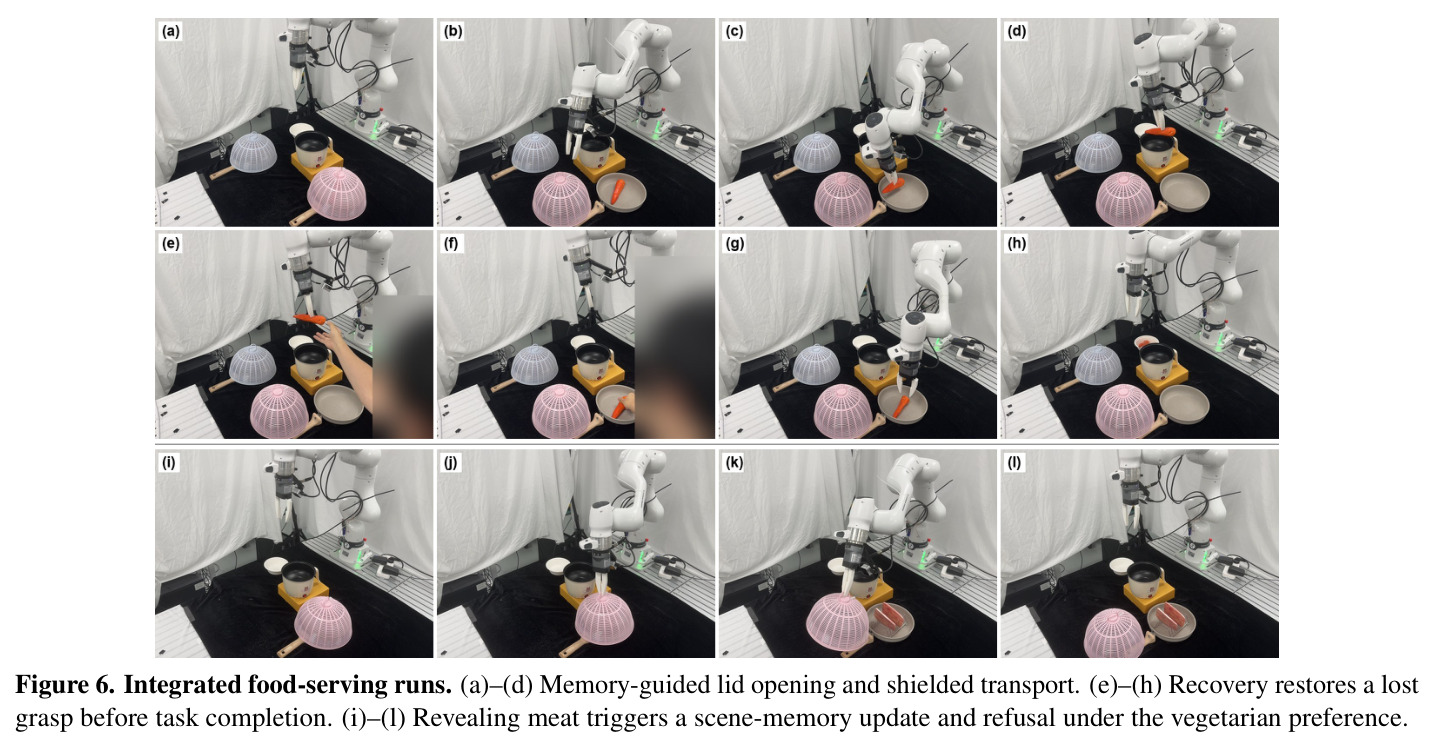
逐实验看。(1) 真机个性化:三明治任务 Textual/Memory 分派准确率均 24/24,偏好更新后 20/24(83.3%);活动打包 Memory 16/16、No-habit 16/20、双档案隔离 16/18;覆盖食材 12/12、8/10、9/12。(2) RoboLab 规划:有记忆时文字/图像查询均 88/88 正确,中位时延从 28.6/34.6 s 降至 7.0/7.1 s;目标挪动后记忆修正成功 76/88(文字)与 77/88(图像),后续分派 83/88、85/88。(3) 安全:LIBERO-Safety 上 π0.5-SFT 违规率 52.6%→加 shield 6.1%(VLSA 仅 37.7%),VF 25.3%→25.6%;原始 π0.5 违规 71.1%→22.7%,VF 6.7%→14.6%;OpenVLA-OFT 61.4%→17.2%;VLAct 69.3%→26.1%,跨骨干一致;真机加障碍后无接触完成 0/20→20/20。(4) 恢复:LIBERO-Object 12 cm 扰动下纯 VLA 13.0%、CaP-X 5.0%、Harness VLA 50.5%,CarryOn R0/R1/R2 为 29.0%/70.5%/80.0%;LIBERO-Recovery 770 例从纯 VLA 32.08%→R0 50.00%→R1 73.90%→R2 76.10%;真机物体被移走 raw 3/20→base 9/20→修订技能($-0.02$ m 偏移+3 次尝试)18/20。(5) 集成演示:按记忆开盖取胡萝卜、屏蔽绕开电饭煲、被打翻后恢复重抓完成上菜;换成肉则触发场景记忆更新并因素食偏好拒绝上菜。
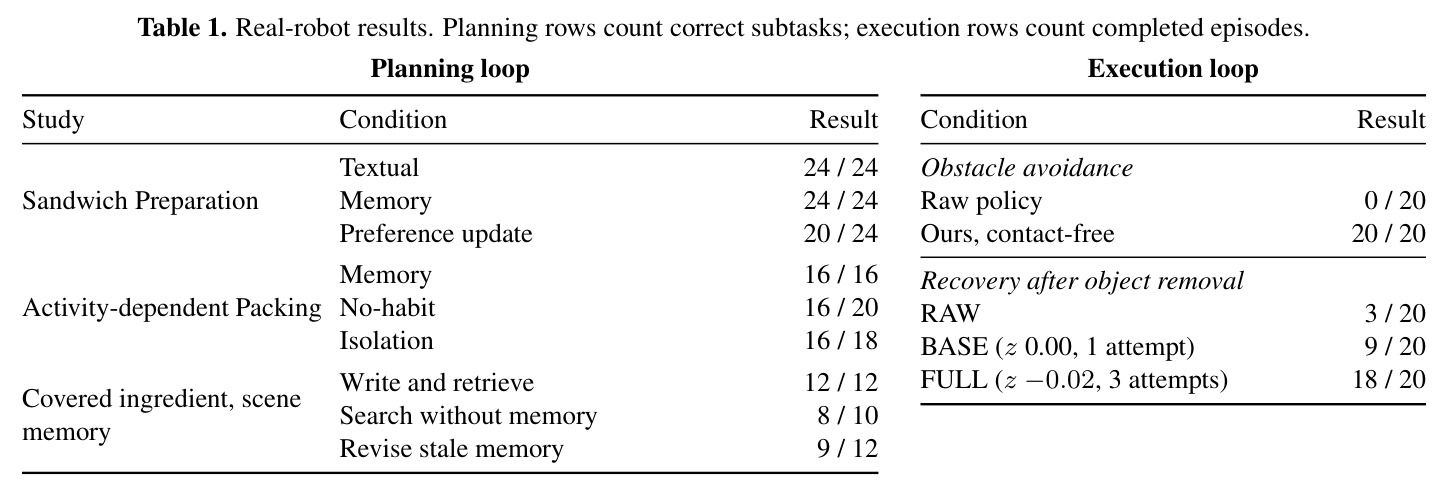
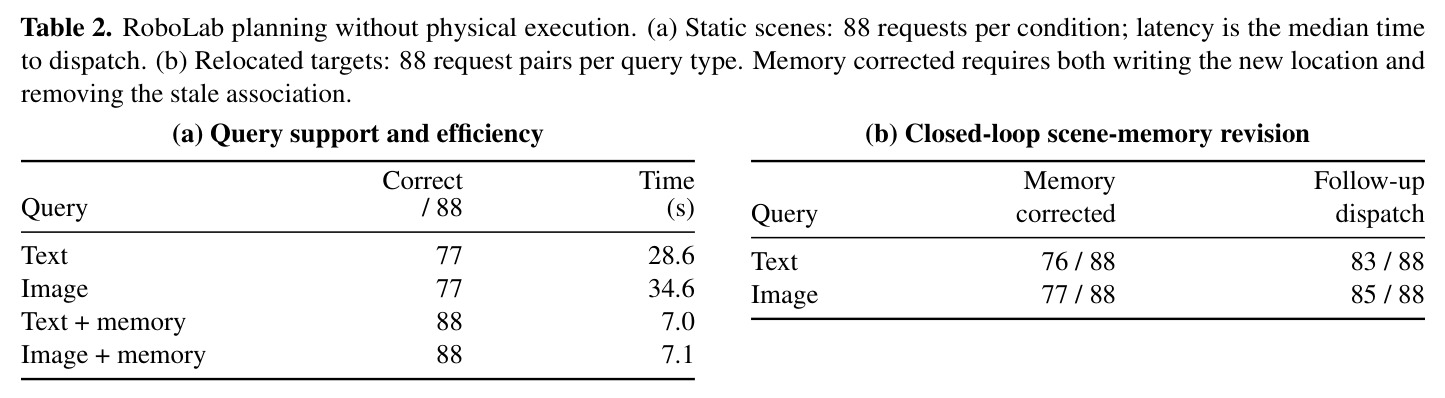
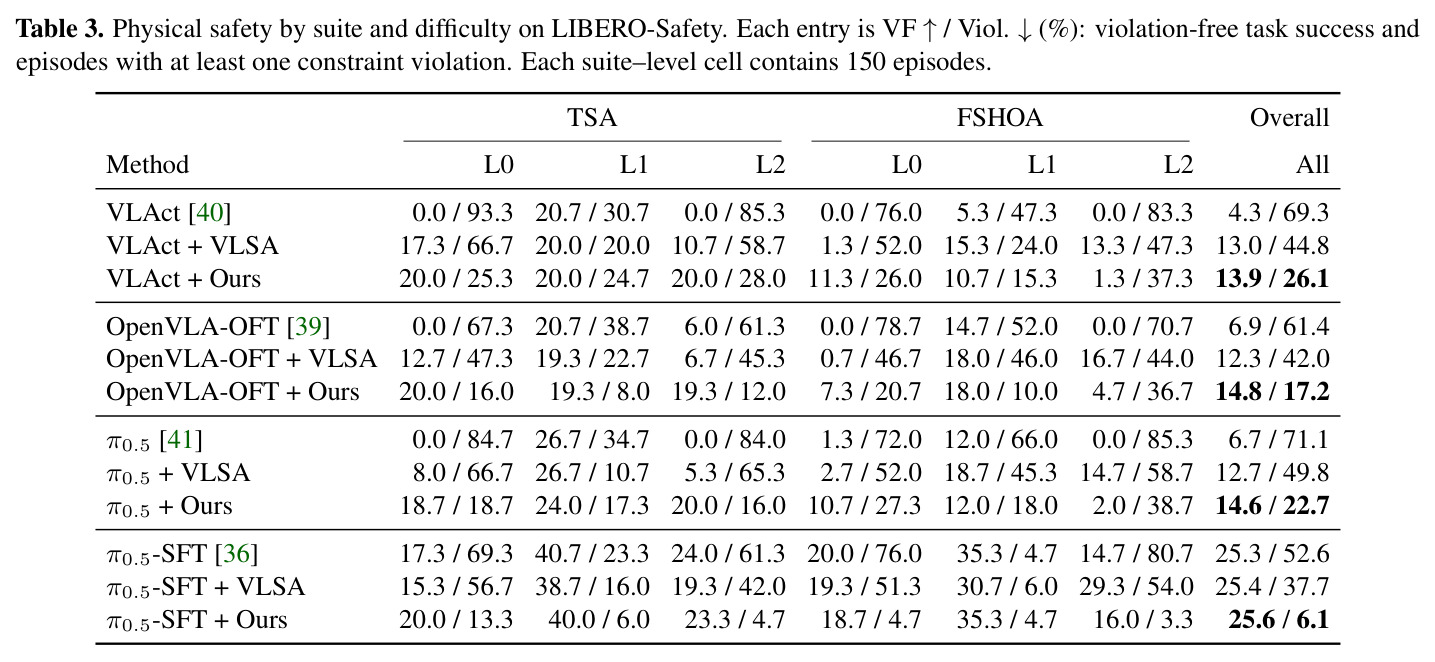
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO-Safety 安全评测(π0.5-SFT,900 回合汇总) | 违规率(至少一次约束违规的回合比例)↓ | 6.1%(π0.5-SFT + Ours shield),VF 25.6% | π0.5-SFT 52.6%;π0.5-SFT + VLSA 37.7% | 较 SFT 降低 46.5 个百分点,较 VLSA 降低 31.6 个百分点 |
| LIBERO-Object 扰动恢复(12 cm 移物,200 回合) | 累计完成率 ↑ | 80.0%(R2:两轮反思+重试),每回合 41,109 tokens | 纯 VLA 13.0%;CaP-X 5.0%;Harness VLA 50.5% | 较纯 VLA +67.0 个百分点,token 开销低 1-2 个数量级 |
| LIBERO-Recovery 自然失败状态恢复(770 例) | 累计完成率 ↑ | 76.10%(R2),每例累计 7,158.77 tokens | 纯 VLA 32.08%;CarryOn R0 基础技能 50.00% | 较纯 VLA +44.02 个百分点,较 R0 +26.10 个百分点 |
| 真机障碍规避(胡萝卜搬运+插入障碍) | 无接触完成回合数 ↑ | 20/20(加 shield) | raw policy 0/20 | 从 0% 到 100% |
| 真机失败恢复(被抓物体被移走,5 位置×2 朝向×2 重复) | 任务完成回合数 ↑ | 18/20(FULL:$z=-0.02$ m + 3 次尝试) | raw policy 3/20;BASE 基础技能 9/20 | 较 raw +75 个百分点,较 base +45 个百分点 |
| RoboLab 跨场景选择(88 请求/条件) | 正确分派数 / 中位时延 | 文字+记忆 88/88(7.0 s);图像+记忆 88/88(7.1 s) | 无记忆:文字 77/88(28.6 s);图像 77/88(34.6 s) | 正确率 +11,时延降至约 1/4-1/5 |
局限与改进
作者承认的局限:未来需评估更长期的适应、恢复经验向新任务迁移,以及'保护性干预'与'任务完成'之间的平衡(shield 过保守会牺牲完成率)。我的补充观察:(1) 违规率大降但违规无关成功率(VF)提升有限——π0.5-SFT 仅从 25.3% 到 25.6%,说明 shield 主要防碰撞而非提成功率,任务能力瓶颈仍在策略本身;(2) 记忆通路不完美:偏好更新后仍有 4/24 子任务出错,过期记忆修正仅 9/12(75.0%)与 76/88,错误记忆可能连锁影响后续计划;(3) 每回合 41,109 tokens 虽远低于基线,大规模部署仍昂贵,反思还依赖 Qwen3-VL-235B 级大模型;(4) shield 依赖文本提示分割与深度投影质量,透明、反光或细长物体的障碍集可能构建失败,最小距离阈值 $\delta_a$ 为固定标量;(5) 实验集中在桌面级 Franka Research 3 单臂与封闭集物品,开放家庭环境、动态行人、双臂/移动操作均未验证;临界阻尼响应模型对高频动态障碍偏短视。
独立分析的弱点
独立分析三个弱点。(1) 恢复技能本质是手工控制流+可调参数:反思只能改数值(如抓取高度偏移 $-0.02$ m)与流程开关,对全新失败模式(物体滚落桌外、卡进缝隙)泛化能力有限——改进方向是扩大恢复技能的参数化空间为可学习技能库,或引入跨任务技能检索复用。(2) 记忆修订依赖规划器自觉写 update_scene 加验证器兜底,本质仍是'提示工程+规则':长期运行中记忆冲突、陈旧与噪声会累积,缺少显式信念状态建模与置信度衰减——可引入概率化场景图并按观测新鲜度加权,让低置信记忆自动触发复检。(3) Visual Judge 是单点仲裁:其成功/失败判定直接决定推进还是恢复,论文未单独消融其准确率——误判成功会漏掉恢复机会,误判失败会空转恢复技能浪费回合预算,建议对 Judge 输出做置信度校准或多帧投票。此外,个性化评估的分派准确率样本量较小(10-24 回合),统计置信度有限,边界情况的失败模式(误识别、漏子任务)值得更大规模的错误分析。
未来方向
作者提出的方向:更长期的适应(记忆跨数天/数周演化)、恢复经验向其他任务迁移(当前技能库按目标绑定修订)、以及保护干预与完成率的更好平衡(何时绕行、何时请求人类帮助)。基于本文成果还可延伸:(1) 把版本化技能库与离线反思迁移到双臂与移动操作平台,检验控制级恢复的平台无关性;(2) 记忆侧引入遗忘与冲突消解机制(经验回放或知识图谱版本管理),应对家庭环境的高频变化;(3) shield 从静态几何最小距离扩展到包含动态障碍速度预测的时空约束;(4) 用仿真大规模自动生成失败案例替代真实失败回合,降低反思成本(当前每回合 41,109 tokens);(5) 把'重定位+重抓+二次检查'等恢复原语开放为技能 API,由规划器在线编排组合,而非只靠离线反思修订;(6) 结合主动学习,让机器人在记忆不确定时主动询问用户而非猜测。
复现评估
代码在 GitHub 开源(JIA-Lab-research/CarryOn)。仿真评测基于公开基准:LIBERO、LIBERO-Safety(每套件 450 回合)与 LIBERO-Recovery(77 个 Object 场景×10 次=770 例)。VLA 使用 Qwen3-VL-4B-OFT(真机与 LIBERO 恢复实验),反思与基线用 Qwen3-VL-235B-A22B-Instruct——后者通常需 API 访问,复现有 token 成本(实测每回合约 41,109 tokens);π0.5 与 π0.5-SFT checkpoint 由官方发布可直接获取。真机部分需要 Franka Research 3 配外部与腕部相机,文本提示分割与深度投影质量直接影响 shield 效果;操作策略需针对任务自行训练(如开盖+食物抓取,使用无障碍数据)。总体:仿真部分复现难度中等,门槛主要是大模型 API 依赖与成本;真机部分难度高,涉及硬件、标定与策略训练;核心算法(shield 过滤公式、恢复流程、两轮反思协议)在正文与附录 C/D.2 描述较完整,具备可复现基础。
论文图表
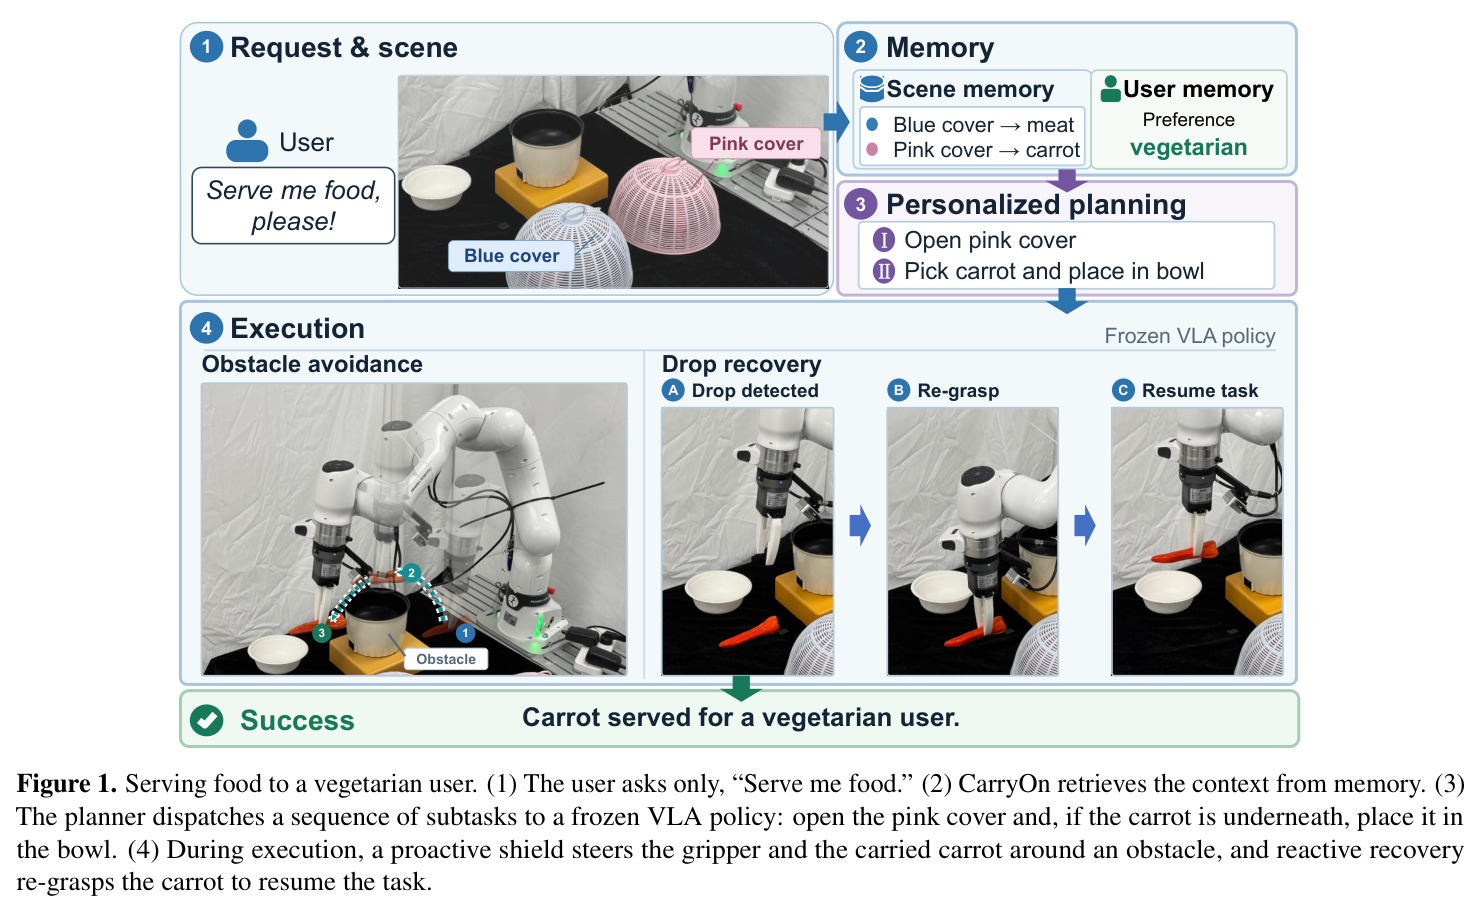
素食用户'给我上吃的'请求的完整流程示例:从记忆取回上下文(蓝盖→肉、粉盖→胡萝卜、素食偏好),规划器向冻结 VLA 分派'开粉盖、若下面是胡萝卜则放入碗中'的子任务,执行中主动 shield 让夹爪与携带的胡萝卜绕开障碍物,被扰动掉落后反应恢复重新抓取并继续任务,最终为素食用户上胡萝卜。
一图看懂论文要解决的问题以及双循环如何协同工作,是全文的引子,也定义了'个性化+可靠执行'两大卖点。
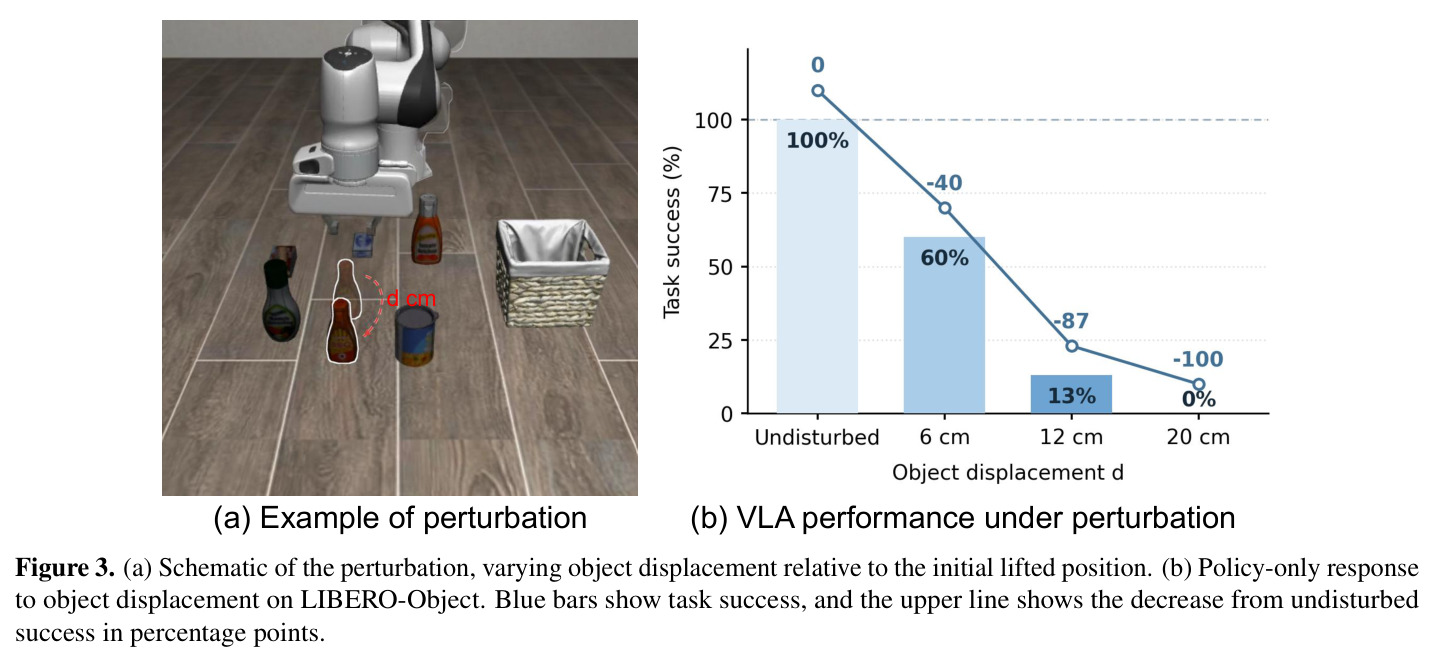
(a) 扰动示意:相对初始抬起位置改变被抓物体的位移 d cm;(b) LIBERO-Object 上冻结策略对位移的响应,蓝柱为任务成功率,上方折线为相对无扰动成功的下降百分点——位移 12 cm 时成功率跌至 13.0%(26/200)。
用受控实验证明冻结 VLA 对物理扰动的脆弱性,是引入反应恢复机制(3.3 节)的直接数据动机。