基于失败库自演化的视觉-语言-动作模型运行时反馈学习 Learning from Runtime Feedback through Failure-Bank Self-Evolution for Vision-Language-Action Models
把运行时安全屏蔽的反事实纠正沉淀为训练数据,让VLA策略自进化
前置知识
视觉-语言-动作(VLA)模型
将视觉观察与语言指令映射为连续机器人控制动作的大模型,单一策略即可覆盖多种操作任务而无需任务专用控制器。代表工作 π0 用流匹配(flow matching)直接生成连续动作序列,π0.5 在此基础上进一步扩展泛化能力。本文使用 VLA-Arena 榜单上官方微调过的 π0.5 与 π0 权重作为基座策略,并在其 29 个上榜模型中筛选出仅有的两个同时具备流匹配动作头和可测量基线提升空间的骨干。
本文的方法、基线与实验全部围绕 VLA 展开,只有理解其动作生成方式,才能明白"流匹配损失"和"首动作漂移"这两个核心约束在守卫更新中的作用。
控制屏障函数(CBF)
一种形式化的运行时安全机制:先在状态空间定义安全集合与屏障函数,再对策略输出的名义控制量做最小改动投影,从数学上保证系统状态不会进入不安全区域。AEGIS 将 CBF 投影与视觉定位结合,作为即插即用的 VLA 安全层,在动作执行前修正不安全指令。本文把一个基于特权仿真几何的固定 CBF 模块当作"只观察不执行"的教师。
FAILBANK 的全部训练信号都来自 CBF 教师的反事实修正提案,理解 CBF 才能明白"修正记录"从何而来、为什么它既能在训练期充当教师又能在部署时被完全移除。
流匹配(Flow Matching)
一种生成模型训练范式:学习一个时变向量场,把简单噪声分布沿连续路径输运到目标数据分布。π0/π0.5 用它把视觉观察与指令编码后直接生成连续动作块,训练目标是最小化模型预测场与目标场之间的流匹配损失 $\ell^{flow}$。论文中 $\ell^{flow}_{i,0}$ 表示对记录 $i$ 的第一动作(first-action)流匹配损失。
FAILBANK 的训练损失(加权第一动作流匹配损失)与守卫条件(held-out 流损失比率)都建立在这一概念上,不懂流匹配就无法理解更新阶段在优化什么。
LoRA 低秩适配
参数高效微调技术:冻结预训练模型的全部权重,只训练插入的少量低秩增量矩阵,其秩远小于原始维度,大幅降低算力与显存需求,且适配器可以独立挂载或卸载。这使"从同一基座检查点反复拟合新适配器"成为成本可控的操作。
FAILBANK 每一轮自演化都从同一基座重新拟合一个全新 LoRA 适配器,通过守卫检查后才替换当前策略——LoRA 是其安全迭代更新的具体载体,也是它敢于"试错后丢弃"的原因。
策略-屏蔽失配
运行时屏蔽只改写当前动作而不更新底层策略,当策略反复生成会被屏蔽修正的同一类动作时,两者持续冲突:每次修正虽然降低局部安全成本,却把机器人反复拉离任务目标,甚至推入陌生状态,最终导致任务超时失败。作者将这种现象称为持久的策略-屏蔽失配,并证明加强屏蔽也无法消除它。
这一现象是全文动机的核心:作者正是要论证运行时反馈应当被转化为持久的策略监督,而不是只作为执行期的临时干预。
研究动机
视觉-语言-动作(VLA)模型虽然能泛化到多种机器人操作任务,但在真实复杂场景中必须同时兼顾任务成功与意外接触:视野里常有小蛮腰易混物体和需要保护的物品,策略既要识别目标并精确执行动作序列,又不能碰扰无关对象,因此任务成功率和累计成本必须联合评估。现有主流做法是运行时安全屏蔽,例如 AEGIS 用视觉定位加控制屏障函数(CBF)在动作执行前修正不安全指令。但屏蔽只改写单个动作、不更新底层策略:在"目标被危险瓶子包围的狭窄抓取"这类困难场景中,投影虽降低了即时成本,却会反复把夹爪从目标洋葱附近拉走,重复干预直到 episode 超时——论文 Figure 2 展示的 Level 2 洋葱任务就是典型例子,AEGIS 使成功率从 Base 的 81.3% 暴跌至 1.3%。作者将此称为持久的策略-屏蔽失配(policy–shield mismatch):加强屏蔽也无法消除,因为策略仍在生成同一类错误动作;而在 Mango 这类较易任务上 AEGIS 又基本无害(SR 88.0% vs Base 89.3%),问题在困难任务上才集中爆发。
本文的目标是本文的核心问题是:能否把运行时证据转化为学习记录,实现自进化的策略更新,让未来的策略行为本身变好?作者指出这不仅仅是记录干预日志,系统必须同时满足四个要求:要能观察策略自身的失败分布;能从失败记录中区分有用的接触前修正与无效动作;能保留已经成功的行为以免更新后遗忘或漂移;还要防止适配器更新使动作分布偏离原始策略。最终目标是得到一个部署时不需要教师、不需要特权几何信息、仅靠 RGB 观察和本体感觉运行的 VLA 策略,并要求它在两个骨干(π0.5 与 π0)、两个难度级别上同时提高任务成功率(SR)并降低策略诱导累计成本(CCpolicy),即改进"成功-成本联合工作点"。
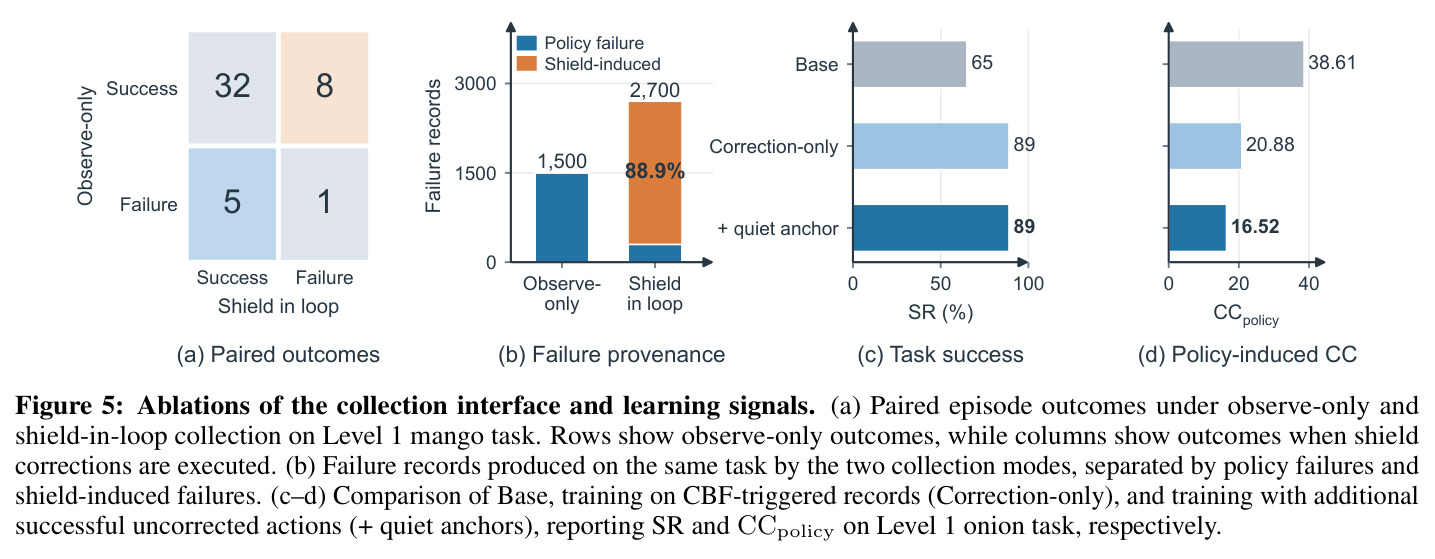
与已有工作不同的是,已有工作把运行时纠正当作临时执行约束(AEGIS),或把安全作为约束学习目标集成进训练(SafeVLA),或从 VLA 内部表征检测失败(SAFE),但都没有把"运行时实际发生的纠正"系统性地转化为策略的持久监督信号。本文的独特切入是 observe-only(只观察)收集接口:固定的 CBF 教师在每个控制步独立提出反事实修正 $\tilde{a}_t = S(a_t, g_t)$,但环境始终执行策略自己的名义动作 $a_t$,教师绝不介入执行。这使 episode 结果完全可归因于当前策略本身。消融实验量化了这一设计的重要性:若把 shield 放进执行回路收集数据,46 个 episode 中 88.9% 的失败记录其实是 shield 自己干预造成的,而非策略本来的失败分布;observe-only 则完好保留了策略真实的失败分布,为自演化学习提供了干净、无偏的监督来源。
核心方法
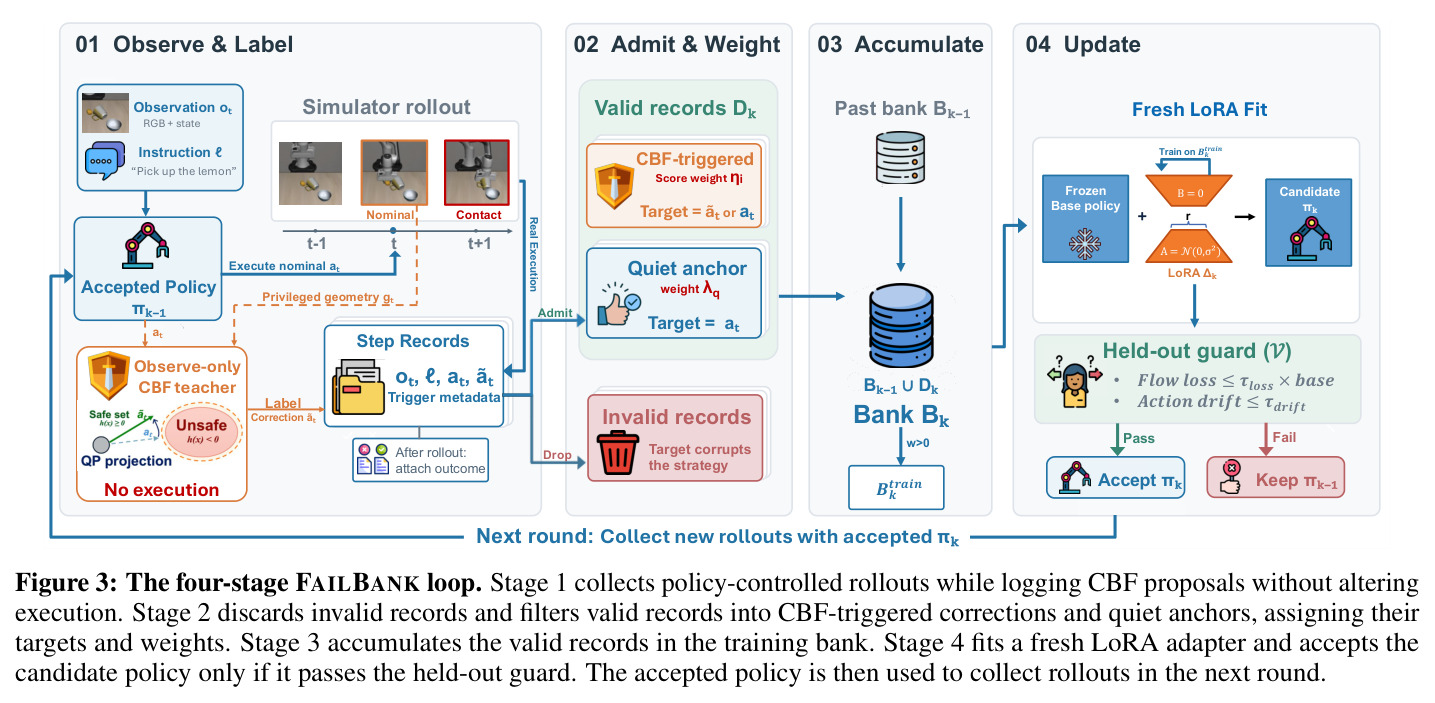
直觉上,与其让屏蔽在执行时反复纠正同类错误,不如把纠正"抄下来"变成训练数据,让策略一次学会、永久受益。技术路线是四阶段闭环。阶段 1(观察标注):当前策略 $\pi_{k-1}$ 执行名义动作 $a_t$,只观察的 CBF 教师用特权几何 $g_t$ 提出反事实修正 $\tilde{a}_t = S(a_t, g_t)$ 并记录触发标志 $z_t$,环境仍执行 $a_t$。阶段 2(准入加权):rollout 结束后回填结果,筛掉无效记录,把有用的 CBF 触发记录转为修正目标,把未触发且成功的动作保留为"安静锚点",按来源赋权 $w_i$(修正为 $\eta_i$,锚点为 $\lambda_q$)。阶段 3(累积):按 $B^{train}_k = B^{train}_{k-1} \cup D_k$ 并入失败库。阶段 4(更新):从同一基座重新拟合全新 LoRA,最小化加权流匹配损失 $\mathcal{L}(\pi) = \sum_i w_i \ell^{flow}_{i,0}/\max(1,\sum_i w_i)$,仅当 held-out 流损失比率 $\bar{\mathcal{L}}_V(\pi_k)/\bar{\mathcal{L}}_V(\pi_{base}) \le \tau_{loss}$ 且首动作漂移 $D_V \le \tau_{drift}$ 才接受新策略,否则丢弃适配器保留旧策略;被接受的策略进入下一轮收集,部署时无需教师与特权几何。
核心创新有三点,本质区别都指向"把运行时反馈从执行约束变成持久监督"。其一是 observe-only 收集接口:shield 不执行动作,策略的 rollout 分布不被改变,episode 结果仍归因于策略本身,因此失败库学到的是策略的真实失败而非收集过程制造的失败——对照实验证明 shield-in-loop 会让 88.9% 的失败记录失真。其二是 outcome-aware 准入加安静锚点:每条修正记录要经过后续 rollout 的安全性、任务进度、恢复情况评分,权重只映射到 $\{0, 0.25, 0.60, 1.00\}$ 四档,同时保留未触发且成功的动作作为锚点,防止策略过拟合于纠正数据而漂离已有效行为;消融显示加入锚点后 SR 保持 89%,CCpolicy 从 20.88 进一步降到 16.52。其三是守卫式 LoRA 更新:每轮从 base 重新拟合,用与训练分离的 held-out 批次同时约束损失退化($\tau_{loss}$)和首动作漂移($\tau_{drift}$),绝不用基准 SR/CC 做模型选择,避免了自演化系统常见的目标过拟合。
方法步骤详情
完整流程如下。输入:基座 VLA(π0.5 或 π0 的 Arena 微调检查点)与基于特权仿真几何的固定 CBF 教师。第 1 步:策略在 Level 1 芒果任务上 rollout,逐步存储观察引用、指令、名义动作 $a_t$、教师提案 $\tilde{a}_t$(只改平移通道)、触发标志 $z_t$ 与审计元数据;结束后为每条记录回填 episode 成败,使结果可归因于 $\pi_{k-1}$。第 2 步:先按 episode 划分训练/验证折;对每条记录做有效性检查,会破坏策略的记录被丢弃;有效的 CBF 触发记录以教师提案为第一动作目标,按后续 rollout 的安全性、任务进度与恢复情况评分加权(重复触发、屏障违例扣分),分数经固定阈值映射到 $\{0, 0.25, 0.60, 1.00\}$;未触发且成功的动作用名义动作做目标、固定权重 $\lambda_q$ 成为安静锚点。第 3 步:训练折记录并入失败库 $B^{train}_k$,从验证折抽取固定的 held-out 批次 $\mathcal{V}$ 并与训练库严格不相交。第 4 步:从基座重新拟合 LoRA,优化加权第一动作流匹配损失;在 $\mathcal{V}$ 上计算整块流损失均值 $\bar{\mathcal{L}}_V$ 与首动作漂移 $D_V$,须同时满足 $\tau_{loss}$ 与 $\tau_{drift}$ 才接受 $\pi_k$ 作为下一轮收集策略。论文共迭代 5 轮,失败库从 3.7k 条增至 22.7k 条。
技术新颖性
与 AEGIS 的区别是根本性的:AEGIS 的 CBF 修正只在执行瞬间生效、策略保持不变,同样的失配会无限重现;FAILBANK 把同样的 CBF 信号当作反事实标签写入训练库,用 LoRA 把修正"内化"进策略权重,部署时可以完全甩掉 shield。与 SafeVLA 的区别在监督来源:SafeVLA 在训练期把安全做成约束优化目标,而 FAILBANK 的监督完全来自部署后真实 rollout 上的运行时证据并按结果筛选,不需要人工设计安全奖励。与失败检测类工作(SAFE)的区别是从"检测"走向"利用":失败不再是报警信号而是学习素材。工程上还有两个新设计:安静锚点机制显式对抗纠正数据导致的分布漂移,是防遗忘思想在动作空间的具体化;守卫式更新用损失比率加漂移的双重阈值替代基于基准指标的模型选择,为自进化系统提供了可复用的安全更新范式。此外,特权几何只存在于训练期教师中,这种信息不对称设计(privileged supervision)使框架天然兼容 sim-to-real:部署端只需要普通传感器输入。
实验结果
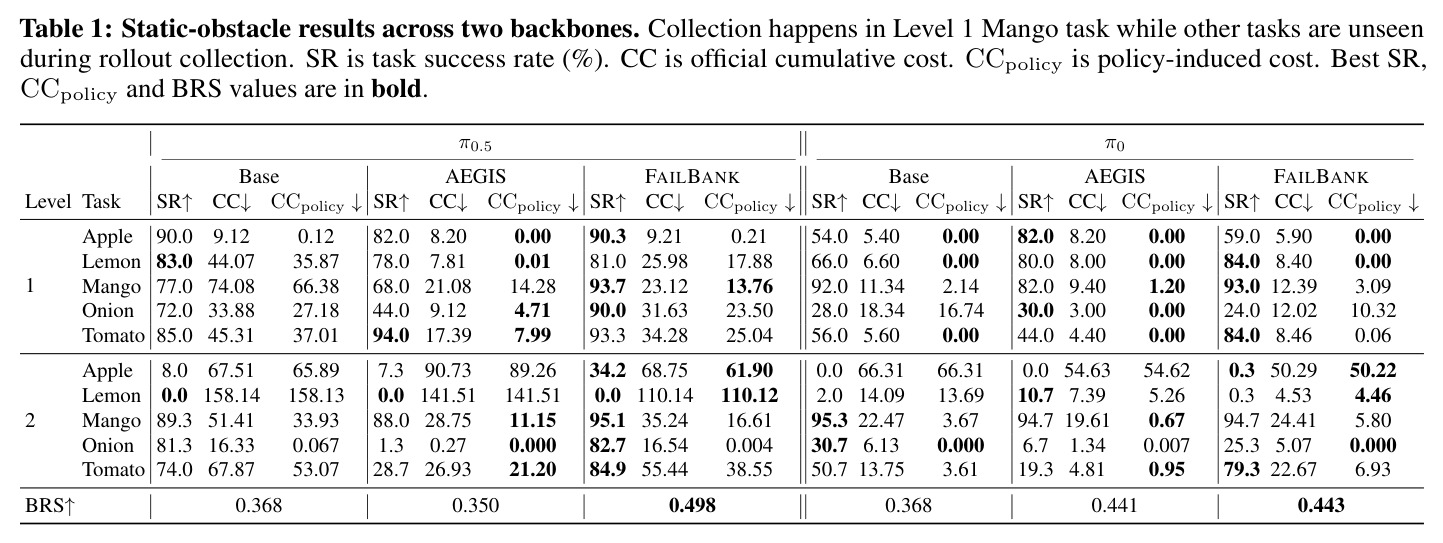
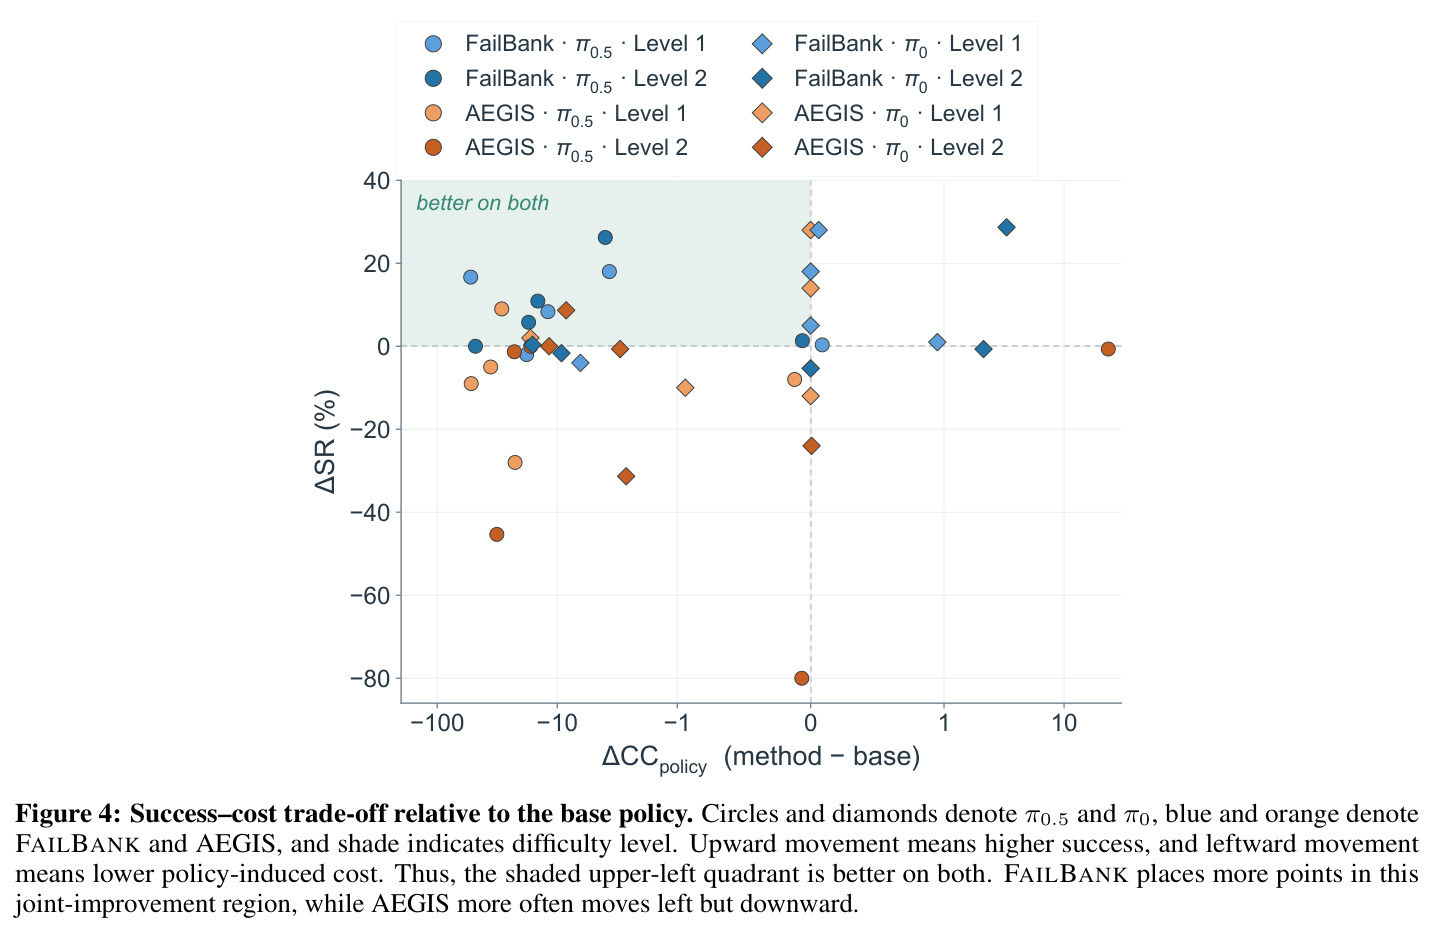
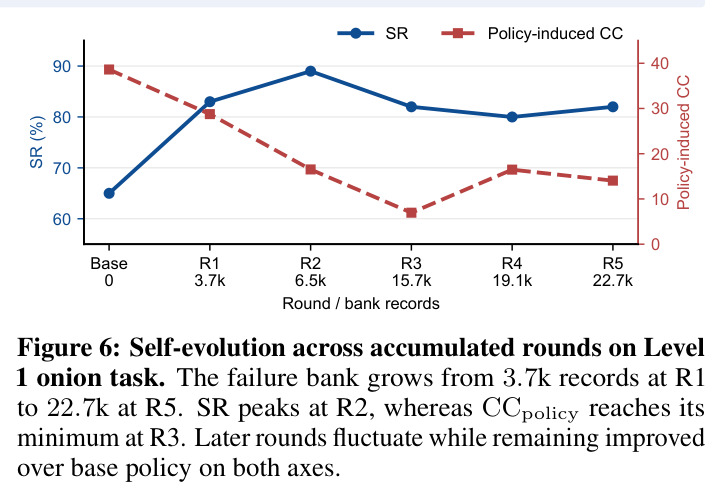
论文围绕四个研究问题给出结果。RQ1:在 VLA-Arena 静态障碍 10 个任务上(仅用 Level 1 芒果收集数据),π0.5 平均 SR 从 66.0% 升至 74.5%(+8.5pp),CCpolicy 从 47.76 降至 30.76(-35.6%);π0 上 SR 47.5%→54.4%(+6.9pp),CCpolicy 10.62→8.09(-23.8%)。对比 AEGIS,SR 在 π0.5 上从 49.1% 升至 74.5%(+25.4pp)、π0 上从 44.9% 到 54.4%(+9.5pp),成本基本相当;按"SR 更高且 CCpolicy 更低"标准,FAILBANK 在 8 个任务-骨干对上双改进,AEGIS 仅 3 个;BRS 为 0.498(Base 0.368、AEGIS 0.350)与 0.443(AEGIS 0.441)。RQ2 泛化:芒果 held-out 状态 SR 71.1%→93.3%;未见 Level 1 任务 82.5%→88.7%(π0:51.0%→62.7%);无 Level 2 数据时 Level 2 平均 50.5%→59.4%(π0:35.7%→40.0%),如 Level 2 苹果 8.0%→34.2%。RQ3 消融:shield-in-loop 使 46 个 episode 中成功从 40 降到 37,88.9% 的失败记录是 shield 造成;仅用修正记录把洋葱任务 SR 65%→89%、CCpolicy 38.61→20.88,加安静锚点后 SR 保持 89%、CCpolicy 降至 16.52。RQ4 迭代:失败库 3.7k→22.7k 条记录,SR 第 2 轮达峰、CCpolicy 第 3 轮最低,所有轮次均优于 Base。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VLA-Arena 静态障碍套件(10 任务,π0.5 骨干) | 平均成功率 SR(%) | 74.5 | Base 66.0;AEGIS 49.1 | 较 Base +8.5pp,较 AEGIS +25.4pp |
| VLA-Arena 静态障碍套件(10 任务,π0.5 骨干) | 策略诱导累计成本 CCpolicy | 30.76 | Base 47.76;AEGIS 29.01 | 较 Base 降 35.6%,与 AEGIS 基本持平 |
| VLA-Arena 静态障碍套件(10 任务,π0 骨干) | 平均成功率 SR(%) | 54.4 | Base 47.5;AEGIS 44.9 | 较 Base +6.9pp,较 AEGIS +9.5pp |
| VLA-Arena 静态障碍套件(10 任务,π0 骨干) | 策略诱导累计成本 CCpolicy | 8.09 | Base 10.62;AEGIS 6.27 | 较 Base 降 23.8%,与 AEGIS 相当 |
| Level 1 芒果 held-out 初始状态(π0.5) | SR(%) | 93.3 | Base 71.1 | +22.2pp |
| Level 2 难度全任务(无 Level 2 训练数据,π0.5) | 平均 SR(%) | 59.4 | Base 50.5 | +8.9pp |
| 联合改进判定(SR 上升且 CCpolicy 下降) | 达成的任务-骨干对数量 | 8 对 | AEGIS 3 对 | 接近 3 倍 |
| π0.5 十任务综合评价 | BRS 基座相对分数 | 0.498 | Base 0.368;AEGIS 0.350 | +0.130 / +0.148 |
局限与改进
作者承认两点局限:方法目前只适用于连续流匹配策略,离散动作 token 或扩散式动作头需要另行设计监督与守卫目标;实验只覆盖静态障碍,动态场景需要时序障碍预测和针对移动危险物的教师修正,作者认为这是教师与更新接口的扩展问题而非核心思想的障碍。我自己的观察还有几点:训练教师依赖特权仿真几何,真实机器人上需要用视觉定位从 RGB 估计几何,感知误差会直接污染修正标签,sim-to-real 差距完全未验证;所有实验都在 VLA-Arena 仿真器内完成,没有真机部署证据;迭代自演化并非单调提升——第 4 轮 SR 回落、CCpolicy 从第 3 轮最低点反弹后持续波动,说明系统缺乏何时停止、选哪一轮产出的自动准则;安静锚点权重 $\lambda_q$、准入评分的四档阈值($\{0, 0.25, 0.60, 1.00\}$)等超参只在附录给出经验值,敏感性分析有限;此外教师只修正平移通道,抓取开合与旋转动作的风险行为不在覆盖范围内;准入评分依赖"后续 rollout"的启发式规则,评分函数本身的有效性缺少独立验证。
独立分析的弱点
第一,特权几何依赖:教师用仿真器内部几何做投影,而作为对照的 AEGIS 基线还需要视觉定位感知才能工作,这对 FAILBANK 天然更有利;真实部署时需从 RGB 估计几何,标签噪声如何影响准入评分尚无答案,改进方向是用视觉模型输出的粗略几何做教师消融。第二,迭代不稳定:SR 在第 2 轮达峰后于第 4 轮回落,CCpolicy 在第 3 轮最低后反弹波动,说明固定轮数的自演化没有收敛保证,可引入基于守卫指标的早停或多轮候选集成选择机制。第三,记录覆盖面窄:只改平移通道意味着旋转与夹爪行为的风险无法被教师发现,可把 CBF 扩展到全自由度或引入任务级失败检测器作为第二教师。第四,准入评分是人工设计的启发式(安全性、进度、恢复加分,重复触发、屏障违例扣分),阈值四档为手工设定,可训练一个价值模型自动估计每条记录的训练效用。第五,评估全在仿真器中:真机上的接触成本定义、感知延迟与控制频率差异都可能显著改变 shield 触发模式与失败分布,需要在真机静态障碍场景复验。第六,收集只用了 Level 1 芒果单一任务,虽然显示出跨任务迁移,但失败库的任务多样性对泛化的贡献尚未解耦。
未来方向
作者明确提出的方向:把教师与更新接口扩展到其他动作形式(离散动作 token、扩散策略),为其设计相应的监督与守卫目标;引入动态障碍支持——用时序预测模型预测移动物体轨迹,让 CBF 教师对运动危险物提出修正,作者认为这只是教师形式的扩展而不触及"运行时反馈转持久改进"的核心。基于本文成果可自然延伸的研究:把失败库与守卫更新搬到真机在线学习,形成"部署-收集-更新"的持续学习闭环;把 observe-only 思想推广到其他运行时机制(软约束优化器、人类远程干预纠正、演示回放),把一切"本可以更好的动作"都变成反事实监督;研究失败库的检索与遗忘机制,避免库无限膨胀并剔除过时或低质记录;将守卫条件与形式化验证、CBF 证书结合,为自演化策略提供可证明的性能边界;探索多任务/多机器人共享失败库,检验跨具身迁移能否进一步放大收益;以及用学习型价值模型替换启发式准入评分。
复现评估
复现条件较好。代码已在 GitHub 开源(仓库 Mingyuee88/FailBank),评测基准 VLA-Arena 及 Arena 微调的 π0.5/π0 检查点均为公开资源;作者在附录中提供了罕见的实现细节完整度:E.1 教师接口与准入/领先时间/加权规则、E.2 失败库构成、E.4 训练配方与 $\lambda_q$ 取值、E.5 库构建审计、E.7 守卫阈值与诊断、G.1 配对统计测试。主要算力需求是每轮拟合 LoRA 适配器和大批量 rollout 评估(每任务数百次试验),单张高端 GPU 可行,但两骨干 × 两级别 × 5 轮的完整复现仍需可观机时。难点在于:需要搭建 VLA-Arena 仿真环境并正确提取特权几何;准入评分、四档权重阈值与守卫阈值涉及大量实现细节,稍有偏差结果可能明显偏离;hold-out 划分与 guard 与训练集的严格分离也需仔细复刻。总体复现难度中等偏高,适合有机器人仿真与 LoRA 微调经验的团队;对只想验证核心思想的用户,先复现单任务(洋葱)消融是性价比最高的入口。
论文图表
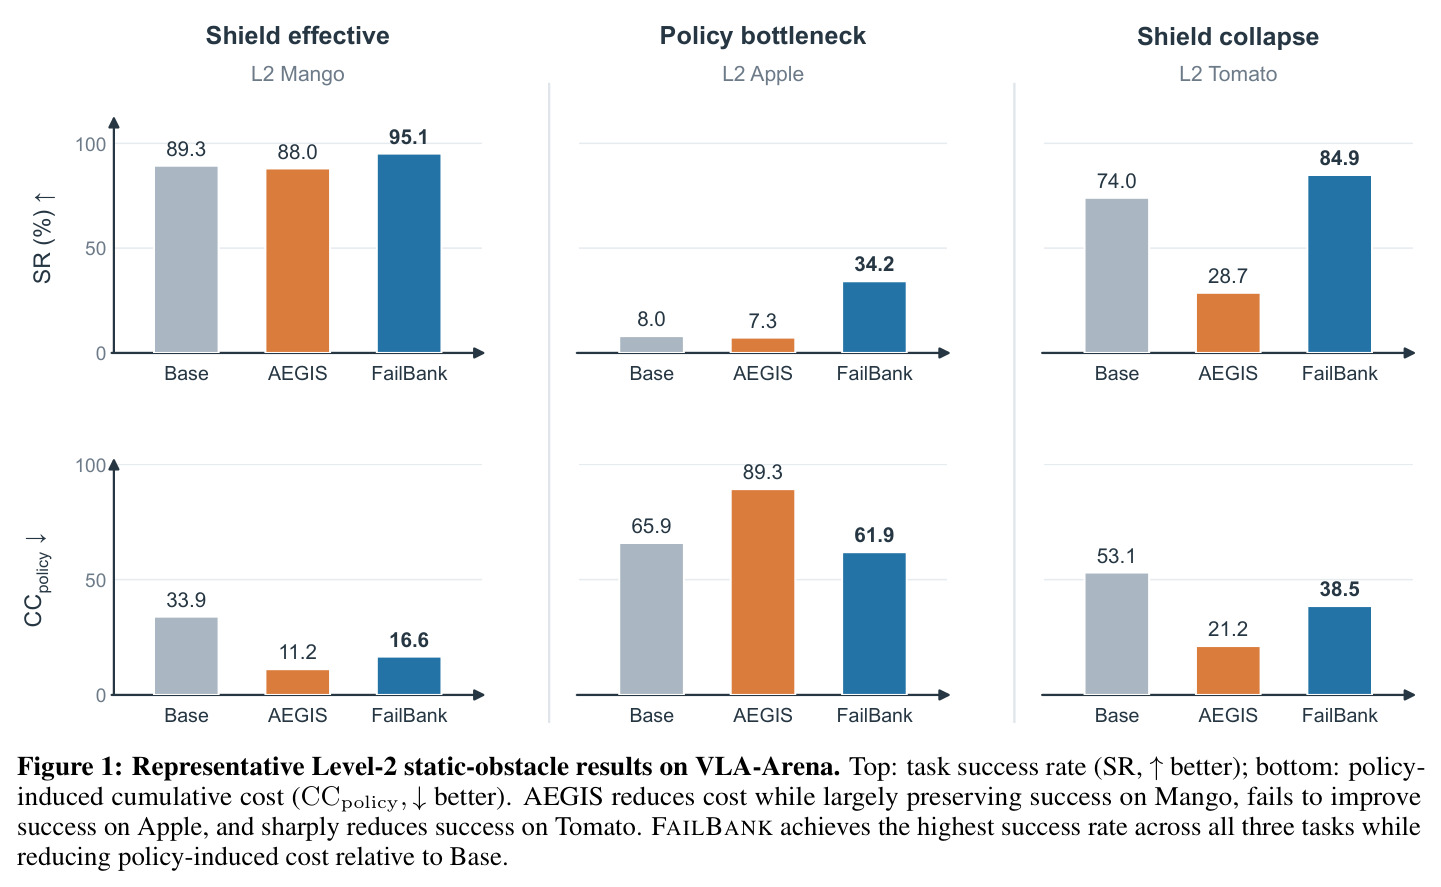
在 Level 2 的三个代表性任务上对比 Base、AEGIS、FAILBANK 的成功率(SR,上排)与策略诱导累计成本(CCpolicy,下排),分别对应三种诊断 regime:shield 有效(Mango:89.3/88.0/95.1)、策略瓶颈(Apple:8.0/7.3/34.2)、shield 崩溃(Tomato:74.0/28.7/84.9,CCpolicy 53.1/21.2/38.5)。
一张图同时呈现了论文的核心动机——运行时屏蔽在困难任务上可能失效甚至崩溃——以及 FAILBANK 在全部三种 regime 下都取得最高成功率的结论,是理解"为什么需要自演化而非更强 shield"的最直接证据。
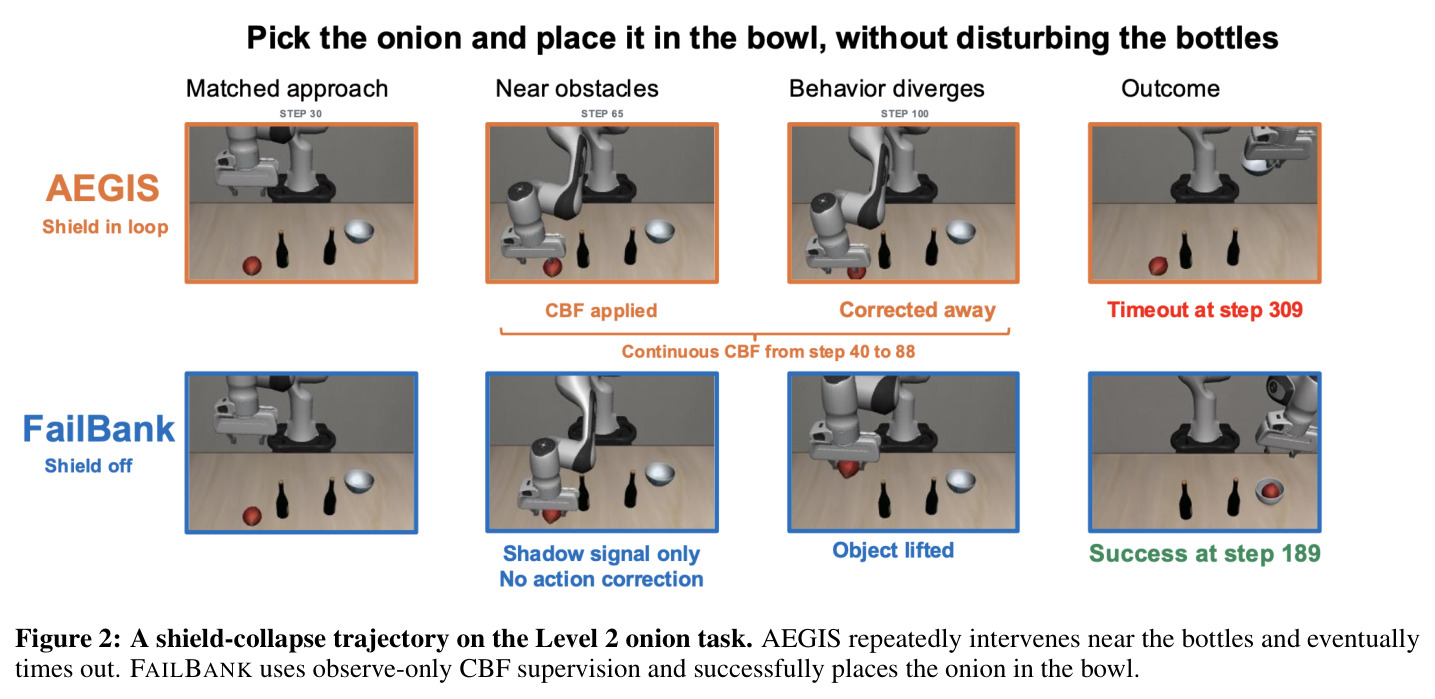
可视化 Level 2 洋葱任务中的一条 shield 崩溃轨迹:名义策略持续靠近目标洋葱,AEGIS 因附近有危险瓶子而反复把夹爪重定向离开受限区域,由于目标恰在同一受限区域内,修正同时也把夹爪拉离洋葱,最终任务超时失败;FAILBANK 从同样的运行时反馈中学习后成功把洋葱放进碗里。
把抽象的"策略-屏蔽失配"概念变成具体可感的轨迹对比,直观解释了为什么只纠正动作不更新策略会永久卡死任务,是动机部分最有说服力的图。